Best web search API for AI agents:六家实测
给 AI agent 选搜索 API:Serper 大用量时每千次 $0.30 最便宜;我们每千次 $0.694,搜一次读 3 页 $2.78,失败不扣钱。
同样搜 1,000 次、每次 10 条结果,六家的入门付费价从每千次 $0.694 到 $25.00 不等:EveryInfra 的 web 工具 $0.694、Serper 的 Starter 包 $1.00、Bright Data 按量 $1.50、Firecrawl Hobby 档折合 $7.60、Tavily 按量 $8.00、SerpAPI Starter 档 $25.00;但用量一过每月约 30 万次,Serper 按 6 个月用完的预付包算就比我们便宜,到每月 100 万次是 $541.67 对我们的 $694.00。agent 真正常做的是「搜一次再读 3 页正文」,按各家入门档算每 1,000 次任务是 $2.78(我们,web 加 3 次 read)、$6.00(Bright Data)、$8.00(Tavily)、$19.00(Firecrawl)和 $100(SerpAPI),Serper 首页列出的 10 类接口里没有抓正文这一项。我们在 2026-11-07 的 20 次真调里,web 工具 8 次调用(含 1 次空结果)的端到端耗时中位 1.74 秒;401、422、429 和空结果共 6 次全部 0 扣费;交叉核对有 1 条检索没跑通,就按跑通的 3 条扣了 $0.002083,而不是标价 $0.002778。
本文给正在给 agent 挑搜索工具的开发者看,回答的是关键词 best web search api for ai agents 背后的那个问题:搜索结果是给模型读的,不是给人看的,所以要按模型的需要来比。我们比了六家:五家点名的同类产品是 Serper、Tavily、SerpAPI、Firecrawl、Bright Data,第六家是我们自己的搜索接口 EverySearch(POST /api/v1/search,工具目录免费可读)。对方五家我们只读公开的定价页、文档和 GitHub 仓库,2026-11-07 00:22 到 00:50(新加坡时间)逐页打开存档,没有注册、没有调用;我们自己这一侧全部是同一天的真调,每个数都能回到原始返回。
先看总表:best web search api for ai agents,六家八个维度
下面这张表把六家放在 agent 最在意的八个维度上。价格一栏是「每 1,000 次搜索、每次 10 条结果」的入门付费价,括号里是页面上最低一档;对方的数字来自各家定价页和文档原文(读取时间 2026-11-07 00:22–00:50 新加坡时间),我们的数字来自搜索工具目录和真调响应里的 billing.charged_usd。
| 维度 | EveryInfra | Serper | Tavily | SerpAPI | Firecrawl | Bright Data |
|---|---|---|---|---|---|---|
| 每千次搜索(入门档 / 最低档) | $0.694 / $0.694 | $1.00 / $0.30 | $8.00 / $5.00 | $25.00 / $9.17 | $7.60 / $1.50 | $1.50 / $1.30 |
| 免费额度 | GitHub 给两个仓库点星领 $1,24 小时内有效 | 2,500 次,不用信用卡 | 每月 1,000 credits,另有免 Key 试用 | 每月 250 次 | 每月 1,000 credits,另有免 Key 试用 | 每月 5,000 次 |
| 返回给模型的东西 | 标题、链接、约 150 字符摘要、日期 | 结果页结构化 JSON | 每条最多 3 段相关片段,可带全文 | JSON 或 Markdown 表 | 标题、描述、亮点,可顺带抓全文 | 原始 HTML 或解析后的 JSON |
| 一次调用拿全文 | deep full=true 可以,另有 read | 首页 10 类接口里没有 | include_raw_content | 另调 Extract | scrapeOptions,每页另计 1 credit | 另调抓取 |
| 新鲜度控制 | after / before 日期 | 原文写不做缓存 | time_range、max_age_hours | 缓存的搜索不计次 | tbs 时间参数 | 按引擎原生参数 |
| 入门档每分钟上限 | 60(账户默认) | 3,000(50 次/秒) | 1,000(Production key) | 约 3.3(200 次/小时) | 100(/search) | 页面写不限并发 |
| 远程 MCP | 有,12 个工具,列工具不用 Key | 首页未列 | 有,OAuth 或 Key | 有,Key | 有,免 Key 端点 3 个工具 | 有,URL 里带 token |
| 失败和空结果 | 失败 0 扣费,空结果退款 | 只对成功响应扣 | 抓取失败不收 | 失败不计,空结果算 1 次 | 没拿到文档不收,403/404 页面收 1 credit | 只对成功收费 |
这张表最容易被读错的是第一行。我们的 $0.694 是没有档位的单价,充多少都一样;Serper 的 $0.30 要一次买 1,250 万次、付 $3,750,而且 6 个月作废;Firecrawl 的 $1.50 是 Scale 档月付 $749 折出来的;Bright Data 的 $1.30 是 Scale 档超出包含量以后的单价。所以只看最低一档,Serper 最便宜;只看第一笔要掏的钱,我们最便宜。下面每一节把一个维度拆开,先给原文,再给我们的真调,最后写这个维度对 agent 意味着什么。
本文怎么比:只用公开价、原文和我们自己的真调
先把比较的规则写清楚,因为六家的计费单位都不一样。Serper 和 SerpAPI 按「次」算,一次就是一页结果;Tavily 按 credit 算,basic 搜索 1 credit、advanced 2 credits(Tavily 计费文档);Firecrawl 按 credit 算,但搜索是「每 10 条结果 2 credits」,不满 10 条向上取整(Firecrawl 计费文档);Bright Data 的 SERP 接口按「请求」算,MCP 按「结果」算,价格都是每千次 $1.5(SERP 定价、MCP 定价);我们按次算,搜索类工具一次 $0.000694,交叉核对一次 $0.002778,按实际跑通的检索方式数计费。为了能放在一张表里,本文把分母统一成「一次拿回 10 条结果的搜索」,再乘 1,000。
第二条规则是我们这一侧的数字只用真调。2026 年 11 月 7 日 00:15 到 00:29(新加坡时间),我们用一把测试 Key 依次调了 web 8 次、web/search 2 次、read 2 次、deep 1 次、crosscheck 1 次、经 MCP 调 web 2 次(其中 1 次被限流),另外故意发了 1 次不带 Key、1 次参数名写错的请求,还撞上 2 次限流,一共 20 条记录,扣费合计 $0.012495。耗时取 curl 的 time_total,即从我们在新加坡的机器发出请求到收完响应的总时间,包含网络往返。
agent 要的不是十条链接:返回给模型的结构
人看搜索结果,扫一眼标题就知道点哪条;模型看搜索结果,每一个字都要进上下文、都要算 token。所以「返回什么」比「返回多快」更先决定一个搜索接口适不适合 agent。六家在这件事上走了四条不同的路。
第一条路是「给结果页」。Serper 和 SerpAPI 都把搜索引擎结果页拆成结构化 JSON:自然结果、知识面板、相关问题、相关搜索各一块。Serper 首页的示例响应里有 knowledgeGraph、organic、peopleAlsoAsk、relatedSearches 四块(Serper 首页)。这种结构对做 SEO、做排名监控的人最有用,因为位次、站点链接、问答框这些信息都保住了;对 agent 来说,它的问题是太多:模型要的往往只是几条可信来源和一两句话,整页 JSON 进上下文很浪费。SerpAPI 显然也意识到了这一点,它在 Markdown 输出页上给了一张自测表:同一次 Google 搜索,JSON 约 150K token,Markdown 约 39K,省 74%;Google Shopping 从 361K 降到 38K,省 90%。加 output=md 参数、改用 /search.md 路径或者发 Accept: text/markdown 头,三种写法都行。
第二条路是「给片段」。Tavily 的每条结果里有一个 content 字段,basic 和 fast 深度下是最多 3 段、每段约 500 字符的相关片段,advanced 深度每段约 800 字符,段数由 chunks_per_source 控制(Tavily 搜索接口文档)。它的设计目标就是「让模型直接读」,所以片段是按和问题的相关度挑出来的,而不是网页开头的那段描述。另外还能加 include_answer 让它先用模型写一段短答案,或者加 include_raw_content 把整页正文按 Markdown 带回来。Firecrawl 的搜索默认也带「亮点」,即和查询相关的段落,想要普通描述时把 highlights 设成 false(Firecrawl 搜索文档)。
第三条路是「给全文」。Firecrawl 在搜索请求里加 scrapeOptions,就能把每条结果的整页 Markdown、HTML 或截图一起抓回来,每抓一页按抓取另计 credit。Bright Data 走的是另一种全文:它的 SERP 接口默认回结果页的原始 HTML,加 brd_json=1 才回解析后的 JSON(Bright Data SERP 文档),读具体网页要另调它的抓取工具。我们的 deep 工具在 full=true 时连全文一起回:本文 00:17:02(新加坡时间)那次调用查「Model Context Protocol specification latest version changes」,回了 5 条,正文分别是 13,611、2,937、10,975、16,667、3,406 个字符,合计 47,596 个字符,扣费 $0.000694。
第四条路是「给核对过的来源」,这是我们的 crosscheck 工具的做法,后面单独一节讲。
我们自己的 web 工具属于第二条路里最朴素的那种:每条结果只有 title、url、snippet、published 四个字段。本文 7 次 REST 加 1 次 MCP、共 8 次有结果的 web 调用一共拿回 75 条结果,72 条带摘要,摘要长度的中位数在 138 到 159 个字符之间;39 条带日期。这个结构的好处是省 token:10 条结果加起来不到 2,000 个字符,放进任何模型的上下文都没有压力;坏处是信息少,没有知识面板、没有相关问题、没有位次字段,agent 想要这些得换工具。同一个词走数据接口的 web/search 能力,会多一个从 1 开始的 rank 和 sub_links(站点链接),价格贵一倍,是 $0.001389。
| 家 | 主要结果字段 | 每条给模型的内容 | 让结果更省 token 的开关 | 出处 |
|---|---|---|---|---|
EveryInfra web | title、url、snippet、published | 摘要中位约 150 字符 | 本来就短;要全文改用 read 或 deep | 搜索工具目录 |
| Serper | organic[].title/link/snippet/position 等 | 结果页摘要 | 原文未写 | Serper 首页 |
| Tavily | results[].title/url/content/score,可选 raw_content | 最多 3 段相关片段 | chunks_per_source、max_results | 搜索接口文档 |
| SerpAPI | organic_results[].position/title/link/snippet | 结果页摘要 | output=md,平均省约 50% token | Markdown 输出 |
| Firecrawl | data.web[].title/url/description,可带 markdown | 亮点或描述 | highlights=false、只在需要时开 scrapeOptions | 搜索文档 |
| Bright Data | 原始 HTML,或 brd_json=1 时的 JSON | 结果页内容 | 用 brd_json=1 只取解析后的结构 | SERP 文档 |
读这张表时要记住,字段越丰富,不等于对 agent 越好。一个在循环里反复搜索的 agent,每轮都把 1 万字符的结果页塞进上下文,几轮之后就会把真正重要的信息挤出去。本文的实测数说明了差距:10 条 web 结果合计不到 2,000 个字符,一次 deep 带全文是 47,596 个字符,相差约 24 倍。所以发现阶段用短摘要(我们的 web、Tavily 的 basic、SerpAPI 的 Markdown 都行),确定了要读哪几页,再用抓全文的工具只读那几页。这也是下一节要算的那笔账。
能不能抓正文:「搜一次再读 3 页」的账
单看搜索单价,会低估大多数 agent 的真实花费,因为 agent 很少只看摘要就回答。研究类、客服类、比价类 agent 的常见动作是:搜一次,挑 2 到 5 条最像答案的结果,读正文,再回答。本文取中间值「搜一次 + 读 3 页」作为一个任务,按各家入门付费档算每 1,000 个任务要多少钱。
| 家 | 一个任务怎么拼 | 用到的单价(入门档) | 每 1,000 个任务 | 出处 |
|---|---|---|---|---|
| EveryInfra | web 1 次 + read 3 次 | 每次 $0.000694 | $2.78 | 搜索工具目录 |
| EveryInfra | deep 1 次,full=true,回 5 条带全文 | 每次 $0.000694 | $0.694 | 本文 00:17:02 真调 |
| Bright Data | MCP 搜索 1 次 + 抓取 3 次 | 每千次结果 $1.50 | $6.00 | MCP 定价 |
| Tavily | basic 搜索 1 次,带 include_raw_content | 1 credit,按量 $0.008 | $8.00 | 计费文档 |
| Firecrawl | 搜索 10 条 2 credits + 抓 3 页各 1 credit | Hobby $19 / 5,000 credits | $19.00 | 计费文档 |
| SerpAPI | 搜索 1 次 + Extract 3 次 | Starter $25 / 1,000 次 | $100 | Extract 文档 |
| Serper | 首页列的 10 类接口里没有抓正文 | — | 要另配抓取工具 | Serper 首页 |
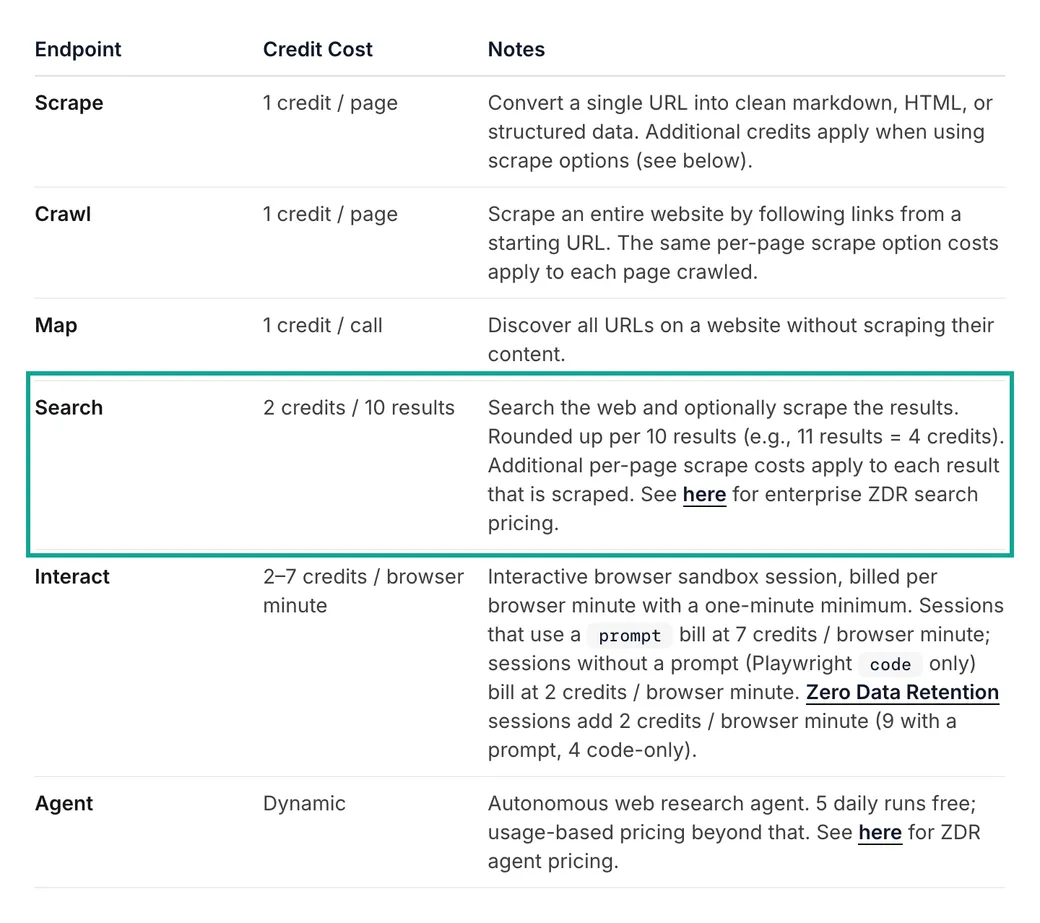
这张表里有几处要说明。Tavily 这一行算得最省,是因为它的计费文档按搜索深度收费,include_raw_content 不另收 credit,所以一次 basic 搜索就能把每条结果的全文带回来;但它带回的是全部结果的全文,max_results 默认 10,进上下文的字符数会远超「读 3 页」。Firecrawl 和 SerpAPI 贵,是因为它们的入门档本身就贵:Firecrawl Hobby 档每 1,000 credits 折合 $3.80,一个任务 5 credits;SerpAPI Starter 档每次 $0.025,一个任务 4 次。如果换成它们的高档位,差距会缩小很多:Firecrawl Scale 档每 credit $749 ÷ 1,000,000 = $0.000749,一个任务 5 credits 是 $0.003745,每千个任务 $3.75;SerpAPI Big Data 档每次 $275 ÷ 30,000 = $0.00917,一个任务 4 次是 $0.0367,每千个任务 $36.67。
我们的 deep 是表里最便宜的,但它有一个代价写在耗时上:本文那次调用用了 16.1 秒,是 web 中位耗时的 9 倍多。对一个要在几秒内回答用户的聊天 agent,这个延迟太长;对一个晚上批量跑的研究任务,它省下的钱更重要。read 能读的范围我们也测了:00:16:44(新加坡时间)读 Firecrawl 博客的一篇榜单文章,2.35 秒拿回 30,957 个字符的 Markdown;00:21:53 把一条搜索结果里的跳转链接直接交给 read,它自己跟到了最终页面 serpapi.com/pricing,1.05 秒拿回 3,450 个字符,正文里就是 SerpAPI 的六个套餐。
每 1,000 次搜索的价格:入门档和最低一档
只看搜索、不读正文的话,价格排序和上一节不一样。这一节把六家的公开价摊开,每一个数都写出处和档位。
| 家 | 档位 | 价格和包含量 | 折合每千次搜索 | 有效期 / 计费周期 | 出处(2026-11-07 读取) |
|---|---|---|---|---|---|
| EveryInfra | 无档位 | web 每次 $0.000694 | $0.694 | 充值余额长期有效 | 定价页、工具目录 |
| Serper | Starter | $50 买 5 万次,50 次/秒 | $1.00 | 6 个月 | Serper 首页 |
| Serper | Standard | $375 买 50 万次,100 次/秒 | $0.75 | 6 个月 | 同上 |
| Serper | Scale | $1,250 买 250 万次,200 次/秒 | $0.50 | 6 个月 | 同上 |
| Serper | Ultimate | $3,750 买 1,250 万次,300 次/秒 | $0.30 | 6 个月 | 同上 |
| Tavily | 按量 | 每 credit $0.008 | $8.00 | 按月 | Tavily 定价 |
| Tavily | Project | $30/月,4,000 credits | $7.50 | 每月 1 日重置 | 同上 |
| Tavily | 月付最低 | 每 credit $0.005 | $5.00 | 按月 | 计费文档 |
| SerpAPI | Starter | $25/月,1,000 次 | $25.00 | 按月 | SerpAPI 定价 |
| SerpAPI | Developer | $75/月,5,000 次 | $15.00 | 按月 | 同上 |
| SerpAPI | Production | $150/月,15,000 次 | $10.00 | 按月 | 同上 |
| SerpAPI | Big Data | $275/月,30,000 次 | $9.17 | 按月 | 同上 |
| Firecrawl | Hobby | $19/月,5,000 credits | $7.60 | 按月,不结转 | Firecrawl 定价 |
| Firecrawl | Standard | $99/月,100,000 credits | $1.98 | 按月,不结转 | 同上 |
| Firecrawl | Scale | $749/月,1,000,000 credits | $1.50 | 结转 1 个月 | 同上 |
| Bright Data | 按量 | 每千次 $1.5 | $1.50 | 按量 | SERP 定价 |
| Bright Data | Scale | 含 38 万次,超出每千次 $1.3 | $1.30(超出部分) | 按月 | 同上 |
这里有三点要特别说明。第一,Serper 的最低档确实比我们便宜,$0.30 对 $0.694,差 2.3 倍;Standard 档 $0.75 也只比我们贵 8%。如果你每月稳定搜几十万次以上,又能在 6 个月内把预付的次数用完,Serper 是这张表里最便宜的选择,这一点我们照实写。第二,Firecrawl 的价格要换算才能比:它的「credit」不等于「一次搜索」,搜索每 10 条 2 credits,所以 Hobby 档的 5,000 credits 只够 2,500 次搜索,定价页自己也写了「2,500 searches or 5,000 pages scraped」。第三,Bright Data 的 Scale 档在定价页上用滑块显示月费,我们读取时页面只写了「380K requests included」和超出单价 $1.3,没有写月费本身,所以表里只写超出部分的单价。
我们的价格为什么没有档位?因为 EveryInfra 的计费是按次从余额里扣,充 $10 和充 $1,000 的单价一样,余额不过期(定价页原文「充值余额长期有效」)。这对小用量、用量波动大的 agent 是好事:你不用为了单价去预付一个用不完的包。对用量大而稳定的团队,这反而是缺点,因为量再大也拿不到更低的单价,除非走企业定制。
每月用量不同,谁最便宜:交点在每月约 30 万次
单价表回答不了「我该选谁」,因为每家的档位门槛、有效期、免费额度都不同。我们按四个月用量(1 千、1 万、10 万、100 万次搜索)算了只搜索不读正文的月成本,规则写在图下面。
| 每月搜索量 | EveryInfra | Serper | Bright Data | Firecrawl | Tavily | SerpAPI |
|---|---|---|---|---|---|---|
| 1,000 | $0.69 | $8.33 | $0(免费 5,000 内) | $19 | $0(免费 1,000 内) | $25 |
| 10,000 | $6.94 | $16.67 | $7.50 | $94 | $72 | $150 |
| 100,000 | $69.40 | $79.17 | $142.50 | $349 | $792 | 不公开 |
| 1,000,000 | $694.00 | $541.67 | $1,492.50 | $1,749 | $7,992 | 不公开 |
算法按每家一行写在下面,读者可以自己复算。共同的前提是只算搜索、每次 10 条结果,免费额度能抵就先抵。
| 家 | 免费额度怎么算 | 档位怎么选 | 超出怎么算 |
|---|---|---|---|
| EveryInfra | 不计 | 无档位 | 每次 $0.000694 直接乘 |
| Serper | 不计(2,500 次是一次性的) | 把 6 个月的用量当成要买的次数,在四种预付包里挑总价最低的组合,再除以 6 | 不超出,多买一个包;例:每月 1 万次 → 6 万次 → 2 个 Starter 共 $100 → 每月 $16.67 |
| Bright Data | 每月 5,000 次先抵(MCP 仓库写免费用完后有余额就转按量) | 按量 | 每千次 $1.5 |
| Firecrawl | 免费档每月 1,000 credits,即 500 次搜索以内为 $0;免费档不能按量追加,超出就要换付费档,付费档不再叠加这 1,000(计费文档) | 每次搜索 2 credits,在四个月付档里挑「月费 + 追加」最便宜的 | 每 $5 追加一笔:Hobby 1,000 credits、Standard 2,000、Growth 2,500、Scale 5,000(定价页 FAQ);例:每月 1 万次 → 2 万 credits → Hobby $19 含 5,000,追加 15 笔 $75,共 $94 |
| Tavily | 每月 1,000 credits 先抵(定价页没写能否和按量叠加,本文按叠加算) | 按量;月付档能低到 $0.005,但只有 Project 档公开了包含量 | 每 credit $0.008;100 万次时按月付最低价是 $5,000 |
| SerpAPI | 每月 250 次含在各档内 | 挑包含量够用的最小档 | 公开的最大档每月 3 万次,再往上要找销售,表里写「不公开」 |
按这个算法,交点在每月 30 万次左右:那时我们是 $208.20,Serper 是 $208.33,几乎一样;再往上 Serper 的大包优势显出来,100 万次时它比我们便宜 $152.33。每月 1 万次以下,我们和 Bright Data、Tavily 的免费额度是最便宜的三种选择。这里还要提醒一个前提:Serper 的折算假设你能在 6 个月内把包用完,如果用不完,作废的那部分会让实际单价变高;我们的余额不过期,没有这个风险。
新鲜度:时间窗、日期字段和缓存
agent 搜索最常见的错误之一,是拿到一条几年前的结果当成今天的事实。所以第三个要比的维度是「能不能只要新结果」和「结果自己带不带日期」。
六家的做法差别很大。Serper 首页 FAQ 原文写的是每次调用都直接去搜索引擎取最新结果,「We do not cache anything」(Serper 首页)。SerpAPI 正好相反,它会缓存,但缓存命中的搜索不计次(SerpAPI 定价页 FAQ),这在 agent 反复问同一个问题时能省钱,代价是拿到的可能是缓存里的旧结果,缓存保留多久 FAQ 没写。Tavily 在 2026 年 10 月的更新日志里加了 max_age_hours 参数,控制它缓存的网页副本最旧能有多旧,取值 1 到 720,写 0 表示每次都现抓;调低这个值不多收 credit,但现抓会更慢,免费档在负载高时还可能被拒、返回 434(Tavily 更新日志、限速文档)。它的搜索接口另有 time_range、start_date、end_date 三个参数按发布或更新日期过滤;默认不剔除测不出日期的结果,要剔除得另加 filter_by_published_date,要在结果里看到日期得加 include_published_date,文档说这个日期是它的「最佳估计」。Firecrawl 用 tbs 参数按时间过滤,但文档写明只对网页结果生效,不过滤新闻和图片结果。我们的 web 工具用 after、before 两个日期参数过滤,和 site、location 可以一起用。
我们测了 after 实际怎么样。2026-11-07 00:16:34(新加坡时间)查「MCP server web search agents」,after 写 2026-10-31,回 10 条,2.50 秒,其中 9 条带日期。但这 9 个日期大多是「1 day ago」「5 days ago」这样的相对说法,不是 ISO 日期,agent 要自己换算;同一批有结果的 8 次调用(7 次 REST、1 次 MCP)里,日期字段还有「Oct 21, 2026」这种格式。更要注意的是,这 10 条里有 7 条的链接是搜索引擎的跳转链接,不是原网页地址;00:21:08 另一次不带时间窗的搜索里,10 条也有 6 条是跳转链接。这 8 次合计 75 条结果,13 条是跳转链接,占 17%。好在 read 能自己跟跳转:00:21:53 我们把其中一条交给 read,它解析到最终地址 serpapi.com/pricing 并拿回正文。如果你的 agent 要把链接直接给用户看,记得先读一次或者自己解开跳转。
| 家 | 按时间过滤 | 结果带日期吗 | 缓存 | 出处 |
|---|---|---|---|---|
| EveryInfra | after、before | 75 条里 39 条带,格式不统一 | 原文未写 | 本文真调、工具目录 |
| Serper | 首页未列 | 示例里有 date | 原文写不做缓存 | Serper 首页 |
| Tavily | time_range、start_date、end_date | 加 include_published_date 才带,是估计值 | max_age_hours 控制缓存副本年龄 | 搜索接口文档 |
| SerpAPI | 按引擎原生参数 | 结果页上有就带 | 有缓存,命中不计次 | 定价页 FAQ |
| Firecrawl | tbs,只对网页结果生效 | 原文未写 | 原文未写搜索缓存 | 搜索文档 |
| Bright Data | 按引擎原生参数 | 结果页上有就带 | 原文未写 | SERP 文档 |
新鲜度这件事上,Tavily 给的控制最细,Serper 的「不缓存」最直接。我们的日期字段覆盖一半左右、格式不统一,这是我们要照实承认的弱项;对时效要求很高的场景(新闻、价格、故障公告),更稳的做法是用 news 工具或者数据接口里的 google_news/search 能力专门搜新闻,再用 read 读原文确认日期。
并发和延迟:每分钟 60 次够不够用
agent 和人用搜索最大的不同,是 agent 会在一个回答里连着搜很多次。一个研究型 agent 一轮可能并行发出 5 到 10 个查询;如果同时有 20 个用户在用,一分钟就是几百次请求。所以每分钟上限是选型时必须先算的数,算错了不是慢一点,而是直接收到 429。
六家的入门档差距有三个数量级。Serper 最小的 Starter 包就是每秒 50 次,最大的 Ultimate 包每秒 300 次,首页 FAQ 换算成「每分钟约 15,000 到 18,000 次搜索」(Serper 首页)。Tavily 按 Key 的环境分:开发 Key 每分钟 100 次,生产 Key 每分钟 1,000 次,抓站和研究两个接口另有更低的单独上限(Tavily 限速文档)。Firecrawl 的 /search 免费档每分钟 10 次、Hobby 100 次、Standard 500 次,定价页上 Growth 和 Scale 分别写 5,000 和 10,000(Firecrawl 限速文档、定价页)。SerpAPI 是按小时给的「保证吞吐」:免费档每小时 50 次,Starter 200 次,Big Data 6,000 次,并建议把搜索均匀摊到一小时里(SerpAPI 定价)。Bright Data 的 SERP 定价页写的是不限并发(SERP 定价)。
我们的默认值在这里偏低:每个账户每分钟 60 次,账户下所有 Key 共用,多开 Key 不会多给;要更高可以买 30 天的提速包,每分钟 180 次 $10、600 次 $30、1,800 次 $78,或者累计充值到 $50、$150、$750 自动拿到对应档位(定价页)。还可以给单个 Key 设更低的上限,本文测试用的 Key 就被单独限在每分钟 10 次,所以我们在 00:17:55、00:19:43、00:19:51(新加坡时间)三次撞上 429。三次的返回都写了 retry_after(5 秒和 8 秒)和「Nothing was charged」,扣费都是 $0;等了 60 秒以后重发,00:19:01 和 00:21:08 两次都正常返回。对 agent 来说,这种「告诉你等几秒、明说没扣钱」的 429 比只回一个状态码好处理,但它解决不了上限本身低的问题:如果你的 agent 要每分钟稳定发几百次搜索,Serper 和 Tavily 的生产 Key 起步就比我们宽。
| 本文真调(2026-11-07,新加坡时间) | 次数 | 端到端耗时 | 每次条数 | 每次扣费 |
|---|---|---|---|---|
web | 8 | 1.34–2.70 秒,中位 1.74 秒 | 0–10 条 | $0.000694(空结果 1 次为 $0) |
web/search(数据接口) | 2 | 6.02 秒、1.59 秒 | 10 条 | $0.001389 |
read | 2 | 2.35 秒、1.05 秒 | 1 页,30,957 和 3,450 字符 | $0.000694 |
deep,full=true | 1 | 16.11 秒 | 5 条带全文,共 47,596 字符 | $0.000694 |
crosscheck | 1 | 5.36 秒 | 3 条检索各 5 条 | $0.002083 |
MCP tools/call 调 web | 1 | 3.96 秒 | 5 条 | $0.000694 |
| 401 / 422 / 429 | 5 | 0.11–1.16 秒 | 0 | $0 |
对方的速度我们没有测,只能引用对方页面自己的说法。Serper 首页写一般 1 到 2 秒返回,需要重试时 2 到 4 秒。SerpAPI 卖一个叫 Ludicrous Speed 的选项,价格是普通档的 2 倍,页面说平均快 2.2 倍、p99 快 4.2 倍,样本 1 万次(Ludicrous Speed 页面)。Bright Data 两处写法不一致:定价页 FAQ 写「response time under 5 sec」,SERP 文档开头写「under 1 second per request」。Tavily 和 Firecrawl 的页面没有给具体秒数,Tavily 用 search_depth 的四个档位(ultra-fast、fast、basic、advanced)让你自己在速度和相关度之间选。
我们的 web 中位 1.74 秒,和 Serper 自称的 1 到 2 秒在一个区间,达到了本文动手前定的「中位不超过 3 秒」的目标。要注意两个慢的地方:数据接口的 web/search 第一次用了 6.02 秒,第二次 1.59 秒,同一个词走搜索接口的 web 是 1.78 秒,所以只要网页搜索结果时,用便宜一半的搜索接口,数据接口那一路本文两次里有一次慢到 6 秒;deep 带全文 16 秒,不适合放在用户等待的同步路径上。另外,经 MCP 调用比直接调 HTTP 多了约 2 秒(3.96 秒对中位 1.74 秒),只有 1 个样本,不能下结论,但如果你的 agent 对延迟敏感,值得自己测一下两种接法。
失败、空结果、限流:哪些情况扣钱
agent 的搜索请求失败率比人高得多:参数是模型自己拼的,常写错;循环里反复搜,常撞限流;问得太偏,常搜不到结果。每一次失败扣不扣钱,乘上 agent 的调用量,就是一笔不小的账。
| 情况 | EveryInfra(本文实测) | Serper | Tavily | SerpAPI | Firecrawl | Bright Data |
|---|---|---|---|---|---|---|
| 鉴权失败、参数错误 | 401、422 都是 $0,422 附改法 | 只对成功响应扣 | 原文未写 | 出错的搜索不计 | 没返回文档不收 | 只对成功收费 |
| 搜到 0 条结果 | 退款,empty_result_refunded | 原文未写 | 原文未写 | 算 1 次 | 原文未写 | 原文未写 |
| 目标网页返回 403/404 | read 原文未写 | 不适用 | 抓取失败不收 | 不适用 | 收 1 credit | 原文未写 |
| 限流 429 | $0,附 retry_after | 原文未写 | 返回 Retry-After | 原文未写 | 原文未写 | 原文未写 |
| 部分成功 | crosscheck 按跑通的检索数扣 | 不适用 | 抓取按成功的 URL 数扣 | 抓站按成功页数扣 | 按返回的文档扣 | 不适用 |
| 出处 | 本文真调 | 首页 FAQ | 计费文档 | 定价页 FAQ | 计费文档 | SERP 文档 |
这张表里最值得 agent 开发者注意的有三格。第一,SerpAPI 的空结果算 1 次。它的定价页原文是:一次返回 100 条和返回 0 条,都算 1 次搜索。agent 问得越偏,这一项越多。第二,Firecrawl 把「目标网页返回了 403 或 404」也算成拿到了文档,收 1 credit(按 Hobby 档 $19 / 5,000 credits 折合约 $0.0038);它在计费文档里建议看 metadata.statusCode,对总是被拒的网址停止重试。第三,我们的 422 不只是「不扣钱」,还告诉模型怎么改:00:15:57(新加坡时间)我们故意把查询参数写成 query,返回里写着 did_you_mean: ["q"] 和全部可用参数 after, before, location, num, page, q, site,模型照着改一次就对了。这类错误信息怎么让 agent 自己修好,站内接口错误自愈指南有更完整的例子;退款怎么对账见失败退款对账。
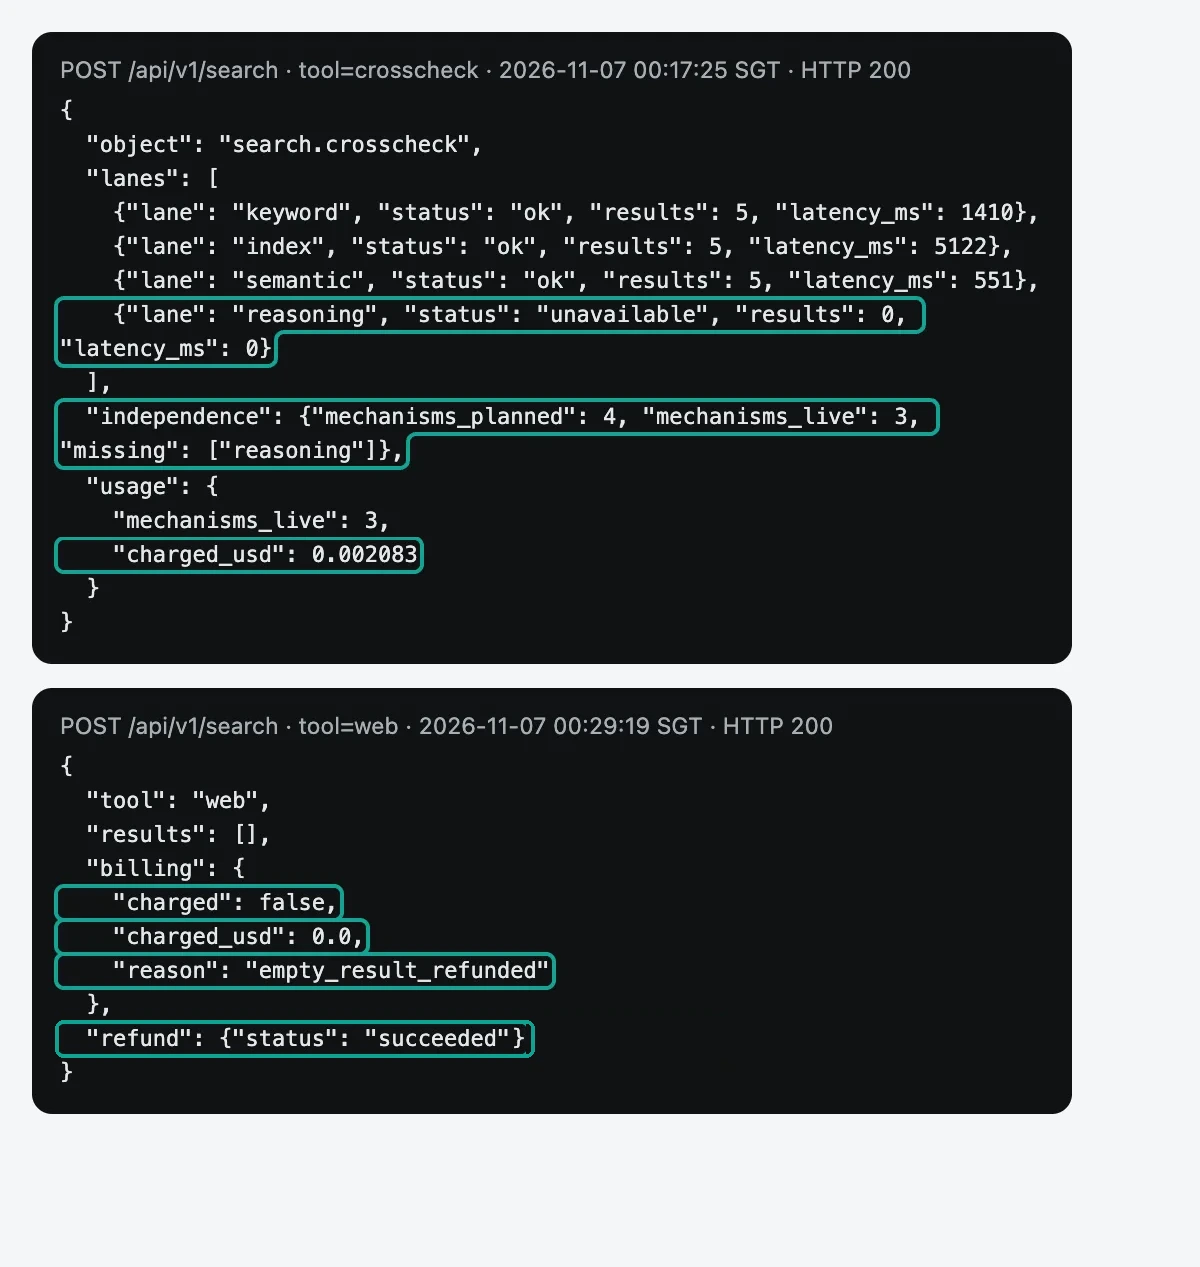
00:29:19(新加坡时间)那次空结果的测试,是我们故意搜一个不存在的长串。返回 200、results 为空,billing.charged 是 false,reason 是 empty_result_refunded,refund 的状态是 succeeded,退回的是这一次的 $0.000694。它的意义在于:agent 的搜索是先扣后退,所以余额在那一瞬间会少一次的钱,之后补回来;你的对账脚本要看最终的 charged_usd,而不是请求发出那一刻的余额变化。
MCP:六家怎么接进 agent
MCP(Model Context Protocol)是现在 agent 接工具的通用方式,规范最近一版是 2026-07-28 发布的(MCP 版本说明、规范发布页)。六家里五家有官方或自家维护的远程 MCP,但接法差别不小,最重要的差别是 Key 放在哪里。
| 家 | 远程地址 | 怎么鉴权 | 工具 | 最近更新 | 出处 |
|---|---|---|---|---|---|
| EveryInfra | https://api.everyinfra.com/mcp | Authorization: Bearer 头;列工具不用 Key | 12 个,搜索走 everyinfra_search(17 种工具) | 本文 2026-11-07 读 | MCP 服务页 |
| Tavily | https://mcp.tavily.com/mcp/ | OAuth 登录,或 URL 里带 Key,或免 Key 头 | search、extract、crawl、map、research | README 2026-11-05 更新 | Tavily MCP 文档 |
| SerpAPI | https://mcp.serpapi.com/mcp | Bearer 头(推荐)或把 Key 放进路径 | 搜索、Extract 等 | v2.2.0,2026-11-04 | SerpAPI MCP 仓库 |
| Firecrawl | https://mcp.firecrawl.dev/v2/mcp | 免 Key 端点只开 3 个工具,带 Key 全开 | 完整 27 个,只搜索端点 9 个 | v3.36.1,2026-11-03 | Firecrawl MCP 仓库 |
| Bright Data | https://mcp.brightdata.com/mcp?token=… | token 放在 URL 里 | 30 个 | v4.6.0,2026-11-05 | Bright Data MCP 仓库 |
| Serper | 首页未列 | — | 首页列的是 LangChain、CrewAI、Haystack 等框架集成 | — | Serper 首页 |
Key 放在 URL 里还是头里,对 agent 有实际影响。URL 会被写进客户端日志、代理日志、浏览器历史,甚至被模型在回答里原样复述出来。SerpAPI 的 README 自己就把两种方式都列出来,并写明推荐用头,理由是「the key stays out of URLs and logs」。Bright Data 的远程地址只有 URL 带 token 一种写法;Tavily 推荐 OAuth,在只能填 URL 的客户端里要把 Key 放进 ?tavilyApiKey=。我们只接受头里的 Bearer。
免 Key 试用是 Tavily 和 Firecrawl 有、我们没有的。Tavily 在请求里加 X-Tavily-Access-Mode: keyless 头就能免费、限速地调搜索和抓取,返回结构和带 Key 时一样(免 Key 文档);Firecrawl 的远程 MCP 不带 Key 时开放搜索、抓取、解析三个工具,按 IP 每天限次数和 credits(限速文档)。我们的 MCP 不带 Key 只能列工具:00:17:48(新加坡时间)发 tools/list,0.10 秒回了 12 个工具和完整的参数说明,模型能先看清楚有哪些工具,但真调必须带 Key。
把我们的 MCP 加进 Claude Code 是一行命令,Key 放环境变量,不写进配置文件:
# Key 只放环境变量;加好以后在 Claude Code 里用 /mcp 查看工具
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
如果你的客户端读 JSON 配置,可以把两家搜索同时挂上,让 agent 按场景选。下面是一个示例,Tavily 一侧照它的文档用 OAuth,不写 Key:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "tavily": { "url": "https://mcp.tavily.com/mcp/" }
  }
}
各客户端的完整写法见站内的 MCP 服务页和远程 MCP 配置指南;2026 年这一版 MCP 规范对生产部署意味着什么,见 MCP 2026 规范的生产就绪度。
一次真实往返:agent 调 everyinfra_search 拿到什么
下面是本文里一次完整的 MCP 往返,模拟 agent 想知道「Tavily 一次搜索扣几个 credit」。00:17:55(新加坡时间)第一次发出时撞上测试 Key 的每分钟 10 次上限,返回 isError: true、rate_limited、retry_after: 5,以及「Nothing was charged」;等了 60 秒,00:19:01 重发,3.96 秒返回 5 条结果,扣 $0.000694。发出的调用和收到的结果(删去余额字段,摘要原样)如下:
// 请求:tools/call
{"name": "everyinfra_search",
 "arguments": {"tool": "web", "params": {"q": "tavily search api credits per request", "num": 5}}}

// 返回(节选)
{"tool": "web",
 "results": [
  {"title": "Credits & Pricing",
   "url": "https://docs.tavily.com/documentation/api-credits",
   "snippet": "You get 1,000 free API Credits every month. No credit card required. Monthly plans: $0.0075 - $0.005 per credit. Each request costs 1 API credit. Advanced ..."},
  {"title": "Tavily Search",
   "url": "https://docs.tavily.com/documentation/api-reference/endpoint/search",
   "snippet": "This uses 2 API credits per request. To avoid the extra cost, you can explicitly set search_depth to basic ..."}
 ],
 "billing": {"charged": true, "charged_usd": 0.000694}}
这次往返说明了两件事。好的一面:前两条都是 Tavily 自己的文档页,摘要里已经有答案(basic 1 credit,advanced 2 credits),模型不用再读正文就能回答,一次 $0.000694 就够了。要小心的一面:第 4、5 条是第三方评测站,其中一条摘要写「$0.008 a credit」,另一条写的是 Tavily 早先的说法;如果模型只看摘要,就可能把第三方的转述当成原文。我们的做法是让 agent 对价格、额度这类会变的数字,只采信官方域名的结果,或者再调一次 read 读原页确认,这正是下一节要讲的交叉核对想解决的问题。
交叉核对:让 agent 知道哪条结论别信
搜索接口给 agent 的最大风险,不是搜不到,而是搜到了错的、旧的、被转述走样的东西,模型又很难自己分辨。我们的 crosscheck 工具做的事是:同一个问题,并行跑几种机制不同的检索(关键词、索引、语义、推理),看每个来源被几种机制同时找到,再把最高一层来源的原文取回来。它不写结论,只告诉你「这条信息有多分散、该不该信」(工具目录里原文是「我们只给证据,不替你写结论」)。
我们拿一个本文自己也要核的说法去测:「Serper free tier gives 2,500 queries」。00:17:25(新加坡时间)调用,5.36 秒返回。四条检索里,关键词检索 1,410 毫秒回 5 条,索引检索 5,122 毫秒回 5 条,语义检索 551 毫秒回 5 条,推理检索这一次没跑通,状态是 unavailable。返回里的 verdict 等级是 scattered,原文说没有来源同时被 3 种以上机制找到、信息分散,别采信任何单一来源;有 2 个页面同时被关键词和索引两种机制找到,都是第三方写的免费搜索接口对比文,被取回的那篇原文写 Serper 的 2,500 次是「one-time」,即一次性的。这和我们自己读 Serper 首页原文的结果一致:首页只写「Get 2,500 free queries」和「No credit card required」,没有「每月」两个字。站内 Serper 免费额度那篇对这 2,500 次有逐字核对。
计费上,这次调用有一个值得写出来的细节:标价是 $0.002778,因为推理检索没跑通,实际只扣了跑通的 3 种机制,$0.002083,返回的 usage.note 写的是「按实际跑通的机制数计费」。别家有没有类似的工具?Tavily 的 research 接口和 Firecrawl 的 agent 接口会自己多轮检索再写答案,但它们的目标是「给答案」,计费按动态用量(Tavily 计费文档、Firecrawl 计费文档);我们的 crosscheck 目标是「给证据分层」,单价固定。两种思路适合不同的 agent:要直接交付一段带引用的答案,用前者;要让你自己的模型来判断、并且在报告里写清来源可信度,用后者。
各家最适合的场景:什么时候选别家
前面每一节都有我们输的项。这一节把它们收拢,按场景写清楚什么时候该选谁。
用量大、只要结果页:选 Serper。 每月 30 万次以上,Serper 的预付包比我们便宜,到 100 万次差 $152.33;它不缓存,每秒 50 到 300 次的上限也宽。代价是要预付、6 个月作废,首页列的接口里没有抓正文,失败扣不扣钱只写了「成功响应才扣」。如果你本来就有抓正文的工具,Serper 是成本最低的搜索层。站内 Serper API 替代和 Serper 定价拆解有更细的账。
要直接给模型读的片段、想零配置试:选 Tavily。 它的片段按相关度挑、每段约 500 字符,一次 basic 搜索 1 credit 就能带回全文,还能先生成一段短答案;免 Key 模式让 agent 在你还没注册时就能用,每月 1,000 credits 免费。代价是按量价 $8.00/千次,是我们的 11.5 倍;生产 Key 每分钟 1,000 次,比我们宽。
要搜索引擎的完整结果页、要供应商承担法律风险:选 SerpAPI。 它支持 100 多种搜索引擎和结果类型,Markdown 输出平均省一半 token;Production 档以上自带 U.S. Legal Shield,页面写为合法抓取公开搜索数据承担最高 $200 万的美国法律责任(U.S. Legal Shield)。代价是贵:入门 $25/千次,空结果也算次数,每小时吞吐有上限。
要一次调用里搜加抓、要现成的专业索引:选 Firecrawl。 搜索请求里加 scrapeOptions 就把结果页的全文一起抓回;它的政府和学术索引调用免费,Alexandria 还接入了授权数据源。代价是 credit 换算复杂,Hobby 档每千次搜索折合 $7.60,403/404 页面也收钱。另外它的文档写明,research 类别会在 2026-11-16 改成搜学术索引,结果从 data.web 挪到 data.research,用到它的解析代码要提前改。
要城市级定位、海量并发:选 Bright Data。 SERP 接口覆盖 195 个国家并支持城市级定位,页面写不限并发,按量 $1.50/千次、每月 5,000 次免费。代价是 token 要放在 URL 里,返回默认是原始 HTML,速度的两处说法不一致。站内 Bright Data 替代页有更多对比。
小用量起步、要失败不扣钱、还要别的数据:选我们。 每千次 $0.694、余额不过期、没有月费,每月 1 万次以下比任何一家付费档都便宜;401、422、429、空结果都不扣钱,422 附改法;交叉核对告诉你哪条别信。同一把 Key 还能调数据接口里 106 个平台、573 项能力(MCP 工具说明原文),比如 bing/search、duckduckgo/search、google_news/search,以及社媒、电商的结构化数据,agent 不用为每一类数据各接一家。代价写在下一节。
我们做不到的
照实写清楚:第一,我们的 web 工具只回标题、链接、摘要、日期,没有知识面板、相关问题、广告、位次这些结果页信息;需要它们,用 Serper 或 SerpAPI。第二,地区只按国家生效,写城市也按所在国家算,做不到 Bright Data 那样的城市级定位。第三,一页最多 10 条,要更多得翻页、每页一次钱;Tavily 一次最多 20 条。第四,日期字段只覆盖约一半结果、格式不统一,约 17% 的结果链接是跳转链接,要用 read 解开。第五,默认每分钟 60 次,是六家入门档里倒数第二。第六,没有免 Key 试用,要先注册,在 GitHub 给两个仓库点星可领 $1、24 小时内有效。第七,我们不写答案:没有 Tavily 那样的 include_answer,也没有 Firecrawl 的 agent 接口,结论要你自己的模型写。第八,deep 带全文便宜但慢,本文一次 16 秒;crosscheck 的推理检索那条不稳定,本文那次就没跑通。
最近的变化(2026 年 10 月到 11 月)
搜索接口这一行这两个月变化很快,下面几条都和 agent 开发者直接有关。
2026-11-05,Bright Data 的 MCP 发了 v4.6.0,删掉了 scrape_as_html 和 extract 两个工具,要拿 HTML 改用 scrape_as_markdown 加 format: 'html'(v4.6.0 发布说明);前一天的 v4.4.0 把所有工具的错误改成统一格式(v4.4.0);2026-11-02 的 v4.3.0 把搜索工具换到 SERP 接口,默认引擎改成 Bing,参数 geo_location 改名 country、cursor 改名 page,旧名直接报 invalid_input,新增 time_range 时间窗,搜不到数据时返回 service_unavailable 错误(v4.3.0);2026-11-01 的 v4.2.0 把抓取工具换到不渲染 JavaScript 的接口(v4.2.0)。对读者意味着:一周之内改了四次工具和参数,如果你的 agent 提示词里写死了工具名,要锁版本或者每次启动重新读工具列表。
2026-11-04,SerpAPI 的 MCP 发了 v2.2.0,加了 extract 工具,可以在同一个 MCP 里先搜再读正文(v2.2.0 发布说明);更早的 v2.0.0 起,搜索失败会返回 isError: true(v2.0.0)。对读者意味着:SerpAPI 现在也能做「搜加读」,但每读一页按一次搜索的额度算,入门档下任务成本很高。
2026-11-03,Firecrawl 的 MCP 发了 v3.36.1(发布说明);它的搜索文档同时预告 research 类别 2026-11-16 改版。11 月上旬,Benzinga 宣布把财经新闻和行情数据放进 Firecrawl 的 Alexandria,供 agent 通过 API 和 MCP 调用(PR Newswire 新闻稿)。对读者意味着:搜索接口正在从「搜开放网页」扩展到「搜授权数据」,金融类 agent 可以少依赖抓来的转述。
2026-10-13,DigitalOcean 和 Bright Data 宣布合作,DigitalOcean 托管 agent 不用单独开 Bright Data 账户和 Key 就能搜索和抓取(新闻稿)。对读者意味着:云平台开始把搜索打包进 agent 托管,单独买搜索接口的人要比的是总账,不只是单价。
2026 年 10 月,Tavily 加了 max_age_hours 参数,可以要求每次现抓网页(更新日志)。对读者意味着:「缓存多旧」变成了一个可以显式控制、写进请求的参数,做价格、比分、状态页这类场景的 agent 应该用上。
还有两件更早、但仍在影响选型的事:Google 的 Custom Search JSON API 已经不接新客户,并将在 2027 年 1 月 1 日停止服务(Google 开发者文档);微软的 Bing Search API 已在 2025 年 8 月 11 日退役,官方建议改用 Azure AI Agents 里的 Bing 落地搜索(Microsoft Learn)。也就是说,Google 和 Bing 的官方通用搜索接口都已不对新用户开放,新做的 agent 要拿搜索结果,只能用第三方的搜索接口。
和站内其他几篇的区别
站内已经有几篇讲搜索的文章,本文不重复它们。Agent 搜索工具怎么选讲的是一个 agent 内部按任务阶段怎么在搜索、读正文、交叉核对之间切换,没有比价;Serper 免费额度那篇只讲 Serper 的 2,500 次免费额度能用多久;Google 搜索结果页爬虫比价那篇比的是「每千页 Google 自然结果」,读者是做排名监控的人。本文是唯一一篇把六家按 agent 的八个维度放在一起、并算「搜一次读 3 页」任务账的。想看单家的对比,站内还有 SerpAPI 替代、Firecrawl 替代、Bright Data 替代三个页面。
上手:三步把搜索接进你的 agent
第一步,不写代码先看结构:在市场页找到「网页检索」,填一个词试一次;或者看网页搜索产品页和搜索产品总览,17 种工具和三档价格都在上面。第二步,按快速上手注册拿 Key,在 GitHub 给两个仓库点星可领 $1 试用额度,24 小时内有效,按 web 的单价够搜约 1,440 次。第三步,把下面这段 curl 放进你的脚本,或者用上一节的一行命令把 MCP 加进你的 agent 客户端。
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"best web search api for ai agents","location":"us","num":10}}'
# 返回 results(最多 10 条:title, url, snippet, published)、location、billing.charged_usd
# 读某一条的正文:把 tool 换成 "read",params 换成 {"url": "<结果里的 url>"}参数以免费的搜索工具目录为准,写错会收到 422 和可用参数列表;想用数据接口的同类能力,看能力目录。如果你在选的不只是搜索,而是整个 agent 的数据层,Bing 数据接口、DuckDuckGo 数据接口和 Google 新闻数据接口三个平台页可以一起看。
常见问题
有免费的 web search api for ai agents 吗?
有,但都有上限。六家里,Bright Data 每月 5,000 次免费并按月重置;Tavily 每月 1,000 credits(按它的按量价约值 $8),另有免 Key 模式;Firecrawl 每月 1,000 credits(约 500 次 10 条结果的搜索),也有免 Key 端点;Serper 注册送 2,500 次,首页没写每月重置;SerpAPI 每月 250 次;我们是在 GitHub 给两个仓库点星领 $1、24 小时内有效,约 1,440 次。只是想让 agent 在个人项目里联网,Bright Data 和 Tavily 的按月免费额度最够用。(问题来自 Google 联想词「free web search api for ai agents」,2026-11-07 读取。)
google search api for ai agents,还能用 Google 官方的接口吗?
新项目不能。Google 的 Custom Search JSON API 已不对新客户开放,老客户每天 100 次免费、超出每千次 $5、每天最多 1 万次,并将在 2027 年 1 月 1 日停止服务(Google 开发者文档)。要在 agent 里拿 Google 风格的结果页,Serper、SerpAPI、Bright Data 都以此为主业;只要通用网页搜索结果,我们的 web 工具每千次 $0.694。(问题来自联想词「google search api for ai agents」。)
Tavily 和 Serper 怎么选?
看你的 agent 要片段还是要结果页。Tavily 回的是按相关度挑过的片段,可以带全文、带短答案,入门按量每千次 $8.00;Serper 回的是结果页的结构化 JSON,入门每千次 $1.00、最低 $0.30,但要预付、6 个月作废,也不带全文。agent 要直接读内容、用量不大,选 Tavily;用量大、自己有抓正文的环节,选 Serper。(问题来自联想词「tavily vs serper」。)
Firecrawl 和 Tavily 有什么区别?
两家都能「搜加读」,计费方式不同。Tavily 一次 basic 搜索 1 credit,带全文不另收;Firecrawl 搜索每 10 条结果 2 credits,抓的每一页再加 1 credit,所以「搜一次读 3 页」在入门档下 Tavily 是 $8.00/千次任务,Firecrawl 是 $19.00。Firecrawl 的优势在抓取本身:能抓截图、HTML、结构化 JSON,还有免费的政府和学术索引。(问题来自联想词「firecrawl vs tavily」。)
SerpAPI 和 Serper 哪个便宜?
Serper 便宜得多。SerpAPI 入门 Starter 档每千次 $25.00,最大的公开档 Big Data 每千次 $9.17;Serper 入门 $1.00,最低 $0.30。SerpAPI 贵在覆盖面和保障:100 多种搜索引擎、Markdown 输出、Production 档以上的 U.S. Legal Shield;另外它的空结果算 1 次、缓存命中不算。有 Reddit 用户在 r/AI_Agents 的讨论里也嫌 SerpAPI「$75/month for just 5k searches」贵(讨论原帖)。(问题来自联想词「serpapi vs serper」。)
bright data serp api pricing 是多少?
SERP 接口按量每千次 $1.5,只对成功请求收费;Scale 档包含 38 万次,超出每千次 $1.3;每月 5,000 次免费(SERP 定价)。MCP 是另一张价目,每月 5,000 次免费,搜索、抓取、提取每千次结果 $1.50,浏览器操作每 GB $8(MCP 定价)。上面那条 Reddit 讨论里也有用户说自己用的就是「$1.5 for 1000 searches」的按量价。(问题来自联想词「bright data serp api pricing」。)
搜索 API 的准确度怎么比?
没有一个各家都认的第三方排名。我们的建议是用你自己的问题集测:挑 50 到 100 个你的 agent 真实会问、答案确定的问题,各家都跑一遍,人工判对错。公开的事实问答基准里,SimpleQA 是专门测「短问题、唯一答案」的一个(论文),可以参考它的出题方式。只看厂商自己公布的分数不够,因为测法、题目和日期都不一样。(问题来自 r/LocalLLaMA 上的讨论标题「What is the most accurate web search API for LLM?」,2026-11-07 用论坛检索读取。)
参考资料
- Serper 首页(定价、免费额度、FAQ),Serper,2026-11-07 读取。
- Serper Terms of Service,Serper,2024-05-29 更新,2026-11-07 读取。
- Tavily Pricing,Tavily,2026-11-07 读取。
- Tavily Credits & Pricing,Tavily 文档,2026-11-07 读取。
- Tavily Rate Limits,Tavily 文档,2026-11-07 读取。
- Tavily Search 接口参考,Tavily 文档,2026-11-07 读取。
- Tavily Changelog,Tavily 文档,2026 年 10 月条目,2026-11-07 读取。
- Tavily MCP,Tavily 文档,2026-11-07 读取。
- Try Tavily Without an API Key,Tavily 文档,2026-11-07 读取。
- tavily-ai/tavily-mcp,GitHub,最近提交 2026-11-05。
- SerpApi Plans and Pricing,SerpApi,2026-11-07 读取。
- SerpApi Markdown Output for AI Agents,SerpApi,2026-11-07 读取。
- SerpApi MCP Integration,SerpApi,2026-11-07 读取。
- SerpApi Ludicrous Speed,SerpApi,2026-11-07 读取。
- SerpApi Extract API,SerpApi,2026-11-07 读取。
- SerpApi U.S. Legal Shield,SerpApi,2026-11-07 读取。
- serpapi/serpapi-mcp,GitHub,2026-11-07 读取。
- serpapi-mcp v2.2.0,GitHub,2026-11-04。
- serpapi-mcp v2.0.0,GitHub,2026-09-22。
- Firecrawl Pricing,Firecrawl,2026-09-04 生效,2026-11-07 读取。
- Firecrawl Billing,Firecrawl 文档,2026-11-07 读取。
- Firecrawl Search,Firecrawl 文档,2026-11-07 读取。
- Firecrawl Rate Limits,Firecrawl 文档,2026-11-07 读取。
- firecrawl/firecrawl-mcp-server,GitHub,2026-11-07 读取。
- firecrawl-mcp-server v3.36.1,GitHub,2026-11-03。
- Best Search Tools for AI Agents in 2026,Firecrawl 博客,2026-09-24,2026-11-07 用
read读取。 - Bright Data SERP API Pricing,Bright Data,2026-11-07 读取。
- Bright Data MCP Server Pricing,Bright Data,2026-11-07 读取。
- Introduction to SERP API,Bright Data 文档,2026-11-07 读取。
- brightdata/brightdata-mcp,GitHub,2026-11-07 读取。
- brightdata-mcp v4.6.0,GitHub,2026-11-05。
- brightdata-mcp v4.4.0,GitHub,2026-11-04。
- brightdata-mcp v4.2.0,GitHub,2026-11-01。
- DigitalOcean and Bright Data Unlock the Web for AI Agents,Business Wire 新闻稿(Yahoo Finance 转载),2026-10-13。
- Benzinga Collaborates With Firecrawl,PR Newswire,2026 年 11 月上旬。
- Custom Search JSON API,Google for Developers,2026-02-18 更新。
- Bing Search APIs Retiring on August 11, 2025,Microsoft Learn。
- MCP Versioning,Model Context Protocol,2026-07-28 版。
- modelcontextprotocol 规范发布页,GitHub,2026-07-28 发布。
- Measuring short-form factuality in large language models(SimpleQA),arXiv,2024-11-07。
- What's the best tool/API for web search in an agentic stack?,Reddit r/AI_Agents,2026-11-07 读取。
- EveryInfra 搜索工具目录,EveryInfra,2026-11-07 00:15 读取。
- EveryInfra 能力目录,EveryInfra,2026-11-07 00:15 读取。
- EveryInfra OpenAPI,EveryInfra,2026-11-07 读取。
- everyinfra/everyinfra-agent-plugins,GitHub,试用额度要点星的仓库之一。
引用编号 BL-105