Apify Google 搜索爬虫替代:每千页自然结果比价
每千页搜索结果,Apify 官方 Google 搜索爬虫 Free 档 $4.50、Business 档 $1.80;我们只回自然结果,实测 $0.694。
结论先说:同样拿 1,000 页网页搜索的自然结果,Apify 官方 Google Search Results Scraper 的 Free 档要价是 EveryInfra 实测的 6.5 倍,Business 档是 2.6 倍。但 Apify 那一页还带 People Also Ask(相关问题)和相关搜索,我们没有;Apify Store 里另有三个第三方作者的同类 scraper 比我们便宜。
具体的数:Apify 的价格是 2026 年 11 月 6 日 00:17(新加坡时间)从公开接口读到的,Free 档每千页 $4.50,月费 $19 的 Starter 档 $2.50,月费 $999 的 Business 档 $1.80;EveryInfra 一侧是同一晚 18 次真调里 13 次网页搜索的实扣,每页 $0.000694,折合每千页 $0.694,只含标题、链接、摘要和日期;那三个第三方 scraper 每千页 $0.45 到 $0.60,比我们便宜 14% 到 35%。下面把价格、字段、翻页去重、失败扣费、速度和接进 AI agent 的方式逐项摆开,哪一项 Apify 更好,就照实写。
本文说的「每千页价」,是把一次请求实际扣掉的钱,按「一页结果」换算到 1,000 页。Apify 官方这个 scraper 的主收费事件就叫「Scraped search result page」,按成功抓到的结果页计费;EveryInfra 的网页搜索按次计费,一次请求回一页、最多 10 条,所以两边天然能落在同一个分母上。Apify 一侧我们只用公开材料:Store 页面、价格页、文档,以及不需要账号就能读的公开接口 api.apify.com/v2/acts/<id>;我们没有注册 Apify,也没有跑它的 actor(Apify 对云端抓取程序的叫法),所以表里 Apify 的数字都是公开单价,不是我们的实测账单。EveryInfra 一侧全部来自本文真调响应里的 charged_usd。还有一点要先交代:EveryInfra 的网页搜索是通用网页搜索(见工具目录),本文比的是「拿到一页 10 条带标题、链接、摘要的网页搜索结果」这件事要花多少钱,不是说两边返回的是同一份 Google 页面。
先看总表:apify google search scraper 和 EveryInfra,同样 1,000 页各多少钱
下表把常见的几种买法放在一起。Apify 官方 scraper 的价格按套餐分六档,Free、Bronze、Silver、Gold 分别对应 Free、Starter、Scale、Business 四个公开套餐,Platinum 和 Diamond 只给企业客户(Actors in Store 文档写明折扣档由套餐决定)。这些单价我们从公开接口的 pricingInfos 字段读出,当前这条定价自 2026 年 10 月 7 日起生效。EveryInfra 有两个入口都能做网页搜索:搜索接口 POST /api/v1/search 的 web 工具每次 $0.000694,数据接口 POST /api/v1/social 的 web/search 能力每次 $0.001389,两者都是一次回一页。
| 买法 | 计费单位 | 每 1,000 页 | 是 EveryInfra 搜索 web 的几倍 | 一页里有什么 |
|---|---|---|---|---|
| Apify 官方,Free 档 | 每页 $0.0045 | $4.50 | 6.5 倍 | 自然结果、PAA、相关搜索;广告、AI 概览另收 |
| Apify 官方,Starter(Bronze) | 每页 $0.0025 | $2.50 | 3.6 倍 | 同上 |
| Apify 官方,Scale(Silver) | 每页 $0.00195 | $1.95 | 2.8 倍 | 同上 |
| Apify 官方,Business(Gold) | 每页 $0.0018 | $1.80 | 2.6 倍 | 同上 |
| Apify 官方,Diamond(企业) | 每页 $0.0012 | $1.20 | 1.7 倍 | 同上 |
EveryInfra 搜索接口 web | 每次 $0.000694 | $0.694 | 1 倍(基准) | 标题、链接、摘要、日期,最多 10 条 |
EveryInfra 数据接口 web/search | 每次 $0.001389 | $1.389 | 2 倍 | 多一个名次 rank,同样最多 10 条 |
EveryInfra web + 联想词 suggest | 两次 $0.001388 | $1.388 | 2 倍 | 自然结果加 10 条联想词,仍无 PAA |
| Store 第三方最低(第三方 F) | 每页 $0.00045 | $0.45 | 0.65 倍(比我们便宜 35%) | 自然结果、PAA、相关搜索、广告 |
读这张表要注意三件事。第一,Apify 的单价是套餐决定的,同一个人用 Free 档和用 Business 档,价格差 2.5 倍,而 Business 档的门槛是每月 $999 的月费(Apify 价格页);绝大多数个人开发者和小团队实际用的是 Free 或 Starter,所以「是我们的 3.6 到 6.5 倍」比「2.6 倍」更接近他们的处境。第二,我们自家两个入口差一倍价,同一个词、同一个国家,/api/v1/search 的 web 回 10 条、扣 $0.000694,/api/v1/social 的 web/search 也回 10 条、扣 $0.001389,多出来的是一个从 1 开始的 rank 字段和统一数据接口的那一套(异步模式、和目录里共 106 个平台同一种请求体)。只是要拿网页搜索结果的话,用便宜的那个。第三,表里最后一行提醒的是:如果你选 scraper 只看价格,Apify Store 里有比我们便宜的选项,后面单独一节写。
Apify Google Search Results Scraper 价格:按结果页计,六档,十个附加项
Apify 官方这个 scraper 的 Store 名叫 Google Search Results Scraper,页面标题写作「Google Search scraper and SERP API」,是 Store 里用的人最多的 Google 搜索工具。公开接口显示它累计 227,822 个用户、近 30 天约 2.7 万个用户、近 7 天 11,769 个,218 条评价平均 4.65 分,累计运行 1.34 亿次;最新一次构建是 2026 年 11 月 2 日的 0.0.476 版(公开接口)。Store 页面的价格标签写的是「from $1.80 / 1,000 scraped search result pages」(Pricing 标签页),也就是说页面上最显眼的数字是 Business 档的价格,Free 档用户实际付的是它的 2.5 倍。
它的计费方式叫按事件计费(pay-per-event):作者定义一组事件,每发生一次扣一次钱。主事件「Scraped search result page」的说明原文是「Cost per page of Google Search results successfully scraped」,按成功抓到的页数收费;另有一个启动事件,按运行的内存每 GB 收 $0.00005,默认 1 GB 就是 $0.00005 一次,可以忽略。README 写明每页「approximately 10 results」,要 100 条结果就把 maxPagesPerQuery 设成 10、翻 10 页(Store 页面 README)。所以「每千页」和「每万条自然结果」在这个 scraper 上是同一件事。
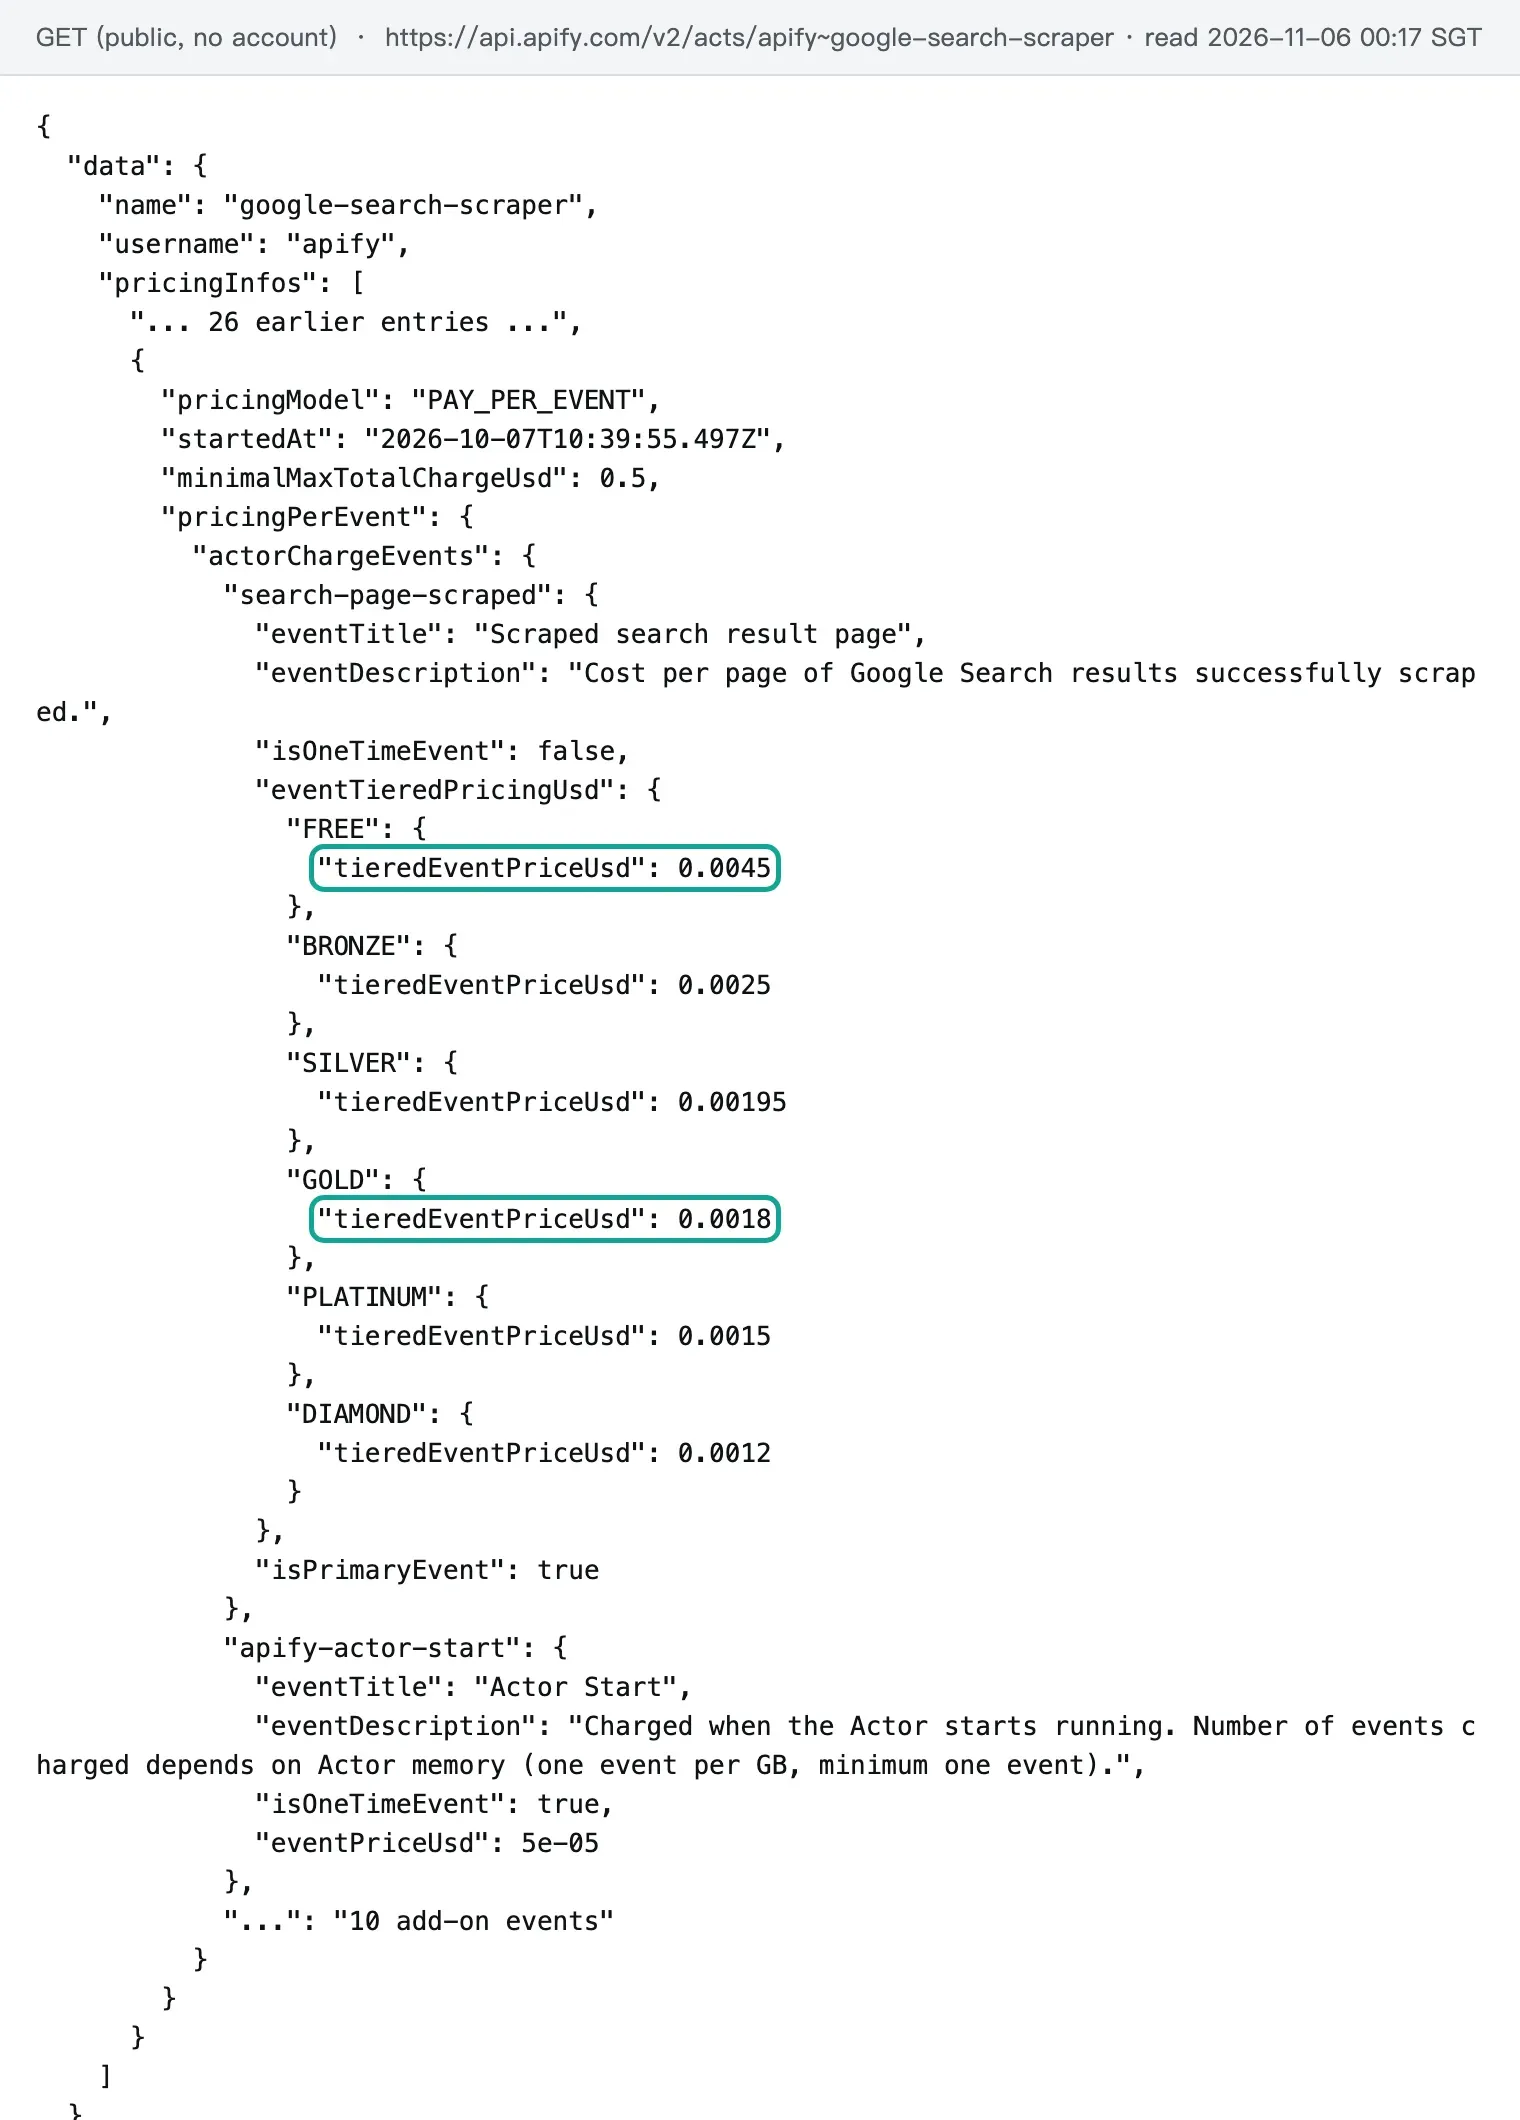
主事件之外,它还有 10 个附加事件,都是你在输入里打开某个开关才会收。附加项的价格差异比主事件大得多,尤其是 Free 档:
| 附加事件(每 1,000 次) | Free | Starter | Scale | Business | 什么时候收 |
|---|---|---|---|---|---|
| 抓结果页(主事件) | $4.50 | $2.50 | $1.95 | $1.80 | 每成功抓一页 |
| 付费广告提取 | $6.50 | $5.00 | $4.00 | $3.50 | 打开广告提取后每页都收,不管有没有广告 |
| 完整 AI 概览 | $3.00 | $2.00 | $1.50 | $1.00 | 成功抓到 AI 概览的查询 |
| Google AI Mode | $200 | $5.00 | $3.00 | $2.00 | 每个成功的 AI Mode 回答 |
| ChatGPT / Copilot / Gemini 搜索 | $200 | $5.00 | $4.00 | $3.00 | 每个成功回答 |
| Perplexity 搜索 | $200 | $13.00 | $10.00 | $9.00 | 每个成功回答 |
| 结果页全文 | $8.00 | $5.00 | $4.00 | $3.00 | 每抓一个结果网站 |
| 商务联系人 | $100 | $5.00 | $5.00 | $4.00 | 每条联系人 |
这张表里有个容易被忽略的数:AI Mode、ChatGPT、Copilot、Gemini、Perplexity 这五个附加项在 Free 档都是每次 $0.20,到 Starter 档就降到 $0.005 到 $0.013,差 15 到 40 倍。Apify 给作者的定价文档其实提过这件事:不建议给 FREE 档定过高的价格,因为那会让用户没法在足够的数据上试用,只有在防欺诈或要覆盖第三方成本(比如大模型调用)时才说得通(Actor pricing and costs)。对读者的意义是:用 Free 账号测 AI 搜索类附加项时,100 次就是 $20,远超每月 $5 的免费额度,测之前先把花费上限设好。广告提取也要注意,它按页收、不按「找到的广告」收,原文是「regardless of whether ads are found on the specific page」,打开以后每页的价格从 $4.50 变成 $11.00(Free 档)。
控制花费的办法两边也不同。Apify 的同步运行并取结果的接口有 maxTotalChargeUsd 参数,说明原文是「Use it to cap the total amount charged for all pricing models」(Run Actor synchronously and get dataset items)。EveryInfra 没有「单次运行上限」这个概念,因为一次请求就是一页、价格固定,单次最多扣 $0.000694;控制总花费靠充值金额本身(最低充 $10,余额不过期,见价格页)。
这个 scraper 的定价史也能从公开接口读出来:一共 27 条定价记录。2024 年 5 月它按数据条目计费,每 1,000 条 $3.50(一条就是一页);2024 年 12 月 12 日有一条记录标过 $1.05,约 1.5 小时后又改回 $3.50;2025 年 6 月 10 日改成按事件计费,Free 档涨到 $4.50,Business 档 $2.45;2026 年 1 月 30 日 Business 档降到 $1.80。之后的记录主要是加附加项(5 月 4 日加 Copilot、5 月 14 日加 Gemini、6 月 22 日加结果页全文、6 月 26 日加完整 AI 概览)和改启动费:启动费从每次 $0.002 降到 $0.001(2026 年 3 月 4 日),再在 2026 年 10 月 7 日换成平台统一的按内存计的 $0.00005。也就是说,过去 17 个月里,Free 档用户的页价一分没降,降价都发生在付费套餐上。
一页里到底有什么:两边字段逐项对
只比价格不比字段,就等于把两样不同的东西放在一个秤上。Apify 这个 scraper 每一页输出一条记录,README 里的样例输出有 searchQuery(查询词、页码、国家、设备)、organicResults(标题、链接、显示网址、描述、站点名、日期、强调词、站内链接、类型、位置)、paidResults、paidProducts、peopleAlsoAsk、relatedQueries 和 aiModeResult 等字段(README 原文)。EveryInfra 的网页搜索每页回一个结果数组,每条只有标题、链接、摘要和日期,location 字段告诉你国家参数是否生效、按哪个国家生效。
| 字段 | Apify 官方 scraper | EveryInfra 搜索 `web` | EveryInfra `web/search` |
|---|---|---|---|
| 自然结果标题、链接 | 有 | 有(title、url) | 有(title、url) |
| 摘要 | 有(description) | 有(snippet) | 有(text) |
| 日期 | 有(date,有就给) | 有(published,有就给) | 有(published_at) |
| 名次 | 有(position) | 没有字段,按数组顺序 | 有(rank) |
| 站内链接、站点名 | 有 | 没有 | 有 sub_links(目录字段) |
| People Also Ask | 有 | 没有 | 没有 |
| 相关搜索 | 有(relatedQueries) | 没有;可另调 suggest 拿联想词 | 没有 |
| 广告、购物广告 | 打开附加项才有,每页另收 | 没有 | 没有 |
| AI 概览、AI Mode | 自动带简版;完整版和 AI Mode 另收 | 没有 | 没有 |
| 结果页 HTML 快照 | 默认存进键值存储 | 没有 | 没有 |
这一节的结论很直接:如果你要的是 People Also Ask、相关搜索、广告位或 AI 概览,Apify 官方 scraper 一页就能给,我们给不了,这时候比价格没有意义。我们能对上的只有「自然结果」这一块:标题、链接、摘要、日期。好在很多用途只要这一块,比如给 AI agent 找资料来源、按关键词监控谁排在前面、收集某个话题下的文章链接、检查自己的页面有没有出现在结果里。这几类用途下,下面的价格比较才成立。
还有一个容易忽略的差别:Apify 那一页是 Google 的结果页,它的 searchQuery.domain 在 2026-10-15 之后一律是 google.com,国家放在 gl 参数里(更新日志);EveryInfra 的网页搜索是通用网页搜索,文档不承诺结果和 Google 某一页逐条一致。如果你的用途是「复现 Google 在某国某天给某个词的排名」,比如给客户出排名报告,就应该用明确抓 Google 结果页的工具,Apify 官方 scraper 是其中之一。
实测一:同一个词翻 10 页,每页多少条、重复多少
我们在 2026 年 11 月 6 日 00:14 到 00:17(新加坡时间)用同一个英文词「best running shoes for flat feet」、国家设为美国,调 EveryInfra 搜索接口的 web 工具,从第 1 页翻到第 10 页,每页一次请求。10 次全部成功,每次扣 $0.000694,合计 $0.00694。10 页一共回了 95 条:第 1、5、8、9、10 页各 10 条,第 2、3、4、6、7 页各 9 条,平均每页 9.5 条。按返回条数算,每千条 $0.0731。
翻页的问题在于重复。我们把每页返回的 url 原样比对,95 条里只有 80 个不同网址,重复 15 条,占 15.8%。重复集中在后面几页:第 8 页 10 条里有 5 条在前面出现过,第 6 页有 3 条,第 2 页和第 5 页各 2 条。比如 doctorsofrunning.com 的一篇跑鞋文章在第 1 页排第 10、第 2 页又出现一次,shoestation.com 的一篇在第 1 页和第 2 页都有。按不重复的条数算,每千条是 $0.087,比按返回条数算贵 19%。这个数对做「关键词覆盖」的人有用:如果你按「我要 1,000 个不同网址」来估预算,要多留两成。
Apify 一侧我们没有真跑,所以不知道它翻 10 页的重复率是多少;但它的计费方式决定了重复的成本落在谁身上:它按页收钱,一页里有 5 条重复和没有重复,价格一样;我们也是按次收钱,一页里有几条重复都扣 $0.000694。两边在这一点上是同一种模型,重复的成本都由用户承担,区别只在单价。另一个相关的事实是,Google 在 2025 年 9 月停掉了每页 100 条的 num=100 参数,此后任何工具要拿前 100 名都得翻 10 页(Search Engine Land 的数据显示,当时 77% 的站点在 Search Console 里关键词曝光下降)。这也是为什么现在按页计价比按条计价更普遍:一页就是一次请求,成本最直接。
实测二:换国家、换语言、加时间范围、限定站点
做排名监控的人最常改的四个参数是国家、语言、时间范围和站点。两边都支持,但写法不同、粒度不同。下面这张表把参数一一对上,Apify 一侧取自输入定义,EveryInfra 一侧取自免费的搜索工具目录:
| 需求 | Apify 官方 scraper | EveryInfra 搜索 `web` | 实测 |
|---|---|---|---|
| 国家 | countryCode(传给 Google 的 gl),另有 locationUule 精确到城市 | location:国家名或两位代码,写城市按所在国家 | mx 生效,返回 country: MX |
| 语言 | languageCode(界面语言 hl)和 searchLanguage(结果语言 lr)分开 | 没有单独参数,靠查询词语种和国家 | 西语词加 mx,10 条全是西语 |
| 时间范围 | quickDateRange(如 d10)、afterDate、beforeDate | after、before(日期) | after=2026-08-01 被接受 |
| 站点 | site、relatedToSite、wordsInTitle 等运算符 | site | site=apify.com 回 10 条,全在该站 |
| 页数 | maxPagesPerQuery | page,一次一页 | 见实测一 |
| 移动端结果 | mobileResults | 没有 | — |
00:15:26(新加坡时间)我们用西语词「mejores tenis para correr pie plano」、location=mx、after=2026-08-01 调了一次,扣 $0.000694,回 10 条,响应里写明「Applied at country level: Mexico」;结果里有 runrepeat.com 的西语版、runna 的帮助文章、三条 Facebook 内容(两条帖子、一条视频)、YouTube 视频和一个 Reddit 帖子的西语译文页。时间参数起了作用:10 条里有 5 条带日期,分别是 8 月 11 日、8 月 19 日、9 月 22 日、9 月 30 日和 10 月 25 日,全部晚于 8 月 1 日;另外 5 条(Facebook、YouTube、Reddit)没有日期字段。也就是说 after 过滤的是搜索引擎认定的日期,没有日期的结果照样会出现,拿去做「近三个月的新内容」时要自己再按日期筛一遍。Apify 的 afterDate 也是把日期交给 Google 的筛选,同样的问题在它那边一样存在。00:15:57 用中文词「扁平足 跑鞋 推荐」、location=cn 调一次,回 10 条,来源有知乎专栏、bilibili 视频、ELLE 香港、淘宝的口碑榜页和一条 Threads 帖子,简繁体混在一起。
00:15:46 我们用 site=apify.com 搜「google search results scraper」,回的 10 条全部在 apify.com 上:官方 scraper 本身、它的 API 页、Store 的 Google 搜索专题页,以及 6 个第三方作者的同类 scraper。这次调用本身也成了本文的一个线索,后面「Store 里不止一个」那一节的几个价格就是顺着这份名单去公开接口里核的。
语言参数是两边差得最多的地方。Apify 把「界面语言」和「结果语言」拆成两个参数,还能用 UULE 编码精确到城市,这对本地商家排名(「牙医 + 城市名」之类)很重要;EveryInfra 的 web 只到国家一级,响应里会明确告诉你「Applied at country level」。如果你的需求是城市级别的本地排名,Apify 官方 scraper 更合适;只要国家级别的结果,两边都够用。
实测三:联想词能不能代替「相关搜索」
People Also Ask 和相关搜索是做内容规划的人最想要的两块。我们没有这两个字段,能拿来替代的最近的东西是联想词工具 suggest:00:14:55(新加坡时间)用同一个词调一次,扣 $0.000694,1.17 秒回 10 条,从「best running shoes for flat feet men」「women」到「and overpronation」「and plantar fasciitis」「and shin splints」「and wide toe box」「and bunions」「and knee pain」。
这些联想词和 Google 结果页底部的「相关搜索」不是一回事:联想词是用户在输入框里打字时弹出的补全,偏向「同一个词加一个限定」;相关搜索和 People Also Ask 是结果页里的推荐,常常是换个说法的问题(「扁平足能不能穿缓震鞋」这一类)。做长尾关键词扩展,联想词很好用;要拿到真实的提问句、做常见问题板块,联想词就不够,这时候 Apify 官方 scraper、或者 Store 里带 PAA 的那几个第三方 scraper 更对口。用我们这套,自然结果加联想词两次请求一共 $0.001388,每千个词 $1.39,仍比 Apify Business 档的 $1.80 便宜,但拿到的东西少一块,这个账要按你的用途算。
实测四:两个入口同一个词,价格差一倍
EveryInfra 的网页搜索有两个入口,这是我们自己产品上一个值得提醒的地方。00:14:45(新加坡时间)我们用数据接口调 web/search,keyword 填同一个词、country=us、language=en,2.32 秒回 10 条,扣 $0.001389;00:14:23 用搜索接口的 web 工具调,2.18 秒回 10 条,扣 $0.000694。两次的前两条一样(runrepeat.com 和一个 Reddit 帖子),后面的排序和条目有出入:数据接口那次多了 hobibear.com、weartesters.com,少了 shoestation.com 和 doctorsofrunning.com 的一篇。
两个入口的价格差来自目录定价:数据接口的 web/search 在能力目录里标 $0.001389,和其他平台的同级能力一个价;搜索接口的工具统一按「一次检索 $0.000694」计(OpenAPI 里 /api/v1/search 的说明)。数据接口的好处是能用 "mode":"async" 拿任务号再轮询、请求体和目录里共 106 个平台一样,适合已经在用数据接口批量跑别的平台的人顺手加一个搜索。只是要网页搜索结果的话,选搜索接口的 web,便宜一半。本文所有「EveryInfra 每千页 $0.694」的数都指这个入口。
失败和空结果扣不扣钱
按次计费的产品,最怕的是「失败也收钱」。我们专门做了三种不会拿到结果的请求,每种一次,看响应里写了什么。
| 时间(新加坡时间) | 请求 | HTTP | 响应里怎么说 | 扣费 |
|---|---|---|---|---|
| 00:15:13 | 不带 Key | 401 | unauthorized,「Nothing was charged.」 | $0 |
| 00:15:04 | 把国家写成 country(web 只认 location) | 422 | unknown_param,列出 after, before, location, num, page, q, site | $0 |
| 00:15:36 | 一串不存在的词,结果为空 | 200 | charged: false,reason: empty_result_refunded,退款 succeeded | $0 |
| 00:14:23 | 正常请求 | 200 | 10 条,charged_usd: 0.000694 | $0.000694 |
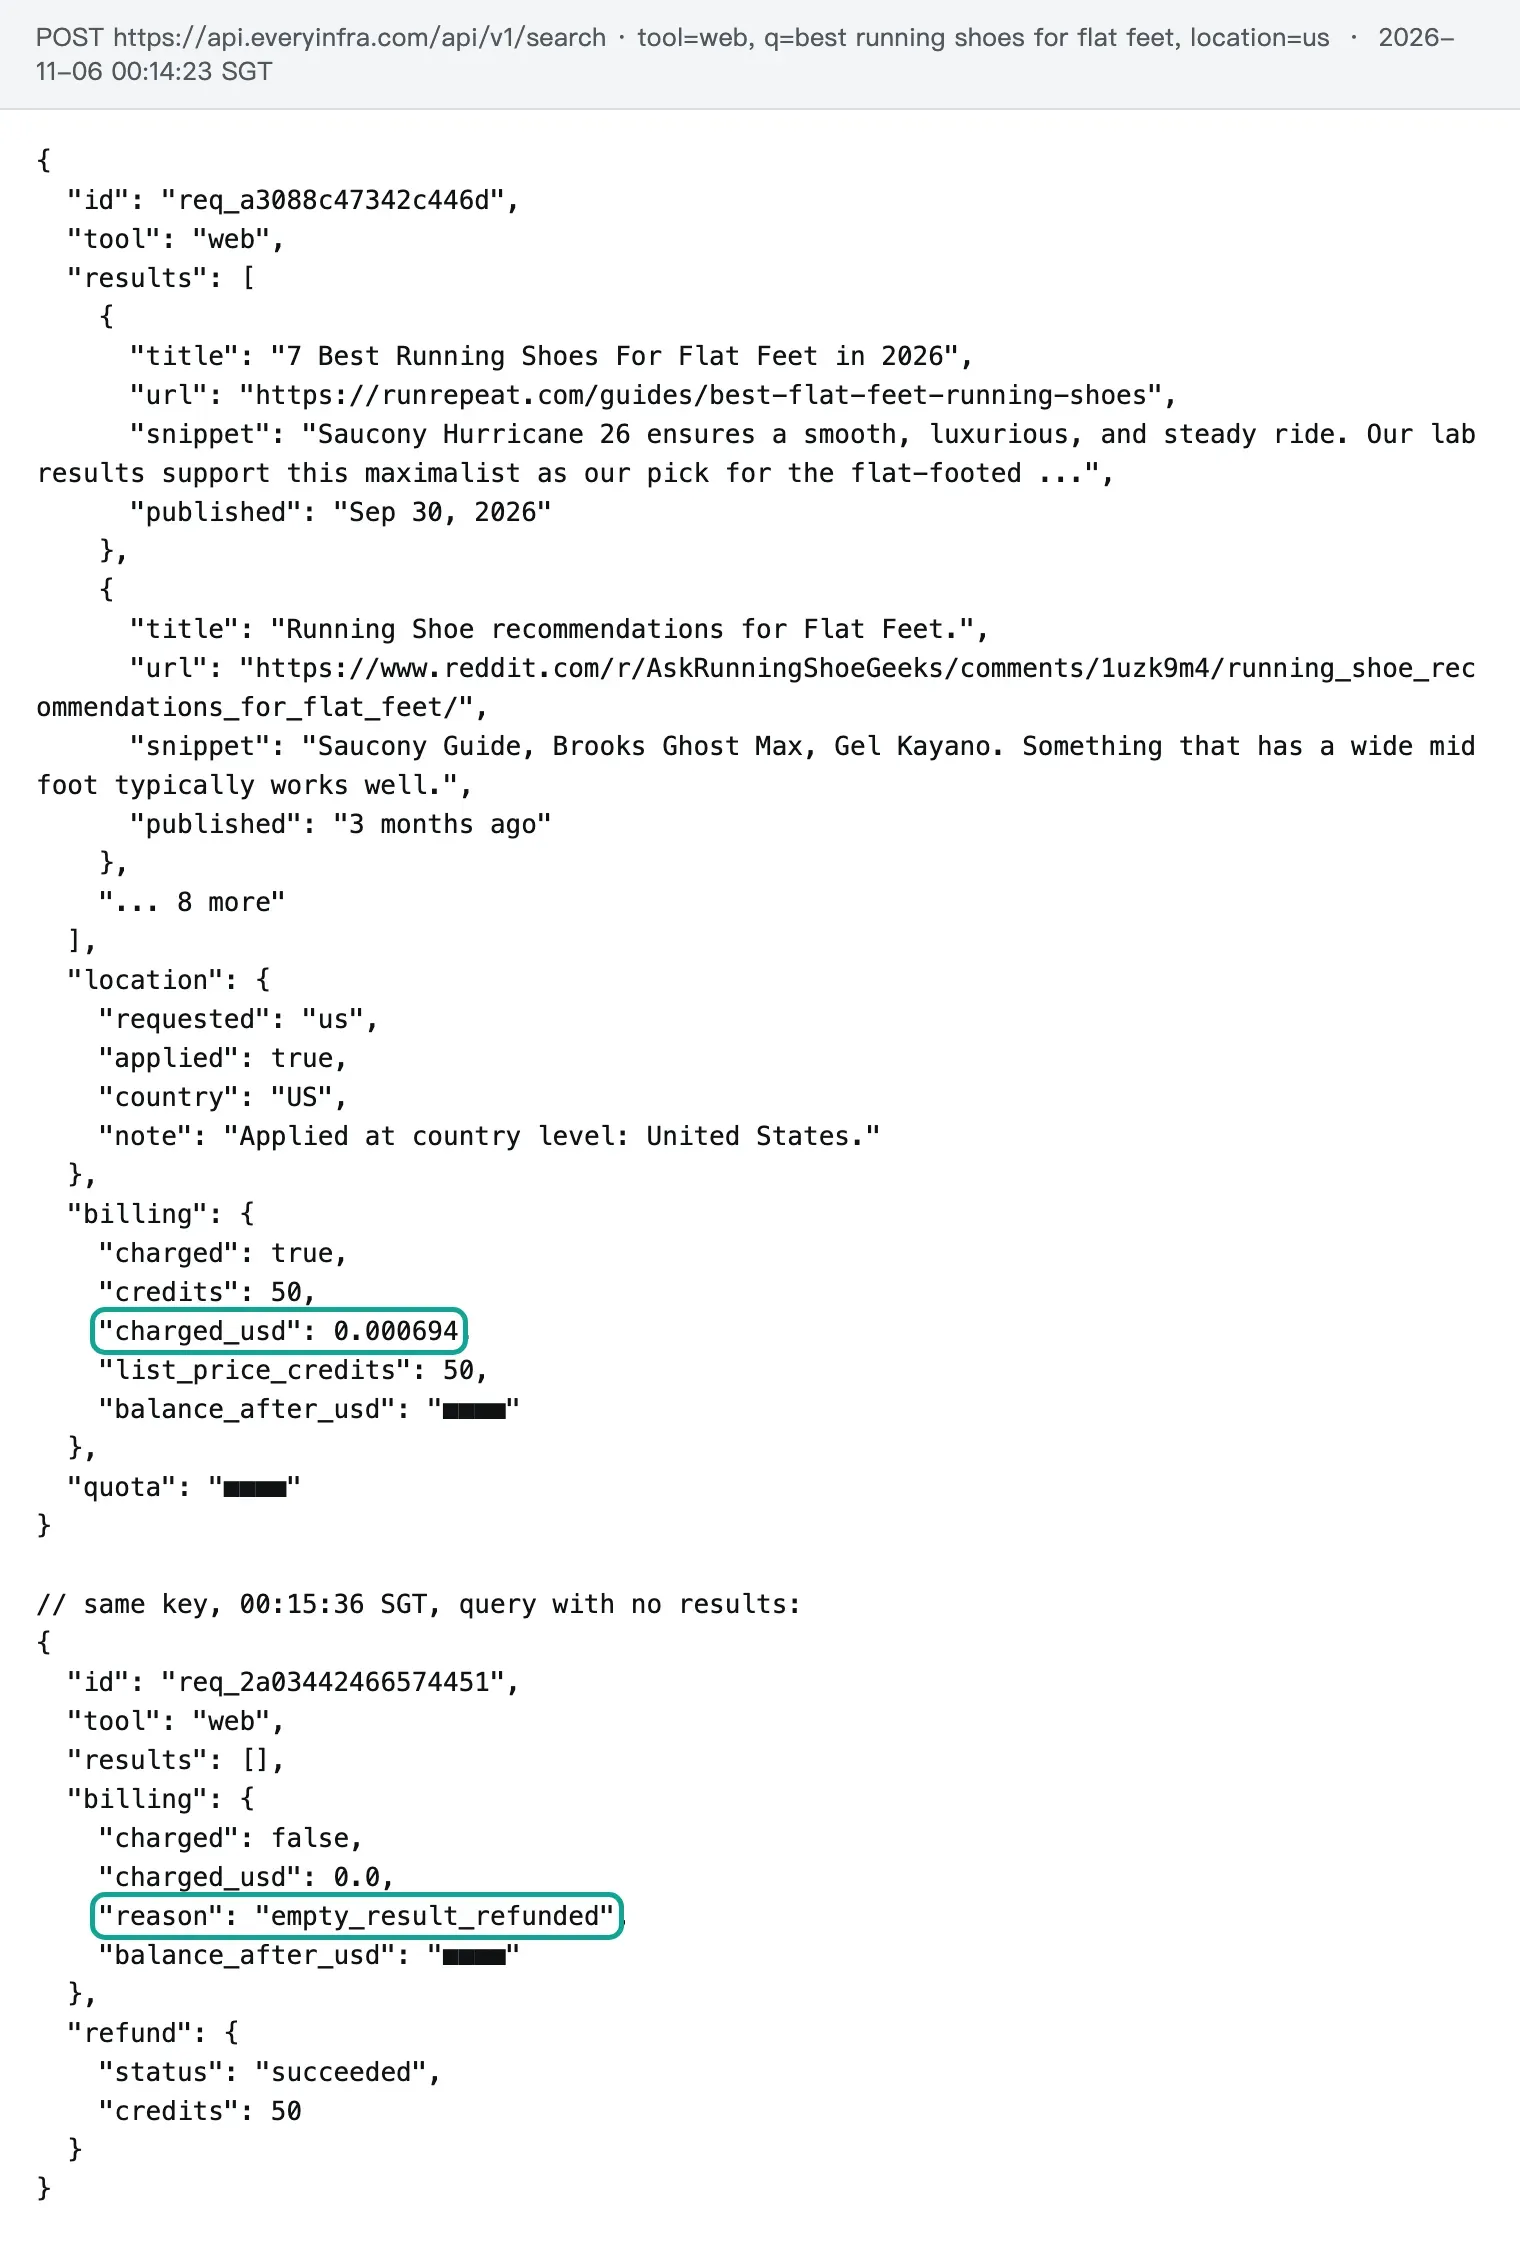
422 那次值得多说一句。我们故意把 Apify 的写法(countryCode 的近亲 country)带进来,接口在 0.12 秒内拒绝,错误信息原文是「country is not a parameter of tool web Supported: after, before, location, num, page, q, site」,next_steps 写「Remove country... Nothing was charged.」。这对从 Apify 迁过来的代码和让 AI agent 自己写调用的场景都有用:参数名写错不会被悄悄忽略、照常扣钱,而是直接告诉你该用哪个。我们另有一篇错误自愈的写法讲 agent 怎么读这类错误自己改。
Apify 一侧的规则从公开材料看是这样的:主事件按「成功抓到的页」收,抓失败的页不收;启动事件在运行开始时就收($0.00005,可以忽略);广告提取附加项是例外,打开后每页都收,不管有没有广告。空结果(Google 对某个词就是没结果)算不算「成功抓到的页」,我们读到的文档和 README 没有写,所以这里标为「未写明」。运行失败的统计倒是公开的,下一节会用到。如果你在乎对账,我们有一篇讲失败退款怎么核对的文章。
速度:同步 2.6 秒,和「起一次运行」
我们这边的速度很好量:15 次有结果的真调,从发出到收完的中位数是 2.57 秒,最快 1.17 秒(联想词),最慢 4.87 秒(第 4 页),平均 2.7 秒;两次被拒的请求(401、422)都在 0.15 秒以内返回。这些都是同步请求,发出去就等结果,没有排队、没有「启动」这一步。计时在新加坡的客户端上做,包括网络往返。
Apify 的模式不一样:每次搜索是一次 actor 运行,要先起一个容器(默认 1 GB 内存、最长 604,800 秒超时,见公开接口的 defaultRunOptions),一次运行可以塞很多个查询词。它的优势在批量:一次运行喂 1,000 个词,平台替你并发、重试、存数据集。它的劣势在单次:只查一个词也要起一次运行。我们没有跑 Apify,所以不报它的实测秒数,也不引用第三方页面上没法核实的计时。要比速度,最可靠的办法是用你自己的词在两边各跑一小批,按同样的方式计时。
可靠性方面,Apify 公开了这个 scraper 近 30 天的运行结果:9,282,238 次运行里,成功 9,087,716 次(97.9%),超时 172,957 次(1.86%),中止 21,143 次(0.23%),失败 422 次。没跑成的里面绝大多数是超时,但这个统计不区分原因,用户自己设了很短的超时、或者花费上限到了被停下,也都算在里面,所以不能直接读成「平台出错率 2.1%」。我们这边 18 次真调没有一次失败,但样本太小,不能拿来和 900 万次比可靠性,这里只写事实,不下结论。我们的实时可用性在状态页公开。
每月账单:四个用量档
单价只是一半,另一半是月费。Apify 的套餐月费就是预付额度:Starter 每月 $19,Scale $199,Business $999,额度在当月用掉,用不完月底作废;Free 账号每月 $5,用完就停到下个周期(价格页 FAQ原文:「unused usage credits are not rolled over to the next billing cycle」)。所以一个月的实付是「月费」和「页数 × 本档单价」两者取大。EveryInfra 没有月费,按次扣,最低充值 $10,余额不过期。
| 每月页数 | Apify 最省的套餐 | Apify 当月实付 | EveryInfra | 差几倍 |
|---|---|---|---|---|
| 1,000 | Free($5 免费额度够用) | $0 | $0.69 | Apify 更省 |
| 10,000 | Starter | $25.00 | $6.94 | 3.6 倍 |
| 100,000 | Scale(月费 $199 覆盖 $195 用量) | $199 | $69.44 | 2.9 倍 |
| 1,000,000 | Business | $1,800 | $694.44 | 2.6 倍 |
这张表最需要照实写的是第一行:每月只要 1,000 页左右(大约 1,111 页以内)的人,用 Apify 的 Free 账号每月 $5 免费额度就能覆盖,一分钱不用付,比我们便宜。README 自己的说法是「$5 of credit, which lets you scrape over 1,000 Google Search results」,按每页约 10 条算,$5 实际能抓约 1,111 页、约 1.1 万条,README 写「1,000 多条结果」是保守的写法。EveryInfra 的免费试用比这少:在 GitHub 给两个仓库点星领 $1,24 小时内有效(快速上手写明),按 $0.000694 一次约 1,440 次搜索,但只有一天。过了 1 万页,Apify 的月费门槛开始起作用:每月 1 万页落在 Starter 档,实付 $25;每月 10 万页时 Starter 档要 $250,换 Scale 档反而只要月费 $199;到 100 万页,Business 档的 $1,800 比 Scale 档的 $1,950 便宜。我们在这四档上一直是线性的,差距在 2.6 到 3.6 倍之间。
两点边界:一是表里没算附加项,打开广告提取或 AI 概览,Apify 这边要另加;二是速率,我们默认每个账户每分钟 60 次请求,每月 100 万页平均每分钟约 23 次,够用,但如果要在一小时内跑完 10 万页,就需要每分钟 1,800 次以上的提速包(价格页上写的档位是每分钟 180、600、1,800 次)。Apify 的 Free 账号最多 5 个并发运行,Starter 32 个,一次运行里还能并发多个查询,爆发能力上它更强。
Store 里不止一个:更便宜的第三方 Google 搜索 scraper
「apify google search scraper」这个词,多数人指的是官方那一个。但 Apify Store 是个市场,用公开接口搜「google search results scraper」能搜到 4,439 个结果(Store 搜索接口,2026 年 11 月 6 日 00:17 新加坡时间读取)。我们按近 30 天用户数挑了前几名同类 scraper,把它们的公开价都换算到「每 1,000 页、每页约 10 条」。第三方作者多是个人账号,表里按用户数从多到少记作第三方 A 到 F,各自的 Store 页面列在文末参考资料里:
| scraper(作者已隐去) | 近 30 天用户 | 计费单位 | Free 档每千页 | Business 档每千页 | 页里有没有 PAA |
|---|---|---|---|---|---|
| apify/google-search-scraper(官方) | 约 2.7 万 | 每页 | $4.50 | $1.80 | 有 |
| 第三方 A | 3,596 | 每页(最多 10 条) | $0.50 | $0.50 | 页面未写 |
| 第三方 B | 251 | 每个查询(含前 10 条),多出的每条另收 | $2.00 | $1.94 | 页面未写 |
| 第三方 C | 117 | 每页;PAA 要开整页附加项 | $0.60 | $0.40 | 附加项每千页 $5.50 |
| 第三方 D | 100 | 每页 + 每次运行 $0.001 | $6.00 | $6.00 | 有 |
| 第三方 E | 69 | 每条,乘 10 折成一页 | $3.50 | $3.50 | 页面未写 |
| 第三方 F | 43 | 每页 | $0.45 | $0.45 | 有,含相关搜索和广告 |
EveryInfra 搜索 web | — | 每次(一页) | $0.694 | $0.694 | 没有 |
这张表推翻了「我们比 Apify 便宜」这个笼统说法的一半。第三方 A 每千页 $0.50,近 30 天有 3,596 个用户、469 万次运行,规模不小;第三方 F 每千页 $0.45,而且一页里就带 People Also Ask、相关搜索、文字广告和购物广告,页面写明「platform usage is included, there is no start fee」(见参考资料 25)。这两家在单价上都比我们便宜,字段还比我们多。代价是:它们都是个人或小团队维护的 scraper。第三方 F 近 30 天只有 43 个用户,94,714 次运行里失败 24,841 次,占 26.2%,比官方 scraper 的 2.1% 高得多;第三方 A 的 469 万次运行几乎全部成功,但页面写着「Includes 100 free searches/month; an Apify paid plan is required to continue afterward」,用超过 100 次就必须有 Apify 付费套餐(至少每月 $19)。对每月几千页的用户来说,$19 的月费会把它们每千页 $0.50 的单价吃掉;对每月几十万页的用户,它们是真便宜。
核对这些价格时,我们发现 Store 页面的文字和公开接口的单价有三处对不上,记在这里供读者自查:第三方 D 的事件说明写「$1.50 per 1,000 pages」,同一事件的 eventPriceUsd 是 0.006,也就是每千页 $6.00;第三方 E 的标题写「only $0.25 per 1,000 results」,单价字段是每条 $0.00035,即每千条 $0.35;第三方 A 页面的对比表把官方 scraper 写成每千次 $3.50,那是 2025 年 6 月 10 日之前的价,现在 Free 档是 $4.50。真正扣钱的是接口里的单价字段,下单前以 Pricing 标签页为准。另外第三方 B 在 2026 年 11 月 4 日刚改过定价,从统一价改成按套餐分档(Free $0.002、Business $0.00194 每个查询),说明 Store 里的价格变动很频繁,本文的数只代表 11 月 6 日这一刻。
自己核价不需要 Apify 账号。把 Store 页面网址里的「作者/名字」换成「作者~名字」,拼到 api.apify.com/v2/acts/ 后面,用浏览器或 curl 打开,看 pricingInfos 数组的最后一条:startedAt 是这条价格开始生效的时间,pricingPerEvent 下面每个事件有 eventPriceUsd(统一价)或按档位分开的 tieredEventPriceUsd,isPrimaryEvent 为真的那个就是主收费事件。把单价乘以 1,000,再看事件说明里一次算一页还是一条,就能折成本文用的「每千页」。用这个办法,下单前花一分钟就能发现页面标题和实际扣费不一致的情况。
curl -s https://api.apify.com/v2/acts/apify~google-search-scraper \
  | jq '.data.pricingInfos[-1] | {startedAt, events: .pricingPerEvent.actorChargeEvents | map_values(.eventPriceUsd // .eventTieredPricingUsd)}'
三种常见用法,各算一笔账
把上面的单价放进真实的用法里,差距会变大或者变小。下面三种是我们最常被问到的,每一种都按 2026 年 11 月 6 日读到的公开价和本文实测价算,不含税。
第一种是 SEO 团队的排名监控:200 个关键词,每天查前 30 名(3 页),一个月按 30 天算是 18,000 页。在 Apify 官方 scraper 上,这个量超过了 Free 账号的 $5,要上 Starter 套餐,实付是 18,000 × $0.0025 = $45;如果还要每页的广告位,打开广告提取再加 18,000 × $0.005 = $90,合计 $135。用 EveryInfra,18,000 × $0.000694 = $12.50,没有广告位。前 30 名里有 15% 左右的重复网址(实测一的比例),做排名报告时要按网址去重,这一步两边都一样要做。这种用法里,如果客户要看的是「Google 在某个城市的排名」,Apify 的 UULE 定位是我们没有的,价格差 3.6 倍也得用它。
第二种是给 AI agent 做联网搜索:一个研究助手每天回答 300 个问题,每个问题搜 2 次、只看第 1 页,一个月 18,000 次。这里的关键不是单价,是一次调用能不能直接拿到结果。Apify 的 MCP 工具 call-actor 返回的是运行编号和存储编号,agent 要再调一次取数据集的工具;而且每次只搜一个词,也要起一次运行。EveryInfra 的 everyinfra_search 一次调用就回结果数组。价格上,Apify Starter 档 $45、我们 $12.50;如果这个助手每月只回答几十个问题,Apify 的免费额度就够了。
第三种是内容团队挖选题:200 个种子词,每个词要 People Also Ask 和相关搜索,每月跑一次,200 页。这个量 Apify Free 账号 $0.90 就够,一分钱不用付,而且字段齐全;我们这边自然结果加联想词是 400 次请求、$0.28,但拿不到 PAA。这种用法 Apify 更合适,没什么可争的。
| 用法 | 每月量 | Apify 官方 scraper | EveryInfra | 谁更合适 |
|---|---|---|---|---|
| 排名监控(200 词 × 前 30 名 × 30 天) | 18,000 页 | Starter $45;加广告位 $135 | $12.50(无广告位) | 只要自然结果选我们;要城市级或广告位选 Apify |
| AI agent 联网搜索(每天 600 次) | 18,000 次 | Starter $45,要两步取结果 | $12.50,一步拿结果 | 我们 |
| 内容选题(200 词,要 PAA) | 200 页 | Free 账号 $0 | $0.28(无 PAA) | Apify |
不用任何一家:自己写一个 Google 搜索爬虫要多少钱
联想词「google search scraper github」「google search scraper python」说明不少人在考虑自己写。开源工具不缺:Apify 自己开源的爬虫库 Crawlee 支持 Playwright、Puppeteer 和纯 HTTP 抓取,Node.js 和 Python 都有;调现成接口的话,Apify 的 Python 客户端和 n8n 节点也是开源的。难的不是写代码,是让它一直能跑:Google 从 2025 年 1 月起要求 JavaScript,纯 HTTP 请求拿不到结果页,要上无头浏览器;无头浏览器要内存,Apify 的文档写明每 4,096 MB 内存才分到一个完整 CPU 核(运行资源说明);还要处理 IP 被封,这就要代理(Apify 代理文档列了数据中心、住宅和 SERP 三类)。
代理是自建方案里最容易算的一块成本。Apify 自己卖专门抓 Google 结果页的 SERP 代理,Free 和 Starter 每 1,000 次请求 $2.50,Business $1.70(价格页),它的说明原文是代理「can only be used for Google Search and Shopping」,按请求数计费、返回的是结果页的原始 HTML(SERP 代理文档)。也就是说,光代理这一项每千页就要 $1.70 到 $2.50,和官方 scraper 同档的整页价格差不多(Starter 档两者都是 $2.50,Business 档 $1.70 对 $1.80),还没算解析 HTML、处理 /goto 跳转、应对 Nozzle 说的那种「假结果页」的人力。对每月几千页的个人项目,自己写可以当学习;超过这个量,现成的接口和 scraper 在成本和稳定性上都更划算。
接进 AI agent:两边的 MCP 怎么配
现在很多人找 Google 搜索 scraper,是为了给 AI agent 一个联网搜索工具。两边都有远程 MCP 服务,但交互方式差得不少。
Apify 的 MCP 服务地址是 mcp.apify.com,推荐用 OAuth 登录,也可以带 API token。默认加载 Actor 搜索、文档和两个网页工具;只想要 Google 搜索时,可以在地址后面加 ?tools=apify/google-search-scraper(Apify MCP 文档)。关键的一点在它的 call-actor 工具说明里:运行后最多等 waitSecs 0–45 秒,「Returns the run status and storage IDs, not the results themselves」,也就是说 agent 拿到的是运行状态和存储编号,还要再调一次工具去取数据集里的结果。
{
  "mcpServers": {
    "apify": { "url": "https://mcp.apify.com?tools=apify/google-search-scraper" },
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
EveryInfra 的 MCP 地址是 api.everyinfra.com/mcp,不带 Key 就能列工具:我们 00:22(新加坡时间)发 tools/list,回了 12 个工具,其中 everyinfra_search 就是本文测的搜索接口,tool 选 web、params 里放 q、location、page,一次调用直接返回结果数组和扣费,不用再取一次。agent 写错参数时拿到的是上面那种 422 和可用参数列表,能自己改。两边可以同时挂在一个客户端里:要 People Also Ask、AI 概览、城市级排名时让 agent 调 Apify,要便宜地多翻几页自然结果、或者顺手查 Reddit、YouTube 等其他平台时调我们。MCP 服务页有各客户端的配置写法,agent 怎么选搜索工具讲了几种搜索机制各自适合什么。
用 HTTP 直接调也很短。下面是本文实测一第 2 页那次请求的原样写法,Key 从环境变量读:
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"best running shoes for flat feet","location":"us","num":10,"page":2}}'
# 返回 results(最多 10 条:title, url, snippet, published)、location、billing.charged_usd
同样的事在 Apify 上,用它的同步接口(Apify API v2 的 Actor 运行部分)是一次 POST 到 /v2/acts/apify~google-search-scraper/run-sync-get-dataset-items,请求体里放 queries、maxPagesPerQuery、countryCode,可以加 maxTotalChargeUsd 封顶。两边都只要一个 HTTP 请求,差别在 Apify 一次请求里可以放很多个词、多页,适合批量;我们一次一页,适合按需。
从 Apify 换过来:参数和字段对照
如果你的代码已经在调 Apify 官方 scraper,只用它的自然结果,换过来要改的地方不多,但有几处名字不一样,照下面对一遍就行:
# Apify 输入 → EveryInfra 搜索接口 web 工具的参数
APIFY_TO_EVERYINFRA = {
    "queries": "q",                 # Apify 一次可多个词(换行分隔);我们一次一个词
    "maxPagesPerQuery": "page",     # Apify 写总页数;我们逐页调,page 从 1 开始
    "countryCode": "location",      # 两位国家代码直接用
    "site": "site",
    "afterDate": "after",
    "beforeDate": "before",
}
# 输出字段:organicResults[].title/url/description/date → results[].title/url/snippet/published
# position 没有单独字段,用数组下标 + (page-1)*10三个要注意的地方。第一,languageCode 和 searchLanguage 没有对应参数,传过来会被 422 拒绝(不扣钱),去掉即可。第二,peopleAlsoAsk、relatedQueries、paidResults 这几个字段在我们这边没有,原来依赖它们的代码要么保留 Apify、要么接受这一块空着。第三,Apify 的一条记录是一页,我们的一条记录是一条结果,存库的结构要从「页」改成「条」。
什么时候 Apify 更合适
把 Apify 更合适的情况照实列出来,每一条都有出处:
- 要 People Also Ask、相关搜索、广告位、AI 概览或 AI Mode:官方 scraper 一页都能给,附加项价格公开;我们没有这些字段。
- 要城市级别的本地排名:它支持 UULE 精确定位和界面语言、结果语言分开设置(输入定义);我们只到国家。
- 每月只要 1,000 页左右:Free 账号每月 $5 免费额度就够,$0 对我们的 $0.69。
- 要它的平台能力:可固定构建版本、避免新版本改字段(运行与构建),定时任务(每个账户最多 100 个,触发误差多数在一秒内,见调度文档)、数据集存储和导出(JSON、CSV、Excel 等,未命名数据集保留 7 天,见数据集文档和存储总览)、运行结束触发 Webhook(Webhook 文档)、n8n 社区节点(n8n 集成)。我们也有异步任务和 Webhook,但没有它那样的存储和调度面板。
- 要大批量自定义抓取:一次运行喂上千个词、顺手把每个结果页的正文抓下来做成 Markdown(它的结果页全文附加项),或者改写成自己的 actor;Apify 是一个能跑任意代码的平台,我们是固定的接口。
- 让 agent 不注册账号就付费:Apify 在 2026 年 10 月上线了实验性的 agent 付款,通过 x402 或 MPP 一次买一个有花费上限的临时 token,最低 $1、14 天过期(agent 付款文档);我们要先注册、充值。
反过来,我们更合适的情况是:只要自然结果、每月过 1 万页,想按次付费、没有月费;想在一个 Key 下同时调网页搜索和 Reddit、YouTube、小红书等 106 个平台的数据;让 agent 一次调用直接拿到结果;或者想让参数写错时直接报错而不是悄悄扣钱。
合规边界:Google 收紧之后,搜索结果更难稳定拿到
无论用哪家,有三件事要知道。第一,抓取越来越难:Google 从 2025 年 1 月起要求 JavaScript,2025 年 9 月停掉 num=100,2026 年 8 月起结果链接改走 google.com/goto 跳转,Search Engine Land 认为这几步一起让第三方 SEO 数据「更薄、和网站真实表现脱节」(原文),Apify 官方 scraper 的更新日志里也能看到 10 月 30 日、11 月 2 日对应的修补。第二,要防假数据:排名监控公司 Nozzle 测到,自 2026 年 9 月 13 日起它抓到的结果页有 8.0% 是「看起来正常、但结果被换掉」的页,之前只有 0.17%(PPC Land 报道);这对任何自动抓搜索结果的工具都成立,包括 Apify、包括我们,所以抓回来的结果要和历史数据比对,单次大幅波动先别下结论。第三,法律边界还在变:Google 2025 年 12 月起诉 SerpApi,法院 2026 年 7 月批准驳回但允许修改后再诉(卷宗和裁定见文末参考资料 39、40),这不说明哪种做法已经「合法」或「违法」;Apify README 的 FAQ 也提醒要考虑 Google 的服务条款。具体用途请咨询律师,本文不给法律意见。
最近的变化(2026 年 9–11 月)
- 2026 年 11 月 4 日,Store 里一个第三方作者的 Google 搜索 scraper(上表的第三方 B)改成按套餐分档定价。意味着:Store 里的价格一周内就可能变,比价要以下单当天的 Pricing 标签页为准。
- 2026 年 11 月 2 日,Apify 官方 scraper 发布 0.0.476 版,
/goto跳转链接还原更可靠;2026 年 10 月 30 日修了site:查询丢结果;2026 年 10 月 26 日起支持短视频标签页(udm=39),AI 概览改为全文逐行输出。意味着:官方 scraper 在跟着 Google 的改动修,用它的人要关注字段变化。 - 2026 年 10 月 15 日,Google 宣布 AI Mode 和 AI 概览加入更多行内链接和来源说明(Google 博客)。意味着:结果页上 AI 部分的链接会变多,只抓自然结果的工具会漏掉一部分来源,这正是 Apify 收附加费的那一块。
- 2026 年 10 月 7 日,Apify 官方 scraper 把每次运行 $0.001 的启动费换成平台统一的每 GB $0.00005。意味着:小批量多次运行的成本降了,但主事件单价没变。
- 2026 年 10 月 8 日前后,Apify 发布 agent 付款文档(x402、MPP),agent 可以不注册账号买临时 token。意味着:Apify 在争取「AI agent 直接付费调用」这类用户。
- 2026 年 9 月 13 日起,Nozzle 测到 Google 给排名监控工具返回被替换的结果页,比例 8.0%;Search Engine Roundtable 在 2026 年 10 月 12 日报道后,几家排名工具厂商发了声明。意味着:任何搜索结果数据都要做历史比对。
- 另一个时间点要记:Google 的 Custom Search JSON API 已不对新客户开放,现有客户要在 2027 年 1 月 1 日前迁走,它的价格是每天 100 次免费、之后每千次 $5(官方文档)。微软的 Bing Search API 已在 2025 年 8 月 11 日退役(微软公告)。官方搜索接口在收缩,这是 Store 里 Google 搜索 scraper 越来越多的背景。
我们怎么核对这些数
Apify 的每一个价格都来自公开接口的原始返回:官方 scraper 读 api.apify.com/v2/acts/apify~google-search-scraper,第三方读 Store 搜索接口和各自的 acts 接口,读取时间是 2026 年 11 月 6 日 00:17(新加坡时间);「当前价」取 pricingInfos 里生效时间早于读取时刻的最后一条。Store 页面文字和接口单价不一致时,以接口单价为准,并在正文写出不一致。我们没有登录 Apify、没有跑任何 actor,所以 Apify 的速度、重复率、空结果是否收费都没有实测值,正文写作「未写明」或「对方说法」。
EveryInfra 的数来自 18 次真调,2026 年 11 月 6 日 00:14:23 到 00:17:20(新加坡时间),用同一把测试 Key:15 次返回结果并扣费,合计 $0.011105(13 次搜索 web、1 次联想词各 $0.000694,1 次 web/search $0.001389);1 次空结果退款、1 次 422、1 次 401,都是 $0。每千页、每千条、重复率、中位耗时都由脚本从原始响应现算。边界:翻页实测只用了一个英文词,重复率会随词变化;耗时是新加坡客户端的数,离服务器远的地区会更慢;Store 价格变动频繁,本文的数只代表读取那一刻。Apify 的价格怎么叠讲 Apify 的月费、按事件和代理费,网页搜索产品页有我们网页搜索的完整参数;本文只比 Apify 的 Google 搜索 scraper 这一个工具,不重复那几篇的内容。
上手:从一次试用到每天自动跑
第一步,在市场页的网页搜索分类里找到「网页检索」,不用写代码就能填一个词试一次,看返回的结构;或者看网页搜索产品页。第二步,按快速上手注册拿 Key,在 GitHub 给两个仓库点星可领 $1 试用额度(24 小时内有效),够跑约 1,440 次搜索。第三步,把上面那段 curl 或 MCP 配置放进你的脚本或 AI 客户端,每天定时跑一轮关键词。如果你同时要别的搜索入口,目录里还有 bing/search、duckduckgo/search、google_news/search 这几项能力,分别在 Bing、DuckDuckGo、Google 新闻平台页上;数据接口的网页搜索是 web/search,在网页搜索平台页。想看其他替代方案的横向比较,见替代方案总览和 Apify 替代方案。
常见问题
Apify Google Search Scraper 多少钱?
按结果页计费。2026 年 11 月 6 日读到的公开价:Free 档每 1,000 页 $4.50,Starter(月费 $19)$2.50,Scale($199)$1.95,Business($999)$1.80,企业的 Platinum、Diamond 档 $1.50、$1.20;每次运行另有 $0.00005 的启动费。打开广告提取、AI 概览、AI Mode 等附加项另收。Free 账号每月 $5 额度约够 1,111 页。(问题来自联想词「apify google search scraper」,价格见 Pricing 标签页。)
Apify Google Search Results Scraper 能抓 People Also Ask 和相关搜索吗?
能。官方 scraper 的输出里有 peopleAlsoAsk 和 relatedQueries,不另收费,包含在每页的价格里。EveryInfra 的网页搜索没有这两个字段,最接近的是联想词工具 suggest,但那是输入框补全,不是结果页的相关问题。(问题来自联想词「apify google search results scraper」;Store 里另一个第三方作者的同类 scraper,标题就写着「Organic SERP, PAA & Related」。)
有免费的 google search scraper 吗?
有几种:Apify Free 账号每月 $5 额度,按官方 scraper 约 1,111 页;Store 里的第三方 A 每月 100 次免费(之后要 Apify 付费套餐);Google 的 Custom Search JSON API 每天 100 次免费,但已不收新客户、2027 年 1 月 1 日停止;自己用开源库写爬虫不要钱,但要自己处理 JavaScript 渲染和封锁。EveryInfra 的试用是 $1、24 小时。(问题来自联想词「google search scraper free」。)
google search scraper api 怎么调?
Apify 用同步接口 run-sync-get-dataset-items,一次 POST 带上 queries 和页数,等运行结束直接拿结果;EveryInfra 用 POST /api/v1/search,tool 填 web,一次一页,正文里有完整的 curl。两边都要 Key,都返回 JSON。(问题来自联想词「google search scraper api」。)
google search scraper python 怎么写?
如果只是调接口,Python 里用 requests 发一个 POST 就够了,结构和上面的 curl 一样;Apify 有官方的 Python 客户端,适合批量启动运行、读数据集。自己从零写抓 Google 结果页的 Python 爬虫,2025 年以后要处理 JavaScript 渲染、跳转链接还原和频繁的封锁,维护成本高,这也是多数人转向现成工具的原因。(问题来自联想词「google search scraper python」。)
抓 Google 搜索结果合法吗?
本文不给法律意见。可以确定的事实是:Apify README 的 FAQ 写的是抓公开数据一般合法,但要尊重个人数据和知识产权、并考虑 Google 的服务条款;Google 2025 年 12 月起诉 SerpApi 的案子在 2026 年 7 月被驳回、但允许修改再诉。具体用途请咨询律师。(问题来自联想词「google search result scraping」和 Apify README 的 FAQ 标题「Is it legal to scrape Google Search data?」。)
Apify 好用吗、安全吗?
从公开数据看,官方 Google 搜索 scraper 有 218 条评价、平均 4.65 分,近 30 天 928 万次运行、成功率 97.9%;平台在 MCP 服务里默认排除需要完整权限的 actor,权限分两级的说明见权限文档。要注意的是 Free 档附加项价格很高(AI 类每次 $0.20),先设好花费上限再试。(问题来自联想词「is apify good reddit」「is apify safe」;数据见公开接口和 MCP 文档。)
参考资料
- Google Search Results Scraper 公开元数据(pricingInfos、stats),Apify,读取于 2026-11-06
- Google Search Results Scraper Store 页面与 README,Apify,读取于 2026-11-06
- Google Search Results Scraper Pricing 标签页,Apify,读取于 2026-11-06
- Google Search Results Scraper 输入定义,Apify,读取于 2026-11-06
- Google Search Results Scraper 更新日志,Apify,2026-11-02
- 公开构建 0.0.476(含输入定义、README、更新日志),Apify,2026-11-02
- Apify pricing,Apify,读取于 2026-11-06
- Actors in Store,Apify 文档,读取于 2026-11-06
- Actor pricing and costs,Apify 文档,读取于 2026-11-06
- Run Actor synchronously and get dataset items,Apify API 文档,读取于 2026-11-06
- Apify MCP server,Apify 文档,读取于 2026-11-06
- Apify MCP server 配置器,Apify,读取于 2026-11-06
- apify-mcp-server 源码,GitHub,读取于 2026-11-06
- Let your AI agent pay for Actor runs,Apify 文档,2026-10-08
- Actor and task schedules,Apify 文档,读取于 2026-11-06
- Dataset,Apify 文档,读取于 2026-11-06
- Webhook integration,Apify 文档,读取于 2026-11-06
- n8n integration,Apify 文档,读取于 2026-11-06
- Limits,Apify 文档,读取于 2026-11-06
- Actor usage and resources,Apify 文档,读取于 2026-11-06
- Google SERP proxy,Apify 文档,读取于 2026-11-06
- Store 搜索接口:google search results scraper,Apify,读取于 2026-11-06
- 第三方 A:Google Search Results (SERP) Scraper 的 Store 页面,Apify Store,读取于 2026-11-06
- 第三方 A 公开元数据,Apify,读取于 2026-11-06
- 第三方 F:Google Search Results Scraper & SERP API 的 Store 页面,Apify Store,读取于 2026-11-06
- 第三方 B:Google Search Results Scraper (SERP) 的 Store 页面,Apify Store,读取于 2026-11-06
- 第三方 B 公开元数据(2026-11-04 新定价),Apify,读取于 2026-11-06
- 第三方 C:Google Search Results Scraper 的 Store 页面,Apify Store,读取于 2026-11-06
- 第三方 D:Google Search Results Scraper 的 Store 页面,Apify Store,读取于 2026-11-06
- 另一个第三方 Google Search Scraper(标题含「Organic SERP, PAA & Related」)的 Store 页面,Apify Store,读取于 2026-11-06
- EveryInfra 搜索工具目录,EveryInfra,读取于 2026-11-06
- EveryInfra 能力目录,EveryInfra,读取于 2026-11-06
- EveryInfra OpenAPI,EveryInfra,读取于 2026-11-06
- Model Context Protocol 规范 2025-06-18,MCP,2025-06-18
- Custom Search JSON API,Google for Developers,2026-02-18 更新
- Visual Elements Gallery of Google Search,Google Search Central,读取于 2026-11-06
- Google 服务条款,Google,读取于 2026-11-06
- Bing Search APIs Retiring on August 11, 2025,Microsoft Learn,读取于 2026-11-06
- Google LLC v. SerpApi, LLC 卷宗,CourtListener,2025-12-19 起
- Google LLC v. SerpApi LLC 驳回裁定,FindLaw 转载法院原文,2026-07-20
- Why we're taking legal action against SerpApi,Google,2025-12-19
- More ways to connect with the web from Search,Google,2026-10-15
- Google is making third-party SEO data harder to trust,Search Engine Land,2026-09-24
- 77% of sites lost keyword visibility after Google removed num=100,Search Engine Land,2025-09-18
- Google feeds rank trackers swapped results on 8% of pages, Nozzle finds,PPC Land,2026-10-19
- Crawlee 源码,GitHub,读取于 2026-11-06
- apify-client-python 源码,GitHub,读取于 2026-11-06
- n8n-nodes-apify 源码,GitHub,读取于 2026-11-06
- RFC 9110 HTTP Semantics,422 Unprocessable Content,IETF,2022-06
- Actor permissions,Apify 文档,读取于 2026-11-06
- Storage,Apify 文档,读取于 2026-11-06
- Actor runs and builds,Apify 文档,读取于 2026-11-06
- Apify API v2,Apify 文档,版本 2026-11-04
- Robots.txt Introduction and Guide,Google Search Central,读取于 2026-11-06
- Proxy,Apify 文档,读取于 2026-11-06
引用编号 BL-99