How to scrape TikTok comments: tres métodos probados (sin código, Python y API) y un script para exportar a CSV
Cómo extraer comentarios de TikTok de tres formas: costos reales de 10,000 comentarios, el límite de 200 por video y un script de Python para CSV.
Para reunir 10,000 comentarios de TikTok, el scraper de comentarios más usado de Apify Store cuesta entre $5.00 y $12.50 según su precio público por comentario, y el scraper de terceros más barato de la Store cuesta $2.50. El 7 de noviembre de 2026 llamamos a tiktok/comments de EveryInfra con videos reales: una llamada devolvió 200 comentarios por $0.000556, así que 50 videos con 200 comentarios cada uno cuestan $0.028. Con los hilos de respuestas, la eliminación de duplicados y el CSV final, el costo medido fue de $0.0114 por cada 1,000 filas, unos $0.11 por 10,000.
Hay un límite que no se puede saltar: devolvemos como máximo 200 comentarios principales por video. Si necesitas 10,000 comentarios de un solo video viral, no podemos dártelos; para ese trabajo conviene Apify o la API oficial de investigación de TikTok. Las pruebas también dejaron tres datos que no encontramos en otras guías. Dos lecturas del mismo video con 75 segundos de diferencia compartían solo 183 de 200 identificadores. Las respuestas que vienen incluidas con cada comentario cubrían solo el 47 % de las respuestas que esos comentarios declaraban, y la paginación de respuestas recuperó 106 de 107 en 9 hilos. Y el 14 % de los comentarios de un video de cuidado de la piel no tenía texto: eran comentarios con foto o sticker.
Esta es una guía práctica. Primero explica las tres rutas (herramientas sin código, tu propio scraper en Python y una API), con sus pasos y sus puntos débiles. Después da un script completo de Python que pagina comentarios y respuestas, quita duplicados y escribe un CSV que Excel abre bien, también con la configuración regional de España o Argentina. Al final compara costo y tiempo con un mismo escenario: 10,000 comentarios. La comparación de precios de todos los datos de TikTok contra Apify ya está en nuestro artículo alternativa a Apify TikTok Scraper; aquí no repetimos esa tabla.
Cómo medimos
Todos los «precios por 1,000» de este artículo salen de la misma fórmula: lo que una llamada cobró de verdad, dividido entre las filas que esa llamada devolvió de verdad, por 1,000. El divisor es el número real de filas, no el limit de la solicitud; si una llamada devuelve menos filas, nuestro precio unitario sube.
De las otras herramientas usamos solo material público: la página de la Store, la página de precios, la documentación y endpoints públicos que no piden cuenta. No abrimos cuenta en Apify ni en ninguna extensión, ni compramos sus servicios, así que sus cifras aquí son precios unitarios públicos, no facturas medidas. Cada número de EveryInfra remite a una respuesta original que guardamos. Las horas están en hora de Singapur (SGT, UTC+8) salvo que se indique otra cosa.
Qué contiene un comentario de TikTok: comentarios, respuestas y respuestas a respuestas
Antes de extraer nada, conviene definir qué quieres. La sección de comentarios de TikTok es un árbol de dos niveles y medio: bajo el video están los comentarios principales; bajo cada uno, sus respuestas; y una respuesta puede mencionar a otra respuesta, lo que crea una «respuesta a una respuesta». En la página, todas siguen al mismo nivel bajo el comentario principal, sin otra sangría.
La API de investigación de TikTok lo deja claro: con video_id obtienes los comentarios de un video y con comment_id las respuestas de un comentario, pero no puedes usar los dos en la misma consulta (Query Video Comments). Por eso, con cualquier herramienta, «extraer comentarios» son dos tareas: primero los comentarios principales y después, uno por uno, los que tienen respuestas. Muchas herramientas hacen solo la primera, o la segunda a medias, y es lo que más se pasa por alto al comparar precios.
Los comentarios, además, tienen cada vez menos texto. El 2026-09-03 TikTok anunció comentarios de voz, encuestas, carruseles de hasta 9 fotos y comentarios con Live Photos, y dio una cifra de más de 1,700 millones de comentarios al día (TikTok Newsroom). Para quien analiza datos, eso significa más filas con texto vacío. El 2026-05-25 un usuario de TikTokApi informó que los comentarios con sticker solo devuelven el marcador [Sticker] (issue #1303).
La tabla resume los campos que devuelven los dos endpoints de comentarios de EveryInfra, junto a los de la API de investigación. El catálogo es público y no necesita clave (catálogo de endpoints, consultado a las 00:13 hora de Singapur del 2026-11-07).
| Campo | `tiktok/comments` | `tiktok/comment_replies` | API de investigación de TikTok | Nota |
|---|---|---|---|---|
| ID del comentario | id | id | id | Sirve para deduplicar y armar el árbol |
| Texto | text | text | text | Puede venir vacío en comentarios de sticker o voz |
| Me gusta | like_count | like_count | like_count | |
| Número de respuestas | reply_count (solo principales) | no | reply_count | Total que declara el comentario |
| Es respuesta | is_reply | is_reply | según parent_comment_id | |
| Comentario padre | reply_to_id | reply_to_id | parent_comment_id | |
| Respuesta a la que contesta | no | reply_to_reply_id | no | Solo en respuestas a respuestas |
| Autor | author_username, author_id | además author_name, author_url, author_avatar_url | display_name (solo en respuestas) | Datos públicos; conviene enmascararlos |
| Me gusta o fijado por el creador | liked_by_author, pinned_by_author | liked_by_author | no | |
| Idioma | no | language | no | |
| Fecha | posted_at (ISO 8601) | posted_at | create_time (segundos Unix) | |
| Paginación | no, máximo 200 por llamada | next_page_token, 20 por página | cursor, has_more, 100 por llamada |
How to scrape TikTok comments: las tres rutas de un vistazo
Si buscas «how to scrape tiktok comments», los primeros resultados son de tres tipos: páginas de scrapers en Apify Store, hilos de Reddit y GitHub, y tutoriales de Python en video. Corresponden a tres rutas: usar una herramienta hecha, escribir Python contra la web de TikTok o llamar a una API que ya devuelve filas limpias. Además del precio, cambian el máximo por video, la cobertura de respuestas, si hace falta iniciar sesión en TikTok y quién resuelve los errores.
| Ruta | Ejemplo | Pasos para empezar | Máximo por video | Respuestas | Cuenta o sesión | Por 1,000 (público o medido) |
|---|---|---|---|---|---|---|
| Extensión del navegador | Una extensión de exportación de comentarios de Chrome Web Store | Instalar, registrarse, pegar enlace, exportar | 200 gratis; más en el plan de pago | Sí | Cuenta de la extensión y tu propio navegador | El precio de pago solo aparece dentro de la extensión |
| Servicio web de exportación | Un sitio de exportación de comentarios con planes por niveles | Pegar enlace, exportar | 100 gratis; planes de pago de 5,000 a 250,000 | Sí | El plan gratuito no pide registro | La tabla de precios carga por script; no la pudimos leer |
| Scraper en la nube | Apify TikTok Comments Scraper | Registrarse, indicar enlaces y cantidades, ejecutar, exportar | Según commentsPerPost | Según maxRepliesPerComment | Cuenta de Apify | $1.25 (Free) a $0.50 (Business) |
| Librería de Python | TikTokApi 7.3.3 | Instalar, añadir Playwright, copiar ms_token, programar | En teoría pagina; en la práctica la bloquean a menudo | Tiene método; no lo probamos | ms_token de tu navegador | Software gratis; proxies y tiempo aparte; no probado |
| API oficial de investigación | TikTok Research API | Solicitar, esperar unas 4 semanas, obtener token | 100 por llamada, con cursor | Sí | Solo investigación académica y sin fines de lucro aprobada | Gratis, 1,000 solicitudes al día |
| API de datos | EveryInfra tiktok/comments + tiktok/comment_replies | Obtener clave, enviar un POST | 200 principales por llamada, sin paginación | 20 por página, hasta el final | Solo clave de API | Medido: $0.0028 (comentarios), $0.0278 (respuestas) |
La columna clave es «máximo por video». Si necesitas todos los comentarios de un video viral, decenas de miles, ni las extensiones gratuitas ni nuestra API alcanzan: las extensiones se quedan en 100 o 200, y tiktok/comments no tiene parámetro de paginación (en el artículo de alternativa a Apify TikTok Scraper comprobamos que cursor devuelve un error 422). Para eso sirve un scraper en la nube que cobre por elemento y pagine hasta el final, como Apify, o la API de investigación.
Si en cambio necesitas los primeros cientos de comentarios de decenas o cientos de videos, por ejemplo para revisar cada semana qué dice la audiencia de los videos nuevos de un competidor, una API que cobra por llamada sale a fracciones de centavo por 1,000 comentarios: dos o tres órdenes de magnitud menos. Decide cuál es tu caso antes de seguir.
Ruta 1: herramientas sin código, de las extensiones al TikTok Comments Scraper de Apify
Hay dos tipos. Unas funcionan en tu navegador y leen la página que tienes abierta; otras funcionan en servidores de otra empresa y solo les das un enlace.
Una extensión de Chrome Web Store dedicada a exportar comentarios de TikTok es el ejemplo típico: instalas, creas cuenta, pegas el enlace y exportas CSV o XLSX. El plan gratuito llega a 200 comentarios y el precio del plan de pago solo aparece dentro de la extensión; la ficha dice que los datos se procesan en tu equipo. Leímos la versión 2.3.1, actualizada el 2026-11-04 (ficha de Chrome Web Store, leída el 2026-11-07). Recorre la página con tu propia sesión de TikTok, así que cada video exige una pestaña abierta y pegar el enlace a mano.
Un sitio de exportación de comentarios con planes por niveles es el servicio web típico. Sin registro da 100 comentarios por video; Personal da 5,000, Premium 50,000 y Business 250,000. El CSV empieza en Personal y una columna reply_to marca las respuestas. Según su página de niveles de la API, la API existe solo en Premium y Business. Su tabla de precios se carga por script y el 2026-11-07 no pudimos leer los importes, así que damos sus límites de filas pero no sus precios.
El scraper en la nube de referencia es el TikTok Comments Scraper de Clockworks en Apify Store. Abres este actor (así llama Apify a sus programas de extracción en la nube), indicas enlaces, commentsPerPost y maxRepliesPerComment, lo ejecutas y exportas el conjunto de datos a CSV, JSON o Excel. Un video borrado o privado genera un registro de error como POST_NOT_FOUND_OR_PRIVATE, no un salto silencioso. Como API, el endpoint de ejecución síncrona devuelve CSV con format=csv, y maxTotalChargeUsd pone un tope al costo de cada ejecución (Run Actor synchronously and get dataset items).
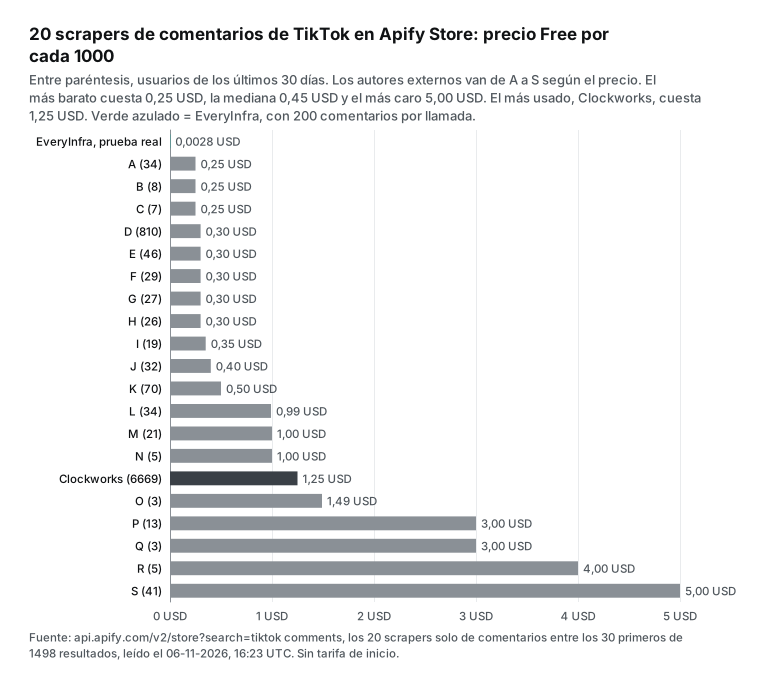
A las 00:16 hora de Singapur del 2026-11-07 leímos los metadatos públicos del actor, que no piden cuenta (endpoint público de Apify). Cobra por evento desde el 2026-03-18 y el único evento es comment, un comentario en el conjunto de datos. Por 1,000 comentarios, los seis niveles cuestan FREE $1.25, BRONZE $1.00, SILVER $0.75, GOLD $0.50, PLATINUM $0.30 y DIAMOND $0.15.
| Nivel de Apify | Plan | Cuota mensual | Por 1,000 comentarios | 10,000 comentarios |
|---|---|---|---|---|
| FREE | Free | $0, con $5 de uso | $1.25 | $12.50 |
| BRONZE | Starter | $19 | $1.00 | $10.00 |
| SILVER | Scale | $199 | $0.75 | $7.50 |
| GOLD | Business | $999 | $0.50 | $5.00 |
| PLATINUM, DIAMOND | Empresa | por contrato | $0.30, $0.15 | $3.00, $1.50 |
Planes y niveles salen de la página de precios de Apify y de Actor pricing and costs. Cada plan incluye el mismo importe en uso prepagado, que caduca a fin de mes. Un aviso: las preguntas frecuentes de la misma página de la Store todavía dicen «$5 por 1,000 resultados» y recomiendan un plan Starter de $29 (página de la Store, leída el 2026-11-07). Ya lo señalamos el 2026-10-27 y sigue igual: para facturar, fíate de la pestaña Pricing y del campo pricingInfos, no de ese texto.
Es un actor muy usado: 52,805 usuarios en total y 6,662 en los últimos 30 días. En ese periodo se ejecutó 2,831,602 veces y 2,821,904 ejecuciones terminaron bien, un 99.66 %; tiene 97 reseñas con una media de 4.73. Por eso encabeza la búsqueda «tiktok comments scraper» y por eso lo usamos como referencia.
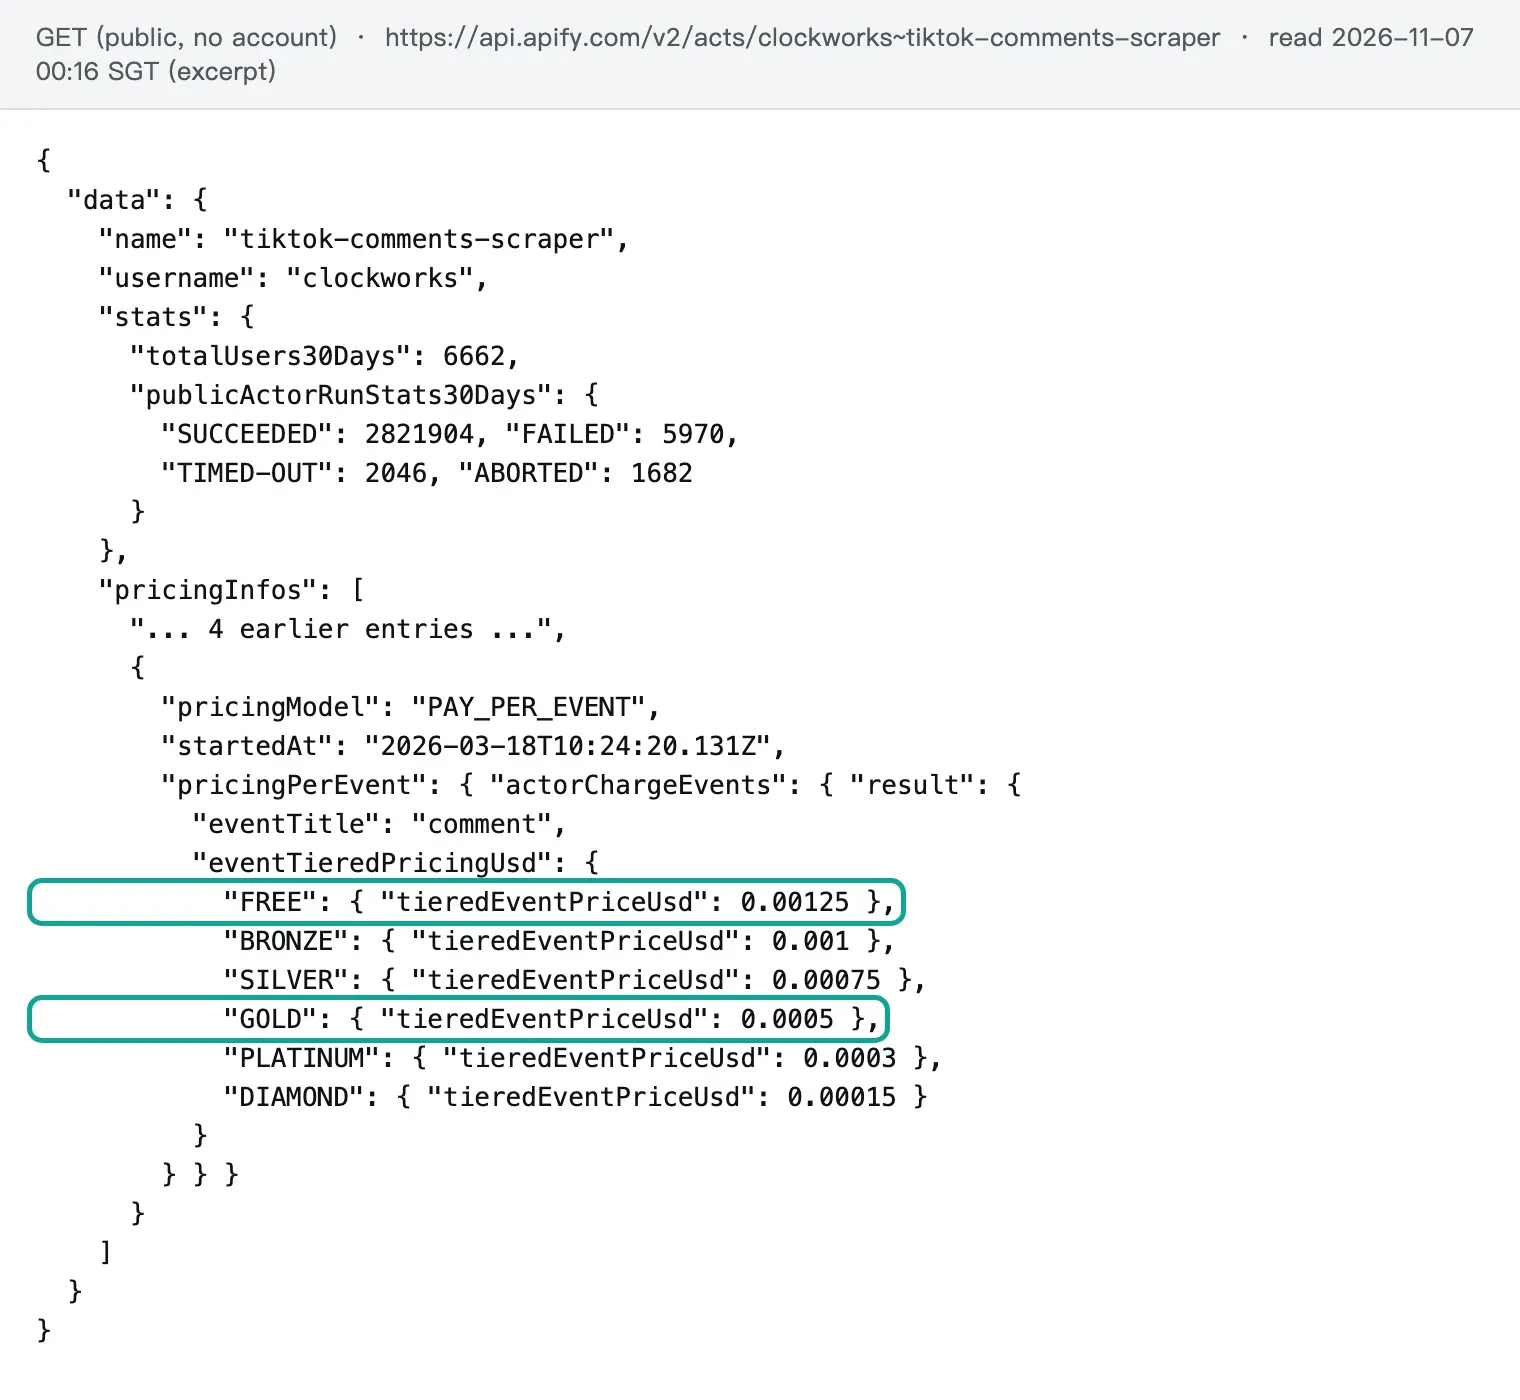
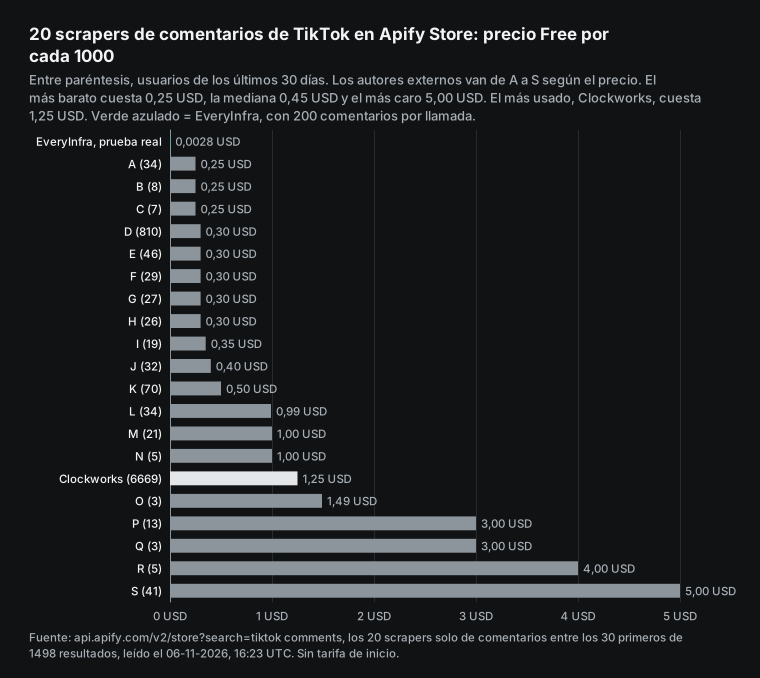
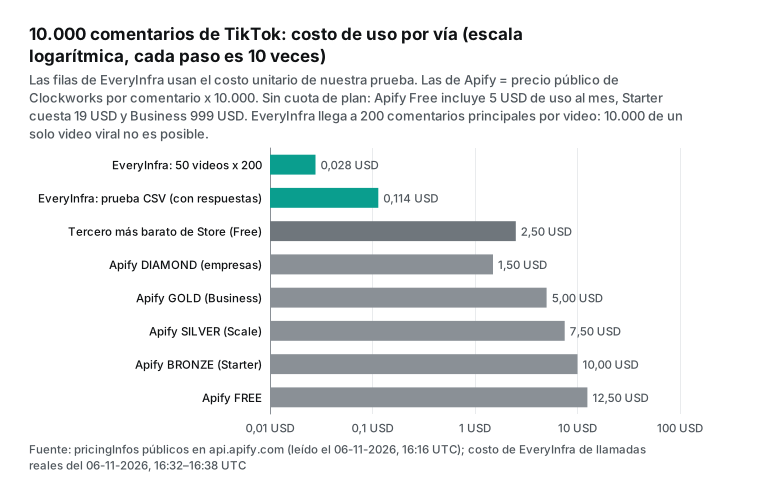
Clockworks no es la única opción. La búsqueda pública de la Store para «tiktok comments» dio 1,498 resultados (endpoint de búsqueda de la Store, leído a las 00:23 hora de Singapur del 2026-11-07). Entre los 30 primeros, 20 extraen solo comentarios de TikTok; en el plan Free cuestan de $0.25 a $5.00 por 1,000, con una mediana de $0.45, y algunos suman una tarifa de arranque de hasta $0.01 por ejecución. Uno dice «$0.25/1000 results» en el título, pero su precio público es de $5 por 1,000. El gráfico ordena los 20 por precio y nombra a los autores externos de la A a la S.
Ruta 2: scraping TikTok comments with Python, y si las librerías abiertas siguen funcionando
«Scraping tiktok comments python» es una búsqueda muy común, con una necesidad sencilla: nada de pagar por elemento, solo un script corto. Revisamos los tres proyectos más recomendados. Pueden funcionar, pero el costo es el mantenimiento, no el dinero.
| Proyecto | Versión o último push | Estrellas | Comentarios | Estado |
|---|---|---|---|---|
| TikTokApi | 7.3.3 en PyPI, 2026-04-01; push 2026-08-24 | 6,733 | comments(count, cursor), 20 por solicitud | Pide Playwright y ms_token; incidencias abiertas |
| yt-dlp | 2026.10.26 | no contadas | Solo el número de comentarios | Petición cerrada en 2022 |
| cubernetes/TikTokCommentScraper | push 2023-08-05 | 212 | Desplazamiento en el navegador | Sin cambios desde hace dos años |
TikTokApi es el envoltorio no oficial de Python más conocido (PyPI, repositorio en GitHub, leídos el 2026-11-07). Su objeto de video llama a la ruta /api/comment/list/ de la web de TikTok y pagina con cursor. Para usarlo hay que ejecutar pip install TikTokApi y python -m playwright install (instalación de Playwright), y copiar la cookie ms_token de tu navegador. El README avisa que un EmptyResponseException significa que TikTok te bloquea como bot y que quizá necesites un proxy. El 2025-08-28 un usuario informó que la extracción de comentarios no funcionaba (issue #1255) y el 2026-07-18 otro reportó respuestas vacías (issue #1311); las dos siguen abiertas.
Mucha gente espera que yt-dlp extraiga comentarios con --write-comments. Leímos su extractor de TikTok (tiktok.py, 1,749 líneas, leído el 2026-11-07): solo toma comment_count y no tiene ninguna función para el texto. La petición de 2022 para añadirlo está cerrada (issue #5037) y la última versión es la 2026.10.26 (página de la versión). Descarga videos de TikTok, pero no sus comentarios.
Los proyectos pequeños de GitHub llamados «TikTok comment scraper» están casi todos parados. Además de cubernetes, xtekky/TikTok-Comment-Scraper tiene 56 estrellas y su último push fue el 2023-12-02; RomySaputraSihananda/tiktok-comment-scrapper tiene 63 y el último fue el 2025-12-08 (cubernetes, xtekky, RomySaputraSihananda). El autor de cubernetes explicó en Reddit que su método de desplazamiento sirve para miles de comentarios, no para decenas de miles (hilo en r/webscraping).
¿Por qué cuesta tanto mantener un scraper propio? La solicitud web de comentarios de TikTok lleva parámetros de firma y cookies que calculan los scripts de la página; cuando esos scripts cambian, los parámetros dejan de valer. No explicamos cómo saltarlos. La sección 3.4 de los Términos de Servicio de TikTok en EE. UU. prohíbe la extracción automatizada sin aprobación por escrito (Términos de Servicio de TikTok, EE. UU., actualizados el 2026-07-15). Además, en octubre de 2026 dos tribunales de EE. UU. se negaron a archivar demandas por eludir medidas antiscraping (MediaPost; hay un análisis jurídico en las referencias).
No es asesoría legal; solo muestra que saltarse la firma exige trabajo constante y suma riesgo jurídico. Los comentarios exportados llevan nombres de usuario, así que trátalos como datos personales, como explica la sección de cumplimiento. No probamos TikTokApi nosotros porque necesita la cookie de una sesión real de TikTok. El script de más abajo usa Python solo para llamar a una API, paginar, deduplicar y escribir el CSV.
Ruta 3: una TikTok comments scraper API, y cómo se combinan sus dos endpoints
La tercera ruta llama a una API que ya convierte los comentarios en filas estructuradas. EveryInfra separa los comentarios de TikTok en dos endpoints. Ambos usan POST https://api.everyinfra.com/api/v1/social y cuestan $0.000556 por llamada (catálogo de endpoints, consultado a las 00:13 hora de Singapur del 2026-11-07). También puedes ver la página del endpoint de comentarios y la de respuestas a comentarios.
tiktok/comments obtiene los comentarios de un video. Solo exige url, el enlace del video; limit es opcional, vale 20 por defecto y como máximo 200. El catálogo indica que cada comentario principal trae como mucho dos respuestas y que no garantiza el árbol completo. Una llamada devuelve todo el lote y no hay parámetro de paginación, así que un video da como máximo 200 filas por esta vía.
tiktok/comment_replies obtiene las respuestas de un comentario. Exige url y comment_id (el id de un comentario principal del endpoint anterior); el page_token opcional recibe el next_page_token de la página previa, y sin él obtienes la primera. Cada página trae como máximo 20 respuestas, cuenta como una llamada y el token vale 24 horas; limit no tiene efecto aquí. Así se cubre el hueco de «dos respuestas por comentario»: con tiktok/comments encuentras los comentarios con muchas respuestas y con tiktok/comment_replies las recorres.
La solicitud más simple es esta:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"tiktok","action":"comments","params":{"url":"https://www.tiktok.com/@<creador>/video/<id_del_video>","limit":200}}'
En la respuesta, results es la lista de comentarios y billing.charged_usd lo que se cobró. Las llamadas fallidas y los resultados vacíos no se cobran: en ese caso billing.charged es false, charged_usd es 0 y billing.reason explica el motivo. Tu script debe manejar dos casos de límite. Cada clave tiene un límite por minuto y, si lo superas, recibes un 429 con retry_after en segundos. Si el servicio no está disponible un momento, recibes un 503 o un 429 con retryable en true y también retry_after. Para solicitudes lentas puedes añadir "mode":"async" y consultar el resultado después con el job_id.
Prueba 1: qué hay en 200 comentarios de un video con 1.2 millones de reproducciones
El video de prueba es uno de cuidado de la piel publicado el 2026-09-25. A las 00:15 hora de Singapur del 7 de noviembre era el de más comentarios en una búsqueda tiktok/search de «skincare routine»: 1,238,029 reproducciones y 1,116 comentarios declarados. La creadora es una persona particular, así que solo damos el ID: 7689447084436573472. Su cifra de comentarios supera por poco los 1,000, lo que permite ver qué 200 devuelve una llamada.
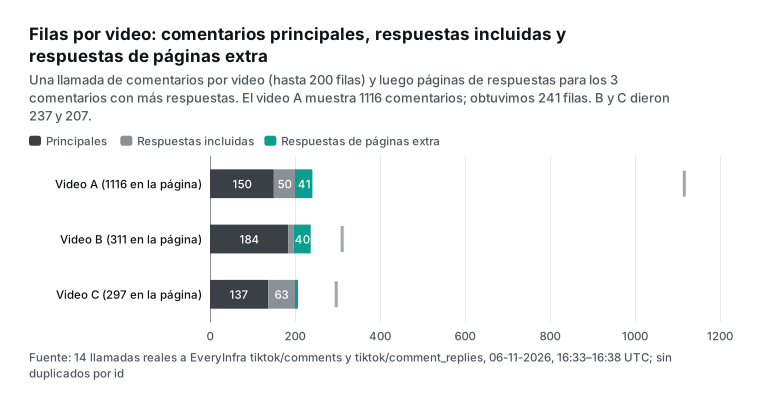
Tras una racha de fallos, la llamada de las 00:32:41 hora de Singapur funcionó en 36.71 segundos: 200 filas por $0.000556, es decir, $0.0028 por 1,000. Había 154 comentarios principales y 46 respuestas incluidas. Los 34 comentarios principales con respuestas declaraban 97 en total, así que las incluidas cubrían el 47 %. Ocho hilos tenían más de 2 respuestas y necesitaban paginación.
Cuatro comentarios no tenían texto, porque TikTok permite comentarios solo con foto o sticker. La creadora dio me gusta a 19 comentarios y ninguno estaba fijado. Las fechas iban del 2026-09-25 al 2026-11-06 y el orden no era estrictamente por me gusta: el primero tenía 1,667, el segundo 0 y el séptimo 1,316. Coincide con el orden por defecto de la app, que mezcla comentarios populares y recientes; la mediana de me gusta era 1. Si te interesan «los comentarios nuevos de esta semana», filtra tú por posted_at.
A las 00:33:56 hora de Singapur, el script del CSV volvió a leer el mismo video, 75 segundos después. También obtuvo 200 filas, pero solo 183 identificadores coincidían. La clasificación está viva: entran comentarios y cambian los me gusta, así que los 200 primeros cambian. Al combinar lecturas, deduplica por id, no por posición.
Para medir el cambio, leímos el video una tercera vez a la 01:06 hora de Singapur, 33 minutos después de la primera: 200 filas en 89.56 segundos por $0.000556. Compartía 169 identificadores con la lectura de las 00:32 y 167 con la de las 00:33, y entre las tres sumaron 243 comentarios distintos. En las tres, el comentario más reciente era de las 14:42 UTC del 6 de noviembre: en esa media hora no entró ningún comentario nuevo entre los 200 primeros y las 31 filas que cambiaron se deben solo a la reordenación. Repetir lecturas es una forma de reunir más comentarios distintos: tres lecturas costaron $0.001668 y dieron 43 comentarios más que una.
Prueba 2: cómo paginar respuestas hasta el final, en un hilo de 24
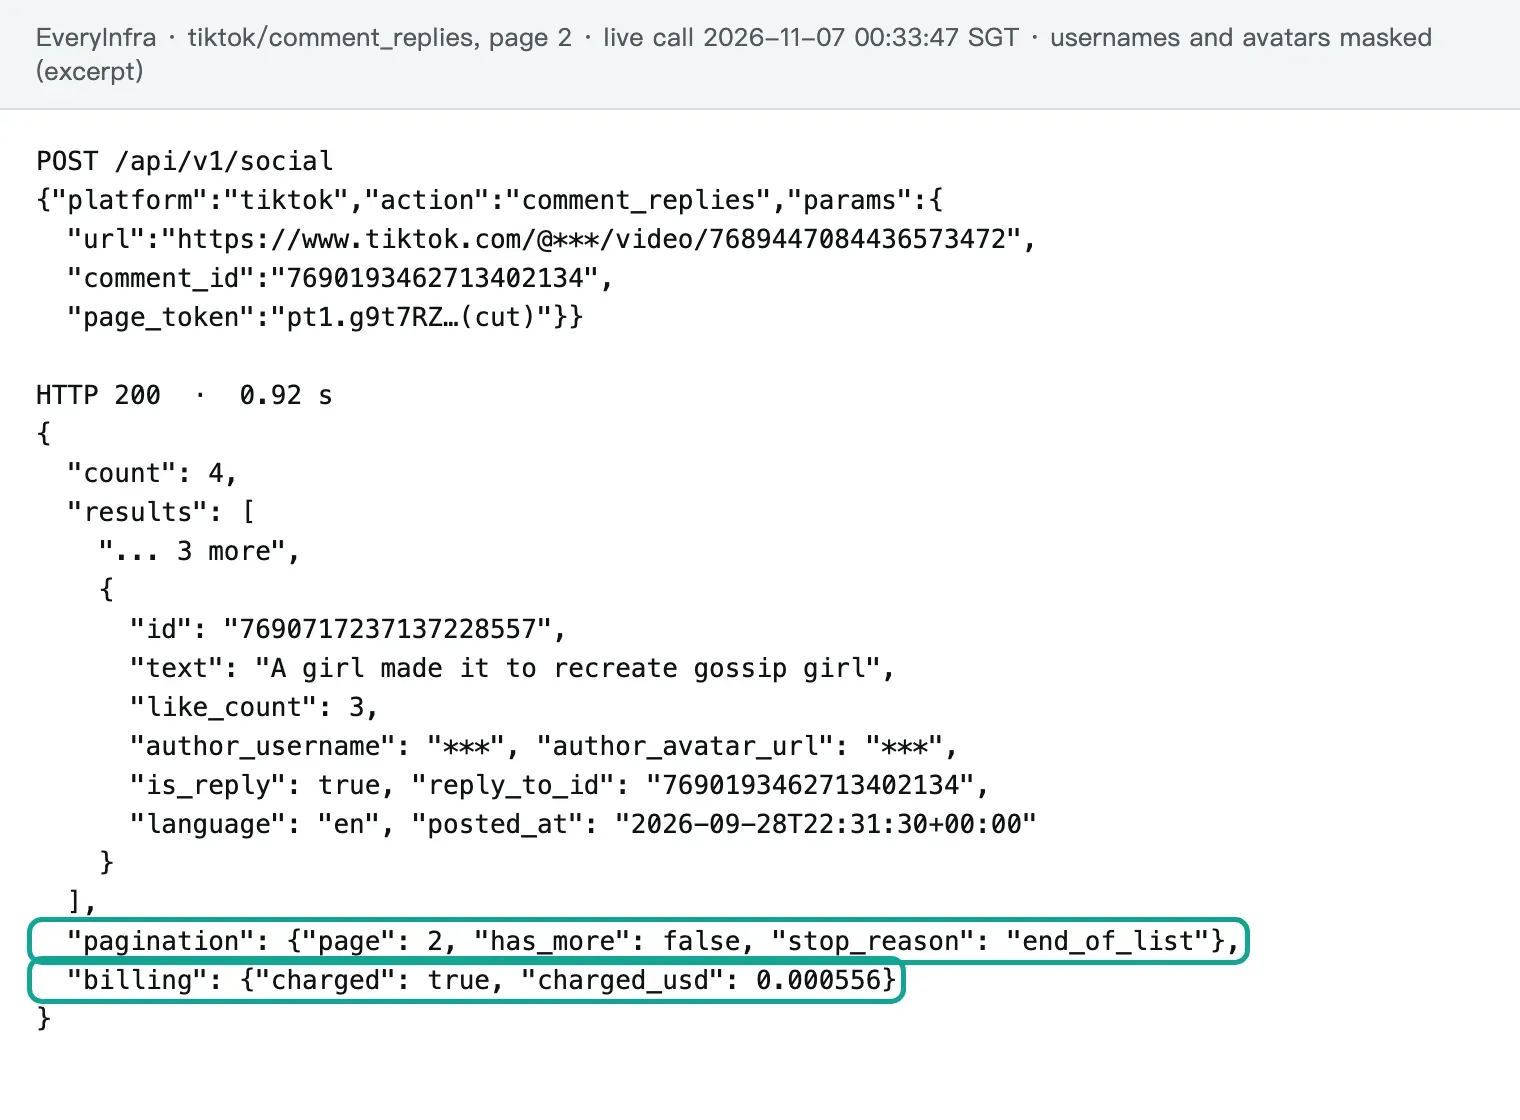
Después abrimos el comentario con más respuestas (ID 7690193462713402134, que declaraba 24). La tabla muestra las dos páginas.
| Página | Hora de Singapur | `page_token` enviado | Filas | Tiempo | `has_more` | `stop_reason` | Cobro |
|---|---|---|---|---|---|---|---|
| 1 | 00:33:41 | ninguno | 20 | 0.99 s | true | vacío | $0.000556 |
| 2 | 00:33:47 | next_page_token de la página 1 | 4 | 0.92 s | false | end_of_list | $0.000556 |
La primera página trajo 20 respuestas y un next_page_token que empieza por pt1.; lo devolvimos sin tocarlo y la segunda trajo 4, con has_more en false. En total 24, igual que lo declarado y sin IDs repetidos. Las 2 respuestas incluidas en la llamada de comentarios también estaban entre esas 24, así que al combinar hay que deduplicar. Una página llena de 20 sale a $0.0278 por 1,000, diez veces más que la llamada de comentarios, porque solo lleva 20 filas.
Las páginas de respuestas tienen más campos. De las 24, 17 llevaban reply_to_reply_id (el 71 %): la mayoría contestaba a otras respuestas, no al comentario original, algo que las dos respuestas incluidas no dejan ver. Cada respuesta trae también language: aquí 23 en inglés y 1 en francés. Iban del 2026-09-27 al 2026-10-18, así que la gente seguía respondiendo tres semanas después.
En la ejecución del CSV, el script abrió 9 hilos, los 3 con más respuestas de cada video. Declaraban 107 respuestas y las páginas devolvieron 106, el 99.1 %. La única diferencia fue un hilo del video B que declaraba 31 y devolvió 30; probablemente la que faltaba se borró o quedó oculta. Las 11 llamadas de respuestas tardaron entre 0.74 y 1.65 segundos, unas cien veces menos que las de comentarios: abrir hilos suma llamadas, pero casi no suma espera.
Prueba 3: 11 fallos en media hora, y cuánto costaron
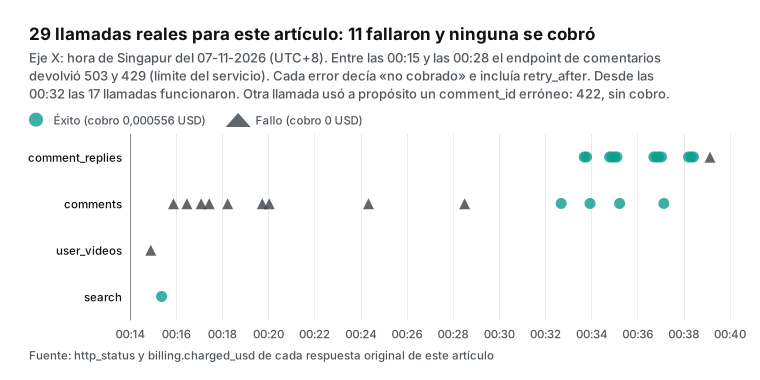
Hicimos 30 llamadas de prueba y 11 fallaron; ninguna se cobró. El gráfico muestra las 29 anteriores a las 00:39 hora de Singapur; la número 30, de la 01:06, está en la prueba 1. Los 9 fallos del servicio tenían charged_usd en 0 y billing.reason request_failed_refunded. El exceso de la clave y el parámetro erróneo se frenaron antes del cobro, y su mensaje decía «Nothing was charged».
| Tipo | Veces | Hora de Singapur | Tiempo por llamada | Código y `fault` | Cobro |
|---|---|---|---|---|---|
| Servicio no disponible temporalmente | 7 | 00:14:54–00:20:02 | 10.4–20.5 s | 503 unavailable, service, retry_after 60 s | $0 |
| Límite del lado del servicio | 2 | 00:24:20, 00:28:30 | 10.4–10.7 s | 429 rate_limited (límite de frecuencia), service, retry_after 60 s | $0 |
| Esta clave superó su límite por minuto | 1 | 00:19:44 | 0.17 s | 429 rate_limited (límite de frecuencia), account, retry_after 16 s | $0 |
Parámetro erróneo (comment_id no válido) | 1 | 00:39:08 | 0.20 s | 422 missing_param, request, no reintentar | $0 |
El endpoint de comentarios estuvo caído de 00:15 a 00:28 hora de Singapur, con cualquier video y también en modo asíncrono; otros endpoints de TikTok también devolvieron 503 en esa franja (tiktok/user_videos a las 00:14:54) y solo funcionó la llamada a tiktok/search de las 00:15:22, así que la API estaba caída en gran parte, no solo en comentarios; ninguno de esos fallos se cobró. Desde las 00:32 no volvió a fallar. Cada error trae retryable, retry_after (60 segundos en fallos del servicio, 16 en el límite de la clave) y max_retries. Al tercer fallo de un mismo endpoint en 10 minutos, el mensaje añade una solicitud example para probar una vez: si funciona, el problema es tu video; si también falla, es nuestro, y el mensaje pide preguntar al usuario antes de abrir un ticket de soporte. Nuestro ejemplo también falló y, al ser una prueba, no abrimos ticket.
El campo fault dice quién tiene que actuar: con service y account hay que esperar y reintentar; con request hay que cambiar los parámetros, porque reintentar no sirve. El script aplica estas reglas. En las otras rutas, Apify advierte que algunos actores con cobro por evento también facturan el uso de la plataforma durante la ejecución (Actors in Store); con un script propio, los fallos se pagan con tu tiempo y tu tráfico de proxy.
Scrape TikTok comments to CSV: el script completo de Python
Este es el script exacto que ejecutamos el 7 de noviembre, sin recortes. Solo necesita requests (documentación de Requests) y la biblioteca estándar. Espacia las llamadas para no pasar de 10 por minuto, reintenta los 429 y los errores retryable tras retry_after y no reintenta los errores de parámetros. Obtiene hasta 200 comentarios por video, pagina los N hilos con más respuestas, deduplica por id, escribe el CSV y guarda un registro .calls.json de cada llamada.
"""Export TikTok comments (and optional reply threads) to CSV with the EveryInfra API.

Usage:
    export EVERYINFRA_API_KEY=...            # never hard-code the key
    python tiktok_comments_to_csv.py urls.txt comments.csv --replies 3 --hash-authors

urls.txt has one public TikTok video URL per line.
"""
import argparse
import csv
import hashlib
import json
import os
import sys
import time

import requests

API = "https://api.everyinfra.com/api/v1/social"
MIN_INTERVAL = 6.5          # seconds between calls: stays under 10 requests per minute
FIELDS = ["video_url", "id", "is_reply", "reply_to_id", "reply_to_reply_id", "text",
          "like_count", "reply_count", "author", "posted_at", "liked_by_author",
          "pinned_by_author", "source"]

session = requests.Session()
session.headers["Authorization"] = "Bearer " + os.environ["EVERYINFRA_API_KEY"]
last_call = 0.0
spent_usd = 0.0
calls = []


def call(action, params, tries=3):
    """One POST with client-side pacing; retries 429 and retryable 5xx, never retries 4xx."""
    global last_call, spent_usd
    for attempt in range(tries):
        wait = MIN_INTERVAL - (time.time() - last_call)
        if wait > 0:
            time.sleep(wait)
        last_call = time.time()
        t0 = time.time()
        r = session.post(API, json={"platform": "tiktok", "action": action, "params": params}, timeout=120)
        body = r.json()
        billing = body.get("billing") or {}
        spent_usd += billing.get("charged_usd") or 0.0
        rows = body.get("results") if isinstance(body.get("results"), list) else []
        calls.append({"action": action, "params": params, "status": r.status_code, "rows": len(rows),
                      "charged_usd": billing.get("charged_usd"), "seconds": round(time.time() - t0, 2),
                      "at_utc": time.strftime("%Y-%m-%dT%H:%M:%SZ", time.gmtime(t0))})
        if r.status_code == 200:
            return body
        err = body.get("error") or {}
        if r.status_code == 429 or err.get("retryable"):
            time.sleep(err.get("retry_after") or 60)
            continue
        print(f"{action} failed: {r.status_code} {err.get('code')} {err.get('message')}", file=sys.stderr)
        return None
    return None


def author_of(row, hash_authors):
    name = row.get("author_username") or ""
    return hashlib.sha256(name.encode()).hexdigest()[:10] if hash_authors and name else name


def to_row(video_url, row, source, hash_authors):
    out = {k: row.get(k) for k in FIELDS if k in row}
    out.update(video_url=video_url, author=author_of(row, hash_authors), source=source)
    return out


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("urls")
    ap.add_argument("out")
    ap.add_argument("--limit", type=int, default=200, help="comments per video, 1-200")
    ap.add_argument("--replies", type=int, default=0, help="pull full reply threads for the N most-replied comments")
    ap.add_argument("--reply-pages", type=int, default=3, help="max reply pages per thread (20 replies per page)")
    ap.add_argument("--hash-authors", action="store_true")
    a = ap.parse_args()

    seen, rows = set(), []
    videos = [u.strip() for u in open(a.urls) if u.strip()]
    for url in videos:
        body = call("comments", {"url": url, "limit": a.limit})
        if not body:
            continue
        top = []
        for c in body["results"]:
            if c["id"] in seen:
                continue
            seen.add(c["id"])
            rows.append(to_row(url, c, "comments", a.hash_authors))
            if not c.get("is_reply"):
                top.append(c)
        # replies: only the threads with more replies than the two that come inline
        threads = sorted((c for c in top if (c.get("reply_count") or 0) > 2),
                         key=lambda c: c["reply_count"], reverse=True)[: a.replies]
        for c in threads:
            token = None
            for _ in range(a.reply_pages):
                params = {"url": url, "comment_id": c["id"]}
                if token:
                    params["page_token"] = token
                page = call("comment_replies", params)
                if not page:
                    break
                for rep in page["results"]:
                    if rep["id"] in seen:
                        continue
                    seen.add(rep["id"])
                    rows.append(to_row(url, rep, "comment_replies", a.hash_authors))
                token = next((x.get("next_page_token") for x in page["results"] if x.get("next_page_token")), None) \
                    or page.get("next_page_token")
                if not token:
                    break

    with open(a.out, "w", newline="", encoding="utf-8-sig") as f:   # BOM so Excel reads UTF-8 and emoji
        w = csv.DictWriter(f, fieldnames=FIELDS, extrasaction="ignore")
        w.writeheader()
        w.writerows(rows)
    print(json.dumps({"videos": len(videos), "rows": len(rows), "calls": len(calls),
                      "spent_usd": round(spent_usd, 6)}, ensure_ascii=False))
    json.dump(calls, open(a.out + ".calls.json", "w"), indent=1)


if __name__ == "__main__":
    main()
Tres decisiones de diseño. El script espera 6.5 segundos entre llamadas para quedarse por debajo de 10 por minuto antes de que llegue un 429. Un único conjunto seen quita duplicados, porque una respuesta incluida vuelve a aparecer en su página: en nuestra ejecución, 18 de 703 filas eran duplicados de este tipo. Y el archivo usa utf-8-sig, que añade una marca BOM al principio (documentación de codecs); Excel la necesita para mostrar bien los emojis y los acentos (soporte de Microsoft).
Hay un detalle que afecta sobre todo a lectores de habla hispana. Excel separa las columnas de un CSV con el «separador de lista» de la configuración regional de Windows, y cuando la coma es el separador decimal, como en España, Argentina, Colombia o Chile, ese separador pasa a ser el punto y coma (importar o exportar archivos de texto, soporte de Microsoft). En esos equipos, un CSV separado por comas puede abrirse con todo en una sola columna. En México, que usa el punto decimal, normalmente se abre bien.
| Configuración regional | Separador decimal | Doble clic en un CSV con comas | Qué hacer |
|---|---|---|---|
| México, EE. UU. | punto | Se abre en columnas | Nada |
| España, Argentina, Colombia, Chile | coma | Puede quedar en una sola columna | Datos > Desde texto/CSV, o escribir con delimiter=";" |
| Google Sheets, pandas | — | Detecta la coma | Nada; en pandas, encoding="utf-8-sig" |
Si prefieres que el archivo se abra con doble clic en esos equipos, cambia una línea del script: csv.DictWriter(f, fieldnames=FIELDS, delimiter=";", extrasaction="ignore"). El módulo csv sigue entrecomillando los saltos de línea y las comillas de los comentarios según RFC 4180 (módulo csv de Python, RFC 4180); con pandas, lee con sep=";" (pandas.read_csv). La opción --hash-authors cambia cada nombre de usuario por 10 caracteres de su hash SHA-256 (hashlib); no es anonimización, pero saca los nombres de las tablas compartidas. Sin requests instalado, ejecuta uv run --with requests python3 tiktok_comments_to_csv.py urls.txt comments.csv --replies 3 --hash-authors (uv, ejecutar scripts).
| Columna | Origen | Significado | Valor en nuestra ejecución |
|---|---|---|---|
video_url | script | Video de la fila | https://www.tiktok.com/@…/video/7689447084436573472 |
id | API | ID único; clave para deduplicar | 7690193462713402134 |
is_reply | API | false si es principal, true si es respuesta | False |
reply_to_id | páginas de respuestas | Comentario principal de la respuesta | 7690193462713402134 |
reply_to_reply_id | páginas de respuestas | Respuesta a la que contesta | 17 de 24 tienen valor |
text | API | Texto; vacío en comentarios de foto o sticker | 39 de 685 filas vacías |
like_count | API | Me gusta | Máximo 1,667 |
reply_count | llamadas de comentarios | Respuestas que declara el comentario | Máximo 31 |
author | script | Usuario, o hash con --hash-authors | 3f9c… (ejemplo) |
posted_at | API | Fecha en UTC, ISO 8601 | 2026-09-27T12:55:18+00:00 |
liked_by_author | API | La creadora le dio me gusta | 19 en el video A |
pinned_by_author | API | La creadora lo fijó | ninguno en el video A |
source | script | comments o comment_replies | 597 / 88 |
Para más columnas, añade los nombres a FIELDS; las filas de respuestas traen también language, author_name, author_url y video_id (catálogo de campos).


Ejecutamos el script con tres videos de 00:33:55 a 00:38:26 hora de Singapur del 7 de noviembre, con --replies 3 --hash-authors. Las 14 llamadas funcionaron en 271 segundos y costaron $0.007784; el script reunió 703 filas y se quedó con 685 únicas, es decir, $0.0114 por 1,000.
| Video | Comentarios declarados | Filas de la llamada | Tiempo de la llamada | Hilos | Llamadas de respuestas | Filas únicas | Sin texto |
|---|---|---|---|---|---|---|---|
| A (cuidado de la piel, 1.24 M reproducciones) | 1,116 | 200 | 51.2 s | 3 | 4 | 241 | 4 |
| B (cuidado de la piel, 816 mil) | 311 | 197 | 89.42 s | 3 | 4 | 237 | 33 |
| C (cuidado de la piel, 336 mil) | 297 | 200 | 64.01 s | 3 | 3 | 207 | 2 |
| Total | 1,724 | 597 | 204.6 s | 9 | 11 | 685 | 39 |
Casi todo el tiempo se va en las llamadas de comentarios: 204.6 segundos para 3, frente a unos 10 para las 11 de respuestas. En videos de unos 300 comentarios, la exportación cubre la mayor parte: el 76 % en B y el 70 % en C; en A, con más de 1,000, solo el 22 %. En B, 33 de 237 filas no tienen texto (14 %) porque mucha gente comentó solo con fotos o stickers. Quítalas antes de un análisis de sentimiento, o un modelo puede clasificarlas como «neutras».
El campo posted_at muestra además la edad de cada sección de comentarios: las 237 filas de B se publicaron entre el 2026-11-02 y el 2026-11-06, y las 207 de C entre el 2026-10-12 y el 2026-11-05. A es un video más viejo, del 2026-09-25, y su comentario más reciente es del 2026-11-06 a las 14:42 UTC. Un video nuevo reúne casi todos sus comentarios en la primera semana, así que basta con exportar a diario los videos nuevos.
10,000 comentarios: costo y tiempo por ruta
Fijemos el escenario: 10,000 comentarios de TikTok en un CSV. Caso uno, los 200 primeros de 50 videos; caso dos, 10,000 de un solo video. Los precios son los públicos que leímos el 2026-11-07 y nuestros cobros medidos ese mismo día; cubren solo el uso, no las cuotas de plan. En la columna de tiempo solo hay valores medidos; el resto dice «no medido».
| Ruta | 50 videos × 200 | Un video, 10,000 | Tiempo | Base y fuente |
|---|---|---|---|---|
| Extensión de exportación de comentarios | El plan gratuito se queda en 200; más requiere pago | Plan de pago | Pegar cada enlace y esperar; no medido | Ficha de Chrome Web Store |
| Sitio de exportación con planes por niveles | 100 gratis por video no alcanzan; el primer plan de pago da 5,000 | Plan intermedio o superior | No medido | Precios cargados por script, no leídos |
| Apify Clockworks, Free | $12.50 | $12.50 | No medido | $0.00125 × 10,000; supera los $5 del plan Free |
| Apify Clockworks, Starter (BRONZE) | $10.00 | $10.00 | No medido | $0.001 × 10,000; Starter cuesta $19 al mes |
| Apify Clockworks, Business (GOLD) | $5.00 | $5.00 | No medido | $0.0005 × 10,000; Business cuesta $999 al mes |
| Scraper externo más barato de la Store | Desde $2.50 | Desde $2.50 | No medido | Free $0.00025 × 10,000; algunos suman tarifa de arranque |
| Script propio en Python | Software $0, más proxies y mantenimiento | Igual | No medido | Ver la ruta 2 |
| EveryInfra, solo comentarios | $0.028 | No es posible | 37–90 s por llamada; unos 55 minutos para 50 en serie | 50 llamadas × $0.000556 |
| EveryInfra, comentarios y respuestas | Unos $0.11 | No es posible | 271 s para 3 videos; unos 75 minutos para 50 | $0.0114 por 1,000 × 10 |
Mira primero la tercera columna. Para 10,000 comentarios de un solo video, nuestra fila dice «no es posible», y no por precio: la API no pagina y 200 es un tope fijo. Para eso usa Apify o un scraper externo de la Store ($2.50 a $12.50), o solicita la API de investigación, que da 100,000 registros al día pero solo a investigadores sin fines comerciales (preguntas frecuentes de la API de investigación). Para los 200 primeros de 50 videos, la diferencia es de dos órdenes de magnitud: nosotros, 2.8 centavos; Apify Clockworks, $5 en Business y $12.50 en Free.
Los tiempos de nuestra fila salen de la medición: las 5 llamadas de comentarios exitosas (36.71 s a las 00:32:41; 51.20, 89.42 y 64.01 s en la ejecución del CSV; 89.56 s a la 01:06) tardaron 66.2 segundos de media, así que 50 videos en serie llevan unos 55 minutos. Con "mode":"async" podrías enviar los 50 trabajos en 5 minutos sin pasar de 10 llamadas por minuto, pero no lo probamos y por eso no está en la tabla; tampoco medimos Apify ni las extensiones, y una celda vacía es más útil que una suposición. Hay además un costo oculto: si el uso del plan Free de Apify pasa de $5, toca esperar al mes siguiente o subir de plan, mientras que nuestra API descuenta cada llamada del saldo y no cobra los fallos.
Precio por 1,000 comentarios: por qué la diferencia es de dos órdenes de magnitud
La brecha se entiende mejor como precio por 1,000 comentarios. El gráfico usa escala logarítmica, así que cada línea vale 10 veces la anterior. Nuestros tres precios unitarios salen de un único número, $0.000556 por llamada; lo que cambia es cuántas filas trae cada llamada.
| Filas por llamada | Dónde se midió | Por 1,000 |
|---|---|---|
200 (tiktok/comments, limit: 200) | Video A, 00:32:41 hora de Singapur | $0.0028 |
197 (tiktok/comments) | Video B, 00:35:13 hora de Singapur | $0.0028 |
20 (tiktok/comment_replies, página llena) | Página 1, 00:33:41 hora de Singapur | $0.0278 |
4 (tiktok/comment_replies, última página) | Página 2, 00:33:47 hora de Singapur | $0.139 |
| 685 filas en 14 llamadas (total del CSV) | 00:33:55–00:38:26 hora de Singapur | $0.0114 |
Para ahorrar con nuestra API, llena cada llamada: envía siempre limit: 200, abre solo los hilos que necesites y no pagines los que tienen menos de 3 respuestas, porque las dos primeras ya vienen incluidas.
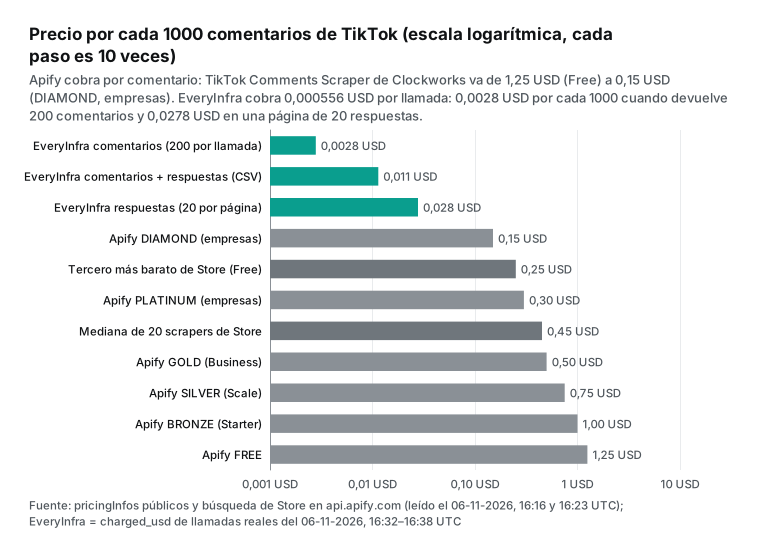
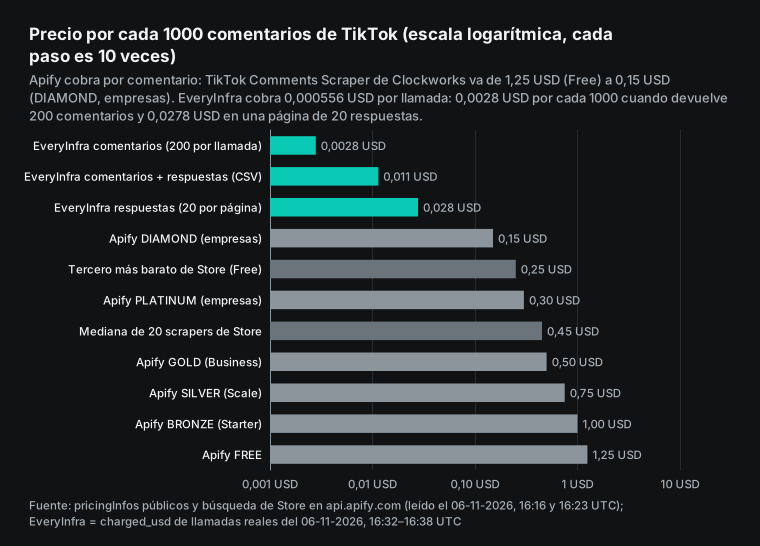
Apify cobra por elemento, así que el tamaño de la ejecución no cambia el precio unitario; lo cambia tu plan, de $1.25 por 1,000 en Free a $0.15 en DIAMOND, más de 8 veces. Nuestro precio más alto, $0.0278 en páginas de respuestas, sigue un orden de magnitud por debajo del más barato de la Store ($0.25). Pero un precio bajo no sirve para todo: una herramienta por elemento recorre un video hasta el final, y una API por llamada con tope de 200 encaja con «muchos videos, los primeros comentarios de cada uno». Decide si necesitas amplitud o profundidad.
Conectarlo a herramientas de IA: ejemplo de configuración MCP remoto
Mucha gente pasa los comentarios a un modelo de lenguaje para etiquetar sentimiento o resumir temas. Si trabajas en un cliente MCP como Claude o Cursor, puedes saltarte el script y dejar que el modelo llame directamente al endpoint de comentarios. MCP (Model Context Protocol) es un protocolo abierto para que los clientes de IA usen herramientas externas (especificación). La dirección MCP remota de EveryInfra es https://api.everyinfra.com/mcp y la herramienta de datos es everyinfra_call_api, con los mismos platform, action y params; los detalles están en la página del servidor MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Es un ejemplo con el formato de la documentación MCP de Claude Code, donde .mcp.json expande variables ${VAR} (documentación MCP de Claude Code); las cifras de este artículo salen de llamadas HTTP directas, no de MCP. Ten en cuenta dos cosas. Primero, el tamaño: 200 comentarios en bruto ocupan decenas de miles de caracteres, y en nuestro artículo sobre subagentes de Claude Code medimos 54,819 caracteres; deja que un subagente los traiga y devuelva un resumen, o pide limit 50. Segundo, la confirmación: everyinfra_call_api cuesta dinero y el cliente pedirá confirmar cada llamada, así que antes de un lote permite solo esa herramienta. Apify tiene su propio servidor MCP (Apify MCP server), que deja al modelo buscar y ejecutar actores con el precio de cada uno.
Cuándo conviene más Apify o una extensión
Según nuestras pruebas y la documentación pública, estos son los casos en que Apify o una extensión encajan mejor.
| Caso | Mejor opción | Motivo |
|---|---|---|
| Todos los comentarios de un video viral | commentsPerPost de Apify, el plan más alto de un sitio de exportación, cursor de la API de investigación | Nuestra API se detiene en 200 comentarios principales por video |
| Uno o dos videos de vez en cuando, sin código | Extensión (200 gratis) o sitio de exportación (100 gratis) | No hace falta clave ni solicitud |
| Un flujo que ya funciona en Apify | Quedarse en Apify | Programaciones, webhooks y conexiones con Make o Zapier ya montadas |
| Investigación académica aprobada | API de investigación de TikTok | Gratis, 100,000 registros al día, teléfonos y correos enmascarados |
El primer caso es el más importante: tiktok/comment_replies recorre hasta el final las respuestas de un comentario, pero ningún endpoint llega al comentario principal número 201. Para contar todas las participaciones de un sorteo en un video viral, las otras herramientas pueden y nosotros no. La vía de investigación también tiene costos: la revisión tarda unas 4 semanas, los datos son solo para investigación y las estadísticas archivadas pueden ser más bajas que las actuales (preguntas frecuentes de la API de investigación). En sentido contrario, para los primeros comentarios de decenas o cientos de videos, con programación y conectados a herramientas de IA, una API por llamada cuesta dos o tres órdenes de magnitud menos y no cobra los fallos.
Cumplimiento y privacidad: los comentarios públicos siguen siendo datos personales
Que un comentario sea público no significa que se pueda usar de cualquier forma. Hay que mirar por separado las condiciones de la plataforma, los datos personales y el uso que vas a dar a los datos. Esto no es asesoría legal.
Condiciones de la plataforma. Los Términos de Servicio de TikTok en EE. UU. se actualizaron el 2026-07-15; su sección 3.4 prohíbe la extracción o exportación automatizada de datos sin aprobación escrita de TikTok USDS Joint Venture (Términos de Servicio de TikTok, EE. UU.). Los datos de la API de investigación solo valen para el proyecto aprobado (Términos de la API de investigación). En hiQ contra LinkedIn, el Noveno Circuito consideró poco probable que extraer páginas públicas sea «acceso no autorizado» según la CFAA (sentencia del Noveno Circuito, 2022); las reclamaciones por contrato o por elusión son otra cuestión.
Datos personales. Nombres de usuario, IDs y enlaces de avatar son datos personales según el RGPD: necesitas una base jurídica y recoger solo lo imprescindible (RGPD, artículos 5 y 6). En España, la Agencia Española de Protección de Datos insiste en la protección de datos por defecto: configurar el tratamiento para que solo se usen los datos necesarios (guía de la AEPD). La API de investigación enmascara teléfonos y correos en el texto (Query Video Comments) y nuestra opción --hash-authors sigue la misma idea: para un análisis de sentimiento o de temas no necesitas el nombre del autor.
El uso. Una revisión interna de la competencia no tiene el mismo riesgo que republicar comentarios con sus autores. El artículo 40 de la Ley de Servicios Digitales de la UE abre un canal formal para que investigadores pidan datos a las plataformas (DSA, artículo 40). EveryInfra devuelve solo comentarios visibles públicamente; no devuelve cuentas privadas, mensajes directos ni contenido que pida iniciar sesión.
Cambios recientes (septiembre a noviembre de 2026)
| Fecha | Cambio | Qué significa para extraer comentarios |
|---|---|---|
| 2026-09-03 | TikTok lanzó comentarios de voz, encuestas y carruseles de fotos, y habló de más de 1,700 millones de comentarios al día (Newsroom) | Habrá más filas sin texto; márcalas y no las trates como borradas |
| 2026-10-09 | Un juez federal de EE. UU. rechazó archivar una demanda contra Apple por scraping de YouTube, tras otra negativa a ByteDance ese mismo mes (MediaPost) | Eludir medidas antiscraping se está convirtiendo en motivo de demanda |
| 2026-10-26 | yt-dlp publicó la 2026.10.26 y su extractor de TikTok sigue sin texto de comentarios (versión) | No cuentes con --write-comments para TikTok |
| 2026-11-04 | La extensión de Chrome de la ruta 1 pasó a la 2.3.1 y su plan gratuito sigue en 200 (ficha de Chrome Web Store, leída el 2026-11-07) | La extensión sigue los cambios de la web; el límite gratuito no cambió |
| 2026-11-06 | Último cambio del TikTok Comments Scraper de Apify, con los seis niveles vigentes desde el 2026-03-18 (endpoint público) | Los precios de Apify de este artículo son los del 7 de noviembre |
Empezar: del entorno de pruebas a una exportación diaria
Primero, abre el mercado de datos, busca los comentarios de TikTok y prueba un enlace en el entorno de pruebas para ver si los campos te sirven; cuesta lo mismo que la API y los fallos no se cobran. Segundo, crea una clave de API en la consola y envía la solicitud de arriba con curl, como muestra el inicio rápido. Tercero, guarda el script como tiktok_comments_to_csv.py, pon los enlaces en urls.txt, uno por línea, ejecútalo y revisa el número de filas.
Para una ejecución diaria, pásale el script a cron, GitHub Actions o tu propio programador y envía solo los videos publicados ese día. Nuestra ejecución del CSV dio 685 filas para 3 videos, unas 228 por video; 50 videos al día con 3 hilos cada uno dan unas 11,400 filas, que a $0.0114 por 1,000 cuestan unos $0.13 diarios, unos $3.90 en un mes de 30 días; los precios vigentes están en la página de precios y en el campo price_usd del catálogo. Para otras plataformas, la clave y el endpoint son los mismos; solo cambia platform, por ejemplo comentarios de YouTube o comentarios de Instagram. Hay resúmenes en TikTok API y YouTube API, y más contexto sobre Apify en precios de Apify explicados y alternativas a Apify.
Preguntas frecuentes
Las preguntas salen de sugerencias de búsqueda y foros, consultados el 2026-11-07.
¿Se pueden extraer comentarios de TikTok (can you scrape TikTok comments)?
Técnicamente sí: las tres rutas obtienen comentarios públicos. Pero la sección 3.4 de los Términos de Servicio de TikTok en EE. UU. prohíbe la extracción automatizada sin aprobación escrita (Términos de Servicio, sección 3.4), y la investigación académica aprobada puede usar la API oficial. Nuestra API solo devuelve comentarios visibles públicamente. Fuente: la sugerencia de Google «can you scrape tiktok comments».
¿Hay un TikTok comments scraper gratis?
Sí, con límites. Un sitio de exportación de comentarios da 100 por video gratis y una extensión de Chrome, 200; el plan Free de Apify incluye $5 de uso al mes, unos 4,000 comentarios al precio Free de Clockworks; la API de investigación es gratuita solo para investigadores aprobados. Fuente: la sugerencia «free tiktok comments scraper» y un hilo de r/DataHoarder sobre extraer comentarios sin pagar (Reddit).
How to scrape TikTok comments to CSV y abrirlos en Excel
Usa el script de este artículo: escribe un CSV UTF-8 con BOM para que Excel muestre bien emojis y acentos, y si tu Excel usa punto y coma como separador de lista, cambia delimiter o importa con Datos > Desde texto/CSV (soporte de Microsoft). En r/DataHoarder, una estudiante pagó una exportación para su tesis y obtuvo «letras al azar», un problema de codificación (Reddit).
¿Existe una TikTok comments scraper API?
La Display API de TikTok solo tiene /v2/user/info/, /v2/video/list/ y /v2/video/query/, que leen los datos del usuario autorizado; ninguna devuelve comentarios (Display API overview). El endpoint oficial de comentarios está en la API de investigación, que exige solicitud (página de la API de investigación). Hay APIs de terceros, como tiktok/comments y tiktok/comment_replies de este artículo. Fuente: la sugerencia «tiktok comments api».
¿Por qué un scraper de comentarios de TikTok en Apify me pide la cookie?
Un usuario de Stack Overflow lo preguntó sobre una configuración de Apify (etiqueta en Stack Overflow). Algunos scrapers externos de la Store piden cookies de sesión, pero el ejemplo de entrada de Clockworks solo lleva enlaces y cantidades. Una cookie entrega tu sesión iniciada, así que evita compartirla si puedes; nuestra API no necesita ninguna cuenta ni cookie de TikTok.
¿Puedo obtener todos los comentarios de un video?
Con nuestra API, no: tiktok/comments devuelve hasta 200 sin paginación, aunque tiktok/comment_replies sí recorre las respuestas hasta el final. Para todos los comentarios, usa commentsPerPost de Apify, el plan de pago de un sitio de exportación o el cursor de la API de investigación. Fuente: la sugerencia «export all tiktok comments».
Referencias
- Research API: Query Video Comments, TikTok for Developers, leído el 2026-11-07
- Say more in the comments, TikTok Newsroom, 2026-09-03
- TikTok-Api issue #1303: sticker comments return a placeholder, GitHub, 2026-05-25
- Social API endpoint catalog (TikTok), EveryInfra, leído a las 00:13 hora de Singapur del 2026-11-07
- TikTok Comments Scraper (Clockworks), Apify Store, leído el 2026-11-07
- Run Actor synchronously and get dataset items, Apify Docs, 2026-11-07
- clockworks~tiktok-comments-scraper public metadata, Apify API, leído a las 00:16 hora de Singapur del 2026-11-07
- Pricing, Apify, 2026-11-07
- Pricing and costs, Apify Docs, 2026-11-07
- Store search for "tiktok comments", Apify API, leído a las 00:23 hora de Singapur del 2026-11-07
- TikTokApi 7.3.3, PyPI, publicado el 2026-04-01
- davidteather/TikTok-Api, GitHub, último push 2026-08-24, leído el 2026-11-07
- Installation (Python), Playwright, leído el 2026-11-07
- TikTok-Api issue #1255: comment scraping does not work, GitHub, 2025-08-28
- TikTok-Api issue #1311: HTTP 200 with an empty body, GitHub, 2026-07-18
- yt-dlp TikTok extractor source, GitHub, leído el 2026-11-07
- yt-dlp issue #5037: TikTok comment extraction, GitHub, cerrado el 2022-10-31
- yt-dlp 2026.10.26 release, GitHub, 2026-10-26
- cubernetes/TikTokCommentScraper, GitHub, último push 2023-08-05
- xtekky/TikTok-Comment-Scraper, GitHub, último push 2023-12-02
- RomySaputraSihananda/tiktok-comment-scrapper, GitHub, último push 2025-12-08
- Does an API exist to scrape TikTok comment text on videos, Reddit r/webscraping, 2026-11-07
- Terms of Service (US), section 3.4, TikTok, actualizado el 2026-07-15
- Apple Must Face Suit Over YouTube Scraping, MediaPost, 2026-10-09
- Web Scraping as Illegal Circumvention?, Communications of the ACM, octubre de 2026
- Actors in Store, Apify Docs, 2026-11-07
- Advanced Usage, Requests, 2026-11-07
- codecs: utf-8-sig, Python documentation, leído el 2026-11-07
- Opening CSV UTF-8 files correctly in Excel, Microsoft Support, 2026-11-07
- Importar o exportar archivos de texto (.txt o .csv), Soporte de Microsoft, leído el 2026-11-07
- csv: CSV File Reading and Writing, Python documentation, leído el 2026-11-07
- RFC 4180: Common Format and MIME Type for CSV Files, RFC Editor, octubre de 2005
- pandas.read_csv, pandas, 2026-11-07
- hashlib, Python documentation, leído el 2026-11-07
- Running scripts, uv documentation, leído el 2026-11-07
- Research API FAQ, TikTok for Developers, 2026-11-07
- Specification, Model Context Protocol, 2026-11-07
- Connect Claude Code to tools via MCP, Claude Code Docs, 2026-11-07
- Apify MCP server, Apify Docs, 2026-11-07
- Research API Terms of Service, TikTok, leído el 2026-11-07
- hiQ Labs v. LinkedIn opinion (17-16783), US Court of Appeals for the Ninth Circuit, 2022-04-18
- Regulation (EU) 2016/679 (GDPR), EUR-Lex, 2016-04-27
- Guía de protección de datos por defecto, AEPD, leído el 2026-11-07
- Regulation (EU) 2022/2065 (DSA), EUR-Lex, 2022-10-19
- Scraping TikTok comments without paying, Reddit r/DataHoarder, 2026-11-07
- How do I extract comments from TikTok for my research, Reddit r/DataHoarder, leído el 2026-11-07
- Display API Overview, TikTok for Developers, 2026-11-07
- Research API product page, TikTok for Developers, leído el 2026-11-07
- Active questions tagged tiktok, Stack Overflow, leído el 2026-11-07
Referencia BL-104