Apify Facebook Scraper 替代:五类实测
千条 Facebook 帖子:Apify 官方款 $5,我们实测 $0.056;评论和 Marketplace 也更省,搜索与主页资料 Apify 便宜。
同样拿 1,000 条 Facebook 公开主页帖子,Apify Store 上用户最多的 Facebook Posts Scraper(apify 官方,近 30 天 18,261 位用户)公开价是 Free 档 $5.00、Business 计划对应的 Gold 档 $2.00;我们在 2026-11-07 凌晨用 EveryInfra 的 facebook/user_posts 真调,一次回 50 条、扣 $0.002778,折合每千条 $0.0556,比它的 Free 档便宜 90 倍,比 Store 里最便宜、用户数过百的帖子 scraper($1.50)便宜 27 倍。评论两次各 50 条,每千条同样 $0.0556,比官方 Facebook Comments Scraper Free 档($2.50)便宜 45 倍,比 Store 最便宜的评论 scraper($0.25)便宜 4.5 倍;Marketplace 一次 200 行、去重 181 条只扣 $0.001389,每千条 $0.0077。反过来也要说清楚:关键词搜帖子这一项,我们实测每千条 $2.91,Store 里有 $1.90 的第三方款比我们便宜;主页资料按 Apify 最高的 Diamond 档($2.00)算,也比我们的 $2.78 便宜;而且我们一次最多回 50 条帖子、50 条评论,不能翻页,要从一个主页挖出 1,000 条历史帖子,现在只有 Apify 那一类工具能做到。
本文的「每千条价」,是把一次请求实际扣掉的钱(响应里的 charged_usd),除以这次实际返回并且去重后的条数,再乘 1,000。它回答的问题是「拿到 1,000 条可用结果要花多少钱」。EveryInfra 按请求计费,一次请求不论回 1 条还是 50 条都是同一个价(关键词搜索例外,按每 10 条一档);Apify Store 里的 Facebook scraper 几乎都按结果计费(Apify 叫 pay per event),每多一条结果就多一笔。两种单位只有换成同一个分母才能比。Apify 一侧我们只用公开材料:Store 页面、价格页、文档,以及不需要账号就能读的公开接口 api.apify.com/v2/acts/<作者>~<名字>;我们没有注册 Apify,也没有跑它的 actor(Apify 对云端抓取程序的叫法),所以表里 Apify 的数字都是「公开单价」,不是「实测账单」,我们这一侧的数字都是真调。
apify facebook scraper 和 EveryInfra:先看总表
下面这张表只放两类数:Apify Store 的公开单价(读取时间 2026-11-07 00:15–00:16 新加坡时间,档位写在格子里),以及我们 2026-11-07 的真调结果(新加坡时间、能力名、返回条数、charged_usd)。Apify 的档位跟着月套餐走:价格页写的是 Free 计划每月送 $5 额度、不打折;Starter $19/月对应 Bronze 档;Scale $199/月对应 Silver;Business $999/月对应 Gold;Platinum 和 Diamond 是更大的定制合同。同一个 scraper 在不同档位的单价能差到 6 倍,所以表里同时列 Free 档、Gold 档和最低的 Diamond 档。「Store 最便宜」一栏的挑法在动笔前就定好:在 Store 搜索接口返回的 195 个 Facebook 相关条目里,取近 30 天用户 ≥100、Free 档单价最低的那一个。
| 数据 | Apify 官方款(30 天用户) | 官方款每千条:Free / Gold / Diamond | Store 最便宜(30 天用户) | EveryInfra 能力 | 实测(新加坡时间、条数、实扣) | EveryInfra 每千条 | 倍数(官方 Free ÷ 我们) |
|---|---|---|---|---|---|---|---|
| 主页帖子 | Facebook Posts Scraper(18,261) | $5.00 / $2.00 / $0.80,另每次启动 $0.001 | curious_coder 帖子 scraper(207)$1.50 | facebook/user_posts | 00:28:54,1 次 50 条,$0.002778 | $0.0556 | 90 倍 |
| 评论 | Facebook Comments Scraper(5,458) | $2.50 / $1.40 / $0.40,另每次启动 $0.001 | thedoor(261)、dami_studio(400)各 $0.25 | facebook/comments | 00:31:04、00:31:54,2 次共 100 条,$0.005556 | $0.0556 | 45 倍 |
| Marketplace 商品 | Facebook Marketplace Scraper(1,092) | $6.20 / $2.60 / $0.80;详情另加同价 | curious_coder(654)$0.50 | facebook/marketplace | 00:30:14,1 次 200 行、181 条,$0.001389 | $0.0077 | 808 倍 |
| 关键词搜帖子 | Facebook Search Scraper(1,597) | $6.00 / $3.00 / $2.00,另每次启动 $0.001 | memo23(262)$1.90,另每次启动 $0.005 | facebook/search | 00:33:17、00:34:58,2 次共 11 条,$0.032 | $2.91 | 2.1 倍 |
| 主页资料 | Facebook Pages Scraper(9,130) | $12.00 / $5.40 / $2.00 | premiumscraper(145)$3.00 | facebook/profile | 00:34:04,1 个主页,$0.002778 | $2.778 | 4.3 倍 |
这张表最容易被误读的地方有三个。第一,两边的字段不一样,倍数只说明「同样拿到一条结果」要花的钱,不说明「拿到的东西一样多」;后面每个场景里,我们把自己实测的字段填充率和 Apify 页面自己写的字段分开列,不写「两边一样」。第二,Apify 的价格是 Store 上的单价乘 1,000,实际账单还会受启动费、日期过滤附加费、Free 计划的 $5 上限和失败重跑影响;我们这一侧是把真实扣费除以真实条数,所以条数少的那次(比如搜索只回了 6 条)价格就被算高。第三,倍数大的都是「一次回一整页」的能力;关键词搜索按每 10 条一档计费,主页资料一次只回一个主页,这两项的倍数只剩 1–4 倍,碰上 Store 里的便宜款或 Apify 的大客户档位,我们反而更贵。
我们怎么测、怎么算
真调全部在 2026-11-07 凌晨完成,时间按新加坡时间记,从 00:16:18 开始。用的是一把测试 Key,每分钟最多 10 次请求,还和另外几位同事共用,所以每次请求之间隔至少 8 秒,碰到 429(请求太频繁)就按响应里的 retry_after 等够再发。挑测试对象的规则也是先定的:帖子和评论用 National Geographic 的公开主页(机构账号,更新频繁,评论多);Marketplace 用纽约站搜 iphone 15(二手手机是 Marketplace 上最常见的比价需求);关键词搜索用两个生活类词。前 2 次调用是我们故意制造的错误(不带 Key、参数拼错),第 3–12 次碰上了 Facebook 能力的临时故障,这件事本身也是数据,下面单独写。
| # | 新加坡时间 | 能力 | 结果 | 返回条数 | 实扣 |
|---|---|---|---|---|---|
| 1 | 00:16:18 | facebook/user_posts(不带 Key) | 401 missing_key | 0 | $0 |
| 2 | 00:16:25 | facebook/user_posts(把 limit 拼成 limt) | 422 unknown_param,提示 did you mean limit | 0 | $0 |
| 3–12 | 00:16:33–00:27:39 | facebook/user_posts、facebook/marketplace、facebook/search | 5 次 503 unavailable、5 次 429(其中 1 次是这把 Key 自己超速,4 次是服务端限流) | 0 | $0 |
| 13 | 00:28:54 | facebook/user_posts(natgeo,异步) | 成功,约 72 秒出结果 | 50 | $0.002778 |
| 14 | 00:30:14 | facebook/marketplace(iphone 15,nyc,limit 200) | 成功,25.3 秒 | 200 行,去重 181 | $0.001389 |
| 15 | 00:31:04 | facebook/comments(评论数 993 的帖子,异步) | 成功,约 42 秒 | 50 | $0.002778 |
| 16 | 00:31:54 | facebook/comments(评论数 718 的帖子,异步) | 成功,约 75 秒 | 50 | $0.002778 |
| 17 | 00:33:17 | facebook/search(air fryer recipe,limit 10) | 成功,20.3 秒 | 6 | $0.016 |
| 18 | 00:34:04 | facebook/profile(natgeo,异步) | 成功,约 46 秒 | 1 | $0.002778 |
| 19 | 00:34:58 | facebook/search(meal prep ideas,latest,limit 20) | 成功,26.8 秒;要 20 条回 5 条,只收 1 档、另 1 档退回 | 5 | $0.016 |
每千条价按同一个公式算:实扣合计 ÷ 去重后的条数 × 1,000。去重键按数据类型定:帖子和商品用 id;评论用 comment_url,原因在场景二里写。失败的钱算进分子,条数不算进分母,所以哪次回得少,我们这边的价格只会被算高。Apify 一侧,我们从公开接口读每个 scraper 的 pricingInfos(每种收费事件在每个档位的单价)和 stats(30 天用户数、运行次数、各状态的运行数),把「每条结果对应的主事件」单价乘 1,000;启动费、日期过滤附加费、详情附加费单独写出来,不混进主单价。
Apify 上的 Facebook scraper 怎么收费
先把 Apify 的收费方式讲清楚,因为它决定了后面每一笔账怎么算。Apify 的文档 Actors in Store 写明,Store 里的每个 scraper 只用两种收费模式之一:按事件(pay per event),由作者定义「产生一条结果」「启动一次」这类事件的价格;或按用量(pay per usage),只收平台的计算单元、存储和代理费。同一页还写了:多数按事件收费的 scraper 把平台用量包含在事件价里,但也有一些另收,运行前要看清楚。我们读到的 14 个 Facebook scraper,用的全是按事件收费。
Apify 官方出的五个 Facebook scraper,价格结构几乎一样:一个主事件按条收费,外加每次启动收 $0.001,再加可选的附加事件。以 Facebook Posts Scraper 为例,公开接口里的 post 事件在六个档位分别是 $0.005、$0.004、$0.0025、$0.002、$0.0016、$0.0008(每条);如果你用了日期范围过滤,每条再加 filter-applied 事件,Free 档 $0.002,相当于每千条从 $5.00 涨到 $7.00。这个附加费很容易被忽略:只想要「最近 7 天的帖子」的人,正是最常用日期过滤的人。
| 档位(对应计划) | 帖子 / 千条 | 评论 / 千条 | Marketplace / 千条 | 关键词搜索 / 千条 | 主页资料 / 千条 | 日期过滤附加 / 千条(帖子) |
|---|---|---|---|---|---|---|
| Free($0,每月 $5 额度) | $5.00 | $2.50 | $6.20 | $6.00 | $12.00 | $2.00 |
| Bronze(Starter,$19/月) | $4.00 | $2.00 | $5.00 | $5.00 | $8.20 | $1.00 |
| Silver(Scale,$199/月) | $2.50 | $1.70 | $3.80 | $4.00 | $6.50 | $0.80 |
| Gold(Business,$999/月) | $2.00 | $1.40 | $2.60 | $3.00 | $5.40 | $0.60 |
| Platinum(定制) | $1.60 | $0.90 | $1.50 | $2.50 | $4.00 | $0.40 |
| Diamond(定制) | $0.80 | $0.40 | $0.80 | $2.00 | $2.00 | $0.20 |
| EveryInfra 实测(不分档) | $0.0556 | $0.0556 | $0.0077 | $2.91 | $2.778 | 不另收 |
这张表能读出两件事。其一,Apify 把折扣给了月费更高的人:Business 计划每月 $999,换来的 Gold 档也只把帖子降到 $2.00;要拿到 $0.80 的 Diamond 档,得签定制合同。按每千条 $5.00 算,Free 计划每月送的 $5 额度刚好够 1,000 条帖子,再加上启动费就超了;Apify 的价格页写明,Free 计划用完额度后服务会被停用到下个计费周期,而付费计划会把超出的部分记到下一张账单上。其二,Apify 的档位折扣对第三方作者是可选的:Store 里不少便宜款在六个档位都是同一个价(比如 curious_coder 的 Marketplace scraper 六档都是 $0.50),这意味着你升级套餐也不会更便宜。
有一项 Apify 一侧的费用我们没法从公开材料算准:结果写进数据集之后,再读、再导出也算平台用量。Apify 文档的原话是,运行结束后对数据集的读写都按标准平台用量收费;价格页给的单价是每千次数据集读取 $0.0004、每千次写入 $0.005。这部分对 1,000 条结果来说只有零点几美分,不影响倍数,但长期把数据留在 Apify 上的团队会看到每月的存储费,所以我们只在这里提一句,不放进表里。
为什么同一类数据在 Store 里能差出 10 倍以上的价格?先看查得到的事实:Apify 给作者的按事件收费说明写明,作者拿事件收入的 80%,再减去自己承担的平台成本;Free 计划用户产生的平台成本由 Apify 承担,也不算进作者收入;作者还可以选择把平台用量另外转嫁给用户,开启后 14 天生效。下面是我们的推断,没有拿到任何作者的成本数据:作者定价时要先扣掉自己的计算单元和代理成本,用浏览器渲染页面的 scraper 跑一次的成本更高,只解析接口数据的更低,所以前者的标价通常也更高。读者能用上的结论是:同一类数据,先在 Store 里多比几款,价格差异主要来自作者的做法,不一定来自数据质量。
场景一:1,000 条主页帖子(apify facebook posts scraper)
我们的做法是一次请求 facebook/user_posts,参数只有主页地址和条数上限。目录(/api/v1/social/catalog?platform=facebook)写的这个能力单价是每次 $0.002778,默认 10 条,最多 50 条,异步执行。00:28:54 发出请求后立刻拿到 job_id,按 poll_url 每 8 秒查一次,00:30:06 进入收尾,结果是 50 条帖子,按 id 去重还是 50 条,时间从 2026-10-28 01:00 UTC 到 2026-11-06 11:00 UTC,正好是这个主页最近 10 天发的全部内容。扣费 $0.002778,每千条 $0.0556。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"facebook","action":"user_posts","mode":"async",
       "params":{"url":"https://www.facebook.com/natgeo","limit":50}}'
# 立刻返回 202 和 job_id,扣 $0.002778;再 GET /api/v1/jobs/<job_id> 取结果
这 50 条里,11 条是 Reels(url 指向 /reel/),播放数 view_count 只有这 11 条带(22%);播放最多的一条 Reels 发于 2026-11-03(UTC),播放 2,447,538 次、点赞 65,875、评论 554、分享 3,510;评论最多的一条图文帖是 2026-11-02(UTC)那条「翻翻你的相册」,993 条评论。这些数字来自原始返回,我们后面的评论测试就挑了这条。字段填充率按 50 条算:text 96%(2 条只有图片)、media 92%、link 76%、comment_count 98%、group_name 0%(主页帖子本来就没有群组),其余 13 个字段都是 100%;图文帖点赞中位数 1,142,最低 83、最高 10,588。
Apify 一侧,官方 Posts Scraper 的 Free 档每条 $0.005,1,000 条是 $5.00,加一次启动 $0.001;Store 里 30 天用户 ≥100 的帖子 scraper 里最便宜的是 curious_coder 的 Facebook posts scraper,Free 档每条 $0.0015,另收启动费(Free 档 $0.005,按内存每 GB 一次;内存规格怎么取,见 Apify 的用量与资源文档),它的公开评分 3.06 分(满分 5)。按我们的实测,同样 1,000 条帖子,我们比官方款 Free 档便宜 90 倍,比 Gold 档便宜 36 倍,比 Diamond 档便宜 14.4 倍,比 curious_coder 便宜 27 倍。
但是有一个限制必须写在倍数旁边:facebook/user_posts 一次最多 50 条,没有翻页参数,回来的是这个主页最新的 50 条。要凑 1,000 条,你得换 20 个不同的主页各拿 50 条,或者每天跑一次、靠时间积累。反过来,如果你的需求是「把一个主页过去两年的帖子全部拉下来」,Apify 的 Posts Scraper 支持设条数和日期范围,一次运行就能往回翻;它页面上写的是「Get 500 posts for free in less than 2 minutes」。这一类「单个主页深挖历史」的活,今天我们做不了,按每千条比价没有意义。我们适合的是「盯 20 个、200 个主页,每天拿最新的帖子」这种横向监控。
这张图只用了一次 $0.002778 的调用。它说明一次 50 条在监控场景里够用:这个主页 10 天发 50 条,一天 5 条,每天调一次就不会漏;更新慢的主页,一次 50 条能覆盖几个月。做竞品内容监控的人,最关心的通常是「对方最近发了什么、哪条火了」,而不是三年前的旧帖。
监控场景还有一笔账要单独算,因为它会把我们的优势缩小。每天调一次 user_posts,回来的是最新 50 条,其中大部分是前一天已经拿过的;按 natgeo 这 10 天的发帖节奏,一天新增大约 5 条。只按「新帖子」算,我们每天每个主页 $0.002778 换 5 条新帖,每千条新帖约 $0.56。Apify 这边可以把条数上限设成 5,每天每个主页付 5 条结果加一次启动:Free 档 $0.026,Gold 档 $0.011,Diamond 档 $0.005。这样比,我们每天每个主页比它的 Free 档便宜约 9.4 倍,比 Gold 档便宜约 4 倍,比 Diamond 档便宜约 1.8 倍。倍数从 90 倍降到个位数,但方向没变。再极端一点:主页一天只发 1 条,Apify Free 档每天每个主页是 1 条结果加 1 次启动,共 $0.006,我们仍便宜约 2.2 倍;到了 Diamond 档,每天 $0.0018,就比我们的 $0.002778 便宜了。所以盯的主页越不活跃、你在 Apify 的档位越高,按次计费的优势越小;盯的主页越活跃、你的用量越小,我们越划算。
场景二:1,000 条评论(apify facebook comments scraper)
评论测了两条帖子,都是 natgeo 的:一条显示 993 条评论,一条显示 718 条。每次请求 facebook/comments 上限 50 条,两次都回满 50 条,各扣 $0.002778,合计 100 条、$0.005556,每千条 $0.0556。两次的构成不一样:第一条帖子回了 30 条一级评论、18 条一级回复、2 条二级回复;第二条回了 11 条一级评论、21 条一级回复、18 条二级回复。也就是说,50 条的额度里一级评论和回复是混着给的,不是先给满一级评论。
这里有一个我们自己踩到的坑,必须写出来。按 id 去重,第一次的 50 条会变成 30 条:回复那一行的 id 填的是它所属的一级评论的 ID,回复自己的 ID 放在 reply_to_id 里,和字段名的字面意思正好相反。我们核对了 comment_url:一级评论是 ?comment_id=<一级 ID>,回复是 ?comment_id=<一级 ID>&reply_comment_id=<回复 ID>,50 行的 comment_url 全部不同。所以去重请用 comment_url,或者用 id 加 reply_to_id 拼成的组合键。字段名这件事是我们这边的问题,已经记下来要改;在改之前,下面的导出脚本就按 comment_url 去重。
Apify 一侧,官方 Facebook Comments Scraper 的 comment 事件 Free 档每条 $0.0025,每千条 $2.50,Diamond 档 $0.40;它页面上写可以按「最相关、最新、全部」排序,还能按时间过滤(过滤另收附加费)。Store 里更便宜的两款是 thedoor 的 Facebook Comments Scraper(30 天 261 位用户)和 dami_studio 的同名 scraper(400 位用户,价格和用户数取自它的公开接口,Store 页面我们没有单独读),都是每千条 $0.25。thedoor 的页面写得很具体:能拿到未登录访客能看到的全部评论,2,000 条来自 50 个帖子的评论约 90 秒,一个大帖子的 10,000 多条评论约 15 分钟,重复运行时只收新增评论的钱。
按每千条算,我们比官方款 Free 档便宜 45 倍,比 Diamond 档便宜 7.2 倍,比 thedoor 和 dami_studio 便宜 4.5 倍。但和帖子一样,我们一次最多 50 条、不能翻页:第一条帖子显示 993 条评论,我们拿到的 50 条只占 5.0%;第二条 718 条,占 7.0%。如果你要的是「这一个爆款帖子底下的全部评论」,thedoor 那一款能拿全,我们拿不全,这时候应该选它。如果你要的是「这 20 个帖子各自最新、最热的一批评论」,比如每天给几十个竞品帖子做情绪抽样,我们更便宜。
这 100 条评论在说什么?我们把原始返回逐条读了一遍,人工归类,一条可以归进多类。第一条帖子请大家翻相册、说说最爱拍的自然题材,30 条一级评论几乎全是正面分享:16 条提到风景、天空、树和水,12 条提到动物(野生动物、鸟、宠物),7 条是建筑、人、自家后院这类其他题材;20 条回复大多是一两句赞美,点赞合计只有 7 个,另有 2 条回复怀疑别人贴的是 AI 生成的图。第二条帖子讲一项研究:美国一个地区 20–54 岁人群的中风率三十年里几乎翻倍,研究者也在查大麻是否有关。它的 11 条一级评论里,6 条为大麻辩护(其中 4 条讲自己的经历),3 条把矛头转向酒(比如说这项研究是酒业赞助的),2 条是玩笑;一级评论点赞中位数 87,是第一条帖子(中位数 7)的 12 倍多。39 条回复以争论为主,还夹着 1 条西班牙语。两条帖子放在一起看:同样 50 条,情绪和话题可以完全不同,做情绪抽样时要按帖子分开统计,不要把一个主页下的评论混成一个平均数。评论作者的名字我们没有放进分析表,本文也不展示。
场景三:1,000 条 Marketplace 商品
Marketplace 测了一次:纽约站(location 填 nyc)、关键词 iphone 15、上限 200。同步返回用了 25.3 秒,200 行,按 id 去重 181 条(有 19 行重复),扣 $0.001389,每千条 $0.0077。181 条里,纽约州 105 条、新泽西 69 条、宾夕法尼亚 5 条、康涅狄格 2 条;价格为 $0 的 2 条,低于 $100 的 19 条(多是手机壳和配件)。把标题里带「iPhone 15」、价格 ≥$100 的 134 条挑出来,中位价 $459.50;其中标准版 56 条中位 $400,Pro 33 条中位 $489,Pro Max 37 条中位 $550。这些数是一次 $0.001389 的调用换来的,做二手比价的人可以直接用。
| 字段 | 填充率(181 条) | 说明 |
|---|---|---|
id、url、name、price、city、state、image_url | 100% | 价格是字符串,例如 "459.50" |
currency | 0% | 这次全部为空;纽约站默认美元,但字段没回 |
condition | 0% | 成色没回,要靠标题判断 |
posted_at | 0% | 发布时间没回,不能按新旧排序 |
这三个空字段要老实说。目录里 facebook/marketplace 的 response_fields 列了 currency、condition、posted_at,这次一个都没回。Apify 官方 Marketplace Scraper 的页面写着能给最低和最高价、售价、位置、卖家、视频、是否已售(Sold、Live、Pending)、配送方式;它的 listing-details 附加事件每条再收一次同价(Free 档 $0.0062),用来抓单个商品的详情。curious_coder 的 Marketplace scraper(654 位用户,评分 4.92)页面样例里有经纬度、邮编、是否已售、卖家 ID。要这些字段的人,我们这边要再按商品调 facebook/marketplace_item(目录价每次 $0.000958),1,000 条详情就是 $0.958,加上列表也才 $0.966,仍然比官方款 Free 档的列表价 $6.20 便宜,但比 curious_coder 列表 $0.50 贵。
所以 Marketplace 这一项的结论分两层:只要列表(标题、价格、城市、图片),我们每千条 $0.0077,比官方款 Free 档便宜 808 倍,比 Store 最便宜的 $0.50 便宜 65 倍;要成色、发布时间、卖家这些详情,按我们的详情能力算每千条约 $0.966,比 curious_coder 只拿列表贵,和官方款带详情的 $12.40(列表 + 详情两个事件)比还是便宜 12.8 倍。
场景四:关键词搜帖子(facebook scraper api 的另一种用法)
关键词搜索是这次唯一「按条数档位」计费的能力:目录写 facebook/search 单价 $0.016、rows_per_unit 为 10,也就是每 10 条一档。00:33:17 搜 air fryer recipe、上限 10,20.3 秒回了 6 条,扣了一整档 $0.016。6 条帖子的发布时间从 2025-09-25 到 2026-11-05,其中 4 条在最近 30 天内,点赞 8 到 436。按实际 6 条算,每千条是 $2.67;00:34:58 又搜了 meal prep ideas,按最新排序、上限 20,26.8 秒回了 5 条。这一次响应里写得很清楚:请求了 2 档(requested_units 为 2),实际只够 1 档(billed_units 为 1),多预扣的那一档当场退回,最终扣 $0.016。两次合计 11 条、$0.032,每千条 $2.91。
这个价格要放在 Apify 的搜索 scraper 旁边看。官方 Facebook Search Scraper 的 facebook-result 事件 Free 档每千条 $6.00、Gold 档 $3.00、Diamond 档 $2.00;Store 里 30 天用户 ≥100 的最便宜一款是 memo23 的 Facebook Search Scraper,每千条 $1.90,外加每次启动 $0.005。所以搜索这一项,我们只比官方款 Free 档便宜 2.1 倍、和 Gold 档几乎持平($2.91 对 $3.00),比 Diamond 档和 memo23 都贵。原因有两个:一是按 10 条一档计费,回 5 条、6 条也收一整档,今天两次都没装满;二是 Facebook 的关键词搜索本身回得少,我们两次要 10 条和 20 条,各回 6 条和 5 条。如果每次都能回满 10 条,我们的每千条会是 $1.60,比 memo23 便宜一点;但今天的实测没有做到,所以这里不写「我们更便宜」。搜索结果里的作者大多是个人账号,本文不展示他们的名字;11 条里有 8 条发布于最近 30 天内,最高的一条 Reels 点赞 9,985。
主页资料:Apify 的 Diamond 档比我们便宜
主页资料是这次唯一「一次只回一个对象」的能力,按次计费的优势在这里消失。facebook/profile 目录价每次 $0.002778,一个主页一次,每千个主页就是 $2.778。00:34:04 我们调了一次 natgeo 的主页资料,异步约 46 秒出结果,扣 $0.002778,回来的是名称、简介、分类(Page、Media/news company)、粉丝数 51,441,764、网站和头像;目录里列的 is_verified、phone、email、rating 这次是空的,like_count 回的是 0,看起来没取到真实值。如果你只要名称、分类、粉丝数、网站这类基础字段,一次 $0.002778 就够;要商家电话、邮箱、评分,今天这次调用没有给出来,我们不把它算作已经做到。 Apify 官方 Facebook Pages Scraper 的页面写得很直接:每千个主页 $12,Free 计划最多抓 416 个主页;Starter 计划降到 $8.20。公开接口里 Gold 档是 $5.40,Diamond 档 $2.00。
所以这一项的倍数是:比官方款 Free 档便宜 4.3 倍,比 Gold 档便宜 1.9 倍;但在 Diamond 档,Apify 每千个 $2.00,比我们的 $2.778 便宜 1.39 倍。Store 里 30 天用户 ≥100 的主页 scraper 最便宜的是 premiumscraper 的 $3.00,和我们只差 8%。主页资料如果是你的主要需求(比如批量补全几万个商家主页的电话、网站、评分),而且你已经是 Apify 的大客户,留在 Apify 更划算。
一篮子:1,000 条帖子、1,000 条评论、1,000 条商品
单项比完,再算一个更接近真实项目的组合:一个做品牌监控的团队,每月要 1,000 条竞品主页帖子、1,000 条这些帖子下的评论、1,000 条 Marketplace 二手价。Apify 官方三款按 Free 档:$5.00 + $2.50 + $6.20 = $13.70,再加几次启动费;按 Business 计划的 Gold 档:$2.00 + $1.40 + $2.60 = $6.00(但月费 $999 先付);按 Diamond 档:$0.80 + $0.40 + $0.80 = $2.00;三类各挑 Store 最便宜的:$1.50 + $0.25 + $0.50 = $2.25。
EveryInfra 按今天的实测条数算:帖子每次 50 条,1,000 条要 20 次 × $0.002778 = $0.0556;评论每次 50 条,20 次 = $0.0556;Marketplace 每次去重 181 条,6 次 × $0.001389 = $0.0083;合计 $0.119。和 Apify 官方三款 Free 档比便宜 115 倍,和 Diamond 档比 16.7 倍,和三款最便宜的组合比 18.8 倍。
这笔账的前提要写清楚:我们的 20 次帖子调用必须是 20 个不同主页(同一主页 5 分钟内重复请求会拿到上一份结果,见上手步骤),20 次评论调用必须是 20 个不同帖子,6 次 Marketplace 要换城市或关键词。如果你的 1,000 条帖子全部来自同一个主页,或者 1,000 条评论来自同一个帖子,这一篮子我们给不出来,只能去用 Apify 那类能翻页的工具。另外,Apify 的 Free 计划每月只有 $5 额度,$13.70 的篮子在 Free 计划上跑不完,最少要 Starter 计划($19/月,Bronze 档价 $4.00 + $2.00 + $5.00 = $11.00)。
facebook scraper api:两边的调用方式
Apify 的调用方式是「启动一次运行,等它跑完,再读数据集」。它的 API 也提供同步跑完就返回数据集的端点,接到程序里大致是:
# Apify:启动官方 Posts Scraper 并等它跑完(配置示例,未实测)
import requests, os
r = requests.post(
    "https://api.apify.com/v2/acts/apify~facebook-posts-scraper/run-sync-get-dataset-items",
    params={"token": os.environ["APIFY_TOKEN"]},
    json={"startUrls": [{"url": "https://www.facebook.com/natgeo"}], "resultsLimit": 50},
    timeout=300,
)
posts = r.json()  # 每条 $0.005(Free 档),外加启动 $0.001
这段我们没有跑(没有 Apify 账号),参数名取自它 Store 页面的输入说明,写成配置示例。EveryInfra 这边,同一件事是一个 POST /api/v1/social,异步能力回 202 和 job_id,再查 /api/v1/jobs/<job_id>。下面是我们把评论导出成 CSV 的完整脚本,按 comment_url 去重,翻多个帖子、写 CSV,标准库的 csv 模块就够:
# 把多条 Facebook 帖子的评论导出到 comments.csv(按 comment_url 去重)
import csv, json, os, time, urllib.request

KEY = os.environ["EVERYINFRA_API_KEY"]
API = "https://api.everyinfra.com"

def call(path, body=None):
    req = urllib.request.Request(API + path, data=json.dumps(body).encode() if body else None,
        headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"},
        method="POST" if body else "GET")
    with urllib.request.urlopen(req, timeout=120) as r:
        return json.loads(r.read())

def comments(post_url):
    job = call("/api/v1/social", {"platform": "facebook", "action": "comments", "mode": "async",
                                  "params": {"url": post_url, "limit": 50}})
    while True:
        time.sleep(8)
        res = call(job["poll_url"])
        if res["status"] in ("succeeded", "failed"):
            return res.get("results", [])

seen, rows = set(), []
for url in open("post_urls.txt").read().split():
    for c in comments(url):
        if c["comment_url"] in seen:
            continue
        seen.add(c["comment_url"])
        rows.append({k: c.get(k) for k in ("comment_url", "depth", "text", "like_count",
                                            "reply_count", "posted_at")})
with open("comments.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.DictWriter(f, fieldnames=rows[0].keys())
    w.writeheader(); w.writerows(rows)
print(len(rows), "comments")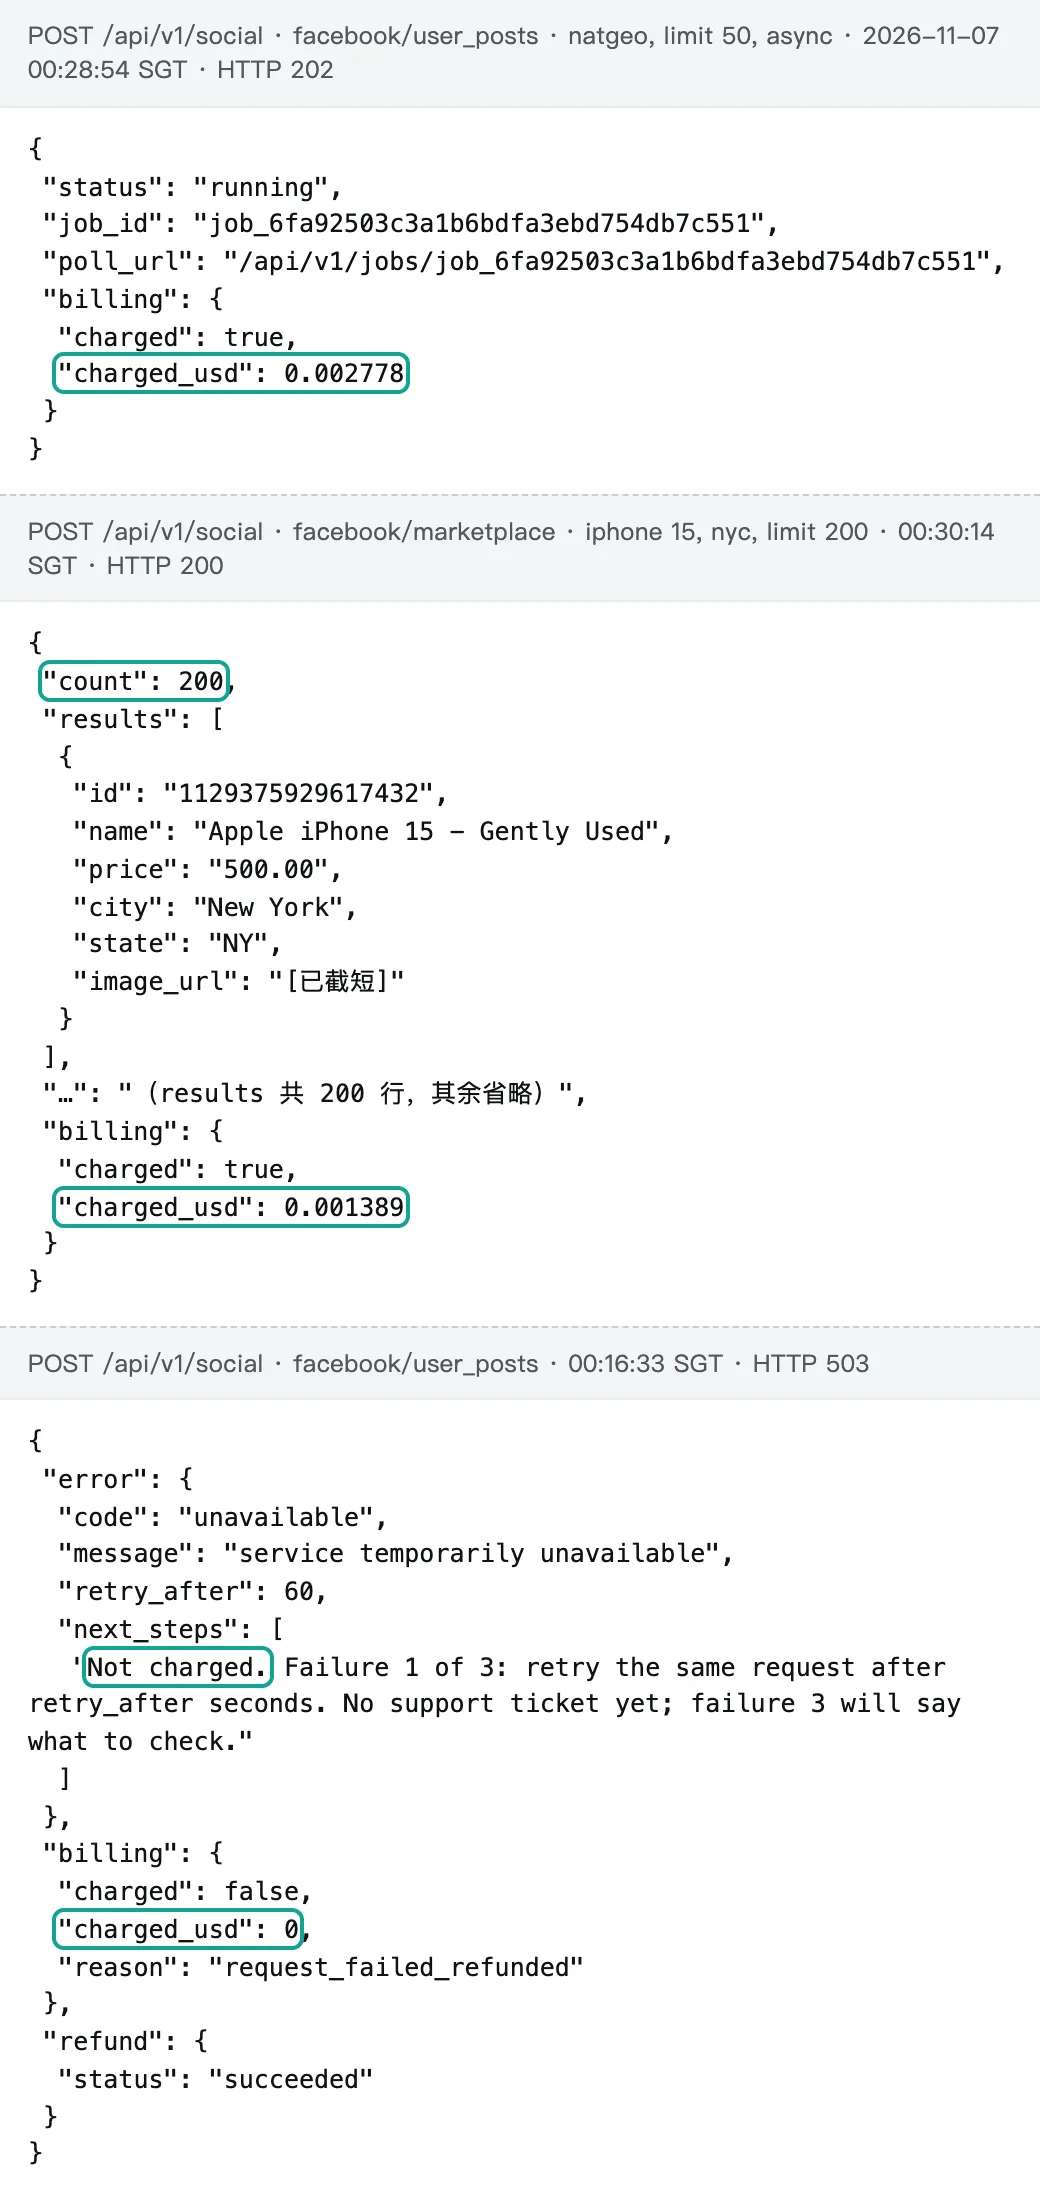
两种方式的差别,除了价格,主要在三处。一是参数:Apify 每个 scraper 的输入字段名各不相同(帖子用 startUrls,评论另有排序和是否带回复的选项),我们 16 个 Facebook 能力用同一个请求格式,参数写错时 422 会回 did_you_mean 和允许的参数名(测试表里第 2 次调用就是 limt 被纠正成 limit)。二是结果的形状:Apify 官方款的样例输出保留了大量 Facebook 原始结构(textReferences、feedbackId、媒体里的 photo_image),信息多但要自己清洗;我们回的是统一的 19 个帖子字段、13 个评论字段,可以直接写 CSV。三是速度:Apify 的优势在「一次跑很多」,thedoor 写的是每分钟最多 1,300 条评论;我们单次请求 20–75 秒,适合一次几十条、每天定时跑。
这张图是我们给自己挑的毛病:评论字段全有值;关键词搜索回的帖子比主页帖子少 7 个字段,没有媒体和播放数;主页资料和 Marketplace 各缺几项商家和商品详情。要这些字段的,先看清再下单。
把今天 7 次成功调用的耗时摊开看,更容易判断适合哪种节奏。同步能力里,Marketplace 一次 200 行用了 25.3 秒,两次关键词搜索分别 20.3 秒和 26.8 秒;异步能力从发出请求到结果可取,主页资料约 46 秒,评论约 42 秒和 75 秒,帖子约 72 秒。换算成吞吐,帖子是每分钟 40 多条,评论每分钟 40–70 条,Marketplace 每分钟 400 多条(按去重后的条数算)。Apify 的官方 Posts Scraper 自己写的是 2 分钟内拿 500 条帖子,thedoor 写的是每分钟最多 1,300 条评论;这两个数是对方页面上的说法,我们没有实测。所以结论要打个折扣:按对方页面的说法,单次要几千条时 Apify 快一个数量级,但这不是同一方法下的实测对比;每天定时给几十个主页各拉一次,我们一分钟左右出结果,已经够用。我们的测试 Key 每分钟只有 10 次请求的额度,正式 Key 的并发和速率以控制台显示为准。Apify 一侧也有并发上限:它的限额文档写明,Free 计划同一时间最多跑 5 个运行(Starter 32 个、Scale 128 个、Business 256 个),每个用户最多 100 个定时任务;要盯几百个主页,就得把多个主页地址放进同一次运行的输入里,而不是一个主页建一个定时任务。
失败和空结果扣不扣钱
今天的真调正好把失败情况测全了。00:16:33 到 00:27:39,Facebook 能力连续 10 次失败:5 次 503「service temporarily unavailable」,4 次服务端 429「rate limited」,另有 1 次是这把共用测试 Key 自己超过了每分钟 10 次。10 次的 billing.charged_usd 都是 0,refund.status 是 succeeded;第 3 次连续失败时,返回里的 next_steps 直接写「3 failures in 10 minutes for facebook/search; none was charged」,并给出一个可以先试的示例请求,建议确认是不是我们这边的问题再决定要不要开工单。加上开头那次不带 Key 的 401 和参数拼错的 422,12 次失败合计 $0。
Apify 一侧,按事件收费的规则决定了失败时扣多少:主事件只在「一条结果写进数据集」时收,没结果就不收;但「启动」事件在运行开始时就收了,官方款每次 $0.001,有的第三方款是 $0.005 到 $0.09(Store 里我们读到的最高启动费是两款 powerai scraper 的 $0.09)。运行失败、超时、被你中途停掉,启动费不退。Apify 自己的数字也说明失败不罕见:Posts Scraper 的公开统计写近 30 天 6,050,949 次运行,其中 14,398 次超时、63 次失败、成功率 99.69%;成功的运行也可能回 0 条(比如主页设了地区限制),那种情况只收启动费。两边在「没拿到数据就不收结果钱」这一点上是一样的;区别是我们没有启动费,失败的请求整笔退回。
还有一种情况要单独说:搜索按 10 条一档,回 6 条也收一档。这不是失败,但会让小批量搜索的每千条价偏高;想把这项成本压下来,就把 limit 设成 10 的倍数,让每档尽量装满。
在 Apify 上防止花超,最有用的是一个参数:同步运行接口上的 maxTotalChargeUsd,限定这次运行的总花费。举个具体数:用官方 Posts Scraper 的 Free 档抓 1,000 条帖子,结果费 $5.00 加启动费 $0.001,把 maxTotalChargeUsd 设成 $5.50,即使输入写错、条数失控,这次运行最多也只花 $5.50。运行有哪几种结束状态、失败后能不能带着原来的存储接着跑,见运行与构建文档。
最后一个和钱有关的坑是结果存多久。Apify 的数据集文档写明,没命名的数据集 7 天后过期,命名的数据集一直保留;数据集只能追加、不能修改。照做只需要一句话:跑完 7 天内导出,或者给数据集命名;否则过期后要再拿,就得重跑一次、再付一次结果费。我们这边的异步结果同样只是临时存放,拿到就写进自己的库。
接 MCP 和 AI 工具
两边都能接 AI 工具。Apify 的 MCP 文档写的是远程地址 https://mcp.apify.com,首次连接走浏览器 OAuth 登录,也可以用 API Token;它能让 AI 搜索 Store、运行 actor、读取结果;开源仓库 apify/apify-mcp-server 在 2026-11-06 还有提交,2026-11-07 读到 15,051 颗星。
EveryInfra 的远程 MCP 是 https://api.everyinfra.com/mcp,今天用 tools/list(不带 Key、不计费)读到 12 个工具,其中和本文有关的是 everyinfra_list_capabilities(列出 106 个平台、573 项能力)、everyinfra_call_api(调任意能力)和 everyinfra_get_job(取异步结果)。在 Claude Code 里加上它,按 Claude Code 的 MCP 文档用 HTTP 方式:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
接上以后,对 AI 说「拉 natgeo 主页最近 50 条帖子,挑评论最多的 3 条,各拿 50 条评论,按 comment_url 去重后总结大家在说什么」,它会依次调 everyinfra_call_api(facebook/user_posts)→ everyinfra_get_job → 三次 facebook/comments,按今天的单价总共 $0.011112。两边的 MCP 都遵循同一个 Model Context Protocol。差别还是计费单位:让 AI 自己决定调多少次的时候,按次计费更好预估,一次最多 $0.016(关键词搜索),而按结果计费要靠 maxTotalChargeUsd 这类上限防止 AI 一次拉太多。thedoor 的页面就专门提醒给 AI 用的时候设 maxTotalChargeUsd,比如 0.50。
自己用 Graph API 或开源库,行不行
在比两家价格之前,先问一句:能不能不花钱,自己拿?Meta 的 Page Feed 接口文档写得很清楚:读一个主页的帖子,申请访问令牌的人要在这个主页上有发帖、管理或审核权限;不是你管理的主页,就得用 Page Public Content Access,而那项功能要过应用审核和企业验证。即使拿到了权限,文档还列了几条限制:一年大约只返回 600 条按排序挑出的已发布帖子;limit 最多 100,超过直接报错;视频帖要主页管理员才能列出来;不用主页令牌请求时,回应里不带用户信息。对「盯住 50 个竞品主页」这种需求,这条路基本走不通。
开源库是另一条路。最常被提到的是 kevinzg/facebook-scraper,GitHub 上 3,323 颗星,但最近一次提交在 2024-06-22,PyPI 上的最新版本 0.2.59 还是 2022-08-31 发布的,已经两年多没更新;Meta 自己在 2021 年的文章《How We Combat Scraping》里写,它有一支 100 多人的外部数据滥用团队,专门检测、拦截抓取,手段包括访问频率限制、数据量限制、识别自动化行为,以及发律师函、封号和起诉。这意味着自己写的脚本,维护成本主要花在跟反爬措施较劲上,而不是业务本身。已经在用 Apify 的团队,最省事的做法是用它的官方 Python 客户端:自带指数退避重试(对网络错误、429 和 5xx),也能直接迭代数据集,不用自己处理分页。
Meta 的条款和公开页面抓取:哪些要注意
这一节不是法律意见,只把公开文件里写的东西摆出来,用不用、怎么用请你自己或律师判断。
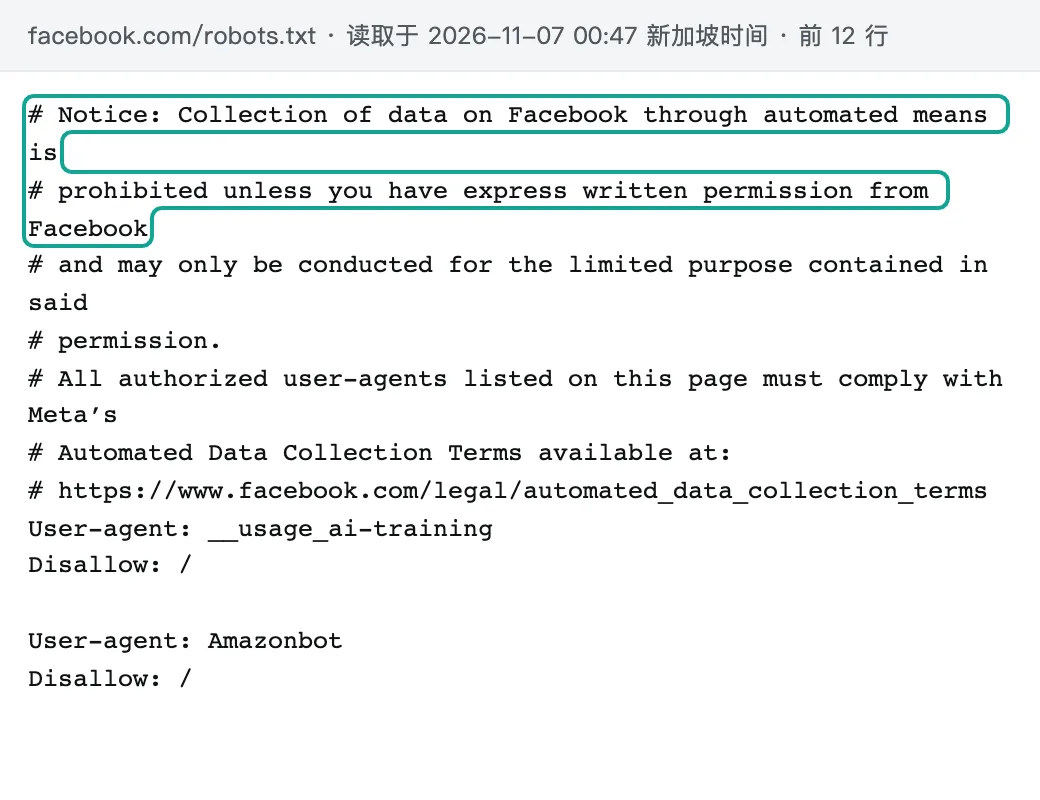
Meta 自己的态度写得很明白。Meta 服务条款第 3.2 节写:不得在未经事先许可的情况下用自动化方式访问或收集 Meta 产品里的数据,并且特意加了一句「不论是否登录 Facebook 账号」。facebook.com/robots.txt 开头的注释写的是:未经 Facebook 明确书面许可,禁止用自动化方式收集 Facebook 上的数据;文件里还点名禁止了 ClaudeBot、GPTBot、Google-Extended、PerplexityBot 等一长串爬虫。
法院的态度没有那么一边倒。2024-01-23,美国加州北区联邦地区法院在 Meta 诉一家数据公司的案子(案号 3:23-cv-00077)里判数据公司一方胜,Meta 的违约主张没有成立;多家律所的解读是,法院区分了「登录后受条款约束的使用」和「未登录抓取公开数据」。更早的 hiQ v. LinkedIn(第九巡回法院,2022-04-18)和美国最高法院的 Van Buren v. United States(2021)都把讨论引向「公开页面不需要授权」这一边。但这些都是美国的判例,只针对特定的诉由,不等于抓取在所有地方都合法。
个人数据是另一条线。欧盟的 GDPR 不因为数据「公开」就不适用;2022-11-28,爱尔兰数据保护委员会因为 Facebook 数据被大规模抓取一事对 Meta 罚了 €2.65 亿,理由是 Meta 没有做到「设计即保护」。这说明监管机构把公开资料被批量抓走当成真实风险。我们的建议很朴素:只拿业务需要的字段,评论作者的名字和主页链接不需要就别存;做情绪统计时只留文本和时间。
监管机构也在盯平台本身。2024-10-29,澳大利亚信息专员办公室(OAIC)和另外 16 个国家和地区的隐私监管机构发布了第二份数据抓取联合声明,要求社交平台组合使用多种防抓取措施并定期更新,同时写明:出于商业或公益目的、被允许的抓取,也要合法并遵守严格的合同条款。对使用方来说,这句话的意思是:即使数据是从合规渠道拿到的,用途和保存方式仍然要经得起问。
如果你要的是「合规地拿公开内容」而且身份合适,Meta 自己有渠道:Page Public Content Access 能读公开主页的帖子和评论,但要过应用审核和企业验证;Meta Content Library 面向学术和非营利研究机构,申请页写了审核约 2–3 周、处理再 2–3 周,Meta 自己的安全环境里不收费;它取代的 CrowdTangle 已于 2024-08-14 停用。Bellingcat 的工具手册转述,SOMAR(密歇根大学 ICPSR 的研究数据平台)2026 年夏季通讯写的是新建虚拟数据环境一次性 $1,000、每月 $371(Bellingcat 工具手册,原文是 SOMAR 通讯,我们没读到原件)。商业公司做竞品监控,这两条路通常走不通,这也是 Apify 和我们这类工具存在的原因。
什么时候 Apify 更合适
把对方比我们强的地方照实列出来,按今天读到的公开材料和我们的实测:
| 场景 | 更合适的一方 | 依据 |
|---|---|---|
| 从一个主页往回翻几百上千条历史帖子 | Apify Posts Scraper | 支持条数和日期范围;我们一次最多最新 50 条、不能翻页 |
| 一个爆款帖子底下的全部评论 | thedoor 等评论 scraper | 能拿到未登录可见的全部评论;我们一次 50 条,993 条里只拿到 5.0% |
| 批量主页资料,且你是 Diamond 档大客户 | Apify Pages Scraper | Diamond 档每千个 $2.00,我们 $2.778 |
| 小批量关键词搜帖子 | memo23 等第三方搜索 scraper | 每千条 $1.90;我们按每 10 条一档计费,今天实测 $2.91 |
| Marketplace 要成色、卖家、是否已售 | curious_coder 或官方款带详情 | 我们列表这次没回成色、发布时间、币种 |
| 已经在 Apify 上搭了 n8n、Make 工作流 | 留在 Apify | 迁移成本可能比省下的接口费高 |
| 我们 16 项能力之外的长尾数据(比如群组成员名单、Reels 专用列表) | Apify Store 搜「facebook」有 3,141 个结果,大概率有现成的 | 我们的 Facebook 能力只有 16 项 |
最后一条要多说一句。Store 搜索「facebook」返回 3,141 个条目,我们读了前 195 个;长尾需求(某种特定页面、特定字段)在 Apify 上大概率有人做过,而我们目录里 Facebook 一共 16 项能力:搜索、主页、帖子、单帖、评论、粉丝数、广告素材、群组帖子、Marketplace 列表和详情、评价、广告主搜索、广告详情、活动搜索、主页活动、视频文稿。需求落在这 16 项里,看价格;落在外面,就用 Apify。Reddit 上也有人说 Apify 的 Facebook scraper 改了收费方式之后「越来越贵」(r/n8n 的讨论),但同一个帖子里也有人提醒:抓别人公开主页的便宜方案,长期不一定稳。凌晨那 10 次 503/429 就是一个提醒:任何一家都可能在某个时段拿不到 Facebook 的数据,重要的流程要有重试。
和站内其他 Apify 文章有什么不同
站内已经有几篇和 Apify 相关的文章,本篇不重复它们。Apify 价格怎么读讲的是 Apify 的计划、计算单元和按事件收费的通用规则;Apify 替代方案是跨平台的总览;Apify TikTok Scraper 替代和 Apify LinkedIn Scraper 替代分别是 TikTok 和 LinkedIn 的每千条实测;n8n 里替换 Apify讲工作流迁移。本篇只讲 Facebook,并且是站内第一次把 Facebook 的帖子、评论、Marketplace、搜索、主页五类数据逐项实测。想看所有替代方案的对照,可以去替代方案页。
最近的变化
最近 30 天里和「抓 Facebook 公开数据」直接相关的有四件事,每件后面写了读者该做什么:
Meta 新版商业条款,从提出到撤回只用了一个月。2026-10-15 前后,Nieman Lab 报道了这份条款:使用 Meta 商业账号的企业,要授权 Meta 用爬虫抓取与其相关的网站内容,原定 2026-10-30 生效;2026-10-28,Meta 宣布暂停并征求业界意见(此前生效日期已推到 2026-11-20);我们 2026-11-07 读到,Meta 在商业帮助中心的通知里写明这些更新已暂停、不会在 2026-11-20 生效,现行条款继续有效,抓取做法不变,网站所有者仍可用 robots.txt 表明偏好。该做什么:不想让 Meta 爬虫抓自己网站的团队,不用等新条款,现在就按 Meta 爬虫文档在 robots.txt 里给 meta-externalagent、meta-externalads 这些爬虫写 Disallow;文档也写明,FacebookExternalHit 做安全检查时、Meta-ExternalFetcher 替用户取单个链接时,可能不遵守 robots.txt。
2026-10-27,Graph API v26.0 的一批变更开始对所有仍在支持的版本生效,包括 Commerce Order Management API 的 47 个端点下线、?ids= 根请求报错等。该做什么:已经用 Graph API 的项目,在代码里搜一遍 ?ids= 根请求和订单管理端点,有就按变更日志改;走官方接口同样要跟着 Meta 的版本节奏改代码。
2026-10-30,英国竞争与市场管理局(CMA)正式立案调查 Meta 的商业条款是否滥用支配地位。该做什么:在英国有业务、靠 Facebook 数据做长期项目的团队,把数据来源和用途写进项目文档,调查结论如果改变条款,可以直接对照调整。
Apify Store 一侧也在变:thedoor 评论 scraper 现行价格从 2026-10-29 起生效,curious_coder 帖子 scraper 的现行价格从 2026-10-31 起生效(都来自各自公开接口的 pricingInfos)。该做什么:本文表格里的 Apify 价格只代表 2026-11-07 那一刻,下单前打开对应 scraper 的公开接口再看一次。
常见问题
apify facebook posts scraper 免费吗?
不完全免费。(问题来自 Google 联想词「apify facebook posts scraper free」。)Apify 的 Free 计划每月送 $5 额度、不用信用卡;官方 Posts Scraper 的 Free 档每条 $0.005,$5 大约够 1,000 条帖子减去启动费,用完后服务停到下个计费周期。我们这边按次计费,今天 50 条帖子扣 $0.002778,按这个价,$5 能拿到大约 90,000 条帖子(要分布在 1,800 个不同主页上)。
apify facebook comments scraper 一次能拿多少条评论?
(问题来自联想词「apify facebook comments scraper」。)官方 Comments Scraper 页面写可以抓「成千上万条」,并按排序和时间过滤;thedoor 的版本写能拿到未登录可见的全部评论,大帖子 10,000 多条约 15 分钟。我们的 facebook/comments 一次最多 50 条、不能翻页,今天两条帖子分别显示 993 和 718 条评论,我们各拿到 50 条。
有没有开源的 Facebook 爬虫,比如 GitHub 上的 Python 库?
(问题来自联想词「apify facebook posts scraper github」「facebook 爬虫 github」「how to scrape facebook posts using python」。)最常被提到的是 kevinzg/facebook-scraper,现状见上文「自己用 Graph API 或开源库,行不行」一节:3,323 颗星,但两年多没有提交,PyPI 最新版停在 2022 年,仓库还有 447 个未关闭的问题;它的 README 里多处要求提供登录后的 cookie。自己维护的成本,主要不是写代码,而是应对 Facebook 页面结构和反爬的频繁变化。
抓取 Facebook 公开数据合法吗?
(问题来自联想词「is it legal to scrape facebook」「is it legal to scrape facebook data」。)没有一句话的答案,本文也不提供法律意见。公开文件能告诉你的是:Meta 条款禁止未经许可的自动化收集;美国法院在 Meta 诉一家数据公司案(2024-01-23)里没有支持 Meta 对未登录抓取公开数据的违约主张;欧盟 GDPR 对公开的个人数据同样适用,爱尔兰监管机构 2022 年就 Facebook 数据抓取对 Meta 罚了 €2.65 亿。用之前请按你所在地区的法律自行判断。
能抓 Facebook Marketplace 吗?
(问题来自联想词「can you scrape facebook marketplace」「facebook marketplace scraper api」。)Meta 没有给第三方读取 Marketplace 商品的公开 API,Reddit 的 r/learnpython 上也有人问过这件事。今天我们用 facebook/marketplace 在纽约搜 iphone 15,一次拿到 181 条不重复商品,扣 $0.001389;Apify 官方 Marketplace Scraper 每千条 $6.20 起,Store 里 curious_coder 的款 $0.50。
Facebook Graph API 能直接拿主页帖子吗?
(问题来自联想词「facebook graph api get page posts」。)能,但只限你有管理权的主页,或者你的应用通过了 Page Public Content Access 审核。这项功能要应用审核和企业验证,Meta 文档写明它的用途限于「分析和展示主页上的帖子与互动」。没有通过审核的应用,上线后看不到任何别人的主页公开内容。
上手步骤
- 在 EveryInfra 控制台注册,拿一把 API Key,按价格页充值,最低额度和计费单位以页面为准;失败和空结果不扣费。
- 先读免费目录
GET /api/v1/social/catalog?platform=facebook,确认 Facebook 平台页上的 16 项能力和单价;要找具体字段,看facebook/user_posts、facebook/comments、facebook/marketplace、facebook/search、facebook/post各自的能力页。 - 用本文的 curl 先调一次
facebook/user_posts,异步能力会回job_id,按poll_url查结果;不要在 5 分钟内重复发同一个请求等结果,那样会拿到「已重放」的 202。 - 要在 AI 里用,按 MCP 接入页把
https://api.everyinfra.com/mcp加进 Claude Code、Cursor 等工具;或者去试用台直接在网页上点几次。 - 同一个 Key 也能调 Instagram 数据接口和其他 100 多个平台;做竞品监控时,把 Facebook 和 Instagram 放在同一个脚本里,计费方式一样。
参考资料
- Facebook Posts Scraper(Store 页),Apify,读取于 2026-11-07,https://apify.com/apify/facebook-posts-scraper
- apify~facebook-posts-scraper 公开接口(pricingInfos、stats),Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/apify~facebook-posts-scraper
- Facebook Comments Scraper(Store 页),Apify,读取于 2026-11-07,https://apify.com/apify/facebook-comments-scraper
- apify~facebook-comments-scraper 公开接口,Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/apify~facebook-comments-scraper
- Facebook Marketplace Scraper(Store 页),Apify,读取于 2026-11-07,https://apify.com/apify/facebook-marketplace-scraper
- apify~facebook-marketplace-scraper 公开接口,Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/apify~facebook-marketplace-scraper
- Facebook Pages Scraper(Store 页),Apify,读取于 2026-11-07,https://apify.com/apify/facebook-pages-scraper
- apify~facebook-pages-scraper 公开接口,Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/apify~facebook-pages-scraper
- apify~facebook-search-scraper 公开接口,Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/apify~facebook-search-scraper
- Facebook Comments Scraper(thedoor,Store 页),Apify Store,读取于 2026-11-07,https://apify.com/thedoor/facebook-comment-scraper
- curious_coder~facebook-marketplace 公开接口,Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/curious_coder~facebook-marketplace
- curious_coder~facebook-post-scraper 公开接口,Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/curious_coder~facebook-post-scraper
- memo23~facebook-search-scraper 公开接口,Apify,读取于 2026-11-07,https://api.apify.com/v2/acts/memo23~facebook-search-scraper
- Store 搜索接口(search=facebook),Apify,读取于 2026-11-07,https://api.apify.com/v2/store?search=facebook&limit=200
- Apify pricing,Apify,读取于 2026-11-07,https://apify.com/pricing
- Actors in Store,Apify 文档,读取于 2026-11-07,https://docs.apify.com/platform/actors/running/actors-in-store
- Limits,Apify 文档,读取于 2026-11-07,https://docs.apify.com/platform/limits
- Apify MCP server,Apify 文档,读取于 2026-11-07,https://docs.apify.com/platform/integrations/mcp
- apify/apify-mcp-server,GitHub,读取于 2026-11-07,https://github.com/apify/apify-mcp-server
- kevinzg/facebook-scraper,GitHub,读取于 2026-11-07,https://github.com/kevinzg/facebook-scraper
- facebook-scraper 0.2.59,PyPI,2022-08-31,https://pypi.org/project/facebook-scraper/
- Meta Terms of Service,Meta,读取于 2026-11-07,https://www.facebook.com/terms/
- robots.txt,Facebook,读取于 2026-11-07,https://www.facebook.com/robots.txt
- Page Public Content Access,Meta for Developers,读取于 2026-11-07,https://developers.facebook.com/docs/features-reference/page-public-content-access/
- Graph API Version 26.0 changelog,Meta for Developers,2026-07-31 更新,https://developers.facebook.com/docs/graph-api/changelog/version26.0/
- CrowdTangle,Meta Transparency Center,2024-08-16,https://transparency.meta.com/researchtools/other-data-catalogue/crowdtangle/
- Meta Content Library and API,Meta Transparency Center,读取于 2026-11-07,https://transparency.meta.com/researchtools/meta-content-library/
- Get access:Meta Content Library and API,Meta for Developers,读取于 2026-11-07,https://developers.facebook.com/docs/content-library-and-api/get-access/
- Meta Platforms, Inc. 诉数据公司案判决(3:23-cv-00077),美国加州北区联邦地区法院(govinfo),2024-01-23,https://www.govinfo.gov/app/details/USCOURTS-cand-3_23-cv-00077/USCOURTS-cand-3_23-cv-00077-7
- hiQ Labs v. LinkedIn,美国第九巡回上诉法院,2022-04-18,https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- Van Buren v. United States,美国最高法院,2021-06-03,https://www.supremecourt.gov/opinions/20pdf/19-783_k53l.pdf
- Facebook「Data Scraping」调查决定,爱尔兰数据保护委员会,2022-11-28,https://www.dataprotection.ie/en/news-media/press-releases/data-protection-commission-announces-decision-in-facebook-data-scraping-inquiry
- 通用数据保护条例(GDPR),EUR-Lex,2016-04-27,https://eur-lex.europa.eu/eli/reg/2016/679/oj
- CMA opens investigation into Meta's commercial terms,英国竞争与市场管理局,2026-10-30,https://www.gov.uk/government/news/cma-opens-investigation-into-metas-commercial-terms--2
- Meta's new commercial terms will allow the scraping of news sites,Nieman Lab,2026-10-15,https://www.niemanlab.org/2026/10/metas-new-commercial-terms-will-allow-the-scraping-of-news-sites-legal-experts-say/
- Updates to Meta's Commercial Terms … Will Not Take Effect on November 20, 2026,Meta 商业帮助中心,读取于 2026-11-07,https://www.facebook.com/business/help/2481113349080785
- Meta Web Crawlers,Meta for Developers,2026-05-21 更新,https://developers.facebook.com/documentation/sharing/webmasters/web-crawlers
- Alternative to Apify for FB Scraping,Reddit r/n8n,读取于 2026-11-07,https://www.reddit.com/r/n8n/comments/1mlgpna/alternative_to_apify_for_fb_scraping/
- Facebook 能力目录,EveryInfra,读取于 2026-11-07,https://api.everyinfra.com/api/v1/social/catalog?platform=facebook
- Model Context Protocol:Introduction,modelcontextprotocol.io,读取于 2026-11-07,https://modelcontextprotocol.io/docs/getting-started/intro
- Connect Claude Code to tools via MCP,Anthropic 文档,读取于 2026-11-07,https://code.claude.com/docs/en/mcp
- csv:CSV File Reading and Writing,Python 文档,读取于 2026-11-07,https://docs.python.org/3/library/csv.html
- Meta Content Library,Bellingcat 在线调查工具手册,读取于 2026-11-07,https://bellingcat.gitbook.io/toolkit/more/all-tools/meta-content-library
- Pay-per-event pricing model,Apify 文档,读取于 2026-11-07,https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event
- Dataset,Apify 文档,读取于 2026-11-07,https://docs.apify.com/platform/storage/dataset
- Actor runs and builds,Apify 文档,读取于 2026-11-07,https://docs.apify.com/platform/actors/running/runs-and-builds
- Run Actor synchronously and get dataset items,Apify API 文档,读取于 2026-11-07,https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post
- Actor usage and resources,Apify 文档,读取于 2026-11-07,https://docs.apify.com/platform/actors/running/usage-and-resources
- apify/apify-client-python,GitHub,读取于 2026-11-07,https://github.com/apify/apify-client-python
- Page Feed,Meta for Developers,读取于 2026-11-07,https://developers.facebook.com/docs/graph-api/reference/page/feed/
- How We Combat Scraping,Meta Newsroom,2021-04,https://about.fb.com/news/2021/04/how-we-combat-scraping/
- Global privacy authorities issue follow-up joint statement on data scraping,澳大利亚信息专员办公室,2024-10-29,https://www.oaic.gov.au/news/media-centre/global-privacy-authorities-issue-follow-up-joint-statement-on-data-scraping
引用编号 BL-106