Apify n8n 替代:同一个工作流算两笔账
n8n 取竞品 YouTube 视频、评论和地图评论:Apify 按条、我们按次收费,整页取数每千条差 29 到 360 倍;小规模增量 Apify 免费。
在 n8n 里每天早上取 3 个竞品的 YouTube 新视频、评论和 Google 地图新评论,用 Apify 的 n8n 节点按 Store 公开价算,每 1,000 条视频 $4.00、评论 $2.00、地图评论 $0.60;我们在 2026-11-04 用 n8n 的 HTTP Request 节点会发出的同一个请求真调 EveryInfra 17 次,每 1,000 条分别是 $0.0111、$0.0170 和 $0.0208,差 360 倍、118 倍和 29 倍。差距来自计费单位:Apify Store 里的 scraper(Apify 叫 actor)按「写进数据集的每一条」收钱,EveryInfra 按「一次请求」收钱,一次最多回 50 到 100 条,回 0 条自动退钱。但倍数不是固定的:每天只取增量、一次只回一两条地图评论时,Apify 反而更便宜;我们这次取到的最新一条地图评论停在 10 月 20 日,而 Apify 的评论 scraper 每次都现抓页面。再说一句钱:按实测频率,这个 3 频道、3 家店的工作流每个月在 Apify 上约 $0.43,首次回填约 $3.28,都在它免费档每月 $5 的预付额度之内,也就是不用付钱。先说明一点:本文的 n8n 节点设置都是照官方文档写的配置示例,没有在 n8n 里跑过;接口请求是真调,响应和扣费取自原始返回。下面把配置、真调、每天和每月的账、以及 Apify 更合适的几种情况逐个写清楚。
本文的「每千条价」,是把实际扣掉的钱除以按 id 去重后的条数,再乘 1,000。它回答的问题是:在 n8n 里拿到 1,000 条同类数据,要付给数据服务多少钱。n8n 本身的费用两边一样,自托管的 Community Edition 不收钱,n8n Cloud 按工作流执行次数收(n8n 价格页写 Starter 档按年付每月 20 欧元、含 2,500 次执行),所以不算进对比。Apify 一侧只用公开材料:Store 页面、价格页、文档,以及不用账号就能读的公开 actor 元数据接口(Get Actor 文档),读取时间是 2026-11-04 02:10 新加坡时间。我们没有注册 Apify,也没有跑它的 actor,所以 Apify 的数字都是公开单价乘条数,不是实测账单。EveryInfra 一侧全部是真调,扣费取响应里的 billing.charged_usd。
先看总表:apify n8n 节点和 HTTP Request 调 EveryInfra,每 1,000 条多少钱
下表是本文的结论。Apify 一侧每行取 Store 里这一类用户最多的 scraper:频道视频用 YouTube Scraper(近 30 天 16,846 个用户),评论用 YouTube Comments Scraper(3,798 个用户),地图评论用 Google Maps Reviews Scraper(9,277 个用户)。单价从公开元数据的 pricingInfos 字段读出,例如 YouTube Scraper 的元数据写着 Free 档每条视频 $0.004、Gold 档 $0.0024,地图评论 scraper 的元数据写着 Free 档每条 $0.0006,外加每次运行 $0.00005 的起步费。EveryInfra 一侧的价格以免费目录的 price_usd 为准:youtube/user_posts 和 youtube/comments 一次 $0.000556,google_maps_reviews/reviews 一次 $0.001389。
| 数据 | Apify scraper(Free 档) | Apify 每千条 | EveryInfra 能力 | 实测:次数 / 条数 / 去重 / 实扣 | EveryInfra 每千条 | 倍数 |
|---|---|---|---|---|---|---|
| 频道视频列表 | YouTube Scraper,$0.004/条 | $4.00 | youtube/user_posts | 2 / 100 / 100 / $0.001112 | $0.0111 | 360 倍 |
| 频道视频列表(便宜版) | Fast YouTube Channel Scraper,$0.0013/条 | $1.30 | youtube/user_posts | 同上 | $0.0111 | 117 倍 |
| 视频评论 | YouTube Comments Scraper,$0.002/条 | $2.00 | youtube/comments | 3 / 98 / 98 / $0.001668 | $0.0170 | 118 倍 |
| Google 地图评论 | Google Maps Reviews Scraper,$0.0006/条 + 起步 $0.00005 | $0.60 | google_maps_reviews/reviews | 3 / 288 / 200 / $0.004167 | $0.0208 | 29 倍 |
倍数都是 Apify 的价格除以我们的价格。读这张表要注意四件事。第一,Apify 的 Free 档是最贵的一档,订阅 Business 档(每月 $999)后 Gold 档单价大约是 Free 档的一半到六成,例如评论从 $0.002 降到 $0.0009;倍数会小一半左右,但仍在两位数以上。第二,地图评论一行,我们的分母是去重后的 200 条:第三次请求用 since 参数取 10 月 1 日以后的评论,和第一页重复了 88 条,我们照样把这次的钱算进去,所以单价被算高;只看前两页,每千条是 $0.0139。第三,表里只比数据费,不比 n8n 执行费、也不比 Apify 的存储读写费;Apify 文档写明运行结束后读写数据集要另算平台用量(Actors in Store)。第四,YouTube 频道列表这一行两边字段不一样:我们这次返回的视频列表里,点赞数和评论数是空的,要这两个数得再调一次 youtube/video;Apify 的 YouTube Scraper 在 Store 页写着会抓点赞、播放和订阅数。
我们怎么测,和怎么判对错
动笔之前,我们先写下判据:三种数据各至少真调 2 次,分布在 3 个以上不同时刻;每千条价一律用去重后的条数做分母;Apify 一侧只用公开单价,不注册账号;只要某一种情况 Apify 更便宜、更新或更方便,就照写;至少记下 1 次没拿到数据的请求和它的扣费。所有请求都发到 POST https://api.everyinfra.com/api/v1/social,用的是一把每分钟限 10 次的测试 Key,经环境变量注入。我们没有在本机装 n8n,n8n 节点的设置照 n8n 文档写成配置示例;HTTP Request 节点发出去的就是一个普通的 HTTPS 请求,所以我们用 curl 发同样的方法、地址、请求头和请求体,拿到的响应就是 n8n 会拿到的响应。
| 场景 | 能力和参数 | 次数 | 时间(新加坡时间,11 月 4 日) | 看什么 |
|---|---|---|---|---|
| 竞品频道的新视频 | youtube/user_posts,Starbucks、Tim Hortons、Dunkin'(两种写法)、Costa,sort newest,limit 50;另试 since | 7 | 02:05 到 02:13 | 每次回几条、since 能不能只取新视频、空结果扣不扣钱 |
| 新视频下的评论 | youtube/comments,3 个视频,sort newest,limit 100 | 3 | 02:09 到 02:12 | 每个视频回几条、有没有回复 |
| 竞品门店的地图评论 | google_maps_reviews/search 找店,google_maps_reviews/reviews 取两页,再试两次 since | 5 | 02:10 到 02:13 | 翻页会不会重复、最新一条是哪天 |
| 写错参数 | 地图搜索把 keyword 写成 query;评论排序写成 latest | 2 | 02:07、02:14 | 错误提示和扣费 |
一共 17 次,实扣合计 $0.008892,其中 10 次扣费,7 次没扣。所有数字由一个脚本从原始响应现算,正文、表和图都取它的输出。
n8n apify node 是什么:社区节点、两种凭据、先运行再取数
很多人搜「apify n8n」时以为 n8n 自带 Apify 节点,其实它是 Apify 团队发在 npm 上的社区节点,包名 @apify/n8n-nodes-apify,源码在 GitHub 的 n8n-nodes-apify 仓库。npm 的版本记录显示,最新的 0.9.0 发布于 2026-10-22,上一版 0.8.1 发布于 2026-10-12,0.8.0 发布于 2026-09-22,大约十天到六周一版。Apify 的 n8n 集成文档写了两种装法:自托管的 n8n 进 Settings > Community Nodes,点 Install,填包名;n8n Cloud 在画布的节点面板里搜 Apify,点 Install node,但前提是实例所有者在后台打开了「已验证社区节点」的显示。凭据也有两种,Apify API token 两边都能用,OAuth2 只在 n8n Cloud 上能用。
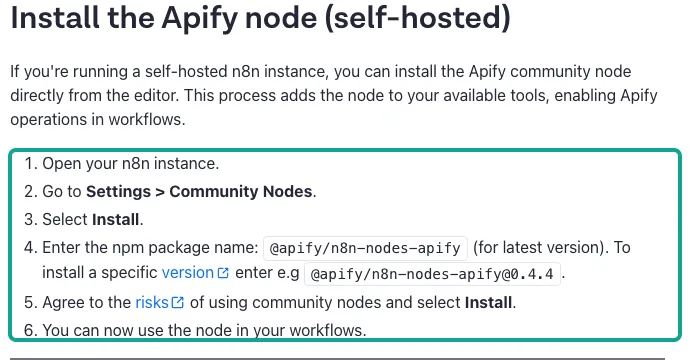
装社区节点不是零成本的事。n8n 的社区节点风险说明写得很直接:社区节点对运行 n8n 的机器有完全访问权限,能读到工作流里的数据,新版本可能带来不兼容的改动;自托管时可以用环境变量 N8N_COMMUNITY_PACKAGES_ENABLED=false 把它整个关掉。很多公司的 n8n 是运维统一管的,装一个第三方包要走审批,这一步对个人用户无所谓,对团队就多了一道审批。HTTP Request 和 MCP Client 是 n8n 自带的核心节点,不需要装任何东西。另一个要留意的时间点是 n8n 自己的大版本:n8n 3.0 在 2026-10-27 发布,是带不兼容改动的大版本(3.0 不兼容改动清单);GitHub 发布记录显示 2026-11-03 发布的 3.1.0 和 2.47.0 里有一条「社区包 supportedNodesApiVersion v3 兼容」的修复。Apify 节点的包声明的是 n8nNodesApiVersion: 1,升级到 3.x 之前,先在测试实例上跑一遍用到它的工作流。
装好以后,Apify 节点的核心用法是两步。集成文档里的例子是:先用 Run Actor 操作启动一个 actor,设置 Custom input(actor 的 JSON 输入)、Timeout、Memory、Build Tag 和 Wait for finish;再加一个 Get Dataset Items 操作,把上一步返回的 defaultDatasetId 填进 Dataset ID,取出这次运行写进数据集的条目。也可以用合并后的「Run an Actor and get dataset」一步完成,它会等运行结束再返回数据。另有一个触发器 On new Apify event,在某个 actor 或任务运行到 Succeeded、Failed、Aborted、Timed Out 时启动工作流,适合「Apify 那边定时跑,n8n 这边收结果」的分工。
| Apify 节点里的操作 | 做什么 | 这个工作流用不用 |
|---|---|---|
| Run an Actor | 启动 actor,可选等它跑完 | 用(三个 scraper 各一次) |
| Run an Actor and get dataset | 启动、等待、返回数据集条目 | 可以代替上下两步 |
| Get dataset items | 按 Dataset ID 取条目 | 用 |
| Run task / Run task and get dataset | 跑在 Apify 控制台里预存好输入的任务 | 可选,输入固定时更省事 |
| On new Apify event(触发器) | actor 或任务结束时启动 n8n 工作流 | 可选,Apify 侧定时时用 |
| Web Fetch | 抓一个网址,返回 Markdown 等格式,要 0.8.0 以上 | 不用 |
如果不想装社区节点,也可以直接用 HTTP Request 节点调 Apify 的 run-sync-get-dataset-items 接口,一次请求启动 actor 并拿回数据。r/n8n 上有人在一个抓取失败的帖子里就是这么建议的:绕开原生节点,改用普通 HTTP 请求调这个同步接口(r/n8n 讨论)。这个接口有两个和钱直接相关的参数:maxItems 限制按条计费的 actor 最多收多少条,maxTotalChargeUsd 限制这次运行最多收多少钱。文档写明 maxItems 不保证 actor 只回这么多条,只保证不会多收;在 n8n 里每天定时跑 Apify,这两个参数建议都填。
同一个工作流:每天早上 3 个竞品的 YouTube 新视频、评论和地图新评论
为了让两边可比,我们定一个具体的工作流,假设你在一家连锁咖啡品牌做市场,要盯 Starbucks、Tim Hortons 和 Dunkin' 三家:每天早上 8 点,取三家 YouTube 频道昨天以后发的新视频;对 7 天内发的新视频取最新评论;取三家各一家旗舰店的 Google 地图新评论;把这些写进一张 Google 表格,再给 Slack 频道发一条摘要。n8n 里这条工作流有六种节点,其中只有「取数」那几步两边不一样。
| 步骤 | n8n 节点 | Apify 做法 | EveryInfra 做法 |
|---|---|---|---|
| 1 定时 | Schedule Trigger,每天 8:00,时区设成你的时区 | 同 | 同 |
| 2 取新视频 | Apify 节点 / HTTP Request | Run Actor(YouTube Scraper,三个频道一起,按日期过滤)+ Get dataset items | 3 次 youtube/user_posts,带 since |
| 3 取评论 | Apify 节点 / HTTP Request,配 Loop Over Items | Run Actor(YouTube Comments Scraper,一次传多个视频网址) | 每个新视频 1 次 youtube/comments,带 since |
| 4 取地图评论 | Apify 节点 / HTTP Request | Run Actor(Google Maps Reviews Scraper,三家店一起) | 3 次 google_maps_reviews/reviews,带 since |
| 5 去重、整理 | Remove Duplicates 或 Code | 同 | 同 |
| 6 写表、发通知 | Google Sheets、Slack | 同 | 同 |
Schedule Trigger 的文档提醒了一个容易忽略的地方:它按工作流时区或实例时区触发,自托管实例默认是纽约时间,n8n Cloud 注册时会尝试识别所有者的时区,识别不到用 GMT。住在新加坡、想每天 8 点出报告的人,要在工作流设置里把时区改成 Asia/Singapore,否则报告会在晚上 8 点出。这个问题两种做法都一样,但它决定了 since 该填哪一天,后面算增量时要用。
Apify 一侧的第 2 到第 4 步,可以把三个频道放进同一次运行,也可以每个频道一次。前者省事,但三个频道的结果混在同一个数据集里,要在第 5 步按频道拆开;后者每次运行都有自己的数据集,好排错,但地图评论 scraper 每次运行多收一次 $0.00005 的起步费。EveryInfra 一侧没有「运行」和「数据集」的概念:一次请求就是一次查询,响应里直接是 results 数组,下一个节点可以直接接。
第一种做法:Apify 节点的配置示例
下面是第 2 步「取新视频」在 Apify 节点里的配置示例。它没有在本机跑过,节点字段取自 Apify 集成文档,actor 输入字段取自 YouTube Scraper 最新构建公开的输入定义(startUrls、maxResults、oldestPostDate,后者的说明是「只抓这个日期以后发布的视频」)。评论 scraper 对应的字段是 startUrls、maxComments、oldestCommentDate,地图评论 scraper 是 startUrls、maxReviews、reviewsSort、reviewsStartDate;三个 actor 都能按日期只取增量,这一点和我们的 since 参数一样。
{
  "node": "Apify",
  "resource": "Actor",
  "operation": "Run an Actor and get dataset",
  "credentials": "Apify API (token)",
  "actor": "streamers/youtube-scraper",
  "customBody": {
    "startUrls": [
      { "url": "https://www.youtube.com/@Starbucks/videos" },
      { "url": "https://www.youtube.com/@TimHortons/videos" },
      { "url": "https://www.youtube.com/@dunkin/videos" }
    ],
    "maxResults": 10,
    "oldestPostDate": "{{ $now.minus({ days: 1 }).toFormat('yyyy-MM-dd') }}"
  },
  "timeout": 300,
  "memory": 1024
}这一步要注意两件事。第一是钱:按日期过滤频道视频(oldestPostDate),在 YouTube Scraper 的价格表里是一个单独的附加项「Date range for channels」,Free 档 $0.0013;元数据里没写它按什么计次,我们在算账时按每条视频各收一次处理,这可能高估也可能低估,用之前在 Store 页的 Pricing 标签核对。第二是时间:一次运行要启动容器、打开页面、写数据集,等待时间取决于 actor;如果 Timeout 设得比实际运行时间短,节点会在拿到数据之前结束。我们没有跑 Apify,所以不写它要多少秒。
还有两个平台限制会影响 n8n 里的写法。Apify 价格页写明,免费档最多同时跑 5 个运行、总内存 16 GB,Starter 档是 32 个运行、64 GB;如果你在 n8n 里用 Loop Over Items 对 30 个视频各启动一次评论 scraper,免费档同时只能跑 5 个,从第 6 个起就要排队,每个运行再设 1,024 MB 内存,5 个就占掉 5 GB;如果 n8n 节点的 Timeout 设得短,排队中的运行还没开始,节点就已经超时报错,工作流会在半路停下,第二天早上你只看到一封报错邮件,而不是早报。所以在 Apify 上,更好的写法是把多个网址放进同一次运行的 startUrls,而不是在 n8n 里循环启动。按用量计费的 actor 还要另算计算单元,免费档和 Starter 档都是每个计算单元 $0.2(1 GB 内存跑 1 小时);本文用到的三个 scraper 都是按事件计费,Apify 的说明是这类 actor 多数已经把平台用量算进事件价里,但也有单独收的,要看各自的 Pricing 标签。
第二种做法:apify alternative n8n,用 HTTP Request 节点调 EveryInfra
HTTP Request 是 n8n 自带的节点,文档写明它可以直接导入一条 curl 命令。凭据用 Generic Credential Type 里的 Bearer Auth 或 Header Auth(HTTP Request 凭据文档写明 Bearer Auth 就是名为 Authorization、值为 Bearer <token> 的请求头),把 EveryInfra 的 Key 存在凭据里,不写进节点参数。下面这条 curl 就是第 4 步「取地图评论」,我们在 2026-11-04 02:13 新加坡时间用它真调过:
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "platform": "google_maps_reviews",
    "action": "reviews",
    "params": {
      "url": "https://www.google.com/maps/search/?api=1&query=Starbucks%20Reserve%20Roastery%20New%20York&query_place_id=ChIJIQDZbb9ZwokRNRez4RviXGQ",
      "sort": "newest",
      "since": "2026-10-01",
      "limit": 100
    }
  }'
在 n8n 里,把它粘进 HTTP Request 节点的 Import cURL,再把 since 换成表达式,例如 {{ $now.minus({ days: 1 }).toFormat('yyyy-MM-dd') }},就成了「只取昨天以后的评论」。响应的结构是这样(节选自这次真调的原始响应,评论正文和点评人名字已删):
{
  "platform": "google_maps_reviews",
  "action": "reviews",
  "count": 88,
  "results": [
    {
      "id": "…",
      "rating": 5,
      "posted_at": "2026-10-20T20:05:52.046000+00:00",
      "reviewer_review_count": 11,
      "is_local_guide": true,
      "place_name": "Starbucks Reserve Roastery New York",
      "platform": "google_maps_reviews"
    }
  ],
  "billing": { "charged": true, "charged_usd": 0.001389 }
}
下一个节点直接对 results 用 Split Out 拆成一行一条,就能写进 Google 表格。字段和目录里的 response_fields 一一对应:地图评论有 id、text、rating、posted_at、owner_response、owner_response_at、detailed_rating、image_urls、place_id、place_name 等 18 个字段(能力页);YouTube 评论有 id、text、author_name、like_count、reply_count、posted_at、is_reply、reply_to_id 共 9 个(能力页);频道视频有 title、view_count、duration、posted_at、description_links 等 25 个(能力页)。有两个节点设置建议改:一是 Options 里把 Timeout 设到 120 秒以上,因为这次 youtube/user_posts 最慢一次用了 69.6 秒,地图搜索最慢一次用了 76.3 秒;二是同一个工作流里请求多时加 Batching,每批之间等几秒,避免超过 Key 的每分钟限速。
第三种做法:用 MCP Client 节点接 https://api.everyinfra.com/mcp
n8n 现在有两个 MCP 节点。MCP Client 节点把 MCP 服务器的工具当成普通的工作流步骤用:设置 Server Transport、MCP Endpoint URL、Authentication(支持 Bearer、通用请求头、多个请求头和 OAuth2),然后在 Tool 下拉框里选一个工具,参数用 Manual 或 JSON 模式填。MCP Client Tool 节点则接在 AI Agent 节点下面,让模型自己决定调哪个工具,可以用 Tools to Include 限定只暴露哪几个。我们的远程 MCP 地址是 https://api.everyinfra.com/mcp,在 2026-11-04 02:13 新加坡时间不带 Key 发了一次 tools/list,返回 12 个工具,其中取数用的是 everyinfra_call_api,查能力用 everyinfra_list_capabilities,取慢任务结果用 everyinfra_get_job。
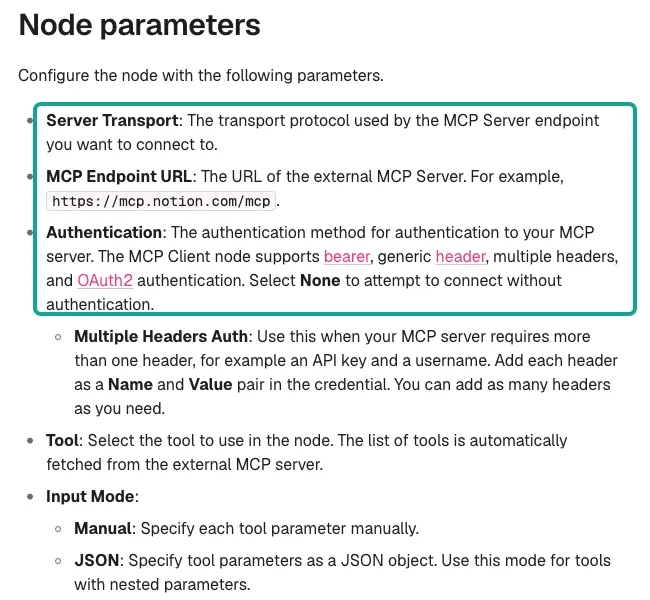
{
  "node": "MCP Client",
  "serverTransport": "HTTP Streamable",
  "endpointUrl": "https://api.everyinfra.com/mcp",
  "authentication": "Bearer Auth (credential holds EVERYINFRA_API_KEY)",
  "tool": "everyinfra_call_api",
  "inputMode": "JSON",
  "toolParameters": {
    "platform": "youtube",
    "action": "comments",
    "params": { "url": "{{ $json.url }}", "sort": "newest", "since": "{{ $now.minus({ days: 1 }).toFormat('yyyy-MM-dd') }}" }
  },
  "options": { "timeout": 90000 }
}
这是配置示例,Server Transport 下拉框里的选项名以你的 n8n 版本为准;MCP 规范把远程传输叫 Streamable HTTP(MCP 传输规范)。站内的 n8n 热榜日报实战在 n8n 2.45.3 上真跑过 MCP Client 节点调我们的能力,截图和排错都在那篇里,本文不重复。三种做法怎么选:工作流固定、每一步调什么都清楚,用 HTTP Request,最直观,排错时能直接看到请求和响应;想让 n8n 里的 AI Agent 自己挑平台和能力,用 MCP Client Tool;介于两者之间、想少写请求体,用 MCP Client。三种走的是同一个接口、同一个价格。Apify 也有自己的 MCP 服务器 mcp.apify.com(Apify MCP 文档),同样可以接到 n8n 的 MCP Client Tool 上,按 actor 的价格计费。
实测一:竞品频道的新视频,3 个频道里 2 个有数据
第一轮在 2026-11-04 02:05 新加坡时间开始。youtube/user_posts 对 Starbucks 频道回了 50 条视频,用时 27.5 秒,扣 $0.000556;对 Tim Hortons 也回了 50 条,用时 33.0 秒,扣 $0.000556。两次合计 100 条、没有重复,每千条 $0.0111。按 YouTube Scraper 的 Free 档每条 $0.004 算,同样 100 条要 $0.40,是我们的 360 倍;换成更便宜的 Fast YouTube Channel Scraper(每条 $0.0013),100 条 $0.13,是 117 倍。这个价差在站内的 Apify YouTube Scraper 对比里已经按搜索、评论和视频详情逐项测过,本文只看它放进 n8n 定时工作流以后怎么变。
第三个竞品不顺利。@dunkin 和 @DunkinDonuts 两种写法在 02:06 和 02:07 新加坡时间各试一次,都返回 0 条,用时 44.4 秒和 69.6 秒,响应里写着 empty_result_refunded,扣费 $0;换成 Costa Coffee 的 @costacoffee,02:11 新加坡时间也是 0 条、没扣钱。原因我们没有核实:可能是频道地址写法不对,也可能这些频道近年主要发 Shorts,而目录写明 youtube/user_posts 只列常规视频,Shorts 要用 youtube/shorts。对 n8n 用户来说,这里的要点是:一个地址写错,工作流不会报错,只会拿到空数组,所以第 5 步最好加一个 IF 节点,三个频道里有一个连续几天都是 0 条,就在 Slack 里提醒你去核对地址。
since 参数的效果和预期一致。02:09 新加坡时间对 Starbucks 带 since: 2026-11-03 请求,返回 0 条、没扣钱,因为这个频道最新一条视频是「3w ago」;02:13 新加坡时间对 Tim Hortons 带 since: 2026-10-01,返回 2 条,扣 $0.000556,分别是 2 周前的一条新品广告和 1 个月前一条 88,000 次播放的球星卡广告。也就是说,这两家大品牌一个月只发一两条常规视频。每天早上的这一步,绝大多数日子会是「请求 3 次、拿到 0 条、扣 $0」。这里有一个字段要注意:这次返回的 posted_at 是「3w ago」「2w ago」这种相对时间,不是日期,要精确到天,用 since 过滤,或者对单条视频再调 youtube/video。
实测二:新视频下的评论,一次请求最多拿多少
02:09 到 02:12 新加坡时间,我们对三个视频各调一次 youtube/comments,sort 设成 newest,limit 100。Tim Hortons 球星卡广告回了 67 条,Tim Hortons 新品广告回了 24 条,Starbucks 那条新视频回了 7 条,三次合计 98 条、没有重复,其中 11 条是回复(is_reply 为 true,reply_to_id 指向被回复的那条),扣 $0.001668,每千条 $0.0170。用时分别是 19.5、16.9 和 11.7 秒。同样 98 条,按 YouTube Comments Scraper 的 Free 档每条 $0.002 是 $0.196,是我们的 118 倍。
这里要说清楚倍数的条件。评论接口一次最多回 100 条,一个视频的评论越多,我们的单价摊得越薄;Starbucks 那条视频只有 7 条,我们一次 $0.000556,摊到每条是 $0.0000794,Apify 每条 $0.002,仍然是 25 倍。Apify 一侧按条计费,这个 scraper 的公开价里没有起步费;但它的说明写着,视频不可用或没有评论时会往数据集写一条带 error 字段的条目,这一条收不收费,公开材料没写,我们也没有跑,所以不下结论。我们这边返回 0 条会自动退钱,响应里写着 empty_result_refunded。真正拉开差距的是有几十上百条评论的热门视频:一次请求回满 100 条时,Apify Free 档是 $0.20,我们是 $0.000556。目录里 youtube/comments 只有 since 和 sort 两个可选参数,没有翻页令牌,所以单个视频要上千条评论,我们一次拿不全,Apify 的 maxComments 可以设得更大,这是它的一个长处。目录的 field_note 也写了边界:其他来源都不可用时,结果来自一个最多只回 40 条评论的兜底来源,这时一次拿不满 100 条。
实测三:Google 地图评论,翻页不重复,但最新一条停在 10 月 20 日
地图评论要先拿到店的地址。02:07 新加坡时间我们第一次调 google_maps_reviews/search 时把参数写成了 query,返回 HTTP 422,没有扣钱,错误信息指出要用的参数是 keyword(那次的原始响应没有存档,这里只写大意);改成 keyword 后在 02:10 新加坡时间返回 1 家店:Starbucks Reserve Roastery New York,地址 61 9th Ave,评分 4.4,7,957 条评论,扣 $0.001389。这个返回里的 url 带着 query_place_id,正好可以原样传给 google_maps_reviews/reviews,目录也建议这样做,因为只有店名和坐标的链接不一定能稳定定位到同一家店。
02:12 新加坡时间取第一页,sort newest,limit 100,回了 100 条,用时 9.4 秒,扣 $0.001389;02:13 新加坡时间把响应里的 next_page_token 原样传回去取第二页,又回 100 条,和第一页 0 条重复,用时 10.2 秒,扣 $0.001389。两页 200 条,每千条 $0.0139;加上后面那次和第一页重复的 since 请求,去重后每千条 $0.0208。同样 200 条,Apify 的 Google Maps Reviews Scraper 按 Free 档是 200 × $0.0006 + $0.00005 = $0.12005,是我们的 29 倍(只按两页算是 43 倍)。这 200 条里,12 条是 1 到 2 星,89 条只有星级、没有文字,只有 2 条有商家回复。对盯竞品差评的人来说,「89 条没有文字」这个数很实用:写进表格之前先过滤掉空文本,表格会干净很多。
但有一件事 Apify 可能做得比我们好。这次第一页最新的一条评论发布于 2026-10-20 20:05(UTC),之后依次是 10-19、10-18 等,200 条里最早的是 2021-08-06。02:13 新加坡时间带 since: 2026-11-03 请求,返回 0 条,自动退钱;02:13 新加坡时间带 since: 2026-10-01 请求,返回 88 条,最新一条同样是 10 月 20 日。一家有 7,957 条评论、10 月前 20 天就有 88 条新评论的店,10 月 21 日到 11 月 3 日之间很可能也有新评论,我们这次没有拿到。我们没法从公开页面核对这两周的真实情况,所以只照实写:如果你的工作流要求「昨天的评论今天早上就到」,先用 since 连续几天试一下,看最新一条的日期跟不跟得上;Apify 的评论 scraper 每次运行都去打开页面现抓,在这一点上更可能是最新的。另外,Apify 的 Store 页说明它按日期过滤时只能配合「Newest」排序,否则会提前停止(Google Maps Reviews Scraper),配置时也要留意。
地图评论里还有两个字段适合放进早报的筛选条件。一个是 reviewer_review_count,点评人一共写过多少条评论,这次第一页第一条的点评人写过 11 条、是本地向导;只写过一两条评论的账号给出的 1 星差评,可信度要打折扣,早报里可以单独列一栏。另一个是 owner_response,这 200 条里只有 2 条有商家回复,说明这家旗舰店基本不在 Google 地图上回评论。盯竞品时,「对方回不回差评、多久回」本身就是一个值得每周看的指标:把 owner_response_at 减去 posted_at,就是回复用了多久。这两个字段 Apify 的地图评论 scraper 也有(reviewerNumberOfReviews、responseFromOwnerText),换哪一边都能做这张表,差别只在每次取数花多少钱、一次拿到多少条。
每次回几条决定谁便宜:分界点在 2 条地图评论
把 17 次真调按「回了几条、扣了多少」画出来,规律很清楚:有数据的请求一次扣一个固定价,不管回 2 条还是 100 条;没数据的请求扣 0。
按次计费和按条计费的交叉点,可以直接算出来。地图评论:Apify 一次运行的钱是 0.0006 × 条数 + 0.00005,我们一次是 $0.001389,两者相等时条数约为 2.23。也就是说,一次只回 1 条新评论,Apify 是 $0.00065,比我们便宜一半;回 2 条是 $0.00125,仍然比我们便宜;回到 3 条,Apify 是 $0.00185,我们反过来便宜。YouTube 评论:Apify 每条 $0.002、没有起步费,交叉点是 0.28 条,只要有 1 条评论,我们就便宜。
这个分界点对「每天早上取增量」的工作流很关键。我们测到这家旗舰店 10 月 1 日到 20 日有 88 条新评论,平均每天约 4.4 条,三家店每天各一次请求,每次约 4 条,我们比 Apify 便宜约一倍(Apify 每次约 $0.00269,我们 $0.001389),而不是表里的 29 倍。换成一家每天只有一两条新评论的社区小店,Apify 每次反而更便宜。所以选哪边,要先看你的数据「一次能攒多少条」:攒得越多,按次计费越划算;每次只有零星一两条,按条计费更划算。
频道视频在增量场景下也一样会缩水。02:13 新加坡时间那次对 Tim Hortons 带 since: 2026-10-01 的请求只回了 2 条,扣 $0.000556,摊到每千条是 $0.278,而不是整页 50 条时的 $0.0111。Apify 的 YouTube Scraper 要按日期过滤,每条除了 $0.004 的结果费还要加 $0.0013 的日期过滤附加项,每千条 $5.30,是我们这次的约 19 倍;如果换成只取频道列表的 Fast Channel Scraper(每千条 $1.30),倍数只有约 4.7 倍。三类数据放在一起看:
| 数据 | 整页取数,每千条 | 只取增量(实测那次) | 整页倍数 | 增量倍数 |
|---|---|---|---|---|
| 频道视频 | Apify $4.00,我们 $0.0111 | 2 条:Apify 带日期过滤每千条 $5.30,我们 $0.278 | 360 倍 | 约 19 倍(对 Fast 版约 4.7 倍) |
| Google 地图评论 | Apify $0.60,我们 $0.0208 | 约 4.4 条:Apify 每次 $0.00269,我们 $0.001389 | 29 倍 | 约 2 倍 |
| 视频评论 | Apify $2.00,我们 $0.0170 | 看当天有没有新视频 | 约 118 倍 | 0 条时我们退回 |
这也是后面算月度账时差距从几十倍掉到约 2 倍的原因。
首次回填和每天、每月的成本
工作流第一次上线时通常要回填历史:三个频道各取最近 50 条视频,对其中 30 条取全部评论,三家店各取 400 条评论。评论条数按实测:这次三个视频分别有 67、24、7 条评论,平均 32.7 条,30 个视频约 980 条;我们一个视频一次请求就能取完(一次最多 100 条)。地图评论要注意目录里的翻页上限:google_maps_reviews/reviews 写着 sync_max_rows: 200、max_rows: 400,也就是同步模式翻页最深 200 行(2 页),要取满 400 行,请求里要加 mode: async,再按返回的 poll_url 取结果;每页仍是一次请求、按目录价扣一次。下表按两边的公开单价和目录价算,是估算,不是账单。
| 首次回填(估算) | 条数 | Apify Free 档 | EveryInfra 请求数 | EveryInfra 目录价 |
|---|---|---|---|---|
| 频道视频 | 150 | $0.60(YouTube Scraper)或 $0.195(Fast Channel Scraper) | 3 | $0.001668 |
| 视频评论 | 980 | $1.96 | 30 | $0.01668 |
| 地图评论 | 1,200 | $0.72015(含 3 次起步费) | 12 | $0.016668 |
| 合计 | 2,330 | $3.28(用 Fast 版 $2.88) | 45 | $0.035016 |
这笔回填在 Apify 上是 $3.28,在免费档每月 $5 的预付额度之内,所以第一个月照实说是不用付钱的;只是这个月剩下的额度只有约 $1.72。我们这边是 45 次请求 $0.035,没有月费,也没有免费额度可以抵。
回填之后是每天的增量。频率全部按实测算:三个频道 10 月 1 日到 11 月 4 日这 34 天合计 3 条新视频(Tim Hortons 2 条,Starbucks 1 条,Dunkin' 没取到数据,按 0 计),每天约 0.09 条;这 3 条视频下合计 98 条评论,摊到 34 天,每天约 2.9 条;三家店每天合计约 13.2 条新地图评论(旗舰店 10 月 1 日到 20 日 88 条,每天 4.4 条,× 3)。
| 每天的频率 | 实测 | 时间窗 | 每天 |
|---|---|---|---|
| 三个频道的新视频 | 3 条(Tim Hortons 2 条、Starbucks 1 条) | 10-01 至 11-04,34 天 | 约 0.09 条 |
| 这些视频下的评论 | 98 条(67 + 24 + 7) | 34 天 | 约 2.9 条 |
| 三家店的新地图评论 | 旗舰店 88 条 | 10-01 至 10-20,20 天 | 4.4 × 3 = 13.2 条 |
EveryInfra 一侧取上限:每天 3 次视频请求、1 次评论请求、3 次地图评论请求全部有数据,$0.006391,30 天 $0.19;实际上大部分日子视频请求是 0 条、不扣钱,所以真实金额更低:按实测频率,三个频道一个月合计只有两三次视频请求会有数据,其余都退回,30 天约 $0.14。Apify 一侧按新增条数乘 Free 档单价,加 3 次地图评论起步费,每天约 $0.0143,30 天约 $0.43。
| 每天跑一次(估算) | 每天新增条数 | Apify Free 档每天 | EveryInfra 每天上限 |
|---|---|---|---|
| 频道新视频 | 0.09 | $0.00047(含日期过滤附加项) | $0.001668(3 次,0 条时退回) |
| 新视频评论 | 2.9 | $0.0058 | $0.000556(1 次) |
| 地图新评论 | 13.2 | $0.00807(含 3 次起步费) | $0.004167(3 次) |
| 合计 / 30 天 | $0.0143 / $0.43 | $0.006391 / $0.19 |
这张图说明了一件对 Apify 有利的事:这个规模的日常工作流,Apify 一个月约 $0.43,落在它免费档每月 $5 的预付额度之内(Apify 价格页),只跑这一条工作流,你在 Apify 上不用付钱,而我们这边每月要付 $0.14 到 $0.19。按每千条算我们便宜几十倍,按现金算,这个规模 Apify 是 $0、我们是几毛钱。差距要等规模上来、超过免费额度以后才变成真金白银;价格页写明免费档超过额度后,要等到下个月才能继续用,而 Starter 档每月 $19 起。EveryInfra 没有月费,也没有每月清零的额度,按实际请求扣钱。
规模放大十倍:30 个频道、30 家店,以及免费额度的门槛在哪
很多团队的工作流不会停在 3 个竞品。把上面的日常工作流放大十倍,盯 30 个频道、30 家店,按同样的实测频率,每天新增约 0.9 条视频、29 条评论、132 条地图评论。Apify 一侧按 Free 档单价算,每天约 $0.143,30 天约 $4.29,仍然在免费档 $5 的额度之内,只是离上限很近;就算订了 Starter 档(每月 $19,Store 价格按 Bronze 档打折),按 Bronze 单价算也只要约 $3.23 的用量,这个规模用不着订。EveryInfra 一侧取上限:每天 30 次视频请求、10 次评论请求、30 次地图评论请求,每天 $0.06391,30 天 $1.92;按实测频率扣掉退回的空结果,约 $1.43,没有月费。
所以免费额度的门槛可以直接算出来:日常增量每放大一倍,Apify 每月多 $0.429,$5 ÷ $0.429 ≈ 11.7,也就是大约 35 个频道加 35 家店、每天跑一次,只算日常增量,Apify 每月才会超过 $5。真正先把额度用完的通常是回填,不是日常:30 个频道、30 家店按同样的条数回填一次,Apify Free 档约 $32.80,我们是 450 次请求 $0.35;热门视频一次几百上千条评论时,也会很快超过。超过以后,免费档要停到下个月,这时才需要比较 Starter 档的 $19 月费和我们按次扣的钱。
| 规模 | Apify Free 档,日常每月 | Apify Free 档,回填一次 | EveryInfra,每月上限 | EveryInfra,回填一次 |
|---|---|---|---|---|
| 3 个频道、3 家店 | $0.43 | $3.28 | $0.19 | $0.035 |
| 30 个频道、30 家店 | $4.29 | $32.80 | $1.92 | $0.35 |
| 约 35 个频道、35 家店 | 约 $5.00,到免费档上限 | 约 $38 | 约 $2.24 | 约 $0.41 |
| 每天跑一次(估算) | 3 个频道、3 家店 | 30 个频道、30 家店 |
|---|---|---|
| Apify,Free 档单价 | $0.43 / 月,免费额度内,现金 $0 | $4.29 / 月,免费额度内,现金 $0 |
| Apify,Starter 档(Bronze 单价) | 不需要 | 不需要(Bronze 单价约 $3.23 用量) |
| EveryInfra,全部非空上限 | $0.19 / 月(按实测约 $0.14) | $1.92 / 月(按实测约 $1.43) |
| 首次回填一次 | Apify $3.28 / 我们 $0.035 | Apify $32.80 / 我们 $0.35 |
这个放大有两个前提要说明。第一,评论条数按这次实测的三个视频估(34 天 98 条),热门频道一条视频几天内就能有上千条评论,那时 Apify 一侧会按条线性上涨,我们一侧受「一次最多 100 条、没有翻页」限制,拿到的条数会少于 Apify,便宜的一部分原因是拿得少,这一点要和价格一起看。第二,地图评论按旗舰店每天 4.4 条估,普通门店通常少得多;门店越小,每次请求回的条数越接近前面算的 2.23 条分界点,我们的价格优势就越小。所以规模放大以后最稳妥的办法,是先用一周的真实数据算出你自己每次请求平均回几条,再套用分界点决定每一步用哪边。
失败、空结果和参数错误,扣不扣钱
| 情况 | 本文实测 | EveryInfra 扣费 | Apify 公开规则 |
|---|---|---|---|
| 返回 0 条 | 5 次(两个 Dunkin' 地址、Costa、两次 since 太晚) | $0,响应写 empty_result_refunded | 按条计费的 actor 没有条目就不收条目费;有起步费的仍收起步费 |
| 参数写错 | 2 次(query 应为 keyword,sort 写成 latest) | $0,HTTP 422,带正确参数和示例 | actor 自己校验输入,失败的运行按 actor 规则 |
| 视频不可用、没有评论 | 本文没碰到 | 返回 0 条时 $0 | YouTube Comments Scraper 会往数据集写一条带 error 字段的错误条目 |
| 设花费上限 | 不需要,单次固定价 | — | maxItems、maxTotalChargeUsd 可以限额 |
两边都把「没拿到数据就不收数据费」做成了规则,但细节不同。我们这边,一次请求要么按固定价扣,要么返回 0 条全额退回,响应里的 billing.charged_usd 直接告诉你这次扣了多少,n8n 里可以在第 5 步把它累加进表格的一列,月底对账。Apify 那边,每次运行的费用在控制台的运行详情页和 Historical usage 里看(Actors in Store),要在 n8n 里拿到,需要再调一次 Get run 读运行信息。评论 scraper 写进数据集的错误条目会不会按条收费,公开材料没写,我们没有跑,所以不下结论。
从 Apify 节点换过来:字段对照和去重键
已经在用 Apify 节点的人,最担心的是换数据源以后,下游的 Google 表格和 Slack 消息全要改。好在 n8n 里两边之间只隔一个 Set 或 Code 节点:把我们的字段名改成你表格里已有的列名,后面的节点不用动。下表把三种数据的关键字段对上。Apify 一侧的字段名取自 Store 页公开的输出样例(YouTube Comments Scraper、Google Maps Reviews Scraper),我们一侧取自目录的 response_fields。两边是各自独立的字段设计,名字和含义不完全一样,下表只对「做同一件事的那一列」,不是说两边字段相同。
| 你要的列 | Apify 评论 scraper | EveryInfra `youtube/comments` | Apify 地图评论 scraper | EveryInfra `google_maps_reviews/reviews` |
|---|---|---|---|---|
| 去重键 | cid | id | reviewId | id |
| 正文 | comment | text | text | text |
| 时间 | 样例未列出,Store 页写会抓发布时间 | posted_at | publishedAtDate | posted_at |
| 热度或评分 | voteCount | like_count | stars | rating |
| 回复关系或商家回复 | replyToCid、replyCount | reply_to_id、reply_count | responseFromOwnerText | owner_response、owner_response_at |
| 作者信息 | author、authorIsChannelOwner | author_name | reviewerNumberOfReviews、isLocalGuide | reviewer_review_count、is_local_guide |
换源的那一周,有一件事最好做:两边并行跑几天,用去重键把结果对一遍。按条计费和按次计费在同一张表里的条数可能不同,原因不只是价格,还有覆盖范围和排序:Apify 的评论 scraper 可以把 maxComments 设得很大,我们一次最多 100 条;我们的地图评论这次最新一条停在 2026-10-20,Apify 现抓可能更新。并行几天以后,你会知道哪一列少了、少多少,再决定是全换、只换评论这一步,还是两边各取所长。地图评论这一步本身就是一个很好的切分点:每天新评论多的门店用我们的接口按次取,零星一两条的小店留在 Apify 按条取,n8n 里用一个 IF 节点按店的日均评论数分流,两条线最后汇进同一张表。
去重是按次计费时最容易漏的一步。我们每次请求都会把这一页的评论完整返回,如果你每天不带 since、固定取最新 100 条,同一条评论会连续几天出现在结果里,表格里就会重复;按条计费的 Apify 也一样,它对重复抓到的评论照样收钱。本文的实测里,10 月 1 日以后的 88 条评论在第一页和 since 请求里各出现了一次,其中最新的几条发布于 2026-10-18、2026-10-19 和 2026-10-20。在 n8n 里,Remove Duplicates 节点可以按 id 跨执行去重,配合 since 用,就不会因为工作流某天失败重跑而多算。我们这边重复的那一次照样扣了 $0.001389,所以真正省钱的是 since,去重节点只负责表格干净。
还有一个容易被忽略的差别是「失败时谁来重试」。Apify 的 actor 运行失败时,Run Actor 节点会拿到一个 FAILED 状态,要你在 n8n 里判断是否再跑一次;我们的接口在失败时直接返回错误码和 retryable 字段,例如这次 sort 写错的那次 422 写着 retryable: false,next_steps 第一条是「只改 sort 再发,没有扣钱」,意思是改参数之前重试没有用。n8n 的 HTTP Request 节点在 Settings 里有 Retry On Fail,可以配合这个字段只对能重试的错误重试。两种做法都能写成稳定的工作流,区别是错误信息落在哪一层:Apify 落在运行状态上,我们落在每一次请求的响应上。
什么时候 Apify 更合适
照实写,下面几种情况选 Apify 的 n8n 节点更合理。第一,平台不在我们的目录里。Apify Store 有几千个 actor,覆盖大量长尾网站;我们的目录目前是 106 个平台、573 项能力(everyinfra_list_capabilities 工具的说明里写的数),先在免费目录里搜一下你要的平台,没有就用 Apify。第二,每次只有零星一两条新数据。上一节算过,地图评论一次少于约 2.23 条时 Apify 更便宜;如果你的工作流是每小时跑一次、每次只有 0 到 2 条,按条计费更省。
第三,规模小到落在免费额度里。只跑本文这一条日常工作流,Apify 一个月约 $0.43,连首次回填 $3.28 一起都在免费档 $5 之内,现金支出是 $0;放大十倍的日常增量($4.29)也还在额度里。如果你已经有 Apify 账号,在这个规模上换平台不但省不了钱,还要多付我们每月几毛到两美元;换的理由只会是以后规模变大,或者想要按次计费的固定账单。第四,要的数据要比我们这次给的新。前面实测里,我们取到的最新地图评论停在 10 月 20 日;要「当天的评论当天到」,先用 since 试几天,跟不上就用 Apify 现抓。第五,需要更全的单条字段。我们的频道视频列表里点赞和评论数这次是空的,要逐条再调 youtube/video;Apify 的 YouTube Scraper 一条结果里就带。按目录价,每条视频补一次详情是 $0.000556,30 条新视频就是 $0.01668,仍然比 Apify 便宜,但工作流多了一个循环节点,也多了 30 次请求的等待时间;对只想要一张简单表格的人,Apify 一步拿全更省心,这个便利本身也值钱。
第六,你想在 Apify 那边定时、用 n8n 收结果。Apify 节点的 On new Apify event 触发器可以在 actor 跑完时启动 n8n 工作流,适合几小时的大任务;我们的慢任务用 mode: async 拿 job_id,再轮询 GET /api/v1/jobs/{job_id},n8n 里要自己搭一个 Wait 加循环。反过来,下面这些情况我们更合适:一次能攒几十上百条(评论、地图评论翻页、频道列表),不想装社区节点,要在一次请求里直接拿到结果,或者要用同一把 Key 在 n8n、Claude、Cursor 这些地方共用同一个 MCP 地址。站内的 Apify 替代总览和 Apify 价格详解把各平台的价差和 Apify 的计费方式按平台列过,适合先看全局再挑平台。
和官方接口比:YouTube Data API 与 Places API
搜「apify alternative n8n」的人,常常也在考虑直接用平台的官方接口。n8n 自带 YouTube 节点,但官方接口有配额:YouTube Data API 的配额文档写明,项目默认每天 10,000 个单位;commentThreads.list 一次花 1 个单位、最多回 100 条,用来取自己或别人视频的评论很省;修订记录显示 2026 年 6 月 1 日起 YouTube 正在把配额拆成按方法分组的细分配额。地图一侧差别更大:Places API 的地点详情最多只回 5 条评论(Place Details 旧版文档写的是 up to five reviews),取不到一家店的历史评论,所以「每天看竞品新评论」基本只能靠抓取类服务。
| 方案 | YouTube 视频和评论 | Google 地图评论 | 要什么 | 在 n8n 里 |
|---|---|---|---|---|
| 官方接口 | 每天默认 10,000 单位,评论一次 1 单位、最多 100 条 | 一个地点最多 5 条 | Google Cloud 项目、API Key 或 OAuth | 自带 YouTube 节点;地图用 HTTP Request |
| Apify 节点 | 按条计费,$0.002 到 $0.004 一条(Free 档) | $0.0006 一条 + 起步 $0.00005 | Apify 账号和 token,装社区节点 | 社区节点,两步或合并一步 |
| EveryInfra | 一次 $0.000556,最多 50 或 100 条 | 一次 $0.001389,最多 100 条,可翻页 | EveryInfra Key | 自带 HTTP Request 或 MCP Client |
如果你只盯自己的频道、评论量不大,官方接口免费又稳定,是第一选择。要盯竞品的地图评论,官方接口的 5 条上限就不够用了,只能在 Apify 和我们这样的服务之间选。
最近的变化
2026-10-22,Apify 发布 n8n 节点 0.9.0;在此之前 2026-10-12 发了 0.8.1,2026-09-22 的 0.8.0 加了 Web Fetch 操作(npm 版本记录)。对读者意味着:社区节点更新快,用它的工作流要固定版本号,升级前先在测试实例上跑。2026-10-27,n8n 发布 3.0,是带不兼容改动的大版本,官方配了迁移工具(发布说明)。对读者意味着:自托管用户升级前要核对社区节点能不能用,HTTP Request 和 MCP Client 是核心节点,跟着 n8n 一起升级。
2026-11-03,n8n 同时发布 3.1.0 和 2.47.0,修复里有一条是社区包在新节点接口版本下的兼容(GitHub 发布记录)。对读者意味着:还在 2.x 的用户有一个维护分支可以继续用一段时间,不必急着上 3.x。2026-09-02,Apify 的 YouTube Scraper 换上了现在这套价格(元数据里的 startedAt)。对读者意味着:Store 价格会改,n8n 工作流里最好每月读一次公开元数据,或者给每次运行设 maxTotalChargeUsd。2026 年 6 月 1 日起,YouTube Data API 开始改成按方法分组的配额。对读者意味着:用官方接口取数据的工作流,要按方法分别申请提额。
常见问题
apify n8n community node 是官方节点吗?
不是 n8n 内置的。它是 Apify 团队维护的社区节点,包名 @apify/n8n-nodes-apify,在 n8n Cloud 上以「已验证社区节点」的形式出现在节点面板里(Apify n8n 文档)。自托管时要在 Settings > Community Nodes 里装,n8n 的风险说明提醒社区节点对机器有完全访问权限。
apify n8n integration 要哪些凭据?
Apify 节点要一个 Apify API token(自托管和 Cloud 都能用)或 OAuth2(只在 Cloud 上能用)。换成 HTTP Request 调 EveryInfra,只要在 n8n 里建一个 Bearer Auth 凭据,填 EveryInfra 的 Key;MCP Client 节点同样支持 Bearer。
n8n apify node 和直接用 HTTP Request 调 Apify 有什么区别?
功能上差不多:节点封装了 Run Actor、Get dataset items 等操作,HTTP Request 可以直接调 run-sync-get-dataset-items 一次拿回数据。r/n8n 上有用户在原生节点出问题时建议改用后者(讨论帖)。两种都按 actor 的价格计费。
apify n8n template 跑起来,一个月大概多少钱?
取决于条数,不取决于模板。按本文的日常工作流和实测频率,Apify 每月约 $0.43,免费档的 $5 额度够用,实际不用付钱;同样数据用 EveryInfra 上限约 $0.19。首次回填 2,330 条时按条差距最大:Apify 约 $3.28,我们约 $0.035,不过 Apify 这笔也在免费额度内。
Apify 免费档和付费档的单价差多少?
付费档单价更低:本文用到的三个 scraper,Gold 档(Business 订阅)大约是 Free 档的 45% 到 60%,例如评论从每条 $0.002 降到 $0.0009。r/n8n 上一位用户在分享 X 发帖工作流时也提到,同一个 actor 免费档和 Starter 档的每千条价相差很大(讨论帖)。
能不能让 n8n 的 AI Agent 自己决定去哪个平台取数?
可以。把 MCP Client Tool 节点接在 AI Agent 下面,地址填 https://api.everyinfra.com/mcp,模型会通过 everyinfra_list_capabilities 查能力、用 everyinfra_call_api 取数;也可以用 Tools to Include 只开放这两个工具。Apify 的 MCP 服务器也能这样接,按 actor 计费。
上手步骤
- 在控制台注册并拿到 Key,在 n8n 里建一个 Bearer Auth 凭据。
- 在免费目录里确认要用的能力和参数,例如 YouTube 数据接口和 Google 地图评论接口。
- 把本文的 curl 粘进 HTTP Request 节点的 Import cURL,
since换成昨天的日期表达式。 - 先手动执行一次,看
count和billing.charged_usd,再打开 Schedule Trigger。
想先在网页上试,可以用数据市场里的试用台;价格以价格页为准,远程 MCP 的接法见 MCP 页。地图评论的完整抓法见如何抓取 Google 地图评论,Apify 的地图 scraper 对比见 Apify Google Maps Scraper 替代,其他平台的对比见 Apify TikTok Scraper 替代、Apify Amazon Scraper 替代和替代方案总览。
参考资料
以下链接均在 2026-11-04 02:05 至 02:30(新加坡时间)用 curl 或网页读取工具实际打开过;npmjs.com 的包页面对脚本返回 403,所以用 npm 官方注册表的元数据接口代替。
- n8n integration,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/integrations/n8n>
- Apify MCP server,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/integrations/mcp>
- Run Actor synchronously and get dataset items,Apify API Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post>
- Actors in Store,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/actors/running/actors-in-store>
- Usage and resources,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/actors/running/usage-and-resources>
- Dataset,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/storage/dataset>
- Webhooks,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/integrations/webhooks>
- Run Actor,Apify API Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/api/v2/act-runs-post>
- Get Actor,Apify API Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/api/v2/act-get>
- Limits,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/limits>
- Pay per event,Apify Docs,读取于 2026-11-04(新加坡时间):<https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event>
- HTTP Request,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest>
- HTTP Request credentials,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/credentials/httprequest>
- MCP Client Tool,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.toolmcp>
- MCP Client,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-langchain.mcpclient>
- Schedule Trigger,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.scheduletrigger>
- Community nodes: Risks,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/community-nodes/risks>
- Install verified community nodes,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/community-nodes/installation-and-management/install-verified-community-nodes>
- Release notes,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/release-notes>
- Google Sheets node,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/app-nodes/n8n-nodes-base.googlesheets>
- Slack node,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/app-nodes/n8n-nodes-base.slack>
- Loop Over Items,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.splitinbatches>
- Code,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.code>
- Remove Duplicates,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.removeduplicates>
- n8n 3.0 breaking changes,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/changelog/v30-breaking-changes>
- Install with npm,n8n Docs,读取于 2026-11-04(新加坡时间):<https://docs.n8n.io/deploy/host-n8n/install-options/install-with-npm>
- apify/n8n-nodes-apify,GitHub,读取于 2026-11-04(新加坡时间):<https://github.com/apify/n8n-nodes-apify>
- n8n releases,GitHub,读取于 2026-11-04(新加坡时间):<https://github.com/n8n-io/n8n/releases>
- apify/apify-mcp-server,GitHub,读取于 2026-11-04(新加坡时间):<https://github.com/apify/apify-mcp-server>
- @apify/n8n-nodes-apify package metadata,npm registry,读取于 2026-11-04(新加坡时间):<https://registry.npmjs.org/@apify/n8n-nodes-apify>
- YouTube Data API Overview,Google for Developers,读取于 2026-11-04(新加坡时间):<https://developers.google.com/youtube/v3/getting-started>
- CommentThreads: list,Google for Developers,读取于 2026-11-04(新加坡时间):<https://developers.google.com/youtube/v3/docs/commentThreads/list>
- Quota and Compliance Audits,Google for Developers,读取于 2026-11-04(新加坡时间):<https://developers.google.com/youtube/data/guides/quota_and_compliance_audits>
- YouTube Data API Revision History,Google for Developers,读取于 2026-11-04(新加坡时间):<https://developers.google.com/youtube/data/revision_history>
- Place Details (New),Google for Developers,读取于 2026-11-04(新加坡时间):<https://developers.google.com/maps/documentation/places/web-service/place-details>
- Place Details (Legacy),Google for Developers,读取于 2026-11-04(新加坡时间):<https://developers.google.com/maps/documentation/places/web-service/legacy/details>
- Transports,Model Context Protocol,读取于 2026-11-04(新加坡时间):<https://modelcontextprotocol.io/specification/2025-06-18/basic/transports>
- Introduction,Model Context Protocol,读取于 2026-11-04(新加坡时间):<https://modelcontextprotocol.io/introduction>
- Apify pricing,Apify,读取于 2026-11-04(新加坡时间):<https://apify.com/pricing>
- YouTube Scraper,Apify Store,读取于 2026-11-04(新加坡时间):<https://apify.com/streamers/youtube-scraper>
- YouTube Scraper pricing,Apify Store,读取于 2026-11-04(新加坡时间):<https://apify.com/streamers/youtube-scraper/pricing>
- YouTube Comments Scraper,Apify Store,读取于 2026-11-04(新加坡时间):<https://apify.com/streamers/youtube-comments-scraper>
- Fast YouTube Channel Scraper,Apify Store,读取于 2026-11-04(新加坡时间):<https://apify.com/streamers/youtube-channel-scraper>
- Google Maps Reviews Scraper,Apify Store,读取于 2026-11-04(新加坡时间):<https://apify.com/compass/google-maps-reviews-scraper>
- streamers/youtube-scraper public metadata,Apify API,读取于 2026-11-04(新加坡时间):<https://api.apify.com/v2/acts/streamers~youtube-scraper>
- streamers/youtube-comments-scraper public metadata,Apify API,读取于 2026-11-04(新加坡时间):<https://api.apify.com/v2/acts/streamers~youtube-comments-scraper>
- compass/google-maps-reviews-scraper public metadata,Apify API,读取于 2026-11-04(新加坡时间):<https://api.apify.com/v2/acts/compass~google-maps-reviews-scraper>
- n8n Plans and Pricing,n8n,读取于 2026-11-04(新加坡时间):<https://n8n.io/pricing/>
- Scraping OLX Brazil to Notion/Sheets failing (thread),Reddit r/n8n,读取于 2026-11-04(新加坡时间):<https://www.reddit.com/r/n8n/comments/1vzd9n6/desperate_for_help_scraping_olx_brazil_to/>
- Never stop posting on X (thread),Reddit r/n8n,读取于 2026-11-04(新加坡时间):<https://www.reddit.com/r/n8n/comments/1ne4iqy/never_stop_posting_on_x_source_code_included/>
- Social data catalog,EveryInfra API,读取于 2026-11-04(新加坡时间):<https://api.everyinfra.com/api/v1/social/catalog>
- Social data catalog, YouTube,EveryInfra API,读取于 2026-11-04(新加坡时间):<https://api.everyinfra.com/api/v1/social/catalog?platform=youtube>
引用编号 BL-86