Apify Amazon Scraper 替代:每千条价格实测
同样 1,000 条 Amazon 搜索结果,Apify 公开价 $3–$5,我们实测 $0.054;评论便宜 8–56 倍,美国站评论被登录墙挡住未扣费。
同样拿 1,000 条 Amazon 搜索结果,Apify Store 里用户最多的 Amazon Product Scraper 公开价是 $3.00(Business 档)到 $5.00(Free 档);我们在 2026 年 11 月 2 日用 EveryInfra 的 amazon/search 真调 6 次,一次 $0.002236 拿回 19 到 50 条,合计 248 条,折合每千条 $0.0541,差 55 到 92 倍。评论这一项,我们在英国、德国、西班牙三个站点每次拿回 13 条,每千条 $0.107,比 Apify 自己维护的 Amazon Reviews Scraper($3.00–$6.00)便宜 28 到 56 倍,比 Store 里最便宜的常用评论 scraper($0.90)便宜 8.4 倍;但美国站的评论今天 4 次全部被登录墙挡住,返回 503,一分钱没扣,而且每个商品只能拿到页面上那十几条精选评论,拿不到几百条历史评论。按 ASIN 一个个查商品详情(amazon/profile)每千个 $1.389,只比 Apify 主力 scraper 的 Business 档便宜 2.2 倍,比它的企业档(Diamond,$0.80)还贵。下面把三类数据逐个实测,连同站点覆盖、失败和空结果扣不扣钱、Apify Store 里 200 多个同类 scraper 的价格分布,一起写清楚。
本文的「每千条价」,是把一次请求实际扣掉的钱,除以这次实际返回的条数,再乘 1,000。它回答的问题是:拿到 1,000 条结果要花多少钱。EveryInfra 按请求计费,一次请求回多少条都收一个价;Apify Store 里的 Amazon scraper 大多按结果计费,每回一条收一次钱。两种单位只有换到同一个分母才能比。分母一律用实际返回条数,不用请求里写的 limit,所以回得少的那几次,我们这一侧的价格只会被算高。Apify 一侧我们只用公开材料:Store 页面、价格页、文档,以及不需要账号就能读的公开接口;我们没有注册 Apify,也没有跑它的 actor(Apify 对云端抓取程序的叫法),所以表里 Apify 的数字都是「公开单价」,不是「实测账单」。
先看总表:Apify Amazon Scraper 和 EveryInfra,三类数据每 1,000 条多少钱
下表是本文的结论。Apify 一侧每一行取两个 scraper:一个是这类数据里近 30 天用户最多的主力 scraper,另一个是 Store 里近 30 天用户不少于 50 个的同类 scraper 中 Free 档最便宜的那个。价格从 Apify 的公开 actor 接口的 pricingInfos 字段读出,2026-11-02 00:13 新加坡时间读取,不需要账号。档位对应关系按 Apify 文档:Free 套餐用 Free 价,Starter 对应 Bronze,Scale 对应 Silver,Business 对应 Gold,另有 Platinum、Diamond 两档只给企业客户(Actor 定价与成本)。EveryInfra 一侧全部是本文真调,实扣金额来自响应里的 billing.charged_usd,条数取响应里的 results。
| 数据 | EveryInfra 能力 | 实测:次数 / 条数 / 实扣 | EveryInfra 每千条 | Apify 主力(Free → Business) | 倍数 | Store 常用最低(Free 档) |
|---|---|---|---|---|---|---|
| 搜索结果 | amazon/search | 6 / 248 / $0.013416 | $0.0541 | Amazon Product Scraper $5.00 → $3.00 | 55–92 倍 | $0.60,差 11 倍 |
| 商品详情 | amazon/profile | 1 / 1 / $0.001389 | $1.389 | Amazon Product Scraper $5.00 → $3.00 | 2.2–3.6 倍 | $2.50,差 1.8 倍 |
| 评论 | amazon/reviews | 3 / 39 / $0.004167 | $0.107 | Amazon Reviews Scraper $6.00 → $3.00 | 28–56 倍 | $0.90,差 8.4 倍 |
倍数一律用 Apify 的价格除以我们的价格,两端分别对应 Business 档和 Free 档。读这张表要注意三件事。第一,差几十倍的两行都是「一次请求回一页」的能力:搜索一次最多 50 条,评论一次十几条,一页越满,我们的单价摊得越薄。第二,商品详情一次只查一个 ASIN,两边都等于「一条一个价」,这时差距只剩 2 到 3 倍;如果你是 Apify 的企业客户,Diamond 档每千条 $0.80,比我们的 $1.389 便宜。第三,评论一行的「便宜」有前提:我们每个商品只能拿到页面上那十几条精选评论,美国站今天还拿不到;Apify 的 Amazon Reviews Scraper 在 Store 页上写的是每个星级最多 100 条、每个商品最多 500 条。两边拿到的不是同一个量级的数据,下文「实测三」会单独讲。
图里我们的点从 $0.0541 散到 $1.389,是因为分母不同:我们按请求收费,搜索一次最多回 50 条,详情一次只回 1 条,同样 $0.001 多一点的单次价,摊到每条上差了几十倍。Amazon 这一篇多了一个变量:评论的条数不由请求决定,而由 Amazon 在商品页上放出多少条精选评论决定。所以「评论便宜 28 到 56 倍」这句话,只在「我只要每个商品最新、最有用的十几条评论」这种需求下成立;你要的是一个商品的全部历史评论,这一行的比较就不成立,应该看下文的「什么时候 Apify 更合适」。
Apify Amazon Product Scraper pricing:一个 actor,四个收费事件
Apify Store 现在的主流收费方式叫按事件计费(pay-per-event):作者定义一组「事件」,每发生一次收一次钱,比如返回一条结果、启动一次运行;大多数按事件计费的 actor 把平台用量算进事件价格里,少数另收平台用量(Actors in Store)。Amazon 这一类里用户最多的是 Apify 自己维护的 Amazon Product Scraper(作者账号 junglee):公开接口显示累计 29,819 个用户、近 30 天 4,147 个用户、近 30 天 890,632 次运行。它当前的价格自 2026 年 8 月 28 日生效,一共 4 个事件:
| 事件(Amazon Product Scraper) | Free | Bronze(Starter) | Silver(Scale) | Gold(Business) | Platinum | Diamond |
|---|---|---|---|---|---|---|
| Result,每千条 | $5.00 | $4.00 | $3.50 | $3.00 | $1.70 | $0.80 |
| Offer(每条报价),每千条另加 | $2.50 | $2.00 | $1.70 | $1.50 | $1.00 | $0.40 |
| Seller(每个卖家),每千条另加 | $2.50 | $2.00 | $1.70 | $1.50 | $1.00 | $0.40 |
| Delivery Location(按国家或邮编取价),每千条另加 | $60 | $50 | $40 | $35 | $22 | $10 |
这张表里最容易被忽略的是最后一行。Amazon 的价格和是否有货随收货地址变,Product Scraper 的页面也提醒,收货国家没有卖家时价格可能缺失,代理所在地不同看到的报价也不同(Amazon Product Scraper 页面)。如果你为了拿到准确的本地价而指定邮编,每条结果要多付一笔 Delivery Location 事件:Free 档每条 $0.06,是基础结果价的 12 倍;Business 档每条 $0.035,是基础价的 11.7 倍。换句话说,「按邮编取价的 1,000 条商品」在 Business 档要 $3.00 + $35.00 = $38.00。EveryInfra 的 amazon/search 和 amazon/profile 没有按邮编取价的参数,这一项是 Apify 有而我们没有的能力,下文会再提。
这个 scraper 是 2026 年 4 月 14 日才从包月改成按事件计费的,评论那个 Amazon Reviews Scraper 是 2025 年 6 月改成按条计费的(公开接口的 pricingInfos 里留着历史)。读别人写的「Apify Amazon scraper 多少钱」时,先看文章日期:2026 年 4 月以前的文章说的大多是包月价,和现在的按条计费不是一回事。
套餐本身也要算进去。Apify 价格页写的是:Free 套餐每月 $5 预付额度,Starter 每月 $19,Scale 每月 $199,Business 每月 $999;预付额度当月有效,用不完不结转;Free 套餐超额后要等到下个月才能继续用。所以「Business 档每千条 $3.00」这个价,前提是你每月已经付了 $999;只付 $19 的 Starter 用户拿到的是 Bronze 价 $4.00。EveryInfra 没有月费,最低充值 $10,价格页写明充值余额长期有效、不清零,失败或空结果不计费。
我们怎么测,和怎么判对错
动手之前我们先写下了判据:价格对比表里只放两类数,一类是 Apify 的公开价(带网址、读取时间、档位),一类是我们的真调(带新加坡时间、能力名、返回条数、实扣金额);每千条价一律用实际返回条数当分母;「支持哪些站点」只以接口真实返回的 422 错误为准,不以文档描述为准;「失败扣不扣钱」至少要有两次没拿到数据的请求和它们的扣费记录。四条里任何一条做不到,就不写对应的结论。
真调全部用同一把测试 Key,时间是 2026 年 11 月 2 日 00:15 到 00:39(新加坡时间),一共 20 次请求:搜索 6 次(美国、德国、墨西哥、西班牙、日本五个站点,美国站隔 23 分钟复测一次),商品详情 2 次,评论 10 次,另有 1 次故意不带 Key、1 次故意写错站点。所有能力的参数、价格、字段都先从免费的能力目录读出:amazon/search 每次 $0.002236,amazon/profile 和 amazon/reviews 每次 $0.001389,三个都是 available: true。目录里 Amazon 一共 10 项能力,另外 7 项(畅销榜、卖家、关键词排名等)本文不比。
Apify 一侧,我们用 Apify 公开的 Store 搜索接口搜了 amazon、amazon reviews、amazon product 三个词:第一个词 Store 报告共有 1,752 个结果,三个词各取前 100 个,去重后 214 个 actor,其中 210 个按事件计费。再用公开的 actor 详情接口逐个读了 11 个主要 scraper 的价格历史和近 30 天运行统计。这些接口都不需要账号,读的是 Apify 自己公开的数据。
实测一:amazon/search,一次最多 50 条,五个站点各回多少
第一次真调在 00:15:12(新加坡时间):amazon/search,关键词 wireless earbuds,limit 50,美国站。55.2 秒后返回 49 条,实扣 $0.002236,折合每千条 $0.0456。每条结果带 20 个字段:ASIN、标题、链接、品牌、现价、划线价、币种、评分、评分人数、是否有货、类目、主图、描述、是否有 Amazon's Choice 标、卖家、图片列表、卖点要点(features)和 Best Sellers 排名,和目录里 response_fields 列的一一对应。
curl -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"amazon","action":"search",
       "params":{"keyword":"wireless earbuds","domain":"amazon.com","limit":50}}'
# 200:count 49,billing.charged_usd 0.002236(2026-11-02 00:15 新加坡时间)
接着在 00:18、00:19、00:22、00:39(新加坡时间)分别搜了德国站(bluetooth kopfhörer,45 条)、墨西哥站(audifonos bluetooth,50 条)、西班牙站(auriculares bluetooth,19 条)和日本站(ワイヤレスイヤホン,42 条)。五个站点每次都扣 $0.002236,返回条数从 19 到 50 不等,6 次合计 248 条、$0.013416,平均每次 41.33 条。西班牙站那次只回 19 条,是这一组里最贵的一次,每千条 $0.1177,仍然只有 Apify Free 档价格的四十分之一。
| 站点 | 时间(新加坡时间) | 返回条数 | 实扣 | 每千条 | 有现价的条数 |
|---|---|---|---|---|---|
| amazon.com | 00:15:12 | 49 | $0.002236 | $0.0456 | 42(86%) |
| amazon.de | 00:18:23 | 45 | $0.002236 | $0.0497 | 33(73%) |
| amazon.com.mx | 00:19:42 | 50 | $0.002236 | $0.0447 | 49(98%) |
| amazon.es | 00:22:50 | 19 | $0.002236 | $0.1177 | 3(16%) |
| amazon.com(复测) | 00:38:28 | 43 | $0.002236 | $0.0520 | 36(84%) |
| amazon.co.jp | 00:39:24 | 42 | $0.002236 | $0.0532 | 13(31%) |
| 合计 | — | 248 | $0.013416 | $0.0541 | — |
价格低,字段满不满是另一回事。我们把五个站点各一次的结果按字段数了一遍:卖点要点 features 五个站都是 100%,Best Sellers 排名在 92% 到 98% 之间,类目在 90% 以上;但现价差得很远,墨西哥站 98% 有价,美国站 86%,德国站 73%,日本站只有 31%,西班牙站 19 条里只有 3 条有价。德国站有价的 33 条里还混着 4 条以美元计价,日本站有 3 条美元、10 条日元,其余没有币种。这说明同一个能力在不同站点的完整度不一样,做跨站比价的人要先看自己关心的站点、关心的字段,有价率不够就换关键词或者改用 amazon/profile 逐个补价。目录的 field_note 也写明了:主数据源不可用时,美国站结果会改从备用来源取,一次最多 20 条,品牌、库存、类目、描述、卖家等字段会缺。
Apify 的 Amazon Product Scraper 这一侧,我们没有跑,所以不知道它在西班牙站的有价率是多少,只能引它页面上的说法:价格可能因收货国家没有卖家而缺失,可以用代理国家设置改善(Amazon Product Scraper 页面)。它的输入也和我们不一样:它要的是 Amazon 的类目或搜索页网址,页面上举的例子是一个 /s?i=specialty-aps 开头的子类目链接,并提醒 Amazon 有时把一个搜索词限制在最多 7 页。我们的 amazon/search 要的是关键词加站点域名,一次一页,不翻页。两边各有用处:它适合「把一个类目整个扫一遍」,我们适合「每天固定看几十个关键词的第一页」。
复测这一项回答「价格稳不稳、内容变不变」。00:38:28(新加坡时间)我们用完全相同的参数又搜了一次美国站:价格一样,还是 $0.002236;条数从 49 变成 43;两次共同出现的 ASIN 有 41 个,合起来 51 个不同的 ASIN;前 10 名里只有 6 个相同;两次都有价的 34 个 ASIN,价格一个都没变。也就是说,23 分钟里排序变了不少,价格没变。做排名监控的人要按 ASIN 去重、按时间存快照,不能只比较「第几名是谁」。
实测二:amazon/profile,一次一个 ASIN,这一项 Apify 不吃亏
00:16:26(新加坡时间)我们用 amazon/profile 查了美国站一个评分人数 259,992 的蓝牙耳机(ASIN B07J2Z5DBM),8.7 秒返回,实扣 $0.001389。返回的是一个商品对象:现价 $29.99、划线价 $32.99、评分 4.3、卖家名、类目路径、8 张大图、10 条卖点要点和 Best Sellers 排名。00:20:53 我们又故意查了一个不存在的 ASIN(B0ZZZZZZZ9),27.8 秒后返回 503「请求失败,稍后重试」,实扣 $0。
这一项单价是每千个 $1.389。Apify 的 Amazon Product Scraper 一样按条收钱,商品详情也是一条一个 Result,所以对比很直接:Free 档 $5.00、Business 档 $3.00,我们便宜 3.6 倍和 2.2 倍;Platinum 档 $1.70 只比我们贵 22%;Diamond 档 $0.80 比我们便宜 42%。Store 里近 30 天用户不少于 50 个的专门「商品详情」scraper,最便宜的是 delicious_zebu 的 Amazon Product Details Scraper,Free 档 $2.50、Gold 档 $1.50,另收每千次启动 $0.05;还有一个标价每千条 $0.25 的 scraper(alfalfa 的 Amazon Product Scraper),基础结果之外另收每千条 $1.00 的「商品详情」事件,近 30 天只有 36 个用户。
我们的建议是:如果你只要每个商品的价格、评分、排名、卖点这些搜索结果里就有的字段,不要逐个查详情,用 amazon/search 按关键词批量拿,一次 50 条摊下来每千条 $0.05 左右;只有在搜索结果缺价、或者你手里本来就是一份 ASIN 清单时,才用 amazon/profile 逐个补。我们实测的 5 个站点搜索结果里,features 和 bestseller_ranks 的有值率都在 92% 以上,大部分监控需求用不到详情接口。
实测三:amazon/reviews 与 Apify Amazon Reviews Scraper:登录墙下各拿到多少
评论是这篇里最需要说清楚的一项。2024 年下半年起,Amazon 开始把商品页上精选评论以外的评论放到登录后才能看,评论列表页对未登录访问跳到登录页。这件事 Amazon 没有发公告,我们只找到用户和工具商的公开说法:Reddit 网页抓取版块一位开发者在帖子里说,几个月前 Amazon 把前 10 条之后的评论锁在了登录后,他只能用临时账号的 Cookie 去取,规模化不了(r/webscraping 讨论);八爪鱼(Octoparse)的帮助中心教程写的是,因为 Amazon 的限制,要先登录账号才能看全部评论(Octoparse 帮助中心)。
我们的 amazon/reviews 在目录里写得很直白:只支持 11 个站点,各站点都只能取到商品页展示的精选评论,每个商品通常十几条,取不到全部历史评论。真调的结果和这句话一致,而且美国站更差:
| 站点 | 时间(新加坡时间) | 商品 | 结果 | 实扣 |
|---|---|---|---|---|
| amazon.com | 00:16:35 | B07J2Z5DBM | 503 access_blocked(需要登录或受限) | $0 |
| amazon.com | 00:17:39 | B0F53L8J78 | 503 access_blocked | $0 |
| amazon.com | 00:22:04 | B0BTYCRJSS | 503 access_blocked | $0 |
| amazon.com(15 分钟后复测) | 00:37:25 | B0BTYCRJSS | 503 access_blocked | $0 |
| amazon.co.uk | 00:21:37 | B0BTYCRJSS | 200,13 条 | $0.001389 |
| amazon.de | 00:19:24 | B0BTYCRJSS | 200,13 条 | $0.001389 |
| amazon.es | 00:23:45 | B0BTYCRJSS | 200,13 条 | $0.001389 |
| amazon.co.jp | 00:24:39、00:38:06 | B0BTYCRJSS | 两次 503,请求失败 | $0 |
| amazon.com.mx | 00:19:19 | — | 422,站点不在支持列表 | $0 |
美国站 4 次请求、3 个不同商品,全部返回 503,错误原因写的是 access_blocked,说明里写「这个商品需要登录或受限,本次已退款,马上重试大概率没用」,并给了 900 秒的建议等待时间。我们按建议隔了 15 分钟重试,还是一样。四次都没扣钱,响应里 charged_usd 是 0,reason 是 request_failed_refunded。日本站两次都是普通的「请求失败,稍后重试」,也没扣钱;这个 ASIN 在日本站可能根本不存在,我们没有再核。
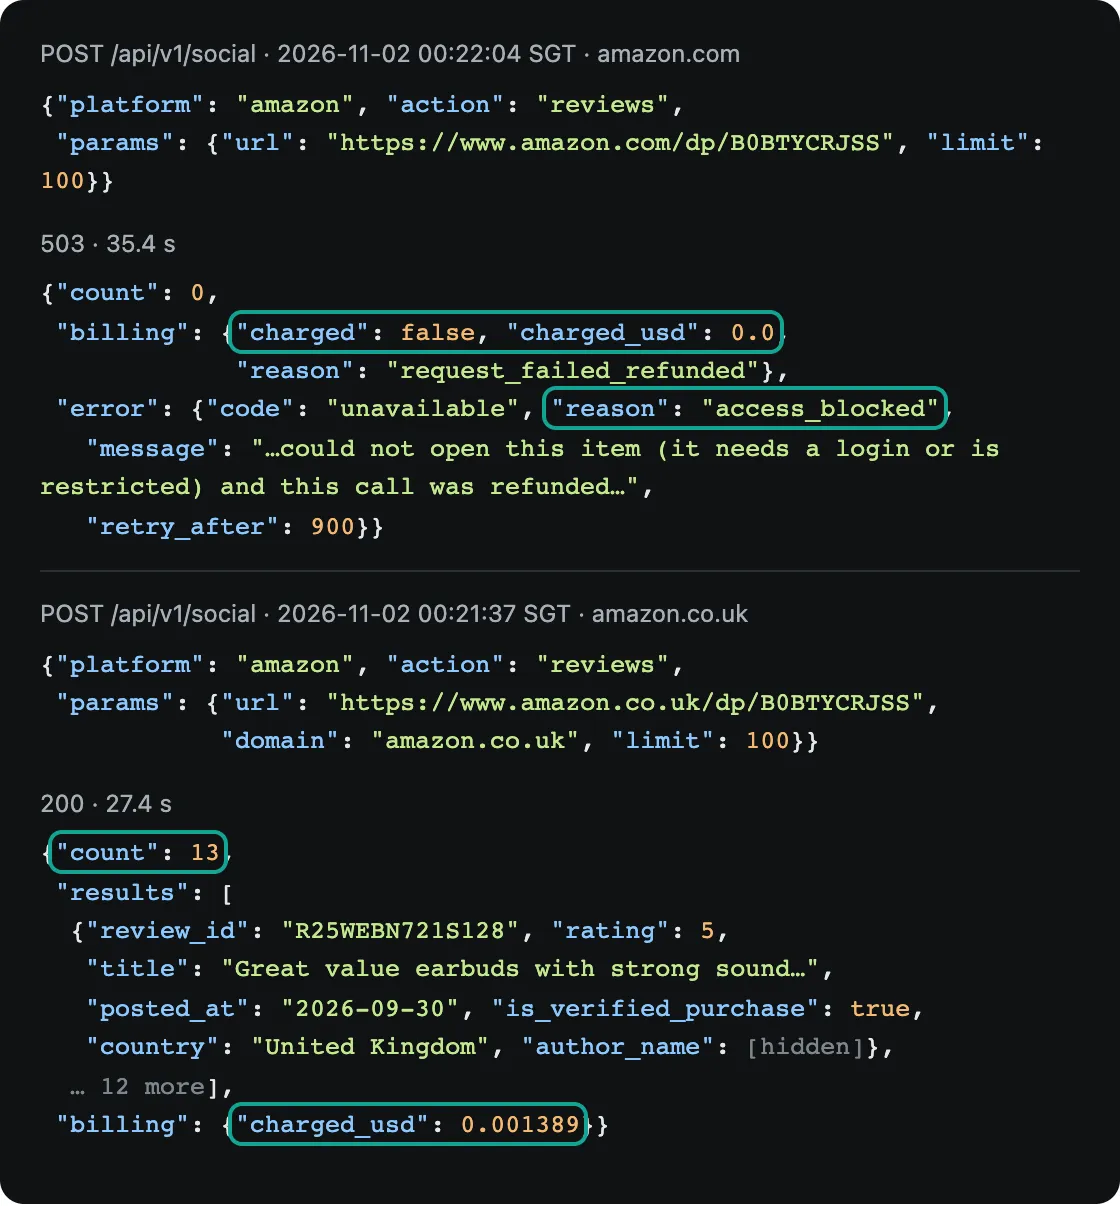
英国、德国、西班牙三站各回 13 条,都是「已验证购买」,没有一条是 Vine 送测评论。评论很新:德国站 13 条里最新一条发布于 2026-10-29,另有 2026-10-26、2026-10-24、2026-10-18、2026-10-17、2026-10-08 和 2026-10-03 各一条,最早一条是 2026-07-30;精选评论并不只是「最老、最高赞」的那几条,Amazon 会混进最近一个月的新评论,够用来看最近买家在说什么。细看还有一个容易踩的坑:三站各自的 13 条里,8 条来自本站(英国、德国、西班牙),另外 5 条是同样 5 条「来自其他国家的评论」,分别标着意大利、埃及、荷兰、爱尔兰、澳大利亚。三站合计 39 行,按 review_id 去重后只有 29 条。如果你按站点循环拉同一个商品的评论再合并,不去重就会把这 5 条算三遍。按去重后的 29 条算,每千条评论是 $0.144,仍然比 Apify 的同类便宜 6 到 42 倍。
再看这 39 行评论的内容。星级全部是 4 星和 5 星:德国站 11 条 5 星、2 条 4 星,英国站和西班牙站都是 12 条 5 星、1 条 4 星,没有一条 3 星及以下。精选评论几乎清一色好评,所以精选评论不能拿来估算星级分布,更不能当作「差评样本」。要做差评预警,应该看评分和评分人数的变化(amazon/search 和 amazon/profile 都有 rating、rating_count),精选评论只用来读「最近买家在夸什么、提了什么问题」。评论长度也随站点不同:按字符数算,德国站中位数 559,英国站 350,西班牙站 252。「有帮助」次数大多是空的:德国站 13 条里 7 条有数,英国站 5 条,西班牙站只有 2 条,最高的一条是德国站的 205 次。按「有帮助」排序挑评论之前,先确认这个字段在你的站点上填得够满。
Apify 这边,Apify 自己维护的 Amazon Reviews Scraper 近 30 天有 2,510 个用户、137,607 次运行,Free 档每千条 $6.00、Business 档 $3.00、Diamond 档 $1.00;按日期筛选另收每千条 $1.30(Free)到 $0.17(Diamond)。它的页面写着每个星级最多返回 100 条,最好的情况一个商品能拿 500 条,并提醒它只抓有文字的评论。近 30 天用户第二多的是 axesso_data 的 Amazon Reviews Scraper:所有档位统一每千条 $0.90,近 30 天 1,188 个用户、961,052 次运行;它的输入是 ASIN 加站点代码,每次最多翻 10 页,页面说这是 Amazon 预设的上限,并列出 15 个支持的站点,比我们多了墨西哥、巴西、荷兰、瑞典、阿联酋,少了新加坡。两家都没有在页面上说明自己怎么处理登录墙,我们也没有跑,所以不知道它们今天在美国站能拿到多少条。
所以评论这一项的结论要分两种需求说。只要每个商品最新、最有帮助的十几条评论,用来读最近买家反馈、提炼卖点、做竞品对比,我们在英德西等站点每千条 $0.107 到 $0.144,是 Apify 同类的几分之一到几十分之一,但美国站今天拿不到,失败不扣钱;要一个商品的几百条历史评论,做全量情感分析或学术研究,我们做不到,只能用 Apify 这类按条计费、能翻页的 scraper,或者走 Amazon 卖家后台和 Amazon 自己的接口。我们在亚马逊评论数据管道实战里讲过精选评论怎么做成周报,这篇不重复。
站点覆盖:以 422 返回为准
「支持哪些站点」我们不抄文档,直接看接口怎么回。00:19:19(新加坡时间)我们故意让 amazon/reviews 去取墨西哥站(domain: amazon.com.mx)。0.12 秒就回了 422,没有发出任何抓取,原文是「domain 必须是以下之一:amazon.ca、amazon.co.jp、amazon.co.uk、amazon.com、amazon.com.au、amazon.de、amazon.es、amazon.fr、amazon.in、amazon.it、amazon.sg(收到的是 amazon.com.mx)」,同时给了 did_you_mean 建议值和「什么都没扣」的说明。这 11 个站点就是评论能力今天真实支持的范围。
搜索不一样。amazon/search 的 domain 参数不做白名单校验:墨西哥站正常返回 50 条,日本站 42 条。我们又故意传了一个不存在的 amazon.xyz,它没有回 422,而是 8.1 秒后回 503 并退款,实扣 $0。所以站点写错不花钱,只是多等 8 秒左右;批量任务里建议先把要用的站点域名列成固定清单,不要从用户输入里直接拼。
| 能力 | 站点规则 | 实测证据 |
|---|---|---|
amazon/reviews | 白名单 11 站:美、英、德、法、意、西、加、澳、印、日、新加坡 | 墨西哥站 422,0.12 秒,列出 11 站;美国站今天 4 次 503 需要登录 |
amazon/search | 传 Amazon 站点域名,不做白名单 | 美、德、墨、西、日 5 站各回 19–50 条;amazon.xyz 503、退款 |
amazon/profile | 用商品链接,站点跟链接走 | 美国站 200;不存在的 ASIN 503、退款 |
| Apify Amazon Reviews Scraper(axesso) | 页面列出 15 个站点代码 | 只读页面,未实跑 |
| Apify Amazon Product Scraper | 输入 Amazon 类目或商品网址 | 只读页面,未实跑 |
失败和空结果扣不扣钱:两边的规则不一样
本篇 20 次请求里,有 10 次没拿到数据:1 次不带 Key(401,missing_key,说明写「什么都没扣」),1 次站点不在白名单(422),1 次站点拼错(503),1 次商品不存在(503),4 次美国站评论被登录墙挡住(503),2 次日本站评论失败(503)。10 次全部 charged_usd 为 0,响应里的 reason 写着 request_failed_refunded 或参数错误。另外 10 次拿到了数据,一共扣了 $0.018972,这就是本篇真调的全部花费。
| 情况 | 次数 | HTTP | 实扣 | 响应里怎么说 |
|---|---|---|---|---|
| 不带 Key | 1 | 401 | $0 | 要在 Authorization 头里带 Key,什么都没扣 |
| 评论站点不在白名单 | 1 | 422 | $0 | 列出 11 个允许值和 did_you_mean,什么都没扣 |
| 搜索站点拼错 | 1 | 503 | $0 | 请求失败,未扣费,可重试 |
| 商品 ASIN 不存在 | 1 | 503 | $0 | 请求失败,未扣费,可重试 |
| 美国站评论需要登录 | 4 | 503 | $0 | access_blocked,已退款,马上重试没用 |
| 日本站评论失败 | 2 | 503 | $0 | 请求失败,未扣费 |
| 拿到数据 | 10 | 200 | $0.018972 | 每次一笔,金额在 billing.charged_usd |
Apify 这边的规则由每个 actor 的作者自己定。按事件计费的文档说,作者可以用一个叫 apify-default-dataset-item 的系统事件,每往结果集里写一条就自动收一次钱;文档同时要求作者在结果保存好、用户拿得到之后再收费,不要为用户拿不到的东西收钱(按事件计费文档)。问题在于「拿不到数据」时 actor 往结果集里写了什么。Apify 自己的 Amazon Product Scraper 和 Amazon Reviews Scraper 在页面上写着:输入取不到数据时,比如商品 404 或网址写错,会往结果集里写一条「错误条目」,带 error 字段,而不是静默跳过;页面没有写这条错误条目收不收钱,它们的主事件是作者自定义的 Result 事件,不是自动按条收费的那个系统事件。
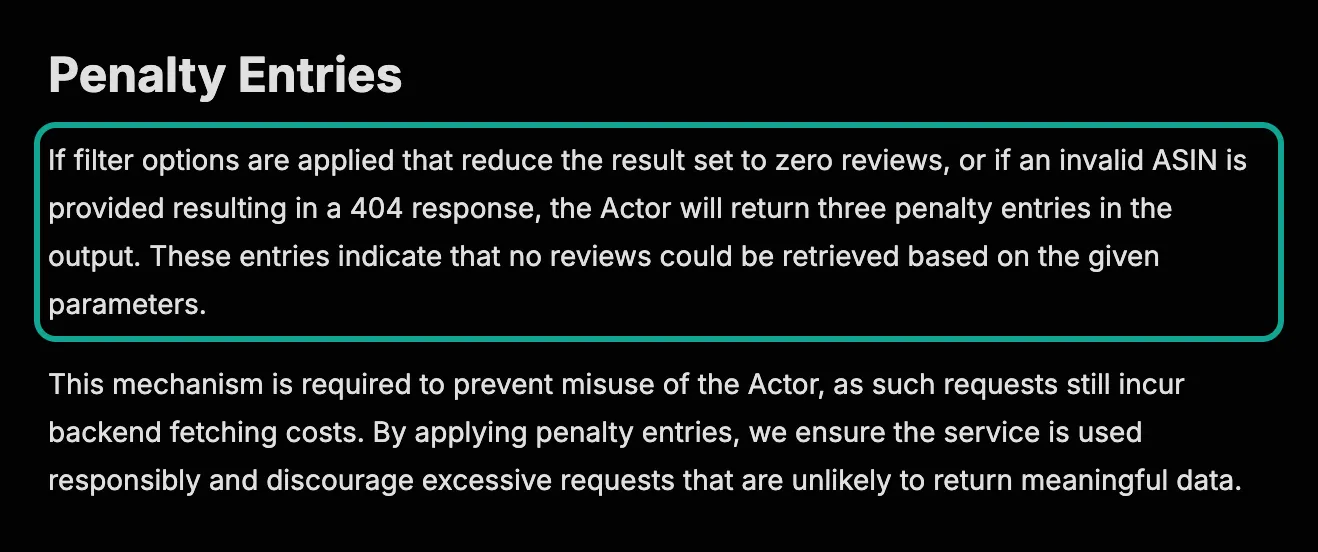
axesso_data 的评论 scraper 写得更明确,见下面的截图:筛选条件把结果筛到 0 条,或者 ASIN 无效返回 404 时,会在输出里写 3 条「罚款条目」(penalty entries),理由是这类请求一样产生抓取成本,要防止滥用。它的主事件正是 apify-default-dataset-item,按文档每写一条收一次,每千条 $0.90。照这两份公开材料推算,一个查不到评论的 ASIN 要付 3 × $0.0009 = $0.0027,比我们一次成功的评论请求($0.001389)还贵。这是按公开文档推算,我们没有实跑核实。
还有一类钱是「跑失败了的运行」。Apify 公开接口里每个 actor 都有近 30 天的运行统计,分成成功、失败、超时、中止四类。我们把 11 个 Amazon scraper 的数字摆在一起:用户最多的 Amazon Product Scraper 每 1 万次运行里有 57.9 次没跑成,axesso_data 的评论 scraper 只有 11.6 次,Apify 自己的 Amazon Reviews Scraper 是 352.2 次,标价最低的两个搜索 scraper 里有一个是 2,704.7 次,也就是四分之一的运行没跑成。中止可能是用户自己停的,所以这不是数据质量,只说明「一次运行能不能跑完」差别很大。按事件计费下,跑到一半失败的运行,已经产生的事件照样收钱。
Apify Store 里 200 多个 Amazon scraper:价格怎么分布
「Store 里有便宜的第三方」是对比 Apify 时最常听到的反驳,所以我们把 Store 里的 Amazon scraper 都摊开看了一遍。三次搜索去重后 214 个 actor,210 个按事件计费,其中能读出主事件单价的有 203 个:商品、搜索类 106 个,评论类 97 个。按 Free 档主事件价格乘 1,000 分桶,两类的中位数都是每千条 $4.00,大部分落在 $1 到 $10 之间;最便宜的那几个每千条不到 $0.10,但近 30 天用户都很少。只看近 30 天用户不少于 50 个的常用 scraper,商品、搜索类 23 个,中位数 $2.50,最低 $0.60;评论类 9 个,中位数 $1.80,最低 $0.90。我们实测的两个价格(搜索 $0.0541、评论 $0.107)都落在最左边那一桶。
这张分布图要配两条说明。第一,主事件不一定都是「一条结果」:有的作者把启动一次运行设成主事件,有的把一页搜索设成主事件,我们按字面取了主事件价格,没有逐个读说明,所以单个 actor 的价格可能有偏差,中位数和区间分布受影响不大。第二,价格会变。排名靠前的搜索 scraper 之一 apt_marble 的 Amazon Search Results Scraper,现价是所有档位每千条 $0.60(10 月 5 日起),公开接口里已经挂出了下一版价格:11 月 6 日起 Free 档涨到 $1.00,Bronze $0.60,Silver $0.55,Gold 降到 $0.50。也就是说,同一个 scraper,Free 用户要多付 67%,Business 用户少付 17%。Apify 按事件计费的价格可以由作者调整,生效前会通知用户,对比价格时要看生效日期。
还有一个名字容易误导的例子。搜索联想词里有「apify free amazon product scraper」,对应的是 Apify 自己维护的一个 actor,网址里带 free,但 Store 标题叫 Amazon Scraper,Free 档每千条 $12.00,Gold 档 $6.20,是本文列出的 Amazon scraper 里单价最高的一个,近 30 天每 1 万次运行里有 806 次没跑成。网址里的 free 是历史遗留,不是免费的意思。Apify 真正的免费,是 Free 套餐每月 $5 的额度:按 Amazon Product Scraper 的 Free 档价,够拿 1,000 条商品;按我们的价,$5 够调 2,236 次搜索,按今天平均每次 41.33 条算,大约 9.2 万条。
算一笔账:三件常见的活,30 天各花多少钱
单价比较之外,更接近真实账单的是「一件活一个月花多少钱」。我们按今天实测的平均条数,算了三件跨境卖家和品牌方常做的事:每天用 20 个关键词搜一次(30 天 600 次请求,约 24,800 条结果);每天检查 500 个 ASIN 的详情(30 天 15,000 次请求);每周拿 200 个商品的精选评论(4 周 800 次请求,约 10,400 条评论)。EveryInfra 按「请求次数 × 目录价」,Apify 按「同样条数 × 主事件单价」,都不含套餐月费。
| 活 | EveryInfra | Apify 主力 Free 档 | Apify 主力 Business 档 | Store 常用最低 |
|---|---|---|---|---|
| 20 个关键词每天搜一次(24,800 条) | $1.34 | $124.00 | $74.40 | $14.88 |
| 500 个 ASIN 每天查详情(15,000 条) | $20.84 | $75.00 | $45.00 | $37.50 |
| 200 个商品每周拿评论(10,400 条) | $1.11 | $62.40 | $31.20 | $9.36 |
第二行是我们差距最小的一项:每天逐个查 500 个 ASIN,一个月 $20.84,是 Apify Business 档的一半不到;如果你是 Apify 的 Diamond 企业客户,同样 15,000 条只要 $12.00,比我们便宜。第三行要再提醒一次:$1.11 只在英、德、西等站点成立,美国站今天拿不到,而且每个商品只有十几条精选评论。如果你的 200 个商品都在美国站,这一行我们今天交不了货,失败不扣钱,但也没有数据。
速度和并发:一天能跑完多少
价格之外,批量任务还要看速度。本篇的 amazon/search 每次在 55.0 到 57.9 秒之间返回,评论 9.3 到 54.0 秒,商品详情 8.7 秒。搜索每次接近一分钟,主要花在把一页结果的卖点、排名、图片一起取全上;这意味着单线程一小时只能跑 60 次左右搜索,按平均每次 41.33 条算约 2,500 条。要跑得更快就得并发:我们的价格页写明,数据接口默认每分钟 60 次(账户下所有 Key 合计),需要更快可以在控制台买提速包,或累计充值到档自动提升。每分钟 60 次足够同时跑几个请求,按 5 个并发算,一小时约 300 次搜索、1.2 万条结果,每天 20 个关键词的任务几分钟就跑完。
Apify 这边,并发按运行算:Free 套餐最多同时 5 个运行,Starter 32 个,Scale 128 个,Business 256 个,每个运行内部能并行抓多少页由 actor 自己决定(价格页,平台限制)。一个 Amazon Product Scraper 运行可以一次喂进很多个类目网址,跑完再把结果一起写进数据集,所以它适合「一次跑大批」;我们是一问一答,适合「随时查一点」。两种方式的账也不一样:Apify 的运行还会消耗内存时长(计算单元,每单元 $0.13 到 $0.20),按事件计费的 actor 大多把这部分算进事件价里,少数另收(用量与资源);我们只按请求次数收,不另收计算和流量。还要留意同步请求的 85 秒上限:搜索每次 55 秒以上,网络慢一点就可能超时,超时的请求不扣钱,但要重发,所以每天定时跑的任务建议直接用 "mode": "async",拿 job_id 回头取结果。
Amazon scraper API:在代码、自动化和 AI 客户端里怎么调
EveryInfra 的 Amazon 能力都走同一个入口:POST https://api.everyinfra.com/api/v1/social,请求体是 platform、action、params 三个字段。慢的请求可以加 "mode": "async",立刻拿到 job_id,再用 GET /api/v1/jobs/{job_id} 取结果;同步请求的等待上限是 85 秒,本篇的搜索每次都在 55 到 58 秒之间返回,离上限不远,每天批量跑的话建议用异步。下面是一个按关键词批量搜索、遇到 503 按建议时间重试、把实扣金额记下来的 Python 片段:
import os, time, requests

API = "https://api.everyinfra.com/api/v1/social"
HEAD = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def amazon(action, **params):
    for attempt in range(3):
        r = requests.post(API, headers=HEAD, timeout=120,
                          json={"platform": "amazon", "action": action, "params": params})
        body = r.json()
        if r.status_code == 200:
            return body["results"], body["billing"]["charged_usd"]
        err = body.get("error", {})
        if r.status_code == 503 and err.get("reason") == "access_blocked":
            return [], 0.0            # 登录墙:已退款,马上重试没用
        if not err.get("retryable"):
            raise RuntimeError(err)   # 401 / 422:改请求,不要重试
        time.sleep(err.get("retry_after", 20))
    return [], 0.0

rows, spent = [], 0.0
for kw in ["wireless earbuds", "bluetooth speaker"]:
    res, usd = amazon("search", keyword=kw, domain="amazon.com", limit=50)
    rows += res; spent += usd
print(len({r["asin"] for r in rows}), "个不重复 ASIN,花费", round(spent, 6))
在 Claude、Cursor 这类支持 MCP 的客户端里,把远程 MCP 服务器加进配置即可,Amazon 的能力会以 everyinfra_* 工具出现,模型自己决定调哪个、传什么参数。MCP 的协议规范见 Model Context Protocol 规范,各客户端的接法见 Claude Code MCP 文档和 OpenAI MCP 连接文档,我们自己的说明在 MCP 接入页:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify 也有自己的 MCP 服务器(https://mcp.apify.com),能让 AI 客户端搜索和运行 Store 里的 actor,推荐用 OAuth 登录,也可以用 API Token(Apify MCP 文档,源码在 GitHub)。两边的区别在于:Apify 的 MCP 把整个 Store 当工具箱,模型要先挑 actor、再填这个 actor 的输入表单,每个 actor 的输入和输出字段都不一样;我们的 MCP 是一套固定的工具,Amazon、Walmart、eBay 等平台的字段名统一,price、rating、rating_count 在每个平台都叫同一个名字,模型不用每次重新读说明。要定时跑,Apify 有定时任务和 Webhook;我们这边是普通 HTTP 接口,用你自己的 cron、n8n 或 GitHub Actions 调就行。
从 Apify 换过来:字段怎么对
如果你已经在用 Apify 的 Amazon scraper,换过来主要改字段名。下表左边是 Apify 两个主力 scraper 页面上公开的样例输出里的字段,右边是我们目录里的字段。两边字段名不同、含义接近,但不是同一套数据,取数方式也不同,换之前请用自己的商品各跑一次对一下。
| Apify Amazon Product Scraper 样例字段 | EveryInfra `amazon/search`、`amazon/profile` | Apify Amazon Reviews Scraper 样例字段 | EveryInfra `amazon/reviews` |
|---|---|---|---|
asin | asin | productAsin | product_asin |
price.value / price.currency | price / currency | ratingScore | rating(另有 rating_scale) |
listPrice.value | list_price | reviewTitle | title |
stars | rating | reviewDescription | text |
reviewsCount | rating_count | reviewedIn(国家和日期写在一句话里) | country + posted_at(拆开) |
breadCrumbs | category | isVerified | is_verified_purchase |
seller.name | seller_name | reviewReaction(如「21 people found this helpful」) | helpful_count(整数) |
features | features | variant | variant |
bestsellerRanks | bestseller_ranks | reviewImages | images |
inStock | in_stock | — | is_vine(Vine 送测标记) |
有两处需要动代码。一是评论日期:Apify 的样例把国家和日期写成一句英文「Reviewed in the United States on February 3, 2022」,要自己解析;我们拆成 country 和 ISO 格式的 posted_at。二是「有帮助」次数:Apify 的样例是一句话,我们是整数。我们的评论还多一个 is_vine 字段,标出 Amazon Vine 计划送测的评论,做口碑分析时建议单独看。Apify Amazon Product Scraper 的样例里有 starsBreakdown(各星级占比)、answeredQuestions、delivery、returnPolicy 这些字段,我们没有。
我们怎么核对这些数
文中每一个 EveryInfra 的数字,都来自 20 次请求的原始响应:条数取 results 的长度,金额取 billing.charged_usd,时间取发出请求那一刻的新加坡时间。每千条价、倍数、字段有值率、去重条数、复测重合度,都由一个脚本从原始响应现算,再和正文、表格、图逐个对过,图上的数字也是同一个脚本生成的。Apify 一侧的每个价格都能在公开接口里查到:打开文中给出的 actor 元数据链接,找 pricingInfos 里开始日期最晚、但不晚于读取时间的那一项,主事件价格乘 1,000 就是表里的数。我们没有读 Apify 的账单,也没有跑它的 actor,所以 Apify 一侧没有「实际花了多少」,只有「公开标价多少」。如果你在 Apify 上跑过同样的任务,欢迎拿账单来对:按事件计费的账单在控制台的历史用量页能看到每个事件的次数和金额(Actors in Store)。
什么时候 Apify 更合适
价格之外,有几种情况 Apify 比我们合适,照实写在这里。第一,要一个商品的全部历史评论:Apify 的 Amazon Reviews Scraper 写明每个商品最多 500 条,axesso_data 的每次最多翻 10 页,我们每个商品只有页面上的十几条精选评论。第二,要按邮编或国家看本地价格和运费:Apify Amazon Product Scraper 有 Delivery Location 事件,我们没有对应参数。第三,要一个商品下所有卖家的报价(Offer)和卖家信息(Seller):Apify 按条另收,我们的详情只给一个当前卖家名。第四,要扫一整个类目:Apify 的输入是类目网址,页面说平均能拿 10 万条以上;我们是按关键词一次一页。第五,要墨西哥、巴西、荷兰、瑞典、阿联酋站的评论:axesso_data 的页面列了这些站点,我们的评论能力不支持。第六,你已经是 Apify 的 Platinum 或 Diamond 企业客户:逐个查详情这一项,你的单价比我们低。
反过来,我们更合适的是:每天按关键词批量拿搜索结果、每周拿几百个商品的精选评论、预算按单次请求精确控制、失败和空结果不想付钱、同一套字段还要接 Walmart、eBay 等其他电商平台的时候。Apify 的整体价格结构我们在 Apify 价格详解里拆过,全平台的替代对比在 Apify 替代方案和替代方案总览,这一篇只讲 Amazon。
合规边界:公开数据、平台条款和假评论规则
我们不提供法律意见,下面只列和 Amazon 数据有关、可以核对原文的几件事。Amazon 的 robots.txt 对通用爬虫禁止了大量路径,评论列表页需要登录后才能看,这是平台自己划的线。我们的评论能力只取商品页上未登录就能看到的精选评论,取不到登录后的内容;美国站今天 4 次请求都按「需要登录」处理并退款,没有绕过。
评论数据还牵涉另一条线:假评论。美国联邦贸易委员会的消费者评论规则(16 CFR Part 465)禁止买卖假评论、压制差评等做法,2024 年 10 月 21 日生效(eCFR 原文,联邦公报);英国《数字市场、竞争和消费者法》2024 也把假评论列为一律禁止的商业行为,竞争与市场管理局发了指引(法案原文);欧盟《数字服务法》对大平台的评论和推荐系统也有透明度要求(EUR-Lex 原文)。抓评论来做分析没有问题,拿抓到的评论去改写、搬运、冒充自家评论,就踩到这些规则了。评论里的昵称、头像是个人信息,Apify 的评论 scraper 默认不输出这些字段,我们的 author_name 等字段只是转录页面公开显示的内容,做分析时建议不存或脱敏。
Amazon 自己的接口为什么不够用
「Amazon 有没有 API」是搜索联想词里常见的问题。答案是有,但都有门槛。给联盟推广用的 Product Advertising API 5.0 已经停用,调用会返回 403,要求迁到新的 Creators API(PA-API 文档页);Creators API 要在联盟后台注册应用、拿 OAuth 凭据,报价改用 OffersV2(迁移指南)。给卖家用的 Selling Partner API 有 Catalog Items 接口,可以按 ASIN 或关键词查商品属性、图片、销售排名,但要卖家账号和「Product Listing」角色(Catalog Items API),各接口有自己的调用频率限制(用量与限速)。两个官方接口都不提供商品评论正文。
| 路子 | 要什么门槛 | 能拿到评论吗 | 适合谁 |
|---|---|---|---|
| Creators API(原 PA-API 5) | Amazon 联盟账号,注册应用 | 不能 | 做导购、比价内容的联盟站 |
| Selling Partner API | 卖家或供应商账号,对应角色 | 不能 | 管自己店铺和商品的卖家 |
| Apify Store 的 Amazon scraper | Apify 账号,按条付费 | 能,可翻页 | 要深度评论、按邮编取价、扫类目 |
EveryInfra amazon/* | Key,按次付费,失败不扣 | 能,只有精选评论 | 关键词监控、批量精选评论、多平台统一字段 |
最近的变化:11 个 Amazon scraper 的调价记录
按条计费的价格不是一成不变的。Apify 公开接口里每个 actor 的 pricingInfos 都留着每一次改价的生效日期,modifiedAt 记着最后一次修改的日期。我们把本文用到的 11 个 Amazon scraper 的记录摊开(2026-11-02 00:13 新加坡时间读取),价格是主事件每千条的 Free 档和 Gold(Business)档:
| scraper(作者/名称) | 近 30 天用户 | 现价 Free / Gold | 现价生效日 | 最近一次改了什么 | 最后修改 |
|---|---|---|---|---|---|
| junglee/Amazon-crawler | 4,147 | $5.00 / $3.00 | 2026-08-28 | 只改事件说明,价格没动;4 月 14 日由包月改按事件计费 | 2026-10-27 |
| junglee/amazon-reviews-scraper | 2,510 | $6.00 / $3.00 | 2026-07-28 | 取消每次启动费(3 月已从 $0.006 降到 $0.001) | 2026-10-27 |
| axesso_data/amazon-reviews-scraper | 1,188 | $0.90 / $0.90 | 2026-06-26 | 每千条从 $0.75 涨到 $0.90,涨 20% | 2026-10-22 |
| web_wanderer/amazon-reviews-extractor | 641 | $1.00 / $0.70 | 2025-10-24 | 改成按条评论计费,另收很小的启动费 | 2026-07-25 |
| apt_marble/amazon-search-results-scraper | 634 | $0.60 / $0.60 | 2026-10-05 | 去掉每千条 $1.00 的「完整商品详情」事件;已挂出 11-06 新价 Free $1.00、Gold $0.50 | 2026-10-30 |
| jdtpnjtp/amazon-reviews | 607 | $1.80 / $1.10 | 2026-06-10 | 同一天从 Free $1.50 改到 $1.80 | 2026-08-19 |
| junglee/amazon-bestsellers | 508 | $5.90 / $3.20 | 2026-03-18 | 事件名调整,价格没动 | 2026-10-27 |
| junglee/free-amazon-product-scraper | 441 | $12.00 / $6.20 | 2026-08-31 | 7 月 28 日取消启动费,之后价格没动 | 2026-10-27 |
| delicious_zebu/amazon-product-details-scraper | 276 | $2.50 / $1.50 | 2026-09-27 | 从各档统一 $1.50 改成分档,Free 涨到 $2.50,另加每千次启动 $0.05 | 2026-11-01 |
| igolaizola/amazon-search | 75 | $1.00 / $0.30 | 2026-06-12 | 从每月 $3 包月改成按条计费 | 2026-08-04 |
| alfalfa/amazon-product-scraper | 36 | $0.28 / $0.25 | 2026-09-17 | 「商品详情」附加事件 Free 档从每千条 $1.50 降到 $1.00 | 2026-10-24 |
这张表能读出三件事。第一,11 个里有 10 个的现价是 2026 年才生效的,只有 web_wanderer 那一个还是 2025 年 10 月的价;最后修改日期有 8 个在 10 月 22 日当天或之后,说明作者们一直在改。第二,调价有升有降,而且常常是「分档」:delicious_zebu 把原来各档统一的价改成 Free 贵、Business 便宜,apt_marble 下周也要这样改,结果是同一个 scraper 上,Free 用户和 Business 用户的价差越来越大。第三,变化不只发生在单价上,还发生在「收哪些事件」上:取消启动费、去掉附加事件、改成按条计费,都会让同样一批任务的账单变样。对读者意味着:用 Apify 跑长期任务,要定期重读公开价格,至少在每次续套餐前看一眼 pricingInfos 里有没有挂出未来日期的新价;我们这边的单价写在免费的能力目录 price_usd 里,同样建议在批量任务开跑前读一次。
上手:从一次试用到每天自动跑
在 GitHub 给我们的插件仓库点星,可以在控制台领 $1 试用额度,24 小时内有效,够把本文的每个请求都跑一遍。正式用的话最低充值 $10,余额长期有效。步骤是:在快速上手拿 Key;在 Amazon 爬虫 API 页面看全部 10 项 Amazon 能力,分别打开 Amazon 搜索爬虫 API、Amazon 商品详情爬虫 API、Amazon 评论爬虫 API 的试用台各跑一次;需要畅销榜的,再看 Amazon 畅销榜爬虫 API;同样的字段还能接 Walmart 爬虫 API 和 eBay 爬虫 API;全部能力和单价在数据市场。失败退款怎么对账,见失败退款对账实战。
同样按「每千条实测价」比 Apify 的,还有 Apify TikTok Scraper 替代。做价格监控的,先读 Amazon 价格监控为什么误报,它讲同一个 ASIN 的不同报价怎么比;想自己写爬虫的,Amazon 商品页的代理流量成本算过自己抓一页要多少流量钱;要让模型稳定地按字段调接口的,看 Claude 严格工具调用接数据接口。
常见问题
Apify Amazon Product Scraper pricing 是多少?
Apify 自己维护的 Amazon Product Scraper 按条计费,2026 年 8 月 28 日起的价格是每千条 Free 档 $5.00、Starter(Bronze)$4.00、Scale(Silver)$3.50、Business(Gold)$3.00,企业档 Platinum $1.70、Diamond $0.80;每条报价、每个卖家另收,按邮编取价每条另收 $0.035 到 $0.06。数字来自它的公开 actor 接口,2026-11-02 00:13 新加坡时间读取。问题来自搜索联想词「apify amazon product scraper」。
Apify Amazon Reviews Scraper 能拿到一个商品的全部评论吗?
它的页面写的是每个星级最多 100 条,最好情况一个商品 500 条,只抓有文字的评论。Amazon 把精选评论以外的评论放到了登录之后,Reddit 上有开发者说只有少数工具能拿到前 10 条之后的评论,而且大约每千条 $1(r/webscraping 讨论)。我们的 amazon/reviews 每个商品只拿精选评论,今天在英德西三站各 13 条,美国站拿不到。问题来自联想词「apify amazon reviews scraper」。
有没有免费的 Amazon scraper API?
没有长期免费的。Apify Free 套餐每月 $5 额度,按 Amazon Product Scraper 的 Free 档价够 1,000 条;网址里带 free 的那个 Amazon Scraper 每千条反而要 $12.00。我们的试用额度是 $1、24 小时有效,按 amazon/search 的价格够调 447 次。问题来自联想词「amazon scraper api free」和「apify free amazon product scraper」。
抓取 Amazon 数据合法吗?
我们不能给法律意见。可以核对的事实是:Amazon 的 robots.txt 限制了大量路径,评论列表要登录;美国第九巡回上诉法院 2026 年 8 月 4 日在 Amazon 诉 Perplexity 案的初步禁令阶段撤销了一审禁令,认为按现有事实,用 AI 助手在 Amazon 上操作的是用户本人,Amazon 不太可能在「未经授权访问」的主张上胜诉;这只是初步禁令阶段的判断,案件发回重审(第九巡回法院判决书)。用数据做分析和把评论搬运冒充,是两回事,后者踩到美国 FTC 和英国的假评论规则。问题来自联想词「is it legal to scrape amazon」。
Amazon 有自己的 API 吗,为什么还要用 scraper?
有两个:给联盟站的 Creators API(PA-API 5 已经停用)和给卖家的 Selling Partner API,都要对应的账号,而且都不提供评论正文。所以要看竞品价格、排名和评论的人,大多还是用 Apify 这类 scraper 或者数据接口。问题来自联想词「does amazon have an api」。
亚马逊评论爬取失败会扣钱吗?
我们这边不会:本篇 10 次没拿到数据的请求全部 0 扣费,响应里写着已退款。Apify 那边看各 actor 作者怎么定:axesso_data 的评论 scraper 写明空结果和无效 ASIN 会写 3 条罚款条目,按它每千条 $0.90 的价,相当于一次 $0.0027。问题来自中文联想词「亚马逊 评论 爬取」。
参考资料
- Amazon Product Scraper 公开 actor 元数据(pricingInfos、运行统计),Apify,2026-11-02 读取,https://api.apify.com/v2/acts/junglee~Amazon-crawler
- Amazon Reviews Scraper 公开 actor 元数据,Apify,2026-11-02 读取,https://api.apify.com/v2/acts/junglee~amazon-reviews-scraper
- axesso_data Amazon Reviews Scraper 公开 actor 元数据,Apify,2026-11-02 读取,https://api.apify.com/v2/acts/axesso_data~amazon-reviews-scraper
- apt_marble Amazon Search Results Scraper 公开 actor 元数据,Apify,2026-11-02 读取,https://api.apify.com/v2/acts/apt_marble~amazon-search-results-scraper
- Apify Store 搜索结果(amazon),Apify,2026-11-02 读取,https://api.apify.com/v2/store?search=amazon&limit=100
- Apify Pricing,Apify,2026-11-02 读取,https://apify.com/pricing
- Amazon Product Scraper 页面,Apify,2026-11-02 读取,https://apify.com/junglee/amazon-crawler
- Amazon Reviews Scraper 页面,Apify,2026-11-02 读取,https://apify.com/junglee/amazon-reviews-scraper
- Amazon Reviews Scraper(axesso_data)页面,Apify,2026-11-02 读取,https://apify.com/axesso_data/amazon-reviews-scraper
- Amazon Scraper(free-amazon-product-scraper)页面,Apify,2026-11-02 读取,https://apify.com/junglee/free-amazon-product-scraper
- Actors in Store,Apify 文档,https://docs.apify.com/platform/actors/running/actors-in-store
- Pay-per-event pricing model,Apify 文档,https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event
- Actor pricing and costs,Apify 文档,https://docs.apify.com/platform/actors/publishing/monetize/pricing-and-costs
- Get list of Actors in Store(API 参考),Apify 文档,https://docs.apify.com/api/v2/store-get
- Get Actor(API 参考),Apify 文档,https://docs.apify.com/api/v2/act-get
- Apify MCP server,Apify 文档,https://docs.apify.com/platform/integrations/mcp
- apify-mcp-server,GitHub,https://github.com/apify/apify-mcp-server
- Schedules,Apify 文档,https://docs.apify.com/platform/schedules
- Webhooks,Apify 文档,https://docs.apify.com/platform/integrations/webhooks
- Usage and resources,Apify 文档,https://docs.apify.com/platform/actors/running/usage-and-resources
- Limits,Apify 文档,https://docs.apify.com/platform/limits
- Residential proxy,Apify 文档,https://docs.apify.com/platform/proxy/residential-proxy
- Actor quality score,Apify 文档,https://docs.apify.com/platform/actors/publishing/quality-score
- Automated testing,Apify 文档,https://docs.apify.com/platform/actors/publishing/test
- General Terms and Conditions,Apify,https://docs.apify.com/legal/general-terms-and-conditions
- Crawlee,GitHub,https://github.com/apify/crawlee
- EveryInfra 能力目录,EveryInfra,2026-11-02 读取,https://api.everyinfra.com/api/v1/social/catalog
- Issues when trying to scrape amazon reviews,Reddit r/webscraping,https://www.reddit.com/r/webscraping/comments/1o49g5o/issues_when_trying_to_scrape_amazon_reviews/
- Scrape product reviews from Amazon,Octoparse 帮助中心,https://helpcenter.octoparse.com/en/articles/6471075-scrape-product-reviews-from-amazon
- PA-API 5 Deprecation Notice,Amazon Associates,https://webservices.amazon.com/paapi5/documentation/
- Migrating to Creators API from Product Advertising API,Amazon Associates,https://affiliate-program.amazon.com/creatorsapi/docs/en-us/migrating-to-creatorsapi-from-paapi
- Catalog Items API,Amazon Selling Partner API,https://developer-docs.amazon.com/sp-api/docs/catalog-items-api
- Usage Plans and Rate Limits,Amazon Selling Partner API,https://developer-docs.amazon.com/sp-api/docs/usage-plans-and-rate-limits
- Amazon.com Services, LLC v. Perplexity AI, Inc., No. 26-1444,美国第九巡回上诉法院,2026-08-04,https://cdn.ca9.uscourts.gov/datastore/opinions/2026/08/04/26-1444.pdf
- 16 CFR Part 465 Use of Consumer Reviews and Testimonials,eCFR,https://www.ecfr.gov/current/title-16/chapter-I/subchapter-D/part-465
- Trade Regulation Rule on the Use of Consumer Reviews and Testimonials,Federal Register,2024-08-22,https://www.federalregister.gov/documents/2024/08/22/2024-18519/trade-regulation-rule-on-the-use-of-consumer-reviews-and-testimonials
- Digital Markets, Competition and Consumers Act 2024,legislation.gov.uk,https://www.legislation.gov.uk/ukpga/2024/13/contents
- Fake reviews(CMA208),英国竞争与市场管理局,https://www.gov.uk/government/publications/fake-reviews-cma208
- Regulation (EU) 2022/2065(Digital Services Act),EUR-Lex,https://eur-lex.europa.eu/eli/reg/2022/2065/oj
- amazon.com robots.txt,Amazon,2026-11-02 读取,https://www.amazon.com/robots.txt
- Model Context Protocol Specification 2025-11-25,modelcontextprotocol.io,https://modelcontextprotocol.io/specification/2025-11-25
- Connect Claude Code to tools via MCP,Anthropic,https://code.claude.com/docs/en/mcp
- Connectors and MCP servers,OpenAI,https://platform.openai.com/docs/guides/tools-connectors-mcp
引用编号 BL-68