n8n每天自动出热榜日报:2.45新调度器实测
实测 n8n 2.45.3 定时调 EveryInfra 微博、抖音和 X 热榜:每次 $0.002224,停机补跑和重放扣费怎么算,配置、截图和账本都在。
能做,而且一次运行只要 $0.002224;真正要花心思的是三件事:n8n 停机时到点的那一次去哪了、补跑会不会重复扣费、失败的那一路会不会拖垮整份日报。2026 年 10 月 26 日 10:36–11:25(新加坡时间),我们在一台 Mac 上用 npm 装了 n8n 2.45.3,让它每 3 分钟调一次 EveryInfra 的微博、抖音和 X 热榜,中间两次故意关掉 n8n,一共跑出 14 份日报。结论是:2.45 默认开启的「持久调度器」把每次运行先写进数据库,停机 32 秒的那一次晚了 21.8 秒照样跑了,停机近 7 分钟的两次按默认策略丢掉,另一个改成「补跑最近一次」的工作流只补了 1 次;钱的账也对得上,但如果你把每个响应里的 charged_usd 直接相加,同一天补跑的那次会被多记一笔。
本文说的「热榜日报工作流」,是一个在你自己机器上跑的 n8n 工作流:一个 Schedule Trigger 节点按时把它叫醒,一个 Code 节点列出要调的几个热榜,一个 HTTP Request 节点带着同一个 API Key 逐个调 EveryInfra,再由第二个 Code 节点把每个榜的前 10 名、和上一次相比留下了几条、本次花了多少钱写成一份 Markdown 文件。它回答的是「今天早上各平台在说什么」,不预测哪条会火,也不替你判断真假。


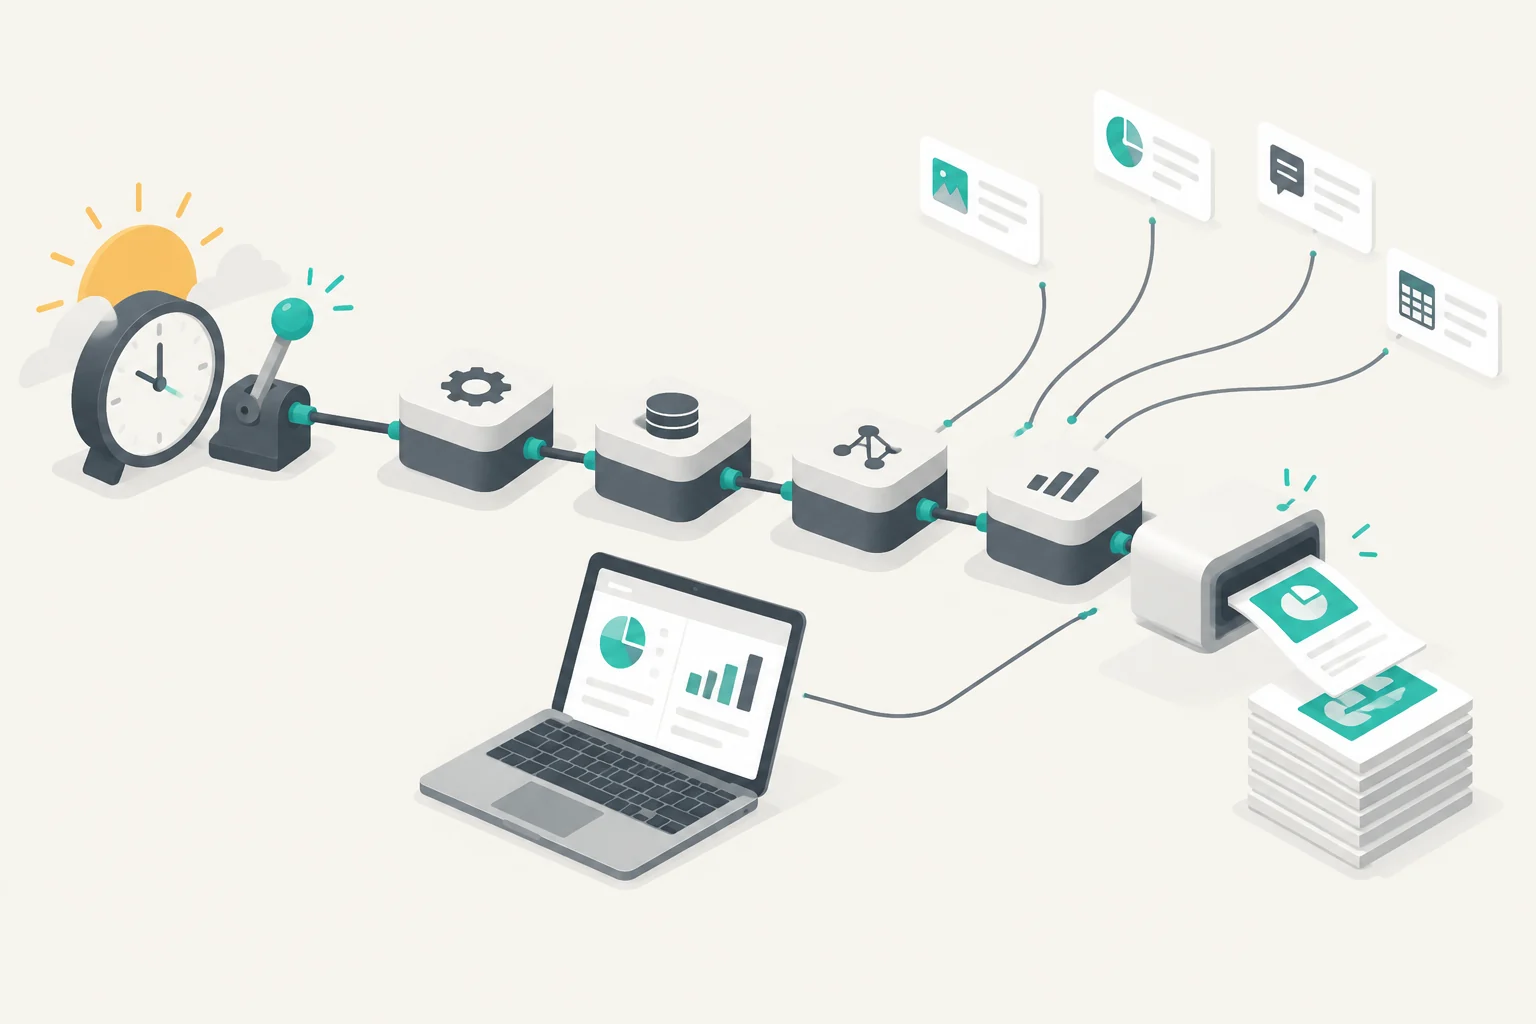
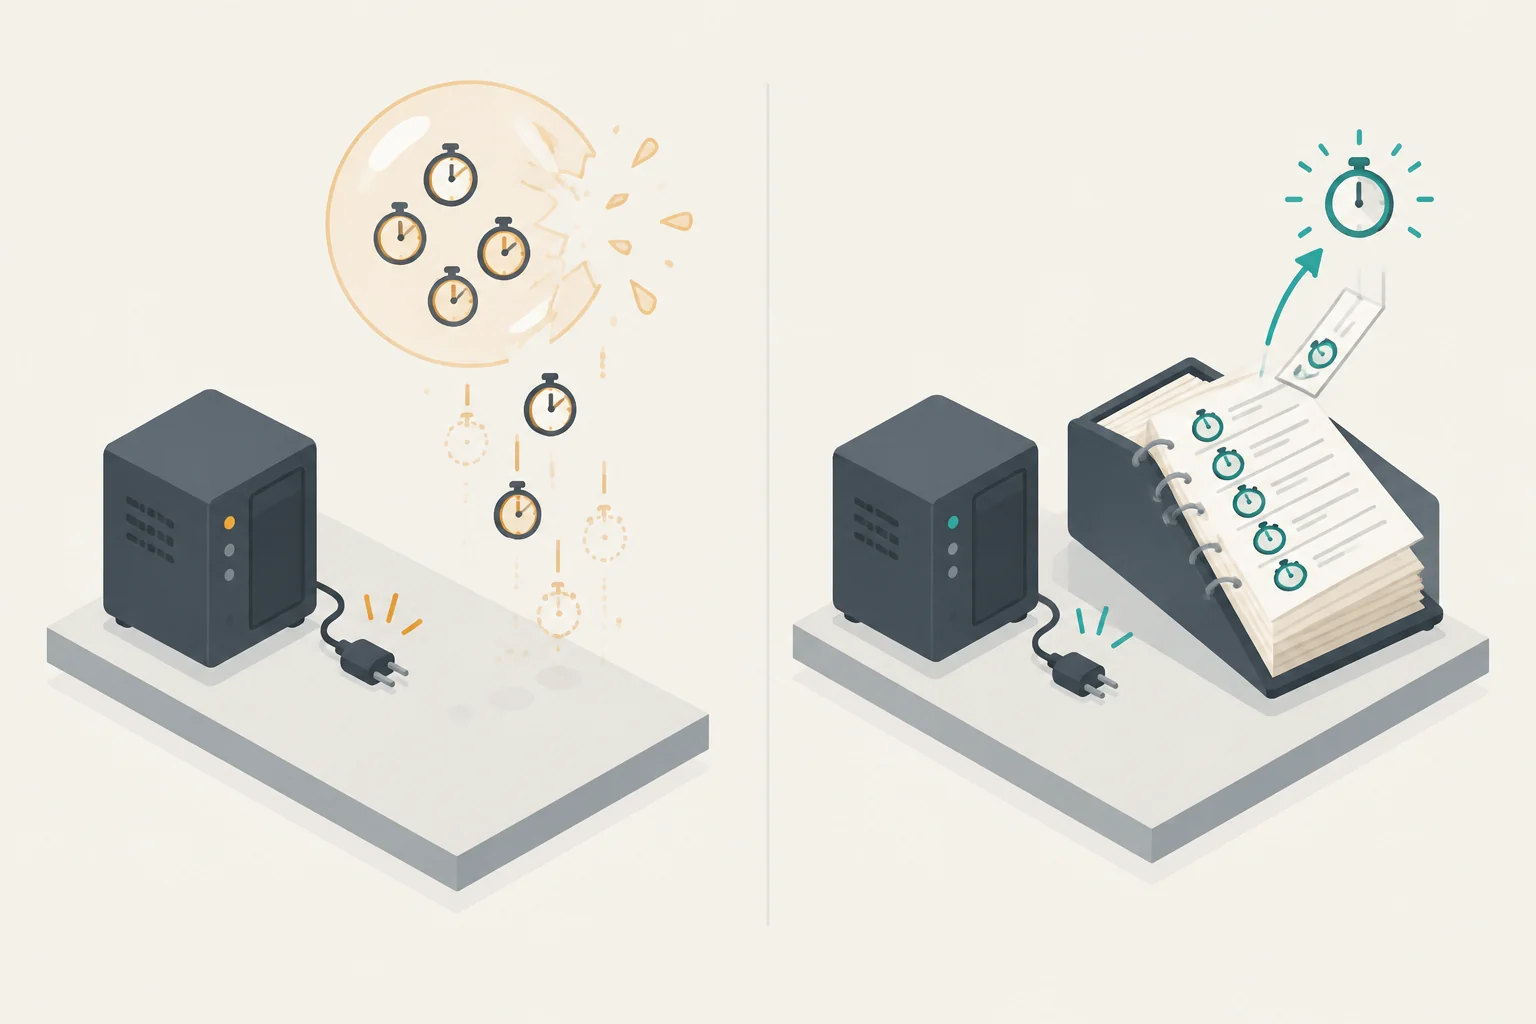
这张图是持久调度器的样子:运行不是靠进程里的一个定时器「记着」,而是到点前就作为一行记录写进数据库,到点时被某个 n8n 进程领走去执行。n8n 的文档把这件事拆成五个阶段:提前写入(materialization)、领取执行、回收、保留和清理。下面的每一步,我们都对着这五个阶段去看 SQLite 里的真实记录。
一份日报长什么样
先看交付物。下面是 10:39:24 那次运行的日报(reports/report-2026-10-26-10-39-24.md)。原文件是用最初版本的第 5 步写的,把微博的一个推广位也编进了名次;这里按修正后的第 5 步(按 rank 排、跳过没有名次的推广位)从当次的原始响应重新生成,只删掉了中间几行榜单:
# EveryInfra 日报 2026-10-26T10:39:24.294+08:00

## 微博热搜(10 条,其中 2 条推广位已跳过,$0.000556)
1. 住房公积金更好用了
2. 武契奇承认败选
4. 巴西总统卢拉赢得连任

## 抖音热点榜(8 条,$0.000556)
1. 持之以恒推进全面从严治党
5. 卢拉再次当选巴西总统

## X 美国趋势(52 条,$0.000556)
1. Lula
2. Brazil

## X 墨西哥趋势(71 条,$0.000556)
1. Lula
3. #EleccionesBrasil2026

## 故意写错的榜单名:失败(HTTP 422,invalid_value)
- `boards` must be one of: challenge, entertainment, hotspot, seeding, social (got 'hot')
- 建议:hotspot

## 本次花费
- 响应里 charged_usd 相加:$0.002224
- 去掉重放后的实际扣费:$0.002224
- 失败 1 路(失败不扣费)
这份文件有两处值得先说。第一,同一个事件在四个榜上同时出现:巴西 10 月 25 日举行总统选举第二轮投票(巴西高等选举法院公告),第二天上午新加坡时间 10:39,「Lula」是 X 美国和 X 墨西哥趋势榜的第 1 名,在微博热搜排第 4、抖音热点榜排第 5。微博这个名次要多说一句:返回的第 4 个位置是「安踏品牌全球代言人刘浩存」,它没有 rank 字段,是商业推广位(微博热搜规则说明里本来就列了「商业广告」这类标识),卢拉那一条的 rank 是 4。我们最初的日报节点按位置编号,把卢拉写成了第 5,也把广告当成了热搜;第 5 步现在按 rank 排序、跳过 rank 为空的条目,并在标题里写明跳过了几条。一份跨平台日报的价值,就在于能把这种「中文平台和海外平台同时在聊」的事一眼摆出来。第二,失败的那一路没有让整份日报失败:它被写成一段带原因和建议值的文字,花费一节也照实写了「失败不扣费」。后面的实测四会专门讲这一点为什么要在工作流里提前设计,而不是等出错了再补。
动手前写下的判据
我们在跑第一次之前,把「这个工作流算不算能用」写成了 10 条判据,写进检查记录,看到结果以后不改线。有一条例外要说明:原计划用「余额差」核对扣费,10:33 发现测试 Key 同时被其他写稿任务在用,余额会混进别人的花费,所以在任何计费调用之前改成按每个 request_id 去服务端调用日志里逐条对账。
| 编号 | 判据 | 通过线 | 结果 |
|---|---|---|---|
| J1 | 自动触发 | mode=trigger 的执行 ≥3 次,每次都写出日报 | 通过:14 次,14 份文件 |
| J2 | 准时 | 正常运行时开始时间与计划时刻之差 ≤5 秒 | 通过:0.008–0.034 秒 |
| J3 | 每 N 分钟从发布起算 | 相邻间隔 180 ±5 秒,触发点不对齐整分 | 通过:都落在整 3 分钟加 24.206 秒 |
| J4a | 宽限期内停机 | 停 32 秒、跨过一个计划点:A、B 都晚跑一次 | 通过:两边都晚 21.8 秒 |
| J4b | 超出宽限,默认策略 | A 那两次丢掉,不补 | 通过 |
| J4c | 超出宽限,补跑最近一次 | B 只补 1 次 | 通过:补 1 次,晚 89.0 秒 |
| J5 | 钱 | 每次去重放后 = 4 × $0.000556;服务端日志逐条一致 | 通过:56 条计费记录全部对上 |
| J6 | 失败不拖垮 | 写错的那路 422、有 did_you_mean、不扣费,其余照常 | 通过 |
| J7 | MCP | MCP Client 节点调 everyinfra_call_api 成功,字段与 REST 一致 | 通过 |
| J8 | 热榜变化 | 只记数:相邻两次、首末两次的前 10 重合 | 见「热榜一小时里变了多少」 |
| J9 | Key 不落盘 | n8n 数据库、执行记录、日报、原始文件里搜 Key 原文 0 命中 | 通过:0 命中 |
| J10 | 重放不重复扣费 | 同一个 Idempotency-Key 再发:replayed: true,日志无第二条 | 通过 |
定时任务最难查的不是「报错」,而是「没报错但少跑了一次」「跑了两次」「钱多扣了一点」,所以判据要事先写到次数、条数和金额。n8n 社区里有人总结过,一次执行在某个节点拿到 0 条数据时,后面的节点不会运行,执行记录却照样显示成功,错误工作流也不会被叫醒(Reddit r/n8n 讨论)。这类问题只有事先写下「应该是几次、几条、多少钱」,事后才能对出来。
准备:装哪个版本,装在哪里
版本。 持久调度器从 n8n 2.45.0(2026 年 10 月 20 日发布)起默认开启,更新日志原话是 Schedule Trigger 节点「now run on the durable scheduler by default」。但 10 月 26 日我们读 npm 仓库元数据时,latest 标签还是 10 月 22 日发布的 2.44.6,2.45.3(10 月 23 日发布)挂在 next 和 beta 标签上。也就是说,你今天执行 npm install n8n,拿到的是还没有默认开启持久调度器的 2.44.6;要测本文的行为,必须显式写版本号。n8n 的安全公告也按这两条线分别出补丁,例如 10 月 14 日那一批写的是「beta patched in v2.44.1,stable patched in v2.43.5」。
| 安装方式 | 拿到的版本(10-26 读) | 持久调度器 | 本文用不用 |
|---|---|---|---|
npm install n8n | 2.44.6(latest) | 2.45 之前默认关,要设 N8N_SCHEDULER_ENABLED=true | 不用 |
npm install n8n@'2.45.3' | 2.45.3(next / beta) | 默认开 | 用 |
| n8n Cloud | 由 n8n 托管升级 | 跟随 Cloud 版本 | 不用(不注册账号) |
| Docker 镜像 | 按你拉的标签 | 2.45 起默认开 | 本机没有 Docker,未测 |
10 月 13 日到 23 日这 10 天里,2.44 和 2.45 两条线在 npm 上交替发了 7 个版本(2.44.0 到 2.45.3)。照着网上某篇教程装「最新版」,拿到的可能是两条线里的任意一个。
安装方式。 我们选 npm,因为这台机器只装了 Node,没有 Docker,而且这是最少依赖的一条路。代价有两个,都要事先知道。第一,npm 安装页顶部已经写明「npm-based installs are deprecated from n8n 3.0」,3.0 破坏性变更说明更直接:3.0 起自托管必须用 Docker,npm 上不再发布可运行的 n8n 包;n8n 的 GitHub 开发说明写 v3 大约在 2026 年 10 月发布。我们启动时 n8n 自己也打出了一条警告:「Running n8n outside a container is deprecated」。
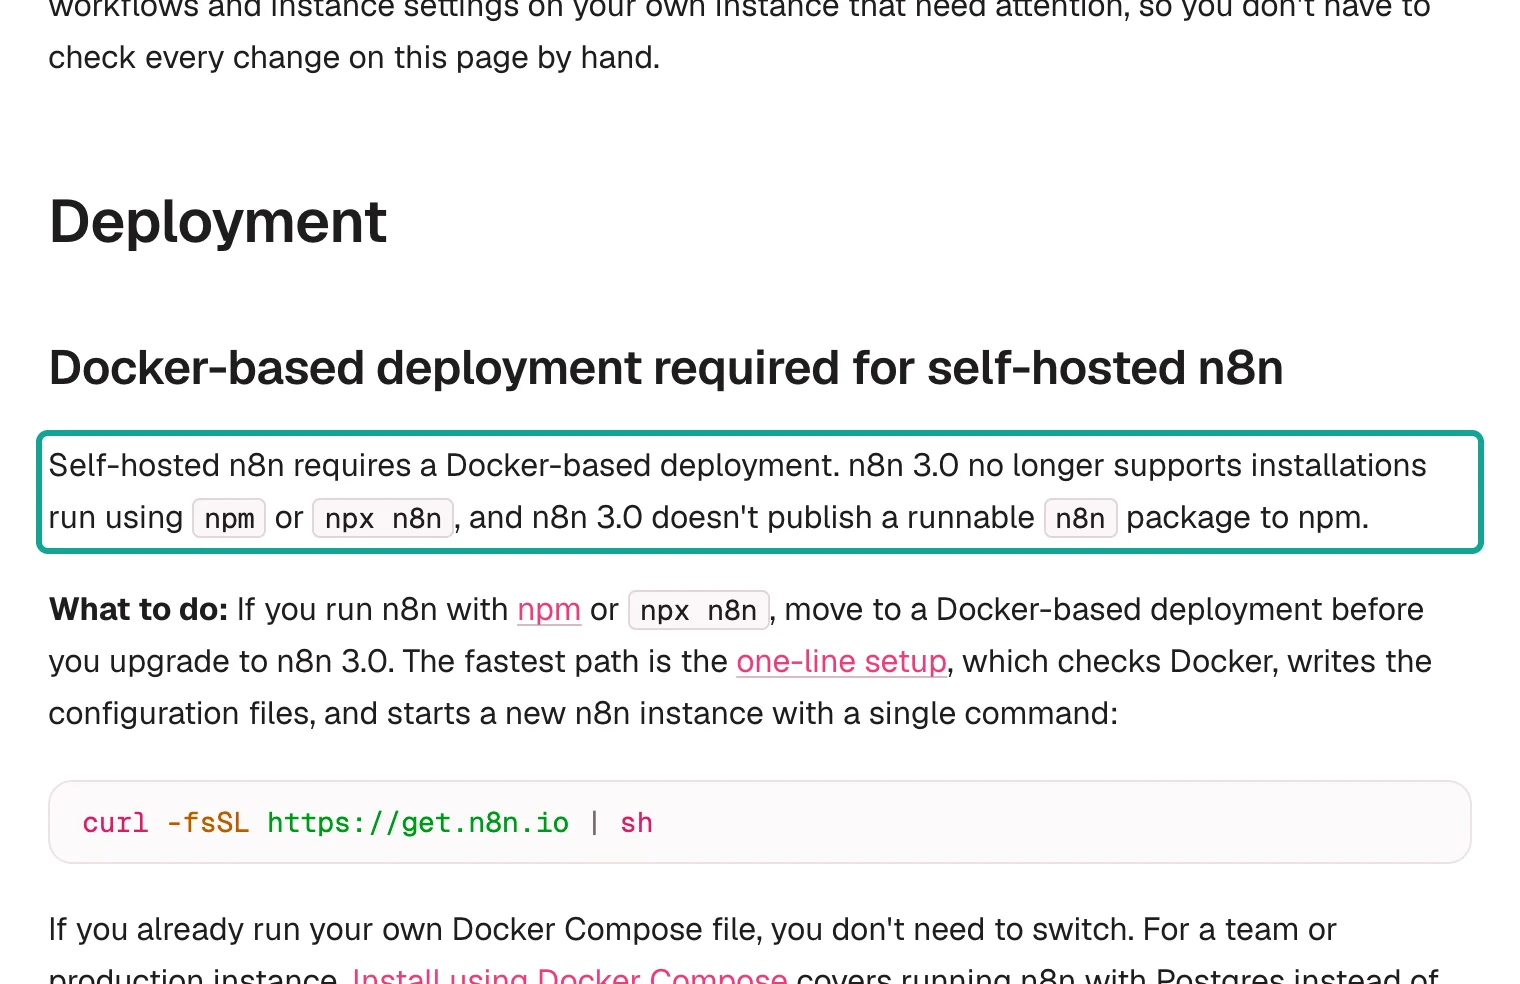
所以 npm 适合本文这种在笔记本上验证的场景;要长期每天跑,请照 Docker Compose 安装说明或一行命令安装部署。第二,体积:干净安装装了 2,328 个包、用了 6 分钟,node_modules 占 4.4 GB。我们第一次安装中途被打断,留下的半截目录启动时报 Cannot find module 'kuler';删掉 node_modules 和 package-lock.json 重装才好。安装被打断后不要在原目录上补装,这是最省时间的做法。
Node 版本。 这里文档和包本身说法不一致。npm 安装页写「n8n requires a Node.js version between 20.19 and 24.x」,而 npm view n8n@'2.45.3' engines 返回的是 >=24.0.0。按 Node.js 官方发布表,20 已于 2026 年 3 月停止支持,24 是 LTS,26 还是 Current。我们本机是 26.11.1,测试期间没有遇到问题,但这超出了文档写的范围;长期跑请用 Node 24 LTS。
还有一个小坑:端口。我们一开始把 n8n 设在 5679 端口,启动时直接退出,日志只有一句「n8n Task Broker's port 5679 is already in use」。原因是 n8n 2.x 的 Code 节点交给内置的任务运行器执行,它的任务中转默认就占 5679。把 N8N_PORT 换成 5690、N8N_RUNNERS_BROKER_PORT 设成 5691 后正常启动。完整的环境变量如下,每一行我们都实际用过:
export N8N_USER_FOLDER=$HOME/Downloads/n8n-lf25/home      # 数据库、加密密钥都放在这里
export N8N_PORT=5690 N8N_LISTEN_ADDRESS=127.0.0.1          # 只监听本机
export N8N_RUNNERS_BROKER_PORT=5691                        # 避开任务中转的默认 5679
export GENERIC_TIMEZONE=Asia/Singapore TZ=Asia/Singapore   # 默认时区是 America/New_York
export N8N_RESTRICT_FILE_ACCESS_TO=$HOME/Downloads/n8n-lf25/reports
export N8N_DIAGNOSTICS_ENABLED=false N8N_VERSION_NOTIFICATIONS_ENABLED=false
export N8N_METRICS=true N8N_METRICS_INCLUDE_SCHEDULER_METRICS=true
npm install [email protected] --no-audit --no-fund时区那一行不能省。时区设置说明写得很清楚,自托管实例默认是 America/New_York,Schedule Trigger 用它来决定「每天 8 点」是哪个 8 点。新加坡比纽约早 12 小时(夏令时期间),不设的话,你以为的早上 8 点会在晚上 8 点跑。工作流设置里也可以单独设时区,我们两处都设成了 Asia/Singapore。文件目录那一行同理:从 n8n 2.0 起,读写文件节点默认只能访问 ~/.n8n-files,要把日报写到别处,必须用 N8N_RESTRICT_FILE_ACCESS_TO 明确放行,而且只放行这一个目录。监听地址那一行设成 127.0.0.1,是为了只让本机访问:网络测绘公司 Censys 10 月 14 日的年度报告说,公网上能看到 113,926 台 n8n 主机,能读出版本号的里 76% 处在至少一个近期严重漏洞的影响范围内(Censys 官方博客),而 n8n 的安全公告按两周一批发布(例如 10 月 1 日那一批)。要从别的机器看日报,就把 reports/ 同步出去,不要把编辑器开到公网上。
搭工作流:六个节点,一步一个动作
整个工作流只有六个节点,下面这张动图按一次运行的顺序走一遍。


我们没有用编辑器界面点出这个工作流,而是写成 JSON,用 n8n 的命令行导入。这样做有两个好处:每一步都能原样复现;也不需要在本机 n8n 里创建所有者账号。下面每一步都写了做什么、预期看到什么,以及为什么这样做。
- 把 API Key 存成 n8n 凭据,不写进工作流。 执行
jq -n --arg t "$EVERYINFRA_API_KEY" '[{"id":"eiBearer000001","name":"EveryInfra API Key","type":"httpBearerAuth","data":{"token":$t}}]' | n8n import:credentials --input=/dev/stdin。预期输出「Successfully imported 1 credential」。
这一步的关键是 --input=/dev/stdin:Key 只经过环境变量和管道,没有落在任何文件里。n8n 的导入命令发现 data 是明文对象时,会用实例的加密密钥加密后再写库(源码里是 cipher.encryptV2)。如果你图省事把 Key 直接写在 HTTP Request 节点的 Header 里,它会以明文进入工作流 JSON、导出文件和版本历史。HTTP Request 凭据文档列了 Bearer、Header 等几种方式,选 Bearer 就行,它对应 RFC 6750 定义的 Authorization: Bearer 头,也正是 EveryInfra 要的格式。
- 用 Schedule Trigger 定时。 测试时设成「每 3 分钟」,正式用时改成每天 08:00。预期:工作流发布后,SQLite 的
scheduled_job表多出一行,intervalSeconds是 180,misfirePolicy是skip,misfireGraceSeconds是 60。
这里要知道 Schedule Trigger 文档里新加的两个节点设置:「If Execution Is Missed」(三选一,默认不补跑)和「Missed Execution Grace Period (Seconds)」(填 0 表示用实例的 N8N_SCHEDULER_MISFIRE_GRACE,默认 60 秒)。它们只对 2.36 及以后新加的节点生效,而且只在持久调度器开着时生效。我们在节点源码里核过参数值:补跑最近一次是 coalesce_owner,按规则各补一次是 coalesce,不补是 skip。
- 用 Code 节点列出要调的请求,每路带一个幂等键。 节点返回 5 个 item,每个 item 带平台、能力、参数和一个
idem字段。预期:执行记录里这一节点输出 5 条。
const now = DateTime.now().setZone('Asia/Singapore');
// 正式用:一天一个 key(同一天重跑只重放,不重复扣费);测试用:精确到分钟
const KEY_BY = 'day';
const keyBase = KEY_BY === 'day' ? now.toFormat('yyyyLLdd') : now.toFormat('yyyyLLdd-HHmm');
const reqs = [
  { label: '微博热搜', platform: 'weibo', action: 'trending', params: {} },
  { label: '抖音热点榜', platform: 'douyin', action: 'trending', params: { boards: 'hotspot' } },
  { label: 'X 美国趋势', platform: 'twitter', action: 'trending', params: { country: 'us' } },
  { label: 'X 墨西哥趋势', platform: 'twitter', action: 'trending', params: { country: 'mx' } },
  { label: '故意写错的榜单名', platform: 'douyin', action: 'trending', params: { boards: 'hot' } },
];
return reqs.map(r => ({ json: { ...r,
  idem: `daily-report-${keyBase}-${r.platform}-${r.params.country || r.params.boards || 'default'}`,
  firedAt: now.toISO() } }));
为什么要自己生成幂等键?因为日报最怕的是「同一天跑了两次,扣了两次钱,还出了两份内容不同的报告」。EveryInfra 的 OpenAPI 说明写的是:同步调用带同一个 Idempotency-Key、同样的平台、能力和参数,24 小时内会原样返回第一次成功的响应,不再执行、也不再扣费;参数不同则返回 409 idempotency_conflict。按日期生成 key,就等于告诉接口「今天这一份只要一次」。这个做法和 IETF 正在制定的 Idempotency-Key 请求头草案一致,该草案 10 月 22 日刚更新到第 8 版。测试阶段我们把 KEY_BY 设成 minute,否则 3 分钟一次的运行会全部变成重放,测不出热榜的变化。
- 用 HTTP Request 节点逐个调用。 方法 POST,地址
https://api.everyinfra.com/api/v1/social,认证选刚导入的 Bearer 凭据,Header 加Idempotency-Key: {{ $json.idem }},Body 选 JSON,内容是{{ JSON.stringify({ platform: $json.platform, action: $json.action, params: $json.params }) }}。选项里打开「Include Response Headers and Status」和「Never Error」,批处理设每批 1 条、间隔 1,500 毫秒。预期:每次运行输出 5 条,4 条statusCode200、1 条 422。
「Never Error」是这一步最重要的开关。HTTP Request 文档写得很清楚,默认情况下非 2xx 响应会让节点报错,整个执行停在这里,后面的「写日报」不会运行。日报需要的恰恰相反:一路坏了,其余几路照常写,坏的那一路写清楚原因。打开 Never Error 加完整响应以后,422 的响应体和状态码都会作为普通数据传给下一个节点。批处理间隔是为了不撞上 EveryInfra 每个 Key 每分钟 10 次的限速(GET /api/v1/account 返回的 key_requests_per_minute 就是 10),5 路请求间隔 1.5 秒,一次运行大约 13–16 秒跑完。
- 用第二个 Code 节点写日报,并记住上一次的榜单。 节点把 5 路响应和第 3 步的 5 个请求按顺序配对,按
rank取每个榜的前 10 名(跳过没有rank的推广位,见下面的代码),用$getWorkflowStaticData('global')读出上一次的前 10 名算重合条数,再把这次的存回去。预期:输出一条带markdown和fileName的 item。
取前 10 名这一段要单独写对。微博热搜的返回里夹着商业推广位,它们有标题和热度,但没有 rank;14 次运行里,微博返回的前 10 个位置共出现过 16 次推广位,抖音和 X 一次都没有。按位置编号,广告会被当成热搜,后面的名次全部错一位。下面这段放在第二个 Code 节点里:只要一个榜的结果里有 rank,就只留有 rank 的条目、按 rank 排;整榜都没有 rank 时才按位置。
function top10(results) {
  const rows = results || [];
  const hasRank = rows.some(x => x.rank != null);
  const kept = hasRank ? rows.filter(x => x.rank != null).sort((a, b) => a.rank - b.rank) : rows;
  return {
    top: kept.slice(0, 10).map((x, i) => ({ rank: x.rank ?? i + 1, title: x.title || x.keyword || x.name })),
    promoted: rows.length - kept.length,   // 写进日报标题:「其中 N 条推广位已跳过」
  };
}
14 次运行里出现过的 7 个推广位如下,位置只有两种:第 4 个和第 8 个。它们的标题和普通热搜看不出区别,只能靠 rank 为空来认;最后一条「多款护眼膏涉嫌虚假宣传」读起来像新闻,返回里同样没有 rank,我们一并跳过,如果你想留下它,就要另写规则。
| 推广位标题 | 出现次数 | 位置 | 出现时段(新加坡时间) |
|---|---|---|---|
| ROSE尊尼获加黑牌系列全球代言 | 5 | 第 4 个 | 10:42–11:18 |
| 过日子的人都来碰一下 | 3 | 第 4 个 | 11:03–11:15 |
| 凭什么领克能拿七年十六冠 | 3 | 第 8 个 | 11:06–11:15 |
| 安踏品牌全球代言人刘浩存 | 2 | 第 4 个 | 10:39–11:00 |
| Mikimoto迪丽热巴时光成珠三部曲 | 1 | 第 8 个 | 10:39 |
| 跟着娄艺潇上京东买5折服饰美妆 | 1 | 第 4 个 | 11:21 |
| 多款护眼膏涉嫌虚假宣传 | 1 | 第 8 个 | 11:21 |
静态数据是 n8n 里最轻的「跨执行记忆」,但 n8n 文档给了两条限制:手动测试时不保存,只有工作流被发布并由触发器调起时才保存;高频执行下可能不可靠。所以手动跑出来的「与上一次重合」永远是空的,这不是 bug。数据要长期保留的话,文档推荐改用数据表(Data tables)。花费也在这一步算:把每路 billing.charged_usd 相加得到「响应里的和」,再把 replayed 为真的那几路去掉得到「实际扣费」,两个数都写进日报。为什么要写两个数,实测三会讲。
- 转成文件,写到磁盘。 用 Convert to File 的「Convert to Text File」把
markdown字段转成二进制文件,再用读写文件节点写到reports/目录。预期:每次运行在reports/下多出一个report-时间戳.md。
如果这一步报「not writable」或「access to the file is not allowed」,多半是上一节说的 N8N_RESTRICT_FILE_ACCESS_TO 没设,或者路径不在它放行的目录里。
- 发布工作流,然后重启 n8n。 执行
n8n import:workflow --input=A.json,再执行n8n publish:workflow --id=eiDailyReport01,最后n8n start。预期:启动日志出现「Scheduler started」和「Processed 0 draft workflows, 2 published workflows」。
命令行发布有一个容易漏的细节:publish:workflow 直接改数据库,命令自己会提示「Changes will not take effect if n8n is running」,正在运行的 n8n 要重启才认。这个细节直接决定了下一节「从哪一刻起算」的答案。
实测一:准时吗,「每 N 分钟」从哪一刻起算
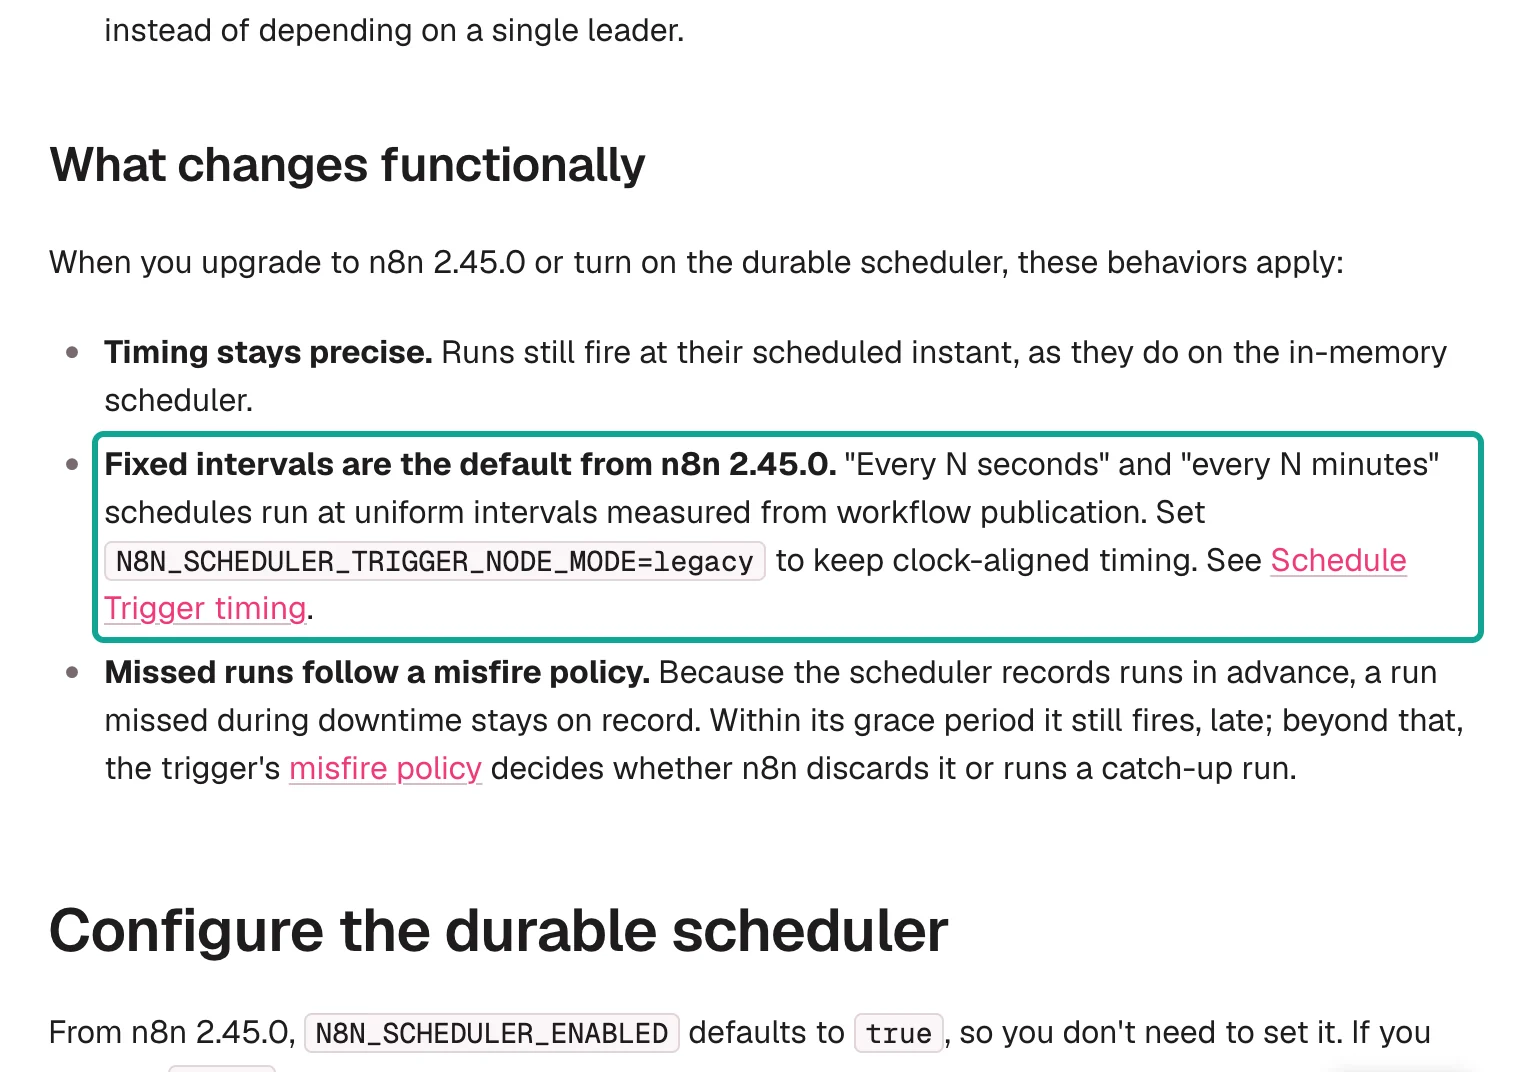
n8n 2.45 改变了「每 N 分钟」的含义。持久调度器文档里写的是,「every N minutes」按固定间隔运行,「measured from workflow publication」,也就是从发布那一刻起算,不再对齐整分;想保留对齐整分的旧行为,要设 N8N_SCHEDULER_TRIGGER_NODE_MODE=legacy。下面是我们截下的官方原文,青绿框是这条规则。
那「发布那一刻」到底是哪一刻?我们 10:32:59 和 10:33:01 用命令行发布了两个工作流,但 n8n 是在 10:36:20 才启动、10:36:24 启用这两个工作流的。SQLite 的 scheduled_job 表给出了答案:两行的 createdAt 都是 10:36:24.207 和 10:36:24.209,第一个计划点 nextRunAt 是 10:39:24.206。也就是说,起算点是工作流在运行中的 n8n 里被启用的那一刻,不是命令行写库的那一刻。在编辑器里点「Publish」时这两件事是同一刻,用命令行发布时就差了 3 分 25 秒。
接下来的 14 次运行全部落在「整 3 分钟加 24.206 秒」这条相位上:10:39:24、10:42:24、10:45:24 ……一直到 11:24:24。正常运行时,执行开始时间比计划时刻晚 0.008–0.034 秒,远低于我们定的 5 秒线;不受停机影响的相邻两次,间隔是 179.978–180.013 秒。中途我们重启了两次 n8n,相位没有变:重启后 scheduled_job 那一行原样保留,nextRunAt 接着往下排,没有因为重启重新起算。这是持久调度器和旧的内存调度器最直观的区别。
下表是 16 个计划点逐个的结果,全部来自 SQLite 和执行记录,由我们的分析脚本 analysis.py 现算;时间是新加坡时间:
| 计划时刻 | 实际开始 | 晚了(秒) | 计费调用 | 实际扣费 | 微博 / 抖音 / X 美国 / X 墨西哥行数 |
|---|---|---|---|---|---|
| 10:39:24.206 | 10:39:24.240 | 0.034 | 4 | $0.002224 | 10 / 8 / 52 / 71 |
| 10:42:24.206 | 10:42:24.218 | 0.012 | 4 | $0.002224 | 17 / 20 / 52 / 71 |
| 10:45:24.206 | 10:45:46.037 | 21.831 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 10:48:24.206 | 10:48:24.216 | 0.010 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 10:51:24.206 | 没跑(停机,默认不补) | — | 0 | $0 | — |
| 10:54:24.206 | 没跑(停机,默认不补) | — | 0 | $0 | — |
| 10:57:24.206 | 10:57:24.227 | 0.021 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:00:24.206 | 11:00:24.215 | 0.009 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:03:24.206 | 11:03:24.223 | 0.017 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:06:24.206 | 11:06:24.236 | 0.030 | 4 | $0.002224 | 17 / 20 / 52 / 71 |
| 11:09:24.206 | 11:09:24.214 | 0.008 | 4 | $0.002224 | 20 / 20 / 52 / 71 |
| 11:12:24.206 | 11:12:24.215 | 0.009 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
| 11:15:24.206 | 11:15:24.220 | 0.014 | 4 | $0.002224 | 15 / 20 / 50 / 72 |
| 11:18:24.206 | 11:18:24.223 | 0.017 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
| 11:21:24.206 | 11:21:24.219 | 0.013 | 4 | $0.002224 | 19 / 20 / 50 / 72 |
| 11:24:24.206 | 11:24:24.219 | 0.013 | 4 | $0.002224 | 20 / 20 / 50 / 72 |
最后一列顺带暴露了一件和调度无关的事:第一次运行时微博只回了 10 条、抖音只回了 8 条,之后两者大多是 20 条,正好是目录里两者的 default_limit。实测三会接着讲这对计费意味着什么。
对日报来说这意味着什么?如果你想让日报在每天 08:00 整生成,直接用「每天」间隔,选 8am、0 分;按文档,「每 N 小时、天、周、月」在两种模式下日常表现一样,只有闰年、第 53 周和夏令时切换这类边界上,持久调度器修正了旧调度器差一个周期的问题。真正受影响的是「每 N 分钟」「每 N 秒」:如果你原来靠「每 30 分钟」让它在 :00 和 :30 跑,升级到 2.45 后会变成「从启用那一刻起每 30 分钟」,相位取决于你哪一秒点了发布。要对齐整点,要么用 Cron 表达式(例如 0 */30 * * * *,文档说 Cron 不受这个开关影响),要么设 legacy,但文档也说了 legacy 已被标为弃用,将来会删。
实测二:停机时到点的那一次去哪了
这是持久调度器最大的改变,也是我们花时间最多的一组实测。旧的内存调度器在进程里记着下一次什么时候跑,文档原话是「Restarts lose pending runs」,停机期间到点的运行直接跳过,不会补。持久调度器把每次运行提前写进数据库,停机期间到点的那一次「stays on record」:在宽限期内恢复,它晚一点照样跑;超出宽限期,交给补跑策略决定。
为了在同一次停机里对照两种策略,我们同时发布了两个工作流:A 是日报本身,用默认的「Don't Run Missed Executions」;B 是一个不调接口、只往磁盘写一行时间的「心跳」,用「Run the Most Recent Missed Execution」。两者都是每 3 分钟、同一相位。停机用一个脚本按进程号发 SIGTERM,等进程退出,到点再启动,所有时间都记进日志。
| 停机(新加坡时间) | 落在里面的计划时间 | A(跳过) | B(只补最近一次) |
|---|---|---|---|
| 10:45:12 → 10:45:40,10:45:44 就绪 | 10:45:24 | 10:45:46.0 运行,晚 21.8 秒 | 10:45:46.0 运行,晚 21.8 秒 |
| 10:49:00 → 10:55:40,10:55:44 就绪 | 10:51:24、10:54:24 | 两次都没跑 | 10:55:53 补跑一次,晚 89.0 秒 |
第一次停机:32 秒,在宽限期内。 10:45:12 停,10:45:40 启动,10:45:44 就绪。10:45:24 这个计划点就在停机中间。SQLite 里,这一次运行在停机前就已经被写进 scheduled_task 表(写入窗口 N8N_SCHEDULER_MATERIALIZATION_WINDOW 默认 60 秒,所以到点前一分钟就有记录),恢复后 A 和 B 都在 10:45:46.0 开始执行,比计划晚 21.8 秒,没有超出 60 秒宽限。有一个细节:这两行记录的 missedAfter 原本是 10:46:24.206(计划点加 60 秒),重启后被改写成 10:46:45.677,看起来恢复时按启动时刻重新给了一段宽限。我们只观察到这一次,没有再去测这个改写的规则。
第二次停机:6 分 44 秒,跨过两个计划点。 10:49:00 停,10:55:40 启动,10:55:44 就绪。10:51:24 和 10:54:24 两个计划点都在停机中,而且恢复时都已经超过各自的 60 秒宽限。结果和文档描述一致:A 两次都没有跑,下一次直接是 10:57:24;B 只在 10:55:53 跑了 1 次,对应的计划点是 10:54:24(最近的那一次),晚了 89.0 秒,10:51:24 那次没有单独补。
光看执行记录还不够,因为「没跑」在执行记录里就是「什么都没有」。我们打开了 n8n 的 Prometheus 指标,在第二次恢复后的 10:56:30 读了一次 /metrics。这几个计数器是这次进程启动后才开始累计的,所以它们只反映第二次停机:
| 指标 | 读数 | 对应的事 |
|---|---|---|
n8n_scheduler_occurrences_misfired_total{policy="skip"} | 2 | A 的 10:51:24 和 10:54:24 被丢弃 |
n8n_scheduler_occurrences_misfired_total{policy="coalesce_owner"} | 1 | B 的 10:51:24 被并进补跑,没有单独执行 |
n8n_scheduler_occurrences_materialized_total | 1 | B 的补跑被写进队列 |
n8n_scheduler_tasks_dispatched_total | 1 | 只派发了 1 次 |
n8n_scheduler_tasks_completed_total{result="success"} | 1 | 补跑成功 |
n8n_scheduler_tasks_reclaimed_total | 0 | 没有被回收的半截运行 |
把日报工作流相邻两次的间隔画出来,两次停机的痕迹也很清楚:第一次停机让一次晚了 21.8 秒,于是它前后两段间隔变成 201.8 秒和 158.2 秒,加起来仍是 360 秒,相位没有被打乱;第二次停机丢了两次,那一段间隔是 540.0 秒,正好 3 个周期。
三个来源(执行记录、scheduled_task 表、指标)给出的是同一个故事,这是我们判 J4 通过的依据。调度器环境变量说明里,这些计数器各自的含义写得很细,n8n 还发布了一个现成的 Grafana 面板。如果你的日报是给别人看的,occurrences_misfired_total 这一项值得接一条告警:它涨了,就说明有一天的日报没出。
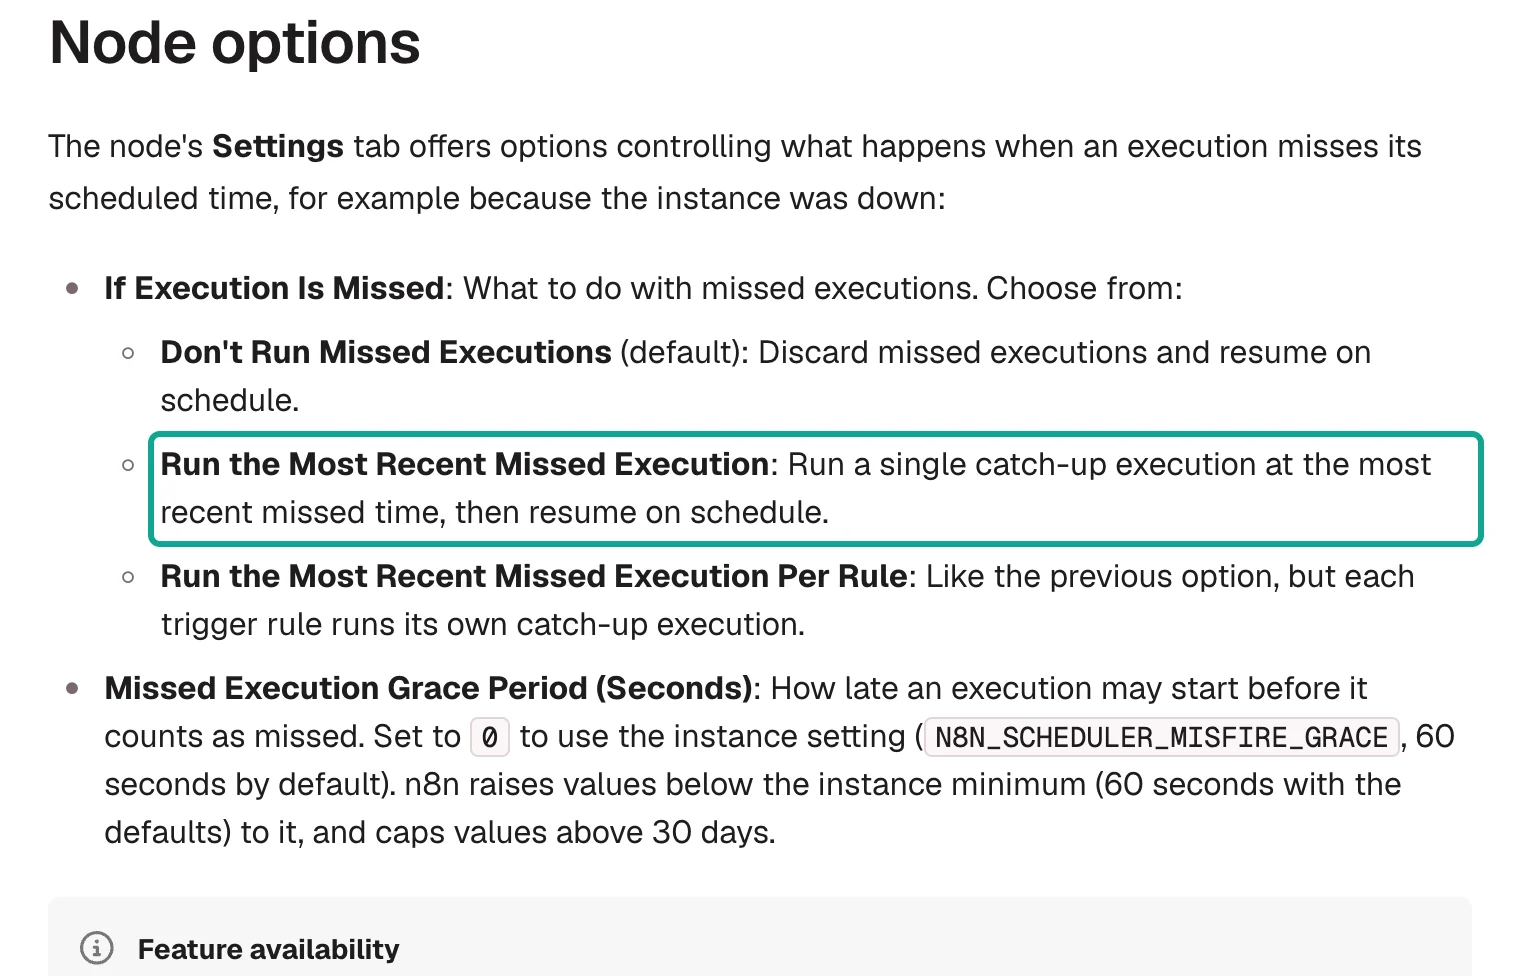
对日报来说该选哪个策略?我们的建议是选「补跑最近一次」,再配合实测三的按日期幂等键。理由是:日报一天只要一份,停机恢复后补出今天那一份是你想要的;如果恢复时已经是第二天,补跑会用新日期生成新 key,正好补出新的一份。默认的「不补」更适合「过时就没有意义」的任务,比如每分钟一次的心跳检查。宽限期则按你的重启时间来定:文档建议它至少大于执行检查间隔、不小于写入窗口,默认 60 秒;如果你的机器升级重启要 3 分钟,就把节点上的宽限设成 300 秒。
实测三:钱,以及重放那一笔
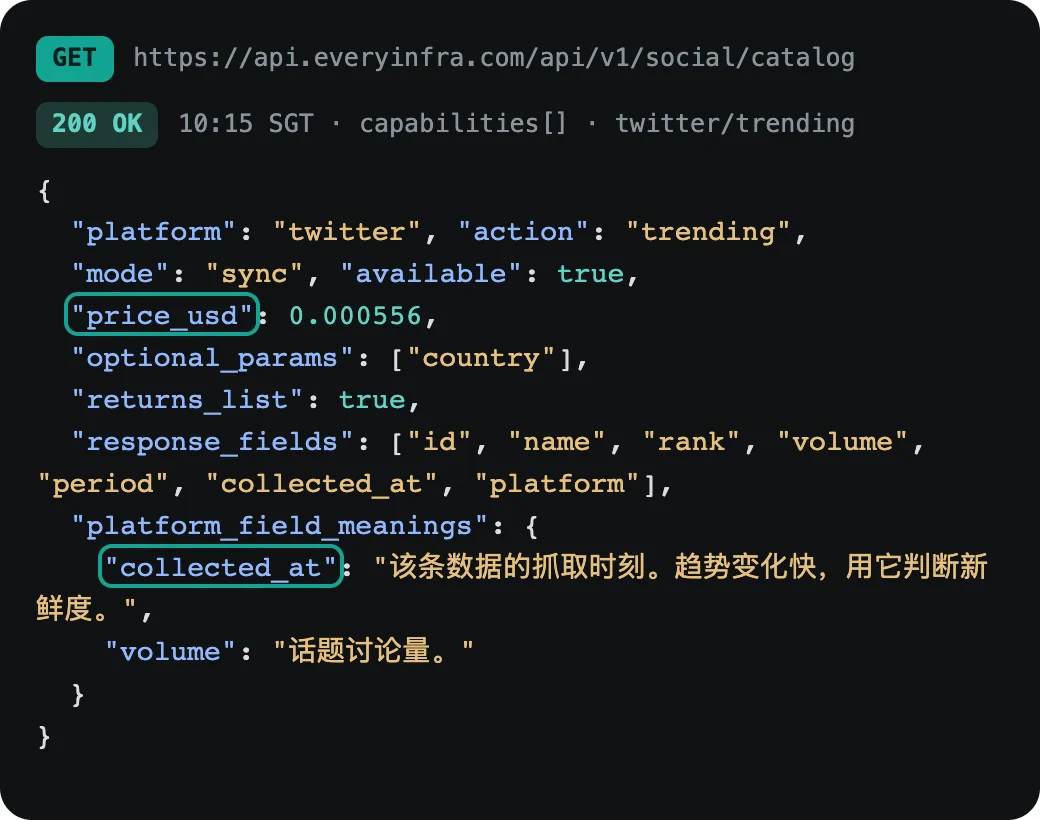
每次运行调 4 个热榜能力:weibo/trending、douyin/trending、twitter/trending(美国、墨西哥各一次)。10:15 读的 EveryInfra 能力目录里,这三个能力的 price_usd 都是 0.000556,按次计费。所以每次运行的应付是 4 × $0.000556 = $0.002224。下面是目录接口对 twitter/trending 的真实返回,青绿框是价格和 collected_at 的说明:
14 次运行,每次去掉重放后的实际扣费都是 $0.002224,合计 $0.031136。
我们没有只看响应自己说花了多少。在测试结束后读了服务端的调用日志 GET /portal/api/logs,按 request_id 逐条对:14 次运行里 56 条计费调用全部在日志里找到,每条 cost 都是 40 credits,折合 $0.000556,和响应里的 charged_usd 一致到小数点后 6 位。故意写错的那 14 条 422 在调用日志里一条都没有,也就是没有任何计费记录。
真正的坑在重放。10:40:46,我们用 10:39 那次运行里微博那一路的幂等键 daily-report-20261026-1039-weibo-default,用 curl 原样再发了一次:
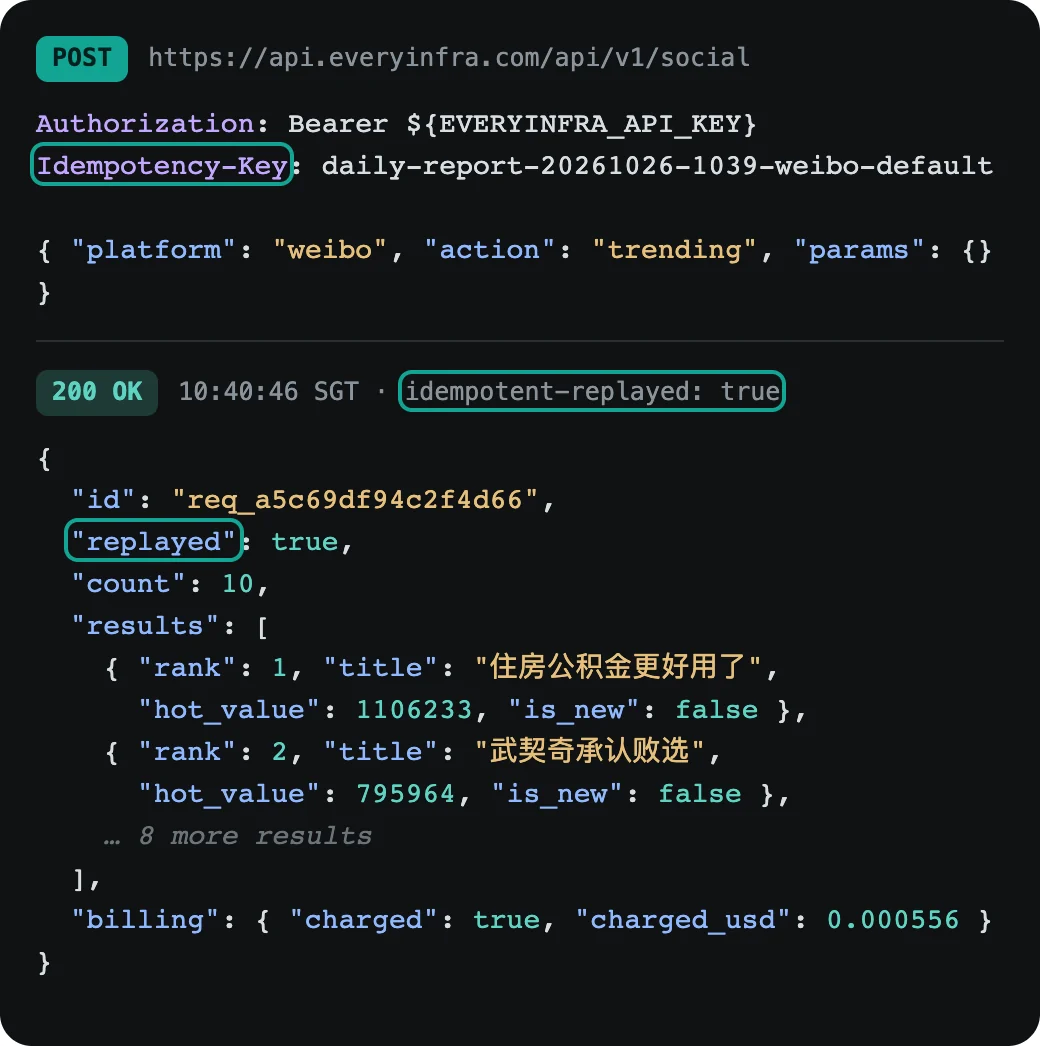
返回是 200,响应头 idempotent-replayed: true,响应体 replayed: true,id 是第一次那条 req_a5c69df94c2f4d66(这次请求自己的编号在响应头 x-request-id 里,是 req_7278432b29f64594),服务端日志里也没有出现第二条计费记录。但 billing 一节原样带回了 "charged": true, "charged_usd": 0.000556。OpenAPI 里对这一点写得很明白:重放「returns the stored first response」,「same billing, not run or charged again」。也就是说,billing 描述的是第一次那笔钱,不是这一次。
把这个放进日报场景,就是下面这张图。我们把工作流的 KEY_BY 改成 day,用 n8n execute 手动跑了两次,执行记录里的开始时间是 10:56:46.565 和 10:57:04.358。第 2 次 4 路全是重放,实际扣费 $0;但如果日报像大多数教程那样把每个响应的 charged_usd 直接相加,第 2 次会显示花了 $0.002224。
所以日报里的花费要这样算:只加 replayed 不为真的那几路。我们的日报两个数都写,一来方便对账,二来一旦两个数不一样,就说明这一天发生过重跑,值得看一眼是谁、为什么。顺带也测了另一种情况:10:40:54 用同一个 key 改了参数再发,返回 409 idempotency_conflict,next_steps 写着「send the new request with a new key. Nothing was charged.」这说明按日期生成 key 时,key 里一定要带上平台和参数,否则同一天两个不同的榜会互相冲突,这也是第 3 步的 key 里拼了平台和国家的原因。
算一笔账
先看这次测试自己的账单。金额都是去掉重放后的真实扣费,逐条和服务端调用记录对过。
| 项目 | 调用次数 | 扣费 |
|---|---|---|
| 14 次定时运行,每次 4 路计费 | 56 | $0.031136 |
| 14 路故意写错的请求(422) | 14 | $0 |
| 2 次手动运行,按日期幂等键:4 路计费、4 路重放、2 路写错 | 10 | $0.002224 |
| MCP Client 节点调用 1 次 | 1 | $0.000556 |
| curl 重放 1 次、同 key 换参数(409)1 次、单独发写错的榜单名(422)1 次、不带 Key(401)1 次 | 4 | $0 |
| EveryInfra 调用合计 | 85 | $0.033916 |
再看你自己的日报按不同跑法要花多少:
| 跑法 | 每天调用 | 每天花费 | 30 天 |
|---|---|---|---|
| 每天 08:00 一次,4 个榜 | 4 | $0.002224 | $0.06672 |
| 每天 08:00 和 20:00 两次 | 8 | $0.004448 | $0.13344 |
| 每小时一次 | 96 | $0.053376 | $1.60128 |
| 每天一次,加上停机补跑和手动重跑各 1 次(按日期幂等键) | 4 次计费 + 8 次重放 | $0.002224 | $0.06672 |
价格都按目录 price_usd 算,读于 2026-10-26 10:15(新加坡时间),只写 USD。最后一行就是幂等键的价值:同一天再怎么重跑,账单都只有一份。另一个容易被忽略的事实是,热榜按次计费,不按行数:同样 $0.000556 一次,X 墨西哥趋势榜一次返回 71 行,微博热搜和抖音热点榜一次 20 行(都是 14 次的中位数),折合每 1,000 行差了 3.6 倍。
行数也不是每次一样。第一次运行(10:39)微博只回了 10 条、抖音只回了 8 条;之后 13 次,抖音每次 20 条,微博在 15 到 20 条之间,大多是 20 条。20 正是目录里两者的 default_limit(weibo/trending 的 max_limit 是 200)。微博热搜规则说明写的是生成「Top50榜单」、每分钟更新一次,所以默认拿到的只是一部分。日报只取前 10 名,第一次那 8 条也只让抖音少了 2 个名次,对本文的用法影响不大;但如果你要做「全榜」,先在目录里查清 limit 能不能传,再用一次真调确认返回多少行,而且要在日报里记下每次的行数,不要按默认值估算。按次计费意味着行数少的那一次也是 $0.000556,这一点在算「每条多少钱」时要算进去。
实测四:故意写错一路,日报照常出
每次运行的第 5 路,我们故意把抖音的 boards 写成 hot(正确的是 hotspot)。14 次运行,这一路每次都返回 422,日报每次都照常写出,其余 4 路数据完整。下面是 10:39 那次运行里这一路的真实返回:
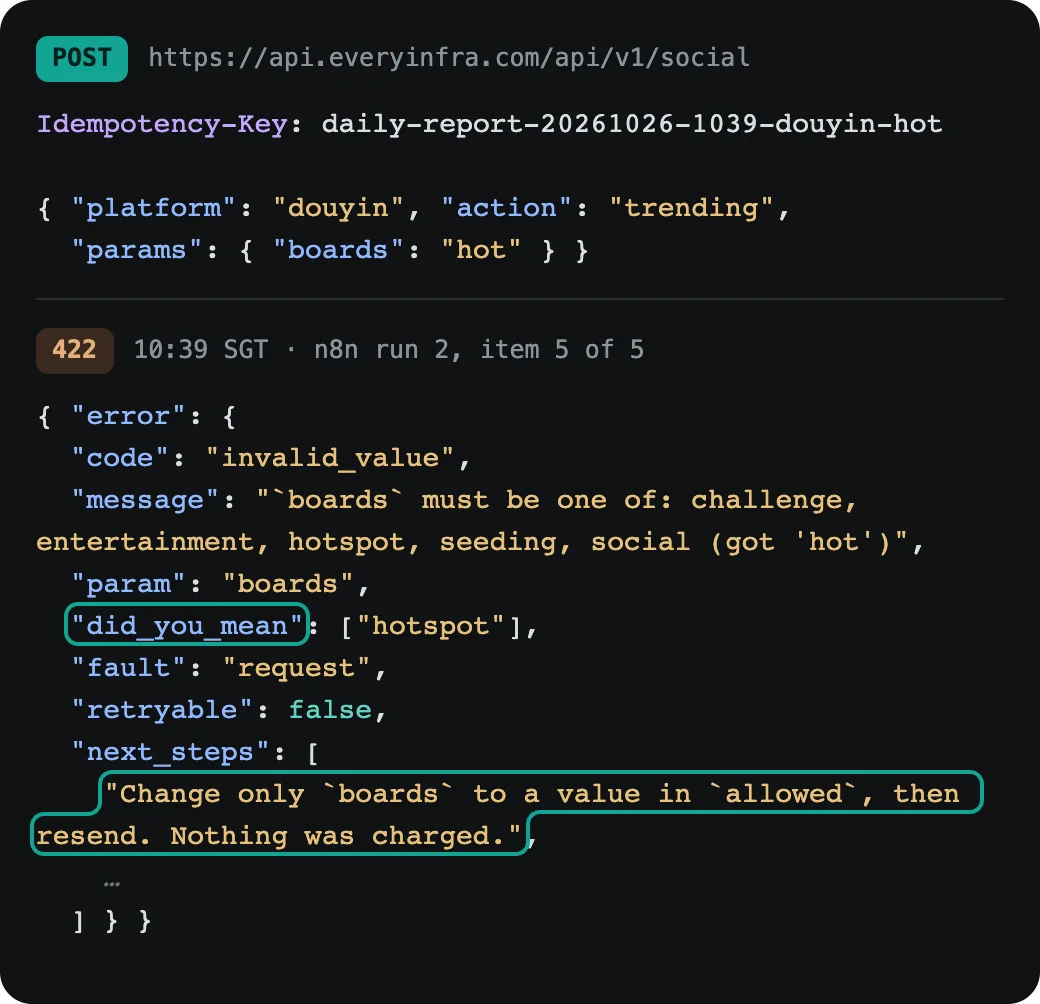
这个返回为什么适合放进自动化?因为它把「该怎么改」写成了机器能读的字段:allowed 是允许值列表,did_you_mean 是最接近的那个,retryable: false 告诉你原样重试没用,next_steps 第一句写明「Nothing was charged」。我们的「写日报」节点就是直接把 message 和 did_you_mean 写进日报的,人看到日报就知道改成 hotspot。422 本身是 RFC 9110 定义的「Unprocessable Content」:请求格式没问题,但内容不能处理,所以重试同样的请求不会成功。
把这一路设计成「照常往下」,靠的是第 4 步的 Never Error。如果没有打开它,n8n 会把这次执行标成失败,触发你设的错误工作流(错误处理文档),而当天的日报一份都没有。对一个每天给人看的文件来说,少一个榜比整份没有好得多。下面是我们在测试里实际碰到或在 OpenAPI 里核过的几种返回,以及它们在日报里该怎么处理:
| 情况 | 状态码和错误码 | 扣不扣费 | 日报里怎么写 |
|---|---|---|---|
| 没带 Key | 401 missing_key | 不扣(返回原文「Nothing was charged」) | 整份停下,告警,检查凭据 |
| 参数值不在允许范围 | 422 invalid_value | 不扣 | 这一路写原因和 did_you_mean,其余照常 |
| 同一个 key 换了参数 | 409 idempotency_conflict | 不扣 | 说明 key 拼得不对,改 key 规则 |
| 同一个 key 的第一次还在跑 | 409 idempotency_in_progress,带 Retry-After | 不扣 | 按 Retry-After 等一会儿再发 |
| 同一个 key 再发 | 200,replayed: true | 不另扣,billing 是第一次的 | 花费只算一次 |
| 成功但空结果 | 200,count: 0 | 全额退回 | 写「今天这一榜为空」 |
| 退款结果未知 | 503 | 状态待核 | 不要盲目重试,先查调用日志 |
前五行我们都实际触发过(401 是 10:18 用一条不带 Key 的请求触发的,原始返回我们存档备查),空结果和 503 两行来自 OpenAPI 原文,本次没有触发。
实测五:用 MCP Client 节点调同一个能力
n8n 还有一个 MCP Client 节点,可以把任何 MCP 服务器的工具当成工作流里的普通一步来用。EveryInfra 的 MCP 端点是 https://api.everyinfra.com/mcp,列工具不需要 Key,10:39 我们读到 25 个工具。我们用这个节点调了一次 everyinfra_call_api,参数和 REST 那一路一样:
{
  "type": "@n8n/n8n-nodes-langchain.mcpClient",
  "typeVersion": 1.1,
  "parameters": {
    "endpointUrl": "https://api.everyinfra.com/mcp",
    "authentication": "bearerAuth",
    "tool": { "__rl": true, "mode": "id", "value": "everyinfra_call_api" },
    "inputMode": "json",
    "jsonInput": "{\"platform\":\"weibo\",\"action\":\"trending\",\"params\":{}}",
    "options": { "timeout": 90000 }
  },
  "credentials": { "httpBearerAuth": { "id": "eiBearer000001", "name": "EveryInfra API Key" } }
}
10:39:52 用 n8n execute --id=eiMcpCheck0001 执行,节点耗时 9.3 秒,返回 content[0].text 是一个对象,顶层字段是 id、platform、action、results、count、billing、quota、async_hint,count 为 10,扣费 $0.000556,服务端日志里有这一条(req_0e075488e27f44e6,10:40:01)。每条结果的字段是 rank、title、hot_value、is_hot、is_new、label、url、platform,和同一时刻 REST 返回的字段完全一样。传输方式用的是默认的 Streamable HTTP,这是 MCP 规范 2025-11-25 版定义的两种标准传输之一。
| REST(HTTP Request 节点) | MCP Client 节点 | |
|---|---|---|
| 请求 | POST /api/v1/social | tools/call 调 everyinfra_call_api |
| 微博条数 | 第一次运行 10 条 | 10 条 |
| 扣费 | $0.000556 | $0.000556 |
| 服务端记录 | 有,带 request_id | 有,req_0e075488e27f44e6 |
Idempotency-Key 头 | 能加 | 没地方加 |
| 适合 | 固定的定时请求 | 让模型自己决定查什么 |
那为什么日报不用 MCP?两个原因。第一,HTTP Request 节点可以加 Idempotency-Key 头,MCP Client 节点的工具参数里没有这个位置,补跑就没有「一天只扣一次」的保护。第二,MCP 的长处是让模型自己选工具、自己拼参数,日报这种固定的 5 路请求用不上。MCP Client 更适合放在 AI Agent 节点后面,让模型根据日报内容决定要不要再查某一条(n8n 为此另有 MCP Client Tool 节点)。用命令行执行还有一个坑:n8n 服务正在运行时,n8n execute 会再起一个任务中转,和服务抢同一个端口,我们给这条命令单独设了 N8N_RUNNERS_BROKER_PORT=5692 才跑通。在 Claude、Cursor 这类客户端里接 EveryInfra MCP 的完整步骤,见远程 MCP 接入指南和 MCP 服务器说明。
热榜一小时里变了多少
日报每天跑一次够不够,取决于榜单变得多快。我们只测了 10:39 到 11:24 这 45 分钟,所以只能回答「一小时内」的问题,不能外推到一天。数字由分析脚本 analysis.py 从 14 份执行记录里现算:
逐个看。微博热搜按 rank 算、推广位不计(每次返回的前 10 个位置里有 0–2 个推广位,最初按位置算时它们会被当成「换上来的新条目」):相邻两次的前 10 名重合 7 到 10 条,也就是每 3 分钟换掉 0 到 3 条,13 次里有 9 次只换 1 条或不换;第 1 名换了两次(10:57 起是「武契奇承认败选」,11:18 起是「65岁以上人口22365万」);第 1 次和第 14 次的前 10 名只剩 4 条相同。抖音热点榜置顶的第 1 名全程没变,相邻两次重合 7 到 10 条,首末两次剩 5 条(第一次只返回了 8 条)。X 的两个榜在前 8 次一条都没变,直到 11:12 那次才一起换了一批:美国榜「Chiefs」升到第 1,墨西哥榜新进了「#LaGranjaGala」,墨西哥榜那一次和上一次只重合 6 条;之后又稳定下来。首末两次,X 美国剩 9 条,X 墨西哥剩 6 条。
| 榜单 | 相邻两次保留 | 第一次和最后一次 | 45 分钟内不同条目 | 第 1 名换了几次 |
|---|---|---|---|---|
| 微博热搜(推广位不计) | 7–10 | 4 | 21 | 2 次(10:57、11:18) |
| 抖音热点榜 | 7–10 | 5 | 18 | 0 次(第 1 名是置顶) |
| X 美国趋势 | 9–10 | 9 | 11 | 1 次(11:12) |
| X 墨西哥趋势 | 6–10 | 6 | 14 | 0 次 |
推广位对统计的影响,单独列一张对照:
| 微博热搜,14 次运行 | 按位置算(最初的日报) | 按 `rank` 算、跳过推广位(修正后) |
|---|---|---|
| 相邻两次前 10 重合 | 7–9 条 | 7–10 条 |
| 首末两次重合 | 4 条 | 4 条 |
| 45 分钟内不同条目 | 27 个 | 21 个 |
| 10:39 卢拉的名次 | 第 5 | 第 4 |
| 第 1 名换了几次 | 2 次 | 2 次 |
换个角度看同一组数:45 分钟里,微博热搜的前 10 名(推广位不计)一共出现过 21 个不同条目,抖音 18 个,X 墨西哥 14 个,X 美国 11 个。按位置算是 27 个,多出来的 6 个是轮换出现的推广位。一份每天只跑一次的日报,每个榜只能看到其中 10 个。对 X 来说这已经覆盖了大部分;对微博来说,这一小时里有一半以上上过前 10 的条目(21 个里的 11 个),你的日报根本见不到。
这组数说明的是「四个榜的节奏不同」,而不是「哪个榜更好」。X 两个国家的趋势榜每次都是新抓的:响应里的 collected_at 每次都在调用前几秒(例如 10:39:34、10:42:35),只是前 10 名大部分时间不动,而且是成批地变;前一晚的巴西选举一直占着头部。我们只看到一次成批的变化,不能据此推断 X 多久刷新一次。X 的趋势推荐说明写的是,趋势是「popular now」的话题,会过滤掉新账号和低关注账号的内容,按国家、地区、城市分别检测,所以它本来就比按分钟更新的微博热搜慢一些。对日报的含义是:如果你只关心海外大事,每天一两次足够;如果你要盯微博的舆情起伏,一天一次会错过很多中间上榜又掉下去的条目,要么跑得更勤,要么把每一次的榜单都存下来做「当天出现过的全部条目」。
Key 有没有落进磁盘
日报是长期跑的东西,Key 一旦落进某个导出文件、执行记录或备份,就会跟着跑很久。测试结束后(11:25 停掉 n8n),我们按 Key 原文在三处搜了一遍:n8n 的整个数据目录(SQLite 主库和 WAL 文件、事件日志、配置),reports/ 下的 16 份日报,以及本文的全部原始文件。结果都是 0 命中。凭据表里存的是加密后的密文,执行记录里 HTTP Request 节点的输出只有状态码、响应头和响应体,没有请求头;422 那一路的错误数据里也没有。
我们特别看了错误数据,是因为 n8n 10 月 14 日刚修过一个相关问题:GHSA-qmvv-q3c9-wpp7 指出,Git、MongoDB Atlas Vector Store 和 Google Cloud Storage 三个节点在操作失败时,会把凭据里的密码或令牌写进执行的错误数据,能看执行记录但不能读凭据的人可以从里面拿到密钥,修复版本是 1.123.85、2.44.1 和 2.43.5。HTTP Request 节点不在名单里,我们的测试也没看到泄露,但这说明「错误数据里会不会带出凭据」值得每次升级后搜一遍。
排错:这次真碰到的问题
下面每一行都是本次测试里实际出现过的现象,按出现顺序排。它们大多不是 n8n 的 bug,而是 2.x 的新默认值和命令行用法叠在一起时才会碰到的。
| 现象 | 原因 | 怎么修 |
|---|---|---|
启动报 Cannot find module 'kuler' | 上一次 npm install 中途被打断,node_modules 只装了一半,再装一遍只补了一部分 | 删掉 node_modules 和 package-lock.json,干净重装(6 分钟) |
| 启动后立刻退出,日志「Task Broker's port 5679 is already in use」 | N8N_PORT 设成了 5679,和内置任务运行器的中转端口撞了 | 换成别的端口,或者显式设 N8N_RUNNERS_BROKER_PORT |
publish:workflow 成功了,但工作流没开始定时 | 命令行发布只改数据库,正在运行的 n8n 不会重读 | 重启 n8n;命令输出里有这句提示 |
| 计划点落在 :24 秒,不是整分 | 2.45 起「每 N 分钟」从工作流被启用的那一刻起算 | 要整点就用「每天 / 每小时」或 Cron 表达式 |
服务开着时 n8n execute 起不来 | 命令行执行会再起一个任务中转,抢同一个端口 | 给这条命令单独设 N8N_RUNNERS_BROKER_PORT 和 N8N_PORT |
| 手动执行时「与上一次重合」一直是空的 | 静态数据只在发布后由触发器调起时保存 | 正常现象;要在手动测试里也能比,改用数据表 |
| 启动日志一串弃用提示 | 2.x 往 3.0 过渡:内部任务运行器模式、容器外运行等都标了弃用 | 验证阶段可以不管;长期运行照提示迁到 Docker 和外部任务运行器 |
第一条最费时间,也最容易被误判。报错指向一个和 n8n 毫无关系的日志依赖,很容易让人以为是 Node 版本不兼容,于是去换 Node;其实只要承认「上一次没装完」,删干净重装就好。第三、四条要放在一起看:在编辑器里点发布,「写库」和「启用」是同一刻,相位就是你点按钮的那一秒;用命令行发布再重启,相位是重启后启用的那一秒。我们这次两者差了 3 分 25 秒。如果你用命令行批量部署日报,又依赖「每 N 分钟」的相位去和别的系统对齐,就要知道相位是在重启时才定下来的。
最后一条弃用提示的完整内容值得读一遍。我们 10:36 的启动日志里列了 6 条:N8N_UNVERIFIED_PACKAGES_ENABLED 的默认值将改为 false,内部任务运行器模式将被删除、要改成外部模式,任务超时 N8N_RUNNERS_TASK_TIMEOUT 的默认值将从 300 秒降到 60 秒,两个压缩节点限制的默认值将调低,以及「Running n8n outside a container is deprecated」。其中任务超时这一条和日报直接相关:如果你的 Code 节点要处理很长的榜单或者做复杂计算,3.0 之后单个任务超过 60 秒就会被中断,届时要么显式把超时设回去,要么把计算拆小。任务运行器说明里写了外部模式怎么配。
怎么自己核对:直接查 SQLite
n8n 的编辑器会列执行记录,但它不会告诉你「哪一次本该跑却没跑」。持久调度器把这件事记在两张表里,用 sqlite3 直接读就行。下面三条查询是我们这次实际用来判 J1–J4 的:
DB=$HOME/Downloads/n8n-lf25/home/.n8n/database.sqlite
# 1. 每个定时任务的相位、间隔、补跑策略和宽限
sqlite3 -header $DB "select name, intervalSeconds, nextRunAt, lastFiredAt, misfirePolicy, misfireGraceSeconds from scheduled_job;"
# 2. 每一次被写进队列的运行:计划时刻、实际开始、最晚允许开始
sqlite3 -header $DB "select id, jobId, status, scheduledFor, startedAt, missedAfter from scheduled_task order by id;"
# 3. 真正执行了的:触发方式、状态、开始时间(全部是 UTC)
sqlite3 -header $DB "select id, workflowId, mode, status, startedAt from execution_entity order by id;"
读这几张表要注意三件事。第一,时间都是 UTC,要加 8 小时才是新加坡时间。第二,scheduled_task 只记已经写进队列的运行:写入窗口默认 60 秒,停机期间到点、恢复时又已经超出宽限的那几次,根本不会出现在这张表里,所以「丢了几次」要用计划点去推,或者看 n8n_scheduler_occurrences_misfired_total 指标,不能只数表里的行。我们这次就是这样:A 的 10:51:24 和 10:54:24 在表里没有任何记录,是靠「相位 + 180 秒 × k」推出来、再用指标里的 2 次对上的。第三,已完成的运行默认保留一天(N8N_SCHEDULER_RETENTION 为 86,400 秒),出问题的保留七天,要做月度复盘就得自己定期导出。我们把三张表导出成 executions.json,本文所有关于时间的数字都由分析脚本 analysis.py 从这份文件现算。
字段说明:日报用到的每一个字段
日报只用了每条结果里的名称和名次,但 4 个能力实际返回的字段更多。下表和 10:15 读的目录 response_fields 逐个对过:「本次返回」一列是 10:39 那次运行里每条结果实际出现的字段。
| 能力 | 目录里的 `response_fields` | 本次返回 | 日报用了 | 含义(目录原文的意思) |
|---|---|---|---|---|
weibo/trending | rank, title, category, hot_value, label, is_hot, is_new, url, platform | 14 次都没有 category;label 有,值是空、「新」或「热」 | title、rank | hot_value 是微博自有热度,只在榜内可比;is_new 是否新上榜 |
douyin/trending | rank, keyword, hot_value, video_count, board, image_url, event_time, sentence_id, group_id, label, word_type, article_count, is_pinned, max_rank, live_room_count, topic_view_count, sentence_tag, label_icon_url, related_music_id, platform | 20 个字段在 14 次里都出现过;置顶的第 1 名 hot_value、max_rank 为空,其余有值 | keyword、rank | hot_value 是抖音自有热度,热点榜上可能为空;event_time 是热点事件时间 |
twitter/trending | id, name, rank, volume, period, collected_at, platform | 全部 7 个 | name、rank | volume 是讨论量;collected_at 是抓取时刻,用它判断新鲜度 |
三点提醒,都是逐条核对原始返回时才发现的。第一,抖音置顶的那一条(is_pinned: true)没有 hot_value,其余 19 条有;按热度排序时置顶条会被排到最后,所以抖音这一榜按 rank 就好。第二,同一个 event_time 字段出现了两种格式:置顶条是「2026-10-26 10:41:56」这种不带时区的写法,其他条是「2026-10-25T01:23:31.000Z」这种带 Z 的 UTC 写法;直接比较字符串会出错,解析时要分两种处理。第三,微博 14 次都没返回 category,日报里不要假设字段一定存在,取值时写成 x.category ?? '' 这种带默认值的形式,否则 Code 节点会在字段缺席的那天抛错。同一个能力换成娱乐榜、社会榜等其他 boards 值,字段表现可能不同,本次没测。各能力的完整参数和字段,在微博热搜 API 页、抖音热榜 API 页和 X(Twitter)趋势 API 页,平台总览在微博爬虫 API、抖音爬虫 API 和 X 爬虫 API。
同一份数据,在代码里怎么调
如果你暂时不想装 n8n,下面这条 curl 和第 4 步的 HTTP Request 节点发的是同一个请求,可以先在终端里确认 Key 和参数都对:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer ${EVERYINFRA_API_KEY}" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: daily-report-$(TZ=Asia/Singapore date +%Y%m%d)-twitter-mx" \
  -d '{"platform":"twitter","action":"trending","params":{"country":"mx"}}' \
| jq '{replayed, count, top3: [.results[0:3][].name], charged_usd: .billing.charged_usd}'同一天第二次运行这条命令,replayed 会变成 true,charged_usd 仍显示第一次的值,但不会再扣费。拿到 Key、看请求格式和响应结构,从 快速上手 开始;各能力的价格在价格页。如果你的日报后面还要接「失败自动退款」的对账,失败退款对账指南讲了怎么用 charge_id 和调用日志核对每一笔。
和其他做法比
日报这件事不一定要用 n8n。下面只列我们能核实的事实和各自适合的场景:
| 做法 | 停机时到点的那次 | 补跑重复扣费的保护 | 适合 |
|---|---|---|---|
| n8n 2.45+ 持久调度器(本文) | 宽限内晚跑;超出后按策略丢弃或补最近一次 | 靠请求里的 Idempotency-Key | 想在界面里改流程、要多个步骤、要失败分支 |
| n8n 2.44 及以前(内存调度器) | 直接跳过,不补 | 同上 | 已在用、暂不升级的实例 |
| 系统 cron + curl 脚本 | 跳过(cron 不补跑错过的时间) | 同上,要自己在脚本里拼 key | 只调一两个接口、不需要界面 |
| 在 AI 客户端里用 MCP 手动问 | 不定时 | 工具参数里没有幂等键 | 临时查一次,不需要每天固定输出 |
第三行的「cron 不补跑」是 cron 的通行行为;如果你的系统用的是带补跑功能的定时器(例如 systemd timer 的 Persistent=true),情况不同,本文没有测。我们自己的结论是:一两个接口、没有失败分支的话,cron 加 curl 更轻;超过三个步骤、要把失败写进报告、要别人也能改,用 n8n。之前的多平台口碑监控指南用的是另一种做法,可以对照着看。
什么时候这套做法不成立
- 你需要「一定恰好一次」。 持久调度器的补跑策略保证的是「最多补一次最近的」,不是「每一次都跑」;文档也写明,没有一种策略会逐个回放积压的运行。如果一天里的每一份都必须有,比如每小时一份、拿来算日均,就要在日报里按计划点检查缺口,自己补。
- 你在多台 n8n 之间共享一个 SQLite。 我们只测了单实例。文档说多主实例时每次运行由一个实例领取,但那需要 Postgres 和队列模式,本文没有测。
- 热榜要的是「全榜」。 默认每次 20 条,第一次还只有 10 条和 8 条,见实测三。
- 测试窗口只有 45 分钟。 热榜变化的数字只代表 10 月 26 日上午这一段,赶上了巴西大选次日这种单一事件占头部的时段。
最近的变化
- 2026-10-20,n8n 2.45 默认开启持久调度器。 见更新日志和 GitHub 发布说明(发布说明里还删除了不再使用的
N8N_SCHEDULER_MIN_INTERVAL)。对读者意味着:升级后「每 N 分钟」的相位会变,停机后的行为也变了,定时任务要重新看一遍补跑策略。 - 3.0 起只支持 Docker 部署。 3.0 破坏性变更说明写明 npm 和
npx n8n不再支持,Cron 和 Interval 两个老节点也会被删。对读者意味着:本文的 npm 安装只适合验证,长期跑请迁到 Docker;还在用 Cron 节点的工作流要换成 Schedule Trigger。 - 2026-10-14,n8n 发布两周一次的安全更新。 这一批共 15 条,其中一条是执行错误数据带出凭据。对读者意味着:自托管实例至少要跟上补丁版本,升级后搜一遍执行记录里有没有密钥。
- 2026-10-14,Censys 报告 n8n 是暴露最多的 AI 相关软件。 Censys 报告统计 113,926 台主机。对读者意味着:日报这种跑在自己机器上的 n8n,没有理由开到公网。
- 2026-10-06,Diagrid 发布 n8n 的持久执行集成。 据商业资讯稿,它让工作流在崩溃后从中断的节点继续,并用幂等账本避免重复的副作用。对读者意味着:n8n 2.45 解决的是「到点的那次会不会丢」,节点级的「跑到一半崩了怎么办」是另一层问题,生态里已经有人在补。
- 2026-10-12,ZoomInfo 发布 n8n 原生节点。 据 Business Wire 发布稿,它同时通过 API 和 MCP 提供数据。对读者意味着:数据服务接入 n8n 正在同时走「专用节点」和「MCP」两条路;EveryInfra 目前没有 n8n 专用节点,本文用的是通用的 HTTP Request 和 MCP Client 节点。
- 2026-10-22,IETF 的 Idempotency-Key 草案更新到第 8 版。 见 IETF 数据跟踪页。对读者意味着:用请求头做幂等正在变成标准做法,日报里按日期拼 key 的写法以后换到别的接口也通用。
常见问题
n8n 定时任务的时区不对,怎么改?(来源:Google 联想词「n8n schedule trigger time zone」「n8n 定时 任务」,2026-10-26 读)
自托管 n8n 默认时区是 America/New_York。设环境变量 GENERIC_TIMEZONE=Asia/Shanghai 或 Asia/Singapore 后重启,或者在工作流设置里单独设时区;工作流设置优先于实例设置(Schedule Trigger 文档)。我们两处都设了 Asia/Singapore,日报文件名里的时间就是新加坡时间。
重启以后定时任务没跑,是坏了吗?(来源:Google 联想词「n8n schedule trigger not running」,2026-10-26 读)
先看版本。2.44 及以前默认是内存调度器,停机期间到点的运行一律跳过;2.45 起默认是持久调度器,停机时间在宽限期(默认 60 秒)内会晚跑,超过宽限按节点的「If Execution Is Missed」处理,默认也是不补。我们停机 6 分 44 秒、默认策略下丢掉了两次,这是设计如此。要补,把节点设置改成「Run the Most Recent Missed Execution」,并按日期生成幂等键,避免补跑重复扣费。
用 n8n 调接口,报错了怎么不让整个流程停下?(来源:Google 联想词「n8n http request error handling」,2026-10-26 读)
在 HTTP Request 节点的选项里打开「Never Error」和「Include Response Headers and Status」,非 2xx 响应就会作为普通数据往下传,下一个节点按 statusCode 分支处理。我们 14 次运行里,故意写错的那一路每次都是 422,日报每次都照常写出。EveryInfra 的 4xx 都带 next_steps,可以直接写进日报给人看。
相关阅读
- 远程 MCP 接入指南:在 Claude、Cursor 等客户端里接 EveryInfra MCP。
- 失败退款对账:怎么核对每一笔扣费和退款。
- 用评论区卖选题报告:另一个「定期出报告」的实战,按月跑。
- MCP 2026 规范与生产可用性:MCP 传输和认证的背景。
参考资料
- Durable scheduler,n8n Docs,2026-10,<https://docs.n8n.io/deploy/host-n8n/configure-n8n/durable-scheduler/>
- Scheduler 环境变量,n8n Docs,2026-10,<https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/use-environment-variables/scheduler/>
- Schedule Trigger 节点,n8n Docs,2026-10,<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.scheduletrigger/>
- Changelog(持久调度器默认开启),n8n Docs,2026-10-20,<https://docs.n8n.io/changelog/>
- Release notes(n8n 2.45、2.44),n8n Docs,2026-10-20,<https://docs.n8n.io/changelog/release-notes/>
- n8n 2.45.0 发布说明,n8n GitHub,2026-10-20,<https://github.com/n8n-io/n8n/releases/tag/n8n%402.45.0>
- v3.0 Breaking changes,n8n Docs,2026-10,<https://docs.n8n.io/changelog/v30-breaking-changes/>
- Developing v3 features,n8n GitHub,2026,<https://github.com/n8n-io/n8n/blob/master/.github/DEVELOPING_V3.md>
- Install with npm,n8n Docs,2026-10,<https://docs.n8n.io/deploy/host-n8n/install-options/install-with-npm/>
- n8n 包元数据(dist-tags 与发布时间),npm registry,2026-10-26 读,<https://registry.npmjs.org/n8n>
- Use Docker Compose,n8n Docs,2026-10,<https://docs.n8n.io/deploy/host-n8n/install-options/install-using-docker-compose/>
- One-line setup,n8n Docs,2026-10,<https://docs.n8n.io/deploy/host-n8n/install-options/one-line-setup/>
- Node.js Releases,Node.js,2026-10-21 更新,<https://nodejs.org/en/about/previous-releases>
- Set the timezone,n8n Docs,<https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/configuration-examples/set-the-timezone/>
- Security 环境变量,n8n Docs,<https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/use-environment-variables/security/>
- Read/Write Files from Disk 节点,n8n Docs,<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.readwritefile/>
- Use the command line,n8n Docs,<https://docs.n8n.io/deploy/host-n8n/configure-n8n/use-the-command-line/>
- HTTP Request credentials,n8n Docs,<https://docs.n8n.io/integrations/builtin/credentials/httprequest/>
- RFC 6750:Bearer Token Usage,IETF,2012,<https://www.rfc-editor.org/rfc/rfc6750>
- EveryInfra OpenAPI(幂等键、重放、错误码),EveryInfra,2026-10-26 读,<https://api.everyinfra.com/openapi.json>
- The Idempotency-Key HTTP Header Field,draft-08,IETF HTTPAPI 工作组,2026-10-22,<https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/>
- HTTP Request 节点,n8n Docs,<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/>
- getWorkflowStaticData,n8n Docs,<https://docs.n8n.io/build/code-in-n8n/cookbook/built-in-methods-and-variables-examples/getworkflowstaticdata/>
- Convert to File 节点,n8n Docs,<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.converttofile/>
- Enable Prometheus metrics,n8n Docs,<https://docs.n8n.io/deploy/host-n8n/configure-n8n/basic-configuration/configuration-examples/enable-prometheus-metrics/>
- n8n-scheduler Grafana 面板,n8n-observability GitHub,<https://github.com/n8n-io/n8n-observability/tree/main/dashboards/grafana/n8n-scheduler>
- EveryInfra 能力目录,EveryInfra,2026-10-26 10:15 读,<https://api.everyinfra.com/api/v1/social/catalog>
- 热搜榜规则说明,微博,<https://m.s.weibo.com/hot/description>
- RFC 9110:HTTP Semantics(422 Unprocessable Content),IETF,2022,<https://www.rfc-editor.org/rfc/rfc9110>
- Handle errors gracefully,n8n Docs,<https://docs.n8n.io/build/flow-logic/handle-errors-gracefully/>
- MCP Client 节点,n8n Docs,<https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-langchain.mcpclient/>
- MCP 规范 2025-11-25:Transports,Model Context Protocol,<https://modelcontextprotocol.io/specification/2025-11-25/basic/transports>
- Trends Recommendations,X 帮助中心,<https://help.x.com/en/resources/recommender-systems/trends-recommendations>
- GHSA-qmvv-q3c9-wpp7:Credential Secrets Exposed in Execution Error Data,n8n GitHub,2026-10-14,<https://github.com/n8n-io/n8n/security/advisories/GHSA-qmvv-q3c9-wpp7>
- 5 Key Takeaways From Censys' State of the Internet Report,Censys,2026-10-14,<https://censys.com/blog/state-of-the-internet-report-2026/>
- Security update — 01 October 2026,n8n 社区,2026-10-01,<https://community.n8n.io/t/security-update-01-october-2026/318054>
- Security update — 14 October 2026,n8n 社区,2026-10-14,<https://community.n8n.io/t/security-update-14-october-2026/321284>
- Diagrid Brings Durable Execution to n8n(商业资讯稿),Business Wire 经 Yahoo Finance,2026-10-06,<https://finance.yahoo.com/technology/ai/articles/diagrid-brings-durable-execution-n8n-130000140.html>
- ZoomInfo Launches Native Integration With n8n Through GTM.AI,Business Wire,2026-10-12,<https://www.businesswire.com/news/home/20261012317239/en/ZoomInfo-Launches-Native-Integration-With-n8n-Through-GTM.AI>
- Faltam 12 dias: consulte propostas das candidaturas que disputam o 2º turno,巴西高等选举法院,2026-10-13,<https://www.tse.jus.br/comunicacao/noticias/2026/Outubro/faltam-12-dias-consulte-propostas-das-candidaturas-que-disputam-o-2o-turno>
- An n8n execution can show Success after processing zero items,Reddit r/n8n,<https://www.reddit.com/r/n8n/comments/1xadlkd/an_n8n_execution_can_show_success_after/>
引用编号 LF-26