Apify Google Maps 爬虫替代:每千条实测
Apify 地图爬虫每千条 $1.50–$4.00,我们实测地点 $0.028、评论 $0.014;一次只查一家店时差距缩到 1.8 倍以内。
同样拿 1,000 家 Google Maps 地点,Apify 的 Google Maps Scraper 公开价从 Free 档的 $4.00 降到 Business 档(月费 $999)的 $1.50,只给 Enterprise 客户的 DIAMOND 档是 $0.756;我们 2026 年 10 月 26 日用 EveryInfra 真调,一次请求拿回 50 家、实付 $0.001389,折合每千家 $0.0278,比 DIAMOND 档便宜约 27 倍,比 Business 档便宜约 54 倍。评论也一样:Apify 的 Google Maps Reviews Scraper 每千条 $0.15 到 $0.60,我们一次 100 条、每千条 $0.0139;但如果每次只查一家店的详情,或者只拉一家店这几天新增的 9 条评论,我们就只比 Business 档便宜 1.8 到 1.9 倍,比 DIAMOND 档还贵一点,因为我们按次收费,一次拿的条数少就摊不薄。本文把 22 次真调(另加 19:53 翻页修复后的 9 次复核)的原始返回、Apify 公开定价接口的原始数据、翻页和去重的实测,以及在 n8n 里两边各要几步,放在一起算清楚。
本文说的「Apify Google Maps Scraper 替代」,是指不在 Apify 平台上运行 Google Maps 类 actor(Apify 对云端抓取程序的叫法),改用一个按请求计费的数据接口,直接拿回同类的公开地图数据:按关键词和城市搜地点、按链接查一家店的详情、翻页拉一家店的评论。我们只比较四件事:同样拿到 1,000 条要多少钱,钱是按什么单位数的,免费额度和失败扣不扣钱,以及在 n8n、API、MCP 里接上要几步。我们没有注册 Apify、没有付费运行它的 actor,所以不评价它的数据质量和成功率,Apify 一侧只用它公开的定价接口、Store 页面和文档;两边返回什么字段,我们只写自己这一边。


Apify Google Maps Scraper 价格:每个计费事件拆开看
先看 Apify 一侧到底怎么收钱。下面的数字全部来自 Apify 的公开接口 api.apify.com/v2/acts/<actor>,这个接口不登录也能读,返回的 pricingInfos 列出每个 actor 的计费事件和各档单价,我们在 2026-10-26 17:05(新加坡时间)读取了 Google Maps Scraper、Google Maps Reviews Scraper、Google Maps Extractor 和 Google Maps Email Extractor 四个 actor。Google Maps Scraper 当前这一版定价从 2026-06-30 起生效,接口里显示它累计有 667,270 个用户、近 30 天 44,777 个,最近修改是 10 月 26 日;Reviews Scraper 的定价从 2026-03-13 起生效,累计 65,028 个用户。
每个事件有六档价格。FREE、BRONZE、SILVER、GOLD 对应 Apify 的四个自助套餐 Free、Starter、Scale、Business,这一点 Apify 的 Actors in Store 文档写明了「每个订阅计划包含一个折扣档」;PLATINUM 和 DIAMOND 两档,定价与成本文档写明只给 Enterprise 客户。下表把 Google Maps Scraper 的全部事件按每 1,000 次列出,最后一行是专门拉评论的 Reviews Scraper。
| 计费事件(每 1,000 次) | Free | Starter | Scale | Business | PLATINUM | DIAMOND |
|---|---|---|---|---|---|---|
| 抓到一个地点(基础) | $4.00 | $3.00 | $2.00 | $1.50 | $1.26 | $0.756 |
| 附加:用了分类筛选 | $1.00 | $1.00 | $0.75 | $0.525 | $0.315 | $0.189 |
| 附加:抓详情页(按链接或 Place ID 输入时必收) | $2.00 | $2.00 | $1.50 | $1.05 | $0.63 | $0.378 |
| 附加:从官网补联系人 | $2.00 | $2.00 | $1.50 | $1.05 | $0.63 | $0.378 |
| 附加:每条评论 | $0.50 | $0.50 | $0.37 | $0.26 | $0.1575 | $0.0945 |
| 附加:每张图片 | $0.50 | $0.50 | $0.37 | $0.26 | $0.1575 | $0.0945 |
| 附加:商务线索(每条) | $100 | $5.00 | $5.00 | $4.00 | $3.00 | $3.00 |
| 附加:社媒主页补全(每个) | $100 | $8.00 | $7.00 | $6.00 | $4.00 | $3.00 |
| 附加:AI 竞品分析(每家) | $25 | $20 | $18 | $16 | $15 | $13 |
| Reviews Scraper:每条评论 | $0.60 | $0.45 | $0.40 | $0.30 | $0.20 | $0.15 |
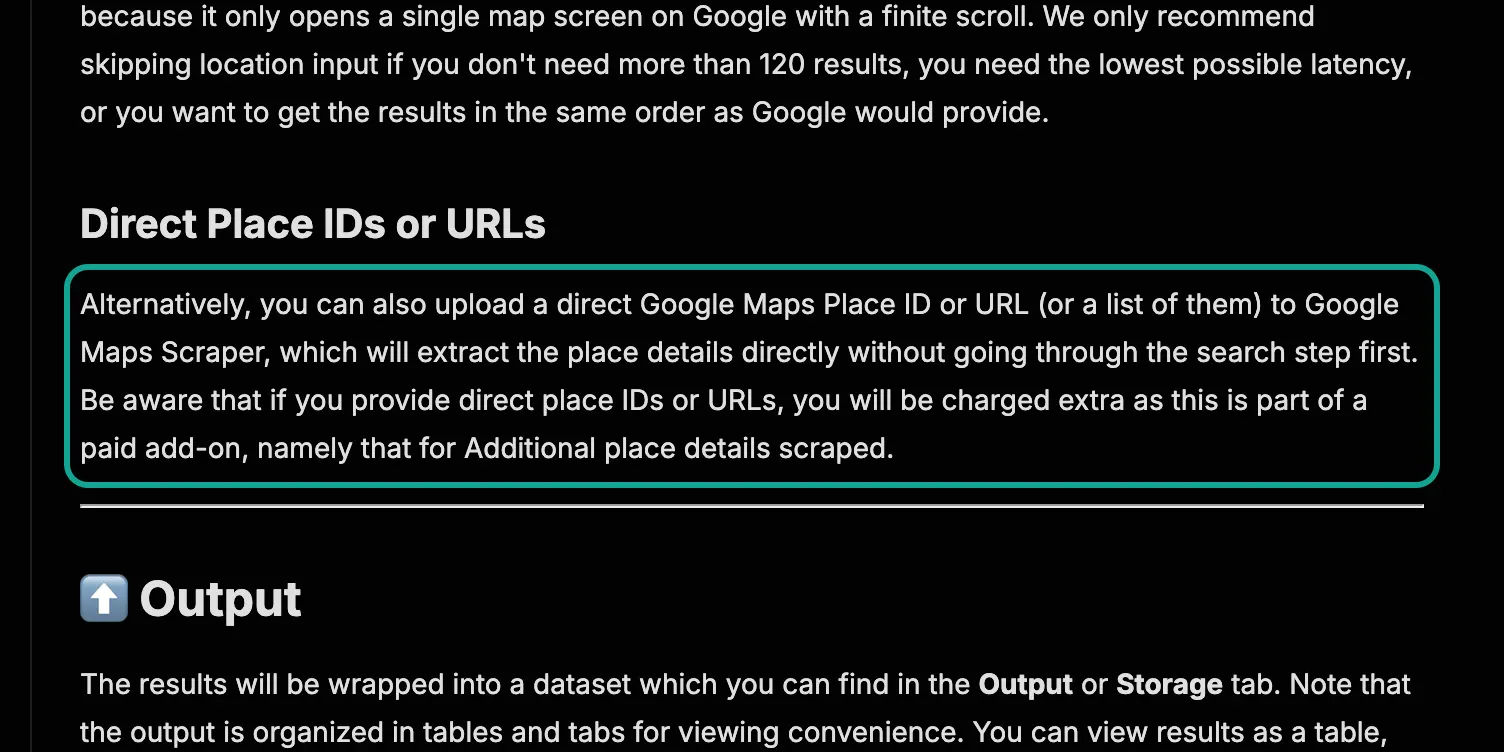
这张表里有三件容易漏看的事。第一,按链接或 Place ID 直接查店,Apify 会额外收「详情页」附加费,它的 Store 页面原话是提供直接的 Place ID 或链接时「会被额外收费」,所以按链接取一家店在 Business 档是 $1.50 + $1.05 = $2.55 每千家。第二,商务线索、邮箱验证和社媒补全三项在 Free 档定价是 $0.10 一次,比付费档贵 12 到 25 倍,Store 页面自己的示例也写了社媒补全在 Free 档「明显更贵」。第三,每次运行另有一个启动事件 apify-actor-start,按事件计费文档写明默认 $0.00005,内存每多 1 GB 多收一次;这一项单次很小,但如果你每天按城市拆成几十次小运行,就要算进去。
附加项叠起来以后,每千家的价格会翻几倍。下图把五个常用事件全部打开:基础地点、详情、筛选、联系人,再加每家 10 条评论。Free 档从 $4.00 涨到 $14.00,Business 档从 $1.50 涨到 $6.72,DIAMOND 档从 $0.756 涨到 $2.65。这和 Reddit 上一位做外呼名单的用户贴出的账单是一个量级:他写 Google Maps actor 只要基础字段每千条 $4,开了邮箱和社媒抓取就到每千条 $6,每月 2 万条一年要 $1,440(原帖)。要说明的是,这位发帖人自己在卖一款桌面工具,帖子是拿 Apify 和自家产品比,所以他的结论我们不引用,只引用他贴出的 Apify 单价,这两个单价和公开接口里的 Free 档对得上。
EveryInfra 的计价方式简单得多,也更死板。目录 GET /api/v1/social/catalog 里,Google Maps 的三个能力 google_maps_reviews/search、google_maps_reviews/profile、google_maps_reviews/reviews 都是 $0.001389 一次请求,属于价格页上的标准档(每千次 $1.39)。一次请求返回 1 条还是 50 条,价格一样;search 一次最多 50 家(目录 max_limit),reviews 一次最多 100 条。没有附加项:电话、网站、评分、评论数、营业时间这些字段本来就在返回里,返回里没有的东西(官网邮箱、社媒主页、热门时段),我们也没有,不能另付钱买。
同样 1,000 条:Apify 三档对 EveryInfra 实测
下表是本文最关键的比较。Apify 一列取公开单价;EveryInfra 一列是当天真调的结果:实付金额除以实际返回的条数,再乘 1,000,条数按返回数组的长度现数,不按 limit 推算。倍数的规则是动手前定好的:2 倍以上写「更便宜」,1 到 2 倍写「接近」,低于 1 倍照实写「Apify 更便宜」。我们同时列 Business 档(自助能买到的最低价,前提是每月先付 $999)和 DIAMOND 档(全部六档里最低,但要签 Enterprise 合同)。
| 数据 | Apify 对应做法 | Apify Free | Apify Business | Apify DIAMOND | EveryInfra 实测(能力,每次条数) | 实测每千条 | 对 Business | 对 DIAMOND |
|---|---|---|---|---|---|---|---|---|
| 地点搜索 | Google Maps Scraper 基础 | $4.00 | $1.50 | $0.756 | google_maps_reviews/search,50 家 | $0.0278 | 便宜约 54 倍 | 便宜约 27 倍 |
| 评论 | Reviews Scraper | $0.60 | $0.30 | $0.15 | google_maps_reviews/reviews,100 条 | $0.0139 | 便宜约 22 倍 | 便宜约 11 倍 |
| 评论(随地点一起拉) | Google Maps Scraper 评论附加 | $0.50 | $0.26 | $0.0945 | 同上,100 条 | $0.0139 | 便宜约 19 倍 | 便宜约 6.8 倍 |
| 只拉新增评论 | Reviews Scraper | $0.60 | $0.30 | $0.15 | google_maps_reviews/reviews,since 筛出 9 条 | $0.1543 | 接近(1.9 倍) | Apify 更便宜约 3% |
| 按链接取一家店 | 基础 + 详情附加 | $6.00 | $2.55 | $1.134 | google_maps_reviews/profile,1 家 | $1.389 | 接近(1.8 倍) | Apify 更便宜约 18% |
前三行的差距来自计费单位。Apify 的 Google Maps 类 actor 都是按事件收费:定价页写得很直白,多数 actor 用按事件计费,你为「返回一条结果」这类事件付钱,返回 1,000 家就是 1,000 个事件。我们按请求收费,一次 50 家只收一次钱,所以每家只摊到 $0.0000278。后两行反过来,是因为那两种活本来就是「一次只拿很少几条」:查一家店的详情只有 1 条,按日期增量拉评论这天只有 9 条新的。这时按次收费就等于按条收费,优势只剩单价本身的差别。写这两行不是为了显得公平,而是因为它们对选型有实际影响:如果你的活主要是「每天把 5,000 家已知店铺的详情各刷新一次」,按我们的单价是每天 $6.95,Apify Business 档的事件费是 $12.75,DIAMOND 档是 $5.67,差距远没有批量搜索那么大。
Apify Google Maps Scraper 免费吗:$5 能抓多少
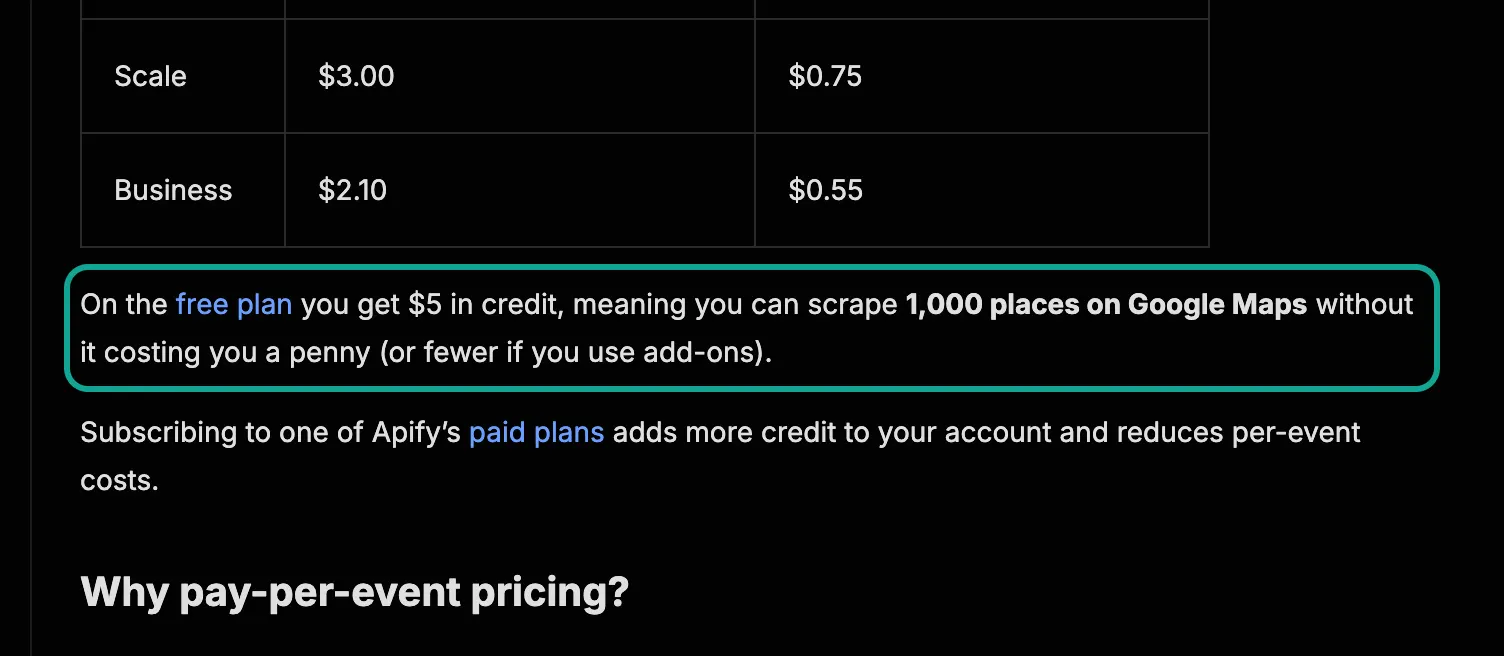
「apify google maps scraper free」是这个话题下最常见的联想词之一。准确的答案是:Apify 有一个不用信用卡的 Free 计划,每月给 $5 的预付用量,可以在 Store 里任何 actor 上花;定价页写明,Free 计划用完以后会被封停到下一个计费周期开始,而且所有计划里没用完的预付用量都不结转,周期结束就作废。Google Maps Extractor 的 Store 页面给了一个算好的数:Free 计划的 $5 可以抓 1,000 个地点,开附加项就更少。这个数和公开接口里 Extractor 的 Free 档单价(每千家 $5.00)正好对得上,算是一个外部的核对点。
我们按同样的方法,把 $5 换算成几种常见做法能拿到的条数。Google Maps Scraper 只要基础字段是 1,250 家,加详情是 833 家,再加一个分类筛选是 714 家;每家再顺带 10 条评论,就只剩 555 家。专门拉评论的 Reviews Scraper 是 8,333 条。Reddit 上那位用户说 Free 计划的 $5「一个上午就用完了」,按这些数字并不奇怪。
EveryInfra 一侧要说清楚两点。第一,我们没有每月赠送的额度。价格页写的是:在 GitHub 给 everyinfra/everyinfra-agent-plugins 点星,注册后在控制台领 $1 试用额度,24 小时内有效,按标准档大约 720 次调用;普通注册不自动赠送。正式使用最低充值 $10(约 7,199 次调用),充进钱包的钱不清零、不设有效期。第二,图里 EveryInfra 的两根条是上限,不是你一定能拿到的数:$5 是 3,599 次请求,要每次都返回满额 50 家或 100 条才有 179,950 家或 359,900 条。实际上一个搜索词最多翻到 120 行,按 place_id 去重后还会少几家(见下一节),想拿更多地点就得换更多不同的搜索词和城市,而近义词会有大量重复;评论也只有评论数在 100 条以上的店才能一次拿满。
| 免费和起步 | Apify | EveryInfra |
|---|---|---|
| 不付钱能用多少 | Free 计划每月 $5,用完封停到下月 | GitHub 点星领 $1,24 小时内有效;普通注册不送 |
| 最低付费 | Starter 月费 $19(含 $19 预付用量),超出部分记到下期账单 | 一次充值最低 $10,没有月费 |
| 没用完的钱 | 周期结束作废,不结转 | 长期有效,用完为止 |
| 超额以后 | Free 计划封停;付费计划按超额计费 | 余额不足时请求失败,不透支 |
| 并发和速率 | Free 计划最多 5 个并发运行 | 每个账户默认每分钟 60 次,所有 Key 共用;累计充值满 $50、$150、$750 升到 180、600、1,800 次 |
每月的账:月费常常比用量还大
按条计价的单价看着小,真正的账单还要加上月费。Apify 的月费本身就是预付用量,所以一个月的实际支出是「月费」和「当月用量」两者取大。我们拿一个常见规模算一遍:每月 1 万家店,加 10 万条评论(大约每家 10 条)。按各档单价,用量是 Starter 档 $75、Scale 档 $60、Business 档 $45;但 Scale 档月费 $199、Business 档 $999,用量低于月费时多出来的预付额度就作废。于是三档的实际支出是 $75、$199、$999,用量越小的档反而越贵。Free 计划不在比较里,因为它用到 $5 就会被封停。
EveryInfra 的同一笔账是 $1.67:1 万家店按每次 50 家要 200 次 search,10 万条评论按每次 100 条要 1,000 次 reviews,共 1,200 次请求,每次 $0.001389。这个数是理想情况,有两个条件要满足。一是 200 次搜索得是 200 个不重复的「词 × 城市」组合,每次都返回 50 家新店;下面的实测显示近义词重复率很高,实际要更多次请求。二是每家店要有 100 条以上评论才能一次拿满。即使按最差的去重情况(第二个近义词只多出 5 家新店,见后文),每千家新店的成本是 $0.278,仍是 Apify Business 档 $1.50 的五分之一左右。
| 每月 1 万家 + 10 万条评论 | 用量(事件费) | 月费 | 实际支出 |
|---|---|---|---|
| Apify Starter | $75.00 | $19 | $75.00($19 + 超额 $56) |
| Apify Scale | $60.00 | $199 | $199.00 |
| Apify Business | $45.00 | $999 | $999.00 |
| Apify DIAMOND(Enterprise) | $22.56 | 合同另议,公开页面没有写 | 未核到 |
| EveryInfra(实测单价) | $1.67 | 无 | $1.67 |
自己算一遍:两个公式和一个例子
上面的数字换成你自己的场景,用两个公式就能算。Apify 一侧,一个月的事件费是:地点数 ×(基础单价 + 你打开的每个附加项单价)+ 评论数 × 评论单价 + 运行次数 × 启动费;实际支出再和你的月费取大。EveryInfra 一侧是:(搜索请求数 + 详情请求数 + 评论请求数)× $0.001389,其中搜索请求数 ≈ 你要的新地点数 ÷ 每次实际拿到的新地点数,评论请求数 ≈ 每家要拉的评论数 ÷ 100(向上取整、每家至少 1 次)× 店数。两个公式里最容易估错的都是「每次实际拿到多少条」:Apify 那边是你打开了几个附加项,我们这边是去重以后每次请求还剩几家新店。
举一个做本地营销代理常见的例子:30 个城市 × 3 个品类,每个组合要 100 家店,每家拉最新 20 条评论,每月刷新一次。地点是 9,000 家,评论是 18 万条。Apify 一侧按 Business 档:地点 9,000 × $1.50 = $13.50,Reviews Scraper 评论 180,000 × $0.30 = $54.00,事件费合计 $67.50,低于 Business 月费 $999,所以实际支出就是 $999;按 Starter 档事件费是 9,000 × $3.00 + 180,000 × $0.45 = $108,加上月费以内的部分,实际支出 $108。EveryInfra 一侧:每个组合翻两页是 2 次 search(实测前两页共 100 行,修复后复核时按 place_id 去重是 92 到 100 家),90 个组合共 180 次;每家 20 条评论 1 次 reviews,9,000 次;合计 9,180 次 × $0.001389 = $12.75。如果你不需要每家都拉评论、只拉评分 4 分以下的店,评论请求数还能再降一大截。这个例子里我们的支出约是 Apify Starter 档的八分之一;它的前提是每个组合去重后都真能搜到 100 家(不够时可以再翻第 3 页,多 20 家、多一次请求),品类太窄或城市太小时,搜索请求数不变、拿到的店会变少。
| 30 城 × 3 品类,每组 100 家、每家 20 条评论 | 地点 | 评论 | 事件费 | 每月实际支出 |
|---|---|---|---|---|
| Apify Business | 9,000 × $1.50 = $13.50 | 180,000 × $0.30 = $54.00 | $67.50 | $999(月费) |
| Apify Starter | 9,000 × $3.00 = $27.00 | 180,000 × $0.45 = $81.00 | $108.00 | $108 |
| EveryInfra | 180 次 | 9,000 次 | 9,180 × $0.001389 | $12.75 |
实测一:地点搜索和翻页(新加坡牙医)
中文版的主样本选新加坡:Google Maps 在新加坡覆盖完整,中文读者里做东南亚本地生意的也多;品类选牙科诊所,因为这是本地商家名单里评论多、竞争也密的一类。第一次请求在 2026-10-26 17:09:23(新加坡时间)发出,google_maps_reviews/search,关键词 dentist、地点 Singapore、国家 sg、limit 50,9.1 秒返回 50 家,扣费 $0.001389。请求就是下面这一段,$EVERYINFRA_API_KEY 换成你自己的 Key:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_maps_reviews","action":"search",
       "params":{"keyword":"dentist","location":"Singapore","country":"sg","limit":50}}'
# 响应里:results(50 家)、next_page_token、pagination.has_more = true、billing.charged_usd = 0.001389
翻第 2 页时遇到了第一个要提前知道的限制。我们把上一页的 next_page_token 原样传回去,其他参数不变,17:09:40 收到 HTTP 422,错误码 async_required,没有扣费。原因写在错误信息里:同步请求从第一条算起最多到 60 条,第 2 页的第 51 到 100 家超过了这个深度,要在请求体里加 "mode":"async",拿到 job_id 以后轮询 GET /api/v1/jobs/{job_id}。目录里 search 的 pagination 也写了 sync_max_rows: 60、max_rows: 120。
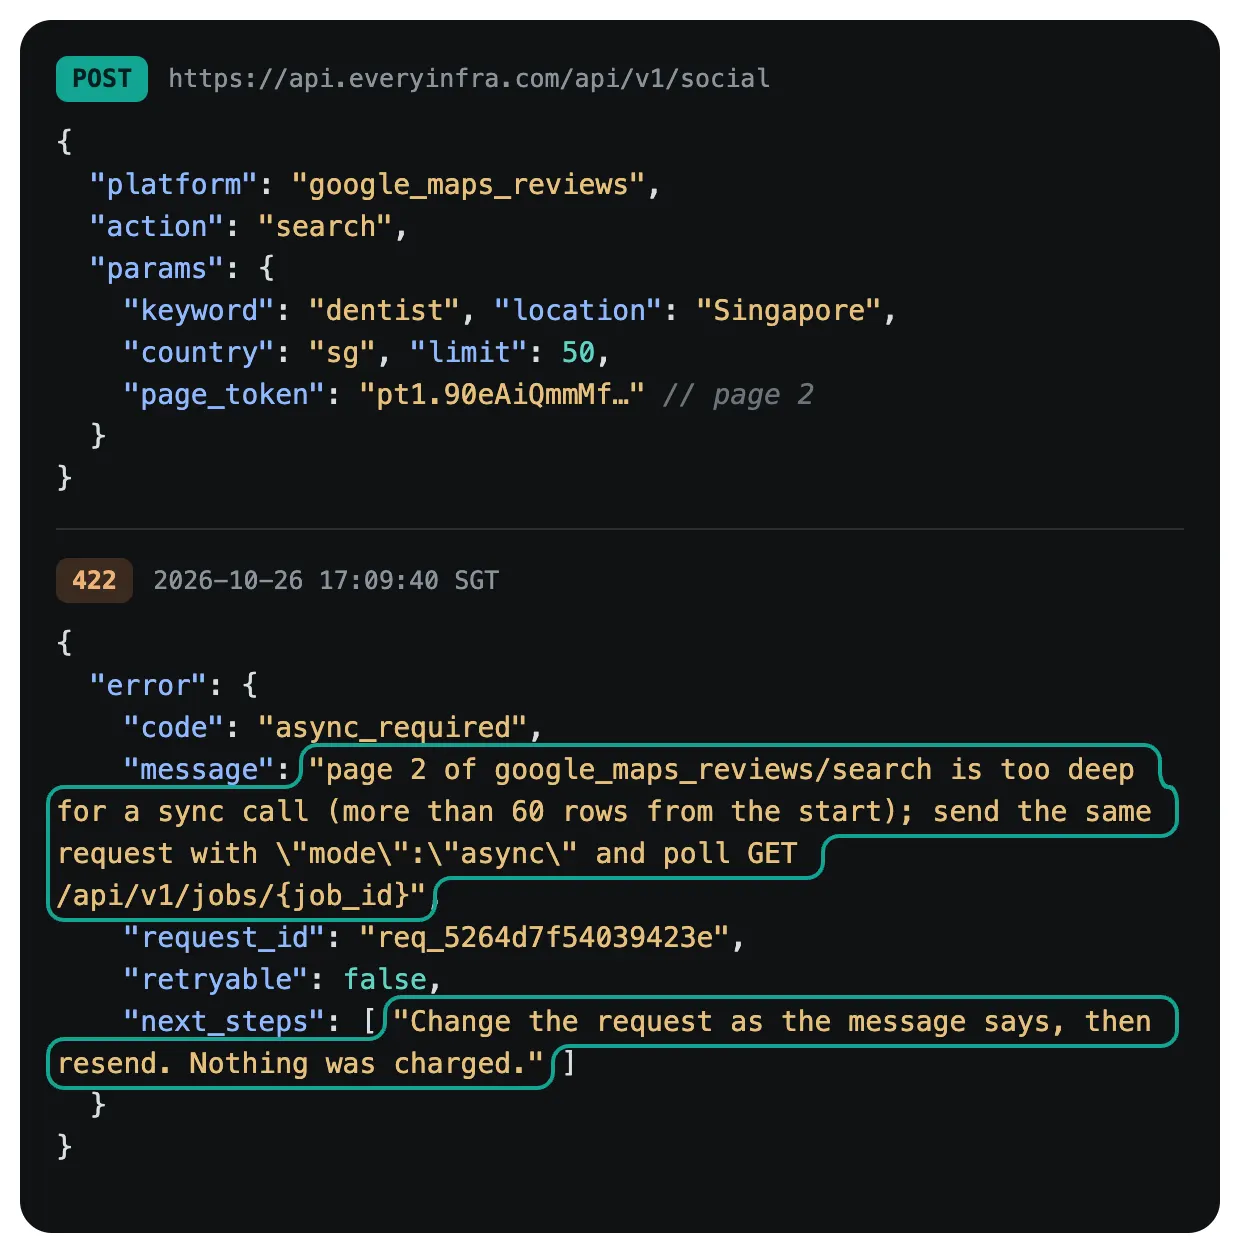
17:09:49 改用异步重发,立刻拿到 202 和 job_id,这一次扣费 $0.001389;42 秒后轮询到 succeeded,第 2 页 50 家,pagination.stop_reason 是 depth_limit,has_more 变成 false。也就是说,在 10 月 26 日 19:53(新加坡时间)翻页修复之前,按每页 50 家翻,一个搜索词到第 2 页、100 家就停了,到不了目录写的 120。英文版和西语版换了 Austin 和墨西哥城重复同样的流程,17:16 和 17:18 的两次第 2 页也都在 100 家时停在 depth_limit。这三组两页之间按 place_id 比对,都没有重复。
修复以后,我们用同样的参数把三个城市各重跑了一遍。新加坡 dentist 在 20:01:41(新加坡时间)发第 1 页,同步 12.2 秒返回 50 家;第 2 页 20:01:53 异步提交,约 43 秒后完成,50 家,has_more 仍是 true;第 3 页 20:02:36 提交,约 68 秒后完成,20 家,stop_reason 是 depth_limit,响应里不再有 next_page_token。三页共 120 行,3 次请求 $0.004167。Austin(20:03–20:05)和墨西哥城(20:03–20:06)也都是 50、50、20。要注意的是,每一页都是从头重新抓取的,排序每次可能变,所以页与页之间会有重复,「一个词 120 家」要按 place_id 去重后的条数算:
| 修复后复核 | 3 页行数 | 去重后家数 | 第 1、2 页之间重复 | 每千家(去重后) |
|---|---|---|---|---|
| 新加坡 dentist | 120 | 120 | 0 | $0.0347 |
| Austin dentist | 120 | 119 | 1 | $0.0350 |
| 墨西哥城 dentista | 120 | 112 | 8 | $0.0372 |
速度也记一笔。同步的 search 在这次测试里 9 到 16 秒返回(新加坡 17:09:23 那次 9.1 秒,中文关键词 17:11:03 那次 16.0 秒);异步的第 2 页从提交到完成 42 到 44 秒(新加坡时间 17:09:49、17:16:26、17:18:13 三次);修复后复核的 6 个异步页(第 2、3 页)是约 42 到 69 秒,我们每 8 秒轮询一次,所以这几个数有 8 秒以内的误差。这比一次本地 Google 搜索慢得多,n8n 里要把 HTTP Request 节点的超时设到 60 秒以上,异步任务的轮询间隔设 10 秒左右就够。Apify 那边一次 Google Maps Scraper 运行要多久,取决于范围、附加项和内存,我们没有跑,不写数字。
| 搜索(新加坡时间) | 页 | 方式 | 返回 | 停止原因 | 扣费 |
|---|---|---|---|---|---|
| dentist, Singapore(17:09:23) | 1 | 同步 | 50 | 还有下一页 | $0.001389 |
| 同上,第 2 页(17:09:40) | 2 | 同步 | 422 async_required | — | $0 |
| 同上,第 2 页(17:09:49) | 2 | 异步,42 秒 | 50 | depth_limit(修复前) | $0.001389 |
| dentist, Austin TX(17:15:52 / 17:16:26) | 1–2 | 同步 + 异步 | 50 + 50 | depth_limit(修复前) | $0.002778 |
| dentista, Ciudad de México(17:17:38 / 17:18:13) | 1–2 | 同步 + 异步 | 50 + 50 | depth_limit(修复前) | $0.002778 |
| dentist, Singapore(20:01:41 起,修复后) | 1–3 | 同步 + 异步 | 50 + 50 + 20,去重后 120 | 第 3 页 depth_limit | $0.004167 |
| dentist, Austin TX(20:03:49 起,修复后) | 1–3 | 同步 + 异步 | 50 + 50 + 20,去重后 119 | 第 3 页 depth_limit | $0.004167 |
| dentista, Ciudad de México(20:03:49 起,修复后) | 1–3 | 同步 + 异步 | 50 + 50 + 20,去重后 112 | 第 3 页 depth_limit | $0.004167 |
这个深度限制不是我们独有的。Google 自己的 Text Search (New) 文档写明,每页 pageSize 最多 20 条,所有页加起来最多 60 条,「这个上限可能会变」,页面最后更新是 2026-10-23。Apify 的 Google Maps Scraper 页面也写了,如果只给搜索词、不给地点,一次最多 120 家,因为它只打开一屏地图、滚动到底为止;要更多就得给一个地理范围,让它把范围切成很多屏去搜。我们修复后一个词最多也是 120 行,按 place_id 去重后会少几家。也就是说,三家都受同一个「一次搜索只返回几十到一百多家」的约束,区别在于谁替你把范围切小:Apify 在 actor 里自动切,单次运行可以覆盖整个城市甚至国家;我们和 Google 的接口都要你自己按街区、邮编或更细的词去拆。
数据本身也有两处要清洗。新加坡这次搜索的第 1 条是一个叫「Chan Jong Dr」的结果,地址就是这个名字,没有评分、没有电话,看起来是一条路名而不是诊所,它在英文和中文两次搜索里都排第一。墨西哥城的 100 家里也有一条没有评分的个人执业医生条目。所以拿到搜索结果后,第一步最好先按 rating 或 review_count 为空过滤一遍。按字段统计,新加坡 100 家里 phone、website、rating、review_count 都是 99 家有值,Austin 100 家全部有值,墨西哥城 website 只有 83 家有值;三地的 price 和 description 在这类搜索结果里全是空的,permanently_closed 也都没有返回 true。
实测二:place_id 去重,换个近义词能多拿几家
做本地商家名单的人通常会多搜几个近义词,希望多拿到一些店。我们在三个城市各做了一组:先用 dentist(或 dentista)翻两页拿到 100 家(17:09–17:18,修复前,当时翻到第 2 页就停),再用 dental clinic(或 clínica dental)搜 50 家,新加坡另加一次中文「牙科诊所」,然后按 place_id 比对。新加坡的 dental clinic 50 家里 41 家已经在 dentist 的 100 家里,只多出 9 家;中文「牙科诊所」50 家里 45 家重复,只多出 5 家;Austin 是 44 家重复、6 家新;墨西哥城是 42 家重复、8 家新。新加坡三个词一共 4 次请求、200 行结果,去重以后是 112 家。
| 城市 | 第一个词(2 页) | 第二个词(50 家) | 已见 | 新出现 | 每千家新店成本 |
|---|---|---|---|---|---|
| 新加坡 | dentist,100 家 | dental clinic | 41 | 9 | $0.154 |
| 新加坡 | dentist,100 家 | 牙科诊所(中文) | 45 | 5 | $0.278 |
| Austin | dentist,100 家 | dental clinic | 44 | 6 | $0.232 |
| 墨西哥城 | dentista,100 家 | clínica dental | 42 | 8 | $0.174 |
这组数字说明两件事。第一,近义词的边际收益很低:在这四组样本里,第二个词只带来 5 到 9 家新店,重复率 82% 到 90%。样本只有一个品类、三个城市,不能外推成「所有品类都这样」,但足以说明不要指望靠堆近义词扩大名单。Apify 的 Store 页面给的建议也一样:用几个意思不同、只轻微重叠的词(比如 restaurant、bar、cafe),不要用 restaurant、restaurants、chinese restaurant 这种一长串近义词,后者「只会拉长运行时间,不会多出结果」。
第二,重复会改变每家新店的真实成本。在我们这边,第二个词的那次请求照样收 $0.001389,但只带来 9 家新店,折合每千家新店 $0.154;最差的中文那组只多 5 家,是每千家 $0.278。这仍然比 Apify Business 档的 $1.50 便宜 5 到 10 倍,但比「每千家 $0.0278」高了一个数量级,算预算时要按去重后的条数算,不要按返回行数算。Apify 那边,同一次运行里的多个搜索词按它的说法不会多出结果;我们没有跑它,所以不确定同一次运行内重复地点会不会重复计费。可以确定的是跨运行:如果你每周跑一次同样的搜索,每次运行都会把同一批店再算一遍「抓到一个地点」。
去重本身用 place_id 就够了:Google 的 Place ID 文档写明,Place ID 不受地图平台服务条款第 3.2.3(b) 节缓存限制,可以存下来以后再用;但同一地点可能有多个 ID,ID 也会随时间变化,Google 建议超过 12 个月的 ID 要刷新一次,过时的 ID 会返回 NOT_FOUND。我们在另一篇讲 Place ID 去重的文章里专门写了怎么维护自己的业务主键和外部 ID 的对应关系,这里不再重复。本篇的四组实测里,同一个 place_id 在不同搜索词下返回的店名和地址都一致,没有出现一家店两个 ID 的情况,但样本只有 112 家,不足以说明这种情况不存在。
实测三:评论翻页,一家 1,868 条评论的诊所
评论是 Google Maps 数据里最贵也最容易拿不全的部分。Reddit 的 r/apify 上有人问为什么他们抓 Google Maps 评论要每千条 $35(原帖),讨论最后的结论不是换哪家,而是要先把成本拆成浏览器算力、代理流量、每家请求数和每家返回条数,并且「对着每家店自己显示的评论总数核对完整性」:一次便宜的运行如果在评论多的店上悄悄停止翻页,不算便宜,只是错了而且不报错。我们照这个思路测了一家店。
样本是新加坡搜索结果里评论最多的诊所之一,google_maps_reviews/profile 在 17:15:10 返回它的评论总数是 1,868 条、评分 4.9、图片 344 张。评论按最新排序、每页 100 条:17:11:28 第 1 页、17:12:02 第 2 页都是同步返回;第 3 页起超过同步深度(目录写 reviews 同步最多 200 行),改成异步,17:12:23 和 17:13:47 提交,分别在 77 秒和 69 秒后完成。第 4 页的 stop_reason 是 depth_limit。四页共 400 条,评论 id 去重后仍是 400 条,没有跨页重复;4 次请求共 $0.005556,折合每千条 $0.0139。
这 400 条只占这家店 1,868 条评论的 21%,覆盖 2025 年 2 月 22 日到 2026 年 10 月 24 日,大约 20 个月。这是 EveryInfra 这一侧的硬上限:目录里 reviews 的 pagination.max_rows 是 400。所以如果你要的是一家店的全部历史评论(做口碑研究、训练分类模型),这家店我们只能给你最近 20 个月;Apify 的 Google Maps Scraper 页面写的是每个地点条目最多带 5,000 条评论,超过就拆成多条记录继续,它的 Reviews Scraper 也按你设定的数量往下抓。这是本文里 Apify 明确更合适的一种情况,后面一节会再列。
400 条的内容也值得看一眼,因为它决定了这些评论能拿来做什么。357 条有文字,43 条只有星级;396 条有商家回复,回复率接近 99%;5 星 388 条、4 星 8 条、1 星 4 条,没有 2 星和 3 星。评分这么集中,做情感分析前要先想清楚样本偏差。换成英文样本差别很大:Austin 一家 1,657 条评论、评分 4.6 的诊所,按 sort=relevance 取 100 条,1 星有 24 条、5 星 62 条,65 条有商家回复,发布日期从 2022 年 12 月到 2026 年 9 月。按相关度排序会把更多差评和更早的长评排到前面,按最新排序则只看最近几个月,两种排序拿到的是两种不同的样本。
西语读者关心的墨西哥城样本,换成本地语言以后情况也差不多。dentista 加 language: es、country: mx 搜两页 100 家,其中评论最多的是纳尔瓦特区一家有 863 条评论、评分 4.7 的诊所;我们在 17:19:02(新加坡时间)用 lang=es 拉它最新的 100 条评论,97 条有文字,84 条有商家回复,发布日期从 2026 年 6 月 9 日到 10 月 24 日,也就是说这家店四个半月就攒了 100 条评论,评论频率比新加坡那家高。评论密度不同,同样「每家拉 100 条」覆盖的时间跨度就不同,做跨城市比较时要按时间窗口取样,而不是按固定条数取样。
做每天或每周的监控,更常用的是增量拉取。我们在 17:19:27 用同一家店、since 设为 2026-10-01 请求了一次,返回 9 条(最早一条是 10 月 6 日),stop_reason 是 end_of_list,扣费 $0.001389。按条算是每千条 $0.1543,比 Apify Reviews Scraper Business 档的 $0.30 便宜 1.9 倍,按我们的规则只算「接近」,比 DIAMOND 档的 $0.15 还贵 3%。如果你监控 1,000 家店、每家每周只新增几条评论,账单主要由「请求次数」决定:每周 1,000 次是 $1.39,和条数关系不大。
| 评论样本(新加坡时间) | 店 | 排序 | 返回 | 关键观察 | 扣费 |
|---|---|---|---|---|---|
| 17:11–17:14,4 页 | 新加坡诊所,1,868 条 | 最新 | 400(第 4 页 depth_limit) | 21% 覆盖、20 个月、396 条有商家回复 | $0.005556 |
| 17:19:27 | 同上 | 最新,since 10-01 | 9(end_of_list) | 增量拉取一次请求 | $0.001389 |
| 17:17:16 | Austin 诊所,1,657 条 | 相关度 | 100 | 1 星 24 条、5 星 62 条 | $0.001389 |
| 17:19:02 | 墨西哥城诊所,863 条 | 最新,lang=es | 100 | 84 条有商家回复,6 月到 10 月 | $0.001389 |
实测四:按链接取一家店,差距最小的一种活
google_maps_reviews/profile 按一个地点链接返回这家店的资料。我们 17:15:10 查的就是上面那家诊所,11.9 秒返回,字段比 search 多了街区、plus_code、营业时间(7 天)、图片数和临时歇业标记。这种活一次只有 1 条结果,所以每千家是 $1.389。对面的做法是 Google Maps Scraper 按链接输入:基础费加上必收的详情附加费,Business 档每千家 $2.55,我们便宜 1.8 倍,只算「接近」;DIAMOND 档是 $1.134,Apify 比我们便宜 18%。Free 档是 $6.00,我们便宜 4.3 倍。
这一节的结论很直接:如果你手里已经有一份 place_id 或链接清单,只是定期刷新每家店的评分、评论数和营业时间,我们的价格优势很小,要看你在 Apify 的哪一档。真正拉开差距的是「从零开始搜一个城市」和「批量拉评论」这两种一次能拿很多条的活。另外,Google 自己的 Place ID 文档提到,只请求 ID 字段刷新 Place ID 是免费的(Place Details 的 IDs Only SKU),如果你只是要确认 ID 还有效,这一步可以直接走 Google 的接口,不用付任何一家的钱。
Google Places API 自己要多少钱
很多人搜「is google maps api free」「cost for google maps api」,是想先确认能不能直接用 Google 的接口。Google 的价格表(页面最后更新 2026-10-23)按 SKU 计价,每个 SKU 每月有一段免费用量。Text Search Pro(返回店名、地址、坐标、类型)每千次请求 $32,每月前 5,000 次免费;要评分、电话、网站和营业时间就进 Text Search Enterprise,每千次 $35,每月前 1,000 次免费;要评论就进 Enterprise + Atmosphere,每千次 $40。按 Text Search 文档每页最多 20 家算,Pro 档最好情况是每千家 $1.60,Enterprise 档每千家 $1.75。评论更受限:Place 资源说明写明一个地点最多返回 5 条评论,按相关度排序。
| 拿 1,000 家地点(带评分和电话) | 单价 | 免费部分 | 评论 | 备注 |
|---|---|---|---|---|
| Google Text Search Enterprise | 每千次 $35,每次最多 20 家 → 每千家约 $1.75 | 每月前 1,000 次请求 | 每家最多 5 条(Atmosphere 档 $40) | 一个查询最多 60 家 |
| Apify Google Maps Scraper,Business | 每千家 $1.50 | Free 计划每月 $5 | 每条 $0.26 附加 | 不给地点时一个查询最多 120 家 |
EveryInfra google_maps_reviews/search | 每次 $0.001389,50 家 → 每千家 $0.0278 | GitHub 点星 $1,24 小时 | reviews 每次 100 条,每家最多 400 条 | 一个查询最多 120 行(第 3 页 depth_limit),按 place_id 去重 |
Google 的接口有两样别人替代不了:它是 Google 自己的数据,有服务条款和使用政策明确约定你能怎么展示、怎么缓存;免费用量对小项目也确实够用。代价是评论只有 5 条、单个查询只有 60 家,而且展示时要按政策标注来源。本文不比较数据来源和授权,只提醒一点:不管用哪家抓公开数据,评论里的个人信息都要按你所在地的隐私法规处理,Apify 的 Store 页面也专门写了这一条。
失败和空结果:谁扣钱
我们这边的规则写在价格页上:参数错误、鉴权失败等异常请求不扣费,失败或空结果不计费。本篇实测了四种情况。17:15:27 故意把 location 拼成 locaton,HTTP 422,错误码 unknown_param,返回里直接给出 did_you_mean: ["location"] 和全部允许的参数,扣费 $0。17:09:40 那次翻页超深的 async_required 也是 422、扣费 $0。17:19:45 用一个不存在的 place_id 查 profile,63 秒后返回空对象,billing.reason 是 empty_result_refunded,扣费 $0,退款状态 succeeded。只有一种情况照常扣费:17:15:32 用一串乱码加 dental 作关键词搜新加坡,返回了 20 家真实的牙科诊所,看起来是把看不懂的那串字符忽略了、按 dental 搜的;结果非空,所以扣了 $0.001389。乱码关键词不会被当成空结果。
| 情况(新加坡时间) | 能力 | HTTP | 结果 | 扣费 |
|---|---|---|---|---|
参数拼错 locaton(17:15:27) | search | 422 unknown_param | 给出 did_you_mean | $0 |
| 第 2 页超过同步深度(17:09:40) | search | 422 async_required | 提示改用异步 | $0 |
| 不存在的 place_id(17:19:45) | profile | 200 | 空,empty_result_refunded | $0 |
| 乱码 + dental(17:15:32) | search | 200 | 20 家真实诊所 | $0.001389 |
Apify 一侧,失败怎么计费由每个 actor 的作者决定。按事件计费文档给开发者的建议里有一条「Charge for invalid input」:对看起来合法、实际出错的输入(比如返回 404 的链接)也可以收费,因为打开页面发现问题本身就花了平台资源。它同时给用户提供了两个保护:启动运行时可以设「每次运行最多扣多少钱」,达到上限 actor 会停,超出部分不收;同步运行并取数据集的接口也有 maxTotalChargeUsd 参数。我们没有运行 Google Maps Scraper,所以不知道它对「搜不到」「链接失效」具体怎么收,只能建议你先用小范围试跑一次,看运行详情页的扣费明细。
在 n8n 里接 Google Maps:apify google maps scraper n8n
「apify google maps scraper n8n」和「google maps scraper n8n template」是这个话题下另一组高频联想词。上面的动画按两边各自的文档数了从空白画布到第一批数据进表要几步。Apify 一侧照 Apify 的 n8n 集成文档:自托管 n8n 要先在 Settings → Community Nodes 里装 @apify/n8n-nodes-apify(n8n Cloud 在节点面板里搜 Apify 安装),用 Apify API 令牌或 OAuth2 建凭据,再加 Run Actor 节点、填 actor 的输入 JSON、打开 Wait for finish,然后加 Get Dataset Items 节点、把上一步的 defaultDatasetId 传进去。这个社区节点在 2026-10-22 发了 v0.9.0,新增「按 schema 字段填输入」的模式,正好降低了填输入 JSON 的门槛;10-12 的 v0.8.1 是按 n8n 审核意见修的问题。
EveryInfra 一侧不需要装节点,n8n 自带的 HTTP Request 节点发一个 POST 就行,凭据用 n8n 的 Header Auth 存 Authorization: Bearer <Key>。翻页用 HTTP Request 节点自带的分页选项:按 n8n 的分页示例,模式选 Update a Parameter in Each Request,类型选 Body,参数名 params.page_token,值用表达式 {{ $response.body.next_page_token }},结束条件写 {{ !$response.body.pagination.has_more }}。下面是这个节点的配置示例,我们没有在本机跑 n8n,这段是按文档写的;等价的 curl 请求就是上面实测一里那段。
{
  "parameters": {
    "method": "POST",
    "url": "https://api.everyinfra.com/api/v1/social",
    "authentication": "genericCredentialType",
    "genericAuthType": "httpHeaderAuth",
    "sendBody": true,
    "specifyBody": "json",
    "jsonBody": "={\"platform\":\"google_maps_reviews\",\"action\":\"search\",\"params\":{\"keyword\":\"{{ $json.keyword }}\",\"location\":\"{{ $json.city }}\",\"limit\":30}}",
    "options": {
      "pagination": {
        "pagination": {
          "parameters": { "parameters": [ { "type": "body", "name": "params.page_token", "value": "={{ $response.body.next_page_token }}" } ] },
          "paginationCompleteWhen": "other",
          "completeExpression": "={{ !$response.body.pagination.has_more }}",
          "maxRequests": 2
        }
      }
    }
  },
  "type": "n8n-nodes-base.httpRequest",
  "name": "EveryInfra Google Maps search"
}
示例里把 limit 设成 30、最多 2 页,是为了让两页都在同步深度(60 行)以内,不用处理异步任务;代价是一个词只拿到 60 家,比修复后能翻到的 120 行少。要拿满 120 行(每页 50 家、翻 3 页),就得在请求体里加 "mode":"async",再接一个 Wait 节点和一个查询 GET /api/v1/jobs/{job_id} 的 HTTP Request 节点,步数会多两步。这是我们在 n8n 里比 Apify 多出来的一点麻烦,照实写在这里。后面两步两边一样:用 Split Out 节点把 results 数组拆成一行一家,再用 Remove Duplicates 节点按 place_id 去重,每页都是重新抓取的,页与页之间会有重复,这一步不能省;它的「Remove Items Processed in Previous Executions」模式能跨多次运行记住见过的 ID,默认记 10,000 个,正好用来做「每周只把新出现的店推到表里」。如果想每天自动跑,前面加一个 Schedule Trigger。我们有一篇用 n8n 每天出热榜日报的实战指南,定时、调用、写表每一步都跑通过,可以直接照着改。
| 上手步骤 | Apify(n8n 社区节点) | EveryInfra(HTTP Request) |
|---|---|---|
| 装东西 | 自托管装 @apify/n8n-nodes-apify;n8n Cloud 在节点面板安装 | 不用装,n8n 自带节点 |
| 凭据 | Apify API 令牌,或 n8n Cloud 上用 OAuth2 | Header Auth:Authorization: Bearer <Key> |
| 发起 | Run Actor,填 actor 的输入 JSON,等运行结束 | 一个 POST,platform、action、params |
| 取结果 | Get Dataset Items,传 defaultDatasetId | 结果就在响应的 results 里 |
| 翻页 | actor 内部处理,你设 maxCrawledPlacesPerSearch | 节点分页选项传 page_token;超过 60 行要异步 |
| 去重 | Remove Duplicates(按 placeId) | Remove Duplicates(按 place_id) |
| 看花费 | 控制台用量图和运行详情 | 每个响应的 billing.charged_usd |
用 API 和 MCP 接:apify google maps scraper api
不用 n8n、直接写代码的话,Apify 的做法是调它的平台接口运行 actor:同步运行并取数据集一个接口就能「启动、等待、拿结果」一步完成,支持 maxItems(按结果计费的 actor 最多按多少条收)和 maxTotalChargeUsd 两个花费上限;运行时间长就改成异步运行,配合 webhook 在结束时通知你。EveryInfra 就是上面那段 curl,同步返回;慢任务加 "mode":"async",轮询 job_id。两边接口风格不同,换过来时要改的主要是三处:请求体从 actor 的输入 JSON 换成 platform + action + params;结果从数据集接口换成响应里的 results;翻页从 actor 参数换成 page_token。
AI 工具里也能直接用。Apify 的 MCP 服务器地址是 mcp.apify.com,推荐 OAuth 登录,AI 可以搜索 Store、挑 actor、启动运行、读结果;它的开源仓库在 10 月 19 日的 v0.19.0 里加了创建 actor 和更新版本的工具,10 月 21 日又发到 v0.19.3。EveryInfra 的远程 MCP 是 https://api.everyinfra.com/mcp,按 MCP 规范 2025-11-25 版的 Streamable HTTP 接入,用 API Key 鉴权;AI 先用 everyinfra_list_capabilities 查到 google_maps_reviews 的三个能力,再用 everyinfra_call_api 调用,慢任务用 everyinfra_get_job 取结果,扣费和 REST 一样。n8n 里也可以把它挂到 AI Agent 节点的 MCP Client Tool 上。配置是:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
我们的返回里有什么:字段逐个对上目录
下面是三个能力在目录里声明的 response_fields,含义取自目录里的 platform_field_meanings 和参数说明,最后一列是本次实测的情况。我们只写自己这一边,不和 Apify 的字段并排比。
| 能力 | 字段 | 含义 | 本次实测 |
|---|---|---|---|
search | place_id、name、url | Google 地点 ID、店名、带 query_place_id 的地图链接 | 本篇 520 行搜索结果全部有 place_id;url 可以直接传给 profile 和 reviews |
search | category、categories | 主分类和全部分类 | 520 行全部有值 |
search | address、city、state、postal_code、country_code、lat、lng | 地址和坐标 | 新加坡 postal_code 99/100 |
search | phone、website | 电话、官网 | 新加坡 99/100;墨西哥城官网 83/100 |
search | rating、rating_scale、review_count | 评分(5 分制)和评论数 | 路名条目和个人执业条目为空 |
search | price、description、permanently_closed、image_url、platform | 价位、简介、是否永久停业、封面图、平台名 | 牙科样本里 price、description 全空 |
profile | 以上全部,另有 neighborhood、plus_code、opening_hours、image_count、temporarily_closed | 街区、Plus Code、营业时间、图片数、是否临时歇业 | 营业时间 7 天、图片 344 张 |
reviews | id、text、rating、rating_scale、posted_at、url | 评论 ID、正文、星级、发布时间、评论链接 | 400 条 id 不重复;43 条无正文 |
reviews | reviewer_name、reviewer_review_count、is_local_guide | 点评人、点评人历史点评数、是否本地向导 | 个人信息,使用前按隐私法规处理 |
reviews | like_count、owner_response、owner_response_at、detailed_rating、image_urls、place_id、place_name、platform | 点赞、商家回复及时间、分维度评分、附图、所属地点 | 新加坡样本 396/400 有商家回复 |
已经在用 Apify,换过来要注意的四件事
第一,旧数据不用扔。Place ID 是 Google 给每个地点的标识,不属于任何一家抓取工具,你在 Apify 数据集里存下的 Place ID 和我们 search 返回的 place_id 指向的是 Google 的同一套编号,可以直接拿来做合并和去重的键;店名、地址这类文本字段就别拿来对齐,同一家店在不同时间、不同语言下的写法会变。第二,先把预算上限设好再切换。Apify 那边你可能习惯了在运行上设 maxTotalChargeUsd;我们的请求里没有按次设花费上限的参数,花费由请求次数决定,所以要在你自己的脚本或 n8n 里限制 maxRequests 和循环次数,并在控制台为这个用途单独建一把 Key,方便随时停用。第三,评论日期要按时间戳处理。我们的 posted_at 是带时区的 ISO 时间,Reddit 那篇讨论里有人提醒,如果你的数据只有「两周前」这类相对时间,又没有记录抓取时刻,做时间序列时事后无法修复。第四,先用一两个城市并行跑一周,对照两边的店铺数、评论数和每千条实付,再决定全部切换;本文的数字只能代表 10 月 26 日这一天、这三个城市的牙科诊所。
什么时候 Apify 更合适
按价格我们大多数时候便宜,但下面这些情况,Apify 的 Google Maps 工具确实更合适,我们照实写:
第一,你要一家店的全部历史评论。我们每家最多 400 条,Apify Google Maps Scraper 每个条目可以带到 5,000 条并继续拆分,Reviews Scraper 按你设的数量抓。第二,你要的是销售线索而不只是地点:官网邮箱和电话、德奥瑞网站的 Impressum 联系人、员工姓名和职位、邮箱验证、社媒主页补全,这些附加项我们都没有。第三,你要一次覆盖一整个城市甚至国家:Apify 会按你给的地点或 GeoJSON 多边形(格式按 RFC 7946)自动切成很多屏去搜,还有一个 Orchestrator 把多个地点拆成多次运行再合并去重;我们这边一个查询最多 120 行就停,大范围要你自己拆词拆区。第四,你要图片、热门时段、菜单、酒店价格这类字段,或者要它的 AI 竞品分析报告。第五,你已经是 Apify Enterprise 客户,主要工作是按链接刷新已知店铺:DIAMOND 档每千家 $1.134,比我们的 $1.389 便宜。第六,你一个月只抓几百家、而且不想充值:Free 计划每月 $5 够用,我们的 $1 试用只有 24 小时。
反过来,EveryInfra 更合适的情况也很清楚:按城市和品类批量搜地点、批量拉评论、按周增量监控大量店铺,而且你不想为月费里用不掉的部分付钱;或者你同一个 Key 还要用别的平台的数据,比如 Yelp 和 Tripadvisor 的点评,可以在一份账单里对照着看。我们有一篇给牙科诊所做点评简报的实战指南,用的就是这一类数据。
| 你的活 | 更合适的一方 | 依据(本文数据) |
|---|---|---|
| 按城市和品类批量搜地点 | EveryInfra | 每千家 $0.0278 对 Business 档 $1.50 |
| 批量拉评论 | EveryInfra | 每千条 $0.0139 对 Business 档 $0.30 |
| 一家店的全部历史评论 | Apify | 我们每家最多 400 条 |
| 邮箱、联系人、社媒主页 | Apify | 我们没有这些附加项 |
| Enterprise 合同下按链接刷新已知店铺 | Apify | DIAMOND 档 $1.134 对我们 $1.389 |
| 每月几百家、不想充值 | Apify | 每月送 $5 对 24 小时内有效的 $1 |
最近 60 天的相关变化
- 2026-10-22,Apify 的 n8n 社区节点发布 v0.9.0,可以按 actor 的输入 schema 逐字段填参数;9 月 22 日的 v0.8.0 加了 Web Fetch 动作。对读者意味着:在 n8n 里用 Apify 填 Google Maps Scraper 输入不再必须手写 JSON,上手门槛在降低。
- 2026-10-19 到 10-21,apify-mcp-server 连发 v0.19.0 到 v0.19.3,加入创建 actor、管理版本的工具。对读者意味着:在 AI 工具里调地图数据,两边都已经是「接一个远程 MCP 就能用」,比较的重点回到价格和覆盖面。
- 2026-10-23,Google 更新了 Text Search (New)、Place ID 和价格表页面,单个查询最多 60 条、Place ID 超过 12 个月建议刷新的说法都还在。对读者意味着:无论用谁的工具,单次搜索深度有限、ID 要定期刷新这两条约束不会消失。
- 2026-10-26,Apify 的 Google Maps Scraper、Reviews Scraper 和 Extractor 三个 actor 同日更新(公开接口
modifiedAt),价格没有变,仍是 6 月 30 日、3 月 13 日和 4 月 29 日起生效的那一版。对读者意味着:本文的价格表在读取当天有效,下次比价前先重读一次公开接口。 - 2026-10-26,n8n 发布 2.45.4,编辑器里迁移报告的文档链接改为指向 v3 的破坏性变更页面。对读者意味着:自托管 n8n 的用户近期要规划一次大版本升级,社区节点的兼容性要单独核对,自带的 HTTP Request 节点受影响更小。
- 2026-10-06,Apify 的开源抓取框架 Crawlee 发布 v4.0.0-rc.1。对读者意味着:自己写地图爬虫的团队,底层框架也在换大版本,自建方案的维护成本要算进比价里。
常见问题
Apify Google Maps Scraper 免费吗?
有免费的部分。Apify Free 计划不用信用卡,每月给 $5 预付用量,用完封停到下个周期,没用完的不结转(Apify 定价页)。按 Google Maps Scraper Free 档单价,$5 约是 1,250 家只要基础字段的地点,或者用 Reviews Scraper 拉 8,333 条评论。EveryInfra 没有每月赠送,GitHub 点星可领 $1、24 小时内有效。问题出处:联想词「apify google maps scraper free」。
Apify Google Maps Scraper 多少钱?
每千家地点 Free 档 $4.00、Starter $3.00、Scale $2.00、Business $1.50,Enterprise 的 DIAMOND 档 $0.756;详情、筛选、联系人、评论、图片各是附加事件,另算(公开定价接口,2026-10-26 读取)。我们实测每千家 $0.0278。问题出处:联想词「apify google maps scraper pricing」。
能在 n8n 里用 Google Maps Scraper 吗?
能。Apify 提供 n8n 社区节点 @apify/n8n-nodes-apify,装好后用 Run Actor 和 Get Dataset Items 两个节点(Apify 文档)。EveryInfra 用 n8n 自带的 HTTP Request 节点,不用装社区节点。问题出处:联想词「apify google maps scraper n8n」。
Apify Google Maps Scraper 有 API 吗?
有。可以用 Apify 平台接口运行它,或用 Node.js、Python 的 apify-client;同步运行并取数据集的接口支持 maxTotalChargeUsd 花费上限(Apify API 文档)。EveryInfra 是一个 POST 请求,结果和扣费在同一个响应里。问题出处:联想词「apify google maps scraper api」。
有没有 Apify Google Maps 爬虫的替代?
r/automation 和 r/n8n 上都有同名帖子「Alternatives for google maps scraper Apify」(原帖),发帖人要按「品类 + 城市」抓本地商家,回复里有人抱怨 Apify 的套餐像「0、40、200、1000」的台阶,不常用的人不划算。按请求计费的数据接口是一种替代,本文第二张表是两边每千条的实测对比;需要邮箱、线索补全或全量历史评论的话,Apify 仍更合适。问题出处:Reddit 原帖。
Google Maps API 免费吗?
部分免费。Google 地图平台按 SKU 计价,每个 SKU 每月有一段免费用量,比如 Text Search Pro 每月前 5,000 次、Text Search Enterprise 每月前 1,000 次请求免费,超出后分别是每千次 $32 和 $35(Google 价格表,2026-10-23 更新)。每个查询最多 60 家、每家最多 5 条评论。问题出处:联想词「is google maps api free」。
三步试用
第一步,注册并拿到 API Key,在控制台的余额页领试用额度或充值(快速上手)。第二步,打开对应能力的文档页,用页上的一键试用跑一次:试 Google Maps 地点搜索、试一家店的详情、试评论翻页。第三步,看响应里的 charged_usd 和 results 的条数,用「实付 ÷ 条数 × 1,000」算出你这个场景的每千条价,再和现在的账单比。全部能力见 Google Maps 数据接口和数据市场;想先看总体比价,可以读我们的 Apify 替代总览。
方法和边界
Apify 一侧,我们只用了公开材料:api.apify.com/v2/acts 公开接口返回的定价(2026-10-26 17:05 新加坡时间读取四个 actor,原始返回存档备查)、定价页、文档、Store 页面和 Reddit 原帖。我们没有注册 Apify、没有运行它的 actor,所以表里的 Apify 价格都是「公开单价」,不是「实测花费」;实际账单可能因为启动费、附加事件和你的套餐月费更高。Google 一侧只用了它的价格表和文档。
EveryInfra 一侧,首轮 22 次请求全部在 2026-10-26 17:09–17:19 新加坡时间完成,19 次扣费,合计 $0.026391;19:53 翻页修复后,我们在 20:01–20:06 按每页 50 家把三个城市各翻了 3 页,9 次请求全部扣费,合计 $0.012501。样本是三个城市的牙科诊所,每个能力测了几次,能说明「这一天、这些目标」的价格、翻页深度和重复率,不能说明长期的成功率、速度,也不能外推到所有品类。每千条价格按实付除以实际返回条数计算,计算脚本和原始返回存档备查。没有核到的:Apify Enterprise 合同除单价外的最低承诺金额;Google Maps Scraper 在同一次运行内对重复地点是否重复计费;修复后翻页的重复率,我们只在三个城市各测了一次(去重后 120、119、112 家),别的词和城市可能更高。
参考资料
- Apify,Google Maps Scraper 公开定价接口(compass/crawler-google-places),读取 2026-10-26。https://api.apify.com/v2/acts/compass~crawler-google-places
- Apify,Google Maps Reviews Scraper 公开定价接口,读取 2026-10-26。https://api.apify.com/v2/acts/compass~Google-Maps-Reviews-Scraper
- Apify,Google Maps Extractor 公开定价接口,读取 2026-10-26。https://api.apify.com/v2/acts/compass~google-maps-extractor
- Apify,Google Maps Email Extractor 公开定价接口,读取 2026-10-26。https://api.apify.com/v2/acts/lukaskrivka~google-maps-with-contact-details
- Apify,Google Maps Scraper Store 页面,读取 2026-10-26。https://apify.com/compass/crawler-google-places
- Apify,Google Maps Reviews Scraper Store 页面,读取 2026-10-26。https://apify.com/compass/google-maps-reviews-scraper
- Apify,Google Maps Extractor Store 页面,读取 2026-10-26。https://apify.com/compass/google-maps-extractor
- Apify,Pricing,读取 2026-10-26。https://apify.com/pricing
- Apify,Google Maps Scraper Orchestrator,读取 2026-10-26。https://apify.com/lukaskrivka/google-maps-scraper-orchestrator
- Apify 文档,Pay-per-event pricing model。https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event
- Apify 文档,Actor pricing and costs。https://docs.apify.com/platform/actors/publishing/monetize/pricing-and-costs
- Apify 文档,Actors in Store。https://docs.apify.com/platform/actors/running/actors-in-store
- Apify 文档,n8n integration。https://docs.apify.com/platform/integrations/n8n
- Apify 文档,Apify MCP server。https://docs.apify.com/platform/integrations/mcp
- Apify API 文档,Run Actor synchronously and get dataset items。https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post
- Apify 文档,Webhooks。https://docs.apify.com/platform/integrations/webhooks
- GitHub,apify/n8n-nodes-apify v0.9.0,2026-10-22。https://github.com/apify/n8n-nodes-apify/releases/tag/v0.9.0
- GitHub,apify/n8n-nodes-apify v0.8.1,2026-10-12。https://github.com/apify/n8n-nodes-apify/releases/tag/v0.8.1
- GitHub,apify/n8n-nodes-apify v0.8.0,2026-09-22。https://github.com/apify/n8n-nodes-apify/releases/tag/v0.8.0
- npm,@apify/n8n-nodes-apify。https://www.npmjs.com/package/@apify/n8n-nodes-apify
- GitHub,apify/apify-mcp-server v0.19.0,2026-10-19。https://github.com/apify/apify-mcp-server/releases/tag/v0.19.0
- GitHub,apify/apify-mcp-server v0.19.3,2026-10-21。https://github.com/apify/apify-mcp-server/releases/tag/v0.19.3
- GitHub,apify/crawlee v4.0.0-rc.1,2026-10-06。https://github.com/apify/crawlee/releases/tag/v4.0.0-rc.1
- GitHub,n8n-io/n8n 2.45.4,2026-10-26。https://github.com/n8n-io/n8n/releases/tag/n8n%402.45.4
- Google,Google Maps Platform pricing,2026-10-23 更新。https://developers.google.com/maps/billing-and-pricing/pricing
- Google,SKU details。https://developers.google.com/maps/billing-and-pricing/sku-details
- Google,Text Search (New),2026-10-23 更新。https://developers.google.com/maps/documentation/places/web-service/text-search
- Google,Place IDs,2026-10-23 更新。https://developers.google.com/maps/documentation/places/web-service/place-id
- Google,REST Resource: places。https://developers.google.com/maps/documentation/places/web-service/reference/rest/v1/places
- Google,Places API (New) release notes。https://developers.google.com/maps/documentation/places/web-service/release-notes
- Google,Places API usage and billing。https://developers.google.com/maps/documentation/places/web-service/usage-and-billing
- Google,Places API policies and attributions。https://developers.google.com/maps/documentation/places/web-service/policies
- Google,Google Maps Platform Terms of Service。https://cloud.google.com/maps-platform/terms
- n8n 文档,HTTP Request node。https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/
- n8n 文档,HTTP Request pagination cookbook。https://docs.n8n.io/build/code-in-n8n/cookbook/http-request-node/pagination/
- n8n 文档,Remove Duplicates。https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.removeduplicates/
- n8n 文档,Split Out。https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.splitout/
- n8n 文档,Community nodes GUI installation。https://docs.n8n.io/integrations/community-nodes/installation/gui-install/
- n8n 文档,MCP Client Tool。https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.toolmcp/
- n8n 文档,Schedule Trigger。https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.scheduletrigger/
- n8n 文档,HTTP Request credentials。https://docs.n8n.io/integrations/builtin/credentials/httprequest/
- Model Context Protocol,Specification 2025-11-25。https://modelcontextprotocol.io/specification/2025-11-25
- IETF,RFC 7946 The GeoJSON Format。https://datatracker.ietf.org/doc/html/rfc7946
- EveryInfra,数据接口目录(google_maps_reviews),读取 2026-10-26。https://api.everyinfra.com/api/v1/social/catalog
- Reddit r/apify,「Google Maps reviews scraping is costing us $35/1k results」,读取 2026-10-26。https://www.reddit.com/r/apify/comments/1vo81i0/title_google_maps_reviews_scraping_is_costing_us/
- Reddit r/B2BLeadGenPro,「I ran the same search through Apify Google Maps Scraper…」(发帖人为另一款工具的作者),读取 2026-10-26。https://www.reddit.com/r/B2BLeadGenPro/comments/1sxd1af/i_ran_the_same_search_through_apify_google_maps/
- Reddit r/n8n,「Alternatives for google maps scraper Apify」,读取 2026-10-26。https://www.reddit.com/r/n8n/comments/1k5jvdj/alternatives_for_google_maps_scraper_apify/
引用编号 BL-52