Google 地图评论怎么批量抓:5 条上限、爬虫与接口实测
官方 Places API 每家店最多给 5 条评论。我们实测三条路,按每 1,000 条评论算美元价,附 Python 导出 CSV 代码与失败退款记录。
想批量拿到 Google 地图上的商家和评论,摆在面前的通常是三条路:用 Google 官方的 Places API、自己写 Python 爬虫、或者用按次付费的数据接口。我们在 2026 年 11 月 2 日凌晨把三条路各走了一遍,结论先放在这里。官方 Places API 的评论字段每家店最多只返回 5 条,而且按「相关度」挑,不能按时间翻页,付费档每 1,000 条评论约 $5.00;自己写 Python,用普通 HTTP 请求拿到的页面里一条评论都没有,必须上浏览器自动化,成本主要花在维护上;EveryInfra 的 google_maps_reviews/reviews 每次调用返回 100 条、扣 $0.001389,折合每 1,000 条评论 $0.01389,失败和空结果不扣钱。
评论数据的分量还在上升。2026 年 10 月 8 日,Google 发布了第一份基于真实评论、评分和导航请求的「粉丝最爱」餐饮榜单[18];10 月 21 日,Google 地图在 Apple CarPlay 上开放了 Gemini 对话[19];按 Search Engine Land 引用的 Google 数字,Ask Maps 回答问题时可以调用超过 5 亿名贡献者写的评论[20]。越来越多的人让 AI 读评论再给结论,所以近期评论在说什么、AI 读到的是哪几条,比只看总评分更重要,这也是本文反复区分「最新」和「相关度」两种排序的原因。
先想清楚要什么
「怎么抓 Google 地图」这个问题,问的人其实想要的东西差别很大。有人只要一个城市里所有牙医诊所的名字、电话、评分,用来做销售线索;有人要自家几十家门店的全部评论,好做回复和舆情;有人要竞品门店最近三个月的差评,找产品问题;也有人做研究,要一个街区几百家餐厅的评分分布。前一种只要商家列表,后三种要评论,而且要的评论数量、时间范围、是不是自己的店,决定了哪条路走得通。
所以在比价之前,先回答三个问题:每家店要多少条评论,五条够不够;这些店是不是你自己在 Google 商家资料里认领过的;团队里有没有人愿意长期维护一个浏览器爬虫和代理池。下面这张流程图就是按这三个问题分流的,后面每一节再把每条路拆开实测。
这张图把 Business Profile API 也画了进去,因为它常被忽略:如果评论是你自己名下、已验证的商家,Google 给店主的接口可以按时间或评分翻页拿全部评论,每页最多 50 条,不需要爬也不需要买[11][12]。它的门槛是 OAuth 授权和商家验证,只能读自己的店,拿不到竞品。下面这张表把四种做法放在一起,列的是本文后面会逐项实测或核对的事实。
| 做法 | 每家店能拿多少评论 | 排序和翻页 | 每 1,000 条评论的钱 | 主要代价 |
|---|---|---|---|---|
| 官方 Places API(Place Details) | 最多 5 条 | 只按相关度,不能翻页 | 免费额度内 $0;之后约 $5.00,量大最低约 $0.456 | 条数上限,必须展示作者署名 |
| Business Profile API | 自己的店全部 | 按评分或更新时间,每页 ≤50 | $0 | 只能读自己已验证的店 |
| 自己写 Python + 浏览器 | 理论上看得到的都能拿 | 靠模拟滚动 | 服务器和代理另算 | 页面一改就要修,违反服务条款的风险 |
| EveryInfra 数据接口 | 每个排序最多 400 行,每次 100 条 | 最新或相关度,带翻页令牌 | $0.01389(每次 100 条时) | 按调用付费,超过 200 行要异步 |
第一条路:官方 Places API 能给多少评论
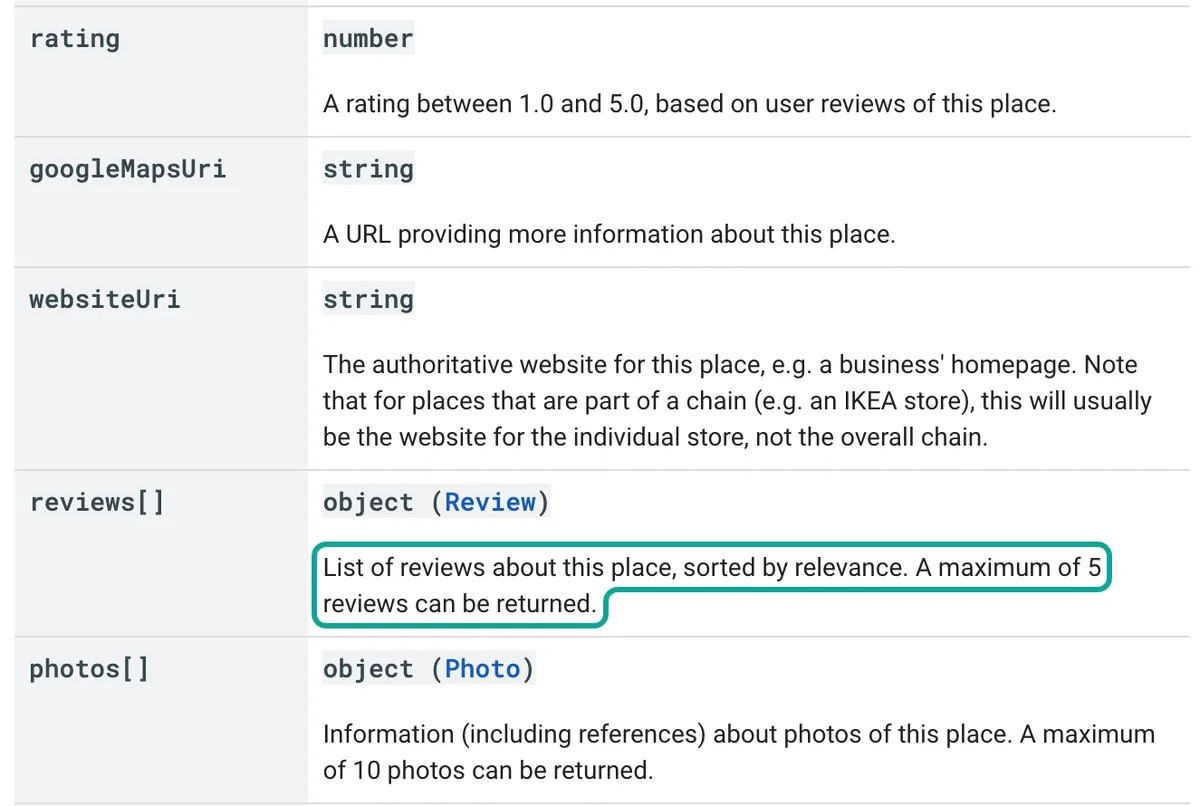
先看官方。Places API(新版)里一个地点的资源对象有 reviews 字段,参考文档原文写的是「关于这个地点的评论列表,按相关度排序,最多可以返回 5 条」[1]。这个上限不随付费档位变化,也没有翻页参数。我们截下了这段原文,用青绿色框标出来:
请求方式本身很简单:Place Details(新版)是一个 GET 请求,地点用 place_id 指定,必须带字段掩码,告诉 Google 你要哪些字段[2]。下面是一个配置示例,我们没有用 Google 的 Key 真调,只是照官方文档写出请求的样子:
# 配置示例(未运行):按官方文档请求一个地点的评分、评论数和最多 5 条评论
curl -s "https://places.googleapis.com/v1/places/ChIJP1jDgAoZ2jER9XCcxNoXvcc" \
  -H "X-Goog-Api-Key: $GOOGLE_MAPS_API_KEY" \
  -H "X-Goog-FieldMask: displayName,rating,userRatingCount,reviews"
字段掩码直接决定账单。Google 的计费按请求里最贵的那个字段所属的 SKU 算,reviews 属于「Place Details Enterprise + Atmosphere」这一档,只要掩码里带了它,这次请求就按最高档计费[3][5]。2025 年 3 月 1 日起,原来每月 $200 的赠送额度取消,改成每个 SKU 每月固定的免费次数:Essentials 一万次,Pro 五千次,Enterprise 一千次[4]。价格表我们在 2026-11-02 读取,概览页底部写着最后更新于 2026-10-30[4]。下面只摘和本文有关的几行,单位是每 1,000 次请求:
| SKU(Places API 新版) | 每月免费 | 前 10 万次 | 10 万–50 万 | 50 万–100 万 | 100 万–500 万 | 500 万以上 |
|---|---|---|---|---|---|---|
| Place Details Pro | 5,000 | $17.00 | $13.60 | $10.20 | $5.10 | $1.28 |
| Place Details Enterprise | 1,000 | $20.00 | $16.00 | $12.00 | $6.00 | $1.51 |
| Place Details Enterprise + Atmosphere(含评论) | 1,000 | $25.00 | $20.00 | $15.00 | $7.50 | $2.28 |
| Text Search Pro | 5,000 | $32.00 | $25.60 | $19.20 | $9.60 | $2.40 |
| Text Search Enterprise + Atmosphere | 1,000 | $40.00 | $32.00 | $24.00 | $12.00 | $3.40 |
按这张表算,用 Place Details 取评论,一次请求 $0.025 换最多 5 条,等于每 1,000 条评论 $5.00;即使月用量超过 500 万次、单价降到 $2.28,每 1,000 条评论也要 $0.456。反过来看,每月前 1,000 次是免费的,如果你只要 1,000 家店、每家 5 条,一分钱都不用花,这是官方这条路最大的优点,后面「什么时候官方更合适」一节会专门讲。
价格之外还有三条使用规则,决定了数据能不能存、怎么展示。第一,Places API 政策要求展示评论时必须同时展示作者署名,包括头像、名字和主页链接[7]。第二,除了 place_id 可以长期保存,其他内容原则上不能缓存,这意味着你不能把官方接口拿到的评论攒成自己的长期数据库[7]。place_id 本身也不是永久的,官方建议超过 12 个月的要重新刷新一次[8]。第三,评论顺序固定是相关度。在论坛里,「怎么拿最新的评论」是被反复问到的问题,Stack Overflow 上 2016 年的「从 Places API 拿超过 5 条评论」和 2019 年的「怎么用 Places API 拿最新评论」两个帖子,答案都绕不开 5 条这个上限[39][40];Reddit 的 r/learnpython 上也有人问过同样的事[41]。
2025 年 5 月 8 日起 Places API 还能返回 Gemini 生成的评论摘要[9][10],但摘要不是原始评论,不能拿来统计星级。
第二条路:自己写 Python 爬,卡在哪一步
「how to scrape google maps with python」是联想词里排在前面的一个问法,网上的教程大多从 requests 加 BeautifulSoup 讲起。我们先做了最朴素的一步:2026 年 11 月 2 日 00:19:50(新加坡时间),用 Python 标准库发一次普通 HTTP GET,打开松发肉骨茶的地图页面。返回状态 200,页面 210,679 字节,里面有 12 个 script 标签,标题只是「Google Maps」;店名只出现在我们自己传进去的 URL 回显里,商家页显示的 8,226 这个评论数不在页面里,我们从接口拿到的 20 条评论原文片段,一条也找不到。也就是说,评论是页面在浏览器里跑起来之后再加载的,不执行 JavaScript 就拿不到。
所以自己写的话,第一步就得上浏览器自动化,比如 Playwright[37]。下面是一段骨架示例,展示一般的写法:打开商家页,点开评论标签,反复滚动评论列表,再从页面元素里读出文本。这段我们没有运行,因为对 Google 地图页面做批量自动抓取违反它的服务条款(下一节细说),我们只用它说明工作量在哪里:
# 配置示例(未运行):浏览器自动化抓评论的一般结构
from playwright.sync_api import sync_playwright

PLACE_URL = "https://www.google.com/maps/place/?q=place_id:ChIJP1jDgAoZ2jER9XCcxNoXvcc&hl=en"

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page(locale="en-US")
    page.goto(PLACE_URL, wait_until="networkidle")
    page.get_by_role("tab", name="Reviews").click()          # 页面文案一改,这行就要改
    panel = page.locator("div[role='feed']")                  # 选择器靠猜,经常变
    for _ in range(30):                                       # 每滚一次大约多 10 条
        panel.evaluate("el => el.scrollBy(0, el.scrollHeight)")
        page.wait_for_timeout(1200)
    texts = page.locator("[data-review-id] span").all_inner_texts()
    print(len(texts))
    browser.close()
这段代码的每一行都在赌页面结构不变:评论标签的名字、评论列表的选择器、每次滚动加载的条数、页面语言。只要 Google 改一次前端,或者对你的出口 IP 弹出验证页面,脚本就停了。为了看清「维护成本」到底有多大,我们去看了 GitHub 上星标最多的开源 Google 地图爬虫之一[32]:截至 2026-11-02,它有 7,148 个星标、1,112 个分叉,MIT 许可,最近一次推送在 2026-10-21。它在 2026 年 7 月 13 日到 9 月 20 日之间发了 8 个版本(v1.16.3 到 v1.18.1)[36],8 月 1 日以来新开了 15 个 issue。下面这几条和评论直接相关,或者会让任务整批停下:
| 日期 | issue | 现象(标题原文的意思) | 状态 |
|---|---|---|---|
| 2026-09-01 | #327 | 开了额外评论选项也只返回约 10 条,内部评论接口返回 403(v1.17.4) | 未关闭 |
| 2026-09-23 | #331 | 运行时大量抓取引擎报错 | 已关闭 |
| 2026-10-05 | #337 | 升级到 v1.18.0 后网页界面的任务列表一直是空的,点开始没有反应 | 未关闭 |
| 2026-10-06 | #338 | 所有任务都失败,报浏览器页面或上下文已被关闭 | 未关闭 |
| 2026-10-09 | #341 | 标题就是「每家店 300 条评论」 | 未关闭 |
| 2026-10-22 | #346 | 抓取引擎退出后任务一直卡在「运行中」,浏览器上下文关不掉 | 未关闭 |
这不是在说这个项目做得不好,恰恰相反,一个有七千多星标、两个月发 8 个版本的项目,仍然隔几周就会遇到「评论突然只剩 10 条」「所有任务一起失败」这种问题[33][34][35],说明对手是 Google 前端本身的变化,而不是代码质量。你自己写,遇到的问题只会更多,而且没有社区帮你先踩坑。表里 #337 和 #346 两条[42][43]则和 Google 无关,是浏览器自动化这件事本身的复杂度:你要管浏览器的启动和关闭、内存、并发、超时,还要管代理和出口 IP。把这些都算进去,一个能长期跑的评论爬虫,至少是一个需要有人值班的小服务,而不是一个周末写完的脚本。
自己写还有一个常被跳过的问题:robots.txt。我们在同一时间下载了 google.com/robots.txt[16],它第 86 行写着 Disallow: /maps/,第 74 行写着 Disallow: /maps?,同时又单独放开了 /maps/place/、/maps/search/ 等路径。按 RFC 9309 的规则,最长匹配的那条生效,所以普通的商家页路径是允许爬取的,而 /maps/ 下没有被单独列出的其他路径都落在禁止范围里[17]。但 RFC 9309 也写得很清楚,robots.txt 不是访问授权,它只是对爬虫的请求[17]。真正约束你的,是下一节要讲的服务条款。
合规:服务条款、判例和个人信息
先说条款。如果你是 Google Maps Platform 的客户(也就是用了官方 API 的人),平台服务条款第 3.2.3(a) 条标题就是「不得抓取」,原文禁止客户导出、提取或以其他方式抓取 Google 地图内容在服务之外使用[13]。如果你只是普通用户,Google 地图的附加服务条款(最后修改于 2026 年 1 月 27 日)同样禁止「大批量下载或建立内容的批量数据源」,也不允许用 Google 地图去建立或扩充其他与地图相关的数据集,其中点名了商家名录数据库[14]。也就是说,无论走官方 API 还是自己爬,Google 都不允许你把它的内容攒成一个替代品。
再说法院。美国第九巡回上诉法院在 2022 年 4 月 18 日的 hiQ 诉 LinkedIn 案判决里认为,抓取公开可见的网页数据,很可能不构成《计算机欺诈和滥用法》意义上的「未经授权访问」[21];2024 年 1 月 23 日,加州北区联邦法院在 Meta 起诉一家数据采集公司的案件(案号 3:23-cv-00077)里批准了被告的简易判决动议,认为 Meta 没能证明它的条款约束了未登录状态下对公开数据的抓取[22]。这两个判决常被引用来说明「抓公开数据合法」,但它们针对的是具体的法律问题和具体的条款文本,不等于违反服务条款没有后果,也不适用于美国以外的地方。本文不是法律意见,商用之前请问律师。
最后是个人信息。评论者的名字、头像、主页链接都是个人信息。在新加坡,《个人数据保护法》(PDPA)管的是机构收集、使用和披露个人数据[25][26];在欧盟是 GDPR[24];在加州是 CCPA,加州总检察长网站的说明页在 2026-08-28 更新过[23];墨西哥则在 2025 年 3 月 20 日的《联邦官方公报》上公布了新的《私人持有个人数据保护联邦法》[27]。实际做法上,大多数分析其实用不到评论者是谁:只保留星级、时间、正文和店家回复,把名字和头像丢掉,能省下一大半合规工作。我们在下文的 CSV 导出代码里就是这么做的,列里没有评论者姓名。
另外,如果你把抓来的别人家评论挪到自己的页面上,还会碰到 Google 用户内容政策对虚假互动的禁止[15]。
第三条路:用按次付费的数据接口
第三条路是按次付费的数据接口:你发一个请求,对方返回结构化的商家或评论数据,按调用次数收费,浏览器、代理和页面变化都由对方处理。这一类服务有好几种计费方式,常见的是按结果条数计费的云端抓取平台、按搜索次数计费的搜索结果接口,以及按调用次数计费的数据接口;EveryInfra 属于最后一种。这篇是教程,不做各家单价的横向比较,重点放在怎么用、数据长什么样、哪里会出问题;我们自己的单价和计费单位写在 Google Maps 评论接口页上。
EveryInfra 的 Google Maps 评论接口目前有四项能力:google_maps_reviews/search 按关键词和地点找商家,google_maps_reviews/profile 取一家店的详情,google_maps_reviews/reviews 取一家店的评论,google_maps_reviews/contributor_reviews 取某个评论者写过的评论。我们在 2026-11-02 00:14:03(新加坡时间)读取了公开目录,四项都是每次调用 $0.001389;搜索每次最多 50 家、翻页总计最多 120 行;评论每次最多 100 条、翻页总计最多 400 行,同步请求最多到第 200 行,再往后要用异步任务。评论支持 newest(最新)和 relevance(相关度)两种排序,可以用 since 只要某个日期之后的评论,用 lang 指定评论语言。
一次评论请求是这样的。地点用 Google 地图的商家链接指定,带上 place_id 最稳:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_maps_reviews","action":"reviews",
       "params":{"url":"https://www.google.com/maps/search/?api=1&query=Song%20Fa%20Bak%20Kut%20Teh&query_place_id=ChIJP1jDgAoZ2jER9XCcxNoXvcc",
                 "sort":"newest","limit":100}}'
我们在 00:15:29(新加坡时间)发出这个请求,7 秒左右返回 100 条评论,billing.charged_usd 是 0.001389,pagination.has_more 是 true,同时给了一个 next_page_token,下一页把它原样放进 page_token 就行。下面是这次真实返回的截取,评论者姓名已经打码:
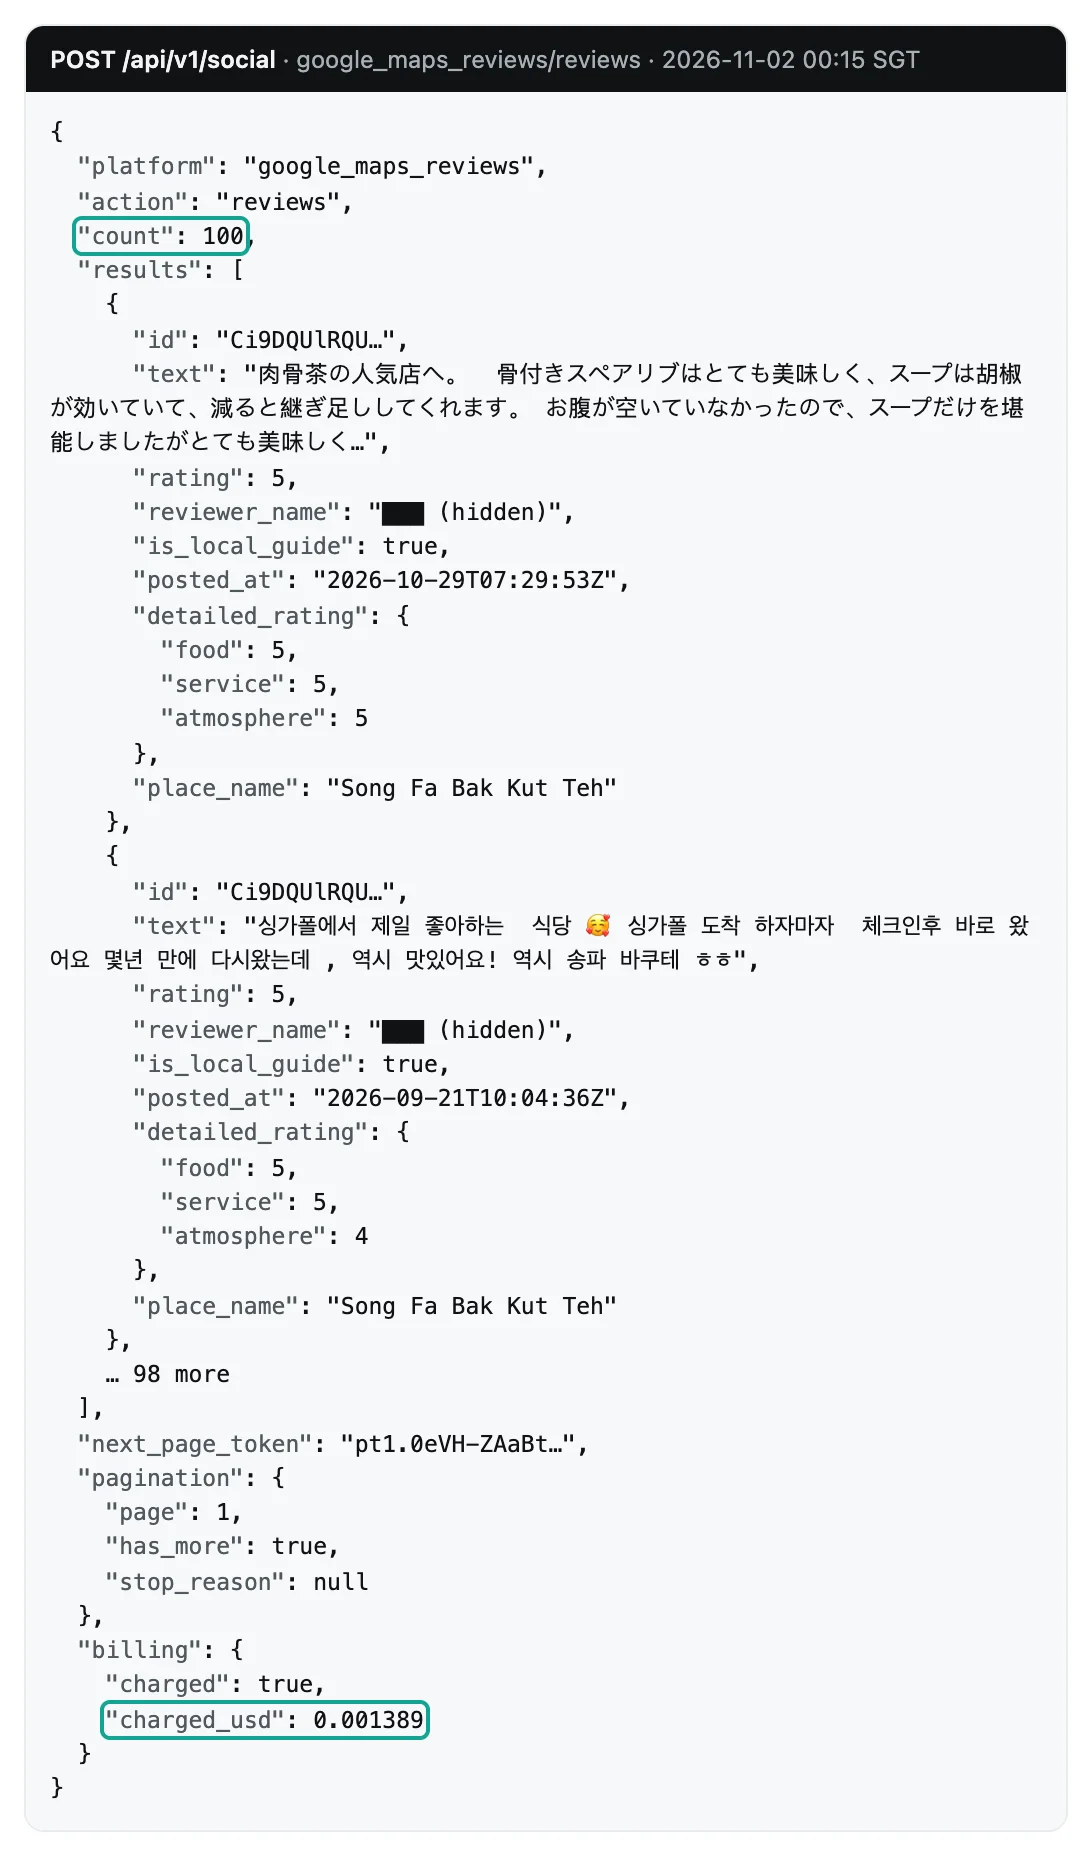
每条评论记录带的字段,和目录里登记的一致。和分析最相关的是下面这些,其中 detailed_rating(分项评分)和 owner_response(店家回复)是官方 Places API 的评论对象里没有的:
| 字段 | 意思 | 松发肉骨茶最新 300 条里的情况 |
|---|---|---|
rating | 1–5 星 | 300 条都有 |
posted_at | 发布时间(UTC) | 300 条都有 |
text | 正文,可能为空 | 189 条有正文(63%) |
owner_response / owner_response_at | 店家回复和回复时间 | 4 条 |
detailed_rating | 分项评分,如食物、服务、氛围 | 258 条 |
image_urls | 评论附图 | 113 条带图 |
is_local_guide / reviewer_review_count | 是否本地向导、此人写过多少评论 | 174 条来自本地向导 |
like_count | 被点「有帮助」的次数 | 300 条都有 |
id / url / place_id | 评论和地点的标识 | 300 条都有 |
商家详情 google_maps_reviews/profile 在 00:15:07(新加坡时间)返回了松发肉骨茶(新桥路 11 号)的资料:4.4 星、8,226 条评论、18,685 张图片、人均 SGD 10–20、每天 9:30 到 21:30 营业,还有 plus code 和经纬度。搜索 google_maps_reviews/search 在 00:14:43(新加坡时间)用关键词「bak kut teh」、地点「Singapore」返回了 50 家店:评论数加起来 53,287 条,中位数 707.5 条,最多 8,226 条,最少 7 条;21 家超过一千条,9 家不到一百条;50 家里 30 家有电话、36 家有网站。如果你的目的是做线索名单,到这一步就够了;我们另有一篇讲用 place_id 给商家去重,多次搜索合并时用得上。
实测一:同一家店,五条评论和三百条评论讲的是两个故事
这一节回答一个具体问题:如果你只用官方能给的那 5 条评论,会看到什么,和真实的近期评论差多少。我们对松发肉骨茶取了两组:按相关度排序的前 100 条(00:16:10,新加坡时间),以及按最新排序翻 3 页拿到的 300 条(00:15:29、00:16:42 两页同步,第 3 页在 00:18:27 用异步任务提交)。相关度前 5 条,就相当于官方 Places API 会给你的那 5 条。
结果差别很明显。相关度前 5 条平均 4.8 星,5 条全部有正文、全部带照片,正文长度中位数 517 个字符,5 位作者全是本地向导,发布时间在 2026 年 4 月到 7 月之间。相关度前 100 条平均 4.5 星,100% 有正文,中位数 357 个字符,时间从 2016 年拉到 2026 年 9 月。最新 300 条平均 4.65 星,只有 63% 写了正文,中位数只有 67 个字符;时间集中在 2026 年 4 月 8 日到 10 月 31 日。商家页上的总评分是 4.4 星。
为什么相关度前 5 条会偏高、偏长?Google 没有公开相关度的算法,但从数据看,它明显偏好写得长、带图、作者活跃的评论,这类评论本身就更可能是好评。这对分析的含义很直接:如果你拿官方接口给的 5 条去判断一家店的口碑,看到的是「最有代表性的好评」,而不是「最近顾客的平均感受」。相关度前 100 条和最新 300 条只有 21 条重合,两组几乎是两批不同的评论。
另一个容易忽略的数字是「没有正文的评论」。最新 300 条里有 111 条只打了星没写字,占 37%。如果你的分析是做关键词或情感,这 37% 是空的;如果你的分析是看星级趋势,这 37% 恰恰是最不受「写长文的人」偏差影响的样本。两种分析要的数据不一样,这也是为什么接口要同时给出星级和正文,而不是只给摘要。
实测二:奥斯汀的牙医和墨西哥城的塔可店
一家店不够说明问题,我们又测了两个完全不同的场景。第一个是美国得州奥斯汀的牙科诊所。00:17:10(新加坡时间)我们搜索「dentist」、地点「Austin, TX」,第 1 页 50 家;第 2 页在 00:23:59 同步请求时被要求改用异步(这一页从第 51 行开始,超出了同步范围),00:24:22 用异步提交后拿到另外 50 家,100 家去重后都是不同的店,99 家地址在奥斯汀。我们挑了 Swish Dental 的 Domain 分店,商家页 4.6 星、1,659 条评论,00:20:36 和 00:23:41 两次取了最新 200 条。
这 200 条平均只有 4.305 星,比商家页的 4.6 星低了将近 0.3 星;5 星 156 条,1 星 26 条,一星占 13%。诊所对 200 条里的 146 条做了回复,回复率 73%,看得出是有专人在管评论的。对一个想知道「这家诊所最近怎么样」的人来说,最新 200 条比总评分更有用:总评分是多年累积的结果,近期的一星集中出现,可能意味着换了医生、换了前台或者改了收费。
第二个场景是墨西哥城科约阿坎区的 Tacos Chupacabras,商家页 4.2 星、18,361 条评论,人均 MXN 100–200。我们用 lang: es419 取了最新 200 条(00:23:05、00:23:24 两页),平均 4.275 星,和总评分接近;5 星 121 条、4 星 42 条、3 星 21 条,1 星 13 条;正文比例 55.5%,中位数 69 个字符;店家一条都没有回复。把三家店的星级分布放在一起,形状完全不同:牙医是两头大中间小,一星和五星多;塔可店的三星、四星明显更多,是「好吃但排队、环境一般」的典型分布。
墨西哥城这一组还碰到了一个搜索参数上的问题。00:17:32(新加坡时间)我们用关键词「taquería」加地点参数「Ciudad de México」搜索,50 家结果都在墨西哥境内,但只有 1 家在墨西哥城,其余 49 家分散在另外 11 个州,最多的是萨卡特卡斯州 14 家、新莱昂州 7 家、奇瓦瓦州 6 家、哈利斯科州 6 家;00:19:39 我们把地点直接写进关键词,改成「taquería en Coyoacán, Ciudad de México」,50 家全部落在墨西哥城,其中 47 家在科约阿坎区。奥斯汀那一组用的是地点参数「Austin, TX」,100 家里 99 家在奥斯汀,剩下 1 家在紧邻的 West Lake Hills。原因我们还没查清:这两组请求之间不止一处不同,墨西哥城那次多带了 language: es,奥斯汀的地点里带了州名缩写,只凭这一次对照分不出是哪一项起了作用。在查清之前,稳妥的做法是把城市甚至城区写进关键词,并且在翻更多页之前先跑一页搜索,数一数有多少家落在目标城市。
「最新」排序并不严格按时间
做监控的人通常会这样写代码:按最新排序取一页,看到比上次记录更早的评论就停。我们在三组最新排序的数据里检查了每一行的发布时间是否晚于上一行,结果新加坡 300 条里有 6 行顺序颠倒,墨西哥城 200 条里 18 行,奥斯汀 200 条里多达 50 行,占 25%。新加坡那 300 条里还夹着两条 2023 年的评论。
这不是接口的问题,而是 Google 地图本身「最新」排序的表现:被编辑过的评论、店家回复后被顶起的评论,都可能出现在不按时间的位置上。实际影响是,「看到旧评论就停」的逻辑会漏数据。更稳的做法有两个:一是多翻一页再停;二是用 since 参数让接口只返回某个日期之后的评论,拿回来以后自己按 posted_at 重新排序。我们在后面的 CSV 导出代码最后一步就做了重新排序。
失败和退款:真实的错误长什么样
按次计费的接口,最怕的是失败也扣钱。我们在实测里故意和不小心地触发了六种错误,下面是原样记录(时间均为 2026-11-02,新加坡时间):
| 时间(SGT) | 我们做了什么 | 返回 | 扣费 | 返回里给的下一步 |
|---|---|---|---|---|
| 00:15:56 | 第 1 页之后马上请求第 2 页,超过每分钟 10 次 | 429 rate_limited,retry_after 4 秒 | 不扣 | 等待后重试 |
| 00:16:03 | 把空的翻页令牌传了回去 | 422 invalid_page_token | 不扣 | 原样传回收到的 next_page_token |
| 00:17:00 | 同步请求评论第 3 页(超过 200 行) | 422 async_required | 不扣 | 加 "mode":"async" 后轮询任务 |
| 00:20:55 | since 设成 2026-11-30,一个将来的日期 | 200,0 条,empty_result_refunded | 退回,$0 | 无 |
| 00:21:38 | url 填了一个不是地图的网址 | 503,可重试,retry_after 20 秒 | 退回,$0 | 提示这是第 1 次失败,共 3 次后会说明要检查什么 |
| 00:22:07 | sort 填了 oldest | 422 invalid_value,列出允许值 newest、relevance | 不扣 | 只改 sort 后重发 |
这里有一条我们认为应该做得更好的:给错网址时,接口返回的是可重试的 503,而不是直接告诉你参数不对的 422。钱确实没扣,但如果你的代码看到 503 就自动重试三次,就是白等一分钟。其余五种错误的行为都符合文档:参数错误和限速不扣钱,空结果退回,错误信息里写清楚了允许的值和下一步该怎么做。网址这一条,在你的代码里发请求之前先自己挡一下就够了,本文用到的商家链接都以 https://www.google.com/maps/ 开头:
if not url.startswith("https://www.google.com/maps/"):
    raise ValueError("不是 Google 地图商家链接,先换成地图里复制的分享链接")
异步任务的扣费时点也要注意:异步任务在提交时就扣费,不是在拿到结果时。我们在 00:18:27 提交松发第 3 页的异步任务,提交返回里 charged_usd 已经是 0.001389,任务状态先是 running,再是 finalizing,最后 succeeded,拿到 100 条。如果任务最终失败,按同一个计费编号退回。
用 Python 把评论导出成 CSV
下面这段代码是本文最短的完整答案:给一个 Google 地图商家链接,按最新排序翻页,把评论写成 CSV。它只用 Python 标准库,处理了限速、深页异步和翻页令牌,最后按发布时间重新排序,列里不放评论者姓名。
"""Export Google Maps reviews of one place to CSV via EveryInfra.
usage: EVERYINFRA_API_KEY=... python3 export_reviews_csv.py "<google maps place url>" reviews.csv [max_pages]
"""
import csv, json, os, sys, time, urllib.request, urllib.error

API = "https://api.everyinfra.com"
KEY = os.environ["EVERYINFRA_API_KEY"]
FIELDS = ["id", "place_name", "rating", "posted_at", "text", "owner_response",
          "owner_response_at", "like_count", "is_local_guide", "reviewer_review_count", "url"]

def call(method, path, body=None):
    req = urllib.request.Request(API + path, method=method,
                                 data=json.dumps(body).encode() if body else None,
                                 headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json",
                                          "User-Agent": "reviews-csv/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            return r.status, json.load(r)
    except urllib.error.HTTPError as e:
        return e.code, json.load(e)

def fetch_page(params):
    body = {"platform": "google_maps_reviews", "action": "reviews", "params": params}
    for attempt in range(4):
        status, data = call("POST", "/api/v1/social", body)
        err = (data.get("error") or {})
        if status == 429 or (err.get("retryable") and status >= 500):
            time.sleep(err.get("retry_after", 20)); continue
        if err.get("code") == "async_required":          # deep pages run as a job
            body["mode"] = "async"; continue
        if status == 202 and data.get("poll_url"):
            billing, poll = data.get("billing"), data["poll_url"]   # async jobs are charged at submit
            while data.get("status") in ("queued", "running", "finalizing"):
                time.sleep(5); status, data = call("GET", poll)
            data["billing"] = data.get("billing") or billing
            return data
        if err:
            raise SystemExit(f"stop: {err.get('code')} {err.get('message')}")
        return data
    raise SystemExit("stop: retries used up")

def main():
    url, out = sys.argv[1], sys.argv[2]
    max_pages = int(sys.argv[3]) if len(sys.argv) > 3 else 2
    params = {"url": url, "sort": "newest", "limit": 100}
    seen, rows, spent = set(), [], 0.0
    for page in range(max_pages):
        data = fetch_page(params)
        spent += (data.get("billing") or {}).get("charged_usd") or 0
        for r in data.get("results") or []:
            if r["id"] in seen:
                continue
            seen.add(r["id"])
            rows.append({k: r.get(k, "") for k in FIELDS})
        token = data.get("next_page_token")
        print(f"page {page + 1}: {data.get('count')} rows, total {len(rows)}")
        if not token or not (data.get("pagination") or {}).get("has_more"):
            break
        params["page_token"] = token
    rows.sort(key=lambda r: r["posted_at"] or "", reverse=True)   # "newest" is not strictly ordered
    with open(out, "w", newline="", encoding="utf-8-sig") as f:
        w = csv.DictWriter(f, fieldnames=FIELDS)
        w.writeheader(); w.writerows(rows)
    print(f"wrote {len(rows)} reviews to {out}; charged: ${spent:.6f}")

if __name__ == "__main__":
    main()
我们用它对墨西哥城的 Tacos Chupacabras 跑了三次,每次 3 页。第一次在 00:32:39(新加坡时间)开始,前两页正常,第 3 页转成异步任务后,轮询那一步崩了:轮询返回的数据里没有 poll_url,代码却每次都去读它。第二次在 00:33:18 开始,修好了这个错误,结果第 3 页拿回 0 条:任务状态除了 running 还有一个 finalizing,代码把它当成了已完成。第三次在 00:35:21 开始,00:36:21 结束,三页各 100 条,写出 300 条评论、300 个不同的 id,扣费 $0.004167。CSV 用 utf-8-sig 编码,Excel 打开不会乱码,正文里的换行会保留在单元格里,所以文件有 374 行而数据只有 300 条,这是正常的。CSV 的写法见 Python 官方文档的 csv 模块[38]。
这两个错误都是读文档时想不到、真跑才暴露的。我们把三次运行的日志都留着,也建议你第一次用任何异步接口时,先跑一家评论多的店、翻到第 3 页,看一下每个状态值。
拿回来以后:五个清洗步骤
数据拿到手只是一半,真正花时间的是清洗。我们在三家店 700 条评论上做分析时,碰到的问题可以归成五类,每一类都有一个简单的处理办法,建议在第一次写分析脚本时就加进去,而不是等结果对不上了再回头查。
第一是时间。posted_at 和 owner_response_at 都是 UTC 时间,带时区后缀。新加坡是 UTC+8,一条在新加坡晚上 11 点写的评论,在 UTC 里是当天下午 3 点;墨西哥城是 UTC−6,一条晚上 8 点写的评论在 UTC 里已经是第二天。如果你按「天」统计评论数,一定要先换成店铺当地时间再分组,否则每天的数字会整体错开几个小时,周末效应也会被抹平。我们在 CSV 里保留原始的 UTC 字符串,分析时再按店铺所在城市换算。
第二是空正文。前面说过,三家店的最新评论里有 35% 到 45% 只有星级没有文字。做情感分析或关键词统计时,要先把空正文排除,并在报告里写清楚分母;做星级趋势时则要保留它们。两种分析最好在同一份数据上各算一遍,然后对比,能看出「写评论的人」和「只打星的人」在态度上有没有系统差别。在奥斯汀那家诊所,26 条一星评论里有 24 条写了正文(92%),正文长度中位数 361.5 个字符;156 条五星评论里只有 89 条写了正文(57%),中位数 119 个字符。这符合直觉:不满意的人更想把原因说清楚,满意的人往往点个五星就走。如果只分析有正文的评论,差评的分量会被放大;如果只看星级,又会错过差评里最有用的细节。
第三是分项评分的语言。detailed_rating 里的键名会跟着评论语言变。我们用 lang: es419 取墨西哥城评论时,分项评分的键是 comida、servicio、ambiente;取新加坡英文评论时是 food、service、atmosphere。如果你把多个国家的数据合在一张表里,要先建一个映射表把键名统一,否则同一个「服务」维度会被当成两列。这一点在目录的字段说明里看不出来,是我们把两份返回放在一起比对时才发现的。
第四是去重。同一条评论可能在两次翻页里都出现,尤其是你隔几个小时再跑一次时,新评论会把旧评论往后挤,翻页边界就会重叠。最稳的办法是用评论的 id 去重,本文的导出代码就是这样做的。商家层面的去重则用 place_id,多次搜索结果合并时,同一家店可能用不同的名字出现。还有一个小细节:评论的 url 字段里带着 hl=en 之类的语言参数,不要用它做去重键。
第五是地区字段的写法。搜索结果里的 state 和 city 是页面上显示的原样文字,不是规范化的值。墨西哥城用地点参数那次的 50 家里,同一个州有全称和缩写两种写法:萨卡特卡斯州 13 家写 Zacatecas、1 家写 Zac.,金塔纳罗奥州 2 家写 Quintana Roo、2 家写 Q.R.,新莱昂、哈利斯科、塔巴斯科也各有缩写;按原始字符串数,那 49 家落在 16 种州名里,合并缩写后其实只有 11 个州。关键词那次的 50 家,state 有 42 家写 Cd. de México、8 家写 CDMX;新加坡那次的 50 家里有 2 家 city 是空值。直接按 state 分组,一个州会被拆成两行。按州或城市汇总之前,先建一张别名表把缩写并到全称,或者用返回里的经纬度落到行政区。
按场景算一笔账
把上面的单价放进三个常见场景,可以更直观地看出三条路的差别。下面的数都是按本文实测单价和 Google 官方价格表现算的,不含服务器、人工等其他成本。
第一个场景是做销售线索:要奥斯汀所有牙科诊所的名称、电话、网站、评分和评论数,不要评论正文。用 EveryInfra 的搜索,每次 50 家、$0.001389,我们两页拿到 100 家不同的诊所,花了 $0.002778;如果要 1,000 家,大约 20 次调用、$0.028,前提是你把城市拆成若干区或者换几组关键词,因为单个关键词翻页最多 120 行。用官方 Text Search,每月前 5,000 次 Pro 档请求免费,超出后每 1,000 次 $32[3][6];对这个量级,官方免费额度完全够,差别在于官方结果有缓存和展示上的限制[7]。
第二个场景是做门店监控:一个连锁品牌 50 家门店,每周拉一次每家店的新评论,看有没有差评需要回复。如果这些店是你自己的,Business Profile API 免费且最合适[12]。如果是加盟店、代理商的店,或者你在帮客户监控,就只能用数据接口:每家店每周一次、每次最多 100 条,一年 52 周、50 家店,共 2,600 次调用,约 $3.61。用官方 Places API 做这件事做不到,因为它不给最新评论,只给相关度最高的 5 条,而这 5 条可能几个月都不变。
第三个场景是做研究:一个城区 500 家餐厅,每家最新 100 条评论,总共 5 万条,用来分析评分和正文。用数据接口,500 次评论调用加十几次搜索,合计约 $0.72。官方 Places API 最多只能给你 2,500 条(500 家 × 5 条),而且是被挑选过的样本,按本文松发肉骨茶的结果,它的平均星级比近期评论高出 0.15 星,正文长度是近期评论的 7 倍以上,做研究用会带来明显偏差。自己写爬虫理论上可以做,但按开源项目的 issue 记录,你很可能会在中途遇到「每家只拿到 10 条」的问题[33]。
Google 地图爬虫怎么挑:六个判据
挑 Google 地图爬虫时,用户真正关心的不是哪个工具名气大,而是它在自己的场景里能不能稳定地拿到数据、账算不算得过来。我们按类别而不是按品牌给出判据,每一条都可以用一次小规模试跑验证:
| 判据 | 怎么验证 | 本文实测的参考值 |
|---|---|---|
| 每家店能拿多少条、能不能按时间翻页 | 选一家评论过千的店,翻到第 3 页 | 官方 5 条;EveryInfra 每个排序 400 行 |
| 计费单位和失败是否扣钱 | 故意传一个错参数、一个将来的 since | 422 和 429 不扣,空结果和失败退回 |
| 每 1,000 条评论的实际花费 | 实际扣费 ÷ 实际返回条数 × 1000 | $0.01389(每次 100 条时) |
| 字段够不够 | 看有没有店家回复、分项评分、附图 | 有 owner_response、detailed_rating、image_urls |
| 搜索的地点准不准 | 同一个城市用两种写法各搜一次 | 墨西哥城地点参数 1/50,写进关键词 50/50 |
| 能不能接进 AI 工具 | 看有没有 MCP 或函数调用的工具定义 | 有远程 MCP |
这张表里最容易被忽略的是第二行。按结果条数计费的工具,空结果通常不收钱,但「拿到一半就失败」的任务怎么算,各家规则不一样;按调用计费的接口,要看失败和空结果是不是退回。验证方法很简单,花几分钱试一次就知道。第三行也一样,不要只看标价,用实际扣费除以实际条数,因为很多工具的「每千条」价格是按满页算的,你要的那家店可能只有几十条评论。
什么时候官方 API 或自己写更合适
数据接口不是所有情况下的最优解,下面几种情况我们会建议别的路。第一,你只要每家店 5 条代表性评论,而且每月不到 1,000 家,官方 Places API 免费额度就够了,还能直接合法地展示在你的应用里,只要按要求带上作者署名。第二,评论是你自己的门店,用 Business Profile API,能拿全部评论、能回复,完全免费,这是任何第三方都比不了的。第三,你只需要一个城市的商家名录,不要评论,先看政府开放数据:新加坡 data.gov.sg 有三万六千多行的持牌餐饮场所数据集[28],新加坡食品局的执法记录页在 2026 年 11 月 1 日更新过[29],墨西哥有国家统计局的 DENUE 经济单位目录[30],美国有人口普查局的 County Business Patterns[31]。这些数据可以放心存、放心用,但没有评分和评论,常见的组合是用它做底表,再给你关心的那部分商家补上近期评论。
自己写爬虫只在一种情况下值得:你的需求非常特殊(比如要抓某个页面上只有浏览器里才看得到的元素),而且团队愿意把它当成一个长期维护的项目,接受随时会失效、以及违反服务条款的风险。如果只是为了省钱,按本文的数字算,一次 100 条评论 $0.001389,一个工程师修一次脚本的时间成本早就超过了一年的接口费。
还要说清楚 EveryInfra 这条路自身的局限。单个排序最多 400 行,像松发这样有 8,226 条评论的店,你拿不到全部历史,只能拿最新 400 条加相关度 400 条(两组有重叠);超过 200 行要异步,代码要多写一个轮询;墨西哥城那次用地点参数只有 1/50 落在城内,原因还没查清。这些都是我们这次实测看到的,写在这里供你判断。
常见问题
抓 Google 地图有免费的办法吗?
有两个合法的免费办法。一是官方 Places API 每月前 1,000 次带评论的 Place Details 请求免费,每次最多 5 条评论[3][4];二是如果是你自己的店,Business Profile API 免费读取全部评论[11]。所谓「免费爬虫」通常指开源工具,软件免费,但服务器、代理和维护时间都要成本。
用 Python 怎么抓 Google 地图评论?
普通 HTTP 请求拿不到评论,我们实测页面里 20 条评论原文一条都没有,必须用浏览器自动化或数据接口。本文给出了两种代码:浏览器自动化的骨架(未运行)和调用数据接口导出 CSV 的完整代码(真跑过 3 次)。Reddit 的 r/learnpython 上也有人问过同样的问题[41]。
抓取 Google 地图合法吗?
服务条款明确禁止批量下载和抓取内容[13][14];美国 hiQ 案和 Meta 起诉一家数据采集公司的案件对抓取公开数据做出了有利判决,但针对的是具体法律问题,不等于违反条款没有后果[21][22]。涉及评论者个人信息的,还要看 PDPA、GDPR、CCPA 等法律。本文不是法律意见。
为什么 Places API 只能拿到 5 条评论,怎么拿最新的?
这是官方接口的设计上限,参考文档写明最多 5 条、按相关度排序[1],没有翻页参数。要拿最新的评论,自己的店用 Business Profile API 按更新时间排序[12],别人的店只能用数据接口或自己爬。Stack Overflow 上 39223719 和 55235501 两个问题的回答也停在这个上限[39][40]。
哪个 Google 地图爬虫最好用?
没有通用的答案,取决于你要多少条、要不要按时间翻页、能接受怎样的计费方式。本文给出了六个可以花几分钱验证的判据:每家店能拿多少、失败扣不扣钱、每 1,000 条实际花费、字段、搜索的地点准不准、能不能接 AI 工具。
抓 Google 地图评论要多少钱?
用 EveryInfra,每次调用最多 100 条评论、$0.001389,每 1,000 条约 $0.01389;我们这篇文章全部实测是 36 次请求、26 次扣费,合计 $0.036113。用官方 Places API,免费额度之外每 1,000 条评论约 $5.00。
上手步骤
第一步,打开快速开始注册并拿到 API Key,新账户有试用额度,具体以价格页为准。第二步,读一次免费目录 GET /api/v1/social/catalog,确认 google_maps_reviews 的参数和单价。第三步,用本文的 curl 请求一家你熟悉的店,看返回的字段是不是你要的。第四步,把 CSV 导出代码存下来,先跑 2 页,再按需加页数。如果你要比较多个评论平台,也可以看 Yelp 数据接口和 Tripadvisor 数据接口;想看更完整的搭建过程,有一篇Google 地图评论接口的搭建教程。
方法与局限
本文所有 EveryInfra 接口实测在 2026 年 11 月 2 日 00:14 到 00:36(新加坡时间)之间完成,测试 Key 被限在每分钟 10 次。三个地点各只有一家店,样本是这几家店当时的评论,不代表所有商家;相关度和最新排序的结果会随时间变化。Places API 的价格和限制来自 Google 官方页面在 2026-11-02 的版本,我们没有用 Google 的 Key 真调。浏览器自动化代码没有运行,只有一次普通 HTTP 请求是真跑的。月度评论数量出现了我们解释不了的波动,所以没有画趋势图。
文中「每 1,000 条评论」的价格是这样算的:EveryInfra 一侧用每次调用返回里的 charged_usd 除以这次实际返回的评论条数,再乘以 1,000,三家店九页评论每页都是 100 条,所以结果都是 $0.01389;如果你要的店评论不足 100 条,或者你把 limit 设得更小,每条评论的单价会相应变高,因为单价是按调用次数收的。Places API 一侧用价格表里含评论那一档的单价除以 5,前提是每次请求都真的返回了 5 条评论;评论不足 5 条的店,实际单价会更高。两边都没有算免费额度和试用额度。
下面是本篇全部扣费调用的流水(时间均为 2026-11-02,新加坡时间):
| 时间(SGT) | 能力 | 地点 | 返回 | 扣费 |
|---|---|---|---|---|
| 00:14:43 | google_maps_reviews/search | 新加坡 bak kut teh | 50 家 | $0.001389 |
| 00:15:07 | google_maps_reviews/profile | 松发肉骨茶 | 1 家 | $0.001389 |
| 00:15:29、00:16:42 | google_maps_reviews/reviews | 松发,最新第 1、2 页 | 各 100 条 | 各 $0.001389 |
| 00:16:10 | google_maps_reviews/reviews | 松发,相关度 | 100 条 | $0.001389 |
| 00:18:27 | google_maps_reviews/reviews 异步 | 松发,最新第 3 页 | 100 条 | $0.001389 |
| 00:17:10、00:24:22 | google_maps_reviews/search | 奥斯汀 dentist 两页 | 各 50 家 | 各 $0.001389 |
| 00:20:02 | google_maps_reviews/profile | Swish Dental | 1 家 | $0.001389 |
| 00:20:36、00:23:41 | google_maps_reviews/reviews | Swish Dental 两页 | 各 100 条 | 各 $0.001389 |
| 00:17:32、00:19:39 | google_maps_reviews/search | 墨西哥城两种写法 | 各 50 家 | 各 $0.001389 |
| 00:22:35 | google_maps_reviews/profile | Tacos Chupacabras | 1 家 | $0.001389 |
| 00:23:05、00:23:24、00:34:37 | google_maps_reviews/reviews | Chupacabras 三页 | 各 100 条 | 各 $0.001389 |
| 00:32:39–00:36:21 | google_maps_reviews/reviews | CSV 导出三次运行 | 9 次扣费 | $0.012501 |
合计 26 次扣费,$0.036113;另有 2 次退回(空结果、失败),5 次参数或限速错误没有扣费。
参考资料
- Google Maps Platform,Places API (New) REST 参考:Place 资源,2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/reference/rest/v1/places
- Google Maps Platform,Place Details (New),2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/place-details
- Google Maps Platform,核心服务价格表,2026-11-02 读取。https://developers.google.com/maps/billing-and-pricing/pricing
- Google Maps Platform,计费与价格概览(最后更新 2026-10-30),2026-11-02 读取。https://developers.google.com/maps/billing-and-pricing/overview
- Google Maps Platform,Places API 用量与计费,2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/usage-and-billing
- Google Maps Platform,Text Search (New),2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/text-search
- Google Maps Platform,Places API 政策(署名与缓存),2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/policies
- Google Maps Platform,Place IDs,2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/place-id
- Google Maps Platform,评论摘要,2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/review-summaries
- Google Maps Platform,Places API 发布说明,2026-11-02 读取。https://developers.google.com/maps/documentation/places/web-service/release-notes
- Google Business Profile API,评论数据指南,2026-11-02 读取。https://developers.google.com/my-business/content/review-data
- Google Business Profile API,accounts.locations.reviews.list,2026-11-02 读取。https://developers.google.com/my-business/reference/rest/v4/accounts.locations.reviews/list
- Google Maps Platform 服务条款,第 3.2.3(a) 条,2026-11-02 读取。https://cloud.google.com/maps-platform/terms
- Google 地图/Google 地球附加服务条款(最后修改 2026 年 1 月 27 日),2026-11-02 读取。https://www.google.com/help/terms_maps/
- Google 地图用户内容政策:禁止和受限内容,2026-11-02 读取。https://support.google.com/contributionpolicy/answer/7400114
- google.com/robots.txt,2026-11-02 下载。https://www.google.com/robots.txt
- IETF,RFC 9309 Robots Exclusion Protocol。https://www.rfc-editor.org/rfc/rfc9309.html
- Google 官方博客,Google Maps Fan-Favorite Dining List,2026-10-08。https://blog.google/products-and-platforms/products/maps/google-maps-fan-favorite-dining-list/
- 9to5Google,Google Maps on CarPlay rolling out Gemini,2026-10-21。https://9to5google.com/2026/10/21/google-maps-carplay-gemini/
- Search Engine Land,Google Ask Maps: How to make your business easier to recommend,2026-10。https://searchengineland.com/google-ask-maps-make-your-business-easier-to-recommend-496672
- 美国第九巡回上诉法院,hiQ Labs v. LinkedIn,2022-04-18。https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- 加州北区联邦法院,Meta Platforms 起诉案,案号 3:23-cv-00077,2024-01-23 裁定。https://www.govinfo.gov/app/details/USCOURTS-cand-3_23-cv-00077/USCOURTS-cand-3_23-cv-00077-7
- 加州总检察长,California Consumer Privacy Act(2026-08-28 更新)。https://oag.ca.gov/privacy/ccpa
- 欧盟,Regulation (EU) 2016/679(GDPR)。https://eur-lex.europa.eu/eli/reg/2016/679/oj
- 新加坡个人数据保护委员会,PDPA 概览。https://www.pdpc.gov.sg/about/the-legislation/pdpa-overview
- 新加坡个人数据保护委员会,Personal Data Protection Act。https://www.pdpc.gov.sg/overview-of-pdpa/the-legislation/personal-data-protection-act
- 墨西哥,Ley Federal de Protección de Datos Personales en Posesión de los Particulares(DOF 2025-03-20)。https://www.ordenjuridico.gob.mx/Documentos/Federal/html/wo125102.html
- data.gov.sg,NEA 持牌餐饮场所数据集。https://data.gov.sg/datasets/d_227473e811b09731e64725f140b77697/view
- 新加坡食品局,执法记录(2026 年 11 月 1 日更新)。https://www.sfa.gov.sg/tools-and-resources/track-records
- 墨西哥国家统计局,DENUE。https://www.inegi.org.mx/app/mapa/denue/default.aspx
- 美国人口普查局,County Business Patterns。https://www.census.gov/programs-surveys/cbp.html
- GitHub,开源 Google 地图爬虫项目主页(7,148 星,2026-11-02 读取)。https://github.com/gosom/google-maps-scraper
- GitHub issue #327,2026-09-01。https://github.com/gosom/google-maps-scraper/issues/327
- GitHub issue #338,2026-10-06。https://github.com/gosom/google-maps-scraper/issues/338
- GitHub issue #341,2026-10-09。https://github.com/gosom/google-maps-scraper/issues/341
- GitHub 版本发布记录,v1.16.3–v1.18.1。https://github.com/gosom/google-maps-scraper/releases
- Playwright for Python,Installation。https://playwright.dev/python/docs/intro
- Python 官方文档,csv 模块。https://docs.python.org/3/library/csv.html
- Stack Overflow,To get more than 5 reviews from google places API。https://stackoverflow.com/questions/39223719/to-get-more-than-5-reviews-from-google-places-api
- Stack Overflow,How to get latest reviews using Google places API。https://stackoverflow.com/questions/55235501/how-to-get-latest-reviews-using-google-places-api
- Reddit r/learnpython,How can I get places reviews。https://www.reddit.com/r/learnpython/comments/1c94ejb/how_can_i_get_places_reviews/
- GitHub issue #337,2026-10-05。https://github.com/gosom/google-maps-scraper/issues/337
- GitHub issue #346,2026-10-22。https://github.com/gosom/google-maps-scraper/issues/346
引用编号 BL-70