Apify Reddit Scraper 替代:每千条实测
1,000 条 Reddit 评论,Apify Lite 要 $4.04,我们实测 $0.0073 但不带父评论 ID;要整棵树或社区历史选 Apify。
同样拿 1,000 条 Reddit 评论,Apify Store 里用户最多的 Reddit Scraper Lite 按公开价要 $4.04(Free 档,每条 $0.004 加一次 $0.04 起步费),常用 scraper 里最便宜的 automation-lab 要 $0.59;我们在 2026 年 11 月 4 日用 EveryInfra 的 reddit/comments 真调 13 个帖子,一次 $0.000556,拿回 997 条不重复评论,实扣 $0.007228,折合每千条 $0.00725,比 Lite 便宜 557 倍、比 automation-lab 便宜 81 倍。帖子这一侧,关键词搜索每千条 $0.0293、subreddit 帖子每千条 $0.0114,比 Lite 便宜 138 倍和 353 倍。但有三件事 Apify 做得到、我们做不到:一个帖子我们每次最多回 100 条评论,771 条评论的热帖只拿到 13%;返回的评论里有二、三层的回复,却没有父评论 ID,拼不回评论树;一个 subreddit 换了 8 种排序也只拿到 286 个不重复帖子,凑不出 1,000 个。下面把四种数据逐个实测,连同 Apify 那边 9 月 21 日下架的「Reddit Scraper」、Store 里 700 多个 Reddit scraper 的价格分布、Reddit 官方 API 10 月 31 日起不收新申请的时间表,一起写清楚。
本文的「每千条价」,是把实际扣掉的钱除以实际拿到的不重复条数,再乘 1,000。它回答的问题是:拿到 1,000 条 Reddit 帖子或评论,要花多少钱。EveryInfra 按请求计费,一次请求回多少条都收一个价,搜索最多 25 条、subreddit 和评论最多 100 条、用户帖子最多 50 条(见免费目录的 max_limit);Apify Store 里的 Reddit scraper 几乎全部按结果计费,每写进数据集一条收一次钱。两种单位要换到同一个分母才能比。我们这一侧的分母一律是按 id 去重后的条数,不用请求里写的 limit,所以回得少、重复多的那几次,我们的价格只会被算高。Apify 一侧只用公开材料:Store 页面、价格页、文档,以及不需要账号就能读的公开 actor 元数据接口(Get Actor 接口文档);我们没有注册 Apify,也没有跑它的 actor(Apify 对云端抓取程序的叫法),所以表里 Apify 的数字都是公开单价,不是实测账单。
先看总表:Apify Reddit Scraper 和 EveryInfra,每 1,000 条多少钱
下表是本文的结论。Apify 一侧每行列两个数:一个是 Store 里 Reddit 类用户最多的 Reddit Scraper Lite,另一个是近 30 天用户不少于 100 个、能做这一类数据的 scraper 里 Free 档最便宜的那个。价格从 Apify 公开元数据的 pricingInfos 字段读出,2026-11-04 00:15 新加坡时间读取,均按「一次运行拿 1,000 条、Free 档」算,起步费按各自默认值计入。EveryInfra 一侧全部是本文真调,实扣金额取响应里的 billing.charged_usd,条数取 results,去重按 id。
| 数据 | EveryInfra 能力 | 实测:次数 / 条数 / 去重 / 实扣 | EveryInfra 每千条(去重) | Reddit Scraper Lite(Free) | 倍数 | Store 常用最低价(Free) | 倍数 |
|---|---|---|---|---|---|---|---|
| 关键词搜索帖子 | reddit/search | 10 / 195 / 190 / $0.00556 | $0.0293 | $4.04 | 138 倍 | clearpath Search $1.00 | 34 倍 |
| 某个 subreddit 的帖子 | reddit/subreddit_posts | 10 / 837 / 486 / $0.00556 | $0.0114 | $4.04 | 353 倍 | automation-lab $1.15 | 101 倍 |
| 帖子下的评论 | reddit/comments | 13 / 997 / 997 / $0.007228 | $0.00725 | $4.04 | 557 倍 | automation-lab $0.59 | 81 倍 |
| 某个用户的评论 | reddit/user_comments | 1 / 100 / 100 / $0.032403 | $0.324 | $4.04 | 12.5 倍 | harshmaur User $1.52 | 4.7 倍 |
倍数都用 Apify 的价格除以我们的价格。读这张表要注意四件事。第一,差距主要来自「一次请求回一页」:评论一次最多 100 条,一页越满,我们的单价摊得越薄;每次只回一两条时,结论会反过来,下文「分界点」一节算给你看。第二,automation-lab 的评论价 $0.59,是按每条 $0.000575、一次起步 $0.003、外加 10 个帖子行各 $0.00115 算的;它的 Store 页写明 11 月 17 日起评论 Free 档涨到 $0.00075,同样算法是 $0.76(automation-lab Store 页)。第三,帖子两行我们便宜,但「1,000 个」这个数量我们不一定凑得出来:搜索只覆盖最近一个月,subreddit 没有翻页,后面两节写了我们实际能拿到多少。第四,Apify 的单价每隔一两个月就会改一次,「最近的变化」一节列了日期。
我们怎么测,和怎么判对错
动笔之前,我们先写下判据:四种数据各至少真调 2 次、分布在 3 个以上不同时刻;每千条价一律用去重后的条数做分母;评论树完不完整,要拿至少两个帖子和第三方读到的页面逐条对照,不凭字段表推断;只要某一项 Apify 更便宜、更全或更合适,正文和总表都照写;至少 2 次「没拿到数据」的请求要记下扣费金额;两项贵能力里 reddit/user_comments 只真调 1 次,reddit/painpoint 不真调,只按目录算账。所有请求都发到 POST https://api.everyinfra.com/api/v1/social,第一次请求在 2026 年 11 月 4 日 00:15 新加坡时间发出,评论那一轮从 00:26 跑到 00:32 新加坡时间,最后一次在 00:36 新加坡时间结束;每次记下发出时间、HTTP 状态、用时、条数和 charged_usd,再用脚本从原始响应重算一遍,正文、表和图的数字都从脚本输出里取。
| 场景 | 能力和参数 | 真调次数 | 时间(新加坡时间,11 月 4 日) | 看什么 |
|---|---|---|---|---|
| 关键词搜索 | reddit/search,limit 25;7 个不同关键词,另对 standing desk 换 newest、top、popular 三种排序 | 10 | 00:15 到 00:19 | 每次回几条、排序对条数的影响、时间范围 |
| subreddit 帖子 | reddit/subreddit_posts,r/Python 8 种排序和时间窗、r/smallbusiness 2 种,limit 100 | 10 | 00:20 到 00:24 | 每多一种排序多几个新帖、一个社区最多拿到多少 |
| 评论 | reddit/comments,13 个帖子,评论数从 16 到 771,limit 100 | 13 | 00:26 到 00:32 | 每帖回几条、占帖子评论数多少、有没有深层回复 |
| 用户 | reddit/user_posts 3 个账号 7 次;reddit/user_comments 1 次 | 8 | 00:24 到 00:35 | 能往前翻多远、贵能力一次回多少 |
| 单帖详情 | reddit/post_detail,2 个帖子 | 2 | 00:33 | 和列表里的评论数对不对得上 |
| 没拿到数据 | 无 Key、非法排序值、多余参数、不存在的社区、不存在的帖子、不存在的用户 | 6 | 00:25 到 00:36 | 哪些情况扣钱 |
本篇一共真调 49 次,实扣合计 $0.056311。所有请求共用一把限速每分钟 10 次的测试 Key,这一轮里碰到过 HTTP 429(请求过多),脚本等 60 秒再发,429 本身不扣费,也不计入上面的次数。
场景一:apify reddit scraper 最常见的用法,关键词搜索 1,000 个帖子
reddit/search 一次最多回 25 条,时间范围固定是最近一个月(目录里 sort 参数的说明原文:时间范围固定为最近一个月,排序不改变这一范围)。我们用 7 个不同的关键词各搜一次:standing desk、notion alternative、claude code、best vpn、airpods pro 3、home espresso machine、sourdough starter,回来的条数是 25、17、25、25、25、24、25,平均每次 23.7 条,发帖时间全部落在 10 月 3 日到 11 月 3 日之间,和目录写的一个月一致。7 次实扣 $0.003892,166 条没有一条重复,每千条 $0.0234。
换排序的结果差别很大。同一个词 standing desk,默认的相关性排序回 25 条,popular 回 22 条,top 只回 4 条,newest 只回 3 条,而且 newest 那 3 条全是 11 月 3 日当天的帖子。原因在目录里也写了:搜索只返回对得上关键词的帖子,只沾一个词的不返回,所以条数可能少于 limit;一条都没有时按空结果退款,但回了 3 条就照常扣 $0.000556。把这 3 次排序加进来,10 次一共 195 条、去重 190 条、实扣 $0.00556,每千条 $0.0293。总表用的是这个更保守的数。
要拿 1,000 个帖子,按平均每次 23.7 条算,需要大约 42 次搜索,也就是 42 个不同的关键词或者关键词组合,花 $0.0234 左右。如果你只关心一两个关键词,就拿不到 1,000 个:一个词一个月里能对得上的帖子就那么多,而且我们的搜索不往一个月以前翻。这一点 Apify 那边不一样:Lite 的 time 参数可以选 all(全部时间)、year、month 等(Store 页「Advanced parameters」一节),clearpath 的搜索 scraper 写明支持 5 种排序和时间过滤,每条结果 $0.00099、写进数据集再收 $0.00001,加上起步费,每千条合计 $1.00(clearpath Search Store 页)。要搜历史上某个话题的 1,000 个帖子,用 Apify 更合适;要每天、每周盯一批关键词最近一个月的新帖,一次 $0.000556 拿 20 多条,便宜得多。
| 关键词 | 排序 | 回几条 | 最早发帖(UTC) | 实扣 |
|---|---|---|---|---|
| standing desk | 默认(relevance) | 25 | 10 月 3 日 | $0.000556 |
| standing desk | popular | 22 | 10 月 27 日 | $0.000556 |
| standing desk | top | 4 | 10 月 6 日 | $0.000556 |
| standing desk | newest | 3 | 11 月 3 日 | $0.000556 |
| notion alternative | 默认 | 17 | 10 月 3 日 | $0.000556 |
| 其余 5 个关键词 | 默认 | 24 到 25 | 10 月 3 日到 6 日 | 各 $0.000556 |
场景二:某个 subreddit 的 1,000 个帖子,我们只拿到 286 个
reddit/subreddit_posts 一次最多回 100 条,没有翻页参数。要拿更多,只能换排序和时间窗:sort 有 newest、popular、top、rising、relevance,date_range 只在 sort=top 时生效(目录原文)。我们在 r/Python 上把 8 种组合各跑一次,下图是每多跑一种,多拿到几个新帖子。
结果很清楚:newest、popular、relevance 三种排序回来的 100 条几乎是同一批(合计 101 个不重复),rising 回 25 条,全部已经见过;真正带来新帖的只有 top 加 all_time(100 个,最早一条是 2017 年)和 top 加 past_year(新增 85 个);top 加 past_month、past_week 回来的 87 条和 25 条也全部已经见过。8 次实扣 $0.004448,只拿到 286 个不重复帖子,每千条 $0.0156。如果一开始就知道只跑 newest、top 全部时间、top 一年这三种,3 次 $0.001668 就能拿到同样的 286 个,每千条 $0.0058。r/smallbusiness 的两次(newest、top 一年)各回 100 条、互不重复,每千条 $0.0056。10 次合计 837 条、去重 486 条、实扣 $0.00556,每千条 $0.0114,就是总表那一行。
所以「一个 subreddit 的 1,000 个帖子」我们做不到,这一项 Apify 更合适。Reddit 的列表本身大约只能往回翻 1,000 条,Lite 的说明里也这样写,并建议组合不同排序、用搜索、用时间过滤来凑更多(Store 页「Reddit's 1,000 items limit」一节)。能翻页的 scraper 每种排序都能翻到将近 1,000 条,我们每种排序只有第一页的 100 条。如果你要的是「每天看一眼这个社区的新帖和热帖」,一次 newest 加一次 top past_day,两次 $0.001112;要一次性导出一个社区几年的历史,就去用 Apify,或者走 Reddit 自己的研究者计划。
场景三:apify reddit comment scraper 要比的,1,000 条评论和评论树
评论是这次差距最大的一项,也是 Apify 在功能上最有优势的一项。reddit/comments 传一个帖子的 URL,一次最多回 100 条评论。我们挑了 13 个帖子,评论数从 16 条到 771 条不等,各请求一次,结果如下。
13 次实扣 $0.007228,997 条评论没有一条重复,每千条 $0.00725。这个数有两个前提。第一,评论数少于 100 的帖子,我们拿到的是帖子显示评论数的 74% 到 90%;差的那部分,一部分是被删除、被移除的评论(帖子的评论数里还算着它们,但已经没有正文),一部分是被 Reddit 折叠在「加载更多」后面的。第二,评论数超过 100 的帖子,一次只能拿 100 条,771 条评论的热帖只拿到 13%。要从一个热帖拿全部评论,按我们的上限做不到;clearpath 的评论 scraper 写明把 maxCommentsPerPost 设成 0、打开 expandAllComments 就能拿全树,包括嵌套 10 层以上、被「continue this thread」藏起来的回复(clearpath Store 页)。这个场景 Apify 更合适。
| 帖子显示的评论数 | 我们拿到 | 覆盖 | 时间(新加坡时间) | 实扣 |
|---|---|---|---|---|
| 771 | 100 | 13% | 00:26 | $0.000556 |
| 681 | 100 | 15% | 00:27 | $0.000556 |
| 639 | 100 | 16% | 00:27 | $0.000556 |
| 529 | 100 | 19% | 00:28 | $0.000556 |
| 478 | 100 | 21% | 00:28 | $0.000556 |
| 389 | 100 | 26% | 00:29 | $0.000556 |
| 374 | 100 | 27% | 00:29 | $0.000556 |
| 120 | 100 | 83% | 00:30 | $0.000556 |
| 118 | 95 | 81% | 00:30 | $0.000556 |
| 40 | 36 | 90% | 00:31 | $0.000556 |
| 39 | 35 | 90% | 00:32 | $0.000556 |
| 23 | 17 | 74% | 00:32 | $0.000556 |
| 16 | 14 | 88% | 00:32 | $0.000556 |
「评论树完不完整」要分两层说。我们先看返回里有没有深层回复:拿评论数 16 和 23 的两个帖子,用一个第三方网页读取工具把帖子页面连评论一起读下来,页面上能看到的评论一共 27 条,其中 1 条是已删除的占位。剩下 26 条,我们按正文开头逐条去返回里找,26 条全部找到了,其中顶层评论 12 条、第二层回复 10 条、第三层回复 4 条;我们还多返回了 5 条那个读取工具没显示出来的评论。所以返回的不只是顶层评论,二、三层的回复也在。第二层是结构:这 13 次返回的每条评论都只有 id、text、author_username、like_count、url、posted_at、platform 七个字段(目录里还列了 community,但这 13 次返回里都没有,别依赖它;要社区名,从帖子列表的 community 或评论的 url 里取),没有父评论 ID,也没有层级。你知道这 14 条里有回复,但不知道谁回的谁。Apify 这边,Lite 的评论记录带 parentId 和 numberOfReplies(Store 页「Example Reddit post」一节),automation-lab 带 depth 和 parentId,并且老实写了 commentCoverage 是 unverified、不保证整棵树(Store 页「Comment fields」一节),clearpath 10 月 6 日的更新专门修了全展开时回复的 depth。
这对用途意味着什么?做情绪统计、关键词频次、主题分类、找差评原文,平铺的评论表够用,而且每千条 $0.00725;做「谁和谁在吵」「回复链有多深」「OP 回了哪些问题」这类需要树结构的分析,要用带 parentId 的工具。我们之前在Reddit 评论为什么采集不完整里写过 PRAW 的 MoreComments 占位和 replace_more 的含义(PRAW 文档):Reddit 返回的评论树本身就有没展开的位置,Reddit 的 JSON 文档把它叫 more 对象(reddit-archive Wiki)。研究上这个问题也有先例:2018 年 Gaffney 和 Matias 发现一个被广泛使用、号称包含「所有公开 Reddit 评论」的数据集有大量缺失,并指出这对研究用户历史和网络结构的风险最大(arXiv 论文)。所以无论用谁,导出时都要把「拿到多少、帖子显示多少」两个数一起存下来。
单帖详情 reddit/post_detail 我们调了两次,771 条和 40 条两个帖子的 comment_count 和列表里的一致,各扣 $0.000556。需要先筛帖子再决定拉哪些评论时,可以先用列表里的 comment_count 排序,不必再单独调详情。
场景四:某个用户的帖子和评论,贵能力什么时候不值得
reddit/user_posts 一次最多 50 条,价格和其他能力一样是 $0.000556。我们先查了 Reddit CEO 的账号 spez,换了 newest、top 全部时间、top 一年、popular 四种排序,四次回来的都是同样 24 条帖子,最早一条是 2015 年 7 月 11 日,最新一条是 10 月 29 日那篇登录墙公告。也就是说,这个账号用这四种排序拿不到更多,排序参数在这里没有改变结果,四次花了 $0.002224,第二到第四次都是浪费。机构账号 washingtonpost 一次就回了满 50 条,从 2026 年 4 月 20 日到 11 月 3 日,每千条 $0.0111。换成 top 全部时间再请求一次,回来的还是同样 50 条。NASA 的账号 nasa 按 newest 一次也是满 50 条,从 2025 年 6 月 5 日到 2026 年 10 月 29 日。所以用户帖子一次最多 50 条,换排序也拿不到更早的;要往回翻一个活跃账号的全部历史,能翻页的 Apify scraper 更合适,比如 harshmaur 的 Reddit User Scraper 写的是能抓一个用户完整的发帖和评论历史,clearpath 的用户内容 scraper 写明每个用户最多 1,000 条。
reddit/user_comments 是另一回事:一次 $0.032403,是普通能力的 58 倍,一次最多 200 条。我们按 limit 200 请求了一次 spez,回来 100 条,从 2025 年 7 月 31 日到 2026 年 10 月 29 日,每千条 $0.324。还有一个要照实写的情况:这 100 条的正文最长都是 300 个字符,平均 160 个。目录对这个能力的 field_note 写的是:其他来源不可用时,结果来自一个兜底来源,评论正文截到前 300 个字符。这一次就是这种情况。所以这一次的结果,适合看一个人最近一年在哪些帖子下发言、发言频率和点赞,不适合拿长评论全文做分析。
这个能力什么时候不值得用?分界点是一次能回多少条。一次 $0.032403,除以 Apify 按条计费的单价,就是我们至少要回多少条才划算:对 Lite(每条 $0.004)是 8.1 条,对 clearpath 的用户内容 scraper(每条 $0.00199,加写入 $0.00001,合计 $0.002)是 16.2 条,对 harshmaur 的用户 scraper(每条 $0.0015)是 21.6 条,对 automation-lab 的评论价(每条 $0.000575)是 56.4 条。所以三种情况别用它:第一,目标用户本来就没几条评论,比如一个新号、一个只发过十几条的账号,按条计费的 scraper 更便宜;第二,你要的其实是某个帖子下的讨论,那直接用 reddit/comments,每千条 $0.00725,是它的 45 分之一;第三,你需要完整长评论,而这一次碰上了 300 字符截断,那就要换工具或者换时间重试。批量研究很多用户的评论历史时,一次能回 100 到 200 条,每千条 $0.16 到 $0.32,比 harshmaur 用户 scraper 的每千条 $1.52 便宜 4.7 到 9.4 倍;但如果你还要每个用户的 karma、注册时间这类资料,harshmaur 那一个一次就给齐了。
reddit/painpoint 更贵,一次 $0.072,我们没有真调,只按目录说清它卖的是什么:按关键词找帖子(最多 15 个),读这些帖子的顶层评论,返回一行汇总(找到多少帖、读了多少评论、负面和正面评论的粗略计数、负面评论里反复出现的词、来自哪些社区),加上热门帖和点赞最多的几条负面评论原文。目录写明负面和正面是按词表判的,反讽和褒贬混杂判不准,是粗略计数,不是不满意率;高频词里会混进 any、it's 这类常用词。自己做同样的事:1 次 reddit/search 加 15 次 reddit/comments,16 次 $0.0089,再交给你自己的模型去分类,比 painpoint 便宜 8 倍,而且评论能拿到每帖 100 条,不只是顶层。它适合不想写代码、只想先看一眼某个产品在 Reddit 上被骂什么的人;要做成每周报告,自己拼更划算,我们在用 Claude Code 定时任务挖 Reddit 痛点里写过完整做法。
失败和空结果扣不扣钱
这一节是 Apify 和我们规则差别最大的地方。我们故意发了 6 个拿不到数据的请求,结果如下表。
| 情况 | 发出时间(新加坡时间) | HTTP 状态 | 返回 | 扣费 |
|---|---|---|---|---|
| 不带 Key | 00:25 | 401 | missing_key,提示放在 Authorization 头里 | $0 |
sort 写成 hot | 00:25 | 422 | invalid_value,列出允许值,did_you_mean 给 popular、top | $0 |
多写一个 time_filter 参数 | 00:25 | 422 | unknown_param,列出必填和可选参数,附一个能跑通的示例 | $0 |
| 不存在的 subreddit | 00:26 | 200 | 1 行占位记录,只有 id、community、platform,按一条结果计费 | $0.000556 |
| 不存在的帖子 | 00:26 | 200 | 0 条,empty_result_refunded,这一次的费用自动退回 | $0 |
| 不存在的用户 | 00:36 | 200 | 0 条,empty_result_refunded | $0 |
前三种是参数问题,我们先查 Key 再查参数,错了直接回 4xx,不扣钱,错误里写明怎么改,方便 AI 客户端自己改了重发。第五种是正常的空结果:请求成功但一条都没有,按空结果自动退款。第四种要单独记住:社区名不存在时,返回是 HTTP 200、count 为 1,唯一的一行 id 以 target-status: 开头,只带 community 和 platform 两个字段,没有标题、正文和链接,这一次按一条结果扣了 $0.000556。所以批量跑 subreddit 时,先按 id 前缀把这一行过滤掉,再数条数、算单价;过滤后一条不剩,说明社区名写错了或者社区已经不存在,把它从名单里拿掉,下次就不会再为它付这一次的钱。
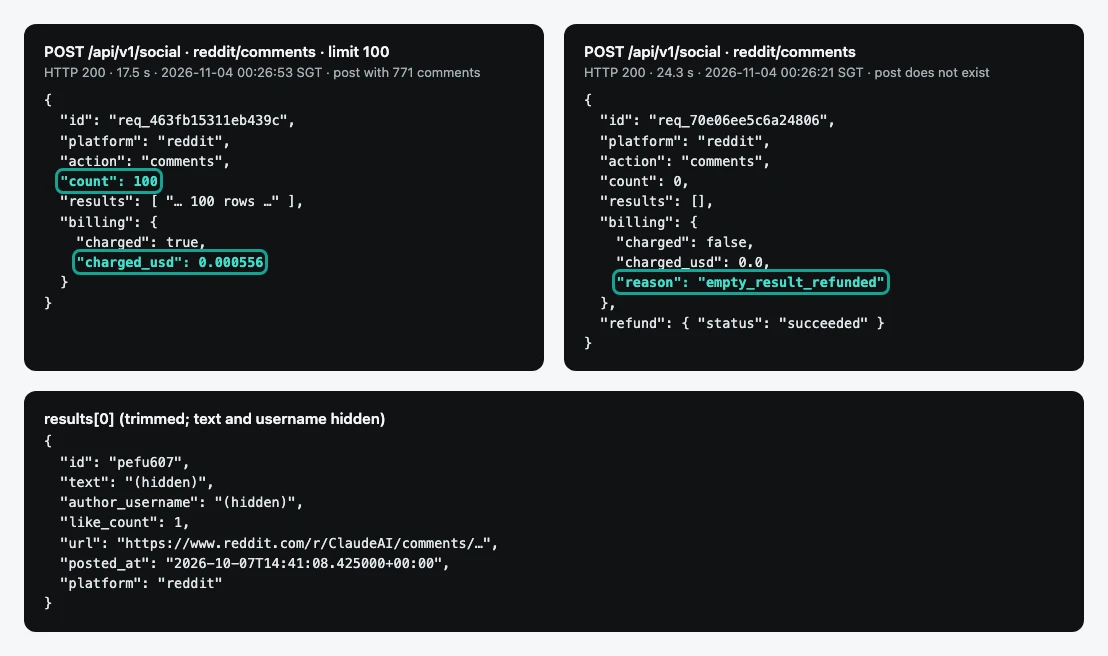
Apify 这边,规则按每个 actor 自己定。Apify 自己做的 Reddit Scraper 有一个「No result」事件,每次 $0.0005:社区已删除、搜索无命中、帖子没有评论,都会写一条说明原因的记录并按这个价收费(Store 页);automation-lab 写的是无结果的运行不收费;Lite 按内存收的起步费在开始运行时就收,哪怕最后一条结果也没有,默认 2 GB 就是 $0.04。运行失败、超时的情况更常见:下一节会看到,Lite 近 30 天的 36 万多次运行里有 10% 超时。Apify 的文档写明用户可以给每次运行设最高扣费,达到上限就停(Actors in Store),跑大任务前一定要设。
Apify Reddit Scraper Lite 怎么收费:每条 $0.004,外加 2 GB 起步费
搜「apify reddit scraper」的人,最先看到的几乎都是 trudax 的 Reddit Scraper Lite。它近 30 天有 8,543 个用户(Store 列表接口,2026-11-04 00:14 新加坡时间读取;同一时刻单个 actor 详情接口的读数是 8,540 个用户、363,964 次运行,差别不到 1%,本文的用户数和运行数统一取列表接口),是 Store 里 Reddit 类用户最多的一个,比第二名多出约 50%。它的收费分两件事:每往数据集里写一条结果收一次钱,Free 档 $0.004,也就是每千条 $4.00,Starter 对应的 Bronze 档 $0.0038,Scale 对应的 Silver 档 $0.0036,Business 对应的 Gold 档 $0.0034;另外每次运行按内存收一笔起步费,每 GB $0.02,默认内存是 2,048 MB,所以默认每次运行先收 $0.04,平台也把这一次运行的最低扣费定成 $0.04(以上全部来自 Lite 的公开元数据的 pricingInfos 和 defaultRunOptions,2026-11-04 00:15 新加坡时间读取)。档位和套餐的对应关系,按 Apify 文档是 Free 用 FREE 价、Starter 对应 BRONZE、Scale 对应 SILVER、Business 对应 GOLD,PLATINUM 和 DIAMOND 只给企业客户(Actor pricing and costs)。
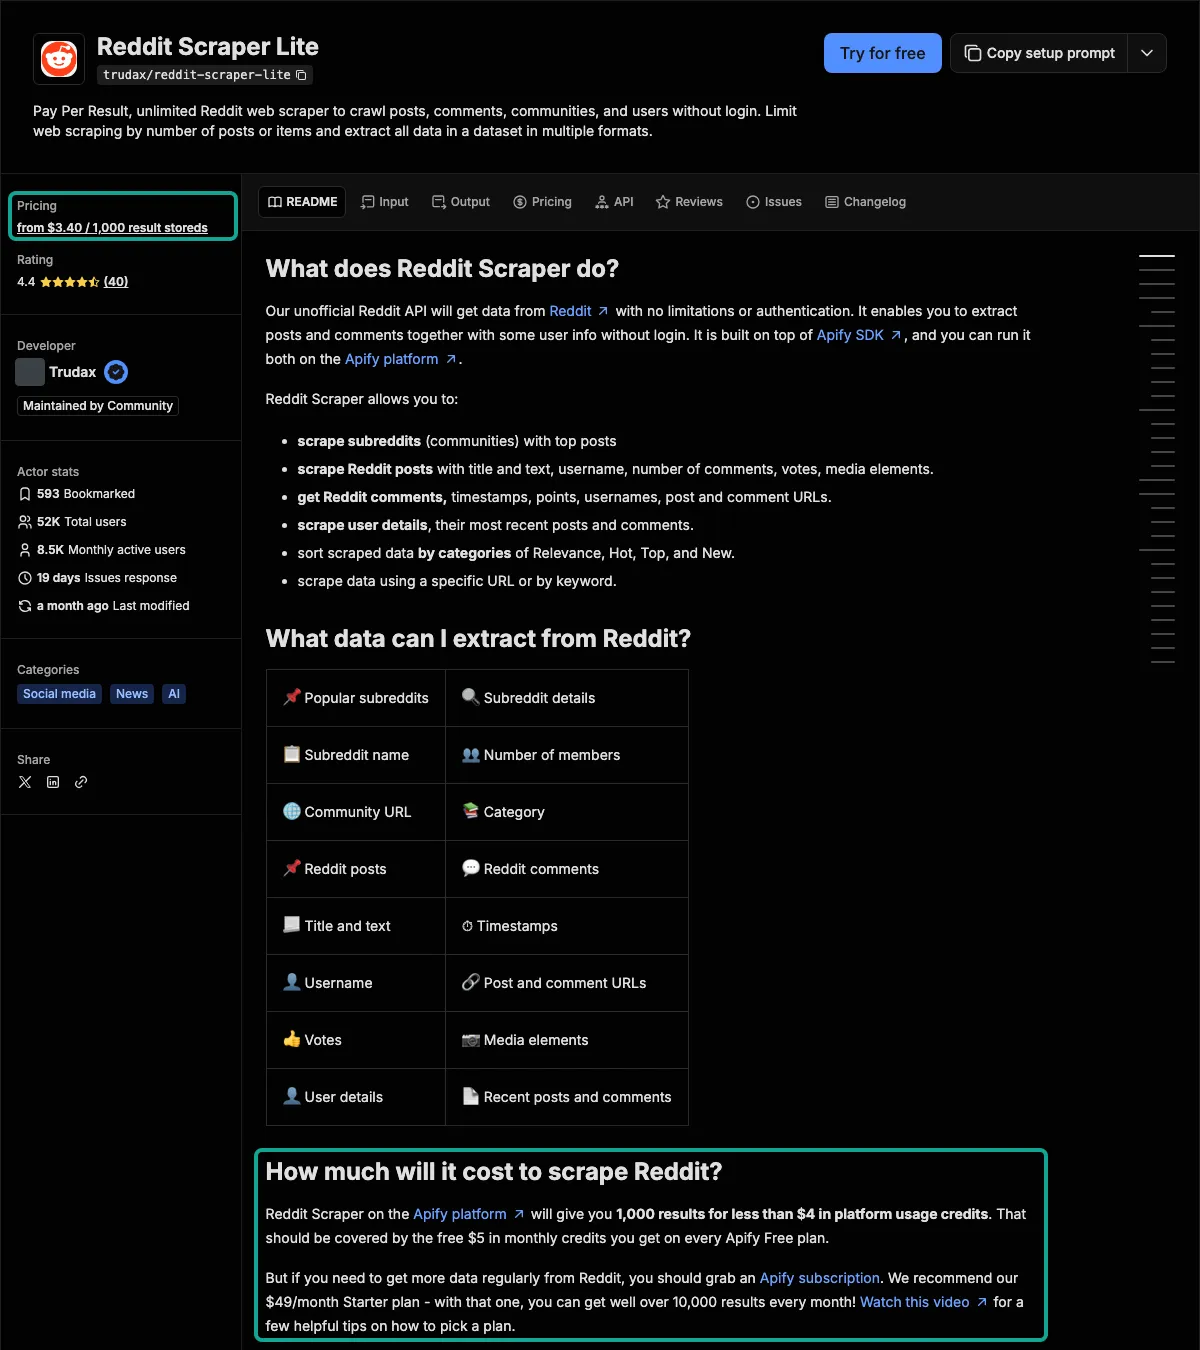
这张截图里有两处容易误读。第一,侧栏写的「from $3.40 / 1,000」是最高折扣档的价,Free 用户实际付 $4.00,再加每次运行的 $0.04;只跑一次拿 1,000 条,Free 档合计 $4.04,Business 档合计 $3.44。第二,正文推荐的「$49/month Starter plan」和 Apify 现行价格页不一致:价格页写的是 Free 每月 $5 预付额度、Starter $19 起、Scale $199、Business $999,额度当月用完不结转。这段说明文字没有跟着价格页更新,算账时以价格页为准。
还有一个算账时常被忽略的细节:Lite 把「每个帖子、每条评论、每个用户、每个社区」都算一条结果(Store 页「Results」一节原文)。所以你让它抓一个 subreddit 的 100 个帖子、不关评论,它会顺带把这些帖子下的评论也写进数据集,每条都按 $0.004 收钱。页面给的参数是 skipComments、maxComments、maxItems;不设上限时,一次「抓 100 个帖子」的运行,最后写进去的可能是几千条。
「Reddit Scraper」本身已经下架:9 月 21 日起只对老用户开放
很多教程里的「Apify Reddit Scraper」指的是 trudax 的另一个 Reddit Scraper。它从 2022 年 2 月起按月租收费,每月 $45,带 1,440 分钟试用;2026 年 9 月 21 日改成按事件计费(每条结果 $0.0001、每次启动 $0.00005),改价说明原文是:Apify 在淘汰月租定价,这个 actor 将不再公开列出,已有用户保留完整访问(公开元数据里的 reasonForChange 字段,2026-11-04 读取)。同一份元数据里 isDeprecated 是 true,Store 页标题也已经带上「[DEPRECATED]」。它近 30 天仍有 459 个用户在跑,但新用户已经开不了。换句话说,今天新来的人能用的「官方同名」选择,就是上面的 Lite 和 Apify 自己做的 Reddit Scraper。
Apify 自己做的这一个按四种结果分开定价:帖子 Free 档 $0.004、Gold 档 $0.0025;评论 Free 档 $0.0032、Gold 档 $0.002;社区 $0.0065;用户 $0.002;每次启动 $0.001;它还有一个很少见的「无结果」事件,每次 $0.0005。页面原文写的是:你要的东西没有结果时(社区已删除、搜索无命中、帖子没有评论),会写一条说明原因的记录,按低于正常结果的价格收费;同一个帖子从两个入口进来,会写两遍、收两次钱(Store 页「How much will it cost?」一节)。这和我们的规则不同,前面「失败和空结果扣不扣钱」一节有实测对比。
Apify Store 里 746 个 Reddit scraper:价格怎么分布、跑得稳不稳
我们用 Apify 公开的 Store 列表接口(Get list of Actors in Store)搜 reddit,翻完 14 页、去重后,标题或名字带 Reddit 的 actor 一共 746 个,其中 717 个按事件计费,29 个免费。近 30 天用户不少于 100 个的有 17 个,下图是其中 16 个按结果计费的 Free 档主事件单价(另一个是免费的 red_crawler,做的是社区信息和社区内浏览)。最便宜的是 clearpath 的搜索 scraper,每千条 $0.99;用户第二、第三多的 harshmaur 通用 scraper 和 fatihtahta 分别是 $2.00 和 $1.49,harshmaur 专做评论的 Reddit Comment Scraper 是 $1.50;最贵的一档是每千条 $4.00,有三个:用户最多的 Lite、practicaltools 的一个,和 Apify 自己做的那一个;中位数约 $2.00。所有价格都不含起步费,起步费按内存、按次另收,比如 Lite 每次 $0.04、harshmaur 每次 $0.02、clearpath 每次 $0.00099。
价格之外,Apify 每个 actor 的公开元数据里还有近 30 天的运行结果统计:成功、失败、超时、中止各多少次。我们把用户最多的 4 个和 Apify 自己做的那一个画在一起:
两个数要读对。第一,Lite 近 30 天 360,661 次运行里有 35,919 次超时,约 10%,比其他几个高一个数量级。超时的原因只能推测:一部分是用户自己设的运行时限太短,一部分是没设 maxItems、一次跑了太多帖子和评论。超时的运行,已经写进数据集的结果照样收费,起步费也照收。第二,Apify 自己的 Reddit Scraper 15,672 次运行里有 5,296 次失败,约 34%;按它的页面说明,没结果的情况会写一条记录收 $0.0005,并不算失败,所以这些失败更可能是输入错误或者被 Reddit 拦下。这些是平台公开统计,不等于 actor 本身的成功率,Apify 文档对运行状态的定义见 Runs and builds。17 个常用 actor 合计 1,526,908 次运行,成功 95.3%、超时 2.6%、失败 1.1%、中止 1.0%。另外,Apify 会给每个公开 actor 跑每日自动测试,连续不过的会被标成「维护中」(Automated testing),选 actor 前看一眼 Store 页上有没有这个标记。
我们这一侧,本篇 49 次请求里 46 次 HTTP 200,只算这 46 次,单次用时 6 到 41 秒,中位 14 秒;最慢的是评论多的帖子和单帖详情。3 次 4xx 是我们故意写错的参数。没有一次请求超时或者返回 5xx,但样本只有 49 次,不足以算成功率;我们只能说这一轮里没有碰到。
在代码和 AI 客户端里怎么调
下面这段 Python 是本文评论实测的写法:给一批帖子 URL,各请求一次 reddit/comments,按评论 id 去重,把每次的 charged_usd 加起来,同时把「帖子显示多少评论、我们拿到多少」两个数一起存下来,后面算覆盖率用。它还顺手跳过了 id 以 target-status: 开头的占位行,原因见「失败和空结果扣不扣钱」一节。
import os, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, **params):
    r = requests.post(API, headers=HEADERS, timeout=120,
                      json={"platform": "reddit", "action": action, "params": params})
    r.raise_for_status()
    body = r.json()
    rows = [x for x in body["results"] if not str(x.get("id", "")).startswith("target-status:")]
    return rows, body["billing"]["charged_usd"]

posts, spent = call("subreddit_posts", subreddit="Python", sort="top", date_range="past_year", limit=100)
seen, coverage = {}, []
for p in posts[:13]:
    rows, cost = call("comments", url=p["url"], limit=100)
    spent += cost
    seen.update({c["id"]: c for c in rows})
    coverage.append((p["url"], p["comment_count"], len(rows)))

print(len(seen), "unique comments, spent", round(spent, 6), "USD")
for url, listed, got in coverage:
    print(f"{got}/{listed}", url)
在 AI 客户端里用,就接我们的远程 MCP 服务 https://api.everyinfra.com/mcp,工具名以 everyinfra_ 开头,模型可以自己决定先搜帖子还是直接拉评论。下面是一份通用的配置示例,Claude Code、Cursor 等支持远程 MCP 的客户端格式相近,具体写法以各客户端文档为准(Claude Code 的 MCP 文档、Cursor 的 MCP 文档、OpenAI 的 MCP 文档,协议本身见 MCP 规范)。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Apify 也有自己的 MCP 服务,能把 Store 里的 actor 当工具给模型用(Apify MCP 文档,源码在 GitHub),写代码则用它的 Python 客户端。两者的区别在于:Apify 的 MCP 是让模型启动一次 actor 运行,等它跑完再读数据集,适合一次导出几万条;我们的 MCP 每次调用直接回一页数据,适合在对话里边问边查。MCP 服务的说明和支持的客户端列表见 MCP 服务页。
算一笔账:三件常见的活,30 天各花多少钱
下面三件活都是按本文实测的每次条数估算的,前提写在表下。EveryInfra 一侧是「请求次数 × $0.000556」(用户评论是 × $0.032403);Apify 一侧按各 actor 的 Free 档公开单价,每做一次活跑一次,每次加一笔默认起步费。
| 30 天的活 | 请求次数和条数 | EveryInfra | Reddit Scraper Lite | Apify 常用里较便宜的 |
|---|---|---|---|---|
| 每天拉 10 个热帖的评论,每帖 100 条 | 300 次,30,000 条 | $0.17 | $121.20 | automation-lab $17.69(11 月 17 日起 $22.94);harshmaur 评论 $45.60 |
| 每天看 5 个 subreddit 的最新 100 帖 | 150 次,15,000 条 | $0.08 | $61.20 | automation-lab $17.34;clearpath subreddit $30.02 |
| 每周看 200 个用户的评论历史,每人 100 条 | 800 次,80,000 条 | $25.92 | $320.16 | harshmaur 用户 scraper $120.08;clearpath 用户内容 $160.00 |
估算的前提有三个。第一,假设每次都回满一页;本文实测里评论超过 100 条的帖子都回满了,但小帖子回不满,用户评论那一次 limit 200 只回了 100 条,回得少时我们的总价不变、单价变高。第二,Lite 一行假设关掉了顺带抓评论(skipComments),否则帖子那一行会多出几倍条数。第三,三件活都不扣除跨天重复:同一个热帖第二天再拉,评论大部分已经拿过,两边都会为重复的部分付钱,Apify 那边可以用时间过滤减少重复,我们这边要自己按 id 去重。即便如此,用户评论这一行我们也贵在每次 $0.032403:要是这 200 个用户大多只有十几条评论,我们的总价不变,Apify 按条计费的总价会降到几美元,这时候 Apify 更划算。
字段:两边拿到的东西一样多吗
便宜的另一面是字段少。我们这一侧,下表是本文 49 次请求里实际返回的字段,不是目录里写的字段表;两者不一致的地方我们照实列出。Apify 一侧各家 scraper 字段差别很大,harshmaur 的通用 scraper 写的是每个帖子 60 多个字段、带媒体和图集,Lite 和 automation-lab 的评论记录带 parentId,具体以各自 Store 页的示例输出为准,我们没有跑它们,不替它们列全。
| 能力 | 实际返回的字段 | 少了什么 |
|---|---|---|
reddit/search、reddit/subreddit_posts | id、title、text、author_username、community、url、like_count、comment_count、posted_at、platform;subreddit 帖子另有 domain、flair | 没有图片和视频地址、没有获奖和置顶标记 |
reddit/comments | id、text、author_username、like_count、url、posted_at、platform | 没有父评论 ID、层级、回复数;目录写了 community,实测返回里没有,别依赖它 |
reddit/user_comments | id、text、author_username、like_count、post_id、post_title、url、posted_at、platform | 正文可能被截到 300 个字符;没有 karma、注册时间 |
对大多数「看大家在说什么」的用途,这几列够用:评论的正文、作者、点赞和时间都在,帖子有标题、社区和评论数,可以先按评论数挑帖子,再拉评论。帖子的 url 可以直接拿去调 reddit/comments,上面的 Python 示例就是这样串起来的。需要媒体文件、需要评论树、需要用户画像的,字段多的 Apify scraper 更合适,按条付钱买的是这部分。
还有一点和计费有关:Lite 的默认运行时限是 3,600 秒、内存 2,048 MB(Lite 公开元数据的 defaultRunOptions),内存越大起步费越高,按 Usage and resources 的说法,内存也决定了它能用多少 CPU。把内存调低能省起步费,但跑得更慢、更容易碰到时限。我们这边没有内存和时限可调,一次请求就是一个价,慢的那次 41 秒,也是 $0.000556。
Apify 上的价格变得很勤
我们读的 15 个 Reddit actor,每一段价格在公开元数据里都带 startedAt。Apify 自己的 Reddit Scraper 从 2026-09-25 到 2026-10-20 一共有 8 段价格记录,其中 2026 年 10 月 1 日一天就有 4 段,当前这一段从 2026-10-20 起生效,页面最近一次修改是 2026-10-27。maximedupre 的评论搜索 scraper 当前价格从 2026-10-18 起生效;automation-lab 已经公布 2026-11-17 起评论涨价;trudax 的老 Reddit Scraper 在 2026-09-21 改成按事件计费并下架。相比之下,Lite 当前这一段价格从 2026 年 6 月 30 日起就没变过。对你意味着:任何一篇比价文章,包括本文,里面的 Apify 单价过一两个月就可能不准;下单前用 Get Actor 接口重新读一次 pricingInfos,并记下读取时间。Apify 的完整接口说明在 API 参考,按事件计费的规则在 Pay-per-event 文档。
Reddit 官方 API 现在什么情况:10 月 31 日起不收新申请
比价绕不开 Reddit 自己的 Data API。按 Reddit Data API Wiki,符合免费条件的用户每个 OAuth client 每分钟 100 次请求,按 10 分钟窗口平均;不用 OAuth 的流量会被直接拦掉;删掉的帖子和评论,你手里的副本也要删,Reddit 建议 48 小时内清理一次。免费用途之外的情况,Data API Terms 第 3.1 条写得很清楚:Reddit 保留对今后使用收费的权利,费率由 Reddit 自行决定;要做商业用途、超出限速的研究,或者条款没有明确允许的用途,都要另签协议。这份条款 2023 年 6 月 19 日生效,最近一次修订是 2026 年 7 月 20 日。
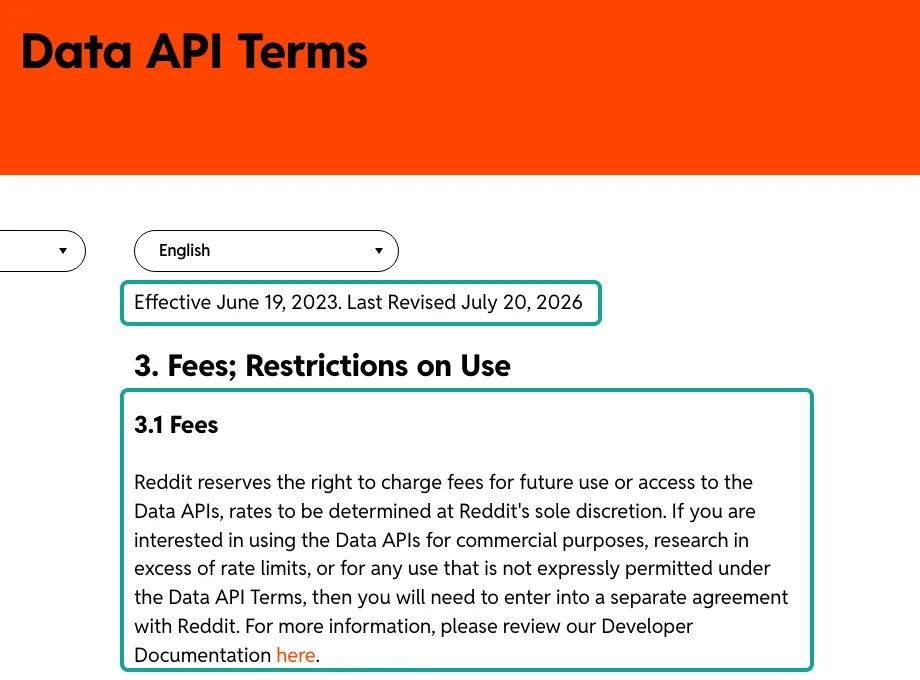
商业用途具体收多少钱,Reddit 现行的公开页面没有写价格。Developer Platform & Accessing Reddit Data 只写了「需要更大访问量的部分开发者可能要付费」,并列出了算作商业用途的例子:带广告或付费墙的 App、按费用提供的服务或数据访问、订阅服务、出售用 Reddit 数据训练的模型等。市面上流传的「每千次请求 $0.24」来自 2023 年:Reddit 当年 5 月 31 日在 r/redditdev 宣布 7 月 1 日起执行免费档限速(原帖),同一天第三方客户端 Apollo 的开发者公开转述 Reddit 给他的报价是每 5,000 万次请求 $12,000(原帖),折合每千次 $0.24。这是一位开发者的转述,不是 Reddit 公开的价目表。如果按这个数、每次列表请求 100 条来算,每千条帖子只要约 $0.0024,比任何一家第三方都便宜;但前提是你拿得到这份合同。
拿合同这条路正在关上。2026 年 8 月,Reddit 先在 r/redditdev 说了公共 Data API 的未来计划(原帖);2026 年 9 月 30 日,Reddit 在 r/redditdev 公布了公共 Data API 的关闭时间表(原帖):
| 日期 | Reddit 原文写的事 | 对拿数据的人意味着什么 |
|---|---|---|
| 2026-10-31 | 不再接受新的公共 API 访问申请 | 今天开始做的新项目,已经申请不到 |
| 2026-11-10 | 发迁移进度和截止提醒 | 看有没有延期或豁免 |
| 2026-11-13 | RSS 停止服务(见 r/modnews 公告;替代做法见 Reddit RSS 停用以后怎么办) | 用 RSS 监控 subreddit 的流程会断 |
| 2026-11-30 | 迁移奖励计划报名截止 | 只和要迁到 Devvit 的 App 有关 |
| 2027-01-12 | 没登记、没回应 Reddit 联系的 App 和用户开始被关掉访问 | 老脚本可能在这天前后失效 |
| 2027-03 | 剩余的公共访问全部关闭(原文没写具体日期) | 只剩签了书面协议的伙伴和 Devvit |
替代路线是 Reddit 自己的开发平台 Devvit:迁移指南写明它主要面向审核工具和社区 App,参加迁移计划的 App 迁完可以拿 $1,000,计划期是 2026 年 3 月 31 日到 12 月 31 日。它不是一个让你把数据导出去做分析的接口:Devvit App 要在 App registration 登记,对外发请求的范围受 HTTP Fetch 的规则限制,完整说明在 Devvit 文档。对研究者,Responsible Builder Policy 写的是:在 Reddit for Researchers 计划之外收集的数据做研究,违反这项政策;未经书面批准,不得出售、授权或拿来训练模型。
10 月 29 日,Reddit CEO Steve Huffman 在个人主页发帖说,Reddit 要改成「以登录为主的体验」,先在美国以外的部分市场测试,理由之一是绝大多数未经授权的数据获取发生在未登录页面上(原帖)。Axios 当天的报道补充,首页和从搜索引擎、外部链接点进来的帖子仍会对未登录访客开放,具体边界在测试里定。
登录墙对所有不登录读页面的工具都是风险,包括 Apify Store 里的 scraper,也包括我们。我们不能保证 Reddit 改版以后每个能力都照常返回。你能做的有三件:第一,失败的请求不扣费,Reddit 那边拦下来的请求你不用付钱;第二,能力出问题时,免费目录里这个能力会标成「暂不可用」(available 为 false),批量任务开跑前读一次目录,就不会白跑;第三,要长期用的数据定期存到自己那边,不要只靠哪一个工具随时能取。是否可以抓取、抓了能怎么用,取决于你所在的司法辖区、用途和 Reddit 的条款,本文不提供法律意见,涉及具体项目请问律师。
什么时候 Apify 更合适
把上面的实测合起来,下面这几种情况,我们建议直接用 Apify Store 里的 scraper,而不是 EveryInfra。要搜一个话题一个月以前的帖子:我们的 reddit/search 只覆盖最近一个月,Lite 的 time 可以选全部时间。要一个 subreddit 的 1,000 个以上帖子:我们每种排序只有第一页 100 条,r/Python 换 8 种组合只拿到 286 个;能翻页的 scraper 每种排序都能翻到将近 1,000 条。要单个热帖的全部评论,或者要完整的评论树:我们每帖最多 100 条、不带父评论 ID;clearpath 能全展开,Lite 和 automation-lab 带 parentId、depth。要用户资料:karma、注册时间这类字段我们没有,harshmaur 的用户 scraper 一次给齐。只看少数几个用户:一个用户一次回不到 22 条评论时,reddit/user_comments 比 harshmaur 的用户 scraper 贵。已经在用 Apify 的定时任务、数据集和集成:换过来要自己写调度和存储,省下的钱不一定抵得上这部分工作。
反过来,需要大量、经常、按页拿的数据时,我们便宜两到三个数量级:每天拉几百个帖子的评论、每天看几十个社区的新帖、给 AI 客户端在对话里查 Reddit。我们另有 reddit/trending_posts,按页给全站热门帖,每页 25 条,用 page_token 翻页,每页同样 $0.000556,可以补上 subreddit 列表不能翻页的缺口,但它是全站热门,不是某个社区的历史。我们之前写过这两种计费方式各自的坑:Apify 的计费说明、Apify 替代方案汇总,以及失败退款怎么对账的失败退款核对。
最近的变化
- 2026-11-17:automation-lab 的 Reddit scraper 评论单价 Free 档从 $0.000575 涨到 $0.00075,涨 30%(automation-lab Store 页)。对你意味着:本文按它算的每千条评论 $0.59,这天以后是 $0.76。
- 2026-10-29:Reddit CEO 关于登录墙的帖子(原帖)。对你意味着:未登录访问会在部分市场先收紧,所有不登录读页面的工具,包括 Apify 的和我们的,都可能受影响。
- 2026-10-20:Apify 自己的 Reddit Scraper 当前价格开始生效,这是它一个月里的第 8 段价格(Store 页)。对你意味着:按它算账,要以读取当天的公开元数据为准。
- 2026-10-18:maximedupre 的评论搜索 scraper 当前价格开始生效,Free 档每条 $0.00265。对你意味着:按关键词搜评论的 scraper 里,它比 harshmaur 的 $0.0015 贵 77%。
- 2026-10-16 和 2026-10-06:clearpath 的评论 scraper 两次更新,修了全展开时深层回复的
depth(clearpath Store 页)。对你意味着:要用depth重建树的,用这两次更新以后的版本。 - 2026-09-21:trudax 的 Reddit Scraper 改成按事件计费并下架,只对老用户开放。对你意味着:教程里写的「每月 $45 不限量」已经不能再订。
上手:从一次试用到每天自动跑
本文除用户评论以外的 48 次请求一共只花了约 $0.024,注册以后先用小额跑通一遍,再决定要不要批量用。步骤是:在快速上手拿 Key;在 Reddit 爬虫 API 页面看全部能力,分别打开 Reddit 搜索爬虫 API、Reddit subreddit 帖子爬虫 API、Reddit 评论爬虫 API 的试用台各跑一次;需要单帖详情和用户数据的,再看 Reddit 帖子详情爬虫 API、Reddit 用户帖子爬虫 API 和 Reddit 用户评论爬虫 API;想先看一眼某个产品在 Reddit 上被抱怨什么的,用 Reddit 痛点爬虫 API;全站热门帖用 Reddit 热门帖子爬虫 API。同样的做法还能用在 Twitter 爬虫 API 和 TikTok 爬虫 API;全部能力和单价在数据市场和价格页,和其他工具的对比在替代方案页。
同样按「每千条实测价」比 Apify 的,还有 Apify Twitter Scraper 替代、Apify TikTok Scraper 替代 和 Apify Amazon Scraper 替代。
常见问题
Apify Reddit Scraper 免费吗?
Apify 的 Free 套餐每月给 $5 预付额度(价格页),用 Lite 按每条 $0.004 加每次 $0.04 起步费算,大约够拿 1,200 条结果;Store 里也有 29 个免费的 Reddit actor,但近 30 天用户过百的只有一个。trudax 那个按月租收费的 Reddit Scraper 已经下架,新用户开不了。Reddit 官方 API 对符合条件的非商业用途免费,每个 OAuth client 每分钟 100 次,但 2026 年 10 月 31 日起不收新申请(Data API Wiki)。
Apify reddit scraper pro 是哪个,比 Lite 好吗?
Store 里名字带 pro、近 30 天用户最多的 Reddit scraper 是 harshmaur 的 reddit-scraper-pro,标题写的是线索、品牌监测和提醒,Free 档每条 $0.0015,近 30 天 435 个用户,运行成功率 98.7%(公开 Store 列表,2026-11-04 读取)。它比 Lite 便宜 60% 多、超时也少得多;Lite 的优点是用户最多、说明最全、评论带 parentId。哪个「好」取决于你要不要评论树,要的话两个都不如 clearpath 的评论 scraper 全。
Apify reddit comment scraper 能拿一个帖子的全部评论吗?
能,但要选对 actor 并设好参数。clearpath 的评论 scraper 把 maxCommentsPerPost 设成 0 并打开全展开,就能拿到包括深层「continue this thread」的整棵树;Lite 用 maxComments 控制上限。Reddit 自己的树里本来就有没展开的 more 位置(Reddit JSON 说明),用 PRAW 自己抓也要调 replace_more。我们的 reddit/comments 每帖最多 100 条,含二、三层回复,但没有父评论 ID,不适合要整棵树的场景。
Reddit 爬虫 API 收费多少,官方 API 和第三方哪个便宜?
Reddit 官方对商业用途要另签协议,现行公开页面没写价格(Developer Platform & Accessing Reddit Data);常被引用的每千次请求 $0.24 是 2023 年一位开发者转述的报价。第三方里,Apify Store 常用的 Reddit scraper 每千条 $0.99 到 $4.00,中位约 $2.00;EveryInfra 按请求计费,本文实测每千条帖子 $0.011 到 $0.029、每千条评论 $0.0073。完整的 OAuth 流程和接口列表见 Reddit 的 OAuth2 说明和 API 文档。
不用 API 抓 Reddit 合法吗?
这要看你所在的司法辖区、用途,以及 Reddit 的用户协议、开发者条款和 Public Content Policy。Reddit 的 Responsible Builder Policy 写明,在 Reddit for Researchers 计划之外收集的数据做研究违反政策,未经书面批准不得出售、授权或训练模型。本文不提供法律意见;拿数据做商业产品或训练模型前,请问律师。
Reddit 爬虫在 GitHub 上有现成的吗,和用 API 服务比怎么选?
有。Reddit 早年的网站代码和接口说明归档在 reddit-archive/reddit,已经不再更新;最常用的现成工具是 Python 的 PRAW,它走 Reddit 官方 OAuth API,免费、字段最全,但受每分钟 100 次限速,而且 2026 年 10 月 31 日以后新申请的 OAuth client 已经拿不到。自己写爬虫要处理登录墙、限速和反爬;用 Apify 或我们这类服务,是用钱换掉这部分工作。无论选哪种工具,都先算清楚每千条价和起步费。
参考资料
- Apify / trudax:Reddit Scraper Lite(Store 页),2026-11-04 读取
- Apify API:trudax~reddit-scraper-lite 公开元数据(pricingInfos、stats),2026-11-04 读取
- [Apify / trudax:Reddit Scraper [DEPRECATED](Store 页),2026-11-04 读取](https://apify.com/trudax/reddit-scraper)
- Apify API:trudax~reddit-scraper 公开元数据(含 2026-09-21 改价说明),2026-11-04 读取
- Apify / harshmaur:Reddit Scraper(Store 页),2026-11-04 读取
- Apify / automation-lab:Reddit Scraper(Store 页,含 2026-11-17 调价说明),2026-11-04 读取
- Apify / clearpath:Reddit Post Comments Scraper(Store 页,含 2026-10-06、10-16 更新记录),2026-11-04 读取
- Apify / fatihtahta:Reddit Scraper Enterprise Grade(Store 页),2026-11-04 读取
- Apify / harshmaur:Reddit Comment Scraper(Store 页),2026-11-04 读取
- Apify / harshmaur:Reddit User Scraper(Store 页),2026-11-04 读取
- Apify / clearpath:Reddit User Posts & Comments Scraper(Store 页),2026-11-04 读取
- Apify / clearpath:Reddit Search Scraper(Store 页),2026-11-04 读取
- Apify:Reddit Scraper: Posts, Comments, and Users(Apify 自己的 Store 页),2026-11-04 读取
- Apify:价格页(套餐、计算单元、Store 折扣档),2026-11-04 读取
- Apify 文档:Pay-per-event pricing model
- Apify 文档:Actor pricing and costs(折扣档 FREE 至 DIAMOND)
- Apify 文档:Actors in Store(计费模式、维护中标记、Store 折扣)
- Apify API 文档:Get Actor
- Apify API 文档:Get list of Actors in Store
- Apify 文档:Usage and resources(内存与计算单元)
- Apify 文档:Runs and builds(运行状态、超时)
- Apify 文档:Automated testing(不过测试会被标维护中)
- Apify 文档:Dataset
- Apify 文档:Apify MCP server
- GitHub:apify/apify-mcp-server
- GitHub:apify/apify-client-python
- Reddit:Data API Terms(2023-06-19 生效,2026-07-20 修订),2026-11-04 读取
- Reddit:Developer Terms
- Reddit:User Agreement
- Reddit Help:Reddit Data API Wiki(免费额度 100 QPM)
- Reddit Help:Responsible Builder Policy
- Reddit Help:Developer Platform & Accessing Reddit Data(商业使用与收费)
- Reddit Help:Public Content Policy
- Reddit Help:App Migration Program 2026 Terms
- Reddit Developer Platform:Migrating apps from the Data API to Devvit
- Reddit Developer Platform:App registration
- Reddit Developer Platform:HTTP Fetch
- r/redditdev:Moving Data API Apps to the Developer Platform: migration dates and next steps(2026-09-30)
- r/modnews:Continuing our infrastructure updates: what's changing in the coming months(2026-09-30,RSS 停用)
- r/redditdev:Our Plans for the Future of Reddit's Public Data API(2026 年 8 月)
- r/redditdev:API Update: Enterprise Level Tier for Large Scale Applications(2023-05-31)
- r/apolloapp:Had a call with Reddit to discuss pricing(2023-05-31,开发者转述报价)
- u/spez:About that login screen(2026-10-29)
- Axios:Reddit moves to logged-in experience as AI eats search(2026-10-29)
- GitHub:reddit-archive/reddit(Reddit 旧版开源代码与 Wiki)
- Reddit Developer Platform:Devvit 文档
- Apify API 文档:API v2 参考
- GitHub:reddit-archive/reddit Wiki,JSON(more 对象)
- GitHub:reddit-archive/reddit Wiki,OAuth2
- GitHub:praw-dev/praw
- PRAW 文档:Comment Extraction and Parsing
- Reddit:API 文档(/dev/api)
- Gaffney、Matias:Caveat Emptor, Computational Social Science: Large-Scale Missing Data in a Widely-Published Reddit Corpus(arXiv,2018)
- Model Context Protocol:Specification 2025-06-18
- Claude Code 文档:Connect Claude Code to tools via MCP
- OpenAI 文档:Connectors and MCP servers
- Cursor 文档:Model Context Protocol
- EveryInfra:数据接口目录(免费,price_usd、max_limit),2026-11-04 00:13 新加坡时间读取
引用编号 BL-84