Apify LinkedIn Scraper 替代:千条实测
千份 LinkedIn 资料,Apify 常用款 $4,我们实测 $0.556;千条职位 $0.0033,差 606 倍;Apify 更便宜的地方也照实写。
同样拿 1,000 份 LinkedIn 个人资料,Apify Store 上近 30 天用户最多的 LinkedIn Profile Scraper(harvestapi,15,718 位用户)公开价是 Free 和 Starter 档 $4.00、Business 档 $3.20,带邮箱查找是 $10.00;我们在 2026-11-05 用 EveryInfra 的 linkedin/person_profile 真调,一次一份、一次 $0.000556,折合每千份 $0.556,比它的 Free 档便宜 7.2 倍。差距最大的是「一次能回很多条」的数据:linkedin/jobs 在新加坡搜 11 个岗位词,1,853 条不重复职位共扣 $0.006116,每千条 $0.0033,比用户最多的 Linkedin Jobs Scraper(curious_coder,Free 档 $2.00)便宜 606 倍;linkedin/profile_search 一次回 78 人,每千人 $0.0071。反过来也要说清楚:Store 里有一个只有 132 位用户的 LinkedIn Profile API,单查个人资料每千份只要 $0.02,比我们便宜 27.8 倍;我们的 linkedin/job_detail 这次 5 次全部 503(没扣钱),单条职位详情这一项,Apify 上能跑通而且更便宜。
本文的「每千条价」,是把一次请求实际扣掉的钱(响应里的 charged_usd),除以这次实际返回、并且去重后的条数,再乘 1,000。它回答的是「拿到 1,000 条可用结果要花多少钱」。EveryInfra 按请求计费,一次请求不论回 1 条还是 200 条都是同一个价;Apify Store 里的 LinkedIn scraper 大多按结果(事件)计费,每多一条结果就多一笔。两种单位只有换成同一个分母才能比。Apify 一侧我们只用公开材料:Store 页面、价格页、文档,以及不需要账号就能读的公开接口 api.apify.com/v2/acts/<作者>~<名字>;我们没有注册 Apify,也没有跑它的 actor(Apify 对云端抓取程序的叫法),所以表里 Apify 的数字都是「公开单价」,不是「实测账单」,我们这一侧的数字都是真调。
apify linkedin scraper 和 EveryInfra:先看总表
下面这张表只放两类数:Apify Store 的公开单价(网址见参考资料,读取时间 2026-11-05 00:16–00:40 新加坡时间,档位写在格子里),以及我们 2026-11-05 的真调结果(新加坡时间、能力名、返回条数、charged_usd)。Apify 的档位跟着你的月套餐走:Free 计划每月送 $5 额度、不打折;Starter $19/月对应 Bronze 档;Scale $199/月对应 Silver;Business $999/月对应 Gold;Platinum 和 Diamond 是更大的定制合同。同一个 actor 在不同档位的单价可以差到一半,所以我们把 Free 档和最低的 Diamond 档都列出来。
| 数据 | Apify 常用 scraper(30 天用户数) | Apify 每千条:Free 档 / Diamond 档 | EveryInfra 能力 | 实测(新加坡时间、条数、实扣) | EveryInfra 每千条 | 倍数(Apify Free ÷ 我们) |
|---|---|---|---|---|---|---|
| 个人资料 | LinkedIn Profile Scraper,harvestapi(15,718) | $4.00 / $2.20 | linkedin/person_profile | 00:14–00:18,5 次各 1 份,各 $0.000556 | $0.556 | 7.2 倍 |
| 个人资料 + 邮箱 | 同上,Profile details + email search | $10.00 / $10.00 | linkedin/person_profile(email 字段) | 同上,5 份里 3 份带 email | $0.556 | 18 倍 |
| 公司资料 | LinkedIn Company Details Scraper,harvestapi(8,071) | $4.00 / $1.20 | linkedin/company_profile | 00:14–00:22,4 次各 1 家,各 $0.000556 | $0.556 | 7.2 倍 |
| 职位列表 | Linkedin Jobs Scraper,curious_coder(15,193) | $2.00 / $1.00 | linkedin/jobs | 00:14–00:53,11 次,1,853 条不重复,共 $0.006116 | $0.0033 | 606 倍 |
| 职位列表(最便宜) | Rapid Linkedin Jobs Scraper 快速模式,worldunboxer(632) | $0.10 / $0.10 | linkedin/jobs | 同上 | $0.0033 | 30 倍 |
| 单条职位详情 | 同上,详细模式 | $0.35 / $0.30 | linkedin/job_detail | 00:25–01:10,5 次全部 503,0 扣费 | 目录价 $1.194(这次没跑通) | Apify 便宜 3.4 倍 |
| 按条件搜人 | LinkedIn Profile Search Scraper,harvestapi(8,094) | short $4.00 / $1.00;full $8.00 / $3.20 | linkedin/profile_search | 00:26,异步 1 次 78 人,$0.000556 | $0.0071 | 561 倍(short) |
| 公司员工名单 | LinkedIn Company Employees Scraper,harvestapi(6,420) | short $3.00 / $1.15,另加每次启动 $0.02 | linkedin/employees | 00:22,1 次 200 人,$0.000556 | $0.0028 | 1,079 倍(short) |
| 个人资料(最便宜) | LinkedIn Profile API,johnvc(132) | $0.02 / $0.02 | linkedin/person_profile | 同第一行 | $0.556 | Apify 便宜 27.8 倍 |
这张表最容易被误读的地方有三个。第一,两边的字段不一样,倍数只说明「同样拿到一条结果」的钱,不说明「拿到的东西一样多」;我们在后面每个场景里,把自己这边实测的字段填充率和 Apify 页面自己写的字段分开列,不写「两边一样」。第二,Apify 的价格是写在 Store 上的单价乘 1,000,实际账单还会受最少结果数、启动费、失败重跑、Free 计划的运行次数上限影响;我们这一侧是把真实扣费除以真实条数,空结果和失败的钱算进分子。第三,倍数大的那几行,都是 EveryInfra「一次回一页」的能力;一次只回一份的个人资料和公司资料,倍数只有 7.2,碰上 Store 里最便宜的第三方,我们反而更贵。
我们怎么测、怎么算
真调全部在 2026-11-05 凌晨完成,时间都按新加坡时间记,从 00:14 开始,到 01:17 结束。用的是一把测试 Key,每分钟最多 10 次请求,还和另外几位同事共用,所以我们每次请求之间隔 8 秒,碰到 429(请求太频繁)就等 62 秒再发,429 的那几次不计入结果。个人资料、公司、职位三类各测了 5 次以上:个人资料 5 位公开人物加 1 个不存在的用户名;公司 4 家加 1 个不存在的公司名,其中 Microsoft、Grab、Santander 各撞过 1 次 429,62 秒后重发,表里只计重发那次;职位在新加坡用 10 个岗位词搜了 11 次(data engineer 隔 39 分钟又搜了一次)。单条职位详情 4 次(01:10 又补了 1 次),按条件搜人同步、异步各 1 次(只有异步那次成功),公司员工名单 1 次,这三类样本小,结论只作参考;再加上「不带 Key」和「参数拼错」各 1 次,用来看失败时扣不扣钱。
每千条价按同一个公式算:实扣合计 ÷ 去重后的条数 × 1,000。空结果、失败的钱算进分子,条数不算进分母,所以我们这边哪次回得少,价格只会被算高。职位按 id 去重,搜人按个人主页地址去重。Apify 一侧,我们从 api.apify.com/v2/acts/<作者>~<名字> 读每个 actor 的 pricingInfos(每种收费事件在每个档位的单价)和 stats(30 天用户数、运行次数、成功率),把「每条结果对应的主事件」单价乘 1,000;如果这个 actor 还收「每次启动」或「每页搜索」的钱,我们按页面写明的每页条数摊进去,并在表里写出来。挑选规则在动笔前就定好:每类数据取「近 30 天用户最多」的一个,再取「用户数 ≥100 里 Free 档最便宜」的一个。
| 场景 | 调用次数 | 成功拿到数据 | 返回条数合计 | 实扣合计 | 时间(新加坡时间) |
|---|---|---|---|---|---|
linkedin/person_profile | 7 | 5 | 5 | $0.002780 | 00:14–00:25 |
linkedin/company_profile | 5(另有 3 次 429 不计) | 4(另 1 次空结果也扣了) | 4 | $0.002780 | 00:14–00:22 |
linkedin/jobs | 12 | 11 | 1,970(去重 1,853) | $0.006116 | 00:14–00:53 |
linkedin/job_detail | 4 | 0 | 0 | $0 | 00:25–00:28 |
linkedin/profile_search | 2 | 1 | 78 | $0.000556 | 00:23–00:26 |
linkedin/employees | 1 | 1 | 200 | $0.000556 | 00:22 |
| 补测:美国、马德里、墨西哥城职位 3 次,BBVA、Mercado Libre 公司 2 次,马德里搜人 1 次,职位详情重试 1 次 | 7 | 6 | 657 | $0.003336 | 00:56–01:10 |
| 经 MCP 调用(带 Key 1 次、不带 Key 2 次) | 3 | 1 | 1 | $0.000556 | 01:02–01:17 |
| 合计 | 41 | 29 | 2,915 | $0.016680 | 00:14–01:17 |
本篇全部真调的接口费合计 $0.016680,没有超过事先定的 $0.10。另外两张示意图用了生图服务,各约 $0.03。我们没有为了凑好看的数字重跑:第一次同步搜人在 89 秒时超时(503,没扣钱),我们照实记下,再按错误提示改成异步跑了一次。
apify linkedin scraper cost:Store 上的价格怎么读
在 Apify Store 搜「linkedin」,2026-11-05 00:17 新加坡时间一共列出 370 个结果。我们按公开接口把这 370 个逐个读了一遍:近 30 天用户数 ≥100 的有 109 个;这 109 个里,有 78 个在标题或简介里明说「No cookies」「No login」之类,不需要你交出自己的 LinkedIn 登录信息。收费方式上,370 个里有 31 个属于「按事件 + 平台用量」,也就是除了每条结果的钱,还要另付运行时的计算、代理和存储费;用户 ≥100 的 109 个里,这样收费的只有 4 个,其余 105 个都是纯按事件收费。只看个人资料类、30 天用户 ≥100 的 12 个 scraper,Free 档每千份的中位价是 $5.00,最低 $0.02,最高 $10.00(带邮箱)。
读 Apify 的价格有四个坑。第一个是档位。Apify 的价格页写得很清楚,Free 计划每月送 $5 额度且「No Apify Store discount」,付费计划才分 Bronze、Silver、Gold 折扣档;Store 的每个 actor 自己决定每档打多少折。harvestapi 的个人资料 scraper 在 Free 和 Bronze 都是每千份 $4.00,Silver $3.60,Gold $3.20,Platinum $2.60,Diamond $2.20;职位 scraper curious_coder 则是 Free $2.00、Bronze 起一律 $1.00,Free 档整整贵一倍。所以同一个 actor,「一个月只抓几千条的个人用户」和「Business 套餐的公司」看到的价可以差将近一倍,比价时要先确认自己在哪一档。
| Apify 套餐 | 月费 | 每月可用额度 | Store 折扣档 | 计算单元价 |
|---|---|---|---|---|
| Free | $0 | $5 | 无折扣 | $0.2 / CU |
| Starter | $19 | $19 | Bronze | $0.2 / CU |
| Scale | $199 | $199 | Silver | $0.16 / CU |
| Business | $999 | $999 | Gold | $0.13 / CU |
| Enterprise | 定制 | 定制 | 定制 | 定制 |
上表来自 Apify 价格页(2026-11-05 00:39 新加坡时间读取)。额度用完之后按用量继续付费,可以在账户里设上限。计算单元(CU)指 1 GB 内存跑 1 小时,按事件收费的 actor 一般不另收 CU,370 个里属于「按事件 + 用量」的 31 个会另收(用户 ≥100 的里只有 4 个)。
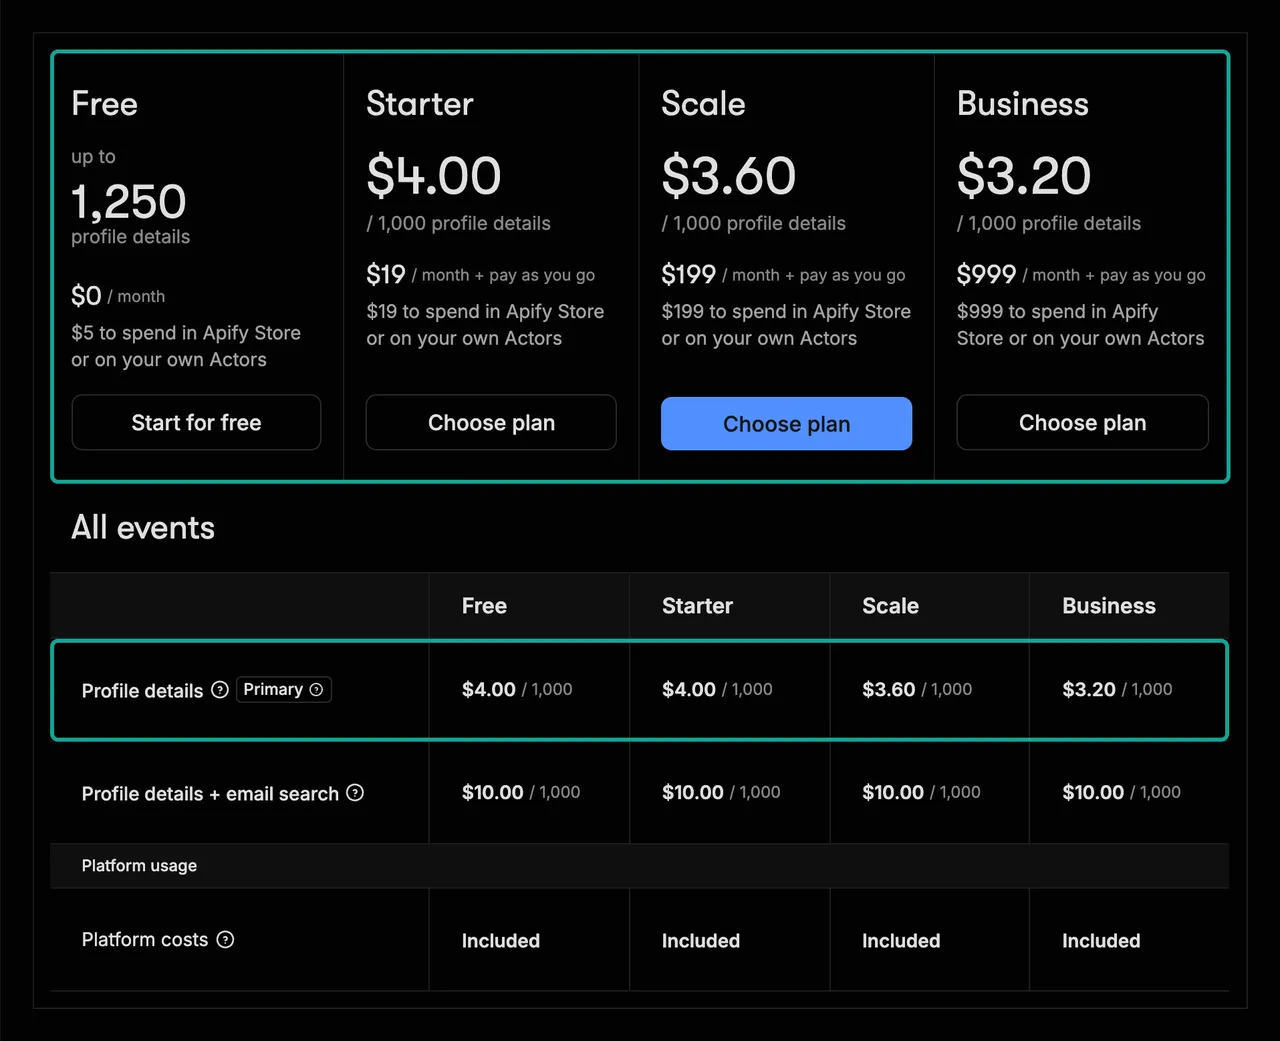
第二个坑是标题价和实际档位。好几个 actor 在标题或简介里写一个很低的价,那往往是高档位的价。datadoping 的个人资料 scraper 简介写「For just $3 per 1,000 profiles」,公开接口里的 Free 档是 $4.00、Bronze $3.50,要 Gold 档才是 $3.00;它的公司 scraper 简介写「$1.2 per 1,000 companies」,Free 档其实是 $1.55。curious_coder 的职位页写「Pricing from $1.00 / 1,000 results」,这个「from」就是 Bronze 以上,Free 计划用户每千条付 $2.00。这不算对方写错,只是读的时候要把「from」当回事。
第三个坑是启动费和每页费。harvestapi 的公司员工 scraper 每次启动收 $0.02,按条件搜人 scraper 每个搜索页收 $0.10、一页最多 25 人,页面原文写「regardless of how many profiles were found on the page」,也就是一页不满 25 人也按一页收。我们把每页费按满页 25 人摊进去算出每千人 $4.00,这是对 Apify 最有利的算法;如果你的条件很窄、一页只有几个人,实际每千人会更贵。valig 的职位 scraper 每次启动收 $0.001,fantastic-jobs 的职位 API 在 Free 档每次启动收 $0.01。跑一次几千条时这些费用可以忽略,但如果你像很多 n8n 流程那样「每来一条线索就启动一次」,启动费会变成主要成本。
第四个坑是 Free 计划的运行次数。harvestapi 的个人资料页写着「Users on free-tier plans are limited to 50 runs in total」,Free 计划用户总共只能跑 50 次。Free 计划每月的 $5 额度,按 $4.00 每千份算能拿 1,250 份个人资料,这也是截图里「up to 1,250」的来历。r/n8n 上有人分享一个「免费」的 LinkedIn 招聘信息抓取流程,用 Apify 的 Free 档抓 LinkedIn 帖子;一位用户回复说试了之后「the apify $5 just went away in a few minutes」,跑一次要 1 美元以上。另一篇求助帖里,两位用户推荐 curious_coder 的职位 scraper,说 Free 档每月大约能拿 5,000 条。我们没法核对他们的账单。按 curious_coder 现在的 Free 档 $2.00 每千条算,$5 只够 2,500 条,比那条回复说的少一半;它的现行价格是 2026-08-14 开始的,帖子里的数可能是旧价。这也说明 Store 上的价格会变,引用别人的经验之前要先看当前的 Pricing 标签。
EveryInfra 这一侧没有档位:LinkedIn 的 person_profile、company_profile、jobs、profile_search、employees 目录价都是每次 $0.000556,job_detail 每次 $0.001194,person_posts 每次 $0.004;不分套餐、没有月费,充多少用多少。试用是在 GitHub 给 2 个仓点星,领 $1 额度、24 小时内有效;正式使用从 $10 起充值。价格也写在每个能力页上,例如 LinkedIn 个人资料接口、LinkedIn 职位搜索接口。
| EveryInfra LinkedIn 能力 | 每次价格 | 每次最多条数 | 每千条(满页时) |
|---|---|---|---|
linkedin/person_profile 个人资料 | $0.000556 | 1 | $0.556 |
linkedin/company_profile 公司主页 | $0.000556 | 1 | $0.556 |
linkedin/followers 粉丝数量 | $0.000556 | 1 | $0.556 |
linkedin/job_detail 职位详情 | $0.001194 | 1 | $1.194 |
linkedin/search 帖子关键词搜索 | $0.000556 | 50 | $0.011 |
linkedin/profile_search 按条件搜人 | $0.000556 | 100 | $0.0056 |
linkedin/jobs 职位搜索 | $0.000556 | 200 | $0.0028 |
linkedin/employees 公司员工 | $0.000556 | 200 | $0.0028 |
linkedin/comments 帖子评论 | $0.000556 | 200 | $0.0028 |
linkedin/company_posts 公司动态 | $0.002319 | 50 | $0.046 |
linkedin/person_posts 个人动态 | $0.004 | 50 | $0.080 |
这张表的最后一列是「每次都回满」时的理论值,实测往往回不满:这次职位搜索平均每次 179 条,所以实测每千条是 $0.0033 而不是 $0.0028;搜人回了 78 人而不是 100 人,实测是 $0.0071 而不是 $0.0056。按次计费的能力,真正的价格取决于你一次能拿回多少条。
场景一:1,000 份个人资料
我们先用 linkedin/person_profile 查了 5 位公开身份的商界人物:Microsoft 的 Satya Nadella、LinkedIn 联合创始人 Reid Hoffman、Bill Gates、前 LinkedIn CEO Jeff Weiner、LinkedIn 高管 Ryan Roslansky。参数 username 可以填主页路径里的用户名,也可以填完整主页地址,我们第 3 次用的是完整地址,结果一样。5 次都返回 200,每次扣 $0.000556,耗时 17.3 到 51.6 秒;最慢的那次(00:18 新加坡时间)返回的资料里没有工作经历也没有教育经历,和目录字段说明写的一致:主来源暂时不可用时,结果来自备用来源,follower_count、top_skills、open_to_work 等字段可能缺,经历条目没有时长文字。
| 字段 | 5 份里有值的份数 | 说明 |
|---|---|---|
| headline、about、location、current_company | 5 / 5 | 个人主页公开填写的内容 |
| follower_count、connection_count | 5 / 5 | 粉丝数和人脉数 |
| experience(工作经历) | 4 / 5 | 有值的 4 份分别有 5、5、3、7 条 |
| education(教育经历) | 4 / 5 | 有值的 4 份分别有 2、2、2、1 条 |
| 3 / 5 | 目录写明:根据公开信息推断的工作邮箱,并做过验证 | |
| open_to_work、account_created_at | 4 / 5 | 备用来源会缺 |
| top_skills | 0 / 5 | 5 份都为空 |
再用一个不存在的用户名查了一次(00:19 新加坡时间),32 秒后回 503,错误码 unavailable,billing.charged 为 false,reason 写 request_failed_refunded,扣费 $0。也就是说,「查无此人」在我们这边表现为「暂时拿不到」而不是「200 空结果」,不扣钱,但你没法从这一次的响应里区分「这个人不存在」和「这次真的没取到」;错误里的 next_steps 会告诉你「Not charged」并建议隔 retry_after 秒再试,连续失败到第 3 次会说明该检查什么。
Apify 这边,个人资料 scraper 的选择最多。用户最多的 harvestapi 每千份 $4.00(带邮箱 $10.00),页面写「No cookies or account required」,可以填用户名、主页地址或内部 ID,邮箱查找模式会做 SMTP 验证,资料不全查不了邮箱时不收邮箱的钱。apimaestro 的 Profile Details Scraper 每千份 $5.00,Diamond 档 $2.10,近 30 天 4,636 位用户、运行成功率 100%。最便宜的是 johnvc 的 LinkedIn Profile API:每份资料 $0.00001,加上每条数据集记录 $0.00001,合计每千份 $0.02,每次启动另收 $0.00001。它只有 132 位用户,近 30 天运行成功率 91.12%,比 harvestapi 的 99.97% 低不少,但按价格看,单查个人资料这件事,它比我们便宜 27.8 倍。我们没有跑过它,不知道它回的字段完整到什么程度;它的页面写的是姓名、头衔、所在地、当前公司、经历、教育和粉丝数。
所以单查个人资料的结论是:和 Store 上用户最多的几个比,我们便宜 7 到 9 倍;和最便宜的那一个比,我们贵。如果你的活就是「每天拿一份名单去补全个人资料」,而且对成功率要求不高,那个 $0.02 的 actor 值得先试;如果你还要搜人、搜职位、拿公司资料,放在一个账户、一把 Key 里按同一个价结算,省掉的是对账和维护几个 actor 的时间。也可以先用一次 按条件搜人,它一次回几十人的完整经历,比逐个查个人资料便宜得多,这一点在场景四里细说。
场景二:1,000 份公司资料
linkedin/company_profile 查了 4 家公司:Stripe、Microsoft、Grab 和西班牙的 Santander(用完整主页地址)。4 次都在 6 到 9 秒内回 200,各扣 $0.000556。Stripe 的员工数是 16,694,employee_count_range 写 5001-10000,14 个办公地点;Microsoft 员工数 231,125,粉丝 29,447,391,45 个办公地点;Grab 员工数 58,341,总部 Singapore,2012 年成立;Santander 员工数 131,291,总部在马德里的 Boadilla del Monte。要留意的是 employee_count(在 LinkedIn 上把这家公司填为现职的会员数)和 employee_count_range(公司自己选的规模档)可以对不上,Stripe 和 Grab 都是会员数超过了自报的规模档,做线索打分时两个字段要分开用。
| 公司 | employee_count | employee_count_range | follower_count | 总部 | 办公地点数 |
|---|---|---|---|---|---|
| Stripe | 16,694 | 5001-10000 | 1,805,161 | South San Francisco, US | 14 |
| Microsoft | 231,125 | 10001+ | 29,447,391 | Redmond, US | 45 |
| Grab | 58,341 | 5001-10000 | 1,056,756 | Singapore | 16 |
| Santander | 131,291 | 10001+ | 2,240,169 | Boadilla del Monte, ES | 3 |
4 家公司的 description、website、industries、headquarters、offices 都有值,founded_year 只有 2 家有,crunchbase_url 和 latest_funding_round 4 家都为空。目录的字段说明写了:主来源不可用时,结果来自备用来源,融资、Crunchbase 链接、坐标等字段会缺。如果你买公司资料主要是为了融资轮次,这次的实测说明这两项我们这边不能指望。
这一节有一个必须照实写的问题。我们用一个不存在的公司名(00:20 新加坡时间)查了一次,返回的是 HTTP 200、results 里所有字段都是空字符串,并且扣了 $0.000556。按我们自己的规则,空结果应该不扣钱,这次是我们的问题,已经报给工程团队修。在修好之前,如果你的公司名单来源不可靠,最好先过一遍格式,或者把 results.name 为空的那几次连同 request_id 记下来,找我们核对。算上这一次空结果,这 5 次的实际每千家价是 $0.695,比只算成功的 $0.556 贵了 25%。
Apify 这边,用户最多的是 harvestapi 的 LinkedIn Company Details Scraper(8,071 位用户),每千家 Free $4.00、Diamond $1.20,另收每次启动 $0.00005,页面写「No cookies or account required」,还能按公司名批量找主页地址。最便宜的是 datadoping 的 Linkedin Company Details Scraper:Free 档 $1.55,Gold 起 $1.20,近 30 天 116 位用户、成功率 99.99%。和它比我们便宜 2.8 倍;和 harvestapi 比便宜 7.2 倍。公司资料一次一家,倍数天然不会大,真正的差距在下面「一次回一页」的能力上。想直接试,可以打开 LinkedIn 公司资料接口 页面用页上的试用框跑一次。
场景三:1,000 条职位(apify linkedin scraper jobs)
职位是 LinkedIn 数据里最常见的需求,也是两种计费方式差距最大的地方。linkedin/jobs 的参数很简单:keyword 是岗位搜索词(也可以直接填 LinkedIn 职位搜索页的完整地址),location 是地点,limit 最多 200。我们在新加坡按 10 个常见岗位词各搜一次(data engineer 后来又搜了一次,共 11 次),limit 都填 200:data engineer、software engineer、product manager、data scientist、data analyst、marketing manager、account executive、business analyst、devops engineer、finance manager。大 limit 的搜索比较慢,第一次同步调用用了 89.9 秒,之后我们都加了 "mode": "async",先拿到 job_id,再按 poll_url 每 8 秒查一次。
11 次搜索(10 个岗位词,data engineer 隔 39 分钟又搜了一次)全部成功,各扣 $0.000556,合计 $0.006116;每次返回 102 到 200 条,合计 1,970 条,按职位 id 去重后 1,853 条,每千条 $0.0033。异步任务从提交到拿到结果用了 115 到 221 秒。第 7 次搜索之后累计就超过了 1,000 条(1,193 条),也就是说,凑够 1,000 条不重复的新加坡职位,在我们这边只用了 7 次请求、$0.003892。重复主要来自复测:00:14 同步搜 data engineer 只回了 102 条,00:53 异步再搜同一个词回了 198 条,其中 101 条和第一次重合;不同岗位词之间只有 14 条重复,来自 data analyst 和 business analyst 这两个和别的词交叉的岗位。
新加坡之外我们也各搜了一次。00:56 搜「software engineer」+「United States」,180.7 秒回 198 条、扣 $0.000556,但这 198 条只来自 31 家公司,其中 Affirm 一家就占 100 条,AWS 32 条,JPMorganChase 20 条;把整个国家当地点、搜一个很宽的词,结果会被几家大量发帖的公司占满,想看一个市场的分布,按城市搜更稳。马德里「analista de datos」回 199 条、来自 165 家公司,墨西哥城「data analyst」回 158 条、来自 126 家公司,分布就均匀得多;两次各扣 $0.000556,带 salary 的分别只有 3 条和 10 条。
| 岗位词 | 时间(新加坡时间) | 返回 | 新增不重复 | 累计不重复 | 耗时(秒) |
|---|---|---|---|---|---|
| data engineer(同步) | 00:14 | 102 | 102 | 102 | 89.9 |
| software engineer | 00:29 | 194 | 194 | 296 | 131.9 |
| product manager | 00:31 | 200 | 200 | 496 | 221.4 |
| data scientist | 00:35 | 196 | 196 | 692 | 140.4 |
| data analyst | 00:37 | 198 | 192 | 884 | 156.6 |
| marketing manager | 00:40 | 189 | 189 | 1,073 | 164.2 |
| account executive | 00:43 | 120 | 120 | 1,193 | 115.4 |
| business analyst | 00:45 | 199 | 191 | 1,384 | 197.3 |
| devops engineer | 00:48 | 200 | 200 | 1,584 | 149.4 |
| finance manager | 00:51 | 174 | 174 | 1,758 | 123.9 |
| data engineer(复测) | 00:53 | 198 | 95 | 1,853 | 156.1 |
字段方面,第一次搜索返回的 102 条职位里,title、text(完整职位描述)、company_name、company_url、location、employment_type、seniority、applicant_count、posted_at 都是 102 条全有,职位描述的中位长度 3,567 个字符;salary 只有 4 条有值,因为新加坡的大多数职位帖本来就不写薪资。发布时间方面,102 条里 64 条是 2026 年 10 月发的,25 条是 11 月头几天发的。把 11 次的 1,970 条放在一起看:salary 只有 66 条有值(3.4%),写的都是新元月薪或年薪区间;employment_type 有 1,884 条是全职;seniority 有 1,046 条写 Not Applicable;applicant_count 的中位数是 101.5;1,853 条不重复职位来自 817 家公司,最多的是 OCBC(35 条)、GovTech Singapore 和 Shopee(各 33 条)。按发布月份看,1,853 条里有 1,232 条是 10 月发的、329 条是 11 月头几天发的,合计 84%;最早的一条是 2024 年 8 月的旧帖,说明搜索结果里会混进少量长期挂着的职位,做「新职位提醒」时要按 posted_at 再筛一遍。
Apify 的职位 scraper 种类最多。用户最多的 curious_coder Linkedin Jobs Scraper(15,193 位用户)每千条 Free $2.00、Bronze 起 $1.00,页面写它能带上职位发布人和公司详情;它也写明了一个 LinkedIn 自己的限制:「Linkedin limits number of jobs per search to 1000」,一次搜索最多 1,000 条,要更多就打开「Split search urls by location」,按城市拆成多个搜索再去重。valig 的 LinkedIn Jobs Scraper(8,091 位用户)每千条 $0.40、每次启动 $0.001;cheap_scraper 写「No login or cookies needed」,每千条 $0.70;worldunboxer 的 Rapid Linkedin Jobs Scraper 快速模式每千条只要 $0.10,详细模式 $0.35,它写自己有「cron schedules, webhooks and MCP for AI agents」。fantastic-jobs 的 Advanced LinkedIn Job Search API 是另一种东西:它说自己是每月 1,000 万条新职位的数据库,有招聘人和 AI 补充字段,Free 档每千条 $5.00、Gold 起 $1.50。
和这些比,我们的 linkedin/jobs 每千条 $0.0033,比 curious_coder 的 Free 档便宜 606 倍,比 valig 便宜 121 倍,比 Store 里最便宜的 $0.10 也便宜 30 倍。但单条职位详情是反过来的:linkedin/job_detail 目录价每次 $0.001194,折合每千条 $1.194,而且这次 5 次(三个真实职位编号,其中一个是 01:10 从 data engineer 搜索结果里另取的;一个不存在的编号;一个错误提示里给的示例编号)全部返回 503、全部没扣钱。worldunboxer 的详细模式每千条 $0.35,比我们的目录价便宜 3.4 倍。好在 linkedin/jobs 的 text 字段已经带了完整职位描述,大多数场景不需要再逐条查详情;需要申请链接、福利这类只在详情页出现的字段时,这一项现在 Apify 更合适。
场景四:按条件搜人、公司员工名单
linkedin/profile_search 是按职位头衔和所在地搜人:keyword 填当前职位头衔,location 填地点,limit 最多 100。我们搜「head of growth」+「Singapore」,limit 填 100。第一次同步调用在 89.4 秒时返回 503 timeout,没扣钱;响应里的提示写着大 limit 应该加 "mode":"async"。00:26 新加坡时间我们改成异步重发,约 2 分钟后拿到 78 人,扣 $0.000556,折合每千人 $0.0071。这 78 人里,experience 78 人都有(中位 7 段经历),education 74 人有,about 59 人有,email 47 人有,is_premium 为 true 的 27 人。也就是说,一次搜人拿回来的就是带完整经历的资料,比逐个查 person_profile 便宜约 78 倍。
要提醒一点:location 不等于「现在人在这个城市」。这 78 人里,location 写着 Singapore 的只有 27 人,其余在悉尼、纽约、旧金山湾区、孟买、伦敦、香港、巴黎等地;但整条记录里出现过 Singapore 的有 48 人,看起来经历里在新加坡待过的人也会被搜进来。01:06 我们在马德里搜「data scientist」复核,limit 100,229.4 秒回 100 人、扣 $0.000556:location 带 Madrid 的 55 人,整条记录里出现过 Madrid 的 77 人,headline 里有 data scien 的 94 人。所以要的是「现在在当地」的名单,拿回来后自己再按 location 过滤一遍;按这次的比例,实际能用的人数大约是返回数的一半。
linkedin/employees 是按公司拿员工:我们查 Stripe、limit 200,61.5 秒回 200 人,扣 $0.000556,折合每千人 $0.0028。这 200 人都有 headline 和 location,email 为 0(目录写明员工名单里的邮箱只在本人公开时才有),is_premium 为 true 的有 106 人。这两次返回的是普通人的姓名和职业信息,本文不展示任何一个人的名字或邮箱。
Apify 上同类的选择:harvestapi 的 LinkedIn Profile Search Scraper(8,094 位用户)short 模式只收每页 $0.10、一页最多 25 人,按满页算每千人 $4.00;full 模式再加每人 $0.004,每千人 $8.00;带邮箱再贵。它的强项是筛选条件多,页面列了按公司、行业、学校、年限等组合搜索,还有专门按姓名搜人的 actor。harvestapi 的 Company Employees Scraper short 模式每千人 $3.00、每次启动 $0.02,full 模式每千人 $8.00,并且写「This actor can try to find contact emails」。和 short 模式比,我们的搜人便宜 561 倍、员工名单便宜 1,079 倍;但我们只有头衔加地点两个条件,没有按行业、学校、在职年限的组合筛选,要精细圈人群,Apify 那几个 actor 更顺手。
一篮子:1,000 份资料、1,000 家公司、1,000 条职位
把三类最常见的需求凑成一篮子,结果取决于你在 Apify 上怎么挑。按「每类用 Store 用户最多的那个」,Free 档是 $4.00 + $4.00 + $2.00 = $10.00,Starter(Bronze)档是 $9.00,Business(Gold)档是 $6.70;Free 计划每月只送 $5,这一篮子 Free 计划的额度都不够,至少要上 $19/月的 Starter。按「每类都挑 Store 里用户 ≥100、Free 档最便宜的」,是 johnvc $0.02 + datadoping $1.55 + worldunboxer $0.10 = $1.67。我们这边是 $0.556 + $0.556 + $0.0033 = $1.12。
| 组合 | 个人资料 | 公司 | 职位 | 合计 | 和 EveryInfra 比 |
|---|---|---|---|---|---|
| Apify 用户最多的三个,Free 档 | $4.00 | $4.00 | $2.00 | $10.00 | 9.0 倍 |
| 同上,Starter(Bronze)档 | $4.00 | $4.00 | $1.00 | $9.00 | 8.1 倍 |
| 同上,Business(Gold)档 | $3.20 | $2.50 | $1.00 | $6.70 | 6.0 倍 |
| Apify 每类最便宜的,Free 档 | $0.02 | $1.55 | $0.10 | $1.67 | 1.5 倍 |
| EveryInfra 实测 | $0.556 | $0.556 | $0.0033 | $1.12 | — |
最后这一行的差距只有 1.5 倍,原因很直接:最便宜的个人资料 actor 比我们便宜 27.8 倍,把职位上的优势吃掉了大半。如果你的篮子里个人资料占多数,在 Apify 上「每类挑最便宜」是可行的省钱路线,代价是要维护三个作者不同、输入格式不同、成功率不同的 actor;如果篮子里职位、搜人、员工名单占多数,按次计费的优势会越拉越大。
再换一个更接近日常的算法:一个招聘或销售团队每天跑一次例行任务,搜 10 个岗位词的职位、更新 50 家目标公司的资料、补 20 份候选人资料,连跑 30 天。职位条数按我们这次实测的每次 179 条算,两边都用同一个条数,只是计费方式不同。
| 每天的任务 | EveryInfra(每月) | Apify 用户最多的三个,Free(每月) | 同上,Starter / Bronze(每月) | Apify 每类最便宜的,Free(每月) |
|---|---|---|---|---|
| 10 次职位搜索,约 1,790 条 | $0.17 | $107.42 | $53.72 | $5.39 |
| 50 家公司资料 | $0.83 | $6.00 | $6.00 | $2.33 |
| 20 份个人资料 | $0.33 | $2.40 | $2.40 | $0.01 |
| 合计 | $1.33 | $115.82 | $62.12 | $7.72 |
这张表说明一件事:例行任务里只要有「一次回一页」的数据,按结果计费的账单就主要由它决定。用 Store 用户最多的三个 actor,Starter 计划每月 $19 的额度不够,要按用量再付约 $43;每类都挑最便宜的,月费在 $8 左右,我们是 $1.33,差 5.8 倍。启动费已按每次运行算进去,金额很小。
apify linkedin scraper api 和 EveryInfra 接口:调用方式对比
Apify 的每个 actor 都能用同一套 REST 接口启动。最常用的是「同步运行并取回数据集」:POST https://api.apify.com/v2/acts/<作者>~<名字>/run-sync-get-dataset-items,请求体是这个 actor 自己的输入(每个 actor 的输入字段不同,要看它 Store 页的 Input 标签),查询参数里可以带 timeout、memory、maxItems、maxTotalChargeUsd。其中 maxItems 按 Apify 文档的说法是「最多为多少条结果付钱」,并不保证 actor 只回这么多条;maxTotalChargeUsd 是这一次运行的花费上限,按次计费和按用量计费的都管用。这两个参数是 Apify 在控制花费上做得很好的地方,我们这边没有对应的「单次花费上限」,因为单次请求的价格本来就是固定的。下面是一段 Apify 的配置示例,我们没有运行它,输入文件要按你选的 actor 填。
# 配置示例(未运行):Apify 同步运行一个 LinkedIn 职位 actor,最多为 1,000 条付钱,整次最多花 $2
curl -X POST \
  "https://api.apify.com/v2/acts/curious_coder~linkedin-jobs-scraper/run-sync-get-dataset-items?maxItems=1000&maxTotalChargeUsd=2" \
  -H "Authorization: Bearer $APIFY_TOKEN" \
  -H "Content-Type: application/json" \
  -d @input.json   # 输入字段以该 actor 的 Input 标签为准
EveryInfra 这边所有平台共用一个地址:POST https://api.everyinfra.com/api/v1/social,请求体固定是 platform、action、params 三个键,换平台、换能力只改这三个值。慢的请求加 "mode": "async",立即拿到 job_id 和 poll_url,再用 GET 轮询;扣费在第一次响应里就写明,任务失败时按同一笔记录退回。下面是我们这次实测用的写法,Key 只从环境变量读。
# 实测写法:在新加坡搜 data scientist 职位,异步,最多 200 条
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"linkedin","action":"jobs","mode":"async",
       "params":{"keyword":"data scientist","location":"Singapore","limit":200}}'
# 返回 202:{"job_id":"…","status":"running","poll_url":"/api/v1/jobs/…","billing":{"charged_usd":0.000556,…}}
curl -s "https://api.everyinfra.com/api/v1/jobs/<job_id>" -H "Authorization: Bearer $EVERYINFRA_API_KEY"
# 轮询到 status=succeeded 后,results 里是职位数组
参数写错时,两边的反馈方式也不一样。我们故意把 location 拼成 locaton 发了一次(00:25 新加坡时间),0.1 秒就回了 422,错误码 unknown_param,里面列出这个能力支持的参数,并给了「did you mean location」,没扣钱;不带 Key 再发一次,回 401 missing_key,同样没扣钱。这样的错误文案是写给 AI 客户端看的:模型读到 422 可以自己改参数重发。Apify 的 actor 输入由各作者用 JSON Schema 定义,平台会在启动前校验类型和必填项,多余字段怎么处理各 actor 不一样,这一点我们没有实测。
除了 REST,Apify 有官方的 JavaScript、Python 客户端和 CLI,有 n8n、Make、Zapier 集成,还有定时任务(Schedules)和 Webhooks;EveryInfra 有 OpenAPI 文档、llms.txt、n8n 里直接用 HTTP Request 节点,以及下面要说的远程 MCP。想从 n8n 流程换过来,可以看站内的 Apify n8n 替代,那篇专门讲节点怎么改。
要不要登录态、要不要自带 cookie
LinkedIn 的大部分资料只有登录后才能完整看到,所以「要不要交出自己的 cookie」是选 LinkedIn scraper 时最该先问的问题。我们这一侧很简单:所有 LinkedIn 能力都只用你的 EveryInfra API Key,不需要、也不接收你的 LinkedIn 账号、密码或 cookie,参数里没有任何登录相关的字段。Apify 这一侧,我们这次读到的主流 actor 大多在标题里写明不要 cookie:harvestapi 的个人资料、公司、搜人、员工四个 actor 都写「No cookies or account required」;apimaestro 写「No Cookies」「No login required」;cheap_scraper 写「No login or cookies needed」;worldunboxer 写「without login cookies」;lergassy 写「No account at risk」。curious_coder 和 valig 的职位 scraper,我们读的简介和说明里没有写要不要 cookie,这里写「页面未说明」。Store 里也有要求填 li_at cookie 的 actor,用户数 ≥100 的 109 个里,没有在标题或简介明说不要 cookie 的有 31 个,用之前要逐个看清。
| 条目 | 页面原文 | 要不要交 LinkedIn cookie |
|---|---|---|
| harvestapi 个人资料、公司、搜人、员工 | No cookies or account required | 不要 |
| apimaestro 个人资料、员工 | No Cookies;No login required | 不要 |
| cheap_scraper 职位 | No login or cookies needed | 不要 |
| worldunboxer 职位 | without login cookies | 不要 |
| lergassy 个人资料 | No account at risk | 不要 |
| curious_coder 职位、valig 职位 | 页面未说明 | 页面未说明 |
| EveryInfra 全部 LinkedIn 能力 | 只用 EveryInfra API Key | 不要,也不接收 |
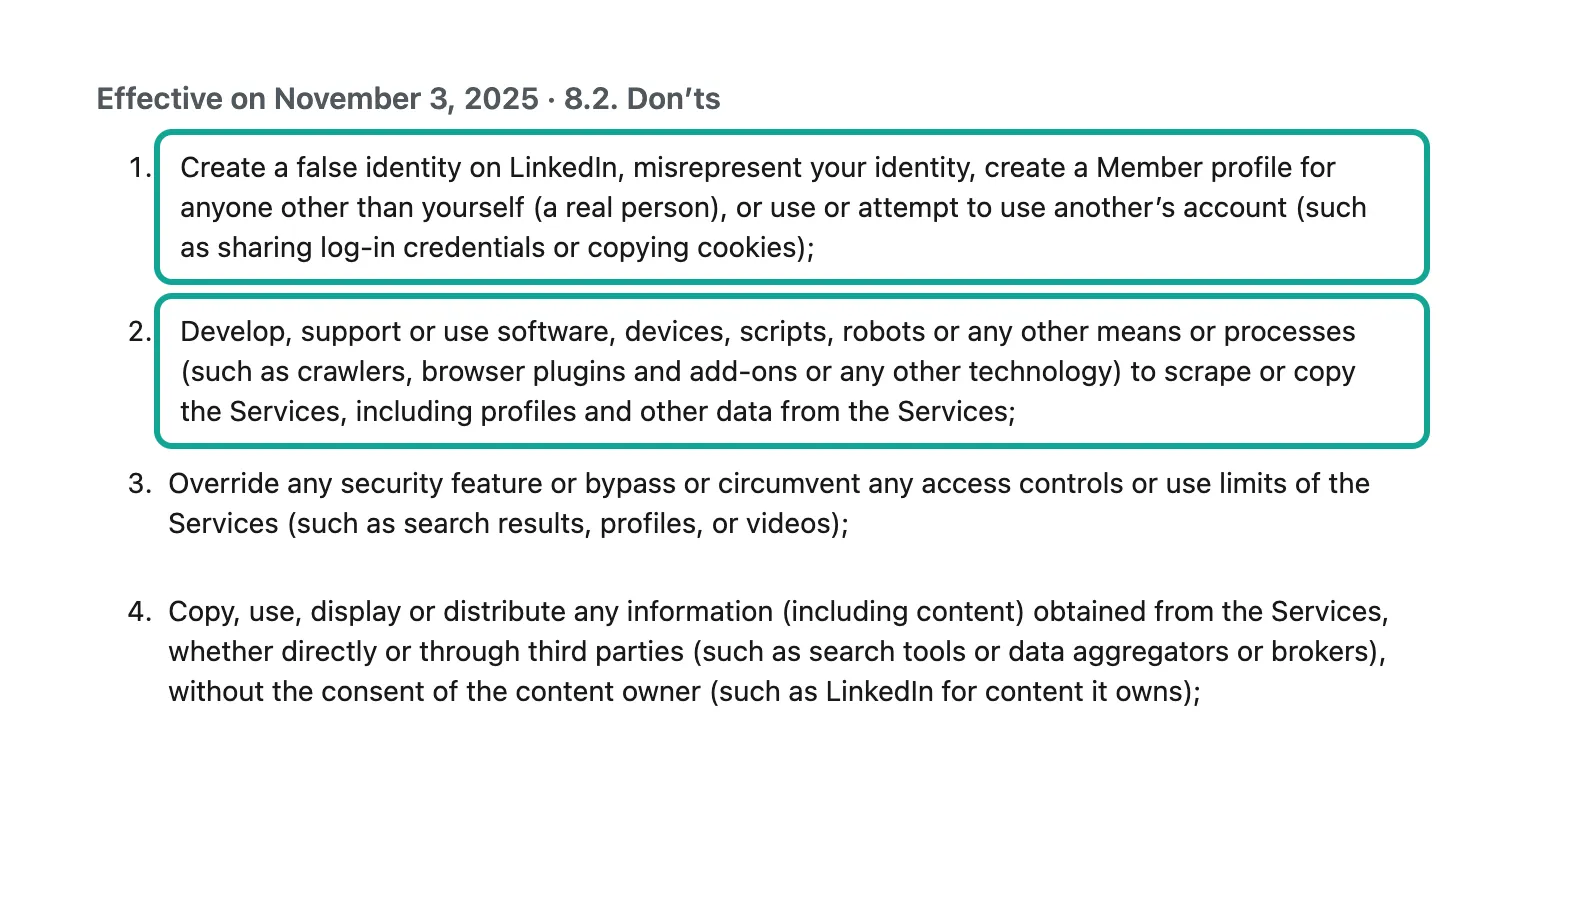
为什么这件事重要?LinkedIn 用户协议 8.2 条第 2 项写明,不得用爬虫、脚本、浏览器插件等手段抓取或复制服务(原文见下一节)。把自己账号的 cookie 交给第三方工具去批量抓取,抓取是挂在你自己的账号下进行的,账号被限制或封禁,损失落在你身上。用别人的 cookie 还会撞上第 1 项:不得「use or attempt to use another's account (such as sharing log-in credentials or copying cookies)」,括号里点名了共享登录凭据和复制 cookie。
LinkedIn 用户协议对抓取写了什么
我们读的是 linkedin.com/legal/user-agreement 当前版本,页面写「Effective on November 3, 2025」(2025 年 11 月 3 日生效)。和抓取最相关的是第 8.2 条「Don'ts」,「You agree that you will not」下面列了很多项,其中第 2 项是不能「Develop, support or use software, devices, scripts, robots or any other means or processes (such as crawlers, browser plugins and add-ons or any other technology) to scrape or copy the Services, including profiles and other data from the Services」,也就是不能开发、支持或使用爬虫、插件、脚本等手段抓取或复制服务,包括个人资料;第 3 项是不能绕过访问控制或使用限制(例如搜索结果、个人资料);还有一项是不能通过第三方(括号里点名了「data aggregators or brokers」,数据聚合商或数据经纪商)复制、分发服务里的信息。第 5 条还写明,8.2 条在合同终止后继续有效。
这些条款约束的是「使用 LinkedIn 服务、同意了这份协议」的人。不登录、只看公开页面的访问是否同样受约束,美国法院在 hiQ Labs 诉 LinkedIn 一案里讨论了多年:第九巡回上诉法院 2022 年 4 月 18 日的意见认为,抓取公开可见的资料,很可能不构成美国《计算机欺诈和滥用法》(CFAA)意义上的「未经授权访问」;这份意见是最高法院 2021 年 Van Buren 案对「超出授权访问」作出解释之后,第九巡回法院重新审理的结果;但同年加州北区联邦地区法院又认定 hiQ 违反了用户协议,案子最后以和解结束。2025 年 1 月 24 日,LinkedIn 在加州北区法院起诉 Proxycurl 的运营方 Nubela(案号 3:25-cv-00828),指控它用几十万个假账号抓取会员资料,Proxycurl 在 2025 年 7 月 4 日宣布关停;2025 年 10 月 LinkedIn 又起诉了 ProAPIs、Netswift 两家公司,指它们用数以百万计的假账号抓资料再转卖,据 The Record 报道,加州联邦法院后来批准了双方的同意判决,要求两家停止抓取、出售和转移会员数据,不再用假账号访问 LinkedIn,并删除已抓的数据。这些案子的共同点,是被告都被指用了假账号或绕过登录墙。
LinkedIn 另有一份「Crawling Terms」(2017 年 5 月 25 日修订)和 robots.txt,写明未经许可的自动抓取被禁止,只给白名单里的搜索引擎放行;它的官方 API(Microsoft Learn 上的 LinkedIn API 文档)对一般开发者开放的权限只有登录、读取自己的基本资料和邮箱、代表会员发帖,按条件搜人、读取别人的完整资料要走 Sales Navigator 或 Talent Solutions 这类合作伙伴计划,审核制。所以 LinkedIn 自己并没有给「批量读取公开资料」开一个人人能申请的口子,这也是第三方 scraper 有市场的原因。
我们不提供法律意见。实际要不要用、怎么用,取决于你的业务、所在地和数据用途,请找你所在地的律师确认。我们能说的事实是:本文用到的 EveryInfra LinkedIn 能力都只返回公开页面能看到的信息,不需要你的账号;person_profile 和 profile_search 里的 email 字段是根据公开信息推断并验证过的工作邮箱,employees 里的邮箱只在本人公开时才有。拿到的个人数据要按你所在地的个人数据法规处理,例如新加坡的 PDPA、欧盟的 GDPR,用来做营销前尤其要先看清对方是否同意。
失败和空结果扣不扣钱
失败扣不扣钱,决定了「跑得不顺」的那一天你要多付多少。这次我们一共遇到 4 类失败。
| 情况 | 时间(新加坡时间) | HTTP | 错误码 | EveryInfra 实扣 | Apify 公开规则 |
|---|---|---|---|---|---|
| 不带 API Key | 00:25 | 401 | missing_key | $0 | 没有 token 无法启动 |
参数拼错(locaton) | 00:25 | 422 | unknown_param | $0 | 平台按输入 Schema 校验,各 actor 处理不同 |
| 查一个不存在的人 | 00:19 | 503 | unavailable | $0 | 按事件收费:没产生结果事件就不收结果的钱,启动费照收 |
| 单条职位详情暂不可用(5 次) | 00:25–01:10 | 503 | unavailable | $0 | 同上 |
| 同步搜人超时 | 00:23 | 503 | timeout | $0 | 运行超时由你设的 timeout 决定,已产生的事件照收 |
| 查一个不存在的公司 | 00:20 | 200 | 无 | $0.000556(我们的问题) | — |
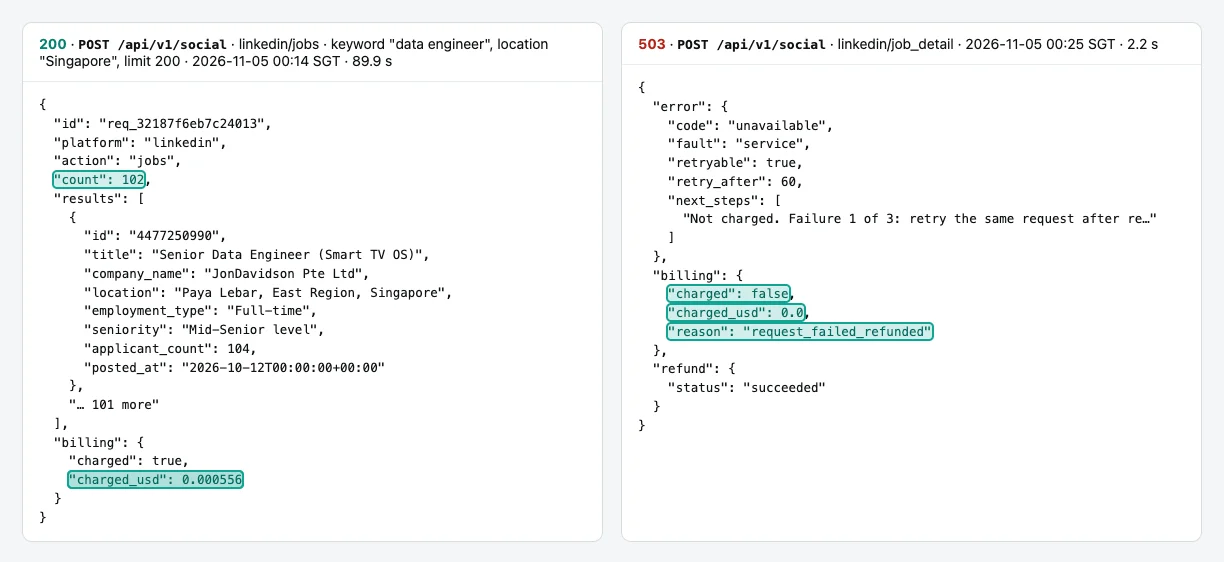
我们这边的规则是:确认失败或空结果,按同一个 charge_id 退回原账户;结果未知时保留真实状态,先核对再处理。这次唯一不符合规则的是「不存在的公司回 200 空结果并扣费」,前面已经写了。Apify 的按事件收费(pay per event),文档的说法是 actor 作者在代码里每产生一个事件才收一次钱;没抓到结果就不会有结果事件,但「Actor start」这类启动事件、按页收的「search page」事件照收。harvestapi 的搜人 actor 明写一页「regardless of how many profiles were found」都收 $0.10;它的邮箱查找写「if a LinkedIn profile is not complete enough to perform the email search - we will not charge you for the search」。所以 Apify 的失败成本由每个作者自己定,要逐个读。
接 MCP 和 AI 工具
两边都能接 MCP(Model Context Protocol,让 AI 客户端调用外部工具的协议)。Apify 的 MCP 服务器在 https://mcp.apify.com,按 Apify 文档,第一次连接会打开浏览器用 OAuth 登录,也可以用 Bearer token;默认加载 actor 搜索、运行和文档几类工具,可以在网址后面用 ?tools= 指定只加载某几个 actor;没有账号时只能用搜索 actor、查文档这类工具;为安全起见,需要完全权限的 actor 被排除在 MCP 之外。它还支持按请求付费的「agentic payments」,只对按事件收费的 actor 有效。我们 2026-11-05 不带 token 访问 https://mcp.apify.com,返回 401,要求认证,这和文档一致。
EveryInfra 的远程 MCP 在 https://api.everyinfra.com/mcp,2026-11-05 我们用 tools/list 读到 12 个工具,名字都以 everyinfra_ 开头,其中 everyinfra_list_capabilities 列能力和价格,everyinfra_call_api 调任意平台能力,everyinfra_get_job 查异步任务,everyinfra_get_account 查余额。2026-11-05 01:02 新加坡时间,我们用 MCP 的 tools/call 调 everyinfra_call_api,参数是 {"platform":"linkedin","action":"company_profile","params":{"company":"openai"}},6.4 秒后返回,结果放在 content 的文本里,就是和 REST 接口一样的 JSON(约 3,300 个字符):OpenAI 的 employee_count 是 11,489,规模档 1001-5000,粉丝 12,126,872,扣费同样是 $0.000556。 在 Claude Code 里加一行就能用:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}| 项目 | Apify MCP | EveryInfra MCP |
|---|---|---|
| 地址 | https://mcp.apify.com | https://api.everyinfra.com/mcp |
| 认证 | 默认 OAuth 登录,也可 Bearer token | API Key(Bearer) |
| 一次工具调用 | 启动一次 actor 运行,跑完回数据集 | 一次接口请求,直接回 JSON |
| 计费 | 按所用 actor 的规则(多为按结果) | 按请求,LinkedIn 多为 $0.000556 |
| 不带凭据 | 只能搜 actor、查文档 | 01:04、01:17 两次实测:工具返回 isError、错误码 unauthorized,写明「Nothing was charged」 |
| 本次实测 | 不带 token 回 401 | 01:02 调公司资料,6.4 秒,$0.000556 |
AI 客户端里最在意的是「一次工具调用回来多少东西」。Apify 的 MCP 每次是启动一个 actor 运行,跑完回数据集;我们的 MCP 每次是一次接口请求,回的就是上面那些 JSON。对 AI 来说,「搜一次职位拿 200 条」用我们这边是一次工具调用、$0.000556;用 Apify 是一次 actor 运行,按 200 条结果收钱。完整的 MCP 配置和各客户端写法见 EveryInfra MCP 服务器。
什么时候 Apify 更合适
这一节照实写 Apify 有、我们没有,或者 Apify 更便宜的地方。第一,单查个人资料:johnvc 的 LinkedIn Profile API 每千份 $0.02,比我们便宜 27.8 倍;即使它的成功率只有 91.12%,失败的不收结果的钱,按成功条数算依然便宜。如果你的活只有「拿 URL 名单补全个人资料」,可以先试它。第二,单条职位详情:我们的 linkedin/job_detail 这次 5 次全部 503,目录价每千条 $1.194;worldunboxer 的详细模式 $0.35,能跑通又便宜。第三,精细筛选:harvestapi 的搜人和员工 actor 能按公司、行业、学校、在职年限组合筛选,还能按姓名搜人;我们的 profile_search 只有头衔加地点,employees 只按公司。
第四,邮箱查找:harvestapi 带 SMTP 验证的邮箱模式、dev_fusion 的「verified email」「phone number」都是专门做的功能,我们这边 email 只是资料里的一个字段,这次 5 份公开人物资料里 3 份有、78 人搜索结果里 47 人有。第五,量大的现成职位库:fantastic-jobs 自称每月 1,000 万条新职位,带招聘人和 AI 补充字段,要做职位市场分析的,它的数据组织方式更合适。第六,运行控制:maxTotalChargeUsd 给单次运行设花费上限,Schedules 定时跑、Webhooks 回调、数据集自动存储和导出 CSV、Excel,这些平台功能我们没有,要自己用 cron 和数据库补。第七,选择多:Store 里光 LinkedIn 就有 370 个 actor,个人资料、公司帖子、活动、群组、Sales Navigator 各有专门的工具,我们 LinkedIn 一共 11 项能力。
| 场景 | 更合适的一方 | 依据 |
|---|---|---|
| 只补全个人资料 URL 名单 | Apify(johnvc) | 每千份 $0.02,比我们便宜 27.8 倍 |
| 单条职位详情、申请链接 | Apify(worldunboxer 详细模式) | $0.35 每千条;我们这次 5 次 503 |
| 按行业、学校、年限精细圈人 | Apify(harvestapi 搜人) | 我们只有头衔加地点 |
| 带 SMTP 验证的邮箱查找 | Apify(harvestapi、dev_fusion) | 我们只有资料里的 email 字段 |
| 一次搜很多职位、搜人、员工名单 | EveryInfra | 每千条 $0.0028–$0.0071,差几百倍 |
| 多平台一把 Key、AI 客户端里固定价调用 | EveryInfra | 一种请求格式、按次固定价 |
反过来,我们更合适的场景是:一次要拿很多条的数据(职位、搜人、员工、评论),倍数从几十到上千;一个项目同时要 LinkedIn 和别的平台(Instagram、TikTok、X 等)的数据,用一把 Key、一种请求格式、一个账户结算;在 AI 客户端里用 MCP 调,每次工具调用的价格是固定的,不会因为结果多而失控;以及不想维护多个作者不同、输入格式不同、价格随时调整的 actor(这次读到的价格里,harvestapi 的四个 actor 都是 2026-10-27 开始的新价,apimaestro 的是 2026-11-02,worldunboxer 是 2026-10-29,cheap_scraper 有一个 2026-11-07 生效的新价)。
和站内其他 Apify 文章有什么不同
站内已经有几篇和 Apify 相关的文章,各管一件事。Apify 价格详解 讲 Apify 的套餐、计算单元和按事件收费是怎么回事,适合第一次接触 Apify 的读者;Apify 替代方案总览 按平台列出替代选择;Apify Twitter Scraper 替代 和 Apify Reddit Scraper 替代 分别比 X 和 Reddit 的价格。本篇只讲 LinkedIn,重点是三件那几篇没有的事:LinkedIn 一次一份和一次一页两类能力的价格差、cookie 和用户协议的问题、以及 Store 里那个比我们便宜的个人资料 actor。各家对比页汇总在 /alternatives。
最近的变化
和选型直接相关的变化有两类。第一类在 LinkedIn 一侧:LinkedIn 帮助中心写,传统的职位搜索从 9 月起逐步由 AI 职位搜索取代,用自然语言描述想找的工作,这可能会改变按关键词搜职位的结果;拿 linkedin/jobs 或 Apify 的职位 actor 做长期监控的,最好定期用同一组关键词抽查返回条数。第二类在 Apify 一侧:主流 LinkedIn actor 最近一个月密集调价(见下表),引用旧文章或旧帖子里的价格之前要先看当前的 Pricing 标签;2026-10-30,Agentic AI Foundation 的博客发了 Apify MCP 团队的文章,他们把省 token 的 TOON 格式在 MCP 服务器上试了 30 天,没有稳定收益,改回了 JSON;它的价格页这次也多了「We're live on x402」,让 AI 代理按次付费跑 actor。
| 日期 | 事件 | 来源 |
|---|---|---|
| 2026-10-07 | johnvc LinkedIn Profile API 现行价生效 | Apify 公开接口 |
| 2026-10-15 | lergassy 个人资料 actor 现行价生效 | Apify 公开接口 |
| 2026-10-22 | johnvc 公司员工 actor 现行价生效 | Apify 公开接口 |
| 2026-10-27 | harvestapi 四个 LinkedIn actor 新价生效 | Apify 公开接口 |
| 2026-10-29 | worldunboxer 职位 actor 新价生效 | Apify 公开接口 |
| 2026-10-30 | Apify MCP 团队发文:TOON 试了 30 天后撤回 | Agentic AI Foundation |
| 2026-11-02 | apimaestro 个人资料、公司 actor 新价生效 | Apify 公开接口 |
常见问题
apify linkedin scraper cost 一般是多少?
按 2026-11-05 读到的 Store 公开价,个人资料类每千份 $0.02 到 $10.00,用户最多的 harvestapi 是 Free 档 $4.00、带邮箱 $10.00;公司资料类 $1.55 到 $5.00;职位类 $0.10 到 $5.00,用户最多的 curious_coder 是 Free 档 $2.00、付费计划 $1.00。实际花费还要看你的套餐档位、启动费和每页费。EveryInfra 的 LinkedIn 能力每次 $0.000556(职位详情 $0.001194),换算成每千条,个人资料和公司 $0.556,职位 $0.0033,搜人 $0.0071。
apify linkedin scraper api 怎么调用?
每个 Apify actor 都能用 POST /v2/acts/<作者>~<名字>/run-sync-get-dataset-items 同步运行并取回结果,输入字段按该 actor 的 Input 标签填写,可以加 maxItems 和 maxTotalChargeUsd 控制花费;也能用 Apify 的 JavaScript、Python 客户端。EveryInfra 是一个固定地址 POST /api/v1/social,请求体写 platform、action、params。
apify linkedin scraper jobs 一次能抓多少条?
curious_coder 的页面写,LinkedIn 自己把每次职位搜索限制在 1,000 条,要更多就按城市拆成多个搜索再去重。我们的 linkedin/jobs 每次 limit 最多 200,这次在新加坡 11 次搜索平均每次回 179 条;目录写明备用来源每次最多 25 条。
有没有免费的 LinkedIn scraper?
Apify 的 Free 计划每月送 $5 额度,按 $4.00 每千份大约能拿 1,250 份个人资料,但 harvestapi 写明 Free 计划总共只能跑 50 次;GitHub 上也能搜到开源的 LinkedIn 抓取脚本,但登录、代理和页面改版都要你自己维护,用自己的账号去跑,同样受用户协议约束。EveryInfra 的试用是给 2 个 GitHub 仓点星领 $1,24 小时有效,按每次 $0.000556 约 1,798 次请求。
LinkedIn 允许抓取吗?
LinkedIn 用户协议 8.2 条明确写了不得用爬虫、脚本等抓取或复制服务,也不得复制 cookie 使用别人的账号;它的 Crawling Terms 写未经许可的自动抓取被禁止。法院对「不登录只看公开页面」是否构成违法有过不同判决,LinkedIn 也持续起诉用假账号抓取的公司。本文不提供法律意见,请咨询你所在地的律师。
LinkedIn 官方 API 要多少钱?
LinkedIn 官方 API 没有按调用量公开售卖会员资料的价目表:一般开发者能直接用的只有登录、读自己的基本资料和邮箱、代表会员发帖;按条件搜人、读别人完整资料要申请 Sales Navigator、Talent Solutions 等合作伙伴计划,审核通过后按合同计费。
在 n8n 或 Claude 里怎么用?
n8n 里用 HTTP Request 节点直接调 POST /api/v1/social 即可,Apify 则有现成的 n8n 节点;Claude Code、Claude 桌面版这类支持 MCP 的客户端,可以加 https://api.everyinfra.com/mcp 或 https://mcp.apify.com,前者用 API Key,后者默认走 OAuth 登录。
上手步骤
第一步,拿到 API Key。在 GitHub 给 2 个 EveryInfra 仓点星,可以在控制台领 $1 试用额度,24 小时内有效;正式使用从 $10 起充值,按每次 $0.000556 算约 17,986 次 LinkedIn 请求(快速上手、价格页)。第二步,打开对应能力的文档页,用页上的试用框跑一次:试 LinkedIn 职位搜索、试按条件搜人、试个人资料、试公司资料、试公司员工。第三步,看响应里的 charged_usd 和返回条数,用「实扣 ÷ 条数 × 1,000」算出你自己这个场景的每千条价,再和你现在的账单比。LinkedIn 全部 11 项能力见 LinkedIn 数据接口;同一把 Key 也能调 TikTok 数据接口 和 Instagram 数据接口,或者在数据市场里按平台找。
从 Apify 换过来时,要改的地方见下表;按次计费时,一次回得越多越便宜,所以「每来一条线索启动一次」最好改成「攒一批再搜一次」。
| 在 Apify 上的做法 | 换到 EveryInfra 的做法 |
|---|---|
| 每个 actor 一套输入字段 | 固定三个键:platform、action、params |
| 运行 actor,等结束,再取数据集 | 同步请求;慢的加 "mode": "async" 再轮询 poll_url |
maxItems、maxTotalChargeUsd 控制花费 | 每次请求价格固定,按请求次数估算 |
| 每来一条线索启动一次 | 攒一批再搜一次,一次回得越多越便宜 |
| Schedules 定时、Webhooks 回调 | 用你自己的 cron 或 n8n 定时触发 |
参考资料
- LinkedIn Profile Scraper(Store 页面、Pricing 标签),Apify / harvestapi,2026-11-05 00:28 新加坡时间截图。https://apify.com/harvestapi/linkedin-profile-scraper
- LinkedIn Profile Scraper 公开元数据(pricingInfos、stats),Apify API,2026-11-05 00:16 新加坡时间读取。https://api.apify.com/v2/acts/harvestapi~linkedin-profile-scraper
- LinkedIn Company Details Scraper,Apify / harvestapi,2026-11-05 读取。https://apify.com/harvestapi/linkedin-company
- LinkedIn Profile Search Scraper(每页 25 人、每页 $0.10 的原文),Apify / harvestapi,2026-11-05 读取。https://apify.com/harvestapi/linkedin-profile-search
- LinkedIn Company Employees Scraper,Apify / harvestapi,2026-11-05 读取。https://apify.com/harvestapi/linkedin-company-employees
- Profile Details Scraper for LinkedIn + EMAIL,Apify / apimaestro,2026-11-05 读取。https://apify.com/apimaestro/linkedin-profile-detail
- LinkedIn Profile API,Apify / johnvc,2026-11-05 读取。https://apify.com/johnvc/linkedin-profile-api
- Linkedin Profile Scraper with Email & Company Data,Apify / datadoping,2026-11-05 读取。https://apify.com/datadoping/linkedin-profile-scraper
- Linkedin Company Details Scraper,Apify / datadoping,2026-11-05 读取。https://apify.com/datadoping/linkedin-company-scraper
- Linkedin Jobs Scraper(每次搜索 1,000 条上限的说明),Apify / curious_coder,2026-11-05 读取。https://apify.com/curious_coder/linkedin-jobs-scraper
- LinkedIn Jobs Scraper,Apify / valig,2026-11-05 读取。https://apify.com/valig/linkedin-jobs-scraper
- Rapid Linkedin Jobs Scraper,Apify / worldunboxer,2026-11-05 读取。https://apify.com/worldunboxer/rapid-linkedin-scraper
- LinkedIn Jobs Scraper,Apify / cheap_scraper,2026-11-05 读取。https://apify.com/cheap_scraper/linkedin-job-scraper
- Advanced LinkedIn Job Search API,Apify / fantastic-jobs,2026-11-05 读取。https://apify.com/fantastic-jobs/advanced-linkedin-job-search-api
- Apify 价格页(Free $5、Starter $19、Scale $199、Business $999,各档 Store 折扣),2026-11-05 00:39 新加坡时间读取。https://apify.com/pricing
- Run Actor synchronously and get dataset items(maxItems、maxTotalChargeUsd),Apify API 文档。https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post
- Get Actor,Apify API 文档。https://docs.apify.com/api/v2/act-get
- Get list of Actors in Store,Apify API 文档。https://docs.apify.com/api/v2/store-get
- Actors in Store(折扣档由作者设定),Apify 文档。https://docs.apify.com/platform/actors/running/actors-in-store
- Monetize your Actor(按事件收费的规则),Apify 文档。https://docs.apify.com/platform/actors/publishing/monetize
- Usage and resources,Apify 文档。https://docs.apify.com/platform/actors/running/usage-and-resources
- Apify MCP server,Apify 文档,2026-11-05 读取。https://docs.apify.com/platform/integrations/mcp
- apify-mcp-server,GitHub。https://github.com/apify/apify-mcp-server
- Schedules,Apify 文档。https://docs.apify.com/platform/schedules
- Webhooks,Apify 文档。https://docs.apify.com/platform/integrations/webhooks
- Dataset,Apify 文档。https://docs.apify.com/platform/storage/dataset
- Limits,Apify 文档。https://docs.apify.com/platform/limits
- n8n integration,Apify 文档。https://docs.apify.com/platform/integrations/n8n
- Zapier integration,Apify 文档。https://docs.apify.com/platform/integrations/zapier
- Apify API client for JavaScript,Apify 文档。https://docs.apify.com/api/client/js
- Apify CLI,Apify 文档。https://docs.apify.com/cli
- LinkedIn User Agreement(Effective on November 3, 2025,第 8.2 条),2026-11-05 00:28 新加坡时间截图。https://www.linkedin.com/legal/user-agreement
- LinkedIn Crawling Terms and Conditions。https://www.linkedin.com/legal/crawling-terms
- LinkedIn Privacy Policy。https://www.linkedin.com/legal/privacy-policy
- LinkedIn Cookie Policy。https://www.linkedin.com/legal/cookie-policy
- LinkedIn Professional Community Policies。https://www.linkedin.com/legal/professional-community-policies
- LinkedIn API Terms of Use。https://www.linkedin.com/legal/l/api-terms-of-use
- Getting Access to LinkedIn APIs,Microsoft Learn。https://learn.microsoft.com/en-us/linkedin/shared/authentication/getting-access
- Sign In with LinkedIn using OpenID Connect,Microsoft Learn。https://learn.microsoft.com/en-us/linkedin/consumer/integrations/self-serve/sign-in-with-linkedin-v2
- LinkedIn Sales Navigator 开发文档,Microsoft Learn。https://learn.microsoft.com/en-us/linkedin/sales/
- Job Posting API overview,Microsoft Learn。https://learn.microsoft.com/en-us/linkedin/talent/job-postings/api/overview
- API rate limiting,Microsoft Learn。https://learn.microsoft.com/en-us/linkedin/shared/api-guide/concepts/rate-limits
- LinkedIn Developer Solutions。https://developer.linkedin.com/
- hiQ Labs v. LinkedIn Corp.,美国第九巡回上诉法院意见,2022-04-18。https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- Van Buren v. United States,美国最高法院,2021。https://www.supremecourt.gov/opinions/20pdf/19-783_k53l.pdf
- hiQ v. LinkedIn Wrapped Up: Web Scraping Lessons Learned,ZwillGen。https://www.zwillgen.com/alternative-data/hiq-v-linkedin-wrapped-up-web-scraping-lessons-learned
- LinkedIn Corp. v. ProAPIs 起诉状,加州北区联邦地区法院(CourtListener)。https://storage.courtlistener.com/recap/gov.uscourts.cand.457309/gov.uscourts.cand.457309.1.0.pdf
- LinkedIn wins court order blocking mass scraping of user data,The Record。https://therecord.media/linkedin-wins-court-order-blocking-mass-scraping
- Proxycurl Shuts Down,Nubela,2025-07-04。https://nubela.co/blog/goodbye-proxycurl/
- 新加坡《个人数据保护法》(PDPA 2012),新加坡法规在线。https://sso.agc.gov.sg/Act/PDPA2012
- 新加坡个人数据保护委员会(PDPC)。https://www.pdpc.gov.sg/
- 欧盟《通用数据保护条例》(GDPR),EUR-Lex。https://eur-lex.europa.eu/eli/reg/2016/679/oj
- EveryInfra LinkedIn 能力目录(price_usd、response_fields、field_note),2026-11-05 00:12 新加坡时间读取。https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra llms.txt。https://api.everyinfra.com/llms.txt
- EveryInfra OpenAPI。https://api.everyinfra.com/openapi.json
- EveryInfra 远程 MCP(tools/list),2026-11-05 读取。https://api.everyinfra.com/mcp
- Model Context Protocol 介绍。https://modelcontextprotocol.io/introduction
- Connect Claude Code to tools via MCP,Claude Code 文档。https://code.claude.com/docs/en/mcp
- HTTP Request node,n8n 文档。https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.httprequest/
- TOON(Token-Oriented Object Notation),GitHub。https://github.com/toon-format/toon
- We Added TOON to Our MCP Server, Then Removed It,Agentic AI Foundation,2026-10-30。https://aaif.io/blog/we-added-toon-to-our-mcp-server-then-removed-it
- AI-powered job search(传统职位搜索自 9 月起逐步下线),LinkedIn 帮助中心。https://www.linkedin.com/help/linkedin/answer/a6889044
- r/n8n:免费 LinkedIn 职位抓取流程及「$5 几分钟用完」的回复(用户名已隐去)。https://www.reddit.com/r/n8n/comments/1t4lk7a/i_built_a_100_free_linkedin_job_scraper_using_n8n/
- r/n8n:LinkedIn 职位抓取流程求助(用户名已隐去)。https://www.reddit.com/r/n8n/comments/1t9trjv/n8n_linkedin_job_scraper_workflow_help/
- LinkedIn Copyright Policy。https://www.linkedin.com/legal/copyright-policy
- LinkedIn User Agreement Summary。https://www.linkedin.com/legal/user-agreement-summary
- LinkedIn Talent Solutions 开发文档,Microsoft Learn。https://learn.microsoft.com/en-us/linkedin/talent/
- LinkedIn Marketing API 文档,Microsoft Learn。https://learn.microsoft.com/en-us/linkedin/marketing/
- Runs and builds,Apify 文档。https://docs.apify.com/platform/actors/running/runs-and-builds
- Billing,Apify 文档。https://docs.apify.com/platform/console/billing
- Apify API client for Python,Apify 文档。https://docs.apify.com/api/client/python
- Make integration,Apify 文档。https://docs.apify.com/platform/integrations/make
- Apify Proxy,Apify 文档。https://docs.apify.com/platform/proxy
引用编号 BL-91