Claude Codeのサブエージェント:HaikuをワーカーにしてTikTokアカウントを調べる
TikTokのブランドアカウント1件の生データは約9,700トークンです。Haiku 5.5のサブエージェントはこれを95トークンの要約にして返します。実際に行った98回の呼び出し、429への対処、50アカウント分のコストを紹介します。
2026年10月26日17:25〜17:48(SGT)に、EveryInfra APIでTikTokブランドアカウント18件のデータを取得しました。各アカウントについて、プロフィール、最新動画10本、1本の動画のコメントを取得しています。生データは1アカウントあたり平均38,794バイトで、Anthropicの料金ページに記載された比率(10 kBで約2,500トークン)で換算すると約9,700トークンです。同じアカウントの要約は約382バイト、約95トークンです。この約100倍の差が、Claude Codeのサブエージェントによって節約できるメインコンテキストの量です。
見落としやすい結果がもう一つあります。テスト用のAPIキーの上限を1分あたり10リクエストに設定しました(アカウントのデフォルトは1分あたり60リクエストです)。6つの並列ワーカーでは、56リクエスト中20件のレート制限エラー(429)が発生しました。クライアント側で上限を設けた4つのワーカーでは、1分あたりの成功件数が50%超増えました。
本記事では、実務上の疑問に一つ答えます。競合、提携候補、自社の地域アカウントなど、数十件のTikTokブランドアカウントのリストがあるとします。Claude Codeでプロフィール、最近の動画、コメントを取得し、比較表を作りたいとします。作業をサブエージェントにどう分割すればよいでしょうか。各サブエージェントにはどのモデルとツールを割り当てるのでしょうか。どのデータ呼び出しを行い、コストはいくらかかり、APIのレート制限で止められたら何が起きるのでしょうか。
本記事のClaude Codeの設定は、公式ドキュメントと変更履歴に基づいています。サブエージェント自体は手元の環境で実行していないため、その部分は設定例として記載しています。EveryInfraに関する数値はすべて、実際の呼び出しで得た生のレスポンスに基づいています。
ジョブ:ブランドアカウント50件から比較表を1つ作る
以降の数値はすべてこの前提に左右されるため、まずジョブを定義します。入力はTikTokのユーザー名のリストです。各アカウントについて、3つの情報を取得します。まずはプロフィール(フォロワー数、動画数、認証ステータス)です。
2つ目は最新の動画10本(再生数、いいね数、コメント数、投稿時刻)です。3つ目は、その10本のうち最もコメントの多い動画のコメント最大50件です。出力はアカウントごとに表の1行です。列はフォロワー数、最近の動画の再生数の中央値、エンゲージメント率、週あたりの投稿数、サンプルしたコメント数で、これに短いメモが1つ付きます。
このジョブには、サブエージェントの用途に合う3つの性質があります。第1に、各アカウントは互いに依存しません。Nikeの取得にAdidasの結果は不要なので、並列に実行できます。第2に、このジョブは保持する量よりはるかに多くのデータを読み込みます。各アカウントは数十KBを返しますが、表に残るのは1行です。第3に、手順が決まっていて判断も単純なので、小型で低コストのモデルで処理できます。
Claude Codeのドキュメントも、サブエージェントを同じように説明しています。サイドタスクがメインの会話を埋め尽くしてしまう場合に使うべきだとしています。埋め尽くすものとは、検索結果、ログ、二度と読まないファイルの内容などです。サブエージェントはその作業を自身のコンテキストで行い、要約だけを返します(Claude Codeのサブエージェントのドキュメント)。
24件のユーザー名を3つのグループに分けてテストしました。米国のスポーツウェアグループには8アカウントあり、Nike、Adidas、Gymshark、lululemon、Under Armour、New Balance、PUMA、HOKAです。中国を拠点とするブランドのグループにはSHEIN、Temu、DJI、OnePlus、EcoFlowが含まれます。さらに、Anker、Insta360、Xiaomiのブランド名から推測した3つのユーザー名も含めました。
スペイン語圏のグループには、Zara、Bershka、Real Madrid、Telcel、Pull&Bearに加え、Mercado Libre、OXXO、Bimboについて推測したユーザー名が3つ含まれていました。推測した6件はすべて誤りで、それがなぜ重要かは失敗に関するセクションで説明します。存在を確認できた残り18件のブランドアカウントが、以下の規模、コスト、速度に関するすべての数値の基礎となっており、明記した箇所では50件に換算しています。


そもそも分割すべきか? Anthropicの10月22日付ガイドが示すこと
構成に入る前に、逆の助言を見ておきましょう。2026年10月22日、Anthropicは「When to fold subagents into your main agent loop」という長いガイドを公開しました(Anthropicのガイド)。このガイドでは、ほとんどのエージェントはサブエージェントを減らすべきだとしています。デフォルトは、1つのモデル、1つのコンテキストウィンドウ、1つのオープンなツールループであるべきだといいます。ドメイン固有の手順はスキルに、ルックアップと厳格な制限はツールにまとめます。Redditのまとめによると、ある顧客の単一ループはマルチエージェント構成より約2倍速く動作したと報告されています。
併せて公開されたsingle-agent-loop-kitは、この主張を慎重に扱っています。READMEには、このキットは単一ループが常に優れているとは想定していない、と書かれています。各変更の前後に同じevalを実施し、その効果を測定します。同じREADMEには、サブエージェントを残すべき正当な理由も挙げられています。新しいコンテキストでの並列リサーチ、独立した検証、そしてメインエージェントが後で必要とする量よりはるかに多くを読み込む作業です。
TikTokの50アカウントの取得は、最後のケースに当たります。アカウントごとに約9,700トークンが入ってきますが、メインセッションに必要なのは95トークンの1行だけです。The Decoderは、サブエージェントを使い続けるべきとするAnthropicの3つの条件を報じています。コンテキストの増大による測定可能な品質低下、別々のコンテキストを持つ並列タスク、ツール選択の難しさのいずれかです。当社のジョブは最初の2つに当てはまります。
| サブエージェントを残す理由(Anthropicのキット) | 今回は該当するか | この記事のデータ |
|---|---|---|
| 新しいコンテキストでの並列リサーチ | 可能 | 各アカウントは互いに依存しない |
| メインエージェントが必要とする量よりはるかに多くを読み込む作業 | 可能 | 1アカウントあたり、読み込み約9,700トークンに対し返却は95トークン |
| 独立した検証 | 一部該当 | 新しいワーカーで1アカウントを再実行して確認できる |
| ツールが多すぎることによる問題 | 該当(フィルタなしの場合) | 25個あるMCPツールのうち、許可するのは2個 |
私たちの判断は分割することですが、階層は1段だけで、「取得して圧縮する」ステップに限ります。表の作成、詳しく調べるべきアカウントの選定、次のラウンドを実行するかどうかの判断はメインセッションに残します。これらの判断には全アカウントを同時に見る必要があるためです。これは、ガイドが警告している「チームごとに1つのサブエージェント」パターンとは異なります。ワーカーごとの役割分担はありません。各ワーカーに割り当てるのは、決まった一連の手順と1つのアカウントだけです。
Claude Codeのサブエージェント:ファイル、modelフィールド、ツールの許可リスト
Claude Codeのサブエージェントは1つのMarkdownファイルです。先頭にYAMLのメタデータ(ドキュメントではfrontmatterと呼ばれます)があり、本文がサブエージェントのシステムプロンプトになります。プロジェクトのサブエージェントは.claude/agents/に置き、チーム向けにコミットできます。ユーザーのサブエージェントは~/.claude/agents/に置きます。
ドキュメントによると、必須なのはnameとdescriptionだけです。フィールド名にはcamelCaseを使います。フィールド名のスペルを間違えても、Claude Codeはエラーを出さずにそのフィールドを無視します(frontmatterリファレンス)。以下は、このジョブ向けの設定例です。続く段落でそれぞれの選択を説明します。
---
name: tiktok-account-worker
description: Pull one TikTok account (profile, newest videos, comments on one video) and return a one-line JSON summary. Use one per account in the list.
model: claude-haiku-5-5
effort: low
tools: mcp__everyinfra__everyinfra_call_api, mcp__everyinfra__everyinfra_get_job
mcpServers:
  - everyinfra:
      type: http
      url: https://api.everyinfra.com/mcp
      headers:
        Authorization: "Bearer ${EVERYINFRA_API_KEY}"
maxTurns: 8
omitClaudeMd: true
---

Work on the one TikTok username in your task. Do these steps in order:
1. Call everyinfra_call_api with platform=tiktok, action=profile, params={username}.
   If is_verified is false and follower_count < 1000, stop and return {"username":..., "flag":"lookalike"}.
2. Call action=user_videos with params={username, limit:10}. Leave out is_pinned=true videos from medians and rates.
3. Take the video with the highest comment_count from step 2. Call action=comments with params={url, limit:50}.
4. On a 429, wait retry_after seconds and retry once. Do not change the parameters.
5. Output one JSON line only: username, verified, followers, median_views, engagement_pct,
posts_per_week, comments_fetched, and one note of 25 words or less. Do not output raw data.modelの行では、haikuエイリアスではなく完全なモデルIDを使っています。理由は次のセクションで説明します。toolsの行は許可リストです。ドキュメントによると、toolsリストを持つサブエージェントはそのツールしか使えません。リストがないサブエージェントは、メインの会話のツールをすべて継承します(利用可能なツール)。
EveryInfraのリモートMCPサーバーは、tools/listで25個のツールを返します。そのうちデータを取得するのはeveryinfra_call_apiとeveryinfra_get_jobの2つです。残りはアカウント、キー、サポートチケット、Webhookを管理するツールです。everyinfra_key_deleteのようなツールは、小さなモデルが50回実行するバッチジョブに含めるべきではありません。許可リストで2つのツールだけを残せば、このリスクを根本から取り除けます。
最もコンテキストを節約できるのはmcpServersの行です。ドキュメントによると、サブエージェント内でインライン定義したMCPサーバーは、サブエージェントの開始時に接続し、終了時に切断します。そのため、サーバーは.mcp.jsonではなくインラインで定義してください。そうすれば、ツールの説明文がメインのコンテキストに入りません(MCPサーバーのスコープをサブエージェントに限定する)。
EveryInfraのtools/listレスポンスを測定したところ、30,682バイト、約7,670トークンでした。initializeレスポンスには、さらに3,924文字のサーバー指示が加わります。許可した2つのツールは2,505バイト、約626トークンです。ドキュメントには信頼に関するルールも記載されています。Claude Codeがプロジェクトの.claude/agents/内にあるファイルからインラインMCPサーバーを読み込むのは、そのフォルダを信頼した後だけです。v2.1.238より前のバージョンでは、このチェックは行われていませんでした。
omitClaudeMd: trueを指定すると、ユーザー、プロジェクト、ローカルのCLAUDE.mdファイルを読み込まずにサブエージェントを起動します。デフォルトでは、サブエージェントはメインの会話が読み込むすべての階層のCLAUDE.mdを読み込みます(起動時に読み込まれるもの)。API呼び出しを3回行うだけのワーカーには、そのルールのほとんどは不要です。しかも50個のワーカーがそれぞれ自分のコピーを読み込みます。このフィールドにはClaude Code v2.1.271以降が必要です。maxTurns: 8はターン数の上限を設定します。上限に達すると、Claude Codeは出力を部分的なものとしてマークし、メインセッションはそのワーカーを再開できます(v2.1.246以降)。
APIキーには環境変数の展開を使っています。Claude CodeのMCPドキュメントによると、.mcp.jsonとサブエージェントのMCPエントリは${VAR}に対応しています。チームで1つのファイルを共有し、各自が個人用のAPIキーを使えます。ただし、一部の認証情報の名前は、リモートサーバーのurlとheadersでは常に空の値に展開されます。
対象にはANTHROPIC_API_KEY、クラウドプロバイダーの認証情報、NPM_TOKENなどが含まれます(MCPドキュメントの環境変数の項)。このルールにより、プロジェクトファイルが、そのファイルで指定されたサーバーにあなたの認証情報を送信することを防げます。EVERYINFRA_API_KEYのように独自の変数名を使ってください。
サーバーをサブエージェントのファイルに書かない方法もあります。1つのコマンドでプロジェクトに追加し、mcpServersではその名前を指定します。
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
--scope project --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"ジョブを止めてしまう設定がもう1つあります。tools/listでは、呼び出しごとに費用が発生するため、everyinfra_call_apiはreadOnlyHint: falseとdestructiveHint: trueになっています。ドキュメントには、バックグラウンドのサブエージェントがツール呼び出しの許可を必要とした場合の動作が書かれています。Claude Codeはメインセッションに確認プロンプトを表示し、どのサブエージェントかを示します(フォアグラウンドとバックグラウンド)。
ワーカーが50個あれば、プロンプトも50回表示される可能性があります。開始前に、設定のpermissions.allowでmcp__everyinfra__everyinfra_call_apiを許可してください(権限のドキュメント)。許可するのはこのツール1つだけにします。
下の表に、各フィールドの役割、公式の出典、必要なバージョンをまとめます。
| フィールド | この例での値 | 内容 | 出典(バージョン) |
|---|---|---|---|
model | claude-haiku-5-5 | サブエージェントのモデルを設定します。haikuやinheritなどのエイリアスも使えます | サブエージェントのドキュメント「Choose a model」 |
tools | MCPツール2つのみ | 許可リスト。指定しない場合、サブエージェントはすべてのツールを継承します | サブエージェントのドキュメント「Available tools」 |
mcpServers | インラインのEveryInfraサーバー | ツールの説明はサブエージェント内でのみ読み込まれます | サブエージェントのドキュメント。信頼チェックはv2.1.238から |
effort | low | このサブエージェントのエフォートレベル | サブエージェントのドキュメント「Choose an effort level」 |
maxTurns | 8 | ターン数の上限。上限に達すると出力が部分的なものとしてマークされます | 部分出力のマークはv2.1.246以降 |
omitClaudeMd | true | CLAUDE.mdファイルをスキップ | v2.1.271以降 |
Claude Codeサブエージェントのモデル選択:4つのステップとhaikuエイリアスの落とし穴
サブエージェントがどのモデルで動作するかは、このジョブで最もコストに影響する部分です。よくある質問のひとつでもあり、Googleのサジェストには「claude code subagents model selection」「claude code subagent model default」「claude_code_subagent_model force」などが表示されます。ドキュメントでは4段階の優先順位が示されています。
1つ目は、メインセッションがサブエージェントを起動するときに渡すmodelパラメータです。2つ目は、サブエージェントファイルのmodelフィールドで、inheritはメインのモデルを意味します。3つ目はCLAUDE_CODE_SUBAGENT_MODEL環境変数です。4つ目はメインの会話のモデルです(Choose a model)。
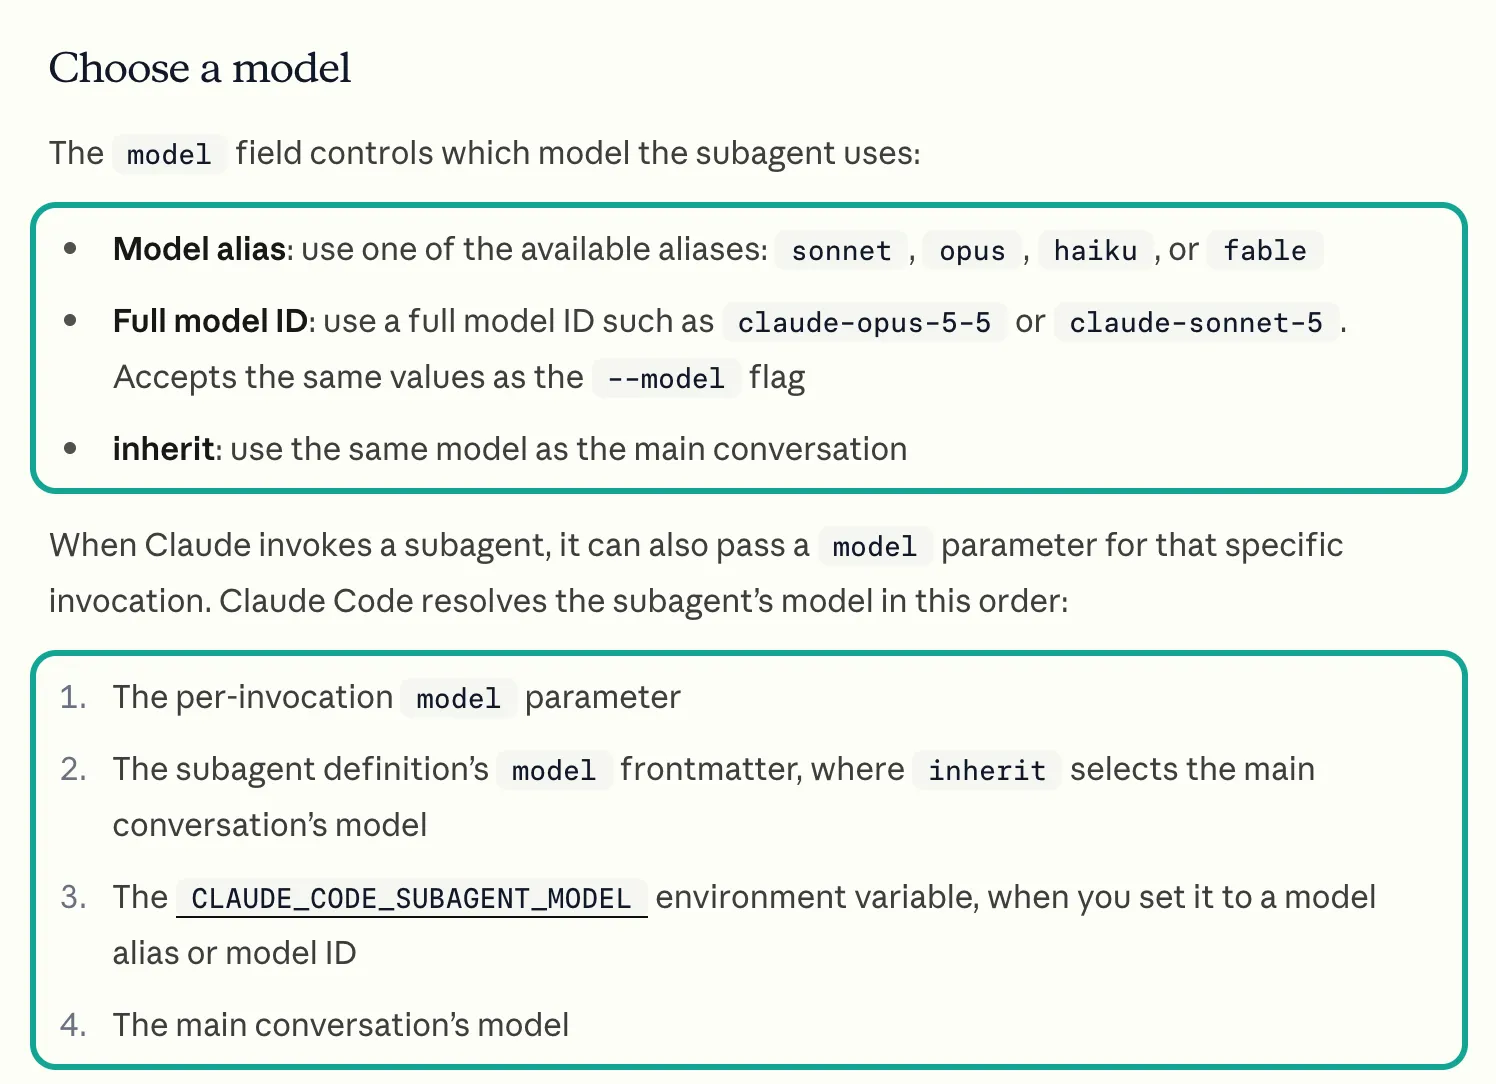
この順序から2つのことがわかります。1つ目は、modelフィールドのないサブエージェントはメインのモデルを継承することです。メインセッションがOpus 5.5で動いていれば、小さなデータ処理ワーカーもOpusの料金で課金されます。736票の賛成を集めたRedditの投稿も同じ注意を促していました。組み込みのExploreサブエージェントは、常にHaikuで動くわけではなくなり、メインセッションのモデルに従います(r/ClaudeCodeのスレッド)。
2つ目は、環境変数の優先順位がファイルより低いため、デフォルト値にすぎないことです。すべてのサブエージェントに同じモデルを強制的に使わせるには、CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1もあわせて設定するようドキュメントに書かれています。このフラグを設定すると、Claude Codeはサブエージェントファイルのmodelフィールドを無視します。古いコミュニティ投稿では、この環境変数が最優先とされています(r/claudeのスレッド)。この順序は現在のドキュメントと一致しないため、ドキュメントに従ってください。
haikuではなく完全なIDを使うのは、このエイリアスがプロバイダーによって異なるモデルを指すためです。Claude Codeのモデル設定ドキュメントに対応表があります。Anthropic APIでは、haikuはHaiku 5.5を指します。Claude Platform on AWS、Amazon Bedrock、Google Cloud、Microsoft Foundryでは、haikuは今もHaiku 4.5を指します(モデル設定のドキュメント)。Haiku 4.5の定価は入力100万トークンあたり$1、出力100万トークンあたり$5で、Haiku 5.5の10倍です(Haiku 5.5発表ページの料金表)。
同じサブエージェントファイルでも、Bedrockではコストが10倍になることがあり、エラーも表示されません。Claude Codeの変更履歴によると、2026年10月7日のv2.1.293で、Anthropic APIにおけるデフォルトのHaikuモデルがHaiku 5.5になりました(Claude Code changelog)。
| プロバイダー | `haiku`エイリアスの参照先 | 100万トークンあたりの入力/出力 | 対処法 |
|---|---|---|---|
| Anthropic API | Haiku 5.5 | $0.10 / $0.50(プロンプト100kトークンまで) | エイリアスまたは完全なID |
| Claude Platform on AWS | Haiku 4.5 | $1 / $5 | 完全なIDを使う |
| Amazon Bedrock、Google Cloud | Haiku 4.5 | 各クラウドプロバイダーの料金 | プロバイダーのモデルIDを使う |
| Microsoft Foundry | Haiku 4.5 | Azureの料金 | 完全なIDを使う |
なぜSonnetではなくHaiku 5.5なのでしょうか。2026年10月7日の発表ページには用途が明記されています。要約、コンパクション、データベースクエリ、分類など、大量に処理するコスト重視のタスクです。同ページでは、このモデルはサブエージェントとしてOpus 5.5やSonnet 5.5と相性が良いとしています。一方で、複雑なエージェント型コーディングには引き続きSonnet 5.5とOpus 5.5の方が適しており、Haiku 5.5は範囲を絞ったタスクに最適だとも書かれています(Haiku 5.5の発表ページ)。
今回のワーカーが行う処理は3つです。APIを順番に呼び出し、コメント数が最も多い動画を選び、いくつかの中央値を計算します。各出力はスクリプトで検証できます。範囲の絞られたタスクです。
コミュニティの報告も同じ傾向です。あるユーザーは、範囲の決まった小さなタスク7つをHaiku 5.5で実行し、140件中140件が採用されました。Opus 5.5と同じ結果です。このユーザーは「1ファイルとチェック1つなら問題ない」としつつ、範囲の定まらない作業では結果がぶれると注意しています(r/ClaudeAIのスレッド)。
Haiku 5.5ではAPIの挙動も一部変わります。移行ガイドによると、Haiku 5.5はtemperature、top_p、top_kを受け付けません。budget_tokensを含むthinkingの値は400エラーになるため、{"type": "adaptive"}を使ってください。アシスタントのプリフィルはサポートされていません(Haiku 5.5移行ガイド)。Claude Codeはこれらのパラメータを自動で処理します。Agent SDKやAPIでワーカーを構築する場合は確認してください。
各ワーカーが実行する3回のEveryInfra呼び出し
3つの機能はいずれもEveryInfraのカタログ(GET /api/v1/social/catalog、無料、APIキー不要)に掲載されています。2026年10月26日17:22(SGT)にカタログを取得して保存しました。3つともTikTokの料金区分で、price_usdは0.000556、つまり1回の呼び出しあたり$0.000556です。返される行数にかかわらず、1回の呼び出しの料金は同じです。
user_videosは1回の呼び出しで最大50件、commentsは最大200件を返します(TikTokカタログ)。各機能のページはtiktok/profile、tiktok/user_videos、tiktok/commentsです。プラットフォームの概要はTikTokデータAPIをご覧ください。
| 機能 | 必須パラメータ | この記事での使い方 | 1回あたりの料金 | 使用するフィールド(カタログのresponse_fieldsと一致) |
|---|---|---|---|---|
tiktok/profile | username | 1アカウントにつき1回 | $0.000556 | username, display_name, follower_count, video_count, like_count, is_verified |
tiktok/user_videos | username | limit: 10 | $0.000556 | url, view_count, like_count, comment_count, posted_at, is_pinned |
tiktok/comments | url | limit: 50 | $0.000556 | id, like_count, reply_count, is_reply, posted_at |
tiktok/search | keyword | content_type: profileで正しいユーザー名を特定 | 返されたアカウント1件あたり$0.000556 | author_username, author_is_verified, author_follower_count |
最後の行には補足が必要です。カタログでは、tiktok/searchにrows_per_unit_whenフィールドがあります。このフィールドは、content_typeをprofileに設定すると、返された各行が1ユニットとしてカウントされることを示しています。私たちはこれを使い、limit: 5で3つのブランドの正しいユーザー名を探しました。1回の呼び出しの費用は$0.002778で、これは5 × $0.000556です。動画検索は1回の呼び出しにつき1ユニットですが、アカウント検索は1アカウントにつき1ユニットです。この違いは予算を見積もる際に見落としがちです。
以下は、REST経由で実行するワーカーの最初のステップです。APIキーは環境変数からのみ取得します。レスポンスのbilling.charged_usdフィールドに、その呼び出しで実際に課金された額が表示されます。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"tiktok","action":"user_videos","params":{"username":"nike","limit":10}}'フィールドに関する2つの細かな仕様によって、表の内容が変わります。1つ目に、user_videosは新しい順に並びますが、ピン留めされた動画(is_pinned: true)が先頭に来ます。18アカウントのうち7アカウントで、最新10本にピン留め動画が含まれており、SHEIN、DJI、Gymsharkはそれぞれ3本でした。ピン留め動画は数か月前のものである場合があります。このフィルタがないと、SHEINの「直近10本の動画」は294日分にわたり、投稿頻度が正しく算出されません。
次に、動画のcomment_countではなく、呼び出しで実際に返されたコメント数を使います。New Balanceの動画はコメント29件と表示されていましたが、呼び出しで返されたのは27件でした。Telcelの動画は表示が10件で、返されたのは5件でした。カタログには、各トップレベルコメントに付く返信は最大2件で、スレッド全体の取得は保証されないとも記載されています。
実際のMCPラウンドトリップ1回:モデルが送る内容と返ってくる内容
MCP経由でAPIを呼び出すサブエージェントは、MCP仕様のStreamable HTTPトランスポートを使用します。呼び出しの順序はinitialize、notifications/initialized、tools/list、tools/callです(MCP 2025-06-18のトランスポート、ライフサイクル)。
2026年10月26日17:30(SGT)に、この手順を手動で実行しました。initializeはプロトコルバージョン2025-06-18で200を返しました。レスポンスにMcp-Session-Idヘッダーがなかったため、このサーバーではセッションIDは不要です。notifications/initializedは、リモートMCPセットアップガイドの記載どおり、空のボディで202を返しました。tools/listは25個のツールを返しました。
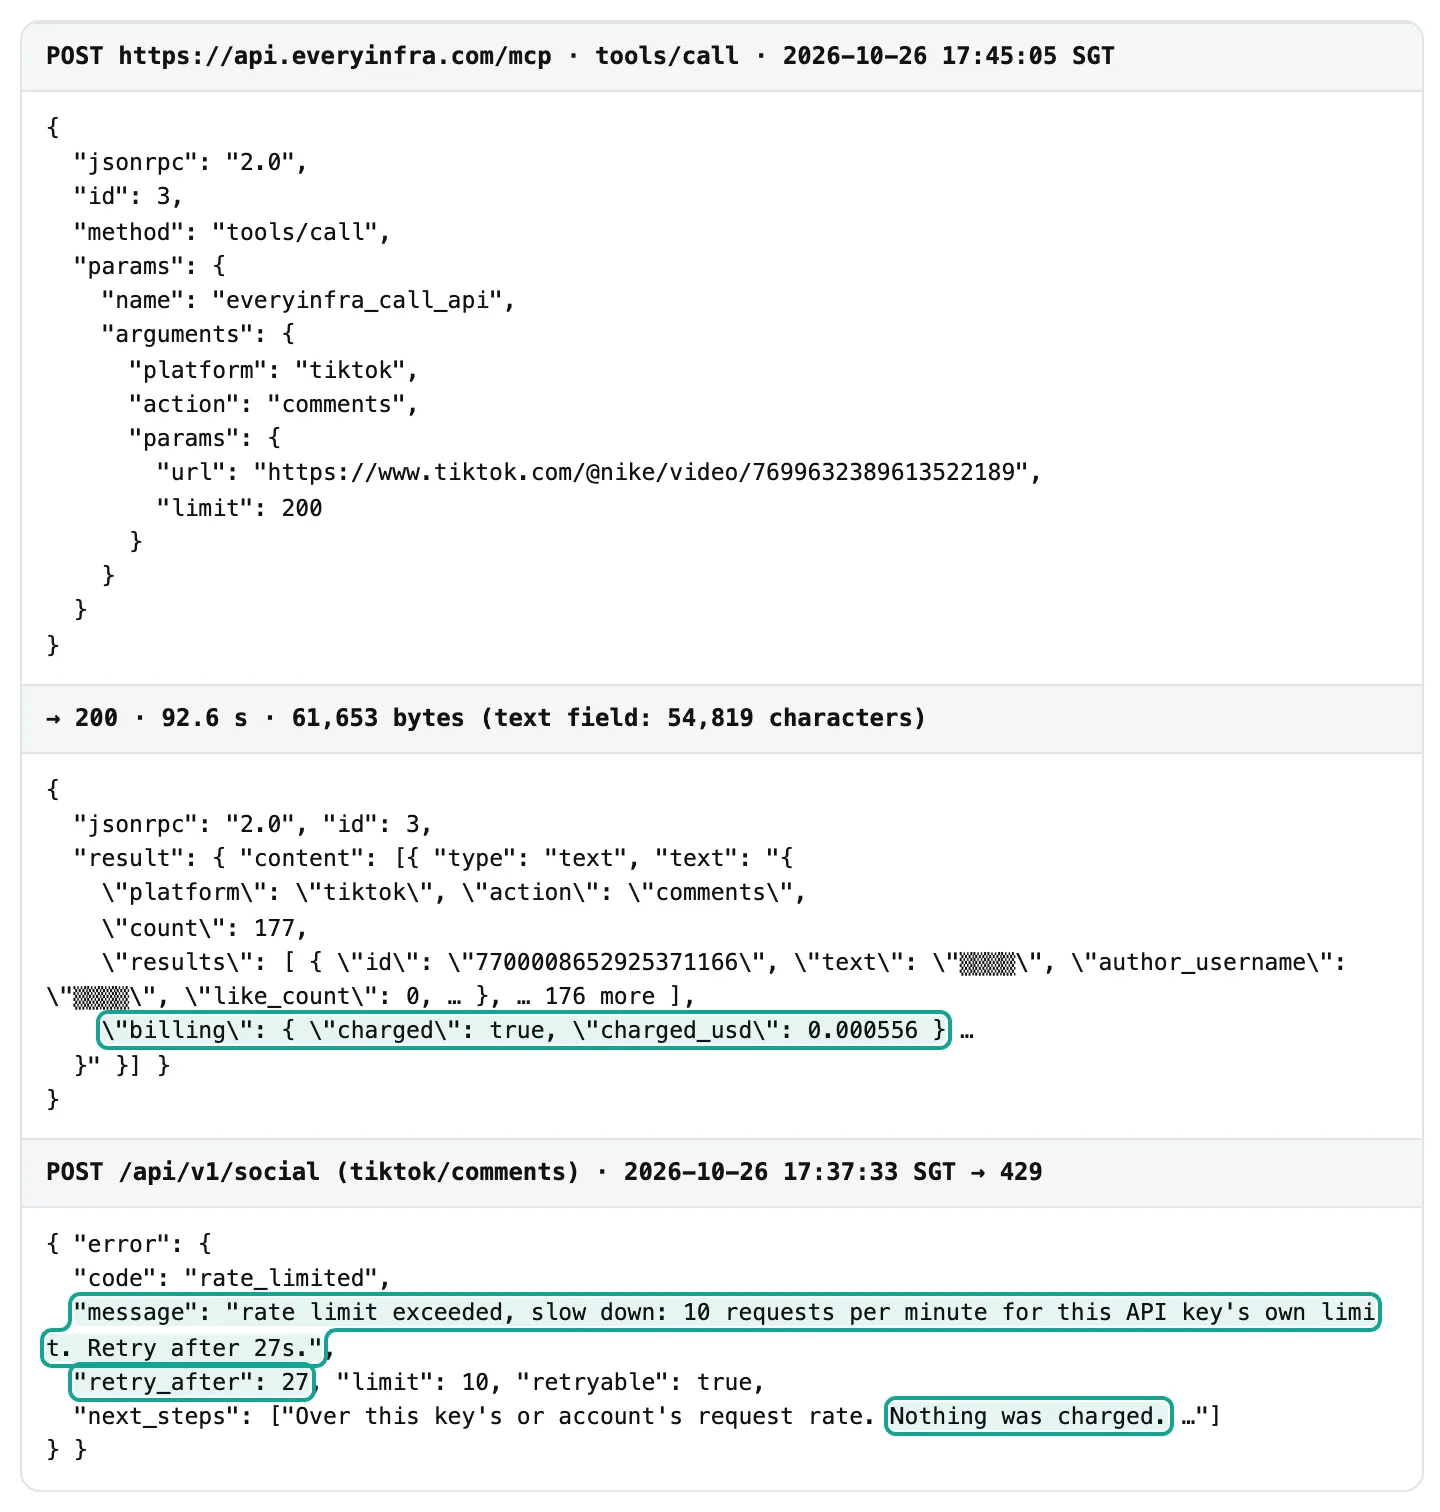
17:45:05(SGT)に、everyinfra_call_apiへtools/callを1回送信し、Nikeの動画のコメントをlimit: 200で取得しました。これは、Claude CodeからHaikuワーカーが送信するのと同じ呼び出しです。APIは92.6秒後に200を返しました。HTTPレスポンス全体は61,653バイトでした。そのcontent[0].textフィールドは54,819文字で、177件のコメントとbilling.charged_usd: 0.000556が含まれていました。
この54,819文字を、Claude Codeの3つの制限と比較してみます。MCPのドキュメントによると、Claude CodeはMCPツールの出力が10,000トークンを超えると警告を表示します。デフォルトの上限は25,000トークンで、MAX_MCP_OUTPUT_TOKENSで引き上げられます。また、anthropic/maxResultSizeCharsアノテーションを持たないツールもあります。こうしたツールでは、Claude Codeは正常に返されたテキスト結果が50,000文字を超えると、ファイルに保存します。会話にはファイルへの参照だけが残ります(MCPの出力制限)。
| MCPの結果に対するClaude Codeの制限 | ドキュメント上の値 | 実測結果 | 超えるか |
|---|---|---|---|
| 警告 | 10,000トークン | コメント200件:約13,865トークン | 可能 |
デフォルトの出力上限(MAX_MCP_OUTPUT_TOKENS) | 25,000トークン | コメント200件:約13,865トークン | 不要 |
ファイルへの保存(anthropic/maxResultSizeCharsなし) | 50,000文字 | コメント200件:54,819文字 | 可能 |
| ファイルに保存 | 50,000文字 | コメント50件:最大24,749文字 | 不要 |
| ファイルに保存 | 50,000文字 | 動画10本:最大29,156文字 | 不要 |
tools/listのレスポンスを確認したところ、EveryInfraのツールにはこのアノテーションがありませんでした。そのため、コメント200件を取得する1回の呼び出しで10,000トークンの警告ラインを超え(1トークン4バイト換算で約13,865トークン)、Claude Codeは結果をディスクに保存します。ワーカーはそのファイルを読むためにRead呼び出しが必要になります。その分、ターンが1回増え、コンテキストも増えます。
解決策は簡単で、コメントにはlimit: 50を使います。コメント50件のレスポンス18件では、JSONの平均は14,106文字、最長は24,749文字でした。いずれも50,000文字を下回っています。動画10本のレスポンスで最長のものは29,156文字で、こちらもラインを下回っています。
コメントが200件必要な場合は、mode: "async"を使い、job_idを受け取ってeveryinfra_get_jobで読み取ります。ツールの説明には、ジョブの読み取りは無料で、1分あたりの制限にもカウントされないと書かれています。モデルからはこの記述は見えません。モデルは保存後に余分なステップを1つ踏むだけです。
テスト1:1アカウント分の生データはどのくらいの大きさか
以下のグラフは、18のブランドアカウントそれぞれについて、3回の呼び出しの結果サイズを示しています。カウントしたのはresultsフィールドのUTF-8バイト数のみで、課金と残高のフィールドは除外しています。平均は1アカウントあたり38,794バイト、中央値は39,983バイトです。最小はPull&Bearの25,426バイトで、これは動画のコメントが2件しかなかったためです。
最大はDJIの53,324バイトです。プロフィールは小さく、平均740バイトです。最も大きい部分は10本の動画で、24,514バイトです。コメントは平均13,540バイトです。
| 1アカウントの内訳 | 平均バイト数 | 推定トークン数(÷ 4) | 新しいトークナイザーの場合(× 1.3) |
|---|---|---|---|
| プロフィール | 740 | 185 | 240 |
| 最新10本の動画 | 24,514 | 6,128 | 7,967 |
| 最大50件のコメント | 13,540 | 3,385 | 4,400 |
| 合計 | 38,794 | 9,698 | 12,608 |
| ワーカーが返す要約 | 382 | 95 | 124 |
なぜ動画のデータはこれほど大きいのでしょうか。1件の動画レコードには、カバー画像のURL、アバターのURL、音楽のURLが含まれています。各URLには300〜400文字の署名付きCDNパラメータが付いています。動画のurlは残したまま、_urlで終わるフィールドをすべて削除したところ、平均サイズは25,175バイトに減りました。つまり、URLフィールドがバイト数の35.1%を占めています。比較表にはこれらのフィールドはどれも必要ありません。
これが、ワーカーが「クリーニングしたデータ」ではなく要約を返す理由です。URLを除いても、メインセッションには1アカウントあたり25 KBが渡ります。私たちの要約形式なら、382バイトで済みます。
バイトとトークンの比率には、Anthropicの料金ページに載っている例を使います。平均的な10 kBのWebページは約2,500トークン、つまりトークンあたり4バイトです(Anthropic pricing, web fetch)。同じページには、Claude 4.7以降のモデルは新しいトークナイザーを使っており、同じテキストでもトークン数が約30%増えるとも書かれています。そのため、ここでのトークン数はすべて推定値で、「トークンあたり4バイト」と「30%増」の両方を示します。正確な数を知りたい場合は、トークンカウント用のエンドポイントを使ってください。ドキュメントによると、無料で、制限は1分あたりのリクエスト数だけです(token counting docs)。
コンテキスト削減の効果が確かな理由:Claude CodeのHaikuサブエージェントに関する3層の試算
アカウント1件あたりのサイズがわかったので、サブエージェントによる削減量を計算できます。最初の層はメインコンテキストです。50アカウントに換算すると、生の結果は約1.94 MB、約485,000トークン(新しいトークナイザーでは約630,000)になります。これはOpus 5.5の1Mトークンのコンテキストの半分から3分の2にあたります。要約にすると、50アカウントで約4,800トークンとなり、約102分の1です。
EveryInfraの全25ツールの説明文は、さらに約7,670トークンを消費します。インラインのmcpServersエントリと許可リストを使うと626トークンまで減り、しかも消費されるのはワーカー内だけです。
2つ目の層は各ワーカーのコンテキストです。ここには、見落とされがちな料金のしきい値があります。Anthropicの料金ページによると、Haiku 5.5の料金はプロンプトの長さによって変わります。キャッシュの読み取りと書き込みを含めてプロンプトが100,000トークンを超えるリクエストでは、入力料金が100万トークンあたり$0.10ではなく$0.50になります。出力は100万トークンあたり$0.50から$2.50に上がります。この高い料金はリクエスト全体に適用されます(長いコンテキストの料金)。
アカウントが1件増えるごとに、ワーカーのコンテキストに約9,700トークンが追加されます。これにプロンプトとツールのテキスト約3,600トークンが加わります。ツールのテキスト626トークンは実測値で、プロンプトとタスクのテキスト3,000トークンは想定値です。この数値では、ワーカー1つに9アカウントまで収まります。トークナイザーによる30%増を考慮すると7アカウントです。それを超えると、リクエストごとの料金が5倍になります。
3つ目の層はコストです。Claude Codeのコストに関するドキュメントでは、長いセッションが高くつく理由が説明されています。Claude Codeはリクエストのたびに会話全体を送信します。ツールを使うたびに、ツールの結果を含むリクエストがもう1回送られます。
プロンプトキャッシュを使うと、履歴はキャッシュ料金で再度読み込まれます(Claude Codeのコストに関するドキュメント)。つまり、メインセッションに置いた生データには、1回だけでなくその後のすべてのリクエストで料金がかかります。定価で見積もった結果は次のとおりです。前提条件は表の下に記載しています。
| 利用形態 | 主な内訳 | 50アカウントの推定コスト |
|---|---|---|
| サブエージェント | Haiku 5.5ワーカー50個で約$0.134、EveryInfra APIで$0.0834、要約を読むOpus 5.5メインセッションで約$0.043 | 約$0.26 |
| 分割なし、メインセッションに生データ | EveryInfra APIで$0.0834、Opus 5.5メインセッションが約485,000トークンを保持し、その後の20リクエストで再度読み込むため約$4.36 | 約$4.45 |
前提条件:各ワーカーは4件のリクエスト(ツール呼び出し3回と最終回答1回)を送信し、出力はそれぞれ約400トークンとします。Haiku 5.5の100万トークンあたりの定価として、入力$0.10、キャッシュ書き込み$0.125、キャッシュ読み取り$0.01、出力$0.50を使い、キャッシュ期間は5分とします。メインセッションには、Opus 5.5の100万トークンあたりの定価として、入力$4、キャッシュ書き込み$5(1.25倍)、キャッシュ読み取り$0.20を使います。データが届いた後、メインセッションはさらに20リクエストを送信します。
Opus 5.5の料金はAnthropicのモデル概要に、キャッシュ読み取りの料金は料金ページのプロンプトキャッシュの項に基づいています。ProまたはMaxプランを使っている場合、Claude Codeはこれらの金額を請求せず、プランの利用上限を消費します。比率は変わらず、メインセッションに生データを置くと利用上限を10倍以上の速さで消費します。コストに関するドキュメントには、サブエージェントのリクエストも同じ利用上限にカウントされると書かれています(コストに関するドキュメント)。
この見積もりには限界があります。メインセッションでの計画と表の作成は、どちらの構成でもほぼ同じなので含めていません。その後の20リクエストは想定値です。セッションが長くなるほど、「分割なし」の行は高くなります。
Claude Codeは、コンテキストがいっぱいになるとメインセッションの圧縮も行います。圧縮自体も大きなリクエストですが、ここでは計算に含めていません。また、485,000トークンは、Haiku 5.5の1Mトークンのコンテキストのほぼ半分です。メインセッションをHaikuで動かした場合も、100,000トークンの料金ラインを超えます。
テスト2:並列ワーカーはいくつにすべきか
サブエージェントは並列で実行できますが、ペースを決めるのはAPIです。今回のテスト用キーは1分あたり10リクエストまでで、それを超えると429を返します。この上限はこのキーだけに設定したもので、429にはreason: key_limitが含まれます。アカウントのデフォルトは1分あたり60リクエストで、すべてのキーで共有されます。チャージの累計額が$50、$150、$750に達すると、それぞれ180、600、1,800に引き上げられます(料金ページ)。以下のワーカー数は、ご自身の上限で計算し直してください。1回の呼び出しが約25秒なら、1分あたり60リクエストで約25個のワーカーを稼働させ続けられます。これはClaude Codeのサブエージェント同時実行数のデフォルト上限である20を上回ります。私たちは3ラウンドのテストを行い、実際の時間を計測しました。
ラウンド1は17:25から17:37(SGT)に実施しました。1つのワーカーが24件のプロフィールを順番に取得しました。10.72分で24件のレスポンスを受け取り、1分あたり2.24件でした。呼び出し時間の中央値は18.2秒でした。429を受けた呼び出しはありませんでしたが、時間の大半はレスポンス待ちに費やされました。
ラウンド2は17:37から17:43(SGT)に実施しました。6つのワーカーが18アカウントの動画とコメントを、アカウントごとに2回の呼び出しで取得しました。429を受けると、各ワーカーはretry_afterの時間だけ待ってから再試行しました。56リクエストのうち36件が成功し、20件が429になりました。所要時間は5.77分で、1分あたりの成功数は6.24件でした。
ラウンド3は17:46から17:48(SGT)に実施しました。4つのワーカーが、1分ごとの固定時間枠で開始できるリクエストを最大9件に制限する、1つのクライアント側リミッターを共有しました。12アカウントの人気動画(sort: popular)を取得しました。12件の呼び出しはすべて成功し、429はありませんでした。所要時間は1.25分で、1分あたりの成功数は9.64件でした。
| ラウンド | 時刻(SGT) | ワーカー数とルール | リクエスト数 | 成功数 | 429s | 1分あたりの成功数 | 呼び出し時間の中央値 |
|---|---|---|---|---|---|---|---|
| 1 | 17:25–17:37 | ワーカー1つ、順次実行 | 24 | 24 | 0 | 2.24 | 18.2 s |
| 2 | 17:37–17:43 | ワーカー6つ、429後に再試行 | 56 | 36 | 20 | 6.24 | 26.1 s |
| 3 | 17:46–17:48 | ワーカー4つ、1分あたり9件の上限 | 12 | 12 | 0 | 9.64 | 19.6 s |
ラウンド2のタイムラインを見ると、429が実行を遅らせた理由がわかります。各行が1つのリクエストです。灰色のバーはレスポンス待ちの時間、ティールのひし形は429を表します。6つのワーカーは最初の16秒でその1分間の上限を使い切り、続くリクエストはすべて失敗しました。失敗した各ワーカーは次の分の始まりまで待ち、一斉に再試行しました。
retry_afterの値は6秒から39秒で、どれも次の分の始まりを指していました。つまり、このキーは時計上の分が変わるたびにカウントをリセットしています。その結果、毎分の始まりにリクエストが殺到し、その後に長い空き時間が生じます。
ここから簡単な上限を計算できます。有効な並列ワーカー数は、おおよそ1分あたりの制限に平均呼び出し時間(秒)を掛け、60で割った値です。3回のラウンドで成功した呼び出し全体の平均時間は25.1秒だったので、10 × 25.1 ÷ 60 ≈ 4.2となります。ワーカーが4未満だと、許容量の一部が使われずに残ります。4を超えると、余分なワーカーは429を増やすだけです。
この計算では、50アカウント分の150回の呼び出しには、1分あたり10リクエストのキーで最低15分、アカウントのデフォルトである1分あたり60リクエストなら2.5分かかります。順次実行では約63分です。Claude Codeはデフォルトで最大20個のサブエージェントを同時に実行できます。21個目を起動すると「Concurrent subagent limit reached」が返され、上限はCLAUDE_CODE_MAX_CONCURRENT_SUBAGENTSで変更できます(サブエージェントの同時実行数上限)。デフォルトの20は4を大きく上回るため、同時に実行するワーカーは最大4つまでとメインセッションに平易な言葉で指示してください。
これらのラウンドは小規模です。ラウンド3は呼び出しがわずか12回で、機能も1つだけでした。また、呼び出し時間は時間帯やアカウントによって変わります。4.2をそのまま使わず、ご自身の上限と平均呼び出し時間で計算し直してください。1分あたりの上限はGET /api/v1/account(MCP:everyinfra_account)で確認できます。APIドキュメントによると、この呼び出しは無料で、上限にはカウントされません。
429への対処法:実際のレスポンスとバックオフのパターン
実際の429を見てみましょう。17:37:33(SGT)に、Nikeのワーカーによるコメントのリクエストが失敗しました。レスポンスボディにはcode: rate_limited、retry_after: 27、limit: 10、retryable: true、max_retries: 3が含まれ、next_stepsフィールドには「Nothing was charged.」と書かれていました。この種のエラー20件をすべて確認しました。
いずれも課金されておらず、待機後の最初のリトライですべて成功しました。HTTPの標準規格では、429は一定時間内のリクエストが多すぎることを示すと定義されています。レスポンスには、クライアントが待つべき時間を伝えるRetry-Afterを含めることができます(RFC 6585、セクション4、RFC 9110、Retry-After)。
対処は3つの層で行います。第1層:上限に達しないようにする。メインセッションで同時に動かすワーカーの数を制限し、呼び出しレベルで共有のリミッターを1つ追加します。ラウンド3で429が発生しなかったのはこのためです。
第2層:上限に達したら待つ。retry_afterの秒数だけ正確に待ち、少しのランダムな遅延を加えます。こうすると、複数のワーカーが同じ秒にリトライすることを防げます。
AWSの記事がこの点をわかりやすく解説しています。負荷はエラーの原因になり得ます。そこで全クライアントが同時にリトライすると、リトライがさらに負荷を悪化させます。そのため、ランダムな時間を加えてリクエストを分散させます(Amazon Builders' Library)。
第3層:課金済みの呼び出しを再送しない。429、422、401は課金前に発生するため、リトライしても安全です。一方、ワーカーが状況を見失ったからといって、すでに200を返した呼び出しを再送してはいけません。リクエストIDで確認する方法は、APIエラーの自己修復と返金の照合のガイドで紹介しています。
以下は、ラウンド3で使ったリミッターの中核部分です。Python標準ライブラリのスレッドプールを使っています(concurrent.futuresのドキュメント)。Claude Codeでは、同じルールでワーカーをスケジュールするようメインセッションに指示できます。このロジックをスクリプトにまとめ、ワーカーから呼び出すこともできます。
import threading, time, random
lock = threading.Lock(); state = {"minute": None, "n": 0}
def acquire(per_min=9):            # at most per_min starts per clock minute
    while True:
        with lock:
            m = int(time.time() // 60)
            if state["minute"] != m:
                state["minute"], state["n"] = m, 0
            if state["n"] < per_min:
                state["n"] += 1
                return
        time.sleep(0.5)
def on_429(err):                    # err is the error object of the response
    time.sleep(err["retry_after"] + random.uniform(0.5, 2.0))
上限は10ではなく9にしています。こうすることで、残高の確認やカタログの読み込みなど、メインセッションからのほかの呼び出し用に毎分1枠を残せます。
失敗と課金:422、空の結果、誤ったユーザー名
429以外にも、同じ1時間内にいくつかの失敗がありました。意図的に発生させたものもあれば、実際に遭遇したものもあります。それぞれがバッチジョブに与える影響は異なります。下の表の各行は、実際のレスポンス1件に対応しています。
| ケース | 時刻(SGT) | HTTPとレスポンス | 課金額 | ワーカーがとるべき対応 |
|---|---|---|---|---|
パラメータ名usernmeのスペルミス | 17:43:20 | 422、missing_param、「usernmeはここで使えるパラメータではありません」、動作する例付き | $0 | パラメータを修正して再送 |
| APIキーなし | 17:43:20 | 401、missing_key | $0 | 停止して設定の問題として報告 |
| リクエストの送信が速すぎる | 17:37:33ほか19件 | 429、retry_after 6~39秒 | $0 | 待ってから再試行 |
| ユーザー名が存在しない | 17:33:34, 17:34:49 | 200、空の結果、reason: empty_result_refunded | $0(課金後に返金) | 「見つからない」とマークし、リトライしない |
| ユーザー名は存在するが、ブランドのアカウントではない | 17:31:16ほか3件 | 200、未認証、フォロワー4~222人 | 通常どおり$0.000556 | 「類似アカウントの可能性」とマークし、判断はメインセッションに任せる |
422のレスポンスは、モデルが読むことを想定して書かれています。usernameが不足していること、usernmeはここでは有効なパラメータではないことを伝え、動作するリクエスト例も示しています。Haikuのような小さなモデルでも、このテキストから呼び出しを修正できます。2件の空の結果(Mercado LibreとOXXOについての推測)は200を返し、charged_usdは0、理由はempty_result_refundedでした。費用はかかっていません。
最も重要なのは最後の行です。ブランド名から推測した4つのユーザー名(Anker、Insta360、Xiaomi、Bimboに各1つ)はすべて存在しますが、いずれも一般の個人アカウントで、認証済みのものは1つもありません。フォロワー数は4、121、222、14人で、動画は0~8本です。APIはこれらのデータを正しく返したため、呼び出しは課金されました。
この種のミスはAPIでは検出できません。ワーカーが検出する必要があります。これが、例のステップ1の根拠です。未認証でフォロワーが1,000人未満のアカウントについては、処理を止めてフラグを立ててください。
正しいユーザー名は、tiktok/searchでアカウント検索すると見つかります。SGT 17:43から17:44にかけて検索を三回実行し、認証済みのinsta360_official(フォロワー2.4M)、xiaomi.official(8.3M)、ankercharging(803,600)を見つけました。費用は1回あたり$0.002778です。リストの出どころによって、表が最初から正しいかどうかが決まります。
請求額:アカウント数別のAPI料金
EveryInfra側の費用は簡単に計算できます。呼び出し回数だけで決まり、返ってくる行数にも、どのモデルでワーカーを動かすかにも左右されません。
| 規模 | 呼び出し回数 | `price_usd`が$0.000556の場合のAPI料金 | 毎分10回での最短所要時間 |
|---|---|---|---|
| 1アカウント | 3 | $0.001668 | 18秒 |
| 50アカウント | 150 | $0.0834 | 15分 |
| 50アカウント、毎週、1か月間 | 約650 | 約$0.361 | 1回の実行あたり15分 |
| 500アカウント | 1,500 | $0.834 | 150分 |
この表はリストが正しいことを前提としています。ユーザー名を調べるために先にtiktok/searchを使う場合は、1アカウントあたり約$0.002778(limit: 5)を加えてください。今回のテスト全体で使ったリクエストは98件で、内訳はREST経由が97件、MCPのtools/callが1件です。これに無料のMCPハンドシェイクメッセージが3件加わります。課金されたのは74件で、合計$0.04781でした。
課金されなかった24件の内訳は、エラー(429)が20件、空の結果が2件、422エラーが1件、401エラーが1件です。いずれも、それぞれのレスポンスのbillingまたはエラーボディの内容と一致しています。セットアップについては、クイックスタートでRESTの3つのステップを、MCPサーバーのページでクライアントの設定を確認できます。
サマリーのフォーマットを選ぶ:その1行でメインセッションにできることが決まる
最も注意すべきなのは、ワーカーが何を返すかです。私たちのルールは次のとおりです。まず、サマリーにはメインセッションが判断に必要な数値だけを含めます。次に、各数値はスクリプトで生のレスポンスから算出できるものにします。このやり方には利点が二つあります。
まず、メインセッションで抜き打ちチェックができます。任意のアカウントを選び、新しいワーカーにもう一度実行させて数値を比較します。どのワーカーの「理解」も信用する必要はありません。次に、サイズを抑えられます。今回のフォーマットのフィールドは15個です。18件のサマリーはJSONで平均382バイトで、最も長いReal Madridでも398バイトにとどまります。Real Madridが長いのは、数値の桁数が多いためです。
ワーカーに「重要そうなもの」を返させてはいけません。自由形式のサマリーは長さがまちまちです。半ページ分を返すワーカーもあれば、コメント本文をそのまま返すワーカーもあります。その結果、メインのコンテキストが再び膨らみます。また、ワーカーによって「重要」の判断が異なることもあり、その場合は行を1つの表にまとめられません。
特にコメントには注意が必要です。コメント本文には一般ユーザーのユーザー名や個人的な発言が含まれており、メインセッションに渡ると最終レポートに紛れ込むおそれがあります。今回のフォーマットでは、コメント数と返信が付いたコメントの数だけを返します。感情分析やトピック分析を行う場合は、ワーカー内で分類し、分類ごとの件数だけを返してください。
メインセッションへの指示は3文で済みます。リスト内の各ユーザー名をtiktok-account-workerに渡し、同時実行は最大4件までとすること。すべて戻ったら、サマリーを1つの表にまとめ、類似アカウントとしてフラグが付いたアカウントに印を付けること。再生数の中央値とエンゲージメントで上位3件と下位3件のアカウントについて、それぞれ1文で説明を書くこと。
最初の2文はスケジューリングです。大規模モデルの判断が必要なのは3文目だけです。Anthropicのガイドでは、この種の作業はメインループで行うべきだとしています。
メインセッションが受け取るもの:米国スポーツウェアの表
米国スポーツウェアグループについて、メインセッションがワーカーのサマリーから作成した表を以下に示します。サイズを再現できるよう、これらのサマリーはワーカーの例と同じルールでスクリプトが生のレスポンスから算出したもので、Haikuが書いたものではありません。Haikuが注記を書くと、各サマリーが数十バイト増えます。再生数の中央値とエンゲージメント率(いいね数を再生数で割った値の中央値)は、固定動画を除いて計算しています。
| アカウント | フォロワー数 | 最近の動画の再生数中央値 | エンゲージメント | 週あたり投稿数 | サンプリングしたコメント数 |
|---|---|---|---|---|---|
| Nike | 9.3M | 24,250 | 3.82% | 11.9 | 50 |
| Adidas | 12.3M | 142,200 | 2.72% | 4.2 | 50 |
| Gymshark | 6.7M | 50,900 | 14.07% | 4.6 | 50 |
| lululemon | 1.5M | 34,900 | 1.08% | 3.0 | 50 |
| Under Armour | 1.0M | 28,600 | 5.20% | 4.8 | 50 |
| New Balance | 1.0M | 24,900 | 1.19% | 1.3 | 27 |
| PUMA | 6.2M | 15,450 | 6.68% | 4.8 | 50 |
| HOKA | 268,300 | 7,912 | 0.99% | 1.2 | 28 |
この表を見ると、判断をメインセッションに残す理由がわかります。Nikeは投稿数が最も多い(週11.9件)ものの、再生数の中央値は週4.2件投稿するAdidasより低くなっています。GymsharkのフォロワーはAdidasの半分ですが、エンゲージメント率は14.07%と5倍以上です。また、Gymsharkの最新10件には7月の固定動画が3件含まれていました。固定動画を除外しなければ、エンゲージメント率に新旧の投稿が混在することになります。
こうした比較には、全行をまとめて見たうえでの常識的な判断が必要です。これは各ワーカー単独ではなく、メインセッションの大規模モデルが担うべき仕事です。このグループ以外では、Real Madridが別の落とし穴を示しています。「週466件の投稿」はエラーではありません。最新の動画10本がすべて同じ日、2026-10-25に公開されており、日単位の投稿ペースで換算すると週あたりの数値が非常に大きくなります。
他のプラットフォームでも同じワーカーを使う:InstagramとYouTube
リストにInstagramやYouTubeのブランドアカウントも含まれている場合でも、ワーカーの構造はそのままです。変更するのはプラットフォーム名、アクション名、パラメータ名の3つです。以下の表は同じカタログ(2026年10月26日17:22 SGT時点)に基づいています。この2つのプラットフォームでは実際の呼び出しを行っていないため、表にはカタログ上の料金とパラメータのみを記載しています。結果のサイズは一度ご自身で測定してください。各プラットフォームの概要はInstagramデータAPIとYouTubeデータAPIをご覧ください。
| プラットフォーム | プロフィール | 最近の投稿 | コメント | 1回あたりの料金 | 備考 |
|---|---|---|---|---|---|
| TikTok(今回測定) | profile、パラメータusername | user_videos、最大50件 | comments、最大200件 | $0.000556 | 固定された動画が先頭に来る |
profile、パラメータusername | user_posts、最大200件 | comments、最大100件 | $0.000556 | reelsは現在利用できません | |
| YouTube | profile、パラメータはチャンネルのurl | user_posts、チャンネルのurl、最大50件 | comments、最大100件 | $0.000556 | ショート動画には別のshortsアクションを使用 |
この3つの機能は、3つのプラットフォームすべてで同じ料金です。そのため、1アカウントあたり3回の呼び出しで$0.001668、50アカウントでは各プラットフォームにつき$0.0834になります。一方、パラメータは異なります。YouTubeのプロフィールと動画一覧はユーザー名ではなくチャンネルURLを受け取るため、ワーカーのステップ1で先にURLを取得する必要があります。
結果のサイズも異なります。Instagramの投稿レコードは、TikTokの動画レコードと同様に多数の画像URLを含みます。TikTokでの結果を踏まえ、まず1アカウント分の生データを測定してください。そのうえで、ワーカーあたりのアカウント数と1回の呼び出しあたりのコメント数を決めます。すでに別のエディタでこれらのプラットフォームにMCPを使っている方もいるでしょう。以前の記事CursorでTikTok、Instagram、Amazonのデータを扱うに呼び出し時間の実測値があり、ワーカー数の見積もりに役立ちます。
制限事項と注意点
1つ目はプラットフォームの規約です。TikTokの米国向け利用規約は、自動化されたデータ収集を制限しています。自動化システムを使ってプラットフォームのデータをスクレイピング、クロール、エクスポート、抽出することはできません。例外はTikTok USDS Joint Ventureの書面による承認がある場合です(TikTok利用規約)。
学術機関や非営利団体の研究者はTikTokの研究ツールに申請でき、承認には通常約4週間かかります(TikTok Research Tools、コードブック)。ご自身の地域とユースケースに照らして、利用が適切かどうかを判断してください。この記事で扱うのはデータ取得の方法のみです。
関連して、混同しやすい点があります。2026年10月5日、TikTokはTikTok for Business MCPがClaudeなどのAIプラットフォームでコネクタとして利用可能になったと発表しました(TikTokニュースルーム)。このMCPが扱うのは自社の広告アカウント、つまりキャンペーン、クリエイティブ、成果です(TikTok for Businessブログ)。他ブランドの公開プロフィールやコメントは読み取れません。
第2に、コメントは網羅的ではありません。commentsはトップレベルのコメントごとに返信を最大2件しか返さず、件数が動画に表示される数より少ないことがあります。18回の呼び出しのうち5回は、コメントが少ない動画だったため、返ってきたのが50件未満でした。感情分析に使う場合は、サマリーにサンプル数を記載してください。
3つ目に、サブエージェントは多ければよいとは限りません。APIの制限に加えて、Claude Code自体にも制限があります。サブエージェントはデフォルトで3階層までネストでき、CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTHで変更できます。ワーカーのコンテキストサイズはメインのモデルではなく、ワーカーのモデルで決まります(サブエージェントのドキュメント)。
数千件のアカウントリストについては、ドキュメントでは動的ワークフローを案内しています。動的ワークフローでは、Claudeがエージェントの実行をスケジュールするJavaScriptスクリプトを書きます。デフォルトの同時実行数は最大16エージェントで、CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTSで256まで引き上げられます(動的ワークフローのドキュメント)。ただし、これによって1分あたりのAPI利用枠が増えるわけではありません。
4つ目は、検証していない点です。このサブエージェントはClaude Codeでは実行していません。Haiku 5.5によるサマリーの品質についての実測データはありません。is_pinnedルールへの準拠度や、50ワーカーでの実際の所要時間も計測していません。サイズ、課金額、429エラー、速度に関する数値は実測値です。
モデルのコストは定価に基づく見積もりです。本格的に使う前に、まず10アカウントで試してください。/tasksで各サブエージェントのモデルを確認し、続いて/usageでサブエージェントが占める割合を確認してください。
最近の変更点
2026-10-07:AnthropicがClaude Haiku 5.5をリリースしました。料金は、100,000トークン以下のプロンプトで入力100万トークンあたり$0.10、出力100万トークンあたり$0.50です。Anthropicは主な用途としてサブエージェントでの作業を挙げています(発表ページ)。同日、Claude Code v2.1.293で、Haiku 5.5がAnthropic API利用時のデフォルトのHaikuモデルになりました(変更履歴)。ユーザーへの影響:データワーカーのコストは先月の約10分の1になりました。ただし、お使いのプロバイダーでhaikuがどのモデルを指すかを確認してください。
2026-10-16:Claude Code v2.1.302では、デスクトップアプリとVS Codeでもターミナルと同様に、メインの会話から起動したサブエージェントが常にバックグラウンドで実行されるようになりました。また、claude -p、Agent SDK、デスクトップアプリ、VS Codeでフォークサブエージェントがデフォルトになりました(変更履歴)。ユーザーへの影響:バックグラウンドワーカーは権限確認のプロンプトをメインセッションに送るため、ワーカーに必要な1つのツールを事前に許可しておいてください。
2026-10-19および2026-10-21:v2.1.304で、多数のサブエージェントを同時に実行する際の速度が向上しました。また、すぐに追加のメッセージを送るとサブエージェントが直前の作業を忘れてしまう問題も修正されました。v2.1.307では、グループ内の各フォークサブエージェントに、どの起動が自分に割り当てられたものかが通知されるようになり、フォークが互いの作業を始めてしまうことが減りました(変更履歴)。ユーザーへの影響:並列ワーカーは1か月前より安定しています。この記事ではフォークではなく通常のサブエージェントを使用しています。
2026-10-22:Anthropicが「When to fold subagents into your main agent loop」を公開しました。多くのエージェントはサブエージェントを減らすべきだという内容です。サブエージェントを残すのは、コンテキストの増加が測定できる場合、使い捨てのコンテキストを並列で使う場合、ツールが多すぎる場合に限るとしています(ガイド、キット)。ユーザーへの影響:分割する前に、そのジョブが大量に読み込むものの残す情報は少なく、独立した部分に分けられるかを確認してください。当てはまらない場合は、スキルを使ってメインセッションで処理してください。
2026-10-05:TikTokはAdvertising Week New Yorkで、同社の広告MCPがClaude、Kimi、Perplexityなどでコネクタとして利用できると発表しました(TikTokニュースルーム)。ユーザーへの影響:自社の広告管理にはこれを使えます。他ブランドのアカウントの公開情報から成果を確認するには、引き続き公開データAPIが必要です。
FAQ
Claude Codeのサブエージェントで別のモデルを使えますか?
はい。サブエージェントのファイルでmodelを設定します。エイリアス(sonnet、opus、haiku、fable)、claude-haiku-5-5のような完全なID、またはinheritを指定できます。優先順位は、起動時のパラメータ、modelフィールド、CLAUDE_CODE_SUBAGENT_MODEL、メインモデルの順です。(質問の出典:Googleサジェスト「claude code subagents different model」「claude code subagents model selection」、回答:サブエージェントのドキュメント)
Claude Codeのサブエージェントはデフォルトでどのモデルを使いますか?
modelフィールドがない場合、上記の優先順位はメインモデルで終わるため、サブエージェントはメインモデルを継承します。また、組み込みのExploreサブエージェントも、常にHaikuで動作するわけではなくなりました。すべてのサブエージェントを1つのモデルに統一するには、CLAUDE_CODE_SUBAGENT_MODELとCLAUDE_CODE_SUBAGENT_MODEL_FORCE=1の両方を設定します。(質問の出典:サジェスト「claude code subagent model default」「claude_code_subagent_model force」、回答:サブエージェントのドキュメント、r/ClaudeCodeのスレッド)
**model: haikuを指定しても、Claude CodeのHaikuサブエージェントのコストが高いのはなぜですか?**
よくある原因は2つあります。1つは、Bedrock、Google Cloud、Foundry、Claude Platform on AWSではhaikuエイリアスがHaiku 4.5を指し、その料金がHaiku 5.5の10倍であることです。もう1つは、CLAUDE_CODE_SUBAGENT_MODEL_FORCEが設定されていて、Claude Codeがmodelフィールドを無視していることです。各サブエージェントが実際に使っているモデルは/tasksで確認できます。(質問の出典:サジェスト「claude code subagent model=haiku」「claude code use haiku for subagents」、回答:モデル設定のドキュメント、サブエージェントのドキュメント)
Claude Codeのサブエージェントとエージェントチームの違いは何ですか?
サブエージェントは結果をメインエージェントに返し、サブエージェント同士はやり取りしません。エージェントチームのメンバーはタスクリストを共有し、互いにメッセージを送れるため、議論や調整が必要な作業に向いています。ドキュメントによると、エージェントチームは実験的な機能で、デフォルトでは無効になっており、トークンの消費量も大幅に増えます。互いに独立した複数のアカウントをまとめて処理するなら、サブエージェントで十分です。(質問の出典:サジェスト「claude code subagents vs agent teams」、回答:エージェントチームのドキュメント)
Claude Codeでは同時にいくつのサブエージェントを実行できますか?
デフォルトでは同時に20個までです。21個目では「Concurrent subagent limit reached.」が返されます。v2.1.217以降はCLAUDE_CODE_MAX_CONCURRENT_SUBAGENTSでこの上限を変更でき、セッション内の合計数には上限がありません。外部APIを呼び出すワーカーの場合、実際の上限はAPIの許容量で決まります。テスト用キーの毎分10リクエスト、呼び出しあたり約25秒という条件では、ワーカーを4個より多くしても429が返るだけです。アカウントのデフォルトである毎分60リクエストなら、約25個です。(質問の出典:サジェスト「claude code run subagents in parallel」、回答:サブエージェントのドキュメント、同時実行数の上限と今回のテスト)
MCPツールの結果が非常に大きい場合、Claude Codeはどう処理しますか?
10,000トークンを超えると警告が表示され、デフォルトの上限は25,000トークンです(MAX_MCP_OUTPUT_TOKENSで変更できます)。anthropic/maxResultSizeCharsが設定されていないツールでは、正常終了した結果が50,000文字を超えるとファイルに保存されます。当社のテストで取得したTikTokコメント200件分の結果は54,819文字だったため、保存されます。コメント50件分の結果で最も長かったものは24,749文字だったため、保存されません。(質問の出典:当社のテスト、回答:MCPのドキュメント(出力の上限))
参考文献
- カスタムサブエージェントの作成、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/sub-agents
- MCPでClaude Codeをツールに接続する、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/mcp
- Claude Code変更履歴(v2.1.293〜v2.1.310)、Anthropic、2026-10-07〜2026-10-23、https://code.claude.com/docs/en/changelog
- コストを効果的に管理する、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/costs
- モデル設定、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/model-config
- 環境変数、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/env-vars
- エージェントチーム、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/agent-teams
- 動的ワークフローでサブエージェントを大規模にオーケストレーションする、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/workflows
- コンテキストウィンドウを確認する、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/context-window
- 権限、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/permissions
- 設定、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/settings
- Claude Codeをプログラムから実行する、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/headless
- スキル、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/skills
- プロンプトキャッシュ、Claude Codeドキュメント、Anthropic、2026-10-26閲覧、https://code.claude.com/docs/en/prompt-caching
- CHANGELOG.md、anthropics/claude-code、GitHub、2026-10-26閲覧、https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Introducing Claude Haiku 5.5、Anthropic、2026-10-07、https://www.anthropic.com/claude-haiku-5-5
- Claude Haiku 5.5 System Card、Anthropic、2026-10-07、https://www.anthropic.com/claude-haiku-5-5-system-card
- 料金、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/about-claude/pricing
- モデルの概要、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/about-claude/models/overview
- Claude Haiku 5.5への移行、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- プロンプトキャッシュ、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- トークン数のカウント、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/build-with-claude/token-counting
- レート制限、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/api/rate-limits
- リリースノート、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/release-notes/overview
- ツール検索ツール、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- ツール使用の概要、Claude Platformドキュメント、Anthropic、2026-10-26閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- Claudeの料金(Pro、Max、Team)、Anthropic、2026-10-26閲覧、https://claude.com/pricing
- エージェント構築:サブエージェントをメインのエージェントループに統合すべきタイミング、Anthropic、2026-10-22、https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- single-agent-loop-kit、anthropics、GitHub、2026-10-26閲覧、https://github.com/anthropics/single-agent-loop-kit
- Transports(2025-06-18)、Model Context Protocol仕様、https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Tools(2025-06-18)、Model Context Protocol仕様、https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Lifecycle(2025-06-18)、Model Context Protocol仕様、https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- RFC 6585:Additional HTTP Status Codes(429)、IETF、2012年4月、https://www.rfc-editor.org/rfc/rfc6585
- RFC 9110:HTTP Semantics(Retry-After)、IETF、2022年6月、https://www.rfc-editor.org/rfc/rfc9110
- タイムアウト、リトライ、ジッター付きバックオフ、Amazon Builders' Library、2019-12-05、https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/
- concurrent.futures、Pythonドキュメント、2026-10-26閲覧、https://docs.python.org/3/library/concurrent.futures.html
- TikTok Research Tools:アクセスと利用資格、TikTok for Developers、2026-10-26閲覧、https://developers.tiktok.com/products/research-api/
- Research API Codebook、TikTok for Developers、2026-10-26閲覧、https://developers.tiktok.com/doc/research-api-codebook
- TikTok Unveils AI-Powered Updates for Advertisers、TikTok Newsroom、2026-10-05、https://newsroom.tiktok.com/tiktok-unveils-ai-powered-updates-for-advertisers-driving-discovery-action-and-measurable-business-outcomes?lang=en
- TikTok for Business MCPの進化、TikTok for Businessブログ、2026-06-30、https://ads.tiktok.com/business/en-US/blog/tiktok-agentic-hub-ai-agents-skills-mcp
- TikTok Terms of Service(US)、TikTok、2026-10-26閲覧、https://www.tiktok.com/legal/page/us/terms-of-service/en
- EveryInfraデータカタログ、EveryInfra、2026-10-26 17:22 SGT閲覧、https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra TikTokカタログ、EveryInfra、2026-10-26閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok
- 「Haiku 5.5はOpus 5.5より40倍安い。Exploreサブエージェントはおそらく今もOpusで動いている」、Reddit r/ClaudeCode、2026-10-08、https://www.reddit.com/r/ClaudeCode/comments/1x0kzbh/haiku_55_is_40x_cheaper_than_opus_55_your_explore/
- 「PSA:Claude Codeのサブエージェントがセッションのモデルを継承するようになった」、Reddit r/claude、2026-10-26閲覧、https://www.reddit.com/r/claude/comments/1v7iqqy/psa_claude_code_subagents_inherit_your_session/
- 「Opus 5.5とHaikuサブエージェントの組み合わせはどれほど効果的か」、Reddit r/ClaudeAI、2026-10-26閲覧、https://www.reddit.com/r/ClaudeAI/comments/1x1buac/how_much_more_effectivebetter_is_using_opus_55/
- 「Anthropicの新ガイド(10月22日)、ほとんどのエージェントはサブエージェントを減らすべきと主張」、Reddit r/ClaudeAI、2026-10-24、https://www.reddit.com/r/ClaudeAI/comments/1xdwquj/anthropics_new_guide_oct_22_argues_most_agents/
- 「Anthropicによると、多数のサブエージェントより単一のAIエージェントのほうが優れている」、The Decoder、2026-10-25、https://the-decoder.com/anthropic-says-one-ai-agent-beats-many-subagents-now-that-models-can-handle-complexity-alone/
参考資料 BL-53