Claude Code dynamic workflows y comentarios de Xiaohongshu: prueba de la API y guion de ejemplo
Claude Code y sus workflows dinámicos clasifican comentarios de Xiaohongshu: 4 de 8 páginas trajeron 10 filas y 500 comentarios cuestan 0,222 USD.
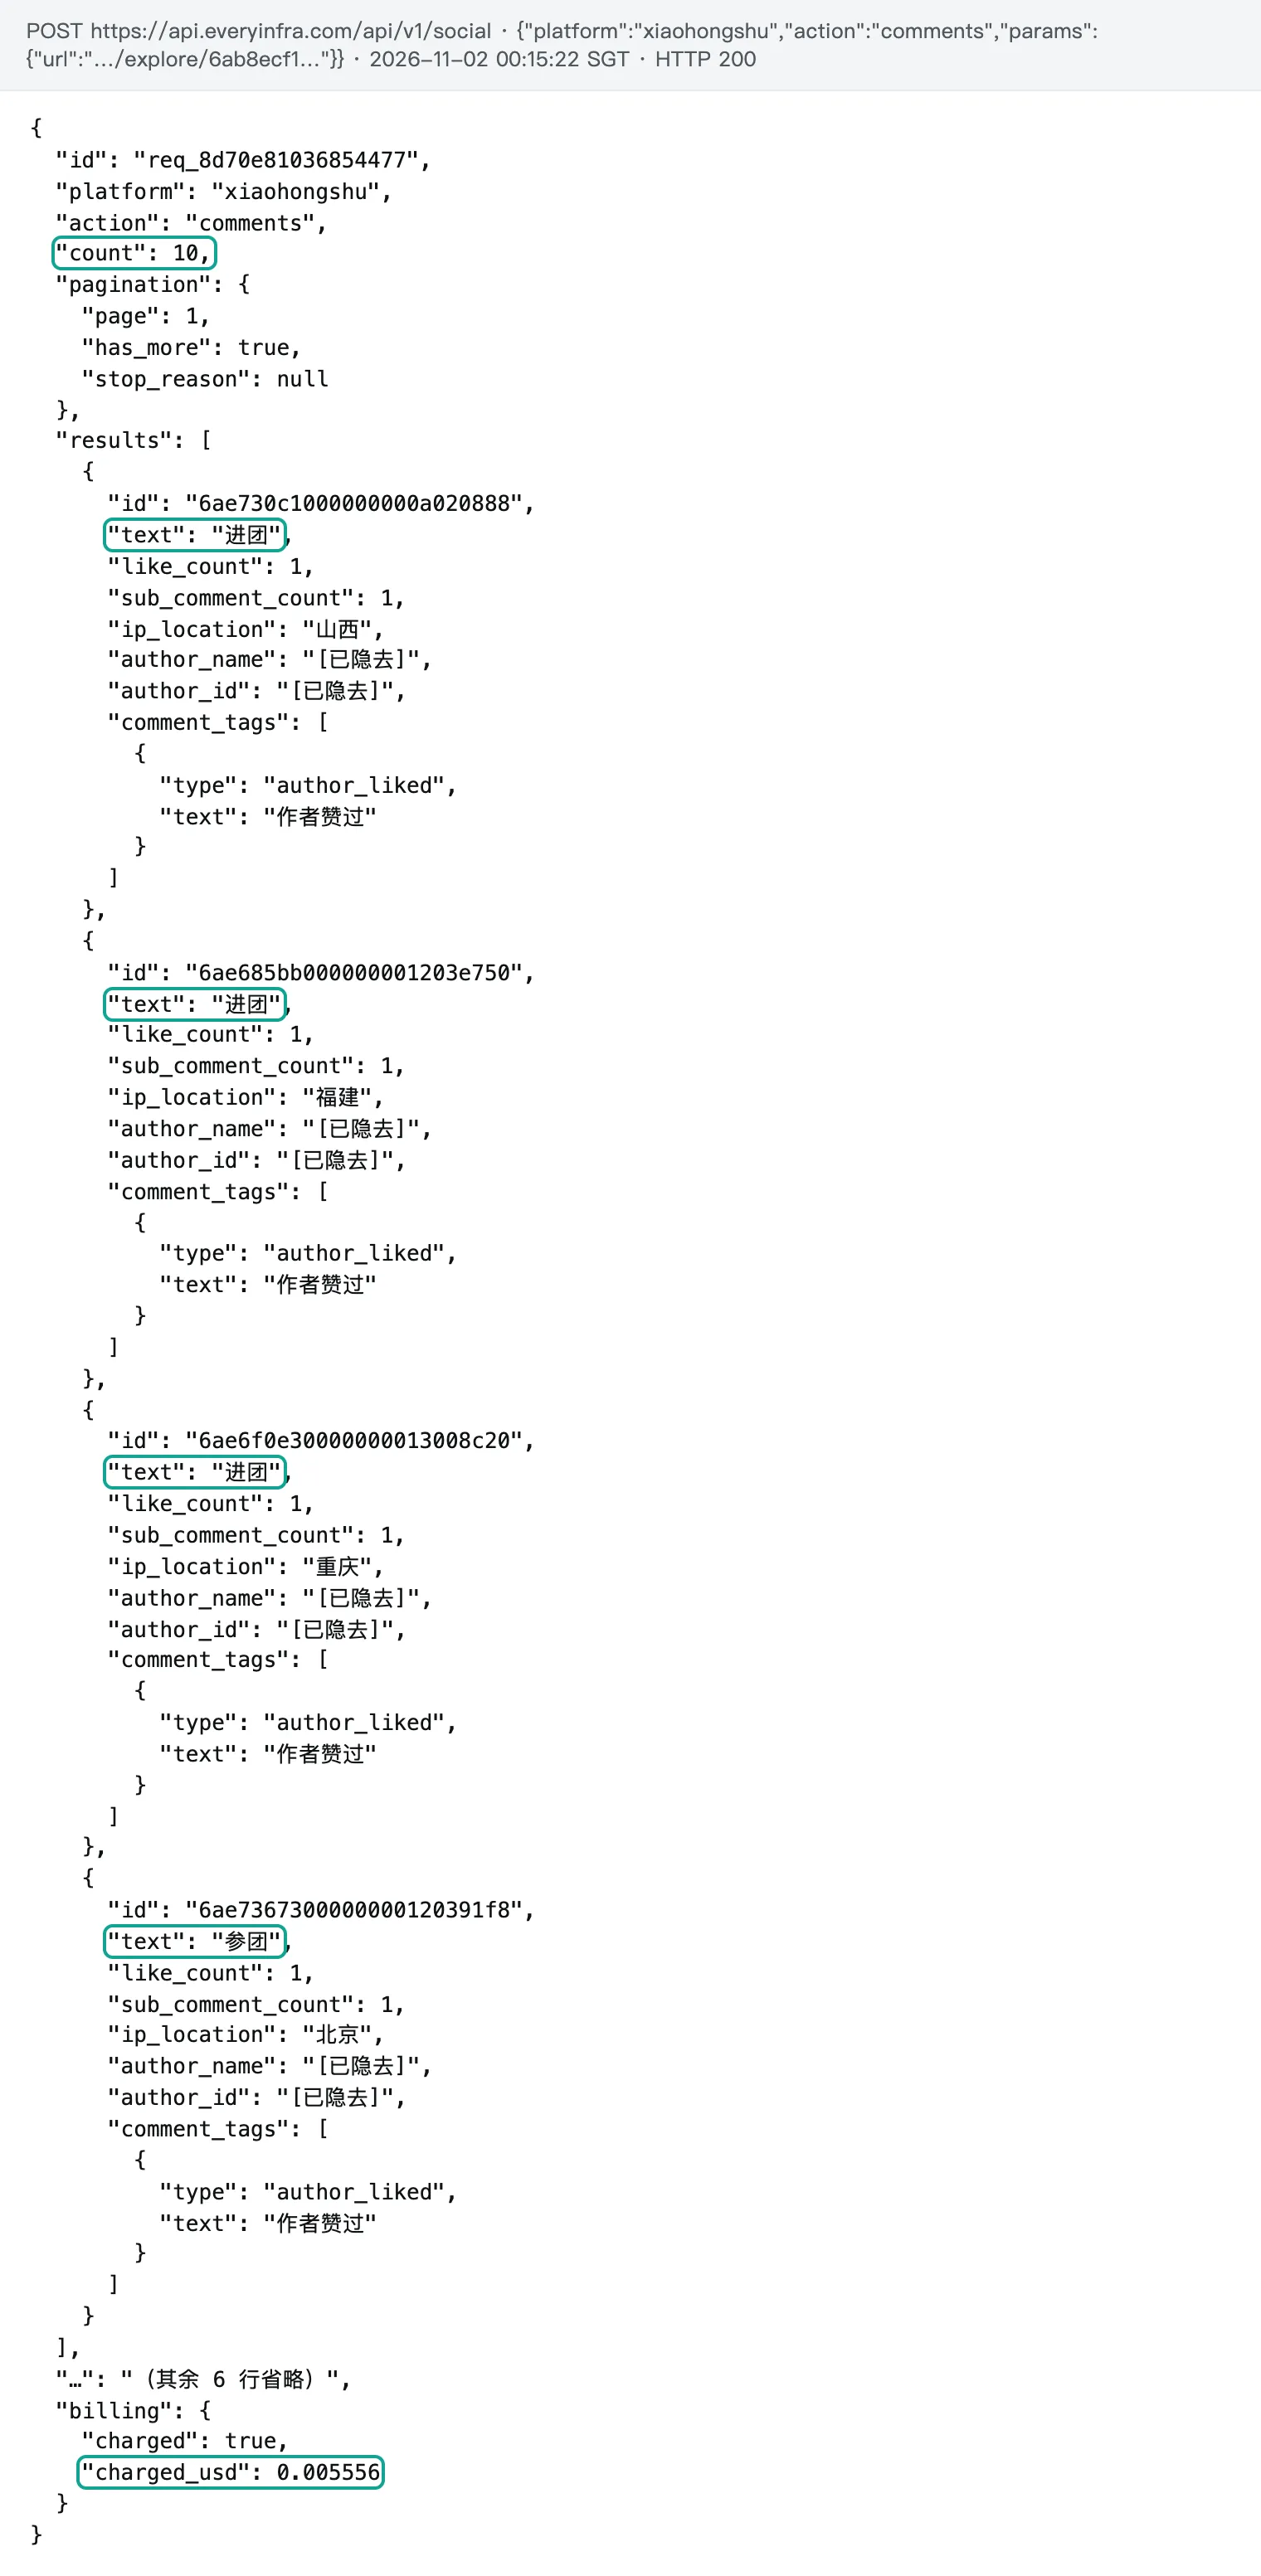
El 2 de noviembre de 2026, entre las 00:14 y las 00:22 (hora de Singapur), hicimos 10 llamadas cobradas a la API de EveryInfra. Devolvieron 100 comentarios de primer nivel de 6 publicaciones de Xiaohongshu (RedNote) sobre robots aspiradores, por 0,066671 USD en total. En una de esas publicaciones, 24 de 25 comentarios solo decían «me apunto al grupo», «me sumo» o «me apunto» en chino. El catálogo dice que xiaohongshu/comments devuelve 15 filas por página, pero 4 de nuestras 8 páginas trajeron 10.
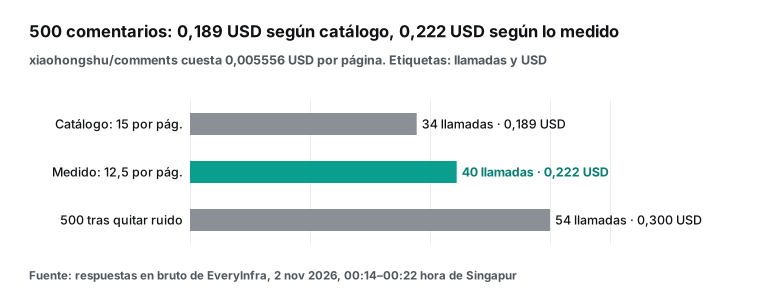
Ese dato cambia el presupuesto de un flujo de trabajo dinámico de Claude Code. Con el tamaño de página del catálogo, 500 comentarios salen en 34 llamadas y 0,189 USD. Con nuestra media medida de 12,5 filas, son 40 llamadas y 0,222 USD. Si además quitas el 25 % de ruido y quieres 500 comentarios útiles, son 54 llamadas y 0,300 USD.
Un cuarto resultado importa para las repeticiones. Pedimos la misma primera página tres veces y, en 6 minutos, cambiaron 7 de sus 15 comentarios. Las tres llamadas se cobraron.
Este artículo es para equipos de comercio electrónico en España y Latinoamérica que venden en China o estudian ese mercado. Si ya lees a mano las reseñas de Mercado Libre o de Amazon.es, Xiaohongshu es el sitio donde un comprador chino pregunta «¿cuál compro?» antes de pagar. A partir de una palabra clave, Claude Code escribe un programa paralelo que trae comentarios, los separa en necesidad, queja, precio y recomendación, y entrega una tabla.
Todo lo que afirmamos sobre Claude Code sale de la página oficial de workflows o del registro de cambios. No ejecutamos un flujo de trabajo en nuestra máquina, así que las partes de Claude Code son ejemplos de configuración. Todos los números de EveryInfra salen de respuestas en bruto de la API.
El encargo: 500 comentarios, cuatro grupos, una tabla
Primero definimos el encargo, porque todos los números dependen de él. La entrada es una palabra clave. Usamos la palabra china para «robot aspirador». Es una categoría con muchos hilos de «¿cuál compro?» y «se me rompió» en torno a las rebajas del 11 de noviembre, el Día de los Solteros, que en China pesa más que el Black Friday. La salida es una tabla con el número y el porcentaje de cada grupo, tres ejemplos por grupo, el coste de la API y la tasa de acuerdo de una revisión por muestreo.
El trabajo tiene tres etapas. xiaohongshu/search encuentra publicaciones. xiaohongshu/comments y xiaohongshu/sub_comments traen comentarios y respuestas. Después, un modelo etiqueta cada comentario. El guion define los cuatro grupos. Una necesidad pregunta qué modelo comprar o pide un enlace. Una queja cuenta un problema del producto o del servicio. Un comentario de precio habla de coste, copias más baratas o dónde comprar. Una recomendación viene de alguien que usa el producto y lo aconseja. Todo lo demás va a «otro».
¿Por qué un programa paralelo? Porque el encargo cumple tres condiciones. Las publicaciones son independientes: la A no necesita el resultado de la B. La entrada es mucho mayor que la salida: un comentario ocupa unos 1.445 bytes de JSON, pero su texto ocupa unos 95. Y la regla de etiquetado es fija, así que un modelo pequeño basta.
El 22 de octubre de 2026, Anthropic publicó una guía que pide a quien construye agentes usar menos subagentes (artículo de Anthropic). La misma guía los mantiene para un caso: varias tareas que necesitan contextos nuevos y separados en paralelo. Clasificar comentarios es justo ese caso.
Buscamos con sort=most_commented, recibimos 20 publicaciones y elegimos 6 con temas distintos. La tabla las resume en español. De las 20, diez tenían is_cooperation_note en true: son publicaciones patrocinadas que pasan por la plataforma Pugongying. Esa plataforma revisa la publicación antes de que salga, y la marca tiene 72 horas para aceptarla o rechazarla (centro de ayuda de Pugongying, página fechada el 2026-10-22; portada de Pugongying). Ninguna de nuestras 6 era patrocinada, y conviene recordarlo al leer los números de recomendaciones.
| Publicación (nuestro código) | Título resumido | Comentarios según la búsqueda | Comentarios que trajimos |
|---|---|---|---|
| A | «No compres robot aspirador aún, mira antes la prueba del 11/11» | 2.069 | 25 (2 páginas) |
| B | Hilo de quejas sobre un aspirador Roborock | 570 | 30 (2 páginas) |
| C | «Guía de compra de robots aspiradores 2026» | 377 | 10 |
| D | Vídeo de humor sobre un aspirador «con mucha fuerza» | 3.278 | 10 |
| E | «Electrodoméstico inútil: el robot aspirador» | 973 | 15 |
| F | Una compradora primeriza pide consejo | 487 | 10 |
Qué son los Claude Code dynamic workflows, según la documentación
La documentación de Claude Code define un flujo de trabajo dinámico como un guion en JavaScript que orquesta muchos subagentes a la vez. Claude escribe el guion para tu tarea y un entorno lo ejecuta en segundo plano, mientras tu sesión sigue disponible (página de workflows). La función salió en la versión 2.1.154, el 2026-05-28. El registro de cambios dice que Claude reparte el trabajo entre decenas o cientos de agentes y que /workflows muestra las ejecuciones (registro de cambios).
El artículo de lanzamiento dice hoy que la función está disponible para todos. Cita la línea de comandos, la aplicación de escritorio y la extensión de VS Code. También cita los planes Pro, Max, Ultra, Team y Enterprise, la API de Claude, Amazon Bedrock, Vertex AI y Microsoft Foundry (artículo de lanzamiento de Anthropic).
La documentación enseña un guion guardado. Empieza con export const meta = { name, description }. El cuerpo es JavaScript normal con await de nivel superior. agent() lanza un subagente. pipeline() pasa cada elemento de una lista por una cadena de etapas. parallel() lanza un grupo de tareas a la vez y espera a todas. phase() agrupa los agentes siguientes bajo un título, log() escribe una línea de progreso y args contiene la entrada (página de workflows, «What the saved script looks like»).
Si pasas un schema a agent(), el subagente devuelve un objeto que cumple ese JSON Schema. Si la salida no valida cinco veces seguidas, la llamada falla; MAX_STRUCTURED_OUTPUT_RETRIES cambia ese número (misma página). Es justo lo que necesita la etapa de etiquetado: cada agente devuelve una lista de {id, label} y el guion la cuenta sin leer texto libre.
| Cómo lo inicias | Quién decide usar un flujo | Nota |
|---|---|---|
Escribes la palabra ultracode en el mensaje | Tú, para ese mensaje | Solo en un mensaje que tecleas tú |
| Pides «un workflow» con tus palabras | Tú, para ese mensaje | Claude escribe el guion para esa tarea |
Ejecutas /effort ultracode o claude --effort ultracode | Claude, tarea por tarea | La opción de arranque también fija el esfuerzo en xhigh |
Ejecutas un comando guardado, como /deep-research | Tú | Reutiliza una ejecución que salió bien |
La tabla resume la sección «Have Claude write a workflow» de la página de workflows y la página de comandos. La palabra clave solo funciona en un mensaje que escribe una persona. No funciona con -p (documentación del modo sin interfaz), ni en una tarea programada, ni en un webhook o un comentario de pull request.
Para un informe semanal, guarda primero una ejecución buena como comando y llama a ese comando desde la tarea programada.
| Subagentes | Skills | Equipos de agentes | Workflows | |
|---|---|---|---|---|
| Qué es | Un trabajador que lanza Claude | Instrucciones que sigue Claude | Un agente líder con sesiones pares | Un guion que ejecuta el entorno |
| Quién decide el paso siguiente | Claude, turno a turno | Claude, según el mensaje | El agente líder | El guion |
| Dónde quedan los resultados | En el contexto de Claude | En el contexto de Claude | En una lista de tareas compartida | En variables del guion |
| Qué puedes repetir | La definición del trabajador | Las instrucciones | La definición del equipo | La orquestación |
| Escala | Pocas tareas por turno | Igual que los subagentes | Pocos pares de larga duración | Decenas o cientos de agentes |
| Tras una interrupción | El turno empieza de nuevo | El turno empieza de nuevo | Los compañeros siguen | Se reanuda en la misma sesión |
La tabla sigue la comparación de la sección «When to use a workflow» de la página de workflows. La fila clave es la tercera: con un workflow, comentarios, etiquetas y revisión se quedan en variables, y la conversación solo recibe la tabla final.
Los equipos de agentes siguen en fase experimental y necesitan CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 (documentación de equipos de agentes), así que no los usamos aquí.
Flujo de trabajo o subagentes: el plan vive en el código
La diferencia de fondo no es el paralelismo, sino quién guarda el plan. Con subagentes, Claude decide en cada turno a quién lanzar. Cada resultado tiene que volver a su contexto antes de la siguiente decisión. La documentación de subagentes dice que, con 20 subagentes en marcha, la siguiente llamada falla con un error que le pide a Claude no reintentar; CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS cambia ese número (documentación de subagentes, «Concurrent subagent limit»).
Con un workflow, bucles, ramas y reintentos están escritos en el guion. Todas las publicaciones reciben el mismo mensaje y el mismo esquema, así que los resultados se pueden comparar entre sí.
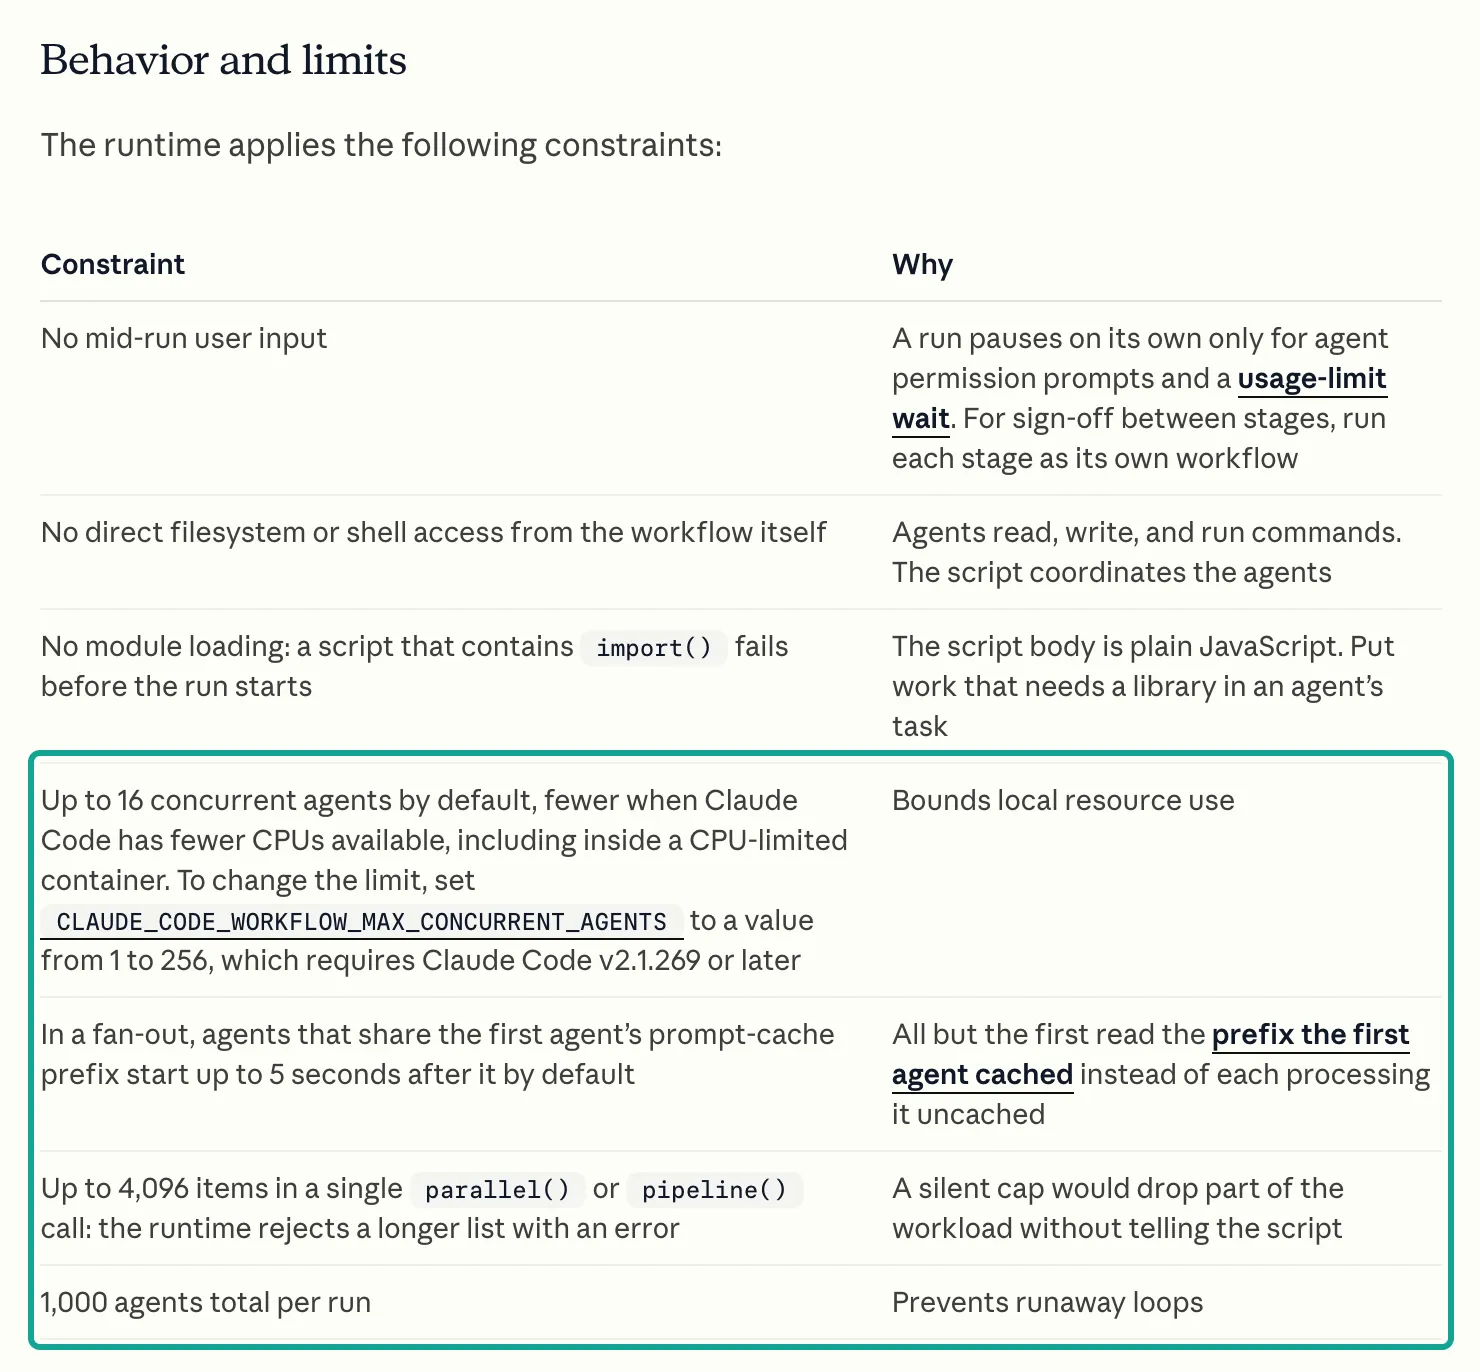
El entorno tiene límites fijos. La captura de abajo sale de la documentación oficial y el recuadro verde azulado marca los tres que más importan aquí. Por defecto corren a la vez hasta 16 agentes, y menos en equipos con pocos núcleos. Desde la versión 2.1.269, CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS acepta un valor entre 1 y 256. Una llamada a parallel() o pipeline() acepta hasta 4.096 elementos y rechaza con error una lista más larga. Una ejecución lanza como máximo 1.000 agentes.
Además, una ejecución no puede pedirte datos, el guion no lee archivos ni ejecuta comandos, y un import() lo hace fallar antes de empezar.
Como el guion no puede llamar a fetch ni a curl, son los agentes quienes llaman a EveryInfra. Un agente puede usar las herramientas MCP que la sesión tenga conectadas, o Bash si tus permisos lo dejan.
La referencia para escribir workflows añade un dato. Los agentes de un workflow ven todas las herramientas MCP de la sesión, pero los servidores que piden un inicio de sesión interactivo pueden faltar en ejecuciones sin interfaz. Esa referencia es la skill /workflow-authoring, que necesita la versión 2.1.248 o posterior (página de workflows, «Edit a saved script»; documentación de skills). El servidor MCP remoto de EveryInfra usa una clave en la cabecera, no un inicio de sesión interactivo, así que también funciona sin interfaz.
Dentro del guion, Date.now(), Math.random() y new Date() sin argumentos lanzan un error. Una ejecución reanudada tiene que repetir las mismas llamadas a agent(), y una marca de tiempo o un número aleatorio lo impedirían (página de workflows). Si necesitas una fecha, pásala por args. Para «comentarios de las últimas 24 horas», usa el filtro de la API: xiaohongshu/search acepta date_range=last_24_hours.
Versiones e interruptores: qué cambió y cuándo
Los flujos de trabajo dinámicos cambiaron mucho entre mayo y noviembre de 2026, y muchos tutoriales describen el comportamiento antiguo. La tabla solo recoge lo que afecta a este encargo. Versiones y fechas salen del registro de cambios de Claude Code, que replica el CHANGELOG.md de GitHub. Las filas marcadas «docs» salen de notas de versión de la página de workflows.
| Versión | Fecha | Cambio | Efecto al clasificar comentarios |
|---|---|---|---|
| 2.1.154 | 2026-05-28 | Llegan los workflows y /workflows | Punto de partida |
| 2.1.157 | 2026-05-29 | Un ajuste desactiva el disparo por palabra clave | Escribir «workflow» ya no lanza una ejecución sin querer |
| 2.1.269 | docs | CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS | Limitar a 2 o 3 los agentes que llaman a la API |
| 2.1.271 | docs | Pausa al llegar al límite de uso; tamaño pequeño por defecto en Pro | Las ejecuciones largas no mueren a medias |
| 2.1.296 | 2026-10-09 | CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL | Una variable pone a todos los agentes en Haiku |
| 2.1.299 | 2026-10-14 | /usage avisa del gasto de workflows | Ves en qué se fueron los tokens |
| 2.1.301 | 2026-10-15 | Corrige agentes que saltaban un paso y la ejecución decía éxito | Un etiquetado omitido ya no parece un éxito |
| 2.1.305 | 2026-10-20 | Corrige reanudaciones que repetían agentes ya terminados | Reanudar ya no paga dos veces los comentarios |
| 2.1.311 | 2026-10-26 | Corrige subagentes que no veían servidores MCP conectados tarde | Una conexión MCP lenta ya no esconde herramientas |
| 2.1.316 | 2026-10-31 | CLAUDE_CODE_SUBAGENT_EFFORT | Esfuerzo bajo para todos los agentes de etiquetado de una vez |
Las filas 2.1.269 y 2.1.271 salen de las secciones «Behavior and limits», «When a run hits your usage limit» y «Set a size guideline» de la página de workflows. La guía de tamaño tiene cuatro valores: unrestricted (sin guía), small (menos de 5 agentes), medium (menos de 10) y large (menos de 50). Claude la toma como consejo, no como tope; el tope duro sigue siendo 1.000 agentes. También puedes fijar workflowSizeGuideline en cualquier archivo de ajustes (referencia de ajustes).
Para 500 comentarios basta con medium, sobre todo si la descarga va por lotes en uno o dos agentes.
ultracode se activa de dos maneras, y no hacen lo mismo. Dentro de la sesión, desde la versión 2.1.284, /effort ultracode solo enciende ultracode y no toca el nivel de esfuerzo; /effort ultracode off lo apaga. Antes de la 2.1.284, /effort ultracode ponía la sesión en esfuerzo xhigh y /effort ultracode off fallaba con Invalid argument. Al arrancar, en cambio, claude --effort ultracode (versión 2.1.203 o posterior) enciende ultracode y además fija el esfuerzo en xhigh (documentación de configuración de modelos, «Adjust effort level»; página de workflows, «Let Claude decide with ultracode»). Con ultracode activo no aparece el aviso de «Large workflow» y no se aplica el límite de subagentes simultáneos. Para encargos que llaman a una API de pago, recomendamos dejarlo apagado y pedir el workflow en un mensaje, para ver el plan antes de que arranque.
Conectar los datos: MCP remoto o POST /api/v1/social
Un workflow puede usar la API de datos de dos maneras: los agentes llaman a EveryInfra como servidor MCP remoto o ejecutan curl contra POST https://api.everyinfra.com/api/v1/social. La documentación de MCP de Claude Code añade un servidor HTTP remoto con claude mcp add --transport http <nombre> <url> y, para una clave Bearer, con --header (documentación de MCP).
Nuestro servidor MCP usa el transporte Streamable HTTP de la especificación (especificación MCP 2025-11-25, transportes). En la especificación, una llamada a herramienta es una petición tools/call y el resultado viene en una lista content (especificación MCP 2025-11-25, herramientas). Nuestra llamada tools/list devolvió 12 herramientas; aquí importan tres: everyinfra_list_capabilities, everyinfra_call_api y everyinfra_get_job.
# Ejemplo de configuración. La clave va en una variable de entorno, nunca en un archivo.
export EVERYINFRA_API_KEY="<tu clave>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Menos avisos de permiso: añade esto a permissions.allow en .claude/settings.json
#   "Workflow", "mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"
# Como mucho 3 agentes a la vez, para no saturar una clave de 10 peticiones por minuto
export CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS=3
Las líneas de permisos tienen tres fuentes. En claude -p y en el Agent SDK, Claude Code nunca muestra el aviso de aprobación del workflow. Para que la ejecución arranque, añade Workflow a tus reglas de permiso, o Workflow(<nombre>) para un workflow guardado concreto (página de workflows, «Approve the plan before it runs»). El artículo de lanzamiento sugiere el modo automático, en el que un clasificador revisa cada llamada (documentación de modos de permiso). Un hook PreToolUse también puede aprobar la llamada (documentación de hooks).
Las reglas de permiso para MCP tienen la forma mcp__<servidor>__<herramienta>. El comodín solo vale detrás del nombre del servidor, como en mcp__everyinfra__* (documentación de permisos). Los subagentes de un workflow usan tus reglas, y la documentación aconseja permitir antes de una ejecución larga las herramientas que necesitan, para que no se pare a pedir aprobaciones.
| Pregunta | MCP remoto | curl a `POST /api/v1/social` |
|---|---|---|
| ¿El agente necesita Bash? | No | Sí, y una regla de red en el sandbox |
| ¿El agente conoce el cobro y la paginación? | Sí, por la descripción de la herramienta | Solo si lo pones en el mensaje |
Campos de error como retry_after y did_you_mean | En el resultado de la herramienta | En el cuerpo de la respuesta |
| JSON en bruto guardado para auditoría | No | Sí, el agente escribe el archivo |
| Mejor para | Etiquetar con un número de llamadas conocido | Encargos que deben guardar cada archivo |
Para etiquetar en modo solo lectura, usamos MCP. El sandbox de Claude Code empieza sin dominios de red permitidos, así que curl necesita una regla extra (documentación del sandbox). Si eliges curl, el agente de descarga escribe cada archivo en bruto y solo devuelve {id, text, like_count} al guion.
Conviene conocer un límite de tamaño. Claude Code avisa cuando la salida de una herramienta MCP pasa de 10.000 tokens y la corta en 25.000 por defecto; MAX_MCP_OUTPUT_TOKENS cambia el tope. Un resultado de texto de más de 50.000 caracteres se guarda en un archivo (documentación de MCP, «MCP output limits and warnings»). Una página de 15 comentarios por MCP ocupó 16.892 bytes y una página de búsqueda de 20 publicaciones, 34.991 bytes: ambas quedan por debajo.
Una llamada a comments_batch con 3 publicaciones ocupó 42.991 bytes. A ese ritmo, 20 publicaciones son unos 280.000 bytes, que irán a un archivo; el agente tendrá que leerlo en un segundo paso. El resultado no cambia, solo hay un paso más. Si quieres que todo quepa en el contexto del agente, pide 3 o 4 publicaciones por llamada.
Una ida y vuelta real: qué envía el agente y qué devuelve la API
El 2 de noviembre de 2026 a las 00:17:55 (hora de Singapur) enviamos por MCP la petición tools/call de abajo. Es la misma petición JSON-RPC que envía un agente de Claude Code cuando llama a mcp__everyinfra__everyinfra_call_api. El objetivo era la publicación F, la de la compradora primeriza, ordenada por «me gusta». El resultado llega como texto JSON en result.content[0].text. Mostramos el primer comentario y el campo de cobro; quitamos la cadena de consulta de la URL de la publicación y ocultamos nombres e identificadores de autor.
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api",
 "arguments":{"platform":"xiaohongshu","action":"comments",
  "params":{"url":"https://www.xiaohongshu.com/explore/692b0d81000000001d03ea4c","sort":"most_liked"}}}}

{"id":"req_b7efc0a2e4784211","platform":"xiaohongshu","action":"comments","count":10,
 "pagination":{"page":1,"has_more":true,"stop_reason":null},
 "results":[{"id":"693ab483000000001702fef1","text":"(en chino) ¿Qué tal el de DJI? Dicen que esquiva muy bien los obstáculos",
   "like_count":3,"author_name":"[oculto]","author_id":"[oculto]","sub_comment_count":0}],
 "billing":{"charged":true,"charged_usd":0.005556}}
Ocho de esos 10 comentarios son necesidades claras, y casi todos dan superficie, presupuesto, mascotas y tipo de suelo. Un ejemplo traducido: «140 metros cuadrados, alfombras, sin mascotas, todo baldosa, mucho pelo, presupuesto 3.000 yuanes, ¿cuál?». Para un equipo de producto o de atención al cliente, este tipo de comentario vale oro. Además está bien estructurado, así que un modelo puede sacar presupuesto, superficie y mascotas como campos.
Los campos coinciden con los 20 response_fields de xiaohongshu/comments en el catálogo. La tabla indica cuáles conserva el agente de descarga.
| Campo | Qué contiene | ¿Lo conservas para etiquetar? |
|---|---|---|
id, text, like_count | Identificador, texto y «me gusta» | Sí |
sub_comment_count | Número de respuestas | Sí, para elegir hilos |
comment_tags | «Le gustó al autor», «fijado», respuestas de encuesta | Opcional, ayuda al filtro de ruido |
posted_at, ip_location | Fecha y región de la IP | Solo para informes por fecha o región |
author_name, author_id, avatar | Quién lo escribió | No, y no van en los informes |
note_url, next_page_token, sub_comments | Paginación y primera respuesta | Solo dentro del agente de descarga |
El esqueleto del guion: buscar, descargar, filtrar, etiquetar, revisar, informar (ejemplo)
El esqueleto sigue la API oficial del guion. No lo ejecutamos: es un ejemplo de configuración. Tiene cinco llamadas a phase() pero seis paradas: el filtro no es un agente, es una expresión regular dentro del guion y no gasta tokens.
Cada decisión sale de una medición de este artículo. La API devuelve 20 campos, pero los agentes de descarga solo pasan al guion id, text y like_count. Los agentes de etiquetado usan un schema con cinco etiquetas fijas. La revisión usa otro modelo para volver a etiquetar el 10 % de los comentarios sin ver las primeras etiquetas.


export const meta = {
  name: 'xhs-comment-triage',
  description: 'Trae comentarios de Xiaohongshu de una palabra clave, quita el ruido, etiqueta necesidad/queja/precio/recomendación y escribe una tabla',
  whenToUse: 'Tienes una palabra clave de producto y quieres saber qué preguntan y de qué se quejan los comentarios',
  phases: [
    { title: 'Buscar', detail: '1 agente busca publicaciones' },
    { title: 'Descargar', detail: '1 agente por publicación trae 2 páginas' },
    { title: 'Clasificar', detail: '1 agente por publicación etiqueta' },
    { title: 'Revisar', detail: 'otro modelo vuelve a etiquetar el 10 %' },
    { title: 'Informe', detail: '1 agente escribe la tabla' },
  ],
}

const KEYWORD = (args && args.keyword) || 'robot aspirador (palabra clave en chino)'
const NOTE_COUNT = (args && args.notes) || 20
const TOOL = 'mcp__everyinfra__everyinfra_call_api'
const LABELS = ['necesidad', 'queja', 'precio', 'recomendacion', 'otro']
const NOISE = /^(进团|参团|进|\s*)$|^(\[[^\]]+R\]|\s)*$/   // «me apunto al grupo», texto vacío, solo emojis

const NOTES = { type: 'object', required: ['notes'], properties: { notes: { type: 'array', items: {
  type: 'object', required: ['url', 'title'],
  properties: { url: { type: 'string' }, title: { type: 'string' }, comment_count: { type: 'integer' } } } } } }
const COMMENTS = { type: 'object', required: ['comments', 'calls', 'charged_usd'], properties: {
  calls: { type: 'integer' }, charged_usd: { type: 'number' },
  comments: { type: 'array', items: { type: 'object', required: ['id', 'text'],
    properties: { id: { type: 'string' }, text: { type: 'string' }, like_count: { type: 'integer' } } } } } }
const LABELED = { type: 'object', required: ['items'], properties: { items: { type: 'array', items: {
  type: 'object', required: ['id', 'label'],
  properties: { id: { type: 'string' }, label: { type: 'string', enum: LABELS } } } } } }

phase('Buscar')
const found = await agent(
  `Usa ${TOOL} con platform=xiaohongshu, action=search, params={keyword:"${KEYWORD}", sort:"most_commented"}. ` +
  `Sigue next_page_token hasta tener ${NOTE_COUNT} publicaciones. Copia cada url tal cual, con xsec_token.`,
  { schema: NOTES, model: 'haiku', effort: 'low', label: 'buscar' })

const results = await pipeline(found.notes.slice(0, NOTE_COUNT),
  (note) => agent(
    `Usa ${TOOL} para xiaohongshu/comments con params={url:"${note.url}"} y pide la página 2 con next_page_token. ` +
    `Con un 429, espera error.retry_after segundos y reintenta, como mucho 3 veces. Con un 422, no reintentes; infórmalo. ` +
    `Conserva solo id, text y like_count. Suma billing.charged_usd en charged_usd.`,
    { schema: COMMENTS, model: 'haiku', effort: 'low', phase: 'Descargar', label: note.title.slice(0, 12) }),
  (r) => ({ ...r, kept: r.comments.filter((c) => !NOISE.test(c.text.trim())),
            dropped: r.comments.filter((c) => NOISE.test(c.text.trim())).length }),
  (r) => agent(
    `Etiqueta cada comentario de Xiaohongshu con una de: ${LABELS.join(', ')}. necesidad = pregunta qué modelo comprar o pide un enlace; ` +
    `queja = problema del producto o del servicio; precio = coste, copias baratas o dónde comprar; ` +
    `recomendacion = quien escribe lo usa y lo aconseja; otro = bromas o temas ajenos.\n` +
    JSON.stringify(r.kept.map((c) => ({ id: c.id, text: c.text }))),
    { schema: LABELED, model: 'haiku', effort: 'low', phase: 'Clasificar', label: 'clasificar' })
    .then((l) => ({ ...r, labels: l ? l.items : [] })),
)

const ok = results.filter(Boolean)
const all = ok.flatMap((r) => r.labels.map((x) => ({ ...x, text: (r.kept.find((c) => c.id === x.id) || {}).text })))
const sample = all.filter((_, i) => i % 10 === 0)
log(`Descargadas ${ok.length}/${found.notes.length} publicaciones; el filtro quitó ${ok.reduce((s, r) => s + r.dropped, 0)} comentarios`)

phase('Revisar')
const second = await agent(
  `Etiqueta estos comentarios por tu cuenta. Etiquetas: ${LABELS.join(', ')}.\n` + JSON.stringify(sample.map(({ id, text }) => ({ id, text }))),
  { schema: LABELED, model: 'sonnet', effort: 'medium', label: 'revisar-10pct' })
const agree = sample.filter((s) => ((second && second.items.find((y) => y.id === s.id)) || {}).label === s.label).length

phase('Informe')
const counts = {}
for (const x of all) counts[x.label] = (counts[x.label] || 0) + 1
return await agent(
  `Escribe una tabla Markdown con número y porcentaje por etiqueta y 3 comentarios de ejemplo por etiqueta, traducidos al español. ` +
  `Termina con el coste de API ${ok.reduce((s, r) => s + r.charged_usd, 0).toFixed(4)} USD y el acuerdo de la revisión ${agree}/${sample.length}.\n` +
  JSON.stringify({ counts, examples: all.slice(0, 150) }),
  { model: 'sonnet', effort: 'low', label: 'informe' })
meta tiene que ser la primera sentencia y un objeto literal puro. Si contiene una variable, una llamada a función o un operador de propagación, /<nombre> desaparece del autocompletado (página de workflows, «Edit a saved script»). Los títulos de phases tienen que coincidir letra por letra con los argumentos de phase(), o la vista de progreso crea un grupo de más.
Cuando falla un agente dentro de pipeline(), su posición queda en null; por eso el guion llama a filter(Boolean). Cuando falla un agente que esperas directamente con await, termina toda la ejecución (sección «When an agent stalls and restarts» de la misma página). Descarga y etiquetado usan haiku; revisión e informe, sonnet. Claude Code elige el modelo de los agentes de un workflow en el mismo orden que para los subagentes. Un modelo indicado en el guion cuenta como modelo de esa llamada y, sin modelo, el agente usa el de la sesión (página de workflows, «Cost»); la documentación de subagentes lista los alias sonnet, opus, haiku y fable.
¿Por qué el filtro va en el guion y no en un modelo? El guion es JavaScript normal: una expresión regular, un filtro y un recuento no cuestan tokens. El filtro quita los «me apunto», el texto vacío y los comentarios de solo emojis, y ninguno de ellos requiere entender nada. La sección siguiente muestra que eran 25 de nuestros 100 comentarios. La referencia de autoría también pide que un workflow use log() para contar lo que descarta cuando limita la cobertura; sin esa línea, quien lee el resultado supone que se cubrió todo. La línea log() del esqueleto cumple esa función.
Prueba 1: el catálogo dice 15 filas por página; 4 de 8 páginas trajeron 10
Para xiaohongshu/comments, el catálogo indica page_size 15 y limit_ignored en true: el tamaño de página es fijo y un valor de limit no tiene efecto. xiaohongshu/sub_comments tiene 10, xiaohongshu/search tiene 20 y comments_batch tiene 15 por publicación. Antes de las pruebas apuntamos la hipótesis «todas las páginas traen 15 filas». Los datos la rechazaron.
A las 00:15:22 (hora de Singapur), la primera página de la publicación A trajo 10 filas, y la segunda, a las 00:15:49, trajo 15. A las 00:17:38, una llamada a comments_batch con 3 publicaciones devolvió 10 filas para C, 10 para D y 15 para E. A las 00:17:55, la publicación F por MCP devolvió 10. La media de las 8 páginas es 12,5 filas.
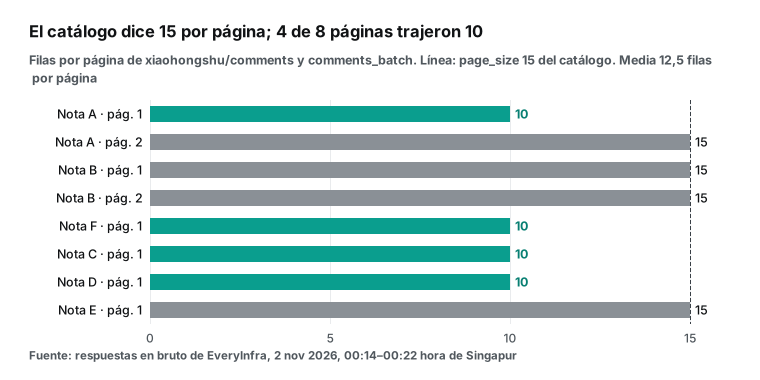
Una página corta no significa el final: en A y F, has_more era true, y en C y D cada fila traía next_page_token. La segunda página de A volvió a 15 filas. No sabemos por qué la primera página sale corta, así que solo contamos lo que vimos.
Por eso la regla de parada correcta es «ya tengo suficientes filas» o «has_more es false», no «ya pedí N páginas».
Las respuestas se comportan igual. Un comentario de B tenía sub_comment_count 52. A las 00:17:17 (hora de Singapur) pedimos xiaohongshu/sub_comments para ese comentario. La página 1 trajo 5 filas, no 10, y 2 tenían el texto vacío, probablemente imágenes o stickers. Una página de primer nivel dio 12,5 filas de media por 0,005556 USD; esta página de respuestas dio 3 filas con texto. Para etiquetar, recomendamos saltar las respuestas por defecto y pedirlas solo para comentarios que el modelo marque como queja y que tengan muchas respuestas.
| Capacidad | page_size del catálogo | Filas por página observadas | Precio por llamada | Coste por fila útil |
|---|---|---|---|---|
xiaohongshu/search | 20 | 20 (1 página) | 0,005556 USD | unos 0,00028 USD por publicación |
xiaohongshu/comments | 15 | de 10 a 15, media 12,5 (8 páginas) | 0,005556 USD | unos 0,00044 USD por comentario |
xiaohongshu/comments_batch | 15 por publicación | de 10 a 15 por publicación (3) | 0,005556 USD por publicación | igual que una sola publicación |
xiaohongshu/sub_comments | 10 | 5, de las que 2 sin texto (1 página) | 0,005556 USD | unos 0,0019 USD por respuesta |
Prueba 2: lo que quita un filtro de reglas y lo que no puede hacer
La tercera hipótesis era «los comentarios pueden ir directos al modelo», con el umbral de menos del 30 % de ruido en cada publicación. La publicación A la suspendió de largo: de sus 25 comentarios en dos páginas, 24 solo decían «me apunto al grupo» (17), «me sumo» (6) o un simple «me apunto» de una palabra (1) en chino. La captura muestra que casi todos llevan la etiqueta «le gustó al autor», algunos llevan una respuesta de encuesta, y cada uno tiene sub_comment_count 1.
Nuestra lectura es que la autora organizó una compra en grupo en los comentarios y la gente respondía para que la añadieran. Si has gestionado redes en México o Colombia, lo reconocerás: es el equivalente a cien «info» o «precio por DM» debajo de una publicación de Instagram. No dicen nada de lo que quiere el cliente, pero llenan páginas cobradas. En las otras 5 publicaciones solo apareció 1 fila de ruido, un comentario vacío en D.
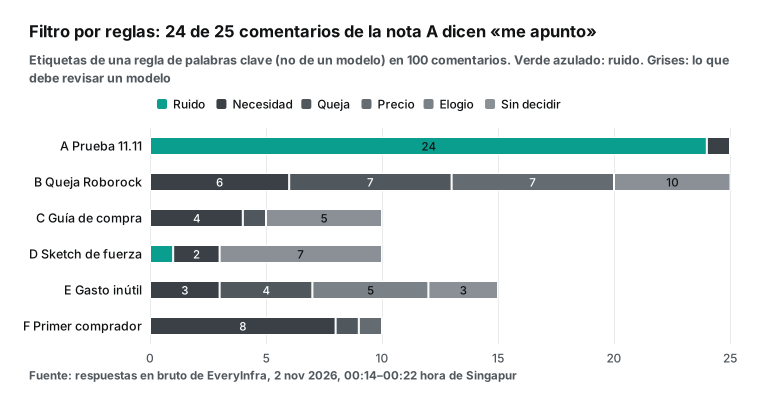
Para ver hasta dónde llega una expresión regular, escribimos como referencia un clasificador por palabras clave. Primero marca el ruido: texto que solo es «me apunto», solo emojis o vacío. Después busca palabras de queja (olor, devolución, timo, se enreda), luego de necesidad (recomendar, cuál, signos de interrogación), luego de precio (precio, yuanes, copia barata, presupuesto) y por último de recomendación (funciona bien, limpio, ahorra tiempo). Lo que no encaja en nada queda «sin decidir».
Esto no es un resultado de modelo. Sirve para ver qué parte hace una regla y qué parte necesita un modelo. Sobre 100 comentarios, la regla dio ruido 25, necesidad 24, queja 13, precio 8, recomendación 5 y sin decidir 25.
| La regla acertó | La regla falló o no supo decidir |
|---|---|
| Los 25 «me apunto» encajaron exactos y se quitaron | «¿Así que el fantasma estuvo escondido cuatro días en casa...?» es una broma, pero el signo de interrogación la hizo necesidad |
| «3 yuanes cada una, dura un mes» pasó a precio | «Mi Xiaomi barato no enreda pelos» es una recomendación, pero la palabra «enreda» la hizo queja |
| «140 metros... presupuesto 3.000, ¿cuál?» pasó a necesidad | «Hasta leer los comentarios no sabía que la bolsa de polvo es de un solo uso» aporta información y quedó sin decidir |
| «La base huele mal al vaciar, ¿cómo lo arreglo?» pasó a queja | «¿Te quedas 30 minutos junto a la lavadora?» es retórica, pero pasó a necesidad |
La tabla explica por qué el guion tiene dos etapas. La regla solo quita ruido, porque el ruido siempre se parece y un descarte erróneo apenas cuesta. Las cuatro intenciones van a un modelo, porque un signo de interrogación puede ser una petición, una pregunta retórica o una broma.
C y D llevan «guía de compra» y «robot aspirador» en el título, pero sus comentarios hablan sobre todo de humor y de gimnasio. Elegir por título sobrestima los comentarios útiles, así que conviene que el agente de búsqueda reciba también is_cooperation_note, el número de comentarios y el título, para saltar primero los vídeos de humor evidentes.
La investigación sobre etiquetado con modelos ayuda a fijar la revisión: un estudio vio que las etiquetas sin ejemplos superaban a trabajadores de crowdsourcing en la mayoría de tareas (arXiv 2303.15056), otro vio mucha variación entre modelos y tareas (arXiv 2311.05769), y un artículo de método considera obligatoria la validación rigurosa (Sociologica, 2024). Aquí eso se traduce en tres reglas. No te saltes la revisión. Usa otro modelo que no vea las primeras etiquetas. Y fija el umbral de antemano, por ejemplo un 80 % de acuerdo; si la ejecución queda por debajo, cambia las definiciones y vuelve a etiquetar todo el lote.
Prueba 3: la misma página tres veces trajo 7 comentarios nuevos y se cobró cada vez
Esta prueba responde a una pregunta de workflows: ¿qué pasa cuando un agente falla y vuelve a ejecutarse? Pedimos la primera página de B a las 00:15:33 (hora de Singapur) y repetimos el mismo cuerpo a las 00:21:35 y a las 00:21:55. La segunda respuesta solo compartía 8 de 15 comentarios con la primera. La tercera compartía 13 con la primera y 10 con la segunda. Entre las tres sumaron 22 comentarios distintos. Cada llamada costó 0,005556 USD: repetir la petición idéntica no la hizo gratis.
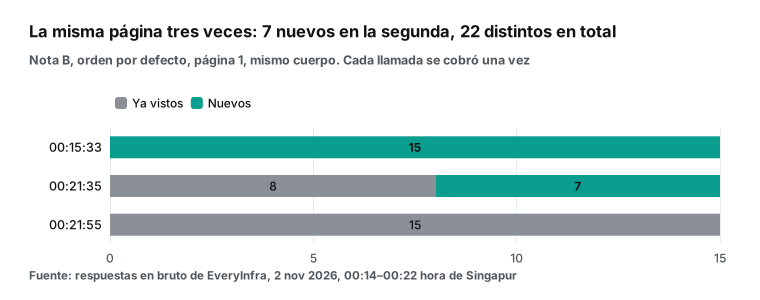
El orden por defecto no es estable, y en un workflow eso se suma a las reglas de reanudación. Al reanudar, los agentes terminados devuelven su resultado guardado. Pero el primer agente cuyo mensaje cambió vuelve a ejecutarse, y con él todos los posteriores. Un agente fallido vuelve a ejecutarse, y también todos los que el guion lanza después, aunque ya hubieran terminado.
La documentación da un ejemplo. Un guion lanza A, B, C y D, y B falla. Al reanudar, A sale de la caché, y B, C y D se ejecutan de nuevo (página de workflows, «Which agents run again»). La versión 2.1.305, del 2026-10-20, corrigió un problema relacionado: antes, un guion sin cambios podía repetir al reanudar agentes ya terminados dentro de pipeline() y parallel() (registro de cambios 2.1.305).
Junta los dos hechos: un agente de descarga repetido vuelve a pagar y puede traer otros comentarios, que ya no cuadran con las etiquetas hechas. Proponemos tres reglas.
Primera: separa descarga y etiquetado en dos workflows. El primero solo descarga y escribe archivos. Cuando los datos están bien, el segundo los lee y los etiqueta, y un fallo en el etiquetado nunca toca la API. Segunda: descarga con sort=newest o sort=most_liked, mucho más estables que el orden por defecto, y no cambies el orden a mitad de paginación, porque el catálogo avisa de que un next_page_token antiguo deja de valer. Tercera: elimina duplicados por id antes de contar, porque un comentario puede aparecer en dos descargas.
Los bloqueos provocan otro tipo de repetición. Si un agente pasa demasiado tiempo sin producir nada, vuelve a empezar desde el mismo mensaje, hasta cinco veces. Los archivos que ya cambió siguen cambiados y sus tokens siguen en el total (página de workflows, «When an agent stalls and restarts»). La espera de sus propias llamadas a herramientas no cuenta, así que una llamada de 2,5 segundos a la API no dispara el bloqueo.
Otro fallo distinto ocurre cuando un flujo de respuesta se queda en silencio: un vigilante de inactividad lo corta, y CLAUDE_STREAM_IDLE_TIMEOUT_MS fija ese tiempo (documentación de configuración de red). Si tras un 429 un agente espera mucho sin producir nada, puede contar como bloqueado y empezar de nuevo, y repetir llamadas que ya pagaste. Nuestro 429 pedía 1 segundo de espera, así que el riesgo era bajo. Con una clave compartida y saturada, las esperas crecen; en ese caso da a los agentes de descarga su propio stallMs, por ejemplo agent(prompt, { stallMs: 600000 }).
Límites de frecuencia en paralelo: 16 agentes contra una clave de 10 por minuto
Un workflow lanza 16 agentes a la vez por defecto. Nuestra clave tiene un límite propio de 10 peticiones por minuto, y otros programas la compartían al mismo tiempo. Llamamos más o menos cada 10 segundos, muy por debajo del límite en teoría. Pero la cabecera x-ratelimit-remaining-requests marcó 5, 5, 2 y 0, y a las 00:15:59 (hora de Singapur) una llamada devolvió 429. Después la cabecera marcó 8, 3, 6, 5 y 1. Así se ve una clave compartida: no sabes cuándo llaman los demás, solo puedes leer la cabecera y los 429. Si solo tu programa usa la clave, el número de peticiones restantes debería bajar con cada llamada tuya, sin saltos arriba y abajo; esos saltos vienen de compartirla y no los verás con una clave propia.
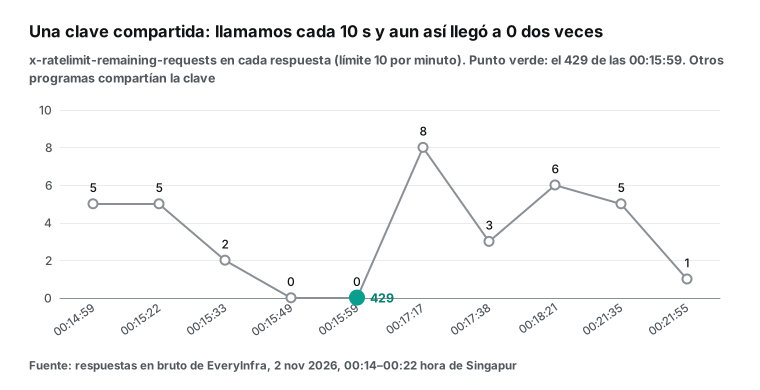
Un agente puede leer el cuerpo del 429 tal cual. El texto era "rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.". El cuerpo también traía retry_after: 1, retryable: true, max_retries: 3 y la frase «Nothing was charged». Esperamos más de 60 segundos por prudencia y recibimos un 200 a las 00:17:17. El 429 no costó nada y no está en nuestro total cobrado.
El mensaje de descarga del esqueleto aplica la misma regla: con un 429, espera error.retry_after segundos y reintenta, como mucho 3 veces. La API de Anthropic también devuelve 429 con una cabecera retry-after cuando vas demasiado rápido (documentación de límites de Anthropic), así que una sola regla en el mensaje cubre los dos casos.
{"error":{"code":"rate_limited",
  "message":"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.",
  "reason":"key_limit","retry_after":1,"limit":10,"fault":"account","retryable":true,"max_retries":3,
  "next_steps":["Over this key's or account's request rate. Nothing was charged. Retry after retry_after seconds, or ask the user to raise the limit."]}}
Hay dos defensas activas. La primera es bajar la concurrencia: fija CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS en 2 o 3. Un agente que trae dos páginas necesita unos 5 segundos de API más su propio tiempo de razonamiento. Con 3 agentes, el ritmo se acerca a 10 por minuto y los reintentos cubren el resto. La variable afecta a toda la ejecución, así que también frena a los agentes de etiquetado. Si te importa el tiempo total, separa descarga y etiquetado en dos workflows y no limites el segundo.
La segunda defensa es la llamada por lotes. xiaohongshu/comments_batch admite hasta 20 publicaciones por petición y cobra por publicación. A las 00:17:38 (hora de Singapur) pedimos 3 publicaciones en una petición: devolvió 35 comentarios y costó 0,016667 USD, es decir, 0,005556 USD por publicación, igual que xiaohongshu/comments. La petición tardó 3,28 segundos; una llamada de una sola publicación tardó unos 2,4.
| Primeras páginas de 40 publicaciones | Peticiones | Minutos mínimos a 10 por minuto | Coste de API |
|---|---|---|---|
Una llamada a xiaohongshu/comments por publicación | 40 | 4 | 0,22224 USD |
xiaohongshu/comments_batch, 20 publicaciones por llamada | 2 | 1 | 0,22224 USD |
El lote cambia el número de peticiones, no el coste, y con una clave compartida el número de peticiones es el cuello de botella. Un esqueleto mejor usa uno o dos agentes que llaman a comments_batch para todas las primeras páginas tras la búsqueda, y solo sigue paginando en las publicaciones con muchos comentarios.
Cada fila de un lote trae next_page_token, así que puedes seguir con xiaohongshu/comments. El catálogo avisa de una cosa: cuando fallan algunas publicaciones, mira partial y missed en la respuesta, y no tomes una publicación ausente por una publicación sin comentarios. Pon esa frase en el mensaje de descarga.
También existe el modo asíncrono. El catálogo dice que cualquier capacidad acepta "mode":"async" en el cuerpo: recibes un 202 con un job_id al instante y luego consultas GET /api/v1/jobs/{job_id}. A las 00:18:21 (hora de Singapur) usamos el modo asíncrono para la segunda página de B; el 202 ya mostraba el estado succeeded, y a las 00:18:30 la consulta devolvió 15 filas. Las consultas son gratis y no cuentan para el límite por minuto, según la descripción de la herramienta everyinfra_get_job. Los comentarios vuelven en 2 o 3 segundos y no necesitan este modo, pero si el mismo workflow llama a capacidades lentas, el modo asíncrono evita que los agentes esperen con peticiones abiertas.
Fallos, reintentos y cobros: qué te puede hacer pagar dos veces
La tabla pone lo que observamos junto al comportamiento del workflow. La columna «Comportamiento del workflow» sale de la página de workflows; la columna «Cobro de la API», de nuestras respuestas en bruto.
| Evento | Comportamiento del workflow | Cobro de la API | Defensa en el guion |
|---|---|---|---|
| 429 por frecuencia | Lo gestiona el agente | No se cobra («Nothing was charged») | Reintentar tras retry_after, como mucho 3 veces |
422 por valor inválido, como sort=hottest | Lo gestiona el agente | No se cobra | No reintentar; informar del mensaje |
| Agente bloqueado | Empieza de nuevo con el mismo mensaje, hasta 5 veces | Las llamadas que ya salieron bien se repiten y se cobran | Fijar stallMs en los agentes de descarga |
| Reanudar tras un agente fallido | Ese agente y todos los posteriores se repiten | Las descargas repetidas se cobran otra vez | Separar descarga y etiquetado en dos workflows |
| Misma petición en 6 minutos | No aplica | Se cobra cada vez y el contenido cambia | Quitar duplicados por id |
| La etiqueta no cumple el esquema | Reintenta y falla al quinto intento | Sin llamada a la API | Mantener el esquema pequeño |
| Límite de uso de la suscripción | Pausa hasta el reinicio, desde la 2.1.271, si se cumplen las condiciones | Sin llamada a la API | Probar antes con una muestra pequeña |
Para la fila del límite de uso, la sesión también puede esperar al reinicio (documentación del modo interactivo). La prueba del 422 fue a las 00:16:07 (hora de Singapur), con sort en hottest a propósito. La respuesta decía `"sort must be one of: default, most_liked, newest (got 'hottest')", traía la lista allowed, sugería did_you_mean: ["most_liked"]` y avisaba de que no se cobró nada.
Un agente de descarga puede leer este error, cambiar el valor y seguir. En nuestro artículo sobre strict tool use mostramos que las definiciones estrictas de herramientas bloquean valores de enumeración inválidos en el lado del modelo. En un workflow, lo más simple es escribir el valor de sort directamente en el mensaje de descarga.
La cuenta: cuántas llamadas y cuánto dinero para 500 comentarios
La API tiene un único precio unitario para este encargo. Leímos el catálogo el 2 de noviembre de 2026 a las 00:14 (hora de Singapur). xiaohongshu/search, xiaohongshu/comments, xiaohongshu/sub_comments y xiaohongshu/comments_batch cuestan 0,005556 USD por llamada (por publicación en el lote). Las llamadas fallidas y los resultados vacíos son gratis. En una capacidad paginada, el número de llamadas es el objetivo de filas dividido entre las filas por página, redondeado hacia arriba.
Los tres métodos siguientes solo cuentan páginas de comentarios. La búsqueda devuelve 20 publicaciones por página, y 500 comentarios suelen necesitar entre 20 y 40 publicaciones, lo que añade 1 o 2 llamadas: entre 0,0056 y 0,0111 USD.
| Método | Filas por página | Llamadas | Coste de API |
|---|---|---|---|
| Valor del catálogo | 15 | 34 | 0,188904 USD |
| Nuestra media medida | 12,5 | 40 | 0,22224 USD |
| 500 comentarios útiles tras un 25 % de ruido | 12,5 | 54 (traer 667 primero) | 0,300024 USD |
| Lo que gastó este artículo: 10 peticiones cobradas, 12 unidades | — | 10 | 0,066671 USD |
La tabla siguiente recoge cada petición de la prueba, con hora de Singapur del 2 de noviembre de 2026. El 429, el 422 y la consulta del trabajo asíncrono fueron gratis.
| Hora (SGT) | Petición | HTTP | Filas | Cobrado |
|---|---|---|---|---|
| 00:14:59 | xiaohongshu/search | 200 | 20 publicaciones | 0,005556 USD |
| 00:15:22 | xiaohongshu/comments, A página 1 | 200 | 10 | 0,005556 USD |
| 00:15:33 | xiaohongshu/comments, B página 1 | 200 | 15 | 0,005556 USD |
| 00:15:49 | xiaohongshu/comments, A página 2 | 200 | 15 | 0,005556 USD |
| 00:15:59 | xiaohongshu/sub_comments, B | 429 | 0 | 0 USD |
| 00:16:07 | xiaohongshu/comments con sort=hottest | 422 | 0 | 0 USD |
| 00:17:17 | xiaohongshu/sub_comments, B | 200 | 5 | 0,005556 USD |
| 00:17:38 | xiaohongshu/comments_batch, C, D y E | 200 | 35 | 0,016667 USD |
| 00:17:55 | MCP everyinfra_call_api, F | 200 | 10 | 0,005556 USD |
| 00:18:21 | xiaohongshu/comments asíncrono, B página 2 | 202 | 15 al consultar | 0,005556 USD |
| 00:21:35 | xiaohongshu/comments, B página 1 otra vez | 200 | 15 | 0,005556 USD |
| 00:21:55 | xiaohongshu/comments, B página 1 otra vez | 200 | 15 | 0,005556 USD |
El tercer método pide cautela. El 25 % de ruido sale de nuestras 6 publicaciones, y casi todo vino de la A. Con otra palabra clave puede ser 0 o mucho más. Lanza primero el workflow sobre 3 a 5 publicaciones, mira el recuento del filtro en la línea de log() y decide después cuántas publicaciones traer. La documentación da el mismo consejo sobre costes: prueba con una porción pequeña, vigila los tokens de cada agente en /workflows y para la ejecución si hace falta (página de workflows, «Cost»).
No medimos el lado de Claude, así que solo damos lo que puedes comprobar. La página de precios de Anthropic, leída el 2026-11-02, da estos precios por millón de tokens: Haiku 5.5, 0,10 USD de entrada y 0,50 USD de salida para mensajes de hasta 100.000 tokens; Sonnet 5.5, 2 USD y 10 USD; Opus 5.5, 4 USD y 20 USD.
Solo con el texto, 500 comentarios son unos 12.000 tokens según la regla aproximada de esa página (10 kB son unos 2.500 tokens): menos de 0,002 USD de entrada en Haiku. El gasto grande es el mensaje de sistema, las herramientas y el razonamiento de cada agente, que no medimos; mira tus números en /workflows.
Con una suscripción, el uso de workflows cuenta para los límites del plan. La documentación de costes dice que cada subagente y cada agente de un workflow envía sus propias peticiones. En el hilo de lanzamiento de Reddit, un usuario contó que un solo mensaje gastó 700.000 tokens y el 36 % del uso de un plan Max; otro, que el primer intento gastó 1,2 millones (hilo de lanzamiento en Reddit). Son testimonios que no podemos verificar, pero explican por qué conviene una primera prueba pequeña.
Contexto y tokens: por qué la descarga tiene que adelgazar los datos
Un comentario ocupa de media unos 1.445 bytes de JSON, y su texto solo, unos 95: unas 15 veces menos. El JSON en bruto trae nombre de autor, URL del avatar, región de la IP, etiquetas, la primera respuesta y una URL de publicación con xsec_token, entre 20 campos, y casi ninguno ayuda a etiquetar. Con la proporción aproximada de la página de precios, un comentario en bruto son unos 361 tokens y su texto, unos 24. El chino usa otra proporción en la práctica; para números exactos, usa el endpoint de conteo de tokens con tu modelo.
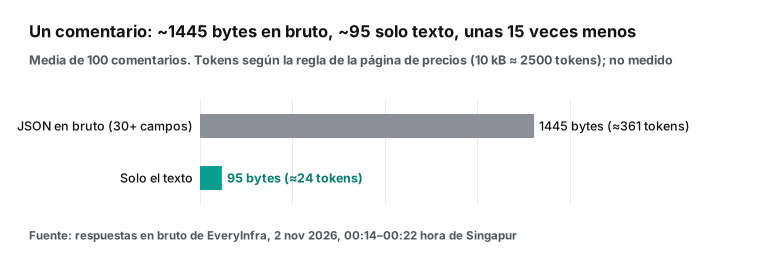
La diferencia pesa en dos sitios. El primero es la entrada de los agentes de etiquetado: si los agentes de descarga devuelven el JSON en bruto, cada agente de etiquetado lee entre 10.000 y 30.000 tokens de JSON por publicación; si devuelven texto, lee unos cientos.
El segundo es la caché de mensajes. La documentación dice que los agentes de una ejecución con el mismo modelo, nivel de esfuerzo, tipo de agente, herramientas, esquema de salida y directorio de trabajo comparten un prefijo, y que un agente posterior puede leer la caché del anterior. Los agentes de un workflow conservan la caché 5 minutos por defecto; subagentPromptCacheTtl en 1h la conserva una hora, con un precio de escritura mayor (página de workflows, «Prompt caching in a fan-out»; documentación de caché de mensajes). En el esqueleto, todos los agentes de descarga usan haiku, esfuerzo low y el esquema COMMENTS, así que pueden compartir ese prefijo. Si das a cada publicación un modelo distinto, pierdes la caché compartida.
La etapa de etiquetado: esquema, definiciones y acuerdo
El esquema de etiquetado tiene dos campos: id y label, con label limitado a cinco valores. Menos campos significan menos errores y menos reintentos de esquema. Si además quieres presupuesto, superficie y mascotas, añade una etapa de extracción aparte que solo se ejecute sobre comentarios etiquetados como necesidad; no llenes el esquema de etiquetado de campos opcionales.
La API de Anthropic limita la salida con un json_schema en output_config.format (documentación de salidas estructuradas). La opción schema de los workflows hace lo mismo dentro de Claude Code: el valor devuelto ya es un objeto y el guion no tiene que interpretar texto.
Escribe cada definición de forma que una persona pueda aplicarla. Los cuatro errores de nuestra regla de referencia vinieron de definiciones vagas: una pregunta retórica y una broma parecían necesidades, y una comparación («mi modelo barato no enreda pelos») parecía una queja. Por eso el esqueleto define qué significa cada etiqueta y no qué palabras contiene. Los ejemplos son comentarios traducidos de nuestras 6 publicaciones.
| Etiqueta | Definición | Ejemplo de nuestros datos |
|---|---|---|
| necesidad | Pregunta qué modelo comprar o pide un enlace | «140 metros, baldosa, mucho pelo, presupuesto 3.000, ¿cuál?» |
| queja | Cuenta un problema del producto o del servicio | «La base huele mal al vaciar, ¿cómo lo arreglo?» |
| precio | Habla de coste, copias baratas o dónde comprar | «3 yuanes cada una, dura un mes» |
| recomendación | Quien escribe usa el producto y lo aconseja | «Mi Xiaomi barato no enreda pelos» |
| otro | Bromas, el argumento del vídeo, temas ajenos | «¿Así que el fantasma estuvo escondido cuatro días en casa...?» |
¿Y un comentario que es necesidad y precio a la vez, como «presupuesto 3.000, ¿cuál?»? Etiquetamos por lo que quiere quien escribe, así que es necesidad. Si a tu equipo le importan más los tramos de precio, pon precio antes que necesidad y deja ese orden escrito en el mensaje.
La revisión toma prestada la revisión adversarial que describe la documentación de workflows, en la que agentes independientes ponen a prueba los hallazgos de otros antes de informar (página de workflows, «When to use a workflow»). Etiquetar no es buscar errores de código, así que nuestro agente de revisión no intenta refutar las primeras etiquetas: vuelve a etiquetar la muestra sin verlas, y el guion calcula el acuerdo. Usar otro modelo (Sonnet en el esqueleto) reduce la probabilidad de que ambos cometan el mismo error.
El acuerdo no garantiza acierto: dos modelos pueden equivocarse igual. Con una palabra clave nueva, lee tú mismo 20 comentarios de la muestra en la primera ejecución, añade los desacuerdos y los errores claros a las definiciones y vuelve a etiquetar todo el lote.
Límites y precauciones
| Límite | Efecto | Qué hacer |
|---|---|---|
| El guion no sale a internet | Cada llamada a la API ocurre dentro de un agente, que a veces hace una llamada adicional | Devolver calls y charged_usd por el esquema y revisar el total |
| La ejecución no puede pedirte datos | No hay revisión entre descarga y etiquetado | Un workflow por etapa |
| La ejecución se para si sales | Los agentes en marcha empiezan de nuevo al relanzar | Relanzar desde los resultados guardados |
Las URL de comentarios necesitan xsec_token | Una URL «limpiada» falla | Copiar la URL tal cual llega |
| Solo comentarios públicos | Faltan los ocultos o plegados | Esperar menos opiniones negativas |
| Nuestras etiquetas son una regla de referencia | Los recuentos no son salida de un modelo | Hacer la revisión con tus propios datos |
| Las versiones cambian | Muchos tutoriales describen lo antiguo | claude --version; este artículo usa la 2.1.316 |
Las dos primeras filas salen de la página de workflows, «Behavior and limits». Una ejecución no sigue sola cuando pasas la sesión a segundo plano o sales: Claude tiene que relanzarla desde los resultados guardados, y los agentes que estaban en marcha empiezan de nuevo y vuelven a gastar tokens (documentación de agent view).
El catálogo pide la URL completa del comentario, sacada de un resultado de búsqueda reciente y con su cadena de consulta. Los tokens de página duran 24 horas, así que una reanudación al día siguiente empieza de cero. Los números de 500 comentarios salen del precio unitario y de los tamaños de página medidos; no trajimos 500 comentarios.
Los datos de comentarios incluyen regiones de IP y nombres visibles. En el informe pon solo etiquetas, recuentos y citas sin nombres. Si vas a enviar citas a un cliente o publicarlas, comprueba que tu uso cumple la ley aplicable (en España y la UE, el RGPD) y las condiciones de la plataforma. Este artículo describe un método de datos y no es asesoramiento legal.
Preguntas frecuentes
¿Qué son los flujos de trabajo de Claude Code, explicado en español?
Un flujo de trabajo dinámico es un guion en JavaScript que Claude escribe para tu tarea y que un entorno ejecuta en segundo plano, con decenas o cientos de subagentes (página de workflows). Lo inicias pidiendo «un workflow» en tu mensaje o escribiendo ultracode, y lo sigues en /workflows. (Origen de la pregunta: la sugerencia de búsqueda «claude code flujos de trabajo en español».)
¿Flujos de trabajo o subagentes de Claude Code?
Los subagentes los lanza Claude turno a turno y sus resultados vuelven a la conversación; con 20 en marcha, la siguiente llamada falla (documentación de subagentes). Un workflow fija el plan en código, lanza hasta 16 agentes a la vez y guarda los resultados en variables. Para cientos de comentarios independientes, encaja mejor el workflow. Para pocas publicaciones que quieres ir corrigiendo, encajan mejor los subagentes, como en nuestro artículo sobre subagentes de Claude Code. (Origen de la pregunta: la sugerencia «subagentes claude code github».)
¿Qué es Xiaohongshu y por qué leer sus comentarios?
Xiaohongshu, también llamada RedNote, es una red china de publicaciones con fotos y vídeos donde mucha gente pregunta qué comprar. Las marcas pagan publicaciones patrocinadas que pasan por la plataforma Pugongying (portada de Pugongying). En nuestra búsqueda, 10 de 20 publicaciones eran patrocinadas, así que conviene separarlas antes de contar recomendaciones. (Origen de la pregunta: la sugerencia «que es xiaohongshu en español».)
¿Cuánto cuesta usar workflows de Claude Code al mes?
La documentación no da una cifra fija para workflows: con suscripción, consumen los límites de tu plan, y una ejecución puede gastar mucho más que el mismo trabajo en una conversación (documentación de costes). En Reddit hay testimonios de 700.000 a 1,2 millones de tokens por mensaje (Reddit). El coste de la API de datos va aparte: unos 0,222 USD por 500 comentarios. (Origen de la pregunta: la sugerencia «cuanto cuesta claude code al mes».)
¿ultracode o esfuerzo máximo?
Son cosas distintas. El esfuerzo (low a max) dice cuánto razona el modelo; ultracode dice si Claude planifica un workflow para cada tarea. Desde la 2.1.284, /effort ultracode dentro de la sesión solo enciende el interruptor y deja el esfuerzo como está; solo la opción de arranque claude --effort ultracode fija además el esfuerzo en xhigh (documentación de configuración de modelos). Para encargos con APIs de pago, déjalo apagado y pide el workflow en un mensaje. (Origen de la pregunta: la sugerencia «claude code ultracode vs max effort».)
¿Cómo hago que un workflow se pare para una revisión humana?
La documentación responde que una ejecución no puede pedir datos, así que una aprobación exige workflows separados (página de workflows, «Behavior and limits»). También puedes seleccionar una ejecución en /workflows y pulsar x para pararla; los agentes terminados conservan sus resultados. En Hacker News, el 2026-05-28, se planteó la misma duda: lo difícil es meter criterio humano en ejecuciones largas. (Origen de la pregunta: en el hilo de lanzamiento de Reddit, alguien preguntó qué señales paran a los subagentes antes de que sigan por una rama mala.)
Cómo empezar
- Consigue una clave en la guía rápida de EveryInfra y lee gratis el catálogo de
xiaohongshu/searchyxiaohongshu/comments. - Añade el servidor MCP remoto a Claude Code con el comando de arriba. Consulta la configuración del MCP remoto y la página del servidor MCP.
- Pide a Claude Code un workflow que siga el esqueleto sobre 5 publicaciones, lee el plan y elige «Yes, run it».
- Al terminar, mira los tokens en
/workflowsy compara el coste de la API con la página de precios. Guarda una ejecución buena como comando cons.
El mismo esqueleto sirve para otras plataformas si cambias los nombres de capacidad. Consulta la API de datos de Xiaohongshu, con comentarios, respuestas y comentarios por lotes. Para otras plataformas chinas, mira la API de datos de Douyin y la de Weibo. Para limpiar comentarios antes de etiquetarlos, lee DeepSeek V4 en Claude Code para limpiar comentarios.
Referencias
- Orchestrate subagents at scale with dynamic workflows. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/workflows
- Claude Code changelog. Anthropic. Última entrada 2.1.316, 2026-10-31. https://code.claude.com/docs/en/changelog
- CHANGELOG.md. anthropics/claude-code en GitHub. Leído el 2026-11-02. https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Introducing dynamic workflows. Anthropic. 2026-05-28. https://claude.com/resources/articles/introducing-dynamic-workflows-in-claude-code
- Claude Code Adds Dynamic Workflows for Parallel Agent Coordination. InfoQ. Junio de 2026. https://www.infoq.com/news/2026/06/dynamic-workflows-claude-code/
- Building agents: When to fold subagents into your main agent loop. Anthropic. 2026-10-22. https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- Create custom subagents. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/sub-agents
- Run agents in parallel. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/agents
- Agent teams. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/agent-teams
- Skills. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/skills
- Settings reference. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/settings-reference
- Model configuration. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/model-config
- Environment variables. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/env-vars
- Agent SDK reference, TypeScript. Anthropic. Leído el 2026-11-02. https://code.claude.com/docs/en/agent-sdk/typescript
- Connect Claude Code to tools via MCP. Anthropic. Leído el 2026-11-02. https://code.claude.com/docs/en/mcp
- Manage costs. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/costs
- Configure permissions. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/permissions
- Permission modes. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/permission-modes
- Prompt caching in Claude Code. Anthropic. Leído el 2026-11-02. https://code.claude.com/docs/en/prompt-caching
- Run Claude Code programmatically. Anthropic. Leído el 2026-11-02. https://code.claude.com/docs/en/headless
- Hooks reference. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/hooks
- Sandboxing. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/sandboxing
- Plugin manifest reference. Anthropic. Leído el 2026-11-02. https://code.claude.com/docs/en/plugins/manifest-reference
- Agent view. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/agent-view
- Claude Code on the web. Anthropic. Leído el 2026-11-02. https://code.claude.com/docs/en/claude-code-on-the-web
- Remote Control. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/remote-control
- Interactive mode. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/interactive-mode
- Network configuration. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/network-config
- Scheduled tasks. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/scheduled-tasks
- Commands. Anthropic, documentación de Claude Code. Leído el 2026-11-02. https://code.claude.com/docs/en/commands
- Pricing. Anthropic, documentación de la plataforma Claude. Leído el 2026-11-02. https://platform.claude.com/docs/en/about-claude/pricing
- Structured outputs. Anthropic, documentación de la plataforma Claude. Leído el 2026-11-02. https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- Rate limits. Anthropic, documentación de la plataforma Claude. Leído el 2026-11-02. https://platform.claude.com/docs/en/api/rate-limits
- Token counting. Anthropic, documentación de la plataforma Claude. Leído el 2026-11-02. https://platform.claude.com/docs/en/build-with-claude/token-counting
- Transports, especificación 2025-11-25. Model Context Protocol. Leído el 2026-11-02. https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- Tools, especificación 2025-11-25. Model Context Protocol. Leído el 2026-11-02. https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- Catálogo de capacidades de Xiaohongshu. EveryInfra. Leído el 2026-11-02 a las 00:14 SGT. https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- Reglas de revisión de contenido. Centro de ayuda de Pugongying (Xiaohongshu). Página fechada el 2026-10-22. https://pgy.xiaohongshu.com/help/detail?id=6495c527d1eedeeb48fb18b1f875650e&userType=4
- Portada de Pugongying. Xiaohongshu. Leído el 2026-11-02. https://pgy.xiaohongshu.com/
- ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks. Gilardi, Alizadeh, Kubli. arXiv 2303.15056, v2 2023-07-19. https://arxiv.org/abs/2303.15056
- Are Chatbots Reliable Text Annotators? Sometimes. Kristensen-McLachlan y otros. arXiv 2311.05769, v2 2025-02-25. https://arxiv.org/abs/2311.05769
- Best Practices for Text Annotation with Large Language Models. Petter Törnberg. Sociologica, 2024. https://sociologica.unibo.it/article/view/19461
- Introducing dynamic workflows in Claude Code, hilo de discusión. r/ClaudeAI. Mayo de 2026. https://www.reddit.com/r/ClaudeAI/comments/1tq9ofy/introducing_dynamic_workflows_in_claude_code/
- Dynamic Workflows in Claude Code, discusión. Hacker News. 2026-05-28. https://news.ycombinator.com/item?id=48311705
Referencia BL-64