Claude Codeのdynamic workflowsでXiaohongshuのコメントを仕分ける:APIテストとスクリプト例
Claude Codeのdynamic workflowsで、Xiaohongshuのコメントを並列に仕分けます。当社のテストでは、8ページ中4ページが10件、1つの投稿は96%がノイズで、コメント500件の費用は$0.222でした。
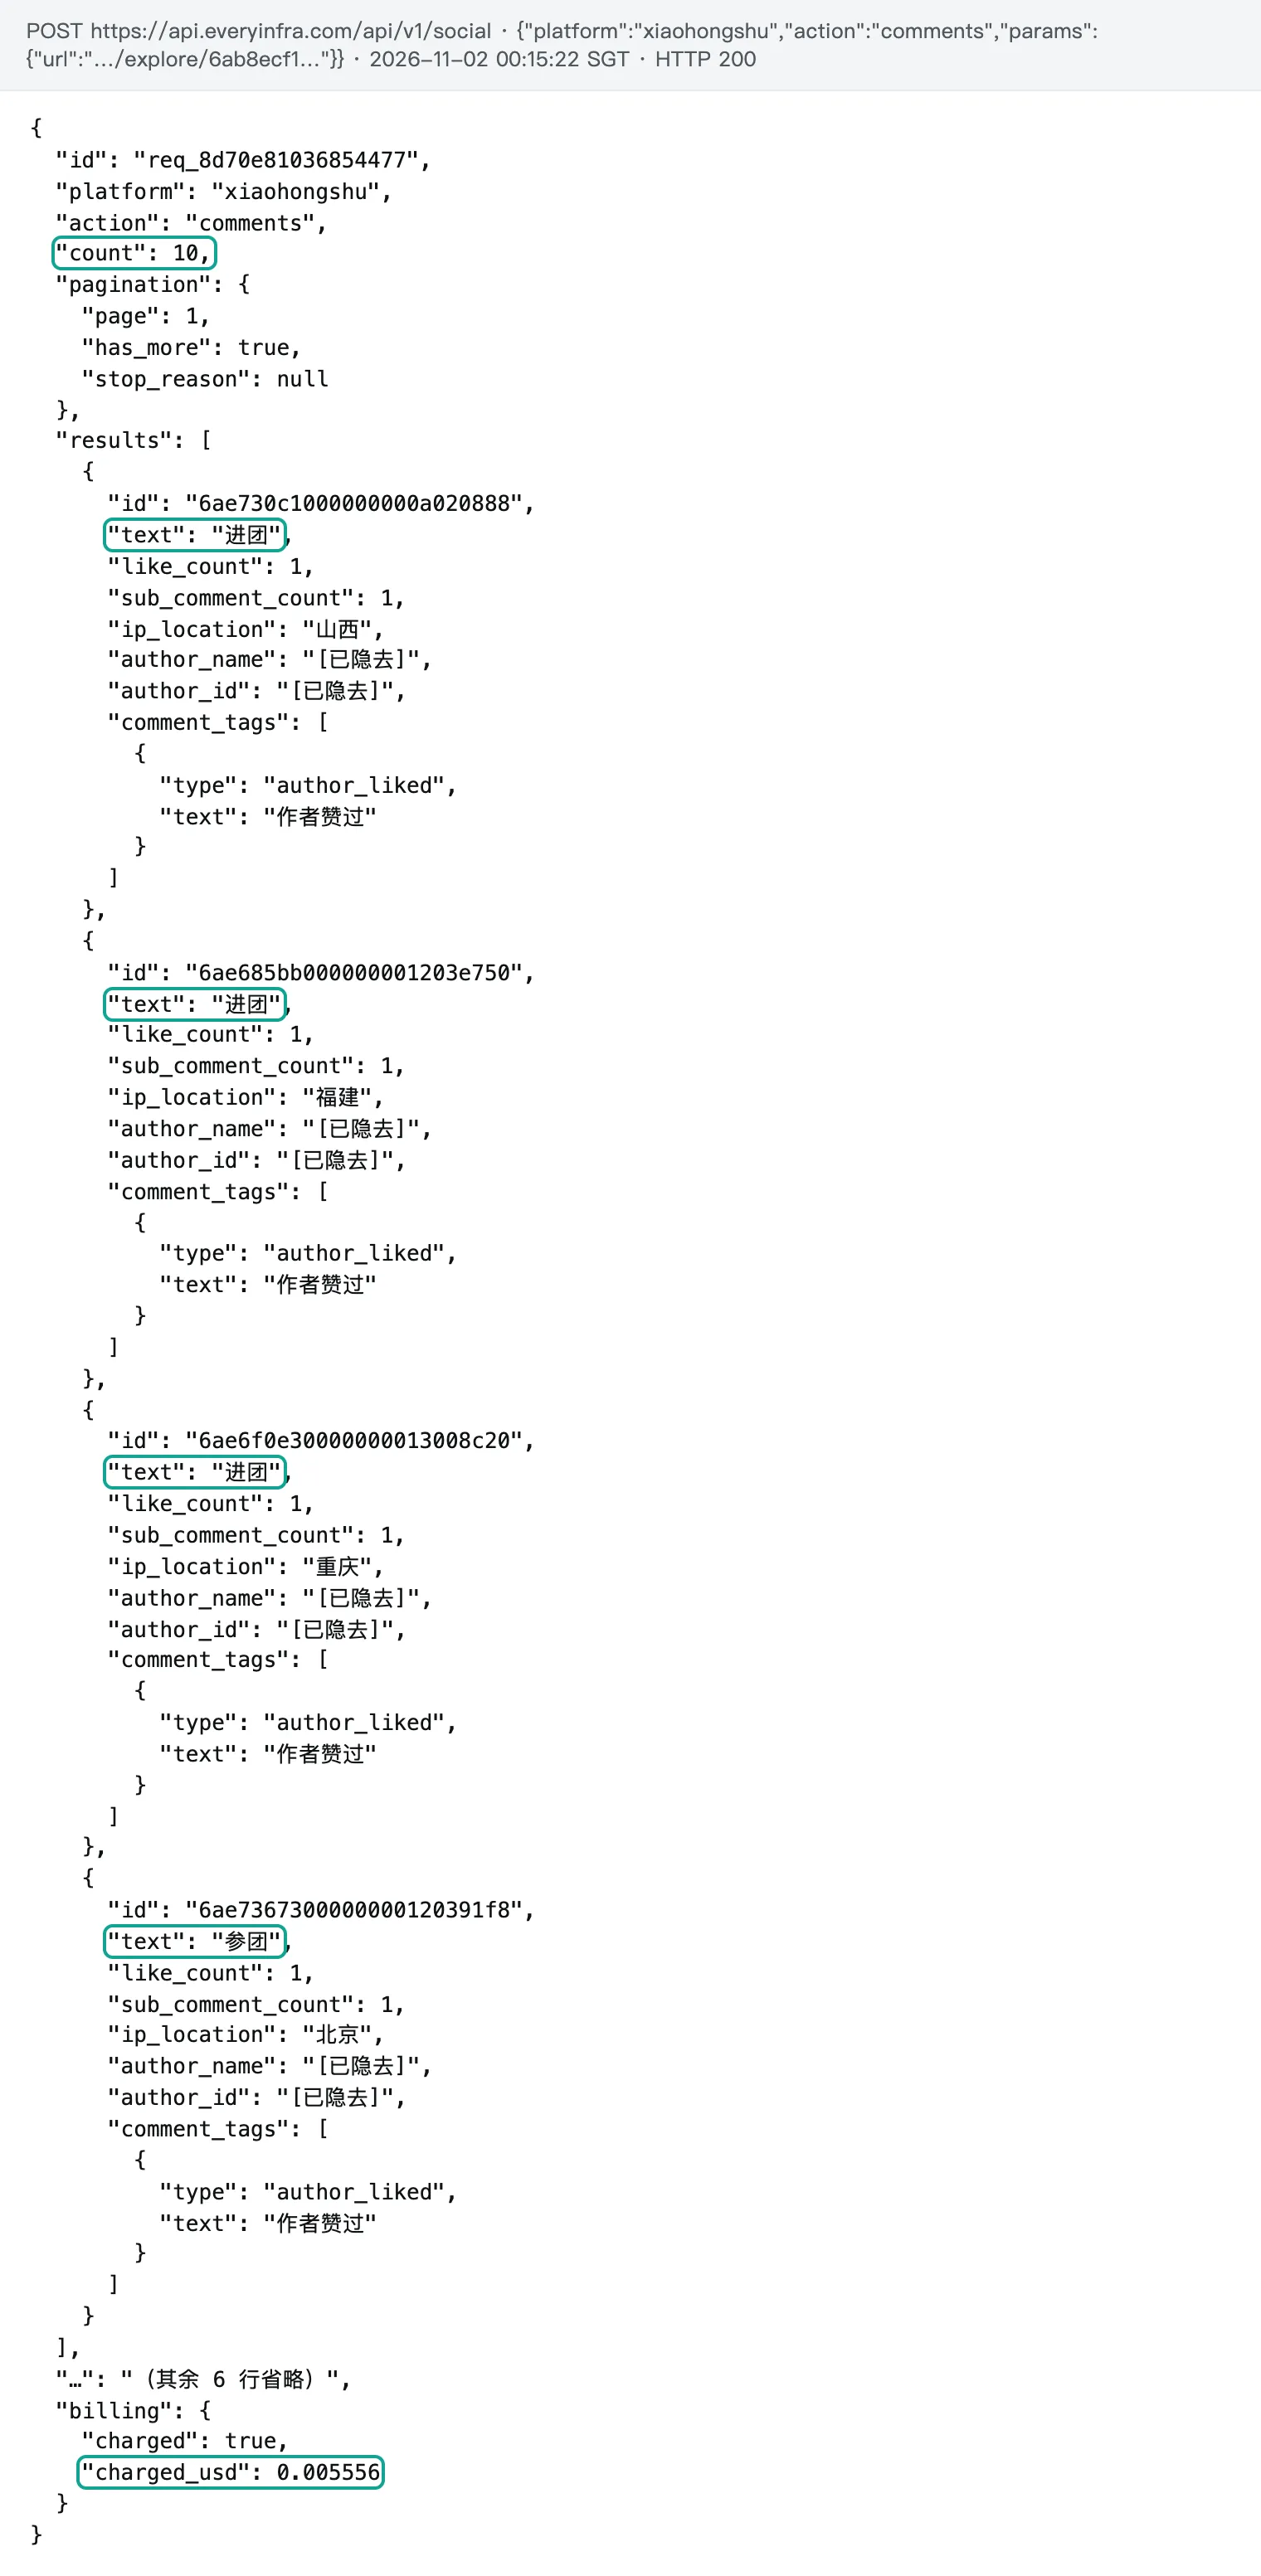
2026年11月2日のシンガポール時間(SGT)00:14〜00:22に、EveryInfra APIへ課金対象の呼び出しを10回行いました。その結果、ロボット掃除機に関するXiaohongshu(RedNote)の投稿6件からトップレベルコメント100件が返され、費用は合計$0.066671でした。ある投稿では、25件中24件のコメントが中国語で「グループに参加」「私も入れて」「参加」とだけ書かれたものでした。カタログではxiaohongshu/commentsは1ページあたり15件を返すとされていますが、計測した8ページのうち4ページは10件でした。
これはClaude Codeの動的ワークフローの予算を左右します。カタログどおりのページサイズなら、コメント500件に必要な呼び出しは34回で、費用は$0.189です。実測平均の1ページあたり12.5件で計算すると、40回の呼び出しが必要で、費用は$0.222です。さらに25%のノイズを除外したうえで有用なコメントを500件確保するには、54回の呼び出しと$0.300が必要です。
再実行については4つ目の結果が重要です。同じリクエストを3回送信したところ、6分間で1ページ目のコメントが7件入れ替わりました。3回の呼び出しはいずれも課金されました。
この記事では、実践的な疑問を1つ取り上げます。製品キーワードがあり、Claude Codeに並列プログラムを書かせたいとします。そのプログラムはXiaohongshuのコメントを取得し、4つのグループ(ニーズ、不満、価格、称賛)に分類して、1つのサマリー表を出力します。どの機能を使い、スクリプトはどのようなものになり、データをどうつなげればよいのでしょうか。
コメント500件には何回の呼び出しが必要で、レート制限やリトライのもとでは何が問題になるのでしょうか。以下のClaude Codeに関する事実はすべてClaude Codeのワークフローページまたは変更履歴に基づいています。手元のマシンではワークフローを実行していないため、Claude Codeの部分は設定例です。EveryInfraの数値はすべて生のAPIレスポンスに基づいています。
課題:Xiaohongshuのコメント500件、4つのグループ、1つの表
まずタスクを定義します。後に出てくる数値はすべてこの定義に左右されるためです。入力はキーワード1つです。「ロボット掃除機」を意味する中国語を使いました。このカテゴリーでは、11月11日のセール前後に「どれを買うべき?」「壊れた」といったスレッドが多く立つためです。出力は1つの表です。各グループの件数と割合、グループごとに3件のコメント例を示します。あわせて、APIコストと抜き取りチェックによる一致率も示します。
処理は3つのステージで行います。xiaohongshu/searchで投稿を探します。xiaohongshu/commentsとxiaohongshu/sub_commentsでコメントと返信を取得します。その後、モデルが各コメントにラベルを付けます。4つのグループはスクリプトで定義します。
「ニーズ」は、どの機種を買うべきかを尋ねる、またはリンクを求めるコメントです。「不満」は、製品やサービスの問題を報告するコメントです。「価格」は、値段、安価な模倣品、購入場所について話すコメントです。「称賛」は、製品を実際に使っている人がそれを薦めるコメントです。それ以外のコメントはすべて「その他」に分類します。
このタスクになぜ並列プログラムを使うのでしょうか。3つの条件を満たしているからです。第一に、投稿は互いに独立しており、投稿Aの処理に投稿Bの結果は必要ありません。第二に、入力が出力よりはるかに大きいことです。コメント1件につき約1,445バイトのJSONが返されますが、本文は約95バイトです。第三に、ラベル付けのルールが固定されているため、小さなモデルで処理できます。
Anthropicは2026年10月22日にガイドを公開し、ほとんどのエージェント開発者に対してサブエージェントを減らすよう勧めています(Anthropicの記事)。ただし同じガイドでも、サブエージェントを使うべきケースが1つ残されています。それは、独立した新しいコンテキストを必要とする複数のタスクを並列で実行するケースです。コメントの分類はまさにこれに当たります。
取得した投稿は6件です。まずsort=most_commentedで検索し、20件の投稿を得ました。その中からトピックの異なる6件を選びました。下の表に、タイトルの要約とあわせて示します。検索結果20件のうち10件はis_cooperation_noteがtrueでした。Xiaohongshuでは、これらはPugongyingプラットフォームを経由するスポンサー投稿です。
このプラットフォームでは、スポンサー投稿は公開前に審査されます。ブランドは72時間以内に承認または却下しなければなりません(Pugongyingヘルプセンター、2026-10-22付のページ、Pugongyingホーム)。今回の6件の投稿にスポンサー投稿は含まれていません。称賛の数値を読む際はこの点に留意してください。
| 投稿(本記事での識別子) | タイトル(要約) | 検索結果上のコメント数 | 取得したトップレベルコメント数 |
|---|---|---|---|
| A | 「独身の日のテストを見るまで、ロボット掃除機はまだ買わないで」 | 2,069 | 25(2ページ) |
| B | Roborockの掃除機に関する不満スレッド | 570 | 30(2ページ) |
| C | 「2026年ロボット掃除機購入ガイド」 | 377 | 10 |
| D | 「強力」な掃除機を題材にした短いコメディ動画 | 3,278 | 10 |
| E | 「お金の無駄だった家電:役に立たないロボット掃除機」 | 973 | 15 |
| F | 初めて購入する人がアドバイスを求める投稿 | 487 | 10 |
Claude Codeの動的ワークフローとは:ドキュメントの定義から
Claude Codeのドキュメントでは、動的ワークフローを、多数のサブエージェントを同時にオーケストレーションするJavaScriptスクリプトと定義しています。Claudeがタスクに合わせてスクリプトを書き、ランタイムがそれをバックグラウンドで実行するため、その間もセッションは応答可能な状態を保ちます(ワークフローのページ)。この機能は2026年5月28日のv2.1.154で初めてリリースされました。変更履歴には、Claudeが「数十から数百のエージェントにまたがる作業をバックグラウンドでオーケストレーションする」こと、そして/workflowsで実行を確認できることが記されています(変更履歴)。
現在、リリース記事では動的ワークフローが一般提供になったと記載されています。対象として挙げられているのはCLI、デスクトップアプリ、VS Code拡張機能です。プランはPro、Max、Ultra、Team、Enterpriseで、さらにClaude API、Amazon Bedrock、Vertex AI、Microsoft Foundryも挙げられています(Anthropicのリリース記事)。
ドキュメントには保存済みスクリプトの例が掲載されています。スクリプトはexport const meta = { name, description }で始まります。本体はトップレベルのawaitを使う通常のJavaScriptです。agent()はサブエージェントを1つ起動します。
pipeline()はリスト内の各アイテムに対して1本のチェーンを実行します。parallel()は複数のタスクを同時に実行し、すべての完了を待ちます。phase()は続くエージェントをタイトルの下にまとめ、log()は1行出力し、argsは入力を保持します(ワークフローのページ「What the saved script looks like」)。
agent()にschemaを渡すと、サブエージェントはそのJSON Schemaに一致するオブジェクトを返します。出力が5回検証に失敗すると、呼び出しは失敗します。この回数はMAX_STRUCTURED_OUTPUT_RETRIESで変更できます(同ページ)。これはまさにラベル付けステージに必要な仕組みです。各ラベル付けエージェントは{id, label}オブジェクトの配列を返し、スクリプトはそれを直接集計します。
ワークフローを開始する方法は4つあります(ワークフローのページ「Have Claude write a workflow」、コマンドのページ)。
| 開始方法 | ワークフロー使用の判断者 | 備考 |
|---|---|---|
プロンプトにキーワードultracodeを入力 | ユーザー(このプロンプトのみ) | 自分で入力したプロンプト内でのみ有効 |
| 自分の言葉で「ワークフロー」を依頼 | ユーザー(このプロンプトのみ) | Claudeがこのタスク用のスクリプトを作成 |
/effort ultracodeまたはclaude --effort ultracodeを実行 | Claude(タスクごと) | このフラグはeffortもxhighに設定 |
/deep-researchなどの保存済みワークフローコマンドを実行 | 本人 | うまくいった実行を再利用 |
このキーワードは、人が入力したプロンプトでのみ機能します。-pで渡したプロンプトでは機能しません(ヘッドレスのドキュメント)。スケジュールタスクのプロンプト、Webhook、プルリクエストのコメントでも機能しません。そのため、週次のコメントレポートを作るなら、まず、うまくいった実行の1つをコマンドとして保存してください。そのうえで、スケジュールタスクからそのコマンドを呼び出します。
| サブエージェント | スキル | エージェントチーム | ワークフロー | |
|---|---|---|---|---|
| 概要 | Claudeが起動するワーカー | Claudeが従う指示 | ピアセッションを持つリードエージェント | ランタイムが実行するスクリプト |
| 次のステップを決める主体 | Claude(ターンごと) | Claude(プロンプトに基づく) | リードエージェント | スクリプト |
| 結果の保存先 | Claudeのコンテキスト | Claudeのコンテキスト | 共有タスクリスト | スクリプト変数 |
| 再利用できるもの | ワーカーの定義 | 指示 | チームの定義 | オーケストレーション |
| Scale | 1ターンあたり数タスク | サブエージェントと同じ | 長時間稼働する少数のピア | 数十〜数百のエージェント |
| 中断後 | ターンをやり直し | ターンをやり直し | チームメイトは動作を継続 | 同じセッション内で再開可能 |
この表は、workflowsのページの「When to use a workflow」セクションにある比較に基づいています。ここで最も重要なのは3行目です。サブエージェントでは、各投稿の要約がメインの会話に入ります。workflowでは、100件のコメント、ラベル、抜き取りチェックの結果がスクリプトの変数に残ります。
会話に届くのは最終的な表だけです。エージェントチームはまだ実験的な機能で、CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1が必要です(エージェントチームのドキュメント)。そのため、ここでは使用しません。
動的ワークフローとサブエージェント:計画はチャットではなくコードにある
本当の違いは並列性ではありません。違いは、誰が計画を持つかです。サブエージェントでは、Claudeが毎ターン、次に誰を起動するかを決めます。判断する前に、すべての結果がClaudeのコンテキストに戻ってくる必要があります。サブエージェントのドキュメントによると、実行中のサブエージェントが20個になると、次のAgent呼び出しは、再試行しないようClaudeに伝えるエラーで失敗します。この数はCLAUDE_CODE_MAX_CONCURRENT_SUBAGENTSで変更できます(サブエージェントのドキュメント「Concurrent subagent limit」)。
ワークフローでは、ループ、分岐、再試行回数はスクリプト内で固定されます。Claudeは投稿ごとに改めて判断しないため、先に出た結果が後の投稿の扱いを変えることはありません。ラベル付けにとって、これは望ましい性質です。すべての投稿に同じプロンプトと同じスキーマが使われるので、投稿間で結果を比較できます。
ランタイムにはハードリミットがあります。下のスクリーンショットはClaude Codeのドキュメントからのものです。青緑色の枠は、ここで特に重要な3つの制限を示しています。デフォルトでは最大16個のエージェントが同時に実行され、CPU数が少ないマシンではそれより少なくなります。
v2.1.269以降、CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTSで1〜256の値を設定できます。1回のparallel()またはpipeline()呼び出しで受け付けるのは最大4,096項目で、それより長いリストはエラーで拒否されます。1回の実行で起動できるエージェントは最大1,000個です。
ほかにも重要な制限が3つあります。実行の途中でユーザーに入力を求めることはできません。スクリプト自体はファイルを読んだりシェルコマンドを実行したりできません。import()を含むスクリプトは開始前に失敗します。
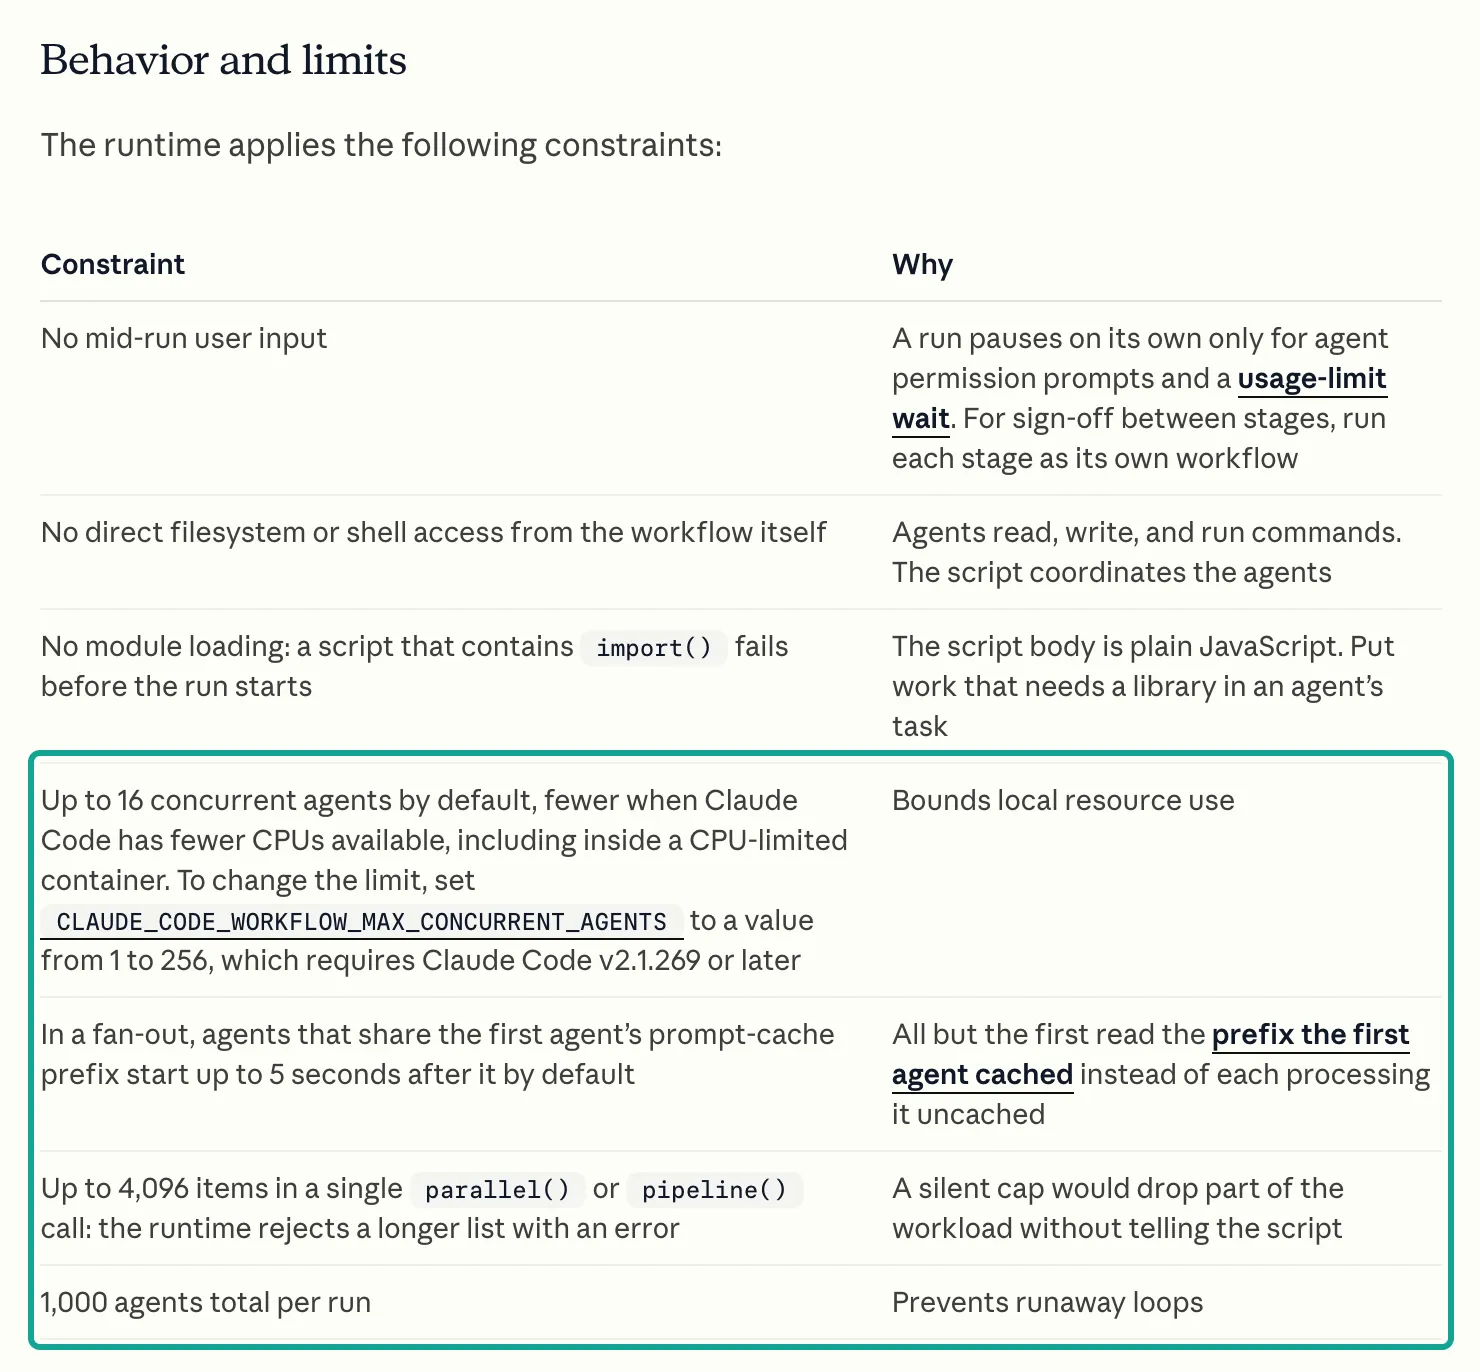
スクリプトがファイルにアクセスしたりコマンドを実行したりできないというルールによって、データの取り込み方が決まります。スクリプトはfetchもcurlも呼び出せません。そのため、EveryInfraへの呼び出しはエージェントが行う必要があります。エージェントは、セッションで接続されているMCPツールを使用できます。権限で許可されていれば、Bashを実行することもできます。
同梱のワークフロー作成リファレンスには、もう1つの事実が記載されています。ワークフローのエージェントはセッションに接続されたすべてのMCPツールにアクセスできますが、対話型のサインインが必要なサーバーはヘッドレス実行では利用できない場合があります。このリファレンスは/workflow-authoringスキルで、v2.1.248以降が必要です(ワークフローのページ「Edit a saved script」、スキルのドキュメント)。EveryInfraのリモートMCPサーバーは、対話型のサインインではなく、リクエストヘッダーに指定したキーを使用します。そのため、ヘッドレス実行でも動作します。
もう1つは時間に関するルールです。スクリプト内では、Date.now()、Math.random()、引数なしのnew Date()はエラーをスローします。再開された実行では同じagent()呼び出しを繰り返す必要があり、タイムスタンプやランダム値があるとそれが成り立たなくなるためです(ワークフローのページ)。日付が必要な場合はargsで渡してください。「過去24時間のコメント」が必要なら、代わりにAPIのフィルターを使用します。xiaohongshu/searchはdate_range=last_24_hoursを受け付けます。
バージョンと設定スイッチ:各動作の導入リリース
動的ワークフローは2026年5月から11月にかけて大きく変わりました。多くのチュートリアルは古い動作を説明しています。この表には、今回の作業に関係する項目だけを記載しています。バージョンと日付はClaude Codeの変更履歴に基づいており、これはGitHubのCHANGELOG.mdと同じ内容です。「docs」と記された行は、ワークフローのページにあるバージョンに関する注記に基づいています。
| バージョン | 日付 | 変更内容 | コメント分類への影響 |
|---|---|---|---|
| 2.1.154 | 2026-05-28 | 動的ワークフローと/workflowsをリリース | 出発点 |
| 2.1.157 | 2026-05-29 | キーワードトリガーを無効にする設定 | 「workflow」と入力しても誤って実行が始まらない |
| 2.1.269 | docs | CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS | APIを呼び出すエージェント数を2〜3に制限 |
| 2.1.271 | docs | 使用量の上限に達すると実行が一時停止。Proのデフォルトサイズはsmall | 長時間の実行が途中で失敗しない |
| 2.1.296 | 2026-10-09 | CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL | 1つの変数ですべてのエージェントをHaikuに |
| 2.1.299 | 2026-10-14 | /usageがワークフローについて警告 | トークンの使い道を確認できる |
| 2.1.301 | 2026-10-15 | 修正:エージェントがステップを飛ばしても実行が成功と報告されていた問題 | ラベル付けステップがスキップされても成功扱いにならない |
| 2.1.305 | 2026-10-20 | 修正:再開時に完了済みのpipeline()およびparallel()エージェントが再実行されていた問題 | 再開時にコメント分の料金が二重に発生しない |
| 2.1.311 | 2026-10-26 | 修正:遅れて接続したMCPサーバーをサブエージェントが認識できなかった問題 | リモートMCPの接続が遅くてもツールが見えなくならない |
| 2.1.316 | 2026-10-31 | CLAUDE_CODE_SUBAGENT_EFFORT | すべてのラベル付けエージェントのeffortを一括でlowに設定 |
2.1.269と2.1.271の行は、ワークフローのページの「Behavior and limits」「When a run hits your usage limit」「Set a size guideline」の各セクションに基づいています。サイズガイドラインには4つの値があります。unrestrictedはガイドラインなし、smallは5エージェント未満、mediumは10未満、largeは50未満を意味します。Claudeはこの値を上限ではなく目安として扱います。厳密な上限は引き続き1,000エージェントです。workflowSizeGuidelineは任意の設定ファイルで設定することもできます(設定リファレンス)。
500件のコメントならmediumで十分です。必要なのは、検索エージェント1個、取得エージェント数個、それと同数のラベル付けエージェント、抜き取りチェックエージェント1個、レポートエージェント1個です。後のセクションでは、バッチ呼び出しによって取得エージェントを1〜2個に減らす方法を紹介します。
ultracodeを有効にする方法は2つあり、それぞれ効果が異なります。v2.1.284以降、セッション内で/effort ultracodeを実行するとultracodeのみが有効になり、effortレベルは変わりません。/effort ultracode offで無効にできます。
v2.1.284より前は、/effort ultracodeでセッションのeffortがxhighに設定され、/effort ultracode offはInvalid argumentで失敗していました。起動フラグclaude --effort ultracode(v2.1.203以降)は動作が異なります。ultracodeを有効にすると同時に、effortもxhighに設定します(モデル設定のドキュメント、ワークフローのページ)。ultracodeが有効な場合、「Large workflow」の警告は表示されず、サブエージェントの同時実行数の制限も適用されません。有料APIを呼び出すジョブでは、ultracodeを無効のままにしておくことをおすすめします。代わりに1つのプロンプトでワークフローを依頼すれば、実行前に計画を確認できます。
データの接続:リモートMCPまたはPOST /api/v1/social
ワークフローからデータAPIを使う方法は2つあります。エージェントはEveryInfraをリモートMCPサーバーとして呼び出すか、POST https://api.everyinfra.com/api/v1/socialに対してcurlを実行できます。Claude CodeのMCPドキュメントでは、claude mcp add --transport http <name> <url>でリモートHTTPサーバーを追加します。Bearer認証の場合は--headerを追加します(MCPドキュメント)。
当社のリモートMCPサーバーは、MCP仕様のStreamable HTTPトランスポートを使用しています(MCP仕様 2025-11-25、トランスポート)。仕様では、ツール呼び出しはtools/callリクエストであり、結果はcontent配列に格納されます(MCP仕様 2025-11-25、ツール)。tools/listを呼び出したところ、12個のツールが返されました。ここで重要なのはeveryinfra_list_capabilities、everyinfra_call_api、everyinfra_get_jobの3つです。
# Configuration example. Keep the key in an environment variable, never in a file.
export EVERYINFRA_API_KEY="<your key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Fewer approval prompts: add these to permissions.allow in .claude/settings.json
#   "Workflow", "mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"
# Keep at most 3 agents running, so a 10-per-minute key is not saturated
export CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS=3権限設定の各行は、3つの情報源に基づいています。claude -pおよびAgent SDKでは、Claude Codeはワークフローの承認プロンプトを表示しません。実行を開始できるようにするには、許可ルールにWorkflowを追加します。保存済みの特定のワークフローだけを許可する場合は、Workflow(<name>)を追加します(ワークフローのページ「Approve the plan before it runs」)。
ローンチ記事では、ワークフローにはautoモードが推奨されています。autoモードでは、分類器が各呼び出しを審査します(権限モードのドキュメント)。また、PreToolUseフックで呼び出しに対してallowを返すこともできます(フックのドキュメント)。
MCPの許可ルールはmcp__<server>__<tool>の形式で記述します。globが有効なのは、mcp__everyinfra__*のようにサーバー名の後だけです(権限のドキュメント)。ワークフローのサブエージェントには、ユーザーの権限ルールが適用されます。ドキュメントでは、長時間の実行の前にエージェントが必要とするツールを許可しておき、承認待ちで実行が止まらないようにすることが推奨されています。
どちらの方法を使うべきでしょうか。呼び出し回数が決まっている読み取り専用のラベル付けには、当社ではMCPを使用しています。以下の表で2つの方法を比較します。サンドボックスの行はサンドボックスのドキュメントに基づいており、初期状態では許可されたネットワークドメインはありません。
| 質問 | リモートMCP | `POST /api/v1/social`へのcurl |
|---|---|---|
| エージェントにBashは必要か | 不要 | 必要。サンドボックスのネットワークルールも必要 |
| エージェントは課金とページングを把握できるか | はい。ツールの説明から把握できます | プロンプトで伝えた場合のみ |
retry_afterやdid_you_meanなどのエラーフィールド | ツールの結果内 | レスポンスボディ内 |
| 監査用に生のJSONをディスクに保存 | 不要 | はい。エージェントがファイルを書き込みます |
| 最適な用途 | 呼び出し回数が決まっているラベル付け | 未加工のファイルをすべて保持する必要があるジョブ |
curlの場合、取得エージェントが未加工のファイルを1つずつ書き込み、スクリプトには{id, text, like_count}のみを返します。
始める前に、サイズ制限を1つ把握しておいてください。Claude Codeは、MCPツールの出力が10,000トークンを超えると警告を出し、デフォルトでは25,000トークンで打ち切ります。上限はMAX_MCP_OUTPUT_TOKENSで変更できます。正常に返されたテキスト結果が50,000文字を超える場合は、ファイルに保存されます(MCPドキュメント、「MCP output limits and warnings」)。
MCP経由で取得したコメント15件の1ページは16,892バイトでした。投稿20件の検索結果1ページは34,991バイトでした。どちらも基準を下回っています。
3件の投稿に対するcomments_batchの呼び出しは42,991バイトでした。この割合だと、20件の投稿で約280,000バイトになります。この結果はファイルに保存されるため、エージェントは次のステップでそのファイルを読み込む必要があります。結果自体は変わらず、手順が1つ増えるだけです。結果をエージェントのコンテキスト内に収めるには、1回の呼び出しで3〜4件の投稿をリクエストしてください。
実際の1往復:エージェントが送信する内容とAPIが返す内容
2026年11月2日 00:17:55(SGT)に、以下のtools/callリクエストをMCP経由で送信しました。これは、Claude Codeのエージェントがmcp__everyinfra__everyinfra_call_apiを呼び出す際に送信するものと同じJSON-RPCリクエストです。対象は初回購入者による投稿Fで、コメントの並び順はいいね数順です。結果はresult.content[0].textにJSONテキストとして格納されています。ここでは最初のコメントと課金フィールドのみを示します。投稿URLからはクエリ文字列を削除し、投稿者名とIDは非表示にしています。
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api",
 "arguments":{"platform":"xiaohongshu","action":"comments",
  "params":{"url":"https://www.xiaohongshu.com/explore/692b0d81000000001d03ea4c","sort":"most_liked"}}}}

{"id":"req_b7efc0a2e4784211","platform":"xiaohongshu","action":"comments","count":10,
 "pagination":{"page":1,"has_more":true,"stop_reason":null},
 "results":[{"id":"693ab483000000001702fef1","text":"(Chinese) How is the DJI one? I hear its obstacle avoidance is strong",
   "like_count":3,"author_name":"[hidden]","author_id":"[hidden]","sub_comment_count":0}],
 "billing":{"charged":true,"charged_usd":0.005556}}
この10件のコメントのうち8件は明確なニーズです。ほぼすべてのコメントに、床面積、予算、ペットの有無、床材の種類が書かれています。翻訳した例を1つ挙げます:「140平方メートル、カーペットあり、ペットなし、全面タイル、髪の毛が多い、予算3,000元、どれがいい?」このようなコメントは、プロダクトチームやサポートチームにとって有用です。また構造もはっきりしているため、モデルが予算、面積、ペットをフィールドとして抽出できます。
返されたフィールドは、カタログにあるxiaohongshu/commentsの20個のresponse_fieldsと一致します。取得エージェントがどれを保持するかを下の表に示します。
| フィールド | 内容 | ラベル付け用に保持するか |
|---|---|---|
id、text、like_count | コメントID、本文、いいね数 | 可能 |
sub_comment_count | 返信数 | はい。返信を取得するスレッドの選定に使用します |
comment_tags | 「投稿者による『いいね』」、「ピン留め」、投票への回答 | 任意。ノイズフィルタに役立ちます |
posted_at、ip_location | 時刻とIPアドレスの地域 | 時刻別・地域別のレポートでのみ使用 |
author_name、author_id、アバター | 投稿者 | いいえ。レポートにも含めないでください |
note_url、next_page_token、sub_comments | ページングと最初の返信 | 取得エージェント内でのみ使用 |
スクリプトの骨組み:探索、取得、フィルタ、ラベル付け、チェック、レポート(例)
以下の骨組みは、ドキュメントのスクリプトAPIをもとに作成しました。実行はしていないため、設定例として扱ってください。phase()の呼び出しは5つですが、段階は6つあります。フィルタはエージェントではなく、スクリプト内の1つの正規表現であり、トークンを消費しません。
各設計上の選択は、この記事での測定結果に基づいています。取得エージェントが返すのはid、text、like_countのみで、投稿者データやその他30個のフィールドは返しません。ラベル付けエージェントは、5つの固定ラベルを持つschemaを使用します。抜き取りチェックでは別のモデルを使ってコメントの10%を再ラベル付けし、そのモデルには最初のラベルを見せません。


export const meta = {
  name: 'xhs-comment-triage',
  description: 'Pull Xiaohongshu comments for a keyword, drop noise, label need/complaint/price/praise, write a table',
  whenToUse: 'You have a product keyword and want to know what the comment sections ask and complain about',
  phases: [
    { title: 'Discover', detail: '1 agent searches posts' },
    { title: 'Fetch', detail: '1 agent per post pulls 2 pages' },
    { title: 'Classify', detail: '1 agent per post labels comments' },
    { title: 'Verify', detail: 'another model relabels 10%' },
    { title: 'Report', detail: '1 agent writes the table' },
  ],
}

const KEYWORD = (args && args.keyword) || 'robot vacuum (Chinese keyword)'
const NOTE_COUNT = (args && args.notes) || 20
const TOOL = 'mcp__everyinfra__everyinfra_call_api'
const LABELS = ['need', 'complaint', 'price', 'praise', 'other']
const NOISE = /^(进团|参团|进|\s*)$|^(\[[^\]]+R\]|\s)*$/   // "join the group" replies, empty text, emoji only

const NOTES = { type: 'object', required: ['notes'], properties: { notes: { type: 'array', items: {
  type: 'object', required: ['url', 'title'],
  properties: { url: { type: 'string' }, title: { type: 'string' }, comment_count: { type: 'integer' } } } } } }
const COMMENTS = { type: 'object', required: ['comments', 'calls', 'charged_usd'], properties: {
  calls: { type: 'integer' }, charged_usd: { type: 'number' },
  comments: { type: 'array', items: { type: 'object', required: ['id', 'text'],
    properties: { id: { type: 'string' }, text: { type: 'string' }, like_count: { type: 'integer' } } } } } }
const LABELED = { type: 'object', required: ['items'], properties: { items: { type: 'array', items: {
  type: 'object', required: ['id', 'label'],
  properties: { id: { type: 'string' }, label: { type: 'string', enum: LABELS } } } } } }

phase('Discover')
const found = await agent(
  `Use ${TOOL} with platform=xiaohongshu, action=search, params={keyword:"${KEYWORD}", sort:"most_commented"}. ` +
  `Follow next_page_token until you have ${NOTE_COUNT} posts. Keep each url exactly as returned, with xsec_token.`,
  { schema: NOTES, model: 'haiku', effort: 'low', label: 'search' })

const results = await pipeline(found.notes.slice(0, NOTE_COUNT),
  (note) => agent(
    `Use ${TOOL} for xiaohongshu/comments with params={url:"${note.url}"}, then fetch page 2 with next_page_token. ` +
    `On 429, wait error.retry_after seconds and retry, at most 3 times. On 422, do not retry; report it. ` +
    `Keep only id, text and like_count. Sum billing.charged_usd into charged_usd.`,
    { schema: COMMENTS, model: 'haiku', effort: 'low', phase: 'Fetch', label: note.title.slice(0, 12) }),
  (r) => ({ ...r, kept: r.comments.filter((c) => !NOISE.test(c.text.trim())),
            dropped: r.comments.filter((c) => NOISE.test(c.text.trim())).length }),
  (r) => agent(
    `Label each Xiaohongshu comment as one of ${LABELS.join(', ')}. need = asks which model to buy or for a link; ` +
    `complaint = a product or service problem; price = cost, cheaper copies or where to buy; ` +
    `praise = the writer uses it and recommends it; other = jokes or off-topic.\n` +
    JSON.stringify(r.kept.map((c) => ({ id: c.id, text: c.text }))),
    { schema: LABELED, model: 'haiku', effort: 'low', phase: 'Classify', label: 'classify' })
    .then((l) => ({ ...r, labels: l ? l.items : [] })),
)

const ok = results.filter(Boolean)
const all = ok.flatMap((r) => r.labels.map((x) => ({ ...x, text: (r.kept.find((c) => c.id === x.id) || {}).text })))
const sample = all.filter((_, i) => i % 10 === 0)
log(`Fetched ${ok.length}/${found.notes.length} posts; filter dropped ${ok.reduce((s, r) => s + r.dropped, 0)} comments`)

phase('Verify')
const second = await agent(
  `Label these comments on your own. Labels: ${LABELS.join(', ')}.\n` + JSON.stringify(sample.map(({ id, text }) => ({ id, text }))),
  { schema: LABELED, model: 'sonnet', effort: 'medium', label: 'relabel-10pct' })
const agree = sample.filter((s) => ((second && second.items.find((y) => y.id === s.id)) || {}).label === s.label).length

phase('Report')
const counts = {}
for (const x of all) counts[x.label] = (counts[x.label] || 0) + 1
return await agent(
  `Write a Markdown table with count and share per label and 3 example comments per label, translated to English. ` +
  `End with API cost $${ok.reduce((s, r) => s + r.charged_usd, 0).toFixed(4)} and spot-check agreement ${agree}/${sample.length}.\n` +
  JSON.stringify({ counts, examples: all.slice(0, 150) }),
{ model: 'sonnet', effort: 'low', label: 'report' })この骨組みには間違えやすい箇所がいくつかあり、いずれもドキュメントで説明されています。metaは最初の文で、単純なオブジェクトリテラルである必要があります。変数、関数呼び出し、スプレッド構文を含めると、/<name>がオートコンプリートに表示されなくなります(workflowsページの「Edit a saved script」)。phases内のタイトルはphase()の引数と完全に一致させる必要があります。一致しないと、進捗ビューに余分なグループが表示されます。
pipeline()内のエージェントが1つ失敗すると、対応する要素がnullになるため、スクリプトはfilter(Boolean)を呼び出します。直接awaitしているエージェントが失敗すると、実行全体が終了します(同ページの「When an agent stalls and restarts」)。取得とラベル付けの段階ではhaikuを、チェックとレポートではsonnetを使用します。
Claude Codeは、ワークフローのエージェントのモデルを、サブエージェントと同じ順序で選択します。スクリプトでモデルを指定した場合は、それが呼び出しごとのモデルになります。モデルを指定しない場合、エージェントはセッションのモデルを使用します(workflowsページの「Cost」。サブエージェントのドキュメントには、エイリアスsonnet、opus、haiku、fableが記載されています)。
フィルターをモデルではなくスクリプトに置くのはなぜでしょうか。スクリプトは普通のJavaScriptなので、正規表現やフィルター、件数の集計にトークンはかかりません。このフィルターは「グループに参加」という返信、空のテキスト、絵文字だけのコメントを除外します。いずれも内容の理解は必要ありません。
次のセクションで示すとおり、これらは100件のコメントのうち25件を占めていました。同梱のオーサリングリファレンスにも、ワークフローの対象範囲を制限する場合は、除外したものをlog()するよう書かれています。この行がないと、読み手は全件が対象だと考えてしまいます。スケルトンのlog()の行がその役割を果たします。
テスト1:カタログでは1ページ15件、実際は8ページ中4ページが10件
xiaohongshu/commentsについて、カタログにはpage_sizeが15、limit_ignoredがtrueと記載されています。つまりページサイズは固定で、limitの値は効果がありません。xiaohongshu/sub_commentsは10、xiaohongshu/searchは20、comments_batchは投稿ごとに15です。テストの前に、「すべてのページが15件」という仮説を書き留めました。データはこの仮説を否定しました。
00:15:22 SGTに取得した投稿Aの1ページ目は10件で、00:15:49の2ページ目は15件でした。00:17:38には、3投稿分のcomments_batchの呼び出し1回で、Cが10件、Dが10件、Eが15件返りました。00:17:55には、MCP経由で取得した投稿Fのデータが10件返りました。8ページの平均は12.5件です。
件数の少ないページが最後のページとは限りません。投稿AとFでは、件数の少ないページでpagination.has_moreがtrueでした。バッチ結果の投稿CとDでは、すべての件にnext_page_tokenがありました。投稿Aの2ページ目は15件に戻りました。プラットフォームが、たとえばピン留めされたコメントや投票コメントのために、1ページ目を別扱いしている可能性があります。これ以上の根拠はないため、観察した内容のみを報告します。
実務上のポイントは停止条件です。ページサイズが変動するため、「目標件数÷15」では呼び出し回数を求められません。正しい停止条件は「十分な行数を取得した」または「has_moreがfalse」です。「Nページ取得した」ではありません。
返信も同じ挙動です。投稿Bのあるコメントはsub_comment_countが52でした。00:17:17 SGTに、そのコメントについてxiaohongshu/sub_commentsを呼び出しました。1ページ目は10件ではなく5件で、そのうち2件はテキストが空でした。おそらく画像かスタンプです。
そのため、返信は有用な1件あたりのコストが高くなります。トップレベルのページは平均12.5件を$0.005556で返しましたが、この返信ページでテキストがあったのは3件でした。ラベル付けでは、デフォルトで返信をスキップすることをおすすめします。返信を取得するのは、モデルが苦情と判定し、かつ返信の多いコメントだけにしてください。
| 機能 | カタログのpage_size | 実測の1ページあたり行数 | 1回あたりの料金 | 有用な1件あたりのコスト |
|---|---|---|---|---|
xiaohongshu/search | 20 | 20(1ページ) | $0.005556 | 投稿1件あたり約$0.00028 |
xiaohongshu/comments | 15 | 10〜15、平均12.5(8ページ) | $0.005556 | コメント1件あたり約$0.00044 |
xiaohongshu/comments_batch | 投稿ごとに15 | 投稿ごとに10〜15(3投稿) | 投稿1件あたり$0.005556 | 単一投稿と同じ |
xiaohongshu/sub_comments | 10 | 5、うち2件はテキストなし(1ページ) | $0.005556 | 返信1件あたり約$0.0019 |
テスト2:ルールフィルターで除外できるものと、できないこと
3つ目の仮説は「コメントはそのままモデルに渡せる」でした。合格基準は、すべての投稿でノイズが30%未満であることです。投稿Aのノイズ率はこの基準を大幅に上回りました。2ページ分の25件のコメントのうち24件は、中国語で「グループに参加」(17件)、「私も参加」(6件)、「参加」(1件)とだけ書かれていました。スクリーンショットを見ると、その大半には投稿者が「いいね」したことを示すタグが付き、一部には投票の回答タグも付いています。これらのコメントはすべてsub_comment_countが1です。
私たちの解釈では、投稿者がコメント欄で共同購入を募り、ユーザーはグループに追加してもらうために返信していました。これらのコメントはユーザーのニーズについて何も語っていませんが、課金対象のページを埋めてしまいます。ほかの5件の投稿では、ノイズ行があったのは投稿Dだけで、空のコメントが1件でした。
1つの正規表現で何ができるかを確かめるため、ベースラインとしてキーワードによるルール分類器を作成しました。ルールはまずノイズを判定します。「グループに参加」だけ、絵文字だけ、または空のテキストです。次に苦情の語(におい、返品、お金の無駄、絡まる)、続いてニーズの語(おすすめ、どれ、疑問符)、価格の語(価格、元、安いコピー品、予算)、称賛の語(よく効く、きれい、時短)を順に確認します。どれにも一致しないコメントは「未判定」になります。
これはモデルの結果ではありません。ルールでできる部分と、モデルが必要な部分を示すものです。100件のコメント全体で、ルールの判定はノイズ25、ニーズ24、苦情13、価格8、称賛5、未判定25でした。
| ルールが正しく判定した例 | ルールが誤判定した、または判定できなかった例 |
|---|---|
| 「グループに参加」の返信25件はすべて完全一致し、除外された | 「じゃあ幽霊が4日間うちに隠れてたってこと…?」は冗談だが、疑問符のせいでニーズになった |
| 「1個3元で1か月もつ」は価格になった | 「うちの安いXiaomiは髪が絡まない」は称賛だが、「絡まる」という語のせいで苦情になった |
| 「140平米…予算3,000、どれがいい?」はニーズになった | 「ダストバッグが使い捨てだとコメントで初めて知った」は新しい知見なので、未判定のままだった |
| 「ドックの排気がくさい、どう直せばいい?」は苦情になった | 「洗濯機の横に30分も立ってるの?」は反語だが、ニーズになった |
この表から、スクリプトが2段階になっている理由がわかります。ルールはノイズを除外するだけです。ノイズは毎回同じ形で現れ、誤って除外してもほとんど損失はありません。4つの意図はモデルに任せます。1つの疑問符が、依頼にも反語にも冗談にもなりうるからです。
投稿Cはタイトルに「購入ガイド」、投稿Dはタイトルに「ロボット掃除機」を含みます。しかし、どちらのコメント欄も話題の中心はクリエイターのコメディ展開やフィットネスでした。そのうち7件以上は、ルールでもモデルでも「その他」と判定すべきジョークです。タイトルだけで投稿を選ぶと、有用なコメントを多く見積もりすぎます。そこで、discoverエージェントにもis_cooperation_note、コメント数、タイトルを渡すことをおすすめします。そうすれば、明らかなコメディ投稿を先に除外できます。
モデルによるテキストのラベル付けに関する研究は、抜き取り検査の設計に役立ちます。ある研究では、ゼロショットで付けたラベルが、ほとんどのタスクでクラウドワーカーによるラベルを上回りました(arXiv 2303.15056)。別の研究では、モデルやタスクによって大きなばらつきが見られ(arXiv 2311.05769)、方法論を扱った論文では、厳密な検証が必須の手順として挙げられています(Sociologica, 2024)。今回の作業には、次の3つのルールを適用します。抜き取り検査を省略しないでください。最初に付けたラベルを見せず、別のモデルを使ってください。たとえば一致率80%のように、合格基準を事前に設定してください。結果が基準を下回った場合は、ラベルの定義を変更し、バッチ全体にラベルを付け直してください。
テスト3:同じページを3回取得して新しいコメントは7件、呼び出しはすべて課金された
このテストは、ワークフローに関する疑問に答えるものです。エージェントが失敗して再実行されると何が起きるのでしょうか。SGT 00:15:33に投稿Bの1ページ目を取得しました。00:21:35と00:21:55に、同じリクエストボディを再度送信しました。2回目のレスポンスで1回目と共通していたコメントは、15件中8件だけでした。
3回目は1回目と13件、2回目と10件が共通していました。3回の呼び出しで返された異なるコメントは合計22件です。各呼び出しの費用は$0.005556で、同一のリクエストでも無料にはなりませんでした。
つまり、デフォルトの並び順は安定した順序ではありません。時間やプラットフォームのランキングによって変わります。ワークフローでは、これが再開時のルールと組み合わさります。ドキュメントの記述は明確です。再開時、完了済みのエージェントは保存された結果を返します。
ただし、プロンプトが変更された最初のエージェントは再実行され、それ以降のすべてのエージェントも再実行されます。失敗したエージェントも再実行され、スクリプトがその後に開始するすべてのエージェントも、完了済みであっても再実行されます。ドキュメントには例があります。スクリプトがA、B、C、Dを開始し、Bが失敗したとします。再開時、Aはキャッシュから取得され、B、C、Dは再実行されます(ワークフローのページ「Which agents run again」)。
2026年10月20日のv2.1.305で、関連する問題が修正されました。この修正以前は、編集していないスクリプトでも、再開時にpipeline()やparallel()内の完了済みエージェントが再実行されることがありました(changelog 2.1.305)。
この2つの事実を合わせて考えます。取得エージェントが再実行されると、APIが再び呼び出され、再び料金が発生します。返ってくるコメントが異なる可能性があるため、後続のエージェントがすでに付けたラベルと一致しないことがあります。スケルトンとは別に、次の3つのルールをおすすめします。
1つ目は、取得とラベル付けを2つのワークフローに分けることです。1つ目のワークフローは、取得とファイルへの書き込みだけを行います。データに問題がないことを確認したら、2つ目のワークフローでファイルを読み込み、ラベルを付けます。こうすれば、ラベル付けの実行で失敗が起きても、APIが呼び出されることはありません。
2つ目は、デフォルトよりはるかに安定しているsort=newestまたはsort=most_likedで取得することです。ページング中は並び順を変更しないでください。カタログによると、古いnext_page_tokenが使えなくなるためです。3つ目は、集計の前にコメントのidでラベルを重複排除することです。1つのコメントが2回の取得に含まれる可能性があるためです。
ストールも、別の種類の再実行を引き起こします。エージェントが一定時間出力を生成しないと、同じプロンプトから最大5回までやり直します。すでに変更したファイルは変更されたままで、使用したトークンも実行全体の合計に含まれたままです(ワークフローのページ「When an agent stalls and restarts」)。自身のツール呼び出しを待つ時間はカウントされないため、2.5秒のAPI呼び出しでストールが発生することはありません。
レスポンスのストリームが途絶えた場合は、別の障害が起きます。ストリーミングのアイドルウォッチドッグがストリームを終了させ、そのタイムアウトはCLAUDE_STREAM_IDLE_TIMEOUT_MSで設定します(ネットワーク設定のドキュメント)。429のあとにエージェントが長時間待機して何も出力しないと、ストールとみなされて再起動することがあります。その場合、すでに課金された呼び出しが繰り返されます。
今回の429が求めた待機時間は1秒だったため、リスクは小さいものでした。利用の多い共有キーでは、待機時間が長くなります。その場合は、取得エージェントに個別のstallMsを設定してください。たとえばagent(prompt, { stallMs: 600000 })のように指定します。
並列実行時のレート制限:1分あたり10リクエストのキーに16エージェント
ワークフローは、デフォルトで16個のエージェントを同時に実行します。今回のキーには1分あたり10リクエストという独自の制限があり、同時に他のプログラムも同じキーを使用していました。呼び出しは約10秒ごとで、制限を十分に下回るはずでした。しかし、x-ratelimit-remaining-requestsヘッダーの値は5、5、2、0と推移しました。
00:15:59 SGTに、ある呼び出しが429を返しました。その後、ヘッダーの値は8、3、6、5、1となりました。これが共有キーの実態です。他のプログラムがいつ呼び出しているかは見えないため、ヘッダーと429から判断するしかありません。自分のプログラムだけがキーを使っている場合、残り回数は呼び出しのたびに減っていくはずで、増減を繰り返すことはありません。ここで見られる変動は共有キーによるもので、専用のキーでは発生しません。
エージェントは429のボディを直接読み取れます。テキストは"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s."でした。ボディにはretry_after: 1、retryable: true、max_retries: 3と「Nothing was charged」という文も含まれていました。念のため60秒以上待機したところ、00:17:17に200が返りました。
429には料金がかからず、課金合計にも含まれていません。スケルトンの取得プロンプトも同じルールを使っています。429の場合はerror.retry_after秒待機して再試行し、最大3回までとします。Anthropic APIも、リクエストが速すぎるとretry-afterヘッダー付きの429を返します(Anthropicのレート制限ドキュメント)。1つのプロンプトルールで両方に対応できます。
{"error":{"code":"rate_limited",
  "message":"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.",
  "reason":"key_limit","retry_after":1,"limit":10,"fault":"account","retryable":true,"max_retries":3,
"next_steps":["Over this key's or account's request rate. Nothing was charged. Retry after retry_after seconds, or ask the user to raise the limit."]}}再試行は受動的な防御策です。能動的な防御策は2つあります。1つ目は、同時実行数を下げることです。CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTSを2または3に設定します。
2ページを取得するエージェントには、約5秒のAPI時間に加えて、エージェント自身の思考時間が必要です。エージェントが3つなら、リクエストレートは1分あたり10件に近くなり、残りは再試行でカバーできます。この変数は実行全体に適用されるため、ラベル付けエージェントも遅くなります。合計時間が重要な場合は、取得とラベル付けを2つのワークフローに分け、ラベル付けの実行には制限をかけないでください。
2つ目の能動的な防御策は、バッチ呼び出しです。xiaohongshu/comments_batchは1リクエストで最大20件の投稿を受け付け、投稿ごとに課金されます。00:17:38 SGTに、1リクエストで3件の投稿を取得しました。35件のコメントが返され、費用は$0.016667、つまり投稿あたり$0.005556で、xiaohongshu/commentsと同じです。リクエストには3.28秒かかり、単一投稿の呼び出しは約2.4秒でした。
| 40件の投稿それぞれの1ページ目 | リクエスト数 | 1分あたり10件での最短所要時間(分) | APIコスト |
|---|---|---|---|
投稿ごとにxiaohongshu/commentsを1回呼び出し | 40 | 4 | $0.22224 |
xiaohongshu/comments_batch、1回の呼び出しで20件の投稿 | 2 | 1 | $0.22224 |
バッチ呼び出しで変わるのはリクエスト数であり、コストは変わりません。共有キーとワークフローの組み合わせでは、リクエスト数こそが本当のボトルネックです。1分あたり10リクエストのキーで40リクエストを送るには、少なくとも4分かかります。2リクエストなら数秒で終わります。そのため、より良いスケルトンでは、投稿の検出後、1つか2つのエージェントでcomments_batchを呼び出して、すべての投稿の1ページ目を取得します。その後、コメントの多い投稿だけをさらにページングします。
バッチ結果の各行にはnext_page_tokenが含まれているため、xiaohongshu/commentsで続きを取得できます。カタログには注意点が1つあります。一部の投稿が失敗した場合は、レスポンスのpartialとmissedを確認してください。取得できなかった投稿を、コメントのない投稿として扱わないでください。この一文を取得プロンプトに入れておきましょう。
非同期モードも利用できます。カタログによると、どの機能でもリクエストボディに"mode":"async"を指定できます。すぐに202とjob_idが返されるので、その後GET /api/v1/jobs/{job_id}をポーリングします。00:18:21 SGTに、投稿Bの2ページ目で非同期モードを使用しました。202の時点で、ステータスはすでにsucceededになっていました。
00:18:30のポーリングで15件が返りました。everyinfra_get_jobツールの説明にあるとおり、ポーリングは無料で、1分あたりのレート制限の対象にもなりません。コメントは2〜3秒で返るため、非同期モードは必要ありません。ただし、同じworkflowで時間のかかる機能も呼び出す場合は、非同期モードとポーリングを使うと、エージェントが未完了のリクエストを待ち続けずに済みます。
失敗、再試行、課金:二重に課金されるケース
下の表は、私たちの観測結果をワークフローの挙動と並べたものです。「ワークフローの挙動」列はワークフローのページ、「API課金」列は実際のレスポンスの生データに基づいています。
| 出来事 | ワークフローの挙動 | API課金 | スクリプトでの対策 |
|---|---|---|---|
| 429(レート制限) | エージェントが処理 | 課金なし(「Nothing was charged」) | retry_after秒後に再試行(最大3回) |
422:不正な値(sort=hottestなど) | エージェントが処理 | 課金対象外 | 再試行せず、メッセージを報告 |
| エージェントのストール | 同じプロンプトから再起動(最大5回) | 成功した呼び出しが再実行され、再度課金 | 取得エージェントにstallMsを設定 |
| エージェント失敗後の再開 | そのエージェント以降をすべて再実行 | 再実行すると取得処理に再度課金 | 取得とラベル付けを2つのワークフローに分割 |
| 6分以内の同一リクエスト | 該当なし | 毎回課金され、内容も変わる | コメントのidで重複排除 |
| ラベル出力がスキーマに適合しない | 再試行し、5回の試行後に失敗扱い | API呼び出しなし | スキーマを小さく保つ |
| サブスクリプションの使用量上限 | v2.1.271以降、条件を満たせばリセットまで一時停止 | API呼び出しなし | まず小規模で試す |
使用量上限の行については、セッション自体がリセットを待つこともできます(インタラクティブモードのドキュメント)。422のテストは00:16:07 SGTに実行し、sortにはあえてhottestを指定しました。レスポンスは`"sort must be one of: default, most_liked, newest (got 'hottest')"でした。あわせてallowedリストとdid_you_mean: ["most_liked"]`も返され、課金が発生していないことも示されていました。
この種のエラーへの対応には、ワークフローが適しています。取得エージェントはエラーを読み取り、値を1つ変更して、ユーザーに確認することなく処理を続行できます。strict tool useに関する記事では、厳格なツール定義によってモデル側で不正なenum値を防げることを紹介しました。ワークフローでは、取得プロンプトにsortの値をハードコードするほうがシンプルです。
コスト:コメント500件に必要な呼び出し回数と金額
このジョブに関わるAPIの単価は1種類です。2026年11月2日00:14 SGTにカタログを確認しました。xiaohongshu/search、xiaohongshu/comments、xiaohongshu/sub_comments、xiaohongshu/comments_batchはいずれも1回の呼び出しあたり$0.005556(バッチの場合は投稿1件あたり)です。失敗した呼び出しと空の結果は無料です。ページネーション対応の機能では、呼び出し回数は目標行数を1ページあたりの行数で割り、切り上げた値になります。
以下の3つの方法では、コメントのページのみを数えています。検索は1ページあたり20件の投稿を返します。コメント500件には通常20〜40件の投稿が必要で、呼び出しが1〜2回($0.0056〜$0.0111)増えます。
| 方法 | 1ページあたりの行数 | 呼び出し回数 | APIコスト |
|---|---|---|---|
| カタログ値 | 15 | 34 | $0.188904 |
| 実測の平均値 | 12.5 | 40 | $0.22224 |
| ノイズ25%を除いた有用なコメント500件 | 12.5 | 54(先に667件を取得) | $0.300024 |
| 本記事の利用実績:課金対象のリクエスト10件、計12課金単位 | n/a | 10 | $0.066671 |
次の表は、このテストで送信したすべてのリクエストを示しています(時刻は2026年11月2日のSGT)。429、422、ジョブのポーリングは無料でした。
| 時刻(SGT) | リクエスト | HTTP | 件数 | 課金額 |
|---|---|---|---|---|
| 00:14:59 | xiaohongshu/search | 200 | 投稿20件 | $0.005556 |
| 00:15:22 | xiaohongshu/comments、投稿Aの1ページ目 | 200 | 10 | $0.005556 |
| 00:15:33 | xiaohongshu/comments、投稿Bの1ページ目 | 200 | 15 | $0.005556 |
| 00:15:49 | xiaohongshu/comments、投稿Aの2ページ目 | 200 | 15 | $0.005556 |
| 00:15:59 | xiaohongshu/sub_comments、投稿B | 429 | 0 | $0 |
| 00:16:07 | sort=hottestを指定したxiaohongshu/comments | 422 | 0 | $0 |
| 00:17:17 | xiaohongshu/sub_comments、投稿B | 200 | 5 | $0.005556 |
| 00:17:38 | xiaohongshu/comments_batch、投稿C、D、E | 200 | 35 | $0.016667 |
| 00:17:55 | MCP everyinfra_call_api、投稿F | 200 | 10 | $0.005556 |
| 00:18:21 | xiaohongshu/comments(非同期)、投稿Bの2ページ目 | 202 | ポーリング時点で15件 | $0.005556 |
| 00:21:35 | xiaohongshu/comments、投稿Bの1ページ目(再取得) | 200 | 15 | $0.005556 |
| 00:21:55 | xiaohongshu/comments、投稿Bの1ページ目(再取得) | 200 | 15 | $0.005556 |
3つ目の方法には注意が必要です。ノイズの割合25%は今回の6件の投稿に基づくもので、そのほぼすべてが投稿Aによるものでした。キーワードが違えば、割合は0にも、はるかに高い値にもなり得ます。そのため、まず3〜5件の投稿でワークフローを実行してください。
log()の行でフィルターされた件数を確認してから、取得する投稿数を決めてください。ドキュメントでもコストについて同じことが推奨されています。まず小規模で実行し、/workflowsで各エージェントのトークンを監視して、必要に応じて実行を停止してください(ワークフローページの「Cost」)。
Claude側は計測していないため、ここでは確認可能な部分のみを示します。2026年11月2日に確認したAnthropicの料金ページでは、100万トークンあたりの価格が次のように記載されています。Haiku 5.5は、100,000トークンまでのプロンプトで入力$0.10、出力$0.50です。Sonnet 5.5は入力$2、出力$10、Opus 5.5は入力$4、出力$20です。
テキストのみであれば、コメント500件は同ページの目安(10 kBで約2,500トークン)で約12,000トークンです。このテキストのHaikuでの入力コストは$0.002未満です。コストの大部分はそれ以外の部分で発生します。各エージェントにはシステムプロンプト、ツール定義、エージェント自身の推論が伴い、それらのサイズは使用するバージョンとMCPツールによって異なります。これらは計測していないため、実際の数値は/workflowsで確認してください。
サブスクリプションでは、ワークフローの使用量はプランの上限にカウントされます。コストに関するドキュメントによると、各サブエージェントと各ワークフローエージェントはそれぞれ独自にリクエストを送信します。Redditのローンチスレッドでは、あるユーザーがプロンプト一つで700,000トークン、Maxプランの使用量の36%を消費したと報告しています。別のユーザーは、最初の試行で1.2Mトークンを使ったと述べています(Redditのローンチスレッド)。これらは当社では検証できないユーザー報告です。それでも、最初は小さくテストすることが重要な理由がわかります。
コンテキストとトークン:取得ステージでのデータ軽量化の必要性
コメント1件は平均で約1,445バイトのJSONを返しますが、テキストだけなら約95バイトです。サイズは約15分の1になります。生のJSONには、投稿者名、アバターURL、IPアドレスの地域情報、タグ、最初の返信、xsec_token付きの投稿URLなど、20個のフィールドが含まれます。そのほとんどはラベル付けに役立ちません。
料金ページの大まかな比率で計算すると、生のコメント1件は約361トークン、そのテキストは約24トークンです。実際には、中国語のテキストは異なる比率になります。正確な数値は、使用するモデルでトークンカウントエンドポイントを使って確認してください。
この差は2つの場面で効いてきます。1つ目はラベル付けエージェントへの入力です。取得エージェントが生のJSONを返すと、各ラベル付けエージェントは投稿1件あたり10,000〜30,000トークンのJSONを読み込むことになります。テキストを返せば、数百トークンで済みます。
2つ目はプロンプトキャッシュです。ドキュメントによると、1回の実行内でモデル、effortレベル、エージェントタイプ、ツール、出力スキーマ、作業ディレクトリが同じエージェントはプレフィックスを共有します。後のエージェントは、先のエージェントのキャッシュを読み込めます。ワークフローエージェントのキャッシュは、デフォルトで5分間保持されます。
subagentPromptCacheTtlを1hに設定すると、書き込み料金は高くなりますが1時間保持されます(ワークフローページの「Prompt caching in a fan-out」、プロンプトキャッシュのドキュメント)。スケルトンでは、すべての取得エージェントがhaikuモデル、effortレベルlow、COMMENTSスキーマを共通して使用するため、このプレフィックスを共有できます。投稿ごとに異なるモデルを割り当てると、キャッシュを共有できなくなります。
ラベル付けステージ:スキーマ、ラベル定義、一致率
ラベル付けのスキーマにはidとlabelの2つのフィールドがあり、labelは5つの値に限定されます。フィールドが少ないほど、エラーもスキーマのリトライも減ります。予算、床面積、ペットの有無も取得したい場合は、別の抽出ステージを追加し、モデルがニーズとラベル付けしたコメントのみに実行してください。ラベル付けスキーマに任意フィールドを多数追加するのは避けてください。
Anthropic APIでは、output_config.formatのjson_schemaで出力を制約します(構造化出力のドキュメント)。ワークフローのschemaオプションは、Claude Code内で同じ役割を果たします。戻り値はすでにオブジェクトなので、スクリプトでテキストをパースする必要はありません。
各ラベルの定義は、人が適用できるように書いてください。今回のルールベースラインで発生した4件のエラーは、すべて曖昧な定義が原因でした。反語的な質問や冗談がニーズに見え、比較(「うちの安いモデルは髪が絡まらない」)が不満に見えてしまいました。そのためスケルトンでは、各ラベルにどの単語が含まれるかではなく、各ラベルが何を意味するかを定義しています。例は、今回の6件の投稿のコメントを翻訳したものです。
| ラベル | 定義 | 実データの例 |
|---|---|---|
| need | 購入すべきモデルを尋ねる、またはリンクを求める | 「140平方メートル、タイル床、抜け毛が多い、予算3,000、どれがいい?」 |
| complaint | 製品やサービスの不具合を報告している | 「ドックの排気が臭い。どう直せばいい?」 |
| price | 費用、安価なコピー品、購入先について話している | 「1個3元で、1か月もつ」 |
| praise | 書き手が製品を使っていて、勧めている | 「うちの安いXiaomiは髪が絡まらない」 |
| other | ジョーク、ストーリーの話、無関係な話題 | 「じゃあ幽霊は4日間もうちに隠れてたってこと…?」 |
「予算3,000、どれがいい?」のように、ニーズと価格コメントの両方に当てはまるコメントは、どうすればよいでしょうか。ラベルは書き手が何を求めているかに基づいて付けるため、この例はニーズになります。チームが価格帯をより重視する場合は、価格をニーズより優先し、その順序をプロンプトに明記してください。
スポットチェックは、ワークフローのドキュメントで説明されている敵対的レビューを参考にしています。独立したエージェント同士が互いの検出結果に異議を唱え、そのうえで実行結果として報告する仕組みです(ワークフローページの「When to use a workflow」)。ラベル付けはバグ探しではないため、チェック用エージェントは最初のラベルに反論しようとはしません。最初のラベルを見ずに、サンプルにもう一度ラベルを付けます。その後、スクリプトが一致率を計算します。別のモデル(スケルトンではSonnet)を使うことで、両方のエージェントが同じ誤りをする可能性を下げられます。
一致率はあくまで下限値です。両方のモデルがジョークをニーズと判定すれば、一致率は高くてもラベルは誤りです。そのため、新しいキーワードでは、初回の実行時にサンプリングされたコメント20件を自分で読んでください。不一致例と明らかな誤りをラベル定義に反映し、そのうえでバッチ全体にラベルを付け直してください。
制限と注意点
この表には、7つの制限とそれぞれへの対処を載せています。最初の2行はworkflowsのページの「Behavior and limits」に基づいています。
| 制約 | 影響 | 対処法 |
|---|---|---|
| スクリプトはオンラインに接続できない | API呼び出しはすべてエージェント内で行われるため、呼び出しが1回増える可能性がある | スキーマ経由でcallsとcharged_usdを返し、合計を確認する |
| 実行中にユーザーへ入力を求められない | 取得とラベル付けの間にレビューを挟めない | ステージごとにワークフローを分ける |
| セッションを終了すると実行が止まる | 再実行すると、実行中だったエージェントは最初からやり直しになる | 保存済みの結果から再実行する |
コメントURLにはxsec_tokenが必要 | 「整形」したURLは失敗する | 返されたURLをそのまま使う |
| 公開コメントのみ | 非表示や折りたたまれたコメントは含まれない | ネガティブな意見は少なめに出ると想定する |
| 本記事のラベルはルールによるベースライン | 件数はモデルの出力ではない | 自分のデータでスポットチェックを実行する |
| バージョンによって挙動が異なる | 多くのチュートリアルは古い挙動に基づいている | claude --versionを実行する。本記事は2.1.316を使用 |
セッションをバックグラウンドに移すか終了すると、実行は自動では継続しません。Claudeが保存済みの結果から実行を再開する必要があり、その時点で実行中だったエージェントは最初からやり直して、トークンを再び消費します(エージェントビューのドキュメント)。
カタログでは、直近の検索結果から得た、クエリ文字列付きの完全なコメントURLを指定するよう求めています。ページトークンの有効期限は24時間のため、翌日に再開する場合は最初からやり直す必要があります。コメント500件の数値は単価と実測したページサイズから算出したもので、実際に500件を取得したわけではありません。本記事は2026年11月2日に参照したドキュメントに基づいています。
コメントデータには、IPアドレスの地域情報と表示名が含まれます。レポートには、ラベル、件数、名前を含まない引用のみを記載してください。コメントの引用を送信または公開する前に、その利用が現地の法律とプラットフォームの規約に沿っていることを確認してください。本記事はデータ手法を説明するもので、法的助言を提供するものではありません。
FAQ
Claude Codeのワークフローとエージェントチーム:コメントの仕分けに合うのはどちら?
エージェントチームは、リードエージェント、長時間動作する少数のピアセッション、共有タスクリストで構成されます。実験的な機能で、フラグが必要です(エージェントチームのドキュメント)。ワークフローは、数十から数百の短命なエージェントを起動するスクリプトです。数百件の独立したコメントを扱うなら、ワークフローが適しています。少数の投稿についてターンごとに指示しながら進めたい場合は、Claude Codeサブエージェントの記事のように、通常のサブエージェントが適しています。(質問の出典:オートコンプリート候補「claude code workflows vs agent teams」。)
Claude Codeのワークフローとスキル:両方とも必要ですか?
スキルは、Claudeが会話の中で従う指示のセットです。ワークフローは、ランタイムが実行するスクリプトです(workflowsページ)。両者は組み合わせて使えます。ラベル定義をスキルにまとめ、ワークフローのエージェントにそのスキルを読み込ませれば、定義を1か所で管理できます。(質問の出典:候補「claude code workflows vs skills」。)
Claude Codeの動的ワークフローは、1回の実行でどれくらいのトークンを使いますか?
ドキュメントには固定の数値は示されていません。1回の実行では、同じ作業を会話で行う場合よりもはるかに多く消費することがあると説明されています。最初は小さな範囲で試し、/workflowsで確認することが推奨されています(workflowsページ「Cost」)。Redditでは、1つのプロンプトで700,000〜1.2Mトークンを消費したという報告があります(Reddit)。このジョブのAPI費用はこれとは別で、500件のコメントで約$0.222です。(質問の出典:検索候補「claude code workflows cost」。「cost per token」「cost reddit」など10種類のバリエーションがあります。)
ultracodeとは何ですか?オンにすべきですか?
ultracodeはClaude Codeのスイッチです。オンにすると、Claudeは実質的な作業を伴うタスクごとに、ワークフローを作成するかどうかを判断します。エフォートレベルではありません。
セッション内で/effort ultracode(v2.1.284以降)を実行すると、スイッチだけがオンになり、エフォートレベルは維持されます。エフォートもxhighに設定されるのは、起動フラグclaude --effort ultracodeを使った場合のみです(モデル設定ドキュメント)。オンにすると、「Large workflow」の警告は表示されません。有料APIを呼び出すジョブでは、オフのままにして、1つのプロンプトでワークフローを依頼することをおすすめします。(質問の出典:候補「ultracode claude」と「ultracode claude reddit」。)
人によるレビューのためにワークフローを止めるにはどうすればよいですか?
ドキュメントによると、実行中に入力を求めることはできないため、承認を挟むにはワークフローを分ける必要があります(workflowsページの「Behavior and limits」)。また、/workflowsで実行を選択してxを押せば停止でき、完了済みのエージェントの結果は保持されます。Hacker Newsのスレッドでも同じ懸念が挙がっており、長時間の実行に人の判断を組み込む部分が難しいと指摘されています(Hacker News、2026-05-28)。(質問の出典:Redditのローンチスレッドで、あるコメント投稿者が、どのシグナルがサブエージェントを停止させ、誤った分岐のまま先へ進むのを防ぐのかを尋ねていました。)
始め方
- EveryInfraのクイックスタートでAPIキーを取得し、
xiaohongshu/searchとxiaohongshu/commentsの無料カタログを読みます。 - 上記のコマンドで、リモートMCPサーバーをClaude Codeに追加します。リモートMCPのセットアップとMCPサーバーのページを参照してください。
- Claude Codeに、スケルトンに沿って5件の投稿を処理するワークフローを依頼します。プランを確認してから、「Yes, run it」を選択します。
- 実行後、
/workflowsでトークンを確認し、API費用を料金ページと比較します。うまくいった実行はsでコマンドとして保存します。
機能名を変更すれば、同じスケルトンを他のプラットフォームでも使えます。XiaohongshuデータAPIのコメント、返信、一括コメントを参照してください。他の中国のプラットフォームについては、DouyinデータAPIとWeiboデータAPIをご覧ください。ラベル付けの前にコメントをクリーニングするには、Claude CodeでDeepSeek V4を使ったコメントのクリーニングをお読みください。
参考文献
- 「動的ワークフローでサブエージェントを大規模にオーケストレーションする」Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/workflows
- Claude Code changelog。Anthropic。最新エントリは2.1.316(2026-10-31)。https://code.claude.com/docs/en/changelog
- CHANGELOG.md。GitHubのanthropics/claude-code。2026-11-02閲覧。https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Introducing dynamic workflows。Anthropic。2026-05-28。https://claude.com/resources/articles/introducing-dynamic-workflows-in-claude-code
- Claude Code Adds Dynamic Workflows for Parallel Agent Coordination。InfoQ。2026年6月。https://www.infoq.com/news/2026/06/dynamic-workflows-claude-code/
- 「エージェントの構築:サブエージェントをメインのエージェントループに統合すべきとき」Anthropic。2026-10-22。https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- Create custom subagents。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/sub-agents
- Run agents in parallel。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/agents
- エージェントチーム。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/agent-teams
- Skills。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/skills
- 設定リファレンス。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/settings-reference
- モデル設定。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/model-config
- 環境変数。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/env-vars
- Agent SDKリファレンス(TypeScript)。Anthropic。2026-11-02閲覧。https://code.claude.com/docs/en/agent-sdk/typescript
- MCPでClaude Codeをツールに接続する。Anthropic。2026-11-02閲覧。https://code.claude.com/docs/en/mcp
- コストの管理。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/costs
- 権限の設定。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/permissions
- 権限モード。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/permission-modes
- Claude Codeのプロンプトキャッシュ。Anthropic。2026-11-02閲覧。https://code.claude.com/docs/en/prompt-caching
- Claude Codeをプログラムから実行する。Anthropic。2026-11-02閲覧。https://code.claude.com/docs/en/headless
- フックリファレンス。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/hooks
- サンドボックス化。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/sandboxing
- プラグインマニフェストのリファレンス。Anthropic。2026-11-02閲覧。https://code.claude.com/docs/en/plugins/manifest-reference
- エージェントビュー。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/agent-view
- Web版Claude Code。Anthropic。2026-11-02閲覧。https://code.claude.com/docs/en/claude-code-on-the-web
- リモートコントロール。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/remote-control
- インタラクティブモード。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/interactive-mode
- ネットワーク設定。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/network-config
- スケジュールされたタスク。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/scheduled-tasks
- コマンド。Anthropic、Claude Codeドキュメント。2026-11-02閲覧。https://code.claude.com/docs/en/commands
- 料金。Anthropic、Claudeプラットフォームドキュメント。2026-11-02閲覧。https://platform.claude.com/docs/en/about-claude/pricing
- 構造化出力。Anthropic、Claudeプラットフォームドキュメント。2026-11-02閲覧。https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- レート制限。Anthropic、Claudeプラットフォームドキュメント。2026-11-02閲覧。https://platform.claude.com/docs/en/api/rate-limits
- トークンのカウント。Anthropic、Claudeプラットフォームドキュメント。2026-11-02閲覧。https://platform.claude.com/docs/en/build-with-claude/token-counting
- トランスポート、2025-11-25版仕様。Model Context Protocol。2026-11-02閲覧。https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- ツール、2025-11-25版仕様。Model Context Protocol。2026-11-02閲覧。https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- Xiaohongshu機能カタログ。EveryInfra。2026-11-02 00:14 SGT閲覧。https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- コンテンツ審査ルール。Xiaohongshu Pugongyingヘルプセンター。2026-10-22付のページ。https://pgy.xiaohongshu.com/help/detail?id=6495c527d1eedeeb48fb18b1f875650e&userType=4
- Pugongyingホームページ。Xiaohongshu。2026-11-02閲覧。https://pgy.xiaohongshu.com/
- 「ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks」。Gilardi、Alizadeh、Kubli著。arXiv 2303.15056、v2(2023-07-19)。https://arxiv.org/abs/2303.15056
- 「Are Chatbots Reliable Text Annotators? Sometimes」。Kristensen-McLachlan他著。arXiv 2311.05769、v2(2025-02-25)。https://arxiv.org/abs/2311.05769
- 「Best Practices for Text Annotation with Large Language Models」。Petter Törnberg著。Sociologica、2024年。https://sociologica.unibo.it/article/view/19461
- 「Introducing dynamic workflows in Claude Code」に関するディスカッションスレッド。r/ClaudeAI。2026年5月。https://www.reddit.com/r/ClaudeAI/comments/1tq9ofy/introducing_dynamic_workflows_in_claude_code/
- 「Dynamic Workflows in Claude Code」に関するディスカッション。Hacker News。2026-05-28。https://news.ycombinator.com/item?id=48311705
参考資料 BL-64