Dynamic workflows в Claude Code для комментариев Xiaohongshu: тест API и пример скрипта
Dynamic workflows в Claude Code параллельно сортируют комментарии Xiaohongshu. Наш тест: на 4 из 8 страниц было по 10 записей, один пост на 96 % состоял из шума, 500 комментариев обошлись в $0,222.
2 ноября 2026 г. с 00:14 до 00:22 по сингапурскому времени (SGT) мы сделали 10 платных вызовов API EveryInfra. Они вернули 100 комментариев верхнего уровня из 6 постов Xiaohongshu (RedNote) о роботах-пылесосах, всего на $0,066671. Под одним постом 24 из 25 комментариев состояли только из китайских «вступить в группу», «я в деле» или «вступаю». В каталоге указано, что xiaohongshu/comments возвращает 15 записей на страницу, но 4 из 8 наших страниц вернули по 10.
Это меняет бюджет dynamic workflow в Claude Code. При размере страницы из каталога на 500 комментариев нужно 34 вызова и $0,189. При измеренном среднем значении 12,5 записи на страницу нужно 40 вызовов и $0,222. Если ещё отбросить 25 % шума и при этом получить 500 полезных комментариев, понадобится 54 вызова и $0,300.
Четвёртый результат важен для повторных запусков. Мы отправили один и тот же запрос трижды, и за 6 минут на первой странице сменились 7 комментариев. За каждый из трёх вызовов списали плату.
Эта статья отвечает на один практический вопрос. У вас есть ключевое слово по товару, и вы хотите, чтобы Claude Code написал параллельную программу. Программа выгружает комментарии Xiaohongshu, сортирует их по четырём группам (потребность, жалоба, цена, похвала) и формирует одну сводную таблицу. Какую возможность использовать, как выглядит скрипт и как подключить данные?
Сколько вызовов нужно на 500 комментариев и что может пойти не так из-за лимита запросов и повторных попыток? Все факты о Claude Code ниже взяты со страницы workflows в Claude Code или из истории изменений. Мы не запускали workflow на своей машине, поэтому разделы о Claude Code содержат примеры конфигурации. Все цифры по EveryInfra взяты из необработанных ответов API.
Задача: 500 комментариев Xiaohongshu, четыре группы, одна таблица
Сначала определим задачу, потому что от неё зависят все последующие цифры. На входе одно ключевое слово. Мы взяли китайское слово «робот-пылесос»: в этой категории в период распродаж 11 ноября появляется много тредов «какой купить» и «он сломался». На выходе одна таблица. В ней указаны количество и доля каждой группы и по три примера комментариев на группу. Также в ней указаны стоимость API и доля совпадений по выборочной проверке.
Работа идёт в три этапа. xiaohongshu/search находит посты. xiaohongshu/comments и xiaohongshu/sub_comments выгружают комментарии и ответы. Затем модель размечает каждый комментарий. Четыре группы задаются в скрипте.
Потребность: вопрос, какую модель купить, или просьба дать ссылку. Жалоба сообщает о проблеме с товаром или сервисом. Ценовой комментарий говорит о стоимости, более дешёвых аналогах или о том, где купить. Похвала исходит от человека, который пользуется товаром и рекомендует его. Все остальные комментарии попадают в группу «другое».
Зачем для этой задачи параллельная программа? Она отвечает трём условиям. Во-первых, посты независимы: посту A не нужен результат поста B. Во-вторых, входные данные намного больше выходных. Один комментарий возвращает около 1 445 байт JSON, а его текст занимает около 95 байт. В-третьих, правило разметки фиксированное, поэтому с ним справится небольшая модель.
22 октября 2026 г. Anthropic опубликовала руководство, в котором советует большинству разработчиков агентов использовать меньше субагентов (статья Anthropic). При этом в том же руководстве субагенты оставлены для одного случая: нескольких параллельных задач, которым нужны свежие раздельные контексты. Сортировка комментариев относится именно к нему.
Мы выгрузили 6 постов. Сначала выполнили поиск с sort=most_commented и получили 20 постов. Затем выбрали 6 постов на разные темы. В таблице ниже они приведены с кратким пересказом заголовков. У 10 из 20 результатов поиска is_cooperation_note было равно true. На Xiaohongshu так помечаются спонсорские посты, которые проходят через платформу Pugongying.
Эта платформа проверяет спонсорский пост до публикации. Бренд должен одобрить или отклонить его в течение 72 часов (справочный центр Pugongying, страница от 2026-10-22; главная страница Pugongying). Ни один из наших 6 постов не был спонсорским. Учитывайте это, когда смотрите на показатели группы «похвала».
| Пост (наш код) | Заголовок (краткий пересказ) | Комментариев в поиске | Выгружено комментариев верхнего уровня |
|---|---|---|---|
| A | «Не покупайте робот-пылесос, пока не увидите тест ко Дню холостяка» | 2,069 | 25 (2 страницы) |
| B | Тред с жалобами на пылесос Roborock | 570 | 30 (2 страницы) |
| C | «Руководство по выбору робота-пылесоса на 2026 год» | 377 | 10 |
| D | Короткое комедийное видео о «мощном» пылесосе | 3,278 | 10 |
| E | «Пустая трата денег: бесполезный робот-пылесос» | 973 | 15 |
| F | Человек, впервые покупающий робот-пылесос, просит совета | 487 | 10 |
Что такое dynamic workflows в Claude Code: формулировки из документации
Документация Claude Code определяет dynamic workflow как скрипт на JavaScript, который одновременно управляет множеством субагентов. Claude пишет скрипт под вашу задачу. Среда выполнения запускает его в фоновом режиме, а сессия при этом не блокируется (страница workflows). Функция впервые появилась 28 мая 2026 г. в версии v2.1.154. В истории изменений сказано, что Claude «координирует работу от десятков до сотен агентов в фоновом режиме», а /workflows показывает ваши запуски (история изменений).
Теперь в статье о запуске сказано, что dynamic workflows стали общедоступны. В ней перечислены CLI, десктопное приложение и расширение для VS Code. Перечислены и тарифы Pro, Max, Ultra, Team и Enterprise, а также Claude API, Amazon Bedrock, Vertex AI и Microsoft Foundry (статья Anthropic о запуске).
В документации показан сохранённый скрипт. Он начинается с export const meta = { name, description }. Тело скрипта написано на обычном JavaScript с await верхнего уровня. agent() запускает один субагент.
pipeline() запускает по одной цепочке на каждый элемент списка. parallel() выполняет набор задач одновременно и ждёт завершения всех. phase() группирует следующие запуски агентов под одним заголовком, log() выводит строку, а args содержит входные данные (страница workflows, раздел «What the saved script looks like»).
Если передать в agent() параметр schema, субагент вернёт объект, соответствующий заданной схеме JSON. Если результат пять раз не проходит валидацию, вызов завершается ошибкой. Это число задаёт MAX_STRUCTURED_OUTPUT_RETRIES (там же). Именно это нужно на этапе разметки. Каждый агент разметки возвращает массив объектов {id, label}, и скрипт сразу их подсчитывает.
Запустить workflow можно четырьмя способами (страница workflows, раздел «Have Claude write a workflow»; страница команд).
| Как запустить | Кто решает использовать workflow | Примечание |
|---|---|---|
Ввести в промпте ключевое слово ultracode | Вы при вводе этого промпта | Только в промпте, который вводите вы |
| Своими словами попросить «workflow» | Вы при вводе этого промпта | Claude пишет скрипт под эту задачу |
Выполнить /effort ultracode или claude --effort ultracode | Claude для каждой задачи | Флаг также устанавливает уровень effort xhigh |
Выполнить сохранённую команду workflow, например /deep-research | Вы | Повторно использует удачный запуск |
Ключевое слово работает только в промпте, который вводит человек. В промпте, переданном через -p, оно не работает (документация по headless-режиму). Не работает оно и в промпте запланированной задачи, вебхуке или комментарии к пул-реквесту. Поэтому для еженедельного отчёта по комментариям сначала сохраните один удачный запуск как команду. Затем вызывайте эту команду из запланированной задачи.
| Субагенты | Skills | Agent teams | Workflows | |
|---|---|---|---|---|
| Что это | Исполнитель, которого запускает Claude | Инструкции, которым следует Claude | Ведущий агент с равноправными сессиями | Скрипт, который выполняет среда выполнения |
| Кто решает, что делать дальше | Claude на каждом ходу | Claude на основе промпта | Ведущий агент | Скрипт |
| Где хранятся результаты | Контекст Claude | Контекст Claude | Общий список задач | Переменные скрипта |
| Что можно повторить | Определение исполнителя | Инструкции | Определение команды | Оркестрация |
| Scale | Несколько задач за ход | Как у субагентов | Несколько долгоживущих равноправных участников | От десятков до сотен агентов |
| После прерывания | Ход начинается заново | Ход начинается заново | Участники команды продолжают работу | Можно возобновить в той же сессии |
Таблица повторяет сравнение из раздела «When to use a workflow» на странице workflows. Здесь важнее всего третья строка. С субагентами сводка по каждому посту попадает в основной диалог. С workflow 100 комментариев, метки и результаты выборочной проверки остаются в переменных скрипта.
В диалог попадает только итоговая таблица. Agent teams пока экспериментальные и требуют CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 (документация agent teams), поэтому здесь мы их не используем.
Dynamic workflows и субагенты: план хранится в коде, а не в чате
Настоящее различие не в параллельности, а в том, у кого находится план. При работе с субагентами Claude на каждом ходу решает, кого запустить следующим. Каждый результат должен вернуться в контекст Claude, прежде чем тот сможет принять следующее решение. Согласно документации по субагентам, когда уже работают 20 субагентов, следующий вызов Agent завершается ошибкой с указанием Claude не повторять попытку. Изменить это число можно с помощью CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS (документация по субагентам, «Concurrent subagent limit»).
В workflow циклы, ветвления и число повторных попыток зафиксированы в скрипте. Claude не принимает решение заново для каждого поста, поэтому ранние результаты не могут изменить обработку следующих постов. Для разметки это полезное свойство. Каждый пост получает тот же промпт и ту же схему, поэтому результаты можно сравнивать между постами.
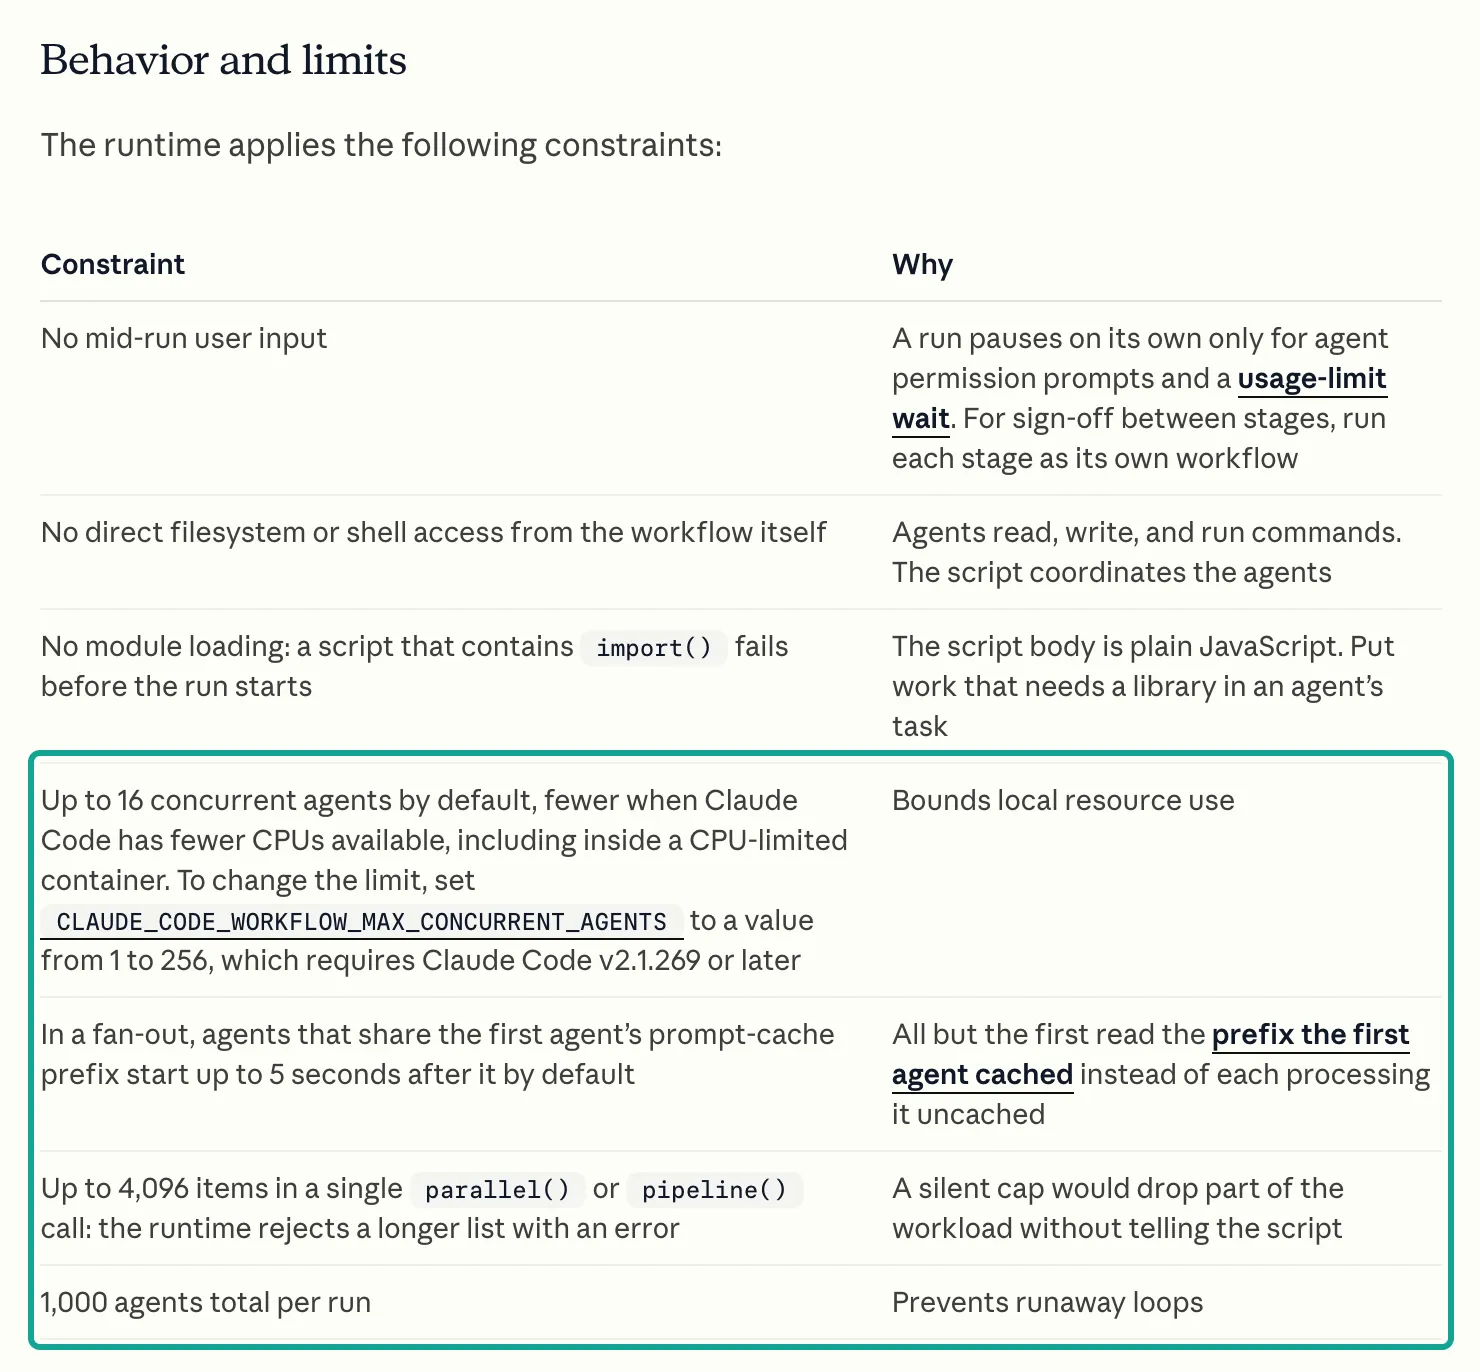
У среды выполнения есть жёсткие ограничения. Скриншот ниже взят из документации Claude Code. Бирюзовая рамка выделяет три ограничения, которые здесь важнее всего. По умолчанию одновременно работают до 16 агентов, а на машинах с меньшим числом процессоров — ещё меньше.
CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS задаёт значение от 1 до 256 (начиная с v2.1.269). Один вызов parallel() или pipeline() принимает до 4 096 элементов, а более длинный список отклоняет с ошибкой. За один запуск стартует не более 1 000 агентов.
Важны ещё три ограничения. Во время запуска у вас нельзя запросить дополнительные данные. Скрипт сам не может читать файлы или выполнять shell-команды. Скрипт, содержащий import(), завершается ошибкой ещё до старта.
Правило, по которому скрипт не может обращаться к файлам и выполнять команды, определяет, как поступают данные. Скрипт не может вызвать fetch или curl. Поэтому обращаться к EveryInfra должны агенты. Агент может использовать MCP-инструменты, подключённые в сессии. Он также может запускать Bash, если это разрешают ваши права доступа.
Встроенный справочник по написанию workflows добавляет ещё один факт. Агентам workflow доступны все MCP-инструменты, подключённые в сессии, но серверы, требующие интерактивного входа, могут отсутствовать в headless-запусках. Этот справочник представляет собой Skill /workflow-authoring, для него нужна v2.1.248 или новее (страница о workflows, «Edit a saved script»; документация по skills). Удалённый MCP-сервер EveryInfra использует ключ в заголовке запроса, а не интерактивный вход. Поэтому он работает и в headless-запусках.
Ещё одно правило касается времени. Внутри скрипта Date.now(), Math.random() и new Date() без аргумента выбрасывают ошибку. Возобновлённый запуск должен повторить те же вызовы agent(), а метки времени или случайные значения это нарушили бы (страница о workflows). Если нужна дата, передайте её через args. Для «комментариев за последние 24 часа» используйте фильтр API: xiaohongshu/search принимает date_range=last_24_hours.
Версии и переключатели: какое поведение появляется в каком релизе
Dynamic workflows сильно изменились с мая по ноябрь 2026 года. Многие руководства описывают старое поведение. В таблице приведены только строки, важные для этой задачи. Версии и даты взяты из истории изменений Claude Code, которая повторяет CHANGELOG.md на GitHub. Строки с пометкой «docs» взяты из примечаний к версиям на странице о workflows.
| Версия | Дата | Изменение | Влияние на сортировку комментариев |
|---|---|---|---|
| 2.1.154 | 2026-05-28 | Выходят Dynamic workflows и /workflows | Отправная точка |
| 2.1.157 | 2026-05-29 | Настройка отключает запуск по ключевому слову | Ввод слова «workflow» больше не приводит к случайному запуску |
| 2.1.269 | docs | CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS | Ограничьте число агентов, вызывающих API, до 2 или 3 |
| 2.1.271 | docs | Запуски приостанавливаются при достижении лимита использования; в Pro размер по умолчанию небольшой | Длинные запуски не обрываются на полпути |
| 2.1.296 | 2026-10-09 | CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL | Одна переменная переводит всех агентов на Haiku |
| 2.1.299 | 2026-10-14 | /usage предупреждает о workflows | Видно, куда ушли токены |
| 2.1.301 | 2026-10-15 | Исправление: агенты пропускали шаг, а запуск всё равно сообщал об успехе | Пропущенный шаг разметки больше не выглядит как успех |
| 2.1.305 | 2026-10-20 | Исправление: при возобновлении заново запускались завершённые агенты pipeline() и parallel() | При возобновлении больше не нужно платить за комментарии дважды |
| 2.1.311 | 2026-10-26 | Исправление: субагенты не видели MCP-серверы, подключившиеся с задержкой | Медленное подключение удалённого MCP больше не скрывает инструменты |
| 2.1.316 | 2026-10-31 | CLAUDE_CODE_SUBAGENT_EFFORT | Задайте низкий уровень effort сразу всем агентам разметки |
Строки 2.1.269 и 2.1.271 взяты из разделов «Behavior and limits», «When a run hits your usage limit» и «Set a size guideline» страницы о workflows. У ориентира по размеру четыре значения: unrestricted означает отсутствие ориентира, small означает меньше 5 агентов, medium означает меньше 10, а large означает меньше 50. Claude воспринимает это значение как рекомендацию, а не как ограничение. Жёсткий лимит по-прежнему составляет 1 000 агентов. Параметр workflowSizeGuideline также можно задать в любом файле настроек (справочник по настройкам).
Для 500 комментариев достаточно medium. Нужны 1 агент поиска, несколько агентов загрузки, столько же агентов разметки, 1 агент выборочной проверки и 1 агент отчёта. В одном из следующих разделов показано, как пакетный вызов сокращает число агентов загрузки до 1 или 2.
Включить ultracode можно двумя способами, и действуют они по-разному. В сессии /effort ultracode начиная с v2.1.284 включает только ultracode и не меняет уровень effort. /effort ultracode off выключает его.
До v2.1.284 /effort ultracode переводил сессию на уровень effort xhigh, а /effort ultracode off завершался ошибкой Invalid argument. Флаг запуска claude --effort ultracode (v2.1.203 или новее) работает иначе. Он включает ultracode и заодно устанавливает effort xhigh (документация по настройке моделей; страница о workflows). При включённом ultracode предупреждение «Large workflow» не появляется, а лимит на число параллельных субагентов не применяется. Для задач, которые вызывают платный API, советуем не включать ultracode. Вместо этого запросите создание workflow одним промптом, чтобы увидеть план до запуска.
Подключите данные: удалённый MCP-сервер или POST /api/v1/social
Workflow может работать с API данных двумя способами. Агент может обращаться к EveryInfra как к удалённому MCP-серверу или отправлять с помощью curl запросы POST https://api.everyinfra.com/api/v1/social. Согласно документации Claude Code по MCP, удалённый HTTP-сервер добавляется командой claude mcp add --transport http <name> <url>. Для аутентификации по схеме Bearer добавьте --header (документация по MCP).
Наш удалённый MCP-сервер использует транспорт Streamable HTTP из спецификации MCP (спецификация MCP 2025-11-25, transports). В спецификации вызов инструмента выполняется запросом tools/call, а результат приходит в массиве content (спецификация MCP 2025-11-25, tools). Наш вызов tools/list вернул 12 инструментов. Здесь важны три из них: everyinfra_list_capabilities, everyinfra_call_api и everyinfra_get_job.
# Configuration example. Keep the key in an environment variable, never in a file.
export EVERYINFRA_API_KEY="<your key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Fewer approval prompts: add these to permissions.allow in .claude/settings.json
#   "Workflow", "mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"
# Keep at most 3 agents running, so a 10-per-minute key is not saturated
export CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS=3
Строки разрешений взяты из трёх источников. В claude -p и в Agent SDK Claude Code никогда не показывает запрос на одобрение workflow. Чтобы запуск мог начаться, добавьте Workflow в правила allow. Для одного сохранённого workflow добавьте Workflow(<name>) (страница о workflows, «Approve the plan before it runs»).
В статье о запуске функции для workflows советуют режим auto. В режиме auto каждый вызов проверяет классификатор (документация по режимам разрешений). Хук PreToolUse тоже может вернуть allow для вызова (документация по хукам).
Правила allow для MCP имеют вид mcp__<server>__<tool>. Glob допустим только после имени сервера, например mcp__everyinfra__* (документация по разрешениям). Субагенты workflow используют ваши правила разрешений. В документации советуют до длинного запуска разрешить инструменты, нужные агентам, чтобы запуск не останавливался ради подтверждений.
Какой способ выбрать? Для разметки в режиме только чтения с известным числом вызовов мы используем MCP. В таблице сравниваются оба способа. Строка о песочнице взята из документации по sandboxing, согласно которой изначально не разрешён ни один сетевой домен.
| Вопрос | Удалённый MCP-сервер | Запрос `POST /api/v1/social` через curl |
|---|---|---|
| Нужен ли агенту Bash? | Нет | Да, а также сетевое правило песочницы |
| Знает ли агент о тарификации и пагинации? | Да, из описания инструмента | Только из вашего промпта |
Поля ошибок, например retry_after и did_you_mean | В результате инструмента | В теле ответа |
| Сырой JSON на диске для аудита | Нет | Да, файл записывает агент |
| Подходит для | Разметки с известным числом вызовов | Задач, где нужно сохранить каждый сырой файл |
При использовании curl агент загрузки записывает каждый сырой файл и возвращает скрипту только {id, text, like_count}.
До начала работы учтите одно ограничение по размеру. Claude Code предупреждает, когда вывод MCP-инструмента превышает 10 000 токенов, и по умолчанию ограничивает его объём 25 000 токенов. Этот предел меняет MAX_MCP_OUTPUT_TOKENS. Успешный текстовый результат длиннее 50 000 символов сохраняется в файл (документация по MCP, «MCP output limits and warnings»).
Одна страница из 15 комментариев через MCP заняла 16 892 байта, а одна страница поиска из 20 постов — 34 991 байт. Обе ниже порога.
Вызов comments_batch для 3 постов занял 42 991 байт. В таком темпе 20 постов дадут около 280 000 байт. Такой результат попадёт в файл, и агенту придётся прочитать файл отдельным шагом. На результат это не влияет, просто добавляется шаг. Чтобы результат оставался в контексте агента, запрашивайте 3 или 4 поста за вызов.
Один реальный цикл «запрос — ответ»: что отправляет агент и что возвращает API
2 ноября 2026 г. в 00:17:55 SGT мы отправили по MCP запрос tools/call, показанный ниже. Это тот же JSON-RPC-запрос, который отправляет агент Claude Code при вызове mcp__everyinfra__everyinfra_call_api. Мы выбрали пост F о покупателе, совершающем первую покупку, и отсортировали комментарии по числу лайков. Результат лежит в result.content[0].text в виде JSON-текста. Мы показываем только первый комментарий и поле тарификации. Из URL поста мы удалили строку запроса, а имена и ID авторов скрыли.
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api",
 "arguments":{"platform":"xiaohongshu","action":"comments",
  "params":{"url":"https://www.xiaohongshu.com/explore/692b0d81000000001d03ea4c","sort":"most_liked"}}}}

{"id":"req_b7efc0a2e4784211","platform":"xiaohongshu","action":"comments","count":10,
 "pagination":{"page":1,"has_more":true,"stop_reason":null},
 "results":[{"id":"693ab483000000001702fef1","text":"(Chinese) How is the DJI one? I hear its obstacle avoidance is strong",
   "like_count":3,"author_name":"[hidden]","author_id":"[hidden]","sub_comment_count":0}],
 "billing":{"charged":true,"charged_usd":0.005556}}
Восемь из этих 10 комментариев выражают явные потребности. Почти в каждом указаны площадь, бюджет, наличие питомцев и тип пола. Пример в переводе: «140 квадратных метров, ковры, питомцев нет, везде плитка, много волос, бюджет 3,000 юаней, какой взять?» Такие комментарии полезны командам продукта и поддержки. Кроме того, они хорошо структурированы, поэтому модель может извлечь из них бюджет, площадь и питомцев в виде полей.
Возвращённый набор полей соответствует 20 полям из списка response_fields для xiaohongshu/comments в каталоге. В таблице показано, какие из них оставляет агент загрузки.
| Поле | Что содержит | Оставлять для разметки? |
|---|---|---|
id, text, like_count | ID комментария, текст и лайки | Да |
sub_comment_count | Число ответов | Да, чтобы выбрать ветки для загрузки ответов |
comment_tags | «Понравилось автору», «закреплено», ответы в опросах | Необязательно, помогает фильтру шума |
posted_at, ip_location | Время и регион по IP | Только для отчётов по времени или регионам |
author_name, author_id, аватар | Кто написал | Нет, и не включайте их в отчёты |
note_url, next_page_token, sub_comments | Пагинация и первый ответ | Только внутри агента загрузки |
Каркас скрипта: поиск, загрузка, фильтрация, разметка, проверка, отчёт (пример)
Каркас ниже мы написали по описанию API скриптов в документации. Мы его не запускали, поэтому считайте его примером конфигурации. В нём пять вызовов phase(), но шесть этапов. Фильтр не является агентом. Это одно регулярное выражение в скрипте, и токенов оно не тратит.
Каждое проектное решение основано на результатах измерений из этой статьи. Агенты загрузки возвращают только id, text и like_count, без данных об авторе и 30 других полей. Агенты разметки используют schema с пятью фиксированными метками. Выборочная проверка повторно размечает 10% комментариев другой моделью, которая не видит исходные метки.


export const meta = {
  name: 'xhs-comment-triage',
  description: 'Pull Xiaohongshu comments for a keyword, drop noise, label need/complaint/price/praise, write a table',
  whenToUse: 'You have a product keyword and want to know what the comment sections ask and complain about',
  phases: [
    { title: 'Discover', detail: '1 agent searches posts' },
    { title: 'Fetch', detail: '1 agent per post pulls 2 pages' },
    { title: 'Classify', detail: '1 agent per post labels comments' },
    { title: 'Verify', detail: 'another model relabels 10%' },
    { title: 'Report', detail: '1 agent writes the table' },
  ],
}

const KEYWORD = (args && args.keyword) || 'robot vacuum (Chinese keyword)'
const NOTE_COUNT = (args && args.notes) || 20
const TOOL = 'mcp__everyinfra__everyinfra_call_api'
const LABELS = ['need', 'complaint', 'price', 'praise', 'other']
const NOISE = /^(进团|参团|进|\s*)$|^(\[[^\]]+R\]|\s)*$/   // "join the group" replies, empty text, emoji only

const NOTES = { type: 'object', required: ['notes'], properties: { notes: { type: 'array', items: {
  type: 'object', required: ['url', 'title'],
  properties: { url: { type: 'string' }, title: { type: 'string' }, comment_count: { type: 'integer' } } } } } }
const COMMENTS = { type: 'object', required: ['comments', 'calls', 'charged_usd'], properties: {
  calls: { type: 'integer' }, charged_usd: { type: 'number' },
  comments: { type: 'array', items: { type: 'object', required: ['id', 'text'],
    properties: { id: { type: 'string' }, text: { type: 'string' }, like_count: { type: 'integer' } } } } } }
const LABELED = { type: 'object', required: ['items'], properties: { items: { type: 'array', items: {
  type: 'object', required: ['id', 'label'],
  properties: { id: { type: 'string' }, label: { type: 'string', enum: LABELS } } } } } }

phase('Discover')
const found = await agent(
  `Use ${TOOL} with platform=xiaohongshu, action=search, params={keyword:"${KEYWORD}", sort:"most_commented"}. ` +
  `Follow next_page_token until you have ${NOTE_COUNT} posts. Keep each url exactly as returned, with xsec_token.`,
  { schema: NOTES, model: 'haiku', effort: 'low', label: 'search' })

const results = await pipeline(found.notes.slice(0, NOTE_COUNT),
  (note) => agent(
    `Use ${TOOL} for xiaohongshu/comments with params={url:"${note.url}"}, then fetch page 2 with next_page_token. ` +
    `On 429, wait error.retry_after seconds and retry, at most 3 times. On 422, do not retry; report it. ` +
    `Keep only id, text and like_count. Sum billing.charged_usd into charged_usd.`,
    { schema: COMMENTS, model: 'haiku', effort: 'low', phase: 'Fetch', label: note.title.slice(0, 12) }),
  (r) => ({ ...r, kept: r.comments.filter((c) => !NOISE.test(c.text.trim())),
            dropped: r.comments.filter((c) => NOISE.test(c.text.trim())).length }),
  (r) => agent(
    `Label each Xiaohongshu comment as one of ${LABELS.join(', ')}. need = asks which model to buy or for a link; ` +
    `complaint = a product or service problem; price = cost, cheaper copies or where to buy; ` +
    `praise = the writer uses it and recommends it; other = jokes or off-topic.\n` +
    JSON.stringify(r.kept.map((c) => ({ id: c.id, text: c.text }))),
    { schema: LABELED, model: 'haiku', effort: 'low', phase: 'Classify', label: 'classify' })
    .then((l) => ({ ...r, labels: l ? l.items : [] })),
)

const ok = results.filter(Boolean)
const all = ok.flatMap((r) => r.labels.map((x) => ({ ...x, text: (r.kept.find((c) => c.id === x.id) || {}).text })))
const sample = all.filter((_, i) => i % 10 === 0)
log(`Fetched ${ok.length}/${found.notes.length} posts; filter dropped ${ok.reduce((s, r) => s + r.dropped, 0)} comments`)

phase('Verify')
const second = await agent(
  `Label these comments on your own. Labels: ${LABELS.join(', ')}.\n` + JSON.stringify(sample.map(({ id, text }) => ({ id, text }))),
  { schema: LABELED, model: 'sonnet', effort: 'medium', label: 'relabel-10pct' })
const agree = sample.filter((s) => ((second && second.items.find((y) => y.id === s.id)) || {}).label === s.label).length

phase('Report')
const counts = {}
for (const x of all) counts[x.label] = (counts[x.label] || 0) + 1
return await agent(
  `Write a Markdown table with count and share per label and 3 example comments per label, translated to English. ` +
  `End with API cost $${ok.reduce((s, r) => s + r.charged_usd, 0).toFixed(4)} and spot-check agreement ${agree}/${sample.length}.\n` +
  JSON.stringify({ counts, examples: all.slice(0, 150) }),
  { model: 'sonnet', effort: 'low', label: 'report' })
Некоторые части каркаса легко сделать неправильно, и каждая из них описана в документации. meta должен быть первым оператором и простым объектным литералом. Если в нём есть переменная, вызов функции или операция spread, /<name> пропадает из автодополнения (страница о рабочих процессах, «Edit a saved script»). Заголовки в phases должны точно совпадать с аргументами phase(), иначе в окне прогресса появится лишняя группа.
Если один агент внутри pipeline() завершается ошибкой, его ячейка становится null, поэтому скрипт вызывает filter(Boolean). Если ошибкой завершается агент, вызов которого ожидается напрямую через await, прерывается весь запуск («When an agent stalls and restarts», на той же странице). Этапы загрузки и разметки используют haiku, а проверка и отчёт используют sonnet.
Claude Code выбирает модель для агентов рабочего процесса в том же порядке, что и для субагентов. Модель, указанная в скрипте, применяется к конкретному вызову. Если модель не указана, агент использует модель сессии (страница о рабочих процессах, «Cost»; в документации по субагентам перечислены псевдонимы sonnet, opus, haiku и fable).
Почему фильтр находится в скрипте, а не в модели? Скрипт написан на обычном JavaScript, поэтому регулярное выражение, фильтр и подсчёт не тратят токенов. Фильтр убирает ответы «хочу в группу», пустые тексты и комментарии из одних эмодзи. Для этого не нужно понимать смысл.
Как показано в следующем разделе, таких было 25 из наших 100 комментариев. Во встроенном справочнике по созданию рабочих процессов также сказано, что рабочий процесс, ограничивающий охват, должен записывать через log(), что он отбрасывает. Без этой строки читатель решит, что охват полный. Эту задачу в каркасе выполняет строка log().
Тест 1: по каталогу на странице 15 записей, но на 4 из 8 страниц их было 10
Для xiaohongshu/comments в каталоге указано, что page_size равен 15, а limit_ignored равен true. Значит, размер страницы фиксирован и значение limit ни на что не влияет. У xiaohongshu/sub_comments он равен 10, у xiaohongshu/search 20, у comments_batch 15 на пост. Перед тестами мы записали гипотезу «на каждой странице 15 записей». Данные её опровергли.
В 00:15:22 SGT первая страница поста A содержала 10 записей, а вторая, полученная в 00:15:49, содержала 15. В 00:17:38 один вызов comments_batch для 3 постов вернул 10 записей для C, 10 для D и 15 для E. В 00:17:55 запрос для поста F через MCP вернул 10 записей. Среднее по 8 страницам составило 12,5 записи.
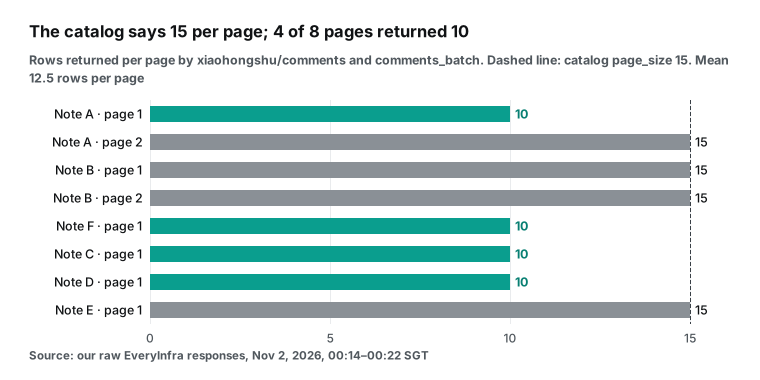
Короткая страница не означает конец. У постов A и F на короткой странице pagination.has_more был true. У постов C и D в пакетном результате у каждой записи был next_page_token. На странице 2 поста A снова было 15 записей. Мы предполагаем, что платформа обрабатывает первую страницу иначе, например из-за закреплённых комментариев или комментариев с опросами. Других данных у нас нет, поэтому сообщаем только то, что видели.
Практический вывод касается правила остановки. При переменном размере страницы «целевое число, делённое на 15» не даёт числа вызовов. Правильное правило остановки звучит как «записей достаточно» или «has_more равен false», а не «загружено N страниц».
С ответами то же самое. У одного комментария к посту B sub_comment_count был равен 52. В 00:17:17 SGT мы вызвали для него xiaohongshu/sub_comments. Страница 1 вернула 5 записей, а не 10, и у 2 из них текст был пустым: вероятно, это были изображения или стикеры.
Поэтому полезная запись среди ответов обходится дороже. Страница верхнего уровня давала в среднем 12,5 записи за $0,005556, а эта страница ответов дала 3 записи с текстом. Для разметки советуем по умолчанию пропускать ответы. Загружайте их только для комментариев, которые модель отметила как жалобу и у которых много ответов.
| Возможность | page_size в каталоге | Записей на странице по нашим данным | Цена за вызов | Стоимость полезной записи |
|---|---|---|---|---|
xiaohongshu/search | 20 | 20 (1 страница) | $0.005556 | около $0,00028 за пост |
xiaohongshu/comments | 15 | от 10 до 15, в среднем 12,5 (8 страниц) | $0.005556 | около $0,00044 за комментарий |
xiaohongshu/comments_batch | 15 на пост | от 10 до 15 на пост (3 поста) | $0,005556 за пост | как для одного поста |
xiaohongshu/sub_comments | 10 | 5, из них 2 без текста (1 страница) | $0.005556 | около $0,0019 за ответ |
Тест 2: что убирает фильтр на основе правил и чего он сделать не может
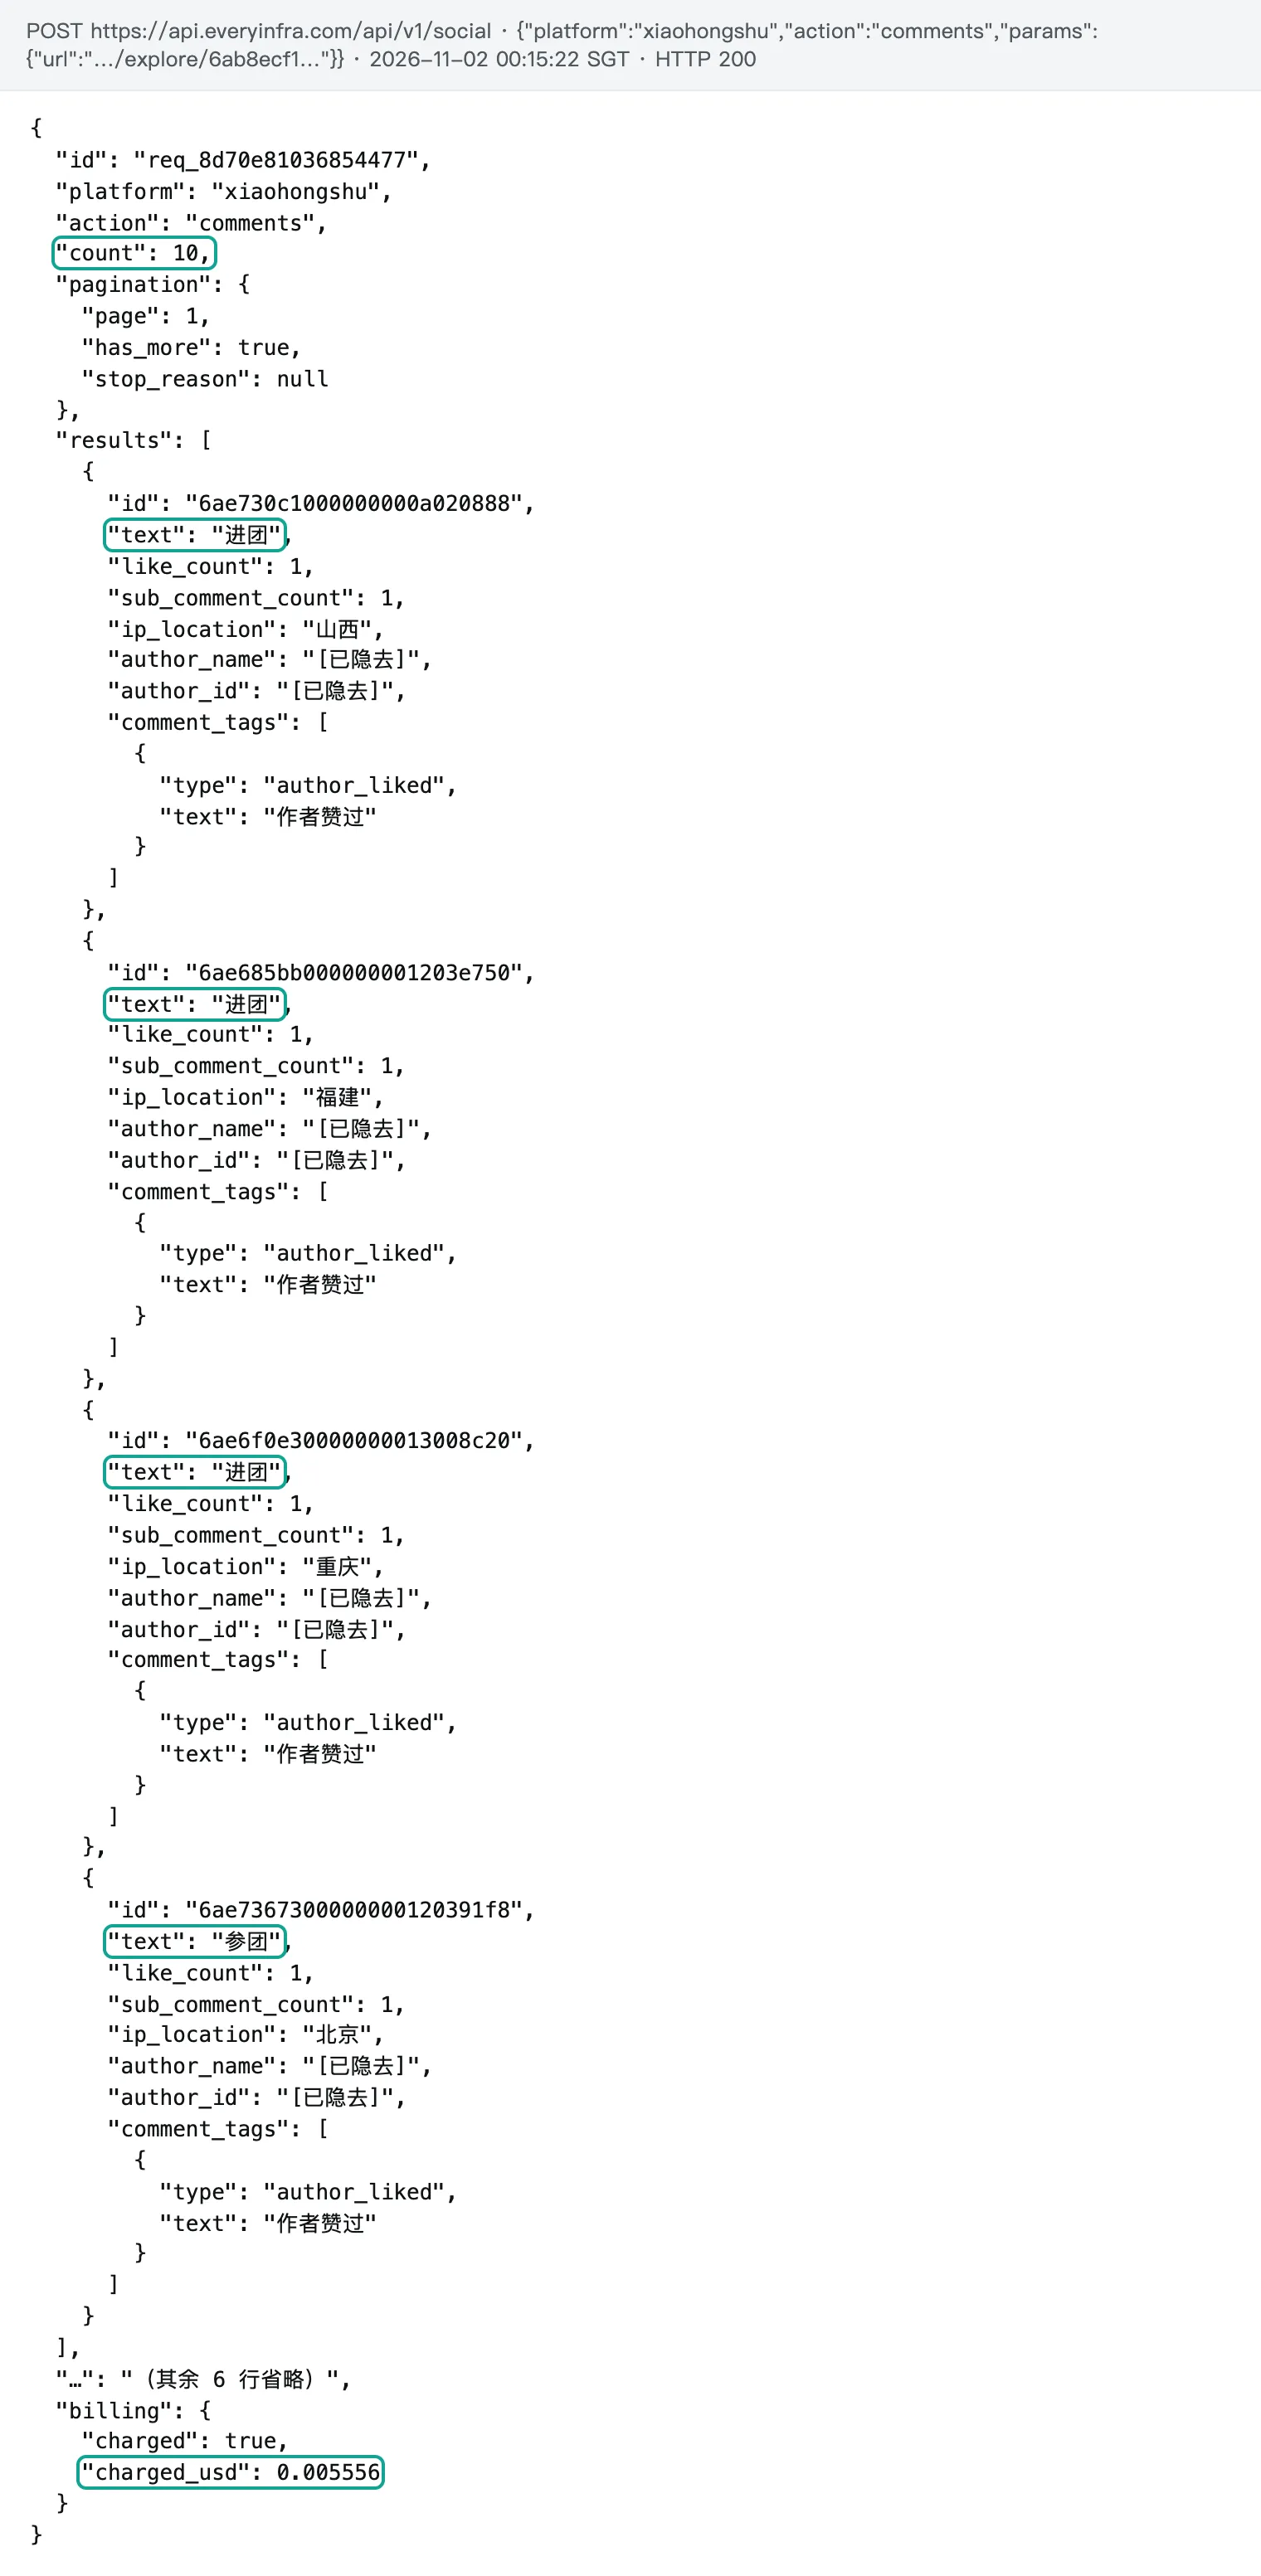
Наша третья гипотеза звучала так: «комментарии можно сразу отдавать модели». Условием прохождения было менее 30% шума в каждом посте. Пост A далеко не прошёл проверку. Из 25 его комментариев на двух страницах 24 содержали только китайские фразы «хочу в группу» (17), «запишите меня» (6) или «вступаю» (1). На скриншоте видно, что у большинства из них есть метка «понравилось автору», а у некоторых — метка с вариантом ответа в опросе. У каждого sub_comment_count равен 1.
Мы считаем, что автор организовал в комментариях совместную покупку, и пользователи отвечали, чтобы их добавили. О потребностях пользователей такие комментарии ничего не говорят, но занимают оплачиваемые страницы. Среди остальных 5 постов только у поста D была 1 шумовая запись, пустой комментарий.
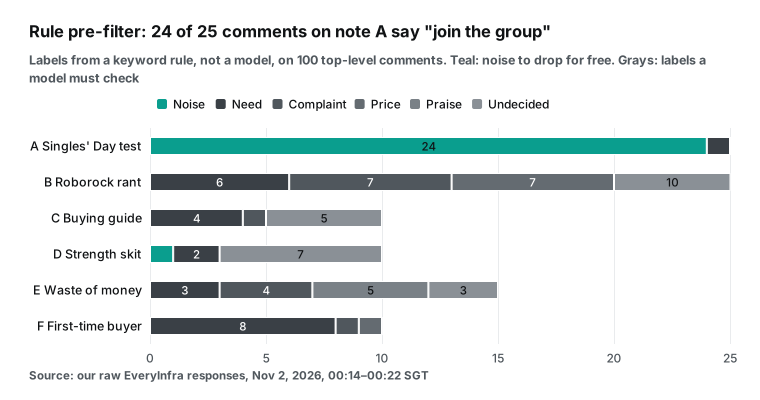
Чтобы понять, на что способно одно регулярное выражение, мы написали в качестве базового варианта классификатор по ключевым словам. Сначала правило относит к шуму текст, состоящий только из фразы «хочу в группу», текст только из эмодзи и пустой текст. Затем классификатор проверяет маркеры жалобы (запах, возврат, деньги на ветер, наматывается), потребности (посоветуйте, какой выбрать, вопросительные знаки), цены (цена, юань, дешёвый аналог, бюджет), а затем похвалы (хорошо работает, чисто, экономит время). Комментарий, который ни с чем не совпал, получает метку «не определено».
Это не результат работы модели. Здесь видно, с чем справляется правило, а для чего уже нужна модель. По 100 комментариям правило выдало: шум 25, потребность 24, жалоба 13, цена 8, похвала 5, не определено 25.
| Правило сработало верно | Правило ошиблось или не смогло определить категорию |
|---|---|
| Все 25 ответов «хочу в группу» совпали точно и были удалены | Комментарий «Так призрак четыре дня прятался у нас дома...?» — это шутка, но из-за вопросительного знака он получил метку «потребность» |
| Комментарий «3 юаня за штуку, хватает на месяц» получил метку «цена» | Комментарий «Мой бюджетный Xiaomi не наматывает волосы» содержит похвалу, но из-за слова «наматывает» получил метку «жалоба» |
| Комментарий «140 квадратных метров... бюджет 3 000, какой взять?» получил метку «потребность» | «Только из комментариев узнал, что мешок для пыли одноразовый» — это новое знание, поэтому комментарий остался неопределённым |
| Комментарий «Из вентиляции базовой станции плохо пахнет, как это исправить?» получил метку «жалоба» | Комментарий «Вы что, 30 минут стоите у стиральной машины?» содержит риторический вопрос, но получил метку «потребность» |
Таблица объясняет, почему в скрипте два этапа. Правило только отсеивает шум. Шум каждый раз выглядит одинаково, а ошибочное удаление почти ничего не стоит. Четыре намерения определяет модель, потому что один вопросительный знак может означать просьбу, риторический вопрос или шутку.
В заголовке поста C есть слова «гид по выбору», а в заголовке поста D — «робот-пылесос». Но в комментариях к ним в основном обсуждают комедийный сюжет и фитнес автора. Семь или более таких записей — шутки, которые и правило, и модель должны пометить как «другое». Если отбирать посты только по заголовку, вы переоцените долю полезных комментариев. Поэтому мы предлагаем передавать агенту поиска также is_cooperation_note, число комментариев и заголовок. Тогда он сможет сразу отсеять явно юмористические посты.
Исследования разметки текста с помощью моделей помогают настроить выборочную проверку. Одно исследование показало, что разметка в режиме zero-shot превосходит краудворкеров в большинстве задач (arXiv 2303.15056). Другое выявило сильный разброс результатов между моделями и задачами (arXiv 2311.05769), а в методологической статье строгая валидация названа обязательным шагом (Sociologica, 2024). Для этой задачи отсюда следуют три правила. Не пропускайте выборочную проверку. Используйте другую модель, которая не видит первую разметку. Заранее задайте проходной порог, например 80% совпадений. Если прогон не дотягивает до порога, уточните определения меток и переразметьте весь пакет.
Тест 3: одна и та же страница, запрошенная три раза, дала 7 новых комментариев, и каждый вызов был оплачен
Этот тест отвечает на вопрос о рабочем процессе: что происходит, когда агент падает и запускается снова? Мы получили первую страницу поста B в 00:15:33 SGT. Затем отправили то же тело запроса в 00:21:35 и в 00:21:55. Во втором ответе с первым совпали только 8 из 15 комментариев.
Третий ответ совпал с первым по 13 комментариям, а со вторым по 10. Всего три вызова вернули 22 разных комментария. Каждый вызов стоил $0,005556, и повтор идентичного запроса не стал бесплатным.
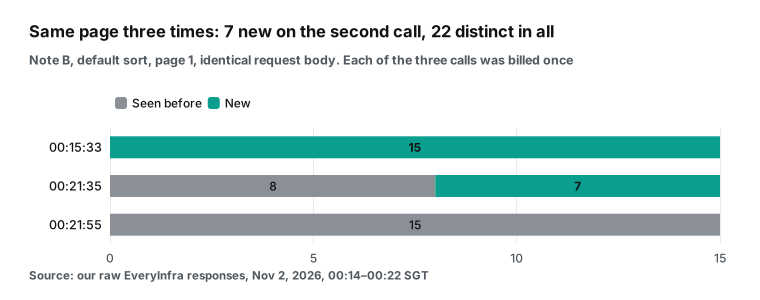
Значит, сортировка по умолчанию не даёт стабильного порядка. Порядок меняется со временем и вместе с ранжированием платформы. В рабочем процессе это нужно учитывать вместе с правилами возобновления. Документация описывает их однозначно. При возобновлении завершённые агенты возвращают сохранённые результаты.
Но первый агент, чей промпт изменился, запускается снова, как и все агенты после него. Упавший агент тоже запускается снова, как и каждый агент, которого скрипт запускает после него, даже завершённый. В документации есть пример. Скрипт запускает A, B, C и D, и B падает. При возобновлении A берётся из кеша, а B, C и D запускаются заново (страница о воркфлоу, «Which agents run again»).
В версии v2.1.305 от 20 октября 2026 г. исправили связанную проблему. До этого исправления неизменённый скрипт при возобновлении мог повторно запускать завершённые агенты в pipeline() и parallel() (история изменений 2.1.305).
Сложим эти два факта. Когда агент загрузки запускается снова, он снова вызывает API, и вы снова платите. Комментарии в новом ответе могут отличаться, поэтому метки, которые уже поставили следующие агенты, могут им не соответствовать. Мы предлагаем три правила, которые выходят за рамки каркаса.
Во-первых, разделите получение данных и разметку на два воркфлоу. Первый только получает данные и записывает файлы. Когда данные выглядят правильно, второй читает файлы и размечает их. Тогда сбой при разметке никак не затрагивает API.
Во-вторых, запрашивайте данные с sort=newest или sort=most_liked: эти варианты намного стабильнее сортировки по умолчанию. Не меняйте сортировку во время пагинации: согласно каталогу, старый next_page_token после этого перестаёт работать. В-третьих, перед подсчётом удаляйте дубликаты меток по id комментария, потому что один комментарий может попасть в два запроса.
Повторный запуск случается и при зависании. Если агент достаточно долго ничего не выводит, он перезапускается с тем же промптом, до пяти раз. Файлы, которые он уже изменил, остаются изменёнными, а его токены остаются в общем итоге запуска (страница о воркфлоу, «When an agent stalls and restarts»). Время ожидания собственных вызовов инструментов не учитывается, поэтому вызов API длительностью 2,5 секунды не приводит к зависанию.
Другой сбой возникает, когда поток ответа замолкает. Такой поток завершает сторожевой таймер простоя, а его таймаут задаёт CLAUDE_STREAM_IDLE_TIMEOUT_MS (документация по настройке сети). Если агент после 429 долго ждёт и ничего не выводит, его могут счесть зависшим и запустить заново. Тогда он повторит вызовы, за которые вы уже заплатили.
Наш ответ 429 просил подождать 1 секунду, так что риск был невелик. Если общий ключ активно используется, время ожидания увеличивается. В таком случае задайте агентам загрузки собственный stallMs, например agent(prompt, { stallMs: 600000 }).
Лимиты запросов при параллельной работе: 16 агентов на ключе с лимитом 10 запросов в минуту
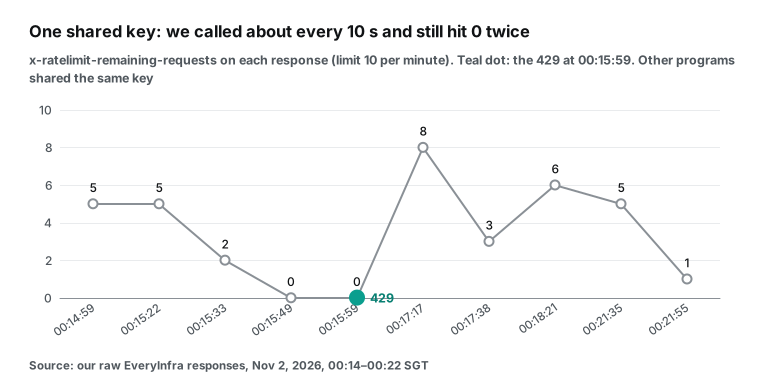
По умолчанию рабочий процесс запускает 16 агентов одновременно. У нашего ключа собственный лимит в 10 запросов в минуту, и в то же время этот ключ использовали другие программы. Мы выполняли вызовы примерно раз в 10 секунд, что должно быть намного ниже лимита. Но заголовок x-ratelimit-remaining-requests показывал 5, 5, 2 и 0.
В 00:15:59 SGT вызов вернул 429. После этого заголовок показывал 8, 3, 6, 5 и 1. Так выглядит общий ключ. Вы не видите, когда его используют другие, поэтому можете ориентироваться только на заголовок и ответы 429. Если ключ использует только ваша программа, остаток должен уменьшаться с каждым вашим вызовом, а не скакать. Скачки здесь вызваны общим ключом, на собственном ключе вы их не увидите.
Агент может прочитать тело ответа 429 напрямую. Текст был таким: "rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.". Также в теле были retry_after: 1, retryable: true, max_retries: 3 и фраза «Nothing was charged». Для надёжности мы подождали больше 60 секунд и в 00:17:17 получили 200.
Ответ 429 ничего не стоил и не вошёл в общую сумму списаний. Промпт загрузки в каркасе использует то же правило: при 429 подождать error.retry_after секунд и повторить попытку, не более 3 раз. Anthropic API тоже возвращает 429 с заголовком retry-after, если запросы идут слишком часто (документация Anthropic по лимитам запросов). Одно правило в промпте покрывает оба случая.
{"error":{"code":"rate_limited",
  "message":"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.",
  "reason":"key_limit","retry_after":1,"limit":10,"fault":"account","retryable":true,"max_retries":3,
  "next_steps":["Over this key's or account's request rate. Nothing was charged. Retry after retry_after seconds, or ask the user to raise the limit."]}}
Повторные попытки — пассивная мера защиты. Есть и две активные меры. Первая — уменьшить число параллельных запросов. Задайте CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS равным 2 или 3.
Агенту загрузки, который получает две страницы, требуется около 5 секунд работы API плюс собственное время на обработку. При 3 агентах частота запросов приближается к 10 в минуту, а с остальным справляются повторные попытки. Эта переменная действует на весь запуск, поэтому замедляет и агентов разметки. Если важно общее время выполнения, разделите загрузку и разметку на два воркфлоу и не ограничивайте запуск разметки.
Вторая активная мера защиты — пакетный вызов. xiaohongshu/comments_batch позволяет обработать до 20 постов за запрос, причём каждый пост тарифицируется отдельно. В 00:17:38 SGT мы одним запросом загрузили комментарии к 3 постам. Запрос вернул 35 комментариев и обошёлся в $0,016667, то есть по $0,005556 за пост — столько же стоит вызов xiaohongshu/comments. Запрос занял 3,28 секунды, а вызов для одного поста — около 2,4 секунды.
| Первые страницы комментариев для 40 постов | Запросы | Минимальное время при 10 запросах в минуту (мин.) | Стоимость API |
|---|---|---|---|
Один вызов xiaohongshu/comments на пост | 40 | 4 | $0.22224 |
xiaohongshu/comments_batch, 20 постов за вызов | 2 | 1 | $0.22224 |
Пакетный вызов меняет количество запросов, но не стоимость. Когда агенты одного воркфлоу используют общий API-ключ, узким местом становится именно количество запросов. 40 запросов при лимите 10 запросов в минуту займут не менее 4 минут. 2 запроса завершатся за считаные секунды. Поэтому лучше выстроить воркфлоу так: после поиска 1 или 2 агента вызывают comments_batch, чтобы получить первые страницы комментариев ко всем найденным постам. Затем воркфлоу продолжает пагинацию только для постов с большим количеством комментариев.
У каждой записи в результате пакетного вызова есть next_page_token, поэтому продолжить можно через xiaohongshu/comments. В каталоге есть одно предупреждение: если обработать некоторые посты не удалось, проверьте поля partial и missed в ответе. Не считайте пост, отсутствующий в результате, постом без комментариев. Добавьте эту фразу в промпт для загрузки.
Доступен и асинхронный режим. Согласно каталогу, для любой возможности можно передать "mode":"async" в теле запроса. Вы сразу получаете ответ с кодом 202 и job_id, а затем опрашиваете GET /api/v1/jobs/{job_id}. В 00:18:21 SGT мы запросили страницу 2 поста B в асинхронном режиме. В ответе с кодом 202 уже был указан статус succeeded.
В 00:18:30 опрос вернул 15 записей. Опросы бесплатны и не учитываются при расчёте лимита запросов в минуту, как сказано в описании инструмента everyinfra_get_job. Комментарии возвращаются за 2–3 секунды, поэтому асинхронный режим для них не нужен. Но если тот же воркфлоу обращается и к возможностям с долгим временем выполнения, асинхронный режим с опросом избавляет агентов от ожидания завершения активных запросов.
Сбои, повторные попытки и оплата: из-за чего можно заплатить дважды
В таблице наши наблюдения сопоставлены с поведением воркфлоу. Данные в столбце «Поведение воркфлоу» взяты со страницы о воркфлоу, а данные в столбце «Оплата API» — из полученных нами необработанных ответов.
| Событие | Поведение воркфлоу | Оплата API | Защита в скрипте |
|---|---|---|---|
| 429: превышен лимит запросов | Агент справляется сам | Плата не списывается («Nothing was charged») | Повторная попытка через retry_after, не более 3 раз |
422: недопустимое значение, например sort=hottest | Агент справляется сам | Плата не списывается | Не повторяйте попытку, передайте сообщение об ошибке |
| Агент зависает | Перезапуск с тем же промптом, до 5 раз | Успешные вызовы выполняются и оплачиваются повторно | Задайте stallMs для агентов загрузки |
| Возобновление после сбоя агента | Этот агент и все последующие запускаются заново | Повторные загрузки оплачиваются снова | Разделите загрузку и разметку на два воркфлоу |
| Тот же запрос в течение 6 минут | Неприменимо | Оплачивается каждый раз, а содержимое меняется | Удаляйте дубликаты по id комментария |
| Результат разметки не проходит проверку по схеме | Повторяет попытку и завершается ошибкой после пяти попыток | Без вызова API | Делайте схему компактной |
| Лимит использования по подписке | С v2.1.271 ждёт сброса лимита, если выполнены условия | Без вызова API | Сначала проверьте на небольшой выборке |
Что касается строки о лимите использования, сама сессия также может дождаться его сброса (документация по интерактивному режиму). Тест с ошибкой 422 мы провели в 00:16:07 SGT, намеренно указав для sort значение hottest. Ответ содержал сообщение `"sort must be one of: default, most_liked, newest (got 'hottest')". В нём также были список allowed и did_you_mean: ["most_liked"]`; кроме того, было указано, что плата не списывалась.
Такая ошибка хорошо подходит для воркфлоу. Агент загрузки может прочитать её, изменить одно значение и продолжить работу, не обращаясь к вам с вопросом. В нашей статье о strict tool use мы показали, что строгие определения инструментов блокируют недопустимые значения перечислений на стороне модели. Для воркфлоу есть более простое решение: жёстко задать значение sort в промпте агента загрузки.
Расчёт стоимости: сколько вызовов нужно для 500 комментариев и во сколько они обойдутся
Для этой задачи в API установлена единая цена за единицу тарификации. Мы сверились с каталогом в 00:14 SGT 2 ноября 2026 года. xiaohongshu/search, xiaohongshu/comments, xiaohongshu/sub_comments и xiaohongshu/comments_batch стоят по $0,005556 за вызов (для пакетного варианта — за пост). За неудачные вызовы и вызовы с пустым результатом плата не взимается. Для возможности с пагинацией число вызовов равно целевому количеству записей, делённому на количество записей на странице, с округлением результата вверх.
Три метода ниже учитывают только страницы комментариев. Поиск возвращает 20 постов на страницу. Для 500 комментариев обычно нужно от 20 до 40 постов, а это ещё 1 или 2 вызова, то есть от $0,0056 до $0,0111.
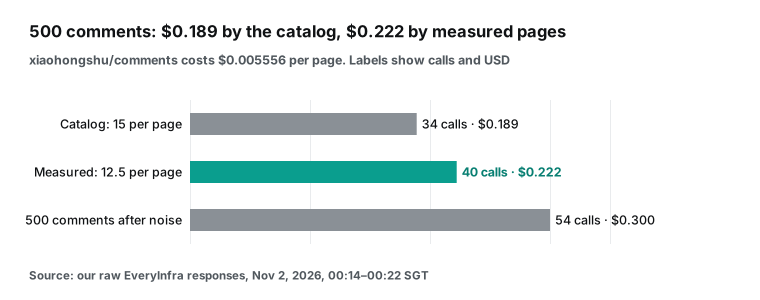
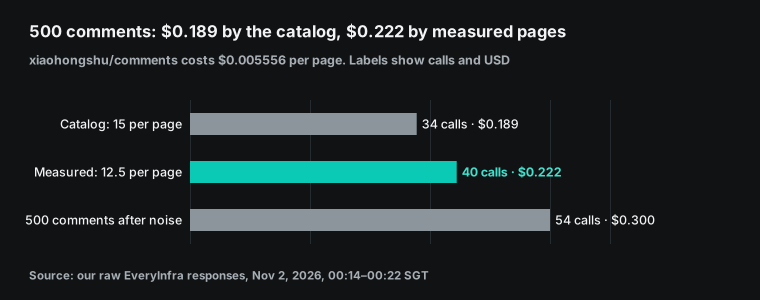
| Метод | Записей на странице | Вызовы | Стоимость API |
|---|---|---|---|
| Значение в каталоге | 15 | 34 | $0.188904 |
| Среднее по нашим замерам | 12.5 | 40 | $0.22224 |
| 500 полезных комментариев с учётом 25 % шума | 12.5 | 54 (сначала нужно получить 667) | $0.300024 |
| Расходы на эту статью: 10 тарифицируемых запросов, 12 тарифицируемых единиц | n/a | 10 | $0.066671 |
В следующей таблице перечислены все запросы этого теста, выполненные 2 ноября 2026 года по времени SGT. Ответы 429 и 422, а также опрос статуса задачи не тарифицировались.
| Время (SGT) | Запрос | HTTP | Записи | Оплачено |
|---|---|---|---|---|
| 00:14:59 | xiaohongshu/search | 200 | 20 постов | $0.005556 |
| 00:15:22 | xiaohongshu/comments, пост A, страница 1 | 200 | 10 | $0.005556 |
| 00:15:33 | xiaohongshu/comments, пост B, страница 1 | 200 | 15 | $0.005556 |
| 00:15:49 | xiaohongshu/comments, пост A, страница 2 | 200 | 15 | $0.005556 |
| 00:15:59 | xiaohongshu/sub_comments, пост B | 429 | 0 | $0 |
| 00:16:07 | xiaohongshu/comments с sort=hottest | 422 | 0 | $0 |
| 00:17:17 | xiaohongshu/sub_comments, пост B | 200 | 5 | $0.005556 |
| 00:17:38 | xiaohongshu/comments_batch, посты C, D, E | 200 | 35 | $0.016667 |
| 00:17:55 | MCP everyinfra_call_api, пост F | 200 | 10 | $0.005556 |
| 00:18:21 | xiaohongshu/comments асинхронно, пост B, страница 2 | 202 | 15 при опросе | $0.005556 |
| 00:21:35 | xiaohongshu/comments, пост B, страница 1 повторно | 200 | 15 | $0.005556 |
| 00:21:55 | xiaohongshu/comments, пост B, страница 1 повторно | 200 | 15 | $0.005556 |
Третий метод требует оговорки. Доля шума в 25 % рассчитана по нашей выборке из 6 постов, причём почти весь шум пришёлся на пост A. Для другого ключевого слова эта доля может составить 0 % или быть намного выше. Поэтому сначала запустите воркфлоу на 3–5 постах.
Посмотрите количество записей после фильтрации в строке log() и только потом решайте, сколько постов выгружать. Документация даёт тот же совет насчёт затрат. Сначала обработайте небольшую выборку. Следите за расходом токенов каждого агента в /workflows и при необходимости остановите запуск (страница о воркфлоу, раздел «Cost»).
Затраты на стороне Claude мы не измеряли, поэтому приводим только то, что вы можете проверить сами. На странице тарифов Anthropic (по состоянию на 2 ноября 2026 г.) указаны такие цены за миллион токенов. Haiku 5.5: $0,10 за вход и $0,50 за выход для промптов до 100 000 токенов. Sonnet 5.5: $2 и $10. Opus 5.5: $4 и $20.
Если брать только текст, 500 комментариев занимают около 12 000 токенов по ориентиру со страницы (10 kB примерно соответствуют 2 500 токенам). Ввод этого текста в Haiku стоит меньше $0.002. Основные затраты приходятся на другое. Каждый агент несёт системный промпт, определения инструментов и собственные рассуждения, и их объём зависит от вашей версии и ваших MCP-инструментов. Мы его не измеряли, поэтому свои цифры смотрите в /workflows.
При подписке использование воркфлоу засчитывается в лимиты вашего плана. В документации о затратах сказано, что каждый субагент и каждый агент воркфлоу отправляет собственные запросы. В ветке о запуске функции на Reddit один пользователь написал, что один промпт израсходовал 700 000 токенов и 36 % лимита плана Max. Другой сообщил, что первая попытка заняла 1,2 млн токенов (ветка о запуске на Reddit). Это сообщения пользователей, и проверить их мы не можем. Но они показывают, почему важен небольшой первый тест.
Контекст и токены: почему на этапе выгрузки нужно уменьшать объём данных
Один комментарий в среднем возвращает около 1 445 байт JSON, а один только его текст занимает около 95 байт. Это примерно в 15 раз меньше. Среди 20 полей исходного JSON есть имя автора, URL аватара, IP-регион, теги, первый ответ и URL поста с xsec_token. Почти ничего из этого не помогает при разметке.
По приблизительному соотношению со страницы тарифов один сырой комментарий занимает около 361 токена, а его текст — около 24 токенов. На практике для китайского текста соотношение другое. Для точных цифр используйте эндпоинт подсчёта токенов со своей моделью.
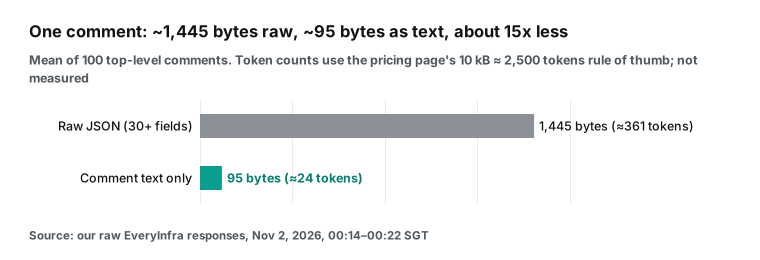
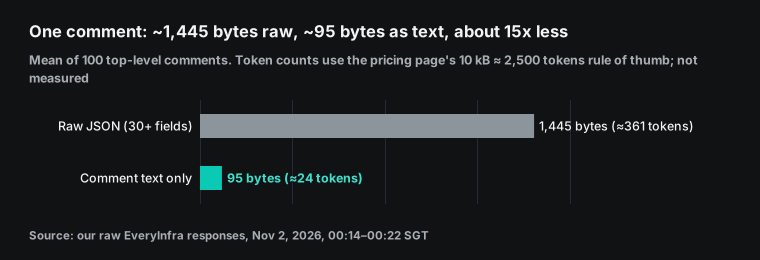
Эта разница важна в двух местах. Первое — входные данные для агентов разметки. Если агенты выгрузки возвращают сырой JSON, каждому агенту разметки приходится читать от 10 000 до 30 000 токенов JSON на пост. Если они возвращают текст, агент читает всего несколько сотен токенов.
Второе — кеширование промптов. В документации сказано, что агенты одного запуска с одинаковыми моделью, уровнем effort, типом агента, инструментами, схемой вывода и рабочим каталогом используют общий префикс. Агент, запущенный позже, может использовать кеш предыдущего агента. По умолчанию кеш агентов воркфлоу хранится 5 минут.
Если задать subagentPromptCacheTtl равным 1h, кеш хранится час, но запись в него обходится дороже (страница о воркфлоу, раздел «Prompt caching in a fan-out»; документация о кешировании промптов). В каркасе все агенты выгрузки используют одну и ту же модель haiku, уровень effort low и схему COMMENTS, поэтому у них может быть общий префикс. Если назначить разным постам разные модели, общий кеш использовать не получится.
Этап разметки: схема, определения меток и согласованность
В схеме разметки два поля: id и label, причём label принимает только пять значений. Чем меньше полей, тем меньше ошибок и повторных попыток из-за схемы. Если вам нужны ещё бюджет, площадь и домашние животные, добавьте отдельный этап извлечения. Запускайте его только для комментариев, которые модель пометила как потребность. Не добавляйте в схему разметки много необязательных полей.
API Anthropic ограничивает формат вывода с помощью json_schema в output_config.format (документация о структурированном выводе). Параметр schema в воркфлоу выполняет ту же задачу внутри Claude Code. Возвращаемое значение уже является объектом, поэтому скрипту не нужно разбирать текст.
Формулируйте каждое определение метки так, чтобы его мог применить человек. Все четыре ошибки нашего базового решения на основе правил возникли из-за размытых определений. Риторический вопрос и шутка выглядели как потребности. Сравнение («моя бюджетная модель не наматывает волосы») выглядело как жалоба. Поэтому в каркасе определено, что означает каждая метка, а не какие слова должны встречаться в комментарии. Примеры — переведённые комментарии из наших 6 постов.
| Метка | Определение | Пример из наших данных |
|---|---|---|
| need | Спрашивает, какую модель купить, или просит ссылку | «140 квадратных метров, плитка, много волос, бюджет 3,000, какой выбрать?» |
| complaint | Сообщает о проблеме с товаром или сервисом | «Из выпускного отверстия док-станции неприятно пахнет. Как это исправить?» |
| price | Обсуждает цену, более дешёвые копии или где купить | «3 юаня за штуку, хватает на месяц» |
| praise | Автор пользуется товаром и рекомендует его | «Мой бюджетный Xiaomi не наматывает волосы» |
| other | Шутки, обсуждение сюжета, офтоп | «Так призрак четыре дня прятался у нас дома?..» |
А как быть с комментарием, который одновременно и про потребность, и про цену, например «бюджет 3,000, какой выбрать?»? Мы размечаем по тому, чего хочет автор, поэтому это потребность. Если для вашей команды важнее ценовые диапазоны, поставьте цену перед потребностью и укажите этот порядок в промпте.
Выборочная проверка заимствует идею состязательной проверки, описанной в документации о воркфлоу. Независимые агенты оспаривают выводы друг друга до того, как эти выводы попадут в результаты запуска (страница о воркфлоу, раздел «When to use a workflow»). Разметка — не поиск багов, поэтому наш проверяющий агент не пытается опровергнуть первые метки. Он заново размечает выборку, не видя исходной разметки. Затем скрипт вычисляет долю совпадений. Другая модель (в каркасе это Sonnet) снижает вероятность того, что оба агента ошибутся одинаково.
Согласованность даёт лишь нижнюю границу. Если обе модели назовут шутку потребностью, согласованность будет высокой, но метка окажется неверной. Поэтому для нового ключевого слова при первом запуске сами прочитайте 20 комментариев из выборки. Добавьте расхождения и явные ошибки в определения меток. Затем заново разметьте весь пакет.
Ограничения и предостережения
В таблице перечислены семь ограничений и способы учесть каждое из них. Первые две строки взяты из раздела «Behavior and limits» страницы о воркфлоу.
| Ограничение | Последствие | Что делать |
|---|---|---|
| Скрипт не может выходить в сеть | Каждый вызов API происходит внутри агента, а агент может сделать один дополнительный вызов | Возвращайте calls и charged_usd как поля схемы и проверяйте итог |
| Запуск не может запросить у вас данные | Нет проверки между выгрузкой и разметкой | Отдельный воркфлоу на каждый этап |
| Запуск останавливается, когда вы выходите | Агенты, работавшие на момент перезапуска, начинают работу заново | Перезапускайте на основе сохранённых результатов |
URL комментариев требуют xsec_token | «Очищенный» URL не работает | Сохраняйте URL ровно в том виде, в каком он вернулся |
| Только публичные комментарии | Скрытых и свёрнутых комментариев нет | Негативных мнений будет меньше |
| Наши метки получены базовым методом на основе правил | Цифры получены не от модели | Проведите выборочную проверку на своих данных |
| Версии различаются | Во многих руководствах описано старое поведение | Выполните claude --version; в статье используется 2.1.316 |
Запуск не продолжается сам, если вы перевели сессию в фон или вышли из неё. Claude должен перезапустить его с сохранённых результатов, а агенты, которые ещё работали, начнут заново и снова потратят токены (документация об agent view).
Каталог требует полный URL комментария из недавнего результата поиска вместе со строкой запроса. Токены пагинации действуют 24 часа, поэтому при возобновлении работы на следующий день придётся начать сначала. Расчёты для 500 комментариев основаны на цене за единицу и измеренных размерах страниц; сами 500 комментариев мы не выгружали. В статье используется документация по состоянию на 2 ноября 2026 г.
Данные комментариев содержат IP-регионы и отображаемые имена. В отчёт включайте только метки, результаты подсчётов и цитаты без имён. Прежде чем отправлять или публиковать цитаты из комментариев, убедитесь, что такое использование соответствует местному законодательству и правилам платформы. Статья описывает метод работы с данными и не является юридической консультацией.
FAQ
Что лучше подходит для сортировки комментариев: workflows в Claude Code или agent teams?
Agent teams — это ведущий агент, несколько долгоживущих равноправных сессий и общий список задач. Функция экспериментальная и включается флагом (документация об agent teams). Воркфлоу — это скрипт, который запускает десятки или сотни кратковременно работающих агентов. Для сотен независимых комментариев лучше подходит воркфлоу. Если постов немного и вы хотите управлять работой шаг за шагом, лучше подходят обычные субагенты, как в нашей статье о субагентах Claude Code. (Источник вопроса: подсказка автодополнения «claude code workflows vs agent teams».)
Workflows и Skills в Claude Code: нужно ли использовать и то, и другое?
Skill — это набор инструкций, которым Claude следует в разговоре. Воркфлоу — это скрипт, который выполняет среда исполнения (страница о воркфлоу). Они работают вместе. Поместите определения меток в Skill, а агенты воркфлоу пусть загружают этот Skill. Тогда определения хранятся в одном месте. (Источник вопроса: подсказка «claude code workflows vs skills».)
Сколько токенов расходуется за один запуск динамического воркфлоу в Claude Code?
Фиксированной цифры в документации нет. Там сказано, что запуск может расходовать намного больше, чем та же работа в разговоре. Документация советует начать с небольшой части и смотреть /workflows (страница о воркфлоу, раздел «Cost»). Пользователи Reddit сообщали о 700 000–1,2 млн токенов на один промпт (Reddit). Стоимость API для этой задачи считается отдельно: около $0,222 за 500 комментариев. (Источник вопроса: подсказка «claude code workflows cost», у которой десять вариантов, например «cost per token» и «cost reddit».)
Что такое ultracode и стоит ли его включать?
Ultracode — это переключатель в Claude Code. Когда он включён, Claude для каждой содержательной задачи сам решает, писать ли воркфлоу. Это не уровень effort.
В сессии команда /effort ultracode (v2.1.284 или новее) только включает переключатель и не меняет уровень effort. Только флаг запуска claude --effort ultracode ещё и устанавливает effort xhigh (документация о настройке моделей). Когда переключатель включён, предупреждение «Large workflow» не появляется. Для задач, которые вызывают платный API, мы советуем держать его выключенным и просить воркфлоу одним промптом. (Источник вопроса: подсказки «ultracode claude» и «ultracode claude reddit».)
Как сделать так, чтобы воркфлоу останавливался для проверки человеком?
Согласно документации, запуск не может запросить ввод, поэтому для подтверждения человеком процесс нужно разделить на отдельные воркфлоу (страница о воркфлоу, раздел «Behavior and limits»). Ещё можно выбрать запуск в /workflows и нажать x, чтобы остановить его; завершённые агенты сохранят свои результаты. В обсуждении на Hacker News подняли ту же проблему: сложнее всего встроить оценку человеком в долгие запуски (Hacker News, 2026-05-28). (Источник вопроса: комментатор в ветке о запуске на Reddit спросил, какие сигналы останавливают субагентов, прежде чем они продолжат работу по неудачной ветке.)
С чего начать
- Получите API-ключ, следуя руководству «Быстрый старт» EveryInfra, затем изучите бесплатный каталог для
xiaohongshu/searchиxiaohongshu/comments. - Добавьте удалённый MCP-сервер в Claude Code командой выше. См. настройку удалённого MCP и страницу MCP-сервера.
- Попросите Claude Code создать воркфлоу, который следует каркасу и обрабатывает 5 постов. Прочитайте план и выберите «Yes, run it».
- После завершения запуска проверьте расход токенов в
/workflowsи сравните стоимость API со страницей тарифов. Удачный запуск сохраните как команду клавишейs.
Тот же каркас подходит и для других платформ, если поменять названия возможностей. См. API данных Xiaohongshu, в том числе комментарии, ответы и пакетную выгрузку комментариев. Для других китайских платформ см. API данных Douyin и API данных Weibo. Чтобы очистить комментарии перед разметкой, прочитайте статью DeepSeek V4 в Claude Code для очистки комментариев.
Источники
- «Orchestrate subagents at scale with dynamic workflows». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/workflows
- «Claude Code changelog». Anthropic. Последняя запись: 2.1.316, 2026-10-31. https://code.claude.com/docs/en/changelog
- «CHANGELOG.md». anthropics/claude-code на GitHub. Дата обращения: 2026-11-02. https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- «Introducing dynamic workflows». Anthropic. 2026-05-28. https://claude.com/resources/articles/introducing-dynamic-workflows-in-claude-code
- «Claude Code Adds Dynamic Workflows for Parallel Agent Coordination». InfoQ. Июнь 2026. https://www.infoq.com/news/2026/06/dynamic-workflows-claude-code/
- «Building agents: When to fold subagents into your main agent loop». Anthropic. 2026-10-22. https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- «Create custom subagents». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/sub-agents
- «Run agents in parallel». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/agents
- «Agent teams». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/agent-teams
- «Skills». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/skills
- «Settings reference». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/settings-reference
- «Model configuration». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/model-config
- «Environment variables». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/env-vars
- «Agent SDK reference, TypeScript». Anthropic. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/agent-sdk/typescript
- «Connect Claude Code to tools via MCP». Anthropic. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/mcp
- «Manage costs». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/costs
- «Configure permissions». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/permissions
- «Permission modes». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/permission-modes
- «Prompt caching in Claude Code». Anthropic. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/prompt-caching
- «Run Claude Code programmatically». Anthropic. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/headless
- «Hooks reference». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/hooks
- «Sandboxing». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/sandboxing
- «Plugin manifest reference». Anthropic. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/plugins/manifest-reference
- «Agent view». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/agent-view
- «Claude Code on the web». Anthropic. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/claude-code-on-the-web
- «Remote Control». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/remote-control
- «Interactive mode». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/interactive-mode
- «Network configuration». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/network-config
- «Scheduled tasks». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/scheduled-tasks
- «Commands». Anthropic, документация Claude Code. Дата обращения: 2026-11-02. https://code.claude.com/docs/en/commands
- «Pricing». Anthropic, документация платформы Claude. Дата обращения: 2026-11-02. https://platform.claude.com/docs/en/about-claude/pricing
- «Structured outputs». Anthropic, документация платформы Claude. Дата обращения: 2026-11-02. https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- «Rate limits». Anthropic, документация платформы Claude. Дата обращения: 2026-11-02. https://platform.claude.com/docs/en/api/rate-limits
- «Token counting». Anthropic, документация платформы Claude. Дата обращения: 2026-11-02. https://platform.claude.com/docs/en/build-with-claude/token-counting
- «Transports», спецификация 2025-11-25. Model Context Protocol. Дата обращения: 2026-11-02. https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- «Tools», спецификация 2025-11-25. Model Context Protocol. Дата обращения: 2026-11-02. https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- «Xiaohongshu capability catalog». EveryInfra. Дата обращения: 2026-11-02 00:14 SGT. https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- «Content review rules». Справочный центр Xiaohongshu Pugongying. Страница датирована 2026-10-22. https://pgy.xiaohongshu.com/help/detail?id=6495c527d1eedeeb48fb18b1f875650e&userType=4
- Главная страница Pugongying. Xiaohongshu. Дата обращения: 2026-11-02. https://pgy.xiaohongshu.com/
- «ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks». Gilardi, Alizadeh, Kubli. arXiv 2303.15056, v2 от 2023-07-19. https://arxiv.org/abs/2303.15056
- «Are Chatbots Reliable Text Annotators? Sometimes». Kristensen-McLachlan и др. arXiv 2311.05769, v2 от 2025-02-25. https://arxiv.org/abs/2311.05769
- «Best Practices for Text Annotation with Large Language Models». Petter Törnberg. Sociologica, 2024. https://sociologica.unibo.it/article/view/19461
- «Introducing dynamic workflows in Claude Code», ветка обсуждения. r/ClaudeAI. Май 2026. https://www.reddit.com/r/ClaudeAI/comments/1tq9ofy/introducing_dynamic_workflows_in_claude_code/
- «Dynamic Workflows in Claude Code», обсуждение. Hacker News. 2026-05-28. https://news.ycombinator.com/item?id=48311705
Справка BL-64