Claude Code 동적 워크플로로 Xiaohongshu 댓글 분석하기: API 테스트와 스크립트 예제
Claude Code 동적 워크플로로 Xiaohongshu 댓글을 병렬로 분류합니다. 테스트 결과 8페이지 중 4페이지가 10행만 반환했고, 한 게시물은 96%가 노이즈였으며, 댓글 500개 비용은 $0.222였습니다.
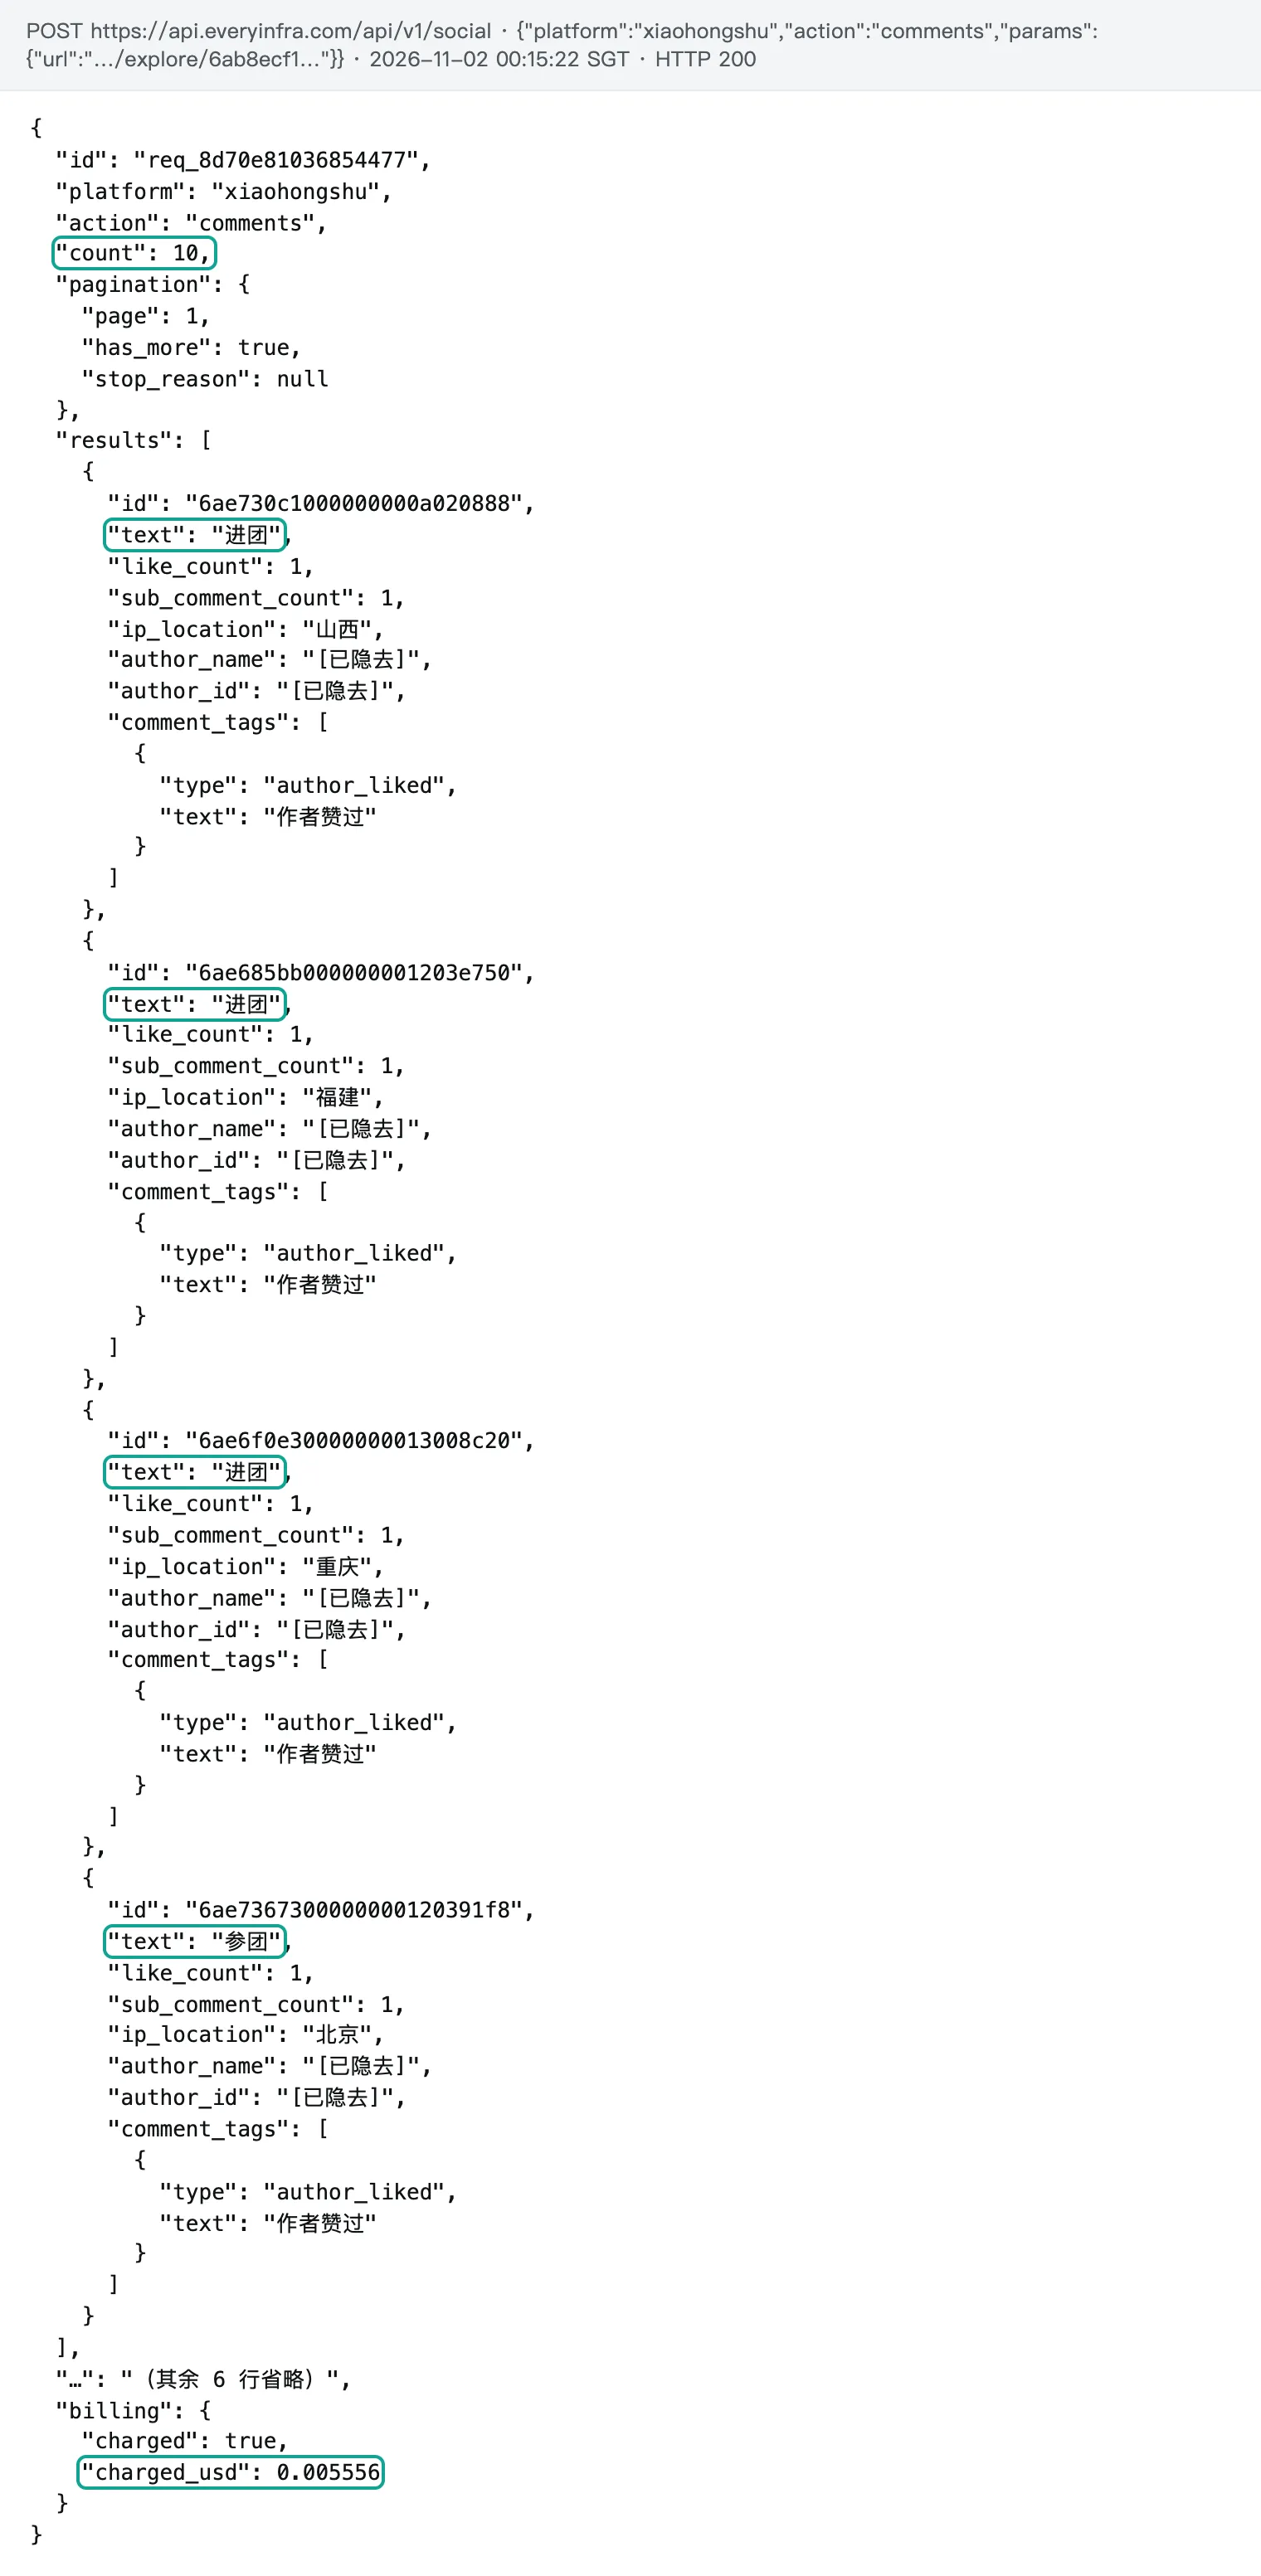
2026년 11월 2일 싱가포르 시간(SGT) 00:14부터 00:22까지 EveryInfra API를 10회 호출했고 모두 과금되었습니다. 이 호출로 로봇청소기에 관한 Xiaohongshu(RedNote) 게시물 6개에서 최상위 댓글 100개를 받았고, 총비용은 $0.066671이었습니다. 한 게시물에서는 댓글 25개 중 24개가 중국어로 "그룹 참여", "저도 끼워 주세요", "참여"라고만 적혀 있었습니다. 카탈로그에는 xiaohongshu/comments가 페이지당 15행을 반환한다고 되어 있지만, 저희가 받은 8페이지 중 4페이지는 10행을 반환했습니다.
이 결과는 Claude Code 동적 워크플로의 예산을 바꿉니다. 카탈로그의 페이지 크기 기준이면 댓글 500개에 호출 34회, $0.189가 듭니다. 실측 평균인 페이지당 12.5행 기준으로는 호출 40회, $0.222가 듭니다. 25%의 노이즈까지 걸러 내고도 유용한 댓글 500개를 얻으려면 호출 54회, $0.300이 필요합니다.
네 번째 결과는 재실행할 때 중요합니다. 같은 요청을 세 번 보냈더니 6분 사이에 첫 페이지의 댓글 7개가 바뀌었습니다. 세 번의 호출은 모두 과금되었습니다.
이 글은 하나의 실무 질문에 답합니다. 상품 키워드가 있고, Claude Code에게 병렬 프로그램을 작성하게 하려는 상황입니다. 이 프로그램은 Xiaohongshu 댓글을 가져와 네 그룹(니즈, 불만, 가격, 칭찬)으로 분류하고 요약 표 하나를 만듭니다. 어떤 기능을 써야 하고, 스크립트는 어떤 모습이며, 데이터는 어떻게 연결할까요?
댓글 500개에 호출이 몇 번 필요하고, 요청 속도 제한과 재시도 상황에서는 무엇이 문제가 될까요? 아래의 Claude Code 관련 사실은 모두 Claude Code 워크플로 페이지 또는 변경 내역에서 가져왔습니다. 저희 환경에서 워크플로를 실행하지는 않았으므로 Claude Code 부분은 구성 예시입니다. EveryInfra 관련 수치는 모두 원본 API 응답에서 나온 것입니다.
작업: Xiaohongshu 댓글 500개를 네 그룹으로 분류해 표 하나로 정리하기
이후의 모든 수치가 작업 정의에 달려 있으므로 작업부터 정의합니다. 입력은 키워드 하나입니다. "로봇청소기"에 해당하는 중국어 단어를 사용했습니다. 이 카테고리에는 11월 11일 세일을 전후해 "뭘 사야 하나요", "이거 고장 났어요" 같은 스레드가 많기 때문입니다. 출력은 표 하나입니다. 표에는 그룹별 건수와 비율, 그룹별 예시 댓글 3개가 들어갑니다. API 비용과 표본 점검의 일치율도 표시합니다.
작업은 세 단계로 진행됩니다. xiaohongshu/search로 게시물을 찾습니다. xiaohongshu/comments와 xiaohongshu/sub_comments로 댓글과 답글을 가져옵니다. 그다음 모델이 각 댓글에 라벨을 붙입니다. 네 그룹은 스크립트에서 정의합니다.
니즈는 어떤 모델을 사야 하는지 묻거나 링크를 요청하는 댓글입니다. 불만은 제품이나 서비스의 문제를 알리는 댓글입니다. 가격은 비용, 저렴한 모조품, 구매처를 이야기하는 댓글입니다. 칭찬은 제품을 직접 쓰면서 추천하는 사람의 댓글입니다. 나머지 댓글은 모두 "기타"로 분류합니다.
이 작업에 병렬 프로그램을 쓰는 이유는 무엇일까요? 세 가지 조건을 충족하기 때문입니다. 첫째, 게시물이 서로 독립적이어서 게시물 A는 게시물 B의 결과가 필요하지 않습니다. 둘째, 입력이 출력보다 훨씬 큽니다. 댓글 하나는 약 1,445바이트의 JSON으로 반환되지만 텍스트는 약 95바이트입니다. 셋째, 라벨링 규칙이 고정되어 있어 작은 모델로도 처리할 수 있습니다.
Anthropic은 2026년 10월 22일 대부분의 에이전트 개발자에게 서브에이전트를 줄이라고 권하는 가이드를 발표했습니다(Anthropic 글). 같은 가이드는 한 가지 경우에만 서브에이전트를 남겨 둡니다. 서로 분리된 새 컨텍스트가 필요한 여러 작업을 병렬로 처리하는 경우입니다. 댓글 분류가 바로 그런 경우입니다.
게시물 6개를 가져왔습니다. 먼저 sort=most_commented로 검색해 게시물 20개를 얻었습니다. 그중 주제가 서로 다른 6개를 골랐습니다. 아래 표에 각 게시물과 제목 요약을 정리했습니다. 검색 결과 20개 중 10개는 is_cooperation_note가 true였습니다. Xiaohongshu에서 이런 게시물은 Pugongying 플랫폼을 거친 협찬 게시물입니다.
이 플랫폼은 협찬 게시물을 게시 전에 검토합니다. 브랜드는 72시간 이내에 승인하거나 거절해야 합니다(Pugongying 도움말 센터, 2026-10-22 페이지; Pugongying 홈). 저희가 고른 게시물 6개 중 협찬 게시물은 없었습니다. 칭찬 수치를 볼 때 이 점을 감안하십시오.
| 게시물(저희가 붙인 코드) | 제목(요약) | 검색에 표시된 댓글 수 | 가져온 최상위 댓글 수 |
|---|---|---|---|
| A | "로봇청소기 아직 사지 마세요, 광군제 테스트부터 보세요" | 2,069 | 25 (2페이지) |
| B | Roborock 청소기에 대한 불만 스레드 | 570 | 30 (2페이지) |
| C | "2026 로봇청소기 구매 가이드" | 377 | 10 |
| D | "힘센" 청소기를 다룬 짧은 코미디 영상 | 3,278 | 10 |
| E | "돈 낭비 가전: 쓸모없는 로봇청소기" | 973 | 15 |
| F | 처음 구매하는 사람의 조언 요청 | 487 | 10 |
Claude Code 동적 워크플로란 무엇인가: 공식 문서의 설명
Claude Code 문서는 동적 워크플로를 여러 서브에이전트를 한 번에 오케스트레이션하는 JavaScript 스크립트로 정의합니다. Claude가 작업에 맞는 스크립트를 작성합니다. 런타임이 이 스크립트를 백그라운드에서 실행하는 동안에도 세션을 계속 사용할 수 있습니다(워크플로 페이지). 이 기능은 2026년 5월 28일 v2.1.154에서 처음 출시되었습니다. 변경 내역에는 Claude가 "백그라운드에서 수십~수백 개의 에이전트에 걸쳐 작업을 오케스트레이션한다"고 되어 있으며, /workflows에서 실행 내역을 볼 수 있습니다(변경 내역).
현재 출시 글에는 동적 워크플로가 정식 출시(GA)되었다고 나와 있습니다. 지원 환경으로 CLI, Desktop 앱, VS Code 확장 프로그램을 명시합니다. 대상으로는 Pro, Max, Ultra, Team, Enterprise 요금제와 Claude API, Amazon Bedrock, Vertex AI, Microsoft Foundry를 명시합니다(Anthropic 출시 글).
문서에는 저장된 스크립트 예시가 있습니다. 스크립트는 export const meta = { name, description }으로 시작합니다. 본문은 최상위 await를 쓰는 일반 JavaScript입니다. agent()는 서브에이전트 하나를 시작합니다.
pipeline()은 목록의 항목마다 체인 하나를 실행합니다. parallel()은 여러 작업을 동시에 실행하고 모두 끝날 때까지 기다립니다. phase()는 이어지는 에이전트를 하나의 제목 아래로 묶고, log()는 한 줄을 출력하며, args에는 입력이 담깁니다(워크플로 페이지, "What the saved script looks like").
agent()에 schema를 전달하면 서브에이전트는 해당 JSON Schema에 맞는 객체를 반환합니다. 출력이 검증에 다섯 번 실패하면 호출이 실패합니다. 이 횟수는 MAX_STRUCTURED_OUTPUT_RETRIES로 바꿀 수 있습니다(같은 페이지). 라벨링 단계에 꼭 필요한 기능입니다. 각 라벨링 에이전트가 {id, label} 객체 배열을 반환하면 스크립트가 바로 집계합니다.
워크플로를 시작하는 방법은 네 가지입니다(워크플로 페이지, "Have Claude write a workflow"; 명령어 페이지).
| 시작 방법 | 워크플로 사용 결정 주체 | 비고 |
|---|---|---|
프롬프트에 키워드 ultracode 입력 | 사용자(해당 프롬프트에 한함) | 사용자가 직접 입력한 프롬프트에서만 작동 |
| 자연어로 "워크플로"를 요청 | 사용자(해당 프롬프트에 한함) | Claude가 이 작업용 스크립트를 작성 |
/effort ultracode 또는 claude --effort ultracode 실행 | Claude(작업마다) | 이 플래그는 effort도 xhigh로 설정 |
/deep-research 같은 저장된 워크플로 명령어 실행 | 사용자 | 성공한 실행을 재사용 |
이 키워드는 사람이 직접 입력한 프롬프트에서만 작동합니다. -p로 전달한 프롬프트에서는 작동하지 않습니다(헤드리스 문서). 예약 작업 프롬프트, 웹훅, 풀 리퀘스트 댓글에서도 작동하지 않습니다. 따라서 주간 댓글 보고서를 만들려면 먼저 잘 된 실행 하나를 명령어로 저장하십시오. 그런 다음 예약 작업에서 그 명령어를 호출합니다.
| 서브에이전트 | 스킬 | 에이전트 팀 | 워크플로 | |
|---|---|---|---|---|
| 정의 | Claude가 시작하는 워커 | Claude가 따르는 지침 | 피어 세션을 둔 리드 에이전트 | 런타임이 실행하는 스크립트 |
| 다음 단계 결정 주체 | Claude(턴마다) | Claude(프롬프트 기반) | 리드 에이전트 | 스크립트 |
| 결과 저장 위치 | Claude의 컨텍스트 | Claude의 컨텍스트 | 공유 작업 목록 | 스크립트 변수 |
| 재사용 가능한 것 | 워커 정의 | 지침 | 팀 정의 | 오케스트레이션 |
| Scale | 턴당 작업 몇 개 | 서브에이전트와 동일 | 장시간 실행되는 피어 에이전트 몇 개 | 에이전트 수십~수백 개 |
| 중단된 후 | 턴을 다시 시작 | 턴을 다시 시작 | 팀원은 계속 실행 | 같은 세션에서 재개 가능 |
이 표는 워크플로 페이지의 "When to use a workflow" 섹션에 있는 비교를 따릅니다. 여기서는 세 번째 행이 가장 중요합니다. 서브에이전트를 쓰면 게시물별 요약이 모두 메인 대화로 들어옵니다. 워크플로를 쓰면 댓글 100개, 라벨, 표본 점검 결과가 스크립트 변수에 남습니다.
대화에는 최종 표만 전달됩니다. 에이전트 팀은 아직 실험 기능이며 CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1이 필요합니다(에이전트 팀 문서). 따라서 여기서는 사용하지 않습니다.
동적 워크플로 vs 서브에이전트: 계획은 대화가 아닌 코드에 담긴다
실제 차이는 병렬 처리에 있지 않습니다. 계획을 누가 쥐고 있느냐가 다릅니다. 서브에이전트 방식에서는 Claude가 턴마다 다음에 어떤 서브에이전트를 시작할지 결정합니다. 모든 결과가 Claude의 컨텍스트로 돌아와야 다음 결정을 내릴 수 있습니다. 서브에이전트 문서에 따르면 서브에이전트 20개가 실행 중일 때 다음 Agent 호출은 실패하며, 이 오류는 Claude에게 재시도하지 말라고 알립니다. 이 숫자는 CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS로 바꿀 수 있습니다(서브에이전트 문서, "Concurrent subagent limit").
워크플로에서는 루프, 분기, 재시도 횟수가 스크립트에 고정되어 있습니다. Claude가 게시물마다 다시 결정하지 않으므로 앞선 결과가 이후 게시물의 처리 방식을 바꿀 수 없습니다. 라벨링에는 바람직한 특성입니다. 모든 게시물이 같은 프롬프트와 같은 스키마를 받으므로 게시물 간 결과를 비교할 수 있습니다.
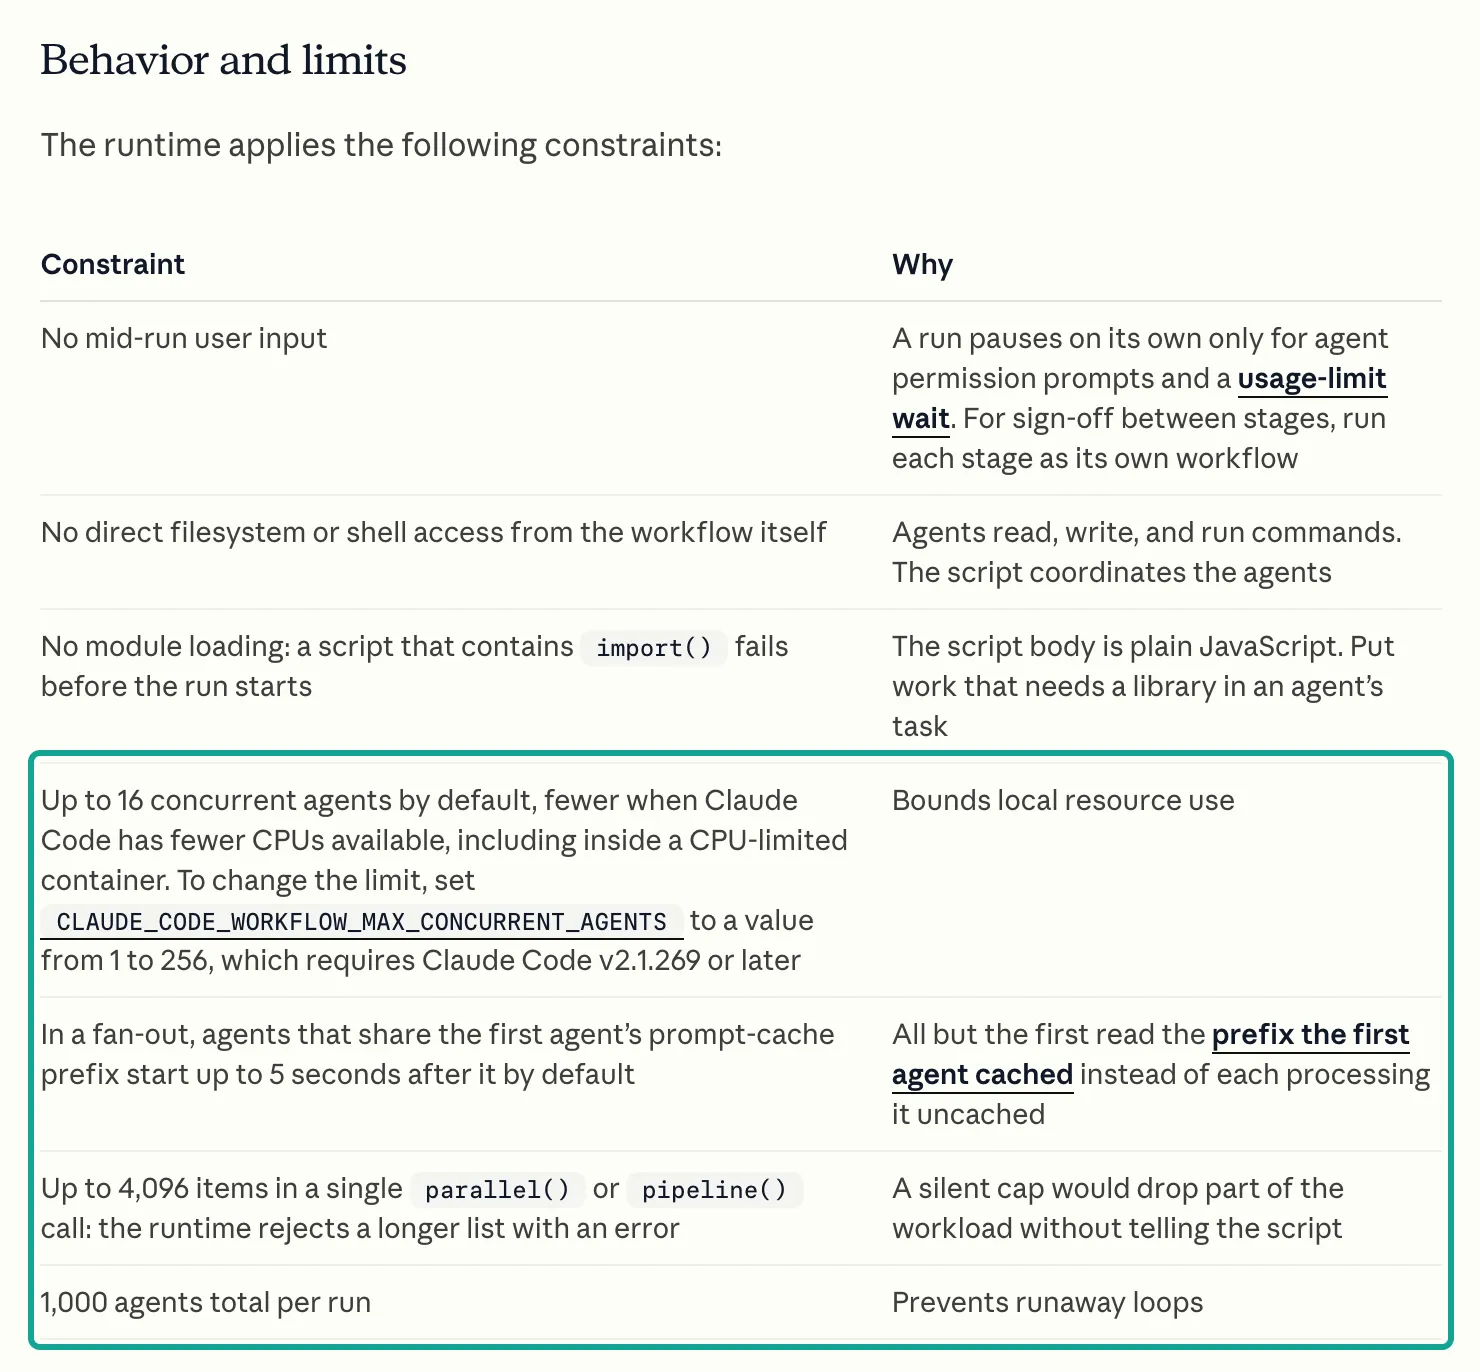
런타임에는 엄격한 제한이 있습니다. 아래 스크린샷은 Claude Code 문서에서 가져왔습니다. 청록색 상자는 여기서 가장 중요한 제한 세 가지를 표시합니다. 기본적으로 최대 16개의 에이전트가 동시에 실행되며, CPU 수가 적은 머신에서는 그보다 적게 실행됩니다.
v2.1.269부터 CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS로 1부터 256까지 값을 설정할 수 있습니다. parallel() 또는 pipeline() 호출 한 번에는 최대 4,096개 항목을 넘길 수 있으며, 이보다 긴 목록은 오류와 함께 거부됩니다. 실행 한 번에 시작되는 에이전트는 최대 1,000개입니다.
그 밖에도 중요한 제한이 세 가지 있습니다. 실행 도중에는 사용자에게 입력을 요청할 수 없습니다. 스크립트는 스스로 파일을 읽거나 셸 명령을 실행할 수 없습니다. import()가 포함된 스크립트는 시작하기 전에 실패합니다.
스크립트가 파일이나 명령에 접근할 수 없다는 규칙에 따라 데이터를 가져오는 방식이 정해집니다. 스크립트는 fetch나 curl을 호출할 수 없습니다. 따라서 에이전트가 EveryInfra를 호출해야 합니다. 에이전트는 세션에 연결된 MCP 도구를 사용할 수 있습니다. 권한이 허용하면 Bash도 실행할 수 있습니다.
함께 제공되는 워크플로 작성 레퍼런스에는 한 가지 사실이 더 나옵니다. 워크플로 에이전트는 세션에 연결된 모든 MCP 도구에 접근할 수 있지만, 대화형 로그인이 필요한 서버는 헤드리스 실행에서 사용하지 못할 수 있습니다. 이 레퍼런스는 /workflow-authoring 스킬이며 v2.1.248 이상이 필요합니다(워크플로 페이지, "Edit a saved script"; 스킬 문서). EveryInfra 원격 MCP 서버는 대화형 로그인 대신 요청 헤더의 키로 인증합니다. 따라서 헤드리스 실행에서도 동작합니다.
시간에 관한 규칙도 하나 있습니다. 스크립트 안에서 Date.now(), Math.random(), 인수 없는 new Date()는 오류를 발생시킵니다. 재개된 실행은 같은 agent() 호출을 반복해야 하는데, 타임스탬프나 난수가 있으면 이 조건이 깨지기 때문입니다(워크플로 페이지). 날짜가 필요하면 args로 전달하세요. "최근 24시간 댓글" 같은 조건에는 API 필터를 대신 사용하세요. xiaohongshu/search는 date_range=last_24_hours를 지원합니다.
버전과 설정: 어떤 동작이 어느 릴리스부터 적용되는가
동적 워크플로는 2026년 5월부터 11월 사이에 크게 바뀌었습니다. 많은 튜토리얼이 이전 동작을 설명합니다. 표에는 이 작업에 중요한 항목만 정리했습니다. 버전과 날짜는 Claude Code 변경 내역에서 가져왔으며, 이 문서는 GitHub의 CHANGELOG.md와 내용이 같습니다. "문서"로 표시된 행은 워크플로 페이지의 버전 노트에서 가져왔습니다.
| 버전 | 날짜 | 변경 사항 | 댓글 분류에 미치는 영향 |
|---|---|---|---|
| 2.1.154 | 2026-05-28 | 동적 워크플로와 /workflows 출시 | 출발점 |
| 2.1.157 | 2026-05-29 | 설정으로 키워드 트리거 비활성화 가능 | "workflow"를 입력해도 실수로 실행이 시작되지 않음 |
| 2.1.269 | docs | CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS | API를 호출하는 에이전트를 2~3개로 제한 |
| 2.1.271 | docs | 사용량 한도에 도달하면 실행이 일시 중지됨, Pro의 기본 규모는 small | 긴 실행이 중간에 실패하지 않음 |
| 2.1.296 | 2026-10-09 | CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL | 변수 하나로 모든 에이전트를 Haiku로 실행 |
| 2.1.299 | 2026-10-14 | /usage에 워크플로 관련 경고 표시 | 토큰이 어디에 쓰였는지 확인 가능 |
| 2.1.301 | 2026-10-15 | 수정: 에이전트가 단계를 건너뛰어도 실행이 성공으로 보고되던 문제 | 건너뛴 라벨링 단계가 더 이상 성공처럼 보이지 않음 |
| 2.1.305 | 2026-10-20 | 수정: 재개 시 완료된 pipeline() 및 parallel() 에이전트를 다시 실행하던 문제 | 재개해도 댓글 비용을 두 번 내지 않음 |
| 2.1.311 | 2026-10-26 | 수정: 늦게 연결된 MCP 서버를 서브에이전트가 인식하지 못하던 문제 | 원격 MCP 연결이 느려도 도구가 누락되지 않음 |
| 2.1.316 | 2026-10-31 | CLAUDE_CODE_SUBAGENT_EFFORT | 모든 라벨링 에이전트를 한 번에 낮은 effort로 설정 |
2.1.269와 2.1.271 행은 워크플로 페이지의 "Behavior and limits", "When a run hits your usage limit", "Set a size guideline" 섹션에서 가져왔습니다. 규모 지침 값은 네 가지입니다. unrestricted는 지침 없음, small은 에이전트 5개 미만, medium은 10개 미만, large는 50개 미만을 뜻합니다. Claude는 이 값을 상한이 아닌 권고로 취급합니다. 엄격한 상한은 여전히 에이전트 1,000개입니다. workflowSizeGuideline은 어느 설정 파일에서든 지정할 수 있습니다(설정 레퍼런스).
댓글 500개라면 medium으로 충분합니다. 검색 에이전트 1개, 수집 에이전트 몇 개, 같은 수의 라벨링 에이전트, 샘플 검수 에이전트 1개, 보고서 에이전트 1개가 필요합니다. 뒤의 섹션에서 배치 호출로 수집 에이전트를 1~2개로 줄이는 방법을 설명합니다.
ultracode를 켜는 방법은 두 가지이며, 효과가 서로 다릅니다. v2.1.284부터 세션에서 /effort ultracode를 실행하면 ultracode만 켜지고 effort 수준은 바뀌지 않습니다. /effort ultracode off로 끌 수 있습니다.
v2.1.284 이전에는 /effort ultracode가 세션의 effort를 xhigh로 설정했고, /effort ultracode off는 Invalid argument로 실패했습니다. 실행 플래그 claude --effort ultracode(v2.1.203 이상)는 다르게 동작합니다. ultracode를 켜는 동시에 effort도 xhigh로 설정합니다(모델 구성 문서; 워크플로 페이지). ultracode가 켜져 있으면 "Large workflow" 경고가 나타나지 않고 서브에이전트 동시 실행 제한도 적용되지 않습니다. 유료 API를 호출하는 작업에서는 ultracode를 꺼 두기를 권장합니다. 대신 프롬프트 하나로 워크플로를 요청하면 실행 전에 계획을 확인할 수 있습니다.
데이터 연결: 원격 MCP 또는 POST /api/v1/social
워크플로에서 데이터 API를 사용하는 방법은 두 가지입니다. 에이전트가 EveryInfra 원격 MCP 서버를 호출하거나, POST https://api.everyinfra.com/api/v1/social에 curl을 실행할 수 있습니다. Claude Code MCP 문서에 따르면 원격 HTTP 서버는 claude mcp add --transport http <name> <url>로 추가합니다. Bearer 인증에는 --header를 덧붙입니다(MCP 문서).
EveryInfra 원격 MCP 서버는 MCP 사양의 Streamable HTTP 전송 방식을 사용합니다(MCP 사양 2025-11-25, transports). 사양에서 도구 호출은 tools/call 요청이며, 결과는 content 배열에 담깁니다(MCP 사양 2025-11-25, tools). tools/list를 호출하자 도구 12개가 반환되었습니다. 여기서 중요한 도구는 everyinfra_list_capabilities, everyinfra_call_api, everyinfra_get_job입니다.
# Configuration example. Keep the key in an environment variable, never in a file.
export EVERYINFRA_API_KEY="<your key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Fewer approval prompts: add these to permissions.allow in .claude/settings.json
#   "Workflow", "mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"
# Keep at most 3 agents running, so a 10-per-minute key is not saturated
export CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS=3
권한 설정은 세 문서를 근거로 합니다. claude -p와 Agent SDK에서는 Claude Code가 워크플로 승인 프롬프트를 표시하지 않습니다. 실행을 허용하려면 허용 규칙에 Workflow를 추가하세요. 저장된 워크플로 하나만 허용하려면 Workflow(<name>)를 추가합니다(워크플로 페이지, "Approve the plan before it runs").
출시 발표 글은 워크플로에 auto 모드를 권장합니다. auto 모드에서는 분류기가 각 호출을 검토합니다(권한 모드 문서). PreToolUse 훅이 해당 호출에 allow를 반환하게 할 수도 있습니다(훅 문서).
MCP 허용 규칙은 mcp__<server>__<tool> 형식입니다. glob은 mcp__everyinfra__*처럼 서버 이름 뒤에서만 쓸 수 있습니다(권한 문서). 워크플로의 서브에이전트는 사용자의 권한 규칙을 따릅니다. 문서는 긴 실행 전에 에이전트에 필요한 도구를 미리 허용해 두라고 권장합니다. 그래야 실행이 승인 대기로 멈추지 않습니다.
어떤 방법을 써야 할까요? 호출 수가 정해진 읽기 전용 라벨링에는 MCP를 사용합니다. 표에서 두 방법을 비교합니다. 샌드박스 행은 샌드박싱 문서를 근거로 하며, 샌드박스는 허용된 네트워크 도메인이 하나도 없는 상태로 시작합니다.
| 질문 | 원격 MCP | `POST /api/v1/social`에 curl 호출 |
|---|---|---|
| 에이전트에 Bash가 필요한가? | 아니요 | 예, 샌드박스 네트워크 규칙도 필요 |
| 에이전트가 과금과 페이지네이션 방식을 아는가? | 예, 도구 설명을 통해 | 프롬프트에 적은 경우에만 |
retry_after, did_you_mean 같은 오류 필드 | 도구 결과에 포함 | 응답 본문에 포함 |
| 감사용 원본 JSON을 디스크에 저장 | 아니요 | 예, 에이전트가 파일 작성 |
| 적합한 용도 | 호출 수가 정해진 라벨링 | 모든 원본 파일을 보관해야 하는 작업 |
curl을 사용하면 수집 에이전트가 원본 파일을 하나씩 작성하고, 스크립트에는 {id, text, like_count}만 반환합니다.
시작하기 전에 크기 제한 하나를 알아 두세요. Claude Code는 MCP 도구 출력이 10,000 토큰을 넘으면 경고하고, 기본적으로 25,000 토큰에서 자릅니다. 이 상한은 MAX_MCP_OUTPUT_TOKENS로 바꿀 수 있습니다. 50,000자를 넘는 성공 텍스트 결과는 파일로 저장됩니다(MCP 문서, "MCP output limits and warnings").
MCP로 받은 댓글 15개짜리 페이지 하나는 16,892바이트였습니다. 게시물 20개짜리 검색 페이지 하나는 34,991바이트였습니다. 둘 다 기준보다 작습니다.
게시물 3개에 대한 comments_batch 호출 한 번은 42,991바이트였습니다. 이 비율이라면 게시물 20개는 약 280,000바이트가 됩니다. 이 결과는 파일로 저장되므로 에이전트가 두 번째 단계에서 파일을 읽어야 합니다. 결과는 달라지지 않고 단계만 하나 늘어납니다. 결과를 에이전트 컨텍스트 안에 두려면 호출당 게시물을 3~4개씩 요청하세요.
실제 왕복 1회: 에이전트가 보내는 요청과 API가 반환하는 응답
2026년 11월 2일 00:17:55 SGT에 MCP로 아래 tools/call 요청을 보냈습니다. Claude Code 에이전트가 mcp__everyinfra__everyinfra_call_api를 호출할 때 보내는 것과 같은 JSON-RPC 요청입니다. 대상은 '첫 구매자' 게시물인 게시물 F였고, 좋아요 순으로 정렬했습니다. 결과는 result.content[0].text에 JSON 텍스트로 들어 있습니다. 첫 번째 댓글과 과금 필드만 보여 드립니다. 게시물 URL의 쿼리 문자열은 제거했고, 작성자 이름과 ID는 가렸습니다.
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api",
 "arguments":{"platform":"xiaohongshu","action":"comments",
  "params":{"url":"https://www.xiaohongshu.com/explore/692b0d81000000001d03ea4c","sort":"most_liked"}}}}

{"id":"req_b7efc0a2e4784211","platform":"xiaohongshu","action":"comments","count":10,
 "pagination":{"page":1,"has_more":true,"stop_reason":null},
 "results":[{"id":"693ab483000000001702fef1","text":"(Chinese) How is the DJI one? I hear its obstacle avoidance is strong",
   "like_count":3,"author_name":"[hidden]","author_id":"[hidden]","sub_comment_count":0}],
 "billing":{"charged":true,"charged_usd":0.005556}}
이 댓글 10개 중 8개는 명확한 니즈입니다. 거의 모든 댓글이 면적, 예산, 반려동물 유무, 바닥재 종류를 밝힙니다. 번역한 예시를 하나 들면 다음과 같습니다. "140제곱미터, 카펫 있음, 반려동물 없음, 전부 타일 바닥, 머리카락 많음, 예산 3,000위안, 뭘 사야 하나요?" 이런 댓글은 제품팀과 고객 지원팀에 유용합니다. 구조도 잘 잡혀 있어 모델이 예산, 면적, 반려동물을 필드로 추출할 수 있습니다.
반환된 필드는 카탈로그에 있는 xiaohongshu/comments의 response_fields 20개와 일치합니다. 표는 수집 에이전트가 어떤 필드를 남기는지 보여 줍니다.
| 필드 | 담긴 내용 | 라벨링에 사용? |
|---|---|---|
id, text, like_count | 댓글 ID, 텍스트, 좋아요 수 | 예 |
sub_comment_count | 답글 수 | 예, 답글을 가져올 스레드 선택용 |
comment_tags | "작성자가 좋아함", "고정됨", 투표 응답 | 선택, 노이즈 필터에 도움 |
posted_at, ip_location | 작성 시각과 IP 지역 | 시간대·지역별 보고서에만 |
author_name, author_id, 아바타 | 작성자 정보 | 아니요, 보고서에도 넣지 않음 |
note_url, next_page_token, sub_comments | 페이지네이션과 첫 번째 답글 | 수집 에이전트 내부에서만 |
스크립트 골격: 탐색, 수집, 필터링, 라벨링, 검수, 보고(예시)
아래 골격은 문서에 나온 스크립트 API를 바탕으로 작성했습니다. 직접 실행하지는 않았으므로 구성 예시로 봐 주세요. phase() 호출은 5개지만 단계는 6개입니다. 필터는 에이전트가 아니라 스크립트 안의 정규식 하나이며, 토큰이 들지 않습니다.
각 설계 선택은 이 글의 측정 결과에서 나왔습니다. 수집 에이전트는 작성자 데이터와 그 밖의 필드 30개를 빼고 id, text, like_count만 반환합니다. 라벨링 에이전트는 고정 라벨 5개로 된 schema를 사용합니다. 샘플 검수는 다른 모델로 댓글의 10%를 다시 라벨링하며, 이 모델은 첫 번째 라벨을 보지 않습니다.


export const meta = {
  name: 'xhs-comment-triage',
  description: 'Pull Xiaohongshu comments for a keyword, drop noise, label need/complaint/price/praise, write a table',
  whenToUse: 'You have a product keyword and want to know what the comment sections ask and complain about',
  phases: [
    { title: 'Discover', detail: '1 agent searches posts' },
    { title: 'Fetch', detail: '1 agent per post pulls 2 pages' },
    { title: 'Classify', detail: '1 agent per post labels comments' },
    { title: 'Verify', detail: 'another model relabels 10%' },
    { title: 'Report', detail: '1 agent writes the table' },
  ],
}

const KEYWORD = (args && args.keyword) || 'robot vacuum (Chinese keyword)'
const NOTE_COUNT = (args && args.notes) || 20
const TOOL = 'mcp__everyinfra__everyinfra_call_api'
const LABELS = ['need', 'complaint', 'price', 'praise', 'other']
const NOISE = /^(进团|参团|进|\s*)$|^(\[[^\]]+R\]|\s)*$/   // "join the group" replies, empty text, emoji only

const NOTES = { type: 'object', required: ['notes'], properties: { notes: { type: 'array', items: {
  type: 'object', required: ['url', 'title'],
  properties: { url: { type: 'string' }, title: { type: 'string' }, comment_count: { type: 'integer' } } } } } }
const COMMENTS = { type: 'object', required: ['comments', 'calls', 'charged_usd'], properties: {
  calls: { type: 'integer' }, charged_usd: { type: 'number' },
  comments: { type: 'array', items: { type: 'object', required: ['id', 'text'],
    properties: { id: { type: 'string' }, text: { type: 'string' }, like_count: { type: 'integer' } } } } } }
const LABELED = { type: 'object', required: ['items'], properties: { items: { type: 'array', items: {
  type: 'object', required: ['id', 'label'],
  properties: { id: { type: 'string' }, label: { type: 'string', enum: LABELS } } } } } }

phase('Discover')
const found = await agent(
  `Use ${TOOL} with platform=xiaohongshu, action=search, params={keyword:"${KEYWORD}", sort:"most_commented"}. ` +
  `Follow next_page_token until you have ${NOTE_COUNT} posts. Keep each url exactly as returned, with xsec_token.`,
  { schema: NOTES, model: 'haiku', effort: 'low', label: 'search' })

const results = await pipeline(found.notes.slice(0, NOTE_COUNT),
  (note) => agent(
    `Use ${TOOL} for xiaohongshu/comments with params={url:"${note.url}"}, then fetch page 2 with next_page_token. ` +
    `On 429, wait error.retry_after seconds and retry, at most 3 times. On 422, do not retry; report it. ` +
    `Keep only id, text and like_count. Sum billing.charged_usd into charged_usd.`,
    { schema: COMMENTS, model: 'haiku', effort: 'low', phase: 'Fetch', label: note.title.slice(0, 12) }),
  (r) => ({ ...r, kept: r.comments.filter((c) => !NOISE.test(c.text.trim())),
            dropped: r.comments.filter((c) => NOISE.test(c.text.trim())).length }),
  (r) => agent(
    `Label each Xiaohongshu comment as one of ${LABELS.join(', ')}. need = asks which model to buy or for a link; ` +
    `complaint = a product or service problem; price = cost, cheaper copies or where to buy; ` +
    `praise = the writer uses it and recommends it; other = jokes or off-topic.\n` +
    JSON.stringify(r.kept.map((c) => ({ id: c.id, text: c.text }))),
    { schema: LABELED, model: 'haiku', effort: 'low', phase: 'Classify', label: 'classify' })
    .then((l) => ({ ...r, labels: l ? l.items : [] })),
)

const ok = results.filter(Boolean)
const all = ok.flatMap((r) => r.labels.map((x) => ({ ...x, text: (r.kept.find((c) => c.id === x.id) || {}).text })))
const sample = all.filter((_, i) => i % 10 === 0)
log(`Fetched ${ok.length}/${found.notes.length} posts; filter dropped ${ok.reduce((s, r) => s + r.dropped, 0)} comments`)

phase('Verify')
const second = await agent(
  `Label these comments on your own. Labels: ${LABELS.join(', ')}.\n` + JSON.stringify(sample.map(({ id, text }) => ({ id, text }))),
  { schema: LABELED, model: 'sonnet', effort: 'medium', label: 'relabel-10pct' })
const agree = sample.filter((s) => ((second && second.items.find((y) => y.id === s.id)) || {}).label === s.label).length

phase('Report')
const counts = {}
for (const x of all) counts[x.label] = (counts[x.label] || 0) + 1
return await agent(
  `Write a Markdown table with count and share per label and 3 example comments per label, translated to English. ` +
  `End with API cost $${ok.reduce((s, r) => s + r.charged_usd, 0).toFixed(4)} and spot-check agreement ${agree}/${sample.length}.\n` +
  JSON.stringify({ counts, examples: all.slice(0, 150) }),
  { model: 'sonnet', effort: 'low', label: 'report' })
이 골격에는 실수하기 쉬운 부분이 몇 군데 있으며, 문서에서 각각 다룹니다. meta는 첫 번째 구문이어야 하고 일반 객체 리터럴이어야 합니다. 변수, 함수 호출, 스프레드가 들어가면 /<name>이 자동 완성에서 빠집니다(워크플로 페이지, "Edit a saved script"). phases의 제목은 phase() 인수와 정확히 일치해야 합니다. 그렇지 않으면 진행 상황 화면에 그룹이 하나 더 생깁니다.
pipeline() 안의 에이전트 하나가 실패하면 그 슬롯은 null이 되므로 스크립트가 filter(Boolean)을 호출합니다. 직접 await한 에이전트가 실패하면 실행 전체가 종료됩니다(같은 페이지의 "When an agent stalls and restarts"). 수집과 라벨링 단계는 haiku를, 검수와 보고 단계는 sonnet을 사용합니다.
Claude Code는 워크플로 에이전트의 모델을 서브에이전트와 같은 순서로 선택합니다. 스크립트에 지정한 모델이 호출별 모델이 됩니다. 모델을 지정하지 않으면 에이전트는 세션 모델을 사용합니다(워크플로 페이지, "Cost". 별칭 sonnet, opus, haiku, fable은 서브에이전트 문서에 나와 있습니다).
필터를 모델이 아닌 스크립트에 두는 이유는 무엇일까요? 스크립트는 일반 JavaScript이므로 정규식, 필터, 개수 세기에 토큰이 들지 않습니다. 필터는 "그룹 참여" 답글, 빈 텍스트, 이모지만 있는 댓글을 제거합니다. 이런 댓글은 의미를 이해하지 않아도 걸러 낼 수 있습니다.
다음 섹션에서 보듯, 이런 댓글이 100개 중 25개였습니다. 함께 제공되는 작성 레퍼런스도 워크플로가 처리 범위를 제한할 때는 제외한 항목을 log()로 남겨야 한다고 설명합니다. 이 줄이 없으면 읽는 사람은 전체를 다 다뤘다고 가정합니다. 골격의 log() 줄이 이 역할을 합니다.
테스트 1: 카탈로그는 페이지당 15행이라고 하지만 8페이지 중 4페이지가 10행이었다
카탈로그에 따르면 xiaohongshu/comments의 page_size는 15이고 limit_ignored는 true입니다. 즉 페이지 크기는 고정이며 limit 값은 효과가 없습니다. xiaohongshu/sub_comments는 10, xiaohongshu/search는 20, comments_batch는 게시물당 15입니다. 테스트 전에 "모든 페이지는 15행이다"라는 가설을 세웠습니다. 데이터는 이 가설을 기각했습니다.
00:15:22 SGT에 받은 게시물 A의 첫 페이지는 10행이었고, 00:15:49에 받은 두 번째 페이지는 15행이었습니다. 00:17:38에는 게시물 3개에 대한 comments_batch 호출 한 번이 C에 10행, D에 10행, E에 15행을 반환했습니다. 00:17:55에 MCP로 받은 게시물 F는 10행이었습니다. 8페이지의 평균은 12.5행입니다.
짧은 페이지가 끝을 뜻하지는 않습니다. 게시물 A와 F에서는 짧은 페이지의 pagination.has_more가 true였습니다. 배치 결과의 게시물 C와 D는 모든 행에 next_page_token이 있었습니다. 게시물 A의 2페이지는 다시 15행이었습니다. 플랫폼이 고정 댓글이나 투표 댓글 등의 이유로 첫 페이지를 다르게 처리하는 것으로 추정합니다. 더 이상의 근거가 없으므로 관찰한 내용만 보고합니다.
실무에서 중요한 점은 중단 규칙입니다. 페이지 크기가 변하므로 "목표 개수 ÷ 15"로는 호출 수를 구할 수 없습니다. 올바른 중단 규칙은 "행이 충분히 모였다" 또는 "has_more가 false다"입니다. "N페이지를 가져왔다"는 중단 기준이 될 수 없습니다.
답글도 마찬가지입니다. 게시물 B의 한 댓글은 sub_comment_count가 52였습니다. 00:17:17 SGT에 이 댓글에 대해 xiaohongshu/sub_comments를 호출했습니다. 1페이지는 10행이 아닌 5행을 반환했고, 그중 2행은 텍스트가 비어 있었습니다. 아마 이미지나 스티커였을 것입니다.
따라서 답글은 유용한 행당 비용이 더 높습니다. 최상위 댓글 페이지는 $0.005556에 평균 12.5행을 반환했지만, 이 답글 페이지에서 텍스트가 있는 행은 3개였습니다. 라벨링에서는 기본적으로 답글을 건너뛰기를 권장합니다. 모델이 불만으로 분류했고 답글이 많은 댓글에 대해서만 답글을 가져오세요.
| 기능 | 카탈로그 page_size | 실제 페이지당 행 수 | 호출당 가격 | 유용한 행당 비용 |
|---|---|---|---|---|
xiaohongshu/search | 20 | 20(1페이지) | $0.005556 | 게시물당 약 $0.00028 |
xiaohongshu/comments | 15 | 10~15, 평균 12.5(8페이지) | $0.005556 | 댓글당 약 $0.00044 |
xiaohongshu/comments_batch | 게시물당 15 | 게시물당 10~15(게시물 3개) | 게시물당 $0.005556 | 단일 게시물과 동일 |
xiaohongshu/sub_comments | 10 | 5, 그중 2개는 텍스트 없음(1페이지) | $0.005556 | 답글당 약 $0.0019 |
테스트 2: 규칙 기반 필터가 걸러 내는 것과 하지 못하는 것
세 번째 가설은 "댓글을 바로 모델에 넣어도 된다"였습니다. 합격 기준은 모든 게시물에서 노이즈 30% 미만이었습니다. 게시물 A는 이 기준에 크게 못 미쳤습니다. 두 페이지에 걸친 댓글 25개 중 24개가 중국어로 "그룹 참여"(17개), "저도요"(6개), "참여"(1개)라고만 적혀 있었습니다. 스크린샷을 보면 대부분 "작성자가 좋아함" 태그가 붙어 있고, 일부에는 투표 응답 태그도 있습니다. 모두 sub_comment_count가 1입니다.
작성자가 댓글로 공동구매를 모집했고, 사용자들이 참여하겠다는 답글을 단 것으로 보입니다. 이런 댓글은 사용자가 무엇을 원하는지 알려 주지 않지만, 과금되는 페이지를 채웁니다. 나머지 게시물 5개 중에서는 게시물 D에만 노이즈 행이 1개 있었고, 빈 댓글이었습니다.
정규식 하나로 무엇을 할 수 있는지 보기 위해 키워드 규칙 분류기를 기준선으로 만들었습니다. 규칙은 먼저 노이즈를 표시합니다. "그룹 참여"만 있는 텍스트, 이모지만 있는 텍스트, 빈 텍스트가 노이즈입니다. 그다음 불만 단어(냄새, 반품, 돈 낭비, 엉킴), 니즈 단어(추천, 어떤 것, 물음표), 가격 단어(가격, 위안, 저렴한 대체품, 예산), 칭찬 단어(잘 됨, 깨끗함, 시간 절약) 순서로 확인합니다. 아무것에도 해당하지 않는 댓글은 "미정"이 됩니다.
이 결과는 모델이 낸 것이 아닙니다. 규칙이 처리할 수 있는 부분과 모델이 필요한 부분을 보여 줄 뿐입니다. 댓글 100개에 대해 규칙은 노이즈 25, 니즈 24, 불만 13, 가격 8, 칭찬 5, 미정 25로 분류했습니다.
| 규칙이 맞힌 경우 | 규칙이 틀렸거나 판단하지 못한 경우 |
|---|---|
| "그룹 참여" 답글 25개가 모두 정확히 일치해 제거됨 | "그러니까 귀신이 우리 집에 나흘이나 숨어 있었다고...?"는 농담이지만 물음표 때문에 니즈로 분류됨 |
| "개당 3위안, 한 달 감"이 가격으로 분류됨 | "내 저가형 Xiaomi는 머리카락이 안 엉켜요"는 칭찬이지만 "엉킴"이라는 단어 때문에 불만으로 분류됨 |
| "140제곱미터... 예산 3,000, 뭘 사야 하나요?"가 니즈로 분류됨 | "먼지 봉투가 일회용이라는 걸 댓글 보고 처음 알았어요"는 새로 알게 된 정보라 미정으로 남음 |
| "도크 배기 냄새가 심한데 어떻게 해결하나요?"가 불만으로 분류됨 | "세탁기 옆에 30분 동안 서 있으세요?"는 반어적 질문이지만 니즈로 분류됨 |
이 표를 보면 스크립트를 두 단계로 나눈 이유를 알 수 있습니다. 규칙은 노이즈만 제거합니다. 노이즈는 매번 같은 형태이고, 잘못 버려도 손실이 거의 없습니다. 네 가지 의도는 모델에 맡깁니다. 물음표 하나가 요청일 수도, 반어적 질문일 수도, 농담일 수도 있기 때문입니다.
게시물 C는 제목에 "구매 가이드"가, 게시물 D는 제목에 "로봇청소기"가 들어 있습니다. 하지만 두 게시물의 댓글은 대부분 크리에이터의 콩트 줄거리와 운동 이야기입니다. 그중 7행 이상은 규칙과 모델 모두 "기타"로 분류해야 할 농담입니다. 제목만 보고 게시물을 고르면 유용한 댓글 수를 과대평가하게 됩니다. 따라서 탐색 에이전트가 제목과 함께 is_cooperation_note와 댓글 수도 받도록 하기를 권장합니다. 그러면 명백한 코미디 게시물을 먼저 건너뛸 수 있습니다.
모델을 이용한 텍스트 라벨링 연구는 샘플 검수 기준을 정하는 데 도움이 됩니다. 한 연구는 제로샷 라벨이 대부분의 작업에서 크라우드 워커보다 낫다는 결과를 보였습니다(arXiv 2303.15056). 다른 연구는 모델과 작업에 따라 편차가 크다는 사실을 발견했고(arXiv 2311.05769), 한 방법론 논문은 엄격한 검증을 필수 단계로 꼽습니다(Sociologica, 2024). 이 작업에 적용하면 규칙은 세 가지입니다. 샘플 검수를 건너뛰지 마세요. 첫 번째 라벨을 보지 않는 다른 모델을 사용하세요. 합격 기준(예: 일치율 80%)을 미리 정하세요. 실행 결과가 기준에 못 미치면 라벨 정의를 수정하고 배치 전체를 다시 라벨링하세요.
테스트 3: 같은 페이지를 세 번 요청하자 새 댓글 7개가 나왔고, 호출마다 과금되었다
이 테스트는 워크플로와 관련된 질문에 답합니다. 에이전트가 실패한 뒤 다시 실행되면 어떻게 될까요? 00:15:33 SGT에 게시물 B의 첫 페이지를 가져왔습니다. 00:21:35와 00:21:55에 같은 요청 본문을 다시 보냈습니다. 두 번째 응답은 첫 번째 응답과 댓글 15개 중 8개만 겹쳤습니다.
세 번째 응답은 첫 번째와 13개, 두 번째와 10개가 겹쳤습니다. 세 번의 호출에서 서로 다른 댓글이 모두 22개 나왔습니다. 호출마다 $0.005556이 들었고, 요청이 동일해도 무료가 되지 않았습니다.
즉 기본 정렬은 안정적인 순서가 아닙니다. 시간과 플랫폼의 순위 산정에 따라 바뀝니다. 워크플로에서는 이 점이 재개 규칙과 맞물립니다. 문서의 설명은 명확합니다. 재개 시 완료된 에이전트는 저장된 결과를 반환합니다.
하지만 프롬프트가 바뀐 첫 번째 에이전트와 그 뒤의 모든 에이전트는 다시 실행됩니다. 실패한 에이전트도 다시 실행되며, 스크립트가 그 뒤에 시작하는 모든 에이전트도 이미 완료된 것까지 포함해 다시 실행됩니다. 문서에 예시가 있습니다. 스크립트가 A, B, C, D를 시작하고 B가 실패합니다. 재개하면 A는 캐시에서 가져오고 B, C, D는 다시 실행됩니다(워크플로 페이지, "Which agents run again").
2026년 10월 20일 릴리스된 v2.1.305에서 관련 문제가 수정되었습니다. 이 수정 전에는 편집하지 않은 스크립트를 재개해도 pipeline()과 parallel()에서 완료된 에이전트가 다시 실행될 수 있었습니다(변경 내역 2.1.305).
두 사실을 합쳐 보겠습니다. 수집 에이전트가 다시 실행되면 API를 다시 호출하므로 비용을 다시 냅니다. 돌아오는 댓글이 달라질 수 있어서, 이후 에이전트가 이미 만든 라벨과 맞지 않을 수 있습니다. 골격 밖에서 지킬 규칙 세 가지를 권장합니다.
첫째, 수집과 라벨링을 별도의 워크플로 두 개로 나누세요. 첫 번째 워크플로는 수집과 파일 저장만 합니다. 데이터가 올바르게 보이면 두 번째 워크플로가 파일을 읽어 라벨링합니다. 그러면 라벨링 실행이 실패해도 API를 전혀 호출하지 않습니다.
둘째, 기본값보다 훨씬 안정적인 sort=newest 또는 sort=most_liked로 가져오세요. 카탈로그에 따르면 정렬을 바꾸면 이전 next_page_token이 더 이상 동작하지 않으므로, 페이지를 넘기는 도중에는 정렬을 바꾸지 마세요. 셋째, 댓글 하나가 두 번의 수집에 모두 나올 수 있으므로 집계 전에 댓글 id로 라벨 중복을 제거하세요.
멈춤(stall)도 재실행을 일으킵니다. 에이전트가 일정 시간 동안 출력을 내지 않으면 같은 프롬프트로 처음부터 다시 시작하며, 최대 5번까지 반복합니다. 이미 변경한 파일은 그대로 남고, 사용한 토큰도 실행 총량에 포함됩니다(워크플로 페이지, "When an agent stalls and restarts"). 자체 도구 호출을 기다리는 시간은 포함되지 않으므로, 2.5초 걸리는 API 호출은 멈춤으로 판정되지 않습니다.
응답 스트림이 멈추면 다른 종류의 실패가 발생합니다. 스트리밍 유휴 감시 기능(watchdog)이 스트림을 종료하며, 이 타임아웃은 CLAUDE_STREAM_IDLE_TIMEOUT_MS로 설정합니다(네트워크 구성 문서). 에이전트가 429를 받은 뒤 오래 기다리면서 출력을 내지 않으면 멈춘 것으로 간주되어 다시 시작될 수 있습니다. 그러면 이미 비용을 낸 호출을 반복합니다.
저희가 받은 429는 1초 대기를 요구했으므로 위험은 작았습니다. 사용량이 많은 공유 키에서는 대기 시간이 길어집니다. 이 경우 agent(prompt, { stallMs: 600000 })처럼 수집 에이전트에 별도의 stallMs를 지정하세요.
병렬 실행과 요청 속도 제한: 분당 10회 제한 키에 에이전트 16개가 몰릴 때
워크플로는 기본적으로 에이전트 16개를 동시에 실행합니다. 저희 키에는 분당 10회라는 자체 제한이 있었고, 같은 시간에 다른 프로그램도 이 키를 함께 사용했습니다. 약 10초마다 호출했으므로 제한보다 한참 낮아야 했습니다. 하지만 x-ratelimit-remaining-requests 헤더 값은 5, 5, 2, 0이었습니다.
00:15:59 SGT에 한 호출이 429를 반환했습니다. 그 뒤 헤더 값은 8, 3, 6, 5, 1이었습니다. 공유 키에서는 이런 패턴이 나타납니다. 다른 프로그램이 언제 호출하는지 볼 수 없으므로 헤더와 429만으로 판단해야 합니다. 자신의 프로그램만 키를 사용한다면 남은 횟수는 호출할 때마다 줄어들어야 하며 오르내리지 않아야 합니다. 여기서 보이는 오르내림은 공유 키 때문이며, 전용 키에서는 나타나지 않습니다.
에이전트는 429 본문을 직접 읽을 수 있습니다. 본문 텍스트는 "rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s."였습니다. 본문에는 retry_after: 1, retryable: true, max_retries: 3과 "Nothing was charged"라는 문장도 있었습니다. 안전을 위해 60초 넘게 기다렸고, 00:17:17에 200을 받았습니다.
429에는 비용이 들지 않았고, 과금 합계에도 포함되지 않았습니다. 골격의 수집 프롬프트도 같은 규칙을 씁니다. 429를 받으면 error.retry_after초 동안 기다린 뒤 재시도하며, 최대 3회까지 시도합니다. Anthropic API도 요청이 너무 빠르면 retry-after 헤더와 함께 429를 반환합니다(Anthropic 요청 속도 제한 문서). 프롬프트 규칙 하나로 두 경우를 모두 처리할 수 있습니다.
{"error":{"code":"rate_limited",
  "message":"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.",
  "reason":"key_limit","retry_after":1,"limit":10,"fault":"account","retryable":true,"max_retries":3,
  "next_steps":["Over this key's or account's request rate. Nothing was charged. Retry after retry_after seconds, or ask the user to raise the limit."]}}
재시도는 수동적인 방어입니다. 능동적인 방어는 두 가지입니다. 첫 번째는 동시 실행 수를 낮추는 것입니다. CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS를 2 또는 3으로 설정하세요.
두 페이지를 가져오는 수집 에이전트에는 약 5초의 API 시간과 자체 추론 시간이 필요합니다. 에이전트가 3개이면 요청 속도가 분당 10회에 가까워지고, 나머지는 재시도로 처리됩니다. 이 변수는 실행 전체에 적용되므로 라벨링 에이전트도 느려집니다. 총 소요 시간이 중요하다면 수집과 라벨링을 별도의 워크플로 두 개로 나누고, 라벨링 실행에는 제한을 두지 마세요.
두 번째 능동적 방어는 배치 호출입니다. xiaohongshu/comments_batch는 요청 한 번에 게시물을 최대 20개까지 받으며, 게시물당 과금됩니다. 00:17:38 SGT에 요청 한 번으로 게시물 3개를 가져왔습니다. 댓글 35개가 반환되었고 비용은 $0.016667, 즉 게시물당 $0.005556으로 xiaohongshu/comments와 같았습니다. 요청은 3.28초가 걸렸고, 단일 게시물 호출은 약 2.4초가 걸렸습니다.
| 게시물 40개의 첫 페이지 | 요청 | 분당 10회 기준 최소 소요 시간(분) | API 비용 |
|---|---|---|---|
게시물당 xiaohongshu/comments 1회 호출 | 40 | 4 | $0.22224 |
xiaohongshu/comments_batch, 호출당 게시물 20개 | 2 | 1 | $0.22224 |
배치 호출은 비용은 그대로 두고 요청 수를 줄입니다. 공유 키와 워크플로에서는 요청 수가 실제 병목입니다. 분당 10회 제한 키로 요청 40건을 보내려면 최소 4분이 걸립니다. 요청 2건은 몇 초 만에 끝납니다. 따라서 더 나은 골격에서는 탐색 후 에이전트 1~2개가 모든 게시물의 첫 페이지를 comments_batch로 가져옵니다. 그런 다음 댓글이 많은 게시물에서만 다음 페이지를 가져옵니다.
배치 결과의 모든 행에는 next_page_token이 있으므로 xiaohongshu/comments로 이어서 가져올 수 있습니다. 카탈로그에는 경고가 하나 있습니다. 일부 게시물이 실패하면 응답의 partial과 missed를 확인해야 합니다. 누락된 게시물을 댓글이 없는 게시물로 취급하지 마세요. 이 문장을 수집 프롬프트에 넣으세요.
비동기 모드도 사용할 수 있습니다. 카탈로그에 따르면 모든 기능은 본문의 "mode":"async"를 지원합니다. 즉시 202와 job_id를 받은 뒤 GET /api/v1/jobs/{job_id}를 폴링합니다. 00:18:21 SGT에 게시물 B의 2페이지를 비동기 모드로 요청했습니다. 202 응답에 이미 succeeded 상태가 표시되었습니다.
00:18:30에 폴링 결과로 15행이 반환되었습니다. everyinfra_get_job 도구 설명에 따르면 폴링은 무료이며 분당 제한에 포함되지 않습니다. 댓글은 2~3초 안에 반환되므로 비동기 모드가 필요하지 않습니다. 하지만 같은 워크플로에서 느린 기능도 호출한다면, 비동기 모드와 폴링을 사용해 에이전트가 요청 연결을 열어 둔 채 기다리는 일을 피할 수 있습니다.
실패, 재시도, 과금: 비용을 두 번 내게 되는 경우
표에서는 저희의 관찰 결과를 워크플로 동작과 나란히 정리했습니다. "워크플로 동작" 열은 워크플로 페이지를, "API 과금" 열은 원본 응답을 근거로 합니다.
| 내용 | 워크플로 동작 | API 과금 | 스크립트의 방어책 |
|---|---|---|---|
| 429 요청 속도 제한 | 에이전트가 처리 | 과금 안 됨("Nothing was charged") | retry_after만큼 기다린 후 재시도, 최대 3회 |
422 잘못된 값(예: sort=hottest) | 에이전트가 처리 | 과금 안 됨 | 재시도하지 않고 메시지 보고 |
| 에이전트 멈춤 | 같은 프롬프트로 재시작, 최대 5회 | 성공한 호출이 다시 실행되어 다시 과금 | 수집 에이전트에 stallMs 설정 |
| 에이전트 실패 후 재개 | 해당 에이전트와 이후 모든 에이전트가 다시 실행 | 다시 실행된 수집은 다시 과금 | 수집과 라벨링을 워크플로 두 개로 분리 |
| 6분 안에 같은 요청 | 해당 없음 | 매번 과금되며 내용이 바뀜 | 댓글 id로 중복 제거 |
| 라벨 출력이 스키마를 통과하지 못함 | 재시도하다가 5회 시도 후 실패 | API 호출 없음 | 스키마를 작게 유지 |
| 구독 사용량 한도 | v2.1.271부터 조건 충족 시 한도 초기화까지 일시 중지 | API 호출 없음 | 먼저 일부 데이터로 테스트 |
사용량 한도 행과 관련해, 세션 자체도 한도 초기화를 기다릴 수 있습니다(대화형 모드 문서). 422 테스트는 00:16:07 SGT에 sort를 일부러 hottest로 설정해 실행했습니다. 응답은 `"sort must be one of: default, most_liked, newest (got 'hottest')"였습니다. 응답에는 allowed 목록과 did_you_mean: ["most_liked"]`도 있었고, 비용이 청구되지 않았다는 내용도 있었습니다.
이런 오류는 워크플로에 잘 맞습니다. 수집 에이전트가 오류를 읽고 값 하나를 바꾼 뒤 사용자에게 묻지 않고 계속 진행할 수 있습니다. strict tool use 글에서는 엄격한 도구 정의가 모델 쪽에서 잘못된 enum 값을 막는다는 점을 보여 드렸습니다. 워크플로에서는 수집 프롬프트에 sort 값을 하드코딩하는 편이 더 간단합니다.
청구 금액: 댓글 500개에 호출은 몇 번, 비용은 얼마인가
이 작업에 쓰이는 API의 단가는 하나입니다. 2026년 11월 2일 00:14 SGT에 카탈로그를 확인했습니다. xiaohongshu/search, xiaohongshu/comments, xiaohongshu/sub_comments, xiaohongshu/comments_batch는 모두 호출당 $0.005556입니다(배치는 게시물당). 실패한 호출과 빈 결과는 무료입니다. 페이지 단위 기능의 호출 수는 목표 행 수를 페이지당 행 수로 나눈 뒤 올림한 값입니다.
아래 세 가지 방법은 댓글 페이지만 계산합니다. 검색은 페이지당 게시물 20개를 반환합니다. 댓글 500개에는 보통 게시물 20~40개가 필요하므로 호출 1~2회, 즉 $0.0056~$0.0111이 추가됩니다.
| 방법 | 페이지당 행 수 | 호출 수 | API 비용 |
|---|---|---|---|
| 카탈로그 값 | 15 | 34 | $0.188904 |
| 실측 평균 | 12.5 | 40 | $0.22224 |
| 노이즈 25% 제거 후 유용한 댓글 500개 | 12.5 | 54(먼저 667개 수집) | $0.300024 |
| 이 글의 실제 사용량: 과금된 요청 10건, 과금 단위 12개 | n/a | 10 | $0.066671 |
다음 표는 이 테스트의 모든 요청을 2026년 11월 2일 SGT 기준으로 정리한 것입니다. 429, 422, 작업 폴링은 무료였습니다.
| 시각(SGT) | 요청 | HTTP | 행 | 과금 |
|---|---|---|---|---|
| 00:14:59 | xiaohongshu/search | 200 | 게시물 20개 | $0.005556 |
| 00:15:22 | xiaohongshu/comments, 게시물 A 1페이지 | 200 | 10 | $0.005556 |
| 00:15:33 | xiaohongshu/comments, 게시물 B 1페이지 | 200 | 15 | $0.005556 |
| 00:15:49 | xiaohongshu/comments, 게시물 A 2페이지 | 200 | 15 | $0.005556 |
| 00:15:59 | xiaohongshu/sub_comments, 게시물 B | 429 | 0 | $0 |
| 00:16:07 | sort=hottest를 적용한 xiaohongshu/comments | 422 | 0 | $0 |
| 00:17:17 | xiaohongshu/sub_comments, 게시물 B | 200 | 5 | $0.005556 |
| 00:17:38 | xiaohongshu/comments_batch, 게시물 C, D, E | 200 | 35 | $0.016667 |
| 00:17:55 | MCP everyinfra_call_api, 게시물 F | 200 | 10 | $0.005556 |
| 00:18:21 | xiaohongshu/comments 비동기, 게시물 B 2페이지 | 202 | 폴링 시 15 | $0.005556 |
| 00:21:35 | xiaohongshu/comments, 게시물 B 1페이지 재요청 | 200 | 15 | $0.005556 |
| 00:21:55 | xiaohongshu/comments, 게시물 B 1페이지 재요청 | 200 | 15 | $0.005556 |
세 번째 방법에는 주의할 점이 있습니다. 노이즈 비율 25%는 저희가 수집한 게시물 6개에서 나온 값이며, 거의 전부가 게시물 A에서 나왔습니다. 다른 키워드에서는 이 비율이 0일 수도 있고 훨씬 높을 수도 있습니다. 따라서 먼저 게시물 3~5개로 워크플로를 실행해 보세요.
log() 줄에 기록된 필터링 결과 개수를 확인한 뒤 가져올 게시물 수를 정하세요. 문서도 비용에 대해 같은 조언을 합니다. 먼저 작은 범위로 실행하고, /workflows에서 에이전트별 토큰을 확인하며, 필요하면 실행을 중단하라는 것입니다(workflows 페이지, “Cost”).
Claude 쪽 비용은 측정하지 않았으므로 직접 확인할 수 있는 부분만 소개합니다. 2026년 11월 2일에 확인한 Anthropic 요금 페이지에는 100만 토큰당 다음 가격이 나와 있습니다. Haiku 5.5는 100,000토큰 이하 프롬프트 기준으로 입력 $0.10, 출력 $0.50입니다. Sonnet 5.5는 각각 $2와 $10입니다. Opus 5.5는 $4와 $20입니다.
텍스트만 놓고 보면 댓글 500개는 해당 페이지의 경험칙(10 kB가 약 2,500토큰)에 따라 약 12,000토큰입니다. 이 텍스트를 Haiku에 입력하는 비용은 $0.002 미만입니다. 비용 대부분은 다른 곳에서 발생합니다. 각 에이전트에는 시스템 프롬프트, 도구 정의, 자체 추론이 포함되며, 이들이 차지하는 크기는 사용하는 버전과 MCP 도구에 따라 달라집니다. 저희는 이 부분을 측정하지 않았으니 /workflows에서 직접 수치를 확인하세요.
구독 요금제에서는 워크플로 사용량이 플랜 한도에 포함됩니다. 비용 문서에 따르면 모든 서브에이전트와 워크플로 에이전트는 각자 별도로 요청을 보냅니다. Reddit 출시 스레드에서 한 사용자는 프롬프트 하나에 700,000토큰, Max 플랜 사용량의 36%가 소모됐다고 밝혔습니다. 다른 사용자는 첫 시도에 1.2M 토큰이 사용됐다고 했습니다(Reddit 출시 스레드). 저희가 검증할 수 없는 사용자 보고이지만, 처음에 작은 규모로 테스트해야 하는 이유를 잘 보여 줍니다.
컨텍스트와 토큰: 수집 단계에서 데이터를 줄여야 하는 이유
댓글 하나는 평균 약 1,445바이트의 JSON으로 반환되며, 본문 텍스트만 따지면 약 95바이트입니다. 약 15배 작은 크기입니다. 원본 JSON에는 20개 필드가 있으며, 그중에는 작성자 이름, 아바타 URL, IP 지역, 태그, 첫 번째 답글, xsec_token이 포함된 게시물 URL이 있습니다. 이 가운데 라벨링에 도움이 되는 필드는 거의 없습니다.
요금 페이지의 대략적인 비율로 계산하면 원본 댓글 하나는 약 361토큰, 텍스트는 약 24토큰입니다. 실제로 중국어 텍스트에는 다른 비율이 적용됩니다. 정확한 수치가 필요하면 사용하는 모델로 토큰 카운팅 엔드포인트를 호출하세요.
이 차이는 두 곳에서 중요합니다. 첫째는 라벨링 에이전트의 입력입니다. 수집 에이전트가 원본 JSON을 반환하면 각 라벨링 에이전트는 게시물당 10,000~30,000토큰의 JSON을 읽습니다. 텍스트를 반환하면 수백 토큰만 읽습니다.
둘째는 프롬프트 캐싱입니다. 문서에 따르면 한 번의 실행에서 모델, effort 수준, 에이전트 유형, 도구, 출력 스키마, 작업 디렉터리가 같은 에이전트들은 프리픽스를 공유합니다. 나중에 실행된 에이전트는 앞선 에이전트의 캐시를 읽을 수 있습니다. 워크플로 에이전트의 캐시는 기본적으로 5분 동안 유지됩니다.
subagentPromptCacheTtl을 1h로 설정하면 캐시가 1시간 동안 유지되지만 캐시 쓰기 비용이 더 높습니다(workflows 페이지, “Prompt caching in a fan-out”; 프롬프트 캐싱 문서). 스켈레톤에서는 모든 수집 에이전트가 같은 haiku 모델, low effort, COMMENTS 스키마를 사용하므로 이 프리픽스를 공유할 수 있습니다. 게시물마다 다른 모델을 지정하면 공유 캐시를 쓸 수 없습니다.
라벨링 단계: 스키마, 라벨 정의, 일치도
라벨링 스키마의 필드는 id와 label 두 개이며, label은 다섯 가지 값으로 제한됩니다. 필드가 적을수록 오류와 스키마 재시도가 줄어듭니다. 예산, 면적, 반려동물 정보도 필요하다면 별도의 추출 단계를 추가하세요. 이 단계는 모델이 니즈로 라벨링한 댓글에만 실행합니다. 라벨링 스키마에 선택 필드를 여러 개 추가하지 마세요.
Anthropic API는 output_config.format의 json_schema로 출력을 제한합니다(구조화된 출력 문서). 워크플로의 schema 옵션은 Claude Code 안에서 같은 역할을 합니다. 반환값이 이미 객체이므로 스크립트에서 텍스트를 파싱하지 않습니다.
라벨 정의는 사람이 그대로 적용할 수 있도록 작성하세요. 저희 규칙 기반 베이스라인의 오류 4건은 모두 모호한 정의에서 나왔습니다. 수사 의문문과 농담이 니즈처럼 보였습니다. 비교(“내 저가 모델은 머리카락이 안 엉킨다”)는 불만처럼 보였습니다. 그래서 스켈레톤은 각 라벨에 어떤 단어가 들어가는지가 아니라 라벨이 무엇을 뜻하는지를 정의합니다. 예시는 게시물 6개의 댓글을 번역한 것입니다.
| 라벨 | 정의 | 실제 데이터 예시 |
|---|---|---|
| need | 어떤 모델을 살지 묻거나 링크를 요청함 | “140제곱미터, 타일 바닥, 머리카락 많음, 예산 3,000, 뭐 살까요?” |
| complaint | 제품이나 서비스의 문제를 보고함 | “도크 배기구에서 냄새가 심해요, 어떻게 고치죠?” |
| price | 가격, 저렴한 호환품, 구매처를 이야기함 | “개당 3위안, 한 달 써요” |
| praise | 작성자가 제품을 사용 중이며 추천함 | “제 저가형 샤오미는 머리카락이 안 엉켜요” |
| other | 농담, 줄거리 이야기, 주제와 무관한 내용 | “그러니까 귀신이 나흘 동안 우리 집에 숨어 있었다는 거죠...?” |
“예산 3,000, 뭐 살까요?”처럼 니즈이면서 가격 댓글이기도 한 경우는 어떻게 할까요? 저희는 작성자가 원하는 것을 기준으로 라벨링하므로 이 댓글은 니즈입니다. 팀에서 가격대를 더 중요하게 본다면 가격을 니즈보다 앞에 두고, 그 순서를 프롬프트에 명시하세요.
스팟 체크는 workflows 문서에서 설명하는 적대적 검토(adversarial review)를 차용했습니다. 적대적 검토에서는 실행 결과를 보고하기 전에 독립된 에이전트들이 서로의 발견에 이의를 제기합니다(workflows 페이지, “When to use a workflow”). 라벨링은 버그 찾기가 아니므로 저희 검사 에이전트는 첫 라벨을 반박하려 하지 않습니다. 대신 첫 라벨을 보지 않은 채 샘플을 다시 라벨링합니다. 그런 다음 스크립트가 일치율을 계산합니다. 다른 모델(스켈레톤에서는 Sonnet)을 쓰면 두 에이전트가 같은 실수를 할 가능성이 줄어듭니다.
일치율은 하한선일 뿐입니다. 두 모델이 모두 농담을 니즈로 분류하면 일치율은 높지만 라벨은 틀립니다. 그러므로 새 키워드라면 첫 실행에서 샘플 댓글 20개를 직접 읽어 보세요. 불일치 항목과 명백한 오류를 라벨 정의에 반영하세요. 그런 다음 전체 배치를 다시 라벨링합니다.
한계와 주의 사항
아래 표에 일곱 가지 한계와 각각의 대응 방법을 정리했습니다. 처음 두 행은 workflows 페이지, “Behavior and limits”에서 가져왔습니다.
| 한계 | 영향 | 대응 방법 |
|---|---|---|
| 스크립트는 인터넷에 접속할 수 없음 | 모든 API 호출이 에이전트 안에서 일어나며, 에이전트가 호출을 한 번 더 할 수 있음 | 스키마로 calls와 charged_usd를 반환받아 합계 확인 |
| 실행 중에는 사용자에게 입력을 요청할 수 없음 | 수집과 라벨링 사이에 검토 불가 | 단계마다 워크플로 하나씩 |
| 세션을 종료하면 실행도 중단됨 | 다시 실행하면 진행 중이던 에이전트는 처음부터 시작 | 저장된 결과에서 다시 실행 |
댓글 URL에 xsec_token 필요 | “정리한” URL은 실패 | 반환된 URL을 그대로 사용 |
| 공개 댓글만 수집 | 숨김·접힌 댓글은 누락 | 부정적 의견이 적게 잡힐 수 있음 |
| 저희 라벨은 규칙 기반 베이스라인 | 집계 수치는 모델 출력이 아님 | 자체 데이터로 스팟 체크 실행 |
| 버전마다 다름 | 많은 튜토리얼이 예전 동작 기준 | claude --version 실행. 이 글은 2.1.316 기준 |
세션을 백그라운드로 보내거나 종료하면 실행은 스스로 이어지지 않습니다. Claude가 저장된 결과에서 다시 실행해야 하며, 아직 실행 중이던 에이전트는 처음부터 다시 시작해 토큰을 또 사용합니다(agent view 문서).
카탈로그는 최근 검색 결과에서 얻은 전체 댓글 URL을 쿼리 문자열까지 포함해 요구합니다. 페이지 토큰은 24시간 동안 유효하므로 다음 날 재개하려면 처음부터 다시 시작해야 합니다. 댓글 500개 기준 수치는 단가와 실측한 페이지 크기로 계산했으며, 실제로 댓글 500개를 가져오지는 않았습니다. 이 글은 2026년 11월 2일에 확인한 문서를 기준으로 합니다.
댓글 데이터에는 IP 지역과 표시 이름이 포함됩니다. 보고서에는 라벨, 집계 수치, 이름을 뺀 인용문만 넣으세요. 댓글 인용문을 전송하거나 게시하기 전에 해당 사용이 현지 법률과 플랫폼 약관을 준수하는지 확인하세요. 이 글은 데이터 처리 방법을 설명할 뿐이며 법률 자문을 제공하지 않습니다.
FAQ
Claude Code 워크플로와 에이전트 팀 비교: 댓글 분류에는 어느 쪽이 맞을까?
에이전트 팀은 리드 에이전트 하나, 장시간 실행되는 피어 세션 몇 개, 공유 작업 목록으로 구성됩니다. 실험적 기능이라 플래그가 필요합니다(에이전트 팀 문서). 워크플로는 짧게 실행되는 에이전트를 수십~수백 개 띄우는 스크립트입니다. 서로 독립적인 댓글 수백 개에는 워크플로가 더 적합합니다. 게시물 몇 개를 턴마다 직접 조정하고 싶다면 Claude Code 서브에이전트 글에서처럼 일반 서브에이전트가 더 적합합니다. (질문 출처: 자동완성 추천 검색어 “claude code workflows vs agent teams”)
Claude Code 워크플로와 스킬 비교: 둘 다 필요할까?
스킬은 Claude가 대화 중에 따르는 지침 묶음입니다. 워크플로는 런타임이 실행하는 스크립트입니다(workflows 페이지). 둘은 함께 쓸 수 있습니다. 라벨 정의를 스킬에 넣고, 워크플로의 에이전트가 그 스킬을 불러오게 하세요. 그러면 정의를 한곳에서 관리할 수 있습니다. (질문 출처: 추천 검색어 “claude code workflows vs skills”)
Claude Code 동적 워크플로는 한 번 실행할 때 토큰을 얼마나 사용할까요?
문서에는 정해진 수치가 없습니다. 같은 작업을 대화로 처리할 때보다 한 번의 실행이 훨씬 많은 사용량을 소모할 수 있다고만 설명합니다. 먼저 작은 범위로 실행해 보고 /workflows를 확인하라고 권장합니다(워크플로 페이지, "Cost"). Reddit 사용자들은 프롬프트 하나에 700,000~1.2M 토큰을 사용했다고 보고했습니다(Reddit). 이 작업의 API 비용은 별도이며, 댓글 500개에 약 $0.222입니다. (질문 출처: 검색 추천어 "claude code workflows cost"로, "cost per token", "cost reddit" 등 변형이 열 가지 있습니다.)
ultracode란 무엇이고, 켜야 할까요?
Ultracode는 Claude Code의 스위치입니다. 켜 두면 Claude가 실질적인 작업마다 워크플로를 작성할지 스스로 판단합니다. effort 수준이 아닙니다.
세션 안에서 /effort ultracode(v2.1.284 이상)를 실행하면 스위치만 켜지고 effort 수준은 그대로 유지됩니다. effort까지 xhigh로 설정하는 것은 실행 플래그 claude --effort ultracode뿐입니다(모델 설정 문서). 켜 두면 “Large workflow” 경고가 표시되지 않습니다. 유료 API를 호출하는 작업이라면 꺼 두고, 프롬프트 하나로 워크플로를 요청하는 방식을 권장합니다. (질문 출처: 추천 검색어 “ultracode claude”, “ultracode claude reddit”)
사람이 검토할 수 있도록 워크플로를 멈추려면 어떻게 하나요?
문서에 따르면 실행 중에는 입력을 요청할 수 없으므로, 승인 단계가 필요하면 워크플로를 나눠야 합니다(workflows 페이지, “Behavior and limits”). /workflows에서 실행을 선택하고 x를 눌러 중단할 수도 있으며, 완료된 에이전트의 결과는 유지됩니다. Hacker News 스레드에서도 같은 우려가 나왔습니다. 장시간 실행에 사람의 판단을 끼워 넣기가 어렵다는 것입니다(Hacker News, 2026-05-28). (질문 출처: Reddit 출시 스레드의 한 댓글 작성자가 서브에이전트가 잘못된 분기로 계속 진행하기 전에 어떤 신호로 멈추는지 물었습니다.)
시작하는 방법
- EveryInfra 빠른 시작에서 API 키를 발급받은 뒤,
xiaohongshu/search와xiaohongshu/comments의 무료 카탈로그를 읽어 보세요. - 위 명령으로 원격 MCP 서버를 Claude Code에 추가하세요. 원격 MCP 설정과 MCP 서버 페이지를 참고하세요.
- Claude Code에 스켈레톤을 따르는 워크플로를 게시물 5개로 실행해 달라고 요청하세요. 계획을 읽은 뒤 “Yes, run it”을 선택합니다.
- 실행이 끝나면
/workflows에서 토큰을 확인하고, API 비용을 요금 페이지와 비교하세요. 결과가 좋은 실행은s를 눌러 명령으로 저장합니다.
기능 이름만 바꾸면 같은 스켈레톤을 다른 플랫폼에도 쓸 수 있습니다. Xiaohongshu 데이터 API의 댓글, 답글, 배치 댓글을 참고하세요. 다른 중국 플랫폼은 Douyin 데이터 API와 Weibo 데이터 API를 참고하세요. 라벨링 전에 댓글을 정리하려면 Claude Code에서 DeepSeek V4로 댓글 정리하기를 읽어 보세요.
참고 자료
- “Orchestrate subagents at scale with dynamic workflows”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/workflows
- “Claude Code changelog”. Anthropic. 최신 항목 2.1.316, 2026-10-31. https://code.claude.com/docs/en/changelog
- CHANGELOG.md. GitHub anthropics/claude-code. 2026-11-02 열람. https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- “Introducing dynamic workflows”. Anthropic. 2026-05-28. https://claude.com/resources/articles/introducing-dynamic-workflows-in-claude-code
- “Claude Code Adds Dynamic Workflows for Parallel Agent Coordination”. InfoQ. 2026년 6월. https://www.infoq.com/news/2026/06/dynamic-workflows-claude-code/
- “Building agents: When to fold subagents into your main agent loop”. Anthropic. 2026-10-22. https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- “Create custom subagents”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/sub-agents
- “Run agents in parallel”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/agents
- “Agent teams”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/agent-teams
- “Skills”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/skills
- “Settings reference”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/settings-reference
- “Model configuration”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/model-config
- “Environment variables”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/env-vars
- “Agent SDK reference, TypeScript”. Anthropic. 2026-11-02 열람. https://code.claude.com/docs/en/agent-sdk/typescript
- “Connect Claude Code to tools via MCP”. Anthropic. 2026-11-02 열람. https://code.claude.com/docs/en/mcp
- “Manage costs”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/costs
- “Configure permissions”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/permissions
- “Permission modes”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/permission-modes
- “Prompt caching in Claude Code”. Anthropic. 2026-11-02 열람. https://code.claude.com/docs/en/prompt-caching
- “Run Claude Code programmatically”. Anthropic. 2026-11-02 열람. https://code.claude.com/docs/en/headless
- “Hooks reference”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/hooks
- “Sandboxing”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/sandboxing
- “Plugin manifest reference”. Anthropic. 2026-11-02 열람. https://code.claude.com/docs/en/plugins/manifest-reference
- “Agent view”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/agent-view
- “Claude Code on the web”. Anthropic. 2026-11-02 열람. https://code.claude.com/docs/en/claude-code-on-the-web
- “Remote Control”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/remote-control
- “Interactive mode”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/interactive-mode
- “Network configuration”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/network-config
- “Scheduled tasks”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/scheduled-tasks
- “Commands”. Anthropic, Claude Code 문서. 2026-11-02 열람. https://code.claude.com/docs/en/commands
- “Pricing”. Anthropic, Claude 플랫폼 문서. 2026-11-02 열람. https://platform.claude.com/docs/en/about-claude/pricing
- “Structured outputs”. Anthropic, Claude 플랫폼 문서. 2026-11-02 열람. https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- “Rate limits”. Anthropic, Claude 플랫폼 문서. 2026-11-02 열람. https://platform.claude.com/docs/en/api/rate-limits
- “Token counting”. Anthropic, Claude 플랫폼 문서. 2026-11-02 열람. https://platform.claude.com/docs/en/build-with-claude/token-counting
- “Transports”, 사양 2025-11-25. Model Context Protocol. 2026-11-02 열람. https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- “Tools”, 사양 2025-11-25. Model Context Protocol. 2026-11-02 열람. https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- Xiaohongshu 기능 카탈로그. EveryInfra. 2026-11-02 00:14 SGT 열람. https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- “Content review rules”. Xiaohongshu Pugongying 고객센터. 페이지 날짜 2026-10-22. https://pgy.xiaohongshu.com/help/detail?id=6495c527d1eedeeb48fb18b1f875650e&userType=4
- Pugongying 홈페이지. Xiaohongshu. 2026-11-02 열람. https://pgy.xiaohongshu.com/
- “ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks”. Gilardi, Alizadeh, Kubli. arXiv 2303.15056, v2 2023-07-19. https://arxiv.org/abs/2303.15056
- “Are Chatbots Reliable Text Annotators? Sometimes”. Kristensen-McLachlan 외. arXiv 2311.05769, v2 2025-02-25. https://arxiv.org/abs/2311.05769
- “Best Practices for Text Annotation with Large Language Models”. Petter Törnberg. Sociologica, 2024. https://sociologica.unibo.it/article/view/19461
- “Introducing dynamic workflows in Claude Code” 토론 스레드. r/ClaudeAI. 2026년 5월. https://www.reddit.com/r/ClaudeAI/comments/1tq9ofy/introducing_dynamic_workflows_in_claude_code/
- “Dynamic Workflows in Claude Code” 토론. Hacker News. 2026-05-28. https://news.ycombinator.com/item?id=48311705
참고 BL-64