小红书数据采集:搜索、笔记、评论全流程和成本实测
同一关键词隔 8 分钟再搜,首页 20 条只剩 7 条相同。真调小红书搜索、笔记、评论 12 次,每千条 $0.368,算每月 1 万到 100 万条花费。
2026 年 11 月 14 日 13:06 我们在小红书搜「流感疫苗」,按相关度排序拿到第一页 20 条笔记;13:14 用同样的参数再搜一次,20 条里只有 7 条和上一次相同,13:26 第三次再搜,三次都出现的只剩 4 条。同一关键词、三个时刻、两种排序,7 页共 140 行结果,去重后是 83 篇不同的笔记,所以一次搜索只能算一个样本,做趋势和舆情要按时刻、按排序多取几次再去重。整条「搜索 → 笔记详情 → 评论 → 子评论 → 机构账号作品列表」流程我们用 EveryInfra 按次付费接口跑了 12 次付费调用,花 $0.066672,返回 181 条,折合每 1,000 条 $0.368;按这个结构,每月 1 万条约 $3.68,10 万条约 $36.84,100 万条约 $368。
小红书数据采集,指的是把小红书上公开的笔记、评论、账号作品等内容按条取下来,存成表,再做统计、舆情、选品或研究。能走的路有三种:小红书自己的官方入口;自己写或用开源的采集脚本;按调用次数付费的数据接口。按次付费一侧的单价按 charged_usd 除以实际返回条数算。
第一种做法:官方开放平台、蒲公英和聚光各能读什么
小红书面向开发者和企业的官方入口有好几个,各管一件事。我们在 2026 年 11 月 14 日逐个重读了官方原文,按「要什么资质、能读到什么」整理成下表。
| 官方入口 | 要什么资质 | 原文写明能读到什么 | 和「采集别人的公开笔记、评论」的关系 |
|---|---|---|---|
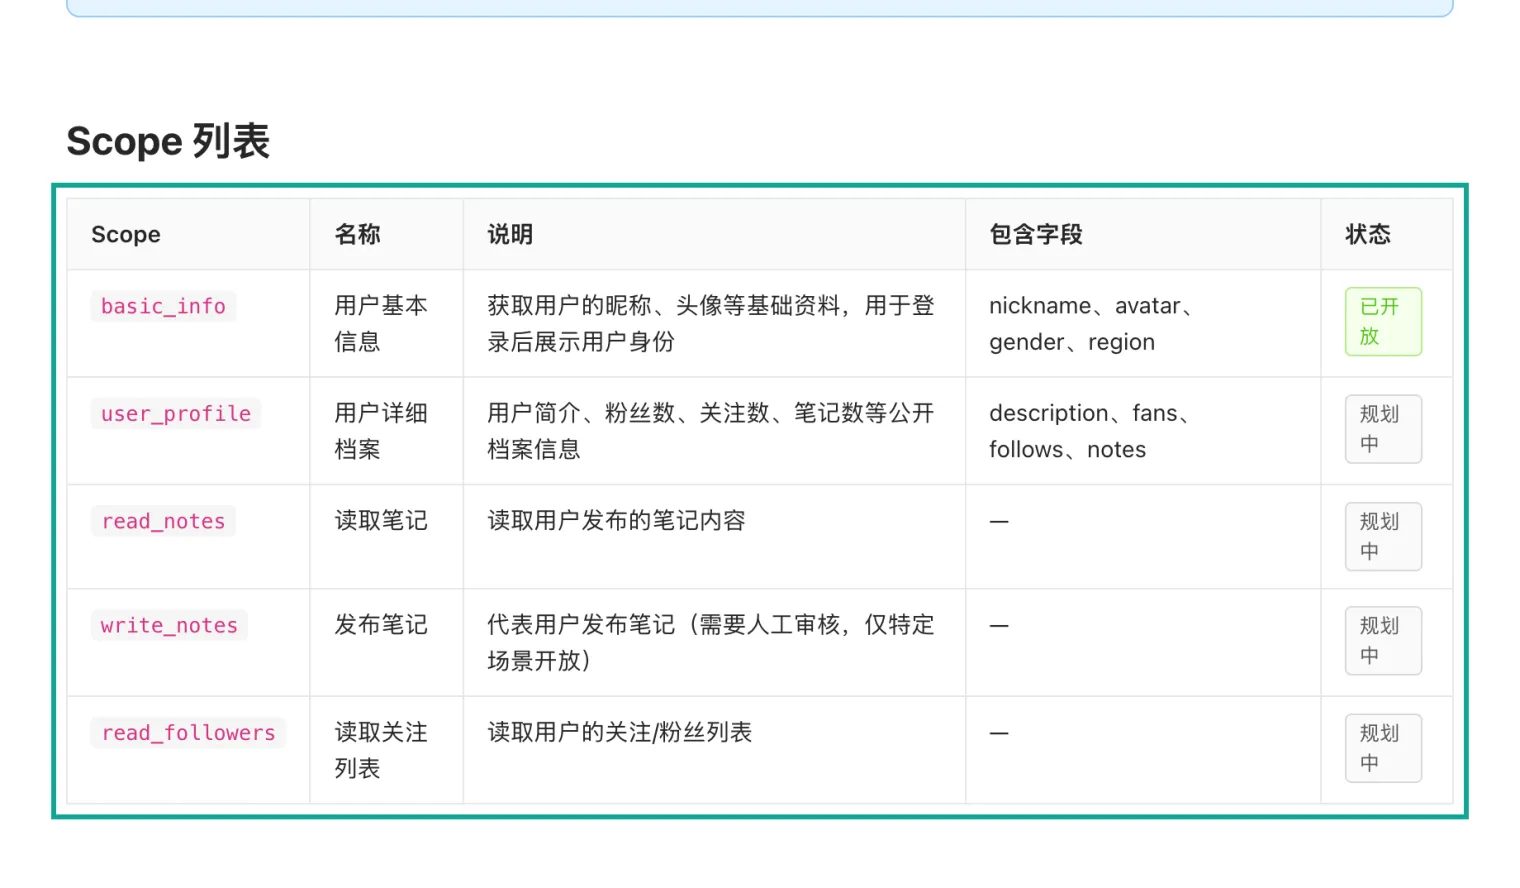
| 开放平台账号能力(openaccount.xiaohongshu.com) | 创建应用后等待审核,约 1–3 个工作日 | 只开放 basic_info:登录用户的昵称、头像、性别、地区 | read_notes、user_profile、read_followers 都是「规划中」 |
| 蒲公英(pgy.xiaohongshu.com) | 品牌先在专业号平台认证企业资质;企业号认证 600 元/次,有效期 1 年 | 品牌找博主做内容和直播合作的平台 | 公开页面没写按条导出笔记、评论的接口 |
| 聚光 Marketing API(ad.xiaohongshu.com) | 有聚光投放账号、有投放经验的行业重点客户,由销售发起审批 | 自己广告账户的报表、计划、创意 | 只读自己的投放数据 |
| 电商开放平台(open.xiaohongshu.com) | 只允许店铺主账号授权 | 授权店铺的商品、订单等 | 只读自己店铺 |
先看第一行。开放平台的授权范围页写着「当前仅开放 basic_info 一个 scope」,五个授权范围里只有 basic_info 是「已开放」,读取笔记的 read_notes 还在「规划中」(授权范围,页面最后更新 2026-03-29,11 月 14 日重读未变)。快速接入文档说,创建应用后要「等待审核(约 1-3 个工作日)」,接上以后能做的是「用户点击 → 跳转小红书授权 → 返回应用并获取用户信息」(快速接入)。所以开放平台解决的是「让用户用小红书账号登录你的应用」,它在今天不提供搜索别人笔记、读别人评论的接口。
蒲公英是品牌和博主谈合作的平台。它的入驻说明写的是:品牌商家先「前往小红书专业号平台」「成功认证企业资质」,再「使用你的专业号信息,即可登陆蒲公英平台」;代理商走合作伙伴平台,店铺走电商入驻(蒲公英入驻说明)。企业号认证的费用写在官方的《小红书企业号认证申请指南》里:「认证费用 600 元/次」「认证有效期为 1 年,每年需要完成一次年审」,认证失败不退审核费(认证申请指南 PDF)。蒲公英里能看到博主报价和合作笔记的表现,这些数据在平台网页里查看;我们读到的公开页面没写可以按条导出笔记和评论的开发者接口。按 2026 年 11 月 13 日的人民币汇率中间价 6.7152(中新网转述中国外汇交易中心),600 元一年约合 $89.35,平摊到每月约 $7.45,这笔钱买的是入驻和合作资格。
聚光 Marketing API 的入门指南把门槛写得很直白:「有聚光投放账号,在小红书聚光平台具有一定投放经验的行业重点客户」,注册「由小红书销售内部发起审批」,能力是数据报表和投放管理(聚光 Marketing API 入门指南,更新于 2024-01-03)。电商开放平台的授权流程写着「只允许店铺主账号才可以授权成功」(授权流程(软件服务商))。另有一个分享开放平台,做的是把内容一键分享、发布到小红书,方向是写入(分享开放平台)。四个入口都管「你自己的东西」:你的登录用户、你的广告账户、你的店铺。研究一个公开话题下别人发了什么、评论里在说什么,这几个入口的公开文档列出的是登录、合作、投放和店铺能力,没有写到对应的读取接口(2026-11-14 读取)。逐项对照见《小红书 API 怎么选:官方平台、开源脚本、按次付费》。
EveryInfra 的能力目录里另有一项 xiaohongshu/pgy_content_square,读蒲公英内容广场的热门内容榜,每页 20 条、每个榜最多 5 页,单价 $0.016(能力目录)。能力目录写明支持,本次没有实测,所以下文的成本都不含它。
第二种做法:自己写采集脚本,开源项目里写了什么
GitHub 上和小红书有关的开源项目很多,我们挑了 6 个星标多或常被引用的仓库,用 GitHub 的公开接口读了仓库信息,并把 2026 年 10 月 15 日到 11 月 14 日这 30 天里新开的 issue(不含合并请求)逐条看了标题和正文(List repository issues 文档)。下面只引这些项目 README 和 issue 的原文。
| 仓库 | 星标 | 许可证 | 最近一次推送 | 30 天新 issue | 其中取不到数 |
|---|---|---|---|---|---|
| NanmiCoder/MediaCrawler | 71,098 | 自定义(README 写明禁止商用) | 2026-11-09 | 3 | 0(2 条是别的平台,1 条是广告帖) |
| xpzouying/xiaohongshu-mcp | 17,115 | Apache-2.0 | 2026-11-10 | 13 | 4 |
| JoeanAmier/XHS-Downloader | 13,292 | GPL-3.0 | 2026-11-13 | 7 | 2 |
| cv-cat/Spider_XHS | 8,467 | 未声明 | 2026-10-22 | 0 | 0 |
| jackwener/xiaohongshu-cli | 2,731 | 未声明 | 2026-03-21 | 0 | 0 |
| ReaJason/xhs | 2,236 | MIT | 2025-07-01 | 0 | 0 |
30 天里 6 个仓库共新开 23 条 issue,其中 6 条是登录失败、搜索受限、取数或解析失败,占 26%。这 6 条集中在两个最活跃的仓库,另外三个仓库 30 天没有新 issue,其中 ReaJason/xhs 最近一次推送停在 2025 年 7 月 1 日。issue 少有两种解释:工具稳定,或者用的人少了、维护停了;单看 issue 数分不出来,选仓库时要和推送时间一起看。
取不到数的那几条,原文是这样写的。xiaohongshu-mcp 的 #877(2026-10-21)标题是「搜索被限制(但是app里面正常使用」,正文说账号收到「疑似使用第三方工具和脚本直接被警告」的提示(#877);#880(2026-10-23)是扫码后又收到验证码、没有登录成功(#880);#874(2026-10-18)是搜索工具约 60 秒后报超时、列首页推荐却正常(#874);#907(2026-11-05)是「获取登录二维码失败」(#907)。XHS-Downloader 的 #497(2026-10-17)写明:小红书「最近(2026-10-15 前后)在部分笔记页面的 SSR 数据」里新增了一个 JavaScript 写法,导致解析笔记时崩溃(#497);五天后的 #499 是「获取笔记失败问题」(#499)。#497 和 #499 都出在笔记详情页的解析上,两条都已关闭,关闭前用这个版本解析笔记会失败。
README 里也写清了自写脚本要自己承担的东西。MediaCrawler 的技术原理一栏写着「基于 Playwright 浏览器自动化框架登录保存登录态」,免责声明写着「禁止用于商业用途」(MediaCrawler README、LICENSE)。xiaohongshu-mcp 的 README 写着「小红书需要进行登录」,并提醒「小红书的同一个账号不允许在多个网页端登录」,否则会把正在用的那个会话「踢出登录」;新号会收到实名认证提醒(xiaohongshu-mcp README)。同一仓库的 #878(2026-10-22)问的是「小红书官方允许吗?使用后会不会遇到笔记推流减少等问题。」,到 11 月 14 日没有回复(#878)。
按这些原文,自写脚本要自己承担四块:一个登录着的账号(README 写明同一账号不能多处登录),页面一变就要有人修(#497、#499),许可证可能不允许商用(MediaCrawler),以及账号收到违规预警的可能(#877)。一项 2026 年的研究也只能对两个平台人工摘录:2026 年发表在 BMC Public Health 的一项登革热和基孔肯雅热讨论研究,B 站、微博、知乎三个平台走接口采集,抖音和小红书「because of platform anti-automation controls」只能人工摘录,最后两平台合计只有 97 条,只做描述性报告(BMC Public Health, 2026)。
第三种做法:小红书 搜索 api 接口按次付费,一条流程实测
按次付费接口把每一步做成一个 HTTP 请求:发一个关键词,回一页结果;发一条笔记链接,回详情或一页评论。EveryInfra 的能力目录里,每项能力写着必填参数、可选参数、每页条数和单价(能力目录,2026-11-14 13:05 读取)。我们这次用到的六项能力,单价都是每次 $0.005556:
| 能力 | 必填参数 | 每页条数 | 翻页 | 本次返回 |
|---|---|---|---|---|
xiaohongshu/search | keyword | 20 | page_token | 7 页,每页 20 条 |
xiaohongshu/note | url | 1 | 无 | 1 条 |
xiaohongshu/comments | url | 最多 15 | page_token | 第 1 页 15 条,第 2 页 1 条 |
xiaohongshu/sub_comments | url、comment_id | 最多 10 | page_token | 1 页 4 条 |
xiaohongshu/user_posts | user_id | 20 | page_token | 1 页 20 条 |
xiaohongshu/hashtag | topic_id | 20 | page_token | 本次没有实测 |
搜索有两个参数会直接改变样本:sort 可选 relevance(相关度)、newest(最新)、most_liked、most_commented、most_collected;date_range 可选最近 24 小时、7 天、30 天、半年、一年。目录对 date_range 写了一条要注意的说明:last_30_days 和 last_1_year 一页可能不足 20 条,「一条都没有的页不收费」,想要更满的页就配 sort=newest。完整说明在小红书数据接口页。
一次往返:请求和真实返回
下面是 13:06:28 那次搜索的请求,Key 从环境变量 EVERYINFRA_API_KEY 读取:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"流感疫苗","sort":"relevance"}}'
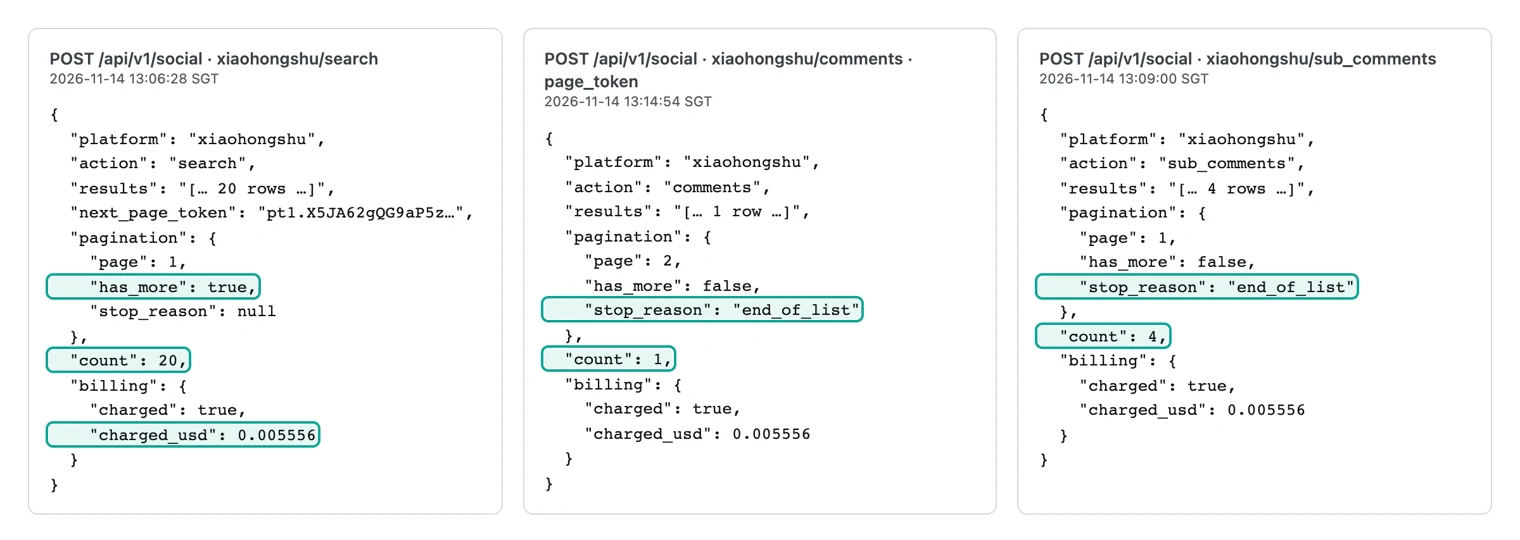
# 下一页:把返回里的 next_page_token 原样放进 params.page_token,其余参数不变返回里我们关心四样:count(这页实际几条)、pagination.has_more 和 stop_reason(还有没有下一页)、next_page_token(下一页的游标)、billing.charged_usd(这次扣了多少)。
| 字段 | 含义 | 13:06 搜索第一页 | 13:14 评论第 2 页 | 13:09 子评论 |
|---|---|---|---|---|
count | 这页实际返回几条 | 20 | 1 | 4 |
pagination.has_more | 还有没有下一页 | true | false | false |
pagination.stop_reason | 为什么停 | 无 | end_of_list | end_of_list |
billing.charged_usd | 这次扣了多少 | 0.005556 | 0.005556 | 0.005556 |
下图是三次真实返回的截取:左边是第一页搜索,has_more 为 true;中间是评论第 2 页,本次返回 1 条,stop_reason 是 end_of_list,平台不再给下一页;右边是一条主评论下的回复,本次返回 4 条,同样停在 end_of_list。
搜索结果每一行的字段和目录里 response_fields 一一对应。我们数了 13:06 那页 20 行里每个字段有值的行数,用来判断哪些字段能直接拿来做统计:
| 字段 | 含义(按目录说明) | 20 行里有值 |
|---|---|---|
id、url、posted_at、author_id | 笔记 ID、带访问令牌的链接、发布时间(UTC)、作者 ID | 20 |
like_count、collect_count、comment_count、share_count | 点赞、收藏、评论、分享数;null 表示没拿到,不等于 0 | 20 |
title | 标题 | 19 |
text | 正文摘要,搜索里约 60 字以内,全文要调 note | 20 |
is_cooperation_note、is_goods_note | 是否品牌合作笔记、是否带货笔记 | 20 |
video_url、duration_sec | 视频地址和时长,图文笔记为空 | 3 |
poi_id | 卡片上标的地点 ID,没标就没有这个字段 | 1 |
text 在搜索和作品列表里是截断的摘要,note 返回全文。做情感或主题分析时,要么只用标题和摘要,要么对筛出来的笔记再调一次 note。后一种每条 $0.005556,是搜索单条成本的 20 倍,所以只对筛过的笔记调。
完整流程:搜索 → 笔记 → 评论 → 子评论
三个实测时刻是新加坡时间(SGT)13:06、13:14 和 13:26,前后跨 20 分钟,我们把下面这条流程按这三个时刻跑完。第一个时刻跑通整条流程,第二、三个时刻重复搜索、补齐评论翻页,并读了一个公共卫生机构账号的作品列表:
| 时刻(SGT) | 能力 | 参数要点 | 本次返回 | charged_usd |
|---|---|---|---|---|
| 13:06:28 | xiaohongshu/search | 流感疫苗,相关度 | 20 条 | 0.005556 |
| 13:06:50 | xiaohongshu/search | 同上,第 2 页 | 20 条 | 0.005556 |
| 13:07:01 | xiaohongshu/search | 流感疫苗,最新 | 20 条 | 0.005556 |
| 13:07:22 | xiaohongshu/note | 一篇讲学校发放三价流感疫苗的提问笔记 | 1 条 | 0.005556 |
| 13:08:41 | xiaohongshu/comments | 同一笔记,第 1 页 | 15 条 | 0.005556 |
| 13:09:00 | xiaohongshu/sub_comments | 点赞最多的那条主评论 | 4 条 | 0.005556 |
| 13:14:28 | xiaohongshu/search | 流感疫苗,相关度 | 20 条 | 0.005556 |
| 13:14:41 | xiaohongshu/search | 流感疫苗,最新 | 20 条 | 0.005556 |
| 13:14:54 | xiaohongshu/comments | 第 2 页 | 1 条,到底 | 0.005556 |
| 13:26:12 | xiaohongshu/search | 流感疫苗,相关度 | 20 条 | 0.005556 |
| 13:26:33 | xiaohongshu/search | 流感疫苗,最新 | 20 条 | 0.005556 |
| 13:26:47 | xiaohongshu/user_posts | 一个市级疾控中心的账号 | 20 条 | 0.005556 |
| 合计 | 12 次付费请求 | 181 条 | 0.066672 |
把流程写成脚本,大约 60 行。下面是可以直接跑的版本:只依赖 requests,Key 从环境变量读;每次逻辑请求带一个 Idempotency-Key,这次调用里的重试沿用同一个键,网络抖动造成的重发只算一次(做法见《AI agent 重试和 Idempotency-Key》);碰到 429 或 503 按返回的 retry_after 等待。整轮任务重跑时脚本会生成新键,按新请求计费,每个时刻拿到的是当时的结果,多时刻采样要的就是这个。
"""小红书 搜索 → 笔记 → 评论(翻到底)→ 子评论。
用法:EVERYINFRA_API_KEY=... python3 xhs_chain.py 流感疫苗
只依赖 requests;结果写成 JSON Lines,一行一条。"""
import json, os, sys, time, uuid
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]

def call(action, params, tries=4):
    idem = str(uuid.uuid4())                      # 同一次逻辑请求,重试共用一个键
    for _ in range(tries):
        r = requests.post(API, timeout=120, json={"platform": "xiaohongshu", "action": action, "params": params},
                          headers={"Authorization": f"Bearer {KEY}", "Idempotency-Key": idem})
        body = r.json()
        if r.status_code in (429, 503):           # 限速或暂时不可用:不扣费,等一会儿再试
            time.sleep((body.get("error") or {}).get("retry_after", 30) + 1)
            continue
        r.raise_for_status()
        return body
    raise RuntimeError(f"{action} 重试 {tries} 次仍未成功")

def pages(action, params, max_pages=10):
    token = None
    for _ in range(max_pages):
        body = call(action, {**params, **({"page_token": token} if token else {})})
        yield from body.get("results") or []
        token = body.get("next_page_token")
        if not token or not (body.get("pagination") or {}).get("has_more"):
            break
        time.sleep(8)                              # 翻页之间留间隔,按自己的任务量调

def main(keyword, out="xhs.jsonl"):
    with open(out, "a", encoding="utf-8") as f:
        notes = list(pages("search", {"keyword": keyword, "sort": "newest"}, max_pages=1))
        for n in notes:
            f.write(json.dumps({"type": "search", **n}, ensure_ascii=False) + "\n")
        target = max(notes, key=lambda n: n.get("comment_count") or 0)       # 只对评论最多的那篇往下取
        detail = call("note", {"url": target["url"]})["results"]
        f.write(json.dumps({"type": "note", **detail}, ensure_ascii=False) + "\n")
        for c in pages("comments", {"url": target["url"]}):
            f.write(json.dumps({"type": "comment", **c}, ensure_ascii=False) + "\n")
            if (c.get("sub_comment_count") or 0) > len(c.get("sub_comments") or []):
                for s in pages("sub_comments", {"url": target["url"], "comment_id": c["id"]}):
                    f.write(json.dumps({"type": "sub_comment", **s}, ensure_ascii=False) + "\n")

if __name__ == "__main__":
    main(sys.argv[1])
脚本里两处判断控制调用次数。第一处是只对评论最多的那一篇往下取:一页搜索 20 篇,每篇都取详情和评论,调用数会乘上 20。第二处是子评论只在 sub_comment_count 大于主评论行里自带的 sub_comments 条数时才去取。这次 16 条主评论里,有 3 条带回复,sub_comment_count 合计 9;主评论行里已经各带了 0 到 1 条回复,所以只有回复多的那几条值得再调一次 sub_comments。
评论翻到底的判断
评论有两层:主评论和楼中楼回复。主评论用 comments 翻页,每页最多 15 条,翻到返回里没有 next_page_token、stop_reason 为 end_of_list 为止。这篇笔记的第 1 页 15 条(13:08:41),第 2 页 1 条(13:14:54),两页共 16 条,ID 没有重复,16 条都带 IP 属地,来自 10 个省级地区。回复用 sub_comments,我们取的那条主评论 sub_comment_count 是 4,sub_comments 一次返回 4 条、stop_reason 为 end_of_list:其中 1 条直接回复主评论,另外 3 条是回复的回复,reply_to_id 指向楼中楼里的上一条。所以要还原对话结构,按 reply_to_id 建树,不能只按时间排。
| 请求 | 时刻(SGT) | 本次返回 | `has_more` / `stop_reason` | 说明 |
|---|---|---|---|---|
comments 第 1 页 | 13:08:41 | 15 条 | true / 无 | 满页,还有下一页 |
comments 第 2 页 | 13:14:54 | 1 条 | false / end_of_list | 平台不再给下一页,两页共 16 条 |
sub_comments 一条楼 | 13:09:00 | 4 条 | false / end_of_list | 1 条回复主评论,3 条回复楼中楼 |
翻到 end_of_list 表示平台不再给下一页。能力目录对 comments 的 sort 参数写明:默认排序是平台的推荐顺序,每次请求都会重排,翻页会漏掉或重复一部分评论;newest 按时间排、翻页稳定,但有的笔记平台只给最新的一部分(能力目录)。本次用的是默认排序,两页隔了 6 分 13 秒取。要更稳的翻页用 sort=newest;用默认排序时多翻一轮、按评论 id 合并。统计报告里写清楚每一页是几点取的、用的哪种排序。
评论计数在单价上有个规律:每次调用的价格固定,每页条数越满,每千条越便宜。这次评论第 2 页只有 1 条,两页 16 条摊下来每千条 $0.695;如果一篇笔记有几百条评论,大部分页都是满的 15 条,每千条会接近 $0.370($0.005556 ÷ 15 × 1,000)。批量取多篇笔记的第一页评论,可以用 xiaohongshu/comments_batch 一次传多条链接,用法见批量评论的实战指南,本次没有实测这项。
把五项能力放在一起看,各能力单价相同,每千条成本由每页条数决定:同样 $0.005556 一次,搜索和作品列表一次 20 条,笔记详情一次 1 条,后者每千条是前者的 20 倍。规划预算时,先决定哪些数据只要列表级字段(标题、摘要、互动数、发布时间),哪些必须调详情(全文、话题标签、地理坐标),再按比例估。本次整条流程 181 条、$0.066672,每千条 $0.368,是一个「以搜索为主、少量详情和评论」的结构;如果你的流程以笔记详情为主,每千条会往 $5.556 靠。
采样设计:同一关键词,不同排序、不同时刻重合多少
一次搜索只是一个时刻的样本。我们用同一关键词「流感疫苗」在三个时刻各搜两种排序,按笔记 id 求两页的交集。每页都是 20 条,所以交集就是「两页共有几篇」。
| 对比 | 13:06 → 13:14 | 13:14 → 13:26 | 13:06 → 13:26 | 三次合计不同笔记 | 三次都出现 |
|---|---|---|---|---|---|
| 相关度排序,第 1 页 | 7 / 20 | 6 / 20 | 5 / 20 | 46 | 4 |
| 最新排序,第 1 页 | 11 / 20 | 12 / 20 | 7 / 20 | 37 | 7 |
| 同一时刻:相关度对最新 | 13:06 是 4 / 20 | 13:14 是 2 / 20 | 13:26 是 7 / 20 | — | — |
第一,相关度排序在 20 分钟内换得最快:三次第一页合起来有 46 篇不同笔记,三次都在的只有 4 篇。「最新」排序三次合起来 37 篇,三次都在的 7 篇。第二,同一时刻两种排序几乎是两份样本,交集只有 2 到 7 篇;同一时刻两页合起来是 36、38、33 篇不同笔记。第三,同一次搜索的第 1 页和第 2 页没有重复,翻页拿到的是新笔记。7 页 140 行,去重后 83 篇,重复率 41%。
两种排序取到的笔记年龄也不同。「最新」三次的中位发布时间是 16.1、6.2、4.3 小时前,20 条里 19 到 20 条是 48 小时内发的;「相关度」三次的中位数是 30.9、58.0、22.0 小时前,单页里最老的一篇在 13:26 那次是 281 天前。互动量也跟着变:相关度第 2 页的评论数中位数是 4.5,「最新」各页是 0 到 0.5,新发的笔记还没来得及积累互动。
据此给一套采样做法,读者可以按自己的预算改:
| 研究目的 | 排序 | 频率和深度 | 去重和记录 |
|---|---|---|---|
| 话题热度趋势 | newest | 每 1–2 小时取第 1 页;新笔记多时多翻 1–2 页 | 按 id 去重,记录首次出现时刻 |
| 主题内容研究 | relevance + most_commented | 同一天 3 个时刻各取 2–3 页 | 合并去重;只对评论数高的笔记取详情和评论 |
| 舆情事件回看 | newest + date_range | 事件后每天 2 次,持续 7 天 | 记录每一页的采集时刻和排序参数 |
| 评论观点分析 | 先用上面任一种筛笔记 | 每篇评论翻到 end_of_list,回复按需 | 按 reply_to_id 建树,作者 ID 先统一再去重 |
最后一行提到作者 ID 要统一:目录写明,评论类结果里的 author_id「多为 29 位的另一种写法」,和笔记类结果里 24 位的 ID 不同,跨批次去重前先用 profile 换成同一种(能力目录)。不统一的话,同一个人会被算成两个人。
重复也要算进预算。7 页搜索共付 $0.038892,拿到 140 行,按行算每千条 $0.278;去重后只有 83 篇不同的笔记,按不同笔记算每千篇约 $0.469。多时刻、多排序采样会让一部分钱花在重复的笔记上,这部分钱买到的是「这篇笔记在几个时刻都出现」这条信息,可以用来给笔记打稳定度分。如果只要不同笔记的清单,本次数据里相关度排序更划算:三次第一页共 60 行,去重后 46 篇,每千篇约 $0.362;「最新」三次 60 行去重后 37 篇,每千篇约 $0.450。「最新」的用处在于及时抓到刚发的笔记,适合趋势监测。
| 计数方式 | 行数 | 花费 | 每千条或每千篇 |
|---|---|---|---|
| 7 页搜索,按行 | 140 | $0.038892 | $0.278 |
| 7 页搜索,去重后的不同笔记 | 83 | $0.038892 | $0.469 |
| 相关度三次第一页,去重后 | 46 | $0.016668 | $0.362 |
| 「最新」三次第一页,去重后 | 37 | $0.016668 | $0.450 |
再按采集顺序看每多取一页能带来几篇新笔记。把 7 页按实际请求时刻排好,每页只数前面各页都没出现过的笔记:
| 采集顺序 | 页 | 本页新笔记 | 累计不同笔记 | 这一页折合每千篇新笔记 |
|---|---|---|---|---|
| 1 | 13:06 相关度第 1 页 | 20 | 20 | $0.278 |
| 2 | 13:06 相关度第 2 页 | 20 | 40 | $0.278 |
| 3 | 13:07 最新第 1 页 | 14 | 54 | $0.397 |
| 4 | 13:14 相关度第 1 页 | 10 | 64 | $0.556 |
| 5 | 13:14 最新第 1 页 | 7 | 71 | $0.794 |
| 6 | 13:26 相关度第 1 页 | 6 | 77 | $0.926 |
| 7 | 13:26 最新第 1 页 | 6 | 83 | $0.926 |
每一页的价格都是 $0.005556,「这一页折合每千篇新笔记」= $0.005556 ÷ 本页新笔记 × 1,000。前两页是同一次搜索往下翻,20 篇全是新的;第 3 页换了排序,还有 14 篇新的;之后每隔几分钟重搜一次,新笔记降到 10、7、6、6 篇,边际成本涨到第一页的 3.3 倍。单看一种排序也是同样走势:相关度三次第一页依次带来 20、13、13 篇新笔记,「最新」依次是 20、9、8 篇。预算有限时,先把同一次搜索往后翻、再加另一种排序,比同一种排序隔几分钟重搜换来的新笔记多;重搜的价值在于记录「哪些笔记一直在」,不在扩大清单。
重合率的算法很简单:把两页的笔记 id 各放进一个集合,交集大小除以并集大小就是 Jaccard 系数。13:06 和 13:14 两次相关度第一页交集 7 篇、并集 33 篇,Jaccard 约 0.21;同样两个时刻的「最新」第一页交集 11 篇、并集 29 篇,约 0.38。每次采样后把这个数记下来,连续几天画成折线,就能看出这个关键词的结果换得快不快,从而决定隔多久取一次。
这套设计的边界:本次只测了一个关键词、三个时刻、20 分钟,样本是 7 页 140 行,上面所有重合率、去重成本都只在这个范围内成立。热词和冷门词的换页速度不同,深夜和白天也不同,换关键词前先按同样办法跑三次,算出自己的重合率,再定频率。社交媒体抽样偏差的问题在学术界讨论得早,Morstatter 等人 2013 年比较过 Twitter 抽样接口和全量数据,发现抽样接口的结果取决于参数和时段(ICWSM 2013)。小红书搜索的样本同样取决于排序和时刻。
每月 1 万、10 万、100 万条:三种做法各花多少
把三种做法放进同一张表,按每月取多少条来算。按次付费一侧用实测:本次整条流程每千条 $0.368,另给「只取搜索页」的下限(每千条 $0.278)和「全是笔记详情」的上限(每千条 $5.556)。自写脚本一侧没有实测,工时、时薪、代理流量都是本文的假设,假设、出处和读取日期列在第二张表里,外部页面原文存档在本篇的原始数据目录,读者把自己的数代进去重算即可。
| 每月条数 | 按次付费(本次流程结构) | 只取搜索页 | 全是笔记详情 | 自写脚本(本文假设) | 官方入口 |
|---|---|---|---|---|---|
| 1 万 | $3.68 | $2.78 | $55.56 | $79.25 | 读不到别人的笔记和评论 |
| 10 万 | $36.84 | $27.80 | $555.60 | $181.77 | 同上 |
| 100 万 | $368.35 | $278.00 | $5,556.00 | $672.57 | 同上 |
| 自写脚本的假设(本文假设,非实测) | 取值 | 出处和读取日期 |
|---|---|---|
| 工程师时薪 | 约 $9.54(64.08 元) | 假设按 2025 年城镇私营单位「信息传输、软件和信息技术服务业」年平均工资 128,166 元(国家统计局,2026-05-15 发布,2026-11-14 读取)÷ 2,000 小时(250 个工作日 × 8 小时,本文假设) |
| 每月维护工时 | 1 万条 8 小时,10 万条 16 小时,100 万条 40 小时 | 本文假设:登录失效、页面结构变化、排错;参考上一节 30 天 6 条取不到数的 issue |
| 代理流量 | 每条 200 KB,每 GB 约 $1.49(¥10) | 每条流量是本文假设;单价取住宅代理公开报价区间 ¥8~20/GB 里的 ¥10/GB 一档(一家代理商公开定价页,2026-11-14 读取) |
| 汇率 | 1 美元 = 6.7152 元 | 2026-11-13 人民币汇率中间价(中新网转述中国外汇交易中心,2026-11-14 读取) |
| 不计入 | 首次开发、服务器、账号 | 首次开发一次性投入,各团队差别大;协议不允许批量注册账号(见下文合规一节) |
量小的时候,按本文假设,自写脚本的成本几乎全是人:每月 1 万条,按次付费 $3.68,自写脚本光维护工时就要约 $76.34,是按次付费的 20.7 倍;连代理费 $2.91 一起是 $79.25,21.5 倍。量大以后,按次付费随条数线性涨,自写脚本的人力不随条数等比例涨,到每月 100 万条时两者只差约 1.8 倍。如果你的流程以笔记详情为主(每千条 $5.556),100 万条要 $5,556,这时自写脚本在纯金额上可能更省,代价是维护、账号风险和下文的协议约束。这张表只算钱,账号被限制、数据断档几天这类损失没有算进去。
两个假设对结果影响最大,可以分别改了重算。一是每条走多少代理流量:本文按 200 KB 算,每月 100 万条时代理费约 $290.85,占自写脚本总成本的 43%;如果你的脚本每条只走 50 KB,代理费降到约 $72.71,自写总成本约 $454.43,仍高于按次付费本次结构的 $368.35。二是维护工时:本文给 100 万条一个月 40 小时;如果页面结构一个月变两次、每次多修一个工作日(8 小时),工时是 56 小时,人力一项约 $534.41,自写合计约 $825.26。
| 情景(每月 100 万条,本文假设) | 代理费 | 人力 | 自写合计 | 是按次付费本次结构($368.35)的几倍 |
|---|---|---|---|---|
| 每条 200 KB,40 小时 | $290.85 | $381.72 | $672.57 | 1.8 |
| 每条 50 KB,40 小时 | $72.71 | $381.72 | $454.43 | 1.2 |
| 每条 200 KB,56 小时 | $290.85 | $534.41 | $825.26 | 2.2 |
金额按 1 美元 = 6.7152 元从人民币换算:代理费 = 条数 × 0.2 MB ÷ 1,024 × ¥10 ÷ 6.7152;人力 = 工时 × 128,166 ÷ 2,000 ÷ 6.7152。
官方入口那一列没有金额:蒲公英要企业号认证(指南写明 600 元/次、有效期 1 年,约合每月 $7.45),开放平台、聚光、电商开放平台的公开页面没写收费标准;四个入口的公开文档都没有写到读取别人笔记和评论的接口,所以和前两种做法比不了价格,只能比用途。
换一个领域:公共卫生话题的笔记和评论怎么取
本次关键词选「流感疫苗」,是因为它有一个可以对照的官方数据源。中国疾控中心 2026 年 11 月 12 日发布的第 45 周(11 月 2 日到 8 日)监测数据显示,全国流感样病例占门急诊就诊比例是 4.1%,流感样病例样本的流感病毒阳性率 18.8%,比上一周高 3.1 个百分点,5 到 14 岁组的阳性率高于其他年龄组(中国疾控中心,第 45 周)。同一周的流感监测周报写到全国报告 125 起流感样病例暴发疫情(第 934 期周报)。官方数据讲的是「多少人病了」,小红书上的笔记和评论讲的是「大家在问什么、担心什么」,两者放在一起看,才知道公众关切和流行强度是不是同步。
这类研究的取数方法可以按下面四步做,每一步都只用上文测过的能力:
| 步骤 | 能力 | 要记录什么 |
|---|---|---|
| 1. 关键词组 | xiaohongshu/search,newest 和 relevance | 采集时刻、排序、页码、笔记 id 和 posted_at |
| 2. 选中笔记的评论 | xiaohongshu/comments、xiaohongshu/sub_comments | reply_to_id、ip_location、发布时间;昵称换成匿名编号 |
| 3. 机构账号 | xiaohongshu/user_posts | 每条机构笔记的发布日期、标题和互动数 |
| 4. 核对说法 | 不调接口,用官方通知和指南 | 每条评论的类别,以及对得上或对不上的官方原文 |
第一步,定关键词组。以疫苗为例,可以按接种场景拆成「流感疫苗 学校」「流感疫苗 儿童」「流感疫苗 医保」「三价 四价」几组,每组用 newest 排序每 2 小时取一次第一页,连续 7 天;同时每天用 relevance 取 2 到 3 页,补上互动多的老笔记。本次相关度第一页里有 281 天前的笔记,研究「本季」时要按 posted_at 过滤掉往季内容。
第二步,选笔记往下取评论。本次那篇笔记的作者问的是学校统一发放的三价流感疫苗该不该打,评论区 16 条主评论来自 10 个省级地区,回复里有人讲自己的接种经历,有人讲费用。这类讨论的价值在评论里,所以对评论数排前的笔记取评论翻到底,楼中楼按 reply_to_id 建树,保留每条评论的 ip_location 和发布时间,方便按地区、按周汇总。
第三步,把机构账号单独取。我们读了一个市级疾控中心账号的作品列表:20 条笔记从 9 月 1 日到 11 月 13 日,点赞 0 到 33,其中一篇标题是「三明农村"一老一小"免费接种流感疫苗」,has_more 为 true,说明还有更早的作品。机构账号发了什么、发得多不多,和用户笔记里的关切放在一起比,能看出科普有没有覆盖到大家问的问题。
第四步,核对说法,不下医学结论。评论里关于价格和报销的说法,可以和地方政府公开的接种通知对照,比如上海普陀区甘泉路街道 10 月 8 日的通知写明三价裂解疫苗 86.4 元或 96.4 元、三价亚单位 306.4 元,另付服务费 6 元,「均可使用医保个人历年账户余额、家庭共济账户支付」(甘泉路街道通知)。接种建议以《中国流感疫苗预防接种技术指南(2026—2027)》为准,指南建议 9 到 10 月完成接种,并把「托幼机构、中小学校、监管场所等重点场所人群」列为优先人群(接种技术指南)。分析报告只统计「多少评论在问价格、多少在讲不良反应、多少在转述政策」,不对个人健康做判断;评论者昵称一律隐去,只保留匿名编号。
评论的分类表要在取数前定好,不要边看边加类别。疫苗话题可以先定五类:问价格和报销、问接种地点和预约、讲接种后反应、转述政策或通知、其他。两个人各自按同一份说明独立标同一批 100 条评论,算一致率,一致率不够就改说明再标,这一步在内容分析里叫编码一致性检验。标完以后,每类的占比按周、按省级地区汇总,和疾控中心的周度阳性率放在同一张时间轴上,可以比较两条曲线的先后。
学术界已经有人这样做过。2025 年发表在 Frontiers in Digital Health 的一项研究,在抖音、B 站、小红书搜「儿童流感疫苗」,每个平台各取 100 条视频共 300 条,发现内容质量评分和评论数的 Spearman 相关系数是 0.90(Frontiers in Digital Health, 2025);另一项 HPV 疫苗舆情研究从知乎、微博、贴吧和小红书收集了 15,391 条帖子(PMC 全文)。Frontiers 那项研究写明是 2025 年 2 月取的样本;按上文的采样设计在多个时刻重复取、按 ID 去重,样本会更接近「这一段时间里出现过的讨论」。同一套方法换到教育话题上也成立:把关键词换成「双减」「课后服务」「升学政策」,机构账号换成地方教育部门的账号即可。
平台也在处理健康类内容。小红书 11 月 4 日启动为期两个月的「清朗·整治科普健康类网络谣言」专项行动,截至 11 月 9 日处置笔记 574 篇、评论 205 条、违规账号 18 个(澎湃新闻,2026-11-09)。这对采样有一个直接影响:被处置的笔记会从搜索结果里消失,今天取到的样本,下周未必还在。研究健康谣言时,取数当天就要把原始返回存下来,并记录每条笔记的采集时刻。
失败、限速和重试:哪些不扣费
接口返回非 200 时,先看返回体里的 error.code 和 next_steps。被限速时返回 429、没扣费,按 retry_after 等待后重试成功;接口暂时不可用时返回 503,同样不扣费。目录还写明,date_range 取到一条都没有的页不收费。
重试时同一请求可能被发两次。REST 接口支持在请求头里带 Idempotency-Key:同一个键的重复请求只执行一次,第二次直接拿到第一次的结果。上文脚本里每次逻辑请求生成一个 UUID,重试时沿用,就是这个用法。原理和各家实现的对照写在《AI agent 重试和 Idempotency-Key》里。另外两条习惯能少踩坑:翻页时除 page_token 外其余参数保持不变,任务中断后从第一页重新取;每次请求把返回里的请求编号 id 和返回原文一起存下来,对账时按它查。
量大的团队可以按任务分开建 Key,各自限速、各自对账,某个任务出问题时也不会拖慢其他任务。
合规要点:协议和法律原文写了什么
采集前要读三份原文。第一份是平台协议。《小红书用户服务协议》(更新日期 2026 年 3 月 23 日)第 3.4 条写着:「未经小红书公司书面许可,您不得复制、读取、采用、统计小红书平台的信息内容及相关数据,或者进行任何形式的销售和商业使用」;第 4.1 条列出不得以「盗链、冗余盗取、非法抓取、模拟下载、深度链接、假冒注册等」方式盗取信息内容,也不得通过未经授权的第三方软件登录或使用;第 2.1 条不允许「频繁注册、批量注册」账号(用户服务协议)。自写脚本要用登录着的账号,这几条直接相关。
第二份是个人信息保护法。第六条要求收集个人信息「应当限于实现处理目的的最小范围」;第十三条第六项允许「在合理的范围内处理个人自行公开或者其他已经合法公开的个人信息」(个人信息保护法全文)。落到采集上,就是只取研究要用的字段,昵称、头像这类个人信息能不存就不存,报告里隐去。第三份是 2025 年 1 月 1 日起施行的《网络数据安全管理条例》,第八条不允许「窃取或者以其他非法方式获取网络数据」(网络数据安全管理条例);2025 年修订的《反不正当竞争法》也有与数据获取相关的条款(国家知识产权局转载)。
| 原文 | 条款 | 对采集意味着什么 |
|---|---|---|
| 小红书用户服务协议 | 3.4、4.1、2.1 | 读取和统计要书面许可;不得非法抓取;不得用未授权第三方软件登录;不得批量注册 |
| 个人信息保护法 | 第六条;第十三条第六项 | 限于处理目的的最小范围;已公开的个人信息在合理范围内处理 |
| 网络数据安全管理条例 | 第八条 | 不得窃取或以其他非法方式获取网络数据 |
我们不提供法律意见,具体项目请找律师看。这三份原文都对目的和范围提了要求,落到采样上:只取要研究的关键词、只往下取需要评论的笔记、只存要统计的字段,数据量和风险会一起降下来。
什么时候选官方入口,什么时候自写
三种做法各有适用的情况,按你手里的需求对一下:
| 你的需求 | 更合适的做法 | 原因 |
|---|---|---|
| 用户用小红书账号登录你的应用 | 官方开放平台 | basic_info 已开放,审核约 1–3 个工作日 |
| 看自己品牌的合作笔记、博主报价 | 蒲公英 | 合作数据只在平台里,按企业号资质开通 |
| 拉自己的广告报表 | 聚光 Marketing API | 只读自己的投放账户,要销售审批 |
| 一次性研究,几千条以内,团队有工程师 | 开源脚本 | 不计工程师工时时现金支出最低(每月 1 万条代理费约 $2.91,按本文假设),但要登录账号、遵守协议、自己修 |
| 定时监测一个话题,每月 1 万到 100 万条 | 按次付费接口 | 不用自己部署和维护,失败不扣费,可以直接接定时任务 |
已经在用开源脚本的团队,可以先把其中一步换成按次付费接口,其余照旧;上文引的 issue 里,搜索受限(#877、#874)和笔记详情解析失败(#497、#499)都出现过,先换哪一步按自己脚本的出错记录定。小红书之外,抖音的评论采集也是同一套流程和采样问题,能力清单在抖音数据接口页。如果目的是做品牌声量周报,现成的做法在《小红书声量周报:新马品牌用 Claude 每周自动出》;要把一次导出存成快照、隔周对比,看《小红书数据导出与快照分析》;想让 Claude Code 自动跑评论分析,看《Claude Code 动态工作流读小红书评论》。
近 30 天和小红书数据有关的动向
几件近期的事会影响采集结果:
| 日期 | 事件 | 对采集的影响 |
|---|---|---|
| 2026-10-15 前后 | 部分笔记页面的页面数据结构变化,开源解析器报错(XHS-Downloader #497,10 月 17 日提交) | 自写脚本要有人值守,修复前取不到数 |
| 2026-10-27 | 小红书公布未成年人治理进展,7 到 9 月处置 AI 魔改、毒动画类内容超 12 万篇,每天学习超 2,000 个新暗语(新京报) | 被处置内容会从结果里消失,样本要当天存档 |
| 2026-11-04 | 「清朗·整治科普健康类网络谣言」专项行动启动,到 11 月 9 日处置笔记 574 篇 | 健康话题的样本会变,回看要用存档 |
| 2026-11-06 | 小红书发布严打虚假低差营销公告,相关笔记和评论会被限流、折叠或删除(界面新闻) | 评论数和可见评论数可能对不上,按翻页结果统计 |
| 2026-11-12 | 中国疾控中心发布第 45 周流感监测数据 | 公共卫生话题有了可对照的官方数据 |
上手:从第一次调用到每天定时跑
第一次调用按快速开始做:注册拿 Key,把上文的 curl 换成你的关键词跑一次,看 count 和 billing.charged_usd。价格以价格页为准,所有能力都可以在数据市场里按平台查。想让 Claude、Cursor 这类 AI 助手直接调,可以接远程 MCP,小红书的工具清单和接法在小红书 MCP 页:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
MCP 适合边问边查;每天固定时刻跑的采样任务,用上文的 REST 脚本加 Idempotency-Key 更稳,失败重试不会重复扣费。MCP 的配置字段按 Model Context Protocol 的规范写(MCP 规范)。定时可以用系统自带的 cron,按上文采样表的频率配;每跑完一次,把当次的 JSON Lines 文件按日期归档,再跑去重和重合率统计。
常见问题
小红书 搜索 api 接口怎么申请?
小红书官方开放平台到 2026 年 11 月 14 日只开放 basic_info 一个授权范围,读取笔记的 read_notes 还在「规划中」,所以目前没有可以申请的官方搜索接口(授权范围)。按次付费接口不用申请:注册拿 Key,调 xiaohongshu/search,每次 $0.005556、每页 20 条。
小红书数据采集合法吗?
要看取什么、怎么取、拿去做什么。平台协议第 3.4 条要求读取、统计平台内容先取得书面许可,第 4.1 条禁止非法抓取和未授权第三方软件登录(用户服务协议);个人信息保护法要求收集「限于实现处理目的的最小范围」(全文)。具体项目请咨询律师。
小红书评论怎么翻到底?
主评论用 comments 每页最多 15 条,翻到返回里没有 next_page_token、stop_reason 为 end_of_list,表示平台不再给下一页;有回复的主评论,当 sub_comment_count 大于行里自带的回复数时,再调 sub_comments 翻到底。目录写明默认排序每次请求会重排、翻页可能漏或重,要更稳的翻页用 sort=newest,用默认排序时多翻一轮、按评论 id 合并。本次一篇笔记两页返回 16 条主评论(能力目录)。
xiaohongshu scraper github 上的项目还能用吗?
能用,但要自己维护。我们看的 6 个仓库在 10 月 15 日到 11 月 14 日新开 23 条 issue,6 条是登录、搜索受限或解析失败;XHS-Downloader #497 记录了 10 月 15 日前后页面结构变化导致解析崩溃(#497)。选仓库时一起看最近推送时间和许可证。
小红书采集工具取到的数据怎么做分析?
先按笔记 id 去重,评论按 reply_to_id 建树,作者 ID 统一成同一种写法;再按发布时间、地区、互动数分组统计。做周报和快照对比的完整流程,见《小红书数据导出与快照分析》。
蒲公英平台有 API 吗?
蒲公英的公开页面写的是入驻和合作流程,品牌要先完成企业号认证(600 元/次,有效期 1 年),我们读到的公开页面没写按条导出笔记和评论的开发者接口(蒲公英入驻说明、认证申请指南)。
参考资料
- 小红书开放平台:授权范围(Scope 列表),2026-11-14 读取。https://openaccount.xiaohongshu.com/docs/scope
- 小红书开放平台:快速接入,2026-11-14 读取。https://openaccount.xiaohongshu.com/docs/quick-start
- 小红书蒲公英:入驻说明,2026-11-14 读取。https://pgy.xiaohongshu.com/role-introduce?needLogout=needLogout
- 小红书蒲公英首页,2026-11-14 读取。https://pgy.xiaohongshu.com/
- 小红书企业号认证申请指南(PDF),2026-11-14 读取。https://fe-video-qc.xhscdn.com/d32a91d3f2fdc2130a7ba5015cc92ca446034613.pdf
- 小红书聚光 Marketing API 入门指南,2026-11-14 读取。https://ad.xiaohongshu.com/openApiDoc?categoryId=761&articleId=3047
- 小红书电商开放平台:授权流程(软件服务商),2026-11-14 读取。https://open.xiaohongshu.com/document/developer/file/38
- 小红书分享开放平台,2026-11-14 读取。https://agora.xiaohongshu.com/index
- 小红书用户服务协议(2026-03-23 更新),2026-11-14 读取。https://agree.xiaohongshu.com/h5/terms/ZXXY20220331001/-1
- NanmiCoder/MediaCrawler README。https://github.com/NanmiCoder/MediaCrawler
- NanmiCoder/MediaCrawler LICENSE。https://github.com/NanmiCoder/MediaCrawler/blob/main/LICENSE
- xpzouying/xiaohongshu-mcp README。https://github.com/xpzouying/xiaohongshu-mcp
- xiaohongshu-mcp issue #874(2026-10-18)。https://github.com/xpzouying/xiaohongshu-mcp/issues/874
- xiaohongshu-mcp issue #877(2026-10-21)。https://github.com/xpzouying/xiaohongshu-mcp/issues/877
- xiaohongshu-mcp issue #878(2026-10-22)。https://github.com/xpzouying/xiaohongshu-mcp/issues/878
- xiaohongshu-mcp issue #880(2026-10-23)。https://github.com/xpzouying/xiaohongshu-mcp/issues/880
- xiaohongshu-mcp issue #907(2026-11-05)。https://github.com/xpzouying/xiaohongshu-mcp/issues/907
- JoeanAmier/XHS-Downloader。https://github.com/JoeanAmier/XHS-Downloader
- XHS-Downloader issue #497(2026-10-17)。https://github.com/JoeanAmier/XHS-Downloader/issues/497
- XHS-Downloader issue #499(2026-10-22)。https://github.com/JoeanAmier/XHS-Downloader/issues/499
- cv-cat/Spider_XHS。https://github.com/cv-cat/Spider_XHS
- jackwener/xiaohongshu-cli。https://github.com/jackwener/xiaohongshu-cli
- ReaJason/xhs。https://github.com/ReaJason/xhs
- GitHub REST API:List repository issues。https://docs.github.com/en/rest/issues/issues#list-repository-issues
- EveryInfra 能力目录,2026-11-14 13:05 读取。https://api.everyinfra.com/api/v1/social/catalog
- 中国疾控中心:2026 年第 45 周流感样病例监测,2026-11-12。https://www.chinacdc.cn/jksj/jksj04_14275/202611/t20261112_1842956.html
- 中国疾控中心:流感监测周报第 934 期,2026-11-11。https://www.chinacdc.cn/jksj/jksj04_14249/202611/t20261111_1842933.html
- 中国疾控中心:中国流感疫苗预防接种技术指南(2026—2027)。https://www.chinacdc.cn/jkts/202609/t20260903_1839780.html
- 上海市普陀区甘泉路街道:流感疫苗接种通知,2026-10-08。https://www.shpt.gov.cn/gqjd-jiedaozhen/gsgg-sqzc-gqjd/20261008/973469.html
- Frontiers in Digital Health:儿童流感疫苗短视频质量研究,2025。https://doi.org/10.3389/fdgth.2025.1591347
- PMC:HPV 疫苗社交媒体讨论研究。https://pmc.ncbi.nlm.nih.gov/articles/PMC13377298/
- BMC Public Health:登革热和基孔肯雅热社交媒体讨论研究,2026。https://doi.org/10.1186/s12889-026-29595-0
- Morstatter 等:Is the Sample Good Enough?,ICWSM 2013。https://doi.org/10.1609/icwsm.v7i1.14401
- 国家统计局:2025 年城镇单位就业人员年平均工资,2026-05-15。https://www.stats.gov.cn/sj/zxfb/202605/t20260515_1963707.html
- 中新网:11 月 13 日人民币汇率中间价,2026-11-13。https://www.chinanews.com.cn/cj/2026/11-13/10731286.shtml
- 中华人民共和国个人信息保护法。https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
- 网络数据安全管理条例(国务院令第 790 号)。https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml
- 中华人民共和国反不正当竞争法(2025 年修订)。https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- 澎湃新闻:小红书启动整治科普健康类网络谣言专项行动,2026-11-09。https://www.thepaper.cn/newsDetail_forward_34439159
- 界面新闻:小红书严打虚假低差营销,2026-11-06。https://m.jiemian.com/article/15301935.html
- 新京报:小红书未成年人治理进展,2026-10-27。https://m.bjnews.com.cn/detail/1793097565129919.html
- Model Context Protocol 规范:Transports。https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
引用编号 BL-155