抖音 用户主页 api 实测:作品列表翻 34 页拿到 672 条
抖音用户主页、作品列表、单条视频能取到什么:官方接口只读授权账号,开源脚本要登录和签名;按次接口翻 34 页拿到 672 条作品,花 $0.0189。
我们在 2026 年 11 月 14 日用 Python 的 requests 读了中国国家博物馆的抖音号:主页、作品列表、单条视频详情、评论、评论回复和视频文稿各跑了一遍,作品列表从第 1 页翻到第 34 页,一共回了 672 条,按作品 id 去重后 0 条重复,翻完花 $0.018904,折合每千条约 $0.028。672 条里 655 条的作者是国博本身,17 条的作者是另外 10 个账号(和国博一起发的共创作品),这 17 条的点赞中位数是 8,810,国博自己作品的点赞中位数是 281。国博 623 条有时长的视频里,60 秒以下的点赞中位数 587,300 秒及以上只有 164。同一条视频我们在 48 分钟里取了三次,单条视频详情三次都比作品列表多出作者抖音号、作者简介和作者获赞三个字段,点赞从 8,691 涨到 8,703。
抖音 用户主页 api 有三条路:先看谁能读谁的数据
官方接口只能读授权给你的应用的那个账号。抖音开放平台的账号类和视频类接口,都绑在一个用户授权的 access_token 上:获取用户公开信息写明 Scope 是 user_info、需要用户授权,接口「获取用户的抖音公开信息,包含昵称、头像、性别和地区」,响应样例里另有 open_id 和 union_id;查询授权账号视频列表的请求头要带「此 token 需要用户授权」的 access-token,文档还写着「目前暂不支持时间过滤」。所以一家机构想看自己账号的数据,官方这条路很合适;想看另一家博物馆、一个科普号的公开主页,就得先让对方在你的应用里点授权。
开源脚本这条路能读公开主页,但要用网页的登录态或者自己算请求签名。DouK-Downloader 的 README 写明,为合法合规「本项目的加密参数算法不再维护」,平台更新导致功能失效时要使用者自己准备加密参数代码;MediaCrawler 靠 Playwright 保存登录态,默认用 CDP 连接本机已登录的 Chrome(要求 Chrome 144 以上),免责声明写着「禁止用于商业用途」。第三条路是按次付费的接口,传账号的 secUid 或视频链接就回结构化 JSON,不需要对方授权,也不用自己部署和维护脚本,代价是每次调用付钱、字段由接口方决定。
| 对照项 | 抖音开放平台 | GitHub 开源脚本 | 按次付费接口(本次用 EveryInfra) |
|---|---|---|---|
| 能读谁的主页和作品 | 只读在你的应用里授权过的账号 | 公开主页,按项目说明多数要登录态 | 公开主页,传 secUid 即可 |
| 准入 | 按能力申请、平台审核;「用户互动数据」限企业、党政和事业单位 | 无准入,要自己部署 | 注册拿 Key |
| 主页字段 | user_info 回昵称、头像、性别和地区 | 取决于项目,字段名随网页接口变 | 目录列 24 个字段,本次 16 个有值 |
| 作品列表 | 授权账号的视频列表,按 cursor 翻页,不支持时间过滤 | 多数支持,README 提示可能只拿到少量作品 | 本次每页 20 条,翻到 next_page_token 消失 |
| 维护 | 2026 年 10 月 31 日前要升级服务器证书 | 签名算法、登录态、风控验证;近 30 天有「重新登录后仍拿不到作品详情」的 issue | 接口方维护 |
| 费用 | 能力本身不收费,人力和审核成本另算 | 服务器和代理费用自担 | 每次 $0.000556;评论、回复每 20 条一档 $0.000556 |
表里官方一列的出处分别是用户互动数据能力页、获取用户公开信息能力页和证书切换公告;开源一列来自下文逐个引用的 README 和 issue;按次付费一列的价格取自 EveryInfra 能力目录,2026 年 11 月 14 日 13:05(新加坡时间)读取。
官方开放平台:账号本人授权,适合机构管自己的号
抖音开放平台把账号数据和视频数据拆成几个能力,申请时各自审核。视频数据能力页写的是「在经过用户授权的情况下可查询视频相关数据,包括视频基本信息(标题、封面、是否置顶、创建时间等)及视频的点赞、播放、分享、评论等官方数据」,使用场景是和「发布内容至抖音」能力一起用,在发布视频时调起授权弹窗。查询特定视频的视频数据的说明是「只返回用户公开的视频数据」,「返回的数据是实时的」,视频设为隐私时返回创建时间为 0 的记录,响应样例的 statistics 里有点赞、下载、播放、分享、转发、评论六个计数。播放数 play_count 就在这六项里,账号本人授权后可以读到,这是官方路线对机构自己最直接的用处。
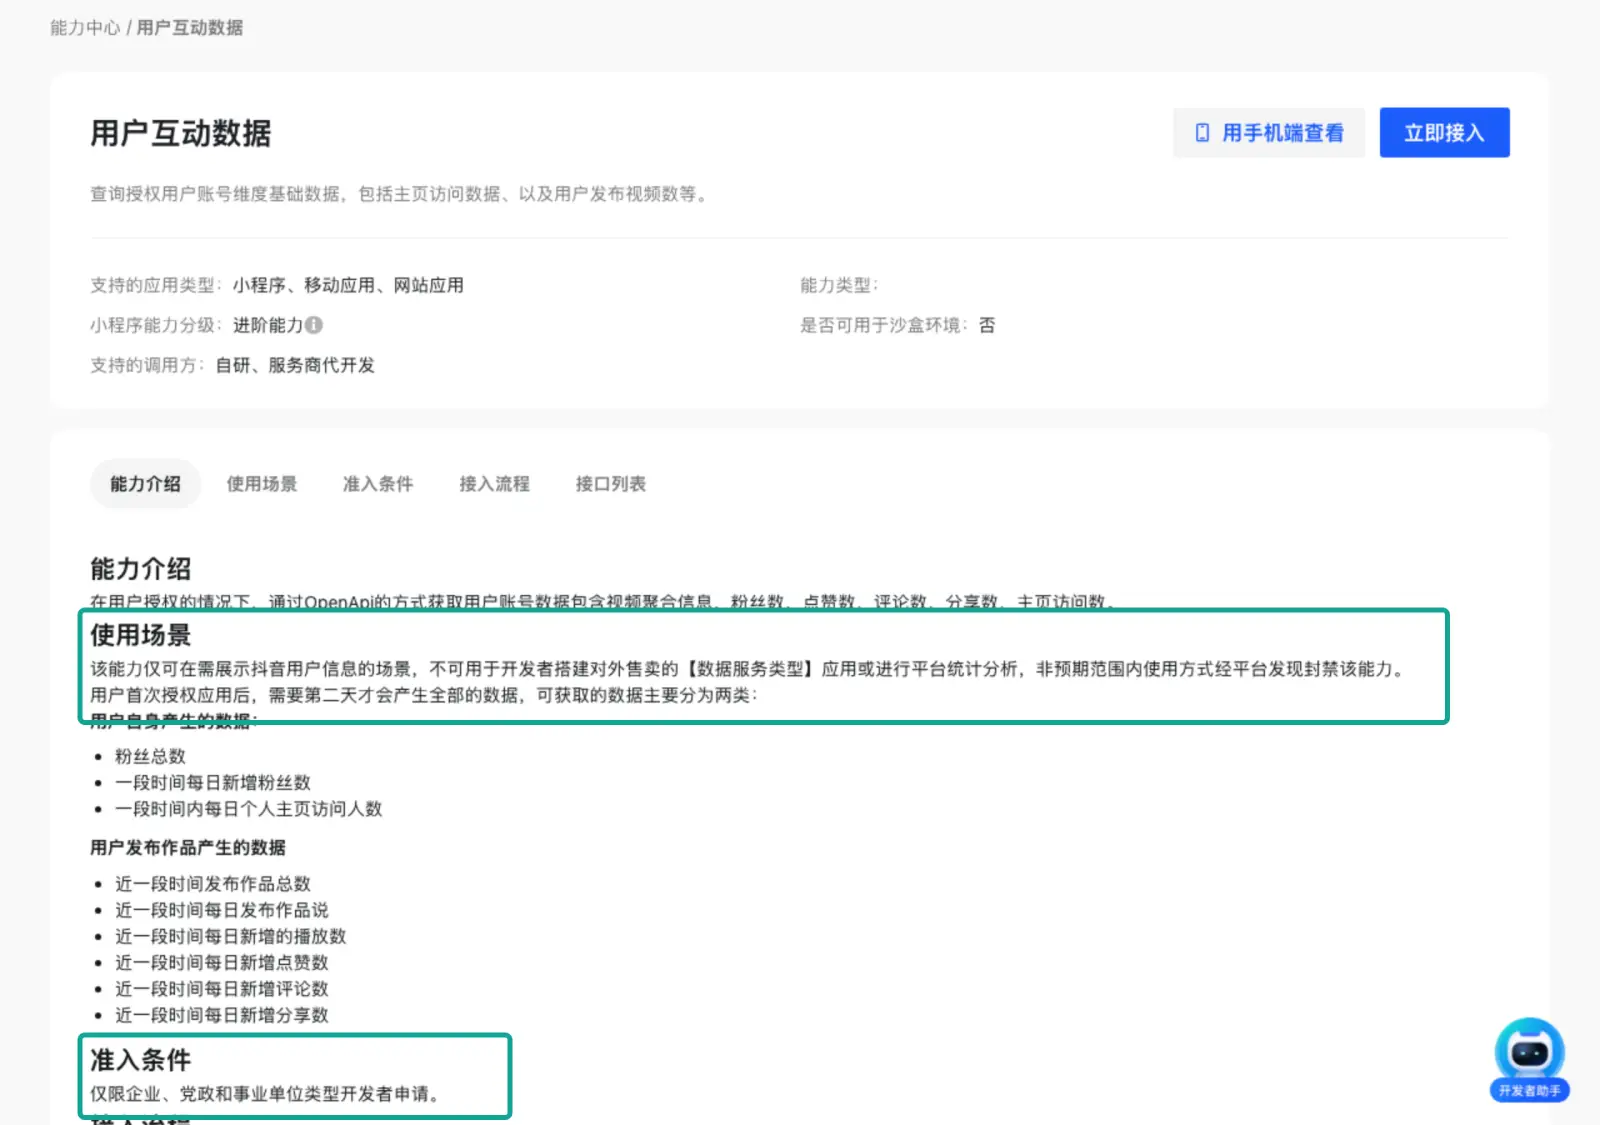
「用户互动数据」能读粉丝总数、每日新增粉丝、主页访问人数和作品的每日新增播放、点赞、评论、分享,使用场景一栏写明「不可用于开发者搭建对外售卖的【数据服务类型】应用或进行平台统计分析」,准入条件是「仅限企业、党政和事业单位类型开发者申请」,并且「用户首次授权应用后,需要第二天才会产生全部的数据」。对一家博物馆的新媒体部门来说,这条路正好:自己的号、自己授权、读到包括播放量在内的完整计数。研究者想横向比较 50 家博物馆的公开作品,这条路就要 50 家逐一授权,而且能力页写明这项数据不能做平台统计分析。
授权的凭证要妥善保管。开放平台获取 access_token的接口说明写着,access_token 存在客户端「可能会被窃取」,「建议存储在服务端」;注意事项一条是拿到 access_token 后,授权临时票据 code「不要再授权刷新,否则会导致上一次获取的 code 过期」。定时任务要把「令牌快过期、要让账号本人重新授权」当成一类要提醒人的事件。另一件 11 月才生效的事:开放平台 2026 年 3 月 23 日更新的证书切换公告写明,平台「将在2026年11月起正式采用非交叉根的证书」,open.douyin.com、v.douyin.com、www.iesdouyin.com 三个域名受影响,开发者要在 2026 年 10 月 31 日前完成升级,自查可参考 DigiCert 的根证书兼容表的 G2 一列。公告的常见问题写明,只有「部分涉及低版本的系统和java」才需要升级,升级不收费,过了期限才升级的程序「后续完成升级后亦可恢复正常」。
小程序一侧另有一个经营授权的版本:查询特定视频的视频数据(经营授权)要求先完成品牌号、员工号或合作号的绑定,再由抖音用户完成经营关系授权,而且只能查 access_token 对应用户上传的视频。海外的 TikTok 是同一种设计:Display API 入门文档要求应用拿到 user.info.basic 和 video.list 两个授权范围,视频列表接口的 max_count 默认 10、最多 20,翻页的 cursor 是毫秒时间戳,可以传一个时间点取那之前发布的视频;读公开数据的 Research API 面向研究机构,申请后「通常在 4 周内」答复,博士生申请还要导师推荐信。两个平台的官方接口都先回答「谁授权了你」,再回答「能读什么」。
开发者类型也决定能申请哪些能力。用户类型及权限说明把开发者分成自研开发者和系统服务商:自研开发者「所有注册用户均可选择」,审核通过后拿到普通开发者的基础能力权限;系统服务商另有生活服务类的专属权限;两类都可以做企业号认证,认证后多一组「企业号开放能力」。结合上面那张截图,「用户互动数据」按机构类型放开,账号和视频数据的完整计数要由机构自己来申请。
开源脚本:README 和 issue 里写的维护情况
Douyin_TikTok_Download_API 的 v5 用无头浏览器生成访客身份、自己维护身份池,能力表里抖音的「作者资料」「作者的作品」都打了勾,同时写明抖音的粉丝和关注列表只对已登录会话开放,所以这两个端点没有注册;搜索和话题下的作品也一样,访客拿不到。它在 2026 年 10 月 31 日的 issue #805 下回复用户:视频直链的路径里带着十六进制的过期时间,那条链接签发后大约三个小时就失效,过期以后换哪个域名都是 403,建议改用实例的下载接口,过期时它会重新解析作品。
douyin-downloader 的中文 README 写明:抖音接口的安全校验目前会挡住命令行版下载单个视频和图文、合集、音乐、喜欢和收藏,主页作品可以改用浏览器自动化去试,但不保证成功;常见问题里第一条是「主页只获取到少量作品?」,给的办法是打开浏览器、关掉无头模式、自己在浏览器里完成验证。它的 issue 列表近 30 天的标题包括:10 月 26 日的 #258「抖音安全校验只放行网页内发起的请求,重试或重新登录都无效」,11 月 9 日的 #263「抖音未返回作品详情」,提问人写已经重新登录获取了 cookies,前几周还能用,桌面版正常。更早的 #253(10 月 9 日)报告下载自己收藏夹时,所有作者昵称都变成了 self。
f2 的功能表把抖音的「用户信息」「主页作品」「单个作品」标成登录和不登录都可用,但请求默认要用它开源的 ab 算法签名;issue #350 的标题是「douyin设置interval为具体的日期后,无法下载作品」,提问人贴的日志里每次请求取 20 条,日期区间是 2025-03-01 到 2025-07-06。douyin-cli 的 README 把认证分成两条线:网页搜索、主页作品、单作品靠浏览器 Cookie,官方用户信息和评论接口靠 OAuth access token,并写明「网页 Cookie 不能替代 OpenAPI token,OAuth token 也不能替代网页 Cookie」。
| 项目 | 怎么读抖音 | 项目自己写的限制 | 近期公开 issue |
|---|---|---|---|
| Douyin_TikTok_Download_API | 无头浏览器生成访客身份 | 粉丝列表、搜索、话题要登录 | #805,2026-10-31:视频直链约 3 小时过期 |
| douyin-downloader | Cookie;主页作品改用浏览器自动化 | 命令行版单视频下载被安全校验挡住 | #263,2026-11-09:重新登录后仍无作品详情 |
| f2 | 自带 ab 签名 | 主页作品登录和不登录都可用 | #350:按日期区间取作品失败 |
| douyin-cli | 浏览器 Cookie 加 OAuth token | 两种凭据不能互相替代 | 未引用 |
| MediaCrawler | Playwright 经 CDP 连已登录的 Chrome | 只供学习研究,禁止商用 | 未引用 |
5 个项目里 4 个要登录态或浏览器(Douyin_TikTok_Download_API 用无头浏览器造访客身份,douyin-downloader 和 douyin-cli 用 Cookie,MediaCrawler 连已登录的 Chrome),只有 f2 写了不登录也能读主页作品,代价是自带签名算法。开源路线的成本集中在三件事上:登录态会过期、签名算法会变、网页端的风控验证会拦住命令行请求。项目维护者在免责声明里普遍把合规责任交还给使用者。我们没有运行这些项目,这一段的每条判断都只来自它们公开的文字。
按次付费 douyin data api:五步读完一个账号
第三条路我们实际跑了一遍。EveryInfra 目录里,抖音账号和作品相关的能力有 douyin/profile(主页)、douyin/user_posts(作品列表)、douyin/video(单条视频详情)、douyin/comments(评论)、douyin/comment_replies(评论回复)和 douyin/transcript(视频文稿)。主页、作品列表、视频详情、文稿四项按次计费,每次 $0.000556;评论和回复按条数分档,每 20 条算一次 $0.000556,一条都没返回的档不扣费。各能力的说明页在 抖音爬虫 API 下,例如主页资料、用户作品列表、视频详情、评论和视频文稿。
账号要用 secUid 定位。目录对 user_id 的说明是「抖音用户的 secUid(通常以 MS4w 开头),不是昵称或短数字抖音号」,可以从网页版主页地址 douyin.com/user/ 后面那一段取,也可以从搜索结果的 author_id 取。国家博物馆的网页版主页是 douyin.com/user/MS4wLjABAAAAH26VW7w8VFw_GxiN0TNSb0HyDLcHkQQdzE2EmUHEJJQ,抖音号是 chnmuseum,两者不是一回事:抖音号是用户自己设的短名,secUid 是网页地址里那一长串。
代码用 Python 的 requests 库(本机版本 2.34.2)。下面是简化后的写法:Key 只从环境变量读;遇到 429 按响应头 Retry-After 等待,没有这个头就逐次加长等待时间再试。
import os, time, requests

API = "https://api.everyinfra.com/api/v1/social"
HEAD = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}

def call(action, params):
    for attempt in range(5):
        r = requests.post(API, headers=HEAD, timeout=180,
                          json={"platform": "douyin", "action": action, "params": params})
        if r.status_code == 429:          # 限速:按 Retry-After 等,没有就逐次加长
            time.sleep(float(r.headers.get("Retry-After", 2 ** attempt * 5)))
            continue
        r.raise_for_status()
        return r.json()
    raise RuntimeError("429 retries exhausted")

SEC = "MS4wLjABAAAAH26VW7w8VFw_GxiN0TNSb0HyDLcHkQQdzE2EmUHEJJQ"   # 中国国家博物馆

profile = call("profile", {"user_id": SEC})["results"]

posts, token = [], ""                     # 第一页传空字符串
while True:
    page = call("user_posts", {"user_id": SEC, "page_token": token})
    posts += page["results"]
    token = page.get("next_page_token")
    if not token:                         # 没有 next_page_token 就是翻到底了
        break

seen = {}
for p in posts:                           # 按 id 去重
    seen.setdefault(p["id"], p)
own = [p for p in seen.values() if p["author_id"] == SEC]   # 只留作者是本账号的

url = max(own, key=lambda p: p["posted_at"])["url"]   # 按发布时间取最新一条
video = call("video", {"url": url})["results"]
comments = call("comments", {"url": url, "page_token": ""})
transcript = call("transcript", {"url": url})["results"]
print(profile["follower_count"], len(seen), len(own), video["like_count"])
同一件事用 curl 是这样,第二页起把上一页的 next_page_token 原样放进 page_token,其余参数不能变,否则令牌失效、返回 422,从第一页重来即可:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"douyin","action":"user_posts",
       "params":{"user_id":"MS4wLjABAAAAH26VW7w8VFw_GxiN0TNSb0HyDLcHkQQdzE2EmUHEJJQ","page_token":""}}'
用 AI 工具的话,同一组能力也在远程 MCP 里,地址是 https://api.everyinfra.com/mcp,配置方法见 MCP 接入说明。要每天定时跑、调用会被自动重试的场景,走 REST 并在请求头带 Idempotency-Key,同一个键重放不会重复扣费,做法见带幂等键的重试。
实测一:主页,一次请求 24 个字段
第一个实测时刻是 2026-11-14 13:07–13:18(新加坡时间)。douyin/profile 13:07:15 发出,返回粉丝 1,067,081,关注 26,获赞 3,001,617,作品数 659,认证说明「国家博物馆官方抖音号」,is_verified 为 true,is_live 为 false;三个时刻三次主页请求的耗时中位数是 1.62 秒。目录给 profile 列了 24 个字段,本次有值的是 16 个,没值的 8 个是性别、IP 属地、国家、语言、喜欢数、是否开店、年龄、是否有合集(gender、ip_location、country、language、likes_given_count、has_shop、age、has_series)。机构号不填性别年龄、IP 属地不在网页主页显示,都说得通;这 8 个字段在个人账号上可能有值,本次样本只有一个机构账号,所以只能写「本次样本里为空」。
主页数据的用法是当快照。粉丝、获赞、作品数这些累计数,每天取一次就能画出账号的增长曲线;作品数反映的是平台对外显示的数字,做「这个账号发了多少条」的统计时,用作品表里按 author_id 过滤后的条数。一次 $0.000556,50 个机构号每天各取一次,一个月是 50 × 30 × $0.000556 = $0.834。
实测二:作品列表翻到底,672 条里 17 条是共创作品
作品列表从 13:07:26 翻到 13:16:57(新加坡时间),一共 34 页。本次每页返回 20 条,第 14 页和第 33 页各 19 条,最后一页 14 条,合计 672 条;按 id 去重后仍是 672 条,0 重复;翻到第 34 页时响应里不再有 next_page_token,pagination.has_more 是 false。34 次调用实扣 $0.018904。耗时分两段看:第一页三个时刻各取过一次,中位数 13.08 秒(3 次);第 2 到 34 页中位数 2.29 秒(33 次)。定时任务的超时时间要按第一页留足。
672 条里,作者字段 author_id 等于国博 secUid 的有 655 条,另外 17 条的作者是 10 个别的账号:有出版机构的旗舰店、有字节跳动和豆包的官方号,也有个人创作者(昵称不列)。这些是抖音的共创作品,发起人是对方,国博是共同创作者,所以会出现在国博的作品列表里。共创作品的互动量和国博自己的作品差得很远:17 条的点赞中位数是 8,810,最高一条 225,867;国博自己 655 条的点赞中位数是 281。共创作品的发起方多是粉丝量更大的平台官方号,作品同时出现在两个账号的主页上,这个差距要归到发起方的流量上,不能算成国博自己内容的表现。统计时,「这个账号发了多少条」「这个账号自己的内容表现如何」只用 author_id 过滤后的 655 条,「出现在这个主页上的内容」用全部 672 条。
| 项 | 数 | 怎么算 |
|---|---|---|
| 翻页次数 | 34 | 从 page_token="" 到响应里没有 next_page_token |
| 返回条数 | 672 | 每页 20 条,第 14、33 页 19 条,第 34 页 14 条 |
按 id 去重后 | 672 | 0 重复 |
| 作者是国博 | 655 | author_id 等于国博 secUid |
| 共创作品 | 17 条 / 10 个账号 | 作者是其他账号 |
| 共创作品点赞中位数 | 8,810 | 17 条的 like_count |
| 国博作品点赞中位数 | 281 | 655 条的 like_count |
| 视频 / 图文 | 640 / 32 | media_type |
| 实扣 | $0.018904 | 34 × $0.000556 |
| 每千条 | $0.0281 | 0.018904 ÷ 672 × 1,000 |
最早一条发布于 2018 年 5 月 15 日(UTC),最新一条是 2026 年 11 月 10 日 12:00(北京时间)发的「九龙九凤冠」专题展视频。目录写明「翻页时不按 since 过滤」,所以要按时间窗口取数,只能翻完以后用 posted_at 自己过滤;官方视频列表也「暂不支持时间过滤」。日常更新的做法是定期重拉第一页,按作品 id 合并进总表:新的 id 插入,已有的 id 更新计数。国博每月发 2 到 15 条,每天重拉一次第一页的 20 条足够覆盖新作品,一个账号每天 1 次调用。
实测三:抖音 视频 详情 api 比列表多出哪些字段
单条视频详情第一次在 13:17:45(新加坡时间)发出,用的是作品列表里最新那一条:2026 年 11 月 10 日发布的「明礼华章——万历孝端皇后九龙九凤冠」专题展视频。这个展览由国家博物馆主办,央视网 11 月 10 日的报道写明它在 2026 年 11 月 4 日正式对公众展出,位于国博北 16 展厅、作为专题展览长期展出;国博官网 2026 年 10 月 30 日的预告说凤冠从 2026 年 11 月 2 日起暂别「古代中国」基本陈列,展览页给出凤冠 1957 年出土于北京昌平定陵,通高 48.5 厘米、重 2320 克,镶宝石 115 块、珍珠 4414 颗。新华网同日刊发了 11 月 9 日拍摄的展厅照片。
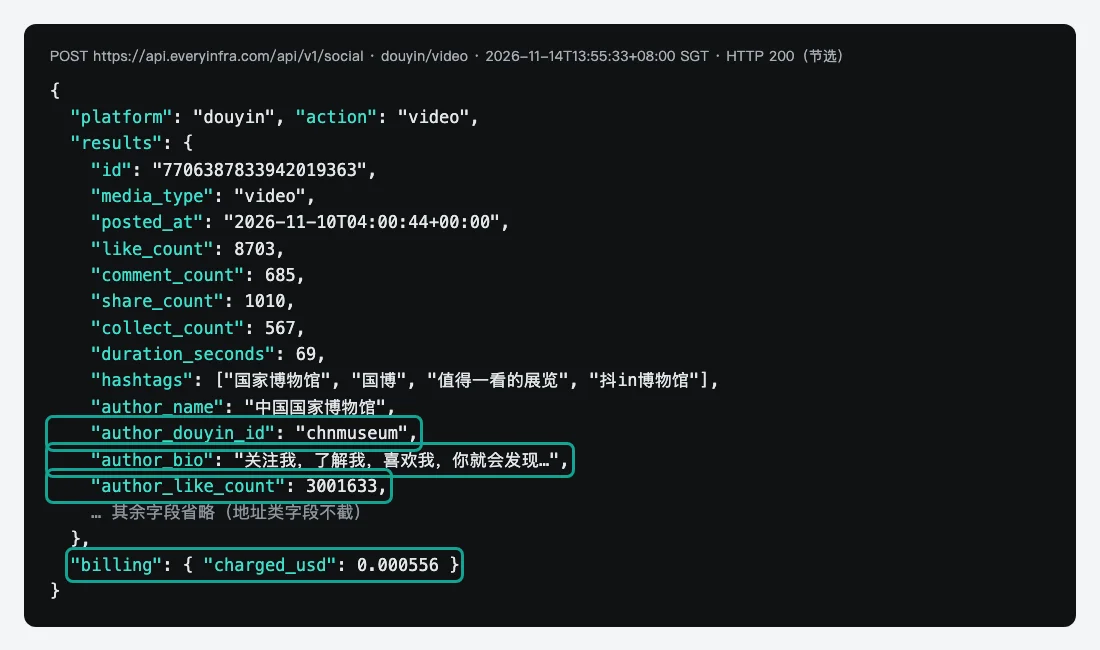
同一条视频,我们在三个时刻各取了一次作品列表第一页和一次单条视频详情,只看三次都有可用值的字段(值为空、0 或 unknown 的不算):作品列表里这条视频有 27 个,详情里有 29 个。详情每次都多出来的是作者快照的三个字段:author_douyin_id(chnmuseum)、author_bio(账号简介)、author_like_count(账号获赞,13:55 那次是 3,001,633)。两边共有的 26 个字段是作品本身和作者的基本信息:id、链接、文案、话题、时长、宽高、发布时间、封面和动态封面、背景音乐、四个互动计数、is_pinned、is_ad,以及作者名称、头像、uid 和认证。所以只为了点赞、评论、分享、收藏四个数去调详情是重复花钱,作品列表第一页已经有;详情的用处是在不另调主页的情况下,把作者的抖音号、简介和获赞一并带回来,适合从一条视频链接反查作者。
目录的 response_fields 还给视频详情列了视频标签、城市、清晰度列表、互动权限和地址失效时间等字段。目录对它们的说明是:video_tags 是「平台给作品打的内容分类标签」,city 是作品发布城市、用拼音写法,video_bitrates 是各清晰度的播放地址,permissions 是作者给作品设的可评论、可下载、可合拍等权限、「只含平台给了的项」,video_url_expires_at 是「播放与下载地址的失效时间」、之后要重新取。这几项我们只按目录说明转述,没有拿来下结论;要用它们做分类或判断能否下载的,先在自己的样本上统计一遍有值的比例。
地址字段的处理方法和开源项目一致。前面引的 issue #805 里,维护者算出那条网页直链签发后三个小时就过期;目录也写明 video_bitrates 里的地址「带签名、会过期」。存档时只存视频 id 和作品链接,播放或下载前按 id 重新取一次详情,地址不当长期字段写进表里。
播放数这一项,目录对 view_count 的说明写明「此字段不是真实播放量。抖音不对外公开视频播放量」,判断热度请用点赞、评论、分享、收藏四个数。要播放量,只能走官方「视频数据」能力,由账号本人授权。对研究者来说,可比较的互动指标就是这四个,它们在列表和详情里都有,而且三次取到的数一致地随时间增长(见下文三个时刻)。
| 字段组 | 列表 `user_posts`(三次都有) | 详情 `video`(三次都有) | 用途 |
|---|---|---|---|
| 计数:点赞、评论、分享、收藏 | 有 | 有 | 每天取列表第一页就能追踪 |
| 作品:id、链接、文案、话题、时长、发布时间 | 有 | 有 | 作品表的主体 |
| 封面、动态封面、背景音乐 | 有 | 有 | 展示和去重 |
| 作者名称、头像、uid、认证 | 有 | 有 | 区分共创作品 |
作者抖音号 author_douyin_id | 无 | 有 | 从视频反查账号 |
作者简介 author_bio | 无 | 有 | 账号画像 |
作者获赞 author_like_count | 无 | 有 | 不调主页也能拿到获赞 |
播放 view_count | — | — | 目录写明不是真实播放量 |
图里作品列表那一行有 10 个「部分有值」的字段,例如 image_urls 只在 32 条图文上有值,video_url 和 duration_seconds 只在视频上有值(占 95.2%),region 在 21.6% 的作品上有值,title 在 20.4% 的作品上有值,hashtags 在 79.3% 的作品上有值。这些比例和作品类型、发布年份有关,不是一个固定的数。把列表当作「目录」、把详情当作「档案」:列表翻完一个账号花不到 2 美分,详情每条 $0.000556,只给需要反查作者或深挖的那几条调用。
实测四:评论、评论回复和视频文稿
评论 13:18:12(新加坡时间)发出,传 page_token 空字符串,返回 20 条顶层评论和下一页令牌,扣一档 $0.000556。目录列 18 个评论字段(不含令牌),本次 14 个有值;ip_location(例如河南、浙江、北京)、reply_count、liked_by_author 都在,is_hot、reply_to_id、images、mentioned_users 本次为空。点赞最多的一条顶层评论有 244 个赞、15 条回复。评论作者都是个人用户,我们在分析时只用计数和地区,不存昵称。
第二个时刻 13:37(新加坡时间)我们用 douyin/comment_replies 取了点赞最多那条顶层评论的回复:传视频链接、评论 id 和空的 page_token,返回 15 条,正好是这条评论 reply_count 写的 15,pagination.has_more 为 false,扣一档 $0.000556。15 条里有 2 条带 reply_to_reply_id 和 reply_to_author_name,是「回复里的回复」,3 条带 mentioned_users。同一分钟用第一页的令牌取评论第二页,返回 13 条,同样扣一档。15 条回复的点赞合计 50,最多一条 30 个,比顶层评论低一个量级,所以做分析时顶层评论和回复要分开统计。
视频文稿 13:18:23 发出,耗时 18.92 秒(1 次),把这条 69 秒的视频切成 9 段带起止时间的句子。文稿是语音识别结果,同音字会出错:国博展览页原文写的是「金翠交辉」,文稿里是「精脆交辉」;文稿里还有一处「威尘」,从上下文看应是「微尘」。用文稿做关键词检索时,建议同时检索标题和话题,不单靠文稿。
三个时刻:同一条视频的计数怎么变
三个实测时刻的时间是:第一个时刻 13:07–13:18(新加坡时间),第二个时刻 13:36–13:37(新加坡时间),第三个时刻 13:55(新加坡时间),从第一次请求到最后一次请求一共 48 分 39 秒。每个时刻都取一次主页、一次作品列表第一页和一次「九龙九凤冠」视频详情,第二个时刻另外取评论第二页和评论回复,第三个时刻再取一次评论第一页。
| 时刻(新加坡时间) | 视频点赞 | 视频评论 | 视频分享 | 视频收藏 | 账号粉丝 | 账号获赞 |
|---|---|---|---|---|---|---|
| 第一个:列表 13:07,详情 13:17,主页 13:07 | 8,691(列表)/ 8,696(详情) | 684 | 1,009 | 566 | 1,067,081 | 3,001,617 |
| 第二个:13:36 | 8,700 | 685 | 1,010 | 567 | 1,067,087 | 3,001,631 |
| 第三个:13:55 | 8,703 | 685 | 1,010 | 567 | 1,067,087 | 3,001,632 |
48 分钟里,这条发布 4 天的专题展视频点赞涨了 12 个(列表 13:07 的 8,691 到 13:55 的 8,703),评论、分享、收藏各涨 1 个;账号粉丝涨 6 个,获赞涨 15 个。同一个时刻的两处数据是一致的:第二个时刻列表 13:36:13 和详情 13:36:35 都是 8,700 个赞,第三个时刻 13:55:11 和 13:55:33 都是 8,703 个赞;第一个时刻列表和详情差 5 个赞,是因为两次请求隔了 10 分钟。第一页其余 19 条作品,第一到第二个时刻只有 1 条变了(+1),第二到第三个时刻一条都没变。
追踪频率按作品新旧分开定:一家博物馆的号,除了最新几天的作品,计数在一小时内几乎不动,每天取一次第一页就够了;要看大展开幕后的传播曲线,只对最新的两三条作品提高频率,例如每小时调一次 douyin/video,一条作品一天 24 次,花 $0.0133。三个时刻的耗时中位数:主页 1.62 秒(3 次),单条视频详情 11.71 秒(3 次),作品列表第一页 13.08 秒(3 次)。
每千条成本:列表和评论约 $0.028,单条请求 $0.556
把本篇全部真调按能力汇总,用实扣金额除以实际返回条数再乘 1,000。按「一次请求回一页」的能力,单价被一页的条数摊薄;按「一次请求回一条」的能力,每千条就是 1,000 × $0.000556。
| 能力 | 调用次数 | 返回条数 | 实扣 | 每千条 | 耗时中位(样本数) |
|---|---|---|---|---|---|
douyin/profile | 3 | 3 | $0.001668 | $0.556 | 1.62 秒(3) |
douyin/user_posts | 36 | 716 | $0.020016 | $0.0280 | 2.37 秒(36) |
douyin/video | 3 | 3 | $0.001668 | $0.556 | 11.71 秒(3) |
douyin/comments | 3 | 53 | $0.001668 | $0.0315 | 1.99 秒(3) |
douyin/comment_replies | 1 | 15 | $0.000556 | $0.0371 | 2.50 秒(1) |
douyin/transcript | 1 | 1 | $0.000556 | $0.556 | 18.92 秒(1) |
| 合计 | 47 | 791 | $0.026132 | — | — |
作品列表的 716 条是 34 页翻页加第二、第三个时刻各 1 次第一页(36 次调用,第一个时刻的第一页就是翻页的第 1 页)实际返回的条数相加,同一条作品可能被算了不止一次;只看翻到底那一轮,34 次、672 条、每千条 $0.0281。评论 53 条是三次调用的合计(20、13、20 条),每次都只扣一档。
按这个单价算三个场景。第一,一家机构每天追踪自己的号:主页 1 次加作品列表第一页 1 次,每天 $0.001112,一个月 $0.033。第二,研究者第一次读完 50 个机构号:假设每个号的规模和国博接近(34 页),一次性约 50 × 35 × $0.000556 = $0.973,之后每天每号 2 次,月费 50 × 2 × 30 × $0.000556 = $1.668。第三,给其中 500 条重点作品各取一次详情和第一页评论:500 × 2 × $0.000556 = $0.556。三个场景的假设都写在式子里,换成你自己的账号数和作品数可以直接重算。
把数据存下来:三张表和每天的增量
上面几个实测合起来,落到库里是三张表。第一张是账号快照表,一个账号每天一行,存 douyin/profile 返回的粉丝、关注、获赞和作品数,主键是账号 secUid 加日期;本次国博三次主页请求跨 48 分钟,粉丝从 1,067,081 变成 1,067,087,获赞从 3,001,617 变成 3,001,632。第二张是作品表,一条作品一行,主键是作品 id,存 author_id、posted_at、media_type、is_pinned、话题和时长;第一次建表时把作品列表翻到底,之后定期重拉第一页,整页按 id 合并:新的 id 插入,已有的 id 只更新计数和 is_pinned。第三张是作品计数表,作品 id 加日期一行,存点赞、评论、分享、收藏四个数,同样从每天的第一页取,较早的作品想继续追踪,就按需要给它单独调一次 douyin/video。
另外三条做法。其一,视频地址和封面地址不进表,用的时候按作品 id 现取,理由见上文 issue #805 和目录对地址字段的说明。其二,共创作品在作品表里加一个「作者是否本账号」的标记,统计机构自己的产出时过滤掉,统计「出现在这个账号主页上的内容」时保留;国博这个例子里,带不带这 17 条,点赞合计从 1,392,825 变成 2,051,983,多出近一半,前 10 条占比从 52.1% 变成 57.3%。其三,评论只存计数、地区和时间,昵称和头像不入库,需要区分同一个人的多条评论时,存一个加盐的哈希值即可。按这个设计,一家机构一天的固定调用是 2 次,50 家是 100 次,月费前面已经算过;50 家第一次建表约 3.4 万行(按每家 672 条估),之后每年新增约 3,750 行(按国博近 12 个月 75 条估),一台普通笔记本就能放下。
公共文化机构的例子:博物馆账号的作品数据能看出什么
用 34 页作品列表里作者是国博的 655 条作品,可以把一家博物馆在抖音上的内容做法量出来。国博的视频时长中位数是 124 秒(623 条有时长的视频,四分位 63 到 205 秒),最长的一条 2,714 秒;655 条里 516 条带话题,出现最多的是「国家博物馆」154 次、「国博」126 次、「文物」104 次、「展览」102 次。按发布年份数,2021 年最多,125 条;2025 年 85 条,2026 年到 11 月 10 日 71 条(按 UTC 年份)。
互动高度集中。655 条作品的点赞合计 1,392,825,平均每条 2,126,中位数只有 281,点赞最多的 10 条占了 52.1%。这 10 条里 6 条是 2019 年 9 月到 10 月「今天是你的生日祖国」系列视频,2 条是 2020 年 2 月「在家云游博物馆」的 VR 看展预告,最高一条 180,091 个赞;另外 2 条是 2019 年 1 月「让文物动起来」和 2023 年 1 月「来国博看中国」。用平均值会被这几次集中传播拉高,用中位数和前 10 条占比两个数一起报,更接近一家机构的日常传播水平。
点赞中位数按年份差得很大,同一个账号不同年份的作品不能直接拿平均数比:
| 发布年份(UTC) | 作品数 | 点赞中位数 |
|---|---|---|
| 2018 | 17 | 2,430 |
| 2019 | 64 | 728.5 |
| 2020 | 46 | 796.5 |
| 2021 | 125 | 181 |
| 2022 | 94 | 312.5 |
| 2023 | 68 | 437.5 |
| 2024 | 85 | 230 |
| 2025 | 85 | 157 |
| 2026(到 11 月 10 日) | 71 | 281 |
不计只有 17 条的 2018 年,年度中位数在 157 到 797 之间,最高的 2020 年约是最低的 2025 年的 5 倍。2021 年发得最多(125 条),中位数却只有 181。最近 12 个月(2025-11-14 以来)发布的 75 条,点赞中位数 283。这组数说明,评估一家机构「今年的内容做得怎么样」,要拿同一年份或同一时间窗里的作品比,翻到底的全量作品表正好给了这个可能。
时长和点赞的关系更清楚。把 623 条视频按时长分四组:60 秒以下 142 条,点赞中位数 587;60 到 119 秒 158 条,302;120 到 299 秒 229 条,245;300 秒及以上 94 条,164。时长越长,中位数越低,最短一组是最长一组的约 3.6 倍。国博的视频有一半以上(323 条)在 2 分钟以上,这些多是讲座、展览导览和直播剪辑,点赞少不等于没人看,可能更适合用收藏和评论来评估。32 条图文的点赞中位数 269.5,和视频的 282 差不多。
话题和发布时间也能量出来。不带话题的 139 条,点赞中位数 314;带「历史」的 69 条,中位数 412;带「文物」的 104 条,375;带出现次数最多的「国家博物馆」的 154 条,只有 222。话题用得多不代表互动高,带内容类话题(历史、文物)的作品比带机构名话题的作品中位数高。按北京时间看,国博周五发得最多(140 条),周六最少(62 条);一天里下午 4 点和 5 点各 89 条,上午 10 点 76 条,晚上 9 点以后只有 20 条,基本按工作日、工作时间发。655 条作品的评论合计 99,934 条,每条评论数中位数 21,分享中位数 37,收藏中位数 23。
公共文化机构为什么要看这些数?福州档案信息网 11 月 4 日转载的《中国档案报》评论(原载 10 月 26 日)写道,微博、视频号、抖音等平台「成为大众获取信息的主阵地」,建议档案部门按不同平台的传播逻辑和用户画像做差异化内容。一家馆要判断「我们发的短视频有没有人看、什么样的内容有人看」,自己账号的完整作品表加上同类机构的对照表就是底表。方法上的边界要写清楚:点赞和评论受平台推荐影响,不等于观众对展览本身的评价;共创作品要单独标出;播放数拿不到,所以不能算完播率或互动率。
计费:按实际返回扣,一条没回的档不扣
本次一共 47 次调用,实扣合计 $0.026132,就是每次响应里 billing.charged_usd 的加总。主页、作品列表、视频详情、文稿每次 $0.000556;评论和回复按档计费,一档 20 条,本次评论 3 次、回复 1 次都只回了一档以内的条数,各扣一档。目录写明一条都没返回的档不扣费。翻页令牌 24 小时内有效,只能在同一账户、同一组参数下使用,参数变了会返回 422,从第一页重新开始。会被自动重试的定时任务带上 Idempotency-Key,重放同一个请求不会重复扣费。
什么时候另外两条路更合适
官方开放平台适合机构管理自己的账号:要播放量、要主页访问人数、要每日新增粉丝,这些只有账号本人授权后才拿得到;数据用途写进了能力页,机构自己用于展示和复盘,正好在允许范围内。开源脚本适合愿意自己维护、数据量不大、想完全掌握请求细节的技术团队,尤其是要下载视频文件本身、或者要用登录态读「喜欢」「收藏」这类只有登录后才能看的列表时,DouK-Downloader 的功能清单比数据接口更全。按次付费接口适合要读很多家公开账号、不想自己部署和维护脚本、要稳定 JSON 字段的场景。这三条路可以同时用:机构自己的号走官方,同行对照走按次接口,偶尔要原视频文件时用开源工具。
| 你的目标 | 合适的路 | 原因 |
|---|---|---|
| 自己账号的播放量、主页访问人数 | 官方开放平台 | 只有账号本人授权才拿得到这些数 |
| 原视频文件,或登录后才能看的列表 | 开源工具 | 数据接口给的是字段和会过期的地址 |
| 每天对照很多家公开账号 | 按次付费接口 | 不用对方授权,不用自己部署和维护 |
| 从一条视频反查作者 | 按次付费 douyin/video | 三次都带作者抖音号、简介、获赞,每次 $0.000556 |
合规和边界
读公开主页也要守几条规则。网络数据安全管理条例第十八条要求,使用自动化工具访问、收集网络数据,应当评估对网络服务带来的影响,不得非法侵入他人网络,不得干扰网络服务正常运行;第二十四条要求,自动化采集无法避免地采到非必要个人信息的,应当删除或匿名化。2025 年 10 月 15 日起施行的反不正当竞争法第十三条写明,经营者不得以欺诈、胁迫、避开或者破坏技术管理措施等不正当方式获取、使用其他经营者合法持有的数据。个人信息保护法第十三条把「在合理的范围内处理个人自行公开或者其他已经合法公开的个人信息」列为可以处理的情形之一。我们自己的做法是:只读公开主页和公开作品;评论里的个人昵称、头像不入库或做匿名化;调用频率按接口限速走,不绕过平台的登录和验证;机构账号署名分析,个人创作者隐去名字。抖音的 robots.txt 对列名的搜索引擎爬虫禁止抓取 /follow 和带 enter_from= 参数的页面。以上是数据方法,不构成法律意见。
样本边界:只测了一个机构账号、一条视频的详情和评论,三个时刻在 60 分钟以内;字段「本次为空」只代表这个样本,个人账号、带货账号、图文为主的账号可能不同;年份、时长、话题和发布时间的分析都只基于国博这 655 条作品。
行业动向
- 2026 年 11 月:抖音开放平台按公告改用非交叉根证书,10 月 31 日前没升级的老系统调用
open.douyin.com会报错,公告写明升级后可以恢复。对读者意味着:用官方接口的老 Java 程序,这个月先查证书。 - 2026 年 11 月 9 日:douyin-downloader #263 报告重新登录后仍拿不到作品详情,桌面版正常。对读者意味着:这个 issue 里重新登录没有恢复,靠 Cookie 的脚本要准备别的排查办法。
- 2026 年 11 月 4 日:国家博物馆「明礼华章」凤冠专题展对公众展出,国博抖音号 11 月 10 日发的专题视频在 11 月 14 日 13:07 有 8,691 个赞,是此前 3 个月其他 19 条作品点赞中位数(314)的 27.7 倍。对读者意味着:机构账号的互动高峰跟着线下大展走,做数据追踪要把展期写进日历。
- 2026 年 10 月 31 日:Douyin_TikTok_Download_API 维护者在 #805 说明视频直链约三小时过期。对读者意味着:视频地址只存
id,用时现取。 - 2026 年 10 月 26 日:douyin-downloader #258 标题写安全校验只放行网页内发起的请求,重试或重新登录都无效。对读者意味着:自建方案要预留浏览器自动化的成本。
常见问题
抖音有 api 吗?
有,叫抖音开放平台,但账号和视频数据接口都要账号本人在你的应用里授权,user_info 回昵称、头像、性别和地区,「用户互动数据」只对企业、党政和事业单位开放申请。想读别人的公开主页,需要开源脚本或按次付费接口。(问题来自 Google 联想词「抖 音 有 api 吗」,2026-11-14 读取。)
抖音用户信息接口能拿到哪些字段?
官方 /oauth/userinfo/ 的文档写的是昵称、头像、性别和地区,样例里另有 open_id、union_id,要用户授权。按次付费的 douyin/profile 目录列了 24 个字段,本次读国家博物馆有值的是 16 个,包括粉丝、关注、获赞、作品数、认证说明、头像和背景图。(问题来自联想词「抖 音 用户 信息 接口」。)
抖音 uid 和 sec_uid 有什么区别?
uid 是数字 id(国博是 92744920981),sec_uid 是网页版主页地址里 MS4w 开头的那一段,按次接口定位账号用的是后者;抖音号(国博是 chnmuseum)是第三种 id,是账号自己设的短名,不能当 secUid 传。视频详情里的 author_douyin_id 会带回作者的抖音号,可以用来核对。(问题来自联想词「抖 音 uid 转 sec_uid」「抖 音 sec_user_id」。)
douyin data api 有免费的吗?
开放平台的能力本身不收费,但要资质、审核和对方授权;GitHub 上的开源项目免费,服务器、代理和维护时间自担。按次付费接口翻完国博的作品列表、拿到 672 条,花了 $0.018904。(问题来自联想词「douyin data api free」。)
抖音 api github 上的开源项目还能用吗?
能用,但要看近期 issue。douyin-downloader 的 README 写明命令行版的单视频下载目前被安全校验挡住,11 月 9 日还有用户报告重新登录后拿不到作品详情;Douyin_TikTok_Download_API 用访客身份池读作者和作品,但粉丝列表、搜索要登录。(问题来自联想词「抖 音 api github」。)
抖音播放量 api 能拿到吗?
官方「查询特定视频的视频数据」接口能返回 play_count,但要账号本人授权,只能读授权账号自己的视频。按次付费接口的目录对 view_count 写明「此字段不是真实播放量。抖音不对外公开视频播放量」,热度请用点赞、评论、分享、收藏。(问题来自联想词「抖音 播放量 api」,2026-11-14 读取。)
上手步骤
- 打开 EveryInfra 快速上手,注册后拿到 API Key,放进环境变量
EVERYINFRA_API_KEY。 - 在网页版抖音打开要读的账号主页,复制地址里
douyin.com/user/后面那段 secUid。 - 把上面的 Python 代码里的
SEC换成它,先跑主页和第一页作品,核对条数;价格以定价页和能力目录为准。 - 要读完就让循环翻到没有
next_page_token,再按author_id过滤共创作品;日常更新就定期重拉第一页,整页按作品id合并进总表。 - 只给要反查作者或深挖的作品调
douyin/video和douyin/comments。要按关键词找作品、要看完整的「搜索到回复」流程,见 douyin api python 实测;要逐项比较两种抖音接口买法的单价,见抖音 API 两种买法逐项比价;其他平台的账号数据见 TikTok 爬虫 API 和 小红书爬虫 API。
参考资料
- 抖音开放平台:用户互动数据能力页(读取 2026-11-14)
- 抖音开放平台:视频数据能力页(读取 2026-11-14)
- 抖音开放平台:获取用户公开信息能力页(读取 2026-11-14)
- 抖音开放平台:获取用户公开信息接口文档(读取 2026-11-14)
- 抖音开放平台:查询授权账号视频列表(读取 2026-11-14)
- 抖音开放平台:查询特定视频的视频数据(读取 2026-11-14)
- 抖音开放平台:获取 access_token(读取 2026-11-14)
- 抖音开放平台:查询特定视频的视频数据(经营授权)(读取 2026-11-14)
- 抖音开放平台:用户类型及权限说明(读取 2026-11-14)
- 抖音开放平台:服务器证书切换公告(2026-03-23 更新)(读取 2026-11-14)
- DigiCert:根证书兼容性(读取 2026-11-14)
- TikTok for Developers:Display API 入门(读取 2026-11-14)
- TikTok for Developers:视频列表接口(读取 2026-11-14)
- TikTok for Developers:Research API(读取 2026-11-14)
- GitHub:Douyin_TikTok_Download_API README(读取 2026-11-14)
- GitHub:Douyin_TikTok_Download_API issue #805(2026-10-31 回复)(读取 2026-11-14)
- GitHub:douyin-downloader README(读取 2026-11-14)
- GitHub:douyin-downloader 中文 README(读取 2026-11-14)
- GitHub:douyin-downloader issue 列表(读取 2026-11-14)
- GitHub:douyin-downloader issue #258(2026-10-26)(读取 2026-11-14)
- GitHub:douyin-downloader issue #263(2026-11-09)(读取 2026-11-14)
- GitHub:douyin-downloader issue #253(2026-10-09)(读取 2026-11-14)
- GitHub:DouK-Downloader(TikTokDownloader)README(读取 2026-11-14)
- GitHub:MediaCrawler README(读取 2026-11-14)
- GitHub:f2 README(读取 2026-11-14)
- GitHub:f2 issue #350(读取 2026-11-14)
- GitHub:douyin-cli README(读取 2026-11-14)
- PyPI:requests(读取 2026-11-14)
- EveryInfra 能力目录(13:05 新加坡时间读取)(读取 2026-11-14)
- 抖音:中国国家博物馆网页版主页(读取 2026-11-14)
- 抖音 robots.txt(读取 2026-11-14)
- 央视网:国博凤冠专题展报道(2026-11-10)(读取 2026-11-14)
- 中国国家博物馆:凤冠专题展预告(2026-10-30)(读取 2026-11-14)
- 中国国家博物馆:凤冠专题展展览页(读取 2026-11-14)
- 新华网:展厅图片报道(2026-11-10)(读取 2026-11-14)
- 福州档案信息网:转载《中国档案报》评论(2026-11-04)(读取 2026-11-14)
- 网络数据安全管理条例(全文)(读取 2026-11-14)
- 中华人民共和国反不正当竞争法(全文)(读取 2026-11-14)
- 中华人民共和国个人信息保护法(全文)(读取 2026-11-14)
- 抖音开放平台:文档中心(读取 2026-11-14)
引用编号 BL-154