Recolección de datos de Xiaohongshu: búsqueda, notas, comentarios y costo
Hicimos 12 llamadas de búsqueda, notas, comentarios y respuestas en Xiaohongshu: 0,368 USD por 1.000 filas. Tras 8 minutos solo se repiten 7 de 20 notas.
El 14 de noviembre de 2026, a las 13:06 hora de Singapur, buscamos en Xiaohongshu (también llamado RedNote) la palabra clave china que significa «vacuna contra la gripe». Ordenamos por relevancia y obtuvimos una primera página de 20 notas. A las 13:14 repetimos la búsqueda con los mismos parámetros. Solo 7 de las 20 notas coincidían con la vez anterior. A las 13:26 buscamos por tercera vez, y solo 4 notas aparecieron en las tres páginas.
En total pedimos 7 páginas con dos órdenes distintos, lo que dio 140 filas. Al quitar los duplicados quedaron 83 notas distintas. Por eso una búsqueda es una muestra y no una foto completa. Para estudiar tendencias u opinión pública hay que muestrear en varios momentos y con varios órdenes, y después quitar los duplicados.
Recorrimos el flujo completo con la API de pago por llamada de EveryInfra: búsqueda, detalle de nota, comentarios, respuestas y la lista de publicaciones de una cuenta de salud pública. Fueron 12 llamadas cobradas, con un costo de 0,066672 USD por 181 filas. Eso equivale a 0,368 USD por 1.000 filas. Con la misma mezcla de llamadas, 10.000 filas al mes cuestan unos 3,68 USD, 100.000 filas unos 36,84 USD y 1.000.000 de filas unos 368 USD.
Recolectar datos de Xiaohongshu significa tomar notas públicas, comentarios y publicaciones de cuentas fila por fila y guardarlos en una tabla. Después esa tabla sirve para estadísticas, seguimiento de opinión, estudios de producto o investigación académica. Hay tres caminos. El primero son las entradas propias de Xiaohongshu. El segundo es un script de recolección que escribes tú o que tomas de un proyecto de código abierto. El tercero es una API de datos que pagas por llamada.
En el pago por llamada, dividimos charged_usd entre el número de filas que devolvió cada llamada.
Primer camino: qué dejan leer la plataforma abierta, Pugongying y Juguang
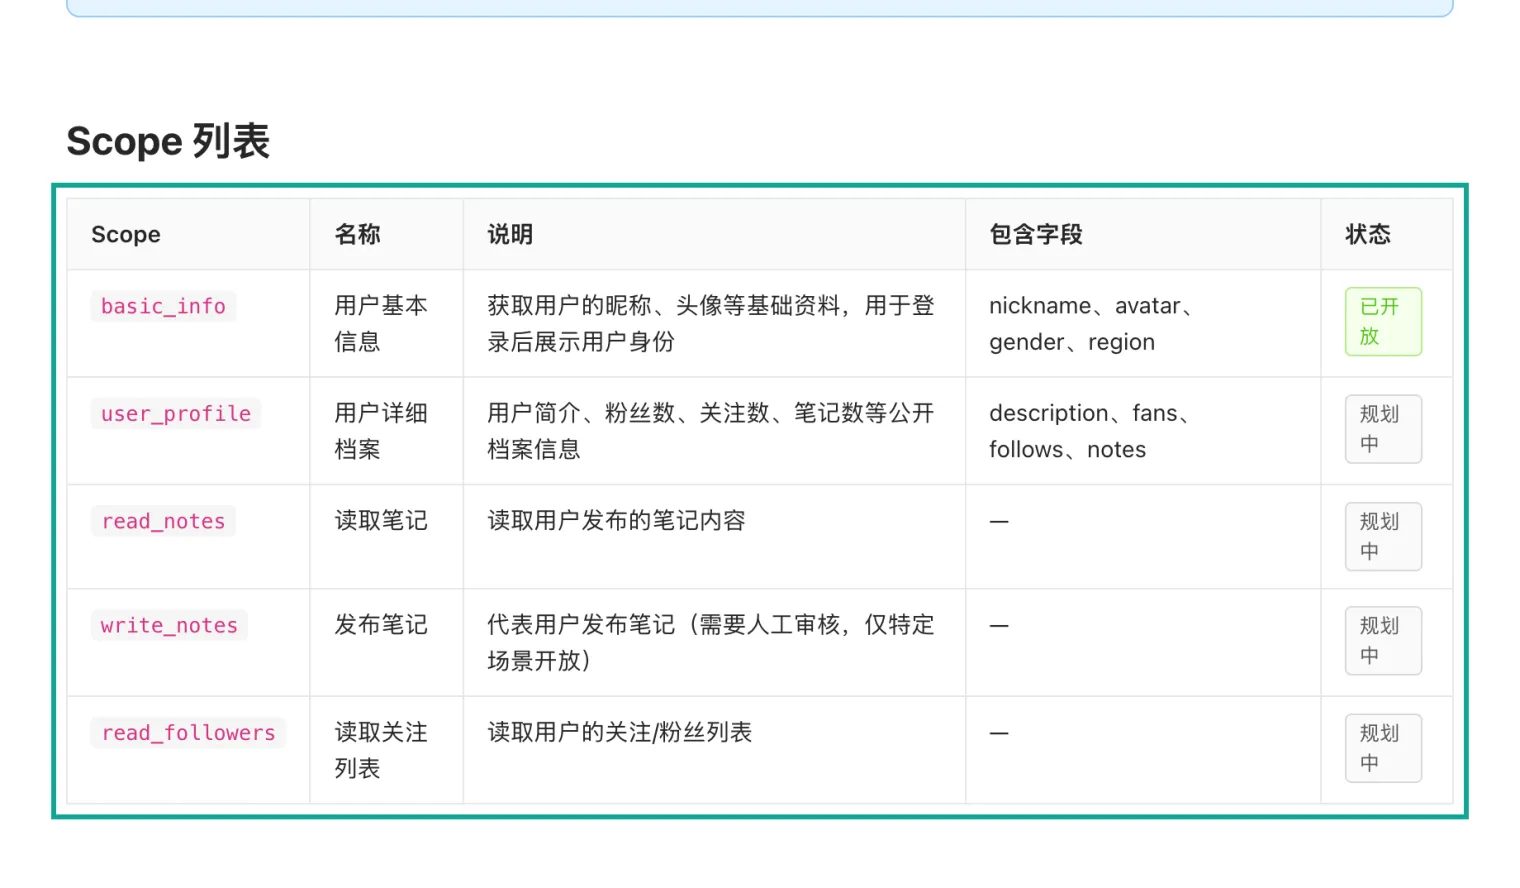
Xiaohongshu tiene varias entradas para desarrolladores y empresas. Cada una cumple una función. El 14 de noviembre de 2026 volvimos a leer las páginas de Xiaohongshu una por una. La tabla muestra qué pide cada entrada y qué permite leer.
| Entrada de Xiaohongshu | Qué necesitas | Qué dice el texto que puedes leer | ¿Sirve para leer notas y comentarios públicos de otros? |
|---|---|---|---|
| Permisos de cuenta de la plataforma abierta (openaccount.xiaohongshu.com) | Crear una aplicación y esperar una revisión de 1 a 3 días hábiles | Solo basic_info: apodo, avatar, género y región del usuario que inicia sesión | No. read_notes, user_profile y read_followers están «en planificación» |
| Pugongying (pgy.xiaohongshu.com) | La marca verifica su empresa en la plataforma de cuentas profesionales; la verificación cuesta 600 CNY por solicitud y dura 1 año | Plataforma donde marcas y creadores acuerdan contenidos y transmisiones en vivo | La página pública no lo dice; no hay exportación de notas ni comentarios por fila |
| Juguang Marketing API (ad.xiaohongshu.com) | Una cuenta publicitaria de Juguang y experiencia en anuncios; solo clientes clave; un comercial inicia la aprobación | Informes, campañas y creatividades de tu propia cuenta publicitaria | No. Solo tus propios datos de anuncios |
| Plataforma abierta de comercio electrónico (open.xiaohongshu.com) | Solo la cuenta principal de la tienda puede autorizar | Productos, pedidos y otros datos de la tienda autorizada | No. Solo tu propia tienda |
Empecemos por la primera fila. La página de permisos de la plataforma abierta dice que, por ahora, solo está abierto un permiso: basic_info. De los cinco permisos, solo basic_info tiene el estado «abierto». El permiso read_notes, que lee notas, sigue «en planificación» (Lista de permisos, actualizada el 2026-03-29 y sin cambios cuando la releímos el 14 de noviembre).
La guía de inicio rápido dice que, después de crear una aplicación, hay que esperar una revisión de 1 a 3 días hábiles. Luego el usuario hace clic, autoriza en Xiaohongshu y vuelve a tu aplicación. Tu aplicación recibe entonces el perfil del usuario (Inicio rápido). Es decir, la plataforma abierta sirve para que los usuarios entren en tu aplicación con su cuenta de Xiaohongshu. Hoy no ofrece ningún endpoint para buscar notas de otras personas ni para leer sus comentarios.
Pugongying es la plataforma donde marcas y creadores acuerdan colaboraciones pagadas. Su página de alta pide a las marcas que primero vayan a la plataforma de cuentas profesionales de Xiaohongshu y verifiquen la empresa. Después la marca usa esa cuenta profesional para entrar en Pugongying. Las agencias usan la plataforma de socios, y las tiendas usan el alta de comercio electrónico (Guía de alta de Pugongying).
La guía de verificación de cuentas de empresa indica la tarifa: 600 CNY por solicitud. La verificación dura 1 año y hay que pasar una revisión cada año. Si la verificación falla, la tarifa no se devuelve (Guía de verificación, PDF). En Pugongying puedes ver las tarifas de los creadores y los resultados de las notas de colaboración en sus páginas web. Las páginas públicas que leímos no describen un endpoint para desarrolladores que exporte notas y comentarios fila por fila.
El 13 de noviembre de 2026, el tipo central era de 6,7152 CNY por USD (China News Service, que cita al China Foreign Exchange Trade System). A ese tipo, 600 CNY al año son unos 89,35 USD, o unos 7,45 USD al mes. Ese dinero paga el derecho a entrar y a hacer colaboraciones.
La guía de inicio de Juguang Marketing API marca el listón con claridad. Es para clientes clave que tienen una cuenta publicitaria de Juguang y cierta experiencia en anuncios. Un comercial de Xiaohongshu inicia la aprobación dentro de la empresa. La API cubre informes y gestión de campañas (Guía de inicio de Juguang Marketing API, actualizada el 2024-01-03). La plataforma abierta de comercio electrónico dice que solo la cuenta principal de la tienda puede completar la autorización (Flujo de autorización para proveedores de software).
También existe una plataforma abierta para compartir. Permite que las aplicaciones compartan y publiquen contenido en Xiaohongshu, así que escribe datos y no los lee (Plataforma abierta para compartir). Las cuatro entradas manejan lo tuyo: tus usuarios, tu cuenta publicitaria y tu tienda. Si quieres estudiar qué publica otra gente sobre un tema público y qué dicen los comentarios, los documentos públicos de estas entradas describen funciones de inicio de sesión, colaboraciones, anuncios y tiendas, y no mencionan un endpoint de lectura para eso (leídos el 2026-11-14). Nuestro artículo anterior, Opciones de API de Xiaohongshu: plataforma propia, scripts abiertos y pago por llamada, compara estas entradas con más detalle.
El catálogo de EveryInfra también incluye xiaohongshu/pgy_content_square. Lee las listas de contenido destacado de la plaza de contenidos de Pugongying. Devuelve 20 filas por página, hasta 5 páginas por lista, a 0,016 USD por llamada (Catálogo). El catálogo la marca como disponible, pero no la probamos en esta ronda, así que los costos de abajo no la incluyen.
Segundo camino: escribir tu propio script, y qué dicen los proyectos abiertos
En GitHub hay muchos proyectos sobre Xiaohongshu. Elegimos 6 repositorios con muchas estrellas o que se citan a menudo. Con la API pública de GitHub leímos cada repositorio. También leímos cada incidencia abierta entre el 15 de octubre y el 14 de noviembre de 2026, sin contar las solicitudes de cambios (List repository issues). Revisamos el título y el texto de cada incidencia. Abajo citamos los README y las incidencias de estos proyectos.
| Repositorio | Estrellas | Licencia | Último push | Incidencias nuevas en 30 días | De ellas, sin datos |
|---|---|---|---|---|---|
| NanmiCoder/MediaCrawler | 71.098 | Propia; el README prohíbe el uso comercial | 2026-11-09 | 3 | 0 (2 son de otras plataformas y 1 es un anuncio) |
| xpzouying/xiaohongshu-mcp | 17.115 | Apache-2.0 | 2026-11-10 | 13 | 4 |
| JoeanAmier/XHS-Downloader | 13.292 | GPL-3.0 | 2026-11-13 | 7 | 2 |
| cv-cat/Spider_XHS | 8.467 | Sin declarar | 2026-10-22 | 0 | 0 |
| jackwener/xiaohongshu-cli | 2.731 | Sin declarar | 2026-03-21 | 0 | 0 |
| ReaJason/xhs | 2.236 | MIT | 2025-07-01 | 0 | 0 |
En esos 30 días, los 6 repositorios recibieron 23 incidencias nuevas. Seis de ellas, el 26 %, informan de un inicio de sesión fallido, una búsqueda limitada o un fallo al obtener o analizar datos. Las seis están en los dos repositorios más activos. Otros tres repositorios no recibieron incidencias nuevas en 30 días, y el último push a ReaJason/xhs fue el 1 de julio de 2025.
Pocas incidencias pueden significar dos cosas. La herramienta puede ser estable, o puede que menos gente la use y que el autor la haya dejado. El número de incidencias no basta para saberlo. Cuando elijas un repositorio, mira a la vez las incidencias y la fecha del último push.
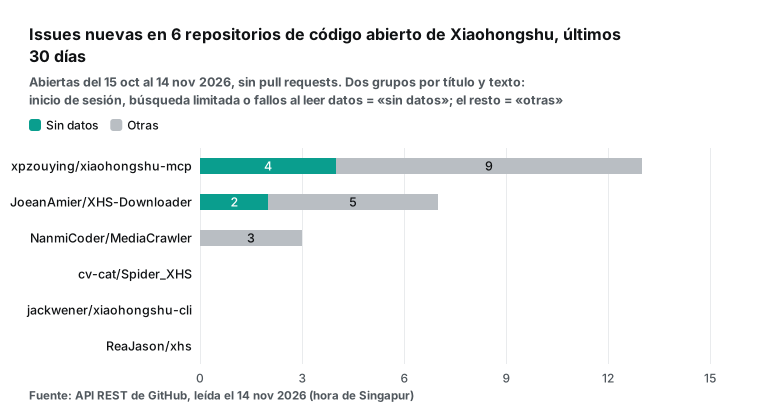
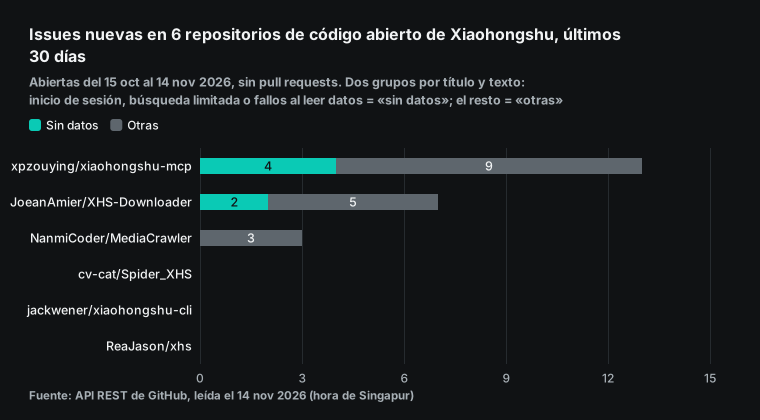
Esto dicen las incidencias sin datos, en nuestra traducción. La #877 de xiaohongshu-mcp (2026-10-21) se titula «La búsqueda está limitada (pero la aplicación funciona normal)». El texto dice que la cuenta recibió un aviso por sospecha de usar herramientas y scripts de terceros (#877). La #880 (2026-10-23) cuenta que tras escanear el código QR llegó un código de verificación y no logró entrar (#880). La #874 (2026-10-18) cuenta que la búsqueda se agota a los 60 segundos, mientras que el inicio sigue funcionando (#874). La #907 (2026-11-05) cuenta que la herramienta no logra obtener el código QR de inicio de sesión (#907).
La #497 de XHS-Downloader (2026-10-17) explica la causa. Dice que hacia el 15 de octubre de 2026 Xiaohongshu añadió una nueva construcción de JavaScript a los datos que el servidor genera en algunas páginas de notas. Ese cambio rompió el analizador de notas (#497). Cinco días después, la #499 informa de que la herramienta no logra obtener notas (#499). La #497 y la #499 tratan del análisis de la página de detalle de la nota. Las dos están cerradas; antes del arreglo, esa versión de la herramienta no podía analizar esas notas.
Los README también dicen qué tienes que resolver tú. El README de MediaCrawler explica que usa el framework de automatización de navegador Playwright para iniciar sesión y guardar la sesión. Su aviso legal prohíbe el uso comercial (README de MediaCrawler, LICENSE). El README de xiaohongshu-mcp dice que Xiaohongshu exige iniciar sesión. Advierte que una cuenta no puede tener la sesión abierta en varios clientes web a la vez. Si lo hace, la plataforma cierra la sesión de la herramienta. Las cuentas nuevas reciben además un aviso de verificación con nombre real (README de xiaohongshu-mcp).
La #878 del mismo repositorio (2026-10-22) pregunta si Xiaohongshu permite este uso y si las notas pierden alcance tras usar la herramienta. El 14 de noviembre no tenía respuesta (#878).
Según estos textos, un script propio tiene cuatro costos. Necesitas una cuenta con la sesión abierta, y el README dice que esa cuenta no puede estar abierta en varios sitios a la vez. Alguien tiene que arreglar el código cuando cambia la página (#497, #499). La licencia puede no permitir el uso comercial (MediaCrawler). La cuenta puede recibir un aviso (#877).
Un estudio de 2026 también tuvo que copiar a mano los datos de dos plataformas. Ese estudio, publicado en BMC Public Health, analizó conversaciones sobre dengue y chikungunya. El equipo recogió datos de Bilibili, Weibo y Zhihu mediante APIs. Para Douyin y Xiaohongshu dice que tuvo que copiar las publicaciones a mano «because of platform anti-automation controls». Esas dos plataformas aportaron solo 97 publicaciones en total, así que el equipo las presentó solo de forma descriptiva (BMC Public Health, 2026).
Tercer camino: una API de búsqueda de Xiaohongshu de pago por llamada, probada de principio a fin
Una API de pago por llamada convierte cada paso en una petición HTTP. Envías una palabra clave y recibes una página de resultados. Envías el enlace de una nota y recibes el detalle de la nota o una página de comentarios. Para cada capacidad, el catálogo de EveryInfra indica los parámetros obligatorios y opcionales, las filas por página y el precio (Catálogo, leído a las 13:05 del 2026-11-14). Las seis capacidades de esta ronda cuestan 0,005556 USD por llamada:
| Capacidad | Parámetros obligatorios | Filas por página | Paginación | Devuelto en esta ronda |
|---|---|---|---|---|
xiaohongshu/search | keyword | 20 | page_token | 7 páginas de 20 filas |
xiaohongshu/note | url | 1 | No tiene | 1 fila |
xiaohongshu/comments | url | Hasta 15 | page_token | Página 1: 15 filas; página 2: 1 fila |
xiaohongshu/sub_comments | url, comment_id | Hasta 10 | page_token | 1 página, 4 filas |
xiaohongshu/user_posts | user_id | 20 | page_token | 1 página, 20 filas |
xiaohongshu/hashtag | topic_id | 20 | page_token | No se probó en esta ronda |
Dos parámetros de búsqueda cambian la muestra de forma directa. sort acepta relevance, newest, most_liked, most_commented y most_collected. date_range acepta las últimas 24 horas, 7 días, 30 días, medio año o un año. El catálogo añade una nota sobre date_range. Con last_30_days y last_1_year, una página puede traer menos de 20 filas. Una página sin ninguna fila no se cobra. Para páginas más llenas, el catálogo sugiere sort=newest. La página de la API de datos de Xiaohongshu tiene la referencia completa.
Una ida y vuelta: la petición y la respuesta real
Esta es la petición de búsqueda de las 13:06:28. La clave sale de la variable de entorno EVERYINFRA_API_KEY:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"流感疫苗","sort":"relevance"}}'
# Página siguiente: copia next_page_token de la respuesta en params.page_token y deja igual el resto
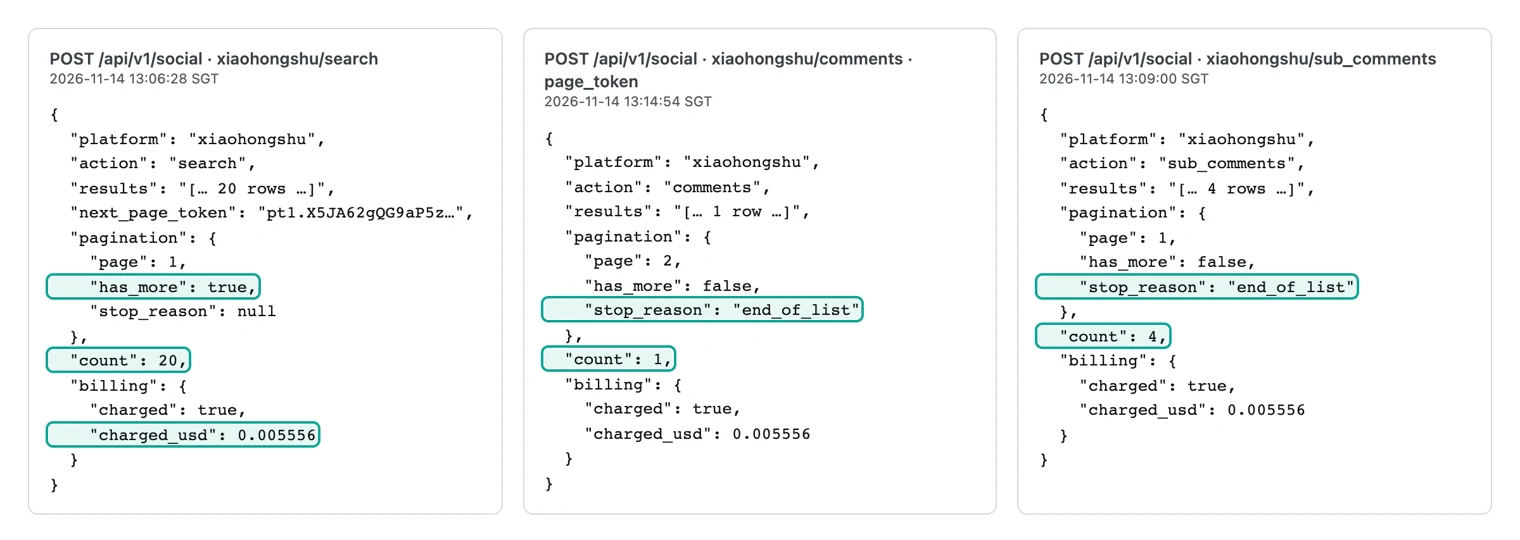
En la respuesta miramos cuatro cosas. count es el número de filas de esta página. pagination.has_more y stop_reason dicen si hay otra página. next_page_token es el cursor de la página siguiente. billing.charged_usd es lo que costó la llamada.
| Campo | Significado | Búsqueda, página 1, 13:06 | Comentarios, página 2, 13:14 | Respuestas, 13:09 |
|---|---|---|---|---|
count | Filas de esta página | 20 | 1 | 4 |
pagination.has_more | Si hay otra página | true | false | false |
pagination.stop_reason | Por qué se detuvo | ninguno | end_of_list | end_of_list |
billing.charged_usd | Costo de esta llamada | 0,005556 | 0,005556 | 0,005556 |
La imagen muestra tres respuestas reales. A la izquierda está la primera página de búsqueda, con has_more en true. En el centro está la página 2 de comentarios. En esta ronda devolvió 1 fila y stop_reason es end_of_list, así que la plataforma ya no da otra página. A la derecha están las respuestas a un comentario principal: la llamada devolvió 4 filas y también se detuvo en end_of_list.
Cada fila de búsqueda tiene campos que coinciden con la lista response_fields del catálogo. Contamos cuántas de las 20 filas de la página de las 13:06 tenían valor en cada campo. Así se ve qué campos puedes usar sin más para estadísticas:
| Campo | Significado (según el catálogo) | Filas con valor, de 20 |
|---|---|---|
id, url, posted_at, author_id | ID de la nota, enlace con token de acceso, hora de publicación en UTC, ID del autor | 20 |
like_count, collect_count, comment_count, share_count | Me gusta, guardados, comentarios, compartidos; null significa que no hay dato, no que sea cero | 20 |
title | Título | 19 |
text | Extracto corto del texto, unos 60 caracteres en la búsqueda; para el texto completo llama a note | 20 |
is_cooperation_note, is_goods_note | Si es nota de colaboración con marca; si es nota de producto | 20 |
video_url, duration_sec | Enlace y duración del video; vacío en notas de imagen | 3 |
poi_id | ID del lugar etiquetado en la tarjeta; el campo no aparece si no hay etiqueta | 1 |
En la búsqueda y en las listas de publicaciones, text es un extracto cortado. note devuelve el texto completo. Para análisis de opinión o de temas, usa solo el título y el extracto, o vuelve a llamar a note para las notas que elegiste. Una llamada a note cuesta 0,005556 USD por una fila, 20 veces el costo de una fila de búsqueda. Llámala solo para las notas que pasen tu filtro.
El flujo completo: búsqueda, nota, comentarios, respuestas
Los tres momentos de prueba fueron las 13:06, las 13:14 y las 13:26 hora de Singapur (SGT), con 20 minutos entre el primero y el último. En el primer momento recorrimos todo el flujo. En el segundo y el tercero repetimos las búsquedas y trajimos el resto de los comentarios. También leímos la lista de publicaciones de la cuenta de un organismo de salud pública:
| Hora (SGT) | Capacidad | Parámetros principales | Devuelto en esta ronda | charged_usd |
|---|---|---|---|---|
| 13:06:28 | xiaohongshu/search | Palabra clave de vacuna contra la gripe, relevancia | 20 filas | 0,005556 |
| 13:06:50 | xiaohongshu/search | Igual, página 2 | 20 filas | 0,005556 |
| 13:07:01 | xiaohongshu/search | Palabra clave de vacuna contra la gripe, más recientes | 20 filas | 0,005556 |
| 13:07:22 | xiaohongshu/note | Una nota que pregunta por una vacuna trivalente repartida en la escuela | 1 fila | 0,005556 |
| 13:08:41 | xiaohongshu/comments | La misma nota, página 1 | 15 filas | 0,005556 |
| 13:09:00 | xiaohongshu/sub_comments | El comentario principal con más me gusta | 4 filas | 0,005556 |
| 13:14:28 | xiaohongshu/search | Palabra clave de vacuna contra la gripe, relevancia | 20 filas | 0,005556 |
| 13:14:41 | xiaohongshu/search | Palabra clave de vacuna contra la gripe, más recientes | 20 filas | 0,005556 |
| 13:14:54 | xiaohongshu/comments | Página 2 | 1 fila, fin de la lista | 0,005556 |
| 13:26:12 | xiaohongshu/search | Palabra clave de vacuna contra la gripe, relevancia | 20 filas | 0,005556 |
| 13:26:33 | xiaohongshu/search | Palabra clave de vacuna contra la gripe, más recientes | 20 filas | 0,005556 |
| 13:26:47 | xiaohongshu/user_posts | La cuenta de un centro municipal de control de enfermedades | 20 filas | 0,005556 |
| Total | 12 peticiones cobradas | 181 filas | 0,066672 |
Como script, el flujo ocupa unas 60 líneas. La versión de abajo funciona tal cual. Solo necesita requests y lee la clave del entorno. Cada petición lógica envía una Idempotency-Key, y los reintentos dentro de la misma llamada usan la misma clave. Así, cuando un error de red envía una petición dos veces dentro de una llamada, se ejecuta y se cobra una sola vez. Nuestro artículo Reintentos de agentes de IA y la cabecera Idempotency-Key explica este patrón. Ante un 429 o un 503, el script espera el valor retry_after de la respuesta. Si vuelves a lanzar la tarea entera, el script crea claves nuevas y cada petición se cobra como nueva; así cada ronda trae los resultados de su momento, que es lo que pide un muestreo en varias horas.
"""Xiaohongshu: búsqueda -> nota -> comentarios (hasta el final) -> respuestas.
Uso: EVERYINFRA_API_KEY=... python3 xhs_chain.py "vacuna gripe"
Solo necesita requests. Escribe JSON Lines, una fila por línea."""
import json, os, sys, time, uuid
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]

def call(action, params, tries=4):
    idem = str(uuid.uuid4())                      # una clave por petición lógica; los reintentos la reutilizan
    for _ in range(tries):
        r = requests.post(API, timeout=120, json={"platform": "xiaohongshu", "action": action, "params": params},
                          headers={"Authorization": f"Bearer {KEY}", "Idempotency-Key": idem})
        body = r.json()
        if r.status_code in (429, 503):           # límite o error temporal: no se cobra, espera y reintenta
            time.sleep((body.get("error") or {}).get("retry_after", 30) + 1)
            continue
        r.raise_for_status()
        return body
    raise RuntimeError(f"{action} falló tras {tries} intentos")

def pages(action, params, max_pages=10):
    token = None
    for _ in range(max_pages):
        body = call(action, {**params, **({"page_token": token} if token else {})})
        yield from body.get("results") or []
        token = body.get("next_page_token")
        if not token or not (body.get("pagination") or {}).get("has_more"):
            break
        time.sleep(8)                              # pausa entre páginas; ajústala a tu volumen

def main(keyword, out="xhs.jsonl"):
    with open(out, "a", encoding="utf-8") as f:
        notes = list(pages("search", {"keyword": keyword, "sort": "newest"}, max_pages=1))
        for n in notes:
            f.write(json.dumps({"type": "search", **n}, ensure_ascii=False) + "\n")
        target = max(notes, key=lambda n: n.get("comment_count") or 0)       # solo baja en la nota con más comentarios
        detail = call("note", {"url": target["url"]})["results"]
        f.write(json.dumps({"type": "note", **detail}, ensure_ascii=False) + "\n")
        for c in pages("comments", {"url": target["url"]}):
            f.write(json.dumps({"type": "comment", **c}, ensure_ascii=False) + "\n")
            if (c.get("sub_comment_count") or 0) > len(c.get("sub_comments") or []):
                for s in pages("sub_comments", {"url": target["url"], "comment_id": c["id"]}):
                    f.write(json.dumps({"type": "sub_comment", **s}, ensure_ascii=False) + "\n")

if __name__ == "__main__":
    main(sys.argv[1])
Dos decisiones del script fijan cuánto gastas. La primera: solo baja en la nota con más comentarios. Una página de búsqueda tiene 20 notas. Si pides el detalle y los comentarios de todas, el número de llamadas se multiplica por 20. La segunda: solo pide respuestas cuando sub_comment_count es mayor que el número de respuestas que la fila ya trae en sub_comments. En esta ronda, 3 de los 16 comentarios principales tenían respuestas, y sus valores de sub_comment_count sumaban 9. Cada fila de comentario ya traía 0 o 1 respuesta. Así que solo los comentarios con más respuestas necesitan otra llamada a sub_comments.
Cómo saber que la paginación llegó al final
Los comentarios tienen dos niveles: comentarios principales y respuestas en hilo. Para los principales, pagina comments, con hasta 15 filas por página. Detente cuando la respuesta ya no traiga next_page_token y stop_reason sea end_of_list. En esta nota, la página 1 tuvo 15 filas (13:08:41) y la página 2 tuvo 1 fila (13:14:54). Las dos páginas dieron 16 comentarios sin IDs repetidos. Los 16 tenían ubicación por IP y venían de 10 regiones provinciales.
Para las respuestas, usa sub_comments. El comentario que elegimos tenía un sub_comment_count de 4. Una llamada a sub_comments devolvió 4 filas con stop_reason en end_of_list. Una respuesta contestaba directamente al comentario principal. Las otras 3 contestaban a respuestas anteriores, y su reply_to_id apunta a la respuesta de arriba. Para reconstruir la conversación, arma un árbol con reply_to_id. No ordenes solo por hora.
| Petición | Hora (SGT) | Filas devueltas | `has_more` / `stop_reason` | Qué te dice |
|---|---|---|---|---|
comments, página 1 | 13:08:41 | 15 | true / ninguno | Página llena; hay otra página |
comments, página 2 | 13:14:54 | 1 | false / end_of_list | La plataforma no da otra página; 16 en total en dos páginas |
sub_comments, un hilo | 13:09:00 | 4 | false / end_of_list | 1 contesta al comentario y 3 a respuestas |
end_of_list significa que la plataforma ya no da otra página. El catálogo describe así el parámetro sort de comments: el orden por defecto es el orden recomendado de la plataforma y se recalcula en cada petición, así que al paginar se pueden perder o repetir algunos comentarios; newest ordena por fecha y pagina de forma estable, pero en algunas notas la plataforma solo da la parte más reciente (Catálogo).
Esta ronda usó el orden por defecto, y las dos páginas se pidieron con 6 minutos y 13 segundos de diferencia. Para paginar de forma más estable, usa sort=newest. Con el orden por defecto, pagina una vuelta más y une por id de comentario. En tu informe, anota la hora y el orden de cada página.
El precio de los comentarios sigue una regla simple. Cada llamada tiene un precio fijo, así que las páginas más llenas bajan el costo por 1.000 filas. En esta ronda, la página 2 tuvo solo 1 fila, por lo que los 16 comentarios costaron 0,695 USD por 1.000 filas. Una nota con varios cientos de comentarios tiene casi todas las páginas llenas de 15 filas, y el costo se acerca a 0,370 USD por 1.000 filas (0,005556 USD / 15 x 1.000). Para pedir la primera página de comentarios de muchas notas, xiaohongshu/comments_batch acepta varios enlaces en una llamada. Nuestra guía de comentarios por lotes explica cómo usarla. No la probamos en esta ronda.
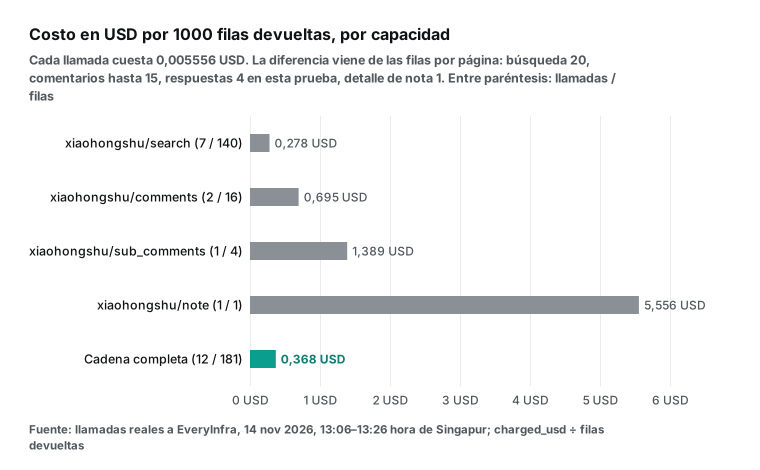
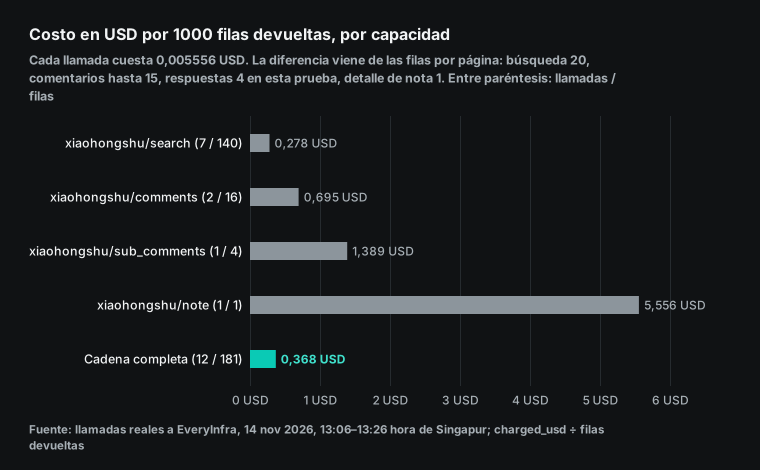
Si pones las cinco capacidades una al lado de otra, cada llamada cuesta 0,005556 USD, así que las filas por página fijan el costo por 1.000 filas. La búsqueda y las listas de publicaciones devuelven 20 filas por llamada, y el detalle de nota devuelve 1. Por eso el detalle de nota cuesta 20 veces más por 1.000 filas.
Para planificar un presupuesto, decide primero qué datos necesitan solo campos de lista (título, extracto, interacciones, hora de publicación) y qué datos necesitan la llamada de detalle (texto completo, etiquetas, coordenadas). Después estima con esa proporción. Esta ronda dio 181 filas por 0,066672 USD, o 0,368 USD por 1.000 filas. Es una mezcla con mucha búsqueda y algo de detalle y comentarios. Si tu flujo es casi todo detalle de nota, el costo por 1.000 filas se acerca a 5,556 USD.
Diseño de muestreo: cuánto coincide la misma palabra clave con otros órdenes y otras horas
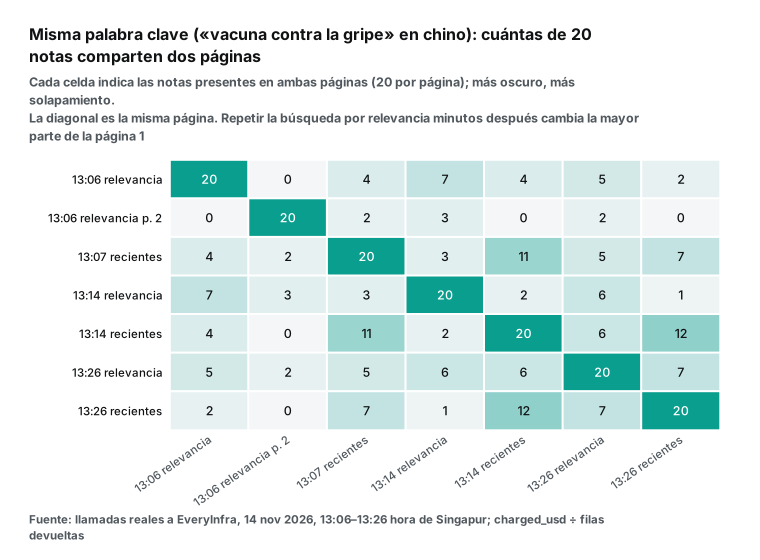
Mucha gente toma los resultados de una búsqueda como «lo que contiene este tema». Nosotros buscamos la palabra clave de la vacuna contra la gripe en tres momentos, con dos órdenes cada vez, y comparamos los valores id de las notas entre páginas. Cada página tenía 20 filas, así que la coincidencia es el número de notas que comparten dos páginas.
| Comparación | 13:06 a 13:14 | 13:14 a 13:26 | 13:06 a 13:26 | Notas distintas en tres rondas | En las tres rondas |
|---|---|---|---|---|---|
| Orden por relevancia, página 1 | 7 / 20 | 6 / 20 | 5 / 20 | 46 | 4 |
| Orden por más recientes, página 1 | 11 / 20 | 12 / 20 | 7 / 20 | 37 | 7 |
| Misma hora: relevancia frente a más recientes | 4 / 20 a las 13:06 | 2 / 20 a las 13:14 | 7 / 20 a las 13:26 | no aplica | no aplica |
Primero, el orden por relevancia cambió más rápido en 20 minutos. Sus tres primeras páginas sumaron 46 notas distintas, y solo 4 estuvieron en las tres. Las tres primeras páginas de más recientes sumaron 37 notas distintas, y 7 estuvieron en las tres.
Segundo, los dos órdenes en el mismo momento son casi dos muestras distintas. Solo comparten entre 2 y 7 notas; juntas, las dos páginas de cada momento suman 36, 38 y 33 notas distintas. Tercero, la página 1 y la página 2 de una misma búsqueda no se solaparon nada, así que paginar trae notas nuevas. Las 7 páginas tenían 140 filas y 83 notas distintas, de modo que el 41 % de las filas eran repetidas.
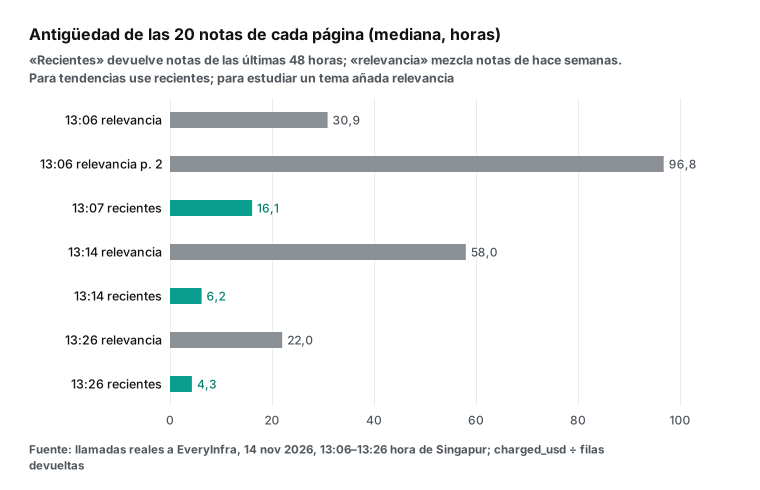
Los dos órdenes también devuelven notas de edades distintas. En las tres páginas de más recientes, la nota mediana tenía 16,1, 6,2 y 4,3 horas. En cada página, 19 o 20 de las 20 notas tenían menos de 48 horas. En las tres páginas de relevancia, las medianas fueron 30,9, 58,0 y 22,0 horas. La nota más antigua de la página de relevancia de las 13:26 tenía 281 días. Las interacciones también cambian. En la página 2 de relevancia, la mediana de comentarios fue 4,5. En las páginas de más recientes fue de 0 a 0,5, porque las notas nuevas no han tenido tiempo de reunir interacciones.
Las repeticiones también cuestan dinero. Las 7 páginas de búsqueda costaron 0,038892 USD por 140 filas, o 0,278 USD por 1.000 filas. Tras quitar duplicados quedaron solo 83 notas distintas, así que el costo por 1.000 notas distintas es de unos 0,469 USD. Cuando muestreas en varios momentos y con varios órdenes, una parte del dinero paga notas repetidas. Ese dinero compra un dato: la nota apareció en varios momentos. Puedes usarlo para dar a cada nota una puntuación de estabilidad.
Si solo necesitas una lista de notas distintas, en esta prueba el orden por relevancia rindió más por el dinero. Sus tres primeras páginas sumaron 60 filas y 46 notas distintas, unos 0,362 USD por 1.000 notas distintas. Las tres páginas de más recientes sumaron 60 filas y 37 notas distintas, unos 0,450 USD por 1.000. El orden por más recientes sirve porque capta las notas poco después de publicarse, así que úsalo para seguir tendencias.
| Base de conteo | Filas | Costo | Por 1.000 filas o notas |
|---|---|---|---|
| 7 páginas de búsqueda, todas las filas | 140 | 0,038892 USD | 0,278 USD |
| 7 páginas de búsqueda, notas distintas | 83 | 0,038892 USD | 0,469 USD |
| Tres primeras páginas de relevancia, notas distintas | 46 | 0,016668 USD | 0,362 USD |
| Tres primeras páginas de más recientes, notas distintas | 37 | 0,016668 USD | 0,450 USD |
Ahora mira cuántas notas nuevas trae cada página extra. Pusimos las 7 páginas en el orden en que las pedimos y, en cada una, contamos solo las notas que no aparecían en ninguna página anterior:
| Orden | Página | Notas nuevas en esta página | Notas distintas acumuladas | Esta página por 1.000 notas nuevas |
|---|---|---|---|---|
| 1 | 13:06, relevancia, página 1 | 20 | 20 | 0,278 USD |
| 2 | 13:06, relevancia, página 2 | 20 | 40 | 0,278 USD |
| 3 | 13:07, más recientes, página 1 | 14 | 54 | 0,397 USD |
| 4 | 13:14, relevancia, página 1 | 10 | 64 | 0,556 USD |
| 5 | 13:14, más recientes, página 1 | 7 | 71 | 0,794 USD |
| 6 | 13:26, relevancia, página 1 | 6 | 77 | 0,926 USD |
| 7 | 13:26, más recientes, página 1 | 6 | 83 | 0,926 USD |
Cada página cuesta 0,005556 USD, y la última columna es 0,005556 ÷ notas nuevas de esta página × 1.000. Las dos primeras páginas salen de una misma búsqueda, así que sus 20 notas son todas nuevas. La tercera usa el otro orden y aún trae 14 notas nuevas. Después, cada búsqueda repetida unos minutos más tarde trae 10, 7, 6 y 6 notas nuevas, y el costo marginal sube a 3,3 veces el de la primera página.
Cada orden por separado muestra la misma tendencia: las tres primeras páginas de relevancia trajeron 20, 13 y 13 notas nuevas, y las de más recientes, 20, 9 y 8. Con poco presupuesto, primero pagina más a fondo en una búsqueda y luego añade el otro orden; en esta prueba eso trajo más notas nuevas que repetir la misma búsqueda unos minutos después. Repetir la búsqueda sirve para saber qué notas se mantienen, no para alargar la lista.
La medida de coincidencia es sencilla. Pon los valores id de dos páginas en dos conjuntos. Divide el tamaño de la intersección entre el tamaño de la unión. El resultado es el índice de Jaccard. Las páginas de relevancia de las 13:06 y las 13:14 comparten 7 notas, y su unión tiene 33, así que el índice es de unos 0,21. Las páginas de más recientes de esas dos horas comparten 11 notas de una unión de 29, así que el índice es de unos 0,38. Anota este número después de cada ronda. Dibújalo como una línea durante unos días. Así verás lo rápido que cambian los resultados de una palabra clave y podrás decidir cada cuánto muestrear.
Este es un plan de muestreo que puedes ajustar a tu presupuesto:
| Objetivo | Orden | Frecuencia y profundidad | Duplicados y registro |
|---|---|---|---|
| Tendencia de un tema | newest | Página 1 cada 1 o 2 horas; 1 o 2 páginas más si llegan muchas notas nuevas | Quita duplicados por id; anota la primera hora en que aparece cada nota |
| Estudio del contenido de un tema | relevance + most_commented | 2 o 3 páginas en 3 momentos del mismo día | Une y quita duplicados; pide detalle y comentarios solo de notas con muchos comentarios |
| Revisión de un suceso | newest + date_range | Dos veces al día durante 7 días tras el suceso | Anota la hora y los parámetros de orden de cada página |
| Análisis de opiniones en comentarios | Elige notas con uno de los planes anteriores | Pagina los comentarios de cada nota hasta end_of_list; respuestas según haga falta | Arma árboles con reply_to_id; normaliza los IDs de autor antes de quitar duplicados |
La última fila pide normalizar los IDs de autor. El catálogo dice que author_id en los resultados de comentarios suele tener otra forma de 29 caracteres, distinta del ID de 24 caracteres de los resultados de notas. Antes de quitar duplicados entre lotes, conviértelos a una sola forma con profile (Catálogo). Si te saltas este paso, una persona cuenta como dos.
Este diseño tiene límites. Probamos una palabra clave, tres momentos y 20 minutos, con una muestra de 7 páginas y 140 filas. Todas las tasas de coincidencia y los costos de quitar duplicados de arriba valen solo para esta muestra. Las palabras clave muy activas y las tranquilas cambian a velocidades distintas, y lo mismo pasa entre el día y la noche. Antes de muestrear una palabra clave nueva, haz las mismas tres búsquedas, calcula tu propia coincidencia y luego fija la frecuencia.
Los investigadores llevan años hablando del sesgo de muestreo en redes sociales. En 2013, Morstatter y sus colegas compararon el flujo de muestra de Twitter con los datos completos. Vieron que la muestra dependía de los parámetros y de la ventana de tiempo (ICWSM 2013). Una muestra de búsqueda en Xiaohongshu también depende del orden y de la hora.
10.000, 100.000 o 1.000.000 de filas al mes: cuánto cuesta cada camino
Pusimos los tres caminos en una sola tabla y les dimos precio según las filas al mes. El lado de pago por llamada usa cifras medidas. El flujo de esta ronda costó 0,368 USD por 1.000 filas. También mostramos un piso (solo páginas de búsqueda, 0,278 USD por 1.000 filas) y un techo (solo detalle de nota, 5,556 USD por 1.000 filas). El lado del script propio no está medido: las horas, el costo por hora y el tráfico de proxy son supuestos nuestros. La segunda tabla lista cada supuesto con su fuente y su fecha de lectura, y guardamos el texto original de cada página externa en la carpeta de datos de este artículo. Puedes poner tus propios números y volver a calcular.
| Filas al mes | Pago por llamada (mezcla de esta ronda) | Solo páginas de búsqueda | Solo detalle de nota | Script propio (nuestros supuestos) | Entradas de Xiaohongshu |
|---|---|---|---|---|---|
| 10.000 | 3,68 USD | 2,78 USD | 55,56 USD | 79,25 USD | No leen notas ni comentarios de otros |
| 100.000 | 36,84 USD | 27,80 USD | 555,60 USD | 181,77 USD | Igual |
| 1.000.000 | 368,35 USD | 278,00 USD | 5.556,00 USD | 672,57 USD | Igual |
| Supuesto del script propio (nuestro, no medido) | Valor | Fuente y fecha de lectura |
|---|---|---|
| Costo por hora de un ingeniero | Unos 9,54 USD (64,08 CNY) | Suponemos el salario medio anual de 2025 en unidades urbanas privadas de transmisión de información, software y servicios de TI: 128.166 CNY (Oficina Nacional de Estadística, publicado el 2026-05-15, leído el 2026-11-14), dividido entre 2.000 horas (250 días laborables × 8 horas, supuesto nuestro) |
| Horas de mantenimiento al mes | 8 horas para 10.000 filas, 16 para 100.000 y 40 para 1.000.000 | Supuesto nuestro: sesiones caducadas, cambios de página y depuración; ver las 6 incidencias sin datos en 30 días |
| Tráfico de proxy | 200 KB por fila, unos 1,49 USD por GB (10 CNY) | El tráfico por fila es un supuesto nuestro; el precio es el tramo de 10 CNY por GB dentro de un rango público de 8 a 20 CNY por GB para proxies residenciales (página pública de precios de un proveedor, leída el 2026-11-14) |
| Tipo de cambio | 1 USD = 6,7152 CNY | Tipo central del 2026-11-13 (China News Service, que cita al China Foreign Exchange Trade System, leído el 2026-11-14) |
| No incluido | Primera construcción, servidores, cuentas | La primera construcción es un costo único que varía mucho entre equipos; el acuerdo de usuario no permite registrar cuentas en masa (ver la sección de cumplimiento) |
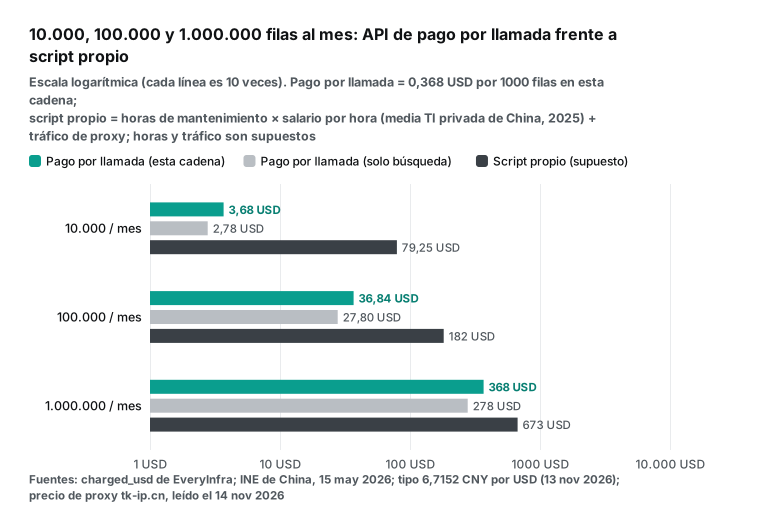
Con poco volumen, y con nuestros supuestos, casi todo el costo del script propio son personas. Con 10.000 filas al mes, el pago por llamada cuesta 3,68 USD. Solo las horas de mantenimiento del script propio cuestan unos 76,34 USD, 20,7 veces más; con los 2,91 USD de proxy, el total es de 79,25 USD, 21,5 veces más. Con mucho volumen, el costo del pago por llamada crece en línea recta con las filas. El trabajo de un script propio crece más despacio. Con 1.000.000 de filas al mes, la diferencia baja a unas 1,8 veces.
Si tu flujo es casi todo detalle de nota (5,556 USD por 1.000 filas), 1.000.000 de filas cuestan 5.556 USD. En ese caso un script propio puede salir más barato en dinero. El precio es el mantenimiento, el riesgo para la cuenta y las condiciones del acuerdo que vemos abajo. Esta tabla solo cuenta dinero. No cuenta la pérdida cuando una cuenta queda limitada o cuando tus datos tienen un hueco de varios días.
Dos supuestos mueven más el resultado, y puedes cambiar cada uno y recalcular. El primero es el tráfico de proxy por fila. Usamos 200 KB. Con 1.000.000 de filas al mes, el proxy cuesta unos 290,85 USD, el 43 % del total del script propio. Si tu script usa solo 50 KB por fila, el proxy baja a unos 72,71 USD y el total queda en unos 454,43 USD, todavía por encima de los 368,35 USD de la mezcla de esta ronda.
El segundo es el número de horas de mantenimiento. Dimos 40 horas al mes para 1.000.000 de filas. Si la estructura de la página cambia dos veces al mes y cada cambio exige un día laborable más de arreglos (8 horas), las horas pasan a 56, solo el trabajo cuesta unos 534,41 USD y el total del script propio llega a unos 825,26 USD.
| Escenario (1.000.000 de filas al mes, nuestros supuestos) | Proxy | Trabajo | Total del script propio | Veces el costo de pago por llamada de esta ronda (368,35 USD) |
|---|---|---|---|---|
| 200 KB por fila, 40 horas | 290,85 USD | 381,72 USD | 672,57 USD | 1,8 |
| 50 KB por fila, 40 horas | 72,71 USD | 381,72 USD | 454,43 USD | 1,2 |
| 200 KB por fila, 56 horas | 290,85 USD | 534,41 USD | 825,26 USD | 2,2 |
Convertimos desde CNY a 1 USD = 6,7152 CNY. Proxy = filas × 0,2 MB ÷ 1.024 × 10 CNY ÷ 6,7152. Trabajo = horas × 128.166 ÷ 2.000 ÷ 6,7152.
La columna de las entradas de Xiaohongshu no tiene importe. Pugongying exige verificar la cuenta de empresa (la guía dice 600 CNY por solicitud, válida 1 año, unos 7,45 USD al mes). Las páginas públicas de la plataforma abierta, Juguang y la plataforma abierta de comercio electrónico no indican tarifas. Los documentos públicos de las cuatro entradas no mencionan un endpoint para leer notas y comentarios de otros. Por eso no se pueden comparar en precio con los otros dos caminos, solo en uso.
Otro campo: cómo recoger notas y comentarios sobre un tema de salud pública
Elegimos la palabra clave de la vacuna contra la gripe porque tiene una fuente oficial de datos con la que comparar. El 12 de noviembre de 2026, el Centro Chino para el Control y la Prevención de Enfermedades (China CDC) publicó los datos de la semana 45 (del 2 al 8 de noviembre). La enfermedad de tipo gripal fue el 4,1 % de las consultas ambulatorias y de urgencias. La tasa de positividad del virus de la gripe en las muestras fue del 18,8 %, 3,1 puntos más que la semana anterior. El grupo de 5 a 14 años tuvo una tasa más alta que los demás (China CDC, semana 45).
El informe de vigilancia de esa misma semana cuenta 125 brotes de enfermedad de tipo gripal (Informe semanal n.º 934). Los datos oficiales dicen cuánta gente enfermó. Las notas y los comentarios de Xiaohongshu dicen qué pregunta la gente y qué le preocupa. Si pones las dos cosas juntas, puedes ver si la preocupación pública se mueve con la temporada de gripe.
Puedes recoger datos para este tipo de estudio en cuatro pasos. Cada paso usa solo las capacidades que probamos arriba.
| Paso | Capacidad | Qué anotar |
|---|---|---|
| 1. Grupos de palabras clave | xiaohongshu/search con newest y relevance | Hora de la consulta, orden, número de página, id y posted_at de cada nota |
| 2. Comentarios de las notas elegidas | xiaohongshu/comments, xiaohongshu/sub_comments | reply_to_id, ip_location y hora; IDs anónimos en lugar de apodos |
| 3. Cuentas de organismos | xiaohongshu/user_posts | Fecha, título e interacciones de cada nota del organismo |
| 4. Contraste de afirmaciones | Sin llamada a la API; avisos y guías oficiales | Categoría de cada comentario y la fuente oficial con la que coincide o choca |
Paso uno: define los grupos de palabras clave. Para vacunas, sepáralas por contexto: escuela, niños, pago con seguro médico, trivalente frente a tetravalente. Para cada grupo, ejecuta el orden newest en la página 1 cada 2 horas durante 7 días. Cada día, ejecuta también relevance en 2 o 3 páginas para sumar notas antiguas con muchas interacciones. En esta ronda, la primera página de relevancia incluía una nota de hace 281 días. Si estudias «esta temporada», filtra las temporadas anteriores con posted_at.
Paso dos: elige notas y baja a los comentarios. La autora de la nota de esta ronda preguntaba si valía la pena ponerse una vacuna trivalente repartida en la escuela. Sus 16 comentarios principales venían de 10 regiones provinciales. Algunas respuestas cuentan la vacunación propia y otras hablan del precio. El valor de esta conversación está en los comentarios. Así que, en las notas con más comentarios, pagina los comentarios hasta el final y arma árboles de respuestas con reply_to_id. Guarda la ip_location y la hora de cada comentario para agrupar por región y por semana.
Paso tres: recoge aparte las cuentas de organismos. Leímos la lista de publicaciones de la cuenta de un centro municipal de control de enfermedades. Sus 20 notas iban del 1 de septiembre al 13 de noviembre y tenían de 0 a 33 me gusta. Un título anunciaba vacunación gratuita contra la gripe para personas mayores y niños pequeños en la zona rural de Sanming. has_more estaba en true, así que hay publicaciones más antiguas. Compara qué publican los organismos, y con qué frecuencia, con lo que la gente pregunta en sus notas. Así se ve si la educación sanitaria cubre las preguntas que la gente hace.
Paso cuatro: contrasta afirmaciones y no saques conclusiones médicas. Puedes comparar lo que dicen los comentarios sobre precios y pagos con los avisos de los gobiernos locales. Un ejemplo es un aviso del 8 de octubre de la subdivisión de Ganquan Road, en el distrito de Putuo, Shanghái. Indica 86,4 o 96,4 CNY para la vacuna trivalente fraccionada y 306,4 CNY para la trivalente de subunidades. Se suma una tarifa de servicio de 6 CNY. Dice que se puede pagar con el saldo de la cuenta personal del seguro médico o con una cuenta familiar compartida (Aviso de Ganquan Road).
Para recomendaciones de vacunación, usa la guía técnica nacional de vacunación contra la gripe 2026-2027. Recomienda vacunarse en septiembre y octubre. Un grupo prioritario son las personas de guarderías, escuelas primarias y secundarias y centros de detención (Guía técnica). Tu informe cuenta cuántos comentarios preguntan por el precio, cuántos describen efectos secundarios y cuántos repiten una política. No juzga la salud de nadie. Oculta todos los apodos de quienes comentan y guarda solo IDs anónimos.
Fija las categorías de comentarios antes de recoger los datos, y no añadas categorías mientras lees. Para vacunas puedes empezar con cinco: precio y pago, lugar y cita, reacciones tras la vacuna, repetición de una política o aviso, y otros. Dos personas etiquetan por separado los mismos 100 comentarios con la misma guía escrita. Después calculas su tasa de acuerdo. Si el acuerdo es bajo, revisa la guía y vuelve a etiquetar. El análisis de contenido llama a este paso prueba de fiabilidad entre codificadores.
Después de etiquetar, suma la proporción de cada categoría por semana y por región provincial. Ponla en la misma línea de tiempo que la tasa de positividad semanal de China CDC. Así puedes comparar cuál de las dos curvas sube primero.
Ya hay investigadores que lo hicieron. Un estudio de 2025 en Frontiers in Digital Health buscó en Douyin, Bilibili y Xiaohongshu videos sobre la vacuna contra la gripe para niños. Tomó 100 videos de cada plataforma, 300 en total. La correlación de Spearman entre la puntuación de calidad y el número de comentarios fue de 0,90 (Frontiers in Digital Health, 2025). Otro estudio sobre la vacuna del VPH reunió 15.391 publicaciones de Zhihu, Weibo, Tieba y Xiaohongshu (Texto completo en PMC).
El estudio de Frontiers indica que tomó su muestra en febrero de 2025. Con el diseño de muestreo de arriba, repites la búsqueda en varios momentos y quitas duplicados por ID. Así la muestra se parece más a «toda la conversación que apareció en ese periodo». El mismo método sirve para temas de educación. Cambia las palabras clave por servicios extraescolares o política de admisión escolar, y las cuentas de organismos por las oficinas locales de educación.
La plataforma también actúa sobre el contenido de salud. El 4 de noviembre, Xiaohongshu inició una campaña de dos meses contra los bulos de salud y ciencia. Hasta el 9 de noviembre había actuado sobre 574 notas, 205 comentarios y 18 cuentas (The Paper, 2026-11-09). Esto afecta al muestreo de forma directa. Las notas que la plataforma retira desaparecen de los resultados de búsqueda, así que una muestra recogida hoy puede no existir la semana que viene. Si estudias bulos de salud, guarda las respuestas originales el mismo día y anota la hora de consulta de cada nota.
Errores, límites de frecuencia y reintentos: qué no se cobra
Cuando la API responde con un estado distinto de 200, lee primero error.code y next_steps en el cuerpo de la respuesta. Cuando una petición supera el límite de frecuencia, la API responde 429 y no cobra nada, y un reintento tras retry_after segundos funciona. Cuando la API no está disponible por un momento, responde 503, que tampoco se cobra. El catálogo también dice que una página de date_range sin filas no se cobra.
Al reintentar, una misma petición puede salir dos veces. La API REST acepta la cabecera Idempotency-Key. Las peticiones repetidas con la misma clave se ejecutan una sola vez, y la segunda recibe el resultado de la primera. El script de arriba crea un UUID por petición lógica y lo reutiliza en los reintentos. Nuestro artículo Reintentos de agentes de IA y la cabecera Idempotency-Key explica la idea y compara implementaciones.
Dos costumbres más ayudan. Al paginar, deja igual todos los parámetros salvo page_token, y si una tarea se detiene, empieza otra vez por la página 1. Guarda el id de petición de cada respuesta junto a la respuesta original, para cuadrar los cobros más tarde.
Los equipos con mucho volumen pueden crear una clave por tarea. Así cada tarea tiene su propio límite y sus propios registros de cobro, y un problema en una tarea no frena a las otras.
Cumplimiento: qué dicen el acuerdo y las leyes
Lee tres textos antes de recoger datos. El primero es el acuerdo de la plataforma. El Acuerdo de Servicio al Usuario de Xiaohongshu se actualizó el 23 de marzo de 2026. La cláusula 3.4 dice que necesitas permiso escrito de Xiaohongshu para copiar, leer, usar o hacer estadísticas con el contenido y los datos de la plataforma. Sin ese permiso, no puedes vender los datos ni usarlos con fines comerciales de ninguna forma.
La cláusula 4.1 prohíbe tomar contenido mediante enlaces directos no autorizados, copia redundante, recolección ilegal, descargas simuladas, enlaces profundos, registros falsos y medios parecidos. También prohíbe entrar o usar el servicio con software de terceros no autorizado. La cláusula 2.1 prohíbe registrar cuentas con frecuencia o en masa (Acuerdo de Servicio al Usuario, traducción nuestra). Un script propio necesita una cuenta con la sesión abierta, así que estas cláusulas le afectan de lleno.
El segundo texto es la Ley de Protección de Información Personal de China. El artículo 6 dice que la recogida de información personal debe limitarse al alcance mínimo necesario para el fin. El artículo 13, punto 6, permite tratar información personal que una persona o una fuente legal hizo pública. Ese tratamiento debe quedarse dentro de un alcance razonable (Texto completo). Para la recolección de datos, esto significa tres cosas. Toma solo los campos que tu estudio necesita. No guardes datos personales como apodos y avatares si puedes evitarlo, y ocúltalos en los informes.
El tercero es el Reglamento de Gestión de la Seguridad de los Datos de Red, vigente desde el 1 de enero de 2025. El artículo 8 prohíbe robar datos de red u obtenerlos por otros medios ilegales (Reglamento). La Ley contra la Competencia Desleal, revisada en 2025, también tiene cláusulas sobre la obtención de datos (Copia en la Administración Nacional de Propiedad Intelectual de China).
| Texto | Cláusula | Qué significa para la recolección |
|---|---|---|
| Acuerdo de Servicio al Usuario de Xiaohongshu | 3.4, 4.1, 2.1 | Permiso escrito para leer y hacer estadísticas; sin recolección ilegal; sin entrada con software de terceros no autorizado; sin cuentas en masa |
| Ley de Protección de Información Personal | Artículo 6; artículo 13, punto 6 | Alcance mínimo para el fin; datos personales públicos dentro de un alcance razonable |
| Reglamento de Gestión de la Seguridad de los Datos de Red | Artículo 8 | Sin robo de datos de red ni otros medios ilegales |
No damos asesoría legal. Consulta a un abogado sobre tu proyecto. Los tres textos fijan reglas sobre el fin y el alcance. En el muestreo, eso se traduce así: recoge solo las palabras clave que estudias. Baja solo a las notas cuyos comentarios necesitas. Guarda solo los campos que cuentas. Así bajan a la vez el volumen de datos y el riesgo.
Cuándo usar una entrada de Xiaohongshu y cuándo construir lo tuyo
Cada uno de los tres caminos encaja con un caso distinto. Compara tu necesidad con esta tabla:
| Tu necesidad | Mejor camino | Por qué |
|---|---|---|
| Que los usuarios entren en tu aplicación con su cuenta de Xiaohongshu | Plataforma abierta de Xiaohongshu | basic_info está abierto; la revisión tarda de 1 a 3 días hábiles |
| Ver las notas de colaboración de tu marca y las tarifas de creadores | Pugongying | Los datos de colaboración se quedan en la plataforma; el acceso exige una cuenta de empresa verificada |
| Sacar tus propios informes de anuncios | Juguang Marketing API | Solo lee tu cuenta publicitaria; necesita aprobación comercial |
| Un estudio puntual de unos miles de filas, con un ingeniero en el equipo | Script de código abierto | El menor costo en dinero, pero necesitas una cuenta con sesión, cumplir el acuerdo y arreglarlo tú |
| Vigilar un tema con una agenda fija, de 10.000 a 1.000.000 de filas al mes | API de pago por llamada | Nada que desplegar ni mantener por tu cuenta; los errores no se cobran; encaja en una tarea programada |
Si tu equipo ya usa un script de código abierto, puedes cambiar un paso por la API de pago por llamada y dejar el resto igual. Las incidencias de arriba muestran tanto límites de búsqueda (#877, #874) como fallos al analizar el detalle de nota (#497, #499); usa el registro de errores de tu propio script para elegir qué paso cambiar primero. Fuera de Xiaohongshu, la recolección de comentarios de Douyin tiene el mismo flujo y las mismas preguntas de muestreo. La lista de capacidades está en la página de la API de datos de Douyin.
Para un informe semanal de cuota de voz de una marca, mira Informe semanal de cuota de voz en Xiaohongshu para marcas de Singapur y Malasia con Claude. Para guardar una exportación como instantánea y compararla dos semanas después, mira Exportación de datos de Xiaohongshu y análisis de instantáneas. Para que Claude Code haga el análisis de comentarios, mira Flujos dinámicos de Claude Code para comentarios de Xiaohongshu.
Hechos recientes que afectan a los datos de Xiaohongshu
Varios hechos recientes cambian lo que recoges:
| Fecha | Hecho | Efecto en la recolección |
|---|---|---|
| Hacia el 2026-10-15 | Cambió la estructura de datos de algunas páginas de notas y un analizador abierto se rompió (XHS-Downloader #497, abierta el 17 de octubre) | Los scripts propios necesitan a alguien de guardia; sin datos hasta el arreglo |
| 2026-10-27 | Xiaohongshu informó de su trabajo para proteger a menores: de julio a septiembre actuó sobre más de 120.000 publicaciones de animación alterada con IA o dañina, y aprende más de 2.000 códigos de jerga nuevos al día (Beijing News) | El contenido retirado desaparece de los resultados; archiva las muestras el mismo día |
| 2026-11-04 | Empezó la campaña contra bulos de salud y ciencia; hasta el 9 de noviembre actuó sobre 574 notas | Las muestras de temas de salud cambian; usa el archivo para mirar atrás |
| 2026-11-06 | Xiaohongshu anunció medidas contra el marketing falso y de baja calidad; notas y comentarios pueden limitarse, plegarse o retirarse (Jiemian) | El contador de comentarios puede no coincidir con los comentarios visibles; cuenta con los resultados de la paginación |
| 2026-11-12 | China CDC publicó los datos de vigilancia de gripe de la semana 45 | Los temas de salud pública tienen ahora datos oficiales con los que comparar |
Primeros pasos: de la primera llamada a una tarea diaria
Para tu primera llamada, sigue el inicio rápido. Regístrate, obtén una clave, pon tu palabra clave en el comando curl de arriba y ejecútalo una vez. Luego revisa count y billing.charged_usd. Los precios están en la página de precios, y puedes ver todas las capacidades por plataforma en el mercado de datos. Para que asistentes de IA como Claude o Cursor llamen a la API directamente, conecta el servidor MCP remoto. La página MCP de Xiaohongshu lista las herramientas y la configuración:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
MCP sirve para preguntar y consultar sobre la marcha. Para tareas de muestreo que corren a horas fijas cada día, el script REST de arriba con Idempotency-Key es más fiable, porque los reintentos no se cobran dos veces. Los campos de configuración de MCP siguen la especificación de Model Context Protocol (Especificación de MCP). Para programar, basta con el cron del sistema. Ajústalo a las frecuencias de la tabla de muestreo. Después de cada ronda, archiva el archivo JSON Lines por fecha y luego ejecuta la eliminación de duplicados y las estadísticas de coincidencia.
Preguntas frecuentes
¿Cómo solicito una API de búsqueda de Xiaohongshu?
El 14 de noviembre de 2026, la plataforma abierta de Xiaohongshu solo abre un permiso, basic_info. El permiso read_notes sigue «en planificación», así que hoy no hay una API de búsqueda de Xiaohongshu que solicitar (Lista de permisos). Una API de pago por llamada no necesita solicitud. Regístrate, obtén una clave y llama a xiaohongshu/search por 0,005556 USD por llamada y 20 filas por página.
¿Es legal recolectar datos de Xiaohongshu?
Depende de qué recoges, cómo lo recoges y para qué lo usas. La cláusula 3.4 del acuerdo de la plataforma exige permiso escrito para leer o hacer estadísticas con su contenido. La cláusula 4.1 prohíbe la recolección ilegal y la entrada con software de terceros no autorizado (Acuerdo de Servicio al Usuario). La Ley de Protección de Información Personal limita la recogida al alcance mínimo necesario para el fin (Texto completo). Consulta a un abogado sobre tu proyecto.
¿Cómo pagino los comentarios de Xiaohongshu hasta el final?
Pagina comments, con hasta 15 filas por página, hasta que la respuesta no traiga next_page_token y stop_reason sea end_of_list; eso significa que la plataforma ya no da otra página. El catálogo advierte que el orden por defecto puede perder o repetir comentarios entre páginas: para paginar de forma más estable usa sort=newest, y con el orden por defecto pagina una vuelta más y une por id de comentario. Algunos comentarios principales tienen un sub_comment_count mayor que las respuestas de su fila. Para esos, llama a sub_comments y pagina hasta el final. En esta ronda, una nota devolvió 16 comentarios principales en dos páginas (Catálogo).
¿Siguen funcionando los proyectos xiaohongshu scraper de GitHub?
Funcionan, pero tienes que mantenerlos. Los 6 repositorios que revisamos recibieron 23 incidencias nuevas entre el 15 de octubre y el 14 de noviembre. Seis de ellas hablan de fallos de inicio de sesión, búsquedas limitadas o errores de análisis. La #497 de XHS-Downloader registra un cambio en la estructura de la página hacia el 15 de octubre que rompió el analizador (#497). Cuando elijas un repositorio, mira también la fecha del último push y la licencia.
¿Cómo analizo los datos que recoge un scraper de Xiaohongshu?
Primero quita duplicados de notas por id, arma los árboles de comentarios con reply_to_id y lleva los IDs de autor a una sola forma. Después agrupa por hora de publicación, región e interacciones. Para el flujo completo de informe semanal e instantáneas, mira Exportación de datos de Xiaohongshu y análisis de instantáneas.
¿Tiene API Pugongying?
Las páginas públicas de Pugongying describen el alta y los flujos de colaboración. Una marca debe verificar primero su cuenta de empresa (600 CNY por solicitud, válida 1 año). Las páginas públicas que leímos no muestran un endpoint para desarrolladores que exporte notas y comentarios fila por fila (Guía de alta de Pugongying, Guía de verificación).
Referencias
- Plataforma abierta de Xiaohongshu: lista de permisos, leída el 2026-11-14. https://openaccount.xiaohongshu.com/docs/scope
- Plataforma abierta de Xiaohongshu: inicio rápido, leída el 2026-11-14. https://openaccount.xiaohongshu.com/docs/quick-start
- Pugongying de Xiaohongshu: guía de alta, leída el 2026-11-14. https://pgy.xiaohongshu.com/role-introduce?needLogout=needLogout
- Página principal de Pugongying, leída el 2026-11-14. https://pgy.xiaohongshu.com/
- Guía de verificación de cuentas de empresa de Xiaohongshu (PDF), leída el 2026-11-14. https://fe-video-qc.xhscdn.com/d32a91d3f2fdc2130a7ba5015cc92ca446034613.pdf
- Guía de inicio de Juguang Marketing API, leída el 2026-11-14. https://ad.xiaohongshu.com/openApiDoc?categoryId=761&articleId=3047
- Plataforma abierta de comercio electrónico de Xiaohongshu: flujo de autorización para proveedores de software, leída el 2026-11-14. https://open.xiaohongshu.com/document/developer/file/38
- Plataforma abierta para compartir de Xiaohongshu, leída el 2026-11-14. https://agora.xiaohongshu.com/index
- Acuerdo de Servicio al Usuario de Xiaohongshu (actualizado el 2026-03-23), leído el 2026-11-14. https://agree.xiaohongshu.com/h5/terms/ZXXY20220331001/-1
- README de NanmiCoder/MediaCrawler. https://github.com/NanmiCoder/MediaCrawler
- LICENSE de NanmiCoder/MediaCrawler. https://github.com/NanmiCoder/MediaCrawler/blob/main/LICENSE
- README de xpzouying/xiaohongshu-mcp. https://github.com/xpzouying/xiaohongshu-mcp
- Incidencia #874 de xiaohongshu-mcp (2026-10-18). https://github.com/xpzouying/xiaohongshu-mcp/issues/874
- Incidencia #877 de xiaohongshu-mcp (2026-10-21). https://github.com/xpzouying/xiaohongshu-mcp/issues/877
- Incidencia #878 de xiaohongshu-mcp (2026-10-22). https://github.com/xpzouying/xiaohongshu-mcp/issues/878
- Incidencia #880 de xiaohongshu-mcp (2026-10-23). https://github.com/xpzouying/xiaohongshu-mcp/issues/880
- Incidencia #907 de xiaohongshu-mcp (2026-11-05). https://github.com/xpzouying/xiaohongshu-mcp/issues/907
- JoeanAmier/XHS-Downloader. https://github.com/JoeanAmier/XHS-Downloader
- Incidencia #497 de XHS-Downloader (2026-10-17). https://github.com/JoeanAmier/XHS-Downloader/issues/497
- Incidencia #499 de XHS-Downloader (2026-10-22). https://github.com/JoeanAmier/XHS-Downloader/issues/499
- cv-cat/Spider_XHS. https://github.com/cv-cat/Spider_XHS
- jackwener/xiaohongshu-cli. https://github.com/jackwener/xiaohongshu-cli
- ReaJason/xhs. https://github.com/ReaJason/xhs
- API REST de GitHub: List repository issues. https://docs.github.com/en/rest/issues/issues#list-repository-issues
- Catálogo de EveryInfra, leído el 2026-11-14 a las 13:05. https://api.everyinfra.com/api/v1/social/catalog
- China CDC: vigilancia de enfermedad de tipo gripal, semana 45 de 2026, 2026-11-12. https://www.chinacdc.cn/jksj/jksj04_14275/202611/t20261112_1842956.html
- China CDC: informe semanal de vigilancia de gripe n.º 934, 2026-11-11. https://www.chinacdc.cn/jksj/jksj04_14249/202611/t20261111_1842933.html
- China CDC: guía técnica de vacunación contra la gripe en China (2026-2027). https://www.chinacdc.cn/jkts/202609/t20260903_1839780.html
- Subdivisión de Ganquan Road, distrito de Putuo, Shanghái: aviso de vacunación contra la gripe, 2026-10-08. https://www.shpt.gov.cn/gqjd-jiedaozhen/gsgg-sqzc-gqjd/20261008/973469.html
- Frontiers in Digital Health: calidad de videos cortos sobre la vacuna contra la gripe para niños, 2025. https://doi.org/10.3389/fdgth.2025.1591347
- PMC: estudio de la conversación sobre la vacuna del VPH en redes sociales. https://pmc.ncbi.nlm.nih.gov/articles/PMC13377298/
- BMC Public Health: conversación sobre dengue y chikungunya en redes sociales, 2026. https://doi.org/10.1186/s12889-026-29595-0
- Morstatter y otros: Is the Sample Good Enough?, ICWSM 2013. https://doi.org/10.1609/icwsm.v7i1.14401
- Oficina Nacional de Estadística de China: salarios medios anuales en unidades urbanas de 2025, 2026-05-15. https://www.stats.gov.cn/sj/zxfb/202605/t20260515_1963707.html
- China News Service: tipo central del renminbi del 13 de noviembre, 2026-11-13. https://www.chinanews.com.cn/cj/2026/11-13/10731286.shtml
- Ley de Protección de Información Personal de la República Popular China. https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
- Reglamento de Gestión de la Seguridad de los Datos de Red (Decreto n.º 790 del Consejo de Estado). https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml
- Ley contra la Competencia Desleal de la República Popular China (revisión de 2025). https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- The Paper: Xiaohongshu inicia una campaña contra bulos de salud y ciencia, 2026-11-09. https://www.thepaper.cn/newsDetail_forward_34439159
- Jiemian: Xiaohongshu actúa contra el marketing falso y de baja calidad, 2026-11-06. https://m.jiemian.com/article/15301935.html
- Beijing News: avances de Xiaohongshu en la protección de menores, 2026-10-27. https://m.bjnews.com.cn/detail/1793097565129919.html
- Especificación de Model Context Protocol: Transports. https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
Referencia BL-155