Tavily alternatives:五种用法每千次比价
Tavily 基础搜索每千次 $5 到 $8,抓 10 页 $15 起;我们实扣搜索和带全文都是 $0.694,失败不扣,Serper 大包更便宜。
Tavily 的账单按 credit 记:一次基础搜索 1 个 credit,高级搜索 2 个,抓正文按每 5 个网址折 1 个,列站点网址按每 10 页折 1 个;套餐里一个 credit 值 $0.005 到 $0.0075,按量 $0.008。换算成每 1,000 次请求,Tavily 基础搜索是 $5.00 到 $8.00,抓一个站的 10 页是 $15 到 $24,列一个站的 200 个网址是 $100 到 $160。我们在 2026 年 11 月 15 日凌晨真调了 EveryInfra 的搜索接口 36 次,网页搜索、带 5 篇全文的深度检索、整站抓取、站点结构这四件事每次都只扣 $0.000694,折合每千次 $0.694;按场景算,Tavily 是我们的 7.2 倍到 230 倍。Firecrawl 列站点网址每次 1 个 credit,最大档每千次 $0.749,和我们几乎一样;Serper 最大预付包每千次 $0.30,只搜索的话比我们便宜。失败、空结果和写错参数的 15 次调用,我们一分没扣。
本文里的「每 1,000 次」,Tavily、Firecrawl、Serper、SerpAPI 四家一侧,是用各自公开定价页或计费文档上的套餐月费,除以这一档每月给的 credit 或次数,再乘每次请求要扣的 credit;每一档都按这个月把额度用完来算,用不完的部分各家都在周期末清零或到期作废,实际单价只会更高。EveryInfra 一侧,是本篇真调响应里 billing.charged_usd 的实扣金额乘 1,000,和当天的 搜索工具目录 与 能力目录 里的价格逐项对过,没有一次偏离。四家对手的数都是 2026-11-15 00:20 到 00:41(新加坡时间)读到的公开标价,我们没有注册、没有调用这四家的接口;EveryInfra 的数是同一时段的实测扣费。两边返回的结果各自独立检索,字段、条数、排序都不同,本篇比价钱、计费规则、免费额度、失败怎么算和 MCP 怎么接,不比两边是不是同一批网页。
Tavily alternatives 总表:五种用法、五家价格
每格是每 1,000 次请求的美元价。对手一侧左边是最大的公开自助档,右边是最小付费档或按量价;最右一列是 Tavily 区间除以我们实扣的倍数。
| 用法(每次请求) | Tavily | Firecrawl | Serper | SerpAPI | EveryInfra 实扣 | Tavily ÷ 我们 |
|---|---|---|---|---|---|---|
| S1 只搜索,约 10 条 | basic $5.00–$8.00;advanced $10–$16 | $1.498–$7.60 | $0.30–$1.00 | $9.17–$25.00 | web $0.694 | 7.2–11.5 倍;advanced 14.4–23.1 倍 |
| S2 搜索并拿回 5 篇全文 | 带全文 $5–$8;搜索加 Extract $10–$16 | $5.243–$26.60 | 只给摘要 | 只给摘要 | deep full $0.694 | 7.2–23.1 倍 |
| S3 抓一个站的 10 页正文 | basic $15–$24;带 instructions $20–$32 | $7.49–$38.00 | 无 | 无 | crawl $0.694 | 21.6–46.1 倍 |
| S4 列一个站的 200 个网址 | $100–$160;带 instructions $200–$320 | $0.749–$3.80 | 无 | 无 | map $0.694 | 144–230 倍 |
| S5 一次多来源核对 | Research mini 每次 4–110 credit,pro 15–250 credit | 无 | 无 | 无 | crosscheck $2.778 | 不可直接比 |
S5 不写倍数:Tavily 的 Research 交付一份报告,crosscheck 只交付证据分层,不写结论。S2 一行 Serper 和 SerpAPI 写「只给摘要」,是指它们的搜索接口返回标题、链接、摘要和结果页上的其他区块,不带每个结果页的正文;要正文得另找抓取服务,这两家不在 S2 的比较范围里。
S1 里,Serper 是四家中唯一有几档比我们便宜的:Ultimate 包 $3,750 买 1,250 万次,每千次 $0.30,比我们 web 工具的 $0.694 低 57%;Scale 包 $1,250 买 250 万次,每千次 $0.50,低 28%。另外两档比我们贵:Standard 包 $375 买 50 万次,每千次 $0.75,高 8%;Starter 包 $50 买 5 万次,每千次 $1.00,高 44%。Firecrawl 的搜索按每 10 条结果 2 个 credit 扣,Scale 档每千次 $1.498,是我们的 2.16 倍;Hobby 档 $7.60,是我们的 11 倍;按年付算,Scale 档每千次 $1.198、Hobby 档 $6.40,仍是我们的 1.7 到 9.2 倍。Tavily basic 落在 $5 到 $8,SerpAPI 落在 $9.17 到 $25,两家都在我们 7 倍以上。图里横轴是对数刻度,青绿色的点是我们的两个价:统一搜索入口的 web 工具 $0.694,和能力目录里的 bing/search、duckduckgo/search 两项 $0.556。
Serper 的两档低价有一个前提:预付包 6 个月有效,到期没用完的次数作废,上面的每千次价按 6 个月内用满算。把它换成「每月至少要搜多少次才比我们便宜」:Scale 包 $1,250 要在 6 个月里用掉 180 万次以上,也就是每月 30 万次;Ultimate 包 $3,750 要用掉 540 万次以上,每月 90 万次。用量不到这条线,按实际用掉的次数摊,单价就高过 $0.694。举两个数:每月 10 万次的团队买 Scale 包,6 个月用掉 60 万次,每千次实付 $2.08,是我们的 3 倍;每月 100 万次的团队买 Ultimate 包,6 个月用掉 600 万次,每千次实付 $0.625,仍比我们低 10%。所以 Serper 便宜的那两档,适合每月几十万到上百万次、只要摘要的稳定用量。
| Serper 预付包 | 价格 | 次数(6 个月有效) | 每千次(用满) | 限速 | 比我们便宜所需的每月用量 |
|---|---|---|---|---|---|
| Starter | $50 | 5 万 | $1.00 | 每秒 50 次 | 用满也比 $0.694 贵 |
| Standard | $375 | 50 万 | $0.75 | 每秒 100 次 | 用满也比 $0.694 贵 |
| Scale | $1,250 | 250 万 | $0.50 | 每秒 200 次 | 每月 30 万次以上 |
| Ultimate | $3,750 | 1,250 万 | $0.30 | 每秒 300 次 | 每月 90 万次以上 |
Tavily 的 credit 怎么折:六个接口逐项换算
Tavily 的 计费文档 把每个接口扣几个 credit 写成一张表,我们在 00:20 读到、00:41 截图。搜索接口按 search_depth 分档:basic、fast、ultra-fast 三档都是 1 个 credit,advanced 是 2 个;auto_parameters 打开时 Tavily 会自己挑参数,文档写明它可能把深度切到 advanced,这时扣 2 个。搜索结果要带全文,加 include_raw_content,搜索接口文档 写它返回清洗过的正文,计费文档里没有为它另加 credit。一次搜索最多 20 条结果,max_results 默认 10、上限 20。
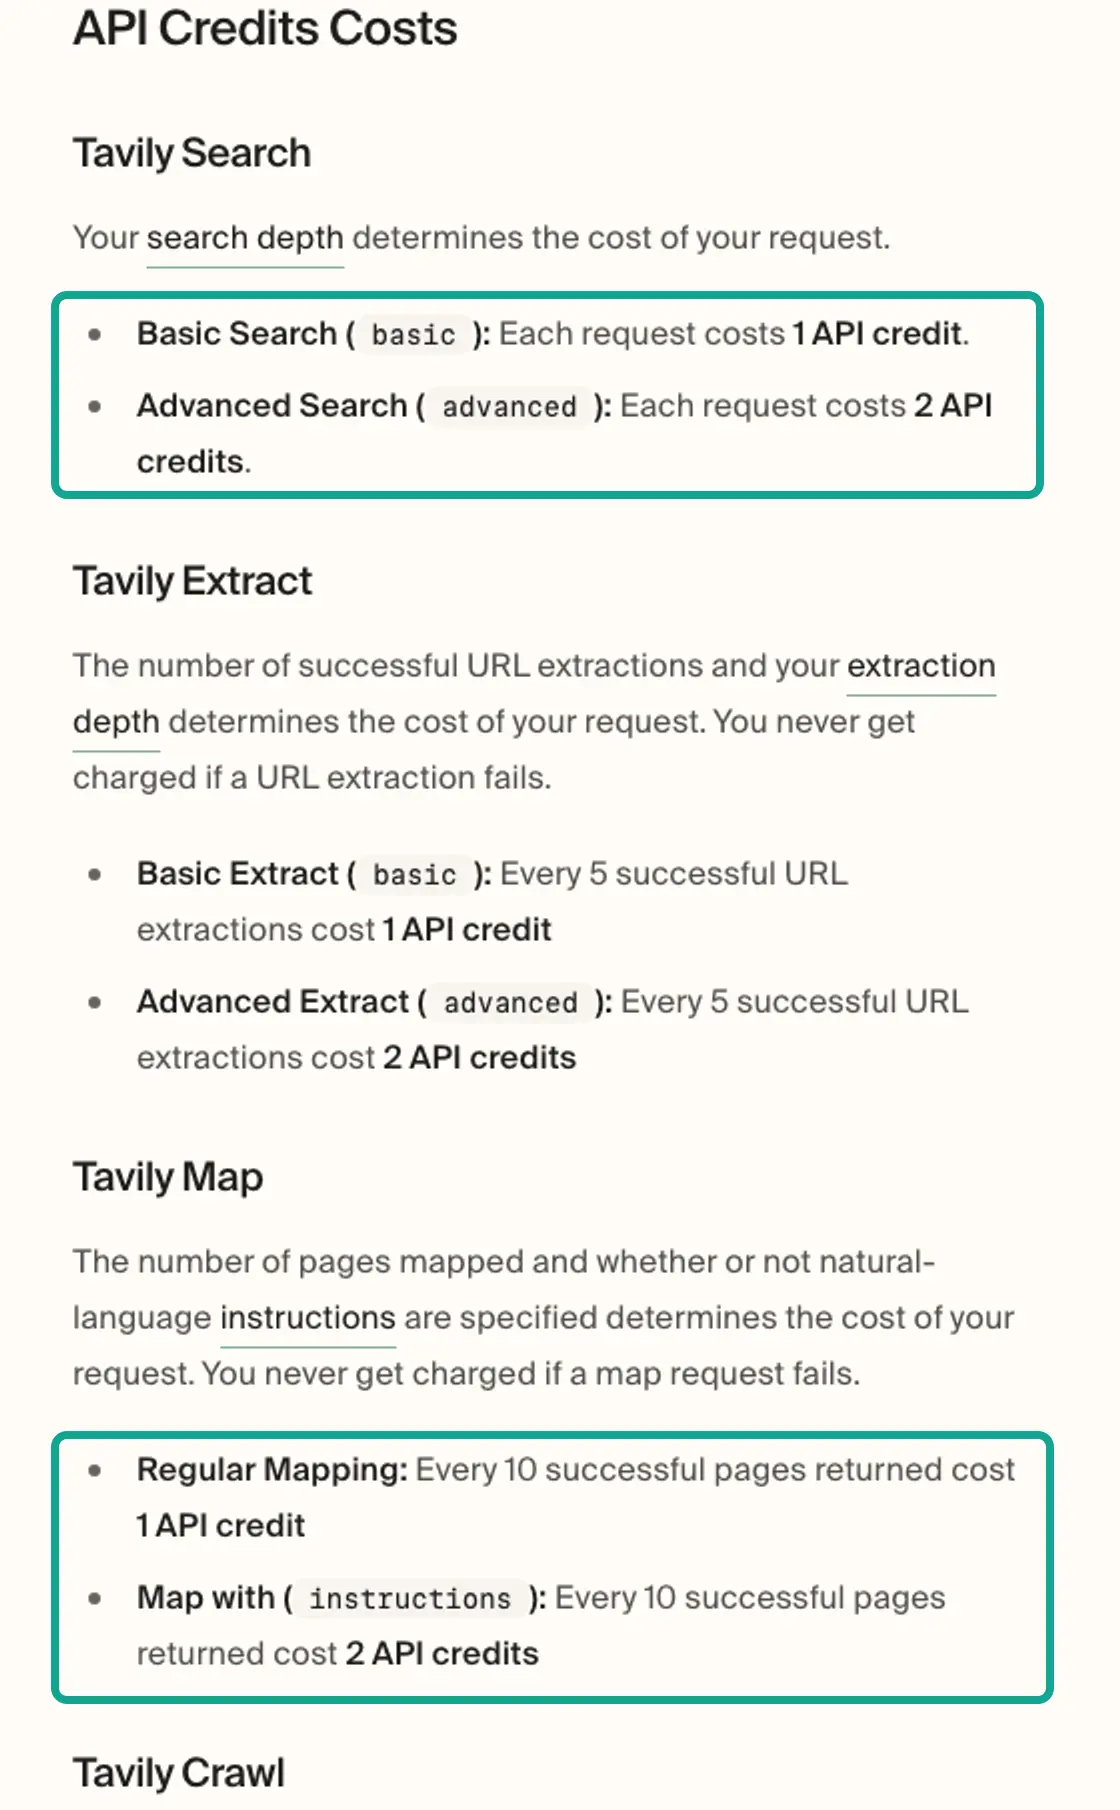
Extract(抓正文)按成功的网址数折算:basic 每 5 个成功网址 1 个 credit,advanced 每 5 个 2 个;抓失败的网址不扣,一次请求最多 20 个网址,见 Extract 接口文档。Map(列站点网址)每 10 个成功返回的页面 1 个 credit,带 instructions 用自然语言筛页面时翻倍成 2 个,见 Map 接口文档。Crawl(整站抓取)等于 Map 的费用加 Extract 的费用,Crawl 接口文档 给的例子是抓 10 页 basic 扣 3 个 credit、advanced 扣 5 个;带 instructions 时 Map 那部分翻倍,10 页 basic 变成 4 个。Research(自动研究并写报告)按模型分两档,mini 每次 4 到 110 个 credit,pro 每次 15 到 250 个,具体扣多少看这次研究读了多少来源,见 Research 接口文档。
| 接口 | Tavily 每次扣多少 credit | 按量 $0.008 时每次 | Growth 档 $0.005 时每次 | EveryInfra 对应工具 | 实扣每次 |
|---|---|---|---|---|---|
| Search basic | 1 | $0.008 | $0.005 | web | $0.000694 |
| Search advanced | 2 | $0.016 | $0.010 | deep | $0.000694 |
Search 带 include_raw_content | 1(basic) | $0.008 | $0.005 | deep 加 full=true | $0.000694 |
| Extract 5 个网址,basic | 1 | $0.008 | $0.005 | read 5 次 | $0.003470 |
| Crawl 10 页,basic | 3 | $0.024 | $0.015 | crawl | $0.000694 |
| Map 200 个网址 | 20 | $0.160 | $0.100 | map | $0.000694 |
| Research mini | 4–110 | $0.032–$0.880 | $0.020–$0.550 | crosscheck | $0.002778 |
Extract 是差距最小的一项:Tavily 一次请求能塞 20 个网址,每 5 个成功网址才扣 1 个 credit,抓 5 页在 Growth 档 $0.005、按量 $0.008;我们 read 一次一个网址,抓 5 页 $0.00347,只比 Tavily 便宜 1.4 到 2.3 倍。整站抓取和列网址两行反过来:Tavily 按页数折,页数越多扣得越多;我们 crawl 一次最多 20 页、map 一次最多 200 个网址,按一次算。所以从 Tavily 换过来能省多少,取决于你的 agent 在哪种接口上花钱最多。
套餐本身的价格在同一份文档里:Researcher 免费,每月 1,000 个 credit;Project 每月 $30 给 4,000 个,合每个 $0.0075;Bootstrap $100 给 15,000 个,合 $0.0067;Startup $220 给 38,000 个,合 $0.0058;Growth $500 给 100,000 个,合 $0.005;按量(Pay As You Go)每个 $0.008;Enterprise 价格面议。额度每月 1 日重置,用完即停,按量要单独打开。Tavily 定价页 的卡片和文档一致。Tavily 还有两条额外的额度来源:创业计划 写着给入选团队 10 万个 credit,学生账号说明 写着学生可以领 4 个月 Project 档。
场景 S1:只搜索,每千次 $0.556 到 $25
只要标题、链接、摘要的场景最常见:agent 先搜一轮,挑出两三条再决定要不要读正文。我们在 00:30 到 00:38(新加坡时间)之间,用统一搜索入口的 web 工具跑了 5 个不同的查询,外加一次重复查询,6 次全部返回 10 条,每次实扣 $0.000694,耗时 1.61 到 3.17 秒,中位数 2.43 秒。同一个词「tavily alternatives」在 00:30:36 和 00:37:54 各搜一次,两次返回的 10 个网址完全一样、顺序也一样,价格也一样,没有因为重复查询加价或打折。
能力目录里还有三项同类能力,我们各调一次:bing/search 在 00:36(新加坡时间)返回 7 条,扣 $0.000556;duckduckgo/search 返回 10 条,扣 $0.000556,前 7 条和 Bing 的顺序一样;web/search 返回 10 条,扣 $0.001389。这三项的入口在 Bing 爬虫 API、DuckDuckGo 爬虫 API 和 网页搜索爬虫 API,平台总览在 Bing 平台页、DuckDuckGo 平台页 和 网页搜索平台页。只算 S1,我们最便宜的一档是每千次 $0.556,最贵的一档 $1.389,两档都低于 Tavily basic 的下限 $5。
| 每月用量 | Tavily basic | Tavily advanced | EveryInfra `web` |
|---|---|---|---|
| 1,000 次 | $0(免费档 1,000 个 credit) | $8(免费 1,000 加按量 1,000) | $0.69 |
| 10,000 次 | $72(免费 1,000 加按量 9,000) | $140(Bootstrap 加按量 5,000) | $6.94 |
| 100,000 次 | $500(Growth) | $1,300(Growth 加按量 100,000) | $69.40 |
| 1,000,000 次 | $7,700(Growth 加按量 900,000) | $15,700(Growth 加按量 1,900,000) | $694 |
这张月账单表的规则是:Tavily 一侧每个用量都挑最省的买法,档内额度先用、超出部分按 $0.008 按量补,假设按量可以和套餐叠加;我们一侧是次数乘 $0.000694。每月 1,000 次的小用量,Tavily 免费档就够,比我们的 $0.69 还省。用量到 1 万次,Tavily basic 是我们的 10.4 倍;到 100 万次,Growth 档的 10 万个 credit 只覆盖十分之一,其余按量补,账单 $7,700,是我们的 11.1 倍。
搜索结果条数是另一处要对齐的地方。Tavily 一次搜索最多 20 条、扣 1 个 credit;我们 web 一次最多 10 条,要 20 条得翻第 2 页,再扣一次。按「每千次拿 20 条」算,Tavily basic 仍是 $5 到 $8,我们变成 $1.388,差距从 7.2 到 11.5 倍缩到 3.6 到 5.8 倍。如果你的 agent 习惯一次要 20 条,迁移时把这一项算进去;大多数 agent 只读前 5 到 10 条,num 不用调到上限。
场景 S2:搜一次并拿回 5 篇全文
带正文的搜索是 agent 搜索和普通搜索接口最不一样的地方。Tavily 的做法是在搜索请求里加 include_raw_content,每条结果附带清洗后的正文,计费文档写 basic 搜索仍是 1 个 credit。Tavily 一次请求同时返回排序和正文,不加 credit,不用再逐条去抓。按这个规则,Tavily 带全文每千次 $5 到 $8;如果改用「先搜索、再把 5 个网址交给 Extract」,就是 1 加 1 等于 2 个 credit,每千次 $10 到 $16。
我们的同类做法是深度检索 deep 带 full=true。00:34:13(新加坡时间)那次查 MCP 规范 2025-11-25 版的更新日志,返回 5 篇,耗时 7.45 秒;00:38:03(新加坡时间)那次查「tavily alternatives pricing per 1000 searches」,返回 5 篇,耗时 8.59 秒,5 篇正文的长度依次是 20,000、20,000、11,152、2,952 和 152 个字符,每篇上限 20,000 字符。两次都扣 $0.000694,每千次 $0.694,是 Tavily 带全文的 7.2 到 11.5 倍便宜。另一种拆开的做法是 web 搜一次加 read 读 5 次,共 6 次调用,每千次 $4.164,比 Tavily 带全文略便宜,比我们自己的 deep 贵 6 倍;只在你要挑着读、不想 5 篇全拿的时候才划算。
Firecrawl 的思路是把搜索和抓取放进同一套 credit:搜索文档 写搜索每 10 条结果 2 个 credit,要抓结果页正文时每页再加 1 个,抓 5 页合计 7 个 credit。Firecrawl 定价页 从 2026-09-04 起生效的四个月付档是 Hobby $19 给 5,000 个、Standard $99 给 10 万个、Growth $399 给 50 万个、Scale $749 给 100 万个,一个 credit 值 $0.00075 到 $0.0038,年付再便宜 16% 到 20%。7 个 credit 换成每千次是 $5.243 到 $26.60。Firecrawl 在 S2 的上限比 Tavily 还高,下限和 Tavily 带全文差不多。
带全文还有一笔账在模型那边:正文越长,模型读进去的 token 越多。我们用 o200k_base 编码数了每次响应里 results 字段的 token:deep 带 full=true 两次是 12,037 和 12,447,中位数 12,242;同样 5 条结果、不带全文的 deep 只有 848。按每百万输入 token $3 的模型价算,一次带全文的检索让模型多读约 $0.034,是这次检索本身价格的 49 倍。所以在 S2 里,挑一家每千次便宜几美元的接口,省下的钱可能抵不过 token 账单;更省的做法是先用不带全文的搜索把结果筛到两三条,再读这几条的正文。
场景 S3:抓一个站的 10 页正文
整站抓取常见于两种 agent:一种要读某家公司的文档站回答问题,一种要定期把某个站点的新页面拉下来做摘要。Tavily 的 Crawl 是 Map 加 Extract:先列出页面,再抓每页正文,10 页 basic 扣 3 个 credit,带 instructions 扣 4 个。换成每千次请求,basic 是 $15 到 $24,带 instructions 是 $20 到 $32。Firecrawl 的 Crawl 文档 写每页 1 个 credit,10 页就是 10 个,每千次 $7.49 到 $38;Firecrawl 的最大档在这一行比 Tavily 便宜,最小档比 Tavily 贵。
我们在 00:34:41(新加坡时间)用 crawl 抓 Tavily 自己的文档站,入口是 docs.tavily.com/documentation,num 设 20,instructions 写「pricing, credits, rate limits and API reference pages」。5.86 秒后返回 11 页:计费说明、用量查询、Crawl、Extract、反馈、日志、Map、Research 三页、Search,全是按指令要的那类页面,没有混进博客或首页;每页正文最长 20,000 字符,11 页合计约 13.8 万字符。这次扣 $0.000694,每千次 $0.694。按 Tavily 的规则抓同样 11 页并带 instructions,Map 部分 2 个单位共 4 个 credit,Extract 部分 3 个单位共 3 个 credit,合计 7 个 credit,按量 $0.056;我们这一次是它的八十分之一。
我们的 crawl 有两个上限要先知道:一次最多 20 页,每页正文最多 20,000 字符,超出部分截断。抓一个几百页的文档站,要先用 map 列出网址,再分批交给 crawl 或 read;Tavily 的 Crawl 有 max_depth、max_breadth、limit 几个参数,limit 默认 50 页,一次请求能走得更深,扣的 credit 也按页数一起涨。如果你的 agent 每次只抓十几页,按次计费最省;如果一次要拿 500 页,Tavily 和 Firecrawl 都是一次请求、按页扣,我们要 25 次 crawl 加 3 次 map,合计约 $0.019,仍远低于按页折算的账单,只是调用次数多。
场景 S4:列一个站的 200 个网址
站点结构(Map)是差距最大的一行。Tavily 的 Map 每 10 个成功返回的页面算 1 个 credit,列 200 个网址就是 20 个,按量 $0.16 一次,Growth 档 $0.10 一次;带 instructions 再翻倍,每次 $0.20 到 $0.32。换成每千次请求,就是 $100 到 $160,带 instructions $200 到 $320。我们在 00:35:03(新加坡时间)用 map 列 Firecrawl 的文档站,num 设 200,0.51 秒返回 200 个网址,扣 $0.000694。每千次 $0.694 对 $100 到 $160,差 144 到 230 倍,是五种用法里倍数最大的一处。
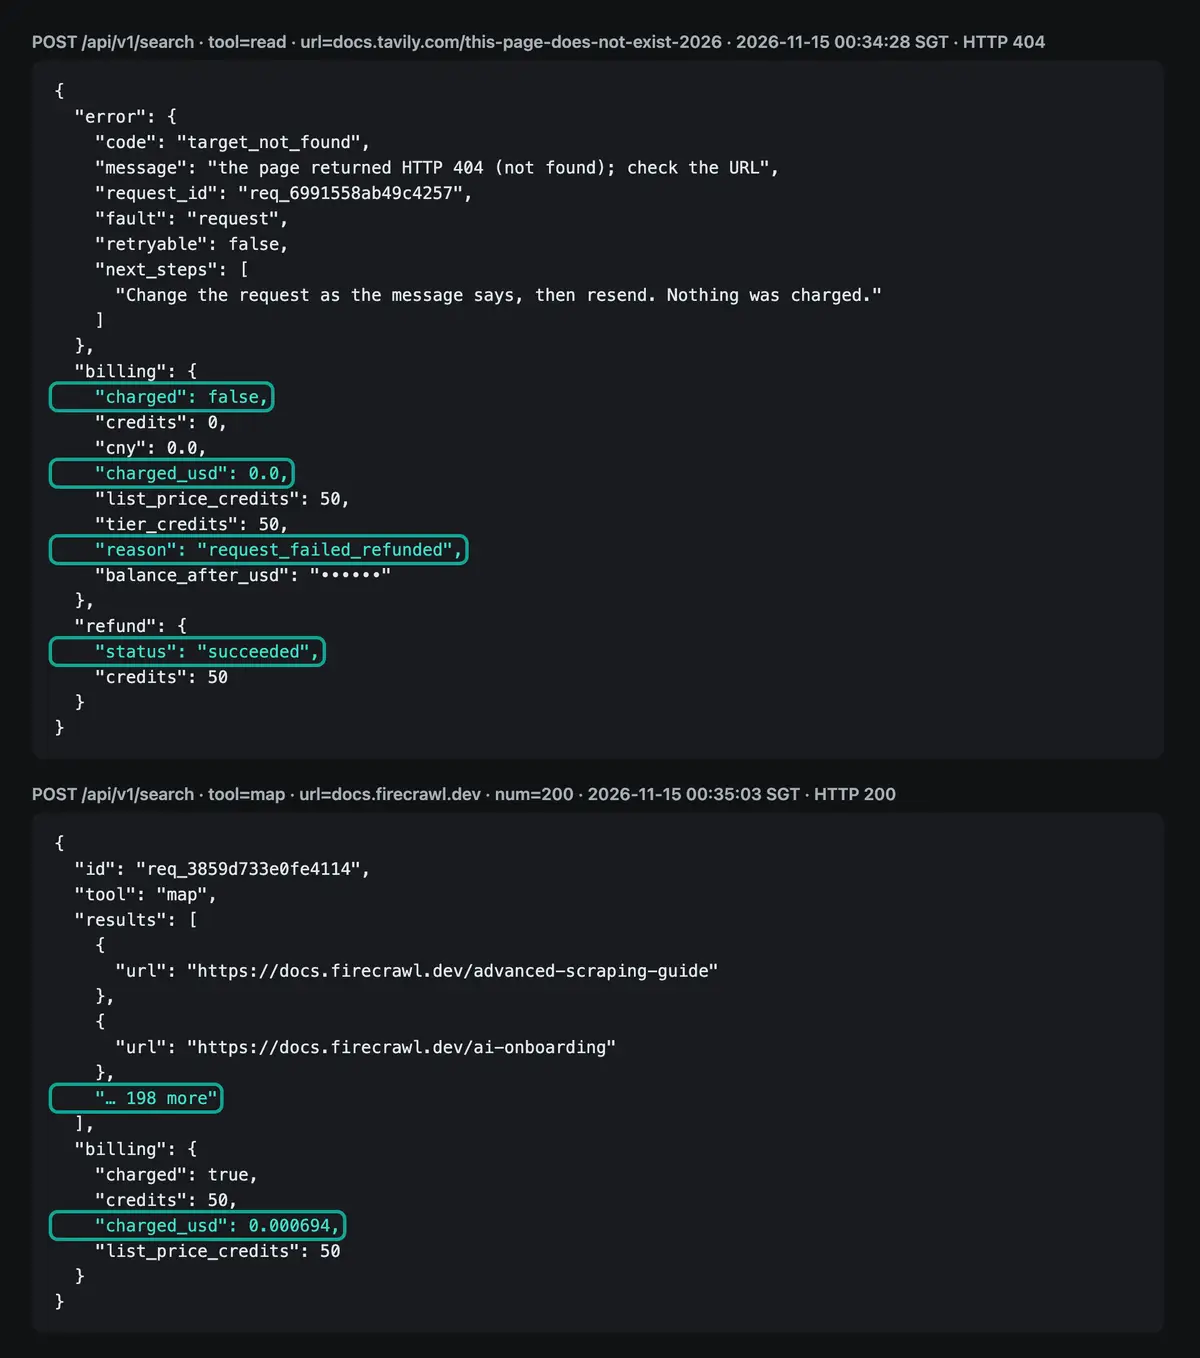
Firecrawl 在这一行和我们差不多。它的 Map 文档 写一次 Map 扣 1 个 credit,不按网址数折算;Scale 档每千次 $0.749,是我们的 1.08 倍,Hobby 档 $3.80,是我们的 5.5 倍。所以 Map 的大差距只在 Tavily 一家:它把 Map 和 Extract 用同一种「按成功页数折」的规则计费,页数一多 credit 就跟着涨。如果你的 agent 主要用 Tavily 做站点发现(例如每天列一遍竞品站点有没有新页面),这一项换掉能省下账单的大头;如果主要用 Tavily 搜索,这一项影响不大。拿一个具体的例子算:每天把 30 个竞品站点各列一遍、每站 200 个网址,一个月 900 次 Map,Tavily 要扣 18,000 个 credit,在 Growth 档折合 $90、按量 $144,单这一项就超过 Bootstrap 档一个月的额度;同样 900 次 map 在我们这边是 $0.62。
场景 S5:Research 和交叉验证,交付的东西不一样
Tavily 的 Research 接口会自己拆问题、搜多轮、读来源,最后写一份带引用的报告;mini 每次 4 到 110 个 credit,pro 每次 15 到 250 个,按量换算成每次 $0.032 到 $0.88 和 $0.12 到 $2.00。我们的 crosscheck(交叉验证)在同一个问题上并行跑四种检索机制,把来源按「几种机制同时命中」分层,再取回最高层的两篇原文,每次扣 $0.002778。00:35:19(新加坡时间)那次核对「Nebius 2026 年 2 月同意以 2.75 亿美元收购 Tavily」,40.97 秒后四种机制收敛,Bloomberg 的报道和 sacra 的公司页各被 3 种机制命中,排在最高层。
两者没有放进同一个倍数,原因是交付物不同:Research 给的是写好的结论,crosscheck 给的是证据和命中分层,结论由你的 agent 或你自己来写。搜索工具目录的原话是「我们只给证据,不替你写结论」。如果你需要的是一份能直接贴给用户的报告,Tavily 的 Research 更省事;如果你的 agent 本来就有自己的模型来写结论,只缺一份可靠的来源清单,crosscheck 每次不到 0.3 美分,Research mini 最低也要 3.2 美分。
同样一笔月费,能搜多少次
把 Tavily 四个付费档的月费原样拿过来,换成我们 web 工具的调用次数:Project 的 $30 在 Tavily 能做 4,000 次 basic 搜索,在我们这里能做 43,227 次,是 10.8 倍;Bootstrap 的 $100 对应 15,000 次和 144,092 次,9.6 倍;Startup 的 $220 对应 38,000 次和 317,002 次,8.3 倍;Growth 的 $500 对应 100,000 次和 720,461 次,7.2 倍。Tavily 档位越高,每个 credit 越便宜,倍数从 10.8 降到 7.2;我们没有档位,每次都是 $0.000694。
还有一个差别在额度的有效期。Tavily 的套餐额度每月 1 日重置,这个月没用完的部分不会留到下个月;Firecrawl 的月付档同样按月给 credit。Serper 的预付包 6 个月有效,SerpAPI 的月付档按月重置。我们的余额充进去不清零、不设有效期,用多少扣多少。对用量起伏大的 agent(例如月初跑一轮大批量、其余时间零星调用),按月重置的额度很容易用不完,实际单价会比上面的满额折算更高。
token 账单:接口费之外的另一半
搜索接口的价格只是 agent 搜索成本的一部分,另一部分是模型读这些结果花的 token。GitHub 上有一份公开测试 search-api-cost-benchmark,2026-08-06 发布,用 100 个问题测了多家搜索接口,按 Claude Sonnet 5 每百万输入 token $3 计价,把「接口费加 token 费」合在一起算每千次:tavily-basic 每次 3,166 个 token,合计每千次 $17.50,答对 88%;tavily-advanced 每次 12,749 个 token,合计每千次 $54.25,答对 91%;firecrawl-search 每次 16,458 个 token,合计每千次 $55.77,答对 94%。测试作者在 Reddit 的 r/AI_Agents 发了 同一组数,帖子开头写明他自己做其中一家搜索接口,所有返回内容、评分和价格都公开可复跑;评论里另一位开发者说,他们在自己的 agent 上测过,大多数接口的读取 token 费占总成本的六到七成。
我们用 tiktoken 的 o200k_base 编码,数了本次每类调用 results 字段的 token:web 6 次在 765 到 879 之间,中位数 807;deep 不带全文 848;read 三次是 643、2,591 和 1,299;deep 带全文中位数 12,242;crawl 那次 11 页合计 45,715。按同样的 $3 每百万 token 算,web 每千次的 token 费约 $2.42,加上接口费 $0.694,合计约 $3.11;deep 带全文每千次 token 费约 $36.73,合计约 $37.42。两组数的问题集、编码方式都不一样,只能看量级,不能当同一把尺子量出来的结果。
第一,只看摘要的搜索,接口费和 token 费是同一个量级,接口每千次便宜几美元,总账也跟着便宜;我们 web 每次 807 个 token,比公开测试里 tavily-basic 的 3,166 少,是因为我们的 web 每条只给标题、链接、摘要和发布时间,Tavily basic 每条附带一段相关内容。第二,带全文的检索,token 费是接口费的几十倍,换哪家接口都省不了多少,能省的地方在少读:先用摘要筛,再读两三篇,比一次拿 5 篇全文省得多。
失败、空结果、写错参数:扣不扣钱
agent 会犯错:网址拼错、页面已删、查询词太偏搜不到、参数名照旧接口写。这些情况怎么算钱,五家写法不一样。我们这次专门做了 6 类失败:00:31 到 00:34(新加坡时间)之间撞上 10 次 429 限速;00:33:22 不带 Key 请求一次,回 401;00:33:14 照 Tavily 的写法发 query 和 search_depth,回 422;00:33:06 读一个不存在的域名,00:34:28 读 docs.tavily.com 下一个不存在的页面,两次都回 404;00:37:35 搜一串不存在的词,回 200 但结果为空。
| 情况 | Tavily | Firecrawl | Serper | SerpAPI | EveryInfra(本次实测) |
|---|---|---|---|---|---|
| 页面抓不到 | Extract、Map 失败的网址不扣 | 目标页回 403、404 仍扣 1 个 credit | 不适用 | 不适用 | 两次 404 扣 $0,request_failed_refunded |
| 搜索空结果 | 计费文档没写 | 无结果不扣 | 成功响应才扣 | 空结果算 1 次 | 扣 $0,empty_result_refunded |
| 出错、超限 | 429,按组织限速 | 文档未单列 | 成功响应才扣 | 出错、缓存不算 | 429 和 401 扣 $0 |
| 参数写错 | 文档未单列 | 文档未单列 | 文档未单列 | 文档未单列 | 422,扣 $0,附 did_you_mean |
两次 404 的响应里,billing 一段写着 charged_usd 为 0.0、reason 为 request_failed_refunded,refund 一段的 status 为 succeeded;空结果那次的 reason 是 empty_result_refunded。10 次 429 的响应写明「Nothing was charged」,并给出 retry_after 22 秒;本次用的测试 Key 自己设了每分钟 10 次的上限,所以撞得多,正式账号默认每分钟 60 次。Firecrawl 在这一行的规则最需要注意:定价页 FAQ 写目标页回 403 或 404 仍按一页扣 1 个 credit,agent 抓一批旧链接时,失效链接越多,白扣越多。
从 Tavily 迁过来,参数名是最先碰到的错:我们把 Tavily 的 query 和 search_depth 原样发给 web 工具,0.10 秒后回 422,错误码 unknown_param,正文写「query is not a parameter of tool web — did you mean q?」,接着列出 web 支持的 7 个参数:after、before、location、num、page、q、site,最后一句写明这次没有扣费。agent 读到这条错误能自己改名重发,不用人介入;也不会出现参数被悄悄忽略、搜了一个默认结果还照常扣费的情况。
EveryInfra 实测:36 次调用、12 个时刻
下表是本篇 36 次调用里扣过费的 21 次,加上 6 类失败各一次的代表。时刻是新加坡时间,耗时取 curl 的总时间,实扣取响应里的 charged_usd。21 次扣费合计 $0.017175,没有一次和目录价不同。
| 时刻(新加坡时间) | 工具或能力 | 参数要点 | 返回 | 耗时 | 实扣 |
|---|---|---|---|---|---|
| 00:30:36 | web | tavily alternatives,num 10 | 10 条 | 2.00 秒 | $0.000694 |
| 00:31:21 | web | Nebius Tavily acquisition | 10 条 | 2.77 秒 | $0.000694 |
| 00:31:32 | web | MCP 规范 2025-11-25 更新日志 | 10 条 | 3.17 秒 | $0.000694 |
| 00:32:07 | deep | EU AI Act 行为准则签署方,不带全文 | 5 条 | 12.08 秒 | $0.000694 |
| 00:32:28 | read | Tavily 计费文档 | 2,412 字符 | 3.56 秒 | $0.000694 |
| 00:32:39 | read | Firecrawl 定价页 | 10,602 字符 | 1.44 秒 | $0.000694 |
| 00:32:49 | read | MCP 规范更新日志 | 5,470 字符 | 0.77 秒 | $0.000694 |
| 00:33:06 | read | 不存在的域名 | 404 | 0.45 秒 | $0 |
| 00:33:14 | web | 照 Tavily 写 query、search_depth | 422 | 0.10 秒 | $0 |
| 00:33:22 | web | 不带 Key | 401 | 0.11 秒 | $0 |
| 00:33:45 | web | firecrawl search credits | 10 条 | 1.61 秒 | $0.000694 |
| 00:34:03 | web | EU AI Act 行为准则签署方 | 10 条 | 3.04 秒 | $0.000694 |
| 00:34:13 | deep | MCP 规范更新日志,full=true | 5 篇全文 | 7.45 秒 | $0.000694 |
| 00:34:28 | read | docs.tavily.com 不存在的页 | 404 | 5.98 秒 | $0(退款成功) |
| 00:34:41 | crawl | docs.tavily.com/documentation,带 instructions | 11 页 | 5.86 秒 | $0.000694 |
| 00:35:03 | map | docs.firecrawl.dev,num 200 | 200 个网址 | 0.51 秒 | $0.000694 |
| 00:35:11 | semantic | 测搜索接口 token 成本的公开测试 | 8 条 | 0.52 秒 | $0.000694 |
| 00:35:19 | crosscheck | Nebius 收购 Tavily | 4 种机制收敛 | 40.97 秒 | $0.002778 |
| 00:36:07 | bing/search | tavily alternatives,us | 7 条 | 3.78 秒 | $0.000556 |
| 00:36:17 | duckduckgo/search | tavily alternatives,us | 10 条 | 5.96 秒 | $0.000556 |
| 00:36:31 | web/search | tavily alternatives,us | 10 条 | 2.13 秒 | $0.001389 |
| 00:37:24 | MCP everyinfra_search | web,一个 Tavily 竞品对比查询 | 10 条 | 2.05 秒 | $0.000694 |
| 00:37:35 | web | 不存在的词 | 0 条 | 2.71 秒 | $0(退款成功) |
| 00:37:45 | google_news/search | Tavily,近一个月 | 10 条 | 2.02 秒 | $0.000792 |
| 00:37:54 | web | tavily alternatives,重复一次 | 10 条 | 2.09 秒 | $0.000694 |
| 00:38:03 | deep | tavily alternatives pricing,full=true | 5 篇全文 | 8.59 秒 | $0.000694 |
耗时分三档。map、semantic 半秒左右,read、web、新闻和 MCP 在 1 到 3 秒,crawl、duckduckgo/search、deep 在 6 到 12 秒,crosscheck 要 41 秒。deep 那次 12.08 秒是不带全文的,比带全文的两次还慢,说明耗时主要花在检索本身,正文长度影响不大。agent 要并行跑多个子问题时,deep 和 crosscheck 适合放在后台,web 适合放在交互里。新闻那次走的是 Google 新闻爬虫 API,平台总览在 Google 新闻平台页;我们在 00:37(新加坡时间)搜「Tavily」近一个月,10 条里和 Tavily 直接相关的只有 2 条:AIMultiple 在 2026-11-10 更新的 agent 搜索测评,和 HPCwire 在 2026-10-19 转发的 Nebius 收购新闻稿;另有 2 条是 Nebius 自己的投资者页和培训课程页,剩下 6 条是投资、博彩、语音模型和电商工具的新闻。品牌词搜新闻,噪音占一大半,agent 用之前要按标题和来源再筛一遍。
搜「tavily alternatives」的 10 条结果本身也有信息量。00:30(新加坡时间)那次 web 返回的 10 个网址里,6 个是卖搜索或抓取服务的公司自己写的对比页,排第一的是 Firecrawl 的 Tavily 替代方案文章;1 个是 Tavily 首页;剩下 3 个是 Reddit 讨论帖、Medium 文章和 GitHub 话题页。bing/search 的第一条也是 Firecrawl 那篇。价格以各家定价页为准。
从 Tavily 迁过来:参数逐项对照
我们的搜索入口是 POST /api/v1/search,请求体写 tool 和 params 两项;参数名和 Tavily 不一样,下表按 Tavily 搜索接口文档 里的参数逐项对过来。写错名字会回 422 并提示正确的名字,所以迁移时可以先照旧写一遍,按错误提示改。
| Tavily 参数或接口 | EveryInfra 写法 | 说明 |
|---|---|---|
query | q | 照旧写 query 回 422,did_you_mean 给 q |
search_depth: basic | 工具选 web | 每条给标题、链接、摘要 |
search_depth: advanced | 工具选 deep | 每条给节选,可加 full |
max_results(0–20) | num(最多 10)加 page | 要 20 条翻第 2 页,再扣一次 |
include_raw_content | deep 加 full=true,或 read | 每篇正文上限 20,000 字符 |
include_domains(最多 300 个) | site(一个域名) | 多个域名要分开调用 |
time_range、start_date、end_date | after、before | 按日期过滤 |
country | location | 写国家名或两位国家代码 |
topic: news | 工具选 news,或 google_news/search | 新闻单独一个工具 |
include_answer | 无 | 我们不生成答案 |
| Extract(一次最多 20 个网址) | read(一次 1 个网址) | 多个网址并行调用 |
| Crawl | crawl(最多 20 页,可带 instructions) | 一次一个价 |
| Map | map(最多 200 个网址) | 一次一个价 |
| Research | crosscheck | 只给证据分层,不写报告 |
下面这段 curl 就是本篇 00:38(新加坡时间)那次带全文的深度检索,换成你的 Key 就能复现;把 tool 换成 web、crawl、map,params 按上表填。
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"deep","params":{"q":"tavily alternatives pricing per 1000 searches","num":5,"full":true}}'
如果你的代码里已经封装了一层 Tavily 客户端,迁移的改动集中在三处:请求体的结构(Tavily 是扁平的参数,我们是 tool 加 params)、结果字段的名字(读 results 数组里的 title、url、snippet、content),和条数上限(20 条改成 10 条一页)。其余的过滤条件大多有一对一的写法,include_domains 多域名和 include_answer 两项没有,要在你这边补:前者拆成多次 site 调用,后者交给你自己的模型写。
MCP 接入:两边都能远程接,认证方式不同
Tavily 的远程 MCP 地址是 mcp.tavily.com/mcp,MCP 文档 列了 5 个工具:tavily_search、tavily_extract、tavily_crawl、tavily_map、tavily_research。它支持 OAuth:在 Claude Code、Claude 桌面版、Cursor 等客户端里点一下,浏览器里登录 Tavily 账号授权,不用手动粘 Key;Claude 的连接器目录里也有 Tavily 的条目。不支持远程 MCP 的客户端可以用 mcp-remote 做本地桥,也可以本地跑 Tavily 的 MCP 服务,配 TAVILY_API_KEY 环境变量。
我们的远程 MCP 在 https://api.everyinfra.com/mcp,tools/list 不用 Key 就能看,我们在 00:37(新加坡时间)读到 12 个工具,其中 everyinfra_search 一个工具里装着搜索入口的 17 个子工具,web、deep、read、crawl、map、crosscheck 都在里面。工具描述原文写「Failed or empty searches leave no final charge」。认证用请求头里的 Bearer Key,不走 OAuth;00:37:24 那次通过 MCP 调 web 搜一个 Tavily 竞品对比查询,2.05 秒返回 10 条,扣 $0.000694,和直接调接口同价。Claude Code 里一行命令就能加上:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user \
  --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
claude mcp get everyinfra
Cursor 等用 JSON 配置的客户端,把下面这段放进 MCP 设置,YOUR_API_KEY 换成自己的 Key。完整的客户端列表和截图在 MCP 接入页。MCP 规范的 2025-11-25 版更新日志 是两边共同遵循的版本,远程传输和授权的写法都以它为准。
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Firecrawl 有自己的 MCP 服务,见 Firecrawl MCP 文档;SerpAPI 的定价页把 MCP 列在集成里;我们读到的 Serper 首页没有写 MCP。五家里,Tavily 的 OAuth 一键接入对不想管 Key 的个人用户最顺手;团队共用一份配置时,Key 放在环境变量里、请求头里带,配置文件里不留明文,我们和 Tavily 的本地模式都是这种写法。
免费额度、限速和最低花费
| Tavily | Firecrawl | Serper | SerpAPI | EveryInfra | |
|---|---|---|---|---|---|
| 免费额度 | 每月 1,000 个 credit,另有免 Key 试用 | 每月 1,000 个 credit | 一次性 2,500 次 | 每月 250 次 | 给两个 GitHub 仓库点星领 $1,24 小时内有效 |
| 免费额度能搜几次 | basic 1,000 次 | 搜索 500 次(每 10 条 2 credit) | 2,500 次 | 250 次 | web 约 1,440 次 |
| 最低付费 | $30/月 或按量 $0.008/credit | $19/月 | $50 预付,6 个月有效 | $25/月 | 按次从余额扣,余额不过期 |
| 默认限速 | 免费 100 次/分钟,付费 1,000 起,Growth 1,500 | Hobby 100 次/分钟 | 每秒 50 到 300 次,按包 | 按档每小时上限 | 每账号 60 次/分钟,可加购或按累计充值升档 |
| 额度到期 | 每月 1 日重置 | 按月 | 6 个月 | 按月 | 不清零 |
Tavily 的 限速文档 写明限速按组织算,同一组织下所有 Key 共用一个上限:免费 Researcher 每分钟 100 次,打开按量或买 Project、Bootstrap、Startup 是 1,000 次,Growth 和 Scale 是 1,500 次;Crawl 和 Map 另有每分钟 100 次的上限,Research 是 20 次。免费档在高负载时还可能对带 max_age_hours 的请求回 434「Flex tier capacity exceeded」。另外 Tavily 有一种 免 Key 访问:请求头加 X-Tavily-Access-Mode: keyless,只开放搜索和 Extract,用来在注册前试几次。
免费额度按 credit 给的两家,换成不同用法能做的次数差得很多。Tavily 每月 1,000 个 credit,做 basic 搜索是 1,000 次,advanced 搜索 500 次,带 instructions 抓 10 页的 Crawl 250 次,列 200 个网址的 Map 只有 50 次。Firecrawl 每月 1,000 个 credit,搜索 500 次,抓 10 页的 Crawl 100 次,Map 是 1,000 次。Serper 和 SerpAPI 只有搜索,2,500 次和 250 次。我们的 $1 试用额度按次扣,web、deep、crawl、map 每次都是 $0.000694,哪种用法都约 1,440 次,crosscheck 约 360 次;限制是 24 小时内用完。拿免费额度先测站点抓取的团队,Tavily 免费档撑不过 50 个站点的 Map。
我们这一侧,每个账号默认每分钟 60 次,账号下所有 Key 共用;要更高有两条路,价格页 上写着:买 30 天的加速包,每分钟 180 次 $10、600 次 $30、1,800 次 $78;或者累计充值满 $50、$150、$750 后,同一档免费包含,两者取高的一档。这一项 Tavily 付费档开箱就比我们高:它的 1,000 次每分钟不另收钱,我们累计充值不满 $750 时,要 1,800 次每分钟得另付 $78 一个月。高并发的 agent 集群在算总账时要把这笔加速费算进去:每月 100 万次 web 是 $694,第一个月加上 $78 加速包是 $772,第二个月累计充值已过 $750,加速费归零;Tavily basic 同样用量每月 $7,700。
Serper 在这一项比我们和 Tavily 都高:它首页的价格卡写 Starter 包每秒 50 次、Standard 100 次、Scale 200 次、Ultimate 300 次,FAQ 里说 Ultimate 每分钟约 15,000 到 18,000 次搜索,需要更高还可以再谈。换成每分钟,Serper 最小的包也有 3,000 次,是我们默认值的 50 倍、Tavily 付费档的 3 倍。只做搜索、要一次扇出几千个查询的批处理,这个限速比单价差更影响选型。
什么时候 Tavily 或另外几家更合适
Tavily 在下面几种情况更合适。第一,一次请求要 20 条带正文的结果:Tavily 的 max_results 上限 20、include_raw_content 不加价,一次 1 个 credit 全拿到;我们 web 一页 10 条,deep 一次最多 10 条,要 20 条得调两次。第二,要一份写好的研究报告:Tavily 的 Research 接口直接交付带引用的报告,include_answer 能在搜索结果上附一段答案;我们只给结果和证据,不生成答案。第三,按多个域名白名单搜:Tavily 的 include_domains 一次最多 300 个域名,exclude_domains 最多 150 个;我们 web 的 site 一次一个域名。
第四,不想管 Key:Tavily 的远程 MCP 走 OAuth,Claude 目录里一键连接,注册前还能用免 Key 模式试搜索和 Extract。第五,高并发开箱即用:付费档每分钟 1,000 到 1,500 次不另收钱。第六,已经在 Nebius 的云上:Nebius 在 2026-02-10 宣布收购 Tavily,Nebius 新闻稿 写的是把 agent 搜索放进它的 AI 云,agentic search 方案页 把 Tavily 和它的推理服务放在一起卖;SiliconANGLE 的报道 引以色列 Calcalist 的消息,首期 2.75 亿美元,加上业绩条款最高 4 亿美元。第七,学生和创业团队:学生账号送 4 个月 Project 档,创业计划送 10 万个 credit,按 basic 搜索就是 10 万次免费。
第八,对数据保留有硬要求的企业:Tavily 宣布加入 Nebius 的那篇博客写明,接口不变、数据政策不变,零数据保留仍是核心;Firecrawl 的企业档也写了搜索的零数据保留和 SAML 单点登录。如果你的采购流程要求供应商签数据处理协议、提供合规报告,Tavily 和 Firecrawl 的企业档有现成的材料,这类需求按次计费的自助接口不在比较范围里,要单独谈。第九,团队已经大量依赖 LangChain 等框架里的 Tavily 集成:这些集成写好了提示词和结果解析,换接口要改的不只是一个请求地址,评估迁移成本时把这部分工时算进去。
另外几家也各有适合的情况。Serper 的最大预付包每千次 $0.30,只搜索、量大、不要正文的场景,它比我们便宜一半多,6 个月有效期也比月付宽松,见 Serper 首页。Firecrawl 的 Map 每次 1 个 credit,和我们几乎同价;它的搜索可以在一次请求里把结果页抓成 Markdown,抓取格式和动作(点击、滚动)的选项比我们多。SerpAPI 返回整页搜索结果的各个区块(广告、知识面板、相关问题),要分析搜索结果页本身而不只是拿链接的时候,它的字段最全,见 SerpAPI 定价页。站内另有两篇专门讲这两家:Serper API 替代方案 和 Firecrawl 替代方案。
一笔被说大了的账:10 万页的 Tavily 账单
Firecrawl 在 2026-10-27 更新的 Tavily 替代方案文章里放了一张对照表,「10 万页的价格」一行,Firecrawl 写 Standard 档每月 $99,Tavily 写约 $800,后面括号注明是按量 basic 搜索。我们按 Tavily 自己的计费文档复算了一遍:$800 是 10 万次 basic 搜索、每个 credit $0.008 的价;如果「10 万页」指的是抓 10 万个页面的正文,按 Extract basic 每 5 个成功网址 1 个 credit,只要 2 万个 credit,按量 $160,Growth 档 $100。这一行拿 Firecrawl 的抓页价对 Tavily 的搜索价,两个「10 万」的单位不一样。
搜索按次扣,Extract 按网址数折,Map 按页数折,同样「10 万」在三个接口上的账单能差 5 倍以上。Firecrawl 自己的 10 万页按每页 1 个 credit 算,Standard 档 $99 正好 10 万个 credit,Scale 档折合 $74.90。我们这一侧,同样抓 10 万页,用 read 是 10 万次、$69.40,用 crawl 每次 20 页是 5,000 次、$3.47,外加 map 列网址的几百次调用;两种做法都按次算,页数怎么分批由你定。
行业动向:2026 年 10–11 月
Tavily 这一侧,npm 上的 @tavily/cli 1.0.0 在 2026-11-13(UTC)发布,把搜索、Extract、Crawl 做成命令行工具,给在终端里跑的 agent 用;Python 客户端是 tavily-python,接口和参数的变化记在 Tavily 的 更新日志 里。Firecrawl 的 Python 客户端 firecrawl-py 4.57.0 在 2026-11-12 发布。SerpAPI 的 更新记录 在 2026-11-11 加了一个新搜索引擎的接口、2026-11-12 加了 DuckDuckGo 图片接口,2026-11-02 给 Google 搜索加了 udm=web 的纯网页结果模式。
测评方面,AIMultiple 的 agent 搜索测评 在 2026-11-10 更新,用 120 个问题测了多家,Tavily Ultra Fast 的结果新鲜度是 26.3%,Firecrawl 和 Tavily Advanced 的出处支持率都是 64.0%。
两边返回什么:字段、长度和账单回执
价格之外,迁移时最先碰到的是结果长什么样。Tavily 搜索接口的响应顶层有 query、answer、images、results、auto_parameters、response_time 和 usage 几项,results 里每条带 title、url、content、score、raw_content、published_date、favicon 和 images;content 是这条结果里和查询相关的一段内容,score 是相关度分数,raw_content 只在打开 include_raw_content 时才有。usage 里写着这次扣了几个 credit,这一点很实用,agent 可以边跑边记账。
我们的 web 每条结果只有四项:title、url、snippet 和 published,本次 10 条的摘要每条 140 字符左右,所以一次 10 条只有 800 个 token 上下。deep 多一项 content,00:32(新加坡时间)那次不带全文的 5 条,每条节选 424 到 469 字符;带 full=true 时 content 换成整篇正文,每篇上限 20,000 字符。我们的响应不带相关度分数,也不带合成好的答案,排序就是返回的顺序。每次响应都有一段 billing,写着 charged_usd、价格档和余额;失败或空结果时还会多出 reason 和 refund 两项,说明为什么没扣、退款有没有成功。
两边都能在响应里看到这次花了多少,区别在单位:Tavily 写 credit,要自己乘套餐的单价才是美元;我们直接写美元。agent 要做预算控制(例如每个任务最多花 1 美分),读我们的 charged_usd 累加即可,读 Tavily 的 usage.credits 要再按你买的档位换算一次。迁移代码里如果有按 score 过滤结果的逻辑,换到我们这边要改成按排名取前几条,或者让模型自己判断相关度。
换不换:拿一个月的 Tavily 账单拆一遍
前面五种用法是分开算的,真实的 agent 往往几种接口混着用。我们拿一个假设的月度用量算一次混合账单:每月 10 万次请求,其中 6 万次 basic 搜索、2 万次 advanced 搜索、1.5 万次 Extract(每次 5 个网址,basic)、4,000 次 Crawl(每次 10 页,basic)、1,000 次 Map(每次 200 个网址)。按 Tavily 的规则,这些请求折成 6 万、4 万、1.5 万、1.2 万和 2 万个 credit,合计 14.7 万个;买 Growth 档 $500 拿 10 万个,剩下 4.7 万个按量 $0.008 补,月账单 $876。
同样这些活换到我们这边:6 万次 web、2 万次 deep、Extract 的 1.5 万次拆成 7.5 万次 read、4,000 次 crawl、1,000 次 map,合计 16 万次调用,每次 $0.000694,月账单 $111.04,是 Tavily 的八分之一。调用次数比 Tavily 多了 6 万次,全部来自 Extract 拆单;如果这部分改用 deep 带 full=true(搜索时直接带回正文,省掉单独抓取),调用次数降到 10 万次,账单降到 $69.40。
| 一个月的用量 | Tavily credit | Tavily 占比 | EveryInfra 调用次数 | EveryInfra 实扣 |
|---|---|---|---|---|
| 6 万次 basic 搜索 | 60,000 | 40.8% | 60,000 次 web | $41.64 |
| 2 万次 advanced 搜索 | 40,000 | 27.2% | 20,000 次 deep | $13.88 |
| 1.5 万次 Extract(5 个网址) | 15,000 | 10.2% | 75,000 次 read | $52.05 |
| 4,000 次 Crawl(10 页) | 12,000 | 8.2% | 4,000 次 crawl | $2.78 |
| 1,000 次 Map(200 个网址) | 20,000 | 13.6% | 1,000 次 map | $0.69 |
| 合计 | 147,000($876) | 100% | 160,000 次 | $111.04 |
第一,Map 只占请求次数的 1%,却吃掉 13.6% 的 credit,因为它按返回的页数折算;如果你的 Tavily 后台显示 Map 和 Crawl 的 credit 占比高,换掉这两项最划算。第二,Extract 是 Tavily 一侧最省的一项,1.5 万次请求只扣 1.5 万个 credit,在我们这边拆成 7.5 万次调用,反而是表里我们花钱最多的一行,仍比 Tavily 那一行的按量价 $120 便宜。所以迁移不一定要一次全换:先把 Map、Crawl 和 advanced 搜索这些按页数或按深度加价的部分换过来,Extract 用得多的话可以晚一点再动。
重试是另一笔要算进去的钱。前面提到的公开测试帖子下面,有开发者说第一次搜得不好时 agent 会再搜一次,返回内容要让模型再读一遍,这笔重读的 token 费常常比接口差价更影响选型。我们的失败和空结果不扣接口费,可模型读错误信息、再发一次请求,token 照样要花。本次那条 422 的说明和下一步提示合起来 60 个英文词,agent 读完把 query 改成 q,重发一次就成功了。
边界:这些数什么时候不成立
本文的对手价格全部来自 2026-11-15 读到的公开页面,四家都可能随时调价;Tavily 的 Enterprise、Firecrawl 的企业档、SerpAPI 的企业档都是面议价,不在表里。每千次的换算假设额度用满,用不满时对手的实际单价更高;Tavily 按量和套餐能否叠加,我们按文档字面理解为可以,如果你的账户不能叠加,大用量那几行的 Tavily 账单会更高。EveryInfra 的价格来自当天目录和实测,同样可能调整,以 价格页 和目录为准。
结果质量本文没有比。两边检索各自独立,同一个查询返回的网页不同,哪边更适合你的 agent,要用你自己的问题集跑一遍才知道;上面引的公开测试和 AIMultiple 测评可以当参考,但问题集和你的业务不一样。
上手:用自己的查询跑一遍
- 按 快速开始 注册拿 Key,先用试用额度。
- 从你的 Tavily 日志里挑 50 条真实查询,按上面的参数对照表改写,分别用
web和deep跑一遍,记下每次的billing.charged_usd、返回条数和耗时。 - 如果你用到 Tavily 的 Crawl 或 Map,挑三个常抓的站点,用
map和crawl各跑一次,对比 Tavily 后台同一站点扣的 credit。 - 把 MCP 加进你的客户端,让 agent 用
everyinfra_search跑同一组问题;更多搜索工具的说明在 搜索产品页,各工具单页在 网页检索、深度检索、正文抓取、整站爬取、站点结构。 - 拿两边一个月的账单和 token 用量对一次总账,再决定切多少流量。选工具的通用思路,见站内 agent 搜索工具怎么选。
相关文章:给 AI agent 选网页搜索 API(比结果质量和接入方式)、SerpAPI pricing 逐档折算(61 档月费折成每千次)、搜索接口停服后的参数迁移。
常见问题
tavily alternatives 有免费的吗?(联想词「tavily alternatives free」) 有几种。Tavily 自己的免费档每月 1,000 个 credit;Firecrawl 每月 1,000 个 credit;Serper 注册送 2,500 次,一次性;SerpAPI 每月 250 次。我们给 GitHub 两个仓库点星可以领 $1 试用额度,24 小时内有效,按 web 约 1,440 次。完全免费、长期可用的路线是自己部署开源的元搜索引擎,没有接口费,服务器和维护要自己出。
有开源、能自己部署的 Tavily 替代方案吗?(联想词「tavily alternative open source」「self hosted」) 有。开源的元搜索引擎可以自己部署,聚合多个搜索服务的结果;这类程序只给搜索结果,不带正文抓取,要正文得另配抓取程序。Firecrawl 的抓取部分也有开源版本。自己部署省接口费,代价是要处理服务器、各搜索引擎的限流和反爬,团队里要有人维护。
联想词「tavily vs exa」该怎么看? 先把 Tavily 自己这一侧算清:basic 搜索 1 个 credit、advanced 2 个,套餐里一个 credit $0.005 到 $0.0075,按量 $0.008,每千次 basic 搜索 $5 到 $8、advanced $10 到 $16。再拿同一组真实查询在两边各跑一遍,同时记接口费、返回条数和返回的 token 数;只给摘要的搜索每次几百到三千个 token,带全文的一次上万,token 账单往往比单价差更能决定选哪家。
tavily vs firecrawl 哪个便宜?(联想词「tavily vs firecrawl」) 看用法:只搜索和列站点网址 Firecrawl 便宜,搜索带 5 篇正文 Tavily 的上限更低,逐项价格见开头的总表。
Tavily API 的价格怎么算?(联想词「tavily api pricing」) 按 credit 算,搜索、Extract、Map、Crawl、Research 各有折算规则,套餐 $30 到 $500 每月、按量每个 $0.008,逐项换算见「Tavily 的 credit 怎么折」一节。
Tavily 被 Nebius 收购以后还能用吗?(联想词「tavily nebius」) 能用。Nebius 在 2026-02-10 宣布收购,Tavily 的博客文章 Tavily is joining Nebius 写的是产品和接口照常运营;我们 2026-11-15 读到的计费文档、限速文档和 MCP 文档都在更新,CLI 1.0 也在 11 月发布。
Reddit 上大家怎么评价 Tavily?(联想词「tavily alternatives reddit」) r/AI_Agents 有人按 token 测了 13 家搜索接口(作者自己做其中一家),tavily-basic 合计每千次 $17.50、答对 88%;r/mcp 一个讨论 Tavily MCP 还值不值得用 的帖子里,有人抱怨免费档很快撞到限速;r/AI_Agents 另一个帖子 最便宜好用的搜索工具 在问同一个问题。论坛里的数要回到各家定价页核一遍。
参考资料
- API Credits Overview(计费文档),Tavily,2026-11-15 00:20 新加坡时间读取
- Tavily Search 接口文档,Tavily,2026-11-15 读取
- Tavily Extract 接口文档,Tavily,2026-11-15 读取
- Tavily Crawl 接口文档,Tavily,2026-11-15 读取
- Tavily Map 接口文档,Tavily,2026-11-15 读取
- Tavily Research 接口文档,Tavily,2026-11-15 读取
- Rate Limits,Tavily,2026-11-15 读取
- Keyless access,Tavily,2026-11-15 读取
- Tavily MCP,Tavily,2026-11-15 读取
- Tavily Changelog,Tavily,2026-11-15 读取
- Tavily 文档索引 llms.txt,Tavily,2026-11-15 读取
- Best practices for search,Tavily,2026-11-15 读取
- Student account,Tavily 帮助中心,2026-11-15 读取
- @tavily/cli,npm,1.0.0 发布于 2026-11-13,2026-11-15 读取
- tavily-python,PyPI,2026-11-15 读取
- Tavily Pricing,Tavily,2026-11-15 读取
- Tavily is joining Nebius,Tavily,2026-11-15 读取
- Tavily for Startups,Tavily,2026-11-15 读取
- Tavily 在 Claude 连接器目录,Anthropic,2026-11-15 读取
- Nebius announces agreement to acquire Tavily,Nebius,2026-02-10
- Agentic search 方案页,Nebius,2026-11-15 读取
- AI infrastructure giant Nebius buys agentic search startup Tavily,SiliconANGLE,2026-02-10
- Firecrawl Pricing,Firecrawl,2026-11-15 00:25 新加坡时间读取
- Firecrawl Search 文档,Firecrawl,2026-11-15 读取
- Firecrawl Crawl 文档,Firecrawl,2026-11-15 读取
- Firecrawl Map 文档,Firecrawl,2026-11-15 读取
- Firecrawl MCP Server,Firecrawl,2026-11-15 读取
- Firecrawl Changelog,Firecrawl,2026-11-15 读取
- firecrawl-py,PyPI,4.57.0 发布于 2026-11-12
- 5 Tavily Alternatives for Better Pricing, Performance, and Extraction Depth,Firecrawl,2026-10-27 更新
- Serper 首页(价格区与 FAQ),Serper,2026-11-15 读取
- SerpApi Plans and Pricing,SerpApi,2026-11-15 读取
- Google Search API,SerpApi,2026-11-15 读取
- Markdown output,SerpApi,2026-11-15 读取
- SerpApi Release Notes,SerpApi,2026-11-12 最新条目
- search-api-cost-benchmark,GitHub,2026-08-06
- tiktoken,OpenAI(GitHub),2026-11-15 读取
- I measured what 13 search APIs actually cost to run inside an agent. The pricing page is the smaller half of the bill,Reddit r/AI_Agents,2026-11-15 读取
- Is Tavily MCP still worth it or are there better options?,Reddit r/mcp,2026-11-15 读取
- Best and cheapest web search tool option?,Reddit r/AI_Agents,2026-11-15 读取
- Agentic Search API Benchmark,AIMultiple,2026-11-10 更新
- MCP 规范 2025-11-25 更新日志,Model Context Protocol,2026-11-15 读取
- EveryInfra 搜索工具目录,EveryInfra,2026-11-15 00:29 新加坡时间读取
- EveryInfra 能力目录,EveryInfra,2026-11-15 读取
- EveryInfra 远程 MCP,EveryInfra,2026-11-15 00:37 新加坡时间读取
引用编号 BL-161