ScraperAPI pricing:每千次实价逐档算
ScraperAPI 每千个 Amazon 页 $2.45 起,月用 10.7 万页以上比我们便宜;Google 搜索各档贵 3.3 到 17.6 倍。
ScraperAPI 的月费看起来只有一个数,例如 Hobby 档每月 $49 买 100,000 个 API credits,可是一次请求扣几个 credit 要看目标网站和参数:普通网页 1 个,Amazon、Walmart、eBay 5 个,Google 和 Bing 25 个,LinkedIn 30 个,开 JS 渲染再加到 10 个以上。把这些倍数乘进去,Hobby 档每千个 Amazon 商品页是 $2.45,每千次 Google 搜索是 $12.25,每千个 LinkedIn 页是 $14.70;最大的自助档 Advanced(每月 $1,975)对应 $0.459、$2.30 和 $2.76。我们在 2026 年 11 月 15 日用 EveryInfra 的接口真调了 12 次,Amazon 商品详情 amazon/profile 每次实扣 $0.001389,合每千个 $1.389;统一搜索的 web 工具每次 $0.000694,合每千次 $0.694;LinkedIn 公司页 linkedin/company_profile 每次 $0.000556。按每千次比,Amazon 商品页只有 Hobby 档比我们贵,Startup 档起 ScraperAPI 便宜 1.9 到 3.0 倍;搜索和 LinkedIn 在 ScraperAPI 的每一个自助档都比我们贵,Google 搜索对 web 工具贵 3.3 到 17.6 倍,LinkedIn 贵 5.0 到 26.4 倍。
「每千次」都按同一种算法:一档的月费除以这一档的月 credit,再乘以一次请求要扣的 credit,再乘以 1,000,前提是当月把额度用完。ScraperAPI 的定价页写明 credit 不结转,续订时清零,所以用不满时实际单价只会更高;后面的月用量曲线就是按「这个月只买够用的最小档」重新算的。ScraperAPI 一侧只用它自己公开的材料:定价页(含它为 AI 读者准备的 Markdown 版)、credit 计费文档、成本控制文档、结构化数据端点文档、FAQ 和更新日志,读取时间是新加坡时间 2026-11-15 00:20 到 00:45。我们没有注册 ScraperAPI,也没有调用它的接口,所以表里 ScraperAPI 的数都是「公开标价」,EveryInfra 的数都是「本次实扣」,取自真调响应里的 billing.charged_usd,并和能力目录里的 price_usd 逐项对过。两家的结果来自各自的系统,字段和条数都不同,这里只比价格和计费规则。
两家逐项对照:计费单位、失败、免费额度、接入
ScraperAPI 和 EveryInfra 的账单形状差别很大。ScraperAPI 是月订阅:每月付一笔固定的钱,换一桶 credit,每次请求按目标网站和参数从桶里扣,桶里剩的在续订时清零。EveryInfra 是预充值:先充一笔余额,每次调用按能力目录里那一项的价格扣钱,余额不清零、不设有效期。下表把两边在计费单位、失败处理、最低花费、免费额度、接入步骤和 MCP 上的做法逐项列出,ScraperAPI 一列来自它的定价页和计费 FAQ,EveryInfra 一列来自我们的价格页、能力目录和本次真调。
| 项目 | ScraperAPI(公开标价,2026-11-15 读取) | EveryInfra(本次实扣和目录价) |
|---|---|---|
| 计费单位 | API credit;一次请求 1 到 75 个,按域名和参数相加 | 每项能力一个固定价,按次扣,单位美元 |
| 最低月花费 | 付费档最低 Hobby 每月 $49,年付每月 $44.10 | 无月费;首次充值最低 $10 |
| 免费额度 | 7 天试用 5,000 credits;之后免费档每月 1,000 credits、5 个并发 | 给两个 GitHub 仓库点星可领 $1 试用额度,领取后 24 小时内有效 |
| 额度结转 | 不结转,续订时清零 | 余额不清零、不过期 |
| 失败扣不扣 | 只对 200 和 404 计费;超并发返回 429,不扣 | 失败和空结果不扣,响应里写 charged: false 和原因 |
| 超额怎么办 | Hobby 到 Business 只能升档或等续订;Scaling 起可开按量付费 | 余额扣完就停,充值后继续 |
| 每次花多少能事先知道 | 响应头 sa-credit-cost;max_cost 参数设上限;/account/urlcost 查价 | 目录里每项 price_usd 公开可读 |
| Amazon 商品页 | 5 credits;Hobby 合每千个 $2.45,Advanced $0.459 | amazon/profile 每次 $0.001389,合每千个 $1.389 |
| Google 或 Bing 搜索 | 25 credits;Hobby 每千次 $12.25,Advanced $2.30 | web 工具 $0.000694;bing/search $0.000556 |
| LinkedIn 公司页 | 30 credits;Hobby 每千个 $14.70,Advanced $2.76 | linkedin/company_profile 每次 $0.000556 |
| 接入 | 注册拿 Key,GET 请求把目标网址放在 url 参数里;结构化端点另有路径 | 注册拿 Key,POST 一个 JSON:平台、能力、参数 |
| MCP | 远程 MCP 服务器和本地包,2026 年 6 月起有 22 个 MCP 工具 | 远程 MCP,工具名以 everyinfra_ 开头 |
接入步骤的差别在请求形状上。ScraperAPI 的普通抓取是一个 GET 请求,把 Key 和目标网址放在查询参数里,例如 api_key、url、render、country_code,返回目标页面本身;它的结构化端点换一个路径,参数换成 ASIN 或关键词。我们是一个 POST 请求,Key 放在 Authorization 请求头里,请求体写平台、能力和参数,返回统一格式的 JSON,results 里是结构化字段,billing 里是这次扣了多少。前者适合已经有解析代码、只缺代理和解封的团队;后者适合不想维护解析、要直接拿字段的团队。
ScraperAPI pricing 总表:8 档月费换算成每千次
ScraperAPI 定价页在 2026 年 11 月 15 日列出 9 个选项:7 天试用、免费档、Hobby、Startup、Business、Scaling 四个自助档,Professional、Advanced 两个高用量档,和需要联系销售的 Enterprise。网页上方的卡片只露出一部分,完整的数据在它给 AI 读者准备的 pricing.md 里,字段是月费、年付月价、每月 credit、并发线程、地区定位范围和支持级别。我们把这份 Markdown 存下来逐行转成数字,下表的「每千次」四列按 1、5、25、30 credits 一次计算,分别对应普通网页、Amazon 等电商页、Google 和 Bing 搜索、LinkedIn。
| 档位 | 月费(年付每月) | 每月 credits | 并发 | 普通页每千次 | Amazon 每千个 | Google 每千次 | LinkedIn 每千个 |
|---|---|---|---|---|---|---|---|
| 免费档 | $0 | 1,000 | 5 | — | — | — | — |
| Hobby | $49($44.10) | 100,000 | 20 | $0.490 | $2.450 | $12.250 | $14.700 |
| Startup | $149($134.10) | 1,000,000 | 50 | $0.149 | $0.745 | $3.725 | $4.470 |
| Business | $299($269.10) | 3,000,000 | 100 | $0.100 | $0.498 | $2.492 | $2.990 |
| Scaling | $475($427.50) | 5,000,000 | 200 | $0.095 | $0.475 | $2.375 | $2.850 |
| Professional | $975($877.50) | 10,500,000 | 300 | $0.093 | $0.464 | $2.321 | $2.786 |
| Advanced | $1,975($1,777.50) | 21,500,000 | 500 | $0.092 | $0.459 | $2.297 | $2.756 |
| Enterprise | 面议 | 22,000,000 以上 | 500 以上 | — | — | — | — |
Professional 和 Advanced 两档在页面上另写了「limited offer」的赠送 credits,分别是 250K 和 500K,本表没有算进去,因为页面写明这是限时活动。年付一律打九折,页面在 Billing and Usage 一栏写「Annual discount 10%」,Enterprise 写「Custom」。档位之间的并发差别也大:Hobby 只有 20 个并发线程,Advanced 有 500 个,超过并发上限的请求返回 429,页面写明不额外收费。Enterprise 档的价格不公开,但 credit 文档的脚注透露了一个底线:签了折扣协议的账户,ultra_premium 域名的 credit 数会被调高,保证每千次不低于 $3(不渲染)和 $7(渲染)。地区定位在 Hobby 和 Startup 只有「US & EU」,Business 起才能按国家定位;这一点对要抓日本或巴西 Amazon 站点的人有影响,因为在 Hobby 档上没有按国家选出口的选项。
Professional 和 Advanced 是 2026 年 5 月才加的两档。ScraperAPI 的更新日志标题是「More Credits, Higher Limits: Introducing New Growth Plans on ScraperAPI」,写明这两档不用找销售就能买;在这个日期之前写的评测里只有 Hobby 到 Scaling 四个自助档,按那时的表,Amazon 商品页最低只能算到 Scaling 的每千个 $0.475。同年 6 月它上线了按域名查 credit 的工具;3 月的 MCP 更新让结构化端点能通过 MCP 调用,6 月的智能体插件带 22 个 MCP 工具,总表里 MCP 一行的「22 个」就出自这一页。
这张点图把六种请求的每千次价放在同一根对数轴上。灰色记号越往右越贵,同一行里三档之间的距离就是买大档省下的钱:普通网页从 Hobby 的 $0.49 降到 Advanced 的 $0.092,差 5.3 倍;Google 搜索从 $12.25 降到 $2.30,同样差 5.3 倍,因为倍数是乘在同一个每 credit 单价上的。青绿圆点是我们本次实扣的价格,它和灰色记号的相对位置在不同行里方向不同:普通网页一行,ScraperAPI 三档都比我们的 read 工具便宜;Amazon 一行,只有 Hobby 比我们贵;搜索和 LinkedIn 两行,三档都比我们贵。
ScraperAPI API credits 怎么扣:域名一层,参数一层
ScraperAPI 的 credit 计费文档把扣费分成两层。第一层按域名:普通网站 1 个 credit,电商站(Amazon、Walmart、eBay)5 个,搜索引擎(Google、Bing,文档写明「applies to all subdomains」)25 个,社交(LinkedIn)30 个;有反爬保护、需要绕过的网站(Cloudflare、Cloudflare Turnstile、DataDome、PerimeterX/HUMAN、Akamai)一次 10 个。第二层按参数:render=true(JS 渲染)10 个,premium=true(高级代理)10 个,screenshot=true 10 个,premium 加 render 一共 25 个,ultra_premium=true 30 个,ultra_premium 加 render 一共 75 个,后两项只对付费档开放。地区定位、会话、设备类型、输出格式、自动解析这些参数不加钱。
| 请求类型 | 每次 credits | 原文所在页面 | Hobby 每千次 | Advanced 每千次 |
|---|---|---|---|---|
| 普通网页 | 1 | 定价页 API Credit Costs 表、credit 文档 Domains 表 | $0.49 | $0.092 |
| 电商(Amazon、Walmart、eBay) | 5 | 同上 | $2.45 | $0.459 |
| 搜索(Google、Bing,含子域) | 25 | 同上 | $12.25 | $2.297 |
| 社交(LinkedIn) | 30 | 同上 | $14.70 | $2.756 |
| 反爬绕过(Cloudflare、DataDome 等) | 10 | credit 文档 Bot-Protected Domains 表 | — | — |
render=true | 10 | credit 文档 Parameters 一节 | $4.90 | $0.919 |
premium=true | 10 | 同上 | $4.90 | $0.919 |
premium=true + render=true | 25 | 同上 | $12.25 | $2.297 |
ultra_premium=true | 30(付费档) | 同上 | $14.70 | $2.756 |
ultra_premium=true + render=true | 75(付费档) | 同上 | $36.75 | $6.890 |
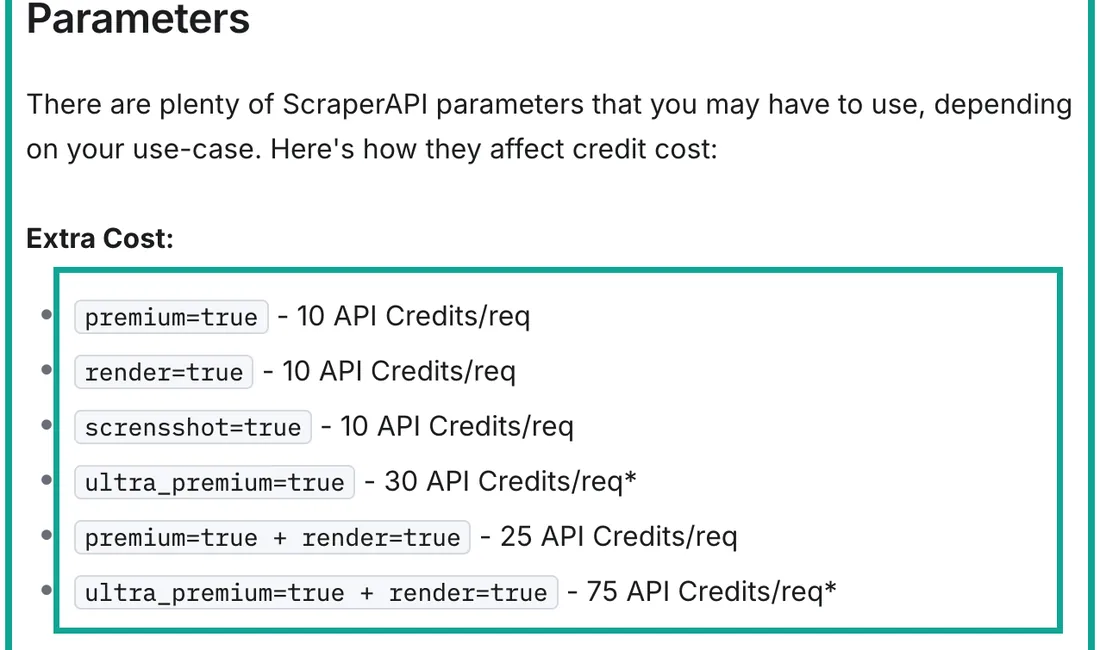
两层怎么叠,ScraperAPI 文档没有写成一条公式。反爬绕过一栏写的是「Cost per Scrape 10」,定价页写的是「Bot-protection bypass 10 credits」;一个有 Cloudflare 的普通网站,是 1 加 10 一共 11,还是直接按 10 算,文档没有一句话明说。GitHub 上一份 ScraperAPI 定价分析按「另加 10」理解,原文是「add another 10 credits on top」。下面 Hobby 柱状图里「反爬页」一栏按 11 个画,图的说明里写明按 1 加 10 计;ScraperAPI 给了两个工具让你在调用前核对:控制台里的 Domain Multiplier 页,和 /account/urlcost 查价接口,文档写明它支持全部参数。
同一笔 $49,换成不同请求,能做的次数差 75 倍。普通网页可以做 100,000 次,Amazon 商品页 20,000 次,Google 搜索 4,000 次,开了 ultra_premium 和 JS 渲染的页面只有 1,333 次。GitHub 上那份分析举过一个例子:Amazon 加 JS 渲染一次 15 个 credit,10 万 credits 只够大约 6,600 次成功请求,和我们按文档算出的 6,666 次一致。r/webdev 上有一位开发者贴过自己抓 36,000 个页面的经历:目标站有 Cloudflare,买了 $49 的档,10 万 credits 在一天之内用完,每个请求要 40 到 50 秒。帖子里的数字我们没有复现;按文档,反爬页一次 11 个 credit,Hobby 的 10 万 credits 只够 9,090 次,是同一档普通页次数的十一分之一。
域名和参数叠起来的完整矩阵,ScraperAPI 只在一个地方给过:DataPipeline 的 Credit costs 页。DataPipeline 是它的定时批量抓取产品,这一页顶部写着价格下调的提示,原文是「DataPipeline credit costs now match our standard scraping rates」,也就是和标准 API 同价;2026 年 7 月的更新日志标题写的是「DataPipeline is now up to 80% cheaper」。这张表按普通、电商、搜索三列给出 6 种参数组合的 credit 数,电商加 JS 渲染 15,搜索加 JS 渲染 35,电商加 premium 和 JS 渲染 25,搜索加 ultra_premium 和 JS 渲染 75。热力图就是把这张表原样画出来的。
两份文档对不上的两处
第一处是 premium 加 JS 渲染。credit 计费文档的 Parameters 一节写「premium=true + render=true - 25 API Credits/req」,定价页的表也写 25;DataPipeline 那张矩阵在「普通网站」一列写的是 20,而这一页又写明「match our standard scraping rates」。两边至少有一边没有更新。对普通网站用 premium 加 JS 渲染的人,每千次的差别在 Hobby 档是 $9.80 和 $12.25。我们在热力图上给这一格画了框,所有计算都按 credit 文档和定价页的 25 算,下单前请用控制台的查价工具核一次。
第二处是取消请求。credit 文档的提示框原文是「We only charge for successful requests (200 and 404 status codes) and for requests that have been cancelled from your side before giving us enough time to finish them (70 seconds)」,意思是你在 70 秒以内主动断开,也会扣 credit;定价页 FAQ 的写法是「and for requests you cancel after 70 seconds」,读起来是 70 秒之后取消才扣。两句话的方向相反。对客户端的影响在超时设置上:如果你的 HTTP 客户端默认 30 秒超时,按文档的写法,这些被你断开的请求会照扣。ScraperAPI 的一般 FAQ写明它会在最长 60 秒内自动重试,所以文档建议的超时至少是 70 秒。
用超了怎么办:自动升档、按量付费和并发
额度用完以后的走向,ScraperAPI 按档位分了三种。Hobby、Startup、Business 三档只有「自动升档」一个选项:打开后,额度用完时账户自动移到下一档,抓取不中断;不打开,抓取暂停,等下个周期续订。Scaling 和 Professional 两档既可以自动升档,也可以开「按量付费」,按固定的每 credit 单价继续扣,并给自己设一个每月上限。Advanced 是最高的自助档,没有下一档可升,只能开按量付费。定价页写明按量付费的单价是固定的,但没有公开具体是多少,所以这里没有算 Scaling 以上档位超额之后的价格。
自动升档对账单的影响很直接:Hobby 用户在月中用完 10 万 credits,账户移到 Startup,这个月就从 $49 变成 $149 档。对用量波动大的团队,这意味着一个用量高峰会把整月的档位推上去。并发线程也会限制你能用多快:Hobby 20 个线程,ScraperAPI 的一般 FAQ 写明平均耗时 4 到 12 秒、单次最长约 60 秒;按 8 秒一次粗算,20 个线程每小时大约能完成 9,000 次请求,Hobby 一个月的 2 万个 Amazon 页两个多小时就能抓完。我们没有月度档位,并发按账户的速率限制走,余额用完就停,充值后继续,不会因为一次高峰换档。
成功才扣:200、404 和失败请求
ScraperAPI 对失败的处理写得很清楚:定价页 FAQ 的问题是「Does ScraperAPI charge for failed requests?」,回答是「No」,只对 200 和 404 计费。404 也扣,是因为目标网站确实回答了「没有这个页面」,ScraperAPI 把它算作一次完成的请求;ZenRows 的定价页有同样的规则,404 和 410 都算成功结果。一般 FAQ 里还给了一个比例:大约 1% 到 3% 的请求会失败,这部分不扣 credit;正常请求的耗时在 4 到 12 秒之间。超过并发线程数的请求返回 429,同样不扣。
EveryInfra 的规则方向一致,写法不同:失败和空结果不扣钱,响应的 billing 一段写明 charged: false、charged_usd: 0.0 和原因,退款在同一个响应里完成。本次 12 次调用里有 2 次失败。一次是 amazon/reviews 读一个耳机的评论,新加坡时间 00:33 发出,29.6 秒后返回 HTTP 503,错误码 access_blocked,说明这件商品的评论需要登录或受限,并写明这次调用已退款、马上重试不太可能成功;另一次是 amazon/profile 读一个不存在的 ASIN(B0ZZZZZZZ9),00:34 发出,15.1 秒后返回 503,扣费也是 $0。两次失败的响应都带着 retry_after 和 next_steps,告诉调用方要不要重试。
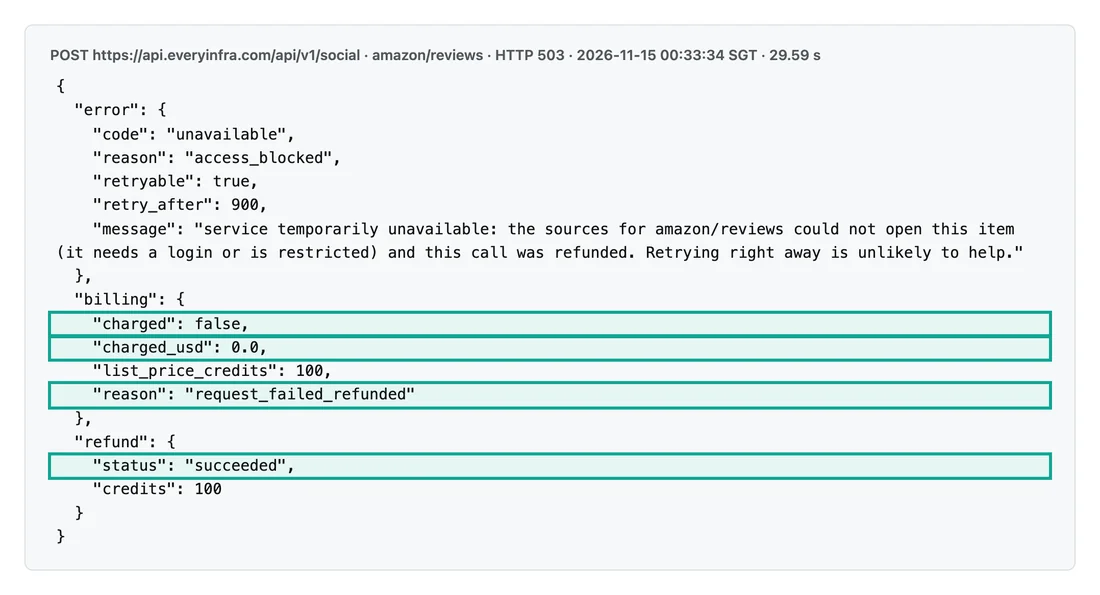
两边都对失败免费,账单上的差别出在「成功但没用」的请求上。ScraperAPI 对 404 计费,你传进一批过期的商品链接,每一个 404 在 Amazon 上都要扣 5 个 credit:一批 10,000 个已下架的商品链接要扣 50,000 credits,是 Hobby 月额度的一半,按 Hobby 单价折合 $24.50。我们对商品不存在的情况返回 503,扣费 $0,本次那个假 ASIN 就是例子。反过来,ScraperAPI 的普通抓取返回的是网页本身,一次请求拿到整页 HTML,解析由你自己做;我们按能力返回结构化字段,例如 amazon/profile 本次返回了 asin、title、price、rating、rating_count、seller_name、bestseller_ranks 等 19 个字段,省掉的是解析代码的维护。
EveryInfra 实测:12 次调用、3 个时段
我们在新加坡时间 2026 年 11 月 15 日 00:30 到 00:40 分三轮调用 EveryInfra 接口:第一轮 00:30 到 00:32 调 Amazon 搜索、网页搜索和地图搜索;第二轮 00:33 到 00:34 调统一搜索的 web 工具、Amazon 商品详情、Amazon 评论、用 read 工具读 Amazon 商品页,以及一个不存在的 ASIN;第三轮 00:39 到 00:40 调 Amazon 搜索拿满 50 条、Bing 搜索、LinkedIn 公司页和 Walmart 搜索。每次的扣费取自响应里的 billing.charged_usd,条数是本次实际返回的条数。
| 时刻(新加坡时间) | 能力 | 参数 | HTTP | 条数 | 耗时 | 实扣 |
|---|---|---|---|---|---|---|
| 00:30 | amazon/search | wireless earbuds | 200 | 10 | 18.5 秒 | $0.002236 |
| 00:32 | web/search | scraperapi pricing,us | 200 | 10 | 1.7 秒 | $0.001389 |
| 00:32 | google_maps_reviews/search | coffee shop Austin TX | 200 | 15 | 7.0 秒 | $0.001389 |
| 00:33 | 统一搜索 web 工具 | scraperapi pricing,us | 200 | 10 | 1.8 秒 | $0.000694 |
| 00:33 | amazon/profile | B09FT58QQP | 200 | 1 | 10.3 秒 | $0.001389 |
| 00:33 | amazon/reviews | B09FT58QQP | 503 | — | 29.6 秒 | $0(退款) |
| 00:34 | 统一搜索 read 工具 | 同一个 Amazon 商品页 | 200 | 1 | 3.1 秒 | $0.000694 |
| 00:34 | amazon/profile | B0ZZZZZZZ9(不存在) | 503 | — | 15.1 秒 | $0(退款) |
| 00:39 | amazon/search | wireless earbuds,limit 50 | 200 | 50 | 41.4 秒 | $0.002236 |
| 00:39 | bing/search | scraperapi pricing | 200 | 10 | 5.2 秒 | $0.000556 |
| 00:40 | linkedin/company_profile | scraperapi | 200 | 1 | 4.6 秒 | $0.000556 |
| 00:40 | walmart/search | wireless earbuds | 200 | 20 | 41.0 秒 | $0.001389 |
12 次合计实扣 $0.012528,10 次成功、2 次失败,每一次成功调用的扣费都和目录价一致。amazon/profile 读的是一款 TOZO 耳机,返回价格 $19.99、评分 4.3、评分数 119,218、卖家名称,耗时 10.3 秒。同一个商品页用 read 工具读,3.1 秒返回 766 个字符的正文,里面没有价格,所以「便宜的通用读取」和「贵一点的结构化商品详情」在 Amazon 上拿到的是两种东西。linkedin/company_profile 读的正好是 ScraperAPI 自己的公司页,返回 37 名员工、规模区间 11 到 50 人、2,266 名关注者、总部在拉斯维加斯。google_maps_reviews/search 搜奥斯汀的咖啡店返回 15 家,每家带评分和评论数,例如第一家 Jo's Coffee 南国会大道店评分 4.4、评论 2,013 条。
两个搜索入口的结果差别也看得出来。web/search 用「scraperapi pricing」搜到的 10 条都是泛泛讲「pricing」的页面,和 ScraperAPI 无关;统一搜索的 web 工具同一个词,第一条就是 ScraperAPI 的定价页,第二条是它的计费 FAQ,价格还只有一半。Bing 搜索 10 条都和 ScraperAPI 定价有关:第 1、2 条是它的定价页和首页,第 8、10 条是它的 AI Parser 价格页和计费 FAQ,其余 6 条是第三方的比价或计算器页面。这 6 条里有 4 条带摘要日期,分别是 2026-11-01、2026-10-16、2026-08-19 和 2026-11-05;8 月 19 日那条的标题已经写着「$49–$1,975/mo」,也就是包含了 5 月新加的 Advanced 档。读第三方比价页时先看日期,2026 年 5 月以前的页面没有 Professional 和 Advanced 两档,算出来的大用量单价会偏高。所以搜索的对照价取 web 工具的 $0.694,同时把 web/search 的 $1.389 也放进比较表,选哪一个看你要哪一种结果。
每一次成功调用的响应里,billing 一段除了 charged_usd,还给出这一次的每千次价,例如第一次 amazon/search 返回的 per_1k 是 $2.236111,和目录价一致;失败的那两次,charged 是 false,credits 是 0。耗时方面,12 次调用从 1.7 秒到 41.4 秒不等:搜索类都在 6 秒以内,Amazon 商品详情 10.3 秒,Amazon 和 Walmart 搜索拿满 20 到 50 条时在 40 秒上下。ScraperAPI 在一般 FAQ 里给自己写的平均耗时是 4 到 12 秒,个别请求要 20 到 30 秒,最长重试 60 秒后返回 500;两边都是「目标站越难,等得越久」,这一点和价格一样要按你自己的目标测。
下面这段 curl 是本次第一轮的 Amazon 搜索请求,换成你自己的 Key 就能复现;platform 和 action 换成上表里的其他能力,params 按目录里每项能力的参数说明填。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"amazon","action":"search","params":{"keyword":"wireless earbuds","limit":50}}'
Amazon:哪几段月用量 ScraperAPI 更便宜
按额度用满算,ScraperAPI 每千个 Amazon 商品页在 Hobby 是 $2.45,比我们 amazon/profile 的 $1.389 贵 1.76 倍;从 Startup 起反过来,Startup $0.745、Business $0.498、Scaling $0.475、Professional $0.464、Advanced $0.459,我们是它的 1.9 到 3.0 倍。可是额度用满是一个理想条件:Hobby 档的 10 万 credits 只够 2 万个 Amazon 页,用 2 万零 1 页就得买 Startup,而 Startup 的 100 万 credits 要用到 20 万页才算满。中间这一段,ScraperAPI 的实付单价远高于表里的数。
| 每月 Amazon 商品页 | ScraperAPI 最小够用档 | ScraperAPI 月付 | EveryInfra `amazon/profile` | 谁便宜 |
|---|---|---|---|---|
| 5,000 | Hobby | $49 | $6.95 | EveryInfra,便宜 7.1 倍 |
| 20,000 | Hobby | $49 | $27.78 | EveryInfra,便宜 1.8 倍 |
| 50,000 | Startup | $149 | $69.45 | EveryInfra,便宜 2.1 倍 |
| 107,271 | Startup | $149 | $149.00 | 打平 |
| 150,000 | Startup | $149 | $208.35 | ScraperAPI,便宜 1.4 倍 |
| 200,001 到 215,262 | Business | $299 | $277.80 到 $299 | EveryInfra,差额在 $21 以内 |
| 1,000,000 | Scaling | $475 | $1,389 | ScraperAPI,便宜 2.9 倍 |
| 4,300,000 | Advanced | $1,975 | $5,972.70 | ScraperAPI,便宜 3.0 倍 |
把每个月用量下的实付画成曲线,就是这张锯齿图。灰线每到换档处往上跳,因为多出来的一页让你多付一整档的月费;跳完之后随着用量增加往下滑,直到这一档用满。青绿横线是我们的 $1.389,和用量无关。两条线第一次交叉在每月 107,271 页,也就是 Startup 的 $149 除以 $1.389 每千个;在 107,272 到 200,000 页之间,ScraperAPI 便宜;到了 200,001 页必须换 Business,$299 要到 215,262 页才和我们打平,中间这一万五千页我们略便宜;215,263 页以上,每一档的打平点都落在它自己的额度以内,ScraperAPI 一路更便宜。用到 Advanced 的上限,每月 430 万页、$1,975,合每千个 $0.459,大约是我们的三分之一。
年付会把交叉点往前挪。Startup 年付每月 $134.10,打平点从 107,271 页降到 96,544 页;签年付后,从每月 96,544 页起 ScraperAPI 一路更便宜:Startup 用到 20 万页,之后 Business 年付每月 $269.10 也低于我们 20 万页的 $277.80,月付时那段约一万五千页的缝隙在年付下不存在。
还有两个前提会改变结果。第一,ScraperAPI 的 5 credits 是不开 JS 渲染的价,Amazon 加 JS 渲染是 15 个,Hobby 每千个 $7.35,Advanced $1.378,那时 Advanced 才和我们差不多。Amazon 商品页一般不需要 JS 渲染,但 ScraperAPI 的低成功率 FAQ建议遇到成功率低时打开 render 或 premium,每打开一个,单价就翻几倍。第二,用 ScraperAPI 的普通抓取,你拿到的是整页 HTML,要自己解析价格、评分和卖家;它另有 Amazon Product API 等结构化端点直接返回 JSON,结构化端点文档本身没有写 credit 数,定价页的 API Credit Costs 表只按域名把 Amazon 归入电商 5 credits 一档,没有给结构化端点单列价格,所以结构化端点按 5 个算是按域名推出来的。
Amazon 搜索:按每千条结果算
搜索页一次返回多条结果,按每千条算更公平。ScraperAPI 的 Amazon Search API 文档给出的样例响应里有 16 条商品,按一页 5 credits 估算,Hobby 每千条 $0.153,Startup $0.047,Business $0.031,Advanced $0.029。我们的 amazon/search 一次 $0.002236,默认返回 10 条,合每千条 $0.224;加 limit=50 一次拿 50 条,价格不变,合每千条 $0.045。本次 00:39 那一次拿满了 50 条,其中 1 条没有价格,耗时 41.4 秒。
| 方案 | 每页条数 | 每千条结果 |
|---|---|---|
| ScraperAPI Hobby(5 credits 一页) | 16(文档样例) | $0.153 |
| ScraperAPI Startup | 16 | $0.047 |
| ScraperAPI Business | 16 | $0.031 |
| ScraperAPI Advanced | 16 | $0.029 |
EveryInfra amazon/search 默认 | 10 | $0.224 |
EveryInfra amazon/search limit=50 | 50 | $0.045 |
结果是:默认参数下我们每千条比 ScraperAPI 每一档都贵,加上 limit=50 之后和 Startup 档基本打平,比 Business 及以上贵 0.4 到 0.6 倍。这里有一个估算成分:ScraperAPI 一页给多少条取的是文档样例里的 16 条,实际会随关键词和页码变化。要把 Amazon 搜索做便宜,在我们这边就是始终带上 limit=50;在 ScraperAPI 那边,就是用 Business 以上的档并把额度用满。
Google、Bing 和地图:25 个 credit 一次
Google 和 Bing 一次 25 个 credit,是域名一层里仅次于 LinkedIn(30)的一档。ScraperAPI 对这两家一律按 25 个计,文档写明包括所有子域,所以 Google Shopping、Google News、Google 地图都落在这一档。Google SERP API 文档和 Google Maps Search API 文档本身都没有写 credit 数,地图搜索按 25 个算是我们根据「applies to all subdomains」这一句推出来的,在表里单独标注。按额度用满算,Google 搜索每千次在 Hobby 是 $12.25,Startup $3.725,Business $2.49,Advanced $2.30。
| 搜索类型 | ScraperAPI Hobby | ScraperAPI Advanced | EveryInfra 本次实扣 | ScraperAPI ÷ EveryInfra |
|---|---|---|---|---|
Google 网页搜索 vs web 工具 | $12.25 | $2.297 | $0.694(10 条) | 17.65 到 3.31 倍 |
Google 网页搜索 vs web/search | $12.25 | $2.297 | $1.389(10 条) | 8.82 到 1.65 倍 |
Bing 搜索 vs bing/search | $12.25 | $2.297 | $0.556(10 条) | 22.03 到 4.13 倍 |
地图搜索(按 25 credits 推算)vs google_maps_reviews/search | $12.25 | $2.297 | $1.389(15 家,最多 50 家) | 8.82 到 1.65 倍 |
Bing 一行是最干净的对照:两边搜的都是 Bing,我们每千次 $0.556,ScraperAPI 用满 Advanced 也要 $2.30,差 4.1 倍。Google 一行要多说一句:我们的 web 工具和 web/search 返回的是一组排好序的网页结果,每条是标题、链接、摘要;ScraperAPI 的 Google SERP 端点返回的是 Google 结果页拆成的 JSON,有自然结果、广告、相关搜索等区块。如果你要的是 Google 结果页上的完整区块,ScraperAPI 的价格对应的是我们这次比较里没有的东西;如果你只要一组相关网页,按每千次比,我们的 web 工具在每一个自助档都便宜 3.3 倍以上。
地图搜索也可以拿 Google 自己的价格作参照。Google Maps Platform 价格页在 2026-11-11 更新过,Text Search Pro 每千次 $32,每月前 5,000 次免费,Enterprise 档 $35;地点详情 Place Details Pro 每千次 $17。这些是 Google 官方接口的价,返回的字段和许可条款都与第三方不同,放在这里只是给出一个量级:每千次地图搜索,Google 官方 $32,ScraperAPI Hobby $12.25(推算),我们本次 $1.389,一次最多 50 家。
按每千个地点算,差距更大。我们 google_maps_reviews/search 一次最多返回 50 家,本次默认参数返回 15 家;按 15 家算每千个地点 $0.093,按 50 家算 $0.028。ScraperAPI 的地图搜索文档列出的参数是关键词和经纬度,没有写一次返回多少个地点,我们没有它的条数,所以这一项只比每千次搜索,不比每千个地点。
用量小的时候差距会被月费放大。每月只做 1,000 次 Google 搜索,ScraperAPI 也得买 Hobby,实付每千次 $49;我们按 web 工具付 $0.69。每月 30,000 次,ScraperAPI 要 Startup(Hobby 的 10 万 credits 只够 4,000 次),$149 对我们的 $20.82,差 7.2 倍。Hobby 档的 10 万 credits 只够 4,000 次搜索,这是小用量搜索在 ScraperAPI 上贵的原因。
LinkedIn、Walmart 和普通网页
LinkedIn 是倍数最高的单个网站,一次 30 个 credit,Hobby 每千个 $14.70,Advanced $2.76。我们的 linkedin/company_profile 每次 $0.000556,合每千个 $0.556,比 ScraperAPI 每一档便宜 5.0 到 26.4 倍。本次 00:40 读 ScraperAPI 自己的公司页,4.6 秒返回员工数、规模区间、关注者和总部。ScraperAPI 的低成功率 FAQ 还写了一条和平台规则有关的提示:Meta 和 X 的条款禁止抓取,它只支持抓取公开数据;LinkedIn 页面同样只适合读公开信息,读之前请看目标网站的条款。
Walmart 和 Amazon 同属电商一档,5 个 credit 一次,每千页在 Hobby 是 $2.45,Advanced $0.459。我们的 walmart/search 一次 $0.001389,本次 00:40 搜「wireless earbuds」返回 20 条,每条带名称、价格、原价、评分、评论数和卖家,第一条是一副 $14.88 的耳机。按每千条结果算,我们是 $0.069;ScraperAPI 的 Walmart 搜索一页给多少条,它的文档没有给样例,这一项我们不做每千条的比较。
普通网页是 ScraperAPI 便宜的另一项。一个不带反爬的普通页面只扣 1 个 credit,Hobby 每千次 $0.49,Advanced $0.092;我们统一搜索的 read 工具每次 $0.000694,合每千次 $0.694,比 ScraperAPI 每一档都贵,比 Advanced 贵 7.6 倍。两者返回的东西也不同:read 给的是清理过的正文,适合交给模型读;ScraperAPI 给的是原始 HTML,也可以用 output_format 参数要 Markdown 或文本,这个参数不加钱。如果你要抓的是一批没有保护的普通网站,量又大,ScraperAPI 的普通抓取在价格上更划算。
和 ZenRows、Bright Data、Firecrawl 的公开价放一起
ScraperAPI 不是唯一按 credit 计费的抓取 API。下表是同一天读取的三家公开价,只取「一个普通网页」这一种请求,每千次按入门付费档的月费除以额度、额度用满来算;Bright Data 的 Web Unlocker 是按请求计费,不用换算。站内另有两篇相关文章:Bright Data 定价拆解按它的各条产品线和按量价逐项算,这里只取 Web Unlocker 一行作对照;给 AI 读网页的几种工具怎么选,见 Firecrawl 替代方案。
| 服务 | 入门付费档 | 普通网页每次 | 每千个普通网页 | 倍数和加价 | 失败或 404 |
|---|---|---|---|---|---|
| ScraperAPI | Hobby $49,100,000 credits | 1 credit | $0.490 | JS 渲染 10、premium 加 JS 25、Amazon 5、Google 25 | 失败不扣;200 和 404 扣 |
| ZenRows | Build 月付 $19,45,000 credits | 1 credit | $0.422 | JS 渲染 5、premium 10、两者 25 | 失败不扣;404、410 算成功 |
| Bright Data Web Unlocker | 按量付 | 1 次请求 | $1.50 | 按成功请求计 | 只对成功付费 |
| Firecrawl | Hobby $19,5,000 credits | 1 credit | $3.80 | 搜索 2 credits 每 10 条;JSON 格式另加 4 | 403、404 照扣 1 credit |
EveryInfra read 工具 | 无月费 | $0.000694 | $0.694 | 无倍数,每项能力一个价 | 失败、空结果不扣 |
ZenRows 的定价页默认显示年付价,Build 档每月 $16,页面写明「Save 17%」;切到月付是 $19,同样 45,000 credits,我们按月付算。定价页写明 JS 渲染 5 个 credit,比 ScraperAPI 的 10 个低一半,premium 加 JS 渲染同样是 25 个。ZenRows 的更新日志还写明两条计费改动:2026-10-02 起可以给每个 Key 单独设按计费周期、天、周或月的 credit 上限,到了上限只停这一个 Key,用到 80% 和 100% 时各提醒一次;2026-10-05 起 AI 智能体可以不开账户、不拿 Key,直接按实时价买它的 Fetch 和 Extract,用 x402、MPP 或银行卡付,credit 权重和账户里一样,只对成功请求扣。按 Key 设上限这一点,ScraperAPI 的对应做法是按请求设 max_cost,我们这边是余额扣完即停。Bright Data 的 Web Unlocker 定价页写的是按量每千次 $1.5,每月 5,000 次免费请求,只对成功请求付费。Firecrawl 的定价页写明一页 1 个 credit,搜索 10 条 2 个 credit,要 JSON 结构化输出再加 4 个,Hobby 档每月 $19 只有 5,000 credits,按普通网页算是这一组里最贵的入门价。
把这张表和前面的总表放在一起看,结论分两半。抓普通网页,按月订阅、用满额度的 credit 制最便宜,ZenRows 和 ScraperAPI 每千个都在 $0.5 以下;抓 Amazon、Google、LinkedIn 这类倍数高的目标,同一个 credit 单价乘上 5 到 30 倍,按次计价、一项一个价的方案就有优势。ScraperAPI 的 Google 和 LinkedIn 是 25 和 30 倍,这是它在搜索和社交数据上比我们贵的根本原因。
额度用完之后,几家的价格走向也不同。ScraperAPI 的 Hobby 到 Business 没有按量付费,只能升档;Scaling 起可以按量付费,单价没有公开。Firecrawl 的定价页写明,付费档用完后按每份 5 美元自动加 credit,Hobby 一份 1,000 credits,折合每千个普通网页 $5.00,比档内的 $3.80 还贵;Standard 一份 2,000 credits,折合 $2.50。Bright Data Web Unlocker 按量付是每千次 $1.5,它的 Scale 档含 383K 次请求,超出部分每千次 $1.3。结转规则上,Firecrawl 只有 Scale 档能把没用完的 credit 留一个月,Hobby、Standard、Growth 和 ScraperAPI 各档一样到期清零;ZenRows 的超额规则这次没有核。我们没有档内和档外之分,第 1 次和第 100 万次 read 都是目录里同一个价 $0.000694。
免费额度、试用和最低花费
ScraperAPI 有两层免费:注册后 7 天试用,5,000 credits,不用绑卡;试用结束后可以留在免费档,每月 1,000 credits、5 个并发。按倍数换算,5,000 试用 credits 能做 1,000 个 Amazon 页或 200 次 Google 搜索,免费档每月能做 200 个 Amazon 页或 40 次 Google 搜索。ultra_premium 两项只对付费档开放,免费档用不了。我们这边给 everyinfra/everyinfra-agent-plugins 和 everyinfra/seo-skills 两个 GitHub 仓库点星后,可以在控制台领 $1 试用额度,领取后 24 小时内有效,不能用于验证码;按本次实扣,$1 能做 719 次 amazon/profile、1,440 次 web 工具搜索或 1,798 次 Bing 搜索;之后首次充值最低 $10,能做 7,199 次 amazon/profile。
ScraperAPI 的退款规则写在计费 FAQ:7 天内无理由退款,随时可以取消,取消不收费。2025 年 11 月它在更新日志里宣布修改服务条款和计费政策,签约主体改为 ScraperAPI LLC,新的计费方式从 2026-01-05 起生效,条款全文在它的条款页。
至于「scraperapi coupon code」这一类联想词,ScraperAPI 的定价页在我们读取时没有公开的优惠码,只有年付九折和高用量档的限时赠送 credits;我们也没有替它发优惠码。想在调用前控制花费,ScraperAPI 的成本控制文档给了 max_cost 参数:一次请求的 credit 超过你设的数,就返回 403,原文是「This request exceeds your max_cost」。这个参数对按倍数计费的服务很有用,可以挡住一个页面意外触发反爬加价。
两边的试用额度都够做一次小规模的对照。用 ScraperAPI 的 5,000 试用 credits,可以拿 200 个你自己的 Amazon 链接各抓一次(1,000 credits),再拿 100 个关键词各搜一次 Google(2,500 credits),剩下的留给反爬页;每次记下响应头里的 sa-credit-cost。用我们的 $1 试用额度,同样 200 个 Amazon 商品详情约 $0.28,100 次 web 工具搜索约 $0.07。把两份记录代进「自己算」一节的 Python,就得到两边在你自己目标上的月账单。
自己算:一段 Python 复算每千次
文中所有「每千次」数字都由下面这段代码算出。ScraperAPI 一侧的月费、credit 和倍数照它的定价页和 credit 文档填写,EveryInfra 一侧的单价取自本次真调;它输出每一档各类请求的每千次价、Amazon 的打平页数,和一个混合用量的月账单。把 MIX 换成你自己每月的请求数,就能算出两边的账。
# ScraperAPI 自助档(scraperapi.com/pricing.md,2026-11-15 读取):名称, 月费, 每月 credits
PLANS = [("Hobby", 49, 100_000), ("Startup", 149, 1_000_000), ("Business", 299, 3_000_000),
         ("Scaling", 475, 5_000_000), ("Professional", 975, 10_500_000), ("Advanced", 1975, 21_500_000)]
CREDITS = {"page": 1, "amazon": 5, "google": 25, "linkedin": 30}          # credit 文档 Domains 表
OURS = {"page": 0.000694, "amazon": 0.001389, "google": 0.000694, "linkedin": 0.000556}  # 本次实扣

for name, usd, credits in PLANS:
    per1k = {k: round(usd / credits * c * 1000, 3) for k, c in CREDITS.items()}
    breakeven = int(usd / OURS["amazon"])          # 每月多少个 Amazon 页时两边打平
    print(name, per1k, "Amazon 打平页数", breakeven)

MIX = {"amazon": 20_000, "google": 5_000, "linkedin": 1_000}      # 你每月的用量
need = sum(n * CREDITS[k] for k, n in MIX.items())
plan = next(p for p in PLANS if p[2] >= need)
ours = sum(n * OURS[k] for k, n in MIX.items())
print(f"ScraperAPI 需要 {need:,} credits,最小够用档 {plan[0]} ${plan[1]};EveryInfra ${ours:.2f}")
拿示例里的混合用量算:每月 2 万个 Amazon 页、5,000 次搜索、1,000 个 LinkedIn 页,一共需要 255,000 credits,Hobby 装不下,最小够用档是 Startup,$149;我们按本次实扣是 $31.81,差 4.7 倍。只要用量里有一部分是搜索或 LinkedIn,25 和 30 倍的倍数就会把总 credit 推高,逼你升档。反过来,如果用量全是 Amazon 商品页且超过每月 10.7 万页,代码会算出 ScraperAPI 便宜,前面的锯齿图就是这段代码在 26 个用量点上跑出的结果。
按场景算 scraperapi pricing:七种常见工作量
下表把几种常见工作量放进同一段代码,ScraperAPI 一列取「能装下这个月用量的最小自助月付档」,EveryInfra 一列按本次实扣乘以次数。倍数一列是 ScraperAPI 月付除以 EveryInfra 月付,小于 1 表示 ScraperAPI 便宜。
| 每月工作量 | 需要的 credits | ScraperAPI 档位和月付 | EveryInfra 月付 | ScraperAPI ÷ EveryInfra |
|---|---|---|---|---|
| 5,000 个 Amazon 商品页 | 25,000 | Hobby $49 | $6.95 | 7.06 |
| 50,000 个 Amazon 商品页 | 250,000 | Startup $149 | $69.45 | 2.15 |
| 150,000 个 Amazon 商品页 | 750,000 | Startup $149 | $208.35 | 0.72 |
| 1,000,000 个 Amazon 商品页 | 5,000,000 | Scaling $475 | $1,389.00 | 0.34 |
2,000 次 Google 搜索(我们用 web 工具) | 50,000 | Hobby $49 | $1.39 | 35.3 |
| 300,000 次 Bing 搜索 | 7,500,000 | Professional $975 | $166.80 | 5.85 |
| 5,000 个 LinkedIn 公司页 | 150,000 | Startup $149 | $2.78 | 53.6 |
表里没有算的两件事会让 ScraperAPI 的账单变高:一是开 JS 渲染或 premium 代理,二是目标站加了反爬保护,每次多 10 个 credit;也有一件事会让它变低:年付九折。我们这边失败和空结果不扣钱,实际花费会略低于表里的数。
什么时候 ScraperAPI 更合适
第一,每月稳定抓 10 万个以上 Amazon 商品页,或者其他电商站的商品页。按上面的算法,每月 107,272 到 200,000 页用 Startup,215,263 页以上用 Business 或更大的档,ScraperAPI 每千页都比我们 amazon/profile 的 $1.389 便宜,用满 Advanced 是 $0.459,大约三分之一。如果你还能签年付,打平点再往前挪到每月 96,544 页。这种用量下,账单上的差额每月可以到几百到几千美元,值得为它写一套自己的解析代码。
第二,抓大量没有保护的普通网站,要的是原始 HTML。普通页 1 个 credit,ScraperAPI 每千页从 Hobby 的 $0.49 到 Advanced 的 $0.092,都比我们 read 工具的 $0.694 便宜;地区定位、会话保持、设备类型、输出格式这些参数都不加钱。我们的 read 工具返回的是清理后的正文,适合直接交给模型;你要的如果是完整 HTML 再自己解析,ScraperAPI 更合适。
第三,需要按国家精确定位出口、需要很高的并发、或者需要异步批量。ScraperAPI 的 Business 档起支持按国家定位,Advanced 有 500 个并发线程;它的异步 API 和 DataPipeline 可以一次提交一批网址再取回结果,Crawler 可以按规则爬整站。我们的能力按「一次请求一个结果」设计,没有定时批量任务。
第四,需要 Google 结果页上的完整区块,例如广告位、相关搜索、知识面板,或者需要它的结构化数据端点总览里列出的 eBay、Redfin 等端点。这些是这次比较的几项能力里没有的东西,价格表比不出来,要按你需要的字段决定。它的 AI Parser 可以按你的描述把网页解析成 JSON,第一个解析器免费,之后每新建一个扣 30,000 credits,付费档最多同时保留 5 个;这类自定义解析,这次比较的几项能力里也没有。
第五,你已经在 ScraperAPI 上写好了解析代码和重试逻辑,用量也稳定。换服务的成本不只在单价:解析规则、字段映射、监控报警、失败重试都要重写和重测。如果你的月账单主要是普通网页和大量 Amazon 商品页,按前面的数字,换过来不一定省钱;账单里的 Google、Bing、地图或 LinkedIn 那部分,单独挪出来按次计费差得最多:按场景表,每月 5,000 个 LinkedIn 公司页,ScraperAPI 最小够用档 Startup 是 $149,我们是 $2.78,每月差 $146。
ScraperAPI 和我们的功能逐项对照,见 ScraperAPI 替代方案;ZenRows 的对照见 ZenRows 替代方案。
行业动向(2026 年 10–11 月)
- 2026-11-05,Benzinga 和 Firecrawl 合作,把有授权的金融数据交给 AI 智能体。 PR Newswire 上的公告写明,Benzinga 的六类内容(美股实时新闻、个股涨跌原因、异常期权成交、分析师评级、并购日历和公司新闻稿)进入 Firecrawl 在 2026 年 9 月推出的 Alexandria 库,开发者通过 Firecrawl 的接口、MCP 和命令行读取。公告没有写这部分怎么计费,我们 11-15 读的 Firecrawl 定价页也没有单列 Alexandria 的价格;按上面的对照表,Firecrawl 普通网页每千页 $3.80,授权内容是否也按 1 个 credit 一页扣,要先问清楚。Firecrawl 的更新日志在公告前后还有 2026-11-02 到 2026-11-13 之间的十个日期条目,我们抓回的页面只有日期没有标题,读不出其中有没有计费改动;能确认的计费变化是定价页底部写的「Effective September 4, 2026」,即现在这张价表从 2026 年 9 月 4 日起生效。
- 2026 年 10 月,ScraperAPI 自动解锁 Akamai 保护的网站。 更新日志写明不再需要加额外参数,并建议原来为 Akamai 专门开
premium或ultra_premium的用户去掉这两个参数重测。credit 文档的反爬表里 Akamai 一行仍是每次 10 个 credit,这一页在 2026-10-30 更新过。按 Hobby 单价,一次ultra_premium请求是 30 个 credit、每千次 $14.70,反爬表里 Akamai 一行是 10 个、每千次 $4.90;「自动解锁」省掉的是参数,反爬价照计。 - 2026-10-14,DigitalOcean 和 Bright Data 合作。 BigDATAwire 的报道写明 DigitalOcean 托管智能体可以直接用 Bright Data 的搜索、访问和提取工具,不需要单独的 Bright Data 账号。报道没有给价格,这一条只说明多了一条不用另开抓取账号的接入路径,这里不做换算。
边界:这些数什么时候不成立
第一,ScraperAPI 的每千次是「额度用满」的下限,用不满时实际单价更高;锯齿图和场景表已经按「当月最小够用档」处理了档位缝隙,但没有处理「这个月用得少、下个月用得多」的波动,也没有算 Scaling 及以上档的按量付费,因为定价页没有公开每 credit 的按量单价。第二,ScraperAPI 一侧的倍数取自它的文档,两份文档在 premium 加 JS 渲染和 70 秒取消规则上不一致,计算按 credit 文档和定价页;地图搜索按 25 个 credit、Amazon 结构化端点按 5 个 credit 都是按域名推算,端点文档没有直接写。第三,我们只测了 EveryInfra 9 项能力,每项 1 到 2 次,耗时和条数会随关键词、地区和时段变化,Amazon 搜索拿满 50 条用了 41.4 秒,这是单次观测。第四,两家返回的字段不同,这里只比价格和计费规则,没有比结果质量和成功率;ScraperAPI 在比较页上写的成功率「Up to 99%」我们没有核。第五,价格读取于 2026-11-15,以后可能调整,下单前请以两边的定价页为准;我们的价格以能力目录为准,目录免费可读。
上手:用试用额度把自己的工作量跑一遍
- 在基础设施市场找到要用的几项能力,点开能力页:Amazon 搜索爬虫 API、Amazon 商品详情爬虫 API、Amazon 评论爬虫 API、网页搜索爬虫 API、Bing 搜索爬虫 API、Google 地图点评爬虫 API、LinkedIn 公司页爬虫 API、Walmart 搜索爬虫 API,每页都有参数说明和试用台。
- 按快速开始注册拿 Key,给两个 GitHub 仓库点星后在控制台领 $1 试用额度。
- 把你上个月真实的目标网址或关键词抽 50 个,各跑一次,记下每次的
billing.charged_usd、返回条数和失败原因。 - 用上面的 Python 把
MIX换成你每月的用量,算出两边的月账单;平台总览看 Amazon 爬虫 API、网页搜索爬虫 API、Google 地图点评爬虫 API、LinkedIn 爬虫 API 和价格页。 - 想在 Claude、Cursor 这类 AI 客户端里直接用,就在客户端配置里加上下面这段远程 MCP,工具名以
everyinfra_开头,说明见 MCP 接入。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
这个配置按 MCP 规范的 Streamable HTTP 传输写,Key 放在请求头里,不放进 URL。ScraperAPI 的 MCP 文档给的远程地址是 https://mcp.scraperapi.com/mcp,同样用 Key 鉴权;两边可以同时加进一个客户端,按任务挑工具。
常见问题
Is ScraperAPI free?scraperapi free plan 每月多少?(联想词「is scraperapi free」「scraperapi free plan」) 7 天试用 5,000 credits,之后免费档每月 1,000 credits、5 个并发,约合 200 个 Amazon 页或 40 次 Google 搜索;换算见「免费额度、试用和最低花费」一节。
ScraperAPI 的 API credits 一次扣几个?(联想词「scraperapi api credits」「scraperapi credits」) 普通页 1、电商 5、Google 和 Bing 25、LinkedIn 30,参数另加,完整表在「ScraperAPI API credits 怎么扣」一节;响应头 sa-credit-cost 写着每次实扣。
ScraperAPI 失败的请求扣钱吗?(联想词「scraperapi pricing」下的计费问题) 不扣,只对 200 和 404 计费;客户端超时请设 70 秒以上,原因见「两份文档对不上的两处」。
scraperapi premium 值得开吗?(联想词「scraperapi premium」) 开 premium=true 一次 10 个 credit,是普通页的 10 倍;和 JS 渲染一起开是 25 个。ScraperAPI 的低成功率 FAQ 建议在成功率低时再开,平时用普通代理就行,配合 max_cost 参数可以给每次请求设上限。
ScraperAPI 抓 Amazon 比 EveryInfra 便宜吗?(联想词「scraper api amazon」「scraperapi amazon reviews」) 看用量。按月付、额度用满,每月 107,272 到 200,000 页和 215,263 页以上 ScraperAPI 便宜,100 万页时 $475 对我们的 $1,389;10 万页以下我们便宜,5,000 页时 $6.95 对它的 $49。Amazon 评论页我们本次那一次需要登录,返回 503 并退款;ScraperAPI 的 Amazon Product API 文档写明商品端点会一并返回该商品页上全部公开的评论,按商品页的 5 个 credit 计,要评论的人可以把这一点算进去。
有没有 scraperapi coupon code?(联想词「scraperapi coupon code」) 读取时定价页没有公开优惠码,能省钱的是年付九折和高用量两档的限时赠送 credits。
scraperapi vs zenrows 怎么选?(联想词「zenrows vs scraperapi」,r/WebScrapingInsider 讨论「按每个域名比每个成功页的成本」) 普通网页两家价接近,ZenRows Build 月付每千页 $0.42,ScraperAPI Hobby $0.49;JS 渲染 ZenRows 5 个 credit,ScraperAPI 10 个。r/WebScrapingInsider 的一个讨论建议拿自己的目标域名各测一遍,比每个成功页的实际成本,上手一节的步骤也是这么做的。r/webscraping 上还有一个讨论抓取的真实成本,可以一起看。
参考资料
- ScraperAPI Pricing(定价页),ScraperAPI,2026-11-15 00:26 新加坡时间读取
- pricing.md(定价页 Markdown 版),ScraperAPI,2026-11-15 读取
- Credits and Requests costs,ScraperAPI 文档,2026-10-30 更新,2026-11-15 读取
- Cost Control(max_cost 参数),ScraperAPI 文档,2026-11-15 读取
- Supported Parameters,ScraperAPI 文档,2026-11-15 读取
- Plans and Billing FAQ,ScraperAPI 文档,2026-11-15 读取
- General FAQ,ScraperAPI 文档,2026-11-15 读取
- Low Success Rates FAQ,ScraperAPI 文档,2026-11-15 读取
- DataPipeline Credit costs,ScraperAPI 文档,2026-11-15 读取
- DataPipeline is now up to 80% cheaper,ScraperAPI 更新日志,2026 年 7 月
- Akamai-protected sites now unblocked automatically,ScraperAPI 更新日志,2026 年 10 月
- Introducing new growth plans,ScraperAPI 更新日志,2026 年 5 月
- New Domain Credit Cost Estimator,ScraperAPI 更新日志,2026 年 6 月
- ScraperAPI MCP expanded capabilities,ScraperAPI 更新日志,2026 年 3 月
- ScraperAPI plugin for AI agents,ScraperAPI 更新日志,2026 年 6 月
- Updates to our Terms of Service and billing policies,ScraperAPI 更新日志,2025 年 11 月
- Release Notes 索引,ScraperAPI 文档,2026-11-15 读取
- Structured Data Endpoints 总览,ScraperAPI 文档,2026-11-15 读取
- Amazon Product API,ScraperAPI 文档,2026-11-15 读取
- Amazon Search API,ScraperAPI 文档,2026-11-15 读取
- Google SERP API,ScraperAPI 文档,2026-11-15 读取
- Google Maps Search API,ScraperAPI 文档,2026-11-15 读取
- MCP Server,ScraperAPI 文档,2026-11-15 读取
- Async API overview,ScraperAPI 文档,2026-11-15 读取
- AI Parser pricing and limits,ScraperAPI 文档,2026-11-15 读取
- ScraperAPI Crawler v2.0,ScraperAPI 文档,2026-11-15 读取
- ScraperAPI Terms,ScraperAPI,2026-11-15 读取
- ZenRows Pricing,ZenRows,2026-11-15 读取
- ZenRows Changelog,ZenRows 文档,2026-11-15 读取
- Web Unlocker pricing,Bright Data,2026-11-15 读取
- Firecrawl Pricing,Firecrawl,2026-11-15 读取
- Firecrawl Changelog,Firecrawl,2026-11-13 最新条目,2026-11-15 读取
- Google Maps Platform pricing,Google for Developers,2026-11-11 更新,2026-11-15 读取
- scraperapi-pricing-analysis,GitHub,2026-11-15 读取
- I had to scrape 36,000 pages…,Reddit r/webdev,2026-11-15 读取
- Which is the best web scraping API for e-commerce,Reddit r/WebScrapingInsider,2026-11-15 读取
- The real costs of web scraping,Reddit r/webscraping,2026-11-15 读取
- Benzinga Collaborates with Firecrawl,PR Newswire,2026-11-05
- DigitalOcean and Bright Data Unlock the Web for AI Agents,BigDATAwire,2026-10-14
- EveryInfra 能力目录,EveryInfra,2026-11-15 00:28 新加坡时间读取
- EveryInfra 搜索工具目录,EveryInfra,2026-11-15 读取
- Model Context Protocol Specification 2025-11-25,MCP,2026-11-15 读取
- October 2026 release notes,ScraperAPI 更新日志,2026 年 10 月
引用编号 BL-162