best instagram scraper 榜单:六种做法每千条实测
六种 Instagram 爬虫实测:千条帖子 Apify $1.50 起、TikHub $0.02 起,我们 $0.003 起;主页差 1.8–4.7 倍。
拿 1,000 条 Instagram 公开帖子,Apify 的 Instagram Scraper 公开价是 $1.50(Business 档)到 $2.70(Free 档),Bright Data 按量付费 $1.50,TikHub 按请求收 $0.001,一页默认 12 条折合约 $0.083,把 count 填到上限 50 条折合 $0.020;我们在 2026 年 11 月 15 日凌晨用 EveryInfra 的 instagram/user_posts 真调两次,一次 $0.000556,natgeo 回了 200 条、bluebottle 回了 50 条,折合每千条 $0.00278 和 $0.0111。差距只在「一次请求回很多条」的数据上拉开,对按条收费的两家有几百倍,对 TikHub 是 1.8 到 30 倍:查主页按账号计费,我们每千个 $0.556,对 TikHub 的 $1.00 只便宜 1.8 倍,对 Bright Data 和 Apify 便宜 2.7 到 4.7 倍。Meta 自己的 Graph API 不按次收钱,可它只能读商业号和创作者号,还要先过应用审核;开源库也不收钱,过去 30 天 instaloader 新开的 14 个 issue 里有 429 限流、登录失效和 Reels 列表读不出来。
这份榜单的「每千条价」只有一种算法:一次请求实际扣掉的美元,除以这次实际回来的条数,再乘 1,000。对方的价格用公开定价页、Store 页和公开 API 在 11 月 15 日读到的数,我们的价格用当天响应里的 charged_usd。两边计量单位不同:Apify 和 Bright Data 按结果条数收,TikHub 和 EveryInfra 按请求次数收,所以只有换成同一个分母才能放在一张表里。分母取实际返回条数,回得少的那几次,我们的价格会被算高。
10 月 26 日我们只拿 Apify 一家做过 26 次真调对比,见《Apify Instagram Scraper 替代》;写代码的步骤见《用 Python 抓 Instagram 帖子和评论》。六种做法的价格和调用,全部是 11 月 15 日重新读、重新调的。
best instagram scraper 总榜:六种做法一张表
| 做法 | 计费单位 | 1,000 条帖子 | 1,000 个主页 | 失败或空结果 | 起步花费 | 拿到第一批数据的步数 | 能接 MCP |
|---|---|---|---|---|---|---|---|
| Meta Graph API(Business Discovery) | 不按次收费,受调用频率限制 | $0 | $0 | 不涉及 | 免费,但要专业账号和应用审核 | 7 步,其中 2 步等审核 | 未查到 |
| 开源库(instaloader、instagrapi) | 不收费 | $0 | $0 | 不涉及 | 免费,自备 IP 和账号 | 3–4 步 | 不涉及 |
| Apify Instagram Scraper | 按结果条数 | $1.50–$2.70 | $1.60–$2.60 | 没有结果就没有结果费 | Free 套餐每月 $5 额度 | 5 步(对方教程视频) | 未在本次读过的页面核实 |
| Bright Data Instagram Scraper API | 按记录条数 | $1.50(按量) | $1.50(按量) | 写明失败不收 | 每月 5,000 条免费 | 4 步,每次任务 1–3 分钟 | README 写了 MCP |
| TikHub | 按请求 | $0.020–$0.083(每页 50 或 12 条) | $1.00 | HTTP 200 就计费,空结果也算 | 最低充值 $5 | 4–5 步(v1 帖子接口要先查 user_id) | FAQ 列了 MCP |
EveryInfra instagram/* | 按请求 | $0.00278–$0.0111(实测) | $0.556(实测) | 不扣费,空结果自动退款 | $1 试用额度,无月费 | 4–5 步 | 远程 MCP |
表里对方的价格是 11 月 15 日 00:33 到 01:10(新加坡时间)读到的公开价;Apify 一栏是 Instagram Scraper 和 Instagram Profile Scraper 两个 actor 的 Free 档到 Business 档,更高的 Platinum、Diamond 档只给企业客户;Bright Data 一栏是按量付费价,Scale 套餐包 384,000 条,超出部分每千条 $1.30。我们一栏是当晚真调的实测值,帖子两个数分别来自 natgeo 和 bluebottle 两个账号。
批量拿帖子、Reels、评论,按请求收费的 TikHub 和我们比按条收费的 Apify、Bright Data 便宜一到三个数量级;逐个查主页,五家都在每千个 $0.5 到 $2.6 之间。Meta 和开源库不花钱,代价换成了审核、账号、IP 和维护时间。
按条收费和按请求收费,对「发帖频率」的反应正好相反。natgeo 在 67 天里发了 200 条,平均每天 3 条;bluebottle 在 139 天里发了 50 条,平均每 2.8 天 1 条。按条收费时,盯 natgeo 一个月要付约 90 条的钱,盯 bluebottle 只付约 11 条,账单跟着对方发帖量走,安静的账号很便宜。按请求收费时,每查一次付一次钱,和对方发了多少无关,所以要按账号的发帖频率安排查询间隔:natgeo 这样的账号一天查一次,一次 30 条就能接上;bluebottle 这样的账号一周甚至一个月查一次,一次 50 条足够覆盖。照这个排法,100 个慢账号每周各查一次,一个月约 430 次请求、$0.24。
怎么比:每千条价、字段数和上手步数
每千条价的算法前面已经写了,这里补两条约定。第一,对方的价格只取公开页面写出来的单价,不算月费,月费另放在「三笔账」一节;第二,TikHub 的帖子价按它 OpenAPI 文档里 v1 fetch_user_posts 的 count 参数折算:默认 12 条,上限 50 条,所以写成区间;它的评论接口没写每页条数,所以评论那一格不算。我们这边每一个价格都能回到一次真调:调用时间写到秒,扣费从响应的 charged_usd 原样抄出来,再用脚本除一遍。
字段数分两层。一层是文档列出的字段,Bright Data 的入门文档写了主页 26 个、帖子 40 个、Reels 27 个、评论 14 个输出字段,我们的目录 response_fields 写了主页 19 个、帖子 21 个、Reels 22 个、评论 11 个。另一层是实测里至少有一行非空的字段,这一层只有我们能数,因为我们只真调了自己。两层放在一起看,能看出「文档写了」和「真的回来」之间的距离,比如 user_posts 的 200 条帖子里 view_count 全部为空,Reels 的 100 条里 play_count 都有值。
上手步数从「什么都没有」数到「手里有第一份 JSON」。注册账号算一步,拿 Key 算一步,充值算一步,查一个中间 ID(比如 TikHub 的 v1 帖子接口要先拿 user_id)算一步,发请求算一步,异步任务要轮询的再加一步。Meta 那边还要加上建应用、绑专业账号、申请权限和两项审核。数步数用的是各家自己的文档和教程,没有注册对方的账号。
| 做法 | 第 1 步 | 第 2 步 | 第 3 步 | 第 4 步 | 第 5 步及以后 |
|---|---|---|---|---|---|
| Meta Graph API | 建 Meta 开发者应用 | 准备一个 Instagram 专业账号(Facebook Login 方案还要绑主页) | 申请 instagram_basic 等三项权限 | App Review | Business Verification、查自己的 IG 用户 ID、发 business_discovery 请求 |
| instaloader | 装 Python | pip install instaloader | 命令行输入账号名 | 被限流时登录或换 IP | — |
| Apify | Store 里找到 Instagram Scraper | 点 Try for free | 填主页链接或搜索词 | 调参数 | 启动并导出数据 |
| Bright Data | 注册(不用绑卡) | 拿 API token | pip install brightdata-sdk | 运行脚本,等 1–3 分钟 | — |
| TikHub | 注册 | 充值 $5(157 个 Instagram 接口里只有 8 个能用赠送额度) | 拿 Key | 用 v1 接口要先按用户名查 user_id;v2、v3 和 web_app 的帖子接口直接收用户名 | 查帖子 |
| EveryInfra | 注册 | 领 $1 试用额度或充值 | 建 Key | POST /api/v1/social,username 直接填账号名 | 帖子是异步任务,按 poll_url 取结果 |
Meta 官方 Graph API:免费,只读专业账号
Meta 的 Instagram Platform 总览在 2026 年 10 月 29 日更新过,现在有三种接法:新接入推荐 Unified Login,另外两种是 Instagram Login 和 Facebook Login,后者要绑一个 Facebook 主页。三种接法的前提一样,你的应用服务的是 Instagram 专业账号,也就是商业号和创作者号。总览里写明,默认的 Standard Access 只适合你自己拥有或管理的账号;要服务你不拥有的账号,得拿 Advanced Access,而 Advanced Access 需要 App Review 和 Business Verification 两项审核。
想读别人的公开数据,Meta 给的入口是 Business Discovery,页面在 2026 年 8 月 12 日更新。它的用法是:用你自己专业账号的 ID 发请求,在 fields 里写 business_discovery.username(对方账号名),就能拿到对方的粉丝数、帖子数,再嵌套 media 拿对方的已发帖子。接口参考页列了三项权限:instagram_basic、instagram_manage_insights、pages_read_engagement。对方必须也是商业号或创作者号,个人号读不到;年龄受限的账号不返回。
# Meta 文档里的示例请求(v27.0),自己的专业账号 ID 放在路径里
curl -i -X GET \
  "https://graph.facebook.com/v27.0/17841405309211844?fields=business_discovery.username(bluebottle){followers_count,media_count}&access_token=<你的用户访问令牌>"
文档示例里 Blue Bottle Coffee 的 followers_count 是 267,793,media_count 是 1,205。我们 11 月 15 日 00:41(新加坡时间)用 instagram/profile 查同一个账号,回来的是 519,718 个粉丝、2,599 条帖子,分类写的是 Coffee shop。两组数差了将近一倍,说明文档示例没有跟着账号增长更新。这本身无所谓,只是提醒一点:照着官方示例估算数据量和调用次数,会估小。
话题数据走 Hashtag Search。限制写得很细:每个商业号或创作者号在滚动 7 天内最多查 30 个不同的话题,查过的话题要占 7 天名额;直接读 recent_media 或 top_media 也算一次查询;Stories 上的话题不支持,带表情的话题不支持,被判为敏感的话题回一个通用错误。用这个接口前要过 App Review,申请 Instagram Public Content Access 功能和 instagram_basic 权限。对做竞品监控的人来说,30 个话题一周的上限通常就是瓶颈。已经用掉了哪些话题名额,可以用 recently_searched_hashtags 这个接口查,它列出当前这一周查过的不同话题。
| Meta 接口 | 能读什么 | 前提 | 硬限制 |
|---|---|---|---|
| Business Discovery | 其他商业号和创作者号的粉丝数、帖子数、已发帖子 | 你自己有专业账号;三项权限;读他人账号要 Advanced Access | 个人号读不到;年龄受限账号不返回 |
| Hashtag Search | 话题下的热门帖和最新帖 | App Review:Instagram Public Content Access + instagram_basic | 每 7 天 30 个不同话题;Stories 话题不支持 |
| 媒体字段 | media_url 等 | 同上 | 带版权音乐的视频、关闭下载的 Reels 不给 media_url |
| 调用频率 | — | — | Instagram 接口走 Business Use Case 限额,超了回 4、17、32、613 等错误码 |
媒体对象参考还有一条和抓数据直接相关:视频里用了带版权或授权的音乐(包括从 Instagram 曲库加的音乐),media_url 字段不返回;对方关掉了 Reels 下载的,读别人内容的几种请求(Business Discovery、标记、提及、话题搜索、合作帖)也不给 media_url。也就是说,Graph API 能告诉你对方发了一条 Reels,却常常拿不到这条视频的地址。
调用频率按 Graph API 限额文档的说法,Instagram 接口走的是 Business Use Case 限额,额度和账号的曝光量挂钩,曝光少的小号能调的次数也少。版本方面,Meta 在 2026 年 11 月 4 日发布了 Graph API v27.0,同一份公告写着 v21.0 在 2027 年 1 月 21 日下线,用老版本写的脚本要排期升级。公告里还有一条容易漏看:从 11 月 4 日起,新建的应用不能再用多 ID 请求、字段别名、JSONP 回调和异步批量请求,老应用也不能给这些功能加新用途,这几项会在 v28.0 正式废弃。抓数脚本里常用的批量拼请求写法,新应用要改成逐个请求。
Facebook Login 这一套接法的说明页把能做的事列得很全:读写自己的帖子、管理评论和回复、找到别人 @ 你的帖子、按话题找帖子、读其他商业号和创作者号的基础数据和指标。五项里前三项都围着自己的账号转;涉及别人的只有按话题找帖子和读其他专业账号两项,前者每周 30 个话题,后者读不到个人号。竞品监控、达人筛选要的是任意账号的数据,这两项都覆盖不全。权限方面,权限参考页写着 instagram_basic 依赖 pages_read_user_content 和 pages_show_list,允许的用途是读取商业账号的基础资料,比如用户名和 ID;申请时要录屏演示完整的登录授权流程。
Graph API 的账很好算:调用本身 $0,能读的范围窄,前期要等两项审核。审核本身也有成本:App Review 说明页写着,Meta 会实际测试你的应用,确认它真的用到了申请的权限,测不到就整份驳回;权限参考页要求为每项权限录屏演示登录和授权流程。也就是说,你得先做出一个能让审核人员登录使用的应用,才能拿到读别人数据的权限,这对只想拉一批数据做分析的人门槛偏高。如果你要的是自己账号的数据(洞察、评论管理、发帖),它是首选,后面「什么时候对方更合适」一节会再写一次;如果你要的是一批个人博主、或者任意话题下的帖子,Graph API 给不了。
开源库:instaloader 和 instagrapi,钱是零,时间要自己出
开源这条路最常被提到的两个库是 instaloader 和 instagrapi。11 月 15 日读 GitHub 接口:instaloader 有 13,888 颗星,MIT 许可,新加坡时间 2026 年 10 月 27 日发了 v4.16;instagrapi 有 7,147 颗星,新加坡时间 11 月 12 日到 14 日连发了 3.2.10、3.2.11、3.2.12 三个版本。两个库一个月内都发了新版,下面的 issue 表是同一段时间里的报错。
instaloader 的问题列表能看出一个月里出了哪些事。从 10 月 16 日到 11 月 11 日一共新开了 14 个 issue,下表挑了和「能不能拿到公开数据」直接相关的几条。它的排错文档也写得很直白:云服务器、VPN 和公共代理这类 IP,匿名访问会遇到明显更严的限制,登录访问似乎不受影响。部署到云上跑批量任务,多半要带登录账号,而用登录账号自动抓取,落在 Instagram 条款限制的范围里。
| issue | 开出日期 | 标题大意 |
|---|---|---|
| #2786 | 2026-10-21 | 2026 年还能稳定用吗?持续 429 错误 |
| #2792 | 2026-10-30 | 登录和导入 Cookie 坏了 |
| #2794 | 2026-10-31 | 不登录下载帖子是不是对所有人都坏了 |
| #2797 | 2026-11-04 | Reels 列表和下载不工作 |
| #2803 | 2026-11-07 | 下载中途因「302 Found」中断 |
instagrapi 走的是 Instagram 手机端的私有接口,功能比 instaloader 多(私信、上传、洞察都有),要求 Python 3.11 以上。README 写明:私有接口自动化在生产环境里很脆弱(原文 fragile in production),因为账号信誉、代理、设备状态、风控验证和限流都会各自变化;它还建议,账号自有的业务流程优先用 Instagram 官方接口。
开源库适合两种人:只想备份自己账号、或者偶尔抓几十条做研究的人,以及有人手长期维护代理池和账号池的团队。按每千条价算它是 $0,按人力算,要把 IP、账号、被封后的恢复和库版本升级都计进去。
Apify Instagram Scraper:按结果计费,六个 actor 的公开价
Apify Store 上 Instagram 相关的官方 actor 有六个,价格都是按「结果」这个事件收费,档位跟着你的订阅走。下表是 11 月 15 日 00:36(新加坡时间)从 Apify 公开 API 读到的每 1,000 条价,不带 Key 就能读,Instagram Scraper 这个主 actor 的价格从 2026 年 2 月 20 日起生效,最后修改时间是 11 月 13 日。
| actor | Free | Starter | Scale | Business | 另收 |
|---|---|---|---|---|---|
| Instagram Scraper | $2.70 | $2.30 | $1.90 | $1.50 | — |
| Instagram Profile Scraper | $2.60 | $2.30 | $2.00 | $1.60 | 账号详情每千个 $7.00(Free)到 $4.00(Business) |
| Instagram Post Scraper | $1.70 | $1.50 | $1.30 | $1.00 | 帖子详情每千条 $1.00–$0.60;音乐信息每千条 $7.00–$4.00 |
| Instagram Comments Scraper | $2.60 | $2.30 | $2.10 | $1.90 | — |
| Instagram Reel Scraper | $2.60 | $2.30 | $1.40 | $1.00 | 每次启动 $0.001;分享数每千条 $7.00–$4.00,视频下载 $20.00–$10.00,字幕 $48.00–$27.00 |
| Instagram Hashtag Scraper | $2.60 | $2.30 | $2.10 | $1.90 | — |
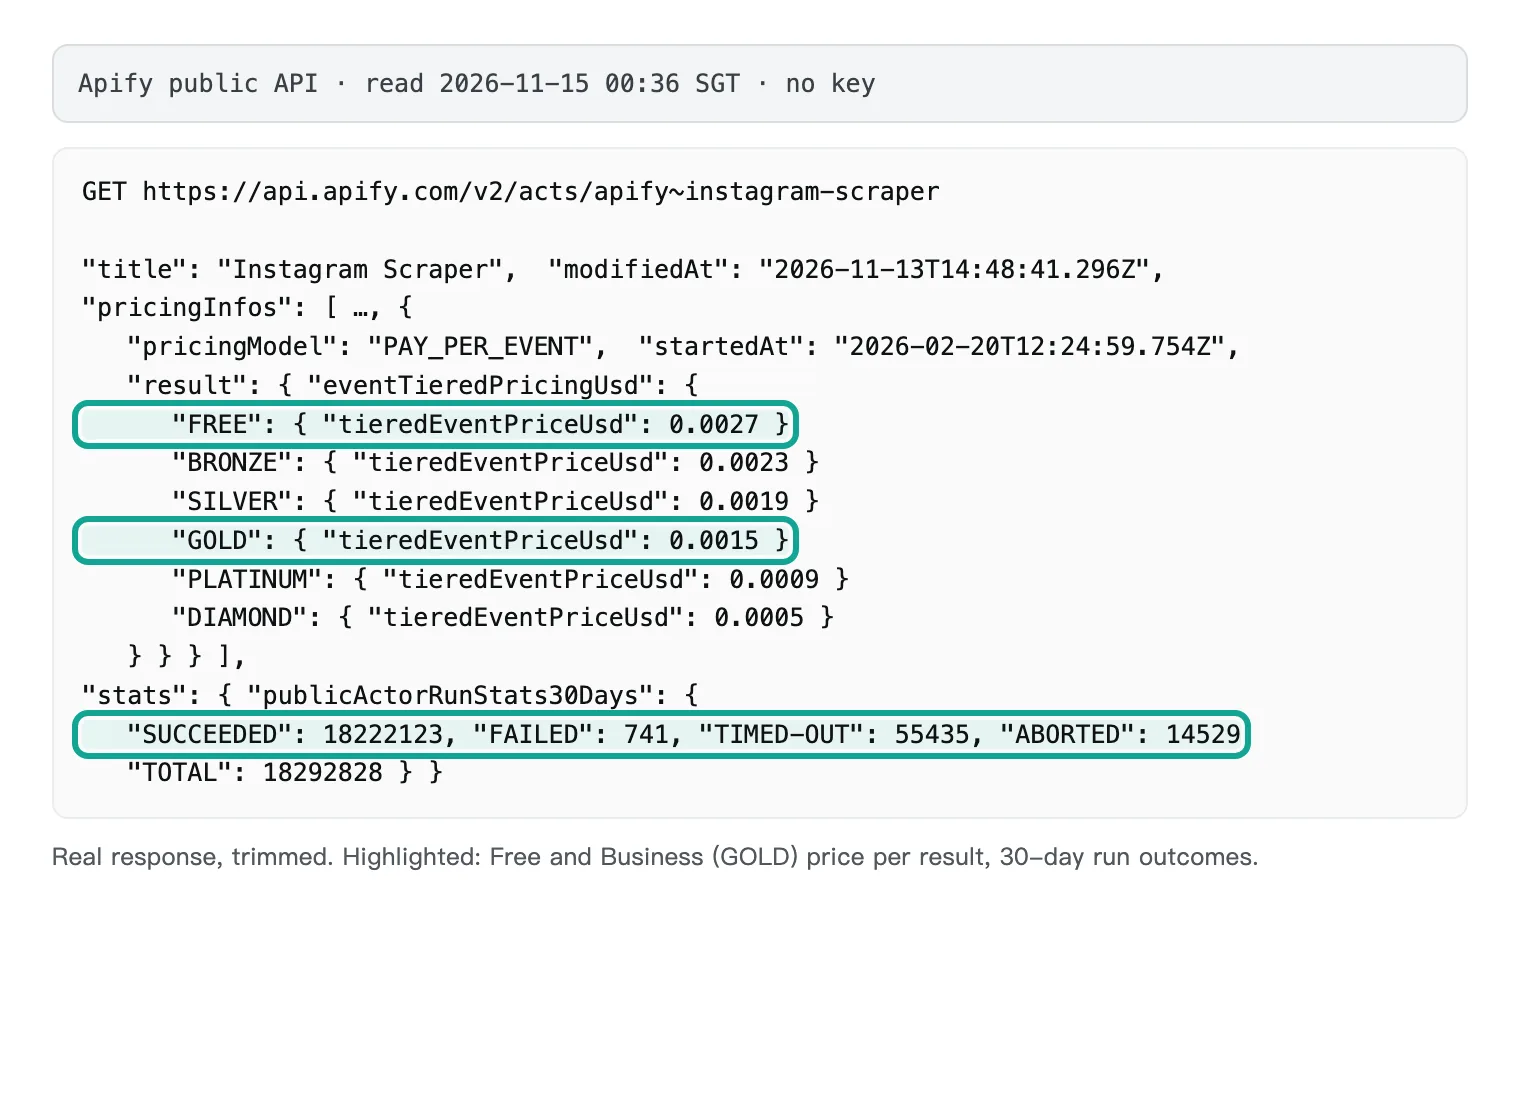
Apify 的文档说,大多数按事件计费的 actor 已经把平台用量算进事件价里,少数会另收平台费,用之前要看清 Pricing 标签;启动时还可以设一个最高花费,到了就停。月费套餐按 Apify 定价页:Free 每月 $5 额度,Starter $19,Scale $199,Business $999;预付额度当月没用完就作废,Free 套餐用完额度后要等下个周期,付费套餐可以超额继续用,直到平台上限。
Instagram Scraper 的 Store 页把套餐换算成了条数:Starter 档每千条 $2.30,每月能拿 8,200 多条;Scale 和 Business 档每千条 $1.90 和 $1.50,每月约 104,700 条和 666,000 条。拿定价页的月费 $19、$199、$999 分别除以这三档单价,得到的就是这三个数(8,261、104,737、666,000),月费买的是一笔预付额度。对每月几万条的用量,Scale 套餐 $199 是一道坎,过了这道坎每千条从 $2.30 降到 $1.90;用量不到 8,200 条时,Starter 的 $19 已经够了,多出来的额度月底作废。
同一份公开 API 还给了 30 天的运行统计。Instagram Scraper 近 30 天跑了 18,292,828 次,成功 18,222,123 次,占 99.61%;失败 741 次,超时 55,435 次,中途终止 14,529 次,近 30 天有 68,866 个用户在用。超时比失败多七十多倍。Instagram Scraper 的价目里只有 result 一个事件,超时的任务没写出结果,就不产生结果费;按定价页的说法,多数按事件计费的 actor 已把平台用量算进事件价。
六个 Instagram actor 的 30 天统计放在一起,量和稳定性差别不小:
| actor | 近 30 天运行次数 | 成功率 | 超时次数 | 超时占比 | 近 30 天用户 | 人均运行次数 |
|---|---|---|---|---|---|---|
| Instagram Scraper | 18,292,828 | 99.61% | 55,435 | 0.30% | 68,866 | 266 |
| Instagram Profile Scraper | 10,985,318 | 99.55% | 43,047 | 0.39% | 44,535 | 247 |
| Instagram Post Scraper | 6,183,573 | 99.88% | 6,109 | 0.10% | 21,011 | 294 |
| Instagram Reel Scraper | 3,747,072 | 99.85% | 3,178 | 0.08% | 27,169 | 138 |
| Instagram Comments Scraper | 1,195,021 | 99.68% | 2,346 | 0.20% | 10,493 | 114 |
| Instagram Hashtag Scraper | 826,451 | 99.51% | 2,206 | 0.27% | 22,310 | 37 |
主页这一项的超时占比最高,0.39%,按量也排第二,近 30 天跑了 1,099 万次;话题这一项用户有 2.2 万,人均只跑 37 次,是六个里最低的,多数人只是偶尔查一个话题。六个 actor 的失败次数都在 110 到 741 之间,比超时少一到两个数量级,所以估算 Apify 的实际开销时,要多看超时和中途终止。
Bright Data Instagram Scraper API:每千条 $1.50,失败的记录不收钱
Bright Data 的 Instagram 产品页写的价格是按量付费每 1,000 条记录 $1.50,Scale 套餐包 384,000 条、超出部分每千条 $1.30;新账号每月有 5,000 条免费额度,不用绑卡,按按量价算约值 $7.50。页面还写了「只为成功交付的记录付费」,失败的交付不收钱,一次请求最多放 5,000 个链接;「失败不收」这句写在定价区的标题上。
Bright Data 的入门文档列了四类数据的输出字段:主页 26 个、帖子 40 个、Reels 27 个、评论 14 个,比我们目录里对应的 19、21、22、11 个都多。同步请求最多等 1 分钟,超时就回 HTTP 202 和一个 snapshot_id,转成异步任务;「抓取全部 Reels」的接口页写着,Instagram 不再向它读取的来源提供 Reels 发布日期,所以 2026 年 8 月起这两个输入字段被移除了。
Bright Data 在 GitHub 上放了一个 Apache-2.0 的 Python 示例仓库,README 写得很实在:每次调用要等 1 到 3 分钟,因为接口在后台跑任务、SDK 等它跑完;每条帖子算 1 个额度;创建客户端时必须传 auto_create_zones=False,否则 SDK 会去建另外两个产品的区域,在没绑支付方式的账号上直接失败(对应它的 sdk-python#57)。README 里 CLI 示例的输出是每条帖子 34 个字段,和文档的 40 个略有出入,可能是示例裁过。
批量任务走异步:异步请求文档写的流程是触发、轮询、下载三步,各类数据用不同的 dataset_id 区分;产品介绍页写着输出格式支持 NDJSON(默认)、JSON、JSON Lines、CSV 和 Parquet。README 补了一句,快照生成后 30 天内都能下载,所以大任务可以先触发、记下快照 ID,过几个小时再取,不用让进程一直等着。
Bright Data 的单价和 Apify 的 Business 档持平,免费额度更大,失败不收写得最清楚,字段最多;短板是慢,以及量大时仍要按条付钱。
TikHub:按请求 $0.001 起,HTTP 200 就计费
TikHub 有一个不用 Key 就能读的价目接口。11 月 15 日 00:33(新加坡时间)我们读到 157 个 Instagram 接口:85 个每次 $0.001,33 个每次 $0.002,39 个每次 $0.008;157 个里只有 8 个能用赠送额度,8 个参与阶梯折扣。v1 帖子接口 fetch_user_posts 每次 $0.001,OpenAPI 文档里 count 参数默认 12、上限 50:按默认值拿 1,000 条帖子约要 84 次请求,折合 $0.083;把 count 填到 50,只要 20 次,折合 $0.020。这个接口要的参数是 user_id,按用户名查要先调一次 fetch_user_info_by_username,也是 $0.001。直接收用户名的帖子接口也有:v2 的 fetch_user_posts 每次 $0.002,文档没写每页条数;v3 的 get_user_posts 每次 $0.008,每页最多 50 条,折合每千条 $0.16;价目接口里还列了 web_app 的 fetch_user_posts_and_reels_by_username,每次 $0.001,可我们读到的 OpenAPI 文件里没有它,每页条数不明。
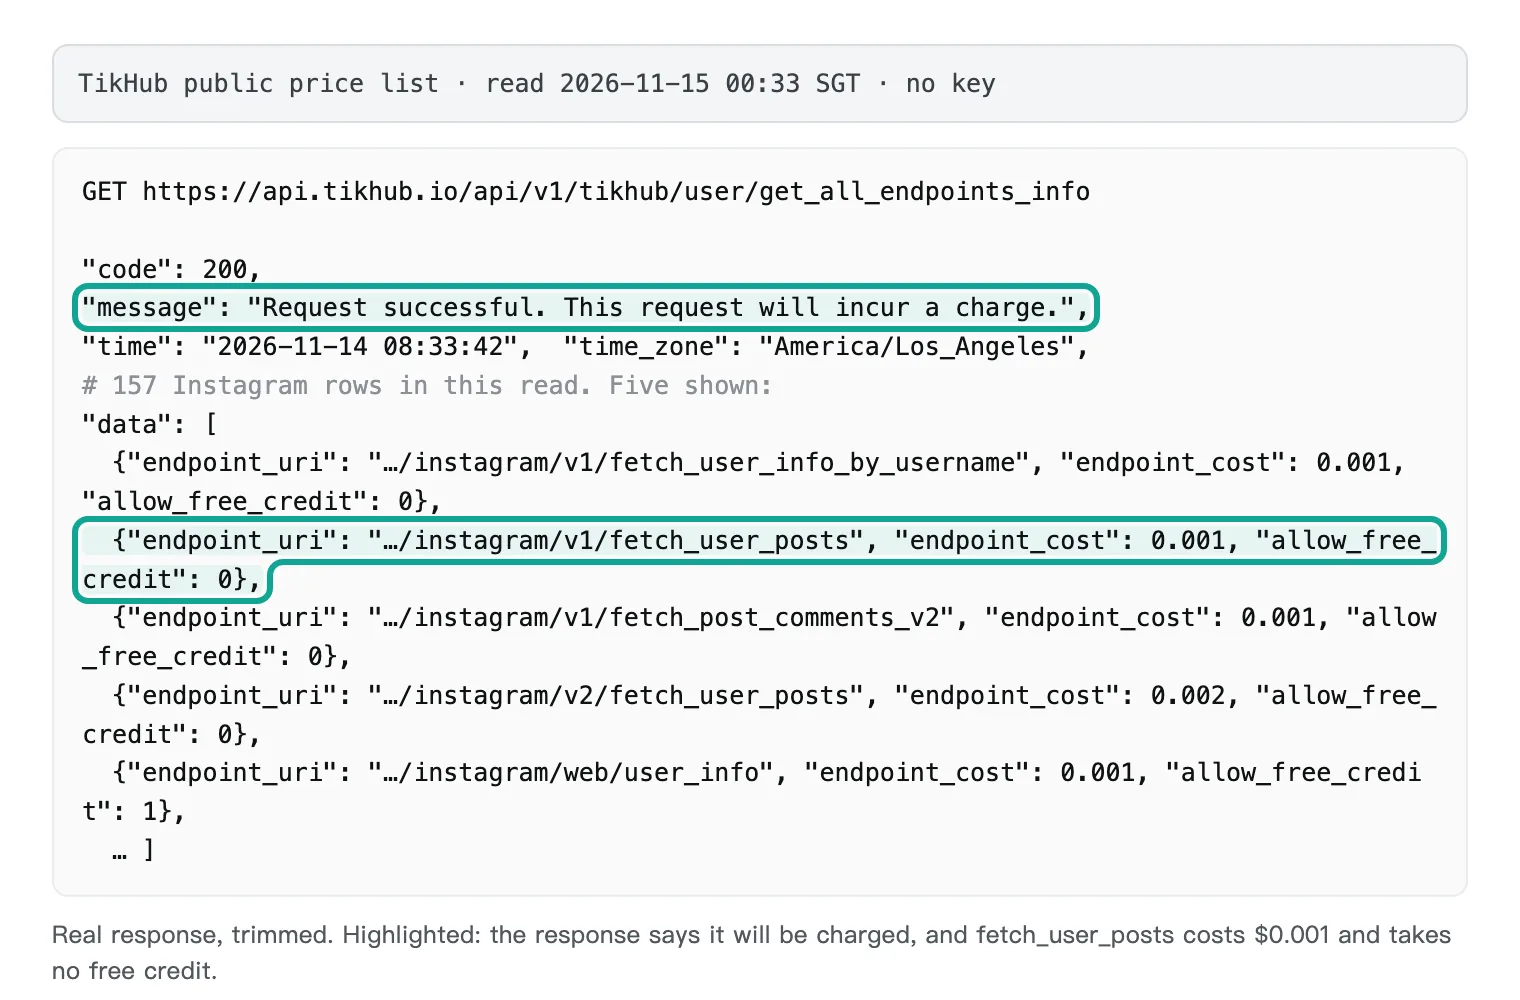
TikHub 的 FAQ 对计费写得直接:请求返回 HTTP 200 就计费,空结果也算,重复请求也算;最低充值 $5,没有上限;新账号自动拿 $0.05 赠送额度,可多数接口不收赠送额度;用量日志和每日阶梯折扣按洛杉矶时间结算。阶梯折扣按 FAQ 的说法从 0% 到 50% 递进,可 Instagram 的 157 个接口里只有 8 个参与折扣,帖子列表、评论这些常用接口都不在其中,所以用量上去以后,Instagram 这一块的单价基本不会降。按TikHub 定价页,没有月费,余额按用量扣。
TikHub 的优势是接口多、单价低,主页接口每次 $0.001,每千个 $1.00,评论接口也是每次 $0.001 起。和我们比,帖子按每页 50 条算差 1.8 到 7.2 倍($0.020 对 $0.0111 和 $0.00278),按默认 12 条算差 7.5 到 30 倍;主页差 1.8 倍。它的风险在「空结果也收钱」:账号名写错、对方改名或删号,每次照样扣 $0.001。走 v1 这条最便宜的路,100 个账号第一次接入要先查 100 次 user_id,多付 $0.10,之后把 user_id 存下来就不用再查。
instagram scraper api 实测:EveryInfra 的 12 次调用,合计 $0.006433
我们的目录里有 18 项 instagram/* 能力(列表见 Instagram 能力页),11 月 15 日读目录时 17 项可用,评论回复 instagram/comment_replies 暂不可用。当晚从 00:26 到 00:45(新加坡时间)一共调了 12 次,覆盖主页、帖子列表、评论、Reels、话题、单帖详情和 Reels 搜索七项能力,另外故意调了一次不存在的账号、一次写错参数。
| 新加坡时间 | 能力 | 请求 | 结果 | 扣费 | 每千条 |
|---|---|---|---|---|---|
| 00:26:55 | instagram/profile | natgeo | 1 行,268,127,355 粉丝、32,168 条帖子 | $0.000556 | $0.556 |
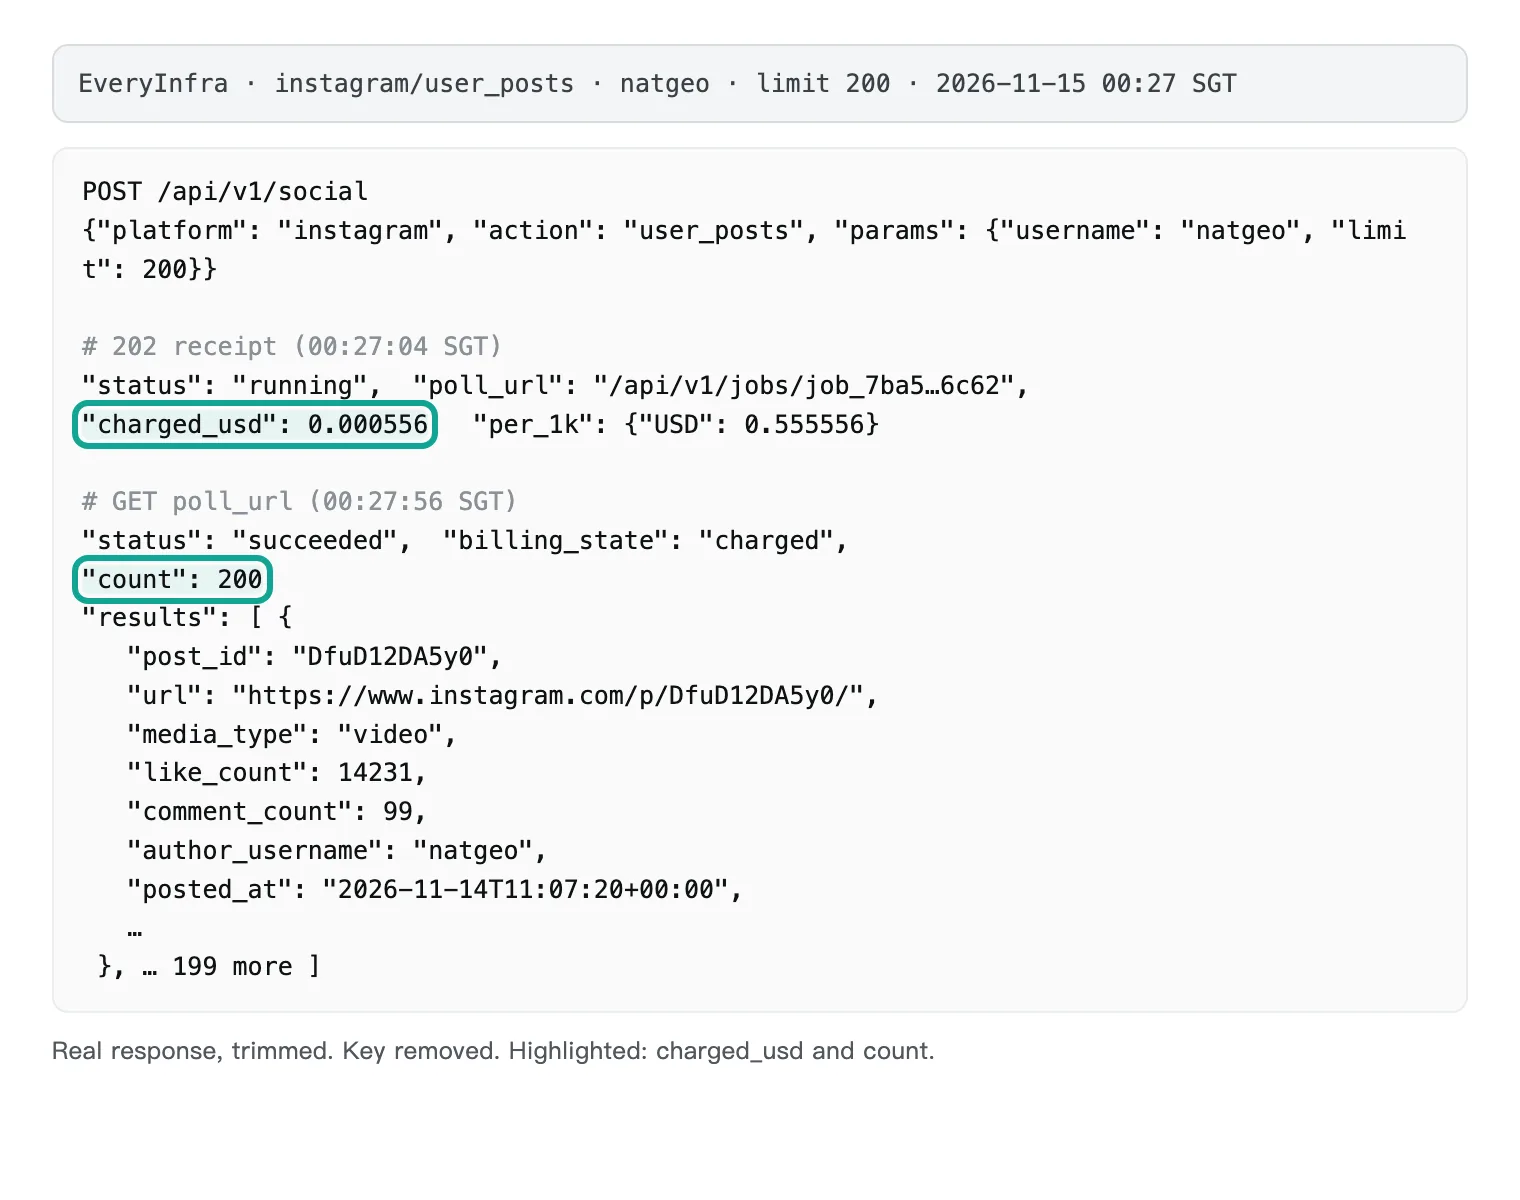
| 00:27:04 | instagram/user_posts | natgeo,limit 200,异步 | 200 条(视频 113、图片 87),00:27:56 完成 | $0.000556 | $0.00278 |
| 00:28:07 | instagram/comments | 一条有 99 条评论的帖子,limit 100 | 15 条,时间跨度 1 小时 44 分 | $0.000792 | $0.0528 |
| 00:28:27 | instagram/reels | natgeo,limit 100 | 100 条,带 play_count | $0.001194 | $0.0119 |
| 00:29:24 | instagram/hashtag | coffee,limit 100 | 30 条,时间跨度 2 小时 8 分 | $0.000556 | $0.0185 |
| 00:30:37 | instagram/profile | 不存在的账号 | 0 行,empty_result_refunded | $0 | — |
| 00:31:33 | instagram/user_posts | 参数写成 user | 422 missing_param,附改法 | $0 | — |
| 00:31:39 | instagram/post | 3 个帖子链接 | 3 行 | $0.001667 | $0.556 |
| 00:32:01 | instagram/reels_search | coffee | 503,error.code 为 unavailable,reason 为 capacity_exhausted,900 秒后再试 | $0 | — |
| 00:41:21 | instagram/profile | bluebottle | 519,718 粉丝、2,599 条帖子 | $0.000556 | $0.556 |
| 00:41:46 | instagram/user_posts | bluebottle,limit 50,异步 | 50 条,00:42:24 完成 | $0.000556 | $0.0111 |
| 00:45:25 | instagram/reels_search | coffee(重试) | 仍是 503,退款 | $0 | — |
12 次里 8 次扣费,合计 $0.006433;4 次没扣钱。帖子列表 instagram/user_posts 是这份榜单里价差最大的一项:目录单价 $0.000556 一次,natgeo 一次回 200 条,时间从 9 月 8 日排到 11 月 14 日,67 天;bluebottle 发帖少,填 50 回 50,时间从 6 月 26 日排到 11 月 12 日,139 天。同样一次的钱,200 条和 50 条差 4 倍,这就是我们每千条价写成区间的原因。
速度方面,两次 user_posts 都是异步任务:natgeo 那次 00:27:04 提交、00:27:56 完成,200 条用了 52 秒;bluebottle 那次 00:41:46 提交、00:42:24 完成,50 条用了 38 秒。202 回执里已经写好这次扣多少钱和每千条折合多少,任务跑完再按 poll_url 取结果,billing_state 会显示计费是否已经结算。对照 Bright Data README 写的每次 1 到 3 分钟,两家都要轮询,量级相近;同步能力(主页、评论、Reels、话题)当晚都是一次请求直接回结果。
# 帖子列表:一次最多 200 条,慢能力先回 202 和 poll_url
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"instagram","action":"user_posts","params":{"username":"natgeo","limit":200}}'

# 按回执里的 poll_url 轮询,status 变成 succeeded 再读 results
curl -s "https://api.everyinfra.com$POLL_URL" -H "Authorization: Bearer $EVERYINFRA_API_KEY"
评论和话题两项把 limit 的意思讲得很清楚。instagram/comments 对一条显示 99 条评论的帖子填了 100,回来 15 条;instagram/hashtag 查 coffee 填了 100,回来 30 条,全是最近 2 小时内发的。扣费按次,回得少每千条就贵:评论 $0.0528、话题 $0.0185,仍比 Apify 便宜 36 到 140 倍,但比 natgeo 那次帖子列表贵 7 到 19 倍。做预算时用实测条数,别用 limit。
instagram/reels 一次 $0.001194,比帖子贵一倍多,回 100 条,时间跨 58 天,22 个目录字段里 21 个有值,play_count 每条都有。user_posts 的 200 条里 view_count 全是空的,要播放量就走 Reels 这一项。单帖详情 instagram/post 按链接数计费,3 个链接 $0.001667,每千条 $0.556,和主页一样属于「一个目标一份钱」。
失败的四次各有各的样子。不存在的账号:请求挂了 29 秒才回,charged_usd 为 0,reason 是 empty_result_refunded,空结果自动退款。参数写错:把 username 写成 user,立即回 422 missing_param,错误里列了正确参数名和下一步怎么改,没扣钱。Reels 搜索 instagram/reels_search:两次都回 503,error.code 是 unavailable,reason 是 capacity_exhausted,retry_after 900 秒,扣款退回。这一项目录价 $0.007194 一次,是 Instagram 能力里最贵的,当晚没拿到结果,所以不进价格表。
字段的对比在下图。我们的目录字段比 Bright Data 少,帖子 21 对 40、主页 19 对 26;实测有值的字段又比目录再少几个。如果你的分析要用到 Bright Data 多出来的那些字段,比如帖子的合作者、品牌标记一类,要先对照它的字段表确认,我们这边没有的就是没有。
| 数据 | Bright Data 文档字段 | EveryInfra 目录字段 | EveryInfra 实测有值 | 实测里缺的 |
|---|---|---|---|---|
| 主页 | 26 | 19 | 17(bluebottle) | natgeo 没有 category |
| 帖子 | 40 | 21 | 15 | view_count 全空 |
| Reels | 27 | 22 | 21 | — |
| 评论 | 14 | 11 | 9 | — |
| 话题帖子 | — | 22 | 17 | location 30 条里 10 条有值 |
一晚样本能看出什么:natgeo、bluebottle 和 #coffee
价格和字段之外,买数据的人还关心一件事:拿回来的东西能不能直接用来下判断。我们把当晚 8 次成功调用的 400 条记录粗算了一遍,下面几组数只代表 11 月 15 日凌晨这一份样本,用来说明数据长什么样,不代表这些账号的长期表现。
| 样本 | 条数 | 指标 | 结果 |
|---|---|---|---|
natgeo 帖子(user_posts) | 图片 87、视频 113 | 点赞中位数 | 图片 72,542,视频 43,880 |
natgeo 帖子(user_posts) | 200 | 评论数中位数 / 最大值 | 205.5 / 15,813 |
natgeo Reels(reels) | 100 | 播放量中位数 | 1,782,073(最少 595,823,最多 35,863,019) |
natgeo Reels(reels) | 100 | 点赞 ÷ 播放的中位数 | 2.26% |
natgeo Reels(reels) | 100 | 时长中位数 | 32.5 秒 |
bluebottle 帖子(user_posts) | 图片 39、视频 11 | 点赞中位数 | 图片 560,视频 487 |
#coffee(hashtag) | 30 | 点赞中位数 / 带地点的条数 | 0 / 10 |
两个账号都是图片的点赞中位数高于视频,natgeo 差得更多,图片比视频高 65%。这类结论要拿更长的时间窗口再核。同一次 user_posts 里就带着 media_type 和 like_count,不用另外调详情接口就能分组比较。Reels 那一组的播放量和时长只有 instagram/reels 才给,前面说过 user_posts 的 view_count 是空的,所以要算完播、播放转化这类指标,Reels 要单独拉。
#coffee 的 30 条全部是最近 2 小时 8 分钟内发的,点赞中位数是 0,三分之一带了地点。话题接口回的是最新帖子,适合看「现在谁在发」,不适合直接拿来找爆款;找爆款要再按作者去拉主页和帖子列表。评论那 15 条也是同一个特点:全部发在最近 1 小时 44 分钟里,点赞中位数 0,没有一条来自认证账号,读到的是最新评论,不是热评。
话题监控:一天要查几次,花多少钱
话题数据的价格要换个算法。#coffee 这样的热门话题,一次 30 条只覆盖 2 个多小时,要连续跟住一天,按这个速度要每 2 小时查一次,一天 12 次,$0.0067;一个月 30 天约 $0.20。冷门话题一天可能只有几条新帖,一天查一次就够,一个月 $0.017。两种情况都按次计价,和话题热不热无关,只和你查得多勤有关。
同样跟一个热门话题,按条收费的算法是:按这一晚的速度,#coffee 一天约 336 条新帖,Apify Hashtag Scraper 每千条 $1.90 到 $2.60,一天 $0.64 到 $0.87,一个月 $19 到 $26;Bright Data 按 $1.50 算一个月约 $15。Meta 的 Hashtag Search 不收钱,可每个账号每 7 天只能查 30 个不同话题,而且回的是热门帖和最新帖两个列表,要连续跟住一个热门话题的全部新帖,频率限额会先到。
这里有一个前提要说清楚:我们的 instagram/hashtag 目录里只有 hashtag 和 results_type 两个参数,没有翻页参数,每次回的是当下最新的一批;默认条数是 30,我们填了 100、回来的正好是 30。所以「每 2 小时查一次」是按这一晚的发帖速度估的,热门话题在高峰时段可能更快,漏掉一部分是可能的。要求一条都不漏的场景,请先小规模试跑,对比前后两次的重叠条数,再定查询间隔。
instagram scraper api cheap:三种月用量的账单
单价表看不出月费和免费额度的影响,下面按三种常见用法算整月账单。算法:我们按目录价乘调用次数;TikHub 按每次价乘请求数;Apify 和 Bright Data 按每千条价乘条数,Bright Data 先扣每月 5,000 条免费额度;Apify 再和对应套餐的月费比,取较高的那个。
| 场景 | EveryInfra | TikHub | Apify(单价算) | Apify(含月费最省) | Bright Data(扣免费额度) |
|---|---|---|---|---|---|
| A:100 个账号每天各拿 30 条新帖,30 天 9 万条 | $1.67 | $3.10 | $135–$243 | $199(Scale) | $127.50 |
| B:每月查 1 万个主页 | $5.56 | $10.00 | $16–$26 | $23(Starter) | $7.50 |
| C:每月拿 10 万条评论 | $5.28 | 未算(每页条数未公开) | $190–$260 | $210(Scale 超额) | $142.50 |
场景 A 里,我们每个账号每天调一次 user_posts,3,000 次 × $0.000556 = $1.67;TikHub 走 v1 帖子接口,count 填 30,每个账号每天 1 页,3,000 次 × $0.001 = $3.00,加上第一次查 100 个 user_id 的 $0.10,共 $3.10(不改默认 12 条的话,每天要 3 页,是 $9.10);Apify 按 Free 到 Business 档的单价是 $243 到 $135,可 Free 套餐每月只有 $5 额度,Starter 超额后是 $207,Scale 的 $199 额度够用,所以最省是 $199;Bright Data 扣掉 5,000 条免费后 85,000 条 × $1.50/千 = $127.50。
场景 B 是差距最小的一种。查 1 万个主页,我们 $5.56,Bright Data 扣掉免费额度后 $7.50,TikHub $10.00,Apify Starter 档 $23。如果你每月只查几千个主页,Bright Data 的 5,000 条免费额度就够,账单是 $0,比我们便宜。场景 C 按我们实测每次回 15 条评论来算,10 万条要 6,667 次,$5.28;要是你的帖子评论更多、每次回得更满,还会更便宜,要是更少就更贵。TikHub 的评论接口每次 $0.001,可它的文档没写每页回多少条,没法换成每千条价,所以这一格空着;Bright Data 的 README 写明评论按条计费,每条评论算 1 个额度,10 万条评论扣掉免费额度后是 $142.50。评论是按条收费方案最贵的一类数据,因为一条热门帖子下动辄几千条评论,条数涨得比帖子快得多。
每种做法出错时是什么样子
挑工具时,「失败的样子」和「成功的价格」同样要紧,因为批量任务一定会碰到失败。六种做法出错时,给你的信号和扣费各不相同:
| 做法 | 常见的出错 | 你看到的 | 扣不扣钱 |
|---|---|---|---|
| Meta Graph API | 超出调用额度;读个人号;话题超过每周 30 个 | 错误码 4、17、32、613 等;个人号查不到 | 不涉及 |
| instaloader | 限流、登录失效、接口变动 | 429、302、登录报错(见上面的 issue 表) | 不涉及,但账号可能被限制 |
| Apify | 任务超时、中途终止 | 运行状态 TIMED-OUT 或 ABORTED,近 30 天超时 55,435 次 | 没回结果就没有结果费;有启动费的 actor 照收启动费 |
| Bright Data | 单条记录失败、同步请求超过 1 分钟 | 错误行(需开 include_errors);HTTP 202 加 snapshot_id | 写明失败的交付不收钱 |
| TikHub | 账号写错、空结果、重复请求 | HTTP 200 加空数据 | HTTP 200 就计费 |
| EveryInfra | 空结果、参数错、容量不够 | empty_result_refunded;422 带改法;503 带 retry_after | 不扣,空结果自动退款 |
我们这边的三种失败,在 11 月 15 日都碰到了。参数错误回得最快,422 里写着缺的是 username、支持哪些参数,客户的 AI 工具读到这段就能自己改了再发。容量不够的 503 带一个 retry_after,当晚是 900 秒,按它等 15 分钟再试是最省事的做法;我们 13 分钟后重试还是 503,没等满 900 秒。空结果最慢,不存在的账号挂了 29 秒才回,钱退回原账户,响应里能看到退款原因。
Bright Data 的 GitHub 示例把一类边界情况写得很细:一个账号「最近没有帖子」算成功,返回空列表,原因写在 note 里;账号不存在才算失败,错误写在 error 里。这个区分对按条收费的平台很重要,空列表不产生记录,自然也不收钱。TikHub 正相反,它按请求成功与否计费,只要返回 HTTP 200,空列表也收 $0.001。名单里有不少失效账号时,这一点会让 TikHub 的实际单价比表上高。
换工具之前的五项自查
Instagram 改版频繁,任何一家今天能用,下个月都可能出问题。下面五项检查花几分钱、十几分钟,适用于这六种做法里任何一种付费方案:
| 检查 | 怎么做 | 我们 11 月 15 日的结果 |
|---|---|---|
| 最近有没有人维护 | 看最后更新时间、近 30 天的运行统计或 issue | Apify 主 actor 11 月 13 日更新过;instaloader 一个月 14 个新 issue |
| 一个大账号能回多少 | 用 natgeo 这类发帖勤的账号,填最大 limit | user_posts 回满 200 条 |
| 一个小账号覆盖多久 | 用发帖少的账号,看回来的时间跨度 | bluebottle 50 条跨 139 天 |
| 不存在的账号扣不扣钱 | 故意填一个不存在的用户名 | 0 行,自动退款,等了 29 秒 |
| 写错参数会怎样 | 故意把参数名写错 | 422,告诉你正确的参数名 |
第一项最省事,也最容易被跳过。Apify 的公开 API 不带 Key 就能读 modifiedAt 和 30 天运行统计;Bright Data 的 GitHub 示例仓库写着每周一跑一次全量检查、隔天跑一次小检查;开源库看 issue 列表的最近一周。第二、三项决定你按条数估预算准不准:按请求收费的方案,一次能回多少条直接决定单价,大账号和小账号要各试一次。第四、五项决定出错时的账单:名单里总会有改名、删号、私密的账号,空结果收不收钱,在几万次请求的规模上会变成一笔明显的差额。
四种常见用途怎么挑
买 Instagram 数据最常见的四种用途,各自该调哪项能力、一个月大概多少钱、哪种情况换别家:
竞品和品牌监控:盯几十到几百个账号的新帖、互动数,每天出报表。用 instagram/user_posts 按账号拉,发帖勤的每天查、发帖少的每周查,100 个账号一个月 $0.24 到 $1.67。如果你只要自己公司账号的数据,或者要同时管评论、回私信,用 Meta Graph API。
达人筛选:给一批候选账号看粉丝数、发帖频率和近期互动。先用 instagram/profile 查主页,每个 $0.000556,再对入围的账号拉 user_posts 或 reels 看互动。1,000 个候选账号的主页是 $0.56;如果候选少于每月 5,000 个,Bright Data 的免费额度能覆盖主页这一步。
评论和舆情:读某几条帖子下的最新评论,看用户在抱怨什么。用 instagram/comments,每次 $0.000792;这一晚一次回 15 条最新评论,要拿更全的评论历史,现阶段 Apify 的 Comments Scraper 和 Bright Data 都能按条拿更多,单价高 28 倍以上。评论下的回复我们暂时不可用,需要回复的用 TikHub 或 Apify。
话题和趋势:跟几个话题的新帖,看谁在发、发什么。用 instagram/hashtag,按上一节的算法,热门话题一个月约 $0.20,冷门话题几美分。Reels 按关键词搜的 instagram/reels_search 当晚两次都暂不可用,要按关键词搜视频的,可以先试话题接口的 results_type: reels(这一项当晚没有实测)。
什么时候选别家更合适
价格只是一项。下面这些情况,别家的方案比我们更合适,或者是我们给不了的:
| 你的情况 | 更合适的做法 | 原因 |
|---|---|---|
| 只读自己账号的洞察、管理评论、发帖 | Meta Graph API | 官方接口,免费,能写入,数据是账号自己的 |
| 每月只查几千个主页 | Bright Data 免费额度 | 每月 5,000 条免费,账单可能是 $0 |
| 一次要提交几千个链接、要 40 个帖子字段 | Bright Data | 一次最多 5,000 个链接,帖子字段 40 个 |
| 不写代码,要点按钮、定时跑、导出表格 | Apify | Store 界面加定时任务和导出,六个 Instagram actor 现成 |
| 要视频字幕、评论回复这类我们暂时没有的数据 | Apify Reel Scraper 或 TikHub | Apify 的 Reel Scraper 有字幕事件;TikHub 有评论回复接口,我们的 instagram/comment_replies 暂不可用 |
| 只备份自己的帖子,偶尔用一次 | instaloader | 免费,命令行一行搞定,量小不容易碰到限流 |
表外还有三条限制:评论一次只回最新的十几条,拿不到完整评论历史;按关键词搜 Reels 当晚两次都是 503;帖子列表是异步任务,要多写一个轮询。
同一家更细的价目和套餐算法,见《Apify 定价详解》《Bright Data 定价详解》《TikHub 定价详解》,以及 Bright Data 替代方案页和 TikHub 替代方案页。
我们适合的是另一类活:按账号或话题批量拿帖子、Reels、评论,按次付钱、空结果不付钱,再让 AI 工具直接调。我们的远程 MCP 服务器把同一套能力暴露给 Claude、Cursor 这类工具,配置在下面的上手步骤里。
常见问题
best instagram scraper reddit 上推荐的是哪些?
这个问法来自搜索联想词「best instagram scraper reddit」。r/apify 上一个问「Instagram 和 TikTok 最省钱的 actor 是哪个」的帖子里,回复的人没有直接推荐某一个 actor,而是建议看最后更新时间,超过两三个月没更新的多半已经半坏,并建议先用免费额度拿自己的关键词试;r/scrapingtheweb 上一个问「怎么抓公开主页又不被封」的帖子,提问的人说不想自己维护登录、Cookie 和请求节奏那一套。两条帖子指向同一件事:选工具先看它最近还能不能用,再看价格。
instagram scraper api free 有能长期用的吗?
联想词里有「instagram scraper api free」和「best instagram scraper free」。能长期免费用的是 Meta Graph API 和开源库,前者限于专业账号,后者要自己扛限流。付费方案的免费额度:Bright Data 每月 5,000 条;Apify Free 套餐每月 $5,按 Instagram Scraper 的 Free 档约 1,850 条;TikHub 新账号 $0.05,且多数 Instagram 接口不收;我们 $1 试用额度,24 小时内有效,按帖子列表能拿几十万条,按主页约 1,800 个。
is instagram scraping legal?抓 Instagram 公开数据合规吗?
联想词「is instagram scraping legal」「instagram scraping against tos」都在搜索建议里。我们不给法律意见,只摆原文:Instagram 使用条款禁止未经明示许可以自动化方式访问或收集信息(accessing or collecting information in an automated way without our express permission),更新后的条款在 2027 年 1 月 20 日生效;帮助中心的一页写着,被系统判为未经授权的抓取,账号可能被限制。10 月 Meta 改过一次商业条款,引起抓取和 AI 训练方面的争议,TechCrunch 10 月 17 日和 Nieman Lab 都有报道;据 MediaPost,Meta 在 11 月 5 日宣布这批更新暂停,原定的 11 月 20 日不生效。具体到你的用途,请问你的律师。
instagram graph api get posts 能拿别人账号的帖子吗?
联想词「instagram graph api get posts」。能,但只限商业号和创作者号:用 Business Discovery,在自己专业账号的 ID 下写 business_discovery.username(对方账号名){media}。个人号读不到,年龄受限的账号不返回,带版权音乐的视频不给 media_url。读不是你管理的账号,应用要有 Advanced Access,也就是过 App Review 和 Business Verification。
instagram scraper api cheap:谁最便宜?
按每千条帖子算,11 月 15 日的公开价和实测里,我们最便宜($0.00278–$0.0111),其次是 TikHub($0.020–$0.083,看每页填多少条),Apify 和 Bright Data 在 $1.00–$2.70。按每千个主页算,我们 $0.556,TikHub $1.00,差距不到 2 倍;每月不到 5,000 个主页的话,Bright Data 免费额度内是 $0。Meta 和开源库按调用是 $0,代价在审核和维护。
instagram scraper github 上哪个还能用?
联想词里有「best instagram scraper github」和「instagram scraper api github」。按 11 月 15 日读到的 GitHub 数据,instaloader(13,888 星,新加坡时间 10 月 27 日发 v4.16)和 instagrapi(7,147 星,新加坡时间 11 月 14 日发 3.2.12)都在更新;instaloader 最近一个月的问题集中在 429、登录和 Reels 列表,instagrapi 自己在 README 里提醒私有接口在生产里不稳。GitHub 上还有 Bright Data 放出的 Python 示例仓库,但它调用的是 Bright Data 的付费接口,代码开源,数据要按条付钱。
instagram 爬虫用 python 怎么写?
联想词里有「scraper instagram python」和「instagram 爬虫 github」。用开源库写,instaloader 一行命令就能下载一个公开账号的帖子,instagrapi 要先登录;用付费接口写,就是一个 HTTP 请求加一个轮询循环,上面那段 curl 换成 Python 的 requests 不到 20 行。完整的 Python 写法、分页和存表,我们在《用 Python 抓 Instagram 帖子和评论》里一步一步写过,这里不重复。
instagram scraper api 失败了扣不扣钱?
四家付费方案各写各的。我们:空结果自动退款,参数错误回 422 不扣,容量不够回 503 并退款,11 月 15 日实测四次都是 $0。Bright Data:定价区写明失败的交付不收钱。Apify:按结果事件收费,没有结果就没有结果费,但有的 actor 另收启动费(Reel Scraper 每次 $0.001)。TikHub:FAQ 写的是 HTTP 200 就计费,空结果和重复请求都算。
上手步骤:注册、建 Key、发请求
第一步,在 EveryInfra 市场页注册账号,不用绑卡;在 GitHub 给两个仓库加星后,可以在控制台领 $1 试用额度,24 小时内有效,或者直接充值,没有月费。第二步,在控制台建一个 API Key,放进环境变量 EVERYINFRA_API_KEY。第三步,照快速开始发上面那条 user_posts 请求,拿回执里的 poll_url 轮询结果;这次实测里主页、评论、Reels、话题四项都是同步能力,直接回结果,不用轮询。各项能力的参数和价格,在 Instagram 能力页和价格页都能查到,同样的写法也能用在 TikTok 能力上。
要在 Claude、Cursor 这类 AI 工具里直接调,把我们的远程 MCP 加进配置,工具会列出一组 everyinfra_* 工具,常用的是 everyinfra_list_capabilities、everyinfra_call_api、everyinfra_get_job 三个,异步任务用最后一个取结果。详细的接法见 MCP 服务器页和《远程 MCP 设置》。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
配好以后,可以直接对 AI 说「拿 natgeo 最近 200 条帖子,按点赞数排前 10」,它会调 instagram/user_posts,一次扣 $0.000556。
参考资料
- Instagram Platform overview,Meta 开发者文档,2026-10-29 更新,2026-11-15 读取
- Business Discovery,Meta 开发者文档,2026-08-12 更新
- IG User Business Discovery 参考,权限列表
- Hashtag Search,Meta 开发者文档,2026-08-17 更新
- IG Media 参考,
media_url省略规则 - Graph API Rate Limits,Business Use Case 限额
- Introducing Graph API v27 and Marketing API v27,Meta,2026-11-04
- App Review,Meta 开发者文档
- Instagram Public Content Access 功能说明,Meta 开发者文档
- instagram_basic 权限,Meta 开发者文档
- Instagram API with Instagram Login,Meta 开发者文档
- Instagram API with Unified Login,Meta 开发者文档
- Instagram Terms of Use,2026-11-15 读取
- Instagram 更新后的使用条款,2027-01-20 生效
- Why your account has been restricted for data scraping,Instagram 帮助中心
- instaloader,GitHub,13,888 星,v4.16(2026-10-27 新加坡时间)
- instaloader issue #2786,2026-10-21
- instaloader issue #2792,2026-10-30
- instaloader issue #2794,2026-10-31
- instaloader issue #2797,2026-11-04
- instaloader issue #2803,2026-11-07
- instaloader 版本列表,GitHub
- instaloader Troubleshooting,云和 VPN IP 的限制
- instaloader 在 PyPI
- instagrapi,GitHub,7,147 星,3.2.12(2026-11-14 新加坡时间)
- instagrapi 在 PyPI
- Actors in Store,Apify 文档,按事件计费说明
- Usage and resources,Apify 文档
- Reaching platform limits,Apify 帮助中心,2026-09-04
- Apify 公开 API:apify~instagram-scraper,2026-11-15 00:36 读取
- Instagram Scraper,Apify Store
- Instagram Profile Scraper,Apify Store
- Instagram Post Scraper,Apify Store
- Instagram Comments Scraper,Apify Store
- Instagram Reel Scraper,Apify Store
- Instagram Hashtag Scraper,Apify Store
- Apify Pricing,2026-11-15 读取
- Bright Data Instagram Scraper API 产品页,2026-11-15 读取
- Bright Data Web Scraper 定价,2026-11-15 读取
- Bright Data:Send your first request,字段数和响应时间
- Bright Data:Instagram reels collect all,2026 年 8 月移除发布日期输入
- Bright Data Instagram Scraper Python 示例,GitHub
- brightdata/sdk-python issue #57,GitHub
- TikHub 价目接口,2026-11-15 00:33 读取,不带 Key
- TikHub OpenAPI,v1
fetch_user_posts的count默认 12、上限 50 - TikHub FAQ,计费规则
- TikHub Pricing
- EveryInfra 目录,2026-11-15 00:2x 读取
- r/apify:最省钱的 Instagram 和 TikTok actor
- r/scrapingtheweb:怎么抓公开 Instagram 主页不被封
- TechCrunch:Meta 删除引发抓取和 AI 训练争议的条款,2026-10-17
- Nieman Lab:Meta 新商业条款与新闻网站抓取
- MediaPost:Meta 暂停数据抓取条款
- Instagram API with Facebook Login,Meta 开发者文档
- Bright Data:Instagram Scraper API 介绍,输出格式
- Bright Data:异步批量请求
- Permissions Reference,Meta 开发者文档
引用编号 BL-163