Serper API 替代:每千次价格、免费额度和过期实测
Serper 四档预付价按 6 个月过期折算,每月 30 万次以下都比 EveryInfra 实测每千次 $0.694 贵;附 35 次真调和空结果退款。
同样拿 1,000 次网页搜索结果,Serper 入门档 Starter 的公开价是 $1.00;EveryInfra 在 2026 年 10 月 26 日 13:37–13:43(新加坡时间)真调 35 次、扣费 29 次,实测每千次 $0.694,便宜 1.44 倍。Serper 的 credits 6 个月过期、最低一次买 $50,月用量 1,000 次的人折算下来每千次实付 $8.33,是我们的 12 倍。条件是你每月的用量在 30 万次以下:过了 30 万次,Serper 的 $1,250 和 $3,750 两档反而比我们便宜,最低到我们价格的 0.43 倍,这一点我们在文中照实写。
本文说的「Serper API 替代」,是指同样输入一个关键词、拿回一页网页搜索结果(标题、链接、摘要、排名,外加新闻、地点、商品、图片、学术这些垂直结果),换一家按次计费的接口来做。我们只比四件事:每千次花多少钱、怎么数次数、失败和空结果扣不扣、上手和接 AI 工具要几步。我们不比两边返回的字段长什么样;EveryInfra 的字段以我们自己的搜索工具目录为准。


先看总表:同样 1,000 次搜索,两边差在哪
下面这张表只有两类数:Serper 写在 serper.dev 首页定价区的公开价和规则(2026 年 10 月 26 日 13:32 新加坡时间读取,原文存档备查),和我们自己在同一天真调接口拿到的结果。Serper 那一侧我们没有注册账号、没有买 credits、也没有用对方的 Key,所以凡是需要登录才能看到的东西(比如控制台里的用量明细),表里都写「页面未写」。
| 比较项 | Serper(公开页面) | EveryInfra(实测) |
|---|---|---|
| 每 1,000 次的价格 | $1.00 / $0.75 / $0.50 / $0.30,按四档套餐 | $0.694,不分档 |
| 最低一次付多少 | $50(Starter,50,000 credits) | $10(最低充值档) |
| 额度过期 | 6 个月 | 余额不过期 |
| 免费额度 | 2,500 次,不用信用卡 | $1 试用额度(约 1,440 次搜索),24 小时内有效,要在 GitHub 点星领取 |
| 一次要超过 10 条结果 | 定价区未写;有用户在公开讨论里说按 2 credits 算 | 每页最多 10 条、每页扣 1 次;要更多用 page 翻页 |
| 什么时候扣 | 收到成功响应时扣 | 有结果才扣;空结果自动退回 |
| 401、422、429 | 页面未写 | 不扣,响应里写 Nothing was charged |
| 退款 | 首次购买 7 天内、用量不到 20% 可全额退 | 余额不清零,不涉及过期退款 |
| 垂直结果 | 搜索、图片、新闻、地图、地点、视频、购物、学术、专利、联想词 | web、news、places、shopping、media(图片和视频)、scholar(论文和专利)、suggest 等 17 种 |
| 速率 | Starter 50 次/秒,到 Ultimate 300 次/秒 | 本次测试 Key 每分钟 10 次(按账户分档) |
| MCP | 官方页面未提供;GitHub 上有第三方实现 | 官方 MCP 端点,一个工具 everyinfra_search |
这张表里最容易被忽略的是第三行和第五行:它们不出现在「每千次价格」这一栏,却决定了你最后真正花了多少钱。下面先把 Serper 的价格拆开,再看我们的价格是怎么来的,然后用五组实测把每一格的数对上。
Serper API 价格怎么算:四档预付、6 个月有效
Serper 的定价是预付套餐,页面原话是「No monthly subscriptions; simply pay for the credits you need」,也就是不订阅、先买 credits 再用。四档分别是:Starter $50 买 50,000 credits,合每千次 $1.00,每秒 50 次;Standard $375 买 500,000 credits,合每千次 $0.75,每秒 100 次;Scale $1,250 买 250 万 credits,合每千次 $0.50,每秒 200 次;Ultimate $3,750 买 1,250 万 credits,合每千次 $0.30,每秒 300 次。四个卡片的最后一行都是同一句「Credits valid for 6 months」,价格旁边有星号,注明不含销售税、增值税或商品服务税。
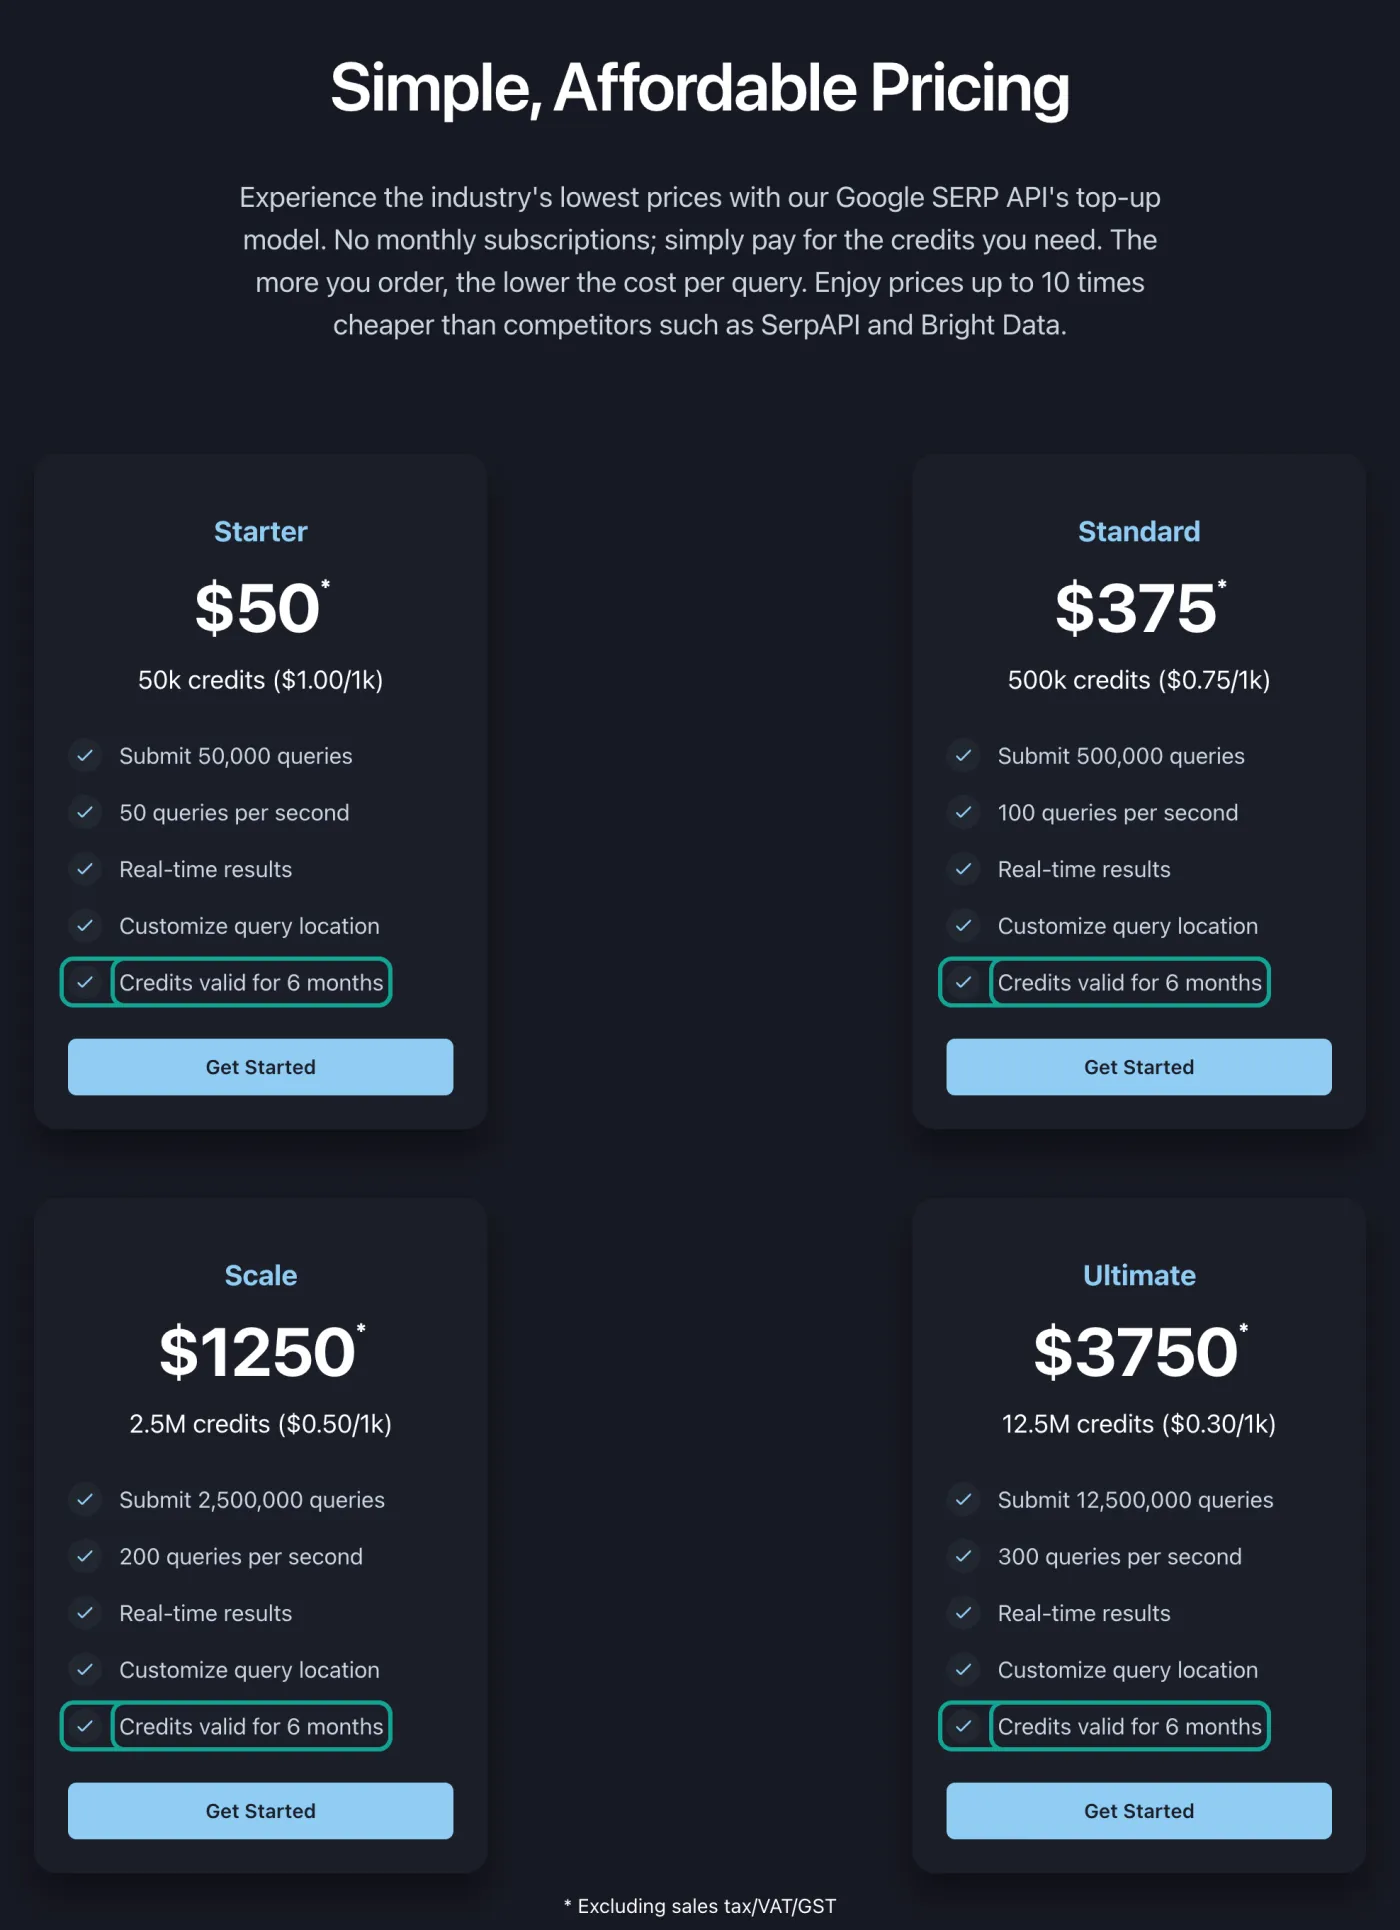
页面的常见问题里还写了三条和钱有关的规则。第一,什么时候扣:「每次你收到查询的成功响应,我们就从余额里扣 credits」,余额到零就不再接受新查询。第二,怎么退:首次购买后 7 天内、用掉的 credits 不到 20%,可以全额退款;服务条款的 Refund Policy 一节写的是同样两个条件,条款页标的更新日期是 2024 年 5 月 29 日。第三,付款方式:Visa、Mastercard、American Express、Discover 和 PayPal。
有一条规则在定价区里找不到,但在用户讨论里反复出现:一次请求要超过 10 条结果时,按 2 个 credits 算。Hacker News 上一位用户的原话是,Serper「把 10 条结果算 1 个 credit,20 到 100 条算 2 个 credits」,所以只要 10 条是每千次 $1,要 100 条就是每千次 $2(Hacker News 讨论)。我们没有 Serper 账号,没办法自己验证这条规则今天是否还成立,所以本文把它当作「用户报告」,在表和图里单独标出来,不和定价区的数混在一起。
把这几条放在一起看,Serper 的「每千次价格」其实有三个变量:你买哪一档、6 个月内用不用得完、每次要不要超过 10 条。定价区只告诉你第一个变量。另外两个变量,一个写在卡片最后一行的小字里,一个只在论坛里。这也是 Reddit 上一位用户说的:Serper 看起来便宜,直到你把 credits 换算成自己的真实用量(r/WebScrapingInsider 讨论)。
6 个月过期把单价抬高多少:按每月用量算一遍
这一节是本文自己算的数。思路很简单:假设你每个月的用量是 V 次,Serper 的 credits 6 个月过期,那每 6 个月你至少要买够 6V 次;在四档里任意组合,取最便宜的那种买法,再除以 6V,就是你真正付出的每千次单价。EveryInfra 不过期,单价始终是 $0.694。复算脚本直接从存档的页面原文里读出四档价格,不手抄;脚本和页面原文存档备查。
结果见下表。月用量 1,000 次的小项目,最省的买法也是一个 Starter 包,6 个月只用掉 6,000 次,剩下 44,000 次作废,折算每千次 $8.33;月用量 5,000 次时是 $1.67;月用量正好 8,333 次、6 个月刚好用完一个 Starter 包时,才回到页面上写的 $1.00。月用量 8.3 万次左右正好用完一个 Standard 包,单价 $0.75,仍比我们贵 8%。一直要到每月 30 万次,6 个月刚好用完一个 $1,250 的 Scale 包,两边打平。
| 每月搜索次数 | 6 个月要买 | Serper 最省买法 | Serper 实付每千次 | EveryInfra 每千次 | Serper ÷ EveryInfra |
|---|---|---|---|---|---|
| 1,000 | 6,000 | 1 个 Starter($50) | $8.33 | $0.694 | 12.0 倍 |
| 5,000 | 30,000 | 1 个 Starter($50) | $1.67 | $0.694 | 2.4 倍 |
| 20,000 | 120,000 | 3 个 Starter($150) | $1.25 | $0.694 | 1.8 倍 |
| 83,333 | 约 50 万 | 1 个 Standard($375) | $0.75 | $0.694 | 1.08 倍 |
| 300,000 | 180 万 | 1 个 Scale($1,250) | $0.694 | $0.694 | 1.0 倍 |
| 500,000 | 300 万 | Standard + Scale($1,625) | $0.54 | $0.694 | 0.78 倍 |
| 2,083,333 | 1,250 万 | 1 个 Ultimate($3,750) | $0.30 | $0.694 | 0.43 倍 |
这个计算有三处边界要说清楚。第一,我们假设你每 6 个月集中买一次;如果你按月少量多次买 Starter 包,月用量 1,000 次时每月都要花 $50,单价会更高,不会更低。第二,我们只用了定价区的四档公开价,没有算 Serper 可能给大客户的私下价格,也没算税。第三,交点「每月 30 万次」是按 Scale 包的 $1,250 除以我们的单价 $0.000694 算出来的:6 个月至少用 180 万次,Scale 才比我们便宜;Ultimate 要 6 个月用满 540 万次才划算,Standard 要用满 54 万次,可它的单价 $0.75 本身就比我们高,所以 Standard 档永远不会比我们便宜,Starter 也一样。
EveryInfra 的价格怎么来的:目录写一个价,响应里写实扣
EveryInfra 的搜索按次计费,价格写在公开的搜索工具目录里,不用登录就能读。目录的 billing.tiers 只有三档:标准档每次 $0.000694(每千次 $0.694),绝大多数搜索工具都在这一档;深度档每次 $0.001389,用于语义检索的深推模式;交叉验证每次 $0.002778,因为它并行跑了好几种检索。网页搜索 web 在标准档。同一个价格也写在定价页和搜索产品页上。


我们不在文章里直接写「每千次 $0.694」就算完,而是拿真调的响应来核对。每一次扣了费的响应都带一个 billing 对象,里面有 charged 和 charged_usd。本文 29 次扣费请求的 charged_usd 全是 0.000694,均值乘以 1,000 就是每千次 $0.694,和目录一致。每次一个固定价,好处是你可以在跑之前就算清总账:10 个关键词查一轮是 $0.00694,查 1 万个关键词是 $6.94。
请求和响应长这样(Key 只从环境变量读,不写进文件):
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"best running shoes 2026","num":10}}'
web 工具的参数一共 7 个:q 查询词;site 只搜某个域名,等同于在查询词前加 site:;location 地区,写国家名或两位国家代码,写城市按所在国家算;after、before 只要某个日期之后或之前的结果;page 页码,从 1 开始;num 每页条数,最多 10,默认 10,写更大时按 10 条返回、不报错。每条结果的字段是 title、url、snippet,有日期时多一个 published。目录里还给每个工具写了 units: 1 和 price_usd: 0.000694,意思是一次请求就是一个计费单位,和 num 设多少无关。
如果你要的是更细的地区和语言控制,数据目录里还有一个 web/search 能力,带 country 和 language 两个参数,价格是每次 $0.001389(标准数据档),在数据目录里能查到。它和搜索产品里的 web 是两个入口,适合需要按语言过滤结果的场景。
五组实测一览
| 组 | 时间(新加坡) | 工具 | 请求 | 扣费 | 主要结果 |
|---|---|---|---|---|---|
| 一、num 和翻页 | 13:37–13:42 | web | 5 | 5 | 每页 9–10 条,上限 10 |
| 二、国家、站内、时间 | 13:38–13:40 | web | 5 | 5 | 各国出现当地网站;site 回 3 条 |
| 三、关键词排名 | 13:41–13:43 | web | 10 | 10 | 96 条,$0.00694,中位 2.07 秒 |
| 四、各类结果 | 13:39–13:40 | 其他 8 种工具 | 9 | 9 | 各回 10 条;read 回 1 页正文 |
| 五、计费边界 | 13:38–13:41 | web | 6 | 0 | 空结果、422、401 和 3 次 429,全部不扣 |
合计 35 次请求、29 次扣费。有 3 次请求先撞了 429、隔几秒重发:重发的那次分别算在第二、三、四组,3 次 429 算在第五组。每一次请求的时间、状态码、耗时、条数和扣费,我们都逐条记录、存档备查。
实测一:num 和翻页,一次回几条、扣几次
先测最直接影响「每千条结果价格」的参数。我们在 2026 年 10 月 26 日 13:37、13:37、13:38、13:42、13:42(新加坡时间)各调一次:num=10、num=100 和第 2 页用的是同一个词「best running shoes 2026」,num=20 和第 3 页用的是实测三里的「best crm software for small business」。结果是:每页最多 10 条,num=10 回 9 条,num=20 回 10 条,num=100 同样按一页返回,就是 num=10 那 9 个网址;第 2 页、第 3 页各回 10 条,和同一个词的第 1 页没有一个重复。5 次每次都只扣 1 次 $0.000694。目录现在也把 web 的 num 上限写成 10(news、scholar、forum 同为 10,places 20,shopping 40);16:04(新加坡时间)我们复测,num=100 不报错、回 9 条,page=2 回 10 条,两页没有重复网址。
为什么每页最多 10 条?这和搜索引擎本身的变化有关。2025 年 9 月,Google 不再支持用网址参数一次显示 100 条结果,Google 的发言人对 Search Engine Land 说,这个网址参数「不是我们正式支持的东西」(Search Engine Land,2025 年 9 月 18 日)。Google 自己的 Custom Search JSON API 也把 num 限定在 1 到 10。所以今天任何接口要拿第 11 条以后的结果,基本都要翻页。
这对比价有直接影响。如果 Serper 仍然按「超过 10 条算 2 个 credits」收费,而一页实际上只有 10 条左右,那么 num=100 的请求付了两倍的钱,拿到的条数可能和 num=10 差不多。这一点我们无法在 Serper 一侧实测,只能给出我们这一侧的事实:在 EveryInfra,每页最多 10 条、每页扣一次,想要 30 条就翻 3 页、付 3 次,总价 $0.002083。按本文 20 次扣费的 web 请求算,一共拿回 186 条结果,平均每次 9.3 条,折合每千条结果 $0.0746;按满页 10 条算是 $0.0694。
每千次请求,还是每千条结果
上面一直在说「每千次请求」,但很多人真正关心的是「每千条结果」:做排名监控的人要前 30 名、做研究的人要前 50 条,一次请求能拿回多少条,直接决定账单。这两个单位之间差的就是每次请求的条数,而这个条数又被搜索引擎本身限制住了。
按本文实测,EveryInfra 的 web 每次平均 9.3 条,每千条结果 $0.0746(满页 10 条时 $0.0694)。Serper 这一侧有两种可能,我们都写出来。如果一次请求仍然只拿得到 10 条左右(这和 Google 去掉 num=100 以后的情况一致),那么 Starter 档每千条结果是 $0.10,要 num=100 并按 2 credits 计就是 $0.20,比我们贵 1.3 到 2.7 倍。如果 Serper 在 num=100 时确实能一次拿回 100 条,那每千条结果只要 $0.02,反而比我们便宜 3.7 倍。我们没有 Serper 账号,无法判断今天是哪一种;上面引用的那条 Hacker News 讨论是在 Google 改动之前写的。
所以如果你的用法是「每个词要很深的结果」,最该先测的就是这一项:在 Serper 的免费额度里,用 num=100 调一次,数一数 organic 里到底有几条、扣了几个 credits。这一次测试花不了钱,却能让你的比价从猜测变成事实。我们这一侧的答案已经在上面:每页最多 10 条、每页扣 1 次,要更多用 page 翻页。
实测二:换国家,结果换成当地网站
第二组测地区参数。我们用当地语言写查询词,再把 location 设成对应国家:德语「beste laufschuhe 2026」设德国(13:38 新加坡时间),西语「mejores tenis para correr 2026」设墨西哥(13:38),中文「跑步鞋 推荐 2026」设台湾地区(13:38)。德国那次 9 条结果里有 stern.de、faz.net 这类德国媒体和 alltricks.de、sport-conrad.com 这类德国零售站;台湾地区那次出现了 adidas.com.tw、salomon.com.tw 和几个香港媒体;墨西哥那次则混着 runnersworld.com 这类英文站和 runnea.com、sprintersports.com 这类西语站。
这说明地区参数确实在改结果,但它是「偏好」,不是「过滤」:目录里对 location 的说明写得很直接,它影响结果的地域,不保证结果都位于那个国家。Serper 页面写的是可以按国家和语言定制查询位置;从 LangChain 的封装代码看,常用的是 gl(国家)、hl(语言)、tbs(时间范围)和 type(search、news、places、images)这几个参数,默认值是 gl=us、hl=en。我们的 web 工具没有单独的界面语言参数,只能靠查询词的语言加 location;需要按语言过滤时,用上一节说的 web/search。
同一组里还测了站内限定和时间范围。13:38(新加坡时间)用 site=serper.dev 查「pricing」,只回 3 条,全部是 serper.dev 自己的页面,第一条的摘要里就列着四档价格,和我们存档的页面一致;13:40 用 after=2026-10-01 查「search api pricing」,10 条结果里带日期的 9 条都在 10 月:最早是 2026 年 10 月 6 日,最晚标的是「3 days ago」,按读取当天折算是 2026 年 10 月 23 日。这两次说明 site 和 after 是真的在缩小范围,而不是只排序:条数少了,就是范围收窄的证据。对监控类任务,用 after 只看新内容,比每次拉全量再自己去重省钱,也更不容易漏。
| 想做的事 | Serper 的参数(据公开封装) | EveryInfra 搜索产品 | 备注 |
|---|---|---|---|
| 按国家看结果 | gl | location(国家名或两位代码) | 都是偏好,不是过滤 |
| 按语言看结果 | hl | web 没有;数据目录 web/search 有 language | 语言代码可按 RFC 5646 写 |
| 只看某段时间 | tbs | after、before(日期) | 我们按日期写,不用记缩写 |
| 只搜一个网站 | 写进查询词 site: | site 参数或 site: | 实测 site=serper.dev 回 3 条 |
| 翻页 | page | page | 每页一次计费 |
| 一次多少条 | num(据用户报告超过 10 算 2 credits) | 每页最多 10 条,按页扣,用 page 翻页 | 实测一页约 9–10 条 |
实测三:10 个关键词查一轮排名,花了多少、多快
第三组模拟最常见的用法:一个做内容或 SEO 的团队,每天查一组关键词的前 10 名。我们在 2026 年 10 月 26 日 13:41 到 13:43(新加坡时间)查了 10 个英文关键词,从「best crm software for small business」到「best air purifier」,地区都设美国。10 次全部成功,一共回 96 条结果,花费 $0.00694,耗时中位数 2.07 秒。
这 96 条结果本身也能看出一些做 SEO 的人关心的事。它们来自 64 个不同的域名,58 条带发布日期;reddit.com 出现在全部 10 个关键词的前 10 名里,其中 9 个关键词它排在第 3 位,另一个排第 2;nytimes.com 和 youtube.com 各出现在 5 个关键词里。排第 1 的 10 个网址分属 10 个不同的网站,多数是产品官网或专门的评测站。也就是说,在「best + 品类」这类查询上,论坛讨论几乎固定占一个前 3 的位置。如果你做排名监控,只看自己网站的名次不够,还要看同一页上论坛和视频占了几个位置,这些位置会把自然结果往下挤。按每个词每天查一次算,这样一份 10 个词的观察每月是 300 次请求、$0.21。
把这一轮放大到真实规模来算:每天 500 个关键词、每个只看第 1 页,一个月是 15,000 次。在 EveryInfra 是 15,000 × $0.000694 = $10.42;在 Serper,按 6 个月 9 万次买,最省是 2 个 Starter 包 $100,折合每月 $16.67,每千次 $1.11。如果每个关键词要看前 30 名,我们翻 3 页,一个月 45,000 次、$31.25;Serper 那边如果选择一次 num=30,并按用户报告的 2 credits 计,一个月要 30,000 credits,6 个月 18 万,最省 4 个 Starter 包 $200,每月约 $33.33,两边接近。这里的关键不是哪一家更便宜,而是你要先把自己的查询方式写清楚,再去比。
速度方面我们照实写:29 次扣费请求从发出到收完,中位 2.02 秒,第 90 百分位 2.77 秒,最快 0.99 秒,最慢 3.09 秒,有 15 次超过 2 秒。这个时间是从新加坡的机器测的,包含网络往返。Serper 页面写的是「一般 1 到 2 秒,需要重试时 2 到 4 秒」,我们没有调 Serper,所以这不是同条件对比;如果你的应用对单次延迟很敏感,比如在聊天界面里同步等搜索结果,建议两边各拿自己的 50 个真实查询测一次再定。
三种典型用户的月账
前面的曲线是抽象的「每月 V 次」。下面换成三种真实存在的用法,各算一遍月账。每一行的数都由同一个计算函数算出:EveryInfra 按实际扣费次数乘以 $0.000694;Serper 按 6 个月的总用量,在四档公开价里取最省的组合,再除以 6。
| 用法 | 每月请求 | EveryInfra 每月 | Serper 每月(最省买法) | 倍数 |
|---|---|---|---|---|
| 个人开发者的 AI 助手,每天约 100 次联网搜索 | 3,000 | $2.08 | $8.33(1 个 Starter,6 个月用掉 36%) | 4.0 倍 |
| 内容团队每天查 500 个关键词的第 1 页 | 15,000 | $10.42 | $16.67(2 个 Starter) | 1.6 倍 |
| 同上,但每个关键词看前 30 名(翻 3 页) | 45,000 | $31.25 | $50.00(6 个 Starter) | 1.6 倍 |
| 品牌舆情监控,假设 15% 的查询是空结果 | 200,000 | $118.05 | $158.33(4 个 Starter + 2 个 Standard) | 1.34 倍 |
| 同上,没有空结果 | 200,000 | $138.89 | $158.33 | 1.14 倍 |
第一行最能说明问题。一个人做的 AI 助手,每天联网搜 100 次左右,一个月 3,000 次。在 EveryInfra 是一个月两美元出头;在 Serper,最小的包是 $50,6 个月只能用掉 18,000 次,剩下的 32,000 次到期作废,折合每月 $8.33。这类用户的痛点通常不是单价,而是「先付 $50 然后看着它过期」。Serper 的 2,500 次免费额度能顶前几周,但用完以后的第一笔钱就是 $50。
第四行里的「15% 空结果」是我们设的假设,不是实测:本文 35 次请求里只有 1 次空结果,但那是我们故意构造的。舆情监控要盯新品牌名、产品型号和小众话题,查不到东西的比例会比日常搜索高得多。我们这边空结果自动退回,所以 15% 的空结果直接让月账从 $138.89 降到 $118.05。Serper 的页面只写了「收到成功响应时扣」,没有说空结果算不算成功,所以表里按全部计费算,这是 Serper 一侧的上界;如果它实际上不扣空结果,第四行的倍数会回到第五行的 1.14 倍。
第二、三行的倍数相同,是因为两者都在 Serper 的 Starter 档里,用量翻 3 倍、包数也翻 3 倍。真正改变倍数的是两件事:月用量跨过某一档的门槛,或者 6 个月里有没有用完。所以在做选型之前,先用过去三个月的日志算出自己的月用量和波动范围,比看任何一张价格表都更有用。
实测四:新闻、地点、商品、图片、学术等各类结果
选搜索接口,除了网页结果,还要看能不能拿到你要的其他类型。下表按结果类型分组:「Serper 首页列出」一列只写 Serper 首页的结果类型清单里有没有这一类;后三列是我们在 13:39–13:40(新加坡时间)用 EveryInfra 对应工具各调一次的实际结果,每次都扣 $0.000694。
| 你要的结果 | Serper 首页列出 | EveryInfra 工具 | 实测条数 | 实测拿到了什么 |
|---|---|---|---|---|
| 网页 | 有 | web | 9–10 | 标题、网址、摘要、发布时间 |
| 新闻 | 有 | news | 10 | 「DeepSeek search API」的报道,最近的 1 天前 |
| 地点和地图 | 有 | places | 10 | 新加坡咖啡馆,评分、评分人数、地址、电话、经纬度、营业时间 |
| 商品 | 有 | shopping | 10 | 跑鞋商品,价格、商家、评分 |
| 图片 | 有 | media(kind=image) | 10 | 图片标题和网址 |
| 视频 | 有 | media(kind=video) | 10 | 视频标题和网址 |
| 论文 | 有 | scholar | 10 | 论文标题、网址、摘要 |
| 专利 | 有 | scholar(kind=patents) | 10 | 专利标题、网址、摘要 |
| 联想词 | 有 | suggest | 10 | 「serper api」的 10 条联想词 |
| 网页正文 | 首页结果类型里没有 | read | 1 | 指定网址的正文 |
地点这一项值得多说一句:places 拿回的第一条是一家新加坡咖啡馆,评分 4.7、2,324 人评分,带地址、电话和经纬度。如果你要的不只是地点列表,而是某家店的全部评价,搜索工具就不够了,要用数据目录里的 google_maps_reviews/search 和评价能力,单价是标准数据档每次 $0.001389,平台页在 Google 地图评论接口。韩国和俄罗斯的本地结果同理,可以用 naver/search 和 yandex/search。
这一组里有两次调用顺便帮我们写了这篇文章。第一次是 suggest:我们在 13:40(新加坡时间)用它查「serper api」,拿回 10 条联想词,其中有「serper api pricing」「serper api free tier」「serper api key free」,和我们写稿前用别的工具查到的联想词一致,本文的标题和常见问题就是照这些词定的。第二次是 news:查「DeepSeek search API」,10 条报道里最新的是 1 天前,最早的是 1 周前,正好对上 DeepSeek 在 2026 年 10 月 17 日开放接口这件事,下面「最近的变化」一节的第一条就是从这里顺藤摸瓜读到原文的。
shopping 那一次也值得一看:10 条跑鞋商品都带价格、商家和评分,第一条是 DICK'S Sporting Goods 卖的 Nike Revolution 8,$74.99;但它的 url 指向的是搜索引擎自己的商品页,不是商家页面。做比价产品的人要注意这一点:如果你要的是商家页上的库存、规格和评价,要再用数据目录里的电商能力去读商品页,不能只靠搜索结果里的价格。
实测五:空结果、超速、参数错、没带 Key,扣不扣钱
这是两家规则差得最多的一项。Serper 页面写的是「收到成功响应就扣」,没有说什么算成功:返回 200 但一条结果都没有,算不算?页面没写。我们这边,规则写在每次的响应里,实测如下。
2026 年 10 月 26 日 13:40(新加坡时间),我们查了一个故意不存在的短语,返回 200、结果为空,billing 里写着 charged: false、charged_usd: 0.0、reason: empty_result_refunded,refund.status 是 succeeded。同一分钟内,我们故意传了一个 web 不支持的参数 gl,返回 422,错误信息列出 7 个支持的参数,最后一句是「Nothing was charged」;不带 Key 的请求返回 401,同样写着没有扣费。
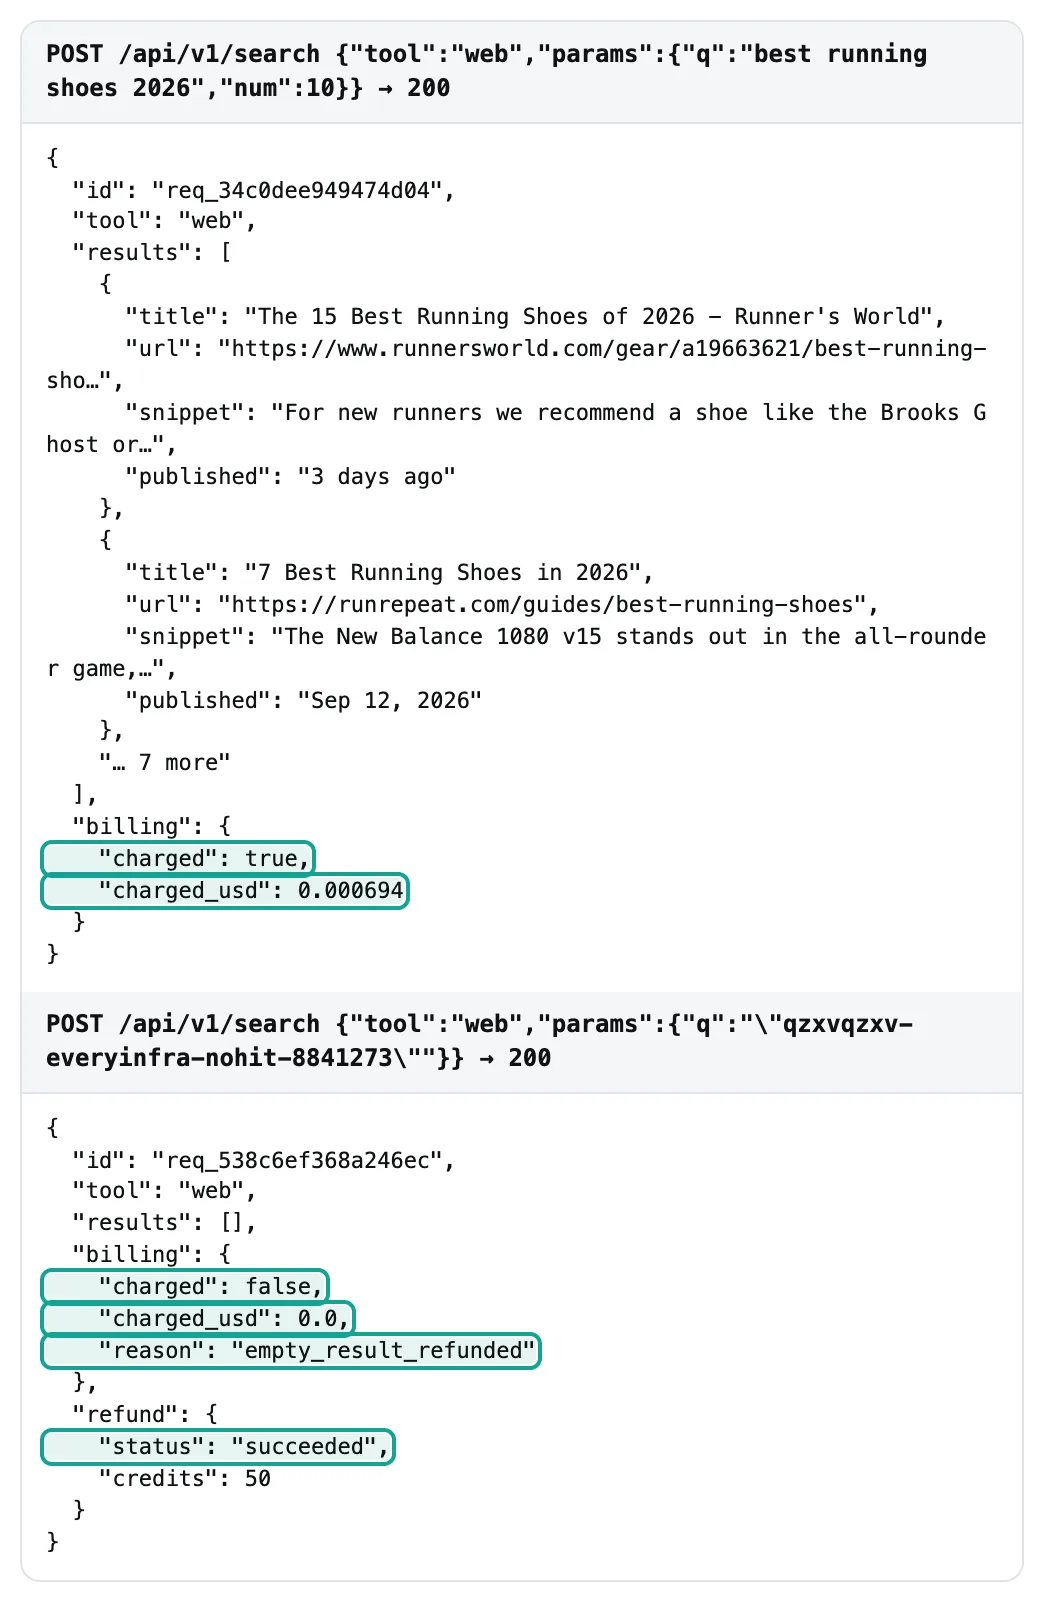
还有一类是我们自己撞上的:测试 Key 的速率是每分钟 10 次,我们在 13:38、13:39、13:41(新加坡时间)各撞了一次 429,响应写明「10 requests per minute for this API key's own limit. Retry after 7s」,同样「Nothing was charged」。按 RFC 6585 的定义,429 表示客户端在一段时间内发了太多请求;401 和 422 的含义见 RFC 9110。其中一次 429 的响应内容,我们按终端输出抄存备查。
为什么这一项值得单独比?在 Google 宣布 Custom Search JSON API 不再接新客户之后,r/googlecloud 上有人在找每月 6 万次的替代方案,一位自称经营同类搜索接口的回答者建议:问清楚每家怎么数一次请求,重试、空结果、多翻的页算不算钱,因为这会改变你每月 6 万次时的真实花费。对监控类任务来说,空结果并不少见:查一个新品牌名、一个冷门关键词,或者加了很窄的时间范围,都可能一条都没有。按我们这次的比例,35 次里 6 次没有扣费,占 17%。
上手要几步:从注册到第一次结果
| 步骤 | Serper | EveryInfra |
|---|---|---|
| 1 | 在 serper.dev 注册,拿 2,500 次免费额度,不用信用卡 | 在 everyinfra.com 注册(免费) |
| 2 | 在控制台复制 API Key | 在控制台复制 API Key;要试用可在 GitHub 给 everyinfra-agent-plugins 点星,领 $1 试用额度 |
| 3 | 用完免费额度后,最少买 $50 的 Starter 包 | 最少充值 $10,余额不过期 |
| 4 | 用 X-API-KEY 请求头调用(见 LangChain 等封装) | 用 Authorization: Bearer 调 /api/v1/search |
| 5 | 在 AI 工具里接入:用 LangChain、CrewAI、Haystack 的现成封装,或第三方 MCP | 在 AI 工具里接入:官方 MCP 端点,一个配置块 |
Serper 的免费额度更大,这是它真实的优点:2,500 次适合「接进真实产品跑几周」,AI 助手每天搜 50 次能撑 50 天,足够看出真实用量再决定买哪一档。我们的 $1 试用额度约合 1,440 次搜索、24 小时内有效,适合「在一个下午里把所有工具和错误情况都试一遍」:本文 35 次请求一共只花了 $0.020126,同样一轮测试在 $1 里能重复将近 50 次。两种额度都不要拿来做压力测试,测试 Key 和免费账户的速率上限都低于正式账户。如果你只想先在浏览器里看看结果,可以在网页搜索工具页上点一键试用,示例参数已经填好;完整步骤见快速上手,所有能力和价格在能力市场。
付费以后,两边的「第一笔钱」差别更大。Serper 的第一笔至少 $50,6 个月后没用完的部分作废;我们的第一笔至少 $10,余额一直留着。对于还在验证想法的团队,这意味着你可以先充 $10,跑一个月看真实用量,再决定要不要继续,而不需要先预估半年的量。对于已经稳定、用量又大的团队,这个差别就不重要了,单价才是关键,这时请回到前面那张月用量表,看你落在交点的哪一边。
从 Serper 换过来,代码要改哪几处
如果你已经在用 Serper,换到 EveryInfra 要改四处,每一处我们都说明为什么这样改、改错了会看到什么。第一处是请求地址和鉴权:Serper 的封装把 Key 放在 X-API-KEY 请求头里,按结果类型分不同的地址;我们只有一个地址 /api/v1/search,Key 放在 Authorization: Bearer 里,结果类型写在请求体的 tool 字段。如果把 Key 放错了请求头,会收到 401,不扣费,错误信息会直接告诉你缺的是什么。
第二处是参数名。gl 换成 location,tbs 换成 after 和 before 两个日期,type=news 换成 tool: "news",type=places 换成 tool: "places"。这里最常见的错误是把旧参数原样带过来,比如继续传 gl。我们不会悄悄忽略它然后照常扣费,而是返回 422,列出 web 支持的 7 个参数,并写明没有扣费;本文实测五里就故意这样传过一次。这个设计对 AI 智能体特别有用:模型读到错误信息里的允许值,下一次就能自己改对。
第三处是解析结果。我们的每条结果是 title、url、snippet,有时多一个 published;places 多出评分、地址、经纬度这些字段;全部字段以搜索工具目录为准。建议在你的代码里先写一层自己的数据结构,把任何一家的返回都转成这层结构,再交给下游。这样以后无论换哪一家,下游都不用动,这也是后面「最近的变化」里 Cloudflare 那一条给出的提示。
第四处是计费和重试逻辑。Serper 的余额到零会拒绝新请求;我们的余额不足时同样会拒绝,但余额不会过期。我们的响应里每次都带 charged_usd,你可以按请求逐条记账,月底和账单核对;遇到 429,按响应里的 retry_after 秒数等一下再重试,不要立刻连发,连发只会继续收到 429。把这四处改完,用你自己的 20 个真实查询跑一遍,对比两边的结果条数和耗时,再决定要不要全部切过来。
接进 AI 工具:MCP、LangChain、n8n
Serper 在 AI 框架里的现成封装很多,这是它的另一个真实优点:LangChain、CrewAI 的 SerperDevTool、Haystack 的 SerperDevWebSearch 都内置了它,只要设一个环境变量就能用。MCP 方面,serper.dev 页面上没有提供官方 MCP,GitHub 上有 mcp-server-serper 和 serper-mcp-server 这样的第三方实现,需要你自己在本机运行。
EveryInfra 提供官方的远程 MCP 端点,按 MCP 规范的 Streamable HTTP 方式接入,不用在本机装任何东西。搜索只有一个工具 everyinfra_search,参数是 tool 加 params,和 REST 接口相同;工具说明里也写着失败或空结果不会留下最终扣费。在 Claude、Cursor 这类支持远程 MCP 的客户端里,配置如下:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
接好以后,在对话里说「用 everyinfra_search 的 web 工具查 best crm software,地区美国,翻到第 2 页」,客户端会发出和上面 curl 一样的请求。要在代码里挑哪个搜索工具,可以看我们的智能体搜索工具选型;错误码怎么让 AI 自己修正参数,见错误自愈指南;对账时怎么核对退款,见失败退款对账。在 n8n 里,没有现成节点时用 HTTP Request 节点发同样的 JSON 就行,n8n 自己的 SerpApi 工具节点文档也可以作为参数写法的参照。
什么时候 Serper 更合适
我们照实写 Serper 更合适的五种情况。第一,月用量很大。每月稳定在 30 万次以上、而且 6 个月内用得完,Serper 的 Scale 档每千次 $0.50、Ultimate 档 $0.30,比我们的 $0.694 便宜 28% 到 57%,量越大差得越多。第二,并发要求高。Serper 的 Ultimate 档默认每秒 300 次,页面说一分钟能跑一万五到一万八千次;我们的速率按账户分档,本次测试 Key 只有每分钟 10 次,大批量要先在控制台确认你的上限。
第三,你已经在用 LangChain、CrewAI、Haystack 的现成封装,代码里直接写着 Serper 的参数和返回结构。换到任何一家都要改代码和解析逻辑,如果每月只花几十美元,迁移的人力成本可能比省下的钱还多。不过这些封装本身也在变:Haystack 的 SerperDevWebSearch 源码里写着,它会在 Haystack 3.0 移出主包、改成单独安装的 serperdev-haystack;CrewAI 原来放 SerperDevTool 的 crewAI-tools 仓库已在 2025 年 11 月 10 日归档。等到你反正要改依赖的时候,就是顺便比价的好时机。第四,你需要按界面语言精细控制结果。Serper 有 hl,我们的搜索产品 web 没有单独的语言参数,要用数据目录里的 web/search,单价是搜索产品的两倍。
第五,你需要搜索结果页上的那些「附加模块」。Serper 首页的示例返回里,除了 organic 结果,还有知识图谱(knowledgeGraph)、「其他人还问了」(peopleAlsoAsk)和相关搜索(relatedSearches)。我们的 web 在本文实测里只返回自然结果的标题、网址、摘要和日期;联想词要另调 suggest,新闻、地点、商品各有各的工具。如果你的产品要在一次请求里拿到整页的这些模块,比如做搜索结果页的完整快照,Serper 这类接口更直接。
还有两条路不在这两家之间。一是自己搭:比如自建 SearXNG,这是一个开源的元搜索引擎(源码在 GitHub),不按次付费,但要自己维护服务器、处理被封和结果不稳定的问题。二是按「结果」而不是按「请求」计费的大厂:同一条 Hacker News 讨论里,另一位用户说 Bright Data 把一次 100 条结果的请求算作 1 次计费,按每千次 $1.5 收,Bright Data 的常见问题里也专门回答了 Google 去掉 num 参数以后计费怎么算。每家数「一次」的方法不同,这正是比价最容易出错的地方。
反过来,EveryInfra 更合适的情况也很清楚:月用量在 30 万次以下;用量不稳定、不想让预付额度过期;经常会查到空结果;要在 AI 工具里直接接远程 MCP;或者除了搜索还要同一把 Key 去取平台数据,比如网页搜索接口以外的 Google 地图评论、Naver、Yandex 这类本地平台。我们也有和 SerpApi、DataForSEO 的对比页,可以一起看。
市场上的其他选择:每千次公开价
Serper 不是唯一的选择。下面是我们 2026 年 10 月 26 日读到的各家公开价,统一换成每 1,000 次请求的美元价。要注意,它们的计费单位不完全一样:模型厂商的搜索工具另外按 token 收搜索内容的费用,Exa 超过 10 条另计,SerpApi 是月订阅,所以这张表只能看量级,不能直接当成同一种东西比。
| 服务 | 每 1,000 次(美元) | 计费条件(原文要点) |
|---|---|---|
| Serper Ultimate / Scale / Standard / Starter | $0.30 / $0.50 / $0.75 / $1.00 | 预付,6 个月有效 |
EveryInfra web(实测) | $0.694 | 按次,有结果才扣,不过期 |
| DeepSeek Search API | $0.75 | 只对返回 200 且有结果的请求计费,空结果和超时不计 |
| Exa Lite Search | $4 | 10 条以内,超过每千次加 $1 |
| Google Custom Search JSON API | $5 | 只对老客户,2027 年 1 月 1 日停止 |
| OpenAI 网页搜索工具 | $10 | 另按模型价收搜索内容 token |
| Claude 网页搜索工具 | $10 | 出错不计费;另收 token |
| Gemini 的 Google 搜索落地 | $14 | 每月前 5,000 次免费 |
| SerpApi Starter | $25 | 月付 $25、1,000 次 |
这张表里和换 Serper 最相关的是 DeepSeek 那一行:它在 2026 年 10 月 17 日开放的搜索接口同样是空结果和超时不收费、每千次 $0.75(DeepSeek 更新日志,2026 年 10 月 17 日),比价时也可以拿来对照。
最近的变化
| 日期 | 事件 | 对读者意味着什么 |
|---|---|---|
| 2026 年 10 月 2 日 | Cloudflare 在 AI Gateway 推出 Web Search API | 搜索服务正在变成可替换的零件 |
| 2026 年 10 月 13 日 | SerpApi 推出 Extract API | 比价要连读正文的价格一起比 |
| 2026 年 10 月 17 日 | DeepSeek Search API 每千次 $0.75 | 空结果不收费正在成为默认 |
| 2027 年 1 月 1 日 | Google Custom Search JSON API 停止 | 年底前会有一波迁移 |
DeepSeek 开放搜索接口(2026 年 10 月 17 日)。 DeepSeek 的 Search & Fetch 指南写明每千次成功请求 $0.75,count 只影响返回条数、不影响价格;Search Engine Journal 在 2026 年 10 月 19 日报道说,每条结果还带一个页面权威度分级。据 PPC Land 转述,在 Claude Code、Codex 里经 DeepSeek 发起的搜索到 2026 年 10 月 31 日前免费。对读者意味着什么:低价、只对有结果的请求收费,正在成为这类接口的基本要求,比价时要把它当成默认项来问。
Cloudflare 推出 Web Search API(2026 年 10 月 2 日)。 Cloudflare 的开发者文档写明,可以在 AI Gateway 里用同一个参数在几家搜索服务之间切换,按各家标价从 AI Gateway 额度里扣,不加价。对读者意味着什么:搜索接口正在变成「可替换的零件」,你的代码最好只依赖自己定义的一层,不要把某一家的返回结构写死。
SerpApi 推出 Extract API(2026 年 10 月 13 日)。 SerpApi 在官方博客里宣布,除了搜索结果页,它现在也抓取任意公开网页,文档写明爬取模式按成功提取的页数扣 credits。对读者意味着什么:搜索和读正文正在合并成一个产品,比较时要连「读正文」的单价一起比;EveryInfra 的 read 也是每次 $0.000694。
Google Custom Search JSON API 只剩两个多月(2027 年 1 月 1 日停止)。 Google 的概览页写明这个接口不再接新客户,老客户必须在 2027 年 1 月 1 日前迁走;老客户的价格是每天前 100 次免费、之后每千次 $5。此前,微软的 Bing Search APIs 已在 2025 年 8 月 11 日退役(Microsoft Learn),推荐的替代是 Azure 智能体里的 Grounding with Bing Search,它不给开发者原始结果。对读者意味着什么:两家搜索引擎都不再直接卖原始结果,第三方接口是剩下的主要选择,迁移潮会在年底前出现。
换之前,用一个下午自己测一遍
比价表只能帮你缩小范围,最后的决定要靠你自己的查询。我们建议的做法分三步,每一步都有明确的通过标准,并且在看到结果之前写下来。第一步,从你的日志里随机抽 50 个真实查询,覆盖你最常用的国家、语言和结果类型;不要只挑热门词,冷门词和长尾词最能暴露空结果和地区偏差。第二步,在两边各跑一遍,记下每次的耗时、条数、是否扣费、扣了多少;Serper 那边用它的 2,500 次免费额度就够了,我们这边用 $1 试用额度,50 次只要 $0.035。
第三步,按你自己的标准比,而不是按任何一家的宣传比。比如:前 10 名里和你人工在浏览器看到的结果重合几条;耗时的第 90 百分位是多少;50 次里有几次空结果、各自扣没扣钱;整轮花了多少。判据写在测试之前,比如「重合不少于 7 条、第 90 百分位不超过 3 秒、空结果不扣费」,看到结果以后不改。这样做出来的结论,比任何一篇对比文章(包括本文)都更适合你。
下面这段 Python 可以直接用来跑我们这一侧,它只打印每次的条数、耗时和实扣金额,Key 从环境变量读:
import json, os, time, urllib.request

def search(q, **params):
    body = json.dumps({"tool": "web", "params": {"q": q, **params}}).encode()
    req = urllib.request.Request(
        "https://api.everyinfra.com/api/v1/search", data=body, method="POST",
        headers={"Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
                 "Content-Type": "application/json", "User-Agent": "price-test/1.0"})
    t0 = time.time()
    with urllib.request.urlopen(req, timeout=60) as r:
        d = json.load(r)
    return len(d.get("results", [])), round(time.time() - t0, 2), d["billing"]["charged_usd"]

for q in ["best crm software for small business", "best air purifier"]:
    print(q, search(q, num=10, location="us"))
    time.sleep(7)  # 测试 Key 每分钟 10 次
这段代码我们在 2026 年 10 月 26 日 14:00(新加坡时间)照原样跑过一次,两个查询各回 10 条,耗时 2.84 秒和 2.02 秒,各扣 $0.000694;这两次不在前面 35 次的统计里,单独记录存档。注意请求头里的 User-Agent:不带 User-Agent 的 Python 默认请求,有时会被网站的防护挡在门外,返回的 403 并不代表 Key 有问题。每次之间睡 7 秒,是为了不撞测试 Key 每分钟 10 次的上限;你自己的账户上限可能更高,在控制台看。
边界:这些结论什么时候不成立
第一,样本小。我们只调了 35 次,覆盖 10 种工具和 4 个国家,足够核对价格和计费规则,但不足以评价结果质量和长期稳定性。耗时的 29 个数据点也只来自一个下午、一台在新加坡的机器。第二,Serper 一侧全部来自公开页面和用户讨论。「超过 10 条算 2 credits」是用户报告;页面没写的规则,比如空结果扣不扣,我们没有猜。第三,比价按标价,不含税;Serper 页面注明价格不含销售税、增值税或商品服务税,我们的充值页面另有说明。第四,我们的速率限制按账户分档,本文的每分钟 10 次只是测试 Key 的设置。
第五,价格会变。Serper 的四档价是 2026 年 10 月 26 日 13:32(新加坡时间)读的,我们的价格也来自同一天的目录;任何一家改价,本文的倍数和交点都要重算。复算只要两步:重新读一次 serper.dev 首页和我们的搜索工具目录,把新的四档价格和单价代进前面「6 个月过期」一节的算法,表和图里的每一个数都会跟着变。我们会在发布前再读一次两边的价格。
还有一条要说清楚:本文没有比较两边对同一个关键词返回的排名。我们比的是价格、计费方式、能拿到哪几类结果、上手要几步。想比结果本身,正确做法是拿你自己的 50 个真实查询,在两边各跑一遍、看原始返回,再决定。
常见问题
Serper API 的免费额度有多少?会过期吗?
这个问题来自 Google 联想词「serper api free tier」「serper dev free tier」。Serper 首页写的是「Get 2,500 free queries」,不用信用卡。页面没有单独写免费额度的有效期;付费 credits 写的是 6 个月有效。EveryInfra 的试用额度是 $1(约 1,440 次搜索),在 GitHub 点星后领取,24 小时内有效。
Serper API 怎么收费?要 100 条结果是不是翻倍?
这个问题来自联想词「serper api pricing」「serper dev pricing」。按四档预付:$50、$375、$1,250、$3,750,每千次 $1.00 到 $0.30,6 个月有效。超过 10 条按 2 credits 算,来自 Hacker News 用户的说法,定价区没写。我们这边每页最多 10 条、每页扣一次,要更多用 page 翻页。
有没有比 Serper 更便宜的 Google 搜索结果接口?
这个问题来自联想词「serper api alternative free」「serper alternatives」。看月用量:每月 30 万次以下,按 6 个月过期折算,EveryInfra 实测的每千次 $0.694 比 Serper 实付便宜,月用量越小差得越多;30 万次以上,Serper 的 Scale 和 Ultimate 档更便宜。DeepSeek 的每千次 $0.75 也在这个区间。
Serper 和 SerpApi 有什么区别?
这个问题来自联想词「serper api vs serpapi」。按两家公开页面:Serper 是预付 credits、每千次 $0.30 到 $1.00;SerpApi 是月订阅,Starter 每月 $25、1,000 次,覆盖的搜索引擎和结果类型更多,还带美国法律保障条款。我们的 SerpApi 对比页有更细的表。
Serper 有速率限制吗?
这个问题来自联想词「serper dev rate limit」。有,按档:Starter 每秒 50 次,Standard 100 次,Scale 200 次,Ultimate 300 次,页面说可以申请提高。EveryInfra 按账户分档,超速返回 429 和 retry_after,不扣费。
失败、空结果、重试会不会扣钱?
这个问题来自 r/googlecloud 的讨论里一位自称经营同类接口的回答者的建议。Serper 写的是「收到成功响应时扣」。EveryInfra 实测:空结果返回 charged: false 并自动退回,401、422、429 都写明「Nothing was charged」。
Google Custom Search API 关了以后用什么?
这个问题同样来自 r/googlecloud 的那条帖子,发帖人每月 4 万到 6 万次、预算按每千次 $5 算。按本文的数字,6 万次在 EveryInfra 是 $41.67;在 Serper 按 6 个月 36 万次买,最省是 1 个 Standard 包 $375,每月 $62.50。
参考资料
- Serper 首页(定价区、常见问题),serper.dev,2026-10-26 读取。https://serper.dev/
- Serper 服务条款(Refund Policy),serper.dev,2024-05-29 更新。https://serper.dev/terms
- 关于 Serper 结果条数和 credits 的讨论,Hacker News。https://news.ycombinator.com/item?id=43921687
- 「2026 年怎么选一个 Google SERP API」,Reddit r/WebScrapingInsider。https://www.reddit.com/r/WebScrapingInsider/comments/1sesvvq/picking_one_google_serp_api_in_2026_feels_less/
- 「Google Custom Search API 要关了,求每月 6 万次的替代」,Reddit r/googlecloud。https://www.reddit.com/r/googlecloud/comments/1qp4mlz/google_custom_search_api_is_closing_need/
- Custom Search JSON API 概览,Google for Developers。https://developers.google.com/custom-search/v1/overview
- Method: cse.list,Google for Developers。https://developers.google.com/custom-search/v1/reference/rest/v1/cse/list
- Bing Search APIs retiring on August 11, 2025,Microsoft Learn。https://learn.microsoft.com/en-us/lifecycle/announcements/bing-search-api-retirement
- Grounding with Bing Search,Microsoft Learn。https://learn.microsoft.com/en-us/azure/ai-foundry/agents/how-to/tools/bing-grounding
- Search & Fetch 指南,DeepSeek API 文档。https://api-docs.deepseek.com/guides/search
- DeepSeek-V4.1-Flash-1017 发布(含 Search / Fetch API),DeepSeek,2026-10-17。https://api-docs.deepseek.com/news/news261017
- 「DeepSeek 向开发者开放自家搜索引擎」,Search Engine Journal,2026-10-19。https://www.searchenginejournal.com/deepseek-opens-its-in-house-search-engine-to-developers/593526/
- 「DeepSeek 网页搜索每千次 0.75 美元」,PPC Land(二手,原文见第 11 条)。https://ppc.land/deepseek-prices-web-search-for-ai-agents-at-0-75-per-1-000-calls/
- Cloudflare Web Search API 文档,Cloudflare,2026-10-02 更新。https://developers.cloudflare.com/web-search/
- 「Introducing the SerpApi Extract API」,SerpApi 博客,2026-10-13。https://serpapi.com/blog/introducing-extract-api/
- Extract API 文档,SerpApi。https://serpapi.com/extract-api
- SerpApi 定价,serpapi.com。https://serpapi.com/pricing
- 「Google Search 确认不支持每页结果数参数」,Search Engine Land,2025-09-18。https://searchengineland.com/google-search-confirms-it-does-not-support-the-results-per-page-parameter-462244
- Exa 定价,exa.ai。https://exa.ai/pricing
- 定价,OpenAI 平台文档。https://platform.openai.com/docs/pricing
- Web search tool,Claude 文档。https://docs.claude.com/en/docs/agents-and-tools/tool-use/web-search-tool
- Gemini Developer API pricing,Google AI for Developers。https://ai.google.dev/gemini-api/docs/pricing
- GoogleSerperAPIWrapper,LangChain Reference。https://reference.langchain.com/python/langchain-community/utilities/google_serper/GoogleSerperAPIWrapper
- google_serper.py 源码,langchain-community,GitHub。https://github.com/langchain-ai/langchain-community/blob/main/libs/community/langchain_community/utilities/google_serper.py
- SerperDevTool,CrewAI 文档。https://docs.crewai.com/v1.15.28/en/tools/search-research/serperdevtool
- SerperDev,Haystack 文档。https://docs.haystack.deepset.ai/reference/integrations-serperdev
- mcp-server-serper,GitHub。https://github.com/marcopesani/mcp-server-serper
- serper-mcp-server,GitHub。https://github.com/garylab/serper-mcp-server
- Model Context Protocol 规范 2025-11-25。https://modelcontextprotocol.io/specification/2025-11-25
- EveryInfra 搜索工具目录(免鉴权),2026-10-26 读取。https://api.everyinfra.com/api/v1/search/tools
- EveryInfra 数据能力目录(免鉴权),2026-10-26 读取。https://api.everyinfra.com/api/v1/social/catalog
- RFC 6585:Additional HTTP Status Codes(429),IETF。https://www.rfc-editor.org/rfc/rfc6585
- RFC 9110:HTTP Semantics(401、422),IETF。https://www.rfc-editor.org/rfc/rfc9110
- RFC 5646:Tags for Identifying Languages,IETF。https://datatracker.ietf.org/doc/html/rfc5646
- SearXNG 文档。https://docs.searxng.org/
- SearXNG,GitHub。https://github.com/searxng/searxng
- SERP API 常见问题,Bright Data 文档。https://docs.brightdata.com/scraping-automation/serp-api/faqs
- SerpApi Tool 节点,n8n 文档。https://docs.n8n.io/integrations/builtin/cluster-nodes/sub-nodes/n8n-nodes-langchain.toolserpapi/
- SerperDevWebSearch 源码,Haystack,GitHub。https://github.com/deepset-ai/haystack/blob/main/haystack/components/websearch/serper_dev.py
- serper_dev_tool.py(crewAI-tools,2025-11-10 归档),GitHub。https://github.com/crewAIInc/crewAI-tools/blob/main/crewai_tools/tools/serper_dev_tool/serper_dev_tool.py
引用编号 BL-48