Firecrawl alternatives:七种抓取方案比价(我们实测,对方按公开价)
Firecrawl 抓普通网页每千页 $0.75–$3.80;TikTok 评论、地图点评,我们实测每千条 $0.003 和 $0.014,失败不扣钱。
抓普通网页的正文,Firecrawl 的替代品里我们不一定最便宜:ZenRows 和 ScraperAPI 入门档的标准请求每千次 $0.42 和 $0.49,都低于我们 read 的 $0.694。差距出在平台条目上:同一个 TikTok 视频,整页读取拿回 0 条评论,tiktok/comments 一次拿回 200 条,折每千条 $0.00278,而 Apify 对应款在 Starter 档是每千条 $1.00。我们这一侧的数字来自 2026-11-08 的 26 次真调,对方一侧只用各家公开价和文档,Firecrawl 的实际抓取效果本文没测。
这篇写给正在找 firecrawl alternatives 的开发者和数据团队。我们先把话说在前面:Firecrawl 是一个好用的通用网页抓取工具,它能做的事我们有不少做不了,后面专门有一节照实写;但「替代」这个词背后通常是两类不同的需求。一类是「把任意网页变成干净的 Markdown」,这一类大家比的是每千页多少钱、JS 渲染和反爬加多少价、整站能爬多深;另一类其实是「我要某个平台上的评论、点评、商品字段」,只是因为手边只有通用抓取工具,才绕道去抓页面再解析。本文把这两类拆开,各用真调数据算账。站内的 Firecrawl 对比页是一页决策表,没有实测数据;本文是带实测的展开版。
先看总表:firecrawl alternatives 七种方案九个维度
下面这张表把 Firecrawl、本文点名比较的五家(Apify、Tavily、Bright Data、ScraperAPI、ZenRows)和我们放在同一组维度上。价格一栏统一换算成「每 1,000 个普通页面」,取最小的付费买法;对方的数来自各家定价页和文档原文,读取时间是 2026-11-08 00:20 到 00:45(新加坡时间),我们的数来自能力目录、搜索工具目录和真调响应里的 charged_usd。
| 维度 | Firecrawl | Apify | Tavily | Bright Data | ScraperAPI | ZenRows | EveryInfra |
|---|---|---|---|---|---|---|---|
| 每千个普通页面(最小付费买法) | $3.80(Hobby) | 约 $0.2(网站内容爬虫 HTTP 模式,README 估算) | $1.60(Extract basic 按量) | $1.50(Web Unlocker 按量) | $0.49(Hobby) | $0.422(Build B1) | read $0.694;crawl 实测 $0.0347 |
| 计费单位 | credit,按页、按选项叠加 | 计算单元或按事件 | credit,按成功 URL 数 | 按请求或按记录 | credit,按域名和参数倍数 | credit,按渲染和代理倍数 | 按次调用,美元标价 |
| 加 JS 渲染或反爬 | 增强代理不加价;JSON 抽取 +4 | 浏览器模式 $0.5–$5/千页 | 文档未单列 | 已含在请求价里 | 渲染 10 credits,高级代理 10 | JS 5、高级代理 10、两者 25 | 不分档,同一价 |
| 目标站返回 403/404 | 照收 1 credit | 按运行资源计 | 抽取失败不收 | 只为成功付费 | 404 照收 | 404/410 照收 | 404 不扣,空结果退款 |
| 免费额度 | 每月 1,000 credits | 每月 $5 | 每月 1,000 credits | 每月 5,000 次 | 1,000 credits | 每月 5,000 credits | 试用金,见价格页 |
| 整站爬取 | 默认上限 1 万页 | 有,按运行计费 | Crawl = Map + Extract | Fetch API 按 URL | 需自己调度 | Crawl,每页按一次 Fetch 计 | crawl 每次最多 20 页 |
| 平台结构化数据 | Alexandria 数据商(列表在登录后台) | Store 里大量现成款 | 无 | Web Scraper API 现成款 | 部分域名结构化端点 | Extract 自动 JSON | 106 个平台、573 项能力 |
| 远程 MCP | 有,含免 Key 端点 | 有 | 有 | 有 | 未在本文核对 | 有 | 有,12 个工具 |
| 自托管 | AGPL-3.0 开源 | 爬虫框架开源 | 无 | 无 | 无 | 无 | 无 |
这张表先看第一行和第七行:只论单抓普通网页,我们不是最便宜的,唯一占优的是一次回 20 页的 crawl;要的是平台条目时,表里一半方案不在同一赛道,要改比每千条结果,那笔账在后面三节里差了两到三个数量级。
本文怎么比:只用公开价、原文和我们自己的真调
先把比较规则写清楚,因为七家的计费单位全都不一样。Firecrawl 按 credit 计,抓取和整站爬取每页 1 credit、Map 每次 1 credit、搜索每 10 条结果 2 credits,JSON 抽取每页另加 4 credits(Firecrawl 计费文档);Tavily 的 Extract 是每 5 个成功 URL 1 credit(Tavily 计费文档);ScraperAPI 和 ZenRows 也按 credit 计,但同一个请求的 credit 数随目标域名、是否渲染、是否用高级代理成倍变化(ScraperAPI 计费文档、ZenRows 计费文档);Bright Data 的 Web Unlocker 按请求、Web Scraper API 按记录;Apify 的 Store 款要么按计算单元,要么按「事件」(比如每返回一条评论)计(Apify Store 计费说明)。我们按调用计费,美元标价写在目录里。为了能放在一张表里,本文把分母统一成两种:通用网页按「每 1,000 个实际返回的页面」,平台数据按「每 1,000 条实际返回的结果」,分母一律取实测返回数,不取参数上限。
第二条规则是对方一侧只用公开材料。六家的定价页、文档、GitHub 仓库和 changelog 我们在 2026-11-08 00:20 到 00:45(新加坡时间)逐页打开并存档,没有注册任何一家的账号,也没有用任何一家的 Key 取过数据。Apify 的四款 Store 产品,价格取自它们公开的产品页和不用登录的产品信息接口,分档按 Apify 定价页上 Starter 对应 Bronze、Scale 对应 Silver、Business 对应 Gold 的对照来读。我们自己这一侧全部是同一时段的真调:用一把测试 Key 在 00:16 到 00:28(新加坡时间)发了 26 次请求,耗时取 curl 的 time_total,也就是从我们在新加坡的机器发出请求到收完响应的总时间。
第三条规则是「整页读取能不能拿到条目」这件事,我们用自己的 read 来测,不用 Firecrawl 测。原因很简单:我们不拿对方的 Key 跑数据。read 和 Firecrawl 的 scrape 都属于「给一个网址、拿回页面正文」这一类做法,它拿不到的东西,说明的是页面里本来就没有直接可读的条目,而不是说 Firecrawl 也一定拿不到。Firecrawl 有浏览器交互和 JSON 抽取,理论上能把更多东西挖出来,这部分我们没测,文中凡是涉及 Firecrawl 实际效果的地方都写成「按页计价,效果没测」。
第四条规则是把限速也算进成本。Firecrawl 的限速文档按档位分两组:抓取、Map 和搜索在免费档每分钟 10 次,Hobby 100 次、Standard 500 次、Growth 5,000 次、Scale 10,000 次;整站爬取、agent 和浏览器交互要低得多,免费档每分钟 2 次,Hobby 20 次,Scale 2,000 次;同时在跑的浏览器数从 2 个到 100 个不等。本文用的测试 Key 自己设了每分钟 10 次(正式账户默认每分钟 60 次,累计充值越多上限越高,见价格页),测试期间撞上了 3 次 429,每次都在响应里写明没有扣费,等几秒重发就过了。限速对比较结果的影响在于:如果你每天要抓几十万页,单价低但限速紧的方案会逼你买更高的档位,真实的每千页价格要按你最终买的那一档来算,而不是按入门档。本文所有的每千页价格都同时给出了入门档和最高一档,就是这个原因。
| Firecrawl 档位 | 抓取、Map、搜索(每分钟) | 整站爬取、agent、浏览器交互(每分钟) | 同时在跑的浏览器 |
|---|---|---|---|
| Free | 10 | 2 | 2 |
| Hobby | 100 | 20 | 5 |
| Standard | 500 | 100 | 25 |
| Growth | 5,000 | 1,000 | 50 |
| Scale | 10,000 | 2,000 | 100 |
这张表里最容易被忽略的是中间一列:整站爬取在 Hobby 档每分钟只能提交 20 次,是抓取的五分之一。如果你的工作流是「每个站点开一个爬取任务」,限速先卡住的是这一列,而不是单页抓取。
Firecrawl 到底怎么收费:一页 1 credit,加选项就翻倍
在找替代之前,先把 Firecrawl 自己的账算清楚。它的定价页标着「Effective September 4, 2026」,免费档每月 1,000 credits、不用信用卡;付费四档按月付分别是 Hobby $19(5,000 credits)、Standard $99(10 万)、Growth $399(50 万)、Scale $749(100 万),年付价对应是 $16、$83、$333、$599。credit 用完以后,付费档可以开按量续费,每次 $5,Hobby 档 $5 买 1,000 credits、Standard 买 2,000、Growth 买 2,500、Scale 买 5,000;只有 Scale 档的 credits 能滚存一个月。
折成每 1,000 credits 的美元价,月付的四档是 $3.80、$0.99、$0.798 和 $0.749,年付是 $3.20、$0.83、$0.666 和 $0.599。一个普通网页 1 credit,所以这也就是每千页的价格。问题出在「选项」:同一份文档的「scrape 选项附加费」表里,JSON 格式(用大模型抽取结构化数据)每页 +4、问题回答格式 +4、亮点格式 +4、音频或视频转写 +4、PII 打码 +4、零数据保留 +1、PDF 解析每页 +1,而且这些加价可以叠加:JSON 加零数据保留是每页 6 credits,JSON 加 PII 打码是 9 credits(计费文档)。另外有两类网址单独计价:X(推特)链接单独计价,一次 30 credits;LinkedIn 个人和公司主页转给你在后台选定的数据商,每次 5 到 40 credits 不等。
| Firecrawl 用法 | 每页 credits | Hobby 月付每千页 | Standard 月付每千页 | Scale 月付每千页 |
|---|---|---|---|---|
| scrape / crawl,Markdown | 1 | $3.80 | $0.99 | $0.749 |
| 加 PDF 解析(每个 PDF 页) | +1 | +$3.80 | +$0.99 | +$0.749 |
| 加 JSON 抽取 | 5 | $19.00 | $4.95 | $3.745 |
| JSON 加零数据保留 | 6 | $22.80 | $5.94 | $4.494 |
| JSON 加 PII 打码 | 9 | $34.20 | $8.91 | $6.741 |
| X 链接 | 30 | $114.00 | $29.70 | $22.47 |
| 搜索(每 10 条结果) | 2 | 每千次 $7.60 | $1.98 | $1.498 |
这张表解释了为什么不少人一边说 Firecrawl 好用、一边在找替代。Reddit 上 r/LocalLLaMA 一个讨论「现在最好的抓取工具」的帖子里,楼主列给 Firecrawl 的第一条建议就是「credits 应该能滚存」,第二条是「有时抓一个网站会用掉好几个 credits,为什么」(帖子原文)。对照计费文档,第二个问题的答案多半就在选项叠加和 PDF 按页计费上:一份 15 页的 PDF,按「基础 1 credit + 每个 PDF 页 1 credit」推算是 16 credits,在 Hobby 档约合 $0.061。本文 00:25(新加坡时间)用我们的 read 读同一份 15 页的论文 PDF(arXiv 1706.03762),1.78 秒拿回 52,380 个字符,扣 $0.000694,按页数不加价。
场景一:普通网页取正文,firecrawl alternative 不一定是我们
如果你要的就是网页正文,比如把一个文档站、一个博客、一批 PDF 喂给 RAG,那 Firecrawl 的替代品很多,而我们只在一种做法上真正便宜。先看单页。我们的 read 是一次一页、$0.000694,折每千页 $0.694。ZenRows 的 计费文档写得很清楚:标准请求 1 credit、JS 渲染 5、高级代理 10、两者都开 25,这些倍数在所有档位都一样;它最便宜的 Build B1 是每月 $19 买 45,000 credits,标准请求折每千次 $0.422,最高的 Scale S5 是每月 $2,999 买 4,500 万,折每千次 $0.0666。ScraperAPI 的定价页上 Hobby 是每月 $49 买 10 万 credits,标准请求每千次 $0.49,最大的 Advanced 档 $1,975 买 2,150 万,折 $0.0919。Apify 的网站内容爬虫在产品页上自己估了一个数:用原始 HTTP 抓取约每千页 $0.2,用无头浏览器每千页 $0.5 到 $5,取决于网站。这三家在「抓一个不难抓的页面」这件事上都比 read 便宜,照实写在这里。
但这几个数都有前提。ZenRows 和 ScraperAPI 的标准请求不渲染 JS、不走高级代理;只要目标站需要渲染,ZenRows 变成每千次 $2.11(B1 档 5 credits),ScraperAPI 的渲染是 10 credits,在 Hobby 档就是 $4.90;遇到 Cloudflare 这类防护,ScraperAPI 每次再加 10 credits,ZenRows 渲染加高级代理是 25 credits,在 B1 档每千次 $10.56。而且它们默认回的是 HTML,要 Markdown 得另外开输出格式或自己转。我们的 read 不分档,同一个价,返回的是已经去掉导航和脚本的正文;Firecrawl 在这一点上和我们一样,增强代理不加价,它的文档写明「增强代理按基础请求的 1 credit 计,升级重试不单独收费」。所以真正的对比要看你的目标站有多少比例需要渲染和反爬:比例低,ZenRows 和 ScraperAPI 最省;比例高,按页不分档的方案更好预算。
| 每 1,000 个普通网页 | 标准页面 | 开 JS 渲染 | 高级代理或反爬 | 默认输出 |
|---|---|---|---|---|
| Firecrawl Hobby | $3.80 | $3.80 | $3.80 | Markdown |
| ZenRows Build B1 | $0.422 | $2.11 | $4.22–$10.56 | HTML |
| ScraperAPI Hobby | $0.49 | $4.90 | $5.39–$12.25 | HTML |
| Apify 网站内容爬虫 | 约 $0.2 | $0.5–$5 | 含在计算单元里 | Markdown 或纯文本 |
| Bright Data Web Unlocker | $1.50 | $1.50 | $1.50 | HTML |
| Tavily Extract(basic,按量) | $1.60 | 文档未单列 | 文档未单列 | Markdown 或纯文本 |
EveryInfra read | $0.694 | $0.694 | $0.694 | 去掉导航的正文 |
表里 ZenRows 和 ScraperAPI 的区间,下限是只开高级代理,上限是渲染和高级代理一起开;同一张表横着看,入门档最便宜的两家在「开渲染加反爬」那一列变成了最贵的两家。
再看整站。我们的 crawl 在搜索工具目录里标着 $0.000694 一次,参数 num 最大 20。00:17(新加坡时间)我们用它爬 Firecrawl 自己的文档站,2.46 秒回了 20 页,正文长度从 1,702 到 20,000 个字符不等;接着爬 MCP 规范的官网,1.28 秒又回 20 页。两次各扣 $0.000694,40 页一共 $0.001388,折每千页 $0.0347,是 Firecrawl Scale 档每千页 $0.749 的二十一分之一。同一时段,map 在 0.84 秒里列出了 Firecrawl 文档站的 200 个网址,也是扣一次 $0.000694。
| 通用网页实测(2026-11-08,新加坡时间) | 时刻 | 耗时 | 返回 | 扣费 |
|---|---|---|---|---|
read 读 Firecrawl 计费文档 | 00:16:43 | 0.85 秒 | 13,372 字符 | $0.000694 |
map 列 Firecrawl 文档站 | 00:16:50 | 0.84 秒 | 200 个网址 | $0.000694 |
crawl 爬 Firecrawl 文档站 | 00:17:02 | 2.46 秒 | 20 页,3 页正好 20,000 字符 | $0.000694 |
crawl 爬 MCP 规范官网 | 00:17:28 | 1.28 秒 | 20 页 | $0.000694 |
read 读 15 页论文 PDF | 00:25:10 | 1.78 秒 | 52,380 字符 | $0.000694 |
read 读一个已下架的 Amazon 商品页 | 00:19:48 | 5.98 秒 | 404,目标页不存在 | $0 |
这个便宜有三条边界,必须写清楚。第一,crawl 一次最多 20 页,你没法像 Firecrawl 那样一次提交 1 万页的任务(它的整站爬取默认上限就是 10,000 页,见 crawl 文档);要爬 1,000 页,得自己把站点拆成 50 个入口,或者先用 map 拿网址、再逐页 read,后者就回到了每千页 $0.694。第二,40 页里有 3 页的正文正好是 20,000 个字符,看起来是单页长度的上限,长页面会被截断;Firecrawl 和 read 都没有这个现象(read 读 PDF 拿回 5 万多字符)。第三,crawl 返回哪 20 页由它自己挑,MCP 官网那次回的 20 页里有 19 页在 /community/ 目录下,按网址排序的味道很重;要指定页面类型,得用 instructions 参数写一句话,本文没测这个参数的效果。另外,这两次爬的都是文档站,没有反爬,耗时 1 到 3 秒很可能沾了缓存的光,换成电商站或需要登录的站,结果会不一样。
所以在普通网页这一类,结论是分情况的:页面不难抓、量大、要原始 HTML,ZenRows 和 ScraperAPI 的高档位最便宜;要干净的 Markdown、只爬文档站这类结构简单的站点、每次 20 页够用,我们的 crawl 最便宜;要一次爬上万页、要控制深度和路径、要截图和浏览器动作,Firecrawl 和 Apify 更合适。还有一个常被忽略的选项:Tavily 的 Extract 每 5 个成功 URL 才 1 credit,按量价每千页 $1.60、月付最低一档 $1.00,而且文档写明抽取失败不收钱;它的 Crawl 是「Map 费 + Extract 费」,10 页 basic 是 3 credits,按量每千页 $2.40。
场景二:你要的其实是 TikTok 评论
很多搜 firecrawl alternative 的人,最后要的并不是网页。比如一个做品牌舆情的团队,要拉某个视频下面的评论来做情感分析;用通用抓取的思路,就是把视频页抓下来,再从页面里把评论挑出来。我们用同一个视频把两种做法各跑了一次。视频是 Duolingo 官方账号在新加坡时间 2026-11-05 凌晨发的一条(UTC 为 2026-11-04 19:58),00:17(新加坡时间)用 tiktok/user_videos 拿账号最近 5 条视频(最新一条发于 2026-11-06,UTC)时,它的评论数是 596。
00:18:45(新加坡时间),read 读这个视频页,2.39 秒返回 17,914 个字符,扣 $0.000694。内容是视频标题、一张封面图,然后是「You may like」下面的推荐视频列表,我们数了一下,里面有 81 个视频链接;我们把 tiktok/comments 返回的前 50 条评论的原文逐条拿去页面正文里查,一条都没出现。也就是说,页面首屏的 HTML 里没有评论,评论是滚动以后由前端另外请求加载的。这不是我们 read 独有的问题,任何「拿一个网址的正文」的工具,在不执行滚动、不点开评论区的情况下都会遇到;Firecrawl 有 Interact 能开一个浏览器会话去点击和滚动,每浏览器分钟 2 到 7 credits,这条路我们没测,不知道它在 TikTok 上能拿回多少条。
00:22:02(新加坡时间),tiktok/comments 对同一个视频、limit 200,49.53 秒返回 200 条评论,按 id 去重还是 200 条,其中 22 条是回复、187 条有文字,每条带点赞数、回复数、是否被作者点赞或置顶、发布时间,扣 $0.000556。按实际返回条数算,每 1,000 条评论 $0.00278。这 200 条评论发布于 2026-11-04 20:00 到 2026-11-07 13:44(UTC),一共 3,683 个赞,但分布极不均:点赞最多的 10 条占了 96.6%,121 条一个赞都没有。做情感分析时按点赞加权和不加权,结论可能完全不同,这也是要拿到按条的结构化字段、而不是一段页面文字的原因。这里要补一句:前面一次 00:19:05 的同样请求等了 31.15 秒,回了 503 和「Not charged」,第二次才成功;评论接口一次要等半分钟以上,适合放进异步任务,不适合放在用户点一下就要出结果的地方。
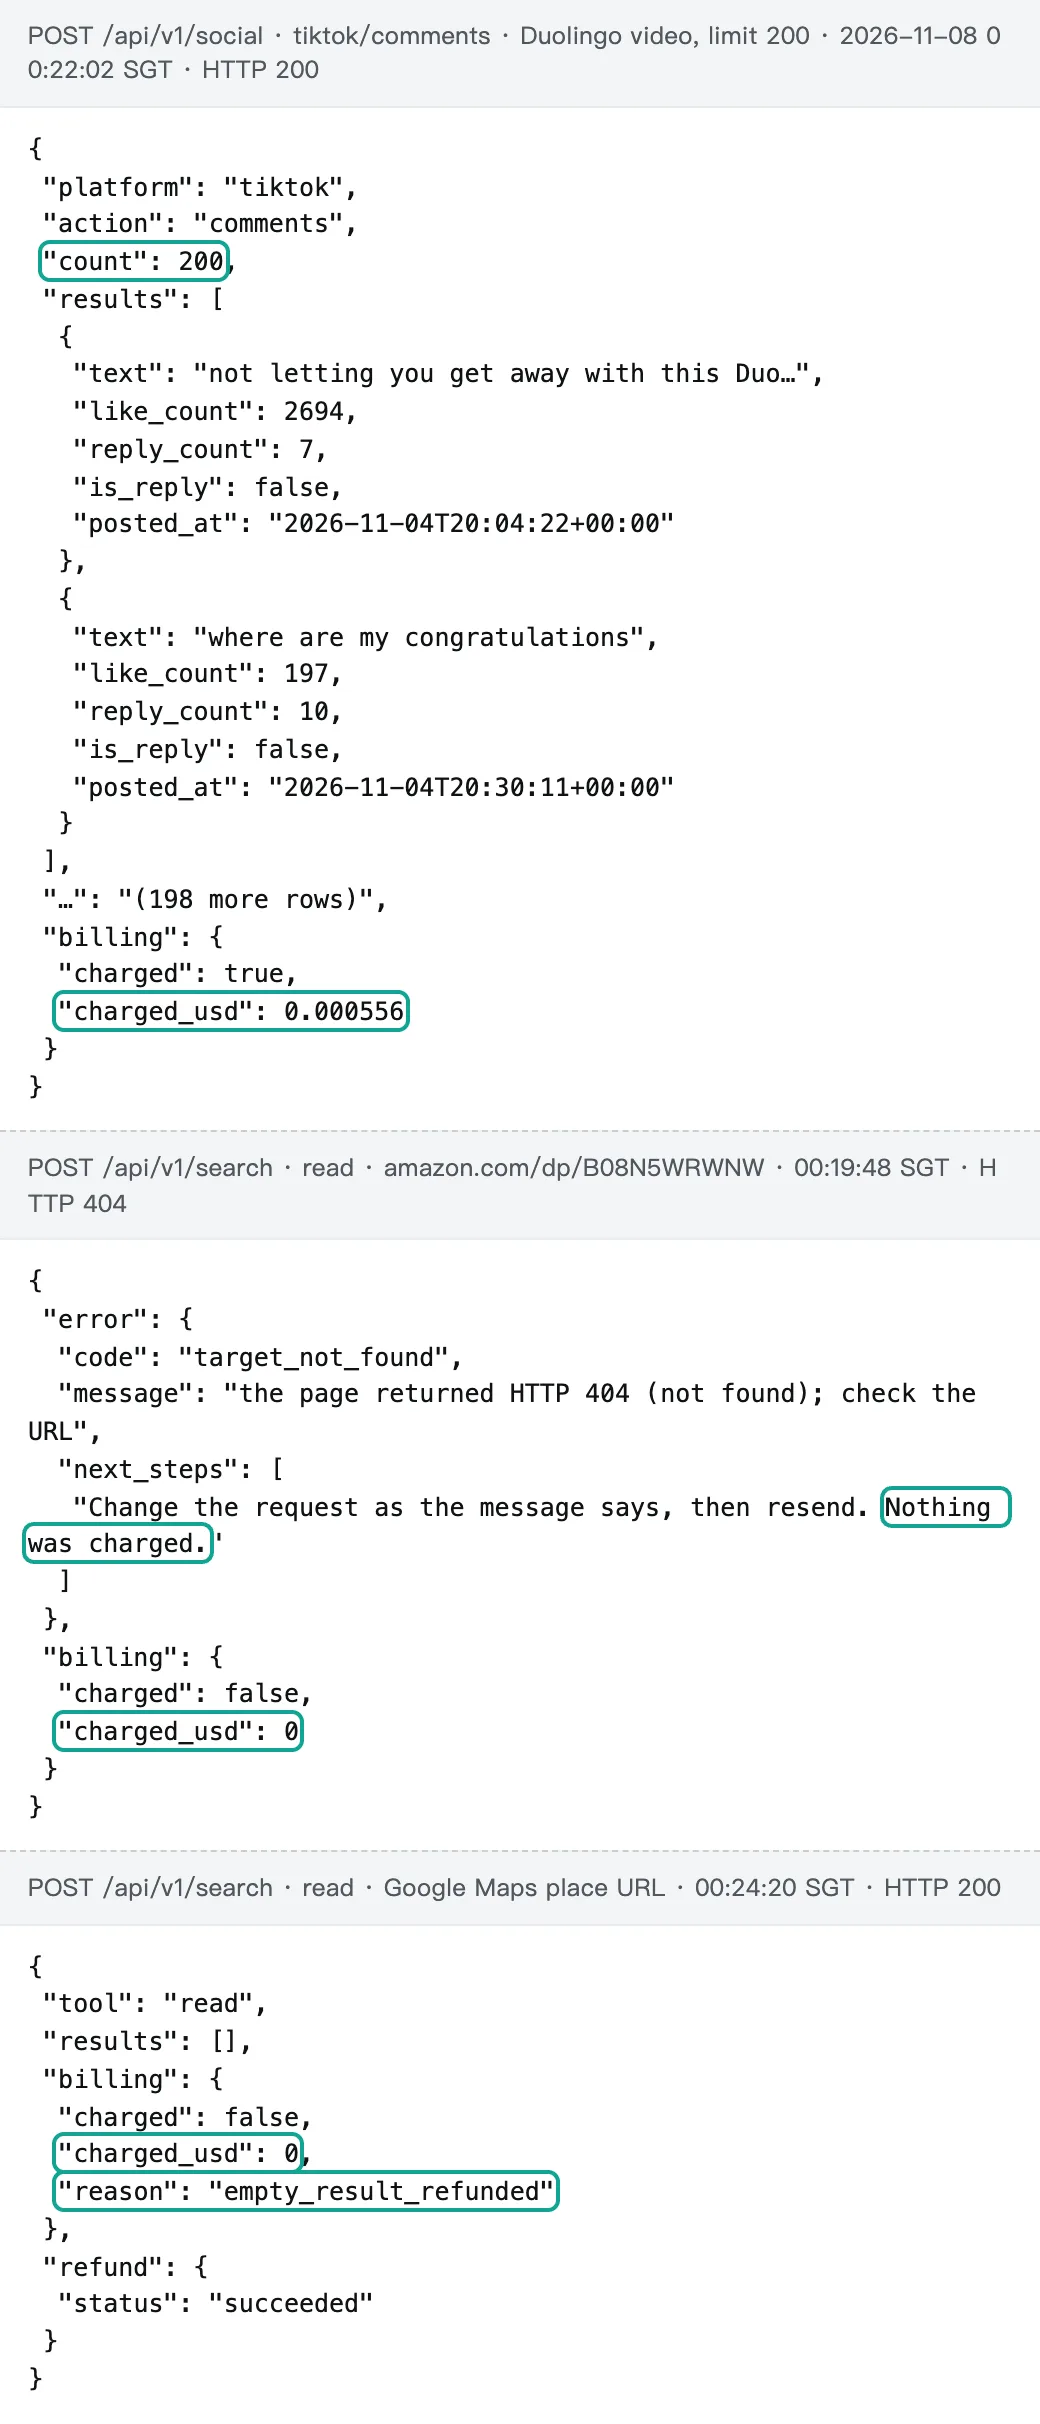
拿同样 1,000 条评论去比,Apify 的 TikTok Comments Scraper 按「每条评论」计费,免费档 $0.00125、Starter 对应的 Bronze 档 $0.001、最低的 Diamond 档 $0.00015,折每千条 $1.25、$1.00 和 $0.15。我们的 $0.00278 是它 Starter 档的约三百六十分之一。Bright Data 的 Web Scraper API 定价页按记录统一收费,按量每千条 $1.50,我们在定价页的现成款列表里看到了 TikTok 帖子,没有找到评论这一项,所以表里留空。Firecrawl 在这个场景里没有一个能直接对比的价,因为它的价是按页、按浏览器分钟算的,拿到多少条评论取决于你怎么操作页面,这部分本文没测。
| TikTok 评论:同一个视频的两种拿法 | 整页读取(`read`) | 结构化能力(`tiktok/comments`) |
|---|---|---|
| 时刻(新加坡时间) | 00:18:45 | 00:22:02 |
| 耗时 | 2.39 秒 | 49.53 秒(前一次 31.15 秒 503,未扣费) |
| 返回 | 17,914 字符、81 个推荐视频链接 | 200 条评论,22 条回复,187 条有文字 |
| 评论条数 | 0 | 200 |
| 扣费 | $0.000694 | $0.000556 |
| 每 1,000 条评论 | 0 条,无法折算 | $0.00278 |
场景三:Amazon 商品详情和评论
电商是另一个常见的「其实要字段」的场景。00:23:04(新加坡时间),read 读一个 Ninja 便携搅拌杯的 Amazon 商品页,3.25 秒返回 785 个字符:商品标题、一句描述,然后是一个「发现更低价格?告诉我们」的反馈表单,没有售价、没有评分、没有库存,扣 $0.000694。15 秒以后,amazon/profile 对同一个网址 16.82 秒返回一个对象,20 个字段都有值:售价 $39.99、原价 $69.99、评分 4.2、14,458 个评分、有货、品牌 Ninja、在「Home & Kitchen」类目排第 369、在「Kitchen Small Appliances」排第 19,另外有 10 条卖点和 12 张图片,扣 $0.001389。
整页读取没拿到 Amazon 的价格,原因和 TikTok 不完全一样:Amazon 对不同的访问者返回不同版本的页面,价格区块经常要在特定的地区、Cookie 和渲染条件下才出现。通用抓取工具通常靠 JSON 抽取来补:Firecrawl 的 JSON 格式每页 5 credits,在 Hobby 档每千个商品 $19.00、Scale 档 $3.745,前提是页面里本来就有价格;ScraperAPI 把 Amazon 定为每次 5 credits,Hobby 档每千页 $2.45,它有一部分域名的结构化输出,本文没有核对 Amazon 那一项的字段。Bright Data 的 Amazon 商品现成款按记录收费,每千条 $1.50,字段列表在定价页上写着标题、卖家、品牌、描述、原价、币种、库存、评论数等。我们的 amazon/profile(字段说明)是每千个商品 $1.389,和 Bright Data 只差 7%,在这一项上我们没有明显优势。
评论这一项,本文没有拿到数据,照实写失败的经过。00:20:06(新加坡时间)amazon/reviews 读一个已下架的商品,返回空结果,自动退款;00:23:48 读 Ninja 搅拌杯,19.10 秒后回 503;00:26:01 改成异步提交,00:27:39 轮询显示任务完成但 0 条,提交时预扣的 $0.001389 已经退回;00:27:46 换一个商品再试,又是 503。四次一共 0 扣费。
| `amazon/reviews` 尝试(新加坡时间) | 商品 | 结果 | 耗时 | 最终扣费 |
|---|---|---|---|---|
| 00:20:06 | 已下架商品 | 空结果,自动退款 | 32.56 秒 | $0 |
| 00:23:48 | Ninja 搅拌杯 | 503 | 19.10 秒 | $0 |
| 00:26:01 异步提交,00:27:39 轮询 | Ninja 搅拌杯 | 任务完成但 0 条,预扣已退 | 提交 1.88 秒 | $0 |
| 00:27:46 | 另一个商品 | 503 | 16.88 秒 | $0 |
目录里对这个能力的说明是「只能取到商品页展示的精选评论,每个商品通常十几条」,所以即使成功,它也不是拿全量历史评论的工具。要大量 Amazon 评论,Apify 的 Amazon Reviews Scraper 按条计费,Starter 档每千条 $5.00、免费档 $6.00、最低 $1.00;Bright Data 每千条 $1.50。站内另一篇 Apify Amazon 爬虫替代专门比了 Amazon 这一类,这里不展开。
场景四:Google 地图点评
地图点评是「页面抓不到、结构化能力很便宜」最极端的一例。00:21:22(新加坡时间),google_maps_reviews/search 搜「Lau Pa Sat Singapore」,57.80 秒返回这家老巴刹的条目:评分 4.4、39,457 条点评,并给出带 query_place_id 的网址,扣 $0.001389。这一次很慢,是本文所有调用里最慢的一次。00:24:20,read 读这个网址,3.02 秒后返回空结果,自动退款,扣 $0;地图页面几乎全靠前端脚本渲染,通用正文抓取在这里拿不到东西。00:24:35,google_maps_reviews/reviews 对同一个网址、limit 100,8.50 秒返回 100 条点评,扣 $0.001389,折每千条 $0.0139。
这 100 条点评的时间从 2026-10-29 到 2026-11-07(UTC),按最新排序;75 条五星、18 条四星、5 条三星、两星和一星各 1 条,平均 4.65 星,比商户总评分 4.4 高,说明最近十天的评价比历史平均好;只有 38 条写了文字,其余是只打星不写字;70 条带有食物、服务、氛围的分项评分,其中食物平均 4.70(69 条)、氛围 4.57(69 条)、服务 4.38(66 条),服务是三项里最低的;100 位评论者里 79 位是本地向导,17 条附了图片。这类分项字段可以直接进报表,不用再让模型读文字打分。响应里带 next_page_token,要更多就把它原样传回去拿下一页,每页算一次调用。对比之下,Apify 的 Google Maps Reviews Scraper 按条计费,免费档每千条 $0.60、Starter 档 $0.45、最低 $0.15,另外每次启动按内存收 $0.00005;Bright Data 的地图点评现成款每千条 $1.50。我们的 $0.0139 是 Apify Starter 档的约三十二分之一。
| 每 1,000 条平台结果 | EveryInfra(实测) | Apify 对应款(Starter / 最低档) | Bright Data(按量) | Firecrawl |
|---|---|---|---|---|
| TikTok 评论 | $0.00278(一次 200 条) | $1.00 / $0.15 | 定价页未见这一款 | 按页计价,效果没测 |
| Google 地图点评 | $0.0139(一次 100 条) | $0.45 / $0.15 | $1.50 | 按页计价,效果没测(我们的 read 读此页为空) |
| Amazon 商品详情 | $1.389(一次 1 个) | 本文未取 | $1.50 | JSON 抽取 $19.00(Hobby)/ $3.745(Scale) |
| Amazon 评论 | 本次 4 次未拿到,0 扣费 | $5.00 / $1.00 | $1.50 | 同上 |
这张表的差距来自计价单位。按次计费的结构化能力,一次调用就把 200 条评论按字段交回来;按页计费的通用抓取,一页只是一个页面,评论要么不在里面,要么要靠浏览器交互和大模型抽取另外付钱;按条计费的现成款,每多一条就多收一次。所以凡是一次调用能回很多条的数据(评论、点评),按次计费有两三个数量级的优势;一次只能回一条的数据(一个商品详情),各家价格挤在一个量级里,比的是字段全不全、失败扣不扣钱。反过来,如果你一次只要 1 条评论,按条计费最便宜,我们的价格优势只在「一次要很多条」时成立。站内的 TikTok 评论抓取和 Google 地图点评抓取两篇,分别把这两类数据的翻页、去重和字段讲得更细,能力页见 TikTok 评论接口和 Google 地图点评接口。
失败和空结果扣不扣钱:七家的规则对照
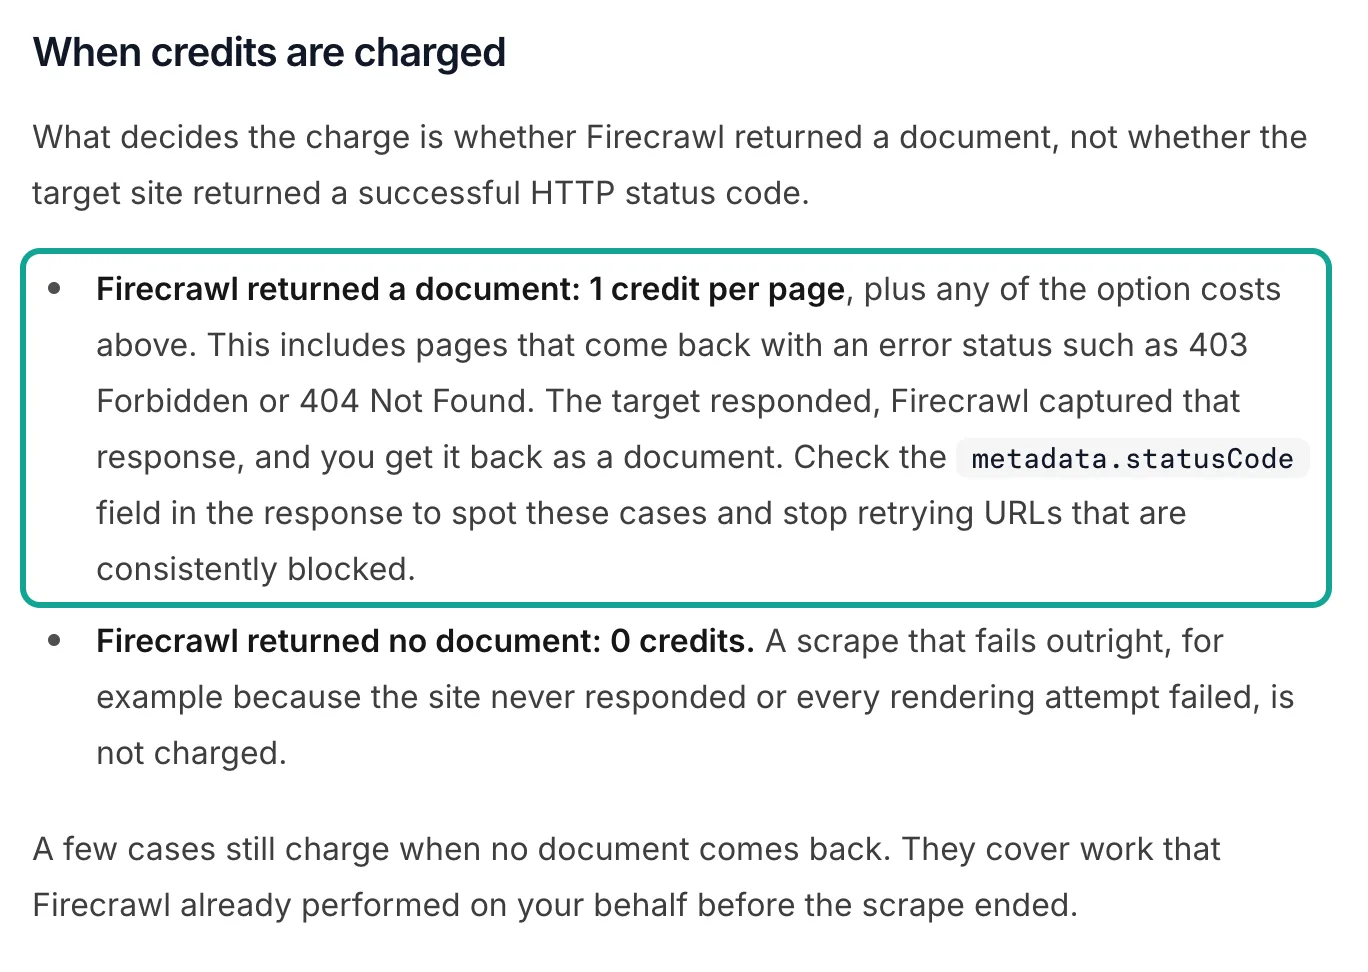
抓取任务里失败是常态,所以「失败扣不扣钱」对账单的影响往往比单价还大。Firecrawl 的规则写在计费文档「When credits are charged」一节:决定扣不扣钱的是 Firecrawl 有没有交回一个文档,而不是目标站有没有返回成功的状态码;目标站返回 403 或 404,Firecrawl 也把这个响应当成文档交给你,照收 1 credit,文档建议你看 metadata.statusCode 字段,别对一直被拦的网址反复重试。完全没拿到文档(比如网站不响应、所有渲染尝试都失败)才是 0 credit。另有几种情况没有文档也收钱:威胁防护扫描每个网址 2 credits、提示注入检查 5 credits、只读缓存未命中 1 credit、浏览器会话按分钟计且至少一分钟。
其他几家各有各的规则。ScraperAPI 的计费文档写「只对成功请求收费(200 和 404 状态码)」,另外你自己在 70 秒内取消的请求也收费;ZenRows 的计费文档写失败和重试不收,但 404 和 410 算成功;Tavily 写「URL 抽取失败永远不收费」,Map 请求失败也不收;Bright Data 的 Web Unlocker 定价页写「只为成功付费」;Apify 按计算单元计费的款,失败重试消耗的运行时间照样计费,按事件计费的款只为产出的结果付钱。我们这一侧,本文 26 次请求里有 13 次没扣钱:不带 Key 的 401、参数写错的 422、3 次撞上这把测试 Key 每分钟 10 次上限的 429、4 次 503、读已下架商品的 404、3 次空结果。其中 00:19:48(新加坡时间)那次 404 最能说明差别:同样一个不存在的 Amazon 页面,按 Firecrawl 和 ScraperAPI 的规则都会扣 1 次。放大到一份清单上算:如果 1,000 个网址里有 10% 已经失效或一直被拦,按「交回文档就收费」的规则,这 100 个网址在 Firecrawl Hobby 档要多付约 $0.38,而且不会有任何可用内容;网址清单越旧,这笔钱越多,所以批量任务前先清一遍死链比挑单价更省。
| 情况 | Firecrawl | Apify | Tavily | Bright Data | ScraperAPI | ZenRows | EveryInfra(本文实测) |
|---|---|---|---|---|---|---|---|
| 目标站 404 | 收 1 credit | 看计费方式 | 抽取失败不收 | 只为成功付费 | 收 | 收 | 不扣(00:19:48) |
| 完全失败、超时 | 不收 | 按运行时间计 | 不收 | 不收 | 不收 | 不收 | 不扣(4 次 503) |
| 空结果 | 交回文档即收 | 按事件款不收 | 不收 | 原文未写 | 原文未写 | 原文未写 | 自动退款(3 次) |
| 参数错误 | 原文未写 | 原文未写 | 原文未写 | 原文未写 | 原文未写 | 原文未写 | 422,扣费前拦下 |
| 限流 | 429 | 原文未写 | 原文未写 | 页面写不限并发 | 429,不额外收 | 原文未写 | 429,写明 Nothing was charged |
什么时候 Firecrawl 更合适:它有、我们没有的
写到这里,必须把 Firecrawl 比我们强的地方逐条写出来,否则这篇比较就不诚实。第一是整站爬取的规模和控制。Firecrawl 的 crawl 默认上限 1 万页,能按路径过滤、限制深度、控制子域名和外链,结果可以轮询、走 WebSocket 或 webhook 推送;它的 batch scrape 能一次提交大批网址;map 一次 1 credit,limit 设到 10 万也是 1 credit。我们的 crawl 每次最多 20 页、map 每次最多 200 个网址,要爬上万页的站,Firecrawl 省事得多,map 在网址多的时候也比我们便宜。
第二是页面能力。Firecrawl 的 scrape 支持截图(整页、指定视口)、品牌识别(抽取网站的颜色、字体、组件)、摘要、链接列表、PDF 和 Word 等文档解析;Interact 能开浏览器会话做点击、输入和滚动;change tracking 能监控页面变化;LLM 抽取能对任意网站按你给的结构抽 JSON。我们的通用网页工具只有取正文、列网址、多页爬取这几样,没有截图、没有浏览器动作、没有变化监控,要对任意网站抽结构化字段,你得自己拿正文去喂模型。Firecrawl 在基准测试页公布过一组自测:2026-01-13 用十类公开网站的 1,000 个网址,覆盖率 96%、正文抽取 F1 0.638、P95 延迟 3,387 毫秒;我们没跑同一批网址,这组数不能拿来比谁的成功率高。
第三是自托管。Firecrawl 的主仓库用 AGPL-3.0 许可开源,2026-11-08 读取时有 199,441 个星,最近一次推送在 2026-11-07;我们和本文其余五家都没有可以整套自己部署的版本(Apify 开源的是爬虫框架,不是整个平台)。不过自托管版和云端版能力不同:自托管文档写明默认那套服务不含 Fire-engine 和它的高级反爬能力,截图和页面动作在默认服务里不可用,要单独部署;上面引用的 Reddit 帖子里,也有好几条回复在抱怨自托管版的文档和报错。另外,主仓库最近一次打版本标签是 2026-06-19 的 v2.11.0(发布列表),之后的改动都只在主分支上,自己部署时要么跟主分支,要么停在 6 月的版本。所以「开源就能免费用」要打折扣,开源与云端的对比页说得很直白:区别在于谁来配置、保护和运行那些配套服务。
第四是它正在长出来的数据业务。2026-09-22 Firecrawl 宣布 7,500 万美元 B 轮融资并推出 Alexandria(公告),把实时网页、官方数据商、站点专用连接器和它自建的索引放到一个入口里,它自测在 845 个任务上答案质量比内置网页工具高 21%。2026-10-08 的 Universal Scrape 让 /scrape 也能调 Alexandria 里的数据商,公告写 Alexandria 有 200 多家数据商;Alexandria 文档写明「发现免费、执行按工具标的 credits 收费」,但完整的数据商列表要登录后台才能看,我们没有登录,所以不知道里面有没有 TikTok 评论、地图点评这类数据。这些数据按数据商的标价计费,不再是「一页 1 credit」那么简单,评估时要逐项看后台标价;我们这一侧是自己维护 106 个平台的结构化能力,价格写在公开目录里,不用登录就能查。如果你已经是 Firecrawl 的用户,先去后台看一眼,可能不用换。
第五是采购。2026-10-19 Firecrawl 上架 Google Cloud Marketplace(公告),定价页也写了可以把费用记到 AWS 或 Google Cloud 的账单上。如果你公司的采购只能走云市场,Firecrawl 比本文其他几家都好买。
| 需求 | 更合适的选择 | 原因 |
|---|---|---|
| 一次爬上万页、控制深度和路径 | Firecrawl、Apify | crawl 默认上限 1 万页;我们每次 20 页 |
| 截图、点击、滚动、登录后操作 | Firecrawl、ZenRows、Bright Data | 有浏览器会话;我们没有 |
| 对任意网站按自定义结构抽 JSON | Firecrawl、ZenRows Extract | 我们只给平台能力的固定字段 |
| 自己部署、数据不出内网 | Firecrawl 开源版 | AGPL-3.0;注意自托管缺高级反爬 |
| 大量不难抓的页面、要原始 HTML | ZenRows、ScraperAPI 高档位 | 标准请求每千次 $0.07–$0.09 |
| 文档站成批取 Markdown | EveryInfra crawl | 实测每千页 $0.0347,单页正文有 20,000 字符上限 |
| 评论、点评、商品等平台条目 | EveryInfra 结构化能力 | 按次计费,一次回 100–200 条 |
其他五家各自适合谁
Apify 最大的优势是现成款多。它的 Store 里几乎每个热门网站都有人做好了抓取程序,网站内容爬虫在 2026-11-08 读取时最近 30 天有 14,350 个用户;按事件计费的款价格透明,按条算,档位越高越便宜,最低的 Diamond 档是 Starter 档的三分之一到七分之一(本文三款里,地图点评约 1/3、Amazon 评论 1/5、TikTok 评论约 1/6.7)。代价是要先挑款:同一个网站常有十几款,字段和稳定性各不相同;按计算单元计费的款要先试跑才知道多少钱。如果你要的平台我们目录里没有,或者你需要按自己的规则深度定制,Apify 是更好的选择。站内的 Apify 替代总览比过它的整体价格结构。
Tavily 的出发点不是抓取而是检索:它把搜索、抽取、Map、Crawl 和研究放在一个接口里,抽取按成功 URL 计费、失败不收,适合「agent 先搜、再读几页」的工作流。它在自己的博客里也写了一篇 Firecrawl 替代的文章,说法是:从一个查询出发,选 Tavily;从一个已知网站出发,选 Firecrawl(原文)。这个划分是公道的。我们在 00:24(新加坡时间)用 web 搜了一次「firecrawl alternatives」(美国地区),Firecrawl 自己的对比页排第 5,Tavily 这篇排第 6,Bright Data 的同题博客排第 7,前 4 位是第三方博客和 Reddit。搜索 API 的比较,站内另一篇 给 AI agent 选网页搜索 API 已经做过,这里不重复。
Bright Data 是七家里产品线最宽的:代理、Web Unlocker、Fetch API(原来叫 Crawl API,给一个网址返回 Markdown、纯文本、HTML 和 JSON-LD)、按记录收费的现成数据款,还有成品数据集。它的价格很整齐,Unlocker 按量每千次 $1.50、现成款每千条 $1.50,每月 5,000 次免费;适合对反爬要求高、要稳定交付大批量数据的团队。ScraperAPI 和 ZenRows 是传统意义上的「抓取 API」:你给网址,它负责代理、渲染和验证,按 credit 计价、倍数透明,大用量档位单价很低,适合已经有自己解析代码、只缺一层稳定抓取的团队。
| 方案 | 每月免费额度 | 计费单位 | 适合谁 |
|---|---|---|---|
| Apify | $5 | 计算单元或按事件,看具体款 | 我们目录里没有的平台、要自定义规则 |
| Tavily | 1,000 credits | 按成功 URL 的 credit | 先搜再读几页的 agent |
| Bright Data | Web Unlocker 5,000 次 | 按请求或按记录 | 反爬要求高、量大要稳 |
| ScraperAPI | 注册送 1,000 credits | 按域名和参数倍数的 credit | 已有解析代码的团队 |
| ZenRows | 5,000 credits | 按渲染和代理倍数的 credit | 已有解析代码、偶尔要自动抽 JSON |
一个月的账单:同一份需求,四种买法
单价比完,再按一个具体团队算一次月账单。假设一个做跨境电商内容的小团队,每月要做四件事:把 5,000 页产品文档和帮助中心喂进知识库;拉 2 万条 TikTok 评论做舆情;跟踪 2,000 个 Amazon 商品的价格和评分;收 1 万条 Google 地图点评做门店口碑。我们按各家公开价和本文实测的每次返回条数算接口费,不算你写解析代码的工时。
用我们这一套,文档用 read 是 5,000 × $0.000694 = $3.47,TikTok 评论 100 次调用 × $0.000556 = $0.0556,Amazon 商品 2,000 × $0.001389 = $2.778,地图点评 100 次 × $0.001389 = $0.1389,合计 $6.44;如果文档站结构简单、改用 crawl 每次 20 页,文档这一项降到 250 次 × $0.000694 = $0.1735,合计 $3.15。只用 Firecrawl,文档 5,000 credits 加 Amazon 商品用 JSON 抽取 2,000 × 5 = 1 万 credits,一共 1.5 万 credits,Hobby 档包含 5,000、再按量追加 10 次 $5,月费 $69;TikTok 评论和地图点评这两项,Firecrawl 要靠 Interact 和 JSON 抽取,本文没测,无法计入,得另找方案或自己试算。只用 Apify,TikTok 评论 2 万条 × $0.001 = $20、地图点评 1 万条 × $0.00045 = $4.50,合计 $24.50(Starter 档每月 $19 起,超出部分按量),但文档和 Amazon 两项没算。Firecrawl 和 Apify 组合起来四项都覆盖,是 $93.50。
| 方案 | 文档 5,000 页 | TikTok 评论 2 万条 | Amazon 商品 2,000 个 | 地图点评 1 万条 | 月合计 |
|---|---|---|---|---|---|
EveryInfra(文档用 read) | $3.47 | $0.056 | $2.778 | $0.139 | $6.44 |
EveryInfra(文档用 crawl) | $0.174 | $0.056 | $2.778 | $0.139 | $3.15 |
| 只用 Firecrawl(Hobby + 按量) | 5,000 credits | 按页计价,效果未测 | 1 万 credits | 按页计价,效果未测 | $69.00 |
| 只用 Apify(Starter) | 未算 | $20.00 | 未算 | $4.50 | $24.50 |
| Firecrawl + Apify | 含在 $69 | $20.00 | 含在 $69 | $4.50 | $93.50 |
这笔账有两个地方会让结论变。第一,如果你的文档站需要渲染或反爬,我们的 read 和 crawl 也可能拿不全,这时文档这一项换成 ZenRows 或 ScraperAPI 的高档位更稳;第二,Amazon 商品这一项我们和 Bright Data 几乎同价,组合方案里把 Firecrawl 的 JSON 抽取换成 Bright Data 的现成款,能省下一大块。账单的差距几乎全在评论和点评两项上,原因同前面那张平台条目汇总表。
速度:哪些调用快,哪些慢
价格之外,耗时决定一个工具能不能放进同步流程。本文 26 次请求里,通用网页工具全都很快:map 0.84 秒、read 成功的 4 次在 0.85 到 3.25 秒之间、中位约 2.08 秒,crawl 两次 2.46 秒和 1.28 秒,web 搜索 2.15 秒。平台结构化能力慢得多:TikTok 账号视频 10.06 秒、Amazon 商品详情 16.82 秒、地图点评 100 条 8.50 秒,TikTok 评论 200 条 49.53 秒,地图搜商户 57.80 秒;失败的请求里,503 都要等 16 到 31 秒才返回。
慢的原因是这些能力要现场去平台取数据,一次几十秒很正常;Firecrawl 的爬取任务同样是异步的,它的文档说 credits 会随每页处理完成陆续扣,可能在提交后几分钟甚至几小时才扣完。对 agent 来说,实际的建议是:通用网页的读取可以放在同步的工具调用里;评论、点评这类平台数据,用异步模式提交(请求体里加 "mode":"async",拿 poll_url 轮询),或者在定时任务里批量跑,不要让用户等一分钟。
接进 AI 工具:两边的 MCP 怎么配
很多人找 Firecrawl 替代,是因为在 Claude、Cursor 这类 AI 工具里用它的 MCP。Firecrawl 的 MCP 文档给了三种接法:免 Key、浏览器登录、带 API Key;免 Key 端点只开放搜索、抓取和解析三个工具,按 IP 每天限次数和 credits,要全部工具就加 Key。它的 MCP 服务器在 2026-11-03 发了 v3.36.1,用 MIT 许可。我们的远程 MCP 在 https://api.everyinfra.com/mcp,00:23(新加坡时间)不带 Key 调 tools/list,0.18 秒列出 12 个工具,其中 everyinfra_search 对应本文的 read、crawl、map,everyinfra_call_api 对应 573 项平台能力。两边可以同时挂在一个客户端里,让 agent 按任务选:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "firecrawl": {
      "type": "http",
      "url": "https://mcp.firecrawl.dev/v2/mcp"
    }
  }
}
上面 Firecrawl 一侧是它文档里的免 Key 写法,没有带 Key;MCP 协议本身的说明见 MCP 规范。实际用下来的分工很自然:「读这个网址」「爬这个文档站」交给任何一边都行,「这个视频下面的人在说什么」「这家店最近的点评」交给 everyinfra_call_api。agent 在调用前可以先用 everyinfra_list_capabilities 查有没有对应的平台和能力,这一步不扣钱。各客户端的完整写法见站内的 MCP 服务页。
上手:三步试一次
第一步,到价格页看试用金怎么领,充值和计费都只写美元,没有月费。第二步,不带 Key 读能力目录和搜索工具目录,确认你要的平台、能力、参数和 price_usd;还没定平台的话,数据市场按平台列出了全部能力和价格,TikTok 平台页、Amazon 平台页和 Google 地图点评平台页各有字段说明和示例。第三步,照快速上手发第一个请求,下面两段就是本文用过的请求,换成你自己的网址即可:
# 通用网页:爬一个文档站,最多 20 页,一次扣 $0.000694
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"crawl","params":{"url":"https://docs.firecrawl.dev","num":20}}'
# 返回 results[]:url、title、content(单页最多约 20,000 字符),billing.charged_usd# 平台数据:一个 TikTok 视频的评论,一次最多 200 条,扣 $0.000556
curl -s https://api.everyinfra.com/api/v1/social \
-H "Authorization: Bearer $EVERYINFRA_API_KEY" \
-H "Content-Type: application/json" \
-d '{"platform":"tiktok","action":"comments","params":{"url":"https://www.tiktok.com/@duolingo/video/7704408143215758605","limit":200}}'
# 返回字段:id、text、author_username、author_id、like_count、reply_count、reply_to_id、
# is_reply、liked_by_author、pinned_by_author、posted_at、platform参数写错会在扣费前收到 422 和可用参数列表(本文 00:16:37 新加坡时间把 url 写成 site,0.15 秒就回了 unknown_param 和允许的三个参数);慢的能力加 "mode":"async",拿 poll_url 轮询;失败和空结果不扣钱,响应里的 billing.charged_usd 就是这次的实际花费。
常见问题
下面的问题都取自 Google 联想词(2026-11-08 读取,原始返回已存档)。
有免费的 firecrawl alternatives 吗?
有,而且不少。Firecrawl 自己每月送 1,000 credits,还有免 Key 端点;ZenRows 每月 5,000 credits、Bright Data 的 Web Unlocker 每月 5,000 次、Tavily 每月 1,000 credits、Apify 每月 $5、ScraperAPI 注册送 1,000 credits;Firecrawl 开源版可以自己部署,但默认不含高级反爬。只是想偶尔读几百个网页,这些免费额度都够用;要长期、成批地拿平台数据,免费额度很快会用完,那时再按本文的每千条价格算。
Firecrawl 是免费的吗?
部分免费。它的定价页写着每月 1,000 credits、按月刷新、不用信用卡,约等于 1,000 个普通网页;免 Key 方式按 IP 每天限量。付费从 Hobby 每月 $19(年付 $16)开始。开源版本身免费,但服务器、代理和维护成本要自己出。
有没有比 Firecrawl 更便宜的替代?
看你抓什么。抓普通网页,ZenRows 和 ScraperAPI 入门档的标准请求每千次 $0.42 和 $0.49,Apify 网站内容爬虫的 HTTP 模式约 $0.2,我们的 crawl 实测每千页 $0.0347,都低于 Firecrawl Hobby 档的 $3.80;要 JSON 抽取,Firecrawl 是每千页 $19.00(Hobby),这时更便宜的做法是直接调平台的结构化能力。抓评论、点评这类平台条目,我们的实测价比按页或按条计费的方案低两到三个数量级。
Firecrawl 和 Apify 怎么选?
Firecrawl 是一个统一的抓取接口,按页计费,适合「给网址、要正文」和整站爬取;Apify 是一个现成抓取程序的市场,每款单独计价,适合「我要某个网站的某种数据、而且有人已经做好了」。两者都能处理反爬和渲染,Apify 的现成款覆盖的网站更多,Firecrawl 的接口更统一。如果要的平台在我们的目录里,按条数算我们通常更便宜;不在目录里,Apify 的现成款是更好的起点。
Firecrawl 和 Tavily 有什么区别?
起点不同:Tavily 从一个问题出发、按成功的 URL 计费,Firecrawl 从一个已知网址出发、目标站 404 也收费;Tavily 自己的博客也这样划分,细节见上文「其他五家各自适合谁」。
Firecrawl 的 MCP 要钱吗?
它的免 Key 端点不要钱,但只有搜索、抓取、解析三个工具,按 IP 每天限量;加上 API Key 后,MCP 的每次调用和直接调接口一样扣 credits。我们的 MCP 也是这样:列工具和查能力目录不扣钱,实际取数据按目录价扣费。
参考资料
- Firecrawl Pricing,Firecrawl,2026-09-04 生效,2026-11-08 读取。
- Billing,Firecrawl 文档,2026-11-08 读取。
- Rate Limits,Firecrawl 文档,2026-11-08 读取。
- Scrape,Firecrawl 文档,2026-11-08 读取。
- Crawl,Firecrawl 文档,2026-11-08 读取。
- Map,Firecrawl 文档,2026-11-08 读取。
- Batch Scrape,Firecrawl 文档,2026-11-08 读取。
- Change Tracking,Firecrawl 文档,2026-11-08 读取。
- Interact,Firecrawl 文档,2026-11-08 读取。
- LLM Extract,Firecrawl 文档,2026-11-08 读取。
- Alexandria,Firecrawl 文档,2026-11-08 读取。
- MCP Server: Get Started,Firecrawl 文档,2026-11-08 读取。
- Keyless MCP,Firecrawl 文档,2026-11-08 读取。
- Self-host,Firecrawl 文档,2026-11-08 读取。
- Open Source vs Cloud,Firecrawl 文档,2026-11-08 读取。
- firecrawl/firecrawl,GitHub,2026-11-08 读取。
- firecrawl/firecrawl Releases,GitHub,2026-11-08 读取。
- LICENSE(AGPL-3.0),GitHub,2026-11-08 读取。
- firecrawl-mcp-server v3.36.1,GitHub,2026-11-03 发布。
- Benchmarks,Firecrawl,2026-11-08 读取。
- Introducing Alexandria and our $75M Series B,Firecrawl,2026-09-22。
- Introducing Universal Scrape,Firecrawl,2026-10-08。
- Firecrawl for Google Cloud,Firecrawl,2026-10-19。
- Apify Pricing,Apify,2026-11-08 读取。
- Website Content Crawler,Apify,2026-11-08 读取。
- TikTok Comments Scraper,Apify Store,2026-11-08 读取。
- Google Maps Reviews Scraper,Apify Store,2026-11-08 读取。
- Amazon Reviews Scraper,Apify Store,2026-11-08 读取。
- Apify Store 计费说明,Apify 文档,2026-11-08 读取。
- Credits & Pricing,Tavily 文档,2026-11-08 读取。
- Tavily Extract,Tavily 文档,2026-11-08 读取。
- Tavily Crawl,Tavily 文档,2026-11-08 读取。
- 7 Best Firecrawl Alternatives for AI Agents in 2026,Tavily,2026-11-08 读取。
- Web Unlocker Pricing,Bright Data,2026-11-08 读取。
- Web Scraper API Pricing,Bright Data,2026-11-08 读取。
- Fetch API,Bright Data 文档,2026-11-08 读取。
- ScraperAPI Pricing,ScraperAPI,2026-11-08 读取。
- Credits and Requests costs,ScraperAPI 文档,2026-11-08 读取。
- Pricing,ZenRows 文档,2026-11-08 读取。
- EveryInfra 能力目录,EveryInfra,2026-11-08 00:15 读取。
- EveryInfra 搜索工具目录,EveryInfra,2026-11-08 00:15 读取。
- Model Context Protocol Specification 2025-11-25,MCP,2026-11-08 读取。
- Attention Is All You Need(arXiv 1706.03762),arXiv,本文 PDF 读取测试的目标。
- What is the best scraper tool right now? Firecrawl is great, but I want to explore more options,Reddit r/LocalLLaMA,2026-11-08 读取。
引用编号 BL-114