SerpAPI vs Tavily:每千次多少钱、模型读多少
每千次搜索 SerpAPI $7.25–$25、Tavily $5–$8,EveryInfra 实测 $0.694;另比 token、读正文和失败扣费。
按 2026 年 11 月 22 日读到的两家定价页换算,SerpAPI 每 1,000 次搜索从 Starter 档的 $25 降到每月 10 万次的 Searcher 档 $7.25,Tavily 一次 basic 搜索扣 1 个 credit,每 1,000 次 $5(Growth 档)到 $8(按量);同一天中午我们在 EveryInfra 真调 web 搜索,每次扣 $0.000694,折合每 1,000 次 $0.694。价格之外,两家交给模型的东西差得更远:SerpAPI 文档里公开的一份「coffee」样例响应有 14 个区块、9 条自然结果,按 cl100k_base 分词约 16,599 个 token,其中标题、链接、摘要三项只占 523 个;Tavily 按它文档写的默认值(10 条结果、每条最多 3 段、每段约 500 字符)算,上限约 3,868 个 token;我们 web 的原样响应 5 个查询平均约 973 个,只留同样三项约 703 个。SerpAPI 还有一条容易漏算的规则:Google 有时把 AI 概览放在第二次请求里,第二次照常计数。
两家的价格和规则取自 SerpAPI 的 定价页、Google 搜索接口文档、Extract API 文档,和 Tavily 的 定价页、计费文档、搜索接口文档,读取时间是 2026-11-22 12:43 到 12:47(新加坡时间,下同)。我们没有开这两家的账号,也没有调用它们的接口;对方一侧的每个数都由公开规则换算,读到的原文和换算过程都留了存档。EveryInfra 一侧的数来自 12:43 到 12:59 三轮真调响应里的 billing.charged_usd。
SerpAPI vs Tavily 总对比:计费单位、免费额度和失败规则
SerpAPI 按「次」计费:一次成功的搜索记 1 次,不管这次返回 100 条还是 0 条;它卖的是 Google、Bing、DuckDuckGo、YouTube、Amazon 等一百多个页面的解析结果,定价页列出的接口超过 160 个。Tavily 按 credit 计费:basic 搜索 1 个、advanced 搜索 2 个,读网页正文的 Extract 每 5 个成功网址 1 个;它不卖某个搜索引擎的原样结果页,交回的是自己挑过、切过段、带相关度分数的内容。两家的计费单位不同,比较之前要先把它们折成同一件活的美元价。
| 项目 | SerpAPI | Tavily |
|---|---|---|
| 计费单位 | 每次成功搜索 1 次(各引擎同价) | credit:basic 搜索 1 个,advanced 2 个 |
| 免费额度 | 每月 250 次,每小时 50 次 | 每月 1,000 个 credit,不绑卡 |
| 入门付费 | Starter $25/月,1,000 次 | 按量 $0.008 一个;或 Project $30/月 4,000 个 |
| 中档 | Developer $75/5,000;Production $150/15,000;Big Data $275/30,000 | Bootstrap $100/15,000;Startup $220/38,000 |
| 高档 | Searcher $725/100,000,再往上到 Cloud 档 | Growth $500/100,000,再往上是企业定制 |
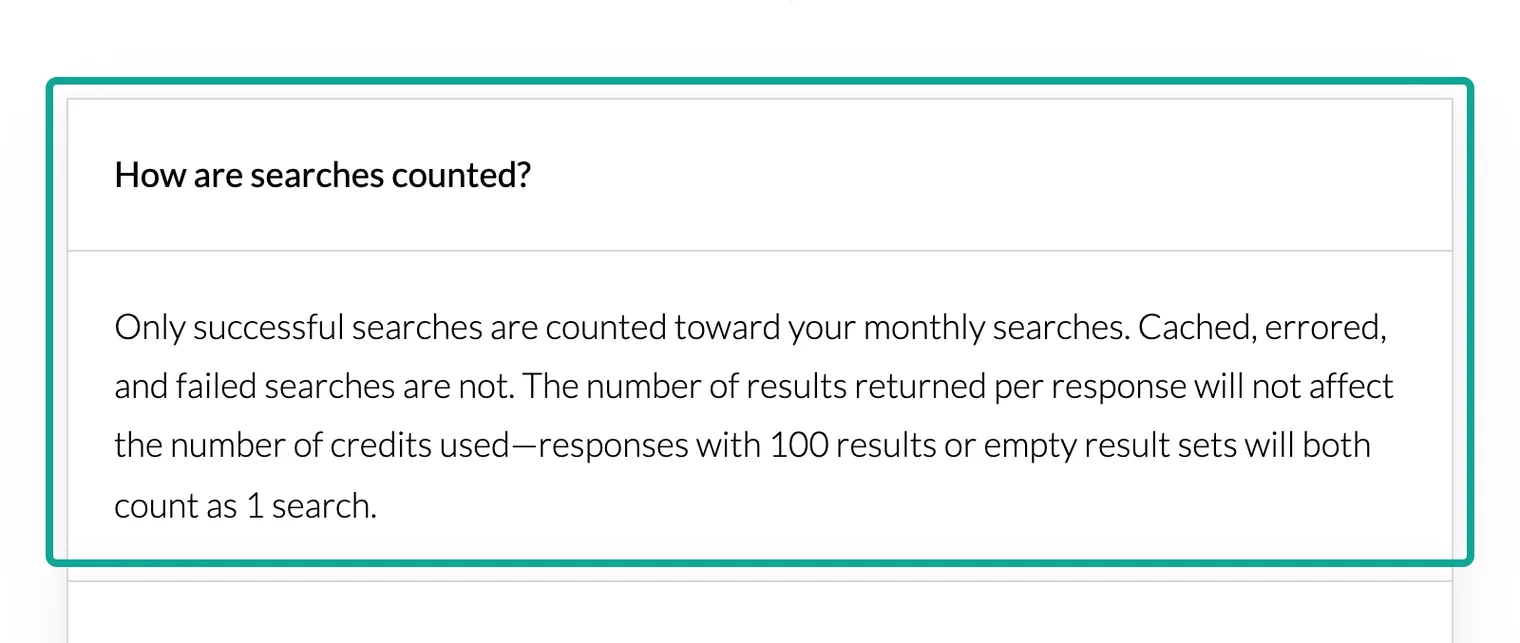
| 失败扣不扣 | 缓存、出错、失败的搜索不数;空结果算 1 次 | Extract 抓失败的网址不扣;Map 失败不扣 |
| 缓存 | 同参数 1 小时内命中缓存免费 | 文档未写缓存免费;max_age_hours 控制取缓存还是现抓 |
| 额度清零 | 按续订日清零;可开「提前续订」 | 每月 1 日清零,和付款日无关 |
| 用完以后 | 手动或自动提前续订 | 请求停止,开了按量才继续 |
| 读网页正文 | Extract API,每页 1 次 | Extract,每 5 个网址 1 个 credit |
| 给模型的格式 | JSON;output=md 出 Markdown,同价 | 结果自带整理过的 content,可要 answer 和 raw_content |
| 限速 | 按档:Starter 每小时 200 次,Searcher 每小时 20,000 次 | 按组织:免费每分钟 100 次,付费 1,000 次,Growth 1,500 次 |
| 远程 MCP | mcp.serpapi.com,Key 放请求头或路径 | mcp.tavily.com,OAuth 登录或 Key,可免 Key 试用 |
SerpAPI 的 AI 概览接口文档写明,缓存只在查询和全部参数完全相同时命中,1 小时后过期,「Cached searches are free」;一个 agent 在一小时内对同一个词重复搜几次,后面几次不花钱,代价是拿到的可能是一小时前的结果,要强制现抓就加 no_cache=true。Tavily 的 定价页问答写的是每月 1 日清零、与付款日无关,用完后请求直接停,要继续就得升级或打开按量;它的 搜索接口文档另列了两个专用错误码:套餐额度用完回 432,按量超过上限回 433;限速文档只写了超速的 429 和高负载时的 434。SerpAPI 按每次搜索成没成功计,Tavily 按当月还剩几个 credit 计,同样的月用量放进去,账单的形状不一样。
免费额度能撑多久,也和计费单位有关。SerpAPI 免费档每月 250 次搜索、每小时 50 次,做原型时一个 agent 每个问题搜 2 次、读 3 页,就要 5 次,一个月只够答 50 个问题;Tavily 免费档每月 1,000 个 credit,同样的问题是搜 2 次加 Extract 1 个,共 3 个 credit,够答 330 个左右。两家的免费额度都不能结转,SerpAPI 按账户的月周期清零,Tavily 每月 1 日清零。EveryInfra 没有按月的免费额度,按次扣,新账户的试用额度和充值方式见 定价页。对只想先跑通流程的开发者,Tavily 的免 Key 模式门槛最低,连注册都不用;SerpAPI 的免费 Key 要先注册账号。
每 1,000 次搜索的价格:从入门档到最低档
把两家的套餐价除以每月额度,SerpAPI 页面内嵌的套餐数据一共列了 183 档(含 Ludicrous Speed 的 2 倍、4 倍价),标准速度的命名档有 7 个,再往上是 Cloud 1M 到 Cloud 54M 的云档;Tavily 的计费文档列了 4 个月付档和 1 个按量价。下表只列两家每 1,000 次 basic 搜索的价钱,SerpAPI 全部 61 档标准速度的明细见站内的 SerpAPI pricing 逐档拆解,Tavily 各接口的 credit 细则见 Tavily 每次调用扣几个 credit。
| 档位 | SerpAPI 月费 / 每月次数 | SerpAPI 每 1,000 次 | Tavily 月费 / 每月 credit | Tavily 每 1,000 次 basic 搜索 |
|---|---|---|---|---|
| 免费 | $0 / 250 | — | $0 / 1,000 | — |
| 入门 | Starter $25 / 1,000 | $25.00 | 按量 $0.008 一个 | $8.00 |
| 小档 | Developer $75 / 5,000 | $15.00 | Project $30 / 4,000 | $7.50 |
| 中档 | Production $150 / 15,000 | $10.00 | Bootstrap $100 / 15,000 | $6.67 |
| 中高档 | Big Data $275 / 30,000 | $9.17 | Startup $220 / 38,000 | $5.79 |
| 每月 10 万次 | Searcher $725 / 100,000 | $7.25 | Growth $500 / 100,000 | $5.00 |
| 每月 100 万次 | Cloud 1M $3,750 / 1,000,000 | $3.75 | 企业定制 | 未公开 |
EveryInfra web | 按次,无月费 | $0.694(实扣) | — | — |
两家在每月 10 万次这一档最接近:SerpAPI Searcher $7.25,Tavily Growth $5.00,Tavily 便宜约 31%。往下走,SerpAPI 的入门档更贵:一个月只搜 1,000 次的项目,Starter 每次 $0.025,Tavily 按量每次 $0.008,差 3 倍多。往上走,SerpAPI 有公开的云档,每 1,000 次能降到 $3.75 甚至 $1.96,Tavily 在 Growth 以上只写「Custom」,没有公开价。所以小用量时 Tavily 便宜得多,十万次附近两家差三成,百万次以上只有 SerpAPI 给了可以直接下单的价格。EveryInfra 的 web 搜索按次扣 $0.000694,没有月费和档位,在下图里是一条贴在最左边的线,比 SerpAPI 公开的最低云档还低约 65%。
交给模型的分量:一份 SerpAPI 样例 16,599 token,Tavily 默认上限约 3,868
给 AI agent 用的搜索接口,账单有两张:一张是搜索接口自己的,一张是模型读结果时的输入 token。我们没法在不开账号的前提下拿到两家的实时响应,所以用两家自己公开的材料来量:SerpAPI 的 Google 搜索接口文档页面里放着一份完整的样例响应(查询「coffee」,地点 Austin,创建时间 2021-12-07),Tavily 的 搜索接口文档写明了 content 字段由几段原文拼成、每段多长、默认几段。量法是:把 JSON 压成一行,用 cl100k_base 分词器数 token,每一家都量两种,一种是整份原样响应,一种是只留标题、链接、摘要。各家模型的分词器不一样,这里只看量级。
| 交给模型的内容 | 字节 | token(cl100k_base) | 说明 |
|---|---|---|---|
| SerpAPI 样例整份 JSON | 43,193 | 16,599 | 14 个区块:元数据、食谱、购物、本地地图、本地商家、知识图谱、相关问题、9 条自然结果、相关搜索、翻页等 |
同一份只留 organic_results | 16,288 | 5,159 | 相当于用 json_restrictor=organic_results |
| 同一份只留标题、链接、摘要 | 2,295 | 523 | 9 条,每条三个字段 |
| Tavily 默认上限(按文档估) | 约 15,000 字符 | 约 3,868 | 10 条 × 最多 3 段 × 约 500 字符;字符与 token 之比 3.88 取自我们的英文摘要 |
EveryInfra web 原样响应,5 个查询平均 | 约 3,414 | 约 973 | 含外层 id、tool、billing、quota,每条 title、url、snippet,部分带 published;实际返回 5 到 10 条 |
| 同样 5 个查询只留标题、链接、摘要 | 约 2,640 | 约 703 | 每条三个字段,和 SerpAPI 那一行同一种裁法 |
EveryInfra deep 带全文 | 72,092 字符 | 16,920 | 5 条结果,每条正文截到 2 万字符 |
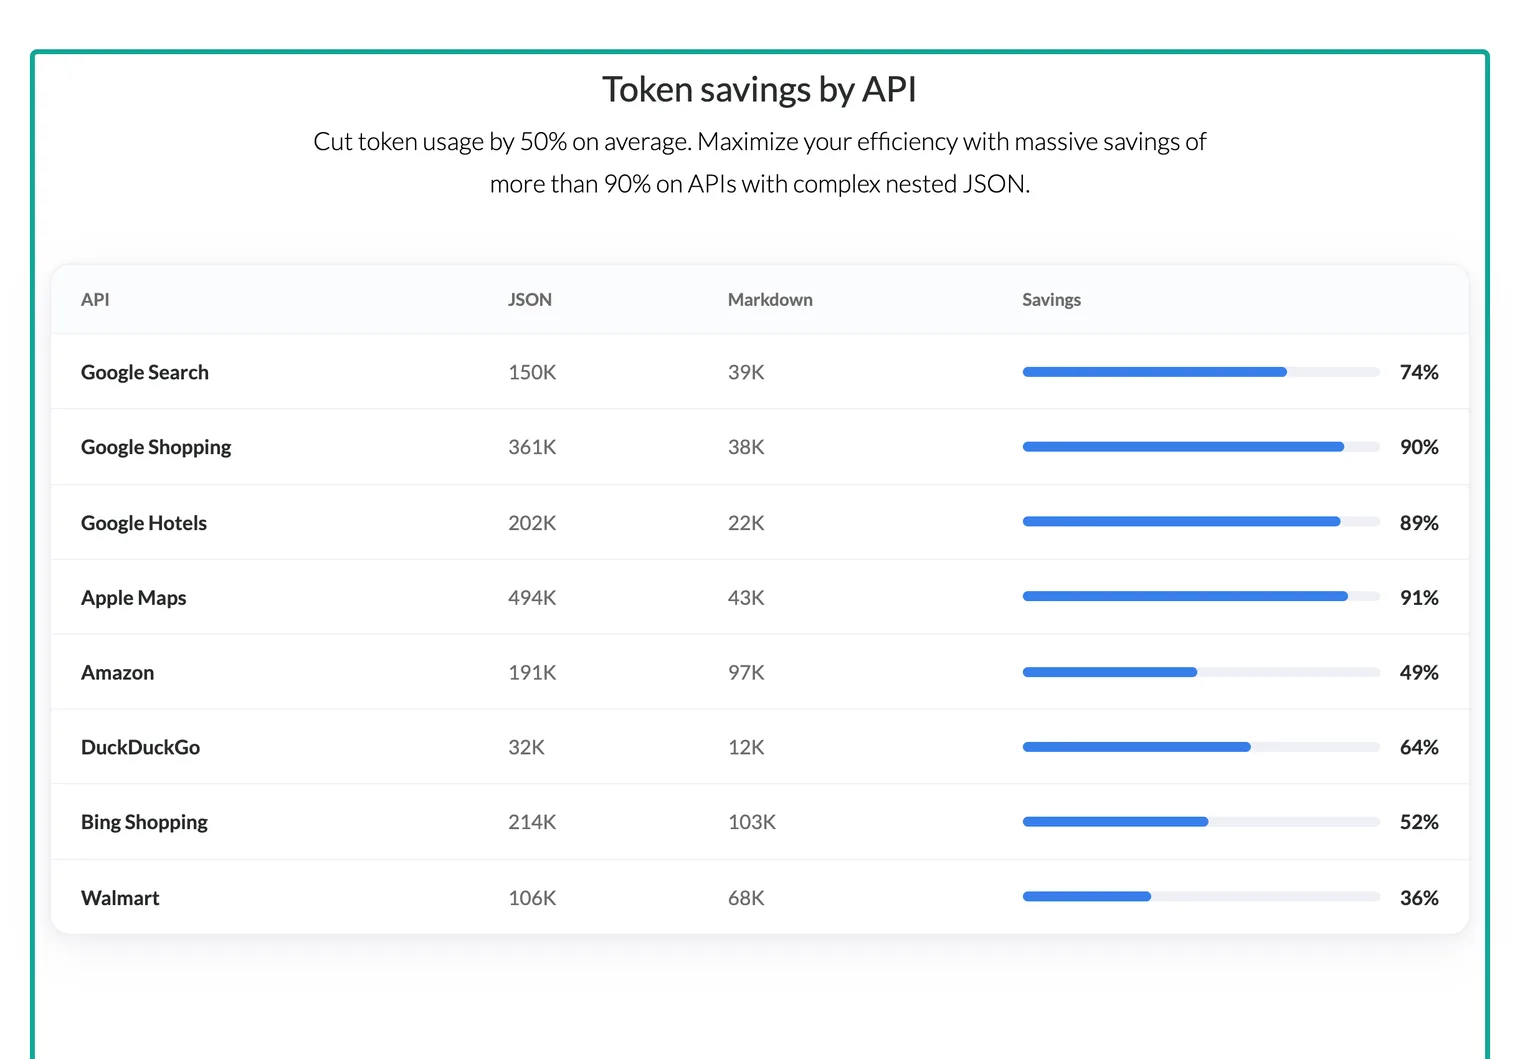
把 SerpAPI 的整份 JSON 原样塞给模型,9 条结果要 1.66 万个 token,其中说明「这条结果讲什么」的标题、链接、摘要只占 3.2%;其余是重定向链接、缩略图地址、站点链接、富摘要、知识图谱和本地商家。这些区块对做排名监控、本地 SEO 的人有用,对一个只想找答案的 agent 是噪音。SerpAPI 在 Markdown 输出页写,output=md 平均能省一半 token,Google 搜索一项从 150K 降到 39K、省 74%,购物和酒店这种嵌套深的接口能省 90% 左右,而且价格和 JSON 一样,每次 1 次搜索。按它说的 Google 搜索平均省 74% 估,那份「coffee」样例换成 Markdown 约 4,300 个 token,这是按它公布的比例算的,我们没有拿 Markdown 版本去量。再配上 json_restrictor 只留需要的区块,就能把 1.66 万压到几百到几千。Tavily 的默认值是按喂给模型来定的:每条结果给 3 段、每段约 500 字符,10 条也就 3,900 个 token 左右;如果把 include_raw_content 打开,拿回的是整页正文,分量会和我们的 deep 带全文一个量级,上万 token 起。
我们这一侧的两行也要分开看。web 的原样响应比只留三项多出 238 到 305 个 token,多出来的是外层的请求编号、工具名、计费和额度信息,以及一部分结果带的 published 发布日期;这一层和 SerpAPI 样例里的 search_metadata、search_parameters 是同一类东西,所以拿整份比整份、三项比三项才对等。5 个查询逐个看:
| 查询 | 返回条数 | 原样响应 token | 只留三项 token |
|---|---|---|---|
| serpapi vs tavily | 10 | 1,132 | 827 |
| best burr coffee grinder 2026 | 9 | 961 | 691 |
| python 3.14 release date | 5 | 668 | 430 |
| nvidia q3 fiscal 2027 earnings | 9 | 1,084 | 825 |
| docker permission denied var run docker.sock | 10 | 1,020 | 743 |
按每条结果算,原样响应约 100 到 135 个 token,只留三项约 75 到 92 个;SerpAPI 样例只留三项是 9 条 523 个,每条约 58 个,比我们的摘要短。原样交给模型时,两边差在区块:SerpAPI 一份 16,599,我们一份不到 1,200。
按每百万输入 token 的单价乘:每 1,000 次搜索,原样交给模型时 SerpAPI 样例约 1,660 万 token,EveryInfra web 约 97 万;只留标题、链接、摘要时 SerpAPI 约 52 万,EveryInfra 约 70 万;Tavily 默认上限约 387 万。再加上搜索接口自己的账单,才是 1,000 次搜索的完整成本。下表假设两种整数单价,每百万输入 token $1 和 $3,方便换成你自己模型的价:
| 每 1,000 次搜索交给模型 | 输入 token | 按 $1/百万 | 按 $3/百万 |
|---|---|---|---|
| SerpAPI 样例,原样 | 约 1,660 万 | $16.60 | $49.80 |
| SerpAPI 样例,只留三项 | 约 52 万 | $0.52 | $1.57 |
| Tavily 默认上限 | 约 387 万 | $3.87 | $11.60 |
EveryInfra web,原样 | 约 97 万 | $0.97 | $2.92 |
EveryInfra web,只留三项 | 约 70 万 | $0.70 | $2.11 |
按 $1 一百万算,SerpAPI 原样交给模型的 token 费 $16.60,已经比它 Searcher 档的搜索费 $7.25 高一倍多;裁到三项以后只剩 $0.52;按 $3 一百万算,两者是 $49.80 对 $1.57,差距跟着单价一起放大。所以用 SerpAPI 时,先裁响应省下的钱,比在 SerpAPI 和 Tavily 之间换家省下的搜索费(每 1,000 次 $2.25)还多。
把 SerpAPI 的响应裁小:三种做法
如果你选了 SerpAPI,又不想让模型每次读 1.6 万个 token,有三种做法,都不额外收费。第一种是 json_restrictor,在请求里写要留哪些区块和字段,比如 organic_results[].{title,link,snippet},服务端只回这几项,我们用样例算下来是 523 个 token。第二种是 output=md,让它直接回 Markdown,按它自己公布的表,Google 搜索平均省 74%,嵌套深的购物、酒店、地图接口省到九成左右。第三种是在你自己的代码里裁,好处是可以留下 position 和 source 这类之后可能用得上的字段,坏处是传输和解析的那部分开销还在。下面这段 Python 用的是第一种,参数名照 SerpAPI 的 json_restrictor 说明写,Key 从环境变量读。
import os, requests

params = {
    "engine": "google",
    "q": "serpapi vs tavily",
    "api_key": os.environ["SERPAPI_API_KEY"],
    # 只留自然结果的标题、链接、摘要
    "json_restrictor": "organic_results[].{title,link,snippet}",
}
data = requests.get("https://serpapi.com/search.json", params=params, timeout=60).json()
for r in data.get("organic_results", []):
    print(r["title"], r["link"])
裁小以后,SerpAPI 交给模型的分量和 EveryInfra web 的响应是同一个量级,每 1,000 次几十万到一百万 token。区别留在两处:SerpAPI 能按需要换回整页结构,比如要看 AI 概览或本地商家时把限制去掉;EveryInfra web 每条只有标题、链接、摘要,部分带发布日期,要正文就另调 read 或 deep。
搜一次再读 5 页:agent 最常见的一步要计几次费
agent 搜完以后通常还要读正文。两家都能做,计法不同。SerpAPI 10 月 13 日上线的 Extract API 每读一页记 1 次搜索,抓失败的页和命中缓存的不记,爬整站时 max_pages 最多 100 页、每页 1 次;所以「搜一次、读前 5 页」在 SerpAPI 上是 6 次。Tavily 有两条路:先搜索、再把 5 个网址交给 Extract,搜索 1 个 credit 加 Extract 1 个(每 5 个成功网址 1 个),一共 2 个;或者搜索时直接带 include_raw_content,按它的 计费文档,搜索的价只由 search_depth 决定,没有给带全文列加价,算 1 个。
| 一个任务:搜 1 次 + 读前 5 页 | 计几次 | 每 1,000 个任务(最省自助档) | 每 1,000 个任务(入门档) |
|---|---|---|---|
| SerpAPI:Google 搜索 + Extract 5 页 | 6 次 | $43.50(Searcher) | $150.00(Starter) |
| Tavily:搜索 + Extract 5 个网址 | 2 个 credit | $10.00(Growth) | $16.00(按量) |
Tavily:搜索带 include_raw_content | 1 个 credit | $5.00(Growth) | $8.00(按量) |
EveryInfra:web 1 次 + read 5 次 | 6 次 × $0.000694 | $4.16(实扣) | 同左,无档位 |
EveryInfra:deep 带全文 1 次 | 1 次 × $0.000694 | $0.694(实扣,一次 5 条) | 同左 |
一读正文,两家的差距就拉开了:只比搜索时 Tavily 在十万次档便宜三成,搜加读时 Tavily 走 Extract 便宜约 77%,直接带全文便宜约 89%。原因在计费单位:SerpAPI 一页一次,Tavily 的 Extract 五页一个 credit。agent 要读 20 页时,SerpAPI 是 21 次,Tavily 搜索加 Extract 是 1 + 4 = 5 个 credit。按每月 10 万次那一档折成钱,这样的任务做 1,000 次,SerpAPI Searcher 是 21 × $7.25 = $152.25,Tavily Growth 是 5 × $5 = $25,EveryInfra 用 web 1 次加 read 20 次是 21 × $0.694 ≈ $14.57;读的页数越多,SerpAPI 按页计费的差距越大,到 20 页时已经是 Tavily 的 6 倍。
EveryInfra 这一侧,read 每页 $0.000694,deep 打开 full 时一次带回 5 条结果和各自的正文,同样 $0.000694。我们在 12:46:07 用 deep 带全文搜「serpapi vs tavily」,5 条结果的正文分别是 238、20,000、20,000、20,000、9,992 字符,扣 $0.000694,但这一次本地计时 48.1 秒,比 web 慢一个数量级;要速度的场景用 web 加按需 read,要一次拿全的批处理用 deep。
Google AI 概览的第二次请求:照常计数
SerpAPI 的 AI 概览说明页写了一种情况:Google 有时把 AI 概览放在单独的请求里返回,这时 SerpAPI 的响应只给一个 page_token 和一条 serpapi_link,要拿到概览正文,得在 1 分钟内再调一次 Google AI Overview API;这第二次是另一次搜索,照常计数。对只看自然结果的 SEO 工具,这不影响账单;对拿 AI 概览当答案来源的 agent,每个问题可能记 2 次。
这个比例我们没测:不开 SerpAPI 账号测不了,公开材料里也没有能复核的原始数据。账单按比例线性变:如果你的查询里有 x 的比例要第二次请求,每 1,000 个问题的价是 Searcher 档 $7.25 乘以(1 + x)。下表的比例是假设,不是测出来的:
| 要第二次请求的比例(假设) | 每题平均请求数 | 每 1,000 个问题(Searcher 档) | 每 1,000 个问题(Starter 档) |
|---|---|---|---|
| 0 | 1.00 | $7.25 | $25.00 |
| 25% | 1.25 | $9.06 | $31.25 |
| 50% | 1.50 | $10.88 | $37.50 |
| 100% | 2.00 | $14.50 | $50.00 |
这个比例还会改变该买哪一档。拿后文「每月 5 万次」的例子算:如果一半问题要第二次请求,实际用量是 7.5 万次;留在 Big Data 档(每月 3 万次 $275)要付三次月费、$825,直接买 Searcher 档(每月 10 万次 $725)反而便宜 $100。没有第二次请求时结论相反,Big Data 加提前续订 1 次是 $550,比 Searcher 省 $175。所以比例不知道时,先按 Searcher 档估上限。
要知道自己的比例,用免费档的 250 次抽样就够:拿你 agent 真实会问的问题跑一遍,数一数响应里 ai_overview 只带 page_token、没有正文的有几次。Tavily 的 include_answer 是它自己的模型写的短答案,按计费文档不另收 credit,和 Google 的 AI 概览是两样东西。EveryInfra 的 web 不返回 AI 概览,只给标题、链接和摘要,适合让 agent 自己去读、自己去综合;需要多个来源互证时,用 网页搜索能力页里列的 crosscheck,每次 $0.002778。
失败、空结果、缓存:哪些请求扣钱
SerpAPI 的规则在定价页问答里一句话写完:只有成功的搜索计数,缓存、出错和失败的搜索不计,返回 100 条和返回 0 条都算 1 次。这里的「成功」指 SerpAPI 拿到并解析了结果页,结果页本身是空的也算成功;比如搜一个拼错的品牌名、Google 显示「没有找到」,这一次照样记 1 次。读正文的 Extract API 补了一条:抓失败的页不记,命中缓存的不记,响应里的 search_metadata.credits_consumed 写着这一次实际扣了几次。
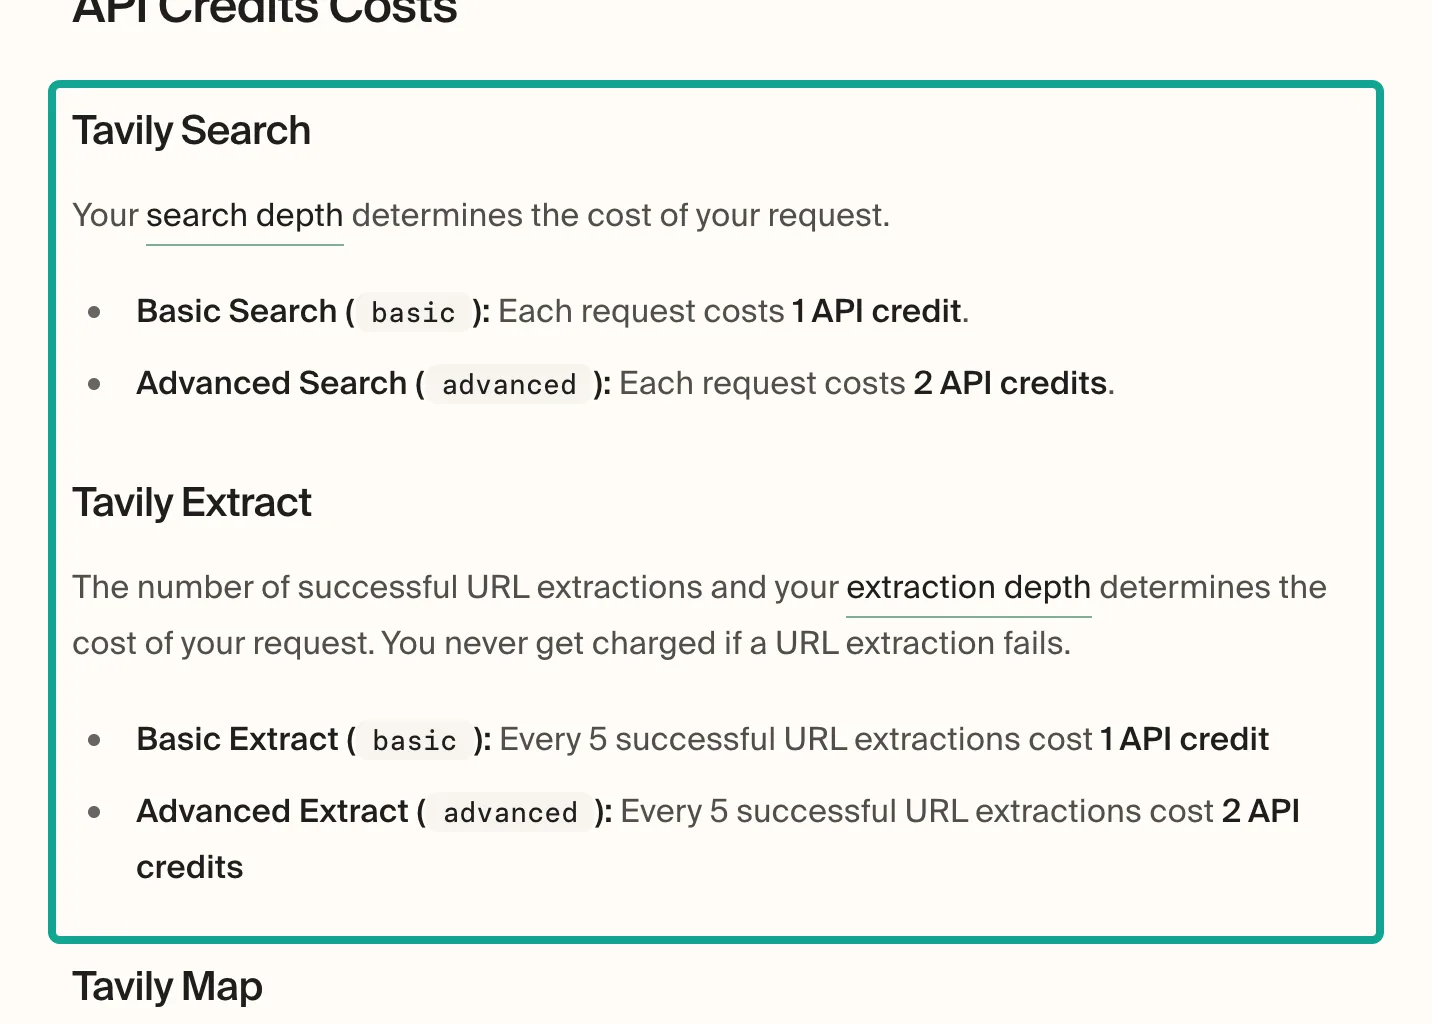
Tavily 的计费文档对 Extract 和 Map 写了「失败不收」,对搜索没有单独写失败怎么算;搜索返回空结果时,按它「每次请求 1 个 credit」的写法,照常扣 1 个。它的 搜索接口文档提到一种会让结果变少的情况:设了 max_age_hours 而缓存太旧、又现抓不到的结果会被去掉,返回的条数可能少于 max_results,较低的值不额外收 credit。免费档在 Tavily 负载高时,带这个参数的请求可能回 434。
agent 碰到错误时要靠状态码决定下一步,三家的码不一样。SerpAPI 的 状态码说明里,429 同时表示「超过每小时吞吐」和「这个月的次数用完了」,只看状态码分不出该等一会儿还是该续订,要读 error 里的文字;搜索引擎本身没有结果时回 200,search_metadata.status 是 Success,organic_results_state 写「Fully empty」,这一次照常计数;503 表示这次搜索没拿到有效结果,不计数,可以重试。Tavily 把这几种情况拆成了不同的码:429 是超速,带 Retry-After;432 是 Key 或套餐额度用完,要升级;433 是按量的上限到了,要去控制台调高;434 是高负载时现抓暂停,可以稍后重试,或者去掉 max_age_hours 改用缓存。
| agent 碰到的情况 | SerpAPI | Tavily | EveryInfra |
|---|---|---|---|
| 请求太快 | 429,和额度用完同一个码 | 429,带 Retry-After | 429,带重试秒数 |
| 额度或余额用完 | 429,看 error 文字 | 432;按量上限是 433 | 按次扣余额,没有月度额度 |
| 引擎没有结果 | 200,Fully empty,计 1 次 | 文档未单独写 | 确认不存在时回空结果并带 empty_reason,不扣 |
| 这次没拿到结果 | 503,不计,可重试 | 434 时稍后重试 | 503,retryable 为真,带 retry_after,扣 $0 |
EveryInfra 这边,三轮真调里有四种不扣费的情况,每种都能用同样的请求复现。12:48:41 对一个不存在的 SerpAPI 页面调 read,回 404,错误码 target_not_found,billing.charged_usd 为 0,reason 是 request_failed_refunded。12:48:49 用 Tavily 的参数名 query、max_results 去调 web,回 422,错误码 unknown_param,响应里写「did you mean q」,列出 7 个允许的参数,不扣费。12:51:01 调 bing/search 回 503,retryable 为真、retry_after 60 秒,扣 $0;12:58:18 再调一次,仍回 503,同样扣 $0。另外,我们用的共用测试 Key 每分钟限 10 次,超了回 429,也不扣费。
| 情况 | SerpAPI | Tavily | EveryInfra(本次实测) |
|---|---|---|---|
| 返回 0 条结果 | 算 1 次 | 搜索按请求扣 1 个 | 确认目标不存在时回空结果并带 empty_reason,不扣(按能力目录,本次未遇到) |
| 目标页面 404 或抓取失败 | 失败不计;Extract 失败页不计 | Extract 失败网址不扣 | read 回 404,扣 $0 |
| 参数写错 | 回错误,不计 | 回 400 或 422 | 回 422 并给出 did you mean,扣 $0 |
| 服务暂时不可用 | 出错不计 | 文档未写是否扣 | bing/search 回 503,扣 $0 |
| 限速 | 超出每小时吞吐要排队或重试 | 回 429 和 Retry-After | 回 429 和重试秒数,扣 $0 |
| 命中缓存 | 1 小时内同参数免费 | 文档未写免费 | 部分能力对确认不存在的目标,短时间内重复请求免费(本次未测) |
同一组查询在 EveryInfra 实测
12:43 到 12:46,我们用 5 个查询跑了 web:「serpapi vs tavily」「best burr coffee grinder 2026」「python 3.14 release date」「nvidia q3 fiscal 2027 earnings」「docker permission denied var run docker.sock」。挑这 5 个,是因为它们代表 agent 最常发的几类搜索:比价选型、购物、事实、新闻、报错排查。每次请求带 num: 10,返回条数分别是 10、9、5、9、10,本地计时 1.41 到 2.48 秒,每次扣 $0.000694。第 3 个查询只回 5 条,说明 num 只是上限;按次计费下,少回几条不少扣钱,这一点和 SerpAPI 的「空结果也算 1 次」是同一个道理。
| 时刻(新加坡时间) | 能力 | 查询或目标 | HTTP | 条数 | 本地用时 | `charged_usd` |
|---|---|---|---|---|---|---|
| 12:43:24 | web | serpapi vs tavily | 200 | 10 | 1.41 秒 | 0.000694 |
| 12:43:31 | web | best burr coffee grinder 2026 | 200 | 9 | 2.48 秒 | 0.000694 |
| 12:43:40 | web | python 3.14 release date | 200 | 5 | 1.83 秒 | 0.000694 |
| 12:46:07 | deep(full: true) | serpapi vs tavily | 200 | 5 | 48.11 秒 | 0.000694 |
| 12:47:15 | read | Tavily 计费文档 | 200 | 1 | 0.63 秒 | 0.000694 |
| 12:48:41 | read | 一个不存在的 SerpAPI 页面 | 404 | 0 | — | 0 |
| 12:48:49 | web(用 query 参数) | serpapi vs tavily | 422 | 0 | — | 0 |
| 12:51:01 | bing/search | serpapi vs tavily | 503 | 0 | — | 0 |
| 12:51:50 | duckduckgo/search | serpapi vs tavily | 200 | 10 | 6.32 秒 | 0.000556 |
| 12:52:03 | google_news/search | SerpApi Google lawsuit | 200 | 20 | 1.98 秒 | 0.000792 |
| 12:52:12 | google_shopping/search | burr coffee grinder | 200 | 20 | 14.23 秒 | 0.000792 |
| 12:55:41 | youtube/search | serpapi vs tavily | 200 | 10 | 2.86 秒 | 0.000778 |
| 12:57:52 | web(重搜) | serpapi vs tavily | 200 | 10 | 1.54 秒 | 0.000694 |
| 12:58:00 | web(page: 2) | serpapi vs tavily | 200 | 9 | 1.99 秒 | 0.000694 |
| 12:59:01 | news | SerpApi Google lawsuit | 200 | 10 | 1.36 秒 | 0.000694 |
不算共用 Key 超出每分钟 10 次时回的 429(等 60 秒后重发),三轮拿到响应的请求 24 次,扣费的 20 次合计 $0.013608,没拿到结果的 4 次(404、422、两次 503)都是 $0。上表只列了其中 15 次,没列的是另外两次 web、两次 read、一次重搜、三次取字幕和第二次 bing/search。先看重搜:12:57:52 我们把 12:43:24 的「serpapi vs tavily」原样再搜一次,10 条里有 8 条和 14 分钟前相同,只有 3 条排在同一个位置;「nvidia q3 fiscal 2027 earnings」隔 14 分钟重搜,9 条里只剩 4 条相同。两次结果不同,说明第二次是现查的,照常扣了 $0.000694。换成 SerpAPI,同参数 1 小时内会命中缓存、不扣次数,但拿到的是 14 分钟前那一份;对盯新闻、盯财报的 agent,要记得加 no_cache=true,加了就照常计 1 次。再看翻页:12:58:00 用 page: 2 取第二页,9 条里只有 1 条和第一页重复,扣 $0.000694。SerpAPI 翻页也是每页 1 次搜索,Tavily 没有翻页参数,单次最多 20 条,要更多结果只能换查询词。
下面这段是这次第一轮用的请求,Key 从环境变量读,换成你自己的就能复现。把 "tool": "web" 换成 "news" 就是新闻搜索,换成 "read"、参数换成 "url" 就是读正文;参数名写错时网关回 422,并在响应里列出允许的参数,不扣费。
export EVERYINFRA_API_KEY="你的 Key"
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool": "web", "params": {"q": "serpapi vs tavily", "num": 10}}' \
  | jq '{n: (.results | length), first: .results[0].title, charged: .billing.charged_usd}'
12:43:24 这一次的输出是 {"n": 10, "first": "...", "charged": 0.000694},第一条结果是一篇 2026 年 11 月 11 日发布的 serpapi vs tavily 对比指南。响应里每条结果有 title、url、snippet,其中一部分另带 published;整份响应 3,874 字节、约 1,132 个 token,只留三项是 3,007 字节、约 827 个。
同一个新闻查询,我们用两种入口各跑了一次。12:52:03 用 google_news/search 搜「SerpApi Google lawsuit」,回 20 条,每条带来源媒体和 published_at,第一条是 Search Engine Journal 2026 年 7 月 21 日那篇;12:59:01 用搜索工具里的 news 搜同一个词,回 10 条,扣 $0.000694,前三条分别来自 Search Engine Journal、Search Engine Land 和 Yahoo Finance。两者的差别在于:前者是 Google 新闻那一页的结果和顺序,适合做媒体监测;后者是按新闻类型筛过的网页搜索结果,字段和 web 一样,适合直接交给模型。SerpAPI 的 Google News API 对应前者,Tavily 的 topic=news 更接近后者。
SerpAPI 的一百多个引擎,在 EveryInfra 对应哪些能力
SerpAPI 的长处是引擎多:它的接口列表里有 Google 搜索、Google 新闻、Google 购物、Google 地图、Google 学术、Bing、DuckDuckGo、Yandex、Baidu、YouTube、Amazon、Walmart、eBay 等一百多个,11 月还接了一个新引擎的搜索和新闻接口,又加了 Naver 知识问答接口。Tavily 只有一个搜索入口,用 topic 在 general、news、finance 之间切,背后用哪些来源它不公开。所以如果你的 agent 要的是「某个搜索引擎这一刻给用户看的那一页」,Tavily 给不了,SerpAPI 和 EveryInfra 的平台搜索能力给得了。
| 想拿的结果页 | SerpAPI 接口 | EveryInfra 能力 | EveryInfra 每次(11月22日目录) | 这次实测 |
|---|---|---|---|---|
| 通用网页搜索 | Google Search API | web | $0.000694 | 5 个查询,返回 5 到 10 条 |
| Bing 结果页 | Bing Search API | bing/search | $0.000556 | 两次都回 503,扣 $0 |
| DuckDuckGo 结果页 | DuckDuckGo Search API | duckduckgo/search | $0.000556 | 10 条,6.32 秒 |
| Google 新闻 | Google News API | google_news/search | $0.000792 | 20 条,带来源和发布时间 |
| Google 购物 | Google Shopping API | google_shopping/search | $0.000792 | 20 条,带价格和商家 |
| Yandex 结果页 | Yandex Search API | yandex/search | $0.001389 | 本次未调 |
| YouTube 搜索 | YouTube Search API | youtube/search | $0.000778 | 10 个视频 |
| YouTube 字幕 | YouTube Video API 的字幕部分 | youtube/transcript | $0.000556 | 3 个视频的全文字幕 |
这张表的价格来自 EveryInfra 能力目录和 搜索工具清单,11月22日 12:42 读取。两边字段不同:SerpAPI 的 Google 购物结果里有 extracted_price、source、rating 等几十个字段,我们的 google_shopping/search 每条给标题、价格、商家、评分和链接,12:52:12 搜「burr coffee grinder」,第一条是一台 48 档的磨豆机,标价 $95,商家 Target。如果你要的是 SerpAPI 那样完整的区块(知识图谱、相关问题、本地商家都拆成字段),EveryInfra 的平台搜索给不了这么全,SerpAPI 更合适;如果只要标题、链接、摘要、价格这些 agent 用得上的字段,按次计费会便宜一个到两个数量级。
接进 Claude、Cursor 和 Codex:三家的 MCP 写法
三家都有远程 MCP 服务,接法几乎一样,差别在 Key 放哪、能不能免 Key 试用。SerpAPI 的 MCP 页面写的地址是 mcp.serpapi.com,Key 可以放在请求头的 Bearer 里,也可以写进路径;它的开源仓库 serpapi-mcp 还提供本地自建和 .mcpb 一键包,MIT 许可,最近一次提交在 2026-11-20。Tavily 的 MCP 文档支持 OAuth 登录,在 Claude、Cursor、VS Code 里点一下授权就能用,也可以在请求头里用 DEFAULT_PARAMETERS 固定默认参数;它的 tavily-mcp 仓库有 2,499 个星,2026-11-18 修了一个会把 Key 写进日志的问题。EveryInfra 的 MCP 地址是 api.everyinfra.com/mcp,工具名都以 everyinfra_ 开头,一次接入就能调搜索、读网页和各个平台的数据能力,说明在 MCP 服务页。
# SerpAPI(官方 MCP 页给的写法)
claude mcp add --transport http serpapi https://mcp.serpapi.com/mcp \
  --header "Authorization: Bearer $SERPAPI_API_KEY"

# Tavily(远程 MCP,Key 放在地址参数里;也可以不带 Key 走 OAuth)
claude mcp add --transport http tavily "https://mcp.tavily.com/mcp/?tavilyApiKey=$TAVILY_API_KEY"

# EveryInfra
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"
接进去以后,模型看到的工具说明决定了它会怎么用。SerpAPI 的 MCP 把 engine 当参数暴露出来,模型可以自己选 Google、Bing 还是 YouTube,代价是响应仍是整份 JSON,最好让它带上 json_restrictor 或 output=md;Tavily 的 MCP 有 search、extract、map、crawl 几个工具,返回的就是整理过的段落,模型拿来就能读。Tavily 11 月 13 日发布的 @tavily/cli 1.0.1 还多了一个 tvly setup mcp 命令,自动把这段配置写进本机的几个编辑器。
YouTube 上三个相关视频讲了什么、漏了什么
12:55:41 我们用 youtube/search 搜「serpapi vs tavily」,回 10 个视频。我们从里面挑了三个讲 Tavily 或 SerpAPI 怎么接、怎么选的,它们在结果里排第 1、6、5 位;第 2 位是一场讲浏览器渲染技术的演讲,第 3、4 位是多家搜索接口的横评,其中一个出自一家自己卖搜索接口的公司,这三个没选;第 7 位是 2025 年 2 月的 Tavily 入门教程,播放 29,286 次,是 10 个里最多的,但只讲 Tavily 一家,也没选。再用 youtube/transcript 取了三个视频的全文字幕(12:56 到 12:57,每个 $0.000556)。三个视频都把「怎么接上」演示了出来,但都没算每 1,000 次多少钱。
| 视频 | 发布日期 | 时长 | 讲了什么 | 没讲什么 |
|---|---|---|---|---|
| 三家搜索接口对比:哪个适合 AI agent | 2026-11-09 | 2:20 | Tavily 给清洗过的、能直接喂模型的内容,免费 1,000 个 credit,basic 1 个、advanced 2 个;SerpAPI 给 Google 原样结果的结构化 JSON,免费 250 次,入门 $25 一千次;建议两个一起用 | 每 1,000 次的折算、token 分量、SerpAPI 10 月新出的 Extract 和 Markdown、AI 概览的第二次请求 |
| n8n AI Agent Live Search | 2026-04-18 | 5:51 | 在 n8n 里 SerpAPI 有内置的工具节点,拖到 AI Agent 节点下填 Key 就能用;Tavily 用通用的 HTTP Request 工具节点自己填地址和请求体 | 两种接法每次调用的费用;Tavily 其实有自己的社区节点 |
| What's the Best Web Search for OpenClaw? | 2026-03-09 | 13:26 | Tavily 每月 1,000 次免费、不绑卡、一条命令接 MCP;同一个提示词下,Tavily 漏掉了 Google 的 A2A 协议 | SerpAPI 不在比较之列,比的是 Tavily 和另外几家有免费档的搜索接口;换提示词或开 advanced 以后的结果 |
第二个视频里的 n8n 做法已经不是最新的。它在 n8n 里用 HTTP Request 工具节点接 Tavily:方法选 POST,地址填 https://api.tavily.com/search,请求头 Authorization: Bearer 加 Key,请求体至少放 query。我们去查了两边的文档:SerpAPI 在 n8n 里是内置节点,n8n 文档里列为 AI Agent 的子节点,装好 n8n 就有;Tavily 的 n8n 集成文档写的是一个经过 n8n 认证的社区节点 @tavily/n8n-nodes-tavily,在节点面板里搜「Tavily」点 Install 就能装,自建的 n8n 要由所有者或管理员到「Settings → Community nodes」里装。npm 上的发布记录显示这个节点 2025 年 4 月就有了,最新的 0.7.0 发布于 2026 年 10 月 19 日,支持 Search、Extract、Crawl、Map、Research 五种操作,挂到 AI Agent 下时,模型自己填查询词、topic、时间范围、搜索深度和是否要答案。Tavily 的文档还多写了一步视频里没有的:在 AI Agent 的系统消息里写上今天的日期,因为模型不知道今天是几号,搜「最新」时会按训练时的年份去搜。这一步对 SerpAPI 节点和 EveryInfra 一样适用。EveryInfra 在 n8n 里暂时用 HTTP Request 工具节点接,地址换成 https://api.everyinfra.com/api/v1/search,请求体换成 {"tool": "web", "params": {"q": ...}}。
第三个视频的单次对比只用了一个提示词,结论不宜外推,但它提醒了一件事:Tavily 默认的 basic 深度只给每条结果 3 段摘录,答案藏在长文第 10 段时,要么开 advanced,要么接着调 Extract。
每月 5 万次搜索:三家的月账单各是多少
按档位算账最容易出错的地方,是用量落在两档之间。假设一个 agent 产品每月稳定搜 5 万次,不读正文。SerpAPI 的 Big Data 档每月 3 万次不够,下一档 Searcher 每月 10 万次 $725,用不完的 5 万次到续订日清零;另一种做法是留在 Big Data 档、打开「自动提前续订」,额度用完时提前进入下一个周期、再付一次月费,一个月提前续订 1 次、付两次月费,合计约 $550、拿到 6 万次,比直接升 Searcher 省约 $175,代价是账单日每个月都在变。Tavily 的 Startup 档每月 38,000 个 credit $220,剩下 12,000 次走按量,每个 $0.008,合计 $316;直接买 Growth 档是 $500。EveryInfra 按次扣,5 万次乘 $0.000694 是 $34.70。
| 每月 5 万次 basic 搜索 | 怎么买 | 月账单 | 每 1,000 次 |
|---|---|---|---|
| SerpAPI | Searcher 档,10 万次额度用一半 | $725 | $14.50 |
| SerpAPI | Big Data 档 + 自动提前续订 1 次(付两次月费) | 约 $550 | 约 $11.00 |
| Tavily | Startup 档 38,000 + 按量 12,000 | $316 | $6.32 |
| Tavily | Growth 档,10 万额度用一半 | $500 | $10.00 |
EveryInfra web | 按次,无月费 | $34.70 | $0.694 |
额度用不满时,每千次单价会翻倍:SerpAPI 的 Searcher 标价每千次 $7.25,只用一半就是 $14.50。Tavily 按量能补零头,所以它在两档之间的账单更平滑。要是 agent 每次还读 5 页正文,SerpAPI 一个月就是 30 万次,要进 Volume 档(每月 25 万次 $1,475)再加提前续订;Tavily 搜索加 Extract 是 10 万个 credit,正好一个 Growth 档 $500;EveryInfra 是 30 万次乘 $0.000694,$208.20。
从 SerpAPI 或 Tavily 换过来,参数和字段怎么对
12:48:49 那次 422 的响应把 web 允许的参数列全了:q、site、location、after、before、page、num,一共 7 个,响应里还写了「Nothing was charged」和改法。拿 SerpAPI 和 Tavily 的常用参数对一遍,大部分有对应,少数要换一种写法。
| 要做的事 | SerpAPI 参数 | Tavily 参数 | EveryInfra `web` |
|---|---|---|---|
| 查询词 | q | query | q |
| 要几条 | num(各引擎不同) | max_results,默认 10、最多 20 | num,是上限 |
| 翻页 | start 或 page | 无 | page,从 1 开始 |
| 只搜某个站 | 在 q 里写 site: | include_domains | site |
| 地区 | location、gl | country | location,按国家生效 |
| 时间范围 | tbs | time_range、start_date、end_date | after、before |
| 结果标题、链接、摘要 | organic_results[].title、link、snippet | results[].title、url、content | results[].title、url、snippet |
| 正文 | 另调 Extract API | include_raw_content 或 Extract | 另调 read,或 deep 带 full |
| 本次扣了多少 | Extract 响应里有 credits_consumed,搜索按次数计 | include_usage 返回 credit | billing.charged_usd |
换的时候最容易漏的是排除某些站:Tavily 有 exclude_domains,web 没有同名参数,可以在 q 里写 -site: 来排除。如果模型照 Tavily 的习惯写了 query 或 max_results,网关回 422 和 did you mean,不扣费,模型照着改一次就能接着跑。
这次是怎么测的,哪些数要打折看
两家的价格和规则我们只读了公开页面,没有开账号、没有调用它们的接口;它们的实际响应大小、延迟和失败率,可能和文档样例不同。SerpAPI 的 token 数来自一份 2021 年的样例响应,现在 Google 的结果页区块更多,实际可能更大;Tavily 的 3,868 是按文档写的上限估的,实际每段常常不满 500 字符。两边的 token 都按同一种裁法比:整份原样响应比整份,只留标题、链接、摘要比三项。AI 概览要第二次请求的比例我们没测,上文只给了按比例换算的算法。EveryInfra 一侧的用时是从新加坡本机测的单次时间,没有做并发和长时间的统计;24 次拿到响应的请求只能说明计费和失败规则,不能代表长期的可用率。这篇也没有比三家结果的好坏:哪一家前 5 条更能答上你的问题,取决于你的问题。要比,可以拿自己 agent 真实会问的 50 个问题,三家各跑一遍,逐条标注前 5 条结果里有没有答案,再把每家的搜索费和 token 费加起来,算出每答对一题花多少钱;三家都有免费额度或试用额度,这样的抽样不用花钱。
什么时候 SerpAPI 更合适
第一,你要的是某个搜索引擎原样的那一页。排名监控、SEO 竞品追踪、广告位监测、看 Google 本地商家和购物位的变化,都要知道「Google 这一刻给谁看了什么」,包括知识图谱、相关问题、AI 概览这些区块的位置。SerpAPI 把这些区块都拆成了字段,Tavily 的结果是它自己挑过的,不对应任何一个引擎的某一页。第二,你要的引擎很冷门。SerpAPI 有 Google 学术、Google 专利、Google 航班、Apple App Store、Home Depot、Naver 这类接口,11 月还在加;Tavily 只有一个搜索入口。第三,你的用量很大、要公开价下单。每月 100 万次以上,SerpAPI 的云档每 1,000 次 $3.75 到约 $1.96,有页面可以直接买;Tavily 在 10 万次以上要谈企业价。第四,你的答案要用 Google 的 AI 概览。SerpAPI 把概览解析成字段,11 月 2 日起还能解析概览里可点开的追问;代价是有时要第二次请求、照常计数,Tavily 和 EveryInfra web 都不返回 Google 的 AI 概览。第五,你在用 n8n 这类低代码工具:SerpAPI 是 n8n 的内置节点,不用另装,自建 n8n 也不用找管理员装社区节点。
SerpAPI 的代价也要算进去:响应大,要配 json_restrictor 或 Markdown 输出;读正文按页计费;月费制,额度到续订日清零;还有一桩没结的官司,下面单独说。
什么时候 Tavily 更合适
第一,你在做 RAG 或问答 agent,只想要「和问题相关的那几段原文」。Tavily 的 content 就是按问题切好的段落,每条最多 3 段,默认 10 条,约 3,900 个 token 以内,不用自己写解析和裁剪。第二,你的 agent 搜完一定要读正文。Tavily 的 Extract 每 5 个成功网址才 1 个 credit,或者在搜索时直接带 include_raw_content,比 SerpAPI 一页一次便宜 77% 到 89%。第三,用量小、不想绑卡。每月 1,000 个免费 credit 不绑卡,按量每次 $0.008,比 SerpAPI Starter 档每次 $0.025 便宜三倍多;学生和初创公司还有额外的免费额度。第四,你想让模型直接拿一个短答案:include_answer 不另收 credit,basic 和 advanced 两档都能用。
Tavily 的代价是:结果来源不透明,你不知道某条结果来自哪个引擎、排在第几;额度每月 1 日清零,用完请求就停;2026 年 2 月 Nebius 宣布收购 Tavily,之后的价格和产品方向要跟着看。
什么时候用 EveryInfra,什么时候不用
EveryInfra 的 web 按次扣 $0.000694,没有月费、没有档位,失败不扣,适合三类情况:用量起伏大、不想为空闲月份付月费的项目;要在一个 Key 下同时搜网页、读正文、搜新闻、搜购物、取 YouTube 字幕的 agent;已经在用我们其他平台数据能力、想把搜索也放进同一份账单的团队。下面几种情况不适合:你要 Google 结果页的完整区块(知识图谱、AI 概览、本地商家),用 SerpAPI;你要按问题切好段、带相关度分数的内容,用 Tavily 或我们的 deep 加你自己的切段;deep 带全文这一次实测用了 48 秒,对交互式的聊天不够快。还有一类情况要单独算:同一个词一小时内要重复搜很多次、又不在乎结果晚一点,SerpAPI 的缓存免费,可能比按次扣更省;EveryInfra 每次现查、每次扣费,重搜的结果会跟着变,我们 14 分钟后重搜同一个词,10 条里换了 2 条。这一类可以算出平衡点:SerpAPI Searcher 档一次 $0.00725,是我们一次 $0.000694 的 10.4 倍,同一个词一小时内重复不到 10 次,按次扣仍然更便宜;换成 SerpAPI 最低云档一次约 $0.00196,平衡点降到约 2.8 次,一小时内同一个词搜 3 次以上,那一档的缓存就开始划算。各能力的价格在 定价页,想看还有哪些可以替代 SerpAPI 的选择,见 SerpAPI 替代方案页。
2026 年 10 月到 11 月,两家都改了什么
SerpAPI 这两个月改得很密。它的 更新日志从 10 月 26 日到 11 月 21 日记了 135 条,其中 11 月 108 条。几条和 agent 有关的:2026 年 10 月 13 日上线 Extract API,可以读任意公开网页、整站最多爬 100 页,抓失败和命中缓存不计费,How-To Geek和 PPC Land都报道了;2026 年 11 月 2 日,Google AI 概览里可点开的追问也能解析了;2026 年 11 月 11 日接了一个新引擎的搜索接口,11 月 20 日又加了它的新闻接口和 Naver 知识问答接口;11 月 19 日 Walmart 搜索开始支持 walmart.ca,同一天修了 Google 轻量搜索把无关文字当成答案框的问题;11 月 18 日修了 AI 模式漏掉表格的问题。Python 客户端 serpapi 1.2.0 在 2026 年 10 月 30 日发布,serpapi-mcp 在 2026 年 11 月 12 日把请求移出事件循环,避免 MCP 服务在并发时卡住,2026 年 11 月 20 日补了 add-mcp 的安装说明。合规方面,2026 年 11 月 5 日 SerpAPI 发新闻稿说已加入互联网基础设施联盟 i2Coalition、拿到 EWDCI 信任标章,并列出 SOC 2 Type II、ISO 27001 等认证。
Tavily 这两个月的改动集中在开发者工具和限速上。2026 年 11 月 13 日发布 @tavily/cli 1.0.1,一条 npx @tavily/cli init 就能登录、写 Key、配 MCP;前一天 @tavily/core 发到 1.1.0;Python 客户端 tavily-python 0.8.5 在 2026 年 10 月 6 日发布。它的 限速文档在 11 月改成按组织计:免费每分钟 100 次,按量和 Project 到 Startup 每分钟 1,000 次,Growth 1,500 次,crawl 和 map 每分钟 100 次,research 20 次。更新日志记了 10 月加入的 max_age_hours 参数,可以指定只要多少小时内抓过的内容;免 Key 模式让没注册的用户也能试几次。往前看,2026 年 2 月 10 日 Nebius 宣布同意收购 Tavily,Tavily 自己的公告说产品和 API 照常可用。
Google 诉 SerpAPI:官司走到哪一步
2025 年 12 月 19 日,Google 在加州北区联邦法院起诉 SerpAPI,案号 4:25-cv-10826,CourtListener 上的案卷可以看到全部文书。核心诉求是 DMCA 的反规避条款:Google 认为 SerpAPI 绕过了它对搜索结果页的技术保护。法院在 2026 年 7 月 20 日第一次驳回起诉,Google 修改诉状后,2026 年 11 月 9 日法院再次驳回,但允许 Google 在 21 天内再改一次,到期不改就是不可再诉的驳回;Search Engine Roundtable和 PPC Land报道了这次裁定。按日期算,Google 要在 2026 年 11 月 30 日前后决定是否再提。对 SerpAPI 的用户,这意味着两件事:到目前为止法院没有支持 Google 的主张,服务照常;但官司没结,后面还可能有上诉。这里只是记录公开的程序进展,不构成法律意见,用数据做什么、在哪个国家用,请问你自己的律师。SerpAPI 的 法律页写了它给客户的 Legal Shield,只在 Production 档及以上的套餐里有。
常见问题
SerpAPI 和 Tavily 能一起用吗?
能,而且 YouTube 上排第一的那个对比视频就是这么建议的。常见的分工是 SerpAPI 拿某个引擎的原样排名和区块,Tavily 读正文或给短答案;Reddit 的 LangChain 板块里也有人说 SerpAPI 好用但不便宜,建议给它加用量上限。两家一起用,要维护两套 Key、两份月费,用量小时不划算。
Tavily API 免费吗?
部分免费。按 Tavily 的 定价页,免费档每月 1,000 个 credit,不绑卡,basic 搜索 1 次 1 个,所以每月能免费搜 1,000 次;advanced 搜索 2 个,Extract 每 5 个网址 1 个。额度每月 1 日清零,不累积。
SerpAPI 合法吗?会被 Google 起诉吗?
Google 已经在 2025 年 12 月起诉了 SerpAPI,法院在 2026 年 7 月和 11 月两次驳回了 Google 的 DMCA 诉求,Google 还有一次修改诉状的机会。这是程序进展,不是法律意见;SerpAPI 对 Production 档及以上的客户提供 Legal Shield。
SerpAPI 是 Google 的吗?
不是。SerpAPI 是一家位于美国得克萨斯州奥斯汀的公司 SerpApi LLC,和 Google 没有隶属关系,双方还在打官司。它卖的是对 Google、Bing 等搜索结果页的解析结果。
Tavily 的时间范围过滤准不准?
Reddit 的 RAG 板块有用户反映,用 Tavily 的时间范围参数时,结果里仍混着较早的内容;同一个帖子里也有人说只用 SERP 摘要做 RAG 效果差,要读正文。Tavily 10 月加了 max_age_hours,能指定只要多少小时内抓过的内容;按它的文档,免费档在负载高时带这个参数的请求可能回 434。
不注册能先试 Tavily 吗?Key 在哪拿?
能。Tavily 的 免 Key 模式让你在请求头里加 X-Tavily-Access-Mode: keyless 就能调搜索和 Extract,不用账号,有限速;它的文档写明免 Key 的响应和带 Key 的一样。要更高的额度,在 Tavily 控制台注册拿免费 Key,每月 1,000 个 credit。SerpAPI 没有免 Key 模式,要注册拿 Key,免费档每月 250 次。
SerpAPI 和 Tavily 哪个更省 token?
默认设置下 Tavily 更省:它默认上限约 3,900 个 token,SerpAPI 文档样例整份约 16,599 个。SerpAPI 样例原样交给模型约 16,599 个,加上 json_restrictor 只留三项以后约 523 个,比 Tavily 默认更小;Tavily 打开 include_raw_content 以后则会到上万。比较的时候要比同一种设置:我们的 web 原样平均约 973 个,只留三项约 703 个。
怎么开始
如果你要在 EveryInfra 上复现上面的实测:先按 快速上手拿到 Key,再用上面那段 curl 调 web,每次 $0.000694,失败不扣;要接进 Claude 或 Cursor,用 MCP 服务页里的写法;平台搜索的完整列表在 能力市场,网页搜索相关的入口在 网页搜索 API、Bing 搜索 API 和 YouTube 数据 API。延伸阅读:两家各自的计费细则见 SerpAPI pricing 逐档拆解 和 Tavily 每次调用扣几个 credit;SerpAPI 的另一组比较见 我们另一篇 SERP 接口对比,Tavily 的另一组比较见 我们另一篇 Tavily 对比;想看更多选择,见 Tavily 替代方案、SerpAPI 替代方案 和 给 AI agent 选网页搜索接口。
参考资料
- SerpAPI 定价页(含套餐与问答),2026-11-22 读取
- SerpAPI Google 搜索接口文档与样例响应
- SerpAPI Markdown 输出说明
- SerpAPI json_restrictor 说明
- SerpAPI 状态码与错误码说明
- SerpAPI Extract API 文档
- SerpAPI MCP 页面
- SerpAPI AI 概览说明
- SerpAPI Google AI Overview API 文档
- SerpAPI 更新日志
- SerpAPI 法律页与 Legal Shield
- serpapi-mcp 仓库
- serpapi-mcp 提交记录
- serpapi-python 仓库
- PyPI:serpapi
- npm:serpapi
- Tavily 定价页,2026-11-22 读取
- Tavily 计费文档 API Credits
- Tavily 搜索接口文档
- Tavily Extract 接口文档
- Tavily Map 接口文档
- Tavily Crawl 接口文档
- Tavily 限速文档
- Tavily MCP 文档
- Tavily 免 Key 模式
- Tavily 搜索最佳实践
- Tavily 更新日志
- tavily-mcp 仓库
- tavily-mcp 提交记录
- tavily-python 仓库
- PyPI:tavily-python
- npm:@tavily/cli
- npm:@tavily/core
- npm:tavily-mcp
- Nebius 宣布收购 Tavily(2026-02-10)
- Tavily 加入 Nebius 的公告
- Google LLC v. SerpApi LLC 案卷,CourtListener
- Search Engine Roundtable:Google 再次败诉(2026-11-10)
- PPC Land:Google 有 21 天修改诉状(2026-11-11)
- How-To Geek:SerpAPI Extract API
- PPC Land:SerpAPI 可以抓任意公开网页
- Reddit r/LangChain:Best Search Tool in Langchain
- Reddit r/Rag:在 Tavily 和 SERP 接口之间怎么选
- YouTube:三家搜索接口对比(2026-11-09)
- YouTube:n8n AI Agent Live Search
- YouTube:What's the Best Web Search for OpenClaw?
- EveryInfra 搜索工具清单,2026-11-22 读取
- EveryInfra 能力目录,2026-11-22 读取
- n8n 文档:SerpApi 工具节点
- Tavily n8n 集成文档
- npm:@tavily/n8n-nodes-tavily
引用编号 BL-212