Tavily vs Firecrawl:按文档算带全文的账
只要链接:Firecrawl 每千次 $1.20 起,Tavily $5 起;带10条全文:Tavily 未列加价,Firecrawl $7.19 起。
只要链接和摘要时,Firecrawl 一次搜索扣 2 个 credit(每 10 条),按 Standard 档折算每 1,000 次 $1.98,Tavily 一次 basic 搜索扣 1 个 credit,每 1,000 次 $5 到 $8,Firecrawl 便宜 2.5 到 4 倍。每次搜索还要带回前 10 条结果的全文时,Firecrawl 每条全文再加 1 个 credit,一次 12 个,按 Standard 档每 1,000 次 $11.88,按 Hobby 档 $45.60;Tavily 的计费文档只写搜索价由 search_depth 决定,没有给 include_raw_content 列加价,照这条算仍是每 1,000 次 $5 到 $8,账就反过来了。两家的数都按 2026-11-20 读到的公开计费页换算,我们没有开这两家的账号验证。2026 年 11 月 20 日凌晨(新加坡时间)我们用同一组 10 个查询在 EveryInfra 真调 web,10 次各扣 $0.000694,折合每 1,000 次 $0.694,每次返回 10 条,耗时 1.54 到 2.36 秒;再对 10 个首条结果调 read 读正文,10 次都拿到正文,每次同样 $0.000694;用 deep 一次带回 10 条结果和正文,也是 $0.000694。
两家的价格取自 Tavily 的 计费文档、定价页、帮助中心套餐说明,和 Firecrawl 的 定价页、计费文档、搜索功能文档,读取时间是 2026-11-20 00:15 到 00:23(新加坡时间);我们没有调用两家的接口,每 1,000 次价格按公开规则换算,换算脚本和输入一起存档。
Tavily vs Firecrawl 总对比:计费单位、免费额度和失败规则
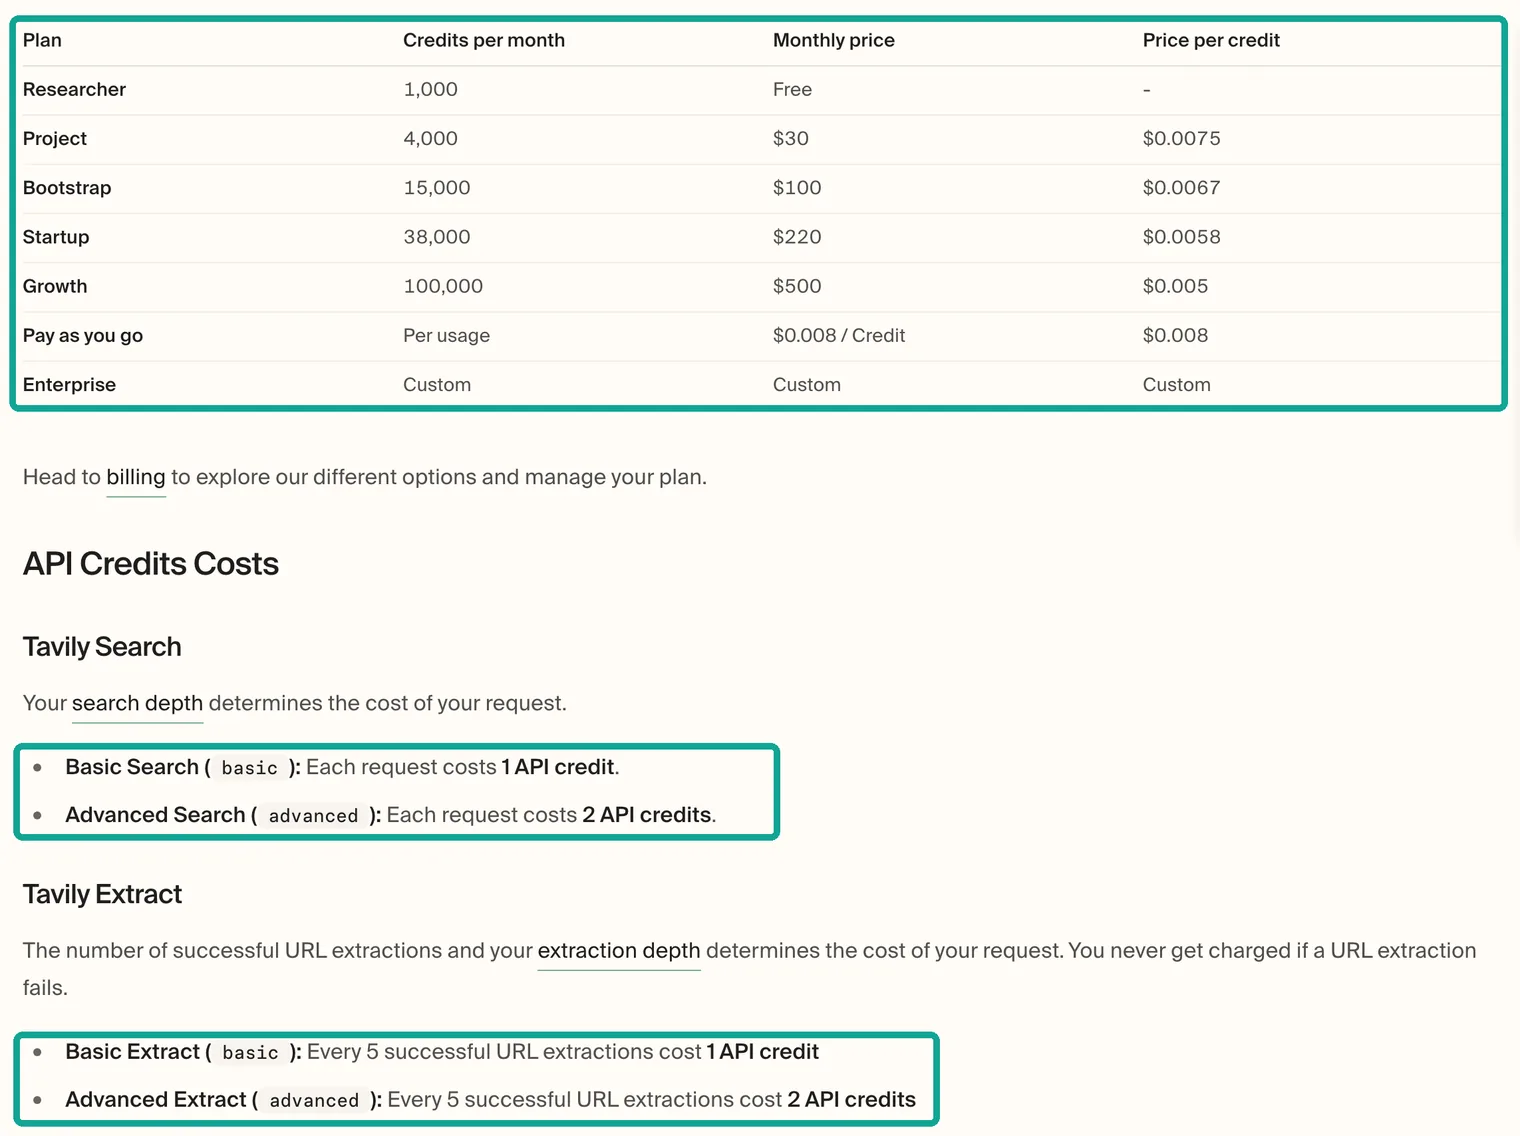
两家都按 credit 计费,免费档都是每月 1,000 个,一个 credit 买到的东西不同:Tavily 的 credit 按「请求」算,一次 basic 搜索不论返回几条都是 1 个;Firecrawl 的 credit 按「页」和「条」算,搜索每 10 条 2 个,抓一页 1 个,列网址一次 1 个。两家的套餐价也不在一个量级:Tavily 最贵的公开档 Growth 是每月 $500 换 100,000 个 credit,每个 $0.005;Firecrawl 的 Standard 是每月 $99 换 100,000 个,每个 $0.00099。
| 项目 | Tavily | Firecrawl |
|---|---|---|
| 计费单位 | credit,按请求和成功网址折算 | credit,按页、按每 10 条搜索结果折算 |
| 免费额度 | 每月 1,000,不绑卡 | 每月 1,000,不绑卡 |
| 最低付费 | 按量 $0.008 一个;或 Project $30/月 4,000 个 | Hobby $19/月(年付 $16)5,000 个 |
| 中档 | Bootstrap $100/15,000、Startup $220/38,000 | Standard $99/月(年付 $83)100,000 个 |
| 高档 | Growth $500/100,000 | Growth $399/500,000、Scale $749/1,000,000 |
| 额度清零 | 每月 1 日,和付款日无关 | 每个续费日;Scale 年付结转 1 个月 |
| 用完以后 | 请求停止,直到下月或升级 | 付费档按 $5 一包自动补;免费档回 402 |
| 一次搜索 | basic 1 个,advanced 2 个 | 每 10 条 2 个,带全文每条再加 1 个 |
| 抓 1 页正文 | 每 5 个成功网址 1 个(advanced 2 个) | 1 个;JSON 抽取再加 4 个 |
| 失败扣不扣 | Extract、Map 失败不扣 | 返回了文档就扣,403、404 也扣 1 个 |
| 每分钟请求 | 免费 100;付费 1,000;Growth 1,500 | 免费 10;Hobby 100;Standard 500;Growth 5,000 |
| 不注册试用 | 搜索、Extract 免 Key(加请求头) | 搜索、抓取免 Key,按 IP 每天限量 |
| 开源自托管 | 没有 | AGPL-3.0,可自托管 |
| 浏览器交互 | 文档写明不做 | Interact,每浏览器分钟 2 到 7 个 credit |
Firecrawl 定价页注明这套价目自 2026 年 9 月 4 日起生效。Tavily 的四档月付套餐在计费文档的表格里列全了,定价页上只直接显示 Project 一档,其余三档藏在滑块里。两家用完额度后的行为差得很远:Tavily 不开按量的话,额度用完请求就停;Firecrawl 付费档打开按量后,余额归零时自动买一包,每包 $5,Hobby 档一包 1,000 个 credit,Standard 2,000 个,Growth 2,500 个,Scale 5,000 个,所以 Hobby 档超额后的 credit 单价是 $0.005,比套餐内的 $0.0038 贵三成。
换算成每 1,000 次:两家各自最便宜和最贵的档
要把两家的价格放在一起比,先把每个 credit 的单价按档位列出来,再乘上每件活要扣的 credit 数。Tavily 的单价从按量的 $0.008 到 Growth 的 $0.005,差 1.6 倍;Firecrawl 从 Hobby 月付的 $0.0038 到 Scale 年付的 $0.000599,差 6.3 倍。Firecrawl 档位跨度大,换算结果就要看用户能用满哪一档:一个月只用两三千个 credit 的团队买不到 Standard 的单价,因为 Standard 是每月 $99 起付。
| 档位 | Tavily 每个 credit | Firecrawl 每个 credit(月付 / 年付) | Firecrawl 超额每个 credit |
|---|---|---|---|
| 入门 | 按量 $0.008;Project $0.0075 | Hobby $0.0038 / $0.0032 | $0.005 |
| 中档 | Bootstrap $0.0067;Startup $0.0058 | Standard $0.00099 / $0.00083 | $0.0025 |
| 高档 | Growth $0.005 | Growth $0.000798 / $0.000666 | $0.002 |
| 最高公开档 | — | Scale $0.000749 / $0.000599 | $0.001 |
每件活扣几个 credit,按两家文档的规则算。Tavily 的 搜索接口文档 写明 max_results 最大 20,计费只看 search_depth,返回 10 条和 20 条一样是 1 个 credit;Firecrawl 的 搜索功能文档 写「每 10 条结果 2 个 credit,向上取整」,1 到 10 条是 2 个,11 到 20 条是 4 个,打开抓取选项时每条结果再按抓取价计。抓一页正文,Tavily Extract 每 5 个成功网址 1 个 credit,Firecrawl Scrape 每页 1 个。整站抓取,Tavily Crawl 等于 Map 加 Extract,每 10 页 basic 3 个 credit;Firecrawl Crawl 每页 1 个。要把页面抽成结构化 JSON,Firecrawl 每页再加 4 个;Tavily 没有按 schema 抽取的计费项,这里用 advanced Extract 的价格对照,两者做的事并不完全相同。
| 一件活(1,000 次或 1,000 页) | Tavily credit | Tavily 美元(Growth 到按量) | Firecrawl credit | Firecrawl 美元(Scale 年付到 Hobby 月付) | EveryInfra 实扣 |
|---|---|---|---|---|---|
| 搜索 1,000 次,每次 10 条 | 1,000 | $5.00 到 $8.00 | 2,000 | $1.20 到 $7.60 | $0.694(web) |
| 搜索 1,000 次,每次 20 条 | 1,000 | $5.00 到 $8.00 | 4,000 | $2.40 到 $15.20 | $1.388(web 翻 2 页) |
| 搜索 1,000 次 + 前 10 条全文 | 1,000(计费表未列加价) | $5.00 到 $8.00 | 12,000 | $7.19 到 $45.60 | $0.694(deep 带全文,一次 10 条) |
| 读 1,000 页正文 | 200 | $1.00 到 $1.60 | 1,000 | $0.60 到 $3.80 | $0.694(read) |
| 整站爬 1,000 页 | 300 | $1.50 到 $2.40 | 1,000 | $0.60 到 $3.80 | $0.0694(crawl 实测一次 10 页) |
| 1,000 页抽成 JSON | 400(advanced Extract 对照) | $2.00 到 $3.20 | 5,000 | $3.00 到 $19.00 | 没有对应能力 |
区间宽度说明了两家的定价思路。Tavily 的区间很窄,从按量到 Growth 只差 1.6 倍,小团队和大团队付的单价差不多;Firecrawl 的区间宽到 6 倍以上,用量越大、越肯年付,单价降得越多。对一个每月只跑几千次搜索的个人项目,Firecrawl 的 Hobby 月付折算下来每 1,000 次搜索 $7.60,和 Tavily 按量的 $8 几乎一样;对一个每月能用满 100,000 个 credit 的团队,Firecrawl Standard 的 $1.98 只有 Tavily Growth $5 的四成。
分岔点:搜索时要不要顺手带回全文
只要标题、链接和摘要的 agent,Firecrawl 在中高用量下便宜得多;每次搜索都要读前几条结果正文的 agent,按两家文档算是 Tavily 便宜得多。Firecrawl 这一侧有明文:搜索文档在「Cost Implications」一节写,打开抓取选项后「标准抓取价适用于每一条搜索结果」,基础抓取每页 1 个 credit,所以一次「搜索 + 前 10 条全文」是 2 + 10 = 12 个。Tavily 这一侧没有明文,只有计费表的沉默:计费文档 写搜索的价格由 search_depth 决定,basic 1 个、advanced 2 个,没有列任何附加项;搜索接口文档 里 include_raw_content 的说明只写「返回每条结果清洗、解析后的 HTML 内容」,text 格式「可能增加延迟」,没有提 credit。
我们 2026-11-20 重新打开 Tavily 的计费文档、搜索接口文档、搜索最佳实践、Extract 最佳实践 和 FAQ,没有一处写「include_raw_content 不另收费」,也没有一处写要加价。同一批文档对会改变价格的参数是写明的:auto_parameters 一节提醒它可能把深度自动切到 advanced、「每次 2 个 credit」;max_age_hours 一节写「更低的值不会多扣 credit」。include_raw_content 两种话都没有。Extract 最佳实践把「搜索时打开 include_raw_content」列为一次调用拿结果和正文的做法,和单独调 Extract 的区别只写成「能不能挑网址」,也没有谈价。下面的换算按「计费表没列,就按 1 个 credit 算」处理;Tavily 搜索接口有 include_usage 参数,打开后响应里的 usage.credits 会写这次扣了几个,开免费账号的读者调一次就能核对,核对结果和 1 不同,下面所有 Tavily 带全文的数都要重算。
按每个 credit 的单价乘回去:Tavily 按量 $0.008、Growth $0.005;Firecrawl 12 个 credit 在 Standard 档是 $0.01188,在 Scale 年付是 $0.00719,在 Hobby 月付是 $0.0456。也就是说,在「搜索带全文」这件活上,Firecrawl 用到最便宜的 Scale 年付,单次价格 $0.00719 仍高于 Tavily Growth 的 $0.005;Hobby 档单次 $0.0456,是 Tavily 按量价的 5.7 倍。只拿前 5 条全文时 Firecrawl 是 7 个 credit,Standard 档每 1,000 次 $6.93,和 Tavily 按量 $8 接近,Scale 年付 $4.19 低于 Tavily Growth。分界大约就在「每次读几条全文」:读 3 条以内,Firecrawl Standard 更省;读 5 条,两家接近;读 10 条,Tavily 更省。这条分界的前提是 Tavily 带全文仍是 1 个 credit。
只搜索时,Firecrawl 的免费 1,000 个 credit 只够 500 次搜索,Tavily 的够 1,000 次,所以在每月 1,000 次以内 Tavily 免费、Firecrawl 要买 $19 的 Hobby;到每月 20,000 次,两家最省的买法分别是 Tavily Bootstrap $140 和 Firecrawl Standard $99;到 100,000 次,Tavily Growth $500,Firecrawl Standard 加超额 $349;到 200,000 次,Tavily 要 $1,300,Firecrawl Growth $399。
加上全文之后(Tavily 仍按 1 个 credit 算),每个用量点的位置都换了。每次 12 个 credit,Firecrawl 的免费额度只够 83 次搜索,每月 1,000 次就要 Hobby 加 7 包超额共 $54,而 Tavily 还在免费档;每月 20,000 次,Firecrawl 要 Growth $399,Tavily Bootstrap $140;每月 50,000 次,Firecrawl $599,Tavily $316。这里有一条边界要写清:Tavily 的 include_raw_content 返回的是 Tavily 缓存或实时抓取的清洗内容,Firecrawl 的对比页 引用其 2026 年 1 月 13 日在 1,000 个网址上的自测,称 Firecrawl 抽取准确率 F1 0.638、Tavily 0.494,P95 延迟 3,387 毫秒对 7,339 毫秒;这是 Firecrawl 自己的测试,测试工具尚未公开。一位 Reddit 用户在 r/WebScrapingInsider 的帖子 里用同一组 100 个网址测,可直接使用的结果 Firecrawl 93 个、Tavily 87 个,他自己也写了样本小。正文质量要拿自己的网址各跑几十个再比。
我们用 EveryInfra 的 youtube/search 搜了「tavily vs firecrawl」,取前 3 个视频用 youtube/transcript 拿字幕(2026-11-20 00:15 到 00:27,新加坡时间),三条都没有算「搜索带全文」各要几个 credit。排第一的 2 分 53 秒对比视频(2026 年 7 月 4 日发布)建议两家一起用:Tavily 找资料,Firecrawl 抽内容。按两家文档的计费规则,「搜到就要读」时这个组合是两份账单:Tavily 搜一次 1 个 credit,再把前 10 条交给 Firecrawl 抓是 10 个,而 Tavily 自己的搜索带全文按计费表算只要 1 个。第二条是一期 27 分钟的 Firecrawl 介绍节目,没有讲 Tavily;第三条是 2026-11-08 发布的五家搜索接口盘点,默认字幕是阿拉伯语,只提到 Tavily 免费档每月 1,000 个 credit、advanced 模式更贵、已归 Nebius 所有,以及 Firecrawl 能读整页和整站,同样没有给出带全文的扣数。
两家自己的对比页各说了什么
两家都写了对方的对比页,读的时候要分清哪些是可核对的规则、哪些是自测结果。Tavily 的 对比页 没有给价格和测试数字,主要是定位:Tavily 做「带引用的检索和研究」,Firecrawl 做「网页数据抽取和浏览器自动化」,并在表格里写明浏览器交互「按设计不做,可以配你喜欢的浏览器工具」,托管方式只有云服务。Firecrawl 的 对比页 给了一串数字:自测 1,000 个网址的抽取准确率和延迟(前文已引);引用第三方 AIMultiple 的 agent 搜索评测,说 Firecrawl 得分 14.58、排第 2,Tavily 13.67、排第 5,Firecrawl 的搜索文档标注这组数取自 2025 年 12 月的评测、来源页 2026 年 5 月更新过,并承认前几名之间置信区间重叠;我们 2026-11-20 打开 AIMultiple 的评测页,页面已经换成 6 家搜索接口、120 个问题的新版本,找不到 14.58 这个数,新版里「摘录有来源支撑」一项 Firecrawl 和 Tavily Advanced 都是 64.0%,「答案时效」一项 Tavily Ultra Fast 是 26.3%;还有一个面向编程 agent 的评测,只搜索时每个任务平均用 7,456 个模型 token,Tavily basic 用 16,299 个。
接口费之外还有模型 token 费。我们 00:29:38 用 EveryInfra deep 带全文搜「tavily vs firecrawl」,10 条结果的正文合计 88,022 个字符,最长一条截在 20,000 个字符,最短的 YouTube 一条只有 64 个;按英文约 4 个字符 1 个 token 估,一次「搜索带前 10 条全文」要喂给模型约 22,000 个 token。假设模型输入价是每百万 token $1,这一次的模型费约 $0.022,是 Tavily 一次搜索 $0.005 到 $0.008 的 3 到 4 倍,也高于 Firecrawl Standard 档 12 个 credit 的 $0.01188。上面那个编程 agent 评测里每个任务相差的 8,800 多个 token,按同一假设单价是 $0.0088,和两家每次搜索的差价在同一量级。Tavily 的 chunks_per_source(每条最多 3 段、每段约 500 个字符)就是用来少喂内容的:只要片段时,10 条结果最多约 15,000 个字符。两家的评测都由一方主导或引用,测试集和方法各不相同,Firecrawl 自己也注明「不能直接互相比较」。
自己测质量:20 个查询、半天就能做完的小评测
价格能从文档算出来,结果好不好只能拿自己的查询测。两家的对比页和第三方评测都用别人的问题集,和你的 agent 实际会搜的东西未必一样。下面是我们给读者的做法,规则在动手前写下,避免看到结果再改标准:
- 从自己 agent 最近的日志里随机抽 20 个真实查询,不挑;一半是事实类(某个价格、某个版本号),一半是开放类(某个库怎么用)。
- 两家都用免费额度:Tavily 每次 basic 搜索 1 个 credit、带全文按计费表也是 1 个(打开
include_usage在响应里核对),20 次 20 个;Firecrawl 每次 2 个 credit、抓前 3 条再加 3 个,20 次 100 个。两家的免费 1,000 个都够,不用付钱。 - 每个查询记三件事:前 5 条里有没有能直接回答问题的页面;正文有没有把导航、广告、Cookie 提示带进来;从发请求到拿全文用了几秒。
- 事实类查询提前写好标准答案,答对与否由人判断,不让模型给自己打分。
- 通过标准写成数:例如「20 题里能答对的题数相差 2 题以内,就按价格选」「正文里夹带的杂项超过 3 成,就算这一项不过」。
测的时候把每次请求的原始响应存成文件,文件名带查询编号和时间,结果出来后谁都能回头核;同一个查询隔一小时再测一次,看结果变动有多大,我们自己的实测里,同一个查询隔 6 分钟重搜,前 10 条只重合 4 条的情况也出现过。EveryInfra 一侧的同一套测试,每次搜索和每次读正文都是 $0.000694,20 个查询各读 3 篇是 80 次调用、$0.0555。
读一千页正文:Extract 对 Scrape,失败怎么算
单独抓正文时,Tavily Extract 的单价比 Firecrawl 低端档便宜、比高端档贵:每 1,000 页 basic $1.00 到 $1.60,Firecrawl $0.60(Scale 年付)到 $3.80(Hobby 月付),Standard 档 $0.99。两家在「失败」上的规则差得更多。Tavily 计费文档写「URL 抽取失败永远不收费」,而且 Extract 的 credit 是按成功网址累计折算的。Firecrawl 计费文档的「When credits are charged」一节写,决定扣不扣的是 Firecrawl 有没有返回文档,跟目标站的 HTTP 状态码无关:目标站回 403 Forbidden 或 404 Not Found,Firecrawl 把这个响应当文档返回,照扣 1 个 credit;只有网站完全没响应、每次渲染都失败、没有文档返回时才是 0。文档建议用 metadata.statusCode 识别这类结果,别再重试一直被拦的网址。
| 情况 | Tavily | Firecrawl |
|---|---|---|
| 目标站正常返回 | Extract 每 5 个成功网址 1 个 | Scrape 每页 1 个 |
| 目标站回 403 或 404 | 抓取失败,不扣 | 返回了文档,扣 1 个 |
| 网站无响应、渲染全失败 | 不扣 | 不扣 |
| 打开 JSON、问答、高亮格式 | 没有这类计费项 | 每页加 4 个 |
| 零数据保留 | 对比页写有此选项,计费文档未单列 | 每页加 1 个 |
| 解析 PDF | 计费文档未单列 | 每个 PDF 页加 1 个 |
| 提示注入检查 | 没有单独计费项 | 每页加 4 个,检查跑完后抓取失败也收 5 个 |
| 搜索结果反馈 | 没有 | 每个搜索任务第一次反馈可退 1 个 |
失败规则会改变「有效单价」。一个监控竞品文档站的 agent,网址清单里有一成页面已经下线(404),用 Firecrawl 抓 1,000 页要付 1,000 个 credit,其中 100 个买到的是 404 页面;用 Tavily 抓同样 1,000 个网址,只为 900 个成功网址付 180 个 credit。反过来,Firecrawl 把 403 页面也交回来,对排查「哪些站在拦我」有用,Tavily 这边只能从失败列表里看。EveryInfra 的 read 在 2026-11-20 00:29:32(新加坡时间)抓一个不存在的 Tavily 文档网址,回 HTTP 404、错误码 target_not_found,billing.charged_usd 为 0,reason 为 request_failed_refunded,和 Tavily 的处理一致,和 Firecrawl 相反。
整站和列网址:Crawl、Map 的计法差几百倍
列一个站的网址时,两家的计价相差几个数量级。Firecrawl 的 Map 文档 写「每次 Map 请求扣 1 个 credit,不论返回多少个网址,把 limit 设成 100,000 也是 1 个」;Tavily 的 Map 每 10 个成功页面 1 个 credit,列 1,000 个网址就是 100 个 credit,按量 $0.80。只列网址、不抓正文的场景(做站点地图、找新页面、给后续抓取排队),Firecrawl 几乎不花钱。整站抓取正文时又反过来:Tavily Crawl 是 Map 加 Extract,每 10 页 3 个 credit,每页 0.3 个;Firecrawl Crawl 每页 1 个。按单价折算,Tavily Growth 每 1,000 页 $1.50,Firecrawl Standard $0.99、Scale 年付 $0.60、Hobby $3.80。Firecrawl 还提醒,整站和批量抓取的 credit 在每页处理完时异步记账,提交任务后几分钟甚至几小时内账面还会继续变,月底对账时要留出这段延迟。
| 列网址、爬整站 | Tavily | Firecrawl | EveryInfra 实测 |
|---|---|---|---|
| 列 1,000 个网址 | 100 个 credit($0.50 到 $0.80) | 1 个 credit($0.0006 到 $0.005) | 实测列 100 个一次 $0.000694 |
| 爬 10 页带正文 | 3 个 credit | 10 个 credit | 实测一次 $0.000694 |
| 每分钟上限 | Crawl、Map 各 100 次 | 免费 2 次,Hobby 20 次,Standard 100 次 | 按账户设上限,超限回 429、不扣费 |
| 记账时间 | 计费文档未写延迟 | 每页处理完时,可能延后数小时 | 请求返回时,响应里带 billing |
额度过期、按量和超额:月底那几天最容易多花
两家的额度都是「用不完就作废」,只是清零的日子不同。Tavily 定价页的 FAQ 写额度在每月第一天重置,跟付款日无关;Firecrawl 计费文档写月付套餐在每个续费日重置,年付也按「虚拟月续费日」每月重置,只有 Scale 年付能把没用完的套餐额度结转 1 个月,Enterprise 年付结转 2 个月。Firecrawl 另有两点 Tavily 没有:一是手动买的 credit 一直留在账上,直到退订才作废;二是升级立即生效、当天按新档全价扣款且不按天折算,原档没用完的 credit 会带到新档。
超额的处理方式决定了「月底突发流量」的成本。Tavily 不开按量,用完就停;开了按量,超出部分每个 $0.008。Firecrawl 付费档打开按量后,余额归零时自动买一包,用户可以给按量设每月上限(按 $5 的整数倍向下取整,设 0 就关掉),文档还写了一段「超额缓冲」:为了让一波请求在补包结算期间不中断,Hobby 有 1,500 个、Standard 30,000 个、Growth 150,000 个、Scale 600,000 个 credit 的透支空间,超过月上限且用完缓冲后才回 402。免费档没有按量,用完直接 402。年付能再省一截,但要一次付清:Firecrawl Hobby 年付每月 $16,一年 $192,月付一年是 $228;Standard 年付一年 $996,月付 $1,188;Scale 年付比月付省 20%,其他档省 16.7%。Tavily 的计费文档和定价页只列了月付价,没有年付折扣;Tavily 的 FAQ 写换档「通常按比例折算」,月中升级只补剩余天数的差价,改成低档要到下个账期才生效,和上一段 Firecrawl 的升级规则不同。对每月用量波动大的 agent,Firecrawl 的「档内平、超额按包」意味着落在档位边缘时最划算,越过边缘一点点就要多付一整包;Tavily 的按量是线性的,没有台阶。
| 月底情况 | Tavily | Firecrawl |
|---|---|---|
| 免费档用完 | 请求停止 | 返回 402 |
| 付费档用完、没开按量 | 请求停止 | 返回 402 |
| 付费档用完、开了按量 | 每个 credit $0.008 | 自动买 $5 一包,Hobby 1,000 个、Scale 5,000 个 |
| 给超额设上限 | 计费文档只写「额度用完后按每个 credit 计费」,没写上限设置 | 每月上限按 $5 整数倍,另可给单个 Key 设每日、每周、每月 credit 上限 |
| 没用完的额度 | 每月 1 日清零 | 续费日清零;Scale 年付结转 1 个月;手动买的保留到退订 |
同一组 10 个查询:EveryInfra 实测
我们挑了 10 个 agent 常见的查询,一半和本题相关(两家的定价、限速),一半是写代码时会搜的东西(MCP 传输层、Python 重试、远程 MCP 配置、LangChain 搜索工具、llms.txt 等),在 2026-11-20 00:17 到 00:23(新加坡时间)用 EveryInfra 搜索接口的 web 工具调用,num 设 10,表中为每个查询最后一次成功调用。10 次全部返回 10 条,每次扣 $0.000694,耗时(本机计时,含网络)从 1.54 秒到 2.36 秒。web 返回的是标题、链接和摘要,不带正文;要正文就对结果网址再调 read,同样每次 $0.000694。每个 Key 都有每分钟请求上限,超过时返回 429,响应写明没扣费并给出重试等待秒数,等待后重发成功。
| # | 查询 | 新加坡时间 | 返回条数 | 耗时(秒) | 第 1 条结果 | `charged_usd` |
|---|---|---|---|---|---|---|
| 1 | tavily vs firecrawl | 00:17:21 | 10 | 1.88 | tavily.com 对比页 | 0.000694 |
| 2 | firecrawl search endpoint pricing credits | 00:17:30 | 10 | 1.77 | firecrawl.dev 定价页 | 0.000694 |
| 3 | tavily search api rate limits | 00:19:39 | 10 | 1.87 | Tavily 限速文档 | 0.000694 |
| 4 | model context protocol streamable http transport | 00:21:49 | 10 | 1.54 | MCP 规范传输层一节 | 0.000694 |
| 5 | python requests retry backoff timeout | 00:21:57 | 10 | 2.36 | requests 高级用法文档 | 0.000694 |
| 6 | claude code add remote mcp server | 00:22:07 | 10 | 1.79 | Reddit 讨论帖 | 0.000694 |
| 7 | langchain web search tool for agents | 00:22:16 | 10 | 2.29 | LangChain 集成文档 | 0.000694 |
| 8 | open source web scraping library llm markdown | 00:22:25 | 10 | 1.73 | GitHub 开源仓库 | 0.000694 |
| 9 | llms.txt proposal website | 00:23:34 | 10 | 2.34 | llmstxt.org | 0.000694 |
| 10 | openai web search tool pricing per call | 00:23:44 | 10 | 2.32 | OpenAI 定价文档 | 0.000694 |
接着对每个查询的第一条结果调 read(第 6 题首条是 Reddit 帖子,按规则跳过,取第二条 MCP 官方文档),时间是 00:23:54 到 00:27:02。10 次都成功返回正文,最短的是 Tavily 限速文档 1,577 个字符,最长的是 requests 高级用法文档 43,614 个字符;耗时 0.78 秒到 3.66 秒,最慢的是 MCP 规范的传输层一节。每次扣 $0.000694,10 次 $0.00694。按页计费的 Firecrawl 读同样 10 页是 10 个 credit,Tavily Extract 是 2 个 credit;页面长短不影响任何一家的价格。
「搜索带全文」在 EveryInfra 对应的是 deep 工具加 full=true。00:29:38 用查询 1 调一次,返回 10 条结果,其中 8 条带 1,000 个字符以上的正文(Reddit 和 YouTube 两条只有几十到两百多个字符),扣 $0.000694,耗时 20.47 秒;00:30:05 用查询 6 再调一次,10 条、5.97 秒、同样 $0.000694。单条正文最长截在 20,000 个字符。慢是这个工具的代价:web 两秒左右,deep 带全文要 6 到 20 秒。整站和列网址各测了一次:00:30:17 对 docs.tavily.com 调 crawl(num 10),1.49 秒拿回 10 页正文;00:30:25 对 docs.firecrawl.dev 调 map(num 100),0.41 秒拿回 100 个网址;两次各扣 $0.000694。
重复和出错的情况也各试了一次。00:29:02 到 00:29:18 把查询 1、5、9 原样再搜一遍:查询 5 的 10 条和第一轮完全相同,查询 1 重合 8 条、第一条换了,查询 9 只重合 4 条,网页搜索的结果本来就会随时间变,做缓存或对账时要按「每次结果可能不同」处理。00:29:26 故意照 Tavily 的写法把参数名写成 query,回 422,错误码 unknown_param,did_you_mean 给出 q,allowed 列出 7 个参数,next_steps 写明没有扣费。00:29:32 读一个不存在的网址,回 404、扣 $0。
这一组数和两家的换算价对照:同样 10 次只要链接的搜索,EveryInfra 实扣 $0.00694;Tavily basic 是 10 个 credit,按量 $0.08;Firecrawl 是 20 个 credit,Standard 档 $0.0198,Hobby 档 $0.076。同样 10 个网址读正文,EveryInfra 实扣 $0.00694;Tavily Extract 2 个 credit,按量 $0.016;Firecrawl 10 个 credit,Standard 档 $0.0099。返回内容的质量我们没有和两家逐条比较:两家的结果需要注册账号调用才能拿到,我们没有开这两家的账号。
一次研究会话的账:10 个查询、每个读 3 篇
把实测的 10 个查询当成一个 agent 一次研究会话的全部搜索,再假设模型每次挑前 3 条读正文,这是写技术方案、查资料时常见的节奏。Tavily 有两种做法:让搜索直接带全文,按计费表一共 10 个 credit;或者先搜、再用 Extract 抓 30 个网址,30 个网址折 6 个 credit,加 10 次搜索共 16 个。Firecrawl 也有两种:搜索时用 scrapeOptions 只抓前 3 条需要把 limit 设成 3,每次 2 + 3 = 5 个 credit,共 50 个;先搜 10 条再单独抓 3 页,每次 2 + 3 = 5 个,同样 50 个。EveryInfra 先 web 再 read 3 次是每个查询 4 次调用,共 40 次 $0.02776;用 deep 带全文一次拿 10 条正文,10 次 $0.00694。
| 一次会话(10 个查询,每个读 3 篇) | 消耗 | 按量或入门档 | 中高档 |
|---|---|---|---|
| Tavily 搜索带全文 | 10 个 credit | $0.08(按量) | $0.05(Growth) |
| Tavily 先搜后 Extract | 16 个 credit | $0.128(按量) | $0.08(Growth) |
| Firecrawl 搜索带 3 条全文 | 50 个 credit | $0.19(Hobby) | $0.0495(Standard) |
EveryInfra web + read ×3 | 40 次调用 | $0.02776(实扣单价) | 同左 |
EveryInfra deep 带全文 | 10 次调用 | $0.00694(实扣单价) | 同左 |
一次会话的差额只有几美分,乘到每天几百次会话才看得出来:按每天 300 次、每月 30 天算,Tavily 搜索带全文是每月 90,000 个 credit,Growth 档 $500 装得下;Firecrawl 每月 450,000 个 credit,Growth 档 $399 装得下。两家在这个量级几乎打平,Firecrawl 便宜约 $100;如果每次只读 1 篇,Firecrawl 每月降到 270,000 个 credit,Growth 年付 $333,Tavily 还是 90,000 个。读的篇数越少,Firecrawl 越占优,这和前面的分岔点一致。
四种月用量:Tavily、Firecrawl 和 EveryInfra 的账单
把前面的规则套到四种典型的月用量上,每种都取各家最省的买法(月付价,含超额补包):A 是一个轻量 agent,每月 1,000 次搜索加 1,000 页正文;B 是一个问答机器人,每月 10,000 次搜索,每次带前 5 条全文;C 是每月整站爬 50,000 页的文档索引;D 是每月 100,000 次只要链接和摘要的搜索。
| 用量 | Tavily credit | Tavily 最省 | Firecrawl credit | Firecrawl 最省(月付 / 年付) | EveryInfra 按实扣 |
|---|---|---|---|---|---|
| A 1,000 次搜索 + 1,000 页 | 1,200 | 免费 + 按量 $1.60 | 3,000 | Hobby $19 / $16 | 2,000 次调用 $1.39 |
| B 10,000 次搜索带前 5 条全文 | 10,000 | 免费 + 按量 $72 | 70,000 | Standard $99 / $83 | 10,000 次 deep 带全文 $6.94 |
| C 每月爬 50,000 页 | 15,000 | Bootstrap $100 | 50,000 | Standard $99 / $83 | 按一次 10 页折 5,000 次 $3.47 |
| D 100,000 次只要链接 | 100,000 | Growth $500 | 200,000 | Standard 加超额 $349 / $333 | 100,000 次 $69.40 |
A、B 两组 Tavily 更省,D 组 Firecrawl 更省,C 组两家差 $1。A 组的量太小,Firecrawl 的免费额度只够 500 次搜索,必须买 $19 的 Hobby,Tavily 只要为超出免费额度的 200 个 credit 付 $1.60。B 组每次要 5 条全文,Firecrawl 每次 7 个 credit,一个月 70,000 个,Standard 档装得下;Tavily 按计费表每次 1 个,按量 $72,比 Firecrawl 便宜 $27,如果 Tavily 实际给带全文加价,这一组会先翻过来。C 组 Tavily Bootstrap $100、Firecrawl Standard $99。D 组只要链接,Firecrawl Standard 加 125,000 个超额 credit 共 $349,比 Tavily Growth 便宜 $151;如果用户能把月量压在 Firecrawl Growth 的 500,000 个 credit 以内并且提前买下这一档,单次价格还会更低。EveryInfra 的四个数都是实扣单价 $0.000694 乘调用次数;C 组假设每次 crawl 带回 10 页,这是本轮实测的值,更大的 num 没有测,一次能带回多少页要以自己的站点实测为准。
Tavily vs Firecrawl 的 MCP 和 AI 工具接入
两家都有托管的远程 MCP 服务,也都能不注册先试。Tavily 的 MCP 文档 列出了 Claude、ChatGPT 和 Codex、Cursor、VS Code 的一键安装,远程地址是 https://mcp.tavily.com/mcp/;免 Key 文档 写,加请求头 X-Tavily-Access-Mode: keyless 就能免费用搜索和 Extract,MCP 里对应 tavily-search、tavily-extract 两个工具,按公平使用限速。Firecrawl 的 MCP 文档 给了三种连法:免 Key(https://mcp.firecrawl.dev/v2/mcp,只开放搜索、抓取和解析三个工具)、浏览器登录(/v2/mcp-oauth)和带 Key;免 Key 说明 写,用 API Key 连接才能拿到完整工具集。
| 接入项 | Tavily | Firecrawl | EveryInfra |
|---|---|---|---|
| 远程 MCP 地址 | https://mcp.tavily.com/mcp/ | https://mcp.firecrawl.dev/v2/mcp | https://api.everyinfra.com/mcp |
| 不注册能用的工具 | 搜索、Extract | 搜索、抓取、解析 | 无,需 Key |
| 登录方式 | OAuth 或 Key | OAuth 或 Bearer Key | Bearer Key |
| 开源 MCP 服务器 | tavily-mcp(MIT,npm 0.2.22;仓库 2026-11-18 有新提交) | firecrawl-mcp(MIT,npm 3.41.0,2026-11-19 发布) | 无 |
| 命令行 | @tavily/cli 1.0.1(2026-11-13) | firecrawl CLI;Python SDK firecrawl-py 4.57.0(2026-11-12) | 无 |
| 一个 MCP 工具覆盖多少能力 | 每个接口一个工具 | 每个接口一个工具,带 Key 时有 Interact、Agent 等 | everyinfra_search 一个工具 17 种搜索;另有社媒、电商等数据能力 |
在 Claude Code 里把三家并排加上,配置大致如下;Tavily 和 Firecrawl 两段照它们文档里的写法,没有在本机跑过,属于配置示例:
# Tavily:免 Key 试用(需要能发请求头的客户端)
claude mcp add tavily --transport http https://mcp.tavily.com/mcp/ \
  --header "X-Tavily-Access-Mode: keyless"
# Firecrawl:免 Key 试用
claude mcp add --transport http firecrawl https://mcp.firecrawl.dev/v2/mcp
# EveryInfra:带 Key
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"
接到 agent 里以后,账单还受模型怎么调工具影响。同一个「查一下 X 的最新价格」,模型如果先搜索、再逐个抓前 5 条,在 Firecrawl 上是 2 + 5 = 7 个 credit,在 Tavily 上是 1 次搜索加 1 个 credit 的 Extract(5 个网址正好折 1 个),共 2 个;如果模型直接让搜索带全文,Firecrawl 还是 7 个,Tavily 按计费表只有 1 个。EveryInfra 的 MCP 工具 everyinfra_search 把 17 种搜索放在一个工具里,用 tool 参数选;除 crosscheck 每次 $0.002778 外,其余 16 种(含搜索、读正文、整站抓取、列网址)都是每次 $0.000694,模型在这几种之间怎么选,单价都不变;接入步骤见 MCP 接入说明。
从一家换到另一家:参数和返回字段对照
两家的搜索接口参数名不同,换供应商时要改的地方集中在三处。Tavily 搜索的必填参数是 query,结果数用 max_results(默认 10、最多 20),要全文就打开 include_raw_content,深度用 search_depth;Firecrawl 搜索的必填参数也叫 query(最长 500 个字符),结果数用 limit(默认 10、最多 100),要全文就在 scrapeOptions 里写 formats。返回字段上,Tavily 每条结果的摘要在 content、全文在 raw_content;Firecrawl 不抓取时每条结果只有 url、title、description,抓取后带 markdown。EveryInfra 的 web 用 q 和 num,返回 title、url、snippet;deep 加 full=true 时每条多一个 content。
| 要做的事 | Tavily | Firecrawl | EveryInfra |
|---|---|---|---|
| 查询词 | query | query(≤500 字符) | q |
| 结果条数 | max_results,默认 10,最多 20 | limit,默认 10,最多 100 | num,web 每页最多 10,翻页用 page |
| 要全文 | include_raw_content: true 或 "markdown" | scrapeOptions.formats | 换成 deep 加 full: true,或对网址调 read |
| 时间范围 | time_range | tbs | after、before |
| 地区 | country | location | location |
| 摘要字段 | content | description | snippet |
| 全文字段 | raw_content | markdown | content |
参数名写错时三家的反应也不一样,这关系到 agent 能不能自己改对。EveryInfra 在实测里对 query 回了 422,并在 did_you_mean 里给出 q,没扣费;模型拿到这条错误就能自己改参数重发。迁移时最容易漏掉的是「全文」那一行:从 Tavily 换到 Firecrawl,如果照搬 include_raw_content 的习惯给每次搜索都开全文,credit 消耗会变成原来的 7 到 12 倍。
限速和并发:大批量时谁先卡住
价格以外,免费档和入门档的限速差别也大。Tavily 免费档每分钟 100 次请求,打开按量或买任一付费档就是 1,000 次,Crawl 和 Map 单独限每分钟 100 次,Research 20 次;限速从 2026 年 11 月起按组织计,同一组织的所有 Key 共用(Tavily Rate Limits 文档)。Firecrawl 免费档的搜索、抓取、列网址每分钟各 10 次,整站抓取每分钟 2 次;Hobby 是 100 次和 20 次,Standard 是 500 次和 100 次,Growth 是 5,000 次和 1,000 次;同时还按「并发浏览器」排队,免费档 2 个、Hobby 5 个、Standard 25 个,超出的任务进队列等待(Firecrawl Rate Limits 文档 和定价页的套餐对比表)。一个每分钟要发几百次搜索的批处理任务,在 Tavily 买最低的 Project 档就够,在 Firecrawl 要 Standard 档才不排队。EveryInfra 超过每分钟上限时返回 429,响应写明没有扣费并给出重试等待秒数。
什么时候选 Tavily
第一种情况是 agent 每次搜索都要读结果正文。问答机器人、研究助手、事实核查流程,一个问题进来先搜、再把前几条的正文喂给模型,按 Tavily 计费文档,搜索带全文仍按次收费,每次 1 个 credit 就能拿到最多 20 条结果的清洗内容;Firecrawl 做同样的事,每条全文多 1 个 credit。上线前用 include_usage 看一次实际扣数。
第二种情况是用量小而且不稳定。每月几百到几千次搜索的个人项目或原型,Tavily 的免费 1,000 次搜索加按量 $0.008 一次,账单是一条斜线,不会因为多搜几次就跳一档;Firecrawl 的免费额度只够 500 次搜索,超过就得买 $19 起的 Hobby。
第三种情况是需要带引用的研究报告。Tavily 的 对比页 把 Research 接口当主打,多步检索后返回带引用的结构化报告;Firecrawl 的对应能力 Agent 还在预览阶段,按动态价计费,每天 5 次免费。Tavily 另有面向学生的免费账号和面向创业团队的 10 万 credit 计划,定价页写明了申请入口。
第四种情况是只用托管服务、不想碰开源许可证。Tavily 是闭源 SaaS,没有自托管版本;Firecrawl 的开源版用 AGPL-3.0 许可证,第 13 条写的是把改过的版本放在网络上给别人用时要提供对应源码,具体义务以许可证原文为准,接入前请自行核对条款。
什么时候选 Firecrawl
第一种情况是只要链接和摘要、量又大。每月几万到几十万次搜索、只把结果当线索的 agent(比如给后续抓取排队、找新页面、做 SEO 排名记录),Firecrawl Standard 档每 1,000 次 $1.98,Growth 年付 $1.33,Scale 年付 $1.20,都比 Tavily 的 $5 低一半以上。
第二种情况是要列整站网址或抓整站。Map 一次 1 个 credit、不论返回多少网址,Crawl 每页 1 个 credit,配合 Standard 以上的单价,做文档站索引、知识库同步都比 Tavily 便宜;Firecrawl 的 Crawl 以异步任务运行,每页处理完时记账,适合几万页的站点。
第三种情况是要和网页交互或者要结构化字段。Firecrawl 的 Interact 文档 提供浏览器沙箱,能点击、填表、登录后再抓,每浏览器分钟 2 到 7 个 credit;Scrape 的 JSON 格式按 schema 抽字段,每页多 4 个 credit。Tavily 的对比页把浏览器交互列为「刻意不做」,建议另配浏览器工具。
第四种情况是要自托管或者要接付费数据源。Firecrawl 的 GitHub 仓库 有 203,806 颗星(2026-11-20 读取),自托管文档 给了 Docker Compose 的部署步骤,适合数据不能出内网的团队;9 月发布的 Alexandria 把付费数据源做成可以在搜索里发现、用抓取接口调用的工具,按每个工具标的价格扣 credit。
按团队情况选:一张对照表
把前面的数归成几类常见团队,每类给出两家里更省的一家和理由。表里的「更省」只看接口费,不含模型 token 和工程时间;质量差异要用自己的网址和查询另测。
| 团队情况 | 更省的一家 | 理由 |
|---|---|---|
| 个人原型,每月几百次搜索 | Tavily | 免费 1,000 次搜索;Firecrawl 免费只够 500 次 |
| 问答机器人,每次读前 5 到 10 条 | Tavily | 搜索带全文按计费表 1 个 credit;Firecrawl 7 到 12 个 |
| SEO 排名记录、线索发现,只要链接 | Firecrawl | Standard 每千次 $1.98,Tavily 至少 $5 |
| 文档站、知识库整站同步 | Firecrawl(量大时) | Crawl 每页 1 个、Map 每次 1 个;50,000 页时两家都在 $100 左右 |
| 网址清单里失效页面多 | Tavily | 失败不扣;Firecrawl 403、404 也扣 1 个 |
| 要登录、点击、填表才能抓 | Firecrawl | Interact 浏览器沙箱;Tavily 不做 |
| 数据不能出内网 | Firecrawl | AGPL-3.0 开源可自托管;Tavily 只有云服务 |
| 要带引用的研究报告 | Tavily | Research 接口已正式提供;Firecrawl Agent 还在预览 |
团队同时落在两行时,比如问答机器人还要每周同步一次文档站,可以两家各开免费档,按活分开调用,等月用量稳定后再决定把哪一边升到付费档。这张表适用于 2026-11-20 读到的价目。两家都在频繁更新:Firecrawl 的现行价目从 9 月 4 日起生效,Alexandria 让同一个余额能买到按数据源标价的调用;Tavily 11 月把限速改为按组织计。价目变了,分岔点会跟着移动。
两家都比 EveryInfra 合适的情况
EveryInfra 的搜索接口按次收费、失败和空结果不扣,适合「搜得多、读得多」的 agent,但有几件事我们做不了。第一,我们没有浏览器交互:要登录、点击、翻页填表才能拿到的内容,用 Firecrawl 的 Interact 或者自己的浏览器自动化。第二,我们没有按 JSON schema 抽字段的读正文接口,read 返回的是正文文本,要结构化还得交给模型;Firecrawl 的 JSON 格式一步到位。第三,我们不提供自托管版本,数据必须留在内网的团队只能选 Firecrawl 开源版。第四,Tavily 的 Research 接口会自己多轮检索并写成带引用的报告,我们的 crosscheck 只给按机制分层的来源和原文,不替用户写结论。第五,EveryInfra 每个 Key 的每分钟上限按账户设定;Firecrawl Growth 档写明每分钟 5,000 次搜索,大批量并发时更从容。
第六,Firecrawl 有 parse 能力处理 PDF 等文档文件,PDF 按页另加 1 个 credit;我们的搜索工具里没有专门的文档解析,扫描件、表格多的 PDF 更适合交给 Firecrawl。第七,两家都有免 Key 的远程 MCP,装上就能试;EveryInfra 的远程 MCP 要先在控制台建 Key,多一步。
我们的建议是按活拆开,不必三选一:要交互、要自托管、要按 schema 抽字段的那部分交给 Firecrawl;要带引用研究报告的交给 Tavily;剩下量最大的「搜一下、读几篇」交给按次计费、失败和空结果不扣的接口。三家的 MCP 可以同时装在一个客户端里,用工具描述告诉模型各自什么时候用。
行业动向:截至 2026 年 11 月
- 2026-11-20:VentureBeat 报道 Firecrawl 正式推出 Alexandria,称目录里已有超过 550 家数据提供方。三天前 Business Wire 稿 写的是 88 家数据提供方和 1.13 亿个索引来源,两个数字统计的范围不同,用之前要看清数的是什么。对读者:Firecrawl 的价格表正在从「按页」扩展到「按数据源标价」,同一个 credit 余额会被更多种调用分走。
- 2026-11-19:Firecrawl 的开源 MCP 服务器
firecrawl-mcp发布 3.41.0;Tavily 的tavily-mcp仓库 2026-11-18 有新提交,npm 上的最新版仍是 8 月的 0.2.22。对读者:Firecrawl 的 MCP 更新频繁,工具名和参数可能变,固定版本号再接进生产。 - 2026-11-17:Firecrawl 通过 Business Wire 宣布在多伦多开设旧金山以外的第一个办公室,招聘 14 个岗位,称有超过 150 万用户。对读者:Firecrawl 在加大 Alexandria 的投入,搜索和抓取以外的能力会继续增加。
- 2026-11-13:Tavily 把命令行工具改成 npm 包
@tavily/cli(1.0.1),更新日志 写一条命令就能装好 MCP 服务器和技能;同月限速改为按组织计,所有 Key 共用。对读者:开发和生产两把 Key 不再各算各的,压测时要留意。 - 2026-11-05:Benzinga 宣布 把新闻和行情数据接入 Firecrawl Alexandria。对读者:付费数据源的价格是数据方自己定的,不再是每页 1 个 credit。
- 2026-02-10:Nebius 宣布收购 Tavily。对读者:收购之后 Tavily 的更新日志仍按月发布,11 月 20 日读到的计费仍是四档月付加按量 $0.008。
上手:用同一组查询给三家算一遍账
- 从自己的 agent 日志里挑 50 个真实查询,记下每个查询后来读了几条结果的正文;这个数决定了 Tavily 和 Firecrawl 谁便宜。
- 按上面的规则折算:Tavily 每次 basic 搜索 1 个 credit(计费表没有给带全文列加价,打开
include_usage核一次),Extract 每 5 个网址 1 个;Firecrawl 每次搜索 2 个(每 10 条),每读一条全文加 1 个;再乘上你能用满的那一档的单价。 - 按 快速开始 注册 EveryInfra 拿 Key,用
web和read把这 50 个查询跑一遍,记下每次的billing.charged_usd;搜索工具的说明见 网页搜索能力页,全部数据能力在 网页数据爬虫 和 数据市场。 - 如果 agent 还要读视频字幕或论坛讨论,把 YouTube 字幕、YouTube 搜索 和 Reddit 搜索 一起加进测试,它们按条计费,价格在目录里;平台总页见 YouTube 数据爬虫 和 Reddit 数据爬虫。
- 拿三家的月账单和返回质量一起比,再决定切多少流量;价格和充值方式在 价格页,Firecrawl 和其他抓取平台的对比见 Firecrawl 替代方案。两家各自的逐项拆账见 Tavily 每次调用扣几个 credit 和 Firecrawl pricing 逐项拆解,更多同类服务的横比见 Tavily alternatives 五家横比 和 Firecrawl alternatives。
第 3 步的请求写法如下,$EVERYINFRA_API_KEY 换成你自己的 Key:
curl -s -X POST https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"web","params":{"q":"tavily vs firecrawl","num":10}}' \
| jq '{n: (.results|length), charged: .billing.charged_usd}'返回字段里,results 每一项有 title、url、snippet;billing 里有 charged、charged_usd,billing.amount.per_1k 是每 1,000 次的美元价。参数写错时回 422,响应里列出允许的参数并给出 did_you_mean,不扣费。
常见问题
Tavily vs Firecrawl 到底选哪个?(联想词「tavily vs firecrawl」) 看每次搜索后要读几条正文。只要链接和摘要、每月几万次以上,选 Firecrawl,Standard 档每 1,000 次搜索 $1.98;每次都要读前 5 到 10 条正文,选 Tavily,按它的计费文档,搜索带全文仍是每次 1 个 credit(文档没列加价,我们没有开账号验证)。 每月几百次的小项目,Tavily 的免费档能用 1,000 次,Firecrawl 只够 500 次。
Tavily or Firecrawl,哪个更适合 RAG?(联想词「tavily or firecrawl」) RAG 分两段:建库时整站抓取,Firecrawl 的 Crawl 每页 1 个 credit、Map 一次 1 个,更便宜;在线问答时现搜现读,按 Tavily 计费文档算,它的搜索带全文更便宜。一位 Reddit 用户在 r/LocalLLM 的帖子 里说 Tavily 来源质量高但规模大了太贵,帖子下的回复建议把搜索和抓取拆成两个问题分别选工具。
Tavily search 和 Firecrawl search 有什么区别?(联想词「tavily search vs firecrawl」) Tavily 搜索按次计价,basic 1 个、advanced 2 个 credit,最多 20 条,可以带清洗后的全文;Firecrawl 搜索按条计价,每 10 条 2 个 credit,可以同时搜网页、新闻、图片和 Alexandria 数据工具,带全文时每条再加 1 个 credit。
Tavily vs Firecrawl 加上一家语义搜索服务,三家怎么选?(联想词「tavily vs firecrawl vs」加一家语义搜索服务名) 语义搜索服务擅长按意思找来源和实体,Tavily 擅长现搜现读,Firecrawl 擅长抓整站和交互。按活分:找来源用语义搜索,读结果用 Tavily 的搜索带全文,建库和抓结构化字段用 Firecrawl。EveryInfra 的 semantic 工具做向量检索,和 web、read 同价,每次 $0.000694。
Reddit 上的 tavily vs firecrawl 讨论怎么说?(联想词「tavily vs firecrawl reddit」) r/n8n 的一个帖子 里,几位回复者的共识是:抓一个已知网址用 Firecrawl 或普通请求,需要外部背景时才用 Tavily 搜索;有人提醒,抓取被拦时返回的 403 页面要先用规则过滤,别让模型拿拦截页写文章。r/WebScrapingInsider 的测试帖 用 100 个网址测出可用结果 Firecrawl 93 个、Tavily 87 个。
Firecrawl 抓到 403 页面也扣钱吗?(来自 r/n8n 帖子里关于 403 页面的讨论) 扣。Firecrawl 计费文档写,只要返回了文档就按每页 1 个 credit 计,包括 403、404;没有文档返回才不扣。Tavily Extract 抓失败的网址不扣。EveryInfra 的 read 在 404 网址上回 404、不扣费(2026-11-20 00:29:32 新加坡时间实测)。
参考资料
- Credits & Pricing(计费文档),Tavily,2026-11-20 00:15 新加坡时间读取
- Tavily Pricing,Tavily,2026-11-20 读取
- Pricing(帮助中心套餐说明),Tavily,2026-11-20 读取
- Tavily Search 接口文档,Tavily,2026-11-20 读取
- Tavily Extract 接口文档,Tavily,2026-11-20 读取
- Tavily Crawl 接口文档,Tavily,2026-11-20 读取
- Rate Limits,Tavily,2026-11-20 读取
- Tavily MCP,Tavily,2026-11-20 读取
- Try Tavily Without an API Key,Tavily,2026-11-20 读取
- Changelog,Tavily,2026-11-20 读取
- Tavily vs Firecrawl,Tavily,2026-11-20 读取
- tavily-ai/tavily-mcp,GitHub,2026-11-20 读取
- @tavily/cli,npm,1.0.1 发布于 2026-11-13
- tavily-python,PyPI,0.8.5 发布于 2026-10-06
- Firecrawl Pricing,Firecrawl,2026-11-20 读取(2026-09-04 起生效)
- Billing(计费文档),Firecrawl,2026-11-20 00:15 新加坡时间读取
- Search 功能文档,Firecrawl,2026-11-20 读取
- Search 接口文档,Firecrawl,2026-11-20 读取
- Rate Limits,Firecrawl,2026-11-20 读取
- Map 功能文档,Firecrawl,2026-11-20 读取
- Interact 功能文档,Firecrawl,2026-11-20 读取
- MCP Server: Get Started,Firecrawl,2026-11-20 读取
- MCP Server: For Agents(免 Key),Firecrawl,2026-11-20 读取
- Self-hosting Firecrawl,Firecrawl,2026-11-20 读取
- firecrawl/firecrawl,GitHub,AGPL-3.0,2026-11-20 读取
- firecrawl/firecrawl-mcp-server,GitHub,2026-11-20 读取
- firecrawl-mcp,npm,3.41.0 发布于 2026-11-19
- firecrawl-py,PyPI,4.57.0 发布于 2026-11-12
- Firecrawl vs Tavily,Firecrawl,2026-11-20 读取
- Firecrawl launches Alexandria…,VentureBeat,2026-11-20
- Firecrawl Brings Its Library for the World's Knowledge to Toronto,Business Wire,2026-11-17
- Benzinga Collaborates With Firecrawl…,PR Newswire,2026-11-05
- Nebius announces agreement to acquire Tavily,Nebius,2026-02-10
- What's the best web extraction tool in 2026?,Reddit r/WebScrapingInsider,2026-11-20 读取
- Struggling to find the perfect Search/Scraping API,Reddit r/LocalLLM,2026-11-20 读取
- Article into a high-quality social post in n8n,Reddit r/n8n,2026-11-20 读取
- Transports(MCP 规范),Model Context Protocol,2026-11-20 读取
- EveryInfra 搜索工具目录,EveryInfra,2026-11-20 00:14 读取
- EveryInfra 数据能力目录,EveryInfra,2026-11-20 00:14 读取
- Requests: Advanced Usage,Requests 文档,2026-11-20 读取(实测查询 5 的首条结果)
- llms.txt,llmstxt.org,2026-11-20 读取(实测查询 9 的首条结果)
- Student account,Tavily 帮助中心,2026-11-20 读取
- Agentic Search Benchmark,AIMultiple,2026-11-20 00:33 新加坡时间读取
引用编号 BL-196