Tavily pricing:每次调用扣几个 credit
Tavily 基础搜索 1 credit,按量 $0.008;Project 可能贵 $6、最多省 $2,看免费额度算不算;MCP 默认值和重试让账单翻倍。
Tavily 的账单只有一个单位:credit,按量每个 $0.008,四档月付套餐里每个 $0.0075 到 $0.005。一次基础搜索扣 1 个,抓正文每 5 个成功网址扣 1 个,列站点每 10 页扣 1 个,研究报告一次 4 到 250 个。$30 的 Project 档划不划算,取决于打开按量后免费的 1,000 个 credit 还算不算:算,Project 在任何用量下都比「免费加按量」贵 $6;不算,Project 每月最多省 $2;Tavily 的文档没有写明是哪一种。我们在 2026-11-18 凌晨 00:17 到 00:35(新加坡时间)用 EveryInfra 做了同一组搜索、抓正文、整站抓取和列站点:和 Tavily 搜索、Extract 一一对位的 14 次调用实扣 $0.0097,同样的活在 Tavily 折 10.4 个 credit,按量 $0.083,Growth 档 $0.052;另外两次列站点和两次整站抓取按返回页数折 41.8 个 credit,两边返回的质量没有比较。
这里的「Tavily 价」全部来自 Tavily 自己的页面:计费文档、定价页、帮助中心的套餐说明和各接口的参数文档,读取时间是 2026-11-18 00:10 到 00:25(新加坡时间);我们没有注册 Tavily 账号,也没有调用 Tavily 的接口。EveryInfra 一侧的数是同一晚三轮真调响应里的 billing.charged_usd。站内另有一篇 Tavily alternatives 五家横比,比的是 Tavily、Firecrawl、Serper、SerpAPI 和我们在五种用法上的每千次价。
Tavily pricing 总账:五档套餐、按量价和免费额度
Tavily 定价页上能直接看到的只有三张卡:免费的 Researcher 每月 1,000 个 credit、按量每个 $0.008、Project 每月 $30 给 4,000 个;另外三档藏在 Project 卡片的滑块里。我们从定价页加载的脚本里读到了滑块的四档数据,和 帮助中心的套餐说明 逐项一致:Bootstrap $100 给 15,000 个,Startup $220 给 38,000 个,Growth $500 给 100,000 个。Enterprise 不标价。定价页的 FAQ 写了两条规则:额度在每月 1 日重置,和你哪天付款无关;额度用完以后请求会停,直到下个月重置或者升级。按量要单独打开,打开后的含义在计费文档里写成一句话:套餐额度用完以后,按每个 credit 计费。Enterprise 档没有公开价,要联系销售单独谈,卡片上列的是定制调用量、定制限速、企业级支持和服务等级、企业级安全和隐私,本文后面的计算都不包括这一档。按量和套餐可以同时开:套餐额度用完以后不再停服,超出的部分按 $0.008 一个计费,这也是本文所有月账单曲线的计算方法。
| 档位 | 月费 | 每月 credit | 每个 credit | 每千次 basic 搜索 | 每千次 advanced 搜索 | 每分钟请求上限 |
|---|---|---|---|---|---|---|
| Researcher(免费) | $0 | 1,000 | — | 前 1,000 次免费 | 前 500 次免费 | 100 |
| 按量(Pay As You Go) | 用多少付多少 | — | $0.008 | $8.00 | $16.00 | 1,000 |
| Project | $30 | 4,000 | $0.0075 | $7.50 | $15.00 | 1,000 |
| Bootstrap | $100 | 15,000 | $0.00667 | $6.67 | $13.33 | 1,000 |
| Startup | $220 | 38,000 | $0.00579 | $5.79 | $11.58 | 1,000 |
| Growth | $500 | 100,000 | $0.005 | $5.00 | $10.00 | 1,500 |
| Enterprise | 面议 | 面议 | 面议 | 面议 | 面议 | 面议 |
表里每分钟请求上限一列来自 限速文档。按量打开以后,免费账户的上限从每分钟 100 次升到 1,000 次,和 Project、Bootstrap、Startup 三档相同。限速文档里还出现了一个叫 Scale 的档位,和 Growth 一样每分钟 1,500 次,定价页和帮助中心都没有这一档的价格,我们没把它放进表。
Project 档:贵 $6 还是省 $2,看免费额度怎么算
把每种买法写成「月费加超出部分按 $0.008 补」,再按每月用掉的 credit 逐档比较。先按「免费额度先用」的读法算:免费档的 1,000 个 credit 用完后按量付费,每月用 4,000 个是 $24;Project 档 $30 正好给 4,000 个,贵 $6。用量超过 4,000 以后两条线斜率相同,都是每个 $0.008,这 $6 的差距一直保持;用量低于 4,000 时,Project 档还是 $30,免费档加按量更便宜。Project 每个 credit 比按量便宜 $0.0005,4,000 个一共省 $2,抵不过免费档那 1,000 个 credit 值的 $8。我们的复算脚本按每 50 个 credit 一步扫到 15 万个,每一步都挑最便宜的买法:0 到 13,500 是免费档加按量,13,500 到 30,000 是 Bootstrap,30,000 到 73,000 是 Startup,73,000 以上是 Growth,Project 一次也没有出现。
这个结论依赖一个假设:打开按量以后,免费档的 1,000 个 credit 仍然先用。计费文档写的是「套餐额度用完以后按 credit 计费」,免费档的额度就是 1,000 个,我们按这个读法算。换一种最保守的读法,按量从第一个 credit 就收费,那么每月 4,000 个是 $32,Project 档便宜 $2;超过 4,000 以后 Project 档每月固定省 $2。两种读法下 Project 档的优势最多每月 $2,而它带来的是一个不用完就作废的月度承诺。两种读法下限速相同,都是每分钟 1,000 次,所以 Project 档没有额外的吞吐可买。
| 每月用掉的 credit | 免费额度先用:免费 + 按量 | 保守读法:按量从第一个起收 | Project 档(超出按量) | Bootstrap 档(超出按量) |
|---|---|---|---|---|
| 2,000 | $8 | $16 | $30 | $100 |
| 4,000 | $24 | $32 | $30 | $100 |
| 8,000 | $56 | $64 | $62 | $100 |
| 20,000 | $152 | $160 | $158 | $140 |
4,000 这一行最能看出两种读法方向相反:免费额度先用时 Project 贵 $6,保守读法下 Project 便宜 $2。到每月 20,000 个,两种读法下最省的都已经是 Bootstrap,$100 加超出的 5,000 个按量 $40,共 $140,Project 档的那 $2 差别不再影响选择。
两种读法的差别可以花不到一美元自己验证。/usage 接口 的账户部分有 plan_usage、plan_limit 和 paygo_usage 三个字段:在免费账号上打开按量,并在后台把按量花费上限设得很低,跑够 1,000 个 credit 以后再发一次 basic 搜索,然后查 /usage。paygo_usage 从第 1,001 个才开始增长,说明免费额度先用,本文的分界成立;如果它从第一次请求就增长,就按保守读法,Project 档在每月 3,750 个 credit 以上开始便宜,最多每月省 $2。我们没有注册 Tavily 账号,这一步没有做;本文的套餐分界和月账单都按免费额度先用的读法计算,保守读法的结果写在旁边。
frontal.so 的 Tavily 评测页 有一个小标题写「A plan beats pay as you go from the first step」,理由是 Project 每个 credit $0.0075 低于按量 $0.008。只比单价,这句成立;把免费档的 1,000 个 credit 和「额度用不完作废」算进去,按免费额度先用的读法,Project 档在月度账单上没有一个用量点比免费加按量便宜;按保守读法,它每月便宜 $2,仍要承担额度作废。同一页还写开发 Key 每分钟 100 次、生产 Key 每分钟 1,000 次;Tavily 的 更新日志 在 2026 年 11 月一节写明限速改成按组织或个人账户计,开发 Key 和生产 Key 共用一个上限,所以那一段已经过时。读第三方评测时,把它的数和 Tavily 当月的原文对一遍。
Tavily 还有三条不走套餐的额度来源。创业计划 给入选团队 10 万个 credit;学生账号说明 写学生免费使用;免 Key 访问 让你在请求头加 X-Tavily-Access-Mode: keyless 就能调搜索和 Extract,不注册、不扣 credit,按公平使用限速。Tavily 的 命令行工具文档 也写了同一条:search 和 extract 不登录就能用,crawl、map、research 必须有凭证。
免 Key 模式有一个和计费有关的细节。免 Key 文档 的问答里写,如果一个请求同时带了 X-Tavily-Access-Mode: keyless 头和有效的 Authorization: Bearer 头,以 Key 为准,这次请求走你账户的额度和限速,不走免 Key 的预算。Tavily 官方的本地 MCP 服务就是按环境变量决定走哪种模式:tavily-mcp 源码 第 14 行先用 dotenv 读当前目录的 .env,第 16–17 行是 const API_KEY = process.env.TAVILY_API_KEY; const IS_KEYLESS = !API_KEY;,环境里有这个变量就带 Key 请求,没有才发免 Key 头。langchain-tavily 的 TavilySearch 安装说明也让你 export TAVILY_API_KEY。shell 配置或 .env 里留着这个变量时,本地 MCP 每次都扣账户里的 credit;想试免 Key,要先把变量清掉。变量清掉以后,tavily-mcp 在免 Key 模式下只开 search 和 extract 两个工具,crawl、map、research 会返回一段要求 API Key 的说明文字,不会扣费,也不会执行。文档还写两种模式的成功响应字段完全一致,从响应本身看不出差别,要靠 include_usage 或 /usage 才能确认。免 Key 模式触发限速时,Tavily 会返回一段自然语言说明,告诉 agent 发生了什么、怎么继续,其中就包括去注册一个免费 Key。
Tavily pricing per search:basic、advanced 和 auto_parameters
搜索接口文档 把 search_depth 分成四档:advanced 2 个 credit,basic、fast、ultra-fast 都是 1 个。fast 和 ultra-fast 是 2026 年 1 月加进来的低延迟档位,价格和 basic 一样,换档不省钱;ultra-fast 每个网址只返回一段摘要,另外三档每个网址返回最多 chunks_per_source 段内容片段,默认 3 段,basic 和 fast 每段约 500 字符,advanced 每段约 800 字符。一次搜索默认 10 条结果,最多 20 条,条数不影响扣费;max_age_hours 控制缓存的新鲜度,文档原话是「更小的值不会多扣 credit」。换成每千次,basic 按量 $8、Growth 档 $5,advanced 按量 $16、Growth 档 $10。
开了 auto_parameters,Tavily 可能把搜索深度升到 advanced。文档写它打开后,Tavily 根据查询内容自动配置参数,「search_depth 可能被自动设成 advanced,这时扣 2 个 credit」,想避开就显式写 search_depth: basic。搜索最佳实践 在示例里把这一行注释成「Override to control cost」。也就是说,开着 auto_parameters 的 agent,每次搜索是 1 个还是 2 个 credit 由 Tavily 决定,月账单的上限是全用 basic 时的两倍。要查每次到底扣了几个,在请求里加 include_usage: true,响应会多一个 usage.credits 字段;最佳实践文档建议批量任务把每次响应里的 usage 加起来对账。
搜索的条数和片段数不进 credit,却会进 token。一次 basic 搜索默认 10 条、每条 3 段、每段约 500 字符,返回给模型的正文大约 1.5 万字符;advanced 每段约 800 字符,同样 10 条就是 2.4 万字符左右;max_results 开到 20,再翻一倍。对 agent 来说,模型读这些片段的费用经常比接口的 1 到 2 个 credit 高。按任务把 max_results 和 chunks_per_source 调到够用为止,是在 Tavily 上控制总成本最直接的两个参数,接口费不会因此变化,模型费会明显下降。
第三方的测量和这套规则对得上。gologin 在 2026-10-20 发布、2026-10-28 更新的 Tavily 评测 用 10 个 agent 式查询各跑一次 basic 和一次 advanced,开着 include_usage,basic 共扣 10 个 credit,advanced 扣 20 个;作者记录 advanced 在新闻类查询上最新结果的中位年龄从 10 天缩到 4 天,在文档类查询上两档返回的头几条来源相同。AIMultiple 在 2026-11-10 更新的 agent 搜索测评 里,Tavily ultra-fast 在要求当前事实的题目上答对 26.3%;ultra-fast 和 basic 同价,选它省的是延迟,账单不会变。
| 你要的东西 | Tavily 参数 | 每次 credit | 每千次按量 | 每千次 Growth 档 | EveryInfra 对应 | 实扣每千次 |
|---|---|---|---|---|---|---|
| 10 条摘要 | basic / fast | 1 | $8.00 | $5.00 | web | $0.694 |
| 低延迟摘要 | ultra-fast | 1 | $8.00 | $5.00 | web | $0.694 |
| 更深的检索 | advanced | 2 | $16.00 | $10.00 | deep | $0.694 |
| 由 Tavily 决定 | auto_parameters: true | 1–2 | $8–$16 | $5–$10 | — | — |
| 带全文 | basic + include_raw_content | 1 | $8.00 | $5.00 | deep 加 full=true | $0.694 |
| 20 条结果 | max_results: 20 | 1 | $8.00 | $5.00 | web 翻 2 页 | $1.388 |
我们这边的同类工具在三轮真调里各跑了几次。web 在 00:17:29(新加坡时间)搜「tavily pricing」,1.91 秒返回 10 条,扣 $0.000694;00:34:20(新加坡时间)原样再搜一次,2.25 秒返回同样 10 个网址、顺序一致,扣费相同。deep 不带全文在 00:26:37(新加坡时间)跑一次,5 条结果用了 48.5 秒,是本次最慢的一次调用;带 full=true 的两次在 00:27:34 和 00:34:30(新加坡时间),5 篇正文分别合计 41,070 和 31,701 字符,耗时 17.1 和 18.6 秒,都扣 $0.000694。表里把 deep 放在 advanced 一行,是按用途对位;两边的排序算法和返回字段各自独立,这张表比的是价钱。
Tavily extract pricing:每 5 个成功网址 1 个 credit,按累计算
Extract 的规则在计费文档和 Extract 接口文档 里写法一致:basic 每 5 个成功抓取的网址扣 1 个 credit,advanced 每 5 个扣 2 个,抓失败的网址不扣;一次请求最多 20 个网址,超过 20 个回 400。默认超时 basic 10 秒、advanced 30 秒,可以在 1 到 60 秒之间调。
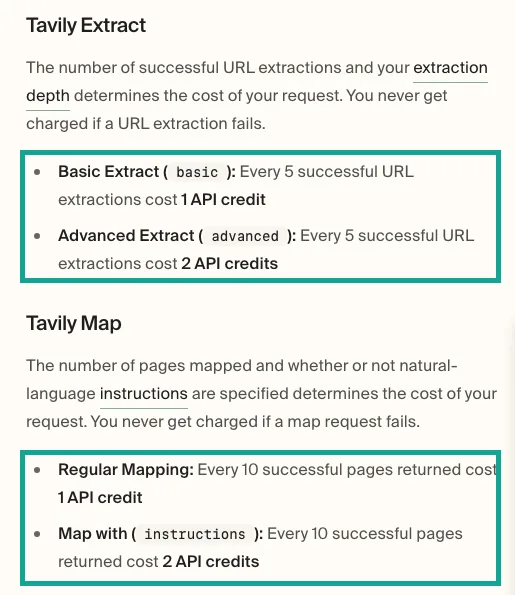
单抓一个网址扣多少,文档没有直接写,但 include_usage 参数的说明给了答案:「如果成功抓取的网址总数还没到 5 个,这个值可能是 0」。Map 的同一个参数写的是「还没到 10 页时可能是 0」。两句话放在一起读,Tavily 按账户累计成功网址数,攒满 5 个才在账面上记 1 个 credit,单次请求不向上取整。按这个规则,一次抓 1 个网址的 agent 平均每次 0.2 个 credit,按量 $0.0016,每千个网址 $1.60,Growth 档 $1.00;advanced 翻倍,每千个网址 $2.00 到 $3.20。
设想一个 agent 每次只抓 1 个网址,连发 7 次,都成功:照文档的说法,前 4 次响应里的 usage.credits 可以都是 0,第 5 次那一刻累计到 5 个网址,账面记 1 个 credit,第 6、7 次又回到 0,要等第 10 个网址才记下一笔。拿单次响应的 usage 乘以请求数去估月账单,会得到一个偏低很多的数;正确的做法是把一段时间内所有响应的 usage 加总,或者直接以 /usage 接口里的 extract_usage 为准。反过来,一次请求塞满 20 个网址时,usage 会稳定显示 4 个 credit(全部成功时),单次读数和月账单就对得上。Map 的规则一样,只是攒满的门槛是 10 页。gologin 那次测试用 8 个网址各跑 basic 和 advanced 两遍,其中 GitHub 设置页和 Reddit 列表页两档都失败,Amazon 商品页 basic 失败,整轮 Extract 记了 3 个 credit,和「失败不扣、按成功数累计」吻合。
Extract 是 Tavily 和我们差距最小的一项。我们的 read 一次一个网址,每次 $0.000694,每千个网址 $0.694,比 Tavily basic 便宜 1.4 到 2.3 倍,比 advanced 便宜 2.9 到 4.6 倍。00:27:59 到 00:28:39(新加坡时间)我们用 read 连抓 5 个 Tavily 文档页,耗时 0.79 到 3.30 秒,5 次各扣 $0.000694,合计 $0.00347;同样 5 个网址交给 Tavily basic Extract 是 1 个 credit,按量 $0.008,Growth 档 $0.005。00:29:13(新加坡时间)我们故意读一个不存在的 Tavily 文档页,回 404,charged_usd 为 0,reason 为 request_failed_refunded。两边对失败的处理相同:抓不到不收钱。
| 每次抓几个网址 | Tavily basic credit | Tavily advanced credit | 按量 basic | Growth basic | EveryInfra `read` |
|---|---|---|---|---|---|
| 1 | 0.2(累计) | 0.4(累计) | $0.0016 | $0.0010 | $0.000694 |
| 5 | 1 | 2 | $0.0080 | $0.0050 | $0.003470 |
| 20(单次上限) | 4 | 8 | $0.0320 | $0.0200 | $0.013880 |
| 每千个网址 | 200 | 400 | $1.60 | $1.00 | $0.694 |
Extract 还有一处容易多花钱的地方是 token。gologin 的测试里,basic 搜索带 include_raw_content 时每个查询平均返回约 10.8 万字符的 Markdown,作者估算 5 个页面约 2.7 万个 token。接口费 1 个 credit 不变,模型读这些正文的费用按 token 另算,往往比 credit 贵。Tavily 的 Extract 最佳实践 给的办法是用 chunks_per_source 只取相关段落,basic 能抓到的页面不用 advanced。
同一份最佳实践列了 advanced 适用的四种情况:动态内容或要执行 JavaScript 才能渲染的页面、表格和结构化信息、嵌入的媒体和富内容,以及需要更高抓取成功率的时候;并提醒 advanced 精度更高,但延迟和费用都会增加,简单内容用 basic。结合「失败不扣」这条规则,一个省钱的顺序是先用 basic 抓,失败或内容残缺的网址再单独用 advanced 补抓。basic 失败的那次不扣 credit,补抓只为确实需要渲染的页面付双倍。
Map 和 Crawl:按页数折,limit 决定上限
Map 接口文档 写每 10 个成功返回的页面扣 1 个 credit,带 instructions 用自然语言筛页面时每 10 页扣 2 个,请求失败不扣。默认参数是 max_depth 1、max_breadth 20、limit 50,limit 是爬虫在停下之前最多处理的链接数。按默认值跑满,一次 Map 返回 50 页,扣 5 个 credit,按量 $0.04;把 limit 调到 200 再加 instructions,扣 40 个,按量 $0.32。Map 本身有每分钟 100 次的单独限速,和你买哪一档无关。
Crawl 接口文档 把 Crawl 定义成 Map 加 Extract,账单也是两部分相加。计费文档给的例子是抓 10 页 basic 扣 3 个(Map 1 个、Extract 2 个),advanced 扣 5 个;带 instructions 时 Map 那部分翻倍。照这个规则,20 页 basic 是 6 个 credit,50 页 advanced 带 instructions 是 30 个。Tavily 的 Crawl 最佳实践 在「常见坑」一节列了「没设 limit」,后果写的是「失控的抓取,意外的花费」,解决办法是每次都设一个合理的 limit。
我们用 map 和 crawl 各跑了两次 Tavily 和 Firecrawl 自己的文档站。00:19:42(新加坡时间)map 列 docs.tavily.com,0.44 秒返回 110 个网址;00:35:15(新加坡时间)列 docs.firecrawl.dev,num 设 200,0.80 秒返回 200 个网址;两次都扣 $0.000694。按 Tavily 的规则,110 页是 11 个 credit,200 页是 20 个,按量 $0.088 和 $0.16。00:20:26(新加坡时间)crawl 抓 docs.tavily.com/documentation,instructions 写「pricing, credits, rate limits, usage and API reference pages」,7.57 秒返回 12 页,合计 150,670 字符,第一页就是计费文档,后面是用量查询、组织用量、Crawl、Extract、Map、Research、Search 等接口页;00:35:05(新加坡时间)不带 instructions 抓 API 参考目录,1.38 秒返回 20 页、225,502 字符。两次都扣 $0.000694。Tavily 抓同样的 12 页带 instructions 是 Map 2.4 个加 Extract 2.4 个,共 4.8 个 credit;20 页不带 instructions 是 6 个。
Map 和 Crawl 按页数计,页数事先不知道:页数由 limit、max_depth、max_breadth 三个参数和目标站点的大小共同决定,agent 每次发请求前并不知道会返回多少页。我们这一侧,map 一次最多 200 个网址、crawl 一次最多 20 页,扣费按次算,页数多少只影响耗时;要抓几百页的站,先 map 再分批 crawl 或 read,次数由你定,单价不变。
Research:4 到 250 个 credit 的浮动价
Research 接口文档 让 Tavily 自己拆问题、搜多轮、读来源,最后交一份带引用的报告。计费文档给的是区间:model=mini 每次最少 4 个、最多 110 个 credit,model=pro 最少 15 个、最多 250 个。按量换算,mini 一次 $0.032 到 $0.88,pro 一次 $0.12 到 $2.00;Growth 档是 $0.02 到 $0.55 和 $0.075 到 $1.25。这个接口的 model 参数默认是 auto,由 Tavily 决定用 mini 还是 pro,所以不指定时单次花费的上限是 250 个 credit。Research 另有每分钟 20 次的单独限速。
我们没有和 Research 对位的报告接口。最接近的是 crosscheck(交叉验证):同一个问题并行跑四种机制不同的检索,按命中情况分层,交回证据,不写结论。00:35:34(新加坡时间)我们用它核对「Tavily 按量每个 credit $0.008」,5.44 秒后四种机制都跑通,Tavily 计费文档被三种机制同时命中,排在最高层;这次从 usage.charged_usd 读到扣费 $0.002778。Research 的区间写在计费文档里,Tavily 把它叫作「动态计价」,每次请求按实际做了多少工作在最小值和最大值之间扣。接口文档对两个模型的说明是:mini 适合范围窄、问题明确的研究,pro 适合跨多个子主题或领域的综合研究。区间的上限决定了预算怎么做:免费档的 1,000 个 credit,按 pro 的上限算只够 4 次,按 mini 的上限算够 9 次;Project 档的 4,000 个 credit,最坏情况下够 16 次 pro。要让 Research 的账单可预测,最直接的办法是显式写 model=mini,并在 agent 的提示词里把问题拆窄,让 Tavily 少做几轮搜索。下表把各档每月额度换成 Research 的次数,最坏情况按区间上限算,最好情况按 mini 的下限算:
| 每月额度 | 按 mini 上限 110 算 | 按 pro 上限 250 算 | 按 mini 下限 4 算 |
|---|---|---|---|
| 免费档 1,000 | 9 次 | 4 次 | 250 次 |
| Project 4,000 | 36 次 | 16 次 | 1,000 次 |
| Bootstrap 15,000 | 136 次 | 60 次 | 3,750 次 |
| Growth 100,000 | 909 次 | 400 次 | 25,000 次 |
这两样东西交付物不同,表里只并排列价格,不算倍数:Research mini 最便宜一次也要 $0.02 到 $0.032,crosscheck 一次 $0.002778。
Tavily MCP pricing:同一个余额,默认值决定账单
Tavily 的远程 MCP 地址是 https://mcp.tavily.com/mcp/,MCP 文档 列了 tavily_search、tavily_extract、tavily_crawl、tavily_map、tavily_research 五个工具,支持 OAuth、URL 参数里的 tavilyApiKey 和 Authorization 请求头三种认证。OAuth 登录时用的是账户下名为 mcp_auth_default 的 Key,没有就自动建一个,组织里所有人共用这一个 Key。MCP 没有单独的价目:每次工具调用就是一次普通接口请求,按同样的规则从同一个余额里扣。
OAuth 登录还带来一个记账问题。组织里所有人通过 OAuth 连上远程 MCP 时用的都是同一个 mcp_auth_default Key,/usage 按 Key 统计,看不出是谁的 agent 用掉了额度。想按人或按项目分账,可以给每个客户端单独建一个 Key,用 URL 参数 tavilyApiKey 或 Authorization 头接入,代价是要自己管理这些 Key;从 2026 年 11 月起这些 Key 仍然共用组织的限速。
模型怎么填参数,取决于工具描述和默认值。我们读了 Tavily 官方 MCP 服务的源码(GitHub tavily-ai/tavily-mcp 主分支,最近一次提交是 2026-11-13):tavily_search 的 search_depth 默认 basic,但参数说明写着「找具体事实、页面或实体时,或者 basic 没找到时,用 advanced」;max_results 默认 5,说明写「找具体事实、页面或实体时要 10 条」。tavily_crawl 和 tavily_map 的默认 limit 是 50、max_depth 1、max_breadth 20,extract_depth 默认 basic;tavily_research 的 model 默认 auto。
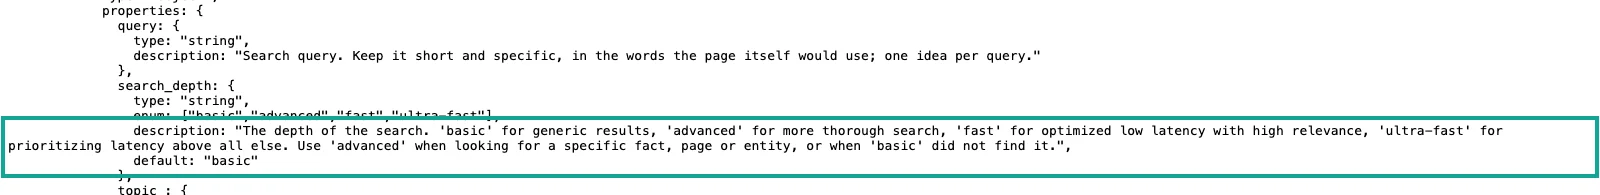
这段说明会直接进模型的上下文。按这段说明,模型可能先用 basic 搜一次,没找到再换 advanced 搜一次,一个问题花 3 个 credit。Tavily 的 LangChain 集成 langchain-tavily 走得更直接:它的 TavilySearch 工具在搜索没有结果时返回错误提示,其中一条建议就是「Try a more detailed search using 'advanced' search_depth」,条件是这次用的是 basic。basic 空结果那一次扣不扣,Tavily 的计费文档没有写;文档只对 Extract 和 Map 写了失败不扣。想确认,可以发一个不会有结果的查询并带上 include_usage: true,看响应里的 usage.credits 是 0 还是 1;我们没有 Tavily 账号,这一项没有测。
另一处在 DEFAULT_PARAMETERS。远程 MCP 允许在请求头里放一段 JSON 作为所有请求的默认参数,文档示例是 {"include_images":true, "search_depth": "advanced", "max_results": 10}。本地跑 tavily-mcp 时同名的环境变量做同样的事,我们读源码发现它的写法是对每个参数「如果默认值里有这一项,就用默认值覆盖」,模型传进来的 search_depth 也会被覆盖。照文档示例配一次,以后每次搜索都是 2 个 credit,账单直接翻倍。
| MCP 里的一个问题 | 调用 | Tavily credit | 按量 | Growth 档 |
|---|---|---|---|---|
| 默认 basic 搜一次 | tavily_search | 1 | $0.008 | $0.005 |
照文档示例配 DEFAULT_PARAMETERS | tavily_search(被改成 advanced) | 2 | $0.016 | $0.010 |
| basic 没找到,换 advanced 重试 | tavily_search ×2 | 3 | $0.024 | $0.015 |
| 搜一次再抓前 3 个结果 | tavily_search + tavily_extract | 1.6 | $0.0128 | $0.008 |
| 默认参数整站抓取,跑满 50 页 | tavily_crawl | 15 | $0.12 | $0.075 |
交给研究工具,model=auto | tavily_research | 4–250 | $0.032–$2.00 | $0.02–$1.25 |
CLI 文档 里的 tvly set-default 会「关掉编码 agent 自带的网页搜索」,让 Tavily 成为它们唯一的网页工具;tvly setup mcp 把远程 MCP 写进 Claude Code、Codex 和 Cursor 的配置。这样配好以后,编码 agent 每一次查网页都走 Tavily 的 credit。要看清 MCP 花了多少,Tavily 给了两个办法:调用时加 include_usage,或者查 /usage 接口按 Key 看搜索、Extract、Crawl、Map、Research 各用了多少;远程 MCP 还会给每个会话带一个 X-Session-Id,同一会话里的调用能归到一起。
我们的远程 MCP 在 https://api.everyinfra.com/mcp,everyinfra_search 一个工具里装着 web、deep、read、crawl、map、crosscheck 等子工具,认证用请求头里的 Bearer Key。00:29:31(新加坡时间)通过 MCP 调 web 搜「tavily mcp pricing credits」,2.60 秒返回 10 条,扣 $0.000694,和直接调接口同价。我们的工具没有「深度」这种会让单价翻倍的默认参数,模型换不换查询深度都是按次扣。Claude Code 里加上它只要一行命令,完整的客户端列表在 MCP 接入页:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
额度清零和用不满:每个 credit 实际多少钱
套餐上写的每个 credit 价格,前提是这个月把额度用满。Tavily 定价页写额度在每月 1 日重置,没有结转的说法;按这条规则,用不完的部分到月底作废。把作废算进去,每个 credit 的实价等于月费除以实际用掉的数量:Project 档用掉一半,每个 credit $0.015;Bootstrap 档用掉一半,$0.0133;Growth 档用掉一半,$0.01,比按量 $0.008 还贵。用掉四分之一时,四档的实价在 $0.02 到 $0.03 之间,是按量价的 2.5 到 3.75 倍。
所以选档的规则可以写得更简单:只按你有把握每个月都用满的那部分买套餐,波动的部分留给按量。拿 Growth 档举例,它比 Startup 档每个 credit 便宜 $0.00079,但要每月用满 10 万个才有这个价;如果你的用量在 5 万到 10 万之间来回,Startup 加按量更稳。别家对额度过期的处理各不相同,可以拿来对照:Firecrawl 定价页 只有 Scale 档的额度能结转一个月;Serper 的预付包 6 个月有效;SerpAPI 用完可以提前续期,降档时剩余次数转进额外余额。EveryInfra 的余额充进去不清零,按次扣。
限速、错误码和按量上限
Tavily 在 2026 年 11 月把限速改成按组织计:同一组织下所有 Key 共用一个上限,开发 Key 和生产 Key 也共用,限速文档 写明「每个请求算一次,与搜索深度、网址数量等参数无关」。免费档每分钟 100 次,打开按量或买前三个付费档 1,000 次,Growth 1,500 次;Crawl 和 Map 每分钟 100 次,Research 20 次,这三项每一档都一样。查用量的 /usage 接口单独限速,每 10 分钟 10 次。
和钱有关的错误码有三个,都列在搜索接口文档的响应部分:432 表示 Key 或套餐的用量上限到了;433 表示按量花费超过了你在后台设的上限,错误文案让你去后台调高;434 是免费档特有的「Flex tier capacity exceeded」,带了 max_age_hours 的请求在 Tavily 负载高时会被拒,去掉这个参数改用缓存就能过。429 是普通限速,响应头的 Retry-After 给出要等几秒。按量的花费上限是保护预算的主要开关:没设上限的账户,一个陷进循环的 agent 会一直扣到月底。
EveryInfra 这一侧,本次用的测试 Key 自己设了每分钟 10 次的上限。00:17:37 到 00:17:56(新加坡时间)我们连发时撞上 4 次 429,响应写明「Nothing was charged」,并给出 retry_after 23 秒。00:29:22(新加坡时间)不带 Key 请求一次,回 401,同样写明没有扣费。
查账:include_usage、/usage 和 X-Project-ID
Tavily 给了三层对账工具。第一层是单次请求的 include_usage,搜索、Extract、Map、Crawl 都支持,响应里多一个 usage.credits;Extract 和 Map 在累计没攒够 5 个网址或 10 页时会显示 0,要按批次加总才准。第二层是 /usage 接口,按 Key 返回本计费周期的总用量和上限,并拆成 search_usage、extract_usage、crawl_usage、map_usage、research_usage 五项,按账户返回当前套餐名、plan_usage、plan_limit 和按量用量。第三层是 请求头文档 里的 X-Project-ID:同一个 Key 用在几个项目上时,每个请求带上项目号,日志和用量面板就能按项目分开,/usage 也能按项目查。
下面是一次带 include_usage 的 Tavily 搜索请求写法,取自搜索接口文档的参数;我们没有 Tavily 账号,这段是配置示例,没有运行过。它把深度写死成 basic,关掉 auto_parameters,并带上项目号:
curl -X POST https://api.tavily.com/search \
  -H "Authorization: Bearer $TAVILY_API_KEY" \
  -H "X-Project-ID: pricing-audit" \
  -H "Content-Type: application/json" \
  -d '{"query":"tavily pricing","search_depth":"basic","auto_parameters":false,"max_results":10,"include_usage":true}'
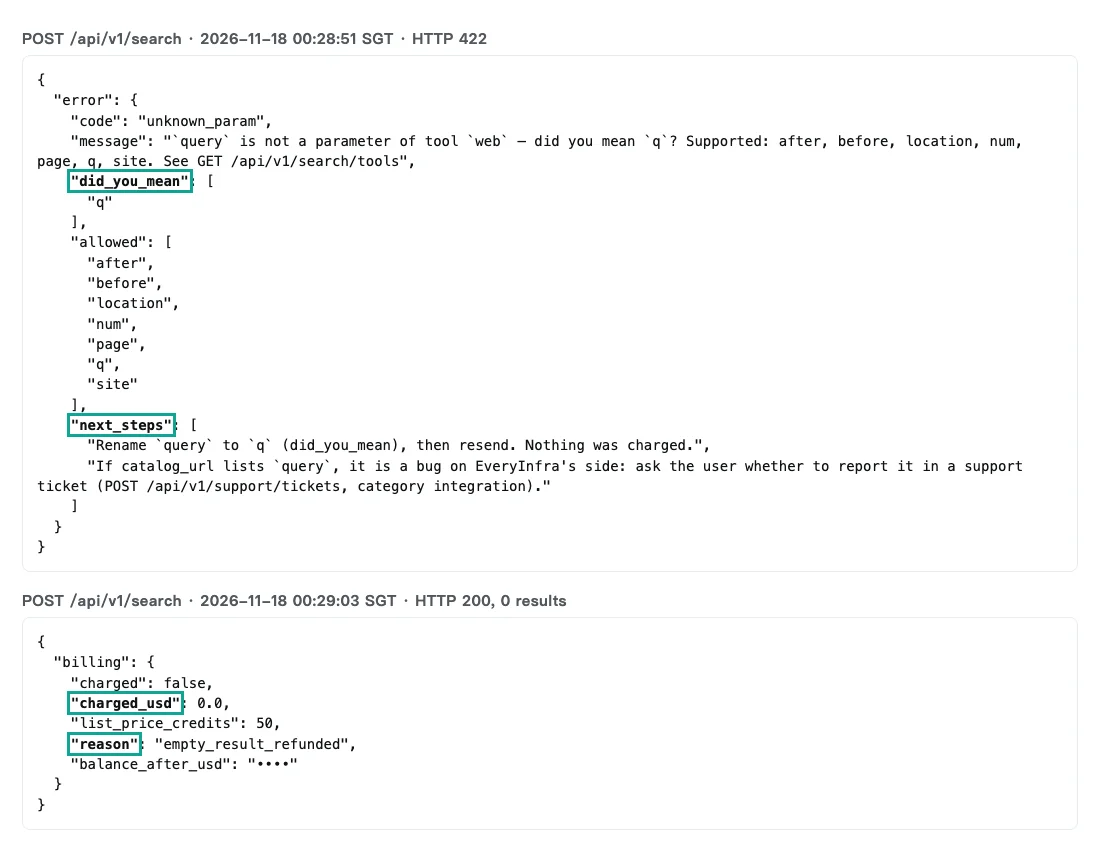
EveryInfra 的每次响应里都有 billing 一段:charged_usd 是这次实扣,list_price_credits 是目录价,失败或空结果时 charged_usd 为 0,reason 写明原因。00:29:03(新加坡时间)我们搜一串不存在的词,返回 0 条,reason 是 empty_result_refunded;00:28:51(新加坡时间)照 Tavily 的写法发 query 和 search_depth,回 422,错误码 unknown_param,did_you_mean 给出 q,next_steps 第一句写「Nothing was charged」。agent 读到这条错误能自己改名重发。
同样一晚的活,EveryInfra 实扣多少
三轮真调从 00:17 到 00:35(新加坡时间),一共 27 次扣费,合计 $0.021009;另有 4 次 429、1 次 422、1 次 401、1 次 404 和 1 次空结果,全部扣 $0。下表是其中 19 次搜索工具调用,合计实扣 $0.015270,按 Tavily 的规则折成 credit,分三组。第一组 14 次一一对位:web 对 basic 搜索,deep 对 advanced,带全文的 deep 对 basic 加 include_raw_content,read 对单网址 basic Extract。第二组 4 次是 crawl 和 map,按返回页数折,只对齐页数,没有比较两边返回的质量。第三组是 crosscheck,和 Research 交付物不同,只列价格,不折 credit、不算倍数。
| 时刻(新加坡时间) | EveryInfra 工具 | 返回 | 实扣 | 同样的活在 Tavily 折几个 credit |
|---|---|---|---|---|
| 00:17:29 | web | 10 条 | $0.000694 | 1 |
| 00:19:06 | deep | 5 条 | $0.000694 | 2 |
| 00:19:29 | read | 1 页 | $0.000694 | 0.2 |
| 00:26:37 | deep | 5 条 | $0.000694 | 2 |
| 00:27:34 | deep full | 5 篇全文 | $0.000694 | 1 |
| 00:27:59–00:28:39 | read ×5 | 5 页 | $0.003470 | 1 |
| 00:29:31 | MCP everyinfra_search → web | 10 条 | $0.000694 | 1 |
| 00:34:20 | web | 10 条 | $0.000694 | 1 |
| 00:34:30 | deep full | 5 篇全文 | $0.000694 | 1 |
| 00:34:57 | read | 1 页 | $0.000694 | 0.2 |
| 第一组小计:搜索和 Extract | 14 次 | $0.009716 | 10.4 | |
| 00:19:42 | map docs.tavily.com | 110 个网址 | $0.000694 | 11(按页数) |
| 00:20:26 | crawl 带 instructions | 12 页 | $0.000694 | 4.8(按页数) |
| 00:35:05 | crawl | 20 页 | $0.000694 | 6(按页数) |
| 00:35:15 | map docs.firecrawl.dev | 200 个网址 | $0.000694 | 20(按页数) |
| 第二组小计:列站点和整站抓取 | 4 次 | $0.002776 | 41.8 | |
| 00:35:34 | crosscheck(第三组) | 四种机制收敛 | $0.002778 | 不折算 |
| 合计 | 19 次 | $0.015270 | — |
倍数只按第一组算:14 次搜索和 Extract 在 Tavily 折 10.4 个 credit,按量 $0.0832,Growth 档 $0.052,是我们实扣 $0.009716 的 8.6 倍和 5.4 倍。deep 对 advanced 是按用途对位;如果把两次不带全文的 deep 改按 basic 折,第一组是 8.4 个 credit,倍数是 6.9 倍和 4.3 倍。第二组 4 次折 41.8 个 credit,按量 $0.3344,Growth 档 $0.209;这是拿 Tavily 的按页计费去对我们的按次计费,两边一次返回多少页、页面内容是否一样都没有放在一起比,所以不给倍数。要比质量,得在同一个站上让两边各列一次,比去重后的网址数和覆盖到的目录,这一步本文没有做。能确定的是方向:同一个 agent 做站点发现时,Tavily 账单里按页数折算的部分涨得最快,两次 map 就是 31 个 credit,占第二组的四分之三,比第一组 14 次调用加起来还多两倍。只做搜索的 agent,差距是每千次 $5 到 $8 对 $0.694。
速度方面,三轮真调里最快的是列站点,0.44 到 0.80 秒;整站抓取 20 页用了 1.38 秒,带 instructions 的 12 页用了 7.57 秒;read 单页 0.65 到 3.30 秒;deep 带全文 17 到 19 秒,不带全文的两次分别是 10.3 秒和 48.5 秒,后一次是本次最慢的调用,也说明深度检索的耗时波动较大。耗时不进账单,但会影响 agent 的超时设置:Tavily Extract 的 advanced 默认超时是 30 秒,我们的 deep 如果按这个值设超时,会有一部分请求超时失败,失败不扣钱,可重试会拖慢整个任务。给深度检索单独设 60 秒左右的超时更稳妥。
如果 agent 只要标题和摘要,单一引擎的搜索接口比聚合搜索更便宜,同一晚我们也跑了四个:bing/search 在 00:18:02(新加坡时间)返回 10 条,扣 $0.000556;duckduckgo/search 在 00:20:43 返回 10 条,扣 $0.000556;web/search 在 00:35:24 返回 10 条,扣 $0.001389;google_news/search 在 00:29:41 搜「Tavily」返回 20 条,扣 $0.000792。入口分别在 Bing 爬虫 API、DuckDuckGo 爬虫 API、网页搜索爬虫 API 和 Google 新闻爬虫 API,平台总览在 Bing 平台页、DuckDuckGo 平台页 和 网页搜索平台页。只看搜索,我们最便宜的一档是每千次 $0.556。
和 Firecrawl、Serper、SerpAPI 的计费单位对照
四家都按「额度」计费,但一个额度换来的东西差很多。下表只列计费规则,数字取自各家 2026-11-18 00:25(新加坡时间)读到的定价页;每千次价格的完整横比在 Tavily alternatives 一文 里,SerpAPI 各档的折算见 SerpAPI pricing 逐档拆解,Firecrawl 的替代方案见 Firecrawl alternatives。
| Tavily | Firecrawl | Serper | SerpAPI | EveryInfra | |
|---|---|---|---|---|---|
| 计费单位 | credit | credit | 次数(credit) | 次数 | 每次调用 |
| 搜索 | basic 1、advanced 2 | 每 10 条结果 2 | 每次 1 | 每次 1 | 每次 $0.000694 |
| 抓正文 | 每 5 个成功网址 1(advanced 2) | 每页 1,JSON 格式每页再加 4 | 无 | 无 | 每次 $0.000694 |
| 列站点 | 每 10 页 1(instructions 2) | 每次 1 | 无 | 无 | 每次 $0.000694,最多 200 个 |
| 失败扣不扣 | Extract、Map 失败不扣;搜索空结果文档未写 | 目标页回 403、404 仍扣 1 | 成功响应才扣 | 只算成功;空结果算 1 次 | 失败、空结果都不扣 |
| 免费额度 | 每月 1,000 | 每月 1,000 | 一次性 2,500 | 每月 250 | 试用额度 |
| 最低付费 | 按量 $0.008/credit,或 $30/月 | $19/月 | $50 预付包 | $25/月 | 按次从余额扣 |
| 额度过期 | 每月 1 日清零 | 按月,Scale 档结转 1 个月 | 6 个月 | 按月,可提前续期 | 不清零 |
Firecrawl 的 Map 每次 1 个 credit、不按页数折,和 Tavily 的规则相反;它的 MCP v3 在 2026-11-12 发布,更新日志 写的是「4x more usage」。Serper 的四个预付包从 $50 买 5 万次到 $3,750 买 1,250 万次,每千次 $1.00 到 $0.30,FAQ 写「每次收到成功响应时扣」。SerpAPI 四个月付档 $25 到 $275,每千次 $25 到 $9.17,FAQ 写「返回 100 条和返回 0 条都算 1 次」。
计费单位不同,换算时要先统一到你关心的产出。按结果条数计费的 Firecrawl 搜索,要 20 条结果就是 4 个 credit;按次计费的 Serper、SerpAPI 和我们,一次 10 条和一次 20 条的单价取决于接口允许每次返回多少条;Tavily 的搜索一次最多 20 条,条数不影响扣费,要的条数越多越划算。抓正文这一项,Firecrawl 按页计、失败也扣,Tavily 按成功网址累计、失败不扣,目标站点经常拦截时两者的实际单价会拉开。拿自己最常抓的 20 个站点各试一次,看成功率,再乘回各家的单价,比只看价目表准。
估一个 agent 的月账单:三种用法
单价表看完,还要按自己的调用习惯算一遍月账单,因为 Tavily 的五种接口折算方式不同,同样的预算在不同用法下能做的事差好几倍。下面三种用法的调用量是我们按常见 agent 设定的假设,计算规则全部来自 Tavily 的计费文档,套餐选每种用量下最便宜的那一档(免费额度先用);EveryInfra 一列按本次真调的实扣单价乘以调用次数。
第一种是客服问答 agent。每天 400 个问题,每个问题先用 basic 搜一次,其中 30% 的问题第一次没找到,按 MCP 工具描述的提示换 advanced 再搜一次。每个问题平均 1.6 个 credit,每月 1.2 万个问题共 19,200 个 credit,最便宜的买法是 Bootstrap 档 $100 加超出部分按量 $33.6,合计 $133.6;免费加按量是 $145.6。同样的 15,600 次搜索在我们这里是 $10.83。第二种是研究 agent。每天 50 个课题,每个课题 5 次 basic 搜索、抓 15 个网址,每题 8 个 credit,每月 1,500 题共 12,000 个 credit,免费加按量 $88 最便宜。我们这边每题 20 次调用,每月 3 万次共 $20.82,差距缩到 4 倍左右,因为 Extract 在 Tavily 一侧是五个网址才折一个 credit,我们是每个网址一次调用。第三种是文档站监控。每周对 40 个文档站各跑一次 200 页的列站点和一次 20 页的 basic 整站抓取,每站每周 26 个 credit,每月 4 周共 4,160 个 credit,免费加按量 $25.28。我们这边每月 320 次调用,合计 $0.22。
| 用法 | 每月 Tavily credit | 最便宜的 Tavily 买法 | Tavily 月账单 | EveryInfra 调用次数 | EveryInfra 月账单 |
|---|---|---|---|---|---|
| 客服问答(含 30% advanced 重试) | 19,200 | Bootstrap + 按量 | $133.60 | 15,600 | $10.83 |
| 研究(5 次搜索 + 15 个网址) | 12,000 | 免费 + 按量 | $88.00 | 30,000 | $20.82 |
| 文档站监控(40 站 × 4 周) | 4,160 | 免费 + 按量 | $25.28 | 320 | $0.22 |
三种用法的差距从 4 倍到 100 倍以上不等,决定倍数的是 Map 和 Crawl 在调用里占多少。抓正文为主的用法,Tavily 一次请求打包 20 个网址的设计让它的单价接近我们;列站点和整站抓取为主的用法,按页数折算让它的账单涨得最快。这些都只是接口费。研究 agent 每题读 15 个网页,模型的 token 费通常比两边的接口费都高,压缩正文、只取相关段落省下的钱,可能比换接口省得多。
什么时候 Tavily 的计费更划算
第一,用量很小、而且稳定在每月 1,000 次 basic 搜索以内:免费档就够,一分钱不花;还在评估阶段的团队可以用免 Key 模式先试搜索和 Extract。第二,学生和入选创业计划的团队:学生免费,创业计划给 10 万个 credit。第三,Extract 一次就要 20 个网址、而且大多能抓成功:Tavily 每 5 个成功网址 1 个 credit,Growth 档每千个网址 $1.00,是我们 read $0.694 的 1.44 倍(按量是 2.3 倍);Tavily 一次请求就办完,我们要发 20 次。第四,你要的是写好的报告:Research 交付带引用的结论,我们只交证据。
第五,高并发开箱即用:Tavily 打开按量就是每分钟 1,000 次搜索,不另收钱。第六,团队已经大量依赖 LangChain、Vercel AI SDK 等框架里现成的 Tavily 工具类,迁移要改提示词和结果解析,工时也是成本。第七,对数据保留和合规有采购要求的企业,Tavily 的 Enterprise 档能单独谈安全和 SLA。在这几种情况里,Tavily 的单价劣势会被免费额度、一次请求的吞吐或者省下的工时抵掉。
反过来,账单里列站点和整站抓取占大头的 agent、搜索量每月几万次以上但每月起伏大的团队、以及开着 auto_parameters 或者照文档示例配了 advanced 默认值的 MCP 用户,按页折算和额度作废这两条会让实际单价比价目表高出一截。这几类用量值得拿一个月的 /usage 数据,按本文的折算规则重算一遍。
行业动向:2026 年 10–11 月
- 2026-11-13:Tavily 把命令行工具发布成 npm 包
@tavily/cli1.0.0(npm 页),npx @tavily/cli init一条命令装好 MCP 和技能包。对读者:编码 agent 接 Tavily 的门槛更低,配了tvly set-default以后它每次查网页都扣 credit,预算要按 agent 的调用频率算。 - 2026 年 11 月:Tavily 限速改成按组织或个人账户计,开发 Key 和生产 Key 共用(更新日志)。对读者:靠开发 Key 隔离测试流量的做法不再有效,测试循环会占用生产的每分钟配额。
- 2026-11-13:Firecrawl 宣布 Alexandria 覆盖 7,500 万家以上的公司数据(Firecrawl 更新日志)。对读者:搜索和抓取接口正在往结构化数据扩,计费单位会跟着变多,比价前先确认你用的是哪一种额度。
- 2026-11-12:Firecrawl 发布 MCP v3,宣称更高的限速和「4x more usage」(Firecrawl 更新日志);同日 firecrawl-py 4.57.0 上架(PyPI)。对读者:MCP 场景下各家都在拿用量和限速竞争,比价时把 MCP 调用的计费规则单独列一行。
- 2026-11-10:AIMultiple 更新 agent 搜索测评,Tavily ultra-fast 在要求当前事实的题目上答对 26.3%(AIMultiple)。对读者:同价的低延迟档位换来的是时效性,不是省钱。
- 2026-10-28:gologin 更新 2026-10-20 首发的 Tavily 评测,10 个查询的 basic 和 advanced 各扣 10 和 20 个 credit,整轮测试 33 个(gologin)。对读者:第三方实测和计费文档一致,
include_usage的读数可以直接拿来对账。 - 2026-10-27:Firecrawl 更新它的 Tavily 替代方案文章,拿 Tavily 按量 basic 搜索每千次 $8 作对照(Firecrawl 博客)。对读者:竞品文章引用的 Tavily 价是按量价,换成你实际所在的档位再比。
- 2026 年 10 月:Tavily 搜索加了
max_age_hours参数,文档写明更小的值不多扣 credit,但免费档在高负载时可能回 434(更新日志)。对读者:要实时页面的免费档用户会遇到间歇失败,付费档没有这个限制。
上手:把一个月的 Tavily 账单搬过来算一遍
- 在 Tavily 后台或
/usage接口导出上个月的用量,按search_usage、extract_usage、crawl_usage、map_usage、research_usage五项记下来;有X-Project-ID的按项目分开。 - 用计费文档的规则把五项换回调用量。
/usage只给每个接口的 credit 总数,不分深度,换出来是一个区间,规则和示例见下表。 - 按 快速开始 注册拿 Key,挑 50 条真实查询,分别用
web、deep、read、crawl、map跑一遍,记下每次的billing.charged_usd;各工具说明在 搜索产品页。 - 把 MCP 加进你的客户端,让 agent 用同一组问题跑一轮,对比两边一个会话的花费;工具选择的思路见 agent 搜索工具怎么选。
- 拿两边的月账单和模型的 token 用量一起比,再决定切多少流量;价格和充值方式在 价格页。
第 2 步的换算按计费文档逐项来,下表的「示例值」取自 /usage 接口文档 的返回示例:
| `/usage` 字段 | 文档示例值 | 计费文档的折算规则 | 换回的量 |
|---|---|---|---|
search_usage | 100 | basic、fast、ultra-fast 每次 1,advanced 每次 2 | 50 到 100 次搜索 |
extract_usage | 25 | basic 每 5 个成功网址 1,advanced 每 5 个 2;全 basic 乘 5,全 advanced 乘 2.5 | 约 62 到 125 个成功网址 |
map_usage | 7 | 每 10 个成功页面 1,带 instructions 每 10 页 2;乘 10 或乘 5 | 35 到 70 页 |
crawl_usage | 15 | Map 加 Extract:每 10 页 basic 3、advanced 5,带 instructions 各加 1 | 约 25 到 50 页 |
research_usage | 3 | mini 每次 4–110,pro 每次 15–250 | 反推不出次数;示例值 3 比 mini 单次下限 4 还小,只是示意 |
Extract 和 Map 还有累计折算:本周期最后不满 5 个网址或 10 页的部分还没记账,换回的量最多少 4 个网址或 9 页。自己的日志里如果记了每次请求的深度和 instructions,按日志拆分就能把区间收成一个数。按示例值走一遍:除 Research 外共 147 个 credit,按量 $1.18;换成调用量是 50 到 100 次搜索、约 62 到 125 个网址、一次 70 页以内的列站点和 2 到 3 次 20 页的整站抓取,在 EveryInfra 按次计是 115 到 229 次调用,$0.080 到 $0.159。
下面是第 3 步里搜索工具的一次真实请求写法,$EVERYINFRA_API_KEY 换成你自己的 Key:
curl -s -X POST https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"map","params":{"url":"https://docs.tavily.com","num":200}}' \
| jq '{n: (.results|length), charged: .billing.charged_usd}'相关文章:另一种按域名倍率扣 credit 的定价拆解、Firecrawl alternatives。
常见问题
Tavily pricing per search 是多少?(联想词「tavily pricing per search」) basic、fast、ultra-fast 每次 1 个 credit,advanced 每次 2 个。按量每个 credit $0.008,所以每千次 basic 搜索 $8、advanced $16;Growth 档每个 credit $0.005,每千次 $5 和 $10。返回 10 条还是 20 条,价格一样。
Tavily extract pricing 怎么算?(联想词「tavily extract pricing」) basic 每 5 个成功抓取的网址 1 个 credit,advanced 每 5 个 2 个,抓失败的不扣。按账户累计计算,单抓 1 个网址平均 0.2 个 credit,include_usage 在没攒够 5 个时显示 0。每千个网址 basic 按量 $1.60、Growth 档 $1.00。
Tavily MCP 收费吗?(联想词「tavily mcp pricing」「is tavily mcp free」) MCP 本身不单独收费,每次工具调用按对应接口的规则扣同一个余额里的 credit。免 Key 模式下 MCP 只有搜索和 Extract 两个工具,按公平使用限速,不扣 credit。要注意的是工具描述和 DEFAULT_PARAMETERS,它们会让模型选 advanced 或者重试。
Tavily 免费吗?学生能免费用吗?(联想词「is tavily free」「is tavily free for students」) 免费档每月 1,000 个 credit,不用绑卡,每月 1 日重置,用完请求就停。学生账号免费,入选创业计划的团队有 10 万个 credit;不注册也能用免 Key 模式试搜索和 Extract。
Tavily API 的限速是多少?(联想词「tavily api rate limit」) 免费档每分钟 100 次,打开按量或买 Project、Bootstrap、Startup 是 1,000 次,Growth 1,500 次;Crawl 和 Map 每分钟 100 次,Research 20 次,/usage 每 10 分钟 10 次。2026 年 11 月起按组织计,所有 Key 共用。
每千次 advanced 搜索 $15 贵不贵?(r/LLMDevs 帖子 Tavily vs Search Router) 发帖人说他们的研究 agent 用 advanced 搜索每千次 $15,开始拖累单位经济。按 Tavily 的价目,这正好是 Project 档的 advanced 价(2 × $0.0075 × 1,000);换到 Growth 档是 $10,按量 $16。如果查询本身不需要 advanced,显式写 basic 能直接减半;EveryInfra deep 每千次实扣 $0.694。
参考资料
- Credits & Pricing(计费文档),Tavily,2026-11-18 00:10 新加坡时间读取
- Tavily Pricing,Tavily,2026-11-18 读取(含滑块档位数据)
- Pricing(帮助中心套餐说明),Tavily,2026-11-18 读取
- Tavily Search 接口文档,Tavily,2026-11-18 读取
- Tavily Extract 接口文档,Tavily,2026-11-18 读取
- Tavily Map 接口文档,Tavily,2026-11-18 读取
- Tavily Crawl 接口文档,Tavily,2026-11-18 读取
- Tavily Research 接口文档,Tavily,2026-11-18 读取
- Usage 接口文档,Tavily,2026-11-18 读取
- Rate Limits,Tavily,2026-11-18 读取
- Headers & Authentication,Tavily,2026-11-18 读取
- Tavily MCP,Tavily,2026-11-18 读取
- Keyless access,Tavily,2026-11-18 读取
- Tavily CLI,Tavily,2026-11-18 读取
- Best practices for search,Tavily,2026-11-18 读取
- Best practices for extract,Tavily,2026-11-18 读取
- Best practices for crawl,Tavily,2026-11-18 读取
- Changelog,Tavily,2026-11-18 读取
- Tavily 文档索引 llms.txt,Tavily,2026-11-18 读取
- Tavily for Startups,Tavily,2026-11-18 读取
- Student account,Tavily 帮助中心,2026-11-18 读取
- tavily-mcp 源码 src/index.ts,GitHub tavily-ai,主分支 2026-11-13 提交,2026-11-18 读取
- tavily-mcp 仓库,GitHub tavily-ai,2026-11-18 读取
- tavily-mcp,npm,0.2.22 发布于 2026-08-05
- @tavily/cli,npm,1.0.0 发布于 2026-11-13
- langchain-tavily 源码 tavily_search.py,GitHub tavily-ai,2026-11-18 读取
- tavily-python,PyPI,0.8.5 发布于 2026-10-06
- Tavily 在 Claude 连接器目录,Anthropic,2026-11-18 读取
- Tavily Agentic Web Search Certification,Nebius,2026-11-18 读取
- Firecrawl Pricing,Firecrawl,2026-11-18 00:25 新加坡时间读取
- Firecrawl Changelog,Firecrawl,最新条目 2026-11-13
- firecrawl-py,PyPI,4.57.0 发布于 2026-11-12
- 5 Tavily Alternatives for Better Pricing, Performance, and Extraction Depth,Firecrawl,2026-10-27 更新
- Serper 首页(价格与 FAQ),Serper,2026-11-18 读取
- SerpApi Plans and Pricing,SerpApi,2026-11-18 读取
- SerpApi Release Notes,SerpApi,最新条目 2026-11-17
- Tavily Review 2026: Search Quality, Formats and Pricing,gologin,2026-10-20 发布,2026-10-28 更新
- Agentic Search API Benchmark,AIMultiple,2026-11-10 更新
- Tavily API review: credits, keys and the auto trap,Frontal,2026-11-18 读取
- Tavily vs Search Router: looking for advice before scaling our RAG pipeline,Reddit r/LLMDevs,2026-11-18 读取
- 51 AI API providers audited in 2026,Reddit r/AI_Agents,2026-11-18 读取
- What My Weekly AI Research Run Actually Costs,LinkedIn,2026-11-18 读取
- EveryInfra 搜索工具目录,EveryInfra,2026-11-18 00:16 新加坡时间读取
- EveryInfra 能力目录,EveryInfra,2026-11-18 00:16 新加坡时间读取
- EveryInfra 远程 MCP,EveryInfra,2026-11-18 00:29 新加坡时间调用
引用编号 BL-184