SerpAPI 替代方案:每千次搜索价格实测对比
SerpAPI 每千次搜索 $15 起;EveryInfra 的 bing、duckduckgo 搜索每千次 $0.556,按请求计费、余额不过期。
同样发 1,000 次网页搜索请求,SerpAPI 最便宜的 Starter 档是 $25、Developer 档 $15(SerpAPI 定价页,2026 年 11 月 17 日读取);同一天我用 EveryInfra 真调,bing/search 和 duckduckgo/search 一次扣 $0.000556、折合每千次 $0.556,web/search 一次 $0.001389、每千次 $1.389。按 Developer 档算,这两项分别差 27 倍和 11 倍。差距最大的几行都来自一件事:SerpAPI 按月订阅、按月预付搜索额度,EveryInfra 按请求计费、充多少用多少、余额不清零。换掉 SerpAPI,要比的不止单价:还有计费单位、失败和空结果扣不扣钱、最低先付多少、免费额度、上手步数、能不能接 MCP,以及四家替代(SerpAPI、Serper、Tavily、Firecrawl)各自比我们强在哪。
会想换掉 SerpAPI 的人,大多卡在两处:一是免费档每月 250 次不够测,二是第一个付费档就要几十美元的月费。社区里反复出现的问法是"有没有更便宜的、按量付的、不用先扛月费的",文末的问答逐条回答。价格按"每千次搜索多少美元"统一到同一个分母,用两类硬数:对方的公开定价页,和我们自己的真调账单,都标了来源和时间,方便你照着套到自己的量上。
本文的"每千次价",是把一次搜索请求实际扣掉的钱乘以 1,000。SerpAPI、Serper、Tavily、Firecrawl 和 EveryInfra 都是"一次请求回一页结果",所以按请求(SerpAPI 和 Serper 叫一次 search、一个 credit)算最直接。对方一侧只用公开材料:定价页、文档、Store 页;我们没有注册它们、没有买它们的套餐,所以表里对方的数字是"公开单价",不是"实测账单"。我们这一侧每个数都来自真调响应里的 billing.charged_usd,时间记到秒、换算成新加坡时间。读下去的时候,凡是带时刻和"新加坡时间"的,都是当天真发出去、真扣了钱的请求,可以按请求体自己复现;凡是带网址和读取日期的,都是对方公开页上的现价,过一阵子要重新读一遍核对。
先看总表:换掉 SerpAPI,每千次搜索各多少钱
下表把五家按每 1,000 次网页搜索放在一起。SerpAPI、Serper、Firecrawl 取公开定价页的套餐档;Tavily 按信用点价换算(一次基础搜索 1 个 credit);EveryInfra 是本文真调,一次请求回一页,价钱固定,和返回条数无关。
| 提供方 | 计费单位 | 入门档每千次 | 最低自助价每千次 | 免费额度 | 余额是否过期 |
|---|---|---|---|---|---|
| SerpAPI | 一次成功 search | $25(Starter) | $9.17(Big Data $275/30,000) | 250 次/月 | 月度额度不结转 |
| Tavily | 1 credit/次基础搜索 | $8.00(按用量 $0.008/credit) | $5.00(月付 $0.005/credit) | 1,000 credit/月 | 月度额度每月清零 |
| Firecrawl | 2 credit/每 10 条结果 | $7.60(Hobby $19/5,000 credit) | $1.50(Scale $749/100 万 credit) | 1,000 credit/月 | 自助档不结转 |
| Serper | 1 credit/次(11–100 条算 2) | $1.00($50/50,000) | $0.30($3,750/1,250 万) | 2,500 次(一次性) | 信用点 6 个月过期 |
EveryInfra web/search | 一次请求 | $1.389(实测) | $1.389(固定) | 领取式试用 | 余额不过期 |
EveryInfra bing、duckduckgo | 一次请求 | $0.556(实测) | $0.556(固定) | 领取式试用 | 余额不过期 |
读这张表要看两件事。第一,SerpAPI 的"最低自助价"是 $9.17,要先每月付 $275、锁定 30,000 次用量;我们的 $0.556 没有月费,充 $10 起就能按请求扣。第二,Serper 把量大价压到每千次 $0.30,比我们低,但那一档要一次性预付 $3,750,而且买来的信用点 6 个月不用就作废(Serper 定价,经 serper.dev 2026 年 11 月 14 日核对)。所以单价最低的一档不等于最省,要看你一个月到底发多少次、肯不肯预付、信用点会不会放到过期。
价格差这么大,根子在计费单位,不在数据好坏。按请求计费的接口,一次请求回一页就收一次固定的钱,和这一页回了几条、要不要翻页都无关;按月费的接口,先把一个月的量买下来,当月用不满也不退、不结转;按信用点的接口,再叠一层"几条算几个点、点会过期"的换算。把这三种单位都换到同一个"每千次搜索"的分母上,差距才显出来,你多付的那部分也才看得清——是月费里没用掉的空档,还是信用点放到过期作废,还是按条数翻倍的叠加。省下的常是月费里没用掉的空档、过期作废的信用点、按条数翻倍这几层,不只是标价差。对一个每月量不固定、时高时低的团队来说,这几层损耗加起来,有时比单价本身还大。
要把这张图用到自己的账上,只需要一步:拿你现在每月的搜索次数,乘以任意一家的每千次价再除以 1,000,就是换过去的月成本。举例每月 4 万次:SerpAPI 超过 Big Data 的 3 万上限,要在 $275 的 Big Data 上再加购 1 万次用量;Serper 一包 $50(5 万次)够用;Tavily 按量是 4 万乘 $0.008、约 $320;Firecrawl 要 Standard $99(10 万 credit、折 5 万次);我们按 bing/search 是 4 万乘 $0.000556、约 $22。同样 4 万次,最低 $22、最高 $320,差一个数量级。结果质量要用你自己的词各搜几次来比,价格先按这个公式估个大概,再决定要不要细测。
SerpAPI 的价格:按成功搜索计费,五档月费
SerpAPI 是一个把 Google 和上百种搜索页解析成 JSON 的接口,按"成功搜索"计费,返回 10 条还是 100 条都算一次,空结果和出错的不算(SerpAPI 定价页 FAQ)。它的套餐按月订阅,2026 年 11 月 17 日读到的现价是:Free $0 给 250 次、Starter $25 给 1,000 次、Developer $75 给 5,000 次、Production $150 给 15,000 次、Big Data $275 给 30,000 次,每档还配一个每小时吞吐上限。
| SerpAPI 套餐 | 月费 | 每月搜索 | 每千次 | 每小时吞吐 |
|---|---|---|---|---|
| Free | $0 | 250 | — | 50 |
| Starter | $25 | 1,000 | $25.00 | 200 |
| Developer | $75 | 5,000 | $15.00 | 1,000 |
| Production | $150 | 15,000 | $10.00 | 3,000 |
| Big Data | $275 | 30,000 | $9.17 | 6,000 |
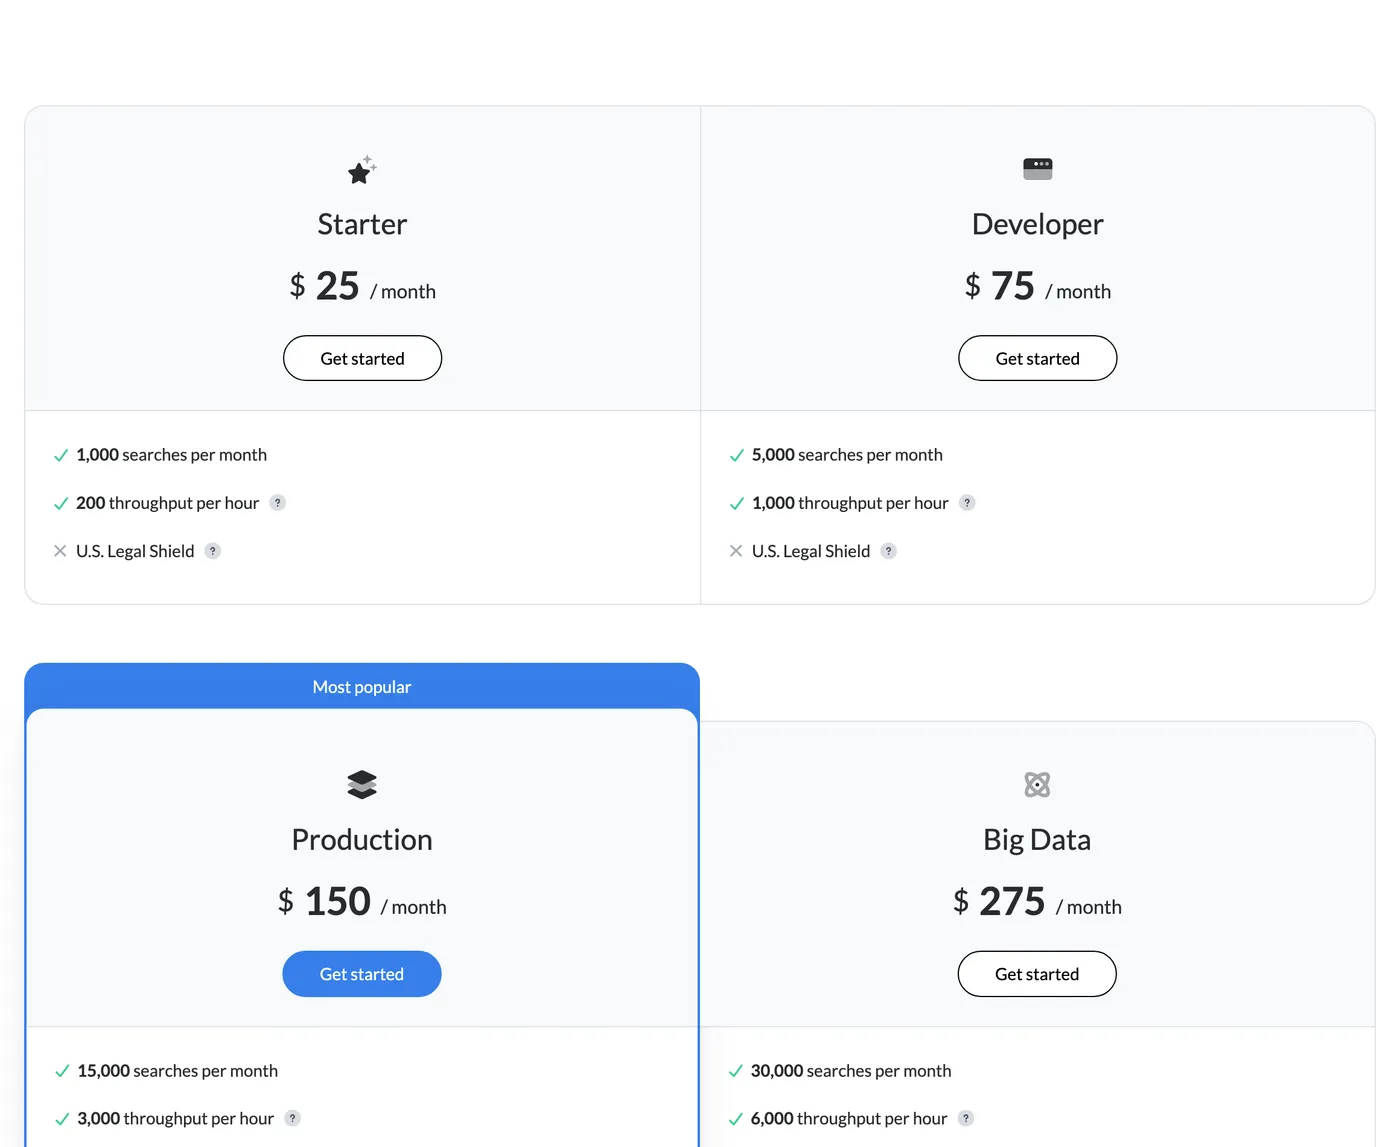
月费是预付:当月没用完的搜索不结转,用超了可以开早续或按反馈档续费(SerpAPI 定价页)。Production 档起附带一个 U.S. Legal Shield,对合法采集公开搜索数据的行为承担一部分责任、最高 200 万美元,这是它比别家多的一层保障。企业档从 $3,750/月、100,000 次起,另有预留搜索每千次 $2.75、按量搜索每千次 $7.50 的说法(SerpAPI 订阅拆解)。要换掉它,先弄清你每月的真实请求量落在哪一档:Reddit 上有人嫌"每月 100 次免费搜索不够用"、也有人说"第一个付费档就要 $75"(r/n8n、r/n8n),这两句就是换替代的起点。
实测一:web 搜索,三个时刻价格都一样
web/search 一次最多回 10 条,字段是 title、url、text、rank、published_at,命中新闻会多一个 image_url、命中带子链接的站点会多一个 sub_links(能力目录)。我在三个不同时刻各发了一次,搜不同的词:2026 年 11 月 17 日 00:19 新加坡时间搜 "best web search api for ai agents" 回 10 条、扣 $0.001389;00:35 搜 "cheaper serpapi alternative" 回 10 条、扣 $0.001389;同在 00:35 把第一条词再搜一次、还是 10 条、$0.001389。三次都是 $0.001389,每千次 $1.389,和请求里有没有写 country、language 无关。
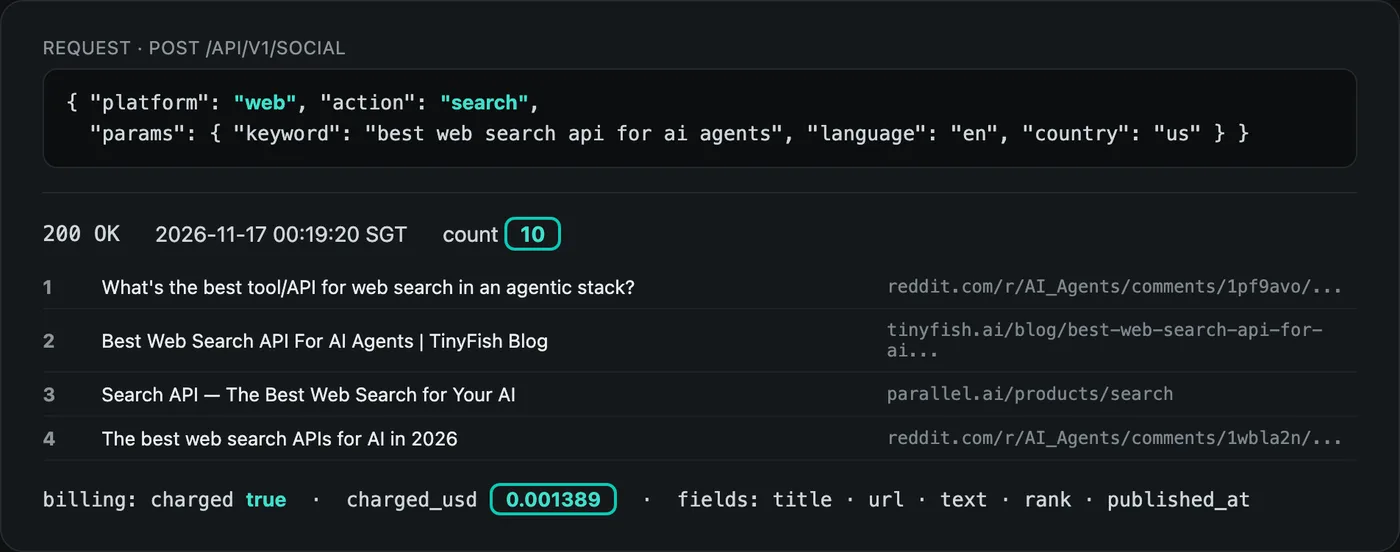
换到搜索引擎页,价格更低。bing/search 一次 $0.000556,00:19 搜同一个词回了 5 条;duckduckgo/search 一次 $0.000556,00:20 回了 10 条,字段多一个 favicon_url、还支持 page 翻页和 time_window 时间窗。两个引擎都是每千次 $0.556,比 SerpAPI 的 Developer 档便宜 27 倍。差的这 27 倍跟结果多少、好坏无关,只跟计费单位有关:计费从"一个月预付几千上万次"换成了"按一次请求扣几厘钱"。要提醒一句,便宜不等于处处够用:bing/search、duckduckgo/search 回的是这两个引擎的结果,和 Google 的排序未必一致,做依赖 Google 排名的监测时,web/search 更贴近;选哪个引擎按你要的结果来源定,价格只是其中一维。把搜索面铺开看:google_news/search 一次 $0.000792、00:20 回了 20 条带 published_at 和 source 的新闻;google_shopping/search 一次 $0.000556、00:22 搜 "mechanical keyboard" 回了 20 条带 price、merchant、rating、review_count 的商品。同一把 Key,这几个面全都按请求计费,价钱各自固定。
搜索面与字段覆盖:一把 Key 回什么
五个搜索面回的字段各不相同,决定了你能不能少做一步解析。web/search 回 title、url、text、rank、published_at,是最接近"网页有机结果"的一组,命中带子链接的站点会多一个 sub_links,命中新闻会多一个 image_url。bing/search 的字段里多一个 displayed_url(给人看的那段域名),少一个 published_at;duckduckgo/search 带 favicon_url,还支持 page 翻页和 time_window 时间窗,想往后翻一页或只要近一周的结果,这两个参数直接写进 params 就行,不用再发别的接口。google_news/search 回的是带 source、published_at、image_url 的新闻条目,一次最多 20 条;google_shopping/search 回的是带 price、price_text、merchant、rating、review_count 的商品,一次最多 100 条。
这些字段都是能直接入表的结构化值。11 月 17 日 00:22 搜 "mechanical keyboard" 的 20 条商品里,Keychron Q1 标 $89.99、评分 4.5、300 条评价,Razer BlackWidow V3 标 $73.97、评分 4.8、1,100 条评价,Womier DUO87 标 $124.99、评分 4.4。做比价或选品,这几个字段省掉了再解析一遍页面的步骤。德语场景也测了一次:00:22 用 language 为 de、country 为 de 搜 "beste suchmaschine api",web/search 回 10 条德语结果、同样扣 $0.001389,换地区和语言不另收费,和写不写这两个参数无关。
SerpAPI 在字段结构上更细:它把一张 Google 结果页拆成有机结果、知识面板、问答框、相关搜索、购物盒等几十种结构化对象,一次请求就能把整页的结构都拿回来(SerpAPI 搜索 API 列表)。Serper 也回知识图谱、问答框和相关搜索(Serper Playground)。要的是"一张 SERP 的完整结构",SerpAPI、Serper 更省事;要的是"几个引擎的有机结果、按引擎切换、按请求付费",这组统一的 snake_case 字段更好接。按引擎对照结果差异也容易:同一个词在 web、bing、duckduckgo 各搜一次,比字段和条数,再决定线上用哪个。
| 搜索面 | 一次上限 | 主要字段 | 翻页/时间窗 |
|---|---|---|---|
web/search | 10 | title、url、text、rank、published_at、sub_links | country、language |
bing/search | — | rank、title、url、displayed_url、text、date_text | country、language |
duckduckgo/search | 50 | rank、title、url、displayed_url、text、favicon_url | page、time_window |
google_news/search | 20 | rank、title、url、source、text、published_at、image_url | time_window |
google_shopping/search | 100 | title、price、merchant、rating、review_count、url | sort、价格区间 |
实测二:计费单位和失败扣费,两边规则不一样
计费单位决定账单怎么涨。SerpAPI、Serper 按"次",一次 search 一个价,回 10 条和回 100 条一样;Tavily 按 credit,一次基础搜索 1 个、深度搜索 2 个(Tavily 信用点说明);Firecrawl 按"每 10 条结果 2 个 credit",搜索和抓取共用一个信用点余额(Firecrawl 搜索文档)。EveryInfra 按请求:web/search 一次 $0.001389、bing 和 duckduckgo 一次 $0.000556,limit 只决定要几条,不超过能力的上限就不影响价钱。
失败和空结果扣不扣钱,是换接口时最容易忽略的一项。我专门测了三种"没拿到数据"的请求:11 月 17 日 00:22 给 web/search 多写一个不存在的 cursor 参数,返回 422,错误里列出允许的 keyword、country、language、limit,附一个能跑的示例,并写明"Nothing was charged",没扣钱;同在 00:22 不带 Key 发请求,返回 401、提示把 Key 放进 Authorization 头、同样没扣钱;00:35 给 duckduckgo/search 传 page 为 2,搜索源暂时满员返回 503,billing.charged_usd 是 0。三种都是 0 扣费。
| 情况 | 新加坡时间 | HTTP | 响应 | 实扣 |
|---|---|---|---|---|
web/search 多写 cursor | 2026-11-17 00:22 | 422 | unknown_param,列允许参数、给示例,附 Nothing was charged | $0 |
| 不带 Key | 2026-11-17 00:22 | 401 | missing_key,提示放 Authorization 头 | $0 |
duckduckgo/search 翻页 | 2026-11-17 00:35 | 503 | 搜索源暂时满员,charged_usd 为 0 | $0 |
SerpAPI 这一侧,只有成功搜索计费,缓存、出错、被封、验证码请求都免费(SerpAPI 定价页 FAQ),这一点和我们一致;Firecrawl 写明没结果的抓取不收费,但返回 403、404 这类带错误状态的页面仍然算一条、收 1 credit(Firecrawl 定价页)。所以四家都有"失败不收费"的说法,细到哪种算失败,各家不同,换之前要按自己的错误类型对一遍。
这件事对账单的影响比看上去大。搜索引擎会改版、会临时限流,批量跑的时候总有一小部分请求拿不到数据;如果这部分照常扣钱,长期下来是一笔隐性支出。我们的错误是 HTTP 状态码加 error.code:401、422 这类请求本身的问题不扣费,503 这类对方搜索源暂时满员也不扣费,空结果在响应里会写明退款原因,这些都能在返回里看到、能复现、能对账。换接口时,别只测"正常情况多少钱",把异常情况也各发一次,看清哪种扣、哪种不扣,再把这条写进你的成本模型——正常请求的单价各家都好查,拉开长期成本的往往是异常请求怎么收费。
四家的账各自怎么涨
按次、按 credit、按月费,三种模型的账涨法不一样,换之前要分别算一遍。SerpAPI 是按月订阅加按成功搜索计费:你选一档,拿到当月的搜索额度,用超了走早续或按反馈档续费,缓存、出错、被封、验证码请求不计费(SerpAPI 定价页 FAQ)。它的企业档另有两种算法,预留搜索每千次 $2.75、按量搜索每千次 $7.50,预留要先承诺每月的数量、按量则用多少付多少(SerpAPI 订阅拆解)。所以 SerpAPI 的真实单价取决于你落在哪一档、当月用没用满:用满 Big Data 是每千次 $9.17,只用一半就是 $18.3。
Serper 是预付信用点:买一包信用点,一次查用 1 个,但要 11 到 100 条结果的请求用 2 个(Serper 定价)。这条"11 到 100 条算 2 个 credit"容易把实际单价翻倍——如果你的脚本默认每次要 100 条,标价每千次 $1.00 实际上是 $2.00。再加信用点 6 个月过期,用量不规律的团队要把作废的那部分摊进单价。Tavily 是按 credit,一次基础搜索 1 个、深度搜索 2 个,按用量是 $0.008/credit、月付能降到 $0.005(Tavily 信用点说明):基础搜索按量就是每千次 $8、月付 $5,深度搜索翻倍到 $16 和 $10。Firecrawl 更要当心共用余额——搜索和抓取、爬取、抽取都从同一份信用点里扣,搜索是每 10 条结果 2 个 credit,JSON、抽取这类高级功能每页再加 credit(Firecrawl 定价页、Firecrawl 搜索文档)。
EveryInfra 是按请求:一次请求一个固定价,web/search $0.001389、bing 和 duckduckgo $0.000556,limit 只决定要几条、不超过能力上限就不改价钱。没有月费、没有信用点换算、没有"要 100 条就翻倍"这类叠加项,账单等于请求次数乘以单价,算起来只有一步。这也是按请求计费和按 credit、按月费的根本差别:前者的真实单价就是标价,后者的真实单价要把档位、过期、附加项、是否用满都算进去。
吞吐与限速:一小时能发多少
单价之外,能多快地发请求也影响选型。SerpAPI 把吞吐和套餐绑在一起:Free 每小时 50 次、Starter 200、Developer 1,000、Production 3,000、Big Data 6,000,要更高的并发就得升档、同时多买月度搜索。Serper 的四档对应 50 到 300 QPS(Serper 定价)。Firecrawl 按套餐给每分钟请求数,自助档从每分钟几次到几千次、越高档越宽(Firecrawl 速率限制)。Tavily 的分档限速没有公开写明,要先问销售或自己压测(Tavily 文档)。EveryInfra 按账户算速率,所有 Key 共用,默认每分钟若干次,充值累计到一定额度再往上升,也可以单买速率包(价格页)。
把吞吐和计费放一起看,取舍就清楚了:SerpAPI 把吞吐和月费绑在同一档,你要更高的并发,就得买更多的月度搜索。举例要稳定跑到每小时 1,000 次,SerpAPI 得上 Developer 档($75/月、5,000 次/月),要每小时 3,000 次就得上 Production($150/月、15,000 次/月);我们把速率和余额分开,速率按账户升、余额按请求扣,量小但偶尔要爆发的场景不用为峰值常年付一个高月费。做大批量前,先按你的峰值 QPS 对一遍各家的吞吐上限,再按月总量对单价,两个维度分别看,不要只盯着每千次价。
还有一种常被忽略的量:定时任务的并发。很多监测场景是"每天固定时间,对一批关键词、一批账号各搜一次",这类活在某个时刻集中发出几百上千次请求,对吞吐的要求是短时的峰值,不是全天的均值。按月费买并发,等于为这几分钟的峰值常年付钱;按账户升速率、按请求扣费,则能把峰值的成本只算在那几分钟。算这类活的账,要把"每天跑几次、每次多少请求、集中在多长时间"三个数一起摆出来,再去对各家的吞吐和计费,而不是拿一个笼统的月总量去套。
实测三:最低先付多少、免费额度和上手步数
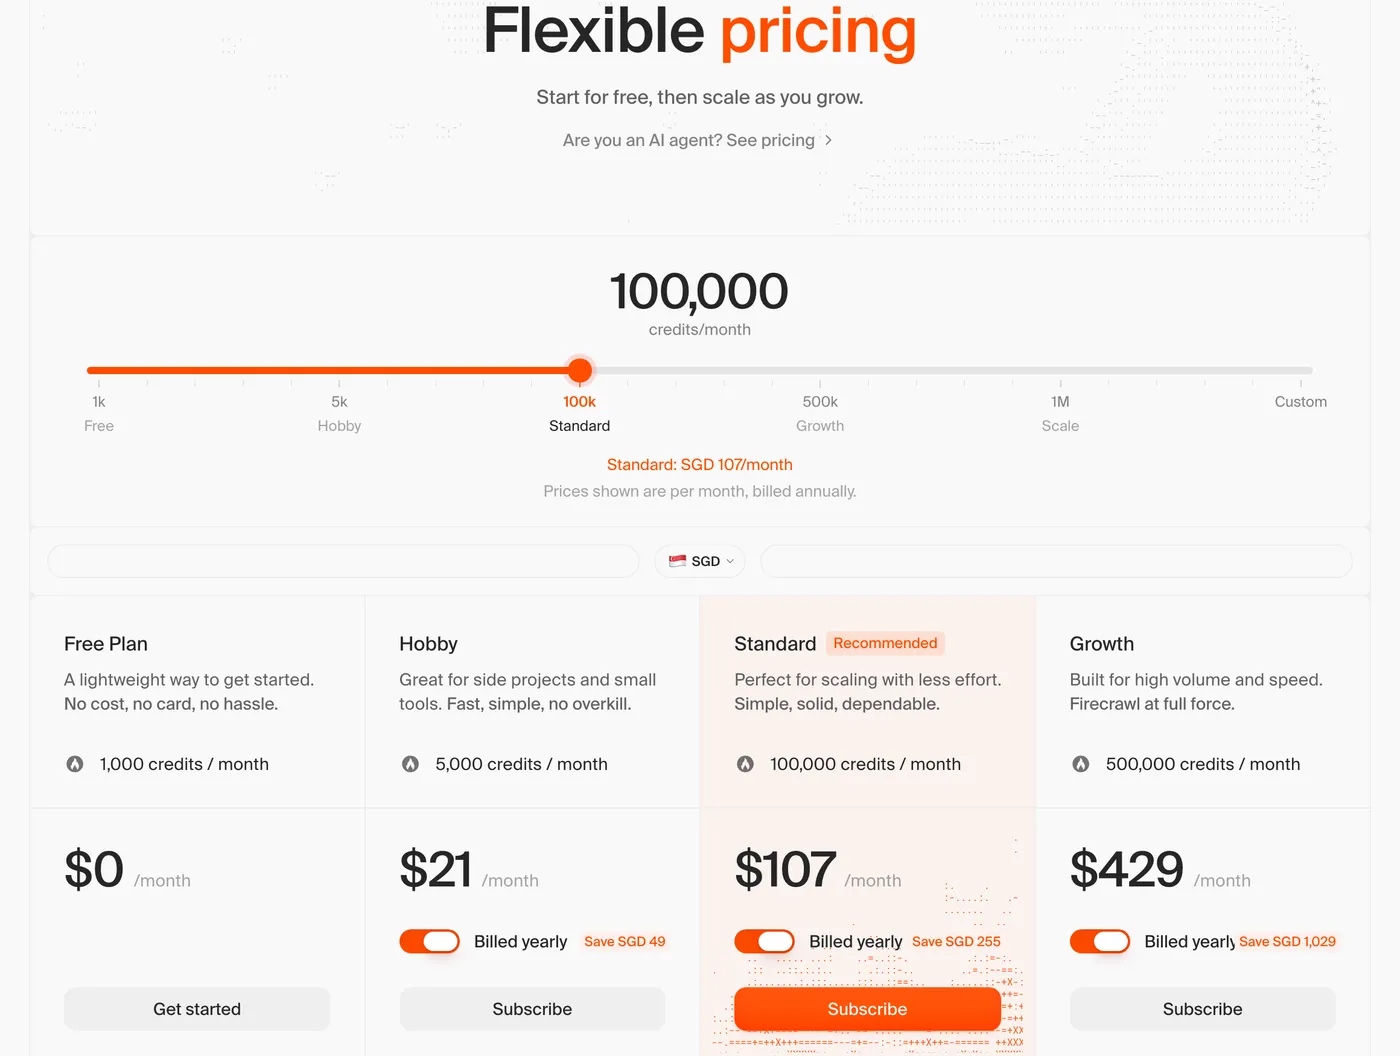
决定能不能"先试一点"的,是最低先付多少。Firecrawl 的 Hobby 月付 $19(年付合 $16)给 5,000 credit,折 2,500 次搜索,Standard $99 给 100,000 credit、折 50,000 次搜索,Scale $749 给 100 万 credit(Firecrawl 定价页,2026 年 11 月 17 日读取,页面标现价自 9 月 4 日生效)。Serper 新账号给 2,500 次一次性额度,之后最小一包 $50 买 50,000 credit。Tavily 每月送 1,000 credit,按用量 $0.008/credit(Tavily 定价),Project 档 $30/月给 4,000 credit。EveryInfra 没有每月赠送,GitHub 给两个仓库点星可领一次试用额度,正式用从 $10 起充值、余额不过期(价格页、快速上手)。
免费额度和过期规则也要一起看。SerpAPI 的 250 次、Firecrawl 和 Tavily 的 1,000 credit 都是月度额度、到月底清零;Serper 的 2,500 次是一次性的,买来的信用点 6 个月过期;我们这边余额不设日期、充了放着不清零(价格页)。对只是想先接上、量不大的团队,这几条比标价更影响体验。
上手步数也值得单独数一遍。按请求计费的接口,从注册到发出第一次真实请求,是"拿 Key、填一个 POST、读 results"三步,不用先选套餐、不用先算要买多少信用点;按月费或信用点的接口,第一步往往要先决定买哪一档、充多少,才能开始。对要在几家之间快速试一轮、比结果质量的团队,少掉"先决定买多少"这一步,就能把试错成本压到几美分。我们这边 GitHub 点两个仓库的星领一次试用额度,正式用从 $10 起,试一轮下来花的钱按真调看是几分钱的量级。
实测四:算一笔账,两种常见用量各花多少
我们按两种常见用量算了一个月的钱。对方一侧对每种用量找"能装下这份用量的最省档":成本取套餐月费和按量价里更划算的那个,Free 档只在用量不超过它的额度时可用;我们一侧等于请求次数乘以单价(bing/search $0.000556)。
| 一个月的活 | 次数 | SerpAPI | Serper | Tavily | Firecrawl | EveryInfra bing |
|---|---|---|---|---|---|---|
| 每月 1 万次网页搜索 | 10,000 | $150(Production) | $50(一包) | $72(按量) | $99(Standard) | $5.56 |
| 每月 10 万次网页搜索 | 100,000 | $3,750(企业) | $100(两包) | $500(月付) | $399(Growth) | $55.6 |
第一行的 SerpAPI 要 $150,是因为 1 万次超过了 Developer 的 5,000 次,得上 Production $150;我们这边 1 万次是 $5.56,比它便宜 27 倍。第二行最明显:10 万次超过 SerpAPI 自助档的上限 30,000,要走企业档、从 $3,750/月起,而我们是 $55.6;Serper 这一行很便宜,两包 $50 就能覆盖 10 万次、合 $100,但要先把钱压进去、信用点 6 个月过期。这张表只算了"搜索本身",没算各家的并发、代理和存储;SerpAPI 的月费是预付用量、当月不结转,我们的余额不清零。
再往上看一档:假如每月 100 万次,SerpAPI 要走定制企业合同;Firecrawl 的 Scale $749 给 100 万 credit、折 50 万次搜索,100 万次要两份、约 $1,498;Serper 用 $1,250 的 Scale 包(250 万 credit)覆盖、合每千次 $0.50;我们按 bing/search 是 100 万乘 $0.000556、约 $556。这一档是四家里差距收窄的地方:Serper 的 $500 级和我们的 $556 接近,Firecrawl 到 $1,498,SerpAPI 走定制。所以越往量大走,越要把"预付多少、信用点会不会过期、吞吐够不够"摆到和单价一样重的位置,单看每千次价会得出偏乐观的结论。把三档(1 万、10 万、100 万)各算一遍,比只盯一个量级更能看清换过去到底省多少。
把四家的每千次价按档位从小到大画出来,走势很清楚:SerpAPI 从 Starter 的 $25 降到 Big Data 的 $9.17,一直在两位数的美元级;Firecrawl 从 Hobby 的 $7.6 降到 Scale 的 $1.5,量大以后和我们接近;Serper 从 $1.0 降到 $0.3,是四家里唯一在量大档低于我们的;我们的 bing/search 不分档,是 $0.556 一条水平线。"谁最便宜"没有单一答案:入门和中等用量,这条水平线在大多数档位下面;只有把量堆到 Serper 的最高档、并且肯预付 $3,750,它才压到水平线下面。换句话说,比价要先定你的量级,再看那一级上谁低。
什么时候这四家比我们更合适
比价容易只写对自己有利的一面。前面几节把"我们更便宜"讲清楚了,这一节反过来讲"我们不如谁"。换接口的决定不该只看每千次价,还要看你要的那类数据、要的字段结构、要的合规保障,哪家做得更到位——价钱便宜但拿不到你要的字段,省下的钱没有意义。下面几种情况,SerpAPI、Serper、Tavily、Firecrawl 比我们更合适,或者是我们目前做不到的。
第一,你要把 Google 的各种垂直页解析成结构化 JSON。SerpAPI 覆盖一百多种搜索页,连 Google 航班、酒店、学术、专利、Lens、AI Overview 都有专门的解析接口(SerpAPI 搜索 API 列表),我们的 web/search 只给标题、链接、正文、名次这几个字段,不拆 SERP 里的知识面板、问答框。第二,你要的是"给模型一段能直接读的答案"。Tavily 的 /search 会把结果整理成适合喂给大模型的内容,还带 PII 过滤和提示注入检测、拿了 SOC 2(Tavily 搜索接口),现在归 Nebius(composio 评测,2026 年 11 月 4 日);我们回的是搜索结果本身,不做答案合成。第三,你要"搜一次顺便把整页正文抓回来"。Firecrawl 的搜索能连页面内容一起返回,还有 /crawl、/map 和结构化抽取(Firecrawl 抓取文档),11 月 11 日它拿了 $75M 的 Series B、发布了 Alexandria 数据库(Firecrawl 博客,2026 年 11 月 11 日);我们只给搜索结果,不抓整页正文。第四,你一个月发几百万次、单价是硬指标。Serper 的量大档每千次 $0.30、吞吐到 300 QPS(Serper 定价),比我们低,但要预付 $3,750、信用点 6 个月过期,11 到 100 条的请求还按 2 个 credit 算。
这四项里,前三项是"结构和内容"上的差别,第四项是"量大时的单价"。要结构,SerpAPI 的垂直接口最全,连航班、酒店、学术、专利都能解析成字段,一张结果页的知识面板、问答框、购物盒都拆成对象;要给模型一段能直接读的答案再加合规,Tavily 把 PII 过滤、提示注入检测做进接口、拿了 SOC 2,归 Nebius 之后仍以自有品牌运营(composio,2026-11-04);要搜索连正文、再往知识库走,Firecrawl 11 月拿了 $75M 的 Series B、把 Alexandria 公司数据做到 7,500 万家(Firecrawl 更新日志,2026-11-13),还有 /crawl、/map 和批量抓取(Firecrawl 批量抓取)。这些都是我们目前不做的方向:我们只回搜索结果本身,不解析整页 SERP 结构、不做答案合成、不抓整页正文。把需求对到这几项上,就知道该不该换、换了会丢什么。
反过来,我们更合适的场景也清楚:你要在 web、bing、duckduckgo、google_news、google_shopping 几个面之间用同一把 Key 切换、按请求付钱、余额不过期;你量不大、不想先压一笔预付或扛一个月费;你在意"失败和空结果不扣钱"这条能在响应里看到;你想把搜索放进 AI 工具,让模型自己调。这几条凑齐,按请求计费的接口在成本和接入上都省事;缺了其中关键的一条,就按上一节的四项去对那家更合适的。
合规与边界:只读公开搜索结果
这类接口读的是搜索引擎的公开结果页,不登录、不碰私密内容。SerpAPI 从 Production 档起带一个 U.S. Legal Shield,对合法采集公开搜索数据承担一部分责任、最高 200 万美元,这是它比别家多的一层法律缓冲;别家没有同款条款,但读的也都是公开结果。要注意的是,结果里可能包含个人信息(商家名、评论作者、联系方式),这类数据在不同地区受不同的隐私法约束,存储和使用要按你所在地的法律来,拿不准问律师。本文不构成法律意见。
从数据能拿到什么的角度看,各家的边界也不同:我们只给搜索结果本身,拿不到需要登录才看得到的内容,也不抓整页正文;要整页内容,Firecrawl 的搜索连正文一起返回更合适;要垂直页的结构化字段(航班价、酒店房态),SerpAPI 的专项接口覆盖更全。换接口换的不只是价格,还有维护成本落在谁身上:谁维护页面解析、谁扛封禁和验证码、谁对合规边界负责,这几件事都随接口一起变,托管接口把它们收进单价、开源方案则落回你自己身上。把"能拿到什么"和"合不合规"一起对一遍,再决定用哪家做哪一步。
结果稳不稳:同一个词再搜一次
搜索接口回的是"当时的一批结果",不是一张固定的表,换接口前最好测一下稳定性。我把 "best web search api for ai agents" 在 00:19 和 00:35 各搜了一次,两次都回 10 条、都扣 $0.001389,价格完全稳定;结果内容会随时间小幅变动,这对趋势和舆情监控是正常现象,按 url 去重累积即可。按请求计费下,重复搜很便宜:同一个词一天搜 10 次也只是 $0.01389,比按 credit 或按月费的方案更适合"定时多抓几次、去重累积"这种用法。要只拿近一段时间的结果,duckduckgo/search 的 time_window 直接限定时间窗,google_news/search 也带 time_window,不用自己按日期过滤。
稳定性还有一层是接口本身返回的一致性。这次 11 次真调的条数分布是:web/search 三次都回满 10 条,bing/search 一次回 5 条,duckduckgo/search 一次回 10 条,google_news/search 一次 20 条,google_shopping/search 一次 20 条,另有一次把 duckduckgo/search 翻到第 2 页、搜索源暂时满员回 503——搜索结果页本身有多少条,接口就回多少条,按请求计费下回 5 条和回 10 条一个价,所以单次的"性价比"会随结果多少波动,长期按请求次数算才稳。这一点和 SerpAPI 一致:它也按"一次搜索"计费,回 10 条还是 100 条算一次。把计费锚在请求上、而不是条数上,账单才好预估。
从 SerpAPI 换过来:改三处
为核这条迁移路径,我用 youtube/search 真调搜 "serpapi alternative" 取回前 10 个视频、扣 $0.000778,再用 youtube/transcript 取其中一个的字幕、扣 $0.000556,同一把 Key 也覆盖 YouTube。字幕把迁移概括成"三行改动":换地址、换参数名、换结果取法,其余不动(YouTube 真调取回的字幕)。照这个思路,从 SerpAPI 换到 EveryInfra 要改三处。第一处是地址和请求体:SerpAPI 是带 api_key、engine、q 的 GET,我们是带 Key 头、body 里写 platform、action、params 的 POST。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"web","action":"search","params":{"keyword":"best web search api for ai agents","language":"en","country":"us"}}'
# 返回 200,results 是结果数组,billing.charged_usd 是这次扣的钱
第二处是参数名:SerpAPI 的 q 在我们这里是 keyword,gl、hl 对应 country、language,要几条用 limit。第三处是结果取法:SerpAPI 把有机结果放在 organic_results,我们放在 results,每条的字段名是统一的 snake_case(title、url、text、rank、published_at),按能力目录的 response_fields 对,不要按记忆。要换引擎只改 platform,bing、duckduckgo 和 web 回同一类结果结构。下面是常用参数和字段的对应,换的时候按这张表改,不按记忆:
| SerpAPI | EveryInfra | 说明 |
|---|---|---|
engine=google | platform 为 web、bing、duckduckgo | 换引擎只改这一处 |
q | keyword | 搜索词 |
gl、hl | country、language | 地区和语言 |
num | limit | 要几条,不超过能力上限 |
organic_results[] | results[] | 有机结果数组 |
organic_results[].position | results[].rank | 名次 |
organic_results[].link | results[].url | 链接 |
改完以后,原来读 organic_results 里 title、link 的循环,换成读 results 里 title、url 就能跑;清洗脚本里按 SerpAPI 结构写的字段映射要照着上表换一遍,按能力目录的 response_fields 核,不要按记忆。要稳妥,先用同一批词在两边并行跑一小段,对名次、字段和返回条数,确认结果够用再把线上切过来。
在 AI 客户端里,EveryInfra 是一个远程 MCP 服务(MCP 是 Model Context Protocol,AI 客户端调用外部工具的协议,见规范 2025-06-18),工具名都以 everyinfra_ 开头,加一段配置就能让模型自己搜:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${env:EVERYINFRA_API_KEY}" }
    }
  }
}
然后可以直接说:"用 EveryInfra 搜 bing 上 'serpapi alternative' 的前 10 条,去掉广告列出标题和链接。"模型自己选引擎、自己发请求、自己读 results,你只管描述要什么。按请求计费在这里也更好预估成本:模型每搜一次就是一次固定价,不会因为它顺手要了 100 条而翻倍,账单跟着请求次数走,看调用记录就能对上。Serper、Tavily、Firecrawl 也各有 MCP(Tavily MCP、Firecrawl MCP),用法差不多,区别仍在计费:让模型多搜几页,按次计费加的是请求费,按 credit 计费加的是信用点。接入细节见远程 MCP 接入验收。
我们怎么核对这些数
每个数字都能回到原始返回或对方的公开定价页。SerpAPI、Firecrawl 的价钱从定价页读、截图留底;Serper 的档位用 serper.dev 的现价、经第三方对照页核过日期;Tavily 用它的信用点文档里的每 credit 价换算。我们这一侧的实扣来自每次响应的 billing.charged_usd,11 月 17 日 00:19 到 00:37 新加坡时间一共发了 11 次带 Key 的搜索请求,web 搜索三个时刻都是 $0.001389,另加三次故意写错或翻页的请求验失败扣费,时间都记到秒。迁移那节的字幕来源也用 youtube/search($0.000778)和 youtube/transcript(有字幕的一条 $0.000556、无字幕的一条退款 $0)各真调核过。图上的每千次价、每月成本由画图脚本直接从这些数算出来,和正文逐个对过。没做的事也写清楚:没有注册这四家、没有买它们的套餐,所以对方只有公开单价,没有实测账单、成功率和结果质量。
对方的价格每一两个月就会变一次:这个月读到的 SerpAPI 四档、Serper 四档、Firecrawl 的信用点换算,都带了读取日期,过一段时间要重新读页核对;我们这一侧的每千次价来自真调账单,谁拿同一把测试 Key、同样的请求体,都能跑出同样的 charged_usd。所以对方价只写公开档、我们价只写真调:能直接拿去估算的,和要自己再核一遍的,分得清。你照着套到自己量上时,建议把读取日期也记下来,隔一两个月重算,别用半年前的价格表做今天的决定。
最近的变化(30 天内)
| 日期 | 事件 | 对读者意味着什么 |
|---|---|---|
| 2026-11-14 | 第三方目录按 serper.dev 现价核对 Serper 四档:$1.00、$0.75、$0.50、$0.30 每千次(The GTM Directory) | Serper 的量大价要预付到 $3,750 才拿得到,比价要看你实际预付多少 |
| 2026-11-13 | DeepSeek 把网页搜索等整套应用接口开放给开发者(DeepSeek 更新日志,2026-11-13) | 搜索接口这一类又多一家,选型前把单价和覆盖面一起比 |
| 2026-11-13 | Firecrawl 的 Alexandria 公司数据覆盖到 7,500 万家(Firecrawl 更新日志,2026-11-13) | Firecrawl 在往"搜索加数据库"走,价格和功能都在变,比价要读当天的页 |
| 2026-11-11 | Firecrawl 宣布 $75M Series B 和 Alexandria 数据库(Firecrawl 博客,2026-11-11) | 融资后功能和定价都可能调,签长期合同前确认续期和涨价条款 |
| 2026-11-04 | 第三方评测写明 Tavily 已归 Nebius、仍以自有品牌运营(composio,2026-11-04) | 被收购的服务要留意路线图和 SLA 是否延续 |
| 2026-10-27 | 第三方定价页更新 Serper 档位,信用点 6 个月过期写进对照(SerpBase) | 信用点过期是隐性成本,用量不规律的团队算总价时要扣掉作废的那部分 |
| 2026-10-22 | DeepSeek 搜索与抓取接口状态盘点,单价 $0.75 每千次(shattered.io,2026-10-22) | 新入场的低价搜索接口在压价,比价窗口期变短 |
| 2026-10-19 | DeepSeek 搜索接口定价与限额说明,$0.75 每千次成功请求(eesel,2026-10-19) | 低价搜索接口多了,但覆盖面和稳定性各不同,别只看单价 |
把选型压成三个问题
换 SerpAPI 时,把问题压成三条就够判断。第一条,你要的是"整张 SERP 的结构"还是"几个引擎的有机结果"。要前者,SerpAPI 的几十种结构化对象、Serper 的知识图谱更合适;要后者,按请求计费、字段统一的接口更好接,省掉再解析的一步。第二条,你一个月发多少次、肯不肯预付。几千到几万次、不想压预付的,按请求计费每千次 $0.556 最省;几百万次、肯一次性预付几千美元的,Serper 的量大档每千次 $0.30 更低;中间地带要把月费、预付和过期一起算。第三条,失败和空结果的扣费你能不能接受。按次或按请求计费的接口里,哪种算"失败"各家不同,换之前拿你真实的错误类型(参数错、无结果、被挡、超时)各发一次,看扣不扣钱、看响应里有没有写明退款,再把这条写进成本估算。
这三条之外,还有两件事容易被标价盖过。一是信用点会不会过期:Serper 的信用点 6 个月作废,用量不规律的团队要把作废的那部分算进真实单价,否则账面单价会比实付低。二是吞吐够不够峰值:SerpAPI 的吞吐和月费绑在一档,峰值高就得常年多付一个高月费;按账户升速率、按请求扣费的接口,能把"常年的量"和"偶尔的峰值"分开算。把这两条和每千次价一起列出来,再做决定。还有一类新入场的低价搜索接口也值得顺手比一下,例如 DeepSeek 2026 年 10 月对开发者开放的搜索接口,每千次成功请求 $0.75(eesel,2026-10-19),覆盖面和稳定性和老牌家各不同,比价时把单价和覆盖一起看。
常见问题
有没有免费的 SerpAPI 替代?
问题来自 Google 联想词 "serpapi alternatives free"。完全免费、每月都给的很少:SerpAPI 每月 250 次、Firecrawl 和 Tavily 每月 1,000 credit,都不结转,到月底清零;Serper 的 2,500 次是一次性的、不是每月。EveryInfra 没有每月赠送,GitHub 给 everyinfra-agent-plugins 和 seo-skills 两个仓库点星可以领一次试用额度,正式用从 $10 起、余额不过期。要"每月免费一批"持续用,Firecrawl 和 Tavily 的月度 1,000 credit 更合适;要"按次付、不压预付、余额不清零",按请求计费的接口更省。几家的免费额度都够先把流程跑通、测一轮结果质量,长期成本要看免费额度用完以后的单价和计费单位,别只被"免费多少"吸引。
SerpAPI 太贵了,n8n 里有便宜的替代吗?
问题来自联想词 "n8n serpapi alternative" 和 Reddit r/n8n 的两个帖子:一位嫌"每月 100 次免费搜索不够用",一位说"SERP 第一个付费档就要 $75"(r/n8n、r/n8n)。n8n 里不用装专门节点,一个 HTTP Request 节点填上面的 URL、请求头和 body 就能调,返回的 results 数组直接往后面的节点传。按本文算账表,"每月 1 万次网页搜索"在 SerpAPI 要 $150,换成 bing/search 按次计费约 $5.56;想让工作流里的 AI 节点自己决定搜什么,还可以把远程 MCP 挂上,让模型按需调。要把结果写进表格或数据库,results 里的字段名统一,映射一次就固定下来,后续加引擎不用重写。
从 SerpAPI 换过来要改多少代码?
问题来自 YouTube 上介绍这类替代的视频,概括成"三行改动"。对 EveryInfra 来说就是换地址、换参数名、换结果取法三处,原来读标题和链接的循环不动,换引擎只改 platform;参数和字段的逐项对照见前面"从 SerpAPI 换过来:改三处"那节的对照表。
Serper 和 EveryInfra 比,哪个更便宜?
问题来自联想词 "serpapi cheaper alternative" 和比价讨论。Serper 入门每千次 $1.00,比我们的 web/search $1.389 低、但比 bing/search $0.556 高;Serper 的量大档每千次 $0.30 比我们低,可那一档要一次性预付 $3,750,信用点 6 个月过期,11 到 100 条的请求按 2 个 credit 算。我们 $0.556 不设预付门槛、余额不过期。小到中等用量、不想压预付的,我们更省;一个月几百万次、肯预付的,Serper 的量大价更低。
开源的 SerpAPI 替代靠谱吗?
问题来自联想词 "serpapi alternatives open source" 和 Reddit r/LocalLLaMA 的讨论(r/LocalLLaMA)。自己跑开源抓取省的是接口费,但要自己处理代理池、页面改版、封禁和验证码,搜索引擎一改结构就得跟着修,稳定性和维护成本都压在自己身上;托管接口把这些收进单价里,换来的是少一套要维护的东西。两条路的分界是你愿不愿意自己运维:量小、偶尔用、能接受偶尔跑不通,开源脚本够;要稳定供数、按量付费、把精力放在业务上,托管接口更省心。折中的做法是先用托管接口把业务跑起来,等量真的大到接口费成为大头,再评估要不要自建——多数团队到不了那个量级,接口费始终比一个工程师的维护工时便宜。
每千次搜索到底怎么算的?
问题来自本文的实测。每千次价等于一次搜索请求实际扣的钱乘以 1,000。SerpAPI、Serper 按次,一次一个价,回多少条都一样;Tavily、Firecrawl 按 credit,换算成"每次基础搜索多少 credit、每 credit 多少钱",Firecrawl 还要记住搜索是每 10 条 2 个 credit;EveryInfra 按请求,web/search 一次 $0.001389、bing 和 duckduckgo 一次 $0.000556。把各家都折成"每 1,000 次搜索多少美元",才在同一个分母上可比。要算你自己的实付,别只看标价:Serper 要把"11 到 100 条翻倍"和"信用点过期"算进去,SerpAPI 要看当月有没有用满,Tavily 要分基础和深度搜索,Firecrawl 要留意和抓取共用的余额。把这些叠加项都摊进去,才是你真实的每千次价。
上手:从一次试用到每天自动搜
第一步,拿到 API Key。在 GitHub 给 everyinfra-agent-plugins 和 seo-skills 两个仓库点星,可以在控制台领一次试用额度;正式用从 $10 起充值,余额不过期(快速上手、价格页)。第二步,打开对应能力的文档页,用页上的一键试用跑一次:试网页搜索、试 Bing 搜索、试 DuckDuckGo 搜索。第三步,看响应里的 charged_usd 和返回条数,用"实扣乘以 1,000"算出你这个场景的每千次价,再和你现在的 SerpAPI 账单比。要迁移线上,先按前面那张参数对照表把请求改掉,再用同一批词在两边并行跑一小段,对名次、字段和返回条数,确认结果够用,最后把流量切过来——整个过程改动集中在三处,清洗脚本的字段映射改一遍就固定。要让 AI 工具自己搜,把远程 MCP 挂上,模型按需调 everyinfra_* 工具,不用你手写每一次请求。全部搜索面见 网页搜索 API、Bing 搜索 API、DuckDuckGo 搜索 API,也可以在数据市场里按类别找。想先读定价拆解,看 SerpAPI 价格拆解和 给 AI 智能体选搜索 API;各家对比页在 SerpAPI 替代页。
参考资料
- SerpAPI 定价页(套餐、每千次、FAQ 计费规则),2026-11-17 新加坡时间读取并截图。https://serpapi.com/pricing
- SerpAPI 首页(四档套餐卡片现价),2026-11-17 读取。https://serpapi.com
- SerpAPI 搜索 API 列表(一百多种搜索页解析),2026-11-17 读取。https://serpapi.com/search-api
- SerpAPI 订阅拆解(企业档、预留与按量搜索价),SerpAPI 博客,2026-11-17 读取。https://serpapi.com/blog/breakdown-of-serpapis-subscriptions/
- DataForSEO vs SerpApi(各档每千次换算表),SerpAPI 博客,2026-11-17 读取。https://serpapi.com/blog/dataforseo-vs-serpapi/
- SerpAPI Python 客户端(google-search-results),GitHub。https://github.com/serpapi/google-search-results-python
- SerpAPI Python SDK,GitHub。https://github.com/serpapi/serpapi-python
- Serper 定价页(四档信用点价、QPS),2026-11-14 经 serper.dev 核对。https://serper.dev/pricing
- Serper 首页(Google 搜索 JSON 示例),2026-11-17 读取。https://serper.dev
- Serper Playground(请求与响应结构),2026-11-17 读取。https://serper.dev/playground
- The GTM Directory:Serper vs Tavily(Serper 四档与 Tavily 档位对照),2026-11-14。https://thegtmdirectory.com/compare/serper-dev-vs-tavily
- SerpBase:Serper.dev 定价与免费额度(信用点 6 个月过期),2026-10-27 更新。https://serpbase.dev/blog/serpbase-vs-serper-dev-serp-api-pricing-and-feature-comparison
- Tavily 信用点与定价(每 credit 价、基础与深度搜索),Tavily 文档。https://docs.tavily.com/documentation/api-credits
- Tavily 搜索接口(搜索深度、字段),Tavily 文档。https://docs.tavily.com/documentation/api-reference/endpoint/search
- Tavily 抽取接口(按成功抽取计费),Tavily 文档。https://docs.tavily.com/documentation/api-reference/endpoint/extract
- Tavily 爬取接口,Tavily 文档。https://docs.tavily.com/documentation/api-reference/endpoint/crawl
- Tavily 站点地图接口,Tavily 文档。https://docs.tavily.com/documentation/api-reference/endpoint/map
- Tavily MCP 服务(搜索、抽取、爬取工具),Tavily 文档。https://docs.tavily.com/documentation/mcp
- Tavily Python SDK 快速上手,Tavily 文档。https://docs.tavily.com/sdk/python/quick-start
- Tavily Python SDK,GitHub。https://github.com/tavily-ai/tavily-python
- Tavily MCP 服务器,GitHub。https://github.com/tavily-ai/tavily-mcp
- Tavily 定价页(Researcher、Pay As You Go、Project 档),2026-11-17 读取。https://tavily.com/pricing
- Firecrawl 定价页(信用点换算、搜索每 10 条 2 credit、失败扣费),2026-11-17 读取并截图,现价自 9 月 4 日生效。https://firecrawl.dev/pricing
- Firecrawl 搜索功能(搜索连正文返回),Firecrawl 文档。https://docs.firecrawl.dev/features/search
- Firecrawl 搜索接口,Firecrawl 文档。https://docs.firecrawl.dev/api-reference/endpoint/search
- Firecrawl 抓取功能,Firecrawl 文档。https://docs.firecrawl.dev/features/scrape
- Firecrawl 爬取功能,Firecrawl 文档。https://docs.firecrawl.dev/features/crawl
- Firecrawl 介绍与端点总览,Firecrawl 文档。https://docs.firecrawl.dev/introduction
- Firecrawl 速率限制,Firecrawl 文档。https://docs.firecrawl.dev/rate-limits
- Firecrawl MCP 服务器,Firecrawl 文档。https://docs.firecrawl.dev/mcp-server
- Firecrawl SDK 总览,Firecrawl 文档。https://docs.firecrawl.dev/sdks/overview
- Firecrawl 源码仓库,GitHub。https://github.com/firecrawl/firecrawl
- Firecrawl MCP 服务器源码,GitHub。https://github.com/firecrawl/firecrawl-mcp-server
- What is Alexandria($75M Series B、Alexandria 数据库),Firecrawl 博客,2026-11-11。https://www.firecrawl.dev/blog/what-is-alexandria
- Firecrawl Alexandria 覆盖 7,500 万家公司,Firecrawl 更新日志,2026-11-13。https://www.firecrawl.dev/changelog/company-data-relaunch
- DeepSeek 更新日志(整套应用接口含网页搜索开放给开发者),2026-11-13。https://api-docs.deepseek.com/updates/
- DeepSeek 搜索接口定价与限额($0.75 每千次),eesel,2026-10-19。https://www.eesel.ai/blog/deepseek-search-api
- DeepSeek API 状态盘点,shattered.io,2026-10-22。https://shattered.io/where-the-deepseek-api-stands-on-october-22-2026/
- 10 Best Web Access Tools for AI Agents(Tavily 归 Nebius),composio,2026-11-04。https://composio.dev/content/best-browser-agent-apis
- EveryInfra 能力目录(price_usd、max_limit、response_fields),2026-11-17 读取。https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra llms.txt(失败和空结果不收费)。https://api.everyinfra.com/llms.txt
- EveryInfra 远程 MCP 端点。https://api.everyinfra.com/mcp
- Model Context Protocol 规范 2025-06-18。https://modelcontextprotocol.io/specification/2025-06-18
- SERP 替代讨论,Reddit r/n8n。https://www.reddit.com/r/n8n/comments/1k5yny8/serp_alternative_web_search/
- 要不要换掉 SerpAPI,Reddit r/n8n。https://www.reddit.com/r/n8n/comments/1gy42z9/we_should_look_for_another_option_besides_serpapi/
- 开源 SERP 替代讨论,Reddit r/LocalLLaMA。https://www.reddit.com/r/LocalLLaMA/comments/1c62wmz/serp_alternative_google_result_scrape_hopefully/
- Tavily 文档入口,Tavily 文档。https://docs.tavily.com/welcome
- Tavily 快速上手,Tavily 文档。https://docs.tavily.com/documentation/quickstart
- Tavily 站点地图接口,Tavily 文档。https://docs.tavily.com/documentation/api-reference/endpoint/map
- Firecrawl API 端点总览,Firecrawl 文档。https://docs.firecrawl.dev/api-reference/introduction
- Firecrawl LangChain 集成,Firecrawl 文档。https://docs.firecrawl.dev/integrations/langchain
- Firecrawl 批量抓取,Firecrawl 文档。https://docs.firecrawl.dev/features/batch-scrape
- Tavily JavaScript SDK,GitHub。https://github.com/tavily-ai/tavily-js
- Firecrawl Python SDK,GitHub。https://github.com/firecrawl/firecrawl-py
- SerpAPI JavaScript 客户端,GitHub。https://github.com/serpapi/serpapi-javascript
引用编号 BL-175