公众号数据 API 推荐(2026)
公众号数据 API 推荐:官方接口只管自己的号且要认证,开源头部项目已停更,按次付费读别人文章每千次 $5.56 起,附 2026 年 11 月实测。
公众号数据 API 有现成的,选哪种先看你要读谁的号。读自己的号(发文、看自己文章的阅读来源和留言),用微信公众平台的官方服务端接口;读别人公众号公开发布的文章、阅读数和留言,官方没有对应接口,只能在 GitHub 上的开源公众号爬虫和按次付费的第三方数据接口之间选。按次付费这一类我们比了两家:EveryInfra 是我们自己的接口,数字来自 2026 年 11 月 22 日三个时刻的真调;TikHub 的数字来自它的公开价目,我们没有实调。
2026 年,三类方案各自有了变动。官方《获取已发布的消息列表》页面在 2026 年 11 月 11 日最后一次编辑,适用范围一栏写着公众号「仅认证」,并注明 2025 年 7 月起个人主体账号、企业主体未认证账号的调用权限被回收。开源一侧,GitHub 上星数最多的公众号文章导出项目 wechat-article-exporter(13,172 星)在 2026 年 7 月 30 日宣布停止维护,在线站 10 月下线;第二多的 wewe-rss(9,615 星)已经归档。按次付费一侧,EveryInfra 的公众号目录 13 项能力里 10 项可用,每千次调用 $5.56 到 $16.00,按次计费、不按条数算;我们 12:56 读一篇丁香生活研究的文章,传播数据返回 read_count 100001、在看 122、分享 3,469,一次扣 $0.005556。
公众号数据采集 api 推荐:三类方案总对比表
表里官方一列来自微信开放文档,2026 年 11 月 22 日逐页读过;开源一列取 GitHub 上星数靠前的 10 个公众号项目的 README,读取时刻是同日 12:44(新加坡时间);按次付费两列,EveryInfra 的价格读自同日 12:37:42 的公开目录,TikHub 的价格读自同日 12:47:43 不带 Key 就能访问的公开价目接口和它的 FAQ。两家逐项比价见 TikHub 替代方案 和 TikHub 价格说明。
| 比较项 | 微信公众平台官方接口 | GitHub 开源公众号爬虫 | TikHub | EveryInfra |
|---|---|---|---|---|
| 能读谁的数据 | 只读自己的号(或授权给你的第三方平台商家) | 任何公开文章,靠公众号后台搜索、微信读书或电脑版微信的会话 | 公开文章、账号、评论 | 公开文章、账号、评论、传播数据 |
| 账号和资质 | 企业主体并完成微信认证,个人主体 2025 年 7 月起回收发布类接口权限 | 多数要扫码登录一个公众号或微信读书账号 | 注册即可 | 注册即可 |
| 要不要 Cookie 或登录态 | 用 AppSecret 换 access_token,服务器 IP 进白名单 | 要,失效了重新扫码 | 公众号接口按文章网址或 gh_ ID 调用,不要你的 Cookie | 不要 |
| 计费单位 | 接口本身不收费,账号认证另付 | 免费,成本是机器、账号和维护 | 按次,200 才扣 | 按次,不按条数,失败和空结果不扣 |
| 每千次价格 | 无 | 无 | $10.00(23 条),$1.00(1 条) | $5.56–$16.00 |
| 每天上限 | 「获取成功发布列表」新号 100 次 | 看账号被限的速度 | 每个接口 10 次/秒 | 按 Key 限速,本篇用的 Key 每分钟 10 次 |
| 能不能接 MCP | 有社区做的自管号 MCP,仍要自己号的 AppSecret | 部分项目提供 RSS 或 API | 有 MCP | 远程 MCP,工具名 everyinfra_* |
| 适合 | 管自己号:发文、读自己文章的阅读来源和留言 | 一次性小批量、能接受随时修 | 已在用它别的平台接口的团队 | 批量读别人公开发布的文章、阅读数和留言 |
两种按次付费接口都按调用次数收钱,比价时要先换算成同一个单位。读一篇文章的正文或传播数据,一次请求就是一条结果,两家直接比每千次;搜索、评论、历史文章列表这类一次回多条的接口,每千条的价钱取决于一次能取多少条。EveryInfra 的 wechat_oa/article_search 一次 $0.008,单次 limit 最多 400 条;我们 12:38 用默认参数搜「露营」回了 18 条,合每千条 $0.444,如果关键词够热、一次取满 400 条,每千条只要 $0.020。TikHub 的 FAQ 写明它的微信搜索不能翻页,要更多结果就重发同一请求、会有重复;它一次回多少条我们没有实调,所以表里不给它的每千条价。
微信公众号有官方 api 吗:公众平台接口只管自己的号
有。微信公众平台给公众号开放了一整套服务端接口,文档在 developers.weixin.qq.com,现在按「公众号(原订阅号)」和「服务号」分成两套目录。调用的前提是你名下有一个公众号:在微信开发者平台扫码登录、拿到这个号的 AppID 和 AppSecret,把服务器 IP 加进白名单,再用获取接口调用凭据换一个 access_token。接口调用概述写明 access_token 有效期 2 个小时,重复获取会让上一个失效,建议用一台中控服务器统一刷新;不在白名单里的 IP 换凭据会收到 61004 错误。
和数据有关的接口有三组,都只认你自己的号。第一组是发布能力:获取已发布的消息列表(/cgi-bin/freepublish/batchget)每次取 1 到 20 篇,返回标题、作者、摘要、正文 HTML 和删除标记;获取已发布图文信息按 article_id 取单篇。第二组是数据统计:数据统计接口介绍写明这组接口「向所有认证公众号开发者开放」,旧的图文群发每日数据已标停止维护,新的发表内容每日阅读数据按阅读场景(公众号消息、聊天会话、朋友圈、推荐、搜一搜等)拆分阅读人数,数据从 2025 年 11 月 1 日起才有,每次只能查 1 天。第三组是留言管理:查看指定文章的评论数据按群发返回的 msg_data_id 取,每次少于 50 条,返回评论者的 openid。
三组接口的适用范围栏都写着同一件事:公众号「仅认证」,即只允许企业主体并已认证的账号调用。发布能力几页还多一句注意:2025 年 7 月起,个人主体账号、企业主体未认证账号及不支持认证的账号将被回收调用权限。下面是 2026 年 11 月 22 日截的原文。
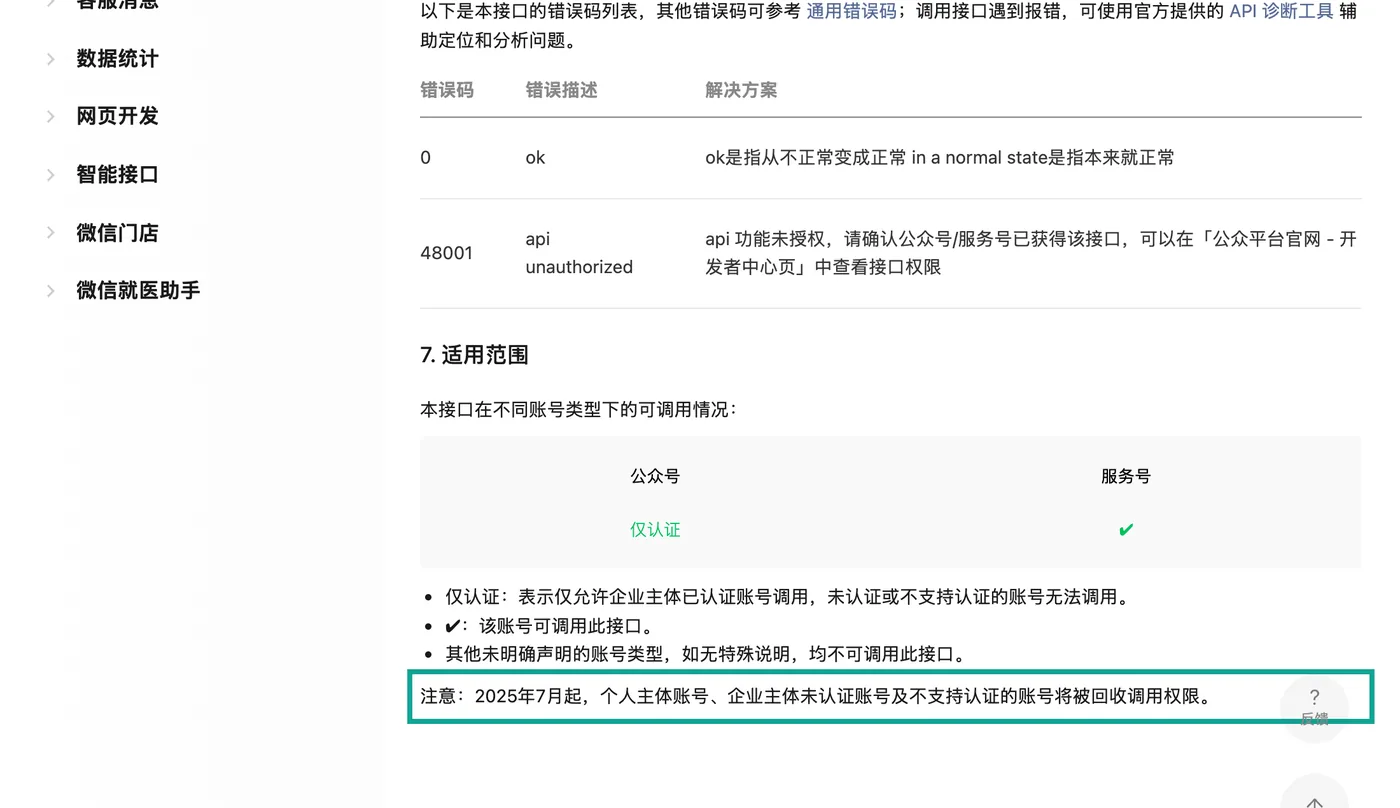
| 官方接口 | 请求路径 | 能拿到什么 | 拿不到什么 | 公众号适用范围 |
|---|---|---|---|---|
| 获取已发布的消息列表 | /cgi-bin/freepublish/batchget | 自己号已发布文章的标题、作者、摘要、正文、删除标记 | 别人号的文章;群发(已通知)的内容,社区答复写明暂不支持 | 仅认证 |
| 获取发表内容每日阅读数据 | /datacube/getarticleread | 自己号每篇文章按场景拆分的阅读人数 | 2025 年 11 月 1 日以前的数据;别人号的阅读数 | 仅认证 |
| 获取图文群发每日数据(旧) | /datacube/getarticlesummary | 阅读、分享、收藏人数和次数 | 已停止维护;阅读、分享、收藏合计不足 3 的不统计 | 仅认证 |
| 查看指定文章的评论数据 | /cgi-bin/comment/list | 自己号文章的留言、精选标记、作者回复、openid | 别人号的留言;每次 50 条及以上会被拒 | 仅认证 |
| 获取接口调用凭据 | /cgi-bin/token | access_token,2 小时有效 | 不在 IP 白名单里时返回 61004 | 全部公众号 |
表里「群发内容暂不支持」一格来自微信开放社区 2024 年 6 月 27 日的置顶答复:「获取成功发布列表」只能取到发布(未通知)的内容。也就是说,一个靠群发推送的号,用官方接口连自己的历史文章都未必列得全,要在公众号后台手动复制链接补齐。
官方接口每天能调几次
接口限制说明给出了新注册账号的每日默认额度:获取 access_token 2,000 次,草稿箱获取草稿列表 1,000 次,获取关注者列表 500 次,发布能力里的「获取成功发布列表」和「通过 article_id 获取已发布文章」各 100 次。第三方平台代调用时消耗的也是这个号自己的额度。按每次最多 20 篇算,新号一天最多能列出 2,000 篇自己已发布的文章,要把自己号的全部历史导出来,多数号一天就够,但群发(已通知)的内容不在这个接口里,要在公众号后台手动复制链接补齐。对管理自己号的团队,100 次够用;拿来做跨号监测就谈不上了,因为接口只回你自己号的内容。
官方渠道更合适的三件事:发文、读自己号的阅读来源、管留言
自己号的数据,官方接口比任何第三方都全。读阅读来源时,getarticleread 能告诉你一篇文章的阅读人数里有多少来自公众号消息、多少来自朋友圈和推荐,这类拆分只有号主自己能拿到,任何读公开页面的方案都没有。管留言时,comment/list 返回评论者的 openid,能和你自己的粉丝数据对上;第三方接口读到的是页面上公开显示的昵称和属地,没有 openid。草稿、发布、删除这一整套写操作,也只有官方接口能做。
自己没写过对接代码的团队,社区有现成的自管号 MCP 服务,例如 xwang152-jack/wechat-official-account-mcp,README 写明 AppSecret 加密存本地,它调的仍是官方接口、读的仍是你自己的号。
微信公众号爬虫:GitHub 开源项目现在还能用吗
GitHub 上搜「微信公众号 爬虫」和「wechat article」,按星数排在前面的项目里,我们挑出 10 个和读公众号文章直接相关的,用 GitHub REST API 在 2026 年 11 月 22 日 12:44(新加坡时间)读了星数、最后一次提交和许可证,再逐个读 README 判断它要不要登录。10 个项目里,没有一个能在不登录、不借任何微信会话的情况下,持续列出一个号的全部历史文章并带上阅读数。
| 仓库 | 星数 | 最后一次提交(UTC) | 许可证 | 取数原理和登录要求(README 原文归纳) | 状态 |
|---|---|---|---|---|---|
| wechat-article/wechat-article-exporter | 13,172 | 2026-11-09 | MIT | 公众号后台写文章时的「搜索其他公众号文章」功能,要扫码登录一个公众号;阅读量和评论要另外抓包拿 credentials | 2026-07-30 宣布停止维护,在线站 10 月下线 |
| cooderl/wewe-rss | 9,615 | 2026-03-20 | MIT | 基于微信读书,扫码登录微信读书账号;README 写「添加频率过高容易被封控,等24小时解封」 | 已归档 |
| chyroc/WechatSogou | 6,411 | 2026-10-23 | Apache-2.0 | 搜狗微信搜索,不登录;有验证码重试参数,可配代理 | 仍有提交 |
| rachelos/we-mp-rss | 5,225 | 2026-11-22 | 自定义 | 自部署服务,扫码授权后定时更新订阅的公众号 | 活跃 |
| wnma3mz/wechat_articles_spider | 3,486 | 2024-04-18 | Apache-2.0 | 手动从电脑版微信取 cookie 和 token;阅读点赞参数「过期时间为4小时」 | 两年多没提交 |
| bowenpay/wechat-spider | 3,402 | 2021-08-10 | 无 | 搜狗微信 | README 写搜狗微信 2019 年 10 月 29 日下线相关功能后废弃 |
| jackwener/wechat-article-to-markdown | 1,091 | 2026-03-22 | 无 | 给一个文章链接,抓正文转 Markdown,不登录 | 只做单篇 |
| yeximm/Access_wechat_article | 749 | 2026-08-23 | 自定义 | Windows 桌面端,MITM 代理解析电脑版微信的请求 | 有更新 |
| wonderfulsuccess/weixin_crawler | 494 | 2024-02-27 | 无 | 代理微信客户端和微信读书的请求,取阅读、点赞、在看 | 停更 |
| Moore-developers/moore-wechat-article-downloader | 297 | 2026-08-01 | MIT | 电脑版微信的短时会话,保存正文、精选评论和互动数据 | 有更新 |
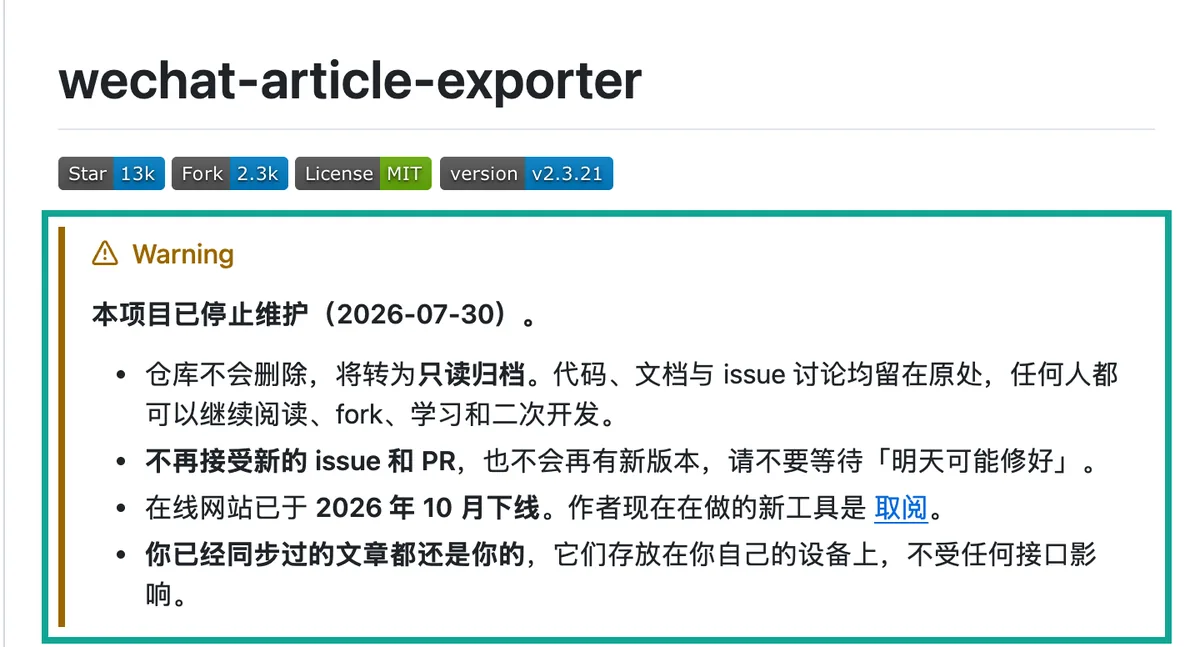
wechat-article-exporter 的原理写在 README 里:公众号后台写文章时可以搜索其他公众号的文章并插入链接,项目借这个功能列出任意公众号的全部文章。2026 年 7 月 30 日,作者在 issue #200 宣布停止维护,原话是「开箱即用的一键同步公众号文章已经不复存在了」,并说明仓库转为只读归档、不再接受新 issue 和 PR。README 顶部的说明补了一句:在线网站已于 2026 年 10 月下线。
排第二的 wewe-rss 走的是另一条路:用微信读书里的公众号订阅功能读文章,README 的账号状态表里有一栏「今日小黑屋」,意思是账号被封控、等一天恢复。这个仓库在 2026 年 3 月 20 日之后已归档。第四名 we-mp-rss 仍然活跃,最后一次提交就在我们读取的当天(2026 年 11 月 22 日 04:22 UTC),近 30 天新开了 5 个 issue;其中 #485(2026 年 10 月 30 日)报告自建的 we-mp-rss 容器里出现挖矿进程和异常 SSH 公钥,报告者自己也写明「目前无法确认入侵入口,也不能据此断定漏洞一定在项目代码中」;#489(11 月 19 日)问获取微信授权二维码返回 404。自部署这类服务时,至少不要把管理端口直接暴露在公网上。
许可证也影响能不能拿来改。10 个仓库里,MIT 的 3 个(wechat-article-exporter、wewe-rss、Moore),Apache-2.0 的 2 个(WechatSogou、wechat_articles_spider),we-mp-rss 和 Access_wechat_article 用的是 GitHub 识别不出的自定义条款,wechat-spider、wechat-article-to-markdown、weixin_crawler 这 3 个仓库没有放许可证文件。没有许可证的代码,默认只能看、不能复制进自家产品;自定义条款的要逐条读,we-mp-rss 的配置项里还有一个授权加密密钥,商用前先问作者。开源项目对个人学习和一次性研究够用,要放进公司的长期数据流程,许可证、维护状态和账号风险三件事都要过一遍。
开源项目的四种取数原理,各卡在哪里
10 个项目归下来是四种原理,每种都有一个公开记录过的卡点。第一种借公众号后台的搜索功能,代表是 wechat-article-exporter 和 we-mp-rss,前者的作者在 issue #200 里写明它依赖的核心接口「已被微信关闭」;第二种借微信读书的订阅,代表是 wewe-rss,README 自己写了封控和 24 小时解封;第三种借搜狗微信搜索,代表是 WechatSogou,搜狗微信只给搜索结果、不给一个号的完整历史,频繁请求会出验证码,bowenpay/wechat-spider 就是在搜狗 2019 年下线相关功能后废弃的;第四种借电脑版微信的会话或抓包,代表是 wnma3mz/wechat_articles_spider、Access_wechat_article 和 Moore,阅读数、点赞、在看这些互动数据只有这一路能拿到,但参数几个小时就过期,要一直有人开着微信客户端。
单篇正文是例外。微信文章页本身是公开网页,jackwener/wechat-article-to-markdown 给一个 mp.weixin.qq.com/s/... 链接就能转成 Markdown;掘金上一篇 2026 年 4 月的测评比较了六种抓公众号文章的办法,作者的经验是普通请求大概率被滑块验证拦下,换成微信内置浏览器的 User-Agent 能拿到完整 HTML,同时提醒频率要克制、微信随时可能改策略。正文能这样拿,阅读数和留言拿不到:这两样不在文章 HTML 里,是页面打开后再向微信请求的,需要微信客户端的身份参数。
YouTube 上的演示视频也落在这四种原理里。我们 12:49 用 youtube/search 搜「微信公众号 爬虫」,前 10 条里播放最多的是一条 2025 年 7 月的 n8n 工作流教程(11,275 次播放):先用一个付费数据服务取公众号历史文章列表(视频里说每次 0.06 元,约合 $0.009,汇率按 12:37 目录里人民币和美元两种标价折出的 1 美元约 6.69 元),再用 HTTP 节点请求每篇文章、去掉网页标签、存进 Notion。评论区 20 条里,有人问「能获取文章的阅读量和公众号的粉丝数量吗」,有人说设置了 User-Agent 仍然取不到正文,还有人问 HTTP 节点为什么一直不出结果。这三个卡点和上面的分析对得上:列表和正文好办,互动数据和稳定性难办。
有没有现成的公众号接口:按次付费怎么比
有。按次付费接口把「登录、会话、换参数、被限后重试」这些事放在服务方,调用方只发一个 HTTP 请求。下面比 EveryInfra 和 TikHub 两家,看计费单位、每千次价、失败扣不扣、要不要你的账号这四项就能分出来。
EveryInfra 的公众号目录在 2026 年 11 月 22 日 12:37:42 有 13 项能力,10 项可用:文章搜索、文章正文、公众号搜索、公众号资料、公众号主体信息、历史文章列表、当日文章、文章评论、评论回复、文章传播数据;小程序搜索、搜索联想、微信指数 3 项标为暂不可用。可用的 10 项只有 4 档价格:文章正文、主体信息、传播数据每次 $0.005556;评论和评论回复每次 $0.006764;文章搜索、公众号资料、历史文章列表、当日文章每次 $0.008;公众号搜索每次 $0.016。每个能力页都写着「按次计费,不按条数算。失败和空结果不收费」,例如 文章评论 的页面写明单次 limit 最多 260 条,历史文章列表 单次最多 160 条。
因为按次计费,同一个能力一次取得越多、每千条越便宜,我们实测时用的 limit 都偏小。12:46 读丁香生活研究那篇文章的评论,limit 20、回 20 条、扣 $0.006764,合每千条 $0.338;同样一次调用如果这篇文章有 260 条可读的评论,每千条就是 $0.026。真能取满多少,看文章的评论数和关键词的热度,图里「取满」那一组是上限,不是我们测到的数。
TikHub 的公开价目接口在 12:47:43 列着 24 条公众号相关接口:wechat_mp/v2 12 条、wechat_mp/web 12 条,其中 23 条每次 $0.01、不能用注册赠送额度和折扣,1 条旧 web 系列的正文 JSON 接口每次 $0.001。它的 FAQ 写着旧的公众号和视频号系列 2026 年 6 月 13 日已全部下线重建,现行的是 v2 系列;文章级接口按文章网址调用,账号级接口按 gh_ 开头的用户名调用;计费按「只收成功请求,返回 200 才算」。价目里旧 web 系列哪些还能用,我们没有实调,分不清。下表左列只有公开价目,右列有我们的目录和真调,两边的证据不对等:TikHub 回几条、字段对不对、失败时怎么回,表里都没有;EveryInfra 一侧取 36氪 的 5 次失败也写在实测一节里。
| 按次付费项 | TikHub(公开价目,未实调) | EveryInfra(目录 + 实测) |
|---|---|---|
| 计费单位 | 每次请求,返回 200 才扣 | 每次调用,失败和空结果不扣 |
| 公众号文章正文 | $0.01/次(v2),旧 web 系列 JSON 版 $0.001/次 | $0.005556/次,实测一次回 3,578 字、27 张图 |
| 文章传播数据 | $0.01/次 | $0.005556/次,实测回阅读、点赞、在看、分享、收藏、评论 6 个数 |
| 文章评论 | $0.01/次 | $0.006764/次,单次最多 260 条 |
| 历史文章列表 | $0.01/次,按 gh_ 用户名 | $0.008/次,单次最多 160 条;目录写明可用微信号、gh_ ID 或文章链接,实测见下文:36氪 用微信号没取到,丁香生活研究用 gh_ ID 取到了 |
| 免费额度 | 注册送 $0.05,这些公众号接口不能用 | 见 定价页 |
| 充值手续费 | 支付宝 2.6% + $0.30,PayPal 和 USDT 5% + $0.30 | 见定价页 |
| MCP | 有 MCP | 远程 MCP |
在 Claude、Cursor 这类支持远程 MCP 的 AI 工具里,可以把 EveryInfra 加成一个 MCP 服务器,让模型自己调用 everyinfra_call_api,把平台写成 wechat_oa。Key 放在环境变量里,配置文件里只写变量名:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
字段:公众号接口回什么,哪些数要换着看
EveryInfra 目录给每项能力列了 response_fields。实测过的五项,字段个数取自 12:37 读到的目录;实际返回以当次响应为准,部分请求里可能缺的字段,目录也写明了。
| 能力 | 字段数 | 常用字段 | 目录写明的缺省情况 |
|---|---|---|---|
wechat_oa/article_search | 10 | title、summary、url、account_name、posted_at | kind 可能缺;部分请求里 id 和 relative_time 也缺 |
wechat_oa/article_detail | 16 | content_text、content_html、author、account_ghid、is_original、ip_region | digest 和 hashtags 可能缺 |
wechat_oa/article_metrics | 7 | read_count、like_count、watching_count、share_count、collect_count、comment_count | 无 |
wechat_oa/article_comments | 11 | text、like_count、reply_count、is_top、province、posted_at | 无 |
wechat_oa/account_articles | 12 | title、url、posted_at、position、is_original | account_id 和 is_deleted 可能缺 |
先看链接。默认参数的文章搜索回来的 url 是带 signature 和 timestamp 的临时链接,我们 12:38 那次 18 条全是这种;12:56 带 "category":"LATEST" 那次,20 条全是带 __biz、mid、idx、sn 的链接。目录写明正文、评论、传播数据这几项要用文章自身的链接(/s/<id> 短链,或带 __biz、mid、idx、sn 的链接)。从默认搜索走到正文,要先拿 account_name 查到这个号,再用 历史文章列表 取永久链接;LATEST 搜索回来的链接按目录的写法可以直接交给正文等三项,我们这次没有拿它们去读正文。再看阅读数:read_count 是 100001 这类数时,我们的理解是它对应微信页面上的「10万+」,只能读作「超过 10 万」;要精确值,只有号主在自己后台看得到。position 也容易读错:它是同一次推送里的排位(头条是 1),不是阅读量排名。
公众号 api 哪家好:按场景怎么选
| 场景 | 选哪类 | 理由 | 要注意 |
|---|---|---|---|
| 给自己公司的号做周报,看阅读来源 | 官方数据统计接口 | 只有号主能拿到按场景拆分的阅读人数 | 要企业认证;数据从 2025 年 11 月 1 日起才有 |
| 自己号的留言审核、精选、回复 | 官方留言管理接口 | 有 openid、能写回 | 每次少于 50 条 |
| 竞品监测:50 个同行号每天发了什么 | 按次付费接口 | 官方读不了别人的号;开源要维护扫码账号 | 文章列表单次最多 160 条 |
| 行业舆情:按关键词盯最新文章 | 按次付费接口 | 文章搜索可以按最新排 | 搜索回的是临时链接,要换永久链接再读正文 |
| 选题研究:看一篇爆文的阅读、点赞和留言 | 按次付费接口 | 传播数据一次 6 个数 | 「10万+」只能读作超过 10 万 |
| 存几十篇正文做知识库 | 开源单篇工具或手动复制 | 量小、只要正文 | 频率克制,别跑成批量 |
| 学术研究,要完整历史存档 | 先联系号主或用公开数据集 | 合规和完整性都更好 | 抓取不等于获得版权 |
拿「盯 50 个同行公众号」算一笔月账。假设这 50 个号每天合计发 100 篇:每天给每个号取一次历史文章列表,50 次 × $0.008,30 天 $12.00;每篇新文取一次传播数据,100 次 × $0.005556,30 天 $16.67;每篇取一次正文,同样 $16.67;挑 20 篇读评论,30 天 $4.06;再用 10 个行业关键词每天搜一次最新文章,30 天 $2.40。五项合计 $51.79 一个月。传播数据和正文是两笔最大的开销,如果只要标题和阅读数,不读正文就省下三分之一。传播数据只取一次会漏掉之后的增长;要看阅读数怎么涨,就按天多取几次,每多取一轮,30 天多 $16.67。
同样的事用官方接口做不了,用开源方案的成本在别处:50 个号的列表要一个扫码登录的公众号后台去搜,wewe-rss 的 README 已经写明添加频率高会被封控;阅读数要开着电脑版微信抓包,参数几个小时过期。站内 抖音数据采集 API 选型 一文比较过抖音的同类情况,公众号这边开源方案的可用面更窄,因为星数最多的两个都已经停了。
一次实测:一篇 10 万+ 文章的正文、评论和传播数据
我们在 2026 年 11 月 22 日 12:38 到 12:56(新加坡时间)对 EveryInfra 的公众号能力发了 13 次请求,选的文章是丁香生活研究 2026 年 7 月 31 日发的一篇(__biz=MzA4MTg0MjA5OQ==,gh_038cf5c345ed),它也是我们公众号能力页上的示例文章。请求长这样,Key 从环境变量读:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"wechat_oa","action":"article_metrics",
       "params":{"url":"https://mp.weixin.qq.com/s?__biz=MzA4MTg0MjA5OQ==&mid=2655362972&idx=1&sn=b56fabd8e4c53259498100f05f20dbb0"}}'
# 12:56:01 返回:read_count 100001,like_count 1043,watching_count 122,
# share_count 3469,collect_count 358,comment_count 40;charged_usd 0.005556
12:46:02 读正文,4.45 秒返回,content_text 3,578 个字,正文里 27 张图,ip_region 是浙江,is_original 为 false,扣 $0.005556。目录列的 16 个字段这次回了 15 个,缺的是 hashtags,目录写明它可能缺。有三个字段要分清:author 是「不刮腋毛的」,这是这篇文章的署名笔名,和公众号名称「丁香生活研究」对不上,按号统计时要用 account_name 或 account_ghid;digest 是号主在后台填的摘要,这篇只有「腋!」两个字,做摘要或分类要用正文;content_text 和 content_html 内容相同,存库只留一种就够。文章的 posted_at 换成北京时间是 11:55,最早的一条评论在 3 分钟后。12:46:15 读评论,limit 20 回 20 条,扣 $0.006764:点赞最多的一条 1,056 赞,20 条合计 2,817 赞;8 条有作者或读者回复,回复数合计 20;评论者属地分布在 10 个省份,广东 7 条最多,全部是 2026 年 7 月 31 日发文后两个小时内的留言。传播数据里的 comment_count 是 40,我们这次 limit 设的是 20,没有再取后面的;评论按次计费,limit 直接设到 40,价钱还是 $0.006764 一次,就能一次取完。
做选题研究时,评论里能读出读者下一步想看什么。这 20 条里,一条 235 赞的留言要一期止汗露测评,另一条问在家用的脱毛仪有什么推荐,这类「求测评」「求推荐」的留言可以直接记进选题表。点赞集中在少数几条:最高 1,056 赞,前 3 条合计 1,586 赞,占 20 条合计 2,817 赞的 56%;20 条的 is_top 都是 0,作者没有置顶精选。按点赞排序读前十几条,基本能看清读者在意什么,不必每篇都取满 260 条。
12:56:13 用这个号的 gh_ 原始 ID 取历史文章列表,2.29 秒回 8 条,扣 $0.008:最新三天每天一次推送、每次 3 篇(position 1 到 3),最新一次推送是 2026 年 11 月 22 日 04:14(UTC)。每条 url 都是带 __biz、mid、idx、sn 的永久链接,可以直接交给正文、评论和传播数据三项。8 条的 posted_at 换成北京时间,是 2026 年 11 月 20 日 12:01、21 日 11:48、22 日 12:14,这个号每天中午前后推一次,8 篇都没有原创声明(is_original 为 false)。同一次推送的 3 篇 posted_at 精确到秒都相同,按 posted_at 分组、再按 position 排序,就能还原这个号每天推了几篇、哪篇是头条。limit 8 在这个号上正好覆盖近三天,盯每天推 3 篇的号,8 条够用,要补历史再调大到 160,价钱不变。照这个节奏,每天取一次列表放在下午就能拿到当天的推送;推送时间不固定的号,先取一周的列表看清时间再定。
12:38:41 用默认参数搜「露营」,等了 75.4 秒回 18 条,发布日期从 2021 年 6 月 12 日到 2024 年 4 月 22 日,2022 年的占 13 条,全是 2024 年以前的旧文;12:56:24 加上 "category":"LATEST" 再搜一次,9.3 秒回 20 条,发布日期全部落在 2026 年 11 月 18 日到 22 日,来自 19 个不同的号。默认排序给的是相关度高的老文章,要做监测必须显式传 LATEST;默认那次慢得多,同步调用接近 85 秒的上限时,可以在请求里加 "mode":"async" 拿 job_id 轮询。
| 对照项 | 默认参数(12:38:41) | 加 `"category":"LATEST"`(12:56:24) |
|---|---|---|
| 响应时间 | 75.4 秒 | 9.3 秒 |
| 返回条数 | 18 | 20 |
| 发布日期 | 2021 年 2 条、2022 年 13 条、2023 年 2 条、2024 年 1 条 | 2026 年 11 月 18 日 2 条、19 日 3 条、20 日 7 条、21 日 5 条、22 日 3 条 |
| 不同公众号 | 14 个,新周刊 3 条、36氪 和虎嗅APP 各 2 条 | 19 个 |
url 形式 | 18 条都带 signature、timestamp | 20 条都带 __biz、mid、idx、sn |
| 扣费 | $0.008 | $0.008 |
两次结果来自两批不同的号。默认排序的 14 个号多是媒体号:新周刊、36氪、虎嗅APP、澎湃新闻、钛媒体、青年文摘。LATEST 的 19 个号里,有地方文旅号(遇见乐昌、品鉴彭州)、地方政务号(仙游城市管理)、营地自己的号(湖北篷客露营地)、企业号和个人旅行号。要找新的同行号,LATEST 这一路更有用;要找一个话题下传播最广的旧文,默认排序更合适,但它回得慢,要配异步模式。
12:40 到 12:47 之间有 5 次返回 503,都没扣费。其中 4 次是取 36氪:12:40:11 和 12:44:02 用微信号 wow36kr 取历史文章列表,12:44:21 用「36氪」搜公众号,12:47:19 用名称「36氪」再取一次历史文章列表(目录写的可用形式是微信号、gh_ ID 或链接,名称不在其中)。另 1 次是 12:47:01 用默认搜索回来的一条临时链接(半月谈的一篇露营文章)读正文。36氪 这次一条也没取到,我们没有用它的 gh_ ID 再试;12:56:13 成功的历史文章列表是另一个号丁香生活研究,用的是它的 gh_ ID。换一种账号写法能不能让 36氪 取到,这次没有验证。
503 的响应体写明了怎么重试,按下表的字段写程序即可:
| 字段 | 这次的值 | 程序里怎么用 |
|---|---|---|
retryable | true | 为 true 才重发 |
retry_after | 20 | 等 20 秒再发同一请求 |
max_retries | 2 | 同一请求最多再发 2 次 |
recent_failures | 历史文章列表依次是 1、2、3 | 同一能力 10 分钟内的失败计数 |
next_steps | 第 3 次写明:用户的其他目标也这样失败,就是 EveryInfra 一侧的问题 | 先问用户,用户同意才开工单 |
support | 第 3 次才出现,给出 POST /api/v1/support/tickets 和本次 request_id | 开工单时原样带上 |
billing.charged | false | 没扣费,refund.status 是 succeeded |
照这张表写重试:读到 503 且 retryable 为 true,等 retry_after 秒重发,最多 max_retries 次;还不行就把这个目标记下来,隔一段时间再排一次,不要在同一分钟里连着打。recent_failures 到 3、next_steps 让你先问用户时,停下这一能力的批量任务,等工单答复。36氪 这类取不到的号,可以再试目录列出的 gh_ ID 或文章链接两种写法,能不能取到,我们这次没有证据。
另有 2 次 429:这把测试 Key 每分钟限 10 次,7 篇文章的写作共用,按 retry_after 等几秒后重发就过了,也没扣费。429 和 503 要分开处理:429 的 fault 是 account、reason 是 key_limit,这次 retry_after 是 9 秒、max_retries 是 3,原因在调用方自己的速率,降速或请用户提高限额就行;503 的 fault 是 service,失败在服务一侧,按上表重试、到第 3 次先问用户。程序里先看 fault 再决定怎么等,两类错误就不会混在一起重试。13 次请求里扣费的 6 次合计 $0.041876。
从搜索到正文:一条能每天跑的取数顺序
每天可以按四步取数,每一步对应一个能力和一笔固定的钱。这四步是按上面几次真调和目录推演的,没有连起来跑过,第二步这次也没跑通。第一步,每天早上用 3 到 10 个行业词调一次带 LATEST 的文章搜索,拿到最近几天提到这些词的文章标题、摘要和公众号名称。我们 12:56 那次搜「露营」,20 条结果的发布时间是 2026 年 11 月 18 日到 22 日,19 个号各不相同,适合发现新的同行号。第二步,把新出现的公众号名称记下来,用公众号搜索(每次 $0.016,是目录里最贵的一项)查一次它的 gh_ 原始 ID,存进自己的表,以后就不用再查;我们 12:44:21 用「36氪」搜公众号返回 503、没取到 ID。第三步,对表里的每个号每天调一次历史文章列表,用永久链接去重,只保留当天新出现的文章。第一步 LATEST 搜索回来的链接已经带 __biz、mid、idx、sn,按目录的写法可以和第三步的结果合在一起去重;这一点我们只核了链接形式,没有拿它们去读正文。第四步,对新文章取传播数据,需要全文做摘要或分类的再取正文,需要读者反馈的再取评论。
这条顺序里,第二步只在发现新号时花钱,第三步的花费和号的数量成正比,第四步和文章数量成正比。按前面「盯 50 个号」的假设,第三、四步合计约占月账的 95%。要压成本,先砍第四步里的正文:标题和传播数据已经能排出哪几篇值得细看,只给阅读数排前 10% 的文章取正文,正文这一项的月费就从 $16.67 降到 $1.67 左右,评论仍按每天挑出的 20 篇另外计算。
什么时候别的方案更合适
读自己号的数据时,官方接口更全。阅读来源拆分、留言的 openid、草稿和发布这些写操作,第三方接口一样都没有;如果你的号是企业认证账号,官方接口不收调用费,只付认证费。要做的是给自己号的运营看板,就别为它付按次的钱。
只存几十篇正文时,开源单篇工具更省事。jackwener/wechat-article-to-markdown 这类工具给一个链接就能转成 Markdown,量小、不碰互动数据时,没必要开一个付费账号。手动在公众号后台复制链接也行,掘金上 2022 年的一篇教程写了从自己号「近期发表」里复制链接的步骤。
已经在用 TikHub 其他平台接口、按 TikHub 的账单对账的团队,加几个公众号接口比再接一家省事。它的公众号 v2 系列覆盖了相关文章、文章广告位、账号服务这几项 EveryInfra 目录里没有的数据;视频号这边它有直播历史、合集,EveryInfra 的 视频号能力 目前是搜索、视频、作品列表、资料和评论 5 项。量大时它的部分接口有按天折扣(公众号这几条不参与),我们没有实调它的公众号接口,换方案前用它的免费额度在别的接口上先试一下返回格式。
合规和边界
按次付费接口读的是公开发布的文章和公开显示的留言,读得到不等于用得随意。留言里的昵称、头像、属地是个人信息,《个人信息保护法》第 13 条允许在合理范围内处理已经合法公开的个人信息,第 27 条同时要求个人明确拒绝的不处理、对个人权益有重大影响的要取得同意。做统计时把昵称和头像去掉,只留文字、点赞数和省份,风险小得多。
批量抓取还涉及平台规则和竞争法。《网络数据安全管理条例》2025 年 1 月 1 日起施行,对网络数据处理者的安全义务写得很细;2025 年修订的《反不正当竞争法》对用技术手段不正当获取、使用其他经营者数据的行为有专门条款。把别人公众号的文章原样搬到自己号上,属于著作权问题,和用了哪种取数方案无关。以上只是数据方法上的边界,具体业务是否合规要问你的法务。
常见问题
公众号数据api有哪些?
三类:微信公众平台官方服务端接口(发布、数据统计、留言管理,只管自己的号)、GitHub 开源公众号爬虫(借公众号后台、微信读书、搜狗或电脑版微信的会话)、按次付费的数据接口(EveryInfra、TikHub 等)。要读别人的号,只能在后两类里选。问题来源:Google 联想词「公众号数据api」(2026 年 11 月 22 日读取)。
公众号数据采集 api 推荐哪几个?
按需求分:自己号的周报用官方数据统计接口;存几十篇正文用 jackwener/wechat-article-to-markdown 这类单篇工具;批量读同行号的文章列表、阅读数和留言,用按次付费接口,EveryInfra 每千次 $5.56–$16.00、TikHub 公众号接口每次 $0.01 为主。问题来源:Google 联想词「公众号 api 接口」(2026 年 11 月 22 日读取)。
公众号 api 哪家好?
没有一家通吃:官方接口对自己的号最全、对别人的号是零;开源项目免费,但星数前两名一个停维护、一个已归档;按次付费省掉登录和维护,按调用次数付钱。用我们的数算,盯 50 个同行号一个月约 $51.79。问题来源:Google 联想词「微信公众号api接口」(2026 年 11 月 22 日读取)。
有没有现成的公众号接口,不用自己写爬虫?
有。按次付费接口发一个 HTTP 请求就回 JSON,例如 wechat_oa/article_metrics 一次回阅读、点赞、在看、分享、收藏、评论 6 个数,$0.005556 一次,失败和空结果不扣费。也可以在 Claude、Cursor 里接远程 MCP,让 AI 自己调。问题来源:V2EX 2026 年 7 月的帖子《用 openclaw,大家是如何爬取/获取微信公众号文章的?》。
微信公众号api能获取别人公众号的文章吗?
不能。官方发布、数据统计、留言接口都只认你自己号的 access_token,返回的是你自己号的内容;第三方平台代调用也要对方号授权。问题来源:Google 联想词「微信公众号api」「公众号获取 access token」(2026 年 11 月 22 日读取)。
微信公众号爬虫 github 上的项目还能用吗?
部分能用、要维护。星数最多的 wechat-article-exporter 2026 年 7 月 30 日停止维护,wewe-rss 已归档;we-mp-rss 仍活跃但要扫码授权;单篇正文工具不登录也能用。问题来源:Google 联想词「微信公众号爬虫github」(2026 年 11 月 22 日读取)。
能获取公众号文章的阅读量和粉丝数吗?
阅读量能:按次付费的传播数据接口回 read_count,超过 10 万时显示为 100001,对应页面上的「10万+」。粉丝数是号主后台的私有数据,公开页面上没有,EveryInfra 目录里也没有这个字段。问题来源:YouTube 视频 ATwEruPuAWI 评论区的提问(2026 年 11 月 22 日 12:50 读取)。
微信公众号爬虫mcp 怎么配?
两种:管自己的号,用社区的自管号 MCP(例如 xwang152-jack/wechat-official-account-mcp),填自己号的 AppID 和 AppSecret;读别人的号,在 AI 工具里加 EveryInfra 的远程 MCP(https://api.everyinfra.com/mcp,Key 放环境变量),让模型调用 everyinfra_call_api。问题来源:Google 联想词「微信公众号爬虫mcp」(2026 年 11 月 22 日读取)。
上手步骤
- 先读免费目录:
GET https://api.everyinfra.com/api/v1/social/catalog,不需要 Key,找platform为wechat_oa的 13 项,看available、price_usd和参数。公众号能力页在 公众号数据接口,视频号在 视频号数据接口。 - 在控制台建一把 Key,照 快速上手 里的 curl 把平台换成
wechat_oa试一次;单价见 定价页,不想写代码可以先在 市场页 的试用台里点一次。 - 从一个号开始:用 gh_ 原始 ID 调
wechat_oa/account_articles拿永久链接,再挑几篇调wechat_oa/article_metrics和wechat_oa/article_comments。 - 按关键词监测时,
wechat_oa/article_search一定带"category":"LATEST",把limit调大到够用,按次计费时一次取多更划算。 - 在 AI 工具里用:把上面的 MCP 配置加进去。和 TikHub 逐项比价,看 TikHub 替代方案 和 TikHub 免费额度说明。
参考资料
- 获取已发布的消息列表,微信开放文档,最后编辑 2026 年 11 月 11 日,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/api/public/api_freepublish_batchget
- 发布能力,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/guide/product/publish.html
- 获取已发布图文信息,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/api/public/api_freepublishgetarticle
- 数据统计接口介绍,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/guide/product/analysis_data/analysis_data.html
- 获取图文群发每日数据,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/api/wedata/news/api_getarticlesummary.html
- 获取发表内容每日阅读数据,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/api/wedata/news/api_getarticleread
- 查看指定文章的评论数据,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/api/leaving/api_listcomment.html
- 接口调用概述,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/guide/dev/api/
- 获取接口调用凭据,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/api/base/api_getaccesstoken
- 接口限制说明,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/subscription/guide/dev/api/limit
- 服务号文档,微信开放文档,2026 年 11 月 22 日读取,https://developers.weixin.qq.com/doc/service/guide/
- 获取发布文章列表有问题(置顶答复),微信开放社区,2024 年 6 月 27 日,https://developers.weixin.qq.com/community/minihome/doc/000684561e06307dd4b10a7386fc00
- wechat-article/wechat-article-exporter,GitHub,2026 年 11 月 22 日读取,https://github.com/wechat-article/wechat-article-exporter
- wechat-article-exporter issue #200(2026 年 7 月 30 日),GitHub,https://github.com/wechat-article/wechat-article-exporter/issues/200
- cooderl/wewe-rss,GitHub,2026 年 11 月 22 日读取,https://github.com/cooderl/wewe-rss
- chyroc/WechatSogou,GitHub,2026 年 11 月 22 日读取,https://github.com/chyroc/WechatSogou
- rachelos/we-mp-rss,GitHub,2026 年 11 月 22 日读取,https://github.com/rachelos/we-mp-rss
- we-mp-rss issue #485(2026 年 10 月 30 日),GitHub,https://github.com/rachelos/we-mp-rss/issues/485
- we-mp-rss issue #489(2026 年 11 月 19 日),GitHub,https://github.com/rachelos/we-mp-rss/issues/489
- wnma3mz/wechat_articles_spider,GitHub,2026 年 11 月 22 日读取,https://github.com/wnma3mz/wechat_articles_spider
- bowenpay/wechat-spider,GitHub,2026 年 11 月 22 日读取,https://github.com/bowenpay/wechat-spider
- jackwener/wechat-article-to-markdown,GitHub,2026 年 11 月 22 日读取,https://github.com/jackwener/wechat-article-to-markdown
- yeximm/Access_wechat_article,GitHub,2026 年 11 月 22 日读取,https://github.com/yeximm/Access_wechat_article
- wonderfulsuccess/weixin_crawler,GitHub,2026 年 11 月 22 日读取,https://github.com/wonderfulsuccess/weixin_crawler
- Moore-developers/moore-wechat-article-downloader,GitHub,2026 年 11 月 22 日读取,https://github.com/Moore-developers/moore-wechat-article-downloader
- xwang152-jack/wechat-official-account-mcp,GitHub,2026 年 11 月 22 日读取,https://github.com/xwang152-jack/wechat-official-account-mcp
- 搜狗微信搜索,2026 年 11 月 22 日读取,https://weixin.sogou.com/
- TikHub 公开价目接口,2026 年 11 月 22 日 12:47 读取,https://api.tikhub.io/api/v1/tikhub/user/get_all_endpoints_info
- TikHub FAQ,2026 年 11 月 22 日读取,https://tikhub.io/faq
- TikHub MCP,2026 年 11 月 22 日读取,https://tikhub.io/mcp
- TikHub 文档,2026 年 11 月 22 日读取,https://docs.tikhub.io/
- EveryInfra 社媒数据目录,2026 年 11 月 22 日 12:37 读取,https://api.everyinfra.com/api/v1/social/catalog
- Model Context Protocol,https://modelcontextprotocol.io/
- 中华人民共和国个人信息保护法,国家统计局转载全文,https://www.stats.gov.cn/gk/tjfg/xgfxfg/202503/t20250310_1958923.html
- 网络数据安全管理条例,国家互联网信息办公室,2024 年 9 月 30 日,https://www.cac.gov.cn/2024-09/30/c_1729384452307680.htm
- 中华人民共和国反不正当竞争法(2025 年修订),国家知识产权局,https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- 用 openclaw,大家是如何爬取/获取微信公众号文章的?,V2EX,2026 年 7 月,https://www.v2ex.com/t/1198827
- 获取微信公众号文章,我试了 6 种方案,掘金,2026 年 4 月,https://juejin.cn/post/7624018983559397376
- 教你如何获取微信公众号历史文章链接,掘金,2022 年,https://juejin.cn/post/7106768099361161223
- 实时监控公众号:自动采集+分发文章的 AI 工作流,YouTube,2025 年 7 月 3 日,https://www.youtube.com/watch?v=ATwEruPuAWI
- 微信公众平台,2026 年 11 月 22 日读取,https://mp.weixin.qq.com/
引用编号 BL-211