SerpAPI vs Tavily: precio por 1.000 búsquedas, tokens y llamadas fallidas
SerpAPI cuesta de 7,25 a 25 USD por 1.000 búsquedas y Tavily de 5 a 8 USD. Comparamos tokens, lectura de páginas, fallos y MCP con llamadas reales.
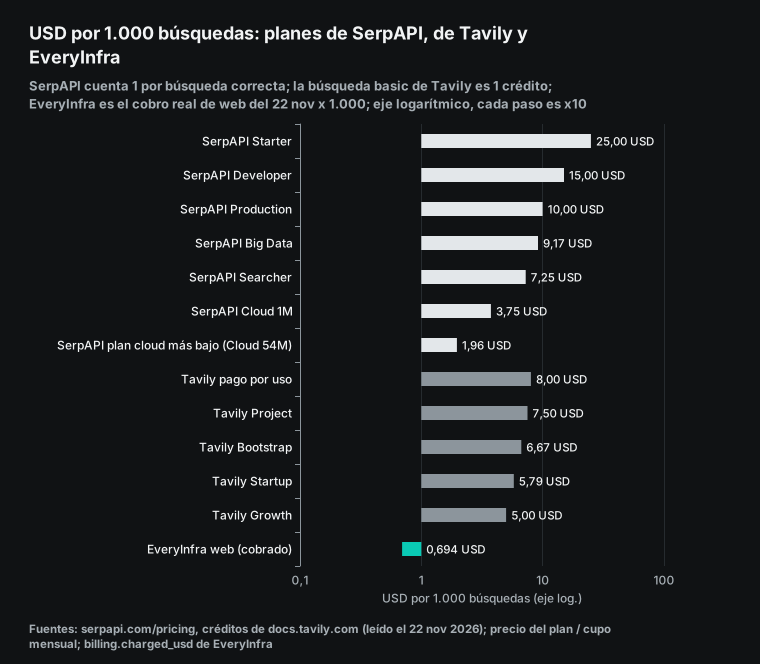
Leímos las dos páginas de precios el 22 de noviembre de 2026. SerpAPI cobra 25 USD por 1.000 búsquedas en su plan Starter y 7,25 USD por 1.000 en Searcher, el plan de 100.000 búsquedas al mes. Tavily cobra 1 crédito por una búsqueda basic, es decir, 5 USD por 1.000 en el plan Growth y 8 USD por 1.000 en pago por uso. Al mediodía del mismo día hicimos llamadas reales a la búsqueda web de EveryInfra, y cada una cobró 0,000694 USD, o 0,694 USD por 1.000. La diferencia más grande está en lo que cada servicio entrega al modelo. La respuesta de ejemplo «coffee» de la documentación de SerpAPI tiene 14 bloques y 9 resultados orgánicos: unos 16.599 tokens con el tokenizador cl100k_base, de los que solo 523 son títulos, enlaces y fragmentos. Con los valores por defecto que documenta Tavily (10 resultados, hasta 3 fragmentos por resultado y unos 500 caracteres por fragmento), el máximo ronda los 3.868 tokens. Nuestras respuestas de web, tal como llegan, midieron de media unos 973 tokens en 5 consultas, y unos 703 con solo esos tres campos. SerpAPI tiene además una regla que es fácil dejar fuera de la cuenta: a veces Google envía la vista general con IA (AI Overview) en una segunda solicitud, y esa segunda solicitud cuenta como una búsqueda.
Tomamos precios y reglas de la página de precios, la documentación de Google Search API y la documentación de Extract API de SerpAPI. Del lado de Tavily usamos su página de precios, su página de créditos y su referencia de búsqueda. Las leímos entre las 12:43 y las 12:47 hora de Singapur del 22-11-2026; todas las horas de este artículo son hora de Singapur. No abrimos cuenta en ninguna de las dos empresas ni llamamos a sus API. Cada número de su lado sale de sus reglas públicas, y guardamos una copia de cada página que leímos. Los números de EveryInfra salen de billing.charged_usd en tres rondas de llamadas reales entre las 12:43 y las 12:59 hora de Singapur.
SerpAPI vs Tavily de un vistazo: unidad de cobro, plan gratis y fallos
SerpAPI cobra por búsqueda. Una búsqueda correcta cuenta como 1, tanto si devuelve 100 resultados como si no devuelve ninguno. Vende páginas de resultados ya analizadas de Google, Bing, DuckDuckGo, YouTube, Amazon y más de cien fuentes, y su página de precios lista más de 160 API. Tavily cobra por crédito. Una búsqueda basic cuesta 1 crédito, una advanced cuesta 2, y Extract, que lee el texto de las páginas, cuesta 1 crédito por cada 5 URL correctas. Tavily no vende la página tal cual de ningún buscador. Devuelve contenido que el propio servicio elige, corta en fragmentos y puntúa por relevancia. Como las unidades son distintas, primero hay que pasar las dos a dólares para el mismo trabajo.
| Punto | SerpAPI | Tavily |
|---|---|---|
| Unidad de cobro | 1 por búsqueda correcta (mismo precio en todos los buscadores) | Créditos: búsqueda basic 1, advanced 2 |
| Plan gratis | 250 búsquedas al mes, 50 por hora | 1.000 créditos al mes, sin tarjeta |
| Primera opción de pago | Starter 25 USD al mes por 1.000 | Pago por uso a 0,008 USD el crédito, o Project 30 USD por 4.000 |
| Planes medios | Developer 75 USD/5.000; Production 150 USD/15.000; Big Data 275 USD/30.000 | Bootstrap 100 USD/15.000; Startup 220 USD/38.000 |
| Planes altos | Searcher 725 USD/100.000 y después planes cloud | Growth 500 USD/100.000 y después precio empresarial a medida |
| Llamadas fallidas | Las búsquedas en caché, con error o fallidas no cuentan; un resultado vacío cuenta como 1 | Las URL de Extract que fallan y los Map fallidos no se cobran |
| Caché | Mismos parámetros dentro de 1 hora: gratis | La documentación no dice que la caché sea gratis; max_age_hours elige caché o descarga en vivo |
| Reinicio del cupo | En tu fecha de renovación; renovación anticipada opcional | El día 1 de cada mes, sea cual sea tu fecha de pago |
| Si se acaba | Renuevas antes, a mano o en automático | Las solicitudes se detienen salvo que actives el pago por uso |
| Leer el texto de la página | Extract API, 1 búsqueda por página | Extract, 1 crédito por 5 URL |
| Formato para modelos | JSON; output=md da Markdown al mismo precio | content limpio por resultado, con answer y raw_content opcionales |
| Límites de solicitudes | Por plan: Starter 200 por hora, Searcher 20.000 por hora | Por organización: gratis 100 por minuto, pago 1.000, Growth 1.500 |
| MCP remoto | mcp.serpapi.com, clave en cabecera o en la ruta | mcp.tavily.com, OAuth o clave, prueba sin clave |
La documentación de AI Overview API de SerpAPI dice que una búsqueda solo sale de la caché si la consulta y todos los parámetros coinciden. La caché caduca a la hora, y «Cached searches are free». Si un agente busca el mismo término varias veces en una hora, las búsquedas siguientes no cuestan nada. A cambio, los resultados pueden tener hasta una hora. Para forzar una descarga nueva, añade no_cache=true. Las preguntas frecuentes de precios de Tavily dicen que los créditos se reinician el día 1 de cada mes, sea cual sea tu fecha de pago. Cuando se acaban, las solicitudes se detienen salvo que subas de plan o actives el pago por uso. Su referencia de búsqueda lista dos códigos de error propios: 432 cuando se acaba el cupo de la clave o del plan y 433 cuando pasas tu límite de pago por uso. Su documentación de límites solo trata el 429 por ir demasiado rápido y el 434 por carga alta. SerpAPI cuenta según si cada búsqueda salió bien y Tavily según cuántos créditos quedan este mes, así que el mismo volumen mensual da dos facturas con forma distinta.
Hasta dónde llega el plan gratis también depende de la unidad. El plan gratis de SerpAPI da 250 búsquedas al mes y 50 por hora. Si un agente de prueba busca dos veces y lee 3 páginas por pregunta, son 5 búsquedas, así que el plan gratis cubre unas 50 preguntas al mes. El plan gratis de Tavily da 1.000 créditos al mes. La misma pregunta cuesta 2 búsquedas más 1 crédito de Extract, o 3 créditos, así que cubre unas 330 preguntas. Ninguno de los dos acumula créditos de un mes a otro. SerpAPI reinicia según el ciclo mensual de tu cuenta y Tavily el día 1. EveryInfra no tiene cupo gratis mensual y cobra por llamada; el crédito de prueba para cuentas nuevas y las formas de recarga están en la página de precios. Si solo quieres ver el flujo funcionando, el modo sin clave de Tavily es la barrera más baja, porque ni siquiera te registras. Para una clave gratis de SerpAPI primero necesitas una cuenta.
| Plan gratis | Cupo mensual | Una pregunta (buscar 2 veces y leer 3 páginas) | Preguntas al mes |
|---|---|---|---|
| SerpAPI | 250 búsquedas, 50 por hora | 5 búsquedas | Unas 50 |
| Tavily | 1.000 créditos, sin tarjeta | 3 créditos | Unas 330 |
| EveryInfra | Sin cupo mensual; crédito de prueba para cuentas nuevas | 5 llamadas, 0,00347 USD | Según tu saldo |
Precio por 1.000 búsquedas: del plan de entrada al más barato
Para sacar el precio por 1.000, divide el precio del plan entre el cupo mensual. Los datos de planes que incluye la página de precios de SerpAPI listan 183 planes, con versiones Ludicrous Speed a 2 y 4 veces el precio. Hay 7 planes con nombre a velocidad estándar y, por encima, planes cloud de Cloud 1M a Cloud 54M. La página de créditos de Tavily lista 4 planes mensuales y una tarifa de pago por uso. La tabla de abajo solo muestra el precio por 1.000 búsquedas basic. Para los 61 planes de SerpAPI a velocidad estándar, mira nuestro desglose de precios de SerpAPI. Para los créditos de cada llamada de Tavily, mira cuántos créditos gasta cada llamada de Tavily.
| Nivel | SerpAPI precio / búsquedas al mes | SerpAPI por 1.000 | Tavily precio / créditos al mes | Tavily por 1.000 búsquedas basic |
|---|---|---|---|---|
| Gratis | 0 USD / 250 | — | 0 USD / 1.000 | — |
| Entrada | Starter 25 USD / 1.000 | 25,00 USD | Pago por uso, 0,008 USD el crédito | 8,00 USD |
| Pequeño | Developer 75 USD / 5.000 | 15,00 USD | Project 30 USD / 4.000 | 7,50 USD |
| Medio | Production 150 USD / 15.000 | 10,00 USD | Bootstrap 100 USD / 15.000 | 6,67 USD |
| Medio alto | Big Data 275 USD / 30.000 | 9,17 USD | Startup 220 USD / 38.000 | 5,79 USD |
| 100.000 al mes | Searcher 725 USD / 100.000 | 7,25 USD | Growth 500 USD / 100.000 | 5,00 USD |
| 1.000.000 al mes | Cloud 1M 3.750 USD / 1.000.000 | 3,75 USD | A medida | No público |
EveryInfra web | Por llamada, sin cuota mensual | 0,694 USD (cobrado) | — | — |
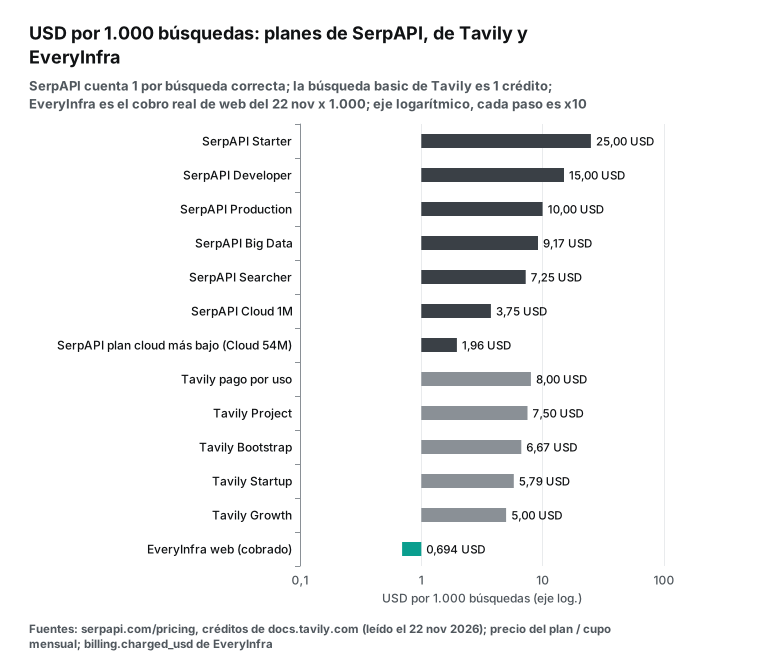
Donde más se acercan es en 100.000 búsquedas al mes: SerpAPI Searcher cuesta 7,25 USD y Tavily Growth 5,00 USD, así que Tavily sale un 31 % más barata. Más abajo, el plan de entrada de SerpAPI es más caro. Con 1.000 búsquedas al mes pagas 0,025 USD por búsqueda en Starter y 0,008 USD en el pago por uso de Tavily, menos de un tercio. Más arriba, SerpAPI publica planes cloud que bajan a 3,75 USD e incluso a 1,96 USD por 1.000, mientras que Tavily solo pone «Custom» (precio a medida) por encima de Growth. Así que Tavily es mucho más barata con poco volumen, y las dos están a un 30 % cerca de las 100.000 búsquedas. Por encima del millón, solo SerpAPI muestra un precio que puedes comprar desde una página web. EveryInfra web cobra 0,000694 USD por llamada, sin cuota mensual ni niveles. En el gráfico de abajo es la barra corta de la izquierda, un 65 % por debajo del plan cloud público más barato de SerpAPI.
Lo que tiene que leer el modelo: 16.599 tokens en un ejemplo de SerpAPI, unos 3.868 en Tavily
Un agente de IA que llama a una API de búsqueda paga dos facturas. Una es la de la API de búsqueda. La otra son los tokens de entrada que el modelo lee al recibir los resultados. Sin cuenta no podíamos obtener respuestas reales de ninguno de los dos servicios, así que medimos el material que publica cada empresa. La página de Google Search API de SerpAPI incluye una respuesta de ejemplo completa para la consulta «coffee» en Austin, creada el 2021-12-07. La referencia de búsqueda de Tavily explica cómo se arma el campo content con fragmentos, cuánto mide cada fragmento y cuántos llegan por defecto. Nuestro método: compactar el JSON en una línea y contar tokens con el tokenizador cl100k_base. En cada lado medimos dos versiones: la respuesta completa tal como llega y solo título, enlace y fragmento. Cada familia de modelos usa otro tokenizador, así que lee estos números como órdenes de magnitud.
| Lo que recibe el modelo | Bytes | Tokens (cl100k_base) | Notas |
|---|---|---|---|
| JSON completo del ejemplo de SerpAPI | 43.193 | 16.599 | 14 bloques: metadatos, recetas, compras, mapa local, negocios locales, panel de conocimiento, preguntas relacionadas, 9 resultados orgánicos, búsquedas relacionadas, paginación y más |
Mismo ejemplo, solo organic_results | 16.288 | 5.159 | Igual que json_restrictor=organic_results |
| Mismo ejemplo, solo título, enlace y fragmento | 2.295 | 523 | 9 resultados, tres campos cada uno |
| Máximo por defecto de Tavily (según la documentación) | unos 15.000 caracteres | unos 3.868 | 10 resultados × hasta 3 fragmentos × unos 500 caracteres; 3,88 caracteres por token, tomado de nuestros fragmentos en inglés |
EveryInfra web, respuesta completa, media de 5 consultas | unos 3.414 | unos 973 | Capa exterior con id, tool, billing y quota; title, url y snippet por resultado, algunos con published; de 5 a 10 resultados |
| Las mismas 5 consultas, solo título, enlace y fragmento | unos 2.640 | unos 703 | Tres campos por resultado, el mismo recorte que en la fila de SerpAPI |
EveryInfra deep con texto completo | 72.092 caracteres | 16.920 | 5 resultados, texto cortado a 20.000 caracteres cada uno |
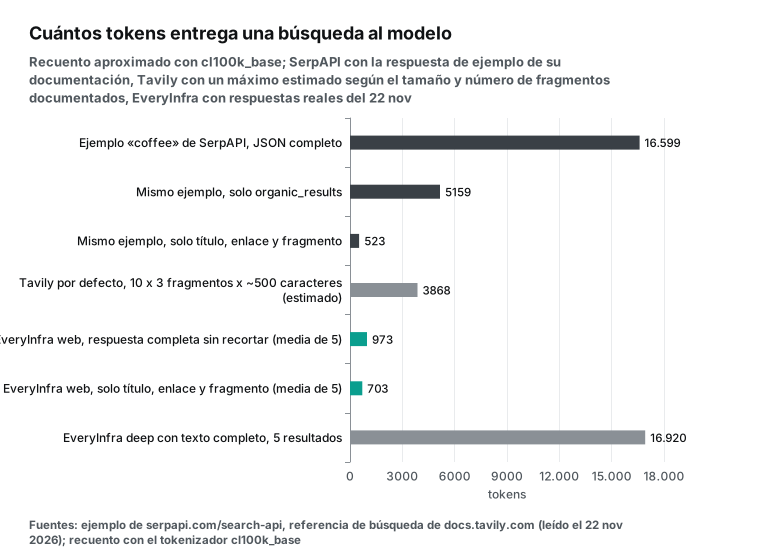
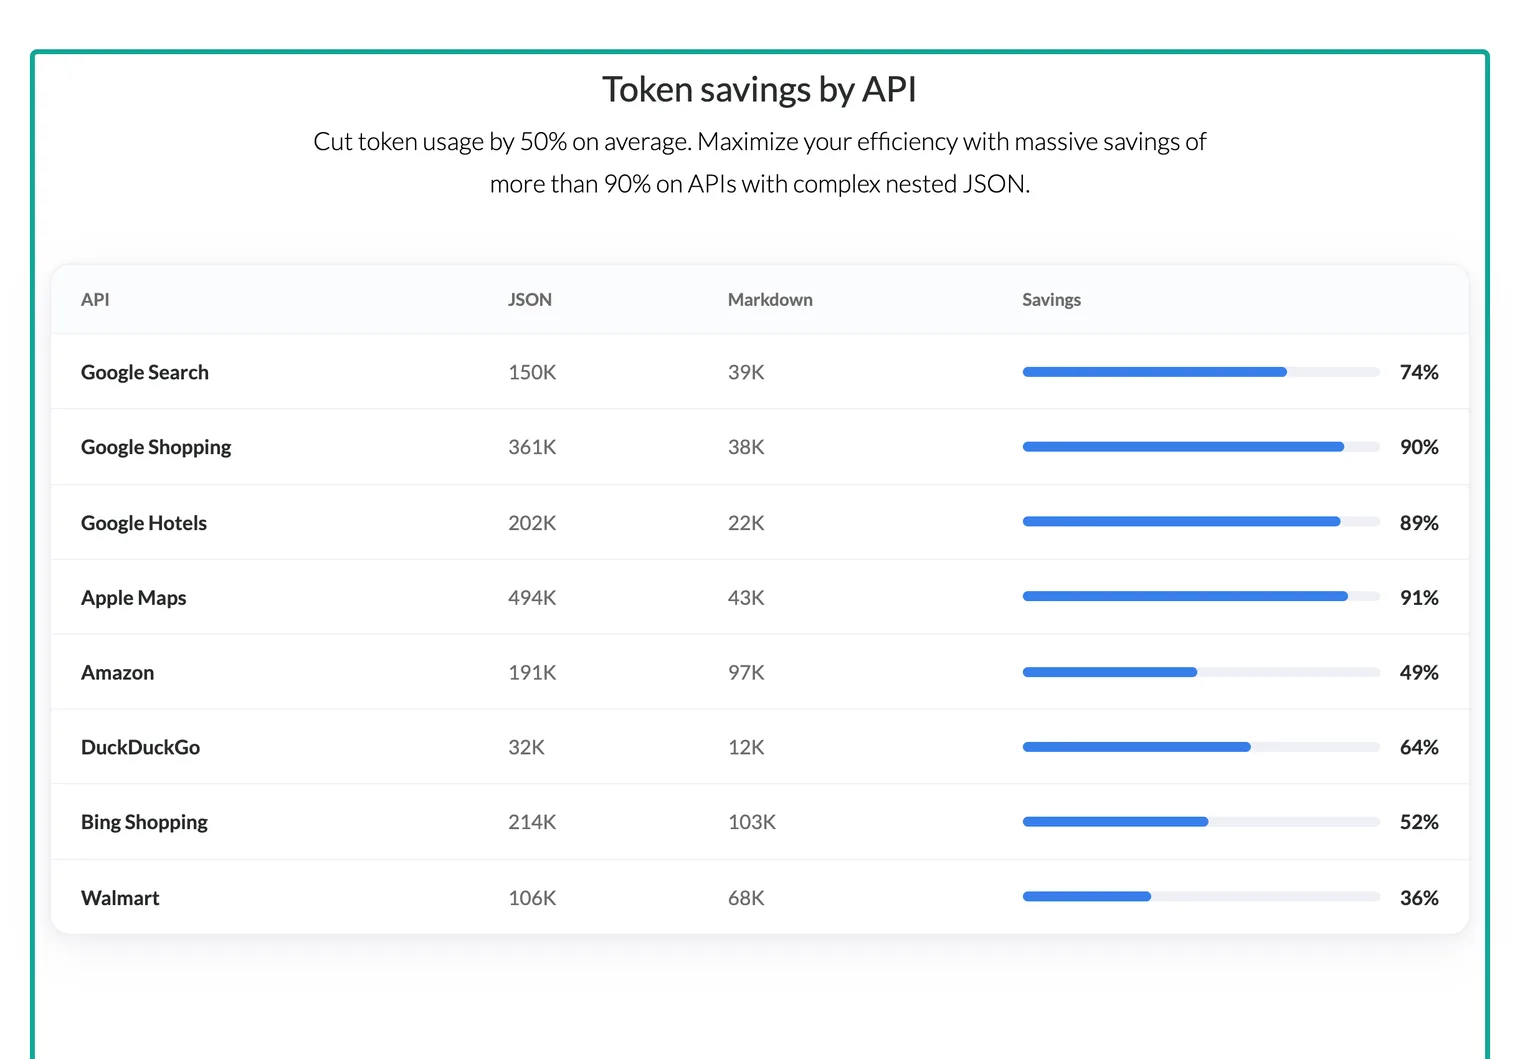
Si pasas el JSON completo de SerpAPI a un modelo, 9 resultados ocupan 16.600 tokens. El título, el enlace y el fragmento, que dicen de qué trata cada resultado, son solo el 3,2 % de eso. El resto son enlaces de redirección, URL de miniaturas, enlaces de sitio, fragmentos enriquecidos, el panel de conocimiento y negocios locales. Esos bloques sirven para seguir posiciones y para SEO local, pero para un agente que solo quiere una respuesta son ruido. La página de salida en Markdown dice que output=md ahorra de media la mitad de los tokens. Google Search baja de 150K a 39K, un 74 % menos, y las API con respuestas muy anidadas, como compras y hoteles, ahorran cerca del 90 %. El precio es el mismo que en JSON, 1 búsqueda por llamada. Con el 74 % de media que da para Google Search, el ejemplo «coffee» quedaría en unos 4.300 tokens en Markdown; es una estimación con su porcentaje publicado, no medimos una copia en Markdown. Con json_restrictor te quedas solo con los bloques que necesitas, y 16.600 tokens bajan a unos cientos o unos miles. Los valores por defecto de Tavily están fijados para dárselos a un modelo. Cada resultado trae 3 fragmentos de unos 500 caracteres, así que 10 resultados son unos 3.900 tokens. Si activas include_raw_content, recibes el texto completo de la página, y el tamaño sube al mismo orden que nuestro deep con texto completo: más de 10.000 tokens.
Nuestras dos filas también hay que leerlas por separado. La respuesta completa de web tiene de 238 a 305 tokens más que la versión de tres campos. Lo que sobra es la capa exterior con el identificador de la solicitud, el nombre de la herramienta, el cobro y el cupo, más la fecha published de algunos resultados. Es el mismo tipo de dato que search_metadata y search_parameters en el ejemplo de SerpAPI, así que lo justo es comparar completa con completa y tres campos con tres campos. Estas son las 5 consultas una a una:
| Consulta | Resultados | Tokens, respuesta completa | Tokens, tres campos |
|---|---|---|---|
| serpapi vs tavily | 10 | 1.132 | 827 |
| best burr coffee grinder 2026 | 9 | 961 | 691 |
| python 3.14 release date | 5 | 668 | 430 |
| nvidia q3 fiscal 2027 earnings | 9 | 1.084 | 825 |
| docker permission denied var run docker.sock | 10 | 1.020 | 743 |
Por resultado, nuestra respuesta completa ocupa de 100 a 135 tokens y la de tres campos de 75 a 92. El ejemplo de SerpAPI con tres campos son 523 tokens para 9 resultados, unos 58 por resultado, así que sus fragmentos son más cortos que los nuestros. Tal como llegan, la diferencia está en los bloques: 16.599 en un ejemplo de SerpAPI y menos de 1.200 en una respuesta nuestra.
Multiplica por el precio por millón de tokens de entrada. Por 1.000 búsquedas tal como llegan, el ejemplo de SerpAPI son unos 16,6 millones de tokens de entrada y EveryInfra web unos 973.000. Con solo tres campos, SerpAPI son unos 523.000 y EveryInfra unos 703.000. El máximo por defecto de Tavily son unos 3,87 millones. Suma la factura de búsqueda y tendrás el costo completo de 1.000 búsquedas. La tabla supone dos precios redondos, 1 USD y 3 USD por millón de tokens de entrada, para que pongas el de tu modelo:
| Lo que recibe el modelo por 1.000 búsquedas | Tokens de entrada | A 1 USD por millón | A 3 USD por millón |
|---|---|---|---|
| Ejemplo de SerpAPI, tal como llega | unos 16,6 millones | 16,60 USD | 49,80 USD |
| Ejemplo de SerpAPI, tres campos | unos 523.000 | 0,52 USD | 1,57 USD |
| Máximo por defecto de Tavily | unos 3,87 millones | 3,87 USD | 11,60 USD |
EveryInfra web, tal como llega | unos 973.000 | 0,97 USD | 2,92 USD |
EveryInfra web, tres campos | unos 703.000 | 0,70 USD | 2,11 USD |
A 1 USD por millón, los tokens de la respuesta completa de SerpAPI cuestan 16,60 USD, más del doble de los 7,25 USD de búsqueda en Searcher. Recortada a tres campos son 0,52 USD. A 3 USD por millón, las dos cifras son 49,80 y 1,57 USD. Así que en SerpAPI recortar la respuesta ahorra más que cambiarse a Tavily por el precio de búsqueda (2,25 USD por 1.000).
Cómo hacer más pequeña la respuesta de SerpAPI: tres formas
Si eliges SerpAPI pero no quieres que el modelo lea 16.000 tokens en cada llamada, hay tres formas de reducir el tamaño, y ninguna cuesta más. La primera es json_restrictor. Indicas los bloques y campos que quieres, por ejemplo organic_results[].{title,link,snippet}, y el servidor solo devuelve eso. En el ejemplo quedan 523 tokens. La segunda es output=md, que devuelve Markdown. Según la tabla de la propia SerpAPI, Google Search se reduce un 74 % de media, y las API con respuestas muy anidadas, como compras, hoteles y mapas, cerca de un 90 %. La tercera es recortar en tu propio código. Así conservas campos como position y source que quizá necesites después, pero sigues pagando la transferencia y el análisis. El código Python de abajo usa la primera forma. Los nombres de parámetros siguen la documentación de json_restrictor de SerpAPI, y la clave sale de una variable de entorno.
import os, requests

params = {
    "engine": "google",
    "q": "serpapi vs tavily",
    "api_key": os.environ["SERPAPI_API_KEY"],
    # solo título, enlace y fragmento de los resultados orgánicos
    "json_restrictor": "organic_results[].{title,link,snippet}",
}
data = requests.get("https://serpapi.com/search.json", params=params, timeout=60).json()
for r in data.get("organic_results", []):
    print(r["title"], r["link"])
Después de recortar, la respuesta de SerpAPI queda en el mismo orden de tamaño que la respuesta de EveryInfra web: de unos cientos de miles a cerca de un millón de tokens por 1.000 búsquedas. Quedan dos diferencias. SerpAPI puede volver a darte la estructura completa cuando la necesites, por ejemplo para ver la vista general con IA o los negocios locales; solo quitas la restricción. EveryInfra web devuelve título, enlace y fragmento por resultado, algunos con fecha de publicación, y para el texto de la página llamas a read o a deep.
Buscar una vez y leer 5 páginas: cuántos cobros tiene el paso más común de un agente
Después de buscar, un agente suele leer algunas páginas. Los dos servicios lo hacen, pero lo cuentan de forma distinta. La Extract API de SerpAPI, lanzada el 13 de octubre de 2026, cuenta 1 búsqueda por página leída. Las páginas que fallan y los aciertos de caché no cuentan. Un rastreo de sitio llega hasta max_pages de 100, a 1 búsqueda por página. Así que «buscar una vez y leer las 5 primeras páginas» son 6 búsquedas en SerpAPI. Tavily tiene dos caminos. Puedes buscar y luego mandar las 5 URL a Extract: 1 crédito por la búsqueda más 1 por Extract (1 crédito por cada 5 URL correctas), o sea 2 créditos. O puedes añadir include_raw_content a la búsqueda. La página de créditos de Tavily dice que el precio de la búsqueda solo depende de search_depth y no indica ningún cargo extra por el texto completo, así que es 1 crédito.
| Una tarea: 1 búsqueda + leer las 5 primeras páginas | Cobros | Por 1.000 tareas (plan de autoservicio más barato) | Por 1.000 tareas (opción de entrada) |
|---|---|---|---|
| SerpAPI: búsqueda en Google + Extract de 5 páginas | 6 búsquedas | 43,50 USD (Searcher) | 150,00 USD (Starter) |
| Tavily: búsqueda + Extract de 5 URL | 2 créditos | 10,00 USD (Growth) | 16,00 USD (pago por uso) |
Tavily: búsqueda con include_raw_content | 1 crédito | 5,00 USD (Growth) | 8,00 USD (pago por uso) |
EveryInfra: 1 web + 5 read | 6 × 0,000694 USD | 4,16 USD (cobrado) | Igual, sin niveles |
EveryInfra: 1 deep con texto completo | 1 × 0,000694 USD | 0,694 USD (cobrado, 5 resultados por llamada) | Igual |
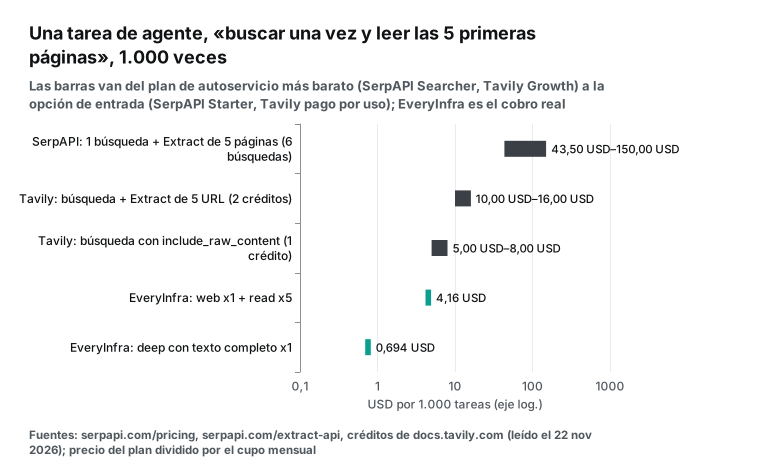
En cuanto el agente lee páginas, la distancia crece. Solo con búsqueda, Tavily es un 30 % más barata en el nivel de 100.000. Con búsqueda y lectura, Tavily con Extract sale un 77 % más barata, y la búsqueda con texto completo, un 89 %. La razón es la unidad: SerpAPI cobra por página y Extract de Tavily cobra 1 crédito por cada 5 páginas. Cuando un agente lee 20 páginas, SerpAPI cuenta 21 búsquedas y Tavily, con búsqueda y Extract, 1 + 4 = 5 créditos. Con los planes de 100.000 al mes, 1.000 tareas así cuestan 21 × 7,25 = 152,25 USD en SerpAPI Searcher y 5 × 5 = 25 USD en Tavily Growth. En EveryInfra, 1 web más 20 read son 21 × 0,694, unos 14,57 USD. Cuantas más páginas lee el agente, más crece la diferencia por página: con 20 páginas, SerpAPI cuesta 6 veces lo que Tavily.
Del lado de EveryInfra, read cuesta 0,000694 USD por página. deep con full activado devuelve 5 resultados con su texto por los mismos 0,000694 USD. A las 12:46:07 hora de Singapur ejecutamos deep con texto completo para «serpapi vs tavily». El texto de los 5 resultados midió 238, 20.000, 20.000, 20.000 y 9.992 caracteres, y la llamada cobró 0,000694 USD. Pero tardó 48,1 segundos en nuestro reloj local, un orden de magnitud más que web. Cuando importa la velocidad, usa web y llama a read solo para las páginas que necesites. Para trabajos por lotes que quieren todo de una vez, usa deep.
La segunda solicitud de la vista general con IA de Google: cuenta como búsqueda
La página de AI Overview de SerpAPI describe un caso especial. A veces Google envía la vista general con IA en una solicitud aparte. Cuando pasa, la respuesta de SerpAPI solo trae un page_token y un serpapi_link. Para obtener el texto tienes que llamar a la Google AI Overview API en menos de 1 minuto. Esa segunda llamada es otra búsqueda y cuenta como siempre. Para una herramienta de SEO que solo lee resultados orgánicos, la factura no cambia. Para un agente que usa la vista general como fuente de respuestas, una pregunta puede contar como 2 búsquedas.
No medimos con qué frecuencia pasa. Sin cuenta de SerpAPI no se puede probar, y no encontramos datos públicos en bruto que pudiéramos revisar. La factura sube en línea recta con la proporción. Si una parte x de tus consultas pide segunda solicitud, 1.000 preguntas cuestan 7,25 USD × (1 + x) en Searcher. Las proporciones de esta tabla son supuestos, no mediciones:
| Parte con segunda solicitud (supuesto) | Solicitudes por pregunta | Por 1.000 preguntas (Searcher) | Por 1.000 preguntas (Starter) |
|---|---|---|---|
| 0 | 1,00 | 7,25 USD | 25,00 USD |
| 25 % | 1,25 | 9,06 USD | 31,25 USD |
| 50 % | 1,50 | 10,88 USD | 37,50 USD |
| 100 % | 2,00 | 14,50 USD | 50,00 USD |
La proporción también puede cambiar qué plan te conviene. Toma el ejemplo de 50.000 al mes que viene más abajo. Si la mitad de las preguntas piden segunda solicitud, el uso real es de 75.000 búsquedas. Quedarte en Big Data (30.000 por 275 USD) supone pagar el plan tres veces, 825 USD, así que Searcher (100.000 por 725 USD) sale 100 USD más barato. Sin segundas solicitudes pasa lo contrario: Big Data con 1 renovación anticipada son 550 USD, 175 USD menos que Searcher. Si no sabes tu proporción, calcula con Searcher como techo.
Para saber tu propia proporción, las 250 búsquedas gratis bastan como muestra. Lanza las preguntas que tu agente hace de verdad y cuenta cuántas respuestas traen un ai_overview con solo page_token y sin texto. include_answer de Tavily es una respuesta corta que escribe su propio modelo; según su página de créditos no cuesta créditos extra, y no es la vista general con IA de Google. EveryInfra web no devuelve la vista general con IA. Da título, enlace y fragmento, y el agente lee y combina las fuentes por su cuenta. Cuando necesites que varias fuentes se confirmen entre sí, usa crosscheck a 0,002778 USD por llamada. Está en la página de la capacidad de búsqueda web.
Llamadas fallidas, resultados vacíos y caché: qué solicitudes cuestan dinero
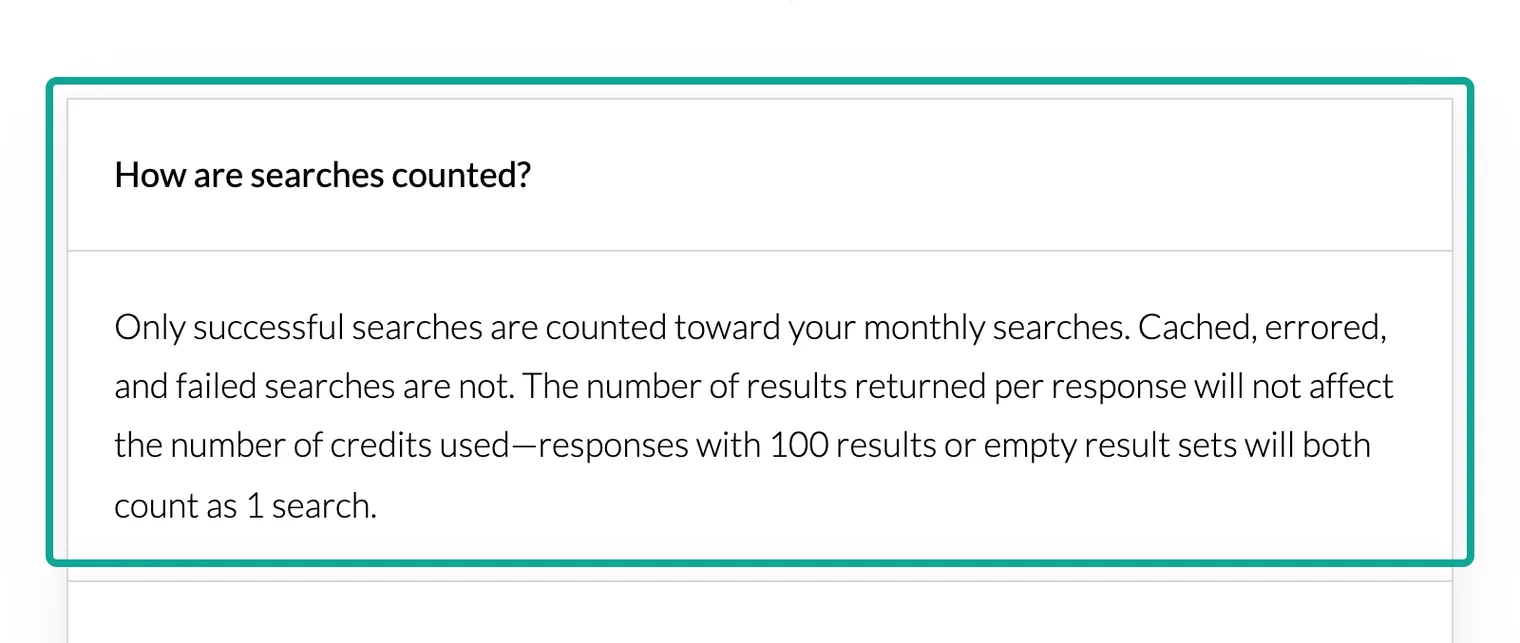
SerpAPI resume su regla en una respuesta de sus preguntas frecuentes. Solo cuentan las búsquedas correctas; las que están en caché, con error o fallidas no cuentan. Una búsqueda con 100 resultados y otra con 0 cuentan como 1 cada una. «Correcta» quiere decir que SerpAPI descargó y analizó la página de resultados, aunque la página esté vacía. Si buscas una marca mal escrita y Google muestra «no se encontraron resultados», eso cuenta como 1. Extract API añade una regla: las páginas que fallan y los aciertos de caché son gratis, y search_metadata.credits_consumed en la respuesta dice cuántas búsquedas gastó la llamada.
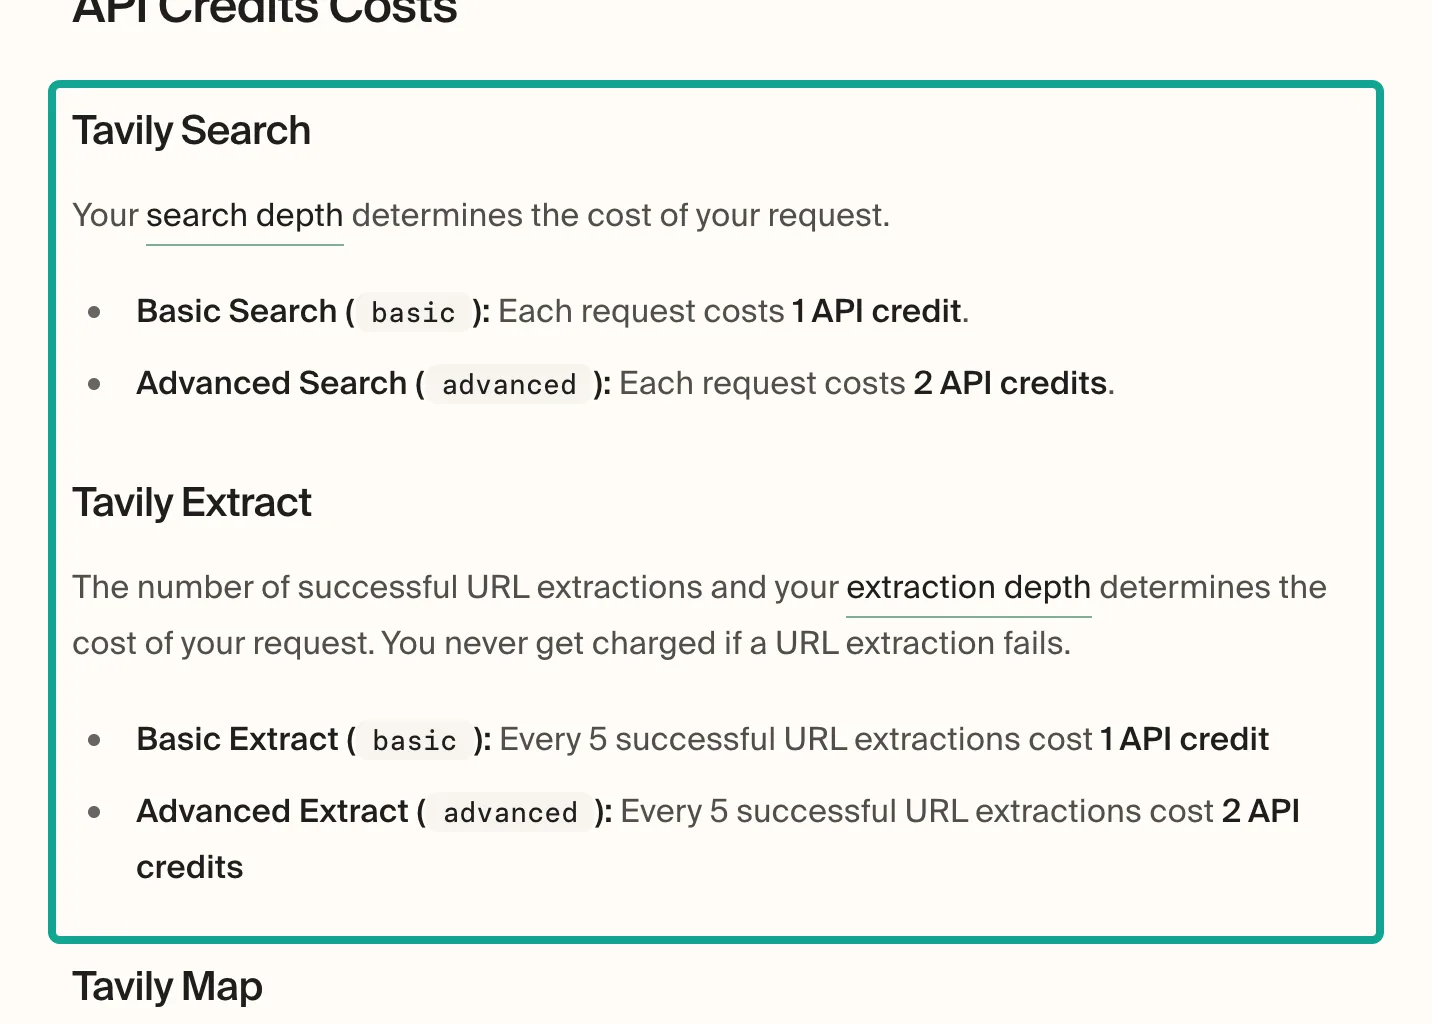
La página de créditos de Tavily dice que Extract y Map fallidos son gratis. No dice cómo cuenta una búsqueda fallida. Para un resultado de búsqueda vacío, su texto de «1 crédito por solicitud» significa 1 crédito. La referencia de búsqueda menciona un caso que puede devolver menos resultados. Si configuras max_age_hours, la copia en caché es demasiado vieja y la descarga en vivo falla, ese resultado se descarta, y puedes recibir menos resultados que max_results. Los valores bajos no cuestan créditos extra. En el plan gratis, cuando Tavily tiene mucha carga, las solicitudes con este parámetro pueden devolver 434.
Un agente decide su siguiente paso por el código de estado, y los tres servicios usan códigos distintos. En la documentación de códigos de estado de SerpAPI, 429 significa «por encima del ritmo por hora» o «tu cuenta se quedó sin búsquedas». El código solo no le dice al agente si esperar o renovar, así que tiene que leer el texto de error. Cuando el propio buscador no tiene resultados, SerpAPI devuelve 200 con search_metadata.status en Success y organic_results_state en «Fully empty», y esa búsqueda cuenta. Un 503 significa que la búsqueda no obtuvo resultados válidos; no cuenta y puedes reintentar. Tavily separa estos casos en códigos distintos. 429 es ir demasiado rápido y trae Retry-After. 432 es que se acabó el cupo de la clave o del plan, y toca subir de plan. 433 es que llegaste al límite de pago por uso, que subes en el panel. 434 es que la descarga en vivo está en pausa por carga alta; reintenta en un momento o quita max_age_hours para recibir contenido en caché.
| Lo que encuentra el agente | SerpAPI | Tavily | EveryInfra |
|---|---|---|---|
| Demasiadas solicitudes | 429, el mismo código que quedarse sin cupo | 429 con Retry-After | 429 con los segundos de espera |
| Cupo o saldo agotado | 429; lee el texto de error | 432; el tope de pago por uso es 433 | Saldo por llamada, sin cupo mensual |
| El buscador no tiene resultados | 200, «Fully empty», cuenta como 1 | La documentación no lo dice | Resultado vacío con empty_reason si se confirma que el objetivo no existe, sin cobro |
| Esta vez no hubo resultado | 503, no cuenta, reintenta | 434, reintenta en un momento | 503 con retryable en true y retry_after, cobró 0 USD |
En EveryInfra, las tres rondas de llamadas reales mostraron cuatro casos sin cobro, y cada uno se puede repetir con la misma solicitud. A las 12:48:41 hora de Singapur llamamos a read sobre una página de SerpAPI que no existe. Devolvió 404 con el código target_not_found, billing.charged_usd en 0 y el motivo request_failed_refunded. A las 12:48:49 llamamos a web con los nombres de parámetros de Tavily, query y max_results. Devolvió 422 con el código unknown_param, dijo «did you mean q», listó los 7 parámetros permitidos y no cobró nada. A las 12:51:01 una llamada a bing/search devolvió 503 con retryable en true y retry_after de 60 segundos, sin cobro (0 USD). A las 12:58:18 lo intentamos otra vez, volvió a dar 503 y otra vez pagamos 0 USD. La clave de prueba compartida que usamos permite 10 llamadas por minuto; por encima devuelve 429, que también es gratis.
| Caso | SerpAPI | Tavily | EveryInfra (esta prueba) |
|---|---|---|---|
| 0 resultados | Cuenta como 1 | La búsqueda cobra 1 por solicitud | Si se confirma que el objetivo no existe, resultado vacío con empty_reason y sin cobro (regla del catálogo, no visto en esta prueba) |
| Página objetivo 404 o descarga fallida | Las búsquedas fallidas no cuentan; las páginas de Extract fallidas no cuentan | Las URL de Extract fallidas son gratis | read devolvió 404, cobró 0 USD |
| Parámetro mal escrito | Error, no cuenta | Devuelve 400 o 422 | Devuelve 422 con «did you mean», cobró 0 USD |
| Servicio no disponible un momento | Los errores no cuentan | La documentación no lo dice | bing/search devolvió 503, cobró 0 USD |
| Límite de solicitudes | Por encima del ritmo por hora esperas o reintentas | Devuelve 429 y Retry-After | Devuelve 429 y los segundos de espera, cobró 0 USD |
| Acierto de caché | Mismos parámetros dentro de 1 hora: gratis | La documentación no dice que sea gratis | Algunas capacidades repiten gratis, por poco tiempo, una solicitud de un objetivo que no existe (no probado) |
Las mismas consultas, en vivo en EveryInfra
Entre las 12:43 y las 12:46 hora de Singapur ejecutamos web con 5 consultas: «serpapi vs tavily», «best burr coffee grinder 2026», «python 3.14 release date», «nvidia q3 fiscal 2027 earnings» y «docker permission denied var run docker.sock». Representan las búsquedas que más manda un agente: comparar herramientas, comprar, un dato, noticias y un mensaje de error. Cada solicitud llevó num: 10. Las llamadas devolvieron 10, 9, 5, 9 y 10 resultados, tardaron de 1,41 a 2,48 segundos en nuestro reloj local y cada una cobró 0,000694 USD. La tercera consulta devolvió solo 5 resultados, así que num es solo un tope. Con cobro por llamada, menos resultados no significan un cobro menor: es la misma idea que SerpAPI al contar como 1 un resultado vacío.
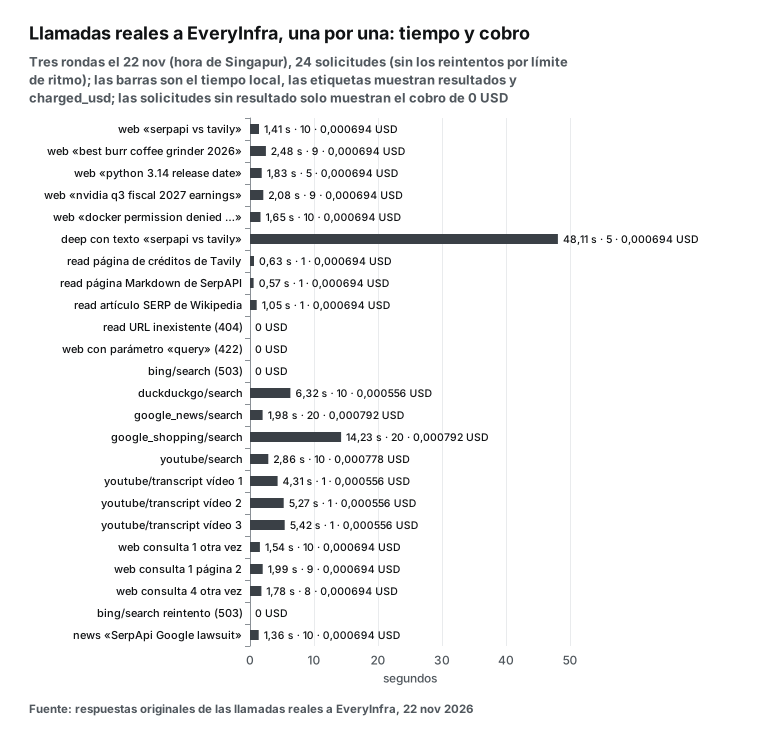
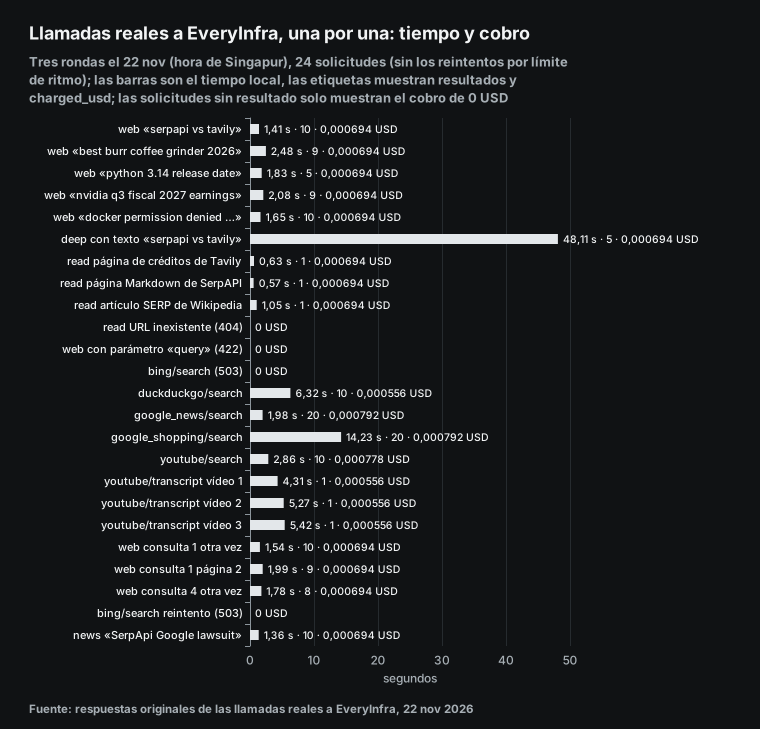
| Hora (hora de Singapur) | Capacidad | Consulta u objetivo | HTTP | Resultados | Tiempo local | `charged_usd` |
|---|---|---|---|---|---|---|
| 12:43:24 | web | serpapi vs tavily | 200 | 10 | 1,41 s | 0,000694 |
| 12:43:31 | web | best burr coffee grinder 2026 | 200 | 9 | 2,48 s | 0,000694 |
| 12:43:40 | web | python 3.14 release date | 200 | 5 | 1,83 s | 0,000694 |
| 12:46:07 | deep (full: true) | serpapi vs tavily | 200 | 5 | 48,11 s | 0,000694 |
| 12:47:15 | read | Página de créditos de Tavily | 200 | 1 | 0,63 s | 0,000694 |
| 12:48:41 | read | Una página de SerpAPI que no existe | 404 | 0 | — | 0 |
| 12:48:49 | web (con query) | serpapi vs tavily | 422 | 0 | — | 0 |
| 12:51:01 | bing/search | serpapi vs tavily | 503 | 0 | — | 0 |
| 12:51:50 | duckduckgo/search | serpapi vs tavily | 200 | 10 | 6,32 s | 0,000556 |
| 12:52:03 | google_news/search | SerpApi Google lawsuit | 200 | 20 | 1,98 s | 0,000792 |
| 12:52:12 | google_shopping/search | burr coffee grinder | 200 | 20 | 14,23 s | 0,000792 |
| 12:55:41 | youtube/search | serpapi vs tavily | 200 | 10 | 2,86 s | 0,000778 |
| 12:57:52 | web (repetida) | serpapi vs tavily | 200 | 10 | 1,54 s | 0,000694 |
| 12:58:00 | web (page: 2) | serpapi vs tavily | 200 | 9 | 1,99 s | 0,000694 |
| 12:59:01 | news | SerpApi Google lawsuit | 200 | 10 | 1,36 s | 0,000694 |
Sin contar los 429 que recibimos cuando la clave compartida pasó de 10 llamadas por minuto (esperamos 60 segundos y volvimos a enviar), 24 solicitudes recibieron respuesta en las tres rondas. Las 20 cobradas sumaron 0,013608 USD, y las 4 sin resultado (404, 422 y dos 503) cobraron 0 USD. La tabla muestra 15 de las 24; las demás son otras dos llamadas a web, dos a read, una búsqueda repetida, tres de subtítulos y la segunda llamada a bing/search. Primero, la búsqueda repetida. A las 12:57:52 volvimos a enviar la consulta «serpapi vs tavily» de las 12:43:24. De los 10 resultados, 8 coincidían con los de 14 minutos antes, y solo 3 estaban en la misma posición. Repetimos «nvidia q3 fiscal 2027 earnings» a los 14 minutos y solo coincidieron 4 de 9 resultados. Los resultados cambiaron, así que la segunda llamada fue una búsqueda en vivo, y cobró 0,000694 USD como siempre. En SerpAPI, los mismos parámetros dentro de 1 hora salen de la caché y no cuentan, pero recibes la copia de 14 minutos antes. Si tu agente vigila noticias o resultados financieros, recuerda añadir no_cache=true, que entonces cuenta como 1 búsqueda. Después, la paginación. A las 12:58:00 pedimos page: 2. Solo 1 de sus 9 resultados estaba también en la página 1, y la llamada cobró 0,000694 USD. SerpAPI también cuenta cada página como 1 búsqueda. Tavily no tiene parámetro de página y devuelve como mucho 20 resultados, así que para tener más cambias la consulta.
Abajo está la solicitud de la primera ronda. La clave sale de una variable de entorno; pon la tuya para repetirla. Cambia "tool": "web" por "news" para buscar noticias, o por "read" con un parámetro "url" para leer el texto de una página. Si mandas un nombre de parámetro mal escrito, la pasarela devuelve 422, lista los parámetros permitidos en la respuesta y no cobra nada.
export EVERYINFRA_API_KEY="tu clave"
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool": "web", "params": {"q": "serpapi vs tavily", "num": 10}}' \
  | jq '{n: (.results | length), first: .results[0].title, charged: .billing.charged_usd}'
A las 12:43:24 la salida fue {"n": 10, "first": "...", "charged": 0.000694}. El primer resultado fue una guía comparativa serpapi vs tavily del 11 de noviembre de 2026. Cada resultado tiene title, url y snippet, y algunos también published. La respuesta completa ocupó 3.874 bytes, unos 1.132 tokens; con solo los tres campos, 3.007 bytes, unos 827 tokens.
También lanzamos una consulta de noticias por dos entradas distintas. A las 12:52:03 enviamos «SerpApi Google lawsuit» a google_news/search. Devolvió 20 resultados, cada uno con el medio y published_at, y el primero fue una nota de Search Engine Journal del 21 de julio de 2026. A las 12:59:01 enviamos las mismas palabras a la herramienta de búsqueda news. Devolvió 10 resultados y cobró 0,000694 USD, y los tres primeros venían de Search Engine Journal, Search Engine Land y Yahoo Finance. La diferencia: la primera es la página de Google News tal cual, con su orden, y sirve para seguir medios. La segunda es búsqueda web filtrada a noticias, con los mismos campos que web, y sirve para pasarla directamente a un modelo. Google News API de SerpAPI equivale a la primera, y topic=news de Tavily se parece más a la segunda.
Los más de cien buscadores de SerpAPI y las capacidades equivalentes de EveryInfra
El punto fuerte de SerpAPI es la cantidad de buscadores. Su lista de API incluye Google Search, Google News, Google Shopping, Google Maps, Google Scholar, Bing, DuckDuckGo, Yandex, Baidu, YouTube, Amazon y más (más de cien en total). En noviembre añadió API de búsqueda y de noticias para un buscador más y una API de Naver Knowledge iN. Tavily tiene una sola entrada de búsqueda y cambia entre general, news y finance con topic; no dice qué fuentes hay detrás. Así que si tu agente necesita «la página que este buscador muestra ahora mismo», Tavily no te la da, y SerpAPI y las capacidades de búsqueda por plataforma de EveryInfra sí.
| Página de resultados que quieres | API de SerpAPI | Capacidad de EveryInfra | EveryInfra por llamada (catálogo, 22 nov) | Esta prueba |
|---|---|---|---|---|
| Búsqueda web general | Google Search API | web | 0,000694 USD | 5 consultas, de 5 a 10 resultados |
| Página de Bing | Bing Search API | bing/search | 0,000556 USD | 503 las dos veces, cobró 0 USD |
| Página de DuckDuckGo | DuckDuckGo Search API | duckduckgo/search | 0,000556 USD | 10 resultados, 6,32 s |
| Google News | Google News API | google_news/search | 0,000792 USD | 20 resultados con medio y fecha |
| Google Shopping | Google Shopping API | google_shopping/search | 0,000792 USD | 20 resultados con precio y tienda |
| Página de Yandex | Yandex Search API | yandex/search | 0,001389 USD | No llamada |
| Búsqueda en YouTube | YouTube Search API | youtube/search | 0,000778 USD | 10 vídeos |
| Subtítulos de YouTube | Parte de subtítulos de YouTube Video API | youtube/transcript | 0,000556 USD | Subtítulos completos de 3 vídeos |
Los precios de esta tabla salen del catálogo de capacidades de EveryInfra y de la lista de herramientas de búsqueda. Leímos los dos a las 12:42 hora de Singapur del 22 de noviembre. Los campos son distintos. Un resultado de Google Shopping en SerpAPI tiene decenas de campos, como extracted_price, source y rating. Nuestro google_shopping/search da título, precio, tienda, valoración y enlace por resultado. A las 12:52:12 buscamos «burr coffee grinder», y el primer resultado fue un molinillo de 48 niveles a 95 USD en Target. Si necesitas toda la estructura de bloques de SerpAPI, con panel de conocimiento, preguntas relacionadas y negocios locales como campos separados, las búsquedas por plataforma de EveryInfra no llegan tan lejos, y SerpAPI encaja mejor. Si solo necesitas los campos que usa un agente (título, enlace, fragmento y precio), el cobro por llamada es de uno a dos órdenes de magnitud más barato.
Conectarlos a Claude, Cursor y Codex: MCP en los tres
Los tres ofrecen un servidor MCP remoto, y la configuración es casi igual. Cambia dónde va la clave y si puedes probar sin clave. La página MCP de SerpAPI da la dirección mcp.serpapi.com, con la clave como token Bearer en una cabecera o en la ruta. Su repositorio abierto serpapi-mcp también permite alojarlo tú mismo y ofrece un paquete .mcpb, con licencia MIT, y su último commit es del 20-11-2026. La documentación MCP de Tavily admite OAuth, así que en Claude, Cursor y VS Code apruebas el acceso con un clic. También puedes fijar parámetros por defecto con la cabecera DEFAULT_PARAMETERS. Su repositorio tavily-mcp tiene 2.499 estrellas, y el 18-11-2026 corrigió un fallo que podía escribir la clave en los registros. La dirección MCP de EveryInfra es api.everyinfra.com/mcp. Todos los nombres de herramienta empiezan por everyinfra_, y una sola conexión te da búsqueda, lectura de páginas y datos de cada plataforma. Los detalles están en la página del servidor MCP.
# SerpAPI (como aparece en su página MCP)
claude mcp add --transport http serpapi https://mcp.serpapi.com/mcp \
  --header "Authorization: Bearer $SERPAPI_API_KEY"

# Tavily (MCP remoto, clave en la URL; o sin clave, con OAuth)
claude mcp add --transport http tavily "https://mcp.tavily.com/mcp/?tavilyApiKey=$TAVILY_API_KEY"

# EveryInfra
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"
Una vez conectados, la descripción de herramientas que ve el modelo decide cómo usa cada servicio. El MCP de SerpAPI expone engine como parámetro, así que el modelo elige Google, Bing o YouTube por su cuenta. El costo es que la respuesta sigue siendo el JSON completo, así que conviene que el modelo añada json_restrictor u output=md. El MCP de Tavily tiene las herramientas search, extract, map y crawl, y devuelve fragmentos limpios que el modelo lee de inmediato. @tavily/cli 1.0.1 de Tavily, publicado el 13 de noviembre de 2026, añade el comando tvly setup mcp, que escribe esta configuración en los editores de tu equipo.
Tres vídeos de YouTube relacionados: qué enseñan y qué dejan fuera
A las 12:55:41 hora de Singapur buscamos «serpapi vs tavily» con youtube/search y recibimos 10 vídeos. Elegimos tres que enseñan cómo conectar o elegir Tavily o SerpAPI; estaban en los puestos 1, 6 y 5. El puesto 2 era una charla sobre renderizado en el navegador, y los puestos 3 y 4 eran comparativas de varias empresas, una de ellas hecha por una empresa que vende su propia API de búsqueda, así que no los usamos. El puesto 7 era un tutorial de inicio de Tavily de febrero de 2025 con 29.286 reproducciones, el más visto de los 10, pero solo trata Tavily, así que tampoco lo usamos. Entre las 12:56 y las 12:57 hora de Singapur sacamos los subtítulos completos de los tres con youtube/transcript, a 0,000556 USD cada uno. Los tres enseñan cómo conectar el servicio, pero ninguno calcula el precio por 1.000.
| Vídeo | Publicado | Duración | Qué cuenta | Qué deja fuera |
|---|---|---|---|---|
| Comparación de tres API de búsqueda para agentes de IA | 09-11-2026 | 2:20 | Tavily devuelve contenido limpio que un modelo puede usar; 1.000 créditos gratis, basic 1 y advanced 2. SerpAPI devuelve resultados reales de Google como JSON estructurado; 250 búsquedas gratis, entrada a 25 USD por 1.000. Consejo: usar los dos | Precio por 1.000, tamaño en tokens, la Extract API y la salida en Markdown de octubre, la segunda solicitud de la vista general |
| n8n AI Agent Live Search | 18-04-2026 | 5:51 | En n8n, SerpAPI tiene un nodo de herramienta integrado: lo pones bajo el nodo AI Agent y pegas la clave. Tavily se conecta con el nodo genérico HTTP Request | El costo por llamada de cada forma; Tavily ya tiene su propio nodo de comunidad |
| What's the Best Web Search for OpenClaw? | 09-03-2026 | 13:26 | Tavily da 1.000 búsquedas gratis al mes sin tarjeta y se conecta a MCP con un comando; con un solo prompt de prueba, Tavily no encontró el protocolo A2A de Google | SerpAPI no aparece: compara Tavily con otras API de búsqueda con plan gratis; resultados con otros prompts o con profundidad advanced |
El método de n8n del segundo vídeo ya está desfasado. Conecta Tavily en n8n con el nodo HTTP Request. Usa el método POST, la URL https://api.tavily.com/search, una cabecera Authorization: Bearer con la clave y un cuerpo con query. Revisamos la documentación de los dos lados. SerpAPI es un nodo integrado de n8n; la documentación de n8n lo lista como subnodo del AI Agent, y viene con n8n. La documentación de integración con n8n de Tavily describe un nodo de comunidad verificado, @tavily/n8n-nodes-tavily. Buscas «Tavily» en el panel de nodos y pulsas Install. En n8n autoalojado, lo instala el propietario o un administrador en Settings, luego Community nodes.
El historial de versiones en npm muestra que el nodo existe desde abril de 2025, y la última versión, 0.7.0, salió el 19-10-2026. Admite cinco operaciones: Search, Extract, Crawl, Map y Research. Cuando lo conectas a un AI Agent, el modelo rellena la consulta, topic, el rango de fechas, la profundidad y la opción de respuesta. La documentación de Tavily añade además un paso que el vídeo no enseña. Pon la fecha de hoy en el mensaje de sistema del AI Agent. El modelo no sabe qué día es, así que busca lo «último» con el año de su entrenamiento. Ese paso sirve también para el nodo de SerpAPI y para EveryInfra. En n8n, por ahora EveryInfra se conecta con el nodo HTTP Request: pon la URL https://api.everyinfra.com/api/v1/search y el cuerpo {"tool": "web", "params": {"q": ...}}.
La prueba del tercer vídeo usó un solo prompt, así que no saques demasiadas conclusiones. Pero muestra una cosa. La profundidad basic por defecto de Tavily da solo 3 extractos por resultado. Cuando la respuesta está en el párrafo 10 de una página larga, activa la profundidad advanced o sigue con Extract.
50.000 búsquedas al mes: la factura mensual en cada servicio
Donde más fácil es equivocarse con los planes es cuando tu volumen cae entre dos niveles. Supón que un producto de agentes hace 50.000 búsquedas al mes, estable, y no lee páginas. El plan Big Data de SerpAPI da 30.000 al mes, que no alcanzan. El siguiente, Searcher, da 100.000 por 725 USD, y las 50.000 que no usas se pierden en la fecha de renovación. La otra opción es quedarte en Big Data y activar la renovación anticipada automática. Cuando se acaba el cupo, empieza un ciclo nuevo antes de tiempo y pagas otra vez el plan. Eso pasa una vez al mes, así que pagas el plan dos veces: unos 550 USD por 60.000 búsquedas, unos 175 USD menos que Searcher. A cambio, tu fecha de cobro se mueve cada mes. Tavily Startup da 38.000 créditos por 220 USD. Las otras 12.000 van por pago por uso a 0,008 USD cada una, y el total es 316 USD. Growth solo cuesta 500 USD. EveryInfra cobra por llamada: 50.000 × 0,000694 USD son 34,70 USD.
| 50.000 búsquedas basic al mes | Cómo compras | Factura mensual | Por 1.000 |
|---|---|---|---|
| SerpAPI | Searcher, usando la mitad de 100.000 | 725 USD | 14,50 USD |
| SerpAPI | Big Data con 1 renovación anticipada automática (el plan se paga dos veces) | Unos 550 USD | Unos 11,00 USD |
| Tavily | Startup 38.000 más 12.000 por pago por uso | 316 USD | 6,32 USD |
| Tavily | Growth, usando la mitad de 100.000 | 500 USD | 10,00 USD |
EveryInfra web | Por llamada, sin cuota mensual | 34,70 USD | 0,694 USD |
Cuando no usas todo el cupo, el precio por 1.000 puede duplicarse. SerpAPI Searcher anuncia 7,25 USD por 1.000, pero usando la mitad son 14,50 USD. El pago por uso de Tavily cubre el hueco, así que su factura entre niveles es más suave. Si el agente además lee 5 páginas por búsqueda, SerpAPI necesita 300.000 búsquedas al mes: el plan Volume (250.000 por 1.475 USD) más renovación anticipada. Tavily, con búsqueda y Extract, necesita 100.000 créditos, justo un plan Growth de 500 USD. EveryInfra son 300.000 × 0,000694 USD, o 208,20 USD.
Cambiar desde SerpAPI o Tavily: parámetros y campos equivalentes
La respuesta 422 de las 12:48:49 hora de Singapur listó todos los parámetros que acepta web: q, site, location, after, before, page y num, 7 en total. La respuesta también decía «Nothing was charged» y cómo corregir la llamada. Si comparas los parámetros habituales de SerpAPI y Tavily con esa lista, casi todos tienen equivalente, y unos pocos se escriben de otra forma.
| Tarea | Parámetro de SerpAPI | Parámetro de Tavily | EveryInfra `web` |
|---|---|---|---|
| Consulta | q | query | q |
| Número de resultados | num (depende del buscador) | max_results, por defecto 10, máximo 20 | num, máximo de resultados (no garantizado) |
| Paginación | start o page | No hay | page, desde 1 |
| Solo un sitio | site: dentro de q | include_domains | site |
| Región | location, gl | country | location, por país |
| Rango de fechas | tbs | time_range, start_date, end_date | after, before |
| Título, enlace, fragmento | organic_results[].title, link, snippet | results[].title, url, content | results[].title, url, snippet |
| Texto de la página | Llamar a Extract API | include_raw_content o Extract | Llamar a read, o deep con full |
| Cuánto costó la llamada | Las respuestas de Extract traen credits_consumed; la búsqueda cuenta por llamada | include_usage devuelve los créditos | billing.charged_usd |
Lo que más se olvida al cambiar es excluir sitios. Tavily tiene exclude_domains, y web no tiene un parámetro con ese nombre; escribe -site: dentro de q. Si un modelo escribe query o max_results por costumbre de Tavily, la pasarela devuelve 422 con «did you mean» y no cobra nada. El modelo corrige la llamada una vez y sigue.
Cómo probamos y qué números conviene leer con cuidado
De las dos empresas solo leímos páginas públicas. No abrimos cuentas ni llamamos a sus API. Por eso el tamaño real de sus respuestas, su latencia y su tasa de fallos pueden ser distintos de los ejemplos de la documentación. El número de tokens de SerpAPI sale de una respuesta de ejemplo de 2021. Las páginas de resultados de Google tienen hoy más bloques, así que una respuesta real puede ser mayor. La cifra de 3.868 de Tavily es un máximo según la documentación, y los fragmentos reales suelen medir menos de 500 caracteres. Comparamos los tokens con el mismo recorte en los dos lados: respuesta completa con respuesta completa, y tres campos con tres campos. No medimos con qué frecuencia SerpAPI pide una segunda solicitud para la vista general con IA; arriba solo damos la fórmula. Los tiempos de EveryInfra son llamadas sueltas desde un equipo en Singapur, sin concurrencia ni estadísticas de largo plazo. Veinticuatro solicitudes con respuesta muestran cómo funcionan el cobro y los fallos, pero no la disponibilidad a largo plazo. Tampoco comparamos la calidad de los resultados. Qué servicio pone la respuesta en sus 5 primeros resultados depende de tus preguntas. Para probarlo, toma 50 preguntas que tu agente hace de verdad, lánzalas en los tres, marca si los 5 primeros resultados contienen la respuesta y suma la tarifa de búsqueda y el costo en tokens para sacar el costo por respuesta correcta. Los tres tienen crédito gratis o de prueba, así que una muestra así no cuesta nada.
| Número | De dónde sale | Cautela |
|---|---|---|
| 16.599 tokens de SerpAPI | Respuesta de ejemplo de 2021 en su documentación | Una respuesta real de hoy puede ser mayor |
| 3.868 tokens de Tavily | Máximo calculado con los valores documentados | Los fragmentos reales suelen ser más cortos |
973 y 703 tokens de EveryInfra web | 5 respuestas reales, completas y con tres campos | Solo 5 consultas |
| 0,000694 USD por llamada | billing.charged_usd de 20 llamadas cobradas | Llamadas sueltas desde Singapur, sin concurrencia |
Cuándo encaja mejor SerpAPI
SerpAPI encaja mejor en cinco tipos de trabajo. La tabla muestra cada uno y el motivo.
| Lo que necesitas | Por qué encaja SerpAPI |
|---|---|
| La página tal cual de un buscador: seguimiento de posiciones, competencia SEO, posiciones de anuncios, resultados locales y de compras | Separa cada bloque (panel de conocimiento, preguntas relacionadas, vista general con IA) en campos; los resultados de Tavily no equivalen a la página de ningún buscador |
| Un buscador poco común | Tiene Google Scholar, Google Patents, Google Flights, Apple App Store, Home Depot, Naver y más, y añade nuevos cada mes |
| Mucho volumen a precio público | Los planes cloud cuestan de 3,75 USD a unos 1,96 USD por 1.000 por encima del millón al mes; Tavily pide hablar con ventas por encima de 100.000 |
| Respuestas que usan la vista general con IA de Google | La separa en campos y, desde el 2 de noviembre, también las preguntas de seguimiento que trae; a veces una segunda solicitud cuenta como otra búsqueda. Tavily y EveryInfra web no devuelven la vista general con IA de Google |
| Flujos en n8n | Es un nodo integrado de n8n, así que no instalas nada ni necesitas un administrador en n8n autoalojado |
Cuenta también las desventajas de SerpAPI. Las respuestas son grandes, así que necesitas json_restrictor o la salida en Markdown. La lectura de páginas se cobra por página. Los planes son mensuales y el cupo se reinicia en tu fecha de renovación. Y hay una demanda abierta, que explicamos abajo.
Cuándo encaja mejor Tavily
Tavily encaja mejor en otros cuatro tipos de trabajo.
| Lo que necesitas | Por qué encaja Tavily |
|---|---|
| RAG o respuestas a preguntas con solo los fragmentos relevantes | content ya viene cortado por relevancia, hasta 3 fragmentos por resultado, unos 3.900 tokens para 10 resultados, sin código de análisis |
| Leer el texto de las páginas después de cada búsqueda | Extract cuesta 1 crédito por 5 URL correctas, o include_raw_content añade el texto sin costo extra: de un 77 % a un 89 % más barato que una búsqueda por página |
| Poco volumen y sin tarjeta | 1.000 créditos gratis al mes sin tarjeta; el pago por uso a 0,008 USD es más de 3 veces más barato que 0,025 USD en SerpAPI Starter |
| Una respuesta corta para el modelo | include_answer no cuesta créditos extra con profundidad basic ni advanced |
Tavily también tiene desventajas. No ves de qué buscador viene un resultado ni en qué posición estaba. El cupo se reinicia el día 1 de cada mes, y las solicitudes se detienen cuando se acaba. Y en febrero de 2026 Nebius anunció que compraría Tavily, así que vigila cambios de precio y de rumbo del producto.
Cuándo usar EveryInfra y cuándo no
EveryInfra web cobra 0,000694 USD por llamada, sin cuota mensual ni niveles, y las llamadas fallidas son gratis. Encaja en tres casos. El primero es un proyecto con volumen que sube y baja y que no quiere pagar cuota en los meses tranquilos. El segundo es un agente que quiere búsqueda web, lectura de páginas, noticias, compras y subtítulos de YouTube con una sola clave. El tercero es un equipo que ya usa nuestros datos de plataformas y quiere la búsqueda en la misma factura. No encaja en estos casos. Si necesitas la página completa de Google (panel de conocimiento, vista general con IA, negocios locales), usa SerpAPI. Si necesitas contenido cortado en fragmentos con puntuación de relevancia, usa Tavily, o nuestro deep más tu propio troceado. En esta prueba, deep con texto completo tardó 48 segundos, demasiado para un chat interactivo.
Hay un caso más que revisar. Supón que repites la misma consulta muchas veces en una hora y te sirven resultados algo más viejos. Entonces la caché gratis de SerpAPI puede salir más barata que el cobro por llamada. EveryInfra busca en vivo y cobra cada vez, y los resultados repetidos cambian. Cuando repetimos una consulta a los 14 minutos, 2 de los 10 resultados eran distintos. El punto de equilibrio se puede calcular. Una búsqueda en SerpAPI Searcher cuesta 0,00725 USD, 10,4 veces nuestros 0,000694 USD. Si la misma consulta se repite menos de 10 veces en una hora, el cobro por llamada sigue saliendo más barato. Con el plan cloud más barato de SerpAPI, unos 0,00196 USD por búsqueda, el equilibrio baja a unas 2,8 repeticiones: a partir de 3 repeticiones de una consulta en una hora, la caché de ese plan empieza a compensar. Los precios de cada capacidad están en la página de precios. Para otras opciones que pueden sustituir a SerpAPI, mira la página de alternativas a SerpAPI.
¿Qué cambiaron las dos empresas en octubre y noviembre de 2026?
| Fecha | Empresa | Cambio |
|---|---|---|
| 13-10-2026 | SerpAPI | Extract API: lee cualquier página pública y rastrea hasta 100 páginas |
| 30-10-2026 | SerpAPI | Cliente de Python serpapi 1.2.0 |
| 02-11-2026 | SerpAPI | Analiza las preguntas de seguimiento de la vista general con IA |
| 11-11-2026 | SerpAPI | API de búsqueda para un buscador más |
| 13-11-2026 | Tavily | @tavily/cli 1.0.1 con tvly setup mcp |
| 18-11-2026 | Tavily | tavily-mcp deja de escribir la clave en los registros |
| 19-11-2026 | SerpAPI | Walmart Search admite walmart.ca |
| 20-11-2026 | SerpAPI | API de noticias de ese buscador; API de Naver Knowledge iN |
| Noviembre de 2026 | Tavily | Límites de solicitudes por organización |
SerpAPI publicó mucho en estos dos meses. Sus notas de versión tienen 135 entradas del 26 de octubre al 21 de noviembre, 108 de ellas en noviembre. Estas importan para agentes. El 13 de octubre de 2026 lanzó la Extract API, que lee cualquier página web pública y rastrea hasta 100 páginas por sitio. Las páginas que fallan y los aciertos de caché son gratis. How-To Geek y PPC Land lo cubrieron. El 11 de noviembre de 2026 añadió una API de búsqueda para un buscador más, y el 20 de noviembre, la API de noticias de ese buscador y una API de Naver Knowledge iN. El 19 de noviembre, Walmart Search empezó a admitir walmart.ca y Google Light Search dejó de tomar texto ajeno de la página como cuadro de respuesta; el 18 de noviembre corrigió las respuestas de AI Mode que dejaban fuera las tablas. El cliente de Python serpapi 1.2.0 salió el 30 de octubre de 2026. En serpapi-mcp, un cambio del 12-11-2026 sacó las solicitudes del bucle de eventos, así el servidor MCP no se atasca con carga. El 20-11-2026 añadió notas de instalación para add-mcp. El 5 de noviembre de 2026, SerpAPI dijo que se había unido a la i2Coalition (Internet Infrastructure Coalition) y que había recibido el sello EWDCI. También listó sus certificaciones SOC 2 Type II e ISO 27001.
Los cambios de Tavily en el mismo periodo fueron sobre todo herramientas para desarrolladores y límites de solicitudes. El 13 de noviembre de 2026 publicó @tavily/cli 1.0.1; un solo comando npx @tavily/cli init inicia sesión, guarda la clave y configura MCP. El día anterior, @tavily/core llegó a 1.1.0, y el cliente de Python tavily-python 0.8.5 salió el 6 de octubre de 2026. Su documentación de límites pasó a límites por organización en noviembre. El plan gratis tiene 100 por minuto, y el pago por uso y los planes de Project a Startup tienen 1.000. Growth tiene 1.500, crawl y map 100 por minuto, y research 20. El registro de cambios recoge el parámetro max_age_hours de octubre. Limita los resultados a contenido descargado dentro de un número de horas. El modo sin clave deja probar unas cuantas llamadas sin registrarse. El 10 de febrero de 2026, Nebius anunció un acuerdo para comprar Tavily. La propia nota de Tavily dijo que el producto y la API seguirían como antes.
Google contra SerpAPI: en qué punto está la demanda
El 19 de diciembre de 2025, Google demandó a SerpAPI ante el Tribunal de Distrito de EE. UU. para el Distrito Norte de California, caso número 4:25-cv-10826. Todos los escritos están en el expediente de CourtListener. La reclamación central se basa en la regla contra la elusión de la DMCA. Google dice que SerpAPI esquivó la protección técnica de sus páginas de resultados.
| Fecha | Paso |
|---|---|
| 19-12-2025 | Google presenta la demanda |
| 20-07-2026 | El tribunal desestima el caso por primera vez |
| 09-11-2026 | El tribunal desestima la demanda modificada y da a Google 21 días para modificarla otra vez |
| Hacia el 30-11-2026 | Plazo para una nueva demanda; sin ella, la desestimación es definitiva |
Search Engine Roundtable y PPC Land informaron de la resolución de noviembre. Para los clientes de SerpAPI esto significa dos cosas. Hasta ahora el tribunal no ha aceptado lo que pide Google, y el servicio funciona como siempre. Pero el caso no ha terminado, y todavía cabe una apelación.
Esta sección solo recoge los pasos públicos del proceso. No es asesoría legal. Para lo que hagas con los datos y en qué país, consulta a tu propio abogado. La página legal de SerpAPI describe su Legal Shield para clientes, que solo viene con Production y planes superiores.
Preguntas frecuentes
¿Puedo usar SerpAPI y Tavily juntos?
Sí, y el primer vídeo de comparación en YouTube lo recomienda. Un reparto habitual es SerpAPI para el orden real y los bloques de un buscador, y Tavily para el texto de las páginas o respuestas cortas. En el hilo de r/LangChain sobre herramientas de búsqueda, un usuario dice que SerpAPI es bueno pero no barato y propone ponerle límites de uso. Usar los dos supone dos claves y dos cuotas mensuales, y con poco volumen no compensa.
¿La API de Tavily es gratis?
En parte. La página de precios de Tavily muestra un plan gratis de 1.000 créditos al mes sin tarjeta. Una búsqueda basic cuesta 1 crédito, así que tienes 1.000 búsquedas gratis al mes. Una búsqueda advanced cuesta 2, y Extract cuesta 1 por cada 5 URL. Los créditos se reinician el día 1 de cada mes y no se acumulan.
¿SerpAPI es legal? ¿Puede demandarla Google?
Google demandó a SerpAPI en diciembre de 2025. El tribunal desestimó las reclamaciones de Google bajo la DMCA en julio y otra vez en noviembre de 2026, y Google tiene una oportunidad más de modificar la demanda. Son pasos del proceso, no asesoría legal. SerpAPI ofrece su Legal Shield a clientes con Production y planes superiores.
¿SerpAPI es de Google?
No. SerpAPI la gestiona SerpApi LLC, en Austin, Texas. No tiene relación de propiedad con Google, y las dos están en litigio. Vende resultados ya analizados de buscadores como Google y Bing.
¿El filtro de fechas de Tavily es preciso?
En el hilo de r/Rag que compara Tavily con una API de SERP, un usuario cuenta que le salía contenido viejo al usar el parámetro de rango de fechas de Tavily. En el mismo hilo, otro usuario dice que un RAG hecho solo con fragmentos de SERP funciona mal y que hace falta el texto de la página. En octubre Tavily añadió max_age_hours, que limita los resultados a contenido descargado dentro de un número de horas. Su documentación dice que en el plan gratis las solicitudes con este parámetro pueden devolver 434 cuando hay mucha carga.
¿Puedo probar Tavily sin registrarme? ¿Dónde consigo una clave?
Sí. El modo sin clave de Tavily te deja llamar a búsqueda y Extract con la cabecera X-Tavily-Access-Mode: keyless. No necesitas cuenta, pero hay un límite de solicitudes. Su documentación dice que las respuestas sin clave son iguales que las respuestas con clave. Para un cupo mayor, regístrate en el panel de Tavily y consigue una clave gratis con 1.000 créditos al mes. SerpAPI no tiene modo sin clave; te registras para tener una clave, y el plan gratis da 250 búsquedas al mes.
¿Cuál gasta menos tokens, SerpAPI o Tavily?
Con los ajustes por defecto, Tavily: su máximo por defecto ronda los 3.900 tokens, y el ejemplo completo de SerpAPI ronda los 16.599. Pero con json_restrictor y solo tres campos, SerpAPI baja a unos 523, menos que Tavily por defecto, y Tavily con include_raw_content pasa de 10.000. Compara los dos con los mismos ajustes: nuestro web ronda los 973 tokens tal como llega y los 703 con tres campos.
Cómo empezar
Para repetir las pruebas de arriba en EveryInfra, consigue una clave en el inicio rápido. Luego lanza la llamada curl de arriba contra web. Cuesta 0,000694 USD por llamada, y las llamadas fallidas son gratis. Para conectar Claude o Cursor, usa la configuración de la página del servidor MCP. La lista completa de búsquedas por plataforma está en el mercado. Las entradas de búsqueda web son la API de búsqueda web, la API de búsqueda de Bing y la API de datos de YouTube. Para seguir leyendo: los detalles de cobro de cada servicio están en el desglose de precios de SerpAPI y en cuántos créditos gasta cada llamada de Tavily. Para otra comparación de SerpAPI, mira nuestra otra comparación de API de SERP. Para otra comparación de Tavily, mira nuestra otra comparación de Tavily. Para más opciones, mira alternativas a Tavily, alternativas a SerpAPI y cómo elegir una API de búsqueda web para agentes de IA.
Referencias
- Página de precios de SerpAPI, planes y preguntas frecuentes, leída el 22-11-2026
- Documentación de Google Search API de SerpAPI y respuesta de ejemplo
- Salida en Markdown de SerpAPI
- json_restrictor de SerpAPI
- Códigos de estado y de error de SerpAPI
- Documentación de Extract API de SerpAPI
- Página MCP de SerpAPI
- Notas de AI Overview de SerpAPI
- Documentación de Google AI Overview API de SerpAPI
- Notas de versión de SerpAPI
- Página legal de SerpAPI y Legal Shield
- Repositorio serpapi-mcp
- Commits de serpapi-mcp
- Repositorio serpapi-python
- PyPI: serpapi
- npm: serpapi
- Página de precios de Tavily, leída el 22-11-2026
- Créditos de la API de Tavily
- Referencia de búsqueda de Tavily
- Referencia de Extract de Tavily
- Referencia de Map de Tavily
- Referencia de Crawl de Tavily
- Límites de solicitudes de Tavily
- Documentación MCP de Tavily
- Modo sin clave de Tavily
- Buenas prácticas de búsqueda de Tavily
- Registro de cambios de Tavily
- Repositorio tavily-mcp
- Commits de tavily-mcp
- Repositorio tavily-python
- PyPI: tavily-python
- npm: @tavily/cli
- npm: @tavily/core
- npm: tavily-mcp
- Nebius anuncia el acuerdo para comprar Tavily (10-02-2026)
- Tavily se une a Nebius
- Expediente Google LLC v. SerpApi LLC, CourtListener
- Search Engine Roundtable: Google vuelve a perder contra SerpApi (10-11-2026)
- PPC Land: Google tiene 21 días (11-11-2026)
- How-To Geek: Extract API de SerpAPI
- PPC Land: SerpAPI ya extrae cualquier página web pública
- Reddit r/LangChain: Best Search Tool in Langchain
- Reddit r/Rag: elegir entre Tavily y una API de SERP
- YouTube: comparación de tres API de búsqueda (09-11-2026)
- YouTube: n8n AI Agent Live Search
- YouTube: What's the Best Web Search for OpenClaw?
- Lista de herramientas de búsqueda de EveryInfra, leída el 22-11-2026
- Catálogo de capacidades de EveryInfra, leído el 22-11-2026
- Documentación de n8n: nodo de herramienta SerpApi
- Documentación de integración de Tavily con n8n
- npm: @tavily/n8n-nodes-tavily
Referencia BL-212