ScraperAPI pricing: cuánto cuestan de verdad 1000 peticiones en cada plan
ScraperAPI cobra de 2,45 a 0,46 USD por 1000 páginas de Amazon y de 12,25 a 2,30 USD por 1000 búsquedas en Google. Lo comparamos con 12 llamadas reales.
Un plan de ScraperAPI muestra un solo precio. Hobby, por ejemplo, cuesta 49 USD al mes por 100.000 créditos de API. Pero una petición puede gastar 1 crédito o 75, según el sitio de destino y los parámetros. Una página normal gasta 1 crédito, Amazon 5, Google y Bing 25, y LinkedIn 30. El renderizado de JavaScript suma 10.
Con esas ponderaciones, Hobby sale a 2,45 USD por 1000 páginas de producto de Amazon y a 12,25 USD por 1000 búsquedas en Google. Las páginas de LinkedIn salen a 14,70 USD por 1000. Advanced, el plan de autoservicio más grande, cuesta 1975 USD al mes y baja esas cifras a 0,459, 2,30 y 2,76 USD. El 2026-11-15 hicimos 12 llamadas reales a la API de EveryInfra. Nuestro endpoint amazon/profile cobró 0,001389 USD por llamada, es decir, 1,389 USD por 1000.
Nuestra herramienta de búsqueda web cobró 0,694 USD por 1000, y linkedin/company_profile, 0,556 USD por 1000. Así que la respuesta depende del destino. En páginas de producto de Amazon, solo Hobby cuesta más que nosotros. Desde Startup, ScraperAPI es entre 1,9 y 3,0 veces más barato, si se gasta todo el cupo. En búsqueda y LinkedIn, todos los planes de autoservicio cuestan más que nosotros: de 3,3 a 17,6 veces en Google y de 5,0 a 26,4 veces en LinkedIn.
Todas las cifras «por 1000» salen de una sola fórmula. Dividimos la cuota del plan entre sus créditos mensuales y multiplicamos por los créditos de cada petición y por 1000. Eso supone que se gasta todo el cupo. Los créditos de ScraperAPI no pasan al mes siguiente, así que gastar menos sube el precio real. Más adelante, una curva por volumen calcula ese caso.
Para ScraperAPI usamos solo sus páginas públicas: precios, documentación de créditos, control de costos, endpoints estructurados, preguntas frecuentes y notas de versión. Las leímos entre las 00:20 y las 00:45 (hora de Singapur) del 2026-11-15. No abrimos cuenta ni llamamos a la API de ScraperAPI, así que sus cifras son precios de lista. Las nuestras son cargos reales de billing.charged_usd, cotejados con price_usd en nuestro catálogo público. Los dos servicios devuelven campos distintos, así que comparamos solo precios y reglas de cobro.
Lado a lado: unidad de cobro, fallos, cupo gratis e integración
ScraperAPI es una suscripción mensual. Pagas una cuota fija por un paquete de créditos, y cada petición descuenta créditos del paquete. Lo que no gastas caduca al renovar. EveryInfra es prepago. Cada llamada descuenta de tu saldo el precio de catálogo de ese endpoint, y el saldo no caduca.
| Concepto | ScraperAPI (precio de lista, leído el 2026-11-15) | EveryInfra (cargo real y catálogo) |
|---|---|---|
| Unidad de cobro | Créditos; de 1 a 75 por petición | Un precio fijo en USD por endpoint |
| Gasto mínimo al mes | Hobby, 49 USD (44,10 USD con pago anual) | Sin cuota; primera recarga de 10 USD |
| Cupo gratis | Prueba de 7 días con 5000 créditos; plan gratis de 1000 créditos al mes | 1 USD de prueba al dar estrella a dos repositorios de GitHub; 24 horas desde que lo reclamas |
| Créditos sobrantes | No pasan al mes siguiente | El saldo no caduca |
| Peticiones fallidas | Solo se cobran 200 y 404; el 429 es gratis | Fallos y resultados vacíos gratis |
| Sin créditos | Subir de plan, pago por uso desde Scaling, o esperar | Las llamadas paran en saldo cero; recargas |
| Precio antes de llamar | Cabecera sa-credit-cost, max_cost, /account/urlcost | price_usd en un catálogo público |
| Página de producto de Amazon | 5 créditos: de 2,45 a 0,459 USD por 1000 | amazon/profile: 1,389 USD por 1000 |
| Búsqueda en Google o Bing | 25 créditos: de 12,25 a 2,30 USD por 1000 | Herramienta web 0,694 USD; bing/search 0,556 USD |
| Página de empresa en LinkedIn | 30 créditos: de 14,70 a 2,76 USD por 1000 | linkedin/company_profile 0,556 USD |
| Forma de la petición | GET con el destino en url | POST con JSON: plataforma, acción, parámetros |
| MCP | Servidor remoto; 22 herramientas MCP desde junio de 2026 | Servidor remoto; herramientas everyinfra_* |
La columna de ScraperAPI cita su página de precios y sus preguntas frecuentes de facturación. Los valores «por 1000» son nuestro cálculo, y un script de Python más abajo los reproduce. La columna de EveryInfra sale de nuestra página de precios, del catálogo y de las llamadas reales.
La forma de la petición encaja con equipos distintos. El scraping básico de ScraperAPI es un GET con api_key, url y opciones como render. Devuelve la página de destino tal cual, así que tú escribes el parser. Nuestra API recibe un POST con la clave en la cabecera Authorization. Devuelve siempre el mismo JSON, con results y billing.
Tabla de precios («ScraperAPI pricing»): ocho planes, precio por 1000 peticiones
El 2026-11-15, la página de precios mostraba una prueba, un plan gratis, cuatro planes de autoservicio, dos de alto volumen y Enterprise. ScraperAPI publica además una copia en Markdown para lectores de IA, con todos los campos. La pasamos a números línea por línea. Las cuatro columnas de precio usan 1, 5, 25 y 30 créditos por petición.
| Plan | Mensual (anual) | Créditos | Hilos | Página normal | Amazon | ||
|---|---|---|---|---|---|---|---|
| Free | 0 USD | 1000 | 5 | — | — | — | — |
| Hobby | 49 USD (44,10) | 100.000 | 20 | 0,490 USD | 2,450 USD | 12,250 USD | 14,700 USD |
| Startup | 149 USD (134,10) | 1.000.000 | 50 | 0,149 USD | 0,745 USD | 3,725 USD | 4,470 USD |
| Business | 299 USD (269,10) | 3.000.000 | 100 | 0,100 USD | 0,498 USD | 2,492 USD | 2,990 USD |
| Scaling | 475 USD (427,50) | 5.000.000 | 200 | 0,095 USD | 0,475 USD | 2,375 USD | 2,850 USD |
| Professional | 975 USD (877,50) | 10.500.000 | 300 | 0,093 USD | 0,464 USD | 2,321 USD | 2,786 USD |
| Advanced | 1975 USD (1777,50) | 21.500.000 | 500 | 0,092 USD | 0,459 USD | 2,297 USD | 2,756 USD |
| Enterprise | A medida | 22.000.000 o más | 500 o más | — | — | — | — |
Los precios son por 1000 peticiones con el cupo entero gastado. Professional y Advanced muestran además créditos extra de «limited offer»: 250.000 y 500.000. No los contamos, porque la página los presenta como temporales. El pago anual descuenta un 10 % en todos los planes de autoservicio.
Los hilos y la geolocalización cambian de un plan a otro. Hobby tiene 20 hilos simultáneos y Advanced, 500. Una petición por encima del límite devuelve 429, sin cargo. Hobby y Startup solo apuntan a «US & EU», y la geolocalización por país empieza en Business. Eso importa si quieres extraer Amazon México o Amazon España con un plan pequeño.
El precio de Enterprise no es público, pero una nota de la documentación de créditos fija un mínimo. Las cuentas con descuento pagan más créditos en los dominios Ultra Premium. El mínimo es de 3 USD por 1000 peticiones sin renderizado y de 7 USD con renderizado.
Professional y Advanced son de 2026. La nota de mayo de 2026 los añadió como planes de autoservicio que se compran sin hablar con ventas. Una reseña anterior a mayo solo muestra de Hobby a Scaling, y con esa tabla el precio más bajo de Amazon es 0,475 USD por 1000 en Scaling. En junio, ScraperAPI añadió un estimador de créditos por dominio.
La nota de MCP de marzo abrió los endpoints estructurados a MCP, y el plugin para agentes de junio trae 22 herramientas MCP: de ahí sale la cifra de la fila MCP de la tabla.
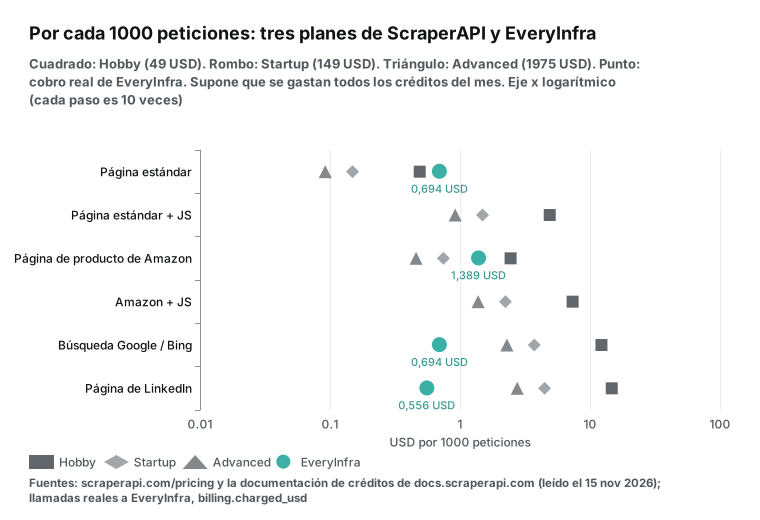
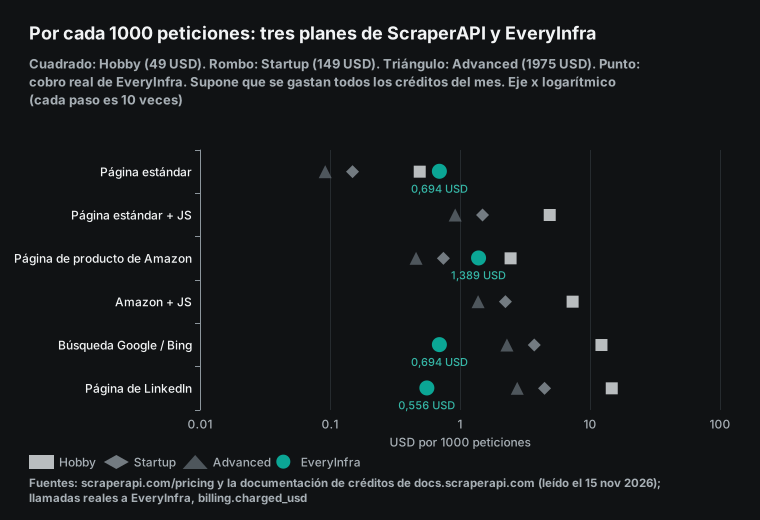
El gráfico pone seis tipos de petición sobre un mismo eje logarítmico. En cada fila, Advanced es 5,3 veces más barato que Hobby, porque un solo precio por crédito mueve todas las ponderaciones. Los puntos turquesa son nuestros cargos reales, y su posición cambia según la fila. En páginas normales, los tres planes de ScraperAPI ganan a nuestra herramienta read. En Amazon, solo Hobby cuesta más que nosotros. En búsqueda y LinkedIn, los tres planes cuestan más que nosotros.
Cómo funcionan los créditos de ScraperAPI: una capa por dominio, otra por parámetros
La documentación de créditos divide el cobro en dos capas. La capa de dominio cobra 1 crédito en sitios normales y 5 en Amazon, Walmart y eBay. Google y Bing cuestan 25, y la documentación dice que esto «applies to all subdomains». LinkedIn cuesta 30. Los sitios detrás de Cloudflare, Turnstile, DataDome, PerimeterX/HUMAN o Akamai cuestan 10 por extracción.
La capa de parámetros suma más. render=true, premium=true y screenshot=true cuestan 10 cada uno. premium con render cuesta 25. ultra_premium=true cuesta 30, y con render, 75, solo en planes de pago. La geolocalización, las sesiones, el tipo de dispositivo, el formato de salida y el análisis automático no suman nada.
| Tipo de petición | Créditos | Dónde lo dice la documentación | Hobby por 1000 | Advanced por 1000 |
|---|---|---|---|---|
| Página normal | 1 | Tabla de precios; documentación, «Domains» | 0,49 USD | 0,092 USD |
| Comercio electrónico (Amazon, Walmart, eBay) | 5 | Igual | 2,45 USD | 0,459 USD |
| Búsqueda (Google, Bing, subdominios) | 25 | Igual | 12,25 USD | 2,297 USD |
| Red social (LinkedIn) | 30 | Igual | 14,70 USD | 2,756 USD |
| Desbloqueo antibots | 10 | Documentación, «Bot-Protected Domains» | — | — |
render=true | 10 | Documentación, «Parameters» | 4,90 USD | 0,919 USD |
premium=true | 10 | Igual | 4,90 USD | 0,919 USD |
premium=true + render=true | 25 | Igual | 12,25 USD | 2,297 USD |
ultra_premium=true | 30 (planes de pago) | Igual | 14,70 USD | 2,756 USD |
ultra_premium=true + render=true | 75 (planes de pago) | Igual | 36,75 USD | 6,890 USD |
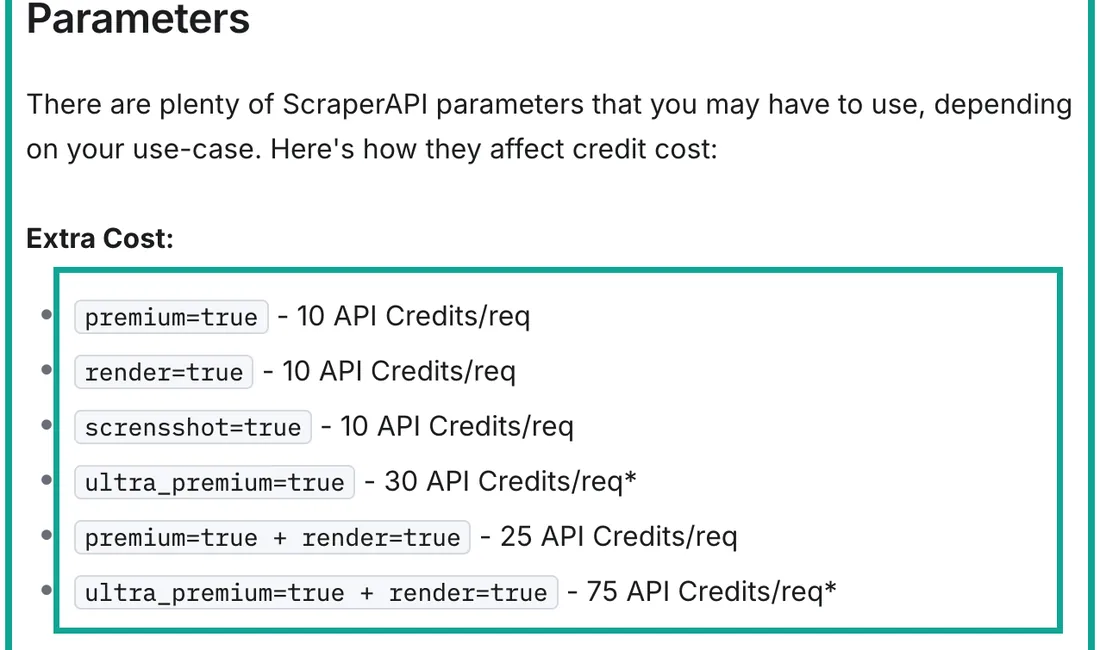
La documentación no da una fórmula para combinar las dos capas. Un sitio normal detrás de Cloudflare podría costar 1 + 10 = 11, o 10. Un análisis de precios en GitHub las suma y dice que los sitios protegidos «add another 10 credits on top». Nuestro gráfico de Hobby usa 11 y lo indica en la etiqueta.
ScraperAPI ofrece dos herramientas para comprobar un costo antes de enviar tráfico. Una es la página Domain Multiplier del panel. La otra es el endpoint /account/urlcost, que acepta todos los parámetros.
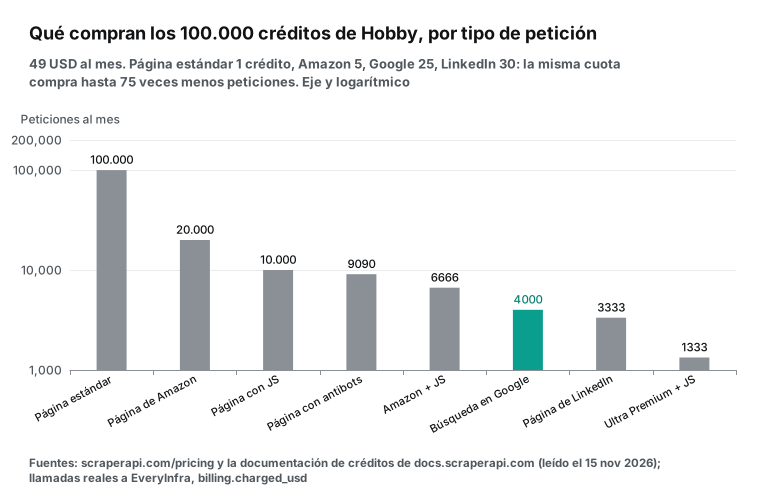
Los 49 USD de Hobby compran peticiones en un rango de 75 veces: 100.000 páginas normales, 20.000 páginas de Amazon o 4000 búsquedas en Google. El análisis de GitHub pone un ejemplo: Amazon con renderizado cuesta 15 créditos, así que 100.000 créditos dan unas 6600 extracciones. Nuestro cálculo con la documentación da 6666.
Un desarrollador en r/webdev contó cómo extrajo 36.000 páginas de un sitio con Cloudflare. Según la publicación, los 100.000 créditos de Hobby se acabaron en un día, a 40 o 50 segundos por petición. No repetimos esa prueba. Según la documentación, una página protegida cuesta 11 créditos, así que Hobby da solo 9090 peticiones, la undécima parte de las páginas normales.
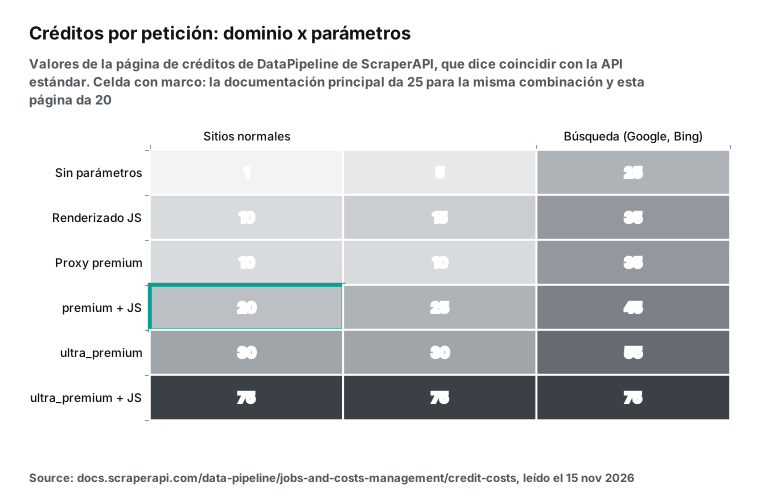
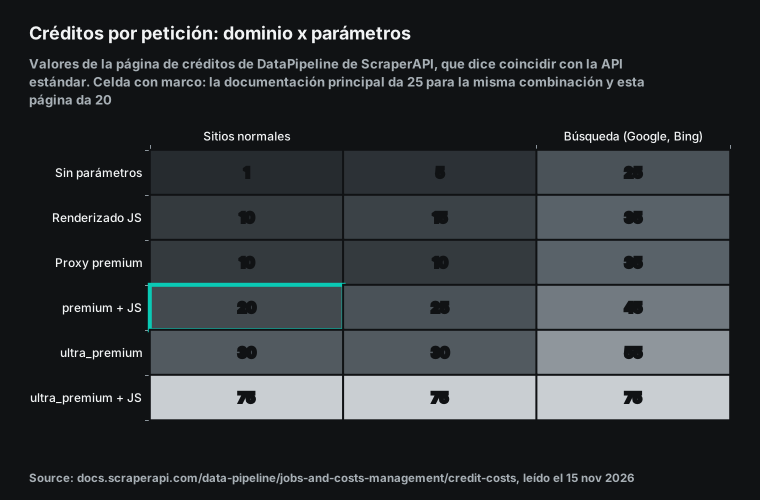
La tabla completa de dominio por parámetro aparece en un solo lugar: la página de créditos de DataPipeline. DataPipeline es el producto de lotes programados. La página dice que «DataPipeline credit costs now match our standard scraping rates». La nota de julio de 2026 habla de un precio «up to 80% cheaper». El mapa de calor dibuja esa tabla tal como está publicada.
Dos puntos donde la documentación no coincide
El primero es premium con renderizado. La documentación de créditos y la página de precios dicen 25 créditos. La tabla de DataPipeline muestra 20 para sitios normales y, a la vez, dice que iguala las tarifas estándar. Una de las dos páginas está desactualizada. En Hobby son 9,80 o 12,25 USD por 1000 peticiones, y nuestros cálculos usan 25.
El segundo es la cancelación. La documentación cobra las peticiones «cancelled from your side before giving us enough time to finish them (70 seconds)». O sea, pagas si te desconectas antes de 70 segundos. Las preguntas frecuentes de precios dicen «for requests you cancel after 70 seconds», que apunta al lado contrario. Las preguntas frecuentes generales dicen que ScraperAPI reintenta hasta 60 segundos. Un tiempo de espera del cliente por encima de 70 segundos es la opción segura.
Cuando se acaban los créditos: subida automática, pago por uso e hilos
| Plan | Al quedarse sin créditos | Opción que puedes activar |
|---|---|---|
| Hobby, Startup, Business | La extracción se pausa hasta la renovación | Subida automática al plan siguiente |
| Scaling, Professional | La extracción se pausa hasta la renovación | Subida automática, o pago por uso con tope mensual |
| Advanced, Enterprise | La extracción se pausa hasta la renovación | Pago por uso con tope mensual |
| EveryInfra (cualquier saldo) | Las llamadas paran en cero | Recargar; sin cambio de plan |
La página de precios no publica la tarifa del pago por uso, así que no calculamos el excedente. La subida automática afecta la factura de forma directa. Un usuario de Hobby que agota el paquete a mitad de mes pasa a Startup ese mes. Un solo pico de tráfico puede encarecer el mes entero.
Los hilos limitan la velocidad. Las preguntas frecuentes generales dan una media de 4 a 12 segundos por petición. A unos 8 segundos, los 20 hilos de Hobby terminan unas 9000 peticiones por hora. Así, un mes de páginas de Amazon en Hobby (20.000) se agota en poco más de dos horas.
Solo se cobra el éxito: 200, 404 y peticiones fallidas
Las preguntas frecuentes de precios preguntan «Does ScraperAPI charge for failed requests?» y responden «No». Solo se cobran las respuestas 200 y 404. El 404 cuenta porque el sitio contestó de verdad que la página no existe. ZenRows también cuenta 404 y 410 como resultados. Las preguntas frecuentes generales prevén entre un 1 % y un 3 % de fallos, sin cargo.
EveryInfra tampoco cobra fallos ni resultados vacíos. El bloque billing muestra charged: false, charged_usd: 0.0 y un motivo, y el reembolso ocurre en la misma respuesta. Dos de nuestras 12 llamadas fallaron. A las 00:33 (hora de Singapur), amazon/reviews devolvió HTTP 503 tras 29,6 segundos con access_blocked. El mensaje decía que el producto pedía inicio de sesión, que la llamada estaba reembolsada y que reintentar enseguida no serviría.
A las 00:34 (hora de Singapur), amazon/profile con un ASIN falso (B0ZZZZZZZ9) devolvió 503 tras 15,1 segundos. También costó 0 USD. Las dos respuestas traían retry_after y next_steps.
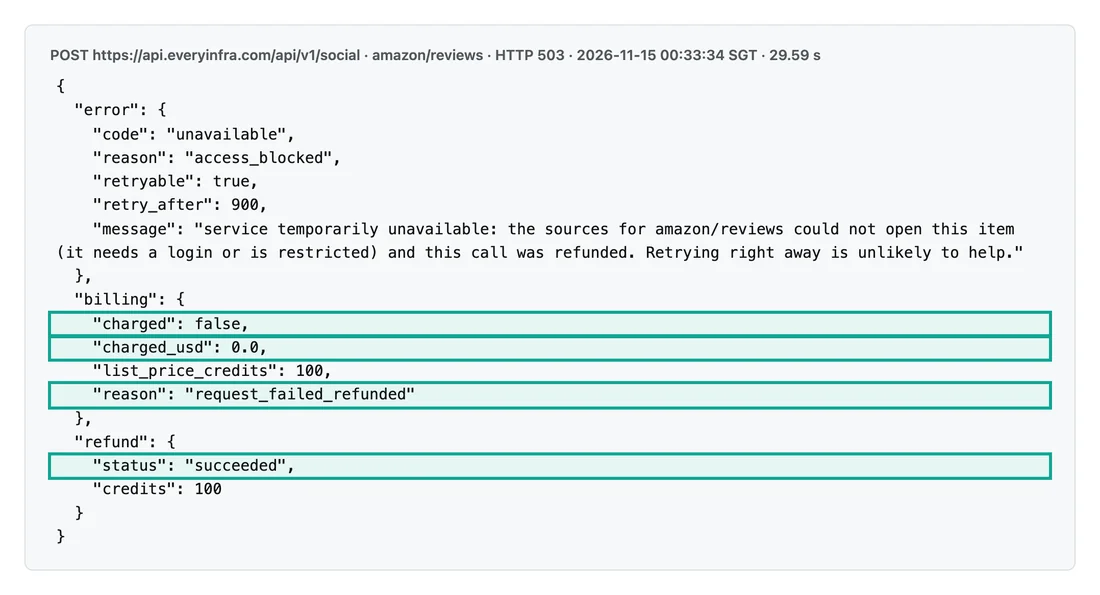
Así que la diferencia está en las peticiones exitosas pero inútiles. ScraperAPI cobra el 404, así que cada enlace caducado de Amazon gasta 5 créditos igual. Por ejemplo, 10.000 enlaces de productos retirados gastan 50.000 créditos: la mitad del cupo de Hobby, o 24,50 USD a la tarifa de Hobby. Nosotros no cobramos un producto inexistente, como muestra el ASIN falso. La salida también cambia. El scraping básico de ScraperAPI devuelve HTML para tu parser. Nuestro amazon/profile devolvió 19 campos, entre ellos price, rating_count, seller_name y bestseller_ranks.
Prueba real de EveryInfra: 12 llamadas en 3 rondas
Llamamos a la API de EveryInfra en tres rondas el 2026-11-15. La primera fue de las 00:30 a las 00:32 (hora de Singapur). La segunda fue de las 00:33 a las 00:34 (hora de Singapur), y la tercera, de las 00:39 a las 00:40 (hora de Singapur). Cada cargo es billing.charged_usd de la respuesta.
| Hora (SGT) | Endpoint | Parámetros | HTTP | Filas | Latencia | Cobrado |
|---|---|---|---|---|---|---|
| 00:30 | amazon/search | wireless earbuds | 200 | 10 | 18,5 s | 0,002236 USD |
| 00:32 | web/search | scraperapi pricing, us | 200 | 10 | 1,7 s | 0,001389 USD |
| 00:32 | google_maps_reviews/search | coffee shop Austin TX | 200 | 15 | 7,0 s | 0,001389 USD |
| 00:33 | Herramienta web | scraperapi pricing, us | 200 | 10 | 1,8 s | 0,000694 USD |
| 00:33 | amazon/profile | B09FT58QQP | 200 | 1 | 10,3 s | 0,001389 USD |
| 00:33 | amazon/reviews | B09FT58QQP | 503 | — | 29,6 s | 0 USD (reembolso) |
| 00:34 | Herramienta read | la misma página de Amazon | 200 | 1 | 3,1 s | 0,000694 USD |
| 00:34 | amazon/profile | B0ZZZZZZZ9 (falso) | 503 | — | 15,1 s | 0 USD (reembolso) |
| 00:39 | amazon/search | wireless earbuds, limit 50 | 200 | 50 | 41,4 s | 0,002236 USD |
| 00:39 | bing/search | scraperapi pricing | 200 | 10 | 5,2 s | 0,000556 USD |
| 00:40 | linkedin/company_profile | scraperapi | 200 | 1 | 4,6 s | 0,000556 USD |
| 00:40 | walmart/search | wireless earbuds | 200 | 20 | 41,0 s | 0,001389 USD |
Las 12 llamadas costaron 0,012528 USD en total. Diez salieron bien, y cada cargo coincidió con el catálogo. amazon/profile leyó unos auriculares TOZO: 19,99 USD, nota de 4,3 y 119.218 valoraciones. La herramienta read sobre la misma página devolvió 766 caracteres, sin precio. O sea, el lector barato y el endpoint de producto devuelven cosas distintas.
linkedin/company_profile leyó la página de la propia ScraperAPI: 37 empleados, una franja de 11 a 50 personas y 2266 seguidores. La búsqueda de cafeterías en Austin devolvió 15 locales. El primero fue Jo's Coffee en South Congress, con nota de 4,4 y 2013 reseñas.
Las dos opciones de búsqueda dieron resultados distintos. web/search con «scraperapi pricing» devolvió 10 páginas genéricas sobre precios. La herramienta web, a mitad de precio, puso primero la página de precios de ScraperAPI. Los 10 resultados de Bing trataban del precio de ScraperAPI. El 1 y el 2 eran su página de precios y su portada; el 8 y el 10, la página de precios de AI Parser y las preguntas frecuentes de facturación. Los otros 6 eran comparadores o calculadoras de terceros.
Cuatro de esos 6 mostraban fecha en el fragmento: 2026-11-01, 2026-10-16, 2026-08-19 y 2026-11-05. El título de la página de agosto ya dice «$49–$1,975/mo», así que incluye el plan Advanced de mayo. Antes de fiarte de un comparador externo, mira la fecha: una página anterior a mayo de 2026 no tiene Professional ni Advanced, y sus precios de alto volumen salen más altos de la cuenta.
Por eso usamos los 0,694 USD de la herramienta web como precio de búsqueda y mostramos también web/search a 1,389 USD.
Cada respuesta indica además un precio per_1k. La primera llamada a amazon/search mostró 2,236111 USD, igual que el catálogo. Las búsquedas tardaron menos de 6 segundos, y las búsquedas de Amazon y Walmart con 20 a 50 filas tardaron unos 40 segundos. ScraperAPI declara de 4 a 12 segundos de media, con reintentos de hasta 60 segundos.
La petición curl de abajo repite nuestra búsqueda en Amazon. Pon tu propia clave, o cambia platform y action para probar otra fila.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"amazon","action":"search","params":{"keyword":"wireless earbuds","limit":50}}'
Amazon: los volúmenes en los que ScraperAPI sale más barato
Con el cupo entero, ScraperAPI cuesta 2,45 USD por 1000 páginas de Amazon en Hobby, 1,76 veces nuestro 1,389. Desde Startup, el orden se invierte. Startup cuesta 0,745 USD, Business 0,498 USD y Advanced 0,459 USD, así que nosotros costamos entre 1,9 y 3,0 veces más.
Pero gastar todo el cupo es un caso ideal. Hobby cubre solo 20.000 páginas de Amazon. La página 20.001 exige Startup, que solo se llena con 200.000 páginas. Entre esos dos puntos, el precio real de ScraperAPI queda muy por encima de la tabla.
| Páginas de Amazon al mes | Plan mínimo de ScraperAPI | ScraperAPI | EveryInfra `amazon/profile` | Más barato |
|---|---|---|---|---|
| 5000 | Hobby | 49 USD | 6,95 USD | EveryInfra, 7,1 veces |
| 20.000 | Hobby | 49 USD | 27,78 USD | EveryInfra, 1,8 veces |
| 50.000 | Startup | 149 USD | 69,45 USD | EveryInfra, 2,1 veces |
| 107.271 | Startup | 149 USD | 149,00 USD | Empate |
| 150.000 | Startup | 149 USD | 208,35 USD | ScraperAPI, 1,4 veces |
| De 200.001 a 215.262 | Business | 299 USD | De 277,80 a 299 USD | EveryInfra, hasta 21 USD menos |
| 1.000.000 | Scaling | 475 USD | 1389 USD | ScraperAPI, 2,9 veces |
| 4.300.000 | Advanced | 1975 USD | 5972,70 USD | ScraperAPI, 3,0 veces |
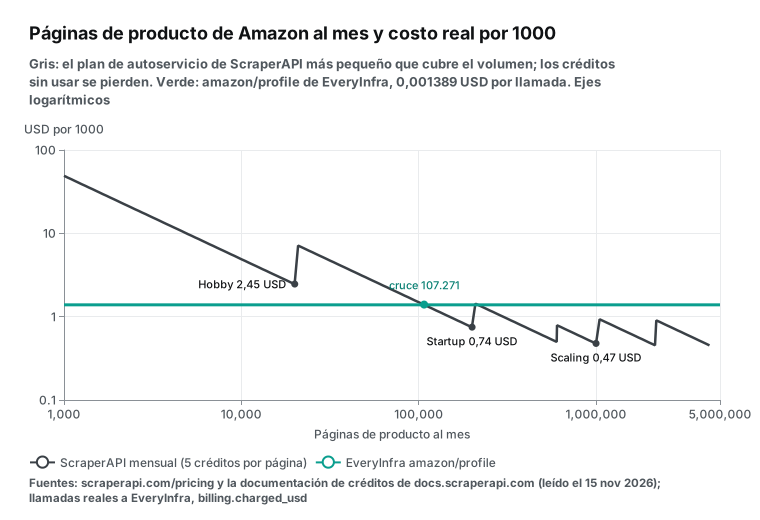
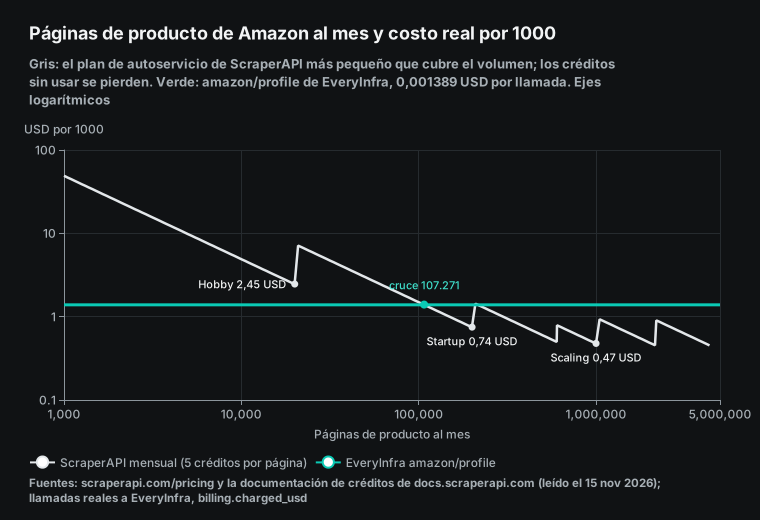
La línea gris salta en cada cambio de plan, porque una página más obliga a comprar un plan entero. Después baja hasta que ese plan se llena. La línea turquesa es nuestro precio fijo de 1,389 USD. Se cruzan por primera vez en 107.271 páginas, que son los 149 USD divididos entre 1,389 USD por 1000. Desde ahí hasta 200.000 páginas, ScraperAPI es más barato.
Con 200.001 páginas hace falta Business, que empata con nosotros en 215.262 páginas. En esa franja de unas 15.000 páginas, nosotros costamos un poco menos. Por encima de 215.262 páginas, cada punto de empate cae dentro de su propio plan, así que ScraperAPI sigue más barato. Un Advanced lleno, 4,3 millones de páginas por 1975 USD, cuesta un tercio de nuestro precio.
El pago anual adelanta el cruce. Startup a 134,10 USD empata en 96.544 páginas. Con pago anual, ScraperAPI sigue más barato desde 96.544 páginas en adelante: Startup cubre hasta 200.000 páginas y, después, Business a 269,10 USD al mes también queda por debajo de nuestros 277,80 USD por 200.000 páginas. La franja de unas 15.000 páginas en la que ganamos con pago mensual desaparece con pago anual.
Dos condiciones pueden cambiar este resultado. Primero, los 5 créditos son el precio sin renderizado. Con renderizado, Amazon cuesta 15 créditos: 7,35 USD por 1000 en Hobby y 1,378 USD en Advanced. Las preguntas frecuentes sobre baja tasa de éxito sugieren render o premium cuando baja el éxito.
Segundo, el scraping básico devuelve HTML, y el precio y la nota los extraes tú. ScraperAPI tiene también una Amazon Product API que devuelve JSON, con todas las reseñas públicas. Su documentación no indica el costo en créditos. La tabla de precios pone Amazon en la franja de comercio electrónico de 5 créditos por dominio y no da un precio aparte para los endpoints estructurados; los 5 créditos de la Amazon Product API son, por tanto, una deducción nuestra a partir del dominio.
Búsqueda en Amazon por cada 1000 resultados
Una página de búsqueda devuelve muchas filas, así que un precio por fila es más justo. El ejemplo de la documentación de Amazon Search API trae 16 productos. A 5 créditos por página, son 0,153 USD por 1000 resultados en Hobby y 0,029 USD en Advanced. Nuestro amazon/search cuesta 0,002236 USD por llamada. Con las 10 filas por defecto, son 0,224 USD por 1000 resultados, y con limit=50, 0,045 USD.
| Opción | Filas por página | Por 1000 resultados |
|---|---|---|
| ScraperAPI Hobby (5 créditos por página) | 16 (ejemplo de la documentación) | 0,153 USD |
| ScraperAPI Startup | 16 | 0,047 USD |
| ScraperAPI Business | 16 | 0,031 USD |
| ScraperAPI Advanced | 16 | 0,029 USD |
EveryInfra amazon/search, por defecto | 10 | 0,224 USD |
EveryInfra amazon/search, limit=50 | 50 | 0,045 USD |
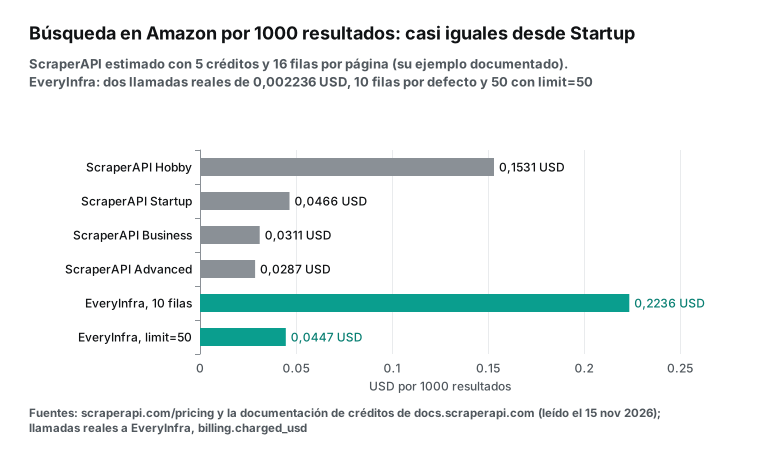
Con los valores por defecto, nuestro precio por fila es el más alto. Con limit=50, igualamos más o menos a Startup, y desde Business ScraperAPI cuesta menos. Las 16 filas por página son una estimación a partir del ejemplo de la documentación. Con nosotros, envía siempre limit=50. Con ScraperAPI, usa Business o más y gasta todo el cupo.
Google, Bing y mapas: 25 créditos por petición
Google y Bing cuestan 25 créditos por petición, la segunda ponderación de dominio más alta tras LinkedIn, con 30. La tarifa incluye todos los subdominios, así que Google Shopping, Noticias y Maps caen en la misma franja. La documentación de Google SERP API y la de Google Maps Search API no indican el costo en créditos. Deducimos 25 para mapas a partir de la frase sobre subdominios.
| Tipo de búsqueda | ScraperAPI Hobby | ScraperAPI Advanced | Cargo real de EveryInfra | ScraperAPI ÷ EveryInfra |
|---|---|---|---|---|
Google frente a nuestra herramienta web | 12,25 USD | 2,297 USD | 0,694 USD (10 filas) | De 17,65 a 3,31 veces |
Google frente a web/search | 12,25 USD | 2,297 USD | 1,389 USD (10 filas) | De 8,82 a 1,65 veces |
Bing frente a bing/search | 12,25 USD | 2,297 USD | 0,556 USD (10 filas) | De 22,03 a 4,13 veces |
Mapas (deducido) frente a google_maps_reviews/search | 12,25 USD | 2,297 USD | 1,389 USD (15 locales, hasta 50) | De 8,82 a 1,65 veces |
La fila de Bing es la comparación más limpia, porque los dos buscan en Bing. Un Advanced lleno cuesta aun así 4,1 veces nuestro precio. La fila de Google necesita una nota. Nuestra herramienta web devuelve páginas ordenadas con título, enlace y fragmento. El endpoint SERP de ScraperAPI devuelve la página de Google como bloques JSON, con anuncios y búsquedas relacionadas. Si necesitas esos bloques, nuestros endpoints de esta comparación no los devuelven.
La página de precios de Google Maps Platform, actualizada el 2026-11-11, sirve de referencia. Text Search Pro cuesta 32 USD por 1000, con 5000 gratis al mes. Place Details Pro cuesta 17 USD por 1000. Esos precios vienen con los campos y la licencia de Google.
Por local, la distancia crece. Nuestra búsqueda de mapas devuelve hasta 50 locales por llamada, así que cuesta de 0,028 a 0,093 USD por 1000 locales. La documentación de mapas de ScraperAPI no indica cuántas filas devuelve, así que comparamos solo por búsqueda.
Con poco volumen la distancia aumenta, porque la cuota del plan no cambia. Con 1000 búsquedas en Google al mes, Hobby sale a 49 USD por 1000. Nuestra herramienta web cuesta 0,69 USD por ese mismo mes. Con 30.000 búsquedas hace falta Startup: 149 USD frente a nuestros 20,82 USD. Los 100.000 créditos de Hobby solo dan 4000 búsquedas, y por eso las búsquedas en poco volumen salen caras en ScraperAPI.
LinkedIn, Walmart y páginas normales
LinkedIn cuesta 30 créditos: 14,70 USD por 1000 en Hobby y 2,76 USD en Advanced. Nuestro linkedin/company_profile cuesta 0,556 USD, así que somos entre 5,0 y 26,4 veces más baratos. Las preguntas frecuentes de ScraperAPI señalan que Meta y X prohíben la extracción y que solo admite datos públicos. Lee las condiciones de cada sitio antes de recoger datos.
Walmart está en la franja de comercio electrónico, a 5 créditos: de 2,45 a 0,459 USD por 1000 páginas. Nuestro walmart/search devolvió 20 filas a las 00:40 (hora de Singapur) por 0,001389 USD. Cada fila traía nombre, precio, precio anterior, nota y vendedor. ScraperAPI no da un ejemplo de búsqueda en Walmart, así que no comparamos por fila.
Las páginas normales son el otro terreno en el que ScraperAPI cuesta menos. Una página sin protección gasta 1 crédito: 0,49 USD por 1000 en Hobby y 0,092 USD en Advanced. Nuestra herramienta read cuesta 0,694 USD, 7,6 veces más que Advanced. read devuelve texto limpio para que lo lea un modelo. ScraperAPI devuelve HTML, o Markdown con el parámetro gratuito output_format.
Junto a ZenRows, Bright Data y Firecrawl
La tabla de abajo suma tres precios públicos más, leídos el mismo día, para una página web normal. Dividimos cada plan de pago de entrada entre su cupo y suponemos que se gasta entero. Web Unlocker de Bright Data cobra por petición, así que no necesita conversión.
Para cada línea de producto de Bright Data, mira el desglose de precios de Bright Data; para herramientas que leen páginas web para IA, el artículo de alternativas a Firecrawl.
| Servicio | Plan de pago de entrada | Por 1000 páginas normales | Ponderaciones y recargos | Fallos y 404 |
|---|---|---|---|---|
| ScraperAPI | Hobby 49 USD, 100.000 créditos | 0,490 USD | JS 10, Amazon 5, Google 25 | Fallos gratis; 404 cobrado |
| ZenRows | Build 19 USD al mes, 45.000 créditos | 0,422 USD | JS 5, premium 10, ambos 25 | Fallos gratis; 404 y 410 cobrados |
| Bright Data Web Unlocker | Pago por uso | 1,50 USD | Por petición exitosa | Solo el éxito |
| Firecrawl | Hobby 19 USD, 5000 créditos | 3,80 USD | Búsqueda 2 por 10 resultados; JSON 4 más | 403 y 404 cuestan 1 crédito |
Herramienta read de EveryInfra | Sin cuota mensual | 0,694 USD | Un precio por endpoint | Fallos y vacíos gratis |
La página de precios de ZenRows muestra por defecto el precio anual, con Build a 16 USD y «Save 17%». Build mensual cuesta 19 USD por los mismos 45.000 créditos, y usamos ese. ZenRows cobra 5 créditos por renderizado, la mitad que ScraperAPI. Su registro de cambios recoge dos cambios de facturación. Desde el 2026-10-02, cada clave de API puede tener su propio tope de créditos por periodo de facturación, día, semana o mes: al llegar al tope solo se para esa clave, con avisos al 80 % y al 100 %. Desde el 2026-10-05, los agentes de IA pueden comprar Fetch y Extract a precio en vivo sin cuenta ni clave, pagando con x402, MPP o tarjeta, con las mismas ponderaciones y cobrando solo las peticiones exitosas. En ScraperAPI el tope va por petición, con max_cost; con nosotros, las llamadas se paran cuando el saldo llega a cero.
La página de Web Unlocker de Bright Data indica 1,5 USD por 1000 peticiones y 5000 peticiones gratis al mes. La página de precios de Firecrawl indica 1 crédito por página y 4 más por salida en JSON. Su plan Hobby tiene el precio de entrada más alto por página normal de este grupo.
El panorama tiene dos partes. En páginas normales, los planes mensuales de créditos con el cupo lleno son los más baratos, por debajo de 0,50 USD por 1000. En Amazon, Google y LinkedIn, el precio por crédito se multiplica por 5 a 30, y un precio fijo por llamada empieza a ganar.
El excedente funciona distinto en cada servicio. ScraperAPI no tiene pago por uso de Hobby a Business, así que toca subir de plan; desde Scaling sí lo tiene, pero la tarifa no es pública. Firecrawl añade créditos en tramos de 5 USD cuando se acaba un plan de pago. En Hobby, un tramo son 1000 créditos, o 5,00 USD por 1000 páginas normales, más que los 3,80 USD dentro del plan; en Standard, un tramo son 2000 créditos, o 2,50 USD por 1000.
Web Unlocker de Bright Data cobra 1,5 USD por 1000 en pago por uso, y su plan Scale incluye 383.000 peticiones y cobra 1,3 USD por 1000 a partir de ahí. En cuanto a créditos sobrantes, solo Firecrawl Scale los guarda, durante un mes; Hobby, Standard y Growth de Firecrawl y todos los planes de ScraperAPI los ponen a cero. No revisamos las reglas de excedente de ZenRows. Nosotros no tenemos precio de excedente: la llamada read número un millón cuesta los mismos 0,000694 USD que la primera.
Plan gratis, prueba y gasto mínimo
| Cupo | Páginas normales | Páginas de Amazon | Búsquedas en Google o web |
|---|---|---|---|
| Prueba de 7 días de ScraperAPI (5000 créditos) | 5000 | 1000 | 200 |
| Plan gratis de ScraperAPI (1000 créditos al mes) | 1000 | 200 | 40 |
| Prueba de 1 USD de EveryInfra (24 horas) | 1440 (read) | 719 (amazon/profile) | 1440 (herramienta web) |
| Primera recarga de 10 USD en EveryInfra | 14.409 (read) | 7199 (amazon/profile) | 14.409 (herramienta web) |
La prueba de ScraperAPI no pide tarjeta, y su plan gratis tiene 5 hilos. Ultra premium solo funciona en planes de pago. Las preguntas frecuentes de facturación ofrecen un reembolso en 7 días sin preguntas, y puedes cancelar cuando quieras. Una nota de noviembre de 2025 fijó una nueva facturación desde el 2026-01-05. El texto completo está en la página de condiciones.
Mucha gente busca «scraperapi coupon code». No encontramos ningún cupón público, solo el 10 % del pago anual y los créditos extra temporales. Para controlar el gasto, la documentación de control de costos describe max_cost. Una petición que supere tu tope devuelve 403 con «This request exceeds your max_cost». Ese tope frena un recargo antibots inesperado.
Las dos pruebas sirven para medir tus propios destinos. Con los 5000 créditos de prueba de ScraperAPI, extrae 200 enlaces de Amazon y haz 100 búsquedas en Google. Anota sa-credit-cost cada vez. Con nuestro dólar de prueba, el mismo trabajo cuesta unos 0,28 USD más 0,07 USD. Mete los dos registros en el script de la sección siguiente y tendrás las dos facturas mensuales con tus propios destinos.
Para nuestro dólar de prueba, da una estrella en GitHub a los repositorios everyinfra/everyinfra-agent-plugins y everyinfra/seo-skills y reclámalo en la consola. Vale 24 horas desde que lo reclamas y no sirve para resolver captchas.
Comprueba las cuentas: un script corto de Python
El script de abajo produce todas las cifras «por 1000» de las secciones anteriores. Imprime el precio por 1000 de cada plan, el volumen de empate en Amazon y la factura de un mes mixto. Cambia MIX por tu propio volumen.
# Planes de autoservicio de ScraperAPI (scraperapi.com/pricing.md, leído el 2026-11-15): nombre, USD al mes, créditos
PLANS = [("Hobby", 49, 100_000), ("Startup", 149, 1_000_000), ("Business", 299, 3_000_000),
         ("Scaling", 475, 5_000_000), ("Professional", 975, 10_500_000), ("Advanced", 1975, 21_500_000)]
CREDITS = {"page": 1, "amazon": 5, "google": 25, "linkedin": 30}          # documentación de créditos, tabla Domains
OURS = {"page": 0.000694, "amazon": 0.001389, "google": 0.000694, "linkedin": 0.000556}  # cargos reales

for name, usd, credits in PLANS:
    per1k = {k: round(usd / credits * c * 1000, 3) for k, c in CREDITS.items()}
    breakeven = int(usd / OURS["amazon"])          # páginas de Amazon al mes con el mismo costo en ambos
    print(name, per1k, "empate en Amazon (páginas)", breakeven)

MIX = {"amazon": 20_000, "google": 5_000, "linkedin": 1_000}      # tu volumen mensual
need = sum(n * CREDITS[k] for k, n in MIX.items())
plan = next(p for p in PLANS if p[2] >= need)
ours = sum(n * OURS[k] for k, n in MIX.items())
print(f"ScraperAPI necesita {need:,} créditos, plan mínimo {plan[0]} ${plan[1]}; EveryInfra ${ours:.2f}")
La mezcla de ejemplo necesita 255.000 créditos, que no caben en Hobby. Así que el plan mínimo es Startup, a 149 USD. Con nuestros precios reales salen 31,81 USD, 4,7 veces menos. Las ponderaciones de búsqueda y LinkedIn suben el total de créditos y obligan a un plan mayor.
scraperapi pricing por carga de trabajo: siete casos
La tabla pasa siete cargas de trabajo por el mismo script. La columna de ScraperAPI usa el plan mensual más pequeño que cubre el mes. Un cociente por debajo de 1 indica que ScraperAPI es más barato.
| Carga mensual | Créditos necesarios | Plan y precio de ScraperAPI | EveryInfra | ScraperAPI ÷ EveryInfra |
|---|---|---|---|---|
| 5000 páginas de Amazon | 25.000 | Hobby 49 USD | 6,95 USD | 7,06 |
| 50.000 páginas de Amazon | 250.000 | Startup 149 USD | 69,45 USD | 2,15 |
| 150.000 páginas de Amazon | 750.000 | Startup 149 USD | 208,35 USD | 0,72 |
| 1.000.000 de páginas de Amazon | 5.000.000 | Scaling 475 USD | 1389,00 USD | 0,34 |
2000 búsquedas en Google (nuestra herramienta web) | 50.000 | Hobby 49 USD | 1,39 USD | 35,3 |
| 300.000 búsquedas en Bing | 7.500.000 | Professional 975 USD | 166,80 USD | 5,85 |
| 5000 páginas de empresa en LinkedIn | 150.000 | Startup 149 USD | 2,78 USD | 53,6 |
El renderizado, los proxies premium y las protecciones antibots suben la factura de ScraperAPI. El descuento anual la baja. Nuestra factura baja un poco, porque los fallos y los resultados vacíos son gratis.
Cuándo conviene más ScraperAPI
Primero, un volumen estable de más de unas 100.000 páginas de producto de Amazon, o de tiendas parecidas, al mes. ScraperAPI es más barato entre 107.272 y 200.000 páginas y por encima de 215.262. Un Advanced lleno cuesta un tercio de nuestro precio. Con ese volumen, el ahorro paga tu propio parser.
Segundo, muchos sitios sin protección de los que quieres el HTML. A 1 crédito por página, ScraperAPI gana a nuestra herramienta read en todos los planes. La geolocalización, las sesiones y el formato de salida son gratis.
Tercero, salida por país, mucha concurrencia o lotes asíncronos. La geolocalización por país empieza en Business, y Advanced tiene 500 hilos. La API asíncrona y DataPipeline manejan lotes, y el Crawler recorre un sitio según reglas. Nuestros endpoints trabajan con una petición cada vez.
Cuarto, los bloques completos de una página de Google, o endpoints como eBay y Redfin del resumen de datos estructurados. El AI Parser además convierte una página en JSON a partir de tu descripción. El primer parser es gratis y cada uno nuevo cuesta 30.000 créditos. Nuestros endpoints de esta comparación no tienen un parser a medida de ese tipo.
Quinto, una instalación de ScraperAPI que ya funciona, con parsers, reintentos y volumen estable. Cambiar exige nuevos parsers, mapas de campos, alertas y pruebas. Si tu factura es sobre todo páginas normales y mucho Amazon, cambiar quizá no ahorre. Si una parte es búsqueda, mapas o LinkedIn, mueve solo esa parte a un precio por llamada. Por ejemplo, con 5000 páginas de empresa de LinkedIn al mes, el plan mínimo de ScraperAPI es Startup a 149 USD y nuestro precio es 2,78 USD: 146 USD de diferencia al mes.
Para una comparación de funciones, mira alternativa a ScraperAPI y alternativa a ZenRows.
Movimientos del mercado, octubre y noviembre de 2026
- 2026-11-05: Benzinga y Firecrawl se aliaron para dar datos financieros con licencia a agentes de IA. El comunicado en PR Newswire suma seis productos de Benzinga, entre ellos noticias de acciones de EE. UU., calificaciones de analistas y un calendario de fusiones, a Alexandria, la biblioteca que Firecrawl abrió en septiembre de 2026; se leen por la API, el MCP y la línea de comandos de Firecrawl. El comunicado no da precio, y la página de precios de Firecrawl que leímos el 2026-11-15 no tiene una línea para Alexandria. Una página normal en Firecrawl Hobby sale a 3,80 USD por 1000, así que conviene preguntar cómo se cobra el contenido con licencia antes de usarlo. El registro de cambios de Firecrawl muestra diez entradas con fecha entre el 2026-11-02 y el 2026-11-13; la página que descargamos traía fechas sin títulos, así que no encontramos ahí ningún cambio de cobro. La página de precios dice que la tabla actual rige desde el «September 4, 2026».
- Octubre de 2026: ScraperAPI desbloquea sitios con Akamai de forma automática. La nota de versión elimina el parámetro extra y pide a quien usaba
premiumoultra_premiumsolo para Akamai que pruebe sin ellos. La documentación de créditos, actualizada el 2026-10-30, sigue poniendo Akamai a 10 créditos. En Hobby, una peticiónultra_premiumson 30 créditos, o 14,70 USD por 1000, y la fila de Akamai son 10, o 4,90 USD: el parámetro desaparece, el recargo no. - 2026-10-14: DigitalOcean y Bright Data se aliaron. BigDATAwire cuenta que los agentes gestionados de DigitalOcean pueden usar las herramientas de búsqueda, acceso y extracción de Bright Data sin una cuenta aparte de Bright Data. La noticia no da precio, así que no hacemos la conversión.
Límites: cuándo no valen estas cifras
Los precios por cada 1000 peticiones de ScraperAPI suponen el cupo entero, y no calculamos el excedente del pago por uso. Dos documentos de ScraperAPI no coinciden, y los 25 créditos de mapas y los 5 de los endpoints estructurados de Amazon son deducciones a partir de la tabla de dominios. Probamos 9 endpoints de EveryInfra una o dos veces cada uno, así que la latencia y las filas variarán. Comparamos precio y reglas de cobro, no la calidad de los resultados. Los dos lados pueden cambiar precios después del 2026-11-15, así que revisa ambas páginas de precios antes de comprar. Nuestros precios están en el catálogo público, de lectura gratuita.
Para empezar: prueba tu propia carga con el crédito de prueba
- Abre el mercado de infraestructura y busca los endpoints que necesitas.
- Prueba búsqueda en Amazon, detalle de producto de Amazon, reseñas de Amazon y búsqueda web.
- Prueba también búsqueda en Bing, búsqueda en Google Maps, páginas de empresa en LinkedIn y búsqueda en Walmart.
- Sigue el inicio rápido para obtener una clave; da estrella a nuestros dos repositorios de GitHub para reclamar el dólar de prueba.
- Llama una vez a 50 destinos reales del mes pasado y anota
billing.charged_usd. - Pon tu volumen mensual en
MIXdentro del script de arriba. - Para una vista general, mira Amazon Scraper API, búsqueda web, reseñas de Google Maps, LinkedIn Scraper API y precios.
- Para un cliente de IA, añade el servidor MCP remoto de abajo y lee la guía de MCP.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Esta configuración usa el transporte Streamable HTTP de la especificación MCP, con la clave en una cabecera. La documentación MCP de ScraperAPI da su servidor remoto en https://mcp.scraperapi.com/mcp. Puedes añadir los dos al mismo cliente.
Preguntas frecuentes
¿ScraperAPI es gratis? ¿Cuánto da el scraperapi free plan? (Sugerencias de búsqueda: «is scraperapi free» y «scraperapi free plan».) Una prueba de 7 días da 5000 créditos y, después, el plan gratis da 1000 créditos al mes; lo que eso compra está en la tabla de pruebas.
¿Cuántos créditos de ScraperAPI gasta una petición? (Sugerencias de búsqueda: «scraperapi api credits» y «scraperapi credits».) Una página normal gasta 1, Amazon 5, Google y Bing 25, y LinkedIn 30. La tabla completa está en la sección de créditos, y la cabecera sa-credit-cost muestra cada costo real.
¿ScraperAPI cobra las peticiones fallidas? (Dudas de facturación bajo «scraperapi pricing».) No. Solo cobra las respuestas 200 y 404. Pon un tiempo de espera de más de 70 segundos, por lo que explica la sección de las dos contradicciones.
¿Vale la pena scraperapi premium? (Sugerencia de búsqueda: «scraperapi premium».) premium=true cuesta 10 créditos, diez veces una página normal. Las preguntas frecuentes lo sugieren cuando baja el éxito. Añade max_cost para poner tope a cada petición.
¿ScraperAPI es más barato que EveryInfra para Amazon? (Sugerencias de búsqueda: «scraper api amazon» y «scraperapi amazon reviews».) Depende del volumen. Por encima de unas 107.000 páginas al mes, ScraperAPI suele ser más barato: 475 USD frente a 1389 USD con 1 millón de páginas. Por debajo, nosotros somos más baratos: 6,95 USD frente a 49 USD con 5000 páginas.
¿Hay algún código de descuento («scraperapi coupon code»)? (Sugerencia de búsqueda: «scraperapi coupon code».) No encontramos ningún cupón público. Los ahorros son el 10 % anual y los créditos extra temporales de los planes altos.
¿ScraperAPI o ZenRows? (Sugerencia de búsqueda: «zenrows vs scraperapi».) En páginas normales, ZenRows Build cuesta 0,42 USD por 1000 y ScraperAPI Hobby, 0,49 USD. El renderizado cuesta 5 créditos en ZenRows y 10 en ScraperAPI. Un hilo en r/WebScrapingInsider recomienda probar con tus propios dominios. Un hilo en r/webscraping habla del costo real de la extracción.
Referencias
- ScraperAPI Pricing, ScraperAPI, consultado el 2026-11-15 a las 00:26 SGT
- pricing.md (copia en Markdown de la página de precios), ScraperAPI, consultado el 2026-11-15
- Credits and Requests costs, documentación de ScraperAPI, actualizada el 2026-10-30, consultado el 2026-11-15
- Cost Control (max_cost), documentación de ScraperAPI, consultado el 2026-11-15
- Supported Parameters, documentación de ScraperAPI, consultado el 2026-11-15
- Plans and Billing FAQ, documentación de ScraperAPI, consultado el 2026-11-15
- General FAQ, documentación de ScraperAPI, consultado el 2026-11-15
- Low Success Rates FAQ, documentación de ScraperAPI, consultado el 2026-11-15
- DataPipeline Credit costs, documentación de ScraperAPI, consultado el 2026-11-15
- DataPipeline is now up to 80% cheaper, notas de versión de ScraperAPI, julio de 2026
- Akamai-protected sites now unblocked automatically, notas de versión de ScraperAPI, octubre de 2026
- Introducing new growth plans, notas de versión de ScraperAPI, mayo de 2026
- New Domain Credit Cost Estimator, notas de versión de ScraperAPI, junio de 2026
- ScraperAPI MCP expanded capabilities, notas de versión de ScraperAPI, marzo de 2026
- ScraperAPI plugin for AI agents, notas de versión de ScraperAPI, junio de 2026
- Updates to our Terms of Service and billing policies, notas de versión de ScraperAPI, noviembre de 2025
- Índice de notas de versión, documentación de ScraperAPI, consultado el 2026-11-15
- Structured Data Endpoints, resumen, documentación de ScraperAPI, consultado el 2026-11-15
- Amazon Product API, documentación de ScraperAPI, consultado el 2026-11-15
- Amazon Search API, documentación de ScraperAPI, consultado el 2026-11-15
- Google SERP API, documentación de ScraperAPI, consultado el 2026-11-15
- Google Maps Search API, documentación de ScraperAPI, consultado el 2026-11-15
- MCP Server, documentación de ScraperAPI, consultado el 2026-11-15
- Async API overview, documentación de ScraperAPI, consultado el 2026-11-15
- AI Parser pricing and limits, documentación de ScraperAPI, consultado el 2026-11-15
- ScraperAPI Crawler v2.0, documentación de ScraperAPI, consultado el 2026-11-15
- ScraperAPI Terms, ScraperAPI, consultado el 2026-11-15
- ZenRows Pricing, ZenRows, consultado el 2026-11-15
- ZenRows Changelog, documentación de ZenRows, consultado el 2026-11-15
- Web Unlocker pricing, Bright Data, consultado el 2026-11-15
- Firecrawl Pricing, Firecrawl, consultado el 2026-11-15
- Firecrawl Changelog, Firecrawl, última entrada el 2026-11-13, consultado el 2026-11-15
- Google Maps Platform pricing, Google for Developers, actualizada el 2026-11-11, consultado el 2026-11-15
- scraperapi-pricing-analysis, GitHub, consultado el 2026-11-15
- I had to scrape 36,000 pages…, Reddit r/webdev, consultado el 2026-11-15
- Which is the best web scraping API for e-commerce, Reddit r/WebScrapingInsider, consultado el 2026-11-15
- The real costs of web scraping, Reddit r/webscraping, consultado el 2026-11-15
- Benzinga Collaborates with Firecrawl, PR Newswire, 2026-11-05
- DigitalOcean and Bright Data Unlock the Web for AI Agents, BigDATAwire, 2026-10-14
- Catálogo de EveryInfra, EveryInfra, consultado el 2026-11-15 a las 00:28 SGT
- Herramientas de búsqueda de EveryInfra, EveryInfra, consultado el 2026-11-15
- Model Context Protocol Specification 2025-11-25, MCP, consultado el 2026-11-15
- October 2026 release notes, notas de versión de ScraperAPI, octubre de 2026
Referencia BL-162