Firecrawl pricing:credit 逐项拆账
Firecrawl 每千页 $0.60–$3.80,每千次搜索 $1.20–$7.60;9 月改价后超额单价近翻倍。我们实测搜索每千次 $0.694。
普通网页每千页,Firecrawl 是 $3.80(Hobby 月付)到 $0.599(Scale 年付),EveryInfra 的 read 是 $0.694:Firecrawl 只有 Growth、Scale 年付比 read 便宜 4% 和 14%,对应每月约 48 万到 51 万页、86 万到 130 万页,前提是当月额度用满。搜索每千次(每次 10 条结果),Firecrawl 是 $7.60 到 $1.198,是我们 web 工具($0.694)的 1.7 到 11 倍。
Firecrawl 一侧的数全部来自它的定价页、计费文档、限速文档、各端点文档、更新日志,以及互联网档案馆保存的两个旧版定价页,读取时间是新加坡时间 2026-11-16 00:12 到 00:40,没有真调它的接口。EveryInfra 的数是本次真调响应里的 charged_usd,并和能力目录、搜索工具目录里的 price_usd 逐项核过。
Firecrawl pricing 总表:五档月费、credit 和每千次
Firecrawl 定价页顶部标着「Effective September 4, 2026」,所有价格以美元计。免费档每月 1,000 个 credit,不要信用卡,月初重置;付费四档按月付分别是 Hobby $19、Standard $99、Growth $399、Scale $749,对应每月 5,000、100,000、500,000、1,000,000 个 credit。年付在卡片上显示为每月 $16、$83、$333、$599,旁边写着每年省 $38、$198、$798、$1,798。用「省下的钱」倒推,Hobby 年付一年 $190,合每月 $15.83,卡片上的 $16 是四舍五入后的数;前三档年付折扣都是 16.7%,Scale 是 20%。下表的每千次价格按这个精确值算,所以和别处引用的整数略有出入。
| 档位 | 月付 / 年付(每月) | 每月 credit | 并发浏览器 | 每千页(月付 / 年付) | 每千次搜索,10 条(月付 / 年付) | 每千页加 JSON(月付) |
|---|---|---|---|---|---|---|
| Free | $0 | 1,000 | 2 | 免费额度内 $0 | 免费额度内 $0 | — |
| Hobby | $19 / $15.83 | 5,000 | 5 | $3.80 / $3.17 | $7.60 / $6.33 | $19.00 |
| Standard | $99 / $82.50 | 100,000 | 25 | $0.99 / $0.825 | $1.98 / $1.65 | $4.95 |
| Growth | $399 / $332.50 | 500,000 | 50 | $0.798 / $0.665 | $1.596 / $1.33 | $3.99 |
| Scale | $749 / $599.17 | 1,000,000 | 100 | $0.749 / $0.599 | $1.498 / $1.198 | $3.745 |
| EveryInfra(实扣) | 无月费 | 按次 | — | read $0.694;crawl 20 页一次 $0.0347(单页截在 20,000 字符) | web $0.694;bing/search $0.556 | harvest 每页一次 $0.694 |
表中 Firecrawl 每千次的算法:套餐月费除以月 credit 数,乘以一次请求要扣的 credit,再乘以 1,000,前提是当月额度用满。
同一个 Hobby,开 LLM 抽取 JSON 就从每千页 $3.80 变成 $19.00,是 5 倍。我们的 harvest 工具按字段抽取,一次调用最多取 50 行,本次抽 Firecrawl 定价表 6 行扣 $0.000694,按「每页调用一次」算每千页是 $0.694。两边做的事有差别:Firecrawl 的 JSON 格式按你给的 schema 或提示让模型从页面里抽字段;我们的 harvest 给字段名,返回一行行带这些字段的记录。比价时把它们当成「从页面拿结构化字段」这同一个需求的两种价格。
Firecrawl 的 Growth、Scale 年付和我们的 read 只差 4% 到 14%,Scale 和 Growth 的月付反过来比 read 贵 8% 和 15%;Hobby 月付是 read 的 5.5 倍。对一个月要抓几十万页普通网页、能把额度用满的团队,Firecrawl 的大档价格有竞争力。crawl 一次 20 页、单页截在 20,000 字符,折合每千页 $0.0347,只适合同站短页;按本次实测把截断的长页再用 read 补读,每千页是 $0.208(见实测一节)。
年付和月付怎么选,要看用量稳不稳。年付前三档便宜 16.7%,Scale 便宜 20%,可是年付的额度照样每个月按虚拟续费日重置,用不完的照样清零,只有年付 Scale 能结转 1 个月。一个团队如果一年里有四个月几乎不用,年付省下的 16.7% 抵不过这四个月白付的月费;反过来,用量每个月都能把额度吃满,年付就是白捡的折扣。Hobby 年付一次付 $190,和按月付一年 $228 差 $38,差额刚好两个月的月费。
按月页数看:只有两段区间 Firecrawl 更便宜
用后文 Python 里的规则按月页数逐百页扫一遍:Firecrawl 取当月最便宜的买法(够用的最低档,不够再按 $5 一包补),EveryInfra 取逐页 read。月付的话,从 1,000 页到 200 万页,Firecrawl 没有任何一个点比 read 便宜,因为 Growth 和 Scale 的月付单价本身就高于 $0.694,超额包更贵。年付有两段区间 Firecrawl 占优:Growth 年付在每月约 479,200 页到 510,000 页之间,Scale 年付在约 863,400 页到 1,305,000 页之间。前一段的上沿来自 Growth 超额每千个 $2.00,后一段的上沿来自 Scale 超额每千个 $1.00,超过之后每多一千页,Firecrawl 多花的钱都比 read 多。每月不到 1,000 页时,Firecrawl 的免费档是 $0,比任何付费方案都便宜。同一站点的短页用 crawl 成批取不在这个比较里,它的单价取决于截断页的比例。
Firecrawl credits pricing:每个端点扣几个
计费文档的「Credit costs per endpoint」表是扣费的原始规则。Scrape 每页 1 个 credit;Crawl 也是每页 1 个,每一页照样套用 Scrape 的选项加价;Map 每次调用 1 个,不论返回多少网址;Search 每 10 条结果 2 个,按 10 条向上取整,11 条就是 4 个;Interact 是浏览器沙盒,按浏览器分钟计,只写 Playwright 代码每分钟 2 个,带自然语言提示每分钟 7 个,开零数据留存再各加 2 个,最低按 1 分钟收;Agent 每天前 5 次免费,之后按用量动态计价。免费档也能调全部核心端点,计费表在各档之间一样。
| 端点 | 文档写的扣法 | 每次多少美元(Hobby 月付) | 每次多少美元(Scale 年付) | EveryInfra 最接近的能力和实扣 |
|---|---|---|---|---|
| Scrape | 1 credit / 页 | $0.0038 | $0.000599 | read $0.000694 / 页 |
| Crawl | 1 credit / 页 | $0.0038 / 页 | $0.000599 / 页 | crawl $0.000694 / 次,最多 20 页 |
| Map | 1 credit / 次 | $0.0038 | $0.000599 | map $0.000694 / 次,最多 200 个网址 |
| Search | 2 credits / 10 条 | $0.0076 | $0.0012 | web $0.000694 / 次,10 条 |
| Search 并抓 10 条全文 | 2 + 10 = 12 credits | $0.0456 | $0.0072 | deep 加 full=true $0.000694 / 次,最多 10 条 |
| Interact | 2–7 credits / 浏览器分钟 | $0.0076–$0.0266 / 分钟 | $0.0012–$0.0042 / 分钟 | 无对应能力 |
| Agent | 每天 5 次免费,之后动态计价 | 文档未写单价 | 文档未写单价 | 无对应能力 |
| Extract(2026-12-10 下线) | 每 credit 折 15 个 token | 视 token 数 | 视 token 数 | harvest $0.000694 / 次 |
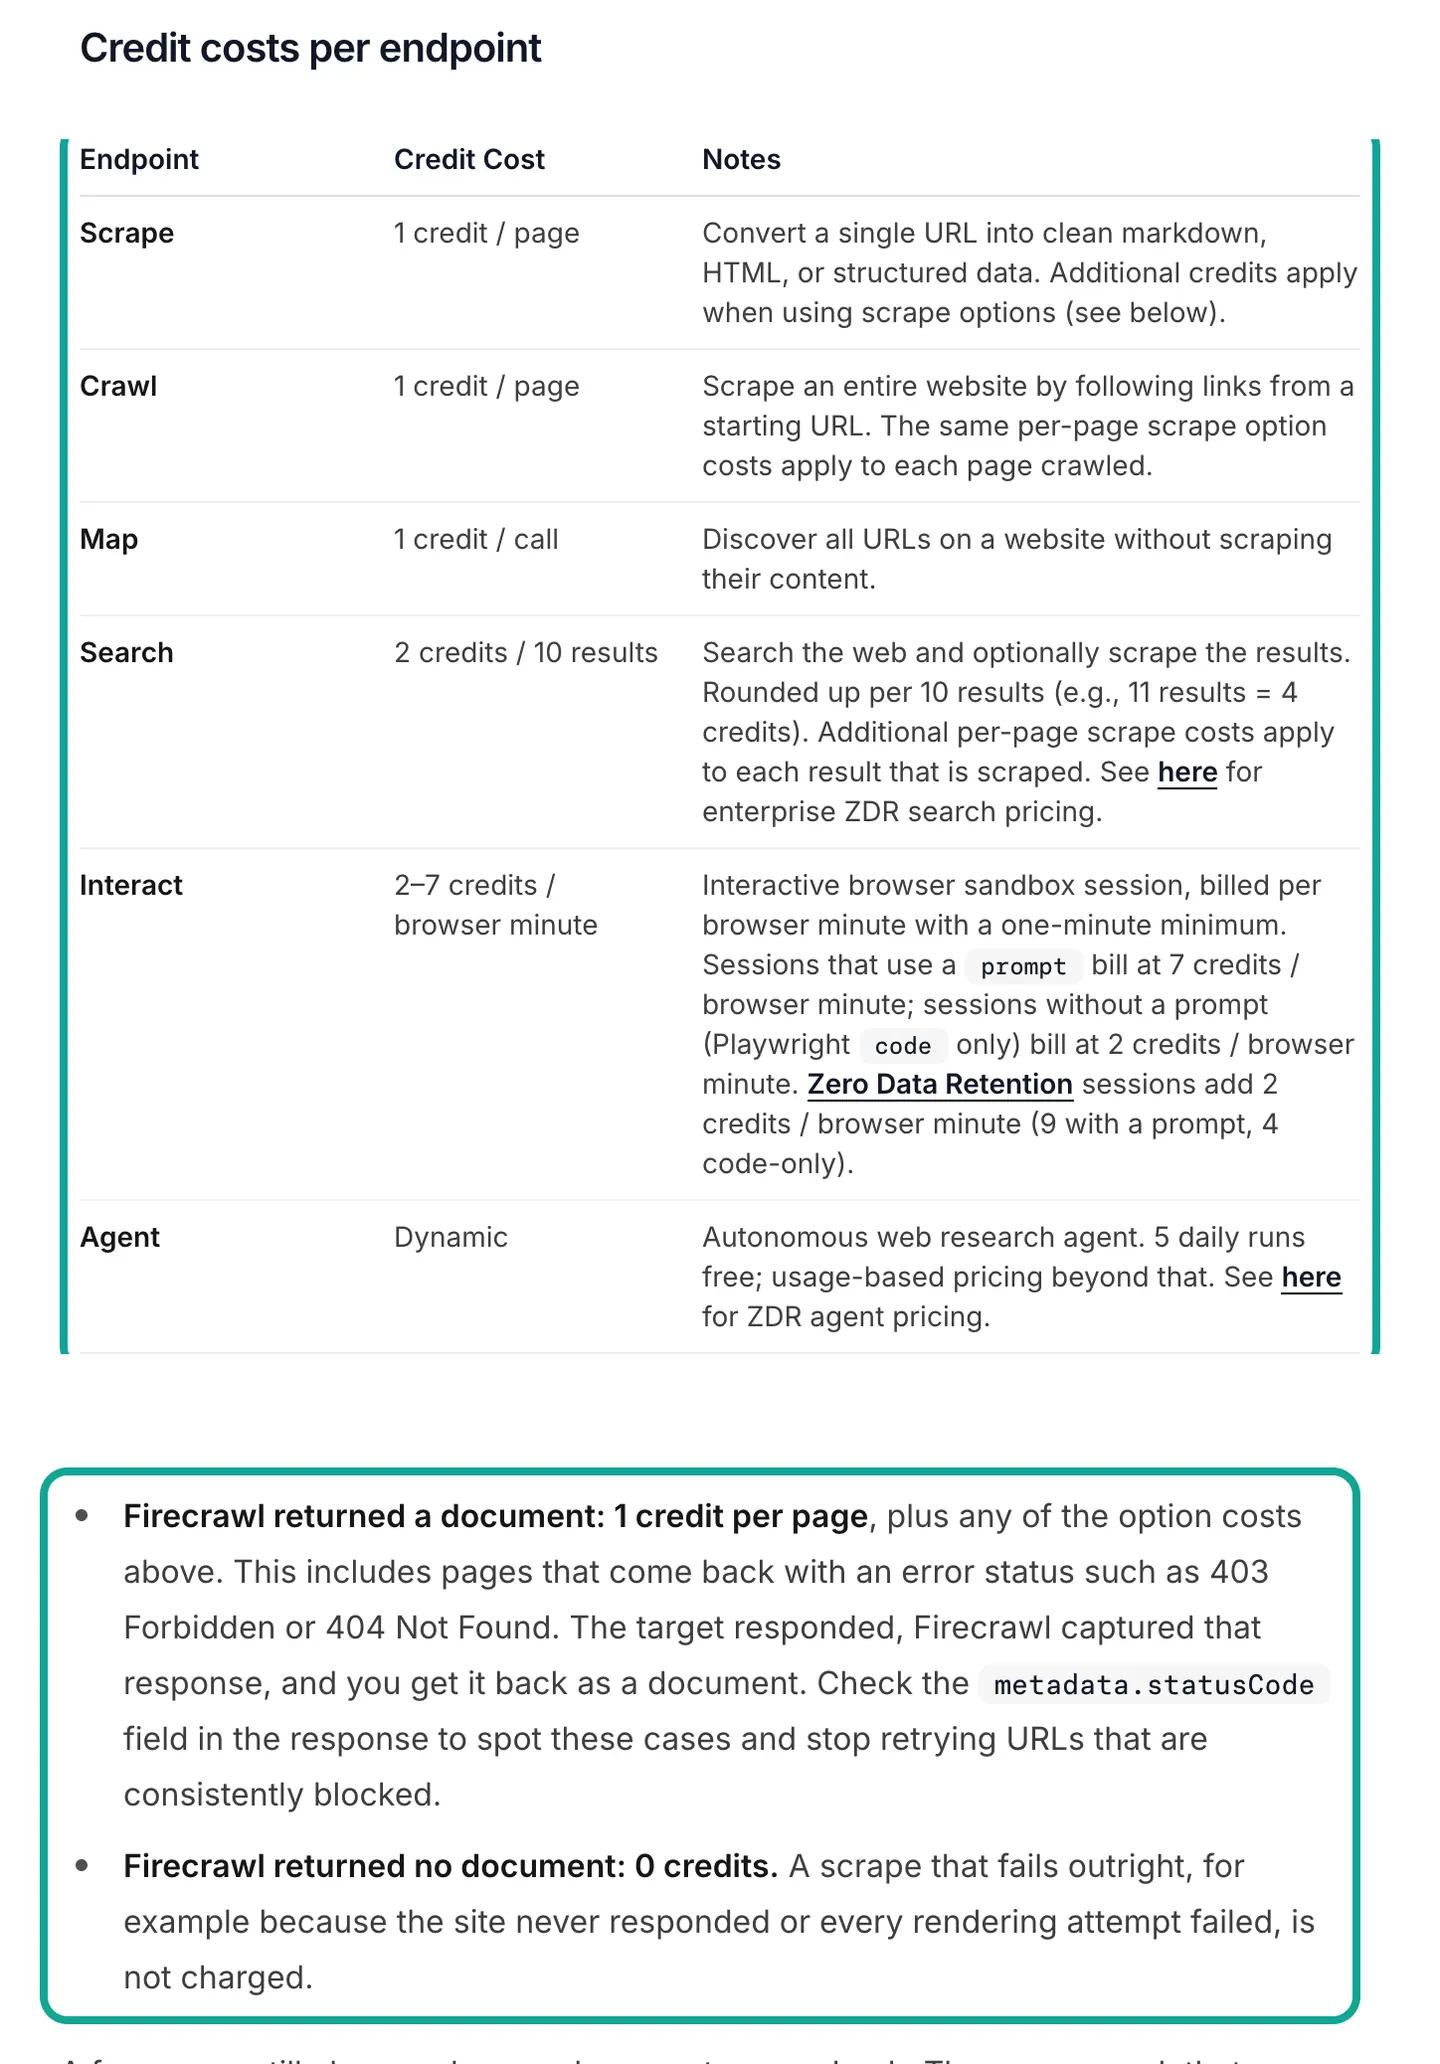
Extract 文档顶部写着它已停止维护,将在 2026 年 12 月 10 日 15:00 UTC 移除,单页抽取改用 Scrape 的 JSON 格式,多页和带搜索的抽取改用 Agent;迁移说明在这里。还在用 Extract 的团队,下个月起账单会从「按 token 折 credit」变成「每页 1 加 4 个 credit」,按 Hobby 月付算每页 $0.019。要估算迁移后的成本,就拿过去一个月 Extract 处理的页数乘以 5。
整站抓取:先 Map 再挑页,比整站 Crawl 省
Crawl 每页 1 个 credit,抓下来的页有多少算多少;Map 不论列出多少网址都只收 1 个。一个两千页的文档站,如果只关心其中讲价格和接口的三百页,先用 Map 花 1 个 credit 列出全部网址,自己按路径筛出三百个,再交给批量抓取,总共 301 个 credit;直接 Crawl 整站是 2,000 个,差 6.6 倍。不想自己筛,也可以在 Crawl 里用 includePaths、excludePaths 按路径的正则过滤,用 maxDiscoveryDepth 限制从起点往下跟几层链接;Crawl 文档写明默认只抓起始网址下面的子路径,要抓同级或上级路径得开 crawlEntireDomain,要跟外链得开 allowExternalLinks。这几个开关都影响页数,也就直接影响 credit。
我们的 map 一次最多列 200 个网址,本次列 docs.firecrawl.dev 用了 0.39 秒;crawl 可以写一句自然语言说明要哪类页面,本次加了「讲 credit、计费、价格或限速的页面」这句之后只回 2 页。两种做法的计价都按调用次数,筛选越严、返回越少,按页算的单价越高,但总账单不变。
选项一叠加,单页就从 1 个变成 9 个
计费文档的第二张表列出 Scrape 的加价选项,规则是「可以叠加」,而且 Crawl 和 Search 内部每页都调用 Scrape,所以同样适用。下表的美元价按 Hobby 月付(每 credit $0.0038)和 Scale 年付(每 credit $0.000599)两档算:
| 选项组合 | credit / 页 | Hobby 月付每千页 | Scale 年付每千页 | 文档出处 |
|---|---|---|---|---|
| 基础抓取 | 1 | $3.80 | $0.599 | Scrape |
| JSON 格式(LLM 抽取) | 5 | $19.00 | $2.996 | LLM Extract |
| JSON + 零数据留存 | 6 | $22.80 | $3.595 | 计费文档示例原文 |
| JSON + 隐去个人信息 | 9 | $34.20 | $5.393 | PII redaction |
| question、highlights、audio、video 格式 | 5 | $19.00 | $2.996 | 计费文档加价表 |
| 15 页 PDF | 15 或 16 | $57.00–$60.80 | $8.99–$9.59 | 文档解析 |
| lockdown 只读缓存,命中 | 5 | $19.00 | $2.996 | Lockdown |
| X 帖子(经 Grok 接口) | 30 | $114.00 | $17.98 | 计费文档 X billing 一节 |
| LinkedIn 资料页(按命中的数据商) | 5–40 | $19.00–$152.00 | $3.00–$23.97 | 计费文档 Provider-routed URLs 一节 |
15 页 PDF 那一行是两个数,因为 Firecrawl 自己的文档写法不一致:计费文档的加价表写「PDF parsing +1 credit / PDF page」,按字面是基础 1 个加每页 1 个,共 16 个;文档解析页和搜索文档的成本一节都写「1 credit per PDF page」,即 15 个。差 1 个 credit 不影响量级,算预算时按 16 个取上限更稳。我们这边用 read 读了一份 15 页的 arXiv 论文 PDF(1706.03762),新加坡时间 00:22 返回 52,380 个字符,用时 1.51 秒,扣 $0.000694,和读一个普通网页同价。
X 和 LinkedIn 两类链接走的是专门的路由。计费文档写明,发往 x.com、twitter.com 的资料页和帖子链接通过 xAI 的 Grok 接口处理,基础 1 个 credit 外加「Grok X Query」29 个,一次 30 个,加 JSON 是 34 个,返回的是 Grok 生成的结构化结果和摘要;文档自己也建议,要大规模的原始结构化数据就去用 X 的企业接口。LinkedIn 个人和公司页交给第三方数据商回答,FullEnrich 5 个、Data Legion 基础版 10 个、Apollo 30 个、Data Legion 高级版 40 个,查不到记录的数据商不收钱,所以一次请求按实际命中的那家计价。这两类我们有专门的能力:twitter/user_posts 一次最多回 200 条帖子,本次取 20 条扣 $0.000556;linkedin/company_profile 查 Firecrawl 自己的公司页,返回关注数 87,606 等字段,扣 $0.000556。
JS 渲染和代理参数加不加价
不加。计费表里没有单独的「JS 渲染」项;增强模式文档写明增强代理请求和基础请求同价,每次 1 个 credit,先走基础代理、失败后自动升级到增强代理的那次重试也不另收。同一份文档和代理文档都写着 proxy 参数已停止维护,推荐用默认的 auto,让 Firecrawl 自己选代理。这和 2026 年初的说法不同:1 月的存档页和 r/ProxyEngineering 上一篇讨论帖都写着 JSON 加增强模式每页 5 到 9 个 credit,8 月的定价页 FAQ 还有一句「Advanced features (JSON format, Enhanced Mode, etc.) cost additional credits」。Firecrawl 自己 2026 年 5 月的一篇博客已经按 1 个 credit 写增强模式。写「enhanced 5 credits」的是 9 月以前的规则。
省 credit 的办法在缓存上。快速抓取文档写明默认 maxAge 是 2 天,缓存里有不到 2 天的副本就直接返回,设成 0 才强制重抓。缓存命中也照常按每页 1 个 credit 计,好处是更快、失败率更低,账单不变。另一个相关选项 lockdown 只从缓存读、绝不访问目标站,命中加 4 个 credit,没命中不返回文档但仍扣 1 个。
Interact 和 Agent:按分钟和按用量
Interact 是 Firecrawl 的浏览器沙盒,文档写的是按浏览器分钟计费,最低 1 分钟。只跑 Playwright 代码每分钟 2 个 credit,用自然语言提示让它自己操作每分钟 7 个;一个带提示、跑了 10 分钟的会话是 70 个 credit,Hobby 月付合 $0.266,Scale 年付 $0.042。开了零数据留存,代码会话每分钟 4 个、提示会话 9 个。会话不管有没有拿到想要的结果都按分钟收,所以给提示会话设一个明确的超时,比事后看账单有用。Agent 是自主调研代理,每天前 5 次免费,之后按实际用量动态计价,定价页和计费文档都没有给出单价公式;要估 Agent 的成本,只能先用免费的 5 次跑几个典型任务,看 Credit Usage 接口里记了多少。
免费额度能做多少事
免费档每月 1,000 个 credit,按上面的规则换算:1,000 个普通网页,或 500 次 10 条结果的搜索,或 200 页 JSON 抽取,或 33 条 X 帖子,或 25 个按 Data Legion 高级版收费的 LinkedIn 资料页。免费档的限速是 Scrape、Map、Search 每分钟 10 次,Crawl、Agent、Interact 每分钟 2 次,并发 2 个浏览器,用完额度返回 402,没有按量付费。不计入这 1,000 个的免费用法还有几种:政府与法律索引的搜索不扣 credit;Agent 每天 5 次免费;免 Key 用法按 IP 每天另有限额;合作方渠道送的 credit 一般是 10,000 个,合作方文档写明 3 个月后过期,送的期间账户仍是免费档的限速和并发。
Firecrawl search pricing:每 10 条 2 个,第 11 条翻倍
搜索的扣法写在搜索文档的「Cost Implications」一节:1 到 10 条结果 2 个 credit,11 到 20 条 4 个,依此类推;如果同时让它抓每条结果的正文,每条再按 Scrape 的规则加 1 个,开 JSON 再加 4 个。政府和法律索引类别的搜索不收搜索 credit。企业版的零数据留存搜索另有两档:端到端零留存每 10 条 10 个 credit,匿名化零留存每 10 条 2 个。
11 条和 20 条同价:都是 4 个 credit。代理程序按默认 10 条搜就没有这个问题,但有些框架默认 limit 写 15 或 20,读账单时会发现搜索单价是标价的两倍。我们 web 工具每次最多 10 条,按次计价 $0.000694,要 20 条就翻第 2 页,本次在新加坡时间 00:20 和 00:22 各搜了一次「firecrawl pricing」的第 1、2 页,各扣 $0.000694,各回 10 条。
搜索加抓全文是代理程序的常见用法:先搜,再把前几条结果的正文拿回来给模型读。Firecrawl 里搜 5 条并抓 5 页是 2 + 5 = 7 个 credit,Hobby 月付 $0.0266,Scale 年付 $0.0042。我们的 deep 工具在 full=true 时连全文一起返回,本次新加坡时间 00:27 用它搜「firecrawl search pricing credits per 10 results」,5 条结果带全文约 81,000 个字符,用时 8.14 秒,扣 $0.000694,比 Firecrawl 最便宜的买法低 6 倍,比 Hobby 低 38 倍。deep 每次最多 10 条,要更多条就分批调。
失败扣不扣:返回了文档就收 1 个 credit
现在的规则写在计费文档「When credits are charged」一节:决定扣不扣的是 Firecrawl 有没有返回文档,跟目标站的 HTTP 状态码无关。只要目标站有响应、Firecrawl 把响应收下来交给你,就按每页 1 个 credit 加选项收费,403 Forbidden 和 404 Not Found 都算在内;文档建议看响应里的 metadata.statusCode,对一直被拦的网址停止重试。目标站根本没响应、所有渲染尝试都失败,才是 0 个 credit。
还有几种情况即使没有返回文档也要扣:开了威胁防护扫描,每个扫描过的网址 2 个 credit,包括被扫描拦下的那次;开了提示注入检查,检查一跑完就收 5 个;lockdown 缓存没命中收 1 个;监控任务里出错的页面照收基础的 1 个;Interact 和浏览器会话按分钟收,最低 1 分钟,不管会话有没有拿到你要的东西。整站抓取和批量抓取的 credit 是异步记账的,每处理完一页记一次,提交任务时看到的余额会滞后,文档说可能要几分钟甚至几小时才记完,查状态本身不扣 credit。
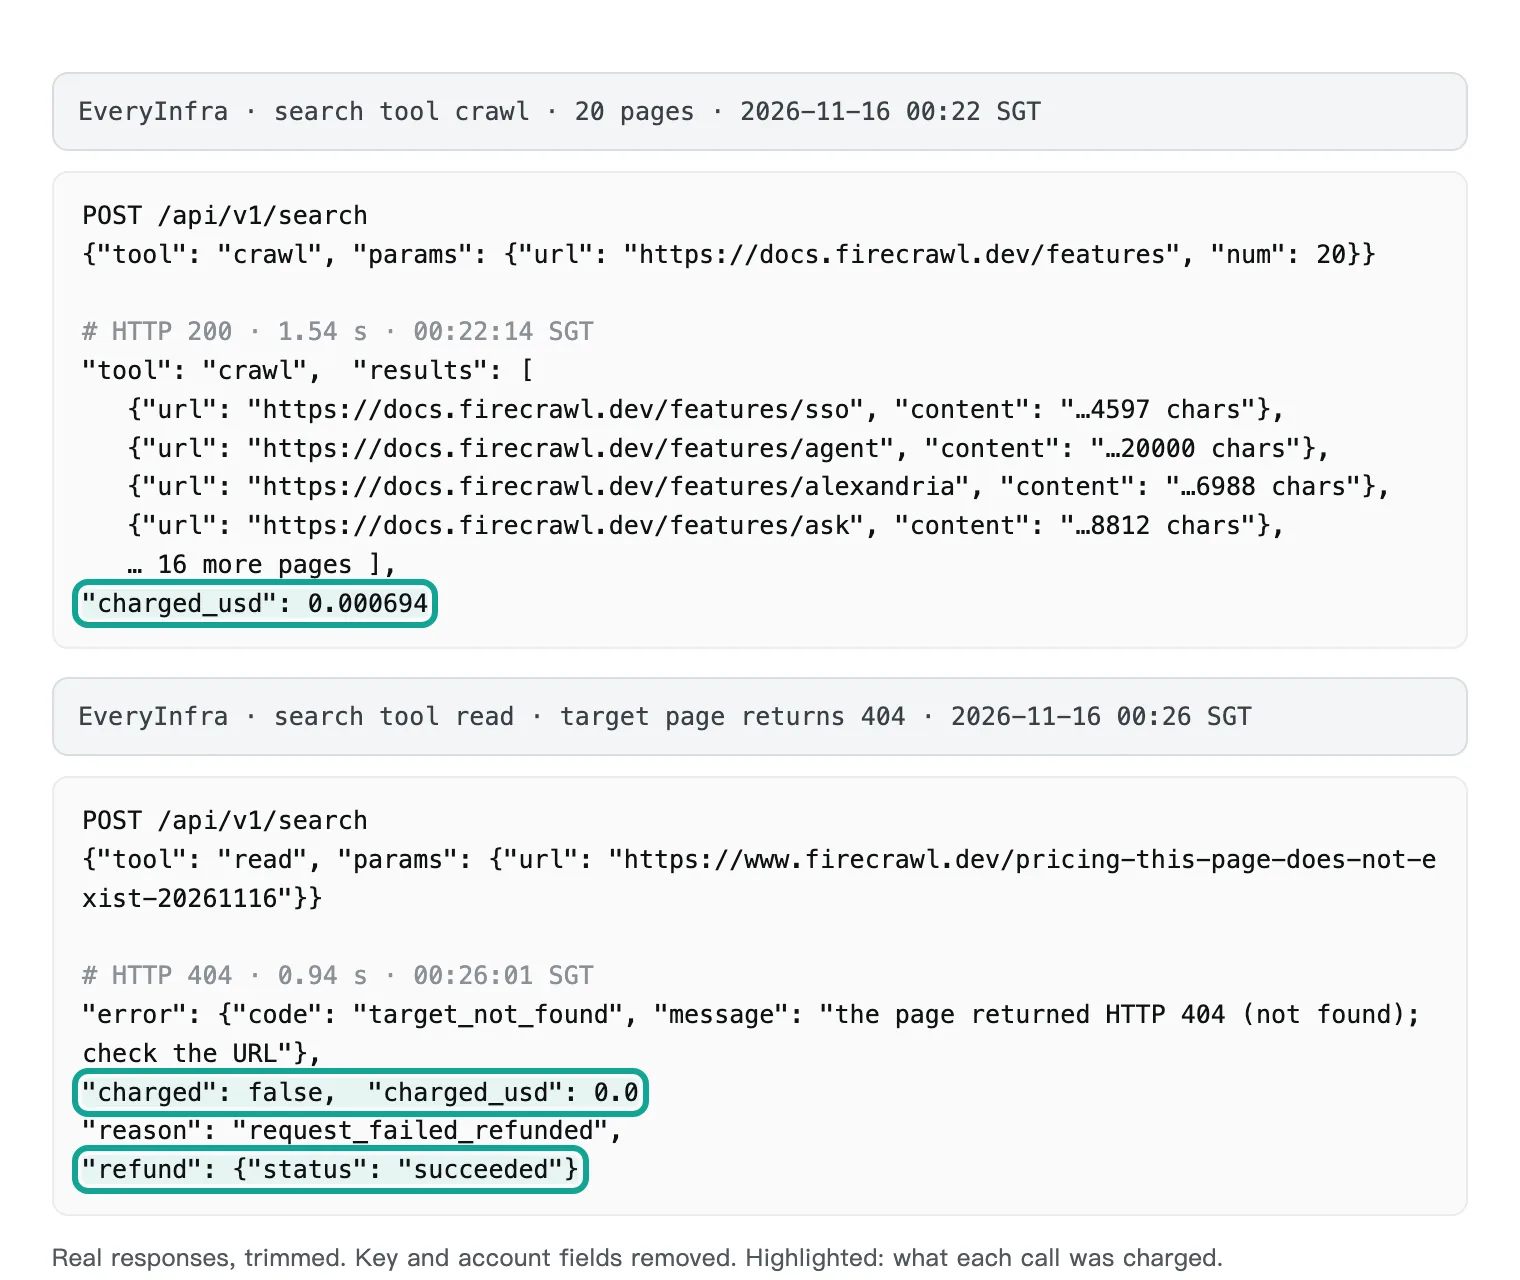
我们这边的规则不同:目标页返回 404、域名不存在这类失败不扣钱。本次专门测了两次,新加坡时间 00:22 读一个不存在的域名,00:26 读 firecrawl.dev 下一个不存在的子页,两次都返回 HTTP 404,error.code 是 target_not_found,billing.charged_usd 是 0,reason 写 request_failed_refunded,refund.status 是 succeeded。同样的两次请求,按 Firecrawl 的规则,第二次目标站回了 404 页面,要扣 1 个 credit;第一次域名解析不到、拿不到文档,扣 0 个。批量抓一批过期链接时,这个差别会直接进账单:一万个网址里有 15% 已经返回 404,Firecrawl 多扣 1,500 个 credit,Hobby 月付合 $5.70。
8 月 11 日存档的定价页上,FAQ「Do you charge for failed requests?」的回答是「No, we only charge for successful requests」;现在同一个问题的回答换成了「403 或 404 的页面仍然返回给你,扣 1 个 credit」。两个回答都对应各自的计费规则,看旧教程时要知道这里改过。
超额怎么算:按量付费、$5 一包、额度上浮
月额度用完以后,Firecrawl 的付费档走按量付费,免费档没有这个选项,直接返回 HTTP 402,等下个月重置。按量付费每次加一包,每包 $5,包里的 credit 数随套餐不同;也可以在账单设置里用「Load more credits」手动买,手动买的和自动加的价格一样。
| 档位 | 每 $5 加多少 credit | 合每千 credit | 是套餐内单价的几倍(月付) | 1 月存档的额外 credit 价 | 变化 | 余额归零后的上浮额度 |
|---|---|---|---|---|---|---|
| Hobby | 1,000 | $5.00 | 1.32 倍 | $9 / 1,000 | −44.4% | 1,500 |
| Standard | 2,000 | $2.50 | 2.53 倍 | $47 / 35,000,合 $1.343 | +86.2% | 30,000 |
| Growth | 2,500 | $2.00 | 2.51 倍 | $177 / 175,000,合 $1.011 | +97.7% | 150,000 |
| Scale | 5,000 | $1.00 | 1.34 倍 | 存档未列 | — | 600,000 |
计费文档里有几条细则决定了实际花多少。第一,月度按量付费上限按整 $5 向下取整,设 $22 等于允许 4 包;留空是不设上限,设 0 是关掉按量付费,关掉后用完额度返回 402,不扣卡。第二,开着按量付费时余额不会在 0 处精确截断,各档有一段上浮额度(Hobby 1,500、Standard 30,000、Growth 150,000、Scale 600,000 个 credit),让一阵突发请求在加包结算期间继续跑;文档说明这是缓冲,不是送的 credit。第三,手动买的 credit 先用,也不计入月度上限。第四,买来的 credit 不随月份清零,但取消订阅时会在当期结束时作废。
Hobby 的超额变便宜了,Standard 和 Growth 的超额贵了近一倍。一个买 Standard 的团队,如果某个月用了 150,000 个 credit,超出的 50,000 个现在要 25 包共 $125,1 月份的规则下是 $47 一包 35,000,两包 $94 就够,还多出 20,000。对用量会季节性冲高的团队,现在的规则下升一档往往比买超额划算:Standard 加 $125 合计 $224,Growth 一个月 $399 给 500,000 个;用到 Standard 额度的 2.2 倍左右,两种买法开始持平。
额度结转也要算进去。计费文档写明,套餐 credit 默认月底清零,只有年付 Scale 能把没用完的结转 1 个月,年付企业版结转 2 个月;年付也是每个月按虚拟续费日重置一次,不会一年给一大桶。升档立刻生效、当天按新套餐全价收费,不按剩余天数折算,账单周期从升档日重算,旧套餐没用完的 credit 会带过去;降档在下个续费日生效,当期剩下的时间不退款。
按 Hobby 计,额度用不满的实际单价是这样:一个月只用 500 个 credit,每千个合 $38;用 1,000 个合 $19;用 2,500 个合 $7.60;用满 5,000 个才是 $3.80。r/n8n 上有人发帖专门找「credit 不过期的按量付费抓取工具」,抱怨的就是月底清零。我们这边没有月费,余额不清零,按次扣,用多少扣多少。
给每把 Key 设上限
计费文档另有一层控制,按 API Key 设花费上限:在账单设置里给某一把 Key 填一个 credit 数,选按天、按周或按月,这把 Key 用到上限就停,团队其他 Key 不受影响。文档特别写明,上限的单位是 credit 数量,不是金额,填 1 就是每个周期 1 个 credit。这对把 Key 交给代理程序跑的团队很有用:一个写错循环的代理可以在几分钟里把整月额度烧完,按 Key 设一个日上限,最坏情况就被限制在一天的量。整站抓取的预检也会看这个上限,计费文档说被单 Key 上限拒绝时同样返回 402。我们这边的做法是余额扣完即停,每次调用的价格在目录里事先写明,按 Key 分开限额目前没有,需要隔离的团队可以分账户充值。
账单里看哪几个字段
Firecrawl 的扣费是事后记账,看账要找三个地方。第一,每次抓取的响应里有 metadata.statusCode,值是 403、404 的那些页面已经扣了 1 个 credit,计费文档建议据此停止重试一直被拦的网址。第二,整站抓取的状态接口返回 creditsUsed,表示到目前为止这次抓取已经扣了多少,异步记账期间这个数会一直涨。第三,Credit Usage 接口和它的历史版本可以按时间拉用量,适合每天自动对一次账。我们这边每次响应都带 billing.charged_usd 和 charged,失败时另有 reason 和 refund.status,一次调用一个金额,不存在事后补扣。
9 月 4 日改价前后:三份定价页对照
互联网档案馆保存了 Firecrawl 定价页的两个旧版本:2026 年 1 月 1 日和 2026 年 8 月 11 日。拿它们和 2026-11-16 读到的现行页逐项对,变化集中在免费档、额外 credit 和并发三处。
| 项目 | 2026-01-01 存档 | 2026-08-11 存档 | 2026-11-16 现行页 |
|---|---|---|---|
| 免费档 | 500 个 credit,一次性 | 每月 1,000 个 | 每月 1,000 个 |
| Hobby 每月 credit | 3,000(年付每月 $16) | 5,000(年付每月 $16) | 5,000(月付 $19、年付每月 $16) |
| 额外 credit | Hobby $9 / 1k、Standard $47 / 35k、Growth $177 / 175k,自动充值包 | FAQ:暂不提供按量付费 | 每包 $5,按量付费 |
| 并发:Standard / Growth / Scale | 50 / 100 / 150 | 50 / 100 / 150 | 25 / 50 / 100 |
| 失败请求 | — | 「只对成功请求收费」 | 403、404 扣 1 个 credit |
| 增强模式 | 另收 credit | FAQ:高级功能另收 credit | +0 |
| 额度结转 | — | 自助档不结转,Scale 和企业版可结转 | 只有年付 Scale(1 个月)和年付企业版(2 个月) |
并发减半对账单没有直接影响,对跑批的时间有影响。限速文档解释,并发浏览器决定同一时刻能渲染几页,超过的任务进队列等空位,排队时间计入请求的 timeout。Standard 档 25 个并发,假设一页平均 3 秒,一小时理论上限约 30,000 页;8 月的 50 个并发是约 60,000 页。每分钟请求数的限制另算:Scrape、Map、Search 三个端点 Free 每分钟 10 次、Hobby 100、Standard 500、Growth 5,000、Scale 10,000;Crawl 和 Agent 是 2、20、100、1,000、2,000。
YouTube 上一个阿拉伯语的 Firecrawl 定价讲解视频(链接)演示了改价前的 credit 滑杆:Standard 档往上拖到 130,000 个 credit 时是 $156,160,000 个是 $213,Growth 档 650,000 个是 $616。现行定价页已经没有滑杆,超出部分统一走 $5 一包。讲解者在视频里说 Scale 档「很贵」;另一段 Crawl4AI 和 Firecrawl 的对比视频(链接)把 Firecrawl 归为「订阅制、有用量上限」,自托管的 Crawl4AI 只付服务器钱。第三个视频(链接)只演示了基础抓取 1 个 credit 和免费档。
Firecrawl 自己的页面对不上的几处
Firecrawl 的定价页和文档有五处说法不一致:对预算影响最大的是第一处:没写 limit 的整站抓取会不会被要求预留一万个 credit。
| 项目 | 一处的说法 | 另一处的说法 | 对账单的影响 |
|---|---|---|---|
| 整站抓取预检 | Crawl 文档:默认 limit 一万页,开跑前检查余额够不够覆盖 limit,不够返回 402 | 计费文档:不写 limit 时预检只用 1 个 credit,不预留一万个,按页记账 | 余额少时按 Crawl 文档会直接 402,按计费文档能跑;两种情况都建议显式写 limit |
| 批量抓取的限速 | 定价页:Batch scrape 和 crawl 共用限额 | 计费文档:Batch scrape 和 scrape 共用限额 | Free 档一个是每分钟 2 次,一个是 10 次 |
| Map 单位 | 定价页 API 表:1 / page | 定价页摘要和计费文档:1 / call | 按 call 计,列 5,000 个网址也是 1 个 credit |
| Interact 单价 | 定价页:2 / 浏览器分钟 | 计费文档:2–7 / 浏览器分钟 | 带提示的会话是 7 个,按定价页估会少算 3.5 倍 |
| 计费文档:每 PDF 页 +1 | 文档解析页:每页 1 个 | 15 页 PDF 是 16 还是 15 个 |
Firecrawl mcp pricing:MCP 和免 Key 用法怎么计
Firecrawl 的 MCP 服务器没有单独的价目。用 API Key 或账号登录接入时,MCP 里的抓取、搜索等工具和直接调 API 一样扣同一个账户的 credit,MCP 文档里没有另外的计价表。2026 年 11 月 12 日的更新日志《Introducing Firecrawl MCP v3》写着「60x higher rate limits」「4x more usage」,没给出基数和具体数字。MCP v3 里接 Alexandria 数据商的工具,文档写的是「发现免费,每次运行按工具上标的价格收」。
另一条路是免 Key 接入。免 Key 文档给的地址是 https://mcp.firecrawl.dev/v2/mcp,不带任何凭证,只开放 Search、Scrape、Parse 三个工具。限速文档写明免 Key 用法免费,按 IP 每天有两道上限,一道是请求次数,一道是 credit 数,超了返回 429;两个上限的具体数字文档没有公开。所以「is firecrawl mcp free」的答案是:试用免费,数字没公开,真要跑任务还是要注册拿 Key,用的是同一个 credit 池。
我们的远程 MCP 地址是 https://api.everyinfra.com/mcp,带 Key 接入,everyinfra_search 工具每次调用按搜索工具的价格扣。本次新加坡时间 00:24 经 MCP 调了一次 web 搜索「firecrawl search pricing」,1.89 秒回 10 条,扣 $0.000694,和直接调 /api/v1/search 同价。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "firecrawl": {
      "type": "http",
      "url": "https://mcp.firecrawl.dev/v2/mcp"
    }
  }
}
这段配置按 MCP 规范的 Streamable HTTP 传输写,第二段是 Firecrawl 文档里的免 Key 地址,原样摘录、我们没有连过。两个服务可以同时放进一个客户端,Key 放在请求头里,不写进网址。
EveryInfra 实测:22 次请求、5 轮
我们在 2026-11-16 新加坡时间 00:18 到 00:27 之间发了 22 次请求,分 5 轮:5 次被这把测试 Key 的每分钟 10 次限速挡回(HTTP 429,响应写明 Nothing was charged),2 次目标失效(退款),15 次成功扣费,合计 $0.010553。下表是成功和失败的 17 次,限流的 5 次在 34 到 80 秒后原样重发,结果并入同名那一行。
| 新加坡时间 | 能力 | 请求 | 结果 | 用时 | 实扣 |
|---|---|---|---|---|---|
| 00:18 | /api/v1/search · read | firecrawl.dev/pricing | 正文 10,602 字符 | 3.72 秒 | $0.000694 |
| 00:19 | /api/v1/search · map | docs.firecrawl.dev,num 200 | 200 个网址 | 0.39 秒 | $0.000694 |
| 00:19 | web/search | 关键词 firecrawl pricing,美国 | 10 条 | 2.02 秒 | $0.001389 |
| 00:20 | /api/v1/search · web | firecrawl pricing,第 1 页 | 10 条 | 1.70 秒 | $0.000694 |
| 00:20 | /api/v1/search · crawl | features 目录,加一句筛选说明 | 2 页(只留讲 credit 的页) | 5.02 秒 | $0.000694 |
| 00:20 | /api/v1/search · harvest | 定价页,5 个字段 | 6 行 | 13.83 秒 | $0.000694 |
| 00:22 | /api/v1/search · web | firecrawl pricing,第 2 页 | 10 条 | 1.91 秒 | $0.000694 |
| 00:22 | /api/v1/search · crawl | features 目录,num 20 | 20 页,209,239 字符 | 1.54 秒 | $0.000694 |
| 00:22 | /api/v1/search · read | arXiv 15 页 PDF | 52,380 字符 | 1.51 秒 | $0.000694 |
| 00:22 | /api/v1/search · read | 不存在的域名 | 404,target_not_found | 4.12 秒 | $0(已退款) |
| 00:24 | MCP · everyinfra_search | web:firecrawl search pricing | 10 条 | 1.89 秒 | $0.000694 |
| 00:25 | bing/search | firecrawl credits pricing | 10 条 | 9.62 秒 | $0.000556 |
| 00:26 | /api/v1/search · read | firecrawl.dev 不存在的子页 | 404,target_not_found | 0.94 秒 | $0(已退款) |
| 00:26 | duckduckgo/search | firecrawl mcp pricing | 10 条 | 3.98 秒 | $0.000556 |
| 00:27 | /api/v1/search · deep,full | 5 条带全文 | 约 81,000 字符 | 8.14 秒 | $0.000694 |
| 00:27 | linkedin/company_profile | firecrawl | 1 家公司资料 | 4.50 秒 | $0.000556 |
| 00:27 | twitter/user_posts | firecrawl,limit 20 | 20 条帖子 | 2.65 秒 | $0.000556 |
crawl 加了一句自然语言筛选说明后只回 2 页,不加说明回满 20 页,两次都是一次 $0.000694,筛选不影响价格,按页算的单价从每千页 $0.0347 变成 $0.347。crawl 20 页那次有 5 页正好 20,000 字符,单页正文在这个长度截断,长页要单独 read。read 读定价页拿到了套餐价格,可是页面里按端点列的那张 credit 小表在转换成正文时丢了格子,只剩标签;要表格的场合改用 harvest 指定字段,6 行数值和定价页逐一相符。速度:harvest 13.83 秒、bing/search 9.62 秒,要低延迟就用 web(1.70–1.91 秒)。
截断的 5 页是 agent、browser、crawl、interact、monitoring 五个功能页,正好是讲得最细的几页;其余 15 页从 2,944 到 17,037 个字符不等,20 页合计 209,239 个字符,平均每页约 10,500 个。按这次的比例算一笔:一次 crawl 取 20 页,再对 5 个截断页各调一次 read,6 次调用 $0.004164,折合每千页 $0.208。这个数介于 crawl 的最好情况 $0.0347 和逐页 read 的 $0.694 之间,仍比 Firecrawl 最便宜的 Scale 年付 $0.599 低六成多;截断比例越高,越接近逐页 read。文档站的长页比例通常比博客、商品页高,估预算时按自己站点先 crawl 一次,数一数正好 20,000 字符的页有几个。
下面是 crawl 那次的写法,Key 从环境变量注入:
curl -s https://api.everyinfra.com/api/v1/search \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"tool":"crawl","params":{"url":"https://docs.firecrawl.dev/features","num":20}}'

curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"web","action":"search","params":{"keyword":"firecrawl pricing","country":"us","language":"en"}}'两个入口的价格差一倍:/api/v1/search 的 web 工具一次 $0.000694,/api/v1/social 的 web/search 一次 $0.001389,后者可以按国家和语言取结果,返回字段按能力目录里 response_fields 列的那些。只要标题、网址、摘要,用前者就够;bing/search 和 duckduckgo/search 一次 $0.000556,是三者里最便宜的。
限流和排队:两边都不收钱
本次 5 次 429 都发生在同一分钟里连发第 11 次请求的时候,响应写明这把 Key 自己的限额是每分钟 10 次,retry_after 给 8 秒,并说明没有扣费;等够时间原样重发,5 次都成功。Firecrawl 的限速文档写明超过每分钟请求数或并发上限都返回 429,排队任务数也有上限,Free 到 Standard 是 50,000 个,Growth 100,000 个,超过的新任务同样被 429 拒绝;被拒的请求没有返回文档,按计费规则不扣 credit。排队本身不收钱,但排队时间算在请求的 timeout 里,超时就成了「没有返回文档」,也不扣。两边在这一点上一样:限流只花时间,不花钱。
把 Firecrawl 每分钟请求数和月额度放在一起算,各档按上限连续打 Scrape,用完一个月的 credit 要多久:Free 1,000 个、每分钟 10 次,100 分钟;Hobby 5,000 个、每分钟 100 次,50 分钟;Standard 100,000 个、每分钟 500 次,200 分钟;Growth 500,000 个、每分钟 5,000 次,100 分钟;Scale 1,000,000 个、每分钟 10,000 次,也是 100 分钟。每分钟请求数对整月账单几乎不构成约束,卡跑批速度的是并发浏览器数和单页渲染时间,限速文档自己也写,配置得当时瓶颈在并发浏览器(「your real bottleneck will be concurrent browsers」),并且同一团队的所有 Key 共用一套每分钟计数;反过来,一个写错循环的代理程序最快不到一小时、最慢三个多小时就能把整月额度用完,前面那个按 Key 设的日上限就是防这个的。
按场景算账:八种月度工作量
Firecrawl 一侧取「够用的最便宜买法」:先选能装下的最低档,不够的部分按该档的 $5 一包补,月付和年付各算一次;EveryInfra 一侧按本次实测里最便宜的做法算。
| 月度工作量 | Firecrawl credit | Firecrawl 月付 | Firecrawl 年付 | EveryInfra | 差多少(月付) |
|---|---|---|---|---|---|
| 代理调研:3,000 次搜索,每次读 3 页全文 | 15,000 | Hobby + 10 包 = $69 | $65.83 | deep 全文 3 条一次 $2.08;web + read $8.33 | 33 倍 |
| 文档入库:10,000 页每月重抓 | 10,000 | Hobby + 5 包 = $44 | $40.83 | crawl 500 次加 map 50 次 $0.38;长页按 5/20 补读 $2.12;逐页 read $6.94 | 115 倍(补读后 21 倍) |
| 2,000 页抽 JSON 字段 | 10,000 | $44 | $40.83 | harvest 每页一次 $1.39 | 32 倍 |
| 500,000 个普通网页 | 500,000 | Growth $399 | $332.50 | read $347 | 月付贵 1.15 倍;年付便宜 4% |
| 1,000,000 个普通网页 | 1,000,000 | Scale $749 | $599.17 | read $694 | 月付贵 1.08 倍;年付便宜 14% |
| 1,000 条 X 帖子 | 30,000 | Standard $99 | $82.50 | twitter/user_posts 每次 20 条 $0.028;逐条 twitter/post $0.556 | 178 到 3,561 倍 |
| 500 个 LinkedIn 公司页(Apollo 路由) | 15,000 | $69 | $65.83 | linkedin/company_profile $0.28 | 248 倍 |
| 500 个 LinkedIn 公司页(FullEnrich 路由) | 2,500 | Hobby $19 | $15.83 | $0.28 | 68 倍 |
文档入库那一行,map 一次最多列 200 个网址,1 万页要列 50 次;按本次 20 页里 5 页截断的比例,2,500 个长页再逐页 read,账单从 $0.38 升到 $2.12,差距从 115 倍缩到 21 倍。大用量场景两边接近,Firecrawl 年付在 50 万页以上占优。X 帖子一行差距最大,原因在于两边的单位:Firecrawl 每条帖子走一次 Grok 接口收 30 个 credit,我们的 twitter/user_posts 一次返回一个账号最多 200 条帖子,按次计价;如果要的是 1,000 个不同账号各一条,就得用 twitter/post 逐条取,$0.556 对 $99,仍差 178 倍。
一个月的账单推演:Standard 档的团队
假设一个做竞品监控的团队,每月抓 60,000 个普通网页,其中 3% 的网址已经失效、返回 404;代理程序每月搜索 5,000 次,框架默认每次要 15 条结果;另有 2,000 个商品页要用 JSON 格式抽价格和库存字段。
按 Firecrawl 的规则,60,000 页每页 1 个,404 的 1,800 页也照收,共 60,000 个;搜索 15 条按 10 条向上取整成 20 条,每次 4 个,共 20,000 个;JSON 每页 5 个,共 10,000 个。合计 90,000 个 credit,落在 Standard 的 100,000 个以内,月账单就是 $99,摊下来每千个 credit $1.10。把搜索的结果数从 15 改成 10,搜索部分从 20,000 个降到 10,000 个,月用量降到 80,000 个,账单不变,但离额度上限多出一截余量。
第二个月业务涨了一半,用量变成 135,000 个 credit。超出的 35,000 个按 Standard 的每包 2,000 个计要 18 包,共 $90,月账单 $189,每千个 credit $1.40;升到 Growth 要 $399,还不划算。如果还是 1 月份的规则,超出部分买一包 $47 的 35,000 个就够,账单是 $146。
同样的工作量放在 EveryInfra:58,200 个有效页面用 read 合 $40.39,1,800 个 404 页面不扣钱;5,000 次搜索每次要 15 条,web 工具每次最多 10 条,所以每次翻两页,共 10,000 次调用 $6.94;2,000 个商品页用 harvest 抽字段 $1.39。合计 $48.72。第二个月按 1.5 倍算是 $73.08。两边差距主要在搜索和 JSON 抽取:这两项在 Firecrawl 占了 30,000 个 credit,按 Standard 单价约 $30,我们这边合计 $8.33。抓普通网页这一项,Standard 的 $0.99 和 read 的 $0.694 只差三成。
和 Tavily、ScraperAPI 的公开价放一起
Firecrawl 常被拿来和 Tavily、ScraperAPI 比。三家都按 credit 计,单位的含义各不相同:Tavily 的计费文档写明基础搜索 1 个 credit、高级搜索 2 个,抽取每 5 个成功网址 1 个,Map 每 10 页 1 个,抽取和 Map 失败不收;按量付费每 credit $0.008,月付档从 Project($30,4,000 个)到 Growth($500,100,000 个)。ScraperAPI 的 credit 文档写普通网页 1 个、电商 5 个、Google 等搜索 25 个、LinkedIn 30 个,JS 渲染 10 个;定价页上 Hobby $49 给 100,000 个,Scaling $475 给 500 万个,对 200 和 404 都计费。
| 每 1,000 次 | Firecrawl(Hobby 月付 → Scale 年付) | Tavily(按量付费 → Growth) | ScraperAPI(Hobby → Scaling) | EveryInfra(本次实扣) |
|---|---|---|---|---|
| 普通网页 | $3.80 → $0.599 | $1.60 → $1.00(抽取每 5 个网址 1 credit) | $0.49 → $0.095 | read $0.694;crawl 加长页补读约 $0.208 |
| 搜索 10 条 | $7.60 → $1.198 | $8.00 → $5.00(基础搜索) | $12.25 → $2.375(Google 25 credit) | web $0.694;bing/search $0.556 |
| JS 渲染页 | 同普通页 | 同抽取价 | $4.90 → $0.95(10 credit) | read $0.694 |
| 404 页面 | 扣 1 credit | 抽取失败不扣 | 扣(200 和 404 都计费) | 不扣,退款 |
普通网页这一行,ScraperAPI 是四家里最便宜的,Hobby 档每千页 $0.49 就比我们的 read 低。搜索这一行,三家都比我们的 web 工具贵,从 1.7 倍到 18 倍不等。三家的细节分别在站内另外三篇里:Firecrawl 之外有哪些抓取方案、各自适合什么,在 Firecrawl alternatives 一篇;Tavily 搜索和抽取的替代方案在 Tavily alternatives;ScraperAPI 各档按目标网站逐项折算在 ScraperAPI pricing。站内也有一页 Firecrawl 替代对比,适合只想看结论的人。
什么时候 Firecrawl 更合适
按 Firecrawl 自己的文档和本节的换算,下面这些情况选 Firecrawl 更合理,其中几项我们没有对应的能力。
大批量、单一类型的普通网页。每月 50 万页以上、能把额度用满、愿意年付时,Growth 年付每千页 $0.665、Scale 年付 $0.599,比我们逐页 read 的 $0.694 便宜 4% 到 14%;Scale 年付还能把没用完的 credit 结转 1 个月,对用量有波动的月份是缓冲。按月页数算,这两段大约是每月 48 万到 51 万页、86 万到 130 万页;用量稳定落在这两段里、而且愿意一次付一年的团队,选 Firecrawl 年付更省。每月不到 1,000 页的个人项目,Firecrawl 的免费档不花钱,也不用绑卡。
一次抓一整个站。Firecrawl 的 Crawl 默认上限一万页,可以按路径规则、深度、是否跟外链来控制,抓完异步记账;我们的 crawl 一次最多 20 页,单页正文在 20,000 个字符处截断,大站要用 map 列网址、再分批调,调用次数多了,管理成本也上去了。要一次性把几千页文档站整个拿下来,Firecrawl 的做法更省事。
要浏览器交互。登录后才能看的页面、要点按钮、翻无限滚动、填表单再取结果,Firecrawl 有 Interact 浏览器沙盒,按分钟计费,可以写 Playwright 代码,也可以用自然语言提示;我们没有这类能力。页面变化监控也是,Firecrawl 有 Monitor 和 Change Tracking,每页每次检查 1 个 credit。
要自己部署、数据不出内网。Firecrawl 的开源仓库以 AGPL-3.0 许可发布,2026 年 11 月 9 日的更新日志说 GitHub 星标过了 20 万,自托管文档给了 Docker Compose 的步骤。自托管不扣 credit,代价是自己管升级、存储、监控,代理和搜索也要自带:r/LocalLLaMA 一个讨论帖里,Firecrawl 的员工回复说自托管版要接自己的代理,搜索要另配 SearXNG。同一帖的发帖人按 50 万页算出每页 $0.0008,和 Growth 月付的 $0.000798 对得上。
要零数据留存、SSO 或合规审计。Firecrawl 的抓取、搜索、Interact 都有零数据留存选项,企业版有 SSO、SIEM 日志和定制并发。我们没有逐请求的零留存开关,有这类采购要求的团队应该先看 Firecrawl 的企业版文档。
只查美国政府和法律资料。2026 年 10 月 22 日上线的政府与法律索引覆盖 3,000 万个美国联邦、州和地方政府页面,文档写明搜索不扣 credit,零留存也不扣;查法规、判例、地方条例时,这是免费的。
自己复算:一段 Python
下面这段把上文所有每千次价格重算一遍。改 MIX 里的数字,就能得到你自己一个月的 Firecrawl 账单和 EveryInfra 账单。
import math

# Firecrawl 定价页(Effective September 4, 2026),2026-11-16 读取
# 档位:(月付, 年付一年省多少, 每月 credit, 每 $5 加多少 credit)
TIERS = {
    "Hobby":    (19, 38, 5_000, 1_000),
    "Standard": (99, 198, 100_000, 2_000),
    "Growth":   (399, 798, 500_000, 2_500),
    "Scale":    (749, 1_798, 1_000_000, 5_000),
}
# 计费文档:每次扣几个 credit
CREDITS = {"page": 1, "page_json": 5, "search10": 2, "x_post": 30}

def search_credits(results: int) -> int:
    return 2 * math.ceil(results / 10)          # 11 条 = 4 个

def firecrawl_month(credits_needed: int, annual: bool = False):
    best = None
    for name, (monthly, save, included, per5) in TIERS.items():
        fee = (monthly * 12 - save) / 12 if annual else monthly
        packs = max(0, math.ceil((credits_needed - included) / per5))
        total = fee + 5 * packs
        if best is None or total < best[1]:
            best = (name, round(total, 2), packs)
    return best

# EveryInfra 本次实扣(charged_usd)
EI = {"read": 0.000694, "web": 0.000694, "crawl_20": 0.000694, "harvest": 0.000694}

MIX = {"searches": 3_000, "pages": 9_000}       # 换成你自己的月用量
need = MIX["searches"] * search_credits(10) + MIX["pages"] * CREDITS["page"]
print("Firecrawl credits:", need)
print("Firecrawl 月付:", firecrawl_month(need))
print("Firecrawl 年付:", firecrawl_month(need, annual=True))
print("EveryInfra:", round(MIX["searches"] * EI["web"] + MIX["pages"] * EI["read"], 3))
按示例里的 3,000 次搜索加 9,000 页,Firecrawl 需要 15,000 个 credit,最便宜的是 Hobby 加 10 包,月付 $69、年付 $65.83;EveryInfra 用 web 加 read 是 $8.33。
行业动向:Firecrawl 最近 30 天的更新
Firecrawl 的更新日志在 10 月中旬到 11 月中旬几乎每两三天一条,大部分和 Alexandria 数据层有关,和抓取计费直接相关的有三条。
2026 年 11 月 12 日,MCP v3 发布,宣称 3,000 多个工具、数据商自动轮替、限速提高 60 倍、用量提高 4 倍,没写对应的 credit 价。2026 年 11 月 13 日,公司数据扩到 7,500 万家公司,按工具标价收费。2026 年 11 月 2 日的 headless Clay 一条写着在 ChatGPT 和 Claude 里每月送 1,000 个免费 credit。
其余更新(论文索引、求职工具、20 万星、eve、人物数据、Google Cloud、9 月 22 日的 Alexandria 与 B 轮)不改计费;和计费有关的是 10 月 8 日的 Universal Scrape,X 和 LinkedIn 链接走专门路由、按数据商另收 credit 就是从这里来的。
这些更新对定价的意思是:Firecrawl 的 credit 池正在从「网页抓取」扩到「数据商查询」,同一个 credit 在不同工具上价值差 5 倍到 40 倍。看账单时要按工具拆,单看总 credit 数看不出钱花在哪。Firecrawl 提供了 Credit Usage 接口查余额和历史用量。
边界:这些数什么时候不成立
所有每千次价格都假设额度用满;用不满时 Firecrawl 的实际单价按比例上升,Hobby 用一成额度时是标价的 10 倍。Firecrawl 的价格以 2026-11-16 读取的页面为准,定价页标的生效日是 2026 年 9 月 4 日,今年已经改过至少两次,下单前要重读。税费另算,定价页写明按所在地规则加收。EveryInfra 的价格来自本次 15 次实扣和当时的目录价,read 遇到需要 JS 渲染的页面也是同价,但我们没有测过每一类反爬站点的成功率。两边返回的内容不同,Firecrawl 默认给 Markdown 并可选 HTML、截图、JSON 等格式,我们的 read 返回正文文本,比价不代表两边的产出可以互相替换。
还有两类成本不在表里。一类是重试:Firecrawl 对返回 403 的页面照收 1 个 credit,代理程序如果不看 metadata.statusCode 就自动重试,同一个被拦的网址可能被收三四次;我们这边失败不扣,重试的代价只有时间。另一类是 token:两边返回的都是长文本,交给模型读时按模型的 token 计价,本次一次 crawl 回了 209,239 个字符,一次 deep 回了约 81,000 个字符,按 4 个字符约 1 个 token 粗算,20 万个字符约 5 万个 token,假设模型输入每百万 token $1,也要 $0.05,是这次抓取费的 72 倍,算总成本时要一起算。
上手:用试用额度跑一遍自己的工作量
- 在基础设施市场找到要用的能力,平台页看 网页搜索爬虫 API、Bing 爬虫 API、DuckDuckGo 爬虫 API,能力页看 网页搜索、Bing 搜索、DuckDuckGo 搜索、LinkedIn 公司页、X 用户帖子,每页都有参数说明和试用台。
- 按快速开始注册拿 Key;网页读取和整站抓取的说明在正文读取和整站爬取两页。
- 从你上个月真实的目标网址和关键词里各抽 50 个,各跑一次,记下每次的
billing.charged_usd、返回条数和失败原因。 - 把用量填进上面那段 Python,算出两边的月账单;EveryInfra 全部价格在价格页,接 AI 客户端按 MCP 接入配置。
常见问题
firecrawl pricing 各档多少钱?(联想词「firecrawl pricing plan」) 免费档每月 1,000 个 credit;Hobby 月付 $19、年付每月约 $15.83,5,000 个;Standard $99,10 万个;Growth $399,50 万个;Scale $749,100 万个。换算成每千页是 $3.80 到 $0.599,见总表。
firecrawl credits pricing:一个 credit 能做什么?(联想词「firecrawl credits pricing」「firecrawl credits usage」) 抓一个普通网页、列一次网址、或者半次 10 条结果的搜索。开 JSON 格式一页 5 个,抓一条 X 帖子 30 个。
Is firecrawl free?(联想词「is firecrawl free」「is firecrawl api free」) 免费档每月 1,000 个 credit,不要信用卡,用完返回 402;另有免 Key 用法,按 IP 每天限次数和 credit,具体数字没公开。自托管开源版不扣 credit,但要自己出服务器和代理。
firecrawl mcp pricing:MCP 另收钱吗?(联想词「firecrawl mcp pricing」「is firecrawl mcp free」) 不另收,MCP 里的工具扣同一个账户的 credit;免 Key 的 MCP 只开放搜索、抓取、解析三个工具,按 IP 每天限额。Alexandria 数据商工具按各自标价收。
firecrawl search pricing 怎么算?(联想词「firecrawl search pricing」「firecrawl search api pricing」) 每 10 条结果 2 个 credit,向上取整,11 条是 4 个;要抓每条结果的正文,每条再加 1 个。政府和法律索引的搜索不扣 credit。
有没有 firecrawl credits coupon 或 free credits code?(联想词「firecrawl credits coupon」「firecrawl free credits code」) 计费文档写明可以在账单页输入 credit 优惠码,送的 credit 不随升降档消失;合作方渠道送的通常是 10,000 个,3 个月过期,见合作方 credit 文档。读取时定价页没有公开的优惠码。
Is firecrawl self hosted free?(联想词「is firecrawl self hosted free」「is firecrawl open source」) 开源版以 AGPL-3.0 许可发布,自己部署不扣 credit;成本变成服务器、代理和运维时间。文档写明自托管版不含云端的全部能力,Agent、Interact 等要用云端。
firecrawl vs tavily 哪个搜索便宜?(联想词「firecrawl search api pricing」,Tavily 计费文档) 按每千次 10 条结果的搜索算,Firecrawl 从 Hobby 月付 $7.60 到 Scale 年付 $1.198,Tavily 基础搜索从按量付费 $8.00 到 Growth $5.00,大档 Firecrawl 便宜;我们的 web 工具是 $0.694。
firecrawl pricing reddit 上的账单怎么说?(联想词「firecrawl pricing reddit」,r/LocalLLaMA 原帖) r/LocalLLaMA 那个帖子的发帖人按每月 50 万页算出每页 $0.0008,和 Growth 月付的每千页 $0.798 一致,帖子在问更便宜的办法,回帖多数建议自托管。r/ProxyEngineering 那篇引用的 Hobby 3,000 个 credit、免费 500 个一次性,都是 1 月份的旧价。
Firecrawl 失败的请求扣钱吗?(r/ProxyEngineering 帖子里的旧说法与现行文档不同) 拿不到任何文档时不扣;目标站返回 403、404 页面时扣 1 个 credit。8 月份的定价页曾写「只对成功请求收费」,现在已改。
参考资料
- Pricing(定价页),Firecrawl,Effective September 4, 2026,2026-11-16 00:15 新加坡时间读取
- Billing(计费文档),Firecrawl 文档,2026-11-16 读取
- Rate Limits,Firecrawl 文档,2026-11-16 读取
- Scrape,Firecrawl 文档
- Crawl,Firecrawl 文档
- Map,Firecrawl 文档
- Search,Firecrawl 文档
- Extract(2026-12-10 移除),Firecrawl 文档
- Migrating from /extract,Firecrawl 文档
- Enhanced Mode,Firecrawl 文档
- Proxies,Firecrawl 文档
- Faster scraping(maxAge 缓存),Firecrawl 文档
- LLM Extract / JSON 格式,Firecrawl 文档
- PII redaction,Firecrawl 文档
- Lockdown,Firecrawl 文档
- Document parsing,Firecrawl 文档
- Interact,Firecrawl 文档
- Agent,Firecrawl 文档
- Batch scrape,Firecrawl 文档
- Monitoring,Firecrawl 文档
- Change Tracking,Firecrawl 文档
- Government & Legal Index,Firecrawl 文档
- MCP Server,Firecrawl 文档
- Keyless MCP,Firecrawl 文档
- Partner Credits,Firecrawl 文档
- Self-hosting Firecrawl,Firecrawl 文档
- Enterprise,Firecrawl 文档
- Credit Usage 接口,Firecrawl 文档
- Changelog,Firecrawl,2026-11-16 读取
- Introducing Firecrawl MCP v3,Firecrawl 更新日志,2026-11-12
- Company data relaunch,Firecrawl 更新日志,2026-11-13
- AI/ML Research Index,Firecrawl 更新日志,2026-11-11
- Job search tools,Firecrawl 更新日志,2026-11-10
- 200K GitHub stars,Firecrawl 更新日志,2026-11-09
- Headless Clay for agents,Firecrawl 更新日志,2026-11-02
- Firecrawl in eve,Firecrawl 更新日志,2026-10-30
- Government & Legal Index,Firecrawl 更新日志,2026-10-22
- Free People Data,Firecrawl 更新日志,2026-10-20
- Firecrawl for Google Cloud,Firecrawl 更新日志,2026-10-19
- Introducing Universal Scrape,Firecrawl 更新日志,2026-10-08
- Introducing Alexandria and our $75M Series B,Firecrawl 更新日志,2026-09-22
- Mastering the Scrape endpoint,Firecrawl 博客,2026-05-04
- firecrawl/firecrawl,GitHub,AGPL-3.0
- 定价页存档 2026-01-01,互联网档案馆
- 定价页存档 2026-08-11,互联网档案馆
- API Credits,Tavily 文档,2026-11-16 00:17 新加坡时间读取
- Tavily Pricing,Tavily,2026-11-16 读取
- Credits and Requests costs,ScraperAPI 文档,2026-11-16 读取
- ScraperAPI Pricing,ScraperAPI,2026-11-16 读取
- EveryInfra 能力目录,2026-11-16 00:17 新加坡时间读取
- EveryInfra 搜索工具目录,2026-11-16 00:18 新加坡时间读取
- MCP Specification 2025-11-25,Model Context Protocol
- Attention Is All You Need(实测用的 15 页 PDF),arXiv
- Low-cost alternatives to Firecrawl?,r/LocalLLaMA
- FireCrawl just hit 121k GitHub stars,r/ProxyEngineering
- Any pay-as-you-go scrapers that don't expire credits,r/n8n
- Firecrawl Pricing Explained: Plans & Features,YouTube
- Crawl4AI vs Firecrawl AI,YouTube
- Firecrawl AI clearly explained,YouTube
引用编号 BL-168