Responses API WebSocket 实测:工具慢时值不值得换
5 步数据 agent 实测 4 轮:工具占耗时 64.4%–79.4%,换 Responses API WebSocket 只省 1.5%–3.9%。
2026 年 11 月 10 日凌晨,我们在新加坡的一台 Mac mini 上,用 EveryInfra 的数据接口模拟了一个「研究型 agent」:先搜网页,再搜 Reddit、读评论,再搜 YouTube、拉字幕,一共 5 次工具调用,同样的流程在新加坡时间 00:17、00:26、00:49、01:12 各跑一遍,共 4 轮。5 次工具加起来要 30.5–65.1 秒(中位 33.6 秒)。OpenAI 一侧我们一次模型请求都没发:模型时间和每轮能省多少,全部借用第三方公开的 84 轮对照,只有工具那一侧是自己真调的。把模型那一侧按这份对照的每次 2.81 秒算进去,工具占整个 agent 耗时的 64.4%–79.4%。OpenAI Responses API 的 WebSocket 模式省的是「每轮续接」那一段:按 Hermes Agent 项目在 GitHub 上公开的 84 轮对照,每轮快 0.24–0.37 秒,放到这 5 步里只省 1.5%–3.9%;就算按 OpenAI 自己「最多约 40%」的说法给一个宽松上限,也只省 6.9%–11.9%。结论很直接:工具一次要好几秒的时候,换传输方式能省的时间很少,先把工具并行、改异步、换更快的能力,收益大得多;WebSocket 值得开,但别指望它解决慢工具。
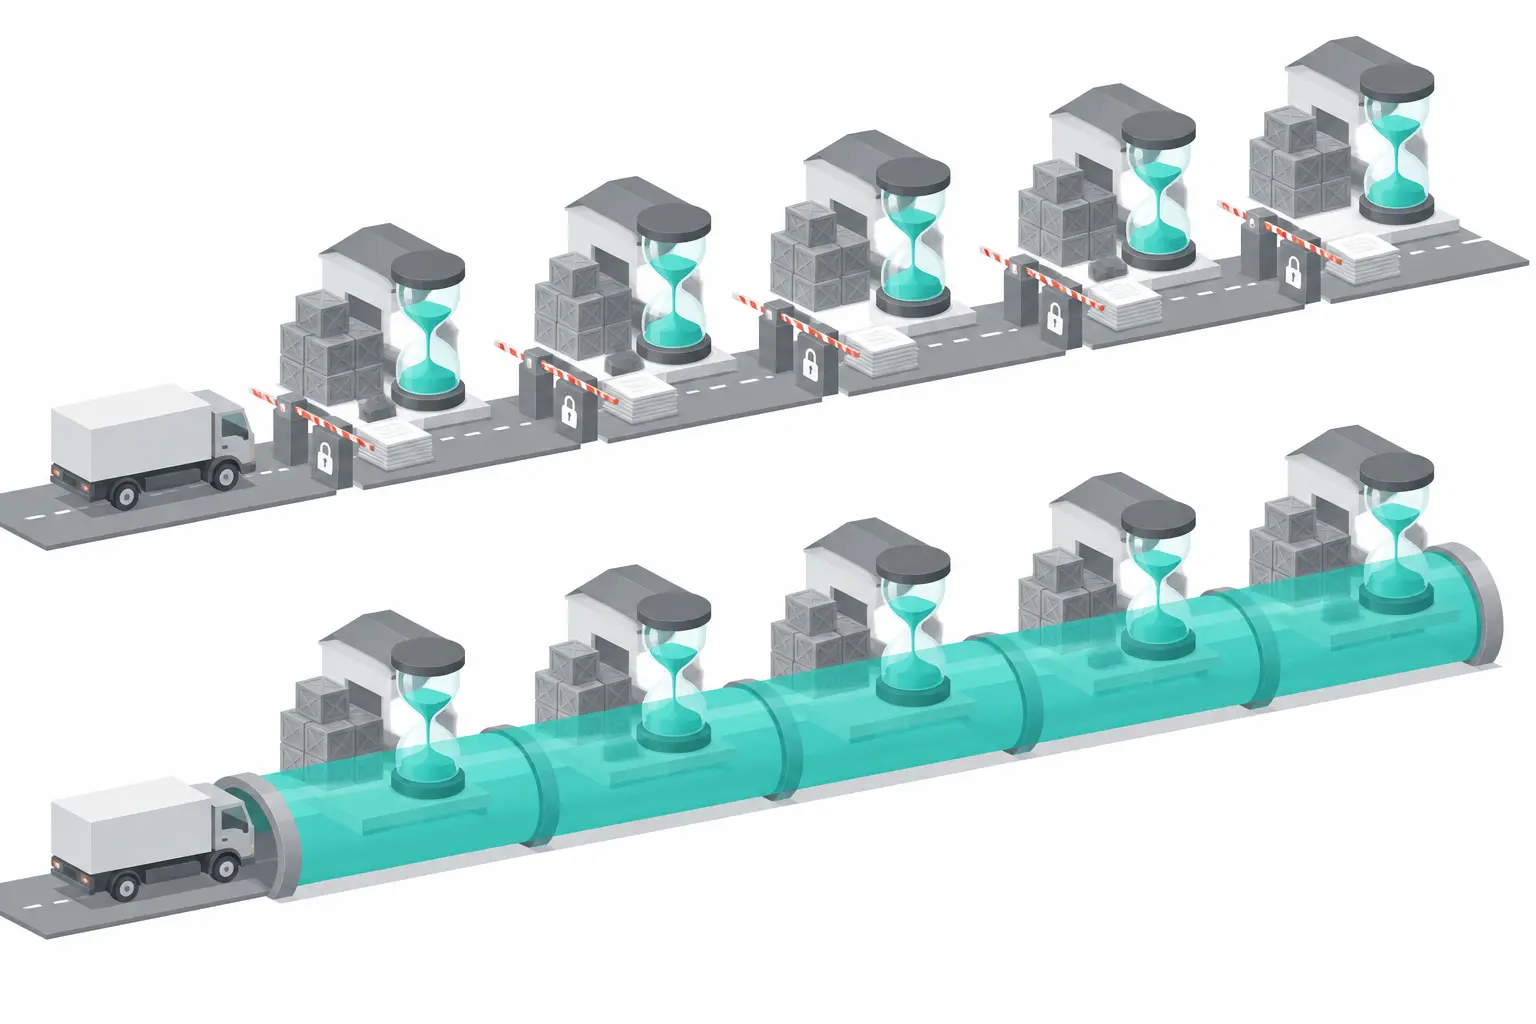
先给结论:5 步数据工具 agent,换 WebSocket 省多少
先把 4 轮的账摆在一张表里,后面各节再拆开。工具耗时是我们真调的客户端墙钟时间(含网络往返),每一步都能在测试账户的请求记录里按 request_id 找到服务端记的耗时。模型耗时我们没有自己测,原因是本文只引用 OpenAI 一侧的公开数字,不编毫秒数:每次模型调用按 Hermes Agent 公开对照里 HTTP 流式那一组的中位完成时间 2.81 秒计,5 次工具调用对应 6 次模型调用(第一次决定调什么,之后每拿到一次工具结果再调一次),合计 16.9 秒。WebSocket 只在后 5 次「续接」上省时间,第一次是新开的回应,没有可续的状态。
| 轮次 | 新加坡时间 | 5 次工具合计 | HTTP 下总耗时 | 工具占比 | 每轮省 0.24 秒 | 每轮省 0.37 秒 | 宽松上限 |
|---|---|---|---|---|---|---|---|
| 第 1 轮 | 00:17 | 65.1 秒 | 81.9 秒 | 79.4% | 1.5% | 2.3% | 6.9% |
| 第 2 轮 | 00:26 | 34.0 秒 | 50.9 秒 | 66.9% | 2.4% | 3.6% | 11.1% |
| 第 3 轮 | 00:49 | 33.2 秒 | 50.1 秒 | 66.3% | 2.4% | 3.7% | 11.2% |
| 第 4 轮 | 01:12 | 30.5 秒 | 47.4 秒 | 64.4% | 2.5% | 3.9% | 11.9% |
三列「省多少」都是「WebSocket 省下的秒数 ÷ HTTP 下的总耗时」。每轮省 0.24 秒和 0.37 秒来自 Hermes Agent 的公开对照,分别是完成时间的平均差和首个事件的中位差;「宽松上限」假设每次续接都能省掉单次模型时间的 40%,相当于把 OpenAI 端到端「最多约 40%」整个算到续接上,5 次续接共省 5.62 秒,现实里很难更多。即便按这个上限,工具最快的那一轮也只省 11.9%;按第三方实测的数,四轮都在 3.9% 以内,换算成秒是 1.20–1.85 秒,比 Reddit 评论那一步在两轮之间的波动还小得多。
openai responses api websocket 是什么:2 月上线,11 月还在改
OpenAI 的更新日志在 2026 年 2 月 23 日这一条写着「Launched WebSocket mode for the Responses API」(OpenAI 更新日志)。官方指南把它定位为「长时间运行、工具调用密集的工作流」用的模式:客户端和 /v1/responses 保持一条长连接,每一轮发一个 response.create 事件,事件体和 HTTP 版 POST /v1/responses 的字段基本相同,只是不用写 stream(WebSocket 上本来就是流式),也不支持 background(WebSocket mode 指南,WebSocket 事件参考)。连接地址是 wss://api.openai.com/v1/responses(Pipecat 文档里 WebSocket 变体的默认值即为此,Pipecat 文档)。继续对话时,客户端只发新的输入项(比如上一轮工具的输出)加上 previous_response_id,不用把整段历史再发一遍。
省时间的关键是一块「连接本地的内存缓存」。指南原文说,连接打开期间,服务端把最近一次回应的状态放在这条连接自己的内存里,续接最新那一次回应时可以直接复用;因为只在内存里、不落盘,所以和 store=false、零数据保留(ZDR)都兼容。代价是:如果 previous_response_id 不在缓存里,store=true 时服务端可能从持久化的数据里补回来,但「会失去内存缓存带来的延迟优势」;store=false 时没有兜底,直接返回 previous_response_not_found。同一条流上的续接如果返回 4xx 或 5xx,被引用的那个 ID 也会从缓存里清掉。
指南里写明的限制,我们整理成下表。注意微软 Azure 上的同名功能和 OpenAI 自家的写法有出入:Azure 的文档(2026 年 7 月 28 日更新)写的是一条连接同一时间只能有一个回应在跑、不支持多路复用,而 OpenAI 的指南写的是通过 stream_id 最多 16 个回应同时在跑(Azure OpenAI WebSocket 模式)。如果你两边都用,代码要按更严的那一边写。
| 项目 | OpenAI 指南原文 | 对 agent 的影响 |
|---|---|---|
| 上线日期 | 2026-02-23(更新日志) | SDK 要 openai[realtime]>=3.8.0(Python)或 openai@^7.10.0 加 ws(Node) |
| 连接时长 | 最长 60 分钟,到点返回 websocket_connection_limit_reached | 长任务要处理重连,重连后缓存清空 |
| 并发 | 每条连接最多 16 个在跑的回应,超出的排队 | 并行工具结果可以分流续接 |
| 命名流 | 最多 32 个不同的 stream_id,同一流内先进先出 | 一条连接里可以跑几条互不干扰的对话 |
| 缓存 | 只在连接内存里,store=false 时未命中返回 previous_response_not_found | 断线后要带完整上下文重新开始 |
| 预热 | response.create 带 generate: false,不出结果,只准备状态 | 已知工具和指令时可提前铺好 |
| 不支持 | background 模式 | 后台长任务仍走 HTTP |
这项功能在 11 月还在频繁改动。openai-python 在 10 月 28 日发布的 v3.41.0 加了「重连后恢复排队中的帧」,10 月 31 日的 v3.42.0 加了 WebSocket 预热支持,11 月 3 日的 v3.43.0 加了「WebSocket 流溢出隔离」(openai-python 发布页)。Agents SDK 一侧,11 月 3 日的 v0.24.0-alpha.6 让原生 MCP 走模型的 WebSocket 路径,11 月 8 日的 alpha.7 明确缓冲模式不走 WebSocket(openai-agents-python 发布页)。另外,OpenAI 在 9 月 3 日推出的中途纠偏 response.steer 只在 WebSocket 上可用,10 月推出的 Ultrafast 模式文档也强烈建议配合 WebSocket 使用(Mid-turn steering,Ultrafast mode)。换句话说,WebSocket 正在从「一个可选的提速开关」变成一部分新功能的前提。
省下的时间从哪来:不是握手,是服务端少做的事
很多人第一反应是「WebSocket 省掉了每次 HTTP 的握手」。这个理解不准确。HTTP/1.1 默认就是长连接,TCP 和 TLS 握手在同一个连接上只做一次(RFC 9112 第 9 节),主流 SDK 都会复用连接池。我们在 4 轮里各量了 10 次新连接和 10 次复用连接:连 api.everyinfra.com,DNS、TCP、TLS 加起来中位 25.5 毫秒,最慢 32.6 毫秒;连 api.openai.com 中位 20.9 毫秒,最慢 44.8 毫秒。复用连接让首字节快了 34.7 毫秒和 22.8 毫秒。这是我们能在本机测到的全部「传输开销」,量级是几十毫秒,放到 30.5–65.1 秒的工具链里只占千分之一左右。
那 OpenAI 说的 40% 从哪来?OpenAI 工程博客《Speeding up agentic workflows with WebSockets in the Responses API》把一次 agent 循环拆成三块:API 服务本身的处理、模型推理、客户端执行工具的时间(OpenAI 工程博客)。WebSocket 优化的是第一块:服务端把上一轮的回应、输出项、工具定义和已经渲染好的 token 都缓存在连接上,下一轮不用重新校验、重新渲染整段历史。博客里提到,Codex 的大部分 Responses API 流量很快切到了 WebSocket;合作方给出的数字是 Vercel 的 AI SDK 最多快 40%,Cline 在多文件任务上快 39%,Cursor 最多快 30%。
YouTube 上播放最多的一条讲解视频(2026 年 3 月 4 日发布,写稿时约 17 万次播放)把这一点讲得更直白:在 HTTP 模式下,每次工具调用之后 agent 都要把整段对话历史重新发一遍,提示缓存(prompt caching)能省掉模型重复计算,但省不掉这些字节的上传和服务端的重新处理;WebSocket 的价值更像是一种「保证」,保证你下一轮还落在同一台 API 机器上,那台机器手里已经有你的状态(视频)。我们抓了这条视频的 50 条评论(含回复),7 条提到粘性会话,1 条直接问和 store: true 有什么区别,质疑都围绕这一点:既然关键是服务端有状态,用 store: true 加 previous_response_id、或者负载均衡的粘性会话不行吗?指南给的答案是:store=true 的续接可以从持久化数据里补回,但「失去内存缓存带来的延迟优势」;内存缓存只绑在这一条连接上。


把这两层放在一起,就能理解为什么 coding agent 能拿到 30%–40%,而数据工具 agent 拿不到。coding agent 的工具大多在本机:读一个文件、跑一条 grep,只要几毫秒,几十次工具调用下来,时间几乎全花在模型和 API 服务上,服务端少做的那一块就很显眼。数据工具 agent 的工具要去外面抓网页、搜社交平台、拉字幕,一次就是几秒到几十秒,服务端省下的那零点几秒被工具时间淹没了。
别人测到多少:官方 40%、Cline 39%、单轮 0.24 秒
在动手测之前,我们把能找到的公开数字全部读了原文,只收有原始出处的,按「测的是什么」分开列。端到端的百分比和单轮的秒数不能直接互换:前者取决于任务里有多少轮、工具多快,后者才是可以搬到别的任务里重新算的量。
| 出处 | 发布日期 | 场景 | 数字 |
|---|---|---|---|
| OpenAI WebSocket 指南 | 读于 2026-11-10 | 20 次以上工具调用的任务 | 端到端「最多约 40%」更快 |
| OpenAI 工程博客 | 2026-04-22 | Vercel AI SDK、Cline、Cursor 接入后 | 最多 40%、39%、最多 30% |
| Cline 在 X 上的帖子 | 2026-02-23 | 简单任务、复杂多文件任务 | 约 15%、约 39%,最好一次 50%;短任务上握手略增首个 token 时间 |
| Hermes Agent PR 评论 | 2026-10-11 | 84 轮 SSE 与 WebSocket 交替,约 1.5 万输入 token | 首个事件中位快 0.37 秒;完成时间中位快 0.16 秒、平均快 0.24 秒;TCP+TLS 约 11 毫秒 |
| YouTube 讲解视频(约 17 万次播放) | 2026-03-04 | 讲解,引用官方说法 | 带宽省 90% 以上,速度快 20%–30% |
这几个数里,最适合拿来算我们这种 agent 的是 Hermes Agent 那一条(GitHub 评论原文)。测试者在日本,用 Codex 的 OAuth 后端、同一个模型,SSE 和 WebSocket 交替发 84 轮,每轮约 15,100 个输入 token:从发出请求到收到 response.created,SSE 中位 1.00 秒、WebSocket 0.59 秒;到收到 response.completed,SSE 中位 2.81 秒、WebSocket 2.61 秒,平均差 0.24 秒。测试者自己的结论是「适度的提升」,20 次连续调用大约省 4 秒。这和 OpenAI 的说法并不矛盾:同一个项目更早的讨论(Hermes Agent issue #6057,2026 年 4 月 8 日开启)里,维护者也是因为收益有限、实现复杂,一度没有合并。
Cline 那条帖子里还有一个容易被忽略的细节:在简单的短任务上,WebSocket 的握手会让首个 token 稍微晚一点(Cline 在 X 上的帖子)。也就是说,只调一两次工具的 agent,换过去甚至可能更慢。Vercel 的 AI SDK 团队在 2 月 23 日宣布支持时用的说法是「首字节时间最多省 40%」(AI SDK 在 X 上的帖子),Cursor 方面给的是「最多快 30%」(X 帖子)。这些数字都来自 coding agent,工具在本机、很快。开源 agent 框架的反应也很快:OpenClaw 在 WebSocket 模式上线当天(2026 年 2 月 23 日)就有人提了功能请求,标题直接写着「为多次工具调用提速」(OpenClaw issue #24830)。可以看出,大家对它的期待一开始就集中在「工具调用多」的场景;但「工具调用多」和「工具调用慢」是两回事,前者正是 WebSocket 擅长的,后者要另想办法。我们下面的实测,就是想把这两件事分开量清楚。
我们怎么测:5 步工具链、4 个时刻、两种计时
测试机是一台位于新加坡的 Mac mini,Python 3 标准库 http.client,整条工具链共用一个 keep-alive 连接(第一步新建,之后复用),和多数 agent 框架用连接池的做法一致。每一轮做五件事:先用 curl -w 量建连耗时(两台主机各 10 次新连接、10 次复用),然后跑 5 步工具链,再用新连接把第一步重做一次作对照,再把一个慢能力分别用同步和异步各调一次,最后走一次 MCP 的 tools/list 和 tools/call。四轮的开始时间是新加坡时间 00:17、00:26、00:49、01:12,第 1、3、4 轮之间相隔 20 分钟以上;第 2 轮是修好第 1 轮的轮询脚本之后补跑的,离第 1 轮只有 9 分钟。
5 步工具链模拟的是一个「查社区怎么评价某个 API」的研究任务:第 1 步用 网页搜索 的 search/web 搜「openai responses api websocket」;第 2 步用 reddit/search 搜「responses api websocket」,取 10 条;第 3 步用 reddit/comments 读第 2 步第一条帖子的评论,取 20 条;第 4 步用 youtube/search 搜「openai websocket mode responses api」,取 10 条;第 5 步用 youtube/transcript 拉第 4 步第一条视频的字幕。后两步依赖前一步的结果,所以不能并行,这正是 WebSocket 想优化的那种「一轮接一轮」的形态。
计时分两种。客户端墙钟是从发出请求到读完响应体,包含网络往返;服务端耗时取自测试账户的请求记录(控制台的 GET /portal/api/logs,每条记录有 latency_ms),按响应里的 request_id 一一对上。两者之差就是「我们这一侧的传输开销」,包括网络、TLS 加解密和响应体传输。测试 Key 每分钟限 10 次,所以两次付费调用之间固定隔 7 秒,遇到 429 就按 Retry-After 等,被挡回的请求不扣费,也不计入统计。OpenAI 一侧我们没有发任何模型请求,只对 api.openai.com 做了不带凭据的建连计时(返回 401 属于预期),所以文中 OpenAI 一侧的每个数都来自上节的原文。
实测一:5 步工具每一步多久
4 轮的每一步耗时如下(客户端墙钟,单位秒)。最快最稳的是网页搜索,四轮都在 2.0–2.3 秒;最不稳定的是读 Reddit 评论,最快 7.6 秒、最慢 41.0 秒,同样的帖子、同样的 20 条,几轮之间差出几倍。YouTube 搜索稳定在 7.6–12.9 秒,字幕 5.1–6.0 秒。
四轮合计的差距几乎全来自这一步。第 1 轮合计 65.1 秒,其中读评论一步就占了 63%;去掉这一步,四轮剩下四步的合计都在 19–26 秒之间,相差不到 7 秒。最快的是第 4 轮(新加坡时间 01:12),合计 30.5 秒。也就是说,同一条依赖链的总耗时,主要由其中最不稳定的那一步决定;做容量预估时,按每一步的 p95 估,比按平均值估更接近真实情况。
| 步骤 | 能力 | 第 1 轮 | 第 2 轮 | 第 3 轮 | 第 4 轮 | 中位 |
|---|---|---|---|---|---|---|
| 1 | search/web | 2.0 | 2.1 | 2.3 | 2.2 | 2.2 |
| 2 | reddit/search | 6.9 | 4.5 | 5.2 | 4.3 | 4.9 |
| 3 | reddit/comments | 41.0 | 11.9 | 7.6 | 11.3 | 11.6 |
| 4 | youtube/search | 9.1 | 10.0 | 12.9 | 7.6 | 9.6 |
| 5 | youtube/transcript | 6.0 | 5.5 | 5.2 | 5.1 | 5.4 |
| 合计 | 5 次 | 65.1 | 34.0 | 33.2 | 30.5 | 33.6 |
客户端和服务端的时间差,就是我们这一侧能测到的传输开销。20 次同步调用里,差值中位 179 毫秒,最小 108 毫秒,最大 556 毫秒;最大的那次是 YouTube 搜索,响应体有 26 KB,主要是传输时间。换句话说,就算把我们这一侧的网络开销全部抹掉,5 步也只省不到 1 秒,和工具本身的几十秒不在一个量级。这里还有一个让人意外的细节:同步调用的返回里带了一个 async_hint 字段,原文是「这次是同步调用;慢任务或大 limit 可以在请求体里加 "mode":"async",立刻拿到 job_id 再轮询」。接口自己就在提醒 agent:慢的时候别干等。
按能力把客户端和服务端的中位放在一起,结论更直观:每一项的差值都只有一两百毫秒,和工具本身的秒数相比可以忽略。
| 能力 | 客户端墙钟中位 | 服务端耗时中位 | 差值中位 |
|---|---|---|---|
search/web | 2.16 秒 | 1.81 秒 | 228 毫秒 |
reddit/search | 4.86 秒 | 4.70 秒 | 160 毫秒 |
reddit/comments | 11.60 秒 | 11.29 秒 | 214 毫秒 |
youtube/search | 9.55 秒 | 9.22 秒 | 177 毫秒 |
youtube/transcript | 5.36 秒 | 5.24 秒 | 125 毫秒 |
单次最大的差值出在 youtube/search,它的响应体最大(约 26 KB),多出来的主要是把结果传回客户端的时间;按中位看,五项都在 125–228 毫秒之间,响应体只有约 4 KB 的 youtube/transcript 最小。这也给了一个实用的提示:响应体越大,传输占比越高,调小 limit 同时省下服务端和传输两段时间。
把每一步的波动和 WebSocket 能省的时间放在一起看,更能说明问题。第 3 步读评论在两轮之间的差距是几十秒,而 WebSocket 每轮能省的是零点几秒,差了两个数量级。如果你的 agent 正被「慢」困扰,排查的第一站应该是哪一个工具慢、为什么慢,而不是连接方式。我们的 Reddit 评论接口 支持 limit 控制条数,条数越少越快;YouTube 搜索接口 和 YouTube 字幕接口 的耗时则比较稳定,适合放在依赖链的中间。
实测二:新连接和复用连接差多少
| 主机 | 新连接建连中位 | 最慢一次 | 新连接首字节中位 | 复用连接首字节中位 | 复用省下 |
|---|---|---|---|---|---|
api.everyinfra.com | 25.5 毫秒 | 32.6 毫秒 | 115.3 毫秒 | 80.6 毫秒 | 34.7 毫秒 |
api.openai.com | 20.9 毫秒 | 44.8 毫秒 | 263.2 毫秒 | 240.4 毫秒 | 22.8 毫秒 |
这张表的意义在于排除一个常见的误会。WebSocket 模式不是靠「少握几次手」变快的:HTTP 下 SDK 本来就复用连接,建连本身也只要二三十毫秒。Hermes 的对照里测到的 TCP 加 TLS 约 11 毫秒,和我们的量级一致,而它测到的每轮差值是 240–370 毫秒,比建连高一个数量级,这部分只能来自服务端少做的事。每轮我们还用一条新连接把第 1 步原样重做一次,TCP 加 TLS 落在 24.5–28.4 毫秒,即使 agent 框架完全不复用连接,5 步也只多花一百多毫秒。所以如果你在评估要不要换,「我的工具服务器离得远、握手慢」不是换的理由;「我的 agent 要连续调几十次模型、上下文很大」才是。
实测三:慢工具同步等,还是异步提交再轮询
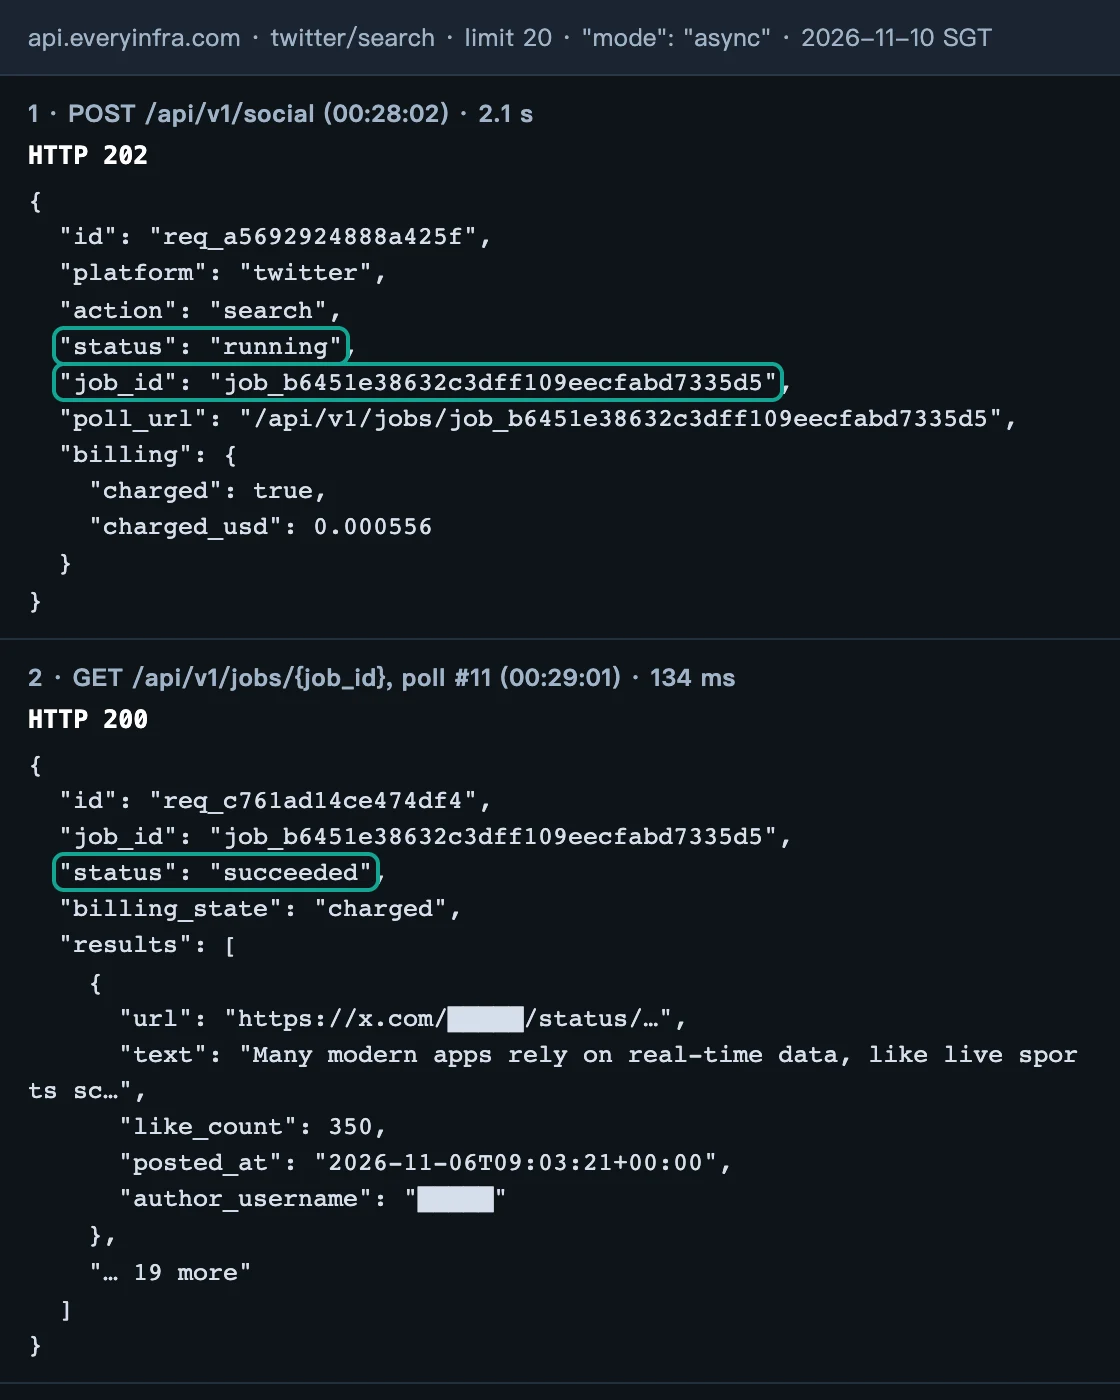
数据工具里有一类天生就慢。我们挑了 30 天里调用最多、也最慢的能力之一 twitter/search(X 搜索接口),每轮各用同步和异步调一次,都取 20 条。同步调用要 22.1–27.5 秒才返回,中位 23.7 秒,这段时间 agent 什么也做不了。异步调用在请求体里加 "mode": "async",接口在 2.43 秒(中位)内返回 HTTP 202 和一个 job_id,之后每 5 秒用 GET /api/v1/jobs/{job_id} 查一次,状态从 running 变成 finalizing 再变成 succeeded。4 轮共 36 次轮询,合并中位 88 毫秒,最快 59 毫秒、最慢 773 毫秒,而且不扣费。
要说清楚的是:异步不会让工具本身变快。轮询到 succeeded 的 3 次异步任务(第 1 轮的轮询脚本把 finalizing 当成终态提前退出,不计入;这个任务事后免费补读过一次,确认已经 succeeded、返回 20 条),从提交到查到 succeeded 分别用了 38.5、38.7、58.4 秒,都比同步慢。拆开看:任务在提交后 23–48 秒进入 finalizing,和同步调用 22.1–27.5 秒是同一量级;之后整理结果又用了 10–15 秒,再加上 5 秒一次的轮询间隔,最多还会晚 5 秒才看到结果。这组数也能用来定轮询节奏:4 轮里提交后头 23 秒内的轮询全是 running,所以第一次轮询可以推迟到 20 秒左右,之后再每 5 秒查一次,每个任务能少发两三次请求,也少占一点每分钟的额度。异步的价值在于把这 20 多秒还给 agent:提交之后,agent 可以先去发别的工具调用、先回复用户、或者先让模型处理已经拿到的结果。OpenAI 在 9 月 3 日随 GPT-6 Astra 推出的异步工具调用(async: true)走的是同一个思路:模型发出工具调用后不用停下来等,之后用一个等待步骤收集结果(Async tool calling)。
实测四:走 MCP 一次往返多久
很多人不会自己写工具函数,而是直接把 EveryInfra 的远程 MCP 服务器(https://api.everyinfra.com/mcp,MCP 服务器说明)接到 agent 上。我们每轮都走了一次 MCP:tools/list 返回 12 个工具、约 16.3 KB 的 JSON,中位 100 毫秒(第 1 轮最慢,264 毫秒,之后三轮都在 71–125 毫秒),不扣费;tools/call 调 everyinfra_search 做同样的网页搜索,成功的 3 次中位耗时 2.26 秒,和 REST 版 search/web 的 2.2 秒是同一量级。第 1 轮的 tools/call 被限速挡回:MCP 的限速错误以 HTTP 200 加 JSON-RPC 的 isError 返回,而不是 HTTP 429,写重试逻辑时要看响应体里的 rate_limited。
在 Responses API 里接 MCP 有三种方式,工具在谁那里执行、WebSocket 能省什么,都不一样:
| 接法 | 工具由谁执行 | 每次工具调用的往返 | WebSocket 的作用 |
|---|---|---|---|
| 函数工具(function tool),你的代码调 REST | 你的进程 | 模型 → 你 → EveryInfra → 你 → 模型 | 每次把工具结果送回模型时省一次续接 |
托管 MCP(type: "mcp") | OpenAI 的服务端 | OpenAI → EveryInfra → OpenAI,不经过你 | 一次回应里可以连调多次工具,续接次数本来就少 |
Agents SDK 的 MCPServerStreamableHttp | 你的进程里的 MCP 客户端 | 同函数工具 | 同函数工具 |
托管 MCP 那一行是理解「值不值」的关键。OpenAI 的 MCP 工具指南写明,同一个回应里模型可以发出多个 mcp_call,工具列表(mcp_list_tools)只要留在上下文里就不会重新拉取,而且 MCP 工具本身不按次另收费(MCP 与连接器指南)。这种接法下,工具结果不需要先回到你的进程再发回去,「续接」本来就少,WebSocket 能省的部分更小;工具耗时则一分不少,还是 EveryInfra 那一侧的几秒。WebSocket 事件参考里 response.create 的工具类型包括 mcp,Agents SDK 的 alpha.6 也让原生 MCP 走 WebSocket,所以两者可以一起用,只是别指望叠加出很大的提速。
30 天 8,823 次调用:数据工具普遍以秒计
上面几轮只是几十次调用,为了确认「工具以秒计」不是这几轮的偶然,我们导出了测试账户在控制台里看到的近 30 天调用质量(2026-10-11 到 2026-11-09,按 UTC 日期;只统计这个账户自己的调用,耗时只算成功的调用)。这段时间共 8,823 次调用,成功 8,070 次,成功率 91.5%(空结果算成功)。有 45 项能力的样本在 30 次以上,它们的中位耗时最短 1.0 秒、最长 32.7 秒;84.4% 的能力中位耗时超过 2 秒,68.9% 超过 5 秒。按调用次数加权,一次调用的中位耗时约 2.1 秒。
这张图里最快的几项,比如评论类能力和网页搜索,中位在 2 秒上下;搜索类能力普遍更慢,twitter/search 中位 22.8 秒、p95 62.4 秒,threads/search 中位 11.7 秒,youtube/search 中位 9.3 秒。p95 普遍是中位的好几倍,意思是每 20 次里总有一次要等很久。对 agent 来说,p95 比中位更要紧:一条 5 步的依赖链,只要有一步落到 p95,整条链就慢下来。WebSocket 每轮省下的零点几秒,放在这张图上就是贴着纵轴的一条细线。
5 步 agent 的账:传输开销和工具耗时各占多少
把前面的数合成一个式子。设每次工具调用平均 t 秒,每次模型调用 M 秒,一个调用 n 次工具的 agent 一共调 n+1 次模型,WebSocket 在后 n 次续接上每次省 s 秒,那么省下的比例就是:
省下的比例 = n × s ÷ ((n+1) × M + n × t)
本文的数字是 n = 5,M = 2.81 秒。代入 Hermes 对照里的 s = 0.24 秒,工具耗时为 0 时(纯模型任务)能省 7.1%;s = 0.37 秒时是 11.0%;按宽松上限(每次续接省 40% 的模型时间)是 33.3%,和 OpenAI「20 次以上工具调用、最多约 40%」的说法量级吻合,说明这个式子没有把 WebSocket 算小。随着 t 变大,这个比例很快往下掉。
反过来算阈值更实用:要让 WebSocket 至少省下某个比例,每次工具调用最多能有多慢。下表是 5 步 agent、每次模型调用 2.81 秒时的结果。
| 每次续接省多少 | 省 ≥10% 需要工具 ≤ | 省 ≥5% 需要工具 ≤ | 省 ≥2% 需要工具 ≤ | 工具耗时为 0 时 |
|---|---|---|---|---|
| 0.24 秒(第三方实测平均) | 做不到 | 1.4 秒 | 8.6 秒 | 7.1% |
| 0.37 秒(第三方实测首个事件中位) | 0.3 秒 | 4.0 秒 | 15.1 秒 | 11.0% |
| 40% 模型时间(宽松上限) | 7.9 秒 | 19.1 秒 | 52.8 秒 | 33.3% |
我们实测的 5 步工具链,每步平均耗时在 30.5 ÷ 5 到 65.1 ÷ 5 秒之间,也就是大约 6 到 13 秒,落在表里「省不到 5%」的区域,只有宽松上限那一行勉强接近。这就是「工具慢时换 WebSocket 值不值」的定量回答:按第三方实测的每轮节省,每次工具超过约 4.0 秒,省下的就不到 5%;超过约 15.1 秒,不到 2%。反过来,如果你的 agent 工具很快(比如读本地文件、查内存缓存)、轮数很多(20 次以上)、上下文很大(每次几万 token),WebSocket 的收益会接近 OpenAI 和 Cline 公布的 30%–40%。
还有一个变量是轮数 n。轮数越多,WebSocket 省下的总秒数越多,但比例几乎不变:分子和分母都随 n 线性增长,当 n 很大时比例趋近 s ÷ (M + t)。所以「我的 agent 要调 50 次工具」本身不是换的理由,「每次工具都很快」才是。对数据工具 agent,这个极限值按 s = 0.37 秒、t = 10 秒算约 2.9%。
四种 agent 套进同一个式子:什么时候 WebSocket 真有用
光看我们这一条工具链还不够,换几种常见的 agent 形态套进同一个式子,界线会更清楚。下表的模型时间都按每次 2.81 秒算,工具时间是我们按场景设定的典型值,不是实测;第 2 行的研究型 agent 取的是本文实测工具链的中位(5 次工具共 33.6 秒)。
| agent 形态 | 工具次数 | 工具总耗时(设定) | 每轮省 0.24 秒 | 每轮省 0.37 秒 | 宽松上限 |
|---|---|---|---|---|---|
| coding agent:读文件、跑 grep,每次约 0.05 秒 | 30 | 1.5 秒 | 8.1% | 12.5% | 38.1% |
| 研究型 agent:本文的 5 步数据工具链 | 5 | 33.6 秒(实测中位) | 2.4% | 3.7% | 11.1% |
| 混合型:8 次查本地缓存各 0.2 秒,2 次慢数据工具各 20 秒 | 10 | 41.6 秒 | 3.3% | 5.1% | 15.5% |
| 对话助手:每次回答前查 2 次知识库,各 1 秒 | 2 | 2 秒 | 4.6% | 7.1% | 21.6% |
coding agent 那一行的宽松上限是 38.1%,和 OpenAI「20 次以上工具调用最多约 40%」、Cline「复杂多文件任务快 39%」都对得上,说明这个式子在工具很快的场景下能复现官方数字;也正因为对得上,换到工具以秒计的场景时,算出来的小比例才可信。混合型那一行最值得注意:只要有两次慢工具,前面八次快工具攒下的优势就被摊薄了一大半。对话助手轮数少,单次请求里模型时间占比高,按第三方实测能省 5%–7%,算是「开了有感觉,但不会翻天覆地」。
换句话说,判断要不要换,先估两个数:你的 agent 平均调几次工具,每次工具平均多久。工具平均在 1 秒以内、次数在 10 次以上,WebSocket 基本都值得开;工具平均在 5 秒以上,先去处理工具,WebSocket 留到最后。另外,如果你需要中途纠偏或 Ultrafast 这类只在 WebSocket 上(或强烈建议配合 WebSocket)使用的功能,那就不是「值不值」的问题,而是「要不要这些功能」的问题了。
怎么量你自己的 agent:把模型时间和工具时间分开记
上面的式子只有两个输入,但很多团队手里恰恰没有这两个数,只有「整个任务跑了 80 秒」这种总时间。我们建议在 agent 的循环里打四个时间点:发出 response.create 的时刻、收到第一个事件(response.created)的时刻、收到 response.completed 的时刻、工具执行开始和结束的时刻。前三个之差是模型侧的时间,后一个是工具侧的时间,两者相加再和总时间对一下,差额就是你这一侧的排队和传输。
工具那一侧还可以再拆一层。EveryInfra 的每个响应都带 id(也就是 request_id),控制台的请求记录里按这个 ID 能查到服务端记的 latency_ms;客户端墙钟减去它,就是网络和传输的部分。我们这次测下来中位只有 179 毫秒,所以对大多数部署在云上的 agent,工具时间几乎全是服务端真实在干活的时间,优化方向是选能力、调参数、并行和异步,而不是换网络。等这些数都有了,再用 HTTP 和 WebSocket 各跑同一批任务十几次、交替进行,像 Hermes 那样比中位数和平均数,结论就是你自己场景下的真实收益。
工具慢的时候,比换 WebSocket 更值得做的四件事
第一件,能并行就并行。5 步链里,第 1、2、4 步互不依赖:网页搜索、Reddit 搜索、YouTube 搜索可以一起发。按我们第 1 轮的数,三步串行要 2.0 + 6.9 + 9.1 秒,并行时只取最慢的那一步,大约 9.1 秒,一下省掉近 9 秒,是 WebSocket 一整轮节省的几十倍。Responses API 默认允许模型在一轮里发出多个工具调用(parallel_tool_calls),你的工具执行层要真的并发去跑;WebSocket 的 stream_id 多路复用则让一条连接上同时跑几条对话,适合把互不依赖的子任务拆开。
第二件,慢工具改异步。WebSocket 优化的是模型等你,异步优化的是你等工具:同步等一次 twitter/search 要二十多秒,相当于 Hermes 对照里 WebSocket 近一百轮的累计节省;改成 mode: async 后两秒拿到 job_id,agent 可以先去做别的。配合 OpenAI 的异步工具调用,模型也不用停下来等。注意轮询间隔别太短:我们的测试 Key 每分钟只有 10 次额度,轮询虽然不扣费,但第 1 轮每 2 秒一次的轮询和其他调用挤在一起时,MCP 调用被限速挡了一次,之后改成 5 秒一次就没再出现。
第三件,选更快的能力、要更少的数据。同样是「看看社区怎么说」,本文实测里网页搜索中位 2.2 秒,Reddit 搜索 4.9 秒,YouTube 搜索 9.6 秒;如果网页搜索的前 10 条已经够用,后面几步可以按需再调。limit 也直接影响耗时:评论取 20 条和取 100 条,差的不只是费用。托管 MCP 用 allowed_tools 只暴露需要的工具,还能让 tools/list 的 16 KB 少进上下文。
第四件,缓存工具结果。研究型 agent 经常在同一个会话里反复查同一个关键词或同一条帖子,把结果按参数缓存几分钟,第二次就是零秒。缓存时间不宜太长:本文四轮用同一个关键词调 reddit/search 取 10 条,几十分钟里实际返回了 8、8、6、7 条,社区内容本身在变,缓存几分钟到十几分钟比较稳妥。这件事和 WebSocket 的缓存是两回事:WebSocket 缓存的是模型侧的对话状态,你缓存的是工具侧的数据,后者对数据工具 agent 的作用大得多。做完这四件事,如果模型侧的时间占比上来了,再开 WebSocket,收益会更明显。
配置示例:Responses API WebSocket 加 EveryInfra 函数工具
下面这段是配置示例,我们没有在本机用 OpenAI 的 Key 跑过;WebSocket 部分照 OpenAI 指南的 Python 示例写,工具部分调用的是本文真调过的接口。要点有三个:用 client.responses.connect() 开一条长连接;工具用一个 requests.Session 复用连接去调 EveryInfra;每拿到一次工具结果,只把 function_call_output 和 previous_response_id 发回去。
# 配置示例:pip install "openai[realtime]>=3.8.0" requests
import json, os, requests
from openai import OpenAI

client = OpenAI()
ei = requests.Session()
ei.headers["Authorization"] = "Bearer " + os.environ["EVERYINFRA_API_KEY"]

TOOLS = [{
    "type": "function",
    "name": "everyinfra_social",
    "description": "Fetch public social data, e.g. reddit/search, youtube/transcript.",
    "parameters": {
        "type": "object",
        "properties": {
            "platform": {"type": "string"},
            "action": {"type": "string"},
            "params": {"type": "object"},
        },
        "required": ["platform", "action", "params"],
    },
}]

def run_tool(args):
    r = ei.post("https://api.everyinfra.com/api/v1/social", json=args, timeout=120)
    return r.text

with client.responses.connect() as conn:
    prev, new_input = None, [{"role": "user", "content": "What do developers say about Responses API WebSocket mode?"}]
    while True:
        conn.response.create(model="gpt-6.1-sol", store=False, tools=TOOLS,
                             previous_response_id=prev, input=new_input)
        for ev in conn:
            if ev.type == "response.completed":
                resp = ev.response
                break
            if ev.type in {"response.failed", "response.incomplete", "error"}:
                raise RuntimeError(ev.to_json())
        calls = [o for o in resp.output if o.type == "function_call"]
        if not calls:
            print(resp.output_text)
            break
        prev = resp.id
        new_input = [{"type": "function_call_output", "call_id": c.call_id,
                      "output": run_tool(json.loads(c.arguments))} for c in calls]
如果你用的是 OpenAI Agents SDK,切换传输只要一行 set_default_openai_responses_transport("websocket"),或者在 OpenAIProvider 上设 use_responses_websocket=True,还可以通过 responses_websocket_options 调心跳间隔(Agents SDK 模型文档)。上面的循环里,run_tool 是串行的;如果模型一次发出多个调用,把它换成线程池并发执行,就是上一节说的第一件事。慢能力可以在 args 里加 "mode": "async",再用 GET /api/v1/jobs/{job_id} 轮询,这部分我们真调过。
长任务的连接管理:60 分钟、重连和预热
数据工具 agent 有一个和 coding agent 不同的特点:任务时间长。一次 5 步研究就要半分钟到一分钟,如果要扫几十个关键词、每个都读评论和字幕,跑上半小时、一小时很常见,正好撞上 WebSocket 连接最长 60 分钟的限制。OpenAI 指南给了三种恢复办法:存过回应(store=true)的,拿有效的回应 ID 继续;不能续的(store=false 或返回 previous_response_not_found),把 previous_response_id 设为空、带完整上下文重新开始;上下文太长的,先用 /responses/compact 压缩,再把压缩后的窗口作为新回应的输入。对数据工具 agent,我们的建议是在每个子任务(比如一个关键词)结束时主动开一条新连接,而不是等到 60 分钟被动断开,这样重连永远发生在两个子任务之间,不会丢掉一半的工具结果。
预热也值得一提。generate: false 的 response.create 不出结果,只把工具定义和指令先铺到连接上,返回的 ID 可以作为下一轮的 previous_response_id。如果你的工具定义很大,比如把 EveryInfra MCP 的 12 个工具全部挂上(tools/list 约 16.3 KB),预热能让第一次真正的请求少处理一大块内容。多路复用则适合「一个关键词一条流」:用不同的 stream_id 在一条连接上并行跑几个子任务,每条流内部仍然先进先出,各自续接各自的状态;但别超过 16 个同时在跑的回应,超出的会排队,而 Azure 上目前不支持这种用法。
一次真实往返
下面是第 2 轮第 2 步的真实请求和返回(新加坡时间 00:26:12 发出,客户端墙钟 4.5 秒,返回 8 条)。响应只保留了和本文相关的字段,用户名已经去掉;async_hint 是接口原样返回的提示。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"reddit","action":"search","params":{"keyword":"responses api websocket","limit":10}}'{
"id": "req_c7040939545343c3",
"platform": "reddit",
"action": "search",
"count": 8,
"results": [
{"title": "Websocket or REST?", "community": "r/Backend", "comment_count": 25, "posted_at": "2026-10-23T23:12:38+00:00"},
{"title": "Responses WebSocket Error", "community": "r/codex", "comment_count": 1, "posted_at": "2026-10-21T16:12:06+00:00"}
],
"billing": {"charged": true, "charged_usd": 0.000556},
"async_hint": "this call was synchronous; add \"mode\":\"async\" to the request body to get a job_id immediately (poll GET /api/v1/jobs/{job_id}) for slow tasks or large limits"
}第二条结果正好说明 WebSocket 模式在社区里还有毛刺:10 月 21 日 r/codex 上有人问反复出现的「Responses WebSocket Error」(帖子)。这也是 openai-python 在 10 月底、11 月初连发几个版本修重连和流隔离的背景。
成本:WebSocket 不另收费,钱主要花在 token 上
OpenAI 的定价页上没有 WebSocket 单独的价目,按 token 计费,和 HTTP 一样(OpenAI 定价,读于 2026-11-10)。我们按 5 步工具链算一次任务的钱:
| 项目 | 单价(读取于 2026-11-10) | 一次 5 步任务 | 1,000 次任务 |
|---|---|---|---|
search/web | $0.000694 / 次 | $0.000694 | $0.69 |
reddit/search、reddit/comments、youtube/search、youtube/transcript | 各 $0.000556 / 次 | $0.002224 | $2.22 |
| EveryInfra 工具费合计 | — | $0.002918 | $2.92 |
| 工具结果读进模型(约 15.3k token,gpt-6.1-sol 未缓存输入 $2.00 / 百万) | 估算 | 约 $0.032 | 约 $32 |
| WebSocket 传输 | 不另收费 | $0 | $0 |
EveryInfra 的单价来自免费目录 GET /api/v1/social/catalog 的 price_usd(能力目录,网页搜索见 搜索工具清单),每次真调的 billing.charged_usd 都和目录一致;失败和空结果不扣费。工具结果的 token 数是按 5 步响应体合计约 61.4 KB、每 4 个字节约 1 个 token 估的,只用来看量级:模型读工具结果的钱,是工具费本身的十倍左右。WebSocket 不改变 token 计费,但 HTTP 模式下每一轮都要把历史重新发送和处理,提示缓存能把重复部分按缓存价算(gpt-6.1-sol 缓存读取 $0.10 / 百万),r/codex 上有用户说切到 WebSocket 后缓存命中率明显变高(讨论帖),这是用户的观察,OpenAI 没有给过对应的数字。本文的 4 轮真调共扣费 35 次、$0.020978:每轮扣费的是 5 步工具链、新连接对照、慢能力的同步调用和异步提交、MCP 的 tools/call 各一次,轮询和 tools/list 不扣费,第 1 轮被限速挡回的 MCP 调用也没扣;加上写稿时读视频字幕和评论的 3 次,一共 38 次、$0.022646。
做不了或要注意的地方
先说本文没有测的部分。我们没有在本机用 OpenAI 的 Key 跑过模型请求,OpenAI 一侧每轮能省多少全部来自原文和第三方公开实测;如果你的模型、推理强度、上下文长度和 Hermes 的设定(约 1.5 万输入 token、中等推理强度、从日本发出)差很多,每轮节省会不同,用上面的式子换成你自己的 s 和 M 重算即可。我们的工具耗时只代表写稿当天凌晨这几个时刻、这几个关键词;30 天的大盘是同一个测试账户的数据,你的账户可以在控制台的调用质量页看自己的分位数,或者看 服务状态页。
再说 WebSocket 本身的限制。连接最长 60 分钟,断开后连接内的缓存全部清空,store=false 时必须带完整上下文重新开始,长任务要写好重连;同一条流上的续接遇到 4xx 或 5xx,被引用的回应会被逐出缓存;background 后台模式不能走 WebSocket。Azure 上的同名功能写的是单连接同一时间只有一个回应、不支持多路复用,和 OpenAI 的 16 个上限不同。Cline 的实测还提醒,短任务上握手可能让首个 token 稍晚。还有一些边角问题要留意:openai-python 的 issue #2919(2026 年 3 月 3 日提出)记录过一个情况,temperature 写成小数(比如 1.2)时连接以 1000 状态码关闭、收不到任何事件(issue #2919),遇到「连接正常关闭但没有输出」时可以先查参数。最后是 SDK 版本:openai-python 在 10 月底到 11 月初连续修了重连恢复、预热和流隔离,用 WebSocket 时建议跟到较新的版本。
最近的变化
- 2026-10-22:Google API Gateway 的流式支持进入公开预览,覆盖 SSE、WebSocket 和 gRPC,单条流最长一小时(Google 开发者博客)。
- 2026-10-20:OpenAI 推出 12 小时提示缓存,写入按普通输入价的 2.5 倍计(提示缓存指南)。
- 2026-10-16:Agents API 支持 Ultrafast 模式;10 月 8 日 Ultrafast 支持 GPT-6.1 Sol,文档强烈建议配合 WebSocket(更新日志)。
常见问题
responses api websocket vs http:到底差在哪?
差在服务端:HTTP 每一轮都要重新接收和处理整段历史,WebSocket 把上一轮的状态留在连接内存里,只处理新增输入。所以省的是服务端处理时间,不是握手(建连只要约 25.5 毫秒),细节见上文「省下的时间从哪来」一节。
用 store: true 加 previous_response_id,不就有一样的效果吗?
这是那条讲解视频评论区里的典型问题。效果不一样:store=true 的续接要从持久化存储里取状态,按 OpenAI 指南原话会「失去内存缓存带来的延迟优势」;WebSocket 的内存缓存还和 store=false、零数据保留兼容。
负载均衡开粘性会话(sticky session)或者 HTTP keep-alive,能达到同样效果吗?
keep-alive 只复用 TCP 和 TLS 连接,我们实测这部分只值几十毫秒。粘性会话是你自己这一侧的负载均衡设置,管不到 OpenAI 服务端把你的请求分给哪台机器;WebSocket 模式等于 OpenAI 在服务端替你做了「同一条连接落在同一处、状态留在内存」这件事。视频评论里有人说得很准:重点不是 WebSocket 比轮询快,而是后端变成了有状态的。
azure responses api websocket 和 OpenAI 的一样吗?
大体一样,差在并发:Azure 文档写一条连接同一时间只跑一个回应、不支持多路复用,OpenAI 允许通过 stream_id 同时跑最多 16 个。两边都用就按 Azure 的写法,完整对照见上文的限制表。
responses api websocket 的 python 示例怎么写?
装 openai[realtime]>=3.8.0,用 client.responses.connect() 开连接,工具结果只带 function_call_output 和 previous_response_id 发回;接 EveryInfra 的完整代码见上文「配置示例」一节,Agents SDK 用户一行 set_default_openai_responses_transport("websocket") 即可。
换成 WebSocket 会更省钱吗?
不会直接省:OpenAI 不对 WebSocket 另收费,token 照常计。数据工具 agent 的钱主要花在模型读工具结果的 token 上,约是工具费的十倍,调小 limit 比换传输更省钱,算法见上文「成本」一节。
上手步骤
第一步,在控制台建一把 EveryInfra API Key,放进环境变量 EVERYINFRA_API_KEY。第二步,读免费目录 GET /api/v1/social/catalog,选好要用的能力,比如 Reddit 数据接口 的 搜索 和评论,YouTube 数据接口 的搜索和字幕,X(Twitter)数据接口 的搜索。第三步,先用 curl 把每个工具单独调一次,记下耗时:超过 10 秒的能力在请求体里加 "mode": "async"。第四步,把工具接进 agent:自己写函数工具就照「配置示例」那段改,想省事就用 远程 MCP 服务器 的 https://api.everyinfra.com/mcp,设置方法见 远程 MCP 接入指南。第五步,跑一遍完整任务,把工具耗时和模型耗时分开记下来,代进本文的式子;模型侧占比大,再开 WebSocket。完整的快速上手在 文档,按次计费的价格在 价格页,全部能力在 数据市场。如果你的 agent 还会因为超时重试工具,可以接着看 API 幂等键实测;选搜索工具可以看 AI agent 用哪个网页搜索 API 和 agent 搜索工具怎么选;用 OpenAI 的 Agents API 做监控 agent,可以看 这篇评测。
参考资料
- WebSocket Mode,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/websocket-mode
- Changelog(2026-02-23 Launched WebSocket mode for the Responses API 等条目),OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/changelog
- Responses WebSocket events(response.create),OpenAI API 参考,读取于 2026-11-10,https://developers.openai.com/api/reference/resources/responses/websocket-events
- Speeding up agentic workflows with WebSockets in the Responses API,OpenAI 工程博客,2026-04-22,https://openai.com/index/speeding-up-agentic-workflows-with-websockets/
- Async tool calling,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/async-tool-calling
- Mid-turn steering,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/steering
- Ultrafast mode,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/ultrafast-mode
- MCP and Connectors,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/tools-connectors-mcp
- Conversation state,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/conversation-state
- Prompt caching,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/prompt-caching
- Latency optimization,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/latency-optimization
- Background mode,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/background
- Pricing,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/pricing
- Rate limits,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/rate-limits
- Multi-agent,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/responses-multi-agent
- Agents API: MCP tools,OpenAI API 文档,读取于 2026-11-10,https://developers.openai.com/api/docs/guides/agents-api/tools/mcp
- Models(Responses WebSocket transport),OpenAI Agents SDK 文档,读取于 2026-11-10,https://openai.github.io/openai-agents-python/models/
- openai-python Releases(v3.43.0、v3.42.0、v3.41.0),OpenAI(GitHub),读取于 2026-11-10,https://github.com/openai/openai-python/releases
- openai-python v3.43.0,OpenAI(GitHub),2026-11-03,https://github.com/openai/openai-python/releases/tag/v3.43.0
- openai-python v3.42.0,OpenAI(GitHub),2026-10-31,https://github.com/openai/openai-python/releases/tag/v3.42.0
- openai-agents-python Releases(v0.24.0-alpha.7、alpha.6),OpenAI(GitHub),读取于 2026-11-10,https://github.com/openai/openai-agents-python/releases
- openai-python issue #2919:Responses WebSocket (/v1/responses) closes with code 1000 and no events when temperature is a decimal,GitHub,2026-03-03,https://github.com/openai/openai-python/issues/2919
- Hermes Agent PR #18436 评论:SSE 与 WebSocket 84 轮对照,GitHub,2026-10-11,https://github.com/NousResearch/hermes-agent/pull/18436#issuecomment-6109869053
- Hermes Agent issue #6057,GitHub,2026-04-08,https://github.com/NousResearch/hermes-agent/issues/6057
- OpenClaw issue #24830:OpenAI Responses API WebSocket mode for multi-tool-call acceleration,GitHub,2026-02-23,https://github.com/openclaw/openclaw/issues/24830
- WebSocket mode for Azure OpenAI Responses API,Microsoft Learn,2026-07-28,https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/websockets
- Multi-agent orchestration(Azure),Microsoft Learn,读取于 2026-11-10,https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/responses-multi-agent
- OpenAI provider:WebSocket fetch,AI SDK 文档,读取于 2026-11-10,https://ai-sdk.dev/providers/ai-sdk-providers/openai
- AI SDK 在 X 上宣布支持 Responses WebSocket,X,2026-02-23,https://x.com/aisdk/status/2026031263925039591
- Cline 在 X 上的实测帖,X,2026-02-23,https://x.com/cline/status/2026031848791630033
- Cursor 方面在 X 上的帖子,X,2026-02-23,https://x.com/leerob/status/2026030244407468259
- OpenAI Responses LLM(WebSocket 变体,默认 wss://api.openai.com/v1/responses),Pipecat 文档,读取于 2026-11-10,https://docs.pipecat.ai/api-reference/server/services/llm/openai-responses
- RFC 6455 The WebSocket Protocol,IETF,2011-12,https://www.rfc-editor.org/rfc/rfc6455
- RFC 9112 HTTP/1.1(第 9 节 连接管理),IETF,2022-06,https://www.rfc-editor.org/rfc/rfc9112
- RFC 8446 TLS 1.3,IETF,2018-08,https://www.rfc-editor.org/rfc/rfc8446
- MCP Specification 2026-07-28: Transports,Model Context Protocol,读取于 2026-11-10,https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- MCP Specification 2026-07-28: Changelog,Model Context Protocol,读取于 2026-11-10,https://modelcontextprotocol.io/specification/2026-07-28/changelog
- curl 手册(-w 计时变量),curl,读取于 2026-11-10,https://curl.se/docs/manpage.html
- http.client — HTTP protocol client,Python 文档,读取于 2026-11-10,https://docs.python.org/3/library/http.client.html
- EveryInfra 完整开发者说明(异步任务、MCP、错误码),EveryInfra,读取于 2026-11-10,https://api.everyinfra.com/llms-full.txt
- EveryInfra 数据能力目录,EveryInfra,读取于 2026-11-10,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra 搜索工具清单,EveryInfra,读取于 2026-11-10,https://api.everyinfra.com/api/v1/search/tools
- I can't believe nobody's done this before...(视频),YouTube,2026-03-04,https://www.youtube.com/watch?v=sFEDAkJy9Dc
- openai websockets is improving our usage cost,Reddit r/codex,读取于 2026-11-10,https://www.reddit.com/r/codex/comments/1t2n38c/openai_websockets_is_improving_our_usage_cost/
- Responses WebSocket Error,Reddit r/codex,2026-10-21,https://www.reddit.com/r/codex/comments/1xbrg4j/responses_websocket_error/
- OpenAI 开发者社区:WebSockets for Responses API,OpenAI Community,读取于 2026-11-10,https://community.openai.com/t/websockets-for-responses-api/1374906
- OpenAI Introduces Websocket-Based Execution Mode to Reduce Latency in Agentic Workflows,InfoQ,2026-05,https://www.infoq.com/news/2026/05/openai-websocket-responses-api/
- Streaming comes to API Gateway,Google 开发者博客,2026-10-22,https://developers.googleblog.com/streaming-comes-to-api-gateway-real-time-and-ai-ready-apis-without-changing-your-spec/
引用编号 BL-125