Responses API WebSocket a prueba: ¿compensa si tus herramientas son lentas?
Medimos 4 veces un agente de datos de 5 pasos: las herramientas fueron el 64,4 %–79,4 % del tiempo y el modo WebSocket ahorra solo un 1,5 %–3,9 %.
OpenAI afirma que el modo WebSocket de la Responses API hace que las ejecuciones largas de un agente sean «hasta un 40 % más rápidas». Ese dato sale de agentes de programación, cuyas herramientas leen archivos locales en milisegundos. Nosotros queríamos saber qué ocurre cuando las herramientas son API de datos que tardan segundos. Por eso, el 10 de noviembre de 2026 ejecutamos 4 veces un agente de investigación de 5 pasos contra las API de datos de EveryInfra, a las 00:17, 00:26, 00:49, 01:12 (hora de Singapur, UTC+8). Cada ejecución hizo lo mismo: una búsqueda web, una búsqueda en Reddit, la lectura de un hilo, una búsqueda en YouTube y la descarga de una transcripción.
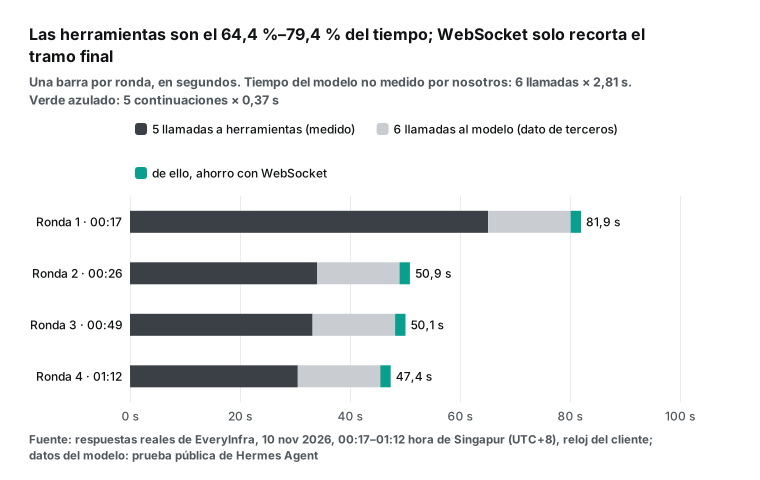
Las cinco llamadas sumaron entre 30,5 y 65,1 segundos por ejecución, con una mediana de 33,6 segundos. No enviamos ni una sola petición de modelo a OpenAI: el tiempo del modelo y el ahorro por turno salen de una prueba pública de terceros, y solo el lado de las herramientas es medición propia. Para el lado del modelo usamos el dato de esa prueba, 2,81 segundos por llamada. Con eso, las herramientas fueron entre el 64,4 % y el 79,4 % del tiempo total. El modo WebSocket solo acelera la «continuación» del modelo después de cada resultado. Una prueba pública de 84 rondas del proyecto Hermes Agent, publicada en GitHub, midió esa ganancia en 0,24 a 0,37 segundos por llamada al modelo. En nuestra cadena, eso es un ahorro del 1,5 % al 3,9 %. Incluso con un tope generoso, que da a cada continuación un 40 % de una llamada al modelo, el ahorro queda entre el 6,9 % y el 11,9 %.
Nuestra respuesta: activa WebSocket, porque es gratis y fácil, pero no esperes que arregle herramientas lentas. Las llamadas en paralelo, los trabajos asíncronos y las funciones más rápidas ahorran mucho más tiempo.
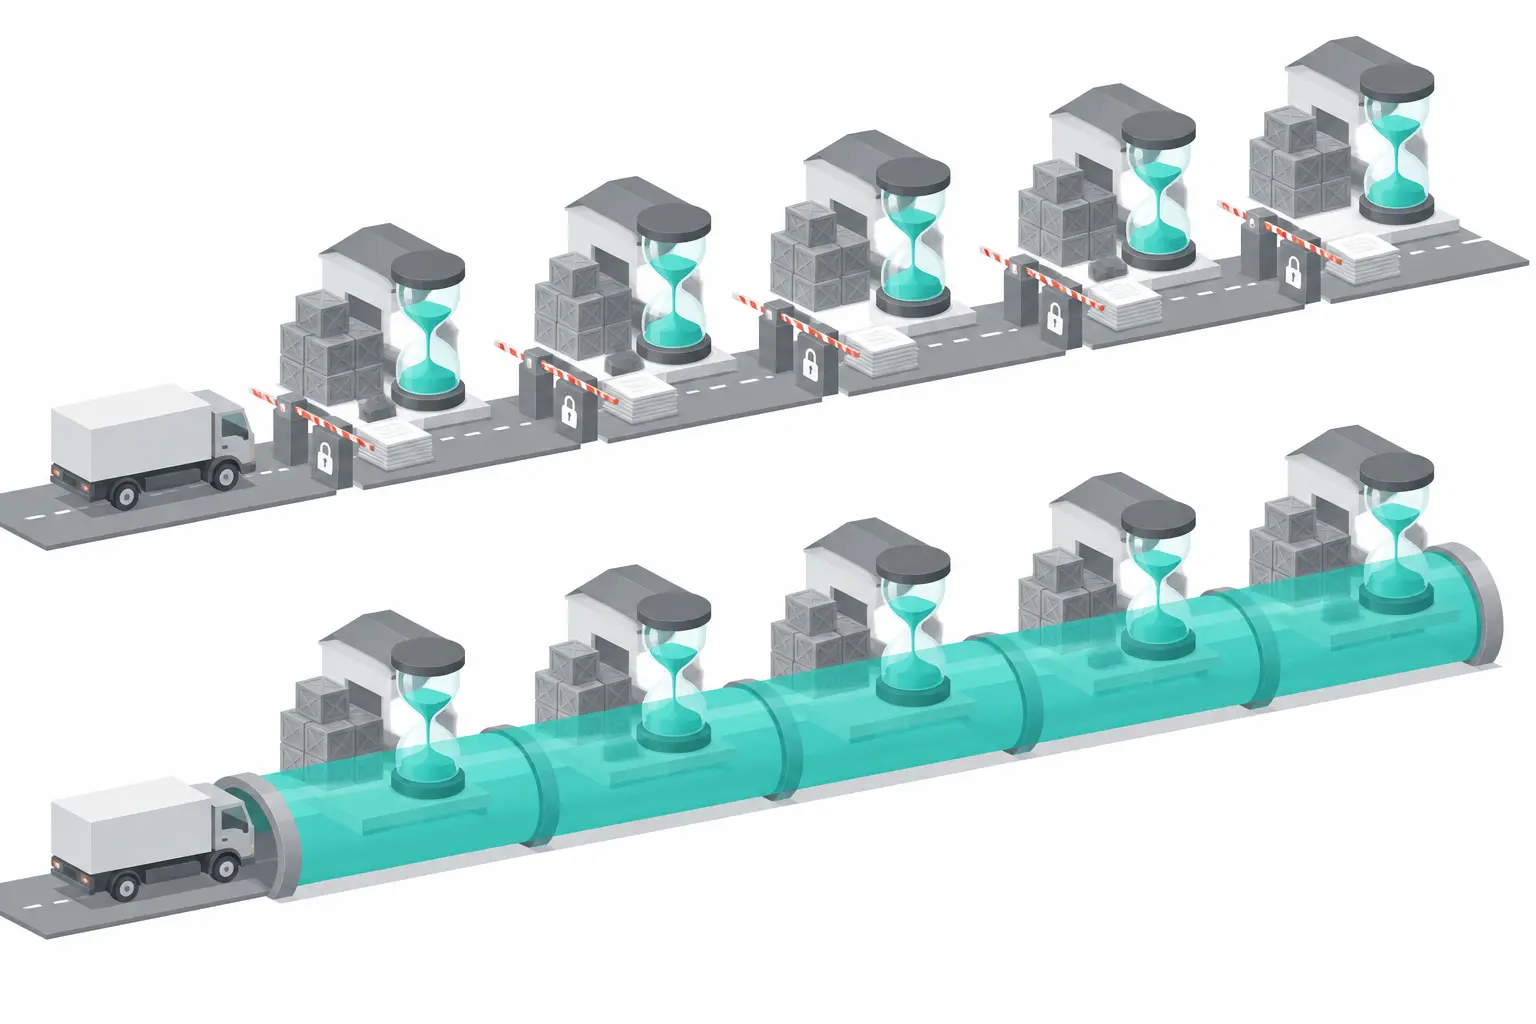
La respuesta corta: cuánto ahorra WebSocket en un agente de datos de 5 pasos
Esta es la cuenta de cada ejecución; las secciones siguientes explican cada parte. El tiempo de herramientas es el reloj del cliente en nuestras llamadas reales, con la red incluida. Cada llamada se cruzó por request_id con la latencia del servidor en el registro de llamadas de la cuenta de prueba.
No ejecutamos modelos de OpenAI, así que no inventamos tiempos del modelo. Usamos una sola medición pública: en la prueba de Hermes Agent, la mediana hasta response.completed por HTTP fue de 2,81 segundos. Un agente con 5 herramientas hace 6 llamadas al modelo: una para decidir la primera herramienta y otra después de cada resultado. Eso suma 16,9 segundos de modelo. WebSocket solo ayuda en las 5 últimas, porque la primera no tiene estado previo que continuar.
| Ejecución | Hora de Singapur | 5 herramientas | Total por HTTP | Peso de herramientas | Ahorro 0,24 s/turno | Ahorro 0,37 s/turno | Tope generoso |
|---|---|---|---|---|---|---|---|
| 1 | 00:17 | 65,1 s | 81,9 s | 79,4 % | 1,5 % | 2,3 % | 6,9 % |
| 2 | 00:26 | 34,0 s | 50,9 s | 66,9 % | 2,4 % | 3,6 % | 11,1 % |
| 3 | 00:49 | 33,2 s | 50,1 s | 66,3 % | 2,4 % | 3,7 % | 11,2 % |
| 4 | 01:12 | 30,5 s | 47,4 s | 64,4 % | 2,5 % | 3,9 % | 11,9 % |
Cada columna de ahorro es el tiempo que quita WebSocket dividido entre el total por HTTP. Los valores de 0,24 s y 0,37 s vienen de la prueba de Hermes Agent: la diferencia media en el tiempo de finalización y la diferencia mediana hasta el primer evento. El «tope generoso» supone que cada continuación ahorra el 40 % de una llamada al modelo. Es decir, carga todo el «hasta un 40 %» de OpenAI sobre la continuación, algo que ningún sistema real consigue.
Aun así, la ejecución más rápida solo ahorra un 11,9 %. Con los datos de terceros, ninguna pasa del 3,9 %, es decir, de 1,20 a 1,85 segundos. Solo el paso de comentarios de Reddit varió más que eso entre dos ejecuciones.
Qué es el modo WebSocket de la OpenAI Responses API
El registro de cambios de la API de OpenAI tiene una entrada del 2026-02-23: «Launched WebSocket mode for the Responses API» (registro de cambios de OpenAI). La guía oficial lo presenta como un modo para flujos largos con muchas llamadas a herramientas (guía del modo WebSocket). El cliente mantiene una conexión persistente con /v1/responses y envía un evento response.create en cada turno. El evento usa los mismos campos que un POST /v1/responses por HTTP, con dos excepciones: no se envía stream, porque el flujo es implícito, y no se admite background (referencia de eventos WebSocket).
La dirección es wss://api.openai.com/v1/responses; la documentación de Pipecat, por ejemplo, la usa como valor por defecto de su variante WebSocket (documentación de Pipecat). Para continuar la conversación, el cliente envía solo los elementos nuevos, como la salida de la última herramienta, más previous_response_id.
La velocidad sale de una caché en memoria ligada a la conexión. Mientras la conexión sigue abierta, el servicio guarda en memoria el estado de la respuesta más reciente. Si continúas desde esa respuesta, el servicio reutiliza el estado. Como no se escribe en disco, el modo es compatible con store=false y con Zero Data Retention (ZDR).
El precio de este diseño: si el previous_response_id no está en la caché, con store=true el servicio puede recuperarlo de lo guardado, pero se pierde la ventaja de latencia de la memoria. Con store=false no hay plan B y la petición falla con previous_response_not_found. Y si una continuación en el mismo carril devuelve un error 4xx o 5xx, ese ID también sale de la caché.
La tabla resume los límites que fija la guía. Ojo con Microsoft Azure: su página sobre la misma función, actualizada el 2026-07-28, dice que una conexión ejecuta una sola respuesta a la vez y sin multiplexación (modo WebSocket en Azure OpenAI). La guía de OpenAI, en cambio, permite hasta 16 respuestas en curso mediante stream_id. Si trabajas con las dos nubes, programa para la más estricta.
| Punto | Lo que dice la guía de OpenAI | Qué significa para un agente |
|---|---|---|
| Lanzamiento | 2026-02-23 (registro de cambios) | Python: openai[realtime]>=3.8.0; Node: openai@^7.10.0 y ws |
| Duración | Hasta 60 minutos; luego websocket_connection_limit_reached | Los trabajos largos deben reconectar; la caché se vacía |
| Concurrencia | Hasta 16 respuestas en curso por conexión; el resto espera | Los resultados en paralelo pueden seguir por carriles distintos |
| Carriles con nombre | Hasta 32 valores de stream_id; orden FIFO dentro de cada carril | Una conexión puede llevar varias conversaciones |
| Caché | Solo en memoria de esa conexión; con store=false, un fallo da previous_response_not_found | Tras una desconexión hay que reenviar todo el contexto |
| Precalentado | response.create con generate: false no genera salida y prepara el estado | Cargar herramientas e instrucciones antes del primer turno real |
| No admitido | Modo background | Los trabajos largos en segundo plano siguen por HTTP |
La función sigue cambiando deprisa. openai-python v3.41.0 (2026-10-28) recupera tramas en cola tras reconectar; v3.42.0 (2026-10-31) añadió el precalentado; y v3.43.0 (2026-11-03) añadió el aislamiento de desbordes por carril (versiones de openai-python). En el Agents SDK, v0.24.0-alpha.6 (2026-11-03) lleva el MCP nativo por la ruta WebSocket del modelo, y alpha.7 (2026-11-08) deja claro que el modo con búfer no usa WebSockets (versiones de openai-agents-python).
La corrección a mitad de turno con response.steer, que OpenAI lanzó en septiembre, solo funciona por WebSocket, y la documentación del modo Ultrafast recomienda WebSocket con insistencia (Mid-turn steering, Ultrafast mode). En resumen, WebSocket está dejando de ser un acelerador opcional para convertirse en requisito de algunas funciones nuevas.
De dónde sale el ahorro: trabajo del servidor, no el saludo inicial
Mucha gente cree que WebSocket ahorra el saludo inicial (el «handshake») de HTTP en cada llamada. No es exacto. Las conexiones HTTP/1.1 son persistentes por defecto y el saludo TCP y TLS se hace una vez por conexión (RFC 9112, sección 9); además, los SDK reutilizan conexiones.
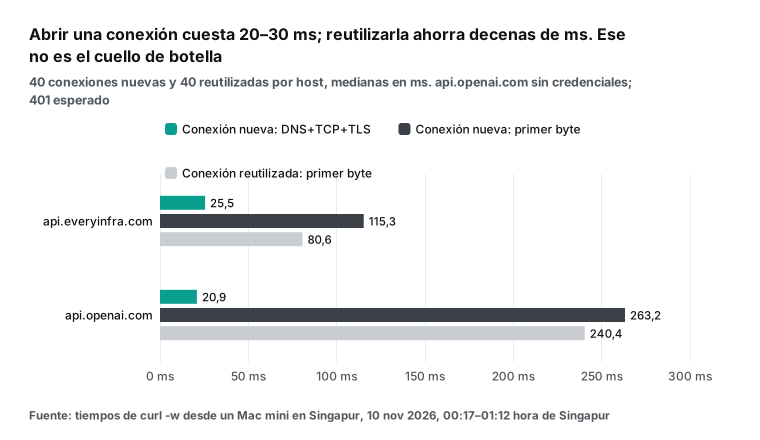
En cada una de nuestras 4 ejecuciones medimos 10 conexiones nuevas y 10 reutilizadas por servidor. Para api.everyinfra.com, DNS más TCP más TLS tuvo una mediana de 25,5 ms y un máximo de 32,6 ms. Para api.openai.com, la mediana fue de 20,9 ms y el máximo de 44,8 ms. Reutilizar la conexión adelantó el primer byte en 34,7 ms y 22,8 ms. Eso es todo el coste de transporte que podemos medir desde nuestro lado: decenas de milisegundos, en torno al 0,1 % de una cadena que tardó entre 30,5 y 65,1 segundos.
¿De dónde sale, entonces, el 40 % de OpenAI? El artículo de ingeniería «Speeding up agentic workflows with WebSockets in the Responses API» divide cada ciclo del agente en tres partes: el trabajo del servicio de la API, la inferencia del modelo y el tiempo de las herramientas en el cliente (artículo de ingeniería de OpenAI). WebSocket recorta la primera. El servicio guarda en la conexión la respuesta anterior, sus elementos de salida, las definiciones de herramientas y los tokens ya procesados. Así, el turno siguiente no vuelve a validar ni a procesar todo el historial.
Según el mismo artículo, Codex pasó pronto la mayor parte de su tráfico a WebSocket. Las cifras de los socios: el AI SDK de Vercel redujo la latencia hasta un 40 %, los flujos de varios archivos de Cline fueron un 39 % más rápidos y los modelos de OpenAI en Cursor ganaron hasta un 30 %.
El vídeo explicativo más visto en YouTube (publicado el 2026-03-04, unas 170.000 visitas cuando lo consultamos), lo dice con palabras más llanas (vídeo). Por HTTP, el agente reenvía la conversación completa tras cada llamada a una herramienta. La caché de prompts evita que el modelo recalcule esos tokens, pero no evita subir esos bytes ni que el servidor los vuelva a procesar. Según el vídeo, el valor real de WebSocket es una garantía: el siguiente turno cae en la misma máquina de la API, que ya tiene tu estado.
Descargamos 50 comentarios y respuestas del vídeo: 7 mencionan las sesiones fijas y 1 pregunta directamente en qué se diferencia de store: true. Todos preguntan lo evidente: si la clave es el estado en el servidor, ¿por qué no usar store: true con previous_response_id, o sesiones fijas («sticky sessions») en el balanceador? La guía de OpenAI responde a lo primero: la continuación con store=true puede recuperar el estado guardado, pero pierde la ventaja de la memoria, que pertenece a una sola conexión.


Si juntamos las dos ideas, el patrón es claro. Un agente de programación gana un 30 % o un 40 % porque sus herramientas son locales: leer un archivo o lanzar grep cuesta milisegundos. En decenas de llamadas, casi todo el tiempo es del modelo y del servicio de la API, y el ahorro del servidor se nota. Un agente de datos llama a herramientas que descargan páginas, buscan en redes sociales o bajan transcripciones. Cada llamada tarda segundos o decenas de segundos, y la fracción de segundo que ahorra el servidor se pierde en ese tiempo.
Lo que midieron otros: 40 % según OpenAI, 39 % según Cline, 0,24 s por turno
Antes de medir, leímos en su fuente original todas las cifras públicas que encontramos. La tabla las agrupa por lo que miden. Un porcentaje de extremo a extremo y una cifra por turno no son lo mismo: el porcentaje depende del número de turnos y de la velocidad de las herramientas de esa prueba. Los segundos por turno sí se pueden trasladar a otro agente.
| Fuente | Fecha | Escenario | Cifra |
|---|---|---|---|
| Guía del modo WebSocket de OpenAI | Leída el 2026-11-10 | Ejecuciones con 20+ llamadas a herramientas | «Hasta un 40 %» más rápido de extremo a extremo |
| Artículo de ingeniería de OpenAI | 2026-04-22 | Vercel AI SDK, Cline, Cursor | Hasta 40 %, 39 %, hasta 30 % |
| Publicación de Cline en X | 2026-02-23 | Tareas simples; tareas complejas de varios archivos | Un 15 %; un 39 %; hasta un 50 % en el mejor caso. El saludo inicial retrasa algo el primer token en tareas cortas |
| Comentario en el PR de Hermes Agent | 2026-10-11 | 84 rondas alternando SSE y WebSocket, unos 15.000 tokens de entrada | Primer evento 0,37 s antes (mediana); finalización 0,16 s (mediana) y 0,24 s (media) antes; TCP+TLS unos 11 ms |
| Vídeo explicativo en YouTube (unas 170.000 visitas) | 2026-03-04 | Explicación que cita a OpenAI | Más de un 90 % menos de ancho de banda; 20 % a 30 % más rápido |
Para un agente de datos, la cifra más útil es la de Hermes Agent (comentario en GitHub). La persona que hizo la prueba estaba en Japón y usó el backend OAuth de Codex con un único modelo. Alternó SSE y WebSocket durante 84 rondas de unos 15.100 tokens de entrada cada una. Desde la petición hasta response.created, SSE tuvo una mediana de 1,00 s y WebSocket de 0,59 s. Hasta response.completed, SSE marcó 2,81 s de mediana y WebSocket 2,61 s, con una diferencia media de 0,24 s.
Su conclusión fue que se trata de una mejora «modesta»: unos 4 segundos en 20 llamadas seguidas. No contradice a OpenAI. Un hilo anterior del mismo proyecto (issue #6057 de Hermes Agent, abierto el 2026-04-08) muestra que los mantenedores descartaron la función al principio porque la ganancia parecía pequeña para la complejidad que añadía.
La publicación de Cline tiene un detalle fácil de pasar por alto: en tareas cortas y simples, el saludo inicial de WebSocket retrasa un poco el primer token (Cline en X). Un agente que solo llama a una o dos herramientas podría incluso ir más lento. El equipo del AI SDK resumió su resultado del día del lanzamiento como un ahorro de «hasta un 40 % del tiempo hasta el primer byte» (AI SDK en X); la publicación de Cursor habló de modelos «hasta un 30 % más rápidos» (publicación en X). Todas estas cifras vienen de agentes de programación con herramientas locales y rápidas.
Los marcos de agentes de código abierto pidieron la función enseguida: el mismo día del lanzamiento apareció en OpenClaw una petición para «acelerar las llamadas múltiples a herramientas» (issue #24830 de OpenClaw). Pero «muchas llamadas» y «llamadas lentas» son problemas distintos. WebSocket resuelve bien el primero; nuestra prueba separa los dos.
Cómo medimos: una cadena de herramientas, 4 horas distintas y dos relojes
La máquina de prueba fue un Mac mini en Singapur con Python 3 y el módulo estándar http.client. Toda la cadena compartió una conexión keep-alive: el primer paso la abrió y los siguientes la reutilizaron, igual que hace un grupo de conexiones en la mayoría de los marcos de agentes. Cada ejecución hizo cinco cosas: medir con curl -w la apertura de conexiones (10 nuevas y 10 reutilizadas por servidor), recorrer la cadena de 5 pasos, repetir el paso 1 con una conexión nueva como control, llamar a una función lenta en modo síncrono y en modo asíncrono, y lanzar un tools/list y un tools/call por MCP.
Las cuatro ejecuciones empezaron a las 00:17, 00:26, 00:49 y 01:12, hora de Singapur. Entre las ejecuciones 1, 3 y 4 hay al menos 20 minutos. La 2 llegó solo 9 minutos después de la 1, porque repetimos tras corregir el script de consulta.
La cadena imita una tarea de investigación habitual: «¿qué opinan los desarrolladores de esta API?». El paso 1 usa nuestra API de búsqueda web. Los pasos 3 y 5 dependen del resultado anterior, así que no pueden ir en paralelo. Esta forma de «un turno tras otro» es justo lo que el modo WebSocket quiere acelerar.
| Paso | Función | Entrada | Depende de |
|---|---|---|---|
| 1 | search/web | «openai responses api websocket», 10 resultados | — |
| 2 | reddit/search | «responses api websocket», 10 resultados | — |
| 3 | reddit/comments | primera publicación del paso 2, 20 comentarios | Paso 2 |
| 4 | youtube/search | «openai websocket mode responses api», 10 resultados | — |
| 5 | youtube/transcript | primer vídeo del paso 4 | Paso 4 |
Usamos dos relojes. El del cliente va desde el envío de la petición hasta leer el cuerpo completo de la respuesta, red incluida. El del servidor sale del registro de llamadas de la cuenta de prueba (GET /portal/api/logs en la consola, que guarda latency_ms de cada llamada), cruzado por request_id. La diferencia es el coste de transporte de nuestro lado: red, TLS y transferencia del cuerpo.
Nuestra clave de prueba tenía un límite de 10 llamadas por minuto. Por eso dejamos 7 segundos entre llamadas de pago y respetamos Retry-After en cada 429; las llamadas rechazadas no se cobran ni entran en los resultados. No enviamos ninguna petición de modelo a OpenAI. A api.openai.com solo le medimos la conexión, sin credenciales, y el 401 de respuesta era el esperado. Cada cifra del lado de OpenAI en este artículo sale de las fuentes de la sección anterior.
Prueba 1: cuánto tarda cada paso
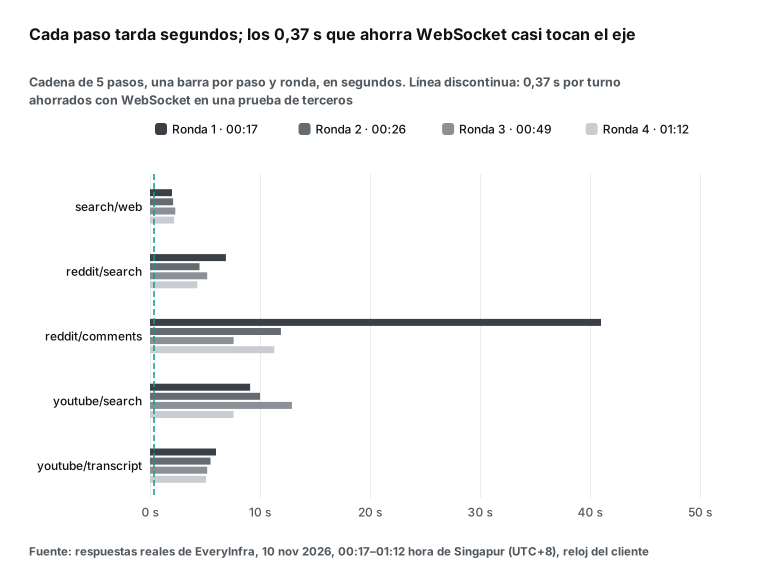
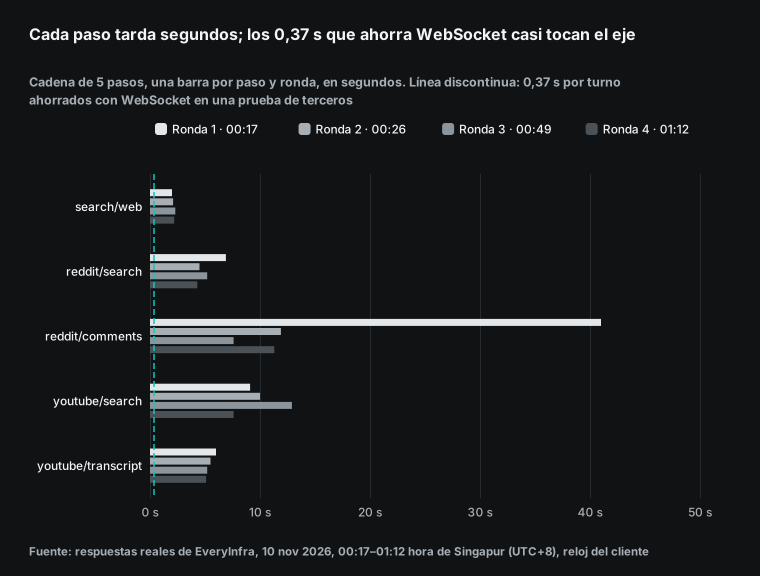
Estos son los tiempos de cada paso en cada ejecución, con el reloj del cliente y en segundos. La búsqueda web fue la más rápida y estable, entre 2,0 y 2,3 s. Leer comentarios de Reddit fue lo más variable: 7,6 s en el mejor caso y 41,0 s en el peor, con la misma publicación y los mismos 20 comentarios. La búsqueda en YouTube se movió entre 7,6 y 12,9 s, y las transcripciones entre 5,1 y 6,0 s.
Casi toda la diferencia entre ejecuciones sale de ese paso. La ejecución 1 sumó 65,1 s, y solo la lectura de comentarios fue el 63 %. Sin ese paso, los otros cuatro sumaron entre 19 y 26 s en todas las ejecuciones, menos de 7 s de diferencia. La más rápida fue la ejecución 4 (a las 01:12, hora de Singapur), con 30,5 s. El tiempo total de una cadena dependiente lo marca su paso menos estable; para planificar capacidad, usa el p95 de cada paso y no la media.
| Paso | Función | Ejec. 1 | Ejec. 2 | Ejec. 3 | Ejec. 4 | Mediana |
|---|---|---|---|---|---|---|
| 1 | search/web | 2,0 | 2,1 | 2,3 | 2,2 | 2,2 |
| 2 | reddit/search | 6,9 | 4,5 | 5,2 | 4,3 | 4,9 |
| 3 | reddit/comments | 41,0 | 11,9 | 7,6 | 11,3 | 11,6 |
| 4 | youtube/search | 9,1 | 10,0 | 12,9 | 7,6 | 9,6 |
| 5 | youtube/transcript | 6,0 | 5,5 | 5,2 | 5,1 | 5,4 |
| Total | 5 llamadas | 65,1 | 34,0 | 33,2 | 30,5 | 33,6 |
La diferencia entre el reloj del cliente y el del servidor es el coste de transporte que vemos. En 20 llamadas síncronas, la mediana fue de 179 ms, la mínima de 108 ms y la máxima de 556 ms. La máxima fue una búsqueda en YouTube con un cuerpo de 26 KB, así que casi todo es tiempo de transferencia. Aunque desapareciera todo nuestro coste de red, los cinco pasos ahorrarían menos de un segundo frente a decenas de segundos de trabajo de las herramientas.
Un detalle nos sorprendió: cada respuesta síncrona trae un campo async_hint. Dice que la llamada fue síncrona y que, para tareas lentas o límites grandes, se puede añadir "mode":"async" para recibir al momento un identificador de trabajo y consultarlo después. La propia API le dice al agente que no espere de brazos cruzados.
Por función, las medianas del cliente y del servidor cuentan lo mismo: la diferencia es de una o dos centenas de milisegundos en cada paso, poca cosa frente a los segundos de trabajo.
| Función | Reloj del cliente (mediana) | Tiempo del servidor (mediana) | Diferencia (mediana) |
|---|---|---|---|
search/web | 2,16 s | 1,81 s | 228 ms |
reddit/search | 4,86 s | 4,70 s | 160 ms |
reddit/comments | 11,60 s | 11,29 s | 214 ms |
youtube/search | 9,55 s | 9,22 s | 177 ms |
youtube/transcript | 5,36 s | 5,24 s | 125 ms |
La mayor diferencia puntual fue una llamada a youtube/search, cuyo cuerpo es el más grande, unos 26 KB, y casi todo ese extra es transferencia. En mediana, las cinco diferencias están entre 125 y 228 ms, y youtube/transcript, con unos 4 KB, tiene la menor. Un limit más pequeño recorta a la vez el tiempo del servidor y el de transferencia.
Compara la variación de cada paso con lo que ahorra WebSocket. Los comentarios de Reddit cambiaron decenas de segundos entre ejecuciones; WebSocket ahorra una fracción de segundo por turno, unas cien veces menos. Si tu agente va lento, busca primero qué herramienta es lenta y por qué, no cómo te conectas. Nuestra API de comentarios de Reddit acepta limit, y menos comentarios llegan antes. La API de búsqueda de YouTube y la API de transcripciones de YouTube fueron estables en nuestras pruebas, lo que las hace buenas para los pasos intermedios de una cadena.
Prueba 2: conexión nueva frente a conexión reutilizada
| Servidor | Apertura, conexión nueva (mediana) | Más lenta | Primer byte, nueva | Primer byte, reutilizada | Ahorro al reutilizar |
|---|---|---|---|---|---|
api.everyinfra.com | 25,5 ms | 32,6 ms | 115,3 ms | 80,6 ms | 34,7 ms |
api.openai.com | 20,9 ms | 44,8 ms | 263,2 ms | 240,4 ms | 22,8 ms |
La tabla descarta una creencia común: el modo WebSocket no es más rápido por saludar menos veces. Por HTTP, el SDK ya reutiliza conexiones y abrir una nueva cuesta 20 a 30 ms. La prueba de Hermes Agent midió TCP más TLS en unos 11 ms, el mismo orden que nosotros. Su diferencia por turno fue de 240 a 370 ms, diez veces más, y eso solo puede venir de trabajo que el servidor deja de hacer. En cada ejecución repetimos además el paso 1 con una conexión nueva, y TCP más TLS tardó entre 24,5 y 28,4 ms: incluso un marco que abriera una conexión por llamada solo añadiría unos cien milisegundos en cinco pasos. Así que «mi servidor de herramientas está lejos y el saludo es lento» no es motivo para cambiar. «Mi agente llama al modelo decenas de veces con un contexto grande», sí.
Prueba 3: ¿esperar a una herramienta lenta o enviarla y consultar?
Algunas herramientas de datos son lentas por naturaleza. Elegimos twitter/search (API de búsqueda de X), una de las funciones más usadas y más lentas de nuestros datos de 30 días. En cada ejecución la llamamos una vez en modo síncrono y otra en asíncrono, 20 resultados cada vez. La llamada síncrona tardó entre 22,1 y 27,5 s, con una mediana de 23,7 s, y el agente no pudo hacer nada mientras tanto.
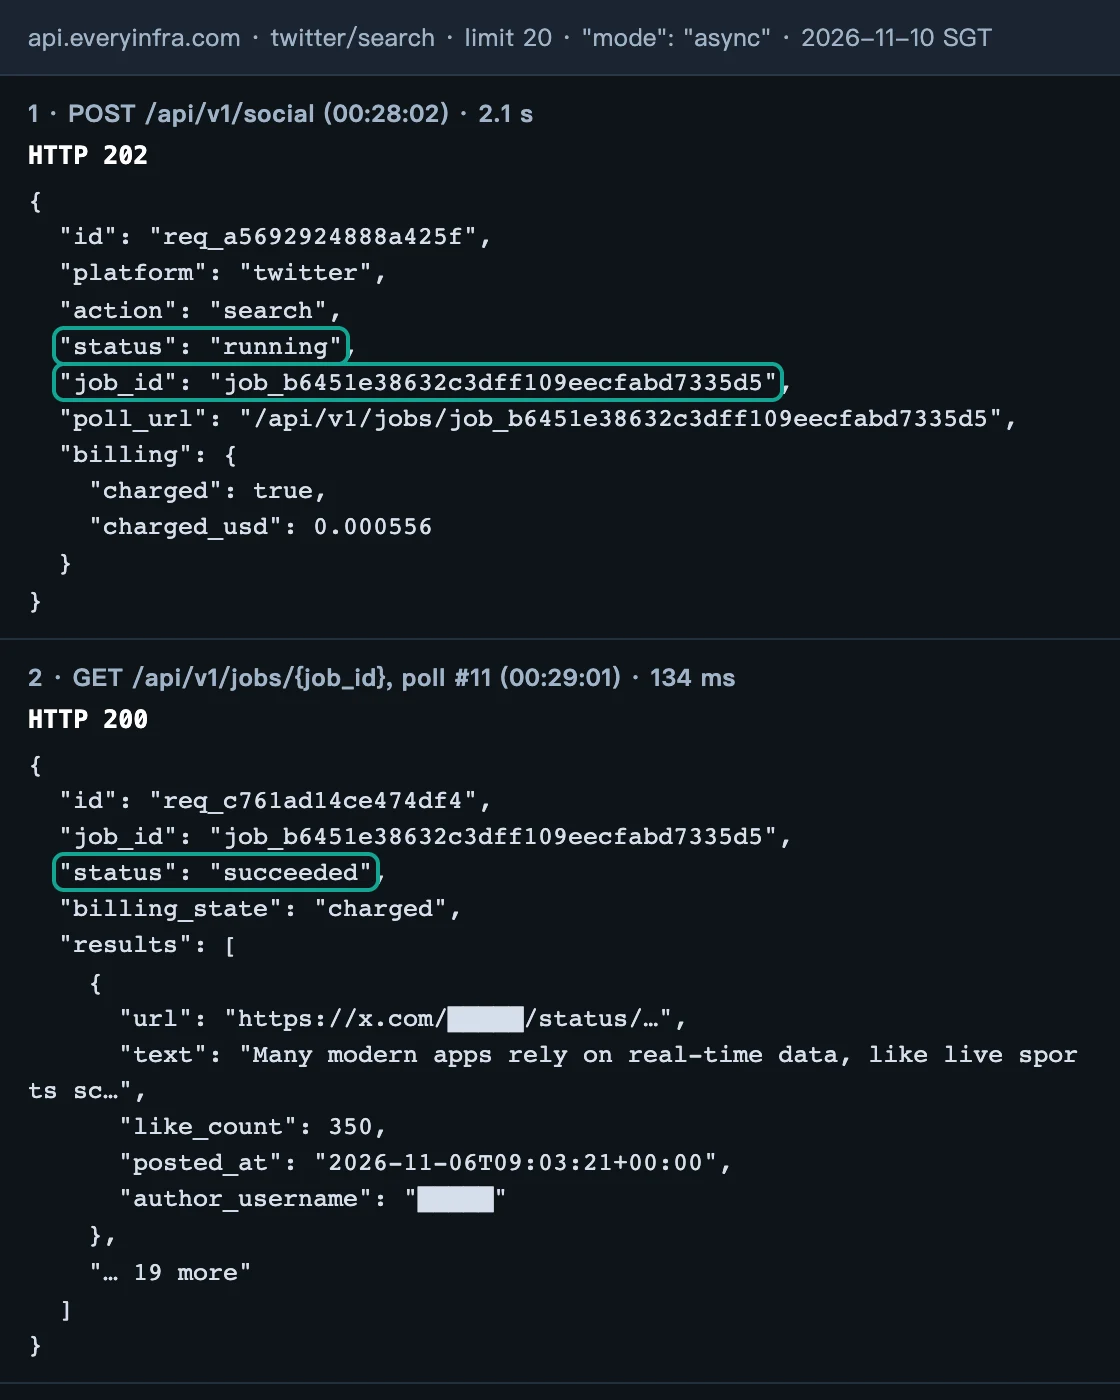
La llamada asíncrona añade "mode": "async" al cuerpo. La API respondió con HTTP 202 y un job_id en 2,43 s (mediana). Después consultamos GET /api/v1/jobs/{job_id} cada 5 segundos y el estado pasó de running a finalizing y a succeeded. En 4 ejecuciones hicimos 36 consultas, con una mediana de 88 ms y un rango de 59 a 773 ms; no se cobran.
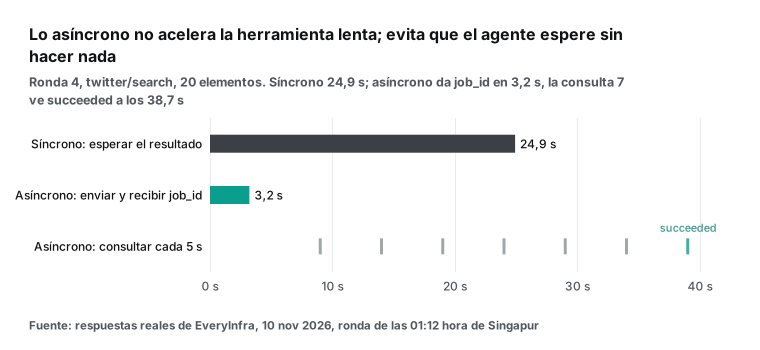
Hay que decirlo claro: el modo asíncrono no hace más rápida la herramienta. Seguimos hasta succeeded 3 trabajos asíncronos (en la ejecución 1, el script de consulta se detuvo antes de tiempo en finalizing, así que no la contamos; una lectura gratuita posterior confirmó que terminó con 20 resultados). Desde el envío hasta succeeded tardaron 38,5, 38,7, 58,4 s, siempre más que la llamada síncrona.
El desglose lo explica. Cada trabajo pasó a finalizing entre 23 y 48 s después del envío, del mismo orden que la llamada síncrona (22,1 a 27,5 s). La fase finalizing sumó otros 10 a 15 s, y el intervalo de 5 segundos entre consultas puede añadir hasta 5 s más. Los mismos datos sirven para fijar el ritmo de consulta: todas las consultas de los primeros 23 s devolvieron running, así que la primera puede esperar unos 20 s y luego seguir cada 5 s. Eso ahorra dos o tres peticiones por trabajo y algo de cuota por minuto.
Su valor está en que el agente recupera esos 20 y pico segundos: puede lanzar otras llamadas, responder al usuario o dejar que el modelo trabaje con lo que ya tiene.
Las llamadas asíncronas a herramientas de OpenAI (async: true), lanzadas el 2026-09-03 junto con GPT-6 Astra, siguen la misma idea. El modelo envía la llamada, sigue trabajando y recoge el resultado después con un paso de espera (Async tool calling).
Prueba 4: una ida y vuelta por MCP
Muchos equipos no escriben funciones de herramientas: conectan a su agente el servidor MCP remoto de EveryInfra (https://api.everyinfra.com/mcp, ver la página del servidor MCP). Usamos MCP una vez por ejecución. tools/list devolvió 12 herramientas en unos 16,3 KB de JSON, con una mediana de 100 ms y sin coste (la ejecución 1 fue la más lenta, 264 ms; las otras tres tardaron de 71 a 125 ms). tools/call lanzó everyinfra_search con la misma búsqueda web; las 3 llamadas que pasaron tardaron 2,26 s de mediana, cerca de los 2,2 s del search/web por REST.
La llamada de la ejecución 1 chocó con el límite de velocidad. Atención: MCP informa de ese límite con HTTP 200 y un resultado JSON-RPC con isError, no con un 429. La lógica de reintento tiene que buscar rate_limited en el cuerpo.
Hay tres formas de conectar herramientas MCP a la Responses API, y cambian quién ejecuta la herramienta y qué puede ahorrar WebSocket:
| Forma | Quién ejecuta la herramienta | Ida y vuelta por llamada | Qué cambia WebSocket |
|---|---|---|---|
| Herramienta de función; tu código llama a la API REST | Tu proceso | Modelo → tú → EveryInfra → tú → modelo | Una continuación ahorrada cada vez que devuelves un resultado |
MCP alojado (type: "mcp") | Los servidores de OpenAI | OpenAI → EveryInfra → OpenAI, sin pasar por ti | Una respuesta puede hacer varias llamadas, así que hay menos continuaciones que ahorrar |
MCPServerStreamableHttp del Agents SDK | Un cliente MCP en tu proceso | Igual que una herramienta de función | Igual que una herramienta de función |
La fila del MCP alojado es la clave para decidir. La guía de MCP de OpenAI dice tres cosas: el modelo puede hacer varios mcp_call en una misma respuesta, la lista de herramientas (mcp_list_tools) no se vuelve a pedir mientras siga en el contexto y las llamadas MCP no tienen tarifa propia por llamada (guía de MCP y conectores). Con esta forma, los resultados no vuelven antes a tu proceso, así que hay menos continuaciones que acelerar, y el tiempo de la herramienta sigue igual.
La referencia de eventos WebSocket incluye mcp entre los tipos de herramienta de response.create, y el alpha.6 del Agents SDK lleva el MCP nativo por WebSocket, así que puedes combinar ambos. Solo que no esperes que las ganancias se sumen mucho.
30 días y 8823 llamadas: las herramientas de datos tardan segundos
Unas decenas de llamadas en cuatro ejecuciones podrían ser casualidad. Por eso sacamos también el informe de calidad de 30 días que la cuenta de prueba ve en su consola (del 2026-10-11 al 2026-11-09, fechas UTC). Solo incluye las llamadas de esta cuenta y mide la latencia solo de las llamadas con éxito.
En ese periodo hubo 8823 llamadas y 8070 con éxito, una tasa del 91,5 % (los resultados vacíos cuentan como éxito). 45 funciones tenían 30 muestras o más. Su mediana fue de 1,0 s en la más rápida y de 32,7 s en la más lenta. El 84,4 % de esas funciones tenía una mediana superior a 2 s y el 68,9 %, superior a 5 s. Ponderada por número de llamadas, la mediana fue de unos 2,1 s.
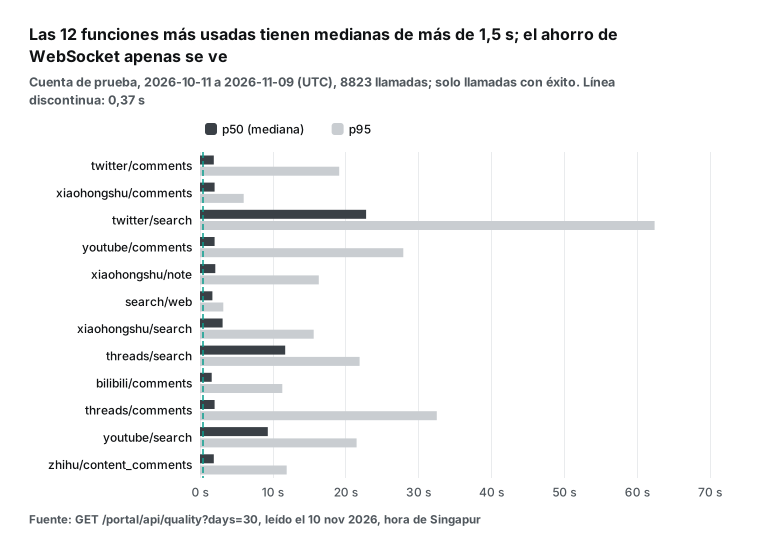
Las funciones más rápidas del gráfico, como las de comentarios y la búsqueda web, rondan los 2 segundos de mediana. Las de búsqueda van más lentas: twitter/search tiene una mediana de 22,8 s y un p95 de 62,4 s; threads/search, 11,7 s; y youtube/search, 9,3 s. El p95 suele ser varias veces la mediana: más o menos una llamada de cada veinte tarda mucho más. Para un agente, el p95 importa más que la mediana, porque en una cadena de 5 pasos dependientes basta un paso en el p95 para frenar todo. En este gráfico, el ahorro de WebSocket por turno es una raya pegada al eje.
Las cuentas de un agente de 5 pasos: transporte frente a herramientas
Pongamos todo en una fórmula. Sea t el tiempo medio por llamada a una herramienta y M el tiempo por llamada al modelo. Un agente que hace n llamadas a herramientas hace n+1 llamadas al modelo, y WebSocket ahorra s segundos en cada una de las n continuaciones. La parte ahorrada es:
parte ahorrada = n × s ÷ ((n+1) × M + n × t)
Aquí, n = 5 y M = 2,81 s. Con s = 0,24 s de Hermes Agent, una tarea solo de modelo (t = 0) ahorra un 7,1 %. Con s = 0,37 s, un 11,0 %. Con el tope generoso (40 % del tiempo del modelo por continuación), un 33,3 %, en línea con el «hasta un 40 %» de OpenAI para 20 o más llamadas. Eso indica que la fórmula no subestima a WebSocket. Cuando t crece, la parte ahorrada cae rápido.
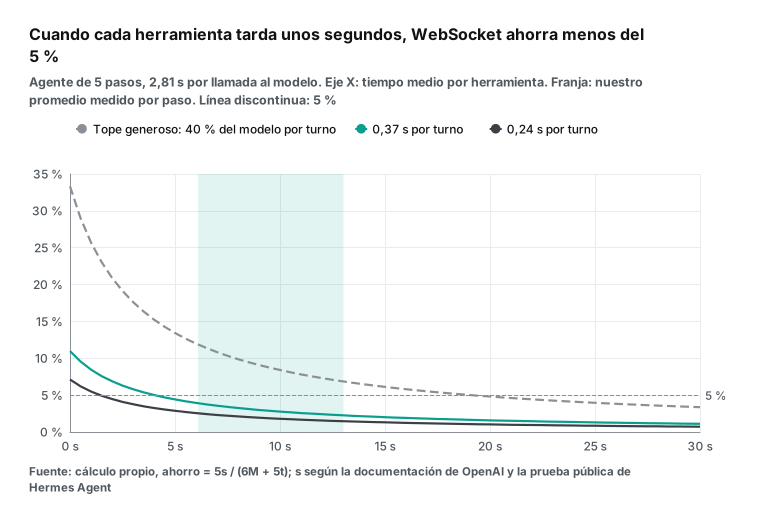
La cuenta inversa es más práctica: ¿cuánto puede tardar cada herramienta si quieres que WebSocket ahorre al menos cierta parte? La tabla da el resultado para un agente de 5 pasos con 2,81 s por llamada al modelo.
| Ahorro por continuación | Herramienta para ≥10 % | Herramienta para ≥5 % | Herramienta para ≥2 % | Con herramientas a 0 s |
|---|---|---|---|---|
| 0,24 s (media de terceros) | Imposible | ≤ 1,4 s | ≤ 8,6 s | 7,1 % |
| 0,37 s (mediana de terceros, primer evento) | ≤ 0,3 s | ≤ 4,0 s | ≤ 15,1 s | 11,0 % |
| 40 % del modelo (tope generoso) | ≤ 7,9 s | ≤ 19,1 s | ≤ 52,8 s | 33,3 % |
Nuestra cadena promedió entre 30,5 ÷ 5 y 65,1 ÷ 5 segundos por paso, es decir, unos 6 a 13 segundos. Eso cae en la zona de «menos del 5 %» de la tabla; solo la fila del tope generoso se acerca. Esta es la respuesta numérica a «¿compensa WebSocket con herramientas lentas?». Con el ahorro por turno de terceros, si cada herramienta tarda más de unos 4,0 s, ahorras menos del 5 %; por encima de unos 15,1 s, menos del 2 %.
En el caso contrario, con herramientas rápidas (archivos locales, una caché en memoria), muchos turnos (20 o más) y un contexto grande (decenas de miles de tokens por llamada), puedes esperar ganancias cercanas al 30 % o 40 % que publican OpenAI y Cline.
El número de turnos, n, importa menos de lo que parece. Más turnos dan más segundos ahorrados, pero la parte casi no cambia, porque el numerador y el denominador crecen con n. Con n grande, la parte tiende a s ÷ (M + t). Así que «mi agente llama a 50 herramientas» no es motivo suficiente para cambiar; «cada herramienta es rápida», sí. Para un agente de datos con s = 0,37 s y t = 10 s, ese límite es de un 2,9 %.
Cuatro tipos de agente con la misma fórmula: ¿cuándo importa WebSocket?
Una sola cadena no lo cuenta todo, así que pasamos cuatro tipos de agente habituales por la misma fórmula. El modelo tarda 2,81 s por llamada en todas las filas. Los tiempos de herramientas son valores típicos que fijamos para cada caso, no mediciones; la fila de investigación usa la mediana de nuestra cadena medida (33,6 segundos en cinco herramientas).
| Tipo de agente | Llamadas | Tiempo total de herramientas (supuesto) | Ahorro 0,24 s/turno | Ahorro 0,37 s/turno | Tope generoso |
|---|---|---|---|---|---|
| Agente de programación: lee archivos y busca texto, unos 0,08 s por llamada | 25 | 2 s | 8,0 % | 12,3 % | 37,4 % |
| Agente de investigación: nuestra cadena de datos de 5 pasos | 5 | 33,6 s (mediana medida) | 2,4 % | 3,7 % | 11,1 % |
| Vigilancia de precios en una tienda online: 8 consultas de 1,5 s | 8 | 12 s | 5,1 % | 7,9 % | 24,1 % |
| Seguimiento de marca en redes: 3 búsquedas sociales de 12 s | 3 | 36 s | 1,5 % | 2,3 % | 7,1 % |
La fila de programación llega al 37,4 % con el tope generoso, en línea con el «hasta un 40 %» de OpenAI y el 39 % de Cline en tareas complejas. La fórmula reproduce las cifras oficiales cuando las herramientas son rápidas, y por eso sus resultados pequeños con herramientas lentas merecen confianza. La vigilancia de precios es el término medio: consultas de 1,5 segundos dejan un 5 % a 8 % con datos de terceros, algo que se nota. El seguimiento de marca, con búsquedas sociales de 12 segundos, se queda en un 1,5 % a 2,3 %: ahí WebSocket casi no aporta.
Para decidir, estima dos números: cuántas herramientas llama tu agente y cuánto tarda cada una de media. Si la media está por debajo de 1 segundo y hay 10 llamadas o más, casi siempre compensa activar WebSocket. Si pasa de 5 segundos, arregla primero las herramientas y deja WebSocket para el final. Y si necesitas la corrección a mitad de turno, o el modo Ultrafast, cuya documentación recomienda WebSocket con insistencia, la pregunta ya no es si compensa, sino si necesitas esas funciones.
Cómo medir tu propio agente: separa el tiempo del modelo y el de las herramientas
La fórmula solo necesita dos datos, pero muchos equipos no los tienen; solo saben que «la tarea tardó 80 segundos». Te proponemos registrar estas marcas de tiempo en el bucle del agente. Suma los dos tipos de tiempo y compáralos con el total: lo que falta es espera en cola y transporte de tu lado.
| Marca | Evento | Qué te dice |
|---|---|---|
| T1 | Envías response.create | Empieza un turno del modelo |
| T2 | Llega response.created | T2 − T1: tiempo hasta el primer evento |
| T3 | Llega response.completed | T3 − T1: tiempo del modelo en ese turno |
| T4, T5 | Empieza y termina una llamada a herramienta | T5 − T4: tiempo de la herramienta; compáralo con latency_ms del registro |
El lado de las herramientas se puede dividir un poco más. Cada respuesta de EveryInfra trae un id (el request_id), y el registro de llamadas de la consola muestra el latency_ms del servidor para ese ID. El reloj del cliente menos ese valor es red y transferencia. En nuestras pruebas, la mediana fue de solo 179 ms. Para la mayoría de los agentes en la nube, el tiempo de las herramientas es casi todo trabajo real del servidor: lo que hay que ajustar es la elección de funciones, los parámetros, el paralelismo y el modo asíncrono, no la red.
Con estos datos, ejecuta el mismo lote de tareas por HTTP y por WebSocket una docena de veces cada uno, alternando los dos, y compara medianas y medias como hizo la prueba de Hermes Agent. Ese es tu ahorro real con tu carga de trabajo.
Con herramientas lentas, haz estas cuatro cosas antes que WebSocket
Primero, ejecuta en paralelo las llamadas independientes. En nuestra cadena, los pasos 1, 2 y 4 no dependen entre sí: la búsqueda web, la de Reddit y la de YouTube pueden salir a la vez. En la ejecución 1, los tres pasos sumaron 2,0 + 6,9 + 9,1 s en serie; en paralelo, el tiempo es el del paso más lento, unos 9,1 s. Eso quita casi 9 segundos, decenas de veces el ahorro completo de WebSocket en la ejecución.
La Responses API permite por defecto que el modelo emita varias llamadas en un turno (parallel_tool_calls), pero tu ejecutor de herramientas tiene que lanzarlas a la vez de verdad. Los carriles stream_id de WebSocket permiten además llevar varias subtareas independientes en una conexión.
Segundo, pasa a asíncrono las herramientas lentas. WebSocket recorta el tiempo que el modelo te espera a ti; el modo asíncrono, el que tú esperas a la herramienta. Un twitter/search síncrono bloquea más de 20 segundos, lo mismo que ahorra WebSocket en unos cien turnos de la prueba de Hermes Agent. Con mode: async recibes un job_id en unos 2 segundos y el agente puede seguir. Con las llamadas asíncronas de OpenAI, el modelo tampoco se detiene a esperar. No consultes demasiado a menudo: nuestra clave de prueba solo admite 10 llamadas por minuto. Las consultas son gratis, pero en la ejecución 1 consultábamos cada 2 segundos y, sumado al resto de llamadas, eso empujó una llamada MCP al límite de velocidad. Con consultas cada 5 segundos no volvió a pasar.
Tercero, elige funciones más rápidas y pide menos datos. Para saber «qué opinan los desarrolladores», en nuestras ejecuciones la búsqueda web tuvo una mediana de 2,2 segundos, la de Reddit de 4,9 y la de YouTube de 9,6. Si los 10 primeros resultados web bastan, llama a las demás solo si hace falta. limit también influye en la latencia: 20 comentarios y 100 comentarios no se diferencian solo en el precio. Con MCP alojado, allowed_tools expone solo las herramientas necesarias y deja fuera del contexto buena parte de los 16 KB de tools/list.
Cuarto, guarda en caché los resultados de las herramientas. Los agentes de investigación suelen repetir la misma palabra clave o la misma publicación en una sesión. Guarda los resultados por parámetros unos minutos y la segunda llamada tardará cero segundos. Que la caché sea corta: en nuestras cuatro ejecuciones, la misma palabra clave en reddit/search con límite 10 devolvió 8, 8, 6 y 7 publicaciones en menos de una hora, porque el contenido de las comunidades cambia. De unos minutos a un cuarto de hora es un margen prudente. No es la caché de WebSocket: WebSocket guarda el estado de la conversación del lado del modelo; tú guardas datos del lado de las herramientas, y para un agente de datos eso pesa mucho más. Hechas estas cuatro cosas, el peso del modelo en el tiempo total sube y entonces WebSocket rinde más.
| Medida | Lo que ahorró o costó en nuestras pruebas | Esfuerzo |
|---|---|---|
| Pasos 1, 2 y 4 en paralelo | Unos 9 s en la ejecución 1 | Un grupo de hilos en el ejecutor |
twitter/search con mode: async | Libera más de 20 s del agente por llamada | Consultar una URL cada 5 s |
| Usar la búsqueda web cuando basta | Mediana de 2,2 s frente a 4,9–9,6 s | Cambiar el orden de herramientas en el prompt |
| Caché de resultados por parámetros | 0 s en una consulta repetida | Un pequeño almacén clave-valor |
| Activar WebSocket | 1,20 a 1,85 s por ejecución | Un ajuste en el SDK |
Ejemplo de configuración: Responses API por WebSocket con una herramienta de EveryInfra
Esto es un ejemplo de configuración: no lo ejecutamos con una clave de OpenAI. La parte de WebSocket sigue el ejemplo en Python de la guía de OpenAI; la parte de la herramienta llama a la misma API que probamos en real. Tres ideas: abre una conexión persistente con client.responses.connect(), llama a EveryInfra con una requests.Session (que reutiliza su conexión) y, tras cada resultado, envía solo los elementos function_call_output y previous_response_id.
# Ejemplo de configuración: pip install "openai[realtime]>=3.8.0" requests
import json, os, requests
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI()
ei = requests.Session()
ei.headers["Authorization"] = "Bearer " + os.environ["EVERYINFRA_API_KEY"]

TOOLS = [{
    "type": "function",
    "name": "everyinfra_social",
    "description": "Public social data, e.g. youtube/search or reddit/comments.",
    "parameters": {
        "type": "object",
        "properties": {
            "platform": {"type": "string"},
            "action": {"type": "string"},
            "params": {"type": "object"},
            "mode": {"type": "string", "enum": ["sync", "async"]},
        },
        "required": ["platform", "action", "params"],
    },
}]

def run_tool(call):
    r = ei.post("https://api.everyinfra.com/api/v1/social",
                json=json.loads(call.arguments), timeout=120)
    return {"type": "function_call_output", "call_id": call.call_id, "output": r.text}

with client.responses.connect() as conn, ThreadPoolExecutor(max_workers=4) as pool:
    prev = None
    new_input = [{"role": "user", "content": "¿Qué dicen en YouTube y Reddit del modo WebSocket de OpenAI?"}]
    while True:
        conn.response.create(model="gpt-6.1-sol", store=False, tools=TOOLS,
                             previous_response_id=prev, input=new_input)
        for ev in conn:
            if ev.type == "response.completed":
                resp = ev.response
                break
            if ev.type in {"response.failed", "response.incomplete", "error"}:
                raise RuntimeError(ev.to_json())
        calls = [o for o in resp.output if o.type == "function_call"]
        if not calls:
            print(resp.output_text)
            break
        prev = resp.id
        new_input = list(pool.map(run_tool, calls))  # llamadas del mismo turno en paralelo
Si usas el OpenAI Agents SDK, cambiar el transporte es una línea: set_default_openai_responses_transport("websocket"). También puedes poner use_responses_websocket=True en OpenAIProvider y ajustar los pings con responses_websocket_options (documentación de modelos del Agents SDK). El bucle de arriba lanza en paralelo las llamadas de un mismo turno, la primera medida de la sección anterior. Para funciones lentas, el modelo puede pasar "mode": "async" y tu código consulta GET /api/v1/jobs/{job_id}; esa parte sí la probamos en real.
Ejecuciones largas: el límite de 60 minutos, las reconexiones y el precalentado
Los agentes de datos tienen otra diferencia con los de programación: sus ejecuciones son largas. Una pasada de investigación de 5 pasos dura entre medio minuto y un minuto. Si recorres decenas de palabras clave con comentarios y transcripciones para cada una, la ejecución puede durar de 30 a 60 minutos, justo en el límite de la conexión.
La guía de OpenAI da tres formas de recuperarse. Si guardaste una respuesta (store=true) y tienes un ID válido, continúa desde ahí. Si no puedes continuar (con store=false o tras previous_response_not_found), pon previous_response_id a nulo y envía todo el contexto. Si el contexto es demasiado largo, compáctalo con /responses/compact y usa la ventana compactada como entrada nueva. Para agentes de datos, te recomendamos abrir una conexión nueva al terminar cada subtarea, por ejemplo cada palabra clave, en lugar de esperar al corte forzoso de los 60 minutos. Así la reconexión cae siempre entre dos subtareas.
El precalentado también ayuda. Un response.create con generate: false no devuelve salida, pero carga en la conexión las definiciones de herramientas y las instrucciones; su ID puede ser el previous_response_id del turno siguiente. Si tus definiciones son grandes, por ejemplo las 12 herramientas del servidor MCP de EveryInfra (unos 16,3 KB), la primera petición real tendrá menos que procesar. La multiplexación encaja con un diseño de «un carril por palabra clave»: varias subtareas en una conexión con distintos stream_id, cada una en orden FIFO y con su propio estado. No pases de 16 respuestas en curso o el resto esperará en cola; y recuerda que Azure no lo admite hoy.
Una ida y vuelta real
Esta es la petición y la respuesta reales del paso 2 de la ejecución 2 (enviada a las 00:26:12, hora de Singapur; 4,5 s de reloj del cliente; 8 resultados). Dejamos solo los campos relevantes y quitamos los nombres de usuario. async_hint es el aviso tal como lo devolvió la API.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"reddit","action":"search","params":{"keyword":"responses api websocket","limit":10}}'{
"id": "req_c7040939545343c3",
"platform": "reddit",
"action": "search",
"count": 8,
"results": [
{"title": "Websocket or REST?", "community": "r/Backend", "comment_count": 25, "posted_at": "2026-10-23T23:12:38+00:00"},
{"title": "Responses WebSocket Error", "community": "r/codex", "comment_count": 1, "posted_at": "2026-10-21T16:12:06+00:00"}
],
"billing": {"charged": true, "charged_usd": 0.000556},
"async_hint": "this call was synchronous; add \"mode\":\"async\" to the request body to get a job_id immediately (poll GET /api/v1/jobs/{job_id}) for slow tasks or large limits"
}El segundo resultado recuerda que la función todavía tiene asperezas: el 2026-10-21, alguien en r/codex preguntó por un «Responses WebSocket Error» que se repetía (hilo). Es el contexto de las versiones de openai-python de finales de octubre y principios de noviembre, que corrigieron la recuperación tras reconectar y el aislamiento por carril.
Coste: WebSocket es gratis; la factura son los tokens
La página de precios de OpenAI no tiene un precio aparte para WebSocket: se pagan tokens, igual que por HTTP (precios de OpenAI, consultada el 2026-11-10). Este es el coste de una ejecución de 5 pasos:
| Concepto | Precio unitario (consultado el 2026-11-10) | Una ejecución de 5 pasos | 1000 ejecuciones |
|---|---|---|---|
search/web | 0,000694 USD por llamada | 0,000694 USD | 0,69 USD |
reddit/search, reddit/comments, youtube/search, youtube/transcript | 0,000556 USD por llamada cada una | 0,002224 USD | 2,22 USD |
| Herramientas de EveryInfra, total | — | 0,002918 USD | 2,92 USD |
| Resultados leídos por el modelo (unos 15,3 mil tokens; entrada sin caché de gpt-6.1-sol a 2,00 USD por millón) | Estimación | Unos 0,032 USD | Unos 32 USD |
| Transporte WebSocket | Sin cargo extra | 0 USD | 0 USD |
Los precios de EveryInfra salen de price_usd en el catálogo gratuito, GET /api/v1/social/catalog (catálogo de funciones; la búsqueda web está en la lista de herramientas de búsqueda). El billing.charged_usd de cada llamada real coincidió con el catálogo, y las llamadas fallidas o vacías no se cobran.
Estimamos los tokens a partir del tamaño de las cinco respuestas, unos 61,4 KB en total, a razón de unos 4 bytes por token. Sirve solo como orden de magnitud: que el modelo lea los resultados cuesta unas diez veces lo que cuestan las herramientas. WebSocket no cambia el precio de los tokens. Por HTTP, cada turno reenvía y reprocesa el historial, y la caché de prompts cobra la parte repetida a precio de caché (la entrada en caché de gpt-6.1-sol cuesta 0,10 USD por millón).
Un usuario de r/codex contó que su tasa de aciertos de caché subió mucho al pasar a WebSocket (hilo); es la observación de un usuario y OpenAI no ha publicado una cifra equivalente. Nuestras 4 ejecuciones reales hicieron 35 llamadas cobradas por un total de 0,020978 USD. Cada ejecución pagó los cinco pasos de la cadena, la repetición con conexión nueva, la llamada síncrona, el envío asíncrono y el tools/call de MCP; las consultas y tools/list son gratis, y la llamada MCP limitada de la ejecución 1 no se cobró. Con 3 llamadas más para leer las transcripciones y los comentarios del vídeo, el total fue de 38 llamadas y 0,022646 USD.
| Cifra del artículo | Medida por nosotros | Tomada de una fuente |
|---|---|---|
| Tiempo de herramientas por paso y por ejecución | Sí, 4 ejecuciones el 2026-11-10 | — |
| Apertura y reutilización de conexiones | Sí, tiempos de curl | — |
| Latencia de 30 días por función | Sí, informe de la cuenta de prueba | — |
| Tiempo del modelo por llamada (2,81 s) | No | Prueba pública de Hermes Agent |
| Ahorro por continuación (0,24 a 0,37 s) | No | Prueba pública de Hermes Agent |
| «Hasta un 40 %» de extremo a extremo | No | Guía y artículo de ingeniería de OpenAI |
Límites y precauciones
Primero, lo que no probamos. No enviamos peticiones de modelo con una clave de OpenAI, así que todo ahorro por turno del lado de OpenAI sale de los documentos originales y de la prueba pública de terceros. Si tu modelo, tu nivel de razonamiento y el tamaño de tu contexto difieren mucho de los de Hermes Agent (unos 15.000 tokens de entrada, razonamiento medio, desde Japón), tu ahorro por turno será otro: pon en la fórmula tus propios valores de s (ahorro por turno) y M (tiempo por llamada al modelo). Nuestros tiempos de herramientas valen para estas palabras clave, a estas horas, la noche en que escribimos. Los datos de 30 días son de la misma cuenta de prueba; tu cuenta muestra sus propios percentiles en la página de calidad de la consola, y también puedes mirar la página de estado.
Segundo, los límites del propio modo WebSocket. Una conexión dura hasta 60 minutos; al cerrarse, la caché desaparece y con store=false hay que reenviar todo el contexto, así que los trabajos largos necesitan lógica de reconexión. Un 4xx o 5xx en una continuación del mismo carril saca de la caché la respuesta referida. El modo background no funciona por WebSocket. Azure documenta una respuesta por conexión sin multiplexación, frente a las 16 de OpenAI. La prueba de Cline avisa de que, en tareas cortas, el saludo inicial puede retrasar el primer token.
Hay casos raros: la issue #2919 de openai-python (abierta el 2026-03-03) describe una conexión que se cierra con el código 1000 y sin eventos cuando temperature es un decimal como 1,2 (issue #2919). Si una conexión se cierra sin errores y sin salida, revisa primero los parámetros. Por último, openai-python corrigió la recuperación tras reconectar, el precalentado y el aislamiento por carril entre finales de octubre y principios de noviembre: usa una versión reciente.
Cambios recientes
- 2026-10-22: el soporte de streaming de Google API Gateway entra en vista previa pública, con SSE, WebSockets y gRPC y flujos de hasta una hora (blog de Google Developers).
- 2026-10-20: OpenAI añade una duración de caché de prompts de 12 horas; la escritura cuesta 2,5 veces el precio normal de entrada (guía de caché de prompts).
- 2026-10-16: la Agents API admite el modo Ultrafast; el 2026-10-08, Ultrafast incorporó GPT-6.1 Sol y su documentación recomienda WebSocket (registro de cambios).
Preguntas frecuentes
¿Cómo se usa el modo websocket de OpenAI en Python?
Instala openai[realtime]>=3.8.0, abre una conexión con client.responses.connect() y devuelve los resultados de herramientas como function_call_output con previous_response_id. La sección «Ejemplo de configuración» tiene el bucle completo con la API de datos de EveryInfra; con el Agents SDK basta set_default_openai_responses_transport("websocket").
¿El modo websocket de OpenAI necesita otra API key?
No. El ejemplo de la guía oficial crea el cliente con OpenAI(), que usa la misma clave de siempre, y la página de precios no tiene un plan ni una tarifa aparte para WebSocket. Lo que sí cambian son las dependencias: en Python hace falta el extra realtime del paquete openai, y en Node, el paquete ws.
¿Responses API WebSocket frente a HTTP: cuál es la diferencia real?
Está en el servidor: por HTTP, cada turno obliga a recibir y procesar todo el historial otra vez; por WebSocket, el estado del último turno queda en la memoria de la conexión y solo se procesa la entrada nueva. Ahorra trabajo del servidor, no saludos (abrir una conexión nos costó unos 25,5 ms). El detalle está en la sección «De dónde sale el ahorro».
¿No es lo mismo usar store: true con previous_response_id?
Es una pregunta típica bajo el vídeo explicativo. No es lo mismo: la continuación con store=true lee el estado del almacenamiento y, según la guía de OpenAI, pierde la ventaja de latencia de la memoria. La caché en memoria de WebSocket además funciona con store=false y con Zero Data Retention.
¿El modo websocket de OpenAI sirve para streaming?
Sí: por WebSocket el flujo es implícito y no se envía stream. Los eventos siguen el mismo modelo que el streaming de la Responses API por HTTP (response.created, deltas de salida, response.completed). Lo que no se admite es el modo background. Si ya consumes eventos en flujo por HTTP, tu lector de eventos cambia poco.
¿El modo WebSocket de Azure es igual que el de OpenAI?
Casi. La diferencia es la concurrencia: Azure documenta una sola respuesta a la vez por conexión, sin multiplexación; OpenAI permite hasta 16 en curso con stream_id. Si usas los dos, sigue el patrón de Azure; la tabla de límites de arriba tiene la comparación completa.
Cómo empezar
Primero, crea una clave de API de EveryInfra en la consola y guárdala en la variable de entorno EVERYINFRA_API_KEY. Segundo, lee el catálogo gratuito en GET /api/v1/social/catalog y elige funciones, por ejemplo la API de datos de Reddit con su búsqueda, la API de datos de YouTube o la API de datos de X (Twitter). Tercero, llama a cada herramienta una vez con curl y anota el tiempo; a las que pasen de 10 segundos, añádeles "mode": "async".
Cuarto, conecta las herramientas a tu agente: adapta el ejemplo de configuración o usa el servidor MCP remoto con la guía de MCP remoto. Quinto, ejecuta una tarea completa, registra por separado el tiempo de herramientas y el del modelo y ponlos en la fórmula; activa WebSocket cuando el peso del modelo sea grande. El inicio rápido tiene la configuración completa, la página de precios los precios por llamada y el mercado de datos todas las funciones.
Si tu agente reintenta herramientas tras un corte, lee nuestra prueba de la API idempotency key. Para elegir herramienta de búsqueda, mira la mejor API de búsqueda web para agentes de IA y cómo eligen los agentes sus herramientas de búsqueda. Y para un agente de vigilancia con la Agents API de OpenAI, tenemos nuestra reseña.
Referencias
- WebSocket Mode, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/websocket-mode
- Changelog (2026-02-23, «Launched WebSocket mode for the Responses API», y entradas posteriores), documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/changelog
- Responses WebSocket events (response.create), referencia de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/reference/resources/responses/websocket-events
- Speeding up agentic workflows with WebSockets in the Responses API, artículo de ingeniería de OpenAI, 2026-04-22, https://openai.com/index/speeding-up-agentic-workflows-with-websockets/
- Async tool calling, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/async-tool-calling
- Mid-turn steering, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/steering
- Ultrafast mode, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/ultrafast-mode
- MCP and Connectors, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/tools-connectors-mcp
- Conversation state, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/conversation-state
- Prompt caching, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/prompt-caching
- Latency optimization, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/latency-optimization
- Background mode, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/background
- Pricing, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/pricing
- Rate limits, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/rate-limits
- Multi-agent, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/responses-multi-agent
- Agents API: MCP tools, documentación de la API de OpenAI, consultada el 2026-11-10, https://developers.openai.com/api/docs/guides/agents-api/tools/mcp
- Models (transporte WebSocket de Responses), documentación del OpenAI Agents SDK, consultada el 2026-11-10, https://openai.github.io/openai-agents-python/models/
- Versiones de openai-python (v3.43.0, v3.42.0, v3.41.0), OpenAI en GitHub, consultada el 2026-11-10, https://github.com/openai/openai-python/releases
- openai-python v3.43.0, OpenAI en GitHub, 2026-11-03, https://github.com/openai/openai-python/releases/tag/v3.43.0
- openai-python v3.42.0, OpenAI en GitHub, 2026-10-31, https://github.com/openai/openai-python/releases/tag/v3.42.0
- Versiones de openai-agents-python (v0.24.0-alpha.7, alpha.6), OpenAI en GitHub, consultada el 2026-11-10, https://github.com/openai/openai-agents-python/releases
- Issue #2919 de openai-python: la conexión WebSocket de Responses se cierra con código 1000 si temperature es decimal, GitHub, 2026-03-03, https://github.com/openai/openai-python/issues/2919
- Comentario en el PR #18436 de Hermes Agent: comparación de 84 rondas entre SSE y WebSocket, GitHub, 2026-10-11, https://github.com/NousResearch/hermes-agent/pull/18436#issuecomment-6109869053
- Issue #6057 de Hermes Agent, GitHub, 2026-04-08, https://github.com/NousResearch/hermes-agent/issues/6057
- Issue #24830 de OpenClaw: modo WebSocket de la Responses API para acelerar llamadas múltiples a herramientas, GitHub, 2026-02-23, https://github.com/openclaw/openclaw/issues/24830
- WebSocket mode for Azure OpenAI Responses API, Microsoft Learn, 2026-07-28, https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/websockets
- Orquestación multiagente (Azure), Microsoft Learn, consultada el 2026-11-10, https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/responses-multi-agent
- Proveedor OpenAI: WebSocket fetch, documentación del AI SDK, consultada el 2026-11-10, https://ai-sdk.dev/providers/ai-sdk-providers/openai
- Publicación del AI SDK en X sobre Responses WebSocket, X, 2026-02-23, https://x.com/aisdk/status/2026031263925039591
- Publicación de Cline en X con sus primeras cifras, X, 2026-02-23, https://x.com/cline/status/2026031848791630033
- Publicación en X sobre los modelos de OpenAI en Cursor, X, 2026-02-23, https://x.com/leerob/status/2026030244407468259
- OpenAI Responses LLM (variante WebSocket, por defecto wss://api.openai.com/v1/responses), documentación de Pipecat, consultada el 2026-11-10, https://docs.pipecat.ai/api-reference/server/services/llm/openai-responses
- RFC 6455: The WebSocket Protocol, IETF, diciembre de 2011, https://www.rfc-editor.org/rfc/rfc6455
- RFC 9112: HTTP/1.1 (sección 9, gestión de conexiones), IETF, junio de 2022, https://www.rfc-editor.org/rfc/rfc9112
- RFC 8446: TLS 1.3, IETF, agosto de 2018, https://www.rfc-editor.org/rfc/rfc8446
- MCP Specification 2026-07-28: Transports, Model Context Protocol, consultada el 2026-11-10, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- MCP Specification 2026-07-28: Changelog, Model Context Protocol, consultada el 2026-11-10, https://modelcontextprotocol.io/specification/2026-07-28/changelog
- Manual de curl (variables de tiempo de -w), curl, consultada el 2026-11-10, https://curl.se/docs/manpage.html
- http.client — HTTP protocol client, documentación de Python, consultada el 2026-11-10, https://docs.python.org/3/library/http.client.html
- Referencia para desarrolladores de EveryInfra (trabajos asíncronos, MCP, errores), EveryInfra, consultada el 2026-11-10, https://api.everyinfra.com/llms-full.txt
- Catálogo de funciones de EveryInfra, EveryInfra, consultada el 2026-11-10, https://api.everyinfra.com/api/v1/social/catalog
- Lista de herramientas de búsqueda de EveryInfra, EveryInfra, consultada el 2026-11-10, https://api.everyinfra.com/api/v1/search/tools
- «I can't believe nobody's done this before...» (vídeo), YouTube, 2026-03-04, https://www.youtube.com/watch?v=sFEDAkJy9Dc
- openai websockets is improving our usage cost, Reddit r/codex, consultada el 2026-11-10, https://www.reddit.com/r/codex/comments/1t2n38c/openai_websockets_is_improving_our_usage_cost/
- Responses WebSocket Error, Reddit r/codex, 2026-10-21, https://www.reddit.com/r/codex/comments/1xbrg4j/responses_websocket_error/
- WebSockets for Responses API, OpenAI Developer Community, consultada el 2026-11-10, https://community.openai.com/t/websockets-for-responses-api/1374906
- OpenAI Introduces Websocket-Based Execution Mode to Reduce Latency in Agentic Workflows, InfoQ, mayo de 2026, https://www.infoq.com/news/2026/05/openai-websocket-responses-api/
- Streaming comes to API Gateway, blog de Google Developers, 2026-10-22, https://developers.googleblog.com/streaming-comes-to-api-gateway-real-time-and-ai-ready-apis-without-changing-your-spec/
Referencia BL-125