Python 抓 Instagram 帖子和评论:三条路实测
用 Python 抓 Instagram 帖子和评论的三条路:官方接口只读授权账号,开源库近月多数新 issue 是被拦,按次付费每千行约 $0.025。
用 Python 抓 Instagram 帖子和评论,2026 年 11 月能走的路只有三条:Meta 的 Instagram 官方接口只让你读自己或客户授权给你的专业账号;开源库不要钱,但最常用的 instaloader 在 10 月 1 日到 11 月 9 日新开的 16 个 issue 里,有 11 个是被平台拦下或登录失败;按次付费接口我们在 11 月 10 日凌晨调用了 35 次(31 次单独调、4 次是完整脚本),脚本抓一个账号 50 条帖子加 3 个帖子的评论共 90 行,花了 $0.002224,折合每 1,000 行约 $0.0247。最需要事先知道的限制是评论数量:我们查了 10 个帖子,评论接口每次最多回 15 条,评论数 959 条的帖子只拿到 1.6%,评论在 15 条以内的帖子能拿全。
文中我们自己的数,都来自 2026 年 11 月 10 日 00:14 到 00:51(新加坡时间)的真实调用;Meta 和开源库一侧的事实,都链到当天打开过的官方文档、GitHub 页面和发布说明。
先看结论:三条路一张表
下表把三条路放在一起比。「能拿到什么」一列只写我们在官方文档、开源库仓库或真调里确认过的东西;「坏在哪里」一列写的是最常见的失败方式,不是全部。表里 EveryInfra 的价格来自当天的公开目录,每次调用的扣费和真调响应里的 charged_usd 一致。
| 路 | 能拿到什么 | 前提 | 钱 | 坏在哪里 |
|---|---|---|---|---|
| Instagram 官方接口(Graph API) | 自己或客户授权的专业账号的帖子、全部评论、回复;别人的商业或创作者账号只有帖子列表、点赞数、评论数 | Meta 开发者应用、专业账号、App Review 和企业验证(要服务别人的账号时) | 接口本身不按次收费,受调用频率限制 | 拿不到不授权给你的账号的评论正文;新建应用不能再用 Instagram Login 那套接入 |
| 开源库(instaloader、instagrapi 等) | 公开主页、帖子、评论、快拍等,取决于版本和登录状态 | 本机 Python 环境;多数功能要登录一个 Instagram 账号 | 库免费;账号、代理和维护时间另算 | 429、401、400 feedback_required、302;平台改接口后要等新版本 |
| 按次付费接口(本文用 EveryInfra) | 公开帖子、单帖详情、评论、话题帖;评论回复在目录里,本文未实测 | 一个 API Key;不需要 Instagram 账号 | 每次 $0.000556 起,失败不扣 | 评论每帖最多回 15 条;单帖详情按链接计费;异步任务 38–66 秒 |


一条 Instagram 帖子和评论里有哪些字段
动手之前,先弄清楚你要的是哪几列数据。一条帖子的核心字段在三条路里大体相同:帖子 ID 或短码、链接、正文、媒体类型、点赞数、评论数、发布时间、作者。区别在于外围字段:官方接口给你的账号返回洞察数据(覆盖人数、播放等),但给别人的账号只返回很少几项;开源库能拿到的字段取决于它解析的是哪个网页接口;我们的接口按目录里的 response_fields 返回,主数据源不可用时会少几个字段,目录的 field_note 里写明了少哪几个。
| 你要的数据 | 官方接口字段(别人的账号经 Business Discovery) | EveryInfra 字段 | 本文实测 |
|---|---|---|---|
| 帖子正文 | caption | text | WHO 50 条全部有 |
| 点赞、评论数 | like_count、comments_count | like_count、comment_count | 全部有 |
| 发布时间 | timestamp | posted_at(UTC) | 全部有 |
| 作者 | 只能是被查询的那个账号 | author_username、author_name、author_id | 合作帖显示发起方 |
| 评论正文 | 只能读自己或授权账号 | instagram/comments 的 text | 每帖最多 15 条 |
| 评论的回复 | replies 字段展开或 /replies | instagram/comment_replies | 本文未实测 |
| 帖子下的几条展示评论 | 无 | top_comments(instagram/post) | 两个帖子分别 10 条、4 条 |
表里有两点容易踩坑。第一,评论数(comment_count)不等于你能拿到的评论条数。Instagram 帮助中心写得很清楚:被「隐藏不想看到的评论」过滤掉的评论,仍然计入评论总数,而这个过滤默认是打开的。所以一个帖子显示 959 条评论,其中有多少是公开可见的,外部谁也说不准。第二,author_username 不一定是你查询的那个账号,这一点下面实测三会用数据说明。
第一条路:Instagram 官方接口,只读你有授权的账号
先把一个流传很广的误解说清楚:Instagram 早就没有「给普通开发者读任意公开帖子」的官方接口了。Meta 在 2024 年 9 月 4 日的开发者博客里宣布,Instagram Basic Display API 从 2024 年 12 月 4 日起停用,原文说那天之后「不再有面向消费者开发者应用的 Instagram 接口」。剩下的官方接口全部面向专业账号(商家和创作者),而且是「替账号主人做事」的设计:发帖、管理评论、回私信、看洞察。
2026 年 10 月这套接口又改了一次接入方式。Meta 的 Instagram 平台总览(页面标注 2026 年 10 月 29 日更新)现在列了三种接法:Unified Login、Instagram Login、Facebook Login,并写明新集成推荐 Unified Login。Unified Login 的说明页(2026 年 10 月 13 日更新)说新功能只在这一种接法上发布;迁移指南(2026 年 10 月 1 日更新)则写了一条对新项目影响很大的规定:新创建的应用不能再设置 Instagram Login 那一套。换句话说,你今天新建一个应用,就要走 Business 资产组合加 Unified Login 这条路。
官方接口读评论:要帖子作者本人的令牌
评论接口的限制写在 Comments 参考页(2026 年 10 月 20 日更新)里。读取 GET /<IG_MEDIA_ID>/comments 需要「创建这个媒体对象的用户」的访问令牌;默认按时间倒序返回;只返回顶层评论,回复要用字段展开请求 replies;每次查询最多 50 条;不能按时间筛选。下面这张截图是我们 11 月 10 日用无头 Chrome 打开的英文原文,青绿框标出的就是这几条。
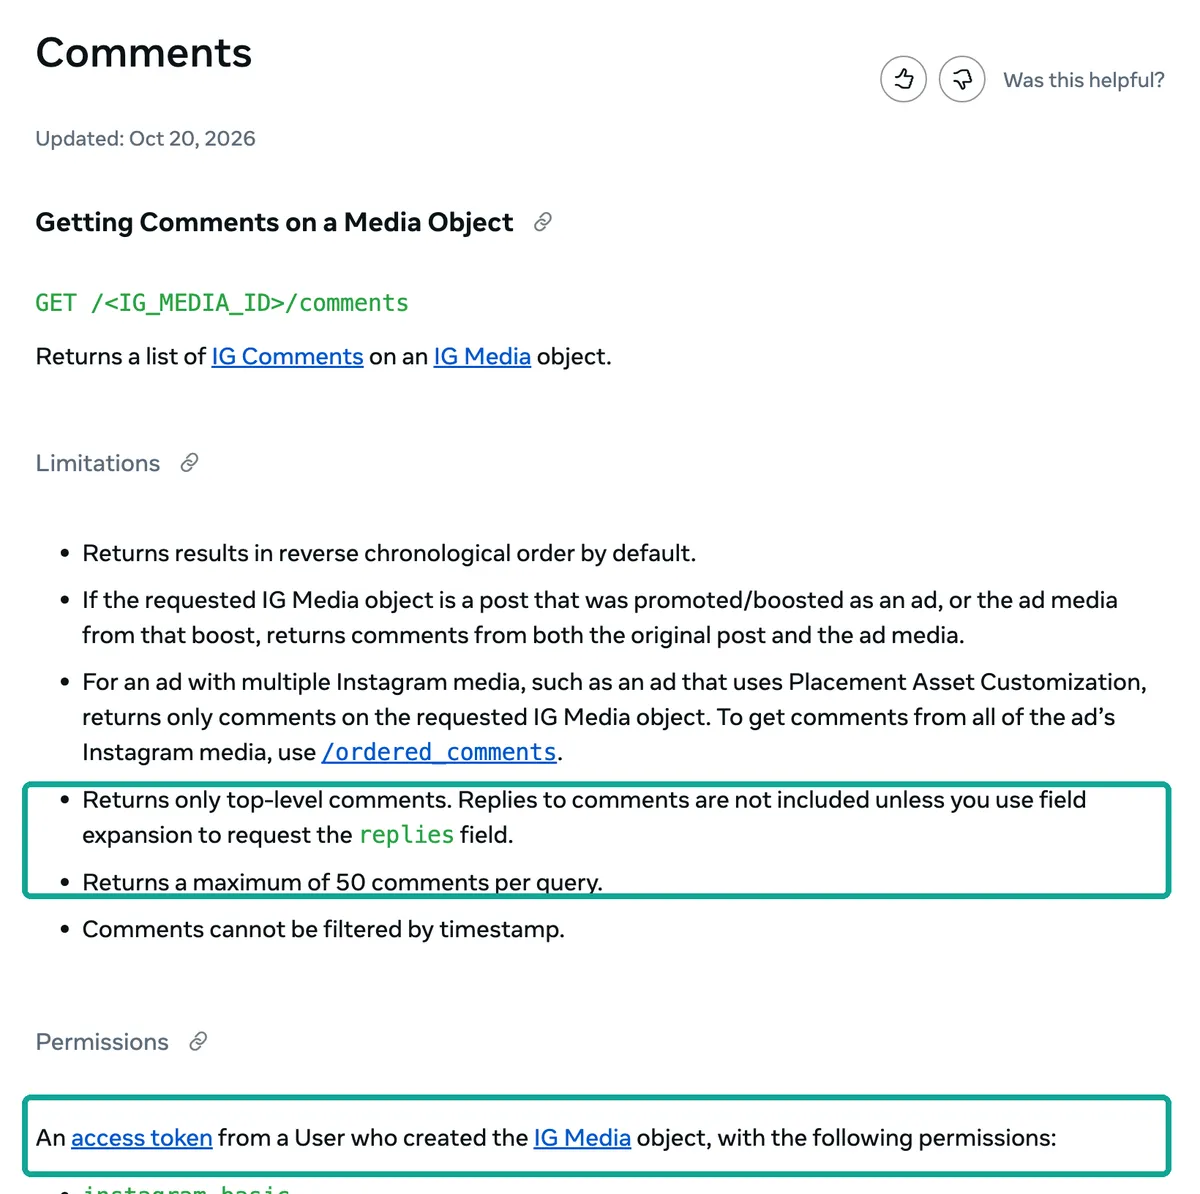
评论回复的参考页也是同样的要求:读回复要评论所在账号授权的令牌,已删除评论的回复拿不到。这意味着官方评论接口只适合一种场景:你在管理自己的品牌号,或者客户把他的专业账号授权给了你的应用。对这类场景,官方接口是最完整、最稳定、也最合规的选择,你能拿到所有顶层评论(每页 50 条往后翻)和回复,不用担心被拦。
读别人的账号:Business Discovery 只给数字
想看竞品、看行业里别的机构,官方给的口子是 Business Discovery:用你自己的专业账号去查另一个商业或创作者账号,能拿到粉丝数、帖子数和帖子列表,帖子上能拿到 comments_count、like_count,文档示例里还有 view_count。它拿不到评论正文,个人账号查不了,有年龄限制的商业账号也不返回。文档还提到一个细节:读别人的媒体时,带版权音乐的视频和关闭了下载的 Reels 不返回 media_url。
话题搜索是另一个口子。IG Hashtag Search 要用「Instagram Public Content Access」这项功能,平台总览写明它的用途是发现和你的话题活动相关的内容、了解公众对你品牌的看法、找抽奖参与者;硬限制是 7 天内最多查 30 个不同的话题,敏感话题直接返回通用错误。
| 官方接口的限制 | 原文 | 对抓取的影响 |
|---|---|---|
| 读评论要帖子作者的令牌 | Comments 参考页,2026-10-20 更新 | 只能读自己或授权账号的评论 |
| 每次最多 50 条评论 | 同上 | 要按游标翻页 |
| 别人的账号只有计数 | Business Discovery,2026-08-12 更新 | 能做互动率,不能做评论分析 |
| 7 天内最多 30 个话题 | IG Hashtag Search | 话题监测要精挑 |
| 服务别人的账号要 Advanced Access | 平台总览,2026-10-29 更新 | 要过 App Review 和企业验证 |
| 新应用不能用 Instagram Login | 迁移指南,2026-10-01 更新 | 新项目走 Unified Login |
官方接口的 Python 写法(配置示例)
下面是读自己账号某个帖子全部评论的写法。我们没有可用的专业账号令牌,所以这段没有真跑,是按官方文档写的配置示例;字段名和翻页方式以文档为准。
# 配置示例:读你自己(或已授权)的专业账号某条帖子的全部评论
# IG_TOKEN 是 Unified Login 拿到的令牌;MEDIA_ID 来自 /{ig-user-id}/media
import os, requests
GRAPH = "https://graph.facebook.com/v27.0"
url = f"{GRAPH}/{os.environ['MEDIA_ID']}/comments"
params = {"fields": "id,text,timestamp,like_count,replies{id,text,timestamp}",
          "access_token": os.environ["IG_TOKEN"]}
rows = []
while url:
    page = requests.get(url, params=params, timeout=30).json()
    rows += page.get("data", [])
    url = page.get("paging", {}).get("next")   # 每页最多 50 条,按游标往后翻
    params = None                              # next 链接里已带全部参数
print(len(rows), "top-level comments")
版本号用的是 v27.0:Meta 在 2026 年 11 月 4 日的发布说明里推出了 Graph API v27.0,同时宣布 v21.0 在 2027 年 1 月 21 日下线、v22.0 在 2027 年 5 月 20 日下线。这次发布还禁止新应用使用多 ID 请求、字段别名等几个老功能;如果你从老代码里抄了 ?ids= 一次查多个帖子的写法,新应用会直接报错。
第二条路:开源库,免费但要和平台拉锯
「instagram scraper python github」这个联想词背后,最常被推荐的是 instaloader(GitHub 约 1.38 万星,MIT 许可证)和 instagrapi(约 7,090 星)。这两个项目的 README 都写得很坦白,值得原样转述。搜这个词排在前面的视频教程多半是几年前录的:我们用 EveryInfra 的 youtube/search 查「scrape instagram comments python」,播放最多的一个发布于 2021 年,演示的库已在 GitHub 归档,没有一个视频讲评论翻页、429 和成本。instaloader 的 README 说它能下载公开和私密主页、话题、快拍、帖子评论等,私密主页要用 --login 登录;文末免责声明写明它与 Instagram 没有任何关联、未获授权,「风险自负」。instagrapi 的 README 说它结合了公开网页和私有移动端接口,并直言私有接口自动化在生产环境里很脆弱,因为账号信誉、代理、设备状态、验证挑战和频率限制都会各自变化,建议做账号自有的业务时优先用官方接口,并说这个项目最适合测试、研究和受控的内部自动化。
近 100 天的 32 个 issue:一半以上是被拦或登录失败
库能不能用,最直接的证据是它的 issue 区。我们用 GitHub 的搜索接口取了 instaloader 在 2026 年 8 月 1 日到 11 月 9 日之间新开的全部 32 个 issue,逐个按标题和正文开头人工分成三类:「被平台拦下」(429、401、400 feedback_required、302 跳转、返回空 JSON)、「登录和会话」(登录失败、cookie 导入、检查点验证、两步验证)、「功能、字段变化和其他」。结果是 8–9 月 16 个 issue 里被拦和登录问题合计 7 个,10 月 1 日到 11 月 9 日的 16 个里是 11 个,占 69%。
时间线比计数更能说明问题。#2750(10 月 10 日)报 web_profile_info 接口 429;#2767(2026 年 10 月 13 日)登录直接返回 feedback_required;#2786(10 月 21 日)是一位研究人员问「2026 年 instaloader 还能稳定用吗」,他要抓政府机关和市政账号的公开帖子做研究,换了干净环境和新版本仍然一直 429。维护者在 10 月 21 日发了 4.16 测试版、10 月 24 日发了 4.15.5、2026 年 10 月 26 日发了正式版 4.16,修复了登录和未登录两种状态下的 Profile.get_posts()。但四天后 #2792(10 月 30 日)又报登录和导入浏览器 cookie 都坏了,社区补丁 PR #2795 在 11 月 2 日被几位用户确认能用,其中一位第二天又说只好了一天;#2794 报未登录下载帖子一连几天 401,升级到 4.16 的人说好了;#2803(2026 年 11 月 7 日)报下载被 302 跳回首页,同一个 IP 用浏览器却能正常打开。
| 日期(2026) | 事件 | 来源 |
|---|---|---|
| 10 月 10 日 | 429 Too Many Requests(web_profile_info) | issue #2750 |
| 10 月 13 日 | 登录返回 feedback_required | issue #2767 |
| 10 月 21 日 | 研究人员:干净环境仍持续 429 | issue #2786 |
| 10 月 24 日 | 发布 4.15.5 | GitHub Releases |
| 10 月 26 日 | 发布 4.16,修复 get_posts() | GitHub Releases |
| 10 月 30 日 | 登录和 cookie 导入失效 | issue #2792 |
| 11 月 2 日 | 社区补丁 PR #2795 被确认可用 | PR #2795 |
| 11 月 7 日 | 302 跳回首页,浏览器同 IP 正常 | issue #2803 |
instagrapi 也不轻松。它在 11 月 7 日和 PyPI 显示的 11 月 9 日连发两个版本(3.2.7、3.2.8);#2920(11 月 3 日)报登录前的一个接口开始返回 404,登录在发密码前就失败;#2890(10 月 18 日)报登录成功后一做预热请求就触发 challenge_required,陷入「请批准这次登录」的循环。这些 issue 我们只引用标题和原文事实,不评价哪个项目好坏:维护者都在积极修,问题的根子在平台那一侧随时会变。
封号风险:条款和帮助中心怎么写
开源库教程很少提的一点,是登录用的那个 Instagram 账号本身的风险。Instagram 使用条款第 4.2 节写明,不得以未经授权的方式访问或收集信息,「包括在未获我们明确许可的情况下以自动化方式访问或收集信息,无论这种自动化访问或收集是否在登录 Instagram 账号的情况下进行」。帮助中心有一篇专门的说明《为什么你的账号因数据抓取被限制》,说 Meta 有团队专门检测、调查和封堵与抓取相关的行为模式,账号可能因此被限制并进入审核。条款页顶部还写着新版条款将于 2027 年 1 月 20 日生效,新版预览已经挂出。
所以第二条路的真实成本不是「免费」:你要准备愿意承担风险的账号,处理检查点和两步验证,跟着平台改版升级库版本,并接受某些天完全跑不通。instaloader 自己的排错文档也写了,它的限速控制假设同一时间只有它一个程序在发请求,频繁重启容易触发 429;云服务器、VPN、公共代理这类 IP 在匿名访问时限制明显更严。
# 配置示例(未在本文运行):instaloader 读一个公开账号最近的帖子
import instaloader                       # pip install instaloader==4.16
L = instaloader.Instaloader(download_pictures=False, download_videos=False,
                            save_metadata=False, max_connection_attempts=1)
# L.load_session_from_file("your_account")   # 很多功能需要先登录
profile = instaloader.Profile.from_username(L.context, "who")
for i, post in enumerate(profile.get_posts()):
    print(post.shortcode, post.date_utc, post.likes, post.comments)
    if i >= 49:
        break
这段我们没有运行:用自己的账号去大量请求违反上面那条条款,我们不在文章里演示。写出来是为了和后面的脚本对照,看清两条路在代码层面的差别:开源库的类名大小写、会话文件、连接重试都要自己管(我们看的那个 instaloader 教学视频里,作者就当场遇到了「module object is not callable」,原因是类名写错了大小写)。
第三条路:按次付费接口,scrape instagram posts python 的完整脚本
第三条路的思路是把「怎么拿到」交给接口,你只管「拿什么、拿多少」。下面用 EveryInfra 的四项能力串成一条完整的抓取:instagram/user_posts 按账号拿帖子列表,instagram/post 按链接拿单帖详情,instagram/comments 按帖子拿评论,instagram/comment_replies 按评论 ID 拿回复。每项能力的参数、价格和返回字段,都可以在不带 Key 的公开目录里查到,也可以看Instagram 平台页和各能力页:用户帖子、单帖详情、评论、评论回复、话题。
| 能力 | 必填参数 | 方式 | 每次价格 | 每次最多 | 本文实测每次回 |
|---|---|---|---|---|---|
instagram/user_posts | username | 异步 | $0.000556 | 200 条 | 50 条(limit 50) |
instagram/post | urls(数组) | 同步,按链接计费 | 每个链接 $0.000556 | 11 个链接 | 每个链接 1 条 |
instagram/comments | url | 同步 | $0.000556 | 100 条 | 7–15 条 |
instagram/comment_replies | url、comment_id | 同步,按页 | 每页 $0.000875 | 约 10 条 | 未实测 |
instagram/hashtag | hashtag | 同步 | $0.000556 | 100 条 | 27–30 条(limit 50) |
可以直接跑的 Python 脚本
下面这份脚本就是我们在 11 月 10 日 00:26(新加坡时间)原样跑过的那一份,只依赖 requests。Key 只从环境变量 EVERYINFRA_API_KEY 读取,不写进代码。脚本做四件事:拉一个账号最近 50 条帖子;只保留这个账号自己发的帖子;按评论数挑前 3 个帖子拉评论;把帖子和评论分别写进两个 CSV,最后打印每千行的成本。
"""Scrape Instagram posts and comments with Python via EveryInfra (pay per call).

usage: EVERYINFRA_API_KEY=... python ig_posts_comments.py <username> [top_k]
writes posts.csv and comments.csv; prints cost per 1,000 rows
"""
import csv, os, sys, time
import requests

API = "https://api.everyinfra.com"
S = requests.Session()
S.headers.update({"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
spent = 0.0


def social(action, params, mode=None):
    """One call. Retries 429 and retryable 503; follows async jobs."""
    global spent
    body = {"platform": "instagram", "action": action, "params": params}
    if mode:
        body["mode"] = mode
    for _ in range(4):
        r = S.post(f"{API}/api/v1/social", json=body, timeout=120)
        d = r.json()
        err = d.get("error") or {}
        if r.status_code == 429 or (r.status_code == 503 and err.get("retryable")):
            time.sleep(err.get("retry_after", 15) + 1)
            continue
        break
    if "error" in d:
        raise RuntimeError(f"{action}: {r.status_code} {err.get('code')} {err.get('message')}")
    while d.get("job_id") and d.get("status") not in ("succeeded", "failed"):
        time.sleep(5)
        d = S.get(f"{API}/api/v1/jobs/{d['job_id']}", timeout=60).json()
    spent += (d.get("billing") or {}).get("charged_usd", 0.0)
    return d


def main(username, top_k=3):
    posts = social("user_posts", {"username": username, "limit": 50}, mode="async")["results"]
    own = [p for p in posts if p["author_username"] == username]   # collab posts carry the partner's name
    with open("posts.csv", "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["post_id", "url", "posted_at", "media_type", "like_count", "comment_count", "author_username", "text"],
                           extrasaction="ignore")
        w.writeheader(); w.writerows(posts)
    rows = []
    for p in sorted(own, key=lambda p: p.get("comment_count") or 0, reverse=True)[:top_k]:
        got = social("comments", {"url": p["url"], "limit": 100})["results"]
        print(f"{p['url']}  comment_count={p['comment_count']}  returned={len(got)}")
        rows += got
    with open("comments.csv", "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["post_url", "id", "posted_at", "like_count", "text"], extrasaction="ignore")
        w.writeheader(); w.writerows(rows)
    n = len(posts) + len(rows)
    print(f"posts={len(posts)} own={len(own)} comments={len(rows)} rows={n} charged=${spent:.6f} "
          f"(user_posts is billed per call: +$0.000556 if not shown) per_1k=${(spent + 0.000556) / n * 1000:.4f}")


if __name__ == "__main__":
main(sys.argv[1], int(sys.argv[2]) if len(sys.argv) > 2 else 3)脚本里有三处是踩过坑以后才加的。第一,requests.Session 复用连接并统一带上认证头,这是 requests 官方文档推荐的写法。第二,429 和可重试的 503 按响应里的 retry_after 等待后重发:我们这把测试 Key 每分钟限 10 次,跑的过程中碰到了 429。第三,异步任务的结果里没有 billing 字段,扣费写在第一次提交的响应里,所以脚本最后那行把 user_posts 的 $0.000556 单独加上;如果你要精确对账,就保存第一次响应里的 billing.charged_usd。CSV 用标准库的 csv.DictWriter 写,extrasaction="ignore" 让多出来的字段不报错。
实测一:美国疾控中心账号,90 行 $0.002224
2026 年 11 月 10 日 00:26:10(新加坡时间)我们用 cdcgov 跑了这份脚本,00:27:35 结束,全程 85 秒。脚本拿回 50 条帖子(发布时间从 10 月 7 日到 11 月 9 日,全部是这个账号自己发的,50 条的评论数合计 502 条),然后对评论数最多的 3 个帖子各调一次评论:两个各 36 条评论的帖子分别拿回 10 条和 15 条,一个 34 条评论的帖子拿回 15 条。合计 90 行数据,扣费 $0.002224(1 次 user_posts 加 3 次 comments,每次 $0.000556),折合每 1,000 行 $0.0247。
这个数要配着它的前提读:每千行的价格高度依赖一次调用能回多少行。帖子列表一次回 50 条,每千行就只要 $0.0111;如果把 limit 提到目录允许的 200,理论上每千行能降到约 $0.0028,但我们这次没有测 200,只能算估算。评论一次最多回 15 条,每千行就在 $0.037 以上;单帖详情按链接计费,一个链接一行,每千行就是 $0.556。下面这张图把本文实测的单价放在一起。
实测二:世卫组织账号,评论到底能拿到多少
00:14 到 00:20(新加坡时间)我们对 who 走了一遍同样的流程,只是拆开来手动调,方便看每一步的原始返回。00:14:21 提交的 user_posts 异步任务 43.6 秒后拿到 50 条帖子,最早一条是 9 月 22 日,最新一条是 11 月 9 日,图片 30 条、视频 20 条,50 条帖子的评论数合计 5,706 条,点赞数中位数 2,116.5。随后 00:15:27 用 instagram/post 查了两个链接(扣 $0.001111,即两个链接各 $0.000556),返回里带 top_comments:一个帖子 10 条、另一个 4 条,hashtags 也解析出来了(COP31、ClimateChange)。
接下来是本文最重要的一组数。我们在 WHO 主页上挑了 5 个评论较多的帖子(其中 4 个其实是谭德塞个人账号发起的合作帖,下文实测三会讲)各调一次 instagram/comments(limit 都设成 100),又在 OPS(泛美卫生组织,opspaho)和 CDC 上各补了几次,一共 10 个帖子。每次都只回 15 条或更少:评论数 959 条的那个帖子(10 月 8 日关于俄罗斯一宗疑似肺鼠疫实验室病例的说明)拿到 15 条,只占 1.6%;评论数 470、466、210、55 条的帖子也都是 15 条;只有评论数 17 条的帖子拿回 15 条(88.2%),评论数 7 条的帖子 7 条全拿到。10 个帖子评论数合计 2,290 条,实际拿回 137 条,约 6.0%。
拿回来的是哪 15 条?看时间戳能看出规律:959 条评论那个帖子发布于 10 月 8 日,拿回的 15 条评论时间在 10 月 19 日到 11 月 2 日之间;10 月 22 日发布、466 条评论的那个帖子,拿回的 15 条集中在 11 月 1 日到 11 月 9 日。也就是说,返回的更像是「最近的一小段」,不是点赞最多的评论,也不是从头开始的评论。15 条里点赞数大多是 0,没有一条超过 2。这和我们 10 月 26 日做 Instagram 五类数据价格对比时观察到的「Instagram 每个帖子对外只开放约 15 条」一致,两周后数字没变。
这个限制决定了第三条路适合做什么、不适合做什么。适合的是「广」:几十上百个账号、每个帖子看最近的一小段评论,拿来判断情绪方向、发现新出现的问题、抽样做人工复核。不适合的是「深」:如果你要一个热门帖子的全部几百条评论做完整的语料分析,第三条路做不到,这时候应该考虑第一条路(让账号主人授权)或者下文讲的研究人员数据通道。我们在目录的 field_note 里也看到,主数据源不可用时评论会更少(最多 80 条或 30 条);实际我们碰到的上限是 15。
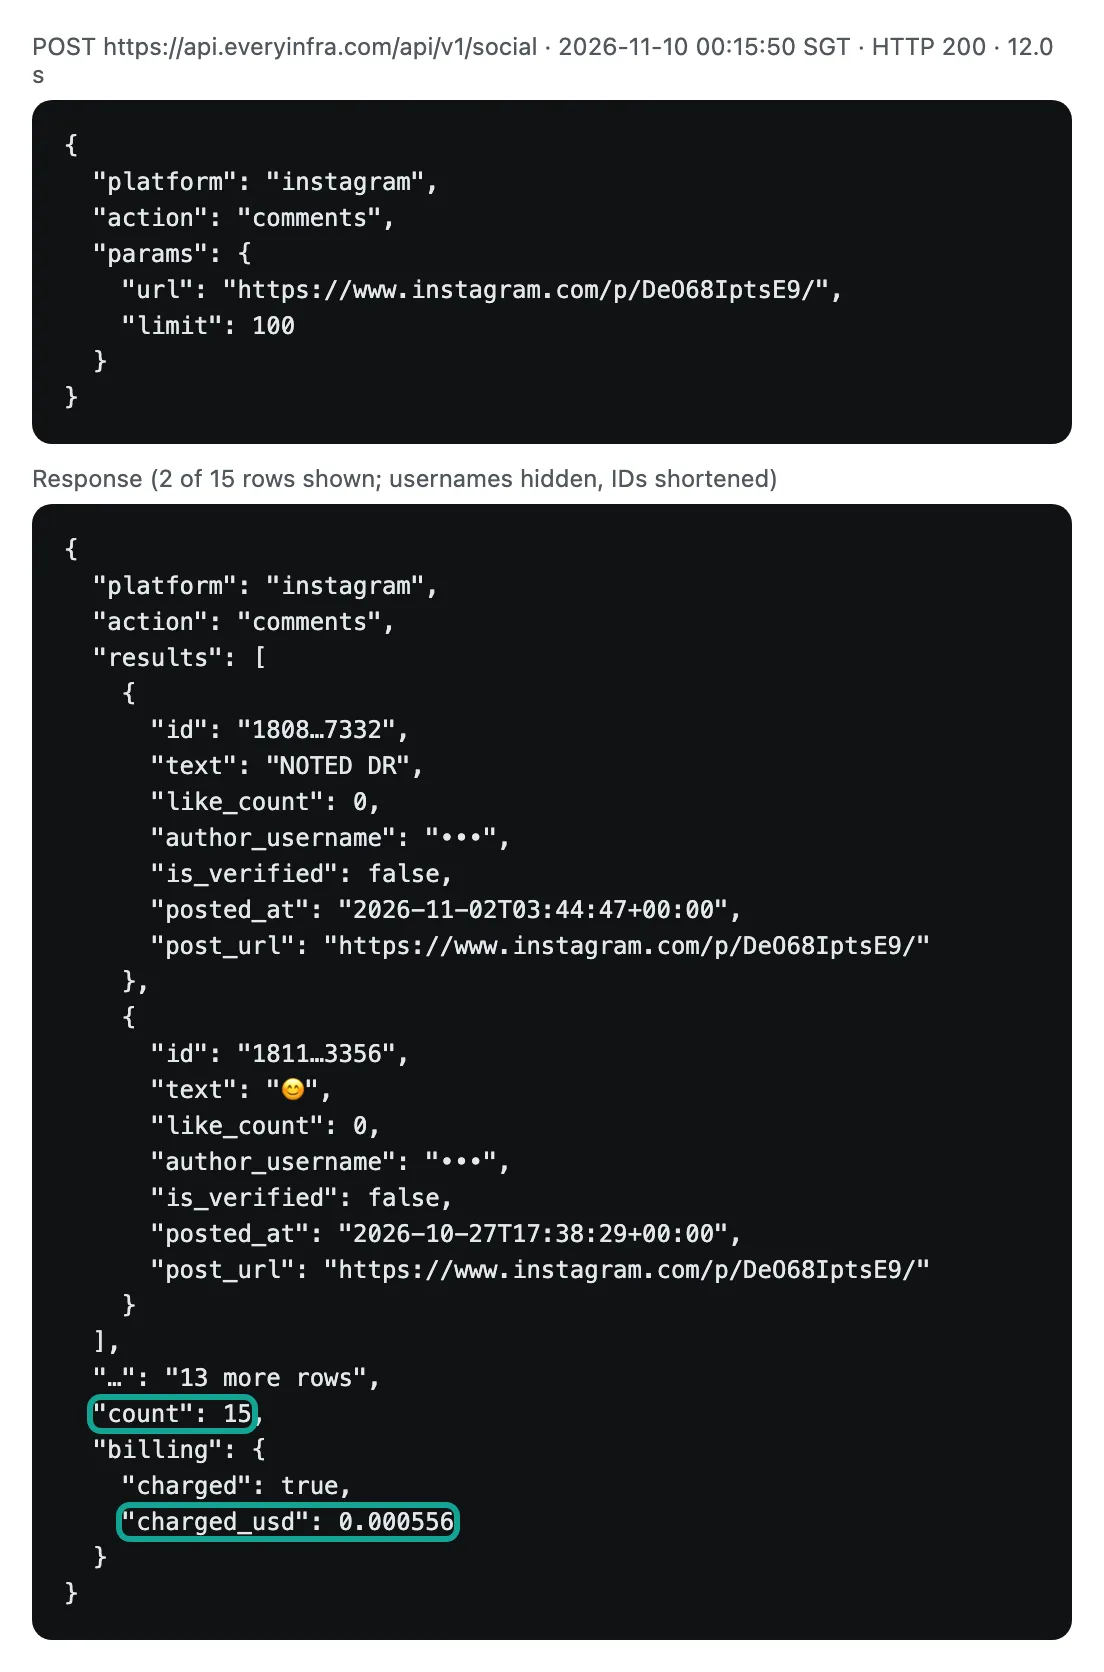
拿回来的 137 条评论长什么样
覆盖率之外,评论本身的样子也决定了后面的分析怎么做。我们把这一轮拿到的全部 137 条评论(WHO 5 个帖子 75 条、OPS 2 个帖子 22 条、CDC 脚本跑出的 40 条)放在一起看:评论 ID 没有一条重复;15 条(10.9%)通篇只有表情符号,没有一个字母或汉字;正文长度中位数 46 个字符,28 条不超过 10 个字符,另一头有 38 条超过 200 个字符,最长的一条 2,177 个字符,长评论多为个人经历叙述;107 条(78%)点赞数是 0,最高的一条 20 个赞;8 条带 @ 提到别的账号,3 条带链接。时间上,96 条发表于 10 月,41 条发表于 11 月。
这几组数对应三个处理建议。第一,纯表情评论不要直接丢掉:在公共卫生账号下,一排鼓掌或一个流泪的表情本身就是情绪信号,但要选能识别表情的情绪模型,或者先把表情转换成文字描述再分析。第二,长评论多半是个人经历或质疑,信息量远大于短评论,做人工复核时可以优先看长度排前 20% 的评论。第三,存储时用评论 id 做主键、posted_at 统一按 UTC 存,评论者的 author_username 只存哈希值;我们在文章里展示的所有评论都隐去了用户名,截图里的评论 ID 也缩短了,你发布任何分析结果时也应该这样做。
实测三:主页上 50 条帖子,28% 不是这个账号发的
00:30(新加坡时间)我们拉了 opspaho 的 50 条帖子,发现一个容易漏掉的细节:50 条里只有 37 条的 author_username 是 opspaho,另外 13 条是合作帖,作者是 OPS 总干事的账号(3 条)、哥伦比亚国家卫生研究院(3 条)、另外 5 家机构(各 1 条)和 2 个个人账号。WHO 也一样:50 条里 36 条是自己发的,11 条是总干事谭德塞的个人认证账号 drtedros 发起、和 WHO 合作的帖子,另有世卫组织欧洲区域办事处、东地中海区域办事处和一家公共卫生机构各 1 条。CDC 的 50 条则全部是自己发的。三家主页各 50 条帖子,评论量差得很远:WHO 合计 5,706 条,CDC(10 月 7 日到 11 月 9 日,UTC)502 条,OPS 只有 134 条,点赞中位数 83。同样拉 50 条帖子,WHO 的评论量是 OPS 的 40 多倍;如果你按账号分配评论抓取的预算,先看一眼每个账号的 comment_count 合计,再决定每个账号抓几个帖子的评论。
这件事对统计影响很大。WHO 主页这 50 条里,评论数最多的 8 条帖子有 4 条是谭德塞账号发起的合作帖;14 条合作帖合计 2,324 条评论,占全部 5,706 条的 41%,点赞中位数 2,412.5,高于 WHO 自己发的 36 条(1,917.5)。如果你在算「WHO 最近 50 条帖子的平均评论数」,不过滤作者,算出来的有四成来自另一个账号的受众。所以脚本里那行 own = [p for p in posts if p["author_username"] == username] 不是可有可无的:要研究一个机构自己的传播效果,先按作者过滤;要看它主页上实际展示了什么,就保留全部。
实测四:话题帖,30 条只覆盖 17 分钟
00:20(新加坡时间)我们用 instagram/hashtag 查了 publichealth,limit 设 50,拿回 30 条;这 30 条全部发布于 11 月 9 日 16:00 到 16:17(UTC),也就是新加坡时间 11 月 10 日零点后的 17 分钟,来自 28 个不同账号,全部是图片帖,点赞中位数 0,30 条加起来只有 7 条评论。西语话题 saludpublica 在 00:28 拿回 27 条,覆盖约 5 个小时(11 月 9 日 11:34 到 16:26,UTC),来自 26 个账号,点赞中位数 2,合计 36 条评论,4 条带地点信息(publichealth 那 30 条里是 7 条)。话题越小,同样 27 到 30 条覆盖的时间越长。两次各扣 $0.000556。
结论是:话题接口返回的是「最新」而不是「最热」。拿它做监测要高频、小步:每隔一段时间拉一次,按 post_id 去重累积;如果想找某个话题下最有影响力的帖子,单靠一次话题请求是找不到的,要配合账号名单(instagram/user_posts)一起用。官方话题搜索也有类似的「最近帖子」和「热门帖子」两种边,但 7 天 30 个话题的上限让高频轮询不太现实。
How to scrape Instagram comments:回复和翻页
评论有两层:顶层评论和回复。官方接口用 replies 字段展开拿回复;我们的接口单独有一项 instagram/comment_replies,参数是帖子链接加评论 ID(取 instagram/comments 结果里的 id),每页约 10 条,响应里的 next_page_token 原样传回去拿下一页,令牌 24 小时有效,每页算一次调用,每页 $0.000875。按目录价推算:一条评论下有 24 条回复,每页约 10 条要翻 3 页,约 $0.0026;要注意的是,instagram/comments 的返回里只有 id、text、like_count、posted_at、author_username、is_verified 等字段,没有回复数,没法事先知道哪条评论下面有回复;给 100 条评论各拉一遍回复就是 100 次调用。更省的做法是先按点赞数或正文长度挑出要深看的评论,只对它们发回复请求。
这一步我们没有测成:本轮对三个帖子的 9 条评论各调一次,都返回 503,没有扣费。所以这里不写字段实测,只列目录里的字段:id、text、like_count、posted_at、author_username、reply_to_id、next_page_token 等。翻页的代码写法如下,结构和顶层评论一样,循环到没有 next_page_token 为止。
# 回复翻页:每页约 10 条,每页一次调用;没有 next_page_token 就到底了
def all_replies(post_url, comment_id, max_pages=20):
    out, token = [], None
    for _ in range(max_pages):
        p = {"url": post_url, "comment_id": comment_id}
        if token:
            p["page_token"] = token          # 24 小时内有效
        d = social("comment_replies", p)
        out += d.get("results", [])
        token = d.get("next_page_token")
        if not token:
            break
    return out
我们在 2026 年 9 月发过一篇 TikTok 版本的评论抓取教程,那边的回复接口当时测通了一个 24 条回复的线程。Instagram 的回复我们会补测,并更新这一节。在那之前,如果你的分析必须包含回复,第一条路(账号授权)是唯一确定能拿全的办法。
失败、限速和扣费:16 次不扣钱的请求
失败扣不扣钱,是按次付费最容易被问的问题。我们这一轮故意做了几种错误,也碰到了几种真实故障,结果整理成下表。所有失败都返回了结构化的错误:code、message、request_id、retryable,参数错误还会带上缺哪个参数、允许哪些值,以及一个能直接用的正确示例。
| 情况 | HTTP | 返回 | 扣费 | 次数 |
|---|---|---|---|---|
| 不带 Key | 401 | missing_key,提示放进 Authorization 头 | $0 | 1 |
评论接口传了 username | 422 | missing_param: url,附正确请求示例 | $0 | 1 |
单帖详情 urls 为空 | 422 | missing_param: urls | $0 | 1 |
results_type 写成 posts | 422 | invalid_value,allowed 为 reel、reels | $0 | 1 |
| 每分钟超过 10 次 | 429 | rate_limited,retry_after 7–17 秒 | $0 | 3(另有 4 次被脚本自动重试吸收) |
| 评论回复 | 503 | 见上一节 | $0 | 9 |
| 账号查不到(两次) | 200 | results 为空,refund_state: refunded | 先扣后退 | 2 |
最后一行值得多说一句。user_posts 是异步能力,提交时会先按 $0.000556 预扣,任务跑完发现结果为空,就把这笔钱退回,任务结果里写着 billing_state: charged 和 refund_state: refunded。我们查的一个拼错的账号名和一个随手编的不存在账号,都是这样先扣后退。这对批量跑账号名单很重要:名单里写错的账号不会让你白花钱,但你要在对账时看 refund_state,不要只看提交时的扣费。
耗时方面,同步的评论和单帖详情都在 9–12 秒,话题 11.5 秒(另一次 32.8 秒是因为先碰到 429 等了一轮),异步的 user_posts 从提交到拿到结果 38–66 秒。参数错误在 0.1–0.4 秒内就返回,不扣费,所以调试阶段可以放心地先用错参数试探格式。如果你用的是会自动重试的 AI 代理,错误响应里的 retryable 字段能帮它判断要不要重发:missing_param、invalid_value 是 false,429 和 503 是 true。
三条路的账:一万条评论、一个月的监测
把前面的实测换算成两个常见的任务。
第一个任务:拿 10,000 条公开评论做情绪分析。第三条路按实测每千行 $0.0401 算(单独调的 7 次评论请求、97 行;把 CDC 脚本里的 3 次一起算是 10 次 137 行,每千行 $0.0406),约 $0.40,前提是帖子足够多:每帖最多 15 条,10,000 条至少要覆盖约 667 个帖子,按实测平均每帖 13.7 条算要约 730 个帖子;如果你只想要 10 个热门帖子的全部评论,第三条路给不了。第一条路如果这些帖子属于你自己或你的客户,接口费是 0,每页 50 条,10,000 条约 200 页请求,主要成本是应用审核和开发时间。第二条路没有接口费,成本在账号、代理和维护上,而且从上面的 issue 时间线看,10 月里有好几段时间是跑不通的。
第二个任务:每天盯 3 个公共卫生机构账号(比如 WHO、OPS、CDC),每天拉一次最近 50 条帖子,并对当天评论最多的 10 个帖子各拉一次评论。每天 3 次 user_posts 加 30 次 comments,共 33 次调用,按目录价 $0.000556 算每天约 $0.0183,一个月 30 天约 $0.55。这个量级下,钱已经不是决定因素,决定因素是每帖 15 条的覆盖率够不够你用。
| 任务 | 官方接口 | 开源库 | 按次付费(EveryInfra) |
|---|---|---|---|
| 1 万条评论(很多帖子各取一段) | 只能是自己或授权账号;接口费 0 | 接口费 0;需账号、代理,有被拦的时段 | 约 $0.40(每千行 $0.0401 实测) |
| 1 万条评论(少数热门帖子全部评论) | 能做(授权账号),每页 50 条 | 取决于登录状态和版本 | 做不到(每帖最多 15 条) |
| 3 个机构账号每日监测,30 天 | 别人的账号只有计数 | 每天都要过登录和限速 | 约 $0.55(每天 33 次调用) |
| 抓 1 万条帖子元数据 | 别人的账号可用 Business Discovery 拿计数 | 可以,受 429 限制 | 约 $0.11(每次 50 条);limit 200 时约 $0.028(估算,未测) |
这里的账只算接口费,不算人。按次付费的价格写的是目录价,我们发稿前会再核一次;当天有效价格以价格页和目录为准,充值和用量折扣不在这张表里。
接进 AI 工具:远程 MCP
如果你的 Python 脚本只是给一个 AI 助手准备数据,也可以不写脚本,直接把 EveryInfra 的远程 MCP 加到支持 MCP 的客户端里。我们 11 月 10 日用 tools/list 查到的工具共 12 个,其中 everyinfra_call_api 就是调用上面这些能力的工具,everyinfra_list_capabilities 列出全部平台和能力,everyinfra_get_job 取异步任务结果。配置写法见 MCP 接入页:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
接上以后,你可以直接让助手「拉 WHO 最近 50 条帖子,挑评论最多的 3 条,各取评论并按主题归类」,它会依次调用 user_posts 和 comments。要注意的还是前面那两件事:评论每帖最多 15 条,助手如果说「这是全部评论」就是在误导你;合作帖要不要算进去,需要你在提示里写明。
研究用途:还有第四个入口
如果你是高校或非营利机构的研究人员,做的是公共利益研究,还有一个前面没列进表的入口:Meta 的 Content Library 和 Content Library API。它覆盖 Facebook、Instagram、WhatsApp 频道的公开内容,Instagram 部分包括商业和创作者账号的帖子,以及认证或粉丝 100 以上的个人账号的帖子;API 端点里包括 Instagram 的账号、帖子和评论,每次查询最多返回 10 万条,但数据只能在安全的计算环境里分析,申请由法国安全数据访问中心(CASD)独立审核。Meta 在一篇更新说明里写到,研究人员现在可以在某个帖子的评论里按关键词搜索、按日期排序和筛选。
在欧盟,《数字服务法》第 40 条要求超大型平台向经过审核的研究人员开放公开数据,欧盟委员会通过的数据访问授权法规规定了具体程序,并上线了数据访问门户。不过这些通道并不完美:一篇 2026 年 9 月 23 日更新的 arXiv 论文对比了用户实际看到的内容和研究接口能取回的内容,发现 Meta Content Library 和 TikTok 研究接口会漏掉最多约一半的内容、丢掉最多约 83% 的上下文元数据,操作限制低到每周约 1,000 次请求。对研究项目来说,比较稳妥的做法是两条线都走:申请正式通道,同时用公开接口做小规模的抽样和交叉核对,并把每种数据的来源和覆盖率写进方法部分。我们在社媒数据做研究样本那篇里讲过同一查询隔两分钟重搜结果就变一半的问题,在健康风险监测那篇里讲过公共卫生机构怎么把社媒信号做成人工分流流程,都可以和本文的评论覆盖率一起看。
合规边界:公开评论也是个人信息
公开不等于可以随便用。2024 年 10 月 29 日,澳大利亚信息专员办公室和另外 16 个国家和地区的数据保护机构发布了关于数据抓取的后续联合声明,要求平台持续部署防抓取措施,并要求出于商业或公益目的的抓取在合法、严格的合同约束下进行。对使用者来说,最低限度要做到三件事:只收集完成任务需要的字段(做情绪分析不需要评论者的头像链接);评论者的用户名在存储和展示时做假名化处理,本文的截图和数据里就把所有评论者用户名隐去了;不收集私密账号,不绕过登录墙和技术限制。上面那份脚本就是按这个原则写的:评论表只写 post_url、id、posted_at、like_count、text 五列,接口返回里的评论者用户名不落盘;如果你的分析确实需要区分同一个人发的多条评论,存用户名的哈希值就够了,不要存原文。
平台条款这一侧,上文引用的 Instagram 使用条款第 4.2 节是关键。Meta 自己的条款也在变:2026 年 10 月中旬,Meta 一度在商业条款里加入可以抓取商业账号所关联网站内容的表述,TechCrunch 在 10 月 17 日报道这段表述被删除,MediaPost 在 11 月 6 日报道这次条款更新已经无限期暂停,原定 11 月 20 日不会生效。这件事和抓 Instagram 帖子不是一回事,但它说明了一点:条款随时会改,做长期项目要把「条款复查」写进日程。本文只讲数据方法和边界,不构成法律意见;涉及具体用途时请咨询你所在地区的律师。
和我们其他文章的区别
各类 Instagram 数据的单价见 Instagram 数据接口页,两周前测得的每帖 15 条评论上限今天没变。Instagram 的同一家公司旗下还有 Facebook 和 Threads,接口用法一样,只是 platform 换一个值。
最近的变化(2026 年 10–11 月)
| 日期 | 变化 | 对你意味着什么 |
|---|---|---|
| 2026-10-01 | Instagram 迁移指南:新建应用不能再用 Instagram Login 接入 | 新项目直接按 Unified Login 设计,准备 Business 资产组合 |
| 2026-10-13 | Unified Login 说明页:新功能只在这一种接法上发布 | 老项目迟早要迁,提前排期 |
| 2026-10-26 | instaloader 4.16 发布 | 还在用 4.15.x 的先升级,但 10 月 30 日起登录问题又出现 |
| 2026-11-04 | Graph API v27.0 发布,v21.0 将于 2027-01-21 下线 | 老代码里写死的版本号要改;新应用不能用多 ID 请求 |
| 2026-11-06 | Meta 商业条款中涉及抓取的更新无限期暂停 | 条款会变,长期项目要定期复查 |
| 2026-11-09 | instagrapi 3.2.8 发布,此前 #2920 报登录失败 | 私有接口类库更新频繁,锁定版本并准备回退 |
另外两条背景:Pew 研究中心在 2026 年 10 月 19 日更新的美国人社交媒体使用情况显示,大约一半的美国成年人使用 Instagram,这也是为什么做美国市场的品牌和机构很难绕开它;2026 年 10 月 5 日发布的一篇 arXiv 论文用超过 1,500 万条带赞助标记的 Instagram 帖子研究互动率,说明在学术界,大规模的 Instagram 帖子数据仍然是常用的研究材料,而帖子级的元数据(点赞、评论数、文案)比评论正文容易拿得多。
三条路混着用时要注意什么
实际项目里,三条路经常混着用:自己品牌号的评论走官方接口,竞品和行业账号的帖子和最近评论走按次付费,研究团队另外申请正式通道做全量分析。混用时最要紧的是在数据表里加一列「来源」,并把每种来源的覆盖率写清楚,不要把不同来源的评论数直接加总比较。以本文为例,按次付费这一路 10 个帖子的覆盖率是 6.0%,而授权账号走官方接口理论上能翻到全部公开顶层评论;两边的评论放进同一张表时,至少要带上「来源」「抓取时间」「该帖评论总数」三列,后面算情绪占比时按来源分开算,再决定要不要合并。
上手:从一次试用到每天自动跑
最快的上手方式是先在接口市场或文档的快速开始里用自己的 Key 跑一次 instagram/user_posts,确认返回的字段是你要的;然后把上面的脚本存成 ig_posts_comments.py,设置环境变量 EVERYINFRA_API_KEY,运行 python ig_posts_comments.py cdcgov 3。要每天跑,就把它交给系统的定时任务,并在脚本里按 post_id 和评论 id 去重追加,而不是每天覆盖。账号名单里写错的账号会自动退款,但要在日志里记下 refund_state,方便你发现名单里的错。
真正要花心思的是两件事:第一,决定评论覆盖率够不够。先拿 5 到 10 个代表性帖子跑一遍,像本文这样算一下「拿回条数 ÷ 评论数」,如果你关心的帖子大多在几十条评论以内,第三条路基本能拿全;如果都是几百上千条评论的热门帖,就要准备第一条路或研究通道。第二,决定合作帖怎么算,并把规则写进代码。
常见问题
能不能用 Python 抓 Instagram 的公开数据?
来源:Google 联想词「can you scrape data from instagram」。技术上可以,但要分清三种做法:官方接口只读自己或授权的专业账号;开源库直接请求网页或移动端接口,Instagram 使用条款第 4.2 节禁止未经许可的自动化收集,登录用的账号可能被限制;按次付费接口不需要你提供 Instagram 账号。无论哪种,都只碰公开内容,不碰私密账号,评论者个人信息要做最小化处理。
Instagram scraping policy 到底怎么写的?
来源:Google 联想词「instagram scraping policy」。条款原文在使用条款第 4.2 节:不得以未经授权的方式创建账号或访问、收集信息,包括未经明确许可的自动化访问或收集,无论是否登录。帮助中心《为什么你的账号因数据抓取被限制》一文说 Meta 有专门团队检测抓取行为。新版条款将于 2027 年 1 月 20 日生效,预览页已公开。
怎么免费抓 Instagram 评论?
来源:Google 联想词「how to scrape instagram comments for free」。免费的只有两种:用官方接口读你自己的专业账号的评论(接口不收费,但要建应用、过审核);用开源库(库免费,但要承担账号风险,10 月以来不少时段跑不通)。按次付费不是免费的,但一个帖子的评论一次 $0.000556,测试阶段花不了几分钱,失败和空结果不扣费。
instaloader 报 401 或 429 怎么办?
来源:Google 联想词「instaloader 401」和 GitHub issue #2794、#2786。issue 区里用户的做法是先升级到 4.16,401 问题有人升级后解决;429 则和 IP 类型、并发、重启频率有关,官方排错文档建议不要同时开多个实例、不要频繁重启。10 月 30 日以后的登录问题(#2792)有社区补丁,但不稳定。如果项目不能接受停摆,就不要把开源库当唯一的数据来源。
Instagram Graph API 能拿别人帖子的评论吗?
来源:Google 联想词「instagram graph api get comments」。不能。Comments 参考页写明读取评论需要创建该媒体对象的用户的访问令牌。别人的商业或创作者账号,只能通过 Business Discovery 拿到帖子的评论数和点赞数,没有评论正文。
抓下来的评论能导出成 Excel 吗?
来源:Google 联想词「extraer comentarios de instagram a excel」(西语用户最常搜的说法之一)。可以,本文脚本写的是 CSV,用 Excel 直接打开即可;中文、西语和表情符号用 UTF-8 写入,Excel 打开乱码时用「数据 → 从文本/CSV 导入」并选 UTF-8。
参考资料
- Instagram Platform overview,Meta for Developers,2026-10-29 更新,<https://developers.facebook.com/documentation/instagram-platform/overview>
- Comments(IG Media 参考),Meta for Developers,2026-10-20 更新,<https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-media/comments>
- IG Comment Replies,Meta for Developers,<https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-comment/replies>
- IG User Business Discovery,Meta for Developers,2026-08-12 更新,<https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-user/business_discovery>
- IG Hashtag Search,Meta for Developers,<https://developers.facebook.com/documentation/instagram-platform/instagram-graph-api/reference/ig-hashtag-search>
- Instagram API with Unified Login,Meta for Developers,2026-10-13 更新,<https://developers.facebook.com/documentation/instagram-platform/instagram-api-with-unified-login>
- Migrate your App(Instagram Login 迁移指南),Meta for Developers,2026-10-01 更新,<https://developers.facebook.com/documentation/instagram-platform/instagram-api-with-instagram-login/migration-guide>
- Update on Instagram Basic Display API,Meta for Developers 博客,2024-09-04,<https://developers.facebook.com/blog/post/2024/09/04/update-on-instagram-basic-display-api/>
- Introducing Graph API v27.0 and Marketing API v27.0,Meta for Developers 博客,2026-11-04,<https://developers.facebook.com/blog/post/2026/11/04/introducing-graph-api-v27-and-marketing-api-v27/>
- Rate Limits,Graph API 文档,Meta for Developers,<https://developers.facebook.com/docs/graph-api/overview/rate-limiting>
- Changelog,Graph API,Meta for Developers,<https://developers.facebook.com/docs/graph-api/changelog>
- Changelog for Instagram Platform,Meta for Developers,2026-10-28 更新,<https://developers.facebook.com/documentation/instagram-platform/changelog>
- Terms of Use,Instagram 帮助中心,<https://help.instagram.com/581066165581870>
- Terms of Use - Preview(2027-01-20 生效),Instagram 帮助中心,<https://help.instagram.com/2159268501666222>
- Why your account has been restricted for data scraping,Instagram 帮助中心,<https://help.instagram.com/740480200552298>
- Hide comments or message requests you don't want to see,Instagram 帮助中心,<https://help.instagram.com/700284123459336>
- Meta Content Library and API,Meta Transparency Center,<https://transparency.meta.com/researchtools/meta-content-library/>
- Updates to Meta Content Library and API in Support of Independent Research,Meta Transparency Center,<https://transparency.meta.com/researchtools/meta-content-library/MCL-API-update-supporting-independent-research/>
- instaloader 仓库与 README,GitHub,<https://github.com/instaloader/instaloader>
- instaloader v4.16 发布说明,GitHub,2026-10-26,<https://github.com/instaloader/instaloader/releases/tag/v4.16>
- instaloader v4.15.5 发布说明,GitHub,2026-10-24,<https://github.com/instaloader/instaloader/releases/tag/v4.15.5>
- instaloader issue #2750「429: Too Many Requests」,GitHub,2026-10-10,<https://github.com/instaloader/instaloader/issues/2750>
- instaloader issue #2767「Login error: feedback_required」,GitHub,2026-10-13,<https://github.com/instaloader/instaloader/issues/2767>
- instaloader issue #2786「Is Instaloader still working reliably in 2026?」,GitHub,2026-10-21,<https://github.com/instaloader/instaloader/issues/2786>
- instaloader issue #2792「login and load-cookies are broken」,GitHub,2026-10-30,<https://github.com/instaloader/instaloader/issues/2792>
- instaloader PR #2795,GitHub,2026-11-02 用户确认,<https://github.com/instaloader/instaloader/pull/2795>
- instaloader issue #2794「Is logged out post downloading broken」,GitHub,2026-10-31,<https://github.com/instaloader/instaloader/issues/2794>
- instaloader issue #2803「Download is aborted with 302 Found」,GitHub,2026-11-07,<https://github.com/instaloader/instaloader/issues/2803>
- instaloader Troubleshooting,instaloader 文档,<https://instaloader.github.io/troubleshooting.html>
- instaloader,PyPI,<https://pypi.org/project/instaloader/>
- instagrapi 仓库与 README,GitHub,<https://github.com/subzeroid/instagrapi>
- instagrapi issue #2920,GitHub,2026-11-03,<https://github.com/subzeroid/instagrapi/issues/2920>
- instagrapi issue #2890,GitHub,2026-10-18,<https://github.com/subzeroid/instagrapi/issues/2890>
- instagrapi,PyPI(3.2.8,2026-11-09),<https://pypi.org/project/instagrapi/>
- instascrape 仓库(已归档),GitHub,<https://github.com/chris-greening/instascrape>
- Search(REST API),GitHub Docs,<https://docs.github.com/en/rest/search/search>
- Advanced Usage,Requests 文档,<https://requests.readthedocs.io/en/latest/user/advanced/>
- csv — CSV File Reading and Writing,Python 文档,<https://docs.python.org/3/library/csv.html>
- Platforms' Research API Data Access: What Users See vs. What Researchers can Retrieve,arXiv,v2 2026-09-23,<https://arxiv.org/abs/2601.12390>
- Predicting Engagement with Sponsored Content Across Account Types on Instagram,arXiv,2026-10-05,<https://arxiv.org/abs/2610.06164>
- Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure,arXiv,2026-10-22,<https://arxiv.org/abs/2610.31573>
- Delegated act on data access under the Digital Services Act,欧盟委员会,<https://digital-strategy.ec.europa.eu/en/library/delegated-act-data-access-under-digital-services-act-dsa>
- Regulation (EU) 2022/2065(数字服务法),EUR-Lex,<https://eur-lex.europa.eu/eli/reg/2022/2065/oj>
- Global privacy authorities issue follow-up joint statement on data scraping,澳大利亚信息专员办公室,2024-10-29,<https://www.oaic.gov.au/news/media-centre/global-privacy-authorities-issue-follow-up-joint-statement-on-data-scraping>
- Meta removes language that raised scraping and AI training concerns,TechCrunch,2026-10-17,<https://techcrunch.com/2026/10/17/meta-removes-language-that-raised-scraping-and-ai-training-concerns/>
- Meta Pauses Data-Scraping Terms Following Criticism,MediaPost,2026-11-06,<https://www.mediapost.com/publications/article/419294/meta-pauses-data-scraping-terms-following-criticis.html>
- Americans' Use of Social Media in 2026,Pew Research Center,2026-10-19,<https://www.pewresearch.org/internet/fact-sheet/social-media/>
- EveryInfra 数据接口目录(公开、无需 Key),2026-11-10 读取,<https://api.everyinfra.com/api/v1/social/catalog>
引用编号 BL-128