bright data alternatives:数据和代理
找 Bright Data 替代先分要数据还是要代理。实测 Instagram 帖子每千条 $0.0028、地图评论 $0.0139,对方按量 $1.50。
Bright Data 的现成爬虫按条收费,按量每 1,000 条 $1.50;2026 年 11 月 16 日 00:21–00:31(新加坡时间)我们用 EveryInfra 真调了 Instagram、Amazon、Google Maps 三个平台,同样拿 1,000 条结果,Instagram 账号帖子实扣 $0.0028,Google Maps 评论 $0.0139,Google Maps 地点 $0.0278,Amazon 搜索商品 $0.0447,比 Bright Data 按量价低 33.5 到 540 倍。差距最小的是 Instagram 单个主页:我们一次只回一个主页,每千个 $0.556,Bright Data 按量 $1.50,只低 2.7 倍;如果用上它定价页挂出的 Scraper API 前 3 个月 6 折码,它的价格降到 $0.60,两边只差 8%。另一类需求是买代理流量自己抓:Bright Data 住宅代理按量每 GB $8(页面挂着 5 折码,用码后 $4),ZenRows 最大自助档折到每 GB $1.67,Apify 每 GB $7 到 $8;EveryInfra 价格页列有按流量包下单的 IP 代理,但 11 月 16 日读到的代理货架上各类都标着暂不可用。
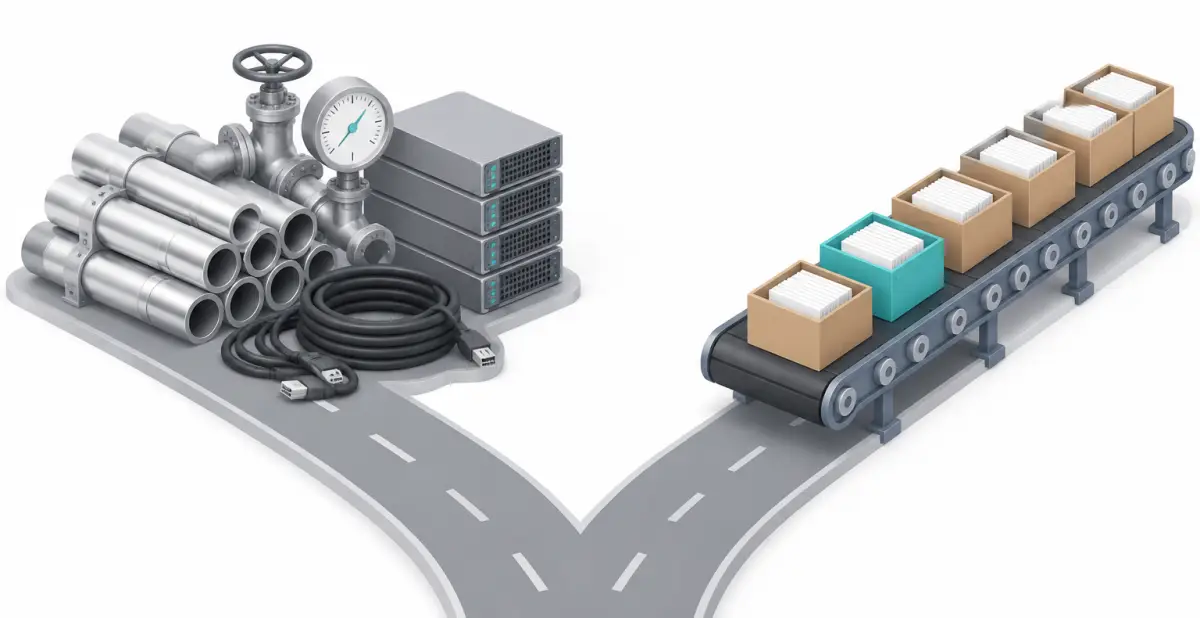
找 Bright Data 替代的人,买的东西分两种。第一种人用的是 Bright Data 的 Web Scraper API、数据集或 Scraper Studio,要的是一条条整理好的 Instagram 主页、Amazon 商品、Google Maps 地点,按条付钱。第二种人用的是它的住宅、数据中心、ISP 代理或 Web Unlocker,自己写爬虫,只缺干净的出口和解封,按 GB、按 IP 或按请求付钱。我们把 ZenRows、ScraperAPI、Apify、Firecrawl 和 EveryInfra 也按这两类放好:Apify 两类都有,它的 Store 里卖按条计价的现成爬虫,也单卖代理;ZenRows、ScraperAPI、Firecrawl 主要卖通用抓取,一次请求返回一个网页,按 credit 计;EveryInfra 的主力在第一类,按次计价、返回统一字段;第二类里有统一搜索的 read 单页读取(每千次 $0.694),价格页列着的 IP 代理当天货架暂不可用。两类的单位不同,下面的每一张价目表都只在同一类里比。
站内已经有一篇 Bright Data pricing 详解,那篇拆的是 Bright Data 自己八个产品的价目和 Scale 套餐分界线,测的是 Amazon 详情、TikTok 帖子和 Google 搜索;Bright Data 替代方案对比页是一页速查。这里把五家替代品都放进来,测前两篇没测过的 Instagram 主页、Instagram 帖子和评论、Google Maps 地点和评论、Amazon 搜索的快速模式,再单列代理和免费额度两张账。对方五家全部取自公开定价页、文档和 Store 页面,没有真调,读取时间是 2026 年 11 月 16 日 00:16–00:40(新加坡时间),表里记作「公开标价」;EveryInfra 一列是「本次实扣」,取自响应里的 billing.charged_usd。两边的字段各自独立,下面只比价格、计费规则和接入方式。
bright data alternatives 先分两类:六家各卖什么
六家公司在 2026 年 11 月 16 日公开售卖的东西差别很大。Bright Data 的定价总页菜单一共列了四组十几个产品:网页访问(Unlocker、Crawl、SERP、Browser API)、数据(Scraper API、Scraper Studio、数据集、Data Firehose)、数据洞察和托管采集、代理(住宅、数据中心、ISP)。菜单栏里写的起步价有 Unlocker 和 SERP 每千次 $1,Scraper API 每千条 $1 划线后 $0.75,数据集 10 万条 $250,住宅代理每 GB $5 划线后 $2.5,数据中心每 IP $0.9,ISP 每 IP $1.3。这些起步价大多是最大档或活动价,进到各产品的定价页才看得到不签月付时的按量价。
| 公司 | 卖整理好的记录 | 卖通用抓取(返回网页) | 卖代理 | 卖历史数据集 | 计价单位 |
|---|---|---|---|---|---|
| Bright Data | Web Scraper API,1,301 个现成爬虫 | Unlocker、Crawl、Browser API | 住宅、数据中心、ISP | 有,10 万条 $250 起 | 每条记录、每次请求、每 GB、每 IP |
| Apify | Store 里第三方和官方爬虫,按结果或用量计 | Website Content Crawler 等 | 住宅代理每 GB $7–$8,数据中心 IP 加购 | 无 | 每条结果、每计算单元、每 GB |
| ZenRows | 无按平台的现成字段,Extract 自动抽 JSON | Fetch、Crawl、Batch、Browser | 住宅流量 25,000 credits 合 1 GB | 无 | 每页 credit |
| ScraperAPI | Amazon、Google、Walmart 等结构化端点 | 普通抓取、Crawler、DataPipeline | 无单独售卖 | 无 | 每次请求 credit |
| Firecrawl | 无按平台的现成字段,JSON 格式另加 credit | Scrape、Crawl、Map、Search | 无 | 无 | 每页 credit |
| EveryInfra | 106 个平台、574 项能力,返回统一字段 | 统一搜索 read 单页读取,按次计 | 价格页列有 IP 代理,11 月 16 日货架暂不可用 | 无 | 每次调用固定美元价 |
表里 Bright Data 的爬虫数来自它每天刷新的 scrapers.json,我们在 2026 年 11 月 16 日读到 1,301 个爬虫、1,207 个域名,其中 instagram.com 4 个(评论、帖子、主页、Reels)、amazon.com 5 个、google.com 10 个。EveryInfra 的平台和能力数来自能力目录,同一天 00:16:37(新加坡时间)读到 106 个平台、574 项能力,其中 539 项可用,available=false 的 35 项不在本文使用。ZenRows 和 Firecrawl 两家都能把网页抽成 JSON,但它们的计费按「一页」走,不按「一条记录」走:一页 Amazon 搜索结果里有几十个商品,ZenRows 和 Firecrawl 都只按一页扣钱,抽出来的字段由模型或规则决定,字段名每次可能不同。
找替代时先回答一个问题:你现在每个月给 Bright Data 的钱,大头花在哪一类?如果大头是住宅代理流量,第二类的 ZenRows、Apify 是同类替代,EveryInfra 的代理货架当天暂不可用,眼下帮不上;如果大头是 Instagram、Amazon、Google Maps 这类现成爬虫的记录费,第一类的 Apify 和 EveryInfra 是同类替代,ScraperAPI 的结构化端点也能替一部分。
总对比表:计费单位、失败、最低花费、免费额度、MCP
| 项目 | Bright Data | Apify | ZenRows | ScraperAPI | Firecrawl | EveryInfra |
|---|---|---|---|---|---|---|
| 最低付费 | 按量无月费,先充值 | Starter $19/月 | Build B1 $19/月 | Hobby $49/月 | Hobby $19/月 | 无月费,首充 $10 |
| 免费额度 | 每月 5,000 credits | 每月 $5 平台额度 | 每月 5,000 credits | 7 天 5,000 credits,之后每月 1,000 | 每月 1,000 credits | 一次性 $1,24 小时 |
| 结构化记录单价 | 每千条 $1.50(Scale $1.30) | 每千条 $1.50–$5.00(三个爬虫) | 无 | Amazon 一页 5 credits,Google 25 | 无 | 每次 $0.000556–$0.002236(本文用到的能力) |
| 代理 | 住宅每 GB $8,5 折码后 $4 | 住宅每 GB $7–$8 | 每 GB 25,000 credits | 不单卖 | 不卖 | 货架暂不可用 |
| 失败扣不扣 | 交付失败不收;输入有误的记录照收 | 按事件计,跑了就收平台用量 | 失败不收,404 和 410 算成功 | 只收 200 和 404 | 无结果不收,403 和 404 收 1 credit | 失败、空结果不收,响应里写退回 |
| 额度结转 | 免费额度不结转;月付承诺不结转 | 预付额度当月用 | 月额度不结转,加购包可结转一期 | 不结转 | Scale 起结转一个月 | 余额不过期 |
| MCP | 远程 MCP,每月 5,000 次免费 | https://mcp.apify.com | https://mcp.zenrows.com/mcp | https://mcp.scraperapi.com/mcp | Firecrawl MCP v3 | https://api.everyinfra.com/mcp |
第一,Bright Data 和 EveryInfra 都没有月费,先充值、按量扣;Apify、ZenRows、ScraperAPI、Firecrawl 都是月订阅,月初给一桶额度,用不完基本作废,ZenRows 的定价文档写明计划内 credits 每次续订都过期,ScraperAPI 定价页写明「Credit rollover」各档都没有。第二,失败的定义五家各不相同:Firecrawl 的定价页写着目标站返回 403 或 404 的页面照样交给你,扣 1 credit;ZenRows 把 404 和 410 算成「有效结果」;ScraperAPI 只对 200 和 404 计费,另外还有一条 70 秒后取消也收费的规则。第三,六家都有 MCP,接 Claude、Cursor 这类 AI 工具不再是区分点,区分点在 MCP 背后按什么单位扣钱。
要数据的一类:同样 1,000 条结果各多少钱
第一类的比较单位是「每 1,000 条结果」。Bright Data 的 Web Scraper API 定价页给出三个数:免费档每月 5,000 条,按量每千条 $1.50,Scale 每月 $499 含 384,000 条、超出每千条 $1.30;页面上方还挂着「Scraper API 前 3 个月 6 折」的优惠码 API60,按量价折后是 $0.60。Apify Store 的爬虫按事件计价,同一个爬虫在免费、Starter、Scale、Business 四档价格不同,我们从三个爬虫页面的定价数据里逐档读出:Instagram Scraper 每条结果 $0.0027、$0.0023、$0.0019、$0.0015;Amazon Product Scraper 每条 $0.005、$0.004、$0.0035、$0.003;Google Maps Scraper 每个地点 $0.004、$0.003、$0.002、$0.0015,另加每次启动 $0.007,每条评论另计 $0.0005 到 $0.00026。
EveryInfra 一侧的算法是:一次调用实扣的 charged_usd 除以这次实际返回的条数,再乘 1,000。分母用实际返回条数,不用参数里写的 limit:Instagram 话题请求写了 100,实际回了 24 条,如果按 100 算会把我们的价算低 4 倍多。下表是 2026 年 11 月 16 日 00:21–00:31(新加坡时间)九次扣费调用的结果。
| 时刻(新加坡时间) | 能力 | 参数 | 返回条数 | 耗时 | 实扣 | 每千条 |
|---|---|---|---|---|---|---|
| 00:21:11 | instagram/profile | nasa | 1 | 12.4 秒 | $0.000556 | $0.556 |
| 00:21:32 | instagram/hashtag | coldbrew,limit 100 | 24 | 8.1 秒 | $0.000556 | $0.0232 |
| 00:22:46 | amazon/search | robot vacuum,limit 50 | 50 | 44.3 秒 | $0.002236 | $0.0447 |
| 00:25:02 | google_maps_reviews/search | dentist,Denver CO,limit 50 | 50 | 8.1 秒 | $0.001389 | $0.0278 |
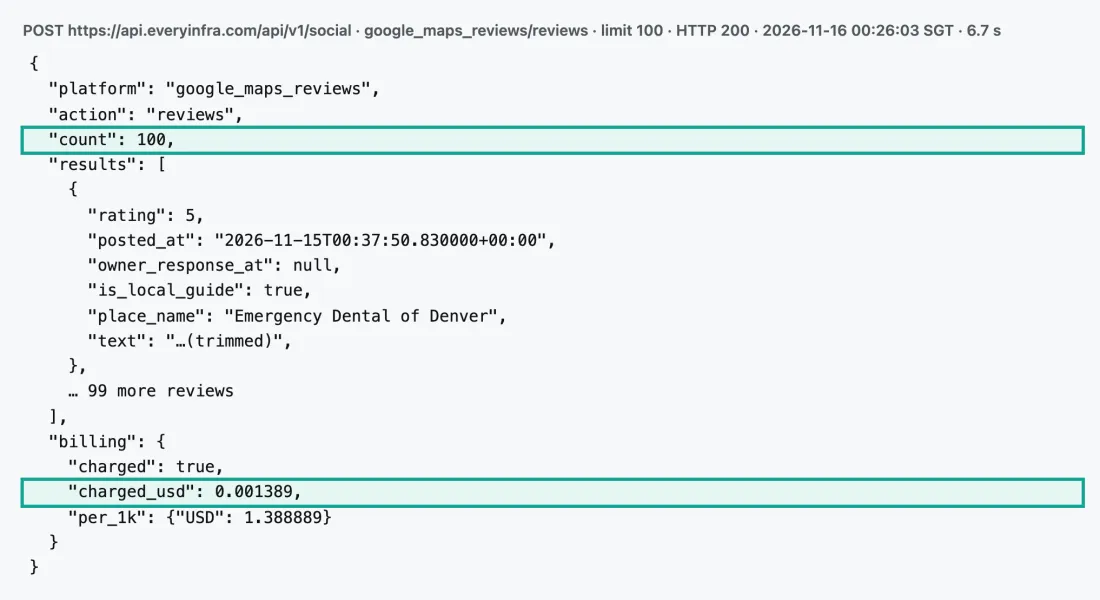
| 00:26:03 | google_maps_reviews/reviews | 一家诊所,limit 100 | 100 | 6.7 秒 | $0.001389 | $0.0139 |
| 00:26:43 | instagram/user_posts | nasa,limit 200,异步 | 200 | 74 秒到结果 | $0.000556 | $0.0028 |
| 00:29:30 | google_maps_reviews/search | 同上第 2 页,异步 | 50 | 64 秒到结果 | $0.001389 | $0.0278 |
| 00:29:39 | amazon/search | 同上,fast: true | 48 | 8.5 秒 | $0.002236 | $0.0466 |
| 00:31:04 | instagram/comments | NASA 一条帖子,limit 100 | 30 | 17.5 秒 | $0.000792 | $0.0264 |
九行就是九次扣费,其中 00:29:30 是 00:25:02 那次地点搜索的异步翻页,单独计一次费。九次实扣合计 $0.011099。另有 7 次没有扣钱:2 次 429 限速、1 次 422 要求改用异步、4 次 503(两次 Amazon 评论、两次查同一个不存在的 Instagram 账号),后面「失败和空结果」一节逐条写。每次实扣都和目录里的 price_usd 一致:instagram/profile、instagram/hashtag、instagram/user_posts 都是 $0.000556,instagram/comments 是 $0.000792,Google Maps 两项都是 $0.001389,amazon/search 是 $0.002236。
Instagram 主页一行离得最近:我们的 $0.556 对 Bright Data 按量 $1.50 是 2.7 倍,对 Apify 免费档 $2.70 是 4.9 倍,对 Apify Business 档 $1.50 也是 2.7 倍。其余四行都隔着一到两个数量级:Instagram 账号帖子 $0.0028 对 $1.50 是 540 倍,Google Maps 评论 $0.0139 对 $1.50 是 108 倍,Google Maps 地点 $0.0278 对 $1.50 是 54 倍,Amazon 搜索商品 $0.0447 对 $1.50 是 33.5 倍。拉开差距的原因是计费单位:Bright Data 和 Apify 按「交付的每一条」计,我们按「每一次调用」计,一次调用回的条数越多,每条越便宜。
场景一:Instagram 主页、帖子和评论
00:21:11(新加坡时间)我们调 instagram/profile 查 NASA 的主页,12.4 秒返回一个对象:显示名 NASA,粉丝 104,331,773,关注 91,帖子 5,010,认证和商家账号两项都是 true,另附外链 5 条和最近帖子。目录里这项能力的字段有 19 个,包括 follower_count、post_count、is_verified、external_urls、recent_posts;目录的说明还写了一条:有的请求会少返回 recent_posts、avatar_hd_url、category、highlight_count 这四个字段。一个主页一次调用,实扣 $0.000556,每千个主页 $0.556。
Bright Data 的 Instagram 爬虫文档把主页、帖子、Reels、评论分成四个数据集编号,一条主页记录里有 followers、posts_count、is_verified、biography 等字段,每条按 Web Scraper API 价计。文档里那条示例记录的抓取日期是 2026 年 9 月 6 日,样例账号是 Instagram 自己。按量价下,1,000 个主页 $1.50。Apify 的 Instagram Scraper 页面原文写着免费档每千条 $2.70、Starter 档 $2.30、Scale 档 $1.90、Business 档 $1.50,一个主页算一条。如果你的任务只是每周刷新几千个达人主页的粉丝数,三家的差距在每月几美元的量级,这时选谁更多看字段和稳定性。
00:26:43 我们提交 instagram/user_posts 异步任务,查 NASA 的帖子、limit 200,1.9 秒拿到 202 和 poll_url,先扣 $0.000556;00:27:57 轮询时任务已经成功,200 条帖子,其中图片 137 条、视频 63 条,发帖时间从 2026 年 6 月 9 日到 11 月 14 日(新加坡时间),轮询本身不扣钱。200 条每条都有文字、点赞数、评论数、发帖时间和图片地址,63 条视频帖有视频地址;view_count 和 top_comments 两个字段在 200 条里一条都没有,目录说明里这两个字段本来就列在「有的请求不返回」一栏。按 200 条算,每千条 $0.0028,对 Bright Data 按量 $1.50 低 540 倍,对 Apify Business 档 $1.50 同样低 540 倍。
话题和评论的每千条价介于两者之间。00:21:32 调 instagram/hashtag 查 #coldbrew,limit 写 100,8.1 秒回了 24 条,每千条 $0.0232,对 $1.50 是 64.7 倍;24 条里 19 条有作者名,8 条带地点。00:31:04 调 instagram/comments 取 NASA 评论数最多的一条帖子(19,543 条评论),limit 100,17.5 秒回了 30 条,扣 $0.000792,每千条 $0.0264,对 $1.50 是 56.8 倍。目录对评论写了上限:有的请求最多回 80 条,少的时候只回 30 条,这次正好是 30。做评论情感分析时,一条热门帖子的几万条评论,我们一次拿不完,要换几条帖子分摊;Bright Data 和 Apify 按条计价,拿得越多付得越多,但一次能拿多深由它们的爬虫决定。Apify 页面还写明免费档每条帖子只能拿一页评论,大约 15 条,付费档没有这个限制。六种 Instagram 做法的字段对比见站内 best instagram scraper 榜单。
场景二:Amazon 搜索商品,以及什么时候 ScraperAPI 更便宜
00:22:46(新加坡时间)调 amazon/search 搜「robot vacuum」、limit 50,44.3 秒返回 50 个商品,扣 $0.002236,每千个 $0.0447。50 个商品逐个数字段:ASIN、标题、链接、品牌、评分、评分数、库存、类目、图片、特性、畅销榜排名 50 个全有,价格 44 个有,卖家 45 个有,划线原价 38 个有,描述 20 个有。00:29:39 用同一个关键词加 "fast": true 再调一次,8.5 秒返回 48 个,同样扣 $0.002236,每千个 $0.0466;目录写明快速模式每行少品牌、库存、类目、描述、卖家、图片组、特性、畅销榜排名 8 个字段,价格不变,这次实测每行 12 个字段。耗时从 44.3 秒降到 8.5 秒,代价是字段从 20 个降到 12 个。
Bright Data 的 Amazon products 爬虫按关键词搜时会打开每个结果、取完整商品记录,一条 $1.50 每千;Apify 的 Amazon Product Scraper 免费档每千条 $5.00、Business 档 $3.00,对我们的 $0.0447 分别是 112 倍和 67 倍。两家一条记录的字段比我们列表行多(详情页才有的描述、变体、评论摘要),所以如果你本来就要逐个商品的详情,应该拿我们的 amazon/profile 比:目录价每次 $0.001389,每千个 $1.389,对 Bright Data 按量只低 7.4%,对 Scale 超出价 $1.30 反而贵,这一点 Bright Data pricing 详解已经实测过,本次没有再调。
ScraperAPI 的 Amazon 搜索结构化端点按普通请求计费,Amazon 域名一次 5 credits,一次返回一页搜索结果。它的每千次请求价,Hobby 档 $2.45、Startup 档 $0.745、Business 档 $0.498、Advanced 档 $0.459;一页里装几个商品,ScraperAPI 文档没有写数字。如果按我们快速模式这次拿到的 48 条估算一页的条数,ScraperAPI 每千个商品在 Hobby 档是 $0.051,比我们贵 1.14 倍;Startup 档 $0.0155,我们贵 2.88 倍;Business 档 $0.0104;Advanced 档 $0.0096,我们贵 4.67 倍。这个结论有两个前提:每月把订阅额度用满,且一页真的有 48 条左右;页数少的类目或翻到后几页时条数会变少。月用量大、只要 Amazon 搜索列表的团队,ScraperAPI 的中高档比我们便宜。
Amazon 评论这次没有拿到。00:26:16 和 00:28:20(新加坡时间)两次调 amazon/reviews,分别用 Shark 的两款扫地机器人,20.5 秒和 23.9 秒后都返回 503,错误原因 access_blocked,说明这件商品要登录或受限,这次已退款,charged_usd 为 0。站内前几篇对比文写 Amazon 评论时也遇到过同样的 503。Bright Data 的 scrapers.json 里有 Amazon Reviews 爬虫,Apify Store 里也有评论爬虫。
场景三:Google Maps 地点和评论
00:25:02(新加坡时间)调 google_maps_reviews/search 搜丹佛的牙医,limit 50,8.1 秒返回 50 个地点,扣 $0.001389。50 个地点 19 个字段全部有值:地点编号、名称、链接、类目、地址、城市、州、邮编、经纬度、电话、网站、评分、评论数、图片。响应里带着 next_page_token;00:28:12 用同步方式翻第 2 页,0.2 秒返回 422 async_required,说明第 2 页从头算超过 60 行,同步翻不了,要加 "mode": "async" 再提交,这次没扣钱。00:29:30 改用异步提交,2.0 秒拿到 202,00:30:34 轮询到结果:又是 50 个地点,扣 $0.001389。两页 100 行里有 1 个地点重复,去重后 99 个,合每千个不重复地点 $0.0281;按 100 行算是 $0.0278。
99 个地点的评分中位数 4.8,评论数中位 371 条、最少 8 条、最多 2,263 条,100 行都有电话,98 行有网站。00:26:03 再调 google_maps_reviews/reviews,取第一页第一家诊所的评论、limit 100,6.7 秒返回 100 条,扣 $0.001389,每千条 $0.0139。100 条里 5 星 94 条、4 星 2 条、3 星 1 条、1 星 3 条;70 条有文字,30 条只打分;88 条有商家回复;评论时间从 2022 年 10 月 8 日到 2026 年 11 月 15 日。这组数据能直接用来做本地商家调研:同一个城市同一类店,按评论数排出头部门店,再拉每家的评论看差评集中在哪几件事,整个流程只用到这两项能力,100 个地点加每家 100 条评论,一共 102 次调用,按目录价约 $0.14。
Apify 的 Google Maps Scraper 按事件计价:每个地点 $0.004(免费档)到 $0.0015(Business 档),每次启动 $0.007,每条评论 $0.0005(免费档和 Starter 档)到 $0.00026(Business 档)。Apify 帮助中心的计价说明用的就是「每 1,000 个地点 $4」这个基础价,另外按类目、最低星级、有没有网站这类筛选条件每个地点每个条件再加 $0.001。所以同样 1,000 个丹佛牙医,Apify 免费档至少 $4.00,加一个「只要有网站的」筛选就是 $5.00;我们按两页 100 个一算是 $0.0278,对 $4.00 低 144 倍。评论这一项 Apify 的单价低得多:按我们这次一个地点 100 条的形状,Apify 免费档折每千条 $0.54(1 个地点费 + 100 条评论费,再除以 100),Business 档 $0.275,对我们的 $0.0139 分别是 38.9 倍和 19.8 倍。Bright Data 的 Google Maps Reviews 爬虫和 Google Maps full information 爬虫都按每条 $1.50 计,它的 Google 爬虫文档写明评论可以按回看时间窗筛选。
ScraperAPI 也有 Google Maps 搜索端点。Google 域名每次 25 credits,Hobby 档每千次请求 $12.25;文档示例里的翻页网址按 20 条一页往后翻,按一页 20 个地点估,每千个地点 Hobby 档 $0.61、Startup 档 $0.19、Advanced 档 $0.11,都比我们的 $0.0278 贵 4 到 22 倍。
按次计价的价目表上只有一个数,比如 Instagram 的 $0.000556,可是落到每千条,主页是 $0.556,帖子是 $0.0028,差 200 倍,因为一个回 1 条、一个回 200 条。估自己的账时,先按目录的 max_limit 和这类调用通常实际回几条,把每次调用换成每千条,再和 Bright Data、Apify 的每条价比;不要拿 limit 参数当分母。
要代理和通用抓取的一类:每 GB 和每页 credit
第二类的单位换成每 GB 流量和每页 credit。先看代理。Bright Data 住宅代理定价页在 2026 年 11 月 16 日列了四档,每档都挂着 5 折优惠码 RESIGB50:按量标价每 GB $8,用码后 $4;月付 $499、$999、$1,999 三档标价每 GB $7、$6、$5,页面写的「含 141 GB、332 GB、798 GB」是按用码后的价算的,即每 GB $3.54、$3.01、$2.51,页面取整显示成 $4、$3、$3。不用码的话,$499 按 $7 只够 71 GB,不到页面写的一半,预算时要确认优惠码对自己的账户有效。定价总页菜单栏写的「住宅代理每 GB $5 划线后 $2.5」就是最大档的标价和用码后的实价。页面还写着首次充值按 1 比 1 赠送、最多 $500。拿每月 100 GB 住宅流量算一笔:Bright Data 按量用码是 $400,不用码 $800;$499 档用码后含 141 GB,用不满也付 $499,所以每月不到约 125 GB($499 ÷ $4)时,按量用码比包月省;同样 100 GB 按 Apify Scale 档每 GB $7 算是 $700。数据中心代理菜单栏写每 IP $0.9 起,ISP 代理每 IP $1.3 起。
ZenRows 不按 GB 单独标价,它的定价文档写明当前付费档的住宅流量统一按 25,000 credits 合 1 GB,并给了一句换算口诀「1 GB = 25,000 credits = 1,000 个受保护页面」。所以它的每 GB 价取决于你买哪一档:Build B1 每月 $19 含 45,000 credits,最多只够 1.8 GB,合每 GB $10.56;Scale S5 每月 $2,999 含 4,500 万 credits,合每 GB $1.67,是图里最便宜的一档,但要整月 1,800 GB 都用在住宅流量上才是这个价。Apify 定价页把住宅代理写在套餐对比表里:免费档每 GB $8、Starter 档 $7.5、Scale 档 $7,数据中心代理每 IP $0.6 起加购。
Bright Data 的住宅代理这两个月有一条门槛变化。它的更新日志在 2026 年 10 月 19 日写明,住宅网络不再支持免 KYC 的即时访问,三个月没用过、账户又没通过 KYC 的住宅代理会被删除;10 月 24 日又通知剩下的即时访问住宅和移动代理要换成 ISP 代理或 Web Unlocker,2026 年 11 月 9 日起从账户删除。住宅代理文档把「完成 KYC、解锁完整住宅访问」单列为一步。对只想买几 GB 流量试一试的个人开发者,这一步比价格更影响上手。
通用抓取按每页 credit 计。三家的倍数都公开:ZenRows 普通页 1 credit、JS 渲染 5、高级代理 10、两者都开 25,文档特意写了「这些倍数固定不变,每一档都一样」;ScraperAPI 普通页 1、Amazon 等电商 5、Google 和 Bing 25、LinkedIn 30、JS 渲染 10、高级代理加渲染 25,见它的 credit 计费文档;Firecrawl 抓一页 1 credit,要 JSON、问答、高亮格式再加 4,搜索每 10 条 2 credits。每页美元价等于月费除以月 credits,再乘这一页的倍数。
| 档位 | 月费 | 月 credits | 普通页每千页 | 受保护页(25 credits)每千页 | 结构化(JSON 或电商) |
|---|---|---|---|---|---|
| ZenRows Build B1 | $19 | 45,000 | $0.42 | $10.56 | Extract 不另收费,按所用 Fetch 计 |
| ZenRows Scale S5 | $2,999 | 45,000,000 | $0.07 | $1.67 | 同上 |
| ScraperAPI Hobby | $49 | 100,000 | $0.49 | $12.25 | Amazon 一页 $2.45 每千 |
| ScraperAPI Advanced | $1,975 | 21,500,000 | $0.09 | $2.30 | Amazon 一页 $0.46 每千 |
| Firecrawl Hobby | $19 | 5,000 | $3.80 | 无此倍数 | JSON 格式 $19.00 每千 |
| Firecrawl Standard | $99 | 100,000 | $0.99 | 无此倍数 | JSON 格式 $4.95 每千 |
同一档里,倍数比档位影响更大。同样在 ZenRows B1 档,普通页每千页 $0.42,受保护页 $10.56,差 25 倍;ZenRows 的定价页 FAQ 说,开了 Adaptive Stealth Mode 它会从最轻的配置试起,只按成功的那一种收费,事先不知道一页要几个 credit。Instagram、Amazon、Google 这类站点通常要渲染或高级代理,按 25 credits 估更稳妥。ZenRows 定价页上显示的 $16、$58、$166、$458 是年付折成每月的价,它的文档写明计划页默认显示年付,月付分别是 $19、$69、$199、$549;比价时要用月付的数,否则会把它算低 17%。
拿第一类的数和这张表比,能看到两类各自划算的地方。一个 Instagram 主页如果用 ZenRows 受保护页去抓,B1 档每千个 $10.56,S5 档 $1.67,再加上自己写解析;用 EveryInfra 的 instagram/profile 是 $0.556,用 Bright Data 按量是 $1.50。反过来,如果你要抓的是一万个普通博客页、文档页、新闻页,没有反爬,ZenRows S5 每千页 $0.07、ScraperAPI Advanced $0.09;这类长尾网页在我们这边只能用统一搜索的 read 逐页读,每千次 $0.694,是这两档的 7.7 到 9.9 倍。
bright data alternatives free:各家免费额度能换多少条
「bright data alternatives free」这个联想词问的是:有没有不花钱的替代?各家都给免费额度,但额度的单位、能用在哪些产品、多久刷新都不一样。
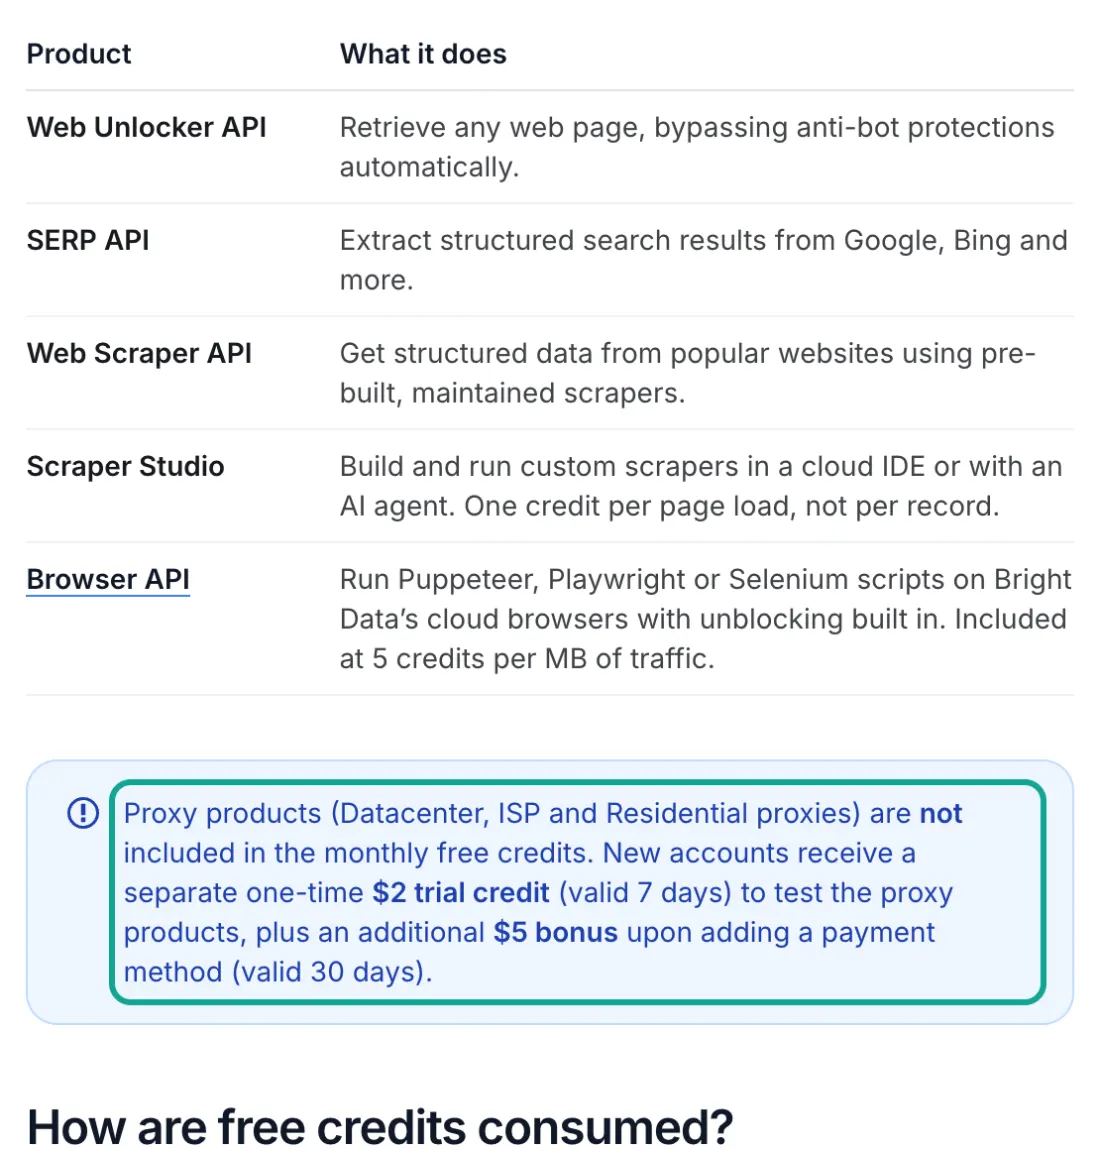
Bright Data 的免费额度文档写明,每个新账户每月 5,000 credits,约值 $7.50,不用信用卡,可以用在 Web Unlocker、SERP、Web Scraper API、Scraper Studio 和 Browser API 五个产品上;Unlocker、SERP、Web Scraper API 一个 credit 是一次请求或一条记录,Browser API 每 MB 流量 5 credits。同一页还写了三个限制:代理产品不在免费额度里,只有一次性的 $2 试用金(7 天)和添加付款方式后的 $5(30 天);没有充值的免费账户在 SERP、Unlocker 和代理上默认每分钟 1,000 次;签了月付承诺的账户不再发每月免费额度。它的 MCP 文档说每月 5,000 次免费 MCP 请求,和这 5,000 credits 是同一个池子。
| 公司 | 免费额度 | 刷新 | 能换多少(按本文场景) |
|---|---|---|---|
| Bright Data | 每月 5,000 credits,约 $7.50 | 每月 1 日,不结转 | 5,000 条 Instagram、Amazon 或 Google Maps 记录;代理不含 |
| Apify | 每月 $5 平台额度 | 每月 | 免费档价下约 1,851 条 Instagram 结果,或 1,250 个地图地点,或 1,000 个 Amazon 商品 |
| ZenRows | 每月 5,000 credits,5 个并发 | 每月,不结转 | 5,000 个普通页,或 200 个受保护页;单独的住宅代理不开放 |
| ScraperAPI | 7 天试用 5,000 credits;之后每月 1,000 credits | 每月 | 免费档每月 200 次 Amazon 请求或 40 次 Google 请求 |
| Firecrawl | 每月 1,000 credits | 每月 | 1,000 页普通抓取,或 200 页 JSON,或 5,000 条搜索结果 |
| EveryInfra | 一次性 $1,领取后 24 小时有效 | 不刷新 | 1,798 次 instagram/profile,或 719 次地图搜索(每次 50 个地点约 3.6 万个) |
按每月折合美元,Bright Data 的免费额度最大,约 $7.50;它按条计价,5,000 credits 直接就是 5,000 条记录。Apify 的 $5 换成条数要看爬虫:同样 $5,免费档价下够 1,851 条 Instagram 结果或 1,250 个地图地点,Apify 的 r/apify 社区帖子里有人问每天 8 到 10 个 LinkedIn 主页够不够用,回复说免费的 $5 就够。ScraperAPI 的免费档在高倍数站点上很快用完:1,000 credits 只够 40 次 Google 请求。EveryInfra 的 $1 额度最小,又只有 24 小时,但按次计价让它在列表类请求上换到的条数多:719 次地图搜索、每次 50 个地点,是约 3.6 万个地点,比 Bright Data 一个月的 5,000 条多;换成 Instagram 主页这种一次一条的请求,$1 只有 1,798 个。免费额度适合拿来跑一次自己的样本;各家的使用条款都限制一人多号,靠多开账户拼额度会被封。
一个月的账:42 万条结果
把三个平台合成一个小团队的月需求:2 万个 Instagram 主页、10 万条 Instagram 帖子、5 万个 Amazon 搜索商品、5 万个 Google Maps 地点、20 万条 Google Maps 评论,一共 42 万条结果。
| 一个月的需求 | Bright Data 按量 | Apify Scale 档($199/月含等额用量) | EveryInfra 调用次数 | EveryInfra 费用 |
|---|---|---|---|---|
| 2 万个 Instagram 主页 | $30.00 | $38.00 | 20,000 次 | $11.12 |
| 10 万条 Instagram 帖子 | $150.00 | $190.00 | 500 次(每次 200 条) | $0.28 |
| 5 万个 Amazon 搜索商品 | $75.00 | $175.00 | 1,000 次(每次 50 条) | $2.24 |
| 5 万个 Google Maps 地点 | $75.00 | $100.00 | 1,000 次(每次 50 个) | $1.39 |
| 20 万条 Google Maps 评论 | $300.00 | $74.00 | 2,000 次(每次 100 条) | $2.78 |
| 免费额度 | −$7.50 | 不计 | 不计 | 不计 |
| 合计 | $622.50 | $577.00 | 24,500 次 | $17.80(按未取整的分项相加) |
Bright Data 如果为这 42 万条签 Scale 套餐,$499 含 38.4 万条,超出 3.6 万条按 $1.30 每千,合计 $545.80,比按量省 $76.70;它的分界线是每月约 33.3 万条,低于这个量按量更便宜。Apify Scale 档每月 $199 包含 $199 用量,这里的用量按 Scale 档单价算出 $577,扣掉已含的 $199 再付 $378。EveryInfra 是 $17.80,其中 $11.12 花在 2 万个 Instagram 主页上,因为主页一次只回一条;剩下四项合计 $6.68。
这笔账有三个前提,任何一个变了结果都会变。一是每次返回条数按 11 月 16 日的实测外推:帖子每次 200 条、地点 50 个、评论 100 条、Amazon 50 个;如果帖子一次只回 48 条(目录写明的少量返回情形),帖子那一项会从 $0.28 涨到约 $1.16,仍然远低于另外两家。二是不算重试:失败本身不扣钱,但等待和重试要算进交付时间。三是对方没算优惠:Bright Data 用 API60 码前 3 个月按量价是 $0.60,同样 42 万条约 $244.50(扣免费额度后);首次充值翻倍最多 $500,用在第一个月几乎全免。
量小的时候账要反过来看。假设一个人做副业项目,每月只要 5,000 条:1,000 个 Instagram 主页、2,000 条 Instagram 帖子、1,000 个 Amazon 搜索商品、1,000 个 Google Maps 地点。Bright Data 每月 5,000 credits 的免费额度正好全部覆盖,花费是 $0,前提是这些爬虫都在免费额度可用的 Web Scraper API 范围内。EveryInfra 是 1,000 次主页调用 $0.556、10 次帖子调用 $0.0056、20 次 Amazon 搜索 $0.0447、20 次地图搜索 $0.0278,合计约 $0.63,而且 $1 试用额度只有 24 小时,过后要充值,首充最低 $10。Apify 按免费档单价算,3,000 条 Instagram 结果 $8.10、1,000 个 Amazon 商品 $5.00、1,000 个地点 $4.00,合计 $17.10,超出免费的 $5,要升 Starter 档($19/月,按 Starter 单价是 $13.90)。所以每月几千条、又不需要实时刷新的用量,Bright Data 的免费额度是最省的选择;用量过了每月 5,000 条,按量价 $1.50 开始计,差距才按上一张表的倍数拉开。
失败和空结果:本次 7 次没扣钱的请求
本次一共发了 16 次请求,9 次扣费,7 次没扣,下表逐条列出。
| 时刻(新加坡时间) | 能力 | HTTP | 原因 | 扣费 |
|---|---|---|---|---|
| 00:21:41 | amazon/search | 429 | 测试 Key 自设的每分钟上限,按响应提示 19 秒后重试 | $0 |
| 00:23:56 | google_maps_reviews/search | 429 | 同上,按提示 4 秒后重试 | $0 |
| 00:26:16 | amazon/reviews | 503 | access_blocked,商品要登录或受限,已退款 | $0 |
| 00:28:12 | google_maps_reviews/search | 422 | async_required,第 2 页同步太深 | $0 |
| 00:28:20 | amazon/reviews | 503 | 同 00:26:16,另一件商品 | $0 |
| 00:29:03 | instagram/profile | 503 | 查一个不存在的账号,已退款 | $0 |
| 00:29:52 | instagram/profile | 503 | 同一个账号再查一次,已退款 | $0 |
最后两条是同一个测试:查一个不存在的 Instagram 用户名,看「查无此人」怎么计费。00:29:03 和 00:29:52 两次都回 503 并退款,没有回 404 或空结果。批量核对一批可能已注销的账号时,503 按待重试处理,隔几分钟重试仍是 503 的,再打开账号页看一眼。
其他几家的失败规则各不相同。Bright Data 的 Web Scraper API 定价页写「只为成功交付付费,交付失败不收费」,它的 Scraper API 常见问题补充了输入有误也会计费的情况;Apify 的按事件计价是「写进数据集一条收一条」,启动费照收,r/automation 一篇使用体验帖的楼主说他设置了条数上限,某个 YouTube 爬虫还是多抓了几千条,费用没有退。ZenRows 和 ScraperAPI 都把 404 算成功收费,Firecrawl 把 403 和 404 都收 1 credit。比单价之前,先看你的数据里有多少比例会是 404 或空结果:做账号存活检查、下架商品监控的任务,这个比例可能很高。
接入:同一件活在六家各要几步
拿 1,000 个 Google Maps 地点为例。Bright Data 要先建账号、拿 API Key,再在 scrapers.json 里查到 Google Maps full information 的数据集编号,用 /datasets/v3/trigger 提交关键词和地点,异步任务结束后下载快照;它的 Scraper API 限制说明写明同步请求最多等 1 分钟。Apify 要选一个 Store 爬虫、填输入 JSON、启动运行、从数据集取结果,按事件计价的爬虫还要看清每个附加功能的单价。ZenRows、ScraperAPI、Firecrawl 三家拿回的是网页或抽取后的 JSON,要自己拼 Google Maps 搜索网址、翻页、解析。EveryInfra 是一个 POST 请求:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_maps_reviews","action":"search","params":{"keyword":"dentist","location":"Denver, CO","limit":50}}'
# 返回 results(50 个地点)、next_page_token 和 billing.charged_usd
# 第 2 页起加 "mode":"async",再按 poll_url 轮询
翻页时把 next_page_token 原样传回,目录写明令牌 24 小时有效,每页算一次调用,翻得深时改用异步。字段名和目录的 response_fields 一一对应:google_maps_reviews/search 返回 place_id、name、category、address、lat、lng、phone、website、rating、review_count 等 22 个字段;google_maps_reviews/reviews 返回 rating、text、posted_at、owner_response、is_local_guide 等 18 个字段。
在 Claude、Cursor 这类 AI 工具里,六家都可以挂 MCP。EveryInfra 的远程 MCP 在 2026 年 11 月 16 日 tools/list 列出 12 个工具,取数据用 everyinfra_call_api,查能力用 everyinfra_list_capabilities,取异步结果用 everyinfra_get_job:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
这个配置按 MCP 规范的 Streamable HTTP 写,Key 放在请求头,不放进网址。Bright Data 的 MCP 源码在 GitHub,Apify 的在 apify-mcp-server,Firecrawl 的在 firecrawl-mcp-server,ZenRows 的在 zenrows-mcp。同一个客户端可以同时挂几家,让模型按任务挑:要 Instagram、地图这类记录走 EveryInfra,要任意网页的正文走 ZenRows 或 Firecrawl,要代理出口的脚本走 Bright Data。站内的 MCP 接入页有更多客户端的写法。
从 Bright Data 迁过来,代码要改哪几处
如果你现在用的是 Bright Data 的 Web Scraper API,迁移的工作量主要在四个地方。第一处是任务模型。Bright Data 的现成爬虫以异步为主:用 /datasets/v3/trigger 提交一批输入,拿到 snapshot_id,再查进度、下载快照,流程见它的异步请求文档,限制说明另写明快照在任务完成后保留 30 天,过期就下载不了。EveryInfra 默认同步,一次请求拿回结果;返回超过 60 行或者翻页较深时要加 "mode": "async",拿 poll_url 轮询,本次 Instagram 帖子 200 条和地图第 2 页都是这样拿到的。原来按快照批量下载的代码,可以改成每个输入发一次请求,或者保留一个轮询循环。
第二处是输入。Bright Data 的输入是网址或关键词数组,一个数据集编号对应一种记录;我们的输入是 platform、action 和 params 三段,参数名以能力目录为准,例如地图搜索用 keyword 加 location,Instagram 主页用 username。参数写错或者带了目录里没有的参数,我们直接回 422,并列出支持的参数和允许的值,不会照常扣钱;批量脚本第一次调错就会收到 422,不会跑完一批才发现字段是空的。
第三处是字段映射。两边字段名不同,也不保证一一对应,迁移时要按目录里的 response_fields 重写一遍解析:Bright Data 主页记录里的 followers,在我们这边是 follower_count;地点的经纬度在我们这边是 lat、lng 两个字段。建议先在旧数据里挑 20 到 50 条有代表性的记录,用同样的输入各调一次,逐字段对齐,把缺失率记下来,再决定哪些字段要从别处补。
第四处是计费核对。Bright Data 按交付条数出账,账单在控制台按数据集汇总;我们每次响应都带 billing 一段,里面有 charged、charged_usd 和是否退回,可以直接写进你自己的日志,按天汇总。迁移前两周可以两边并跑:同一批输入,旧系统照跑,新系统抽 10% 跑,对比每千条的实际花费和字段缺失率,数字稳定后再切。
迁移顺序上,先迁列表类请求(帖子、地图地点和评论、Amazon 搜索),这几类每千条差几十到几百倍,账单降得最快;单个主页、商品详情这类一次一条的请求差距小,可以放后面;代理流量和长尾网站继续留在原来的服务商。
bright data competitors 里,什么时候 Bright Data 或其他家更合适
第一类的大多数场景 EveryInfra 便宜一到两个数量级;下面八种情况 Bright Data 或其他家更合适,每一条都能在它们的公开材料里查到。
第一,你要代理本身。Bright Data 住宅、数据中心、ISP 三种代理都能自助买,按量没有月费;ZenRows 和 Apify 也卖住宅流量。EveryInfra 的价格页列有 IP 代理(POST /api/v1/proxy/order,按流量包下单,不按时长计),但 11 月 16 日 01:45(新加坡时间)读到的代理货架上,动态住宅、静态住宅等五类都标着暂不可用。眼下要按 GB 随买随用,选这三家。
第二,你要的网站不在我们的目录里。Bright Data 的 scrapers.json 有 1,301 个现成爬虫、1,207 个域名,Web Unlocker 号称能打开任意公开网址;Apify Store 有数千个社区爬虫。我们的目录是 106 个平台,长尾网站多半找不到。反过来,Bright Data 的清单里没有小红书、抖音、淘宝、京东、微博、快手,这些在我们的目录里。
第三,你要的是一次性的大批量历史数据。Bright Data 的数据集定价页和菜单栏写 10 万条 $250 起,合每千条 $2.50,月度刷新最多省 80%;它的 Marketplace 数据集接口可以按条件筛选后下载。几千万条的 Amazon 商品或 LinkedIn 主页,实时一条条调不如直接买现成数据集。
第四,Amazon 评论这周就要。本次两次 amazon/reviews 都是 503,Bright Data 的 Amazon Reviews 爬虫和 Apify 的评论爬虫在列。
第五,Amazon 搜索列表的月用量很大。按一页约 48 个商品估算,ScraperAPI Startup 档每千个商品约 $0.0155,Advanced 档约 $0.0096,比我们的 $0.0447 便宜 2.9 到 4.7 倍,前提是额度用满、一页条数够。
第六,你要很高的并发。Bright Data 的 Web Scraper API 写着无限并发,ZenRows Scale 档 200 到 400 个并发,ScraperAPI Advanced 500 个;我们默认每个账户每分钟 60 次,买 30 天提速包或累计充值后升到每分钟 180 次、600 次,见价格页。
第七,采购要合规文件。Bright Data 的安全与合规页写了 ISO 27001 和 SOC 2,信息安全政策对齐 ISO 27001:2022、ISO 27017、ISO 27018,另附 Deloitte 网络内一家事务所出具的 SOC 3 报告(覆盖 2024 年 6 月 1 日到 2025 年 5 月 31 日);ZenRows 的 Enterprise 档也写了 SOC 2、ISO 27001 和 DPA。企业采购流程要这些文件时,它们准备得更齐。
第八,你的任务是把任意网页喂给模型。Firecrawl 抓一页 1 credit、默认输出 Markdown,Standard 档每千页 $0.99;它在 2026 年 11 月 12 日发布的 MCP v3 写了 3,000 多个工具和 60 倍的速率上限。量大时 ZenRows S5 普通页每千页 $0.07,比我们统一搜索 read 的 $0.694 便宜得多;小批量给 agent 读文档,用 read 逐页读就够,它比 Firecrawl Standard 满额用的每千页 $0.99 低。详见站内 Firecrawl alternatives 比价。
最近 30 天的变化
2026 年 11 月 10 日,Bright Data 更新日志写 Perplexity 爬虫暂不可用,请求拿不到成功结果。对读者意味着:按条计价的现成爬虫也会整类停摆,关键任务要有第二家备选。
2026 年 11 月 8 日,Bright Data 新增代理错误码 peer_30060(HTTP 501)和 policy_20231(HTTP 402,目标在政策禁止的地区)。对读者意味着:按错误码重试的脚本要把 402 当成不可重试。
2026 年 11 月 5 日,Bright Data 浏览器扩展默认端口改成 44445,22225 端口 2026 年 11 月 25 日后停用。对读者意味着:老配置要在月底前改。
2026 年 10 月 30 日,Apify 更新日志宣布 Store 搜索接口 11 月 15 日换新后端,返回字段有删减。对读者意味着:用接口按关键词找爬虫的自动化流程,结果排序和字段都会变,要回归测一遍。
2026 年 10 月,ScraperAPI 的更新日志写 Akamai 保护的网站不用再加 premium 参数就能自动解封。对读者意味着:原来为 Akamai 站点开 premium=true 的请求可以先去掉再测,可能少扣 credit。
2026 年 10 月 27 日,Bright Data 的 Unlocker 成功率查询接口支持按日期和网址模式筛选,并返回 P90 响应时间。2026 年 10 月 9 日,ZenRows 更新日志上线 Crawl,10 月 5 日开放 AI agent 自己在 agents.zenrows.com 购买 Fetch 和 Extract。
论坛里大家怎么说
在 Reddit 搜「bright data alternatives」,排在前面的讨论分成两种。r/proxies 一篇帖子的楼主用的是 Bright Data 的独享数据中心代理和 ISP 代理,嫌贵,回复里多是代理商自荐,还有人提醒这类帖子常是代理商自己发的引流帖;这是第二类需求,比价看本文代理一节。r/automation 那篇使用体验帖的楼主在评论里说 Bright Data 错误率低、表现稳定,但对个人用户「定价相当激进」;正文列了 Apify Store 里某个 YouTube 爬虫的几件事:设了最大条数还多抓几千条、取回的是旧视频而不是最新的、提出后没有退款。比价前先问清两件事:设了条数上限会不会超,超了退不退。本文用到的 EveryInfra 能力都按次计价,一次调用回多少条都只扣一次,limit 写多写少不改变单次费用;价格页另写明少数列表能力按返回条数计费,单价旁会注明每多少条算一次。
r/apify 那篇定价困惑帖问的是另一件常见的事:只想跑一个每千条 $4 的爬虫,要不要买每月 $29 的 Starter?回复说免费档的 $5 就够。这篇帖子写的 $29 现在已经过时:Apify 在 2026 年 9 月 11 日把 Starter 从 $29 降到 $19,第三方定价追踪站 UsagePricing 记下了这次变化,Apify 的订阅变更文档举例时用的也是 $19。读论坛时要留意帖子的日期,价格几个月就会变。
边界:哪些结论不成立
对方价格全部来自 2026 年 11 月 16 日 00:16–00:40(新加坡时间)读到的公开页面,没有注册、登录或调用,企业合同价、叠加优惠码后的价、账户里的实际价都可能不同;Bright Data 定价页底部写明本地货币只供参考,按美元结算。EveryInfra 一侧是 9 次扣费请求,每个场景 1 到 2 次,样本很小:Instagram 帖子这次回 200 条,目录写明有的请求最多回 48 条;Instagram 话题写 100 回 24;Amazon 搜索 44.3 秒,慢的时候更慢。ScraperAPI 每页条数(Amazon 48、Google Maps 20)是估算,正文已标出。两边「一条」的字段不同:Bright Data、Apify 的一条商品或地点往往是详情级,我们的列表行字段少一些,需要详情时要换 amazon/profile 这类详情能力,每千条价随之变成 $1.389。本文不比较两边数据是否相同,也不涉及法律意见,抓取公开数据前请自行确认目标网站条款。
常见问题
bright data alternatives free 有哪些?
出处:Google 联想词「bright data alternatives free」。免费额度最大的是 Bright Data 自己,每月 5,000 credits,约 $7.50;替代品里 Apify 每月 $5、ZenRows 每月 5,000 credits、Firecrawl 每月 1,000 credits、ScraperAPI 试用 7 天 5,000 credits 后每月 1,000,EveryInfra 一次性 $1、24 小时有效。按本文场景换算,免费额度够做一次小样本测试,长期跑都要付费。
bright data competitors 有哪些,怎么分?
出处:Google 联想词「bright data competitors」「bright data competition」。按你买的东西分:买现成记录的,替代品是 Apify Store 和 EveryInfra,ScraperAPI 的结构化端点能替一部分;买通用抓取的,替代品是 ZenRows、ScraperAPI、Firecrawl;买代理的,替代品是 ZenRows、Apify 和其他代理商。
bright data vs apify 哪个便宜?
出处:Google 联想词「bright data vs apify」。按本文三个爬虫:Instagram 两家按量都是每千条 $1.50 左右(Apify Business 档 $1.50,免费档 $2.70);Amazon 商品 Apify 更贵,$3.00 到 $5.00;Google Maps 地点 Apify 免费档 $4.00、Business 档 $1.50,评论附加费只有 $0.26 到 $0.50,比 Bright Data 的 $1.50 便宜。Apify 还要算月费和启动费。
bright data vs firecrawl 怎么选?
出处:Google 联想词「bright data vs firecrawl」。Firecrawl 只卖通用抓取,一页 1 credit、默认 Markdown,适合把任意网页喂给模型;Bright Data 两类都卖。要 Instagram、Amazon 这类平台的整理好的字段,Firecrawl 要加 JSON 格式(每页再加 4 credits),Hobby 档每千页 $19.00,比 Bright Data 按条的 $1.50 贵。
is bright data free?
出处:Google 联想词「is bright data free」。有每月 5,000 credits 的免费额度,不能用在代理上,细节见上文「各家免费额度能换多少条」一节。
is bright data legit,用它安全吗?
出处:Google 联想词「is bright data legit」「is bright data safe」。从公开材料看,Bright Data 在安全与合规页写了 ISO 27001、SOC 2 和一份 SOC 3 审计报告,住宅代理要求完成 KYC 才开放完整访问,2026 年 10 月起还收紧了免审核的即时访问。是否「安全」还取决于你抓什么、怎么用:公开数据也要看目标网站条款和所在地法规,本文不给法律意见。换到任何替代品,这个判断同样要自己做一遍。
Reddit 上大家推荐的 cheaper alternative to bright data 靠谱吗?
出处:Google 联想词「cheaper alternative to bright data」「bright data alternatives reddit」,以及 r/proxies 原帖。代理类帖子下面的推荐多来自代理商自荐,有回复直接点出这一点;判断时看对方是否公开写明每 GB 或每条的价格、失败扣不扣、额度会不会作废,再用免费额度跑自己的样本。
上手:用自己的样本复算一遍
第一步,在快速上手注册并拿 API Key,到价格页领 $1 试用额度(在 GitHub 给两个仓库点星,24 小时内有效)。第二步,在 Instagram 平台页、Amazon 平台页、Google Maps 评论平台页找到你要的能力,或者直接读能力目录里的 price_usd、max_limit 和 response_fields。第三步,用上面的 curl 跑 5 到 10 次你自己的关键词或账号,每次记下 billing.charged_usd 和实际返回条数,算出每千条。第四步,拿这个数和你现在 Bright Data 账单上的每千条比,再决定是整体换、部分换,还是只把列表类请求搬过来。也可以在 API 市场按平台浏览能力。
参考资料
- Bright Data Pricing(定价总页),Bright Data,2026-11-16 读取
- Web Scraper API Pricing,Bright Data,2026-11-16 读取
- Datasets Pricing,Bright Data,2026-11-16 读取
- Residential Proxies Pricing,Bright Data,2026-11-16 读取
- SERP API Pricing,Bright Data,2026-11-16 读取
- Free tier,Bright Data 文档,2026-11-16 读取
- Release notes,Bright Data 文档,2026-11-10 最近一条,2026-11-16 读取
- Instagram Scraper API,Bright Data 文档,2026-11-16 读取
- Google Scraper API,Bright Data 文档,2026-11-16 读取
- Scraper API FAQs,Bright Data 文档,2026-11-16 读取
- Scraper API limits,Bright Data 文档,2026-11-16 读取
- MCP server overview,Bright Data 文档,2026-11-16 读取
- scrapers.json(现成爬虫清单),Bright Data 文档,每日刷新,2026-11-16 读取
- Security and compliance,Bright Data 文档,2026-11-16 读取
- Async requests,Bright Data 文档,2026-11-16 读取
- SERP API rate limits,Bright Data 文档,2026-11-16 读取
- Marketplace Dataset API,Bright Data 文档,2026-11-16 读取
- Residential proxies introduction,Bright Data 文档,2026-11-16 读取
- Proxy error catalog,Bright Data 文档,2026-11-16 读取
- brightdata-mcp,Bright Data,GitHub,2026-11-16 读取
- ZenRows Pricing,ZenRows,2026-11-16 读取
- Zenrows Pricing(文档),ZenRows 文档,2026-11-16 读取
- Changelog,ZenRows,2026-10-09 最近一条,2026-11-16 读取
- MCP tool reference,ZenRows 文档,2026-11-16 读取
- Agentic Payments,ZenRows 文档,2026-11-16 读取
- Crawl endpoints,ZenRows 文档,2026-11-16 读取
- zenrows-mcp,ZenRows,GitHub,2026-11-16 读取
- ScraperAPI Pricing,ScraperAPI,2026-11-16 读取
- pricing.md,ScraperAPI,2026-11-16 读取
- Credits and Requests costs,ScraperAPI 文档,2026-11-16 读取
- Google Maps Search API,ScraperAPI 文档,2026-11-16 读取
- Amazon Search API,ScraperAPI 文档,2026-11-16 读取
- Akamai-protected sites now unblocked automatically,ScraperAPI 文档,2026 年 10 月,2026-11-16 读取
- Release Notes,ScraperAPI 文档,2026-11-16 读取
- ScraperAPI MCP Server,ScraperAPI 文档,2026-11-16 读取
- Apify pricing,Apify,2026-11-16 读取
- Instagram Scraper,Apify Store,2026-11-16 读取
- Google Maps Scraper,Apify Store,2026-11-16 读取
- Amazon Product Scraper,Apify Store,2026-11-16 读取
- Apify Store API: new search backend and breaking changes,Apify,2026-10-30
- Apify Store 文档(运行 Store 里的爬虫),Apify 文档,2026-11-16 读取
- Apify MCP server,Apify 文档,2026-11-16 读取
- Google Maps Scraper is going to pay-per-event pricing,Apify 帮助中心,2026-11-16 读取
- Subscription changes,Apify 文档,2026-11-16 读取
- apify-mcp-server,Apify,GitHub,2026-11-16 读取
- Firecrawl Pricing,Firecrawl,2026-09-04 生效,2026-11-16 读取
- Billing,Firecrawl 文档,2026-11-16 读取
- Introducing Firecrawl MCP v3,Firecrawl,2026-11-12
- Firecrawl MCP Server,Firecrawl 文档,2026-11-16 读取
- firecrawl-mcp-server,Firecrawl,GitHub,2026-11-16 读取
- MCP Specification 2025-11-25,Model Context Protocol,2026-11-16 读取
- EveryInfra 能力目录,EveryInfra,2026-11-16 00:16 新加坡时间读取
- EveryInfra 搜索工具目录,EveryInfra,2026-11-16 读取
- Whats a better/cheaper alternative to Brightdata?,Reddit r/proxies,2026-11-16 读取
- Reviews after getting into web scrape tools,Reddit r/automation,2026-11-16 读取
- Confusion on Apify Pricing!,Reddit r/apify,2026-11-16 读取
- Apify cuts the Starter plan from $29 to $19,UsagePricing,2026-09-11
引用编号 BL-170