Firecrawl alternatives: siete opciones de scraping con precio por 1.000 páginas y por 1.000 resultados
Firecrawl alternatives con precio por 1.000 páginas y por 1.000 resultados, y 26 pruebas reales: reseñas de Maps, comentarios de TikTok, Amazon y fallos.
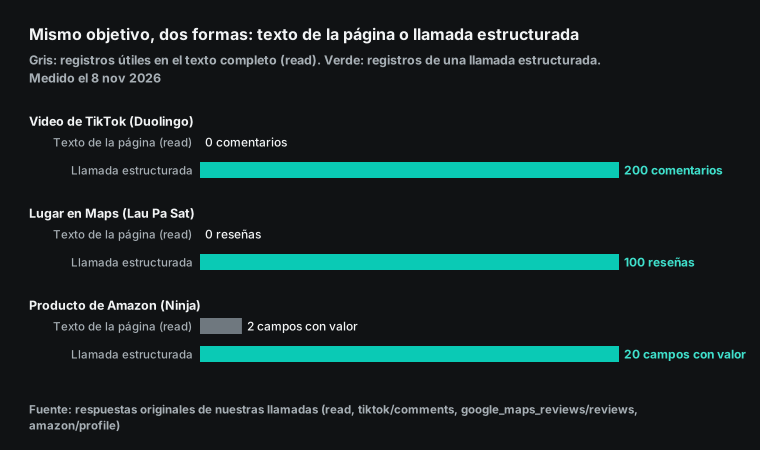
El 8 de noviembre de 2026 pedimos las reseñas de Lau Pa Sat, un mercado de comida de Singapur, de dos maneras. Al leer la página del lugar en Google Maps, nuestra herramienta de texto devolvió un resultado vacío y no cobró nada. Al llamar al endpoint de reseñas, recibimos 100 reseñas en 8,50 segundos por 0,001389 USD, es decir, 0,0139 USD por cada 1.000 reseñas. Ese contraste resume este artículo. Mucha gente busca firecrawl alternatives porque el precio por página le parece alto. A menudo el problema real es otro: necesita elementos de una plataforma, y un lector de páginas no devuelve elementos.
Este texto es para equipos técnicos y de datos que buscan una firecrawl alternative y quieren cifras, no una lista de logotipos. Comparamos siete opciones: Firecrawl, Apify, Tavily, Bright Data, ScraperAPI, ZenRows y EveryInfra. Leímos cada precio en la página de precios o en la documentación del propio proveedor el 2026-11-08, entre las 00:20 y las 00:45, hora de Singapur. No abrimos cuenta en ninguno de estos servicios ni usamos una clave de ninguno para sacar datos. Todas las pruebas en vivo de este artículo fueron contra nuestra propia API, con una clave de prueba, desde una máquina en Singapur. Nuestra página de comparación con Firecrawl es una tabla de decisión sin pruebas en vivo; este artículo añade los datos medidos.
Cinco preguntas para elegir entre las firecrawl alternatives
Antes de mirar tablas de precios, conviene responder cinco preguntas. Cada una cambia el resultado de la comparación, y casi nadie las responde antes de elegir.
La primera pregunta es qué quieres al final: una página o una lista de elementos. Si quieres el texto de una página para un índice RAG, compara precio por página. Si quieres comentarios, reseñas o fichas de producto, compara precio por elemento. Son dos mercados distintos aunque las herramientas se parezcan.
La segunda pregunta es qué parte de tus páginas necesita JavaScript o pasar protecciones contra bots. Muchos servicios cobran varias veces más por esas páginas. Con pocas páginas difíciles, gana el precio estándar más bajo. Con muchas, gana un precio plano.
La tercera pregunta es cuántas páginas tiene cada sitio que quieres rastrear. Si son decenas, casi cualquier opción sirve. Si son decenas de miles, necesitas un rastreador con límites altos y control de profundidad.
La cuarta pregunta es cuántos fallos esperas y quién los paga. Un 404 o un bloqueo puede costar un crédito o nada, según el proveedor. Con muchos destinos rotos, esa regla pesa más que el precio unitario.
La quinta pregunta es si necesitas instalar la herramienta en tus propios servidores. Si la respuesta es sí, de las siete opciones solo Firecrawl tiene una versión completa de código abierto. Con esas cinco respuestas en la mano, la tabla siguiente se lee en un minuto.
| Lo que necesitas | Mejor opción | Motivo | Precio por 1.000 (primer plan) |
|---|---|---|---|
| Rastrear 10.000 páginas de un sitio con reglas de ruta y profundidad | Firecrawl | Límite por defecto de 10.000 páginas | 3,80 USD (Hobby) |
| Capturas, clics, desplazamiento, formularios | Firecrawl, ZenRows, Bright Data | Sesiones de navegador reales | Según minutos de navegador |
| Muchas páginas sencillas, HTML sin procesar | ZenRows, ScraperAPI | Petición estándar de 1 crédito | 0,422 / 0,49 USD |
| El agente busca primero y luego lee unas páginas | Tavily | Búsqueda y extracción en una API; los fallos no se cobran | 1,60 USD (pago por uso) |
| Sitios de documentación a Markdown, 20 páginas por llamada | EveryInfra crawl | Se cobra por llamada, no por página | 0,0347 USD (medido) |
| Comentarios, reseñas y fichas de una plataforma conocida | Endpoints estructurados de EveryInfra | Una llamada devuelve de 100 a 200 elementos | 0,00278 a 1,389 USD |
| Una plataforma que no está en nuestro catálogo | Apify | Gran tienda de scrapers ya hechos | Según el scraper |
| Tus servidores, los datos no salen de tu red | Firecrawl de código abierto | Licencia AGPL-3.0 | Tu propio coste de servidores |
Cómo medimos: precios públicos, texto original y 26 llamadas reales
Las siete opciones usan siete unidades de cobro distintas. Firecrawl cobra en créditos. Una página extraída o rastreada cuesta 1 crédito, igual que una llamada de mapa. La búsqueda cuesta 2 créditos por cada 10 resultados, y la extracción JSON suma 4 créditos por página (documentación de facturación de Firecrawl). Tavily cobra 1 crédito por cada 5 URL extraídas con éxito en modo básico (documentación de créditos de Tavily). ScraperAPI y ZenRows también cobran en créditos, pero el número de créditos cambia según el dominio, el renderizado de JavaScript y los proxies premium.
Bright Data cobra por petición en Web Unlocker y por registro en su Web Scraper API. Los scrapers de la tienda de Apify cobran por unidad de cómputo o por evento, por ejemplo por comentario (documentación de cobro de la tienda de Apify). Nosotros cobramos por llamada, con el precio en USD en el catálogo. Para poner todo en una tabla usamos dos divisores. En páginas genéricas dividimos por las páginas que la llamada devolvió de verdad. En datos de plataforma dividimos por los elementos que la llamada devolvió de verdad, nunca por el parámetro limit o num.
En nuestro lado usamos una clave de prueba a la que pusimos un límite propio de 10 peticiones por minuto; una cuenta normal tiene por defecto 60 por minuto, y el límite sube con las recargas acumuladas (página de precios). Enviamos 26 peticiones entre las 00:16 y las 00:28 del 2026-11-08, hora de Singapur. La latencia que damos es el time_total de curl, desde nuestra máquina en Singapur hasta el último byte de la respuesta. Se cobraron 13 peticiones, con un total de 0,010831 USD. Las otras 13 no costaron nada. Fueron un 401 sin clave, un 422 por un parámetro mal escrito, tres 429 por límite de frecuencia, cuatro 503, un 404 del destino y tres resultados vacíos.
Para representar «un scraper genérico» en las pruebas sobre el mismo destino usamos nuestra herramienta read. No llamamos a Firecrawl, así que no podemos decir qué devuelve Firecrawl para un vídeo de TikTok. Sí podemos decir qué contiene el texto de la página cuando una herramienta pide la URL sin desplazarse ni hacer clic. Firecrawl tiene acciones de navegador y extracción JSON que podrían sacar más de la página. No probamos esas funciones, y lo indicamos donde importa.
Cuánto cuesta Firecrawl: el crédito y los recargos
Antes de buscar una alternativa, calcula lo que te cuesta Firecrawl con tu mezcla de trabajo. Su página de precios dice que los precios rigen desde el 4 de septiembre de 2026. El plan gratuito da 1.000 créditos al mes y no pide tarjeta. Hay cuatro planes de pago. Con pago mensual, Hobby cuesta 19 USD por 5.000 créditos y Standard 99 USD por 100.000. Growth cuesta 399 USD por 500.000, y Scale 749 USD por 1.000.000. Con pago anual bajan a 16, 83, 333 y 599 USD al mes.
Solo los créditos de Scale pasan al mes siguiente, y solo durante un mes. Cuando se acaban los créditos, los planes de pago pueden comprar más en tramos de 5 USD. En Hobby, 5 USD dan 1.000 créditos; en Standard, 2.000; en Growth, 2.500; y en Scale, 5.000. Así, en Hobby cada 1.000 créditos extra cuestan 5,00 USD, más que los 3,80 USD del plan.
| Plan de Firecrawl | Precio mensual | Créditos al mes | USD por 1.000 créditos (mensual) | USD por 1.000 créditos (anual) | Créditos extra por 5 USD |
|---|---|---|---|---|---|
| Free | 0 USD | 1.000 | 0 USD | 0 USD | No disponible |
| Hobby | 19 USD | 5.000 | 3,80 USD | 3,20 USD | 1.000 |
| Standard | 99 USD | 100.000 | 0,99 USD | 0,83 USD | 2.000 |
| Growth | 399 USD | 500.000 | 0,798 USD | 0,666 USD | 2.500 |
| Scale | 749 USD | 1.000.000 | 0,749 USD | 0,599 USD | 5.000 |
El precio base es solo una parte de la factura. La documentación de facturación lista recargos por página. El formato JSON suma 4 créditos. Los formatos de pregunta, de destacados, la transcripción de audio o vídeo y el enmascarado de datos personales suman 4 créditos cada uno. La retención cero de datos suma 1 crédito, y el análisis de PDF suma 1 crédito por cada página del PDF. Los recargos se acumulan: JSON con retención cero son 6 créditos por página.
Dos tipos de URL tienen precio propio. Las URL de X (Twitter) tienen precio propio: 30 créditos cada una. Las URL de perfiles y empresas de LinkedIn van a un proveedor de datos que eliges en el panel, por 5 a 40 créditos. Un PDF de 15 páginas, por ejemplo, son 1 crédito base más 15 créditos de página, es decir, 16 créditos. En Hobby son unos 0,061 USD por documento. A las 00:25, hora de Singapur, enviamos ese mismo artículo de 15 páginas (arXiv 1706.03762) a nuestro read. Devolvió 52.380 caracteres en 1,78 segundos por 0,000694 USD, sin cobro por página.
| Uso de Firecrawl | Créditos por página | Hobby, por 1.000 páginas | Standard, por 1.000 páginas | Scale, por 1.000 páginas |
|---|---|---|---|---|
| Extraer o rastrear a Markdown | 1 | 3,80 USD | 0,99 USD | 0,749 USD |
| Más análisis de PDF (por página de PDF) | +1 | +3,80 USD | +0,99 USD | +0,749 USD |
| Más extracción JSON | 5 | 19,00 USD | 4,95 USD | 3,745 USD |
| JSON con retención cero | 6 | 22,80 USD | 5,94 USD | 4,494 USD |
| JSON con enmascarado de datos personales | 9 | 34,20 USD | 8,91 USD | 6,741 USD |
| URL de X (Twitter) | 30 | 114,00 USD | 29,70 USD | 22,47 USD |
En el foro r/LocalLLaMA, un usuario preguntó cuál es la mejor herramienta de scraping del momento y pidió dos cosas a Firecrawl (hilo en Reddit). La primera era que los créditos no caducaran. La segunda era entender por qué un mismo sitio a veces gasta varios créditos. La tabla de recargos responde a la segunda. Varias respuestas del mismo hilo se quejan además de la documentación y de los errores de la versión instalada por uno mismo; son experiencias de usuarios concretos, no de todos.
Reseñas de Google Maps: el caso más claro
Empezamos por el caso con la diferencia más grande. A las 00:21:22, hora de Singapur, google_maps_reviews/search con la consulta «Lau Pa Sat Singapore» devolvió el lugar en 57,80 segundos por 0,001389 USD. El resultado traía una nota de 4,4, 39.457 reseñas y una URL con query_place_id. Fue la llamada más lenta de toda la prueba. A las 00:24:20, read pidió esa URL. A los 3,02 segundos devolvió un resultado vacío con reembolso automático, así que costó 0 USD. La página de un lugar en Maps se construye con scripts en el navegador, y una lectura de texto no encuentra nada.
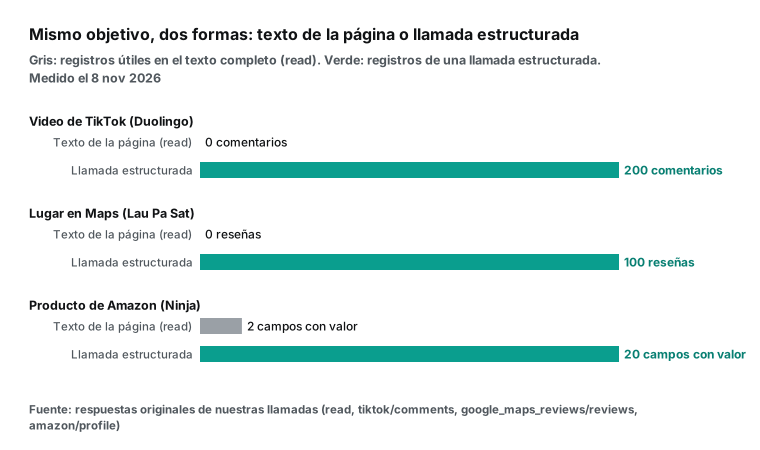
A las 00:24:35, google_maps_reviews/reviews sobre la misma URL, con limit 100, devolvió 100 reseñas en 8,50 segundos por 0,001389 USD. Son 0,0139 USD por cada 1.000 reseñas. Las reseñas iban del 2026-10-29 al 2026-11-07 (UTC), de la más nueva a la más antigua. Hubo 75 de cinco estrellas, 18 de cuatro y 5 de tres, más una de dos y una de una. La media fue 4,65, por encima del 4,4 histórico, así que los últimos diez días fueron mejores que la media de siempre.
Solo 38 reseñas traían texto; el resto solo tenía estrellas. Setenta traían notas separadas de comida, servicio y ambiente: la comida promedió 4,70 (69 reseñas), el ambiente 4,57 (69) y el servicio 4,38 (66), el más bajo de los tres. De los 100 autores, 79 eran Local Guides y 17 reseñas traían fotos. La respuesta incluía un next_page_token para pedir la página siguiente, y cada página es una llamada. Si tu equipo mide la reputación de varias tiendas, esos campos ya vienen separados, sin tener que leer el texto con un modelo.
El Google Maps Reviews Scraper de Apify cobra por reseña. Son 0,60 USD por 1.000 en el plan gratuito, 0,45 USD en Starter y 0,15 USD en el nivel más bajo. Cada inicio de ejecución suma 0,00005 USD. El scraper de reseñas de Maps de Bright Data cuesta 1,50 USD por 1.000 registros. Nuestros 0,0139 USD son más o menos 1/32 del precio de Apify en Starter. Los campos están en nuestra página de la API de reseñas de Google Maps, y la guía cómo extraer reseñas de Google Maps explica la paginación y el orden.
| Mismo lugar en Google Maps (Lau Pa Sat) | Texto de la página (`read`) | Estructurado (`google_maps_reviews/reviews`) |
|---|---|---|
| Hora (Singapur) | 00:24:20 | 00:24:35 |
| Latencia | 3,02 s | 8,50 s |
| Resultado | Vacío, reembolso automático | 100 reseñas, 38 con texto, 70 con notas por apartado |
| Reseñas útiles | 0 | 100 |
| Cobro | 0 USD | 0,001389 USD |
| Por 1.000 reseñas | No es posible | 0,0139 USD |
Comentarios de TikTok: el mismo vídeo, dos métodos
El segundo caso es el de un equipo de marca que quiere los comentarios de un vídeo de TikTok para medir opiniones. Con un scraper genérico, el plan es pedir la página del vídeo y sacar los comentarios del texto. Probamos los dos métodos con el mismo vídeo: una publicación de Duolingo del 2026-11-05, hora de Singapur (2026-11-04 19:58 en UTC). A las 00:17, hora de Singapur, nuestra llamada tiktok/user_videos trajo los cinco vídeos más recientes de la cuenta, el último del 2026-11-06 (UTC), y el nuestro tenía 596 comentarios.
A las 00:18:45, read pidió la página del vídeo y devolvió 17.914 caracteres en 2,39 segundos por 0,000694 USD. El texto traía el título, una imagen de portada y una lista «You may like» con 81 enlaces a otros vídeos. Tomamos los primeros 50 textos de comentario de la llamada estructurada y buscamos cada uno en el texto de la página. No apareció ninguno. El primer HTML de la página no contiene los comentarios; el navegador los carga después, al desplazarse. Cualquier herramienta que solo pida la URL choca con esa pared.
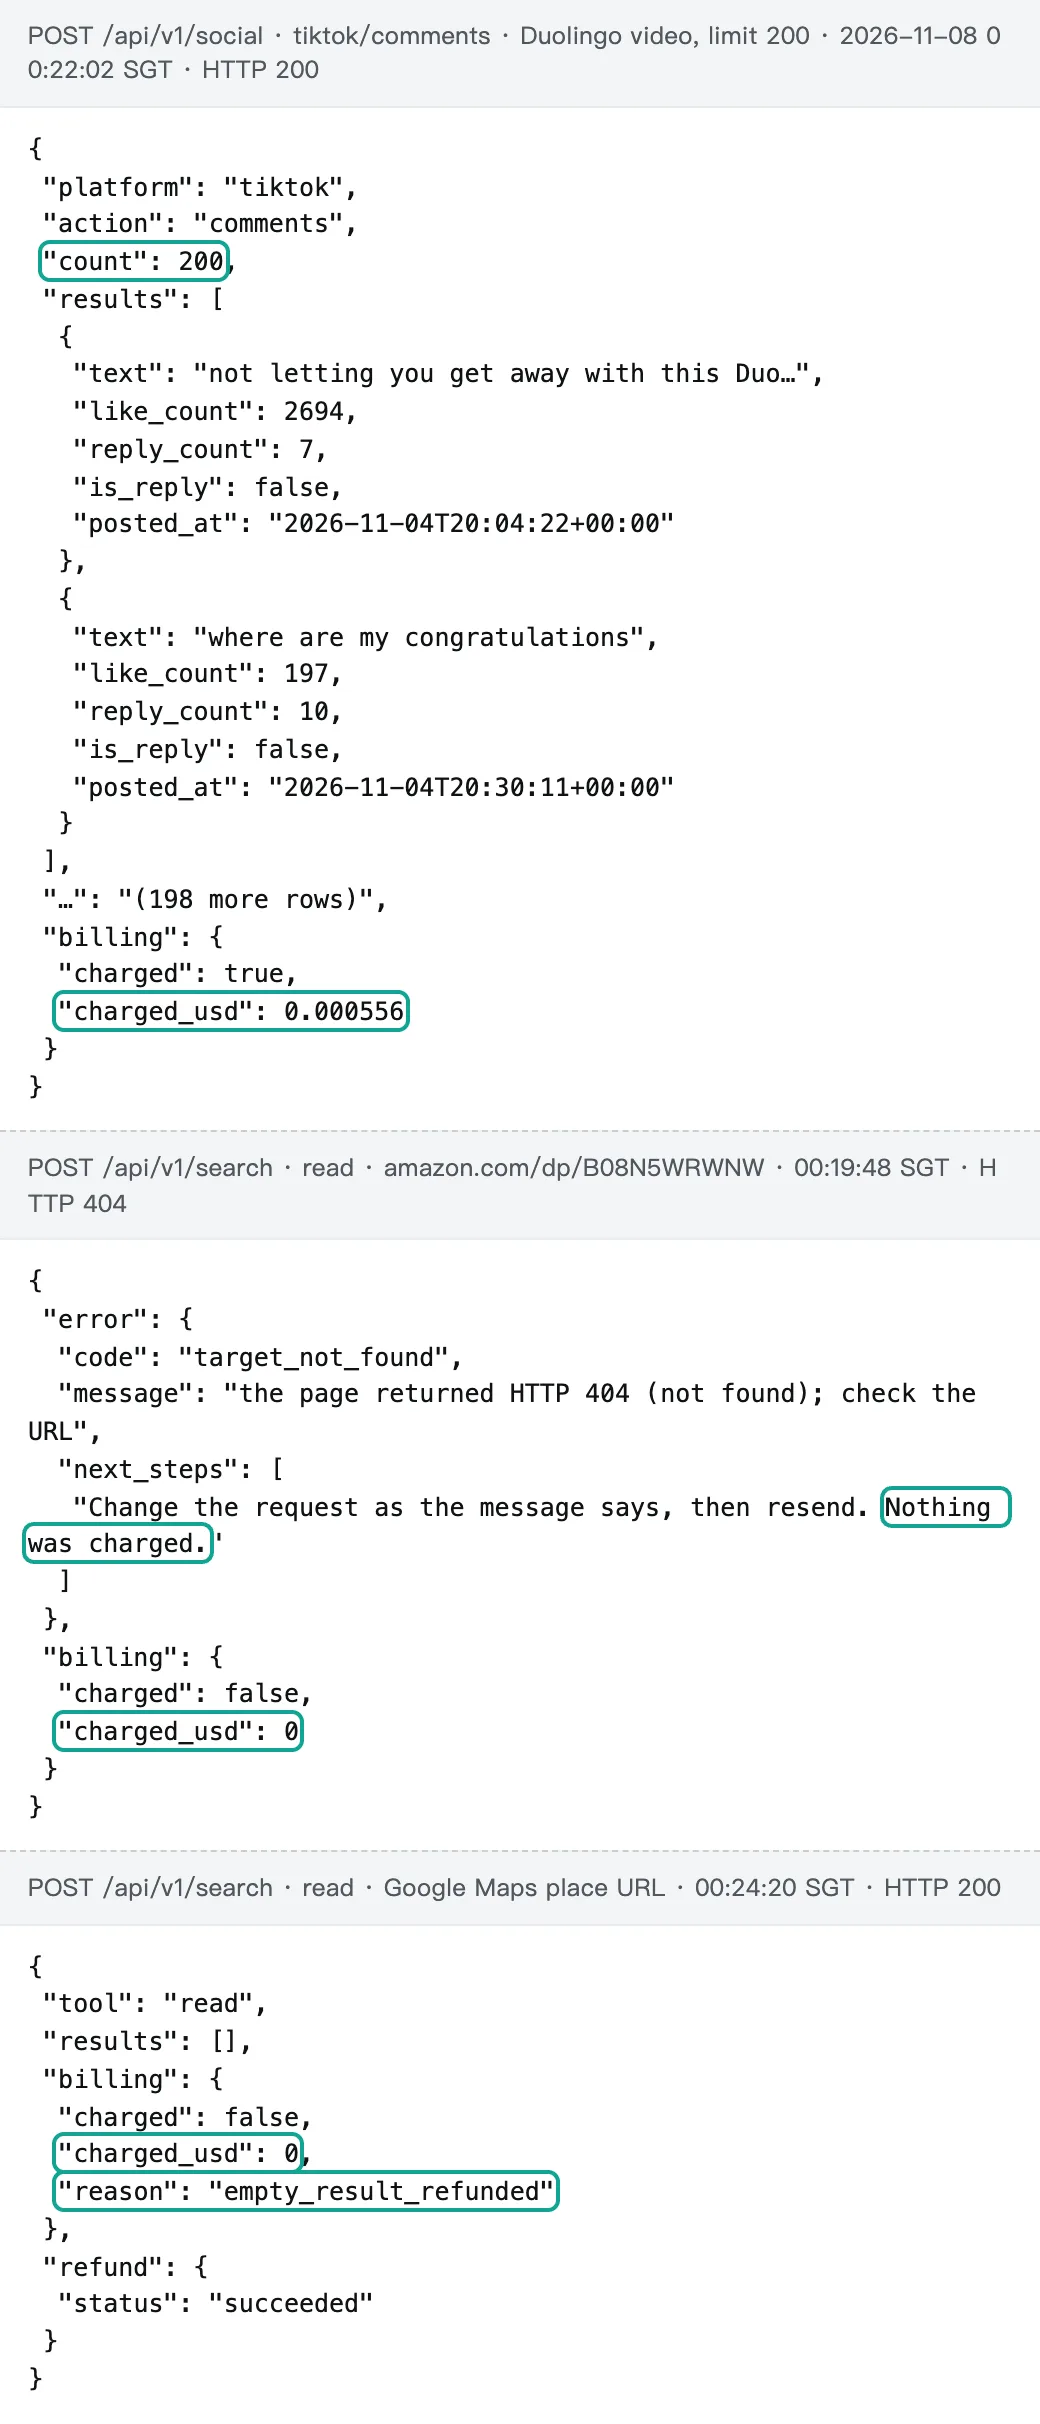
Firecrawl tiene Interact, que abre una sesión de navegador por 2 a 7 créditos por minuto. No lo probamos, así que no sabemos cuántos comentarios reuniría. A las 00:22:02, tiktok/comments con limit 200 devolvió 200 comentarios en 49,53 segundos por 0,000556 USD. Los 200 tenían identificadores únicos; 22 eran respuestas y 187 tenían texto. Cada comentario traía «me gusta», número de respuestas, marcas de «le gusta al autor» y «fijado por el autor», y la fecha. Una llamada anterior, a las 00:19:05, esperó 31,15 segundos y devolvió 503 con «Not charged», así que la repetimos.
Los 200 comentarios se publicaron entre el 2026-11-04 a las 20:00 y el 2026-11-07 a las 13:44 (UTC). Sumaban 3.683 «me gusta», muy mal repartidos: los 10 comentarios con más «me gusta» se llevaban el 96,6 %, y 121 no tenían ninguno. Si ponderas la opinión por «me gusta», el resultado puede cambiar por completo, y eso solo se puede hacer cuando cada comentario llega como registro con sus campos.
Para los mismos 1.000 comentarios, el TikTok Comments Scraper de Apify cobra por comentario. Son 0,00125 USD en el plan gratuito, 0,001 USD en el nivel Bronze, que corresponde a Starter, y 0,00015 USD en Diamond. Es decir, 1,25, 1,00 y 0,15 USD por 1.000. Nuestros 0,00278 USD son más o menos 1/360 del precio en Starter. La página de precios de Web Scraper API de Bright Data marca 1,50 USD por 1.000 registros en pago por uso. Esa página lista publicaciones de TikTok, pero no encontramos un scraper de comentarios, así que dejamos la celda vacía.
Más detalle en cómo extraer comentarios de TikTok y en la página de la API de comentarios de TikTok.
Fichas de producto de Amazon: precios parecidos, campos distintos
Las páginas de producto son un caso intermedio. A las 00:23:04, hora de Singapur, read pidió la página de Amazon de un vaso batidor portátil de Ninja. En 3,25 segundos devolvió 785 caracteres por 0,000694 USD. El texto traía el título, una línea de descripción y un formulario de «¿Has visto un precio más bajo?». No había precio, ni nota, ni disponibilidad.
Quince segundos después, amazon/profile sobre la misma URL devolvió un objeto en 16,82 segundos por 0,001389 USD, con 20 campos con valor. El precio era 39,99 USD, el precio de lista 69,99 USD, la nota 4,2 y había 14.458 valoraciones. También indicaba que había existencias y que la marca era Ninja. Traía el puesto 369 en Home & Kitchen y el 19 en Kitchen Small Appliances, 10 puntos de características y 12 imágenes.
Amazon muestra versiones distintas de la página a visitantes distintos, y el bloque de precio suele depender de la región, las cookies o el renderizado. Los scrapers genéricos lo suelen resolver con extracción JSON. En Firecrawl, el formato JSON cuesta 5 créditos por página: 19,00 USD por 1.000 productos en Hobby y 3,745 USD en Scale. Eso solo funciona si el precio está en la página que ve el scraper. ScraperAPI cuenta Amazon como 5 créditos por petición, es decir, 2,45 USD por 1.000 en Hobby.
El scraper de productos de Amazon de Bright Data cuesta 1,50 USD por 1.000 registros. Nuestro amazon/profile cuesta 1,389 USD por 1.000 productos, solo un 7 % menos que Bright Data. En fichas sueltas de producto no tenemos una ventaja de precio fuerte, y lo decimos claro. Los campos están en la página de la API de productos de Amazon.
| Por 1.000 fichas de producto de Amazon | Precio | Unidad | Notas |
|---|---|---|---|
EveryInfra amazon/profile | 1,389 USD | Por llamada, 1 producto | 20 campos con valor en la prueba |
| Bright Data Web Scraper API | 1,50 USD | Por registro, pago por uso | 1,30 USD por encima de 384.000 registros |
| ScraperAPI Hobby | 2,45 USD | 5 créditos por petición a Amazon | Devuelve la página; no revisamos su salida estructurada |
| Firecrawl JSON, Scale | 3,745 USD | 5 créditos por página | El precio debe estar en la página que ve |
| Firecrawl JSON, Hobby | 19,00 USD | 5 créditos por página | La misma condición |
Las reseñas de Amazon no funcionaron en nuestra prueba, y contamos los fallos. A las 00:20:06, amazon/reviews sobre un producto retirado devolvió un resultado vacío con reembolso. A las 00:23:48, la llamada para el vaso de Ninja devolvió 503 a los 19,10 segundos. A las 00:26:01 la enviamos en modo asíncrono. La consulta de las 00:27:39 mostró la tarea terminada con 0 reseñas, y el cobro previo de 0,001389 USD ya estaba devuelto. A las 00:27:46 probamos otro producto y volvió el 503. Cuatro intentos, 0 USD en total.
| Intento de `amazon/reviews` (hora de Singapur) | Producto | Resultado | Latencia | Cobro final |
|---|---|---|---|---|
| 00:20:06 | Producto retirado | Resultado vacío, reembolso | 32,56 s | 0 USD |
| 00:23:48 | Vaso batidor Ninja | 503 | 19,10 s | 0 USD |
| 00:26:01 (asíncrono) y consulta a las 00:27:39 | Vaso batidor Ninja | Tarea terminada con 0 reseñas, cobro previo devuelto | 1,88 s al enviar | 0 USD |
| 00:27:46 | Otro producto | 503 | 16,88 s | 0 USD |
Nuestro catálogo dice además que este endpoint solo devuelve las reseñas destacadas de la página, unas doce por producto. Para el historial completo, el Amazon Reviews Scraper de Apify cuesta 5,00 USD por 1.000 en Starter, y Bright Data 1,50 USD. Nuestro texto sobre alternativas al scraper de Amazon de Apify entra más a fondo en esta categoría.
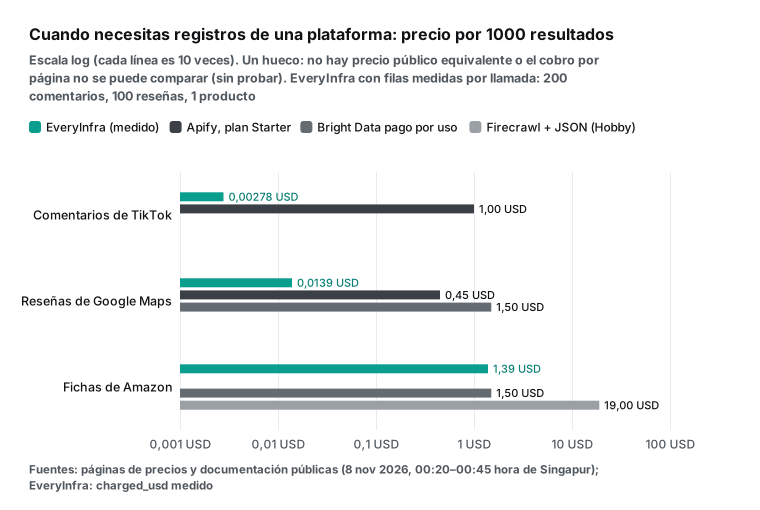
| Por 1.000 elementos de plataforma | EveryInfra (medido) | Apify (Starter / nivel más bajo) | Bright Data (pago por uso) | Firecrawl |
|---|---|---|---|---|
| Reseñas de Google Maps | 0,0139 USD (100 por llamada) | 0,45 / 0,15 USD | 1,50 USD | Por página; sin probar (nuestro read dio texto vacío) |
| Comentarios de TikTok | 0,00278 USD (200 por llamada) | 1,00 / 0,15 USD | No aparece en la página de precios | Por página; sin probar |
| Fichas de producto de Amazon | 1,389 USD (1 por llamada) | Sin revisar | 1,50 USD | JSON: 19,00 Hobby / 3,745 Scale |
| Reseñas de Amazon | 0 en 4 intentos, 0 USD | 5,00 / 1,00 USD | 1,50 USD | Igual que arriba |
La diferencia de esta tabla viene de la unidad de cobro. Un endpoint que cobra por llamada devuelve 200 comentarios por un cobro. Un scraper que cobra por página factura una página, y los comentarios no están en ella salvo que pagues minutos de navegador. Un scraper que cobra por elemento cobra de nuevo por cada comentario. Por eso, cuando una llamada puede traer muchos elementos, como comentarios o reseñas, el cobro por llamada es dos o tres órdenes de magnitud más barato. Cuando una llamada trae un solo elemento, como una ficha de producto, los precios quedan cerca, y lo que compara es qué campos trae cada uno y qué pasa con los fallos. También vale al revés: si solo quieres un comentario, el cobro por elemento es lo más barato.
Páginas genéricas: la firecrawl alternative más barata depende de lo difícil que sea el sitio
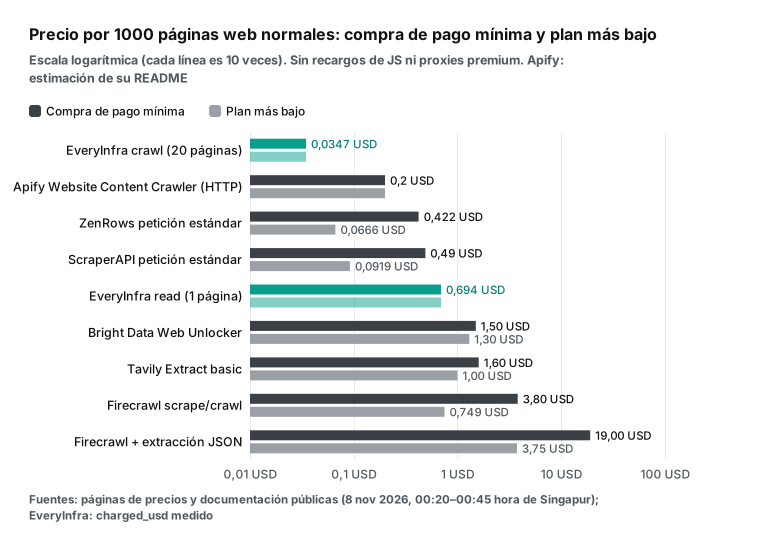
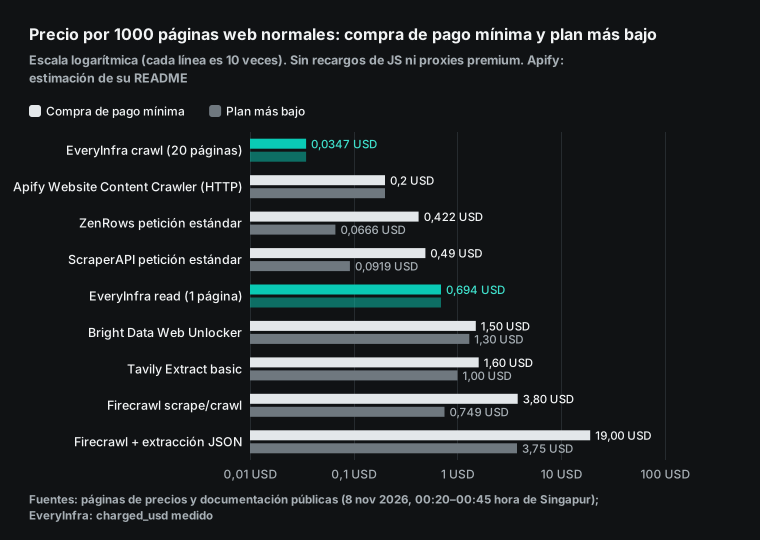
Si lo que necesitas es el texto de páginas para un índice RAG o para un agente, hay muchas alternativas a Firecrawl. En páginas sencillas, tres de ellas cuestan menos que nuestro read. ZenRows cobra 1 crédito por una petición estándar, 5 con renderizado de JavaScript, 10 con proxies premium y 25 con las dos cosas (documentación de precios de ZenRows). Su plan más pequeño, Build B1, cuesta 19 USD por 45.000 créditos: 0,422 USD por 1.000 peticiones estándar. Su plan más grande, Scale S5, cuesta 2.999 USD por 45 millones: 0,0666 USD por 1.000.
La página de precios de ScraperAPI marca Hobby a 49 USD por 100.000 créditos, es decir, 0,49 USD por 1.000 peticiones estándar. El plan Advanced cuesta 1.975 USD por 21,5 millones: 0,0919 USD por 1.000. El Website Content Crawler de Apify da su propia estimación: unos 0,2 USD por 1.000 páginas con HTTP simple, y de 0,5 a 5 USD con un navegador sin interfaz. Nuestro read cuesta 0,694 USD por 1.000 páginas. En precio por página sencilla, ganan estos tres.
Esos precios bajos tienen condiciones. Una petición estándar no renderiza JavaScript ni usa proxies premium. Si el sitio necesita renderizado, ZenRows B1 sube a 2,11 USD por 1.000 y ScraperAPI Hobby a 4,90 USD. Con protecciones fuertes contra bots, ScraperAPI suma 10 créditos más, y ZenRows con renderizado y proxy premium llega a 10,56 USD por 1.000 en B1. Además, estos servicios devuelven HTML por defecto. Firecrawl y nuestro read no cobran más por los proxies: la documentación de Firecrawl dice que los proxies mejorados cuestan el mismo crédito base.
| Por 1.000 páginas genéricas | Página estándar | Con JavaScript | Con proxy premium o antibots | Salida por defecto |
|---|---|---|---|---|
| Firecrawl Hobby | 3,80 USD | 3,80 USD | 3,80 USD | Markdown |
| ZenRows Build B1 | 0,422 USD | 2,11 USD | 4,22 a 10,56 USD | HTML |
| ScraperAPI Hobby | 0,49 USD | 4,90 USD | 5,39 a 12,25 USD | HTML |
| Apify Website Content Crawler | unos 0,2 USD | 0,5 a 5 USD | Incluido en el cómputo | Markdown o texto |
| Bright Data Web Unlocker | 1,50 USD | 1,50 USD | 1,50 USD | HTML |
| Tavily Extract (básico, pago por uso) | 1,60 USD | No indicado | No indicado | Markdown o texto |
EveryInfra read | 0,694 USD | 0,694 USD | 0,694 USD | Texto limpio |
Tavily también es una opción razonable. Su Extract cobra 1 crédito por cada 5 URL con éxito, y su documentación de extracción dice que las extracciones fallidas no se cobran. Su endpoint de rastreo suma créditos de mapa y de extracción: 10 páginas básicas cuestan 3 créditos.
Nuestro `crawl`: 20 páginas por cobro, con tres límites
Nuestro único precio fuerte en páginas genéricas es la herramienta crawl. El catálogo de herramientas de búsqueda la marca a 0,000694 USD por llamada, con un num máximo de 20. A las 00:17:02, hora de Singapur, rastreamos el sitio de documentación de Firecrawl y recibimos 20 páginas en 2,46 segundos. A las 00:17:28 rastreamos el sitio del Model Context Protocol y recibimos otras 20 en 1,28 segundos. Dos cobros de 0,000694 USD nos dieron 40 páginas: 0,001388 USD en total, o 0,0347 USD por 1.000 páginas. Es más o menos 1/21 del precio por página de Firecrawl en Scale.
| Prueba de páginas genéricas (2026-11-08, hora de Singapur) | Hora | Latencia | Resultado | Cobro |
|---|---|---|---|---|
read documentación de facturación de Firecrawl | 00:16:43 | 0,85 s | 13.372 caracteres | 0,000694 USD |
map sitio de documentación de Firecrawl | 00:16:50 | 0,84 s | 200 URL | 0,000694 USD |
crawl sitio de documentación de Firecrawl | 00:17:02 | 2,46 s | 20 páginas | 0,000694 USD |
crawl sitio del protocolo MCP | 00:17:28 | 1,28 s | 20 páginas | 0,000694 USD |
read PDF de 15 páginas de arXiv | 00:25:10 | 1,78 s | 52.380 caracteres | 0,000694 USD |
read página retirada de Amazon | 00:19:48 | 5,98 s | 404, destino no encontrado | 0 USD |
El precio bajo trae tres límites que debes conocer. Primero, una llamada devuelve como máximo 20 páginas. La documentación de rastreo de Firecrawl da un límite por defecto de 10.000 páginas por tarea. Para sacar 1.000 páginas con nosotros puedes partir el sitio en 50 URL de inicio. También puedes usar map para listar URL y luego pasar read por cada una, pero así vuelves a 0,694 USD por 1.000 páginas.
Segundo, 3 de nuestras 40 páginas tenían justo 20.000 caracteres de texto. Parece un tope por página, así que las páginas largas se cortan; read no tiene ese tope, porque devolvió más de 52.000 caracteres del PDF. Tercero, crawl elige él mismo las 20 páginas. En el sitio del MCP, 19 de las 20 estaban bajo /community/, en un orden que parecía el del mapa del sitio. El parámetro instructions sirve para orientarlo, pero no lo probamos. Los dos sitios eran de documentación y sin protección contra bots. Una tienda o un sitio con inicio de sesión pueden dar otro resultado y otros tiempos.
Nuestro map también tiene un límite: devolvió 200 URL, el máximo por llamada. La documentación de mapa de Firecrawl dice que una llamada cuesta 1 crédito aunque el limit llegue a 100.000 URL. Para un sitio con muchos miles de URL, el mapa de Firecrawl es más barato que el nuestro.
Fallos: ¿quién cobra un 404?
En el scraping los fallos son normales, así que la regla de fallos puede mover la factura más que el precio unitario. La regla de Firecrawl está en el apartado «When credits are charged» de su documentación de facturación. Lo que decide el cobro es si Firecrawl devuelve un documento, no el código de estado del destino. Si el destino responde 403 o 404, Firecrawl devuelve esa respuesta como documento y cobra 1 crédito. La documentación recomienda mirar metadata.statusCode y dejar de reintentar las URL que siguen bloqueadas. Si no vuelve ningún documento, el cobro es 0. Llevado a una lista entera: si el 10 % de 1.000 URL están muertas o siempre bloqueadas, con la regla de «se cobra todo documento devuelto» esas 100 URL cuestan unos 0,38 USD extra en Firecrawl Hobby, sin darte texto útil. Cuanto más vieja la lista, más pagas, así que limpia los enlaces muertos antes de un trabajo grande.
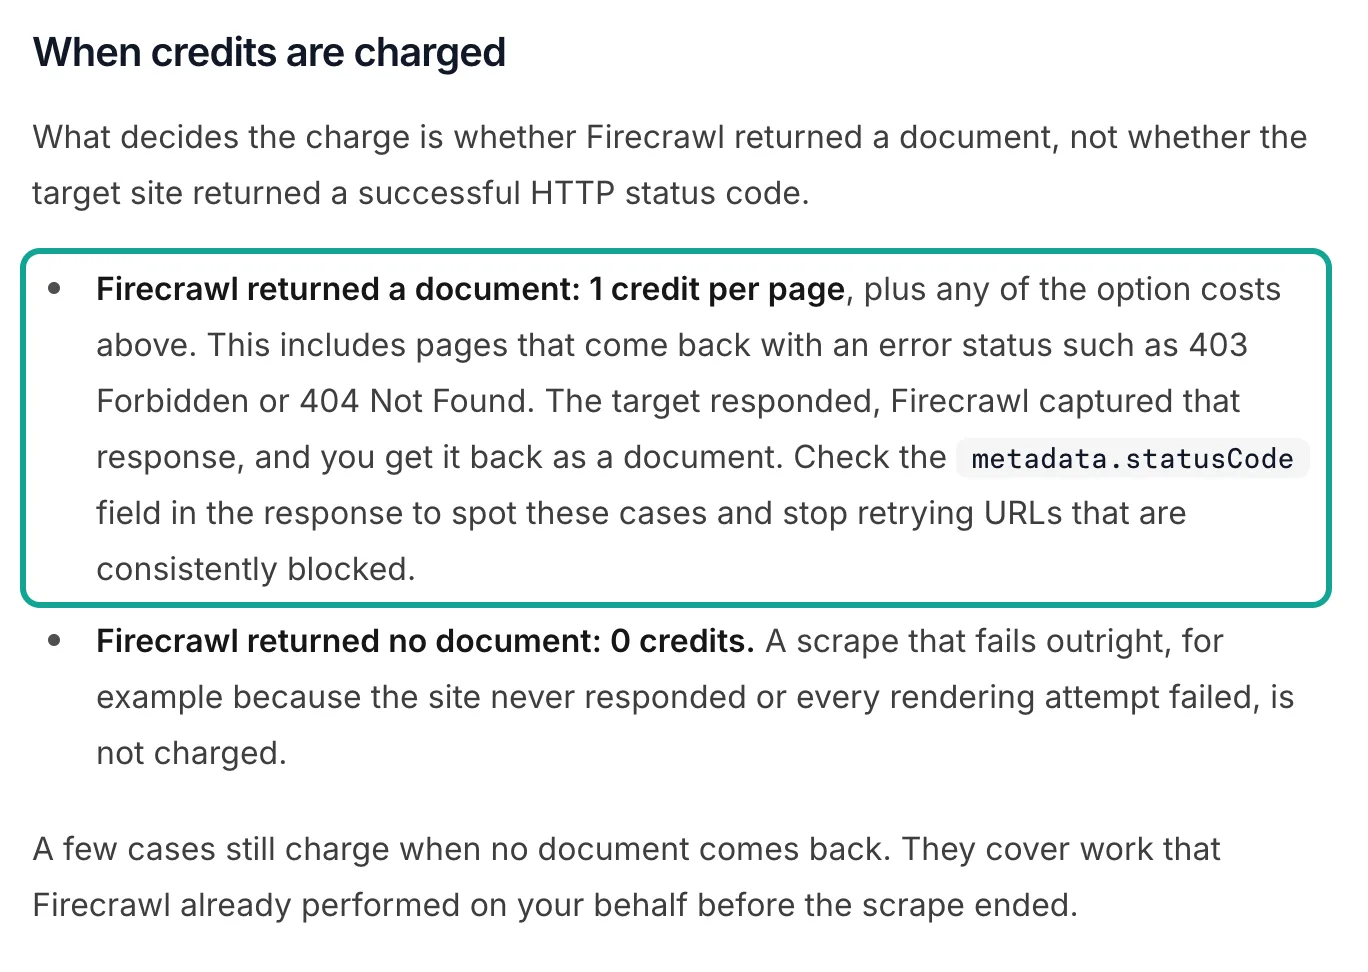
La documentación también lista casos que cuestan créditos sin documento. Un análisis de protección contra amenazas cuesta 2 créditos por URL y una comprobación de inyección de instrucciones cuesta 5. Una petición solo a caché que no encuentra nada cuesta 1 crédito. Una sesión de navegador se cobra por minuto, con un mínimo de un minuto. Las demás opciones tienen reglas distintas. La documentación de créditos de ScraperAPI cobra las respuestas 200 y 404, y también las peticiones que cancelas en menos de 70 segundos. ZenRows no cobra los fallos, pero cuenta los 404 y 410 como éxitos.
Tavily nunca cobra una extracción de URL fallida. La página de precios de Web Unlocker de Bright Data dice que solo pagas los éxitos. Los scrapers de Apify que cobran por cómputo facturan el tiempo de los reintentos; los que cobran por evento solo cobran los resultados.
| Caso | Firecrawl | Apify | Tavily | Bright Data | ScraperAPI | ZenRows | EveryInfra (nuestra prueba) |
|---|---|---|---|---|---|---|---|
| El destino responde 404 | 1 crédito | Según el tipo de cobro | La extracción fallida es gratis | Solo pagas éxitos | Se cobra | Se cobra | 0 USD (00:19:48) |
| Tiempo agotado o fallo total | Gratis | Se cobra el cómputo | Gratis | Gratis | Gratis | Gratis | 0 USD (cuatro 503) |
| Resultado vacío | Se cobra si vuelve un documento | Gratis en los de cobro por evento | Gratis | No indicado | No indicado | No indicado | Reembolso (tres veces) |
| Parámetro incorrecto | No indicado | No indicado | No indicado | No indicado | No indicado | No indicado | 422 antes de cobrar |
| Límite de frecuencia | 429 | No indicado | No indicado | La página dice que no limita la concurrencia | 429, sin cobro | No indicado | 429, «Nothing was charged» |
Nuestra llamada de las 00:19:48 con un 404 muestra bien la diferencia. Esa misma página retirada de Amazon costaría 1 crédito en Firecrawl y en ScraperAPI. En nuestro lado, la respuesta decía target_not_found y daba el 404 del destino. También decía «Nothing was charged». A las 00:16:37 enviamos además un crawl con el parámetro site en lugar de url. La API respondió en 0,15 segundos con 422, el código unknown_param y los tres parámetros permitidos. No hubo cobro, y un agente puede corregir la llamada con ese mensaje.
Límites de frecuencia y latencia
Los límites de frecuencia también son coste. La página de límites de Firecrawl tiene dos grupos. Extraer, mapear y buscar permiten 10 peticiones por minuto en Free, 100 en Hobby, 500 en Standard, 5.000 en Growth y 10.000 en Scale. Rastrear, agent e interact permiten muchas menos: 2 por minuto en Free, 20 en Hobby y 2.000 en Scale. Los navegadores simultáneos van de 2 en Free a 100 en Scale.
| Plan de Firecrawl | Extraer, mapear, buscar (por minuto) | Rastrear, agent, interact (por minuto) | Navegadores simultáneos |
|---|---|---|---|
| Free | 10 | 2 | 2 |
| Hobby | 100 | 20 | 5 |
| Standard | 500 | 100 | 25 |
| Growth | 5.000 | 1.000 | 50 |
| Scale | 10.000 | 2.000 | 100 |
Si necesitas cientos de miles de páginas al día, un precio de entrada bajo con un límite estrecho te puede obligar a subir de plan. Entonces el precio real por 1.000 páginas es el del plan más alto, no el de entrada. Por eso todas las tablas de este artículo dan el primer plan y el nivel más bajo. Nuestra clave de prueba tenía un límite propio de 10 peticiones por minuto, y chocamos con ese límite tres veces. Cada 429 decía que no se había cobrado nada, y el reintento a los pocos segundos funcionó.
La latencia decide si una herramienta cabe en un paso síncrono de un agente. En nuestras 26 peticiones, las herramientas de páginas genéricas fueron rápidas. map tardó 0,84 segundos. Las cuatro llamadas read con éxito tardaron entre 0,85 y 3,25 segundos, con una mediana de unos 2,08 segundos. Los dos crawl tardaron 2,46 y 1,28 segundos, y la búsqueda web 2,15 segundos.
Los endpoints de plataforma fueron mucho más lentos. Los vídeos de una cuenta de TikTok tardaron 10,06 segundos y la ficha de Amazon 16,82 segundos. Cien reseñas de Maps tardaron 8,50 segundos, 200 comentarios de TikTok 49,53 segundos y la búsqueda del lugar en Maps 57,80 segundos. Los fallos también fueron lentos: cada 503 tardó entre 16 y 31 segundos. Estos endpoints buscan datos frescos en la plataforma en el momento de la petición. El rastreo de Firecrawl también es asíncrono, y su documentación dice que los créditos se cobran al terminar cada página, a veces minutos u horas después.
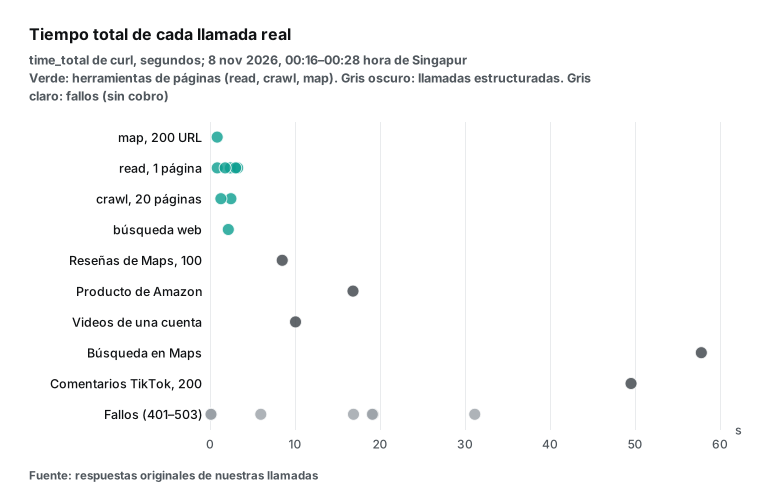
La regla práctica para un agente es simple. Pon la lectura de páginas genéricas en una llamada síncrona. Envía comentarios y reseñas en modo asíncrono: añade "mode":"async" al cuerpo y consulta el poll_url. O ejecútalos en un lote programado, sin hacer esperar un minuto a quien usa la herramienta.
Un mes de trabajo, cuatro maneras de pagarlo
Los precios unitarios son abstractos, así que aquí va una factura mensual. Imagina el equipo pequeño de una tienda online con cuatro tareas. Carga 5.000 páginas de documentación y ayuda en una base de conocimiento. Saca 20.000 comentarios de TikTok para seguir la marca. Vigila precio y nota de 2.000 productos de Amazon. Y reúne 10.000 reseñas de Google Maps de sus tiendas. Contamos solo el coste de la API, con precios públicos y los elementos por llamada de nuestra prueba, sin las horas de escribir código de análisis.
Con nuestra API, la documentación con read cuesta 5.000 × 0,000694 = 3,47 USD. Los comentarios de TikTok son 100 llamadas × 0,000556 = 0,0556 USD. Los productos de Amazon son 2.000 × 0,001389 = 2,778 USD, y las reseñas de Maps 100 llamadas × 0,001389 = 0,1389 USD. El total es 6,44 USD. Si el sitio de documentación es sencillo y vale crawl con 20 páginas por llamada, esa línea baja a 250 × 0,000694 = 0,1735 USD, y el total queda en 3,15 USD.
Solo con Firecrawl, la documentación son 5.000 créditos y los productos de Amazon con JSON son 2.000 × 5 = 10.000 créditos: 15.000 créditos en total. Hobby incluye 5.000, y 10 recargas de 5 USD cubren el resto, así que la factura es 69 USD. Para comentarios de TikTok y reseñas de Maps, Firecrawl necesita Interact y extracción JSON; no lo probamos, así que no podemos poner precio a esas dos tareas. Solo con Apify, los comentarios son 20.000 × 0,001 = 20 USD y las reseñas 10.000 × 0,00045 = 4,50 USD: 24,50 USD en Starter, que empieza en 19 USD al mes (precios de Apify), sin documentación ni Amazon. Firecrawl más Apify cubre las cuatro tareas por 93,50 USD.
| Opción | 5.000 páginas de documentación | 20.000 comentarios de TikTok | 2.000 productos de Amazon | 10.000 reseñas de Maps | Total al mes |
|---|---|---|---|---|---|
EveryInfra, documentación con read | 3,47 USD | 0,056 USD | 2,778 USD | 0,139 USD | 6,44 USD |
EveryInfra, documentación con crawl | 0,174 USD | 0,056 USD | 2,778 USD | 0,139 USD | 3,15 USD |
| Solo Firecrawl (Hobby más recargas) | 5.000 créditos | Precio por página, sin probar | 10.000 créditos | Precio por página, sin probar | 69,00 USD |
| Solo Apify (Starter) | Sin calcular | 20,00 USD | Sin calcular | 4,50 USD | 24,50 USD |
| Firecrawl más Apify | Dentro de los 69 USD | 20,00 USD | Dentro de los 69 USD | 4,50 USD | 93,50 USD |
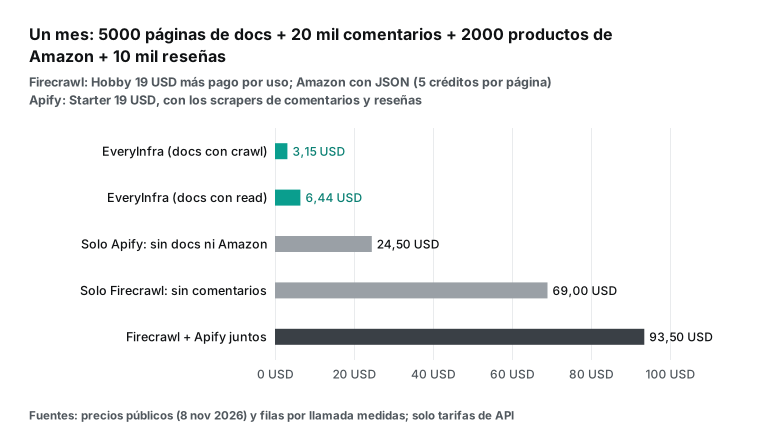
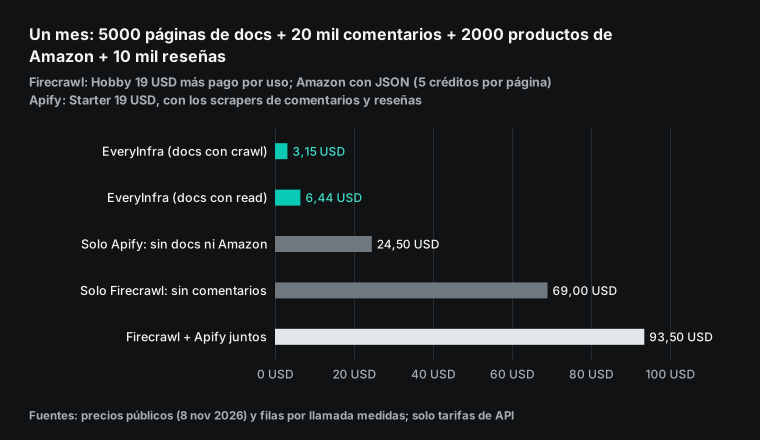
Dos cambios pueden dar la vuelta al resultado. Si tu sitio de documentación necesita renderizado o tiene protección contra bots, nuestro read y nuestro crawl pueden no traer todas las páginas. En ese caso, ZenRows o ScraperAPI en un plan alto pueden ser más seguros para esa línea. Además, nuestro precio en Amazon está cerca del de Bright Data. En la opción combinada, cambiar la extracción JSON de Firecrawl por el scraper de productos de Bright Data baja mucho esa línea. La gran diferencia de esta factura viene de los comentarios y las reseñas, porque cada llamada trae muchos elementos.
Cuándo Firecrawl es la mejor opción
Una comparación honesta tiene que decir en qué gana Firecrawl. Lo primero es la escala y el control del rastreo. Firecrawl rastrea hasta 10.000 páginas por defecto. Puedes filtrar por ruta, limitar la profundidad e incluir o excluir subdominios y enlaces externos. Los resultados llegan por consulta, por WebSocket o por webhook. Batch scrape envía una lista grande de URL en una sola tarea. Nuestro crawl para en 20 páginas por llamada, y nuestro map en 200 URL.
Lo segundo son las funciones de página. El endpoint de extracción de Firecrawl hace capturas de página completa y de ventana, cuyas URL caducan a las 24 horas. También extrae la marca de un sitio (colores, fuentes y componentes), resúmenes y listas de enlaces, y analiza archivos PDF y Word. Interact hace clics, escribe y se desplaza en una sesión de navegador. Change tracking vigila cambios en las páginas. La extracción con LLM saca JSON de cualquier sitio con un esquema que defines tú. Nuestras herramientas genéricas leen texto, listan URL y rastrean lotes pequeños; no tenemos capturas, acciones de navegador ni seguimiento de cambios.
Lo tercero es la instalación propia. El repositorio principal de Firecrawl es de código abierto con la licencia AGPL-3.0. El 2026-11-08 tenía 199.441 estrellas, y el último envío de código fue el 2026-11-07. Ni nosotros ni las otras cinco opciones tenemos una versión completa que puedas instalar tú. Apify publica una biblioteca de rastreo, no su plataforma. Además, la última versión etiquetada del repositorio principal es la v2.11.0, del 2026-06-19 (versiones); los cambios posteriores solo están en la rama principal, así que si instalas tú, o sigues esa rama o te quedas en la versión de junio.
Eso sí, la versión propia no es igual que la de la nube. La guía de instalación propia dice que la configuración por defecto no incluye Fire-engine ni sus funciones avanzadas contra bots. Las capturas y las acciones de página tampoco están en esa configuración. La página de código abierto o nube dice que la diferencia es quién monta, protege y mantiene esos servicios extra.
Lo cuarto son los datos de calidad publicados. La página de pruebas comparativas de Firecrawl recoge una prueba propia del 13 de enero de 2026 con 1.000 URL: cobertura del 96 %, F1 de contenido de 0,638 y latencia P95 de 3.387 ms. No pasamos esas mismas URL, así que no podemos comparar tasas de éxito.
Lo quinto es la compra. Firecrawl está en Google Cloud Marketplace desde el 19 de octubre de 2026 (anuncio), y su página de precios dice que puedes pagar por AWS o Google Cloud. Si tu empresa solo compra a través de un marketplace de nube, Firecrawl es más fácil de comprar que casi todas las opciones de aquí.
| Función | Firecrawl | EveryInfra |
|---|---|---|
| Rastreo de un sitio | Hasta 10.000 páginas por defecto, con ruta y profundidad | 20 páginas por llamada, sin control de profundidad |
| Mapa de URL | 1 crédito por llamada, hasta 100.000 URL | 0,000694 USD por llamada, hasta 200 URL |
| Capturas de pantalla | Sí, página completa o ventana | No |
| Clics, escritura, desplazamiento | Sí, con Interact | No |
| Seguimiento de cambios | Sí | No |
| JSON en cualquier sitio con tu esquema | Sí, 5 créditos por página | No; solo campos fijos por plataforma |
| Instalación propia | Sí, AGPL-3.0, sin funciones avanzadas contra bots | No |
| Comentarios, reseñas y fichas de 106 plataformas | Por proveedores de Alexandria, lista tras iniciar sesión | Sí, con precio público por llamada |
Las otras cinco, en un párrafo cada una
La fuerza de Apify es su tienda. Casi todos los sitios populares tienen allí un scraper ya hecho, y el Website Content Crawler tenía 14.350 usuarios en los últimos 30 días cuando leímos la página el 2026-11-08. Los scrapers con cobro por evento tienen precios claros por elemento, y los planes altos cuestan menos: en los tres scrapers de este artículo, el precio Diamond queda entre un tercio y una séptima parte del de Starter. El coste es tener que elegir, porque un sitio puede tener una docena de scrapers con campos y estabilidad distintos. Si la plataforma que necesitas no está en nuestro catálogo, Apify es un buen punto de partida. Nuestro repaso de alternativas a Apify compara su estructura de precios.
Tavily parte de la búsqueda, no del scraping. Búsqueda, extracción, mapa, rastreo e investigación están en una sola API. La extracción se cobra por URL con éxito y los fallos son gratis, algo que encaja con un agente que primero busca y luego lee unas páginas. Tavily escribió su propio artículo sobre alternativas a Firecrawl (blog de Tavily). Su regla es: si partes de una consulta, Tavily; si partes de un sitio conocido, Firecrawl. Nos parece una división justa. Los precios de búsqueda los cubre nuestra comparación de APIs de búsqueda web para agentes de IA. A las 00:24, hora de Singapur, buscamos «firecrawl alternatives» con nuestra herramienta web para Estados Unidos. La página propia de Firecrawl salió en el puesto 5, el texto de Tavily en el 6 y el de Bright Data en el 7.
Bright Data tiene la gama de productos más amplia de las siete. Vende proxies, Web Unlocker y la Fetch API, antes llamada Crawl API, que convierte una URL en Markdown, texto, HTML o JSON-LD. También vende scrapers ya hechos cobrados por registro y conjuntos de datos terminados. Sus precios son simples: 1,50 USD por 1.000 en Unlocker y en registros de scraper en pago por uso, con 5.000 peticiones gratis al mes en Unlocker. Encaja con equipos que necesitan un buen manejo de bloqueos y entregas estables a gran volumen.
ScraperAPI y ZenRows son APIs de scraping clásicas. Envías una URL y ellas se ocupan de los proxies, el renderizado y los bloqueos. Los multiplicadores de créditos son claros, y los planes altos tienen precios unitarios muy bajos. Encajan con equipos que ya tienen sus propios analizadores y solo necesitan una capa de descarga fiable. ZenRows vende además una función Extract para JSON automático y tiene servidor MCP.
| Opción | Gratis al mes | Unidad de cobro | Para quién encaja |
|---|---|---|---|
| Apify | 5 USD | Cómputo o evento, según el scraper | Sitios fuera de nuestro catálogo, reglas propias |
| Tavily | 1.000 créditos | Crédito por URL con éxito | Agentes que buscan y luego leen |
| Bright Data | 5.000 peticiones de Unlocker | Petición o registro | Gran volumen con bloqueos fuertes |
| ScraperAPI | 1.000 créditos al registrarte | Crédito con multiplicadores por dominio | Equipos con analizadores propios |
| ZenRows | 5.000 créditos | Crédito con multiplicadores por renderizado y proxy | Equipos con analizadores propios, extracción JSON |
Conectar con una herramienta de IA: MCP en los dos lados
Mucha gente usa Firecrawl por MCP en Claude, Cursor o herramientas parecidas. La documentación MCP de Firecrawl da tres formas de conexión: sin clave, con inicio de sesión en el navegador o con clave de API. El endpoint sin clave ofrece tres herramientas, Search, Scrape y Parse, con límites diarios por dirección IP. Su servidor MCP publicó la versión 3.36.1 el 2026-11-03, con licencia MIT.
Nuestro servidor MCP remoto está en https://api.everyinfra.com/mcp. A las 00:23:40, hora de Singapur, llamamos a tools/list sin clave. Devolvió 12 herramientas en 0,18 segundos, sin cobro. everyinfra_search cubre read, crawl y map, y everyinfra_call_api cubre nuestras 573 capacidades de plataforma. Puedes añadir los dos servidores a un mismo cliente y dejar que el agente elija:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "firecrawl": {
      "type": "http",
      "url": "https://mcp.firecrawl.dev/v2/mcp"
    }
  }
}
La entrada de Firecrawl es la forma sin clave de su documentación. El protocolo está descrito en la especificación MCP. El reparto es natural: «lee esta URL» o «rastrea esta documentación» puede ir a cualquiera de los dos; «qué dice la gente bajo este vídeo» o «reseñas recientes de esta tienda» va a everyinfra_call_api. Antes de llamar, el agente puede usar everyinfra_list_capabilities para comprobar que existen la plataforma y el endpoint, y ese paso es gratis. La configuración de cada cliente está en nuestra página del servidor MCP.
Alexandria: los datos de plataforma que Firecrawl empieza a vender
Firecrawl se está moviendo de lector de páginas a punto de entrada de datos para agentes. El 22 de septiembre de 2026 anunció una ronda Serie B de 75 millones de USD y Alexandria (anuncio). Alexandria reúne páginas web en vivo, proveedores de datos, conectores por sitio y el índice propio de Firecrawl tras una sola entrada. La documentación de Alexandria dice que descubrir es gratis y que cada herramienta cuesta los créditos que indica. La lista completa de proveedores solo se ve con sesión iniciada; no la abrimos, así que no sabemos si cubre comentarios de TikTok o reseñas de Maps. El 2026-10-08, Universal Scrape permitió que /scrape llame a proveedores de Alexandria; el anuncio habla de más de 200.
Esas llamadas tienen precio por proveedor, no un «1 crédito por página» plano, así que revisa cada precio en el panel. Si ya usas Firecrawl, mira esa lista antes de cambiar; puede que no te haga falta. Nuestro enfoque es otro: mantenemos nosotros mismos los endpoints estructurados de 106 plataformas, y cada precio está en un catálogo público que puedes leer sin iniciar sesión.
Empezar en tres pasos
Primero, abre la página de precios para ver el crédito de prueba. Las recargas y los cobros van en USD, sin cuota mensual. Segundo, lee sin clave el catálogo de capacidades y el catálogo de herramientas de búsqueda. Comprueba la plataforma, el endpoint, los parámetros y el price_usd que necesitas. Si todavía no has elegido plataforma, el mercado de datos lista todos los endpoints y precios, y las páginas de la API de TikTok, la API de Amazon y la API de reseñas de Google Maps tienen campos y ejemplos. Tercero, sigue la guía rápida y envía tu primera petición. Estas son las dos peticiones de este artículo; cambia la URL por la tuya:
# Datos de plataforma: reseñas de un lugar de Google Maps, hasta 100 por llamada, 0,001389 USD
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"google_maps_reviews","action":"reviews","params":{"url":"https://www.google.com/maps/search/?api=1&query=Lau%20Pa%20Sat&query_place_id=ChIJ5Y6l4Q0Z2jERYL0KDIjT6v0","limit":100}}'
# Devuelve rating, text, posted_at, detailed_rating, like_count y next_page_token para la página siguiente# Páginas genéricas: rastrear un sitio de documentación, hasta 20 páginas, un cobro de 0,000694 USD
curl -s https://api.everyinfra.com/api/v1/search \
-H "Authorization: Bearer $EVERYINFRA_API_KEY" \
-H "Content-Type: application/json" \
-d '{"tool":"crawl","params":{"url":"https://docs.firecrawl.dev","num":20}}'
# Devuelve results[]: url, title, content (unos 20.000 caracteres como máximo por página), billing.charged_usdUn parámetro incorrecto devuelve 422 y la lista de parámetros permitidos antes de cualquier cobro. Los endpoints lentos aceptan "mode":"async", y luego consultas el poll_url. Los fallos y los resultados vacíos no cuestan nada, y billing.charged_usd en cada respuesta es el coste real de esa llamada.
Preguntas frecuentes sobre firecrawl alternatives
Tomamos cada pregunta de las sugerencias de búsqueda de Google, leídas el 2026-11-08; guardamos las listas originales.
¿Hay firecrawl alternatives gratis?
Sí, varias. El propio Firecrawl da 1.000 créditos gratis al mes y un endpoint MCP sin clave. ZenRows da 5.000 créditos al mes, y Web Unlocker de Bright Data da 5.000 peticiones al mes. Tavily da 1.000 créditos al mes, Apify da 5 USD al mes y ScraperAPI da 1.000 créditos al registrarte. También puedes instalar tú la versión de código abierto de Firecrawl, aunque sin las funciones avanzadas contra bots. Para unos cientos de páginas de vez en cuando, estos planes gratuitos bastan.
¿Firecrawl es gratis?
En parte. Su página de precios da 1.000 créditos al mes, renovados cada mes y sin tarjeta, que equivalen a unas 1.000 páginas estándar. El modo sin clave tiene un límite diario por dirección IP. Los planes de pago empiezan en 19 USD al mes con Hobby, o 16 USD al mes con pago anual. La versión de código abierto es gratis, pero pagas tú los servidores, los proxies y el mantenimiento.
¿Hay una firecrawl alternative más barata?
Depende de lo que extraigas. En páginas genéricas sencillas, Firecrawl Hobby cuesta 3,80 USD por 1.000. ZenRows (0,422 USD), ScraperAPI (0,49 USD) y el Website Content Crawler de Apify en modo HTTP (unos 0,2 USD) cuestan menos, y nuestro crawl midió 0,0347 USD. Con extracción JSON, Firecrawl Hobby cuesta 19,00 USD por 1.000 páginas, y un endpoint estructurado para esa plataforma suele salir más barato. En comentarios y reseñas, nuestros precios medidos están dos o tres órdenes de magnitud por debajo.
¿Firecrawl o Apify?
Firecrawl es una sola API de scraping que cobra por página, buena para «dame una URL y su texto» y para rastrear sitios enteros. Apify es un mercado de scrapers ya hechos, cada uno con su precio, bueno para «necesito estos datos de este sitio y alguien ya hizo el scraper». Los dos manejan renderizado y bloqueos. Apify cubre más sitios; Firecrawl tiene una API más uniforme. Si la plataforma está en nuestro catálogo, nuestro precio por elemento suele ser menor.
¿En qué se diferencian Firecrawl y Tavily?
Parten de puntos distintos: Tavily parte de una pregunta y solo cobra las URL con éxito; Firecrawl parte de una URL conocida y cobra 1 crédito aunque el destino responda 404. Más detalle en «Las otras cinco» arriba.
¿El MCP de Firecrawl es gratis?
El endpoint sin clave es gratis, pero solo tiene tres herramientas (Search, Scrape y Parse) y un límite diario por dirección IP. Con clave de API, cada llamada MCP cuesta los mismos créditos que una llamada directa a la API. Nuestro servidor MCP funciona igual: listar herramientas y leer el catálogo es gratis, y las llamadas de datos cuestan el precio del catálogo.
Referencias
- Firecrawl Pricing, Firecrawl, vigente desde el 2026-09-04, leído el 2026-11-08.
- Billing, documentación de Firecrawl, leído el 2026-11-08.
- Rate Limits, documentación de Firecrawl, leído el 2026-11-08.
- Scrape, documentación de Firecrawl, leído el 2026-11-08.
- Crawl, documentación de Firecrawl, leído el 2026-11-08.
- Map, documentación de Firecrawl, leído el 2026-11-08.
- Batch Scrape, documentación de Firecrawl, leído el 2026-11-08.
- Change Tracking, documentación de Firecrawl, leído el 2026-11-08.
- Interact, documentación de Firecrawl, leído el 2026-11-08.
- LLM Extract, documentación de Firecrawl, leído el 2026-11-08.
- Alexandria, documentación de Firecrawl, leído el 2026-11-08.
- MCP Server: Get Started, documentación de Firecrawl, leído el 2026-11-08.
- Keyless MCP, documentación de Firecrawl, leído el 2026-11-08.
- Self-host, documentación de Firecrawl, leído el 2026-11-08.
- Open Source vs Cloud, documentación de Firecrawl, leído el 2026-11-08.
- firecrawl/firecrawl, GitHub, leído el 2026-11-08.
- firecrawl/firecrawl Releases, GitHub, leído el 2026-11-08.
- LICENSE (AGPL-3.0), GitHub, leído el 2026-11-08.
- firecrawl-mcp-server v3.36.1, GitHub, publicado el 2026-11-03.
- Benchmarks, Firecrawl, leído el 2026-11-08.
- Introducing Alexandria and our $75M Series B, Firecrawl, 2026-09-22.
- Introducing Universal Scrape, Firecrawl, 2026-10-08.
- Firecrawl for Google Cloud, Firecrawl, 2026-10-19.
- Apify Pricing, Apify, leído el 2026-11-08.
- Website Content Crawler, Apify, leído el 2026-11-08.
- TikTok Comments Scraper, Apify Store, leído el 2026-11-08.
- Google Maps Reviews Scraper, Apify Store, leído el 2026-11-08.
- Amazon Reviews Scraper, Apify Store, leído el 2026-11-08.
- Cobro en Apify Store, documentación de Apify, leído el 2026-11-08.
- Credits & Pricing, documentación de Tavily, leído el 2026-11-08.
- Tavily Extract, documentación de Tavily, leído el 2026-11-08.
- Tavily Crawl, documentación de Tavily, leído el 2026-11-08.
- 7 Best Firecrawl Alternatives for AI Agents in 2026, Tavily, leído el 2026-11-08.
- Web Unlocker Pricing, Bright Data, leído el 2026-11-08.
- Web Scraper API Pricing, Bright Data, leído el 2026-11-08.
- Fetch API, documentación de Bright Data, leído el 2026-11-08.
- ScraperAPI Pricing, ScraperAPI, leído el 2026-11-08.
- Credits and Requests costs, documentación de ScraperAPI, leído el 2026-11-08.
- Pricing, documentación de ZenRows, leído el 2026-11-08.
- Catálogo de capacidades de EveryInfra, EveryInfra, leído el 2026-11-08 a las 00:15, hora de Singapur.
- Catálogo de herramientas de búsqueda de EveryInfra, EveryInfra, leído el 2026-11-08 a las 00:15, hora de Singapur.
- Model Context Protocol Specification 2025-11-25, MCP, leído el 2026-11-08.
- Attention Is All You Need (arXiv 1706.03762), arXiv, destino de nuestra prueba de lectura de PDF.
- What is the best scraper tool right now? Firecrawl is great, but I want to explore more options, Reddit r/LocalLLaMA, leído el 2026-11-08.
Referencia BL-114