Claude Fable 5.2 API 工具调用省钱与重试
Claude Fable 5.2 API 长任务实测 20 次数据工具调用,裁剪后返回少 78%;附工具定义、幂等键重试和 422 自修代码与模型费估算。
Claude Fable 5.2 在 2026 年 11 月 9 日发布,官方给它的定位是跑几个小时的 agent 长任务。这类任务的账单里,有一笔容易被低估:模型每调一次数据工具,返回的结果就留在对话里,下一次请求要把之前所有结果再送一遍。调 20 次工具,第 20 次请求背着前 19 次的全部结果。工具结果有多大、要不要裁、什么时候裁、失败了怎么重发才不重复扣费:按我们下面的估算,同一轮 18 次调用,模型输入费随做法不同在 $0.512 到 $10.383 之间。
我们按一个常见的调研任务,在新加坡时间 2026 年 11 月 14 日 13:07、13:26 和 13:44 三个时刻,向 EveryInfra 的 Reddit、Trustpilot、YouTube 三个平台的数据接口共发了 20 次真实请求,记下每次返回的字节数、条数、耗时和扣费,再按 Fable 5.2 的公开价格算出模型这一侧的 token 费。模型一侧我们没有真跑,相关代码和估算都标为配置示例。
Claude Fable 5.2 API 动手前先核的八件事
Anthropic 在 2026 年 11 月 9 日(美国时间周一)发布 Claude Fable 5.2 和 Claude Mythos 5.2,两者是同一个底层模型,Fable 带网络安全和生物方向的防护,所有用户都能用,Mythos 只给通过审核的机构(Anthropic 发布稿)。发布稿、同日的系统卡和 CNBC 当天的报道写的都是美国时间 11 月 9 日,下文一律按原文写这一天。发布稿在 2026 年 11 月 11 日又改过一处(数学形式化一节的措辞和脚注),API 相关的内容没有变。
写长任务代码之前,要先把 API 一侧会影响成本和重试的事实逐条落到官方原文上。我们在 11 月 14 日读了模型页、「What's new」页、定价页和几篇功能文档,原文都存了档,整理成下表。
| 事项 | 官方原文写的 | 对长任务的影响 | 出处 |
|---|---|---|---|
| 模型 ID | claude-fable-5-2;Bedrock 上是 global.anthropic.claude-fable-5-2 | 代码里只改这一处 | What's new |
| 价格 | 输入 $8、输出 $40(每百万 token);5.1 是 $10 / $50 | 输出比输入贵 5 倍,思考也按输出算 | 模型页 |
| 缓存读 | 基础输入价的 0.025 倍,即 $0.20 | 每一轮重复送的历史能便宜 40 倍 | Prompt caching |
| 批处理 | 输入 $4、输出 $20 | 不赶时间的整批任务减半 | What's new |
| 上下文与输出 | 100 万 token 上下文(默认即最大),单次最多输出 12.8 万 token | 装得下,但装得越多每轮越贵 | 模型页 |
| 思考 | 自适应思考一直开着,关不掉;用 effort 调深浅,API 默认 high | 不能靠关思考省钱 | 模型页 |
| 强制调用工具 | tool_choice 设成 any 或指定工具名返回 400 | 只能用 auto,要合法 JSON 就加 strict: true | What's new |
| 改历史 | 系统提示、工具列表、任何一条旧消息改过,带着旧思考块的请求返回 400 | 裁剪只能在结果进历史之前做 | Prefix checks |
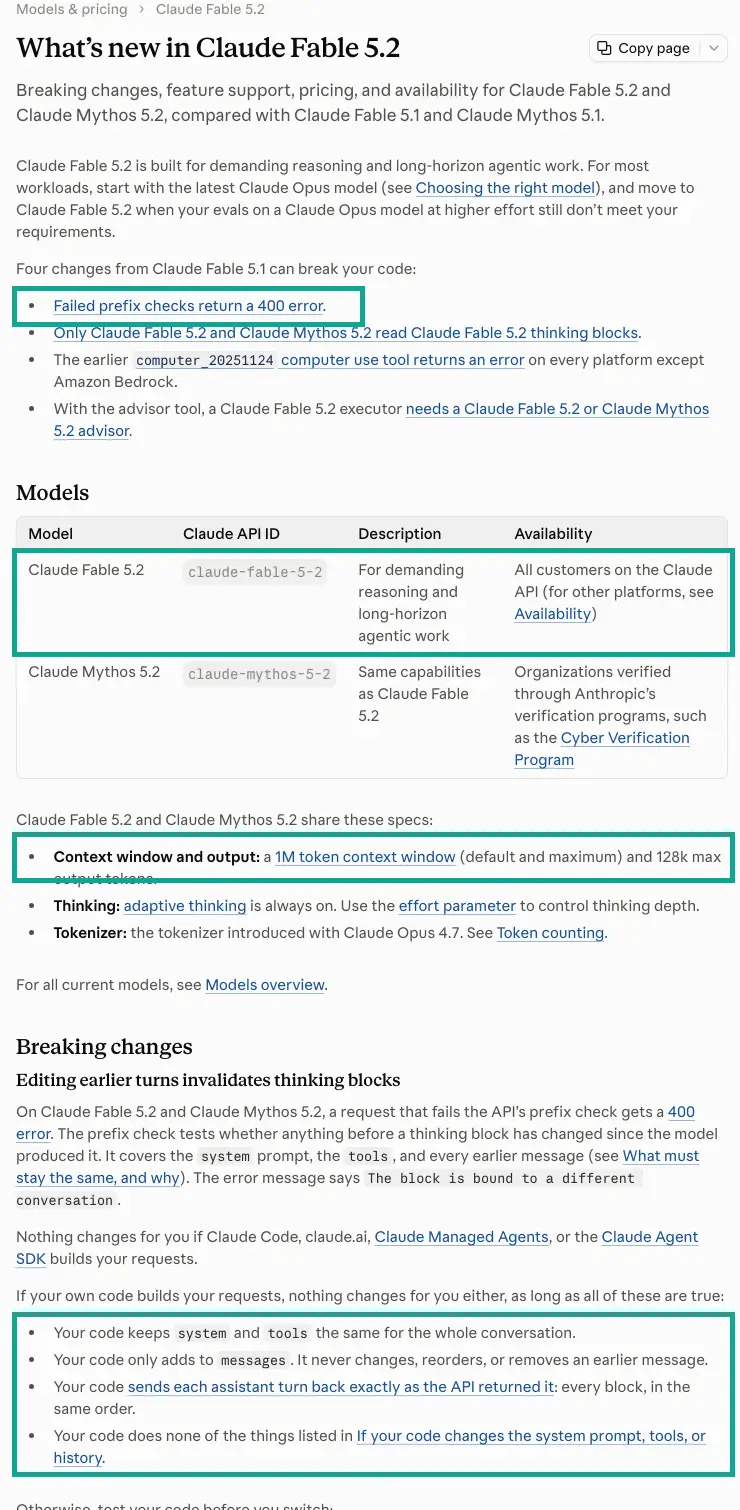
强制调用工具和改历史这两项,会让 5.1 上的旧代码在 5.2 上直接收到 400。第一处是强制调用工具:5.1 上用 tool_choice: {"type": "tool", "name": "..."} 逼模型调指定工具的代码,在 5.2 上会直接 400;官方给的替代写法是保持 auto,在工具定义上加 strict: true,让模型的参数一定符合 JSON Schema(strict tool use 文档)。我们 10 月写过一篇 Claude strict tool use 调数据接口,讲的是 Opus 5.5 上同样的限制;这里不重复 strict 本身,只在后面的工具定义里用它。
第二处,改历史会 400。Fable 5.2 的思考块里记着它之前看到的全部内容(系统提示、工具定义、每一条旧消息)的指纹,下一次请求把思考块送回去时,API 会核对这些内容有没有变。官方文档的说法是:哪怕改一个工具描述里的一个词,也算改了(原文)。等对话变长以后回头把早先的工具结果删短,在 Fable 5.2 上,下一轮就会拿到 The block is bound to a different conversation 的 400 错误(What's new 原文)。所以裁剪要放在工具结果第一次写进 messages 之前;要在事后清掉旧结果,就交给服务端的上下文编辑,文档写明服务端做的清理不会让思考块失效(Context editing)。
还有一个数和后面的估算有关。Fable 5.2 用的是 Opus 4.7 起的新分词器,官方说同样的文字算出来的 token 数大约比旧分词器多 30%(Token counting)。我们手上没有 Fable 5.2 的 API Key,没法用官方的 token 计数接口去数工具结果,所以后文的 token 数都是估算:下限按定价页「平均 10 kB 的网页约 2,500 token」的比例,即每 4 字节约 1 个 token(定价页 web fetch 一节),上限再乘 1.3。token 计数接口本身免费,读者有 Key 的话可以把我们存下的原始返回送进去,换成准确的数。
这个长任务是什么:一轮里连调 20 次数据工具
AWS 的上线博客写 Fable 5.2 能无人值守地跑几个小时到几天(AWS 博客)。我们拿一件常见的活来量:给 agent 一句话的任务,「比较 Notion、ClickUp、Asana、monday.com 四款项目管理软件近一个月的用户口碑,列出各自被夸最多和被骂最多的三件事」。agent 要去三个地方找原话:Reddit 上的讨论帖、Trustpilot 上的评价、YouTube 测评视频下面的评论。对应 EveryInfra 的四项能力:reddit/search(能力页)、trustpilot/reviews(能力页)、youtube/search(能力页)和 youtube/comments(能力页),都走同一个入口 POST /api/v1/social。
agent 会发出哪些工具调用,我们按任务的需要排好,再逐个真调,记下每次的原始返回、耗时、字节数和扣费。这样量出来的是「工具结果本身有多大、花多少钱」,这部分不依赖模型。
| 能力 | 价格(每次) | 本次用的参数 | 目录写的返回字段数 | 说明 |
|---|---|---|---|---|
reddit/search | $0.000792 | keyword、sort | 15 | 只搜最近一个月的帖子,排序有 6 个合法值 |
trustpilot/reviews | $0.001389 | company 域名、stars、date | 24 | stars 是字符串数组,date 只接受 5 个固定值 |
youtube/search | $0.000778 | keyword | 25 | 用来找测评视频的链接 |
youtube/comments | $0.000556 | url、sort | 9 | 按视频链接取评论 |
价格、参数和字段都取自 11 月 14 日的免费目录 GET /api/v1/social/catalog。四项能力都是按次计费,返回 0 条时不扣费,这一点在后面的实测里也碰上了。
claude fable 5.2 tool use:四个工具的定义怎么写
工具定义每一轮都会随请求送一遍,Anthropic 的定价页把工具名、描述和 JSON Schema 都算进输入 token,此外只要带了 tools,API 还会自动加一段让模型会用工具的系统提示(定价页 Tool use pricing)。所以工具不宜多,描述要把模型最容易写错的地方写进去。我们给这件活定义四个工具,一项能力对应一个,下面是配置示例(模型一侧没有真跑):
TOOLS = [
  {
    "name": "reddit_search",
    "description": "Search Reddit posts from the last month. Returns at most 25 posts. "
                   "sort must be one of: relevance, newest, popular, rising, top, controversial.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "keyword": {"type": "string"},
        "sort": {"type": "string", "enum": ["relevance", "newest", "popular", "rising", "top", "controversial"]},
        "limit": {"type": "integer"}
      },
      "required": ["keyword", "sort", "limit"],
      "additionalProperties": False
    }
  },
  {
    "name": "trustpilot_reviews",
    "description": "Reviews of one company on Trustpilot. company is the website domain, e.g. notion.so. "
                   "stars is a list of strings such as [\"1\",\"2\"]. date is one of last7days, last30days, "
                   "last3months, last6months, last12months.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}},
        "date": {"type": "string", "enum": ["last7days", "last30days", "last3months", "last6months", "last12months"]},
        "limit": {"type": "integer"}
      },
      "required": ["company", "stars", "date", "limit"],
      "additionalProperties": False
    }
  },
  {
    "name": "youtube_search",
    "description": "Search YouTube videos by keyword. Use it to find review videos; "
                   "pass a result url to youtube_comments.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "keyword": {"type": "string"},
        "limit": {"type": "integer"}
      },
      "required": ["keyword", "limit"],
      "additionalProperties": False
    }
  },
  {
    "name": "youtube_comments",
    "description": "Comments under one YouTube video URL. sort is newest or popular.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string"},
        "sort": {"type": "string", "enum": ["newest", "popular"]},
        "limit": {"type": "integer"}
      },
      "required": ["url", "sort", "limit"],
      "additionalProperties": False
    }
  }
]

resp = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=16000,
    tools=TOOLS,                      # 整段对话只建一次,之后每轮原样送
    tool_choice={"type": "auto"},     # Fable 5.2 上 any / tool 会返回 400
    output_config={"effort": "medium"},
    cache_control={"type": "ephemeral"},   # 自动缓存:断点跟着对话往后挪
    messages=messages,
)
枚举值直接写进 schema,再在描述里重复一遍:strict: true 让模型生成的参数一定在枚举里,描述里的那句是给模型选值用的。trustpilot_reviews 的 stars 在 EveryInfra 目录里写明是字符串数组,不是最低星级数字,这正是模型容易写成 "stars": 1 的地方,schema 里写成 items 为字符串的数组就挡住了。limit 我们留给模型填,但在工具执行那一层还会再压一次上限(下一节的代码),因为 strict 只保证类型,不保证模型挑一个合适的数。
tools 和系统提示在整段对话里不能变。Fable 5.2 的前缀检查把工具定义算在里面,哪天想加一个工具,按官方的办法在对话末尾追加一条 role: "system" 消息,用 tool_addition 块把工具加进来,tools 数组本身保持原样,缓存也不会断(Mid-conversation tool changes,测试版,要带 inline-tools-2026-09-15 请求头)。effort 我们写的是 medium:官方说 Fable 5.2 在 high 及以上几乎每次回复前都会思考,effort 越低工具调用越少越简短(Effort 文档),这件活每一步的判断都很简单,没必要用默认的 high。但官方同时提醒,low 和 medium 下模型更容易在长任务里提前收工,列一张「还剩什么」的清单就停(Prompting Claude Fable 5.2),所以系统提示里要写明「遇到超时、报错这类普通障碍,自己诊断后继续做完」。
工具执行层:裁剪、重试和报错三段可抄的写法
模型发出 tool_use 以后,执行工具的是你自己的代码。成本和出错重试的大部分决定都在这一层做,因为这里能看到接口的完整返回,又在结果写进对话之前。下面这段 Python 是我们量数用的同一套逻辑,接口一侧真跑过;它被模型调用的那部分是配置示例。
import os, json, time, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}
ROUTE = {"reddit_search": ("reddit", "search"),
         "trustpilot_reviews": ("trustpilot", "reviews"),
         "youtube_search": ("youtube", "search"),
         "youtube_comments": ("youtube", "comments")}
KEEP = {"reddit_search": ["title", "community", "like_count", "comment_count", "posted_at", "url", "text"],
        "trustpilot_reviews": ["rating", "title", "text", "posted_at", "country", "is_verified"],
        "youtube_search": ["url", "title", "view_count", "comment_count", "posted_at"],
        "youtube_comments": ["text", "like_count", "reply_count", "posted_at"]}
MAX_LIMIT = {"reddit_search": 25, "trustpilot_reviews": 50, "youtube_search": 10, "youtube_comments": 50}
TEXT_MAX = 280

def trim(name, body):
    """只留模型要用的字段,长正文截到 280 字;账单只留 charged_usd。"""
    rows = []
    for r in body.get("results", []):
        row = {k: r[k] for k in KEEP[name] if r.get(k) not in (None, "", [])}
        if len(row.get("text", "")) > TEXT_MAX:
            row["text"] = row["text"][:TEXT_MAX] + "…"
        rows.append(row)
    return {"id": body.get("id"), "count": body.get("count"),
            "charged_usd": body.get("billing", {}).get("charged_usd"), "results": rows}

def run_tool(name, args, idem_key):
    platform, action = ROUTE[name]
    args = dict(args, limit=min(args.get("limit", 20), MAX_LIMIT[name]))
    payload = {"platform": platform, "action": action, "params": args}
    for attempt in range(4):
        r = requests.post(API, json=payload, timeout=110,
                          headers={**HEADERS, "Idempotency-Key": idem_key})
        if r.status_code == 200:
            return {"content": json.dumps(trim(name, r.json()), ensure_ascii=False)}
        err = r.json().get("error", {})
        if r.status_code == 422:                      # 参数错:原样交给模型改
            return {"content": json.dumps({"error": err.get("message"), "param": err.get("param"),
                                           "allowed": err.get("allowed")}, ensure_ascii=False),
                    "is_error": True}
        if err.get("retryable"):                      # 429、504 一类:按 retry_after 等,再用同一个 Key 发
            time.sleep(float(err.get("retry_after") or 2 ** attempt))
            continue
        return {"content": json.dumps({"error": err.get("message")}, ensure_ascii=False), "is_error": True}
    return {"content": "tool gave up after 4 tries", "is_error": True}

# 主循环里:Key = 任务号 + 本轮第几次工具调用;整轮重跑时同一步拿回第一次的结果
# task_id 在建任务时定下,重跑沿用;step_no 在一轮开始时设为 0,跨多次模型请求累加
for block in resp.content:
    if block.type == "tool_use":
        step_no += 1
        key = f"{task_id}-{step_no}"
        out = run_tool(block.name, block.input, key)
        tool_results.append({"type": "tool_result", "tool_use_id": block.id, **out})
messages.append({"role": "assistant", "content": resp.content})   # 原样送回,一块不少
messages.append({"role": "user", "content": tool_results})        # 只往末尾追加
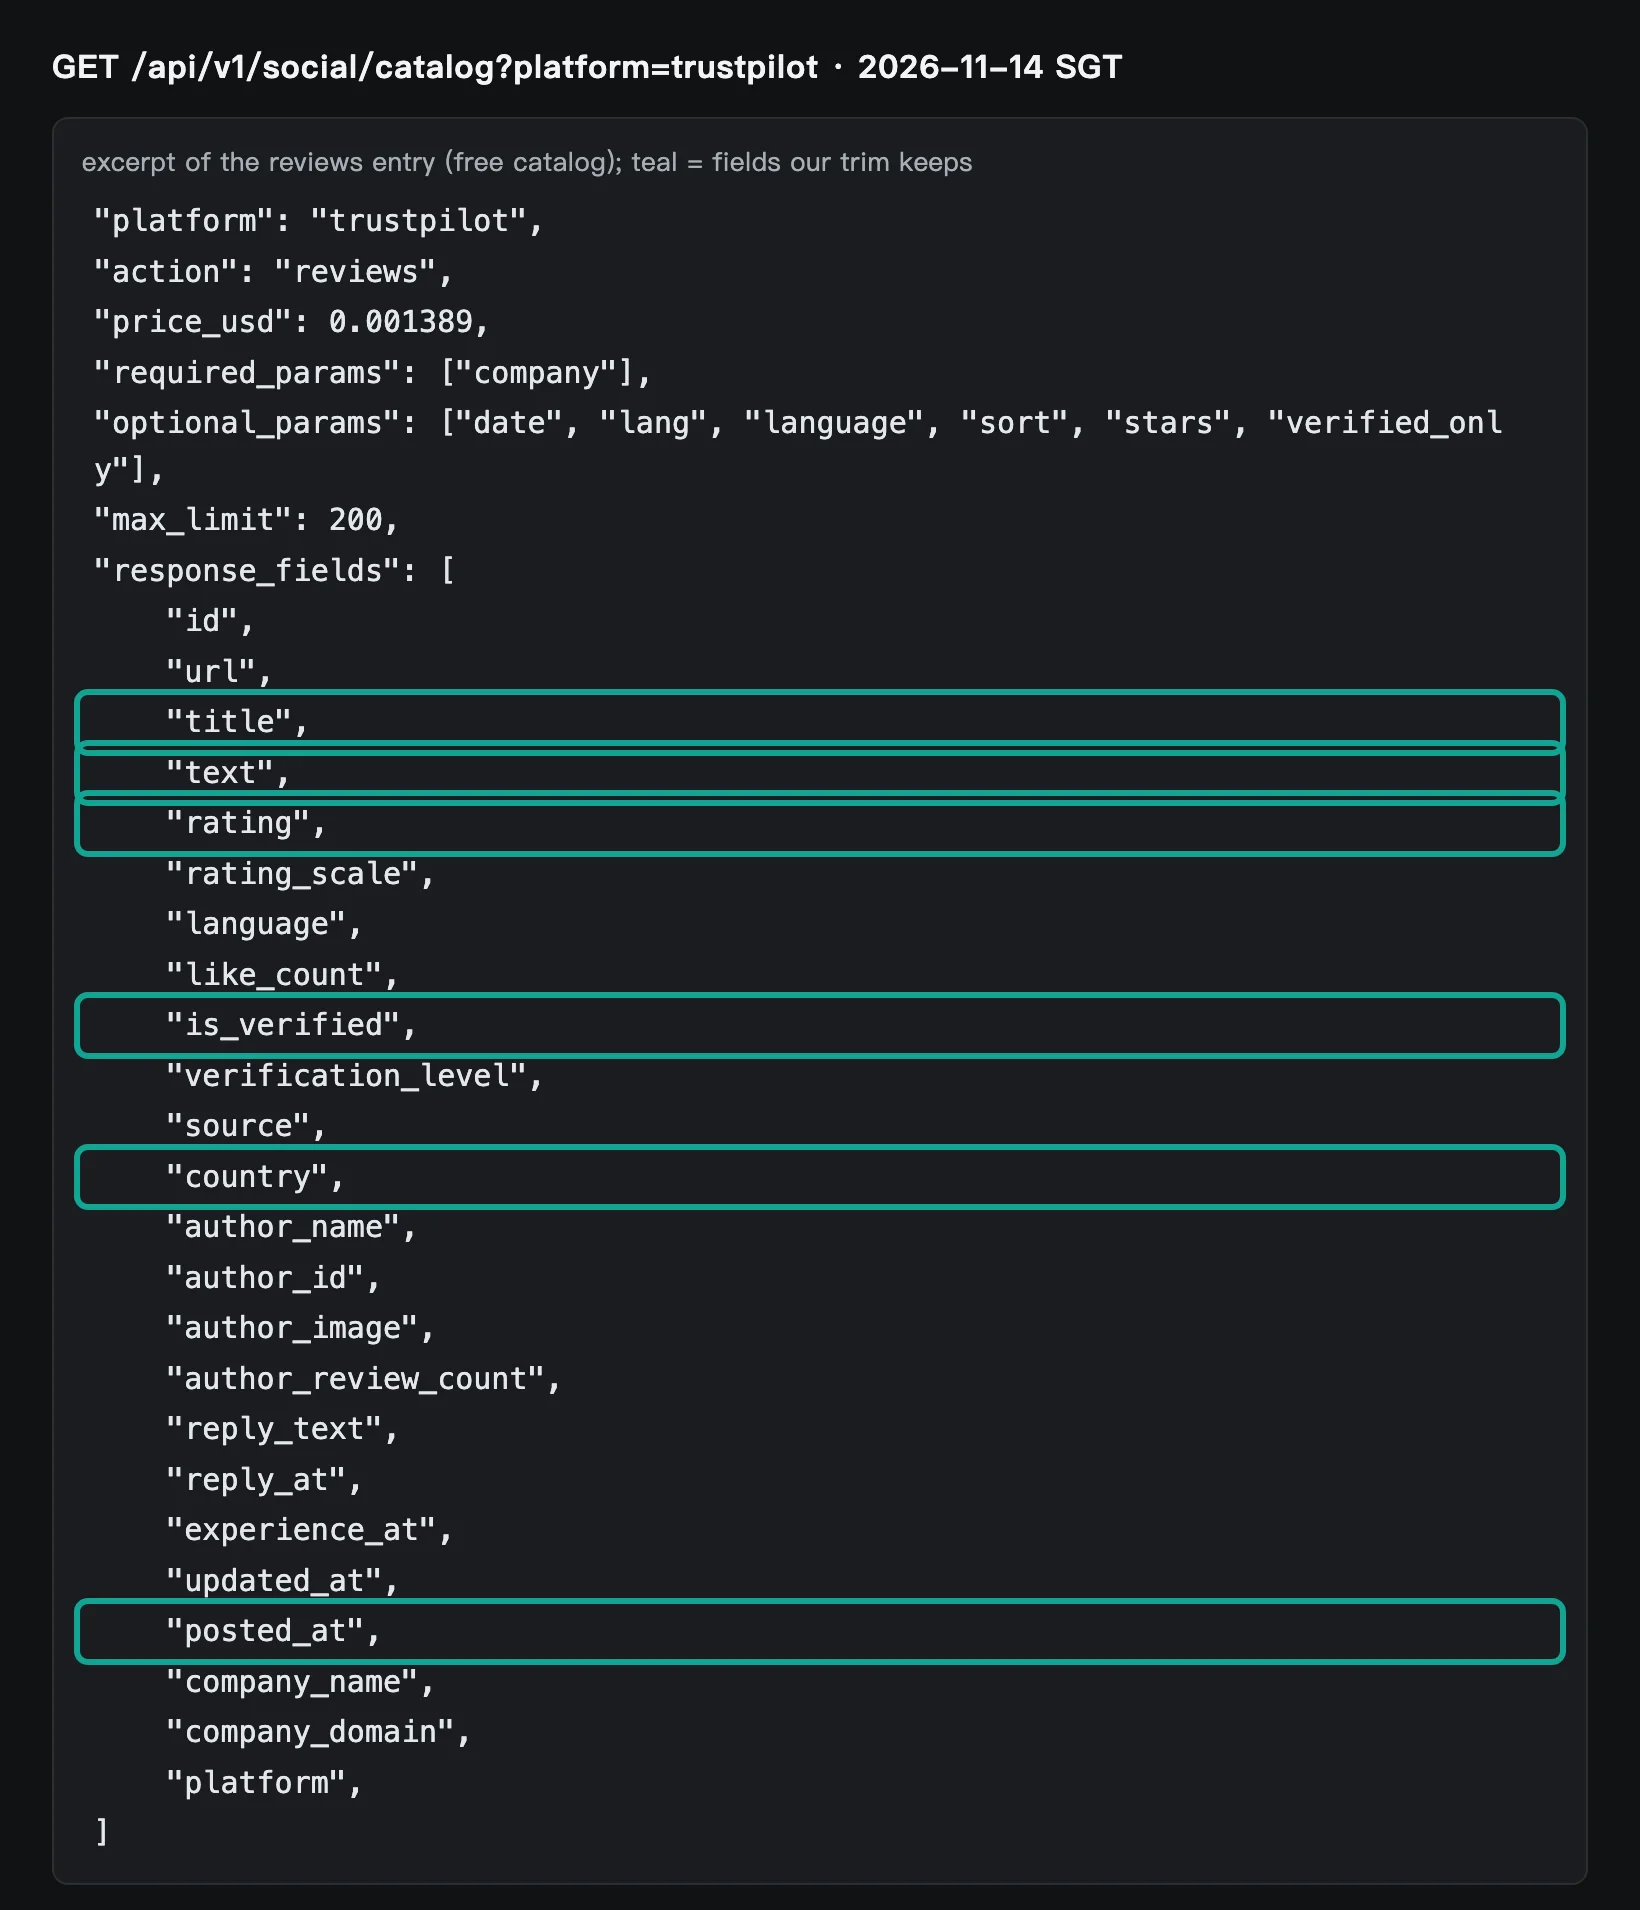
裁剪。 trim 只留下回答问题要用的字段,评价和帖子的正文截到 280 个字符,接口返回里的余额、配额这一类账户信息只留一个 charged_usd。字段清单按目录里的 response_fields 来挑,用白名单写:目录以后新加的字段默认不进上下文,免得哪天返回里多出一个大字段,悄悄把每一轮都撑大。截断长度 280 是我们这件活的选择,做情感分类够用;要逐字引用原话的任务,可以把正文留全,只去掉其他字段。
重试不重复扣费。 每次工具调用对应一个 Idempotency-Key,由任务号和本轮第几次调用拼成,网络超时、504 或者 429 以后重发,用的都是同一个 Key;整轮从头重跑时,同一步还是同一个 Key,前面成功过的调用直接拿回第一次的结果。EveryInfra 的规则是:同一个 Key、同样的参数,24 小时内重发,拿回第一次的结果,不再执行,也不再扣费;参数变了就回 409,不执行(llms-full.txt 的重试与幂等一节)。这几种情况我们在 11 月 9 日专门测过一轮,写在 API 幂等键:AI agent 重试不重复扣费,这里只在长任务里复核一次。
把参数错误交还给模型。接口回 422 时,错误体里带着出错的参数名、全部合法值和建议值,代码把这几项原样包进 tool_result,加上 is_error: true。官方文档写明,工具执行出错时就用这个字段告诉模型(Handle tool calls),模型下一步会自己改参数重发。422 不扣费,所以这一次往返只花模型那边几百个 token。
留哪些字段:从免费目录里挑
EveryInfra 的能力目录免费,不扣费,每项能力都列着必填参数、可选参数、单次最多条数和 response_fields(返回里会有的全部字段)。2026 年 11 月 14 日的目录里,Trustpilot 评价能力有 24 个返回字段,我们留 6 个。
| 能力 | 目录里的返回字段 | 我们留下的字段 | 丢掉的大头 | 正文怎么处理 |
|---|---|---|---|---|
reddit/search | 15 个 | 标题、社区、点赞、评论数、发布时间、链接、正文 | 作者名、帖子 ID、平台名 | 截到 280 字符 |
trustpilot/reviews | 24 个 | 星级、标题、正文、发布时间、国家、是否验证 | 作者头像、作者 ID、评价链接、体验日期、验证级别 | 截到 280 字符 |
youtube/search | 25 个 | 链接、标题、播放量、评论数、发布时间 | 视频简介、缩略图、频道信息 | 简介整段不要 |
youtube/comments | 9 个 | 正文、点赞、回复数、发布时间 | 评论 ID、作者名、平台名、回复对象 | 约 16% 超过 280,被截断 |
比较几款产品的口碑,要的是星级、正文和时间,作者头像和评价链接用不上;任务换成分语言比较口碑,就把目录里的 language 加进白名单。Trustpilot 的 country 我们留着,是因为要分地区看口碑;只看总体情绪的话,这个字段也可以去掉。
参数也会改变返回的时间分布,进而影响一轮要调几次。13:45 按 newest 搜 Asana,本次返回 21 个帖子,发布时间在新加坡时间 2026 年 11 月 13 日 03:46 到 2026 年 11 月 14 日 12:00 之间;13:27 查 Notion 最近 30 天的 Trustpilot 评价,7 条发于 2026 年 10 月 20 日到 2026 年 11 月 13 日。一个月只有 7 条,说明 Notion 在 Trustpilot 上的新评价不多,要看更多样本,可以把时间放宽到最近 3 个月或 6 个月,调用次数不变,单次返回会更大。在 Asana 这种讨论多的词上,按 newest 排的 21 个帖子只覆盖了最近一天半;要覆盖一整个月,Reddit 按 top 排更合适。这些选择最好写进工具描述,让模型一开始就选对,省掉一次重调。
实测:三个时刻、20 次请求
三轮请求分别在新加坡时间 13:07、13:26 和 13:44 开始,最早一次和最晚一次相隔 38 分钟。每轮按任务里会出现的顺序发:先在 Reddit 搜品牌名,再拉 Trustpilot 的评价,用 YouTube 搜测评视频,然后取视频下的评论。中间夹了三种特殊情况:一次故意写错的排序参数、一次没有结果的搜索,以及一对带同一个幂等键的重复请求。
| 轮次 | 新加坡时间 | 请求数 | 用到的能力 | 特殊情况 |
|---|---|---|---|---|
| 第一轮 | 13:07–13:11 | 6 | reddit/search、trustpilot/reviews、youtube/search | 一次 0 条结果;一次 422 |
| 第二轮 | 13:26–13:28 | 7 | reddit/search、trustpilot/reviews、youtube/comments | 同一个幂等键发两次 |
| 第三轮 | 13:44–13:45 | 7 | reddit/search、trustpilot/reviews、youtube/comments、youtube/search | Trustpilot 按西班牙语筛选一次 |
20 次请求里,18 次返回 200(其中 1 次 0 条),17 次拿到数据,一共 335 条结果;0 条那次和参数错误返回 422 的那次都没扣费;还有一次是幂等重放,拿回的是第一次的结果,也没有再扣。实扣的数据接口费合计 $0.0169,平均每条结果 $0.000050。
上图每一行是一次调用,共 18 行,包括那次 0 条结果的搜索。灰色条差别很大:同样是一次调用,Reddit 搜索动辄几十 KB,YouTube 评论只有几 KB;返回大小主要由正文长度决定,字段多少影响反而小。18 次返回 200 的原样合计 594.5 KB,裁剪后 128.2 KB,少了 78%。
| 能力 | 返回 200 的次数 | 结果条数 | 每次原样(字节) | 每次裁剪后(字节) | 每条结果原样(字节) | 正文占比 | 耗时中位数 |
|---|---|---|---|---|---|---|---|
reddit/search | 6 | 96 | 56,895 | 8,955 | 3,491 | 90% | 5.6 秒 (6) |
trustpilot/reviews | 7 | 143 | 24,297 | 7,733 | 1,126 | 49% | 10.1 秒 (7) |
youtube/search | 2 | 20 | 26,933 | 2,002 | 2,585 | 73% | 7.7 秒 (2) |
youtube/comments | 3 | 76 | 9,732 | 5,436 | 341 | 48% | 16.6 秒 (3) |
表里「正文占比」是结果中 text 字段的字节占所有结果字段的比例。耗时中位数算的是返回 200 的调用(不含幂等重放),括号里是样本数,reddit/search 那 6 次含 0 条的那一次。正文长度用 Python 的 len() 按字符数量。
Reddit 和 YouTube 搜索的大头是正文。 96 个 Reddit 帖子的正文中位数 1,222 个字符(其中 6 帖没有正文,算作 0;去掉这 6 帖是 1,256.5),84% 的帖子超过 280 个字符,正文占了结果字节的 90%。YouTube 搜索结果里的 text 是视频简介,20 条的中位数 1,426 个字符,全部超过 280,占 73%;找视频这一步模型只需要链接、标题和播放量,简介可以整段不要,所以这一项裁掉了 93%。只删字段、不截正文,Reddit 搜索最多只能省一成左右。
YouTube 评论本来就短。 76 条评论的正文中位数只有 136.5 个字符,只有 16% 的评论会被 280 的截断碰到;正文以外的字节分散在评论 ID、作者名、平台名、回复对象这些字段上,裁剪靠的是删字段。Trustpilot 介于两者之间:143 条评价的正文中位数 347 个字符,57% 的评价会被截断,作者头像、评价链接、体验日期这些字段也占了不少。
Trustpilot 的截断比例还跟星级有关。这 143 条里有 117 条是 1 到 2 星(两次调用按 1–2 星筛过),正文中位数 441 个字符,63% 超过 280;3 到 5 星的 26 条,中位数 212 个字符,27% 超过 280。差评写得长,而找「被骂最多的三件事」恰好要读差评,所以按低星筛的那几次调用,可以把截断放宽到 500 字符左右,其余调用仍用 280。3 到 5 星这一组只有 26 条,比例只能看个方向。
每次返回都带着约 830 字节的账户信息:本次扣费和余额这一类。这一块和结果条数无关,0 条结果的那次返回也有 868 字节。调 20 次就是 16.6 KB,按每 4 字节 1 个 token 算约 4,200 token,而且之后的每一轮都要再送一遍。模型做调研用不上余额,裁剪时只留 charged_usd 一个数就够了。
裁剪后,每条结果的大小变得可以预估。 同一项能力,不同关键词的原样返回差得很远:Reddit 5 次拿到数据的搜索,每个帖子平均 1,462 到 5,812 字节,相差约 4 倍,整次返回从 32.2 KB 到 101.6 KB;Trustpilot 7 次每条 1,021 到 1,420 字节,整次返回从 6.5 KB 到 59.1 KB。裁剪以后,Reddit 每帖稳定在 525 到 582 字节,Trustpilot 每条 356 到 403 字节,YouTube 搜索每个视频约 200 字节,YouTube 评论每条 169 到 284 字节。原因很直接:280 字符的截断给正文定了上限,白名单给字段定了上限,剩下的变化只来自短于 280 的正文。
| 能力(有数据的调用次数) | 每条原样字节 | 每条裁剪后字节 | 整次原样返回 |
|---|---|---|---|
reddit/search(5) | 1,462–5,812 | 525–582 | 32.2–101.6 KB |
trustpilot/reviews(7) | 1,021–1,420 | 356–403 | 6.5–59.1 KB |
youtube/search(2) | 2,513–2,874 | 200–201 | 25.1–28.7 KB |
youtube/comments(3) | 330–456 | 169–284 | 4.8–13.2 KB |
这样就能在发请求之前估出这次结果要占多少上下文:按 Reddit 每帖约 560 字节、每 4 字节 1 个 token 算,一次返回 20 个帖子约 11 KB、约 2,800 token;同样 20 个帖子原样回填,按实测的每帖 1,462 到 5,812 字节,会落在 7,300 到 29,000 token 之间。上下文预算和任务预算都要在开跑前定下,裁剪后按每帖约 560 字节乘以条数去定就够了。
这些数都按本次 18 次返回 200 的调用现算,样本里 Reddit 只有 5 次有数据、YouTube 搜索只有 2 次,换成别的关键词、别的社区,每条的原样大小还会变;裁剪后的上限由 280 字符和白名单决定,不随样本变。
耗时也要算进成本里。17 次拿到数据的调用,耗时中位数是 9.2 秒(样本 17)。提示缓存默认 5 分钟过期,如果一轮里模型两次请求之间要等好几个慢工具,缓存可能已经失效,下一次请求就按写入价重新算。工具普遍慢、或者一次并行发很多个的任务,可以考虑 1 小时的缓存档位(Prompt caching),差价怎么算见下文「缓存断点放在哪」。
这一轮要花多少钱
把这 18 次返回 200 的调用按时间顺序排成一轮任务,就能算出每一次模型请求要背多少输入。假设系统提示、工具定义和用户问题合计 3,000 token,模型每一步输出 500 token(工具调用块加上思考),最后写结论再输出 2,000 token。第 k 次请求的输入,等于起始的 3,000 token 加上前面所有的助手输出和工具结果。这些假设都是配置示例,读者应该换成自己任务里 usage 的实际值。
原样回填时,最后一次请求的输入约 160,627 token;裁剪后约 44,042 token。这是按每 4 字节 1 个 token 估的下限,按新分词器多 30% 算,上限分别是 206,115 和 54,555 token。100 万 token 的上下文装得下,但每一次请求都要按全部输入计费。官方文档也提醒,token 越多,模型的准确率和召回率越会下降,这种现象叫 context rot(Context windows)。
| 这一轮的费用(美元) | 原样回填 | 裁剪后回填 |
|---|---|---|
| 模型输入,不开缓存 | $10.383 | $3.230 |
| 模型输入,开 5 分钟缓存 | $1.834 | $0.512 |
| 模型输入,开缓存,按多 30% 的上限算 | $2.352 | $0.634 |
| 模型输出(假设每步 500 token) | $0.440 | $0.440 |
| 数据接口费(实扣) | $0.0169 | $0.0169 |
| 合计(开缓存,下限) | $2.291 | $0.969 |
数据接口费在这一轮里是 $0.0169,模型输入在四种做法下从 $0.512 到 $10.383;拉开差距的是工具结果在上下文里被重送了多少次。不开缓存、原样回填是 $10.383,开缓存加裁剪是 $0.512,相差约 20 倍。两种手段里,缓存把重送的历史按 $0.20 / 百万 token 计,效果最大;裁剪在缓存之上还能再少 72%,因为每一段新结果第一次写进缓存时,按 $10 / 百万 token 的写入价计费,写得越少越省。
把输入费拆到每一次工具结果上,还能看出该先裁哪一类。第 k 次结果会在之后的 19 − k 次请求里被重送。不开缓存时,单次结果最贵的是第 9 次调用(13:27 的 Reddit 搜「clickup」):原样 72.7 KB,约 18,200 token,重送 10 次,按 $8 / 百万算约 $1.45;最大的那次(13:45 的 Reddit 搜「asana」,101.6 KB)排在最后,只重送 1 次,约 $0.20。开了 5 分钟缓存,每次结果第一次写入按 $10、之后每次读按 $0.20 计,位置的影响就小了:最贵的两次变成 13:44 的 Reddit 搜「notion」(98.8 KB,约 $0.28)和 13:45 那次(约 $0.25),都是因为大。按这个算法,18 次结果里前三贵的都是 Reddit 搜索,所以裁剪白名单和 280 字符截断要先在 Reddit 这一项上写好。
| 工具结果(第几次调用) | 时间 | 原样大小 | 重送次数 | 不开缓存 | 开 5 分钟缓存 |
|---|---|---|---|---|---|
| Reddit「asana alternative」(5) | 13:11 | 35.2 KB | 14 | $0.99 | $0.11 |
| Reddit「clickup」(9) | 13:27 | 72.7 KB | 10 | $1.45 | $0.21 |
| Reddit「notion」(12) | 13:44 | 98.8 KB | 7 | $1.38 | $0.28 |
| Reddit「asana」(18) | 13:45 | 101.6 KB | 1 | $0.20 | $0.25 |
每行的算法:token = 字节 / 4;不开缓存时,费用 = token × 重送次数 × $8 / 100 万;开缓存时,费用 = token × $10 / 100 万(写入一次)+ token ×(重送次数 − 1)× $0.20 / 100 万(之后的读取)。
输出费在这个估算里是 $0.440,裁不裁剪都一样,开不开缓存也一样。Fable 5.2 的思考按输出价计费,如果每一步实际花的思考比我们假设的 500 token 多,输出很快会变成最大的一项。控制它只能靠 effort 和任务预算,见下一节。
计算按 2026 年 11 月 14 日读取的官方价:输入 $8、输出 $40、缓存读 $0.20、5 分钟缓存写 $10,单位都是每百万 token(定价页)。数据接口费是每次返回里 billing.charged_usd 的合计,和目录里每项能力的 price_usd 一致。
实测里的三次往返
| 新加坡时间 | 请求 | HTTP | 结果 | 扣费 |
|---|---|---|---|---|
| 13:10:16 | Reddit 搜「notion vs clickup」 | 200 | 本次返回 0 条 | $0 |
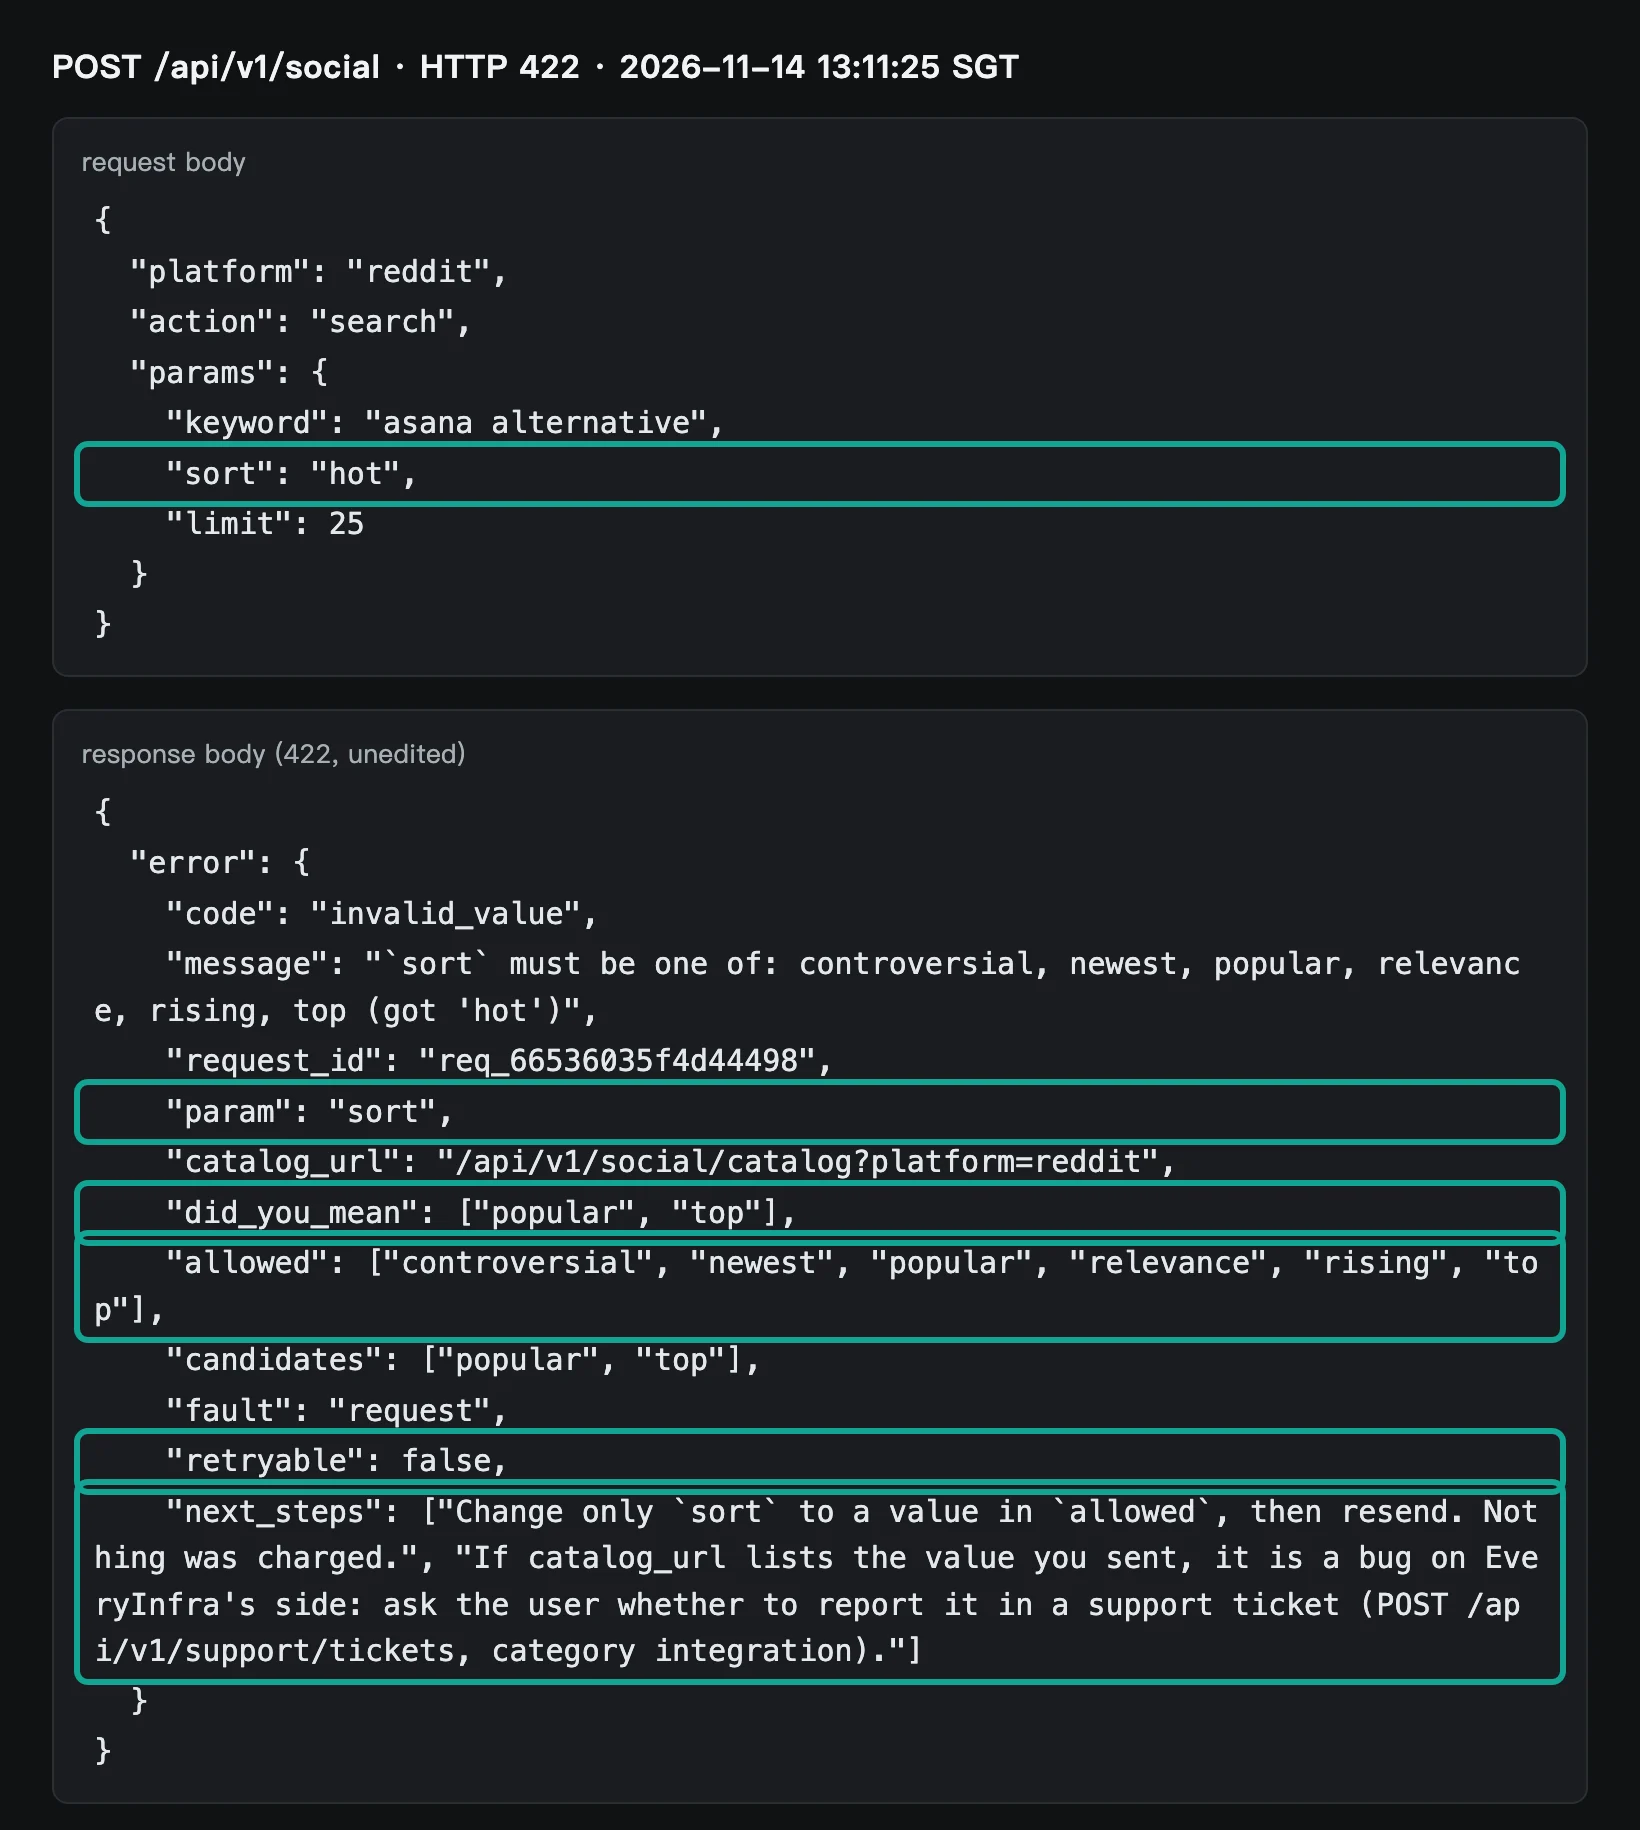
| 13:11:25 | Reddit 搜「asana alternative」,sort 写成 hot | 422 | 几乎立即返回,错误体带合法值和建议值 | $0 |
| 13:11:34 | 同一搜索,sort 改成 top | 200 | 本次返回 13 个帖子 | $0.000792 |
| 13:27:50 | Notion 最近 30 天评价,带幂等键 | 200 | 本次返回 7 条 | $0.001389 |
| 13:28:16 | 同一个键、同样参数再发 | 200 | 几乎立即返回,同样 7 条,replayed: true | 不另扣 |
422:写错参数,模型自己改。 13:11:25,我们故意把 Reddit 搜索的 sort 写成 hot。接口几乎立即回了 422,错误体里写明出错的参数是 sort,列出全部六个合法值,did_you_mean 给了 popular 和 top 两个建议,next_steps 第一条写着只改 sort 再发,并说明没有扣费。我们的执行层把这几项原样包进 is_error 结果;模拟模型照建议改成 top 以后,9 秒后的下一次请求返回了 13 个帖子,按次扣了一次。
幂等重放:同一个键发两次。 13:27:50 我们带着幂等键 bl150-notion-30d-20261114-a 查 Notion 最近 30 天的 Trustpilot 评价,本次返回 7 条;13:28:16 用同一个键、同样的参数再发一次,几乎立即返回。第二次的响应头有 Idempotent-Replayed: true,响应体有 replayed: true,响应体里的 id 和第一次相同,结果也相同。我们随后用账户接口 GET /portal/api/requests/{id} 查这个请求号:账户请求记录里这把键只有一条扣费记录,金额 $0.00138889。
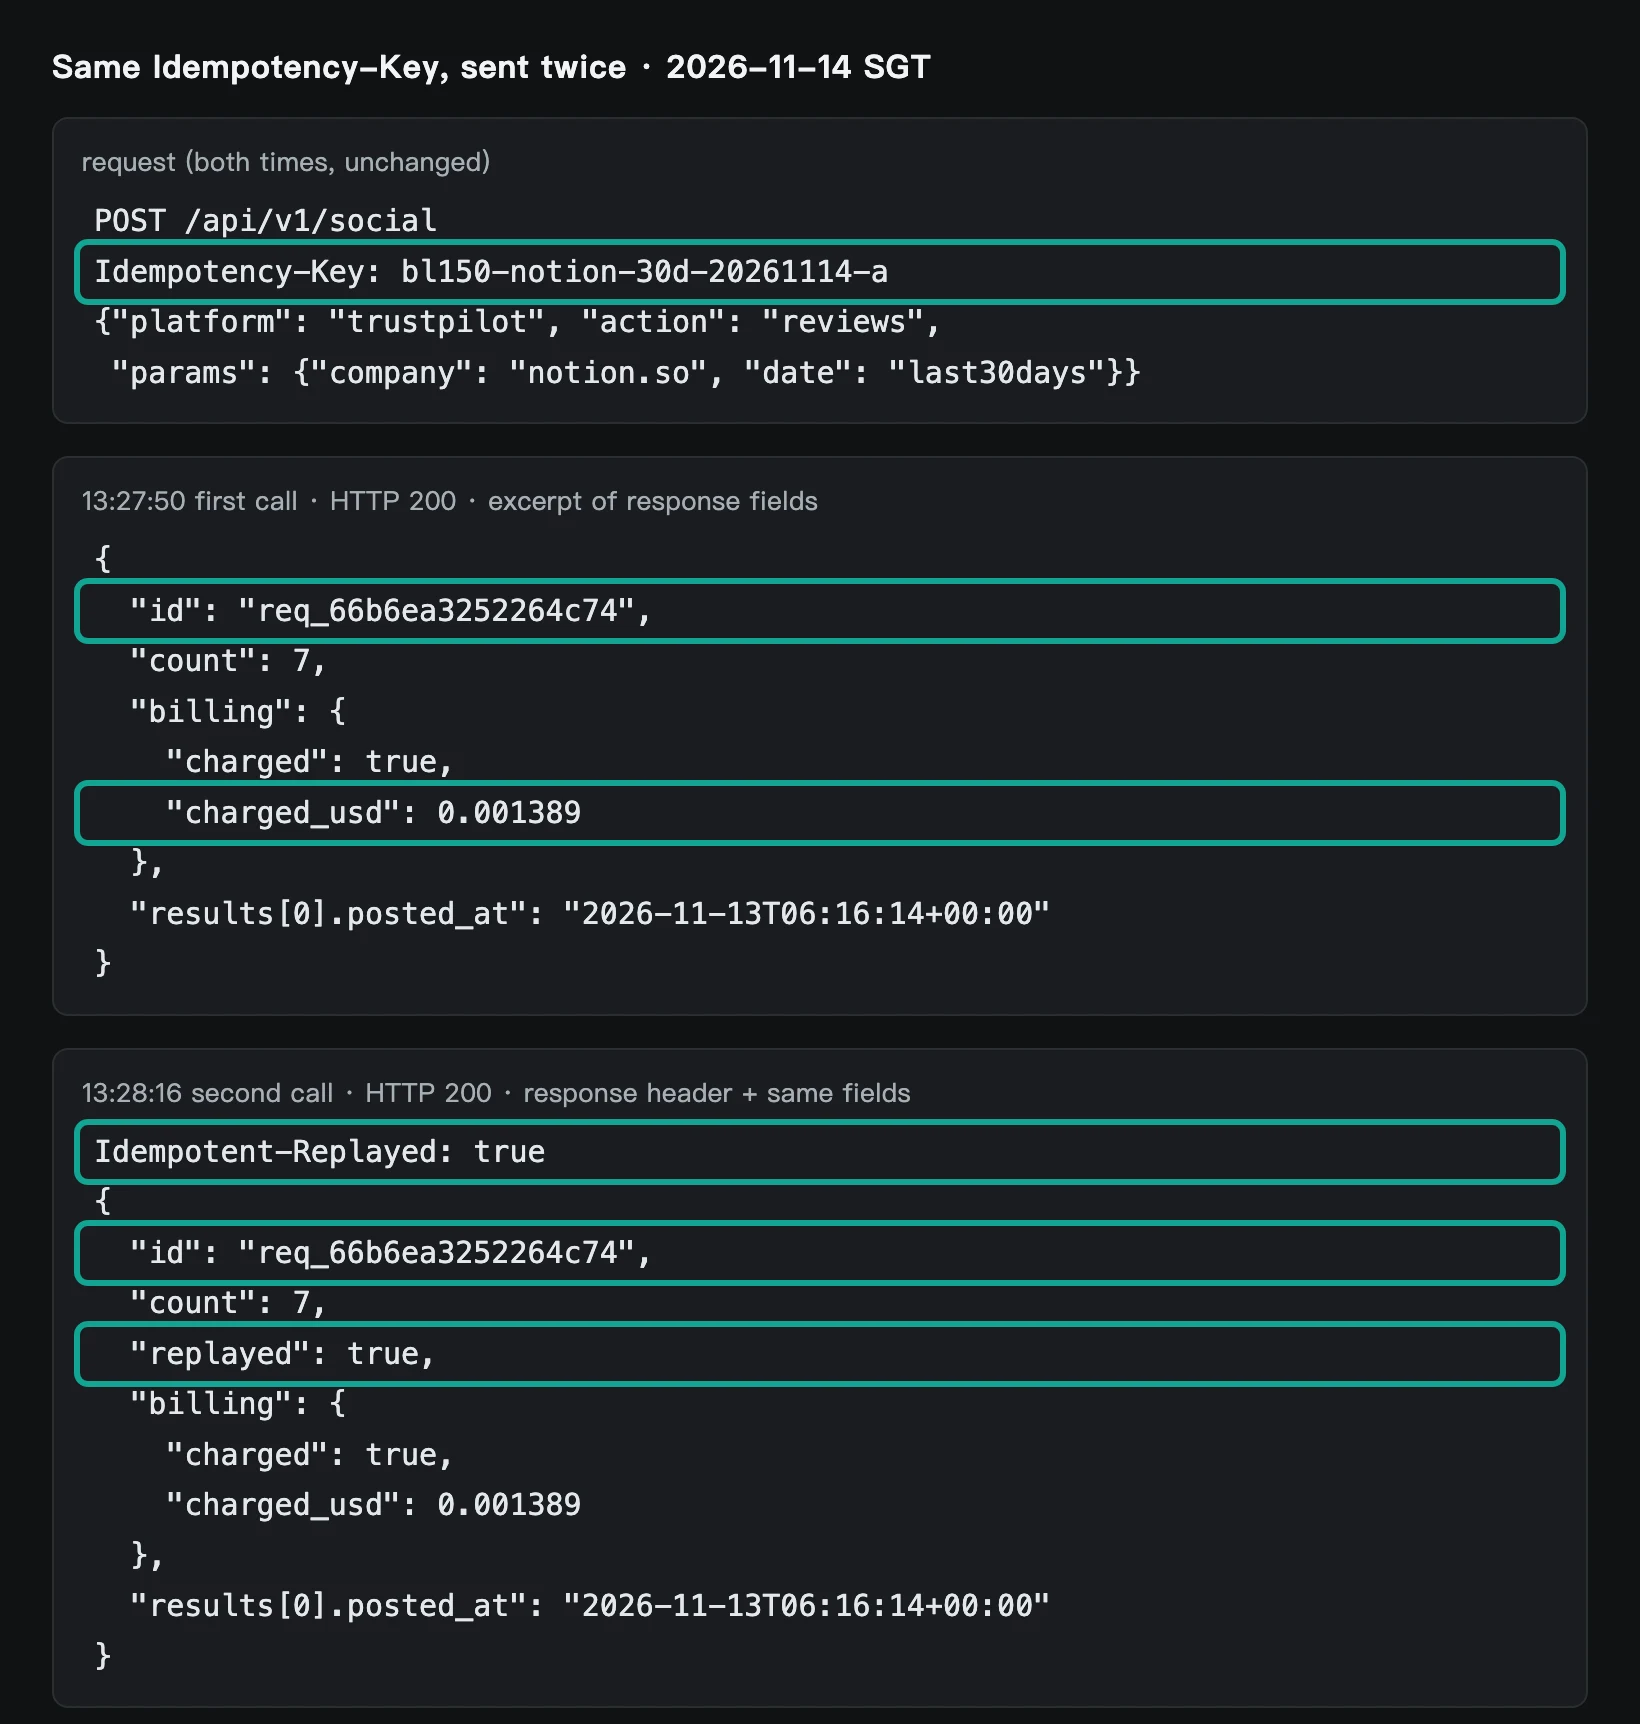
这里有一个写代码时要注意的地方。重放返回的是第一次那份响应,billing 也原样带回来,所以第二次的响应体里同样写着 charged: true 和 charged_usd。EveryInfra 的说明写的是「同样的 billing,不再执行,也不再扣费」(llms-full.txt)。如果你在代码里把每次返回的 charged_usd 加起来记账,要跳过 replayed 为 true 的那几次,否则账面会比实扣多。
0 条结果:换关键词,不扣费。 第一轮第一次请求搜的是「notion vs clickup」,返回 0 条,charged_usd 为 0。Reddit 搜索只看最近一个月,对比型的长关键词很容易落空;换成单个品牌名以后,每次拿到 13–23 个帖子。这种结果要原样交给模型,让它自己决定换词,不要在执行层悄悄重试同一个词。
裁掉的内容放哪:给模型留一个取原文的工具
裁剪有一个代价:模型看不到被截掉的那部分。做情感归类时 280 个字符够用,但到了写结论、要引用一位用户的原话时,模型可能正好需要那条评价的后半段。把全文塞回对话会让后面每一轮都多背一截,更好的做法是让执行层把每次的原样返回存在本地,按返回里的 id 和结果序号建索引,再给模型加一个很小的工具,例如 get_full_text(id, index),只取一条结果的完整正文。
前面的工具结果不用改,前缀检查不会失败:需要原文时是新追加一次工具调用,历史只增不改。取原文不调数据接口,没有数据费,模型这边也只多几百 token。存下来的原样返回还能当审计材料,哪次调用、几点、扣了多少钱、拿回了什么,都能对得上。
这个工具要在对话一开始就放进 tools,不要等到需要时再加。中途加工具会改动 tools 数组,前缀检查会失败;如果一定要中途加,就用前面提到的 tool_addition 系统消息(测试版)。工具描述里写清楚它只返回一条结果的正文、不联网、不扣费,模型才不会把它当成搜索工具反复调用。
缓存断点放在哪
开了自动缓存以后,缓存断点会随着对话往后移,每一轮新追加的内容先按写入价计费,下一轮再按读取价计费(Prompt caching)。对长任务来说,这意味着每一段工具结果都会被写一次、读很多次:第 3 次调用的结果,在第 4 次到第 20 次请求里都会被读一遍。所以缓存之后,账单里占比最大的往往是每一步新写入的那一段,而这一段的大小正好由裁剪决定。
工具定义和系统提示放在最前面,它们在整轮里不变,第一次写入以后一直按读取价计费。顺序上要注意两件事。一是每个工具的描述一个字都不要动,包括时间戳、随机示例这类看起来无害的内容;二是不要在系统提示里放「当前时间」这种每次都会变的字段,它会让后面所有缓存都失效。需要时间的话,放在用户消息里,或者让模型调一个取时间的工具。
缓存有效期是另一个要算的数。上面的实测里,17 次拿到数据的工具调用耗时中位数是 9.2 秒。如果模型一次发出 5 个并行调用,再加上模型自己思考的时间,两次请求之间隔一两分钟很常见,5 分钟的缓存一般还来得及;但如果中间有人工审批,或者工具是要排队的长任务,就该换成 1 小时档。1 小时档的写入价是基础输入价的 2 倍,即 $16 / 百万 token,比 5 分钟档的 $10 贵 $6;缓存过期一次,整段前缀都要按写入价重写。拿本文的裁剪做法算:最后一次请求约 44,042 token,按 5 分钟档在这时过期一次,重写要 44,042 × $10 / 100 万 ≈ $0.44;而整轮里每一段新内容都按 1 小时档写入,多出的差价是新写入总量 44,042 token × $6 / 100 万 ≈ $0.26。过期一次的代价就超过了整轮换 1 小时档的差价。
换算到每天 100 轮
假设一个团队每天让 agent 跑 100 轮这样的调研,每轮的调用和上面的实测一样。原样回填、不开缓存时,模型输入加输出再加数据费,一天约 $1,083.94;裁剪加缓存以后约 $96.93。两者的差额,主要来自模型输入那一项,数据接口费在两种做法里都一样,一天约 $1.69。
| 每天 100 轮(美元) | 原样回填、不缓存 | 裁剪加缓存 |
|---|---|---|
| 模型输入 | $1,038.25 | $51.24 |
| 模型输出(假设每步 500 token) | $44.00 | $44.00 |
| 数据接口费 | $1.69 | $1.69 |
| 合计 | $1,083.94 | $96.93 |
这个换算没有算重试,重试怎么不重复扣费见下一节。
哪些错误该重发,哪些交还给模型
长任务里一轮可能有几十次工具调用,只要其中一次卡住,整轮就停在那里等。工具执行层要替模型做一个判断:这次失败是换个时间再发就能好,还是参数本身写错了、要模型改;前一种由代码自己重发,后一种原样交给模型。判断不要靠解析错误文案,EveryInfra 的每个错误体都带 fault(是请求的问题、账户的问题还是服务的问题)和 retryable(同样的请求再发一次能不能成功),可以重试的还带 retry_after 秒数(llms-full.txt 的错误一节)。
| 返回 | 含义 | 工具执行层怎么做 | 扣费 |
|---|---|---|---|
200,count 大于 0 | 拿到数据 | 裁剪后放进 tool_result | 按次扣一次 |
200,count 为 0 | 没有符合条件的结果 | 照常交给模型,让它换关键词 | 不扣 |
422 invalid_value 等参数错误 | 参数名或取值不对 | 把 param、allowed、did_you_mean 包进 is_error 结果交给模型 | 不扣 |
| 429 | 这把 Key 每分钟的次数用完 | 等 retry_after 秒,用同一个幂等键重发 | 不扣 |
504 response_timeout | 100 秒内没答复,可能还在跑 | 用同一个幂等键重发,拿第一次的结果 | 第一次成功才扣一次 |
502 response_interrupted | 答复中途断开,可能已经做完 | 用同一个幂等键重发 | 同上 |
409 idempotency_in_progress | 同一个键的第一次请求还没结束 | 等 Retry-After 后再发 | 不额外扣 |
409 idempotency_conflict | 同一个键配了不同的参数 | 代码有错,换一个新键;不要交给模型 | 不扣 |
503 refund_outcome_unknown | 账还在核对 | 不要重发,记下请求号以后再查 | 以核对结果为准 |
| 401、402、403 | Key、余额或权限的问题 | 停下来告诉用户,模型改不了 | 不扣 |
409 冲突和 503 待核对这两种,不要交给模型,也不要直接重发。409 冲突它说明代码给两次不同的调用用了同一个键,模型看到这个错误也改不了什么,所以应该在代码里报警,而不是塞进对话。503 的「结果待核对」这时候账还没定,重发反而可能多出一笔,官方说明里写的是「不要再发,留着请求号以后再查」。
模型自己的接口也会失败,这一层和工具层要分开管。Anthropic 的错误文档里,429 是速率限制,529 是 API 暂时过载,两者都可以等一会儿重发(Errors);官方 Python SDK 默认对连接错误、408、409、429 和 5xx 自动重试两次,退避时间很短(Python SDK 文档)。同一页还写明,SDK 2.0.0 是第一个默认使用 2026-10-21 版 API 的版本,升级大版本时要按官方迁移说明核对一遍。模型请求重发不会让工具再跑一遍,因为工具是你的代码在收到 tool_use 以后才执行的;但如果整轮从头重跑,模型会再次发出同样的工具调用,这时候工具层按「任务号 + 第几次工具调用」生成的幂等键就派上用场:键不随机,整轮重跑时同一步拿到的还是同一个键,前面已经成功过的调用直接拿回结果,不重复扣费。
速率限制方面,Anthropic 用令牌桶算法,官方举的例子是每分钟 60 次的限额,实际可能按每秒 1 次来执行(Rate limits)。工具层也一样:如果模型一次发出好几个并行的 tool_use,你的代码同时打出去,很容易在同一秒撞上每分钟的限额。并行工具调用的文档要求下一条用户消息里一次性交回所有 tool_result,哪个失败了也要交一个 is_error: true 的结果,并附一句简短说明(Parallel tool use)。所以并行的几个调用里有一个在等 retry_after,其他几个的结果要先存着,等最后一个回来再一起交。
如果不想自己写工具执行层,官方 SDK 里有 Tool Runner,会自动跑工具调用循环(Tool Runner);Messages API 也能直接连远程 MCP 服务器(MCP connector)。这两种方式省掉了循环代码,代价是工具结果进上下文之前你插不了手,裁剪只能靠服务端返回的格式。要按次计费、会重试的任务,我们建议用上面那种自己写的执行层,走 REST 并带 Idempotency-Key,写法见 API 幂等键:AI agent 重试不重复扣费。
裁剪之外还有五个旋钮
裁剪管的是工具结果本身的大小。Fable 5.2 的 API 另外有五个和长任务成本直接相关的设置,作用的地方各不相同,可以叠着用。下表的每一项都来自官方文档原文,读取日期 2026 年 11 月 14 日;状态写「测试版」的要带对应的请求头。
| 旋钮 | 管什么 | 怎么开 | 状态 | 要注意 |
|---|---|---|---|---|
| 提示缓存 | 每轮重复送的历史按 $0.20 / 百万 token 计 | 请求顶层加 cache_control | 正式 | 默认 5 分钟过期,工具慢的话考虑 1 小时档(写入价 2 倍) |
| effort | 每一步想多深、调多少次工具 | output_config.effort | 正式 | 对话中途改顶层值会让缓存失效 |
| 任务预算 | 告诉模型整轮还剩多少 token,自己收尾 | output_config.task_budget,最少 20,000 | 测试版 | 软上限,硬上限仍靠 max_tokens;Claude Code 里不支持 |
| 服务端清理旧工具结果 | 上下文超过阈值时,把最早的工具结果换成占位文字 | context_management 加 clear_tool_uses_20250919 | 测试版 | 不触发前缀检查,但会让清理点之后的缓存失效 |
| 按需压缩 | 由你决定什么时候把旧对话换成一段摘要 | compaction: {"type": "summarize"} | 测试版 | 摘要这一次照常计费;最后一轮停在没有结果的工具调用上时会被拒绝 |
出处依次是 Prompt caching、Effort、Task budgets、Context editing 和 Compaction on demand。
任务预算这一项和工具调用的关系最近。官方文档举了一个三次请求的例子:客户端每次都把完整历史重新送一遍,送出去的内容越来越多,但预算只按「模型新看到的东西」扣,例子里三次请求一共只扣了 100,000 里的 19,000(Task budgets 原文)。任务预算只扣模型新看到的 token,账单按每次送出的全部输入计;裁剪同时减少这两样,预算只帮模型在快用完时收尾。官方建议先不设预算跑一批代表性的任务,记下每个任务实际花的 token,从第 99 百分位起步。
服务端清理和自己裁剪也不冲突。我们的裁剪发生在结果第一次进对话时,留下来的是以后还要用的字段;服务端清理处理的是那些已经用过、后面不会再看的旧结果,例如前 10 次搜索的结果,在模型写完中间小结以后就可以清掉。官方提醒清理会让缓存在清理点之后失效,所以要用 clear_at_least 一次清够一定的量,不要每轮清一点(Context editing 原文)。
做不了或要注意的地方
模型一侧我们没有真跑。上面的工具定义、主循环和 token 费都是配置示例和估算,token 数按字节折算,没有用官方计数接口核过;读者自己跑时,以每次响应的 usage 为准。估算里假设的「每一步模型输出 500 token」是给数据调研这类判断简单的任务定的;思考按 $40 / 百万的输出价计费,每步输出翻到 2,000 token 的话,这一轮 18 步加结论的输出费就从 $0.440 变成 (18 × 2,000 + 2,000) × $40 / 100 万 = $1.52,比裁剪加缓存后的输入费 $0.512 还高。这部分只能靠 effort 和任务预算控制。
Reddit 搜索的时间范围固定为最近一个月,排序参数不会改变这个范围,目录里写明了这一点。想看更早的讨论,要用别的能力,例如按社区翻帖子。Trustpilot 按公司域名查,例如 notion.so;YouTube 评论按视频链接查,所以要先用 youtube/search 找到视频,这一步也算一次调用。
Fable 5.2 的思考块只在产生它的账户(或关联账户)里有效;从 Fable 5.2 换到别的模型,那几轮的思考也会丢掉(What's new 原文)。如果你的代码在 Fable 5.2 被安全分类器拒绝时自动换到别的模型重试,那一轮的思考要重新来,成本会比估算高。另外 Fable 5.2 默认要求 30 天数据保留,零数据保留要单独获批,这对处理用户评论原文的团队是一个合规上要先确认的点。
最近的变化
- 2026 年 11 月 9 日,Claude Fable 5.2 发布,输入输出价从 $10 / $50 降到 $8 / $40,缓存读 $0.20(Anthropic 发布稿)。对读者:同样的长任务,模型费直接少两成,缓存读的价格让「每轮重送历史」这件事便宜了很多。
- 2026 年 11 月 9 日,GitHub Copilot 上线 Fable 5.2,更新日志写它在早期测试里「用更少的步骤和工具调用」做完了更多任务(GitHub 更新日志)。对读者:工具调用次数少了,每次调用的结果大小就更值得管。
- 2026 年 11 月 9 日,Amazon Bedrock 和 Claude Platform on AWS 同步上线;AWS 博客写明在 Bedrock 上被拒请求的重试要你自己的代码来做(AWS 博客)。对读者:重试逻辑放在工具执行层之外,还要多管一层模型的重试。
- 2026 年 10 月 22 日,IETF 的 Idempotency-Key 请求头草案更新到第 08 版,目标是让 POST 这类方法也能安全重发(IETF 草案)。对读者:给数据接口带幂等键,正在变成通用写法。
常见问题
claude fable 5.2 api key 要单独申请吗?模型 ID 写什么?
不用单独申请。官方写的是 Claude API 所有客户都能用,模型 ID 是 claude-fable-5-2;Mythos 5.2 才需要通过审核计划(What's new)。从 5.1 迁过来,官方迁移指南给了一条 Claude Code 命令,让它替你改代码(迁移指南)。问题来自谷歌联想词「claude fable 5.2 api key」,2026 年 11 月 14 日读取。
claude fable 5.2 的 context window 和 token limit 是多少?
上下文 100 万 token,单次最多输出 12.8 万 token(模型页)。按我们的估算,实测的这一轮(18 次返回 200 的工具调用),原样回填时最后一次请求已经约 160,627 token,裁剪后约 44,042 token。问题来自联想词「claude fable 5.2 context window size」「claude fable 5.2 api token limit」。
claude fable 5.2 的 tool_choice 为什么返回 400?
Fable 5.2 不支持强制调用工具,tool_choice 设成 any 或指定某个工具都会返回 400 invalid_request_error。官方的替代写法是保持 auto,在工具上加 strict: true,或者改用 JSON 输出(What's new)。问题来自联想词「claude fable 5.2 tool_choices」。
思考用的 token 是不是也按输出价算?
是。r/claude 上有开发者发帖提醒,思考 token 按 $40 / 百万的输出价计费(r/claude 帖子)。Fable 5.2 的自适应思考关不掉,能调的是 effort;官方建议从 API 默认的 high 起测(Prompting Claude Fable 5.2)。工具调用很多、每一步判断简单的数据任务,适合用 medium 或 low。
缓存读到底比写便宜多少?
r/ClaudeCode 有一条 346 赞的帖子在吐槽 Fable 5.2 太耗额度(r/ClaudeCode 帖子)。按官方价算:1 小时档写入是基础输入价的 2 倍,即 $16,缓存读 $0.20,相差 80 倍;5 分钟档写入 $10,相差 50 倍;输出 $40,相差 200 倍。长任务里每轮重送的历史几乎都能走缓存读,前提是 tools、系统提示和旧消息一个字都不改。
一轮里调几十次工具,Fable 5.2 适合吗?
官方把「跑几个小时的 agent 会话、多步深度调研」列为 Fable 5.2 的典型用法,但也建议多数任务先用 Opus 5.5,评测不够再换 Fable(发布稿)。发布稿还写到,Fable 5.2 可以当 Orchestrator,把简单的活分给更小的模型;在本文这类任务里,取数和裁剪交给代码,模型只做判断,也是同一个思路。问题来自联想词「claude fable 5.2 tool use cases」。
上手步骤
- 在 EveryInfra 控制台 注册并拿一把 API Key,按文档的快速上手跑通一次
POST /api/v1/social。 - 读免费目录
GET https://api.everyinfra.com/api/v1/social/catalog?platform=reddit,确认能力名、参数的合法值和response_fields,把要用的字段写进裁剪白名单。 - 照上文写四个工具定义(
strict: true、tool_choice用auto),工具执行层带Idempotency-Key和 422 回填。 - 先不设任务预算跑 10 个代表性任务,记下每次响应的
usage和工具结果大小,再决定 effort、缓存档位和预算。 - 不想自己写工具执行层,也可以走远程 MCP(MCP 接入说明),工具名是
everyinfra_*;定时任务和会重试的调用,按本文第二段代码走 REST 并带Idempotency-Key(幂等键写法)。
价格以 定价页 和目录为准;三个平台的全部能力见 Reddit、Trustpilot、YouTube 平台页。
参考资料
读取时间均为 2026 年 11 月 14 日(新加坡时间),括号里是页面自己的日期。
- Anthropic:Claude Fable 5.2 与 Claude Mythos 5.2 发布稿(2026-11-09,11-11 修订)<https://www.anthropic.com/claude-fable-and-mythos-5-2>
- Anthropic:Claude Fable 5.2 / Mythos 5.2 系统卡(2026-11-09)<https://www.anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card>
- Claude 文档:Claude Fable 5.2 模型页 <https://platform.claude.com/docs/en/models/fable-5-2/overview>
- Claude 文档:What's new in Claude Fable 5.2 <https://platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2>
- Claude 文档:迁移到 Claude Fable 5.2 <https://platform.claude.com/docs/en/models/fable-5-2/migration-guide>
- Claude 文档:定价 <https://platform.claude.com/docs/en/about-claude/pricing>
- Claude 文档:模型总览 <https://platform.claude.com/docs/en/about-claude/models/overview>
- Claude 文档:工具使用总览 <https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview>
- Claude 文档:处理工具调用 <https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls>
- Claude 文档:严格工具调用 <https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use>
- Claude 文档:并行工具调用 <https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use>
- Claude 文档:Tool Runner <https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner>
- Claude 文档:MCP connector <https://platform.claude.com/docs/en/agents-and-tools/mcp-connector>
- Claude 文档:前缀检查 <https://platform.claude.com/docs/en/build-with-claude/preserved-thinking/prefix-checks>
- Claude 文档:上下文编辑 <https://platform.claude.com/docs/en/build-with-claude/context-editing>
- Claude 文档:按需压缩 <https://platform.claude.com/docs/en/build-with-claude/compaction-on-demand>
- Claude 文档:任务预算 <https://platform.claude.com/docs/en/build-with-claude/task-budgets>
- Claude 文档:对话中途的系统消息与工具增减 <https://platform.claude.com/docs/en/build-with-claude/mid-conversation-system-messages>
- Claude 文档:提示缓存 <https://platform.claude.com/docs/en/build-with-claude/prompt-caching>
- Claude 文档:Effort <https://platform.claude.com/docs/en/build-with-claude/effort>
- Claude 文档:Token 计数 <https://platform.claude.com/docs/en/build-with-claude/token-counting>
- Claude 文档:上下文窗口 <https://platform.claude.com/docs/en/build-with-claude/context-windows>
- Claude 文档:Prompting Claude Fable 5.2 <https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2>
- Claude 文档:拒答与备用模型 <https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback>
- Claude 文档:快速模式 <https://platform.claude.com/docs/en/build-with-claude/fast-mode>
- Claude 文档:批处理 <https://platform.claude.com/docs/en/build-with-claude/batch-processing>
- Claude 文档:错误码 <https://platform.claude.com/docs/en/api/errors>
- Claude 文档:速率限制 <https://platform.claude.com/docs/en/api/rate-limits>
- Claude 文档:Python SDK <https://platform.claude.com/docs/en/api/sdks/python>
- GitHub:anthropic-sdk-python 仓库 <https://github.com/anthropics/anthropic-sdk-python>
- Anthropic 工程博客:给 agent 写工具 <https://www.anthropic.com/engineering/writing-tools-for-agents>
- Anthropic 工程博客:agent 的上下文工程 <https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents>
- IETF:Idempotency-Key 请求头草案第 08 版(2026-10-22)<https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/>
- RFC 9110:HTTP 语义,幂等方法一节 <https://www.rfc-editor.org/rfc/rfc9110#name-idempotent-methods>
- Stripe 文档:幂等请求 <https://docs.stripe.com/api/idempotent_requests>
- Model Context Protocol 规范:工具 <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- EveryInfra:llms-full.txt(重试与幂等、错误两节)<https://api.everyinfra.com/llms-full.txt>
- EveryInfra:Reddit 能力目录(免费)<https://api.everyinfra.com/api/v1/social/catalog?platform=reddit>
- GitHub 更新日志:Copilot 上线 Claude Fable 5.2(2026-11-09)<https://github.blog/changelog/2026-11-09-claude-fable-5-2-in-github-copilot/>
- AWS 机器学习博客:Claude Fable 5.2 上线 AWS(2026-11-09)<https://aws.amazon.com/blogs/machine-learning/introducing-claude-fable-5-2-on-aws/>
- CNBC:Anthropic 发布 Claude Fable 5.2 和 Mythos 5.2(2026-11-09)<https://www.cnbc.com/2026/11/09/anthropic-claude-fable-5-2-mythos-5-2.html>
- The Verge:Anthropic 发布 Fable 5.2 与 Mythos 5.2 <https://www.theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2>
- Reddit r/claude:Fable 5.2 计费提醒,思考 token 按输出价计 <https://www.reddit.com/r/claude/comments/1xtz7tp/psa_on_claude_fable_52_pricing_so_the_base_price/>
- Reddit r/ClaudeCode:Fable 5.2 太耗额度(346 赞)<https://www.reddit.com/r/ClaudeCode/comments/1xusayn/fable_52_uses_so_much_usage_its_basically/>
- Reddit r/ClaudeAI:Fable 5.2 每个任务的成本 <https://www.reddit.com/r/ClaudeAI/comments/1xs292a/>
- YouTube:Fable 5.2 上手视频(2026-11-12)<https://www.youtube.com/watch?v=xKlUf-dw_Lw>
引用编号 BL-150