API de Claude Fable 5.2: coste de herramientas y reintentos
Enviamos 20 llamadas reales de herramientas de datos para un agente con Claude Fable 5.2. Recortar redujo los resultados un 78 %. Código para reintentar.
Anthropic lanzó Claude Fable 5.2 el 09-11-2026, pensado para tareas de agente que duran horas. En esas tareas hay un coste fácil de subestimar: cada resultado de una herramienta de datos se queda en la conversación, y la petición siguiente vuelve a enviar todos los anteriores. La petición número 20 carga con los resultados de las 19 llamadas previas. El tamaño de cada resultado, el momento de recortarlo y la forma de reintentar sin pagar dos veces deciden el coste: según nuestra estimación, la entrada del modelo en un mismo turno de 18 llamadas va de 0,512 USD a 10,383 USD.
Para medirlo usamos una tarea de investigación habitual. El 14-11-2026, a las 13:07, 13:26 y 13:44, hora de Singapur, enviamos 20 peticiones reales a la API de datos de EveryInfra para Reddit, Trustpilot y YouTube, y anotamos los bytes, el número de resultados, el tiempo y el cobro de cada una. Después estimamos el coste en tokens del modelo con los precios públicos de Fable 5.2. No ejecutamos el modelo, así que su código y las estimaciones de tokens son ejemplos de configuración.
API de Claude Fable 5.2: ocho datos que conviene comprobar antes de construir
Anthropic lanzó Claude Fable 5.2 y Claude Mythos 5.2 el 09-11-2026, un lunes en Estados Unidos (anuncio de Anthropic). Según el anuncio, los dos nombres corresponden al mismo modelo base. Fable lleva protecciones adicionales en ciberseguridad y biología, y cualquier cliente puede usarlo. Mythos solo está disponible para organizaciones que superan un programa de verificación. La ficha del sistema lleva la misma fecha, y CNBC publicó la noticia ese mismo día.
Todas las fuentes primarias dan el 9 de noviembre como fecha de lanzamiento, y este artículo usa esa fecha. Anthropic editó el anuncio el 11-11-2026: cambió una frase sobre formalización matemática y añadió una nota al pie. La edición no tocó nada de la API.
Un agente de larga duración suele fallar de dos maneras: cuesta más de lo previsto o se rompe al reintentar. Por eso leímos el 14-11-2026 la página del modelo, la página de novedades, la de precios y varias páginas de funciones, y guardamos una copia de cada una. La tabla recoge los datos que cambian la forma de escribir un bucle largo de herramientas.
| Dato | Qué dice la página oficial | Efecto en un bucle largo | Fuente |
|---|---|---|---|
| ID del modelo | claude-fable-5-2; en Bedrock, global.anthropic.claude-fable-5-2 | Basta con cambiar una cadena | Novedades |
| Precio | 8 USD de entrada y 40 USD de salida por millón de tokens; Fable 5.1 costaba 10 y 50 USD | La salida cuesta cinco veces más y el razonamiento cuenta como salida | Página del modelo |
| Lectura de caché | 0,025 veces el precio base de entrada: 0,20 USD por millón | El historial que se reenvía en cada petición puede costar 40 veces menos | Caché de prompts |
| Lotes | 4 USD de entrada y 20 USD de salida por millón | Mitad de precio para trabajos que pueden esperar | Novedades |
| Contexto y salida | Ventana de 1 millón de tokens (por defecto y máximo), salida máxima de 128 000 | La ventana es grande, pero cada petición factura todo lo que envía | Página del modelo |
| Razonamiento | El razonamiento adaptativo siempre está activo; effort fija la profundidad y el valor por defecto es high | No se puede ahorrar desactivándolo | Página del modelo |
| Uso forzado de herramientas | tool_choice con any o con una herramienta concreta devuelve un error 400 | Hay que usar auto y añadir strict: true | Novedades |
| Historial editado | Si cambian el prompt de sistema, las herramientas o un mensaje anterior, las peticiones con bloques de razonamiento antiguos fallan con 400 | Hay que recortar los resultados antes de que entren en el historial | Comprobación de prefijo |
El uso forzado de herramientas y la edición del historial hacen que código escrito para Fable 5.1 reciba un 400 en Fable 5.2. La primera: el código que en Fable 5.1 pone tool_choice: {"type": "tool", "name": "..."} para obligar al modelo a llamar a una herramienta devuelve 400 en Fable 5.2. La alternativa oficial es dejar auto y marcar la herramienta con strict: true, de modo que la entrada siempre cumpla el esquema JSON (uso estricto de herramientas).
En octubre probamos ese mismo límite con Opus 5.5 en uso estricto de herramientas de Claude con una API de datos. Aquí no repetimos la prueba: el modo estricto solo aparece en las definiciones de herramientas de más abajo. El tema de este artículo es otro: cuánto cuesta una tanda larga de llamadas a herramientas de datos y cómo reintentarlas sin pagar dos veces.
La segunda: editar el historial ahora falla. Cada bloque de razonamiento de Fable 5.2 guarda una huella de todo lo anterior: el prompt de sistema, las definiciones de herramientas y cada mensaje previo. Cuando se reenvía el bloque, la API comprueba que nada de eso cambió. La documentación aclara que incluso una palabra distinta en la descripción de una herramienta cuenta como cambio (comprobación de prefijo).
Si acortas los resultados antiguos cuando la conversación crece, en Fable 5.2 esa edición hace que la siguiente petición falle con el mensaje The block is bound to a different conversation (Novedades). Por tanto, el resultado se recorta antes de añadirlo por primera vez a messages. Para quitar resultados antiguos más tarde, existe la edición de contexto en el servidor, que según la documentación nunca invalida los bloques de razonamiento (edición de contexto).
Hay un dato más que afecta a todas las cifras de tokens de este artículo. Fable 5.2 usa el tokenizador que estrenó Opus 4.7, y la documentación dice que cuenta alrededor de un 30 % más de tokens para el mismo texto (conteo de tokens). No tenemos clave de la API de Fable 5.2, así que no pudimos contar los tokens con el endpoint oficial.
Por eso todas las cifras de tokens son estimaciones. La cota inferior parte del ejemplo de la página de precios, «Average webpage (10 kB): ~2,500 tokens», es decir, unos 4 bytes por token (precios). La cota superior multiplica ese valor por 1,3. El endpoint de conteo es gratuito: con una clave, se pueden enviar nuestras respuestas guardadas y obtener la cifra exacta.
La tarea: unas 20 llamadas a herramientas de datos en un solo turno
El blog de AWS dice que Fable 5.2 puede trabajar sin supervisión durante horas o días.
Para medirlo elegimos un encargo de investigación habitual. El prompt es una frase: «Compara las opiniones de usuarios del último mes sobre Notion, ClickUp, Asana y monday.com, y resume los tres elogios y las tres quejas principales de cada uno». El agente necesita palabras reales de usuarios en tres sitios: hilos de Reddit, reseñas de Trustpilot y comentarios bajo vídeos de análisis en YouTube.
Para esta versión en español añadimos una llamada que interesa a equipos hispanohablantes: las reseñas de Notion en Trustpilot filtradas por idioma español. Así se ve qué parte de la conversación en español llega al agente y cuánto pesa.
EveryInfra tiene cuatro capacidades para el encargo: reddit/search (página de la capacidad), trustpilot/reviews (página de la capacidad), youtube/search (página de la capacidad) y youtube/comments (página de la capacidad). Las cuatro usan un único endpoint, POST /api/v1/social. Cada llamada tiene un precio fijo, y una llamada sin resultados no se cobra.
Escribimos las llamadas que la tarea necesita, en un orden realista, y enviamos cada una a la API real. De cada llamada guardamos la respuesta original, la hora, el tamaño en bytes y el cobro. El tamaño y el coste de la API de datos no dependen del modelo.
| Capacidad | Precio por llamada | Parámetros usados | Campos en el catálogo | Notas |
|---|---|---|---|---|
reddit/search | 0,000792 USD | keyword, sort | 15 | Busca publicaciones del último mes; 6 valores válidos de sort |
trustpilot/reviews | 0,001389 USD | dominio de la empresa, stars, date, language | 24 | stars es una lista de cadenas; date admite 5 valores fijos |
youtube/search | 0,000778 USD | keyword | 25 | Encuentra enlaces de vídeos de análisis |
youtube/comments | 0,000556 USD | url, sort | 9 | Trae los comentarios de un vídeo |
Precios, parámetros y campos proceden del catálogo gratuito, GET /api/v1/social/catalog, consultado el 14-11-2026.
Uso de herramientas en Claude Fable 5.2: cómo definir las cuatro herramientas
Cada petición vuelve a enviar las definiciones de herramientas. La página de precios cuenta los nombres, descripciones y esquemas como tokens de entrada, y cuando una petición lleva tools, la API añade además un prompt de sistema especial para que el modelo pueda usarlas (precios del uso de herramientas). Conviene, por tanto, una lista corta, con los detalles que el modelo suele equivocar escritos en la descripción. Este encargo necesita cuatro herramientas, una por capacidad. El código es un ejemplo de configuración, porque no ejecutamos la parte del modelo.
TOOLS = [
  {
    "name": "reddit_search",
    "description": "Busca publicaciones de Reddit del último mes. Devuelve como máximo 25. "
                   "sort debe ser uno de: relevance, newest, popular, rising, top, controversial.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "keyword": {"type": "string"},
        "sort": {"type": "string", "enum": ["relevance", "newest", "popular", "rising", "top", "controversial"]},
        "limit": {"type": "integer"}
      },
      "required": ["keyword", "sort", "limit"],
      "additionalProperties": False
    }
  },
  {
    "name": "trustpilot_reviews",
    "description": "Reseñas de una empresa en Trustpilot. company es el dominio, por ejemplo notion.so. "
                   "stars es una lista de cadenas como [\"1\",\"2\"]. date es last7days, last30days, "
                   "last3months, last6months o last12months. language filtra por idioma, por ejemplo es.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}},
        "date": {"type": "string", "enum": ["last7days", "last30days", "last3months", "last6months", "last12months"]},
        "language": {"type": "string"},
        "limit": {"type": "integer"}
      },
      "required": ["company", "stars", "date", "language", "limit"],
      "additionalProperties": False
    }
  },
  {
    "name": "youtube_search",
    "description": "Busca vídeos de YouTube por palabra clave. Sirve para encontrar vídeos de análisis; "
                   "la url de un resultado se pasa a youtube_comments.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "keyword": {"type": "string"},
        "limit": {"type": "integer"}
      },
      "required": ["keyword", "limit"],
      "additionalProperties": False
    }
  },
  {
    "name": "youtube_comments",
    "description": "Comentarios bajo un vídeo de YouTube, a partir de su URL. sort es newest o popular.",
    "strict": True,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string"},
        "sort": {"type": "string", "enum": ["newest", "popular"]},
        "limit": {"type": "integer"}
      },
      "required": ["url", "sort", "limit"],
      "additionalProperties": False
    }
  }
]

resp = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=16000,
    tools=TOOLS,                      # se construye una vez por conversación y se envía igual en cada turno
    tool_choice={"type": "auto"},     # "any" o "tool" devuelven 400 en Fable 5.2
    output_config={"effort": "medium"},
    cache_control={"type": "ephemeral"},   # la caché automática mueve el punto de corte hacia delante
    messages=messages,
)
Cada enum aparece en el esquema y otra vez en la descripción. Con strict: true, el modelo solo puede generar valores del enum; la frase de la descripción le ayuda a elegir el adecuado. En el catálogo de EveryInfra, el parámetro stars de Trustpilot es una lista de cadenas, no un mínimo de estrellas. Un modelo puede escribir fácilmente "stars": 1, así que el esquema lo define como lista de cadenas.
En modo estricto todos los campos de properties deben ir en required. Si el modelo no quiere filtrar por idioma, puede enviar una cadena vacía y el ejecutor la elimina antes de llamar a la API. El ejecutor también vuelve a limitar limit, como se ve en la sección siguiente: el modo estricto comprueba el tipo, no que el número tenga sentido.
tools y el prompt de sistema deben quedarse igual durante toda la conversación, porque la comprobación de prefijo los cubre. Para añadir una herramienta más tarde, se añade un mensaje role: "system" con un bloque tool_addition; el array tools no cambia y la caché sigue siendo válida (cambios de herramientas a mitad de conversación). Esta función está en beta y necesita la cabecera inline-tools-2026-09-15.
Elegimos effort medium. La documentación dice que, con high o más, Fable 5.2 razona antes de casi cada respuesta, y que un effort menor implica menos llamadas a herramientas y más cortas (effort). Cada paso de este encargo es una decisión sencilla, así que el high por defecto aporta poco. La documentación también avisa de que con low y medium el modelo abandona antes las tareas largas (prompts para Claude Fable 5.2). Por eso el prompt de sistema debe pedir que siga ante tiempos de espera y errores hasta terminar.
El ejecutor: código listo para recortar, reintentar y gestionar errores
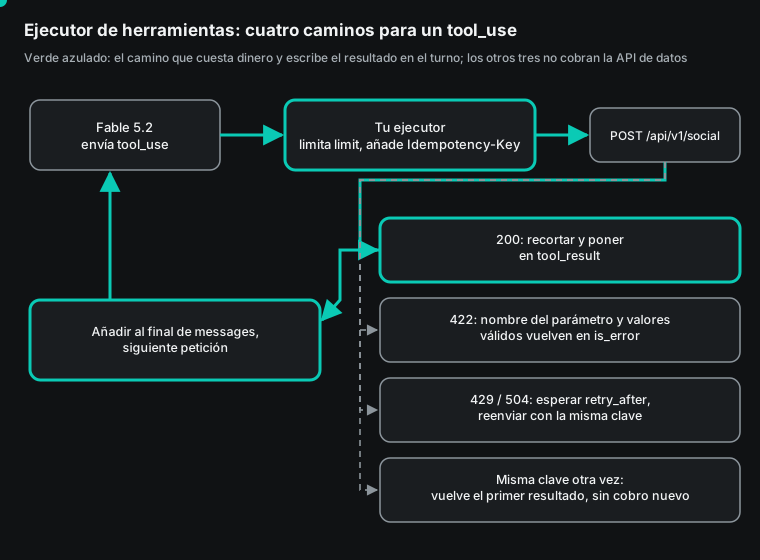
Cuando el modelo envía un bloque tool_use, es tu propio código el que ejecuta la herramienta. En esa capa se toman casi todas las decisiones de coste y de reintento: ahí se ve la respuesta completa de la API y ahí se actúa antes de que el resultado entre en la conversación. El Python siguiente usa la misma lógica que empleamos en las mediciones. La parte de la API se ejecutó de verdad; el bucle del modelo que la rodea es un ejemplo de configuración.
import os, json, time, requests

API = "https://api.everyinfra.com/api/v1/social"
HEADERS = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}
ROUTE = {"reddit_search": ("reddit", "search"),
         "trustpilot_reviews": ("trustpilot", "reviews"),
         "youtube_search": ("youtube", "search"),
         "youtube_comments": ("youtube", "comments")}
KEEP = {"reddit_search": ["title", "community", "like_count", "comment_count", "posted_at", "url", "text"],
        "trustpilot_reviews": ["rating", "title", "text", "posted_at", "country", "is_verified"],
        "youtube_search": ["url", "title", "view_count", "comment_count", "posted_at"],
        "youtube_comments": ["text", "like_count", "reply_count", "posted_at"]}
MAX_LIMIT = {"reddit_search": 25, "trustpilot_reviews": 50, "youtube_search": 10, "youtube_comments": 50}
TEXT_MAX = 280

def trim(name, body):
    """Deja solo los campos que el modelo necesita, corta el texto a 280 caracteres y conserva solo charged_usd."""
    rows = []
    for r in body.get("results", []):
        row = {k: r[k] for k in KEEP[name] if r.get(k) not in (None, "", [])}
        if len(row.get("text", "")) > TEXT_MAX:
            row["text"] = row["text"][:TEXT_MAX] + "…"
        rows.append(row)
    return {"id": body.get("id"), "count": body.get("count"),
            "charged_usd": body.get("billing", {}).get("charged_usd"), "results": rows}

def run_tool(name, args, idem_key):
    platform, action = ROUTE[name]
    args = {k: v for k, v in args.items() if v not in ("", [])}          # filtros vacíos fuera
    args["limit"] = min(args.get("limit", 20), MAX_LIMIT[name])
    payload = {"platform": platform, "action": action, "params": args}
    for attempt in range(4):
        r = requests.post(API, json=payload, timeout=110,
                          headers={**HEADERS, "Idempotency-Key": idem_key})
        if r.status_code == 200:
            return {"content": json.dumps(trim(name, r.json()), ensure_ascii=False)}
        err = r.json().get("error", {})
        if r.status_code == 422:                      # parámetro incorrecto: se lo devolvemos al modelo
            return {"content": json.dumps({"error": err.get("message"), "param": err.get("param"),
                                           "allowed": err.get("allowed")}, ensure_ascii=False),
                    "is_error": True}
        if err.get("retryable"):                      # 429, 504 y similares: esperar y reenviar con la misma clave
            time.sleep(float(err.get("retry_after") or 2 ** attempt))
            continue
        return {"content": json.dumps({"error": err.get("message")}, ensure_ascii=False), "is_error": True}
    return {"content": "la herramienta se rindió tras 4 intentos", "is_error": True}

# Bucle principal: clave = ID de la tarea + número de esta llamada en el turno; al repetir el turno, cada paso recibe su primer resultado
# task_id se fija al crear la tarea y no cambia al repetirla; step_no vale 0 al empezar el turno y suma en todas las peticiones al modelo
for block in resp.content:
    if block.type == "tool_use":
        step_no += 1
        key = f"{task_id}-{step_no}"
        out = run_tool(block.name, block.input, key)
        tool_results.append({"type": "tool_result", "tool_use_id": block.id, **out})
messages.append({"role": "assistant", "content": resp.content})   # se devuelve tal cual llegó
messages.append({"role": "user", "content": tool_results})        # solo se añade al final
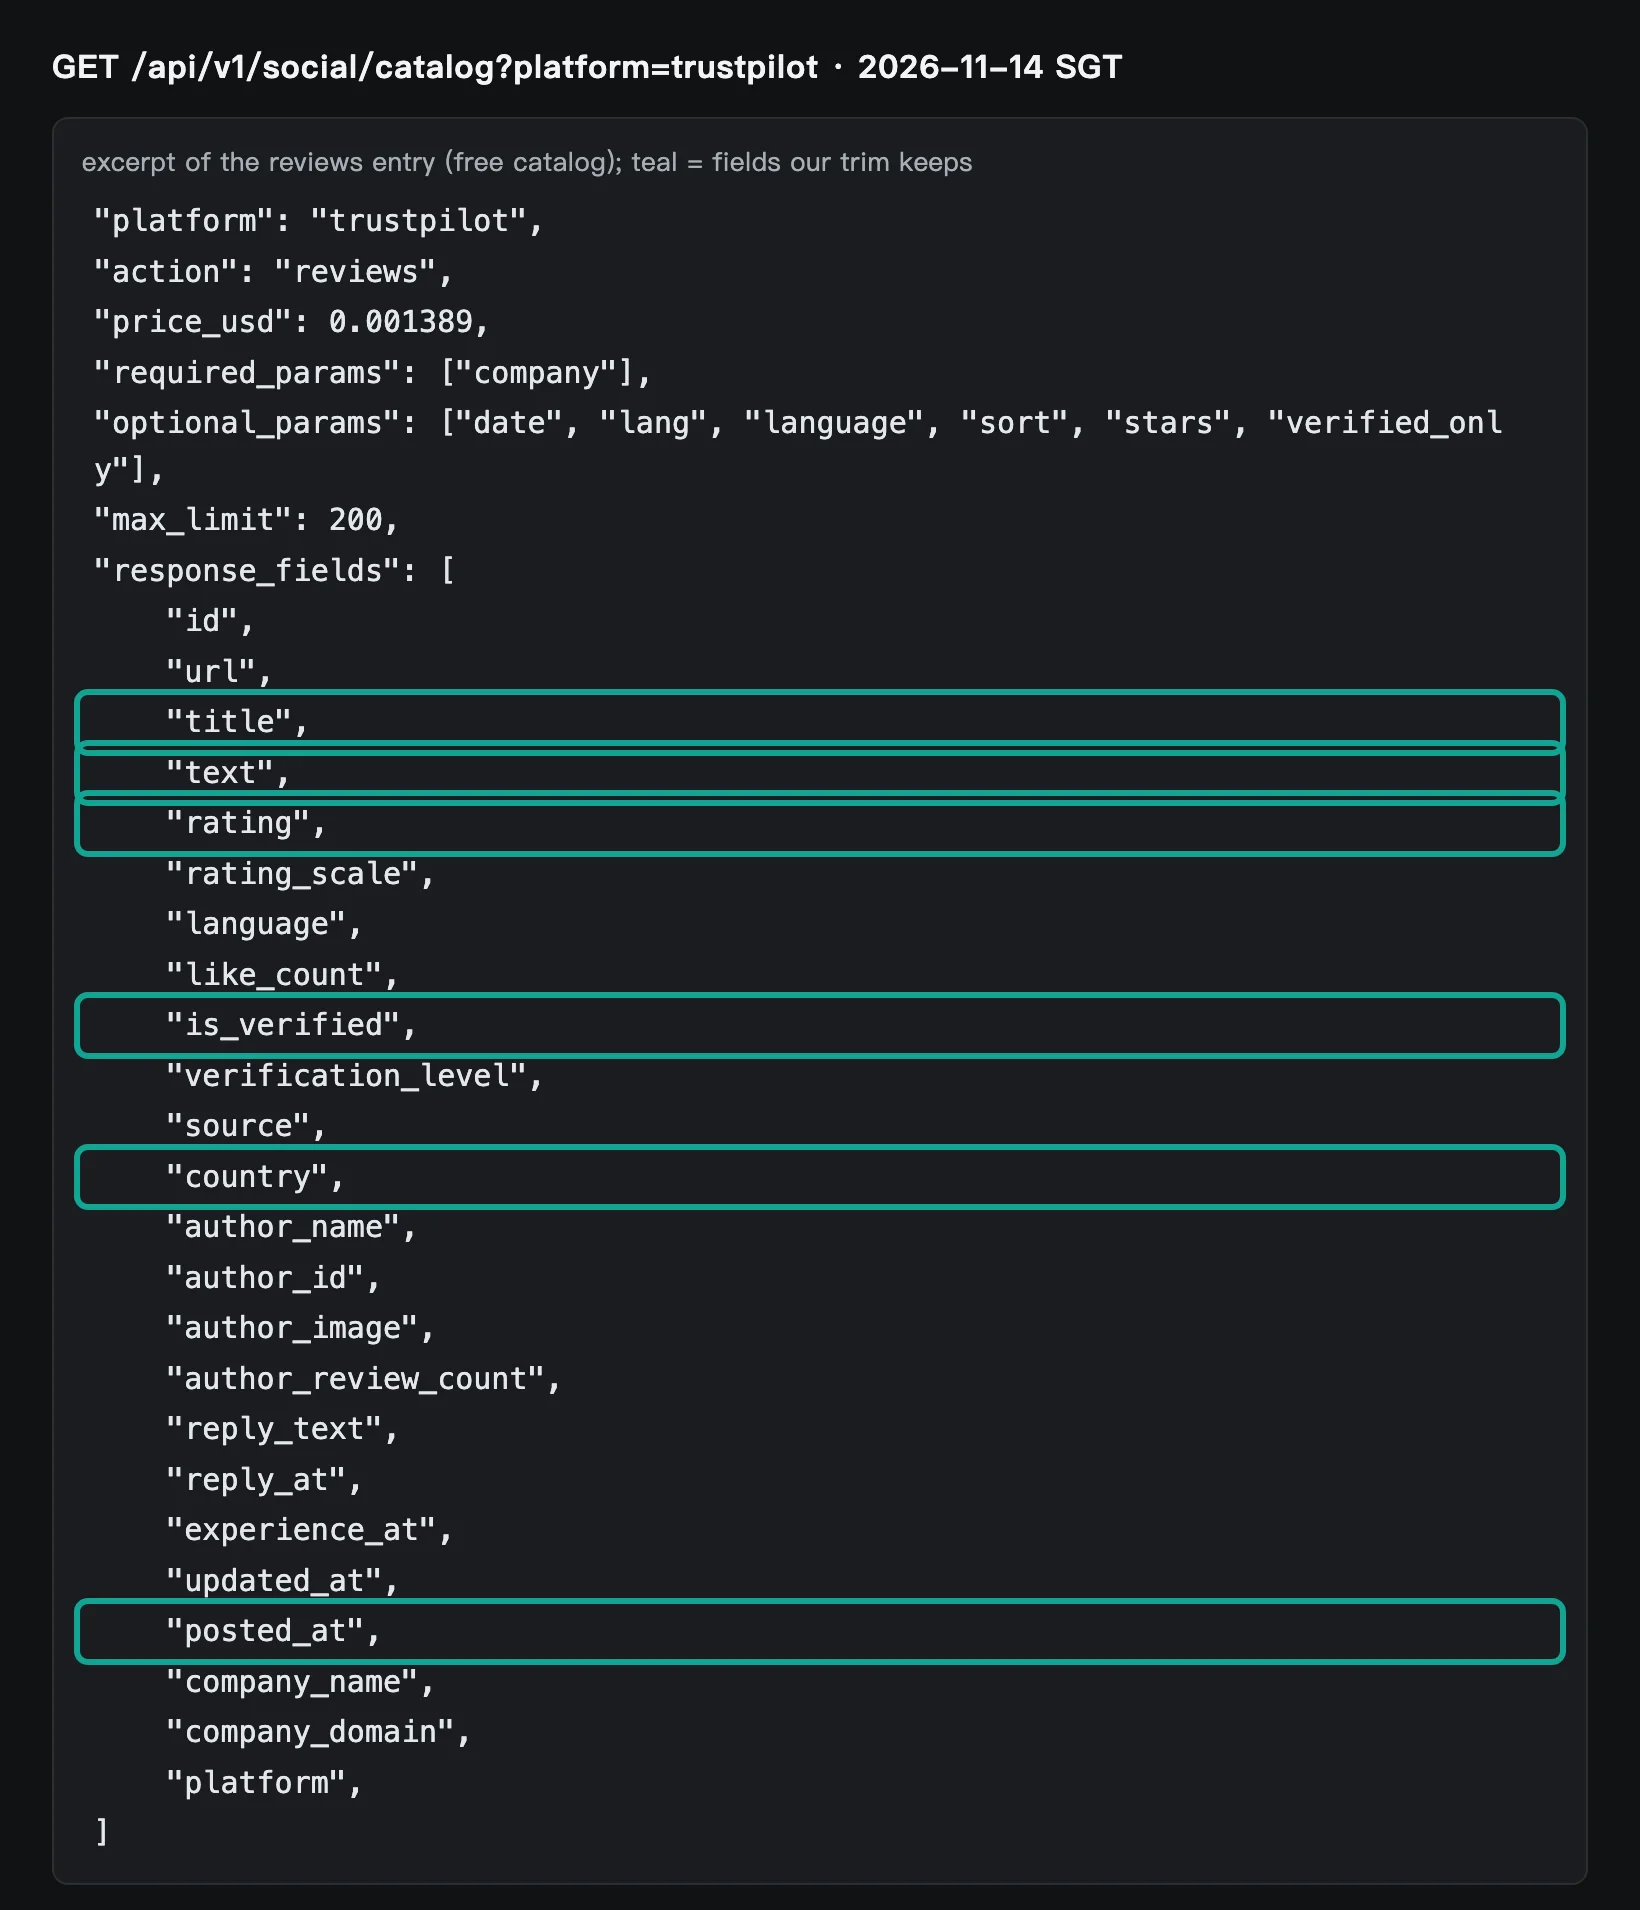
El recorte. La función trim conserva solo los campos que responden a la pregunta, corta el texto de reseñas y publicaciones a 280 caracteres y, de los datos de cuenta de la respuesta, deja únicamente charged_usd. Los campos se eligen a partir de la lista response_fields del catálogo y se escriben como lista blanca: si el catálogo añade un campo nuevo, ese campo no entra en el contexto por defecto. El límite de 280 caracteres es nuestra elección para análisis de sentimiento; una tarea que necesite citar reseñas literalmente puede conservar el texto completo y quitar solo los demás campos.
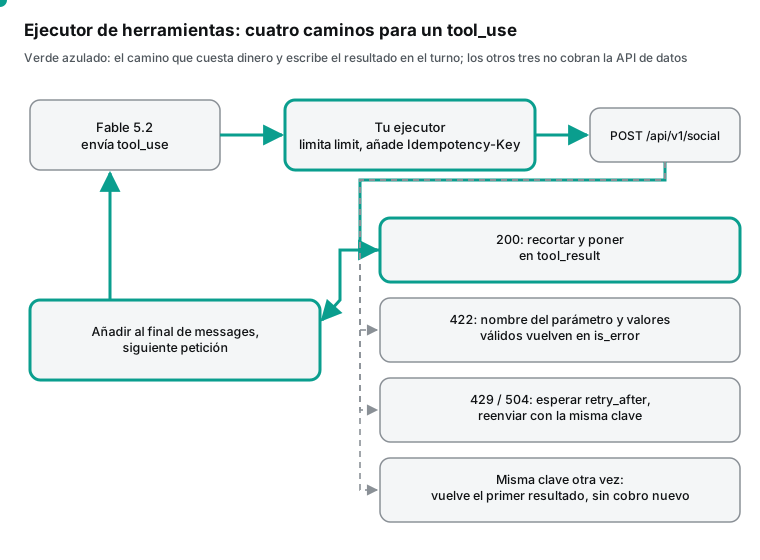
Reintentar sin pagar dos veces. Cada llamada a una herramienta recibe un Idempotency-Key formado por el ID de la tarea y el número de llamada dentro del turno. Tras un tiempo de espera agotado, un 504 o un 429, el código reenvía la petición con la misma clave; si se repite el turno entero, cada paso vuelve a recibir la misma clave y las llamadas que ya habían salido bien devuelven su primer resultado. La regla de EveryInfra es sencilla: la misma clave con los mismos parámetros en 24 horas devuelve el primer resultado, sin ejecutar de nuevo y sin un segundo cobro; la misma clave con parámetros distintos devuelve 409 y no se ejecuta (llms-full.txt, reintentos e idempotencia). Probamos todos esos casos el 09-11-2026 en claves de idempotencia para reintentos de agentes; aquí solo volvemos a comprobar la regla dentro de una tanda larga.
Devolver al modelo los errores de parámetros. Cuando la API responde 422, el cuerpo del error trae el nombre del parámetro incorrecto, todos los valores válidos y una sugerencia. El código los mete en el tool_result y marca is_error: true, como indica la documentación oficial para herramientas que fallan (gestionar llamadas a herramientas). El modelo corrige el parámetro y vuelve a llamar. Un 422 no tiene coste de datos, así que esa ida y vuelta solo cuesta unos cientos de tokens del modelo.
Qué campos conservar: elegirlos en el catálogo gratuito
El catálogo de capacidades de EveryInfra es gratuito y, para cada capacidad, indica los parámetros obligatorios y opcionales, el máximo de resultados y response_fields, todos los campos que puede traer un resultado. El 14-11-2026, el catálogo listaba 24 campos de resultado para la capacidad de reseñas de Trustpilot; conservamos 6.
| Capacidad | Campos en el catálogo | Campos que conservamos | Lo más pesado que se descarta | Texto |
|---|---|---|---|---|
reddit/search | 15 | Título, comunidad, votos, comentarios, fecha, URL, texto | Autor, ID de la publicación, plataforma | Corte a 280 caracteres |
trustpilot/reviews | 24 | Estrellas, título, texto, fecha, país, verificación | Imagen y ID del autor, URL de la reseña, fecha de la experiencia, nivel de verificación | Corte a 280 caracteres |
youtube/search | 25 | URL, título, visualizaciones, comentarios, fecha | Descripción del vídeo, miniatura, datos del canal | Descripción fuera |
youtube/comments | 9 | Texto, votos, respuestas, fecha | ID del comentario, autor, plataforma, comentario al que responde | Alrededor del 16 % pasa de 280 y se corta |
Para comparar productos, el modelo necesita estrellas, texto y fecha; no le sirven la imagen del autor ni la URL de la reseña. Si la tarea es comparar opiniones por idioma, hay que añadir a la lista blanca el campo language del catálogo. Nosotros dejamos country de Trustpilot porque comparamos regiones; si solo interesa el sentimiento general, también puede salir.
Los parámetros cambian además el rango de fechas, y con él el número de llamadas del turno. A las 13:45 buscamos Asana con newest: esta llamada devolvió 21 publicaciones, de entre las 03:46 del 13-11-2026 y las 12:00 del 14-11-2026, hora de Singapur. A las 13:27 pedimos las reseñas de Notion en Trustpilot de los últimos 30 días: las 7 eran del 20-10-2026 al 13-11-2026. En una palabra con tanta conversación como Asana, las 21 publicaciones más recientes cubrían apenas un día y medio; para abarcar un mes entero en Reddit conviene ordenar por top. Esas decisiones deben ir en la descripción de la herramienta, para que el modelo acierte a la primera y no necesite una segunda llamada.
Prueba real: 20 peticiones en tres momentos
Las tres rondas empezaron a las 13:07, a las 13:26 y a las 13:44, hora de Singapur; entre la primera y la última petición pasaron 38 minutos. En cada ronda las llamadas siguieron el orden que necesita la tarea: primero el agente busca un nombre de marca en Reddit, después trae reseñas de Trustpilot y busca vídeos de análisis en YouTube, y por último descarga los comentarios de un vídeo.
Añadimos tres casos especiales: un valor de sort incorrecto, una búsqueda sin resultados y dos peticiones con la misma clave de idempotencia.
| Ronda | Hora de Singapur | Peticiones | Capacidades | Caso especial |
|---|---|---|---|---|
| Ronda 1 | 13:07–13:11 | 6 | reddit/search, trustpilot/reviews, youtube/search | Una búsqueda sin resultados; un 422 |
| Ronda 2 | 13:26–13:28 | 7 | reddit/search, trustpilot/reviews, youtube/comments | Una clave de idempotencia enviada dos veces |
| Ronda 3 | 13:44–13:45 | 7 | reddit/search, trustpilot/reviews, youtube/comments, youtube/search | Una llamada a Trustpilot filtrada por español |
De las 20 peticiones, 18 devolvieron HTTP 200 (una de ellas con 0 resultados) y 17 trajeron datos, con 335 resultados en total. La búsqueda sin resultados y el parámetro incorrecto que devolvió un 422 no se cobraron. Otra petición fue un reenvío idempotente: devolvió el primer resultado sin un cobro nuevo. El coste de la API de datos fue de 0,0169 USD en total, unos 0,000050 USD por resultado.
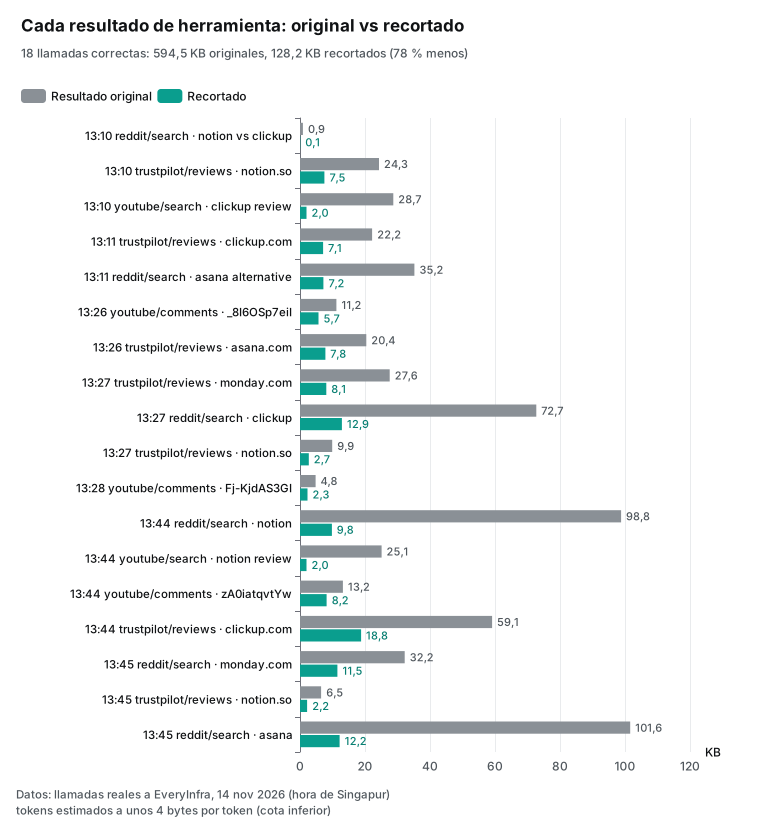
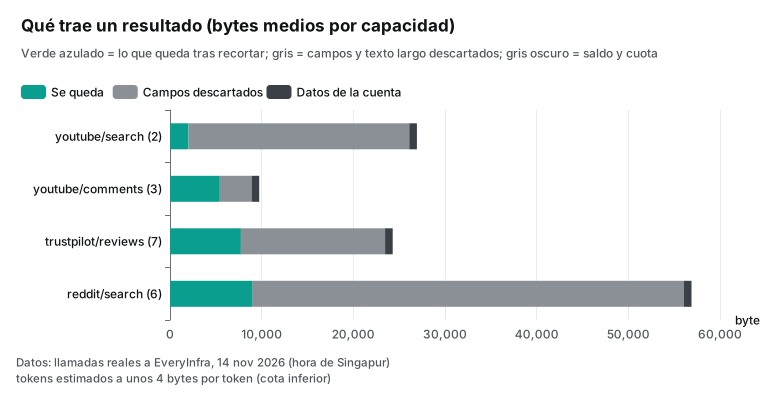
Cada fila del gráfico es una llamada (18 en total, incluida la búsqueda sin resultados), y las barras grises varían mucho: una búsqueda de Reddit puede devolver decenas de KB, mientras que los comentarios de YouTube ocupan pocos KB. El tamaño depende sobre todo de la longitud del texto, más que del número de campos. Las 18 respuestas con HTTP 200 sumaron 594,5 KB sin recortar y 128,2 KB recortadas, un 78 % menos.
| Capacidad | Llamadas con HTTP 200 | Resultados | Bytes originales por llamada | Bytes recortados por llamada | Bytes originales por resultado | Peso del texto | Tiempo mediano |
|---|---|---|---|---|---|---|---|
reddit/search | 6 | 96 | 56.895 | 8955 | 3491 | 90 % | 5,6 s (6) |
trustpilot/reviews | 7 | 143 | 24.297 | 7733 | 1126 | 49 % | 10,1 s (7) |
youtube/search | 2 | 20 | 26.933 | 2002 | 2585 | 73 % | 7,7 s (2) |
youtube/comments | 3 | 76 | 9732 | 5436 | 341 | 48 % | 16,6 s (3) |
«Peso del texto» es la parte de los bytes de resultados que ocupa el campo text. El tiempo mediano cuenta las llamadas con HTTP 200 (sin el reenvío), y el número entre paréntesis es el tamaño de la muestra; las 6 de reddit/search incluyen la que devolvió 0 resultados. La longitud del texto se mide en caracteres con len() de Python.
En las búsquedas de Reddit y de YouTube casi todo el tamaño es texto. La mediana de las 96 publicaciones de Reddit es de 1222 caracteres de texto; 6 no tienen texto y cuentan como 0, y sin ellas la mediana sería de 1256,5. El 84 % supera los 280 caracteres y el texto es el 90 % de los bytes. En la búsqueda de YouTube, text es la descripción del vídeo: la mediana de las 20 descripciones es de 1426 caracteres, todas pasan de 280 y el texto ocupa el 73 %. Para elegir un vídeo, el modelo solo necesita el enlace, el título y las visualizaciones, así que quitamos la descripción y esta capacidad queda un 93 % más pequeña. Si solo se quitan campos y se conserva el texto completo, una búsqueda de Reddit apenas baja un 10 %.
Los comentarios de YouTube son cortos. La mediana de los 76 comentarios es de solo 136,5 caracteres y el corte de 280 solo afecta al 16 % de los comentarios; el resto del peso está en campos como el ID del comentario, el nombre del autor, la plataforma y la respuesta a la que contesta. En los comentarios, recortar es quitar campos. Trustpilot queda en medio: la mediana de las 143 reseñas es de 347 caracteres, el corte afecta al 57 % de las reseñas, y campos como la imagen del autor, la URL de la reseña o la fecha de la experiencia también ocupan sitio.
Las estrellas también cambian cuánto afecta el corte. De las 143 reseñas, 117 son de 1 o 2 estrellas, porque dos de las llamadas filtraban por 1 y 2 estrellas: su mediana es de 441 caracteres y el 63 % pasa de 280. Las 26 reseñas de 3 a 5 estrellas tienen una mediana de 212 caracteres, y el 27 % pasa de 280. Las reseñas negativas son más largas, y justo son las que hacen falta para listar las quejas principales; en las llamadas que filtran por pocas estrellas se puede subir el corte a unos 500 caracteres y dejar 280 en el resto. El grupo de 3 a 5 estrellas tiene solo 26 reseñas, así que su porcentaje solo sirve como orientación.
Cada respuesta lleva unos 830 bytes de datos de la cuenta, como el cobro y el saldo. Su tamaño no depende del número de resultados; incluso la respuesta con 0 resultados tenía 868 bytes. En 20 llamadas suman 16,6 KB, unos 4200 tokens a 4 bytes por token, y cada petición posterior los vuelve a enviar. El modelo no necesita el saldo para investigar: al recortar, basta con conservar charged_usd.
Tras el recorte, el tamaño de cada resultado se puede prever. En una misma capacidad, las respuestas originales cambian mucho según la palabra clave. En las 5 búsquedas de Reddit que trajeron datos, la publicación media ocupó entre 1462 y 5812 bytes, unas 4 veces de diferencia, y la respuesta completa entre 32,2 KB y 101,6 KB. En las 7 llamadas a Trustpilot, una reseña ocupó entre 1021 y 1420 bytes, y la respuesta completa entre 6,5 KB y 59,1 KB.
Tras el recorte, una publicación de Reddit ocupó entre 525 y 582 bytes y una reseña de Trustpilot entre 356 y 403. Un vídeo de la búsqueda de YouTube ocupó unos 200 bytes y un comentario entre 169 y 284. La razón es sencilla: el corte de 280 caracteres pone techo al texto y la lista blanca pone techo a los campos; solo los textos de menos de 280 caracteres siguen variando el tamaño.
| Capacidad (llamadas con datos) | Bytes originales por resultado | Bytes recortados por resultado | Respuesta original completa |
|---|---|---|---|
reddit/search (5) | 1462–5812 | 525–582 | 32,2–101,6 KB |
trustpilot/reviews (7) | 1021–1420 | 356–403 | 6,5–59,1 KB |
youtube/search (2) | 2513–2874 | 200–201 | 25,1–28,7 KB |
youtube/comments (3) | 330–456 | 169–284 | 4,8–13,2 KB |
Así se puede estimar el coste de contexto de una llamada antes de enviarla. Con unos 560 bytes por publicación recortada de Reddit y 4 bytes por token, una llamada que devuelve 20 publicaciones añade unos 11 KB, unos 2800 tokens. Las mismas 20 publicaciones sin recortar, a entre 1462 y 5812 bytes cada una, añaden entre 7300 y 29 000 tokens. El presupuesto de contexto y el de tarea se fijan antes de arrancar; tras el recorte, basta con multiplicar el número de publicaciones por unos 560 bytes.
Calculamos estas cifras con las 18 llamadas con HTTP 200 de esta prueba. Solo 5 llamadas a Reddit y 2 búsquedas de YouTube trajeron datos; con otras palabras clave u otras comunidades, el tamaño original por resultado puede cambiar. El techo tras el recorte sale del corte de 280 caracteres y de la lista blanca, así que no depende de la muestra.
Las reseñas en español. En la tercera ronda pedimos las reseñas de Notion en Trustpilot con language en es. Llegaron 6 reseñas, publicadas entre el 26-05-2023 y el 09-05-2026. Por estrellas: 3 de 5 estrellas, 1 de 4 estrellas, 2 de 2 estrellas. Por país: España (4), Venezuela (1), Colombia (1). La reseña mediana tiene 192 caracteres, y la respuesta pesó 6474 bytes sin recortar y 2182 recortada. Para un equipo que atiende a clientes en España o Latinoamérica, este filtro es la forma barata de saber qué se dice en su idioma: una sola llamada, al precio normal de trustpilot/reviews (0,001389 USD).
| Estrellas | País | Fecha | Caracteres | Verificada |
|---|---|---|---|---|
| 2 | España | 09-05-2026 | 765 | no |
| 2 | Venezuela | 10-02-2026 | 226 | no |
| 4 | Colombia | 07-04-2025 | 112 | no |
| 5 | España | 19-09-2024 | 157 | no |
| 5 | España | 23-08-2024 | 143 | no |
| 5 | España | 26-05-2023 | 388 | no |
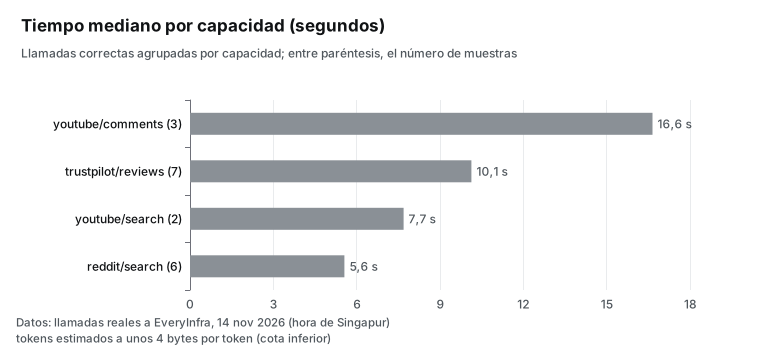
El tiempo también forma parte del coste. En las 17 llamadas que trajeron datos, la mediana fue de 9,2 segundos (muestra de 17). La caché de prompts caduca a los 5 minutos por defecto; si el modelo espera varias herramientas lentas entre dos peticiones, la caché puede caducar y la siguiente petición vuelve a pagar el precio de escritura. En tareas con herramientas lentas, o con muchas llamadas en paralelo, merece la pena valorar la caché de 1 hora (caché de prompts); cómo comparar los dos precios se explica en «Dónde va el punto de corte de la caché».
Cuánto cuesta este turno
Colocamos las 18 respuestas con HTTP 200 en orden de hora, como un único turno, y calculamos la entrada de cada petición al modelo. Supuestos: el prompt de sistema, las definiciones de herramientas y la pregunta del usuario suman 3000 tokens; el modelo escribe 500 tokens por paso, entre la llamada y su razonamiento; la respuesta final añade 2000 tokens de salida. La entrada de la petición k son los 3000 tokens iniciales más toda la salida del asistente y todos los resultados anteriores. Estos supuestos son un ejemplo de configuración: sustitúyelos por las cifras de usage de tu propia tarea.
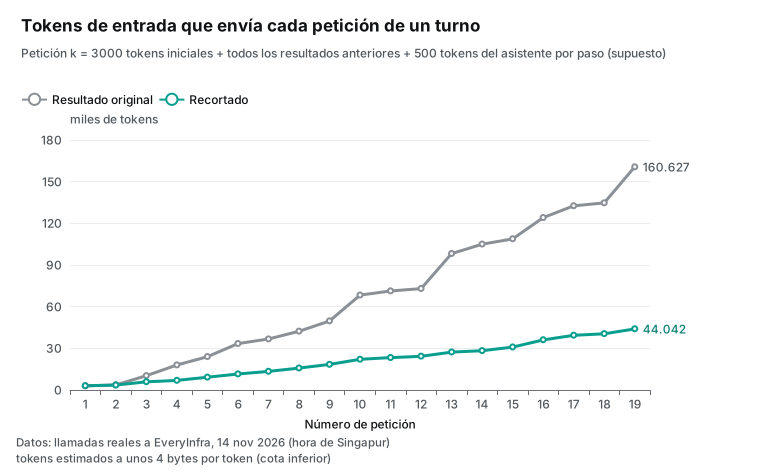
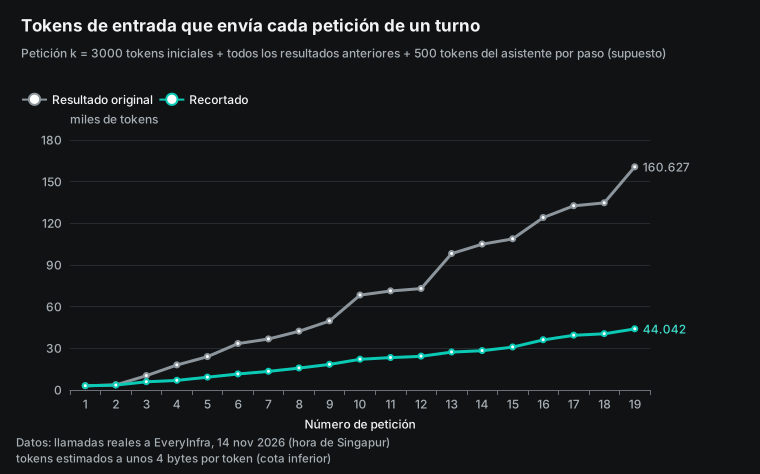
Con resultados originales, la última petición lleva unos 160.627 tokens de entrada; recortados, unos 44.042. Son cotas inferiores a 4 bytes por token; con el nuevo tokenizador, un 30 % más, las cotas superiores son 206.115 y 54.555 tokens. La ventana de 1 millón de tokens lo admite, pero cada petición factura toda su entrada. La documentación también advierte que la precisión y la recuperación empeoran a medida que crece el número de tokens, un fenómeno que llama «context rot» (ventanas de contexto).
| Coste de este turno (USD) | Resultados originales | Resultados recortados |
|---|---|---|
| Entrada del modelo, sin caché | 10,383 USD | 3,230 USD |
| Entrada del modelo, caché de 5 minutos | 1,834 USD | 0,512 USD |
| Entrada del modelo, caché, cota superior (30 % más tokens) | 2,352 USD | 0,634 USD |
| Salida del modelo (500 tokens por paso, supuesto) | 0,440 USD | 0,440 USD |
| API de datos (cobrado) | 0,0169 USD | 0,0169 USD |
| Total (caché, cota inferior) | 2,291 USD | 0,969 USD |
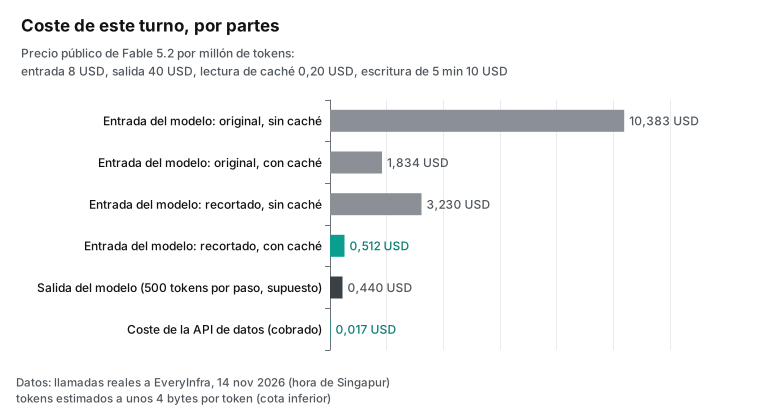
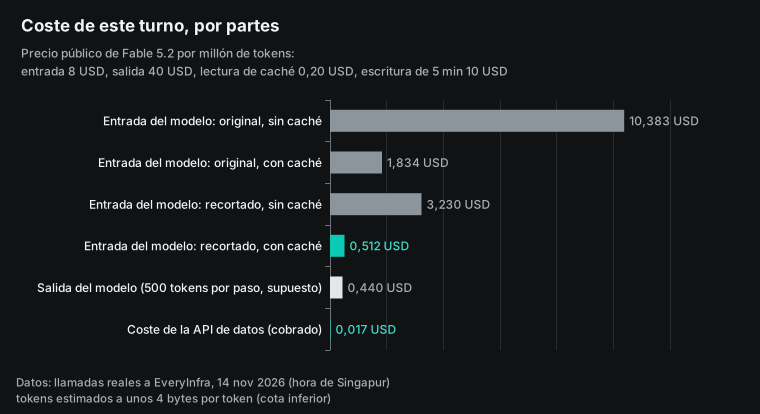
La API de datos cuesta 0,0169 USD en este turno, frente a una entrada del modelo que va de 0,512 USD a 10,383 USD. La gran diferencia está en cuántas veces se reenvía cada resultado. Sin caché y con resultados originales, la entrada del modelo cuesta 10,383 USD; con caché y recorte, 0,512 USD, unas 20 veces menos. De los dos métodos, la caché pesa más, porque el historial reenviado se factura a 0,20 USD por millón de tokens. El recorte ahorra un 72 % adicional sobre la caché, porque cada resultado nuevo se escribe primero en la caché a 10 USD por millón: cuanto más pequeño, menos cuesta.
El coste de entrada también se puede repartir por resultado, y así se ve qué conviene recortar primero. El resultado k se reenvía en las 19 − k peticiones siguientes. Sin caché, el resultado más caro es el de la llamada 9, la búsqueda de Reddit de «clickup» a las 13:27: 72,7 KB sin recortar, unos 18 200 tokens, reenviados 10 veces, unos 1,45 USD a 8 USD por millón. El resultado más grande, la búsqueda de «asana» a las 13:45 (101,6 KB), llega el último y solo se reenvía una vez, por unos 0,20 USD.
Con la caché de 5 minutos, cada resultado se escribe primero a 10 USD y luego se lee a 0,20 USD por millón, así que la posición pesa menos. Los dos resultados más caros pasan a ser la búsqueda de Reddit de «notion» a las 13:44 (98,8 KB, unos 0,28 USD) y la de las 13:45 (unos 0,25 USD), por su tamaño. Con los dos métodos, los tres resultados más caros de los 18 son búsquedas de Reddit; por eso conviene escribir primero la lista blanca y el corte de 280 caracteres para Reddit.
| Resultado (número de llamada) | Hora | Tamaño original | Reenvíos | Coste sin caché | Coste con caché de 5 min |
|---|---|---|---|---|---|
| Reddit «asana alternative» (5) | 13:11 | 35,2 KB | 14 | 0,99 USD | 0,11 USD |
| Reddit «clickup» (9) | 13:27 | 72,7 KB | 10 | 1,45 USD | 0,21 USD |
| Reddit «notion» (12) | 13:44 | 98,8 KB | 7 | 1,38 USD | 0,28 USD |
| Reddit «asana» (18) | 13:45 | 101,6 KB | 1 | 0,20 USD | 0,25 USD |
Cálculo de cada fila: tokens = bytes / 4; sin caché, tokens × reenvíos × 8 USD / 1.000.000; con caché, tokens × 10 USD / 1.000.000 por la escritura más tokens × (reenvíos − 1) × 0,20 USD / 1.000.000 por las lecturas.
En esta estimación la salida cuesta 0,440 USD, y ni el recorte ni la caché la cambian. Fable 5.2 factura el razonamiento como salida; si cada paso razona más que nuestros 500 tokens, la salida puede convertirse rápidamente en la partida mayor. Solo el parámetro effort y el presupuesto de tarea la controlan, y de eso trata la sección siguiente.
Usamos los precios oficiales leídos el 14-11-2026: entrada 8 USD, salida 40 USD, lectura de caché 0,20 USD y escritura de 5 minutos 10 USD, todo por millón de tokens (precios). El coste de la API de datos es la suma de billing.charged_usd de cada respuesta y coincide con el price_usd de cada capacidad en el catálogo.
Tres idas y vueltas de la prueba
| Hora de Singapur | Petición | HTTP | Resultado | Cobro |
|---|---|---|---|---|
| 13:10:16 | Búsqueda en Reddit de «notion vs clickup» | 200 | Esta llamada devolvió 0 resultados | 0 USD |
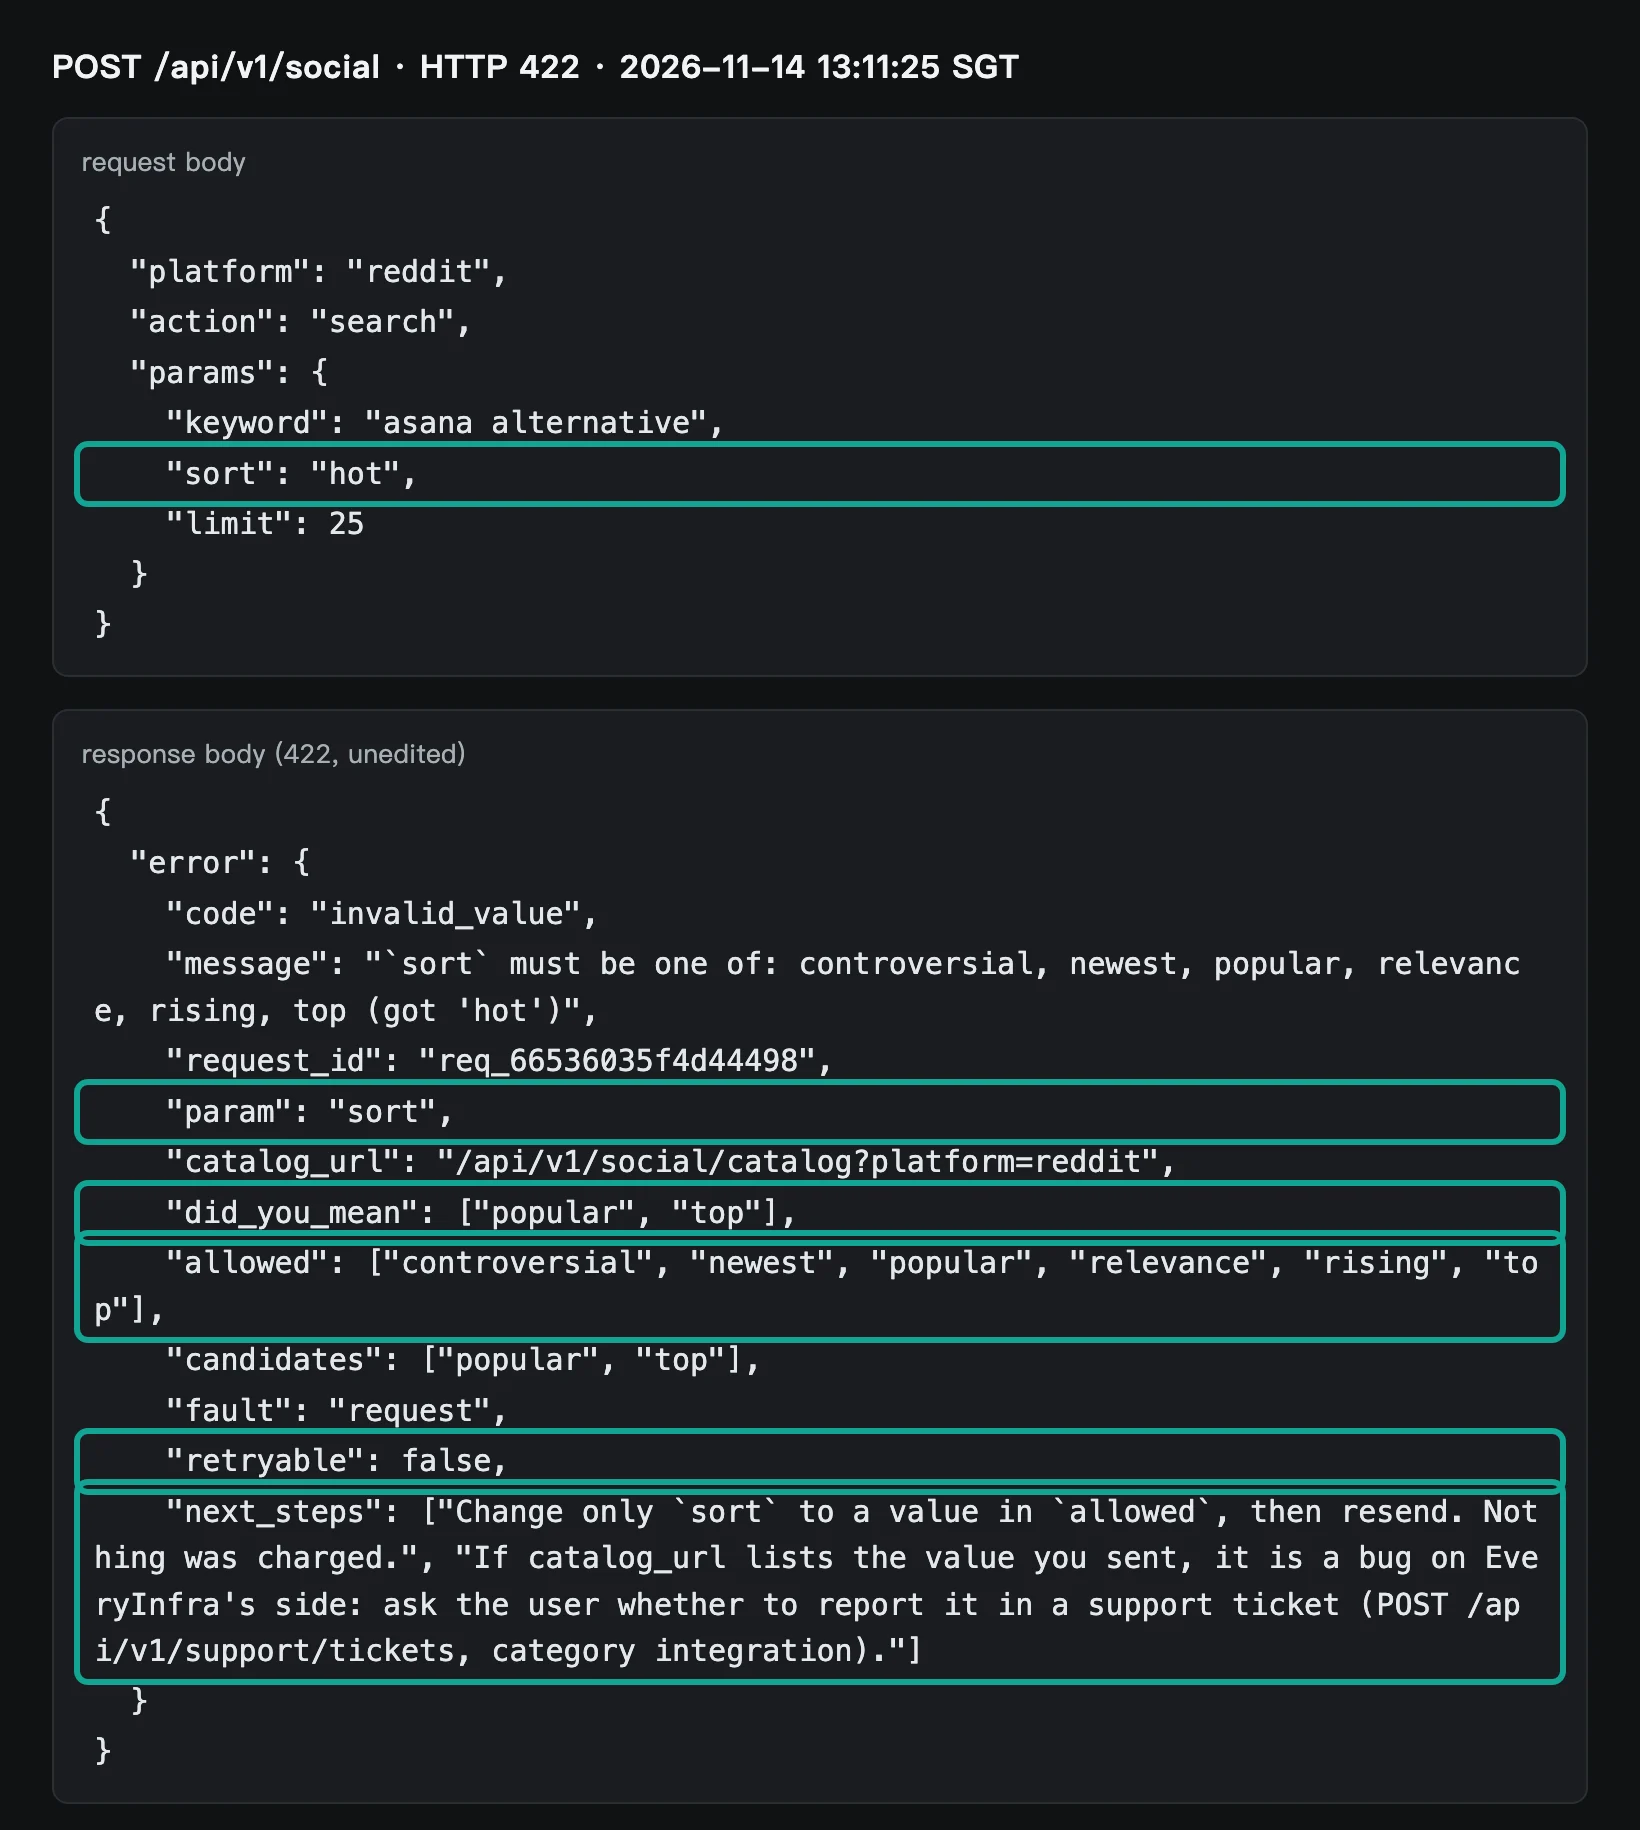
| 13:11:25 | Búsqueda de «asana alternative» con sort en hot | 422 | Respuesta casi inmediata; error con valores válidos y sugeridos | 0 USD |
| 13:11:34 | La misma búsqueda con sort en top | 200 | Esta llamada devolvió 13 publicaciones | 0,000792 USD |
| 13:27:50 | Reseñas de Notion de los últimos 30 días, con clave de idempotencia | 200 | Esta llamada devolvió 7 reseñas | 0,001389 USD |
| 13:28:16 | Misma clave y mismos parámetros | 200 | Respuesta casi inmediata; las mismas 7 reseñas, replayed: true | Sin cobro nuevo |
422: un parámetro incorrecto que corrige el modelo. A las 13:11:25 pusimos a propósito hot como valor de sort en Reddit. La API respondió un 422 casi al instante. El cuerpo del error señala sort como parámetro incorrecto y enumera los seis valores válidos; did_you_mean sugiere popular y top; y el primer punto de next_steps dice que se cambie solo sort y se reenvíe, y que no se cobró nada. Nuestro ejecutor metió esos campos en un resultado is_error; el modelo simulado siguió la sugerencia y cambió el valor a top, y la petición siguiente, 9 segundos después, devolvió 13 publicaciones con un único cobro.
Reenvío idempotente: una clave enviada dos veces. A las 13:27:50 enviamos la clave de idempotencia bl150-notion-30d-20261114-a con una petición de reseñas de Notion en Trustpilot de los últimos 30 días; esta llamada devolvió 7 reseñas. A las 13:28:16 enviamos otra vez la misma clave con los mismos parámetros, y la respuesta llegó casi al instante. La segunda respuesta traía la cabecera Idempotent-Replayed: true y el campo replayed: true, con el mismo id en el cuerpo y los mismos resultados que la primera. Después consultamos ese ID con el endpoint de cuenta GET /portal/api/requests/{id}: en los registros de peticiones de la cuenta, esta clave tiene un único cobro, de 0,00138889 USD.
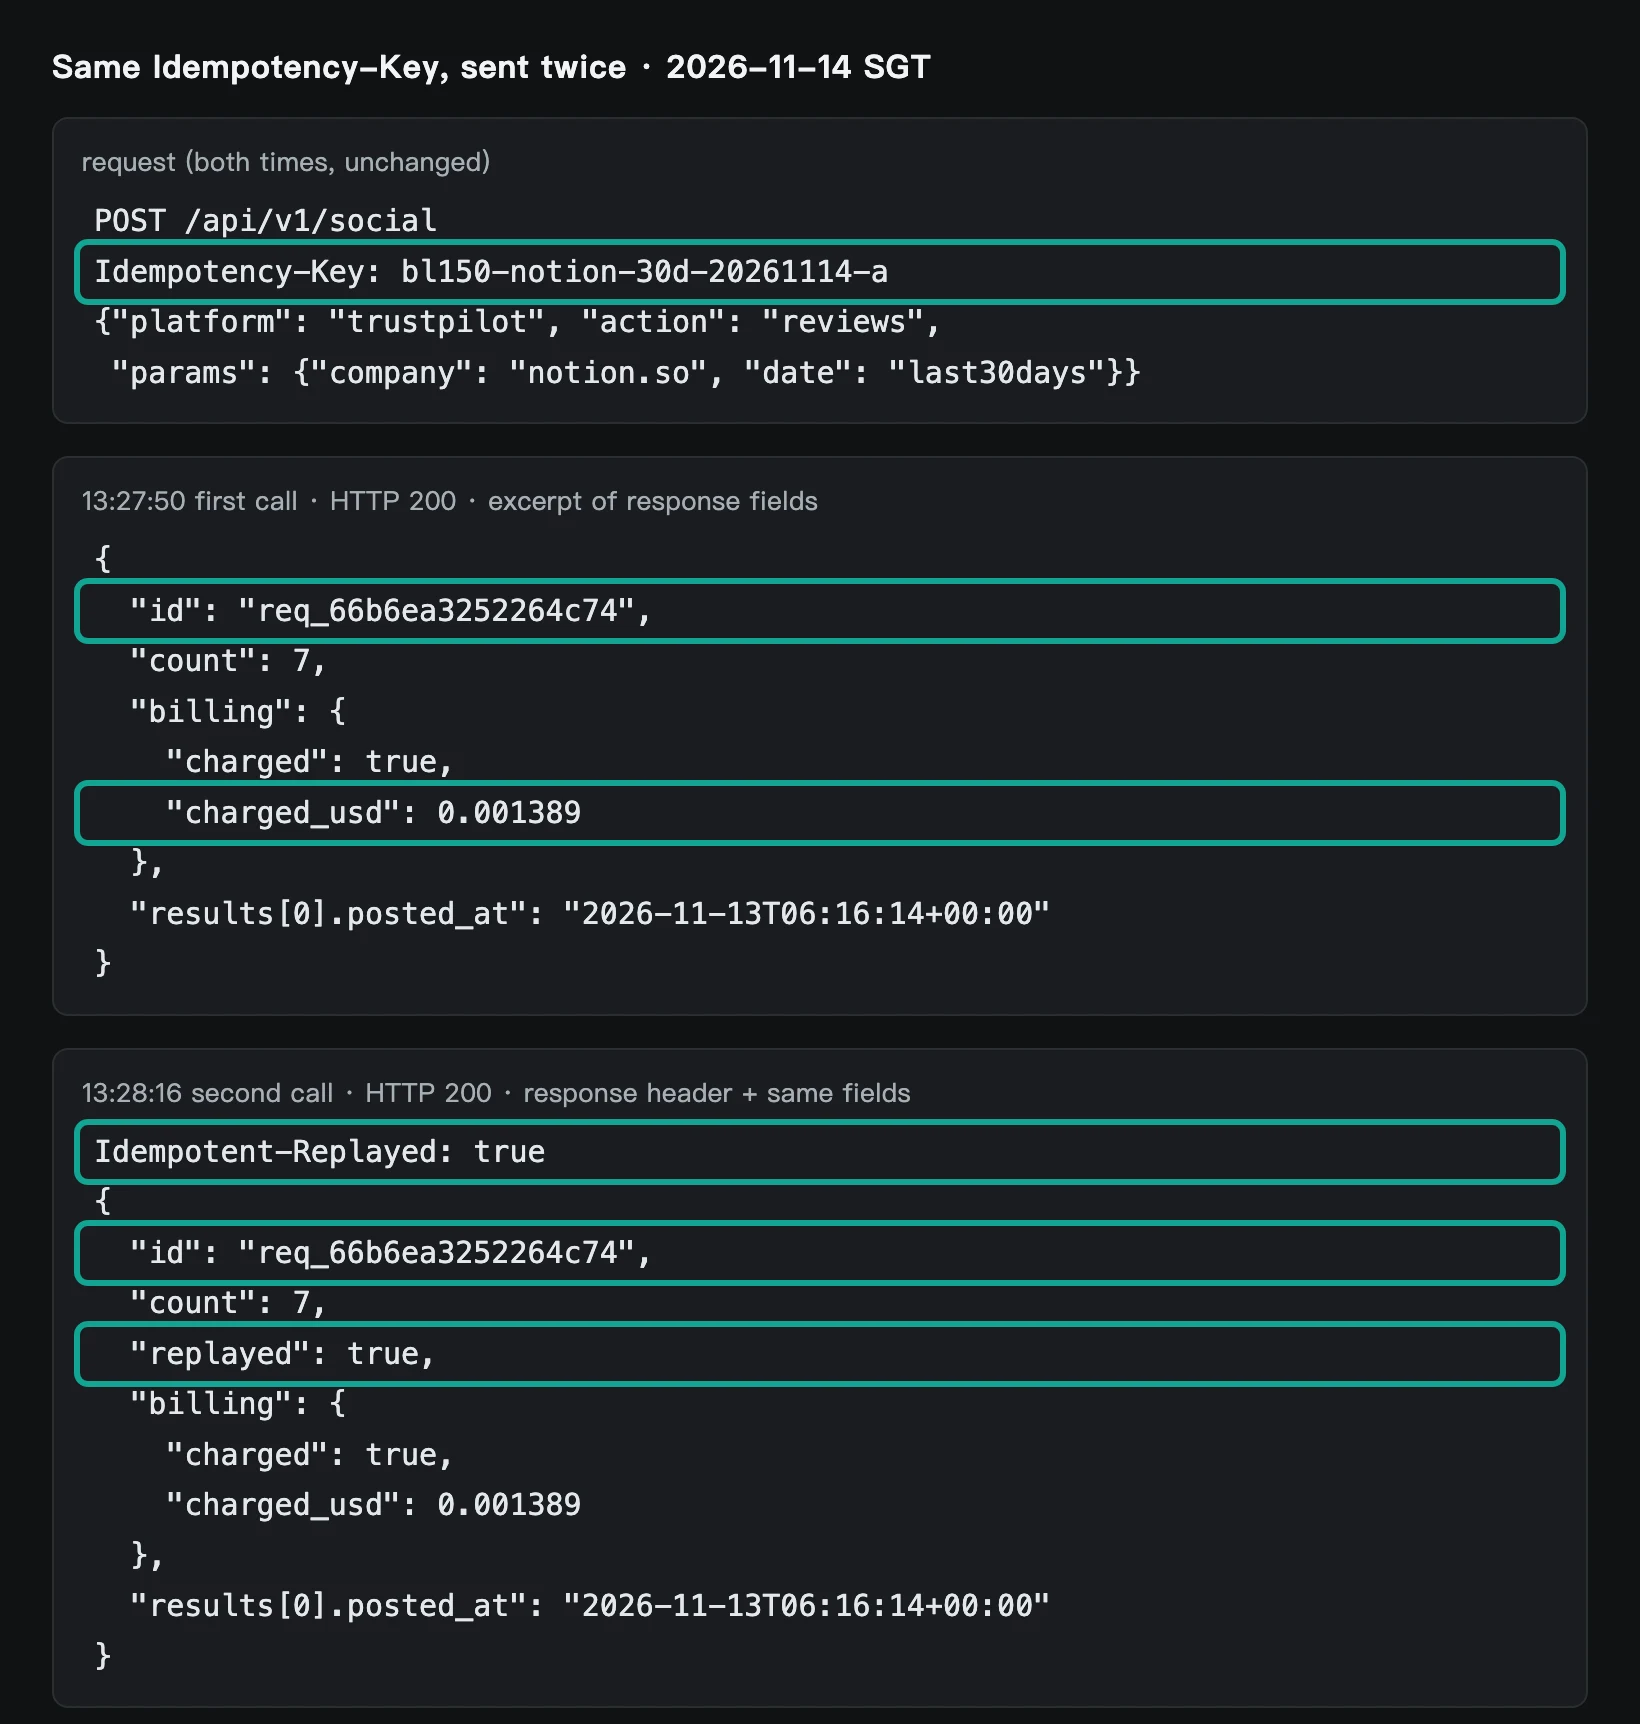
Hay un detalle a tener en cuenta en el código. El reenvío devuelve la primera respuesta, objeto billing incluido, así que el segundo cuerpo también muestra charged: true y charged_usd. La documentación de EveryInfra dice que un reenvío lleva la misma facturación y que no se ejecuta ni se cobra de nuevo (llms-full.txt). Si tu código suma el charged_usd de cada respuesta, salta las que tengan replayed en true; si no, tus registros mostrarán más de lo cobrado.
0 resultados: cambiar la palabra clave, sin cobro. La primera petición de la primera ronda buscó «notion vs clickup», devolvió 0 resultados y charged_usd fue 0. La búsqueda de Reddit solo cubre el último mes, y las palabras clave largas de comparación suelen quedarse vacías; con un solo nombre de marca, cada búsqueda trajo 13–23 publicaciones. Un resultado vacío se devuelve al modelo tal cual para que elija otra palabra clave; el ejecutor no debe reintentar la misma.
Dónde queda lo recortado: una herramienta para pedir el texto completo
Recortar tiene un precio: el modelo no ve lo que se cortó. Para clasificar sentimiento bastan 280 caracteres, pero al redactar la conclusión el modelo puede necesitar la segunda mitad de una reseña para citar a un usuario. La solución no es devolver el texto completo a la conversación, sino que el ejecutor guarde cada respuesta original en disco, indexada por el id de la respuesta y el número de resultado, y que el modelo tenga una herramienta pequeña, por ejemplo get_full_text(id, index), que devuelva el texto completo de un solo resultado.
Los resultados anteriores no cambian, así que la comprobación de prefijo no falla: pedir el texto completo es una llamada nueva al final y el historial solo crece. La herramienta no llama a la API de datos, así que no tiene coste de datos y solo añade unos cientos de tokens del modelo. Además, las respuestas guardadas sirven de registro de auditoría: de cada llamada se conoce la hora, el cobro y lo que devolvió.
La herramienta debe estar en tools desde el principio de la conversación. Si se añade después, el array tools cambia y la comprobación de prefijo falla; si no queda otra, se usa el mensaje de sistema tool_addition, que está en beta. En la descripción conviene aclarar que devuelve el texto de un resultado, que no se conecta a internet y que no tiene coste, para que el modelo no la use como buscador.
Dónde va el punto de corte de la caché
Con la caché automática, el punto de corte avanza a medida que crece la conversación: el contenido nuevo se factura primero al precio de escritura y, en la petición siguiente, al de lectura (caché de prompts). En un turno largo, cada resultado se escribe una vez y se lee muchas: el resultado de la llamada 3 se vuelve a leer en las peticiones 4 a 20. Por eso, con caché, la parte mayor de la factura de entrada suele ser lo nuevo que escribe cada paso, y el tamaño de esa parte lo decide el recorte.
Las definiciones de herramientas y el prompt de sistema van primero; no cambian durante el turno, así que tras la primera escritura se facturan como lectura. Dos reglas: no cambies ni una palabra de la descripción de una herramienta, tampoco marcas de tiempo o ejemplos aleatorios; y no pongas un campo que cambie, como la hora actual, en el prompt de sistema, porque invalida todas las entradas de caché posteriores. Si el modelo necesita la hora, va en un mensaje del usuario o en una herramienta.
La duración de la caché es otra cifra que calcular. En nuestra prueba, las 17 llamadas que trajeron datos tuvieron una mediana de 9,2 segundos. Si el modelo lanza 5 llamadas en paralelo y luego razona, uno o dos minutos entre peticiones es normal, y la caché de 5 minutos suele aguantar. Si un paso necesita aprobación humana o una herramienta espera en cola, conviene la caché de 1 hora. Su escritura cuesta el doble del precio base de entrada, 16 USD por millón de tokens, 6 USD más que los 10 USD de la de 5 minutos; cuando la caché caduca, todo el prefijo vuelve a facturarse como escritura.
Las cuentas con nuestro turno recortado: la última petición lleva unos 44.042 tokens. Si la caché de 5 minutos caduca en ese momento, reescribirla cuesta 44.042 × 10 USD / 1.000.000 ≈ 0,44 USD. Si todo lo nuevo del turno se escribe al precio de 1 hora, el sobrecoste del turno completo es de 44.042 tokens × 6 USD / 1.000.000 ≈ 0,26 USD. Una sola caducidad cuesta más que pasar todo el turno a la caché de 1 hora.
Las mismas cifras con 100 turnos al día
Supongamos un equipo que lanza cada día 100 turnos de investigación como el nuestro. Con resultados originales y sin caché, entrada, salida y API de datos suman unos 1083,94 USD al día; con recorte y caché, unos 96,93 USD. Casi toda la diferencia es entrada del modelo; la API de datos cuesta lo mismo en los dos casos, unos 1,69 USD al día.
| 100 turnos al día (USD) | Original, sin caché | Recortado, con caché |
|---|---|---|
| Entrada del modelo | 1038,25 USD | 51,24 USD |
| Salida del modelo (500 tokens por paso, supuesto) | 44,00 USD | 44,00 USD |
| API de datos | 1,69 USD | 1,69 USD |
| Total | 1083,94 USD | 96,93 USD |
La estimación no incluye reintentos; cómo reintentar sin pagar dos veces se explica en la sección siguiente.
Qué errores se reintentan y cuáles se devuelven al modelo
Un turno largo puede tener decenas de llamadas a herramientas, y si una se atasca, el turno entero espera. El ejecutor tiene que decidir por el modelo: hay fallos que desaparecen si se envía lo mismo un poco más tarde, y hay fallos que vienen de un parámetro mal escrito que solo el modelo puede corregir. Los primeros los reintenta el código; los segundos se devuelven al modelo tal cual.
No hace falta interpretar el texto del error. Todo cuerpo de error de EveryInfra lleva fault, que dice si el problema es de la petición, de la cuenta o del servicio, y retryable, que dice si la misma petición puede funcionar más tarde. Los errores reintentables añaden retry_after en segundos (llms-full.txt, sección de errores).
| Respuesta | Significado | Qué hace el ejecutor | Cobro |
|---|---|---|---|
200 con count mayor que 0 | Hay datos | Recortarlos y meterlos en el tool_result | Un cobro por llamada |
200 con count igual a 0 | Ningún resultado cumple el filtro | Devolverlo al modelo para que pruebe otra palabra clave | Sin cobro |
422 invalid_value y otros errores de parámetros | Nombre o valor de parámetro incorrecto | Devolver param, allowed y did_you_mean al modelo como is_error | Sin cobro |
| 429 | La clave agotó sus llamadas del minuto | Esperar retry_after segundos y reenviar con la misma clave de idempotencia | Sin cobro |
504 response_timeout | Sin respuesta en 100 segundos; la llamada aún puede terminar | Reenviar con la misma clave para recibir el primer resultado | Un cobro solo si la primera llamada termina bien |
502 response_interrupted | La respuesta se cortó; la llamada puede haber terminado | Reenviar con la misma clave | Igual que la fila anterior |
409 idempotency_in_progress | La primera petición con esa clave sigue en curso | Esperar Retry-After y reenviar | Sin cobro adicional |
409 idempotency_conflict | La misma clave se usó con parámetros distintos | Hay un fallo en tu código: usa otra clave y no se lo pases al modelo | Sin cobro |
503 refund_outcome_unknown | El cobro todavía se está comprobando | No reenviar; guardar el ID de la petición y consultar después | Según la comprobación |
| 401, 402, 403 | Problema de clave, saldo o permisos | Parar y avisar al usuario; el modelo no puede arreglarlo | Sin cobro |
Un conflicto 409 o un 503 de «resultado pendiente» no se pasan al modelo ni se reenvían tal cual. El conflicto 409 indica que tu código usó la misma clave para dos llamadas distintas, algo que el modelo no puede arreglar, así que conviene registrar una alerta en el código y dejarlo fuera de la conversación. En el 503 de «resultado pendiente», el cobro aún no es definitivo y un reenvío podría añadir otro. La documentación lo dice claro: no volver a enviar, guardar el ID de la petición y consultar más tarde.
La API del modelo también falla, y eso se gestiona en otra capa. En la documentación de errores de Anthropic, 429 es un límite de uso y 529 significa que la API está sobrecargada temporalmente; ambos se pueden reintentar tras una breve espera (errores). Por defecto, el SDK oficial de Python reintenta dos veces, con una espera corta, los errores de conexión, 408, 409, 429 y 5xx (SDK de Python). La misma página indica que la versión 2.0.0 del SDK es la primera que usa la versión 2026-10-21 de la API; antes de subir de versión mayor conviene revisar las notas de migración.
Reintentar la petición al modelo no vuelve a ejecutar la herramienta, porque tu código solo la ejecuta al recibir un bloque tool_use. Pero si se repite todo el turno desde el principio, el modelo vuelve a emitir las mismas llamadas, y ahí es donde protege la clave de idempotencia de las herramientas. Como sale del ID de la tarea y del número de llamada, y no del azar, al repetir el turno cada paso recibe la misma clave: las llamadas que ya habían salido bien devuelven su primer resultado y solo se pagan una vez.
Anthropic aplica los límites con un algoritmo de cubo de tokens; su ejemplo es un límite de 60 peticiones por minuto que puede aplicarse como 1 petición por segundo (límites de uso). Lo mismo puede pasar en el lado de las herramientas: si el modelo emite varios tool_use en paralelo y tu código los lanza todos a la vez, pueden chocar con el límite por minuto en el mismo segundo.
La documentación de herramientas en paralelo pide devolver un tool_result por cada bloque tool_use, todos juntos en el siguiente mensaje del usuario; si uno falla, también hay que devolverlo con is_error: true y una explicación breve (herramientas en paralelo). Por eso, si una de las llamadas paralelas espera retry_after, los demás resultados se guardan y se envían todos cuando llegue el último.
Si no quieres escribir un ejecutor, el SDK oficial incluye un Tool Runner que gestiona el bucle por ti (Tool Runner), y la Messages API puede conectarse directamente a servidores MCP remotos (conector MCP). Las dos opciones ahorran el código del bucle, pero no permiten tocar un resultado antes de que entre en el contexto, así que el recorte depende solo del formato del servidor. Para llamadas de pago que se reintentan, recomendamos un ejecutor propio, con REST y un Idempotency-Key; los detalles están en claves de idempotencia para reintentos de agentes.
Cinco controles más, aparte del recorte
El recorte controla el tamaño de cada resultado. La API de Fable 5.2 tiene otros cinco ajustes que influyen en el coste de un turno largo. Cada uno actúa sobre una parte distinta de la factura, así que se pueden combinar. Cada fila procede de la documentación oficial, leída el 14-11-2026; las marcadas como beta necesitan su cabecera beta.
| Control | Qué cambia | Cómo se activa | Estado | Ojo con |
|---|---|---|---|---|
| Caché de prompts | El historial reenviado se factura a 0,20 USD por millón de tokens | cache_control en el nivel superior de la petición | Disponible | Caduca a los 5 minutos por defecto; la opción de 1 hora escribe al doble del precio de entrada |
| Effort | Cuánto razona cada paso y cuántas herramientas llama | output_config.effort | Disponible | Cambiar el valor a mitad de conversación invalida la caché |
| Presupuesto de tarea | Indica al modelo cuántos tokens le quedan en el turno | output_config.task_budget, mínimo 20 000 | Beta | Es un límite blando; el límite duro sigue siendo max_tokens; no está en Claude Code |
| Limpieza de resultados antiguos en el servidor | Sustituye los resultados más antiguos por un texto de relleno a partir de un umbral | context_management con clear_tool_uses_20250919 | Beta | Supera la comprobación de prefijo, pero invalida la caché a partir del punto limpiado |
| Compactación a demanda | Tú decides cuándo los turnos antiguos se convierten en un resumen | compaction: {"type": "summarize"} | Beta | La llamada de resumen se cobra; la API rechaza la petición si el último turno termina en una llamada a herramienta sin resultado |
Las fuentes son, por orden: caché de prompts, effort, presupuestos de tarea, edición de contexto y compactación a demanda.
El presupuesto de tarea es el ajuste más cercano a las llamadas a herramientas. La documentación pone un ejemplo con tres peticiones: el cliente reenvía el historial completo cada vez, así que el volumen enviado crece, pero el presupuesto solo cuenta lo que es nuevo para el modelo, y en el ejemplo las tres peticiones solo gastan 19 000 de un presupuesto de 100 000 tokens (presupuestos de tarea). El presupuesto de tarea solo descuenta los tokens nuevos para el modelo; la factura cobra toda la entrada que se envía en cada petición. El recorte reduce las dos cosas; el presupuesto solo ayuda al modelo a cerrar bien cuando se le acaba el margen.
Para elegir la cifra, la documentación propone ejecutar un conjunto de tareas típicas sin presupuesto, anotar los tokens de cada una y empezar por el percentil 99. El presupuesto debe ser de al menos 20 000 tokens; si no, la petición falla con un 400.
La limpieza en el servidor y tu propio recorte no chocan. Nuestro recorte actúa cuando el resultado entra por primera vez en la conversación y conserva los campos que el modelo usará después. La limpieza del servidor quita resultados antiguos que el modelo ya aprovechó: por ejemplo, cuando el modelo ya resumió las diez primeras búsquedas, esos resultados pueden salir. La documentación avisa de que la limpieza invalida la caché a partir del punto limpiado, así que conviene usar clear_at_least para limpiar un bloque grande de una vez y no un poco en cada turno (edición de contexto).
Límites y puntos a vigilar
No ejecutamos la parte del modelo. Las definiciones de herramientas, el bucle principal y los costes en tokens son ejemplos de configuración y estimaciones: convertimos bytes en tokens sin comprobarlos con el contador oficial. En tu propio bucle, usa el objeto usage de cada respuesta. Nuestro supuesto de 500 tokens de salida por paso está pensado para una investigación de datos, donde cada paso es una decisión sencilla.
El razonamiento se factura al precio de salida, 40 USD por millón. Si cada paso gasta 2000 tokens de salida, la salida de este turno de 18 pasos más la conclusión pasa de 0,440 USD a (18 × 2000 + 2000) × 40 USD / 1.000.000 = 1,52 USD, más que los 0,512 USD de entrada recortada y con caché. Solo el parámetro effort y el presupuesto de tarea controlan esa parte.
La búsqueda de Reddit solo cubre el último mes, y el valor de sort no cambia ese periodo; el catálogo lo indica. Para hilos más antiguos hace falta otra capacidad, como listar publicaciones de una comunidad. Trustpilot necesita el dominio de la empresa, por ejemplo notion.so. Los comentarios de YouTube necesitan la URL del vídeo, así que el agente llama antes a youtube/search, y esa es otra llamada de pago.
Los bloques de razonamiento de Fable 5.2 solo valen en la cuenta que los creó o en una cuenta vinculada; al pasar de Fable 5.2 a otro modelo, se pierde el razonamiento de esos turnos (Novedades). Si tu código reintenta en otro modelo una petición rechazada, ese turno pierde su razonamiento y el coste sube. Además, Fable 5.2 exige por defecto una retención de datos de 30 días; la retención cero necesita una aprobación aparte. Los equipos que procesan texto de reseñas deberían revisarlo antes de empezar.
Cambios recientes
- 09-11-2026: Anthropic lanzó Claude Fable 5.2. El precio bajó de 10 y 50 USD a 8 y 40 USD por millón de tokens, y la lectura de caché cuesta 0,20 USD (anuncio). Para ti: la misma tarea larga cuesta un 20 % menos en la parte del modelo, y el historial reenviado sale barato si acierta la caché.
- 09-11-2026: GitHub Copilot incorporó Fable 5.2. Su changelog dice que en las primeras pruebas resolvió más tareas «while using fewer steps and tool calls» (changelog de GitHub). Para ti: con menos llamadas, el tamaño de cada resultado importa más.
- 09-11-2026: Fable 5.2 llegó a Amazon Bedrock y a Claude Platform on AWS. El blog de AWS aclara que en Bedrock los reintentos de peticiones rechazadas los hace tu código (blog de AWS). Para ti: además de reintentar herramientas, hay que reintentar el modelo.
- 22-10-2026: el borrador del IETF para la cabecera Idempotency-Key llegó a la versión 08, con el objetivo de que métodos como POST se puedan reintentar sin riesgo (borrador del IETF). Para ti: poner una clave de idempotencia en las llamadas a APIs de datos se está convirtiendo en práctica habitual.
Preguntas frecuentes
¿Hace falta una clave aparte para la API de Claude Fable 5.2, y cuál es el ID del modelo?
No. La documentación dice que Fable 5.2 está disponible para todos los clientes de la API de Claude, con el ID claude-fable-5-2; solo Mythos 5.2 exige un programa de verificación (Novedades). La guía de migración incluye un comando de Claude Code que adapta el código por ti. Origen de la pregunta: la sugerencia de Google «claude fable 5.2 api key», consultada el 14-11-2026.
¿Cuál es la ventana de contexto y el límite de tokens de Claude Fable 5.2?
La ventana es de 1 millón de tokens y una respuesta puede tener hasta 128 000 tokens de salida (página del modelo). En nuestra estimación, la última petición de nuestro turno de prueba (18 llamadas con HTTP 200) lleva 160.627 tokens con resultados originales y unos 44.042 con resultados recortados. Origen: las sugerencias «claude fable 5.2 context window size» y «claude fable 5.2 api token limit».
¿Por qué tool_choice devuelve un error 400 en Claude Fable 5.2?
Fable 5.2 no admite el uso forzado de herramientas. Un tool_choice con any o con una herramienta concreta devuelve un 400 invalid_request_error. La documentación propone dejar auto y añadir strict: true, o usar salidas JSON (Novedades). Origen: la sugerencia «claude fable 5.2 tool_choices».
¿Los tokens de razonamiento se cobran al precio de salida?
Sí. Un desarrollador lo advirtió en r/claude: los tokens de razonamiento se facturan a 40 USD por millón, el precio de salida (publicación en r/claude). En Fable 5.2 el razonamiento adaptativo no se puede desactivar; solo se puede cambiar effort. La documentación sugiere empezar en high, el valor por defecto de la API (prompts para Claude Fable 5.2). Las tareas de datos con muchos pasos sencillos encajan con medium o low.
¿Cuánto más barata es una lectura de caché que una escritura?
Una publicación de r/ClaudeCode con 346 puntos se queja de que Fable 5.2 consume demasiado límite del plan (publicación en r/ClaudeCode). Las cuentas con los precios oficiales: la escritura de 1 hora cuesta el doble de la entrada, 16 USD, y la lectura 0,20 USD, 80 veces menos; la escritura de 5 minutos cuesta 10 USD, 50 veces más que una lectura; la salida cuesta 40 USD, 200 veces más. En un turno largo, casi todo el historial reenviado puede ser lectura de caché, siempre que no cambies tools, el prompt de sistema ni los mensajes antiguos.
¿Es Claude Fable 5.2 adecuado para decenas de llamadas a herramientas en un solo turno?
La documentación cita las sesiones de agente de varias horas y la investigación en varios pasos como usos típicos de Fable 5.2, y Anthropic recomienda empezar la mayoría de tareas con Opus 5.5 y pasar a Fable solo si las evaluaciones se quedan cortas (anuncio). El anuncio añade que Fable 5.2 puede actuar como orquestador que reparte las tareas sencillas entre modelos más pequeños; en el encargo de este artículo, el código descarga y recorta los datos y el modelo solo decide, que es la misma idea. Origen: la sugerencia «claude fable 5.2 tool use cases».
Cómo empezar
- Regístrate y consigue una clave de API en la consola de EveryInfra. Haz una llamada a
POST /api/v1/socialcon la guía rápida. - Lee el catálogo gratuito,
GET https://api.everyinfra.com/api/v1/social/catalog?platform=reddit. Revisa nombres de capacidades, valores válidos yresponse_fields, y pasa los campos que necesitas a tu lista blanca de recorte. - Escribe las cuatro definiciones de herramientas como arriba, con
strict: trueytool_choiceenauto. Añade la cabeceraIdempotency-Keyy la gestión del 422 en el ejecutor. - Ejecuta 10 tareas típicas sin presupuesto de tarea. Anota el
usagede cada respuesta y el tamaño de cada resultado. Después elige effort, duración de caché y presupuesto. - Si no quieres escribir un ejecutor, usa el servidor MCP remoto (configuración MCP), con herramientas que empiezan por
everyinfra_. Para trabajos programados y llamadas que se reintentan, usa REST con unIdempotency-Key, como en el código del ejecutor (claves de idempotencia).
Los precios están en la página de precios y en el catálogo. Todas las capacidades están en las páginas de Reddit, Trustpilot y YouTube.
Referencias
Todas las páginas se leyeron el 14-11-2026, hora de Singapur. Las fechas entre paréntesis son las de cada página.
- Anthropic: anuncio de Claude Fable 5.2 y Claude Mythos 5.2 (09-11-2026, editado el 11-11) <https://www.anthropic.com/claude-fable-and-mythos-5-2>
- Anthropic: ficha del sistema de Claude Fable 5.2 / Mythos 5.2 (09-11-2026) <https://www.anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card>
- Documentación de Claude: página del modelo Claude Fable 5.2 <https://platform.claude.com/docs/en/models/fable-5-2/overview>
- Documentación de Claude: novedades de Claude Fable 5.2 <https://platform.claude.com/docs/en/models/fable-5-2/whats-new-fable-5-2>
- Documentación de Claude: migrar a Claude Fable 5.2 <https://platform.claude.com/docs/en/models/fable-5-2/migration-guide>
- Documentación de Claude: precios <https://platform.claude.com/docs/en/about-claude/pricing>
- Documentación de Claude: resumen de modelos <https://platform.claude.com/docs/en/about-claude/models/overview>
- Documentación de Claude: uso de herramientas <https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview>
- Documentación de Claude: gestionar llamadas a herramientas <https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls>
- Documentación de Claude: uso estricto de herramientas <https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use>
- Documentación de Claude: herramientas en paralelo <https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use>
- Documentación de Claude: Tool Runner <https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner>
- Documentación de Claude: conector MCP <https://platform.claude.com/docs/en/agents-and-tools/mcp-connector>
- Documentación de Claude: comprobación de prefijo <https://platform.claude.com/docs/en/build-with-claude/preserved-thinking/prefix-checks>
- Documentación de Claude: edición de contexto <https://platform.claude.com/docs/en/build-with-claude/context-editing>
- Documentación de Claude: compactación a demanda <https://platform.claude.com/docs/en/build-with-claude/compaction-on-demand>
- Documentación de Claude: presupuestos de tarea <https://platform.claude.com/docs/en/build-with-claude/task-budgets>
- Documentación de Claude: mensajes de sistema y cambios de herramientas a mitad de conversación <https://platform.claude.com/docs/en/build-with-claude/mid-conversation-system-messages>
- Documentación de Claude: caché de prompts <https://platform.claude.com/docs/en/build-with-claude/prompt-caching>
- Documentación de Claude: effort <https://platform.claude.com/docs/en/build-with-claude/effort>
- Documentación de Claude: conteo de tokens <https://platform.claude.com/docs/en/build-with-claude/token-counting>
- Documentación de Claude: ventanas de contexto <https://platform.claude.com/docs/en/build-with-claude/context-windows>
- Documentación de Claude: prompts para Claude Fable 5.2 <https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2>
- Documentación de Claude: rechazos y modelo de respaldo <https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback>
- Documentación de Claude: modo rápido <https://platform.claude.com/docs/en/build-with-claude/fast-mode>
- Documentación de Claude: procesamiento por lotes <https://platform.claude.com/docs/en/build-with-claude/batch-processing>
- Documentación de Claude: errores <https://platform.claude.com/docs/en/api/errors>
- Documentación de Claude: límites de uso <https://platform.claude.com/docs/en/api/rate-limits>
- Documentación de Claude: SDK de Python <https://platform.claude.com/docs/en/api/sdks/python>
- GitHub: repositorio anthropic-sdk-python <https://github.com/anthropics/anthropic-sdk-python>
- Blog de ingeniería de Anthropic: herramientas para agentes <https://www.anthropic.com/engineering/writing-tools-for-agents>
- Blog de ingeniería de Anthropic: ingeniería de contexto para agentes <https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents>
- IETF: borrador de la cabecera Idempotency-Key, versión 08 (22-10-2026) <https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/>
- RFC 9110: semántica HTTP, métodos idempotentes <https://www.rfc-editor.org/rfc/rfc9110#name-idempotent-methods>
- Documentación de Stripe: peticiones idempotentes <https://docs.stripe.com/api/idempotent_requests>
- Especificación de Model Context Protocol: herramientas <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- EveryInfra: llms-full.txt (reintentos, idempotencia y errores) <https://api.everyinfra.com/llms-full.txt>
- EveryInfra: catálogo de capacidades de Reddit (gratis) <https://api.everyinfra.com/api/v1/social/catalog?platform=reddit>
- Changelog de GitHub: Claude Fable 5.2 en GitHub Copilot (09-11-2026) <https://github.blog/changelog/2026-11-09-claude-fable-5-2-in-github-copilot/>
- Blog de Machine Learning de AWS: Claude Fable 5.2 en AWS (09-11-2026) <https://aws.amazon.com/blogs/machine-learning/introducing-claude-fable-5-2-on-aws/>
- CNBC: Anthropic lanza Claude Fable 5.2 y Mythos 5.2 (09-11-2026) <https://www.cnbc.com/2026/11/09/anthropic-claude-fable-5-2-mythos-5-2.html>
- The Verge: Anthropic lanza Fable 5.2 y Mythos 5.2 <https://www.theverge.com/ai-artificial-intelligence/1030005/anthropic-claude-fable-mythos-5-2>
- Reddit r/claude: aviso sobre el precio de Fable 5.2, los tokens de razonamiento se cobran como salida <https://www.reddit.com/r/claude/comments/1xtz7tp/psa_on_claude_fable_52_pricing_so_the_base_price/>
- Reddit r/ClaudeCode: Fable 5.2 gasta demasiado del límite del plan (346 puntos) <https://www.reddit.com/r/ClaudeCode/comments/1xusayn/fable_52_uses_so_much_usage_its_basically/>
- Reddit r/ClaudeAI: coste por tarea de Fable 5.2 <https://www.reddit.com/r/ClaudeAI/comments/1xs292a/>
- YouTube: primera prueba de Fable 5.2 (12-11-2026) <https://www.youtube.com/watch?v=xKlUf-dw_Lw>
Referencia BL-150