Databricks Genie Agent 和 Databricks Genie MCP 怎么接公开评论:落表与实时查询
Genie Agent 文档只列 9 个自带连接器,评论先落进表;每天一轮 $0.003334,HelloFresh 当天自发评价 6/7 差评。
Databricks 在 11 月 11 日发布了第二代 Genie。企业的销量表、工单表已经在 Unity Catalog 里,Trustpilot、Google Play、Reddit 上顾客公开说的话,要怎么让 Genie 也查到?我们读了 Databricks 官方的新闻稿、博客和 11 月更新的文档,再用 EveryInfra 的三项能力对 HelloFresh 这个公开品牌在 11 月 14 日做了三轮真实调用,把能走通的两种接法、表结构、去重和每天的费用都写在下面。Databricks 工作区一侧我们没有跑,相关的 SQL 和步骤都标了「配置示例」。
11 月 11 日的第二代 Genie 发布了什么
Databricks 在 2026 年 11 月 11 日的新闻稿里把第二代 Genie 写成「常驻、自主的企业 agent」:员工给一个目标,Genie 自己拆活、把子任务派给子代理、跟进缺的输入,需要人拍板时进收件箱或发邮件。新闻稿「Availability」一段写:Genie 和 Genie Ontology 对所有客户正式可用(GA),Genie Search、Ontology Manager 和常驻的新 Genie「即将进入预览和 Beta 计划」。所以 11 月 14 日能在工作区里直接用的,是 Genie One 对话、Genie Agents(原来叫 Genie Spaces)和 Genie One MCP;常驻任务这一层还要等预览名额。
同一天的产品博客补了两处和本篇有关的细节。第一,常驻任务可以按时间表跑,也可以由触发条件启动,博客举的触发例子是「某个指标下滑,或者超过 10 个客户提了同一个功能」。第二,Genie 除了用 Databricks 自带的 MCP 连接器读写 Slack、Jira、GitHub,还能「通过自定义 MCP」接 ServiceNow、PagerDuty 这类系统。注意博客说的是常驻的新 Genie,它还没有开放;今天工作区里能用的 Genie Agent 能挂什么,要看下文引的 Genie Agents 文档。
本篇实测选的公开品牌是 HelloFresh:它在 Trustpilot、Google Play 和 Reddit 上都有足够多的公开内容,能把三种来源放在一起比。HelloFresh 和 EveryInfra 没有任何业务关系,下文用的都是公开可见的评论和帖子。
| 项目 | 原文怎么说 | 阶段(11 月 14 日) | 出处 |
|---|---|---|---|
| 第二代 Genie(常驻、自主) | 给目标后自己拆活、派子代理、进收件箱和邮件 | 即将进入预览和 Beta | 新闻稿 11-11 |
| Genie、Genie Ontology | 业务定义、指标、人和流程组成的上下文层 | GA | 新闻稿 11-11 |
| Genie Search | 100 多个来源,可经 MCP 实时查询应用 | 即将进入预览和 Beta | 新闻稿 11-11 |
| Genie One MCP | 把 Genie 以 MCP 服务开放给外部 agent | GA(9 月 22 日) | 官方博客、文档 |
| Genie Agents 的 MCP 连接器 | Agent mode 里调用 Databricks 自带连接器 | Beta,管理员在 Previews 页打开 | 文档 |
| 自定义 MCP 服务(外部 MCP) | 在 Unity Gateway 登记后给 Genie One 用 | 文档已上线 | 文档 |
databricks genie mcp 指的是三件不同的事
「databricks genie mcp」这个词在官方文档里对应三种不同的接法:有的把 Genie 往外开放,有的让 Genie 去调外部服务,接外部数据之前要先分清。
第一条是 Genie 当 MCP 服务器,被别人调用。Genie One MCP 文档写明它的地址是 https://<workspace-hostname>/ai-gateway/mcp-services/system.ai.genie_one_mcp?o=<workspace-id>,调用方要有 system.ai.genie_one_mcp 这个 mcp_service 的 EXECUTE 权限,工具有 genie_ask、genie_poll_response、genie_get_query_result,支持 MCP Apps 的客户端还有 view_ask。正式可用的博客说它让 Claude、ChatGPT、Cursor 这类 agent 把 Genie 当成一个「懂数据的同事」来问。文档同时提醒,旧的 Beta 地址 /api/2.0/mcp/genie 在 2026 年 11 月 30 日停用,之后请求会失败。这条路解决的是「外面的 agent 怎么问 Databricks 里的数据」,和把外部数据接进来是两回事。
第二条是 Genie One 调用外部 MCP 服务器。Genie One 外部应用文档列了三类可接的服务器:Databricks 自带的连接器、Databricks Marketplace 上的 MCP 服务器,以及「你的组织在 Unity Catalog 里登记的自定义 MCP 服务」。登记的步骤在外部 MCP 服务器文档里:服务器要支持 Streamable HTTP 传输,在 Unity Gateway 的 MCPs 页面选「Connect an existing MCP server」,新建一个 HTTP 连接填地址和凭据,载入工具后挑要开放的那些。EveryInfra 的远程 MCP 地址 https://api.everyinfra.com/mcp 走的就是 Streamable HTTP,鉴权是 Authorization: Bearer 加 API Key,对应 HTTP 连接文档列的五种鉴权方式里的第一种「Bearer token」。
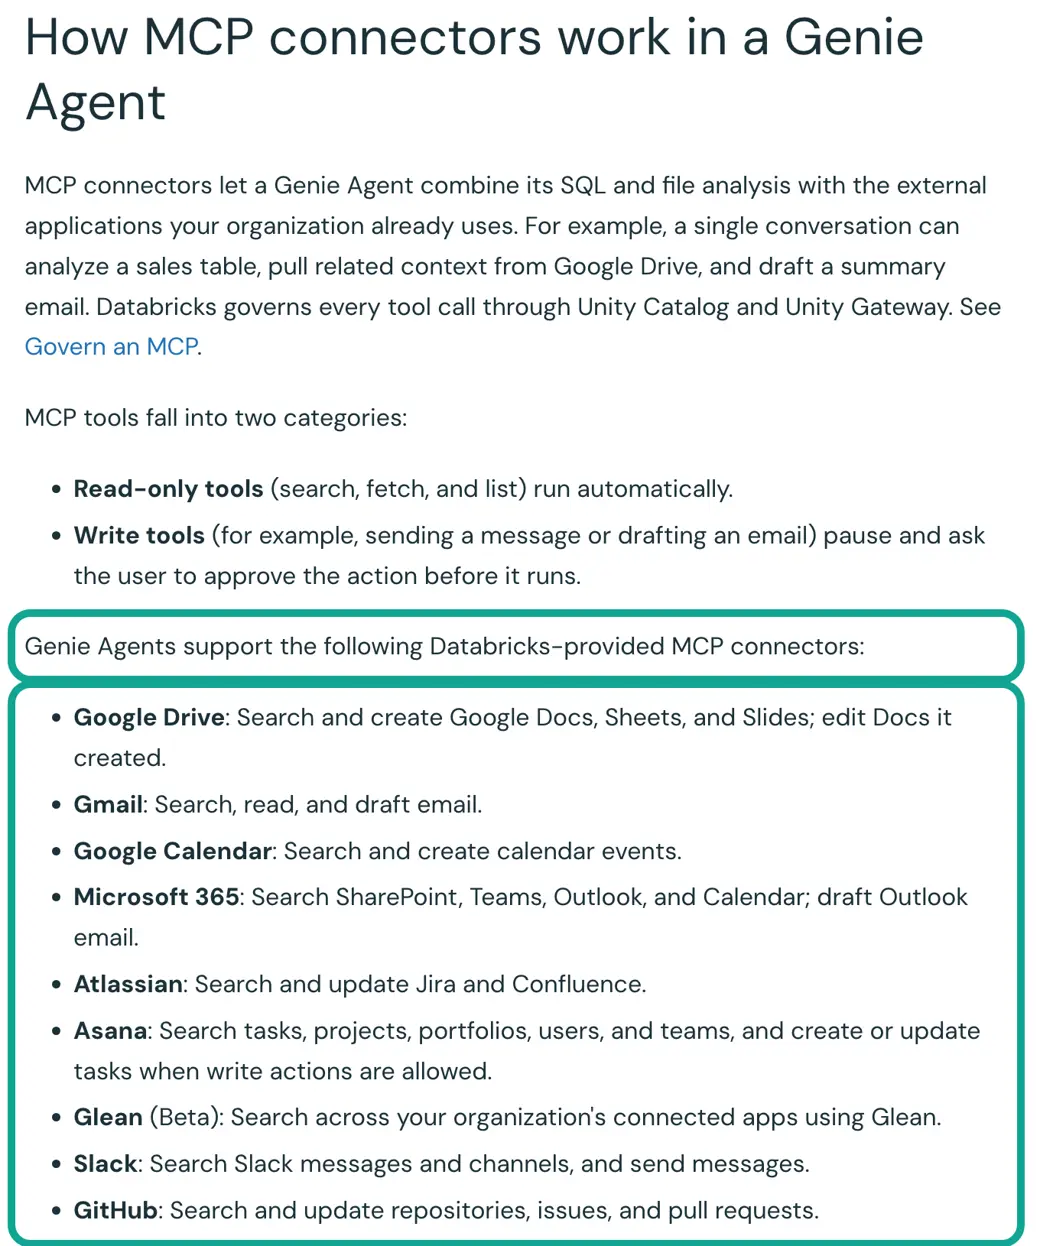
第三条是 Genie Agents 在 Agent mode 里调用连接器。Genie Agents 连接 MCP 的文档(页面写的更新日期是 2026 年 11 月 9 日)把这项功能标为 Beta,要工作区管理员在 Previews 页打开「MCP tools in Genie Agents」,列出的连接器是 Google Drive、Gmail、Google Calendar、Microsoft 365、Atlassian、Asana、Glean、Slack、GitHub 九个,全部是 Databricks 自带的。文档列出的是这 9 个自带连接器,没有写到自定义 MCP 服务(2026 年 11 月 14 日读取)。11 月 12 日的发布说明又写,Agent 配置页新增了单独的连接器区(Beta),这一块还在变,接之前再看一次这页。
| 路 | 方向 | 谁来加 | 外部数据能不能进来 | 阶段 |
|---|---|---|---|---|
Genie One MCP(system.ai.genie_one_mcp) | 外部 agent 调 Genie | 有 EXECUTE 的用户或服务主体 | 不能,它只把 Databricks 里的答案往外给 | GA |
| Genie One + 自定义 MCP 服务 | Genie One 调外部服务器 | 有 CREATE SERVICE 的人登记,用户在对话里从 Browse connectors 加 | 能,实时查询 | 文档已上线 |
| Genie Agents + MCP 连接器 | Genie Agent 调 Databricks 自带连接器 | Agent 作者在 Sources 里加 | 文档列出的是九个自带连接器,没有写到自定义 MCP | Beta |
ai_enrich 的 mcp 知识源 | SQL 函数逐行调外部 MCP 的搜索工具 | 写 SQL 的人 | 能,按行补字段 | 文档已上线,要 Databricks Runtime 18.2 以上 |
ai_enrich 函数可以把一个在 Unity Gateway 登记过的外部 MCP 当知识源,逐行生成新列;文档要求这个连接用共享凭据(例如服务商的 API Key 当 bearer token),因为函数没法弹出登录框,并提醒每行拼出的查询会发到外部服务商。它适合「给已有的品牌表逐行补一个外部字段」,不适合按时间增量拉评论的活。
为什么要把公开评论放在销量表旁边
企业仓库里的销量表、退货表、工单表记录的是「自己的客户做了什么」。Trustpilot、Google Play、Reddit 上的公开内容记录的是「客户在外面怎么说」,其中有一部分人根本没进过你的客服系统。两边放在同一个 Unity Catalog 里,Genie 才能回答跨两边的问题,例如「上周 1 星评论里提到牛排的,有没有在同一周的退款工单里出现」。Genie Agents 概念文档写明,Genie Agent 的数据必须是登记在 Unity Catalog 里的表、视图、指标视图或物化视图,生成的 SQL 只读;设置文档写一个 Agent 最多加 50 张表,最佳实践建议控制在 5 张以内。公开评论在这个上限里只占一到三张表。
我们拉的前排 YouTube 演示里,一位作者在建 Genie Agent 时说「这里最多能连 30 张表」,这和 11 月的文档(50 张)对不上,以文档为准。另一段官方演示讲了外部 MCP 在 Unity Catalog 里存成 HTTP 类型的连接,也可以从 Marketplace 直接安装;下文接法一的第一步建的就是这种 HTTP 连接。
实测:HelloFresh 的三个来源、三个时刻
表结构和调用频率都要靠真实数据定,所以动手写配置之前,我们先对 HelloFresh 做了三轮调用。每一轮调三项能力:trustpilot/reviews 查 hellofresh.com、按最新排序取 50 条;google_play/reviews 查安卓应用 com.hellofresh.androidapp、按最新排序取 100 条;reddit/subreddit_posts 读 r/hellofresh、按最新排序取 50 个帖子。另外每轮顺手用 reddit/search 按关键词「HelloFresh」搜一次全站。三轮的时刻是 11 月 14 日新加坡时间 13:08、13:28 和 13:48,最后一次调用在 13:49,前后约 41 分钟。
第一轮是全量,后两轮只数「之前任何一轮都没见过的 ID」。去重按「平台 + id」做,和后面 Delta 表里的 dedupe_key 是同一个规则。
| 轮次(新加坡时间) | 能力 | 本次返回 | 新出现的 ID | 内容有变化的老 ID | `charged_usd` |
|---|---|---|---|---|---|
| T1 13:08 | trustpilot/reviews | 50 | — | — | $0.001389 |
| T1 13:10 | google_play/reviews | 100 | — | — | $0.001389 |
| T1 13:11 | reddit/subreddit_posts | 50 | — | — | $0.000556 |
| T1 13:08 | reddit/search | 2 | — | — | $0.000792 |
| T2 13:28 | trustpilot/reviews | 50 | 0 | 0 | $0.001389 |
| T2 13:28 | google_play/reviews | 100 | 0 | 0 | $0.001389 |
| T2 13:28 | reddit/subreddit_posts | 50 | 0 | 0 | $0.000556 |
| T2 13:28 | reddit/search | 2 | 0 | 1 | $0.000792 |
| T3 13:48 | trustpilot/reviews | 50 | 0 | 0 | $0.001389 |
| T3 13:48 | google_play/reviews | 100 | 0 | 0 | $0.001389 |
| T3 13:49 | reddit/subreddit_posts | 50 | 0 | 0 | $0.000556 |
| T3 13:48 | reddit/search | 1 | 0 | 1 | $0.000792 |
13:28 和 13:48 两轮,Trustpilot、Google Play、r/hellofresh 三个来源新出现的 ID 都是 0,返回的仍是 T1 那一批,三个来源里内容有变化的老 ID 也是 0。这和前面算的速度对得上:Trustpilot 一天约 7.4 条,平均三个多小时才来一条新评论;T1 里最新那条 Trustpilot 评论发布于 UTC 02:19,到 T3 时已经过了三个半小时,40 分钟里没有新评论很正常。唯一有变化的是 reddit/search:T2 时有一个帖子的点赞数变了,T3 本次返回 1 条,它的点赞数和评论数又变了。公开数据里变得最勤的是互动数,所以 MERGE 要能更新 like_count、comment_count,但没必要为了这几列高频重拉。各来源的互动量也差得很远:Google Play 那 100 条里只有 9 条的 thumbs_up 大于 0,最多的一条是 5;r/hellofresh 那 50 个帖子的点赞数中位数是 7.5,最多的一个是 78。所以 Genie 回答「哪条评价最受认同」时,Google Play 的点赞数几乎没有区分度,应该在列说明里写明只对 Reddit 帖子按点赞排序。
三轮里每次调用的响应时间中位数是 12.2 秒(n=12,即上表 12 次调用,含四项能力)。放在 Genie One 对话里实时调用,提问人要等十几秒,Genie 才拿到数据开始组织回答。
还有一个数和对话里的实时调用直接相关:返回体有多大。T1 那一轮,trustpilot/reviews 50 条是 71,697 字节,平均每条约 1.4 KB;google_play/reviews 100 条是 71,202 字节,每条约 0.7 KB;reddit/subreddit_posts 50 条是 38,531 字节,每条约 0.8 KB。13:29 经 MCP 只取 10 条 1–2 星 Trustpilot 评价,返回 16,447 字节。按英文每 4 个字节约 1 个 token 粗估,50 条 Trustpilot 评价一次就要占掉一万多个 token 的上下文。在对话里实时问,limit 要压小、用 stars 先筛;要看全量和趋势,就交给落表那条路。
三个来源各自的样子
下面的数字来自三轮按 ID 去重后的数据:HelloFresh 一个品牌、一天的样本,不代表行业。
Trustpilot 那 50 条里,verification_level 为 invited 的有 43 条,source 字段是 InvitationLinkApi,也就是商家通过邀请链接请顾客来写的;not-verified 的 7 条,source 是 Organic,顾客自己找上门写的。Trustpilot 帮助中心对评价标签的说明把经 Invitation Link API 收来的评价标为「Invited」,自发写的评价标为「Unprompted review」,两类在公开页面上就分开显示。在这次样本里,两类的星级差得很远:自发的 7 条里 6 条是 1–2 星,占 85.7%;邀请的 43 条里 1–2 星只有 8 条,占 18.6%。13:29 那次经 MCP 专门取最新 10 条 1–2 星评价,自发和邀请各占 5 条,而自发评价在全部 50 条里只占 7 条。如果 Genie Agent 不分这两类直接算平均分,邀请评价会把自发的抱怨冲淡。按 1–5 星算平均分,邀请的 43 条是 3.70 分,自发的 7 条是 1.57 分,50 条合起来是 3.40 分;自发的 7 条里只有 1 条 4 星,没有 5 星。
回复速度也不一样。Trustpilot 那 50 条里商家回了 42 条,从评论发布到商家回复的中位数是 22.1 小时。按两类分开看,邀请评价 43 条回了 38 条,中位数 22.3 小时;自发评价 7 条回了 4 条,中位数 17.3 小时,只有 4 个数,只能看量级。Google Play 那 100 条里开发者回了 23 条,中位数 0.8 小时。Google Play 回得少但回得快,23 条回复里有 11 条回的是 1–2 星评价,17 条 1 星里回了 10 条,5 星的 54 条只回了 4 条;Trustpilot 几乎每条都回,但要隔天。所以 MERGE 要能更新老行:Trustpilot 的回复大多在评论入表之后一天左右才出现。
按星级看回复率,两个平台的做法相反。Trustpilot 上 4–5 星 27 条回了 26 条,1–2 星 14 条回了 10 条,好评几乎全回,差评反而漏得多;Google Play 上 1–2 星 20 条回了 11 条(55%),4–5 星 71 条只回了 8 条(11%),开发者把回复留给了差评。只看「回复率」一个数,Trustpilot 的 84% 比 Google Play 的 23% 好看得多,但「差评有没有人管」这个问题上,两边差得没有那么远。给 Genie Agent 写基准问题时,最好把「差评回复率」单独列一条,不要只问总回复率。
Google Play 那 100 条按 score 分,5 星 54 条、4 星 17 条、3 星 9 条、2 星 3 条、1 星 17 条,1–2 星合计 20%。这 100 条里有 85 条集中在 26.42 到 26.45 四个版本,20 条 1–2 星里也有 15 条落在这四个版本。按版本算差评占比,结果在下表:最高的 26.44 是 6/25,最低的 26.43 是 2/15。每个版本只有十几到二十几条,这点差别说明不了哪一版更差;要看版本趋势,得在表里攒几周的数据再比。这也是 app_version 做成正式列、不丢进 extra 的原因:Genie 按版本分组时,要的是一个有列说明的普通列。
| `app_version` | 本次样本条数 | 其中 1–2 星 | 差评占比 |
|---|---|---|---|
| 26.42 | 28 | 4 | 14% |
| 26.44 | 25 | 6 | 24% |
| 26.45 | 17 | 3 | 18% |
| 26.43 | 15 | 2 | 13% |
| 其余 15 条 | 15 | 5 | — |
差评的正文也更长。按正文字符数取中位数,Trustpilot 的 14 条 1–2 星是 206.5 个字符,27 条 4–5 星是 102 个;Google Play 的 20 条 1–2 星是 162.5 个,71 条 4–5 星是 63 个。差评大约是好评的两倍到两倍半长。这和返回体的大小对得上:13:29 经 MCP 只取 10 条差评,返回 16,447 字节,每条约 1.6 KB,比 T1 那 50 条混合评价平均每条 1.4 KB 还大。在对话里实时问差评时,limit 要比问全部评价时再压小一些。
r/hellofresh 那 50 个帖子没有星级,信息在 flair 和 comment_count 里:没有 flair 的 22 个,「United States」13 个,「Question」8 个,「Picture」4 个。Reddit 帖子适合回答「顾客在问什么」,例如取消订阅、配送区域、某道菜怎么做;它和评论表的星级不能放在一起平均。讨论热度也很集中:50 个帖子的评论数中位数是 4,评论最多的 3 个帖子分别有 79、43、27 条评论,合计 149 条,占全部 453 条评论的 32.9%。所以每天的简报只列评论数最多的几个帖子,就能盖住三分之一的讨论。reddit/search 按「HelloFresh」搜全站最新内容,本次返回 2 条:它用来发现别的社区里的提及,r/hellofresh 的 50 条用来做每天的增量。
| 来源 | 本次样本 | 1–2 星 | 有商家或开发者回复 | 回复时间中位数 | 适合回答的问题 |
|---|---|---|---|---|---|
trustpilot/reviews(邀请) | 43 条 | 8 条 | 38 条 | 22.3 小时 | 下单顾客的整体满意度 |
trustpilot/reviews(自发) | 7 条 | 6 条 | 4 条 | 17.3 小时(只有 4 个数) | 主动来投诉的人在说什么 |
google_play/reviews | 100 条 | 20 条 | 23 条 | 0.8 小时 | 应用版本和功能问题 |
reddit/subreddit_posts | 50 个帖子 | 无星级 | 无 | 无 | 顾客在问什么、讨论什么 |
落表:一张 Delta 表装下三种来源
Trustpilot 评价、Google Play 评价和 Reddit 帖子的字段名各不相同:星级在 Trustpilot 叫 rating,在 Google Play 叫 score;点赞在 Google Play 叫 thumbs_up,另外两边叫 like_count。如果每个来源一张表,Genie Agent 回答「三个渠道上周一共多少条 1–2 星」时要自己写三段 UNION,出错的机会多一倍。我们的做法是一张宽表,公共字段做成列,各来源独有的字段放进一个 VARIANT 列备查。下表右边三列是目录 response_fields 里的原字段名,「—」表示这个来源没有这一项。我们用脚本把表里每个原字段和当天目录的 response_fields 比了一遍,差集为空。
| Delta 列 | `trustpilot/reviews` | `google_play/reviews` | `reddit/subreddit_posts` |
|---|---|---|---|
source_id | id | id | id |
url、title、text | 同名 | 同名 | 同名 |
rating | rating(1–5) | score(1–5) | — |
like_count | like_count | thumbs_up | like_count |
comment_count | — | — | comment_count |
reply_text、reply_at | 同名(商家回复) | 同名(开发者回复) | — |
posted_at | posted_at | posted_at | posted_at |
updated_at、experience_at | 同名 | — | — |
language | language | language | — |
country、verification_level、review_source | country、verification_level、source | — | — |
app_version | — | app_version | — |
community、flair | — | — | community、flair |
author_hash | author_name 取哈希 | author_name 取哈希 | author_username 取哈希 |
作者名只存哈希。Genie Agent 的回答会被很多同事看到,评论人的名字对分析没有用,留着反而要处理隐私问题;哈希值仍然能数「同一个人发了几条」。头像地址(author_image、author_avatar_url)直接丢掉。三列是我们自己加的:dedupe_key(来源加原 id,例如 trustpilot:6af7a918…)、snapshot_ts(这次调用的时刻)、ingested_at(写入表的时刻)。
-- 配置示例:Unity Catalog 里的目标表(没有在 Databricks 上执行过)
CREATE TABLE IF NOT EXISTS main.voice.public_brand_reviews (
  dedupe_key         STRING NOT NULL COMMENT '来源:原id,例如 trustpilot:6af7…;去重和 MERGE 的键',
  source             STRING NOT NULL COMMENT 'EveryInfra 能力名:trustpilot/reviews、google_play/reviews、reddit/subreddit_posts',
  brand              STRING NOT NULL COMMENT '品牌,例如 hellofresh',
  source_id          STRING NOT NULL,
  url STRING, title STRING, text STRING,
  rating             INT    COMMENT '1–5 星;Reddit 为空',
  like_count         INT, comment_count INT,
  reply_text         STRING COMMENT '商家或开发者的回复;为空表示没回',
  reply_at           TIMESTAMP,
  posted_at          TIMESTAMP NOT NULL,
  updated_at         TIMESTAMP, experience_at TIMESTAMP,
  language STRING, country STRING,
  verification_level STRING COMMENT 'Trustpilot:invited 邀请评价 / not-verified 自发评价',
  review_source STRING, app_version STRING, community STRING, flair STRING,
  author_hash        STRING COMMENT 'sha256(作者名),不存原名',
  extra              VARIANT COMMENT '其余原字段',
  snapshot_ts        TIMESTAMP NOT NULL,
  ingested_at        TIMESTAMP NOT NULL
) CLUSTER BY (brand, source, posted_at)
COMMENT '公开评论与帖子,按 dedupe_key 去重,每天增量 MERGE';
CLUSTER BY 用的是 Delta 的液体聚簇,Genie 生成的查询大多按品牌、来源和时间过滤,按这三列聚簇能少扫数据。列注释要写清楚,Genie Agents 最佳实践把「Unity Catalog 里的表和列描述」列为准确率的第一条,verification_level 这一列尤其要写明两个取值的意思,原因见前面「三个来源各自的样子」一节的数字。
每天增量怎么取:水位线加回看窗口
这三个来源都没有「给我某个时间点以后的新评论」这种参数。trustpilot/reviews 有一个 date 参数,只能取 last7days、last30days 这类相对时段;google_play/reviews 和 reddit/subreddit_posts 按最新排序,返回最新的若干条。所以增量要靠我们自己:每个来源记一个水位线(上次见过的最新 posted_at),每次按最新排序拉一批,用 dedupe_key 去重后 MERGE 进表。
拉多少条够,要看这个来源一天出多少条。T1 那一轮的数字是:Trustpilot 最新 50 条覆盖了 6.77 天,Google Play 最新 100 条覆盖了 27.59 天,r/hellofresh 最新 50 个帖子覆盖了 9.17 天。按这个速度,每天跑一次时,Trustpilot 一天约 7.4 条、Google Play 约 3.6 条、r/hellofresh 约 5.5 条,每次拉 50 条都有好几倍的余量。判断余量够不够有一个简单的检查:如果这一批里最旧的一条 posted_at 仍然晚于水位线,说明这批没盖住上次到这次之间的全部新内容,要翻页(Google Play 用响应里的 next_page_token)或者加大 limit。
水位线不能卡得太死。Trustpilot 的评论有 posted_at 和 updated_at 两个时间,T1 里第一条评论 posted_at 是 02:19:36(UTC),updated_at 是 02:49:31,评论人发布半小时后又改过;商家回复也是后补上去的。只按「比水位线新的 id」插入,会漏掉老评论后来加上的回复和修改。所以 MERGE 分两种情况:没见过的 dedupe_key 插入;见过的,只在回复、正文、点赞这几列变了时更新。Delta 的 MERGE 文档提醒两件事:源数据自己要先去重,否则同一批里的重复行会被一起插入;只在最近几天里找重复,可以用时间条件缩小范围。时间条件放在哪里很要紧,见代码后的说明。
-- 配置示例:每天的增量写入(staging 表由下一节的作业写入)
MERGE INTO main.voice.public_brand_reviews AS t
USING (
  SELECT * FROM main.voice.public_brand_reviews_staging
  WHERE posted_at > current_timestamp() - INTERVAL 60 DAYS   -- 回看窗口放在源一侧
  QUALIFY ROW_NUMBER() OVER (PARTITION BY dedupe_key ORDER BY snapshot_ts DESC) = 1
) AS s
ON t.dedupe_key = s.dedupe_key                                -- 匹配条件只用去重键
WHEN MATCHED AND (t.reply_text IS DISTINCT FROM s.reply_text
               OR t.text IS DISTINCT FROM s.text
               OR t.like_count IS DISTINCT FROM s.like_count) THEN
  UPDATE SET t.reply_text = s.reply_text, t.reply_at = s.reply_at, t.text = s.text,
             t.like_count = s.like_count, t.updated_at = s.updated_at, t.snapshot_ts = s.snapshot_ts
WHEN NOT MATCHED THEN INSERT *;
回看窗口取 60 天,是按 Google Play 最新 100 条覆盖 27.59 天、再放一倍余量定的。这个时间条件要写在 USING 子查询里过滤 staging,不能写进 ON。写进 ON 时,staging 里一条 60 天以前发的评论(低频来源按最新排序拉一页,就可能带回这样的老评论)会让 ON 不成立,被当成 NOT MATCHED,每天再插入一次,表里就出现重复行。放在源一侧,60 天以前的老评论这一轮直接不参与合并,表里已有的那一行保持不变。评论被删掉的情况这里不处理,因为按最新排序只拉一页时,「这一页里没出现」不等于「被删了」。
多个作业写同一张表时怎么避免冲突
一个品牌一个作业很简单。真到用起来,市场部会再加竞品,客服会要自己的产品线,很快就有五六个作业在同一时段往 public_brand_reviews 里写。Databricks 的隔离级别与写冲突文档写明:多个作业或用户同时写同一张表时,其中一些写入会因冲突异常失败。Databricks 一侧同样没有实测,下面是配置示例。
第一件事是让表满足行级并发的条件。行级并发文档列了三个条件:Databricks Runtime 14.3 LTS 及以上、表不分区、表开了删除向量。三个都满足时,两个并发的 MERGE 改的是同一个数据文件里的不同行,也能自动解决,不再报冲突。前面的建表语句用的是液体聚簇,没有分区,第二条已经满足;删除向量用一句 ALTER TABLE 打开。注意这句本身是元数据变更,文档写明元数据变更可能让同一时刻所有并发写入失败,所以要在建表时、没有作业在跑的时候执行一次,不要放进每天的作业里。
第二件事是让每个作业只碰自己那一块。同一份文档建议在 MERGE 的匹配条件里显式写上隔离用的列,让两个操作涉及的文件集合不重叠。对这张表来说就是把 brand 写进 ON 条件,再配合按 brand 聚簇,HelloFresh 的作业和竞品的作业基本不会读到对方的文件。staging 表也按品牌分开,每个作业写自己的 public_brand_reviews_staging_<品牌>,避免一个作业的 INSERT OVERWRITE 把另一个作业还没合并的数据冲掉。
-- 配置示例:建表后执行一次,打开删除向量(元数据变更,避开作业运行时段)
ALTER TABLE main.voice.public_brand_reviews SET TBLPROPERTIES ('delta.enableDeletionVectors' = true);

-- 每个品牌的作业只合并自己的品牌
MERGE INTO main.voice.public_brand_reviews AS t
USING (
  SELECT * FROM main.voice.public_brand_reviews_staging_hellofresh
  WHERE posted_at > current_timestamp() - INTERVAL 60 DAYS
  QUALIFY ROW_NUMBER() OVER (PARTITION BY dedupe_key ORDER BY snapshot_ts DESC) = 1
) AS s
ON t.brand = 'hellofresh' AND t.dedupe_key = s.dedupe_key
WHEN MATCHED AND (t.reply_text IS DISTINCT FROM s.reply_text
               OR t.text IS DISTINCT FROM s.text
               OR t.like_count IS DISTINCT FROM s.like_count) THEN
  UPDATE SET t.reply_text = s.reply_text, t.reply_at = s.reply_at, t.text = s.text,
             t.like_count = s.like_count, t.updated_at = s.updated_at, t.snapshot_ts = s.snapshot_ts
WHEN NOT MATCHED THEN INSERT *;
第三件事是把重试放在对的地方。文档写明,两个操作冲突时只有「读了受影响数据」的那个会失败,单纯追加的 INSERT 不会是失败的一方,所以重试逻辑要加在 MERGE 上,而不是加在调接口那一步。调接口那一步已经有自己的重试和幂等键,重跑也不会重复扣费;MERGE 失败时只需要隔几十秒再执行一次同一条语句,因为 staging 表里的数据还在。
第四件事和表结构有关。文档提醒带自增标识列(identity column)的表不支持并发事务,所以这张表的主键用字符串 dedupe_key,不用自增 ID。另一个原因是新字段:某个来源以后多返回一个字段时,如果每次都 ALTER TABLE ADD COLUMNS,就会撞上前面说的元数据变更,让当时所有作业一起失败。来源独有的字段先进 extra 这个 VARIANT 列,等确认要长期用、要给 Genie 写列说明了,再挑一个没有作业在跑的时间加成正式列。读的一方不用担心:文档写明读者看到的是查询开始那一刻的一致快照,Genie Agent 查询时如果有作业在写,也不会读到写了一半的数据。
接法一:在 Genie One 对话里经远程 MCP 直接问(配置示例)
这条路适合临时的问题:产品经理在 Genie One 里问「HelloFresh 最近 10 条 1–2 星 Trustpilot 评论在抱怨什么」,Genie 当场调 EveryInfra 的工具拿数据,不落表。Databricks 一侧我们没有工作区实测,下面的步骤按外部 MCP 服务器文档(页面更新日期 2026 年 10 月 27 日)整理。
第一步,在 Unity Catalog 里建一个 HTTP 连接存 Key。HTTP 连接文档给的 SQL 写法支持从密钥范围读 bearer token,Key 不会出现在任何人的代码里;文档还写明,令牌只会发往建连接时填的那个主机名。
-- 配置示例:Key 先放进密钥范围 everyinfra,再建连接
CREATE CONNECTION everyinfra_mcp TYPE HTTP
OPTIONS (
  host 'https://api.everyinfra.com',
  port '443',
  base_path '/mcp',
  bearer_token secret('everyinfra', 'api_key')
);
第二步,在 Unity Gateway 的 MCPs 页面点「+ MCP」,选「Connect an existing MCP server」,挑一个 catalog 和 schema(例如 main.voice),名字填 everyinfra(建了以后不能改),连接选上一步的 everyinfra_mcp,点「Create & load tools」。EveryInfra 的 MCP 服务器会列出 12 个工具(11 月 14 日 13:11 调 tools/list 实测),只需要勾 everyinfra_list_capabilities、everyinfra_call_api、everyinfra_get_job 三个读数据的工具,其余的(工单、充值链接、验证码、对话接口)在这个场景里用不上,关掉能少占模型的上下文,也少一类误调用。登记完的完整名是 main.voice.everyinfra,URL 是 https://<workspace-hostname>/ai-gateway/mcp-services/main.voice.everyinfra。文档建议先在 AI Playground 里选一个开了工具的模型,加上这个外部 MCP,让它调一次只读工具确认能通。
第三步,授权。Unity Gateway 的 MCP 治理文档讲怎么把 EXECUTE 授给一个组;Genie One 外部应用文档写明,用户在对话框左下角的加号里点「Connectors」→「Browse connectors」就能把它加进当前对话,网关在每次工具调用前检查调用人有没有 EXECUTE,并把用量和审计记录写进系统表。这里的 Key 是连接上的共享凭据,所有有 EXECUTE 的人调用时扣的是同一个 EveryInfra 账户,所以授权范围要和预算一起定。
HTTP 连接文档一共列了五种鉴权方式:Bearer token、动态客户端注册、OAuth M2M、共享的 OAuth U2M 和每个用户各自的 OAuth U2M。EveryInfra 的远程 MCP 用 API Key 鉴权,对应第一种。如果你的团队希望每个人用自己的 EveryInfra 账户、各扣各的钱,就不能用一个共享连接,而要给每个团队各建一个连接、各存一把 Key,再分别授权,这样账单也能按团队分开看。
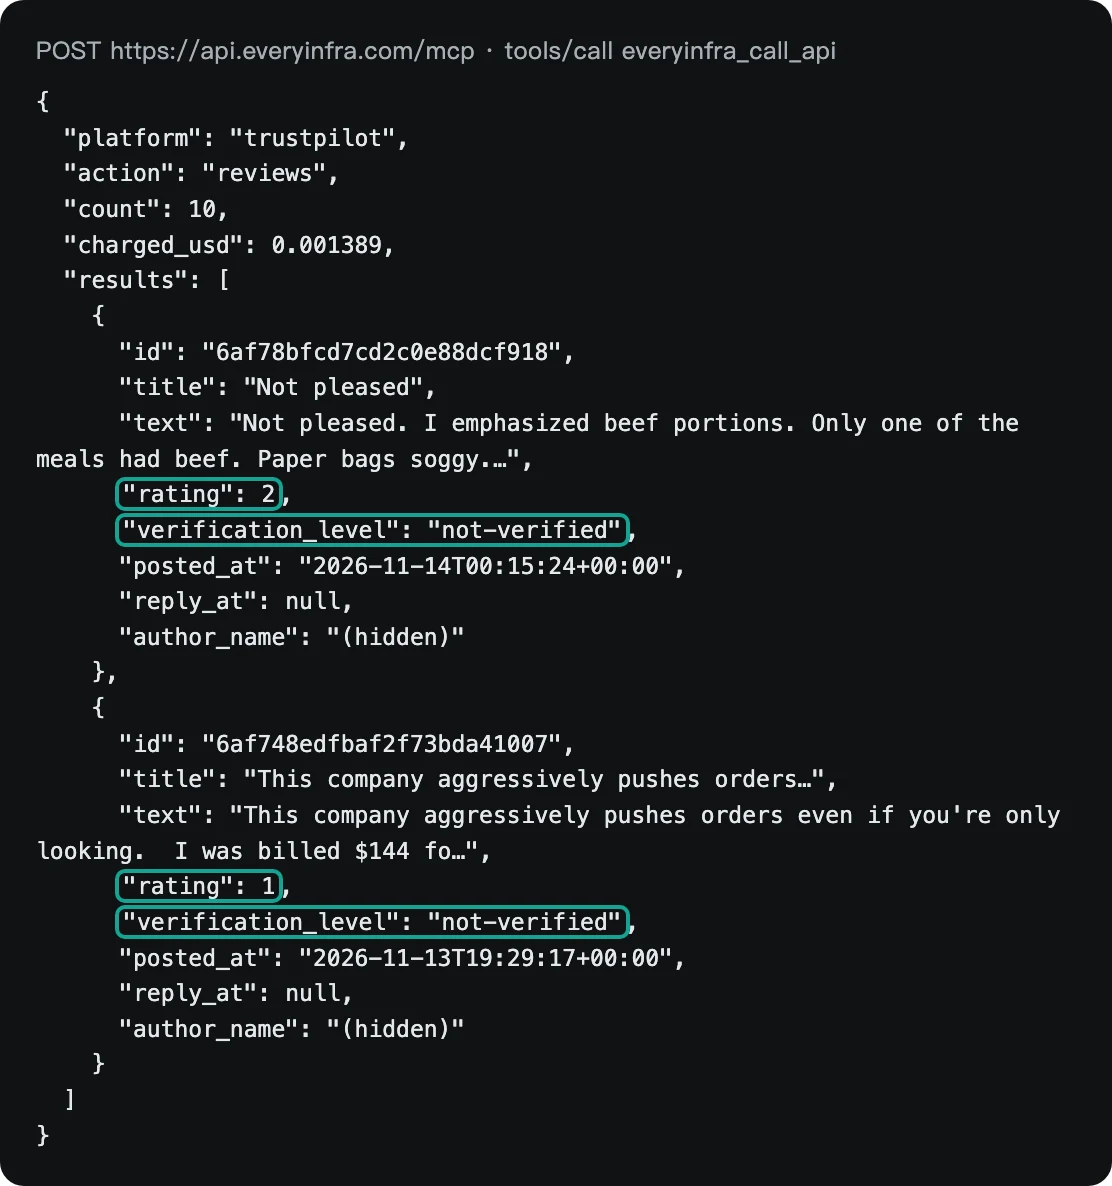
Genie 发出的工具调用长这样(这是我们 11 月 14 日 13:29(新加坡时间)经 https://api.everyinfra.com/mcp 发出的真实请求,参数和对话里的提问一一对应):
{"jsonrpc": "2.0", "id": 3, "method": "tools/call",
 "params": {"name": "everyinfra_call_api",
            "arguments": {"platform": "trustpilot", "action": "reviews",
                          "params": {"company": "hellofresh.com", "stars": ["1", "2"], "limit": 10}}}}
返回的 results 是 10 条 1–2 星评价,其中 1 星 8 条、2 星 2 条;charged_usd 是 $0.001389,和走 REST 同一个价,一次调用扣一次,不按条数加价。10 条里 verification_level 为 not-verified 和 invited 的各 5 条,而且全部出现在 13:28 那一轮按最新排序取的 50 条里。对话里临时问「最近的差评」时,用 stars 先筛、只取 10 条,模型要读的内容少得多,回答也更集中。下图是这次返回的前两条,作者名已隐去。
接法二:定时作业经 REST 落进 Delta 表,再让 Genie Agent 查(配置示例)
要回答「上个月」「和去年同期比」这类问题,就要有历史;要让 Genie Agent(而不只是 Genie One)回答,就要有表。这条路由一个 Lakeflow 作业每天跑一次:调 EveryInfra 的 REST 接口,写进 staging 表,再执行「每天增量怎么取」一节的 MERGE。
请求可以不碰 Key。HTTP 连接文档写了一个代理地址:对 https://<workspace-hostname>/api/2.0/unity-catalog/connections/<连接名>/proxy/<子路径> 发请求,Databricks 会把连接里存的凭据加上再转发。为 REST 另建一个 base_path 为 /api/v1 的连接 everyinfra_api,作业里的请求就发到 .../connections/everyinfra_api/proxy/social。文档没有写代理会不会原样转发自定义请求头;如果 Idempotency-Key 被丢掉,就退回到用 dbutils.secrets.get 读 Key、直接请求 https://api.everyinfra.com/api/v1/social。密钥文档写明作业里的 dbutils.secrets 读工作区密钥范围是支持的。
# 配置示例:Lakeflow 作业里的一个 Python 任务。请求参数和我们 11 月 14 日本地实测用的一样;Databricks 一侧没有跑过。
import hashlib, json, time, datetime, requests
from pyspark.sql import Row

KEY = dbutils.secrets.get("everyinfra", "api_key")
URL = "https://api.everyinfra.com/api/v1/social"
RUN_DAY = datetime.date.today().isoformat()
JOBS = [
    ("trustpilot", "reviews", {"company": "hellofresh.com", "sort": "newest", "limit": 50}),
    ("google_play", "reviews", {"app_id": "com.hellofresh.androidapp", "sort": "newest", "limit": 100}),
    ("reddit", "subreddit_posts", {"subreddit": "hellofresh", "sort": "newest", "limit": 50}),
]

def call(platform, action, params):
    # 同一天同一项能力用同一个幂等键:作业被重跑时不会重复扣费
    idem = f"hellofresh:{platform}:{action}:{RUN_DAY}"
    for attempt in range(4):
        r = requests.post(URL, timeout=120, json={"platform": platform, "action": action, "params": params},
                          headers={"Authorization": f"Bearer {KEY}", "Idempotency-Key": idem})
        if r.status_code == 429:
            time.sleep(int(r.json()["error"].get("retry_after", 60))); continue
        if r.status_code in (502, 503, 504):
            time.sleep(30 * (attempt + 1)); continue   # 失败不扣费,稍后重试
        r.raise_for_status()
        return r.json()
    raise RuntimeError(f"{platform}/{action} 重试 4 次仍失败")

rows, snap = [], datetime.datetime.utcnow()
for platform, action, params in JOBS:
    body = call(platform, action, params)
    for x in body["results"]:
        rows.append(Row(
            dedupe_key=f"{platform}:{x['id']}", source=f"{platform}/{action}", brand="hellofresh",
            source_id=x["id"], url=x.get("url"), title=x.get("title"), text=x.get("text"),
            rating=x.get("rating", x.get("score")), like_count=x.get("like_count", x.get("thumbs_up")),
            comment_count=x.get("comment_count"), reply_text=x.get("reply_text"), reply_at=x.get("reply_at"),
            posted_at=x["posted_at"], updated_at=x.get("updated_at"), experience_at=x.get("experience_at"),
            language=x.get("language"), country=x.get("country"), verification_level=x.get("verification_level"),
            review_source=x.get("source"), app_version=x.get("app_version"), community=x.get("community"),
            flair=x.get("flair"),
            author_hash=hashlib.sha256((x.get("author_name") or x.get("author_username") or "").encode()).hexdigest(),
            extra=json.dumps({k: v for k, v in x.items() if k in ("author_review_count", "is_verified", "domain", "external_link")}),
            snapshot_ts=snap.isoformat(), ingested_at=datetime.datetime.utcnow().isoformat()))

spark.createDataFrame(rows).createOrReplaceTempView("batch")
spark.sql("""INSERT OVERWRITE main.voice.public_brand_reviews_staging
             SELECT dedupe_key, source, brand, source_id, url, title, text, CAST(rating AS INT),
                    CAST(like_count AS INT), CAST(comment_count AS INT), reply_text, CAST(reply_at AS TIMESTAMP),
                    CAST(posted_at AS TIMESTAMP), CAST(updated_at AS TIMESTAMP), CAST(experience_at AS TIMESTAMP),
                    language, country, verification_level, review_source, app_version, community, flair,
                    author_hash, parse_json(extra), CAST(snapshot_ts AS TIMESTAMP), CAST(ingested_at AS TIMESTAMP)
             FROM batch""")
# 接着执行「每天增量怎么取」一节的 MERGE幂等键的写法和为什么要带,单独写过一篇:AI agent 重试时怎么用 Idempotency-Key 防重复扣费。作业的时间表按定时作业文档在「Schedules & Triggers」里设,高级模式可以写 Quartz cron 并选时区;文档提醒,选了有夏令时的时区,按小时跑的作业在夏令时切换那天会被跳过或推迟一两个小时,每天一次的作业不受影响。
表建好以后,在 Genie Agent 的配置里把 public_brand_reviews 和企业自己的销量表、工单表放在一起,再写几条说明。Genie Agents 概念文档写了数据权限的规则:SQL 用作者嵌入的计算凭据在 SQL 仓库上跑,数据权限按提问人自己的 Unity Catalog 权限判断,所以评论表可以单独授权给市场和客服团队。下面是我们建议写进 Agent 说明里的三条:
1. 「差评」指
rating为 1 或 2;Reddit 帖子没有星级,不计入差评。 2. Trustpilot 的verification_level = 'invited'是商家邀请来的评价,'not-verified'是自发评价,问「顾客自发怎么说」时只看后者。 3. 时间按posted_at算;问「最近」默认指最近 7 天。
Databricks Genie Agent 里能问出什么:三条示例 SQL
Genie Agents 最佳实践更推荐另一种写法:业务含义尽量用 SQL 表达式和示例 SQL 来定义,纯文字说明只留给其他办法表达不了的情况。文档的原意是,示例 SQL 能让 Genie 把用户的问题匹配到验证过的查询上,再照着它回答相近的问题。所以表建好以后,第一件事是把三个最常被问到的问题写成示例 SQL 放进 Agent。下面三条是我们按 HelloFresh 的数据设计的,表名和列名和前文一致,工单表 main.support.tickets 是假设的结构,换成你自己的即可。
第一个问题是「上周顾客自发的差评都在说什么」。关键在于先按 verification_level 过滤,再按星级过滤,并且按发布时间而不是入表时间算「上周」。前文的样本里,14 条差评有 8 条是邀请评价,不先过滤的话,「上周差评摘要」大半写的是邀请评价。
「上周」用哪个时间算,也要按数据定。Trustpilot 每条评价有 experience_at(顾客说的体验日期)和 posted_at(发布时间)。T1 那 50 条里,从体验到发布的中位数是 12.7 天:3 天以内写的只有 9 条,3–15 天的 29 条,15–60 天的 4 条,60 天以上的 8 条,最久的一条隔了 304.8 天。如果按 experience_at 算「上周」,上周的差评数在之后两三周里还会一直往上涨,同一个问题这周问和下周问答案不一样;按 posted_at 算,一周过完这个数基本就定了。所以示例 SQL 和 Agent 说明都按 posted_at,experience_at 只在要看「顾客在哪天遇到问题」时用。
-- 配置示例:示例 SQL 1「上周顾客自发的差评」
SELECT posted_at, rating, title, text, reply_text IS NOT NULL AS replied
FROM main.voice.public_brand_reviews
WHERE brand = 'hellofresh'
  AND source = 'trustpilot/reviews'
  AND verification_level = 'not-verified'
  AND rating <= 2
  AND posted_at >= date_trunc('WEEK', current_date()) - INTERVAL 7 DAYS
  AND posted_at <  date_trunc('WEEK', current_date())
ORDER BY posted_at DESC;
第二个问题是「差评里说的事,退款工单里有没有」。示例 SQL 按天和关键词把两边对上,关键词表 main.voice.issue_keywords 由业务方维护,例如「steak、beef」对应「肉类品质」。这种对法是近似的,评论人和下单人对不上号,只能看同一时段同一类问题在两边是不是一起冒出来。
-- 配置示例:示例 SQL 2「差评话题和退款工单按周对比」
WITH r AS (
  SELECT date_trunc('WEEK', posted_at) AS wk, k.issue, count(*) AS low_reviews
  FROM main.voice.public_brand_reviews v
  JOIN main.voice.issue_keywords k ON lower(v.text) LIKE concat('%', k.keyword, '%')
  WHERE v.brand = 'hellofresh' AND v.rating <= 2
  GROUP BY 1, 2),
t AS (
  SELECT date_trunc('WEEK', created_at) AS wk, issue, count(*) AS refund_tickets
  FROM main.support.tickets
  WHERE brand = 'hellofresh' AND ticket_type = 'refund'
  GROUP BY 1, 2)
SELECT coalesce(r.wk, t.wk) AS wk, coalesce(r.issue, t.issue) AS issue,
       coalesce(low_reviews, 0) AS low_reviews, coalesce(refund_tickets, 0) AS refund_tickets
FROM r FULL OUTER JOIN t ON r.wk = t.wk AND r.issue = t.issue
ORDER BY wk DESC, low_reviews DESC;
第三个问题是「哪个渠道我们回得慢」。用 percentile 算回复时间中位数,结果应该和前文实测的量级一致:Trustpilot 约 22 小时,Google Play 不到 1 小时。如果 Genie 回答的数和这个差得很远,多半是它把没回复的评论也算进去了,可以把它加成基准问题。最后一列是上文说的差评回复率,按本次样本,Trustpilot 应该是 10/14,Google Play 是 11/20;percentile 会跳过 reply_at 为空的行,所以同一条 SQL 里不用再按是否回复过滤。
-- 配置示例:示例 SQL 3「各渠道回复时间中位数(小时)」
SELECT source,
       count(*) AS reviews,
       count(reply_at) AS replied,
       percentile(timestampdiff(MINUTE, posted_at, reply_at) / 60.0, 0.5) AS median_reply_hours,  -- 没回复的行 reply_at 为空,不参与
       count_if(rating <= 2 AND reply_at IS NOT NULL) / count_if(rating <= 2) AS low_star_reply_rate
FROM main.voice.public_brand_reviews
WHERE brand = 'hellofresh' AND rating IS NOT NULL
GROUP BY source;最佳实践页还建议,问题核对过以后加成基准问题(benchmark),用不同的问法反复测、按准确率打分。上面三条的答案都能从原始数据复算,适合做第一批基准。监控 Genie Agent 的文档写了另一条反馈渠道:用户可以把回答标记为需要复核,有 CAN MANAGE 权限的人在监控页里确认或修正。
权限方面,评论原文里偶尔会有顾客自己写的订单号、电话或地址。行过滤和列掩码文档给的办法是给 text 列加列掩码,例如只有客服组看得到原文,其他人看到的是去掉数字串以后的版本。Genie Agent 的数据权限按提问人自己的 Unity Catalog 权限判断,Genie 生成的查询也在 Unity Catalog 的权限检查下运行,所以列掩码可以和 Agent 一起用。
每天早上发一份评论简报:Genie One 定时任务
表和 Agent 都有了以后,最常见的下一个需求是「别让我每天去问,直接发给我」。常驻的新 Genie 还在等预览名额,但 Genie One 现在就有定时任务。Genie One 对话文档写明,定时任务在指定时间自动运行,结果发到一个对话线程里,同时给你发一封带图表和 PDF 附件的邮件;11 月 12 日的发布说明又加了一条,定时任务可以发邮件给组织里的其他人。文档举的例子是:「每天给我发一份我这家门店所有新顾客评论的简报」。
建任务有两种方式。一种是在对话里直接用自然语言说,Genie One 会追问时间、范围这些细节,然后把任务加进 Schedules;另一种是在侧边栏点 Schedules,在「+ Create in chat」旁边的下拉里选「Create manually」,填标题、说明、连接、时间表和时区。我们建议用第二种,把说明写死,免得每天的简报范围和写法变来变去。下面是按本文的表写的任务说明,属于配置示例:
每天新加坡时间上午 9 点运行。用 public_brand_reviews 表,只看 brand = 'hellofresh'。第一段:过去 24 小时三个来源各新增多少条,按 posted_at 算。第二段:Trustpilot 自发评价(verification_level = 'not-verified')里 1–2 星的全部列出,每条一句话概括,标出是否已回复。第三段:Google Play 1–2 星评价里提到的应用版本(app_version),按次数排序。第四段:r/hellofresh 评论数最多的 3 个帖子标题。没有新数据的段落写「无新增」,不要编造。
这份说明里的每个过滤条件都对应前文的一个实测发现:自发评价单独列,是因为在这次样本里两类的差评率差得很远(6/7 对 8/43);Google Play 看版本,是因为评价带 app_version,样本里 85 条集中在最近四个版本,能直接对上你们的发版记录;Reddit 只取评论数最多的帖子,是因为它没有星级,而评论最多的 3 个帖子就占了三分之一的评论。任务运行的时间要排在评论作业之后,例如作业在新加坡时间早上 8 点跑完写表,简报 9 点发,中间留出 MERGE 和重试的时间。简报的收件人也写在任务里,换人时只改任务,不用动作业和表。
简报只查表,不调接口,多发几个人也不多扣费。如果有人想在简报里顺手加「今天 Trustpilot 最新的 10 条差评」,那是接法一的实时调用,它和表里的数据会有重叠,最好在说明里写清楚以表为准。
两种接法怎么选
建议先建表,再给少数人开对话里的实时查询。
| 比较项 | 接法一:Genie One + 自定义 MCP | 接法二:作业落表 + Genie Agent |
|---|---|---|
| 新鲜度 | 问的那一刻 | 最多晚一个作业周期(每天 1 次就是最多晚 24 小时) |
| 历史和同比 | 没有,每次只拿最新一批 | 有,表里一直累积 |
| 能不能和销量表、工单表一起查 | 要靠模型在对话里拼 | 一条 SQL 就能 JOIN |
| 谁能用 | Genie One 用户,从 Browse connectors 加 | Genie Agent 的所有用户,按表授权 |
| Genie Agent 能不能用 | 文档列出的连接器里没有自定义 MCP | 能,表是 Unity Catalog 里的普通表 |
| 接口费 | 每问一次扣一次 | 每天固定几次,见下一节 |
| 审计 | 网关按调用记用量和审计日志 | 作业运行记录 + 表的版本历史 |
| 阶段 | 文档已上线 | 用到的全是正式功能(作业、Delta、Genie Agents) |
一笔账:每天一次要多少钱
EveryInfra 一侧按目录 price_usd 和响应里的 charged_usd 算。三项能力当天的目录价是:trustpilot/reviews 每次 $0.001389,google_play/reviews 每次 $0.001389,reddit/subreddit_posts 每次 $0.000556,都是一次调用返回最多 limit 条、只扣一次。T1 那一轮三次调用的 charged_usd 和目录价一致,加起来是 $0.003334,这就是作业跑一次的接口费。
| 频率 | 每天调用次数 | 每天接口费 | 30 天接口费 |
|---|---|---|---|
| 每天 1 次 | 3 | $0.003334 | $0.10 |
| 每 6 小时 1 次 | 12 | $0.013336 | $0.40 |
| 每小时 1 次 | 72 | $0.080016 | $2.40 |
算法:$0.001389 + $0.001389 + $0.000556 = $0.003334,再乘以每天轮数和 30 天。每小时跑一次对这个品牌没有意义:Trustpilot 一天约 7.4 条,每小时跑大多数时候拿回来的都是已经见过的 id,钱花了,新数据没有多。T2、T3 两轮(见实测一节)隔 20 分钟、40 分钟再拉,三个来源新出现的 ID 都是 0。
Databricks 一侧有三块钱要分开看。第一块是 Genie 本身:Genie 文档写明,Genie One 和 Genie Agents 对用户的使用到 2027 年 1 月 31 日前免费,服务主体不在优惠里,按标准价计费。接法二的作业用服务主体跑,但只调 EveryInfra 和写表,不调 Genie,所以不产生 Genie 费用;用户在 Genie Agent 里提问,算的是用户自己的用量。Genie 价格页的注释写,免费额度只覆盖 Genie 的大模型用量,Genie 生成的查询跑在 SQL 仓库上,仓库费另算,并给了一个换算「150 DBU 在美国东部约合 $10.50」。Azure Databricks 的成本监控文档给了按 GENIE_FREE_USAGE 这个 SKU 查免费额度用量的 SQL。第二块是作业的计算费,取决于你用无服务器计算还是自己的集群,这里不估。第三块是存储,这张表一个品牌一年也就几千行,可以忽略。
做不了的和要注意的
第一,Genie Agents 连接 MCP 的文档写明,通过 Agent mode 的 API 只能用读工具,用户也没法在 API 里完成连接器登录;想从自己的应用里程序化地问 Genie Agent,连接器那部分要先在界面里授权好。第二,Genie One 里加自定义 MCP 服务时,如果服务用的是每个用户各自的 OAuth,每个用户都要自己登录一次;用共享 bearer token 就没有这一步,但所有人扣同一个账户。
数据一侧也有边界。hellofresh.com 这个域名下 T1 那 50 条 Trustpilot 评价的 country 全是 US;要看其他国家的评价,把 company 换成那个国家站点的域名分别查。
最后是平台规则。公开页面能看到的评论,用于内部分析和改进产品是常见做法,但转载评论原文、拿评论训练模型、对外发布评论人的信息,各平台的条款有不同要求,例如 Reddit 数据 API 条款和 Trustpilot 的评论人准则。这一类问题请让法务看,本篇不给法律意见;表里只存作者名哈希,就是为了减少这方面的麻烦。
和前几篇的区别
站内写过两篇相近的:Airbyte MCP 接社媒数据:差评和退货合表讲的是 Airbyte 的 MCP 能查仓库里的订单退货、查不了公开评论,重点在评论和订单能不能对上;Google Data Agent Kit 接入社媒数据讲的是 BigQuery 一侧的表结构。还有一篇 SMS MCP 差评短信提醒讲按评论 ID 去重后发提醒。本篇的重点是 Databricks 这一侧:第二代 Genie 的三条 MCP 路分别能做什么、Genie Agent 文档没有写到自定义 MCP 时怎么用落表补上、Delta MERGE 怎么处理后补的商家回复,以及 Trustpilot 邀请评价和自发评价要分开看。评论数据怎么做成产品,可以再看评论数据如何做成付费产品。
行业动向
- 2026 年 11 月 11 日:Databricks 发布第二代 Genie,同时推出给 ChatGPT、Claude、Microsoft Copilot Cowork、Grok Bot 用的 Genie 插件(插件博客),同日 Genie Ontology 正式可用。对读者的意思是:别的 agent 能经 Genie 读你的仓库,但往仓库里补外部数据仍要你自己接。
- 2026 年 11 月 12 日:AI/BI 与 Genie One 发布说明写,Genie Agent 的配置页有了单独的连接器区(Beta),Genie One 的定时任务可以给其他同事发邮件。意味着按天出的评论简报可以直接发给团队。
- 2026 年 11 月 5 日:同一份发布说明写,用户只能访问 Genie Agent 挂的部分 MCP 连接时,不再被整个挡住,Agent 只用他能访问的来源回答。意味着评论表和连接器可以分团队授权。
- 2026 年 11 月 2 日:同一份发布说明写,Genie Agent 可以分析 Unity Catalog 卷里的文件(公开预览),例如 PDF、幻灯片和图片,回答时附带指向原页的引用。意味着评论截图、门店照片这类非结构化材料以后也能放进同一个 Agent,但星级和时间这些结构化字段仍然放表里最好查。
- 2026 年 10 月 29 日:发布说明写,新增了引导式创建 Genie Agent 的流程。第一次建评论 Agent 的团队可以照着走,再把本文的三条示例 SQL 加进去。
- 2026 年 11 月 30 日(将到):Genie MCP 的旧 Beta 地址
/api/2.0/mcp/genie停用(Genie One MCP 文档)。用旧地址接 Claude、Cursor 的团队要在月底前换成 Unity Gateway 地址,OAuth 范围从genie换成ai-gateway。 - 2026 年 10 月 20 日:Databricks 在 Agent Bricks 上推出agent 记忆。意味着「哪些评论已经看过、哪些问题跟进过」这类状态以后可能交给平台记,但评论原始数据仍建议放表里。
常见问题
databricks genie mcp server 的地址在哪里找?
在工作区里打开 Unity Gateway → MCPs 能看到所有 MCP 和它们的 URL。Genie 自己的 MCP 服务器地址是 https://<workspace-hostname>/ai-gateway/mcp-services/system.ai.genie_one_mcp?o=<workspace-id>,工作区 ID 可以从工作区 URL 里的 o= 取(Genie One MCP 文档)。
databricks genie mcp oauth 要怎么配?
调 Genie One MCP 时,任何放在 Authorization: Bearer 里的 Databricks 令牌都可以,包括 OAuth 的 U2M、M2M 和个人访问令牌;用代用户身份的 OAuth 时要带 ai-gateway 范围。反过来让 Genie 调外部 MCP(例如 EveryInfra),用的是 Unity Catalog HTTP 连接的鉴权方式,EveryInfra 用 Bearer token 就够了。
databricks genie agent 能挂自己的 MCP 服务器吗?
Genie Agents 的 MCP 连接器是 Beta,文档列出的是 Databricks 自带的九个连接器,没有写到自定义 MCP(2026 年 11 月 14 日读取,页面 11 月 9 日更新)。自定义 MCP 服务的接法写在 Genie One 的文档里。要让 Genie Agent 用外部数据,能确认走得通的是先落进 Unity Catalog 的表。
databricks genie agent pricing 怎么算?
用户使用到 2027 年 1 月 31 日免费、服务主体按标准价,细节见上文「一笔账」一节;同一页还写,Genie Code 从 2026 年 7 月 8 日起按量计费,每人每月有免费额度。SQL 仓库的计算费一直另算。新闻稿写的是按用量付费、不按席位收费,管理员可以在 Unity Gateway 里按团队或用户设上限。
databricks genie agent api 能调 MCP 连接器吗?
能调读工具,不能调写工具,也不能在 API 里完成连接器登录;写工具的批准和登录都要在界面里做(文档的 Limitations 一节)。所以如果你的应用要经 API 问一个挂了连接器的 Genie Agent,先让用户在界面里把连接器授权好。
上手步骤
- 在 EveryInfra 控制台注册并拿到 API Key,充值或用试用额度;价格见定价页。
- 在能力目录里核对
trustpilot/reviews、google_play/reviews、reddit/subreddit_posts的参数和当天价格,也可以先读能力页:Trustpilot 评论、Google Play 评论、Reddit 社区帖子、Reddit 搜索。 - 用本文「接法二」的 Python 片段在本地跑一次,确认三项能力都有返回、
charged_usd和目录价一致。 - 在 Databricks 里把 Key 放进密钥范围,建
public_brand_reviews表和作业,按天跑。 - 需要在 Genie One 里实时问时,按「接法一」登记远程 MCP(EveryInfra 的 MCP 说明见 MCP 服务器页)。
各平台的总览页:Trustpilot 数据接口、Google Play 数据接口、Reddit 数据接口。
参考资料
以下页面都在 2026 年 11 月 14 日(新加坡时间)打开核对过;日期是发布日期,没有发布日期的写页面更新日期或查阅日期。前 33 条在正文里引用,后面几条是写作时核对过的补充材料。
- Databricks Launches New Always-on Genie: Autonomous AI for Complex Enterprise Work — Databricks, 2026-11-11
- The new Genie: autonomous AI for complex enterprise work — Databricks, 2026-11-11
- Genie One MCP server — Databricks Docs, 2026-11-12
- The Genie One MCP is now Generally Available — Databricks, 2026-09-22
- Connect Genie One to external applications with MCP — Databricks Docs, 2026-11-09
- External MCP servers — Databricks Docs, 2026-10-27
- Transports: Streamable HTTP — Model Context Protocol, 2026-11-14
- Connect to external HTTP services — Databricks Docs, 2026-11-14
- Connect a Genie Agent to MCP tools and sources — Databricks Docs, 2026-11-09
- ai_enrich function — Databricks Docs, 2026-11-14
- Genie Agents concepts — Databricks Docs, 2026-11-14
- Set up and manage a Genie Agent — Databricks Docs, 2026-11-14
- Curate an effective Genie Agent — Databricks Docs, 2026-11-14
- Trustpilot's review labels — Trustpilot Help Center, 2026-11-14
- Use liquid clustering for tables — Databricks Docs, 2026-11-14
- Upsert into a Delta Lake table using merge — Databricks Docs, 2026-11-14
- Isolation levels and write conflicts — Databricks Docs, 2026-11-14
- Row-level concurrency — Databricks Docs, 2026-11-14
- Govern an MCP — Databricks Docs, 2026-11-14
- Secret management — Databricks Docs, 2026-11-14
- Run jobs on a schedule — Databricks Docs, 2026-11-14
- Monitor a Genie Agent — Databricks Docs, 2026-11-14
- Row filters and column masks — Databricks Docs, 2026-11-14
- Chat in Genie One — Databricks Docs, 2026-11-14
- Genie — Databricks Docs, 2026-11-14
- Genie pricing — Databricks, 2026-11-14
- Monitor and understand your Genie cost — Microsoft Learn, 2026-11-14
- Data API Terms — Reddit, Inc., 2026-11-14
- Guidelines for reviewers — Trustpilot, 2026-11-14
- Bring your business context to ChatGPT, Claude, Microsoft Copilot Cowork and Grok Bot — Databricks, 2026-11-11
- Announcing GA of Genie Ontology — Databricks, 2026-11-11
- AI/BI and Genie One release notes 2026 — Databricks Docs, 2026-11-12
- Introducing Agent Memory on Databricks — Databricks, 2026-10-20
- View and analyze your app's ratings and reviews — Play Console Help, 2026-11-14
- Trustpilot Developers — Trustpilot, 2026-11-14
- EveryInfra social catalog — EveryInfra, 2026-11-14
- MCP Apps overview — Model Context Protocol, 2026-11-14
- Host an MCP server on Databricks Apps — Databricks Docs, 2026-11-12
- MCP authentication — Databricks Docs, 2026-11-14
- MCP networking — Databricks Docs, 2026-11-14
- Supported coding and work agents — Databricks Docs, 2026-11-14
- Databricks-provided MCPs — Databricks Docs, 2026-11-14
- Analyze files in volumes with a Genie Agent — Databricks Docs, 2026-11-14
- Databricks AI assistive features trust and safety — Databricks Docs, 2026-11-14
- Get access to data products and MCP servers in Databricks Marketplace — Databricks Docs, 2026-11-14
- Monitor Genie Code and Genie One with the unified trace table — Databricks Docs, 2026-11-05
- MERGE INTO — Databricks Docs, 2026-11-14
- Call MCP tools from a Python agent — Databricks Docs, 2026-11-14
- Databricks' new AI agent tells CEO Ali Ghodsi the unvarnished truth — TechCrunch, 2026-11-11
- Databricks turns Genie into always-on agent for complex work — TechTarget, 2026-11-11
- Databricks Launches Native Genie Plugins for Four AI Agents — Unite.AI, 2026-11-11
- Table deletes, updates, and merges — Delta Lake, 2026-11-14
- HelloFresh: Meal Kit & Recipes — Google Play, 2026-11-14
- r/hellofresh — Reddit, 2026-11-14
- Lakeflow Connect — Databricks Docs, 2026-11-14
- Embed a Genie Agent in an external app — Databricks Docs, 2026-11-14
- Databricks Designated Services — Databricks Docs, 2026-11-14
- Databricks preview releases — Databricks Docs, 2026-11-14
引用编号 BL-151