Apify LinkedIn Jobs Scraper 替代
1,000 条 LinkedIn 职位:Apify 公开价 $0.28–$5,我们实测 $0.0028;纽约薪资只两成在 salary 字段,过半写在正文。
只要职位列表(每条带描述全文),EveryInfra 的 linkedin/jobs 在 2026 年 11 月 10 日实测每千条 $0.00278,Apify Store 上同类 actor 的公开价是每千条 $0.28–$5,我们低 100 倍以上,前提是一次搜索最多 200 条,要 1,000 条得拆成 5 次搜索。纽约三类数据岗位里,只有 20%–28% 的薪资进了 salary 字段,一半以上写在职位描述正文里,只读字段会把覆盖率低估三倍。如果每一条都要申请链接、远程标记这类详情字段,按目录价算 Apify 更便宜,而且我们的详情接口目前暂不可用。
站内的 Apify LinkedIn Scraper 替代 在 11 月 5 日比了个人资料、公司和职位三类数据的价格,职位只是其中一个场景;这一篇只讲职位,把重点放在招聘和劳动力市场分析用得到的四个字段:薪资、发布时间、申请人数、远程标记,在每个字段上数「200 条里有几条有值」,再用纽约、马德里、墨西哥城、新加坡四个城市的数据岗位做一次真实的薪资区间测算。Apify 一侧我们只用公开材料:Store 页、Apify 公开接口里的 pricingInfos、官方文档、Reddit 帖子和 YouTube 教程,没有注册、也没有付费。两边是各自独立的服务,字段名和取值各写各的,下面不会把它们当成同一份数据比较。
apify linkedin jobs scraper 和 EveryInfra:先看总表
下表左边三列是 Apify 一侧:actor 名、近 30 天用户数、当前生效的每千条结果价(Free 档和 Gold 档)。这些数是 2026-11-10 00:14 新加坡时间从 Apify 公开接口 api.apify.com/v2/acts/<actor> 读的,接口返回里 pricingInfos 这一项记着每次改价的生效时间,取「生效时间不晚于读取时刻」的最后一条。右边是我们同一天真调 linkedin/jobs 的结果:10 次搜索、每次 limit 200,成功的 9 次都回满 200 条,每次扣 $0.000556。
| Apify actor(Store 页) | 近 30 天用户 | Free 档每千条 | Gold 档每千条 | 启动费(每次运行) | 当前价生效日 | 对我们 $0.00278 的倍数(Free / Gold) |
|---|---|---|---|---|---|---|
| curious_coder/linkedin-jobs-scraper | 14,455 | $2.00 | $1.00 | $0.00005 | 2026-08-14 | 719 / 360 |
| valig/linkedin-jobs-scraper | 8,356 | $0.40 | $0.28 | $0.001 / $0.0007 | 2026-05-16 | 144 / 101 |
| bebity/linkedin-jobs-scraper | 4,806 | $1.50 | $1.00 | $0.00005 | 2026-09-15 | 540 / 360 |
| cheap_scraper/linkedin-job-scraper | 4,369 | $0.70 | $0.35 | 每 GB 内存 $0.005 | 2026-11-07 | 252 / 126 |
| fantastic-jobs/advanced-linkedin-job-search-api | 1,690 | $5.00 | $1.50 | $0.01 / $0.0001 | 2026-06-09 | 1,799 / 540 |
| openclawai/job-board-scraper | 1,316 | $5.00 | $5.00 | $0.00005 | 2026-05-25 | 1,799 / 1,799 |
| worldunboxer/rapid-linkedin-scraper(快速 + 详细) | 690 | $0.35 | $0.30 | $0.00005 | 2026-10-29 | 126 / 108 |
| memo23/linkedin-jobs-scraper | 107 | $0.69 | $0.25 | $0.01 | 2026-10-13 | 248 / 90 |
EveryInfra linkedin/jobs(实测) | — | $0.00278 | $0.00278 | 无 | 2026-11-10 00:14–00:39 真调 | 1 |
倍数这一列只比「列表一行」。Apify 这几个 actor 的一条结果大多也带职位描述、薪资和申请人数,有的还多带详情页才有的字段,例如 curious_coder 列出了是否允许远程、申请方式、公司人数,信息量不低于我们列表里的一行,所以倍数是在「拿到一条可用的职位」这个意义上比的;但 worldunboxer 的快速模式(每千条 $0.10)不带描述全文,要加 $0.25 的详细模式才有,我们在表里写的是两者之和。fantastic-jobs 是另一类东西:它卖的是自己整理好的职位库,数据有约 1 小时的延迟,适合按行业、公司规模这类条件一次拉几千条,和实时搜 LinkedIn 不是一回事,放进表里是因为它在 Store 里搜「LinkedIn jobs」排得靠前。
Store 里搜「LinkedIn jobs」一共有 2,533 个结果(同一时刻读的 Store 搜索接口)。我们按近 30 天用户数取了前几名,再补上两个价格特别低或者近期改价特别频繁的,凑成八个列表 actor,另加一个只做详情的 piotrv1001(每千条 $4.00)。如果你在用的不在表里,同样的读法在下面「价格怎么读」那一节,几分钟就能自己算出来。
我们怎么测、怎么算
真调全部在 2026 年 11 月 10 日凌晨,用一把测试 Key,从新加坡时间 00:14 开始,到 00:40 结束。这把 Key 每分钟最多 10 次请求,所以每次提交之间隔 7 秒,碰到 429 等 65 秒再试;整场一共被限流 9 次,429 不扣费,也不算进下文的请求次数。职位搜索用异步模式:请求体里加 "mode":"async",立即拿到 job_id,再每 15 秒查一次 /api/v1/jobs/{job_id},直到状态变成 succeeded 或 failed。返回里 billing.charged_usd 是这次实际扣的钱,失败的那次会写 refund_state: refunded。
| 编号 | 搜索词和地点 | 提交(新加坡时间) | 完成 | 用时(秒) | 返回条数 | 扣费 |
|---|---|---|---|---|---|---|
| j01 | data analyst · New York, NY | 00:14:35 | 00:17:39 | 184.8 | 200 | $0.000556 |
| j02 | data engineer · New York, NY | 00:18:00 | 00:22:39 | 275.7 | 200 | $0.000556 |
| j03 | data scientist · New York, NY | 00:18:10 | 00:22:42 | 270.2 | 200 | $0.000556 |
| j04 | analista de datos · Madrid | 00:18:19 | 00:22:45 失败 | 264.2 | 0 | 已退回,$0 |
| j05 | data engineer · Madrid | 00:21:43 | 00:24:53 | 187.8 | 200 | $0.000556 |
| j06 | analista de datos · Mexico City | 00:21:52 | 00:25:15 | 200.4 | 200 | $0.000556 |
| j07 | data analyst · Singapore | 00:22:02 | 00:24:57 | 172.8 | 200 | $0.000556 |
| j08 | LinkedIn 搜索网址:美国、近 7 天、远程 | 00:22:11 | 00:25:19 | 185.8 | 200 | $0.000556 |
| j11 | j01 原样复测 | 00:36:17 | 00:39:09 | 169.2 | 200 | $0.000556 |
| j12 | j04 原样重试 | 00:36:27 | 00:39:28 | 179.4 | 200 | $0.000556 |
每千条价按同一个式子算:这次扣的钱 ÷ 实际返回条数 × 1,000,即 $0.000556 ÷ 200 × 1,000 = $0.00278。如果把整场测试算在一起,9 次成功搜索共扣 $0.005004,失败那次退回,按 id 去重后一共 1,618 条不重复职位(j11 和 j01 重合 176 条;j08 全美近 7 天和纽约 j01、j03 重合 5 条;j11 和 j03、j08 另重合 5 条;其余各组之间没有重合),每千条不重复职位 $0.0031。薪资、申请人数、发布时间这些比例的分母一律是实际返回的 200 条,不挑样本。
除了 10 次搜索,我们还发了 27 次请求专门看「出错时扣不扣钱」和「详情能不能用」:1 次不带 Key、1 次把参数名写错、23 次 linkedin/job_detail(19 条从列表里挑的职位、1 个不存在的编号、1 次异步模式、1 次完整网址、1 次接口自己给的示例),再加 2 次 MCP 请求。全部原始返回和统计脚本都留了存档,图里的每个数都是脚本从原始返回现算的。
Apify LinkedIn Jobs Scraper 的价格怎么读:三种收费结构、两个排好的涨价
Apify Store 上的 actor 现在大多用「按事件计费」(pay per event)。官方文档 的意思是:开发者自己定义收费事件,比如「启动一次」「产出一条结果」「做一次 AI 分析」,每个事件一个单价;Store 里的 actor 说明 写明大多数按事件计费的 actor 已经把平台用量算进事件价,但也有一些另收平台费,运行前要自己看清。同一个事件在 FREE、BRONZE、SILVER、GOLD 四个折扣档上可以有不同价,对应 Apify 的 Free、Starter、Scale、Business 四个套餐;开发者定价文档 还写了开发者拿事件收入的 80%。
我们读到的八个列表 actor 可以归成三种收费结构。第一种只收「每条结果」一个事件加一个几乎可以忽略的启动费,curious_coder、bebity、valig、memo23 都是这样,价格一眼能算。第二种按内存收启动费:cheap_scraper 的启动事件是每 GB 内存 $0.005,它的 Store 页写默认 4 GB,一次运行就是 $0.02,跑 20 条的小任务时这笔启动费比结果费还多。Apify 的 资源说明 写明运行内存只能取 2 的幂,从 128 MB 到 32,768 MB,每 4,096 MB 配一个 CPU 核,所以把内存调小可以降低这类启动费,代价是跑得慢。第三种把一条职位拆成几个事件:worldunboxer 的快速模式每千条 $0.10,打开「完整详情」再加每千条 $0.25(Gold 档 $0.20);bebity 的「高级公司信息」每千条再加 $1.00;cheap_scraper 在 2026-11-07 新加的「AI 职位分析」事件每千条 $0.50;memo23 的「AI 补全」每千条 $8.00。
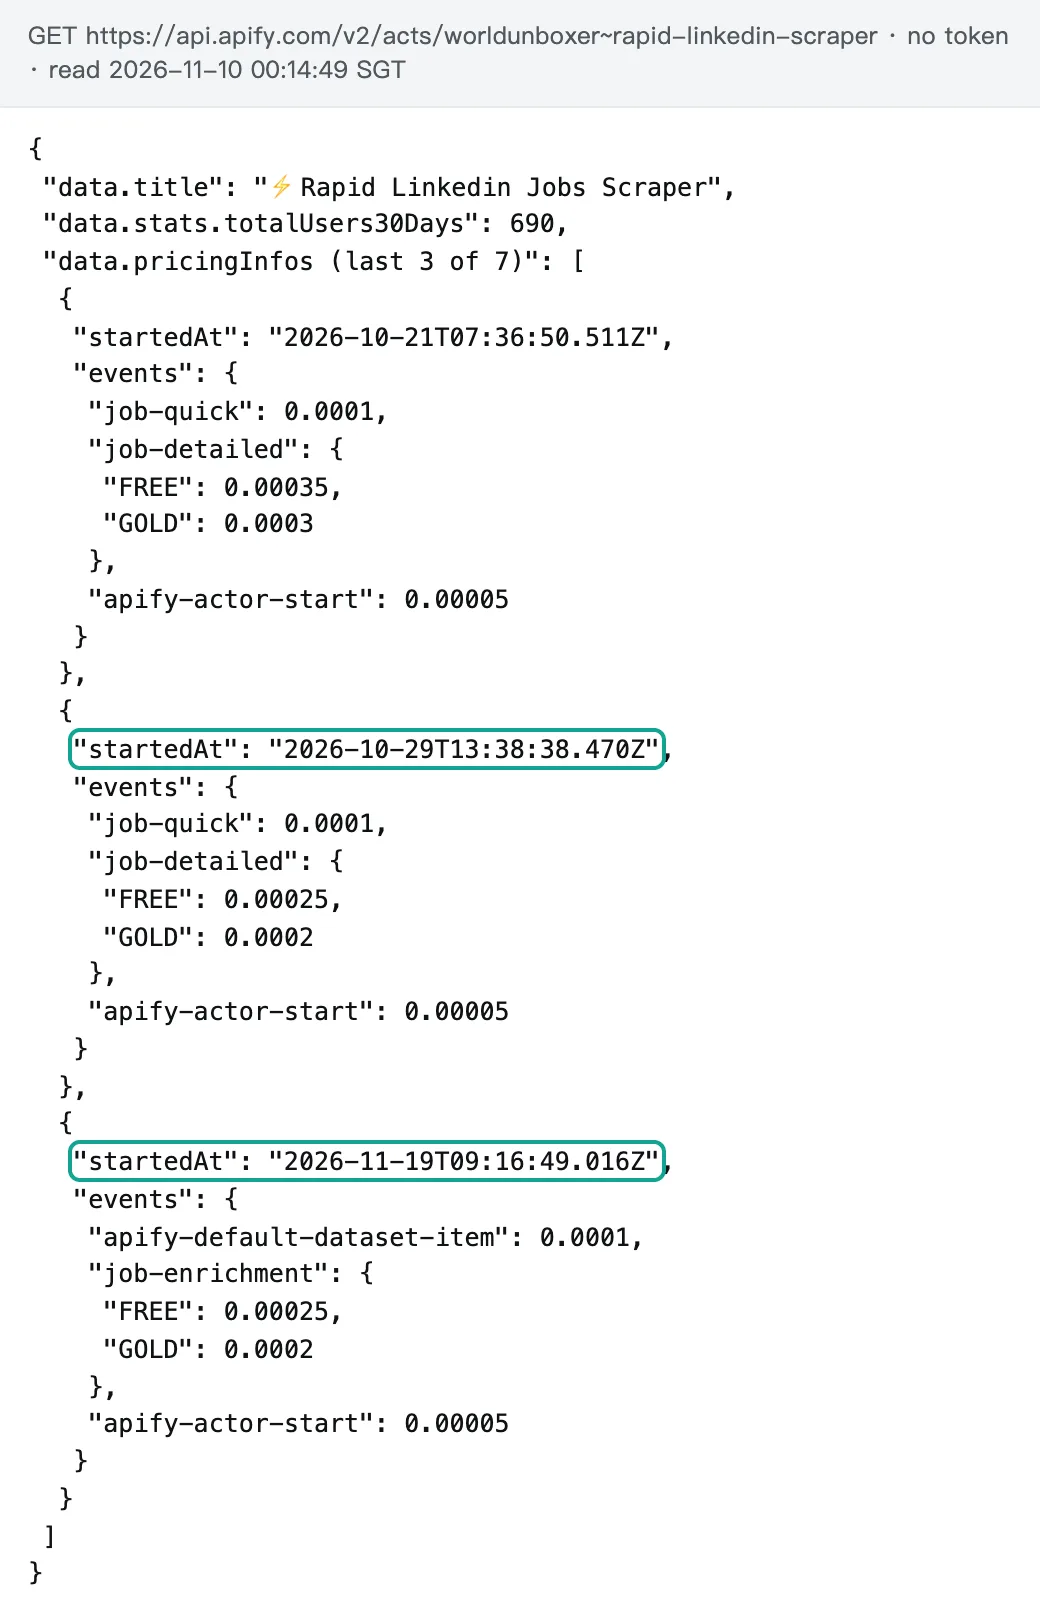
pricingInfos 里还能看到已经公布、尚未生效的价格。openclawai 的 job-board-scraper 在 2026-11-11 从每千条 $5.00 涨到 Free 档 $6.00、Gold 档 $4.00;worldunboxer 在 2026-11-19 把详细模式的事件名换成 job-enrichment,价格不变。改价的频率也差很多:worldunboxer 从 5 月到现在改了 7 次,memo23 从 7 月起改了 8 次,curious_coder 在 2026-08-14 把 Free 档从每千条 $1.00 提到 $2.00,详情 actor piotrv1001 从 $6.00 降到 $3.00 又回到 $4.00。按次计费的服务也会改价,但对一个每天定时跑的任务来说,「下个月是什么价」是要写进预算表的。
Apify 套餐本身的价格在 apify.com/pricing:Free 每月送 $5 平台额度,Starter $19/月,Scale $199/月,Business $999/月,月费等额变成当月可用的预付额度,定价页 写明用不完不结转到下个月,Free 套餐超出 $5 后要等到下个月才能继续用。所以「Gold 档价」只有每月付 $999 的账户才拿得到;每月不到几百美元用量的团队,看 Free 和 Bronze 档就够了。读价格最省事的办法是不进 Store 页,直接打开 https://api.apify.com/v2/acts/<作者>~<名字>,在返回里找 pricingInfos 的最后一条,再看 pricingPerEvent.actorChargeEvents 下每个事件的 eventPriceUsd 和 eventTieredPricingUsd。这是 Get Actor 接口,我们读公开 actor 时没有带 Token。
城市场景:纽约、马德里、墨西哥城、新加坡的数据岗位
招聘和劳动力市场分析常见的第一问是「某个城市现在有多少数据岗位、开多少钱」。我们用同一套参数在四个城市各搜了数据岗位:纽约搜 data analyst、data engineer、data scientist 三类,马德里搜 data engineer 和西语的 analista de datos,墨西哥城搜 analista de datos,新加坡搜 data analyst,另外用一条 LinkedIn 搜索网址搜了全美近 7 天的 data analyst。每次 200 条,算的是这 200 条里各字段的情况,不是这个城市所有职位的普查。
宏观背景先摆一下,方便判断这 200 条落在什么样的市场里。美国劳工统计局 2026-11-03 发布的 JOLTS 显示 9 月底职位空缺约 750 万个;2026-11-06 的 就业报告 写 10 月非农新增 16.5 万、失业率 4.1%。西班牙统计局 2026-10-27 发布的 第三季度劳动力调查 失业率 10.18%;墨西哥 INEGI 在 2026-10-22 发布的 9 月就业调查 失业率 2.8%。新加坡人力部的 公平考量要求 规定雇主为外籍员工申请就业准证前,要先在 MyCareersFuture 上公开招聘,所以新加坡的大量职位信息不只在 LinkedIn 上。
| 城市 · 职位 | 返回条数 | salary 字段有值 | 只在描述里写了薪资区间 | 合计能拿到薪资 | 申请人数 = 200 | 发布天数中位数 |
|---|---|---|---|---|---|---|
| 纽约 · data analyst | 200 | 40(20%) | 111(55.5%) | 75.5% | 125(62.5%) | 14 |
| 纽约 · data engineer | 200 | 56(28%) | 97(48.5%) | 76.5% | 91(45.5%) | 15 |
| 纽约 · data scientist | 200 | 41(20.5%) | 116(58%) | 78.5% | 89(44.5%) | 13 |
| 全美 · 近 7 天(网址搜索) | 200 | 22(11%) | 111(55.5%) | 66.5% | 110(55%) | 4 |
| 马德里 · data engineer | 200 | 11(5.5%) | 8(4%) | 9.5% | 16(8%) | 15.5 |
| 马德里 · analista de datos | 200 | 3(1.5%) | 7(3.5%) | 5% | 70(35%) | 12 |
| 墨西哥城 · analista de datos | 200 | 11(5.5%) | 5(2.5%) | 8% | 47(23.5%) | 12.5 |
| 新加坡 · data analyst | 200 | 6(3%) | 0 | 3% | 75(37.5%) | 13 |
这张表里最有用的一列是「只在描述里写了薪资区间」。纽约市从 2022 年 11 月 1 日起要求招聘广告写出善意估计的最低和最高薪资(纽约市人权委员会说明),所以纽约三类岗位合计有 75%–79% 能拿到薪资;但其中只有 20%–28% 进了结构化的 salary 字段,剩下一大半是雇主写在职位描述正文里的,比如「The base salary range for this role is $95,000 – $120,000」。如果你的流程只读 salary 字段,纽约的薪资覆盖率会被低估三倍。
薪资字段:salary 只填两成,薪资透明法让正文里多出一半
「只在正文里」的判断方法要说清楚,免得把数读大了。我们只统计 salary 字段为空、而描述正文里出现「货币符号 + 数字 + 连字符或 to + 数字」这类区间的职位,货币包括美元、欧元、英镑、墨西哥比索和新币;单个数字(比如「up to $150,000」)不算,所以这一列是偏保守的下限。我们从纽约 data analyst 的 111 条里随机抽了 20 条逐条看,20 条都是薪资区间,其中 1 条是同一职位在另一个州的区间,没有把融资额这类数字误认成薪资。
这个比例和外部数据对得上。Headcount Labs 在 Hugging Face 上公开的 薪资透明职位数据集 是 2026-10-19 的快照,收了 3,145,962 条美国职位;IBTimes 2026-10-20 的报道 引用这份数据说全美 44.7% 的职位写了薪资,纽约州 69.9%、华盛顿州 70.9%,广告薪资区间中点的中位数是 $107,450。我们纽约三类数据岗位的 75%–79% 略高于纽约州整体,数据岗位集中在大公司、合规更到位,这个差距说得通。
美国其他州的规定也在推高这一列。华盛顿州 RCW 49.58.110 要求 15 人以上雇主在职位发布里写工资范围;值得做数据的人注意的是,这条法律对「职位发布」的定义排除了未经雇主同意、被数字复制再发布的帖子,也就是说聚合站上转贴的职位不一定受这条约束,薪资缺失不一定是违规。科罗拉多州的 平等薪酬法 也要求写薪资;克利夫兰市的薪资透明条例 2026-10-27 刚满一年,Signal Cleveland 的报道 写到雇主在适应、缺口仍在,市政府还开了 薪资投诉入口。
欧洲这边,马德里两组只有 5%–9.5% 能拿到薪资,和西班牙的整体情况一致。欧盟薪酬透明指令 2023/970 要求成员国在 2026 年 6 月 7 日前转为本国法,其中包括招聘前告知起薪或薪资范围;Revelio Labs 的分国统计 显示 2026 年 8 月欧盟职位里写薪资的占 30.4%,西班牙 19%、德国 20%、法国 43%、意大利 48%、荷兰 59%,到那时 27 国里只有 7 国完成转化。El Confidencial 2026-11-07 的文章 比较了各国落地这部指令的速度,认为进度参差不齐,西班牙的进度不算差。我们在马德里看到的比例比 Revelio 的西班牙整体数更低,样本里能看到一个现象:data engineer 的 200 条里有 42 条(21%)在正文里用了 competitive 或 competitivo 这个词,却没给数字。
英国在 2026-11-05 宣布要立「say what you pay」法,招聘广告必须写薪资(英国政府新闻稿、路透社报道)。新闻稿里引用的数据是 41% 的雇主总是公布薪资范围、18% 写确切数,咨询中 94% 的回应支持立法。如果你在做英国的薪资分析,明年这一列会明显变大,现在建的流程最好已经能读正文里的薪资。
纽约数据岗位薪资区间:analyst 约 $11.5 万,scientist 约 $19.5 万
我们只用 salary 字段里按年计的区间来算,每条取上限和下限的中点,再看这些中点的分布。纽约 data analyst 有 39 条按年计的薪资,中点的中位数 $115,000,四分位 $83,750 到 $132,500;data engineer 53 条,中位数 $180,188,四分位 $147,500 到 $205,000;data scientist 41 条,中位数 $195,000,四分位 $162,000 到 $222,500。区间本身的宽度也值得看:analyst 中位的「上限比下限高多少」是 26.7%,三类岗位在 26%–35% 之间,也就是说同一个职位的写法本身就有三成左右的弹性。
这些数有三个边界。第一,样本是一次搜索的 200 条里写了年薪的那部分,n 只有 39–53,适合看量级和相对高低,不适合当成纽约全市的薪资基准。第二,salary 字段有几条明显的录入问题:纽约一条 data engineer 写成「$65.00/yr - $70.00/yr」,看起来是时薪被标成了年薪;马德里有两条「€50.00/yr - €75.00/yr」,像是以千欧元为单位却少写了三个零。我们没有替雇主改数,统计时原样保留;如果把低于 $1,000 的值去掉,data engineer 的中位数从 $180,188 变成 $182,594,马德里 data engineer 从 €45,000 变成 €47,000,量级不变。第三,22 分钟后的复测(下文「复测」一节)里,同一个搜索的 analyst 中位数从 $115,000 变成 $108,120,n 从 39 变成 45,说明一次搜索的样本会漂,做趋势要固定时间点、多次取样。
如果要把「只在正文里」的那一半也算进来,需要再做一步正文抽取。我们用一条规则做了这一步:在 salary 字段为空的职位正文里取第一个美元区间,认「$95,000 – $120,000」「$160K - $210K」「$85-$115k」这几种写法,带 hour 或 hr 的乘 2,080 换成年薪,换算后不在 $20,000 到 $1,000,000 之间的丢掉。这条规则比上表「只在描述里」那一列宽一点(多认了只在后一个数写 k 的写法),所以抽出的条数略多:analyst 115 条、engineer 106 条、scientist 117 条,只有 1 条是时薪、1 条被丢掉。
结果有一个方向一致的差别:正文里的区间普遍比 salary 字段里的低。analyst 正文区间中点的中位数是 $107,500,字段里是 $115,000;engineer 是 $162,750 对 $182,594(字段去掉那条时薪错标的);scientist 是 $169,800 对 $195,000。两部分合在一起,analyst 的样本从 39 条变成 154 条,中位数 $108,120,四分位 $85,000 到 $132,725;engineer 158 条,中位数 $170,000;scientist 158 条,中位数 $173,850。也就是说,只读 salary 字段的中位数比合并后高 6%–11%。为什么会这样,这 200 条样本回答不了,做薪资基准时两种算法都要标明。正文抽取的规则选择会影响结果,所以上面「纽约数据岗位薪资区间」开头的三个中位数仍按字段算,合并后的数单独列在这里,规则和脚本都留了存档。
发布时间和申请人数:两个字段都有,读法要注意
applicant_count 在我们的 1,800 条里没有一条是空的,但它不是精确的人数。LinkedIn 对外显示的是分档文字:「Be among the first 25 applicants」和「Over 200 applicants」,中间才是具体数字。所以返回里 25 是下限、200 是上限:纽约 data analyst 的 200 条里 125 条正好是 200,占 62.5%,只有 12 条在 25 及以下。对招聘方来说,这意味着「申请人多不多」在纽约这类市场只能分出「已经超过 200」和「还没到」,超过 200 的职位彼此比不出热度;在马德里 data engineer 这种只有 8% 到顶的市场,这个字段才更有区分度。
posted_at 是日期(时分都是零点),1,800 条里同样没有空值。默认搜索不加时间条件时,200 条的发布天数中位数是 12–15.5 天,有 4%–9% 超过 90 天,最老的一条 data scientist 发布于 719 天前,墨西哥城有一条 648 天前的。做「新增职位」统计时这些老职位会拉高数量,最简单的办法是把搜索换成 LinkedIn 搜索网址,在网址里带上 f_TPR=r604800(近 7 天)或 f_TPR=r86400(近 24 小时):我们 j08 这次带了近 7 天,200 条里 189 条在 7 天内,最老的 8 天,中位数 4 天。keyword 参数本来就支持直接填完整的 LinkedIn 职位搜索网址,目录里的参数说明 写了这一点。
seniority 和 employment_type 也都有值,但信息量不同。纽约 data analyst 的 200 条里 148 条的 seniority 是「Not Applicable」,占 74%;employment_type 则 95% 以上是 Full-time。如果你要按初级、中级拆分薪资,seniority 字段在纽约基本帮不上忙,只能从标题里的 Senior、Lead、Junior 这些词来判断。
远程标记:LinkedIn 改版后,网址里的远程筛选失效了
远程是这次四个字段里最难拿的一个。我们列表里没有专门的远程字段,只能看标题和地点里有没有写 remote:纽约 data analyst 200 条只有 2 条。于是我们在 j08 用了 LinkedIn 搜索网址,带上 f_WT=2(远程)和 f_TPR=r604800(近 7 天)。结果时间筛选生效了,远程筛选没有:200 条里只有 22 条在标题或地点里写了 remote,占 11%,其余都是具体城市。
原因在 LinkedIn 自己。LinkedIn 帮助中心 写着职位搜索已经换成 AI 搜索,旧版搜索从 9 月开始逐步下线;curious_coder 的 Store 页也提示,从 2026 年 8 月起搜索网址里只剩 f_TPR(发布时间)、f_C(公司)、f_AL(Easy Apply)、f_EA(申请人少于 10)这几个筛选还有效,旧的远程筛选 f_WT 被它改成在关键词后面追加自然语言描述,作者自己也写了不能保证完全准确。所以不管用 Apify 哪个 actor 还是我们的 linkedin/jobs,凡是靠 LinkedIn 搜索网址做远程筛选的,现在都要自己再核一遍结果。
远程信息在详情页里是有的。我们的 linkedin/job_detail 在目录里列了 workplace_type 和 is_remote 两个字段,Google 的 JobPosting 结构化数据规范 也用 jobLocationType: TELECOMMUTE 表示远程,雇主在自己官网写了这一项时搜索引擎能读到。但详情接口目前暂不可用(见下文「职位详情」一节),我们没法用实测证明这两个字段的覆盖率,只能写「目录里有」。
复测:22 分钟后再搜一次,176 条相同、24 条换了
为了看一次搜索结果有多稳定,我们在 00:36:17(新加坡时间)把 j01 原样再发了一次,编号 j11,和第一次相隔约 22 分钟。两次都是 200 条,按 id 比对有 176 条相同(88%),各有 24 条只出现在其中一次。换掉的 24 条并不是最新发布的职位:新出现的那批发布日期从 7 月到 11 月 9 日都有,消失的那批也一样分散,说明 LinkedIn 的结果排序本身在变,200 条这个窗口里装的是哪 200 条会轮换。前 20 名里只有 12 条两次都在,相同职位的排名中位数移动了 11 位。
相同的 176 条里,字段也有变化。9 条的 applicant_count 涨了 1 到 4 个人,例如从 25 变成 28、从 68 变成 72,一条已经在 200 的保持 200;1 条的 posted_at 从 2026-10-02 变成 2026-11-09,这是雇主把旧职位重新发布了一次,LinkedIn 把它当成新职位显示。salary 字段没有一条变化。对做申请热度追踪的人,这说明申请人数可以按天采;对做「每天新增多少职位」统计的人,这说明不能只看 posted_at,还要用 id 去重,否则重新发布的职位会被算两次。
整体统计跟着样本变:j11 的 salary 字段有值 47 条(23.5%,j01 是 20%),只在正文里的 104 条,年薪中点中位数 $108,120(n=45),比第一次的 $115,000 低 6%。同一个搜索、同一个城市、隔 22 分钟,中位数就能差 6%,所以单次 200 条的薪资中位数最好当成区间来读,做周报或月报时固定采集时间,每次采几轮再合并去重。
分页和上限:一次 200 条,要 1,000 条就拆成 5 次搜索
linkedin/jobs 一次最多回 200 条(目录里 max_limit 是 200,默认 20),目前没有 offset 或页码参数。也就是说,同一个搜索词加同一个地点,你只能拿到排在前面的 200 条。要 1,000 条,就要把一次搜索拆成 5 次不同的搜索:换城市、换职位词、换时间窗口(近 24 小时、近 7 天),或者换公司。我们这次 9 次成功搜索拿到 1,618 条不重复职位,除了故意复测的那一组,组与组之间几乎不重合,拆分本身不会造成浪费。
Apify 这边的上限来自 LinkedIn。curious_coder 的 Store 页写着 LinkedIn 每次搜索最多显示 1,000 条,建议「按地点拆分搜索网址」;cheap_scraper 也写每次搜索最多 1,000 条。开源的 JobSpy 在说明里写大多数招聘网站每次搜索的上限在 1,000 条左右,LinkedIn 抓得快时会返回 429,等一分钟左右会恢复。所以「1,000 条以上」不管用哪家都要拆搜索,差别只在一次请求回 200 还是一次运行回 1,000:用 Apify 时一次运行就能把这 1,000 条拿完,按条付钱;用我们时发 5 次请求,按次付钱。
拆分的代码很短。下面的 Python 例子把三个职位词和两个城市组合成 6 次搜索,用异步模式提交,再按 id 去重;同样 6 次请求按目录价是 6 × $0.000556 = $0.003336,最多拿到 1,200 条。
import os, time, requests

API = "https://api.everyinfra.com"
H = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}
roles = ["data analyst", "data engineer", "data scientist"]
cities = ["New York, NY", "Madrid, Spain"]

jobs, seen = [], set()
for role in roles:
    for city in cities:
        body = {"platform": "linkedin", "action": "jobs", "mode": "async",
                "params": {"keyword": role, "location": city, "limit": 200}}
        poll = requests.post(f"{API}/api/v1/social", json=body, headers=H).json()["poll_url"]
        while True:
            r = requests.get(API + poll, headers=H).json()
            if r["status"] in ("succeeded", "failed"):
                break
            time.sleep(15)
        for row in r.get("results", []):
            if row["id"] not in seen:
                seen.add(row["id"])
                jobs.append(row)
print(len(jobs), "unique jobs")
职位详情 job_detail:暂不可用,没有扣费
单条职位详情这次没有跑通。linkedin/job_detail 在目录里标着可用,价格每次 $0.001194,参数是职位网址或 8 到 12 位的职位编号,目录列出的字段比列表多出 apply_url、workplace_type、is_remote、industries、benefits、view_count、job_state、expires_at、country_code、company_employee_count、company_website 这些。我们从 00:29:51 到 00:40:47(新加坡时间)一共发了 23 次:19 条是从各城市列表里挑的职位(有 salary 字段的、薪资只在正文里的、都没有的各挑几条),1 个不存在的编号 9999999999,1 次异步模式,1 次完整网址,1 次接口给的示例请求;01:20 又复测了 1 次。本文测试时详情接口返回 503、不扣费,每次 2 到 4 秒返回,错误码 unavailable,返回里写明「Not charged」。对方案的影响是:申请链接、远程标记、行业、福利、浏览数、截止日期这几项目前只能从别处拿;列表里的描述全文(纽约 data analyst 描述长度中位数 6,068 个字符)、薪资、申请人数、发布日期、资历和雇佣类型不受影响。下文的「一篮子」表照目录价把详情算进去,和 Apify 的详情价放在一起比。
失败和空结果扣不扣钱
| 情况 | 时间(新加坡时间) | 返回 | 扣费 |
|---|---|---|---|
不带 Key 调 linkedin/jobs | 00:14:20 | 401 missing_key,提示「Nothing was charged.」 | $0 |
参数名写成 keywrd | 00:14:27 | 422 missing_param,提示正确参数名是 keyword 并给出可用示例 | $0 |
| 马德里 analista de datos 搜索失败 | 00:18:19 提交,00:22:45 失败 | 任务状态 failed,refund_state: refunded,提示 20 秒后重试 | 先扣后退,净 $0 |
| 同一搜索 18 分钟后重试 | 00:36:27 | 200 条 | $0.000556 |
linkedin/job_detail 23 次(含不存在的编号 9999999999) | 00:29:51–00:40:47 | unavailable,详情暂不可用(见上文) | $0 |
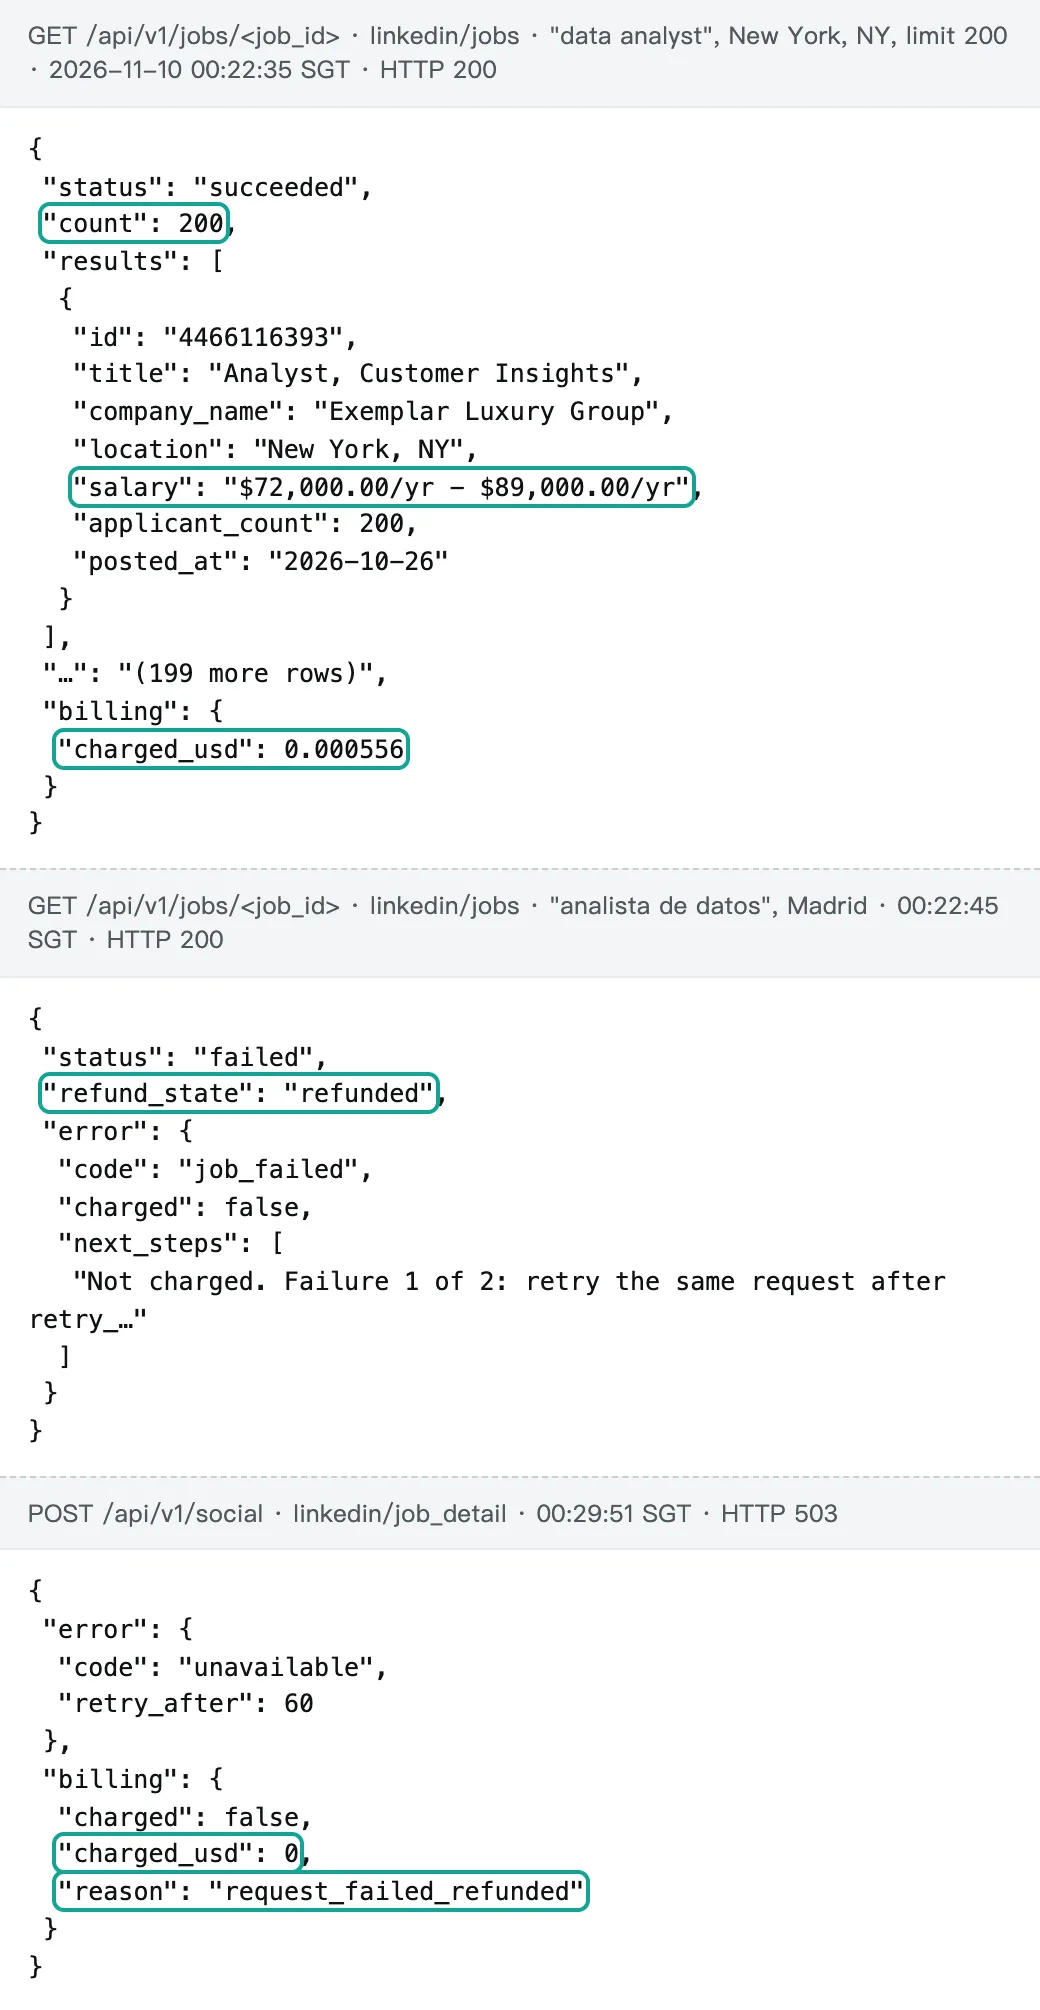
Apify 一侧的规则要按事件看。按事件计费的 actor 是「发生了才收」:一次运行失败、一条结果都没产出,你仍然要付启动事件;产出了几条就付几条。Apify 的同步运行接口有两个保护参数:maxItems 限制按条付费的 actor 最多收多少条,maxTotalChargeUsd 限制这次运行最多收多少钱(接口文档),到了上限 actor 会停下来,已经拿到的结果保留。几位作者也在 Store 页上写了自己的规则:worldunboxer 的「Exclude Job IDs」把上次拿过的职位编号传进去,这些职位不返回也不收费;cheap_scraper 的教程视频里讲,排除类筛选在收费前生效,但它的「动态筛选」是先抓再筛,筛掉的照样收费。
两边的根本差别是计费单位:Apify 按「产出一条」收钱,结果越多越贵,空结果几乎不花钱;我们按「一次请求」收钱,回 200 条和回 20 条一个价,失败和报错不收。所以用我们时 limit 一定要填满 200,否则每千条价会成倍上升:我们用 MCP 那次只要了 25 条,同样扣 $0.000556,折算每千条就是 $0.0222,是填满 200 时的 8 倍。
一篮子:1,000 条列表、1,000 条详情、每天一次的职位提醒
把常见的三种用法分开算,每种都写清前提。
| 用法 | Apify(Free / Gold 档) | EveryInfra | 谁便宜 |
|---|---|---|---|
| 1,000 条列表(含描述) | curious_coder $2.00 / $1.00;valig $0.40 / $0.28 | 5 次 linkedin/jobs,$0.00278 | 我们,101–719 倍 |
| 1,000 条带详情字段(申请链接、远程、行业) | worldunboxer 快速 + 详细 $0.35 / $0.30;valig $0.40 / $0.28(单价已含描述、招聘人、申请方式) | 列表 $0.00278 + 1,000 次 linkedin/job_detail 目录价 $1.194 = $1.197(详情暂不可用,见上文) | Apify,约 3–4 倍 |
| 每天 20 条新职位,一个月 30 次 | valig $0.27、worldunboxer $0.21、curious_coder $1.20、cheap_scraper $1.02 | 30 次 × $0.000556 = $0.0167 | 我们,但 Apify Free 套餐每月 $5 额度已经够用 |
第三行要多说一句。一个人每天跑一次 20 条的职位提醒,在 Apify 上一个月是 $0.21 到 $3.30,全部在 Free 套餐每月 $5 的额度之内,等于不花钱;在我们这里是 $0.0167,也几乎不花钱。小规模个人使用两边都便宜,差距随用量拉开:每天 10 个城市 × 5 个职位词 × 200 条,一个月 30 万条,Apify 用 valig 的 Gold 档约 $85(含 1,500 次启动费),用 curious_coder 的 Free 档约 $600,我们是 1,500 次请求 × $0.000556 = $0.834。
apify linkedin scraper jobs 和 EveryInfra:调用方式对比
在 Apify 上跑一个职位 actor,常见的写法是调「同步运行并取数据集」接口:把 actor 的输入作为请求体发过去,运行结束后直接拿到结果。下面是按 Apify 接口文档 写的配置示例,我们没有 Apify 账号,没有运行过;输入字段名以每个 actor 自己的输入说明为准,这里以 curious_coder 为例,它接受 LinkedIn 搜索网址。
# 配置示例(未运行):Apify 同步运行一个职位 actor,最多收 1,000 条、最多花 $2
curl -X POST "https://api.apify.com/v2/acts/curious_coder~linkedin-jobs-scraper/run-sync-get-dataset-items?maxItems=1000&maxTotalChargeUsd=2" \
  -H "Authorization: Bearer $APIFY_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"urls": ["https://www.linkedin.com/jobs/search/?keywords=data%20analyst&location=New%20York&f_TPR=r604800"]}'
我们这边是一条固定的 POST /api/v1/social,换平台只换 platform 和 action,参数名在 LinkedIn 职位搜索文档 和免费的目录接口里都查得到。下面是我们这次真调用的同一种写法:异步提交、按 poll_url 轮询。
# 提交(立即返回 job_id 和 poll_url)
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"linkedin","action":"jobs","mode":"async",
       "params":{"keyword":"data analyst","location":"New York, NY","limit":200}}'

# 每 15 秒查一次,直到 status 是 succeeded 或 failed
curl -s https://api.everyinfra.com/api/v1/jobs/<job_id> \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY"
两种写法的工作量差不多,区别在等待时间和失败处理。我们这次 200 条一次的异步搜索,从提交到拿到结果用了 169 到 276 秒,中位数约 186 秒;不加 mode 的同步请求适合小批量,MCP 那次 25 条用了 18.4 秒。Apify 同步接口在运行结束前保持连接,大任务更适合改用异步运行加 Webhook 通知,结果存在 数据集 里,可以按 JSON、CSV、Excel 导出。我们的结果在轮询返回里直接给出,存不存、存在哪由你自己决定。失败时我们在返回里写清楚扣没扣钱、多久后重试,失败退款对账 一文讲了怎么按 charge_id 核对。
接 MCP:在 AI 客户端里直接搜职位
两边都能接进支持 MCP 的 AI 客户端。Apify 的 MCP 服务 地址是 mcp.apify.com,推荐用 OAuth 登录,也可以用 API Token;它能搜索 Store、运行 actor、读结果,开源实现在 GitHub。文档还写了「agentic payments」,让智能体不注册 Apify 账号也能直接付费调用。我们的远程 MCP 地址是 https://api.everyinfra.com/mcp,配置方法在 MCP 服务说明 和 远程 MCP 配置 里,两边都按 MCP 规范 的远程连接方式接入。
我们在 00:39:32(新加坡时间)不带 Key 调了一次 tools/list,0.34 秒返回 12 个工具,包括 everyinfra_list_capabilities、everyinfra_call_api、everyinfra_get_job;00:39:41 带 Key 调 everyinfra_call_api 搜「Singapore 的 data engineer」、limit 25,18.4 秒返回 25 条,扣 $0.000556。AI 客户端里的配置大致如下:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
接好以后,在对话里说「查一下纽约最近 7 天的 data engineer 职位,按薪资区间排一下」,模型会自己先查目录、再调 linkedin/jobs。如果要把职位和公司信息连起来,例如「这家公司有多少人、最近在招哪些岗位」,可以再调 公司资料 和 公司员工 两项;在 Copilot Studio 里用 MCP 做 LinkedIn 客户调研 写了一个完整例子。用 MCP 时记得在提示里要模型把 limit 设成 200,否则模型常常只要 20 或 25 条,按次计价时每千条会贵好几倍。
什么时候 Apify 更合适
下面这些情况,Apify 上的职位 actor 比我们更合适。
第一,你每一条都要详情字段,而且今天就要。我们的 linkedin/job_detail 暂不可用(见上文);Apify 上 valig 一条结果就带描述、招聘人姓名和链接、申请方式(Easy Apply 或外部)、行业和职能,worldunboxer 的详细模式给 23 个字段,含行业、是否在积极招聘、是否早期申请者,每千条 $0.28–$0.40。用户最多的 curious_coder 一条结果里还列了是否允许远程(workRemoteAllowed)、办公方式、申请方式、截止时间、公司人数和职位发布人,全部含在每千条 $2.00(Gold 档 $1.00)里,远程标记这一项正是我们列表拿不到的。按目录价,即使我们的详情恢复,「列表 + 详情」也要每千条约 $1.197,比它们贵 3 到 4 倍,因为按次计价的详情本来就是一次一条。
第二,你要「一个搜索里的全部 1,000 条」。LinkedIn 每次搜索最多显示 1,000 条,Apify 的列表 actor 一次运行就能拿完;我们一次请求最多 200 条、没有翻页,同一个搜索词和地点只能拿到前 200 条,要靠换城市、换时间窗口来拆。如果你的分析需要某个关键词在一个城市的完整列表,例如统计纽约所有 data analyst 职位的公司分布,Apify 更省事。
第三,你需要它自带的筛选和去重。worldunboxer 能按公司编号、地理编号、半径、是否 Easy Apply、是否早期申请者筛选,curious_coder 的输入里有「申请人少于 10」这类 AI 搜索筛选,还能传入上次的职位编号排除已拿过的、不收这部分的钱;bebity 能加「高级公司信息」。这些筛选我们没有,我们只有关键词、地点和 LinkedIn 搜索网址里仍然有效的那几个筛选。
第四,你需要平台本身的定时、存储和集成。Apify 的 定时任务 可以每天自动跑,结果存进数据集,再通过 Webhook、Make、Zapier、n8n 发到表格或 Slack;Free 套餐就能同时跑 5 个运行,Starter 32 个(平台限制)。我们只给接口,定时和存储要你自己写或者放进 n8n 这类工具里,Apify n8n 替代 一文写了怎么搭。
第五,你要历史职位库或 AI 加工。fantastic-jobs 卖的是自己整理的职位库(约 1 小时延迟),一次最多 5,000 条,有已过期职位的配套 actor(每月 $20),它在 Apify 之外还有自己的 开发者接口,按套餐给额度,Pro-100k 套餐超额按每条 $0.0025 计;cheap_scraper 和 memo23 有内置的 AI 职位分析和补全事件。我们只返回职位本身,分析要你自己接模型。最后,Store 里搜「LinkedIn jobs」有 2,533 个结果,某个小众需求很可能已经有人做好了。
合规边界:LinkedIn 的条款和公开职位数据
这一节只陈述条款和判决原文的意思,不构成法律意见,具体做法请咨询你自己的律师。LinkedIn 用户协议(2025 年 11 月 3 日生效)第 8.2 节列明不得使用爬虫、机器人等软件抓取服务内容;LinkedIn 抓取条款 写明未经明确许可的抓取是禁止的;职位条款 约束的是发布职位的雇主。LinkedIn 自己的 Job Posting API 是给招聘系统往 LinkedIn 发职位用的,文档写明目前不接受新的合作伙伴,所以「官方接口读职位」这条路对大多数团队是走不通的。
美国第九巡回上诉法院在 2022 年 4 月 18 日的 hiQ Labs 诉 LinkedIn 案判决 里,讨论的是抓取不需要登录就能看到的公开资料是否属于《计算机欺诈和滥用法》里的「未经授权访问」;这份判决处理的是这一部法律下的问题,没有处理违反用户协议这类合同问题。对招聘分析的读者,更实际的风险在个人信息:职位里可能出现招聘人员姓名和主页,欧盟和英国的数据保护规则会管到这些,LinkedIn 隐私政策 也写了它对会员数据的处理方式。我们返回的职位字段里没有招聘人信息,如果你从别处拿到了,存储和使用前要单独评估。
最近的变化(2026 年 10–11 月)
| 日期 | 变化 | 对职位数据的影响 |
|---|---|---|
| 2026-10-19 | Headcount Labs 发布 314 万条美国职位快照 | 按州对照:你的样本里纽约职位的薪资覆盖率明显低于它的 69.9%,先检查正文抽取有没有漏 |
| 2026-10-27 | 克利夫兰薪资透明条例满一年 | 克利夫兰的职位和纽约一样处理:先读 salary 字段,再抽正文 |
| 2026-11-05 | 英国宣布「say what you pay」立法 | 正文抽取规则现在就加上英镑区间,立法生效后不用改脚本 |
| 2026-11-07 | cheap_scraper 新增 AI 职位分析事件,每千条 $0.50 | 跑完看账单明细,确认这一项有没有出现;不需要分析就不要打开 |
| 2026-11-11(已公布) | openclawai 涨到 Free 档每千条 $6.00 | 11 日以后的预算按新价算,读价时看 pricingInfos 里的未来日期 |
| 2026-11-19(已公布) | worldunboxer 详细模式改名 job-enrichment | 按事件名记账的脚本在 19 日前加上新名字 |
另外两条背景变化影响所有做 LinkedIn 职位数据的人:LinkedIn 用 AI 搜索替代旧版职位搜索,搜索网址里多数筛选不再起作用(见上文远程一节);欧盟薪酬透明指令的转化期限 2026 年 6 月 7 日已过,到 8 月 27 国里只有 7 国完成转化。
视频和论坛里的卡点
YouTube 上播放最多的相关教程之一「Scrape 1,000+ LinkedIn Jobs for 35 Cents」有 9,488 次播放(视频),标题里的每千条 35 美分,和上表里几个低价 actor 的价位在同一档。2026-06-22 发布的一个 cheap_scraper 教程(视频,1,718 次播放)把几个容易踩的坑讲得很清楚:搜索网址要从无痕窗口复制;多个关键词乘多个地点,每个组合都是一次单独的搜索;用「最低薪资」筛选会把没写薪资的职位全部漏掉;雇主没填 LinkedIn 筛选项的职位,按那个筛选搜不到。最后一点和我们在远程筛选上看到的现象是同一类问题。
Reddit 的 r/n8n 上有两个帖子值得看。一位用户在 自己搭免费职位抓取流程的帖子 里说,用 Apify 时「the apify $5 just went away in a few minutes」,一次运行就花了 1 美元多,于是改成自己搭;另一个 求助帖 讲的是空结果、登录墙和限流,发帖人最后换了另一个职位 actor。两个帖子的共同点是:Free 套餐的 $5 额度对小规模试用够,但只要一次运行没设上限、拿了几千条,额度很快就没了。所以在 Apify 上跑职位 actor 时,最好每次都填 maxItems 和 maxTotalChargeUsd。
给招聘分析的四条做法:这四个字段怎么读才不出错
不管数据从 Apify 的 actor 拿还是从我们这里拿,下面四条都值得写进处理脚本。每一条的依据在对应小节里。
| 字段 | 怎么读 | 依据 |
|---|---|---|
| 薪资 | 先读 salary 字段,字段为空的再抽正文;统一换成年薪(时薪 × 2,080),换算规则写进报表脚注 | 「薪资字段」「纽约数据岗位薪资区间」两节 |
| 申请人数 | 25 当「不到 25」、200 当「超过 200」,排序时单独处理这两档,不拿 200 算平均数 | 「发布时间和申请人数」一节 |
| 发布时间 | 用 f_TPR 限定时间窗口,再按职位 id 去重,重新发布的职位会带新日期再出现 | 「发布时间和申请人数」「复测」两节 |
| 远程 | 不信搜索网址里的远程筛选,先用标题和地点里的 remote、hybrid、remoto 粗筛 | 「远程标记」一节 |
任何比例都写清分母:「200 条里有几条」比「多少职位有薪资」更不容易被误读;样本是一次搜索还是多次合并,也在图表下面写明。
常见问题
apify linkedin job scraper 有免费的吗?
(问题来自搜索联想词「apify linkedin job scraper free」。)没有完全免费的,但 Apify 的 Free 套餐每月送 $5 平台额度,不用绑卡。按今天的 Free 档价,$5 够 valig 跑约 12,500 条、worldunboxer 快速模式约 50,000 条、curious_coder 约 2,500 条;超出后 Free 套餐要等到下个月才能继续用。我们这边在 GitHub 给两个仓库点星可以领 $1 试用额度,24 小时内有效;文档按一般数据调用估约 720 次,按 linkedin/jobs 每次 $0.000556 算约 1,800 次,每次 200 条,够拿几十万条列表。
apify curious_coder linkedin jobs scraper 现在多少钱?
(联想词「apify curious_coder linkedin jobs scraper」。)2026-11-10 00:14(新加坡时间)读到的是:每条结果 Free 档 $0.002、Bronze/Silver/Gold 档 $0.001,也就是每千条 $2.00 和 $1.00,另有每次运行 $0.00005 的启动费。这个价从 2026-08-14 起生效,之前 Free 档是每千条 $1.00。近 30 天用户 14,455 位,是 Store 里用户最多的 LinkedIn 职位 actor。
linkedin job scraper api free:LinkedIn 自己有免费的职位接口吗?
(联想词「linkedin job scraper api free」。)LinkedIn 有 Job Posting API,但它是给招聘系统往 LinkedIn 发职位用的,不是读职位的;微软的文档写明这个接口目前不接受新的合作伙伴。Google 的 JobPosting 结构化数据是雇主在自己网站上标注职位的格式,搜索引擎用它,但它不是 LinkedIn 的数据。所以读 LinkedIn 公开职位,现在的选择是开源库、Apify 这类平台上的 actor,或者我们这样的接口。
linkedin jobs scraper github 上的开源项目能直接用吗?
(联想词「linkedin jobs scraper github」「linkedin jobs scraper python」。)能用,最常见的是 JobSpy(PyPI 包名 python-jobspy)和 py-linkedin-jobs-scraper。前者一个函数同时搜 LinkedIn、Indeed、Glassdoor 等几家,后者用无头浏览器。它们免费,但要你自己处理限流(JobSpy 的说明写了 LinkedIn 抓快了会回 429)、代理和 LinkedIn 的改版;9 月 LinkedIn 换成 AI 搜索后,不少基于旧搜索网址的脚本要改。要做多平台对比,我们也有 Indeed 数据接口 和 Glassdoor 数据接口。
how to scrape linkedin jobs:不写代码能做吗?
(联想词「how to scrape linkedin jobs」。)能。Apify Console 里填好搜索网址点运行,结果可以直接下载成 Excel;我们的文档页有一键试用,填关键词和地点就能看到返回。
上手步骤:用自己的城市和职位复算一遍
第一步,拿到 API Key。在 GitHub 给 everyinfra-agent-plugins 和 seo-skills 两个仓库都点星,注册后在控制台「余额与充值」领 $1 试用额度,24 小时内有效;正式使用的充值余额不过期,参数错误、鉴权失败这类请求不扣费(快速上手、价格页)。第二步,打开 LinkedIn 职位搜索文档 用页上的试用跑一次你自己的城市和职位,limit 填 200;需要详情时再看 职位详情文档,这项能力目前暂不可用。第三步,看返回里的 charged_usd 和条数,按「实扣 ÷ 条数 × 1,000」算出每千条价,再和你在 Apify 上的运行账单比;数一数 salary 字段和正文里各有多少条写了薪资,判断你的市场需不需要做正文抽取。
LinkedIn 全部能力见 LinkedIn 数据接口,按平台找其他招聘数据可以去 数据市场。还在评估 Apify 整体账单的,可以看 Apify 价格详解 和 Apify 替代方案总览;TikTok 场景的同类对比在 Apify TikTok Scraper 替代,各家对比页在 /alternatives。
参考资料
- Apify Store:curious_coder/linkedin-jobs-scraper,<https://apify.com/curious_coder/linkedin-jobs-scraper>(2026-11-10 读取)
- Apify Store:valig/linkedin-jobs-scraper,<https://apify.com/valig/linkedin-jobs-scraper>(2026-11-10 读取)
- Apify Store:bebity/linkedin-jobs-scraper,<https://apify.com/bebity/linkedin-jobs-scraper>(2026-11-10 读取)
- Apify Store:cheap_scraper/linkedin-job-scraper,<https://apify.com/cheap_scraper/linkedin-job-scraper>(2026-11-10 读取)
- Apify Store:fantastic-jobs/advanced-linkedin-job-search-api,<https://apify.com/fantastic-jobs/advanced-linkedin-job-search-api>(2026-11-10 读取)
- Apify Store:openclawai/job-board-scraper,<https://apify.com/openclawai/job-board-scraper>(2026-11-10 读取)
- Apify Store:worldunboxer/rapid-linkedin-scraper,<https://apify.com/worldunboxer/rapid-linkedin-scraper>(2026-11-10 读取)
- Apify Store:memo23/linkedin-jobs-scraper,<https://apify.com/memo23/linkedin-jobs-scraper>(2026-11-10 读取)
- Apify Store:piotrv1001/linkedin-job-details-scraper,<https://apify.com/piotrv1001/linkedin-job-details-scraper>(2026-11-10 读取)
- Apify 公开接口:worldunboxer/rapid-linkedin-scraper 的 pricingInfos,<https://api.apify.com/v2/acts/worldunboxer~rapid-linkedin-scraper>(2026-11-10 00:14 新加坡时间读取)
- Apify 定价页,<https://apify.com/pricing>
- Apify 文档:Pay per event,<https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event>
- Apify 文档:Actors in Store,<https://docs.apify.com/platform/actors/running/actors-in-store>
- Apify 文档:Actor pricing and costs,<https://docs.apify.com/platform/actors/publishing/monetize/pricing-and-costs>
- Apify 文档:Actor usage and resources,<https://docs.apify.com/platform/actors/running/usage-and-resources>
- Apify 接口文档:Get Actor,<https://docs.apify.com/api/v2/actor-get>
- Apify 接口文档:Run Actor synchronously and get dataset items,<https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post>
- Apify 文档:Webhooks,<https://docs.apify.com/platform/integrations/webhooks>
- Apify 文档:Dataset,<https://docs.apify.com/platform/storage/dataset>
- Apify 文档:Schedules,<https://docs.apify.com/platform/schedules>
- Apify 文档:Limits,<https://docs.apify.com/platform/limits>
- Apify 文档:Apify MCP server,<https://docs.apify.com/platform/integrations/mcp>
- GitHub:apify/actors-mcp-server,<https://github.com/apify/actors-mcp-server>
- Model Context Protocol 规范 2026-07-28 更新记录,<https://modelcontextprotocol.io/specification/2026-07-28/changelog>
- EveryInfra 数据目录(LinkedIn),<https://api.everyinfra.com/api/v1/social/catalog?platform=linkedin>(2026-11-10 00:13 新加坡时间读取)
- LinkedIn 帮助中心:AI 职位搜索,<https://www.linkedin.com/help/linkedin/answer/a6889044>
- LinkedIn User Agreement,<https://www.linkedin.com/legal/user-agreement>
- LinkedIn Crawling Terms,<https://www.linkedin.com/legal/crawling-terms>
- LinkedIn Jobs Terms and Conditions,<https://www.linkedin.com/legal/jobs-terms-conditions>
- LinkedIn Privacy Policy,<https://www.linkedin.com/legal/privacy-policy>
- Microsoft Learn:LinkedIn Job Posting API overview,<https://learn.microsoft.com/en-us/linkedin/talent/job-postings/api/overview>
- 美国第九巡回上诉法院:hiQ Labs v. LinkedIn,2022-04-18,<https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf>
- Google 搜索中心:JobPosting 结构化数据,<https://developers.google.com/search/docs/appearance/structured-data/job-posting>
- 纽约市人权委员会:Pay Transparency,<https://www.nyc.gov/site/cchr/media/pay-transparency.page>
- 华盛顿州 RCW 49.58.110,<https://app.leg.wa.gov/rcw/default.aspx?cite=49.58.110>
- 科罗拉多州劳工厅:Equal Pay for Equal Work Act,<https://cdle.colorado.gov/dlss/equal-pay-for-equal-work-act>
- 克利夫兰市:薪资投诉,<https://www.clevelandohio.gov/city-hall/boards-commissions/fair-employment-wage-board/salary-complaint>
- Signal Cleveland:Cleveland's pay transparency law turns one,<https://signalcleveland.org/clevelands-pay-transparency-law-turns-one-employers-adapt-but-gaps-remain/>
- 英国政府:New say what you pay law,2026-11-05,<https://www.gov.uk/government/news/new-say-what-you-pay-law-to-help-young-people-into-work>
- 路透社:Britain to make salary disclosure in job ads mandatory,2026-11-05,<https://www.reuters.com/business/world-at-work/britain-make-salary-disclosure-job-ads-mandatory-2026-11-05/>
- 欧盟指令 2023/970,<https://eur-lex.europa.eu/eli/dir/2023/970/oj>
- Revelio Labs:EU pay transparency directive, country by country,<https://www.reveliolabs.com/news/macro/eu-pay-transparency-directive-country-by-country>
- El Confidencial:transparencia salarial en la UE,2026-11-07,<https://www.elconfidencial.com/empleo/2026-11-07/ley-de-transparencia-salarial-que-paises-de-la-ue_4458005/>
- Headcount Labs:pay-transparency-jobs 数据集,<https://huggingface.co/datasets/HeadcountLabs/pay-transparency-jobs>
- IBTimes:Median advertised annual salary in US tops $100,000,2026-10-20,<https://www.ibtimes.com/median-advertised-annual-salary-us-tops-100000-most-job-listings-still-hide-pay-3808786>
- 美国劳工统计局:JOLTS,2026-11-03,<https://www.bls.gov/news.release/jolts.nr0.htm>
- 美国劳工统计局:Employment Situation,2026-11-06,<https://www.bls.gov/news.release/empsit.nr0.htm>
- 西班牙统计局:EPA 2026 年第三季度,2026-10-27,<https://www.ine.es/dyngs/Prensa/EPA3T26.htm>
- 墨西哥 INEGI:就业与职业指标,2026-10-22,<https://www.inegi.org.mx/contenidos/saladeprensa/boletines/2026/iooe/IOE2026_10.pdf>
- 新加坡人力部:Consider all candidates fairly,<https://www.mom.gov.sg/passes-and-permits/employment-pass/consider-all-candidates-fairly>
- Fantastic.jobs 开发者文档,<https://developer.fantastic.jobs/documentation/country-job-statistics>
- GitHub:speedyapply/JobSpy,<https://github.com/speedyapply/JobSpy>
- PyPI:python-jobspy,<https://pypi.org/project/python-jobspy/>
- GitHub:spinlud/py-linkedin-jobs-scraper,<https://github.com/spinlud/py-linkedin-jobs-scraper>
- Reddit r/n8n:I built a 100% free LinkedIn job scraper using n8n,<https://www.reddit.com/r/n8n/comments/1t4lk7a/i_built_a_100_free_linkedin_job_scraper_using_n8n/>
- Reddit r/n8n:Need help searching jobs on LinkedIn using n8n,<https://www.reddit.com/r/n8n/comments/1t61zji/need_help_searching_jobs_on_linkedin_using_n8n/>
- YouTube:Scrape 1,000+ LinkedIn Jobs for 35 Cents,<https://www.youtube.com/watch?v=nxhJJCMVl-0>
- YouTube:cheap_scraper LinkedIn Job Scraper 教程,2026-06-22,<https://www.youtube.com/watch?v=7oZorJOOa5Y>
引用编号 BL-126