Alternativa a Apify LinkedIn Jobs Scraper: precio por 1000 empleos
1000 empleos de LinkedIn: en Apify, de 0,28 a 5 USD; en nuestra prueba, 0,0028 USD. En Madrid y Ciudad de México, menos del 10 % muestra salario.
Si solo necesitas la lista de empleos con la descripción completa, linkedin/jobs de EveryInfra costó 0,00278 USD por cada 1000 empleos en nuestra prueba del 10 de noviembre de 2026. Los actors parecidos de Apify publican precios de 0,28 a 5 USD por 1000: somos más de 100 veces más baratos, con una condición: cada búsqueda trae como máximo 200 empleos, así que 1000 empleos son 5 búsquedas.
En Madrid y Ciudad de México, menos del 10 % de las ofertas de datos muestra salario. En Nueva York la ley obliga a publicarlo, pero más de la mitad del salario está en el texto y no en el campo salary.
Si necesitas en cada fila campos de detalle como el enlace de candidatura o el remoto, Apify sale más barato a precio de catálogo, y nuestro endpoint de detalle no está disponible por ahora.
Nuestra alternativa a Apify LinkedIn Scraper, del 5 de noviembre, comparaba perfiles, empresas y empleos, y los empleos eran un escenario entre tres. Esta comparación trata solo de empleos. Se centra en los cuatro campos que más piden quienes reclutan o analizan el mercado laboral: salario, fecha de publicación, número de candidatos y trabajo en remoto. Para cada campo contamos cuántas de 200 filas tienen valor. Después estimamos rangos salariales reales de empleos de datos en Madrid, Ciudad de México, Nueva York y Singapur.
Del lado de Apify usamos solo material público: páginas de la Store, el objeto pricingInfos de su API pública, la documentación oficial, hilos de Reddit y tutoriales de YouTube. No abrimos cuenta ni pagamos. Son dos servicios distintos. Cada uno tiene sus propios nombres de campo y sus valores, y aquí no los tratamos como los mismos datos.
Apify LinkedIn Jobs Scraper frente a EveryInfra: la tabla resumen
Las columnas de la izquierda son del lado de Apify. Muestran el nombre del actor, los usuarios de los últimos 30 días y el precio vigente por 1000 resultados en los niveles Free y Gold. Leímos estas cifras a las 00:14 hora de Singapur del 2026-11-10 en el endpoint público api.apify.com/v2/acts/<actor>. Su lista pricingInfos guarda cada cambio de precio con su fecha de inicio. Usamos la última entrada que ya estaba en vigor. La última fila son nuestras llamadas reales a linkedin/jobs esa misma noche.
| Actor de Apify (página de la Store) | Usuarios, 30 días | Free por 1000 | Gold por 1000 | Cuota de inicio | Precio vigente desde | Veces nuestro 0,00278 USD (Free / Gold) |
|---|---|---|---|---|---|---|
| curious_coder/linkedin-jobs-scraper | 14.455 | 2,00 USD | 1,00 USD | 0,00005 USD | 2026-08-14 | 719 / 360 |
| valig/linkedin-jobs-scraper | 8356 | 0,40 USD | 0,28 USD | 0,001 / 0,0007 USD | 2026-05-16 | 144 / 101 |
| bebity/linkedin-jobs-scraper | 4806 | 1,50 USD | 1,00 USD | 0,00005 USD | 2026-09-15 | 540 / 360 |
| cheap_scraper/linkedin-job-scraper | 4369 | 0,70 USD | 0,35 USD | 0,005 USD por GB de memoria | 2026-11-07 | 252 / 126 |
| fantastic-jobs/advanced-linkedin-job-search-api | 1690 | 5,00 USD | 1,50 USD | 0,01 / 0,0001 USD | 2026-06-09 | 1799 / 540 |
| openclawai/job-board-scraper | 1316 | 5,00 USD | 5,00 USD | 0,00005 USD | 2026-05-25 | 1799 / 1799 |
| worldunboxer/rapid-linkedin-scraper (rápido + detallado) | 690 | 0,35 USD | 0,30 USD | 0,00005 USD | 2026-10-29 | 126 / 108 |
| memo23/linkedin-jobs-scraper | 107 | 0,69 USD | 0,25 USD | 0,01 USD | 2026-10-13 | 248 / 90 |
EveryInfra linkedin/jobs (medido) | — | 0,00278 USD | 0,00278 USD | ninguna | llamadas reales, 00:14–00:39 hora de Singapur | 1 |
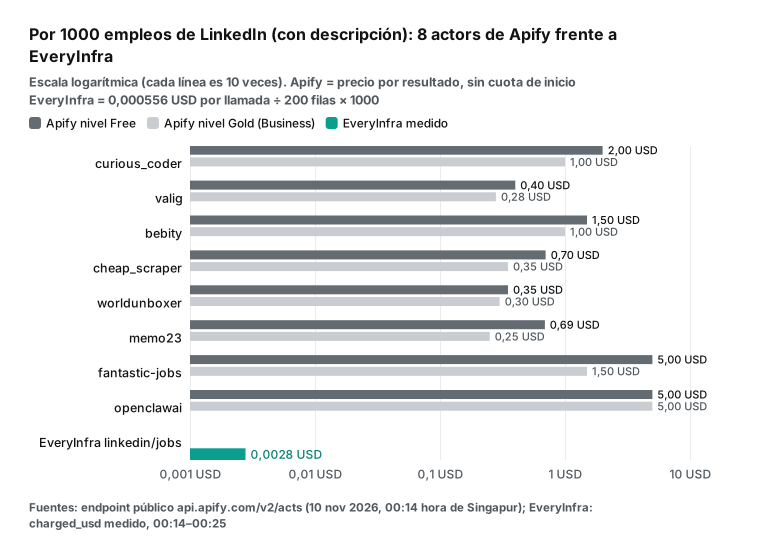
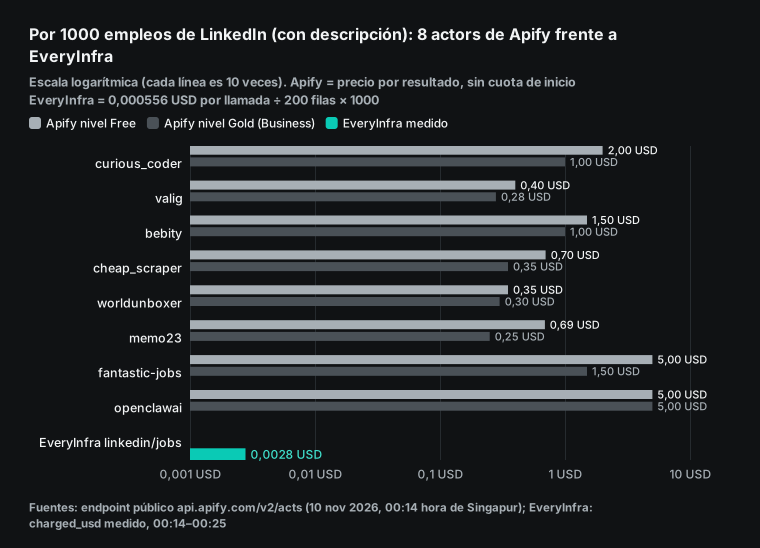
El múltiplo de la última columna compara una fila útil de empleo en cada lado. Casi todos estos actors devuelven descripción, salario y número de candidatos en cada fila. Algunos dan más. Por ejemplo, curious_coder incluye si se admite remoto, el método de candidatura y el tamaño de la empresa, y nuestras filas de lista no tienen esos datos. Así que el múltiplo compara «un empleo útil», no registros idénticos.
El modo rápido de worldunboxer cuesta solo 0,10 USD por 1000, pero no trae la descripción completa. Para tenerla hace falta su modo detallado, que suma 0,25 USD, y la tabla muestra la suma. fantastic-jobs es otro tipo de producto: vende su propia base de datos de empleos, con un retraso de alrededor de una hora. Sirve para extraer en bloque por sector o tamaño de empresa, que no es lo mismo que buscar en LinkedIn en directo.
Una búsqueda de «LinkedIn jobs» en la Store devolvía 2533 resultados cuando la leímos. Tomamos los actors con más usuarios recientes y añadimos dos muy baratos o que cambian de precio a menudo. También seguimos un actor solo de detalle, piotrv1001, a 4,00 USD por 1000.
Cómo probamos y cómo hicimos las cuentas
Todas las llamadas reales se hicieron de madrugada, el 10 de noviembre de 2026, entre las 00:14 y las 00:40 hora de Singapur. Usamos una clave de prueba con un límite de 10 peticiones por minuto. Por eso dejamos 7 segundos entre envíos y 65 segundos tras cualquier HTTP 429. En total recibimos 9 respuestas 429. No se cobran y no entran en los recuentos de peticiones de más abajo. Las búsquedas usaron el modo asíncrono. Añadimos "mode":"async" al cuerpo de la petición y recibimos un job_id al momento. Después consultamos /api/v1/jobs/{job_id} cada 15 segundos hasta que el estado fue succeeded o failed.
Cada respuesta incluye billing.charged_usd, el importe cobrado. Una tarea fallida muestra además refund_state: refunded. La tabla recoge todas las búsquedas.
| ID | Palabra clave y lugar | Enviada (hora de Singapur) | Terminada | Segundos | Filas | Cobro |
|---|---|---|---|---|---|---|
| j01 | data analyst · New York, NY | 00:14:35 | 00:17:39 | 184,8 | 200 | 0,000556 USD |
| j02 | data engineer · New York, NY | 00:18:00 | 00:22:39 | 275,7 | 200 | 0,000556 USD |
| j03 | data scientist · New York, NY | 00:18:10 | 00:22:42 | 270,2 | 200 | 0,000556 USD |
| j04 | analista de datos · Madrid | 00:18:19 | fallida 00:22:45 | 264,2 | 0 | reembolsada, 0 USD |
| j05 | data engineer · Madrid | 00:21:43 | 00:24:53 | 187,8 | 200 | 0,000556 USD |
| j06 | analista de datos · Ciudad de México | 00:21:52 | 00:25:15 | 200,4 | 200 | 0,000556 USD |
| j07 | data analyst · Singapur | 00:22:02 | 00:24:57 | 172,8 | 200 | 0,000556 USD |
| j08 | URL de búsqueda: EE. UU., última semana, remoto | 00:22:11 | 00:25:19 | 185,8 | 200 | 0,000556 USD |
| j11 | repetición de j01 | 00:36:17 | 00:39:09 | 169,2 | 200 | 0,000556 USD |
| j12 | reintento de j04 | 00:36:27 | 00:39:28 | 179,4 | 200 | 0,000556 USD |
El precio por 1000 sale de una sola fórmula: importe cobrado ÷ filas devueltas × 1000. Es decir, 0,000556 ÷ 200 × 1000 = 0,00278 USD. En toda la prueba, las 9 búsquedas correctas costaron 0,005004 USD. Al quitar duplicados por id quedan 1618 empleos únicos, lo que da 0,0031 USD por 1000 empleos únicos. Casi todo el solapamiento es la repetición a propósito: j11 y j01 comparten 176 empleos. La búsqueda de EE. UU. de la última semana (j08) comparte 5 con j01 y j03, y la repetición j11 comparte otros 5 con j03 y j08. Ningún otro par de búsquedas se solapa.
Cada porcentaje de este artículo usa las 200 filas completas como denominador. También enviamos otras 27 peticiones para probar errores y el detalle: una sin clave, una con un parámetro mal escrito, 23 a linkedin/job_detail y 2 por MCP. Guardamos cada respuesta original y los scripts que hacen los recuentos. Cada cifra de los gráficos sale de esos scripts.
Cómo leer los precios de Apify LinkedIn Jobs Scraper: tres formas de cobro y dos cambios ya anunciados
Casi todos los actors de la Store cobran hoy por evento. La documentación de Apify sobre pago por evento explica el modelo. El desarrollador define eventos como «inicio del actor», «un resultado» o «un análisis con IA», y cada evento tiene un precio. La página Actors in Store dice que la mayoría de estos actors incluye el uso de la plataforma en el precio del evento. Algunos lo cobran aparte, así que conviene revisarlo antes de lanzar una ejecución.
Cada evento puede tener precios distintos en los niveles de descuento FREE, BRONZE, SILVER y GOLD. Corresponden a los planes Free, Starter, Scale y Business. La página de precios para desarrolladores también indica que el desarrollador se queda con el 80 % de los ingresos por eventos.
| Forma de cobro | Actors | Eventos que pagas | Ojo con |
|---|---|---|---|
| Un evento por resultado | curious_coder, bebity, valig, memo23 | inicio + cada resultado | cambios de precio en pricingInfos |
| Inicio según memoria | cheap_scraper | 0,005 USD por GB al inicio + cada resultado | 0,02 USD por ejecución con 4 GB |
| Varios eventos por empleo | worldunboxer, bebity, cheap_scraper, memo23 | resultado rápido + detalle, datos de empresa o análisis con IA | los extras pueden costar más que la fila base |
En la segunda forma, cheap_scraper cobra 0,005 USD por GB al arrancar, y su página dice que usa 4 GB por defecto. Así, cada ejecución cuesta 0,02 USD antes de dar un solo resultado. En una ejecución de 20 empleos, esa cuota supera al coste de los resultados. La página de Apify sobre uso y recursos dice que la memoria debe ser una potencia de 2, entre 128 MB y 32.768 MB, y que cada 4096 MB dan un núcleo de CPU. Con menos memoria baja esa cuota, pero la ejecución va más lenta.
En la tercera forma, un empleo se divide en varios eventos. worldunboxer cobra 0,10 USD por 1000 en modo rápido y 0,25 USD más por el detalle completo (0,20 USD en Gold). bebity suma 1,00 USD por 1000 por datos premium de empresa. El 2026-11-07, cheap_scraper añadió un evento de análisis de empleo con IA a 0,50 USD por 1000. memo23 cobra 8,00 USD por 1000 por su enriquecimiento con IA.
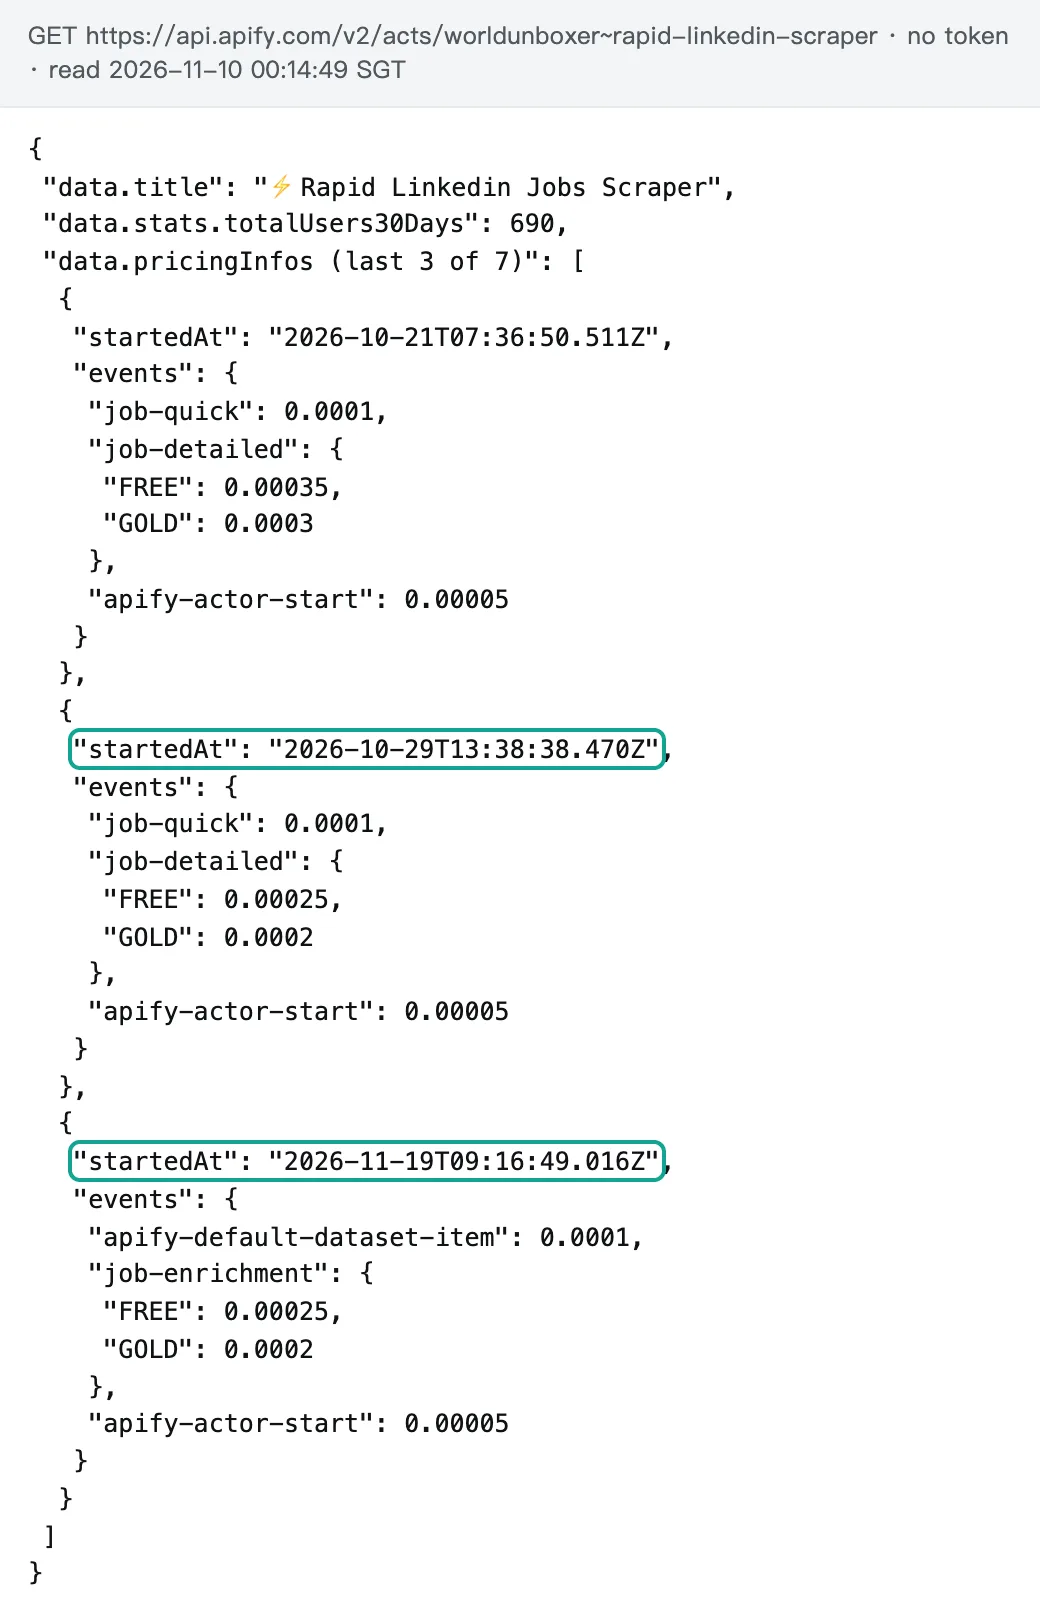
pricingInfos también enseña precios anunciados que aún no están en vigor. El 2026-11-11, el job-board-scraper de openclawai pasa de 5,00 USD por 1000 a 6,00 USD en Free y 4,00 USD en Gold. El 2026-11-19, worldunboxer cambia el nombre de su evento detallado a job-enrichment, sin tocar el precio. El ritmo de cambios varía mucho: worldunboxer cambió su lista 7 veces desde mayo y memo23, 8 veces desde julio. curious_coder subió su precio Free de 1,00 a 2,00 USD por 1000 el 2026-08-14. El actor de detalle piotrv1001 pasó de 6,00 a 3,00 USD y luego a 4,00 USD.
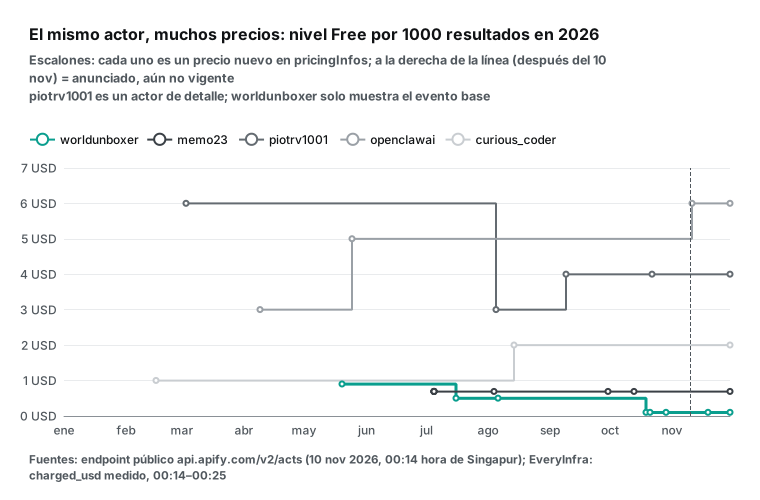
Los planes de Apify están en apify.com/pricing. Free incluye 5 USD de uso al mes. Starter cuesta 19 USD al mes, Scale 199 USD y Business 999 USD. La cuota del plan se convierte en uso prepagado de ese mes. La página de precios dice que el uso no consumido no pasa al mes siguiente. En el plan Free, el acceso se corta al gastar los 5 USD hasta el siguiente ciclo. Por tanto, el precio Gold es solo para cuentas que pagan 999 USD al mes. La mayoría de los equipos pequeños debe mirar las columnas Free y Bronze.
La forma más rápida de leer un precio es saltarse la página de la Store. Abre https://api.apify.com/v2/acts/<autor>~<nombre> y busca la última entrada de pricingInfos. Después lee eventPriceUsd y eventTieredPricingUsd de cada evento en pricingPerEvent.actorChargeEvents. Es el endpoint Get Actor. Leímos actors públicos sin token.
Escenario por ciudades: empleos de datos en Madrid, Ciudad de México, Nueva York y Singapur
En análisis de reclutamiento, la primera pregunta suele ser sencilla. ¿Cuántos empleos de datos hay abiertos en una ciudad y cuánto pagan? Usamos los mismos parámetros en cuatro ciudades. En Madrid buscamos data engineer y analista de datos. En Ciudad de México, analista de datos. En Nueva York, data analyst, data engineer y data scientist, y en Singapur, data analyst. También lanzamos una URL de búsqueda de LinkedIn para data analyst en EE. UU. de la última semana. Cada búsqueda devolvió 200 filas: son recuentos de campos sobre 200 filas, no un censo de la ciudad.
Un poco de contexto ayuda. La Encuesta de Población Activa del tercer trimestre, publicada por el INE el 2026-10-27, sitúa el paro en España en el 10,18 %. El boletín de ocupación y empleo del INEGI, del 2026-10-22, da una desocupación del 2,8 % en México. En EE. UU., el informe JOLTS del 2026-11-03 cuenta unos 7,5 millones de vacantes a final de septiembre, y el informe de empleo del 2026-11-06 suma 165.000 puestos en octubre con un paro del 4,1 %.
| Ciudad · puesto | Filas | Campo salary con valor | Rango solo en la descripción | Salario visible en total | applicant_count = 200 | Mediana de días desde la publicación |
|---|---|---|---|---|---|---|
| Madrid · data engineer | 200 | 11 (5,5 %) | 8 (4 %) | 9,5 % | 16 (8 %) | 15,5 |
| Madrid · analista de datos | 200 | 3 (1,5 %) | 7 (3,5 %) | 5 % | 70 (35 %) | 12 |
| Ciudad de México · analista de datos | 200 | 11 (5,5 %) | 5 (2,5 %) | 8 % | 47 (23,5 %) | 12,5 |
| Singapur · data analyst | 200 | 6 (3 %) | 0 | 3 % | 75 (37,5 %) | 13 |
| Nueva York · data analyst | 200 | 40 (20 %) | 111 (55,5 %) | 75,5 % | 125 (62,5 %) | 14 |
| Nueva York · data engineer | 200 | 56 (28 %) | 97 (48,5 %) | 76,5 % | 91 (45,5 %) | 15 |
| Nueva York · data scientist | 200 | 41 (20,5 %) | 116 (58 %) | 78,5 % | 89 (44,5 %) | 13 |
| EE. UU. · última semana (URL) | 200 | 22 (11 %) | 111 (55,5 %) | 66,5 % | 110 (55 %) | 4 |
La diferencia entre las dos mitades de la tabla es la ley. Desde el 1 de noviembre de 2022, Nueva York exige que los anuncios indiquen un salario mínimo y máximo de buena fe. Lo explica la Comisión de Derechos Humanos de Nueva York. Por eso entre el 75 % y el 79 % de sus empleos de datos muestra salario. En Madrid y Ciudad de México, la suma no llega al 10 %.
El campo salary: en Madrid casi vacío, en Nueva York la mitad del salario está en el texto
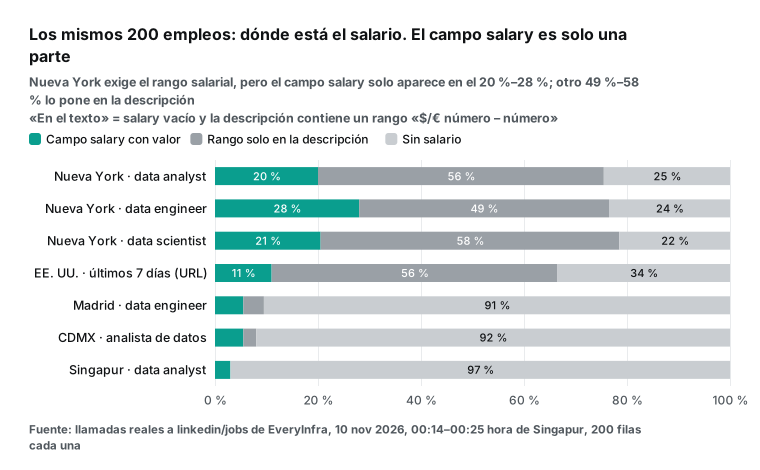
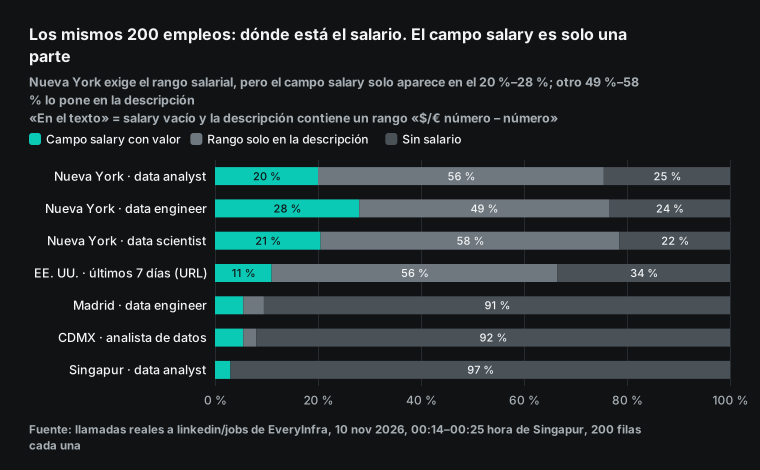
Así contamos «solo en la descripción», para no inflar la cifra. Un empleo cuenta solo si el campo salary está vacío y el texto contiene un rango: un símbolo de moneda, un número, un guion o «to», y otro número. Aceptamos dólares, euros, libras, pesos mexicanos y dólares de Singapur. Un número suelto, como «hasta 150.000 USD», no cuenta. Por eso esta columna es un mínimo prudente.
Tomamos 20 empleos al azar entre los 111 casos de Nueva York, data analyst, y los leímos uno a uno. Los 20 eran rangos salariales. Uno era el rango del mismo puesto en otro estado. Ninguno era una ronda de financiación ni otro tipo de cifra.
En Europa, la referencia es la Directiva (UE) 2023/970 de transparencia retributiva. Fijó el 7 de junio de 2026 como plazo para trasladarla a las leyes nacionales, e incluye informar del salario inicial o de su banda antes de contratar. Según Revelio Labs, en agosto de 2026 el 30,4 % de las ofertas de la UE mostraba salario. España estaba en el 19 %, Alemania en el 20 %, Francia en el 43 %, Italia en el 48 % y Países Bajos en el 59 %. En ese momento, solo 7 de los 27 Estados habían aprobado su ley.
El Confidencial publicó el 2026-11-07 un repaso país por país. Su conclusión: cada Estado avanza a su ritmo, y España no va tan mal. Nuestra muestra de Madrid queda por debajo del 19 % de Revelio para toda España. Hay un detalle que se ve en los datos: en la búsqueda de data engineer, 42 de 200 empleos (21 %) usan la palabra «competitive» o «competitivo» en el texto, sin dar cifras.
| Lugar | Norma sobre salario en anuncios | Desde | Qué vimos en 200 filas |
|---|---|---|---|
| Unión Europea | Directiva 2023/970, leyes nacionales pendientes | plazo 2026-06-07 | Madrid 5 %–9,5 % |
| España | trasposición en curso | — | data engineer 9,5 %, analista 5 % |
| México | no lo analizamos en este artículo | — | Ciudad de México 8 % |
| Ciudad de Nueva York | mínimo y máximo de buena fe | 2022-11-01 | 75,5 %–78,5 % visible, 20 %–28 % en el campo |
| Reino Unido | ley «say what you pay» anunciada | 2026-11-05 | sin muestra |
| Estado de Washington | escala o rango salarial, empleadores con 15 o más personas (RCW 49.58.110) | en vigor | sin muestra |
En el Reino Unido, el Gobierno anunció el 2026-11-05 una ley que hará obligatorio el salario en los anuncios. Lo cuentan la nota de GOV.UK y Reuters. Según la nota, el 41 % de los empleadores publica siempre una banda y el 18 % una cifra exacta. El 94 % de las respuestas a la consulta apoyó el cambio. Cuando España complete su ley, la columna de salario de Madrid debería crecer como lo hizo la de Nueva York.
Para tener una referencia de EE. UU., Headcount Labs publica en Hugging Face un conjunto de datos de ofertas con salario. Su foto del 2026-10-19 reúne 3.145.962 empleos. Un artículo de IBTimes del 2026-10-20 lo usó para contar que el 44,7 % de las ofertas de EE. UU. muestra salario, con un 69,9 % en el estado de Nueva York. Nuestro 75 %–79 % para empleos de datos en Nueva York queda algo por encima.
Rangos salariales: Madrid, Ciudad de México y Nueva York
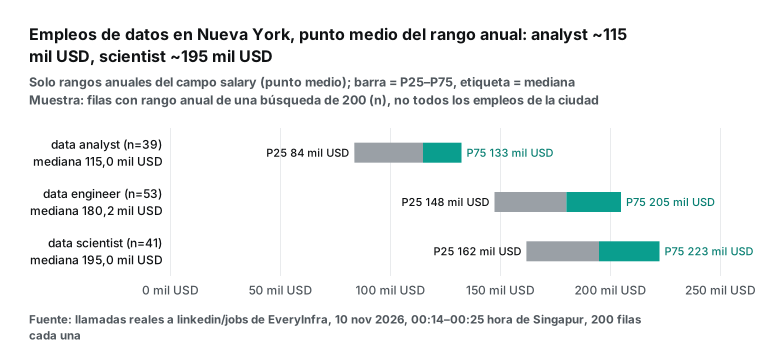
Usamos solo los rangos del campo salary. Para cada empleo tomamos el punto medio entre el mínimo y el máximo, y luego miramos cómo se reparten esos puntos medios. En Madrid, data engineer, hay 11 rangos anuales en euros. La mediana del punto medio es 45.000 EUR, con cuartiles de 34.000 a 50.000 EUR. En analista de datos solo hay 3, con valores de 29.000, 40.000 y 65.000 EUR de punto medio: demasiado pocos para sacar conclusiones.
En Ciudad de México, 9 de los 11 empleos con salario dan un rango mensual en pesos. La mediana del punto medio es 33.000 MXN al mes, entre 16.500 y 57.500 MXN. Hay además un rango anual en dólares y un «24.000–25.000 MXN al año» que parece mensual con la unidad equivocada. En Nueva York las muestras son mayores. Data analyst tiene 39 rangos anuales con mediana de 115.000 USD, data engineer 53 con 180.188 USD y data scientist 41 con 195.000 USD.
| Ciudad · puesto | Rangos usados | Unidad | P25 | Mediana | P75 |
|---|---|---|---|---|---|
| Madrid · data engineer | 11 | EUR al año | 34.000 | 45.000 | 50.000 |
| Ciudad de México · analista de datos | 9 | MXN al mes | 23.500 | 33.000 | 36.500 |
| Nueva York · data analyst | 39 | USD al año | 83.750 | 115.000 | 132.500 |
| Nueva York · data engineer | 53 | USD al año | 147.500 | 180.188 | 205.000 |
| Nueva York · data scientist | 41 | USD al año | 162.000 | 195.000 | 222.500 |
Estas cifras tienen tres límites. Primero, la muestra es la parte de una búsqueda de 200 filas que muestra salario. Con n entre 9 y 53, sirve para ver el orden de magnitud y para ordenar puestos. No es una referencia de toda la ciudad.
Segundo, el campo salary tiene errores de carga. Dos empleos de Madrid dicen «€50.00/yr - €75.00/yr», que parecen miles de euros sin los ceros. Uno de Nueva York dice «$65.00/yr - $70.00/yr», que parece una tarifa por hora con la unidad equivocada. Dejamos los valores tal cual. Si se quitan los valores por debajo de 1000, la mediana de Madrid pasa de 45.000 a 47.000 EUR. El orden de magnitud no cambia.
Tercero, una repetición 22 minutos después movió la mediana de data analyst en Nueva York de 115.000 a 108.120 USD, con n de 39 a 45. La sección de repetición da el detalle. Una sola búsqueda es una muestra que se mueve. Para ver tendencias, fija la hora y junta varias ejecuciones.
Para sumar el salario que solo está en el texto hace falta un paso más. En Madrid el efecto es pequeño: solo 8 empleos más, así que la mediana de la tabla apenas puede moverse. En Nueva York sí cambia el resultado, y lo medimos con una regla sencilla. En cada oferta con el campo salary vacío tomamos el primer rango en dólares del texto. La regla lee «$95,000 – $120,000», «$160K - $210K» y «$85-$115k», multiplica por 2080 los rangos por hora y descarta lo que queda fuera de 20.000 a 1.000.000 USD al año. Es algo más amplia que la columna «solo en el texto» de arriba, por eso encuentra unos pocos casos más: 115 en data analyst, 106 en data engineer y 117 en data scientist.
El resultado va siempre en la misma dirección: los rangos del texto son más bajos que los del campo salary. En data analyst, la mediana del texto es 107.500 USD, frente a 115.000 USD del campo. En data engineer, 162.750 frente a 182.594 USD (sin la fila por hora mal marcada). En data scientist, 169.800 frente a 195.000 USD. Al juntar las dos partes, data analyst pasa de 39 a 154 rangos y la mediana queda en 108.120 USD; data engineer, 158 rangos y 170.000 USD; data scientist, 158 rangos y 173.850 USD. Es decir, la mediana del campo solo es entre un 6 % y un 11 % más alta que la combinada. Estas muestras no dicen por qué. Para un estudio salarial, indica qué método usaste; la tabla de arriba sigue usando solo el campo, y guardamos la regla y el script junto a los datos originales.
Fecha de publicación y número de candidatos: siempre llenos, pero hay que leerlos bien
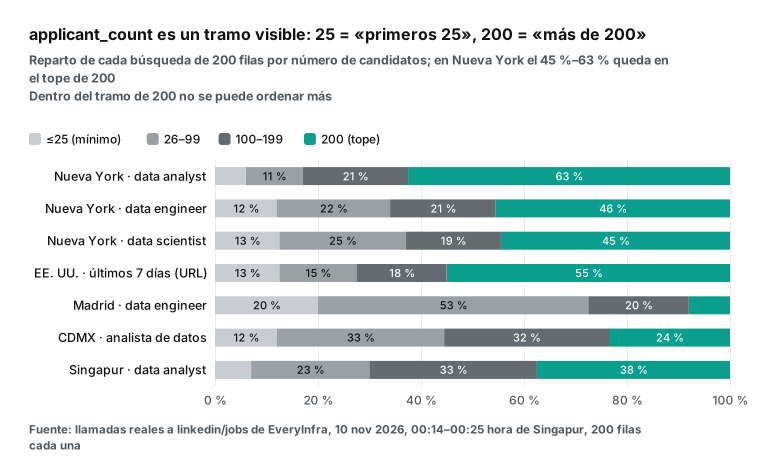
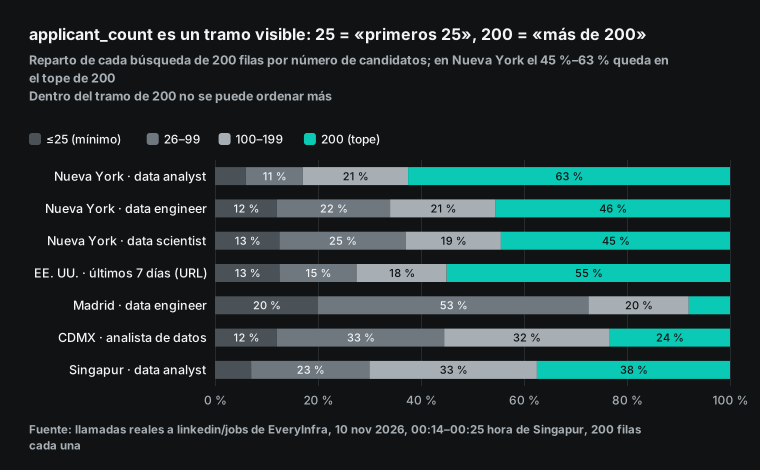
applicant_count tenía valor en las 1800 filas recibidas. Pero no es un recuento exacto. LinkedIn muestra tramos de texto, como «Be among the first 25 applicants» y «Over 200 applicants», y solo da números exactos entre medias. Así que 25 es un suelo y 200 es un techo.
En Madrid, data engineer, solo 16 de 200 empleos (8 %) llegan a 200, y 40 se quedan en 25 o menos. Ahí el campo distingue bien entre ofertas con mucha y poca demanda. En analista de datos de Madrid, el 35 % llega a 200. En Ciudad de México, el 23,5 %. En Nueva York, data analyst, son 125 de 200 (62,5 %): el campo solo separa «más de 200» de «todavía no».
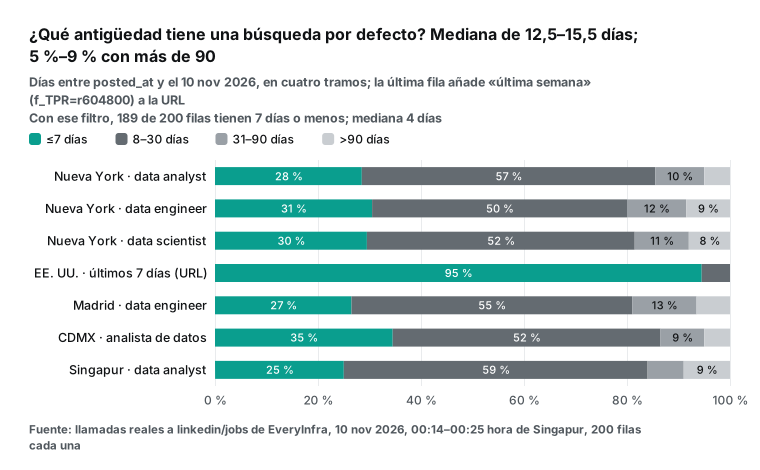
posted_at es una fecha, con la hora a medianoche, y también estaba en las 1800 filas. Sin filtro de tiempo, la mediana de antigüedad iba de 12 a 15,5 días. Entre un 4 % y un 9 % de los empleos tenía más de 90 días. El más antiguo de Ciudad de México tenía 648 días, y uno de Madrid, 413. Estos empleos viejos inflan cualquier recuento de «ofertas nuevas».
La solución sencilla es pasar una URL de búsqueda de LinkedIn con f_TPR=r604800 (última semana) o f_TPR=r86400 (últimas 24 horas). Nuestra búsqueda j08 usó el filtro de última semana. De 200 empleos, 189 tenían 7 días o menos, el más antiguo 8 días y la mediana 4 días. El parámetro keyword acepta una URL completa de búsqueda de empleos de LinkedIn, como indica la documentación del parámetro.
seniority y employment_type también tienen valor, pero informan distinto. En analista de datos de Ciudad de México, 100 de 200 empleos dicen «Not Applicable» en seniority. En Madrid, analista de datos, son 104. Más del 95 % dice Full-time en employment_type. Para separar salarios por nivel, el campo seniority ayuda poco. Usa palabras del título como Senior, Junior o Lead.
Trabajo en remoto: tras el cambio de búsqueda de LinkedIn, el filtro de la URL dejó de funcionar
El remoto fue el más difícil de los cuatro campos. Nuestras filas de lista no tienen un campo de remoto. Solo podemos buscar la palabra en el título o el lugar. En Madrid, data engineer, salió en 8 de 200 filas, y en Ciudad de México, en 3. Por eso en j08 usamos una URL de búsqueda con f_WT=2 (remoto) y f_TPR=r604800 (última semana). El filtro de tiempo funcionó y el de remoto no. Solo 22 de 200 empleos decían remote en el título o el lugar, un 11 %.
La causa está en LinkedIn. Su centro de ayuda dice que la búsqueda de empleos usa ahora búsqueda con IA y que la búsqueda clásica se retira desde septiembre. La página de curious_coder en la Store dice que desde agosto de 2026 solo funcionan unos pocos filtros de URL: f_TPR (fecha), f_C (empresa), f_AL (Easy Apply) y f_EA (menos de 10 candidatos). Ese actor convierte el antiguo filtro de remoto f_WT en palabras que añade a la búsqueda, y su autor avisa de que puede no ser exacto. Con cualquier actor de Apify o con nuestro linkedin/jobs, revisa tú mismo el resultado de un filtro de remoto por URL.
Las páginas de detalle sí traen el dato. En nuestro catálogo, linkedin/job_detail lista los campos workplace_type e is_remote. La guía de datos estructurados JobPosting de Google usa jobLocationType: TELECOMMUTE para el teletrabajo en las webs de los empleadores. Pero nuestro endpoint de detalle no está disponible por ahora (lo explicamos más abajo). No podemos medir la cobertura de esos dos campos; solo podemos decir que están en el catálogo.
Repetición: la misma búsqueda 22 minutos después conservó 176 empleos y cambió 24
Para ver lo estable que es una búsqueda, repetimos j01 a las 00:36:17 hora de Singapur como j11, unos 22 minutos después. Las dos devolvieron 200 empleos. Por id, 176 coincidían (88 %) y 24 aparecían solo en una de las dos. Los empleos que cambiaron no eran los más nuevos. Los que entraron tenían fechas de julio al 9 de noviembre, y los que salieron estaban igual de repartidos. El orden de LinkedIn se mueve, y la ventana de 200 filas rota.
| Medida | j01 (00:14 hora de Singapur) | j11 (00:36 hora de Singapur) |
|---|---|---|
| Filas | 200 | 200 |
| Mismos ID | 176 | 176 |
| Solo en esta ejecución | 24 | 24 |
| Mismos empleos en el top 20 | 12 | 12 |
| Campo salary con valor | 40 (20 %) | 47 (23,5 %) |
| Salario solo en el texto | 111 | 104 |
| Mediana del punto medio anual | 115.000 USD (n=39) | 108.120 USD (n=45) |
| applicant_count = 200 | 125 | 123 |
También cambiaron algunos campos. En 9 de los 176 empleos comunes, applicant_count subió entre 1 y 4. Por ejemplo, 25 pasó a 28 y 68 a 72. En 1 empleo, posted_at pasó del 2026-10-02 al 2026-11-09: el empleador volvió a publicar una oferta antigua y LinkedIn la muestra como nueva. Ningún campo salary cambió.
Si sigues la demanda de candidatos, esto indica que la recogida diaria funciona. Si cuentas «ofertas nuevas por día», tienes que quitar duplicados por id y no solo por fecha. Sin ese paso, las ofertas republicadas cuentan dos veces. La mediana bajó un 6 % en 22 minutos con la misma búsqueda. Trata la mediana de una sola búsqueda de 200 filas como un rango, y para informes semanales o mensuales junta varias ejecuciones a hora fija.
Paginación y límites: 200 empleos por llamada, así que 1000 empleos son 5 búsquedas
linkedin/jobs devuelve como máximo 200 empleos por llamada. En el catálogo, max_limit es 200 y el valor por defecto es 20. Hoy no hay parámetro offset ni de página. Para una palabra clave y un lugar, solo obtienes los 200 primeros. Para llegar a 1000, divide el trabajo en 5 búsquedas distintas: cambia la ciudad, el puesto, la ventana de tiempo o la empresa. Nuestras 9 búsquedas correctas dieron 1618 empleos únicos. Sin contar la repetición a propósito, los grupos casi no se solaparon.
En Apify, el límite viene de LinkedIn. La página de curious_coder dice que LinkedIn muestra como máximo 1000 empleos por búsqueda y recomienda dividir las URL por ubicación. cheap_scraper también habla de 1000 empleos por búsqueda. El proyecto abierto JobSpy dice en su README que la mayoría de los portales corta en unos 1000 resultados por búsqueda. También dice que LinkedIn responde 429 si vas demasiado rápido, y que el bloqueo se levanta en un minuto aproximadamente.
Así que, por encima de 1000 empleos, cualquier herramienta exige dividir búsquedas. La diferencia está en la unidad. Una ejecución de Apify puede traer los 1000 empleos de una vez, y pagas por fila. Con nosotros envías 5 llamadas y pagas por llamada. El código para dividir es corto. Este ejemplo en Python combina tres puestos y dos ciudades en 6 búsquedas asíncronas y quita duplicados por id. A precio de catálogo, 6 llamadas cuestan 6 × 0,000556 = 0,003336 USD por hasta 1200 empleos.
import os, time, requests

API = "https://api.everyinfra.com"
H = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}
puestos = ["analista de datos", "data engineer", "data scientist"]
ciudades = ["Madrid, Spain", "Mexico City, Mexico"]

empleos, vistos = [], set()
for puesto in puestos:
    for ciudad in ciudades:
        body = {"platform": "linkedin", "action": "jobs", "mode": "async",
                "params": {"keyword": puesto, "location": ciudad, "limit": 200}}
        poll = requests.post(f"{API}/api/v1/social", json=body, headers=H).json()["poll_url"]
        while True:
            r = requests.get(API + poll, headers=H).json()
            if r["status"] in ("succeeded", "failed"):
                break
            time.sleep(15)
        for fila in r.get("results", []):
            if fila["id"] not in vistos:
                vistos.add(fila["id"])
                empleos.append(fila)
print(len(empleos), "empleos únicos")
Detalle del empleo: no disponible por ahora, 0 USD cobrados
El detalle de un empleo no funcionó en esta prueba. El catálogo marca linkedin/job_detail como disponible, a 0,001194 USD por llamada. Acepta una URL de empleo o un ID de 8 a 12 dígitos. Frente a una fila de lista, el catálogo añade apply_url, workplace_type, is_remote, industries, benefits, view_count, job_state, expires_at, country_code, company_employee_count y company_website.
Entre las 00:29:51 y las 00:40:47 hora de Singapur enviamos 23 peticiones. 19 eran empleos de las listas de cada ciudad, con y sin salario. Una era el ID falso 9999999999. Otra usaba el modo asíncrono, otra una URL completa y otra era la petición de ejemplo de la propia API. A las 01:20 repetimos una vez más. Durante nuestra prueba, el endpoint de detalle devolvió HTTP 503 y no cobró nada. Cada error llegó en 2 a 4 segundos, con el código unavailable y el texto «Not charged». Para tu flujo, esto significa que el enlace de candidatura, el remoto, los sectores, los beneficios, las visitas y la caducidad tienen que salir de otra fuente por ahora; los campos de la lista de la tabla siguiente no cambian.
| Grupo de campos | Fila de lista `linkedin/jobs` (medido) | `linkedin/job_detail` (solo catálogo, no disponible por ahora) |
|---|---|---|
| Título, empresa, lugar, URL | sí, 1800 de 1800 filas | sí |
| Descripción completa | sí, 1800 de 1800 filas | sí |
| salary | 1,5 %–5,5 % en Madrid y Ciudad de México, 20 %–28 % en Nueva York | sí, si se publica |
| applicant_count, posted_at | sí, 1800 de 1800 filas | sí |
| seniority, employment_type | sí | sí |
| apply_url, workplace_type, is_remote | no | en catálogo |
| industries, benefits, view_count, expires_at | no | en catálogo |
| company_employee_count, company_website | no | en catálogo |
La descripción mediana de data analyst en Nueva York tenía 6068 caracteres. La sección de la cesta suma el detalle a precio de catálogo y lo compara con los precios de detalle de Apify.
¿Se cobran los fallos y los resultados vacíos?
| Caso | Hora (hora de Singapur) | Respuesta | Cobro |
|---|---|---|---|
linkedin/jobs sin clave | 00:14:20 | 401 missing_key, «Nothing was charged.» | 0 USD |
Parámetro escrito keywrd | 00:14:27 | 422 missing_param, indica keyword y da un ejemplo válido | 0 USD |
| Búsqueda fallida de analista de datos en Madrid | enviada 00:18:19, fallida 00:22:45 | estado failed, refund_state: refunded, reintentar en 20 segundos | cobrada y devuelta, neto 0 USD |
| La misma búsqueda 18 minutos después | 00:36:27 | 200 empleos | 0,000556 USD |
23 llamadas a linkedin/job_detail (incluido el ID falso 9999999999) | 00:29:51–00:40:47 | unavailable, no disponible por ahora (ver arriba) | 0 USD |
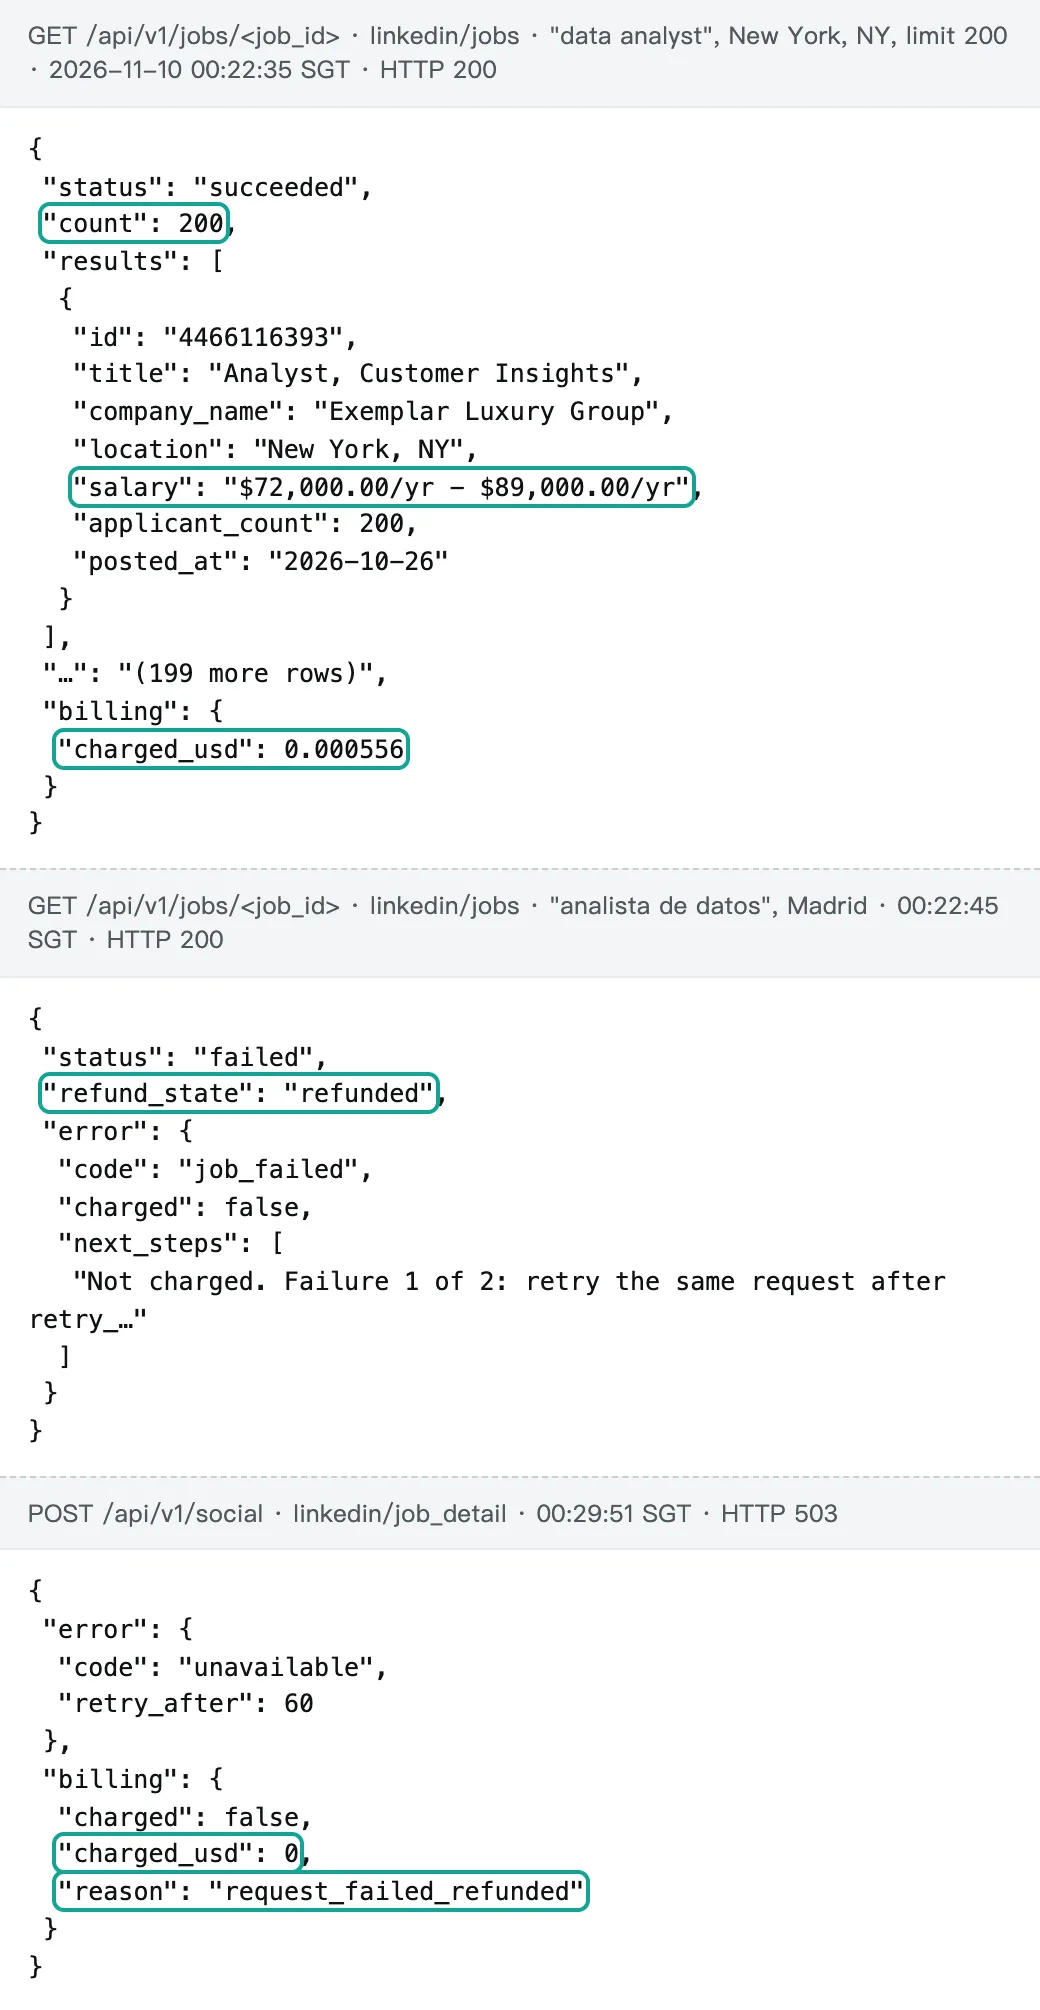
En Apify, las reglas siguen a los eventos. Un actor de pago por evento cobra solo los eventos que ocurren. Si una ejecución falla sin resultados, pagas igualmente el evento de inicio. Si devuelve algunas filas, pagas esas filas. El endpoint de ejecución síncrona tiene dos protecciones: maxItems limita cuántas filas puede cobrar un actor de pago por resultado, y maxTotalChargeUsd limita el cobro total de la ejecución. Lo explica la referencia de la API. Al llegar al límite, el actor se detiene y conserva lo que ya recogió.
Algunos autores añaden reglas propias en la Store. worldunboxer tiene «Exclude Job IDs»: le pasas los ID de la ejecución anterior, y esos empleos no se devuelven ni se cobran. Un vídeo tutorial de cheap_scraper explica que los filtros de exclusión actúan antes del cobro. Sus «filtros dinámicos», en cambio, extraen primero y filtran después, así que los empleos filtrados se cobran igual.
La diferencia de fondo es la unidad de cobro. Apify cobra por fila producida: más filas cuestan más y una ejecución vacía casi no cuesta. Nosotros cobramos por llamada: 200 filas y 20 filas cuestan lo mismo, y los errores no cuestan nada. Por eso, con nosotros, pon siempre limit en 200. En nuestra prueba por MCP pedimos solo 25 empleos y pagamos los mismos 0,000556 USD. Eso son 0,0222 USD por 1000, ocho veces más que con 200.
La cesta: 1000 filas de lista, 1000 de detalle y una alerta diaria
Estos son tres usos habituales, cada uno con sus condiciones.
| Uso | Apify (Free / Gold) | EveryInfra | Más barato |
|---|---|---|---|
| 1000 filas de lista con descripción | curious_coder 2,00 / 1,00 USD; valig 0,40 / 0,28 USD | 5 llamadas a linkedin/jobs, 0,00278 USD | Nosotros, de 101 a 719 veces |
| 1000 filas con campos de detalle (enlace, remoto, sectores) | worldunboxer rápido + detallado 0,35 / 0,30 USD; valig 0,40 / 0,28 USD | lista 0,00278 + 1000 llamadas a linkedin/job_detail a 1,194 USD = 1,197 USD (detalle no disponible por ahora, ver arriba) | Apify, de 3 a 4 veces |
| 20 empleos nuevos al día, 30 ejecuciones al mes | valig 0,27, worldunboxer 0,21, curious_coder 1,20, cheap_scraper 1,02 USD | 30 × 0,000556 = 0,0167 USD | Nosotros, aunque los 5 USD del plan Free de Apify lo cubren |
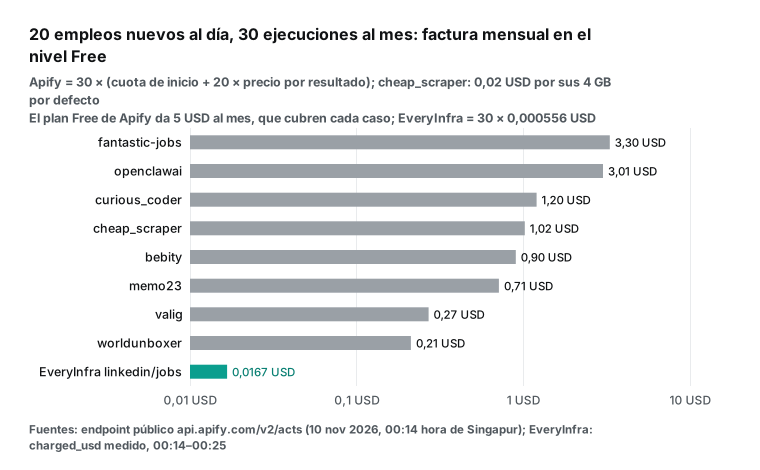
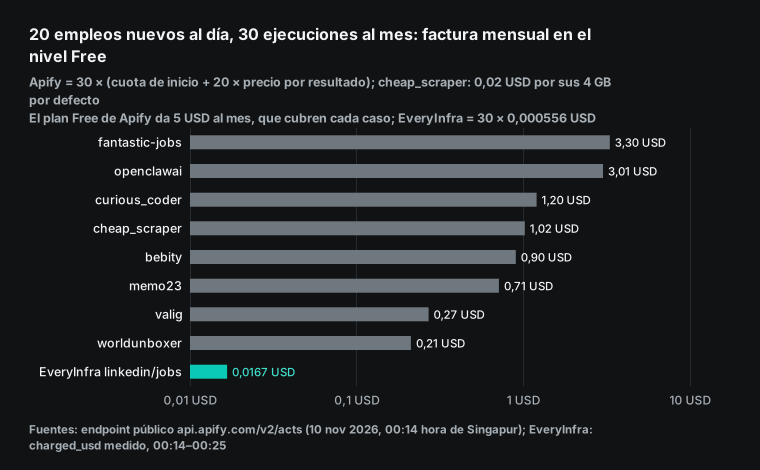
En la tercera fila, una persona con una alerta diaria de 20 empleos paga en Apify entre 0,21 y 3,30 USD al mes. Todo cabe en los 5 USD del plan Free, así que en la práctica no paga nada. Con nosotros son 0,0167 USD, también casi nada. A pequeña escala, los dos lados son baratos. La diferencia aparece con volumen.
Pongamos 10 ciudades × 5 puestos × 200 empleos al día: 300.000 empleos al mes. En Apify, valig en Gold cuesta unos 85 USD, con 1500 cuotas de inicio incluidas. curious_coder en Free cuesta unos 600 USD. Con nosotros son 1500 llamadas × 0,000556 = 0,834 USD.
La segunda fila es donde gana Apify. Si necesitas el enlace de candidatura, el remoto y los sectores de cada empleo, los actors que dan el detalle en una sola fila cuestan entre 0,28 y 0,40 USD por 1000. Nuestra «lista más detalle» a precio de catálogo es 1,197 USD, de 3 a 4 veces más, y hoy nuestro detalle no funciona. Esto seguirá así cuando vuelva, porque el detalle por llamada siempre es un empleo por llamada.
apify linkedin scraper jobs frente a EveryInfra: cómo se hacen las llamadas
En Apify, una forma habitual de lanzar un actor de empleos es el endpoint «run synchronously and get dataset items». Envías la entrada del actor como cuerpo de la petición, y al terminar la ejecución la respuesta trae los resultados. El ejemplo sigue la referencia de la API de Apify. No tenemos cuenta en Apify, así que no lo ejecutamos. Los nombres de los campos de entrada dependen de cada actor; aquí usamos curious_coder, que acepta URL de búsqueda de LinkedIn.
# Solo ejemplo (no ejecutado): ejecución síncrona de un actor de empleos, como máximo 1000 filas y 2 USD
curl -X POST "https://api.apify.com/v2/acts/curious_coder~linkedin-jobs-scraper/run-sync-get-dataset-items?maxItems=1000&maxTotalChargeUsd=2" \
  -H "Authorization: Bearer $APIFY_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"urls": ["https://www.linkedin.com/jobs/search/?keywords=analista%20de%20datos&location=Madrid&f_TPR=r604800"]}'
Nuestro lado es un único POST /api/v1/social. Para cambiar de plataforma cambias platform y action. Los nombres de los parámetros están en la documentación de búsqueda de empleos de LinkedIn y en el catálogo gratuito. Este es el mismo patrón que usamos en la prueba: envío asíncrono y consulta de poll_url.
# Envío (devuelve job_id y poll_url al momento)
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"linkedin","action":"jobs","mode":"async",
       "params":{"keyword":"analista de datos","location":"Madrid, Spain","limit":200}}'

# Consulta cada 15 segundos hasta que status sea succeeded o failed
curl -s https://api.everyinfra.com/api/v1/jobs/<job_id> \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY"
El esfuerzo es parecido. Las diferencias están en la espera y en el manejo de fallos. Nuestras búsquedas asíncronas de 200 empleos tardaron entre 169 y 276 segundos del envío al resultado, con una mediana de unos 186 segundos. Las llamadas síncronas, sin mode, sirven para lotes pequeños. Nuestra llamada por MCP de 25 empleos tardó 18,4 segundos.
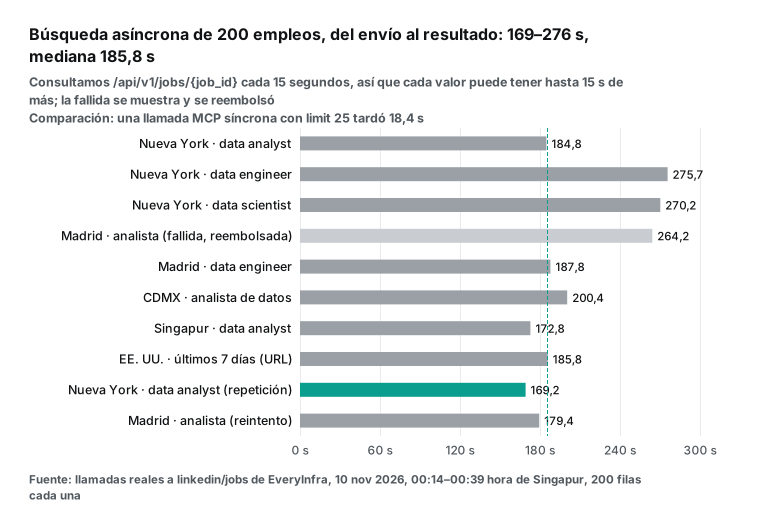
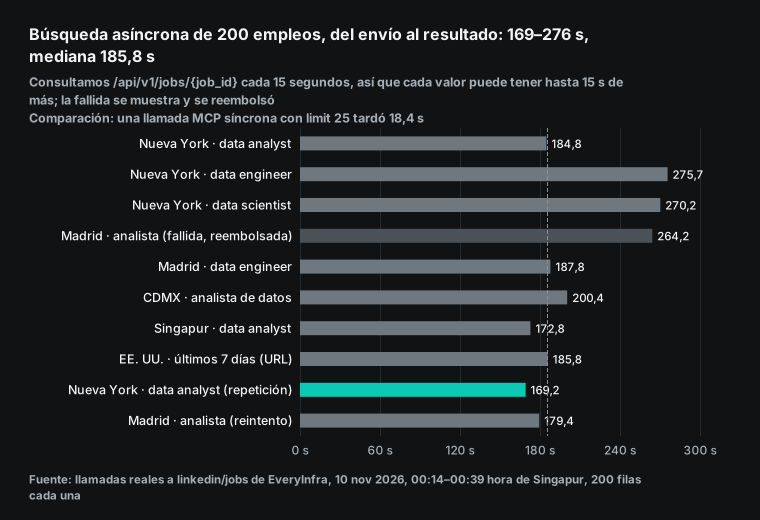
El endpoint síncrono de Apify mantiene la conexión abierta hasta que termina la ejecución. Para ejecuciones grandes encaja mejor una ejecución asíncrona con un webhook. Los resultados van a un dataset, que se exporta a JSON, CSV o Excel. Nuestros resultados llegan en la respuesta de la consulta, y tú decides dónde guardarlos. Cuando una llamada falla, la respuesta dice si se cobró y cuándo reintentar. Nuestra guía de conciliación de fallos y reembolsos explica cómo revisar los cobros por charge_id.
MCP: buscar empleos desde un cliente de IA
Los dos lados funcionan con clientes MCP. El servidor MCP de Apify está en mcp.apify.com. Recomienda entrar con OAuth, y también acepta un token de API. Puede buscar en la Store, lanzar actors y leer resultados, y su código es abierto en GitHub. La documentación describe además los «agentic payments», que permiten a un agente pagar sin cuenta de Apify. Nuestro endpoint MCP remoto es https://api.everyinfra.com/mcp. La configuración está en nuestra página del servidor MCP y en la guía de MCP remoto. Los dos siguen el transporte remoto de la especificación MCP.
| Servidor MCP de Apify | MCP de EveryInfra | |
|---|---|---|
| Endpoint | mcp.apify.com | https://api.everyinfra.com/mcp |
| Acceso | OAuth (recomendado) o token de API | clave de API Bearer |
| Qué puede hacer el modelo | buscar en la Store, lanzar actors, leer datasets | listar capacidades, llamar endpoints, consultar tareas |
| Coste de una búsqueda de empleos | los precios por evento del actor | 0,000556 USD por llamada |
| Nuestra prueba | no ejecutada (sin cuenta) | 12 herramientas, 25 empleos en 18,4 s |
A las 00:39:32 hora de Singapur llamamos a tools/list sin clave. Devolvió 12 herramientas en 0,34 segundos, entre ellas everyinfra_list_capabilities, everyinfra_call_api y everyinfra_get_job. A las 00:39:41 hora de Singapur llamamos a everyinfra_call_api con la clave. Pedimos empleos de data engineer en Singapur con limit 25. Devolvió 25 empleos en 18,4 segundos y cobró 0,000556 USD. Una configuración de cliente tiene este aspecto:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Después puedes pedir en el chat: «Busca empleos de analista de datos en Madrid de los últimos 7 días y ordénalos por rango salarial». El modelo lee el catálogo y llama a linkedin/jobs. Para cruzar empleos con datos de empresa, también puede llamar a perfil de empresa y empleados de la empresa. Nuestra guía de investigación de cuentas de LinkedIn con MCP en Copilot Studio muestra un ejemplo completo. Pide al modelo que use limit 200: los modelos suelen pedir 20 o 25 filas, y con precio por llamada eso multiplica el coste por 1000 filas.
Cuándo conviene más Apify
En estos casos, un actor de empleos de Apify encaja mejor que nuestro endpoint.
| Necesidad | Opción en Apify | Nuestro estado hoy |
|---|---|---|
| Campos de detalle en cada fila | valig, worldunboxer detallado, curious_coder | linkedin/job_detail no disponible por ahora |
| Los 1000 empleos de una búsqueda | cualquier actor de lista, una ejecución | 200 por llamada, sin páginas |
| Filtros como menos de 10 candidatos o Easy Apply | curious_coder, worldunboxer | palabra clave, lugar y filtros de URL que aún funcionan |
| Programación, datasets, webhooks | plataforma de Apify | solo API |
| Base de datos de empleos o enriquecimiento con IA | fantastic-jobs, cheap_scraper, memo23 | solo empleos |
Primero: necesitas campos de detalle en cada empleo, y los necesitas hoy. Nuestro linkedin/job_detail no está disponible por ahora (ver arriba). En Apify, valig devuelve en una fila la descripción, el nombre y enlace del reclutador, el tipo de candidatura, el sector y la función. El modo detallado de worldunboxer da 23 campos, entre ellos sectores, «contratando activamente» y «candidato temprano». Ambos cuestan entre 0,28 y 0,40 USD por 1000.
El actor más usado, curious_coder, incluye si se admite remoto (workRemoteAllowed), el tipo de lugar de trabajo, el método de candidatura, la caducidad, el tamaño de la empresa y quién publicó la oferta. Todo eso entra en sus 2,00 USD por 1000 (1,00 USD en Gold). El remoto es justo el campo que nuestra lista no da. A precio de catálogo, nuestra «lista más detalle» cuesta unos 1,197 USD por 1000, de 3 a 4 veces más. Seguirá así cuando el endpoint vuelva, porque cada llamada de detalle trae un solo empleo.
Segundo: necesitas los 1000 empleos de una sola búsqueda. LinkedIn muestra como máximo 1000 por búsqueda, y un actor de lista de Apify los trae en una ejecución. Nosotros damos como máximo 200 por llamada, sin páginas. Para una palabra clave en un lugar, solo tienes los 200 primeros. Si quieres, por ejemplo, todos los empleos de analista de datos de Madrid para mapear empleadores, Apify es más cómodo.
Tercero: necesitas sus filtros y su control de duplicados. worldunboxer filtra por ID de empresa, ID geográfico, radio, Easy Apply y candidatos tempranos. curious_coder tiene filtros de búsqueda con IA como «menos de 10 candidatos». worldunboxer puede excluir los ID de la ejecución anterior sin cobrarlos, y bebity añade datos premium de empresa. Nosotros tenemos palabra clave, lugar y los filtros de URL de LinkedIn que aún funcionan.
Cuarto: necesitas la plataforma alrededor. Las programaciones de Apify lanzan tareas a diario y guardan los resultados en datasets. Webhooks, Make, Zapier y n8n los envían a una hoja de cálculo o a Slack. El plan Free ejecuta 5 actors a la vez y Starter, 32, según sus límites. Nosotros damos solo la API: la programación y el almacenamiento los montas tú o una herramienta como n8n. Nuestra alternativa a Apify con n8n explica cómo.
Quinto: quieres una base histórica o procesamiento con IA. El actor fantastic-jobs vende su propia base de datos de empleos, con alrededor de una hora de retraso, y devuelve hasta 5000 empleos por ejecución. Tiene un actor complementario de empleos caducados a 20 USD al mes. Fuera de Apify también tiene su API para desarrolladores con cuotas por plan, y el plan Pro-100k cobra 0,0025 USD por empleo por encima de la cuota. cheap_scraper y memo23 tienen eventos de análisis con IA. Nosotros devolvemos solo los empleos, y el modelo lo pones tú. Por último, buscar «LinkedIn jobs» en la Store da 2533 resultados: quizá alguien ya resolvió tu caso concreto.
Condiciones y límites legales: las reglas de LinkedIn y los datos públicos de empleo
Esta sección solo resume lo que dicen las condiciones y las sentencias. No es asesoramiento legal; consulta a tu abogado para tu caso. El Acuerdo de usuario de LinkedIn entró en vigor el 3 de noviembre de 2025. Su sección 8.2 prohíbe usar bots u otro software para extraer datos del servicio. Las condiciones de rastreo de LinkedIn prohíben rastrear sin permiso expreso. Las condiciones de empleos regulan a los empleadores que publican ofertas.
La Job Posting API de LinkedIn sirve para que los sistemas de reclutamiento publiquen ofertas en LinkedIn. Su documentación dice que ahora no acepta socios nuevos. Así que una API oficial para leer empleos no está abierta para la mayoría de los equipos.
El Tribunal de Apelaciones del Noveno Circuito de EE. UU. dictó su sentencia hiQ Labs v. LinkedIn el 18 de abril de 2022. Analizó si extraer páginas públicas que no piden inicio de sesión es «acceso no autorizado» según la ley federal de fraude informático. No resolvió cuestiones de contrato, como el incumplimiento del acuerdo de usuario.
Para quien analiza reclutamiento en España o México, el riesgo más práctico son los datos personales. Las ofertas pueden mostrar nombres y perfiles de reclutadores, y la normativa de protección de datos de la UE se aplica a esos datos. La Política de privacidad de LinkedIn explica cómo trata los datos de sus miembros. Nuestros campos de empleo no incluyen datos del reclutador. Si los obtienes por otra vía, evalúa aparte cómo los guardas y los usas.
Cambios recientes (octubre y noviembre de 2026)
| Fecha | Cambio | Efecto en los datos de empleo |
|---|---|---|
| 2026-10-19 | Headcount Labs publica una foto de 3,1 millones de empleos de EE. UU. | Compara tu cobertura salarial por estado; si en Nueva York quedas muy por debajo de su 69,9 %, revisa primero la extracción del texto |
| 2026-10-22 | INEGI publica la desocupación de septiembre en México: 2,8 % | Úsalo como contexto: el número de ofertas de una búsqueda de 200 no mide el empleo de un país |
| 2026-10-27 | El INE publica la EPA del tercer trimestre: paro del 10,18 % | Para Madrid, cruza tus recuentos de ofertas con la EPA antes de hablar de tendencia |
| 2026-11-05 | El Reino Unido anuncia «say what you pay» | Añade ya los rangos en libras a tu extracción de texto |
| 2026-11-07 | cheap_scraper añade un evento de análisis con IA a 0,50 USD por 1000 | Revisa las líneas de eventos de cada factura y no actives el análisis si no lo necesitas |
| 2026-11-07 | El Confidencial repasa la directiva europea país por país | Para ofertas de España, prepara la extracción de rangos en euros antes de que llegue la ley |
| 2026-11-11 (anunciado) | openclawai sube a 6,00 USD por 1000 en Free | Presupuesta las ejecuciones desde el 11 de noviembre al precio nuevo |
| 2026-11-19 (anunciado) | worldunboxer renombra su evento detallado a job-enrichment | Añade el nombre nuevo a tus scripts de facturación antes del 19 de noviembre |
Hay dos cambios más que afectan a todos los que trabajan con empleos de LinkedIn. LinkedIn sustituyó la búsqueda clásica por la búsqueda con IA, y la mayoría de los filtros de URL ya no funcionan; la sección de remoto lo detalla. Y el plazo de la directiva europea, el 7 de junio de 2026, ya pasó: en agosto, solo 7 de los 27 Estados tenían ley propia.
Lo que cuentan los vídeos y los foros
Uno de los tutoriales más vistos sobre el tema es «Scrape 1,000+ LinkedIn Jobs for 35 Cents», con 9488 visualizaciones (vídeo). Su precio de 35 centavos por 1000 está en la misma franja que los actors baratos de nuestra tabla. Un tutorial de cheap_scraper del 2026-06-22 (vídeo, 1718 visualizaciones) explica varias trampas. Copia la URL de búsqueda desde una ventana de incógnito. Cada par de palabra clave y lugar es una búsqueda aparte. Un filtro de salario mínimo deja fuera todos los empleos sin salario. Y los empleos cuyo anunciante no rellenó un filtro de LinkedIn no aparecen al usar ese filtro, el mismo tipo de problema que vimos con el remoto.
Dos hilos de Reddit en r/n8n muestran qué pasa con el plan Free. En un hilo sobre un extractor gratuito con n8n, un usuario escribió que «the apify $5 just went away in a few minutes». Una sola ejecución le costó más de 1 USD, así que montó su propio flujo. En un hilo de ayuda, la persona se encontró con resultados vacíos, un muro de inicio de sesión y límites de velocidad, y acabó pasando a otro actor de empleos. Los dos hilos muestran lo mismo: los 5 USD del plan Free bastan para una prueba pequeña, pero una ejecución sin límite que trae unos miles de filas los agota. En Apify, pon maxItems y maxTotalChargeUsd en cada ejecución.
Cuatro reglas para leer estos campos en análisis de reclutamiento
Estas reglas valen tanto si tus datos vienen de un actor de Apify como si vienen de nosotros. Ponlas en tu script de procesamiento.
| Campo | Regla | Por qué |
|---|---|---|
| Salario | lee el campo, extrae después los rangos del texto y pásalos a una unidad común (anual o mensual) | en Nueva York el texto suma un 49 %–58 % más; en Madrid, un 4 % |
| Candidatos | trata 25 como «menos de 25» y 200 como «más de 200»; no los promedies | en Madrid el 8 % llega a 200, en Nueva York hasta el 63 % |
| Fecha | fija la ventana con f_TPR y quita duplicados por ID | las ofertas republicadas vuelven con fecha nueva |
| Remoto | filtra títulos con remote, remoto, híbrido o hybrid y confirma con el detalle | el filtro f_WT de la URL ya no funciona |
Por último, indica el denominador de cada porcentaje. «X de 200 filas» se malinterpreta menos que «el X % de las ofertas muestra salario». Di también si la muestra es una búsqueda o varias ejecuciones juntas.
Preguntas frecuentes
¿Hay un apify linkedin job scraper gratis?
(La pregunta viene de la sugerencia de búsqueda «apify linkedin job scraper free».) Ningún actor es gratis del todo. Pero el plan Free de Apify da 5 USD de uso al mes sin tarjeta. Con los precios Free de hoy, 5 USD dan para unos 12.500 empleos con valig, unos 50.000 con el modo rápido de worldunboxer o unos 2500 con curious_coder. Después, el plan Free espera al mes siguiente. Con nosotros, si das una estrella a dos repositorios de GitHub, recibes 1 USD de prueba válido 24 horas. Nuestra documentación calcula unas 720 llamadas de datos típicas con 1 USD. A 0,000556 USD por llamada a linkedin/jobs, son unas 1800 llamadas de 200 empleos.
¿Cuánto cuesta ahora apify curious_coder linkedin jobs scraper?
(Sugerencia «apify curious_coder linkedin jobs scraper».) A las 00:14 hora de Singapur del 2026-11-10, cada resultado costaba 0,002 USD en Free y 0,001 USD en Bronze, Silver y Gold. Son 2,00 y 1,00 USD por 1000, más 0,00005 USD de inicio por ejecución. Este precio está en vigor desde el 2026-08-14; antes, el precio Free era de 1,00 USD por 1000. Tenía 14.455 usuarios en los últimos 30 días, más que ningún otro actor de empleos de LinkedIn en la Store.
¿LinkedIn tiene una API gratis para leer empleos?
(Sugerencia «linkedin job scraper api free».) LinkedIn tiene una Job Posting API, pero sirve para publicar ofertas en LinkedIn, no para leerlas. La documentación de Microsoft dice que ahora no acepta socios nuevos. Los datos estructurados JobPosting de Google son el formato con el que los empleadores marcan ofertas en sus webs. Los buscadores los leen, pero no son datos de LinkedIn. Para leer empleos públicos de LinkedIn hoy, las opciones son bibliotecas abiertas, actors en plataformas como Apify o una API como la nuestra.
¿Puedo usar tal cual un linkedin jobs scraper de GitHub?
(Sugerencias «linkedin jobs scraper github» y «linkedin jobs scraper python».) Sí. Los más comunes son JobSpy (paquete python-jobspy en PyPI) y py-linkedin-jobs-scraper. El primero busca en LinkedIn, Indeed, Glassdoor y otros portales con una función, y el segundo usa un navegador sin interfaz. Los dos son gratis, pero tú gestionas los límites de velocidad, los proxies y los cambios de LinkedIn. El README de JobSpy dice que LinkedIn responde 429 si vas demasiado rápido. Tras el paso de LinkedIn a la búsqueda con IA, muchos scripts basados en URL antiguas necesitan cambios. Para comparar varios portales, también ofrecemos una API de datos de Indeed y una API de datos de Glassdoor.
¿Cómo extraer empleos de LinkedIn sin programar?
(Sugerencia «how to scrape linkedin jobs».) Se puede. En la consola de Apify pegas una URL de búsqueda, pulsas ejecutar y descargas los resultados en Excel. De nuestro lado, cada página de endpoint tiene un formulario de prueba: escribe una palabra clave y un lugar, y verás la respuesta.
Primeros pasos: repite la prueba con tu ciudad y tus puestos
Paso 1: consigue una clave de API. Da una estrella a los repositorios everyinfra-agent-plugins y seo-skills en GitHub. Después regístrate y reclama el crédito de prueba de 1 USD en «Saldo y recarga» de la consola. El crédito vale 24 horas. Las recargas no caducan, y las peticiones con parámetros erróneos o autenticación fallida no se cobran. Consulta el inicio rápido y los precios.
Paso 2: abre la documentación de búsqueda de empleos de LinkedIn. Usa el formulario de prueba con tu ciudad y tu puesto, y pon limit en 200. Para los campos de detalle, consulta la documentación del detalle de empleo; ese endpoint no está disponible por ahora.
Paso 3: lee charged_usd y el número de filas en la respuesta. Calcula tu precio como cobro ÷ filas × 1000 y compáralo con la factura de tu ejecución en Apify. Cuenta cuántos empleos muestran salario en el campo salary y cuántos en el texto: así sabrás si tu mercado necesita extracción de texto.
Todos los endpoints de LinkedIn están en la página de la API de datos de LinkedIn. Para buscar otros datos de reclutamiento por plataforma, mira el mercado de datos. Si estás revisando toda tu factura de Apify, lee los precios de Apify explicados y nuestro resumen de alternativas a Apify. La versión de TikTok de esta comparación es la alternativa a Apify TikTok Scraper. Todas las comparativas están en /alternatives.
Referencias
- Apify Store: curious_coder/linkedin-jobs-scraper, <https://apify.com/curious_coder/linkedin-jobs-scraper> (leído el 2026-11-10)
- Apify Store: valig/linkedin-jobs-scraper, <https://apify.com/valig/linkedin-jobs-scraper> (leído el 2026-11-10)
- Apify Store: bebity/linkedin-jobs-scraper, <https://apify.com/bebity/linkedin-jobs-scraper> (leído el 2026-11-10)
- Apify Store: cheap_scraper/linkedin-job-scraper, <https://apify.com/cheap_scraper/linkedin-job-scraper> (leído el 2026-11-10)
- Apify Store: fantastic-jobs/advanced-linkedin-job-search-api, <https://apify.com/fantastic-jobs/advanced-linkedin-job-search-api> (leído el 2026-11-10)
- Apify Store: openclawai/job-board-scraper, <https://apify.com/openclawai/job-board-scraper> (leído el 2026-11-10)
- Apify Store: worldunboxer/rapid-linkedin-scraper, <https://apify.com/worldunboxer/rapid-linkedin-scraper> (leído el 2026-11-10)
- Apify Store: memo23/linkedin-jobs-scraper, <https://apify.com/memo23/linkedin-jobs-scraper> (leído el 2026-11-10)
- Apify Store: piotrv1001/linkedin-job-details-scraper, <https://apify.com/piotrv1001/linkedin-job-details-scraper> (leído el 2026-11-10)
- API pública de Apify: pricingInfos de worldunboxer/rapid-linkedin-scraper, <https://api.apify.com/v2/acts/worldunboxer~rapid-linkedin-scraper> (leído a las 00:14 hora de Singapur, 2026-11-10)
- Precios de Apify, <https://apify.com/pricing>
- Documentación de Apify: Pay per event, <https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event>
- Documentación de Apify: Actors in Store, <https://docs.apify.com/platform/actors/running/actors-in-store>
- Documentación de Apify: Actor pricing and costs, <https://docs.apify.com/platform/actors/publishing/monetize/pricing-and-costs>
- Documentación de Apify: Actor usage and resources, <https://docs.apify.com/platform/actors/running/usage-and-resources>
- API de Apify: Get Actor, <https://docs.apify.com/api/v2/actor-get>
- API de Apify: Run Actor synchronously and get dataset items, <https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post>
- Documentación de Apify: Webhooks, <https://docs.apify.com/platform/integrations/webhooks>
- Documentación de Apify: Dataset, <https://docs.apify.com/platform/storage/dataset>
- Documentación de Apify: Schedules, <https://docs.apify.com/platform/schedules>
- Documentación de Apify: Limits, <https://docs.apify.com/platform/limits>
- Documentación de Apify: Apify MCP server, <https://docs.apify.com/platform/integrations/mcp>
- GitHub: apify/actors-mcp-server, <https://github.com/apify/actors-mcp-server>
- Especificación Model Context Protocol, cambios del 2026-07-28, <https://modelcontextprotocol.io/specification/2026-07-28/changelog>
- Catálogo de datos de EveryInfra (LinkedIn), <https://api.everyinfra.com/api/v1/social/catalog?platform=linkedin> (leído a las 00:13 hora de Singapur, 2026-11-10)
- Ayuda de LinkedIn: búsqueda de empleo con IA, <https://www.linkedin.com/help/linkedin/answer/a6889044>
- Acuerdo de usuario de LinkedIn, <https://www.linkedin.com/legal/user-agreement>
- Condiciones de rastreo de LinkedIn, <https://www.linkedin.com/legal/crawling-terms>
- Condiciones de empleos de LinkedIn, <https://www.linkedin.com/legal/jobs-terms-conditions>
- Política de privacidad de LinkedIn, <https://www.linkedin.com/legal/privacy-policy>
- Microsoft Learn: LinkedIn Job Posting API overview, <https://learn.microsoft.com/en-us/linkedin/talent/job-postings/api/overview>
- Tribunal de Apelaciones del Noveno Circuito de EE. UU.: hiQ Labs v. LinkedIn, 2022-04-18, <https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf>
- Google Search Central: datos estructurados JobPosting, <https://developers.google.com/search/docs/appearance/structured-data/job-posting>
- Comisión de Derechos Humanos de Nueva York: Pay Transparency, <https://www.nyc.gov/site/cchr/media/pay-transparency.page>
- Estado de Washington: RCW 49.58.110, <https://app.leg.wa.gov/rcw/default.aspx?cite=49.58.110>
- Directiva (UE) 2023/970, <https://eur-lex.europa.eu/eli/dir/2023/970/oj>
- Revelio Labs: EU pay transparency directive, country by country, <https://www.reveliolabs.com/news/macro/eu-pay-transparency-directive-country-by-country>
- El Confidencial: transparencia salarial en la UE, 2026-11-07, <https://www.elconfidencial.com/empleo/2026-11-07/ley-de-transparencia-salarial-que-paises-de-la-ue_4458005/>
- INE: Encuesta de Población Activa, tercer trimestre de 2026, 2026-10-27, <https://www.ine.es/dyngs/Prensa/EPA3T26.htm>
- INEGI: Indicadores de ocupación y empleo, 2026-10-22, <https://www.inegi.org.mx/contenidos/saladeprensa/boletines/2026/iooe/IOE2026_10.pdf>
- GOV.UK: New say what you pay law, 2026-11-05, <https://www.gov.uk/government/news/new-say-what-you-pay-law-to-help-young-people-into-work>
- Reuters: Britain to make salary disclosure in job ads mandatory, 2026-11-05, <https://www.reuters.com/business/world-at-work/britain-make-salary-disclosure-job-ads-mandatory-2026-11-05/>
- Oficina de Estadísticas Laborales de EE. UU.: JOLTS, 2026-11-03, <https://www.bls.gov/news.release/jolts.nr0.htm>
- Oficina de Estadísticas Laborales de EE. UU.: Employment Situation, 2026-11-06, <https://www.bls.gov/news.release/empsit.nr0.htm>
- Headcount Labs: conjunto de datos pay-transparency-jobs, <https://huggingface.co/datasets/HeadcountLabs/pay-transparency-jobs>
- IBTimes: Median advertised annual salary in US tops $100,000, 2026-10-20, <https://www.ibtimes.com/median-advertised-annual-salary-us-tops-100000-most-job-listings-still-hide-pay-3808786>
- Documentación para desarrolladores de Fantastic.jobs, <https://developer.fantastic.jobs/documentation/country-job-statistics>
- GitHub: speedyapply/JobSpy, <https://github.com/speedyapply/JobSpy>
- PyPI: python-jobspy, <https://pypi.org/project/python-jobspy/>
- GitHub: spinlud/py-linkedin-jobs-scraper, <https://github.com/spinlud/py-linkedin-jobs-scraper>
- Reddit r/n8n: I built a 100% free LinkedIn job scraper using n8n, <https://www.reddit.com/r/n8n/comments/1t4lk7a/i_built_a_100_free_linkedin_job_scraper_using_n8n/>
- Reddit r/n8n: Need help searching jobs on LinkedIn using n8n, <https://www.reddit.com/r/n8n/comments/1t61zji/need_help_searching_jobs_on_linkedin_using_n8n/>
- YouTube: Scrape 1,000+ LinkedIn Jobs for 35 Cents, <https://www.youtube.com/watch?v=nxhJJCMVl-0>
- YouTube: tutorial de cheap_scraper LinkedIn Job Scraper, 2026-06-22, <https://www.youtube.com/watch?v=7oZorJOOa5Y>
Referencia BL-126