Alternativa a Apify Facebook Scraper: coste real por cada 1000 resultados
1000 posts de páginas de Facebook cuestan 5,00 USD en el nivel Free de Apify y 0,056 USD en nuestra prueba real. También medimos comentarios y Marketplace.
En Apify Store, el scraper de Facebook más usado es Facebook Posts Scraper, de Apify, con 18.261 usuarios en 30 días. Cuesta 5,00 USD por cada 1000 en el nivel Free y 2,00 USD en el nivel Gold. El 07-11-2026 llamamos a la capacidad facebook/user_posts de EveryInfra. Una sola llamada devolvió 50 posts y cobró 0,002778 USD: 0,0556 USD por cada 1000. Es 90 veces menos que el nivel Free de Apify y 27 veces menos que el scraper de posts más barato de la Store con más de 100 usuarios al mes (1,50 USD). Los comentarios salieron al mismo precio por cada 1000, y los anuncios de Marketplace a 0,0077 USD.
Apify gana en dos casos, y lo decimos. La búsqueda por palabra clave nos costó 2,91 USD por cada 1000, y en la Store hay un scraper de búsqueda a 1,90 USD. Para perfiles de página, el nivel Diamond de Apify (2,00 USD) es más barato que nuestros 2,78 USD. Además, nuestras llamadas de posts y comentarios se paran en 50 filas y no tienen página siguiente. Si necesita todo el historial de una sola página, hoy le hace falta una herramienta como Apify.
Aquí, «coste por cada 1000» es el cargo que muestra la respuesta (charged_usd), dividido entre las filas únicas devueltas y multiplicado por 1000. EveryInfra cobra por solicitud: 1 fila o 50 filas cuestan lo mismo. La excepción es la búsqueda por palabra clave, que cobra por bloques de 10 filas. Los scrapers de Apify Store cobran por resultado, un modelo que Apify llama pago por evento. Del lado de Apify usamos solo material público: páginas de la Store, la página de precios, la documentación y el endpoint público api.apify.com/v2/acts/<autor>~<nombre>, que no pide cuenta. No nos registramos ni ejecutamos sus actors (así llama Apify a sus scrapers en la nube). Por eso los números de Apify son precios unitarios públicos, y los nuestros son cargos reales.
Apify Facebook scraper frente a EveryInfra: la tabla resumen
La tabla solo tiene dos tipos de números. Uno es el precio unitario público de Apify Store, leído a las 00:15 hora de Singapur del 07-11-2026, con el nivel en cada celda. El otro es nuestra llamada real: hora de Singapur, capacidad, filas y cargo. Los niveles de Apify siguen al plan mensual. Según la página de precios, Free incluye 5 USD de uso al mes, Starter (19 USD) da el nivel Bronze, Scale (199 USD) da Silver y Business (999 USD) da Gold. Platinum y Diamond son contratos a medida. Fijamos la regla de «lo más barato de la Store» antes de ver resultados. El endpoint de búsqueda de la Store dio 195 elementos de Facebook, y tomamos el que tenía más de 100 usuarios en 30 días y el precio Free más bajo.
| Datos | Apify oficial (usuarios en 30 días) | Oficial por cada 1000: Free / Gold / Diamond | Lo más barato de la Store | Capacidad de EveryInfra | Llamada real (hora de Singapur, filas, cargo) | Nuestro coste por cada 1000 | Oficial Free / nuestro |
|---|---|---|---|---|---|---|---|
| Posts de páginas | Posts Scraper (18.261) | 5,00 / 2,00 / 0,80 USD, +0,001 USD por inicio | curious_coder, 1,50 USD | facebook/user_posts | 00:28:54, 50 filas, 0,002778 USD | 0,0556 USD | 90 veces |
| Comentarios | Comments Scraper (5458) | 2,50 / 1,40 / 0,40 USD, +0,001 USD por inicio | thedoor, dami_studio, 0,25 USD | facebook/comments | 00:31:04 y 00:31:54, 100 filas, 0,005556 USD | 0,0556 USD | 45 veces |
| Marketplace | Marketplace Scraper (1092) | 6,20 / 2,60 / 0,80 USD; detalles aparte | curious_coder, 0,50 USD | facebook/marketplace | 00:30:14, 181 filas únicas, 0,001389 USD | 0,0077 USD | 808 veces |
| Búsqueda por palabra clave | Search Scraper (1597) | 6,00 / 3,00 / 2,00 USD, +0,001 USD por inicio | memo23, 1,90 USD, +0,005 USD por inicio | facebook/search | 00:33:17 y 00:34:58, 11 filas, 0,032 USD | 2,91 USD | 2,1 veces |
| Perfiles de páginas | Pages Scraper (9130) | 12,00 / 5,40 / 2,00 USD | premiumscraper, 3,00 USD | facebook/profile | 00:34:04, 1 página, 0,002778 USD | 2,778 USD | 4,3 veces |
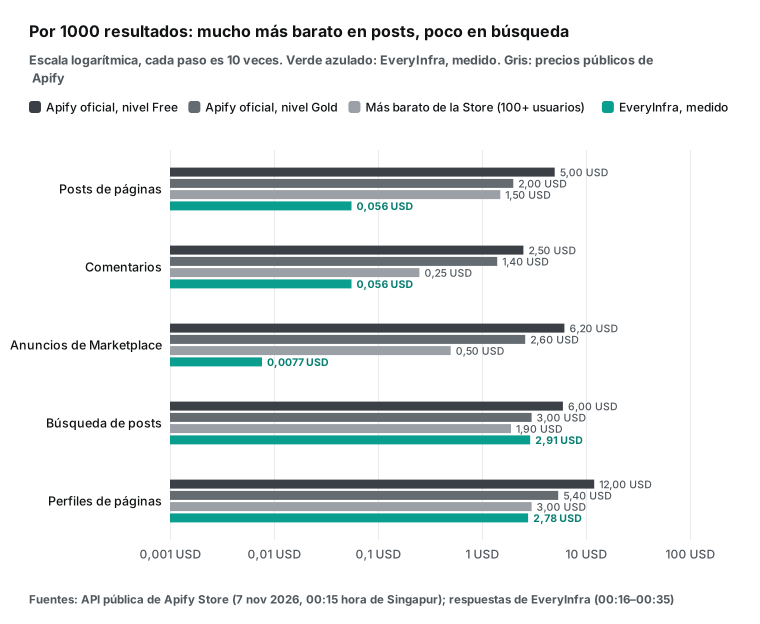
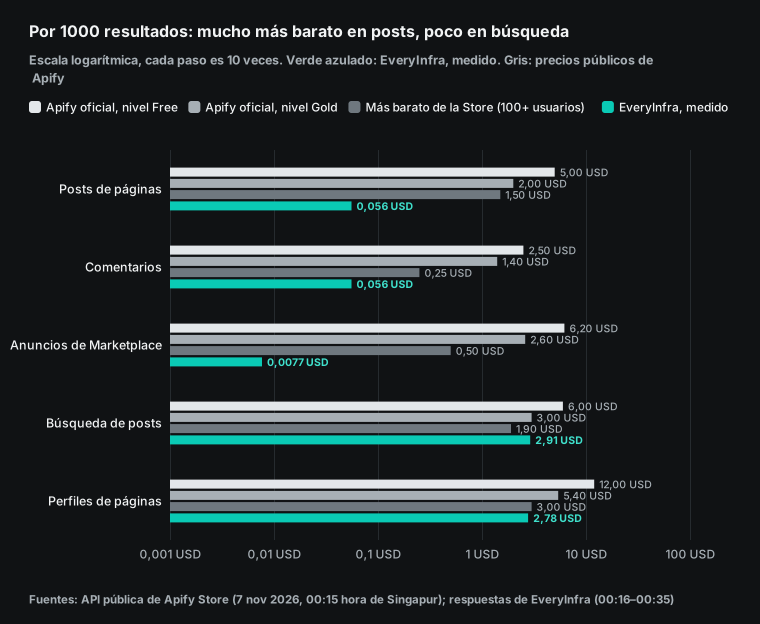
Lea las proporciones con cuidado. Los campos no son iguales, así que una proporción compara el coste de un resultado, no su contenido. Cada escenario muestra nuestras tasas de relleno y la lista de campos que publica cada página de Apify. La factura de Apify también incluye cuotas de inicio, el extra por filtro de fechas, el tope de 5 USD del plan Free y las ejecuciones repetidas. Nuestro número es el cargo real entre las filas reales. Las proporciones grandes salen solo de las capacidades que devuelven una página entera por llamada. La búsqueda (por bloques de 10) y los perfiles (uno por llamada) bajan a entre 1 y 4 veces, y ahí un scraper barato de la Store o un nivel alto de Apify cuestan menos que nosotros.
Cómo probamos y cómo calculamos
Todas las llamadas se hicieron el 07-11-2026, desde las 00:16:18 hora de Singapur. La clave de prueba permitía 10 solicitudes por minuto y la compartíamos con otros, así que dejamos al menos 8 segundos entre solicitudes y respetamos cada retry_after. Fijamos los objetivos antes. Para posts y comentarios usamos la página pública de National Geographic, que publica a menudo y recibe muchos comentarios. Para Marketplace buscamos "iphone 15" en Nueva York, y para la búsqueda usamos dos frases de cocina. Las llamadas 1 y 2 fueron errores provocados a propósito (sin clave y con un parámetro mal escrito); de la 3 a la 12 coincidieron con una caída temporal, que tratamos como un dato más en la sección de fallos.
| N.º | Hora de Singapur | Capacidad | Resultado | Filas | Cargo |
|---|---|---|---|---|---|
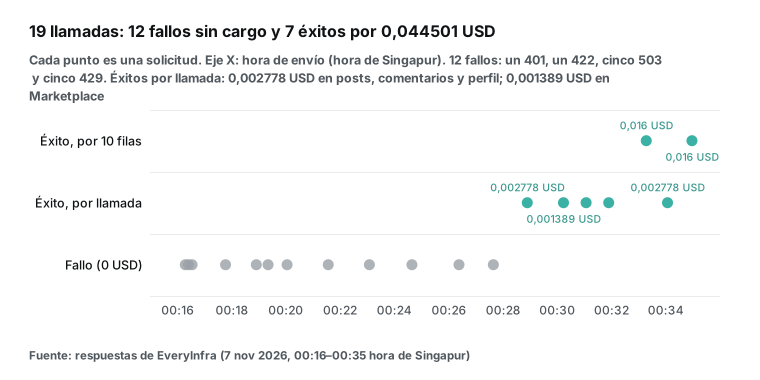
| 1 | 00:16:18 | facebook/user_posts (sin clave) | 401 missing_key | 0 | 0 USD |
| 2 | 00:16:25 | facebook/user_posts ("limt" mal escrito) | 422 unknown_param, propone limit | 0 | 0 USD |
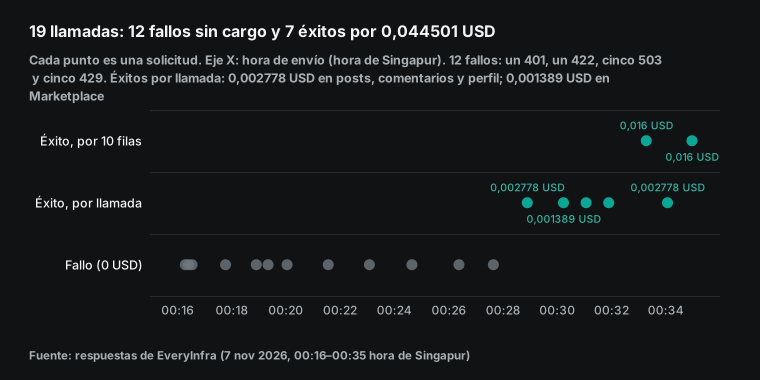
| 3–12 | 00:16:33–00:27:39 | user_posts, marketplace, search | 5 x 503, 5 x 429 | 0 | 0 USD |
| 13 | 00:28:54 | facebook/user_posts (natgeo, asíncrona) | Éxito, unos 72 s | 50 | 0,002778 USD |
| 14 | 00:30:14 | facebook/marketplace (iphone 15, nyc, 200) | Éxito, 25,3 s | 181 únicas | 0,001389 USD |
| 15 | 00:31:04 | facebook/comments (post con 993 comentarios) | Éxito, unos 42 s | 50 | 0,002778 USD |
| 16 | 00:31:54 | facebook/comments (post con 718 comentarios) | Éxito, unos 75 s | 50 | 0,002778 USD |
| 17 | 00:33:17 | facebook/search (air fryer recipe, 10) | Éxito, 20,3 s | 6 | 0,016 USD |
| 18 | 00:34:04 | facebook/profile (natgeo, asíncrona) | Éxito, unos 46 s | 1 | 0,002778 USD |
| 19 | 00:34:58 | facebook/search (meal prep ideas, recientes, 20) | Éxito, 26,8 s; 1 bloque cobrado y 1 devuelto | 5 | 0,016 USD |
Una sola fórmula sirve para todo: cargo total entre filas únicas, por 1000. Los posts y los anuncios son únicos por id; los comentarios, por comment_url (la sección de comentarios explica por qué). Las llamadas fallidas suman coste y no suman filas, así que solo pueden empeorar nuestro número. Para Apify leímos en cada endpoint público pricingInfos (precio de cada evento en cada nivel) y stats (usuarios en 30 días y resultado de las ejecuciones). Multiplicamos por 1000 el precio del evento que corresponde a un resultado. Las cuotas de inicio, de filtro de fechas y de detalles van aparte.
Cómo cobra Apify sus scrapers de Facebook
La documentación Actors in Store dice que cada scraper de la Store usa uno de dos modelos. En el pago por evento, el autor pone precio a eventos como «un resultado» o «un inicio». En el pago por uso, usted paga cómputo, almacenamiento y proxies de la plataforma. La mayoría de los scrapers por evento incluyen el uso de la plataforma, pero algunos lo cobran aparte. Los 14 scrapers de Facebook que leímos cobran por evento.
Los cinco scrapers de Facebook que publica la propia Apify siguen la misma estructura: un evento principal por resultado, una cuota de inicio de 0,001 USD y extras opcionales. En el endpoint de Posts Scraper, el evento post cuesta 0,005, 0,004, 0,0025, 0,002, 0,0016 y 0,0008 USD en los seis niveles. Si filtra por fechas, cada post suma un evento filter-applied, de 0,002 USD en Free, y 1000 posts pasan de 5,00 a 7,00 USD. Justo quien quiere «los posts de los últimos 7 días» es quien paga ese extra.
| Nivel (plan) | Posts | Comentarios | Marketplace | Búsqueda | Perfiles | Filtro de fechas (posts) |
|---|---|---|---|---|---|---|
| Free (0 USD, 5 USD de uso) | 5,00 USD | 2,50 USD | 6,20 USD | 6,00 USD | 12,00 USD | 2,00 USD |
| Bronze (Starter, 19 USD) | 4,00 USD | 2,00 USD | 5,00 USD | 5,00 USD | 8,20 USD | 1,00 USD |
| Silver (Scale, 199 USD) | 2,50 USD | 1,70 USD | 3,80 USD | 4,00 USD | 6,50 USD | 0,80 USD |
| Gold (Business, 999 USD) | 2,00 USD | 1,40 USD | 2,60 USD | 3,00 USD | 5,40 USD | 0,60 USD |
| Platinum (a medida) | 1,60 USD | 0,90 USD | 1,50 USD | 2,50 USD | 4,00 USD | 0,40 USD |
| Diamond (a medida) | 0,80 USD | 0,40 USD | 0,80 USD | 2,00 USD | 2,00 USD | 0,20 USD |
| EveryInfra, medido | 0,0556 USD | 0,0556 USD | 0,0077 USD | 2,91 USD | 2,778 USD | Sin extra |
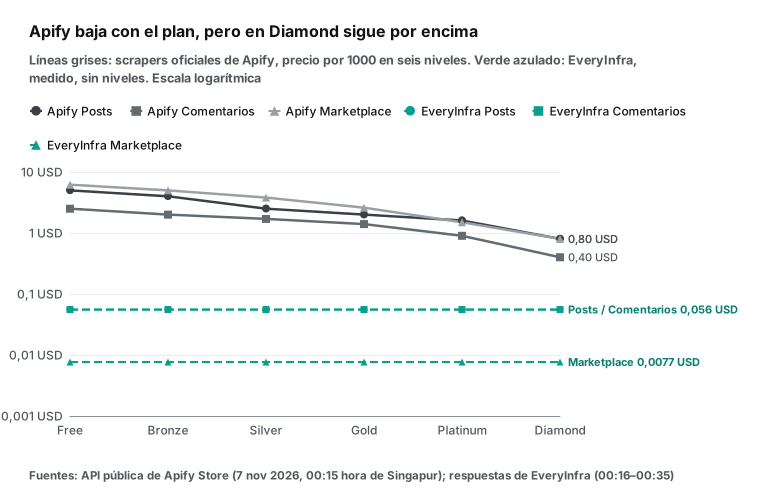
Apify da los descuentos a los planes caros. Con Business, a 999 USD al mes, 1000 posts siguen costando 2,00 USD, y los 0,80 USD exigen un contrato a medida. En Free, los 5 USD cubren unos 1000 posts. La página de precios dice que una cuenta Free se detiene al gastar su crédito, mientras que los planes de pago pasan el exceso a la factura siguiente. Los descuentos por nivel son opcionales para los autores externos. Por eso muchos scrapers baratos de la Store, como el de Marketplace de curious_coder a 0,50 USD, cuestan lo mismo en todos los niveles.
¿Por qué dos scrapers de los mismos datos pueden diferir 10 veces en precio? La guía de pago por evento para autores da los hechos: el autor se queda con el 80 % de los ingresos por eventos y paga el coste de la plataforma, y Apify cubre el coste de los usuarios Free. Lo que sigue es una inferencia nuestra, sin datos de costes de ningún autor: un scraper que abre las páginas en un navegador cuesta más de ejecutar que uno que lee JSON, así que probablemente cobra más. Para usted, la conclusión es comparar varios scrapers de los mismos datos, porque la diferencia de precio viene sobre todo del autor, no de la calidad de los datos.
Escenario 1: 1000 posts de páginas (Apify Facebook Posts Scraper)
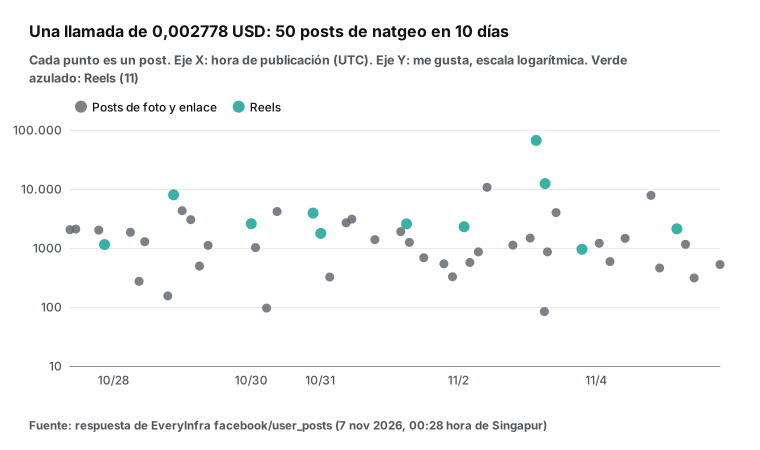
El catálogo da facebook/user_posts a 0,002778 USD por llamada, asíncrona, con 10 filas por defecto y 50 como máximo. Enviamos la solicitud a las 00:28:54 hora de Singapur, recibimos un job_id al momento y consultamos cada 8 segundos. El trabajo terminó hacia las 00:30:06 con 50 posts únicos, del 28-10-2026 al 06-11-2026 (UTC). Son todos los posts de la página en 10 días. Coste: 0,0556 USD por cada 1000.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"facebook","action":"user_posts","mode":"async",
       "params":{"url":"https://www.facebook.com/natgeo","limit":50}}'
# Devuelve 202 y un job_id al momento y cobra 0,002778 USD.
# Luego GET /api/v1/jobs/<job_id> para leer los 50 posts.
Once de los 50 posts son Reels, y solo esos 11 traen view_count. El Reel más visto (03-11-2026, UTC) tuvo 2.447.538 reproducciones y 65.875 me gusta. El post de foto con más comentarios (993) pedía a la gente que revisara el carrete de su móvil, y lo usamos para la prueba de comentarios. Tasas de relleno: text 96 %, media 92 %, link 76 %, comment_count 98 %, group_name 0 % (los posts de una página no tienen grupo) y 100 % en los otros 13 campos. Los posts de foto y enlace tuvieron una mediana de 1142 me gusta.
El Posts Scraper oficial cobra 5,00 USD por cada 1000 en Free más 0,001 USD por inicio. La opción más barata de la Store con más de 100 usuarios es el scraper de posts de curious_coder. Cobra 1,50 USD más una cuota de inicio y tiene una valoración pública de 3,06 sobre 5. Costamos 90 veces menos que el oficial en Free, 36 veces menos que en Gold, 14,4 veces menos que en Diamond y 27 veces menos que curious_coder.
El límite importa tanto como el precio. user_posts devuelve los 50 posts más recientes y no tiene página siguiente. Para llegar a 1000 posts necesita 20 páginas, o llamadas diarias durante un tiempo. Para «todos los posts de esta página en dos años», el Posts Scraper de Apify acepta un número de filas y un rango de fechas; su página habla de 500 posts en menos de 2 minutos. Hoy no podemos ir hacia atrás en una sola página. Lo nuestro es la vigilancia amplia: muchas páginas, los posts nuevos, cada día.
Vigilar cambia las cuentas. Esta página publica unas 5 veces al día, así que una llamada diaria trae unos 5 posts nuevos y 45 repetidos. Si solo cuenta los nuevos, paga 0,002778 USD por 5, unos 0,56 USD por cada 1000. En Apify puede poner el límite en 5 y pagar 5 resultados y un inicio. Eso son 0,026 USD por página y día en Free, 0,011 USD en Gold y 0,005 USD en Diamond. Aun así costamos 9,4, 4 y 1,8 veces menos.
Ahora piense en una página que publica una vez al día. En Free de Apify cuesta 0,006 USD al día, y nosotros 2,2 veces menos. En Diamond cuesta 0,0018 USD al día y gana a nuestros 0,002778 USD. Las páginas tranquilas y los niveles altos de Apify reducen nuestra ventaja; las páginas activas y los volúmenes pequeños la aumentan.
Escenario 2: 1000 comentarios (Apify Facebook Comments Scraper)
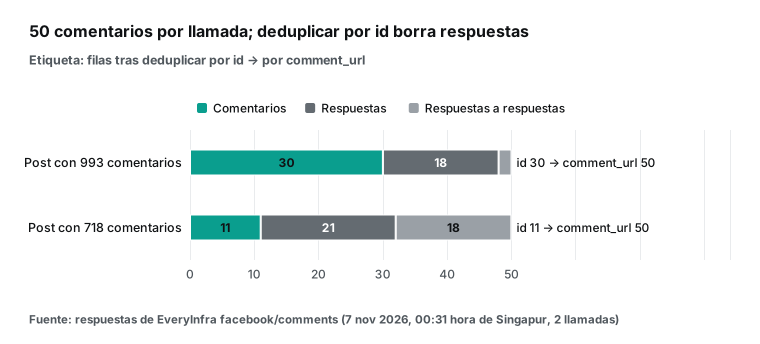
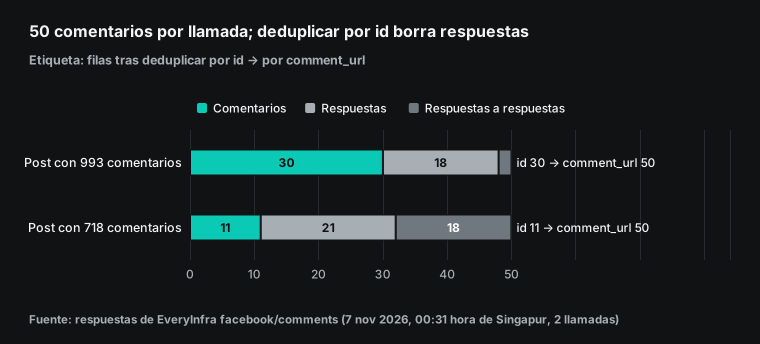
Probamos dos posts de natgeo que mostraban 993 y 718 comentarios. Cada llamada a facebook/comments devolvió las 50 filas completas por 0,002778 USD, así que 100 filas costaron 0,005556 USD: 0,0556 USD por cada 1000. La primera llamada traía 30 comentarios principales, 18 respuestas y 2 respuestas a respuestas; la segunda, 11, 21 y 18. Las 50 filas mezclan niveles.
Encontramos un fallo nuestro. En una fila de respuesta, id guarda el ID del comentario principal, y el ID propio de la respuesta va en reply_to_id, al revés de lo que sugieren los nombres. Si deduplica por id, la primera llamada baja a 30 filas. Los 50 valores de comment_url eran únicos (la URL de una respuesta añade reply_comment_id), así que deduplique por comment_url. Ya lo apuntamos para corregir los nombres.
El Facebook Comments Scraper oficial cuesta 2,50 USD por cada 1000 en Free y 0,40 USD en Diamond, y ordena y filtra por fecha (el filtro se cobra aparte). Los scrapers de thedoor y dami_studio cuestan 0,25 USD (el precio de dami_studio sale de su API pública, no de su página en la Store). La página de thedoor dice que obtiene todos los comentarios que ve un visitante sin sesión. También dice que saca más de 10.000 comentarios de un post grande en unos 15 minutos. Las ejecuciones repetidas solo cobran los comentarios nuevos.
Costamos 45 veces menos que el oficial en Free, 7,2 veces menos que en Diamond y 4,5 veces menos que thedoor. Pero nuestras 50 filas cubrieron solo el 5,0 % de los 993 comentarios y el 7,0 % de los 718. Si quiere todos los comentarios de un post viral, elija thedoor. Si quiere una muestra diaria de comentarios recientes en muchos posts, nosotros costamos menos.
¿Qué dicen esos 100 comentarios? Los leímos uno por uno y los clasificamos a mano; un comentario puede caer en más de un grupo.
| Post | Primer nivel | De qué hablan | Mediana de likes | Respuestas |
|---|---|---|---|---|
| Pide la foto de naturaleza favorita (993 comentarios) | 30 | 16 paisaje, cielo, árboles o agua; 12 animales o mascotas; 7 otros temas | 7 | 20, casi todas elogios breves (7 likes en total); 2 dicen que una foto parece hecha con IA |
| Estudio: los ictus entre adultos de 20 a 54 años casi se duplicaron en una región de EE. UU. en tres décadas, y se estudia el papel del cannabis (718 comentarios) | 11 | 6 defienden el cannabis (4 con experiencia propia); 3 desvían el tema al alcohol; 2 bromas | 87 | 39, sobre todo discusiones; 1 en español |
Con 50 comentarios por post, el tono cambia por completo de un post a otro. Mida el sentimiento por post, no como una media de toda la página. No guardamos los nombres de los autores en la tabla de análisis.
Un caso típico en una agencia de Madrid o de Ciudad de México: cada mañana el equipo elige los 20 posts de la competencia con más comentarios y saca 50 de cada uno. Después, un modelo de IA los clasifica en elogios, quejas y preguntas. Son 20 llamadas, 0,0556 USD al día, unos 1,67 USD al mes. Los mismos 1000 comentarios diarios en el nivel Free oficial de Apify costarían 2,50 USD al día sin contar inicios.
Escenario 3: 1000 anuncios de Marketplace
Una llamada síncrona (Nueva York, iphone 15, límite 200) tardó 25,3 segundos y devolvió 200 filas, 181 únicas, por 0,001389 USD: 0,0077 USD por cada 1000. Los anuncios estaban en el estado de Nueva York (105), Nueva Jersey (69), Pensilvania (5) y Connecticut (2). Los 134 anuncios de iPhone 15 de 100 USD o más tuvieron una mediana de 459,50 USD. Por modelo: base 400 USD (56 anuncios), Pro 489 USD (33) y Pro Max 550 USD (37). En España o México bastaría con cambiar location y el término de búsqueda.
| Campo | Relleno (181 filas) | Nota |
|---|---|---|
id, url, name, price, city, state, image_url | 100 % | El precio es texto, por ejemplo "459.50" |
currency | 0 % | Vacío en todas las filas |
condition | 0 % | Hay que deducirlo del título |
posted_at | 0 % | No se puede ordenar por antigüedad |
El catálogo incluye estos tres campos y ninguno llegó. La página del Marketplace Scraper oficial lista rangos de precio, ubicación, vendedor, estado (Sold, Live, Pending) y tipo de entrega. Su extra listing-details cobra de nuevo el precio de la lista por cada anuncio.
El scraper de curious_coder (654 usuarios, valoración 4,92) muestra coordenadas, código postal, si está vendido e ID del vendedor. Con nosotros, los detalles piden una llamada a facebook/marketplace_item por anuncio, a 0,000958 USD, y lista más detalles suma unos 0,966 USD por cada 1000. Es más que los 0,50 USD de la lista de curious_coder, y 12,8 veces menos que el oficial con detalles (12,40 USD). Si solo necesita la lista, costamos 808 veces menos que el oficial en Free y 65 veces menos que curious_coder.
Escenario 4: búsqueda de posts con una API de scraper de Facebook
facebook/search cuesta 0,016 USD por bloque de 10 filas (rows_per_unit es 10). A las 00:33:17 hora de Singapur, "air fryer recipe" con límite 10 devolvió 6 posts en 20,3 segundos y cobró un bloque. A las 00:34:58, "meal prep ideas" (recientes, límite 20) devolvió 5 posts en 26,8 segundos. La respuesta mostró 2 bloques reservados, 1 cobrado y 1 devuelto al momento. En total: 11 filas, 0,032 USD, o 2,91 USD por cada 1000.
El Search Scraper oficial cuesta 6,00 USD por cada 1000 en Free, 3,00 USD en Gold y 2,00 USD en Diamond. El scraper de búsqueda de memo23 cuesta 1,90 USD más 0,005 USD por inicio.
Así que costamos 2,1 veces menos que el oficial en Free, casi lo mismo que en Gold, y más que en Diamond y que memo23. Hay dos motivos. Un bloque medio vacío cuesta como uno lleno, y la búsqueda de Facebook devolvió pocos posts (6 de 10 y 5 de 20). Con bloques llenos estaríamos en 1,60 USD, pero la prueba no lo mostró, así que no lo afirmamos. La mayoría de los autores son personas particulares y no mostramos sus nombres. De los 11 posts, 8 eran de los últimos 30 días.
Perfiles de página: el nivel Diamond de Apify nos gana
Una llamada de perfil devuelve una sola página, así que cobrar por solicitud no da ventaja: 2,778 USD por cada 1000 páginas. A las 00:34:04 hora de Singapur, el perfil de natgeo llegó en unos 46 segundos con nombre, biografía, categorías, 51.441.764 seguidores y web. is_verified, phone, email y rating venían vacíos, y like_count llegó como 0, que parece un valor ausente. El Pages Scraper oficial cuesta 12 USD por cada 1000 en Free (caben 416 páginas en el plan Free), 5,40 USD en Gold y 2,00 USD en Diamond (endpoint).
Costamos 4,3 veces menos que en Free y 1,9 veces menos que en Gold. Pero Diamond es 1,39 veces más barato que nosotros, y premiumscraper (3,00 USD) solo está un 8 % por encima. Para perfiles de negocio en masa con teléfono y valoración, un cliente grande de Apify debería quedarse en Apify.
La cesta: 1000 posts, 1000 comentarios y 1000 anuncios
Un equipo de vigilancia de marca necesita cada mes 1000 posts de la competencia, 1000 comentarios y 1000 anuncios de segunda mano. Apify oficial en Free: 5,00 + 2,50 + 6,20 = 13,70 USD. En Gold: 6,00 USD, tras pagar el plan de 999 USD. En Diamond: 2,00 USD. Lo más barato de la Store: 1,50 + 0,25 + 0,50 = 2,25 USD.
EveryInfra, con las filas medidas: 20 llamadas de posts (0,0556 USD), 20 de comentarios (0,0556 USD) y 6 de Marketplace (0,0083 USD), en total 0,119 USD. Es 115 veces menos que el oficial en Free, 16,7 veces menos que Diamond y 18,8 veces menos que la combinación más barata.
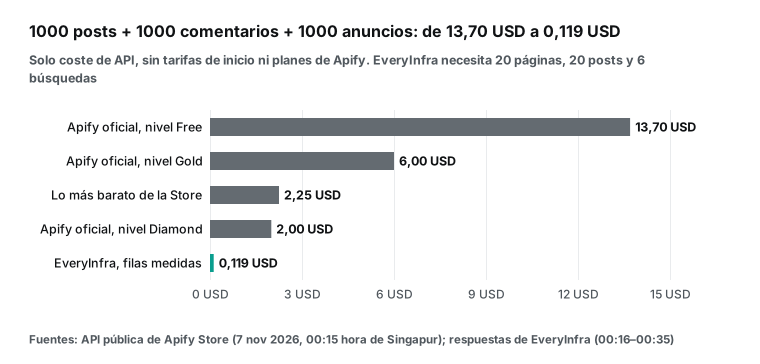
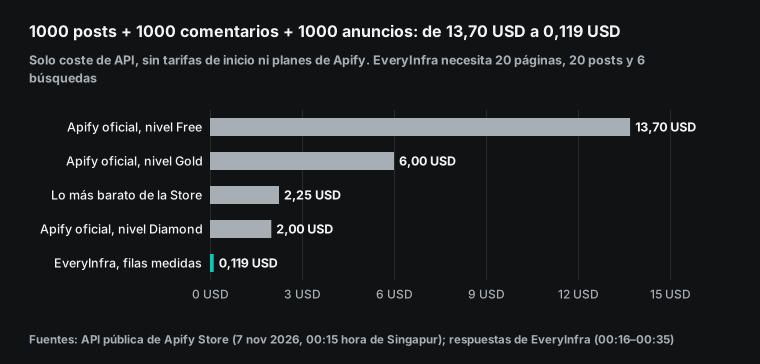
Las condiciones: 20 páginas distintas, 20 posts distintos y 6 búsquedas distintas, porque la misma solicitud en menos de 5 minutos devuelve el resultado anterior. Si los 1000 posts tienen que salir de una sola página, no podemos llenar esta cesta. Y el plan Free de 5 USD no alcanza para una cesta de 13,70 USD; con Starter y precios Bronze cuesta 11,00 USD.
API de scraper de Facebook: cómo se llama a cada uno
En Apify se lanza una ejecución y se lee su dataset, o se usa el endpoint síncrono que hace las dos cosas:
# Apify: ejecutar el Posts Scraper oficial (ejemplo de configuración, no lo ejecutamos)
import requests, os
r = requests.post(
    "https://api.apify.com/v2/acts/apify~facebook-posts-scraper/run-sync-get-dataset-items",
    params={"token": os.environ["APIFY_TOKEN"], "maxTotalChargeUsd": 0.50},
    json={"startUrls": [{"url": "https://www.facebook.com/natgeo"}], "resultsLimit": 50},
    timeout=300,
)
posts = r.json()  # 0,005 USD por post en Free, más 0,001 USD por inicio
No tenemos cuenta en Apify, así que los nombres de entrada salen de la página de la Store y esto es un ejemplo de configuración. En EveryInfra es un solo POST /api/v1/social; las capacidades asíncronas devuelven un job_id que se consulta. Este script exporta a CSV los comentarios de varios posts con el módulo csv de la biblioteca estándar y deduplica por comment_url:
# Exportar a comentarios.csv los comentarios de varios posts de Facebook
import csv, json, os, time, urllib.request

KEY = os.environ["EVERYINFRA_API_KEY"]
API = "https://api.everyinfra.com"

def call(path, body=None):
    req = urllib.request.Request(API + path, data=json.dumps(body).encode() if body else None,
        headers={"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"},
        method="POST" if body else "GET")
    with urllib.request.urlopen(req, timeout=120) as r:
        return json.loads(r.read())

def comentarios(post_url):
    job = call("/api/v1/social", {"platform": "facebook", "action": "comments", "mode": "async",
                                  "params": {"url": post_url, "limit": 50}})
    while True:
        time.sleep(8)
        res = call(job["poll_url"])
        if res["status"] in ("succeeded", "failed"):
            return res.get("results", [])

vistos, filas = set(), []
for url in open("post_urls.txt").read().split():
    for c in comentarios(url):
        if c["comment_url"] not in vistos:
            vistos.add(c["comment_url"])
            filas.append({k: c.get(k) for k in ("comment_url", "depth", "text", "like_count",
                                                 "reply_count", "posted_at")})
with open("comentarios.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.DictWriter(f, fieldnames=filas[0].keys())
    w.writeheader(); w.writerows(filas)
print(len(filas), "comentarios")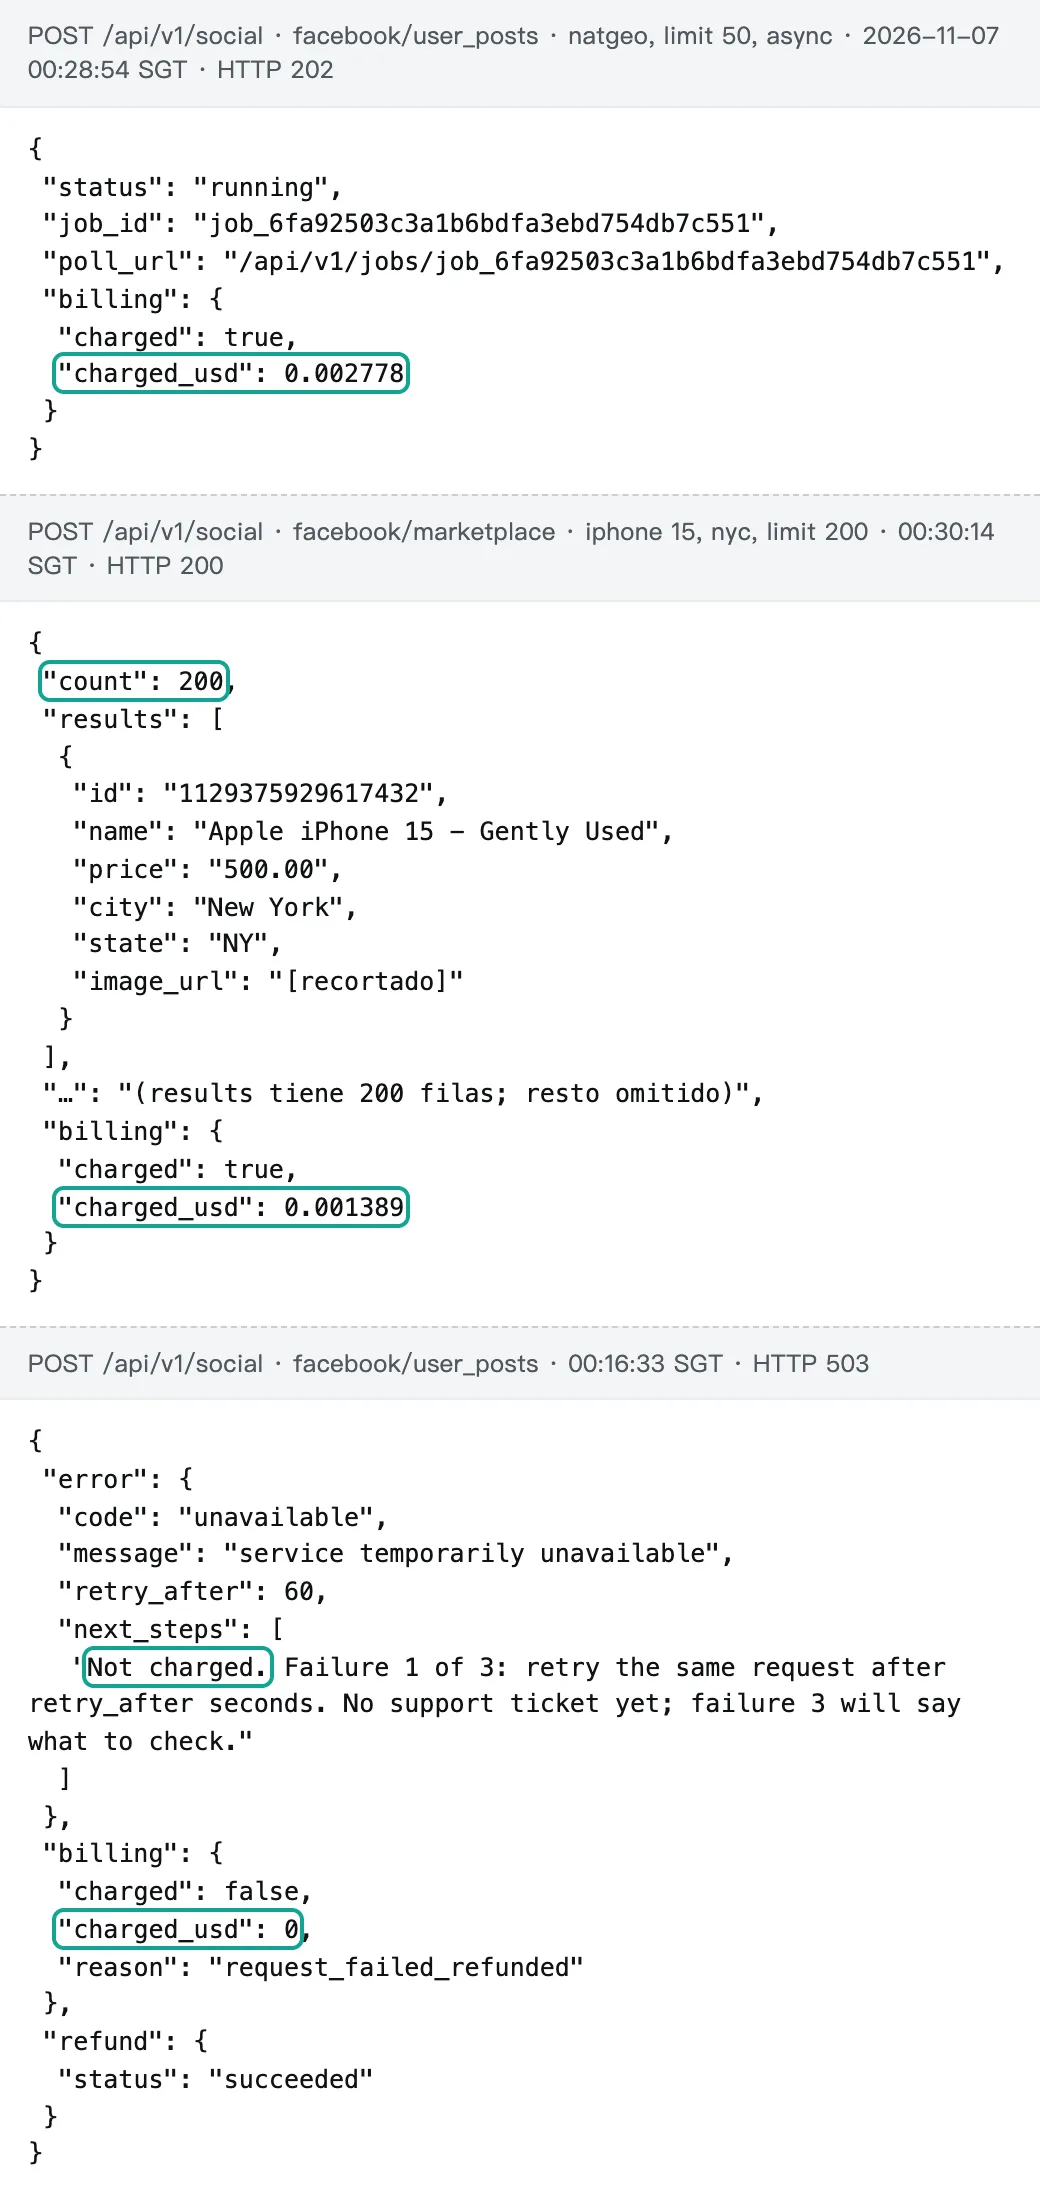
Además del precio, cambian tres cosas. Parámetros: cada scraper de Apify tiene sus propios nombres de entrada, y nuestras 16 capacidades de Facebook comparten un mismo formato. Un nombre equivocado devuelve 422 con did_you_mean (la llamada 2 de la tabla).
Salida: las muestras de Apify conservan estructuras originales de Facebook como textReferences y feedbackId, y nosotros devolvemos 19 campos de post y 13 de comentario listos para CSV. Velocidad: según sus propias páginas, Apify está hecho para ejecuciones grandes, y thedoor habla de hasta 1300 comentarios por minuto. Nuestras llamadas tardaron de 20 a 75 segundos, unos 40 posts o de 40 a 70 comentarios por minuto. Eso encaja con trabajos diarios de unas decenas de filas por página. No medimos las cifras de Apify. Apify también limita el trabajo en paralelo: su documentación de límites permite 5 ejecuciones simultáneas en Free (32 en Starter, 128 en Scale, 256 en Business) y 100 programaciones por usuario. Para vigilar cientos de páginas, ponga muchas URL en una sola ejecución.
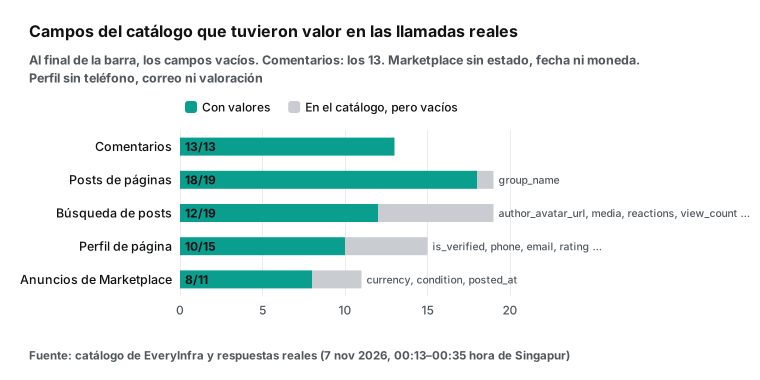
Este gráfico enseña nuestras propias carencias: la búsqueda no trae media ni reproducciones, y los perfiles y Marketplace no traen algunos datos de negocio. Revíselo antes de comprar.
¿Se cobran los fallos y los resultados vacíos?
Entre las 00:16:33 y las 00:27:39 hora de Singapur, las capacidades de Facebook fallaron 10 veces: 5 con 503 y 5 con 429 (una porque nuestra clave compartida pasó su límite). Todas las respuestas traían charged_usd en 0 y refund.status en "succeeded". En el tercer fallo, next_steps decía que había 3 fallos en 10 minutos en facebook/search y que ninguno se había cobrado, y ofrecía antes una solicitud de ejemplo. Con el 401 y el 422, 12 fallos costaron 0 USD.
En Apify, el evento de resultado solo se cobra cuando se guarda un resultado. El evento de inicio se cobra al arrancar la ejecución y se queda aunque la ejecución falle o agote el tiempo. Los scrapers oficiales cobran 0,001 USD por inicio; la cuota más alta que vimos en la Store fue de 0,09 USD. Las estadísticas de Posts Scraper muestran 6.050.949 ejecuciones en 30 días, con 14.398 que agotaron el tiempo y un 99,69 % de éxito.
Para no gastar de más en Apify, use maxTotalChargeUsd en el endpoint síncrono: limita el coste total de una ejecución. Ejemplo: 1000 posts en el nivel Free del Posts Scraper oficial cuestan 5,00 USD más 0,001 USD de inicio; con un tope de 5,50 USD, un error en la entrada no puede costar más. La documentación de ejecuciones explica cómo termina una ejecución y cómo continuarla, y la de recursos, las cuotas de inicio por memoria.
Otra trampa es el almacenamiento. La documentación de datasets dice que los datasets sin nombre caducan a los 7 días. Exporte o ponga nombre al dataset en esos 7 días; si no, tendrá que repetir la ejecución y pagar otra vez los resultados. Nuestros resultados asíncronos también duran poco: guárdelos en su base de datos al recibirlos.
Los dos lados no cobran resultados que no existen; nosotros, además, no tenemos cuota de inicio. Nuestras respuestas de error también le dicen a un agente de IA qué hacer. retry_after da la espera en segundos y retryable dice si tiene sentido reintentar. next_steps dice si hubo cargo y cuándo conviene abrir un ticket. En la búsqueda, ponga limit en múltiplos de 10 para que los bloques puedan llenarse.
Conectar MCP y herramientas de IA
La documentación MCP de Apify da la dirección https://mcp.apify.com, con OAuth o con un token. Con ella, una IA puede buscar en la Store, ejecutar actors y leer resultados. El repositorio apify-mcp-server tuvo un commit el 06-11-2026 y 15.051 estrellas el 07-11-2026. Nuestro servidor es https://api.everyinfra.com/mcp. Una llamada gratuita a tools/list devolvió 12 herramientas, entre ellas everyinfra_call_api y everyinfra_get_job. En Claude Code, según la documentación MCP de Claude Code:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
Después puede pedir: «Saca los últimos 50 posts de natgeo, elige los 3 con más comentarios, trae 50 comentarios de cada uno, deduplica por comment_url y resume lo que dice la gente». Son una llamada de posts y tres de comentarios, 0,011112 USD a precios de hoy.
Los dos servidores siguen el Model Context Protocol. Con precio por llamada, lo máximo que cuesta una llamada es 0,016 USD. Con precio por resultado, ponga un tope como maxTotalChargeUsd.
Graph API o código abierto: ¿se puede hacer uno mismo?
La referencia Page Feed de Meta exige una tarea en la página, como crear contenido, gestionar o moderar. Para páginas que no gestiona, necesita Page Public Content Access, con App Review y verificación de la empresa. Aun así, devuelve unos 600 posts ordenados al año y como mucho 100 por solicitud. El código abierto es la otra vía. La librería más conocida es kevinzg/facebook-scraper, con 3323 estrellas, pero no tiene commits desde el 22-06-2024 y su última versión en PyPI, la 0.2.59, es del 31-08-2022. En How We Combat Scraping, Meta describe un equipo de más de 100 personas que usa límites de frecuencia y de datos, detección de bots, bloqueo de cuentas y demandas. Un scraper casero pasa casi todo el tiempo peleando con esas defensas. Si se queda en Apify, su cliente de Python reintenta los errores 429 y 5xx.
Condiciones de Meta y scraping de páginas públicas: qué vigilar
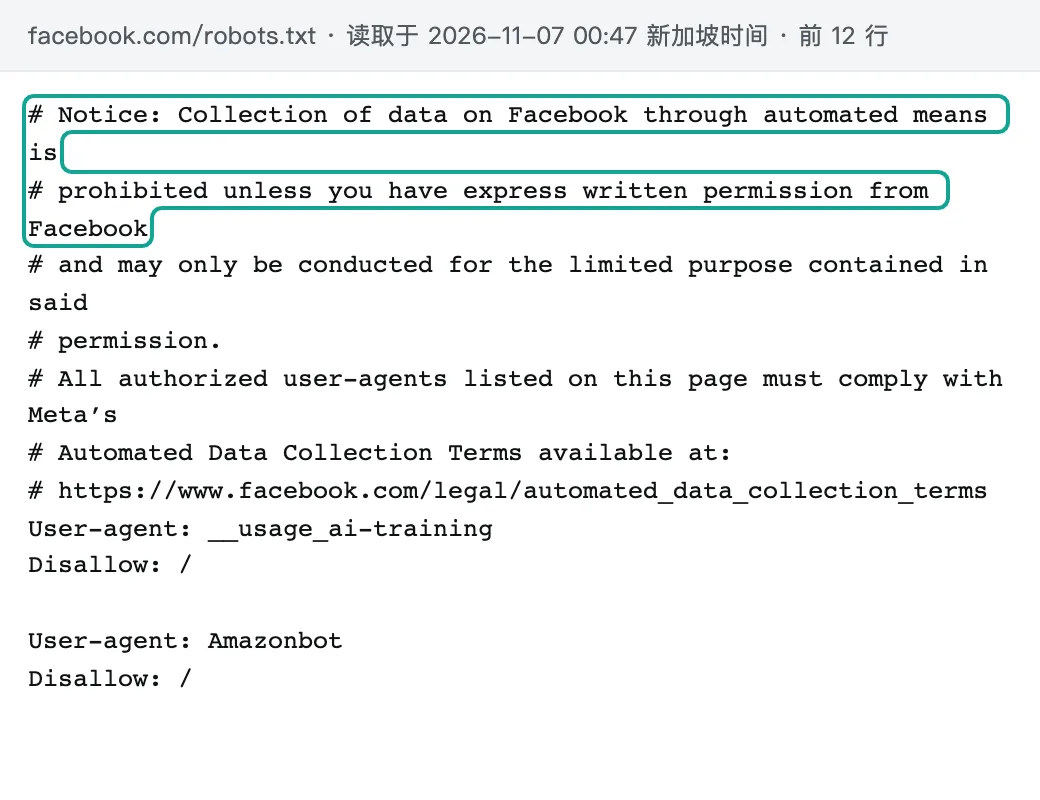
Esto no es asesoramiento legal; resume lo que dicen documentos públicos. La sección 3.2 de las Condiciones de Meta prohíbe recoger datos por medios automáticos sin permiso previo, tenga o no sesión iniciada. El aviso al inicio de robots.txt dice lo mismo y bloquea rastreadores como ClaudeBot y GPTBot.
En Estados Unidos, los tribunales han sido menos tajantes. El 23-01-2024, el tribunal del Distrito Norte de California falló en contra de Meta en su demanda contra una empresa de datos (caso 3:23-cv-00077), y la demanda contractual de Meta sobre el scraping sin sesión no prosperó. hiQ v. LinkedIn (2022) y Van Buren (2021) también apuntan a que las páginas públicas no necesitan autorización. Son fallos estadounidenses sobre demandas concretas, no un permiso general.
Para lectores en España y el resto de la Unión Europea, el riesgo principal está en los datos personales. El RGPD se aplica aunque los datos sean públicos. En noviembre de 2022, el regulador irlandés multó a Meta con 265 millones de euros por el scraping masivo de datos de Facebook. En octubre de 2024, 17 reguladores de privacidad publicaron una segunda declaración conjunta. Pide a las plataformas que actualicen sus medidas contra el scraping y dice que el scraping comercial permitido debe ser legal y cumplir condiciones contractuales estrictas.
Guarde solo los campos que necesite. Para contar opiniones, basta con el texto y la fecha, sin nombres de autores. Tres hábitos cubren casi todo: borrar author_name, author_url y los avatares al importar si el análisis no los usa; fijar un plazo para borrar las filas originales y quedarse con los agregados; y escribir en un párrafo por qué recoge cada campo. Esa nota ayuda si tiene que demostrar que el uso es legal.
Hay vías aprobadas si cumple los requisitos. Page Public Content Access exige App Review. La Meta Content Library es para investigadores académicos y de entidades sin ánimo de lucro. Su página de acceso habla de unas 2 a 3 semanas de revisión y otras 2 a 3 de trámite.
La Content Library sustituyó a CrowdTangle, que cerró el 14-08-2024. El manual de Bellingcat cita un boletín de SOMAR (no leímos el original) con 1000 USD de alta y 371 USD al mes por un entorno de datos nuevo. Una empresa que vigila a su competencia no suele poder usar ninguna de las dos vías.
Cuándo conviene más Apify
| Caso | Mejor opción | Por qué |
|---|---|---|
| Cientos de posts antiguos de una página | Apify Posts Scraper | Número de filas y rango de fechas frente a nuestros 50 últimos |
| Todos los comentarios de un post viral | thedoor y similares | Todos los visibles sin sesión frente a nuestro 5,0 % de 993 |
| Perfiles en masa con contrato Diamond | Apify Pages Scraper | 2,00 USD por cada 1000 frente a 2,778 USD |
| Búsquedas pequeñas por palabra clave | memo23 y similares | 1,90 USD frente a nuestros 2,91 USD medidos |
| Marketplace con estado, vendedor y vendido | curious_coder u oficial con detalles | Nuestra lista no trajo esos campos |
| Flujos ya montados en n8n o Make sobre Apify | Quedarse en Apify | Migrar puede costar más que el ahorro |
| Datos fuera de nuestras 16 capacidades | Apify Store (3141 resultados para "facebook") | Nuestro catálogo de Facebook tiene 16 capacidades |
Nuestras 16 capacidades cubren búsqueda, perfil, posts de página, post individual, comentarios y seguidores. También cubren anuncios, posts de grupos, lista y ficha de Marketplace, reseñas, búsqueda de anunciantes, detalle de anuncios, búsqueda de eventos, eventos de página y transcripciones de vídeo. Dentro de esa lista, compare precios; fuera, use Apify. Un usuario de Reddit dijo que los scrapers de Facebook de Apify se encarecieron tras un cambio de precios. Otro usuario del mismo hilo de r/n8n avisó de que el scraping barato puede no ser estable. Los 10 errores 503 y 429 de esta madrugada dicen lo mismo: ponga reintentos en cualquier flujo importante.
En qué se diferencia de nuestros otros artículos sobre Apify
Los precios de Apify, explicados trata los planes y el pago por evento en general. Alternativas a Apify cubre todas las plataformas. Alternativa a Apify TikTok Scraper y Alternativa a Apify LinkedIn Scraper miden otras redes, y sustituir Apify en n8n trata los flujos. Este es nuestro primer análisis de Facebook capacidad por capacidad. Todas las opciones están en la página de alternativas.
Cambios recientes
| Fecha | Qué pasó | Qué hacer |
|---|---|---|
| 15-10-2026 | Nieman Lab informó de nuevas condiciones comerciales de Meta que le permitían rastrear webs ligadas a cuentas de empresa | Si tiene cuenta de empresa en Meta, no cambie todavía sus contratos por estas condiciones |
| 27-10-2026 | Los cambios de Graph API v26.0 se aplicaron a todas las versiones, con errores en las solicitudes raíz ?ids= | Si usa Graph API, busque ?ids= en su código y corríjalo |
| 30-10-2026 | La CMA británica abrió una investigación sobre esas condiciones | Si opera en el Reino Unido, documente el origen y el uso de sus datos para ajustarse si cambian |
| 28-10-2026 a 07-11-2026 | Meta pausó las condiciones el 28-10-2026 (la fecha de inicio ya se había movido al 20-11-2026). El 07-11-2026, un aviso del centro de ayuda para empresas de Meta decía que no entrarán en vigor el 20-11-2026, que siguen las condiciones actuales y que los sitios pueden usar robots.txt | Para frenar a los rastreadores de Meta, añada ya reglas Disallow para meta-externalagent y meta-externalads, como muestra la documentación de rastreadores de Meta; dos rastreadores pueden saltarse robots.txt en algunos casos |
| 29-10-2026 y 31-10-2026 | thedoor y curious_coder cambiaron sus precios en la Store (según pricingInfos) | Abra la API pública del scraper y revise el precio antes de comprar |
Preguntas frecuentes
¿Apify Facebook Posts Scraper es gratis?
(De la sugerencia de búsqueda "apify facebook posts scraper free".) No del todo. El plan Free da 5 USD al mes. A 0,005 USD por post son unos 1000 posts menos las cuotas de inicio, y después la cuenta se detiene hasta el ciclo siguiente. Con nuestros 0,002778 USD por 50 posts, 5 USD dan para unos 90.000 posts repartidos en 1800 páginas.
¿Cómo extraer comentarios de una publicación de Facebook?
(De las sugerencias "extraer comentarios de facebook" y "extraer comentarios de facebook de una publicacion".) Con Apify, el Comments Scraper oficial o thedoor reciben la URL del post y devuelven un dataset que puede exportar. Con EveryInfra, facebook/comments recibe la URL y devuelve hasta 50 comentarios por llamada, sin página siguiente; el script de este artículo los guarda en CSV.
¿Hay un scraper de Facebook de código abierto en GitHub para Python?
(De las sugerencias "scraper facebook github" y "scraper facebook python".) El más conocido es kevinzg/facebook-scraper (vea la sección sobre Graph API más arriba): 3323 estrellas, pero sin commits desde 2024, sin versiones en PyPI desde 2022 y con 447 incidencias abiertas. El coste real es seguir los cambios de páginas y de defensas anti-bot.
¿Es legal hacer scraping de Facebook?
(De la sugerencia de búsqueda "is it legal to scrape facebook".) Esto no es asesoramiento legal. Las condiciones de Meta prohíben la recogida automática sin permiso. En 2024, un tribunal de EE. UU. no dio la razón a Meta en su demanda contractual contra el scraping sin sesión. Y en la UE el RGPD se aplica a los datos personales públicos. Consulte la ley de su país.
¿Se puede hacer scraping de Facebook Marketplace?
(De la sugerencia "scraper facebook marketplace"; también se pregunta en r/learnpython de Reddit.) Meta no ofrece una API pública de Marketplace para terceros. Nuestra llamada a facebook/marketplace devolvió 181 anuncios únicos de Nueva York por 0,001389 USD; en Apify, desde 0,50 USD por cada 1000.
Primeros pasos
- Regístrese en la consola de EveryInfra, obtenga una clave y añada saldo en la página de precios. Las llamadas fallidas y los resultados vacíos no cuestan nada.
- Lea el catálogo gratuito,
GET /api/v1/social/catalog?platform=facebook, o la página de la plataforma Facebook. Las listas de campos están en las páginas deuser_posts,comments,marketplace,searchypost. - Ejecute el comando curl de arriba. No reenvíe la misma solicitud en menos de 5 minutos para esperar resultados: recibirá un 202 «replayed».
- Para herramientas de IA, siga la página de configuración MCP, o pruebe llamadas en el navegador en el mercado de datos.
- La misma clave llama a la API de datos de Instagram y a más de 100 plataformas con el mismo cobro.
Referencias
- Facebook Posts Scraper (página de la Store), Apify, leído el 07-11-2026, https://apify.com/apify/facebook-posts-scraper
- Endpoint público apify~facebook-posts-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/apify~facebook-posts-scraper
- Facebook Comments Scraper (página de la Store), Apify, leído el 07-11-2026, https://apify.com/apify/facebook-comments-scraper
- Endpoint público apify~facebook-comments-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/apify~facebook-comments-scraper
- Facebook Marketplace Scraper (página de la Store), Apify, leído el 07-11-2026, https://apify.com/apify/facebook-marketplace-scraper
- Endpoint público apify~facebook-marketplace-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/apify~facebook-marketplace-scraper
- Facebook Pages Scraper (página de la Store), Apify, leído el 07-11-2026, https://apify.com/apify/facebook-pages-scraper
- Endpoint público apify~facebook-pages-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/apify~facebook-pages-scraper
- Endpoint público apify~facebook-search-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/apify~facebook-search-scraper
- Facebook Comments Scraper de thedoor, Apify Store, leído el 07-11-2026, https://apify.com/thedoor/facebook-comment-scraper
- API pública de dami_studio~facebook-comments-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/dami_studio~facebook-comments-scraper
- Endpoint público curious_coder~facebook-marketplace, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/curious_coder~facebook-marketplace
- Endpoint público curious_coder~facebook-post-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/curious_coder~facebook-post-scraper
- Endpoint público memo23~facebook-search-scraper, Apify, leído el 07-11-2026, https://api.apify.com/v2/acts/memo23~facebook-search-scraper
- Endpoint de búsqueda de la Store (search=facebook), Apify, leído el 07-11-2026, https://api.apify.com/v2/store?search=facebook&limit=200
- Apify pricing, Apify, leído el 07-11-2026, https://apify.com/pricing
- Actors in Store, documentación de Apify, leído el 07-11-2026, https://docs.apify.com/platform/actors/running/actors-in-store
- Pay-per-event pricing model, documentación de Apify, leído el 07-11-2026, https://docs.apify.com/platform/actors/publishing/monetize/pay-per-event
- Dataset, documentación de Apify, leído el 07-11-2026, https://docs.apify.com/platform/storage/dataset
- Actor runs and builds, documentación de Apify, leído el 07-11-2026, https://docs.apify.com/platform/actors/running/runs-and-builds
- Run Actor synchronously and get dataset items, documentación de la API de Apify, leído el 07-11-2026, https://docs.apify.com/api/v2/act-run-sync-get-dataset-items-post
- Actor usage and resources, documentación de Apify, leído el 07-11-2026, https://docs.apify.com/platform/actors/running/usage-and-resources
- Apify MCP server, documentación de Apify, leído el 07-11-2026, https://docs.apify.com/platform/integrations/mcp
- apify/apify-mcp-server, GitHub, leído el 07-11-2026, https://github.com/apify/apify-mcp-server
- apify/apify-client-python, GitHub, leído el 07-11-2026, https://github.com/apify/apify-client-python
- kevinzg/facebook-scraper, GitHub, leído el 07-11-2026, https://github.com/kevinzg/facebook-scraper
- facebook-scraper 0.2.59, PyPI, 31-08-2022, https://pypi.org/project/facebook-scraper/
- Condiciones del servicio de Meta, Meta, leído el 07-11-2026, https://www.facebook.com/terms/
- robots.txt, Facebook, leído el 07-11-2026, https://www.facebook.com/robots.txt
- Page Public Content Access, Meta for Developers, leído el 07-11-2026, https://developers.facebook.com/docs/features-reference/page-public-content-access/
- Page Feed, Meta for Developers, leído el 07-11-2026, https://developers.facebook.com/docs/graph-api/reference/page/feed/
- Graph API Version 26.0 changelog, Meta for Developers, actualizado el 31-07-2026, https://developers.facebook.com/docs/graph-api/changelog/version26.0/
- How We Combat Scraping, Meta Newsroom, abril de 2021, https://about.fb.com/news/2021/04/how-we-combat-scraping/
- CrowdTangle, Meta Transparency Center, 16-08-2024, https://transparency.meta.com/researchtools/other-data-catalogue/crowdtangle/
- Meta Content Library and API, Meta Transparency Center, leído el 07-11-2026, https://transparency.meta.com/researchtools/meta-content-library/
- Get access: Meta Content Library and API, Meta for Developers, leído el 07-11-2026, https://developers.facebook.com/docs/content-library-and-api/get-access/
- Demanda de Meta Platforms, Inc. contra una empresa de datos (3:23-cv-00077), tribunal de distrito de EE. UU., N.D. Cal. (govinfo), 23-01-2024, https://www.govinfo.gov/app/details/USCOURTS-cand-3_23-cv-00077/USCOURTS-cand-3_23-cv-00077-7
- hiQ Labs v. LinkedIn, Tribunal de Apelaciones del Noveno Circuito, 18-04-2022, https://cdn.ca9.uscourts.gov/datastore/opinions/2022/04/18/17-16783.pdf
- Van Buren v. United States, Tribunal Supremo de EE. UU., 03-06-2021, https://www.supremecourt.gov/opinions/20pdf/19-783_k53l.pdf
- Decisión sobre el scraping de datos de Facebook, Comisión de Protección de Datos de Irlanda, 28-11-2022, https://www.dataprotection.ie/en/news-media/press-releases/data-protection-commission-announces-decision-in-facebook-data-scraping-inquiry
- Reglamento General de Protección de Datos, EUR-Lex, 27-04-2016, https://eur-lex.europa.eu/eli/reg/2016/679/oj
- Segunda declaración conjunta sobre scraping de datos, OAIC, 29-10-2024, https://www.oaic.gov.au/news/media-centre/global-privacy-authorities-issue-follow-up-joint-statement-on-data-scraping
- CMA opens investigation into Meta's commercial terms, CMA del Reino Unido, 30-10-2026, https://www.gov.uk/government/news/cma-opens-investigation-into-metas-commercial-terms--2
- Meta's new commercial terms will allow the scraping of news sites, Nieman Lab, 15-10-2026, https://www.niemanlab.org/2026/10/metas-new-commercial-terms-will-allow-the-scraping-of-news-sites-legal-experts-say/
- Updates to Meta's Commercial Terms will not take effect on November 20, 2026, centro de ayuda para empresas de Meta, leído el 07-11-2026, https://www.facebook.com/business/help/2481113349080785
- Meta Web Crawlers, Meta for Developers, actualizado el 21-05-2026, https://developers.facebook.com/documentation/sharing/webmasters/web-crawlers
- Limits, documentación de Apify, leído el 07-11-2026, https://docs.apify.com/platform/limits
- Alternative to Apify for FB scraping, Reddit r/n8n, leído el 07-11-2026, https://www.reddit.com/r/n8n/comments/1mlgpna/alternative_to_apify_for_fb_scraping/
- Catálogo de capacidades de Facebook, EveryInfra, leído el 07-11-2026, https://api.everyinfra.com/api/v1/social/catalog?platform=facebook
- Model Context Protocol: Introduction, modelcontextprotocol.io, leído el 07-11-2026, https://modelcontextprotocol.io/docs/getting-started/intro
- Connect Claude Code to tools via MCP, documentación de Anthropic, leído el 07-11-2026, https://code.claude.com/docs/en/mcp
- csv: CSV File Reading and Writing, documentación de Python, leído el 07-11-2026, https://docs.python.org/3/library/csv.html
- Meta Content Library, manual de investigación de Bellingcat, leído el 07-11-2026, https://bellingcat.gitbook.io/toolkit/more/all-tools/meta-content-library
Referencia BL-106