Claude Code 서브에이전트: Haiku 워커로 TikTok 계정 분석
TikTok 브랜드 계정 하나의 원본 데이터는 약 9,700토큰입니다. Haiku 5.5 서브에이전트는 이를 95토큰 요약으로 돌려줍니다. 실제 호출 98건, 429 오류 처리, 계정 50개 기준 비용을 정리했습니다.
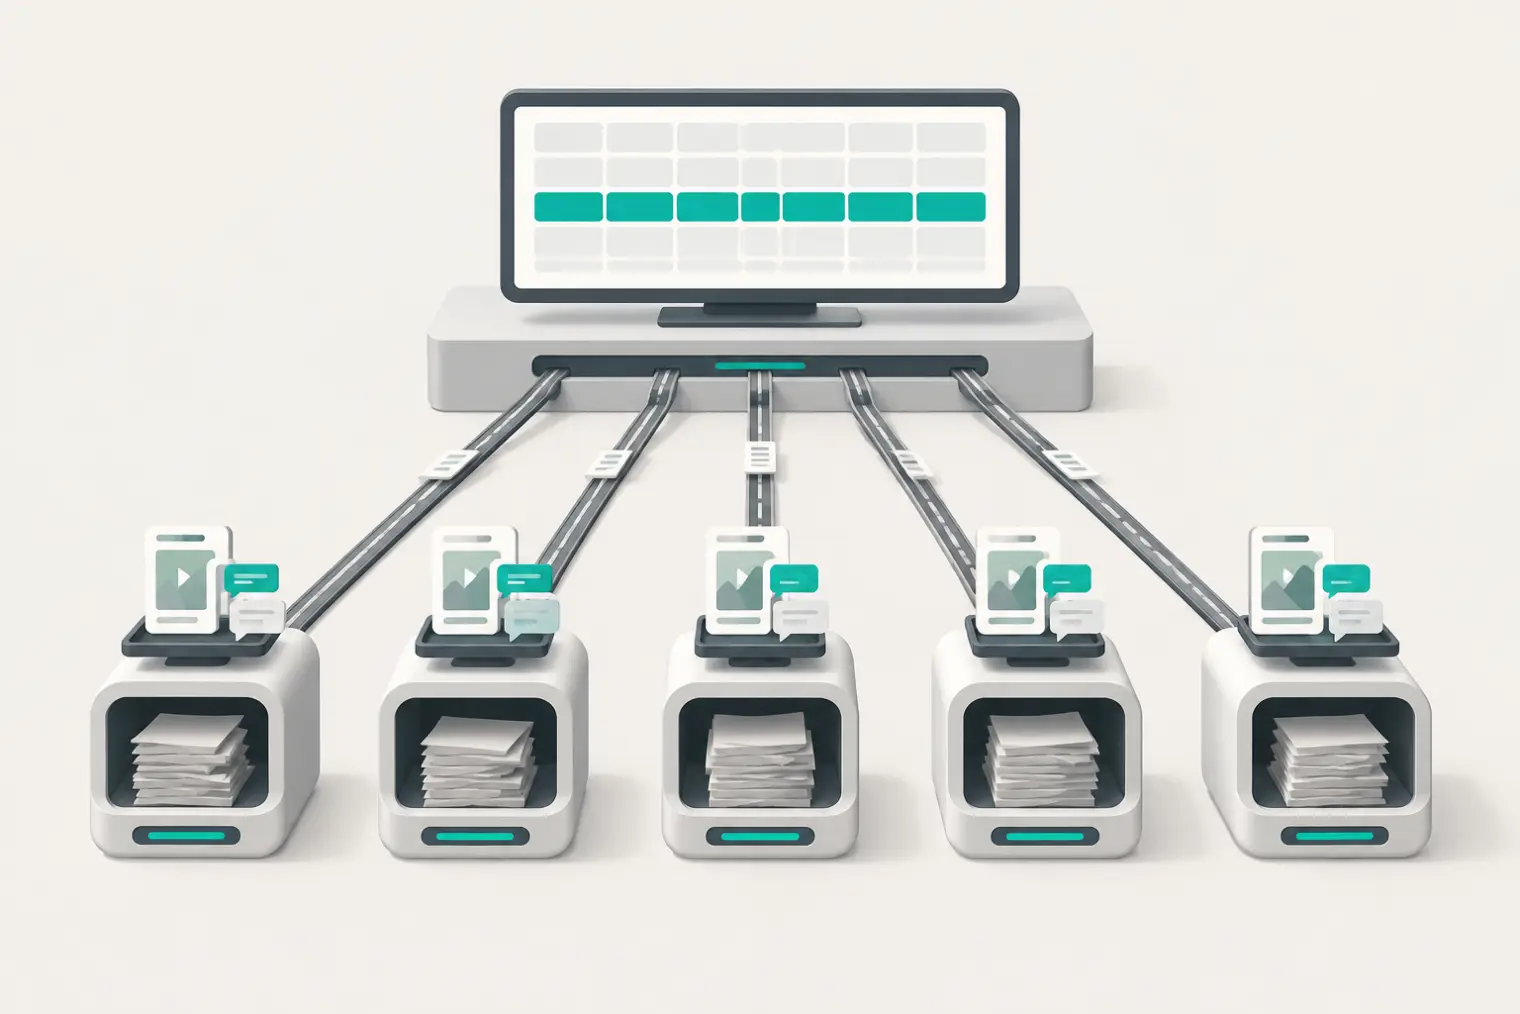
2026년 10월 26일 17:25~17:48 SGT에 EveryInfra API로 TikTok 브랜드 계정 18개를 수집했습니다. 계정마다 프로필, 최신 동영상 10개, 동영상 1개의 댓글을 가져왔습니다. 원본 결과는 계정당 평균 38,794바이트였습니다. Anthropic 요금 페이지의 비율(10kB가 약 2,500토큰)로 환산하면 약 9,700토큰입니다. 같은 계정의 요약은 약 382바이트, 즉 95토큰입니다. 원본과 요약의 크기는 약 100배 차이 나며, Claude Code 서브에이전트는 요약만 메인 컨텍스트로 보내 그만큼 컨텍스트 사용량을 줄입니다.
놓치기 쉬운 결과가 하나 더 있습니다. 저희는 테스트 키의 한도를 분당 10건으로 제한했습니다(계정 기본값은 60건). 병렬 워커 6개는 요청 56건 중 20건에서 요청 속도 제한 오류(429)를 받았습니다. 클라이언트 측 상한을 둔 워커 4개는 분당 50% 이상 더 많은 결과를 얻었습니다.
이 글은 실무 질문 하나에 답합니다. 경쟁사, 협업 후보, 자사 지역 계정 등 수십 개의 TikTok 브랜드 계정 목록이 있다고 가정합니다. Claude Code로 프로필, 최근 동영상, 댓글을 가져와 비교표를 만들려고 합니다. 작업을 서브에이전트에 어떻게 나눠야 할까요? 각 서브에이전트에는 어떤 모델과 도구를 줘야 할까요? 어떤 데이터 호출을 하고 비용은 얼마이며, API 요청 속도 제한에 걸리면 어떻게 될까요?
이 글의 Claude Code 설정은 공식 문서와 변경 내역을 바탕으로 했습니다. 서브에이전트 자체는 저희 환경에서 실행하지 않았으므로 해당 부분은 설정 예시로 표시했습니다. EveryInfra 수치는 모두 실제 호출의 원본 응답에서 나왔습니다.
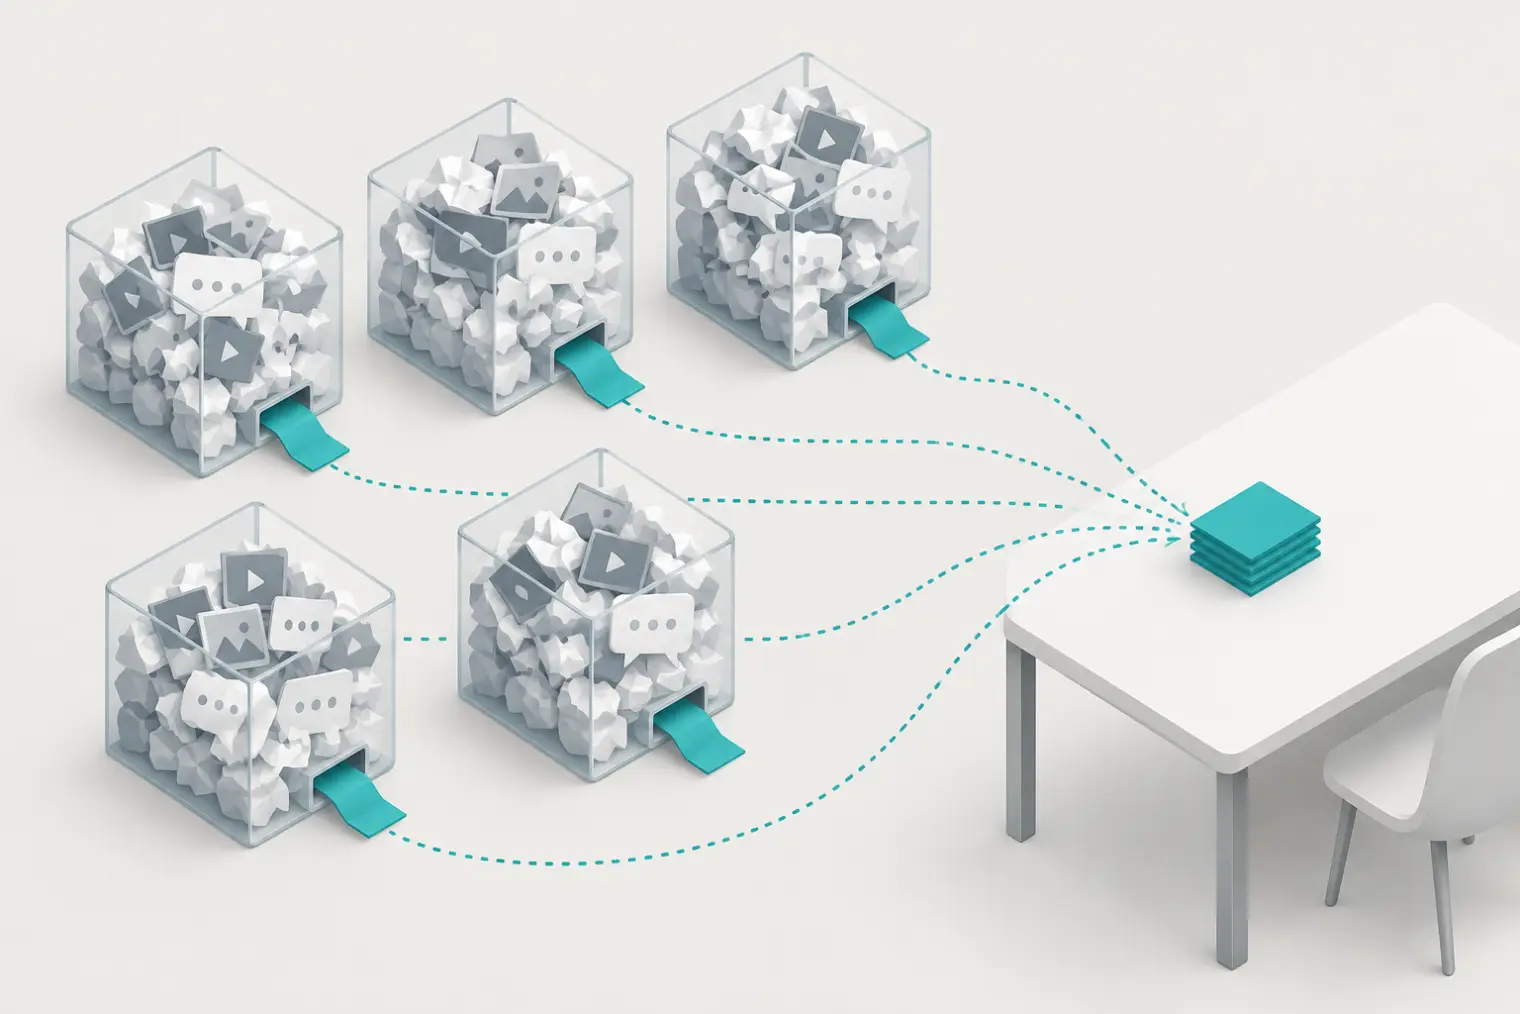
작업 정의: 브랜드 계정 50개를 비교표 하나로
이후의 모든 수치가 작업 정의에 따라 달라지므로 작업부터 정의합니다. 입력은 TikTok 사용자 이름 목록입니다. 계정마다 세 가지를 수집합니다. 첫째는 프로필(팔로워, 동영상 수, 인증 여부)입니다.
둘째는 최신 동영상 10개(조회수, 좋아요, 댓글, 게시 시각)입니다. 셋째는 그 10개 중 댓글이 가장 많은 동영상의 댓글 최대 50개입니다. 출력은 계정당 한 행인 표입니다. 열은 팔로워, 최근 동영상 조회수 중앙값, 참여율, 주간 게시 수, 샘플링한 댓글 수이며, 짧은 메모 하나가 함께 붙습니다.
이 작업에는 서브에이전트의 용도와 맞아떨어지는 세 가지 특성이 있습니다. 첫째, 계정끼리 서로 의존하지 않습니다. Nike 데이터를 가져올 때 Adidas 결과가 필요 없으므로 작업을 병렬로 실행할 수 있습니다. 둘째, 남기는 것보다 읽는 것이 훨씬 많습니다. 계정마다 수십 KB가 반환되지만 표에는 한 행만 남습니다. 셋째, 단계가 정해져 있고 판단이 단순하므로 작고 저렴한 모델로도 처리할 수 있습니다.
Claude Code 문서도 서브에이전트를 같은 관점에서 설명합니다. 곁가지 작업이 메인 대화를 가득 채울 때 서브에이전트를 쓰라고 안내합니다. 다시 읽지 않을 검색 결과, 로그, 파일 내용 등이 대화를 채우는 경우입니다. 서브에이전트는 이 작업을 자체 컨텍스트에서 처리하고 요약만 반환합니다(Claude Code 서브에이전트 문서).
사용자 이름 24개를 세 그룹으로 나눠 테스트했습니다. 미국 스포츠웨어 그룹은 Nike, Adidas, Gymshark, lululemon, Under Armour, New Balance, PUMA, HOKA의 8개 계정입니다. 중국에 기반을 둔 브랜드 그룹에는 SHEIN, Temu, DJI, OnePlus, EcoFlow가 있습니다. 여기에 Anker, Insta360, Xiaomi의 브랜드명으로 추측한 사용자 이름 3개도 포함했습니다.
스페인어권 그룹에는 Zara, Bershka, Real Madrid, Telcel, Pull&Bear와 함께 Mercado Libre, OXXO, Bimbo의 추측 사용자 이름 3개가 있었습니다. 추측한 6개는 모두 틀렸으며, 이것이 왜 중요한지는 실패 사례 섹션에서 설명합니다. 나머지 검증된 브랜드 계정 18개가 아래 모든 크기, 비용, 속도 수치의 기준이며, 명시한 곳에서는 50개로 환산했습니다.


애초에 나눠야 할까? Anthropic의 10월 22일 가이드가 말하는 것
설정에 앞서 반대 의견부터 살펴보겠습니다. 2026년 10월 22일 Anthropic은 "When to fold subagents into your main agent loop"라는 긴 가이드를 발표했습니다(Anthropic 가이드). 이 가이드는 대부분의 에이전트가 서브에이전트를 덜 써야 한다고 말합니다. 기본은 모델 하나, 컨텍스트 창 하나, 열린 도구 루프 하나여야 한다는 것입니다. 도메인 절차는 스킬에, 조회와 엄격한 제한은 도구에 넣습니다. Reddit 요약에 따르면 한 고객의 단일 루프는 멀티 에이전트 구성보다 약 2배 빠르게 실행되었습니다.
함께 공개된 single-agent-loop-kit은 이 주장을 신중하게 다룹니다. README에는 이 키트가 단일 루프가 항상 낫다고 가정하지 않는다고 적혀 있습니다. 변경할 때마다 동일한 평가로 전후를 측정합니다. 같은 README에는 서브에이전트를 유지할 타당한 이유도 나와 있습니다. 새 컨텍스트에서 진행하는 병렬 리서치, 독립적인 검증, 그리고 메인 에이전트가 이후에 필요로 하는 것보다 훨씬 많이 읽는 작업입니다.
TikTok 계정 50개를 가져오는 작업은 마지막 경우에 해당합니다. 계정마다 약 9,700토큰이 들어오지만 메인 세션에 필요한 것은 95토큰짜리 행 하나입니다. The Decoder는 서브에이전트를 유지할 Anthropic의 세 가지 조건을 전합니다. 컨텍스트 증가로 인한 측정 가능한 품질 저하, 별도 컨텍스트가 필요한 병렬 작업, 도구 선택의 어려움입니다. 이 작업은 앞의 두 조건을 충족합니다.
| 서브에이전트를 유지할 이유(Anthropic 키트) | 이 작업에 해당 여부 | 이 글의 데이터 |
|---|---|---|
| 새 컨텍스트에서 진행하는 병렬 리서치 | 예 | 계정끼리 서로 의존하지 않음 |
| 메인 에이전트에 필요한 것보다 훨씬 많이 읽는 작업 | 예 | 계정당 약 9,700토큰을 읽고 95토큰 반환 |
| 독립적인 검증 | 부분적으로 | 새 워커로 계정 하나를 다시 실행해 확인 가능 |
| 도구가 너무 많아 생기는 문제 | 예, 필터가 없다면 | MCP 도구 25개 중 2개만 허용 |
결론은 분할하되 한 계층으로만 구성하고, '가져와서 압축하기' 단계에만 적용하는 것입니다. 표 작성과 자세히 살펴볼 계정 선택, 추가 라운드 실행 여부 판단은 메인 세션에서 처리합니다. 이런 판단을 내리려면 모든 계정을 동시에 봐야 합니다. 이는 가이드가 경고하는 '팀마다 서브에이전트 하나' 패턴이 아닙니다. 워커마다 별도의 역할을 부여하지 않습니다. 각 워커는 정해진 단계와 계정 하나만 맡습니다.
Claude Code 서브에이전트: 파일, model 필드, 도구 허용 목록
Claude Code 서브에이전트는 Markdown 파일입니다. 파일은 YAML 메타데이터(문서에서는 프런트매터라고 부릅니다)로 시작하며, 본문은 서브에이전트의 시스템 프롬프트가 됩니다. 프로젝트 서브에이전트는 .claude/agents/에 두며 팀과 공유하도록 커밋할 수 있습니다. 사용자 서브에이전트는 ~/.claude/agents/에 둡니다.
문서에 따르면 필수 필드는 name과 description뿐입니다. 필드 이름은 camelCase를 쓰며, Claude Code는 철자가 틀린 필드를 오류 없이 무시합니다(프런트매터 레퍼런스). 다음은 이 작업에 쓴 설정 예시입니다. 이어지는 단락에서 각 선택을 설명합니다.
---
name: tiktok-account-worker
description: Pull one TikTok account (profile, newest videos, comments on one video) and return a one-line JSON summary. Use one per account in the list.
model: claude-haiku-5-5
effort: low
tools: mcp__everyinfra__everyinfra_call_api, mcp__everyinfra__everyinfra_get_job
mcpServers:
  - everyinfra:
      type: http
      url: https://api.everyinfra.com/mcp
      headers:
        Authorization: "Bearer ${EVERYINFRA_API_KEY}"
maxTurns: 8
omitClaudeMd: true
---

Work on the one TikTok username in your task. Do these steps in order:
1. Call everyinfra_call_api with platform=tiktok, action=profile, params={username}.
   If is_verified is false and follower_count < 1000, stop and return {"username":..., "flag":"lookalike"}.
2. Call action=user_videos with params={username, limit:10}. Leave out is_pinned=true videos from medians and rates.
3. Take the video with the highest comment_count from step 2. Call action=comments with params={url, limit:50}.
4. On a 429, wait retry_after seconds and retry once. Do not change the parameters.
5. Output one JSON line only: username, verified, followers, median_views, engagement_pct,
   posts_per_week, comments_fetched, and one note of 25 words or less. Do not output raw data.
model 줄에는 haiku 별칭 대신 전체 모델 ID를 씁니다. 이유는 다음 섹션에서 설명합니다. tools 줄은 허용 목록입니다. 문서에 따르면 tools 목록이 있는 서브에이전트는 그 도구만 사용할 수 있습니다. 목록이 없는 서브에이전트는 메인 대화의 모든 도구를 상속합니다(사용 가능한 도구).
EveryInfra 원격 MCP 서버는 tools/list에서 도구 25개를 반환합니다. 이 중 데이터를 가져오는 도구는 everyinfra_call_api와 everyinfra_get_job 두 개입니다. 나머지는 계정, 키, 지원 티켓, 웹훅을 관리합니다. 작은 모델이 50번 실행하는 배치 작업에 everyinfra_key_delete 같은 도구가 있을 이유가 없습니다. 허용 목록으로 도구를 두 개만 남기면 이 위험을 원천적으로 없앨 수 있습니다.
컨텍스트를 가장 많이 절약하는 것은 mcpServers 줄입니다. 문서에 따르면 서브에이전트에 인라인으로 정의한 MCP 서버는 서브에이전트가 시작될 때 연결되고 끝날 때 연결이 끊깁니다. 따라서 서버를 .mcp.json이 아닌 인라인으로 정의하세요. 그러면 도구 설명 텍스트가 메인 컨텍스트에 들어가지 않습니다(MCP 서버 범위를 서브에이전트로 지정).
측정해 보니 EveryInfra tools/list 응답은 30,682바이트, 약 7,670토큰이었습니다. initialize 응답에는 서버 지침 3,924자가 추가됩니다. 허용한 도구 두 개는 2,505바이트, 약 626토큰입니다. 문서에는 신뢰 규칙도 명시되어 있습니다. Claude Code는 프로젝트 .claude/agents/ 파일의 인라인 MCP 서버를 해당 폴더를 신뢰한 뒤에만 로드합니다. v2.1.238 이전 버전은 이를 확인하지 않았습니다.
omitClaudeMd: true를 설정하면 사용자, 프로젝트, 로컬 CLAUDE.md 파일 없이 서브에이전트가 시작됩니다. 기본적으로 서브에이전트는 메인 대화가 로드하는 모든 수준의 CLAUDE.md를 로드합니다(시작 시 로드되는 항목). API를 세 번 호출하는 워커에는 그 규칙 대부분이 필요 없으며, 워커 50개가 각자 사본을 로드하게 됩니다. 이 필드는 Claude Code v2.1.271 이상이 필요합니다. maxTurns: 8은 턴 제한을 설정합니다. 제한에 도달하면 Claude Code는 출력을 부분 결과로 표시하며, 메인 세션은 워커를 재개할 수 있습니다(v2.1.246 이상).
키는 환경 변수 확장을 사용합니다. Claude Code MCP 문서에 따르면 .mcp.json과 서브에이전트 MCP 항목은 ${VAR}를 지원합니다. 팀은 파일 하나를 공유하고 각자 개인 키를 사용할 수 있습니다. 단, 일부 자격 증명 이름은 원격 서버의 url과 headers에서 항상 빈 값으로 확장됩니다.
여기에는 ANTHROPIC_API_KEY, 클라우드 제공업체 자격 증명, NPM_TOKEN이 포함됩니다(MCP 문서, 환경 변수). 이 규칙은 프로젝트 파일이 해당 파일에 지정된 서버로 자격 증명을 보내는 것을 막습니다. EVERYINFRA_API_KEY처럼 직접 정한 변수 이름을 사용하세요.
서버를 서브에이전트 파일 밖에 둘 수도 있습니다. 명령 하나로 프로젝트에 추가한 다음, mcpServers에서 이름으로 참조하세요:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope project --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
작업을 멈추게 할 수 있는 설정이 하나 더 있습니다. tools/list에서 everyinfra_call_api는 호출할 때마다 비용이 발생하므로 readOnlyHint: false, destructiveHint: true로 되어 있습니다. 문서는 백그라운드 서브에이전트에 도구 호출 권한이 필요할 때 어떻게 되는지 설명합니다. Claude Code는 메인 세션에 권한 프롬프트를 표시하고 해당 서브에이전트의 이름을 보여 줍니다(포그라운드와 백그라운드).
워커 50개를 실행하면 권한 요청이 50번 표시될 수 있습니다. 시작하기 전에 설정의 permissions.allow에서 mcp__everyinfra__everyinfra_call_api를 허용하세요(권한 문서). 단, 이 도구 하나만 허용하세요.
아래 표에 각 필드와 그 역할, 필요한 버전을 포함한 공식 출처를 정리했습니다.
| 필드 | 이 예시의 값 | 동작 | 출처(버전) |
|---|---|---|---|
model | claude-haiku-5-5 | 서브에이전트 모델 설정. haiku, inherit 같은 별칭도 사용 가능 | 서브에이전트 문서, "Choose a model" |
tools | MCP 도구 2개만 | 허용 목록. 없으면 서브에이전트가 모든 도구를 상속 | 서브에이전트 문서, "Available tools" |
mcpServers | 인라인 EveryInfra 서버 | 도구 설명이 서브에이전트에서만 로드됨 | 서브에이전트 문서. 신뢰 확인은 v2.1.238부터 |
effort | low | 이 서브에이전트의 effort 수준 | 서브에이전트 문서, "Choose an effort level" |
maxTurns | 8 | 턴 제한. 제한 도달 시 출력을 부분 결과로 표시 | 부분 결과 표시는 v2.1.246부터 |
omitClaudeMd | true | CLAUDE.md 파일 건너뜀 | v2.1.271 이상 |
Claude Code 서브에이전트 모델 선택: 4단계 우선순위와 haiku 별칭의 함정
이 작업에서 비용에 가장 민감한 부분은 서브에이전트가 어떤 모델로 실행되느냐입니다. 가장 흔한 질문 중 하나이기도 합니다. Google 추천 검색어에는 "claude code subagents model selection", "claude code subagent model default", "claude_code_subagent_model force"가 있습니다. 문서는 4단계 우선순위를 제시합니다.
첫째, 메인 세션이 서브에이전트를 시작할 때 전달하는 model 파라미터입니다. 둘째, 서브에이전트 파일의 model 필드이며, 여기서 inherit는 메인 모델을 뜻합니다. 셋째, CLAUDE_CODE_SUBAGENT_MODEL 환경 변수입니다. 넷째, 메인 대화의 모델입니다(Choose a model).
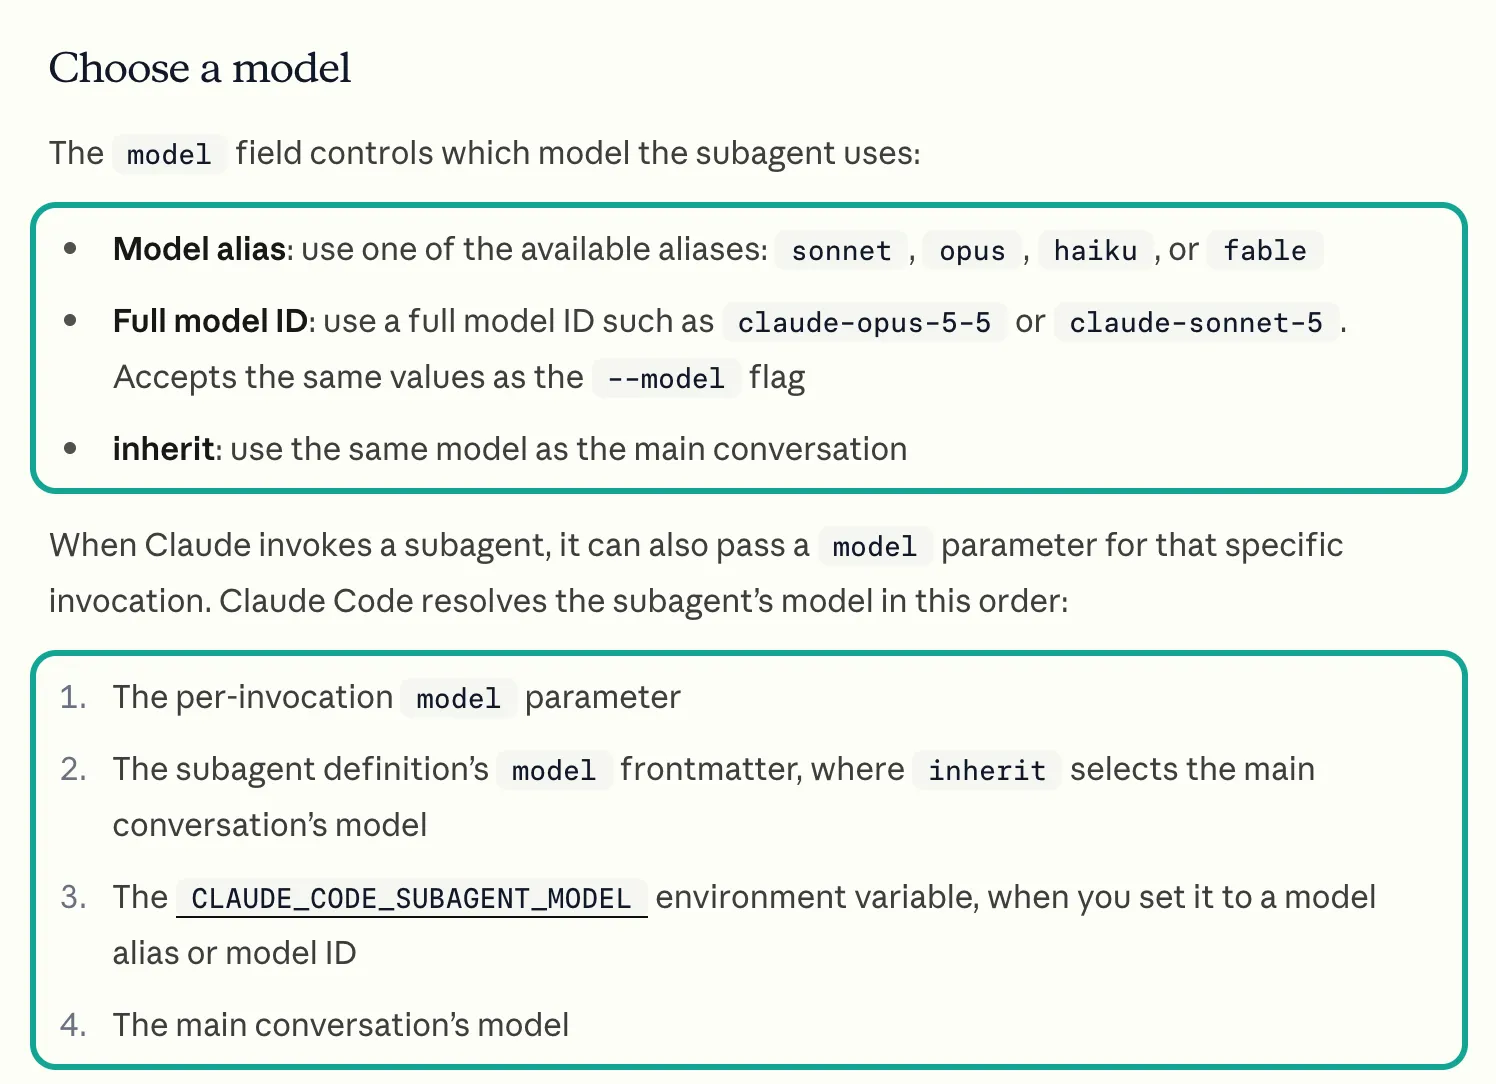
이 순서에서 두 가지 결과가 나옵니다. 첫째, model 필드가 없는 서브에이전트는 메인 모델을 상속합니다. 메인 세션이 Opus 5.5로 실행 중이면 작은 데이터 워커도 Opus 요금으로 과금됩니다. 업보트 736개를 받은 Reddit 게시물도 같은 경고를 했습니다. 기본 제공 Explore 서브에이전트가 더 이상 항상 Haiku로 실행되지 않고 메인 세션을 따른다는 내용입니다(r/ClaudeCode 스레드).
둘째, 환경 변수는 파일보다 우선순위가 낮으므로 기본값 역할만 합니다. 모든 서브에이전트에 한 모델을 강제하려면 문서에 따라 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1도 설정해야 합니다. 이 플래그가 있으면 Claude Code는 서브에이전트 파일의 model 필드를 무시합니다. 예전 커뮤니티 게시물에는 이 변수가 가장 우선한다고 나와 있습니다(r/claude 스레드). 이 순서는 현재 문서와 맞지 않으므로 문서를 따르세요.
haiku 대신 전체 ID를 쓰는 이유는 이 별칭이 제공업체마다 다른 모델을 가리키기 때문입니다. Claude Code 모델 구성 문서에 관련 표가 있습니다. Anthropic API에서 haiku는 Haiku 5.5를 뜻합니다. Claude Platform on AWS, Amazon Bedrock, Google Cloud, Microsoft Foundry에서는 haiku가 여전히 Haiku 4.5를 뜻합니다(모델 구성 문서). Haiku 4.5의 정가는 입력 토큰 100만 개당 $1, 출력 토큰 100만 개당 $5로, Haiku 5.5 가격의 10배입니다(Haiku 5.5 출시 페이지 가격표).
Bedrock에서 같은 서브에이전트 파일을 사용하면 비용이 10배로 늘 수 있지만 오류는 표시되지 않습니다. Claude Code 변경 내역에 따르면 Haiku 5.5는 v2.1.293(2026-10-07)부터 Anthropic API의 기본 Haiku 모델이 되었습니다(Claude Code 변경 내역).
| 제공업체 | `haiku` 별칭이 가리키는 모델 | 토큰 100만 개당 입력 / 출력 | 대응 방법 |
|---|---|---|---|
| Anthropic API | Haiku 5.5 | $0.10 / $0.50(프롬프트 100k 이하) | 별칭 또는 전체 ID |
| Claude Platform on AWS | Haiku 4.5 | $1 / $5 | 전체 ID 사용 |
| Amazon Bedrock, Google Cloud | Haiku 4.5 | 클라우드 제공업체 요금 | 제공업체 모델 ID 사용 |
| Microsoft Foundry | Haiku 4.5 | Azure 요금 | 전체 ID 사용 |
Sonnet이 아니라 Haiku 5.5를 쓰는 이유는 무엇일까요? 2026년 10월 7일 출시 페이지에는 요약, 컨텍스트 압축, 데이터베이스 쿼리, 분류처럼 처리량이 많고 비용에 민감한 작업에 사용한다고 명시되어 있습니다. 이 페이지는 Haiku 5.5가 서브에이전트로서 Opus 5.5, Sonnet 5.5와 잘 어울린다고 설명합니다. 또한 복잡한 에이전틱 코딩에는 여전히 Sonnet 5.5와 Opus 5.5가 더 낫고, Haiku 5.5는 범위가 명확히 제한된 작업에 가장 적합하다고 말합니다(Haiku 5.5 출시 페이지).
이 워커가 하는 일은 세 가지입니다. API를 순서대로 호출하고, 댓글이 가장 많은 동영상을 고르고, 중앙값 몇 개를 계산합니다. 각 출력은 스크립트로 검증할 수 있습니다. 범위가 좁은 작업입니다.
커뮤니티 사례도 같은 결과를 보여 줍니다. 한 사용자는 작고 범위가 정해진 작업 7개에 Haiku 5.5를 실행해 140건 중 140건이 승인되었고, Opus 5.5와 같은 결과를 얻었습니다. 같은 사용자는 "파일 하나에 검증 하나라면 괜찮다"면서도, 범위가 열린 작업에서는 결과가 흐트러진다고 경고했습니다(r/ClaudeAI 스레드).
Haiku 5.5에서는 일부 API 동작도 달라졌습니다. 마이그레이션 가이드에 따르면 Haiku 5.5는 temperature, top_p, top_k를 받지 않습니다. thinking 값에 budget_tokens를 넣으면 400 오류가 반환되므로 {"type": "adaptive"}를 사용하세요. 어시스턴트 프리필은 지원되지 않습니다(Haiku 5.5 마이그레이션 가이드). Claude Code는 이 파라미터를 알아서 처리합니다. Agent SDK나 API로 워커를 만든다면 직접 확인하세요.
각 워커가 수행하는 EveryInfra 호출 3가지
세 기능은 모두 EveryInfra 카탈로그(GET /api/v1/social/catalog, 무료, 키 불필요)에 있습니다. 2026년 10월 26일 17:22(SGT)에 카탈로그를 읽어 저장했습니다. 세 기능 모두 TikTok 등급에 속하며 price_usd는 0.000556, 즉 호출당 $0.000556입니다. 반환되는 행 수와 관계없이 호출 1회의 비용은 같습니다.
user_videos는 호출당 최대 50행, comments는 최대 200행을 반환합니다(TikTok 카탈로그). 기능 페이지는 tiktok/profile, tiktok/user_videos, tiktok/comments입니다. 플랫폼 개요는 TikTok 데이터 API에서 확인할 수 있습니다.
| 기능 | 필수 파라미터 | 이 글에서의 용도 | 호출당 가격 | 사용한 필드(카탈로그 response_fields와 일치) |
|---|---|---|---|---|
tiktok/profile | username | 계정당 1회 호출 | $0.000556 | username, display_name, follower_count, video_count, like_count, is_verified |
tiktok/user_videos | username | limit: 10 | $0.000556 | url, view_count, like_count, comment_count, posted_at, is_pinned |
tiktok/comments | url | limit: 50 | $0.000556 | id, like_count, reply_count, is_reply, posted_at |
tiktok/search | keyword | 올바른 사용자 이름을 찾기 위한 content_type: profile | 반환된 계정당 $0.000556 | author_username, author_is_verified, author_follower_count |
마지막 행은 설명이 필요합니다. 카탈로그에서 tiktok/search에는 rows_per_unit_when 필드가 있습니다. 이 필드에 따르면 content_type을 profile로 설정할 때 반환된 행마다 1단위로 계산됩니다. 저희는 limit: 5로 브랜드 3곳의 올바른 사용자 이름을 찾는 데 이를 사용했고, 호출마다 5 × $0.000556인 $0.002778이 과금되었습니다. 동영상 검색은 호출당 1단위지만 계정 검색은 계정당 1단위입니다. 예산을 짤 때 놓치기 쉬운 차이입니다.
다음은 REST로 수행하는 워커의 첫 단계입니다. 키는 환경 변수에서만 가져옵니다. 응답의 billing.charged_usd 필드에 해당 호출의 실제 과금액이 표시됩니다.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"tiktok","action":"user_videos","params":{"username":"nike","limit":10}}'
표의 결과를 바꾸는 필드 세부 사항이 두 가지 있습니다. 첫째, user_videos는 최신순으로 정렬되지만 고정된 동영상(is_pinned: true)이 맨 앞에 옵니다. 18개 계정 중 7개는 최신 10개 안에 고정 동영상이 있었고, SHEIN, DJI, Gymshark는 각각 3개였습니다. 고정 동영상은 몇 달 전 것일 수 있습니다. 필터를 적용하지 않으면 SHEIN의 '최근 동영상 10개'가 294일에 걸쳐 있어 게시 빈도가 잘못 계산됩니다.
둘째, 동영상의 comment_count가 아니라 호출이 실제로 반환한 댓글 수를 사용하세요. New Balance 동영상은 댓글 29개로 표시되었지만 호출은 27개를 반환했습니다. Telcel 동영상은 10개로 표시되었지만 5개가 반환되었습니다. 카탈로그에는 최상위 댓글마다 답글이 최대 2개까지만 포함되며 전체 스레드는 보장되지 않는다고도 나와 있습니다.
실제 MCP 왕복 1회: 모델이 보내는 것과 돌아오는 것
MCP로 API를 호출하는 서브에이전트는 MCP 사양의 Streamable HTTP 전송 방식을 사용합니다. 순서는 initialize, notifications/initialized, tools/list, tools/call입니다(MCP 2025-06-18 transports, lifecycle).
2026년 10월 26일 17:30(SGT)에 이 과정을 직접 수행했습니다. initialize는 프로토콜 버전 2025-06-18과 함께 200을 반환했습니다. 응답에 Mcp-Session-Id 헤더가 없으므로 이 서버에는 세션 ID가 필요 없습니다. notifications/initialized는 원격 MCP 설정 가이드에 나온 대로 빈 본문과 함께 202를 반환했습니다. tools/list는 도구 25개를 반환했습니다.
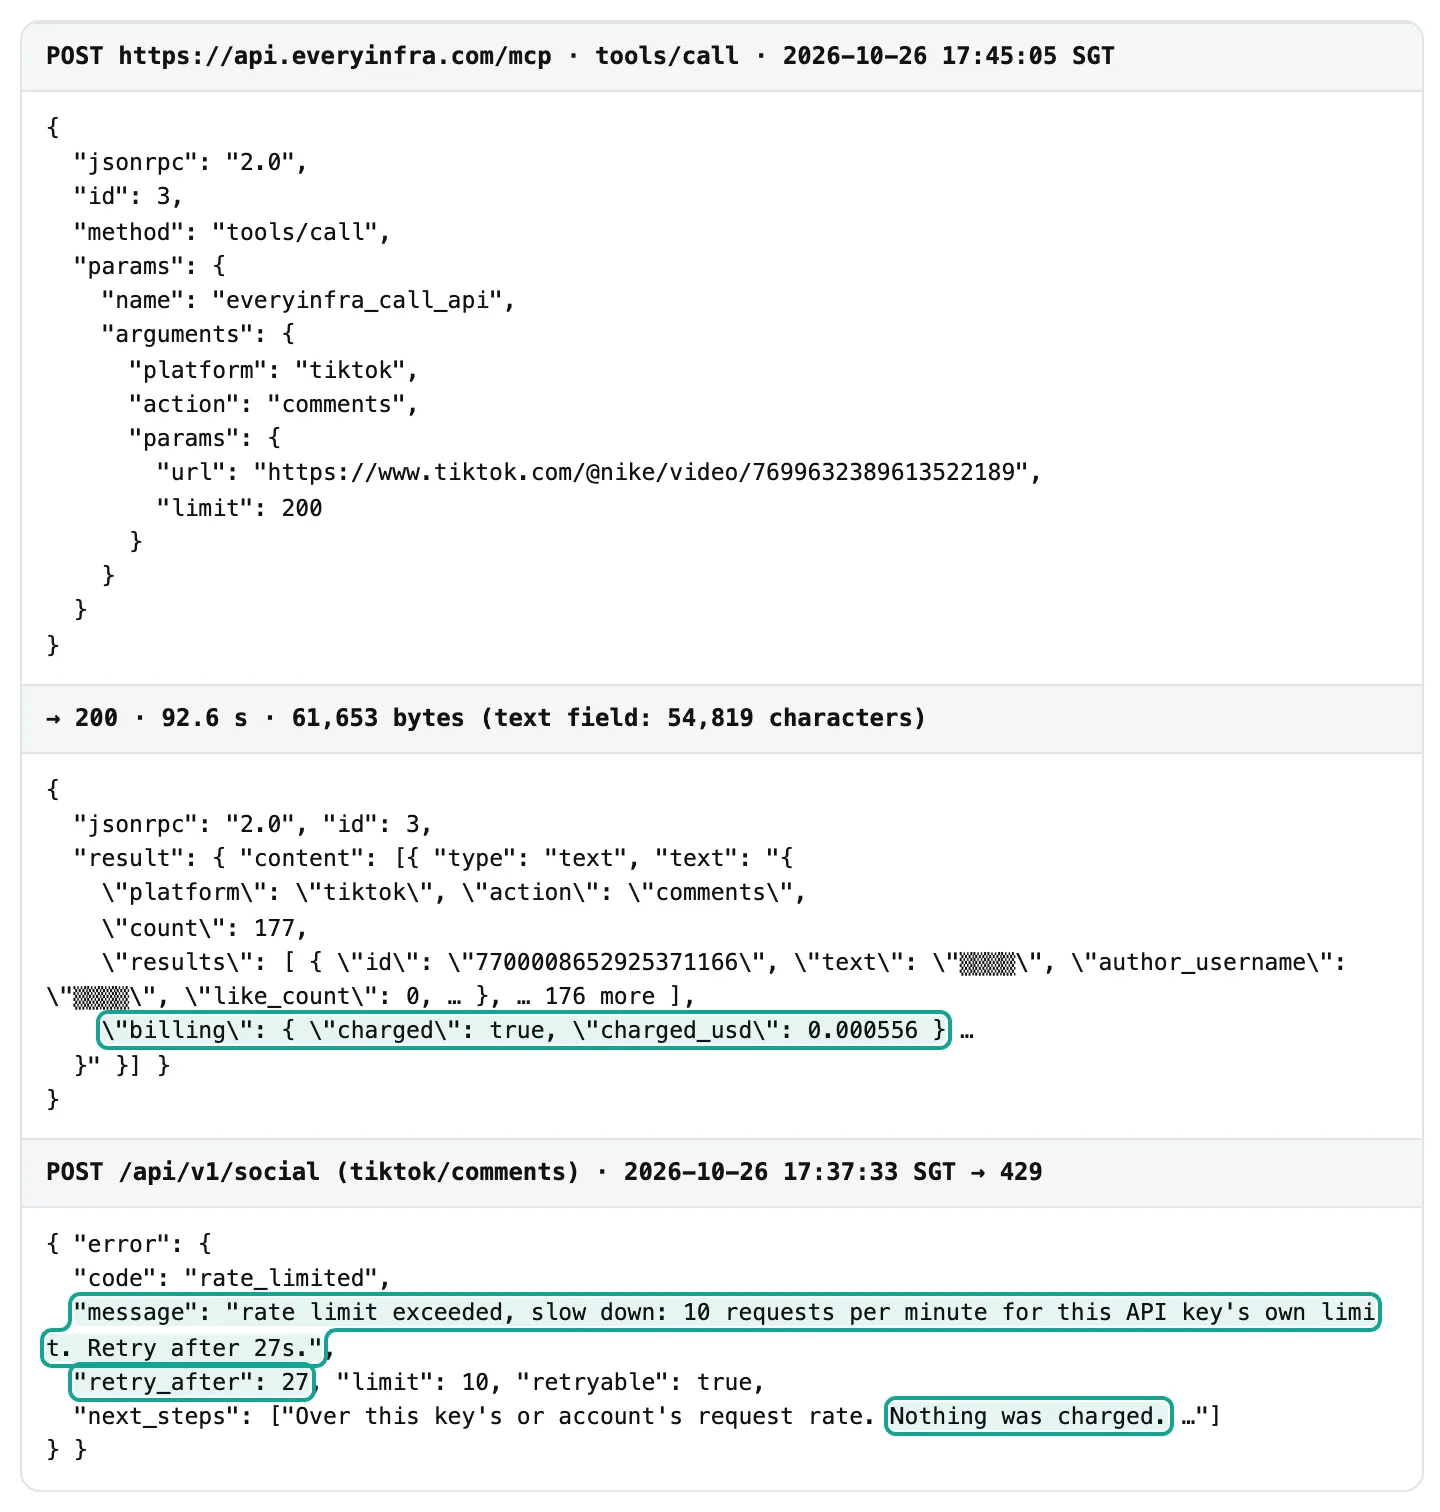
17:45:05(SGT)에 Nike 동영상 하나의 댓글을 limit: 200으로 요청하는 tools/call을 everyinfra_call_api에 한 번 보냈습니다. Haiku 워커가 Claude Code에서 보내는 것과 같은 호출입니다. API는 92.6초 후 200을 반환했습니다. 전체 HTTP 응답은 61,653바이트였습니다. content[0].text 필드는 54,819자였고 댓글 177개와 billing.charged_usd: 0.000556이 들어 있었습니다.
54,819자를 Claude Code의 세 가지 제한과 비교해 보겠습니다. MCP 문서에 따르면 Claude Code는 MCP 도구 출력이 10,000토큰을 넘으면 경고를 표시합니다. 기본 제한은 25,000토큰이며 MAX_MCP_OUTPUT_TOKENS로 늘릴 수 있습니다. 또한 anthropic/maxResultSizeChars 어노테이션이 없는 도구도 있습니다. 이런 도구의 경우 Claude Code는 50,000자를 넘는 성공한 텍스트 결과를 파일로 저장합니다. 대화에는 파일 참조만 남습니다(MCP 출력 제한).
| MCP 결과에 대한 Claude Code 제한 | 문서상 값 | 측정 결과 | 초과 여부 |
|---|---|---|---|
| 경고 | 10,000토큰 | 댓글 200개: 약 13,865토큰 | 예 |
기본 출력 제한(MAX_MCP_OUTPUT_TOKENS) | 25,000토큰 | 댓글 200개: 약 13,865토큰 | 아니요 |
파일로 저장(anthropic/maxResultSizeChars 없음) | 50,000자 | 댓글 200개: 54,819자 | 예 |
| 파일로 저장 | 50,000자 | 댓글 50개: 최대 24,749자 | 아니요 |
| 파일로 저장 | 50,000자 | 동영상 10개: 최대 29,156자 | 아니요 |
tools/list 응답을 확인한 결과 EveryInfra 도구에는 이 어노테이션이 없습니다. 따라서 댓글 200개를 가져오는 호출 한 번이 10,000토큰 경고선을 넘고(토큰당 4바이트 기준 약 13,865토큰), Claude Code는 결과를 디스크에 저장합니다. 그러면 워커는 그 파일을 읽는 Read 호출이 필요합니다. 턴이 하나 늘고 컨텍스트도 더 쓰게 됩니다.
해결 방법은 간단합니다. 댓글에 limit: 50을 사용하세요. 댓글 50개를 가져온 응답 18건의 JSON은 평균 14,106자였고 가장 긴 것은 24,749자였습니다. 모두 50,000자 미만입니다. 동영상 10개 응답 중 가장 긴 것은 29,156자로, 역시 기준선 아래였습니다.
댓글 200개가 필요하다면 mode: "async"를 사용하고 job_id를 받아 everyinfra_get_job으로 읽으세요. 도구 설명에 따르면 작업 읽기는 무료이며 분당 제한에 포함되지 않습니다. 모델은 이 기준선을 볼 수 없습니다. 저장이 일어난 뒤 단계를 하나 더 거칠 뿐입니다.
테스트 1: 계정 하나의 원시 데이터는 얼마나 클까?
아래 차트는 브랜드 계정 18개 각각에 대해 호출 3회의 결과 크기를 보여 줍니다. results 필드의 UTF-8 바이트만 세고 과금 및 잔액 필드는 제외했습니다. 계정당 평균은 38,794바이트, 중앙값은 39,983바이트입니다. 가장 작은 것은 Pull&Bear로 25,426바이트인데, 동영상에 댓글이 2개뿐이었기 때문입니다.
가장 큰 것은 DJI로 53,324바이트입니다. 프로필은 평균 740바이트로 작습니다. 동영상 10개가 24,514바이트로 가장 큰 비중을 차지합니다. 댓글은 평균 13,540바이트입니다.
| 계정 하나의 구성 요소 | 평균 바이트 | 추정 토큰(÷ 4) | 새 토크나이저 적용 시(× 1.3) |
|---|---|---|---|
| 프로필 | 740 | 185 | 240 |
| 최신 동영상 10개 | 24,514 | 6,128 | 7,967 |
| 댓글 최대 50개 | 13,540 | 3,385 | 4,400 |
| 합계 | 38,794 | 9,698 | 12,608 |
| 워커가 반환하는 요약 | 382 | 95 | 124 |
동영상은 왜 이렇게 클까요? 동영상 레코드 하나에는 커버 이미지 URL, 아바타 URL, 음악 URL이 있습니다. 각 URL에는 300~400자 길이의 서명된 CDN 파라미터가 붙어 있습니다. 동영상 url은 남기고 _url로 끝나는 필드를 모두 제거했더니 평균 크기가 25,175바이트로 줄었습니다. 즉 URL 필드가 바이트의 35.1%를 차지합니다. 비교 표에는 이 필드가 하나도 필요 없습니다.
그래서 워커는 '정리된 데이터'가 아니라 요약을 반환합니다. URL을 빼더라도 메인 세션은 계정마다 25KB를 받게 됩니다. 저희 요약 형식으로는 382바이트만 받습니다.
바이트 대비 토큰 비율에는 Anthropic 요금 페이지의 예시를 사용합니다. 평균 10kB 웹 페이지는 약 2,500토큰, 즉 토큰당 4바이트입니다(Anthropic 요금, 웹 페치). 같은 페이지에 따르면 Claude 4.7 이후 모델은 같은 텍스트에 대해 토큰을 약 30% 더 생성하는 새 토크나이저를 사용합니다. 따라서 이 글의 토큰 수치는 모두 추정치이며, '토큰당 4바이트'와 '30% 증가' 두 가지를 함께 제시합니다. 정확한 수치가 필요하면 토큰 카운팅 엔드포인트를 사용하세요. 문서에 따르면 이 엔드포인트는 무료이며 분당 요청 수로만 제한됩니다(토큰 카운팅 문서).
컨텍스트가 실제로 절약되는 이유: Claude Code Haiku 서브에이전트 계산의 세 가지 층위
계정 하나의 크기를 알았으니 서브에이전트가 얼마나 절약하는지 계산할 수 있습니다. 첫 번째 층은 메인 컨텍스트입니다. 50개 계정으로 확장하면 원본 결과는 약 1.94백만 바이트, 토큰으로는 약 485,000개(새 토크나이저 기준 약 630,000개)입니다. 이는 Opus 5.5의 1백만 토큰 컨텍스트 중 절반에서 삼분의 이에 해당하는 양입니다. 요약으로 전달하면 50개 계정이 약 4,800토큰을 차지해 약 102배 줄어듭니다.
EveryInfra 도구 25개의 설명이 약 7,670토큰을 추가로 차지합니다. 인라인 mcpServers 항목과 허용 목록을 쓰면 626토큰으로 줄고, 그마저도 워커 안에서만 사용됩니다.
두 번째 층위는 각 워커의 컨텍스트로, 여기에는 놓치기 쉬운 가격 기준선이 있습니다. Anthropic 요금 페이지에 따르면 Haiku 5.5는 프롬프트 길이에 따라 가격이 매겨집니다. 캐시 읽기와 쓰기를 포함한 프롬프트가 100,000토큰을 넘는 요청은 입력 토큰 100만 개당 $0.10이 아니라 $0.50을 냅니다. 출력은 100만 개당 $0.50에서 $2.50으로 오릅니다. 요청 전체에 높은 가격이 적용됩니다(장문 컨텍스트 요금).
계정이 하나 늘 때마다 워커에 약 9,700토큰이 추가됩니다. 여기에 프롬프트와 도구 텍스트 약 3,600토큰이 더해집니다. 도구 텍스트 626토큰은 측정값이고, 프롬프트와 작업 텍스트 3,000토큰은 저희 가정입니다. 이 수치로 계산하면 워커 하나에 계정 9개가 들어갑니다. 토크나이저로 30% 늘어나면 7개입니다. 그 이상이면 요청마다 비용이 5배가 됩니다.
세 번째 층위는 비용입니다. Claude Code 비용 문서는 긴 세션이 비싸지는 이유를 설명합니다. Claude Code는 요청할 때마다 전체 대화를 보냅니다. 도구를 사용할 때마다 도구 결과를 담은 요청이 하나 더 전송됩니다.
프롬프트 캐싱을 쓰면 이전 기록을 캐시 요금으로 다시 읽습니다(Claude Code 비용 문서). 따라서 메인 세션에 들어간 원시 데이터는 한 번이 아니라 이후 요청마다 비용이 발생합니다. 정가 기준 추정치는 다음과 같으며, 가정은 표 아래에 있습니다:
| 설정 | 주요 구성 요소 | 계정 50개 추정 비용 |
|---|---|---|
| 서브에이전트 | Haiku 5.5 워커 50개 약 $0.134, EveryInfra API $0.0834, 요약을 읽는 Opus 5.5 메인 세션 약 $0.043 | 약 $0.26 |
| 분할 없음, 메인 세션에 원시 데이터 | EveryInfra API $0.0834, 약 485,000토큰을 보유하고 이후 요청 20건에서 다시 읽는 Opus 5.5 메인 세션 약 $4.36 | 약 $4.45 |
가정은 다음과 같습니다. 각 워커는 요청 4건(도구 호출 3건, 최종 답변 1건)을 보내며 요청마다 출력 토큰은 약 400개입니다. Haiku 5.5 정가는 100만 토큰당 입력 $0.10, 캐시 쓰기 $0.125, 캐시 읽기 $0.01, 출력 $0.50이며 캐시는 5분입니다. 메인 세션에는 Opus 5.5 정가인 100만 토큰당 입력 $4, 캐시 쓰기 $5(1.25배), 캐시 읽기 $0.20을 적용합니다. 데이터를 받은 뒤 메인 세션은 요청을 20건 더 보냅니다.
Opus 5.5 가격은 Anthropic 모델 개요에서, 캐시 읽기 가격은 요금 페이지의 프롬프트 캐싱 항목에서 가져왔습니다. Pro 또는 Max 플랜을 쓴다면 Claude Code는 이 금액을 청구하지 않고 플랜 한도를 사용합니다. 비율은 같으므로, 메인 세션의 원시 데이터는 한도를 10배 이상 빠르게 소진합니다. 비용 문서에는 서브에이전트 요청도 같은 사용 한도에 포함된다고 나와 있습니다(비용 문서).
이 추정에는 한계가 있습니다. 메인 세션의 계획 수립과 표 작성은 두 구성에서 거의 같으므로 제외했습니다. 이후 요청 20건은 가정입니다. 세션이 길어질수록 '분할 없음' 행의 비용은 더 커집니다.
Claude Code는 컨텍스트가 가득 차면 메인 세션을 압축하기도 합니다. 압축 자체도 큰 요청이며, 이 비용은 계산에 포함하지 않았습니다. 또한 485,000토큰은 Haiku 5.5의 1백만 토큰 컨텍스트의 거의 절반입니다. Haiku에서 메인 세션을 실행하면 100,000토큰 가격 기준선도 넘게 됩니다.
테스트 2: 병렬 워커는 몇 개가 적당할까?
서브에이전트는 병렬로 실행할 수 있지만 속도는 API가 결정합니다. 테스트 키는 분당 요청 10건을 허용하며 이를 넘으면 429를 반환합니다. 이 상한은 저희가 이 키 하나에만 설정한 것이며, 429에는 reason: key_limit이 표시됩니다. 계정 기본값은 분당 요청 60건이며 모든 키가 공유합니다. 누적 충전액이 $50, $150, $750이 되면 각각 180, 600, 1,800으로 늘어납니다(요금 페이지). 아래 워커 수는 자신의 제한으로 다시 계산하세요. 호출당 약 25초라면 분당 요청 60건으로 워커 약 25개를 계속 가동할 수 있습니다. 이는 Claude Code의 기본 동시 서브에이전트 한도인 20개보다 많습니다. 세 라운드를 실행해 실제 시간을 측정했습니다.
1라운드는 17:25부터 17:37(SGT)까지 진행했습니다. 워커 하나가 프로필 24개를 순차적으로 가져왔습니다. 10.72분 동안 응답 24건, 분당 2.24건을 받았습니다. 호출 시간 중앙값은 18.2초였습니다. 429를 받은 호출은 없었지만 대부분의 시간을 응답 대기에 썼습니다.
2라운드는 17:37부터 17:43(SGT)까지 진행했습니다. 워커 6개가 계정 18개의 동영상과 댓글을 계정당 두 번씩 호출해 가져왔습니다. 429를 받으면 각 워커는 retry_after만큼 기다린 뒤 재시도했습니다. 요청 56건 중 36건이 성공하고 20건이 429를 받았습니다. 라운드는 5.77분이 걸렸고 분당 6.24건이 성공했습니다.
3라운드는 17:46부터 17:48(SGT)까지 진행했습니다. 워커 4개가 정각 기준 1분마다 요청 시작을 최대 9건으로 제한하는 클라이언트 측 리미터 하나를 공유했습니다. 계정 12개의 인기 동영상(sort: popular)을 가져왔습니다. 호출 12건이 모두 429 없이 성공했습니다. 라운드는 1.25분이 걸렸고 분당 9.64건이 성공했습니다.
| 라운드 | 시각(SGT) | 워커 수와 규칙 | 요청 | 성공 건수 | 429s | 분당 성공 건수 | 호출 시간 중앙값 |
|---|---|---|---|---|---|---|---|
| 1 | 17:25–17:37 | 워커 1개, 순차 실행 | 24 | 24 | 0 | 2.24 | 18.2 s |
| 2 | 17:37–17:43 | 워커 6개, 429 후 재시도 | 56 | 36 | 20 | 6.24 | 26.1 s |
| 3 | 17:46–17:48 | 워커 4개, 분당 9건 상한 | 12 | 12 | 0 | 9.64 | 19.6 s |
2라운드의 타임라인을 보면 429가 실행을 늦춘 이유를 알 수 있습니다. 각 행은 요청 하나입니다. 회색 막대는 응답 대기 시간이고 청록색 마름모는 429입니다. 워커 6개가 처음 16초 만에 1분치 허용량을 다 써서 이후 요청은 모두 실패했습니다. 실패한 워커는 각자 다음 정각 분까지 기다렸다가 다 같이 다시 시도했습니다.
retry_after 값은 6초에서 39초 사이였고, 모두 다음 정각 분의 시작을 가리켰습니다. 즉 이 키는 정각 분마다 카운트를 초기화합니다. 그 결과 매분 시작에 요청이 몰리고 그 뒤에는 긴 유휴 시간이 생깁니다.
여기서 간단한 상한을 계산할 수 있습니다. 유효한 병렬 워커 수는 대략 분당 제한에 평균 호출 시간(초)을 곱하고 60으로 나눈 값입니다. 세 라운드에서 성공한 모든 호출의 평균 시간은 25.1초였으므로 10 × 25.1 ÷ 60 ≈ 4.2입니다. 워커가 4개보다 적으면 허용량 일부가 남습니다. 4개보다 많으면 늘어난 워커는 429만 만들어 냅니다.
이 계산에 따르면 50개 계정에 필요한 호출 150건은 분당 요청 10건인 키에서 최소 15분, 계정 기본값인 분당 60건에서는 2.5분이 걸립니다. 순차 실행하면 약 63분이 걸립니다. Claude Code는 기본적으로 서브에이전트를 동시에 20개까지 허용합니다. 21번째를 생성하면 "Concurrent subagent limit reached"가 반환되며, CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS로 한도를 바꿀 수 있습니다(동시 서브에이전트 한도). 기본값 20은 4보다 훨씬 크므로, 메인 세션에 워커를 한 번에 최대 4개까지만 실행하라고 명확하게 지시하세요.
이 라운드들은 규모가 작습니다. 3라운드는 호출 12건, 기능 하나뿐이었고, 호출 시간은 시간대와 계정에 따라 달라집니다. 4.2를 그대로 쓰지 마세요. 자신의 제한과 평균 호출 시간으로 다시 계산하세요. GET /api/v1/account(MCP: everyinfra_account)로 분당 제한을 확인할 수 있습니다. API 문서에 따르면 이 호출은 무료이며 제한에 포함되지 않습니다.
429 대처법: 실제 응답과 백오프 패턴
실제 429 응답을 보겠습니다. 17:37:33(SGT)에 Nike 워커의 댓글 요청이 실패했습니다. 본문에는 code: rate_limited, retry_after: 27, limit: 10, retryable: true, max_retries: 3이 있었습니다. next_steps 필드에는 "Nothing was charged."라고 적혀 있었습니다. 이런 오류 20건을 모두 확인했습니다.
과금된 것은 하나도 없었고, 모두 대기 후 첫 재시도에서 통과했습니다. HTTP 표준은 429를 주어진 시간 동안 요청이 너무 많은 상태로 정의합니다. 응답에 Retry-After를 포함해 클라이언트에 대기 시간을 알려 줄 수 있습니다(RFC 6585, 4절; RFC 9110, Retry-After).
세 단계로 대응하세요. 1단계는 제한에 걸리지 않도록 예방하는 것입니다. 메인 세션에서 동시에 실행되는 워커 수를 제한하고, 호출 단위에는 모든 워커가 공유하는 리미터 하나를 추가합니다. 3라운드에서 429가 없었던 이유입니다.
2단계는 제한에 걸렸을 때 기다리는 것입니다. retry_after에 지정된 시간만큼 정확히 기다린 뒤 짧은 무작위 지연을 추가하세요. 그러면 여러 워커가 같은 초에 재시도하지 않습니다.
AWS의 한 글이 이를 잘 설명합니다. 부하가 오류를 일으킬 수 있습니다. 이때 모든 클라이언트가 동시에 재시도하면 재시도가 부하를 더 키웁니다. 따라서 무작위 지연 시간을 추가해 요청을 분산해야 합니다(Amazon Builders' Library).
3단계는 이미 과금된 호출을 다시 보내지 않는 것입니다. 429, 422, 401은 과금 전에 발생하므로 재시도해도 안전합니다. 워커가 진행 상황을 놓쳤다는 이유로 이미 200을 반환한 호출을 다시 보내지 마세요. API 오류 자가 복구와 환불 확인 가이드에서 요청 ID로 확인하는 방법을 소개합니다.
다음은 3라운드에서 쓴 리미터의 핵심 부분입니다. Python 표준 라이브러리의 스레드 풀을 사용합니다(concurrent.futures 문서). Claude Code에서는 메인 세션에 같은 규칙으로 워커를 스케줄링하라고 지시할 수 있습니다. 이 로직을 워커가 호출하는 스크립트에 넣을 수도 있습니다.
import threading, time, random
lock = threading.Lock(); state = {"minute": None, "n": 0}
def acquire(per_min=9):            # at most per_min starts per clock minute
    while True:
        with lock:
            m = int(time.time() // 60)
            if state["minute"] != m:
                state["minute"], state["n"] = m, 0
            if state["n"] < per_min:
                state["n"] += 1
                return
        time.sleep(0.5)
def on_429(err):                    # err is the error object of the response
    time.sleep(err["retry_after"] + random.uniform(0.5, 2.0))
상한은 10이 아니라 9입니다. 잔액 확인이나 카탈로그 읽기처럼 메인 세션에서 보내는 다른 호출을 위해 매분 호출 한 건분의 여유를 남겨 둡니다.
실패와 과금: 422, 빈 결과, 잘못된 사용자 이름
같은 한 시간 동안 429 외에도 여러 실패를 직접 일으키거나 겪었습니다. 각 실패가 배치 작업에 미치는 영향은 서로 다릅니다. 아래 표의 각 행은 실제 응답 하나에 해당합니다.
| 사례 | 시각(SGT) | HTTP 및 응답 | 과금 | 워커의 대응 |
|---|---|---|---|---|
철자가 틀린 파라미터 usernme | 17:43:20 | 422, missing_param, "usernme is not a parameter here", 동작하는 예시 포함 | $0 | 파라미터 수정 후 다시 전송 |
| API 키 없음 | 17:43:20 | 401, missing_key | $0 | 중단하고 설정 문제 보고 |
| 요청이 너무 빠름 | 17:37:33 외 19건 | 429, retry_after 6–39초 | $0 | 대기 후 재시도 |
| 사용자 이름이 존재하지 않음 | 17:33:34, 17:34:49 | 200, 빈 결과, reason: empty_result_refunded | $0 (과금 후 환불) | "찾을 수 없음"으로 표시, 재시도하지 않음 |
| 사용자 이름은 존재하지만 해당 브랜드가 아님 | 17:31:16 외 3건 | 200, 미인증, 팔로워 4–222명 | 평소대로 $0.000556 | "유사 계정 가능성"으로 표시, 판단은 메인 세션에 맡김 |
422 응답은 모델이 읽도록 작성되어 있습니다. username이 누락되었고 usernme은 이 엔드포인트의 파라미터가 아니라고 알려 주며, 동작하는 요청 예시도 제공합니다. Haiku 같은 작은 모델도 이 텍스트만 보고 호출을 고칠 수 있습니다. 빈 결과 두 건(Mercado Libre와 OXXO용으로 추측한 사용자 이름)은 200을 반환했고, charged_usd는 0, reason은 empty_result_refunded였습니다. 비용은 들지 않았습니다.
가장 중요한 것은 마지막 행입니다. 브랜드 이름으로 추측한 사용자 이름 4개(Anker, Insta360, Xiaomi, Bimbo 각 1개)는 모두 존재하지만 평범한 개인 계정입니다. 인증된 계정은 하나도 없습니다. 팔로워는 각각 4명, 121명, 222명, 14명이고 동영상은 0~8개입니다. API가 이 계정들의 데이터를 정확히 반환했으므로 호출은 과금되었습니다.
이런 실수는 API가 잡아낼 수 없습니다. 워커가 잡아내야 합니다. 예시의 1단계는 이 때문에 들어 있습니다. 인증되지 않았고 팔로워가 1,000명 미만인 계정이면 작업을 멈추고 표시합니다.
계정 기준으로 tiktok/search를 사용하면 정확한 사용자 이름을 찾을 수 있습니다. SGT 기준 17:43부터 17:44까지 세 번 검색해 인증된 계정인 insta360_official(팔로워 2.4M), xiaomi.official(8.3M), ankercharging(803,600)을 찾았으며, 각 검색 비용은 $0.002778였습니다. 목록을 어디서 가져오느냐에 따라 표가 처음부터 정확한지가 결정됩니다.
비용: 계정 수별 API 요금
EveryInfra 쪽 비용은 계산하기 쉽습니다. 반환되는 행 수나 워커를 실행하는 모델과 관계없이 호출 수에만 좌우됩니다.
| 규모 | 호출 수 | `price_usd` $0.000556 기준 API 요금 | 분당 10건 기준 최단 시간 |
|---|---|---|---|
| 계정 1개 | 3 | $0.001668 | 18초 |
| 계정 50개 | 150 | $0.0834 | 15분 |
| 계정 50개, 매주, 1개월 | 약 650 | 약 $0.361 | 실행당 15분 |
| 계정 500개 | 1,500 | $0.834 | 150분 |
이 표는 목록이 정확하다고 가정합니다. 먼저 tiktok/search로 사용자 이름을 찾아야 한다면 계정당 약 $0.002778(limit: 5)을 더하세요. 이번 테스트 전체에서 요청은 98건이었습니다. REST 97건과 MCP tools/call 1건이며, 여기에 무료 MCP 핸드셰이크 메시지 3건이 더해졌습니다. 과금된 요청은 74건이고 합계는 $0.04781입니다.
과금되지 않은 호출 24건은 오류(429) 20건, 빈 결과 2건, 422 오류 1건, 401 오류 1건입니다. 각각 응답의 billing 또는 오류 본문과 일치합니다. 설정 방법은 빠른 시작에 REST 3단계가 나와 있고, MCP 서버 페이지에서 클라이언트 설정을 확인할 수 있습니다.
요약 형식 고르기: 한 줄 요약이 메인 세션이 할 수 있는 일을 정한다
워커가 무엇을 반환하느냐가 가장 신경 써야 할 단계입니다. 저희 규칙은 두 가지입니다. 요약에는 메인 세션이 판단에 필요한 숫자만 담습니다. 그리고 각 숫자는 스크립트가 원본 응답에서 계산할 수 있는 값이어야 합니다. 이렇게 하면 두 가지 이점이 있습니다.
첫째, 메인 세션이 표본 검증을 할 수 있습니다. 아무 계정이나 골라 새 워커에게 다시 실행시키고 숫자를 비교하면 됩니다. 어떤 워커의 "이해"도 믿을 필요가 없습니다. 둘째, 크기가 통제됩니다. 저희 형식은 필드 15개로 이루어져 있습니다. 요약 18개는 JSON 기준 평균 382바이트이고, 가장 긴 Real Madrid도 398바이트에 불과합니다. 숫자 자릿수가 더 많아서 조금 길어진 것입니다.
워커가 "중요해 보이는 것"을 마음대로 반환하게 두지 마세요. 자유 형식 요약은 길이가 들쭉날쭉합니다. 어떤 워커는 반 페이지를 반환하고, 어떤 워커는 댓글 텍스트를 그대로 옮겨 옵니다. 그러면 메인 컨텍스트가 다시 커집니다. 두 워커가 "중요함"을 다르게 판단할 수도 있고, 그러면 각 행을 하나의 표에 맞출 수 없습니다.
특히 댓글은 조심해야 합니다. 댓글 텍스트에는 일반 사용자의 사용자 이름과 개인적인 발언이 들어 있으며, 이것이 메인 세션에 들어가면 최종 보고서에까지 실릴 수 있습니다. 저희 형식은 댓글 수와 답글이 달린 댓글 수만 반환합니다. 감성 분석이나 주제 분석이 필요하다면 워커 안에서 분류하고 분류별 개수만 반환하세요.
메인 세션에 줄 지시는 세 문장이면 충분합니다. 목록의 각 사용자 이름을 tiktok-account-worker에 넘기되, 동시에 최대 4개까지만 실행하세요. 모든 결과가 돌아오면 요약을 하나의 표로 합치고, 유사 계정 플래그가 지정된 계정을 표시하세요. 조회수 중앙값과 참여율 기준 상위 3개와 하위 3개 계정에 대해 각각 한 문장으로 설명을 쓰세요.
앞의 두 문장은 스케줄링입니다. 대형 모델의 판단이 필요한 것은 세 번째 문장뿐입니다. Anthropic의 가이드에서도 이런 작업은 메인 루프에서 처리해야 한다고 말합니다.
메인 세션이 받는 결과: 미국 스포츠웨어 브랜드 비교표
다음은 메인 세션이 미국 스포츠웨어 그룹의 워커 요약을 모아 만든 표입니다. 크기를 재현할 수 있도록, 이 요약은 워커 예시와 같은 규칙으로 스크립트가 원본 응답에서 계산했습니다. Haiku가 작성한 것이 아닙니다. Haiku가 메모를 덧붙이면 요약마다 수십 바이트가 늘어납니다. 조회수 중앙값과 참여율(좋아요 수를 조회수로 나눈 값의 중앙값)은 고정 동영상을 제외하고 계산했습니다.
| 계정 | 팔로워 | 최근 동영상 조회수 중앙값 | 참여율 | 주당 게시물 수 | 샘플링한 댓글 수 |
|---|---|---|---|---|---|
| Nike | 9.3M | 24,250 | 3.82% | 11.9 | 50 |
| Adidas | 12.3M | 142,200 | 2.72% | 4.2 | 50 |
| Gymshark | 6.7M | 50,900 | 14.07% | 4.6 | 50 |
| lululemon | 1.5M | 34,900 | 1.08% | 3.0 | 50 |
| Under Armour | 1.0M | 28,600 | 5.20% | 4.8 | 50 |
| New Balance | 1.0M | 24,900 | 1.19% | 1.3 | 27 |
| PUMA | 6.2M | 15,450 | 6.68% | 4.8 | 50 |
| HOKA | 268,300 | 7,912 | 0.99% | 1.2 | 28 |
이 표를 보면 판단을 메인 세션에 맡기는 이유를 알 수 있습니다. Nike는 게시물이 가장 많지만(주 11.9개) 조회수 중앙값은 주 4.2개를 올리는 Adidas보다 낮습니다. Gymshark는 팔로워 수가 Adidas의 절반이지만 참여율은 14.07%로 5배 이상 높습니다. 또한 Gymshark의 최신 동영상 10개 중 3개는 7월에 게시된 고정 동영상이었습니다. 고정 동영상을 제외하지 않으면 오래된 게시물과 새 게시물이 섞인 상태로 비율을 계산하게 됩니다.
이런 비교에는 모든 행을 한꺼번에 보는 시야와 어느 정도의 상식이 필요합니다. 각 워커가 혼자 할 일이 아니라 메인 세션의 대형 모델이 할 일입니다. 이 그룹 밖에서는 Real Madrid가 또 다른 함정을 보여 줍니다. "주당 게시물 466개"는 오류가 아닙니다. 최신 동영상 10개가 모두 같은 날인 2026-10-25에 올라왔고, 일별 게시 빈도를 주간 수치로 환산하면서 매우 큰 숫자가 된 것입니다.
Instagram과 YouTube에서도 같은 워커 사용하기
목록에 Instagram과 YouTube 브랜드 계정도 있다면 워커 구조는 그대로 둡니다. 플랫폼 이름, 액션 이름, 파라미터 이름 세 가지만 바꾸면 됩니다. 아래 표는 같은 카탈로그(2026년 10월 26일 17:22 SGT 기준)에서 가져왔습니다. 이 두 플랫폼에서는 실제 호출을 하지 않았으므로 표에는 카탈로그상의 가격과 파라미터만 나와 있습니다. 결과 크기는 직접 한 번 측정해 보세요. 플랫폼별 개요는 Instagram 데이터 API와 YouTube 데이터 API에서 볼 수 있습니다.
| 플랫폼 | 프로필 | 최근 게시물 | 댓글 | 호출당 가격 | 비고 |
|---|---|---|---|---|---|
| TikTok(이번 측정 대상) | profile, 파라미터 username | user_videos, 최대 50개 | comments, 최대 200개 | $0.000556 | 고정 동영상이 먼저 반환됨 |
profile, 파라미터 username | user_posts, 최대 200개 | comments, 최대 100개 | $0.000556 | reels는 현재 사용할 수 없음 | |
| YouTube | profile, 파라미터는 채널 url | user_posts, 채널 url, 최대 50개 | comments, 최대 100개 | $0.000556 | Shorts는 별도의 shorts 액션 사용 |
이 세 가지 기능은 세 플랫폼 모두에서 가격이 같습니다. 따라서 계정당 3회 호출에 $0.001668, 계정 50개면 플랫폼마다 $0.0834가 듭니다. 파라미터는 다릅니다. YouTube 프로필과 동영상 목록은 사용자 이름이 아니라 채널 URL을 받으므로, 워커의 1단계에서 먼저 URL을 가져와야 합니다.
결과 크기도 다릅니다. Instagram 게시물 레코드는 TikTok 동영상 레코드처럼 이미지 URL을 많이 담고 있습니다. TikTok에서 확인한 결과를 고려해, 먼저 계정 하나의 원본 데이터 크기를 측정하세요. 그다음 워커당 계정 수와 호출당 댓글 수를 정하세요. 이미 다른 에디터에서 이 플랫폼들에 MCP를 써 봤을 수도 있습니다. 이전 글 Cursor에서 TikTok, Instagram, Amazon 데이터 다루기에 워커 수를 정하는 데 도움이 되는 호출 시간 측정치가 있습니다.
한계와 주의할 점
첫째, 플랫폼 약관입니다. TikTok 미국 서비스 약관은 자동화된 데이터 수집을 제한합니다. 자동화된 시스템으로 플랫폼 데이터를 스크래핑, 크롤링, 내보내기 또는 추출해서는 안 됩니다. 예외는 TikTok USDS Joint Venture의 서면 승인을 받은 경우입니다(TikTok 서비스 약관).
학술 및 비영리 연구자는 TikTok 연구 도구를 신청할 수 있으며, 승인에는 보통 4주 정도 걸립니다(TikTok Research Tools, 코드북). 자신의 지역과 사용 사례에서 이런 사용이 적절한지는 직접 판단하세요. 이 글은 데이터를 다루는 방법만 설명합니다.
이와 관련해 혼동하기 쉬운 점이 있습니다. TikTok은 2026년 10월 5일, TikTok for Business MCP를 이제 Claude를 비롯한 AI 플랫폼에서 커넥터로 쓸 수 있다고 발표했습니다(TikTok 뉴스룸). 이 MCP는 사용자 본인의 광고 계정, 즉 캠페인, 크리에이티브, 성과를 다룹니다(TikTok for Business 블로그). 다른 브랜드의 공개 프로필과 댓글은 읽지 않습니다.
둘째, 댓글 데이터는 완전하지 않습니다. comments는 최상위 댓글마다 답글을 최대 2개까지만 반환하며, 반환 개수가 동영상에 표시된 댓글 수보다 적을 수 있습니다. 18회 호출 중 5회는 해당 동영상의 댓글이 적어서 50개 미만이 반환되었습니다. 감성 분석을 한다면 요약에 표본 크기를 함께 넣으세요.
셋째, 서브에이전트가 많다고 항상 좋은 것은 아닙니다. API 제한 외에 Claude Code에도 자체 제한이 있습니다. 서브에이전트는 기본적으로 3단계까지 중첩할 수 있으며, CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH로 이 값을 바꿀 수 있습니다. 워커의 컨텍스트 크기는 메인 모델이 아니라 워커 모델에 따라 정해집니다(서브에이전트 문서).
계정이 수천 개인 목록이라면 문서에서는 동적 워크플로를 안내합니다. 동적 워크플로에서는 Claude가 에이전트를 스케줄링하는 JavaScript 스크립트를 작성합니다. 기본값은 동시에 최대 16개 에이전트이며, CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS로 256개까지 늘릴 수 있습니다(동적 워크플로 문서). 그렇다고 분당 API 허용량이 늘어나지는 않습니다.
넷째, 테스트하지 않은 부분입니다. 이 서브에이전트를 Claude Code에서 실행하지는 않았습니다. Haiku 5.5 요약 품질에 대한 측정 데이터도 없습니다. is_pinned 규칙을 얼마나 잘 따르는지, 워커 50개의 실제 소요 시간도 측정하지 않았습니다. 크기, 과금, 429, 속도 수치는 실측값입니다.
모델 비용은 정가 기준 추정치입니다. 이 방식에 의존하기 전에 먼저 계정 10개로 실행해 보세요. /tasks에서 각 서브에이전트의 모델을 확인하고, /usage에서 서브에이전트가 차지하는 비중을 확인하세요.
최근 변경 사항
2026-10-07: Anthropic이 Claude Haiku 5.5를 출시했습니다. 프롬프트가 100,000토큰 이하일 때 입력 토큰 100만 개당 $0.10, 출력 토큰 100만 개당 $0.50입니다. Anthropic은 주요 용도로 서브에이전트 작업을 꼽았습니다(출시 페이지). 같은 날 Claude Code v2.1.293은 이 모델을 Anthropic API의 기본 Haiku 모델로 지정했습니다(변경 내역). 의미: 이제 데이터 워커 비용이 지난달의 약 10분의 1입니다. 다만 사용하는 제공업체에서 haiku가 어떤 모델을 가리키는지 확인하세요.
2026-10-16: Claude Code v2.1.302부터 데스크톱 앱과 VS Code도 터미널처럼 메인 대화의 서브에이전트를 항상 백그라운드에서 실행합니다. claude -p, Agent SDK, 데스크톱 앱, VS Code에서는 포크 서브에이전트가 기본값이 되었습니다(변경 내역). 의미: 백그라운드 워커는 권한 요청을 메인 세션으로 보내므로, 워커에 필요한 도구 하나를 미리 허용해 두세요.
2026-10-19 및 2026-10-21: v2.1.304는 많은 서브에이전트가 동시에 실행될 때의 속도를 개선했습니다. 후속 메시지를 빠르게 보내면 서브에이전트가 최근 작업을 잊어버리던 문제도 고쳤습니다. v2.1.307은 그룹 안의 각 포크 서브에이전트에게 어떤 실행이 자기 것인지 알려 주어, 포크가 서로의 작업을 시작하는 일이 줄었습니다(변경 내역). 의미: 병렬 워커가 한 달 전보다 안정적입니다. 이 글은 포크가 아닌 일반 서브에이전트를 사용합니다.
2026-10-22: Anthropic이 "When to fold subagents into your main agent loop"를 발표했습니다. 대부분의 에이전트에는 서브에이전트를 더 적게 사용하라고 권합니다. 컨텍스트가 측정 가능할 만큼 늘어나거나, 병렬로 처리하고 버릴 컨텍스트가 있거나, 도구가 너무 많은 경우에만 서브에이전트를 유지하라고 합니다(가이드, 키트). 의미: 작업을 나누기 전에, 읽을 것은 많고 남길 것은 적으며 서로 독립된 부분으로 나뉘는 작업인지 확인하세요. 그렇지 않다면 스킬과 함께 메인 세션에서 처리하세요.
2026-10-05: TikTok은 Advertising Week New York에서 자사 광고 MCP를 Claude, Kimi, Perplexity 등에서 커넥터로 쓸 수 있다고 발표했습니다(TikTok 뉴스룸). 의미: 이 MCP는 본인 광고 관리에 쓰세요. 다른 브랜드 계정의 공개 성과를 보려면 여전히 공개 데이터 API가 필요합니다.
FAQ
Claude Code 서브에이전트에 다른 모델을 쓸 수 있나요?
네. 서브에이전트 파일에서 model을 설정하세요. 별칭(sonnet, opus, haiku, fable), claude-haiku-5-5 같은 전체 ID, 또는 inherit를 쓸 수 있습니다. 우선순위는 생성 시점의 파라미터, model 필드, CLAUDE_CODE_SUBAGENT_MODEL, 메인 모델 순입니다. (질문 출처: Google 추천 검색어 "claude code subagents different model", "claude code subagents model selection"; 답변 출처: 서브에이전트 문서)
Claude Code 서브에이전트는 기본적으로 어떤 모델을 쓰나요?
model 필드가 없으면 위의 우선순위가 메인 모델에서 끝나므로 서브에이전트는 메인 모델을 상속합니다. 기본 제공 Explore 서브에이전트도 더 이상 항상 Haiku로 실행되지 않습니다. 모든 서브에이전트를 하나의 모델로 고정하려면 CLAUDE_CODE_SUBAGENT_MODEL과 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1을 모두 설정하세요. (질문 출처: 추천 검색어 "claude code subagent model default", "claude_code_subagent_model force"; 답변 출처: 서브에이전트 문서, r/ClaudeCode 스레드)
**model: haiku로 설정했는데 Claude Code Haiku 서브에이전트 비용이 왜 여전히 비싼가요?**
흔한 원인은 두 가지입니다. Bedrock, Google Cloud, Foundry, Claude Platform on AWS에서는 haiku 별칭이 Haiku 4.5를 가리키며, 이 모델은 Haiku 5.5보다 10배 비쌉니다. 또는 CLAUDE_CODE_SUBAGENT_MODEL_FORCE가 설정되어 있어 Claude Code가 model 필드를 무시하는 경우입니다. /tasks에서 각 서브에이전트의 실제 모델을 확인할 수 있습니다. (질문 출처: 추천 검색어 "claude code subagent model=haiku", "claude code use haiku for subagents"; 답변 출처: 모델 구성 문서, 서브에이전트 문서)
Claude Code 서브에이전트와 에이전트 팀은 무엇이 다른가요?
서브에이전트는 결과를 메인 에이전트에 반환하며, 서브에이전트끼리는 대화하지 않습니다. 에이전트 팀 구성원은 작업 목록을 공유하고 서로 메시지를 주고받을 수 있어 토론과 조율이 필요한 작업에 적합합니다. 문서에 따르면 에이전트 팀은 실험적 기능이고 기본적으로 꺼져 있으며 토큰을 훨씬 많이 씁니다. 독립된 계정을 일괄 처리하는 작업이라면 서브에이전트로 충분합니다. (질문 출처: 추천 검색어 "claude code subagents vs agent teams"; 답변 출처: 에이전트 팀 문서)
Claude Code는 서브에이전트를 동시에 몇 개까지 실행할 수 있나요?
기본값은 동시에 20개입니다. 21번째는 "Concurrent subagent limit reached."를 반환합니다. v2.1.217부터 CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS로 이 값을 바꿀 수 있으며, 한 세션의 총 개수에는 제한이 없습니다. 외부 API를 호출하는 워커라면 실제 한도는 API 허용량입니다. 테스트 키의 분당 10건, 호출당 약 25초 기준으로는 워커를 4개보다 많이 돌려도 429 응답만 늘어납니다. 계정 기본값인 분당 60건이면 약 25개입니다. (질문 출처: 추천 검색어 "claude code run subagents in parallel"; 답변 출처: 서브에이전트 문서, 동시 실행 제한, 자체 테스트)
Claude Code는 매우 큰 MCP 도구 결과를 어떻게 처리하나요?
10,000토큰을 넘으면 경고하고, 기본 한도는 25,000토큰입니다(MAX_MCP_OUTPUT_TOKENS로 변경 가능). anthropic/maxResultSizeChars가 없는 도구의 경우 50,000자를 넘는 성공 결과는 파일로 저장됩니다. 댓글 200개짜리 TikTok 결과는 54,819자였으므로 파일로 저장되고, 가장 긴 댓글 50개짜리 결과는 24,749자였으므로 저장되지 않습니다. (질문 출처: 자체 테스트; 답변 출처: MCP 문서, 출력 한도)
참고 자료
- “Create custom subagents”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/sub-agents
- “Connect Claude Code to tools via MCP”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/mcp
- “Claude Code changelog”(v2.1.293~v2.1.310), Anthropic, 2026-10-07~2026-10-23, https://code.claude.com/docs/en/changelog
- “Manage costs effectively”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/costs
- “Model configuration”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/model-config
- “Environment variables”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/env-vars
- “Agent teams”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/agent-teams
- “Orchestrate subagents at scale with dynamic workflows”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/workflows
- “Explore the context window”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/context-window
- “Permissions”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/permissions
- “Settings”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/settings
- “Run Claude Code programmatically”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/headless
- “Skills”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/skills
- “Prompt caching”, Claude Code 문서, Anthropic, 2026-10-26 확인, https://code.claude.com/docs/en/prompt-caching
- “CHANGELOG.md”, anthropics/claude-code, GitHub, 2026-10-26 확인, https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- “Introducing Claude Haiku 5.5”, Anthropic, 2026-10-07, https://www.anthropic.com/claude-haiku-5-5
- “Claude Haiku 5.5 System Card”, Anthropic, 2026-10-07, https://www.anthropic.com/claude-haiku-5-5-system-card
- “Pricing”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/about-claude/pricing
- “Models overview”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/about-claude/models/overview
- “Migrating to Claude Haiku 5.5”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- “Prompt caching”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- “Token counting”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/build-with-claude/token-counting
- “Rate limits”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/api/rate-limits
- “Release notes”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/release-notes/overview
- “Tool search tool”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- “Tool use overview”, Claude Platform 문서, Anthropic, 2026-10-26 확인, https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- “Claude pricing”(Pro, Max, Team), Anthropic, 2026-10-26 확인, https://claude.com/pricing
- “Building agents: When to fold subagents into your main agent loop”, Anthropic, 2026-10-22, https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- “single-agent-loop-kit”, anthropics, GitHub, 2026-10-26 확인, https://github.com/anthropics/single-agent-loop-kit
- “Transports”(2025-06-18), Model Context Protocol 사양, https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- “Tools”(2025-06-18), Model Context Protocol 사양, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- “Lifecycle”(2025-06-18), Model Context Protocol 사양, https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- “RFC 6585: Additional HTTP Status Codes”(429), IETF, 2012년 4월, https://www.rfc-editor.org/rfc/rfc6585
- “RFC 9110: HTTP Semantics”(Retry-After), IETF, 2022년 6월, https://www.rfc-editor.org/rfc/rfc9110
- “Timeouts, retries, and backoff with jitter”, Amazon Builders' Library, 2019-12-05, https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/
- “concurrent.futures”, Python 문서, 2026-10-26 확인, https://docs.python.org/3/library/concurrent.futures.html
- “TikTok Research Tools: Access and Eligibility”, TikTok for Developers, 2026-10-26 확인, https://developers.tiktok.com/products/research-api/
- “Research API Codebook”, TikTok for Developers, 2026-10-26 확인, https://developers.tiktok.com/doc/research-api-codebook
- “TikTok Unveils AI-Powered Updates for Advertisers”, TikTok Newsroom, 2026-10-05, https://newsroom.tiktok.com/tiktok-unveils-ai-powered-updates-for-advertisers-driving-discovery-action-and-measurable-business-outcomes?lang=en
- “Evolving TikTok for Business MCP”, TikTok for Business 블로그, 2026-06-30, https://ads.tiktok.com/business/en-US/blog/tiktok-agentic-hub-ai-agents-skills-mcp
- “TikTok Terms of Service (US)”, TikTok, 2026-10-26 확인, https://www.tiktok.com/legal/page/us/terms-of-service/en
- EveryInfra 데이터 카탈로그, EveryInfra, 2026-10-26 17:22 SGT 확인, https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra TikTok 카탈로그, EveryInfra, 2026-10-26 확인, https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok
- “Haiku 5.5 is 40x cheaper than Opus 5.5. Your Explore subagent is probably still running on Opus”, Reddit r/ClaudeCode, 2026-10-08, https://www.reddit.com/r/ClaudeCode/comments/1x0kzbh/haiku_55_is_40x_cheaper_than_opus_55_your_explore/
- “PSA: Claude Code subagents inherit your session model now”, Reddit r/claude, 2026-10-26 확인, https://www.reddit.com/r/claude/comments/1v7iqqy/psa_claude_code_subagents_inherit_your_session/
- “How much more effective is using Opus 5.5 with Haiku subagents”, Reddit r/ClaudeAI, 2026-10-26 확인, https://www.reddit.com/r/ClaudeAI/comments/1x1buac/how_much_more_effectivebetter_is_using_opus_55/
- “Anthropic's new guide (Oct 22) argues most agents should have fewer subagents”, Reddit r/ClaudeAI, 2026-10-24, https://www.reddit.com/r/ClaudeAI/comments/1xdwquj/anthropics_new_guide_oct_22_argues_most_agents/
- “Anthropic says one AI agent beats many subagents”, The Decoder, 2026-10-25, https://the-decoder.com/anthropic-says-one-ai-agent-beats-many-subagents-now-that-models-can-handle-complexity-alone/
참고 BL-53