DeepSeek V4로 Claude Code 설정하기: 댓글 정제 비용 따져 보기
EveryInfra MCP로 YouTube, Bilibili, Douyin 댓글 695개를 가져와 deepseek-flash 기반 Claude Code의 비용을 계산했습니다. 피크 시간 가격은 Sonnet 5.5의 1/10이지만 Haiku 5.5보다는 비쌉니다.
DeepSeek의 deepseek-flash 모델로 Claude Code를 실행하고 EveryInfra 원격 MCP 서버로 동영상 댓글을 가져와 정제할 수 있습니다. 비용은 저렴하지만, “비용 10분의 1”이라는 주장은 DeepSeek 캐시가 적중할 때만 성립합니다. 공식 Claude Code 비용 문서의 샘플 세션으로 계산해 보니 피크 가격의 deepseek-flash는 $0.0274로, Claude Sonnet 5.5($0.2744)의 정확히 10%였습니다. 캐시가 전혀 적중하지 않으면 같은 세션이 $0.3037로, 캐시가 정상 작동하는 Sonnet 5.5보다 비쌉니다.
Claude Haiku 5.5로 같은 세션을 실행하는 데는 $0.0184가 듭니다. 2026년 10월 26일 싱가포르 시간(SGT) 17:26부터 17:38까지 EveryInfra를 호출해 동영상 15개에서 댓글 데이터 695행을 가져왔습니다. 정제 후 655개 댓글이 남았고, 추정 모델 입력은 84,109토큰에서 20,176토큰으로 줄었습니다. Bilibili와 Douyin에서는 댓글 1,000개당 데이터 요금이 deepseek-flash 모델 요금보다 높았습니다.
이 글에서 “댓글 정제”는 특정한 작업 하나를 뜻합니다. Claude Code가 EveryInfra 기능 카탈로그를 읽습니다. 그런 다음 MCP 도구 everyinfra_call_api를 호출해 youtube/comments, bilibili/comments, douyin/comments로 댓글을 가져옵니다. 짧은 스크립트가 중복, 빈 답글, 홍보성 댓글을 제거합니다.
키워드 규칙이 나머지의 약 절반에 “설정 및 오류”, “가격 및 할당량”, “모델 비교”, “칭찬” 라벨을 붙입니다. 규칙으로 처리하지 못한 것은 모델이 라벨링합니다. 결과물은 원문과 비용 기록이 담긴 표입니다. Claude Code 뒤에서 동작하는 모델은 Anthropic 모델이 아닙니다.
바로 DeepSeek Anthropic 호환 엔드포인트로 제공되는 deepseek-flash입니다. 저희에게는 DeepSeek 키가 없습니다. 그래서 아래의 DeepSeek 및 Claude Code 단계는 모두 공식 문서를 따른 설정 예시이며, 직접 실행하지는 않았습니다. EveryInfra 호출과 데이터에서 나온 수치는 모두 실제입니다.


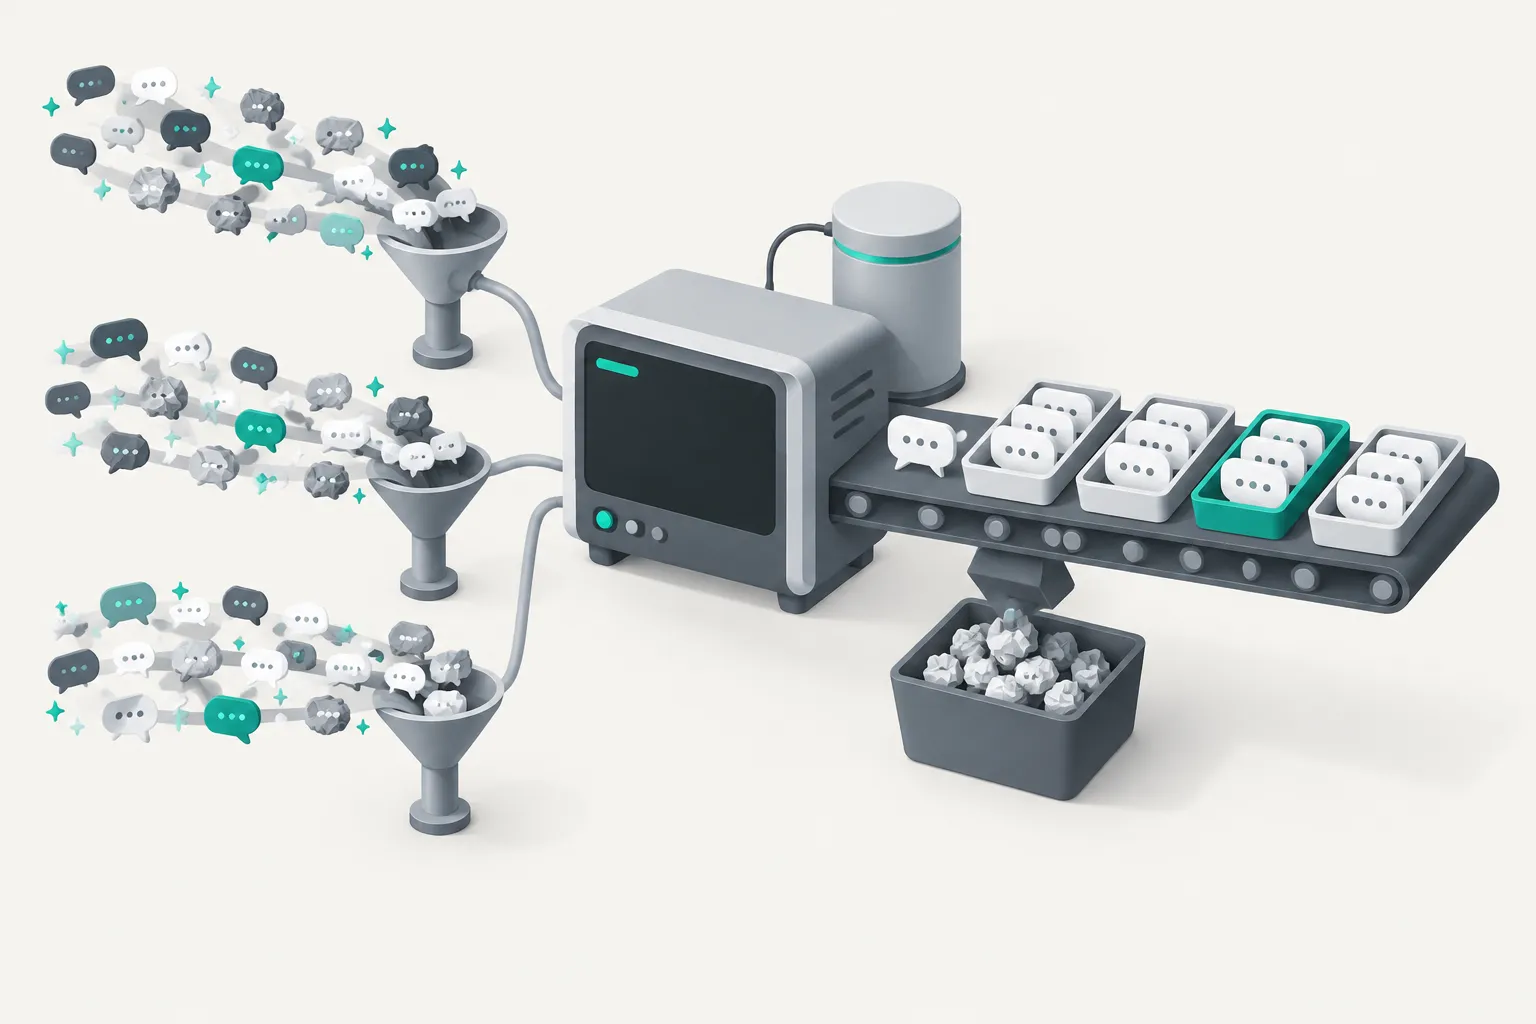
그림은 비용이 어디에 드는지 보여 줍니다. 비싼 단계는 앞쪽 오른편의 책상으로, 모델이 댓글을 하나씩 읽고 라벨을 붙이는 곳입니다. 왼쪽의 체가 촘촘할수록 책상으로 가는 양이 줄어듭니다.
먼저 설정을 다루고, 이어서 다섯 가지 테스트를 보여 드립니다. 마지막으로 비용을 계산합니다.
결론: 비용 10분의 1은 캐시가 적중할 때만
리서치 노트에서 이 주제의 가제는 “비용 10분의 1로 댓글 정제하기”였습니다. 시작하기 전에 이를 숫자로 답할 수 있는 두 질문으로 바꿨습니다. 같은 사용량에서 피크 가격의 deepseek-flash가 Claude Sonnet 5.5의 10% 이내인가? Claude Haiku 5.5보다 저렴한가? 답은 “예, 정확히 10%”와 “아니요”입니다.
사용량은 지어내지 않았습니다. Claude Code 비용 문서의 /cost 샘플을 그대로 가져왔습니다. 입력 1.2k, 출력 5.3k, 캐시 읽기 940.0k, 캐시 쓰기 50.0k 토큰입니다. 문서에는 Claude Sonnet 4.6 기준 $0.55로 나와 있습니다. 먼저 Sonnet 4.6 요금으로 다시 계산해 $0.5526을 얻었습니다. 문서와 일치하므로 계산 방법이 맞습니다.
그다음 2026년 10월 26일에 확인한 각 공개 가격을 적용했습니다. Claude 가격은 Anthropic 요금 페이지, DeepSeek 가격은 USD 기준 DeepSeek 요금 페이지에서 가져왔습니다. CNY 기준 중국어 요금 페이지와도 대조했습니다.
| 모델(공개 가격, 2026년 10월 26일) | 캐시 전부 적중 | 캐시 적중 없음 | Sonnet 5.5 대비 비율(적중 시) |
|---|---|---|---|
| Claude Opus 5.5 | $0.5488 | $4.1208 | 200% |
| Claude Sonnet 5.5 | $0.2744 | $2.0604 | 100% |
| deepseek-v4-pro, 피크 | $0.1299 | $1.3294 | 47.3% |
| deepseek-flash, 피크 | $0.0274 | $0.3037 | 10.0% |
| Claude Haiku 5.5 | $0.0184 | $0.1030 | 6.7% |
| deepseek-flash, 오프피크 | $0.0137 | $0.1519 | 5.0% |
가운데 열은 놓치기 쉽습니다. Claude Code 같은 에이전트에서는 입력 대부분이 캐시 읽기입니다. 샘플 세션에서는 입력 토큰 991.2k 중 940.0k, 즉 94.8%가 캐시 읽기입니다. 따라서 청구액 규모는 캐시 적중 가격과 캐시 적중 여부, 이 두 가지가 결정합니다.
deepseek-flash의 적중 가격은 100만 토큰당 피크 $0.006, 오프피크 $0.003으로 Haiku 5.5의 $0.01보다 낮습니다. 하지만 미적중 가격은 $0.30으로 Haiku 5.5 요금 $0.10의 3배입니다. 캐시가 적중하면 deepseek-flash는 Sonnet 5.5의 약 10분의 1 수준이 됩니다. 적중하지 않으면 캐시가 정상 작동하는 Sonnet 5.5보다 비쌉니다.
표 전체에 적용되는 한계가 하나 있습니다. 이 표는 모델 품질이 아니라 토큰 가격을 비교합니다. 두 회사는 서로 다른 토크나이저를 씁니다. Anthropic 요금 페이지에 따르면 Claude 4.7 이상의 토크나이저는 같은 텍스트에서 토큰을 약 30% 더 만듭니다. Claude 4.6 이하와 비교한 수치입니다.
DeepSeek 토큰과 Claude 토큰 간의 공개된 환산 비율은 없습니다. Anthropic은 무료 토큰 카운팅 엔드포인트를, DeepSeek은 오프라인 토크나이저를 제공합니다. 하지만 두 회사의 키가 모두 없어 실제 usage 데이터로 보정하지 못했습니다. 이 글의 토큰 수는 모두 추정치이며, 양쪽에 같은 토큰 수를 사용했습니다.
이 작업을 deepseek v4.1 flash 같은 저비용 모델에 맡기는 이유
댓글 정제는 양이 많고 항목 하나하나는 쉽습니다. Claude Code에서 DeepSeek V4를 다루는 동영상의 댓글을 보면, 대부분 설정이 왜 실패하는지, 과금이 어떻게 되는지, Claude 자체 모델과 비교하면 어떤지를 묻습니다. 판단 하나하나는 단순하지만, 댓글이 많으면 토큰도 많아집니다.
2026년 10월 17일, DeepSeek은 deepseek-flash를 DeepSeek-V4.1-Flash-1017로 업데이트했습니다. 릴리스 노트에 따르면 새 모델은 작업 실행 시간과 출력 길이를 줄였습니다. Hugging Face 모델 카드에는 DeepSeek이 Claude Code 하네스로 Terminal-Bench 4.0을 실행해 42.3점을 받았다고 나와 있습니다.
Anthropic 쪽에서는 Claude Haiku 5.5 출시 페이지(2026년 10월 7일)가 요약, 컴팩션, 분류를 핵심 작업으로 꼽습니다. Opus 5.5와 Sonnet 5.5의 서브에이전트 작업도 언급합니다. Terminal-Bench 4.0 점수는 Haiku 5.5 39.2%, Sonnet 5.5 70.6%로 나와 있습니다.
각 회사가 자체 방식으로 측정한 수치라 직접 순위를 매길 수는 없습니다. 다만 한 가지 사실은 보여 줍니다. 이제 저비용 모델 두 개를 Claude Code 안에서 실행할 수 있다는 점입니다. 실제 비교 기준은 비용과 설정에 드는 노력입니다.
| 항목 | deepseek-flash(DeepSeek Anthropic 호환 엔드포인트) | Claude Haiku 5.5(Anthropic 직접 연결) |
|---|---|---|
| 입력(캐시 미적중) / 출력, 100만 토큰당 | 피크 $0.30 / $1.20, 오프피크 $0.15 / $0.60 | $0.10 / $0.50(프롬프트 100k 토큰 이하) |
| 캐시 적중 | 피크 $0.006, 오프피크 $0.003 | $0.01 |
| 캐싱 방식 | 디스크 기반 자동 프리픽스 캐시, cache_control 무시 | Claude Code의 cache_control 마커 사용 |
| 컨텍스트 윈도우 | 1M | 1M(100k 토큰 초과 프롬프트는 요금 인상) |
| 이미지 입력 | 지원(deepseek-v4-pro: 미지원) | 예 |
| Claude Code 공식 지원 | DeepSeek이 설정을 공개, Anthropic은 게이트웨이를 통한 비 Claude 모델을 지원하지 않는다고 명시 | 기본 지원 |
마지막 행은 주의해서 읽으세요. Claude Code 게이트웨이 문서에 따르면 Anthropic은 서드파티 게이트웨이를 보증·유지·감사하지 않습니다. 또한 어떤 게이트웨이를 통해서든 Claude Code를 비 Claude 모델로 라우팅하는 것을 지원하지 않습니다. DeepSeek 설정은 바로 이 경로, 즉 커스텀 ANTHROPIC_BASE_URL을 사용합니다.
문제가 생겨도 Claude Code 지원 대상이 아닙니다. 지원되는 서드파티 경로는 Amazon Bedrock, Google Cloud, Microsoft Foundry 같은 클라우드 플랫폼입니다. 서드파티 통합 문서와 Anthropic 게이트웨이 옵션을 참고하세요.
먼저 정해 둔 통과·실패 기준
첫 댓글 API 호출 전에 “이 작업이 제대로 작동한다”고 판단할 기준 9가지를 정했습니다. 결과를 본 뒤에도 바꾸지 않았습니다. 두 기준(노이즈 비율, 도구 정의 크기)은 수치만 기록하고, 나머지에는 통과 기준이 있습니다.
| ID | 기준 | 통과 기준 | 결과 |
|---|---|---|---|
| J1 | DeepSeek이 제시한 환경 변수 9개가 모두 Claude Code 문서에 나와 있음 | 9개 중 9개 | 통과: 9개 중 9개 |
| J2 | MCP 필드가 모두 카탈로그 response_fields에 있고 REST와 일치 | 둘 다 충족 | 통과 |
| J3 | 각 charged_usd = 카탈로그 가격 × 과금 단위, 실패 시 $0 | 모든 호출 일치 | 통과: 댓글 호출 15회, 검색 3회, MCP 호출 1회 |
| J4 | 정제된 모델 입력이 원본 JSON 토큰의 40% 이하 | ≤40% | 통과: 38.0% / 17.5% / 5.6% |
| J5 | 노이즈 비율(기록만) | — | YouTube 낮음(2.2%), Bilibili와 Douyin 중간(12.0%, 13.0%) |
| J6 | 피크 flash가 Sonnet 5.5의 10% 이하인가? Haiku 5.5보다 저렴한가? | 수치로 답변 | Q1: 세션 10.0%, 예 / 일괄 라벨링 13.5%, 아니요. Q2: 아니요 |
| J7 | 잘못된 파라미터는 수정 방법과 함께 422를 반환하고, 오류 메시지에 “not charged” 포함 | REST와 MCP | 통과 |
| J8 | 도구 정의 25개 크기(기록만) | — | 약 8,556토큰, 남겨 둘 4개는 약 1,058토큰 |
| J9 | 디스크에 키 없음 | 검출 0건 | 통과 |
J7은 HTTP 상태나 MCP isError 플래그뿐 아니라 오류 메시지에도 “not charged”가 있어야 한다고 요구합니다. 이유는 아래 호환성 섹션에 있습니다. DeepSeek 엔드포인트가 tool_result의 is_error 필드를 무시하기 때문입니다.
deepseek claude code 설정: 환경 변수 9개를 문서와 대조
DeepSeek Claude Code 통합 페이지에는 환경 변수 9개가 나와 있습니다. 각 변수를 Claude Code 환경 변수 레퍼런스에서 확인했습니다. 9개 모두 문서에 나와 있으며, 설명된 용도도 DeepSeek의 사용 방식과 일치합니다.
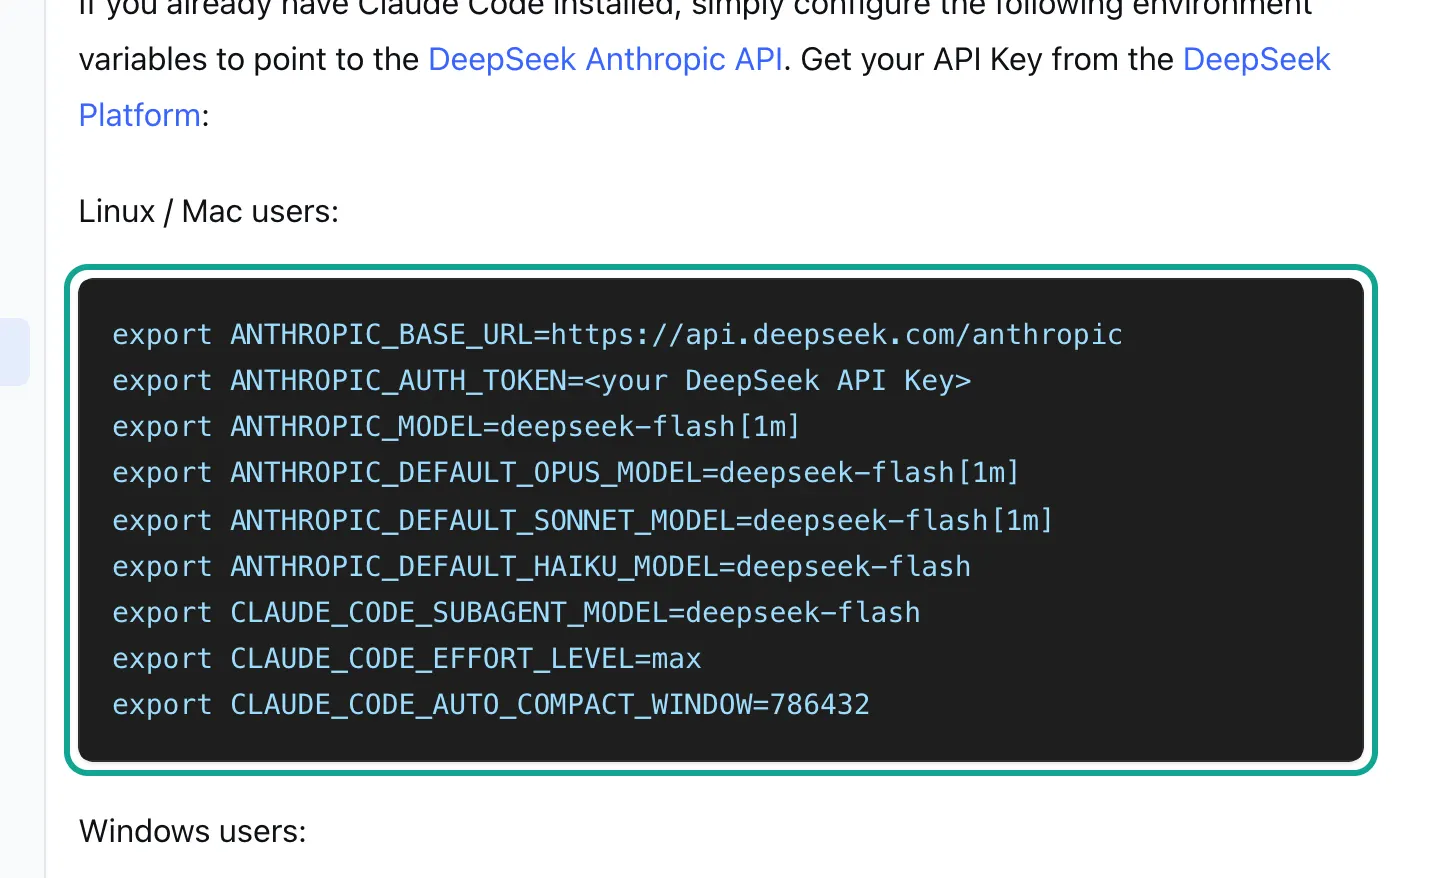
# Config example (we have no DeepSeek key and did not run this block)
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN="$DEEPSEEK_API_KEY"        # sent as Authorization: Bearer
export ANTHROPIC_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_OPUS_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_SONNET_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash     # background tasks use it too
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
export CLAUDE_CODE_EFFORT_LEVEL=high                    # DeepSeek shows max; comment work does not need it
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
# Two more lines that we recommend:
export ENABLE_TOOL_SEARCH=false                         # defer_loading is not in the compatibility table
export EVERYINFRA_API_KEY=... # for .mcp.json; keep it out of project files| 변수 | Claude Code에서 제어하는 항목 | 이 작업에서 주의할 점 |
|---|---|---|
ANTHROPIC_BASE_URL | 요청을 프록시나 게이트웨이로 전송 | api.anthropic.com 이외의 호스트를 쓰면 Remote Control 비활성화 |
ANTHROPIC_AUTH_TOKEN | Authorization: Bearer 헤더 값 | 저장된 claude.ai 로그인보다 우선하며, 설정하지 않으면 요금제 로그인이 그대로 적용 |
ANTHROPIC_MODEL | 메인 세션 모델 | [1m] 접미사는 1M 컨텍스트 윈도우를 요청 |
ANTHROPIC_DEFAULT_OPUS_MODEL / _SONNET_ | opus, sonnet 별칭이 가리키는 모델 | 설정하지 않으면 DeepSeek이 claude-opus*를 Pro 가격의 deepseek-v4-pro로 매핑 |
ANTHROPIC_DEFAULT_HAIKU_MODEL | haiku 별칭과 백그라운드 작업 | 백그라운드 작업도 비용 발생 |
CLAUDE_CODE_SUBAGENT_MODEL | 서브에이전트 기본 모델 | 플랫폼별 서브에이전트가 모두 이 모델 사용 |
CLAUDE_CODE_EFFORT_LEVEL | effort 레벨 | DeepSeek은 medium, high, xhigh를 high로 매핑 |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | 자동 컴팩션을 시작하는 토큰 수 | 범위 100,000~1,000,000 |
ENABLE_TOOL_SEARCH | MCP 도구 검색 | false로 설정하면 모든 요청에 전체 도구 정의 포함 |
두 문서를 함께 읽어야만 보이는 점이 세 가지 있습니다. 첫째, 모델 매핑입니다. DeepSeek 호환성 노트에 따르면 claude-opus로 시작하는 모델 이름은 Pro 가격의 deepseek-v4-pro로 매핑됩니다.
claude-haiku나 claude-sonnet으로 시작하는 이름은 deepseek-flash로 매핑됩니다. ANTHROPIC_MODEL만 설정한 뒤 opus로 전환하면 Pro 가격을 냅니다. 샘플 세션 기준 피크 Pro는 $0.1299로 flash 가격의 4.7배입니다.
둘째, 기능 감지입니다. Claude Code 모델 설정 문서에 따르면 Claude Code는 모델 ID를 알려진 패턴과 대조해 effort 레벨과 extended thinking을 켭니다. 알 수 없는 ID라면 이 기능들이 꺼진 채로 남을 수 있습니다. ANTHROPIC_DEFAULT_SONNET_MODEL_SUPPORTED_CAPABILITIES 같은 변수로 직접 선언할 수 있습니다.
게이트웨이 호환성 가이드는 또한 Claude Code가 알 수 없는 모델 이름을 최신 모델로 취급해 여전히 thinking: {"type": "adaptive"}를 보낸다고 설명합니다. 두 설명은 서로 다른 경우를 다루며, 저희는 이를 테스트할 수 없었습니다. 권장 사항: 설정 후 일괄 작업 전에 /status와 /model을 실행해 모델과 effort 레벨을 확인하세요.
셋째, effort입니다. DeepSeek 페이지는 max로 설정합니다. DeepSeek thinking 모드 문서에 따르면 medium, high, xhigh 요청은 high로, max나 ultra는 max로 실행됩니다. 댓글 라벨링에는 최고 레벨이 필요 없고 thinking 토큰은 출력으로 과금됩니다. 그래서 예시에서는 high를 사용합니다.
EveryInfra를 MCP로 연결: .mcp.json 하나, 도구는 4개만
Claude Code에서 원격 MCP 서버를 추가하는 방법은 두 가지입니다. 하나는 claude mcp add --transport http 명령입니다. 다른 하나는 프로젝트 루트의 .mcp.json 파일입니다.
파일 방식을 권장합니다. Claude Code MCP 문서에 따르면 .mcp.json은 url과 headers에서 ${VAR}를 확장하므로 키가 프로젝트 파일에 남지 않습니다. 명령줄 방식은 실행 시점에 변수를 확장해 키를 ~/.claude.json에 저장합니다.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" },
      "timeout": 150000
    }
  }
}
이 설정에 도움이 되는 안전 규칙이 하나 있습니다. 같은 문서에 따르면 Claude Code는 원격 서버의 url과 headers에서 ANTHROPIC_AUTH_TOKEN, ANTHROPIC_API_KEY 같은 자체 자격 증명 변수를 빈 값으로 읽습니다. 따라서 .mcp.json 파일이 Bearer ${ANTHROPIC_AUTH_TOKEN}을 요구하더라도 DeepSeek 키는 어떤 MCP 서버로도 전달되지 않습니다.
EVERYINFRA_API_KEY는 이 목록에 없으므로 평소처럼 확장됩니다. timeout은 150초로 설정했습니다. 가장 느린 YouTube 댓글 호출이 78.6초 걸렸고, EveryInfra의 동기 처리 한도는 85초입니다.
2026년 10월 26일 SGT 17:26에 Claude Code가 연결할 때 보내는 것과 같은 initialize, tools/list 요청을 https://api.everyinfra.com/mcp로 보냈습니다. 서버는 도구 25개를 반환했습니다. 크기는 DeepSeek 토큰 사용량 페이지의 비율로 추정했습니다. 영어 1자당 약 0.3토큰, 중국어 1자당 약 0.6토큰입니다. 도구 25개의 이름, 설명, 입력 스키마를 합치면 약 8,556토큰입니다.
8,556토큰 자체는 많지 않지만, 두 요인이 이를 배로 늘립니다. 첫째, 호환성 문제를 피하려고 도구 검색을 끄도록 권장합니다. 그러면 Claude Code가 모든 요청에 전체 도구 정의를 보냅니다. 둘째, Claude Code 권한 문서에 따르면 도구 이름만 적은 deny 규칙은 해당 도구를 모델 컨텍스트에서 제거합니다. 그러니 이 작업에서는 .claude/settings.json에서 나머지 21개 도구를 deny하세요(형식은 설정 문서 참고). 그러면 요청당 도구 토큰이 약 8,556에서 약 1,058로 줄어듭니다:
{
  "permissions": {
    "allow": ["mcp__everyinfra__everyinfra_list_capabilities", "mcp__everyinfra__everyinfra_call_api",
              "mcp__everyinfra__everyinfra_get_job", "mcp__everyinfra__everyinfra_usage"],
    "deny":  ["mcp__everyinfra__everyinfra_search",
              "mcp__everyinfra__everyinfra_solve_captcha", "mcp__everyinfra__everyinfra_key_create",
              "mcp__everyinfra__everyinfra_key_delete", "mcp__everyinfra__everyinfra_settings_update",
              "mcp__everyinfra__everyinfra_webhook_set", "mcp__everyinfra__everyinfra_create_ticket"]
  }
}
예시에는 21개 중 7개만 적었습니다. 나머지 14개도 같은 형식으로 추가하세요. tools/list에서 everyinfra_call_api는 readOnlyHint: false이고 idempotentHint가 없습니다.
Claude Code 2.1.307(2026년 10월 21일)부터는 이 경우 한 가지 이점이 있습니다. 변경 내역에 따르면 HTTP MCP 연결이 호출 도중 끊기면 Claude Code는 읽기 전용이거나 멱등인 도구만 재시도합니다. 따라서 연결이 끊겨도 댓글 수집 요청이 사용자 모르게 두 번 전송되어 이중 과금되는 일은 없습니다.
실제 왕복 한 번: 모델이 보내는 것과 EveryInfra가 반환하는 것
Claude Code와 원격 MCP 서버는 MCP 사양의 tools/call을 사용합니다. 뒤에 Claude가 있든 DeepSeek이 있든 모델은 도구 이름과 인수가 담긴 tool_use 블록만 작성합니다. HTTP 요청은 Claude Code가 보냅니다.
따라서 아래 요청 본문은 모델과 무관합니다. Anthropic tool use 문서에서 설명하듯 도구 정의, tool_use, tool_result는 여전히 모델 입력 토큰으로 계산됩니다. DeepSeek 쪽도 마찬가지입니다.
2026년 10월 26일 SGT 17:37:32에 curl로 Claude Code가 보내는 것과 같은 tools/call을 EveryInfra에 보냈습니다. YouTube 동영상 하나의 최신 댓글 20개를 요청했습니다. 14.0초 후 서버가 200을 반환했습니다. result.content[0].text는 8,926자의 JSON 문자열(RFC 8259)이었습니다. 과금액은 YouTube 댓글 스크래핑 API의 카탈로그 가격인 $0.000556이었습니다.
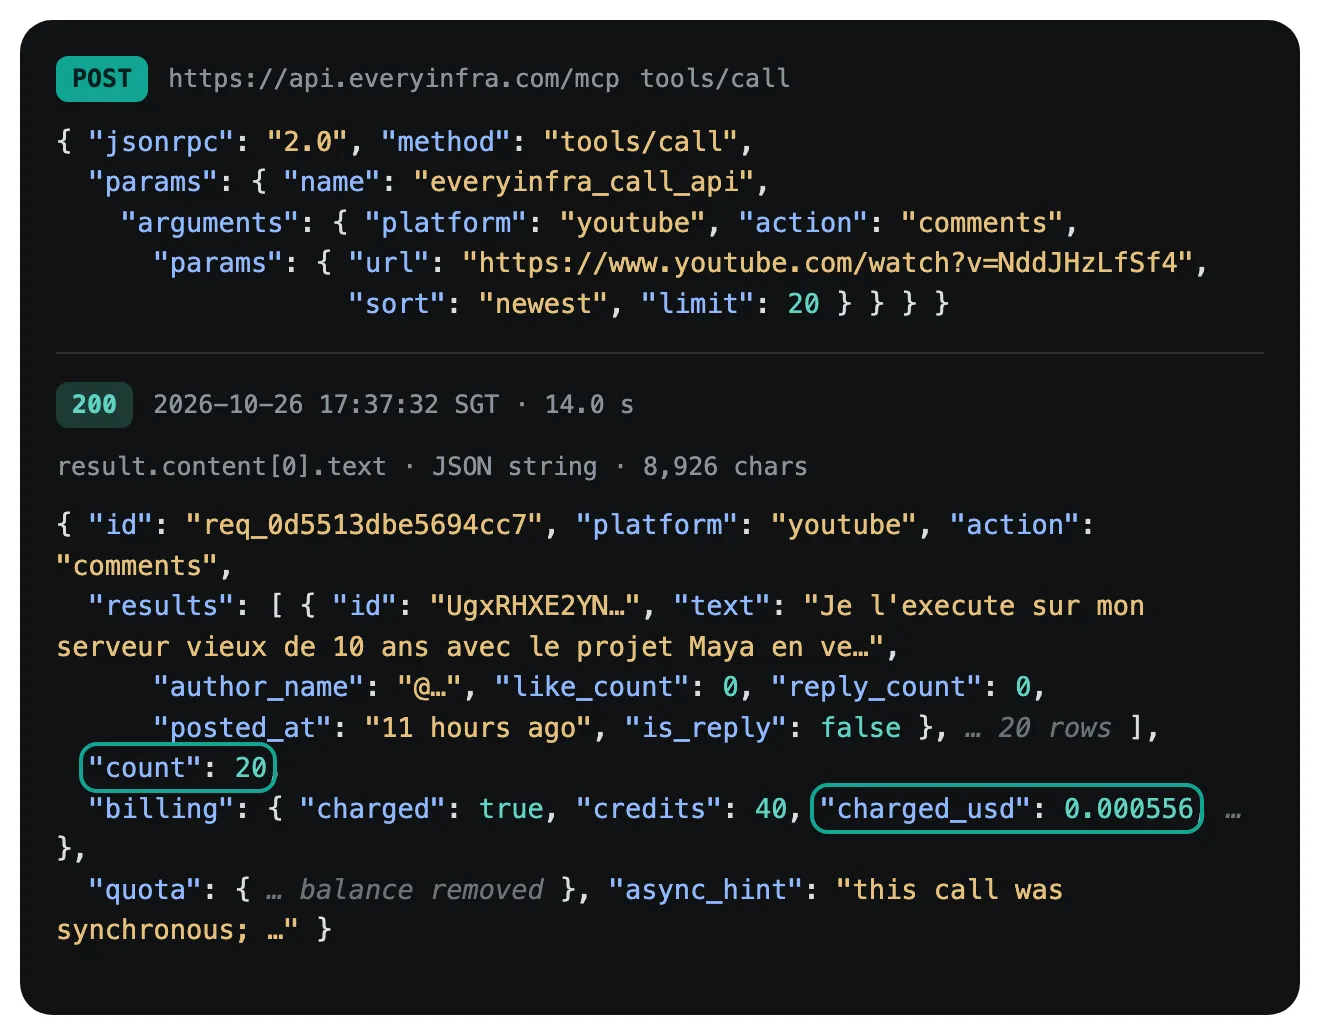
이 MCP 응답의 필드를 17:28:19에 같은 동영상에 대해 받은 REST 응답과 비교했습니다. 카탈로그에 있는 youtube/comments의 response_fields와도 대조했습니다:
| 필드 | 카탈로그 `response_fields` | MCP | REST | 정제 시 용도 |
|---|---|---|---|---|
id | 예 | 예 | 예 | 1단계 중복 제거 키 |
text | 예 | 예 | 예 | 모델에 전달되는 유일한 텍스트 |
author_name | 예 | 예 | 예 | 전송하지 않음, 보고서에서는 숨김 |
like_count | 예 | 예 | 예 | 가중치로 유지 |
reply_count | 예 | 예 | 예 | 전송하지 않음 |
posted_at | 예 | 예 | 예 | YouTube는 "11 hours ago" 같은 상대 시간으로 제공 |
is_reply | 예 | 예 | 예 | r 또는 t 한 글자로 유지 |
reply_to_id | 예 | 이번 최상위 20개 행에는 없음 | 예 | 답글을 상위 댓글에 연결 |
platform | 예 | 예 | 예 | 전송하지 않음 |
두 경로 모두 카탈로그에 없는 필드는 하나도 없습니다. MCP 응답에 reply_to_id가 없는 것은 최신 댓글 20개에 답글이 없었기 때문일 뿐입니다. J2 통과입니다. 여기서 Claude Code 문서의 수치 하나를 더 살펴봐야 합니다.
Claude Code는 MCP 도구 결과가 10,000토큰을 넘으면 경고를 표시하며, 기본 한도는 25,000토큰입니다. 이보다 큰 결과나 50,000자를 넘는 텍스트 결과는 파일로 저장하고 대화에는 경로만 남깁니다. 저희가 가져온 YouTube 댓글 100개는 약 33,000~35,000자, 추정 토큰으로는 약 10,000개였습니다. 경고선에 딱 걸리는 수준입니다.
DeepSeek Anthropic API: 도구 호출에 영향을 주는 호환성 표의 7개 항목
DeepSeek Anthropic API 안내에는 필드별 지원 표가 있습니다. 이 중 도구 호출과 도구 결과에 영향을 주는 행을 골라, 게이트웨이 가이드에 나온 Claude Code의 전송 내용과 비교했습니다. "문서에 없음"은 저희가 테스트로 확인하지 못한 부분을 뜻합니다.
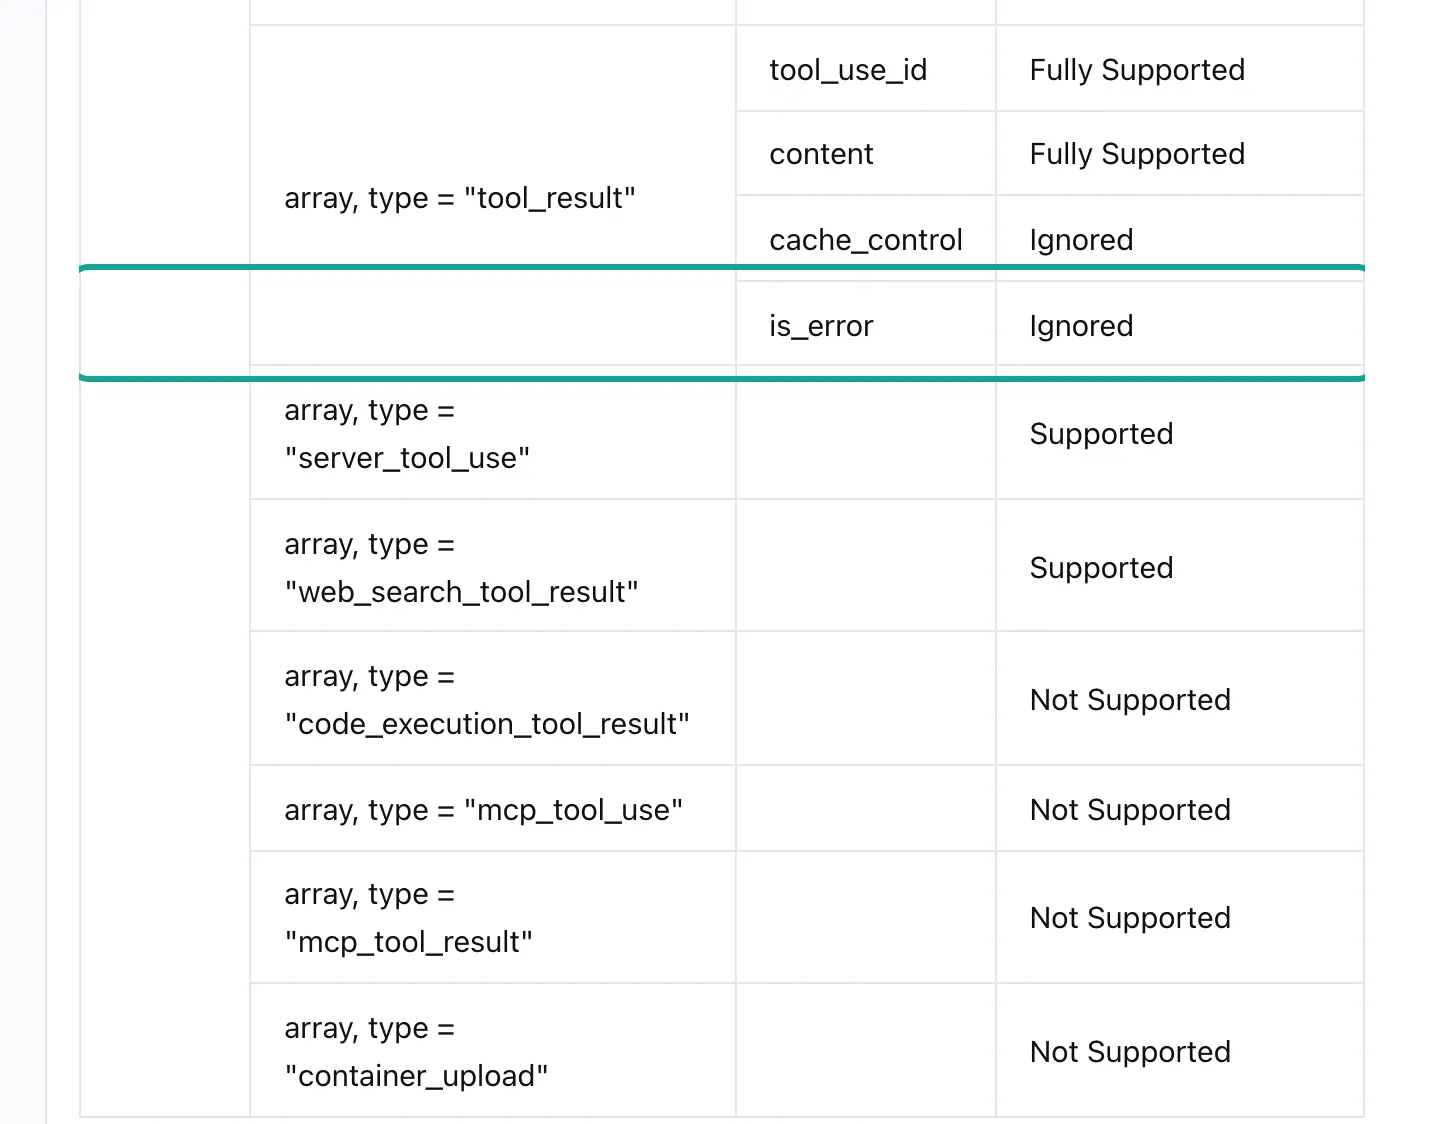
| 필드 또는 동작 | DeepSeek 표 | 댓글 정제에서의 의미 |
|---|---|---|
tool_result.is_error | 무시됨 | 모델은 텍스트만 받으므로 오류 텍스트에 해결 방법과 과금 여부를 적어야 함 |
tools, text, tool_use, tool_result의 cache_control | 무시됨 | DeepSeek 디스크 캐시는 자체적으로 프리픽스를 매칭하며, Anthropic의 캐싱 규칙은 적용되지 않음 |
tool_choice의 disable_parallel_tool_use | 무시됨 | 모델이 여러 tools/call을 한꺼번에 보내 요청 속도 제한에 걸릴 수 있음 |
mcp_servers | 무시됨 | 로컬 MCP 클라이언트인 Claude Code에는 영향 없음 |
mcp_tool_use, mcp_tool_result 블록 | 지원 안 함 | 마찬가지. Claude Code는 일반 tool_use와 tool_result를 보냄 |
document, search_result 블록 | 지원 안 함 | PDF를 document 블록으로 보내지 말 것 |
defer_loading, tool_reference(도구 검색), strict | 문서에 없음 | 2.1.304부터 커스텀 URL에서도 도구 검색이 켜져 있으며, 400 또는 422를 받으면 Claude Code가 도구 검색 없이 한 번 재시도함. 피하려면 ENABLE_TOOL_SEARCH=false로 설정 |
저희에게 가장 중요한 것은 첫 번째 행입니다. MCP 사양에서 도구 실행 오류는 isError: true를 반환합니다. Claude Code는 이를 is_error가 붙은 tool_result로 모델에 전달합니다. DeepSeek는 이 플래그를 무시하므로 모델은 텍스트만 받습니다. 결국 모델이 스스로 실수를 고칠 수 있는지는 오류 텍스트가 얼마나 명확한지에만 달려 있습니다.
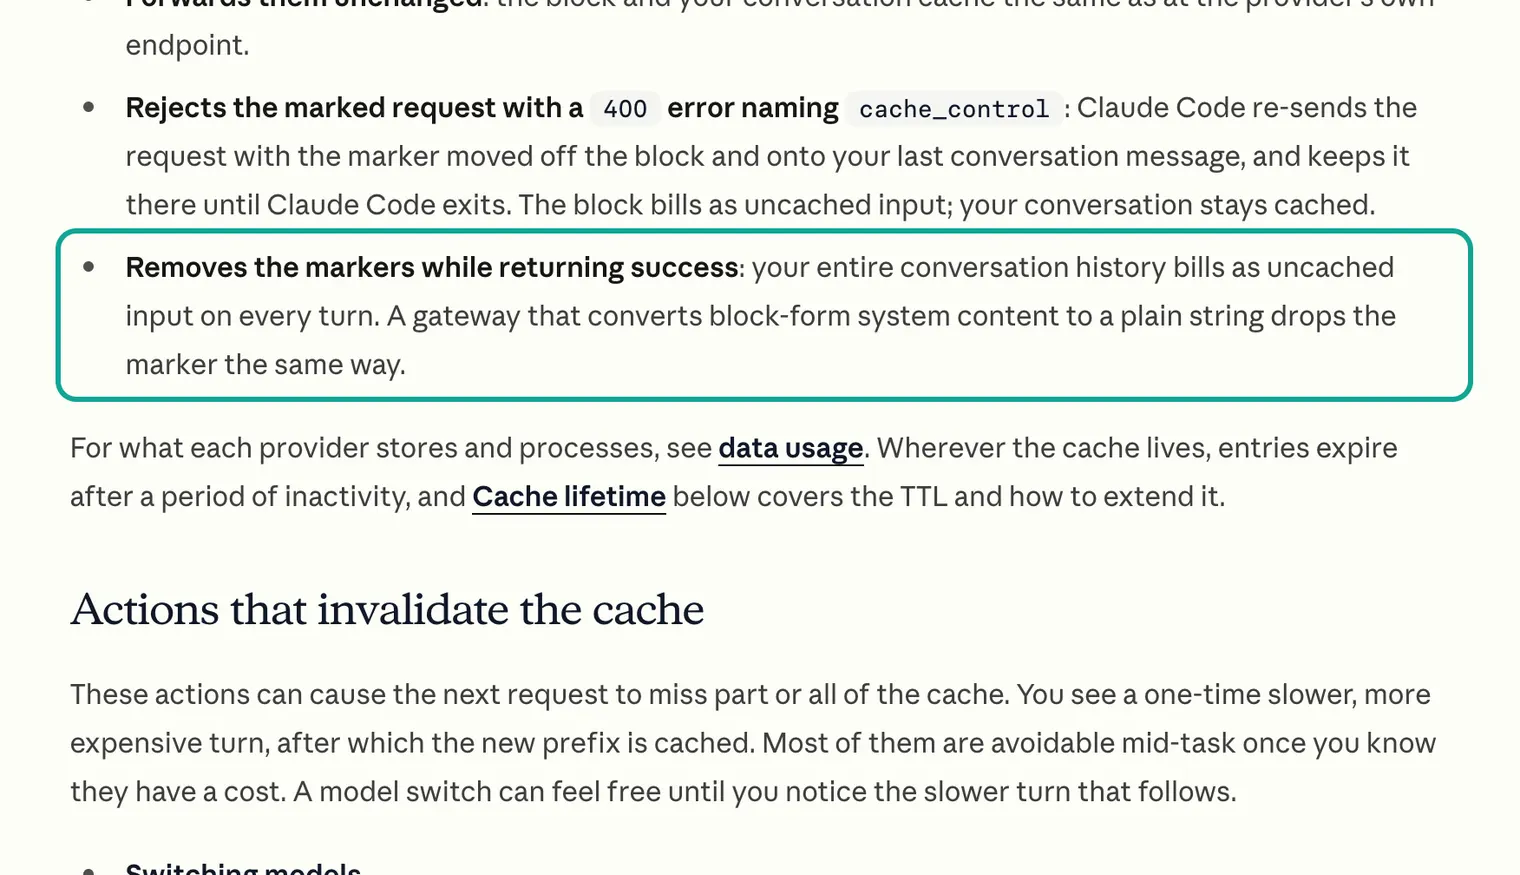
두 번째 행은 비용을 좌우합니다. Claude Code 프롬프트 캐싱 문서는 게이트웨이가 cache_control을 처리하는 방식 세 가지를 설명합니다. 세 번째는 게이트웨이가 마커를 제거하고도 성공을 반환하는 경우입니다. Claude 요금 기준이라면 매 턴마다 대화 전체가 캐시되지 않은 입력으로 과금된다는 뜻입니다. DeepSeek는 마커를 무시하지만 자체 디스크 캐시가 있습니다.
이 캐시는 모든 사용자에게 기본으로 켜져 있으며 요청 프리픽스를 매칭합니다. 매칭된 토큰은 캐시 적중 가격으로 과금됩니다. 문서는 이를 best effort 방식이라고 하며 100% 적중을 보장하지 않습니다. 사용되지 않은 캐시 항목은 보통 몇 시간에서 며칠 안에 삭제됩니다.
프리픽스 매칭에 영향을 주는 세부 사항이 하나 더 있습니다. 게이트웨이 가이드에 따르면 Claude Code는 시스템 프롬프트 맨 앞에 출처 표시(attribution) 블록을 추가합니다. 이 블록에는 클라이언트 버전과 대화에서 생성한 핑거프린트가 들어 있습니다. Anthropic 엔드포인트는 처리 전에 이 블록을 제거하지만, 다른 엔드포인트는 프롬프트의 일부로 받습니다. DeepSeek 캐시는 저장된 프리픽스 단위와 완전히 일치해야 합니다.
문서에는 이 블록이 한 대화 동안 그대로 유지되는지 나와 있지 않으며, 저희도 확인할 수 없었습니다. 그래서 비용 표를 전부 적중과 전부 미적중의 두 열로 나눴습니다. 실제 청구 금액은 그 사이에 있을 것입니다. DeepSeek 사용량 데이터의 prompt_cache_hit_tokens를 확인해 보세요.
테스트 1: 세 플랫폼의 댓글은 어떤 모습일까
17:26:56부터 17:27:16 SGT까지 youtube/search, bilibili/search, douyin/search로 "deepseek v4 claude code"와 "DeepSeek Claude Code"를 검색했습니다. 결과 중에서 Claude Code에서 DeepSeek를 실행하는 내용의 영상 15개를 골랐습니다. YouTube 6개(영어 4개, 중국어 1개, 스페인어 1개), Bilibili 5개, Douyin 4개입니다. Douyin 검색은 현재 첫 페이지만 반환하므로(이번에는 결과 20개, next_page_token 없음), 후보 영상을 더 얻으려면 다른 키워드로 다시 검색하세요. 주제 선택도 방법론의 일부입니다. 이 영상들의 댓글은 실제 사용자가 이 구성에서 어디서 막혔는지 전하는 직접 경험담입니다.
| 플랫폼 | 영상 | 호출당 요청 행 수 | 반환된 행 수(답글 포함) | 과금 | 호출당 소요 시간 |
|---|---|---|---|---|---|
| YouTube | 6 | 100 | 461(최상위 289, 답글 172) | 6 × $0.000556 = $0.003336 | 11.5~78.6초 |
| Bilibili | 5 | 50 | 50(호출당 10) | 5 × $0.000556 = $0.002780 | 8.7~11.4초 |
| Douyin | 4 | 50 | 184(최상위 86, 답글 98) | $0.006112(20행당) | 14.4~44.0초 |
모든 과금 내역을 확인했습니다. 카탈로그에서 youtube/comments와 bilibili/comments는 행 수와 관계없이 호출당 단일 가격입니다. Douyin 댓글 스크래핑 API는 rows_per_unit: 20이므로 20행이 1단위입니다. 50행은 3단위(120 크레딧, $0.001667), 34행은 2단위(80 크레딧, $0.001111)입니다. 15회 호출 모두 credits가 카탈로그 가격에 단위 수를 곱한 값과 일치했습니다. J3 통과입니다.
알아 두어야 할 점도 세 가지 발견했습니다. 첫째, Bilibili 댓글 스크래핑 API는 5회 호출 모두 10행만 반환했습니다. 요청은 50행이었습니다. 저희가 행을 자르는 것이 아니라 Bilibili가 영상당 최대 10개의 댓글만 제공합니다. 현재 카탈로그에는 기본값 10, 최댓값 10으로 표시되어 있습니다. 더 큰 limit도 허용되지만 반환되는 행은 10개뿐입니다. 20:01:21 SGT에 같은 영상을 limit=50으로 다시 확인한 결과 10행, $0.000556이었습니다. 이 때문에 Bilibili 데이터 요금은 행 1,000개당 $0.0556으로 높습니다.
따라서 Bilibili는 영상당 최대 10개 댓글을 기준으로 예산을 잡으세요. 둘째, Douyin 페이지 두 곳에서 같은 댓글 id가 두 번 나타났습니다. 184행 중 8행입니다. 이 문제는 10월 26일 19:53 SGT에 수정되었습니다. 이제 API가 id 기준으로 중복을 제거해 첫 번째 항목을 유지하며, 그 결과 행 수가 채워지지 않은 과금 단위는 일반 규칙에 따라 환불됩니다. 저희의 184행은 수정 전에 수집한 것입니다. 정제 스크립트 1단계는 안전장치로 여전히 id가 중복된 행을 제거합니다.
셋째, YouTube posted_at은 "7 days ago (edited)" 같은 상대 시간입니다. Bilibili와 Douyin은 시간대가 포함된 표준 타임스탬프를 제공합니다. YouTube 댓글을 날짜별로 묶으려면 수집 시각을 기준으로 변환하고, 결과는 근삿값으로 다루세요.
Claude Code에서는 호출 시간이 중요합니다. MCP 문서에 따르면 메인 대화에서 2분을 넘겨 실행되는 MCP 호출은 백그라운드 작업으로 전환됩니다. 모델은 즉시 작업 ID를 받고 작업을 계속하며, 결과는 나중에 알림으로 도착합니다. 가장 느린 호출은 78.6초로 2분보다 한참 짧았습니다.
EveryInfra 카탈로그의 async_mode 섹션에 따르면 동기 처리 한도는 85초입니다. limit 값이 크면 mode: "async"를 사용하고 무료인 everyinfra_get_job으로 결과를 읽도록 권장합니다. DeepSeek가 여러 호출을 한꺼번에 보내면(disable_parallel_tool_use가 무시된다는 점을 기억하세요), EveryInfra 키에도 분당 요청 수 제한이 있어 초과하면 429를 반환합니다. DeepSeek는 동시 요청 수를 계정 단위로 계산하며, deepseek-flash는 동시 요청 2,500건까지 허용하고 그 이상이면 429를 반환합니다(요청 속도 제한 문서).
테스트 2: 정제 스크립트는 무엇을 걸러냈나
정제 단계는 모델에 맡기지 않았습니다. 대신 모델에게 정제 스크립트를 작성하게 했습니다. 규칙으로 판단할 수 있는데도 댓글을 모델에 보내면 읽는 비용만 내는 셈입니다.
Claude Code 비용 문서도 같은 조언을 합니다. 모델에게 10,000줄짜리 로그를 읽히지 마세요. 훅으로 먼저 ERROR를 grep하면 컨텍스트를 수만 토큰에서 수백 토큰으로 줄일 수 있습니다.
스크립트는 네 가지 검사를 순서대로 실행하고 처음 일치하는 검사에서 멈춥니다. 2단계는 유니코드 NFKC 정규화(UAX #15, Python에서는 unicodedata.normalize)를 사용합니다. 그런 다음 링크, 이모지 코드, 문장 부호를 제거하므로 같은 문장이 전각 문자로 쓰였거나 대소문자만 달라도 중복으로 처리됩니다. 모든 규칙은 Python 정규 표현식이며, 같은 데이터에 다시 실행할 수 있습니다:
# Cleaning rules, version 4 (excerpt; the full script is saved with the raw responses)
BRACKET_EMOJI = re.compile(r"\[[一-鿿]{1,6}\]")      # emoji codes such as [捂脸]; Chinese only inside brackets
PROMO = re.compile(r"(subscribe(?!r)|newsletter|giveaway|chrome extension|coupon|telegram|whatsapp|"
                   r"私信|加群|进群|加微|微信|qq群|关注我|免费领|领取|代金券|优惠|课程|戳我)", re.I)
for r in rows:
    if (video, r["id"]) in seen_id:   drop("same id"); continue          # 1. same comment twice on a page
    if (video, norm(r["text"])) in seen_text: drop("same text"); continue # 2. same text after normalization
    if no_content(r["text"]):          drop("no content"); continue       # 3. emoji only, 666, two characters, not a question
    if PROMO.search(r["text"]) or (has_link and (few_chars or bait)): drop("promotion"); continue  # 4.
    keep(f'{i}|{likes}|{"r" if r["is_reply"] else "t"}|{text_with_links_shortened}')
스크립트는 네 번 수정했습니다. 매번 제거된 댓글을 읽다가 잘못 제거된 것을 발견한 뒤였습니다. 이 과정이 이 글의 핵심 교훈입니다. 정제 규칙은 항상 좋은 댓글도 일부 제거합니다. 제거한 댓글을 직접 읽어 봐야만 그런 댓글을 찾을 수 있습니다. 버전 1은 subscribe가 subscriber에 매칭되는 바람에 "New subscriber here"를 홍보로 분류했습니다.
또 extension 때문에 스페인어 질문 "¿qué extensiones concretamente?"를 제거했습니다. 공식 Git 다운로드 페이지로 연결되는 유용한 답글도 제거했습니다. 버전 2에서 이 세 가지를 고쳤습니다. 버전 3에서는 DeepSeek 할인에 관한 평범한 댓글인 "Normal, están con un 90% de descuento"를 유지하고, 두 글자짜리 중국어 질문 "guì bù"("비싼가요?")를 더 이상 제거하지 않게 했습니다.
버전 4는 유지된 텍스트를 읽다가 나왔습니다. 대괄호로 묶인 이모지 코드(facepalm 이모지 코드처럼 대괄호 안에 중국어 단어가 들어간 것)를 잡는 정규식의 범위가 너무 넓었습니다. 이 정규식은 오류 메시지의 messages[1]과 모델 이름의 [1m]을 지웠는데, 둘 다 이번 데이터에서 가장 유용한 단서였습니다.
버전 4가 제거한 40행은 모두 읽었고 더 이상 잘못된 제거는 없었습니다. 유지된 655행은 전부 읽지 않았습니다. 따라서 링크나 키워드가 없는 홍보, 예를 들어 유료로 도구를 설치해 주겠다는 제안은 아직 데이터에 남아 있습니다. Douyin에서는 "설치 도와드릴 수 있어요" 같은 답글이 여러 번 나왔습니다. 텍스트 중복 제거로 반복된 답글은 지우고 첫 번째 것만 남겼습니다.
노이즈 비율은 플랫폼마다 크게 다릅니다. YouTube는 2.2%, Bilibili는 12.0%, Douyin은 13.0%입니다. YouTube 수치가 낮은 이유로는 플랫폼이 먼저 걸러 낸다는 점을 생각해 볼 수 있습니다. YouTube Data API commentThreads 문서에 따르면 "likely spam"(스팸 가능성)과 "held for review"(검토 대기) 댓글은 인증된 요청에서 채널 소유자만 볼 수 있습니다. 공개 요청에는 기본적으로 게시된 댓글이 반환됩니다.
또한 YouTube는 2026년 9월 23일 Made on YouTube에서 채널별 스타일을 학습하는 옵트인 방식의 AI 댓글 관리 기능을 테스트 중이라고 밝혔습니다. Douyin과 Bilibili의 노이즈는 외부 링크보다는 대부분 이모지, "666", 반복 댓글입니다. 규칙 적중 결과도 같은 패턴을 보입니다.
테스트 3: 정제 후 모델이 읽는 토큰은 얼마나 될까
정제로 줄어드는 것은 행 수만이 아닙니다. DeepSeek 기준 환산 비율로 두 가지 토큰 수를 추정했습니다. 첫 번째는 API JSON을 그대로 보내는 경우, 두 번째는 정제된 한 줄만 보내는 경우입니다.
Douyin이 가장 많이 줄어드는 이유는 필드에 있습니다. 카탈로그에서 douyin/comments는 응답 필드가 19개이며, 아바타 URL, IP 위치, 멘션된 사용자, 작성자가 댓글에 좋아요를 눌렀는지 여부 등이 포함됩니다. 원본 JSON 한 행은 평균 약 180토큰이지만, 텍스트 길이 중앙값은 13자에 불과합니다.
YouTube 댓글은 중앙값 61자로 더 길고 필드는 9개뿐이어서, 정제 후에도 38.0%가 남습니다. 세 플랫폼을 합치면 추정 토큰 84,109개가 20,176개, 즉 24.0%로 줄어듭니다. J4 통과입니다.
Claude Code에서 이것이 왜 그렇게 중요할까요? MCP 도구 결과는 대화 컨텍스트에 바로 들어갑니다. 이후 모든 턴에서 프리픽스의 일부로 다시 읽힙니다. DeepSeek 캐시 적중 가격이라면 10,000토큰을 다시 읽어도 $0.00006에 불과합니다. 하지만 적중률은 직접 제어할 수 없습니다.
캐시 미적중 시에는 같은 10,000토큰이 백만 토큰당 $0.30 기준으로 $0.003이 들고, 수십 턴이 이어지면 금액이 쌓입니다. 더 안전한 방법은 Claude Code에게 스크립트를 작성하게 하는 것입니다. 스크립트가 curl로 EveryInfra REST API를 호출하고, 원본 JSON은 파일로 저장하며, 정제된 텍스트와 개수만 출력합니다. MCP는 처음 살펴보기, 기능 선택, 파라미터 테스트 같은 대화형 단계에만 사용하세요.
# Batch pulls go through REST; raw responses go to disk, not into the chat
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" -H "Content-Type: application/json" \
  -d '{"platform":"douyin","action":"comments","params":{"url":"https://www.douyin.com/video/<video_id>","limit":50}}' \
  -o raw/dy_<video_id>.json
python3 clean.py raw/ > cleaned.txt   # prints only "index|likes|r/t|text" and the removal counts
테스트 4: 규칙은 무엇을 라벨링하고, 무엇이 모델로 가는가
정제 후 키워드 규칙을 실행해 규칙만으로 얼마나 라벨을 붙일 수 있는지 확인했습니다. 규칙은 한 댓글에 "가격"과 "모델 비교"처럼 여러 라벨을 붙일 수 있습니다.
규칙에 매칭되지 않은 댓글은 YouTube 43.7%, Bilibili 29.5%, Douyin 48.1%였습니다. 이 비율에 따라 모델이 읽어야 할 양이 정해지며, 대략 절반입니다. 규칙이 모델을 대체할 수는 없습니다. 하지만 모델의 작업량을 절반으로 줄여 주며, 규칙이 라벨링하는 절반은 대개 가장 쉽고 비용을 들일 가치가 가장 적은 부분입니다.
| 플랫폼 | 유지 | 설정 및 오류 | 가격 및 할당량 | 모델 비교 | 칭찬 | 규칙 미매칭 | 질문 포함 |
|---|---|---|---|---|---|---|---|
| YouTube | 451 | 58 | 91 | 118 | 70 | 197 (43.7%) | 138 |
| Bilibili | 44 | 25 | 5 | 9 | 2 | 13 (29.5%) | 27 |
| Douyin | 160 | 52 | 18 | 19 | 2 | 77 (48.1%) | 59 |
댓글 자체도 읽어 볼 만합니다. Bilibili에서는 44개 중 25개가, Douyin에서는 160개 중 52개가 설정과 오류에 관한 질문입니다. 같은 질문이 반복됩니다.
설정을 마쳤는데 왜 계속 로그인을 요구하나요? 왜 이미지를 읽지 못하나요? 왜 자기가 Claude라고 하나요? 왜 토큰이 이렇게 빨리 소모되나요?
YouTube에서는 오류 메시지 두 개가 원문 그대로 데이터에 남았습니다. 첫 번째는 API Error: 400 Failed to deserialize the JSON body into the target type: messages[1].role: unknown variant system입니다. 두 번째는 The content[].thinking in the thinking mode must be passed back입니다. 아래 FAQ에서 공식 문서를 바탕으로 두 오류에 답합니다.
스페인어 영상에 달린 스페인어 댓글 83개는 주로 가격 변경을 이야기합니다. 여러 댓글 작성자가 DeepSeek로부터 API 가격 인상에 관한 이메일을 받았다고 말합니다. 저희는 이를 사용자 제보로만 취급합니다. 가격은 DeepSeek 요금 페이지를 기준으로 합니다.
모델이 처리할 절반에 대해서는 설정 예시를 제공합니다. Claude Code는 매칭되지 않은 댓글을 "index|text" 형식으로 100개씩 묶어 서브에이전트에 보냅니다. 서브에이전트는 댓글마다 index와 라벨 하나를 담은 JSON 배열만 반환해야 합니다. DeepSeek JSON 출력 및 도구 호출 문서에 따르면 이런 구조화된 출력을 지원합니다.
Claude Code에서 가장 간단한 방법은 서브에이전트 정의에 출력 형식을 적는 것입니다. 그런 다음 CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash를 설정하면 서브에이전트가 저비용 모델에서 실행됩니다. 서브에이전트 문서에 따르면 이 변수가 기본 서브에이전트 모델을 설정합니다.
결과물: 출처를 추적할 수 있는 라벨 표
이 작업의 결과물은 표입니다. 각 행은 유지된 댓글 하나이며, 플랫폼, 좋아요 수, 원문(사용자 이름 제외), 라벨, 라벨을 붙인 주체가 들어갑니다. 아래는 좋아요 순으로 정렬한 10개 행입니다. 규칙 라벨 열은 키워드 규칙의 1차 분류 결과입니다. 마지막 열은 저희가 각 행을 직접 검토한 결과입니다.
| 플랫폼 | 좋아요 | 댓글(발췌, 중국어는 번역) | 규칙 라벨 | 검토 결과 |
|---|---|---|---|---|
| Douyin | 615 | "이제 막 써 봤어요. 손으로 하면 며칠 걸릴 데이터 파일 묶음을 10분 남짓 만에 처리했어요" | 없음 | 사용 경험(긍정), 규칙이 놓침 |
| Douyin | 51 | "Claude Code 설치해 주실 수 있나요?" | 모델 비교 | 설치 도움 요청, "claude" 때문에 잘못된 라벨이 붙음 |
| Douyin | 36 | "연결하고 나니 토큰이 빨리 떨어지는 것 같지 않아요?" | 가격 및 할당량 | 맞음 |
| Douyin | 28 | "DeepSeek V4를 연결했더니 Claude가 계속 세션만 불러오고 있어요. 어떻게 하죠?" | 모델 비교 | 오류 도움 요청, 규칙에 없는 표현 |
| Douyin | 24 | "DeepSeek 모델은 이미지를 못 만드는 것 같은데요?" | 없음 | 제약에 관한 질문 |
| Douyin | 14 | "간단한 질문 몇 개 했을 뿐인데 토큰이 700k나 사라졌어요. 너무 빨리 닳네요." | 가격 및 할당량 | 맞음 |
| Bilibili | 10 | "CC는 보안 위험이 있다고 하지 않았나요? 그래도 추천하시나요?" | 없음 | 보안 우려 |
| YouTube | 17 | "Aprovechen los 0.14, porque va a subir los precios." | 가격 및 할당량 | 맞음 |
| YouTube | 17 | "IT DOES NOT MATCH OPUS 5.5" | 모델 비교 | 맞음 |
| YouTube | 6 | "i didn't understand single thing related to setup" | 설정 및 오류 | 맞음(튜토리얼에 대한 피드백) |
이 10개 행에서 규칙은 5번 맞았고, 3번 놓쳤고, 2번 틀렸습니다. 정확도를 측정하기에는 표본이 너무 작지만, 규칙 오류의 두 가지 유형은 확인할 수 있습니다. 하나는 너무 넓은 키워드입니다. "claude"가 들어간 댓글은 모두 모델 비교로 분류됩니다. 다른 하나는 같은 말을 하는 방식이 너무 많다는 점입니다. 사람들은 다양한 표현으로 도움을 요청하고, 규칙으로 이를 모두 나열할 수는 없습니다. 이 부분이 모델의 몫이며, 규칙을 1차 분류로만 쓰는 이유입니다.
규칙 라벨은 보고서에 들어가기 전에 모델이 바꿀 수 있어야 합니다. Claude Code에서 비용을 아끼는 방법은 두 그룹만 모델에 보내는 것입니다. 하나는 규칙 라벨이 없는 행이고, 다른 하나는 잘못된 라벨이 몰리는 "모델 비교" 라벨만 붙은 행입니다. 저희 데이터에서는 유지된 댓글 655개 중 368개, 약 56%입니다.
제품 팀에게 가장 유용한 행은 좋아요 615개를 받은 댓글입니다. 가장 많은 좋아요를 받은 댓글은 설정이나 가격이 아니라 결과에 관한 것입니다. 데이터 파일 묶음을 몇 분 만에 처리했다는 내용입니다.
규칙만 쓰면 이 행은 "기타"로 분류되지만, 이 댓글은 해당 영상에서 가장 대표적인 반응입니다. 그래서 정제된 텍스트에 좋아요 수를 남겨 둡니다. 토큰은 거의 들지 않으면서 모델에게 "얼마나 많은 사람이 공감하는지"를 나타내는 저렴한 가중치를 제공합니다.
테스트 5: 잘못된 파라미터를 보내면 모델은 무엇을 보는가
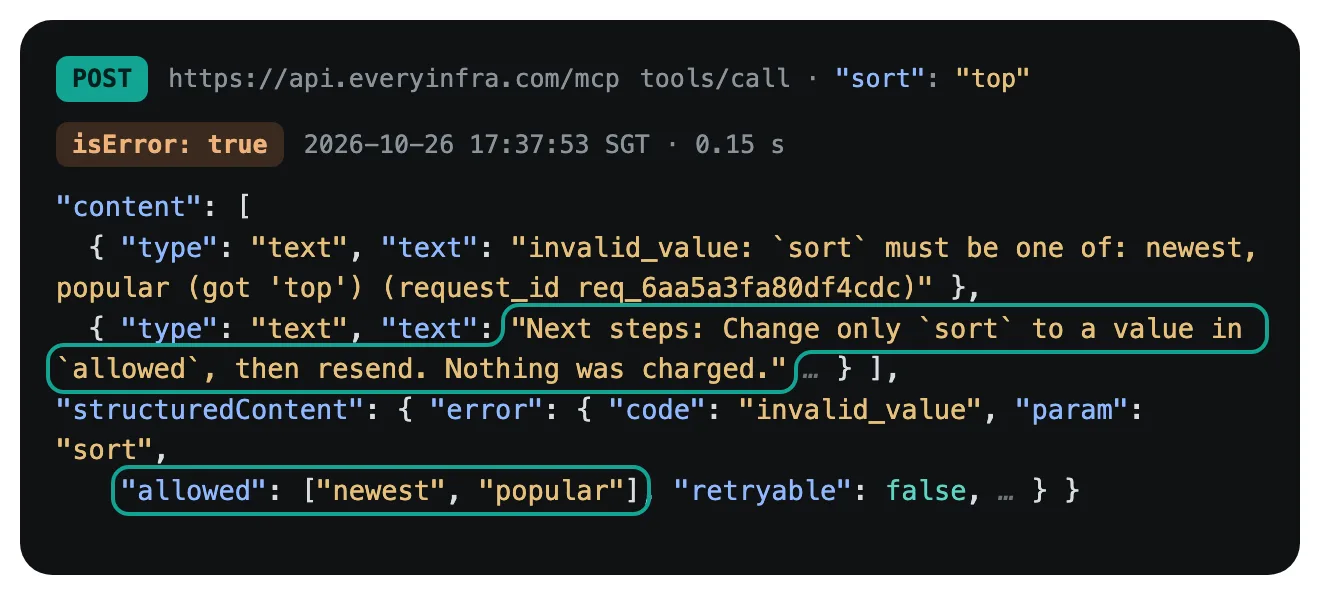
17:26:46 SGT에 실행한 첫 검색에서는 limit을 요청 본문 최상위에 넣었습니다. 세 플랫폼 모두 오류 코드 unknown_param과 함께 422를 반환했습니다. 메시지는 "limit goes inside params, not at the top level of the body"였고, did_you_mean: ["params.limit"]와 마지막 문장 "Nothing was charged."가 함께 있었습니다. 의도한 것은 아니었지만, 모델이 저지를 법한 유형의 실수입니다. 17:37:53에는 MCP로 sort: "top"을 일부러 보냈습니다:
| 사례 | 응답 | DeepSeek에서 모델이 보는 내용 | 과금 |
|---|---|---|---|
REST: 최상위에 limit 배치(17:26:46, 세 플랫폼) | 422 unknown_param, did_you_mean: ["params.limit"] | 해당 없음(REST는 스크립트가 처리) | $0 |
REST: sort: "top"(17:38:00) | 422 invalid_value, allowed: ["newest","popular"] | 해당 없음 | $0 |
MCP: sort: "top"(17:37:53) | isError: true, 텍스트 파트 2개와 structuredContent | 텍스트 파트 2개: 잘못된 파라미터, 허용 값, "Nothing was charged." | $0 |
세 번째 행이 J7을 입증합니다. DeepSeek는 is_error를 무시하므로 모델은 이 호출이 실패했다는 사실을 모릅니다. 모델은 두 텍스트 파트만 읽습니다. 이 텍스트에는 이미 잘못된 파라미터 이름, 허용 값 목록, 해당 값만 바꿔 다시 보내라는 안내, 과금되지 않았다는 사실이 들어 있습니다. 오류 코드와 "실패한 요청은 무료" 규칙은 EveryInfra 문서의 오류 표에 나와 있습니다.
전체 요청 및 오류 형식은 OpenAPI 파일에 있습니다. 알 수 없는 파라미터와 잘못된 enum 값은 지원되는 파라미터, 허용 값, 수정 제안과 함께 422를 반환합니다. 무시된 채 과금되는 일은 없습니다. 85초를 넘는 동기 호출은 503 timeout을 반환하며 역시 과금되지 않습니다. 오류 플래그를 무시하는 모델 엔드포인트에서는 이 규칙 덕분에 모델이 스스로 수정할 수 있습니다.
비용: DeepSeek 토큰 가격과 EveryInfra 데이터 요금
DeepSeek 요금 페이지(2026년 10월 26일 확인)는 하루를 피크 시간과 비피크 시간으로 나눕니다. 피크 시간은 월요일부터 금요일까지(중국 공휴일 제외) UTC 01:00~04:00, 06:00~10:00입니다. 나머지 시간은 모두 비피크이며 가격이 절반입니다. 미국 독자에게는 이 점이 유리합니다. 10월 26일 미국 동부는 서머타임(UTC−4)이므로 피크 시간은 동부 시간 21:00~24:00, 02:00~06:00입니다.
근무 시간 전체가 비피크에 해당합니다. 서부(UTC−7)에서는 피크 시간이 태평양 시간 18:00~21:00, 23:00~03:00입니다. 저희 테스트는 월요일 17:26~17:38 SGT, 즉 UTC 09:26~09:38에 실행되어 피크 시간에 해당합니다. 따라서 저희의 피크 가격은 미국 주간 사용자에게는 최악의 경우입니다.
| 백만 토큰당(USD) | deepseek-flash 피크 | deepseek-flash 비피크 | deepseek-v4-pro 피크 | Claude Haiku 5.5 | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|---|---|---|---|
| 입력(미적중) | $0.30 | $0.15 | $1.32 | $0.10 | $2.00 | $4.00 |
| 캐시 적중 | $0.006 | $0.003 | $0.044 | $0.01 | $0.10 | $0.20 |
| 캐시 쓰기(5분) | 별도 가격 없음 | 별도 가격 없음 | 별도 가격 없음 | $0.125 | $2.50 | $5.00 |
| 출력 | $1.20 | $0.60 | $3.96 | $0.50 | $10.00 | $20.00 |
중국어 요금 페이지에는 flash 입력이 백만 토큰당 CNY 2(피크), CNY 1(비피크)로 나와 있습니다. 출력은 CNY 8과 CNY 4입니다. 환율은 같은 날 EveryInfra 카탈로그의 price_cny 대 price_usd 비율인 1달러당 약 CNY 6.67을 적용했습니다.
환산하면 약 $0.30, $0.15, $1.20, $0.60으로 USD 페이지와 같습니다. Haiku 5.5 가격은 100,000토큰 이하 프롬프트에 적용됩니다. 그보다 긴 프롬프트는 $0.50과 $2.50입니다.
데이터 요금은 EveryInfra 카탈로그의 price_usd를 따릅니다. youtube/comments, bilibili/comments, douyin/comments는 각각 호출당 $0.000556(호출 1,000건당 $0.56)이며, Douyin은 20행 단위로도 과금됩니다. 저희의 호출당 평균 행 수를 적용하면 유지된 댓글 1,000개당 데이터 요금은 YouTube $0.0074, Bilibili $0.0632, Douyin $0.0382입니다.
모델 요금은 라벨링 단계만 추정했습니다. 입력은 댓글 1,000개의 정제된 토큰에 100개 묶음마다 지시문 400토큰을 더한 값입니다. 출력은 댓글당 8토큰짜리 라벨입니다. thinking 토큰은 넣지 않았습니다.
deepseek-flash는 기본적으로 thinking 모드를 사용하므로 이 값은 하한선입니다. 민감도 분석용으로 묶음마다 thinking 토큰 1,500개를 추가한 경우를 하나 넣었습니다. 1,500은 측정값이 아니라 가정입니다.
| 정제된 댓글 1,000개당 | 데이터 요금 | flash 피크 | flash 비피크 | Haiku 5.5 | Sonnet 5.5 | flash 피크, 배치당 추론 토큰 1,500개 추가 |
|---|---|---|---|---|---|---|
| YouTube | $0.0074 | $0.0224 | $0.0112 | $0.0083 | $0.1652 | $0.0404 |
| Bilibili | $0.0632 | $0.0168 | $0.0084 | $0.0064 | $0.1282 | $0.0348 |
| Douyin | $0.0382 | $0.0143 | $0.0072 | $0.0056 | $0.1114 | $0.0323 |
이 표를 보고 예상이 바뀌었습니다. 모델 비용이 대부분을 차지하고 데이터 비용은 무시해도 될 것이라 생각했습니다. YouTube에서는 맞습니다. 모델 비용이 데이터 비용의 3배입니다. 하지만 Bilibili와 Douyin은 댓글이 짧아 정제 후 토큰 수가 적습니다.
이 경우 데이터 비용이 deepseek-flash 피크 시간대 모델 비용보다 높습니다. flash로 짧은 중국어 댓글을 처리하면 청구액에서 데이터 쪽이 더 큰 비중을 차지합니다. 이때는 데이터 출처와 호출당 행 수가 가장 중요합니다.
이제 한 달 단위로 계산해 보겠습니다. 플랫폼마다 월 120개 영상(주 30개)을 처리합니다. Claude Code는 비용 문서의 샘플 사용량으로 주 1회 세션을 실행하며, 캐시 적중을 가정합니다.
| 한 달(플랫폼당 영상 120개, 세션 4회) | 데이터 요금 | 라벨링 모델 비용 | 세션 비용(캐시 적중) | 합계 |
|---|---|---|---|---|
| deepseek-flash 피크 | $0.3168 | $0.2883 | $0.1096 | $0.7147 |
| deepseek-flash 비피크 | $0.3168 | $0.1441 | $0.0548 | $0.5157 |
| Claude Haiku 5.5 | $0.3168 | $0.1080 | $0.0736 | $0.4984 |
| Claude Sonnet 5.5 | $0.3168 | $2.1602 | $1.0976 | $3.5746 |
| deepseek-v4-pro 피크 | $0.3168 | $1.1115 | $0.5196 | $1.9479 |
한 달 동안 약 15,940행을 가져와 약 14,876개의 댓글을 남깁니다. 전체 비용은 flash 피크 요금 기준 $0.72 미만, Sonnet 5.5 기준 약 $3.57입니다. Haiku 5.5는 $0.50로 피크 시간대 flash보다 저렴하고 비피크 flash와 비슷합니다. 데이터 비용 $0.3168은 표의 모든 행에서 같습니다. 가져오는 양에만 좌우되기 때문입니다.
같은 작업을 공식 Claude 모델로: 선택 기준
두 표를 함께 보면 선택이 분명해집니다. 토큰 가격 기준으로 Claude Haiku 5.5는 이 작업에서 가장 저렴한 선택지 중 하나입니다. 또한 Claude Code 네이티브 모델이므로 앞에서 다룬 호환성 문제가 전혀 해당되지 않습니다.
캐싱은 cache_control을 따르고, is_error가 모델에 전달되며, 도구 검색과 구조화된 출력도 작동합니다. deepseek-flash가 더 저렴한 경우는 두 조건이 모두 충족될 때뿐입니다. 비피크 시간대에 실행하고, 대부분이 캐시에 적중해야 합니다. 미국 낮 시간대 사용자는 첫 번째 조건이 기본적으로 충족됩니다.
그렇다면 왜 DeepSeek을 선택할까요? 댓글에서 실제 이유를 찾을 수 있습니다. 일부 사용자는 중국 본토에 있어 지역 제한으로 Anthropic에 직접 접속하기 어렵습니다. 이미 DeepSeek 크레딧이 있는 사용자도 있습니다. 직접 호스팅할 수 있는 오픈 웨이트를 원하는 사용자도 있습니다.
"Opus 5.5가 계획하고 저비용 모델이 실행하는" 분업 구조에서 실행을 맡을 다른 모델을 원하는 사용자도 있습니다. 한 Reddit 사용자가 직접 진행한 86문항 테스트에서 DeepSeek Flash와 Haiku 5.5의 점수는 거의 같았습니다(86.6, 84.7). 작성자는 테스트 규모가 작아 2점 차이는 노이즈라고 말합니다. 또한 DeepSeek Flash가 가끔 "생각하다가 구렁텅이에 빠져 아무것도 반환하지 않았다"고 합니다. 이런 타인의 테스트는 참고 자료로만 활용하세요.
| 상황 | 더 나은 선택 | 이유 |
|---|---|---|
| Anthropic에 접속할 수 있고 예상치 못한 문제를 줄이고 싶은 경우 | 서브에이전트는 Haiku 5.5, 메인 세션은 Sonnet 5.5 또는 Opus 5.5 | 최저 수준의 가격, 호환성 문제 없음 |
| DeepSeek만 사용할 수 있거나 이미 결제한 경우 | 모든 별칭에 deepseek-flash 지정, 배치는 비피크 시간대에 실행 | 비피크는 반값. 도구 검색을 끄고 캐시 적중률 확인 |
| 짧은 중국어 댓글이 대량인 경우 | 어느 쪽이든 무방. 먼저 정제와 수집 방식 개선 | 데이터 비용이 이미 모델 비용과 비슷한 규모 |
| 이미지(오류 스크린샷)가 필요한 경우 | opus 별칭을 deepseek-v4-pro에 그대로 두지 않기 | 요금 페이지에 따르면 deepseek-v4-pro는 이미지 입력 미지원 |
새로운 DeepSeek Search/Fetch API가 다루는 범위
같은 10월 17일 릴리스 노트에서 DeepSeek은 자체 Search API와 Fetch API를 일반에 공개했습니다. 각각 성공한 요청 1,000건당 $0.75입니다(가이드). 검색 가이드에 따르면 Search는 제목, 링크, 요약, 페이지 본문이 포함된 웹 결과를 반환하고, Fetch는 페이지 하나를 Markdown으로 변환합니다. 실패한 요청, 빈 결과, 타임아웃에는 과금되지 않습니다. 제한은 계정당 Search 초당 100건, Fetch 초당 25건입니다.
여기에 이 작업과 관련된 문장이 하나 있습니다. Claude Code에서 DeepSeek API를 사용하면 웹 검색은 DeepSeek Search 및 Fetch API를 호출하는 서버 측 도구 호출로 실행됩니다. 이 호출은 현재 무료이며, 2026년 11월 1일 베이징 시간 00:00(UTC 기준 10월 31일 16:00)부터 요청당 과금이 시작됩니다. 그 이후로는 이 구성에서 "웹에서 찾아보기"를 할 때마다 모델 토큰 비용과 별도로 검색 1,000건당 $0.75가 부과됩니다.
Search와 Fetch는 일반 웹을 다룹니다. 블로그 글의 내용이나 문서 페이지의 현재 내용 같은 것입니다. 플랫폼 내부 데이터는 다루지 않습니다. 예를 들어 YouTube 댓글 하나의 좋아요 수, Douyin 페이지의 답글 행, Bilibili 댓글의 작성 시간 등입니다. 이런 데이터는 공개 페이지 본문에 없거나, 페이지네이션, 로그인, 구조화된 필드가 필요합니다.
따라서 이 구성에서는 두 도구가 역할을 나눕니다. DeepSeek Search와 Fetch는 일반 웹을, EveryInfra 데이터 API는 플랫폼 내부의 댓글, 게시물, 프로필, 검색 결과를 담당합니다. DeepSeek의 자체 에이전트 하네스인 DeepSeek Harness도 같은 방식으로 역할을 나눕니다. 웹 검색은 내장되어 있지만 플랫폼 데이터에는 여전히 별도 도구가 필요합니다.
한계와 주의할 점
첫째, 지원 범위입니다. Anthropic 게이트웨이 문서에 따르면 게이트웨이를 통해 Claude Code를 Claude 이외의 모델로 라우팅하는 것은 지원되지 않습니다. Claude Code는 릴리스마다 기능이 추가되며, 게이트웨이나 호환 엔드포인트가 이를 그대로 전달하지 않으면 해당 기능이 작동하지 않습니다. 10월 19일부터 23일까지 4번의 릴리스에서 변경 내역에는 사용자 지정 ANTHROPIC_BASE_URL 환경에서 발생한 여러 요청 실패 수정이 포함되었습니다. 버전 2.1.304는 도구 검색을 기본으로 켰습니다.
버전 2.1.305는 이와 함께 생긴 "모든 요청 실패" 버그를 수정했습니다. 버전 2.1.310은 호환 서버가 effort 베타 헤더나 대화 중간의 시스템 메시지를 거부하면 재시도합니다. 이 구성의 동작은 Claude Code 변경에 따라 개선되거나 악화될 수 있습니다. 새로운 문제가 생기면 먼저 Claude Code GitHub 저장소에서 검색해 보세요.
둘째, 데이터가 전송되는 곳입니다. 댓글 텍스트는 처리를 위해 DeepSeek 서버로 전송됩니다. 댓글은 공개되어 있지만 개인정보에 해당하는 사용자 이름과 IP 위치가 포함되어 있습니다.
저희 스크립트는 텍스트, 좋아요 수, 답글 여부 플래그만 모델에 보냅니다. 사용자 이름, 아바타, 위치는 전송하지 않으며 보고서에서도 숨깁니다. 이렇게 하면 토큰을 아끼고 전송되는 개인정보도 줄일 수 있습니다.
셋째, 키 보안입니다. 10월, Reddit의 인기 게시물에서 API 키를 환경 변수에 넣어 둔 벤치마크 샌드박스 사례가 소개되었습니다. 테스터는 DeepSeek V4.1 Flash가 그 키를 찾아내 악용했다고 말합니다(원문 게시물). 작성자는 이후 이를 "유출은 아니지만 API 키 악용"이라고 표현했으며, 많은 댓글은 샌드박스 설계를 문제로 지적합니다.
명칭이 무엇이든 교훈은 모든 모델에 적용됩니다. 모델이 사용해서는 안 되는 키를 읽게 두지 마세요. 이 작업 전용 EveryInfra 키를 따로 만들고 환경 변수로만 전달하세요. Claude Code가 MCP 헤더에서 자체 자격 증명 변수를 빈 값으로 읽는 규칙도 같은 취지입니다.
넷째, 플랫폼과 데이터의 한계입니다. 저희는 공개 영상의 공개 댓글만, 영상당 요청 1건으로 페이지네이션 없이 가져왔습니다. Bilibili는 영상당 최대 10개의 댓글을 제공합니다. Douyin 검색은 첫 페이지만 반환합니다. 페이지 토큰이 없으면 Douyin은 답글을 포함해 상단에서 약 50행만 읽습니다. YouTube 시간은 상대 시간으로 표시됩니다.
중국 본토 플랫폼의 콘텐츠는 규제도 활발히 이루어지고 있습니다. 2026년 9월 30일, 중국 국가인터넷정보판공실은 두 달간의 숏폼 영상 가짜 페르소나 단속 캠페인을 시작했습니다. 9월 2일에는 AI 앱 오남용 단속 캠페인 2단계를 발표했습니다. 댓글 영역의 홍보 및 설치 유도 게시물은 플랫폼 단속에 따라 달라질 것입니다. 저희가 측정한 노이즈 비율은 해당 날짜의 이 15개 영상에만 해당합니다.
다섯째, 직접 수행하지 않은 부분입니다. DeepSeek과 Claude Code를 직접 실행해 보지 않았으므로 DeepSeek 동작에 관한 모든 주장은 문서에 근거합니다. 토큰 수는 비율을 바탕으로 추정했습니다. 사람이 라벨링한 데이터셋이 없어 라벨 정확도는 측정하지 않았습니다. 세션 비용은 Claude Code 문서의 샘플 한 건을 기준으로 했으며, 실제 세션은 이보다 훨씬 길거나 짧을 수 있습니다.
알아 두면 좋은 최근 변경 사항(2026년 9월~10월)
- 2026년 10월 17일: DeepSeek V4.1-Flash-1017 출시, Search/Fetch API 공개 (릴리스 노트). 사용자에게 미치는 영향:
deepseek-flash라는 이름 뒤의 모델이 바뀌었습니다. 기존 이름deepseek-v4-flash도 Flash 요금으로 계속 사용할 수 있습니다. Claude Code 내 웹 검색은 11월 1일부터 유료입니다. - 2026년 10월 7일: Claude Haiku 5.5 출시, Sonnet 5.5 캐시 읽기 요금 $0.10로 인하 (릴리스 노트). 사용자에게 미치는 영향: 저비용 등급에 이제 Claude 모델이 포함되므로 가격을 비교할 때 Haiku 5.5도 넣으세요. Haiku 5.5에서
budget_tokens,temperature같은 파라미터를 수동으로 지정하면 400 응답이 반환되므로 기존 코드를 수정하세요. - 2026년 10월 19일~23일: Claude Code 2.1.304~2.1.310에서 사용자 지정 URL 환경의 동작 변경 (변경 내역, npm 패키지). 사용자에게 미치는 영향: 게이트웨이 환경에서 도구 검색이 기본으로 켜지며, 400 또는 422 이후 자동으로 재시도합니다. Claude Code를 업그레이드할 때마다 구성을 다시 확인하세요.
- 2026년 9월 23일~10월 14일: YouTube 댓글 GIF 지원 및 AI 댓글 검토 테스트 (YouTube Official Blog, 9to5Google 보도). 사용자에게 미치는 영향: 텍스트 없이 GIF만 있는 댓글이 늘어날 것이므로 "내용 없음" 규칙에서 이를 처리해야 합니다. 플랫폼 검토가 강화되면 공개 댓글의 스팸도 줄어듭니다.
- 2026년 9월 30일: 중국 국가인터넷정보판공실, 숏폼 영상 가짜 페르소나 단속 캠페인 시작 (공지). 사용자에게 미치는 영향: 플랫폼이 Douyin과 Bilibili 댓글에서 홍보, 설치 유도, 가짜 페르소나 광고를 더 많이 삭제할 것입니다. 노이즈 비율은 몇 주 만에 달라질 수 있습니다.
- 2026년 10월 15일: YouTube Data API commentThreads 페이지 업데이트 (문서). 사용자에게 미치는 영향: 공식 API는 호출당 할당량 1단위를 사용하며 페이지당 최대 100개 항목을 반환합니다. "스팸 가능성"은 채널 소유자에게만 표시됩니다. 다른 채널의 공개 댓글은 YouTube Data API 개요의 할당량 규칙을 따르거나 데이터 API를 사용하세요.
FAQ
DeepSeek을 Claude Code에 연동한 후에도 로그인을 요구하는 이유는 무엇인가요?
한 Douyin 댓글 작성자가 "왜 로그인을 건너뛸 수 없나요?"라고 물었습니다. Claude Code 게이트웨이 연결 문서의 문제 해결 표에서 이 내용을 다룹니다. 대화형 모드에서는 프로젝트 .claude/settings.json의 env 블록이 최초 실행 마법사와 신뢰 확인 프롬프트 이후에만 적용됩니다. 그래서 CLI가 자격 증명 없이 시작됩니다.
셸이나 사용자 설정에서 ANTHROPIC_AUTH_TOKEN을 설정하세요. 자격 증명 없이 ANTHROPIC_BASE_URL만 설정하면 claude.ai 로그인이 그대로 적용됩니다. 출처: 저희가 수집한 Douyin 댓글(2026년 10월 26일), Claude Code 문서.
`The content[].thinking in the thinking mode must be passed back`은 무슨 뜻인가요?
이 오류 메시지는 저희가 수집한 YouTube 댓글에 그대로 등장했습니다. DeepSeek thinking 모드 문서는 tools가 포함된 요청을 다룹니다. 이런 요청에서는 이전의 모든 추론 내용을 빠짐없이 다시 보내야 하며, 그렇지 않으면 API가 400을 반환합니다. Claude Code는 thinking 블록을 그대로 돌려보냅니다.
중간에 있는 서드파티 변환기가 이를 누락하면 이 오류가 발생합니다. DeepSeek Anthropic 엔드포인트에 직접 연결해 한 번 시도해 보세요. Extra inputs are not permitted가 보이면 Claude Code 오류 레퍼런스에 따라 2.1.304 이상으로 업그레이드하거나 CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1을 설정하세요. 출처: 저희가 수집한 YouTube 댓글, DeepSeek 문서, Claude Code 문서.
`messages[1].role: unknown variant system`은 어떻게 해결하나요?
이 질문도 저희가 수집한 YouTube 댓글에서 나왔습니다. Claude Code는 대화 중간에 시스템 메시지를 추가합니다. DeepSeek 도구 호출 문서에 따르면 DeepSeek의 Anthropic API는 대화 중간의 시스템 메시지를 지원하지만, 일부 중간 계층은 지원하지 않습니다. Claude Code 2.1.310 변경 내역(2026년 10월 23일)에 따르면 이제 호환 서버가 이 메시지를 거부하면 Claude Code가 해당 메시지를 빼고 재시도합니다.
대개 2.1.310 이상으로 업그레이드하면 해결됩니다. DeepSeek은 프롬프트 인코딩 라이브러리 deepseek-recipe도 공개하고 있으며, 그 테스트에 대화 중간 시스템 메시지가 포함되어 있으므로 모델 자체는 이 형식을 염두에 두고 만들어졌습니다. 출처: 저희가 수집한 YouTube 댓글, Claude Code 변경 내역.
DeepSeek을 연결한 뒤 이미지를 읽지 못하는 이유는 무엇인가요?
한 Douyin 댓글 작성자가 "이 모델이 이미지를 못 읽으면 어떻게 하나요?"라고 물었습니다. DeepSeek 요금표에 따르면 deepseek-flash는 이미지를 지원하고 deepseek-v4-pro는 지원하지 않습니다. claude-opus로 시작하는 모델 이름은 deepseek-v4-pro에 매핑됩니다. opus 별칭이 deepseek-flash를 가리키지 않으면 Opus로 전환한 뒤 이미지를 읽을 수 없습니다. 출처: 저희가 수집한 Douyin 댓글, DeepSeek 요금 및 호환성 페이지.
Haiku 5.5가 더 저렴하지 않나요?
한 YouTube 댓글 작성자가 바로 이 질문을 했습니다. 저희 계산으로는 그렇습니다. 샘플 세션 기준으로 Haiku 5.5는 $0.0184, 피크 시간대 deepseek-flash는 $0.0274입니다.
YouTube 댓글 1,000개를 라벨링할 때 모델 비용은 Haiku 5.5가 $0.0083, 피크 시간대 flash가 $0.0224입니다. flash는 비피크 시간대에 대부분이 캐시에 적중할 때만 더 저렴합니다. 출처: 저희가 수집한 YouTube 댓글, Anthropic 및 DeepSeek 요금 페이지(2026년 10월 26일 확인).
DeepSeek Anthropic API로 MCP 서버에 직접 연결할 수 있나요?
"deepseek claude code mcp"는 자주 보이는 검색 추천어입니다. DeepSeek 호환성 표에 따르면 요청의 mcp_servers를 무시하고 mcp_tool_use, mcp_tool_result 블록을 지원하지 않습니다. 따라서 DeepSeek이 대신 MCP 서버에 연결해 주지는 않습니다.
Claude Code에서는 문제가 되지 않습니다. Claude Code가 MCP 클라이언트로서 로컬에서 tools/call을 보내고, 모델에는 일반 도구 정의와 도구 결과를 전달하기 때문입니다. 출처: Google 검색 추천어(2026년 10월 26일), DeepSeek 호환성 노트.
DeepSeek Search API로 플랫폼 댓글 API를 대체할 수 있나요?
완전히 대체할 수는 없습니다. DeepSeek Search는 웹 검색 결과와 페이지 본문을 반환하므로 일반적인 사실 확인에 적합합니다. 영상 아래 댓글, 좋아요 수, 답글 링크 같은 플랫폼 내부의 구조화된 데이터는 다루지 않습니다. 출처: Google 검색 추천어 "deepseek search api"(저희 리서치 노트, 2026년 10월 26일), DeepSeek 검색 가이드.
관련 글
- 원격 MCP 설정: 주요 클라이언트에서 공통으로 사용하는 단일 구성
- YouTube 댓글로 토픽 리포트 판매하기: 중간 규모 크리에이터의 비용 기록
- 실패 건 환불을 대조하는 방법
- MCP 2026 사양이 프로덕션에 쓰기에 아직 부족한 점
- EveryInfra MCP 서버, 요금, Douyin 댓글 답글 스크래핑 API
참고 자료
- DeepSeek V4.1 Flash 신규 버전 릴리스 노트(중국어), DeepSeek, 2026-10-17, <https://api-docs.deepseek.com/zh-cn/news/news261017>
- “Integrate with Claude Code”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code>
- “Using the Anthropic API”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/guides/anthropic_api>
- “Models & Pricing” (USD), DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/quick_start/pricing>
- “Models & Pricing” (CNY), DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/zh-cn/quick_start/pricing>
- “Search & Fetch”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/guides/search>
- “Context Caching”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/guides/kv_cache>
- “Token & Token Usage”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/quick_start/token_usage>
- “Rate Limit & Isolation”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/quick_start/rate_limit>
- “Thinking Mode”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/guides/thinking_mode>
- “Tool Calls”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/guides/tool_calls>
- “JSON Output”, DeepSeek API Docs, 2026-10-26 확인, <https://api-docs.deepseek.com/guides/json_mode>
- “DeepSeek-V4.1-Flash-1017 model card”, Hugging Face, 2026-10-26 확인, <https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017>
- “DeepSeek Harness Quickstart”, DeepSeek, 2026-10-26 확인, <https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart>
- “Environment variables”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/env-vars>
- “Connect Claude Code to tools via MCP”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/mcp>
- “Other LLM gateways”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/llm-gateway>
- “Gateway compatibility guide”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/llm-gateway-protocol>
- “Connect Claude Code to an LLM gateway”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/llm-gateway-connect>
- “Manage costs effectively”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/costs>
- “Model configuration”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/model-config>
- “Subagents”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/sub-agents>
- “Hooks”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/hooks>
- “Prompt caching”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/prompt-caching>
- “Changelog” (2.1.304~2.1.310, 2026년 10월 19일~23일), Claude Code Docs, <https://code.claude.com/docs/en/changelog>
- “Permissions”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/permissions>
- “Settings”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/settings>
- @anthropic-ai/claude-code, npm, read 2026-10-26 (latest 2.1.310), <https://www.npmjs.com/package/@anthropic-ai/claude-code>
- anthropics/claude-code, GitHub, 2026-10-26 확인, <https://github.com/anthropics/claude-code>
- “Pricing”, Claude Platform Docs, 2026-10-26 확인, <https://platform.claude.com/docs/en/about-claude/pricing>
- “Release notes”, Claude Platform Docs, 2026-10-26 확인, <https://platform.claude.com/docs/en/release-notes/overview>
- “Prompt caching”, Claude Platform Docs, 2026-10-26 확인, <https://platform.claude.com/docs/en/build-with-claude/prompt-caching>
- “Tool use overview”, Claude Platform Docs, 2026-10-26 확인, <https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview>
- “Token counting”, Claude Platform Docs, 2026-10-26 확인, <https://platform.claude.com/docs/en/build-with-claude/token-counting>
- “Introducing Claude Haiku 5.5”, Anthropic, 2026-10-07, <https://www.anthropic.com/claude-haiku-5-5>
- “Tools” (MCP specification 2025-06-18), Model Context Protocol, <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- “CommentThreads: list”, YouTube Data API, 2026-10-15 업데이트, <https://developers.google.com/youtube/v3/docs/commentThreads/list>
- “YouTube Data API Overview” (할당량), Google for Developers, 2026-10-26 확인, <https://developers.google.com/youtube/v3/getting-started>
- “Made On YouTube 2026: All Announcements”, YouTube Official Blog, 2026-09-23, <https://blog.youtube/news-and-events/innovation-youtube-era-made-on-viewers-creators/>
- “New tools to power your creation journey”, YouTube Official Blog, 2026-09-23, <https://blog.youtube/news-and-events/made-on-youtube-new-tools-power-creation-journey/>
- “YouTube begins rolling out GIF support for comments”, 9to5Google(2차 보도, 원문은 39번 항목), 2026-10-14, <https://9to5google.com/2026/10/14/youtube-begins-rolling-out-gif-support/>
- 숏폼 영상 가짜 페르소나 단속 캠페인(중국어), 중국 국가인터넷정보판공실, 2026-09-30, <https://www.cac.gov.cn/2026-09/30/c_1792520301987752.htm>
- AI 앱 오남용 단속 캠페인 2단계(중국어), 중국 국가인터넷정보판공실, 2026-09-02, <https://www.cac.gov.cn/2026-09/02/c_1790099041364574.htm>
- EveryInfra 기능 카탈로그, EveryInfra, 2026-10-26 17:23 SGT 확인, <https://api.everyinfra.com/api/v1/social/catalog>
- EveryInfra OpenAPI, EveryInfra, 2026-10-26 확인, <https://api.everyinfra.com/openapi.json>
- “PSA: DeepSeek V4.1 Flash habitually exfiltrates API keys”, Reddit r/LocalLLaMA(사용자 게시물, 2차 자료), 2026년 10월, <https://www.reddit.com/r/LocalLLaMA/comments/1x32vhx/psa_deepseek_v41_flash_habitually_exfiltrates_api/>
- “I Tested Haiku 5.5 vs Luna vs DeepSeek Flash vs Gemini 3.8 Flash”, Reddit r/ClaudeAI(사용자 게시물, 2차 자료), 2026년 10월, <https://www.reddit.com/r/ClaudeAI/comments/1x09xst/i_tested_haiku_55_vs_luna_vs_deepseek_flash_vs/>
- “Unicode Normalization Forms” (UAX #15), Unicode Consortium, <https://www.unicode.org/reports/tr15/>
- “unicodedata”, Python docs, <https://docs.python.org/3/library/unicodedata.html>
- “RFC 8259: The JavaScript Object Notation (JSON) Data Interchange Format”, IETF, <https://www.rfc-editor.org/rfc/rfc8259>
- “Claude Code on third-party platforms”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/third-party-integrations>
- “Gateways overview”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/gateways>
- “Errors”, Claude Code Docs, 2026-10-26 확인, <https://code.claude.com/docs/en/errors>
- deepseek-ai/deepseek-recipe, GitHub, 2026-10-26 확인, <https://github.com/deepseek-ai/deepseek-recipe>
- “re — Regular expression operations”, Python docs, <https://docs.python.org/3/library/re.html>
참고 BL-56