Gemini Deep Research API에 원격 MCP 서버 연결하기: 출처를 검증할 수 있는 소셜 데이터
Gemini Deep Research API는 원격 MCP 서버는 지원하지만 커스텀 함수는 지원하지 않습니다. 실제 소셜 데이터 API 호출 7회의 총비용은 $0.0046입니다. 설정, 요금, 인용 검증 방법을 정리했습니다.
결론부터 말하면 가능합니다. Gemini Deep Research API는 현재 원격 MCP 서버를 호출할 수 있습니다. 커스텀 함수 선언은 받지 않으며, 구조화된 출력도 지원하지 않습니다. 이 세 가지 사실은 모두 Google Deep Research 페이지의 "Limitations" 섹션에 나와 있습니다(Deep Research 문서, 2026-10-13 업데이트). 따라서 https://api.everyinfra.com/mcp의 EveryInfra 원격 MCP 서버를 연결할 수 있습니다.
저희는 2026-11-02 00:16~00:20 SGT에 소셜·뉴스 데이터 API를 실제로 7회 호출했습니다. 응답은 131행이었고 총비용은 $0.0046이었습니다. 데이터를 보면 검증 가능한 인용의 약점은 모델이 아니라 데이터 자체에 있었습니다. 영어 뉴스 날짜는 0~1일 늦었고, 스페인어 뉴스 10건은 날짜가 모두 비어 있었습니다. YouTube 댓글 50개에는 링크가 하나도 없었지만, Reddit 댓글 35개에는 모두 퍼머링크가 있었습니다.
이 글은 실무 질문 하나에 답합니다. Gemini Deep Research로 공개 주제에 대한 보고서를 작성하려 합니다. 그리고 보고서에 담긴 소셜 미디어 관련 주장마다 독자가 직접 열어 볼 수 있는 행을 가리키게 하고 싶습니다. 이렇게 하려면 에이전트에 구조화된 소셜 데이터를 어떻게 제공해야 할까요?
테스트 주제로는 뉴욕시의 전기자전거 배터리 화재를 골랐습니다. 2026-10-28 브롱크스의 한 아파트에서 난 화재로 소년 한 명이 숨졌고, 이후 3명이 더 사망했습니다. 며칠 만에 영어·스페인어 뉴스, Reddit 스레드, YouTube 동영상이 나왔기 때문에 네 가지 출처 유형을 시험하기에 적합합니다.
이 글에서 Google에 관한 모든 사실은 ai.google.dev, Google Cloud 문서, Google 블로그의 페이지에서 가져왔습니다. 저희에게는 Gemini API 키가 없으며 Deep Research를 실행하지 않았습니다. 아래 Gemini 코드는 모두 설정 예시이며 테스트 결과가 아닙니다. EveryInfra 관련 수치는 모두 실제 호출의 원본 응답에서 나왔습니다.
Gemini Deep Research API는 원격 MCP 서버에 연결할 수 있을까?
가능합니다. Deep Research 페이지에는 다섯 가지 도구 유형이 나와 있습니다. 그중 google_search, url_context, code_execution은 기본으로 켜져 있습니다. mcp_server와 file_search는 직접 추가해야 합니다(Deep Research 문서, "Supported tools"). 이 기능은 2026-04-21 새 Deep Research 에이전트와 함께 출시되었습니다. 변경 내역 항목에는 협업 계획, 시각화, MCP 서버 통합, File Search가 언급되어 있습니다(Gemini API 변경 내역).
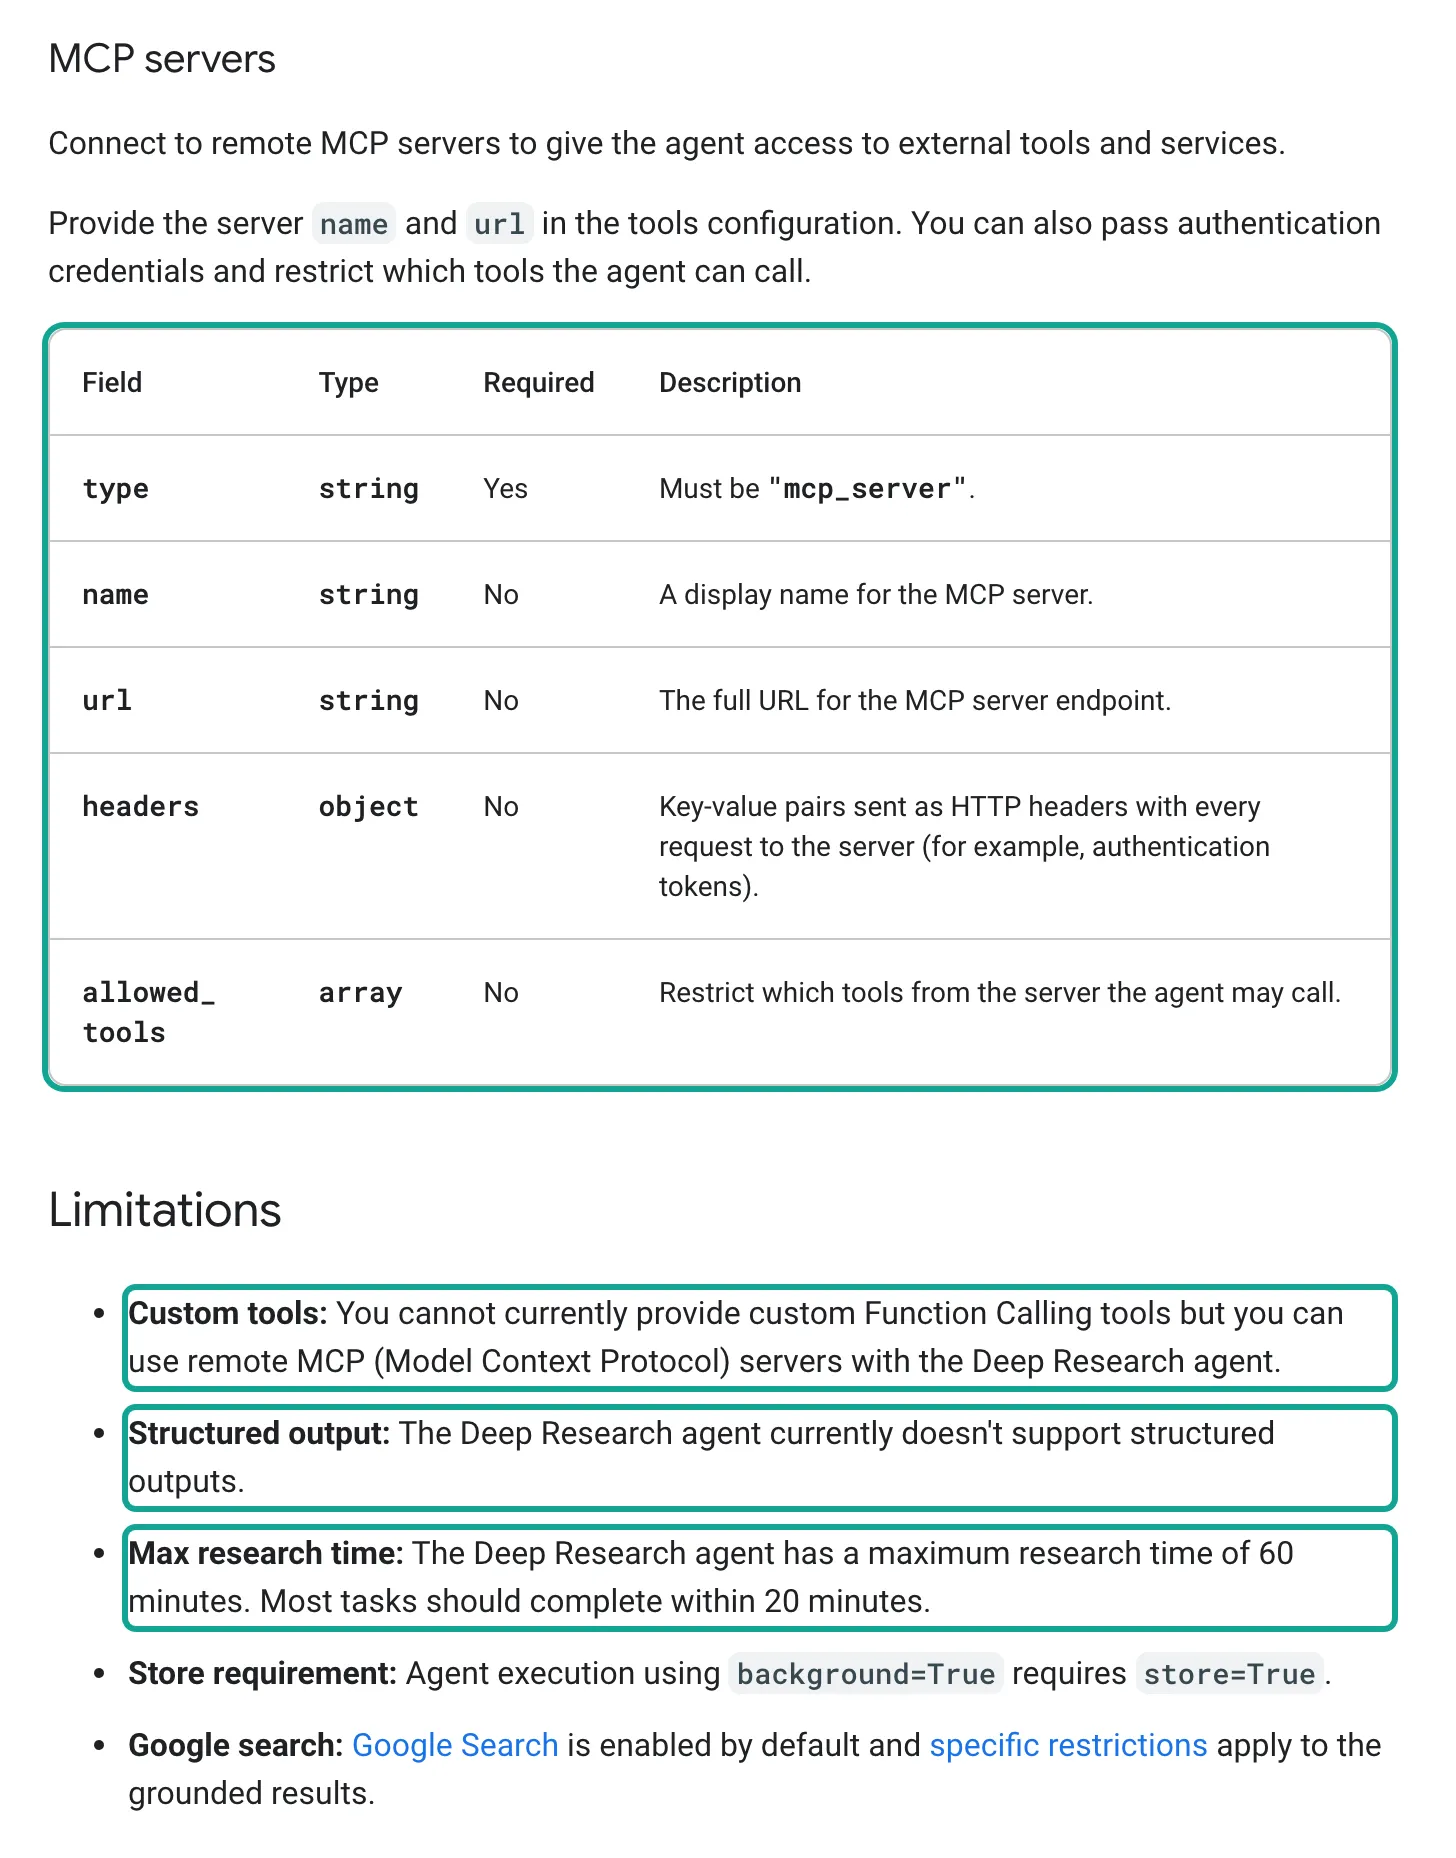
mcp_server 도구에는 필드가 다섯 개 있습니다. type은 필수이며 값은 "mcp_server"여야 합니다. name은 표시 이름이고, url은 MCP 엔드포인트의 전체 URL입니다. headers에는 모든 요청에 함께 전송되는 HTTP 헤더를 넣으며, 문서에서는 인증 토큰을 예로 듭니다. allowed_tools는 해당 서버의 도구 중 에이전트가 호출할 수 있는 도구를 제한합니다.
커스텀 함수는 사정이 다릅니다. 같은 페이지의 첫 번째 제한 사항에 따르면 현재 Deep Research에는 커스텀 Function Calling 도구를 제공할 수 없으며, 대신 원격 MCP 서버를 사용할 수 있다고 덧붙입니다. 두 번째 제한 사항은 구조화된 출력을 지원하지 않는다는 것입니다. 세 번째는 최대 조사 시간이 60분이라는 것이며, 대부분의 작업은 20분 안에 끝나는 것이 일반적입니다.
Google 페이지에는 헷갈릴 만한 문장이 두 개 더 있습니다. Deep Research Max에 관한 Google 블로그 글은 Deep Research가 "임의의 도구 정의를 지원한다"고 씁니다(Google 블로그, 2026-04-21). 문서와 함께 읽으면, 이는 요청에 넣는 함수 선언이 아니라 MCP로 노출된 도구를 뜻합니다. Interactions API 개요에도 Gemini 3가 아직 원격 MCP를 지원하지 않는다는 내용이 있습니다(Interactions API 개요, 2026-10-15 업데이트). 이 안내는 model 파라미터로 호출하는 모델에 관한 것입니다. Deep Research는 agent 파라미터로 호출하는 에이전트이므로 이 안내가 적용되지 않습니다.
| 질문 | Google 문서의 답변 | 출처 및 날짜 |
|---|---|---|
| 원격 MCP 서버 지원 여부 | 지원, 도구 유형 mcp_server(headers, allowed_tools 포함) | Deep Research 문서, 2026-10-13 |
| 커스텀 함수 지원 여부 | 아니요, 현재 미지원 | 같은 페이지, Limitations |
| 구조화된 JSON 출력 지원 여부 | 아니요 | 같은 페이지, Limitations |
| 최대 실행 시간 | 60분, 대부분 20분 이내 | 같은 페이지, Limitations |
| 백그라운드 모드 필수 여부 | 필수, background=true와 store=true | 같은 페이지, 백그라운드 문서 |
| 컨텍스트 및 출력 한도 | 입력 1,048,576토큰, 출력 65,536토큰 | 모델 페이지, 2026-10-29 |
| 에이전트 이름 | deep-research-preview-04-2026, deep-research-max-preview-04-2026 | 모델 페이지, 변경 내역 |
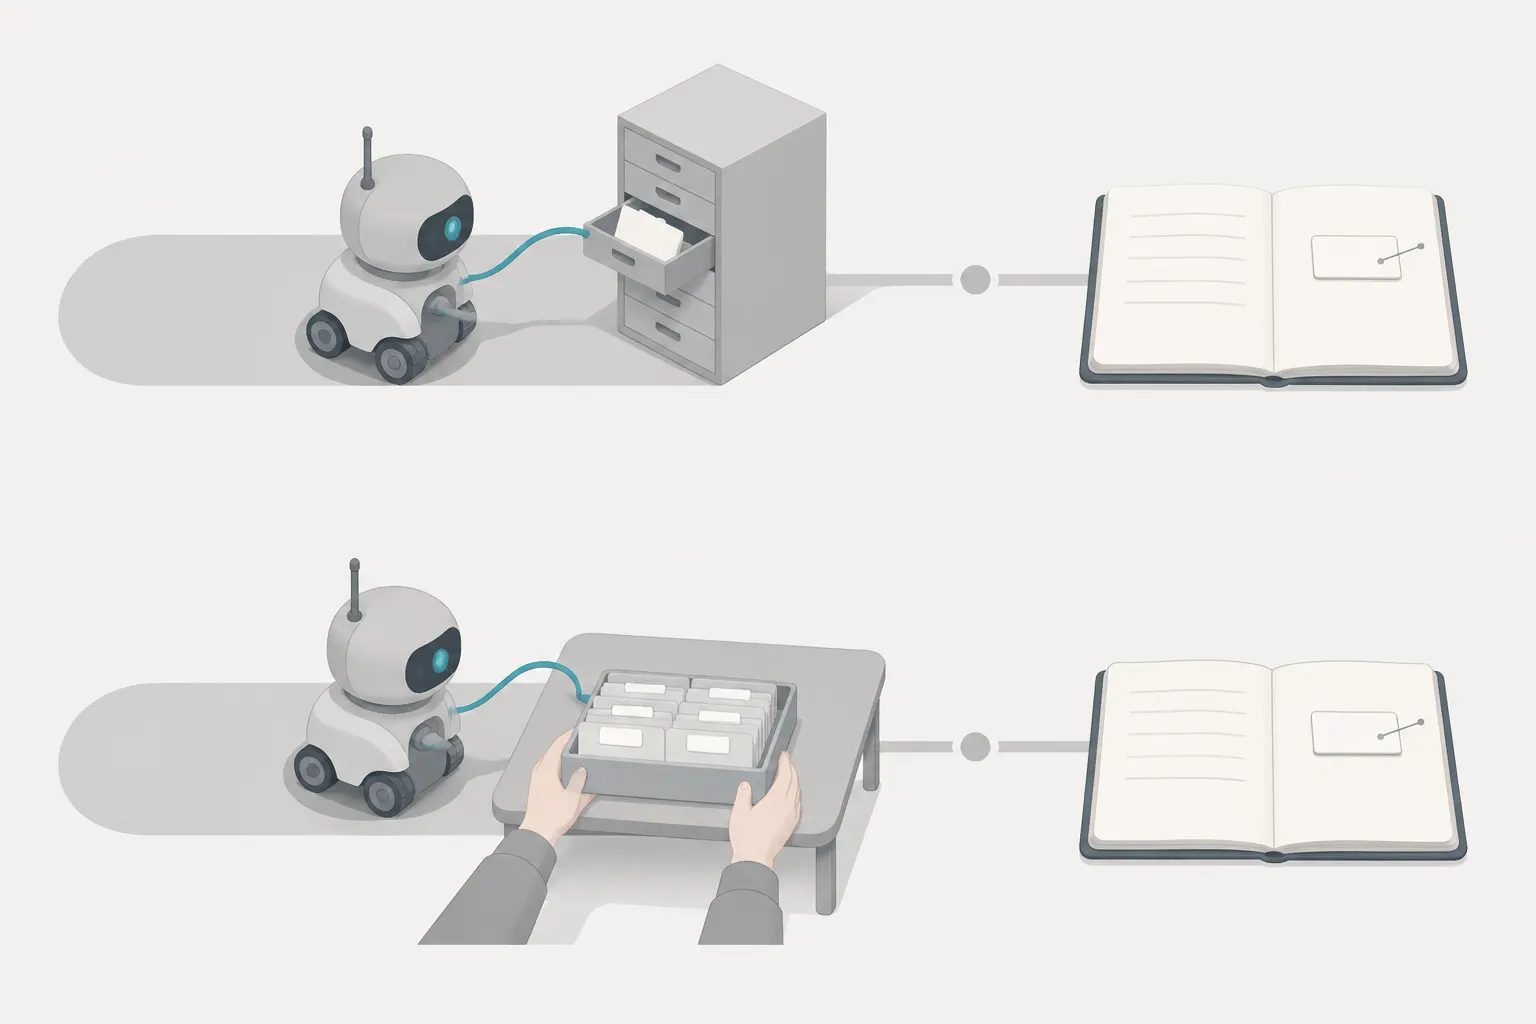
따라서 저희가 구상한 두 경로 모두 작동하지만 순서가 달라집니다. 경로 A에서는 tools에 EveryInfra MCP URL을 넣습니다. 그러면 에이전트가 실행 중에 Reddit을 검색하거나 뉴스를 가져올 시점을 스스로 판단합니다. 경로 B에서는 프로그램이 먼저 POST /api/v1/social을 호출합니다. 그 결과를 표로 만들어 에이전트에 입력이나 File Search 문서로 전달합니다.
경로 B가 필수는 아니지만, 검증 가능한 인용을 원한다면 더 안전한 경로입니다. 이유는 Gemini가 아니라 데이터에 있습니다.
Gemini Deep Research API 호출 방식: 백그라운드 모드, 폴링, 스트리밍
Deep Research는 기존 generateContent 메서드가 아닌 Interactions API로만 실행됩니다. Interactions API는 2025-12-11에 출시되어 2026년 6월에 정식 출시(GA)되었습니다. Google은 현재 이를 새 프로젝트의 기본 인터페이스로 안내합니다(Interactions API 개요).
Deep Research 호출은 일반 모델 호출과 세 가지 점에서 다릅니다. model 대신 agent 파라미터를 사용합니다. background=true를 반드시 설정해야 하며, API는 id가 담긴 부분 객체를 즉시 반환합니다. 이후 그 id로 폴링하거나 스트림을 엽니다.
아래 블록은 문서의 REST 예시를 따랐습니다. 저희가 실행하지 않은 설정 예시입니다.
# Configuration example: start Deep Research with the EveryInfra remote MCP server (not run by us)
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "Content-Type: application/json" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -d '{
    "agent": "deep-research-preview-04-2026",
    "input": "Research how e-bike battery fires in New York City were discussed in news, Reddit and YouTube in October 2026. For every claim about social media, quote the row id and url from the EveryInfra tool result. If a date is approximate, say so.",
    "tools": [
      {"type": "google_search"},
      {"type": "url_context"},
      {"type": "mcp_server",
       "name": "EveryInfra",
       "url": "https://api.everyinfra.com/mcp",
       "headers": {"Authorization": "Bearer '"$EVERYINFRA_API_KEY"'"},
       "allowed_tools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]}
    ],
    "agent_config": {"type": "deep-research", "thinking_summaries": "auto"},
    "background": true
  }'

# Poll (replace INTERACTION_ID with the id from the first response)
curl "https://generativelanguage.googleapis.com/v1beta/interactions/INTERACTION_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
백그라운드 인터랙션에는 in_progress, requires_action, completed, failed, cancelled 다섯 가지 상태가 있습니다(백그라운드 실행 문서). background=true에는 store=true가 필요하며, 백그라운드 모드에서 store=false로 설정하면 400 오류가 반환됩니다. 저장된 인터랙션은 유료 등급에서 55일, 무료 등급에서 1일 동안 보관됩니다. 유료 프로젝트는 AI Studio에서 이 기간을 7일, 14일, 28일로 바꿀 수 있습니다. 이는 데이터 측면에서 중요합니다. headers에 넣은 EveryInfra 키는 인터랙션에 나타나지 않지만, 에이전트가 가져온 소셜 데이터 행은 모두 단계(step)로 저장됩니다.
스트리밍에는 stream=true와 background=true가 모두 필요합니다. 실행 중 사고 요약을 보려면 agent_config.thinking_summaries도 "auto"로 설정하세요. 문서의 예시는 연결이 끊기는 경우를 처리합니다. interaction_id와 마지막 event_id를 저장해 두었다가, 연결이 끊기면 GET /interactions/{id}?stream=true&last_event_id=...를 호출해 재개합니다. 문서는 연결이 끊기는 원인 중 하나로 600초 타임아웃을 꼽으므로, 오래 걸리는 실행에서는 이 재연결 로직이 필수입니다.
| `agent_config` 필드 | 기본값 | 동작 | 여기서 중요한 이유 |
|---|---|---|---|
type | 필수, "deep-research" | Deep Research 호출임을 표시 | — |
thinking_summaries | "none" | "auto"로 설정하면 스트림에 단계 표시 | 에이전트가 MCP를 호출하는 시점을 확인 가능 |
visualization | "auto" | 차트를 허용하되, 프롬프트에서 요청할 때만 생성 | 프롬프트에서 차트 요청 |
collaborative_planning | false | 먼저 계획을 반환함. previous_interaction_id로 계획을 수정한 뒤 마지막 턴에서 false로 설정. 설정을 바꾸지 않고 "좋아요" 같은 답만 보내면 보고서가 생성되지 않음(Philipp Schmid, 2026-04-29) | 계획 단계에서 사용할 기능을 제한 |
Gemini Deep Research API 요금: 작업당 $1~$3, Max는 $3~$7
Google은 Deep Research에 별도 가격을 매기지 않습니다. 모델 추론과 도구 사용에 각각 비용을 지불합니다(요금 페이지, "Pricing for agents", 2026-10-30 업데이트). 모든 추론은 Gemini 표준 요금으로 과금되며, 에이전트 루프의 중간 토큰도 포함됩니다. 도구는 각자의 요금으로 과금됩니다. Google 검색 결과는 토큰으로 계산되지 않지만, URL Context와 File Search로 가져온 콘텐츠는 토큰으로 계산됩니다.
Deep Research 페이지에는 비용 추정치가 나와 있습니다(Deep Research 문서, "Estimated costs"). 분석 수준이 보통인 표준 작업은 검색 약 80회와 입력 토큰 250,000개를 쓰며, 이 중 50~70%가 캐시됩니다. 출력 토큰도 약 60,000개를 써서 합계는 약 $1~$3입니다. 심층 경쟁 분석용 Max 작업은 최대 약 160회 검색, 입력 토큰 900,000개, 출력 토큰 80,000개를 씁니다. 추정치는 약 $3~$7입니다.
요금 페이지에는 Google 검색 가격도 나와 있습니다. Gemini 3 이후 모델은 월 5,000회 무료 검색을 공유합니다. 그 이후에는 1,000회당 $14이며, 프로젝트마다 하루 1,500회의 기본 상한이 있습니다. 문서에는 Deep Research 내부의 검색이 이 가격으로 과금되는지, 일일 상한에 포함되는지가 나와 있지 않습니다. 포함된다면 보고서당 80회 검색 기준으로 하루 약 18건까지 가능합니다. 저희는 Deep Research를 실행하지 않았으므로, 직접 청구 내역의 usage를 확인하세요.
지출 한도는 놓치기 쉽습니다. 요청 속도 제한 페이지에 따르면 Gemini API는 10분 롤링 윈도우 단위로 지출도 제한합니다. 한도는 Tier 1이 $10, Tier 2가 $50, Tier 3이 $200입니다. 한도를 넘은 프로젝트는 429 RESOURCE_EXHAUSTED를 받습니다(요청 속도 제한, 2026-10-28 업데이트). 작업당 $3라면 Tier 1 프로젝트는 10분 안에 작업 3~4건으로 한도에 도달할 수 있습니다.
유료 등급에는 진입 절차도 있습니다. 결제 페이지에 따르면 무료 등급에서 유료 등급으로 전환하려면 결제 계정을 연결해야 합니다. 신규 계정에는 기본적으로 선불 요금제가 적용되며, 최소 충전 금액은 $5입니다(결제 문서). 선불 잔액이 소진되면 요청이 실패합니다. 예약 보고서를 실행하는 프로젝트라면 잔액을 충분히 유지하거나 자동 충전을 켜 두세요.
보고서가 많은 팀이라면 Google Cloud를 검토해 볼 만합니다. Google Cloud의 Deep Research 페이지에는 stream=false일 때 쓸 수 있는 service_tier="deferred" 옵션이 설명되어 있습니다. 이 옵션은 백그라운드 작업을 사용량이 적은 시간대로 미루고 요금을 절반으로 낮춥니다(Google Cloud Deep Research 문서).
| 비용 항목 | 가격(2026-11-02 기준) | Deep Research 작업 1건의 사용량 |
|---|---|---|
| 모델 추론 | Gemini 표준 요금, 중간 토큰 포함 | 입력 약 250k, 출력 약 60k(Max는 900k, 80k) |
| Google 검색 | 월 5,000회 무료, 이후 1,000회당 $14, 하루 1,500회 상한 | 검색 약 80회(Max는 약 160회) |
| URL Context | 콘텐츠를 입력 토큰으로 과금 | 읽은 페이지에 따라 다름 |
| File Search | 인덱싱은 임베딩 토큰 1M개당 $0.15, 저장과 쿼리 임베딩은 무료 | 파일을 업로드할 때만 |
| 코드 실행 | 코드와 결과를 토큰으로 과금 | 에이전트가 계산하거나 차트를 그릴 때 |
| EveryInfra 소셜 데이터 | 카탈로그의 호출당 price_usd, 실패하거나 결과가 비면 과금 없음 | 보고서 1건에 23회 호출, 약 $0.0135 |
전체 비용에서 소셜 데이터가 차지하는 부분은 작습니다. 2026-11-02 카탈로그 가격 기준으로 google_news/search는 호출당 $0.000792입니다. reddit/search, reddit/comments, youtube/search, youtube/comments는 호출당 $0.000556입니다. 반환되는 행 수와 관계없이 호출당 요금은 동일합니다. 보고서 1건에 뉴스 검색 3회, Reddit 검색 3회, Reddit 스레드 10개의 댓글, YouTube 검색 2회, 동영상 5개의 댓글을 쓴다고 가정해 보겠습니다. 합계 23회 호출에 $0.0135로, Deep Research 작업 1건 비용의 0.45~1.35%입니다.
따라서 보고서 비용은 데이터 호출이 아니라 Deep Research가 좌우합니다. 신경 써야 할 부분은 데이터를 검증할 수 있는지입니다.
| 기능 | 카탈로그 호출당 가격 | 보고서 1건의 호출 수 | 소계 |
|---|---|---|---|
google_news/search | $0.000792 | 3(영어, 스페인어, 중국어) | $0.002376 |
reddit/search | $0.000556 | 3 | $0.001668 |
reddit/comments | $0.000556 | 10 | $0.005560 |
youtube/search | $0.000556 | 2 | $0.001112 |
youtube/comments | $0.000556 | 5 | $0.002780 |
| 합계 | — | 23 | $0.013496 |
소요 시간: Deep Research는 수 분, 저희 호출 7회는 77초
Deep Research는 수 분 동안 실행됩니다. 문서의 비교 표는 일반 모델의 지연 시간을 초 단위로, Deep Research의 지연 시간을 분 단위(비동기, 백그라운드)로 제시합니다. 한도는 60분이며 대부분의 작업은 20분 안에 끝납니다.
2026-03-05에 컴플라이언스 리서치 도구를 만드는 한 포럼 사용자는 이전 에이전트의 한 번 실행에 약 7분이 걸렸다고 밝혔습니다. 이후 비슷한 프롬프트로 실행한 작업은 in_progress에 머물렀습니다. 스트림에는 사고 단계가 네다섯 개 표시된 뒤 오류 없이 연결이 끊겼습니다(개발자 포럼 스레드). 폴링 코드에는 completed와 failed 처리뿐 아니라 in_progress에 대한 자체 타임아웃도 필요합니다.
호출 7회를 순차적으로 실행하는 데 약 77초가 걸렸습니다. 가장 느린 것은 댓글로, YouTube 댓글 50개에 30.1초, Reddit 댓글 35개에 19.3초가 걸렸습니다. 뉴스 검색은 각각 3.7~4.7초였습니다. 경로 A에서는 에이전트가 호출마다 기다립니다. 댓글 호출이 십여 회면 이미 오래 걸리는 실행에 몇 분이 더해집니다.
댓글처럼 느린 요청 때문에 에이전트가 기다려서는 안 됩니다. everyinfra_call_api 도구 설명에 에이전트가 할 일이 적혀 있습니다. 느린 작업이나 limit이 큰 경우 mode=async를 전달하라고 안내합니다. 그러면 에이전트는 즉시 job_id를 받고, 무료인 everyinfra_get_job으로 결과를 읽습니다.
동기 응답 7건에는 모두 비동기 모드를 안내하는 async_hint도 들어 있어 에이전트가 읽을 수 있습니다. 경로 B에서는 프로그램이 호출을 병렬로 실행할 수 있습니다. 수십 회 호출이 1~2분 안에 끝나고, 그다음 모든 결과를 한 번에 Deep Research에 넘깁니다.
인용 형식: url_citation, file_citation, 바이트 오프셋
Deep Research는 보고서 본문에 각주를 넣지 않습니다. 인용은 출력 단계의 annotations 배열에 붙습니다. Interactions API 레퍼런스에는 여러 어노테이션 유형이 나와 있습니다(API 레퍼런스, 2026-10-28 업데이트). 여기서 중요한 것은 두 가지입니다. url_citation에는 url, title, start_index, end_index 네 필드가 있습니다. file_citation에는 document_uri, file_name, source, custom_metadata, page_number, media_id와 함께 같은 두 인덱스 필드가 있습니다.
레퍼런스에 따르면 인덱스는 바이트 단위이며 end_index는 해당 위치를 포함하지 않습니다. 이는 ASCII가 아닌 문자가 들어 있는 모든 보고서에 영향을 줍니다. UTF-8에서 곡선형 따옴표는 3바이트, 악센트가 붙은 스페인어 문자는 2바이트입니다. 이 인덱스로 Python 문자열을 자르면 첫 특수 문자 이후의 인용 위치가 모두 어긋납니다. 텍스트를 먼저 바이트로 인코딩한 뒤 자르세요. 아래 코드는 레퍼런스의 필드 이름을 사용한 설정 예시입니다.
# Configuration example: map Deep Research citations back to text spans (field names from the Interactions API reference)
def cited_spans(interaction):
    out = []
    for step in interaction["steps"]:
        if step.get("type") != "model_output":
            continue
        for block in step.get("content", []):
            if block.get("type") != "text":
                continue
            raw = block["text"].encode("utf-8")          # indexes count bytes
            for a in block.get("annotations", []):
                span = raw[a["start_index"]:a["end_index"]].decode("utf-8", "replace")
                meta = {m["key"]: m.get("string_value", m.get("numeric_value"))
                        for m in a.get("custom_metadata", [])}
                out.append({"type": a["type"], "text": span,
                            "url": a.get("url") or meta.get("source_url"),
                            "row_id": meta.get("row_id")})
    return out
MCP 호출과 결과는 별도의 단계 유형 두 가지로 나타납니다. mcp_server_tool_call에는 name, server_name, arguments, id가 있습니다. mcp_server_tool_result에는 call_id와 result가 있으며, call_id로 해당 호출과 연결됩니다. 레퍼런스에는 MCP 결과가 url_citation 항목을 만드는지 나와 있지 않습니다. 따라서 경로 A에서는 Reddit 스레드에 관한 문장에 스레드 URL이 인용으로 붙는다고 가정하지 마세요.
더 안전한 방법은 에이전트에게 문장 안에 행의 id와 url을 쓰도록 지시하는 것입니다. 실행이 끝나면 저장된 mcp_server_tool_result 단계와 하나씩 대조하세요. File Search를 쓰는 경로 B에서는 각 문서에 추가한 custom_metadata가 file_citation에 담겨 돌아옵니다(File Search 문서, "Citations", 2026-10-13 업데이트). 직접 지정한 행 ID가 인용에 포함되어 돌아오게 하는 방법으로 문서화된 것은 이것뿐입니다.
| 인용 텍스트의 출처 | 어노테이션 유형 | 반환 내용 | 검증 방법 |
|---|---|---|---|
| Google 검색 또는 URL Context로 읽은 페이지 | url_citation | URL, 제목, 바이트 범위 | URL을 열어 문장과 비교 |
| File Search에 넣은 문서 | file_citation | 파일 이름, custom_metadata, 바이트 범위 | 메타데이터의 행 ID로 원본 행 찾기 |
| 원격 MCP 서버가 반환한 행 | 문서에 없음 | 단계에 담긴 전체 mcp_server_tool_result | 본문에 id와 url을 쓰게 한 뒤 비교 |
경로 A: Gemini Deep Research API에 EveryInfra MCP 서버 연결하기
경로 A는 위 curl 예시의 mcp_server 블록입니다. 세 필드는 자세히 볼 필요가 있습니다. url은 https://api.everyinfra.com/mcp로, 2026-07-28자 MCP 사양을 따르는 공개 HTTPS 엔드포인트입니다. 이 버전에서는 initialize 핸드셰이크가 없어졌습니다. 요청마다 자체 프로토콜 버전을 담고, Streamable HTTP에서는 메시지 하나가 POST 하나입니다(MCP 변경 내역, 전송 방식).
headers에는 Authorization: Bearer <your EveryInfra key>를 넣습니다. 저희 엔드포인트는 이 형식을 받으며, Google 문서의 예시도 같은 형태입니다. MCP 사양에서 인증은 선택 사항이며, OAuth 2.1 토큰도 같은 헤더에 넣습니다(MCP 인증). 전체 사양은 MCP 2026-07-28 인덱스에 있으며, 서버, 클라이언트, 전송 방식별 섹션으로 나뉘어 있습니다.
가장 주의해야 할 필드는 allowed_tools입니다. 2026-11-02 00:15 SGT에 키 없이 tools/list를 호출하자 도구 12개가 16,247바이트로 반환되었습니다.
이 중 조사에 필요한 것은 3개뿐입니다. everyinfra_list_capabilities는 플랫폼과 기능 목록을 보여 주고, everyinfra_call_api는 모든 데이터 기능을 호출하며, everyinfra_get_job은 비동기 결과를 가져옵니다. 나머지 9개는 웹 검색 도구 1개와 계정 관리용 도구입니다. 조사 작업에는 필요하지 않습니다.
사람이 지켜보지 않는 조사 에이전트에게 이 9개 도구는 쓸모가 없습니다. 첫째, 도구 정의는 컨텍스트를 차지합니다. 12개 정의 전체는 약 16,610바이트이고, 조사용 도구 3개는 3,309바이트로 약 80% 적습니다. 둘째, everyinfra_call_api는 비용이 발생하므로 destructiveHint가 true로 설정되어 있습니다. 아무도 지켜보지 않는 백그라운드 작업에서 계정 관련 액션이 실행되어서는 안 됩니다.
MCP 도구 섹션에는 경고도 있습니다. 클라이언트는 신뢰할 수 있는 서버에서 온 것이 아니라면 도구 어노테이션을 신뢰할 수 없는 것으로 취급해야 합니다(MCP 도구 사양). 따라서 Deep Research가 destructiveHint를 보고 신중하게 행동하리라 기대하지 마세요. 믿을 수 있는 통제 수단은 allowed_tools에 직접 작성하는 허용 목록입니다.
| 도구 | 정의 크기(바이트) | 조사용 여부 | 이유 |
|---|---|---|---|
everyinfra_list_capabilities | 816 | 예 | 무료. 이름과 파라미터를 먼저 조회 |
everyinfra_call_api | 1,695 | 예 | 데이터 조회. 호출당 과금, 실패 시 과금 없음 |
everyinfra_get_job | 798 | 예 | 무료. 비동기 결과 조회 |
everyinfra_search | 2,632 | 아니요 | 웹 검색은 Google Search로 이미 가능 |


프롬프트는 도구와 맞물려야 합니다. Deep Research 페이지의 모범 사례 섹션은 데이터가 없을 때 에이전트가 무엇을 해야 하는지 알려 주라고 권합니다. 예를 들어 수치를 추정하지 말고 알 수 없다고 말하게 하는 것입니다.
소셜 데이터를 다룬다면 프롬프트에 최소한 세 가지를 명시해야 합니다. 첫째, 소셜 플랫폼에 관한 모든 주장에는 행의 id와 url을 붙입니다. 둘째, 날짜가 정확하지 않으면 에이전트가 "약"이라고 씁니다. 셋째, 에이전트는 새 기능을 쓰기 전마다 everyinfra_list_capabilities를 호출하고 파라미터를 추측하지 않습니다.
세 번째 규칙에는 이유가 있습니다. EveryInfra는 알 수 없는 파라미터나 잘못된 값에 422를 반환합니다. 오류에는 허용 값과 제안이 함께 담기며, 과금되지 않습니다. 오류를 읽는 에이전트는 스스로 호출을 고칠 수 있으며, 다음 섹션에 실제 예시가 있습니다. 오류 처리는 API 오류와 자가 복구를 참고하세요. 다른 클라이언트의 MCP 설정은 원격 MCP 설정과 MCP 서버 페이지를 참고하세요.
실제 왕복 1회: 에이전트가 보내는 요청과 돌아오는 응답
Deep Research를 직접 실행하지는 않았습니다. 하지만 클라이언트가 서버로 보내는 요청 형식은 MCP 사양에 정해져 있습니다. 도구 name과 arguments를 담은 JSON-RPC tools/call입니다. 같은 JSON-RPC 형식의 요청을 테스트 키로 EveryInfra MCP 엔드포인트에 보냈습니다.
이 결과는 서버 쪽만 보여 줍니다. 즉 서버가 무엇을 받고 무엇을 반환하는지입니다. Deep Research 쪽은 테스트하지 않았습니다. Deep Research가 어떤 도구를 고르는지, 인수를 어떻게 채우는지는 알 수 없습니다. 행을 어떻게 읽는지, 행을 인용으로 바꾸는지도 알 수 없습니다. 이를 확인하려면 직접 작업을 하나 실행하고 mcp_server_tool_call과 mcp_server_tool_result를 읽어 보세요.
2026-11-02 00:16:51 SGT에 platform=reddit, action=search로 everyinfra_call_api를 호출했습니다. 쿼리는 e-bike battery fire였고 sort=relevance, limit=10을 지정했습니다. 응답은 6.0초 만에 상태 200, count 6으로 돌아왔습니다.
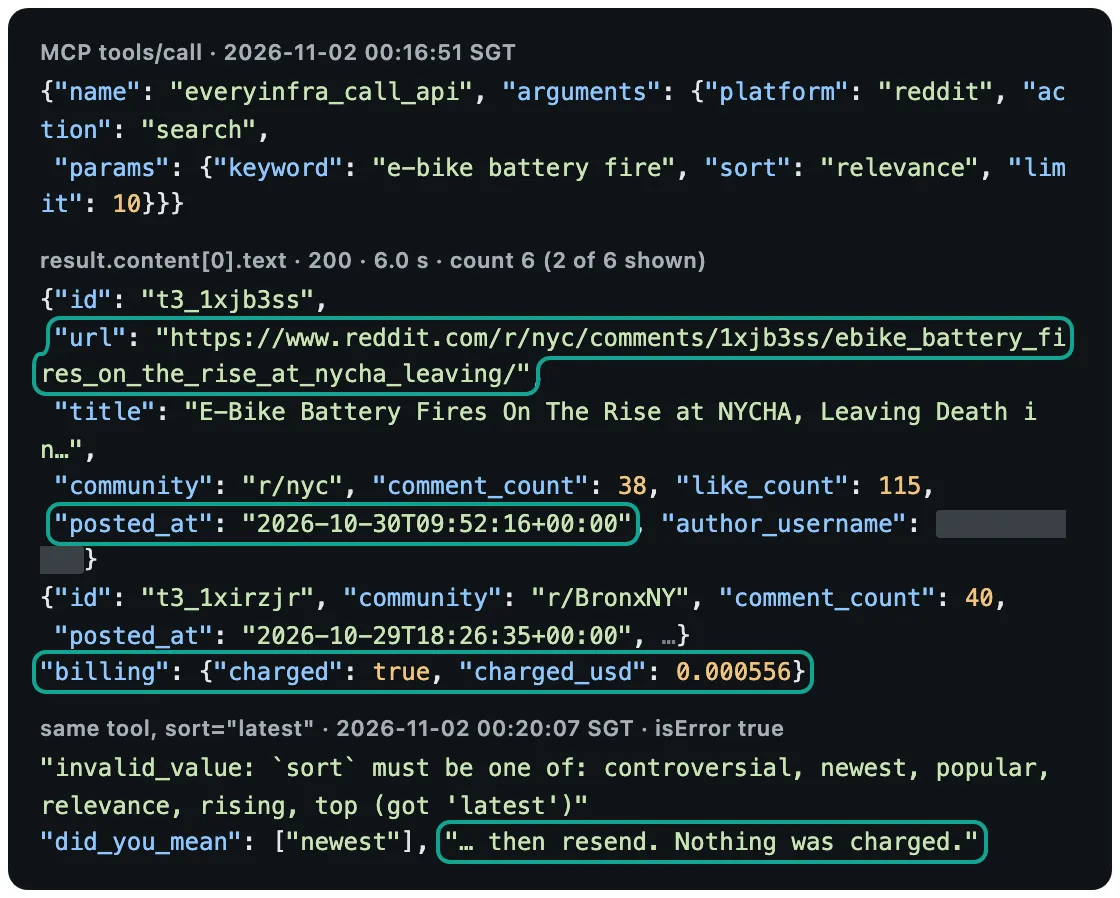
이 6개 행에서 세 가지를 알 수 있습니다. 첫째, limit은 10이었지만 스레드는 6개만 돌아왔습니다. 이 기능은 쿼리와 일치하는 스레드만 반환합니다. 카탈로그에는 세 가지 일치 방식이 나와 있습니다. 단어가 제목이나 커뮤니티 이름에 있는 경우, 스레드 전체에 있는 경우, 본문에서 서로 붙어 있는 경우입니다. 기간은 최근 한 달로 고정되어 있습니다.
둘째, 6개 스레드는 r/nyc, r/BronxNY, r/ebikes, r/interesting, r/MTB의 5개 커뮤니티에서 나왔습니다. 댓글은 모두 1,293개였습니다. 리튬 화재가 얼마나 진화하기 어려운지를 다룬 r/interesting 스레드 하나에만 댓글이 1,137개 달렸습니다. 제목만 읽는 에이전트는 이런 인기 스레드로 흘러가 브롱크스 화재에서 멀어질 수 있습니다.
셋째, 모든 행에 url과 초 단위까지 정확한 posted_at이 있습니다. 이 글 뒤쪽의 모든 검증은 이 두 필드에 의존합니다. 필드 상세 정보는 Reddit 검색 기능 페이지에 있습니다.
같은 1분 동안 무료 호출을 두 번 했습니다. 00:20:00 SGT에 Reddit에 대한 everyinfra_list_capabilities가 0.28초 만에 응답했습니다.
00:20:07 SGT에는 일부러 sort를 latest로 지정했습니다. 응답은 0.19초 만에 isError: true와 함께 "sort must be one of: controversial, newest, popular, relevance, rising, top (got 'latest')"라는 메시지로 돌아왔습니다. did_you_mean은 newest였고, 메시지는 "Nothing was charged"로 끝났습니다. 사람이 지켜보지 않는 에이전트에게 이 메시지는 호출을 고쳐 재시도할 수 있다는 뜻입니다. 실패한 호출을 "Reddit에 관련 논의 없음"으로 기록하지 않게 됩니다.
경로 B: 구조화된 소셜 데이터를 먼저 수집한 뒤 Gemini Deep Research API에 넘기기
경로 B는 데이터 수집을 에이전트에게서 떼어 내 사용자 프로그램이 맡도록 합니다. 00:16~00:19 SGT 사이에 보고서 하나를 위해 유료 호출을 7번 했습니다. 세 언어의 뉴스, Reddit 스레드와 댓글, YouTube 동영상과 댓글을 수집했습니다. 아래 표에 각 호출을 정리했으며, charged_usd는 billing 필드의 값입니다.
| 시간 | 기능 | 주요 파라미터 | 행 | 과금액 | 소요 시간 |
|---|---|---|---|---|---|
| 00:16:32 SGT | google_news/search | 전기자전거 배터리 화재, us / en, 지난 1개월 | 10 | $0.000792 | 4.3 s |
| 00:16:51 SGT | reddit/search(MCP 경유) | e-bike battery fire, relevance | 6 | $0.000556 | 6.0 s |
| 00:17:23 SGT | reddit/comments | r/nyc 스레드 1개, limit 50 | 35 | $0.000556 | 19.3 s |
| 00:18:02 SGT | youtube/search | e-bike battery fire, relevance | 10 | $0.000556 | 8.6 s |
| 00:18:29 SGT | youtube/comments | FDNY 동영상 1개, popular, limit 50 | 50 | $0.000556 | 30.1 s |
| 00:19:16 SGT | google_news/search | incendio batería bicicleta eléctrica, mx / es | 10 | $0.000792 | 4.7 s |
| 00:19:36 SGT | google_news/search | 전기자전거 배터리 화재에 관한 중국어 쿼리, hk / zh | 10 | $0.000792 | 3.7 s |
| 합계 | 기능 5개 | — | 131 | $0.004600 | 76.9 s |
이 5개 기능의 파라미터, 허용 값, 필드는 플랫폼별 카탈로그에 있으며 키 없이 볼 수 있습니다. Reddit 카탈로그, YouTube 카탈로그, Google News 카탈로그를 참고하세요. 이 글에 나오는 가격, limit 상한, 필드 메모는 2026-11-02 기준 카탈로그에서 가져왔습니다. 실제로 호출하는 날의 카탈로그 price_usd 값을 기준으로 삼으세요.
호출을 마친 뒤에는 필드 구성이 서로 다른 행들을 하나의 표로 합쳐 각 행을 검증할 수 있게 합니다. 열은 최소 6개를 유지합니다. row_id는 플랫폼과 원본 ID를 결합한 값으로, 예를 들면 reddit:t3_1xjb3ss입니다. source_url은 해당 항목 자체를 엽니다. 여기에 platform, published_at, date_precision, fetched_at을 더합니다. date_precision에는 second, day, week, unknown 중 하나를 쓰고, fetched_at은 호출한 시각입니다. 정밀도 열이 왜 필요한지는 아래 네 가지 테스트에서 확인할 수 있습니다.
표를 넘기는 방법은 두 가지입니다. 첫 번째는 input에 넣는 방법입니다.
Deep Research는 멀티모달 입력을 받으며, Google 블로그에는 PDF, CSV, 이미지, 오디오, 동영상이 나와 있습니다. 문서에서는 파일을 {"type": "document", "uri": ..., "mime_type": "application/pdf"} 형태로 전달합니다. 131행짜리 표는 약 20,000토큰으로, 100만 토큰 창에 비하면 작습니다. 두 번째 방법은 File Search 스토어입니다. 각 행이나 출처를 문서로 업로드하고 custom_metadata에 row_id, source_url, date_precision을 넣습니다. 그러면 인용이 이 필드를 담은 file_citation 항목으로 돌아옵니다.
# Configuration example: turn EveryInfra responses into checkable rows for Deep Research (Gemini side not run)
import csv

def rows_from(resp, platform, fetched_at):
    for r in resp["results"]:
        url = r.get("url")
        if platform == "youtube_comments":            # comment rows have no url, so build one from the video url and comment id
            url = f'{resp["_video_url"]}&lc={r["id"]}'
        exact = isinstance(r.get("posted_at"), str) and r["posted_at"][:4].isdigit()
        yield {"row_id": f'{platform}:{r.get("id") or r.get("rank")}',
               "source_url": url, "platform": platform,
               "published_at": r.get("posted_at") or r.get("published_at") or "",
               "date_precision": "second" if exact and platform != "news" else ("day" if exact else "unknown"),
               "fetched_at": fetched_at,
               "text": (r.get("title") or r.get("text") or "")[:500]}

with open("evidence.csv", "w", newline="") as f:
    w = csv.DictWriter(f, fieldnames=["row_id", "source_url", "platform", "published_at",
                                      "date_precision", "fetched_at", "text"])
    w.writeheader()
    # for each saved response: w.writerows(rows_from(resp, "...", "2026-11-02T00:16:51+08:00"))
Google 문서끼리 한 가지 점에서 설명이 엇갈리므로 먼저 테스트하세요. File Search 제한 사항에는 내장 검색 도구를 함께 쓸 수 없다고 나와 있습니다. 예를 들어 같은 요청에서 File Search를 Google Search나 URL Context와 함께 쓸 수 없습니다. 하지만 Google 블로그에는 Deep Research가 Google Search, 원격 MCP, URL Context, 코드 실행, File Search를 동시에 쓸 수 있다고 나와 있습니다. Deep Research 페이지의 File Search 예시는 내부 보고서와 최신 웹 뉴스를 비교하지만, 코드에서는 File Search만 켭니다.
Google이 이 부분을 명확히 밝힐 때까지는 file_search와 google_search를 함께 켠 작은 작업을 하나 실행해 보세요. 실패하면 표를 File Search가 아닌 input에 넣으세요.
테스트 1: 뉴스 날짜는 "며칠 전" 표기에서 나온다
google_news/search의 영어와 중국어 결과에는 published_at이 완전한 ISO 타임스탬프로 들어 있습니다. 정확해 보이지만, 영어 결과 10개는 모두 시각이 16:16:35 UTC였고 중국어 결과 10개는 모두 16:19:38 UTC였습니다. 두 요청을 보낸 시각은 16:16:32와 16:19:36 UTC, 즉 00:16과 00:19 SGT입니다. 따라서 이 필드는 요청 시각에서 "며칠 전" 값을 뺀 것입니다. 날짜 부분은 의미가 있지만 시각 부분은 의미가 없습니다.
날짜 부분을 URL 경로의 날짜와 대조했습니다. URL에 날짜가 있는 영어 결과 4개 중 3개는 1일 늦었고 1개는 일치했습니다. The New York Times 기사는 URL에 2026/10/28이 있었지만 published_at은 2026-10-29였습니다. NY1 기사는 URL에 10/30, 필드에 2026-10-31이었습니다. Billy Penn은 URL에 10/17, 필드에 2026-10-18이었습니다. The City Reporter는 일치했습니다.
| 영어 매체 | URL의 날짜 | `published_at` 날짜 | 지연 일수 |
|---|---|---|---|
| The New York Times | 2026-10-28 | 2026-10-29 | 1 |
| Spectrum News NY1 | 2026-10-30 | 2026-10-31 | 1 |
| Billy Penn at WHYY | 2026-10-17 | 2026-10-18 | 1 |
| The City Reporter | 2026-10-30 | 2026-10-30 | 0 |
중국어 결과는 오차가 더 커서 최대 4일까지 차이가 났으며, "1주 전"처럼 더 거친 표기를 쓰는 것으로 보입니다. 스페인어 결과는 다른 방식으로 더 나빴습니다. 10개 모두 published_at이 null이었고, URL에 날짜가 있는 스페인어 결과는 하나뿐이었습니다.
보고서에 미치는 영향은 구체적입니다. 보고서에 영어 매체가 브롱크스 화재를 하루 안에 보도했다고 쓴다고 가정해 보겠습니다. 영어 날짜는 1일 늦을 수 있으므로, 이 주장은 URL 날짜나 기사 본문으로 확인해야 합니다.
스페인어 날짜는 비어 있으므로 이 필드로는 스페인어 타임라인을 아예 만들 수 없습니다. 표에서 영어는 date_precision을 "day, 1일 늦을 수 있음"으로, 스페인어는 "unknown"으로 지정하세요. URL에 날짜가 있으면 URL 날짜를 우선합니다. 필드 메모는 Google News 검색 기능 페이지에 있습니다.
테스트 2: 화재 한 건, 출처 넷, 사망자 수는 세 가지
검증 가능한 행끼리도 항상 내용이 일치하지는 않습니다. 브롱크스 화재가 그 예입니다. 2026-10-28 The New York Times는 Patterson Houses 아파트에서 발생한 전기자전거 배터리 화재로 11세 소년이 숨졌다고 보도했습니다. 소방국장 Lillian Bonsignore는 이 화재가 올해 401번째 전기자전거 배터리 화재라고 밝혔습니다(The New York Times, 2026-10-28). Gothamist도 같은 날 FDNY의 조사 결과를 보도했습니다(Gothamist, 2026-10-28).
2026-10-31 New York Daily News는 같은 화재로 3명이 추가로 숨졌다고 보도했습니다. 이 기사는 올해 리튬 배터리 화재 사망자를 9명으로 집계했습니다(New York Daily News, 2026-10-31). 스페인어 매체 Spectrum Noticias는 소방국장이 앞서 밝힌 수치를 인용했습니다. 올해 화재 401건, 부상 74명, 사망 6명이며, 지난해는 화재 292건, 부상 51명, 사망 1명이었습니다(Spectrum Noticias, 2026-10-31). 2026-10-14에는 Streetsblog NYC가 그때까지 사망 5명, 화재 41% 증가를 보도했습니다(Streetsblog NYC, 2026-10-14).
| 출처 | 게시일 | 올해 화재 건수 | 올해 사망자 수 | 수치 출처 |
|---|---|---|---|---|
| Streetsblog NYC | 2026-10-14 | 41% 증가 | 5 | FDNY 데이터 |
| The New York Times | 2026-10-28 | 401번째 화재 | 연간 합계 없음 | 소방국장 |
| Spectrum Noticias | 2026-10-31 | 401 | 6 | 소방국장, 2026-10-28 브리핑 |
| New York Daily News | 2026-10-31 | 401건(지난주 기준) | 9 | FDNY 관계자 |
이 수치들은 서로 모순되지 않습니다. 하나의 수치를 서로 다른 시점에 찍은 스냅숏입니다. 5명은 10월 중순 집계, 6명은 화재 당일 집계, 9명은 3명이 추가로 숨진 뒤의 집계입니다. 하지만 보고서에 "스페인어 매체는 올해 사망자를 6명으로 보도했다"라고 쓰고 2026-10-31 기사를 링크했다고 가정해 보겠습니다. 독자가 링크를 열면 인용문은 일치하지만, 해당 수치는 이미 최신 정보가 아닙니다.
따라서 표에는 수치를 위한 열이 하나 더 필요합니다. 기사가 게시된 시점뿐 아니라 그 수치가 언급된 시점입니다. 연구도 이를 뒷받침합니다. 2026년 5월에 나온 한 논문은 14개 모델의 딥 리서치 보고서를 평가했습니다. 인용 링크는 94% 이상 유효했고 80% 이상 관련성이 있었습니다. 하지만 사실 정확도는 39~77%에 그쳤습니다(arXiv 2605.06635).
같은 논문에 따르면 도구 호출이 2회에서 150회로 늘어날수록 사실 확인 정확도가 평균 약 42% 떨어졌습니다. 링크가 작동한다고 문장이 옳다는 증거가 되지는 않습니다. 위 표의 수치는 뉴스 보도에서 가져온 것으로, 인용된 수치가 어떻게 시의성을 잃는지 보여 줍니다. 정확한 화재 및 사상자 수치는 FDNY 공식 발표를 사용하세요. 공공주택 화재를 다룬 The City Reporter의 2026-10-30 기사도 보고서에 인용할 수 있는 출처입니다(The City Reporter, 2026-10-30).
테스트 3: 댓글에서 원본으로 돌아갈 수 있을까? Reddit은 35개 중 35개, YouTube는 50개 중 0개
뉴스를 제외하면 소셜 리서치는 대부분 댓글을 다룹니다. 댓글 두 세트를 수집했습니다. 하나는 공공주택의 전기자전거 화재를 다룬 r/nyc 스레드의 댓글입니다. 다른 하나는 전기자전거 매장 화재를 다룬 FDNY YouTube 동영상의 인기 댓글입니다. 두 세트는 추적 가능성 면에서 크게 달랐습니다.
Reddit 댓글 35개에는 모두 reddit.com/r/nyc/comments/1xjb3ss/comment/19rvuy7xzfh7n/ 형식의 url이 있었습니다. 이 URL을 열면 해당 댓글 하나가 표시됩니다. posted_at은 모두 밀리초 단위까지 정확했으며, 예를 들면 2026-10-30T14:43:08.086000+00:00입니다. 보고서에 "r/nyc 댓글 작성자들은 ...라고 말했다"라고 쓰면 해당 댓글을 정확히 링크할 수 있고, 독자는 클릭 한 번으로 확인할 수 있습니다.
스레드에는 댓글이 38개로 표시되었지만 수집된 댓글은 35개였습니다. 빠진 댓글은 삭제되었거나 접혀 있었을 수 있습니다. Reddit 댓글 수가 다른 이유는 Reddit 댓글 완전성에서 테스트했습니다. r/nyc 스레드 자체는 공개되어 있습니다(r/nyc 스레드).
YouTube 댓글 50개에는 url 필드가 없었습니다. posted_at에는 "1 year ago"나 "7 months ago" 같은 상대 시간이 들어 있었습니다. 50개 중 15개에는 "year"가, 4개에는 "(edited)"가 들어 있었고 14개는 답글이었습니다.
여기서 두 가지 문제가 생깁니다. 첫째, 댓글에 직접 링크할 수 없습니다. 표에서는 동영상 URL에 &lc=<comment id>를 붙여 링크를 만들었습니다. YouTube 웹사이트에서 댓글을 열 때 흔히 쓰는 방법입니다. 하지만 반환된 필드가 아니고 이 파라미터에 대한 Google 문서도 찾지 못했으므로, "생성"으로 표시합니다.
| 필드 확인 | Reddit 댓글(35행) | YouTube 댓글(50행) |
|---|---|---|
댓글별 직접 url | 35 | 0 |
절대 시각 posted_at | 35개, 밀리초 단위 | 0개, 상대 시간 텍스트만 |
| "year"가 들어간 시간 | 0 | 15 |
| "(edited)" 표시 | 표시 안 됨 | 4 |
| 세트에 포함된 답글 | 스레드에 표시 | 14 |
둘째, "1 year ago"는 연 또는 월 단위까지만 정확하고, 그마저도 요청 시각 기준입니다. "최근 한 달간의 YouTube 논의"를 다루는 보고서라면 이 50개 댓글 중 4개만 확인할 수 있습니다. "1 hour ago", "2 weeks ago", 그리고 "3 weeks ago" 2개입니다. youtube/comments 카탈로그 메모에 따르면 since 파라미터로 댓글 날짜를 필터링할 수 있으므로, 수집할 때 기간을 제한할 수 있습니다. 답글 페이지네이션은 YouTube 댓글 답글과 페이지네이션에서 다룹니다. 필드 상세 정보는 YouTube 댓글 기능 페이지에 있습니다.
테스트 4: YouTube 관련성 검색은 대부분 오래된 동영상을 반환한다
시간 문제는 YouTube 검색 결과에서 더 뚜렷합니다. 같은 1분 안에 같은 쿼리 e-bike battery fire를 사용했습니다. 뉴스 결과 10개는 모두 최근 30일 이내였습니다. 관련성 기준 youtube/search 상위 10개 결과는 2022년 2개, 2023년 4개, 2024년 2개, 2025년 1개, 2026년 1개였습니다. 연도 중앙값은 2023년이었습니다. 2026년 동영상 1개도 2026-09-09에 게시되어 최근 30일 범위 밖입니다.
데이터가 틀린 것은 아닙니다. YouTube 관련성 순위는 조회수가 많고 오래된 동영상을 우대합니다. 10개 중 조회수가 가장 많은 동영상은 510,000회였고 2022년 동영상이었습니다. 하지만 에이전트가 이 10개 동영상의 댓글을 현재 여론으로 다룬다고 가정해 보겠습니다. 그러면 보고서에 3~4년 전 이야기가 섞이게 됩니다.
해결 방법은 간단합니다. 최근 논의를 보려면 sort=newest를 쓰거나 표에서 posted_at으로 행을 필터링하세요. 장기간의 논의를 다룬다면 보고서에 기간을 명시하세요. 이런 표본 편향은 소셜 미디어 리서치 표본 무결성에서 다룹니다. 검색 필드는 YouTube 검색 기능 페이지에 있습니다.
컨텍스트 예산: 131행은 약 20,000토큰으로 일반 작업의 8%
경로 B는 데이터를 입력에 넣으므로 그 크기를 알아야 합니다. 7번의 호출에서 받은 원시 JSON은 79,787바이트였습니다. 토큰당 약 4바이트로 계산하면 19,947토큰입니다. 모델 페이지에 따르면 입력 창은 1,048,576토큰, 출력 한도는 65,536토큰입니다. 문서에서는 표준 작업에 약 250,000 입력 토큰, Max 작업에 약 900,000 입력 토큰이 든다고 추정합니다. 저희 데이터는 일반 작업 입력의 8%이므로, 에이전트가 직접 검색하고 읽을 여유가 충분히 남습니다.
정리한 표는 이보다 더 작습니다. 원시 응답에는 썸네일 URL, 채널 통계, 과금 상세처럼 리서치에 필요 없는 필드가 많습니다. 6개 열과 최대 500자의 텍스트만 남기면 131행이 원시 크기의 절반 미만으로 줄어듭니다.
반대 방향의 주의 사항도 있습니다. 모범 사례에 따르면 멀티모달 입력은 비용을 늘리고 컨텍스트를 초과할 수 있습니다. 실제 위험은 131행이 아니라 수십 개 스레드에서 모은 댓글 1,000개입니다. 이 정도 양이라면 행을 input에 넣기 전에 먼저 주제와 시간으로 필터링하거나 File Search로 검색하세요.
구조화된 소셜 데이터로 인용을 검증 가능하게 만드는 방법
네 가지 테스트에서 간단한 방법 하나가 나옵니다. 목표는 독자가 소셜 미디어에 관한 각 주장을 하나의 행으로 추적할 수 있게 하는 것입니다. 그 행에는 항목이 플랫폼 어디에 있는지와 시간이 얼마나 정확한지가 드러나야 합니다.
첫째, 각 행에는 항목을 여는 링크가 있어야 합니다. Reddit 스레드와 댓글, YouTube 동영상, 뉴스는 이 조건을 충족합니다. YouTube 댓글은 충족하지 못하므로 동영상 URL과 댓글 ID로 링크를 만들고 직접 만든 링크라고 표시하세요. 둘째, 각 행에는 시간 정밀도가 있어야 합니다. 이번 테스트에서는 네 단계를 확인했습니다. Reddit 댓글은 밀리초, Reddit 스레드와 YouTube 동영상은 초, 영어 뉴스는 일 단위였습니다. 마지막 단계인 상대 시간 또는 시간 없음은 YouTube 댓글과 스페인어 뉴스에 해당했습니다.
셋째, 호출한 시각인 fetched_at을 기록하세요. 상대 시간이나 "올해 401번째 화재" 같은 수치는 이 시각이 있어야 의미가 있습니다.
넷째, 수치가 들어간 주장에는 "누가 언제 말했는지"가 필요합니다. 사망자 수 예시에서 보듯 링크가 작동한다고 수치가 최신으로 유지되지는 않습니다. 다섯째, 행 ID를 인용에 포함하세요. File Search를 쓴다면 custom_metadata에 넣습니다. MCP나 input을 쓴다면 에이전트에게 각 문장 뒤에 row_id를 쓰라고 지시하세요.
| 확인한 내용 | 보고서에 미치는 위험 | 표에서 할 일 |
|---|---|---|
뉴스 published_at은 요청 시각을 사용, 영어 날짜는 0~1일 늦음 | 잘못된 타임라인 | date_precision=day, URL 날짜 우선 |
| 스페인어 뉴스 날짜 10개 모두 비어 있음 | 타임라인 작성 불가 | date_precision=unknown, 기사를 열어 날짜 확인 |
| YouTube 댓글: 50개 중 링크 0개, 상대 시간 | 인용으로 원본에 도달 불가 | 링크를 만들어 표시, since 또는 sort로 기간 제한 |
| YouTube 관련성 검색: 10개 중 9개가 2026년 이전 | 과거 이야기를 현재로 오인 | posted_at으로 필터링하거나 sort=newest 사용 |
| 서로 다른 날짜의 사망자 수 5명, 6명, 9명 | 유효한 링크, 최신이 아닌 정보 | "수치가 언급된 시점" 열 추가 |
| Reddit 검색: 5개 커뮤니티의 스레드 6개, 그중 하나는 댓글 1,137개 | 에이전트가 인기 있는 곁가지 주제로 치우침 | community를 유지하고 주제로 필터링 |
이 단계 중 새로운 Gemini 기능이 필요한 것은 없습니다. 현재 인용 유형으로 충분합니다. 웹 페이지에는 url_citation, File Search에는 메타데이터가 담긴 file_citation을 쓰면 됩니다. 부족한 것은 검증 가능한 입력 데이터입니다. 그래서 가능하다면 경로 B를 권장합니다.
경로 A에서는 에이전트가 원시 응답을 받습니다. YouTube 댓글 시간이 상대 시간이라는 점을 알아차리는지는 그 실행에서 에이전트가 어떻게 판단하느냐에 달려 있습니다. 경로 B에서는 사용자 프로그램이 이런 결정을 한 번 내리고 모든 행에 같은 열로 기록합니다. 에이전트는 그 열을 인용하기만 하면 됩니다.
카탈로그 확인: 댓글 기능 38개 중 링크를 반환하는 것은 10개
테스트 3은 Reddit과 YouTube만 다뤘습니다. 다른 플랫폼의 댓글이 원본으로 이어지는지 보려고 플랫폼마다 실제 호출을 할 필요는 없습니다. 무료 카탈로그에 기능별 response_fields가 나와 있습니다. 2026-11-02 00:28 SGT에 GET /api/v1/social/catalog를 조회했습니다. 기능 573개가 나와 있었고 그중 569개를 사용할 수 있었습니다. 사용 가능한 기능 중 38개가 액션 이름에 comment나 replies가 들어간 댓글 기능입니다.
38개 모두 시간 필드(posted_at 또는 created_at)가 있습니다. 하지만 댓글별 url을 반환하는 기능은 10개뿐입니다. 나머지 28개에는 링크가 없습니다. 이 28개 중 27개는 최소한 댓글 id를 반환합니다. 이런 기능은 YouTube에서 한 것처럼 게시물 주소와 ID로 링크를 만들 수 있습니다. 링크도 댓글 ID도 반환하지 않는 기능이 1개 있습니다.
| 댓글 기능 | 행별 `url` | 기능(카탈로그 이름) |
|---|---|---|
| 링크 있음 | 10 | reddit/comments, reddit/user_comments, twitter/comments, threads/comments, instagram/comments, linkedin/comments, github/issue_comments, netease_music/comments, gab/replies, truth_social/replies |
| 링크 없음, 댓글 ID 있음 | 27 | youtube/comments, tiktok/comments, facebook/comments, weibo/comments, douyin/comments, xiaohongshu/comments 등 |
| 링크와 댓글 ID 모두 없음 | 1 | naver/comments |
따라서 표의 링크 열에는 "출처 링크"와 "게시물 링크 + 댓글 ID"라는 두 가지 값이 필요합니다. 두 번째 경우에는 에이전트에게 "이 게시물의 댓글 참고"라고 쓰게 하세요. 독자가 댓글로 바로 이동할 수 있는 것처럼 보고서가 암시하지 않도록 해야 합니다.
카탈로그에 필드가 있다고 값이 정확하다는 보장은 없습니다. 카탈로그에는 youtube/comments의 posted_at도 나와 있지만, 실제 호출에서는 "1 year ago" 같은 상대 시간이 반환되었습니다. 카탈로그로는 필드가 있는지를, 실제 호출로는 그 값이 얼마나 정확한지를 알 수 있습니다. 카탈로그는 무료이고 MCP에서는 everyinfra_list_capabilities로 조회하므로, 프롬프트에서 에이전트에게 댓글을 수집하기 전에 확인하라고 지시할 수 있습니다.
뉴욕 독자를 위한 두 번째 예시: 화재 한 건을 넘어 배터리 안전을 살펴보다
같은 방법을 관련 주제에도 쓸 수 있습니다. 뉴욕시는 2023년부터 리튬 배터리 안전 프로그램을 운영하고 있습니다. 2024년 7월 뉴욕시장실 페이지에는 2023년 수치가 나와 있습니다. 그해 리튬 배터리 화재의 59%는 충전 중이 아닌 배터리에서 발생했습니다(NYC Mayor's Office, 2024-07).
다른 도시도 같은 문제를 겪고 있습니다. 2026년 10월 CBC 해설 기사는 소방관들의 조언을 모았습니다(CBC, 2026-10). Billy Penn은 2026-10-17에 필라델피아의 화재 안전을 다뤘습니다(Billy Penn at WHYY, 2026-10-17).
공공 권고가 시간에 따라 어떻게 바뀌었는지 다루는 보고서라면 세 종류의 행이 섞입니다. 시 정부 페이지는 날짜가 고정된 공식 발표를 제공합니다. 뉴스는 날짜가 있는 기사를 제공하지만, 이번 테스트에서 날짜는 최대 1일 늦었습니다. 소셜 게시물에는 의견이 담겨 있으며, Reddit은 정확한 시각을, YouTube는 상대 시간을 제공합니다. 종류마다 별도의 date_precision이 필요하며, 프롬프트에서 에이전트에게 별도 설명 없이 하나의 타임라인에 섞지 말라고 지시해야 합니다.
작동하지 않는 것과 주의할 점
첫째, 구조화된 출력을 요청할 수 없습니다. 제한 사항에 명확히 나와 있으므로 "JSON 표로 반환하라"는 지시는 통하지 않습니다. 기계가 읽을 수 있는 결과가 필요하면 고정된 Markdown 표를 요청해 파싱하세요. 또는 문서대로 previous_interaction_id를 일반 모델과 함께 사용하세요. 문서 예시에서는 gemini-4-argon을 쓰며, 일반 모델은 구조화된 출력을 지원합니다.
둘째, 에이전트 버전은 지원이 종료됩니다. 현재 두 에이전트 이름에는 모두 preview와 04-2026이 붙어 있습니다. 2025년 12월 에이전트인 deep-research-pro-preview-12-2025는 2026-10-08에 지원 중단이 공지되었고 2026-10-23에 종료되었습니다. 출시 후 약 10개월 반 만입니다(변경 내역, 지원 중단). 에이전트 이름은 코드가 아닌 설정에 두세요.
셋째, Google Search 결과에는 사용 규칙이 있습니다. Gemini API 추가 약관에 따르면 Grounding with Google Search 결과는 검색 제안과 함께 최종 사용자에게 표시해야 합니다. 또한 결과를 캐시하거나 재판매하거나 분석하거나 학습에 사용해서는 안 됩니다. 일부 경우에는 최대 2년간 저장할 수 있습니다(Gemini API 추가 약관). 보고서를 보관하거나 재사용한다면 먼저 해당 섹션을 읽으세요. 이 섹션은 Google Search 결과에 적용되며, 자체 MCP 서버나 파일에서 가져온 데이터에는 각각의 약관이 적용됩니다. 이 글은 법률 자문이 아닙니다.
넷째, 보안을 고려하세요. Deep Research 페이지의 안전 섹션은 세 가지 위험을 꼽습니다. 파일 속 프롬프트 인젝션, 위험한 웹 콘텐츠, 에이전트가 내부 데이터와 웹을 함께 읽을 때의 데이터 유출입니다. 소셜 댓글은 공개된 사용자 텍스트이므로 AI를 노린 지시가 들어 있을 수 있습니다. EveryInfra MCP 서버는 사용자 텍스트를 그대로 반환하므로, 에이전트에게 댓글 텍스트는 지시가 아니라 데이터라고 알려 주세요.
headers에 넣은 EveryInfra 키는 MCP 요청마다 EveryInfra 서버로 전송됩니다. Deep Research용 EveryInfra 키를 별도로 만들고 지출 한도를 설정하세요. 그러면 그 키만 따로 비활성화할 수 있습니다.
다섯째, 비용은 usage에서 확인하세요. 얼마나 읽고 검색할지는 에이전트가 정하므로 미리 추정만 할 수 있습니다. Google은 프롬프트에서 범위를 제한하라고 권합니다.
Google 개발자 포럼에서 이 기능의 프로덕트 매니저가 한 사용자에게 답변했습니다. 최종 사용량은 Interaction 객체의 usage 필드에 나타나며, countTokens는 에이전트에서 작동하지 않습니다(개발자 포럼 스레드, 2025-12-21). EveryInfra에서는 각 응답의 billing.charged_usd에 비용이 표시됩니다. 요금 페이지에 설명된 대로 빈 결과와 실패한 요청은 무료입니다.
여섯째, URL Context에는 한도가 있습니다. 문서에 따르면 요청당 최대 20개 URL, URL당 최대 34 MB를 처리합니다. 유료 구독 콘텐츠나 YouTube 동영상은 지원하지 않습니다(URL context 문서). 따라서 Deep Research는 YouTube 동영상 페이지를 읽는 방식으로 댓글을 가져올 수 없습니다. 그래서 youtube/comments로 댓글을 먼저 수집해야 합니다.
| 한계 | 문서 내용 | 대안 |
|---|---|---|
| 구조화된 출력 | 지원 안 함 | 고정된 Markdown 표를 파싱하거나 결과를 일반 모델에 전달 |
| 에이전트 버전 | 프리뷰 이름. 2025년 12월 에이전트는 2026-10-23에 종료 | 에이전트 이름은 설정에 보관 |
| Google Search 결과 | 검색 제안과 함께 표시, 캐시·분석 금지 | 보고서 보관 전 약관 확인 |
| 프롬프트 인젝션 | 파일과 웹 페이지의 위험으로 명시 | 에이전트에게 댓글 텍스트는 데이터라고 지시 |
| 비용 | 실행 후 usage에서만 확인 가능 | 범위 제한, 지출 한도가 설정된 별도 EveryInfra 키 사용 |
| URL Context | URL 20개, 각 34 MB, YouTube 동영상 불가 | youtube/comments로 댓글 먼저 수집 |
최근 변경 사항
2026-10-27에 Google은 베타 명령줄 도구 gemini-api를 출시했습니다. 이 도구를 사용하면 스크립트와 CI에서 Interactions API와 호스팅 에이전트를 호출할 수 있습니다(Gemini API CLI 문서). 정기 Deep Research 보고서를 만드는 데는 Python 프로그램이 필요하지 않습니다. 명령 하나와 스케줄러면 충분합니다.
2026-10-23에 기존 Deep Research 에이전트가 종료되었고, 2026-10-13에는 Gemini 4 Argon이 정식 출시되었습니다. 따라서 12월 에이전트 이름을 계속 사용하는 코드는 더 이상 작동하지 않습니다. deep-research-preview-04-2026으로 바꾸세요.
FAQ
Python에서 Gemini Deep Research API를 어떻게 호출하나요?
google-genai 패키지를 사용하세요. Interactions API에는 2.3.0 이상 버전이 필요하며(Interactions API 개요), 소스는 python-genai 저장소에 있습니다. client.interactions.create(agent="deep-research-preview-04-2026", input=..., background=True)를 호출한 뒤, 상태가 completed 또는 failed가 될 때까지 client.interactions.get(id)를 반복 호출합니다. MCP를 추가하려면 tools에 {"type": "mcp_server", "url": ..., "headers": ...}를 넣습니다. 이 질문은 Google 자동 완성 문구 "gemini deep research api python"에서 가져왔습니다.
Gemini Deep Research API 요금은 어떻게 책정되며, 무료 등급이 있나요?
별도 요금은 없습니다. 모델 추론과 도구 사용료를 내며, Google은 표준 작업당 $1~$3, Max 작업당 $3~$7로 추정합니다. Google 블로그에 따르면 공개 프리뷰는 유료 등급에서 제공되므로 결제를 활성화해야 합니다. Google Search에는 매월 5,000회의 무료 검색이 포함되며, 이후에는 1,000회당 $14입니다. 이 질문은 자동 완성 문구 "gemini deep research api pricing"과 "deep research api free"에서 가져왔습니다.
Vertex에서 Gemini Deep Research API를 쓸 수 있나요?
예. Google Cloud에는 별도의 Deep Research 페이지가 있습니다. aiplatform.googleapis.com의 글로벌 v1beta1 엔드포인트, Google Cloud 액세스 토큰, 반값인 service_tier="deferred" 옵션을 사용합니다. 요금 페이지에 따르면 Vertex의 기본 Google Search 할당량은 하루 1,000,000회입니다. Gemini Developer API의 기본값은 하루 1,500회입니다(Vertex grounding 문서). 이 질문은 자동 완성 문구 "gemini deep research api vertex"에서 가져왔습니다.
Deep Research 작업이 in_progress 상태에서 멈추면 어떻게 하나요?
2026년 3월 한 포럼 사용자가 기존 에이전트에서 이 문제를 보고했습니다. 인터랙션은 시작되었지만 사용량 없이 in_progress 상태에 머물렀습니다. 문서는 last_event_id를 저장하면서 스트리밍하는 방식을 권하며, 이렇게 하면 연결이 끊긴 뒤 재개할 수 있습니다. 자체 타임아웃도 추가하세요. 문서상 최대 시간인 60분이 지나면 작업을 취소하고 로그를 남기세요. 이 질문은 해당 포럼 스레드와 자동 완성 문구 "gemini deep research stuck on starting research"에서 가져왔습니다.
Deep Research가 Reddit이나 YouTube 댓글을 스스로 읽을 수 있나요?
Google Search와 URL Context로 공개 페이지를 읽을 수는 있습니다. 하지만 URL Context 문서에 따르면 YouTube 동영상은 지원하지 않으며, 페이지에 나중에 로드되는 댓글은 보이지 않을 수 있습니다. 안정적인 댓글 데이터가 필요하면 reddit/comments와 youtube/comments에서 가져온 구조화된 행을 MCP나 미리 준비한 표로 에이전트에게 제공하세요. 이 질문은 MCP용으로 제대로 된 딥 리서치 도구가 있는지 묻는 Reddit 스레드에서 가져왔습니다(r/LocalLLM 스레드).
Gemini Deep Research API 키와 EveryInfra 키는 어디에 넣나요?
Gemini 키는 x-goog-api-key 헤더에 넣거나, SDK가 환경 변수에서 GEMINI_API_KEY를 읽도록 하세요. EveryInfra 키는 mcp_server 도구의 headers에 Authorization: Bearer <key> 형태로 넣습니다. 두 키 모두 프롬프트 텍스트에 넣지 마세요. 이 질문은 자동 완성 문구 "gemini deep research api key"에서 가져왔습니다.
시작하는 방법
첫째, EveryInfra에 회원가입하고 API 키를 발급받으세요. 데이터 마켓에서 카탈로그를 둘러보고 한 번은 무료로 호출해 볼 수 있으며, 빠른 시작은 문서에 있습니다. 둘째, 처음에는 Gemini를 건너뛰세요. curl로 reddit/search나 google_news/search를 호출해 url, posted_at, billing이 이 글의 예시와 같은 형태인지 확인하세요. 플랫폼 페이지는 Reddit 데이터 API, YouTube 데이터 API, Google News API입니다.
셋째, 경로 A 예시를 사용하세요. Deep Research tools에 https://api.everyinfra.com/mcp를 넣고 allowed_tools에는 도구 3개만 남깁니다. 작은 주제로 실행해 mcp_server_tool_call 단계를 확인하세요. 넷째, 독자가 검증할 수 있는 보고서가 필요하면 경로 B를 사용하세요. 데이터를 수집하고 6개 열을 만든 뒤 표를 Deep Research에 넘깁니다. 서브에이전트로 데이터를 병렬 수집하는 방법은 TikTok 계정용 Claude Code 서브에이전트를 참고하세요. 새 MCP 사양을 프로덕션에서 쓰는 방법은 MCP 2026 사양과 프로덕션 준비를 참고하세요.
참고 자료
- “Gemini Deep Research agent”, Google AI for Developers, 2026-10-13 업데이트, https://ai.google.dev/gemini-api/docs/deep-research
- “Deep Research preview model page”, Google AI for Developers, 2026-10-29 업데이트, https://ai.google.dev/gemini-api/docs/models/deep-research-preview-04-2026
- “Interactions API overview”, Google AI for Developers, 2026-10-15 업데이트, https://ai.google.dev/gemini-api/docs/interactions-overview
- “Interactions API reference”, Google AI for Developers, 2026-10-28 업데이트, https://ai.google.dev/api/interactions-api
- “Background execution”, Google AI for Developers, https://ai.google.dev/gemini-api/docs/background-execution
- “Gemini Developer API pricing”, Google AI for Developers, 2026-10-30 업데이트, https://ai.google.dev/gemini-api/docs/pricing
- “Rate limits”, Google AI for Developers, 2026-10-28 업데이트, https://ai.google.dev/gemini-api/docs/rate-limits
- “File Search”, Google AI for Developers, 2026-10-13 업데이트, https://ai.google.dev/gemini-api/docs/file-search
- “Grounding with Google Search”, Google AI for Developers, 2026-10-28 업데이트, https://ai.google.dev/gemini-api/docs/google-search
- “URL context”, Google AI for Developers, 2026-10-13 업데이트, https://ai.google.dev/gemini-api/docs/url-context
- “Gemini API changelog”, Google AI for Developers, 2026-10-30 항목, https://ai.google.dev/gemini-api/docs/changelog
- “Gemini deprecations”, Google AI for Developers, 2026-10-22 업데이트, https://ai.google.dev/gemini-api/docs/deprecations
- “Gemini API CLI”, Google AI for Developers, 2026-10-28 업데이트, https://ai.google.dev/gemini-api/docs/cli
- “Billing”, Google AI for Developers, https://ai.google.dev/gemini-api/docs/billing
- “Gemini API Additional Terms of Service”, Google, https://ai.google.dev/gemini-api/terms
- “Gemini Deep Research agent”, AI Studio 문서, Google, https://aistudio.google.com/docs/deep-research
- “Use the Gemini Deep Research Agent”, Google Cloud, https://docs.cloud.google.com/gemini-enterprise-agent-platform/agents/use-deep-research
- “Grounding with Google Search”, Google Cloud, https://docs.cloud.google.com/vertex-ai/generative-ai/docs/grounding/grounding-with-google-search
- “Get started with Deep Research”, Gemini cookbook 노트북, https://github.com/google-gemini/cookbook/blob/main/quickstarts/Get_started_Deep_Research.ipynb
- “python-genai”, Google, https://github.com/googleapis/python-genai
- “Introducing Deep Research and Deep Research Max”, Google 블로그, 2026-04-21, https://blog.google/innovation-and-ai/models-and-research/gemini-models/next-generation-gemini-deep-research/
- “Build with Gemini Deep Research”, Google 블로그, 2025-12-11, https://blog.google/innovation-and-ai/technology/developers-tools/deep-research-agent-gemini-api/
- “How to use Deep Research with the Gemini API”, Philipp Schmid, 2026-04-29, https://www.philschmid.de/deep-research-update
- “일부 도메인에서 Deep Research API 인터랙션이 in_progress 상태에 멈추는 문제”, Google 개발자 포럼, 2026-03-05, https://discuss.ai.google.dev/t/deep-research-api-interaction-stuck-in-progress-for-some-domains/129020
- “Google Gemini Deep Research 비용”, Google 개발자 포럼, 2025-12-21, https://discuss.ai.google.dev/t/google-gemini-deep-research-costs/112804
- “Deep Research 에이전트 API의 요청 속도 제한과 비용 관련 질문”, Google 개발자 포럼, 2025-12-12, https://discuss.ai.google.dev/t/deep-research-agent-api-questions-for-rate-limitsand-costs/111904
- “MCP 사양 2026-07-28 색인”, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28
- “MCP 사양 2026-07-28 변경 내역”, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/changelog
- “MCP 전송 방식”, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- “MCP 권한 부여”, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- “MCP 도구”, Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- “인용은 했지만 검증하지 않았다: 딥 리서치 에이전트의 출처 귀속”, arXiv, 2026-05-07, https://arxiv.org/html/2605.06635v1
- “딥 서치 및 딥 리서치 에이전트 벤치마킹과 오류 분석”, arXiv, 2026-10-21, https://arxiv.org/html/2610.29346v1
- “DeepResearch Bench: 딥 리서치 에이전트를 위한 벤치마크”, arXiv, https://arxiv.org/abs/2506.11763
- EveryInfra 데이터 기능 카탈로그, 2026-11-02 조회, https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra Reddit 카탈로그, 2026-11-02 조회, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- EveryInfra YouTube 카탈로그, 2026-11-02 조회, https://api.everyinfra.com/api/v1/social/catalog?platform=youtube
- EveryInfra Google News 카탈로그, 2026-11-02 조회, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- “브롱크스 아파트 전기자전거 배터리 화재로 11세 소년 사망”, The New York Times, 2026-10-28, https://www.nytimes.com/2026/10/28/nyregion/fire-e-bike-battery-bronx.html
- “FDNY ‘소년이 숨진 브롱크스 화재 원인은 리튬 이온 배터리’”, Gothamist, 2026-10-28, https://gothamist.com/news/lithium-ion-battery-caused-bronx-fire-that-killed-11-year-old-fdny-says
- “뉴욕시 전역에서 전기자전거 화재 급증”, New York Daily News, 2026-10-31, https://www.nydailynews.com/2026/10/31/as-bronx-family-reels-from-devastating-blaze-that-killed-4-e-bike-fires-have-skyrocketed-across-nyc/
- “NYCHA에서 전기자전거 배터리 화재 증가”, The City Reporter, 2026-10-30, https://www.thecityreporter.nyc/2026/10/30/e-bike-battery-fires-on-the-rise-at-nycha-leaving-death-in-their-wake/
- “공공 대책이 지연되는 사이 리튬 이온 배터리 화재 41% 증가”, Streetsblog NYC, 2026-10-14, https://nyc.streetsblog.org/2026/10/14/everyone-should-be-furious-lithium-ion-battery-fires-are-up-41-as-public-fix-stalls
- “브롱크스 전기자전거 배터리 화재로 4명 사망”, Spectrum Noticias, 2026-10-31, https://spectrumnoticias.com/ny/nyc/noticias/2026/10/31/cuatro-muertos-tras-un-incendio-en-la-bateria-de-una-bicicleta-electrica-en-el-bronx--nypd
- “브롱크스에서 전기자전거 배터리 화재로 11세 소년 사망”, Univision, 2026-10-29, https://www.univision.com/local/nueva-york-wxtv/muere-nino-de-11-anos-en-incendio-provocado-por-bateria-de-bicicleta-electrica-en-el-bronx
- “애덤스 시장, 리튬 이온 배터리 화재 예방을 위한 새 조치 시행”, NYC Mayor's Office, 2024-07, https://www.nyc.gov/mayors-office/news/2024/07/mayor-adams-takes-new-actions-prevent-deadly-lithium-ion-battery-fires-promote-safe-e-bike
- “소방관들이 알려 주는 리튬 배터리 화재 필수 정보”, CBC, 2026-10, https://www.cbc.ca/news/science/lithium-battery-fire-faq-9.7371004
- “필라델피아에서 리튬 이온 배터리 화재를 예방하는 방법”, Billy Penn at WHYY, 2026-10-17, https://billypenn.com/2026/10/17/lithium-ion-battery-fire-safety-philadelphia/
- “NYCHA에서 전기자전거 배터리 화재 증가”, r/nyc 스레드, Reddit, 2026-10-30, https://www.reddit.com/r/nyc/comments/1xjb3ss/ebike_battery_fires_on_the_rise_at_nycha_leaving/
- “MCP용 진정한 딥 리서치 도구가 있을까”, r/LocalLLM 스레드, Reddit, https://www.reddit.com/r/LocalLLM/comments/1pw1ukl/is_there_a_true_deep_research_mcp_deep_research/
참고 BL-66