Le skill di Gemini sostituiscono i Gem: un riepilogo settimanale dei post più popolari
I Gem di Gemini diventano di sola lettura il 17 novembre. Passa alle skill di Gemini con un riepilogo settimanale dei post più popolari: SKILL.md, tre percorsi per i dati e test reali di quattro API per le classifiche dei contenuti più popolari.
Cosa fare subito: su un account Google personale (18 anni o più), i Gem di Gemini diventano di sola lettura il 17 novembre 2026. Google li rimuove il 17 dicembre 2026. Mancano 13 giorni da oggi. Ricrea subito come skill ogni Gem che usi ancora ogni settimana e scarica i suoi file di conoscenza.
Per gli account di lavoro e scolastici le date sono successive: non prima del 1° marzo 2027 e del 1° giugno 2027. Anche le skill nelle app di Workspace sono «rinviate fino a nuovo avviso». Tutte queste date provengono dal blog Workspace Updates e dalle pagine della Guida di Gemini di Google. La prima sezione indica la fonte di ogni data.
Questo articolo usa un job reale per mostrare il passaggio. Costruiamo un riepilogo settimanale dei post più popolari come file SKILL.md. Ogni lunedì, Gemini legge i post popolari dell'ultima settimana su Reddit, la classifica dei contenuti più popolari di Zhihu, le ricerche di tendenza di Weibo e le tendenze di X, quindi scrive un report di una pagina. Nel farlo, ci scontriamo con il limite più importante dell'app Gemini: gli script delle skill non possono accedere a internet né inviare richieste a siti web esterni. Quindi il recupero dei dati deve restare fuori dalla skill.
Proponiamo tre modi per portare i dati in Gemini: snapshot locali con upload, una Connected App personalizzata e un agente della Gemini API con un trigger. Verifichiamo anche se lo stesso SKILL.md funziona in Claude e Codex.
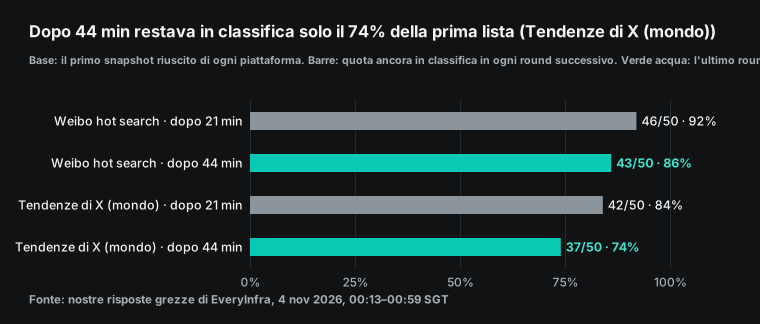
Sul lato dati abbiamo fatto chiamate reali. Il 4 novembre 2026, dalle 00:13 alle 00:59 SGT, abbiamo chiamato reddit/trending_posts, zhihu/hot_list, weibo/trending e twitter/trending di EveryInfra in 3 round. Una chiamata è passata per il metodo tools/call del server MCP remoto. Alle 02:05 SGT abbiamo riprovato una volta le due classifiche che avevano fallito. Il risultato principale è che le classifiche cambiano in fretta. Dopo 44 minuti, solo l'86% della classifica di Weibo era ancora presente.
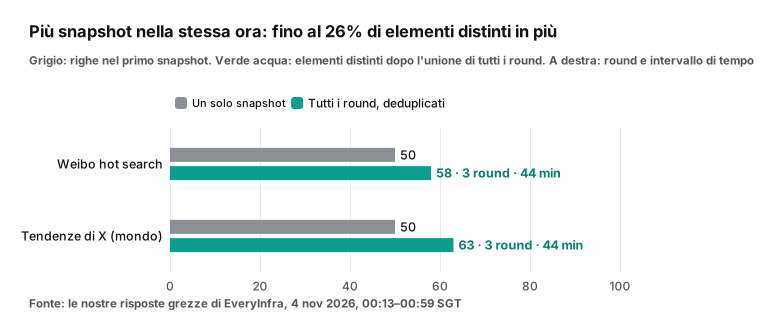
Dopo 44 minuti, solo il 74% della classifica di X era ancora presente. I 3 round insieme hanno trovato il 16% e il 26% di argomenti distinti in più rispetto a un solo snapshot, quindi un riepilogo settimanale richiede diversi snapshot al giorno.
La classifica dei contenuti più popolari di Zhihu e i post popolari di Reddit non erano disponibili durante il test. Tutte le 8 richieste a Zhihu hanno restituito 503, e Reddit ha fornito dati solo nel round 1. Le chiamate fallite non sono state addebitate. Per questo i numeri del riepilogo qui sotto vengono solo da Weibo e X. Questo mostra anche perché la skill deve dire «se non ci sono dati, dillo». Ai prezzi del catalogo, la nostra frequenza di esempio di quattro snapshot al giorno costa 0,297 $ al mese per tutte e quattro le classifiche.
Sulla nostra macchina di test non abbiamo effettuato l'accesso a Gemini. Quindi l'upload della skill, l'app personalizzata e il trigger della Gemini API sono esempi di configurazione, non esecuzioni reali. Vengono dalla documentazione ufficiale del 4 novembre.


Cosa fare subito: i Gem di Gemini diventano di sola lettura il 17 novembre
Le date contano più delle funzionalità, quindi partiamo da quelle. La pagina della Guida di Gemini Apps sulla transizione è chiara. Per gli account Google personali di utenti dai 18 anni in su, i Gem diventano di sola lettura il 17 novembre 2026. Puoi ancora aprirli, ma non puoi usarli, modificarli né crearne di nuovi. Il 17 dicembre 2026 i Gem vengono rimossi da Gemini Apps e perdi l'accesso (Gemini Apps Help: About the transition from Gems to skills).
Gli account di lavoro hanno più tempo. La stessa pagina indica marzo 2027 per gli account Workspace business, enterprise e non profit, e giugno 2027 per gli account education. La pagina della Guida per gli amministratori di Workspace riporta i giorni esatti: 1° marzo 2027 e 1° giugno 2027 (Admin Help). Il post di Workspace Updates usa la formula «non prima del» per entrambe le date (Workspace Updates, 30 settembre 2026).
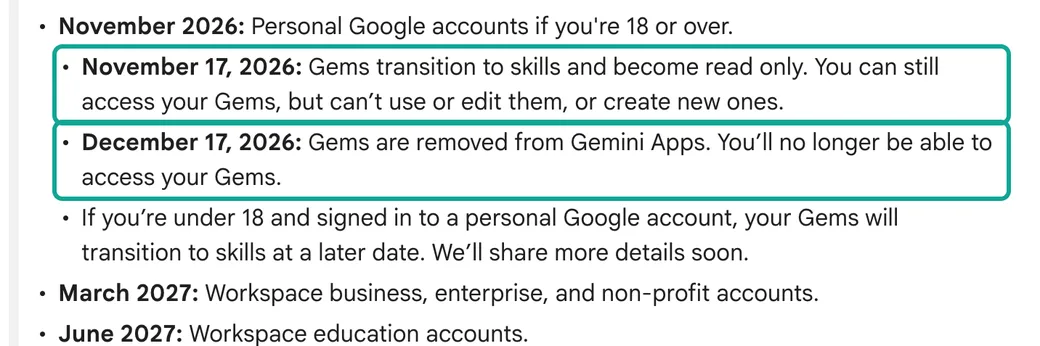
Un dettaglio crea confusione. Il post di Workspace Updates del 30 settembre contiene un elenco «Key dates». La riga del 17 novembre dice che i Gem passano al pannello Impostazioni e che gli utenti possono ancora crearli, modificarli e usarli. La pagina della Guida per gli account personali dice «sola lettura» per lo stesso giorno. Le due righe riguardano account diversi.
La riga del blog si trova nella timeline di Workspace. La riga della pagina della Guida vale solo per gli account personali di utenti dai 18 anni in su. Molti articoli di seconda mano fondono le due righe in «sola lettura per tutti dal 17 novembre». Le fonti non dicono questo.
| Tipo di account | Sola lettura o spostati nelle Impostazioni | I Gem smettono di funzionare | Gem rimossi | Fonte |
|---|---|---|---|---|
| Account Google personale, 18 anni o più | 2026-11-17, sola lettura | 2026-11-17 | 2026-12-17 | Guida di Gemini Apps |
| Account personale, meno di 18 anni | «una data successiva» | Non indicato | Non indicato | Guida di Gemini Apps |
| Workspace business, enterprise e non profit | 2026-11-17, spostati nelle Impostazioni, ancora utilizzabili | Non prima del 2027-03-01 | Lo stesso giorno; i Gem rimanenti diventano bozze di skill | Workspace Updates, Guida per gli amministratori |
| Workspace education | Come sopra | Non prima del 2027-06-01 | Lo stesso giorno, anche Classroom e LTI | Come sopra |
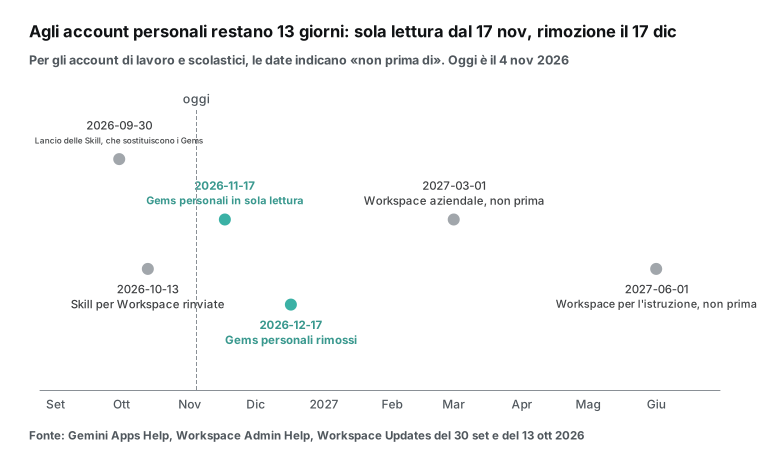
Con un account personale hai 13 giorni dal giorno in cui abbiamo scritto questo articolo. Le cose da fare sono tre. Primo, scarica le istruzioni e i file di conoscenza di ogni Gem che usi ancora. Una skill può contenere al massimo 100 MB di file.
Se un Gem è più grande, la migrazione automatica rimuove prima i file più grandi. Audio, video, archivi, file di GitHub e file Office legacy (.doc, .xls, .ppt) non vengono trasferiti affatto. Dopo il 17 dicembre non puoi più recuperarli (stessa pagina della Guida, «Limits on files during the transition»).
Secondo, ricrea a mano come skill i tuoi Gem settimanali. Non aspettare la migrazione automatica. La migrazione crea «bozze inattive», e devi rivederle e attivarle una per una prima di poterle usare o condividere (Admin Help, «How automated migration will work»). Terzo, controlla gli strumenti di cui ha bisogno ogni Gem. La pagina della Guida dice che le skill non funzionano ancora con Create video, Create music, Canvas, Deep Research e Guided learning. Se un Gem dipende da uno di questi strumenti, prevedi un metodo diverso.
Gli account di lavoro hanno tempo, ma una cosa è già cambiata. In Workspace Studio non puoi aggiungere un passaggio «Ask a Gem» a un nuovo flusso. I flussi esistenti continuano a funzionare fino al 2027. Inoltre, le skill nelle app di Workspace sono state rinviate. L'aggiornamento del 13 ottobre dice che il rilascio ai domini Rapid Release e Scheduled Release è «rinviato fino a nuovo avviso» (Workspace Updates, 13 ottobre 2026).
Le skill nell'app Gemini sono nei tempi previsti. Il rilascio è iniziato il 13 ottobre, con completamento previsto entro metà novembre. Lo stesso post dice che le skill non si sincronizzano tra l'app Gemini e le app di Workspace. Devi creare ogni skill in entrambi i posti.
Skill di Gemini vs Gem: cosa è cambiato
Un Gem è una versione personalizzata e separata di Gemini. Lo apri e chatti nella sua finestra. Una skill è un insieme di istruzioni che puoi portare in qualsiasi chat. Digiti / e il nome della skill, e la pagina della Guida dice che la scorciatoia diventerà @.
Gemini può anche scegliere una skill da solo quando il nome e la descrizione corrispondono al tuo prompt. Puoi combinare più skill nella stessa chat (Create & manage skills for Gemini Apps). Workspace Updates dice che le skill sono «basate interamente sullo standard aperto SKILL.md, nativo in Markdown». Quindi puoi copiare in Gemini skill create su altre piattaforme (Workspace Updates, 30 settembre 2026).
| Voce | Gem | Skill nell'app Gemini (al 4 nov 2026) |
|---|---|---|
| Come si usa | Apri il Gem nella sua finestra | Digita / (in seguito @) in qualsiasi chat, oppure lascia che sia Gemini ad applicarla |
| Quanti insieme | Uno | Diverse; una skill può anche richiamare altre skill |
| Formato | Modulo web | Modulo web, oppure upload di SKILL.md, di una cartella o di un .zip |
| Regola per il nome | Testo libero | Tutto minuscolo con trattini, per esempio my-new-skill |
| File | File di conoscenza | 100 MB in totale; solo file di tipo testuale; niente audio, video o archivi |
| Strumenti | Video, musica, Canvas, Deep Research e altro | Funziona con le Connected Apps; non ancora con video, musica, Canvas, Deep Research, Guided learning |
| Script con accesso a internet | Non applicabile | No: gli script caricati non possono accedere a internet né inviare richieste a siti web esterni |
| Piano richiesto | Gratis | Le skill sono gratuite; le attività pianificate richiedono Google AI Pro o Ultra |
| Condivisione | Sì | «Nelle prossime settimane» |
La riga sugli script è il problema che questo articolo risolve. Un riepilogo settimanale dei post più popolari ha bisogno di dati esterni: i post più popolari su Reddit, la classifica dei contenuti più popolari di Zhihu, le ricerche di tendenza di Weibo e le tendenze di X. In Claude Code o Codex, una skill può eseguire uno script che chiama un'API, oppure l'agente può chiamare un tool MCP. Il nostro articolo su un solo SKILL.md per quattro strumenti di AI mostra questo metodo. L'app Gemini funziona diversamente.
La pagina della Guida indica due limiti nella sezione sull'upload. Gli script che richiedono l'accesso a internet non sono supportati. Nella sezione «Security restrictions», gli script non possono eseguire azioni né inviare richieste a siti web esterni. Quindi nell'app Gemini la skill non recupera i dati. I dati devono arrivare da un'altra fonte.
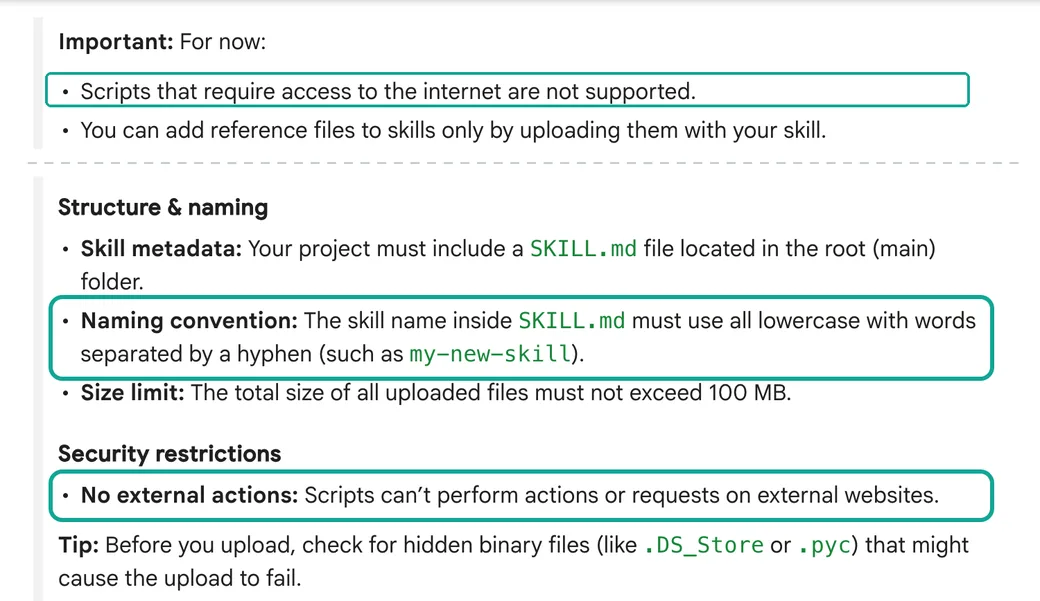
Questo limite determina la struttura dell'articolo. La skill dice a Gemini come scrivere il riepilogo. I dati seguono un percorso separato. Prima descriviamo il job, poi tre percorsi per portare i dati in Gemini.
Come trasformare un Gem in una skill
La pagina della Guida indica tre passaggi manuali. Apri il Gem e scarica i suoi file di conoscenza uno per uno. Crea una nuova skill e copia nome, descrizione e istruzioni dal Gem. Per aggiungere file, scarica la skill come cartella, aggiungi i file e carica la cartella completa (pagina della Guida). In pratica, conviene riscrivere quattro parti invece di copiarle.
La prima parte è il nome. Un Gem può avere qualsiasi nome. Il nome di una skill deve essere composto da parole inglesi minuscole separate da trattini, come weekly-hot-posts-digest. L'articolo della Guida sulle skill efficaci consiglia di iniziare il nome con un verbo. Consiglia anche di evitare parole vuote come helper, tools o data (Write effective skills).
La seconda parte è la descrizione. La descrizione di un Gem è per le persone. La descrizione di una skill è per Gemini, perché Gemini legge solo nome e descrizione per decidere se la skill si applica. Scrivila in terza persona: cosa fa la skill, poi «Da usare quando…» con i casi d'uso.
Il limite è di 1.024 caratteri. Lo stesso articolo consiglia di scrivere i passaggi come checklist e di dire a Gemini cosa fare quando mancano dati. Per un riepilogo, questo secondo punto è fondamentale. Un esempio di regola è «se una piattaforma non ha dati questa settimana, dillo e non riempire il vuoto a memoria».
La terza parte sono i file di conoscenza. Un Gem spesso legge ogni volta un grande file di riferimento. Una skill carica i contenuti solo quando servono. Gemini legge prima nome e descrizione.
Legge le istruzioni complete solo se la skill sembra pertinente, e apre i file allegati solo quando un passaggio ne ha bisogno. Quindi metti template lunghi e report di esempio in una cartella references/. Poi scrivi nelle istruzioni «al passaggio 5, usa references/report-template.md».
La quarta parte sono gli strumenti. Se un Gem usava Deep Research o Canvas, quella parte non funziona ancora in una skill. Il nostro riepilogo non ha bisogno di quegli strumenti. Serve solo che Gemini legga una tabella, raggruppi gli elementi e scriva il testo.
Il job: un riepilogo settimanale dei post più popolari, e quanti snapshot servono
Il risultato finale è un report settimanale di una pagina. Risponde a tre domande sugli ultimi sette giorni su Reddit, Zhihu, Weibo e X. Quali argomenti sono rimasti in classifica per molti giorni? Quali argomenti sono saliti in fretta e poi sono spariti?
La stessa notizia è comparsa su più di una piattaforma? I lettori sono content planner, team di brand e PR e analisti di mercato. Il lunedì mattina aprono una sola pagina invece di leggere quattro classifiche.
Scrivere il report è la parte facile. La parte difficile è ottenere una settimana di dati. Una classifica dei contenuti più popolari è uno snapshot, non un log. Ogni piattaforma mostra solo gli elementi in cima in quel momento e la classifica cambia dopo pochi minuti. Nessuna piattaforma ti dà «tutti gli elementi che sono stati in classifica questa settimana». Lo dicono le piattaforme stesse nelle loro regole.
Weibo dice che la sua classifica delle ricerche di tendenza si aggiorna ogni minuto e mostra i primi 50 (Weibo hot search rules). Zhihu dice che la sua classifica si aggiorna ogni 10 minuti e mostra i primi 30 (Zhihu hot list introduction). Reddit e X non pubblicano una frequenza di aggiornamento. Nel nostro catalogo, reddit/trending_posts restituisce circa 25 post per pagina, e il suo token di pagina è valido per 24 ore. twitter/trending restituisce la classifica per una località, e ogni riga ha un orario collected_at. La nota del campo dice che le tendenze cambiano rapidamente, quindi usa quell'orario per valutare quanto è recente una riga.
| Classifica dei contenuti più popolari | Funzionalità EveryInfra | Righe per chiamata | Come classifica la piattaforma | Frequenza di aggiornamento | Prezzo di catalogo (4 nov 2026) |
|---|---|---|---|---|---|
| Post popolari di Reddit | reddit/trending_posts | Circa 25 per pagina; altre pagine con un token | Non pubblicata | Non pubblicata | 0,000556 $ per pagina |
| Classifica dei contenuti più popolari di Zhihu | zhihu/hot_list | Fino a 30 | Ricerca, lettura, interazione e tasso di clic | Ogni 10 minuti | 0,000806 $ per chiamata |
| Hot Search di Weibo | weibo/trending | Predefinito 20, fino a 200 (la classifica ne contiene 50) | (Ricerca + discussione + diffusione) × tasso di interazione | Ogni minuto | 0,000556 $ per chiamata |
| Tendenze di X | twitter/trending | Circa 50 per località | Non pubblicata | Non pubblicata | 0,000556 $ per chiamata |
Il metodo corretto per un riepilogo settimanale, quindi, è acquisire molti snapshot durante la settimana e poi unirli. Per ogni elemento il report ha bisogno di tre numeri: in quanti snapshot è comparso, la sua posizione migliore e il suo indice di popolarità più alto. Uno snapshot di tutte e quattro le classifiche costa 0,002474 $ (3 × 0,000556 $ + 0,000806 $, dal campo del catalogo price_usd). La vera domanda è quanti snapshot servono.
Se sono troppo pochi, perdi dei temi. Se sono troppi, paghi per dati che non usi. Per rispondere a questa domanda abbiamo eseguito 3 round di chiamate reali. I risultati sono nella sezione sul test più avanti.
Un confronto dei prezzi mostra anche perché per questo lavoro non consigliamo le API ufficiali delle piattaforme. La documentazione per sviluppatori di X riporta prezzi a consumo, e l'endpoint Trends costa 0,010 $ per richiesta («X API pricing»). È circa 18 volte il prezzo di catalogo di twitter/trending. L'API di Reddit richiede prima un'approvazione. I dettagli sono nella nota «Termini delle piattaforme» della sezione sui limiti.
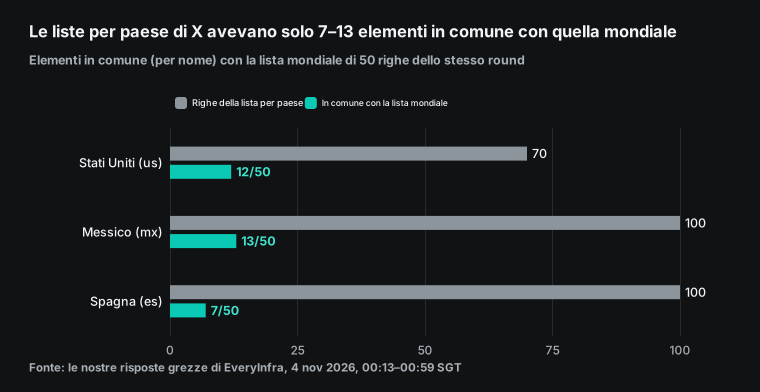
Per un lettore statunitense conta la località di X. La classifica predefinita country=world è un mix globale. Nel secondo round abbiamo chiamato anche country=us, che ha restituito 70 righe invece di 50. Se il tuo pubblico è negli Stati Uniti, usa us. Il catalogo elenca gli altri valori di località.
Lo scheletro di SKILL.md: weekly-hot-posts-digest
Di seguito trovi la cartella completa e il file SKILL.md. La skill fa una sola cosa: prende una settimana di snapshot delle classifiche dei contenuti più popolari sotto forma di tabella e scrive un riepilogo di una pagina. Non recupera dati, perché gli script delle skill nell'app Gemini non possono accedere a internet.
Abbiamo scritto le istruzioni in inglese. Gli esempi nelle pagine di assistenza di Gemini, Claude e Codex sono in inglese, e tutte e tre le piattaforme le leggono. Se vuoi il riepilogo in un'altra lingua, indicalo quando richiami la skill.
weekly-hot-posts-digest/
├── SKILL.md                     # required: name, description, instructions
└── references/
└── report-template.md # output template for step 5---
name: weekly-hot-posts-digest
description: Builds a one-page weekly digest of hot posts and trending topics from Reddit, Zhihu, Weibo and X snapshot data. Use when the user uploads this week's weekly.csv or snapshots.jsonl, or asks for a weekly trending summary across these four platforms.
---
# Weekly hot posts digest
## Inputs
- weekly.csv: one row per post or topic. Columns: platform, key, title, url, community, first_seen, last_seen, times_seen, snapshots_total, best_rank, max_heat.
- If the user gives snapshots.jsonl instead, group rows by platform and key first, then work from the grouped rows.
## Steps
Copy this checklist and track progress:
- [ ] 1. For each platform, count snapshots_total and the date range. Write them at the top of the digest.
- [ ] 2. Rank items by times_seen / snapshots_total first, then by best_rank. An item seen in most snapshots is a "week topic". An item seen once is a "spike".
- [ ] 3. Pick 5 week topics and 3 spikes per platform. Keep the original title. For Zhihu and Weibo, add a one-line English gloss after the title.
- [ ] 4. Group the picked items into at most 6 themes across platforms. A theme needs items from 2 or more platforms.
- [ ] 5. Fill the template in references/report-template.md.
## Rules
- max_heat is only comparable inside one platform. Do not compare Weibo hot_value with Zhihu hot_value or Reddit like_count.
- X trends may have an empty volume. Write "no volume" instead of 0.
- Do not guess why a topic is hot. If the title is not enough, write "reason unclear" and give the url.
- Remove user names from Reddit titles and text if they appear. Keep brand and organization names.
## Missing information
- If a platform has 0 snapshots this week, write "no data for <platform> this week" and continue with the others. Do not fill it from memory or web search.
- If snapshots_total is below 5 for a platform, add the line "low coverage: N snapshots".Il file del template è breve. Contiene una riga del titolo con le date della settimana in SGT e una riga sulla copertura. Seguono una tabella dei temi, una sezione «week topics» per ogni piattaforma, una sezione «spikes» e le note. Il file completo pesa 399 byte. Sta in un file separato per la progressive disclosure: Gemini lo apre solo al passaggio 5, quindi non consuma token mentre decide se la skill è pertinente.
Ogni regola delle istruzioni nasce da qualcosa che abbiamo visto nelle chiamate reali. La regola «max_heat è confrontabile solo all'interno di una piattaforma» viene dalle note sui campi del catalogo. Il hot_value di Weibo è una metrica di Weibo «confrontabile solo all'interno della classifica». Il hot_value di Zhihu è il testo della pagina, ad esempio «5,97 milioni di popolarità», convertito in intero.
Le due piattaforme usano formule diverse. Secondo le regole di Weibo, l'indice è «(popolarità di ricerca + popolarità di discussione + popolarità di diffusione) × tasso di interazione». La pagina di Zhihu elenca popolarità di ricerca, popolarità di lettura, popolarità di interazione e tasso di clic (regole della Hot Search di Weibo, presentazione della classifica di Zhihu). Un ordinamento che mescola le due classifiche non ha senso.
La regola «le tendenze di X possono avere il volume vuoto» viene dai nostri test; i numeri sono nella sezione sui campi più avanti. La regola «se mancano dati, dillo» viene dalla classifica dei contenuti più popolari di Zhihu, che durante questo test ha restituito HTTP 503 a ogni tentativo. Senza questa regola, Gemini può riempire il buco con vecchi elementi della classifica che ha in memoria. Il riepilogo sembra completo, ma in parte è inventato.
| Regola nella skill | Risultato del test o documento da cui deriva | Senza la regola |
|---|---|---|
| Confronta max_heat solo all'interno di una piattaforma | Weibo e Zhihu usano formule di popolarità diverse; secondo il catalogo, la popolarità di Weibo è confrontabile solo all'interno della sua classifica | Una «classifica di popolarità» tra piattaforme priva di senso |
| Scrivi «no volume» se il volume di X è vuoto | Il campo volume di X era vuoto in tutti i nostri snapshot di X | Il modello interpreta il valore vuoto come 0 |
| Non tirare a indovinare; scrivi «reason unclear» | Una classifica dei contenuti più popolari fornisce solo un titolo e un link | Il modello inventa un motivo attingendo alla memoria |
| Nessun dato significa «no data» | In questo test la classifica dei contenuti più popolari di Zhihu ha restituito 503 a ogni richiesta | Il modello riempie il buco con elementi vecchi |
| Con meno di 5 snapshot, scrivi «low coverage» | Una parte di ogni classifica cambia nel giro di 44 minuti | I lettori pensano che il riepilogo copra l'intera settimana |
Claude e Codex possono usare lo stesso SKILL.md?
Sì. Gemini, Claude Code, Codex e Antigravity dichiarano tutti che le loro skill seguono lo standard aperto Agent Skills. La specifica ha solo due campi obbligatori. name usa lettere minuscole, cifre e trattini, fino a 64 caratteri. description arriva a 1.024 caratteri («Agent Skills specification»).
Claude Code aggiunge campi di estensione, come il controllo dell'invocazione e l'esecuzione in subagent (documentazione di Claude Code). Codex richiede sia name sia description («Codex: Build skills»). Antigravity permette di omettere name e in quel caso usa il nome della cartella (documentazione di Antigravity). La nostra skill ha entrambi i campi e nessun campo di estensione, quindi tutti e quattro gli strumenti possono leggerla senza modifiche.
Cambia solo una cosa. In Claude Code, Codex e Antigravity CLI, la stessa skill può chiamare il server MCP remoto di EveryInfra e ottenere le classifiche. Nell'app Gemini una skill non può accedere a internet, quindi devi preparare prima i dati. Il nostro articolo un solo SKILL.md in quattro strumenti AI: test sull'analisi delle recensioni dei concorrenti confronta cartelle delle skill, modalità di chiamata e regole di rete. Quell'articolo mostra una skill che lavora insieme alle chiamate MCP. Questo articolo mostra come separare dati e istruzioni quando la skill non può accedere a internet.
Come l'app Gemini riceve dati esterni: tre strade
La skill non recupera dati, quindi i dati devono arrivare dall'esterno. Il 4 novembre 2026 abbiamo letto la documentazione ufficiale e abbiamo individuato tre strade. Ognuna ha requisiti diversi ed è adatta a un utente diverso. Ogni strada descritta qui sotto è un esempio di configurazione. Sulla nostra macchina di test non abbiamo effettuato l'accesso a Gemini e non abbiamo eseguito nessun passaggio lato Gemini.
| Strada | Chi può usarla | Come arrivano i dati | Automazione settimanale | Cosa abbiamo testato |
|---|---|---|---|---|
| A. Snapshot in locale, caricamento di una tabella nel weekend | Tutti gli account che hanno le skill | weekly.csv come allegato della chat | Il recupero è automatico; il file lo carica una persona | Le chiamate API per i dati (i nostri 3 round) |
| B. Connected App personalizzata (MCP remoto) | Almeno 18 anni, negli USA, account personale, inglese | Gemini chiama gli strumenti MCP | La pagina di assistenza dice che le app personalizzate funzionano in Tasks | Solo il nostro lato MCP |
| C. Gemini API: agente Antigravity e un trigger | Sviluppatori con una chiave API di Gemini | L'agente chiama uno strumento mcp_server in una sandbox | Sì, un trigger viene eseguito secondo una pianificazione cron | Solo il nostro lato MCP |
Le strade che puoi usare dipendono da dove ti trovi e dal tuo account:
| La tua situazione | Strade | Perché |
|---|---|---|
| Negli USA, account personale, inglese | A, B, C | Le app personalizzate sono disponibili solo per gli account personali negli USA |
| Account personale in un altro paese (ad esempio Canada o Singapore) | A, C | Niente app personalizzate; Tasks richiede AI Pro o Ultra |
| Nel SEE, in Svizzera o nel Regno Unito | A (il caricamento lo fa una persona), C | Lì i Tasks pianificati di Gemini non sono disponibili |
| Account di lavoro Workspace | A, C (dopo il lancio delle skill in Workspace) | Le skill di Workspace sono rinviate e i due tipi di skill non si sincronizzano |
Strada A: snapshot in locale, caricamento nel weekend. È la strada con i requisiti più bassi e quella che ti dà più controllo. Sul tuo computer o su un piccolo server, esegui uno script di recupero una o più volte al giorno. Lo script aggiunge a snapshots.jsonl i risultati grezzi delle quattro classifiche.
Nel weekend, uno script di unione trasforma gli snapshot della settimana in weekly.csv. Carichi quel file in una chat di Gemini e digiti /weekly-hot-posts-digest. Il CSV è tra i tipi di file supportati indicati nella pagina di assistenza di Gemini («Create & manage skills»).
Il vantaggio è che recupero e scrittura sono del tutto separati. Il recupero lo fa un programma fisso, che registra in un file ogni addebito e ogni errore. Il modello che scrive il riepilogo vede solo una tabella, quindi non può «cercare e riempire i buchi». Lo svantaggio è che ogni settimana una persona deve caricare il file. Le chiamate reali della sezione successiva sono le stesse chiamate API.
Strada B: una Connected App personalizzata. Nell'app web di Gemini puoi aggiungere una «app personalizzata» con l'URL di un server MCP. Una volta collegata, funziona nell'app mobile, sul web e in Tasks (pagina di assistenza sulle app personalizzate). I requisiti sono chiari: devi avere almeno 18 anni, trovarti negli Stati Uniti, accedere con un Account Google personale e tenere attiva l'opzione Keep Activity. Per ora la funzionalità supporta solo l'inglese e puoi aggiungere un'app solo dal web.
Per l'autenticazione, la documentazione della Developer Mode usa la Dynamic Client Registration (RFC 7591). Configuri tu come Gemini crea le credenziali del client e dell'utente con il tuo server MCP. Esiste anche una guida separata su OAuth 2.1 («Gemini Apps Developer Mode overview»). Questa strada usa quindi un accesso OAuth.
Non incolli una chiave API in un'intestazione della richiesta. Il server MCP remoto di EveryInfra ha un punto di accesso OAuth su https://api.everyinfra.com/mcp/all, con i metadati in /.well-known/oauth-protected-resource/mcp/all. Non abbiamo provato a collegarlo in Gemini, quindi non possiamo garantire che la connessione funzioni. Se sei negli USA e provi questa strada, mandaci l'errore se la connessione non riesce.
La strada B ha un altro dettaglio che deriva dalla documentazione, ma che non abbiamo testato. La pagina della Developer Mode dice che Gemini legge le annotazioni readOnlyHint e destructiveHint di ogni strumento MCP (specifica degli strumenti MCP). Insieme al contesto della chat, le usa per decidere se mostrare prima una scheda di conferma. La pagina di assistenza dice anche che Gemini chiede sempre conferma per le azioni di scrittura. Il 4 novembre abbiamo letto l'elenco degli strumenti MCP di EveryInfra con tools/list.
Questa chiamata funziona senza chiave e non ha addebiti. Lo strumento generale per i dati everyinfra_call_api ha le annotazioni readOnlyHint: false e destructiveHint: true, perché ogni chiamata ha un addebito. In base alla documentazione, questo significa probabilmente che Gemini ti chiede di confermare ogni chiamata alle classifiche. Un'attività pianificata senza supervisione può quindi fermarsi al passaggio di conferma. Verificalo quando colleghi l'app.
Strada C: l'agente Antigravity della Gemini API e un trigger. Se sai scrivere qualche riga di Python, usa questa strada. È l'unica in cui recupero, scrittura e pianificazione avvengono tutti dal lato di Google. L'endpoint Interactions della Gemini API può usare un server MCP remoto come strumento. I campi sono type: "mcp_server", name, url, headers e allowed_tools. È supportato solo Streamable HTTP, non SSE, e il nome non deve contenere trattini («Gemini API: Function calling, Remote MCP section»).
L'agente Antigravity è un agente generico che gira in una sandbox Linux gestita da Google. Puoi montare nella sandbox AGENTS.md e le skill in .agents/skills/ («Gemini API: Antigravity agent»). Il riferimento della Interactions API contiene un esempio che usa una sorgente inline per scrivere un file SKILL.md in .agents/skills/<name>/SKILL.md («Interactions API reference»). Secondo la sezione «Triggers», un trigger unisce agente, ambiente, prompt e pianificazione cron in un'unica risorsa persistente. Ogni esecuzione usa lo stesso ambiente, quindi i file dell'esecuzione precedente sono ancora lì. Per le esecuzioni senza supervisione, la pagina suggerisce una credenziale archiviata invece di un token nella richiesta.
Messi insieme, questi tre fatti danno una configurazione che scrive un riepilogo ogni lunedì mattina. Di seguito trovi un esempio di configurazione. Abbiamo copiato i nomi dei campi dalla documentazione ufficiale, ma non abbiamo eseguito il codice.
# Configuration example (not run): one snapshot each day at 08:00 SGT,
# and on Mondays also the digest for the last week.
# Sources: ai.google.dev/gemini-api/docs/antigravity-agent (MCP servers, Triggers, Budget controls)
#          ai.google.dev/api/interactions-api (inline sources for an environment)
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY from the environment
SKILL_MD = open("weekly-hot-posts-digest/SKILL.md", encoding="utf-8").read()
TEMPLATE = open("weekly-hot-posts-digest/references/report-template.md", encoding="utf-8").read()

everyinfra = {
    "type": "mcp_server",
    "name": "everyinfra",                     # lowercase letters and digits only
    "url": "https://api.everyinfra.com/mcp",
    "headers": {"Authorization": "Bearer " + EVERYINFRA_API_KEY},  # read from a secret store
    "allowed_tools": ["everyinfra_call_api"],
}
environment = {
    "type": "remote",
    "sources": [
        {"type": "inline", "content": SKILL_MD,
         "target": ".agents/skills/weekly-hot-posts-digest/SKILL.md"},
        {"type": "inline", "content": TEMPLATE,
         "target": ".agents/skills/weekly-hot-posts-digest/references/report-template.md"},
    ],
}
PROMPT = (
    "Step 1: call everyinfra_call_api four times: reddit/trending_posts, zhihu/hot_list (limit 30), "
    "weibo/trending (limit 50), twitter/trending (country us). Append one JSON line per call to "
    "/workspace/snapshots.jsonl with taken_at, platform, http status, charged_usd and results. "
    "If a call fails, write the error and continue. "
    "Step 2: only if today is Monday in Asia/Singapore, use the weekly-hot-posts-digest skill on the "
    "last 7 days of /workspace/snapshots.jsonl and save the digest to /workspace/digests/."
)
trigger = client.triggers.create(
    schedule="0 8 * * *", time_zone="Asia/Singapore", display_name="hot-lists-weekly",
    interaction={
        "agent": "antigravity-preview-09-2026",
        "agent_config": {"type": "antigravity", "model": "gemini-3.5-flash-lite",
                         "max_total_tokens": 300000},
        "environment": environment,
        "tools": [everyinfra],
        "input": PROMPT,
    },
)
print(trigger.id, trigger.next_run_time)
Tre parti di questo esempio richiedono una spiegazione. Primo, recupero e scrittura stanno in un solo trigger. La documentazione dice che ogni esecuzione «riusa lo stesso ambiente», quindi i file dell'esecuzione precedente sono visibili. Quella frase si riferisce a un singolo trigger. Con due trigger, il secondo deve fare riferimento all'ambiente tramite il suo ID per leggere gli snapshot. La sezione Environments mostra che puoi passare un ID esistente come env_abc123, ma è un passaggio in più che può fallire.
Secondo, il modello è gemini-3.5-flash-lite, il più economico, e l'esempio imposta un limite max_total_tokens. L'agente Antigravity gira in un ciclo autonomo. Per un'attività di «ricerca e sintesi», la documentazione stima da 100.000 a 500.000 token di input. Sono circa da 0,30 $ a 1,00 $ per esecuzione, e fino a circa 5 $ per le attività complesse. Quando raggiunge il limite, l'esecuzione si ferma e restituisce status: "incomplete".
Terzo, non mettere la chiave nel codice. Per le esecuzioni senza supervisione, la sezione Triggers dice di fare riferimento a una credenziale archiviata. Il proxy in uscita legge la credenziale a ogni esecuzione, quindi puoi cambiare la chiave senza modificare il trigger. La riga headers dell'esempio serve solo per un primo test manuale.
Sulla strada C tieni d'occhio anche tre voci del changelog della Gemini API («Gemini API changelog»). Dal 26 ottobre 2026, i nuovi progetti del livello a pagamento archiviano per impostazione predefinita le richieste generateContent (store=true). Se il testo del tuo riepilogo contiene dati degli utenti, valuta se impostare store=false per singola richiesta. Il 27 ottobre 2026 il client stateless da riga di comando gemini-api è entrato in beta pubblica. Può eseguire agenti gestiti sull'endpoint Interactions, ma non abbiamo verificato se supporta i trigger.
Un avviso di deprecazione del 2 novembre 2026 dice che dal 1° dicembre le richieste a gemini-2.5-flash vengono inoltrate a gemini-3.5-flash-lite. Il function calling ha modifiche non retrocompatibili. Se un vecchio script del riepilogo fissa un modello 2.5, cambia il nome del modello e testalo di nuovo prima di quella data.
Un'altra strada: Antigravity CLI. Se lavori già nel terminale, Antigravity CLI è lo strumento con cui Google sostituisce Gemini CLI. Anche questo legge le skill in .agents/skills/. Inserisci il server MCP remoto in mcp_config.json e lo scheduler di sistema (cron o launchd) esegue agy -p. Il nostro articolo Antigravity CLI per il monitoraggio dei commenti ai video: test e configurazione descrive la configurazione completa.
La differenza rispetto alla strada C è dove viene eseguito. La CLI gira sulla tua macchina, quindi si ferma quando la macchina è spenta. La strada C gira nella sandbox di Google. Il nostro articolo sulla Gemini Deep Research API con un server MCP remoto riguarda un uso diverso: ricerche con citazioni, non snapshot pianificati.
Il test: una chiamata reale, dalla richiesta alla risposta, per ognuna delle quattro classifiche
Questa sezione è il nostro test reale. Il 4 novembre 2026, dalle 00:13 alle 00:59 SGT, abbiamo eseguito 3 round sulle quattro classifiche. Alle 02:05 SGT abbiamo riprovato ancora una volta la classifica dei contenuti più popolari di Zhihu e i post popolari di Reddit, e abbiamo chiamato due endpoint sostitutivi (vedi la fine di questa sezione).
In totale abbiamo inviato 27 richieste. 13 sono andate a buon fine con addebito, per un totale di 0,007228 $. Le 14 richieste fallite non hanno avuto addebiti. Abbiamo conservato la risposta grezza, le intestazioni e l'orario di ogni richiesta, quindi ogni numero di questo articolo è riconducibile a una risposta grezza.
Uno snapshot corrisponde a quattro chiamate. Eccolo con curl. Tieni la chiave in una variabile d'ambiente, non nello script.
# One snapshot: one call to each of the four hot lists (as tested on 2026-11-04)
API=https://api.everyinfra.com/api/v1/social
for body in \
  '{"platform":"reddit","action":"trending_posts","params":{}}' \
  '{"platform":"zhihu","action":"hot_list","params":{"limit":30}}' \
  '{"platform":"weibo","action":"trending","params":{"limit":50}}' \
  '{"platform":"twitter","action":"trending","params":{"country":"us"}}'
do
  curl -s -X POST "$API" -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
       -H 'Content-Type: application/json' -d "$body" \
  | jq -c '{platform, action, count, charged: .billing.charged_usd, error: .error.code}'
  sleep 7   # stay under 10 calls per minute
done
La struttura della risposta è la stessa per tutte e quattro le piattaforme. results è l'array degli elementi, count è il numero di elementi e billing.charged_usd è l'addebito della chiamata. Una chiamata fallita non ha results, ma ha error, con fault (di chi è il problema), retryable, retry_after (i secondi da attendere) e i passi successivi. I campi degli elementi cambiano da piattaforma a piattaforma. È il punto più importante quando unisci una settimana di dati.
| Funzionalità | Chiave dell'elemento | Posizione | Campo della popolarità | Righe nel primo snapshot valido | Testo, immagini, volume |
|---|---|---|---|---|---|
reddit/trending_posts | id | Ordine della risposta | like_count, comment_count | 25 | text vuoto in 18 righe |
zhihu/hot_list | id | rank | hot_value (il valore «10k di popolarità» della pagina come intero) | 0 | — |
weibo/trending | Titolo (nessun id) | rank | hot_value | 50 | label vuoto in 26 righe |
twitter/trending | Nome (nessun id stabile) | rank | volume | 50 | volume vuoto in 50/50 righe |
Lo script di recupero giornaliero esegue le stesse quattro chiamate in Python. Aggiunge una riga per snapshot a snapshots.jsonl.
Di seguito trovi un esempio di collect.py, con commenti in inglese. Invia le stesse chiamate API dei nostri 3 round. Usa solo la libreria standard di Python (urllib.request) e legge la chiave solo dall'ambiente. Con un 503 per cui è previsto un nuovo tentativo, attende retry_after e riprova una volta. Se la chiamata fallisce di nuovo, scrive l'errore nel file.
#!/usr/bin/env python3
"""Run once (or a few times) a day: fetch four hot lists and append one snapshot line each to snapshots.jsonl. The key comes only from the EVERYINFRA_API_KEY environment variable."""
import json, os, sys, time, urllib.request, urllib.error
from datetime import datetime, timezone, timedelta

API = "https://api.everyinfra.com/api/v1/social"
LISTS = [
    ("reddit", "trending_posts", {}),
    ("zhihu", "hot_list", {"limit": 30}),
    ("weibo", "trending", {"limit": 50}),
    ("twitter", "trending", {"country": "world"}),
]
SGT = timezone(timedelta(hours=8))

def call(platform, action, params):
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    req = urllib.request.Request(API, data=body, method="POST", headers={
        "Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
        "Content-Type": "application/json", "User-Agent": "hot-digest/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            return r.status, json.loads(r.read())
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")

def main(out_path):
    taken_at = datetime.now(SGT).isoformat(timespec="seconds")
    with open(out_path, "a", encoding="utf-8") as out:
        for platform, action, params in LISTS:
            status, data = call(platform, action, params)
            if status == 503 and (data.get("error") or {}).get("retryable"):
                time.sleep(int(data["error"].get("retry_after", 60)))
                status, data = call(platform, action, params)
            row = {"taken_at": taken_at, "platform": platform, "action": action, "http": status,
                   "charged_usd": (data.get("billing") or {}).get("charged_usd", 0),
                   "error": (data.get("error") or {}).get("code"), "results": data.get("results", [])}
            out.write(json.dumps(row, ensure_ascii=False) + "\n")
            print(platform, action, status, len(row["results"]), row["charged_usd"])
            time.sleep(7)  # stay under 10 calls per minute

if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else "snapshots.jsonl")
Nel weekend, merge.py trasforma gli snapshot della settimana in un'unica tabella. Le regole sono semplici. Gli elementi di Reddit e Zhihu si abbinano tramite id. Weibo e X non hanno un id stabile, quindi si abbinano per titolo.
Ogni riga registra prima apparizione, ultima apparizione, numero di apparizioni, posizione migliore e popolarità massima. Per ogni piattaforma, la tabella registra anche il numero di snapshot validi della settimana (snapshots_total). La skill usa quel numero per verificare la copertura. L'output è CSV standard (RFC 4180) e la pagina di assistenza di Gemini elenca il CSV tra i tipi di file caricabili.
#!/usr/bin/env python3
"""Merge one week of snapshots.jsonl into weekly.csv: one row per post or topic, with first and last seen, times seen, best rank and highest heat."""
import csv, json, sys
from collections import defaultdict

def key_of(platform, r):
    return r.get("id") if platform in ("reddit", "zhihu") else (r.get("title") or r.get("name"))

def heat_of(platform, r):
    if platform == "reddit": return r.get("like_count")
    if platform in ("zhihu", "weibo"): return r.get("hot_value")
    v = r.get("volume")  # X volume can be an empty string
    return v or None

def main(src, dst):
    rows = [json.loads(l) for l in open(src, encoding="utf-8") if l.strip()]
    snaps = defaultdict(set); items = {}
    for s in rows:
        if s["http"] != 200: continue
        p = s["platform"]; snaps[p].add(s["taken_at"])
        for i, r in enumerate(s["results"], 1):
            k = key_of(p, r)
            if not k: continue
            it = items.setdefault((p, k), {"platform": p, "key": k, "title": r.get("title") or r.get("name"),
                 "url": r.get("url", ""), "community": r.get("community", ""), "first_seen": s["taken_at"],
                 "last_seen": s["taken_at"], "times_seen": 0, "best_rank": None, "max_heat": None})
            it["last_seen"] = max(it["last_seen"], s["taken_at"]); it["first_seen"] = min(it["first_seen"], s["taken_at"])
            it["times_seen"] += 1
            rank = r.get("rank") or i
            it["best_rank"] = rank if it["best_rank"] is None else min(it["best_rank"], rank)
            h = heat_of(p, r)
            if isinstance(h, (int, float)): it["max_heat"] = h if it["max_heat"] is None else max(it["max_heat"], h)
    out = sorted(items.values(), key=lambda x: (x["platform"], -x["times_seen"], x["best_rank"] or 999))
    for it in out: it["snapshots_total"] = len(snaps[it["platform"]])
    with open(dst, "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=["platform", "key", "title", "url", "community", "first_seen", "last_seen",
                                          "times_seen", "snapshots_total", "best_rank", "max_heat"])
        w.writeheader(); w.writerows(out)
    print(dst, len(out), {p: len(v) for p, v in snaps.items()})

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
Le stesse funzionalità sono disponibili anche tramite il server MCP remoto. In un client MCP, aggiungi https://api.everyinfra.com/mcp e chiama lo strumento generale everyinfra_call_api con gli stessi argomenti del corpo della richiesta visto sopra. L'immagine qui sotto è la nostra richiesta MCP tools/call reale per weibo/trending delle 00:37:15 SGT, mostrata con solo 2 righe e link abbreviati. Ha risposto in 0,6 secondi, con un addebito di 0,000556 $.
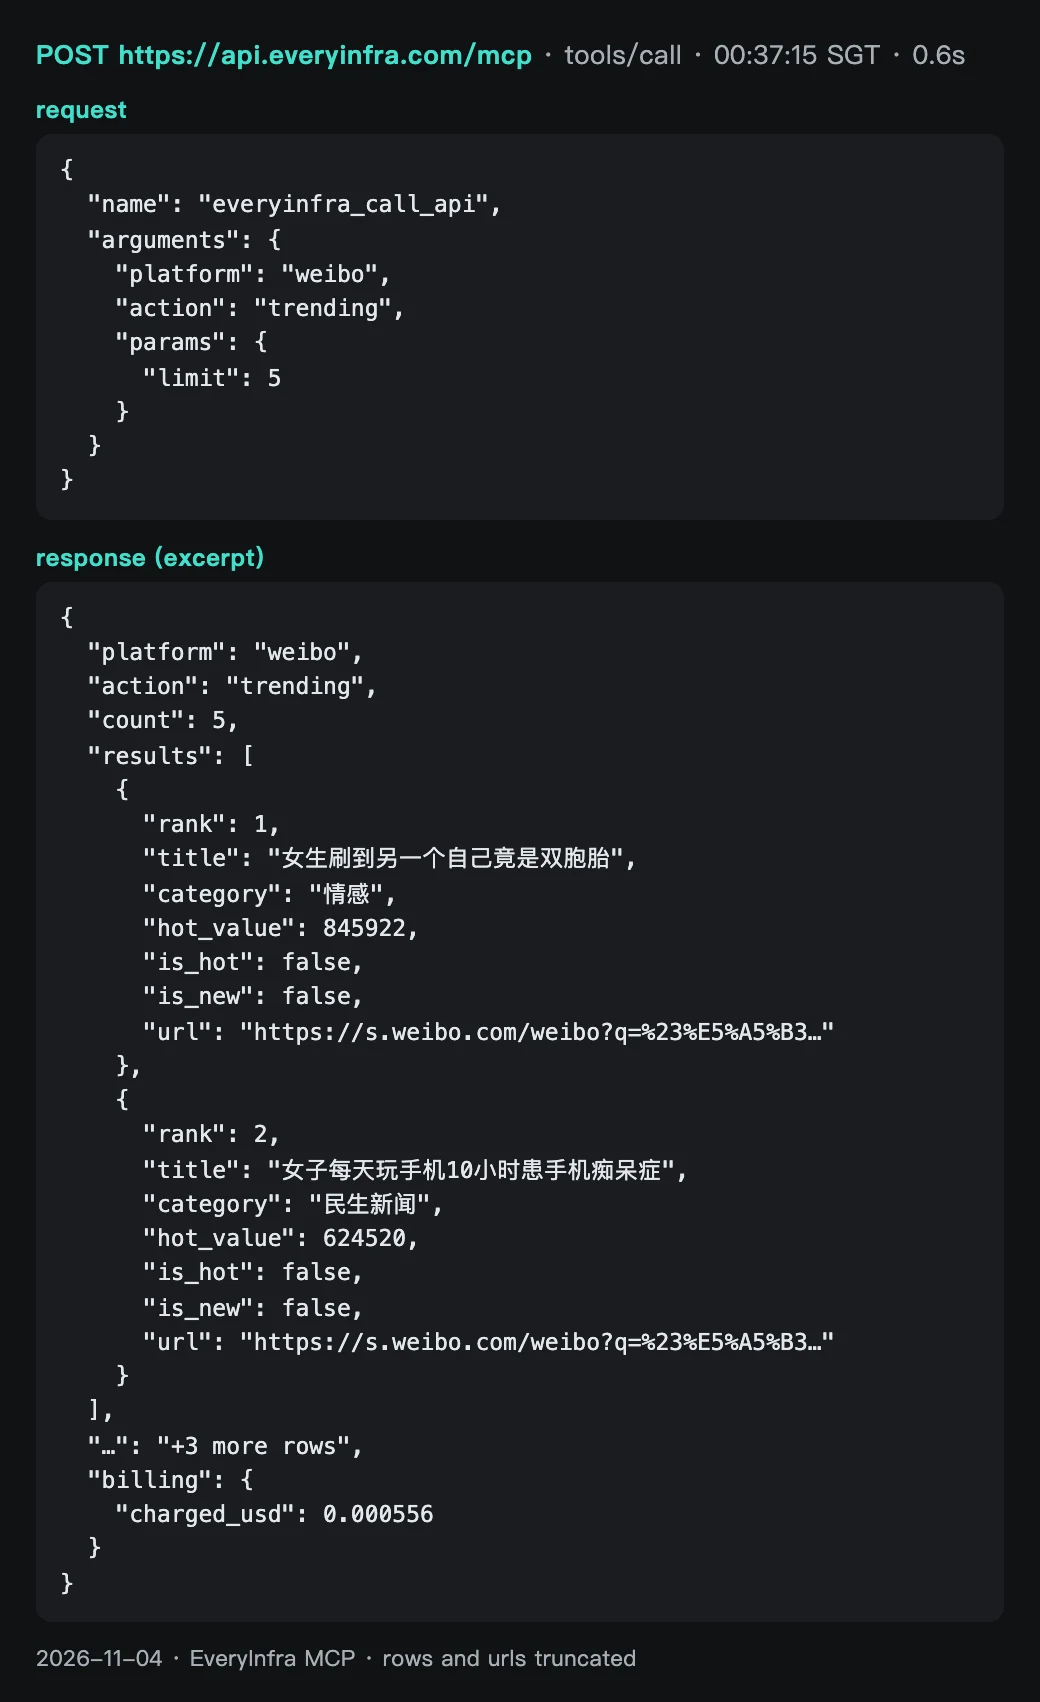
Di seguito i 3 round e i relativi risultati. Ogni round chiama le quattro classifiche nello stesso ordine, con qualche secondo tra una chiamata e l'altra per restare sotto le 10 chiamate al minuto. Dopo un errore abbiamo atteso 60 secondi, come indicato da retry_after, e abbiamo riprovato una volta.
| Round (SGT) | Post popolari di Reddit | Classifica dei contenuti più popolari di Zhihu | Hot Search di Weibo | Tendenze di X | Chiamate extra |
|---|---|---|---|---|---|
| Round 1, 00:13–00:15 | 25 righe | 503 ×3 | 50 righe | 50 righe | — |
| Round 2, 00:35–00:37 | 503 ×3 | 503 ×2 | 50 righe | 50 righe | X us 70 righe |
| Round 3, 00:58–00:59 | 503 ×2 | 503 ×2 | 50 righe | 50 righe | X mx 100 righe, X es 100 righe |
| Extra, 00:37 | — | — | 5 righe (MCP, limit=5) | — | È la chiamata dello screenshot della risposta API |
| Nuovo tentativo, 02:05 | 503 ×1 | 503 ×1 | — | — | Sostituti: reddit/subreddit_posts 25 post, zhihu/search 20 righe |
Durante il test, la classifica dei contenuti più popolari di Zhihu e i post popolari di Reddit non erano disponibili. Dalle 00:13 alle 02:05 tutte le 8 richieste a Zhihu hanno restituito 503, con fault: service e retryable: true, e nessuna ha avuto addebiti. I post popolari di Reddit hanno restituito 25 righe nel round 1. Dopo, 6 richieste non hanno restituito dati: 4 chiamate REST hanno restituito 503 e 2 chiamate MCP hanno restituito isError. Nessuna ha avuto addebiti.
Alle 02:05 anche un ulteriore tentativo per ciascuna classifica ha restituito 503. Per questo i numeri su permanenza, unione e campi delle sezioni successive vengono solo da weibo/trending e twitter/trending. Le colonne delle classifiche di Zhihu e Reddit sono vuote.
Per un riepilogo questa parte conta. Un endpoint di classifica può restare non disponibile a lungo. Lo script di recupero deve scrivere ogni errore nel file. La skill deve scrivere «no data for Zhihu this week» nel riepilogo, senza lasciare che il modello riempia il buco.
Se una classifica non è disponibile, il riepilogo può riempire quella colonna con un altro endpoint, ma deve indicare la nuova fonte. Alle 02:05 SGT abbiamo chiamato due endpoint sostitutivi, a 0,000556 $ ciascuno. reddit/subreddit_posts su r/GeminiAI (sort=top, date_range=past_week) ha restituito 25 post, pubblicati dal 28 ottobre 2026 al 3 novembre 2026 (SGT), con un numero di upvote da 156 a 1.583. 11 titoli contenevano «Carbon», 21 post avevano text vuoto e tutti e 25 avevano un flair.
zhihu/search per «Gemini», ordinato dal più recente, ha restituito 20 righe: 13 articoli e 7 risposte, pubblicati dal 23 ottobre 2026 al 4 novembre 2026 (SGT). Il like_count più alto era 294 e 4 righe avevano 0 like.
Nessuno dei due endpoint è una classifica dei contenuti più popolari. Il primo fornisce i post migliori di una community in una settimana. Il secondo fornisce i risultati per parola chiave in ordine di tempo. Nel riepilogo, quindi, non chiamarli «post popolari di Reddit» o «classifica dei contenuti più popolari di Zhihu». Aggiungi una regola alla skill: per un endpoint sostitutivo, scrivi il suo nome dopo il titolo della colonna.
Risultati del test: quanto velocemente cambiano le classifiche e quanti snapshot servono in una settimana
La nostra domanda era: per un riepilogo settimanale dei post più popolari basta un'estrazione a settimana? Abbiamo fissato il criterio del test prima delle chiamate. Se una classifica resta quasi uguale dopo qualche decina di minuti, bastano una o due estrazioni a settimana. Se cambia una quota evidente della classifica, servono molti snapshot al giorno da unire.
La risposta è il secondo caso. Come base abbiamo usato il primo snapshot valido di ogni piattaforma. Dopo 44 minuti era ancora in classifica solo l'86% degli elementi della Hot Search di Weibo. Dopo 44 minuti era ancora in classifica solo il 74% delle tendenze di X (world). In 44 minuti, i 3 round insieme hanno mostrato 58 temi diversi su Weibo e 63 tendenze diverse su X: il 16% e il 26% in più rispetto alle 50 righe di un singolo snapshot.
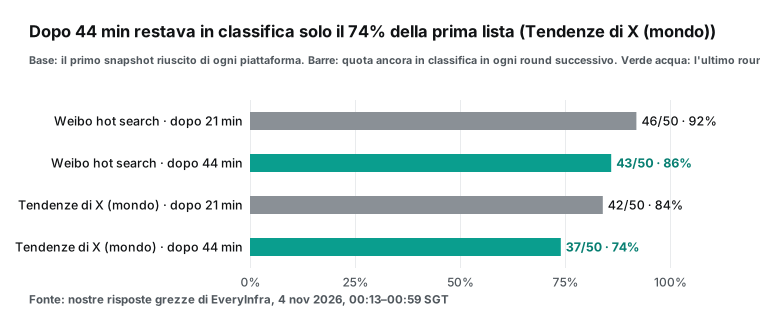
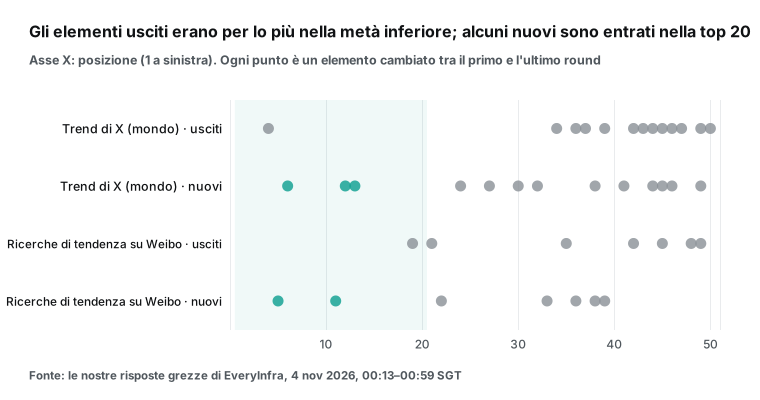
Anche la posizione degli elementi cambiati segue uno schema. Dal primo all'ultimo round, 5 dei 7 elementi usciti dalla classifica di Weibo erano nella metà inferiore. Per X erano 12 su 13. La metà inferiore di una classifica è quella che cambia più in fretta.
Non tutti i nuovi elementi, però, partono dal fondo. 2 nuovi elementi di Weibo e 3 di X erano nella top 20 alla loro prima comparsa. Sono i «picchi» che un riepilogo cerca di più. Salgono e scendono tra due snapshot, e una singola classifica del lunedì mattina non li mostra.
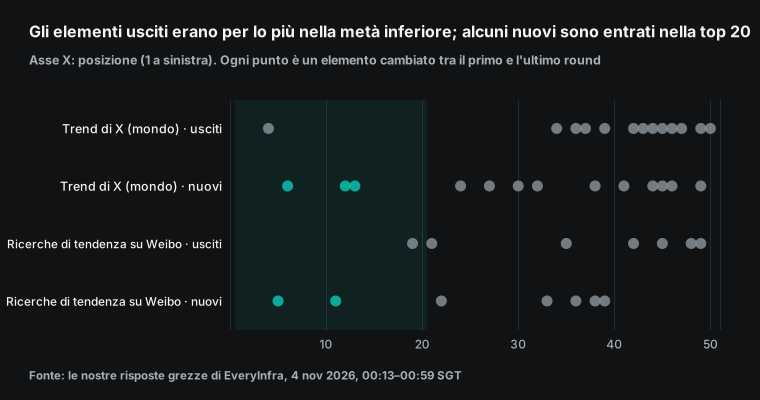
Da qui si ricava una frequenza degli snapshot, ma solo come esempio. Abbiamo misurato per soli 44 minuti, quindi non possiamo proiettare i numeri su un'intera settimana. Non abbiamo misurato nemmeno la permanenza dopo 6 o 24 ore. Possiamo dare solo un limite inferiore: in 44 minuti è cambiato circa il 26% della classifica di X.
Con uno snapshot al giorno passano 24 ore tra uno snapshot e l'altro, e perdi alcuni temi che salgono e scendono in quell'intervallo. La frequenza che proponiamo come esempio è di quattro snapshot al giorno, ad esempio alle 08:00, 13:00, 18:00 e 23:00 del tuo fuso orario. Sono 28 snapshot a settimana. Con un budget ridotto, acquisiscine uno al giorno e scrivi «covers one time of day» nel riepilogo. Per stabilire la tua frequenza, acquisisci uno snapshot all'ora per un giorno. Poi verifica quanta parte della classifica resta dopo 6 e 24 ore, e scegli una frequenza più bassa se la maggior parte degli elementi resta.
Quali campi sono utilizzabili e quali numeri il riepilogo non può mostrare
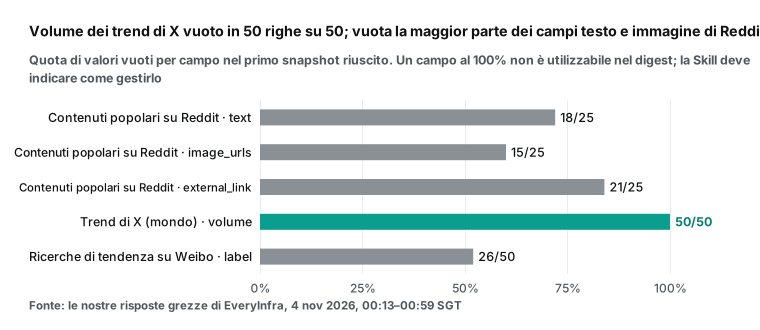
I campi mancanti determinano le regole della skill. Il campo volume di X era vuoto in tutti e 6 gli snapshot, su tre località, e period era sempre «Live». Per X, quindi, il riepilogo può mostrare solo posizione e numero di apparizioni, non il volume delle discussioni. Dei 25 post popolari di Reddit, text era vuoto in 18 righe (perlopiù post con immagini o link) e image_urls era vuoto in 15 righe.
Per questo la skill dice a Gemini di leggere solo il titolo. Il campo label di Weibo (contrassegni come «nuovo» e «hot») era vuoto in 26 righe. Quegli elementi non hanno contrassegni nella classifica: il dato non manca.
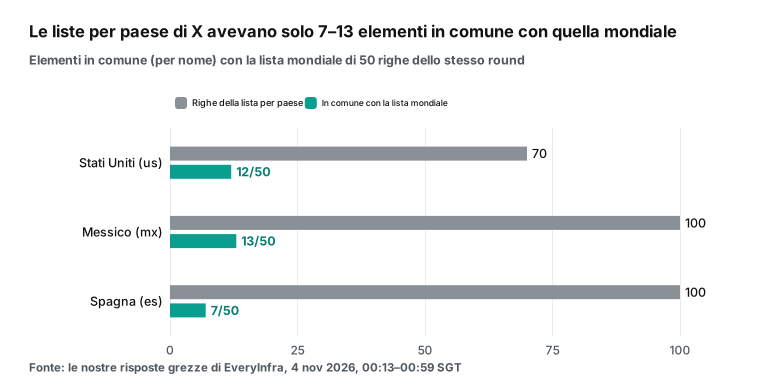
Scegli la località giusta su X. Nello stesso periodo, le 50 righe di country=world avevano in comune solo 12 elementi con le 70 righe di us. Con mx (100 righe) ne avevano in comune 13 e con es (100 righe) 7. La classifica world è un mix globale.
Le elezioni di metà mandato negli Stati Uniti si sono tenute il 3 novembre 2026 (ora degli Stati Uniti). Quel giorno «Election Day» era in posizione 1 nella classifica us e in posizione 6 nella classifica world dello stesso round. Per un riepilogo dedicato a un solo mercato, usa la classifica di quel paese.
Unisci i dati prima di inviarli a Gemini
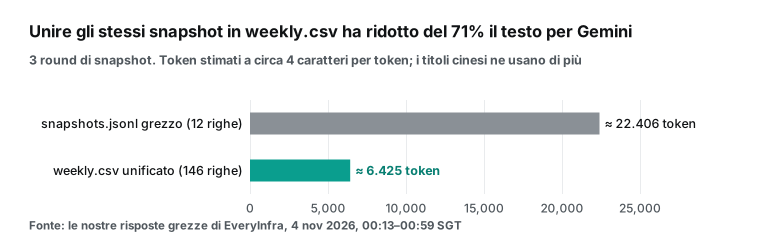
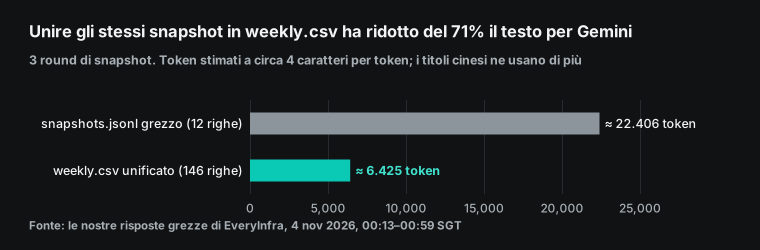
Perché la skill vuole weekly.csv e non gli snapshot grezzi? Abbiamo scritto i risultati grezzi dei nostri 3 round in snapshots.jsonl nel formato di collect.py: 12 righe, circa 22.406 token. Dopo merge.py, weekly.csv ha 146 righe e circa 6.425 token, il 71% in meno. Abbiamo usato la regola empirica della Gemini API di circa 4 caratteri per token («Understand and count tokens»); i titoli in cinese ne usano di più. Con quattro snapshot al giorno per una settimana, i soli snapshot grezzi di Reddit, Weibo e X arrivano a circa 304.000 token (la dimensione media per classifica nei nostri round × 28).
La tabella unita cresce solo con il numero di elementi distinti, perché un tema ripetuto occupa una sola riga. Soprattutto, l'unione la fa un programma fisso. Numero di apparizioni, posizione migliore e popolarità massima sono calcolati. Gemini si limita a selezionare e scrivere, senza contare.
Costo settimanale e mensile
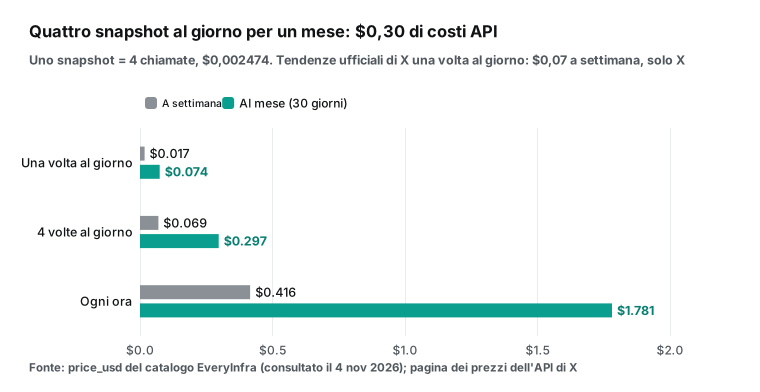
I costi delle API dipendono solo dal numero di snapshot a settimana. In base al price_usd del catalogo al 4 novembre 2026, uno snapshot corrisponde a quattro chiamate e costa 0,002474 $. Una volta al giorno: 0,017 $ a settimana e 0,074 $ al mese (30 giorni). Quattro volte al giorno: 0,069 $ a settimana e 0,297 $ al mese.
Una volta all'ora: 0,416 $ a settimana e 1,781 $ al mese. Una seconda pagina di Reddit aggiunge 0,000556 $ per snapshot. Le chiamate fallite non hanno addebiti, quindi gli errori di Zhihu non hanno inciso sul conto.
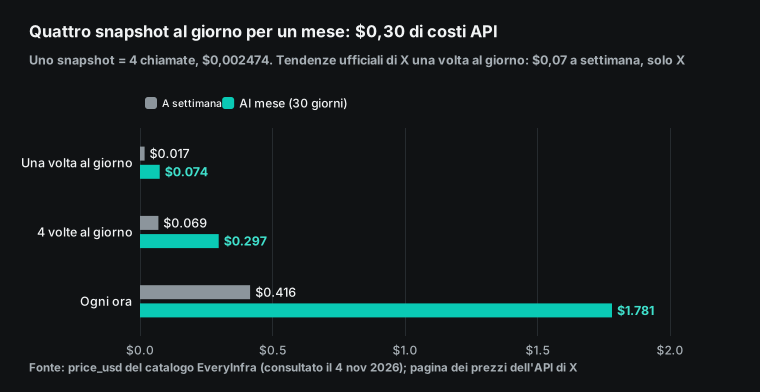
| Frequenza | Snapshot a settimana | Costi API a settimana | Costi API al mese (30 giorni) | Adatto a |
|---|---|---|---|---|
| Una volta al giorno | 7 | $0.017 | $0.074 | Solo «di cosa si è parlato questa settimana» |
| Quattro volte al giorno (esempio) | 28 | $0.069 | $0.297 | Per distinguere i temi della settimana dai picchi |
| Una volta all'ora | 168 | $0.416 | $1.781 | Eventi dell'ultima ora e monitoraggio del brand |
Anche il lato Gemini ha un costo. Le skill nell'app Gemini non richiedono un piano. Le esecuzioni pianificate (Tasks) richiedono Google AI Pro o Ultra e l'account personale di un utente con almeno 18 anni («Manage your tasks & workflows»). La strada C sulla Gemini API ha prezzi a token. La pagina dei prezzi indica gemini-3.5-flash-lite a 0,30 $ per milione di token di input e 2,50 $ per milione di token di output. gemini-3.8-flash costa 0,75 $ e 3,75 $ fino al 31 dicembre 2026, e dal 1° gennaio 2027 il prezzo raddoppia («Gemini API pricing»).
Dall'8 ottobre 2026 le richieste a gemini-3.7-flash vengono inoltrate a gemini-3.8-flash, quindi uno script con il vecchio nome paga già il nuovo prezzo.
L'agente Antigravity gira in un ciclo autonomo, quindi la maggior parte dei token va nel suo ragionamento e negli scambi con gli strumenti. La documentazione stima da 100.000 a 500.000 token di input per un'attività di «ricerca e sintesi». Al prezzo di input di Flash-Lite sono circa da 0,03 $ a 0,15 $ per esecuzione, cioè da circa 12 a 60 volte il costo API di uno snapshot. Non l'abbiamo misurato: il riferimento è il tuo conto.
Limiti e aspetti da tenere d'occhio
| Limite | Effetto sul riepilogo | Cosa fare |
|---|---|---|
| Le skill nell'app Gemini non possono accedere a internet | La skill non può ottenere da sola le classifiche | Recupera i dati fuori dalla skill (strada A, B o C) |
| App personalizzate solo per gli account personali negli USA | Niente strada B negli altri paesi | Usa la strada A o C |
| Niente Tasks nel SEE, in Svizzera, nel Regno Unito o in Nigeria | Gemini non può avviarsi da solo ogni settimana | Usa uno scheduler di sistema o un trigger della Gemini API |
| Un endpoint di classifica può restituire 503 a lungo | Una piattaforma potrebbe non avere dati questa settimana | Registra l'errore; la skill scrive «no data» |
| Le tendenze di X non hanno volume | Solo posizione e numero di apparizioni | Chiama twitter/search se ti serve il volume |
Non abbiamo eseguito nessun passaggio lato Gemini. La pagina Skills, le app personalizzate, Tasks e il trigger della Gemini API sono tutti esempi di configurazione. Li abbiamo scritti partendo dalle pagine di assistenza e dalla documentazione per sviluppatori lette il 4 novembre 2026. Negli ultimi due mesi Google ha cambiato spesso questi prodotti (persino la scorciatoia delle skill sta passando da / a @). Se quando provi l'interfaccia è diversa da quella descritta qui, segui la pagina ufficiale di quel giorno.
La skill non recupera dati e non deve riempire i buchi. È un limite rigido dell'app Gemini, ed è anche il motivo per cui la nostra skill dice «se non ci sono dati, dillo». In un'attività di sintesi il rischio principale è che il modello usi vecchi elementi della classifica presi dalla sua memoria come se fossero i dati di questa settimana, più che una scrittura scadente. Una regola nella skill è più affidabile di un promemoria in ogni chat, ma devi comunque leggere la riga sulla copertura ogni lunedì.
Una classifica dei contenuti più popolari è un ranking della piattaforma, non la «popolarità reale». La formula di Weibo include un peso per il tasso di interazione, e la classifica ha contrassegni separati per i posizionamenti a pagamento. Il punteggio di Zhihu include il tasso di clic. Entrambe le piattaforme dicono che i loro algoritmi hanno controlli contro la manipolazione, ma non pubblicano i pesi. Una posizione nel riepilogo è quindi un segnale, non una quota di mercato. Per questo la nostra skill ordina per numero di apparizioni e posizione migliore, e non confronta i valori di popolarità tra piattaforme.
Nei nostri round le tendenze di X non avevano volume. La nota del catalogo sui campi di twitter/trending cita una sorgente di riserva: quando le altre sorgenti non sono disponibili, i risultati arrivano da lì, e questa sorgente non restituisce volume né periodo. In tutti i nostri round volume era vuoto per ogni riga delle classifiche di X, e period era «Live». Per X il riepilogo può quindi mostrare solo posizione e numero di apparizioni. Se ti serve il volume delle discussioni, chiama twitter/search per i pochi temi selezionati dal riepilogo.
Alcune classifiche possono restare non disponibili per un certo periodo. Nel nostro test tutte le 8 richieste a zhihu/hot_list hanno restituito HTTP 503, e reddit/trending_posts non ha restituito dati in 6 richieste dopo il round 1. In quel momento le classifiche non erano disponibili, e nessuna di queste chiamate ha avuto addebiti.
Lo script di recupero deve registrare l'errore e proseguire. Non saltarlo senza lasciarne traccia, altrimenti nel weekend non puoi capire se un tema di Zhihu «non era in classifica» o «non è stato recuperato».
La classifica di Reddit ha 25 post per pagina. reddit/trending_posts restituisce circa 25 post per pagina. Per averne di più, passa next_page_token; ogni pagina ha il suo addebito e il token è valido 24 ore. La classifica dell'intero sito mescola molte community e pende verso intrattenimento e argomenti generali: nel nostro primo round, 25 post venivano da 24 community. Per un riepilogo su un singolo settore è più adatto reddit/subreddit_posts su alcune community fisse.
Termini delle piattaforme. La «Responsible Builder Policy» di Reddit dice che ogni sviluppatore deve ottenere un'approvazione prima di accedere ai suoi dati, e che l'uso commerciale richiede un'approvazione scritta.
La policy pone anche limiti chiari all'addestramento dell'AI, all'uso commerciale e all'inferenza di caratteristiche sensibili degli utenti. Anche i termini per sviluppatori di X fissano regole sull'uso dei dati. Un riepilogo che usa solo titoli, link, posizioni e conteggi pubblici, senza costruire profili utente, è il metodo più sicuro. Per capire come i termini si applicano alla tua attività, leggi i testi originali o rivolgiti a un avvocato. Questo articolo non costituisce consulenza legale.
Novità recenti: quattro date che contano per il riepilogo
Questo elenco include solo le modifiche che riguardano un riepilogo settimanale dei post più popolari. È in ordine cronologico, e le date sono quelle riportate nelle pagine ufficiali.
30 settembre 2026: le skill arrivano nelle chat di Gemini e sostituiscono i Gem. Secondo il blog di Google, quel giorno le skill sono state lanciate nelle chat di Gemini in tutto il mondo. I clienti Workspace le riceveranno «nelle prossime settimane». Lo stesso post dice che i Gem per gli account personali spariranno da novembre. Opal chiude nello stesso periodo (blog di Google). Cosa significa: se il tuo report settimanale è un Gem, spostalo subito.
13 ottobre 2026: le skill in Workspace sono rinviate. Quel giorno è iniziato il rollout delle skill nell'app Gemini. Le skill in Workspace Studio e nelle app Workspace sono «rinviate fino a nuovo avviso». Il post dice anche che condivisione e integrazione con Google Drive arriveranno più avanti («Workspace Updates, October 13, 2026»). Cosa significa: se il tuo team vuole usare la stessa skill del riepilogo direttamente in Docs o Sheets, deve aspettare. Intanto usala nell'app Gemini.
28 ottobre 2026: la piattaforma Connected Apps apre in anteprima. Ora gli sviluppatori possono collegare le loro app a Gemini e alla Ricerca Google tramite server MCP in cloud. Le registrano, le testano e le inviano per la revisione nella Google Connected Console (blog di Google). Cosa significa: oltre all'«app personalizzata» personale della strada B, in futuro i servizi di dati potrebbero comparire in Gemini come app revisionate.
17 novembre 2026 (tra 13 giorni): i Gem diventano di sola lettura per gli account personali. Vedi la prima sezione di questo articolo.
Guida rapida
- Registrati a EveryInfra e ottieni una chiave API.
- Segui la guida rapida. Chiama una volta
weibo/trendingcon curl. - Verifica che la risposta contenga
resultsebilling.charged_usd. - Consulta parametri e campi: post popolari di Reddit, classifica dei contenuti più popolari di Zhihu, Hot Search di Weibo, tendenze di X.
- Metti
collect.pysu un computer che resta acceso ogni giorno. Imposta la chiave nella variabile d'ambienteEVERYINFRA_API_KEY. - Usa cron o launchd per eseguire lo script da una a quattro volte al giorno.
- Dopo una settimana, controlla
httpecharged_usdin ogni riga disnapshots.jsonl. - Comprimi la cartella
weekly-hot-posts-digest/in un file zip e caricala nella pagina Skills di Gemini. - Nel fine settimana, esegui
merge.py, caricaweekly.csvin una chat e digita/weekly-hot-posts-digest.
Ogni pagina dedicata a una piattaforma ne elenca tutte le funzionalità. Vedi API di scraping per Reddit e API di scraping per Zhihu. Vedi anche API di scraping per Weibo e API di scraping per X (Twitter). Per un'automazione completa, usa l'esempio del percorso C. Puoi anche eseguire il job sul tuo computer, come nell'articolo su Antigravity CLI.
La pagina del server MCP spiega come connetterti. La pagina dei prezzi spiega come funziona la fatturazione. Per lo stesso metodo con altri strumenti, leggi Attività pianificate di Claude Code per scovare i problemi degli utenti su Reddit. Leggi anche Le attività pianificate di ChatGPT come radar della domanda.
| Passaggio | Dove | Costo API | Quando |
|---|---|---|---|
| 1. Testa una chiamata | Terminale con curl | $0.000556 | Una volta |
| 2. Acquisisci le quattro classifiche | cron o launchd con collect.py | $0,017–$0,069 a settimana (da 1 a 4 snapshot al giorno) | Ogni giorno |
| 3. Scrivi il riepilogo | Chat di Gemini con la skill | Nessun costo API; le skill non richiedono un abbonamento | Ogni lunedì |
| 4. Automatizza tutto | Trigger della Gemini API | Token Gemini per esecuzione; vedi la sezione sui costi | Facoltativa |
FAQ
Le domande provengono dai suggerimenti di ricerca di Google e da una discussione pubblica nella Gemini Help Community. Le risposte si basano sulle pagine ufficiali così come le abbiamo lette il 4 novembre 2026.
Skill di Gemini vs Gem: devo cambiare subito i miei Gem?
Per un account personale, sì. Dal 17 novembre 2026 i Gem sono in sola lettura: non puoi usarli né modificarli. Il 17 dicembre vengono rimossi. La migrazione automatica trasforma ogni Gem in una bozza di skill inattiva, che devi controllare e attivare una per una. I file che superano il limite di 100 MB, i file audio e video, gli archivi e i file Office legacy non vengono trasferiti. Ricrea a mano fin da ora i Gem che usi ogni settimana.
Nel frattempo, riscrivi ogni descrizione come «cosa fa» più «Usa quando…». Gli account di lavoro e quelli scolastici hanno più tempo. Business ed enterprise: non prima del 1° marzo 2027. Education: non prima del 1° giugno 2027. (Domanda dai suggerimenti di ricerca «gemini skills vs gems» e «claude skills vs gemini gems».)
Gemini Gems in sola lettura: posso ancora esportarli dopo il 17 novembre?
Puoi visualizzare i Gem e scaricarne i file, ma non puoi usarli. La pagina di assistenza dice che dopo il 17 novembre puoi ancora accedere ai tuoi Gem, ma non puoi usarli, modificarli né crearne di nuovi. Invita inoltre chi usa un account personale a scaricare entro il 17 dicembre i file che non possono essere migrati. Il mese di sola lettura è quindi la tua ultima occasione per recuperare i file di conoscenza. (Domanda dal suggerimento «gemini gems read only mode».)
Skill di Gemini e MCP: una skill nell'app Gemini può chiamare MCP direttamente?
La skill in sé non può accedere a internet. La pagina di assistenza dice che gli script caricati non possono accedere a internet né inviare richieste a siti esterni. Una skill può però interagire con le Connected Apps, e un'«app personalizzata» è l'URL di un server MCP. Per usarla devi avere almeno 18 anni, trovarti negli Stati Uniti, usare un account personale e usare l'inglese.
Se non soddisfi questi requisiti, recupera i dati in locale e carica una tabella. Puoi anche usare l'agente Antigravity della Gemini API (supporta uno strumento mcp_server) oppure Antigravity CLI. (Domanda dai suggerimenti «gemini skills mcp» e «gemini cli skills mcp».)
Skill di Gemini come quelle di Claude: posso caricare una skill di Claude in Gemini?
Per il formato, sì. Entrambe si basano sullo standard aperto Agent Skills e la pagina di assistenza di Gemini dice che puoi caricare SKILL.md, una cartella o un .zip. Controlla tre cose. Il nome deve essere in minuscolo, con trattini.
Gemini non legge i campi di estensione specifici di Claude Code, come il controllo dell'invocazione o l'esecuzione tramite subagent. Se la skill contiene uno script che accede a internet, quello script non viene eseguito nell'app Gemini. La nostra skill usa solo name e description, e il recupero dei dati resta fuori dalla skill. (Domanda dal suggerimento «gemini skills like claude».)
Perché Gemini non usa automaticamente la mia skill?
La pagina di assistenza dice che Gemini applica solo le skill attivate. Puoi disattivare o riattivare una skill nella pagina Skills. Gemini decide basandosi solo su nome e descrizione. Se la descrizione è troppo generica (per esempio «data helper»), Gemini non sa quando usarla.
Il metodo più affidabile è digitare / (o @) nella chat e selezionare la skill. Inoltre, la pagina di assistenza dice che le skill sono ora disponibili per gli utenti di almeno 18 anni con account personali e, «a breve», per gli account di lavoro e scolastici. Se il tuo account Workspace non mostra una pagina Skills, il rollout potrebbe non essere ancora disponibile per il tuo account. (Domanda da una discussione della Gemini Help Community, «Will a Skill have an always on state».)
Riferimenti
Abbiamo letto tutte le pagine qui sotto il 4 novembre 2026 (SGT).
- Gemini Apps Help: «About the transition from Gems to skills»
- Workspace Admin Help: «About the transition from Gems to skills»
- Workspace Updates, 30 settembre 2026: «skills in the Gemini app and Workspace»
- Workspace Updates, 13 ottobre 2026: «an update on the skills launch»
- Blog di Google, 30 settembre 2026: «automate tasks with skills»
- Gemini Apps Help: «release updates» (30 settembre e 13 ottobre 2026)
- Gemini Apps Help: «Create & manage skills»
- Gemini Apps Help: «Write effective skills»
- Gemini Apps Help: «Manage your tasks & workflows» (limiti per area geografica e abbonamento)
- Gemini Apps Help: «limits and upgrades for Google AI subscribers»
- Gemini Apps Help: «Connect & manage custom apps»
- Gemini Help Community: «Will a Skill have an always on state»
- Documentazione per sviluppatori di Google Connected Apps
- «Gemini Apps Developer Mode overview»
- Blog di Google, 28 ottobre 2026: «the Connected Apps platform preview»
- Specifica MCP: «Tools» (annotazioni readOnlyHint, destructiveHint)
- Specifica MCP: «Transports» (Streamable HTTP)
- RFC 7591: «OAuth 2.0 Dynamic Client Registration»
- RFC 9728: «OAuth 2.0 Protected Resource Metadata»
- Bozza IETF: «The OAuth 2.1 Authorization Framework»
- Gemini API: «Function calling» (sezione Remote MCP)
- Gemini API: «Antigravity agent» (MCP, Triggers, Budget)
- Gemini API: «managed agents overview»
- Gemini API: «Interactions API overview»
- Riferimento della Gemini API: «Interactions» (inline environment sources)
- «Gemini API pricing»
- Gemini API: «Understand and count tokens»
- Changelog della Gemini API
- Gemini API: «deprecations»
- Guida alla CLI della Gemini API (gemini-api)
- Gemini API: «Computer Use»
- Gemini API: «Coding agent setup»
- Repository GitHub «google-gemini/gemini-skills»
- Specifica di Agent Skills
- Repository GitHub «agentskills/agentskills»
- Antigravity: «Agent skills»
- Documentazione di Antigravity: «MCP»
- Antigravity CLI: «headless mode»
- Claude Code: «Extend Claude with skills»
- Documentazione di Claude: «Agent Skills overview»
- Claude Help: «Use skills in Claude»
- Codex: «Build skills»
- Regole della classifica Hot Search di Weibo
- Presentazione della classifica dei contenuti più popolari di Zhihu
- Prezzi della X API
- X API: «Trends»
- «X Developer Agreement and Policy»
- «Reddit Responsible Builder Policy»
- «Reddit Data API Terms»
- Catalogo delle funzionalità di EveryInfra (price_usd e note sui campi, consultato il 4 novembre 2026)
- Documentazione Python: urllib.request
- RFC 4180: il formato CSV
- Documentazione per sviluppatori Apple: pianificare job temporizzati con launchd
Riferimenti BL-82