Gemini skills 取代 Gems:每周热帖摘要实测
Gems 11 月 17 日只读,改用 Gemini skills 做每周热帖摘要:SKILL.md 骨架、三条取数路线,X 趋势 44 分钟换掉四分之一。
先说现在该做什么:如果你用的是个人 Google 账号(18 岁以上),Gemini 里的 Gems 会在 2026 年 11 月 17 日变成只读,12 月 17 日移除,离今天只剩 13 天。每周还在用的 Gem,现在就手动重建成 skill,并把知识文件下载下来;工作和学校账号的日期是「不早于」2027 年 3 月 1 日和 6 月 1 日,而且 Workspace 里的 skills 已经「推迟、另行通知」。这些日期全部来自 Google 自己的 Workspace Updates 和 Gemini 帮助页,下面第一节逐条给出处。
本文拿一个具体的活来做迁移示范:把「每周热帖摘要」做成一个 SKILL.md,让 Gemini 每周一读一周的 Reddit 全站热帖、知乎热榜、微博热搜和 X 趋势,写成一页周报。做的过程中我们碰到了 Gemini 应用最关键的一条限制:skill 里的脚本不能联网,也不能对外部网站发请求。所以取数必须放在 skill 外面。我们给出三条把数据送进 Gemini 的路(本地拍快照后上传、自定义 Connected App、Gemini API 的 Antigravity 智能体加触发器),并说明同一份 SKILL.md 拿到 Claude 和 Codex 里能不能直接用。
数据这一侧我们真调了:2026 年 11 月 4 日 00:13–00:59(新加坡时间),对 EveryInfra 的 reddit/trending_posts、zhihu/hot_list、weibo/trending、twitter/trending 跑了 3 轮,其中一次走远程 MCP 的 tools/call;02:05 又对拿不到的两个榜各重试 1 次。最重要的实测结果是热榜换得很快:微博热搜 44 分钟后只剩 86% 还在榜上,X 趋势 44 分钟后只剩 74%,3 轮合起来比一次快照多出 16% 和 26% 的不同话题,所以每周摘要必须一天拍几次快照再合并;知乎热榜和 Reddit 全站热帖在测试期间一直不可用(知乎 8 次全部 503,Reddit 只有第一轮拿到),失败都不扣费,所以下面的摘要数字只来自微博和 X,这也说明 skill 里为什么要写「没有数据就写没有」。按目录价,示例频率每天拍 4 次,四个热榜一个月的接口费是 $0.297。Gemini 一侧本机没有登录,文中的 skill 上传、自定义应用和 Gemini API 触发器都是按 11 月 4 日读到的官方文档写的配置示例,不是我们跑过的结果。


现在该做什么:gemini gems read only(11 月 17 日)之前的三件事
先把日期说清楚,因为它比功能介绍更急。Gemini Apps 帮助中心的过渡页写得很直接:用个人 Google 账号、年满 18 岁的用户,2026 年 11 月 17 日 Gems 转成 skills 并变成只读,还能打开看,但不能再用、不能再改、也不能新建;2026 年 12 月 17 日 Gems 从 Gemini Apps 里移除,之后就打不开了(Gemini Apps 帮助:About the transition from Gems to skills)。工作账号晚得多:Workspace 商业、企业和非营利账号是 2027 年 3 月,教育账号是 2027 年 6 月;Workspace 管理员帮助把商业和企业的日子写成 2027 年 3 月 1 日、教育写成 2027 年 6 月 1 日(Workspace 管理员帮助:About the transition from Gems to skills),Workspace Updates 博客原文用的是「不早于」这个说法(Workspace Updates,2026-09-30)。
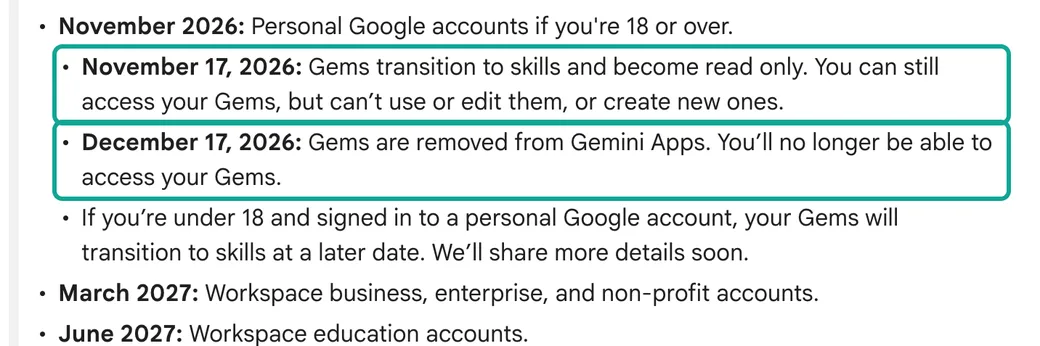
这里有一处容易看错的地方。Workspace Updates 博客 9 月 30 日那篇的「关键日期」里,11 月 17 日这一条写的是「Gems 移到 Gemini 应用的设置面板,用户仍可创建、编辑和使用」;而面向个人用户的帮助页写的是同一天「只读」。两者说的是不同账号:博客这一条放在 Workspace 的时间线里,帮助页那一条明确限定「个人 Google 账号、18 岁以上」。网上不少二手文章把两句混成一句,写成「所有人 11 月 17 日只读」,这是不对的。我们按帮助页原文处理个人账号,按博客和管理员帮助处理工作账号。
| 账号类型 | Gems 只读或移入设置 | Gems 不能再用 | Gems 移除 | 出处 |
|---|---|---|---|---|
| 个人 Google 账号,18 岁以上 | 2026-11-17 只读 | 2026-11-17 | 2026-12-17 | Gemini Apps 帮助过渡页 |
| 个人账号,18 岁以下 | 原文:以后再定 | 原文未写 | 原文未写 | 同上 |
| Workspace 商业、企业、非营利 | 2026-11-17 移入设置面板,仍可用 | 不早于 2027-03-01 | 同一天移出设置,剩余 Gems 自动转成草稿 skill | Workspace Updates 09-30、管理员帮助 |
| Workspace 教育 | 同上 | 不早于 2027-06-01 | 同上,另含 Classroom 和 LTI | 同上 |
所以对个人账号来说,现在离只读还有 13 天,能做的事有三件。第一,把还在用的 Gem 的说明文字和知识文件先下载下来,因为帮助页说明了,skill 的文件总量上限是 100 MB,超过的部分在自动迁移时会从最大的文件开始删;音频、视频、压缩包、GitHub 文件和老式 Office 格式(.doc、.xls、.ppt)都不会跟过去,12 月 17 日之后这些文件就拿不回来了(同一帮助页「Limits on files during the transition」)。第二,把每周都要跑的那几个 Gem 手动重建成 skill,不要等自动迁移:自动迁移出来的是「未启用的草稿」,要人逐个审核、启用后才能用和分享(管理员帮助「How automated migration will work」)。第三,检查 Gem 里依赖的默认工具:帮助页列出 skills 目前还不能配合「生成视频、生成音乐、Canvas、Deep Research、Guided learning」使用,如果你的 Gem 靠这些工具出结果,迁过去之后要换做法。
对工作账号,时间宽裕,但有一件事已经变了:Workspace Studio 里不能再新建带「Ask a Gem」步骤的流程,已有的流程能用到 2027 年。而且 Workspace 里的 skills 本身推迟上线了,10 月 13 日的更新写的是 Rapid 和 Scheduled 两种发布节奏的域都「推迟,另行通知」(Workspace Updates,2026-10-13)。Gemini 应用里的 skills 不受影响,10 月 13 日开始逐步推送,预计 11 月中旬推完;同一篇还说明,Gemini 应用里的 skills 和 Workspace 应用里的 skills 目前不同步,要在两边各建一份。
gemini skills vs gems:差在哪里
Gems 是一个单独的「定制版 Gemini」:点进去,换一套说明,在那个窗口里聊。Skills 换了思路,它是一段可以带进任何对话的说明,用 / 加名字调用(帮助页说之后会改成 @),也可以不点名,由 Gemini 看名字和描述自己判断要不要用;一次对话里还能叠好几个 skill(Create & manage skills for Gemini Apps)。Workspace Updates 的原话是 skills 「完全建立在开放、以 Markdown 为原生格式的 SKILL.md 标准上」,所以别的平台写好的 skill 可以拷进来(Workspace Updates,2026-09-30)。
| 对比项 | Gems | Skills(Gemini 应用,2026-11-04 读取) |
|---|---|---|
| 怎么用 | 打开某个 Gem 的单独窗口 | 任何对话里输入 /(以后是 @)选,或由 Gemini 自动套用 |
| 一次用几个 | 一个 | 可以叠加多个,skill 里还能引用别的 skill |
| 格式 | 页面表单 | 表单,或上传 SKILL.md、文件夹、.zip |
| 名称规则 | 随意 | 全小写、单词用连字符,如 my-new-skill |
| 附带文件 | 知识文件 | 总量 ≤100 MB,只收纯文本类文件,音视频和压缩包不收 |
| 能配合的工具 | 视频、音乐、Canvas、Deep Research 等 | 能配合 Connected Apps;视频、音乐、Canvas、Deep Research、Guided learning 暂不行 |
| 脚本能不能联网 | 不适用 | 不能:上传的脚本不能访问互联网,也不能对外部网站发请求 |
| 要不要订阅 | 免费可用 | skills 免费可用;用 skill 跑定时 Tasks 要 Google AI Pro 或 Ultra |
| 能不能分享 | 能 | 帮助页说「接下来几周」加上 |
表里倒数第三行,是这篇文章要解决的问题。我们想做的「每周热帖摘要」需要外部数据:Reddit 的热帖、知乎热榜、微博热搜、X 的趋势话题。在 Claude Code 或 Codex 里,skill 可以带一个脚本去调接口,也可以让智能体调 MCP 工具(站内那篇 一份 SKILL.md 通用四个 AI 工具 就是这么做的)。但 Gemini 应用的帮助页在「上传文件或文件夹创建 skill」一节写了两条限制:需要访问互联网的脚本目前不支持;安全限制一节又写,脚本不能对外部网站执行操作或发请求。也就是说,在 Gemini 应用里,skill 本身不会去取数,数据要从别的地方进来。
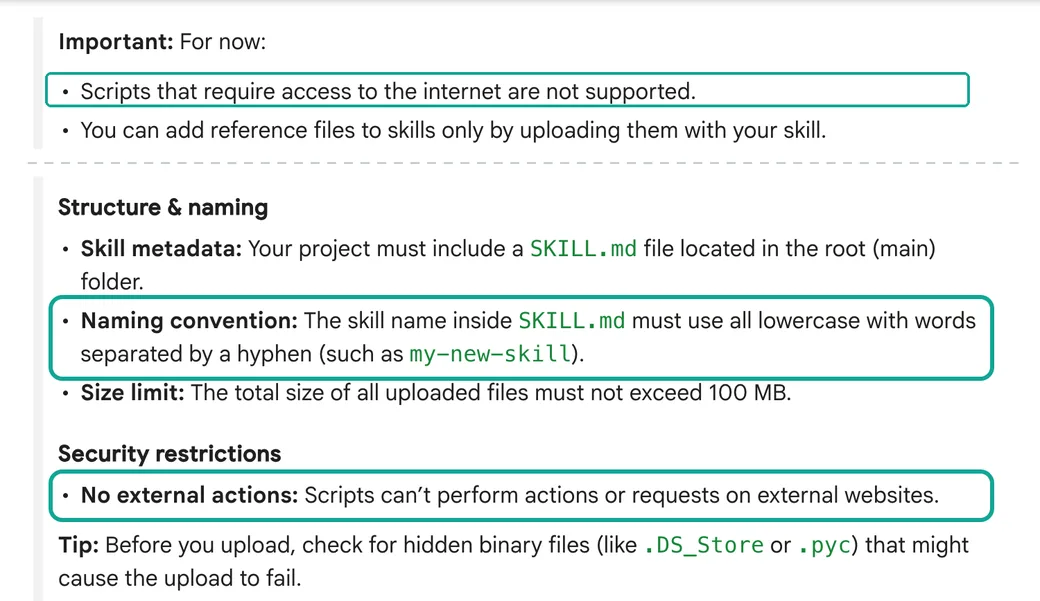
这条限制决定了整篇文章的结构:skill 负责「怎么写摘要」,数据另走一条路进来。下面先把这件活本身讲清楚,再讲三条把数据送进 Gemini 的路。
gem 迁到 skill:手动重建的步骤
帮助页给的手动重建只有三步:打开要迁的 Gem,把知识文件逐个下载下来;新建一个 skill,把 Gem 的名称、说明和指令抄过去;如果要带文件,先把 skill 下载成文件夹,把文件放进去,再整包上传(gems_to_skills 帮助页「Recreate your Gem as a skill」)。实际做的时候,有几处要改写,而不是原样照抄。
第一处是名字。Gem 的名字可以是「每周热点小助手」这样的中文,skill 的名字必须是全小写加连字符的英文,比如 weekly-hot-posts-digest。帮助页「写出好用的 skill」一文还建议名字用动词开头、避免 helper、tools、data 这类空词(Write effective skills for Gemini Apps)。
第二处是描述。Gem 的说明是写给人看的,skill 的描述是写给 Gemini 看的:Gemini 只靠名字和描述判断要不要用这个 skill,所以描述要用第三人称写「它做什么」,再写「Use when…」列出该用它的场合,上限 1024 个字符。同一篇帮助还建议,指令写成清单,告诉 Gemini 缺信息时怎么办(例如「某平台本周没有数据,就写没有,不要凭记忆补」),这对摘要类任务尤其要紧。
第三处是知识文件。Gem 里常见的做法是上传一份「参考资料」,让它每次都读。Skill 是「用到才读」:Gemini 先看名字和描述,觉得相关才读完整指令,指令里提到的附带文件也是需要时才打开。所以长的模板、样例报告放进 references/ 这样的子文件夹,在指令里写清楚「第 5 步用 references/report-template.md」,比把它们全塞进指令正文更省。
第四处是工具。如果 Gem 原来靠 Deep Research 或 Canvas 出结果,迁成 skill 后这部分暂时不能用;我们这个摘要任务不需要它们,只需要 Gemini 读表、分组、写字。
这件活是什么:一份每周热帖摘要,要拍几次快照
我们要的交付物是一页周报:这一周 Reddit、知乎、微博、X 上,哪些话题反复上榜、哪些只是冲上来一下,跨平台有没有同一件事在被讨论。读者是做内容选题、品牌舆情或者市场观察的人,周一早上打开就能用,不用自己翻四个榜。
难点不在「写」,在「拿到一周的数据」。热榜是快照,不是日志:每个平台只展示此刻的前几十条,过一会儿就换了,平台不会给你一份「本周上过榜的全部条目」。官方规则写得很清楚:微博热搜「每分钟更新一次」,展示 Top 50(微博热搜榜规则说明);知乎热榜「每 10 分钟更新一次」,展示 top 30(知乎热榜介绍)。Reddit 和 X 没有写更新频率,但目录里 reddit/trending_posts 一页约 25 帖、翻页令牌 24 小时有效,twitter/trending 一次给一个地区的榜单,每条带 collected_at 抓取时刻,字段说明专门提醒「趋势变化快,用它判断新鲜度」。
| 热榜 | EveryInfra 能力 | 一次拿多少 | 平台怎么排 | 更新频率 | 目录单价(2026-11-04) |
|---|---|---|---|---|---|
| Reddit 全站热帖 | reddit/trending_posts | 一页约 25 帖,可翻页 | 平台未公开 | 平台未公开 | $0.000556 / 页 |
| 知乎热榜 | zhihu/hot_list | 最多 30 条 | 搜索热度 + 消费热度 + 互动热度 + 点击率 | 每 10 分钟 | $0.000806 / 次 |
| 微博热搜 | weibo/trending | 默认 20 条,最多 200(榜单本身 50) | (搜索热度 + 讨论热度 + 传播热度)× 互动率 | 每分钟 | $0.000556 / 次 |
| X 趋势 | twitter/trending | 一个地区约 50 条 | 平台未公开 | 平台未公开 | $0.000556 / 次 |
所以「每周热帖摘要」的正确做法,是一周里拍很多次快照,再合并:一个条目在几次快照里出现过、最好排到第几、最高热度多少,这些才是周报要的数。拍一次的成本是四个能力加起来 $0.002474(3 × $0.000556 + $0.000806,按目录 price_usd 现算)。真正要回答的问题是:要拍多少次才够?拍少了漏掉话题,拍多了白花钱。下面 3 轮真调就是为了回答这个问题。
和官方接口比一下价格,能看出为什么不建议为这件事去申请平台自己的接口。X 的开发者文档写的是按用量计费,Trends 每次请求 $0.010(X API 价格页),是 twitter/trending 目录单价的约 18 倍。Reddit 自己的接口要先申请批准,条款见后面「平台条款」一段。
SKILL.md 骨架:weekly-hot-posts-digest
下面是这个技能的完整目录和 SKILL.md。它只做一件事:拿到一周的热榜快照表,写成一页摘要。取数不在 skill 里做,原因上一节说过:Gemini 应用里的 skill 脚本不能联网。我们把指令写成英文,因为 Gemini 帮助页的示例和 Claude、Codex 文档的示例都是英文,三个平台都能读;摘要要用中文输出的话,在调用时说一句「用中文写」即可。
weekly-hot-posts-digest/
├── SKILL.md                     # 必需:名称、描述、指令
└── references/
└── report-template.md # 第 5 步用的输出模板---
name: weekly-hot-posts-digest
description: Builds a one-page weekly digest of hot posts and trending topics from Reddit, Zhihu, Weibo and X snapshot data. Use when the user uploads this week's weekly.csv or snapshots.jsonl, or asks for a weekly trending summary across these four platforms.
---
# Weekly hot posts digest
## Inputs
- weekly.csv: one row per post or topic. Columns: platform, key, title, url, community, first_seen, last_seen, times_seen, snapshots_total, best_rank, max_heat.
- If the user gives snapshots.jsonl instead, group rows by platform and key first, then work from the grouped rows.
## Steps
Copy this checklist and track progress:
- [ ] 1. For each platform, count snapshots_total and the date range. Write them at the top of the digest.
- [ ] 2. Rank items by times_seen / snapshots_total first, then by best_rank. An item seen in most snapshots is a "week topic". An item seen once is a "spike".
- [ ] 3. Pick 5 week topics and 3 spikes per platform. Keep the original title. For Zhihu and Weibo, add a one-line English gloss after the title.
- [ ] 4. Group the picked items into at most 6 themes across platforms. A theme needs items from 2 or more platforms.
- [ ] 5. Fill the template in references/report-template.md.
## Rules
- max_heat is only comparable inside one platform. Do not compare Weibo hot_value with Zhihu hot_value or Reddit like_count.
- X trends may have an empty volume. Write "no volume" instead of 0.
- Do not guess why a topic is hot. If the title is not enough, write "reason unclear" and give the url.
- Remove user names from Reddit titles and text if they appear. Keep brand and organization names.
## Missing information
- If a platform has 0 snapshots this week, write "no data for <platform> this week" and continue with the others. Do not fill it from memory or web search.
- If snapshots_total is below 5 for a platform, add the line "low coverage: N snapshots".指令里的几条规则不是凭空加的,每一条都对应我们真调时看到的情况。「max_heat 只在同一平台内可比」来自目录的字段说明:微博的 hot_value 是「微博自有指标,只在榜单内可比」,知乎的 hot_value 是把页面上的「597 万热度」换成整数,两边算法不同(微博热搜官方规则写的是「(搜索热度+讨论热度+传播热度)×互动率」,知乎热榜写的是「搜索热度+消费热度+互动热度+点击率」,见 微博热搜榜规则说明 和 知乎热榜介绍),放在一起排序没有意义。「X 的 volume 可能为空」来自本文的实测,后面「字段能不能用」一节有数。「数据缺失时写没有」对应知乎热榜在我们每一次请求里都返回 503 的情况:如果 skill 不写这一条,Gemini 很可能会用它记得的旧热榜补上,摘要看起来完整,其实是编的。
| skill 里的规则 | 对应的实测或文档 | 不写会怎样 |
|---|---|---|
| max_heat 只在同一平台内比 | 微博和知乎的热度算法不同,目录说微博热度只在榜内可比 | 跨平台排出一个没有意义的「热度榜」 |
| X 的 volume 为空写「no volume」 | 本文所有 X 快照 volume 都为空 | 模型把空值当成 0,写出「讨论量为 0」 |
| 不猜原因,写「reason unclear」 | 热榜只有标题和链接 | 模型凭记忆编一个上榜原因 |
| 没有数据就写没有 | 知乎热榜本次全部 503 | 模型用记忆里的旧热榜补齐 |
| 快照少于 5 次标「low coverage」 | 44 分钟内榜单就换掉一部分 | 读者以为一周都看到了 |
同一份 SKILL.md,Claude 和 Codex 能不能直接用
能。Gemini、Claude Code、Codex、Antigravity 都说自己基于同一个开放标准 Agent Skills,规范里必填的只有 name(小写字母、数字和连字符,最多 64 个字符)和 description(最多 1024 个字符)(Agent Skills 规范)。Claude Code 在上面加了调用控制、子代理执行等扩展字段(Claude Code:Extend Claude with skills),Codex 要求 name 和 description 都写(Codex:Build skills),Antigravity 允许不写 name、默认用文件夹名(Antigravity:Agent skills)。所以我们这份 skill 两个字段都写、不用任何扩展字段,四家都能原样读。真正不同的只有一处:在 Claude Code、Codex、Antigravity CLI 里,skill 可以顺手调 EveryInfra 的远程 MCP 去拉热榜;在 Gemini 应用里,skill 不能联网,数据必须先准备好。各家放 skill 的目录、调用方式和联网规则的逐项对比,见站内 一份 SKILL.md 通用四个 AI 工具:竞品评论实测,那篇讲 skill 怎么带着 MCP 调用一起跑;这篇讲 skill 不能联网时,数据和指令怎么拆开。
Gemini 应用里怎么接外部数据:三条路,各有门槛
既然 skill 自己不取数,数据就得从外面进来。按我们 2026 年 11 月 4 日读到的官方文档,有三条路,门槛和适合的人都不一样。下面每条都写成配置示例:本机没有登录 Gemini,没有在 Gemini 一侧跑过任何一步。
| 路线 | 谁能用 | 数据怎么进来 | 能不能每周自动跑 | 我们实测了哪一侧 |
|---|---|---|---|---|
| A. 本地脚本拍快照,周末上传表格 | 所有能用 skills 的账号 | weekly.csv 作为附件上传到对话 | 取数能自动,上传要人做 | 取数接口真调过(本文 3 轮) |
| B. 自定义 Connected App(远程 MCP) | 18 岁以上、在美国、个人账号、英文界面 | Gemini 调 MCP 工具 | 原文写可以在 tasks 里用 | 只核了我们的 MCP 一侧 |
| C. Gemini API:Antigravity 智能体 + 触发器 | 有 Gemini API Key 的开发者 | 沙箱里调 mcp_server 工具 | 能,触发器按 cron 跑 | 只核了我们的 MCP 一侧 |
按你在哪里、用什么账号,能走的路不一样:
| 你的情况 | 能用的路线 | 原因 |
|---|---|---|
| 美国、个人账号、英文界面 | A、B、C | 自定义应用只对美国个人账号开放 |
| 新加坡、中国香港等其他地区的个人账号 | A、C | 没有自定义应用;Tasks 要 AI Pro 或 Ultra |
| 欧洲经济区、瑞士、英国 | A(上传要人做)、C | Gemini 的定时 Tasks 在这些地区不可用 |
| Workspace 工作账号 | A、C(等 Workspace skills 上线) | Workspace 里的 skills 推迟;两边 skills 不同步 |
路线 A:本地拍快照,周末上传。 这是门槛最低、最可控的一条。在自己的电脑或一台小服务器上,每天定时跑一次取数脚本,把四个热榜的原始结果追加到 snapshots.jsonl;周末再用一个合并脚本把一周的快照合成 weekly.csv,上传到 Gemini 对话里,输入 /weekly-hot-posts-digest 让 skill 出摘要。CSV 在 Gemini 帮助页的「支持的文件类型」里(Create & manage skills)。这条路的好处是取数和写摘要完全分开:取数用的是确定的程序,扣多少钱、哪一次失败都记在文件里;写摘要的模型只看到一张表,不会自己去「搜一下补上」。缺点是每周要人上传一次。后面的实测调的就是这几个接口。
路线 B:自定义 Connected App。 Gemini 网页版可以添加一个「自定义应用」,填一个 MCP 服务器地址,连好之后在 Gemini 手机版和网页版都能用,在 tasks 里也能用(Connect & manage custom apps for Gemini Apps)。门槛写得很清楚:年满 18 岁、人在美国、用个人 Google 账号登录、开着 Keep Activity,目前只支持英文,只能在网页版添加。认证方面,Google 给开发者的 Developer Mode 文档写的是「在 Dynamic Client Registration 下配置 Gemini 怎样和你的 MCP 服务器建立客户端和用户凭据」,并另有一篇 OAuth 2.1 实现指南(Gemini Apps Developer Mode overview)。也就是说,这条路走的是 OAuth 登录,而不是把一个 API Key 贴进请求头。EveryInfra 的远程 MCP 有 OAuth 入口(https://api.everyinfra.com/mcp/all,元数据在 /.well-known/oauth-protected-resource/mcp/all),但我们没有在 Gemini 里试过连接,不保证能连上;如果你在美国、想试这条路,连不上时请把报错发给我们。
路线 B 还有一个文档里能推出来、但我们没测过的细节:Developer Mode 文档说,Gemini 会根据 MCP 工具声明的 readOnlyHint 和 destructiveHint 注解,加上对话上下文,决定执行前要不要弹确认卡片;帮助页也说 Gemini 目前对任何写操作都要人工确认。我们在 11 月 4 日用 tools/list 读了 EveryInfra MCP 的工具清单(不带 Key 也能读,不扣费),通用取数工具 everyinfra_call_api 的注解是 readOnlyHint: false、destructiveHint: true,因为每次调用都会扣费。按文档的说法,这意味着在 Gemini 里每拉一次热榜,很可能都要你点一次确认,无人值守的定时任务会停在确认这一步。这一点以你实际连上后的表现为准。
路线 C:Gemini API 的 Antigravity 智能体加触发器。 如果你写得了几行 Python,这是唯一一条「取数、写摘要、每周自动跑」都在 Google 一侧完成的路。Gemini API 的 Interactions 接口支持把远程 MCP 服务器当工具,字段是 type: "mcp_server"、name、url、headers、allowed_tools,只支持 Streamable HTTP,不支持 SSE,名字里不要用连字符(Gemini API:Function calling 的 Remote MCP 一节)。Antigravity 智能体是跑在 Google 托管的 Linux 沙箱里的通用智能体,可以把 AGENTS.md 和 .agents/skills/ 下的 skill 挂进沙箱(Gemini API:Antigravity agent),Interactions 接口参考里给了用 inline 来源把一段 SKILL.md 写到 .agents/skills/<名>/SKILL.md 的例子(Interactions API 参考)。同一份文档的「Triggers」一节说,触发器把智能体、环境、提示词和 cron 时间表绑成一个持久资源,每次执行复用同一个环境,上一次写的文件下一次还在;无人值守时建议引用存好的凭据,而不是把令牌写在请求里。
这三点拼起来,就是一个每周一早上自动出摘要的配置。下面是配置示例,字段名照官方文档抄,我们没有运行过:
# 配置示例(未运行):每天 08:00(新加坡时间)拍一次快照,周一顺带出上周摘要
# 依据:ai.google.dev/gemini-api/docs/antigravity-agent(MCP servers、Triggers、Budget controls)
#       ai.google.dev/api/interactions-api(environment 的 inline sources)
from google import genai

client = genai.Client()  # 读环境变量 GEMINI_API_KEY
SKILL_MD = open("weekly-hot-posts-digest/SKILL.md", encoding="utf-8").read()
TEMPLATE = open("weekly-hot-posts-digest/references/report-template.md", encoding="utf-8").read()

everyinfra = {
    "type": "mcp_server",
    "name": "everyinfra",                     # 只用小写字母和数字
    "url": "https://api.everyinfra.com/mcp",
    "headers": {"Authorization": "Bearer " + EVERYINFRA_API_KEY},  # 从密钥管理处读,不要写死
    "allowed_tools": ["everyinfra_call_api"],
}
environment = {
    "type": "remote",
    "sources": [
        {"type": "inline", "content": SKILL_MD,
         "target": ".agents/skills/weekly-hot-posts-digest/SKILL.md"},
        {"type": "inline", "content": TEMPLATE,
         "target": ".agents/skills/weekly-hot-posts-digest/references/report-template.md"},
    ],
}
PROMPT = (
    "Step 1: call everyinfra_call_api four times: reddit/trending_posts, zhihu/hot_list (limit 30), "
    "weibo/trending (limit 50), twitter/trending (country world). Append one JSON line per call to "
    "/workspace/snapshots.jsonl with taken_at, platform, http status, charged_usd and results. "
    "If a call fails, write the error and continue. "
    "Step 2: only if today is Monday in Asia/Singapore, use the weekly-hot-posts-digest skill on the "
    "last 7 days of /workspace/snapshots.jsonl and save the digest to /workspace/digests/."
)
trigger = client.triggers.create(
    schedule="0 8 * * *", time_zone="Asia/Singapore", display_name="hot-lists-weekly",
    interaction={
        "agent": "antigravity-preview-09-2026",
        "agent_config": {"type": "antigravity", "model": "gemini-3.5-flash-lite",
                         "max_total_tokens": 300000},
        "environment": environment,
        "tools": [everyinfra],
        "input": PROMPT,
    },
)
print(trigger.id, trigger.next_run_time)
这段示例有三处要特别说明。第一,取数和写摘要放在同一个触发器里,是因为文档说「每次执行复用同一个环境,上一次创建的文件下一次能看到」,这句话说的是同一个触发器;拆成两个触发器的话,第二个要用环境 ID(Environments 一节写了可以传 env_abc123 这样的已有环境)才读得到第一个写的快照,多一层出错的机会。第二,模型换成了最便宜的 gemini-3.5-flash-lite 并加了 max_total_tokens 上限:Antigravity 智能体是自主循环,文档自己估的「研究和信息汇总」类任务一次是 10 万到 50 万输入 token、约 $0.30–$1.00,复杂的可以到 $5 左右;达到上限时这次运行停下,返回 status: "incomplete"。第三,Key 不要写在代码里:文档在 Triggers 一节专门建议无人值守时引用存好的凭据(credential),由出网代理每次运行时解析,换 Key 不用改触发器;上面的 headers 写法只适合先手动试跑。
走路线 C 还要留意 Gemini API 更新日志里的三条(Gemini API 更新日志)。2026 年 10 月 26 日起,付费层新项目的 generateContent 一类请求默认 store=true,周报原文里如果带用户信息,先决定要不要逐个请求设 store=false。2026 年 10 月 27 日,无状态的命令行客户端 gemini-api 进入公测,可以在 Interactions 接口上跑托管智能体,我们还没核它是否支持 triggers。2026 年 11 月 2 日的弃用通知写明,12 月 1 日起 gemini-2.5-flash 的请求自动转到 gemini-3.5-flash-lite,函数调用有不兼容的改动;写死 2.5 模型名的旧周报脚本,要在那之前改名并重测一次。
还有一条路:Antigravity CLI。 如果你本来就在终端里工作,Google 用来接替 Gemini CLI 的 Antigravity CLI 也读 .agents/skills/ 下的 skill,远程 MCP 写在 mcp_config.json 里,定时交给系统的 cron 或 launchd 调 agy -p。这套配置站内另一篇写得很细:Antigravity CLI 做视频评论巡检:实测与配置。它和路线 C 的差别是:CLI 跑在你自己的机器上,机器关了就不跑;路线 C 跑在 Google 的沙箱里。另一篇 Gemini Deep Research API 接远程 MCP 讲的是 Deep Research 智能体接 MCP 做带引用的调研,和这里的「定时拍快照」是两种用法。
实测:四个热榜各调一遍,一次完整往返
这一节是我们真调的部分。时间是 2026 年 11 月 4 日 00:13–00:59(新加坡时间),四个热榜各跑了 3 轮;02:05 对知乎热榜和 Reddit 全站热帖各重试 1 次,并补调 2 个替代能力(见本节末尾)。合计 27 次请求,其中 13 次成功扣费,接口费合计 $0.007228;失败的 14 次都没有扣费。每一次请求的原始返回、响应头和耗时我们都存了下来,文中每个数字都能回到原始返回。
一次快照就是四次调用。用 curl 写是这样(把 Key 放在环境变量里,不要写进脚本):
# 一次快照:四个热榜各调一次(2026-11-04 实测的写法)
API=https://api.everyinfra.com/api/v1/social
for body in \
  '{"platform":"reddit","action":"trending_posts","params":{}}' \
  '{"platform":"zhihu","action":"hot_list","params":{"limit":30}}' \
  '{"platform":"weibo","action":"trending","params":{"limit":50}}' \
  '{"platform":"twitter","action":"trending","params":{"country":"world"}}'
do
  curl -s -X POST "$API" -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
       -H 'Content-Type: application/json' -d "$body" \
  | jq -c '{platform, action, count, charged: .billing.charged_usd, error: .error.code}'
  sleep 7   # 每分钟 10 次的 Key,留出余量
done返回的结构四个平台一样:results 是条目数组,count 是条数,billing.charged_usd 是这次扣的钱;失败时没有 results,有 error,里面写着 fault(是谁的问题)、retryable(能不能重试)、retry_after(等几秒)和下一步该做什么。四个平台的条目字段不一样,这是周报合并时最要注意的地方:
| 能力 | 每条的主键 | 名次 | 热度字段 | 第一次成功快照的条数 | 文本、图片、讨论量 |
|---|---|---|---|---|---|
reddit/trending_posts | id | 按返回顺序 | like_count、comment_count | 25 | 正文 text 有 18 条为空 |
zhihu/hot_list | id | rank | hot_value(页面「万热度」换成整数) | 0 | — |
weibo/trending | 标题(没有 id) | rank | hot_value | 50 | label 有 26 条为空 |
twitter/trending | 名称(没有稳定 id) | rank | volume | 50 | volume 50/50 条为空 |
每天跑的取数脚本就是把上面这四次调用写成 Python,结果一行一个快照追加到 snapshots.jsonl。下面是示例脚本 collect.py,接口调用方式与上面几轮相同,只用 Python 标准库(urllib.request,见 Python 文档),Key 只从环境变量读;遇到可重试的 503 就按 retry_after 等一次再试,还失败就把错误照实写进文件:
#!/usr/bin/env python3
"""每天跑一次(或几次):拉四个热榜,一行一个快照追加到 snapshots.jsonl。Key 只从环境变量 EVERYINFRA_API_KEY 读。"""
import json, os, sys, time, urllib.request, urllib.error
from datetime import datetime, timezone, timedelta

API = "https://api.everyinfra.com/api/v1/social"
LISTS = [
    ("reddit", "trending_posts", {}),
    ("zhihu", "hot_list", {"limit": 30}),
    ("weibo", "trending", {"limit": 50}),
    ("twitter", "trending", {"country": "world"}),
]
SGT = timezone(timedelta(hours=8))

def call(platform, action, params):
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    req = urllib.request.Request(API, data=body, method="POST", headers={
        "Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
        "Content-Type": "application/json", "User-Agent": "hot-digest/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            return r.status, json.loads(r.read())
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")

def main(out_path):
    taken_at = datetime.now(SGT).isoformat(timespec="seconds")
    with open(out_path, "a", encoding="utf-8") as out:
        for platform, action, params in LISTS:
            status, data = call(platform, action, params)
            if status == 503 and (data.get("error") or {}).get("retryable"):
                time.sleep(int(data["error"].get("retry_after", 60)))
                status, data = call(platform, action, params)
            row = {"taken_at": taken_at, "platform": platform, "action": action, "http": status,
                   "charged_usd": (data.get("billing") or {}).get("charged_usd", 0),
                   "error": (data.get("error") or {}).get("code"), "results": data.get("results", [])}
            out.write(json.dumps(row, ensure_ascii=False) + "\n")
            print(platform, action, status, len(row["results"]), row["charged_usd"])
            time.sleep(7)  # 每分钟 10 次的 Key 留余量

if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else "snapshots.jsonl")
周末用 merge.py 把一周的快照合成一张表。合并规则很简单:Reddit 和知乎按 id 认同一条,微博和 X 没有稳定 id,按标题认;每条记首次出现、末次出现、出现几次、最好名次和最高热度,每个平台再记这一周一共拍成功了几次(snapshots_total),skill 用它判断覆盖够不够。输出是标准 CSV(RFC 4180),Gemini 帮助页列明支持上传 CSV。
#!/usr/bin/env python3
"""把一周的 snapshots.jsonl 合成一张表 weekly.csv:每个帖子或话题一行,记首次、末次出现、出现几次、最好名次、最高热度。"""
import csv, json, sys
from collections import defaultdict

def key_of(platform, r):
    return r.get("id") if platform in ("reddit", "zhihu") else (r.get("title") or r.get("name"))

def heat_of(platform, r):
    if platform == "reddit": return r.get("like_count")
    if platform in ("zhihu", "weibo"): return r.get("hot_value")
    v = r.get("volume")  # X 的 volume 可能是空串
    return v or None

def main(src, dst):
    rows = [json.loads(l) for l in open(src, encoding="utf-8") if l.strip()]
    snaps = defaultdict(set); items = {}
    for s in rows:
        if s["http"] != 200: continue
        p = s["platform"]; snaps[p].add(s["taken_at"])
        for i, r in enumerate(s["results"], 1):
            k = key_of(p, r)
            if not k: continue
            it = items.setdefault((p, k), {"platform": p, "key": k, "title": r.get("title") or r.get("name"),
                 "url": r.get("url", ""), "community": r.get("community", ""), "first_seen": s["taken_at"],
                 "last_seen": s["taken_at"], "times_seen": 0, "best_rank": None, "max_heat": None})
            it["last_seen"] = max(it["last_seen"], s["taken_at"]); it["first_seen"] = min(it["first_seen"], s["taken_at"])
            it["times_seen"] += 1
            rank = r.get("rank") or i
            it["best_rank"] = rank if it["best_rank"] is None else min(it["best_rank"], rank)
            h = heat_of(p, r)
            if isinstance(h, (int, float)): it["max_heat"] = h if it["max_heat"] is None else max(it["max_heat"], h)
    out = sorted(items.values(), key=lambda x: (x["platform"], -x["times_seen"], x["best_rank"] or 999))
    for it in out: it["snapshots_total"] = len(snaps[it["platform"]])
    with open(dst, "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=["platform", "key", "title", "url", "community", "first_seen", "last_seen",
                                          "times_seen", "snapshots_total", "best_rank", "max_heat"])
        w.writeheader(); w.writerows(out)
    print(dst, len(out), {p: len(v) for p, v in snaps.items()})

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
同一套能力也可以走远程 MCP:在支持 MCP 的客户端里配 https://api.everyinfra.com/mcp,调通用工具 everyinfra_call_api,参数和上面的请求体一样。下图是我们 00:37:15(新加坡时间)走 MCP tools/call 调 weibo/trending 的真实请求和返回(只留 2 条、链接截短),0.6 秒返回,扣 $0.000556。
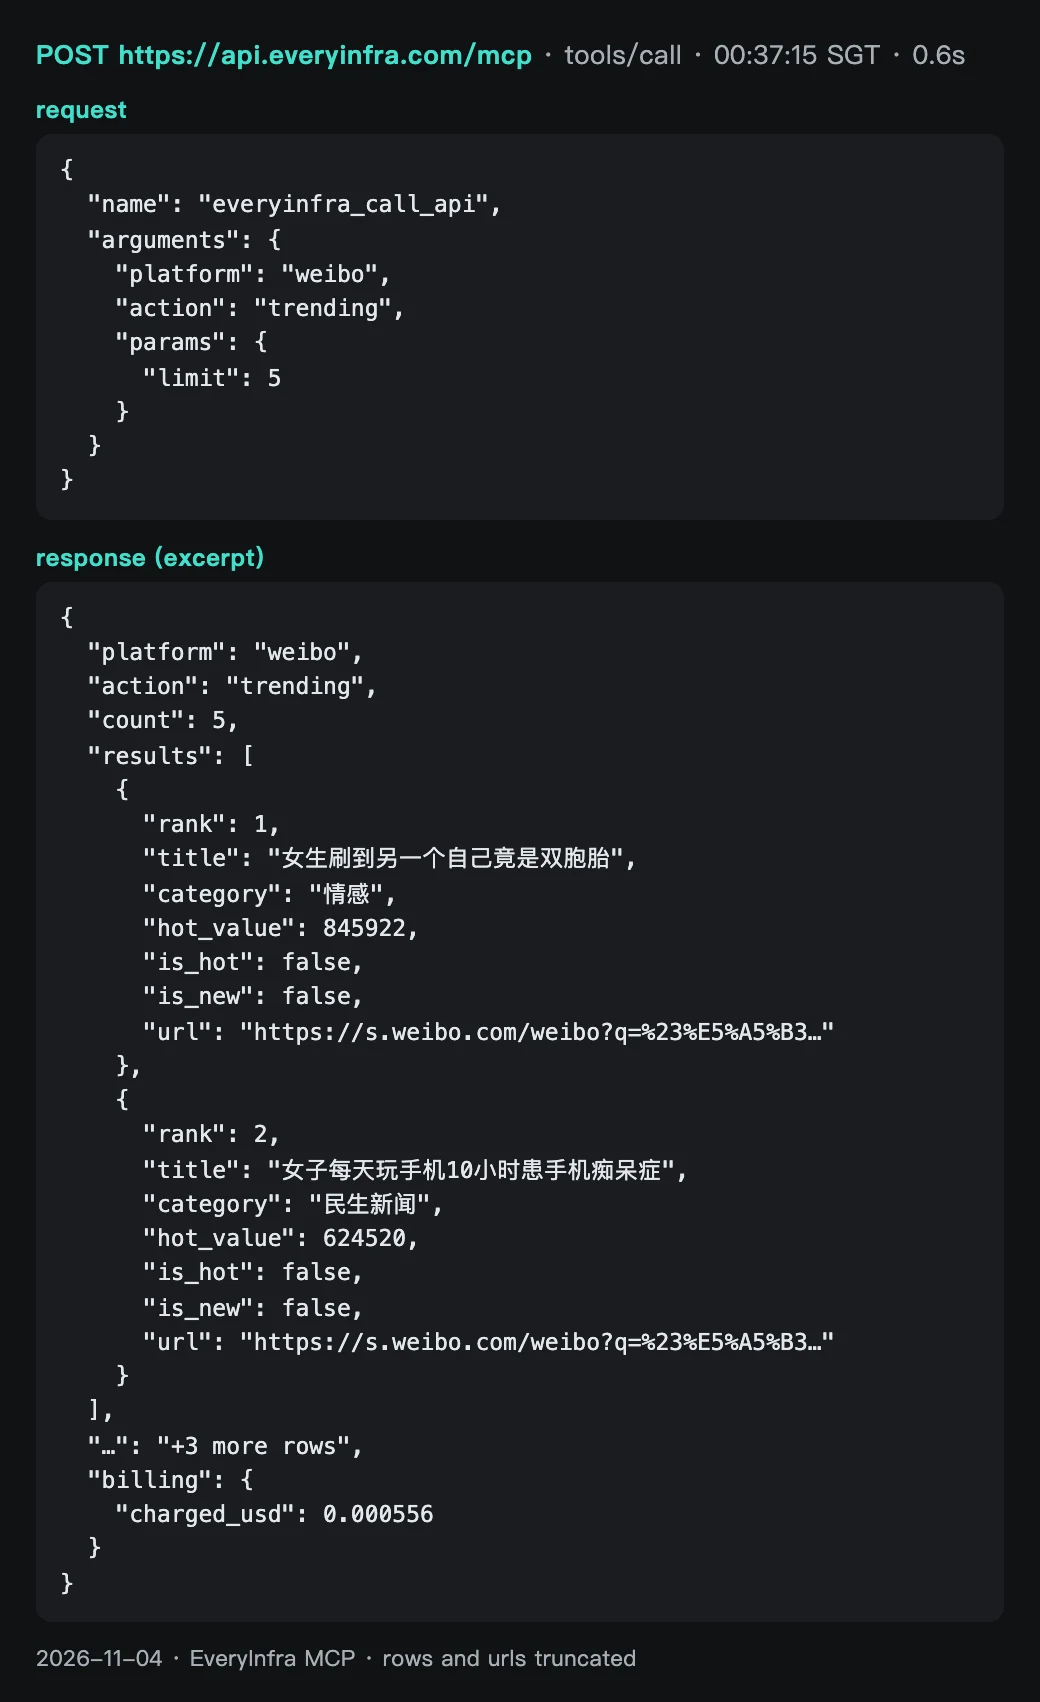
三轮的时间和结果如下。每一轮都按同一顺序调四个榜,两次调用之间隔几秒,避开每分钟 10 次的限制;失败的按返回里的 retry_after 等 60 秒再试一次。
| 轮次(新加坡时间) | Reddit 热帖 | 知乎热榜 | 微博热搜 | X 趋势 | 另外调了 |
|---|---|---|---|---|---|
| 第 1 轮 00:13–00:15 | 25 条 | 503 ×3 | 50 条 | 50 条 | — |
| 第 2 轮 00:35–00:37 | 503 ×3 | 503 ×2 | 50 条 | 50 条 | X us 70 条 |
| 第 3 轮 00:58–00:59 | 503 ×2 | 503 ×2 | 50 条 | 50 条 | X mx 100 条、X es 100 条 |
| 另 00:37 | — | — | 5 条(MCP,limit=5) | — | 接口返回截图用的就是这一次 |
| 重试 02:05 | 503 ×1 | 503 ×1 | — | — | 替代:reddit/subreddit_posts 25 帖、zhihu/search 20 条 |
知乎热榜和 Reddit 全站热帖在测试期间不可用。知乎热榜从 00:13 到 02:05 一共 8 次请求,全部返回 503,fault 是 service,retryable 为真,一次都没扣费;Reddit 全站热帖第一轮拿到了 25 条,从 00:35 起 6 次请求都没拿到(4 次 REST 返回 503,2 次 MCP 返回 isError),同样不扣费。02:05 我们对这两个榜各重试 1 次,仍然是 503。所以本文后面的留存、合并和字段数字只来自拿到数据的 weibo/trending 和 twitter/trending,知乎和 Reddit 热榜那一栏是空的。对做周报的人,这一段的意义是:热榜接口会有整段时间拿不到的情况,取数脚本必须把失败写进文件,skill 必须在周报里写「本周知乎无数据」,而不是让模型自己补。
某个热榜拿不到时,周报还能用别的能力补一栏,但要标明来源换了。我们在 02:05 补调了两个替代能力,各扣 $0.000556。reddit/subreddit_posts 盯 r/GeminiAI(sort=top,date_range=past_week)返回 25 帖,发帖时间从 2026 年 10 月 28 日到 2026 年 11 月 3 日(新加坡时间),赞数 156 到 1,583,标题里带「Carbon」的有 11 帖,正文 text 为空的有 21 帖,flair 25 帖都有。zhihu/search 搜「Gemini」、按最新排序返回 20 条,13 篇文章、7 个回答,发布时间从 2026 年 10 月 23 日到 2026 年 11 月 4 日(新加坡时间),赞数最高 294,有 4 条还是 0 赞。这两个都不是热榜:前者是一个社区一周内的高分帖,后者是关键词结果按时间排,热度要看 like_count,不能写成「Reddit 热帖」或「知乎热榜」。skill 里可以加一条规则:来源是替代能力时,在那一栏标题后面写明能力名。
实测结果:热榜换得多快,一周要拍几次
我们想回答的问题是:做一份「每周热帖摘要」,一周拉一次热榜够不够?判断标准在动笔前写好了:同一个榜单,隔几十分钟再拉一次,如果榜上的条目基本不变,一周拉一两次就够;如果换掉的比例明显,就必须一天拍多次快照再合并。
结果是后者。以第一次成功的快照为基准,微博热搜 44 分钟后还在榜上的只剩 86%,X 趋势(world)44 分钟后只剩 74%。44 分钟里三轮合起来去重,微博一共出现过 58 个不同的话题,X 出现过 63 个,比任何一次快照的 50 条多出 16% 和 26%。
换掉的条目在哪里,也有规律。从第一轮到最后一轮,微博掉出去的 7 条里有 5 条原来排在后半段,X 掉出去的 13 条里有 12 条在后半段:榜单的下半截换得最快。但新进来的条目不全在下面,微博有 2 条、X 有 3 条一进榜就在前 20 名。这正是周报最想要的「一闪而过」的话题:两次快照之间冲上来又掉下去,只看周一早上那一张榜,它们根本不存在。
由此推出拍快照的频率。我们只测了 44 分钟,不能直接外推到一周,隔 6 小时、24 小时的留存这次也没有测,所以下面的频率是示例,不是测出来的最优值。能确定的只是一个下限:44 分钟里 X 榜就换掉了约 26%,一天只拍一次,两次之间隔 24 小时,中间上来又下去的话题会漏掉一部分。示例频率是每天 4 次(例如新加坡时间 08:00、13:00、18:00、23:00),一周 28 次快照;预算更紧就每天 1 次,但要在周报里写明「只覆盖每天一个时刻」。想定自己的频率,可以先按每小时拍一天,看隔 6 小时和 24 小时还剩多少,再往下调。
字段能不能用:哪些数周报里写不出来
字段缺失决定了 skill 里那几条规则。X 趋势的 volume 在三个地区、6 次快照里全部为空,period 一律是「Live」,所以周报里 X 只能写名次和出现次数,不能写「讨论量多少」。Reddit 全站热帖的 25 条里,正文 text 有 18 条为空(多数是图片或链接帖),image_urls 有 15 条为空,所以 skill 只让 Gemini 读标题。微博的 label(「新」「热」这类角标)有 26 条为空,是榜单本来就没有角标,不是没拿到。
X 的地区也要选对。同一时段 country=world 的 50 条,和 us 的 70 条只重合 12 条,和 mx 的 100 条重合 13 条,和 es 的 100 条重合 7 条。world 榜是全球混合:美国中期选举投票日(2026 年 11 月 3 日,美国时间)当天,「Election Day」在 us 榜排第 1,在同一轮的 world 榜排第 6。做面向某个市场的周报,用那个国家的榜。
送给 Gemini 的数据要先合并
为什么 skill 要的是 weekly.csv,而不是原样的快照?我们把这 3 轮的原始结果按 collect.py 的格式写成 snapshots.jsonl,12 行、约 22,406 token;用 merge.py 合成 weekly.csv 后是 146 行、约 6,425 token,少了 71%(按 Gemini API 文档「约 4 个字符 1 个 token」的经验值粗估,中文标题实际会更多,见 Understand and count tokens)。按每天 4 次拍一周,光 Reddit、微博、X 三个榜的原样快照就有约 304,000 token(按这 3 轮每个榜每次的平均体积乘 28 次);合并后的行数只随「不同条目」增长,重复上榜的话题只占一行。更重要的是,合并这一步是确定的程序做的:出现几次、最好名次、最高热度都是算出来的,Gemini 只负责挑选和写,不负责数数。
每周、每月要花多少钱
接口费只跟「一周拍几次快照」有关。按 2026 年 11 月 4 日目录的 price_usd 现算:一次快照 4 次调用,$0.002474;每天 1 次,一周 $0.017、一个月(30 天)$0.074;每天 4 次,一周 $0.069、一个月 $0.297;每小时 1 次,一周 $0.416、一个月 $1.781。Reddit 如果每次再翻一页,每次快照多 $0.000556。失败的调用不扣费,所以知乎拿不到的那几次不会让账单变多。
| 频率 | 每周快照数 | 每周接口费 | 每月(30 天)接口费 | 适合 |
|---|---|---|---|---|
| 每天 1 次 | 7 | $0.017 | $0.074 | 只想知道「这周在聊什么」 |
| 每天 4 次(示例) | 28 | $0.069 | $0.297 | 要分清「整周话题」和「一闪而过」 |
| 每小时 1 次 | 168 | $0.416 | $1.781 | 盯突发、做舆情 |
Gemini 一侧的钱另算。Gemini 应用里的 skills 不要订阅;要让 Gemini 自己按时间跑(Tasks),需要 Google AI Pro 或 Ultra,而且只有 18 岁以上的个人账号能用,欧洲经济区、瑞士、英国和尼日利亚用不了(Manage your tasks & workflows)。路线 C 走 Gemini API 按 token 计费:价格页写 gemini-3.5-flash-lite 输入每百万 token $0.30、输出 $2.50,gemini-3.8-flash 在 2026 年 12 月 31 日前是输入 $0.75、输出 $3.75,2027 年 1 月 1 日起翻倍;更新日志记着 2026 年 10 月 8 日起发往 gemini-3.7-flash 的请求自动转到 gemini-3.8-flash,写死旧模型名的脚本其实已经按新价计费(Gemini API 价格页)。Antigravity 智能体是自主循环,一次运行的 token 主要花在智能体自己的思考和工具往返上,文档估的「研究和信息汇总」类任务是 10 万到 50 万输入 token;照 Flash-Lite 的价,一次大约 $0.03 到 $0.15,约是一次快照接口费的 12 到 60 倍。这一项我们没有实测,以你的账单为准。
做不到和要注意的地方
| 限制 | 对周报的影响 | 怎么办 |
|---|---|---|
| Gemini 应用里 skill 不能联网 | skill 自己拿不到热榜 | 取数放在 skill 外面(路线 A、B、C) |
| 自定义应用只限美国个人账号 | 其他地区没有路线 B | 用路线 A 或 C |
| Tasks 不在欧洲经济区、瑞士、英国、尼日利亚 | Gemini 不能自己每周跑 | 用系统定时器或 Gemini API 触发器 |
| 热榜接口会整段时间 503 | 某个平台这周可能没数据 | 失败照记,skill 写「无数据」 |
| X 趋势没有讨论量 | 只能写名次和出现次数 | 要讨论量另调 twitter/search |
Gemini 一侧,本文没有跑过任何一步。 Skills 页面、自定义应用、Tasks、Gemini API 触发器,全部是按 2026 年 11 月 4 日读到的帮助页和开发者文档写的配置示例。Google 这两个月改得很快(skills 的快捷键都还在从 / 换成 @),你照做时如果界面和本文不一样,以当时的官方页面为准。
Skill 不会替你取数,也不该替你补数。 这是 Gemini 应用的硬限制,也是我们在 skill 里专门写「没有数据就写没有」的原因。摘要类任务最怕的不是写得不好,而是模型拿记忆里的旧热榜冒充本周的数据;规则写进 skill,比每次在对话里提醒更可靠,但仍然要你周一看一眼「覆盖」那一行。
热榜是平台的排序,不是「真实热度」。 微博热搜的计算公式里有互动率加权,榜单另有「商业广告、品牌助力」的标识;知乎热榜的分数里有点击率。平台自己写明了榜单算法里有防刷机制,但没有公开权重,所以周报里「排第几」只能当信号,不能当市场份额。我们在 skill 里只让 Gemini 按「出现次数」和「最好名次」排,不让它跨平台比热度值,就是这个原因。
X 趋势在这 3 轮里没有讨论量。 目录对 twitter/trending 的字段说明写着:其他来源不可用时,结果会来自一个不返回 volume 和 period 的兜底来源。我们 6 次拿到的 X 榜(三个地区)volume 全部为空,period 都是「Live」,所以周报里 X 只能写名次和出现次数。需要讨论量的话,可以对周报里挑出来的几个话题再用 twitter/search 单独查。
热榜会有整段拿不到的时候。 这次 zhihu/hot_list 从头到尾 8 次请求全是 503,reddit/trending_posts 第一轮之后 6 次都没拿到,当时不可用,没有扣费。取数脚本要把失败也记下来,不要静默跳过,否则周末合并时你不知道知乎那一栏是「没上榜」还是「没拿到」。
Reddit 的榜只有一页 25 帖。 reddit/trending_posts 一页约 25 帖,要更多就带 next_page_token 翻页,每页另算一次钱;令牌 24 小时内有效。全站热帖来自各个社区,我们第一轮的 25 帖分属 24 个不同的社区,偏娱乐和泛话题,做垂直领域的周报,更适合换成 reddit/subreddit_posts 盯几个固定的社区。
平台条款。 Reddit 的 Responsible Builder Policy 要求通过它的接口拿数据之前先申请、拿到明确批准,商业用途还要书面批准,并对 AI 训练、商业使用、推断用户敏感特征都有明确限制;X 的开发者条款对数据用途也有要求。周报只用标题、链接、名次和公开互动数,不收集用户画像,是比较稳妥的做法;具体怎么适用于你的业务,请读原文或问律师,本文不做法律判断。
最近的变化:和每周摘要有关的四个日子
这一段只列和「每周热帖摘要」直接有关的变化,按时间排,日期都是官方页面上写的日子。
- 2026 年 9 月 30 日,skills 进入 Gemini 对话,宣布取代 Gems。 Google 博客说 skills 当天在 Gemini 对话里全球推出,Workspace 客户「接下来几周」跟上;同时宣布 Gems 个人账号 11 月起下线,Opal 同期关停(Google 博客,2026-09-30)。意味着:如果你的每周报告是一个 Gem,现在就要动手迁。
- 2026 年 10 月 13 日,Workspace 里的 skills 推迟。 Gemini 应用里的 skills 当天开始推送,Workspace Studio 和 Workspace 应用里的 skills「推迟,另行通知」,并预告会加分享和 Google Drive 集成(Workspace Updates,2026-10-13)。意味着:团队想在 Docs、Sheets 里直接用同一个摘要 skill,要再等;先在 Gemini 应用里用。
- 2026 年 10 月 28 日,Connected Apps 平台开放预览。 Google 博客说开发者可以用云端 MCP 服务器把自己的应用接进 Gemini 和搜索,在 Google Connected Console 注册、测试、提交审核(Google 博客,2026-10-28)。意味着:路线 B 的「自定义应用」之外,数据服务以后可能以正式应用的身份出现在 Gemini 里,不再限于个人添加。
- 2026 年 11 月 17 日(还有 13 天),个人账号 Gems 只读。 见本文第一节。
上手步骤
- 注册 EveryInfra 并拿到 API Key,按 快速上手 用 curl 调一次
weibo/trending,确认返回里有results和billing.charged_usd。四个热榜的参数和字段见 Reddit 全站热帖、知乎热榜、微博热搜、X 趋势,各平台的全部能力在 Reddit 爬虫 API、知乎爬虫 API、微博爬虫 API、X(Twitter)爬虫 API。 - 把本文的
collect.py放到一台每天开机的电脑或小服务器上,EVERYINFRA_API_KEY写进环境变量,用 cron 或 launchd 每天跑一次到四次。跑一周,看snapshots.jsonl里每次的http和charged_usd。 - 把
weekly-hot-posts-digest/文件夹打包上传到 Gemini 的 Skills 页面(名字保持小写连字符),周末跑merge.py生成weekly.csv,上传到对话里,输入/weekly-hot-posts-digest。 - 想全自动:按「路线 C」的配置示例在 Gemini API 里建一个触发器,或者按 Antigravity CLI 那篇 在自己机器上定时跑。远程 MCP 的通用接法见 MCP 服务器说明,计费方式见 价格页。
- 同样的思路换到别的工具:Claude Code 的定时任务见 Claude Code 定时任务抓 Reddit 痛点,ChatGPT 见 ChatGPT 定时任务做需求雷达。
| 步骤 | 在哪做 | API 费用 | 什么时候 |
|---|---|---|---|
| 1. 试一次调用 | 终端里用 curl | 0.000556 美元 | 一次 |
| 2. 抓四个榜 | cron 或 launchd 跑 collect.py | 每周 0.017–0.069 美元(每天 1 到 4 次) | 每天 |
| 3. 写摘要 | Gemini 对话里用 skill | 没有 API 费用;skills 不要求套餐 | 每周一 |
| 4. 全自动 | Gemini API 触发器 | 每次运行的 Gemini token,见费用一节 | 可选 |
常见问题
问题来自 Google 联想词和 Gemini 帮助社区的公开帖子,答案按 2026 年 11 月 4 日读到的官方原文写。
gemini skills vs gems:已经有的 Gem 要不要马上改?
个人账号要。2026 年 11 月 17 日起 Gem 只读,不能用也不能改;12 月 17 日移除。自动迁移会把 Gem 转成「未启用的草稿 skill」,要你逐个审核启用,而且超过 100 MB 的文件、音视频、压缩包和老式 Office 文件不会跟过去。每周固定要用的那几个,建议现在手动重建,顺便按 skill 的写法把描述改成「它做什么 + Use when…」。工作和学校账号不急,商业和企业不早于 2027 年 3 月 1 日,教育不早于 2027 年 6 月 1 日。(问题来自联想词「gemini skills vs gems」「claude skills vs gemini gems」。)
gemini gems read only:只读之后还能导出吗?
能看、能下载文件,不能再用。帮助页的原话是 11 月 17 日之后「你仍然可以访问你的 Gems,但不能使用或编辑,也不能新建」,并提醒个人账号在 12 月 17 日之前把不能迁移的文件下载下来。所以只读的这一个月,是你最后拿回知识文件的窗口。(问题来自联想词「gemini gems read only mode」。)
gemini skills mcp:Gemini 应用里的 skill 能直接调 MCP 吗?
Skill 本身不能联网:帮助页写明上传的脚本不能访问互联网,也不能对外部网站发请求。但 skill 可以配合 Connected Apps 使用,其中「自定义应用」就是填一个 MCP 服务器地址,前提是你年满 18 岁、在美国、用个人账号、界面是英文。不满足这些条件的话,可以本地取数后上传表格,或者改用 Gemini API 的 Antigravity 智能体(它支持 mcp_server 工具)和 Antigravity CLI。(问题来自联想词「gemini skills mcp」「gemini cli skills mcp」。)
gemini skills like claude:Claude 的 skill 能直接上传到 Gemini 吗?
格式上可以:两边都基于 Agent Skills 开放标准,Gemini 帮助页说可以上传 SKILL.md、文件夹或 .zip。要注意三件事:名称必须全小写加连字符;Claude Code 特有的扩展字段(如调用控制、子代理执行)Gemini 不认;skill 里如果带了要联网的脚本,到了 Gemini 应用里跑不了。我们的做法是只用 name 和 description 两个字段,取数放在 skill 外面。(问题来自联想词「gemini skills like claude」。)
gemini skills 怎么开启:skill 建好了,为什么 Gemini 不自动用?
帮助页说 Gemini 只会自动使用「已开启」的 skill,可以在 Skills 页面关掉或重新激活;它判断要不要用,只看名称和描述。描述写得太笼统(比如「数据助手」),Gemini 就不知道什么时候该用。最稳的做法是在对话里输入 /(或 @)手动选。另外,帮助页写的是 skills 目前对 18 岁以上的个人账号开放,工作和学校账号「很快」开放;如果你的 Workspace 账号还没看到 Skills 页面,可能是还没推到。(问题来自联想词「gemini skills como activar」和 Gemini 帮助社区帖子「Will a Skill have an always on state」,帖子链接。)
参考资料
以下页面均在 2026 年 11 月 4 日(新加坡时间)读取。
- Gemini Apps 帮助:About the transition from Gems to skills
- Workspace Admin 帮助:About the transition from Gems to skills
- Workspace Updates,2026-09-30:skills 进入 Gemini 应用和 Workspace
- Workspace Updates,2026-10-13:skills 上线进度更新
- Google 博客,2026-09-30:用 skills 自动处理任务
- Gemini Apps 帮助:版本更新记录(2026-09-30、2026-10-13)
- Gemini Apps 帮助:Create & manage skills
- Gemini Apps 帮助:Write effective skills
- Gemini Apps 帮助:Manage your tasks & workflows(地区和订阅限制)
- Gemini Apps 帮助:Google AI 订阅的用量和升级
- Gemini Apps 帮助:Connect & manage custom apps
- Gemini 帮助社区:Will a Skill have an always on state
- Google Connected Apps 开发者文档
- Gemini Apps Developer Mode overview
- Google 博客,2026-10-28:Connected Apps 平台预览
- MCP 规范:Tools(工具注解 readOnlyHint、destructiveHint)
- MCP 规范:Transports(Streamable HTTP)
- RFC 7591:OAuth 2.0 Dynamic Client Registration
- RFC 9728:OAuth 2.0 Protected Resource Metadata
- IETF 草案:The OAuth 2.1 Authorization Framework
- Gemini API:Function calling(Remote MCP 一节)
- Gemini API:Antigravity agent(MCP、Triggers、Budget)
- Gemini API:Managed agents 总览
- Gemini API:Interactions API 总览
- Gemini API 参考:Interactions(environment 的 inline sources)
- Gemini API 价格页
- Gemini API:Understand and count tokens
- Gemini API 更新日志
- Gemini API:弃用和下线时间表
- Gemini API CLI(gemini-api)指南
- Gemini API:Computer Use
- Gemini API:Coding agent setup
- GitHub:google-gemini/gemini-skills
- Agent Skills 规范
- GitHub:agentskills/agentskills
- Antigravity:Agent skills
- Antigravity:MCP
- Antigravity CLI:无头模式
- Claude Code:Extend Claude with skills
- Claude 文档:Agent Skills overview
- Claude 帮助:Use skills in Claude
- Codex:Build skills
- 微博热搜榜规则说明
- 知乎热榜介绍
- X API 价格页
- X API:Trends
- X 开发者协议与政策
- Reddit Responsible Builder Policy
- Reddit Data API Terms
- EveryInfra 能力目录(price_usd、字段说明,2026-11-04 读取)
- Python 文档:urllib.request
- RFC 4180:CSV 格式
- Apple 开发者文档:用 launchd 定时运行任务
引用编号 BL-82