Gemini SkillsがGemsに取って代わる:人気投稿の週次ダイジェストを作る
Gemini Gemsは11月17日に読み取り専用になります。週次の人気投稿ダイジェストを例にGeminiスキルへ移行します。SKILL.md、3つのデータ取得ルート、4つのランキングAPIの実測結果を紹介します。
今やるべきこと:個人のGoogleアカウント(18歳以上)では、Gemini Gemsは2026年11月17日に読み取り専用になり、2026年12月17日にGoogleによって削除されます。11月17日は今日から13日後です。毎週使っているGemは今のうちにスキルとして作り直し、ナレッジファイルをダウンロードしておきましょう。
仕事用および学校用アカウントでは移行時期が遅く、それぞれ早くても2027年3月1日、2027年6月1日です。Workspaceアプリ内のスキルも「追って通知があるまで延期」とされています。これらの日付の出典はすべて、Google公式のWorkspace UpdatesブログとGeminiヘルプページです。各日付の出典は最初のセクションに記載しています。
この記事では、実際のタスクを例に移行手順を示します。週次の人気投稿ダイジェストをSKILL.mdファイルとして作成します。毎週月曜日に、GeminiがRedditの人気投稿、Zhihuのホットリスト、Weiboのホット検索、Xのトレンドを1週間分読み込み、1ページのレポートを作成します。その過程で、Geminiアプリの最も重要な制限に突き当たります。スキルのスクリプトはインターネットにアクセスできず、外部サイトにリクエストを送ることもできません。そのため、データ取得はスキルの外で行う必要があります。
Geminiにデータを取り込む方法を3つ紹介します。ローカルのスナップショットをアップロードする方法、カスタムのConnected Appを使う方法、トリガー付きのGemini APIエージェントを使う方法です。同じSKILL.mdがClaudeやCodexでも動くかどうかも確認します。
データ取得については、実際にAPIを呼び出しました。2026年11月4日00:13–00:59 SGTに、EveryInfraのreddit/trending_posts、zhihu/hot_list、weibo/trending、twitter/trendingを3ラウンドにわたって呼び出しました。そのうち1回はリモートMCPのtools/callメソッド経由です。02:05 SGTには、取得に失敗した2つのリストをもう一度試しました。主な結果は、リストの入れ替わりが速いということです。44分後もWeiboのリストに残っていた項目は86%だけでした。
44分後もXのリストに残っていた項目は74%だけでした。3ラウンドを合わせると、1回のスナップショットに比べてそれぞれ16%、26%多くの異なるトピックが見つかりました。つまり、週次ダイジェストには1日に複数回のスナップショットが必要です。
テスト中、ZhihuのホットリストとRedditの人気投稿は利用できませんでした。Zhihuへの8件のリクエストはすべて503を返し、Redditはラウンド1でしかデータを返しませんでした。失敗した呼び出しには課金されていません。そのため、以下のダイジェストの数値はWeiboとXのみに基づいています。これは、スキルに「データがない場合はその旨を伝える」と明記すべき理由でもあります。カタログ価格では、例として1日4回スナップショットを取る場合、4つのリスト合計で月額$0.297です。
テスト用のマシンではGeminiにサインインしていません。そのため、スキルのアップロード、カスタムアプリ、Gemini APIのトリガーは実行結果ではなく設定例です。いずれも11月4日時点の公式ドキュメントに基づいています。


今すぐやるべきこと:Gemini Gemsは11月17日に読み取り専用に
機能よりも日付のほうが重要なので、まずは日付から説明します。移行に関するGemini Appsヘルプのページは明快です。18歳以上のユーザーの個人用Googleアカウントでは、2026年11月17日にGemが読み取り専用になります。引き続き開くことはできますが、使用、編集、新規作成はできません。2026年12月17日にはGemがGemini Appsから削除され、アクセスできなくなります(Gemini Appsヘルプ:Gemからスキルへの移行について)。
職場のアカウントには、もう少し猶予があります。同じページでは、Workspaceのビジネス、エンタープライズ、非営利団体向けアカウントは2027年3月、教育機関向けアカウントは2027年6月とされています。Workspace管理者ヘルプのページには正確な日付が記載されており、2027年3月1日と2027年6月1日です(管理者ヘルプ)。Workspace Updatesの投稿では、どちらの日付にも「no sooner than」(早くても)という表現が使われています(Workspace Updates、2026年9月30日)。
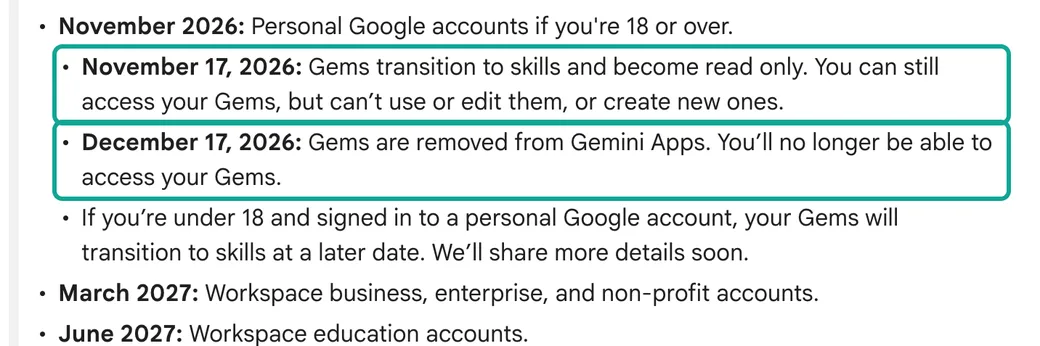
混乱を招きやすい点が1つあります。9月30日のWorkspace Updatesの投稿には「Key dates」のリストがあります。その11月17日の項目には、Gemが設定パネルに移動し、ユーザーは引き続き作成、編集、使用できると書かれています。一方、個人アカウント向けのヘルプページには、同じ日に「読み取り専用」と書かれています。この2つの記述は、それぞれ別のアカウントについてのものです。
ブログの記述はWorkspaceのタイムラインの中にあります。ヘルプページの記述は、18歳以上のユーザーの個人アカウントのみが対象です。多くの二次情報の記事は、この2つを混同して「11月17日に全員が読み取り専用になる」としています。しかし、情報源にはそうは書かれていません。
| アカウントの種類 | 読み取り専用、または設定に移動 | Gemが使えなくなる日 | Gemの削除 | 出典 |
|---|---|---|---|---|
| 個人用Googleアカウント(18歳以上) | 2026-11-17、読み取り専用 | 2026-11-17 | 2026-12-17 | Gemini Appsヘルプ |
| 個人アカウント(18歳未満) | 「後日」 | 記載なし | 記載なし | Gemini Appsヘルプ |
| Workspaceのビジネス、エンタープライズ、非営利団体 | 2026-11-17、設定に移動、引き続き使用可能 | 早くても2027-03-01 | 同日。残っているGemは下書きのスキルになる | Workspace Updates、管理者ヘルプ |
| Workspaceの教育機関向け | 同上 | 早くても2027-06-01 | 同日(ClassroomとLTIも対象) | 同上 |
個人アカウントの場合、本記事の執筆時点から13日間しかありません。やるべきことは3つあります。1つ目は、今も使っている各Gemの指示とナレッジファイルをダウンロードすることです。スキルに含められるファイルの合計容量は最大100 MBです。
Gemのサイズがそれより大きい場合、自動移行では大きいファイルから順に削除されます。音声、動画、アーカイブ、GitHubのファイル、旧形式のOfficeファイル(.doc、.xls、.ppt)は一切移行されません。12月17日以降は復元できません(同じヘルプページの「移行中のファイルに関する制限」)。
2つ目は、毎週使うGemを手作業でスキルとして作り直すことです。自動移行を待たないでください。自動移行で作成されるのは「無効な下書き」で、使用や共有の前に1つずつ確認して有効化する必要があります(管理者ヘルプ「自動移行の仕組み」)。3つ目は、各Gemが必要とするツールを確認することです。ヘルプページによると、スキルは現時点で「動画を作成」「音楽を作成」「Canvas」「Deep Research」「ガイド付き学習」に対応していません。Gemがこれらのツールに依存している場合は、別の方法を検討してください。
仕事用アカウントにはまだ猶予がありますが、すでに変わったことが1つあります。Workspace Studioでは、新しいフローに「Ask a Gem」ステップを追加できなくなりました。既存のフローは2027年まで引き続き動作します。また、Workspaceアプリ内でのスキル提供は遅れています。10月13日の更新では、即時リリース方式と計画的リリース方式のドメインへの展開が「追って通知があるまで延期」とされています(Workspace Updates、2026年10月13日)。
Geminiアプリのスキルは予定どおり進んでいます。10月13日に展開が始まり、11月中旬までに完了する見込みです。同じ投稿によると、スキルはGeminiアプリとWorkspaceアプリの間で同期されません。それぞれの場所でスキルを作成する必要があります。
GeminiのスキルとGemの違い:何が変わったか
Gemは、Geminiを個別にカスタマイズした独立したバージョンです。Gemを開き、専用のウィンドウでチャットします。スキルは、どのチャットにも呼び出せる指示のセットです。/に続けてスキル名を入力します。ヘルプページによると、このショートカットは@に変更される予定です。
名前と説明がプロンプトに合致する場合、Geminiが自動でスキルを選ぶこともあります。1つのチャットで複数のスキルを組み合わせることもできます(Geminiアプリのスキルを作成、管理する)。Workspace Updatesは、スキルが「オープンでMarkdownネイティブなSKILL.md標準に完全に基づいて構築されている」と説明しています。そのため、他のプラットフォームのスキルをGeminiにコピーできます(Workspace Updates、2026年9月30日)。
| 項目 | Gem | Geminiアプリのスキル(2026年11月4日時点) |
|---|---|---|
| 使い方 | 専用ウィンドウでGemを開く | 任意のチャットで/(今後は@)を入力、またはGeminiに自動で適用させる |
| 同時に使える数 | 1つ | 複数。スキルから別のスキルを参照することも可能 |
| 形式 | Webフォーム | Webフォーム、またはSKILL.md、フォルダ、.zipをアップロード |
| 名前のルール | 自由記述 | すべて小文字、単語はハイフン区切り(例:my-new-skill) |
| ファイル | ナレッジファイル | 合計100 MB。プレーンテキスト形式のファイルのみ。音声、動画、アーカイブは不可 |
| ツール | 動画、音楽、Canvas、Deep Researchなど | Connected Appsに対応。動画、音楽、Canvas、Deep Research、ガイド付き学習には未対応 |
| スクリプトからのインターネットアクセス | 該当なし | 不可:アップロードしたスクリプトはインターネットにアクセスできず、外部サイトへのリクエストも送信できません |
| 必要なプラン | 無料 | スキルは無料。スケジュール設定したタスクにはGoogle AI ProまたはUltraが必要 |
| 共有 | 可能 | 「今後数週間以内」 |
この記事が解決するのは、表の「スクリプトからのインターネットアクセス」の行に示した問題です。週次の人気投稿ダイジェストには、Redditの人気投稿、Zhihuのホットリスト、Weiboのトレンド検索、Xのトレンドなどの外部データが必要です。Claude CodeやCodexでは、スキルがAPIを呼び出すスクリプトを実行するか、エージェントがMCPツールを呼び出せます。その方法は、1つのSKILL.mdを4つのAIツールで使うという記事で紹介しています。しかし、Geminiアプリでは事情が異なります。
ヘルプページのアップロードのセクションには、2つの制限が記載されています。インターネットアクセスを必要とするスクリプトはサポートされていません。また「セキュリティ上の制限」として、スクリプトは外部サイトでアクションを実行したり、リクエストを送信したりできません。つまりGeminiアプリでは、スキルがデータを取得することはできません。データは別の経路から用意する必要があります。
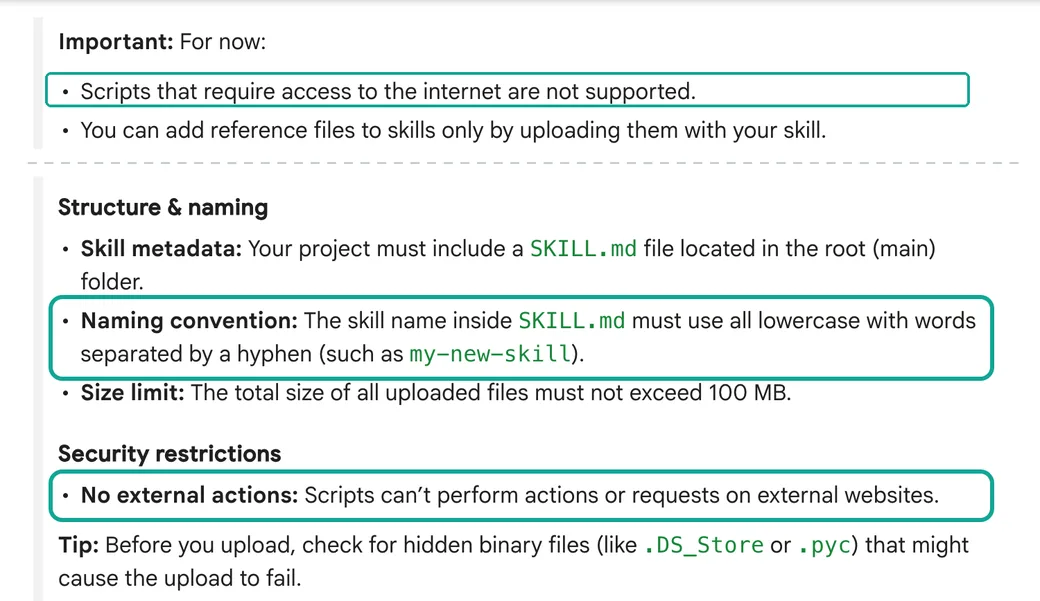
この制限が記事の構成を決めています。スキルはGeminiにダイジェストの書き方を伝え、データは別の経路で渡します。まずジョブの内容を説明し、次にGeminiへデータを渡す3つの経路を紹介します。
Gemをスキルに移行する方法
ヘルプページでは、3つの手動ステップが案内されています。Gemを開き、ナレッジファイルを1つずつダウンロードします。新しいスキルを作成し、Gemの名前、説明、指示をコピーします。ファイルを追加するには、スキルをフォルダとしてダウンロードし、ファイルを追加してからフォルダ全体をアップロードします(ヘルプページ)。実際には、4つの部分はコピーするのではなく書き直すべきです。
1つ目は名前です。Gemには任意の名前を付けられますが、スキル名はweekly-hot-posts-digestのように、小文字の英単語をハイフンでつないだものにする必要があります。効果的なスキルに関するヘルプ記事では、名前を動詞で始めることを推奨しています。また、helper、tools、dataのような意味の薄い単語は避けるよう求めています(効果的なスキルを作成する)。
2つ目は説明です。Gemの説明は人に向けたものですが、スキルの説明はGeminiに向けたものです。Geminiはスキルを適用するかどうかを、名前と説明だけを読んで判断するためです。三人称で、スキルが何をするかを書き、続けて「Use when…」として適用するケースを記述します。
上限は1,024文字です。同じ記事では、手順をチェックリストとして書くこと、データが欠けている場合の対処をGeminiに指示することも推奨しています。ダイジェストでは、この2点目が特に重要です。たとえば「今週データがないプラットフォームがあれば、その旨を明記し、記憶で補わない」といったルールです。
3つ目はナレッジファイルです。Gemは毎回1つの大きな参照ファイルを読み込むことがよくあります。一方、スキルは必要なときにだけ内容を読み込みます。Geminiはまず名前と説明を読みます。
スキルが関連していそうな場合にのみ指示全体を読み、添付ファイルはステップで必要になったときにだけ開きます。そのため、長いテンプレートやサンプルレポートはreferences/フォルダに置きます。そのうえで、指示に「ステップ5でreferences/report-template.mdを使用する」と書きます。
4つ目はツールです。GemでDeep ResearchやCanvasを使っていた場合、その部分はまだスキルでは動作しません。今回のダイジェストではこれらのツールは不要です。Geminiに必要なのは、表を読み、項目をグループ化し、文章を書くことだけです。
ジョブ:週次の人気投稿ダイジェストと、必要なスナップショットの数
成果物は1ページの週次レポートです。Reddit、Zhihu、Weibo、Xの過去7日間について、3つの問いに答えます。何日もホットリストに残り続けたトピックはどれか。急上昇してすぐに消えたトピックはどれか。
同じ話題が複数のプラットフォームに現れたか。読者はコンテンツプランナー、ブランド・PRチーム、市場アナリストです。月曜の朝に1ページを開くだけで済み、4つのホットリストを読む必要はありません。
レポートを書くのは簡単です。難しいのは、1週間分のデータを集めることです。ホットリストはログではなくスナップショットです。各プラットフォームに表示されるのは現在の上位項目だけで、リストは数分後には変化します。「今週リストに載ったすべての項目」を提供しているプラットフォームはありません。各プラットフォームのルールにも、そのことが明記されています。
Weiboは、ホット検索リストが1分ごとに更新され、上位50件を表示するとしています(Weiboホット検索のルール)。Zhihuは、ホットリストが10分ごとに更新され、上位30件を表示するとしています(Zhihuホットリストの紹介)。RedditとXは更新頻度を公開していません。当社のカタログでは、reddit/trending_postsは1ページあたり約25件の投稿を返し、ページトークンの有効期間は24時間です。twitter/trendingは1つの地域のリストを返し、各行にcollected_atの時刻が含まれます。フィールドの注記にあるとおり、トレンドは変化が速いため、この時刻を使って各行の鮮度を判断してください。
| ホットリスト | EveryInfraの機能 | 1回の呼び出しあたりの行数 | プラットフォームのランキング方法 | 更新頻度 | カタログ価格(2026年11月4日時点) |
|---|---|---|---|---|---|
| Redditの人気投稿 | reddit/trending_posts | 1ページあたり約25件。トークンで次ページを取得可能 | 非公表 | 非公表 | 1ページあたり$0.000556 |
| Zhihuホットリスト | zhihu/hot_list | 最大30件 | 検索、閲覧、インタラクション、クリック率 | 10分ごと | 1回の呼び出しあたり$0.000806 |
| Weiboホット検索 | weibo/trending | デフォルト20件、最大200件(リスト自体は50件) | (検索 + 議論 + 拡散)× インタラクション率 | 1分ごと | 1回の呼び出しあたり$0.000556 |
| Xのトレンド | twitter/trending | 1地域あたり約50件 | 非公表 | 非公表 | 1回の呼び出しあたり$0.000556 |
そのため、週次ダイジェストを作るには、1週間のあいだに何度もスナップショットを取得し、それらを統合するのが正しい方法です。レポートには項目ごとに3つの数値が必要です。その項目が何回のスナップショットに出現したか、最高順位、最大の熱度です。4つのリストすべてのスナップショット1回分の費用は$0.002474です(3 × $0.000556 + $0.000806、カタログのフィールドprice_usdより)。本当の問題は、スナップショットが何回必要かです。
少なすぎるとトピックを見逃し、多すぎると使わないデータに費用を払うことになります。この疑問に答えるため、実際の呼び出しを3ラウンドにわたって行いました。結果は後述のテストセクションにあります。
料金を確認すると、この用途に各プラットフォームの公式APIをおすすめしない理由もわかります。X開発者ドキュメントには従量課金の料金が掲載されており、Trendsエンドポイントは1リクエストあたり$0.010です(X APIの料金)。これはtwitter/trendingのカタログ価格の約18倍です。Reddit独自のAPIは、利用前に承認を受ける必要があります。詳細は制限のセクションにある「プラットフォームの規約」の注記を参照してください。
米国の読者向けなら、Xの地域設定が重要です。デフォルトのcountry=worldのリストには、世界各地の項目が混在しています。2回目のラウンドではcountry=usでも呼び出したところ、50件ではなく70件が返りました。読者が米国にいるならusを使ってください。そのほかの地域の値はカタログに載っています。
SKILL.mdのひな型:weekly-hot-posts-digest
以下に、フォルダ全体とSKILL.mdファイルを示します。このスキルの役割は1つだけです。1週間分のホットリストのスナップショットを表として受け取り、1ページのダイジェストを書きます。Geminiアプリのスキルスクリプトはオンラインにアクセスできないため、データの取得は行いません。
指示は英語で書きました。Gemini、Claude、Codexのヘルプページにある例は英語で、3つのプラットフォームはいずれも英語の指示を読み込めます。ダイジェストを別の言語で出力したい場合は、スキルを呼び出す際にその旨を伝えてください。
weekly-hot-posts-digest/
├── SKILL.md                     # required: name, description, instructions
└── references/
└── report-template.md # output template for step 5---
name: weekly-hot-posts-digest
description: Builds a one-page weekly digest of hot posts and trending topics from Reddit, Zhihu, Weibo and X snapshot data. Use when the user uploads this week's weekly.csv or snapshots.jsonl, or asks for a weekly trending summary across these four platforms.
---
# Weekly hot posts digest
## Inputs
- weekly.csv: one row per post or topic. Columns: platform, key, title, url, community, first_seen, last_seen, times_seen, snapshots_total, best_rank, max_heat.
- If the user gives snapshots.jsonl instead, group rows by platform and key first, then work from the grouped rows.
## Steps
Copy this checklist and track progress:
- [ ] 1. For each platform, count snapshots_total and the date range. Write them at the top of the digest.
- [ ] 2. Rank items by times_seen / snapshots_total first, then by best_rank. An item seen in most snapshots is a "week topic". An item seen once is a "spike".
- [ ] 3. Pick 5 week topics and 3 spikes per platform. Keep the original title. For Zhihu and Weibo, add a one-line English gloss after the title.
- [ ] 4. Group the picked items into at most 6 themes across platforms. A theme needs items from 2 or more platforms.
- [ ] 5. Fill the template in references/report-template.md.
## Rules
- max_heat is only comparable inside one platform. Do not compare Weibo hot_value with Zhihu hot_value or Reddit like_count.
- X trends may have an empty volume. Write "no volume" instead of 0.
- Do not guess why a topic is hot. If the title is not enough, write "reason unclear" and give the url.
- Remove user names from Reddit titles and text if they appear. Keep brand and organization names.
## Missing information
- If a platform has 0 snapshots this week, write "no data for <platform> this week" and continue with the others. Do not fill it from memory or web search.
- If snapshots_total is below 5 for a platform, add the line "low coverage: N snapshots".テンプレートファイルは短く、SGT基準の週の日付を示すタイトル行と、対象範囲を示す行があります。その後に、テーマの表、プラットフォームごとの「週のトピック」セクション、「急上昇」セクション、注記が続きます。ファイル全体で399バイトです。別ファイルにしているのは段階的開示(progressive disclosure)のためです。Geminiはステップ5で初めてこのファイルを開くため、スキルを適用するかどうかを判断する段階ではトークンを消費しません。
指示に含まれる各ルールは、実際の呼び出しで確認した事柄に基づいています。「max_heatは単一のプラットフォーム内でのみ比較可能」というルールは、カタログのフィールドに関する注記に由来します。Weiboのhot_valueはWeibo独自の指標で、「リスト内でのみ比較可能」です。Zhihuのhot_valueは、「5.97 million heat」のようなページ上のテキストを整数に変換したものです。
2つのプラットフォームは異なる計算式を使っています。Weiboのルールでは「(検索熱度 + 議論熱度 + 拡散熱度)× インタラクション率」とされています。Zhihuのページには、検索熱度、閲覧熱度、インタラクション熱度、クリック率が挙げられています(Weiboホット検索のルール、Zhihuホットリストの紹介)。2つのリストをまたいで並べ替えても意味がありません。
「Xのトレンドではvolumeが空の場合がある」というルールは、私たちのテスト結果に基づいています。具体的な数値は、後述のフィールドに関するセクションに記載しています。「データがない場合はそう明記する」というルールは、Zhihuのホットリストでのテスト結果に基づいています。今回のテストでは、Zhihuのホットリストがすべての試行でHTTP 503を返しました。このルールがないと、Geminiが記憶にある古いホットリストの項目で欠落を埋めることがあります。そうなると、ダイジェストは一見完全に見えても、一部に事実でない内容が混じります。
| スキルのルール | 根拠となるテスト結果・ドキュメント | ルールがない場合 |
|---|---|---|
| max_heatは同じプラットフォーム内でのみ比較する | WeiboとZhihuでは熱度の計算式が異なります。カタログでは、Weiboの熱度はWeiboのリスト内でのみ比較可能とされています | 意味のないプラットフォーム横断の「熱度ランキング」 |
| Xのvolumeが空なら「no volume」と書く | Xのすべてのスナップショットで、volumeが空でした | モデルが空の値を0と解釈する |
| 推測せず「reason unclear」と書く | ホットリストにはタイトルとリンクしかない | モデルが記憶をもとに理由を作り出す |
| データがなければ「no data」と書く | 今回のテストでは、Zhihuのホットリストはすべてのリクエストで503を返しました | モデルが古い項目で欠落を埋める |
| スナップショットが5回未満なら「low coverage」と書く | 各リストの一部は44分以内に入れ替わる | 読者は、ダイジェストが1週間全体をカバーしていると思い込む |
ClaudeとCodexでも同じSKILL.mdを使えますか?
はい。Gemini、Claude Code、Codex、Antigravityはいずれも、各スキルがオープンなAgent Skills標準に準拠していると明記しています。仕様の必須フィールドは2つだけです。nameには小文字、数字、ハイフンを使い、最大64文字です。descriptionは最大1,024文字です(Agent Skillsの仕様)。
Claude Codeは、呼び出しの制御やサブエージェントでの実行など、拡張フィールドを追加しています(Claude Codeのドキュメント)。Codexではnameとdescriptionの両方が必須です(Codex: Build skills)。Antigravityではnameを省略でき、その場合はフォルダ名が使われます(Antigravityのドキュメント)。今回のスキルは両方のフィールドを持ち、拡張フィールドは使っていないため、4つのツールすべてで変更なしに読み込めます。
違いは1点だけです。Claude Code、Codex、Antigravity CLIでは、同じスキルからEveryInfraのリモートMCPサーバーを呼び出してホットリストを取得できます。Geminiアプリではスキルがオンラインにアクセスできないため、事前にデータを用意する必要があります。記事1つのSKILL.mdを4つのAIツールで:競合レビューのテストでは、スキルフォルダ、呼び出し方法、ネットワークのルールを比較しています。その記事では、MCPの呼び出しと組み合わせて動くスキルを紹介しました。この記事では、スキルがオンラインにアクセスできない場合に、データと指示を分ける方法を紹介します。
Geminiアプリに外部データを取り込む3つの方法
スキルはデータを取得しないため、外部からデータを取り込む必要があります。2026年11月4日に公式ドキュメントを確認したところ、3つの方法が見つかりました。方法ごとに要件が異なり、適したユーザーも異なります。以下の各方法は設定例です。テスト用マシンではGeminiにサインインしておらず、Gemini側の手順は一切実行していません。
| 方法 | 利用できるユーザー | データの取り込み方 | 週次の自動化 | テストした内容 |
|---|---|---|---|---|
| A. ローカルでスナップショットを取得し、週末に表をアップロード | スキルを利用できるすべてのアカウント | weekly.csvをチャットに添付 | 取得は自動、ファイルのアップロードは手動 | データAPIの呼び出し(今回の3ラウンド) |
| B. Custom Connected App(リモートMCP) | 18歳以上、米国在住、個人アカウント、英語 | GeminiがMCPツールを呼び出す | ヘルプページには、カスタムアプリはTasksで動作すると記載されています | 当社のMCP側のみ |
| C. Gemini API:Antigravityエージェントとトリガー | Gemini APIキーを持つ開発者 | エージェントがサンドボックス内でmcp_serverツールを呼び出す | はい。トリガーがcronスケジュールで実行されます | 当社のMCP側のみ |
使えるルートは、利用する場所とアカウントによって異なります。
| 状況 | 方法 | 理由 |
|---|---|---|
| 米国内、個人アカウント、英語 | A, B, C | カスタムアプリは米国の個人アカウントのみ対象 |
| その他の国の個人アカウント(例:カナダ、シンガポール) | A, C | カスタムアプリは利用不可。TasksにはAI ProまたはUltraが必要 |
| EEA、スイス、英国 | A(人がアップロード)、C | スケジュール実行のGemini Tasksは利用不可 |
| Workspaceの仕事用アカウント | A、C(Workspaceスキルの提供開始後) | Workspaceスキルの提供は遅れており、2種類のスキルは同期されない |
ルートA:ローカルでスナップショットを取得し、週末にアップロード。要件が最も少なく、最も細かく制御できるルートです。手元のPCまたは小規模なサーバーで、取得スクリプトを1日1回以上実行します。スクリプトは4つの人気ランキングの生データをsnapshots.jsonlに追記します。
週末には、マージスクリプトで1週間分のスナップショットをweekly.csvにまとめます。このファイルをGeminiのチャットにアップロードし、/weekly-hot-posts-digestと入力します。CSVは、Geminiヘルプページ(Create & manage skills)に記載された対応ファイル形式に含まれています。
利点は、取得と執筆が完全に分離されていることです。取得は固定のプログラムが行い、課金の発生と失敗を1件ずつファイルに記録します。ダイジェストを書くモデルが見るのは1つの表だけなので、「検索して欠けた部分を埋める」ことはできません。欠点は、毎週、手動でファイルをアップロードする必要があることです。次のセクションで実際に行う呼び出しも、これと同じAPI呼び出しです。
ルートB:カスタムConnected App。Geminiのウェブアプリでは、MCPサーバーのURLを指定して「カスタムアプリ」を追加できます。接続すると、モバイルアプリ、ウェブ、Tasksで利用できます(カスタムアプリのヘルプページ)。要件は明確です。18歳以上であること、米国に所在すること、個人のGoogleアカウントでログインすること、Keep Activityをオンにしておくことが必要です。現時点では英語のみに対応しており、アプリの追加はウェブからのみ可能です。
認証について、Developer Modeのドキュメントでは動的クライアント登録(Dynamic Client Registration、RFC 7591)を使用しています。GeminiがMCPサーバーとの間でクライアントとユーザーの認証情報をどのように設定するかを構成します。別途OAuth 2.1のガイドもあります(Gemini Apps Developer Mode overview)。つまり、このルートではOAuthによるログインを使います。
リクエストヘッダーにAPIキーを貼り付ける必要はありません。EveryInfraのリモートMCPサーバーにはhttps://api.everyinfra.com/mcp/allにOAuthのエントリポイントがあり、メタデータは/.well-known/oauth-protected-resource/mcp/allにあります。Geminiでの接続は試していないため、接続できるとは断言できません。米国でこのルートを試して接続に失敗した場合は、エラー内容をお知らせください。
ルートBには、ドキュメントから導かれるものの未検証の点がもう1つあります。Developer Modeのページによると、Geminiは各MCPツールのreadOnlyHintとdestructiveHintアノテーションを読み取ります(MCP tools specification)。これとチャットのコンテキストをもとに、先に確認カードを表示するかどうかを判断します。ヘルプページにも、書き込みアクションについてはGeminiが常に確認を求めると記載されています。11月4日、tools/listでEveryInfraのMCPツール一覧を取得しました。
この呼び出しはキーなしで実行でき、課金もありません。汎用データツールeveryinfra_call_apiには、呼び出しごとに課金が発生するため、readOnlyHint: falseとdestructiveHint: trueのアノテーションが付いています。ドキュメントから判断すると、Geminiは人気ランキングを呼び出すたびに確認を求める可能性が高いと考えられます。そのため、無人で実行するスケジュールタスクが確認ステップで止まることがあります。アプリを接続する際に確認してください。
ルートC:Gemini APIのAntigravityエージェントとトリガー。Pythonを数行書けるなら、このルートをおすすめします。取得、執筆、スケジューリングのすべてがGoogle側で完結する唯一のルートです。Gemini APIのInteractionsエンドポイントでは、リモートMCPサーバーをツールとして使用できます。フィールドはtype: "mcp_server"、name、url、headers、allowed_toolsです。対応しているのはStreamable HTTPのみでSSEには対応しておらず、名前にハイフンを含めることはできません(Gemini API: Function calling, Remote MCP section)。
Antigravityエージェントは、Googleが管理するLinuxサンドボックスで動作する汎用エージェントです。AGENTS.mdと.agents/skills/配下のスキルをサンドボックスにマウントできます(Gemini API: Antigravity agent)。Interactions APIリファレンスには、inlineソースを使ってSKILL.mdファイルを.agents/skills/<name>/SKILL.mdに書き込む例があります(Interactions API reference)。「Triggers」セクションによると、トリガーはエージェント、環境、プロンプト、cronスケジュールを1つの永続リソースにまとめたものです。毎回同じ環境で実行されるため、前回の実行で作成したファイルはそのまま残ります。無人実行の場合は、リクエストにトークンを含めるのではなく、保存済みの認証情報を使うよう推奨されています。
この3つを組み合わせると、毎週月曜の朝にダイジェストを書く構成ができます。以下は構成例です。フィールド名は公式ドキュメントからそのまま引用していますが、コードは実行していません。
# Configuration example (not run): one snapshot each day at 08:00 SGT,
# and on Mondays also the digest for the last week.
# Sources: ai.google.dev/gemini-api/docs/antigravity-agent (MCP servers, Triggers, Budget controls)
#          ai.google.dev/api/interactions-api (inline sources for an environment)
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY from the environment
SKILL_MD = open("weekly-hot-posts-digest/SKILL.md", encoding="utf-8").read()
TEMPLATE = open("weekly-hot-posts-digest/references/report-template.md", encoding="utf-8").read()

everyinfra = {
    "type": "mcp_server",
    "name": "everyinfra",                     # lowercase letters and digits only
    "url": "https://api.everyinfra.com/mcp",
    "headers": {"Authorization": "Bearer " + EVERYINFRA_API_KEY},  # read from a secret store
    "allowed_tools": ["everyinfra_call_api"],
}
environment = {
    "type": "remote",
    "sources": [
        {"type": "inline", "content": SKILL_MD,
         "target": ".agents/skills/weekly-hot-posts-digest/SKILL.md"},
        {"type": "inline", "content": TEMPLATE,
         "target": ".agents/skills/weekly-hot-posts-digest/references/report-template.md"},
    ],
}
PROMPT = (
    "Step 1: call everyinfra_call_api four times: reddit/trending_posts, zhihu/hot_list (limit 30), "
    "weibo/trending (limit 50), twitter/trending (country us). Append one JSON line per call to "
    "/workspace/snapshots.jsonl with taken_at, platform, http status, charged_usd and results. "
    "If a call fails, write the error and continue. "
    "Step 2: only if today is Monday in Asia/Singapore, use the weekly-hot-posts-digest skill on the "
    "last 7 days of /workspace/snapshots.jsonl and save the digest to /workspace/digests/."
)
trigger = client.triggers.create(
    schedule="0 8 * * *", time_zone="Asia/Singapore", display_name="hot-lists-weekly",
    interaction={
        "agent": "antigravity-preview-09-2026",
        "agent_config": {"type": "antigravity", "model": "gemini-3.5-flash-lite",
                         "max_total_tokens": 300000},
        "environment": environment,
        "tools": [everyinfra],
        "input": PROMPT,
    },
)
print(trigger.id, trigger.next_run_time)この例には説明が必要な点が3つあります。1つ目は、取得と執筆を1つのトリガーにまとめていることです。ドキュメントには各実行で「同じ環境を再利用する」とあり、前回の実行のファイルを参照できます。ただし、この記述は1つのトリガーについてのものです。トリガーを2つに分けると、2つ目のトリガーがスナップショットを読むには、環境をIDで指定する必要があります。Environmentsセクションにはenv_abc123のような既存のIDを渡せると書かれていますが、失敗しうるステップが1つ増えます。
第2に、モデルは最も低コストのgemini-3.5-flash-liteで、例ではmax_total_tokensの上限を設定しています。Antigravityのエージェントは自律ループで動作します。「調査と要約」タスクの場合、ドキュメントでは入力トークンを100,000〜500,000と見積もっています。1回の実行あたり約$0.30〜$1.00で、複雑なタスクでは最大約$5になります。上限に達すると実行は停止し、status: "incomplete"を返します。
3つ目に、APIキーはコードに書かないでください。Triggersセクションでは、無人実行には保存済みの認証情報を参照するよう指示しています。アウトバウンドプロキシが実行のたびに認証情報を読み込むため、トリガーを変更せずにAPIキーを差し替えられます。例のheadersの行は、最初の手動テスト専用です。
ルートCでは、Gemini APIの変更履歴(Gemini API changelog)にある3つの項目にも注意してください。2026年10月26日以降、有料ティアで新規作成されたプロジェクトではgenerateContentリクエストがデフォルトで保存されます(store=true)。ダイジェストのテキストにユーザーデータが含まれる場合は、リクエストごとにstore=falseを設定するかどうかを検討してください。2026年10月27日には、ステートレスなコマンドラインクライアントgemini-apiがパブリックベータになりました。Interactionsエンドポイントでマネージドエージェントを実行できますが、トリガーに対応しているかは確認していません。
2026年11月2日の非推奨のお知らせによると、12月1日以降、gemini-2.5-flashへのリクエストはgemini-3.5-flash-liteに転送されます。Function callingには後方互換性のない変更があります。古いダイジェストスクリプトで2.5のモデルを固定している場合は、その日までにモデル名を変更して再テストしてください。
もう1つのルート:Antigravity CLI。普段からターミナルで作業しているなら、Antigravity CLIがあります。GoogleがGemini CLIの後継とするツールで、.agents/skills/配下のスキルも読み込みます。リモートMCPサーバーをmcp_config.jsonに設定し、システムのスケジューラー(cronまたはlaunchd)でagy -pを実行します。セットアップの詳細は、記事動画コメント監視のためのAntigravity CLI:検証と設定をご覧ください。
ルートCとの違いは実行場所です。CLIは手元のマシンで動作するため、マシンの電源が切れていると止まります。ルートCはGoogleのサンドボックスで動作します。リモートMCPサーバーを使ったGemini Deep Research APIの記事は別の用途を扱っており、定期的なスナップショットではなく、出典付きのリサーチが対象です。
検証:4つの人気ランキングをそれぞれ実際に1回呼び出す
このセクションでは、実際に行った検証を説明します。2026年11月4日00:13〜00:59(SGT)に、4つのホットリストを3ラウンドにわたって取得しました。02:05(SGT)には、ZhihuホットリストとReddit人気投稿をもう一度試し、代替エンドポイントを2つ呼び出しました(このセクションの末尾を参照)。
リクエストは合計27件で、そのうち13件が成功して課金され、合計は$0.007228でした。失敗した14件は課金されていません。各リクエストの生のレスポンス、ヘッダー、時刻を保存しているため、この記事の数値はすべて生のレスポンスまでさかのぼって確認できます。
1回のスナップショットは4回の呼び出しです。curlでの例を以下に示します。キーはスクリプトに書かず、環境変数に保存してください。
# One snapshot: one call to each of the four hot lists (as tested on 2026-11-04)
API=https://api.everyinfra.com/api/v1/social
for body in \
  '{"platform":"reddit","action":"trending_posts","params":{}}' \
  '{"platform":"zhihu","action":"hot_list","params":{"limit":30}}' \
  '{"platform":"weibo","action":"trending","params":{"limit":50}}' \
  '{"platform":"twitter","action":"trending","params":{"country":"us"}}'
do
  curl -s -X POST "$API" -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
       -H 'Content-Type: application/json' -d "$body" \
  | jq -c '{platform, action, count, charged: .billing.charged_usd, error: .error.code}'
  sleep 7   # stay under 10 calls per minute
doneレスポンスの構造は4つのプラットフォームすべてで共通です。resultsはアイテムの配列、countはアイテム数、billing.charged_usdはその呼び出しの課金額です。失敗した呼び出しにはresultsがありません。代わりにerrorが含まれ、fault(どちらに原因があるか)、retryable、retry_after(待機すべき秒数)、次に取るべき対応が返されます。アイテムのフィールドはプラットフォームごとに異なります。1週間分のデータを統合する際には、この点が最も重要です。
| 機能 | アイテムキー | 順位 | 熱度フィールド | 最初の正常なスナップショットの行数 | テキスト・画像・ボリューム |
|---|---|---|---|---|---|
reddit/trending_posts | id | レスポンス内の順序 | like_count、comment_count | 25 | 18件でtextが空 |
zhihu/hot_list | id | rank | hot_value(ページ上の「10k heat」を整数にしたもの) | 0 | — |
weibo/trending | タイトル(idなし) | rank | hot_value | 50 | 26件でlabelが空 |
twitter/trending | 名前(安定したidなし) | rank | volume | 50 | 50件中50件でvolumeが空 |
毎日の取得スクリプトは、同じ4つの呼び出しをPythonで書いたものです。スナップショットごとに1行をsnapshots.jsonlに追記します。
以下はcollect.pyの例です(コメントは英語)。今回の3ラウンドと同じAPI呼び出しを送信します。Python標準ライブラリ(urllib.request)のみを使用し、APIキーは環境変数からのみ読み込みます。再試行可能な503が返った場合は、retry_afterの秒数だけ待ってからもう1回だけ試します。再び失敗した場合は、エラーをファイルに書き込みます。
#!/usr/bin/env python3
"""Run once (or a few times) a day: fetch four hot lists and append one snapshot line each to snapshots.jsonl. The key comes only from the EVERYINFRA_API_KEY environment variable."""
import json, os, sys, time, urllib.request, urllib.error
from datetime import datetime, timezone, timedelta

API = "https://api.everyinfra.com/api/v1/social"
LISTS = [
    ("reddit", "trending_posts", {}),
    ("zhihu", "hot_list", {"limit": 30}),
    ("weibo", "trending", {"limit": 50}),
    ("twitter", "trending", {"country": "world"}),
]
SGT = timezone(timedelta(hours=8))

def call(platform, action, params):
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    req = urllib.request.Request(API, data=body, method="POST", headers={
        "Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
        "Content-Type": "application/json", "User-Agent": "hot-digest/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            return r.status, json.loads(r.read())
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")

def main(out_path):
    taken_at = datetime.now(SGT).isoformat(timespec="seconds")
    with open(out_path, "a", encoding="utf-8") as out:
        for platform, action, params in LISTS:
            status, data = call(platform, action, params)
            if status == 503 and (data.get("error") or {}).get("retryable"):
                time.sleep(int(data["error"].get("retry_after", 60)))
                status, data = call(platform, action, params)
            row = {"taken_at": taken_at, "platform": platform, "action": action, "http": status,
                   "charged_usd": (data.get("billing") or {}).get("charged_usd", 0),
                   "error": (data.get("error") or {}).get("code"), "results": data.get("results", [])}
            out.write(json.dumps(row, ensure_ascii=False) + "\n")
            print(platform, action, status, len(row["results"]), row["charged_usd"])
            time.sleep(7)  # stay under 10 calls per minute

if __name__ == "__main__":
main(sys.argv[1] if len(sys.argv) > 1 else "snapshots.jsonl")週末には、merge.pyが1週間分のスナップショットを1つのテーブルにまとめます。ルールはシンプルです。RedditとZhihuのアイテムはidで照合します。WeiboとXには安定したidがないため、タイトルで照合します。
各行には、初回検出日時、最終検出日時、検出回数、最高順位、最高熱度を記録します。テーブルには、プラットフォームごとにその週の正常なスナップショット数(snapshots_total)も記録します。スキルはこの数を使ってカバレッジを確認します。出力は標準的なCSV(RFC 4180)で、GeminiのヘルプページでもCSVはアップロード可能な形式として挙げられています。
#!/usr/bin/env python3
"""Merge one week of snapshots.jsonl into weekly.csv: one row per post or topic, with first and last seen, times seen, best rank and highest heat."""
import csv, json, sys
from collections import defaultdict

def key_of(platform, r):
    return r.get("id") if platform in ("reddit", "zhihu") else (r.get("title") or r.get("name"))

def heat_of(platform, r):
    if platform == "reddit": return r.get("like_count")
    if platform in ("zhihu", "weibo"): return r.get("hot_value")
    v = r.get("volume")  # X volume can be an empty string
    return v or None

def main(src, dst):
    rows = [json.loads(l) for l in open(src, encoding="utf-8") if l.strip()]
    snaps = defaultdict(set); items = {}
    for s in rows:
        if s["http"] != 200: continue
        p = s["platform"]; snaps[p].add(s["taken_at"])
        for i, r in enumerate(s["results"], 1):
            k = key_of(p, r)
            if not k: continue
            it = items.setdefault((p, k), {"platform": p, "key": k, "title": r.get("title") or r.get("name"),
                 "url": r.get("url", ""), "community": r.get("community", ""), "first_seen": s["taken_at"],
                 "last_seen": s["taken_at"], "times_seen": 0, "best_rank": None, "max_heat": None})
            it["last_seen"] = max(it["last_seen"], s["taken_at"]); it["first_seen"] = min(it["first_seen"], s["taken_at"])
            it["times_seen"] += 1
            rank = r.get("rank") or i
            it["best_rank"] = rank if it["best_rank"] is None else min(it["best_rank"], rank)
            h = heat_of(p, r)
            if isinstance(h, (int, float)): it["max_heat"] = h if it["max_heat"] is None else max(it["max_heat"], h)
    out = sorted(items.values(), key=lambda x: (x["platform"], -x["times_seen"], x["best_rank"] or 999))
    for it in out: it["snapshots_total"] = len(snaps[it["platform"]])
    with open(dst, "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=["platform", "key", "title", "url", "community", "first_seen", "last_seen",
                                          "times_seen", "snapshots_total", "best_rank", "max_heat"])
        w.writeheader(); w.writerows(out)
    print(dst, len(out), {p: len(v) for p, v in snaps.items()})

if __name__ == "__main__":
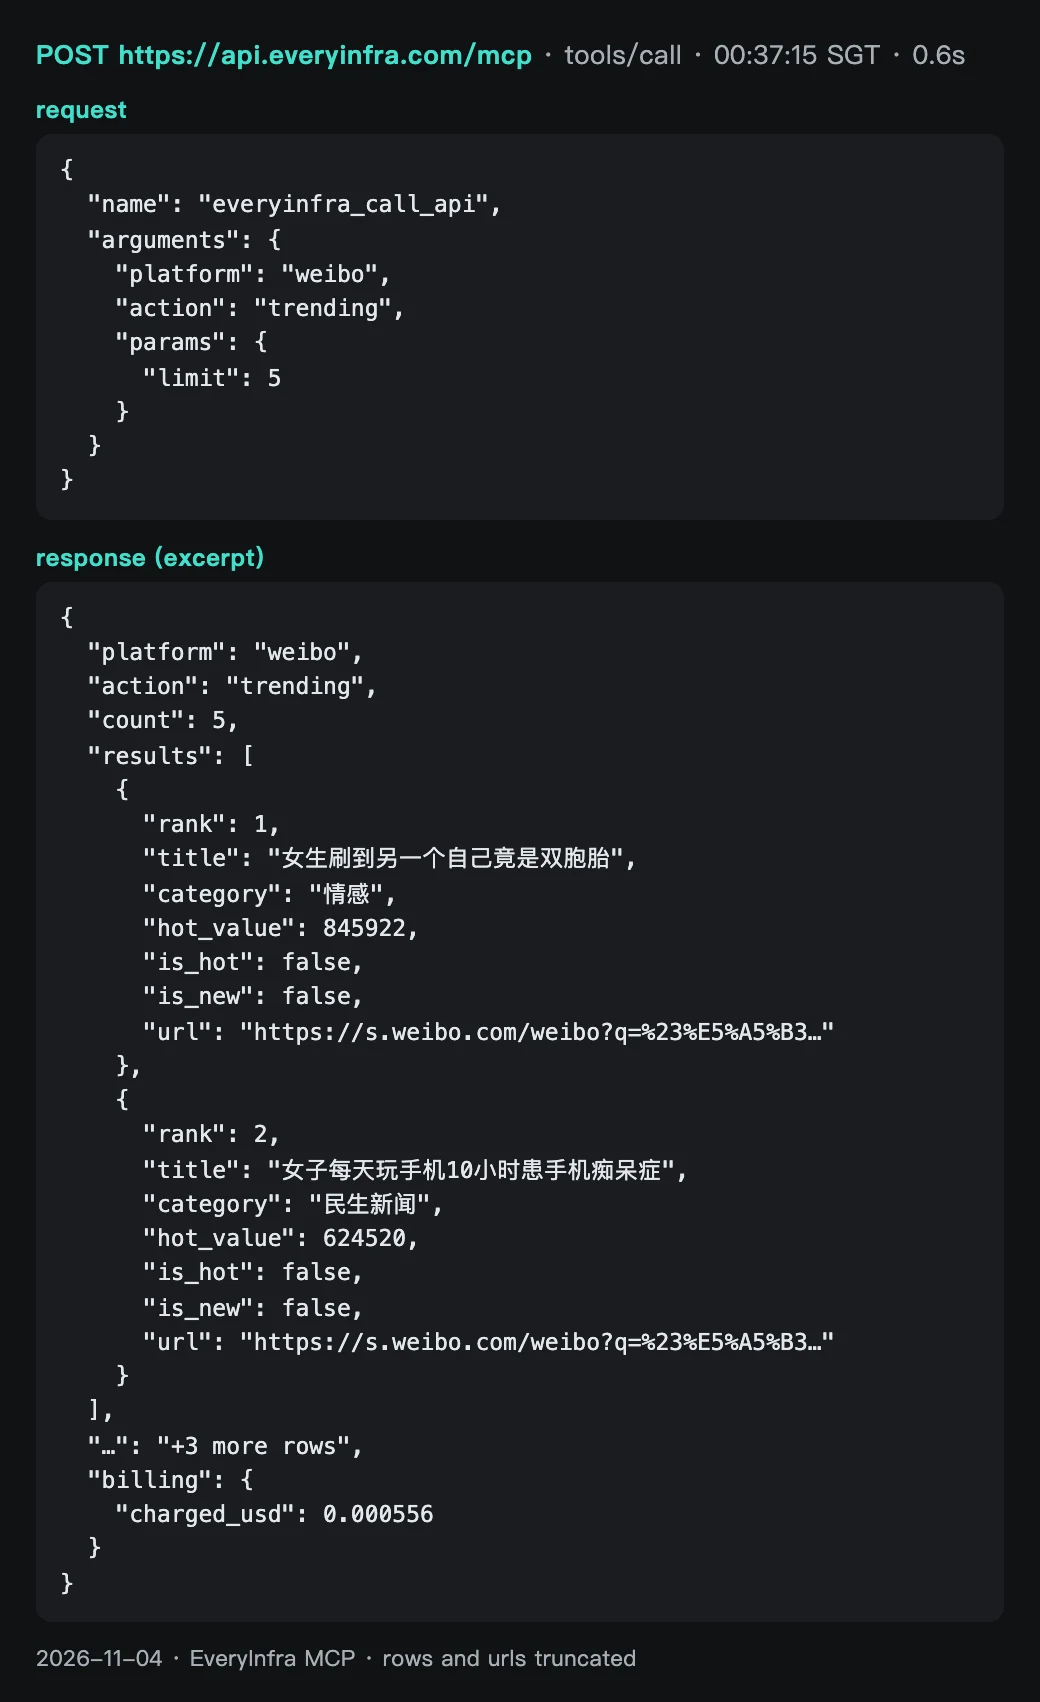
main(sys.argv[1], sys.argv[2])同じ機能はリモートMCPサーバー経由でも使えます。MCPクライアントにhttps://api.everyinfra.com/mcpを追加し、汎用ツールeveryinfra_call_apiを上記のリクエストボディと同じ引数で呼び出します。下の画像は、00:37:15 SGTに実際に送信したweibo/trendingのMCPのtools/callリクエストで、2件と短いリンクだけを表示しています。0.6秒でレスポンスが返り、課金額は$0.000556でした。
3ラウンドとその結果は以下のとおりです。各ラウンドでは4つのリストを同じ順序で呼び出し、1分あたり10回未満に収まるよう、呼び出しの間に数秒空けました。失敗した場合は、retry_afterの指示どおり60秒待ってから、もう1回だけ試しました。
| ラウンド(SGT) | Reddit人気投稿 | Zhihuホットリスト | Weiboホット検索 | Xトレンド | 追加の呼び出し |
|---|---|---|---|---|---|
| ラウンド1、00:13〜00:15 | 25件 | 503 ×3 | 50件 | 50件 | — |
| ラウンド2、00:35〜00:37 | 503 ×3 | 503 ×2 | 50件 | 50件 | X us:70件 |
| ラウンド3、00:58–00:59 | 503 ×2 | 503 ×2 | 50件 | 50件 | X mx:100件、X es:100件 |
| 追加、00:37 | — | — | 5件(MCP、limit=5) | — | APIレスポンスのスクリーンショットは、この呼び出しのものです |
| 再試行、02:05 | 503 ×1 | 503 ×1 | — | — | 代替:reddit/subreddit_postsで投稿25件、zhihu/searchで20件 |
テスト中、Zhihuの人気ランキングとRedditの人気投稿は利用できませんでした。00:13から02:05まで、Zhihuへの8回のリクエストはすべて503を返し、fault: serviceとretryable: trueが付いていました。いずれも課金はありませんでした。Redditの人気投稿はラウンド1では25件を返しました。その後の6回のリクエストはデータを返さず、REST呼び出し4回は503、MCP呼び出し2回はisErrorを返しました。いずれも課金はありませんでした。
02:05に各リストをもう一度試しましたが、いずれも503を返しました。そのため、以降のセクションの残存率、統合、フィールドに関する数値はweibo/trendingとtwitter/trendingのみに基づいています。ZhihuとRedditのホットリスト列は空です。
ダイジェストでは、この点が重要です。ホットリストのエンドポイントは、長期間利用できなくなることがあります。取得スクリプトは、失敗をすべてファイルに書き出す必要があります。スキルは、ダイジェストに「今週はZhihuのデータなし」と書く必要があります。モデルに空白を埋めさせてはいけません。
ホットリストが1つ使えない場合、ダイジェストはその欄を別のエンドポイントで埋められます。ただし、新しいソースの名前を明記する必要があります。SGTの02:05に、代替エンドポイントを2つ呼び出しました(各$0.000556)。r/GeminiAIに対するreddit/subreddit_posts(sort=top、date_range=past_week)は25件の投稿を返しました。投稿日は2026年10月28日から2026年11月3日(SGT)で、upvote数は156〜1,583でした。タイトルに「Carbon」を含む投稿が11件、textが空の投稿が21件あり、25件すべてにflairがありました。
「Gemini」を新しい順で検索したzhihu/searchは20件を返し、内訳は記事13件と回答7件でした。投稿日は2026年10月23日〜2026年11月4日(SGT)です。like_countの最大は294で、4件はいいねが0でした。
どちらのエンドポイントもホットリストではありません。1つ目は1つのコミュニティの1週間の上位投稿を返し、2つ目は時系列のキーワード検索結果を返します。そのため、ダイジェストでは「Reddit popular」や「Zhihuホットリスト」と呼ばないでください。スキルには、代替エンドポイントを使う場合、欄タイトルの後にそのエンドポイント名を書くというルールを追加してください。
テスト結果:リストの変化の速さと、1週間に必要なスナップショット数
検証したかったのは、週次のホット投稿ダイジェストに週1回の取得で十分かという点です。呼び出しの前に、テストの判定基準を決めました。数十分後もリストがほぼ変わらなければ、週1〜2回の取得で十分です。リストの無視できない割合が入れ替わるなら、1日に何度もスナップショットを取って統合する必要があります。
答えは後者です。各プラットフォームで最初に正常に取得できたスナップショットを基準にしました。44分後も残っていたのは、Weiboのホット検索ランキングでは86%だけでした。X(world)のトレンドランキングでは、44分後に残っていたのは74%だけでした。44分間の3回分を合わせると、Weiboでは58件、Xでは63件の異なるトピックが現れました。これはどのスナップショットでも50件だったのに比べ、それぞれ16%、26%多い数です。
入れ替わった項目の順位にも傾向があります。最初のラウンドから最後のラウンドまでに、リストから外れたWeiboの7項目のうち5項目は下位半分にありました。Xでは13項目中12項目でした。リストの下位半分が最も速く入れ替わります。
ただし、新しい項目がすべて下位から始まるわけではありません。Weiboの新項目2件とXの新項目3件は、初めて現れた時点で上位20位以内にありました。こうした「急上昇」こそ、ダイジェストで最も拾いたいものです。急上昇は2つのスナップショットの間に上がって下がるため、月曜朝のリスト1回分には現れません。
ここからスナップショットの頻度を導けますが、あくまで一例です。計測したのは44分間だけなので、この数値を1週間全体に当てはめることはできません。6時間後や24時間後の残存率も計測していません。示せるのは下限だけで、44分間でXのリストの約26%が入れ替わりました。
1日1回のスナップショットでは間隔が24時間になり、その間に上がって下がるトピックの一部を取りこぼします。例として挙げる頻度は1日4回で、たとえばお使いのタイムゾーンで08:00、13:00、18:00、23:00です。1週間で28スナップショットになります。予算が少ない場合は1日1回にして、ダイジェストに「1日のうち1つの時刻のみを対象」と書いてください。自分に合った頻度を決めるには、1日だけ1時間ごとにスナップショットを取ります。そのうえで6時間後と24時間後にリストがどれだけ残っているかを確認し、ほとんどの項目が残っていれば頻度を下げます。
使えるフィールドと、ダイジェストで示せない数値
欠けているフィールドが、スキルのルールを決めます。Xのvolumeフィールドは3つの地域の6回のスナップショットすべてで空で、periodは常に「Live」でした。そのため、Xについてダイジェストに出せるのは順位と出現回数だけで、話題量は出せません。Redditの人気投稿25件のうち、textは18件で空(大半は画像またはリンクの投稿)、image_urlsは15件で空でした。
そこでスキルでは、Geminiにタイトルだけを読むよう指示しています。Weiboのlabelフィールド(「new」や「hot」などのマーク)は26件で空でした。これらの項目はランキング上にマークが付いていないだけで、データが欠けているわけではありません。
Xの地域を正しく選んでください。同じ期間に、country=worldの50件とusの70件で共通していた項目は12件だけでした。mx(100件)とは13件、es(100件)とは7件が共通していました。worldのリストには世界各地の項目が混在しています。
米国の中間選挙は2026年11月3日(米国時間)に行われました。その日、同じラウンドで「Election Day」はusリストで1位、worldリストで6位でした。1つの市場を対象とするダイジェストでは、その国のリストを使ってください。
Geminiに送信する前のデータ統合
スキルが生のスナップショットではなくweekly.csvを求めるのはなぜでしょうか。3ラウンドの生の結果をcollect.pyの形式でsnapshots.jsonlに書き出すと、12行で約22,406トークンでした。merge.pyを通すと、weekly.csvは146件で約6,425トークンとなり、71%減ります。トークン数は、Gemini APIの目安である1トークンあたり約4文字で計算しました(「Understand and count tokens」)。中国語のタイトルはこれより多くのトークンを使います。1日4回のスナップショットを1週間続けると、Reddit、Weibo、Xの生のスナップショットだけで約304,000トークンになります(今回のラウンドでのリストあたりの平均サイズ×28)。
統合後の表は、異なる項目の数に応じてしか増えません。繰り返し出たトピックは1件にまとめられるためです。さらに重要なのは、統合を固定のプログラムが行うことです。出現回数、最高順位、最大熱度は計算で求めます。Geminiは選んで書くだけで、数えることはしません。
週あたり・月あたりのコスト
API料金は、1週間あたりのスナップショット数だけで決まります。2026年11月4日時点のカタログのprice_usdでは、1スナップショットは4回の呼び出しで$0.002474です。1日1回なら週$0.017、月$0.074(30日)です。1日4回なら週$0.069、月$0.297です。
1時間に1回なら週$0.416、月$1.781です。Redditの2ページ目を取得すると、1スナップショットあたり$0.000556が加わります。失敗した呼び出しは課金されないため、Zhihuの失敗は請求額に影響しませんでした。
| 頻度 | 週あたりのスナップショット数 | 週あたりのAPI料金 | 月あたりのAPI料金(30日) | 用途 |
|---|---|---|---|---|
| 1日1回 | 7 | $0.017 | $0.074 | 「今週話題になったこと」のみ |
| 1日4回(例) | 28 | $0.069 | $0.297 | 週の話題と急上昇を区別する |
| 1時間に1回 | 168 | $0.416 | $1.781 | 突発的な出来事とブランドモニタリング |
Gemini側にも別途コストがかかります。Geminiアプリのスキルは、プランなしで使えます。スケジュール実行(Tasks)には、Google AI ProまたはUltraと、18歳以上のユーザーの個人アカウントが必要です(Manage your tasks & workflows)。Gemini APIを使うルートCには、トークン料金がかかります。料金ページでは、gemini-3.5-flash-liteは入力100万トークンあたり$0.30、出力100万トークンあたり$2.50です。gemini-3.8-flashは2026年12月31日までは入力$0.75、出力$3.75で、2027年1月1日から料金が2倍になります(Gemini API pricing)。
2026年10月8日以降、gemini-3.7-flashへのリクエストはgemini-3.8-flashに転送されるため、古い名前を使うスクリプトもすでに新しい料金で課金されています。
Antigravityのエージェントは自律ループで動作するため、トークンの大半はエージェント自身の推論とツールとのやり取りに使われます。ドキュメントでは、「調査と要約」タスクの入力トークンを100,000〜500,000と見積もっています。Flash-Liteの入力料金では、1回の実行あたり約$0.03〜$0.15です。これはスナップショット1回分のAPI料金の約12〜60倍にあたります。この値は私たちが計測したものではありません。実際の請求額を基準にしてください。
制限事項と注意点
| 制約 | ダイジェストへの影響 | 対処法 |
|---|---|---|
| Geminiアプリのスキルはインターネットにアクセスできない | スキル自体ではリストを取得できない | スキルの外部で取得する(ルートA、B、またはC) |
| カスタムアプリは米国の個人アカウントのみ | その他の国ではルートBを利用できない | ルートAまたはCを使用する |
| EEA、スイス、英国、ナイジェリアではTasksを利用できない | Geminiだけでは毎週自動実行できない | システムのスケジューラまたはGemini APIトリガーを使用する |
| ホットリストのエンドポイントが長期間503を返すことがある | 今週はデータがないプラットフォームが出ることがある | 失敗をログに記録し、スキルが「データなし」と記載する |
| Xのトレンドにはボリュームがない | 順位と出現回数のみ | ボリュームが必要な場合はtwitter/searchを呼び出す |
Gemini側の手順は一切実行していません。スキルページ、カスタムアプリ、Tasks、Gemini APIトリガーはすべて設定例です。2026年11月4日に確認したヘルプページと開発者向けドキュメントをもとに作成しました。Googleはこの2か月間、これらのプロダクトを頻繁に変更しています(スキルのショートカットも/から@に変わりつつあります)。実際に試す際にインターフェースが本記事と異なる場合は、その時点の公式ページに従ってください。
スキルはデータを取得せず、欠けた部分を補ってもいけません。これはGeminiアプリの厳格な制限です。私たちのスキルに「データがない場合はそう伝える」と書いている理由でもあります。要約タスクの主なリスクは、文章の質ではありません。モデルが記憶にある古いホットリストの項目を、今週のデータであるかのように使ってしまうことです。チャットのたびに念押しするよりスキル内のルールのほうが確実ですが、それでも毎週月曜日に「カバレッジ」の行を確認する必要があります。
ホットリストはプラットフォームによるランキングであり、「本当の人気」ではありません。Weiboの算出式にはインタラクション率の重みが含まれ、リストでは有料掲載に別のマークが付きます。Zhihuのスコアにはクリック率が含まれます。どちらのプラットフォームもアルゴリズムに不正操作への対策があるとしていますが、重みは公開していません。そのため、ダイジェスト内の順位はシグナルであり、市場シェアではありません。こうした理由から、私たちのスキルは「出現回数」と「最高順位」で順位付けし、プラットフォーム間で熱度の値を比較しません。
私たちが実施したラウンドでは、Xのトレンドにボリュームがありませんでした。twitter/trendingのカタログのフィールド注記には、フォールバックソースについての記載があります。ほかのソースが利用できない場合、結果はこのソースから返され、ボリュームや期間は含まれません。すべてのラウンドで、Xのリストの全行でvolumeが空になり、periodは「Live」でした。そのため、ダイジェストではXについて順位と出現回数しか表示できません。議論のボリュームが必要な場合は、ダイジェストで選ばれた少数のトピックについてtwitter/searchを呼び出してください。
一部のリストは一定期間利用できないことがあります。テストでは、zhihu/hot_listへの8件のリクエストがすべてHTTP 503を返し、reddit/trending_postsはラウンド1の後に行った6件のリクエストでデータを返しませんでした。その時点ではリストが利用できない状態で、これらの呼び出しはいずれも課金されませんでした。
取得スクリプトは失敗を記録して処理を続行する必要があります。記録を残さずにスキップしないでください。スキップすると、週末にZhihuのトピックが「リストに載っていなかった」のか「取得できなかった」のかを判別できなくなります。
Redditのリストは1ページ25件です。reddit/trending_postsは1ページあたり約25件の投稿を返します。それ以上取得するにはnext_page_tokenを渡します。ページごとに課金され、トークンの有効期限は24時間です。サイト全体のリストには多くのコミュニティが混在し、エンターテインメントや一般的な話題に偏ります。最初のラウンドでは、25件の投稿が24のコミュニティから集まりました。特定業界のダイジェストには、決まったいくつかのコミュニティに対してreddit/subreddit_postsを使うほうが適しています。
プラットフォームの規約。RedditのResponsible Builder Policyでは、すべての開発者はデータにアクセスする前に承認を得る必要があり、商用利用には書面による承認が必要とされています。
このポリシーでは、AIの学習、商用利用、ユーザーのセンシティブな属性の推測についても明確な制限が設けられています。Xの開発者規約にもデータ利用に関するルールがあります。タイトル、リンク、順位、公開されているカウントのみを使い、ユーザープロファイルを作成しないダイジェストのほうが安全です。規約が自社のビジネスにどう適用されるかについては、原文を確認するか弁護士に相談してください。本記事は法的助言を提供するものではありません。
最近の変更:ダイジェストに関わる4つの日付
このリストには、週次のホット投稿ダイジェストに影響する変更のみを掲載しています。日付順に並べており、日付は公式ページに記載されたものです。
2026年9月30日:Gemsに代わってスキルがGeminiのチャットに登場。Googleのブログによると、スキルは同日に全世界のGeminiチャットで提供が開始されました。Workspaceのお客様には「今後数週間のうちに」提供されます。同じ投稿では、個人アカウント向けのGemsが11月から廃止されることも示されています。Opalも同時期に終了します(Googleブログ)。影響:週次レポートをGemで作成している場合は、今すぐ移行してください。
2026年10月13日:Workspaceでのスキル提供が延期。Geminiアプリのスキルは同日に順次提供が始まりました。Workspace StudioとWorkspaceアプリのスキルは「追って通知があるまで延期」とされています。投稿では、共有機能とGoogleドライブとの連携は後日提供されるとも述べられています(Workspace Updates、2026年10月13日)。影響:チームで同じダイジェスト用スキルをGoogleドキュメントやスプレッドシートで直接使いたい場合は、待つ必要があります。まずはGeminiアプリで使ってください。
2026年10月28日:Connected Appsプラットフォームがプレビューとして公開。開発者は、クラウドのMCPサーバーを使って自分のアプリをGeminiやGoogle検索に接続できるようになりました。アプリの登録、テスト、審査への提出はGoogle Connected Consoleで行います(Googleブログ)。影響:ルートBの個人向け「カスタムアプリ」に加えて、今後はデータサービスが審査済みアプリとしてGeminiに登場する可能性があります。
2026年11月17日(13日後):個人アカウントではGemが読み取り専用に。本記事の最初のセクションをご覧ください。
クイックスタート
- EveryInfraに新規登録し、APIキーを取得します。
- クイックスタートに従い、curlで
weibo/trendingを1回呼び出します。 - レスポンスに
resultsとbilling.charged_usdが含まれていることを確認します。 - パラメータとフィールドを確認します:Redditの人気投稿、Zhihuホットリスト、Weiboホット検索、Xトレンド。
- 毎日稼働しているコンピュータに
collect.pyを配置し、キーをEVERYINFRA_API_KEYに設定します。 - cronまたはlaunchdで、スクリプトを1日1〜4回実行します。
- 1週間後、
snapshots.jsonlの各行のhttpとcharged_usdを確認します。 weekly-hot-posts-digest/フォルダをZIPファイルに圧縮し、Geminiの「スキル」ページにアップロードします。- 週末に
merge.pyを実行し、weekly.csvをチャットにアップロードして/weekly-hot-posts-digestと入力します。
各プラットフォームのページに、すべての機能が掲載されています。RedditスクレイピングAPIとZhihuスクレイピングAPI、WeiboスクレイピングAPIとX (Twitter)スクレイピングAPIをご覧ください。完全に自動化する場合は、ルートCの例を使ってください。Antigravity CLIの記事のように、自分のマシンでジョブを実行することもできます。
接続方法はMCPサーバーのページ、課金の仕組みは料金ページで確認できます。ほかのツールで同じ手法を使う場合は、Claude CodeのスケジュールタスクでRedditのペインポイントを探るをお読みください。ChatGPTのスケジュールタスクを需要レーダーとして使うもあわせてご覧ください。
| ステップ | 場所 | APIコスト | タイミング |
|---|---|---|---|
| 1. 1回の呼び出しをテスト | ターミナル(curl) | $0.000556 | 1回 |
| 2. 4つのリストを取得 | collect.pyを使ったcronまたはlaunchd | 1週間あたり$0.017〜$0.069(1日1〜4回のスナップショット) | 毎日 |
| 3. ダイジェストを作成 | スキルを使ったGeminiチャット | API費用なし。スキルはプラン不要 | 毎週月曜日 |
| 4. すべてを自動化 | Gemini APIトリガー | 実行ごとのGeminiトークン(費用のセクションを参照) | 任意 |
FAQ
質問はGoogle検索のサジェストと、Geminiヘルプコミュニティの公開スレッドから選びました。回答は、2026年11月4日時点で確認した公式ページの内容に基づいています。
GeminiのスキルとGem:今すぐGemを変更する必要がありますか?
個人アカウントの場合は必要です。2026年11月17日からGemは読み取り専用になり、使用も編集もできなくなります。12月17日には削除されます。自動移行では各Gemが有効化されていない下書きのスキルに変換されるため、1つずつ確認して有効化する必要があります。100 MBの上限を超えるファイル、音声、動画、アーカイブ、旧形式のOfficeファイルは移行されません。毎週使っているGemは、今のうちに手作業で作り直してください。
あわせて、各説明文を「何をするか」に「Use when…」を加えた形に書き換えてください。仕事用・学校用アカウントには猶予があります。ビジネス・エンタープライズ向けは早くても2027年3月1日、教育機関向けは早くても2027年6月1日となります。(検索サジェスト「gemini skills vs gems」「claude skills vs gemini gems」からの質問)
Gemの読み取り専用化:11月17日以降もエクスポートできますか?
Gemの閲覧とファイルのダウンロードはできますが、Gemを使うことはできません。ヘルプページによると、11月17日以降もGemにはアクセスできますが、使用、編集、新規作成はできません。また、個人アカウントには、移行できないファイルを12月17日までにダウンロードするよう案内しています。つまり、読み取り専用の1か月間が、ナレッジファイルを取り戻す最後の機会です。(サジェスト「gemini gems read only mode」からの質問)
GeminiのスキルとMCP:GeminiアプリのスキルからMCPを直接呼び出せますか?
スキル自体はインターネットに接続できません。ヘルプページには、アップロードしたスクリプトはインターネットにアクセスできず、外部のウェブサイトにリクエストを送信することもできないと書かれています。ただし、スキルはConnected Appsと連携でき、「カスタムアプリ」の実体はMCPサーバーのURLです。これを使うには、18歳以上であること、米国内で利用すること、個人アカウントを使うこと、英語で利用することが条件です。
これらの条件を満たさない場合は、データをローカルで取得し、表としてアップロードしてください。Gemini APIのAntigravityエージェント(mcp_serverツールに対応)やAntigravity CLIを使う方法もあります。(サジェスト「gemini skills mcp」「gemini cli skills mcp」からの質問)
ClaudeのようなGeminiスキル:ClaudeのスキルをGeminiにアップロードできますか?
形式の面では可能です。どちらもオープンなAgent Skills標準に基づいており、GeminiのヘルプページにはSKILL.md、フォルダ、または.zipをアップロードできると書かれています。確認すべき点は3つあります。まず、名前はハイフン区切りの小文字にする必要があります。
Geminiは、呼び出し制御やサブエージェント実行など、Claude Code固有の拡張フィールドを読み込みません。インターネットに接続するスクリプトがスキルに含まれている場合、そのスクリプトはGeminiアプリでは実行されません。私たちのスキルはnameとdescriptionだけを使い、データの取得はスキルの外で行います。(サジェスト「gemini skills like claude」からの質問)
Geminiがスキルを自動で使わないのはなぜですか?
ヘルプページによると、Geminiが適用するのはオンになっているスキルだけです。スキルのオン・オフは「スキル」ページで切り替えられます。Geminiは名前と説明だけを見て判断します。説明が一般的すぎる(例:「data helper」)と、Geminiはいつ使えばよいか判断できません。
最も確実なのは、チャットで/(または@)と入力してスキルを選ぶ方法です。また、ヘルプページによると、スキルは現在18歳以上のユーザーの個人アカウントで利用でき、仕事用・学校用アカウントでも「近日中」に利用可能になります。Workspaceアカウントに「スキル」ページが表示されない場合は、まだロールアウトの対象になっていない可能性があります。(Geminiヘルプコミュニティのスレッド「Will a Skill have an always on state」からの質問)
参考文献
以下のページはすべて2026年11月4日(SGT)に確認しました。
- Geminiアプリヘルプ:Gemからスキルへの移行について
- Workspace管理者ヘルプ:Gemからスキルへの移行について
- Workspace Updates(2026年9月30日):GeminiアプリとWorkspaceのスキル
- Workspace Updates(2026年10月13日):スキルのリリースに関する最新情報
- Googleブログ(2026年9月30日):スキルでタスクを自動化
- Geminiアプリヘルプ:リリースアップデート(2026年9月30日・10月13日)
- Geminiアプリヘルプ:スキルの作成と管理
- Geminiアプリヘルプ:効果的なスキルの書き方
- Geminiアプリヘルプ:タスクとワークフローの管理(地域とプランの制限)
- Geminiアプリヘルプ:Google AIサブスクライバー向けの上限とアップグレード
- Geminiアプリヘルプ:カスタムアプリの接続と管理
- Geminiヘルプコミュニティ:スキルに常時オンの状態は用意されますか
- Google Connected Appsの開発者向けドキュメント
- GeminiアプリのDeveloper Modeの概要
- Googleブログ(2026年10月28日):Connected Appsプラットフォームのプレビュー
- MCP仕様:Tools(アノテーションreadOnlyHint、destructiveHint)
- MCP仕様:Transports(Streamable HTTP)
- RFC 7591:OAuth 2.0 Dynamic Client Registration
- RFC 9728:OAuth 2.0 Protected Resource Metadata
- IETFドラフト:The OAuth 2.1 Authorization Framework
- Gemini API:関数呼び出し(リモートMCPのセクション)
- Gemini API:Antigravityエージェント(MCP、Triggers、Budget)
- Gemini API:マネージドエージェントの概要
- Gemini API:Interactions APIの概要
- Gemini APIリファレンス:Interactions(インライン環境ソース)
- Gemini APIの料金
- Gemini API:トークンの理解とカウント
- Gemini APIの変更履歴
- Gemini API:非推奨の機能
- Gemini API CLI(gemini-api)ガイド
- Gemini API:Computer Use
- Gemini API:コーディングエージェントのセットアップ
- GitHub:google-gemini/gemini-skills
- Agent Skillsの仕様
- GitHub:agentskills/agentskills
- Antigravity:エージェントスキル
- Antigravity:MCP
- Antigravity CLI:ヘッドレスモード
- Claude Code:スキルでClaudeを拡張する
- Claudeドキュメント:Agent Skillsの概要
- Claudeヘルプ:Claudeでスキルを使う
- Codex:スキルを作成する
- Weiboホット検索のルール
- Zhihuホットリストの紹介
- X APIの料金
- X API:トレンド
- X開発者契約およびポリシー
- Redditの責任ある開発者ポリシー
- Reddit Data API利用規約
- EveryInfra機能カタログ(price_usdとフィールドに関する注記、2026年11月4日に参照)
- Pythonドキュメント:urllib.request
- RFC 4180:CSV形式
- Apple開発者向けドキュメント:launchdによる定時ジョブのスケジューリング
参考資料 BL-82