Gemini skills sustituyen a los Gems: resumen semanal
Los Gems pasan a solo lectura el 17 nov. Pasa a Gemini skills con un resumen semanal: SKILL.md, tres vías de datos y pruebas reales de cuatro listas.
Qué hacer ya: si usas una cuenta personal de Google (mayor de 18 años), los Gems de Gemini pasan a solo lectura el 17 de noviembre de 2026 (2026-11-17) y Google los retira el 17 de diciembre (2026-12-17). Quedan 13 días. Rehaz ahora como skill cada Gem que sigas usando cada semana y descarga sus archivos de conocimiento. Las cuentas de trabajo y de centros educativos tienen fechas más tardías, "no antes de" el 1 de marzo y el 1 de junio de 2027, y las skills dentro de Workspace están "retrasadas hasta nuevo aviso". Todas las fechas salen del blog Workspace Updates y de las páginas de ayuda de Gemini; la primera sección da la fuente de cada una.
El artículo usa un trabajo real para enseñar el cambio: convertir un resumen semanal de publicaciones populares en un archivo SKILL.md. Cada lunes, Gemini lee una semana de publicaciones populares de Reddit, la lista caliente de Zhihu, las búsquedas en tendencia de Weibo y las tendencias de X, y escribe un informe de una página. Por el camino aparece el límite más importante de la aplicación Gemini: los scripts de una skill no salen a internet ni hacen peticiones a sitios externos. La obtención de datos tiene que quedar fuera de la skill.
Explicamos tres maneras de llevar los datos a Gemini (capturas locales y subida, una Connected App personalizada y un agente Antigravity de la API de Gemini con un disparador) y si el mismo SKILL.md sirve en Claude y en Codex. Desde España hay un matiz más: las tareas programadas de Gemini no están disponibles en el Espacio Económico Europeo, así que la automatización tiene que venir de fuera de la aplicación.
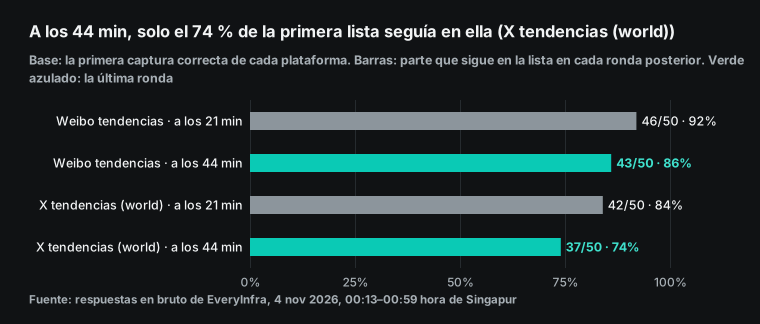
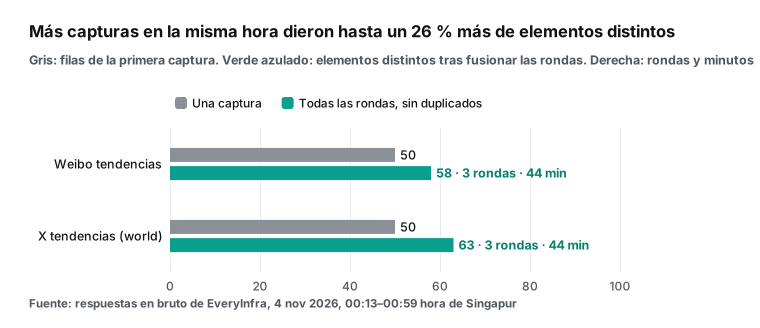
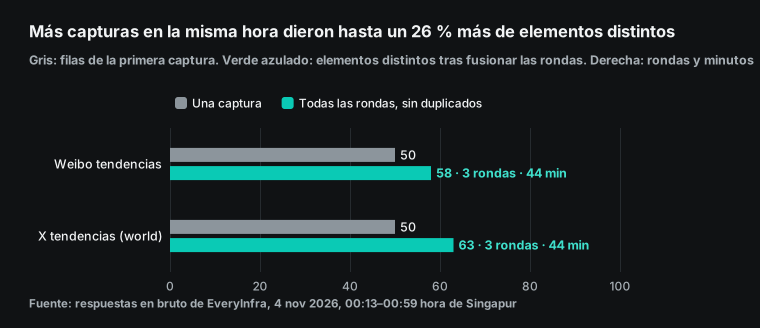
En el lado de los datos hicimos llamadas reales. El 4 de noviembre de 2026, entre las 00:13–00:59 hora de Singapur, llamamos a reddit/trending_posts, zhihu/hot_list, weibo/trending y twitter/trending de EveryInfra en 3 rondas, una de ellas a través del método tools/call del servidor MCP remoto; a las 02:05 repetimos una vez las dos listas que fallaban. El resultado principal es que las listas cambian rápido: a los 44 minutos solo seguía el 86 % de la lista de Weibo, y a los 44 minutos el 74 % de la de X. Las 3 rondas juntas dieron un 16 % y un 26 % más de temas distintos que una sola captura, así que un resumen semanal necesita varias capturas al día. La lista caliente de Zhihu y las publicaciones populares de Reddit no estuvieron disponibles durante la prueba (Zhihu devolvió 503 en las 8 peticiones y Reddit solo dio datos en la ronda 1), y los fallos no se cobraron; por eso las cifras del resumen salen solo de Weibo y X, y por eso la skill debe decir "si no hay datos, dilo". A precio de catálogo, con la frecuencia de ejemplo de cuatro capturas al día de las cuatro listas cuestan 0,297 USD al mes. Gemini no tiene sesión iniciada en nuestra máquina de pruebas: la subida de la skill, la aplicación personalizada y el disparador de la API son ejemplos de configuración según la documentación oficial del 4 de noviembre, no ejecuciones.


Qué hacer ya: Gemini Gems read only (solo lectura) el 17 de noviembre
Empezamos por las fechas, porque importan más que las funciones. La página de ayuda de Gemini sobre la transición es clara. En las cuentas personales de Google de mayores de 18 años, los Gems pasan a solo lectura el 17 de noviembre de 2026 (2026-11-17): se pueden abrir, pero no usar, editar ni crear. El 17 de diciembre de 2026 (2026-12-17) desaparecen de Gemini y se pierde el acceso (Ayuda de Gemini: transición de Gems a skills).
Las cuentas de trabajo tienen más margen. La misma página da marzo de 2027 para las cuentas de Workspace de empresa y de organizaciones sin ánimo de lucro, y junio de 2027 para las de educación. La ayuda para administradores de Workspace concreta los días: 1 de marzo de 2027 (2027-03-01) y 1 de junio de 2027 (2027-06-01) (Ayuda de administración de Workspace: transición a skills). El anuncio de Workspace Updates usa la expresión "no sooner than", es decir, "no antes de", para las dos fechas (Workspace Updates, 30-09-2026).
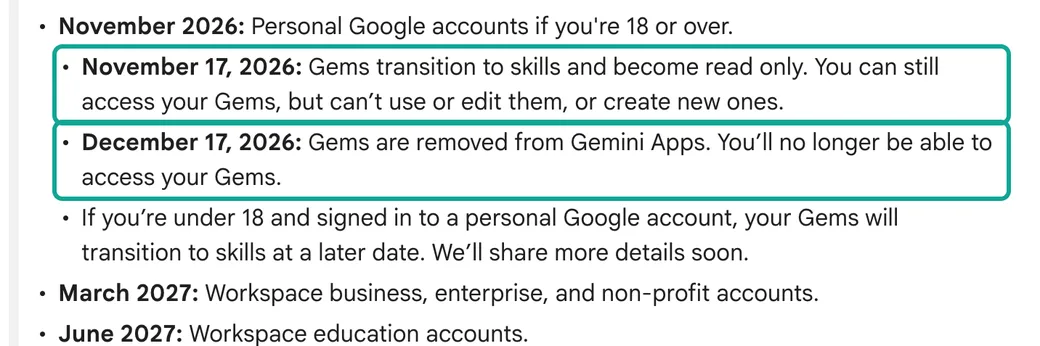
Hay un detalle que confunde. El anuncio del 30 de septiembre en Workspace Updates incluye una lista de fechas clave. Su línea del 17 de noviembre dice que los Gems se mueven al panel de ajustes y que todavía se pueden crear, editar y usar. La ayuda para cuentas personales dice "solo lectura" ese mismo día. Las dos líneas hablan de cuentas distintas: la del blog está en el calendario de Workspace y la de la ayuda solo cubre cuentas personales de mayores de 18 años. Muchos artículos de segunda mano mezclan las dos y escriben "solo lectura para todos el 17 de noviembre". Las fuentes no dicen eso.
| Tipo de cuenta | Solo lectura o paso a ajustes | Los Gems dejan de funcionar | Retirada | Fuente |
|---|---|---|---|---|
| Cuenta personal de Google, mayores de 18 | 2026-11-17, solo lectura | 2026-11-17 | 2026-12-17 | Ayuda de Gemini |
| Cuenta personal, menores de 18 | "Más adelante" | No indicado | No indicado | Ayuda de Gemini |
| Workspace de empresa y sin ánimo de lucro | 2026-11-17, pasan a ajustes y siguen funcionando | No antes de 2027-03-01 | Ese día; los Gems que queden pasan a borradores de skill | Workspace Updates, ayuda de administración |
| Workspace de educación | Igual que arriba | No antes de 2027-06-01 | Ese día, también en Classroom y LTI | Las mismas |
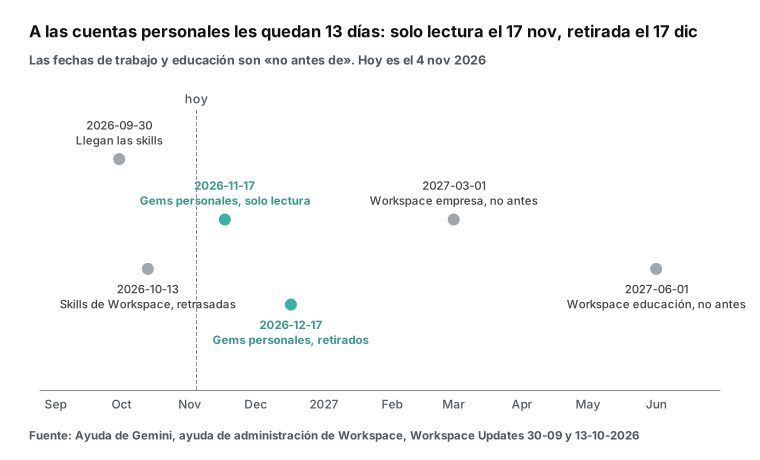
Con una cuenta personal, quedan 13 días desde la fecha de este artículo. Vemos tres tareas. Primera: descargar las instrucciones y los archivos de conocimiento de cada Gem que todavía uses. Una skill admite como máximo 100 MB de archivos; si un Gem pesa más, la migración automática quita primero los archivos más grandes. El audio, el vídeo, los archivos comprimidos, los archivos de GitHub y los formatos antiguos de Office (.doc, .xls, .ppt) no se migran. Después del 17 de diciembre no hay forma de recuperarlos (misma página de ayuda, límites de archivos).
Segunda: rehacer a mano como skills los Gems que usas cada semana, sin esperar a la migración automática. La migración crea "borradores inactivos", y hay que revisar y activar cada uno antes de poder usarlo o compartirlo (ayuda de administración, cómo funciona la migración). Tercera: revisar qué herramientas necesita cada Gem. La ayuda dice que las skills todavía no funcionan con la creación de vídeo, la creación de música, Canvas, Deep Research ni el aprendizaje guiado. Si un Gem depende de alguna, toca buscar otro método.
Para quien está en España o en otro país del Espacio Económico Europeo hay un límite más. La ayuda de Gemini dice que las tareas programadas (Tasks) requieren Google AI Pro o Ultra, una cuenta personal y mayoría de edad, y que no están disponibles en el EEE, Suiza, el Reino Unido ni Nigeria (Gestionar tareas y flujos en Gemini). Es decir, desde Madrid o Barcelona no se puede pedir a Gemini que ejecute una skill cada lunes por sí solo. Desde México, Colombia o Argentina sí, si se tiene el plan.
Las cuentas de trabajo tienen tiempo, pero algo ya cambió. En Workspace Studio ya no se puede añadir un paso "Ask a Gem" a un flujo nuevo; los flujos existentes siguen hasta 2027. Además, las skills dentro de las aplicaciones de Workspace llegan tarde. La actualización del 13 de octubre dice que el despliegue en los dominios de Rapid Release y Scheduled Release queda "retrasado hasta nuevo aviso" (Workspace Updates, 13-10-2026). Las skills de la aplicación Gemini sí van según lo previsto: empezaron el 13 de octubre y deberían completarse a mediados de noviembre. El mismo anuncio aclara que las skills no se sincronizan entre la aplicación Gemini y las aplicaciones de Workspace, así que hay que crear cada skill en los dos sitios.
Gemini skills vs Gems: qué cambia
Un Gem es una versión personalizada de Gemini con su propia ventana de chat. Una skill es un conjunto de instrucciones que se puede llevar a cualquier chat: se escribe / y el nombre de la skill (la ayuda avisa de que el atajo pasará a ser @). Gemini también puede elegir una skill por su cuenta si el nombre y la descripción encajan con lo que pides, y se pueden combinar varias en el mismo chat (Crear y gestionar skills en Gemini). Workspace Updates dice que las skills se basan por completo en el estándar abierto SKILL.md, escrito en Markdown, así que se pueden traer skills de otras plataformas (Workspace Updates, 30-09-2026).
| Aspecto | Gems | Skills en la aplicación Gemini (leído el 2026-11-04) |
|---|---|---|
| Cómo se usa | Se abre el Gem en su ventana | / (luego @) en cualquier chat, o Gemini la aplica solo |
| Cuántos a la vez | Uno | Varias; una skill puede citar otras |
| Formato | Formulario web | Formulario web, o subir SKILL.md, una carpeta o un .zip |
| Nombre | Texto libre | Todo en minúsculas con guiones, por ejemplo my-new-skill |
| Archivos | Archivos de conocimiento | 100 MB en total; solo archivos tipo texto; sin audio, vídeo ni comprimidos |
| Herramientas | Vídeo, música, Canvas, Deep Research y más | Funciona con Connected Apps; aún no con vídeo, música, Canvas, Deep Research ni aprendizaje guiado |
| Scripts con internet | No aplica | No: los scripts subidos no pueden acceder a internet ni hacer peticiones a sitios externos |
| Plan | Gratis | Las skills son gratis; las tareas programadas piden Google AI Pro o Ultra |
| Compartir | Sí | "En las próximas semanas" |
La fila de los scripts es justo el problema que resuelve este artículo. Un resumen semanal de temas en tendencia necesita datos de fuera: las publicaciones populares de Reddit, la lista caliente de Zhihu, las búsquedas en tendencia de Weibo y las tendencias de X. En Claude Code o Codex, una skill puede ejecutar un script que llama a una API, o el agente puede llamar a una herramienta MCP; nuestro artículo sobre un mismo SKILL.md en cuatro herramientas de IA muestra ese método. En la aplicación Gemini no es así. La sección de subida de la ayuda tiene dos límites: los scripts que necesitan internet no están admitidos y, en las restricciones de seguridad, los scripts no pueden hacer acciones ni peticiones a sitios web externos. Por tanto, la skill no obtiene datos: los datos tienen que llegar por otro camino.
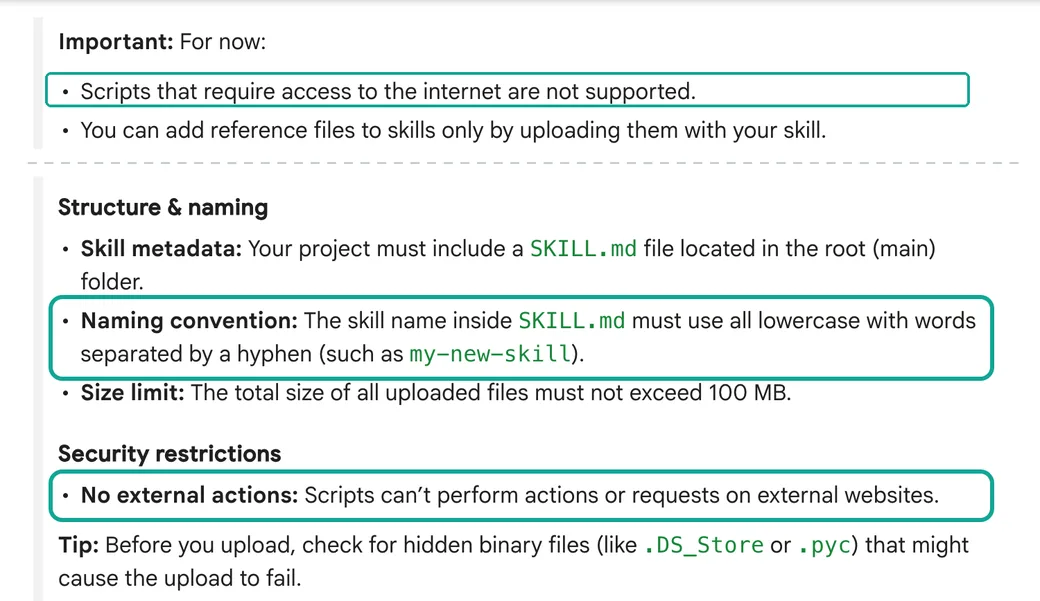
Ese límite da forma al resto del artículo. La skill le dice a Gemini cómo escribir el resumen; los datos llegan por un camino aparte. Primero describimos el trabajo y después tres caminos para llevar los datos a Gemini.
Cómo pasar un Gem a una skill
La ayuda da tres pasos manuales. Abrir el Gem y descargar sus archivos de conocimiento uno por uno. Crear una skill nueva y copiar el nombre, la descripción y las instrucciones del Gem. Para añadir archivos, descargar la skill como carpeta, meter los archivos y volver a subir la carpeta completa (ayuda gems_to_skills, recrear un Gem como skill). En la práctica, conviene reescribir cuatro partes en vez de copiarlas.
La primera es el nombre. Un Gem puede llamarse como quieras; una skill necesita palabras en inglés, en minúsculas y con guiones, como weekly-hot-posts-digest. El artículo de ayuda sobre skills eficaces recomienda además empezar con un verbo y evitar palabras vacías como helper, tools o data (Escribir skills eficaces en Gemini). Aunque escribas el resto en español, el nombre tiene que seguir esa regla.
La segunda es la descripción. La de un Gem está pensada para personas; la de una skill, para Gemini, porque Gemini solo lee el nombre y la descripción para decidir si la usa. Se escribe en tercera persona: qué hace la skill y, después, "Use when…" con los casos. El límite es de 1.024 caracteres. El mismo artículo pide escribir los pasos como una lista de comprobación y decir qué hacer cuando faltan datos. En un resumen semanal, eso es lo más importante: una regla como "si una plataforma no tiene datos esta semana, dilo y no lo rellenes de memoria".
La tercera son los archivos de conocimiento. Un Gem suele leer un archivo grande cada vez; una skill carga el contenido solo cuando lo necesita. Gemini lee primero el nombre y la descripción, lee las instrucciones completas solo si la skill parece útil y abre los archivos adjuntos solo cuando un paso los pide. Por eso las plantillas largas y los informes de ejemplo van en una carpeta references/, y en las instrucciones se escribe "en el paso 5, usa references/report-template.md".
La cuarta son las herramientas. Si un Gem usaba Deep Research o Canvas, esa parte todavía no funciona en una skill. Nuestro resumen no las necesita: solo pide a Gemini leer una tabla, agrupar elementos y escribir texto.
| Parte | En un Gem | En una skill | Qué hacer |
|---|---|---|---|
| Nombre | Texto libre | Palabras en inglés, minúsculas y guiones, empezando por un verbo | Usar un nombre como weekly-hot-posts-digest |
| Descripción | Para personas | Para que Gemini decida; tercera persona; hasta 1.024 caracteres | Escribir "qué hace" más "Use when…" |
| Archivos de conocimiento | Se leen siempre | Se cargan cuando hacen falta; 100 MB en total | Plantillas largas en references/, citadas en un paso |
| Herramientas | Deep Research, Canvas y otras | Aún no admitidas | Buscar otro método o mantener el Gem hasta la fecha de solo lectura |
El trabajo: un resumen semanal de publicaciones populares y cuántas capturas necesita
Lo que queremos entregar es un informe semanal de una página. Responde a tres preguntas sobre los últimos siete días en Reddit, Zhihu, Weibo y X. ¿Qué temas se mantuvieron en las listas varios días? ¿Cuáles subieron rápido y desaparecieron? ¿La misma historia apareció en más de una plataforma? Los lectores son equipos de contenidos, de marca y comunicación, y analistas de mercado. El lunes por la mañana abren una página y no tienen que revisar cuatro listas.
Escribir el informe es lo fácil. Lo difícil es tener los datos de una semana. Una lista de tendencias es una foto, no un registro: cada plataforma muestra solo los primeros puestos del momento, y la lista cambia en minutos. Ninguna plataforma ofrece "todo lo que estuvo en la lista esta semana". Lo dicen sus propias reglas. Weibo indica que su lista de búsquedas en tendencia se actualiza cada minuto y muestra los 50 primeros (reglas de la lista de Weibo). Zhihu indica que su lista caliente se actualiza cada 10 minutos y muestra los 30 primeros (presentación de la lista de Zhihu). Reddit y X no publican su frecuencia. En nuestro catálogo, reddit/trending_posts devuelve unas 25 publicaciones por página y su token de página vale 24 horas; twitter/trending devuelve la lista de un país, y cada fila trae la hora collected_at, que la nota del campo recomienda usar para saber lo reciente que es.
| Lista | Capacidad de EveryInfra | Filas por llamada | Cómo ordena la plataforma | Actualización | Precio de catálogo (2026-11-04) |
|---|---|---|---|---|---|
| Publicaciones populares de Reddit | reddit/trending_posts | Unas 25 por página; más páginas con token | No publicado | No publicada | 0,000556 USD por página |
| Lista caliente de Zhihu | zhihu/hot_list | Hasta 30 | Búsqueda, lectura, interacción y tasa de clics | Cada 10 minutos | 0,000806 USD por llamada |
| Búsquedas en tendencia de Weibo | weibo/trending | 20 por defecto, hasta 200 (la lista tiene 50) | (Búsqueda + debate + difusión) × tasa de interacción | Cada minuto | 0,000556 USD por llamada |
| Tendencias de X | twitter/trending | Unas 50 por país | No publicado | No publicada | 0,000556 USD por llamada |
Por eso el método correcto para un resumen semanal es tomar muchas capturas durante la semana y fusionarlas. De cada elemento, el informe necesita tres datos: en cuántas capturas apareció, su mejor puesto y su valor de popularidad más alto. Una captura de las cuatro listas cuesta 0,002474 USD (3 × 0,000556 + 0,000806, según el campo price_usd del catálogo). La pregunta de verdad es cuántas capturas hacen falta: con pocas se pierden temas, y con demasiadas se paga por datos que no se usan. Hicimos 3 rondas de llamadas reales para responderla; los resultados están en la sección de pruebas.
La comparación de precios también explica por qué no recomendamos las API propias de cada plataforma para esto. La documentación de X tiene precios por uso, y el endpoint de tendencias cuesta 0,010 USD por petición (precios de la API de X), unas 18 veces el precio de twitter/trending en el catálogo. La API propia de Reddit exige pedir aprobación antes; los detalles están en la nota «Condiciones de las plataformas» de la sección de límites.
Para un público hispanohablante, el país de X importa. El valor por defecto country=world es una mezcla global. En la tercera ronda llamamos también a country=mx y country=es, y los datos de cada lista están en la sección de pruebas. Si tu audiencia está en México, usa mx; si está en España, es. El catálogo recoge el resto de valores.
El esqueleto de SKILL.md: weekly-hot-posts-digest
Abajo están la carpeta completa y el archivo SKILL.md. La skill hace una sola cosa: recibe una semana de capturas de listas de tendencias en forma de tabla y escribe un resumen de una página. No obtiene datos, porque en la aplicación Gemini los scripts de una skill no salen a internet. Las instrucciones están en inglés porque los ejemplos de las ayudas de Gemini, Claude y Codex están en inglés y las tres plataformas las leen igual. Si quieres el resumen en español, pídelo al llamar a la skill ("escribe el resumen en español") o añade esa línea a las reglas.
weekly-hot-posts-digest/
├── SKILL.md                     # obligatorio: nombre, descripción, instrucciones
└── references/
└── report-template.md # plantilla de salida del paso 5---
name: weekly-hot-posts-digest
description: Builds a one-page weekly digest of hot posts and trending topics from Reddit, Zhihu, Weibo and X snapshot data. Use when the user uploads this week's weekly.csv or snapshots.jsonl, or asks for a weekly trending summary across these four platforms.
---
# Weekly hot posts digest
## Inputs
- weekly.csv: one row per post or topic. Columns: platform, key, title, url, community, first_seen, last_seen, times_seen, snapshots_total, best_rank, max_heat.
- If the user gives snapshots.jsonl instead, group rows by platform and key first, then work from the grouped rows.
## Steps
Copy this checklist and track progress:
- [ ] 1. For each platform, count snapshots_total and the date range. Write them at the top of the digest.
- [ ] 2. Rank items by times_seen / snapshots_total first, then by best_rank. An item seen in most snapshots is a "week topic". An item seen once is a "spike".
- [ ] 3. Pick 5 week topics and 3 spikes per platform. Keep the original title. For Zhihu and Weibo, add a one-line English gloss after the title.
- [ ] 4. Group the picked items into at most 6 themes across platforms. A theme needs items from 2 or more platforms.
- [ ] 5. Fill the template in references/report-template.md.
## Rules
- max_heat is only comparable inside one platform. Do not compare Weibo hot_value with Zhihu hot_value or Reddit like_count.
- X trends may have an empty volume. Write "no volume" instead of 0.
- Do not guess why a topic is hot. If the title is not enough, write "reason unclear" and give the url.
- Remove user names from Reddit titles and text if they appear. Keep brand and organization names.
## Missing information
- If a platform has 0 snapshots this week, write "no data for <platform> this week" and continue with the others. Do not fill it from memory or web search.
- If snapshots_total is below 5 for a platform, add the line "low coverage: N snapshots".La plantilla es corta: una línea de título con las fechas de la semana en hora de Singapur, una línea de cobertura, una tabla de temas, un apartado de "temas de la semana" por plataforma, otro de "picos" y uno de notas. Ocupa 399 bytes. Va en un archivo aparte por la carga progresiva: Gemini solo la abre en el paso 5, así que no gasta tokens mientras decide si la skill sirve.
Si el equipo lee en español, cambia "add a one-line English gloss" por "add a one-line Spanish gloss" en el paso 3. Es el único cambio necesario: el resto de reglas no depende del idioma.
Cada regla sale de algo que vimos en las llamadas reales. "max_heat solo se compara dentro de una plataforma" viene de las notas de campo del catálogo. El hot_value de Weibo es una métrica propia de Weibo que solo se compara dentro de la lista; el de Zhihu es el texto de la página, por ejemplo "5,97 millones de popularidad", convertido en entero. Las fórmulas son distintas: Weibo da "(búsqueda + debate + difusión) × tasa de interacción" y Zhihu habla de búsqueda, lectura, interacción y tasa de clics (reglas de Weibo, presentación de Zhihu). Ordenar las dos listas juntas no tiene sentido.
"El volumen de X puede venir vacío" viene de nuestras pruebas; la sección de campos tiene las cifras. "Si faltan datos, dilo" viene de la lista caliente de Zhihu, que respondió HTTP 503 en nuestros intentos. Sin esta regla, Gemini puede rellenar el hueco con elementos antiguos que recuerda. El resumen parece completo, pero una parte es inventada.
| Regla de la skill | Prueba o documento que la respalda | Sin la regla |
|---|---|---|
| max_heat solo se compara dentro de una plataforma | Weibo y Zhihu usan fórmulas distintas; el catálogo dice que la popularidad de Weibo solo se compara dentro de su lista | Un "ranking de popularidad" entre plataformas sin sentido |
| Si el volumen de X viene vacío, "no volume" | El volume de X vino vacío en todas nuestras capturas | El modelo lee el vacío como 0 |
| No adivinar; escribir "reason unclear" | La lista solo da título y enlace | El modelo inventa un motivo de memoria |
| Sin datos, "no data" | La lista de Zhihu devolvió 503 en esta prueba | El modelo rellena con temas antiguos |
| Menos de 5 capturas, "low coverage" | Parte de cada lista cambia en 44 minutos | El lector cree que el resumen cubre toda la semana |
¿Sirve el mismo SKILL.md en Claude y en Codex?
Sí. Gemini, Claude Code, Codex y Antigravity dicen que sus skills siguen el estándar abierto Agent Skills, y la especificación solo pide dos campos: name (minúsculas, dígitos y guiones, hasta 64 caracteres) y description (hasta 1.024 caracteres) (especificación de Agent Skills). Claude Code añade campos de extensión, como el control de invocación o la ejecución en subagentes (Claude Code: Extend Claude with skills); Codex exige name y description (Codex: Build skills); Antigravity permite omitir name y entonces usa el nombre de la carpeta (Antigravity: Agent skills). Nuestra skill lleva los dos campos y ninguna extensión, así que las cuatro herramientas la leen sin cambios.
Solo cambia una cosa. En Claude Code, Codex y Antigravity CLI, la misma skill puede llamar al servidor MCP remoto de EveryInfra y traer las listas; en la aplicación Gemini la skill no sale a internet, y hay que preparar los datos antes. La comparación de carpetas, formas de llamada y reglas de red de cada herramienta está en nuestro artículo un mismo SKILL.md en cuatro herramientas de IA: prueba con reseñas de la competencia, que muestra una skill que se ejecuta junto con llamadas MCP. Este muestra cómo separar datos e instrucciones cuando la skill no tiene red.
Cómo lleva datos externos la aplicación Gemini: tres caminos
La skill no obtiene datos, así que tienen que llegar de fuera. Con la documentación oficial que leímos el 4 de noviembre de 2026 (2026-11-04) hay tres caminos, cada uno con requisitos distintos y pensado para un tipo de usuario. Todos aparecen abajo como ejemplos de configuración: Gemini no tiene sesión iniciada en nuestra máquina de pruebas y no ejecutamos ningún paso del lado de Gemini.
| Camino | Quién puede usarlo | Cómo entran los datos | Automatización semanal | Qué probamos |
|---|---|---|---|---|
| A. Capturas locales y subida de una tabla el fin de semana | Toda cuenta con skills, también en España | weekly.csv como adjunto del chat | La captura es automática; la subida la hace una persona | Las llamadas a la API de datos (nuestras 3 rondas) |
| B. Connected App personalizada (MCP remoto) | Mayores de 18, en Estados Unidos, cuenta personal, en inglés | Gemini llama a herramientas MCP | La ayuda dice que funciona en Tasks | Solo nuestro lado MCP |
| C. API de Gemini: agente Antigravity y un disparador | Desarrolladores con clave de la API de Gemini | El agente llama a una herramienta mcp_server en un sandbox | Sí, el disparador sigue un horario cron | Solo nuestro lado MCP |
Los caminos posibles dependen de dónde estés y de tu cuenta:
| Tu caso | Caminos | Por qué |
|---|---|---|
| España u otro país del EEE, Suiza o Reino Unido | A (la subida la hace una persona), C | Las Tasks programadas de Gemini no están disponibles ahí |
| México, Colombia, Argentina, Chile u otro país de Latinoamérica | A, C | No hay aplicaciones personalizadas fuera de Estados Unidos; las Tasks piden AI Pro o Ultra |
| Estados Unidos, cuenta personal, en inglés | A, B, C | Las aplicaciones personalizadas solo existen para cuentas personales en Estados Unidos |
| Cuenta de trabajo de Workspace | A, C (cuando lleguen las skills de Workspace) | Las skills de Workspace se retrasan y no se sincronizan con las de la aplicación |
Para un lector en España o en Latinoamérica, el camino B queda fuera por ahora, porque exige estar en Estados Unidos. En España, además, las tareas programadas de Gemini no están disponibles. Así que la elección real está entre A y C.
Camino A: capturas locales y subida el fin de semana. Es el de menos requisitos y el que da más control. En tu ordenador o en un servidor pequeño, ejecuta un script de captura una o varias veces al día. El script añade los resultados en bruto de las cuatro listas a snapshots.jsonl. El fin de semana, un script de fusión convierte la semana de capturas en weekly.csv. Subes ese archivo a un chat de Gemini y escribes /weekly-hot-posts-digest. El CSV figura entre los tipos de archivo admitidos en la ayuda de Gemini (Crear y gestionar skills).
La ventaja es que capturar y escribir quedan totalmente separados. Un programa fijo captura y deja anotados cada cobro y cada fallo en un archivo. El modelo que escribe el resumen solo ve una tabla, así que no puede "buscar y rellenar". El inconveniente es que alguien tiene que subir el archivo cada semana. Nuestras llamadas reales de la sección siguiente usan esas mismas llamadas a la API.
Camino B: una Connected App personalizada. En la versión web de Gemini se puede añadir una "aplicación personalizada" con la URL de un servidor MCP. Una vez conectada, funciona en la aplicación móvil y en la web, y también en Tasks (Conectar y gestionar aplicaciones personalizadas en Gemini). Los requisitos son claros: tener 18 años o más, estar en Estados Unidos, usar una cuenta personal de Google y tener activada la actividad. Por ahora solo admite inglés, y la aplicación se añade solo desde la web.
En la autenticación, la documentación de Developer Mode explica que, con Dynamic Client Registration, se configura cómo Gemini crea las credenciales de cliente y de usuario con tu servidor MCP; hay además una guía aparte de OAuth 2.1 (Gemini Apps Developer Mode overview). Es decir, este camino usa un inicio de sesión OAuth, no una clave pegada en una cabecera. El servidor MCP remoto de EveryInfra tiene una entrada OAuth en https://api.everyinfra.com/mcp/all, con los metadatos en /.well-known/oauth-protected-resource/mcp/all. No probamos la conexión en Gemini, así que no podemos asegurar que conecte.
La documentación permite deducir otro detalle que no probamos. Según Developer Mode, Gemini usa las anotaciones readOnlyHint y destructiveHint de cada herramienta MCP, junto con el contexto, para decidir si muestra una tarjeta de confirmación antes de ejecutarla; la ayuda añade que Gemini siempre pide confirmar las acciones de escritura. El 4 de noviembre leímos la lista de herramientas de EveryInfra con tools/list, que funciona sin clave y sin cobro. La herramienta general de datos everyinfra_call_api declara readOnlyHint: false y destructiveHint: true, porque cada llamada tiene un cobro. Según la documentación, eso probablemente significa que Gemini pedirá confirmar cada llamada, y una tarea programada sin nadie delante se quedaría parada ahí.
Camino C: el agente Antigravity de la API de Gemini y un disparador. Si sabes escribir unas líneas de Python, es el único camino en el que capturar, escribir y programar cada semana ocurre todo del lado de Google, y funciona igual desde España. El endpoint Interactions de la API de Gemini acepta un servidor MCP remoto como herramienta, con los campos type: "mcp_server", name, url, headers y allowed_tools. Solo admite Streamable HTTP, no SSE, y el nombre no puede llevar guiones (API de Gemini: Function calling, sección Remote MCP).
El agente Antigravity es un agente general que se ejecuta en un sandbox Linux gestionado por Google, en el que se pueden montar AGENTS.md y skills bajo .agents/skills/ (API de Gemini: Antigravity agent). La referencia de Interactions trae un ejemplo con una fuente inline que escribe un SKILL.md en .agents/skills/<nombre>/SKILL.md (referencia de Interactions API). La sección "Triggers" de la página del agente explica que un disparador une un agente, un entorno, un prompt y un horario cron en un recurso persistente. Cada ejecución reutiliza el mismo entorno, así que los archivos de la anterior siguen ahí. Para ejecuciones desatendidas recomienda una credencial guardada en lugar de un token en la petición.
Con esas tres piezas sale una configuración que escribe el resumen cada lunes por la mañana. Abajo va el ejemplo; copiamos los nombres de campo de la documentación oficial, pero no lo ejecutamos.
# Ejemplo de configuración (no ejecutado): una captura diaria a las 08:00 de Madrid
# y, los lunes, también el resumen de la semana anterior.
# Fuentes: ai.google.dev/gemini-api/docs/antigravity-agent (MCP servers, Triggers, Budget controls)
#          ai.google.dev/api/interactions-api (fuentes inline del entorno)
from google import genai

client = genai.Client()  # lee GEMINI_API_KEY del entorno
SKILL_MD = open("weekly-hot-posts-digest/SKILL.md", encoding="utf-8").read()
TEMPLATE = open("weekly-hot-posts-digest/references/report-template.md", encoding="utf-8").read()

everyinfra = {
    "type": "mcp_server",
    "name": "everyinfra",                     # solo minúsculas y dígitos
    "url": "https://api.everyinfra.com/mcp",
    "headers": {"Authorization": "Bearer " + EVERYINFRA_API_KEY},  # leer de un gestor de secretos
    "allowed_tools": ["everyinfra_call_api"],
}
environment = {
    "type": "remote",
    "sources": [
        {"type": "inline", "content": SKILL_MD,
         "target": ".agents/skills/weekly-hot-posts-digest/SKILL.md"},
        {"type": "inline", "content": TEMPLATE,
         "target": ".agents/skills/weekly-hot-posts-digest/references/report-template.md"},
    ],
}
PROMPT = (
    "Step 1: call everyinfra_call_api four times: reddit/trending_posts, zhihu/hot_list (limit 30), "
    "weibo/trending (limit 50), twitter/trending (country es). Append one JSON line per call to "
    "/workspace/snapshots.jsonl with taken_at, platform, http status, charged_usd and results. "
    "If a call fails, write the error and continue. "
    "Step 2: only if today is Monday in Europe/Madrid, use the weekly-hot-posts-digest skill on the "
    "last 7 days of /workspace/snapshots.jsonl and write the digest in Spanish to /workspace/digests/."
)
trigger = client.triggers.create(
    schedule="0 8 * * *", time_zone="Europe/Madrid", display_name="hot-lists-weekly",
    interaction={
        "agent": "antigravity-preview-09-2026",
        "agent_config": {"type": "antigravity", "model": "gemini-3.5-flash-lite",
                         "max_total_tokens": 300000},
        "environment": environment,
        "tools": [everyinfra],
        "input": PROMPT,
    },
)
print(trigger.id, trigger.next_run_time)
Tres partes del ejemplo necesitan explicación. Primera: captura y resumen van en el mismo disparador. La documentación dice que cada ejecución reutiliza el mismo entorno y ve los archivos de la anterior, y eso se refiere a un mismo disparador. Con dos disparadores, el segundo tendría que referirse al entorno por su ID para leer las capturas (la sección Environments muestra que se puede pasar un ID existente como env_abc123), y eso es un paso más que puede fallar.
Segunda: el modelo es gemini-3.5-flash-lite, el más barato, y el ejemplo fija un tope con max_total_tokens. El agente Antigravity trabaja en un bucle autónomo. La documentación estima entre 100.000 y 500.000 tokens de entrada para una tarea de "investigación y resumen", unos 0,30–1,00 USD por ejecución, y hasta unos 5 USD en tareas complejas. Al llegar al tope, la ejecución se detiene y devuelve status: "incomplete". Tercera: no pongas la clave en el código. La sección Triggers recomienda una credencial guardada para las ejecuciones desatendidas; el proxy de salida la lee en cada ejecución, y se puede cambiar la clave sin tocar el disparador. La línea headers del ejemplo es solo para una primera prueba manual.
En el camino C conviene vigilar tres entradas del registro de cambios de la API de Gemini (registro de cambios). Desde el 26-10-2026, los proyectos nuevos del nivel de pago guardan por defecto las peticiones generateContent (store=true); si el texto del resumen lleva datos de usuarios, decide si pones store=false en cada petición, algo que en la UE conviene revisar también a la luz del RGPD. El 27-10-2026, el cliente de línea de comandos sin estado gemini-api entró en beta pública y puede ejecutar agentes gestionados sobre Interactions; no comprobamos si admite disparadores. El aviso de obsolescencia del 02-11-2026 indica que desde el 1 de diciembre las peticiones a gemini-2.5-flash pasan a gemini-3.5-flash-lite, con cambios incompatibles en function calling: si un script antiguo fija un modelo 2.5, cambia el nombre y vuelve a probarlo antes de esa fecha.
Un camino más: Antigravity CLI. Si ya trabajas en una terminal, Antigravity CLI es la herramienta con la que Google sustituye a Gemini CLI. También lee skills de .agents/skills/. El servidor MCP remoto va en mcp_config.json, y el programador del sistema (cron o launchd) ejecuta agy -p. Nuestro artículo Antigravity CLI para vigilar comentarios de vídeos: pruebas y configuración da la configuración completa. La diferencia con el camino C es dónde se ejecuta: la CLI corre en tu máquina y se para si la apagas; el camino C corre en el sandbox de Google. El artículo sobre la API de Gemini Deep Research con un servidor MCP remoto cubre otro uso: investigación con citas, no capturas programadas.
La prueba: una llamada real de ida y vuelta para cada una de las cuatro listas
Esta sección es la parte que probamos de verdad. El 4 de noviembre de 2026, entre las 00:13–00:59 hora de Singapur, hicimos 3 rondas de las cuatro listas. A las 02:05 repetimos una vez la lista caliente de Zhihu y las publicaciones populares de Reddit, y llamamos a dos endpoints de sustitución (al final de esta sección). En total fueron 27 peticiones, de las que 13 salieron bien y se cobraron, con un total de 0,007228 USD. Las 14 que fallaron no se cobraron. Guardamos la respuesta en bruto, las cabeceras y el tiempo de cada petición, así que cada cifra del artículo se puede comprobar en una respuesta original.
Una captura son cuatro llamadas. Con curl queda así (la clave va en una variable de entorno, nunca dentro del script):
# Una captura: una llamada a cada una de las cuatro listas (probado el 2026-11-04)
API=https://api.everyinfra.com/api/v1/social
for body in \
  '{"platform":"reddit","action":"trending_posts","params":{}}' \
  '{"platform":"zhihu","action":"hot_list","params":{"limit":30}}' \
  '{"platform":"weibo","action":"trending","params":{"limit":50}}' \
  '{"platform":"twitter","action":"trending","params":{"country":"es"}}'
do
  curl -s -X POST "$API" -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
       -H 'Content-Type: application/json' -d "$body" \
  | jq -c '{platform, action, count, charged: .billing.charged_usd, error: .error.code}'
  sleep 7   # por debajo de 10 llamadas por minuto
done
La estructura de la respuesta es igual en las cuatro plataformas: results es la lista de elementos, count el número de elementos y billing.charged_usd lo cobrado en esa llamada. Si la llamada falla, no hay results sino error, con fault (de quién es el problema), retryable (si se puede reintentar), retry_after (segundos de espera) y los pasos siguientes. Los campos de cada elemento cambian según la plataforma, y eso es lo que más importa al fusionar una semana de datos.
| Capacidad | Clave del elemento | Puesto | Campo de popularidad | Filas en la primera captura correcta | Texto, imágenes, volumen |
|---|---|---|---|---|---|
reddit/trending_posts | id | Orden de la respuesta | like_count, comment_count | 25 | text vacío en 18 filas |
zhihu/hot_list | id | rank | hot_value (el "diez mil de popularidad" de la página, como entero) | 0 | — |
weibo/trending | Título (sin id) | rank | hot_value | 50 | label vacío en 26 filas |
twitter/trending | Nombre (sin id estable) | rank | volume | 50 | volume vacío en 50/50 filas |
El script diario son esas mismas cuatro llamadas en Python, con una línea por captura en snapshots.jsonl. Abajo hay un collect.py de ejemplo, con los comentarios en español; hace las mismas llamadas a la API que nuestras 3 rondas. Solo usa la biblioteca estándar de Python (urllib.request) y lee la clave del entorno. Ante un 503 reintentable, espera retry_after y vuelve a probar una vez; si falla otra vez, escribe el error en el archivo.
#!/usr/bin/env python3
"""Se ejecuta una o varias veces al día: trae cuatro listas y añade una línea por captura a snapshots.jsonl. La clave solo se lee de la variable de entorno EVERYINFRA_API_KEY."""
import json, os, sys, time, urllib.request, urllib.error
from datetime import datetime, timezone, timedelta

API = "https://api.everyinfra.com/api/v1/social"
LISTS = [
    ("reddit", "trending_posts", {}),
    ("zhihu", "hot_list", {"limit": 30}),
    ("weibo", "trending", {"limit": 50}),
    ("twitter", "trending", {"country": "world"}),
]
SGT = timezone(timedelta(hours=8))

def call(platform, action, params):
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    req = urllib.request.Request(API, data=body, method="POST", headers={
        "Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
        "Content-Type": "application/json", "User-Agent": "hot-digest/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=120) as r:
            return r.status, json.loads(r.read())
    except urllib.error.HTTPError as e:
        return e.code, json.loads(e.read() or b"{}")

def main(out_path):
    taken_at = datetime.now(SGT).isoformat(timespec="seconds")
    with open(out_path, "a", encoding="utf-8") as out:
        for platform, action, params in LISTS:
            status, data = call(platform, action, params)
            if status == 503 and (data.get("error") or {}).get("retryable"):
                time.sleep(int(data["error"].get("retry_after", 60)))
                status, data = call(platform, action, params)
            row = {"taken_at": taken_at, "platform": platform, "action": action, "http": status,
                   "charged_usd": (data.get("billing") or {}).get("charged_usd", 0),
                   "error": (data.get("error") or {}).get("code"), "results": data.get("results", [])}
            out.write(json.dumps(row, ensure_ascii=False) + "\n")
            print(platform, action, status, len(row["results"]), row["charged_usd"])
            time.sleep(7)  # por debajo de 10 llamadas por minuto

if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else "snapshots.jsonl")
El fin de semana, merge.py convierte la semana de capturas en una tabla. Las reglas son sencillas: en Reddit y Zhihu un elemento se identifica por id; Weibo y X no tienen un id estable, así que se identifican por el título. Cada fila guarda la primera y la última aparición, las veces vista, el mejor puesto y la popularidad máxima, y cada plataforma guarda cuántas capturas correctas hubo en la semana (snapshots_total), que la skill usa para valorar la cobertura. La salida es CSV estándar (RFC 4180), un formato que la ayuda de Gemini admite como adjunto.
#!/usr/bin/env python3
"""Fusiona una semana de snapshots.jsonl en weekly.csv: una fila por publicación o tema, con primera y última aparición, veces vista, mejor puesto y popularidad máxima."""
import csv, json, sys
from collections import defaultdict

def key_of(platform, r):
    return r.get("id") if platform in ("reddit", "zhihu") else (r.get("title") or r.get("name"))

def heat_of(platform, r):
    if platform == "reddit": return r.get("like_count")
    if platform in ("zhihu", "weibo"): return r.get("hot_value")
    v = r.get("volume")  # el volumen de X puede venir vacío
    return v or None

def main(src, dst):
    rows = [json.loads(l) for l in open(src, encoding="utf-8") if l.strip()]
    snaps = defaultdict(set); items = {}
    for s in rows:
        if s["http"] != 200: continue
        p = s["platform"]; snaps[p].add(s["taken_at"])
        for i, r in enumerate(s["results"], 1):
            k = key_of(p, r)
            if not k: continue
            it = items.setdefault((p, k), {"platform": p, "key": k, "title": r.get("title") or r.get("name"),
                 "url": r.get("url", ""), "community": r.get("community", ""), "first_seen": s["taken_at"],
                 "last_seen": s["taken_at"], "times_seen": 0, "best_rank": None, "max_heat": None})
            it["last_seen"] = max(it["last_seen"], s["taken_at"]); it["first_seen"] = min(it["first_seen"], s["taken_at"])
            it["times_seen"] += 1
            rank = r.get("rank") or i
            it["best_rank"] = rank if it["best_rank"] is None else min(it["best_rank"], rank)
            h = heat_of(p, r)
            if isinstance(h, (int, float)): it["max_heat"] = h if it["max_heat"] is None else max(it["max_heat"], h)
    out = sorted(items.values(), key=lambda x: (x["platform"], -x["times_seen"], x["best_rank"] or 999))
    for it in out: it["snapshots_total"] = len(snaps[it["platform"]])
    with open(dst, "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=["platform", "key", "title", "url", "community", "first_seen", "last_seen",
                                          "times_seen", "snapshots_total", "best_rank", "max_heat"])
        w.writeheader(); w.writerows(out)
    print(dst, len(out), {p: len(v) for p, v in snaps.items()})

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
Las mismas capacidades funcionan también a través del servidor MCP remoto: en un cliente MCP se añade https://api.everyinfra.com/mcp y se llama a la herramienta general everyinfra_call_api con los mismos argumentos del cuerpo de la petición. La imagen muestra nuestra petición real tools/call a weibo/trending a las 00:37:15 hora de Singapur, con solo 2 filas y enlaces recortados: respondió en 0,6 segundos y cobró 0,000556 USD.
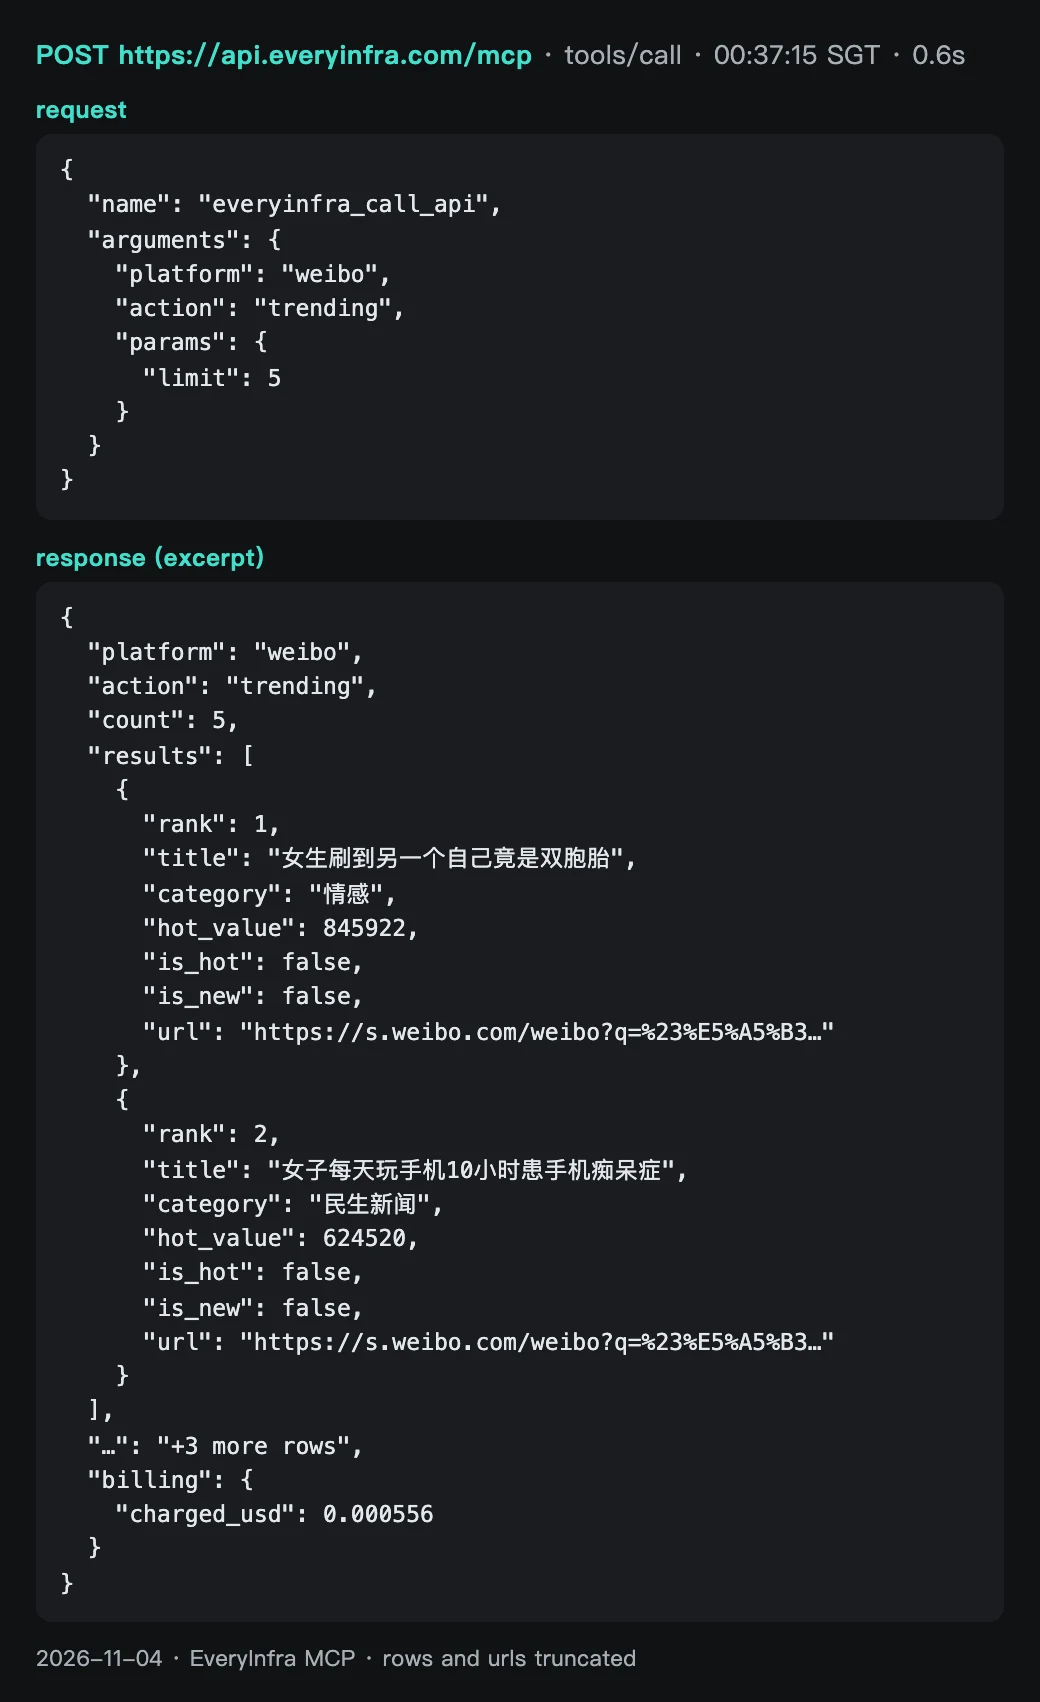
Estas son las 3 rondas y sus resultados. En cada ronda llamamos a las cuatro listas en el mismo orden, con unos segundos entre llamadas para no pasar de 10 por minuto. Tras un fallo esperamos los 60 segundos que indicaba retry_after y probamos una vez más.
| Ronda (hora de Singapur) | Reddit populares | Zhihu lista caliente | Weibo tendencias | X tendencias | Llamadas extra |
|---|---|---|---|---|---|
| Ronda 1, 00:13–00:15 | 25 filas | 503 ×3 | 50 filas | 50 filas | — |
| Ronda 2, 00:35–00:37 | 503 ×3 | 503 ×2 | 50 filas | 50 filas | X us 70 filas |
| Ronda 3, 00:58–00:59 | 503 ×2 | 503 ×2 | 50 filas | 50 filas | X mx 100 filas, X es 100 filas |
| Extra, 00:37 | — | — | 5 filas (MCP, limit=5) | — | La captura de la respuesta es esta llamada |
| Reintento, 02:05 | 503 ×1 | 503 ×1 | — | — | Sustitutos: reddit/subreddit_posts 25 publicaciones, zhihu/search 20 filas |
La lista caliente de Zhihu y las publicaciones populares de Reddit no estuvieron disponibles durante la prueba. Entre las 00:13 y las 02:05, las 8 peticiones a Zhihu devolvieron 503, con fault: service y retryable: true, y ninguna se cobró. Reddit dio 25 filas en la ronda 1; después, 6 peticiones no trajeron datos (4 por REST con 503 y 2 por MCP con isError), también sin cobro. A las 02:05, un intento más para cada lista volvió a dar 503. Por eso las cifras de retención, fusión y campos de las secciones siguientes salen solo de weibo/trending y twitter/trending, y las columnas de Zhihu y Reddit populares quedan vacías.
Para un resumen semanal, esto importa: una lista puede estar caída durante un buen rato. El script de captura tiene que anotar cada fallo, y la skill tiene que escribir "no data for Zhihu this week" en el resumen en lugar de dejar que el modelo rellene el hueco.
Si una lista no responde, el resumen puede llenar esa columna con otro endpoint, pero tiene que nombrar la fuente nueva. A las 02:05 (hora de Singapur) llamamos a dos endpoints de sustitución, a 0,000556 USD cada uno:
| Endpoint de sustitución | Parámetros | Filas | Fechas de publicación (hora de Singapur) | Interacción | Qué falta |
|---|---|---|---|---|---|
reddit/subreddit_posts | r/GeminiAI, sort=top, date_range=past_week | 25 | 28-10-2026 a 03-11-2026 | 156–1.583 votos; 11 títulos con "Carbon" | text vacío en 21 |
zhihu/search | "Gemini", sort=time_descending | 20 (13 artículos, 7 respuestas) | 23-10-2026 a 04-11-2026 | like_count máximo 294; 4 con 0 | — |
Ninguno de los dos es una lista de tendencias: el primero da lo mejor votado de una comunidad en una semana, y el segundo, resultados de una palabra clave por fecha. En el resumen no hay que llamarlos "Reddit populares" ni "lista caliente de Zhihu". Una regla útil para la skill: si una columna usa un endpoint de sustitución, escribe su nombre junto al título de la columna.
Resultados: qué tan rápido cambian las listas y cuántas capturas hacen falta
La pregunta era: para un resumen semanal, ¿basta con consultar las listas una vez por semana? El criterio lo escribimos antes de las llamadas. Si una lista apenas cambia al cabo de unas decenas de minutos, una o dos consultas por semana bastan; si cambia una parte clara, hay que tomar varias capturas al día y fusionarlas.
Pasó lo segundo. Tomamos como base la primera captura correcta de cada plataforma. A los 44 minutos solo seguía en la lista el 86 % de las búsquedas en tendencia de Weibo; a los 44 minutos, solo el 74 % de las tendencias de X (world). En 44 minutos, las 3 rondas juntas mostraron 58 temas distintos en Weibo y 63 en X: un 16 % y un 26 % más que las 50 filas de una sola captura.
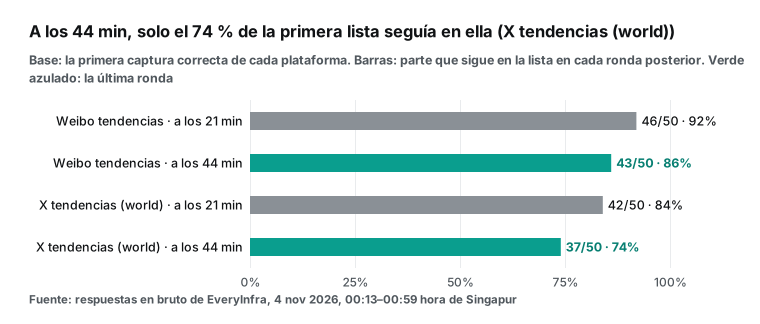
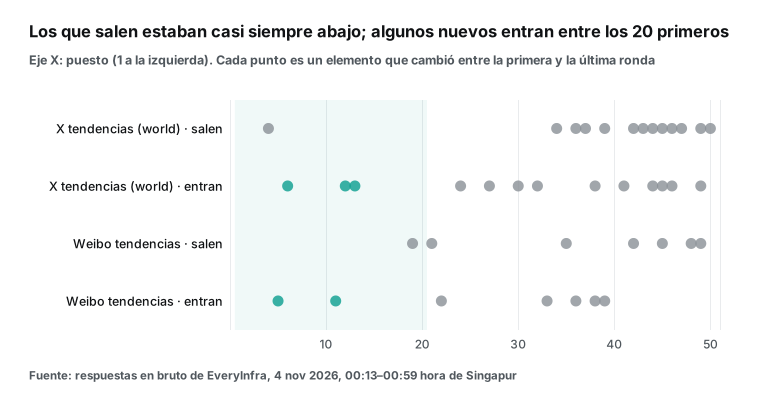
Dónde cambian los elementos también sigue un patrón. De la primera a la última ronda, 5 de los 7 temas que salieron de Weibo estaban en la mitad inferior; en X fueron 12 de 13. La parte baja de la lista es la que más cambia. Pero no todo lo nuevo entra por abajo: 2 temas nuevos de Weibo y 3 de X aparecieron directamente entre los 20 primeros. Son los "picos" que más interesan en un resumen: suben y bajan entre dos capturas, y una sola lista del lunes por la mañana no los muestra.
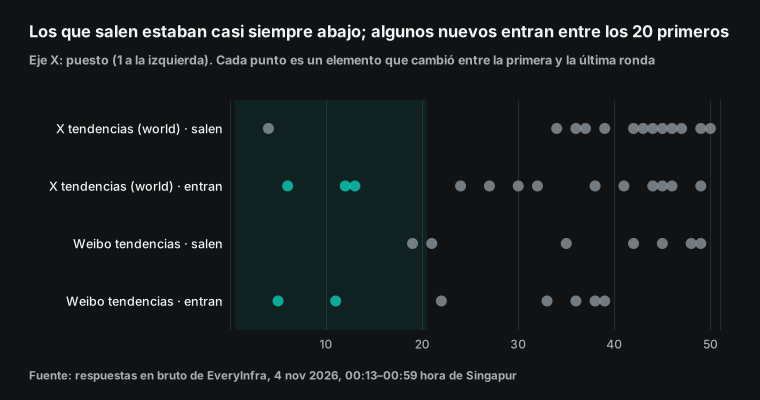
De ahí sale la frecuencia de captura, pero solo como ejemplo. Solo medimos 44 minutos, así que no se puede extrapolar a una semana, y tampoco medimos la retención a las 6 ni a las 24 horas. Lo que sí se puede dar es un mínimo: en 44 minutos cambió alrededor del 26 % de la lista de X; con una captura al día pasan 24 horas entre dos fotos, y parte de lo que sube y baja en ese tiempo se pierde. La frecuencia de ejemplo son cuatro capturas al día, por ejemplo a las 08:00, 13:00, 18:00 y 23:00 de tu zona horaria, es decir, 28 por semana. Con poco presupuesto, una al día, indicando en el resumen que "cubre un momento del día". Para fijar tu propia frecuencia, captura cada hora durante un día, mira cuánto queda de la lista a las 6 y a las 24 horas, y baja la frecuencia si casi todo sigue.
Qué campos sirven y qué cifras no puede dar el resumen
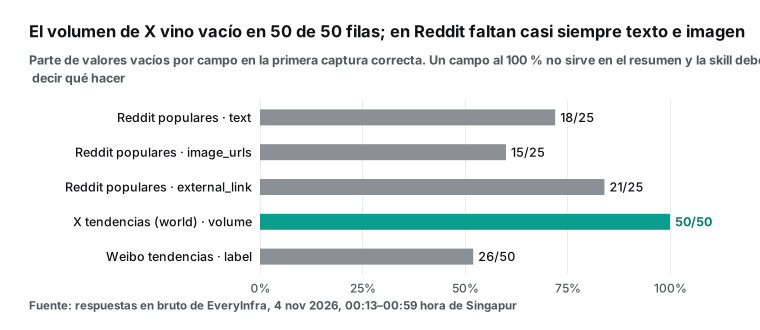
Los campos vacíos marcan las reglas de la skill. El volume de X vino vacío en las 6 capturas de tres zonas, y period siempre decía "Live", así que para X el resumen solo puede dar puesto y veces vista, no volumen de conversación. De las 25 publicaciones populares de Reddit, text vino vacío en 18 filas (casi todas son publicaciones de imagen o enlace) e image_urls en 15, por eso la skill solo hace leer el título. El campo label de Weibo (marcas como "nuevo" o "caliente") vino vacío en 26 filas: esos temas no llevan marca en la lista, no es que falte el dato.
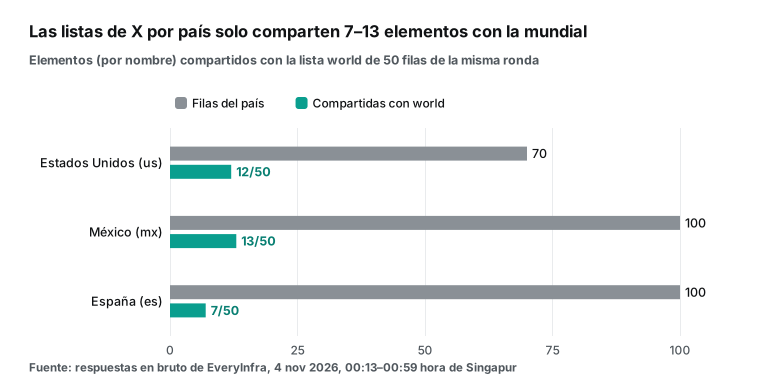
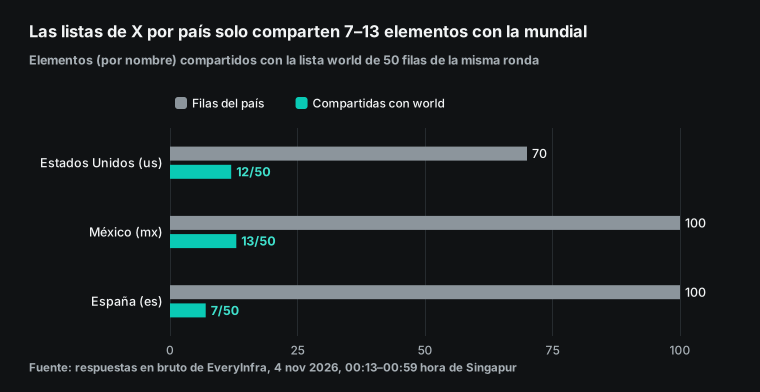
Hay que elegir bien el país de X. En el mismo periodo, las 50 filas de country=world solo compartían 12 elementos con las 70 de us, 13 con las 100 de mx y 7 con las 100 de es. La lista world es una mezcla global. El día de las elecciones de mitad de mandato en Estados Unidos (2026-11-03, hora de EE. UU.), "Election Day" estaba en el puesto 1 de la lista us y en el 6 de la lista world de la misma ronda. Para un resumen de México o de España, usa la lista de ese país: comparte muy poco con la mundial.
Fusiona los datos antes de pasárselos a Gemini
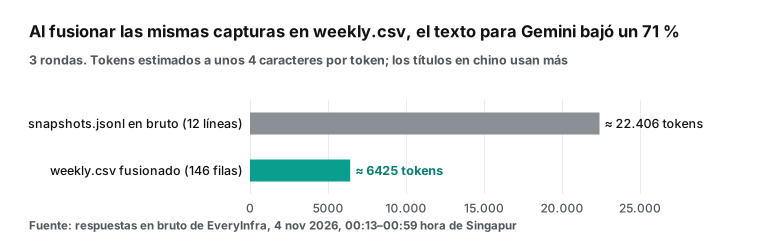
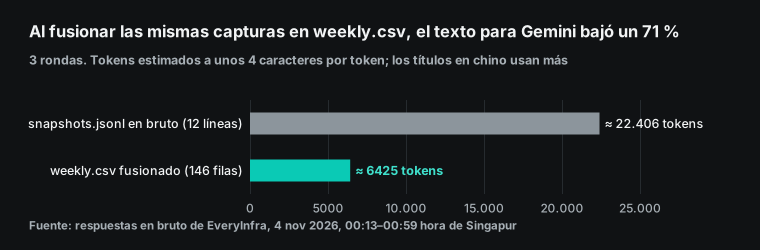
¿Por qué la skill pide weekly.csv y no las capturas en bruto? Escribimos los resultados de nuestras 3 rondas en snapshots.jsonl con el formato de collect.py: 12 líneas y unos 22.406 tokens. Tras merge.py, weekly.csv tiene 146 filas y unos 6.425 tokens, un 71 % menos. Usamos la regla de la API de Gemini de unos 4 caracteres por token (Understand and count tokens); los títulos en chino gastan más. Con cuatro capturas al día durante una semana, solo las de Reddit, Weibo y X en bruto sumarían unos 304.000 tokens (tamaño medio por lista en nuestras 3 rondas × 28). La tabla fusionada solo crece con los elementos distintos, porque un tema repetido ocupa una fila. Y, sobre todo, la fusión la hace un programa fijo: veces vista, mejor puesto y popularidad máxima son cálculos. Gemini solo elige y redacta; no cuenta.
Coste semanal y mensual
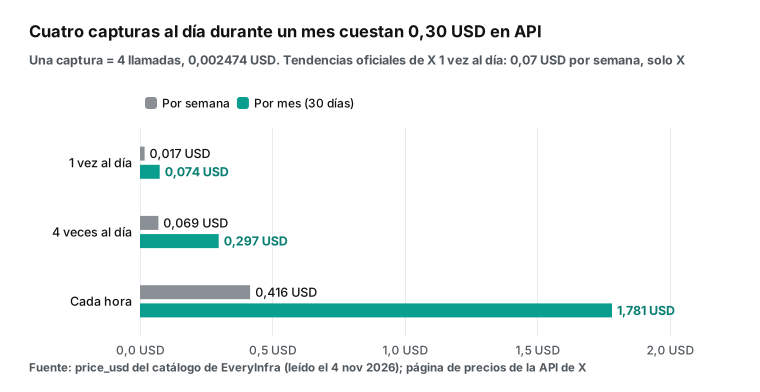
El coste de API depende solo del número de capturas por semana. Con el price_usd del catálogo del 4 de noviembre de 2026, una captura son cuatro llamadas y cuesta 0,002474 USD. Una al día: 0,017 USD por semana y 0,074 USD al mes (30 días). Cuatro al día: 0,069 USD por semana y 0,297 USD al mes. Una por hora: 0,416 USD por semana y 1,781 USD al mes. Una segunda página de Reddit suma 0,000556 USD por captura. Las llamadas fallidas no se cobran, así que los fallos de Zhihu no encarecieron la factura.
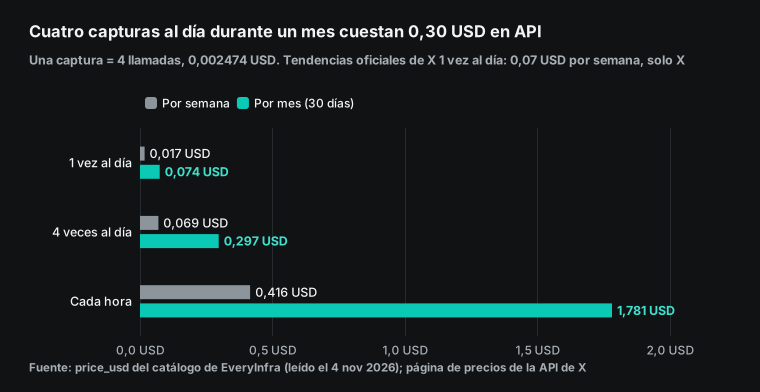
| Frecuencia | Capturas por semana | API por semana | API por mes (30 días) | Para qué |
|---|---|---|---|---|
| 1 vez al día | 7 | 0,017 USD | 0,074 USD | Saber "de qué se habló esta semana" |
| 4 veces al día (ejemplo) | 28 | 0,069 USD | 0,297 USD | Separar los temas de la semana de los picos |
| Cada hora | 168 | 0,416 USD | 1,781 USD | Noticias de última hora y reputación de marca |
El lado de Gemini se paga aparte. Las skills de la aplicación Gemini no piden plan. Para que Gemini se ejecute con horario (Tasks) hace falta Google AI Pro o Ultra y una cuenta personal de mayor de 18 años, y no está disponible en el EEE, Suiza, el Reino Unido ni Nigeria (Manage your tasks & workflows). El camino C de la API de Gemini se paga por tokens: la página de precios da para gemini-3.5-flash-lite 0,30 USD por millón de tokens de entrada y 2,50 USD de salida; gemini-3.8-flash cuesta 0,75 y 3,75 USD hasta el 31 de diciembre de 2026 y dobla el precio desde el 1 de enero de 2027 (precios de la API de Gemini). Desde el 08-10-2026, las peticiones a gemini-3.7-flash pasan a gemini-3.8-flash, así que un script con el nombre antiguo ya paga el precio nuevo. El agente Antigravity trabaja en un bucle autónomo, así que casi todos los tokens se van en su propio razonamiento y en las idas y vueltas con las herramientas. La documentación estima entre 100.000 y 500.000 tokens de entrada para una tarea de "investigación y resumen": al precio de entrada de Flash-Lite, unos 0,03–0,15 USD por ejecución, entre 12 y 60 veces el coste de API de una captura. No lo medimos; manda tu factura.
Límites y precauciones
| Límite | Efecto en el resumen | Qué hacer |
|---|---|---|
| Las skills de la aplicación Gemini no salen a internet | La skill no puede traer las listas | Capturar fuera de la skill (camino A, B o C) |
| Aplicaciones personalizadas solo para cuentas personales en Estados Unidos | No hay camino B fuera de EE. UU. | Usar el camino A o el C |
| Sin Tasks en el EEE, Suiza, Reino Unido y Nigeria | Gemini no puede ejecutarse cada semana por sí solo | Usar el programador del sistema o un disparador de la API |
| Una lista puede devolver 503 durante un buen rato | Una plataforma puede quedarse sin datos esa semana | Anotar el fallo; la skill escribe "no data" |
| Las tendencias de X no traen volumen | Solo puesto y veces vista | Usar twitter/search si hace falta volumen |
No ejecutamos ningún paso del lado de Gemini. La página de skills, las aplicaciones personalizadas, Tasks y el disparador de la API de Gemini son ejemplos de configuración escritos a partir de las ayudas y la documentación para desarrolladores que leímos el 4 de noviembre de 2026. Google ha cambiado mucho estos productos en dos meses (hasta el atajo de las skills pasa de / a @). Si al probarlo la interfaz no coincide con este artículo, manda la página oficial de ese día.
La skill no obtiene datos y no debe rellenar huecos. Es un límite fijo de la aplicación Gemini y también la razón de que nuestra skill diga "si no hay datos, dilo". El mayor riesgo de un resumen no es que esté mal escrito, sino que el modelo use temas antiguos que recuerda como si fueran de esta semana. Una regla dentro de la skill es más fiable que un recordatorio en cada chat, pero conviene mirar la línea de cobertura cada lunes.
Una lista de tendencias es un orden de la plataforma, no "la popularidad real". La fórmula de Weibo pondera la tasa de interacción, y la lista marca aparte los contenidos promocionados. La puntuación de Zhihu incluye la tasa de clics. Las dos plataformas dicen tener controles contra la manipulación, pero no publican los pesos. Por eso un puesto en el resumen es una señal y no una cuota de mercado, y nuestra skill ordena por "veces vista" y "mejor puesto", sin comparar valores de popularidad entre plataformas.
Las tendencias de X no trajeron volumen en nuestras rondas. La nota del catálogo sobre twitter/trending dice que, si las demás fuentes no están disponibles, los resultados vienen de una fuente de respaldo que no devuelve volumen ni periodo. En todas nuestras rondas, volume vino vacío en todas las filas de X y period decía "Live", también en las listas de México y España. El resumen solo puede mostrar puesto y veces vista para X. Si necesitas volumen de conversación, usa twitter/search con los pocos temas que elija el resumen.
Algunas listas pueden fallar durante un rato. En nuestra prueba, las 8 peticiones a zhihu/hot_list respondieron HTTP 503, y reddit/trending_posts no trajo datos en 6 peticiones después de la ronda 1. En ese momento no estaban disponibles, y ninguna de esas llamadas se cobró. El script de captura tiene que anotar el fallo y seguir; si lo salta sin dejar rastro, el fin de semana no sabrás si un tema de Zhihu "no estaba en la lista" o "no se capturó".
La lista de Reddit trae 25 publicaciones por página. reddit/trending_posts devuelve unas 25 por página; para más hay que pasar next_page_token, cada página se cobra aparte y el token vale 24 horas. La lista general mezcla muchas comunidades y tira a entretenimiento y temas generales: en nuestra primera ronda, 25 publicaciones venían de 24 comunidades distintas. Para un resumen de un sector concreto encaja mejor reddit/subreddit_posts con unas pocas comunidades fijas, por ejemplo las de tu país.
Condiciones de las plataformas. La política Responsible Builder de Reddit exige pedir aprobación antes de acceder a sus datos, y el uso comercial necesita aprobación por escrito. También pone límites claros al entrenamiento de IA, al uso comercial y a la inferencia de rasgos sensibles de los usuarios; las condiciones para desarrolladores de X también regulan el uso de los datos. Un resumen que solo usa títulos, enlaces, puestos y recuentos públicos, sin crear perfiles de usuarios, es lo más prudente. En la Unión Europea, además, cualquier dato personal entra en el RGPD. Cómo se aplica todo esto a tu negocio lo tienes que valorar con los textos originales o con un abogado; este artículo no da asesoría legal.
Cambios recientes: cuatro fechas que importan para el resumen
Aquí solo van los cambios que afectan a un resumen semanal de publicaciones populares, por orden de fecha. Las fechas son las que figuran en las páginas oficiales.
30-09-2026: las skills llegan a los chats de Gemini y sustituyen a los Gems. El blog de Google dice que las skills se lanzaron ese día en los chats de Gemini en todo el mundo y que los clientes de Workspace las tendrían "en las próximas semanas". La misma entrada anuncia que los Gems de cuentas personales desaparecen a partir de noviembre y que Opal cierra en las mismas fechas (blog de Google, 30-09-2026). Qué supone: si tu informe semanal es un Gem, muévelo ya.
13-10-2026: las skills de Workspace se retrasan. Las skills de la aplicación Gemini empezaron a desplegarse ese día; las de Workspace Studio y las aplicaciones de Workspace quedan "retrasadas hasta nuevo aviso". La entrada adelanta que llegarán la opción de compartir y la integración con Google Drive (Workspace Updates, 13-10-2026). Qué supone: si tu equipo quiere usar la misma skill dentro de Docs o Sheets, tendrá que esperar. Empieza en la aplicación Gemini.
28-10-2026: la plataforma Connected Apps abre en vista previa. El blog de Google dice que los desarrolladores pueden conectar sus aplicaciones a Gemini y al buscador con servidores MCP en la nube, y registrarlas, probarlas y enviarlas a revisión en Google Connected Console (blog de Google, 28-10-2026). Qué supone: además de la "aplicación personalizada" del camino B, los servicios de datos podrían aparecer en Gemini como aplicaciones revisadas, quizá también fuera de Estados Unidos. Hoy no hay fecha para eso.
17-11-2026 (dentro de 13 días): los Gems de cuentas personales pasan a solo lectura. Ver la primera sección.
Primeros pasos
- Regístrate en EveryInfra y consigue una clave de API. Sigue el inicio rápido y llama una vez a
weibo/trendingcon curl. Comprueba que la respuesta traeresultsybilling.charged_usd. Los parámetros y campos de las cuatro listas están en las páginas de publicaciones populares de Reddit, lista caliente de Zhihu, búsquedas en tendencia de Weibo y tendencias de X. Todas las capacidades de cada plataforma están en Reddit Scraper API, Zhihu Scraper API, Weibo Scraper API y X (Twitter) Scraper API. - Pon el script
collect.pyde este artículo en un ordenador o servidor pequeño que esté encendido cada día. GuardaEVERYINFRA_API_KEYen una variable de entorno y usa cron o launchd para ejecutarlo de una a cuatro veces al día, concountryenmxoespara X según tu público. Pasada una semana, revisahttpycharged_usden cada línea desnapshots.jsonl. - Comprime la carpeta
weekly-hot-posts-digest/y súbela en la página de skills de Gemini, con el nombre en minúsculas y guiones. El fin de semana, ejecutamerge.pypara generarweekly.csv, súbelo a un chat y escribe/weekly-hot-posts-digest escribe el resumen en español. - Para automatizarlo todo, crea un disparador en la API de Gemini con el ejemplo del camino C, o ejecútalo en tu máquina como en el artículo de Antigravity CLI. La página del servidor MCP explica cómo conectarlo y la página de precios, cómo se cobra.
- Para aplicar el mismo método en otras herramientas, lee tareas programadas de Claude Code para encontrar problemas en Reddit y tareas programadas de ChatGPT como radar de demanda.
| Paso | Dónde | Coste de API | Cuándo |
|---|---|---|---|
| 1. Probar una llamada | Terminal con curl | 0,000556 USD | Una vez |
| 2. Capturar las cuatro listas | cron o launchd con collect.py | 0,017–0,069 USD por semana (1 a 4 capturas al día) | Cada día |
| 3. Escribir el resumen | Chat de Gemini con la skill | Sin coste de API; las skills no piden plan | Cada lunes |
| 4. Automatizar todo | Disparador de la API de Gemini | Tokens de Gemini por ejecución, ver la sección de costes | Opcional |
Preguntas frecuentes
Las preguntas salen de las sugerencias de búsqueda de Google y de un hilo público de la comunidad de ayuda de Gemini. Las respuestas siguen las páginas oficiales tal como las leímos el 4 de noviembre de 2026.
Gemini skills vs Gems: ¿tengo que cambiar mis Gems ya?
Con una cuenta personal, sí. Desde el 17 de noviembre de 2026 los Gems quedan en solo lectura y no se pueden usar ni editar; el 17 de diciembre se retiran. La migración automática convierte cada Gem en un borrador inactivo de skill que hay que revisar y activar, y no se llevan los archivos que superan los 100 MB, el audio, el vídeo, los comprimidos ni los formatos antiguos de Office. Rehaz ahora a mano los Gems que usas cada semana y aprovecha para escribir la descripción como "qué hace" más "Use when…". Las cuentas de trabajo y de centros educativos tienen más tiempo: no antes del 1 de marzo de 2027 para empresas, y no antes del 1 de junio de 2027 para educación. (Pregunta de las sugerencias "gemini skills vs gems" y "claude skills vs gemini gems".)
Gemini Gems read only: ¿se puede exportar después del 17 de noviembre?
Se pueden ver y descargar sus archivos, pero no usarlos. La ayuda dice que, tras el 17 de noviembre, se puede seguir accediendo a los Gems, pero no usarlos ni editarlos, ni crear otros, y pide a las cuentas personales que descarguen antes del 17 de diciembre los archivos que no se migran. Ese mes de solo lectura es la última ocasión de recuperar los archivos de conocimiento. (Pregunta de la sugerencia "gemini gems read only mode".)
Gemini skills cómo activar: ¿por qué Gemini no usa mi skill solo?
La ayuda dice que Gemini solo aplica las skills que están activadas, y que se pueden desactivar o reactivar en la página de skills. Gemini decide solo con el nombre y la descripción; si la descripción es demasiado general (por ejemplo, "asistente de datos"), no sabe cuándo usarla. Lo más fiable es escribir / (o @) en el chat y elegirla. Además, la ayuda dice que las skills están disponibles para cuentas personales de mayores de 18 años y que llegarán "pronto" a las de trabajo y de centros educativos; si tu cuenta de Workspace no muestra la página de skills, puede que el despliegue no haya llegado. (Pregunta de las sugerencias "gemini skills como activar" y del hilo Will a Skill have an always on state de la comunidad de ayuda.)
Gemini skills cómo funciona con datos de internet: ¿puede una skill llamar a MCP?
La skill en sí no sale a internet: la ayuda dice que los scripts subidos no pueden acceder a internet ni hacer peticiones a sitios externos. Una skill sí puede trabajar con Connected Apps, y una "aplicación personalizada" es la URL de un servidor MCP, pero para eso hay que tener 18 años o más, estar en Estados Unidos, usar una cuenta personal y usar Gemini en inglés. Desde España o Latinoamérica, la alternativa es capturar los datos en local y subir una tabla, o usar el agente Antigravity de la API de Gemini (admite una herramienta mcp_server) o Antigravity CLI. (Pregunta de las sugerencias "gemini skills como funciona", "gemini skills mcp" y "gemini cli skills mcp".)
Gemini skills cómo usar una skill de Claude: ¿se puede subir tal cual?
En cuanto al formato, sí. Las dos se basan en el estándar abierto Agent Skills, y la ayuda de Gemini dice que se puede subir SKILL.md, una carpeta o un .zip. Revisa tres cosas: el nombre en minúsculas con guiones; que Gemini no lee los campos de extensión propios de Claude Code, como el control de invocación o la ejecución en subagentes; y que, si la skill trae un script que sale a internet, en la aplicación Gemini no se ejecuta. Nuestra skill usa solo name y description, y la captura de datos queda fuera. (Pregunta de las sugerencias "gemini skills como usar" y "gemini skills like claude".)
Referencias
Leímos todas las páginas siguientes el 4 de noviembre de 2026 (hora de Singapur).
- Ayuda de Gemini: About the transition from Gems to skills
- Ayuda de administración de Workspace: transición a skills
- Workspace Updates, 30-09-2026: skills en la aplicación Gemini y Workspace
- Workspace Updates, 13-10-2026: actualización del lanzamiento de skills
- Blog de Google, 30-09-2026: automatizar tareas con skills
- Ayuda de Gemini: novedades de versiones (30-09 y 13-10-2026)
- Ayuda de Gemini: Create & manage skills
- Ayuda de Gemini: Write effective skills
- Ayuda de Gemini: Manage your tasks & workflows (límites de región y plan)
- Ayuda de Gemini: límites y mejoras para suscriptores de Google AI
- Ayuda de Gemini: Connect & manage custom apps
- Comunidad de ayuda de Gemini: Will a Skill have an always on state
- Documentación para desarrolladores de Google Connected Apps
- Gemini Apps Developer Mode overview
- Blog de Google, 28-10-2026: vista previa de la plataforma Connected Apps
- Especificación MCP: Tools (anotaciones readOnlyHint, destructiveHint)
- Especificación MCP: Transports (Streamable HTTP)
- RFC 7591: OAuth 2.0 Dynamic Client Registration
- RFC 9728: OAuth 2.0 Protected Resource Metadata
- Borrador IETF: The OAuth 2.1 Authorization Framework
- API de Gemini: Function calling (sección Remote MCP)
- API de Gemini: Antigravity agent (MCP, Triggers, Budget)
- API de Gemini: agentes gestionados
- API de Gemini: Interactions API
- Referencia de la API de Gemini: Interactions (fuentes inline)
- Precios de la API de Gemini
- API de Gemini: Understand and count tokens
- Registro de cambios de la API de Gemini
- API de Gemini: modelos obsoletos
- Guía de Gemini API CLI (gemini-api)
- API de Gemini: Computer Use
- API de Gemini: Coding agent setup
- GitHub: google-gemini/gemini-skills
- Especificación de Agent Skills
- GitHub: agentskills/agentskills
- Antigravity: Agent skills
- Antigravity: MCP
- Antigravity CLI: modo sin interfaz
- Claude Code: Extend Claude with skills
- Documentación de Claude: Agent Skills overview
- Ayuda de Claude: Use skills in Claude
- Codex: Build skills
- Reglas de la lista de tendencias de Weibo
- Presentación de la lista caliente de Zhihu
- Precios de la API de X
- API de X: Trends
- Acuerdo y política para desarrolladores de X
- Reddit Responsible Builder Policy
- Reddit Data API Terms
- Catálogo de capacidades de EveryInfra (price_usd y notas de campo, leído el 2026-11-04)
- Documentación de Python: urllib.request
- RFC 4180: el formato CSV
- Documentación de Apple: tareas programadas con launchd
Referencia BL-82